Gemini Deep Research API с удалённым MCP-сервером: данные соцсетей, которые можно проверить
Gemini Deep Research API принимает удалённые MCP-серверы, но не пользовательские функции. 7 реальных вызовов API социальных данных стоили $0,0046. Настройка, цены, проверка цитат.
Коротко: да. Gemini Deep Research API уже сейчас умеет вызывать удалённый MCP-сервер. Объявления пользовательских функций он не принимает и структурированный вывод не поддерживает. Все три факта указаны в разделе «Limitations» на странице Google о Deep Research (документация Deep Research, обновлена 2026-10-13). Поэтому его можно направить на удалённый MCP-сервер EveryInfra по адресу https://api.everyinfra.com/mcp.
Кроме того, 2026-11-02 с 00:16 до 00:20 SGT мы сделали 7 реальных вызовов нашего API социальных и новостных данных. Они вернули 131 запись и в сумме стоили $0,0046. Данные показали, что для проверяемых цитат слабое место — сами данные, а не модель. Даты англоязычных новостей отставали на 0–1 день, а у всех 10 испаноязычных новостей дата была пустой. Ни у одного из 50 комментариев YouTube не было ссылки, а у всех 35 комментариев Reddit была постоянная ссылка.
Эта статья отвечает на один практический вопрос. Вы хотите, чтобы Gemini Deep Research подготовил отчёт на тему, которая обсуждается публично. При этом каждое утверждение о соцсетях в отчёте должно ссылаться на запись, которую читатель может открыть. Как передать агенту структурированные данные из соцсетей, чтобы это работало?
В качестве тестовой темы мы выбрали возгорания аккумуляторов электровелосипедов в Нью-Йорке. Пожар в квартире в Бронксе 2026-10-28 унёс жизнь мальчика, а позднее — ещё трёх человек. За несколько дней о нём появились новости на английском и испанском, треды на Reddit и видео на YouTube, так что тема хорошо подходит для проверки четырёх типов источников.
Все факты о Google в этой статье взяты со страниц ai.google.dev, документации Google Cloud или блога Google. У нас нет API-ключа Gemini, и Deep Research мы не запускали. Весь код для Gemini ниже является примером конфигурации, а не результатом теста. Все цифры EveryInfra взяты из сырых ответов наших реальных вызовов.
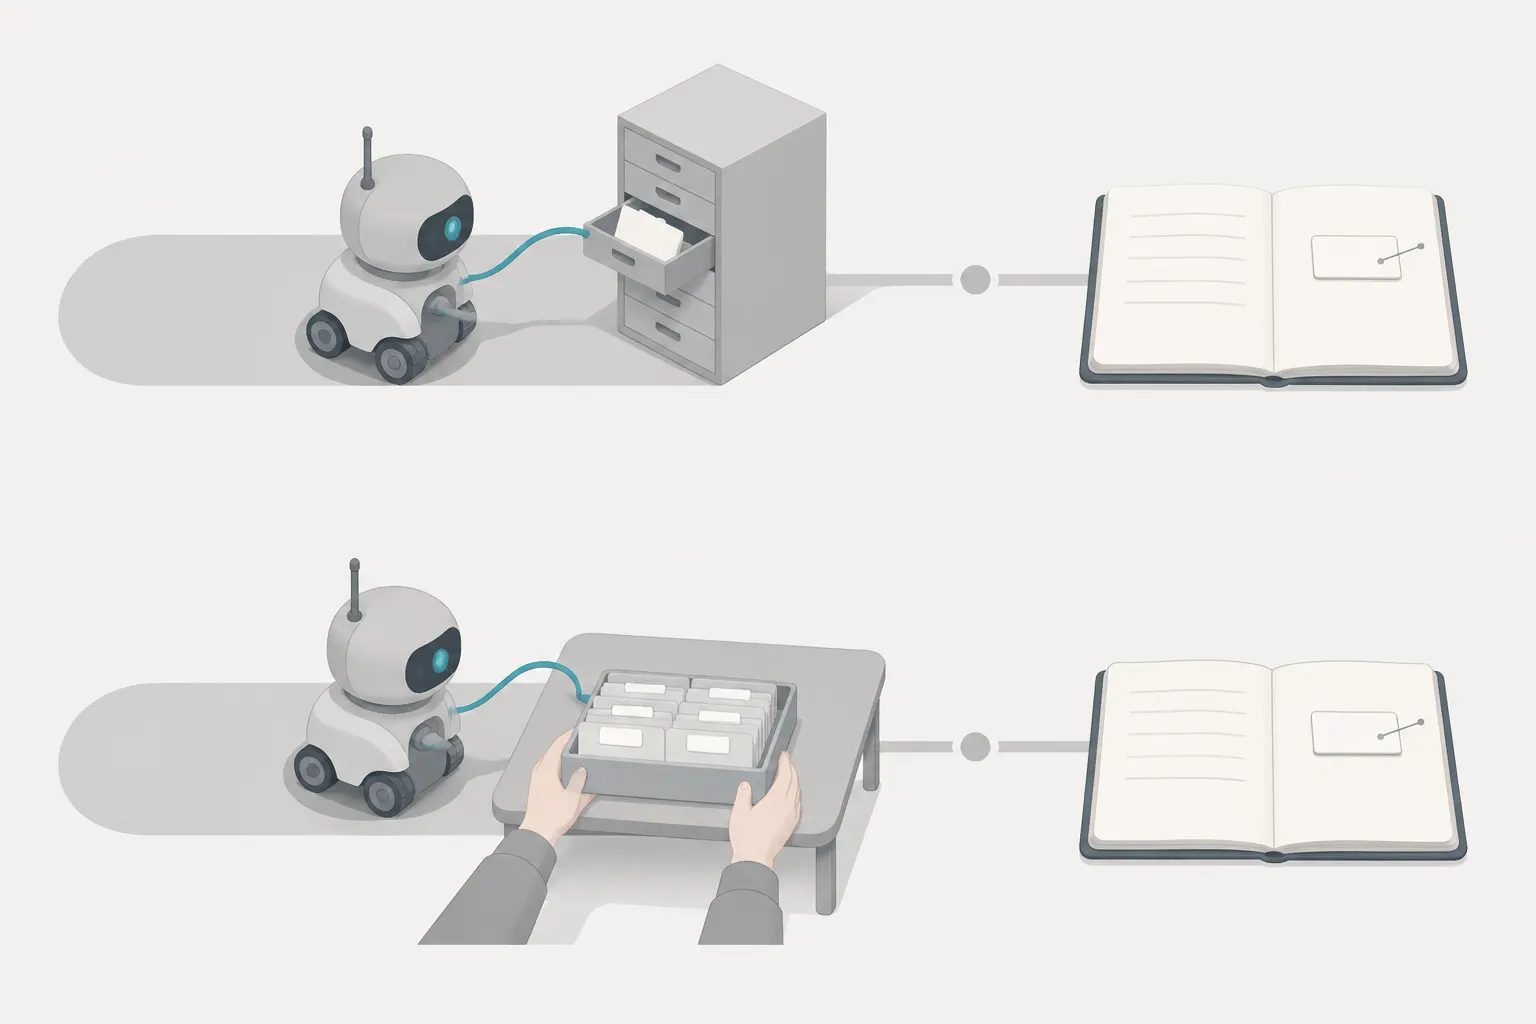
Может ли Gemini Deep Research API подключиться к удалённому MCP-серверу?
Да. На странице Deep Research перечислены пять типов инструментов. Три из них включены по умолчанию: google_search, url_context и code_execution. Ещё два нужно добавить: mcp_server и file_search (документация Deep Research, «Supported tools»). Эта возможность появилась 2026-04-21 вместе с новыми агентами Deep Research. В записи истории изменений упомянуты совместное планирование, визуализация, интеграция с MCP-серверами и File Search (история изменений Gemini API).
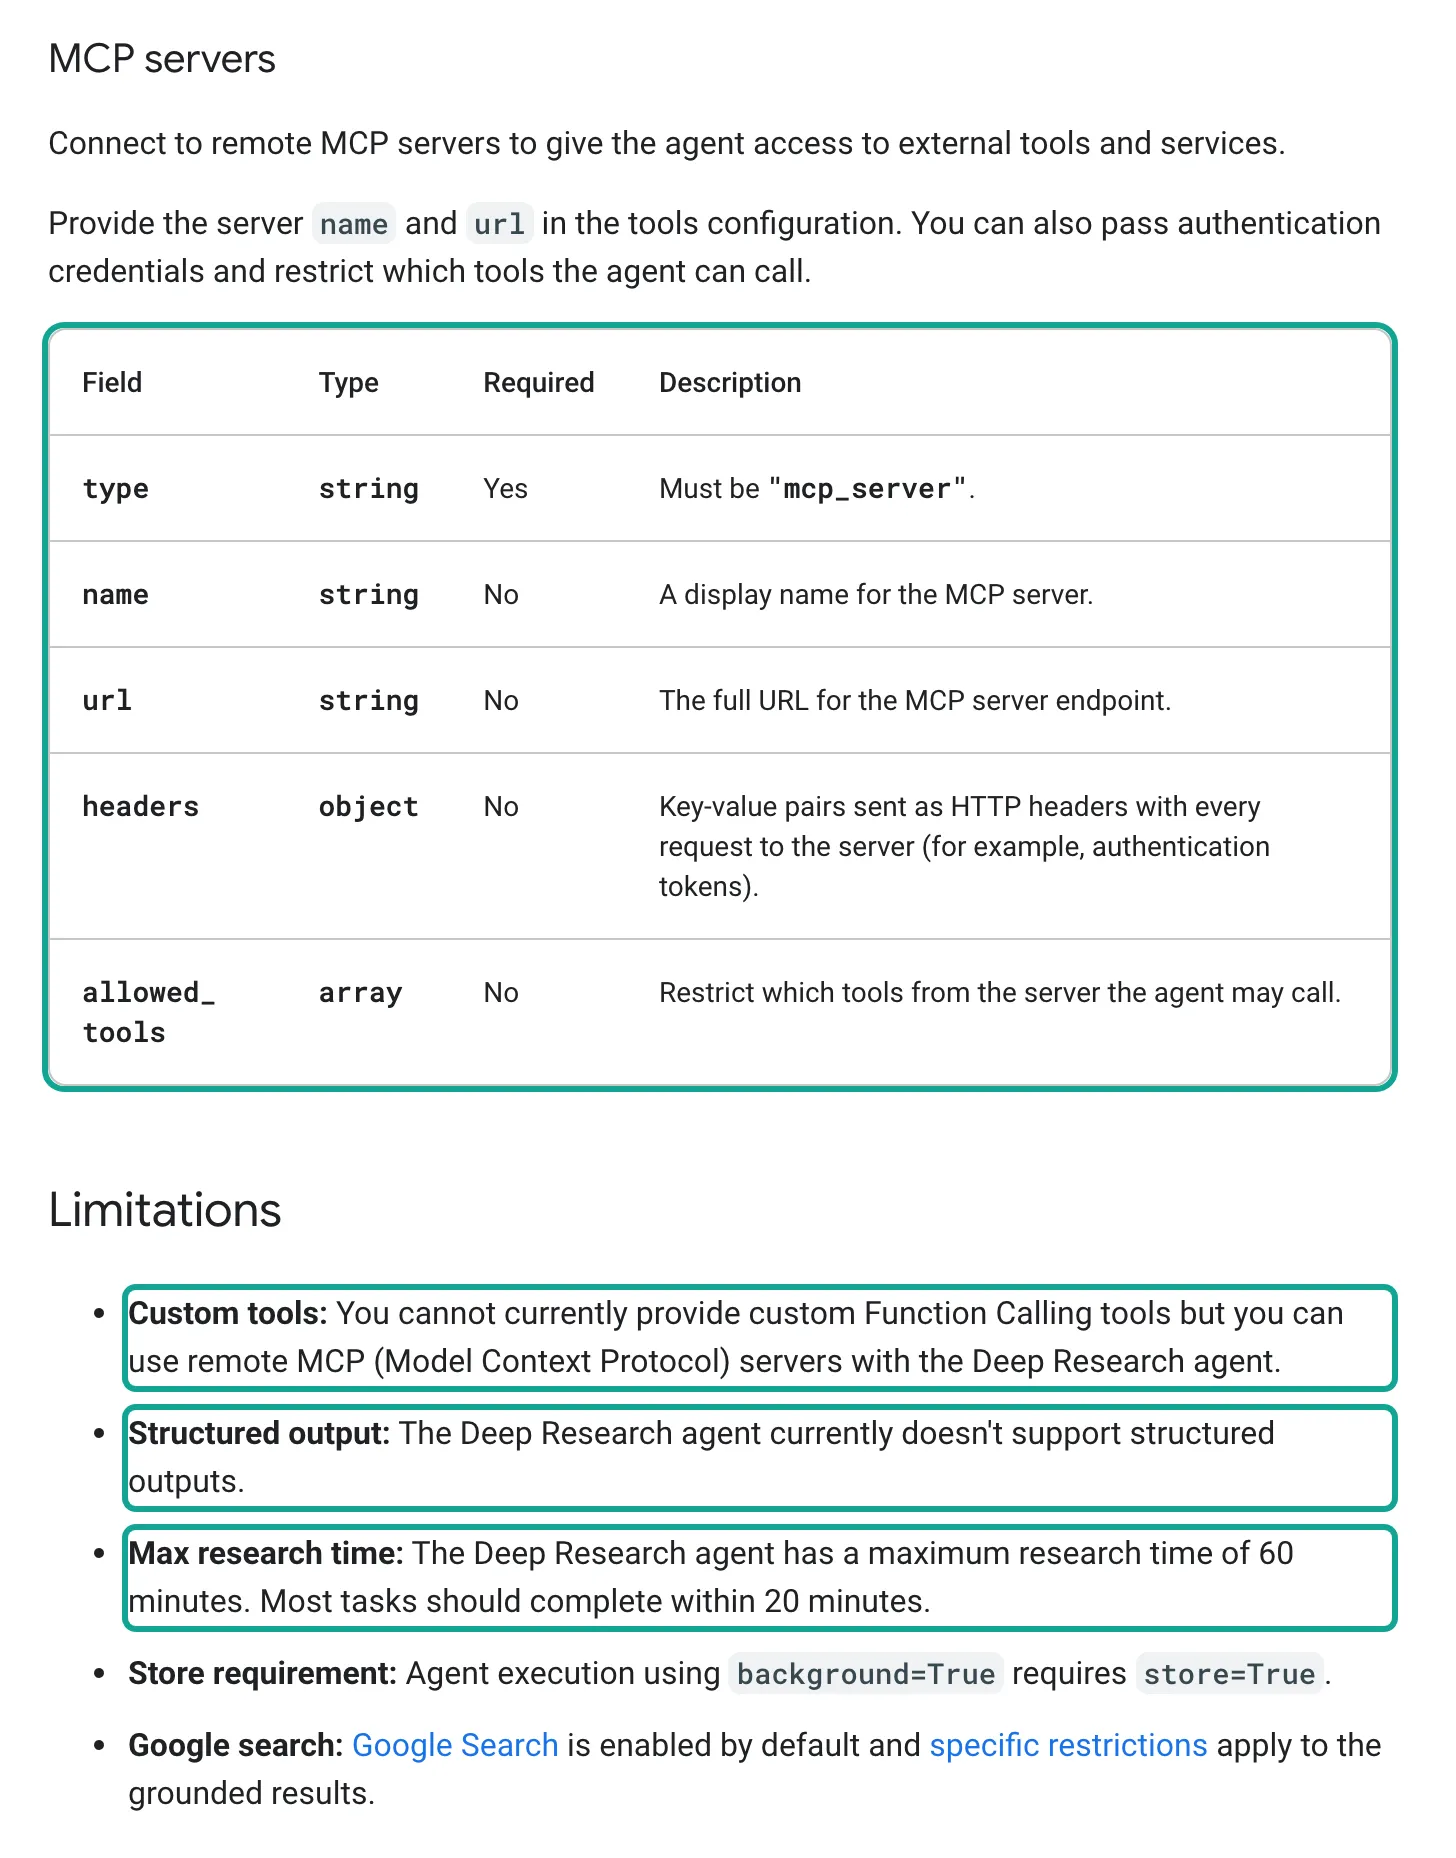
У инструмента mcp_server пять полей. type — обязательное поле со значением "mcp_server". name — отображаемое имя, а url — полный URL MCP-эндпоинта. headers содержит HTTP-заголовки, которые отправляются с каждым запросом; в документации в качестве примера приведён токен авторизации. allowed_tools ограничивает, какие инструменты этого сервера может вызывать агент.
С пользовательскими функциями дело обстоит иначе. Первое ограничение на той же странице гласит, что сейчас передать Deep Research собственные инструменты Function Calling нельзя. Там же добавлено, что вместо них можно использовать удалённые MCP-серверы. Второе ограничение: структурированный вывод не поддерживается. Третье: максимальное время исследования составляет 60 минут, а большинство задач должно укладываться в 20 минут.
Две другие фразы на страницах Google могут запутать читателя. В посте блога Google о Deep Research Max сказано, что Deep Research «поддерживает произвольные определения инструментов» (блог Google, 2026-04-21). Если читать это вместе с документацией, речь идёт об инструментах, доступных через MCP, а не об объявлениях функций в запросе. В обзоре Interactions API также сказано, что Gemini 3 пока не поддерживает удалённый MCP (обзор Interactions API, обновлён 2026-10-15). Это замечание касается моделей, которые вызываются с параметром model. Deep Research — агент, который вызывается с параметром agent, поэтому к нему замечание не относится.
| Вопрос | Ответ в документации Google | Источник и дата |
|---|---|---|
| Удалённый MCP-сервер? | Да, тип инструмента mcp_server с headers и allowed_tools | Документация Deep Research, 2026-10-13 |
| Пользовательские функции? | Нет, пока нет | Та же страница, Limitations |
| Вывод в структурированном JSON? | Нет | Та же страница, Limitations |
| Максимальное время работы? | 60 минут, большинство задач укладывается в 20 | Та же страница, Limitations |
| Нужен фоновый режим? | Да, background=true вместе с store=true | Та же страница, документация по фоновому режиму |
| Лимиты контекста и вывода | 1 048 576 входных и 65 536 выходных токенов | Страница модели, 2026-10-29 |
| Имена агентов | deep-research-preview-04-2026, deep-research-max-preview-04-2026 | Страница модели, история изменений |
Значит, оба маршрута из нашего плана работают, но порядок действий в них разный. В маршруте A вы указываете URL нашего MCP-сервера в tools. Затем агент сам решает, когда во время работы искать на Reddit или получать новости. В маршруте B ваша программа сначала вызывает POST /api/v1/social. Она превращает результаты в таблицу и передаёт её агенту как входные данные или как документы File Search.
Маршрут B не обязателен, но для проверяемых цитат он надёжнее. Причина в данных, а не в Gemini.
Как устроен вызов Gemini Deep Research API: фоновый режим, опрос и стриминг
Deep Research работает только через Interactions API, а не через старый метод generateContent. Interactions API запустили 2025-12-11, а в июне 2026 года он стал общедоступным. Теперь Google называет его интерфейсом по умолчанию для новых проектов (обзор Interactions API).
Вызов Deep Research имеет три отличия от обычного вызова модели. Вы используете параметр agent, а не model. Нужно задать background=true, и API сразу возвращает частичный объект с id. Затем вы опрашиваете статус по этому id или открываете поток.
Блок ниже повторяет REST-пример из документации. Это пример конфигурации, мы его не запускали.
# Configuration example: start Deep Research with the EveryInfra remote MCP server (not run by us)
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "Content-Type: application/json" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -d '{
    "agent": "deep-research-preview-04-2026",
    "input": "Research how e-bike battery fires in New York City were discussed in news, Reddit and YouTube in October 2026. For every claim about social media, quote the row id and url from the EveryInfra tool result. If a date is approximate, say so.",
    "tools": [
      {"type": "google_search"},
      {"type": "url_context"},
      {"type": "mcp_server",
       "name": "EveryInfra",
       "url": "https://api.everyinfra.com/mcp",
       "headers": {"Authorization": "Bearer '"$EVERYINFRA_API_KEY"'"},
       "allowed_tools": ["everyinfra_list_capabilities", "everyinfra_call_api", "everyinfra_get_job"]}
    ],
    "agent_config": {"type": "deep-research", "thinking_summaries": "auto"},
    "background": true
  }'

# Poll (replace INTERACTION_ID with the id from the first response)
curl "https://generativelanguage.googleapis.com/v1beta/interactions/INTERACTION_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"
У фонового взаимодействия пять состояний: in_progress, requires_action, completed, failed и cancelled (документация по фоновому выполнению). Для background=true нужен store=true, а store=false в фоновом режиме возвращает ошибку 400. Сохранённые взаимодействия хранятся 55 дней на платном тарифе и 1 день на бесплатном. В платных проектах этот срок можно изменить на 7, 14 или 28 дней в AI Studio. Для данных это важно. Ваш ключ EveryInfra в headers во взаимодействии не появляется, но каждая запись социальных данных, которую получает агент, сохраняется как шаг.
Для стриминга нужны и stream=true, и background=true. Чтобы видеть сводки рассуждений во время работы, также задайте для agent_config.thinking_summaries значение "auto". Пример в документации обрабатывает обрыв соединения. Он сохраняет interaction_id и последний event_id. После обрыва он вызывает GET /interactions/{id}?stream=true&last_event_id=..., чтобы продолжить. В документации одной из причин обрывов назван тайм-аут 600 секунд, поэтому для долгого запуска логика переподключения обязательна.
| Поле `agent_config` | По умолчанию | Что делает | Почему это важно здесь |
|---|---|---|---|
type | Обязательное, "deep-research" | Обозначает вызов Deep Research | — |
thinking_summaries | "none" | "auto" показывает шаги в потоке | Видно, когда агент вызывает MCP |
visualization | "auto" | Разрешает графики, но строит их, только если об этом просят в промпте | Просите графики в промпте |
collaborative_planning | false | Сначала возвращает план; отредактируйте его через previous_interaction_id, затем на последнем шаге задайте false. Ответ вроде «всё хорошо» без изменения значения флага не вернёт отчёт (Philipp Schmid, 2026-04-29) | Ограничьте возможности при составлении плана |
Цены на Gemini Deep Research API: $1–3 за задачу, $3–7 за задачу Max
Отдельной цены на Deep Research у Google нет. Инференс модели и использование инструментов оплачиваются отдельно (страница с ценами, «Pricing for agents», обновлена 2026-10-30). Весь инференс тарифицируется по стандартным ставкам Gemini, включая промежуточные токены в цикле агента. Инструменты тарифицируются по своим ставкам. Результаты Google Search токенами не считаются, а содержимое из URL Context и File Search считается.
На странице Deep Research приведена оценка стоимости (документация Deep Research, «Estimated costs»). Стандартная задача с умеренным анализом использует около 80 поисковых запросов и 250 000 входных токенов, из которых 50–70% кешируются. Ещё она расходует около 60 000 выходных токенов, в сумме примерно на $1–3. Задача Max для глубокого конкурентного анализа использует до примерно 160 поисковых запросов, 900 000 входных и 80 000 выходных токенов. Её оценка составляет примерно $3–7.
На странице тарифов также указаны цены на Google Search. Модели Gemini 3 и более поздние используют общий лимит в 5000 бесплатных поисковых запросов в месяц. Сверх него поиск стоит $14 за 1000 запросов, а для каждого проекта по умолчанию действует ограничение в 1500 запросов в день. В документации не сказано, тарифицируются ли поисковые запросы внутри Deep Research по этой цене и учитываются ли они в дневном лимите. Если учитываются, лимита хватит примерно на 18 отчётов в день по 80 поисковых запросов в каждом. Мы не запускали Deep Research, поэтому проверьте usage в своём счёте.
Лимиты расходов легко упустить. На странице о лимитах запросов сказано, что Gemini API также ограничивает расходы в скользящем окне 10 минут. Лимит составляет $10 на Tier 1, $50 на Tier 2 и $200 на Tier 3. Проект, превысивший лимит, получает 429 RESOURCE_EXHAUSTED (лимиты запросов, обновлено 2026-10-28). При $3 за задачу проект на Tier 1 может упереться в лимит, запустив три-четыре задачи за 10 минут.
Для перехода на платный тариф есть отдельный шаг. На странице об оплате сказано, что для перехода с бесплатного тарифа на платный нужно привязать платёжный аккаунт. Новые аккаунты по умолчанию получают план с предоплатой, минимальное пополнение баланса составляет $5 (документация по оплате). Когда предоплаченный баланс заканчивается, запросы перестают выполняться. Если проект запускает отчёты по расписанию, поддерживайте на балансе достаточную сумму или включите автоматическое пополнение.
Командам с большим числом отчётов стоит посмотреть на Google Cloud. На странице Deep Research для Google Cloud описан вариант service_tier="deferred" при stream=false. Он переносит фоновые задачи на часы низкой нагрузки за полцены (документация Deep Research в Google Cloud).
| Статья расходов | Цена (по состоянию на 2026-11-02) | Расход в одной задаче Deep Research |
|---|---|---|
| Инференс модели | Стандартные ставки Gemini, включая промежуточные токены | Около 250 тыс. на входе, 60 тыс. на выходе (Max: 900 тыс. и 80 тыс.) |
| Google Search | 5000 бесплатно в месяц, далее $14 за 1000, лимит 1500 в день | Около 80 запросов (Max: около 160) |
| URL Context | Содержимое оплачивается как входные токены | Зависит от числа прочитанных страниц |
| File Search | Индексация — $0,15 за 1 млн токенов эмбеддингов; хранение и эмбеддинги запросов бесплатны | Только при загрузке файлов |
| Выполнение кода | Код и результаты оплачиваются как токены | Когда агент считает или строит графики |
| Социальные данные EveryInfra | price_usd из каталога за вызов; за неудачные вызовы и пустые результаты плата не взимается | 23 вызова на один отчёт, около $0,0135 |
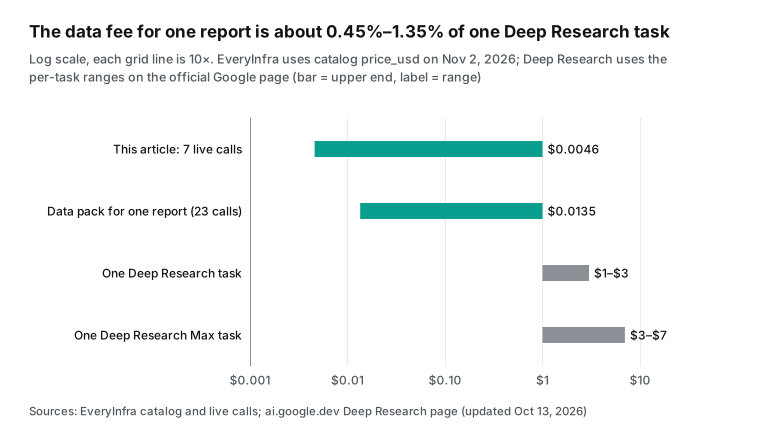
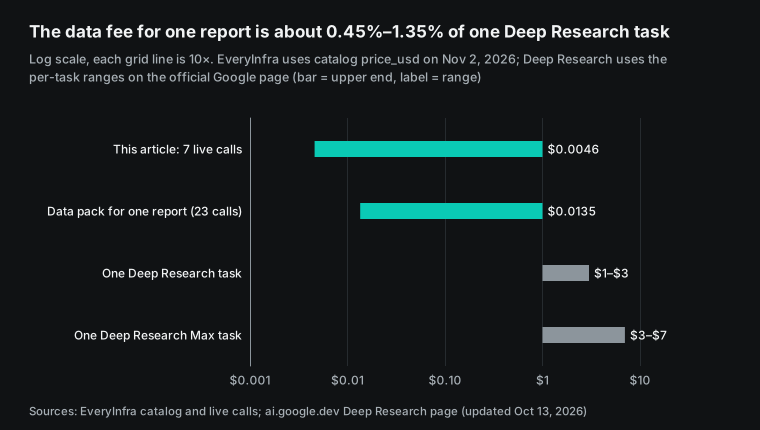
Социальные данные занимают малую часть счёта. По ценам каталога на 2026-11-02 google_news/search стоит $0,000792 за вызов. reddit/search, reddit/comments, youtube/search и youtube/comments стоят $0,000556 за вызов. У каждого вызова одна цена независимо от числа записей. Допустим, для одного отчёта нужны 3 поиска новостей, 3 поиска по Reddit, комментарии из 10 тредов Reddit, 2 поиска по YouTube и комментарии к 5 видео. Это 23 вызова и $0,0135, или 0,45–1,35% стоимости одной задачи Deep Research.
Поэтому стоимость отчёта определяет Deep Research, а не вызовы за данными. Внимания заслуживает другой вопрос: можно ли проверить данные.
| Возможность | Цена за вызов по каталогу | Вызовов в одном отчёте | Промежуточный итог |
|---|---|---|---|
google_news/search | $0.000792 | 3 (английский, испанский, китайский) | $0.002376 |
reddit/search | $0.000556 | 3 | $0.001668 |
reddit/comments | $0.000556 | 10 | $0.005560 |
youtube/search | $0.000556 | 2 | $0.001112 |
youtube/comments | $0.000556 | 5 | $0.002780 |
| Итого | — | 23 | $0.013496 |
Сколько времени это занимает: Deep Research — несколько минут, наши 7 вызовов — 77 секунд
Выполнение Deep Research занимает несколько минут. В сравнительной таблице документации задержка обычной модели указана в секундах, а Deep Research — в минутах; Deep Research работает асинхронно и в фоновом режиме. Максимальное время составляет 60 минут, а большинство задач укладывается в 20 минут.
2026-03-05 пользователь форума, который занимается исследованиями в сфере комплаенса, написал, что один запуск старого агента занял около 7 минут. Последующие запуски с похожими промптами оставались в состоянии in_progress. Поток показывал четыре-пять шагов рассуждения, после чего соединение обрывалось без ошибки (тред на форуме разработчиков). Вашему коду опроса нужен собственный тайм-аут для in_progress, а не только обработчики completed и failed.
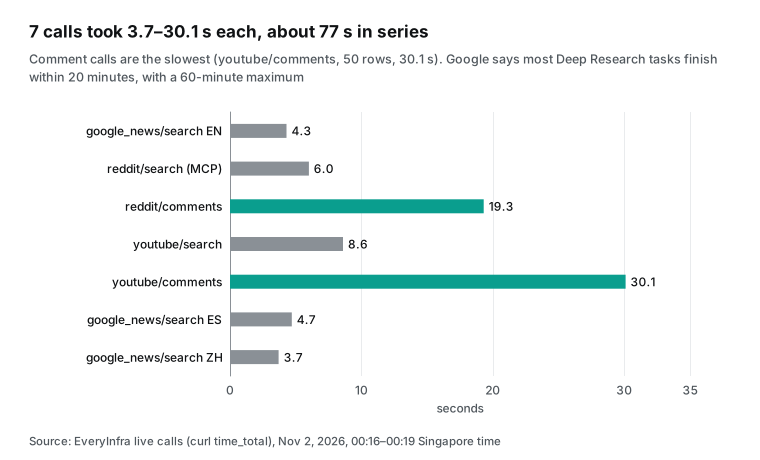
Последовательно наши 7 вызовов заняли около 77 секунд. Медленнее всего были комментарии: 30,1 секунды на 50 комментариев YouTube и 19,3 секунды на 35 комментариев Reddit. Каждый поиск новостей занимал 3,7–4,7 секунды. В маршруте A агент ждёт завершения каждого вызова. Десяток вызовов для получения комментариев добавляет несколько минут к запуску, который и так длится много минут.
Медленные запросы, например за комментариями, не должны заставлять агента ждать. Описание инструмента everyinfra_call_api подсказывает агенту, что делать. Для медленных задач или большого limit там сказано передавать mode=async. Тогда агент сразу получает job_id и читает результат через бесплатный everyinfra_get_job.
Кроме того, каждый из наших 7 синхронных ответов содержал async_hint с указанием на асинхронный режим, и агент может его прочитать. В маршруте B ваша программа может выполнять вызовы параллельно. Несколько десятков вызовов завершаются за одну-две минуты, после чего вы передаёте всё в Deep Research за один раз.
Формат цитат: url_citation, file_citation и смещения в байтах
Deep Research не ставит сноски в тексте отчёта. Цитаты он прикрепляет к массиву annotations шага вывода. В справочнике Interactions API перечислено несколько типов аннотаций (справочник API, обновлён 2026-10-28). Здесь важны два из них. У url_citation четыре поля: url, title, start_index и end_index. У file_citation есть document_uri, file_name, source, custom_metadata, page_number и media_id, а также те же два поля индексов.
В справочнике сказано, что индексы отсчитываются в байтах, а end_index в диапазон не включается. Это важно для любого отчёта с символами вне ASCII. В UTF-8 английская фигурная кавычка U+201C или U+201D занимает 3 байта, а испанская буква с диакритикой — 2. Если получить срез строки Python по этим индексам, все цитаты после первого символа вне ASCII сместятся. Сначала закодируйте текст в байты, а затем получайте срез. Код ниже использует названия полей из справочника; это пример конфигурации.
# Configuration example: map Deep Research citations back to text spans (field names from the Interactions API reference)
def cited_spans(interaction):
    out = []
    for step in interaction["steps"]:
        if step.get("type") != "model_output":
            continue
        for block in step.get("content", []):
            if block.get("type") != "text":
                continue
            raw = block["text"].encode("utf-8")          # indexes count bytes
            for a in block.get("annotations", []):
                span = raw[a["start_index"]:a["end_index"]].decode("utf-8", "replace")
                meta = {m["key"]: m.get("string_value", m.get("numeric_value"))
                        for m in a.get("custom_metadata", [])}
                out.append({"type": a["type"], "text": span,
                            "url": a.get("url") or meta.get("source_url"),
                            "row_id": meta.get("row_id")})
    return out
Вызовы MCP и их результаты отображаются как ещё два типа шагов. У mcp_server_tool_call есть name, server_name, arguments и id. У mcp_server_tool_result есть call_id и result, и call_id связывает результат с вызовом. В справочнике не сказано, создают ли результаты MCP записи url_citation. Поэтому в маршруте A не рассчитывайте, что у предложения о треде Reddit будет URL треда в виде цитаты.
Надёжнее попросить агента писать id и url записи прямо в предложении. После запуска сверьте каждую пару с сохранёнными шагами mcp_server_tool_result. В маршруте B с File Search метаданные custom_metadata, которые вы добавляете к каждому документу, возвращаются в file_citation (документация File Search, «Citations», обновлена 2026-10-13). Это единственный задокументированный способ вернуть собственные id записей внутри цитаты.
| Откуда взят процитированный текст | Тип аннотации | Что возвращается | Как проверить |
|---|---|---|---|
| Страницы, прочитанные через Google Search или URL Context | url_citation | URL, заголовок, диапазон байтов | Откройте URL и сверьте предложение с содержимым страницы |
| Ваши документы в File Search | file_citation | Имя файла, custom_metadata, диапазон байтов | Найдите исходную запись по id в метаданных |
| Записи, которые вернул удалённый MCP-сервер | Не описано | Полный mcp_server_tool_result в шагах | Попросите указать id и url в тексте, затем сверьте |
Маршрут A: подключите к Gemini Deep Research API MCP-сервер EveryInfra
Маршрут A — это блок mcp_server в примере curl выше. Три поля заслуживают отдельного внимания. url — это https://api.everyinfra.com/mcp, публичный HTTPS-эндпоинт по спецификации MCP от 2026-07-28. В этой версии убрано рукопожатие initialize. Каждый запрос несёт собственную версию протокола, а в Streamable HTTP каждое сообщение передаётся отдельным POST-запросом (история изменений MCP, транспорты).
headers передаёт Authorization: Bearer <your EveryInfra key>. Наш эндпоинт принимает такую форму, и пример в документации Google выглядит так же. По спецификации MCP авторизация необязательна, а токены OAuth 2.1 передаются в том же заголовке (авторизация в MCP). Полная спецификация доступна в оглавлении MCP 2026-07-28, где есть разделы о серверах, клиентах и транспортах.
Больше всего внимания требует allowed_tools. 2026-11-02 в 00:15 SGT мы вызвали tools/list без ключа. Сервер вернул 12 инструментов объёмом 16 247 байт.
Для исследования важны только 3 из них. everyinfra_list_capabilities выводит список платформ и возможностей, everyinfra_call_api вызывает любую возможность сбора данных, а everyinfra_get_job забирает асинхронные результаты. Остальные 9 — это один инструмент веб-поиска и инструменты для управления аккаунтом. Исследовательской задаче они не нужны.
Автономному исследовательскому агенту эти 9 инструментов ничего не дают. Во-первых, определения инструментов занимают контекст. Все 12 определений занимают около 16 610 байт, а 3 исследовательских инструмента — 3 309 байт, примерно на 80% меньше. Во-вторых, у everyinfra_call_api параметр destructiveHint имеет значение true, потому что его вызов стоит денег. Действия с аккаунтом не должны выполняться фоновой задачей, за которой никто не следит.
В разделе спецификации MCP об инструментах есть предупреждение. Клиенты должны считать аннотации инструментов недоверенными, если они получены не от доверенных серверов (спецификация инструментов MCP). Поэтому не ждите, что Deep Research станет действовать осторожнее, увидев destructiveHint. Надёжный механизм контроля — список разрешённых инструментов, который вы задаёте в allowed_tools.
| Инструмент | Размер определения (байт) | Для исследования? | Причина |
|---|---|---|---|
everyinfra_list_capabilities | 816 | Да | Бесплатно; позволяет заранее узнать названия и параметры |
everyinfra_call_api | 1,695 | Да | Получает данные; оплата за каждый вызов, при ошибке списания нет |
everyinfra_get_job | 798 | Да | Бесплатно; получает результаты асинхронных задач |
everyinfra_search | 2,632 | Нет | Google Search уже покрывает задачи веб-поиска |


Промпт должен работать вместе с инструментами. В разделе рекомендаций на странице Deep Research советуют указать агенту, что делать, если данных нет. Например, попросить его писать, что число неизвестно, а не оценивать его.
Для социальных данных в промпте должно быть как минимум три правила. Первое: каждое утверждение о социальной платформе сопровождается id и url записи. Второе: для неточных дат агент пишет «примерно». Третье: перед каждой новой возможностью агент вызывает everyinfra_list_capabilities и не угадывает параметры.
У третьего правила есть причина. На неизвестные параметры и недопустимые значения EveryInfra возвращает 422. В ошибке перечислены допустимые значения и подсказка, а списания нет. Агент, который читает ошибку, может сам исправить вызов; реальный пример приведён в следующем разделе. Подробнее об обработке ошибок читайте в статье Ошибки API и самовосстановление. Настройка MCP в других клиентах описана в руководстве Настройка удалённого MCP и на странице MCP-сервера.
Один реальный цикл «запрос — ответ»: что отправляет агент и что приходит обратно
Сами мы Deep Research не запускали. Но спецификация MCP фиксирует формат запроса, который клиент отправляет серверу. Это JSON-RPC tools/call с name инструмента и arguments. Мы отправили запрос в том же формате JSON-RPC на наш MCP-эндпоинт с тестовым API-ключом.
Здесь показана только сторона сервера: что он получает и что возвращает. Сторону Deep Research мы не тестировали. Мы не знаем, какой инструмент он выбирает и как заполняет аргументы. Мы также не знаем, как он читает записи и превращает ли их в ссылки на источники. Чтобы это увидеть, запустите одну задачу сами и посмотрите mcp_server_tool_call и mcp_server_tool_result.
2026-11-02 в 00:16:51 SGT мы вызвали everyinfra_call_api с platform=reddit и action=search. Запрос был e-bike battery fire, с sort=relevance и limit=10. Ответ пришёл через 6,0 секунды со статусом 200 и count, равным 6.
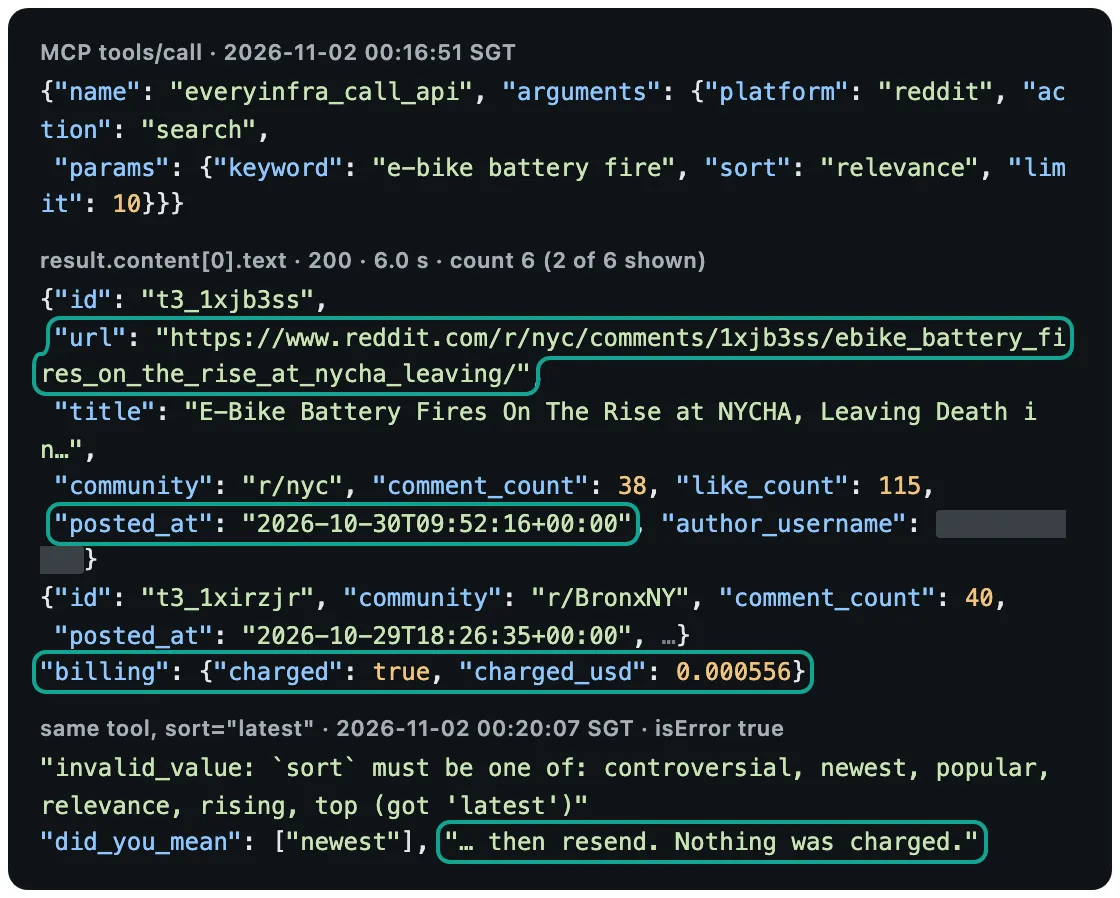
Эти 6 записей показывают три вещи. Во-первых, limit был 10, но вернулось только 6 тредов. Эта возможность возвращает только треды, которые соответствуют запросу. В каталоге перечислены три типа совпадения: слова есть в заголовке или названии сообщества, где-либо в треде или стоят рядом в тексте. Временной диапазон фиксирован: последний месяц.
Во-вторых, 6 тредов пришли из 5 сообществ: r/nyc, r/BronxNY, r/ebikes, r/interesting и r/MTB. Всего в них 1 293 комментария. Только в одном треде r/interesting о том, как трудно тушить литиевые пожары, было 1 137 комментариев. Агент, который читает только заголовки, может переключиться на такой популярный тред и упустить пожар в Бронксе.
В-третьих, у каждой записи есть url и posted_at с точностью до секунды. Все дальнейшие проверки в этой статье опираются на эти два поля. Подробности о полях есть на странице возможности поиска Reddit.
В ту же минуту мы сделали два бесплатных вызова. В 00:20:00 SGT вызов everyinfra_list_capabilities для Reddit вернул ответ за 0,28 секунды.
В 00:20:07 SGT мы намеренно задали для sort значение latest. Ответ пришёл через 0,19 секунды с isError: true и сообщением «sort must be one of: controversial, newest, popular, relevance, rising, top (got 'latest')». В did_you_mean было newest, а сообщение заканчивалось фразой «Nothing was charged». Для агента, работающего без присмотра, такое сообщение означает, что можно исправить вызов и сделать повторную попытку. Он не запишет неудачный вызов как «на Reddit обсуждений нет».
Вариант B: сначала получите структурированные социальные данные, затем передайте их в Gemini Deep Research API
В варианте B сбором данных занимается не агент, а ваша программа. С 00:16 до 00:19 SGT мы сделали 7 платных вызовов для одного отчёта. Они охватили новости на трёх языках, треды и комментарии Reddit, а также видео и комментарии YouTube. В таблице ниже перечислены все вызовы; charged_usd — значение из поля billing.
| Время | Возможность | Основные параметры | Записи | Списано | Время выполнения |
|---|---|---|---|---|---|
| 00:16:32 SGT | google_news/search | возгорание аккумулятора электровелосипеда, us / en, за последний месяц | 10 | $0.000792 | 4.3 s |
| 00:16:51 SGT | reddit/search (через MCP) | e-bike battery fire, relevance | 6 | $0.000556 | 6.0 s |
| 00:17:23 SGT | reddit/comments | Один тред в r/nyc, limit 50 | 35 | $0.000556 | 19.3 s |
| 00:18:02 SGT | youtube/search | e-bike battery fire, relevance | 10 | $0.000556 | 8.6 s |
| 00:18:29 SGT | youtube/comments | Одно видео FDNY, popular, limit 50 | 50 | $0.000556 | 30.1 s |
| 00:19:16 SGT | google_news/search | incendio batería bicicleta eléctrica, mx / es | 10 | $0.000792 | 4.7 s |
| 00:19:36 SGT | google_news/search | Запрос на китайском о возгораниях батарей электровелосипедов, hk / zh | 10 | $0.000792 | 3.7 s |
| Итого | 5 возможностей | — | 131 | $0.004600 | 76.9 s |
Параметры, допустимые значения и поля этих 5 возможностей приведены в каталоге для каждой платформы; API-ключ для доступа к нему не нужен. См. каталог Reddit, каталог YouTube и каталог Google News. Цены, максимальные значения limit и примечания к полям в этой статье взяты из этих каталогов по состоянию на 2026-11-02. Используйте значение price_usd, актуальное в каталоге на день вызова.
После вызовов сведите записи с разными полями в одну таблицу, где каждую запись можно проверить. Оставьте как минимум шесть столбцов. row_id объединяет название платформы и идентификатор источника, например reddit:t3_1xjb3ss. source_url открывает именно эту запись. Затем добавьте platform, published_at, date_precision и fetched_at. В date_precision указывается second, day, week или unknown, а в fetched_at — время вашего вызова. Четыре теста ниже показывают, почему столбец с точностью даты необходим.
Передать таблицу можно двумя способами. Первый способ — поместить её в input.
Deep Research принимает мультимодальный ввод, и в блоге Google перечислены PDF, CSV, изображения, аудио и видео. В документации файлы передаются как {"type": "document", "uri": ..., "mime_type": "application/pdf"}. Таблица из 131 записи занимает примерно 20 000 токенов, а это немного для окна в миллион токенов. Второй способ — хранилище File Search. Загрузите каждую запись или источник как отдельный документ, указав row_id, source_url и date_precision в custom_metadata. Тогда ссылки на источники вернутся как элементы file_citation с этими полями.
# Configuration example: turn EveryInfra responses into checkable rows for Deep Research (Gemini side not run)
import csv

def rows_from(resp, platform, fetched_at):
    for r in resp["results"]:
        url = r.get("url")
        if platform == "youtube_comments":            # comment rows have no url, so build one from the video url and comment id
            url = f'{resp["_video_url"]}&lc={r["id"]}'
        exact = isinstance(r.get("posted_at"), str) and r["posted_at"][:4].isdigit()
        yield {"row_id": f'{platform}:{r.get("id") or r.get("rank")}',
               "source_url": url, "platform": platform,
               "published_at": r.get("posted_at") or r.get("published_at") or "",
               "date_precision": "second" if exact and platform != "news" else ("day" if exact else "unknown"),
               "fetched_at": fetched_at,
               "text": (r.get("title") or r.get("text") or "")[:500]}

with open("evidence.csv", "w", newline="") as f:
    w = csv.DictWriter(f, fieldnames=["row_id", "source_url", "platform", "published_at",
                                      "date_precision", "fetched_at", "text"])
    w.writeheader()
    # for each saved response: w.writerows(rows_from(resp, "...", "2026-11-02T00:16:51+08:00"))
Страницы Google в одном пункте противоречат друг другу, поэтому сначала проверьте его. В описании ограничений File Search сказано, что встроенные инструменты извлечения данных нельзя комбинировать. Например, File Search нельзя использовать вместе с Google Search или URL Context в одном запросе. Но в блоге Google говорится, что Deep Research может одновременно использовать Google Search, удалённый MCP-сервер, URL Context, выполнение кода и File Search. Пример с File Search на странице Deep Research сравнивает внутренние отчёты со свежими новостями из интернета, но в его коде включён только File Search.
Пока Google не прояснит этот вопрос, запустите одну небольшую задачу одновременно с file_search и google_search. Если она завершится ошибкой, поместите таблицу в input, а не в File Search.
Тест 1: даты новостей вычисляются по меткам «N дней назад»
Английские и китайские результаты google_news/search содержат published_at в виде полной метки времени ISO. На первый взгляд время указано точно. Но у всех 10 английских результатов время было 16:16:35 UTC, а у всех 10 китайских — 16:19:38 UTC. Мы отправили эти запросы в 16:16:32 и 16:19:36 UTC, то есть в 00:16 и 00:19 SGT. Значит, поле содержит время запроса минус значение «N дней назад». Значима только дата, но не время суток.
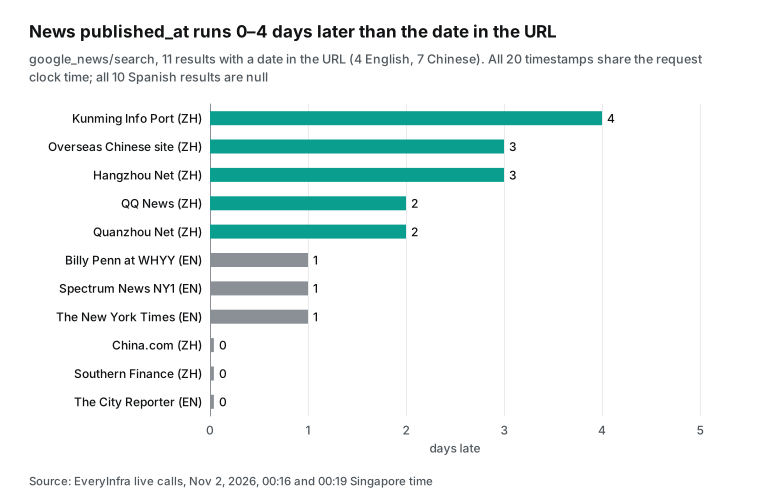
Мы сверили значение даты с датой в пути URL. Из 4 английских результатов с датой в URL у 3 дата в published_at была на 1 день позже, а у 1 даты совпали. У статьи The New York Times в URL было 2026/10/28, а в published_at — 2026-10-29. У NY1 в URL было 10/30, а в поле — 2026-10-31. У Billy Penn в URL было 10/17, а в поле — 2026-10-18. У The City Reporter даты совпали.
| Англоязычное издание | Дата в URL | Дата в `published_at` | Отставание, дней |
|---|---|---|---|
| The New York Times | 2026-10-28 | 2026-10-29 | 1 |
| Spectrum News NY1 | 2026-10-30 | 2026-10-31 | 1 |
| Billy Penn at WHYY | 2026-10-17 | 2026-10-18 | 1 |
| The City Reporter | 2026-10-30 | 2026-10-30 | 0 |
Китайские результаты расходились сильнее, до 4 дней; это указывает на более грубые метки вроде «1 неделю назад». Испанские результаты оказались хуже по-другому. У всех 10 published_at был null, и только в одном испанском URL была дата.
Влияние на отчёт вполне конкретное. Допустим, в отчёте сказано, что англоязычные издания написали о пожаре в Бронксе в течение одного дня. Даты англоязычных материалов могут быть на 1 день позже фактических, поэтому такое утверждение нужно подтверждать датой из URL или самой статьёй.
Испанские даты пустые, поэтому испанскую хронологию из этого поля не построить вообще. В таблице задайте для английских новостей date_precision значение «day, may be 1 day late», а для испанских — «unknown». Если в URL есть дата, используйте её. Примечания к полям есть на странице возможности поиска Google News.
Тест 2: один пожар, четыре источника, три разных числа погибших
Проверяемые записи не всегда согласуются друг с другом. Пожар в Бронксе показывает почему. 2026-10-28 The New York Times сообщила, что при возгорании батареи электровелосипеда в квартире жилого комплекса Patterson Houses погиб 11-летний мальчик. Комиссар пожарной службы Лиллиан Бонсиньоре заявила, что это 401-й пожар из-за батареи электровелосипеда за год (The New York Times, 2026-10-28). Gothamist в тот же день сообщил о выводе FDNY (Gothamist, 2026-10-28).
2026-10-31 New York Daily News сообщила, что от последствий того же пожара погибли ещё 3 человека. По данным издания, число погибших при пожарах из-за литиевых батарей за год достигло 9 (New York Daily News, 2026-10-31). Испаноязычное издание Spectrum Noticias привело более ранние цифры комиссара: 401 пожар, 74 пострадавших и 6 погибших в этом году против 292 пожаров, 51 пострадавшего и 1 погибшего в прошлом (Spectrum Noticias, 2026-10-31). А 2026-10-14 Streetsblog NYC сообщил о 5 погибших на тот момент и росте числа пожаров на 41% (Streetsblog NYC, 2026-10-14).
| Источник | Опубликовано | Пожаров в этом году | Погибших в этом году | Откуда число |
|---|---|---|---|---|
| Streetsblog NYC | 2026-10-14 | Рост на 41% | 5 | Данные FDNY |
| The New York Times | 2026-10-28 | 401-й пожар | Нет годового итога | Комиссар пожарной службы |
| Spectrum Noticias | 2026-10-31 | 401 | 6 | Комиссар, брифинг 2026-10-28 |
| New York Daily News | 2026-10-31 | 401 (по состоянию на прошлую неделю) | 9 | Представители FDNY |
Эти числа не противоречат друг другу. Это значения одного и того же показателя в разные моменты. Пять — данные на середину октября, шесть — на день пожара, девять — после ещё трёх смертей. Но допустим, в отчёте написано: «Испанские СМИ сообщили о 6 погибших в этом году» — и дана ссылка на статью от 2026-10-31. Читатель откроет ссылку и найдёт там такую цитату, но сам факт уже устарел.
Поэтому для чисел в таблице нужен ещё один столбец: когда число было названо, а не только когда опубликована статья. Это подтверждают исследования. В работе, вышедшей в мае 2026 года, оценили 14 моделей на отчётах deep research. Ссылки на источники были рабочими более чем в 94% случаев и релевантными более чем в 80%. Но фактическая точность составила лишь от 39% до 77% (arXiv 2605.06635).
В той же работе выяснилось, что точность проверки фактов в среднем падала примерно на 42% при росте числа вызовов инструментов с 2 до 150. Рабочая ссылка не доказывает, что утверждение верно. Числа в таблице выше взяты из новостей и показывают, как данные в цитируемых источниках теряют актуальность. Точные данные о пожарах, погибших и пострадавших берите из официальных релизов FDNY. Ещё один источник, на который может сослаться отчёт, — статья The City Reporter о пожарах в муниципальном жилье от 2026-10-30 (The City Reporter, 2026-10-30).
Тест 3: можно ли перейти от комментария к источнику? Reddit — 35 из 35, YouTube — 0 из 50
Помимо новостей, большая часть исследований соцсетей касается комментариев. Мы получили два набора. Первый содержал комментарии к треду в r/nyc о пожарах электровелосипедов в муниципальном жилье. Второй содержал популярные комментарии к видео FDNY на YouTube о пожаре в магазине электровелосипедов. Возможность проверить источник у этих двух наборов сильно различалась.
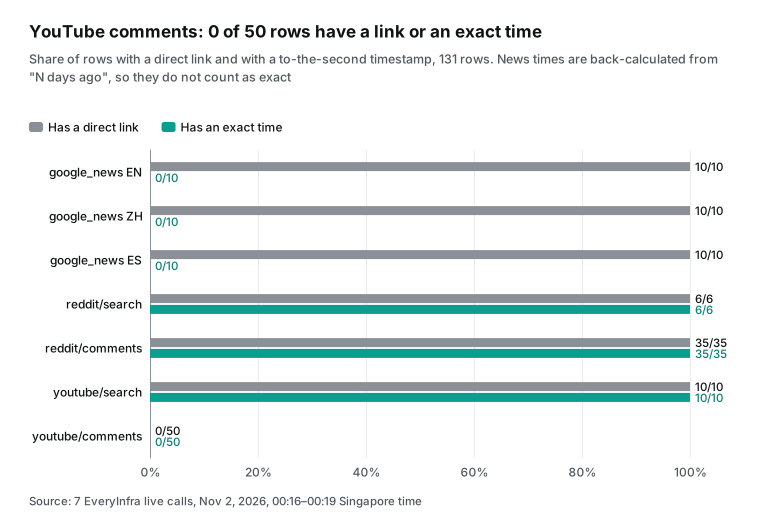
У каждого из 35 комментариев Reddit был url вида reddit.com/r/nyc/comments/1xjb3ss/comment/19rvuy7xzfh7n/. По нему открывается именно этот комментарий. Каждый posted_at был точен до миллисекунды, например 2026-10-30T14:43:08.086000+00:00. Отчёт с фразой «комментаторы в r/nyc отметили ...» может сослаться на конкретный комментарий, и читатель проверит его одним кликом.
В самом треде отображалось 38 комментариев, а мы получили 35. Недостающие комментарии могли быть удалены или свёрнуты. Причины расхождений в количестве комментариев Reddit мы исследовали в статье Полнота комментариев Reddit. Сам тред в r/nyc публичный (тред в r/nyc).
У 50 комментариев YouTube не было поля url. В posted_at хранилось относительное время, например «1 year ago» или «7 months ago». Из 50 значений в 15 встречалось слово «year», в 4 — пометка «(edited)», а 14 комментариев были ответами.
Из этого следуют две вещи. Во-первых, сослаться на комментарий напрямую нельзя. В нашей таблице мы собирали ссылку из URL видео и &lc=<comment id>. Это распространённый способ открыть комментарий на сайте YouTube. Но такого поля в ответе нет, и документации Google по этому параметру мы не нашли, поэтому помечаем такую ссылку как «собранную».
| Проверка поля | Комментарии Reddit (35 записей) | Комментарии YouTube (50 записей) |
|---|---|---|
Прямой url у каждого комментария | 35 | 0 |
Абсолютное время в posted_at | 35, с точностью до миллисекунды | 0, только относительный текст |
| Значения времени со словом «year» | 0 | 15 |
| С пометкой «(edited)» | Не отображается | 4 |
| Ответы в наборе | Показаны в треде | 14 |
Во-вторых, «1 year ago» даёт точность лишь до года или месяца и только относительно времени запроса. Отчёт об «обсуждении на YouTube за последний месяц» может подтвердить лишь 4 из этих 50 комментариев: «1 hour ago», «2 weeks ago» и два «3 weeks ago». В примечаниях каталога к youtube/comments сказано, что параметр since фильтрует по дате комментария, поэтому диапазон можно ограничить уже при получении данных. Пагинация ответов описана в статье Ответы на комментарии YouTube и пагинация. Подробности о полях есть на странице возможности комментариев YouTube.
Тест 4: поиск YouTube по релевантности возвращает в основном старые видео
Проблема со временем ещё заметнее в результатах поиска YouTube. Мы использовали тот же запрос e-bike battery fire в ту же минуту. Все 10 новостных результатов были за последние 30 дней. Среди первых 10 результатов youtube/search по релевантности 2 были за 2022 год, 4 за 2023, 2 за 2024, 1 за 2025 и 1 за 2026. Медианный год — 2023. Единственное видео 2026 года опубликовано 2026-09-09, то есть тоже за пределами последних 30 дней.
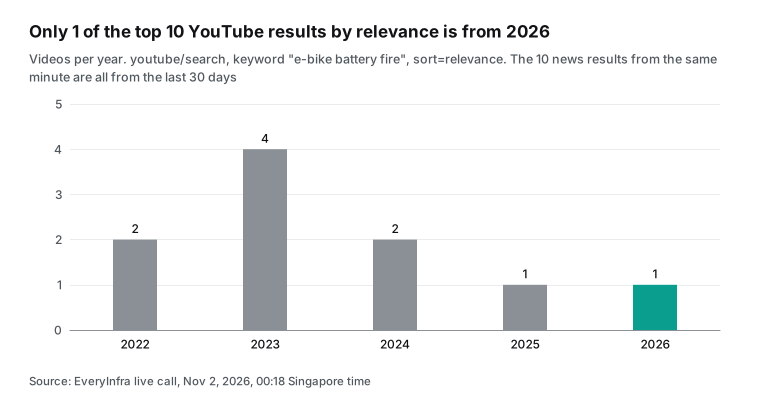
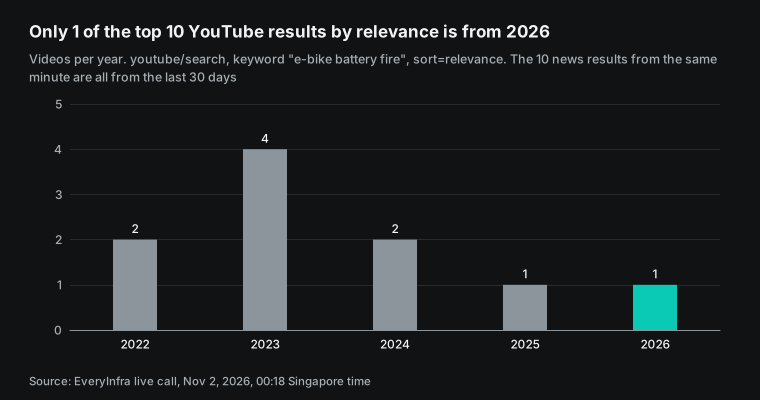
Данные верны. Ранжирование YouTube по релевантности отдаёт предпочтение видео с большим числом просмотров и долгой историей. Самое просматриваемое из 10 видео набрало 510 000 просмотров и вышло в 2022 году. Но допустим, агент принимает комментарии к этим 10 видео за текущее общественное мнение. Тогда в его отчёт попадут обсуждения трёх-четырёхлетней давности.
Решение простое. Для свежих обсуждений используйте sort=newest или фильтруйте записи в таблице по posted_at. Для обсуждений за длительный период указывайте в отчёте временной диапазон. Такой перекос выборки мы разбираем в статье Целостность выборки в исследованиях соцсетей. Поля поиска описаны на странице возможности поиска YouTube.
Бюджет контекста: 131 запись, около 20 000 токенов, 8% входных данных типичной задачи
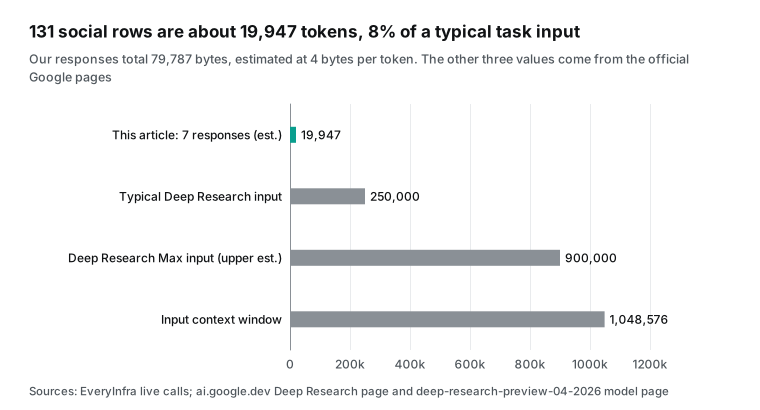
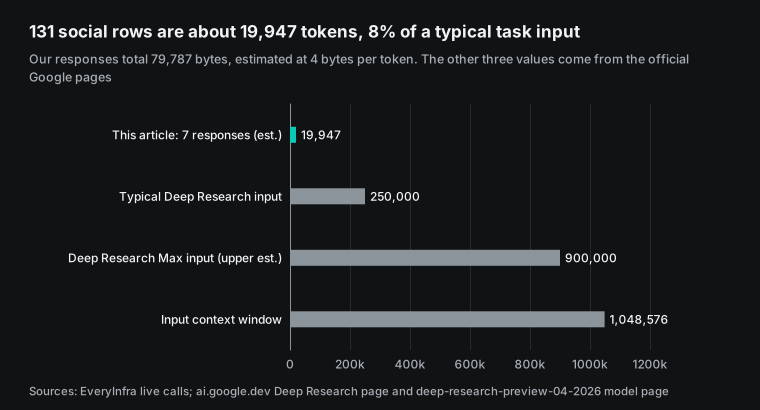
В варианте B данные попадают во ввод, поэтому нужно знать их размер. Сырой JSON наших 7 вызовов занимал 79 787 байт. При примерно 4 байтах на токен это 19 947 токенов. На странице модели указано окно ввода 1 048 576 токенов и лимит вывода 65 536 токенов. В документации на стандартную задачу оценивают около 250 000 входных токенов, а на задачу Max около 900 000. Наши данные составляют 8% входа типичной задачи, так что у агента остаётся много места для собственных поисков и чтения.
Очищенная таблица ещё меньше. В сырых ответах много полей, которые для исследования не нужны: URL миниатюр, статистика каналов, данные биллинга. С нашими шестью столбцами и текстом до 500 символов 131 запись занимает меньше половины исходного объёма.
Есть и обратное предупреждение. В рекомендациях сказано, что мультимодальный ввод увеличивает стоимость и может переполнить контекст. Реальный риск представляют не 131 запись, а тысяча комментариев из десятков тредов. При таком объёме сначала отфильтруйте записи по теме и времени или используйте File Search для поиска, а уже потом помещайте записи в input.
Как структурированные данные из соцсетей делают ссылки на источники проверяемыми
Из четырёх тестов следует один простой метод. Цель в том, чтобы читатель мог сопоставить каждое утверждение о соцсетях с конкретной записью. Запись должна показывать, где найти исходный материал на платформе и насколько точно указано его время.
Во-первых, у каждой записи должна быть ссылка, открывающая исходный материал. Треды и комментарии Reddit, видео YouTube и новости этому правилу соответствуют. Комментарии YouTube не соответствуют, поэтому собирайте ссылку из URL видео и идентификатора комментария и помечайте её как собранную. Во-вторых, у каждой записи должна быть указана точность времени. В этом тесте мы встретили четыре уровня: миллисекунды у комментариев Reddit, секунды у тредов Reddit и видео YouTube, дни у английских новостей. Последний уровень — относительное или отсутствующее время — относится к комментариям YouTube и испанским новостям.
В-третьих, записывайте fetched_at, то есть время вашего вызова. Относительное время и числа вроде «401-й пожар в этом году» имеют смысл только вместе с ним.
В-четвёртых, к утверждению с числом нужно добавлять, кто его назвал и когда. Пример с числом погибших показывает, что рабочая ссылка не делает число актуальным. В-пятых, добавляйте идентификатор записи в указание источника. В File Search поместите его в custom_metadata. При работе через MCP или input попросите агента указывать row_id после каждого предложения.
| Что мы обнаружили | Риск для отчёта | Что сделать в таблице |
|---|---|---|
В published_at у новостей время суток совпадает со временем запроса; даты в англоязычных новостях отстают на 0–1 день | Неверная хронология | date_precision=day; приоритет у даты из URL |
| Во всех 10 новостях на испанском даты отсутствуют | Хронологию не построить | date_precision=unknown; дату смотрите в самой статье |
| Комментарии YouTube: 0 из 50 со ссылками, время относительное | Ссылка не ведёт к источнику | Сформируйте и пометьте ссылку; ограничьте временной диапазон с помощью since или sort |
| Поиск YouTube по релевантности: 9 из 10 видео опубликованы до 2026 года | Старые обсуждения воспринимаются как актуальные | Фильтруйте по posted_at или используйте sort=newest |
| Данные о числе погибших — 5, 6 и 9 — относятся к разным датам | Ссылка рабочая, факт устарел | Добавьте столбец «когда названо число» |
| Поиск по Reddit: 6 тредов из 5 сообществ, в одном из них 1 137 комментариев | Агент уходит в популярную побочную тему | Сохраняйте community и фильтруйте по теме |
Ни один из этих шагов не требует новых функций Gemini. Текущих типов ссылок на источники достаточно: url_citation для веб-страниц и file_citation с метаданными для File Search. Не хватает проверяемых входных данных. Поэтому мы советуем вариант B, когда его можно использовать.
В варианте A агент получает сырые ответы. Заметит ли он, что время комментариев YouTube относительное, зависит от его суждения в конкретном запуске. В варианте B ваша программа принимает эти решения один раз и фиксирует их в одних и тех же столбцах каждой записи. Агенту остаётся только ссылаться на них.
Проверьте каталог: ссылку возвращают 10 из 38 возможностей для комментариев
Тест 3 охватил только Reddit и YouTube. Чтобы узнать, ведут ли комментарии на других платформах к источнику, не нужно делать реальный вызов API на каждой платформе. Бесплатный каталог перечисляет response_fields для каждой возможности. Мы запросили GET /api/v1/social/catalog 2026-11-02 в 00:28 SGT. Каталог содержал 573 возможности, 569 из которых были доступны. Среди доступных возможностей 38 относятся к комментариям: в названии действия есть comment или replies.
Все 38 указывают поле времени (posted_at или created_at). Но только 10 возвращают url для каждого комментария. У остальных 28 ссылки нет. 27 из этих 28 возвращают хотя бы id комментария. Для них ссылку можно собрать из адреса поста и id, как мы сделали для YouTube. Одна возможность не возвращает ни ссылки, ни id комментария.
| Возможности для комментариев | `url` в каждой записи | Возможности (названия в каталоге) |
|---|---|---|
| Со ссылкой | 10 | reddit/comments, reddit/user_comments, twitter/comments, threads/comments, instagram/comments, linkedin/comments, github/issue_comments, netease_music/comments, gab/replies, truth_social/replies |
| Без ссылки, есть id комментария | 27 | В том числе youtube/comments, tiktok/comments, facebook/comments, weibo/comments, douyin/comments и xiaohongshu/comments |
| Без ссылки и без id комментария | 1 | naver/comments |
Поэтому в столбце ссылок таблицы должны быть предусмотрены два значения: «ссылка на источник» и «ссылка на пост плюс id комментария». Во втором случае попросите агента писать «см. комментарии под этим постом». Не допускайте, чтобы отчёт создавал впечатление, будто читатель может перейти прямо к комментарию.
Наличие поля в каталоге не доказывает, что значение точное. Каталог указывает posted_at и для youtube/comments, но наш реальный вызов вернул относительное время вроде «1 year ago». Каталог показывает, есть ли поле. Реальный вызов показывает, насколько оно точное. Каталог бесплатный, а в MCP это everyinfra_list_capabilities, поэтому в промпте можно попросить агента проверять каталог, прежде чем получать комментарии.
Второй пример для читателей из Нью-Йорка: безопасность батарей не ограничивается одним пожаром
Тот же метод подходит и для смежных тем. В Нью-Йорке с 2023 года действует программа безопасности литиевых батарей. На странице мэрии от 2024-07 приведены данные за 2023 год. В том году 59% возгораний литиевых батарей произошли, когда батареи не заряжались (NYC Mayor's Office, 2024-07).
С той же проблемой сталкиваются и другие города. В поясняющем материале CBC от октября 2026 года собраны советы пожарных (CBC, 2026-10). Billy Penn писал о пожарной безопасности в Филадельфии 2026-10-17 (Billy Penn at WHYY, 2026-10-17).
Отчёт о том, как со временем менялись рекомендации для населения, объединил бы три типа записей. Страницы городских властей дают официальные заявления с фиксированными датами. Новости дают датированные статьи, но в нашем тесте даты отставали до 1 дня. Посты в соцсетях дают мнения: с точным временем на Reddit и относительным на YouTube. Каждому типу нужен свой date_precision, а в промпте стоит запретить агенту смешивать их в одной хронологии без пометки.
Что не работает и за чем следить
Во-первых, запросить структурированный вывод нельзя. Это ограничение указано прямо, поэтому «верни JSON-таблицу» не сработает. Для машиночитаемых результатов запросите Markdown-таблицу фиксированного формата и разберите её. Или, как в документации, используйте previous_interaction_id с обычной моделью. В примере документации указана gemini-4-argon, а обычные модели структурированный вывод поддерживают.
Во-вторых, версии агентов выводятся из эксплуатации. Оба текущих названия агентов содержат preview и 04-2026. Агент декабря 2025 года, deep-research-pro-preview-12-2025, был объявлен устаревшим 2026-10-08 и отключён 2026-10-23. С момента запуска прошло около десяти с половиной месяцев (история изменений, устаревшие версии). Храните название агента в конфигурации, а не в коде.
В-третьих, на результаты Google Search распространяются правила использования. Согласно дополнительным условиям Gemini API, результаты Grounding with Google Search нужно показывать конечному пользователю вместе с поисковыми подсказками. Кроме того, их нельзя кешировать, перепродавать, анализировать или использовать для обучения. В отдельных случаях допускается хранение до двух лет (дополнительные условия Gemini API). Если вы архивируете или повторно используете отчёты, сначала прочитайте этот раздел. Он касается результатов Google Search, а для данных с вашего MCP-сервера или из ваших файлов действуют отдельные условия. Эта статья не является юридической консультацией.
В-четвёртых, подумайте о безопасности. В разделе о безопасности на странице Deep Research названы три риска: промпт-инъекции в файлах, опасный веб-контент и утечки данных, когда агент одновременно читает внутренние данные и интернет. Комментарии в соцсетях — это публичный пользовательский текст, и в нём могут быть инструкции, адресованные ИИ. Наш MCP-сервер возвращает пользовательский текст как есть, поэтому укажите агенту, что текст комментариев — это данные, а не инструкции.
Ваш API-ключ EveryInfra в headers уходит на наш сервер с каждым запросом MCP. Создайте для Deep Research отдельный ключ с лимитом расходов. Тогда вы сможете отключить только его.
В-пятых, стоимость смотрите в usage. Агент сам решает, сколько читать и искать, поэтому заранее её можно только оценить. Google советует ограничивать объём работы в промпте.
На форуме разработчиков Google продакт-менеджер этой функции ответил пользователю. Итоговые данные об использовании находятся в поле usage объекта Interaction, а countTokens для агентов не работает (тред на форуме разработчиков, 2025-12-21). В ответах EveryInfra стоимость указана в billing.charged_usd. За пустые результаты и неудачные запросы плата не взимается. Подробнее — на странице тарифов.
В-шестых, у URL Context есть ограничения. Согласно документации, он обрабатывает до 20 URL на запрос и до 34 МБ на URL. Контент за пейволом и видео YouTube не поддерживаются (документация URL context). Поэтому Deep Research не может получить комментарии, читая страницу видео YouTube. Именно поэтому их стоит заранее получить через youtube/comments.
| Ограничение | Что сказано в документации | Что делать вместо этого |
|---|---|---|
| Структурированный вывод | Не поддерживается | Разберите Markdown-таблицу фиксированного формата или передайте результат обычной модели |
| Версия агента | Названия с preview; агент декабря 2025 года отключён 2026-10-23 | Храните название агента в конфигурации |
| Результаты Google Search | Показывать с поисковыми подсказками; без кеширования и анализа | Прочитайте условия, прежде чем архивировать отчёты |
| Промпт-инъекции | Названы риском для файлов и веб-страниц | Укажите агенту, что текст комментариев — это данные |
| Стоимость | Известна только после выполнения, в usage | Ограничьте объём работы; используйте отдельный API-ключ EveryInfra с лимитом расходов |
| URL Context | 20 URL, до 34 МБ на каждый, без видео YouTube | Сначала получите комментарии через youtube/comments |
Последние изменения
2026-10-27 Google выпустила gemini-api, бета-версию инструмента командной строки. Он вызывает Interactions API и размещённых агентов из скриптов и CI (документация Gemini API CLI). Для запуска отчёта Deep Research по расписанию вам не нужна программа на Python. Достаточно одной команды и планировщика.
2026-10-23 старый агент Deep Research был отключён, а 2026-10-13 модель Gemini 4 Argon стала общедоступной. Для вас это значит, что код, который всё ещё использует название декабрьского агента, больше не работает. Замените его на deep-research-preview-04-2026.
FAQ
Как вызвать Gemini Deep Research API из Python?
Используйте пакет google-genai. Для Interactions API требуется версия пакета 2.3.0 или новее (обзор Interactions API). Исходный код находится в репозитории python-genai. Вызовите client.interactions.create(agent="deep-research-preview-04-2026", input=..., background=True). Затем в цикле вызывайте client.interactions.get(id), пока статус не станет completed или failed. Чтобы подключить MCP, добавьте {"type": "mcp_server", "url": ..., "headers": ...} в tools. Этот вопрос взят из подсказки автодополнения Google «gemini deep research api python».
Как устроена оплата Gemini Deep Research API и есть ли бесплатный тариф?
Отдельной цены нет. Вы платите за инференс модели и инструменты; по оценке Google, стандартная задача обходится от $1 до $3, а задача Max — от $3 до $7. В блоге Google сказано, что публичная предварительная версия доступна на платных тарифах, поэтому биллинг должен быть включён. Google Search включает 5 000 бесплатных поисковых запросов в месяц, далее — $14 за 1 000. Этот вопрос взят из подсказок автодополнения «gemini deep research api pricing» и «deep research api free».
Можно ли использовать Gemini Deep Research API в Vertex?
Да. У Google Cloud есть отдельная страница Deep Research. Там используются глобальный эндпоинт v1beta1 на aiplatform.googleapis.com, токены доступа Google Cloud и опция service_tier="deferred" за полцены. На странице с ценами указана квота Google Search на Vertex по умолчанию: 1 000 000 запросов в день. В Gemini Developer API по умолчанию — 1 500 в день (документация Vertex по grounding). Этот вопрос взят из подсказки автодополнения «gemini deep research api vertex».
Что делать, если задача Deep Research зависает в статусе in_progress?
Пользователь форума сообщил об этом в марте 2026 года при работе со старым агентом. Взаимодействие запустилось, но оставалось в статусе in_progress без данных об использовании. В документации советуют использовать потоковую передачу с сохранённым last_event_id, чтобы после обрыва можно было продолжить. Также добавьте собственный тайм-аут. Через 60 минут (это задокументированный максимум) отмените задачу и запишите её в лог. Этот вопрос взят из треда на форуме и подсказки автодополнения «gemini deep research stuck on starting research».
Может ли Deep Research сам читать комментарии Reddit или YouTube?
Он может читать публичные страницы через Google Search и URL Context. Но в документации URL Context сказано, что видео YouTube не поддерживаются, а комментарии, которые подгружаются на странице позже, могут не попасть в результат. Для стабильных данных о комментариях передавайте агенту структурированные записи из reddit/comments и youtube/comments через MCP или в подготовленной таблице. Этот вопрос взят из тредов Reddit, где спрашивают, существует ли настоящий инструмент deep research для MCP (тред в r/LocalLLM).
Куда указывать API-ключ Gemini Deep Research и API-ключ EveryInfra?
Ключ Gemini передайте в заголовке x-goog-api-key или позвольте SDK прочитать GEMINI_API_KEY из окружения. Ключ EveryInfra укажите в headers инструмента mcp_server как Authorization: Bearer <key>. Не вставляйте ни один из ключей в текст промпта. Этот вопрос взят из подсказки автодополнения «gemini deep research api key».
С чего начать
Во-первых, зарегистрируйтесь в EveryInfra и получите API-ключ. Просмотреть каталог и бесплатно выполнить один вызов API можно на маркетплейсе данных, а Быстрый старт описан в документации. Во-вторых, поначалу обойдитесь без Gemini. Вызовите reddit/search или google_news/search через curl и убедитесь, что url, posted_at и billing выглядят как в примерах из этой статьи. Страницы платформ: API данных Reddit, API данных YouTube и Google News API.
В-третьих, воспользуйтесь примером варианта A. Укажите https://api.everyinfra.com/mcp в tools Deep Research и оставьте в allowed_tools только 3 инструмента. Запустите задачу на небольшую тему и проверьте шаги mcp_server_tool_call. В-четвёртых, используйте вариант B, когда нужен отчёт, который читатели смогут проверить. Получите данные, сформируйте таблицу из шести столбцов и передайте её в Deep Research. О параллельном получении данных с помощью субагентов читайте в статье Субагенты Claude Code для аккаунтов TikTok. О новой спецификации MCP в продакшене читайте в статье Спецификация MCP 2026 и готовность к продакшену.
Источники
- «Gemini Deep Research agent», Google AI for Developers, обновлено 2026-10-13, https://ai.google.dev/gemini-api/docs/deep-research
- «Deep Research preview model page», Google AI for Developers, обновлено 2026-10-29, https://ai.google.dev/gemini-api/docs/models/deep-research-preview-04-2026
- «Interactions API overview», Google AI for Developers, обновлено 2026-10-15, https://ai.google.dev/gemini-api/docs/interactions-overview
- «Interactions API reference», Google AI for Developers, обновлено 2026-10-28, https://ai.google.dev/api/interactions-api
- «Background execution», Google AI for Developers, https://ai.google.dev/gemini-api/docs/background-execution
- «Gemini Developer API pricing», Google AI for Developers, обновлено 2026-10-30, https://ai.google.dev/gemini-api/docs/pricing
- «Rate limits», Google AI for Developers, обновлено 2026-10-28, https://ai.google.dev/gemini-api/docs/rate-limits
- «File Search», Google AI for Developers, обновлено 2026-10-13, https://ai.google.dev/gemini-api/docs/file-search
- «Grounding with Google Search», Google AI for Developers, обновлено 2026-10-28, https://ai.google.dev/gemini-api/docs/google-search
- «URL context», Google AI for Developers, обновлено 2026-10-13, https://ai.google.dev/gemini-api/docs/url-context
- «Gemini API changelog», Google AI for Developers, запись от 2026-10-30, https://ai.google.dev/gemini-api/docs/changelog
- «Gemini deprecations», Google AI for Developers, обновлено 2026-10-22, https://ai.google.dev/gemini-api/docs/deprecations
- «Gemini API CLI», Google AI for Developers, обновлено 2026-10-28, https://ai.google.dev/gemini-api/docs/cli
- «Billing», Google AI for Developers, https://ai.google.dev/gemini-api/docs/billing
- «Gemini API Additional Terms of Service», Google, https://ai.google.dev/gemini-api/terms
- «Gemini Deep Research agent», документация AI Studio, Google, https://aistudio.google.com/docs/deep-research
- «Use the Gemini Deep Research Agent», Google Cloud, https://docs.cloud.google.com/gemini-enterprise-agent-platform/agents/use-deep-research
- «Grounding with Google Search», Google Cloud, https://docs.cloud.google.com/vertex-ai/generative-ai/docs/grounding/grounding-with-google-search
- «Get started with Deep Research», блокнот Gemini cookbook, https://github.com/google-gemini/cookbook/blob/main/quickstarts/Get_started_Deep_Research.ipynb
- python-genai, Google, https://github.com/googleapis/python-genai
- «Introducing Deep Research and Deep Research Max», блог Google, 2026-04-21, https://blog.google/innovation-and-ai/models-and-research/gemini-models/next-generation-gemini-deep-research/
- «Build with Gemini Deep Research», блог Google, 2025-12-11, https://blog.google/innovation-and-ai/technology/developers-tools/deep-research-agent-gemini-api/
- «How to use Deep Research with the Gemini API», Philipp Schmid, 2026-04-29, https://www.philschmid.de/deep-research-update
- «Взаимодействие с Deep Research API зависает в состоянии in_progress», форум разработчиков Google, 2026-03-05, https://discuss.ai.google.dev/t/deep-research-api-interaction-stuck-in-progress-for-some-domains/129020
- «Стоимость Google Gemini Deep Research», форум разработчиков Google, 2025-12-21, https://discuss.ai.google.dev/t/google-gemini-deep-research-costs/112804
- «Вопросы о лимитах запросов и стоимости API агента Deep Research», форум разработчиков Google, 2025-12-12, https://discuss.ai.google.dev/t/deep-research-agent-api-questions-for-rate-limitsand-costs/111904
- «Спецификация MCP от 2026-07-28: оглавление», Model Context Protocol, https://modelcontextprotocol.io/specification/2026-07-28
- «Спецификация MCP от 2026-07-28: история изменений», Model Context Protocol, https://modelcontextprotocol.io/specification/2026-07-28/changelog
- «Транспорты MCP», Model Context Protocol, https://modelcontextprotocol.io/specification/2026-07-28/basic/transports
- «Авторизация MCP», Model Context Protocol, https://modelcontextprotocol.io/specification/2026-07-28/basic/authorization
- «Инструменты MCP», Model Context Protocol, https://modelcontextprotocol.io/specification/2026-07-28/server/tools
- «Цитируется, но не проверено: атрибуция источников в агентах глубокого исследования», arXiv, 2026-05-07, https://arxiv.org/html/2605.06635v1
- «Сравнительное тестирование и анализ ошибок агентов глубокого поиска и глубокого исследования», arXiv, 2026-10-21, https://arxiv.org/html/2610.29346v1
- «DeepResearch Bench: бенчмарк для агентов глубокого исследования», arXiv, https://arxiv.org/abs/2506.11763
- Каталог возможностей EveryInfra для работы с данными, дата обращения: 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog
- Каталог EveryInfra для Reddit, дата обращения: 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=reddit
- Каталог EveryInfra для YouTube, дата обращения: 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=youtube
- Каталог EveryInfra для Google News, дата обращения: 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=google_news
- «11-летний мальчик погиб при пожаре из-за аккумулятора электровелосипеда в квартире в Бронксе», The New York Times, 2026-10-28, https://www.nytimes.com/2026/10/28/nyregion/fire-e-bike-battery-bronx.html
- «По данным FDNY, причиной пожара в Бронксе, в котором погиб мальчик, стал литий-ионный аккумулятор», Gothamist, 2026-10-28, https://gothamist.com/news/lithium-ion-battery-caused-bronx-fire-that-killed-11-year-old-fdny-says
- «Число пожаров, связанных с электровелосипедами, резко выросло по всему Нью-Йорку», New York Daily News, 2026-10-31, https://www.nydailynews.com/2026/10/31/as-bronx-family-reels-from-devastating-blaze-that-killed-4-e-bike-fires-have-skyrocketed-across-nyc/
- «На объектах NYCHA растёт число пожаров из-за аккумуляторов электровелосипедов», The City Reporter, 2026-10-30, https://www.thecityreporter.nyc/2026/10/30/e-bike-battery-fires-on-the-rise-at-nycha-leaving-death-in-their-wake/
- «Число пожаров из-за литий-ионных аккумуляторов выросло на 41%, пока решение проблемы на общественном уровне буксует», Streetsblog NYC, 2026-10-14, https://nyc.streetsblog.org/2026/10/14/everyone-should-be-furious-lithium-ion-battery-fires-are-up-41-as-public-fix-stalls
- «Четыре человека погибли при пожаре из-за аккумулятора электровелосипеда в Бронксе», Spectrum Noticias, 2026-10-31, https://spectrumnoticias.com/ny/nyc/noticias/2026/10/31/cuatro-muertos-tras-un-incendio-en-la-bateria-de-una-bicicleta-electrica-en-el-bronx--nypd
- «11-летний мальчик погиб при пожаре в Бронксе из-за аккумулятора электровелосипеда», Univision, 2026-10-29, https://www.univision.com/local/nueva-york-wxtv/muere-nino-de-11-anos-en-incendio-provocado-por-bateria-de-bicicleta-electrica-en-el-bronx
- «Мэр Адамс принимает новые меры по предотвращению пожаров из-за литий-ионных аккумуляторов», мэрия Нью-Йорка, 2024-07, https://www.nyc.gov/mayors-office/news/2024/07/mayor-adams-takes-new-actions-prevent-deadly-lithium-ion-battery-fires-promote-safe-e-bike
- «Что пожарные советуют знать о возгораниях литиевых аккумуляторов», CBC, 2026-10, https://www.cbc.ca/news/science/lithium-battery-fire-faq-9.7371004
- «Как предотвратить пожары из-за литий-ионных аккумуляторов в Филадельфии», Billy Penn at WHYY, 2026-10-17, https://billypenn.com/2026/10/17/lithium-ion-battery-fire-safety-philadelphia/
- «На объектах NYCHA растёт число пожаров из-за аккумуляторов электровелосипедов», ветка r/nyc, Reddit, 2026-10-30, https://www.reddit.com/r/nyc/comments/1xjb3ss/ebike_battery_fires_on_the_rise_at_nycha_leaving/
- «Есть ли полноценный инструмент глубокого исследования для MCP?», ветка r/LocalLLM, Reddit, https://www.reddit.com/r/LocalLLM/comments/1pw1ukl/is_there_a_true_deep_research_mcp_deep_research/
Справка BL-66