GPT-6.1 Sol API 구조화된 출력: 리뷰 태깅 비용은 얼마일까
GPT-6.1 Sol의 strict JSON과 Batch API로 리뷰를 태깅합니다. 데이터 수집: 실제 리뷰 412건. 모델 비용은 공개 가격 기준 추정치로, 1,000건당 약 $0.81입니다.
자체 추정에 따르면 GPT-6.1 Sol로 리뷰 1,000건을 1달러 미만에 태깅할 수 있습니다. strict JSON Schema 출력, Batch API, 리뷰당 추론 토큰 약 50개를 가정한 결과입니다. 모델을 직접 실행하지는 않았으므로 추정치입니다. 비용에서 큰 비중을 차지하는 것은 데이터가 아닙니다. 비용을 좌우하는 것은 요청을 묶는 방식입니다. 2026-11-06 00:16~00:25 SGT에 EveryInfra 데이터 API를 7회 실제로 호출했습니다.
로봇청소기 앱 Roborock과 iRobot의 Google Play 리뷰 400건과, 리뷰 영상 1개에 달린 TikTok 댓글 12건을 수집했습니다. 총비용은 $0.003334였습니다. 호출별 실제 행 수로 계산하면 리뷰 1,000건당 데이터 비용은 Google Play가 $0.006945, TikTok이 $0.046704입니다.
이 머신에는 OpenAI API 키가 없습니다. 따라서 이 글의 모델 관련 내용은 설정 예시와 추정치입니다. 토큰 수는 공개된 o200k_base 인코딩으로 세고, 2026-11-06에 확인한 공개 가격을 적용했습니다. 핵심 결과는 간단합니다.
요청 하나에 리뷰를 1건씩 보내면 시스템 프롬프트와 스키마만 967토큰입니다. 이는 전체 입력 토큰의 92%이며, 프롬프트 캐싱 최소 기준인 1,024토큰에 못 미칩니다. 결국 같은 지시문에 정가를 1,000번 내게 됩니다.
이번에는 요청 하나에 리뷰 25건을 보내고 리뷰당 추론 토큰을 50개로 가정합니다. 그러면 리뷰 1,000건의 Batch 모델 비용은 약 $1.74에서 약 $0.81로 줄어듭니다. 추론 토큰이 없다면 하한선은 $1.49에서 $0.56까지 내려갑니다. 하지만 Sol은 low보다 낮은 추론 강도를 지원하지 않으므로 이 하한선에는 도달할 수 없습니다.
이 글에서는 한 가지 구체적인 질문에 답합니다. 리뷰 데이터가 있고, GPT-6.1 Sol로 각 리뷰에 네 가지 태그, 즉 감성, 이슈 카테고리, 경쟁사 언급, 액션 아이템 1개를 붙이려고 합니다. 각 태그는 스프레드시트에 바로 들어가야 하고, 전체 비용도 알고 싶습니다. 리뷰는 EveryInfra 데이터 API에서 가져옵니다.
태깅에는 OpenAI Responses API와 Batch API를 사용합니다. 아래의 EveryInfra 수치는 모두 원본 응답에서 가져온 것이며 직접 다시 계산할 수 있습니다. OpenAI 관련 단계는 모두 설정 예시 또는 가격 추정치로 표시했습니다. 이 배치를 OpenAI에서 실제로 실행하지는 않았습니다.
아래 표는 실제로 측정한 항목과 추정한 항목을 보여 줍니다. 이후 나오는 모든 수치는 이 표의 행 중 하나에 대응합니다.
| 단계 | 확인 방법 | 재계산 가능 여부 |
|---|---|---|
| 리뷰 데이터(EveryInfra) | 2026-11-06 실제 호출 7회, 원본 응답 저장 | 예. 모든 수치가 응답 기반 |
| 토큰 수 | o200k_base로 실제 시스템 프롬프트, 스키마, 리뷰 412건의 토큰 수 계산 | 예. 단, Sol 토크나이저는 비공개 |
| 출력 태그 | 사람이 작성한 예시 태그 12개(GPT-6.1 Sol 출력 아님) | 출력 길이 추정에만 사용 |
| 추론 토큰 | 측정하지 않음. 리뷰당 0, 50, 200개로 가정 | 아니요. 파일럿 실행과 해당 실행의 usage 값 필요 |
| 모델 비용 | 2026-11-06 공개 가격 × 위 행의 수치 | 예. 직접 수치를 넣어 계산 가능 |
| 태그 정확도 | 없음 | 파일럿 실행 후 직접 확인 |
GPT-6.1 Sol API란? 출시일, 컨텍스트, 가격 정리
먼저 모델에 관한 사실부터 정리합니다. OpenAI API 변경 내역에는 2026-09-29 항목이 있습니다. 이 항목에 따르면 OpenAI는 복잡한 코딩과 전문 업무용으로 GPT-6.1 Sol(gpt-6.1-sol)을 출시했습니다. 가격은 GPT-6 Astra보다 낮습니다.
입력 272K 토큰 이하 기준으로 1M 토큰당 표준 가격은 입력 $2, 캐시된 입력 $0.10, 캐시 쓰기 $2.50, 출력 $10입니다. 같은 항목에 따르면 도구 호출에는 Responses API가 필요합니다. 출시 글 “Introducing GPT-6.1 Sol”은 Sol이 기능 면에서 GPT-6 Astra에 가깝다고 설명합니다. 또한 표준 입력·출력 가격이 Astra의 5분의 1이라고 밝힙니다.
2026-11-06에 확인한 GPT-6.1 Sol 모델 페이지에는 태깅에 중요한 사양이 나와 있습니다. 컨텍스트 윈도우는 1,050,000토큰, 최대 출력은 128,000토큰, 지식 기준일은 2026-04-30입니다. reasoning.effort 값은 low, medium(기본값), high, xhigh, max입니다. 기능 목록에는 Structured outputs와 Function calling이 “Supported”로 표시되어 있습니다.
모델 페이지에는 배치 작업과 관련된 가격 규칙 4가지도 나와 있습니다. 캐시된 입력은 입력 가격의 5%입니다. 캐시 쓰기는 1.25배입니다. 입력 토큰이 272K를 넘으면 해당 요청 전체에 입력 2배, 출력 1.5배가 적용됩니다. Batch와 Flex는 50% 저렴합니다.
| 항목 | 출처 내용 | 출처(2026-11-06 열람) | 태깅에 미치는 영향 |
|---|---|---|---|
| API 출시 | gpt-6.1-sol 2026-09-29 출시 | API 변경 내역 | 작성 시점 기준 출시 후 38일 |
| 컨텍스트 및 출력 | 컨텍스트 1,050,000, 최대 출력 128,000 | 모델 페이지 | 요청 하나에 리뷰 수십 건을 넣어도 여유 있음 |
| 추론 강도 | low, medium, high, xhigh, max(none 없음) | 모델 페이지, GPT-6 가이드 | 모든 요청에서 추론 토큰이 발생하며 출력으로 과금 |
| 표준 가격 | 1M당 입력 $2, 캐시된 입력 $0.10, 출력 $10 | 요금 페이지, 변경 내역 | 동기 방식 기준 리뷰 1,000건당 최소 약 $2.99 |
| Batch 가격 | 1M당 입력 $1, 캐시된 입력 $0.05, 출력 $5 | 요금 페이지 | 같은 요청을 절반 가격에 처리 |
| 긴 입력 할증 | 입력 272K 초과 시 입력 2배, 출력 1.5배 | 모델 페이지 | 요청 하나에 리뷰를 너무 많이 넣지 말 것 |
| Chat Completions | 지원되지만 도구 호출은 지원하지 않음 | 모델 페이지, GPT-6 가이드 | 이 글에서는 Responses API만 사용 |
가장 많이 놓치는 행은 추론 강도(reasoning effort)입니다. GPT-6 가이드는 이 점을 분명히 밝힙니다. GPT-6 Astra와 GPT-6.1 Sol은 none을 지원하지 않습니다. 기존 요청에서 minimal을 쓰고 있다면 low로 바꾸고 결과를 비교해 보시기 바랍니다. GPT-6.1 Terra, GPT-6 Sol, GPT-6 Luna는 none을 지원합니다. 추론 가이드에 따르면 추론 토큰은 출력 토큰으로 계산됩니다.
태깅에서는 이 점이 중요합니다. 리뷰마다 보이지 않는 출력이 1M 토큰당 $10(Batch에서는 $5)씩 추가됩니다. 이 양은 실제로 호출해 보지 않고는 측정할 수 없습니다. 그래서 비용 표에서는 추론을 별도의 가정으로 표시합니다.
다음은 Batch 행 전체입니다. 요금 페이지에서는 Flex와 Batch를 같은 가격대로 묶습니다. gpt-6.1-sol의 Batch 요금은 1M 토큰당 입력 $1, 출력 $5, 캐시된 입력 $0.05입니다. 30분 캐시 쓰기는 $1.25, 12시간 캐시 쓰기는 $2.50입니다. 아래의 모든 비용 표는 이 가격대를 기준으로 합니다.
GPT-6.1 구조화된 출력: json_schema strict 모드의 한계
OpenAI Structured Outputs 가이드는 첫머리에서 핵심 약속을 밝힙니다. 모델 출력은 항상 사용자가 제공한 JSON Schema와 일치합니다. 필수 키를 빠뜨리지 않으며, 없는 enum 값을 만들어 내지도 않습니다. Responses API에서는 text.format을 {"type":"json_schema","strict":true,"schema":…}로 설정합니다. 가이드는 strict 모드가 JSON Schema의 일부만 지원한다는 점도 밝힙니다. 스키마에 이 범위 밖의 키워드가 있으면 strict: true 요청은 실패합니다.
태깅 스키마는 한 번 확정하면 수천 번 실행됩니다. 그래서 가이드에서 개수를 세거나 확인할 수 있는 규칙을 모두 옮겨 적었습니다. 그런 다음 스키마가 이 규칙을 지키는지 검사하는 작은 스크립트를 작성했습니다. 기억에 의존하지 않았습니다.
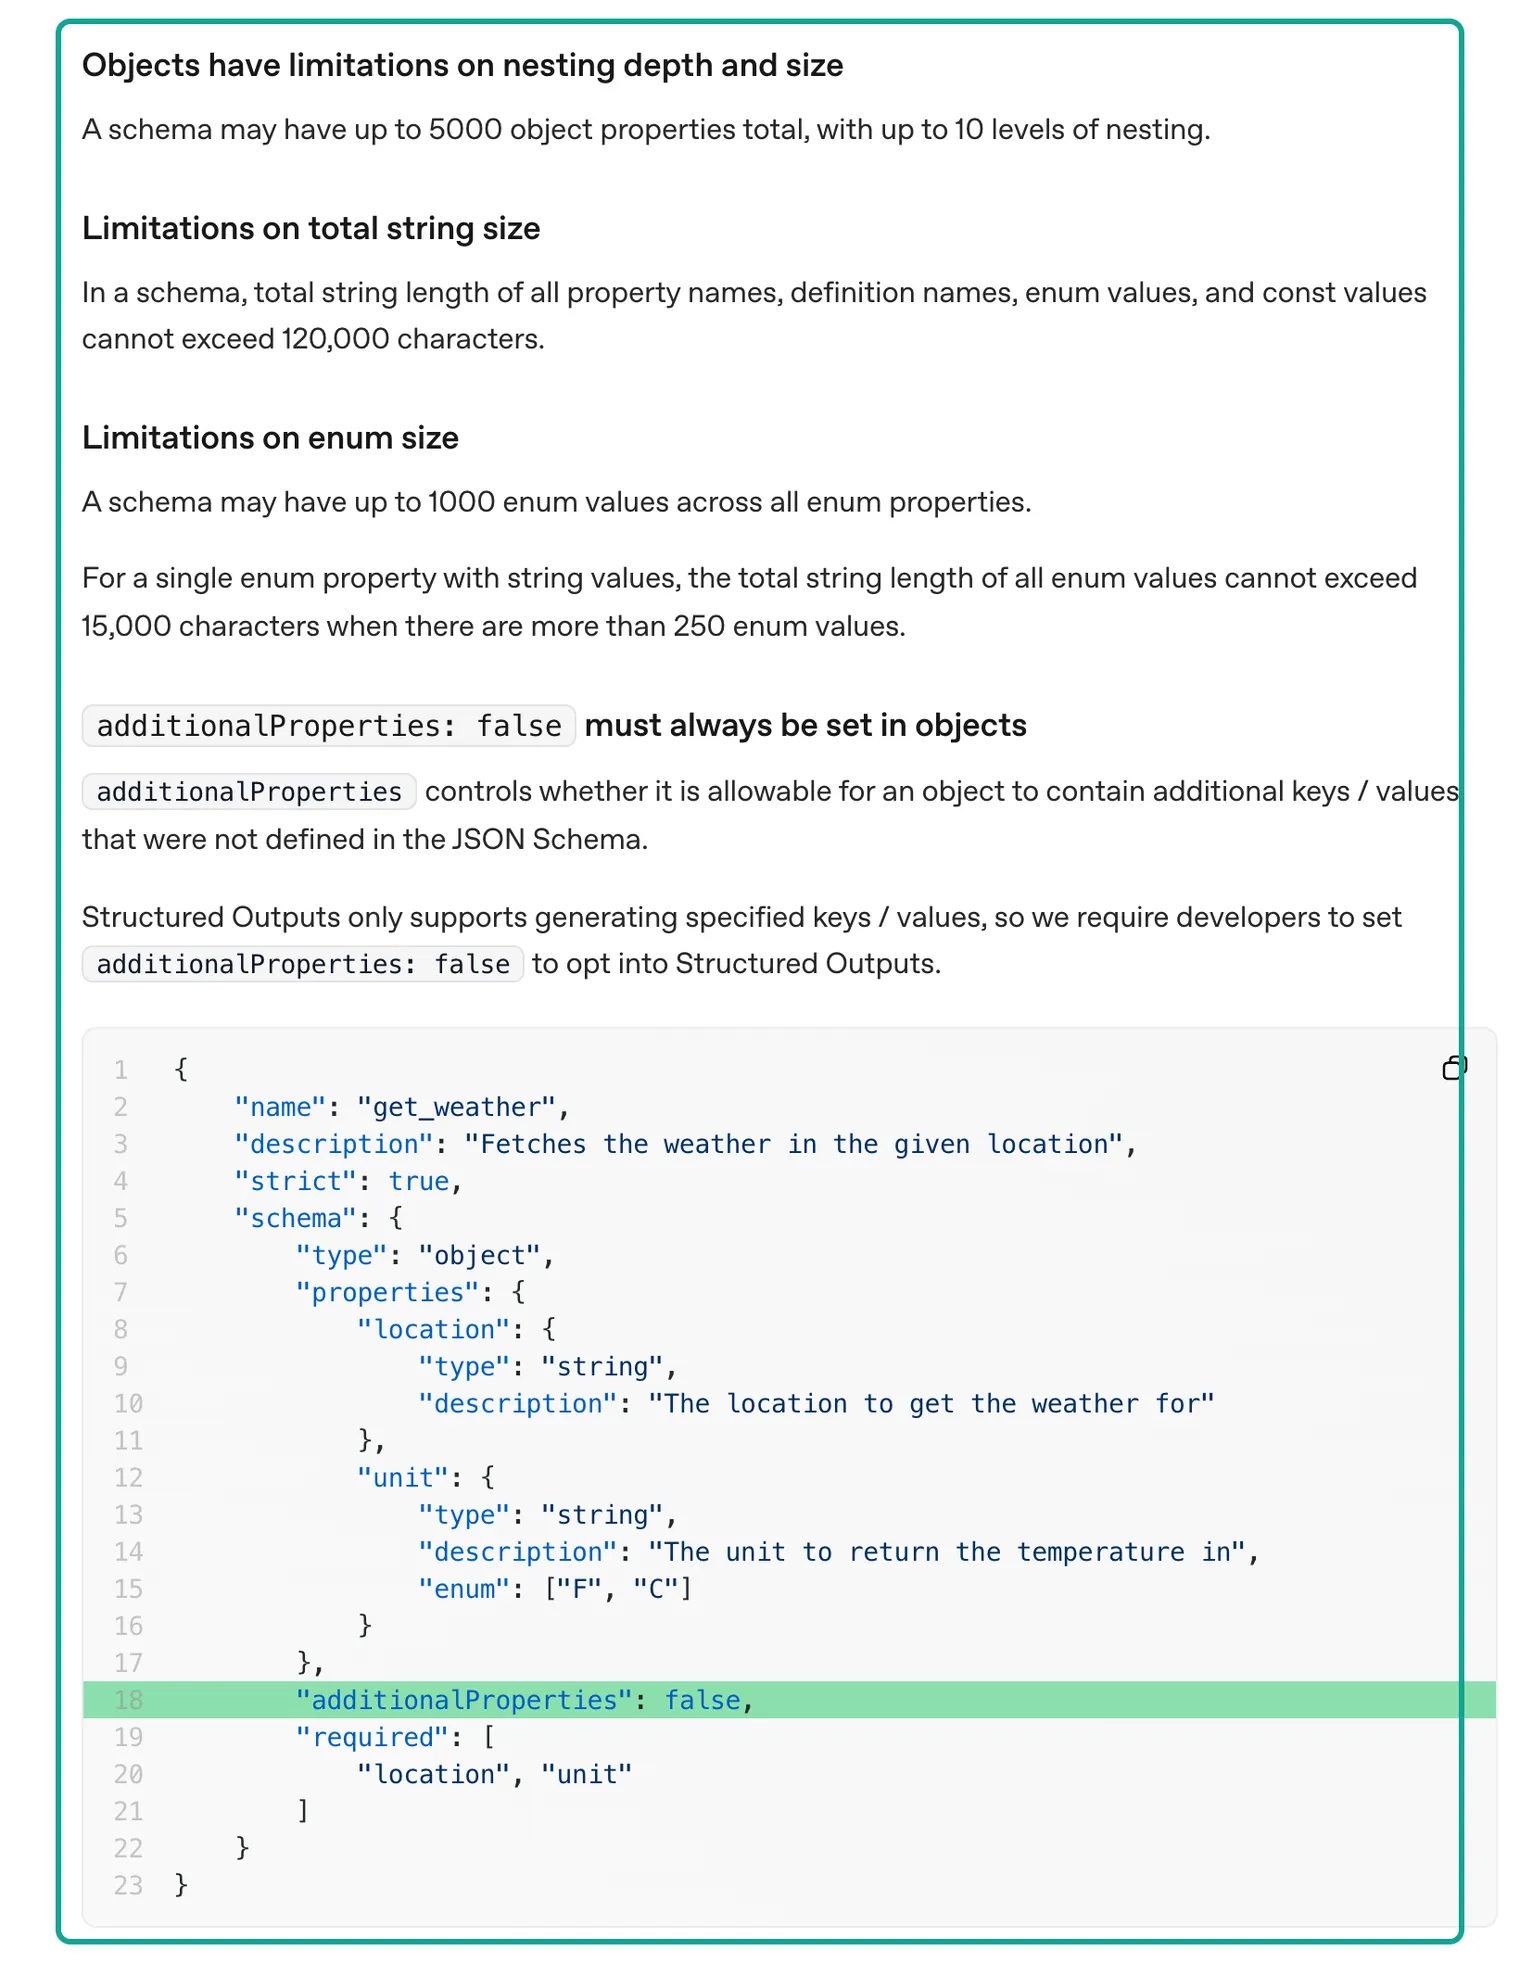
청록색 상자 안의 네 부분은 크기 제한입니다. 상자 밖에도 가이드에는 스키마 작성 방식에 관한 엄격한 규칙이 더 있습니다.
- 루트는 객체여야 합니다.
anyOf일 수 없습니다. - 모든 객체의 모든 필드가
required에 있어야 합니다. 필드를 선택 항목으로 만들려면["string","null"]같은 타입을 지정합니다. - 가이드에 따르면
allOf,not,dependentRequired,dependentSchemas,if,then,else는 지원하지 않습니다. - 문자열에 대해 가이드가 나열하는 키워드는
pattern과format뿐입니다.format키워드는date-time,time,date,duration,email,hostname,ipv4,ipv6,uuid의 9가지 값을 받습니다. - 배열은
minItems와maxItems를 지원합니다.$defs와 재귀 참조도 지원합니다.
가이드에 따르면 새 스키마로 보내는 첫 요청에는 추가 처리 지연이 발생합니다. 같은 스키마를 쓰는 이후 요청에는 발생하지 않습니다.
| 규칙(가이드의 섹션) | 제한 또는 요구 사항 | 저희 태그 스키마 | 오류가 있는 테스트 스키마 |
|---|---|---|---|
| 전체 객체 속성 수(Objects have limitations…) | ≤ 5000 | 9 | 8 |
| 중첩 깊이 | ≤ 10 | 1단계 | 1단계 |
| 전체 enum 값 수(Limitations on enum size) | ≤ 1000 | 31 | 31 |
| 이름 및 enum 값의 문자 수(“Limitations on total string size”) | ≤ 120,000 | 416 | 408 |
additionalProperties: false | 모든 객체에 필수 | 예 | 루트가 true로 설정됨, 검출됨 |
모든 필드가 required에 포함됨 | 필수 | 9개 중 9개 | required에 존재하지 않는 필드가 있음 |
| 지원되지 않는 키워드 | allOf, if, then 등 | 0 | 3 |
| 지원 목록에 없는 키워드 | 경고만 표시 | 0 | minLength, 1 |
스크립트는 리뷰 1개용 스키마와 리뷰 25개용 스키마에 대해 문제 0건, 경고 0건을 보고합니다. 오류가 있는 스키마에서는 문제 5건, 경고 1건을 보고합니다. 이 스키마는 아무렇게나 만든 것이 아닙니다. "mentions_competitor가 true이면 competitors에 항목이 하나 이상 있어야 한다"는 자연스러운 발상에서 나왔습니다. JSON Schema에서는 이 규칙을 allOf와 if/then으로 작성합니다.
strict 모드는 이를 지원하지 않습니다. 두 필드 사이의 이런 규칙은 스키마로 강제할 수 없습니다. 결과를 받은 뒤 코드에서 확인해야 합니다. 방법은 아래 "스키마로 강제할 수 없는 것" 섹션에서 설명합니다.
minLength에 관한 참고 사항입니다. 가이드는 minLength와 maxLength를 파인튜닝된 모델에서만 지원하지 않는다고 명시하지만, 지원되는 문자열 키워드 목록에는 pattern과 format만 있습니다. 그래서 스크립트는 경고를 표시하고, 저희 스키마에서는 이 키워드를 쓰지 않습니다. 액션 항목의 20단어 제한은 description과 프롬프트에 적고, 코드에서 측정합니다.
다음은 단일 리뷰용 태그 스키마입니다. 필드는 9개이며 모두 필수입니다. other_brand_name과 action_item은 null일 수 있습니다.
{
  "name": "review_label",
  "strict": true,
  "schema": {
    "type": "object",
    "properties": {
      "item_id": {"type": "string", "description": "Copy the item_id of the input item."},
      "sentiment": {"type": "string", "enum": ["positive", "negative", "mixed", "neutral"]},
      "issue_categories": {"type": "array", "minItems": 1, "maxItems": 3,
        "items": {"type": "string", "enum": ["app_connectivity", "account_login", "mapping_navigation",
          "suction_cleaning", "mopping", "dock_self_empty", "battery_charging", "hardware_defect",
          "firmware_update", "customer_service_warranty", "price_value", "noise", "app_usability", "other", "none"]}},
      "mentions_competitor": {"type": "boolean"},
      "competitors": {"type": "array", "maxItems": 5,
        "items": {"type": "string", "enum": ["roborock", "irobot_roomba", "ecovacs_deebot", "dreame", "eufy",
          "shark", "narwal", "mova", "dyson", "samsung", "xiaomi", "other_brand"]}},
      "other_brand_name": {"type": ["string", "null"]},
      "action_item": {"type": ["string", "null"], "description": "One concrete action, 20 words or fewer, or null."},
      "evidence": {"type": "string", "description": "Up to 15 words copied from the text."},
      "language": {"type": "string", "description": "ISO 639-1 code."}
    },
    "required": ["item_id", "sentiment", "issue_categories", "mentions_competitor", "competitors",
                 "other_brand_name", "action_item", "evidence", "language"],
    "additionalProperties": false
  }
}
25개 리뷰 버전은 바깥쪽에 계층을 하나 더합니다. 루트 객체에는 labels 배열 필드 하나만 있습니다. 배열의 각 항목은 $ref로 $defs의 같은 태그 객체를 가리킵니다. 가이드에 따르면 $defs와 $ref는 지원됩니다. 중첩 깊이는 1단계에서 2단계로 늘어나며, 한도인 10단계보다 훨씬 낮습니다.
필드 순서도 중요합니다. 가이드에 따르면 출력은 스키마의 키 순서를 따릅니다. 그래서 item_id를 맨 앞에 두었습니다. action_item과 evidence는 모델이 리뷰 전체를 읽어야 작성할 수 있으므로 끝부분에 두었습니다. 출력이 중간에 잘려도 앞부분의 ID와 감성 값은 남습니다.
태그 설계 방법: 질문 4개, 필드 9개
태그를 설계하기 전에 누가 사용할지 먼저 정해야 합니다. 로봇청소기 브랜드의 앱 팀은 Wi-Fi 연결 끊김, 로그인 실패, 맵 손실에 관심이 있습니다. 고객 지원 팀은 보증 관련 불만을 찾습니다. 제품 팀은 사용자가 어떤 다른 브랜드와 비교하는지 알고 싶어 합니다.
그래서 네 가지 질문으로 태그를 만들었습니다. 어조는 어떤가? 어떤 종류의 문제인가? 다른 브랜드를 언급하는가?
구체적인 개선 사항 하나로 이어질 수 있는가? 문제 카테고리는 15개 값으로 고정된 enum입니다. 경쟁사는 12개 값의 enum이며, 해당하는 값이 없을 때를 위해 other_brand를 둡니다.
가장 오래 걸린 것은 문제 카테고리입니다. 먼저 실제 호출로 받은 리뷰 412개를 읽고, 실제 불만을 13개 그룹으로 분류했습니다. 그런 다음 other와 none을 추가했습니다. 예를 들어 별점이 낮은 iRobot 리뷰에는 "명령이 전달되지 않는다"거나 "iRobot 클라우드에 연결할 수 없다"는 내용이 많습니다.
이런 리뷰는 app_connectivity로 분류합니다. "인증 코드가 오지 않는다"와 "계정 연동에 실패했다"는 account_login으로 분류합니다. Roborock 리뷰에는 "업데이트 후 맵이 망가졌다"는 내용이 많습니다. 이는 firmware_update와 mapping_navigation 모두에 해당합니다. 그래서 리뷰 하나에 카테고리를 최대 3개까지 지정할 수 있습니다.
시스템 프롬프트에는 카테고리마다 한 줄씩 지침이 있습니다. 이 부분이 프롬프트의 절반 이상을 차지합니다. 아래 토큰 수에서 고정 접두사가 645 토큰인 주된 이유도 이 때문입니다.
감성 값은 positive, negative, mixed, neutral의 네 가지입니다. 시스템 프롬프트에는 "별점만으로 감성을 판단하지 말 것"이라고 적혀 있습니다. 별점과 본문은 자주 엇갈립니다. Roborock 리뷰 중 별 1개짜리 리뷰 하나는 "앱은 아주 좋다"로 시작하고, 뒤에 가서야 맵에 문제가 있다고 말합니다. 별 3개짜리 리뷰 하나는 앞부분에서 앱을 칭찬합니다.
뒷부분에서는 삼성 폴더블폰에서 하단 버튼이 작동하지 않는다고 말합니다. 시스템 프롬프트는 이런 리뷰를 mixed로 태깅합니다. TikTok 댓글에는 별점이 없습니다. "어느 게 제일 좋아요?" 같은 질문은 neutral로 태깅합니다.
action_item은 확인하기 가장 어려운 태그라서 제약이 가장 엄격합니다. 20단어 이하의 영어 문장 하나이거나 null이어야 합니다. evidence는 리뷰에서 최대 15단어를 원문 언어 그대로 옮겨야 합니다. 이 두 필드가 있으면 리뷰 전체를 읽지 않고도 몇 초 만에 태그를 확인할 수 있습니다.
이 스키마로 실제 리뷰 12개에 대한 출력 예시를 직접 작성했습니다. 이 예시로 출력 토큰을 추정하며, 각 필드가 어떤 모습인지도 확인할 수 있습니다. 표에는 그중 4개를 실었습니다.
리뷰 본문은 일부만 싣고 작성자 정보는 삭제했습니다. 이 12개 예시는 사람이 작성한 것이며, GPT-6.1 Sol의 출력이 아닙니다.
| 출처 | 별점 | 리뷰 발췌 | 감성 | 문제 카테고리 | 경쟁사 |
|---|---|---|---|---|---|
| Roborock 앱 | 2 | "지난 업데이트 이후로 내 로봇을 망쳐 놨네요! 맵이 완전히 엉망이에요…" | negative | firmware_update, mapping_navigation | none |
| Roborock 앱 | 3 | "…삼성 Z Fold 8의 화면 비율을 지원하지 않아요…" | mixed | app_usability | none(여기서 삼성은 휴대폰을 가리킴) |
| iRobot 앱 | 1 | "청소기 2대 중 하나꼴로 연결 문제가 생깁니다. 다시는 Roomba를 사지 않을 겁니다" | negative | app_connectivity | none |
| TikTok 댓글 | n/a | "Dreame X60 Pro Ultra는 어때요?…" | neutral | none | dreame |
EveryInfra로 리뷰 가져오기: 실제 요청부터 응답까지
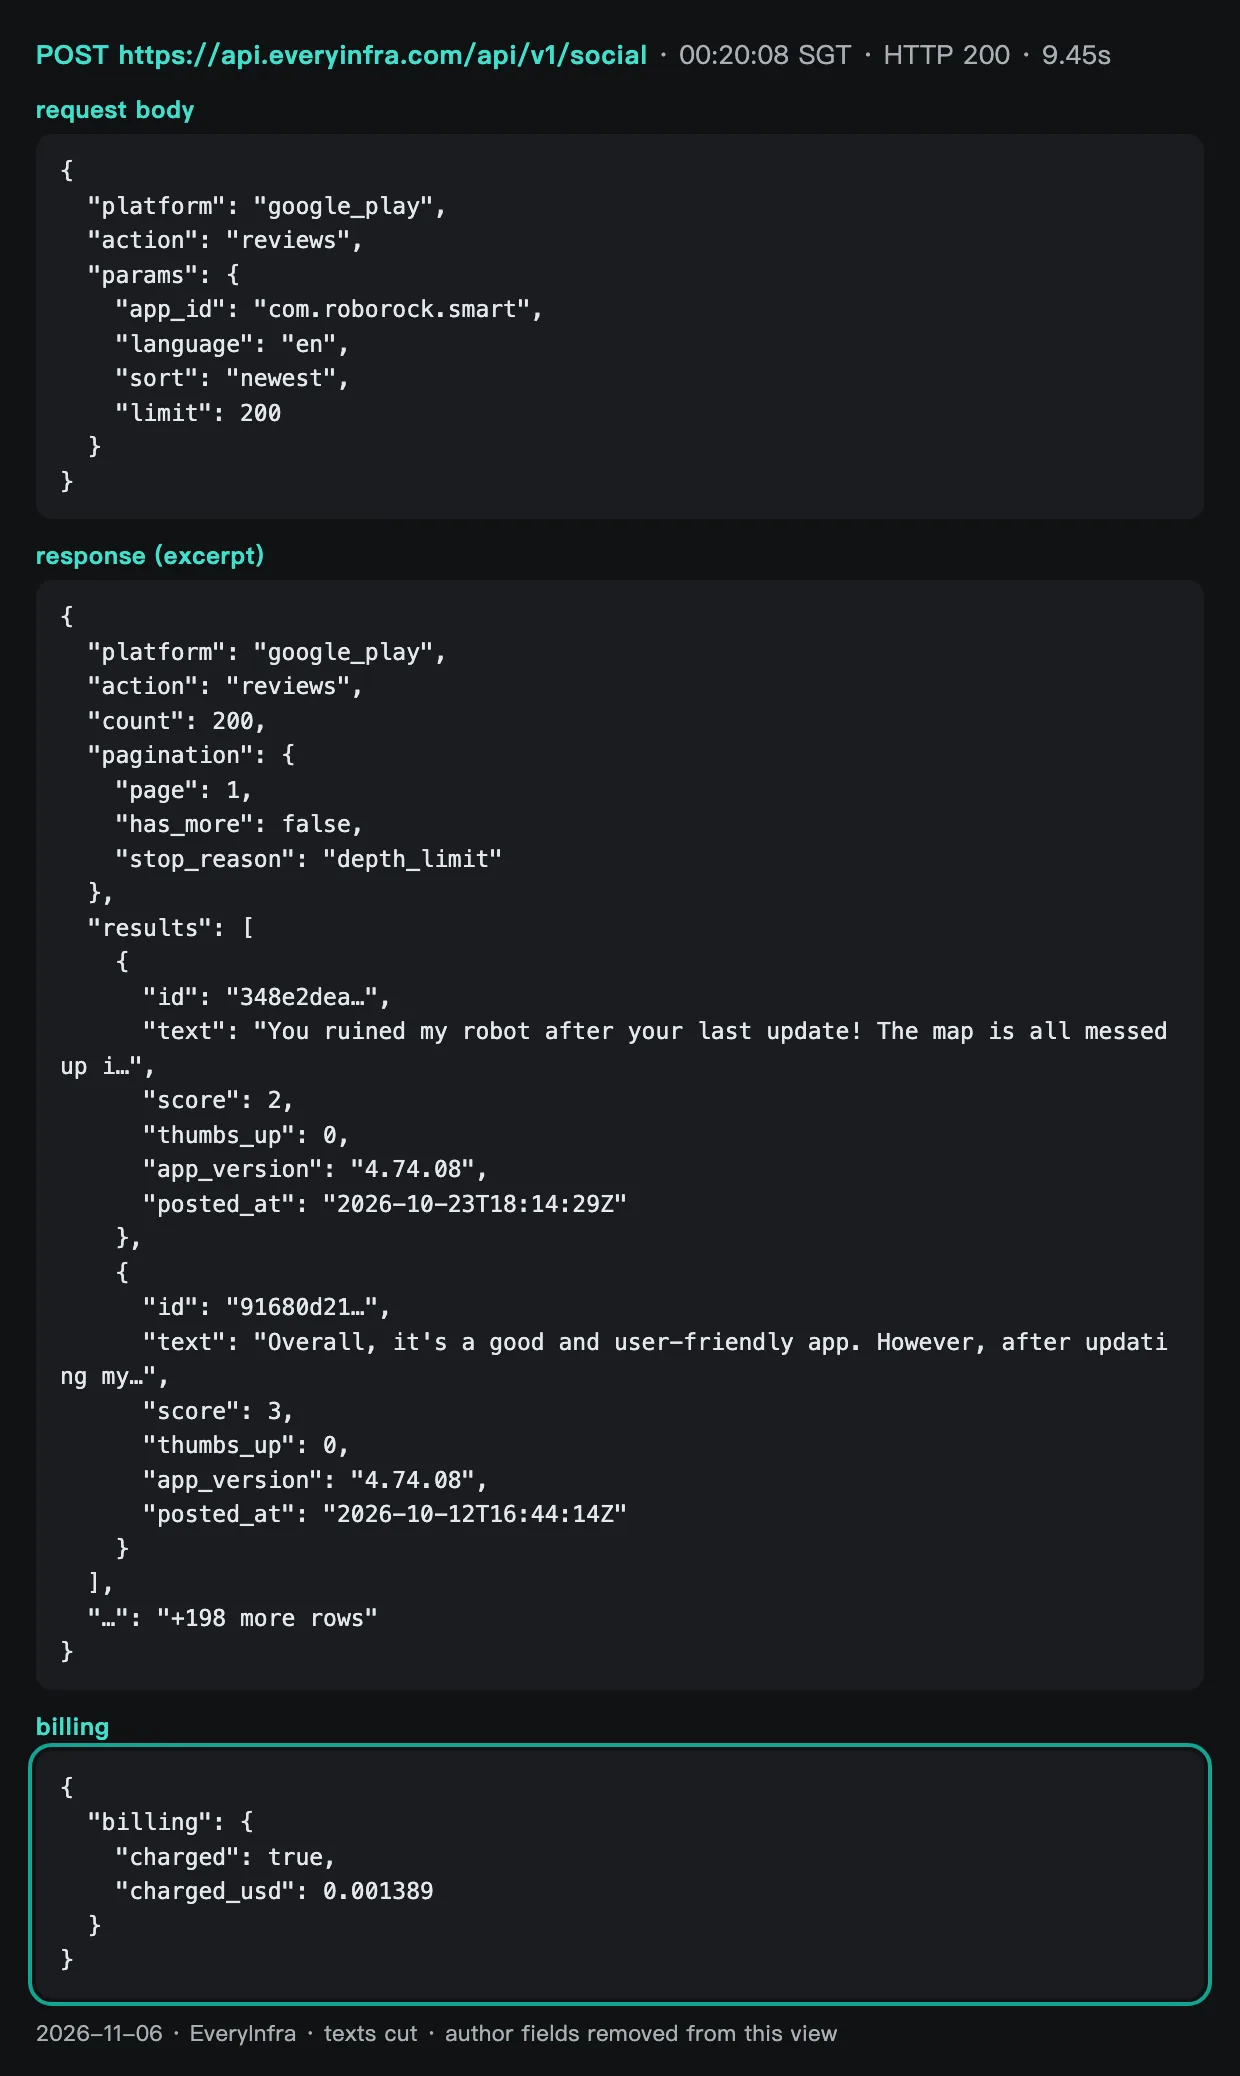
리뷰를 가져오는 데는 EveryInfra 데이터 엔드포인트 POST /api/v1/social을 사용했습니다. 요청 본문에 플랫폼, 액션, 파라미터를 지정합니다. 첫 호출 전인 2026-11-06 00:15 SGT에 무료 기능 카탈로그를 읽고 각 리뷰 기능의 가격, 파라미터, 응답 필드를 확인했습니다. 내용은 다음과 같습니다.
google_play/reviews는 호출당 $0.001389입니다. 동기 호출 한 번에 최대 200행을 반환합니다.language와sort파라미터를 지원합니다.tiktok/comments는 호출당 $0.000556입니다. 동영상 URL을 입력받습니다.amazon/reviews는 호출당 $0.001389입니다. 카탈로그에 따르면 각 Amazon 사이트는 상품 페이지에 추천 리뷰만 표시하며, 보통 상품당 십여 개 정도입니다.trustpilot/reviews는 호출당 $0.001389입니다.
다음은 Google Play 요청 전체입니다.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"google_play","action":"reviews",
       "params":{"app_id":"com.roborock.smart","language":"en","sort":"newest","limit":200}}'
이 요청은 2026-11-06 00:20:08 SGT에 보냈으며, 9.45초 만에 HTTP 200을 반환했습니다. count는 200이었습니다. pagination.stop_reason은 depth_limit, has_more는 false였습니다. 과금액은 $0.001389이었습니다.
각 리뷰에는 id, text, score, thumbs_up, reply_text, reply_at, app_version, posted_at 같은 필드가 있습니다. 이는 카탈로그의 response_fields 목록과 일치합니다. 응답에는 작성자 이름과 아바타 필드도 있지만, 태깅에는 필요 없으므로 모델 요청을 만들기 전에 삭제했습니다.
00:16:42부터 00:24:27 SGT까지 총 7번 호출했으며, 아래 표에 각 호출을 정리했습니다. 동기 tiktok/comments 호출은 90.21초가 걸렸고 HTTP 200과 12행을 반환했습니다. limit 200으로 보낸 amazon/reviews와 trustpilot/reviews 동기 호출 2건은 85초를 넘겨 503 타임아웃을 반환했으며, 과금되지 않았습니다. 오류 메시지는 "mode":"async"를 쓰거나 limit을 줄이라고 안내했습니다. Roborock 상품 2개에 대한 비동기 amazon/reviews 작업 2건은 0행으로 성공했고, 과금액은 환불되었습니다.
| 시각(SGT) | 기능 | 결과 | 클라이언트 측 소요 시간 | 행 | 과금 |
|---|---|---|---|---|---|
| 00:16:42 | amazon/reviews 동기 | 503 타임아웃 | 89.91 s | 0 | $0 |
| 00:18:21 → 00:19:57 | amazon/reviews 비동기 | 성공, 0행, 환불됨 | 제출 2.08초, 약 96초 후 완료 | 0 | $0 (과금 후 환불) |
| 00:18:26 | tiktok/comments 동기 | 200 | 90.21 s | 12 | $0.000556 |
| 00:20:08 | google_play/reviews Roborock | 200 | 9.45 s | 200 | $0.001389 |
| 00:20:25 | google_play/reviews iRobot | 200 | 9.24 s | 200 | $0.001389 |
| 00:20:34 → 00:24:18 | amazon/reviews 비동기 | 성공, 0행, 환불됨 | 제출 2.04초, 약 224초 후 완료 | 0 | $0 (과금 후 환불) |
| 00:24:27 | trustpilot/reviews 동기 호출 | 503 타임아웃 | 88.2 s | 0 | $0 |
응답 시간 하나는 짚고 넘어가야 합니다. tiktok/comments 호출은 90.21초가 걸려 두 건의 503 타임아웃(89.91초, 88.2초)보다 길었지만, 200을 반환하고 12행을 돌려줬습니다. 두 503 오류 메시지에는 모두 "request timed out after 85s"라고 적혀 있습니다. 즉 서버 측 대기 한도는 85초입니다. 저희가 잰 시간은 요청을 보낸 시점부터 전체 응답을 받은 시점까지이므로 네트워크 시간과 대기열 시간이 포함됩니다.
응답에는 서버 측 처리 시간이 나오지 않으므로 TikTok 호출이 서버에서 얼마나 걸렸는지는 알 수 없습니다. 한도에 근접했다는 것만 말할 수 있습니다. 같은 요청이라도 다른 시간에 보내면 503이 반환될 수 있습니다. TikTok 댓글처럼 느린 기능을 일괄 수집할 때는 비동기 모드를 사용하세요.
이 표 자체가 하나의 발견입니다. 7건의 호출 중 데이터를 반환한 것은 3건뿐입니다. 하지만 데이터가 없는 4건에는 비용이 전혀 들지 않았습니다. 503 응답 2건은 본문에 charged_usd: 0이 표시됩니다. 빈 결과로 끝난 비동기 작업 2건은 요청을 보낼 때 호출 가격만큼 과금되었다가 작업이 끝나면서 환불되었습니다.
일괄 태깅 작업에서 데이터 수집이 실패하면 잃는 것은 돈이 아니라 시간입니다. 실제 위험은 다른 데 있습니다. "0행"을 보고서에 "부정적 리뷰 없음"으로 적으면 안 됩니다. 빈 결과로 끝난 Amazon 작업 2건은 더 파고들지 않았습니다. 그 이유는 "한계와 주의할 점" 섹션에서 설명합니다.
리뷰 412건은 어떤 모습인가
모델에 무엇이든 보내기 전에 데이터부터 살펴보세요. 앱마다 최신 영어 리뷰 200건씩을 받았습니다. 건수는 같지만 기간은 다릅니다. Roborock 리뷰 200건은 2026-10-03부터 2026-11-04까지 32일에 걸쳐 있습니다.
iRobot 리뷰 200건은 2026-07-27부터 2026-11-04까지 99일에 걸쳐 있습니다. 같은 $0.001389로 Roborock 호출은 최근 한 달을, iRobot 호출은 석 달이 넘는 기간을 보여 줍니다. "최신 200건"으로 주간 보고서를 만들면 iRobot 쪽에는 7월의 문제가 이번 주 문제로 섞여 들어갑니다.
별점 차이는 더 큽니다. iRobot 세트에서는 별 1개가 100건, 별 2개가 26건입니다. 합치면 126건, 즉 63%가 별 1~2개입니다. Roborock 세트에서는 46건에 22건을 더해 68건, 즉 34%입니다.
개발자 답글에도 차이가 있습니다. iRobot 세트는 리뷰 200건 중 100건에 reply_text가 있습니다. Roborock 세트는 49건입니다.
이 수치는 이 리뷰 200건만 설명할 뿐, 두 제품의 전반적인 평판을 나타내지는 않습니다. 태그 결과에 영향을 주기 때문에 보여 드리는 것입니다. iRobot 세트의 대부분은 negative와 app_connectivity로 분류될 것입니다.
토큰 수는 리뷰 길이에 따라 정해집니다. Google Play 리뷰의 길이 중앙값은 Roborock이 94.5자, iRobot이 128.5자입니다. 양쪽 모두 가장 긴 리뷰는 정확히 500자입니다. 이것이 Google Play의 리뷰 글자 수 한도입니다.
Google Play 고객센터 커뮤니티에서 한 사용자가 이 500자 한도에 대해 질문했습니다. 20자 미만 리뷰는 Roborock 쪽이 35건, iRobot 쪽이 24건입니다. "Great robovac great", "iRobot is awful" 같은 리뷰입니다.
TikTok 댓글 12건의 길이 중앙값은 51.5자이며, 대부분 질문입니다. 작성 시점은 2026-06-13부터 2026-11-01까지로 거의 다섯 달에 걸쳐 있습니다. 영상 하나에 달리는 댓글은 날마다 늘어나지 않습니다. 영상이 더 이상 인기를 끌지 않으면 새 댓글을 다는 사람이 거의 없습니다.
호출 1건이 12행만 반환한 이유가 여기에 있습니다. 짧은 리뷰에서 얻을 교훈은 간단합니다. 리뷰 하나는 수십 토큰에 불과할 수 있습니다. 리뷰마다 수백 토큰의 지시문이 붙는다면 비용 대부분은 지시문에 들어갑니다.
작은 발견이 하나 더 있습니다. language: "en"을 요청했지만 Roborock 세트에는 중국어와 슬로바키아어 리뷰가 섞여 있습니다. 카탈로그에 따르면 language는 조회 언어일 뿐, 개별 리뷰의 언어를 보장하지 않습니다. 그래서 스키마에 language 필드를 두고, evidence는 원문 언어 그대로 둡니다.
"경쟁사 언급": 키워드 규칙으로 어디까지 가능한가
네 가지 태그 중 "경쟁사 언급"은 키워드 규칙에 가장 잘 맞아 보입니다. 규칙에는 모델 비용이 들지 않습니다. 리뷰 412건으로 이를 테스트했습니다. 로봇청소기와 가전 브랜드 29개를 담은 정규 표현식을 사용했습니다.
앱 자체의 브랜드는 제외했습니다. 규칙에 걸린 리뷰는 17건이었습니다. 이어서 17건을 모두 읽고 각 리뷰가 실제로 다른 로봇청소기 브랜드를 언급하는지 판단했습니다.
17건 중 13건은 실제 언급입니다. Roborock 앱 리뷰 중 5건은 iRobot, Roomba, Shark, Bissell과 비교하는 내용입니다. 그중 4건은 별 5개로, "a great upgrade from the iRobot" 같은 내용입니다. 나머지 1건은 별 1개이며, 5년 전에는 Roomba가 더 나았다고 말합니다.
iRobot 앱에서는 리뷰 5건이 대신 Roborock, Shark, Rowenta, Ecovacs를 사라고 권합니다. 5건 모두 별 1개 또는 2개입니다. TikTok에서 걸린 3건은 Dreame, Roborock, Mova 모델에 대해 묻는 내용입니다.
3건은 오탐입니다. 하나는 Samsung Z Fold 8 휴대폰의 화면 비율에 관한 내용입니다. 하나는 Samsung 태블릿에 앱이 설치되지 않는다는 내용입니다. 나머지 하나는 슬로바키아어 단어 "mi"("나"라는 뜻)이며, 규칙이 이를 Xiaomi로 잘못 인식했습니다.
마지막 1건은 불분명합니다. 이 리뷰는 앱의 새 "Explore" 페이지를 낚시성 콘텐츠이자 "typical xiaomi" 마케팅이라고 부릅니다. 브랜드를 언급하긴 하지만 로봇청소기를 비교하지는 않습니다.
놓친 사례도 중요합니다. 별 5개 리뷰 하나는 "Sharks, Bissell's, iRomba's"를 언급합니다. 복수형과 오타가 일치하지 않아 규칙은 Bissell만 찾았습니다. 가장 흔한 브랜드 13개로 된 짧은 목록은 리뷰 14건만 찾고 Rowenta와 Bissell을 놓칩니다.
교훈은 분명합니다. 키워드 규칙은 1차 필터로는 괜찮지만 태그로 쓰기에는 부족합니다. 오탐은 같은 브랜드명을 쓰는 휴대폰과 외국어 단어에서 나옵니다. 누락은 복수형, 오타, 목록에 없는 브랜드에서 생깁니다.
그래서 스키마에 competitors enum과 other_brand를 두고, 이 열은 모델에 맡깁니다. mentions_competitor 불리언은 competitors가 비어 있는지로 바로 정할 수 있습니다. 시트에서 필터링하기 쉽게 하려고 남겨 둔 것뿐입니다. 두 필드가 일치하는지 확인하는 방법은 뒤에서 보여 드립니다.
토큰은 어떻게 추정하나: 고정 프리픽스가 92%를 차지한다
OpenAI API 키가 없으므로 모델 비용은 추정할 수밖에 없습니다. 각 단계를 모두 보여 드리니 직접 숫자를 넣어 보세요. OpenAI는 GPT-6.1 Sol의 토크나이저를 공개하지 않았습니다. 그래서 OpenAI의 오픈소스 라이브러리 tiktoken(PyPI의 0.14.0 버전)에 있는 최신 공개 인코딩 o200k_base를 사용합니다.
시스템 프롬프트, 스키마, 입력 형식은 실제 파일입니다. 리뷰는 실제 호출로 받은 412행입니다. 출력 토큰은 직접 작성한 예시 태그 12개의 평균 길이로 계산했습니다. 추론 토큰은 별도의 가정입니다.
실제 과금은 Responses API 응답마다 들어 있는 usage 객체를 따릅니다. 전체 실행 전에 리뷰 20건을 파일럿으로 보내 보세요. input_tokens, output_tokens, output_tokens_details.reasoning_tokens를 확인한 뒤 아래 표를 업데이트하세요.
| 구성 요소 | 토큰 수(o200k_base) | 비고 |
|---|---|---|
| 시스템 프롬프트(카테고리 가이드와 규칙) | 645 | 모든 요청에 포함 |
| 리뷰 1건용 태그 스키마 | 322 | 불필요한 공백을 제거한 JSON 기준으로 계산했습니다. 실제 과금 방식은 OpenAI가 정합니다. |
| 리뷰 25건용 스키마 | 362 | labels 배열 계층이 하나 더 있음 |
| 고정 프리픽스(1건 / 25건) | 967 / 1,007 | 둘 다 캐시 최소 기준인 1,024토큰 미만 |
| 입력 리뷰 1건(ID, 출처, 별점 포함) | 평균 81.1, 중앙값 73.5, 최대 205 | 실제 리뷰 412건 |
| 리뷰 본문만 | 평균 32.6 | 토큰의 절반 이상이 형식 줄에 쓰임 |
| 출력 태그 1개 | 평균 87.3(65~107) | 직접 작성한 예시 12개 |
이 수치를 리뷰 1,000건 규모로 환산하면 차이가 분명해집니다. 요청당 리뷰 1건이면 요청 1,000건에 입력 토큰이 약 1,056,100개 필요합니다. 요청마다 고정 프리픽스 967토큰에 메시지 형식 8토큰이 더해집니다. 합하면 975,000토큰으로 입력의 92.3%입니다. 요청당 리뷰 25건으로 묶으면 요청은 40건만 필요합니다.
고정 프리픽스는 40,600토큰으로, 전체 입력은 약 121,700토큰으로 줄어듭니다. 88.5% 감소입니다. 리뷰 내용 81,100토큰은 두 방식에서 같습니다. 절감분은 모두 같은 지시문을 반복해서 보내지 않는 데서 나옵니다.
프리픽스가 반복되니 캐시가 해결해 줄 거라고 생각할 수도 있습니다. 프롬프트 캐싱 가이드에 따르면 GPT-5.6 이후 모델에서 캐시할 수 있는 프리픽스의 최소 길이는 보이는 입력 토큰 1,024개입니다. OpenAI가 추가하는 숨겨진 시스템 콘텐츠는 포함되지 않습니다. GPT-6.1 Sol에서 캐시 읽기는 일반 입력 가격의 0.05배입니다. 30분 캐시 쓰기는 1.25배, 12시간 캐시 쓰기는 2.5배입니다.
저희 프리픽스는 o200k_base 기준 967토큰으로, 최소 기준보다 57토큰 모자랍니다. OpenAI가 스키마를 숨겨진 시스템 콘텐츠로 바꾼다면 보이는 부분은 645토큰뿐이라 최소 기준에서 더 멀어집니다. 어느 쪽이든 이 프리픽스는 캐시에 들어갈 수 없습니다. 즉 이 프롬프트 길이에서는 "요청당 리뷰 1건 + 캐시" 방식이 통하지 않습니다.
프롬프트가 이미 1,024토큰보다 길다면 캐시가 작동할 수 있습니다. 전체 프리픽스를 캐시 가격으로 읽는다고 가정하면, Batch에서 요청당 리뷰 1건 방식의 비용은 1,000건당 약 $0.57입니다. 이 수치는 첫 캐시 쓰기 비용을 뺀 것이며, 요청당 25건 방식의 $0.56과 비슷합니다. 하지만 요청당 25건 방식은 캐시 적중에 의존하지 않고 프롬프트를 부풀릴 필요도 없습니다. 그래서 Batch 파일은 요청당 리뷰 25건으로 구성합니다.
Batch API 워크플로: JSONL 작성, 업로드, 다운로드
Batch API 가이드의 설명은 명확합니다. 각 요청을 .jsonl 파일의 한 줄로 작성합니다. 각 줄에는 고유한 custom_id, method, url, body가 들어갑니다. body는 동기 엔드포인트의 요청 본문과 같습니다.
파일 하나에는 모델을 하나만 사용할 수 있습니다. 파일은 purpose를 batch로 설정해 업로드합니다. 배치를 생성할 때 completion_window는 현재 24h만 지정할 수 있습니다. 가격은 동기 엔드포인트보다 50% 저렴하며, Batch에는 별도의 더 높은 요청 속도 제한이 적용됩니다.
가이드에는 태깅 작업에서 마주칠 한도도 세 가지 나와 있습니다. 배치 하나에는 요청을 최대 50,000건까지 넣을 수 있고, 입력 파일은 최대 200 MB입니다. 배치는 시간당 최대 2,000개까지 생성할 수 있습니다. 출력 파일은 입력 순서를 유지하지 않으므로 결과는 custom_id로 매칭해야 합니다.
파일 크기를 확인하려고 실제 리뷰 412건으로 Batch 파일 두 개를 만들었습니다. 요청당 리뷰 1건 파일은 412줄, 2,018,830바이트입니다. 줄마다 시스템 프롬프트와 스키마 전체가 들어가므로 한 줄에 약 4,900바이트입니다. 요청당 리뷰 25건을 담은 파일은 17줄, 191,412바이트로 한 줄에 약 11,260바이트입니다.
200 MB 한도로 계산하면 요청당 리뷰 1건 파일에는 약 42,798건이 들어갑니다. 50,000줄 한도보다 크기 한도에 먼저 걸립니다. 요청당 리뷰 25건을 담는 파일에는 크기 기준으로 약 451,000건, 줄 수 기준으로 1,250,000건이 들어갑니다. 리뷰 1,000건 실행은 모든 한도에 한참 못 미칩니다. 하지만 리뷰가 수만 건이면 요청당 1건 방식은 예상보다 빨리 200 MB에 도달합니다.
Batch를 쓰지 않고 동기 엔드포인트를 쓰면 대규모 실행 중에 분당 토큰 한도에 걸릴 수 있습니다. OpenAI는 2026-10-06에 사용량 티어를 Build, Launch, Grow 세 단계로 줄였습니다(요청 속도 제한 가이드). Sol 모델 페이지에 따르면 Build 티어의 한도는 분당 1,000,000토큰입니다. Batch에는 동기 할당량과 별개로 더 높은 자체 한도가 있습니다. 대규모 실행 전에 본인 계정의 한도 페이지를 확인하세요.
아래는 요청당 리뷰 25건을 담은 파일의 첫 줄로, 줄바꿈을 넣고 프롬프트와 스키마는 생략했습니다. 그 뒤에는 업로드와 배치 생성을 위한 Python 코드가 이어집니다. 문서에 나온 설정 예시이며, OpenAI에서 실제로 실행하지는 않았습니다.
# One JSONL line (cut):
# {"custom_id": "chunk-000", "method": "POST", "url": "/v1/responses",
#  "body": {"model": "gpt-6.1-sol", "reasoning": {"effort": "low"}, "max_output_tokens": 12000, "store": false,
#           "input": [{"role": "developer", "content": "You label customer reviews ..."},
#                     {"role": "user", "content": "item_id: 56a3b9f4-...\nsource: google_play/reviews app=com.roborock.smart\nrating: 5/5\ntext: ..."}],
#           "text": {"format": {"type": "json_schema", "name": "review_labels", "strict": true, "schema": {...}}}}}
from openai import OpenAI
client = OpenAI()  # reads OPENAI_API_KEY from the environment
f = client.files.create(file=open("x25.jsonl", "rb"), purpose="batch")
batch = client.batches.create(input_file_id=f.id, endpoint="/v1/responses", completion_window="24h",
                              metadata={"job": "review-tagging-2026-11-06"})
print(batch.id, batch.status) # validating -> in_progress -> finalizing -> completedmax_output_tokens는 충분히 높게 설정하세요. 태그 25개가 각각 약 87토큰이면 약 2,200토큰입니다. 여기에 추론 토큰이 더해집니다. 저희는 12,000으로 설정했습니다.
값이 너무 낮으면 구조화된 출력이 중간에 끊깁니다. Structured Outputs 가이드에서 이 경우를 다룹니다. 응답 상태는 incomplete이고 사유는 max_output_tokens입니다. 받은 JSON은 완전하지 않으므로 실패로 처리하세요.
store: false는 나중에 참조할 수 있도록 응답을 보관하지 말라고 OpenAI에 지시합니다. 하지만 Batch API FAQ에 따르면 데이터 무보존(zero data retention)은 Batch API에 적용되지 않습니다. 입력, 출력, 오류 파일은 Batch 및 Files 서비스의 보존 규칙을 따릅니다. 리뷰에 개인정보가 들어 있다면 보내기 전에 제거하세요. 저희는 요청을 구성할 때 작성자 이름, 작성자 아바타, 리뷰 URL을 제거하고 리뷰 ID, 출처, 별점, 본문만 남겼습니다.
결과를 다운로드하기까지 상태는 validating, in_progress, finalizing, completed 순으로 바뀝니다. 24시간 안에 끝나지 않은 배치는 expired가 됩니다. 이 경우 완료된 부분만 받고 그만큼 비용을 냅니다. 완료되지 않은 요청은 batch_expired 코드와 함께 오류 파일에 들어갑니다. 출력 파일은 배치가 끝나고 30일 후 삭제되므로 제때 다운로드하세요.
Batch API 레퍼런스와 Files API 레퍼런스에 모든 필드가 나와 있습니다. 가격은 낮추면서 응답은 동기식으로 받고 싶다면 Batch 가격이 적용되는 Flex processing을 쓰면 됩니다. 대신 응답이 느리고 가끔 429 "resource unavailable" 오류가 발생합니다. 이 오류에는 과금되지 않습니다.
리뷰 1,000건당 비용: 데이터 요금과 모델 요금
이제 데이터 요금과 태깅 요금을 합쳐 보겠습니다. 데이터 요금은 실제로 확인한 호출당 행 수와 카탈로그 가격으로 계산합니다. Google Play는 호출당 200행을 반환하므로 리뷰 1,000건에 호출이 5회 필요하며, 비용은 $0.006945입니다. 이 TikTok 동영상은 호출당 12행을 반환했으므로 리뷰 1,000건에 호출이 84회 필요하며, 비용은 $0.046704입니다. TikTok 비용은 Google Play의 약 6.7배입니다. 리뷰 412건으로 구성된 저희 혼합 데이터셋의 비용은 $0.003334로, 1,000건당 $0.008092입니다.
TikTok 수치는 동영상당 12행을 가정한 것입니다. 인기 동영상은 호출당 더 많은 행을 반환하므로 데이터 요금이 훨씬 낮아집니다. 이 수치는 한 가지를 보여 드리기 위해 넣었습니다. 리뷰 1,000건당 데이터 요금은 단가뿐 아니라 호출 한 번이 반환하는 행 수에 따라서도 달라집니다.
모델 요금은 2026-11-06 기준 OpenAI 공개 가격과 위의 토큰 수로 추정합니다. 리뷰당 추론 토큰은 0, 50, 200의 세 단계로 잡았습니다. 0은 Sol로는 도달할 수 없는 하한값입니다. Sol의 가장 낮은 설정이 low이기 때문입니다. 아래 값은 모두 리뷰 1,000건당 미국 달러 기준이며, EveryInfra 데이터 요금은 포함하지 않습니다.
| 구성(리뷰 1,000건당) | 추론 토큰 0개(하한) | 리뷰당 추론 토큰 50개(가정) | 리뷰당 추론 토큰 200개(가정) |
|---|---|---|---|
| Sol 표준, 요청당 리뷰 1건 | $2.99 | $3.49 | $4.99 |
| Sol Batch, 요청당 리뷰 1건 | $1.49 | $1.74 | $2.49 |
| Sol Batch, 요청당 1건, 프리픽스에 캐시 가격 적용(가정, 프리픽스가 1,024토큰 미만) | $0.57 | $0.82 | $1.57 |
| Sol Batch, 요청당 리뷰 25건 | $0.56 | $0.81 | $1.56 |
Terra Batch, 요청당 25건, none | $0.28 | n/a | n/a |
Luna Batch, 요청당 25건, none | $0.028 | n/a | n/a |
이 표는 세 가지 관점으로 읽을 수 있습니다. 첫째, 모델과 프롬프트가 같은 상태에서 "표준, 요청당 1건"에서 "Batch, 요청당 25건"으로 바꾸면 하한이 $2.99에서 $0.56으로 내려갑니다. 비용이 약 5.3분의 1로 줄어드는 셈입니다.
둘째, 요청당 25건일 때 비용 대부분은 출력에서 발생합니다. $0.56 중 출력이 $0.44로 약 78%입니다. 리뷰당 추론 토큰이 50개 늘 때마다 $0.25(50 × 1,000 × $5 ÷ 1,000,000)가 추가됩니다. 따라서 최종 청구 금액은 여러분의 리뷰에서 low가 추론 토큰을 얼마나 만드는지에 달려 있습니다. 이 값은 파일럿 실행으로만 측정할 수 있습니다.
셋째, 데이터 요금은 전체에서 작은 부분을 차지합니다. Google Play $0.006945에 Sol Batch 요청당 25건($0.56)을 더하면 약 $0.566입니다. 데이터 요금은 그중 1.2%입니다. TikTok 요금 $0.046704를 적용해도 7.7%에 불과합니다.
직접 수치를 넣어 계산하려면 값 네 개가 필요합니다. P는 고정 프리픽스의 토큰 수입니다. x는 리뷰당 평균 입력 토큰 수입니다. y는 태그당 평균 출력 토큰 수입니다.
r은 리뷰당 추론 토큰 수입니다. Batch 가격으로 요청당 리뷰를 k건 넣으면 리뷰 1,000건당 모델 요금은 약 (1,000 ÷ k × P + 1,000 × x) × $1 ÷ 1,000,000에 1,000 × (y + r) × $5 ÷ 1,000,000을 더한 값입니다. 이 글에서 P는 967 또는 1,007, x는 81.1, y는 87.3이며 r은 알 수 없습니다.
리뷰가 더 길면 x 항이 커지고 k의 영향은 줄어듭니다. 긴 전자상거래 리뷰는 평균 300~400토큰에 이르기도 합니다. 프롬프트가 더 길면 P 항이 커지고 k를 키우는 효과가 커집니다. 이 공식은 입력 토큰 272K 초과분에 붙는 추가 요금을 반영하지 않습니다. 요청당 25건이면 요청 하나가 3,000토큰을 조금 넘으므로 그 기준과는 거리가 멉니다. 요청 하나에 리뷰를 수천 건 넣을 계획이라면 추가 요금을 계산에 넣거나 요청을 나누세요.
규모를 가늠해 보면, Gilardi 등이 2023년에 발표한 논문 "ChatGPT Outperforms Crowd-Workers for Text-Annotation Tasks"는 트윗 2,382건에서 주석 1건당 $0.003 미만의 비용을 보고했습니다. 요청당 25건 기준 저희 Sol Batch 하한은 리뷰당 약 $0.00056이며, 추론 토큰 50개를 더하면 $0.00081입니다.
한쪽은 논문의 측정 결과입니다. 다른 쪽은 저희 추정치이며, OpenAI에서 실제로 실행하지 않았습니다. 작업과 모델도 다릅니다. 따라서 규모감을 잡는 용도로만 참고하세요. 가격이 얼마나 내려갔는지 보여 주는 비교가 아니며, 정확도에 대해서도 알려 주는 바가 없습니다.
Sol, Terra, Luna와 Decisions API: Sol을 쓰지 말아야 할 때
비용 표의 마지막 두 행은 의도적으로 넣었습니다. GPT-6.1 Terra는 2026-10-26에 출시되었습니다. 출시 발표에 따르면 표준 가격이 GPT-6.1 Sol보다 50% 낮고 대량 문서 작업에 적합합니다. none 추론을 지원합니다. Batch 가격은 입력 $0.50, 출력 $2.50입니다. OpenAI는 GPT-6 Luna를 범위가 명확한 대량 작업에 적합한 효율적인 모델이라고 설명합니다.
Luna도 none을 지원합니다. Batch 가격은 입력 $0.05, 출력 $0.25입니다. 같은 토큰 추정치로 계산하면 리뷰 1,000건당 Terra는 $0.28, Luna는 $0.028입니다. Sol 하한의 2분의 1과 20분의 1입니다. 게다가 둘 다 예측할 수 없는 추론 토큰 비용이 없습니다.
그렇다면 Sol은 언제 써야 할까요? 첫째, "마지막 펌웨어 버전이 이 결함을 일으켰는가?"처럼 태그에 추론이 필요하거나, action_item을 제품 매니저가 쓴 것처럼 작성해야 할 때입니다. 둘째, Luna나 Terra 실행 결과를 표본 검사했을 때 mixed 감성처럼 일부 그룹에서 오류가 많이 나올 때입니다. 이때는 그 부분만 Sol로 다시 실행하세요. 문장에서 바로 읽어 낼 수 있는 태그라면 Sol의 추론은 낭비입니다.
OpenAI에는 분류 전용 경로도 있습니다. Decisions API는 2026-10-06에 베타로 나왔고 2026-10-22에 정식 출시되었습니다. 현재는 gpt-6-luna만 지원합니다. 모델에게 JSON을 작성하게 하지 않습니다. 사용자가 제시한 질문에 타입이 지정된 답을 반환합니다.
predicate는 0에서 1 사이의 확률을 반환합니다. choice는 지정한 선택지 중 하나를 고르고 각 선택지의 확률을 제공합니다. score는 2~10점 척도로 평가합니다. 요청 하나에 질문을 최대 400개까지 담을 수 있습니다. OpenAI는 Responses API보다 약 10배 빠르다고 설명합니다.
가이드는 역할 분담을 명시합니다. 확률, 단일 선택, 점수에는 Decisions를 쓰고, 스키마에 맞는 객체를 생성할 때는 Structured Outputs를 씁니다. 감성, 이슈 카테고리, 경쟁사 언급은 신뢰도 값을 함께 받는 Decisions 질문으로 처리할 수 있습니다. action_item과 evidence에는 여전히 Structured Outputs가 필요합니다.
| 옵션 | 적합한 용도 | 1,000건당 모델 비용(추정) | 주요 제약 |
|---|---|---|---|
| GPT-6.1 Sol + Structured Outputs + Batch | 추론이 필요한 태그, 액션 문구 작성 또는 일부 데이터의 고품질 재실행 | $0.56부터, 리뷰당 추론 토큰 50개마다 $0.25 추가 | 추론을 끌 수 없음. 24시간 이내 결과 제공. |
| GPT-6.1 Terra + Structured Outputs + Batch | 대량 처리, 명확한 필드, 한 문장 작성 | 약 $0.28(none) | 어려운 판단에서는 Sol보다 약함 |
| GPT-6 Luna + Structured Outputs + Batch | 초대량 순수 분류 | 약 $0.028(none) | 액션 문구 품질 표본 검사 필요 |
| Decisions API(Luna) | 신뢰도를 포함한 감성, 카테고리, 경쟁사 언급 | 여기서는 추정하지 않음(Luna 토큰 가격 적용, 질문 수가 사용량에 영향) | 자유 텍스트 불가. Luna 전용. |
스키마로 강제할 수 없는 것: 결과를 받은 뒤의 검사
Strict 모드는 형태를 보장합니다. 모든 필드가 존재하고, 타입이 맞으며, enum 값이 유효합니다. 하지만 내용이 맞는지는 보장하지 않습니다. 두 필드가 서로 모순되는 것도 막지 못합니다.
Python jsonschema 라이브러리로 간단히 테스트해 봤습니다. TikTok 댓글에 직접 붙인 태그를 competitors: ["dreame"]와 mentions_competitor: false로 바꿨습니다. 두 필드가 분명히 충돌하는데도 태그는 스키마 검증을 통과했습니다.
Structured Outputs 가이드에서도 Structured Outputs에 여전히 오류가 있을 수 있다고 설명합니다. 지시문을 조정하거나, 예시를 추가하거나, 작업을 나누라고 권합니다. 따라서 결과를 받으면 최소한 아래 검사는 실행하세요.
def check(label, item):
    errs = []
    if label["mentions_competitor"] != bool(label["competitors"]):
        errs.append("mentions_competitor does not match competitors")
    if ("other_brand" in label["competitors"]) != (label["other_brand_name"] is not None):
        errs.append("other_brand does not match other_brand_name")
    if "none" in label["issue_categories"] and len(label["issue_categories"]) > 1:
        errs.append("none cannot appear with other categories")
    if label["action_item"] and len(label["action_item"].split()) > 20:
        errs.append("action_item is longer than 20 words")
    if label["evidence"] and label["evidence"].lower()[:30] not in item["text"].lower():
        errs.append("evidence is not a quote from the text")
    if label["item_id"] != item["id"]:
        errs.append("item_id does not match")
    return errs
각 검사는 스키마로 표현할 수 없는 규칙을 다룹니다. 두 필드는 함께 참이거나 함께 거짓이어야 합니다. 일부 enum 값은 다른 값과 함께 쓸 수 없습니다. 단어 수 제한도 적용됩니다.
그리고 인용문은 원문에서 가져와야 합니다. 마지막 검사가 가장 유용합니다. 모델이 지어낸 "인용문"을 잡아내기 때문입니다.
리뷰 25건짜리 요청에는 검사가 하나 더 필요합니다. labels 배열에 항목이 25개 있어야 하고, 각 item_id가 입력 하나와 일치해야 합니다. 가이드에 따르면 출력은 스키마의 키 순서를 따릅니다. 하지만 배열 항목이 입력 순서대로 돌아온다고 보장하지는 않습니다. 위치보다 ID로 매칭하는 편이 안전합니다.
별도로 처리해야 할 경우가 두 가지 더 있습니다. 첫째는 거부 응답입니다. 가이드에 따르면 모델이 안전상의 이유로 거부하면 콘텐츠 타입이 refusal이 되며 사용자가 지정한 스키마를 따르지 않습니다. 일부 리뷰에는 욕설이나 극단적인 표현이 들어 있습니다. 저희가 읽은 iRobot 리뷰 중 하나는 모욕적인 단어로 개발자들을 비하합니다. refusal을 감지해 처리할 수 있도록 준비하세요.
둘째는 주제와 무관한 입력입니다. 가이드는 작업에 맞지 않는 입력에 무엇을 반환할지 프롬프트에 명시하라고 권합니다. 저희 시스템 프롬프트의 규칙 8이 이 역할을 합니다. 빈 리뷰, 광고, 관련 없는 텍스트에는 neutral, none, 경쟁사 없음을 지정합니다.
한계와 주의할 점
이번에는 Amazon 리뷰가 반환되지 않았습니다. 비동기 작업 두 개 모두 0행으로 성공했고, 요금은 환불되었습니다. 카탈로그에 따르면 각 Amazon 사이트는 상품 페이지에 추천 리뷰만 표시하며, 보통 상품당 십여 건입니다. 호출당 십여 행이라면 데이터 요금은 리뷰 1,000건당 $0.08을 넘어 Google Play의 10배 이상이 됩니다. Amazon 예산을 잡기 전에 상품 몇 개로 테스트해 보세요. 저희 비용 표에는 Amazon이 포함되지 않습니다.
동기 호출의 시간 한도는 85초입니다. 이번에 amazon/reviews와 trustpilot/reviews(limit 200)는 모두 85초 넘게 기다린 끝에 503 타임아웃을 반환했습니다. 비용은 청구되지 않았습니다. 응답에는 "mode":"async"를 쓰거나 limit을 줄이라는 안내가 있었습니다. 85초는 서버 기준으로 측정됩니다. tiktok/comments 호출은 저희 쪽에서 90.21초가 걸렸지만 200을 반환했으므로, 이 호출도 한도에 가까웠습니다.
대량 데이터 수집에서는 느린 기능에 비동기 모드를 쓰세요. 즉시 job_id와 함께 202가 반환되고, 이후 poll_url을 폴링합니다. 저희 비동기 작업 두 개는 시작부터 완료까지 각각 약 1분 36초와 3분 44초가 걸렸습니다.
"최신 200건"은 고정된 기간이 아닙니다. 위에서 본 것처럼 Roborock 리뷰 200건은 32일, iRobot 리뷰 200건은 99일에 걸쳐 있습니다. 주간 비교를 하려면 태깅 전에 posted_at을 기준으로 동일한 주에 해당하는 리뷰만 추리세요.
동기 모드에서는 Google Play 페이지네이션으로 최대 200행까지 가져올 수 있습니다. 그보다 더 많은 행을 가져오려면 비동기 모드를 쓰세요. 한도는 카탈로그의 pagination 필드에서 확인할 수 있습니다.
자사 앱이라면 Google Reply to Reviews API는 최근 1주일간의 리뷰만 반환합니다. 페이지당 최대 100건, 시간당 GET 요청 200회까지입니다. 그보다 오래된 리뷰는 Play Console의 CSV 다운로드로 받아야 합니다. 경쟁사 앱이라면 Google API로는 아무것도 얻을 수 없습니다.
리뷰가 진짜일까요? 미국 FTC의 가짜 리뷰에 관한 최종 규칙(2024년 8월)은 AI가 생성한 가짜 리뷰를 금지합니다. 태그는 리뷰의 내용을 알려 줄 뿐, 진짜인지는 알려 주지 않습니다. 별점 5점 또는 1점 리뷰가 비정상적으로 몰린 사례부터 살펴보세요.
구조화된 출력이 추론 품질에 영향을 줄 수 있습니다. 논문 "Let Me Speak Freely?"(2024)는 JSON 같은 엄격한 형식이 추론 성능을 떨어뜨릴 수 있다고 밝혔습니다. "JSONSchemaBench"(2025)는 OpenAI 방식을 포함한 제약 디코딩 방법 6가지를 실제 스키마 10,000개로 테스트해 큰 차이를 확인했습니다. 두 연구 모두 이전 세대 모델을 대상으로 했습니다. 그래도 이 글의 한 가지 선택을 뒷받침합니다. action_item을 스키마 뒤쪽에 두는 것입니다. 특정 태그 그룹의 점수가 낮다면 먼저 자유 형식으로 답하게 한 다음, 저렴한 모델로 JSON으로 변환해 보세요.
정확도는 모델이 아닌 사람이 확인하세요. 저희는 OpenAI에서 배치를 실행하지 않았으므로 정확도 수치가 없습니다. 다음 방법을 권합니다. 파일럿 리뷰 20건과 전체 실행에서 무작위로 고른 리뷰 50건을 준비합니다. 제품을 잘 아는 사람에게 각 태그를 원문과 대조해 확인하게 합니다. 카테고리별로 오류를 집계합니다. 그런 다음 어떤 카테고리는 프롬프트를 새로 써야 하고 어떤 카테고리는 다른 모델로 다시 실행해야 하는지 결정합니다.
위의 키워드 일치 17건도 같은 방법으로 확인했습니다. 데이터 주석용 LLM 서베이 논문에는 모델이 만든 주석을 평가하는 방법을 다룬 섹션이 있습니다. 사람이 검토하는 것이 한 가지 방법이고, 사람이 라벨링한 기존 데이터셋과 비교하는 것이 또 다른 방법입니다.
이 사이트의 다른 리뷰 관련 글과 다른 점
Claude Code에서 DeepSeek V4로 댓글 정리하기는 대화형 세션에서 동영상 댓글 695행을 정리하며, 비용은 캐시 적중에 따라 달라집니다. 데이터 API와 Claude strict tool use는 도구 입력을 엄격하게 만듭니다. Qwen Agent 리뷰 분석 에이전트는 에이전트 하나로 가격을 비교하고 리뷰를 읽습니다. 이 글에서는 출력 형식을 엄격하게 만들고, 작업은 오프라인 배치 한 번이며, 비용을 좌우하는 것은 요청 구성입니다.
ChatGPT 안에서 보고서를 만들려면 소셜 데이터 보고서를 위한 GPT-6 Intelligent UI를 참고하세요.
최근 60일간의 변경 사항
2026-09-29: GPT-6.1 Sol이 API에 출시되었습니다(변경 내역). 이제 대규모 구조화 작업에 최상위 모델에 가까운 모델을 Astra 가격의 5분의 1로 쓸 수 있습니다. 다만 추론은 끌 수 없습니다.
2026-10-06: Decisions API가 베타로 출시되었고, 2026-10-22에 정식 출시되었습니다(Decisions 가이드). 이제 단일 선택 태그는 JSON 없이 신뢰도 값과 함께 받을 수 있으며, Luna에서만 지원됩니다.
2026-10-20: 12시간 프롬프트 캐싱이 API에 도입되었으며, 쓰기 비용은 입력 가격의 2.5배입니다(프롬프트 캐싱 가이드). 프롬프트가 1,024토큰을 넘고 하루에 여러 번 실행되는 작업에 도움이 됩니다. 짧은 프리픽스에는 효과가 없습니다.
2026-10-21: 조직과 프로젝트 단위로 서비스 티어를 제한할 수 있게 되었습니다. 플랫폼 설정에서 지정합니다(변경 내역). 시사점: 관리자가 기본 티어만 허용할 수 있습니다. 그러면 Flex 등 기본이 아닌 티어로 보낸 요청은 서비스 티어 오류로 실패합니다. 배치가 실패한 뒤가 아니라 실행하기 전에 프로젝트 설정을 확인하세요.
2026-10-26: GPT-6.1 Terra가 출시되었습니다. 표준 가격은 Sol의 절반이며 none 추론을 지원합니다(Terra 모델 페이지). 시사점: 이제 Sol과 Luna 사이에 추론을 끌 수 있는 중간 선택지가 생겼습니다. 많은 태깅 작업은 Terra부터 시도해 볼 만합니다.
2026-10-28: ChatGPT 구독자는 API 크레딧을 받을 수 있습니다. 자격을 갖춘 Pro 및 Business 구독자는 매월 최대 $500를 받습니다(크레딧 가이드). 파일럿 실행 비용은 충분히 감당할 수 있는 금액입니다. 사용하지 않은 크레딧은 매월 소멸됩니다.
GPT-6.1 Sol과 Structured Outputs FAQ
gpt-6.1 sol API 가격은 얼마인가요?
전체 요금표는 이 글의 첫 번째 섹션에 있습니다. 요약하면, OpenAI 요금 페이지 기준 표준 가격은 1M 토큰당 입력 $2, 출력 $10입니다. Batch와 Flex는 그 절반입니다. Fast 모드는 표준 가격의 2배, Ultrafast는 6배이며, 배치 태깅에는 둘 다 필요하지 않습니다. 추론 토큰은 출력 토큰으로 과금됩니다. (질문 출처: Google 자동완성, 2026-11-06.)
gpt 6.1 sol API 모델 이름은 무엇이고, 어떻게 호출하나요?
모델 이름은 gpt-6.1-sol입니다. Responses API 요청의 model 필드에 넣으면 됩니다(모델 페이지). Chat Completions에서도 사용할 수 있지만 도구 호출은 지원되지 않습니다.
도구를 사용하려면 마이그레이션 가이드에서 권장하는 Responses API를 사용하십시오. 추론 수준은 reasoning.effort로 설정합니다. 가장 낮은 값은 low입니다. (질문 출처: Google 자동완성, "gpt 6.1 sol api name")
gpt 6.1 Structured Outputs 예제는 어떻게 작성하나요?
가장 짧은 방법은 Responses API 요청에 text: {format: {type: "json_schema", name: "...", strict: true, schema: {...}}}를 추가하는 것입니다. 스키마의 모든 객체에 additionalProperties: false가 있어야 하고, 모든 필드가 required에 포함되어야 합니다. Python에서는 SDK의 responses.parse에 Pydantic 모델을 전달하는 방법도 있습니다. 이 경우 SDK가 스키마를 대신 만들어 줍니다(openai-python helpers, Pydantic JSON Schema 문서). 이 글의 9개 필드 스키마를 복사해 수정해서 사용해도 됩니다. (질문 출처: Google 자동완성, "gpt 6.1 structured outputs example")
OpenAI Batch API와 Structured Outputs를 함께 쓸 수 있나요?
네. Structured Outputs 가이드에 따르면 Structured Outputs와 JSON 모드 모두 Batch API에서 동작합니다. Batch 입력 파일에서 각 줄의 body는 동기 요청의 요청 본문과 같으므로 text.format을 그대로 두면 됩니다.
다음 세 가지에 주의해야 합니다. 파일 하나에는 모델 하나만 사용할 수 있습니다. JSON이 잘리지 않도록 max_output_tokens를 충분히 크게 설정해야 합니다. 결과는 줄 순서가 아니라 custom_id를 기준으로 매칭해야 합니다. (질문 출처: Google 자동완성, "openai batch api structured output")
GPT-6.1 Sol은 max effort에서 왜 GPT-5.6 Sol보다 훨씬 느린가요?
이 질문은 OpenAI 개발자 커뮤니티의 스레드에서 나왔습니다. 같은 프롬프트로 max 설정의 GPT-6.1 Sol은 1,846초 동안 약 62,708개의 출력 토큰(추론 토큰 52,552개)을 생성했습니다. GPT-5.6 Sol은 373초 동안 약 31,426개를 생성했습니다. 태깅에는 max를 사용하지 마십시오. low로 충분하며, 추론 토큰이 2배가 되면 출력 요금도 2배가 됩니다.
시작하기
- EveryInfra 빠른 시작에서 API 키를 발급합니다. 무료로 제공되는 기능 카탈로그를 읽고
google_play/reviews,tiktok/comments,amazon/reviews의 가격과 응답 필드를 확인합니다. - 먼저 소스별로 한 페이지씩 가져옵니다. Google Play 리뷰 API와 TikTok 댓글 API 플레이그라운드에서 직접 호출해 보고, 호출마다 몇 개의 행이 반환되는지 확인합니다. 그런 다음 리뷰 1,000건당 예산을 계산합니다. 응답이 느린 기능에는
"mode":"async"를 추가합니다. - 이 글의 9개 필드 스키마를 자체 카테고리에 맞게 수정합니다. 그런 다음 Structured Outputs 가이드의 strict 모드 규칙을 기준으로 스크립트로 검사합니다.
- OpenAI에서 리뷰 20건으로 동기 방식 파일럿을 실행합니다.
usage에서 입력, 출력, 추론 토큰을 확인해 비용표를 업데이트한 뒤 Sol, Terra, Luna 중 하나를 선택합니다. - 요청당 리뷰 25건으로 JSONL 파일을 작성하고 Batch API를 사용합니다. 결과가 돌아오면 일관성 검사를 실행합니다.
evidence일부를 원문과 대조해 확인합니다. - 코드 없이 Claude, Cursor, ChatGPT에서 필요할 때마다 리뷰를 조회하려면 EveryInfra 원격 MCP 서버를 연결하십시오. 플랫폼별 개요는 Google Play 데이터 API, TikTok 데이터 API, Amazon 데이터 API를 참고하십시오. Amazon 리뷰는 Amazon 리뷰 API를, 가격은 요금 페이지를 참고하십시오.
참고 자료
- “GPT-6.1 Sol Model”, OpenAI 개발자 문서, 2026-11-06 확인
- “Introducing GPT-6.1 Sol”, OpenAI, 2026-09-29
- “API Changelog”, OpenAI 개발자 문서, 2026-11-06 확인
- “Pricing”, OpenAI 개발자 문서, 2026-11-06 확인
- “Structured model outputs”, OpenAI 개발자 문서, 2026-11-06 확인
- “Batch API”, OpenAI 개발자 문서, 2026-11-06 확인
- “Prompt caching”, OpenAI 개발자 문서, 2026-11-06 확인
- “Using GPT-6 (latest model guide)”, OpenAI 개발자 문서, 2026-11-06 확인
- “Reasoning models”, OpenAI 개발자 문서, 2026-11-06 확인
- “Decisions”, OpenAI 개발자 문서, 2026-11-06 확인
- “GPT-6.1 Terra Model”, OpenAI 개발자 문서, 2026-11-06 확인
- “GPT-6 Luna Model”, OpenAI 개발자 문서, 2026-11-06 확인
- “Rate limits”, OpenAI 개발자 문서, 2026-11-06 확인
- “Flex processing”, OpenAI 개발자 문서, 2026-11-06 확인
- “Function calling”, OpenAI 개발자 문서, 2026-11-06 확인
- “Batch API reference”, OpenAI 개발자 문서, 2026-11-06 확인
- “Files API reference”, OpenAI 개발자 문서, 2026-11-06 확인
- “Ultrafast mode”, OpenAI 개발자 문서, 2026-11-06 확인
- “Error codes”, OpenAI 개발자 문서, 2026-11-06 확인
- “Your data”, OpenAI 개발자 문서, 2026-11-06 확인
- “API credits for ChatGPT subscribers”, OpenAI 개발자 문서, 2026-11-06 확인
- “Migrate to the Responses API”, OpenAI 개발자 문서, 2026-11-06 확인
- “Prompt cache diagnostics”, OpenAI 개발자 문서, 2026-11-06 확인
- “GPT-6.1 Sol system card addendum”, OpenAI Deployment Safety Hub, 2026-09-29
- “Introducing GPT-6.1 Terra”, OpenAI, 2026-10-26
- “Batch API FAQ”, OpenAI 고객센터, 2026-11-06 확인
- “tiktoken”, OpenAI, GitHub
- “openai-python helpers”, OpenAI, GitHub
- “tiktoken 0.14.0”, PyPI
- “jsonschema”, PyPI
- “JSON Schema (Pydantic docs)”, Pydantic
- “JSON Schema Draft 2020-12”, JSON Schema
- “RFC 8259: The JSON Data Interchange Format”, IETF, 2017-12
- “Reply to Reviews”, Google Play Developer API, 2026-11-06 확인
- “Download and export monthly reports”, Play Console 고객센터, 2026-11-06 확인
- “Why is there a 500 character limit on Google Play reviews?”, Google Play 고객센터 커뮤니티, 2022-07-31
- “Query Video Comments”, TikTok for Developers, 2026-11-06 확인
- “FTC Announces Final Rule Banning Fake Reviews and Testimonials”, 미국 연방거래위원회(FTC), 2024-08-14
- “ChatGPT Outperforms Crowd-Workers for Text-Annotation Tasks”, Gilardi et al., arXiv, 2023-03-27
- “Let Me Speak Freely? A Study on the Impact of Format Restrictions on Performance of Large Language Models”, Tam et al., arXiv, 2024-08-05
- “JSONSchemaBench: A Rigorous Benchmark of Structured Outputs for Language Models”, Geng et al., arXiv, 2025-01-18
- “Large Language Models for Data Annotation and Synthesis: A Survey”, Tan et al., arXiv, 2024-02-21
- “Why is GPT-6.1 Sol MAX dramatically slower than GPT-5.6 Sol MAX using the same prompt?”, OpenAI 개발자 커뮤니티, 2026-11-06 확인
- EveryInfra 기능 카탈로그, EveryInfra, 2026-11-06 00:15 SGT 확인
- Roborock(Google Play 앱 페이지), Google Play, 2026-11-06 확인
- iRobot Home(Google Play 앱 페이지), Google Play, 2026-11-06 확인
- “Model Context Protocol Specification”, MCP, 2025-06-18
- “json — JSON encoder and decoder”, Python 문서
- “JSON Lines”, jsonlines.org
- “Introduction to Structured Outputs (Cookbook)”, OpenAI Cookbook
참고 BL-95