GPT-6.1 Sol APIの構造化出力でレビューにタグ付けすると、コストはいくらになるか
GPT-6.1 SolのstrictモードのJSON出力とBatch APIで、レビューにタグを付けます。データ取得:実際のレビュー412件。モデルのコストは公開価格に基づく試算で、1,000件あたり約$0.81です。
私たちの試算では、GPT-6.1 Solを使うと、1,000件のレビューに1ドル未満でタグを付けられます。前提は、strictモードのJSON Schema出力とBatch APIを使い、レビュー1件あたりの推論トークン数を約50とすることです。モデルは実際には実行していないため、この数値は試算です。費用を左右するのはデータではなく、リクエストのまとめ方です。2026-11-06の00:16から00:25(SGT)にかけて、EveryInfraのデータAPIを実際に7回呼び出しました。
ロボット掃除機のアプリ2つ(RoborockとiRobot)のGoogle Playレビューを400件、さらにレビュー動画1本についたTikTokコメントを12件取得しました。支払った金額は合計$0.003334です。各呼び出しで実際に返された件数から計算すると、レビュー1,000件あたりのデータ料金はGoogle Playが$0.006945、TikTokが$0.046704です。
このマシンにはOpenAIのAPIキーがありません。そのため、この記事ではモデルに関しては設定例と試算のみを示します。トークン数は公開されているo200k_baseエンコーディングで数え、料金は2026-11-06に確認した公開価格を使っています。主な結論はシンプルです。
1リクエストにレビューを1件ずつ送ると、システムプロンプトとスキーマだけで967トークンになります。これは入力トークン全体の92%にあたり、プロンプトキャッシュの適用に必要な最小の1,024トークンを下回ります。そのため、同じ指示に対して1,000回分の正規料金を支払うことになります。
次に、1リクエストにレビューを25件ずつ送り、レビュー1件あたりの推論トークンを50と仮定します。すると、1,000件あたりのBatchでのモデルコストは約$1.74から約$0.81に下がります。推論トークンがなければ、下限は$1.49から$0.56まで下がります。ただし、Solではlowより低いeffortを指定できないため、この下限には届きません。
この記事が答えるのは、1つの限定的な問いです。手元にレビューのセットがあり、GPT-6.1 Solで各レビューに4つのタグ(感情、問題カテゴリ、競合への言及、アクションアイテム1つ)を付けたいとします。各タグはそのままスプレッドシートに入れられる形で出力する必要があり、総コストも把握したいという状況です。レビューはEveryInfraのデータAPIから取得します。
タグ付けにはOpenAIのResponses APIとBatch APIを使います。以下に出てくるEveryInfraの数値はすべて生のレスポンスから取ったもので、再計算できます。OpenAI側の手順にはすべて、設定例か価格の試算であることを明記しています。このバッチはOpenAI上では実行していません。
次の表は、実測した項目と試算した項目をまとめたものです。以下の数値はすべて、この表のいずれかの行に対応します。
| ステップ | 取得方法 | 再計算できるか |
|---|---|---|
| レビューデータ(EveryInfra) | 2026-11-06に実際に7回呼び出し、生のレスポンスを保存 | 可能。すべての数値がレスポンスに基づく |
| トークン数 | 実際のシステムプロンプト、スキーマ、レビュー412件をo200k_baseでカウント | 可能。ただしSolのトークナイザーは非公開 |
| 出力タグ | 人が書いたタグの例12件(GPT-6.1 Solの出力ではない) | 出力長の推定にのみ使用 |
| 推論トークン | 未計測。レビュー1件あたり0、50、200を想定 | 不可。パイロット実行とそのusageが必要 |
| モデルのコスト | 上記の各行の数値に2026-11-06時点の公開価格を乗算 | 可能。自分の数値で計算できる |
| タグの精度 | なし | パイロット実行後に手作業で確認 |
GPT-6.1 Sol APIとは:リリース日、コンテキスト、価格
まず、モデルに関する事実を確認します。OpenAIのAPI changelogには、2026-09-29付けのエントリがあります。それによると、OpenAIは複雑なコーディングや専門業務向けにGPT-6.1 Sol(gpt-6.1-sol)をリリースしました。価格はGPT-6 Astraより低く設定されています。
272Kトークンまでの入力では、1Mトークンあたりの標準価格は入力$2、キャッシュ入力$0.10、キャッシュ書き込み$2.50、出力$10です。同じエントリには、ツール呼び出しにはResponses APIが必要だとも書かれています。リリース記事の「Introducing GPT-6.1 Sol」によると、Solの性能はGPT-6 Astraに近いとされています。また、標準の入力・出力価格はAstraの5分の1だとしています。
2026-11-06に確認したGPT-6.1 Solのモデルページには、タグ付けに関係する仕様が載っています。コンテキストウィンドウは1,050,000トークン、最大出力は128,000トークン、知識のカットオフは2026-04-30です。reasoning.effortの値はlow、medium(デフォルト)、high、xhigh、maxです。機能一覧では、Structured outputsとFunction callingが「Supported」となっています。
モデルページには、バッチ処理に関わる料金ルールがほかに4つあります。キャッシュされた入力は入力料金の5%です。キャッシュ書き込みは1.25倍です。入力トークンが272Kを超えると、そのリクエストでは入力料金が2倍、出力料金が1.5倍になります。BatchとFlexは50%安くなります。
| 項目 | 情報源の記載内容 | 出典(2026-11-06閲覧) | タグ付けへの影響 |
|---|---|---|---|
| APIリリース | gpt-6.1-solは2026-09-29にリリース | API変更履歴 | 執筆時点でリリースから38日 |
| コンテキストと出力 | コンテキスト1,050,000、最大出力128,000 | モデルページ | 数十件のレビューが1リクエストに余裕をもって収まる |
| 推論エフォート | low、medium、high、xhigh、max(noneなし) | モデルページ、GPT-6ガイド | すべてのリクエストで推論トークンが発生し、出力として課金 |
| 標準料金 | 1Mあたり入力$2、キャッシュ$0.10、出力$10 | 料金ページ、変更履歴 | 同期処理で最低でも1,000件あたり約$2.99 |
| Batch料金 | 1Mあたり入力$1、キャッシュ$0.05、出力$5 | 料金ページ | 同じリクエストが半額 |
| 長い入力の割増料金 | 入力272K超:入力2倍、出力1.5倍 | モデルページ | 1リクエストにレビューを詰め込みすぎない |
| Chat Completions | 対応(ツール呼び出しは非対応) | モデルページ、GPT-6ガイド | 本記事ではResponses APIのみを使用 |
最も見落とされやすいのは推論エフォートの行です。GPT-6ガイドにははっきり書かれています。GPT-6 AstraとGPT-6.1 Solはnoneに対応していません。既存のリクエストでminimalを使っている場合は、lowに変更して結果を比較してください。GPT-6.1 Terra、GPT-6 Sol、GPT-6 Lunaはnoneに対応しています。推論ガイドによると、推論トークンは出力トークンとしてカウントされます。
これはタグ付けに影響します。レビューごとに見えない出力が発生し、料金は1Mトークンあたり$10、Batchでは$5です。そのトークン数は、実際に呼び出してみなければ測定できません。そのため、コスト表では推論を別の前提として示しています。
Batchの行を詳しく見ます。料金ページでは、FlexとBatchが同じ価格帯に置かれています。gpt-6.1-solのBatchは、1Mトークンあたり入力$1、出力$5、キャッシュ入力$0.05です。30分のキャッシュ書き込みは$1.25、12時間のキャッシュ書き込みは$2.50です。以下のコスト表はすべてこの価格帯で計算しています。
gpt 6.1のstructured outputs:json_schemaのstrictモードにはどんな制限があるのか
OpenAI Structured Outputsガイドは、冒頭でその保証を明記しています。モデルの出力は、指定したJSON Schemaに常に一致します。必須のキーが欠けることも、enumにない値を作り出すこともありません。Responses APIでは、text.formatを{"type":"json_schema","strict":true,"schema":…}に設定します。ガイドには、strictモードがサポートするのはJSON Schemaの一部だけだとも書かれています。その範囲外のキーワードをスキーマで使うと、strict: trueのリクエストは失敗します。
タグ付け用のスキーマは、一度確定すると何千回も実行されます。そこで、ガイドのルールのうち、数えたり確認したりできるものをすべて書き写しました。そのうえで、スキーマがそれらのルールに沿っているかを確認する小さなスクリプトを書きました。記憶には頼っていません。
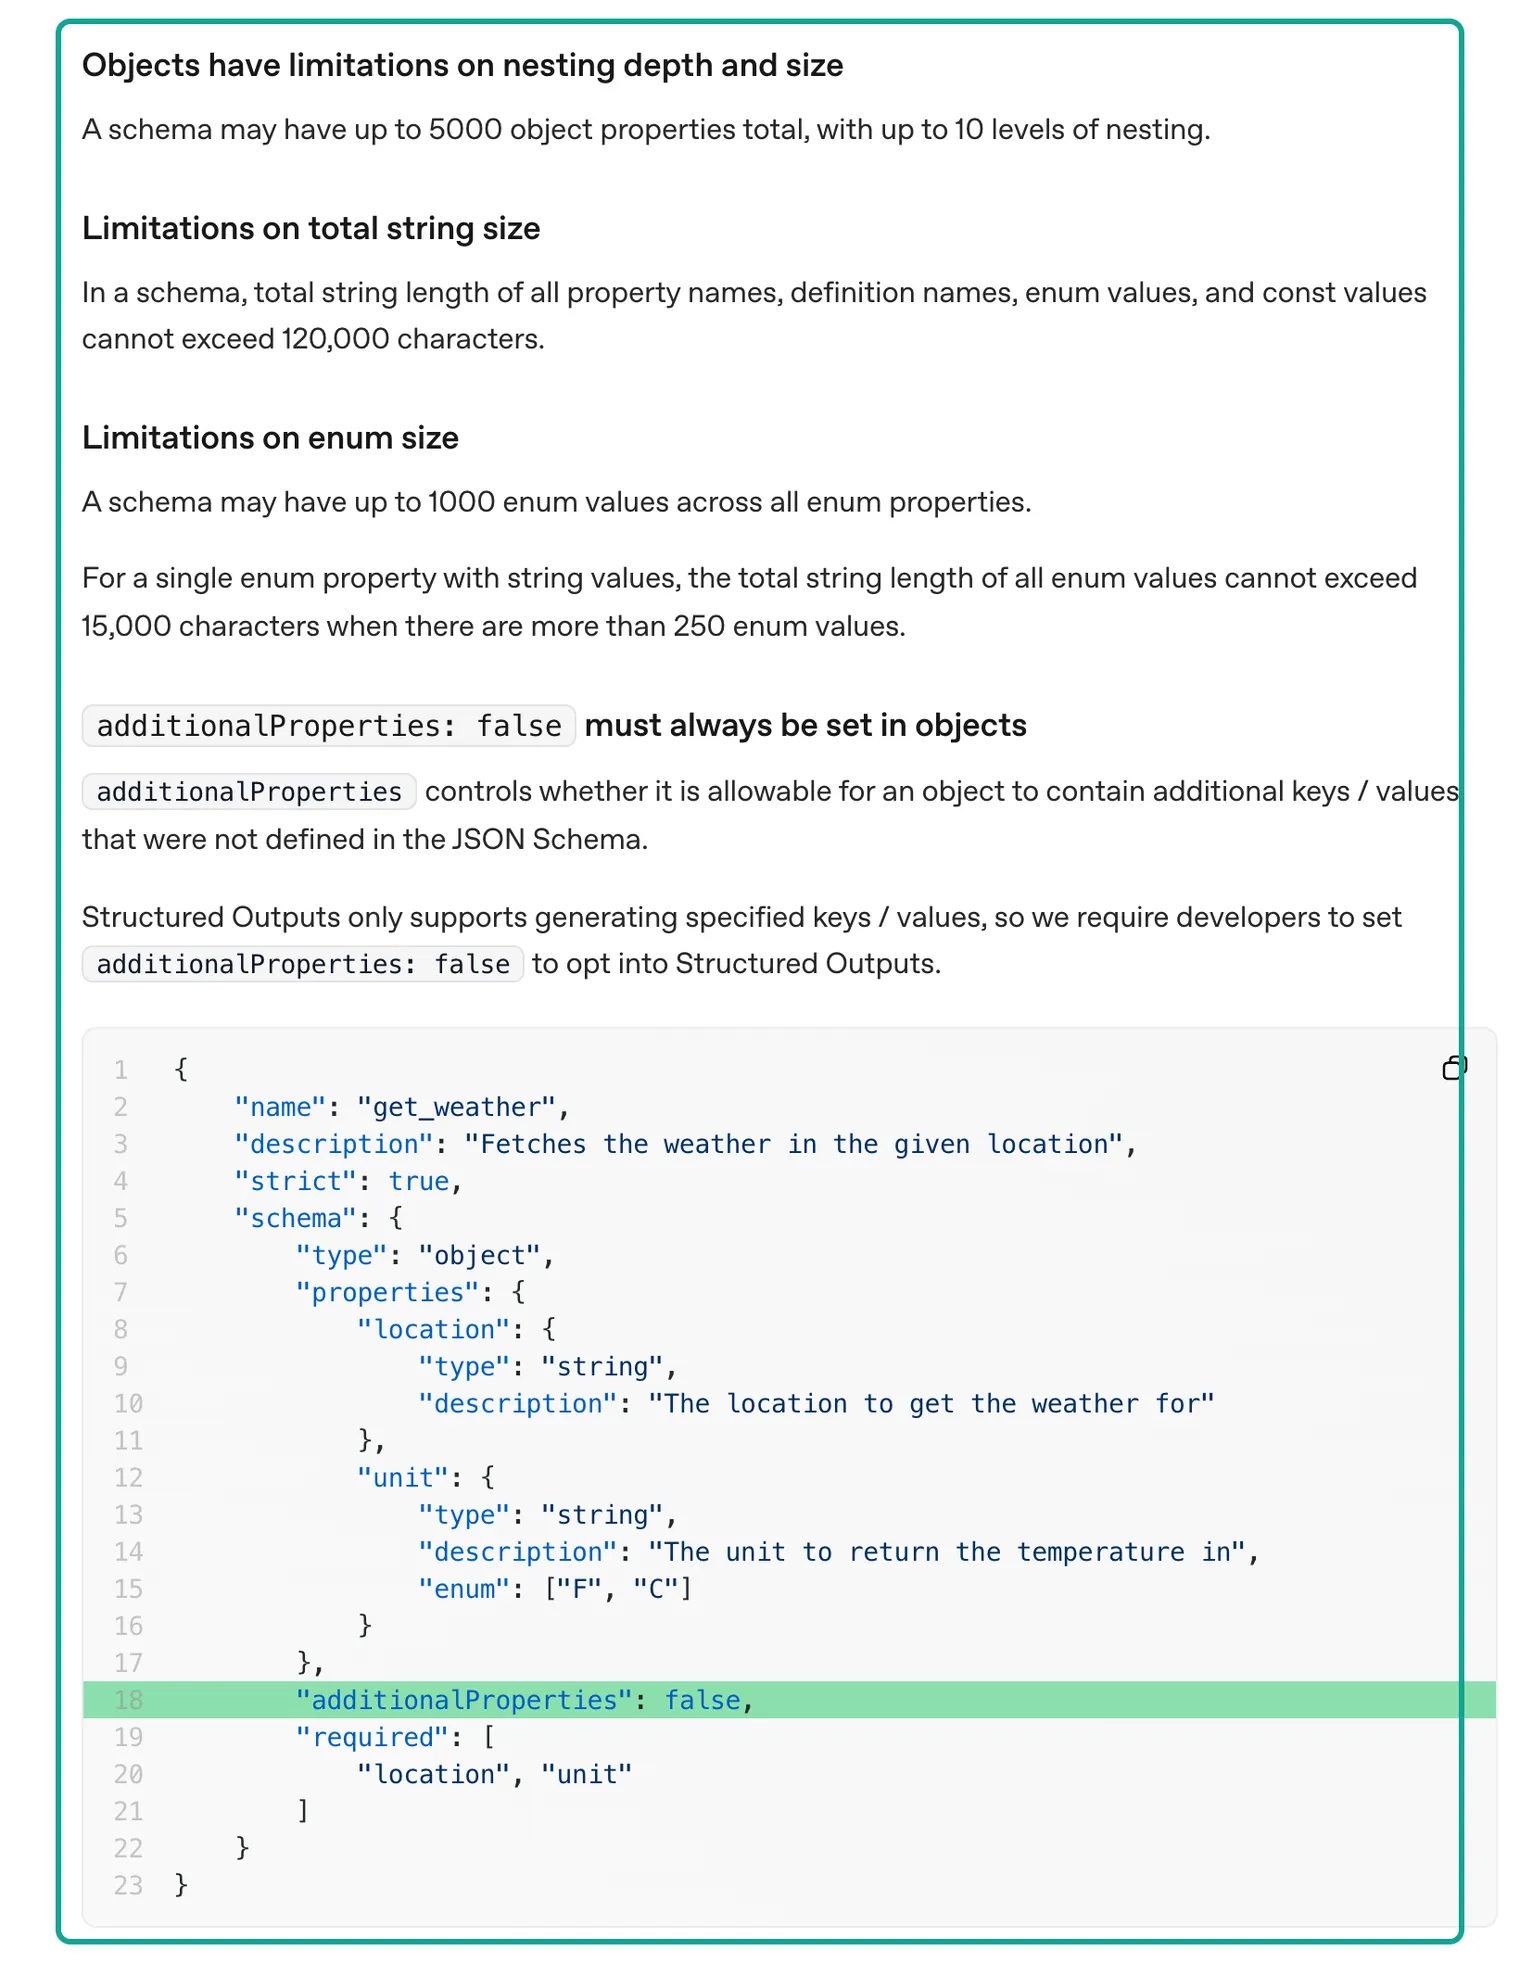
ティール色の枠内の4項目はサイズの制限です。枠の外にも、スキーマの書き方に関する厳格なルールがガイドに書かれています。
- ルートはオブジェクトでなければなりません。
anyOfにはできません。 - すべてのオブジェクトのすべてのフィールドを
requiredに含める必要があります。フィールドを任意にするには、["string","null"]のような型を指定します。 - ガイドによると、
allOf、not、dependentRequired、dependentSchemas、if、then、elseはサポートされていません。 - 文字列について、ガイドに記載されているのは
patternとformatだけです。formatキーワードに指定できる値は、date-time、time、date、duration、email、hostname、ipv4、ipv6、uuidの9つです。 - 配列は
minItemsとmaxItemsに対応しています。$defsと再帰参照もサポートされています。
ガイドには、新しいスキーマを使う最初のリクエストでは追加の処理レイテンシが発生するとも書かれています。同じスキーマを使う以降のリクエストでは発生しません。
| ルール(ガイド内のセクション) | 上限または要件 | 当社のタグスキーマ | 不正なテスト用スキーマ |
|---|---|---|---|
| オブジェクトプロパティの総数(Objects have limitations…) | ≤ 5000 | 9 | 8 |
| ネストの深さ | ≤ 10 | 1階層 | 1階層 |
| enum値の総数(Limitations on enum size) | ≤ 1000 | 31 | 31 |
| 名前と列挙値の文字数(文字列の合計サイズの制限) | ≤ 120,000 | 416 | 408 |
additionalProperties: false | すべてのオブジェクトで必須 | 可能 | ルートでtrueに設定、検出 |
全フィールドをrequiredに記載 | 必須 | 9件中9件 | requiredに存在しないフィールドを記載 |
| 非対応のキーワード | allOf、if、thenなど | 0 | 3 |
| サポート一覧にないキーワード | 警告のみ | 0 | minLength、1 |
スクリプトの結果は、単一レビュー用スキーマと25件用スキーマでは問題0件、警告0件でした。不正なスキーマでは問題5件、警告1件でした。この不正なスキーマは適当に作ったものではありません。「mentions_competitorがtrueなら、competitorsには1件以上の項目が必要」という自然な発想から生まれたものです。JSON Schemaでは、このルールをallOfとif/thenで書きます。
strictモードはこれをサポートしていません。スキーマでは、2つのフィールド間のこうしたルールを強制できません。結果が返ってきた後にコードで確認する必要があります。方法は後述の「スキーマで強制できないこと」で説明します。
minLengthについて補足します。ガイドでminLengthとmaxLengthが非対応とされているのはファインチューニング済みモデルだけですが、サポートされる文字列キーワードの一覧にはpatternとformatしかありません。そのため、スクリプトは警告を出し、当社のスキーマでは使っていません。アクションの20語制限はdescriptionとプロンプトに書き、コードで計測しています。
単一レビュー用のタグスキーマは次のとおりです。フィールドは9つで、すべて必須です。other_brand_nameとaction_itemはnullを取れます。
{
  "name": "review_label",
  "strict": true,
  "schema": {
    "type": "object",
    "properties": {
      "item_id": {"type": "string", "description": "Copy the item_id of the input item."},
      "sentiment": {"type": "string", "enum": ["positive", "negative", "mixed", "neutral"]},
      "issue_categories": {"type": "array", "minItems": 1, "maxItems": 3,
        "items": {"type": "string", "enum": ["app_connectivity", "account_login", "mapping_navigation",
          "suction_cleaning", "mopping", "dock_self_empty", "battery_charging", "hardware_defect",
          "firmware_update", "customer_service_warranty", "price_value", "noise", "app_usability", "other", "none"]}},
      "mentions_competitor": {"type": "boolean"},
      "competitors": {"type": "array", "maxItems": 5,
        "items": {"type": "string", "enum": ["roborock", "irobot_roomba", "ecovacs_deebot", "dreame", "eufy",
          "shark", "narwal", "mova", "dyson", "samsung", "xiaomi", "other_brand"]}},
      "other_brand_name": {"type": ["string", "null"]},
      "action_item": {"type": ["string", "null"], "description": "One concrete action, 20 words or fewer, or null."},
      "evidence": {"type": "string", "description": "Up to 15 words copied from the text."},
      "language": {"type": "string", "description": "ISO 639-1 code."}
    },
    "required": ["item_id", "sentiment", "issue_categories", "mentions_competitor", "competitors",
                 "other_brand_name", "action_item", "evidence", "language"],
    "additionalProperties": false
  }
}25件版では、外側に1層追加します。ルートオブジェクトのフィールドはlabels配列の1つだけです。配列の各項目は、$refで$defs内の同じタグオブジェクトを参照します。ガイドによると、$defsと$refはサポートされています。ネストの深さは1階層から2階層になり、上限の10階層を大きく下回ります。
フィールドの順序も重要です。ガイドによると、出力はスキーマのキー順に従います。そこでitem_idを先頭に置きました。action_itemとevidenceは、モデルがレビュー全体を読まないと書けないため、末尾近くに置いています。出力が途中で切れても、先頭にあるIDと感情は残ります。
タグの設計方法:4つの問いと9つのフィールド
タグを設計する前に、誰が使うのかを決めます。ロボット掃除機ブランドのアプリチームが気にするのは、Wi-Fiの切断、ログインの失敗、マップの消失です。サポートチームは保証に関する苦情を探します。プロダクトチームは、ユーザーがどの他社ブランドと比較しているかを知りたがります。
そこで、4つの問いからタグを作りました。トーンはどうか。どんな種類の問題か。他社ブランドの名前が出ているか。
1つの具体的な改善策につなげられるか。問題カテゴリは15個の値からなる固定のenumです。競合は12個の値からなるenumで、それ以外を扱うためにother_brandを用意しています。
最も時間がかかったのは問題カテゴリです。まず、実際の呼び出しで取得した412件のレビューを読みました。次に、実際の苦情を13のグループに分類しました。最後にotherとnoneを追加しました。たとえば、iRobotの低評価レビューの多くには「コマンドが通らない」や「iRobotクラウドに接続できない」と書かれています。
これらはapp_connectivityに分類します。「認証コードが届かない」や「アカウント連携に失敗した」はaccount_loginです。Roborockのレビューの多くには「アップデート後にマップが壊れた」とあります。これはfirmware_updateとmapping_navigationの両方に当てはまります。そのため、1件のレビューに最大3つのカテゴリを付けられます。
システムプロンプトには、カテゴリごとに1行のガイダンスがあります。この部分がプロンプトの半分以上を占めます。後述のトークン数で固定プレフィックスが645トークンになる主な理由もここにあります。
感情はpositive、negative、mixed、neutralの4値です。システムプロンプトには「星の評価だけで感情を判断しないこと」と書かれています。星の数と本文が食い違うことはよくあります。Roborockのレビューには、「アプリはとても良い」で始まる星1のレビューがあります。マップの問題に触れるのはその後です。前半でアプリを褒めている星3のレビューもあります。
そのレビューは後半で、Samsungの折りたたみスマートフォンでは下部のボタンが動かないと書いています。システムプロンプトでは、こうしたレビューをmixedとします。TikTokのコメントには星がありません。「どれが一番いい?」のような質問はneutralになります。
action_itemは最も検証しにくいタグなので、制限を最も厳しくしています。20語以内の英語1文、またはnullです。evidenceには、レビューから最大15語を原文の言語のまま引用する必要があります。この2つのフィールドがあれば、レビュー全体を読まなくても数秒でタグを確認できます。
このスキーマを使い、実際のレビュー12件について出力例を手作業で書きました。これを出力トークンの見積もりに使います。各フィールドがどのような形になるかもわかります。表にはそのうち4件を示します。
レビュー本文は一部を省略し、投稿者の情報は削除しています。この12件の例は人が書いたもので、GPT-6.1 Solの出力ではありません。
| 出典 | スター数 | レビューの抜粋 | 感情 | 問題カテゴリ | 競合 |
|---|---|---|---|---|---|
| Roborockアプリ | 2 | 「You ruined my robot after your last update! The map is all messed up…」 | negative | firmware_update, mapping_navigation | none |
| Roborockアプリ | 3 | 「…it doesn't support the Samsung Z Fold 8's screen aspect ratio…」 | mixed | app_usability | none(ここでのSamsungはスマートフォン) |
| iRobotアプリ | 1 | 「every 2nd vacuum I have a connection issue. I will never buy another Roomba」 | negative | app_connectivity | none |
| TikTokのコメント | n/a | 「How about the Dreame X60 Pro Ultra?…」 | neutral | none | dreame |
EveryInfraでレビューを取得する:実際に1回リクエストしてレスポンスを受け取るまで
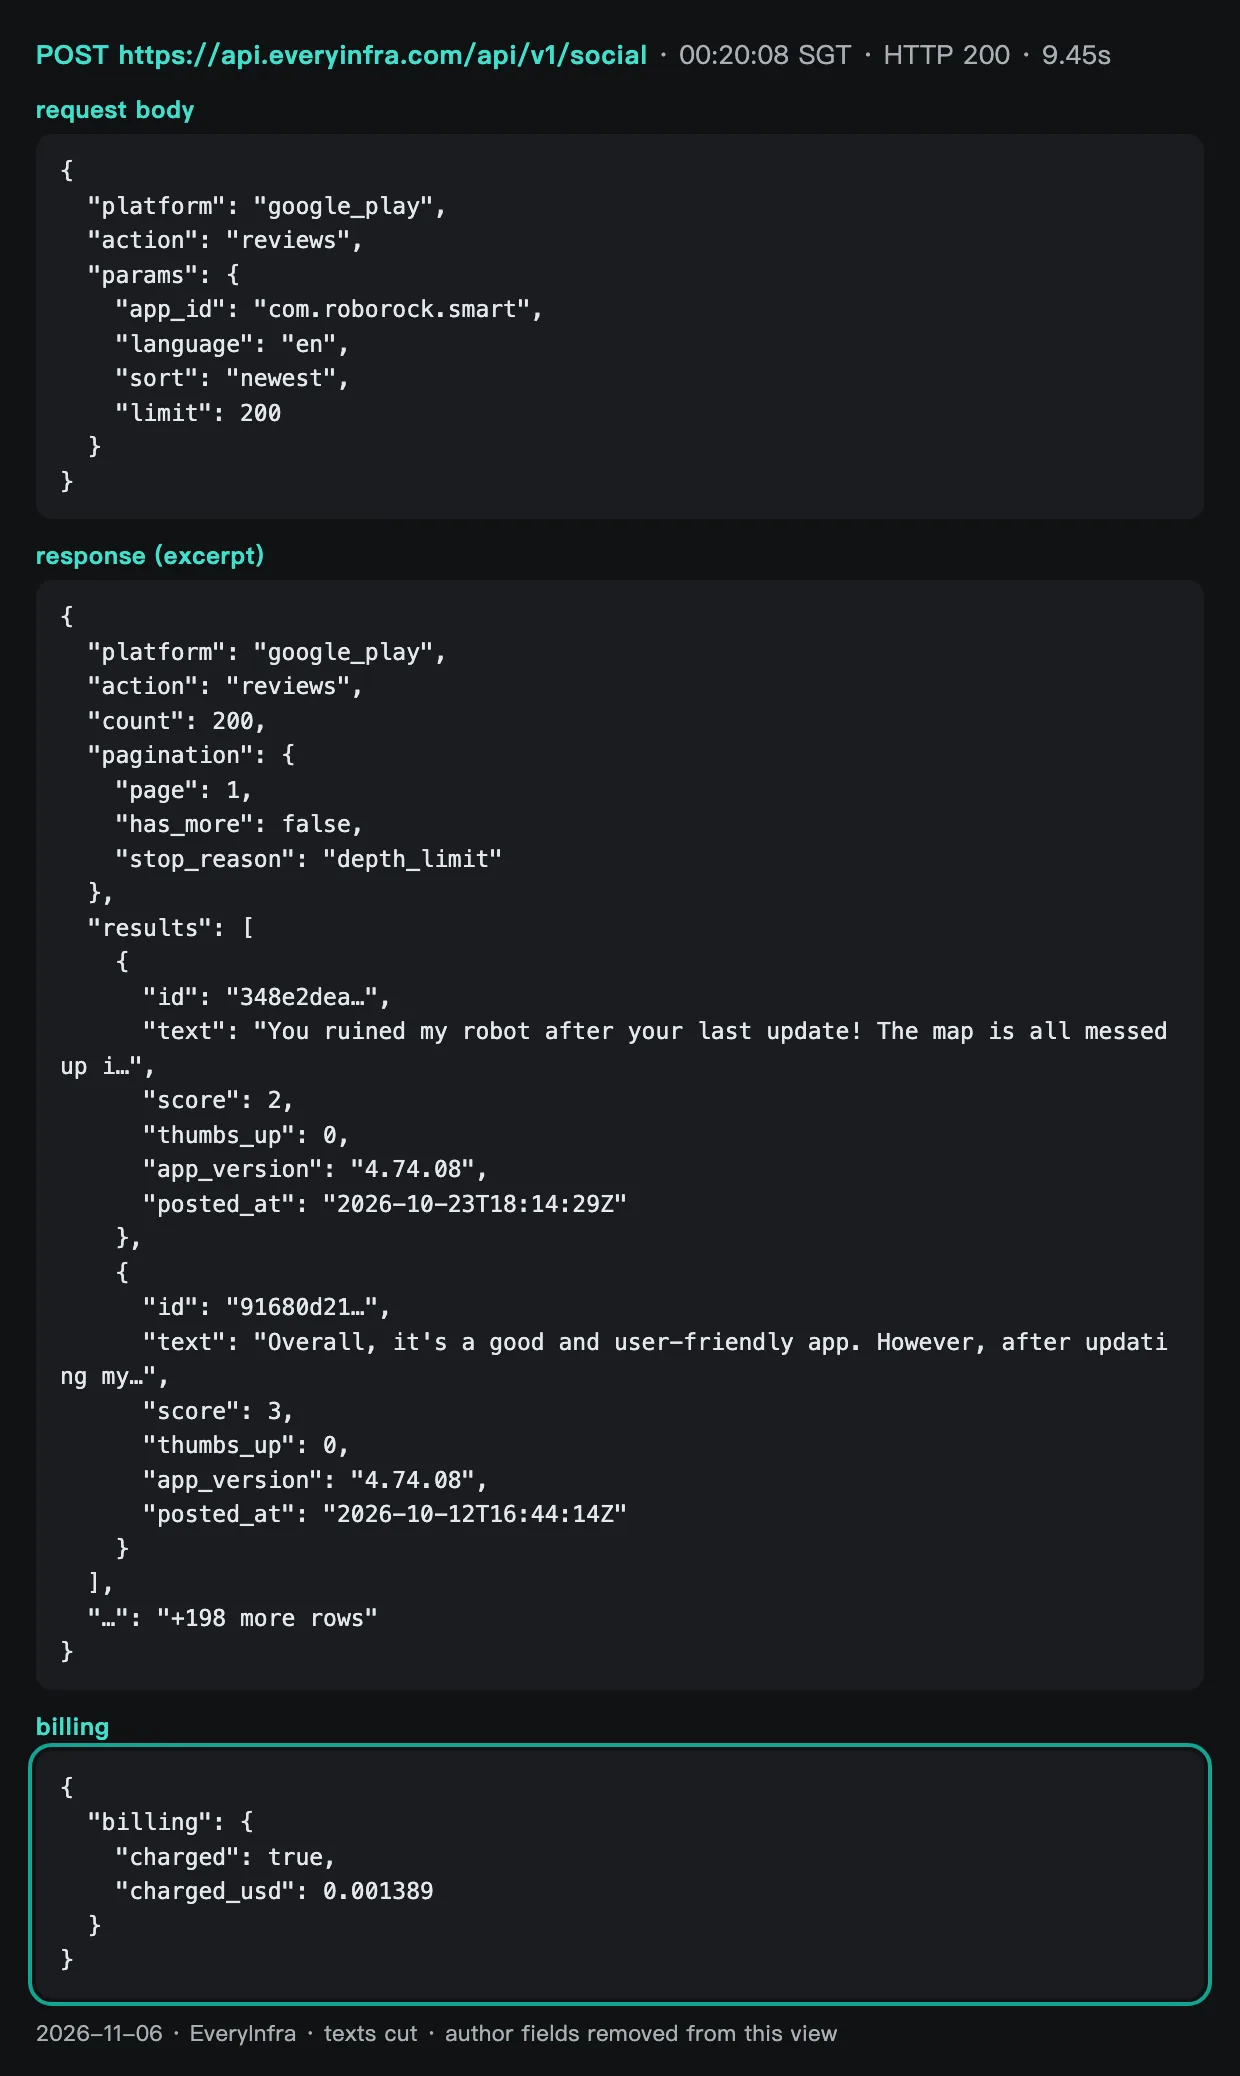
レビューの取得には、EveryInfraのデータエンドポイントPOST /api/v1/socialを使いました。リクエストボディでプラットフォーム、アクション、パラメータを指定します。最初の呼び出しの前に、2026-11-06 00:15(SGT)に無料の機能カタログを読み、各レビュー機能の料金、パラメータ、レスポンスフィールドを確認しました。
google_play/reviewsは1回の呼び出しあたり$0.001389です。同期呼び出しで最大200件を返します。languageとsortを指定できます。tiktok/commentsは1回の呼び出しあたり$0.000556です。動画URLを指定します。amazon/reviewsは1回の呼び出しあたり$0.001389です。カタログによると、Amazonの各サイトの商品ページに表示されるのは注目のレビューのみで、通常は1商品あたり十数件です。trustpilot/reviewsは1回の呼び出しあたり$0.001389です。
Google Playへのリクエスト全体は次のとおりです。
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"google_play","action":"reviews",
"params":{"app_id":"com.roborock.smart","language":"en","sort":"newest","limit":200}}'このリクエストは2026-11-06 00:20:08(SGT)に送信し、9.45秒でHTTP 200が返りました。countは200、pagination.stop_reasonはdepth_limit、has_moreはfalseでした。課金額は$0.001389です。
各レビューにはid、text、score、thumbs_up、reply_text、reply_at、app_version、posted_atなどのフィールドがあり、カタログのresponse_fieldsリストと一致します。レスポンスには投稿者名とアバターのフィールドも含まれますが、タグ付けには不要なため、モデルへのリクエストを作成する前に削除しました。
呼び出しは00:16:42から00:24:27(SGT)までに合計7回行いました。各呼び出しを下の表にまとめています。同期のtiktok/comments呼び出しは90.21秒かかり、HTTP 200で12件を返しました。limit 200で行ったamazon/reviewsとtrustpilot/reviewsへの同期呼び出し2回は85秒を超え、503タイムアウトとなり、課金はされませんでした。エラーメッセージには、"mode":"async"を使うかlimitを小さくするよう書かれていました。Roborockの2製品に対する非同期のamazon/reviewsジョブ2件は成功したものの0件で、課金は返金されました。
| 時刻(SGT) | 機能 | 結果 | クライアント側の計測時間 | 件数 | 課金額 |
|---|---|---|---|---|---|
| 00:16:42 | amazon/reviews(同期) | 503タイムアウト | 89.91 s | 0 | $0 |
| 00:18:21 → 00:19:57 | amazon/reviews(非同期) | 成功、0件、返金済み | 送信2.08秒、約96秒で完了 | 0 | $0(課金後に返金) |
| 00:18:26 | tiktok/comments(同期) | 200 | 90.21 s | 12 | $0.000556 |
| 00:20:08 | google_play/reviews Roborock | 200 | 9.45 s | 200 | $0.001389 |
| 00:20:25 | google_play/reviews iRobot | 200 | 9.24 s | 200 | $0.001389 |
| 00:20:34 → 00:24:18 | amazon/reviews(非同期) | 成功、0件、返金済み | 送信2.04秒、約224秒で完了 | 0 | $0(課金後に返金) |
| 00:24:27 | trustpilot/reviews(同期) | 503タイムアウト | 88.2 s | 0 | $0 |
所要時間について1点補足します。tiktok/commentsの呼び出しは90.21秒かかり、2回の503タイムアウト(89.91秒と88.2秒)より長かったものの、200で12件を返しました。2つの503エラーメッセージにはどちらも「request timed out after 85s」とあります。つまり、85秒はサーバー側の待機上限です。こちらの計測時間はリクエストの送信時に始まり、レスポンス全体の受信時に終わります。そのため、ネットワーク時間とキュー待ち時間を含みます。
レスポンスにはサーバー側の処理時間が含まれないため、TikTokの呼び出しがサーバー上でどれだけかかったかはわかりません。言えるのは、上限に近かったということだけです。同じリクエストでも、時間帯によっては503が返る可能性があります。TikTokのコメントのように遅い機能をまとめて取得する場合は、非同期モードを使ってください。
この表自体が1つの発見です。7回の呼び出しのうち、データを返したのは3回だけでした。しかし、データのなかった4回は費用がかかっていません。2つの503レスポンスでは、ボディにcharged_usd: 0と表示されています。空だった2件の非同期ジョブは送信時に呼び出し料金で課金され、ジョブ終了時に返金されました。
一括タグ付けジョブでは、データ取得に失敗しても失うのは時間だけで、費用はかかりません。本当のリスクは別にあります。「0件」を「ネガティブなレビューなし」としてレポートに書かないでください。空だった2件のAmazonジョブは深追いしませんでした。理由は「制限と注意点」のセクションで説明します。
412件のレビューはどんな内容か
モデルに送る前に、まずデータを確認しましょう。各アプリから最新の英語レビューを200件ずつ取得しました。件数は同じでも、期間は異なります。Roborockの200件は2026-10-03から2026-11-04までの32日間です。
iRobotの200件は2026-07-27から2026-11-04までの99日間です。同じ$0.001389で、Roborockの呼び出しは直近1か月、iRobotの呼び出しは3か月以上をカバーします。「最新200件」から週次レポートを作ると、iRobot側では7月の問題が今週分に入り込みます。
星評価の差はさらに大きくなります。iRobotでは星1が100件、星2が26件で、星1〜2は合計126件、全体の63%です。Roborockでは46件と22件で合計68件、34%です。
開発者の返信にも差があります。iRobotでは200件中100件にreply_textがありますが、Roborockでは49件です。
これらの数値はこの200件だけを表すもので、どちらの製品の全体的な評判を示すものでもありません。タグ付けの結果に影響するため掲載しています。iRobotのデータの大半はnegativeとapp_connectivityに分類されるでしょう。
トークン数を左右するのはレビューの長さです。Google Playレビューの長さの中央値は、Roborockが94.5文字、iRobotが128.5文字です。どちらも最長のレビューはちょうど500文字で、これはGoogle Playのレビューの文字数上限です。
Google Playヘルプコミュニティでも、あるユーザーがこの500文字の上限について質問しています。20文字未満のレビューは、Roborock側で35件、iRobot側で24件あります。例としては「Great robovac great」や「iRobot is awful」があります。
TikTokのコメント12件は文字数の中央値が51.5文字で、大半が質問です。期間は2026-06-13から2026-11-01までで、ほぼ5か月に及びます。1本の動画のコメントは日々増えていくわけではありません。動画の話題性が落ちると、新しいコメントを書く人はほとんどいなくなります。
1回の呼び出しで12件しか返らなかったのはこのためです。短いレビューについてのポイントは単純です。レビューは数十トークンしかないこともあります。1件ごとに数百トークンの指示を付けると、費用の大半は指示の分になります。
もう1つ小さな発見があります。language: "en"を指定しましたが、Roborockのデータには中国語とスロバキア語のレビューも含まれていました。カタログによると、languageは検索に使う言語で、各レビューの言語を保証するものではありません。そのため、スキーマにlanguageフィールドを設け、evidenceは原文の言語のままにしています。
「競合に言及」はキーワードルールでどこまで判定できるか
4つのタグのうち、「競合に言及」はキーワードルールに最も向いているように見えます。ルールならモデルの料金はかかりません。そこで、ロボット掃除機と家電の29ブランド名を含む正規表現を使い、412件のレビューで試しました。
アプリ自身のブランドは除外しました。ルールに一致したのは17件です。その17件をすべて読み、それぞれが本当に別のロボット掃除機ブランドに言及しているかを判断しました。
17件中13件は正しい一致です。Roborockアプリでは、5件のレビューがiRobot、Roomba、Shark、Bissellと比較しています。そのうち4件は星5で、「a great upgrade from the iRobot」などです。残る1件は星1で、5年前のRoombaのほうが良かったと述べています。
iRobotアプリでは、5件のレビューが代わりにRoborock、Shark、Rowenta、Ecovacsを買うよう勧めています。5件とも星1か星2です。TikTokで一致した3件は、Dreame、Roborock、Movaの機種について質問しています。
誤検出は3件です。1件はSamsung Z Fold 8の画面比率について、1件はアプリがSamsungのタブレットにインストールできないという内容です。最後の1件はスロバキア語の「mi」(「私」の意味)で、ルールがXiaomiと誤認しました。
残る1件は判断が分かれます。このレビューは、アプリの新しい「Explore」ページをクリックベイトだとし、「typical xiaomi」なマーケティングだと評しています。ブランド名は出てきますが、ロボット掃除機を比較しているわけではありません。
見逃しも問題です。ある星5のレビューは「Sharks, Bissell's, iRomba's」と書いていますが、ルールが検出したのはBissellだけでした。複数形とタイプミスが一致しなかったためです。よく使われる13ブランドに絞った短いリストでは14件しか見つからず、RowentaとBissellを見逃します。
教訓ははっきりしています。キーワードルールは最初のフィルターとしては使えますが、タグとしては不十分です。誤検出は、同じブランド名のスマートフォンや外国語の単語から生じます。見逃しは、複数形、タイプミス、リストにないブランドから生じます。
そのため、スキーマではcompetitorsのenumとother_brandを使い、この列はモデルに任せています。mentions_competitorのbooleanは、competitorsが空かどうかからそのまま導けます。シートで絞り込みやすくするためだけに残しています。2つのフィールドの整合性を確認する方法は後ほど紹介します。
トークン数の見積もり方:固定プレフィックスが92%を占める
OpenAIのキーがないため、モデルの費用は見積もるしかありません。各手順を示すので、ご自身の数値に置き換えて計算できます。OpenAIはGPT-6.1 Solのトークナイザーを公開していません。そこで、OpenAIのオープンソースライブラリtiktoken(PyPIのバージョン0.14.0)に含まれる最新の公開エンコーディングo200k_baseを使います。
システムプロンプト、スキーマ、入力フォーマットは実際のファイルです。レビューはライブ呼び出しで取得した412件です。出力トークンは、手書きしたタグの例12件の平均長から算出しています。推論トークンは別途仮定した値です。
実際の課金は、Responses APIの各レスポンスに含まれるusageオブジェクトに従います。本番実行の前に、パイロットとして20件のレビューを送ってください。input_tokens、output_tokens、output_tokens_details.reasoning_tokensを確認し、下の表を更新します。
| 項目 | トークン数(o200k_base) | 備考 |
|---|---|---|
| システムプロンプト(カテゴリガイドとルール) | 645 | 毎回のリクエストで送信 |
| レビュー1件用のタグスキーマ | 322 | コンパクトなJSONとして計算。実際の課金方法はOpenAIが決定。 |
| レビュー25件用のスキーマ | 362 | labels配列の階層が1つ増える |
| 固定プレフィックス(1件/25件) | 967 / 1,007 | どちらもキャッシュ最小値の1,024トークンを下回る |
| 入力としてのレビュー1件(ID、取得元、星評価付き) | 平均81.1、中央値73.5、最大205 | 実際のレビュー412件 |
| レビュー本文のみ | 平均32.6 | トークンの半分以上がフォーマット行に使われる |
| 出力としてのタグ1件 | 平均87.3(65〜107) | 手書きの例12件 |
これを1,000件のレビューに掛けると、差ははっきりします。1リクエストに1件の場合、1,000リクエストで約1,056,100入力トークンが必要です。各リクエストには、固定プレフィックスの967トークンと、メッセージフォーマット分の8トークンが含まれます。その合計は975,000トークンで、入力の92.3%を占めます。1リクエストに25件なら、必要なリクエストは40回だけです。
固定プレフィックスは40,600トークンに、入力の合計は約121,700トークンに減ります。88.5%の削減です。レビュー本文の81,100トークンは、どちらの構成でも同じです。削減分はすべて、同じ指示を何度も送らずに済むことによるものです。
プレフィックスが繰り返されるならキャッシュが効くはずだ、と考えるかもしれません。プロンプトキャッシュのガイドによると、GPT-5.6以降では、キャッシュ可能なプレフィックスの最小値は表示される入力トークンで1,024です。OpenAIが追加する非表示のシステムコンテンツはカウントされません。GPT-6.1 Solでは、キャッシュ読み取りは通常の入力料金の0.05倍、30分のキャッシュ書き込みは1.25倍、12時間の書き込みは2.5倍です。
今回のプレフィックスはo200k_baseで967トークンで、最小値に57トークン足りません。OpenAIがスキーマを非表示のシステムコンテンツに変換する場合、表示される部分は645トークンしかなく、最小値からさらに遠ざかります。いずれにしても、このプレフィックスはキャッシュされません。つまり、このプロンプトの長さでは「1リクエストに1件+キャッシュ」は成り立ちません。
プロンプトがすでに1,024トークンを超えているなら、キャッシュは効きます。プレフィックス全体がキャッシュ料金で読み取られると仮定した場合、Batchで1リクエストに1件だと1,000件あたり約$0.57です。これは1リクエストに25件の場合の$0.56に近い数字ですが、初回のキャッシュ書き込みは含んでいません。一方、1リクエストに25件の方式はキャッシュヒットに依存せず、プロンプトを水増しする必要もありません。そこで、Batchファイルは1リクエストに25件で作成します。
Batch APIの手順:JSONLの作成からアップロード、ダウンロードまで
Batch APIのガイドの説明は明快です。各リクエストを.jsonlファイルの1行として書きます。各行には、一意のcustom_id、method、url、bodyを含めます。bodyの内容は同期エンドポイントと同じです。
1つのファイルで使えるモデルは1つだけです。ファイルはpurposeをbatchにしてアップロードします。バッチ作成時のcompletion_windowは、現時点では24hしか指定できません。料金は同期エンドポイントより50%安く、Batchには独自の、より高いレート制限があります。
ガイドには、タグ付けジョブで直面する3つの制限も記載されています。1つのバッチに含められるのは最大50,000リクエストで、入力ファイルは最大200 MBです。バッチは1時間あたり最大2,000件まで作成できます。出力ファイルは入力の順序を保たないため、結果はcustom_idで照合する必要があります。
ファイルサイズを確認するため、実際の412件のレビューから2つのBatchファイルを作成しました。1リクエストに1件のレビューを入れたファイルは412行、2,018,830バイトです。各行にシステムプロンプトとスキーマ全体が含まれるため、1行あたり約4,900バイトになります。25件ずつのファイルは17行、191,412バイトで、1行あたり約11,260バイトです。
200MBの上限から計算すると、1リクエストに1件のファイルに入るレビューは約42,798件です。50,000行の上限より先にサイズの上限に達します。25件ずつのファイルなら、サイズでは約451,000件、行数では1,250,000件まで入ります。1,000件のレビューなら、どの上限にも遠く及びません。ただし数万件規模になると、1リクエスト1件の構成は想定より早く200MBに達します。
Batchを使わずに同期エンドポイントを使うと、大規模な実行では1分あたりのトークン数の上限に達することがあります。2026-10-06に、OpenAIは利用ティアをBuild、Launch、Growの3つに整理しました(レート制限ガイド)。Solのモデルページでは、Buildティアの上限は1分あたり1,000,000トークンです。Batchには同期処理の枠とは別に、より高い上限があります。大規模に実行する前に、ご自身のアカウントの制限ページを確認してください。
以下は25件ずつのファイルの1行目で、改行を加え、プロンプトとスキーマは省略しています。続いて、アップロードとバッチ作成のPythonコードを示します。これはドキュメントに基づく設定例で、OpenAI上では実行していません。
# One JSONL line (cut):
# {"custom_id": "chunk-000", "method": "POST", "url": "/v1/responses",
#  "body": {"model": "gpt-6.1-sol", "reasoning": {"effort": "low"}, "max_output_tokens": 12000, "store": false,
#           "input": [{"role": "developer", "content": "You label customer reviews ..."},
#                     {"role": "user", "content": "item_id: 56a3b9f4-...\nsource: google_play/reviews app=com.roborock.smart\nrating: 5/5\ntext: ..."}],
#           "text": {"format": {"type": "json_schema", "name": "review_labels", "strict": true, "schema": {...}}}}}
from openai import OpenAI
client = OpenAI()  # reads OPENAI_API_KEY from the environment
f = client.files.create(file=open("x25.jsonl", "rb"), purpose="batch")
batch = client.batches.create(input_file_id=f.id, endpoint="/v1/responses", completion_window="24h",
                              metadata={"job": "review-tagging-2026-11-06"})
print(batch.id, batch.status) # validating -> in_progress -> finalizing -> completedmax_output_tokensは十分大きく設定してください。1件あたり約87トークンのタグが25件で、約2,200トークンになります。さらに推論トークンが加わります。今回は12,000に設定しました。
値が小さすぎると、構造化出力が途中で止まります。このケースはStructured Outputsガイドで説明されています。レスポンスのステータスはincomplete、理由はmax_output_tokensになります。得られるJSONは不完全なので、失敗として扱ってください。
store: falseは、後で参照するためにレスポンスを保存しないようOpenAIに指示します。ただしBatch API FAQによると、ゼロデータリテンションはBatch APIには適用されません。入力・出力・エラーファイルは、BatchとFilesサービスの保持ルールに従います。レビューに個人データが含まれる場合は、送信前に削除してください。今回はリクエストの作成時に投稿者名、投稿者のアバター、レビューのURLを削除し、レビューID、ソース、星の数、本文だけを残しました。
結果をダウンロードする際、ステータスはvalidating、in_progress、finalizing、completedの順に進みます。24時間以内に完了しなかったバッチはexpiredになります。完了した分は受け取ることができ、その分の料金が発生します。未完了のリクエストは、コードbatch_expiredとしてエラーファイルに入ります。出力ファイルはバッチ終了から30日後に削除されるので、期限内にダウンロードしてください。
すべてのフィールドはBatch APIリファレンスとFiles APIリファレンスに記載されています。低価格で同期的な応答が欲しい場合は、Flex processingをBatch料金で利用できます。その代わり応答は遅くなり、ときどき429「resource unavailable」エラーが返ります。このエラーは課金されません。
1,000件のレビューあたりのコスト:データ料金とモデル料金の合計
ここでデータ料金とタグ付けの料金を合わせてみます。データ料金は、実際に確認した1回の呼び出しあたりの件数とカタログ価格から計算しました。Google Playは1回の呼び出しで200件を返すので、1,000件のレビューに必要な呼び出しは5回で、$0.006945です。今回のTikTok動画は1回の呼び出しで12件だったため、1,000件には84回の呼び出しが必要で、$0.046704になります。6.7倍の差です。412件の混合セットの費用は$0.003334で、1,000件あたり$0.008092でした。
TikTokの数字は、動画1本あたり12件を前提にしています。人気の動画なら1回の呼び出しで返る件数が多くなり、データ料金はずっと下がります。この数字を示したのは、1つの点を伝えるためです。1,000件あたりのデータ料金は、単価だけでなく、1回の呼び出しで返る件数によって決まります。
モデル料金は、2026-11-06時点のOpenAIの公開価格と上記のトークン数から見積もりました。レビュー1件あたりの推論トークンは、0、50、200の3段階を想定しています。0は下限値ですが、Solの最低設定はlowなので、実際には到達できません。以下はすべて、レビュー1,000件あたりの金額(米ドル)です。EveryInfraのデータ料金は含みません。
| 構成(レビュー1,000件あたり) | 推論トークン0(下限) | 1件あたり推論トークン50(想定) | 1件あたり推論トークン200(想定) |
|---|---|---|---|
| Sol標準、1リクエストに1件 | $2.99 | $3.49 | $4.99 |
| Sol Batch、1リクエストに1件 | $1.49 | $1.74 | $2.49 |
| Sol Batch、1リクエストに1件、プレフィックスをキャッシュ価格で計算(仮定。プレフィックスは1,024未満) | $0.57 | $0.82 | $1.57 |
| Sol Batch、1リクエストに25件 | $0.56 | $0.81 | $1.56 |
Terra Batch、1リクエストに25件、none | $0.28 | n/a | n/a |
Luna Batch、1リクエストに25件、none | $0.028 | n/a | n/a |
この表は3つの観点で読めます。第1に、同じモデル・同じプロンプトでも、「標準、1リクエストに1件」から「Batch、1リクエストに25件」に変えると、下限は$2.99から$0.56に下がります。5.3分の1です。
第2に、1リクエスト25件の場合、費用の大半は出力です。$0.56のうち出力は$0.44で、約78%を占めます。レビュー1件あたりの推論トークンが50増えるごとに、$0.25(50 × 1,000 × $5 ÷ 1,000,000)増えます。つまり最終的な請求額は、ご自身のレビューでlowがどれだけ推論トークンを生成するかで決まります。それを測れるのはパイロット実行だけです。
第3に、データ料金は全体のごく一部です。Google Playの$0.006945とSol Batch(1リクエスト25件)の$0.56を足すと約$0.566で、データ料金はその1.2%です。TikTokの$0.046704で計算しても、7.7%にすぎません。
ご自身の数字で計算するには、4つの値が必要です。Pは固定プレフィックスのトークン数、xはレビュー1件あたりの平均入力トークン数、yはタグ1件あたりの平均出力トークン数です。
rはレビュー1件あたりの推論トークン数です。Batch料金で1リクエストにk件のレビューを入れる場合、1,000件あたりのモデル料金はおよそ(1,000 ÷ k × P + 1,000 × x) × $1 ÷ 1,000,000に、1,000 × (y + r) × $5 ÷ 1,000,000を足した額です。この記事では、Pは967または1,007、xは81.1、yは87.3で、rは不明です。
レビューが長いとxの項が大きくなり、kの影響は小さくなります。長いECレビューでは、平均300〜400トークンになることもあります。プロンプトが長いとPの項が大きくなり、kを大きくする効果が増します。この式には、入力が272Kトークンを超えた場合の追加料金は含まれていません。1リクエスト25件なら各リクエストは3,000トークン強で、その境界からは十分離れています。1リクエストに数千件のレビューを入れる予定なら、追加料金を加算するか、リクエストを分割してください。
規模感の目安として、Gilardiらによる2023年の論文「ChatGPT Outperforms Crowd-Workers for Text-Annotation Tasks」では、2,382件のツイートでアノテーション1件あたり$0.003未満と報告されています。今回のSol Batch(1リクエスト25件)の下限はレビュー1件あたり約$0.00056、推論トークン50の場合は$0.00081です。
一方は論文の実測値で、もう一方は私たちの見積もりであり、OpenAI上では実行していません。タスクとモデルも異なります。あくまで規模感の目安として使ってください。価格がどれだけ下がったかを示すものではなく、精度についても何も示していません。
Sol、Terra、LunaとDecisions API:Solを使うべきでない場面
コスト表の最後の2行は、意図的に入れています。GPT-6.1 Terraは2026-10-26に公開されました。発表記事によると、標準価格はGPT-6.1 Solより50%安く、大量の文書処理に向いています。推論のnoneに対応しています。Batch価格は入力$0.50、出力$2.50です。OpenAIはGPT-6 Lunaを、用途を絞った大量処理向けの効率的なモデルと位置づけています。
Lunaもnoneに対応しています。Batch価格は入力$0.05、出力$0.25です。同じトークン見積もりで、Terraは1,000件のレビューあたり$0.28、Lunaは$0.028です。それぞれSolの下限の2分の1と20分の1です。しかも、どちらにも推論トークンという不確定なコストがありません。
では、Solを使うべきなのはどんなときでしょうか。第1に、「直近のファームウェアバージョンがこの不具合の原因か?」のようなタグに推論が必要な場合や、action_itemをプロダクトマネージャーが書いたような内容にする必要がある場合です。第2に、LunaやTerraの実行結果を抜き取りチェックし、感情がmixedに分類されたケースなど、一部のグループで誤りが多いとわかった場合です。その場合は、その部分だけをSolで再実行します。文言から読み取れるタグなら、Solの推論は無駄になります。
OpenAIには分類専用の手段もあります。Decisions APIは2026-10-06にベータ版として公開され、2026-10-22に一般提供が始まりました。現在対応しているのはgpt-6-lunaだけです。モデルにJSONを書かせる方式ではありません。与えた質問に対して、型付きの回答を返します。
predicateは0〜1の確率を返します。choiceは指定した選択肢から1つを選び、各選択肢の確率を返します。scoreは2〜10点の尺度で評価します。1回のリクエストに最大400問を含められます。OpenAIによると、Responses APIより約10倍高速です。
ガイドには使い分けが明記されています。確率、単一選択、スコアにはDecisionsを使います。スキーマに沿ったオブジェクトを生成するには、Structured Outputsを使います。感情、問題カテゴリ、競合への言及はDecisionsの質問として設定し、信頼度を得られます。action_itemとevidenceには、引き続きStructured Outputsが必要です。
| オプション | 適した用途 | 1,000件あたりのモデル費用(見積もり) | 主な制約 |
|---|---|---|---|
| GPT-6.1 Sol + Structured Outputs + Batch | 推論が必要なタグ、文章形式のアクション、一部を対象とした高品質な再実行 | $0.56〜(レビュー1件あたり推論トークン50ごとに+$0.25) | 推論はオフにできません。24時間以内に返却されます。 |
| GPT-6.1 Terra + Structured Outputs + Batch | 大量処理、明確なフィールド、1文の記述 | 約$0.28(none) | 難しい判断ではSolに劣る |
| GPT-6 Luna + Structured Outputs + Batch | 分類のみの超大規模処理 | 約$0.028(none) | 文章形式のアクションの品質を抜き取りチェック |
| Decisions API(Luna) | 信頼度付きの感情、カテゴリ、競合への言及 | ここでは見積もりなし(Lunaのトークン価格。質問数が使用量に影響) | 自由記述は不可。Lunaのみ。 |
スキーマでは強制できないこと:結果が返ってきた後のチェック
strictモードが保証するのは形です。すべてのフィールドがそろい、型が正しく、enum値が有効であることは保証されます。内容が正しいことは保証されません。2つのフィールドが互いに矛盾することも防げません。
Pythonのjsonschemaライブラリで小さなテストをしました。TikTokコメントに手書きしたタグを、competitors: ["dreame"]とmentions_competitor: falseに変更しました。2つのフィールドは明らかに矛盾していますが、このタグはスキーマ検証を通過しました。
Structured Outputsガイドにも、Structured Outputsの結果に誤りが含まれる場合があると書かれています。対策として、指示の調整、例の追加、タスクの分割が勧められています。そのため結果が返ってきたら、少なくとも以下のチェックを実行してください。
def check(label, item):
    errs = []
    if label["mentions_competitor"] != bool(label["competitors"]):
        errs.append("mentions_competitor does not match competitors")
    if ("other_brand" in label["competitors"]) != (label["other_brand_name"] is not None):
        errs.append("other_brand does not match other_brand_name")
    if "none" in label["issue_categories"] and len(label["issue_categories"]) > 1:
        errs.append("none cannot appear with other categories")
    if label["action_item"] and len(label["action_item"].split()) > 20:
        errs.append("action_item is longer than 20 words")
    if label["evidence"] and label["evidence"].lower()[:30] not in item["text"].lower():
        errs.append("evidence is not a quote from the text")
    if label["item_id"] != item["id"]:
        errs.append("item_id does not match")
    return errs
各チェックは、スキーマでは表現できないルールを扱います。2つのフィールドは、同時にtrueか同時にfalseでなければなりません。一部のenum値は、他の値と両立しません。語数の上限があります。
そして、引用は元の文章から取られていなければなりません。最後のチェックが最も役に立ちます。モデルがでっち上げた「引用」を検出できます。
1リクエスト25件の場合は、もう1つチェックが必要です。labels配列には25個の要素があり、各item_idが入力のいずれかと一致しなければなりません。ガイドによると、出力はスキーマのキー順に従います。配列の要素が入力順に返るとは保証されていません。位置ではなくIDで照合するほうが安全です。
さらに2つのケースには個別の対応が必要です。第1に、モデルが拒否するケースです。ガイドによると、モデルが安全上の理由で拒否した場合、コンテンツタイプはrefusalになり、スキーマには従いません。レビューには、暴言や過激な言葉を含むものがあります。私たちが読んだiRobotのレビューの1件は、侮辱的な言葉で開発者をののしっていました。refusalを捕捉できるようにしておいてください。
第2に、タスクと関係のない入力です。ガイドでは、タスクに合わない入力に対して何を返すかを、プロンプトで指定するよう勧めています。システムプロンプトのルール8がこれに当たります。空のレビュー、広告、無関係なテキストには、neutral、none、競合なしを返させます。
制限事項と注意点
今回はAmazonのレビューが返ってきませんでした。2つの非同期ジョブはいずれも取得件数0件で正常終了し、料金は返金されました。カタログによると、Amazonの各サイトでは商品ページに注目のレビューしか表示されず、通常は1商品あたり十数件です。1回の呼び出しで十数件だと、データ料金は1,000件のレビューあたり$0.08を超え、Google Playの10倍以上になります。Amazonの予算を決める前に、いくつかの商品で試してください。コスト表にAmazonは含めていません。
同期呼び出しの処理時間の上限は85秒です。今回、amazon/reviewsとtrustpilot/reviews(limit 200)は、どちらも85秒以上待った後に503タイムアウトを返しました。料金はかかっていません。レスポンスでは、"mode":"async"を使うか、limitを小さくするよう案内されました。85秒はサーバー側で計測されます。tiktok/commentsの呼び出しはこちら側で90.21秒かかりましたが、HTTP 200が返りました。これも上限に近い状態でした。
バッチでデータを取得する場合、時間のかかる機能には非同期モードを使ってください。すぐにjob_id付きの202が返るので、その後poll_urlをポーリングします。今回の2つの非同期ジョブは、開始から完了まで約1分36秒と3分44秒でした。
「最新200件」は一定の期間ではありません。前述のとおり、Roborockの200件は32日間、iRobotの200件は99日間にわたります。週ごとの比較をするなら、タグ付けの前にposted_atで同じ週を切り出してください。
同期モードでは、Google Playのページネーションは200件までです。それ以上取得するには、非同期モードを使ってください。上限はカタログのpaginationフィールドで確認できます。
自社アプリの場合、GoogleのReply to Reviews APIが返すのは直近1週間のレビューだけです。1ページあたり最大100件で、GETリクエストは1時間あたり200回までです。それより古いレビューは、Play ConsoleのCSVダウンロードから取得します。競合のアプリについては、Google APIでは何も取得できません。
レビューは本物か。米国FTCの偽レビューに関する最終規則(2024年8月)は、AIが生成した偽レビューを禁止しています。タグからわかるのはレビューに何が書かれているかであり、そのレビューが本物かどうかではありません。まずは、星5つや星1つのレビューが不自然に集中していないかを確認してください。
構造化出力は推論の質に影響する可能性があります。論文「Let Me Speak Freely?」(2024年)は、JSONなどの厳格な形式によって推論性能が下がる場合があることを示しました。「JSONSchemaBench」(2025年)は、OpenAIの方式を含む6つの制約付きデコーディング手法を10,000件の実際のスキーマで検証し、手法間に大きな差があることを確認しました。どちらも検証対象は旧世代のモデルです。それでも、本記事で採用した方針の1つを裏付けています。action_itemをスキーマの後方に置くことです。あるタググループのスコアが低い場合は、まず自由形式で回答させ、その後、安価なモデルでJSONに変換してみてください。
精度はモデルではなく人が確認してください。今回はOpenAIでバッチを実行していないため、精度の数値はありません。推奨する手順は次のとおりです。まず、パイロットの20件のレビューに、本番実行から無作為に選んだ50件を加えます。次に、製品に詳しい人に、各タグを本文と照らし合わせて確認してもらい、カテゴリごとに誤りを数えます。最後に、新しいプロンプトが必要なカテゴリと、別のモデルでの再実行が必要なカテゴリを判断します。
キーワードに一致した上記17件にも、同じ方法を使いました。データアノテーション向けLLMのサーベイには、モデルが作成したアノテーションの評価方法を扱う節があります。人によるレビューはその方法の1つです。人がラベル付けした既存のデータセットとの比較も、別の方法として挙げられています。
本サイトの他のレビュー記事との違い
Claude CodeでDeepSeek V4を使ってコメントをクリーニングするでは、動画コメント695件を対話型セッションでクリーニングします。そのコストはキャッシュヒットに左右されます。ClaudeでデータAPIへのツール入力を厳格化するでは、ツールへの入力を厳格にします。Qwen Agentでレビュー分析エージェントを作るでは、1つのエージェントが価格を比較し、レビューを読みます。本記事で厳格にするのは出力形式です。ジョブは1回のオフラインバッチで、コストを左右するのはリクエストの構成です。
ChatGPT内でレポートを作成する方法は、GPT-6のIntelligent UIでソーシャルデータのレポートを作成するを参照してください。
直近60日間の変更点
2026-09-29:GPT-6.1 SolがAPIで利用可能に(変更履歴)。大規模な構造化ジョブで、最上位モデルに近いモデルをAstraの5分の1の価格で使えるようになりました。ただし、推論をオフにすることはできません。
2026-10-06:Decisions APIがベータ版として公開されました。その後、2026-10-22に一般提供が始まりました(Decisionsガイド)。単一選択タグでは、JSONを使わずに信頼度付きの結果を得られるようになりました。Lunaでのみ利用できます。
2026-10-20:12時間のプロンプトキャッシュがAPIで利用可能になりました。書き込みは入力価格の2.5倍です(プロンプトキャッシュのガイド)。1日に数回実行し、プロンプトが1,024トークンを超えるジョブで効果があります。短いプレフィックスでは効果がありません。
2026-10-21:組織とプロジェクトでサービスティアを制限可能に。プラットフォームの設定から行えます(変更履歴)。実務への影響:管理者はデフォルトのティアだけを許可できます。その場合、Flexなどデフォルト以外のティアへのリクエストは、サービスティアのエラーで失敗します。バッチが失敗してからではなく、実行前にプロジェクト設定を確認してください。
2026-10-26:GPT-6.1 Terraが登場。標準価格はSolの半分で、推論レベルnoneに対応しています(Terraのモデルページ)。実務への影響:SolとLunaの中間にあたり、推論をオフにできる選択肢ができました。多くのタグ付けジョブでは、まずTerraを試すとよいでしょう。
2026-10-28:ChatGPTの契約者がAPIクレジットを受け取れるように。対象となるProおよびBusinessの契約者は、毎月最大$500を受け取れます(クレジットのガイド)。パイロット実行には十分な額です。未使用のクレジットは毎月失効します。
GPT-6.1 Solと構造化出力のよくある質問
GPT-6.1 Sol APIの料金はいくらですか?
料金表の全体は、この記事の最初のセクションに掲載しています。要点をまとめると、OpenAIの料金ページでは、標準料金で入力が1Mトークンあたり$2、出力が1Mトークンあたり$10です。BatchとFlexはその半額です。Fastモードは標準料金の2倍、Ultrafastは6倍ですが、バッチでのタグ付けにはどちらも必要ありません。推論トークンは出力として課金されます。(質問の出典:Googleのオートコンプリート、2026-11-06。)
GPT-6.1 SolのAPIでのモデル名は何で、どう呼び出せばよいですか?
モデル名はgpt-6.1-solです。Responses APIのリクエストで、modelフィールドに指定します(モデルページ)。Chat Completionsでも使えますが、ツール呼び出しには対応していません。
ツールを使う場合、移行ガイドではResponses APIを推奨しています。推論はreasoning.effortで設定します。最も低い値はlowです。(質問の出典:Googleのオートコンプリート、「gpt 6.1 sol api name」)
GPT-6.1のStructured Outputsの例はどう書けばよいですか?
最も短い書き方は、Responses APIのリクエストにtext: {format: {type: "json_schema", name: "...", strict: true, schema: {...}}}を追加する方法です。スキーマ内のすべてのオブジェクトにadditionalProperties: falseが必要で、すべてのフィールドをrequiredに含める必要があります。Pythonでは、SDKのresponses.parseにPydanticモデルを渡すこともできます。その場合、スキーマはSDKが生成します(openai-python helpers、PydanticのJSON Schemaドキュメント)。本記事の9フィールドのスキーマをコピーして、変更して使えます。(質問の出典:Googleのオートコンプリート、「gpt 6.1 structured outputs example」)
OpenAIのBatch APIとStructured Outputsは併用できますか?
できます。Structured Outputsガイドによると、Structured OutputsとJSONモードはどちらもBatch APIで使えます。Batchの各行のbodyは同期リクエストと同じなので、text.formatはそのままで構いません。
注意点は3つです。まず、1つのファイルで使えるモデルは1つだけです。次に、JSONが途中で切れないよう、max_output_tokensを十分に大きく設定します。最後に、結果は行の順序ではなくcustom_idで照合します。(質問の出典:Googleのオートコンプリート、「openai batch api structured output」)
max effortのGPT-6.1 Solが、GPT-5.6 Solよりはるかに遅いのはなぜですか?
この質問はOpenAI開発者コミュニティのスレッドから取り上げました。同じプロンプトで、maxに設定したGPT-6.1 Solは1,846秒で約62,708出力トークン(うち推論52,552)を生成しました。GPT-5.6 Solは373秒で約31,426トークンでした。タグ付けではmaxを使わないでください。lowで十分です。推論トークンが2倍になれば、出力料金も2倍になります。
始め方
- EveryInfraのクイックスタートでAPIキーを作成します。無料の機能カタログを確認します。
google_play/reviews、tiktok/comments、amazon/reviewsの料金とレスポンスフィールドを確認します。 - 最初に、各ソースから1ページずつ取得します。Google PlayレビューAPIとTikTokコメントAPIのプレイグラウンドで試し、1回の呼び出しで何件返るかを確認します。そのうえで、レビュー1,000件あたりの予算を計算します。処理に時間がかかる機能には
"mode":"async"を追加します。 - 本記事の9フィールドのスキーマを、自社のカテゴリに合わせて変更します。Structured Outputsガイドにあるstrictモードのルールを満たしているか、スクリプトで確認します。
- OpenAIで、20件のレビューを使った同期のパイロットを実行します。
usageで入力、出力、推論のトークン数を読み、コスト表を更新します。そのうえで、Sol、Terra、Lunaのいずれかを選びます。 - 1リクエストあたり25件のレビューでJSONLファイルを作成し、Batch APIを使います。結果が返ってきたら、整合性チェックを実行します。
evidenceを元のテキストと照らし合わせて抜き取り確認します。 - コードを書かずにClaude、Cursor、ChatGPTでその都度レビューを調べるには、EveryInfraのリモートMCPサーバーに接続します。各プラットフォームの概要は、Google PlayデータAPI、TikTokデータAPI、AmazonデータAPIを参照してください。AmazonのレビューについてはAmazonレビューAPIを、料金については料金ページを参照してください。
参考文献
- 「GPT-6.1 Sol Model」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「Introducing GPT-6.1 Sol」、OpenAI、2026-09-29
- 「API Changelog」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「Pricing」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「Structured model outputs」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「Batch API」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「Prompt caching」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「Using GPT-6 (latest model guide)」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「Reasoning models」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「Decisions」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「GPT-6.1 Terra Model」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「GPT-6 Luna Model」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「Rate limits」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「Flex processing」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「Function calling」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「Batch API reference」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「Files API reference」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「Ultrafast mode」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「Error codes」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「Your data」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「API credits for ChatGPT subscribers」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「Migrate to the Responses API」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「Prompt cache diagnostics」、OpenAI開発者ドキュメント、2026-11-06閲覧
- 「GPT-6.1 Sol system card addendum」、OpenAI Deployment Safety Hub、2026-09-29
- 「Introducing GPT-6.1 Terra」、OpenAI、2026-10-26
- 「Batch API FAQ」、OpenAIヘルプセンター、2026-11-06閲覧
- 「tiktoken」、OpenAI、GitHub
- 「openai-python helpers」、OpenAI、GitHub
- 「tiktoken 0.14.0」、PyPI
- 「jsonschema」、PyPI
- 「JSON Schema (Pydantic docs)」、Pydantic
- 「JSON Schema Draft 2020-12」、JSON Schema
- 「RFC 8259: The JSON Data Interchange Format」、IETF、2017-12
- 「Reply to Reviews」、Google Play Developer API、2026-11-06閲覧
- 「Download and export monthly reports」、Play Consoleヘルプ、2026-11-06閲覧
- 「Why is there a 500 character limit on Google Play reviews?」、Google Playヘルプコミュニティ、2022-07-31
- 「Query Video Comments」、TikTok for Developers、2026-11-06閲覧
- 「FTC Announces Final Rule Banning Fake Reviews and Testimonials」、米国連邦取引委員会、2024-08-14
- 「ChatGPT Outperforms Crowd-Workers for Text-Annotation Tasks」、Gilardiほか、arXiv、2023-03-27
- 「Let Me Speak Freely? A Study on the Impact of Format Restrictions on Performance of Large Language Models」、Tamほか、arXiv、2024-08-05
- 「JSONSchemaBench: A Rigorous Benchmark of Structured Outputs for Language Models」、Gengほか、arXiv、2025-01-18
- 「Large Language Models for Data Annotation and Synthesis: A Survey」、Tanほか、arXiv、2024-02-21
- 「Why is GPT-6.1 Sol MAX dramatically slower than GPT-5.6 Sol MAX using the same prompt?」、OpenAI開発者コミュニティ、2026-11-06閲覧
- 「EveryInfra機能カタログ」、EveryInfra、2026-11-06 00:15 SGT閲覧
- 「Roborock(Google Playのアプリページ)」、Google Play、2026-11-06閲覧
- 「iRobot Home(Google Playのアプリページ)」、Google Play、2026-11-06閲覧
- 「Model Context Protocol Specification」、MCP、2025-06-18
- 「json — JSON encoder and decoder」、Pythonドキュメント
- 「JSON Lines」、jsonlines.org
- 「Introduction to Structured Outputs (Cookbook)」、OpenAI Cookbook
参考資料 BL-95