Структурированные выходные данные API GPT-6.1 Sol: оценка стоимости разметки отзывов
Разметка отзывов с помощью строгого JSON в GPT-6.1 Sol и Batch API. Данные: 412 реальных отзывов. Стоимость модели оценена по публичным ценам: около $0.81 за 1 000.
По нашей оценке, GPT-6.1 Sol может разметить 1 000 отзывов меньше чем за один доллар. Расчёт предполагает строгий вывод по JSON Schema, Batch API и около 50 токенов рассуждения на отзыв. Мы не запускали модель, поэтому это оценка. Дорого обходятся не данные. Дорого обходится то, как вы упаковываете запросы. 2026-11-06 с 00:16 до 00:25 по сингапурскому времени (SGT) мы сделали 7 реальных вызовов API данных EveryInfra.
Мы получили 400 отзывов из Google Play о двух приложениях для роботов-пылесосов, Roborock и iRobot, а также 12 комментариев TikTok под одним видеообзором. Всего мы заплатили $0.003334. Исходя из фактического числа записей на вызов, стоимость данных за 1 000 отзывов составляет $0.006945 для Google Play и $0.046704 для TikTok.
На этой машине у нас нет ключа OpenAI. Поэтому часть статьи про модель состоит из примера конфигурации и оценки. Токены мы подсчитываем с помощью общедоступной кодировки o200k_base и используем публичные цены по состоянию на 2026-11-06. Главный вывод простой.
Если отправлять по 1 отзыву в запросе, системный промпт вместе со схемой занимает 967 токенов. Это 92% всех входных токенов, и это меньше минимума в 1 024 токена для кеширования промптов. В итоге вы 1 000 раз платите полную цену за одни и те же инструкции.
Теперь отправим по 25 отзывов в запросе и примем 50 токенов рассуждения на отзыв. Тогда стоимость модели в Batch для 1 000 отзывов снизится примерно с $1.74 до примерно $0.81. Без токенов рассуждения нижняя граница снизилась бы с $1.49 до $0.56. Но у Sol нельзя выставить уровень усилий ниже low, поэтому до этой границы не дойти.
Статья отвечает на один узкий вопрос. У вас есть набор отзывов. Вы хотите, чтобы GPT-6.1 Sol добавила к каждому четыре тега: тональность, категорию проблемы, упоминание конкурента и одно рекомендуемое действие. Каждый тег должен сразу попадать в таблицу, и вы хотите знать полную стоимость. Отзывы берутся из API данных EveryInfra.
Для разметки используются Responses API и Batch API от OpenAI. Все приведённые ниже показатели EveryInfra взяты из сырых ответов, и их можно пересчитать. Каждый шаг на стороне OpenAI помечен как пример конфигурации или оценка цены. Это пакетное задание мы не запускали через OpenAI.
В таблице показано, что мы измерили, а что оценили. Каждое число ниже соответствует одной из этих строк.
| Шаг | Как получено | Можно пересчитать? |
|---|---|---|
| Данные отзывов (EveryInfra) | 7 реальных вызовов 2026-11-06, сырые ответы сохранены | Да, каждое число взято из ответа |
| Число токенов | Подсчёт токенов с помощью o200k_base для фактического системного промпта, схемы и 412 отзывов | Да, но токенизатор Sol не общедоступен |
| Теги на выходе | 12 примеров тегов, написанных человеком, а не сгенерированных GPT-6.1 Sol | Только для оценки длины вывода |
| Токены рассуждения | Не измерялись; предполагаем 0, 50 или 200 на отзыв | Нет, нужен пилотный запуск и его usage |
| Стоимость модели | Расчёт по публичным ценам на 2026-11-06 и показателям из строк выше | Да, если подставить свои данные |
| Точность разметки | Нет | Проверить вручную после пилотного запуска |
Что такое API GPT-6.1 Sol: дата выхода, контекст и цена
Сначала факты о модели. В истории изменений API OpenAI есть запись от 2026-09-29. В ней сказано, что OpenAI выпустила GPT-6.1 Sol (gpt-6.1-sol) для сложных задач программирования и профессиональной работы. Цена ниже, чем у GPT-6 Astra.
При объёме входных данных до 272K токенов стандартные цены за 1 млн токенов составляют: вход — $2, кешированный вход — $0.10, запись в кеш — $2.50, выход — $10. В той же записи указано, что для вызова инструментов необходимо использовать Responses API. В анонсе «Introducing GPT-6.1 Sol» говорится, что по возможностям Sol близка к GPT-6 Astra. Там же сказано, что стандартные цены на вход и выход составляют одну пятую от цен Astra.
На странице модели GPT-6.1 Sol, которую мы изучили 2026-11-06, приведены характеристики, важные для разметки. Контекстное окно — 1 050 000 токенов. Максимальный объём выходных данных — 128 000 токенов. Дата среза знаний — 2026-04-30. Значения reasoning.effort: low, medium (по умолчанию), high, xhigh и max. В списке возможностей для Structured outputs и Function calling указано «Supported».
На странице модели есть ещё четыре ценовых правила для пакетной обработки. Кешированный вход стоит 5% от цены входа. Запись в кеш стоит в 1,25 раза дороже. Если вход больше 272K токенов, весь запрос тарифицируется в 2 раза дороже на входе и в 1,5 раза дороже на выходе. Batch и Flex дешевле на 50%.
| Пункт | Что говорит источник | Источник (дата обращения: 2026-11-06) | Что это значит для разметки |
|---|---|---|---|
| Выход в API | Модель gpt-6.1-sol выпущена 2026-09-29 | История изменений API | На момент написания статьи модели 38 дней |
| Контекст и вывод | Контекстное окно — 1 050 000 токенов, максимальный объём вывода — 128 000 токенов | Страница модели | В один запрос с запасом помещаются десятки отзывов |
| Уровень рассуждения | low, medium, high, xhigh, max, без none | Страница модели, руководство по GPT-6 | При каждом запросе генерируются токены рассуждения, которые оплачиваются как выходные токены |
| Стандартная цена | За 1 млн токенов: вход — $2, кешированный вход — $0.10, выход — $10 | Страница цен, история изменений | Минимум около $2.99 за 1 000 отзывов, синхронно |
| Цена Batch | За 1 млн токенов: вход — $1, кешированный вход — $0.05, выход — $5 | Страница тарифов | Те же запросы за полцены |
| Надбавка за длинный вход | При входе свыше 272K токенов: вход × 2, выход × 1,5 | Страница модели | Не отправляйте слишком много отзывов в одном запросе |
| Chat Completions | Поддерживается, но без вызова инструментов | Страница модели, руководство по GPT-6 | В этой статье используется только Responses API |
Чаще всего упускают строку про уровень рассуждения. В руководстве по GPT-6 об этом сказано прямо. GPT-6 Astra и GPT-6.1 Sol не поддерживают none. Если в старых запросах используется minimal, замените его на low и сравните результаты. GPT-6.1 Terra, GPT-6 Sol и GPT-6 Luna none поддерживают. В руководстве по рассуждению сказано, что токены рассуждения считаются выходными токенами.
Для тегирования это важно. При обработке каждого отзыва добавляются скрытые выходные токены по цене $10 за 1 млн токенов, или $5 в Batch. Без реального вызова их количество измерить нельзя. Поэтому в таблице стоимости объём рассуждений указан как отдельное допущение.
Ниже приведена полная строка для Batch. На странице тарифов Flex и Batch относятся к одной тарифной группе. Для gpt-6.1-sol в режиме Batch цена за 1 млн токенов составляет $1 за ввод, $5 за вывод и $0.05 за кешированный ввод. Запись в кеш на 30 минут стоит $1.25, на 12 часов — $2.50. Все таблицы расходов ниже рассчитаны по тарифам этой группы.
Structured Outputs в GPT-6.1: ограничения строгого режима json_schema
В руководстве OpenAI по Structured Outputs главное обещание сформулировано в самом начале: вывод модели всегда соответствует переданной вами JSON Schema. Модель не пропускает обязательные ключи и не выдумывает значения enum. В Responses API для этого text.format задаётся как {"type":"json_schema","strict":true,"schema":…}. В руководстве также сказано, что строгий режим поддерживает лишь подмножество JSON Schema. Если в схеме есть ключевое слово вне этого подмножества, запрос с strict: true завершается ошибкой.
После окончательной настройки схема тегирования используется тысячи раз. Поэтому мы выписали из руководства все правила, которые можно посчитать или проверить, и написали небольшой скрипт, проверяющий схему на соответствие этим правилам. На память мы не полагались.
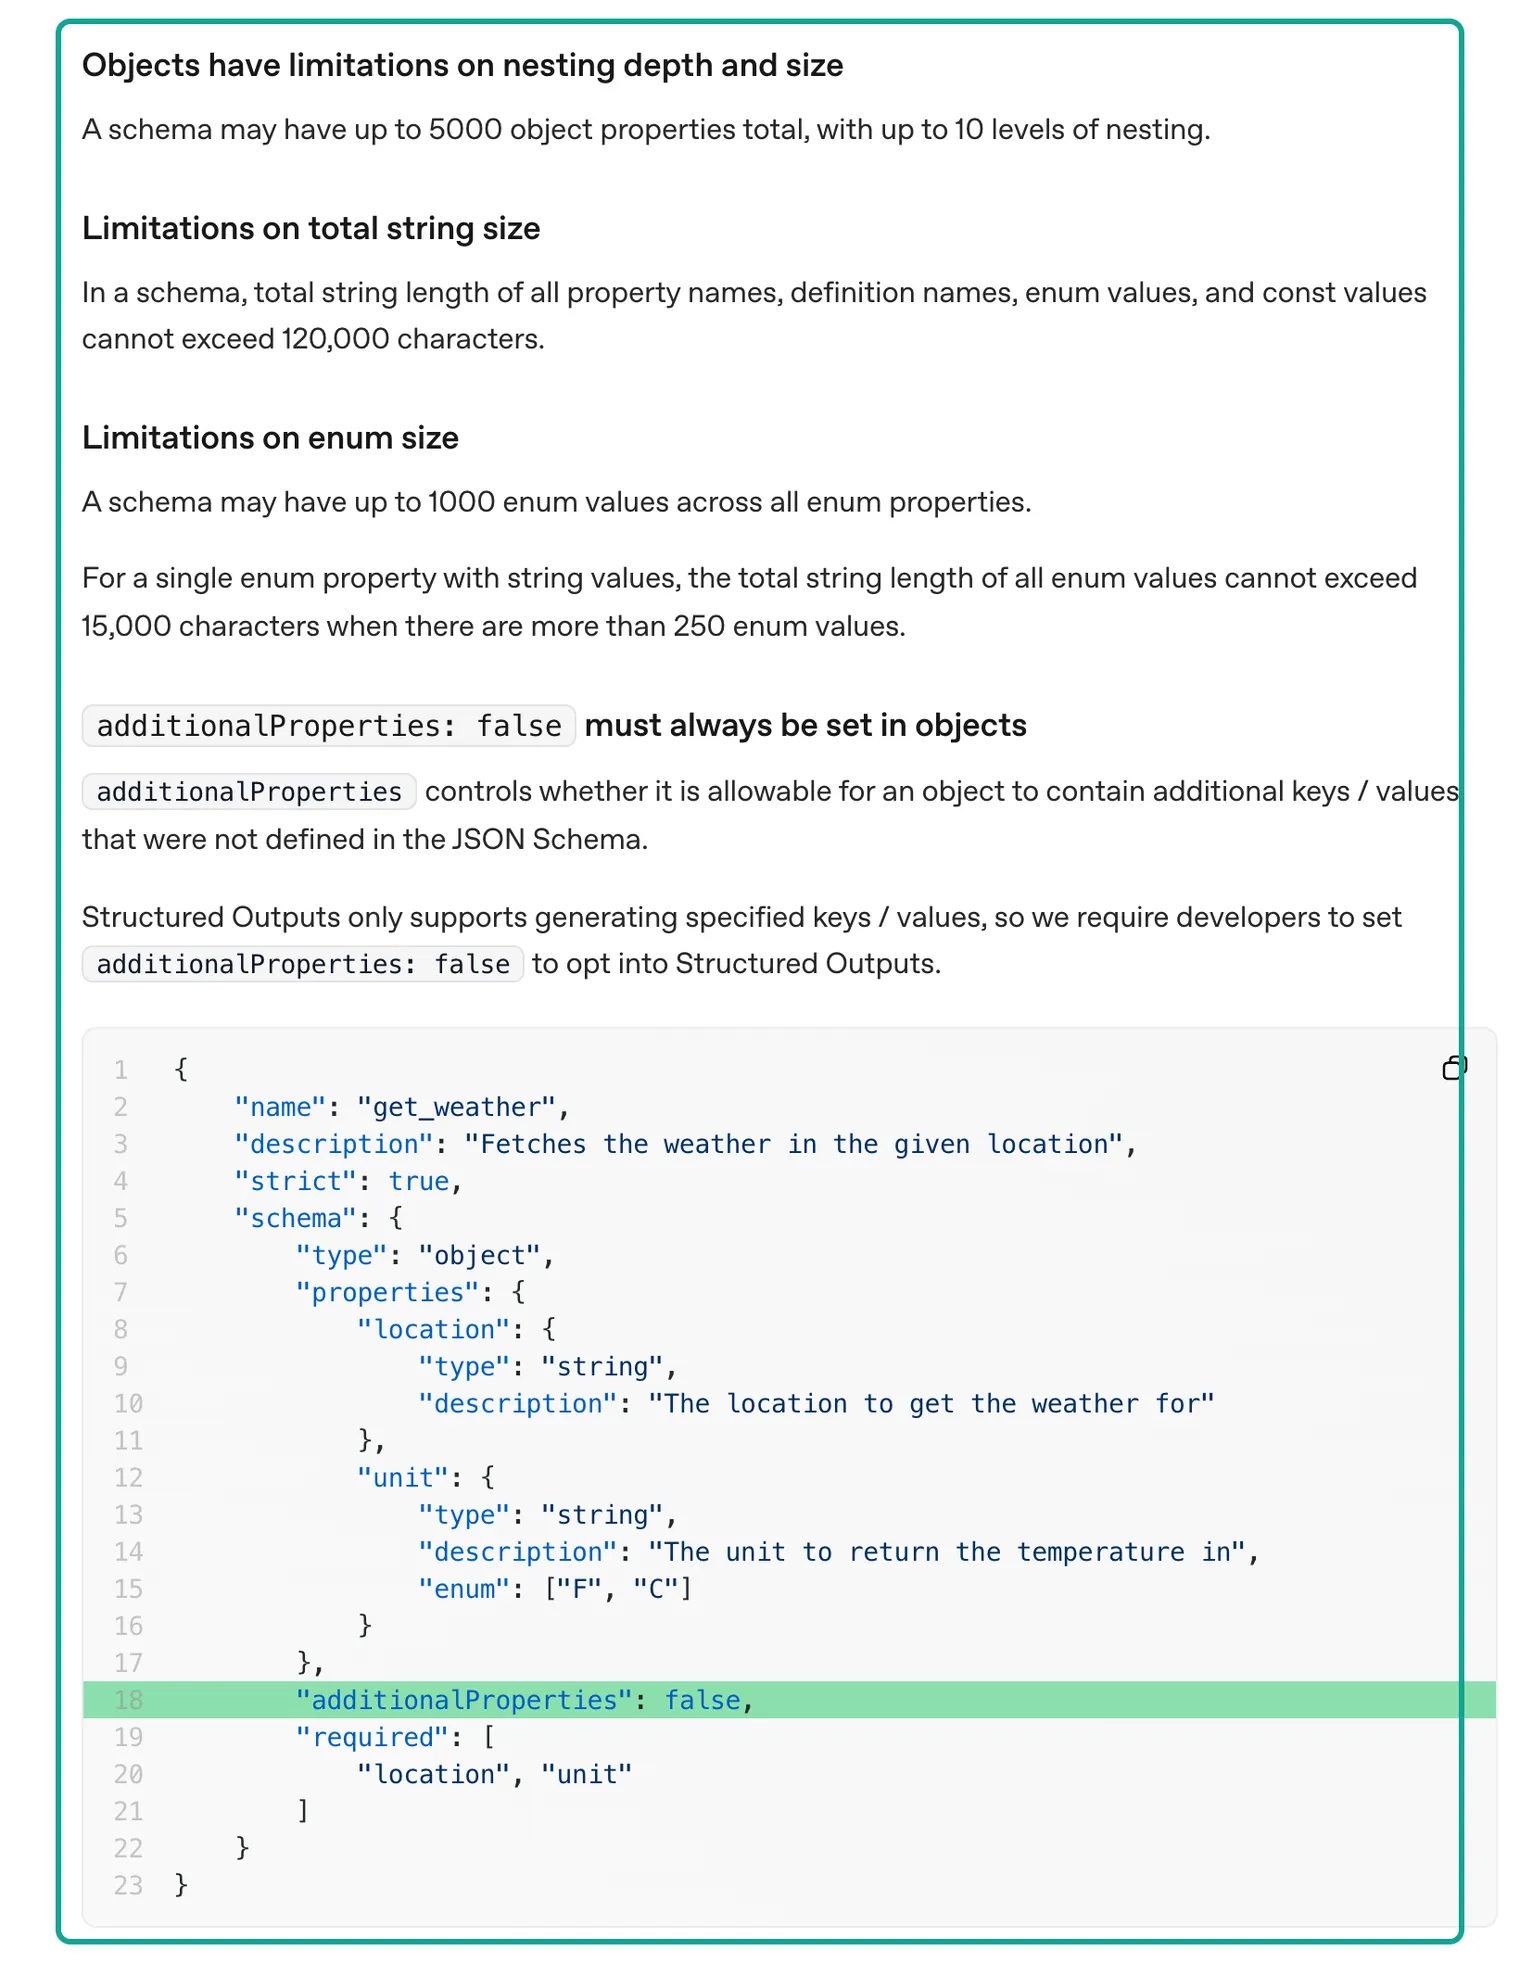
Четыре пункта в бирюзовой рамке — это ограничения на размер. За пределами рамки в руководстве есть и другие жёсткие правила составления схемы:
- Корень должен быть объектом. Использовать в корне
anyOfнельзя. - Каждое поле каждого объекта должно быть указано в
required. Чтобы сделать поле необязательным, задайте ему тип вроде["string","null"]. - Согласно руководству,
allOf,not,dependentRequired,dependentSchemas,if,thenиelseне поддерживаются. - Для строк в руководстве перечислены только
patternиformat. Ключевое словоformatпринимает девять значений:date-time,time,date,duration,email,hostname,ipv4,ipv6иuuid. - Для массивов поддерживаются
minItemsиmaxItems.$defsи рекурсивные ссылки тоже поддерживаются.
В руководстве также сказано, что первый запрос с новой схемой обрабатывается с дополнительной задержкой. Для последующих запросов с той же схемой её нет.
| Правило (раздел руководства) | Лимит или требование | Наша схема тегов | Тестовая схема с ошибками |
|---|---|---|---|
| Всего свойств объектов (Objects have limitations…) | ≤ 5000 | 9 | 8 |
| Глубина вложенности | ≤ 10 | 1 уровень | 1 уровень |
| Всего значений enum (Limitations on enum size) | ≤ 1000 | 31 | 31 |
| Количество символов в именах и значениях enum (Limitations on total string size) | ≤ 120,000 | 416 | 408 |
additionalProperties: false | Обязательно для каждого объекта | Да | В корне задано true, нарушение выявлено |
Все поля в required | Обязательное | 9 из 9 | В required указано несуществующее поле |
| Неподдерживаемые ключевые слова | allOf, if, then и другие | 0 | 3 |
| Ключевые слова не из списка поддерживаемых | Только предупреждение | 0 | minLength, 1 |
Для нашей схемы на один отзыв и для схемы на 25 отзывов скрипт сообщает 0 проблем и 0 предупреждений. Для схемы с ошибками — 5 проблем и 1 предупреждение. Эта схема не случайна. Она основана на логичном требовании: «Если mentions_competitor равно true, в competitors должен быть хотя бы один элемент». В JSON Schema такое правило записывается через allOf и if/then.
Строгий режим этого не поддерживает. Схема не может контролировать соблюдение такого правила, связывающего два поля. Его нужно проверять в коде после получения результатов. Как это сделать, показано ниже в разделе «Что схема не может гарантировать».
Отдельно о minLength. В руководстве minLength и maxLength названы неподдерживаемыми только для дообученных моделей, но в списке поддерживаемых строковых ключевых слов есть лишь pattern и format. Поэтому наш скрипт выдаёт предупреждение, а в нашей схеме это ключевое слово не используется. Ограничение в 20 слов для действий мы указываем в description и в промпте, а затем проверяем в коде.
Ниже наша схема тегов для одного отзыва. В ней девять полей, и все они обязательны. other_brand_name и action_item могут быть null.
{
  "name": "review_label",
  "strict": true,
  "schema": {
    "type": "object",
    "properties": {
      "item_id": {"type": "string", "description": "Copy the item_id of the input item."},
      "sentiment": {"type": "string", "enum": ["positive", "negative", "mixed", "neutral"]},
      "issue_categories": {"type": "array", "minItems": 1, "maxItems": 3,
        "items": {"type": "string", "enum": ["app_connectivity", "account_login", "mapping_navigation",
          "suction_cleaning", "mopping", "dock_self_empty", "battery_charging", "hardware_defect",
          "firmware_update", "customer_service_warranty", "price_value", "noise", "app_usability", "other", "none"]}},
      "mentions_competitor": {"type": "boolean"},
      "competitors": {"type": "array", "maxItems": 5,
        "items": {"type": "string", "enum": ["roborock", "irobot_roomba", "ecovacs_deebot", "dreame", "eufy",
          "shark", "narwal", "mova", "dyson", "samsung", "xiaomi", "other_brand"]}},
      "other_brand_name": {"type": ["string", "null"]},
      "action_item": {"type": ["string", "null"], "description": "One concrete action, 20 words or fewer, or null."},
      "evidence": {"type": "string", "description": "Up to 15 words copied from the text."},
      "language": {"type": "string", "description": "ISO 639-1 code."}
    },
    "required": ["item_id", "sentiment", "issue_categories", "mentions_competitor", "competitors",
                 "other_brand_name", "action_item", "evidence", "language"],
    "additionalProperties": false
  }
}
В версии на 25 отзывов добавлен один внешний уровень. У корневого объекта одно поле — массив labels. Каждый элемент массива через $ref ссылается на тот же объект тегов в $defs. Согласно руководству, $defs и $ref поддерживаются. Глубина вложенности растёт с 1 до 2 уровней, что намного ниже лимита в 10.
Порядок полей тоже важен. Согласно руководству, вывод следует порядку ключей в схеме. Поэтому item_id идёт первым. action_item и evidence мы поставили ближе к концу: чтобы их заполнить, модель должна прочитать отзыв целиком. Если вывод будет обрезан, ID и тональность всё равно останутся в начале.
Как спроектировать теги: четыре вопроса, девять полей
Прежде чем проектировать теги, решите, кто будет ими пользоваться. Команду, отвечающую за приложение бренда роботов-пылесосов, волнуют сбои Wi-Fi, ошибки входа в аккаунт и исчезновение карт. Служба поддержки отслеживает жалобы на гарантийное обслуживание. Продуктовая команда хочет знать, с какими другими брендами пользователи проводят сравнения.
Поэтому при разработке тегов мы исходили из четырёх вопросов. Какова тональность? К какому типу относится проблема? Упоминается ли другой бренд?
Можно ли превратить отзыв в одно конкретное улучшение? Категория проблемы — фиксированный enum из 15 значений. Конкурент — enum из 12 значений с запасным вариантом other_brand.
Больше всего времени ушло на категорию проблемы. Сначала мы прочитали 412 отзывов, полученных в ходе фактических вызовов API. Жалобы из этих отзывов мы распределили по 13 группам, а затем добавили other и none. Например, во многих отзывах об iRobot с низкой оценкой пишут «команды не проходят» или «не удаётся подключиться к облаку iRobot».
Такие отзывы попадают в app_connectivity. «Не приходит код подтверждения» и «не удалось привязать аккаунт» относятся к account_login. Во многих отзывах о Roborock пишут «после обновления сломалась карта». Это относится и к firmware_update, и к mapping_navigation. Поэтому у одного отзыва может быть до 3 категорий.
В системном промпте для каждой категории есть одна строка с пояснением. Эта часть занимает больше половины промпта. Именно из-за неё фиксированный префикс в подсчёте токенов ниже составляет 645 токенов.
У тональности четыре значения: positive, negative, mixed и neutral. В системном промпте сказано: «Не определяйте тональность только по количеству звёзд». Звёзды и текст часто расходятся. Среди отзывов о Roborock есть отзыв на 1 звезду, который начинается со слов «App is very good». Лишь дальше в нём говорится, что с картой есть проблема. Один отзыв на 3 звезды в первой половине хвалит приложение.
Во второй половине говорится, что нижние кнопки не работают на складном смартфоне Samsung. Системный промпт помечает такие отзывы как mixed. У комментариев в TikTok нет звёзд. Вопрос вроде «Какой лучше?» получает neutral.
action_item проверить сложнее всего, поэтому ограничения для него самые жёсткие: одно предложение на английском длиной не более 20 слов или null. В evidence должно быть дословно скопировано до 15 слов из отзыва на языке оригинала. Благодаря этим двум полям человек может проверить тег за несколько секунд, не читая отзыв целиком.
Для 12 реальных отзывов мы вручную написали примеры вывода по этой схеме. По ним мы оцениваем количество выходных токенов. Заодно они показывают, как выглядит каждое поле. В таблице приведены 4 из них.
Текст отзывов обрезан, данные авторов удалены. Эти 12 примеров написаны людьми, а не сгенерированы GPT-6.1 Sol.
| Источник | Звёзды | Фрагмент отзыва | Тональность | Категории проблем | Конкуренты |
|---|---|---|---|---|---|
| Приложение Roborock | 2 | «You ruined my robot after your last update! The map is all messed up…» | negative | firmware_update, mapping_navigation | none |
| Приложение Roborock | 3 | «…it doesn't support the Samsung Z Fold 8's screen aspect ratio…» | mixed | app_usability | none (здесь Samsung — марка телефона) |
| Приложение iRobot | 1 | «every 2nd vacuum I have a connection issue. I will never buy another Roomba» | negative | app_connectivity | none |
| Комментарий в TikTok | n/a | «How about the Dreame X60 Pro Ultra?…» | neutral | none | dreame |
Сбор отзывов через EveryInfra: один реальный запрос и ответ
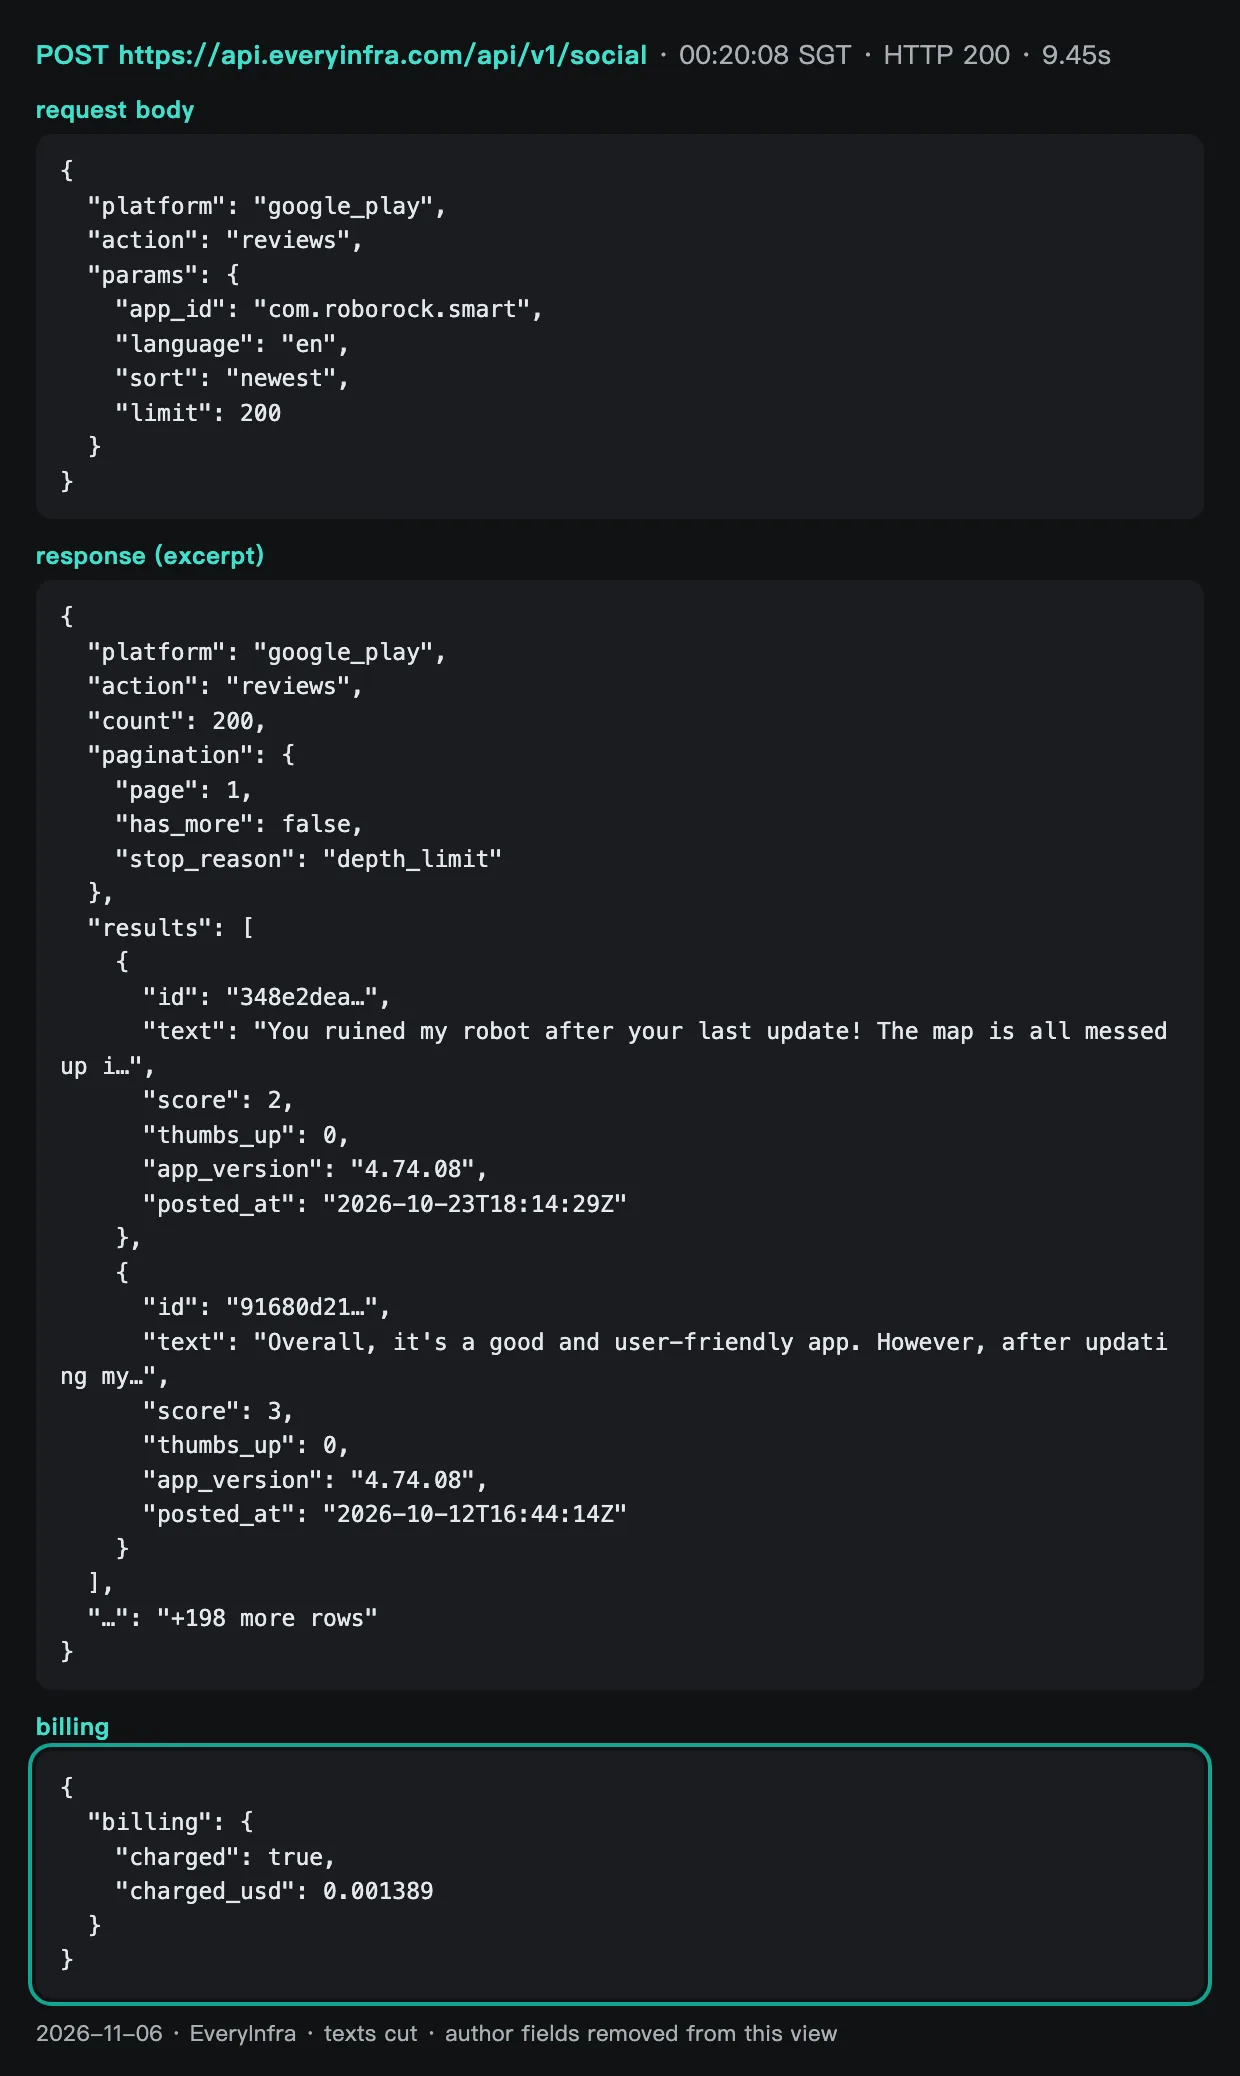
Для получения отзывов мы использовали эндпоинт данных EveryInfra POST /api/v1/social. В теле запроса указываются платформа, действие и параметры. Перед первым вызовом, в 00:15 SGT 2026-11-06, мы изучили бесплатный каталог возможностей. Для каждой возможности получения отзывов мы проверили цену, параметры и поля ответа:
google_play/reviewsстоит $0.001389 за вызов. Синхронный вызов возвращает до 200 записей. Поддерживаются параметрыlanguageиsort.tiktok/commentsстоит $0.000556 за вызов. На вход принимает URL видео.amazon/reviewsстоит $0.001389 за вызов. Согласно каталогу, каждый сайт Amazon показывает на странице товара только избранные отзывы, обычно около десятка на товар.trustpilot/reviewsстоит $0.001389 за вызов.
Полный запрос к Google Play:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"google_play","action":"reviews",
       "params":{"app_id":"com.roborock.smart","language":"en","sort":"newest","limit":200}}'
Мы отправили этот запрос в 00:20:08 SGT 2026-11-06. Ответ HTTP 200 пришёл через 9,45 секунды. Поле count содержало значение 200. Значение pagination.stop_reason было depth_limit, а has_more — false. Было списано $0.001389.
У каждого отзыва есть поля id, text, score, thumbs_up, reply_text, reply_at, app_version, posted_at и другие. Они совпадают со списком response_fields в каталоге. В ответе также есть поля с именем и аватаром автора. Для тегирования они не нужны, поэтому мы удалили их перед формированием запросов к модели.
Всего мы сделали 7 вызовов, с 00:16:42 до 00:24:27 SGT. Каждый из них приведён в таблице ниже. Синхронный вызов tiktok/comments занял 90,21 секунды и вернул HTTP 200 с 12 записями. Два синхронных вызова, к amazon/reviews и к trustpilot/reviews с limit 200, выполнялись более 85 секунд и завершились таймаутом с кодом 503 без списания. В сообщении об ошибке предлагалось использовать "mode":"async" или меньший limit. Два асинхронных задания amazon/reviews для двух товаров Roborock завершились успешно, но вернули 0 записей, а списанные средства были возвращены.
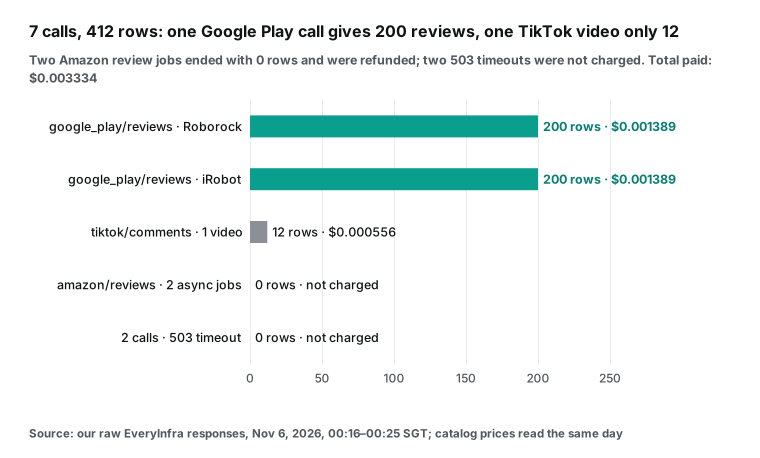
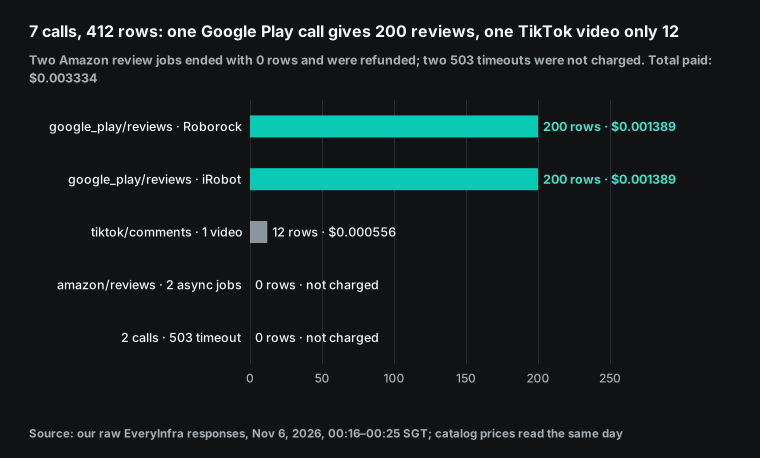
| Время (SGT) | Возможность | Результат | Время по нашим замерам | Записи | Списание |
|---|---|---|---|---|---|
| 00:16:42 | amazon/reviews синхронно | 503, тайм-аут | 89.91 s | 0 | $0 |
| 00:18:21 → 00:19:57 | amazon/reviews асинхронно | Успешно, 0 записей, средства возвращены | Отправка 2,08 с, готово примерно через 96 с | 0 | $0 (списано, затем возвращено) |
| 00:18:26 | tiktok/comments синхронно | 200 | 90.21 s | 12 | $0.000556 |
| 00:20:08 | google_play/reviews Roborock | 200 | 9.45 s | 200 | $0.001389 |
| 00:20:25 | google_play/reviews iRobot | 200 | 9.24 s | 200 | $0.001389 |
| 00:20:34 → 00:24:18 | amazon/reviews асинхронно | Успешно, 0 записей, средства возвращены | Отправка заняла 2,04 с, выполнение — около 224 с | 0 | $0 (списано, затем возвращено) |
| 00:24:27 | trustpilot/reviews синхронно | 503, тайм-аут | 88.2 s | 0 | $0 |
Один замер требует пояснения. Вызов tiktok/comments занял 90,21 секунды, дольше двух тайм-аутов с кодом 503 (89,91 с и 88,2 с), но вернул 200 и 12 записей. В обоих сообщениях об ошибке 503 сказано «request timed out after 85s». Значит, лимит ожидания на стороне сервера составляет 85 секунд. Наши замеры начинаются в момент отправки запроса и заканчиваются при получении полного ответа, поэтому включают сетевые задержки и время в очереди.
В ответе нет серверного времени выполнения, поэтому мы не можем сказать, сколько вызов TikTok длился на сервере. Можно лишь утверждать, что он приблизился к лимиту. Тот же запрос в другое время мог бы вернуть 503. Для пакетной выгрузки медленных возможностей, таких как комментарии TikTok, используйте асинхронный режим.
Эта таблица сама по себе — результат. Данные вернули только 3 из 7 вызовов. Но 4 вызова без данных ничего не стоили. В теле обоих ответов 503 указано charged_usd: 0. За два пустых асинхронных задания при отправке списали стоимость вызова, а после завершения заданий списанные суммы вернули.
В пакетной разметке неудачная выгрузка данных стоит времени, а не денег. Реальный риск в другом: не записывайте в отчёт «0 записей» как «негативных отзывов нет». Мы не стали разбираться с двумя пустыми заданиями Amazon. Почему, объясняется в разделе «Ограничения и на что обратить внимание».
Что представляют собой эти 412 отзывов
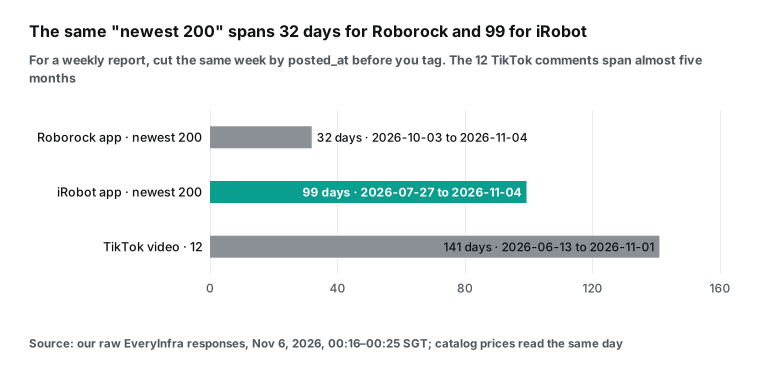
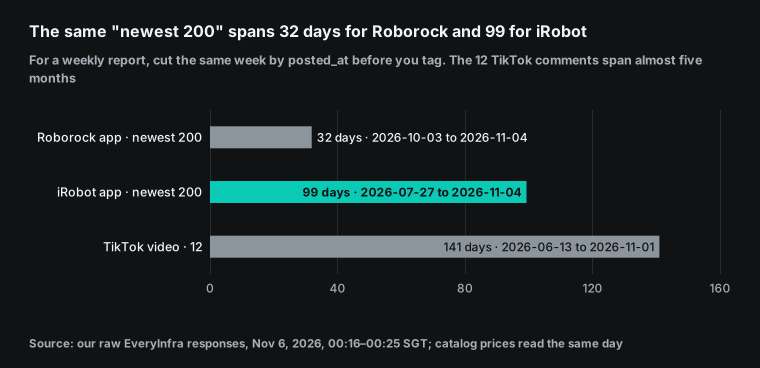
Прежде чем отправлять что-либо модели, посмотрите на данные. По каждому приложению мы получили 200 самых новых отзывов на английском. Количество отзывов одинаковое, но временной охват различается. 200 отзывов Roborock охватывают период с 2026-10-03 по 2026-11-04, то есть 32 дня.
200 отзывов iRobot охватывают период с 2026-07-27 по 2026-11-04, то есть 99 дней. За те же $0,001389 вызов для Roborock охватывает последний месяц, а вызов для iRobot — более трёх месяцев. Если строить еженедельный отчёт по «200 самым новым», данные iRobot перенесут июльские проблемы в текущую неделю.
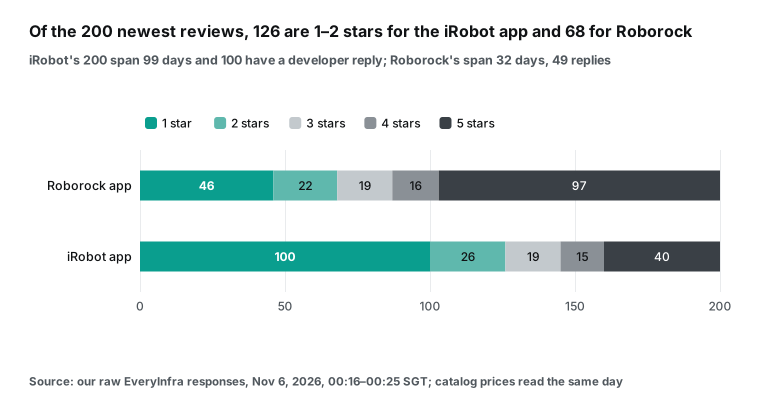
Оценки различаются ещё сильнее. В выборке iRobot 100 отзывов с 1 звездой и 26 с 2 звёздами. Это 126 отзывов, или 63%, с оценкой в 1 или 2 звезды. В выборке Roborock это 46 + 22 = 68 отзывов, или 34%.
Различаются и ответы разработчиков. В выборке iRobot reply_text есть у 100 отзывов из 200, а в выборке Roborock — у 49.
Эти цифры описывают только эти 200 отзывов, а не общую репутацию этих продуктов. Мы приводим их, потому что они влияют на результаты разметки. Большая часть выборки iRobot получит теги negative и app_connectivity.
Длина отзыва определяет количество токенов. Медианная длина отзыва в Google Play составляет 94,5 символа у Roborock и 128,5 символа у iRobot. Самый длинный отзыв в каждой выборке занимает ровно 500 символов. Это лимит Google Play на длину отзыва.
Пользователь Справочного сообщества Google Play спросил об этом лимите в 500 символов. У Roborock 35 отзывов короче 20 символов, у iRobot — 24. Например, «Great robovac great» и «iRobot is awful».
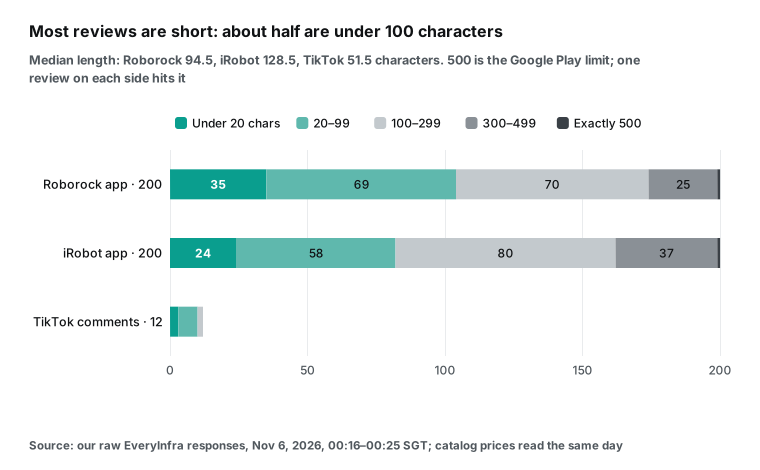
Медианная длина 12 комментариев TikTok составляет 51,5 символа, большинство из них — вопросы. Они охватывают период с 2026-06-13 по 2026-11-01, почти пять месяцев. Число комментариев под отдельным видео не растёт изо дня в день. Когда видео перестаёт быть популярным, новые комментарии оставляют немногие.
Поэтому один вызов вернул всего 12 записей. Вывод о коротких отзывах простой. Отзыв может занимать всего несколько десятков токенов. Если к каждому прилагается несколько сотен токенов инструкций, вы платите в основном за инструкции.
Ещё одно небольшое наблюдение. Мы запросили language: "en", но в выборке Roborock всё равно есть отзывы на китайском и словацком. В каталоге сказано, что language задаёт язык запроса, но не гарантирует язык каждого отзыва. Поэтому в схеме есть поле language, а evidence остаётся на языке оригинала.
«Упоминает конкурента»: на что способно правило по ключевым словам
Из четырёх тегов «упоминает конкурента» кажется самым подходящим для правила по ключевым словам. Использование такого правила не требует затрат на модель. Мы проверили его на 412 отзывах с помощью регулярного выражения с 29 названиями брендов роботов-пылесосов и бытовой техники.
Бренд самого приложения мы исключили. Правило сработало на 17 отзывах. Затем мы прочитали все 17, чтобы решить, действительно ли каждый из них упоминает другой бренд роботов-пылесосов.
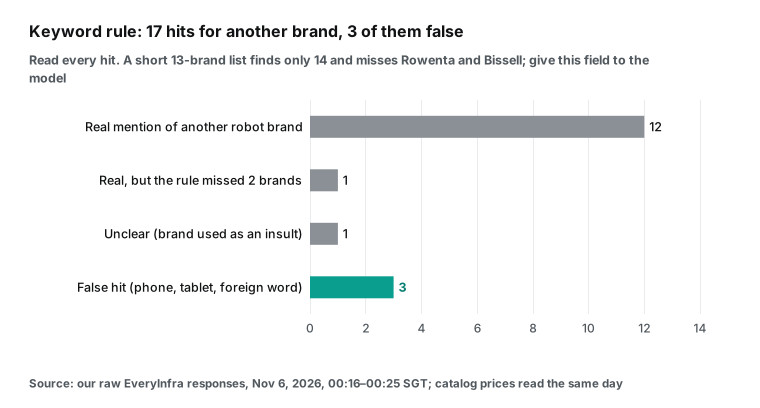
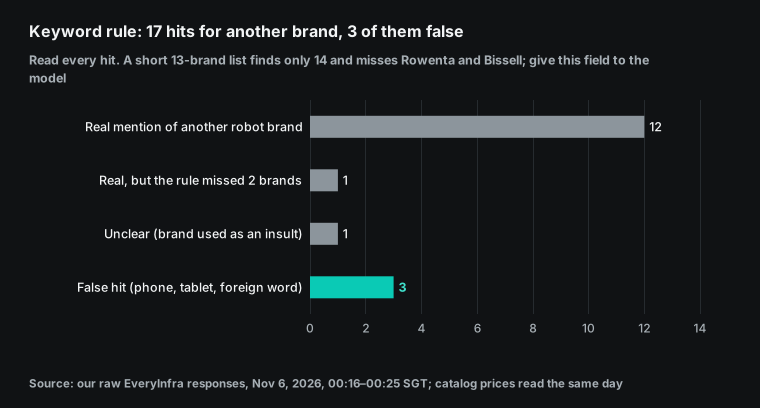
Верными оказались 13 из 17 совпадений. В приложении Roborock 5 отзывов сравнивают его с iRobot, Roomba, Shark или Bissell. Четыре из них получили 5 звёзд, например «a great upgrade from the iRobot». Пятый получил 1 звезду; в нём сказано, что пять лет назад Roomba был лучше.
В приложении iRobot 5 отзывов советуют вместо него купить Roborock, Shark, Rowenta или Ecovacs. Все 5 получили 1 или 2 звезды. В 3 совпадениях из TikTok спрашивают о моделях Dreame, Roborock и Mova.
Ложных срабатываний три. Одно касается соотношения сторон экрана телефона Samsung Z Fold 8. В другом сказано, что приложение не устанавливается на планшет Samsung. Третье связано со словацким словом «mi» (означает «мне»), которое правило приняло за Xiaomi.
Последний случай неоднозначный. В отзыве новая страница «Explore» в приложении названа кликбейтом и маркетингом в духе «typical xiaomi». Бренд упомянут, но роботы-пылесосы не сравниваются.
Пропуски тоже важны. В одном отзыве с 5 звёздами упомянуты «Sharks, Bissell's, iRomba's». Правило нашло только Bissell: оно не распознало форму множественного числа и вариант с опечаткой. Короткий список из 13 самых распространённых брендов находит только 14 отзывов и пропускает Rowenta и Bissell.
Вывод очевиден. Правило по ключевым словам годится как первичный фильтр, но не как тег. Ложные срабатывания возникают из-за телефонов с тем же названием бренда и иностранных слов. Пропуски возникают из-за форм множественного числа, опечаток и брендов, которых нет в списке.
Поэтому в схеме есть перечисление competitors и поле other_brand, а этот столбец заполняет модель. Булево поле mentions_competitor можно вывести напрямую из того, пуст ли competitors. Мы оставляем его только потому, что по нему удобно фильтровать таблицу. Ниже покажем, как проверить, что эти два поля согласованы.
Как оценить токены: фиксированный префикс занимает 92%
Без ключа OpenAI мы можем только оценить стоимость модели. Мы показываем каждый шаг, чтобы вы могли подставить свои цифры. OpenAI не публиковала токенизатор для GPT-6.1 Sol. Мы используем новейшую публичную кодировку o200k_base из tiktoken, библиотеки OpenAI с открытым исходным кодом, в версии 0.14.0 на PyPI.
Системный промпт, схема и формат входных данных взяты из реальных файлов. В качестве отзывов использованы 412 записей из наших реальных вызовов. Выходные токены рассчитаны по средней длине 12 написанных вручную примеров тегов. Для токенов рассуждений используется отдельное допущение.
Фактическая стоимость определяется объектом usage в каждом ответе Responses API. Перед полным запуском отправьте 20 отзывов в рамках пробного запуска. Посмотрите input_tokens, output_tokens и output_tokens_details.reasoning_tokens, затем обновите таблицу ниже.
| Часть | Токены (o200k_base) | Примечание |
|---|---|---|
| Системный промпт (руководство по категориям и правила) | 645 | Отправляется с каждым запросом |
| Схема тега для одного отзыва | 322 | Объём подсчитан для компактного JSON. Фактический порядок тарификации определяет OpenAI. |
| Схема для 25 отзывов | 362 | Ещё один уровень массива labels |
| Фиксированный префикс (один отзыв / 25 отзывов) | 967 / 1,007 | Оба ниже минимального порога кеширования в 1 024 токена |
| Один отзыв на входе (с ID, источником, оценкой) | Среднее 81,1, медиана 73,5, максимум 205 | 412 реальных отзывов |
| Только текст отзыва | Среднее 32,6 | Больше половины токенов уходит на строки формата |
| Один тег на выходе | Среднее 87,3 (от 65 до 107) | 12 примеров, написанных вручную |
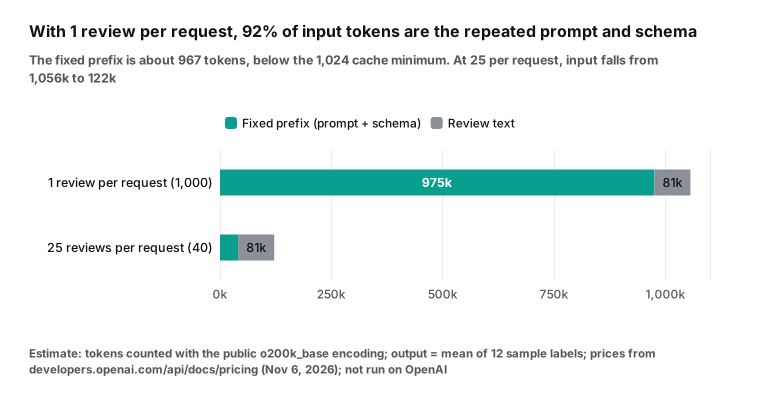
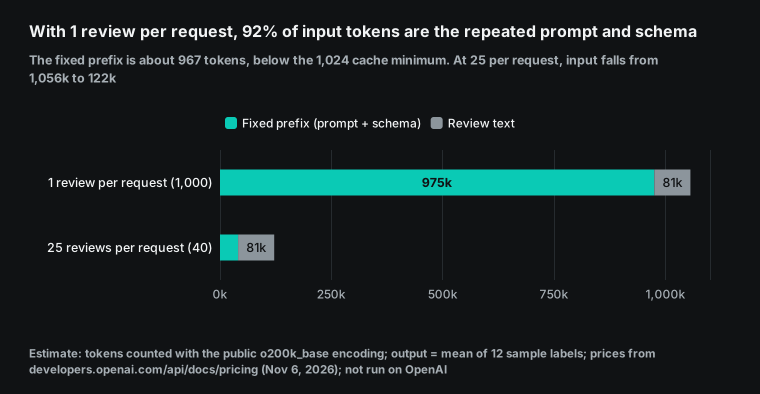
Умножьте эти цифры на 1 000 отзывов, и разница станет очевидной. При 1 отзыве на запрос 1 000 запросов потребуют около 1 056 100 входных токенов. Фиксированный префикс в каждом запросе составляет 967 токенов плюс 8 токенов на формат сообщения. Это 975 000 токенов, или 92.3% входных данных. При 25 отзывах на запрос понадобится всего 40 запросов.
Фиксированный префикс сокращается до 40 600 токенов, а общий объём входных данных до примерно 121 700 токенов. Это на 88,5% меньше. Содержимое отзывов, 81 100 токенов, одинаково в обоих вариантах. Вся экономия достигается за счёт того, что одни и те же инструкции не отправляются снова и снова.
Можно подумать: префикс повторяется, значит, с ним справится кеш. В руководстве по кешированию промптов сказано, что для GPT-5.6 и более поздних моделей минимальный кешируемый префикс составляет 1 024 видимых входных токена. Скрытое системное содержимое, которое добавляет OpenAI, не учитывается. Для GPT-6.1 Sol чтение из кеша стоит 0.05 от обычной цены входных токенов. Запись в кеш на 30 минут стоит в 1.25 раза больше обычной цены, а запись на 12 часов стоит в 2.5 раза больше.
Наш префикс в o200k_base занимает 967 токенов, на 57 токенов меньше минимума. Если OpenAI превратит схему в скрытое системное содержимое, видимая часть составит всего 645 токенов, что ещё меньше минимального порога. В любом случае этот префикс не попадёт в кеш. Иными словами, вариант «1 отзыв на запрос плюс кеш» при такой длине промпта не работает.
Если ваш промпт уже длиннее 1 024 токенов, кеш может сработать. В гипотетическом случае, когда весь префикс читается по цене кеша, 1 отзыв на запрос в Batch обойдётся примерно в $0.57 за 1 000 отзывов. Это близко к $0.56 при 25 отзывах на запрос, причём без учёта первой записи в кеш. Но вариант с 25 отзывами на запрос не зависит от попаданий в кеш, и промпт не нужно искусственно удлинять. Поэтому мы собираем файл Batch по 25 отзывов на запрос.
Процесс работы с Batch API: JSONL, загрузка, скачивание
Руководство по Batch API описывает процесс чётко. Каждый запрос записывается одной строкой файла .jsonl. В каждой строке есть уникальный custom_id, а также method, url и body. Тело запроса такое же, как для синхронного эндпоинта.
В одном файле можно использовать только одну модель. Файл загружается со значением purpose, равным batch. При создании пакета completion_window сейчас может принимать только значение 24h. Цена на 50% ниже, чем у синхронного эндпоинта, а у Batch собственные, более высокие лимиты запросов.
В руководстве также перечислены три лимита, с которыми столкнётся задача по разметке тегами. Один батч может содержать до 50 000 запросов, а входной файл может весить до 200 МБ. Можно создавать до 2 000 батчей в час. Выходной файл не сохраняет порядок входных данных, поэтому результаты нужно сопоставлять по custom_id.
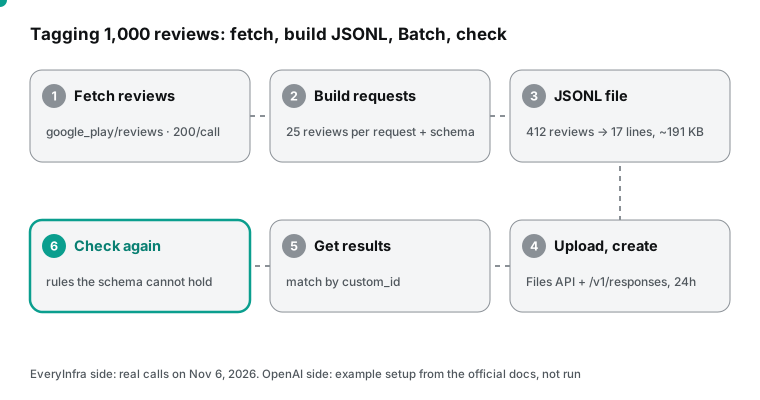
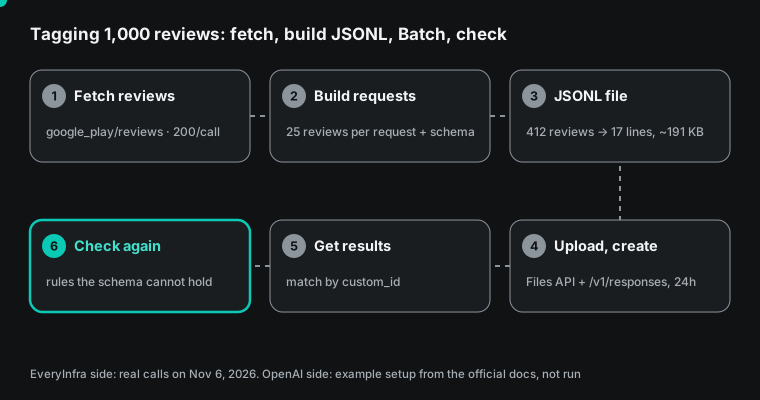
Чтобы оценить размеры файлов, мы собрали из 412 реальных отзывов два файла Batch. Файл с 1 отзывом на запрос содержит 412 строк и весит 2 018 830 байт. Это около 4 900 байт на строку, потому что каждая строка несёт полный системный промпт и схему. Файл с 25 отзывами на запрос содержит 17 строк и весит 191 412 байт, то есть около 11 260 байт на строку.
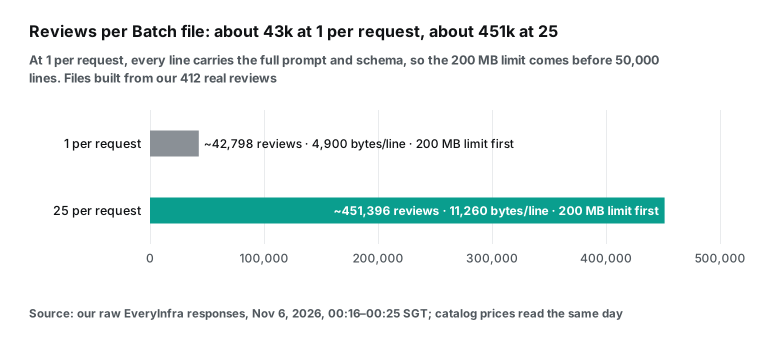
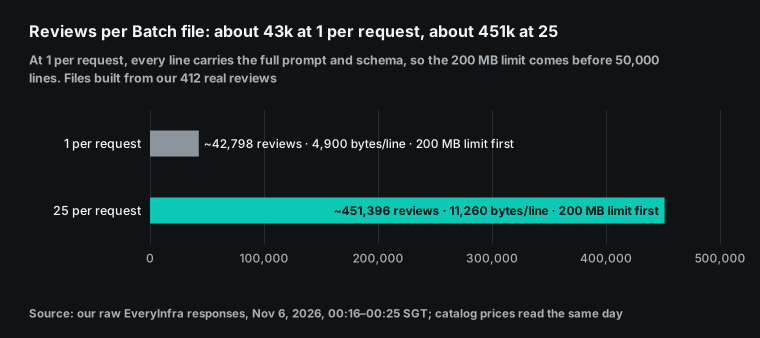
С учётом лимита в 200 МБ файл с 1 отзывом на запрос вмещает около 42 798 отзывов. Он упирается в ограничение по размеру раньше, чем в лимит в 50 000 строк. Файл с 25 отзывами на запрос вмещает около 451 000 отзывов по размеру и 1 250 000 по числу строк. Запуск на 1 000 отзывов далеко не достигает ни одного из лимитов. Но при десятках тысяч отзывов схема с 1 отзывом на запрос упрётся в 200 МБ раньше, чем можно ожидать.
Если отказаться от Batch и использовать синхронный эндпоинт, при большом запуске можно упереться в лимит токенов в минуту. OpenAI 2026-10-06 сократила число уровней использования до трёх: Build, Launch и Grow (руководство по лимитам запросов). На странице модели Sol для уровня Build указано 1 000 000 токенов в минуту. У Batch собственные, более высокие лимиты, отдельные от синхронной квоты. Перед большим запуском проверьте свою страницу лимитов.
Ниже приведена первая строка файла с 25 отзывами на запрос: переносы строк добавлены, а промпт и схема сокращены. За ней следует код на Python для загрузки файла и создания пакета. Это пример конфигурации из документации. Мы не выполняли этот запуск через OpenAI.
# One JSONL line (cut):
# {"custom_id": "chunk-000", "method": "POST", "url": "/v1/responses",
#  "body": {"model": "gpt-6.1-sol", "reasoning": {"effort": "low"}, "max_output_tokens": 12000, "store": false,
#           "input": [{"role": "developer", "content": "You label customer reviews ..."},
#                     {"role": "user", "content": "item_id: 56a3b9f4-...\nsource: google_play/reviews app=com.roborock.smart\nrating: 5/5\ntext: ..."}],
#           "text": {"format": {"type": "json_schema", "name": "review_labels", "strict": true, "schema": {...}}}}}
from openai import OpenAI
client = OpenAI()  # reads OPENAI_API_KEY from the environment
f = client.files.create(file=open("x25.jsonl", "rb"), purpose="batch")
batch = client.batches.create(input_file_id=f.id, endpoint="/v1/responses", completion_window="24h",
                              metadata={"job": "review-tagging-2026-11-06"})
print(batch.id, batch.status)  # validating -> in_progress -> finalizing -> completed
Задайте достаточно большое значение max_output_tokens. Двадцать пять тегов примерно по 87 токенов каждый дают около 2 200 токенов. Сверх этого добавляются токены рассуждений. Мы указали 12 000.
Если значение слишком мало, структурированный вывод обрывается на середине. Этот случай описан в руководстве по Structured Outputs. Статус ответа будет incomplete, а причина max_output_tokens. Полученный JSON неполный, поэтому считайте такой ответ ошибкой.
store: false указывает OpenAI не хранить ответ для последующего обращения. Но в FAQ по Batch API сказано, что режим нулевого хранения данных (zero data retention) не распространяется на Batch API. Входные, выходные файлы и файлы ошибок подчиняются правилам хранения сервисов Batch и Files. Если в отзывах есть персональные данные, удалите их перед отправкой. При формировании запросов мы удалили имя автора, аватар автора и URL отзыва. Остались только ID отзыва, источник, оценка и текст.
При получении результатов статус последовательно проходит этапы validating, in_progress, finalizing и completed. Пакет, не завершённый за 24 часа, получает статус expired. Вы получаете выполненную часть и платите за неё. Незавершённые запросы попадают в файл ошибок с кодом batch_expired. Выходные файлы удаляются через 30 дней после завершения пакета, поэтому скачайте их вовремя.
Все поля описаны в справочнике Batch API и справочнике Files API. Если нужна низкая цена, но синхронный ответ, используйте Flex processing: там действуют цены Batch. Взамен ответы приходят медленнее, а иногда возникает ошибка 429 «resource unavailable», которая не оплачивается.
Стоимость 1 000 отзывов: плата за данные плюс плата за модель
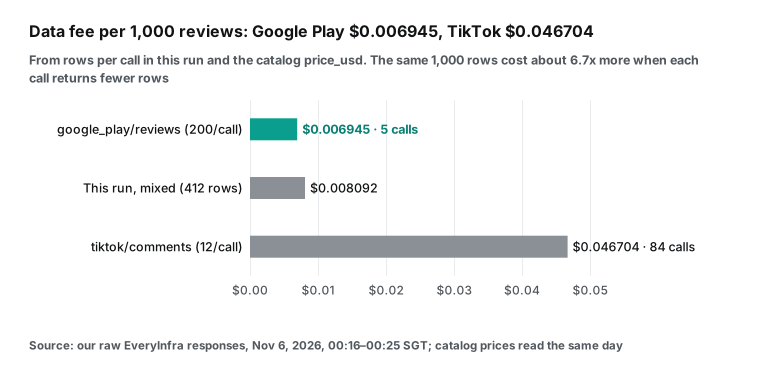
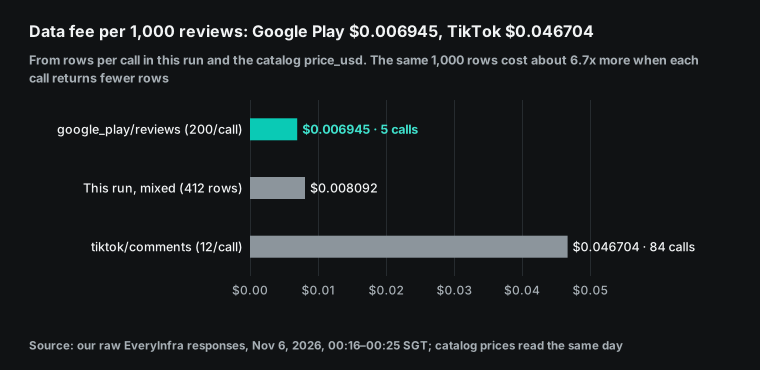
Теперь сложим плату за данные и плату за разметку. Плату за данные мы рассчитываем по фактическому числу записей за вызов и цене из каталога. Google Play возвращает 200 записей за вызов, поэтому для 1 000 отзывов нужно 5 вызовов, то есть $0.006945. Это видео в TikTok вернуло 12 записей за вызов, поэтому для 1 000 отзывов нужно 84 вызова, то есть $0.046704. Это в 6.7 раза больше. Наш смешанный набор из 412 отзывов обошёлся в $0.003334, то есть $0.008092 за 1 000.
Цифра для TikTok исходит из 12 записей на видео. Популярное видео возвращает больше записей за вызов, и тогда плата за данные намного ниже. Мы приводим эту цифру, чтобы показать одно: плата за данные за 1 000 отзывов зависит от того, сколько записей возвращает каждый вызов, а не только от цены за единицу.
Плату за модель мы оцениваем по публичным ценам OpenAI на 2026-11-06 и приведённому выше количеству токенов. Мы берём три уровня токенов рассуждения на отзыв: 0, 50 и 200. Ноль — нижняя граница, недостижимая для Sol, потому что его минимальная настройка — low. Все значения ниже указаны в долларах США за 1 000 отзывов. Плата EveryInfra за данные в них не входит.
| Конфигурация (на 1 000 отзывов) | 0 токенов рассуждения (нижняя граница) | 50 токенов рассуждения на отзыв (допущение) | 200 токенов рассуждения на отзыв (допущение) |
|---|---|---|---|
| Sol, стандартный режим, 1 отзыв на запрос | $2.99 | $3.49 | $4.99 |
| Sol Batch, 1 отзыв на запрос | $1.49 | $1.74 | $2.49 |
| Sol Batch, 1 на запрос, префикс по цене кеша (гипотетически, префикс меньше 1 024) | $0.57 | $0.82 | $1.57 |
| Sol Batch, 25 отзывов на запрос | $0.56 | $0.81 | $1.56 |
Terra Batch, 25 на запрос, none | $0.28 | n/a | n/a |
Luna Batch, 25 на запрос, none | $0.028 | n/a | n/a |
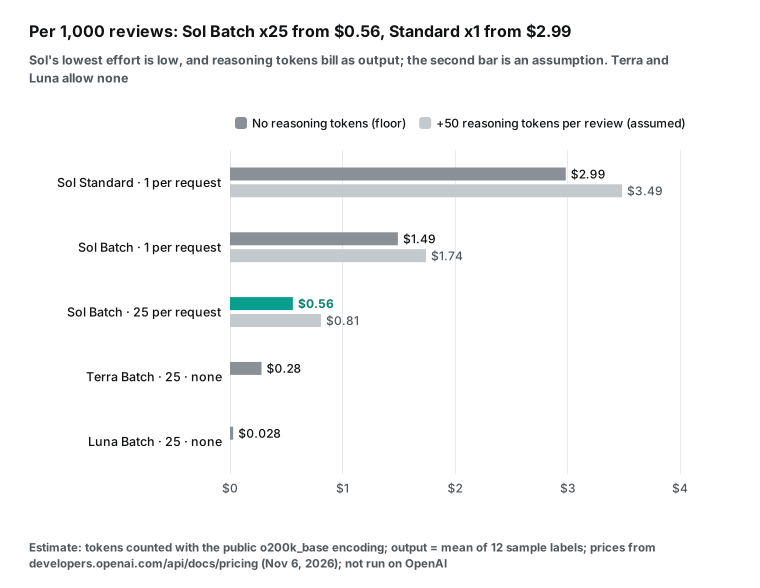
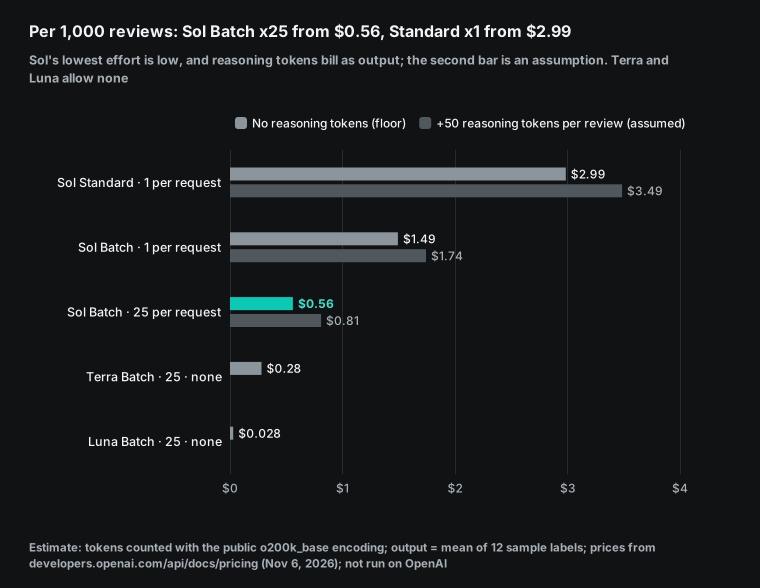
Эту таблицу можно прочитать тремя способами. Во-первых, при той же модели и том же промпте переход от «стандартный режим, 1 на запрос» к «Batch, 25 на запрос» снижает нижнюю границу с $2,99 до $0,56. Это в 5,3 раза меньше.
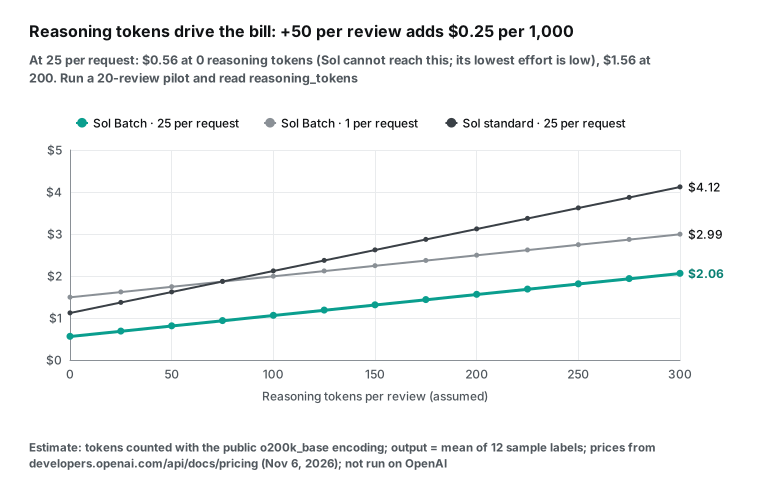
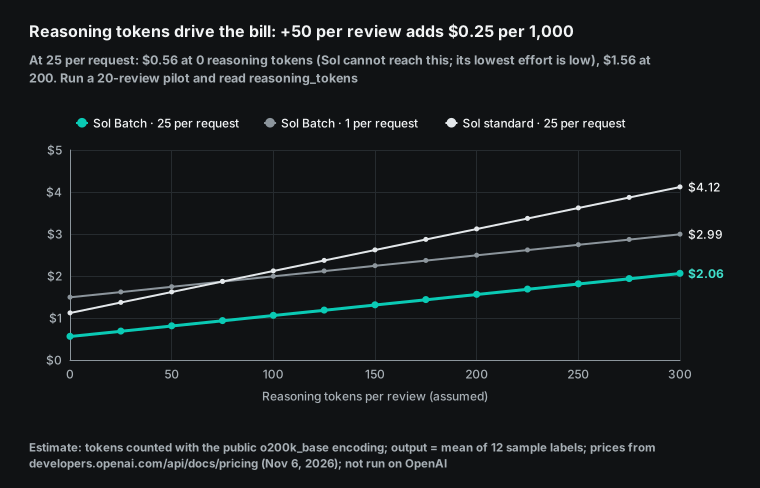
Во-вторых, при 25 отзывах на запрос большая часть денег уходит на выходные токены. Из $0.56 на них приходится $0.44, то есть около 78%. Каждые 50 дополнительных токенов рассуждения на отзыв добавляют $0.25 (50 × 1 000 × $5 ÷ 1 000 000). Поэтому итоговый счёт зависит от того, сколько токенов рассуждения low генерирует на ваших отзывах. Измерить это можно только пилотным запуском.
В-третьих, плата за данные — небольшая часть общей суммы. Google Play за $0,006945 плюс Sol Batch при 25 на запрос ($0,56) дают около $0,566. Плата за данные составляет 1,2% от этой суммы. Даже с платой за TikTok в $0,046704 это всего 7,7%.
Чтобы подставить свои цифры, нужны четыре значения. P — число токенов в фиксированном префиксе. x — среднее число входных токенов на отзыв. y — среднее число выходных токенов на тег.
r — число токенов рассуждения на отзыв. При k отзывах на запрос по цене Batch плата за модель за 1 000 отзывов составляет примерно (1 000 ÷ k × P + 1 000 × x) × $1 ÷ 1 000 000 плюс 1 000 × (y + r) × $5 ÷ 1 000 000. В этой статье P равно 967 или 1 007, x — 81.1, y — 87.3, а r неизвестно.
Если ваши отзывы длиннее, слагаемое x растёт, и k влияет меньше. Длинные отзывы в e-commerce в среднем могут занимать триста-четыреста токенов. Если длиннее ваш промпт, растёт слагаемое P, и больший k становится важнее. Формула не учитывает надбавку за входные токены свыше 272K. При 25 отзывах на запрос каждый запрос занимает чуть больше 3 000 токенов, это далеко от порога. Если вы планируете помещать тысячи отзывов в один запрос, учтите надбавку или разбейте запрос.
Для масштаба: в статье Gilardi и соавторов 2023 года «ChatGPT Outperforms Crowd-Workers for Text-Annotation Tasks» сообщается о стоимости менее $0.003 за аннотацию на 2 382 твитах. Наша нижняя граница для Sol Batch при 25 на запрос составляет около $0.00056 за отзыв, или $0.00081 с 50 токенами рассуждения.
Одно число — измеренный результат из статьи. Другое — наша оценка; эксперимент в OpenAI для неё не проводился. Задачи и модели тоже различаются. Поэтому используйте это сравнение только для понимания масштаба. Оно не показывает, насколько упали цены, и ничего не говорит о точности.
Sol, Terra, Luna и Decisions API: когда не стоит использовать Sol
Две последние строки таблицы стоимости добавлены намеренно. GPT-6.1 Terra была выпущена 2026-10-26. В анонсе сказано, что её стандартная цена на 50% ниже, чем у GPT-6.1 Sol, и что она подходит для работы с документами в больших объёмах. Она поддерживает режим рассуждения none. Её цена в Batch — $0,50 за входные токены и $2,50 за выходные. GPT-6 Luna OpenAI называет своей эффективной моделью для узких задач в больших объёмах.
Luna тоже поддерживает none. Её цена в Batch: $0.05 за входные и $0.25 за выходные токены. При той же оценке токенов Terra стоит $0.28 за 1 000 отзывов, а Luna — $0.028. Это половина и одна двадцатая от нижней границы Sol. И ни у одной из них нет неизвестной стоимости токенов рассуждения.
Так когда стоит использовать Sol? Во-первых, когда для определения тега нужны рассуждения, например чтобы ответить на вопрос «Вызвала ли эту неисправность последняя версия прошивки?», или когда action_item должен быть сформулирован так, будто его написал продакт-менеджер. Во-вторых, когда выборочная проверка результатов Luna или Terra выявляет много ошибок в отдельных группах, например среди отзывов с тональностью mixed. Тогда повторно обработайте на Sol только эту часть. Для тегов, которые можно определить непосредственно по словам отзыва, использовать рассуждения Sol незачем.
У OpenAI также есть решение, созданное специально для классификации. Decisions API вышел в бета-версии 2026-10-06 и стал общедоступным 2026-10-22. Сейчас он поддерживает только gpt-6-luna. Он не заставляет модель писать JSON, а возвращает типизированные ответы на заданные вами вопросы.
predicate возвращает вероятность от 0 до 1. choice выбирает один из ваших вариантов и даёт вероятность для каждого из них. score выставляет оценку по шкале от 2 до 10 баллов. Один запрос может содержать до 400 вопросов. По словам OpenAI, это примерно в 10 раз быстрее, чем Responses API.
В руководстве чётко указано, что для чего использовать. Используйте Decisions для вероятностей, выбора одного варианта или оценок. Используйте режим Structured Outputs, чтобы сгенерировать объект, соответствующий вашей схеме. Тональность, категорию проблемы и упоминание конкурента можно оформить как вопросы Decisions со значениями уверенности. Для action_item и evidence по-прежнему нужен режим Structured Outputs.
| Вариант | Для чего подходит | Стоимость модели за 1 000 (оценка) | Главное ограничение |
|---|---|---|---|
| GPT-6.1 Sol + Structured Outputs + Batch | Теги, требующие рассуждений; текстовые рекомендации по действиям; качественная повторная обработка небольшой части данных | От $0,56 плюс $0,25 за каждые 50 токенов рассуждения на отзыв | Рассуждение нельзя отключить. Результат в течение 24 часов. |
| GPT-6.1 Terra + Structured Outputs + Batch | Большие объёмы, чёткие поля, одно предложение свободного текста | Около $0,28 (none) | Уступает Sol в сложных случаях, требующих оценки |
| GPT-6 Luna + Structured Outputs + Batch | Только классификация при очень больших объёмах | Около $0,028 (none) | Выборочно проверяйте качество текстовых рекомендаций по действиям |
| Decisions API (Luna) | Тональность, категория и упоминание конкурента с уровнем уверенности | Здесь не оценивается (цена токенов Luna; на расход влияет число вопросов) | Без свободного текста. Только Luna. |
Что нельзя обеспечить с помощью схемы: проверки после получения результатов
Строгий режим гарантирует структуру: все поля на месте, типы верны, значения enum допустимы. Но он не гарантирует правильность содержания и не мешает двум полям противоречить друг другу.
Мы провели небольшой тест с Python-библиотекой jsonschema. В теге, который мы вручную составили для комментария из TikTok, мы указали competitors: ["dreame"] и mentions_competitor: false. Эти поля явно противоречат друг другу, но тег всё равно прошёл валидацию по схеме.
В руководстве по Structured Outputs тоже сказано, что Structured Outputs всё равно может содержать ошибки. Там советуют уточнить инструкции, добавить примеры или разбить задачу. Поэтому, когда результаты вернутся, выполните как минимум следующую проверку:
def check(label, item):
    errs = []
    if label["mentions_competitor"] != bool(label["competitors"]):
        errs.append("mentions_competitor does not match competitors")
    if ("other_brand" in label["competitors"]) != (label["other_brand_name"] is not None):
        errs.append("other_brand does not match other_brand_name")
    if "none" in label["issue_categories"] and len(label["issue_categories"]) > 1:
        errs.append("none cannot appear with other categories")
    if label["action_item"] and len(label["action_item"].split()) > 20:
        errs.append("action_item is longer than 20 words")
    if label["evidence"] and label["evidence"].lower()[:30] not in item["text"].lower():
        errs.append("evidence is not a quote from the text")
    if label["item_id"] != item["id"]:
        errs.append("item_id does not match")
    return errs
Каждая проверка охватывает правило, которое нельзя выразить в схеме. Два поля должны быть одновременно истинными или одновременно ложными. Одни значения enum исключают другие. Действует ограничение на число слов.
А цитата должна быть взята из исходного текста. Последняя проверка самая полезная: она ловит «цитату», которую модель выдумала.
Для запроса на 25 отзывов нужна ещё одна проверка. Массив labels должен содержать 25 элементов, и каждый item_id должен соответствовать одному входному отзыву. В руководстве сказано, что вывод следует порядку ключей в схеме. Но там не обещано, что элементы массива вернутся в порядке ввода. Сопоставлять по ID надёжнее, чем по позиции.
Ещё два случая требуют отдельной обработки. Первый — отказ. В руководстве сказано, что когда модель отказывается отвечать по соображениям безопасности, тип содержимого — refusal, и ответ не соответствует вашей схеме. В некоторых отзывах есть оскорбления или резкие выражения. В одном из прочитанных нами отзывов об iRobot разработчиков оскорбляют грубым словом. Будьте готовы обработать refusal.
Второй случай — входные данные не по теме. В руководстве советуют указать в промпте, что возвращать для входных данных, которые не соответствуют задаче. Это делает правило 8 нашего системного промпта: пустые отзывы, реклама и посторонний текст получают neutral, none и пустой список конкурентов.
Ограничения и важные моменты
В этот раз отзывы с Amazon не вернулись. Обе асинхронные задачи завершились успешно, но вернули 0 записей, и плата вернулась на баланс. В каталоге указано, что каждый сайт Amazon показывает на странице товара только избранные отзывы, обычно около дюжины на товар. При дюжине записей на вызов плата за данные превышает $0.08 за 1 000 отзывов, более чем в десять раз дороже, чем у Google Play. Прежде чем закладывать бюджет на Amazon, протестируйте несколько товаров. Amazon в нашу таблицу стоимости не входит.
У синхронных вызовов лимит времени 85 секунд. В этот раз amazon/reviews и trustpilot/reviews (limit 200) ожидали больше 85 секунд и вернули ответ 503 из-за тайм-аута. Плата за эти вызовы не взималась. В ответе нам предложили использовать "mode":"async" или меньшее значение limit. 85 секунд измеряются на сервере. Наш вызов tiktok/comments занял на нашей стороне 90,21 секунды и всё же вернул ответ 200, так что он тоже был близок к лимиту.
Для пакетной выгрузки данных используйте асинхронный режим для медленных возможностей. Сразу приходит ответ 202 с job_id. Затем вы опрашиваете poll_url. Наши два асинхронных задания заняли от начала до конца около 1 минуты 36 секунд и 3 минут 44 секунд.
«Последние 200» — это не фиксированный временной интервал. Как показано выше, 200 отзывов о Roborock охватывают 32 дня, а 200 отзывов об iRobot — 99 дней. Для еженедельного сравнения перед разметкой отберите по posted_at отзывы за один и тот же недельный интервал.
В синхронном режиме с помощью пагинации Google Play можно получить до 200 записей. Чтобы получить больше, используйте асинхронный режим. Ограничение указано в поле pagination в каталоге.
Для вашего собственного приложения Reply to Reviews API от Google возвращает только отзывы за последнюю неделю: до 100 на страницу, не более 200 GET-запросов в час. Более старые отзывы можно получить через выгрузку CSV в Play Console. Для приложения конкурента API Google ничего не даёт.
Настоящие ли это отзывы? Окончательное правило FTC США о фейковых отзывах (август 2024 года) запрещает фейковые отзывы, сгенерированные ИИ. Теги показывают, о чём говорится в отзыве, но не то, настоящий ли он. Сначала обратите внимание на необычные скопления отзывов на 5 или 1 звезду.
Структурированный вывод может влиять на качество рассуждений. В статье «Let Me Speak Freely?» (2024) показано, что строгие форматы вроде JSON могут снижать качество рассуждений. В работе «JSONSchemaBench» (2025) шесть методов ограниченного декодирования, включая метод OpenAI, проверили на 10 000 реальных схемах и обнаружили большие различия. Обе работы тестировали более старые модели. Но они подкрепляют одно наше решение: ставить action_item ближе к концу схемы. Если какая-то группа тегов получает низкие оценки, сначала попробуйте ответ в свободной форме, а затем преобразуйте его в JSON дешёвой моделью.
Поручайте проверку точности людям, а не модели. Мы не запускали пакет в OpenAI, поэтому данных о точности у нас нет. Вот что мы предлагаем. Возьмите 20 пилотных отзывов и 50 случайных отзывов из полного прогона. Попросите человека, который знает продукт, сверить каждый тег с текстом. Посчитайте ошибки по категориям. Затем решите, для каких категорий нужен новый промпт, а какие нужно перезапустить на другой модели.
Тем же методом мы проверяли 17 совпадений по ключевым словам выше. В обзоре LLM для разметки данных есть раздел о том, как оценивать разметку, сделанную моделью. Один из методов — проверка человеком. Другой — сравнение с существующим набором, размеченным людьми.
Чем эта статья отличается от других статей об отзывах на этом сайте
В статье «DeepSeek V4 в Claude Code для очистки комментариев» 695 записей комментариев к видео очищаются в интерактивной сессии, и стоимость зависит от попаданий в кэш. Статья «Строгий вызов инструментов Claude с API данных» задаёт строгую схему входных данных инструментов. В статье «Аналитик отзывов на Qwen Agent» один агент сравнивает цены и читает отзывы. Здесь строгим является формат вывода, задача выполняется как одна офлайн-пакетная обработка, а стоимость определяется компоновкой запросов.
Отчёт внутри ChatGPT описан в статье «GPT-6 Intelligent UI для отчётов по данным соцсетей».
Изменения за последние 60 дней
2026-09-29: GPT-6.1 Sol стала доступна в API (история изменений). Теперь для крупных задач со структурированным выводом можно использовать модель, близкую к топовой, за пятую часть цены Astra. Но у неё нельзя отключить рассуждение.
2026-10-06: Decisions API вышел в бета-версии, а 2026-10-22 стал общедоступным (руководство по Decisions). Для тегов с одиночным выбором теперь можно получать значения уверенности без JSON с помощью Decisions API, который работает только на Luna.
2026-10-20: 12-часовое кэширование промптов появилось в API, запись в кэш стоит в 2.5 раза больше цены входных токенов (руководство по кэшированию промптов). Оно выгодно задаче, которая запускается несколько раз в день с промптом длиннее 1 024 токенов. Короткому префиксу оно не помогает.
2026-10-21: организации и проекты могут ограничивать уровни обслуживания в настройках платформы (история изменений). Что это значит для вас: администратор может разрешить только уровень по умолчанию. Тогда запросы с уровнем Flex или другим уровнем, отличным от уровня по умолчанию, завершатся ошибкой уровня обслуживания. Проверьте настройки проекта до запуска, а не после сбоя пакета запросов.
2026-10-26: вышла GPT-6.1 Terra. Её стандартная цена вдвое ниже, чем у Sol, и она поддерживает режим рассуждений none (страница модели Terra). Что это значит для вас: теперь между Sol и Luna есть промежуточный вариант, в котором можно отключить рассуждения. Во многих задачах разметки можно сначала попробовать Terra.
2026-10-28: подписчики ChatGPT могут получить кредиты для API. Подписчики тарифов Pro и Business, отвечающие условиям, получают до $500 в месяц (руководство по кредитам). Этого с запасом хватит на пилотные запуски. Неиспользованные кредиты сгорают каждый месяц.
Частые вопросы о GPT-6.1 Sol и Structured Outputs
Сколько стоит API GPT-6.1 Sol?
Полная таблица цен приведена в первом разделе статьи. Вкратце: по данным страницы тарифов OpenAI, стандартная цена составляет $2 за 1M входных и $10 за 1M выходных токенов. Batch и Flex стоят вдвое дешевле. Режим Fast стоит в 2 раза дороже стандартной цены, а Ultrafast в 6 раз; для пакетной разметки не нужен ни тот, ни другой. Токены рассуждений оплачиваются как выходные. (Источник вопроса: автодополнение Google, 2026-11-06.)
Как называется модель GPT-6.1 Sol в API и как её вызвать?
Имя модели: gpt-6.1-sol. Укажите его в поле model запроса к Responses API (страница модели). Chat Completions тоже работает, но без вызова инструментов.
Для работы с инструментами руководство по миграции рекомендует Responses API. Уровень рассуждений задаётся параметром reasoning.effort. Минимальное значение: low. (Источник вопроса: автодополнение Google, «gpt 6.1 sol api name».)
Как написать пример использования Structured Outputs для GPT-6.1?
Самый короткий вариант: добавить text: {format: {type: "json_schema", name: "...", strict: true, schema: {...}}} в запрос к Responses API. В каждом объекте схемы нужно указать additionalProperties: false, а каждое поле должно быть перечислено в required. В Python можно также передать модель Pydantic в responses.parse из SDK. SDK сам построит схему (openai-python helpers, документация Pydantic по JSON Schema). Схему из девяти полей из этой статьи можно скопировать и изменить. (Источник вопроса: автодополнение Google, «gpt 6.1 structured outputs example».)
Можно ли использовать Structured Outputs вместе с Batch API OpenAI?
Да. В руководстве по Structured Outputs сказано, что и Structured Outputs, и режим JSON работают с Batch API. body каждой строки Batch совпадает с синхронным запросом, поэтому text.format остаётся без изменений.
Учтите три момента. В одном файле можно использовать только одну модель. Задайте достаточно большое значение max_output_tokens, чтобы JSON не обрезался. Сопоставляйте результаты по custom_id, а не по порядку строк. (Источник вопроса: автодополнение Google, «openai batch api structured output».)
Почему GPT-6.1 Sol на максимальном уровне рассуждений намного медленнее GPT-5.6 Sol?
Этот пример взят из обсуждения на форуме разработчиков OpenAI. С одним и тем же промптом GPT-6.1 Sol на уровне max сгенерировала около 62 708 выходных токенов (из них 52 552 токена рассуждений) за 1 846 секунд. GPT-5.6 Sol сгенерировала около 31 426 токенов за 373 секунды. Для разметки тегами max не нужен. Достаточно low, а вдвое больше токенов рассуждений означает вдвое большую плату за выходные токены.
С чего начать
- Создайте API-ключ по инструкции из раздела Быстрый старт EveryInfra. Изучите бесплатный каталог возможностей. Проверьте цену и поля ответа для
google_play/reviews,tiktok/commentsиamazon/reviews. - Сначала получите по одной странице из каждого источника. Попробуйте песочницы API отзывов Google Play и API комментариев TikTok. Посмотрите, сколько записей возвращает каждый вызов. Затем рассчитайте бюджет на 1 000 отзывов. Для медленных возможностей добавьте
"mode":"async". - Адаптируйте под свои категории приведённую в этой статье схему из девяти полей. Проверьте её с помощью скрипта на соответствие правилам строгого режима из руководства по Structured Outputs.
- Выполните в OpenAI синхронный пилотный запуск на 20 отзывах. Посмотрите в
usageколичество входных и выходных токенов, а также токенов рассуждений, а затем обновите таблицу затрат. После этого выберите Sol, Terra или Luna. - Сформируйте JSONL-файл по 25 отзывов на запрос и используйте Batch API. Когда придут результаты, запустите проверку согласованности. Выборочно сверьте
evidenceс исходным текстом. - Чтобы искать отзывы по мере необходимости в Claude, Cursor или ChatGPT без кода, подключите удалённый MCP-сервер EveryInfra. Обзор платформ: API данных Google Play, API данных TikTok и API данных Amazon. Отзывы Amazon: API отзывов Amazon. Цены: страница тарифов.
Источники
- «GPT-6.1 Sol Model», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «Introducing GPT-6.1 Sol», OpenAI, 2026-09-29
- «API Changelog», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «Pricing», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «Structured model outputs», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «Batch API», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «Prompt caching», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «Using GPT-6 (latest model guide)», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «Reasoning models», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «Decisions», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «GPT-6.1 Terra Model», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «GPT-6 Luna Model», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «Rate limits», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «Flex processing», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «Function calling», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «Batch API reference», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «Files API reference», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «Ultrafast mode», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «Error codes», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «Your data», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «API credits for ChatGPT subscribers», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «Migrate to the Responses API», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «Prompt cache diagnostics», документация OpenAI для разработчиков, дата обращения: 2026-11-06
- «GPT-6.1 Sol system card addendum», OpenAI Deployment Safety Hub, 2026-09-29
- «Introducing GPT-6.1 Terra», OpenAI, 2026-10-26
- «Batch API FAQ», Справочный центр OpenAI, дата обращения: 2026-11-06
- tiktoken, OpenAI, GitHub
- «openai-python helpers», OpenAI, GitHub
- tiktoken 0.14.0, PyPI
- jsonschema, PyPI
- «JSON Schema (Pydantic docs)», Pydantic
- «JSON Schema Draft 2020-12», JSON Schema
- «RFC 8259: The JSON Data Interchange Format», IETF, 2017-12
- «Reply to Reviews», Google Play Developer API, дата обращения: 2026-11-06
- «Download and export monthly reports», Справка Play Console, дата обращения: 2026-11-06
- «Why is there a 500 character limit on Google Play reviews?», Сообщество Google Play, 2022-07-31
- «Query Video Comments», TikTok for Developers, дата обращения: 2026-11-06
- «FTC Announces Final Rule Banning Fake Reviews and Testimonials», Федеральная торговая комиссия США, 2024-08-14
- «ChatGPT Outperforms Crowd-Workers for Text-Annotation Tasks», Gilardi et al., arXiv, 2023-03-27
- «Let Me Speak Freely? A Study on the Impact of Format Restrictions on Performance of Large Language Models», Tam et al., arXiv, 2024-08-05
- «JSONSchemaBench: A Rigorous Benchmark of Structured Outputs for Language Models», Geng et al., arXiv, 2025-01-18
- «Large Language Models for Data Annotation and Synthesis: A Survey», Tan et al., arXiv, 2024-02-21
- «Why is GPT-6.1 Sol MAX dramatically slower than GPT-5.6 Sol MAX using the same prompt?», сообщество разработчиков OpenAI, дата обращения: 2026-11-06
- «Каталог возможностей EveryInfra», EveryInfra, дата обращения: 2026-11-06 00:15 SGT
- «Roborock (Google Play app page)», Google Play, дата обращения: 2026-11-06
- «iRobot Home (Google Play app page)», Google Play, дата обращения: 2026-11-06
- «Model Context Protocol Specification», MCP, 2025-06-18
- «json — JSON encoder and decoder», документация Python
- «JSON Lines», jsonlines.org
- «Introduction to Structured Outputs (Cookbook)», OpenAI Cookbook
Справка BL-95