GPT-6.1 Sol API 结构化输出打标签:成本估算
GPT-6.1 Sol 严格 JSON 加 Batch 打评论标签:取数真调 412 条;模型费未实跑,按公开价估算,每次 25 条时千条约 $0.81。
用 GPT-6.1 Sol 的 json_schema 严格模式加 Batch API 给 1,000 条评论打标签,最贵的一步不是取数,而是你怎么拼请求。2026 年 11 月 6 日 00:16–00:25(新加坡时间),我们用 EveryInfra 真调 7 次,拿到 Roborock 和 iRobot 两个扫地机器人应用的 400 条 Google Play 评论和一个 TikTok 测评视频下的 12 条评论,实付 $0.003334;按每次实际回来的条数推算,每千条评论的数据费是 $0.006945(Google Play)到 $0.046704(TikTok)。模型一侧我们没有 OpenAI 的 Key,全部按官方文档写成配置示例,用公开的 o200k_base 编码数 token、按 2026-11-06 读到的公开价估算:每次只送 1 条评论时,967 token 的提示词和 schema 占了输入的 92%,而且低于 1,024 token 的缓存门槛,拿不到缓存折扣;改成每次送 25 条,同样 1,000 条在 Batch 下的模型费,按每条 50 个推理 token 的假设从约 $1.74 降到约 $0.81;不含推理 token 的理论下限是 $1.49 降到 $0.56,但 Sol 最低只能设 low,这个下限实际达不到。
这篇文章回答的问题很窄:手里有一批评论,想用 GPT-6.1 Sol 打上情绪、问题类别、是否提到竞品和一句可执行的建议,四个标签都要能直接进表格,钱要算清楚。数据来自 EveryInfra 的数据接口,打标签用的是 OpenAI 的 Responses API 和 Batch API。EveryInfra 一侧每个数都来自真调的原始返回,能复算;OpenAI 一侧每一步都标成「配置示例」或「按公开价估算」,我们没有在 OpenAI 上实跑过这批请求。站内已有的几篇评论文章侧重不同:DeepSeek V4 驱动 Claude Code 洗评论讲交互式清洗和缓存命中,Claude strict tool use 调数据接口讲让模型严格地调接口,本篇讲的是离线、一次性的大批量打标签,以及 OpenAI 这一侧的严格 JSON 输出和 Batch 折扣怎么叠在一起算。
先把哪些是实测、哪些是估算列清楚,后面每个数都能对回这张表:
| 环节 | 本文怎么得到的 | 你能不能复算 |
|---|---|---|
| 取评论(EveryInfra) | 2026-11-06 真调 7 次,原始返回存档 | 能,每个数都来自返回 |
| token 数 | 用 o200k_base 数真实的系统提示、schema 和 412 条评论 | 能;Sol 实际用的分词器没有公开 |
| 输出标签 | 12 条人手写的示例,不是 GPT-6.1 Sol 的输出 | 只用来估输出长度 |
| 推理 token | 没测,按每条 0、50、200 三档假设 | 不能,要试跑读 usage |
| 模型费 | 按 2026-11-06 的公开价乘上面几项 | 能,换成你的数重算 |
| 标签准确率 | 没有 | 试跑后由人抽查 |
GPT-6.1 Sol API 是什么:上 API 日期、上下文和价格
先把模型本身的事实对准。OpenAI 的 API 更新日志在 2026-09-29 那一条写:发布 GPT-6.1 Sol(gpt-6.1-sol),用于复杂编码和专业工作,价格低于 GPT-6 Astra;272K 以内的输入,每百万 token 标准价是输入 $2、缓存输入 $0.10、缓存写入 $2.50、输出 $10。同一条还写了要用工具调用就走 Responses API。发布文《Introducing GPT-6.1 Sol》给的定位是「接近 GPT-6 Astra 的能力,标准输入和输出价是 Astra 的五分之一」,缓存输入比 GPT-6 Sol 再便宜一半。
GPT-6.1 Sol 模型页(2026-11-06 读取)补上了打标签要用到的规格:上下文 1,050,000 token,单次最多输出 128,000 token,知识截止 2026-04-30;reasoning.effort 支持 low、medium(默认)、high、xhigh、max;功能列表里 Structured outputs 和 Function calling 都标「Supported」。模型页的价格说明写了四条对批量任务很要紧的规则:缓存输入按未缓存价的 5% 收;缓存写入按 1.25 倍收;输入超过 272K token 的请求,整次按 2 倍输入价和 1.5 倍输出价算;Batch 和 Flex 比标准价低 50%。
| 项目 | 原文怎么写 | 出处(2026-11-06 读取) | 对打标签的意思 |
|---|---|---|---|
| 上 API 日期 | 2026-09-29 发布 gpt-6.1-sol | API 更新日志 | 发稿时上线 38 天 |
| 上下文与输出 | 1,050,000 上下文,128,000 最大输出 | 模型页 | 一次塞几十条评论绰绰有余 |
| 推理强度 | low、medium、high、xhigh、max,不支持 none | 模型页、GPT-6 指南 | 每次请求都会有推理 token,按输出价算 |
| 标准价 | 输入 $2、缓存 $0.10、输出 $10(每百万 token) | 价格页、更新日志 | 同步跑千条约 $2.99 起 |
| Batch 价 | 输入 $1、缓存 $0.05、输出 $5 | 价格页 | 同一份请求打五折 |
| 长输入加价 | 超过 272K 输入,整次 2 倍输入、1.5 倍输出 | 模型页 | 单次请求别塞太多评论 |
| Chat Completions | 支持,但不带工具调用 | 模型页、GPT-6 指南 | 本文只用 Responses API |
上表最容易被忽略的一行是推理强度。GPT-6 使用指南的「限制」一节写得很直接:GPT-6 Astra 和 GPT-6.1 Sol 不支持 none,原来用 minimal 的请求先改成 low 再比较结果;GPT-6.1 Terra、GPT-6 Sol 和 GPT-6 Luna 支持 none。推理指南说明推理 token 计入输出 token。对打标签这种短输出的活来说,这意味着每条评论都会多出一段你看不见、但按 $10(Batch 下 $5)每百万收费的输出。推理 token 有多少,取决于评论本身和 low 档的实际表现,我们没法在不调用的情况下测出来,下面的成本表把它单独列成假设,不混进估算。
Batch 这一行再补全一点:价格页把 Flex 和 Batch 放在同一档,gpt-6.1-sol 的 Batch 价是输入 $1、输出 $5、缓存输入 $0.05、30 分钟缓存写入 $1.25、12 小时缓存写入 $2.50。后面的成本表全部按这一档算。
gpt 6.1 structured outputs:json_schema 严格模式的限制
Structured Outputs 的承诺写在 OpenAI 的 Structured Outputs 指南开头:模型的回答一定符合你给的 JSON Schema,不会漏掉必填键,也不会编出枚举之外的值。打开方式是在 Responses API 里设 text.format 为 {"type":"json_schema","strict":true,"schema":…}。指南同时写了它只支持 JSON Schema 的一个子集,不在子集里的写法,带着 strict: true 调用会直接报错。打标签的 schema 一旦定下来就要跑上千次,所以我们把指南里所有能量化、能检查的规则抄下来,写成一个检查脚本,而不是凭印象写 schema。
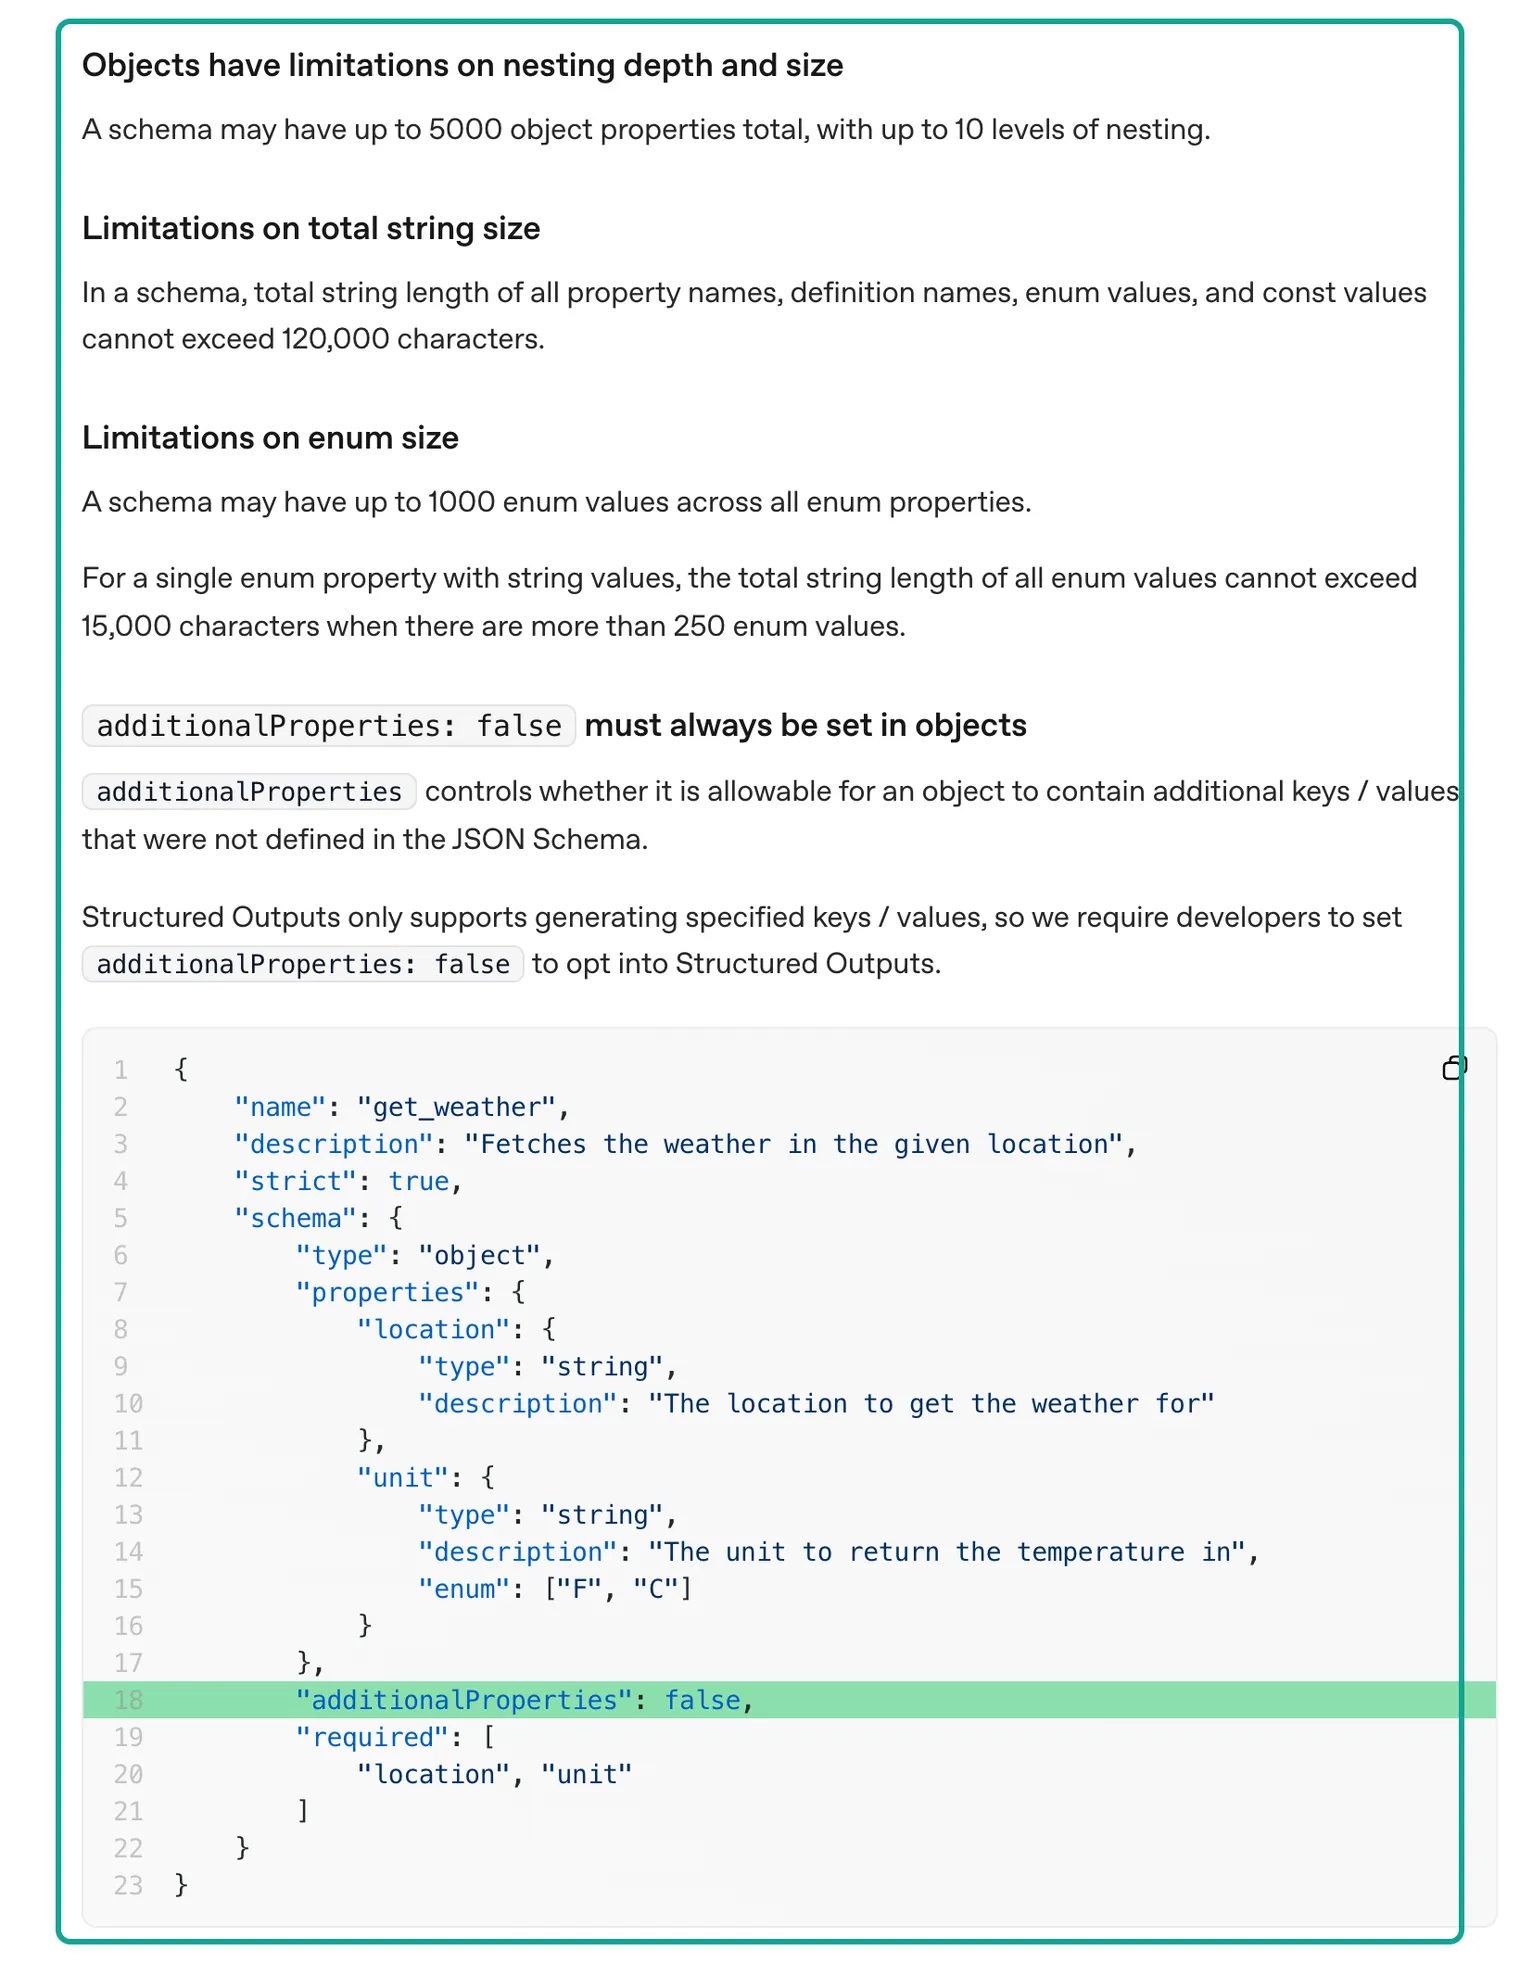
截图框里的四段是数量上限,框外还有几条写法上的硬规定:根对象必须是 object,不能是 anyOf;每个对象的所有字段都必须列进 required,可选字段的做法是把类型写成 ["string","null"];allOf、not、dependentRequired、dependentSchemas、if、then、else 这些组合关键字不支持;字符串只列了 pattern 和 format 两种约束,format 只认 date-time、time、date、duration、email、hostname、ipv4、ipv6、uuid 九种;数组支持 minItems 和 maxItems;$defs 和递归引用支持。指南还写了第一次用某个 schema 的请求会多一段处理延迟,之后同一份 schema 不再有。
| 规则(指南原文的小节) | 上限或要求 | 本文标签 schema | 故意写坏的一版 |
|---|---|---|---|
| 对象属性总数(Objects have limitations…) | ≤ 5000 | 9 个 | 8 个 |
| 嵌套层数 | ≤ 10 | 1 层 | 1 层 |
| 枚举值总数(Limitations on enum size) | ≤ 1000 | 31 个 | 31 个 |
| 名字和枚举的总字符数(Limitations on total string size) | ≤ 120,000 | 416 | 408 |
additionalProperties: false | 每个对象必须有 | 有 | 根对象写成 true,报错 |
所有字段 required | 必须 | 9/9 | required 里多了一个不存在的字段 |
| 不支持的关键字 | allOf、if、then 等 | 0 处 | 3 处 |
| 不在支持列表里的关键字 | 只给警告 | 0 处 | minLength 1 处 |
检查脚本的结论是:本文用的单条标签 schema 和 25 条一组的 schema 都是 0 处问题、0 条警告;故意写坏的那版查出 5 处问题和 1 条警告。写坏的那版不是随便造的,它代表一个很自然的念头:「如果 mentions_competitor 是 true,那 competitors 至少要有一个」,用 JSON Schema 写出来就是 allOf 套 if/then,恰好是严格模式不支持的写法。这类字段之间的逻辑关系,schema 管不住,只能在结果回来以后用代码再查一遍,后面「schema 管不住的事」一节专门讲。
minLength 那条要多说一句。指南在「暂不支持的关键字」里只对微调模型列出了 minLength、maxLength,对一般模型没写不支持,但「支持的字符串约束」也只列了 pattern 和 format。原文对 minLength 在 GPT-6.1 Sol 上能不能用,没有给出明确答案,所以我们的脚本只给警告,不判错,schema 里也不用它;要限制「一句建议不超过 20 个英文词」,写在 description 和系统提示里,再在结果里用代码量长度。
下面是本文的单条标签 schema,九个字段,全部必填,other_brand_name 和 action_item 允许为 null:
{
  "name": "review_label",
  "strict": true,
  "schema": {
    "type": "object",
    "properties": {
      "item_id": {"type": "string", "description": "Copy the item_id of the input item."},
      "sentiment": {"type": "string", "enum": ["positive", "negative", "mixed", "neutral"]},
      "issue_categories": {"type": "array", "minItems": 1, "maxItems": 3,
        "items": {"type": "string", "enum": ["app_connectivity", "account_login", "mapping_navigation",
          "suction_cleaning", "mopping", "dock_self_empty", "battery_charging", "hardware_defect",
          "firmware_update", "customer_service_warranty", "price_value", "noise", "app_usability", "other", "none"]}},
      "mentions_competitor": {"type": "boolean"},
      "competitors": {"type": "array", "maxItems": 5,
        "items": {"type": "string", "enum": ["roborock", "irobot_roomba", "ecovacs_deebot", "dreame", "eufy",
          "shark", "narwal", "mova", "dyson", "samsung", "xiaomi", "other_brand"]}},
      "other_brand_name": {"type": ["string", "null"]},
      "action_item": {"type": ["string", "null"], "description": "One concrete action, 20 words or fewer, or null."},
      "evidence": {"type": "string", "description": "Up to 15 words copied from the text."},
      "language": {"type": "string", "description": "ISO 639-1 code."}
    },
    "required": ["item_id", "sentiment", "issue_categories", "mentions_competitor", "competitors",
                 "other_brand_name", "action_item", "evidence", "language"],
    "additionalProperties": false
  }
}
25 条一组的版本,是在外面再包一层:根对象只有一个 labels 数组,数组元素用 $ref 指向 $defs 里的同一个标签对象。指南写明 $defs 和 $ref 支持,嵌套层数从 1 层变成 2 层,离 10 层的上限很远。字段顺序也有讲究:指南写了输出会按 schema 里键的顺序生成,所以我们把 item_id 放第一个,把需要模型先读懂全文才能定的 action_item 和 evidence 放在后面。这样即使某次输出被截断,前面的 id 和情绪也能先对上。
标签怎么设计:四个问题,九个字段
打标签之前先想清楚这批标签给谁用。一个扫地机器人品牌的应用团队、客服团队和产品团队,各自想从评论里拿到的东西不一样:应用团队关心连不上网、登录失败、地图丢了;客服关心哪些评论在抱怨售后;产品经理关心用户拿谁来比。所以我们把标签设计成四个问题:这条评论的态度是什么,讲了哪类问题,有没有提到别家,能不能变成一条可执行的改进。每个问题对应一到两个字段,问题类别用 15 个枚举值写死,竞品用 12 个枚举值加一个「其他品牌」的出口。
问题类别是本文花时间最多的地方。我们先读了真调回来的 412 条评论,把实际出现的抱怨归成 13 类,再加上 other 和 none。比如 iRobot 应用的低分评论里,大量是「命令发不出去」「连不上 iRobot 云」,这归到 app_connectivity;「验证码收不到」「账号绑定失败」归到 account_login;Roborock 应用里有不少「更新以后地图乱了」,这同时属于 firmware_update 和 mapping_navigation,所以我们允许一条评论最多挂 3 个类别。系统提示里给每个类别写了一句判定说明,这一段占了提示词的一大半,也是后面 token 账里「固定前缀」那 645 token 的主要来源。
情绪只给四个值:positive、negative、mixed、neutral。系统提示里写明「不要只看星级判断情绪」,因为星级和正文经常对不上。我们读到的 Roborock 应用评论里,就有一条 1 星评论开头写「App is very good」,后面才说地图有问题;也有一条 3 星评论,前半句夸应用好用,后半句说三星折叠屏手机上底部按钮点不到。这类评论在系统提示里约定标成 mixed。TikTok 评论没有星级,像「哪款最好?」这种提问,约定标 neutral。
action_item 是四个问题里最难验收的一个,所以我们限制得最死:一句英文,20 个词以内,没有可执行的内容就返回 null。evidence 要求从原文里摘 15 个词以内的原话,保留原语言。这两个字段的作用是让人能抽查:标签说这条评论是「固件更新导致地图出错」,人只要看 evidence 那半句原话,就能在几秒内判断对不对,不用回去读全文。
我们按这套 schema 给 12 条真实评论手写了示例输出,用来估算输出 token,也让读者看到每个字段长什么样。下表是其中 4 条(评论原文节选,作者信息已隐去)。这 12 条示例是人写的,不是 GPT-6.1 Sol 的输出。
| 来源 | 星级 | 评论节选 | 情绪 | 问题类别 | 竞品 |
|---|---|---|---|---|---|
| Roborock 应用 | 2 | 「You ruined my robot after your last update! The map is all messed up…」 | negative | firmware_update、mapping_navigation | 无 |
| Roborock 应用 | 3 | 「…it doesn't support the Samsung Z Fold 8's screen aspect ratio…」 | mixed | app_usability | 无(三星是手机) |
| iRobot 应用 | 1 | 「every 2nd vacuum I have a connection issue. I will never buy another Roomba」 | negative | app_connectivity | 无 |
| TikTok 评论 | 无 | 「How about the Dreame X60 Pro Ultra?…」 | neutral | none | dreame |
用 EveryInfra 拉评论:一次真实往返
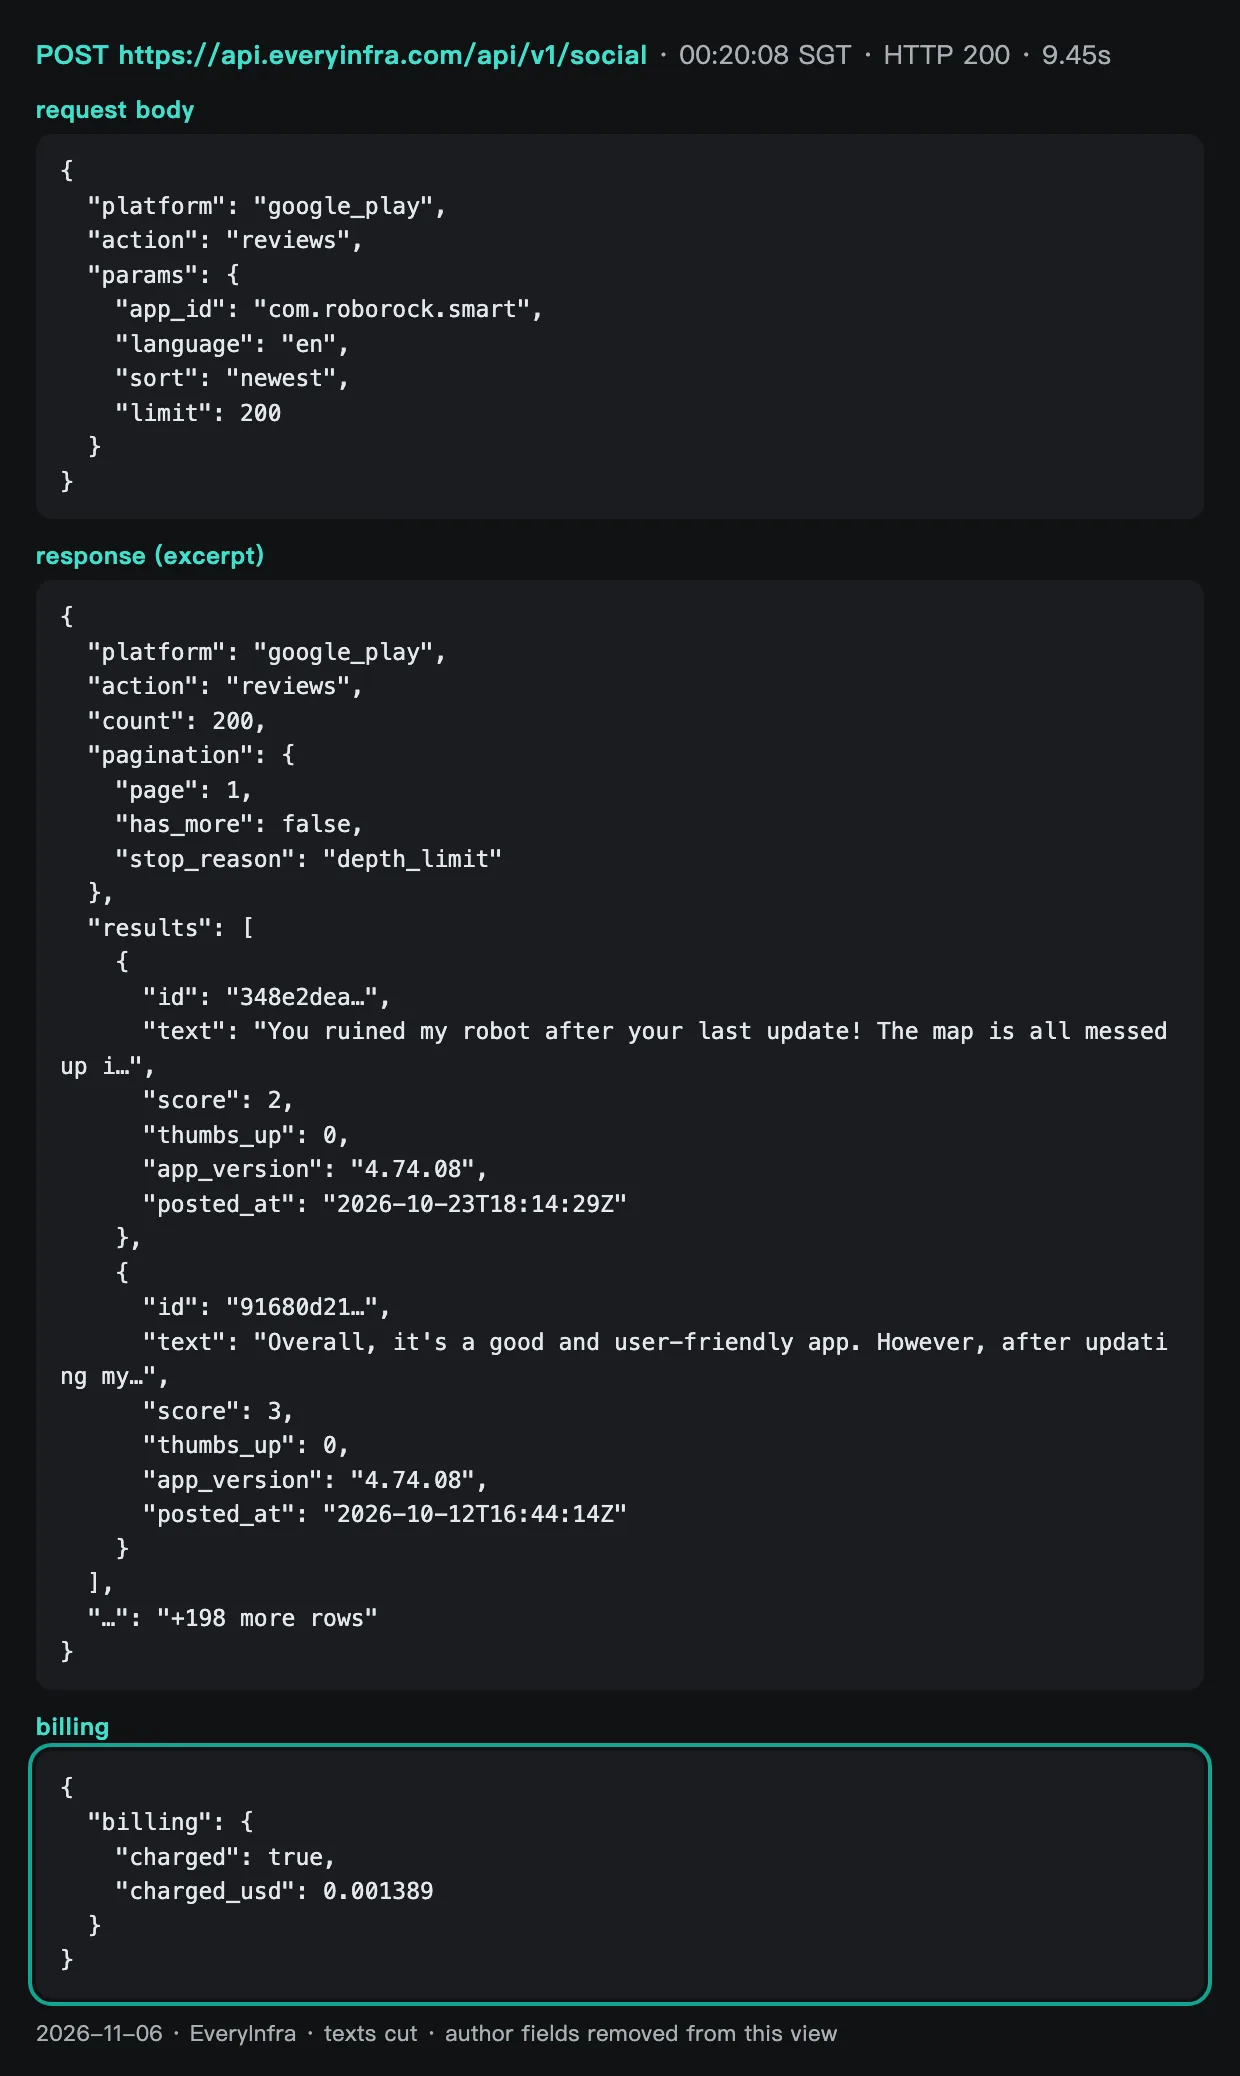
取数用的是 EveryInfra 的统一数据接口 POST /api/v1/social,请求体写平台、能力和参数。动手前我们先读了免费的能力目录(2026-11-06 00:15 读取),确认评论类能力的价格、参数和返回字段:google_play/reviews 每次 $0.001389,同步最多 200 条,支持 language 和 sort;tiktok/comments 每次 $0.000556,按视频链接取评论;amazon/reviews 每次 $0.001389,目录写明各站点只能取到商品页展示的精选评论,每个商品通常十几条;trustpilot/reviews 每次 $0.001389。下面是 Google Play 那一次的完整请求:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"google_play","action":"reviews",
       "params":{"app_id":"com.roborock.smart","language":"en","sort":"newest","limit":200}}'
这次请求在新加坡时间 2026-11-06 00:20:08 发出,9.45 秒返回 HTTP 200,count 是 200,pagination.stop_reason 是 depth_limit,has_more 是 false,扣费 $0.001389。返回的每条评论有 id、text、score、thumbs_up、reply_text、reply_at、app_version、posted_at 等字段,和目录里 response_fields 列的一致;作者名和头像字段也在返回里,但打标签用不到,我们在送给模型之前就去掉了。
一共 7 次调用,按新加坡时间排列:00:16:42 同步调 amazon/reviews(Roborock Q7 M5+),等了 89.91 秒回 503 超时,不扣费,错误里直接写了「改用 "mode":"async" 拿 job_id」;00:18:21 改成异步,202 立即返回 job_id,00:19:57 任务成功但 0 条,refund_state 为 refunded;00:18:26 同步调 tiktok/comments,等了 90.21 秒回 200,一个测评视频只回来 12 条;00:20:08 和 00:20:25 两次 google_play/reviews,各 200 条;00:20:34 换一个 Roborock 商品再试 amazon/reviews 异步,00:24:18 仍是成功但 0 条、已退;00:24:27 调 trustpilot/reviews(limit 200)同步 503 超时,不扣费,错误提示建议减小 limit 或改异步。
| 时间(新加坡时间) | 能力 | 结果 | 耗时(我们这边计时) | 条数 | 扣费 |
|---|---|---|---|---|---|
| 00:16:42 | amazon/reviews 同步 | 503 超时 | 89.91 秒 | 0 | $0 |
| 00:18:21 → 00:19:57 | amazon/reviews 异步 | 成功,0 条,已退 | 提交 2.08 秒,完成约 96 秒 | 0 | $0(先扣后退) |
| 00:18:26 | tiktok/comments 同步 | 200 | 90.21 秒 | 12 | $0.000556 |
| 00:20:08 | google_play/reviews Roborock | 200 | 9.45 秒 | 200 | $0.001389 |
| 00:20:25 | google_play/reviews iRobot | 200 | 9.24 秒 | 200 | $0.001389 |
| 00:20:34 → 00:24:18 | amazon/reviews 异步 | 成功,0 条,已退 | 提交 2.04 秒,完成约 224 秒 | 0 | $0(先扣后退) |
| 00:24:27 | trustpilot/reviews 同步 | 503 超时 | 88.2 秒 | 0 | $0 |
耗时那一列有一处要说明。tiktok/comments 用了 90.21 秒,比两次 503 超时(89.91 秒、88.2 秒)还长,却回了 200 和 12 条。两次 503 的错误原文都写着「request timed out after 85s」,所以 85 秒是服务端等数据的上限;表里的秒数是我们这边从发出请求到收完返回的时间,多出来的几秒是网络往返和排队。返回里没有服务端自己的计时,我们没法确认 TikTok 那次在服务端用了多少秒,只能说它离超时线很近:同样的请求换个时间再发,可能就是 503。所以取 TikTok 评论这类慢能力,批量时也建议直接用异步。
这张表本身就是一个可写的观察。7 次里只有 3 次拿到数据,但 4 次没拿到数据的调用一分钱没收:两次 503 在返回里就写了 charged_usd: 0,两次空结果的异步任务先按调用价预扣,任务结束时自动退回。对批量打标签的人来说,这意味着取数这一步失败的代价是时间,不是钱;真正要防的是把「0 条」当成「没有差评」写进报告。Amazon 那两次 0 条我们没有继续追,原因在后面「做不了或要注意的地方」一节说明。
这 412 条评论长什么样
送给模型之前,先看一眼数据本身。两款应用各 200 条最新英文评论,看起来量一样,覆盖的时间却差了三倍:Roborock 应用的 200 条从 2026-10-03 到 2026-11-04,跨 32 天;iRobot 应用的 200 条从 2026-07-27 到 2026-11-04,跨 99 天。也就是说,同样每次 $0.001389,Roborock 一侧拿到的是最近一个月的声音,iRobot 一侧拿到的是三个多月的。做周报时,如果只按「最新 200 条」取,iRobot 这一侧会把七月的旧问题也算进本周。
星级分布差得更多。iRobot 应用的 200 条里,1 星 100 条、2 星 26 条,合计 126 条是 1–2 星,占 63%;Roborock 应用是 46 条加 22 条,合计 68 条,占 34%。开发者回复也不一样:iRobot 应用 200 条里 100 条带 reply_text,Roborock 应用 49 条。这些数只说明「这 200 条」的样子,不代表两家产品的整体口碑,因为 Google Play 的排序、哪些用户会来写评论,都会影响样本;我们写出来,是因为它直接决定了标签结果的分布:iRobot 这一批里大部分评论会落进 negative 和 app_connectivity,类别分布会很偏。
评论的长度决定了 token 账。Google Play 评论的正文中位数,Roborock 应用 94.5 个字符、iRobot 应用 128.5 个字符,两边最长都是 500 个字符,正好是 Google Play 评论的长度上限(Google Play 帮助社区里有用户专门发帖问过这个 500 字符的上限)。不到 20 个字符的短评,Roborock 一侧 35 条、iRobot 一侧 24 条,比如「Great robovac great」「iRobot is awful」。TikTok 的 12 条评论中位数 51.5 个字符,多是提问,时间从 2026-06-13 到 2026-11-01,跨了将近五个月:一个视频下的评论不是按天增长的,热度过了以后就很少有人再来留言,这也是它每次只回 12 条的原因。短评的意思是:一条评论本身只有几十个 token,如果每条都要配上几百 token 的说明书,钱就花在说明书上了。
还有一个小发现:我们请求的是 language: "en",Roborock 那 200 条里仍有中文和斯洛伐克语评论。目录的参数说明写得很清楚,language 是查询语言,不保证每条评论都是这个语言。所以 schema 里留了 language 字段让模型回填,系统提示里也写了「action_item 一律用英文写,evidence 保留原语言」。
「是否提到竞品」:关键词规则能做到几成
四个标签里,「是否提到竞品」看起来最适合用关键词规则做,不用花模型的钱。我们拿 412 条评论试了一下:用 29 个扫地机器人和家电品牌名做正则匹配(排除评论所在应用自己的品牌),命中 17 条;然后逐条读完这 17 条,判断是不是真的在提另一家扫地机器人。
17 条里 13 条是真的:Roborock 应用里有 5 条拿 iRobot、Roomba、Shark 或 Bissell 做对比,其中 4 条是 5 星,比如「a great upgrade from the iRobot」,另一条 1 星的反过来说五年前的 Roomba 更好;iRobot 应用里有 5 条劝人换 Roborock、Shark、Rowenta 或 Ecovacs,全是 1–2 星;TikTok 的 3 条在问 Dreame、Roborock、Mova 的型号。3 条是误报:一条说的是三星 Z Fold 8 手机屏幕比例不兼容,一条说三星平板装不了应用,还有一条是斯洛伐克语评论里的「mi」(意思是「我」),被当成了小米。剩下 1 条说不清:评论骂应用新加的「探索」页是标题党,顺带说这是「typical xiaomi」式的营销,提了品牌名,但不是在比扫地机器人。
规则的漏网之鱼同样说明问题。那条把「Sharks、Bissell's、iRomba's」一起点名的 5 星评论,规则只认出了 Bissell,复数的「Sharks」和拼错的「iRomba」都没匹配上;如果品牌名单只用最常见的 13 个,命中会降到 14 条,Rowenta 和 Bissell 那两条都会丢掉。这组数的意思是,关键词规则做「初筛」可以,做「标签」不够:误报来自同名的手机和外语词,漏报来自复数、拼写错误和名单外的品牌。schema 里 competitors 枚举加 other_brand 的设计,就是把这一列交给模型的理由。反过来,mentions_competitor 这个布尔值完全可以由 competitors 是否为空推出来,我们保留它,只是为了让表格好筛,后面会讲怎么查它和 competitors 是否一致。
token 怎么估:固定前缀占了 92%
没有 OpenAI 的 Key,模型费只能估。我们的估法每一步都写出来,方便你换成自己的数:OpenAI 没有公开 GPT-6.1 Sol 用的分词器,我们用 OpenAI 开源的 tiktoken(PyPI 0.14.0)里最新公开的 o200k_base 编码去数;系统提示、schema、每条评论的输入格式都是真文件,评论是真调回来的 412 条;输出按 12 条手写示例标签的平均长度算;推理 token 单列为假设。真实计费以 Responses API 返回的 usage 为准,正式跑之前用 20 条做一次试跑,读出 input_tokens、output_tokens 和 output_tokens_details.reasoning_tokens 再回来改表。
| 组成部分 | token(o200k_base) | 说明 |
|---|---|---|
| 系统提示(类别说明 + 规则) | 645 | 每次请求都要送 |
| 单条标签 schema | 322 | 按紧凑 JSON 序列化后计数,实际怎么计入由 OpenAI 决定 |
| 25 条一组的 schema | 362 | 多一层 labels 数组 |
| 固定前缀(单条 / 25 条一组) | 967 / 1,007 | 都低于缓存门槛 1,024 |
| 一条评论的输入(含 id、来源、星级) | 平均 81.1,中位数 73.5,最长 205 | 412 条真实评论 |
| 其中评论正文 | 平均 32.6 | 一半以上的 token 花在格式行上 |
| 一条标签的输出 | 平均 87.3(65–107) | 12 条手写示例 |
把这些数乘到 1,000 条上,差别一下子就出来了。每次请求只送 1 条评论,1,000 次请求的输入约 1,056,100 token,其中固定前缀(每次 967 token 加 8 token 消息格式的占位)就占了 975,000,占 92.3%。每次送 25 条,只要 40 次请求,固定前缀降到 40,600 token,总输入降到约 121,700 token,少了 88.5%。评论本身的 81,100 token 两种跑法完全一样,省下来的全是重复送的说明书。
你可能会想:前缀重复,那就靠缓存。Prompt caching 指南写了 GPT-5.6 及以后的模型最小可缓存前缀是 1,024 个可见输入 token,而且 OpenAI 自己加的隐藏系统内容不算在内;GPT-6.1 Sol 的缓存读按普通输入价的 0.05 倍收,30 分钟写入按 1.25 倍、12 小时写入按 2.5 倍收。我们的前缀按 o200k_base 数是 967 token,比门槛少 57 个;schema 如果被转成隐藏的系统内容,可见部分就只剩 645 token,离门槛更远。不管哪种情况,这份前缀本身都进不了缓存。换句话说,「每次 1 条 + 指望缓存」这条路,在这个提示词长度下走不通。
如果你的系统提示本来就更长(比如加了十几条示例),超过 1,024 token 以后,缓存就能生效。我们按「前缀全部按缓存价读」算了一个假想值:同样每次 1 条、Batch 价,千条模型费会从 $1.49 降到约 $0.57,和每次 25 条的 $0.56 几乎一样,而且这个假想值还没算第一次写入缓存的 1.25 倍费用。两条路效果接近,但每次 25 条不依赖缓存是否命中,也不用为了凑够 1,024 token 去加没用的提示词,所以本文按每次 25 条写 Batch 文件。
如果不用 Batch、改走同步接口,大量请求还会碰到每分钟 token 限额:限额指南在 2026-10-06 把用量档位简化成 Build、Launch、Grow 三档,Sol 模型页给 Build 档的是每分钟 1,000,000 token。Batch 有自己单独的、更高的限额,不占同步额度;大批量跑之前,先到自己账户的限额页看一眼。
Batch API 跑法:JSONL、上传、取回
Batch API 指南写得很清楚:把每个请求写成 .jsonl 文件的一行,每行有唯一的 custom_id、method、url 和与同步接口相同的 body;一个文件只能用一个模型;上传时 purpose 设 batch;建批时 completion_window 目前只能是 24h;比同步接口便宜 50%,有单独的、更高的限额。指南还写了三个打标签时一定会遇到的限制:一批最多 50,000 个请求,输入文件最大 200 MB;每小时最多建 2,000 批;输出文件里的行序不保证和输入一致,要按 custom_id 对回去。
我们用真调回来的 412 条评论生成了两份 Batch 文件,看文件本身的大小。每次 1 条的版本是 412 行、2,018,830 字节,平均每行约 4,900 字节,因为每一行都带着整份系统提示和 schema;每次 25 条的版本是 17 行、191,412 字节,平均每行约 11,260 字节。按 200 MB 的上限推算,每次 1 条的写法一个文件大约装得下 42,798 条评论,先碰到的是文件大小,不是 50,000 行;每次 25 条的写法按大小能装约 45 万条,按行数能装 125 万条。千条规模离这些上限都很远,但如果你要一次跑几万条,每次 1 条的写法会比你预想的更早碰到 200 MB。
下面是每次 25 条那份文件的第一行(为了好读,换了行,系统提示和 schema 用省略号代替),以及上传和建批的 Python 写法。这段是按官方文档写的配置示例,我们没有在 OpenAI 上运行:
# 一行 JSONL(节选):
# {"custom_id": "chunk-000", "method": "POST", "url": "/v1/responses",
#  "body": {"model": "gpt-6.1-sol", "reasoning": {"effort": "low"}, "max_output_tokens": 12000, "store": false,
#           "input": [{"role": "developer", "content": "You label customer reviews ..."},
#                     {"role": "user", "content": "item_id: 56a3b9f4-...\nsource: google_play/reviews app=com.roborock.smart\nrating: 5/5\ntext: ..."}],
#           "text": {"format": {"type": "json_schema", "name": "review_labels", "strict": true, "schema": {...}}}}}
from openai import OpenAI
client = OpenAI()  # 读环境变量 OPENAI_API_KEY
f = client.files.create(file=open("x25.jsonl", "rb"), purpose="batch")
batch = client.batches.create(input_file_id=f.id, endpoint="/v1/responses", completion_window="24h",
                              metadata={"job": "review-tagging-2026-11-06"})
print(batch.id, batch.status)  # validating -> in_progress -> finalizing -> completed
max_output_tokens 要给够。25 条标签按每条约 87 token 算是 2,200 token 左右,再加推理 token,我们给了 12,000。给少了,结构化输出会在中途被截断,Structured Outputs 指南专门写了这种情况:响应状态是 incomplete,原因是 max_output_tokens,这时拿到的 JSON 不完整,要按失败处理。store: false 表示不让 OpenAI 存这条响应供以后引用;但 Batch API 常见问题写明零数据保留(ZDR)不适用于 Batch API,输入文件、输出和错误文件按 Batch 和文件服务的保留规则保存,评论里如果有个人信息,送进去之前先去掉。我们在拼请求时已经去掉了作者名、作者头像和评论链接,只留评论 id、来源、星级和正文。
取回结果时,状态依次是 validating、in_progress、finalizing、completed;过了 24 小时没跑完的批次变成 expired,已完成的部分照常交付、照常收费,没跑的写进错误文件,错误码是 batch_expired。输出文件在批次完成 30 天后自动删除,要及时下载。Batch 接口参考和 Files 接口参考列了每个字段;如果你更想要「便宜但同步返回」,Flex 处理按 Batch 价收费,代价是更慢、偶尔回 429 资源不足(这时不收费)。
千条成本表:接口费加模型费
把取数和打标签两笔钱放在一起。数据费按本次实测的每次条数和目录价推算:Google Play 每次 200 条,1,000 条要 5 次,$0.006945;TikTok 这个视频每次 12 条,1,000 条要 84 次,$0.046704,贵 6.7 倍;本次混合的 412 条实付 $0.003334,折合每千条 $0.008092。TikTok 那个数是按「每个视频 12 条」推的,热门视频一次能回更多,数据费会低得多;这里写出来,是提醒你每千条的数据费取决于「每次能回多少条」,而不只是单价。
模型费按 OpenAI 价格页 2026-11-06 的公开价、上一节的 token 数估算。推理 token 我们分三档:每条 0(这是下限,Sol 实际做不到,因为最低是 low)、每条 50、每条 200。下表所有数都是每 1,000 条评论的美元,不含 EveryInfra 的数据费。
| 跑法(每 1,000 条) | 推理 0(下限) | 推理每条 50(假设) | 推理每条 200(假设) |
|---|---|---|---|
| Sol 标准接口,每次 1 条 | $2.99 | $3.49 | $4.99 |
| Sol Batch,每次 1 条 | $1.49 | $1.74 | $2.49 |
| Sol Batch,每次 1 条,前缀按缓存价(假想,前缀不够 1,024) | $0.57 | $0.82 | $1.57 |
| Sol Batch,每次 25 条 | $0.56 | $0.81 | $1.56 |
Terra Batch,每次 25 条,none | $0.28 | 不适用 | 不适用 |
Luna Batch,每次 25 条,none | $0.028 | 不适用 | 不适用 |
这张表有三个读法。第一,同一个模型,从「标准接口每次 1 条」换成「Batch 每次 25 条」,下限从 $2.99 降到 $0.56,差 5.3 倍,模型和提示词一个字没改。第二,每次 25 条以后,钱主要花在输出上:$0.56 里输出占 $0.44,约 78%;每条评论多 50 个推理 token,就多 $0.25(50 × 1,000 × $5 ÷ 1,000,000)。所以真正决定最终账单的,是 low 档在你这批评论上实际产生多少推理 token,这只能靠试跑量出来。第三,数据费在总账里很小:Google Play 的 $0.006945 加上 Sol Batch 每次 25 条的 $0.56,合计约 $0.566,数据费占 1.2%;换成 TikTok 的 $0.046704,也只占 7.7%。
要把这张表换成你自己的数,只需要四个量:固定前缀的 token 数 P,每条评论的平均输入 token 数 x,每条标签的平均输出 token 数 y,每条评论的推理 token 数 r。每次送 k 条、Batch 价下,每千条的模型费约等于(1,000 ÷ k × P + 1,000 × x)× $1 ÷ 1,000,000,加上 1,000 ×(y + r)× $5 ÷ 1,000,000。本文的 P 是 967 或 1,007,x 是 81.1,y 是 87.3,r 未知。你的评论如果更长(比如电商长评平均三四百 token),x 那一项会变大,k 的作用就变小;你的提示词如果更长,P 那一项会变大,加大 k 的作用就更明显。这个式子没有算超过 272K 输入的加价,每次送 25 条只有三千多 token,离那条线很远;但如果你想一次塞几千条,就要把加价算进去,或者干脆拆开。
拿一个外部的数对照一下量级。2023 年 Gilardi 等人的论文《ChatGPT Outperforms Crowd-Workers for Text-Annotation Tasks》用 2,382 条推文测试,报告当时每条标注成本不到 $0.003,约为众包平台的二十分之一。我们表里 Sol Batch 每次 25 条的下限折合每条约 $0.00056,加上 50 个推理 token 约 $0.00081。两个数一边是论文的实测,一边是本文没在 OpenAI 上跑过的估算,任务和模型也不同,这里只作量级参考,不拿来推断价格降了多少,也不比谁更准。
Sol、Terra、Luna 和 Decisions API:什么时候不用 Sol
成本表最后两行是故意放进去的。GPT-6.1 Terra 在 2026-10-26 上线,发布文说它的标准价比 GPT-6.1 Sol 低 50%,适合处理大批量的文书工作;它支持 none 推理,Batch 价输入 $0.50、输出 $2.50。GPT-6 Luna 是 OpenAI 写的「最适合专注、大批量任务的高效模型」,同样支持 none,Batch 价输入 $0.05、输出 $0.25。按同一份 token 估算,Terra 每千条 $0.28,Luna 每千条 $0.028,分别是 Sol 下限的一半和二十分之一,而且没有推理 token 这个不确定项。
那什么时候用 Sol?我们的看法是两种情况。一是标签本身需要推理:比如「这条评论说的故障,是不是上个固件版本引入的」,需要结合 app_version 和正文判断;或者 action_item 要写得像产品经理写的一样具体。二是你已经用 Luna 或 Terra 跑过一遍,抽查发现某几类(比如 mixed 情绪、竞品比较)错得多,只把这一部分重跑在 Sol 上。像「这条评论是不是 1 星」「是不是讲连接问题」这种几乎看字面就能判的标签,用 Sol 的推理是浪费。
OpenAI 还有一条专门为分类做的路。Decisions API 在 2026-10-06 以 beta 发布,2026-10-22 正式可用,目前只支持 gpt-6-luna;它不让模型生成 JSON,而是对你给的问题返回类型化的答案:predicate 返回一个 0 到 1 的概率,choice 从你给的选项里选一个并带每个选项的概率,score 按 2 到 10 档打分;一次请求最多 400 个问题,官方说比 Responses API 快约 10 倍。指南自己写了分工:要概率、单选或打分,用 Decisions;要生成符合自己 schema 的对象,比如抽字段或写一段解释,用 Structured Outputs。本文的四个标签里,情绪、问题类别、是否提到竞品都能写成 Decisions 的问题,而且能拿到置信度;action_item 和 evidence 这种要写字的字段,仍然要靠 Structured Outputs。
| 选择 | 适合 | 每千条模型费(估算) | 主要限制 |
|---|---|---|---|
| GPT-6.1 Sol + Structured Outputs + Batch | 要推理、要写建议、要高质量的少量重跑 | $0.56 起,每条每 50 推理 token 加 $0.25 | 不能关推理;24 小时内交付 |
| GPT-6.1 Terra + Structured Outputs + Batch | 大批量、字段清楚、需要写一句话 | 约 $0.28(none) | 复杂判断不如 Sol |
| GPT-6 Luna + Structured Outputs + Batch | 纯分类,量很大 | 约 $0.028(none) | 写建议的质量要抽查 |
| Decisions API(Luna) | 情绪、类别、是否提到竞品,要置信度 | 本文没估(按 Luna token 价,问题数影响用量) | 不生成自由文本;只支持 Luna |
schema 管不住的事:结果回来以后还要查什么
严格模式保证的是形状:每个字段都在、类型对、枚举值合法。它不保证内容对,也不保证字段之间不矛盾。我们用 Python 的 jsonschema 库做了一个小实验:把手写示例里那条 TikTok 评论的标签改成 competitors: ["dreame"]、mentions_competitor: false,两个字段明显矛盾,但它照样通过了 schema 校验。Structured Outputs 指南自己也写了「Structured Outputs 仍可能出错」,建议调整指令、给示例或拆分任务。所以结果回来以后,我们建议至少再跑下面这段检查:
import json
def check(label, item):
    errs = []
    if label["mentions_competitor"] != bool(label["competitors"]):
        errs.append("mentions_competitor 与 competitors 不一致")
    if ("other_brand" in label["competitors"]) != (label["other_brand_name"] is not None):
        errs.append("other_brand 与 other_brand_name 不一致")
    if "none" in label["issue_categories"] and len(label["issue_categories"]) > 1:
        errs.append("none 不能和其他类别同时出现")
    if label["action_item"] and len(label["action_item"].split()) > 20:
        errs.append("action_item 超过 20 个词")
    if label["evidence"] and label["evidence"].lower()[:30] not in item["text"].lower():
        errs.append("evidence 不是原文摘录")
    if label["item_id"] != item["id"]:
        errs.append("item_id 对不上")
    return errs
这几条检查对应的都是 schema 写不出来的规则:两个字段之间的「当且仅当」,枚举值之间的互斥,字数上限,以及「摘录必须来自原文」。最后一条最有用,它能抓出模型自己编的「原话」。25 条一组的请求还要多查一件事:回来的 labels 数组长度是不是 25,item_id 是不是和输入一一对上;指南写了输出按 schema 的键序生成,但没有承诺数组里元素的顺序和你输入的顺序一致,按 id 对比按位置对更安全。
还有两种情况要单独处理。一是拒答:指南写明模型出于安全原因拒绝时,返回的内容类型是 refusal,不按你的 schema;评论里偶尔有脏话或极端言论(我们读到的 iRobot 评论里就有一条用侮辱性词汇骂开发者),要准备好接住 refusal。二是和主题无关的输入:指南建议在提示里说明「输入不符合任务时返回什么」,否则模型会努力把不相关的内容硬套进 schema。我们的系统提示第 8 条就是干这个的:空评论、广告、和扫地机器人无关的内容,一律标 neutral、none、空竞品。
做不了或要注意的地方
第一,Amazon 评论这次没拿到。两次异步任务都显示成功但 0 条,费用自动退回;目录本来就写了 Amazon 各站点只能取到商品页展示的精选评论,每个商品通常十几条,取不到全部历史评论。即使取到,单个商品一次十几条,按每次 $0.001389 推算,每千条的数据费会在 $0.08 以上,是 Google Play 的十几倍。要做大样本的 Amazon 评论分析,请先用少量商品试,确认每次实际能回多少条再算预算;本文的千条成本表没有包含 Amazon。
第二,同步请求有 85 秒的时间预算,按服务端计时。amazon/reviews 和 trustpilot/reviews(limit 200)这次都是同步等到 85 秒以上回 503 超时,不扣费,返回里写明了改用 "mode":"async" 或减小 limit;tiktok/comments 在我们这边量到 90.21 秒才回 200,说明它也贴着这条线。批量取数时,建议对慢的能力直接用异步:202 立刻返回 job_id,再按 poll_url 轮询。我们那两次异步任务从提交到完成分别用了约 1 分 36 秒和 3 分 44 秒。
第三,「最新 200 条」不是一个固定的时间窗。前面看到 Roborock 的 200 条跨 32 天、iRobot 的跨 99 天。如果你要做每周对比,应该按 posted_at 先切出同一周,再去打标签;Google Play 的翻页在同步模式下最深 200 条,要更深要用异步,目录的 pagination 字段写了上限。另外,如果评论来自你自己的应用,Google 官方的 Reply to Reviews API 只能取最近一周创建或修改过的评论,每页最多 100 条,GET 每小时 200 次,更早的要从 Play Console 下载 CSV;看竞品应用的评论,官方接口是拿不到的。
第四,评论本身的真实性。美国联邦贸易委员会 2024 年 8 月公布的禁止虚假评论和推荐的最终规则,把 AI 生成的假评论、以特定好评或差评为条件的激励都列为禁止行为。打标签能告诉你评论说了什么,不能告诉你评论是不是真的;如果标签结果要拿去给团队做决策,样本里异常集中的 5 星或 1 星,值得先单独看一眼。
第五,结构化输出对推理质量可能有影响。论文《Let Me Speak Freely?》(2024)发现,把模型限制在 JSON 这类固定格式里,推理任务的表现会明显下降,格式限制越严,下降越多;JSONSchemaBench(2025)用 1 万份真实 schema 评估了包括 OpenAI 在内的六种约束解码方案,结论是各家对不同 schema 的覆盖和输出质量差异很大。这两篇测的都是更早的模型,不能直接套到 GPT-6.1 Sol 上,但它们支持本文的一个做法:把需要动脑的字段(action_item)放在 schema 后面,让模型先写完简单字段;如果某一类标签抽查准确率低,试试先让模型自由回答、再用一个便宜模型转成 JSON。
第六,标签准不准,要靠人抽查,不能靠模型自评。本文没有在 OpenAI 上实跑,所以没有准确率数字;我们建议的做法是:试跑的 20 条加上正式结果里随机抽的 50 条,由熟悉产品的人逐条对照原文判对错,按类别记下错误数,再决定哪些类别要改提示词、哪些要换模型重跑。前面关键词审计那 17 条,就是用同样的办法逐条读出来的。数据标注综述有专门一节讨论怎么评估大模型生成的标注,人工评估是其中的一种做法,另一种是拿已有的人工标注集做对照。
和站内其他评论文章的区别
站内已经有几篇用模型处理评论的文章,这篇刻意不重复它们。DeepSeek V4 驱动 Claude Code 洗评论讲的是在 Claude Code 里交互地清洗 695 行视频评论,钱主要看缓存是否命中;Claude strict tool use 调数据接口讲的是让模型用严格的工具定义去调我们的接口,严格的是「输入参数」;Qwen Agent 做电商评论员讲的是智能体边比价边读评论。本篇的严格是「输出格式」,场景是一次性的离线批处理,钱的大头是怎么拼请求。
如果你想在 ChatGPT 里直接看报告而不是跑批处理,可以看 GPT-6 Intelligent UI 社媒报告,那篇讲的是 Chat 里的 GPT-6 怎么把 MCP 返回的数据做成表和图。
最近 60 天的相关变化
2026-09-29,GPT-6.1 Sol 上 API(更新日志)。对读者的意思:Sol 这一档的标准价是 Astra 的五分之一,大批量的结构化任务第一次可以用到接近旗舰的模型,但它不能关推理。
2026-10-06,Decisions API 以 beta 发布,2026-10-22 正式可用,每次请求最多 400 个问题(Decisions 指南)。对读者的意思:情绪、类别这类单选标签,多了一条不用写 JSON、还带置信度的路,目前只有 Luna。
2026-10-20,API 可以选 12 小时的提示缓存,写入按输入价的 2.5 倍收(更新日志、Prompt caching 指南)。对读者的意思:如果你的打标签任务一天分几次跑、提示词超过 1,024 token,长缓存能把固定前缀的成本压到很低;前缀不够长时它帮不上忙。
2026-10-21,组织和项目可以在平台设置里限定能用哪些服务档位(更新日志)。对读者的意思:如果你所在团队的管理员只放开了默认档,Flex 这类非默认档的请求会直接报服务档位错误;跑之前先确认项目设置,别等批量请求失败了才发现。
2026-10-26,GPT-6.1 Terra 发布,标准价比 Sol 低一半,支持 none 推理(Terra 模型页)。对读者的意思:在 Sol 和 Luna 之间多了一个能关推理的中档,很多打标签任务可以先试 Terra。
2026-10-28,符合条件的 ChatGPT Pro 和 Business 订阅可以每月领最多 $500 的 API 额度(说明页)。对读者的意思:千条评论的模型费在几毛钱到几美元之间,有订阅的团队可以先用这笔额度做试跑,额度当月不用就过期。
GPT-6.1 Sol 与结构化输出常见问题
gpt-6.1 sol api price 是多少?
完整价格见前面「GPT-6.1 Sol API 是什么」一节的表。一句话版本:按 OpenAI 价格页,标准价每百万 token 输入 $2、输出 $10,Batch 和 Flex 减半;Fast 是标准的两倍,Ultrafast 是 6 倍,批量打标签用不上这两档。推理 token 按输出价算。(问题来自 2026-11-06 的 Google 联想词,中文还有「gpt 6.1 sol api 价格」。)
gpt 6.1 sol api name 是什么,怎么调?
模型名是 gpt-6.1-sol,写在 Responses API 请求的 model 字段里(模型页)。Chat Completions 也能用,但不支持工具调用;要用工具,迁移指南建议换 Responses API。推理强度用 reasoning.effort,最低 low。(问题来自 Google 联想词「gpt 6.1 sol api name」。)
gpt 6.1 structured outputs example 怎么写?
最小写法是在 Responses API 里加 text: {format: {type: "json_schema", name: "...", strict: true, schema: {...}}},schema 的每个对象都要 additionalProperties: false、所有字段都列进 required。Python 里也可以用 Pydantic 模型交给 SDK 的 responses.parse,SDK 会替你生成 schema(openai-python 辅助函数说明、Pydantic 的 JSON Schema 文档)。本文前面那段九字段的 schema 可以直接拿去改。(问题来自 Google 联想词「gpt 6.1 structured outputs example」。)
openai batch api structured output 能一起用吗?
能。Structured Outputs 指南写明 Structured Outputs 和 JSON mode 都支持 Batch API;Batch 文件每一行的 body 和同步请求完全一样,text.format 照写。要注意三点:一个文件只能用一个模型;max_output_tokens 给够,免得 JSON 被截断;结果按 custom_id 对回,不要按行序。(问题来自 Google 联想词「openai batch api structured output」。)
为什么 GPT-6.1 Sol 在 max 档比 GPT-5.6 Sol 慢那么多?
这个问题来自 OpenAI 开发者社区的一个讨论帖:发帖人同一个提示词,GPT-6.1 Sol 在 max 档输出约 62,708 token、其中推理 52,552 token,用了 1,846 秒;GPT-5.6 Sol 输出约 31,426 token,用了 373 秒。帖子里的回复认为不能只凭这一组数断定是限速。对打标签来说,结论很简单:不要开 max,low 就够;Batch 本来就是 24 小时内交付,慢一点不影响,但推理 token 多一倍,输出费也多一倍。
上手步骤
- 在 EveryInfra 快速开始创建 API Key,读一遍免费的能力目录,确认
google_play/reviews、tiktok/comments、amazon/reviews的价格和返回字段。 - 先各取一页:在 Google Play 评论接口、TikTok 评论接口的试用台里试一次,看每次实际回多少条,再按条数算千条预算;慢的能力加
"mode":"async"。 - 用本文的九字段 schema 改出你自己的类别,先用脚本对照 Structured Outputs 指南查一遍严格模式的规则。
- 用 20 条评论在 OpenAI 上同步试跑,读
usage里的输入、输出和推理 token,回来改成本表;再决定用 Sol、Terra 还是 Luna。 - 按每次 25 条写 JSONL,走 Batch API;结果回来后跑一致性检查,抽查
evidence和原文。 - 要在 Claude、Cursor、ChatGPT 里临时查评论,不用写代码,接 EveryInfra 远程 MCP;平台总览见 Google Play 数据接口、TikTok 数据接口、Amazon 数据接口和 Amazon 评论接口,价格见价格页。
参考资料
- GPT-6.1 Sol Model,OpenAI 开发者文档,2026-11-06 读取
- Introducing GPT-6.1 Sol,OpenAI,2026-09-29
- API Changelog,OpenAI 开发者文档,2026-11-06 读取
- Pricing,OpenAI 开发者文档,2026-11-06 读取
- Structured model outputs,OpenAI 开发者文档,2026-11-06 读取
- Batch API,OpenAI 开发者文档,2026-11-06 读取
- Prompt caching,OpenAI 开发者文档,2026-11-06 读取
- Using GPT-6(latest model guide),OpenAI 开发者文档,2026-11-06 读取
- Reasoning models,OpenAI 开发者文档,2026-11-06 读取
- Decisions,OpenAI 开发者文档,2026-11-06 读取
- GPT-6.1 Terra Model,OpenAI 开发者文档,2026-11-06 读取
- GPT-6 Luna Model,OpenAI 开发者文档,2026-11-06 读取
- Rate limits,OpenAI 开发者文档,2026-11-06 读取
- Flex processing,OpenAI 开发者文档,2026-11-06 读取
- Function calling,OpenAI 开发者文档,2026-11-06 读取
- Batch API reference,OpenAI 开发者文档,2026-11-06 读取
- Files API reference,OpenAI 开发者文档,2026-11-06 读取
- Ultrafast mode,OpenAI 开发者文档,2026-11-06 读取
- Error codes,OpenAI 开发者文档,2026-11-06 读取
- Your data,OpenAI 开发者文档,2026-11-06 读取
- API credits for ChatGPT subscribers,OpenAI 开发者文档,2026-11-06 读取
- Migrate to the Responses API,OpenAI 开发者文档,2026-11-06 读取
- Prompt cache diagnostics,OpenAI 开发者文档,2026-11-06 读取
- GPT-6.1 Sol system card addendum,OpenAI Deployment Safety Hub,2026-09-29
- Introducing GPT-6.1 Terra,OpenAI,2026-10-26
- Batch API FAQ,OpenAI 帮助中心,2026-11-06 读取
- tiktoken,OpenAI,GitHub
- openai-python helpers,OpenAI,GitHub
- tiktoken 0.14.0,PyPI
- jsonschema,PyPI
- JSON Schema(Pydantic 文档),Pydantic
- JSON Schema Draft 2020-12,JSON Schema
- RFC 8259: The JSON Data Interchange Format,IETF,2017-12
- Reply to Reviews,Google Play Developer API,2026-11-06 读取
- Download and export monthly reports,Play Console 帮助,2026-11-06 读取
- Why is there a 500 character limit on Google Play reviews?,Google Play 帮助社区,2022-07-31
- Query Video Comments,TikTok for Developers,2026-11-06 读取
- FTC Announces Final Rule Banning Fake Reviews and Testimonials,美国联邦贸易委员会,2024-08-14
- ChatGPT Outperforms Crowd-Workers for Text-Annotation Tasks,Gilardi 等,arXiv,2023-03-27
- Let Me Speak Freely? A Study on the Impact of Format Restrictions on Performance of Large Language Models,Tam 等,arXiv,2024-08-05
- JSONSchemaBench: A Rigorous Benchmark of Structured Outputs for Language Models,Geng 等,arXiv,2025-01-18
- Large Language Models for Data Annotation and Synthesis: A Survey,Tan 等,arXiv,2024-02-21
- Why is GPT-6.1 Sol MAX dramatically slower than GPT-5.6 Sol MAX using the same prompt?,OpenAI 开发者社区,2026-11-06 读取
- EveryInfra 能力目录,EveryInfra,2026-11-06 00:15 读取
- Roborock(Google Play 应用页),Google Play,2026-11-06 读取
- iRobot Home(Google Play 应用页),Google Play,2026-11-06 读取
- Model Context Protocol Specification,MCP,2025-06-18
- json — JSON encoder and decoder,Python 文档
- JSON Lines,jsonlines.org
- Introduction to Structured Outputs(Cookbook),OpenAI Cookbook
引用编号 BL-95