GPT-6.1 Sol API con salidas estructuradas: coste estimado de etiquetar reseñas
Etiquete reseñas con GPT-6.1 Sol, JSON estricto y Batch API. Datos: 412 reseñas reales. Modelo estimado a precio público: unos 0,81 USD por 1.000.
Según nuestra estimación, etiquetar 1.000 reseñas con GPT-6.1 Sol, salida JSON Schema estricta y la Batch API cuesta menos de un dólar si cada reseña usa unos 50 tokens de razonamiento. No ejecutamos el modelo, así que es una estimación. Lo caro no son los datos. Lo caro es cómo se arman las solicitudes. El 2026-11-06, entre las 00:16 y las 00:25 hora de Singapur, hicimos 7 llamadas reales a la API de datos de EveryInfra. Obtuvimos 400 reseñas de Google Play de dos apps de robots aspiradores, Roborock e iRobot, y 12 comentarios de TikTok bajo un vídeo comparativo. Pagamos 0,003334 USD en total. Con las filas reales que devolvió cada llamada, la tarifa de datos por 1.000 reseñas es de 0,006945 USD en Google Play y 0,046704 USD en TikTok.
En esta máquina no tenemos una clave de OpenAI. Por eso, la parte del modelo es un ejemplo de configuración más una estimación. Contamos los tokens con la codificación pública o200k_base y usamos los precios públicos que leímos el 2026-11-06. El hallazgo principal es sencillo. Si envía 1 reseña por solicitud, el prompt de sistema más el esquema suman 967 tokens. Eso es el 92 % de todos los tokens de entrada y queda por debajo del mínimo de 1.024 tokens para la caché de prompts. Paga a precio completo las mismas instrucciones 1.000 veces. Con 25 reseñas por solicitud y 50 tokens de razonamiento por reseña (supuesto), el coste del modelo en Batch para 1.000 reseñas baja de unos 1,74 USD a unos 0,81 USD. Sin razonamiento, el suelo teórico bajaría de 1,49 a 0,56 USD, pero Sol no baja de low, así que ese suelo no se alcanza.
Este artículo responde a una pregunta concreta. Tiene un conjunto de reseñas y quiere que GPT-6.1 Sol añada cuatro etiquetas a cada una: sentimiento, categoría del problema, mención de la competencia y una acción concreta. Cada etiqueta debe ir directa a una hoja de cálculo, y quiere conocer el coste total. Las reseñas vienen de la API de datos de EveryInfra. El etiquetado usa la Responses API y la Batch API de OpenAI. Cada número de EveryInfra sale de una respuesta en bruto y se puede recalcular. Cada paso de OpenAI está marcado como ejemplo de configuración o como estimación de precio: no ejecutamos este lote en OpenAI.
Esta tabla separa lo que medimos de lo que estimamos. Cada número del artículo remite a una de sus filas.
| Paso | Cómo lo obtuvimos | ¿Se puede recalcular? |
|---|---|---|
| Reseñas (EveryInfra) | 7 llamadas reales el 2026-11-06, con las respuestas en bruto guardadas | Sí, cada número sale de una respuesta |
| Recuento de tokens | o200k_base sobre el prompt de sistema, el esquema y las 412 reseñas reales | Sí; el tokenizador real de Sol no es público |
| Etiquetas de salida | 12 ejemplos escritos por una persona, no salida de GPT-6.1 Sol | Solo sirven para estimar la longitud de salida |
| Tokens de razonamiento | Sin medir; suponemos 0, 50 o 200 por reseña | No; hace falta una prueba y leer usage |
| Coste del modelo | Precios públicos del 2026-11-06 por las filas anteriores | Sí, con sus propios números |
| Precisión de las etiquetas | No la tenemos | Revisión manual tras una prueba |
Qué es la GPT-6.1 Sol API: fecha, contexto y precio
Primero, los hechos del modelo. El registro de cambios de la API de OpenAI tiene una entrada del 2026-09-29. Dice que OpenAI lanzó GPT-6.1 Sol (gpt-6.1-sol) para programación compleja y trabajo profesional, a un precio menor que GPT-6 Astra. Para entradas de hasta 272K tokens, el precio estándar por millón es 2 USD de entrada, 0,10 USD de entrada en caché, 2,50 USD de escritura en caché y 10 USD de salida. La misma entrada indica que las llamadas a herramientas requieren la Responses API. El anuncio, Introducing GPT-6.1 Sol, presenta a Sol como cercano a GPT-6 Astra en capacidad, con precios de entrada y salida que son una quinta parte de los de Astra.
La página del modelo GPT-6.1 Sol, leída el 2026-11-06, da los datos que importan para etiquetar. La ventana de contexto es de 1.050.000 tokens y la salida máxima, de 128.000. El corte de conocimiento es el 2026-04-30. Los valores de reasoning.effort son low, medium (por defecto), high, xhigh y max. La lista de funciones marca Structured outputs y Function calling como «Supported».
La página del modelo también tiene cuatro reglas de precio que pesan en un trabajo por lotes. La entrada en caché cuesta el 5 % del precio de entrada. Una escritura en caché cuesta 1,25 veces. Por encima de 272K tokens de entrada, toda la solicitud cuesta el doble en entrada y 1,5 veces en salida. Batch y Flex cuestan un 50 % menos.
| Dato | Qué dice la fuente | Fuente (leída el 2026-11-06) | Qué significa al etiquetar |
|---|---|---|---|
| Llegada a la API | gpt-6.1-sol, 2026-09-29 | Registro de cambios | 38 días en el mercado al escribir esto |
| Contexto y salida | 1.050.000 de contexto, 128.000 de salida | Página del modelo | Caben decenas de reseñas por solicitud |
| Esfuerzo de razonamiento | low, medium, high, xhigh, max; sin none | Página del modelo, guía de GPT-6 | Cada solicitud genera tokens de razonamiento, cobrados como salida |
| Precio estándar | 2 USD entrada, 0,10 USD caché, 10 USD salida por millón | Página de precios | Unos 2,99 USD por 1.000 reseñas como mínimo, en síncrono |
| Precio Batch | 1 USD entrada, 0,05 USD caché, 5 USD salida | Página de precios | Las mismas solicitudes a mitad de precio |
| Recargo por entrada larga | Más de 272K: 2× entrada, 1,5× salida | Página del modelo | No meta demasiadas reseñas en una solicitud |
| Chat Completions | Compatible, pero sin llamadas a herramientas | Página del modelo | Aquí solo usamos la Responses API |
La fila que más se pasa por alto es la del esfuerzo de razonamiento. La guía de GPT-6 es clara: GPT-6 Astra y GPT-6.1 Sol no admiten none. Si sus solicitudes usaban minimal, cámbielas a low y compare resultados. GPT-6.1 Terra, GPT-6 Sol y GPT-6 Luna sí admiten none. La guía de razonamiento dice que los tokens de razonamiento cuentan como tokens de salida.
Para etiquetar, esto importa. Cada reseña añade una salida oculta a 10 USD por millón de tokens, o 5 USD en Batch. No podemos medir esa cantidad sin una llamada real. Por eso la tabla de costes muestra el razonamiento como un supuesto aparte.
Completamos la fila de Batch. La página de precios pone Flex y Batch en la misma franja. Para gpt-6.1-sol, Batch cuesta 1 USD de entrada, 5 USD de salida y 0,05 USD de entrada en caché por millón de tokens; escribir en caché cuesta 1,25 USD a 30 minutos y 2,50 USD a 12 horas. Todas las tablas de coste de este artículo usan esta franja.
gpt 6.1 structured outputs: límites del modo estricto de json_schema
La guía de Structured Outputs de OpenAI explica la promesa al principio. La salida del modelo siempre cumple el JSON Schema que usted proporciona. No omite claves obligatorias ni inventa valores de enumeración. En la Responses API se fija text.format en {"type":"json_schema","strict":true,"schema":…}. La guía también dice que el modo estricto solo admite un subconjunto de JSON Schema. Si el esquema usa una palabra clave fuera de ese subconjunto, la solicitud con strict: true falla.
Un esquema de etiquetas se ejecuta miles de veces. Por eso copiamos cada regla de la guía que se podía contar o comprobar y escribimos un pequeño script que revisa el esquema contra esas reglas. No confiamos en la memoria.
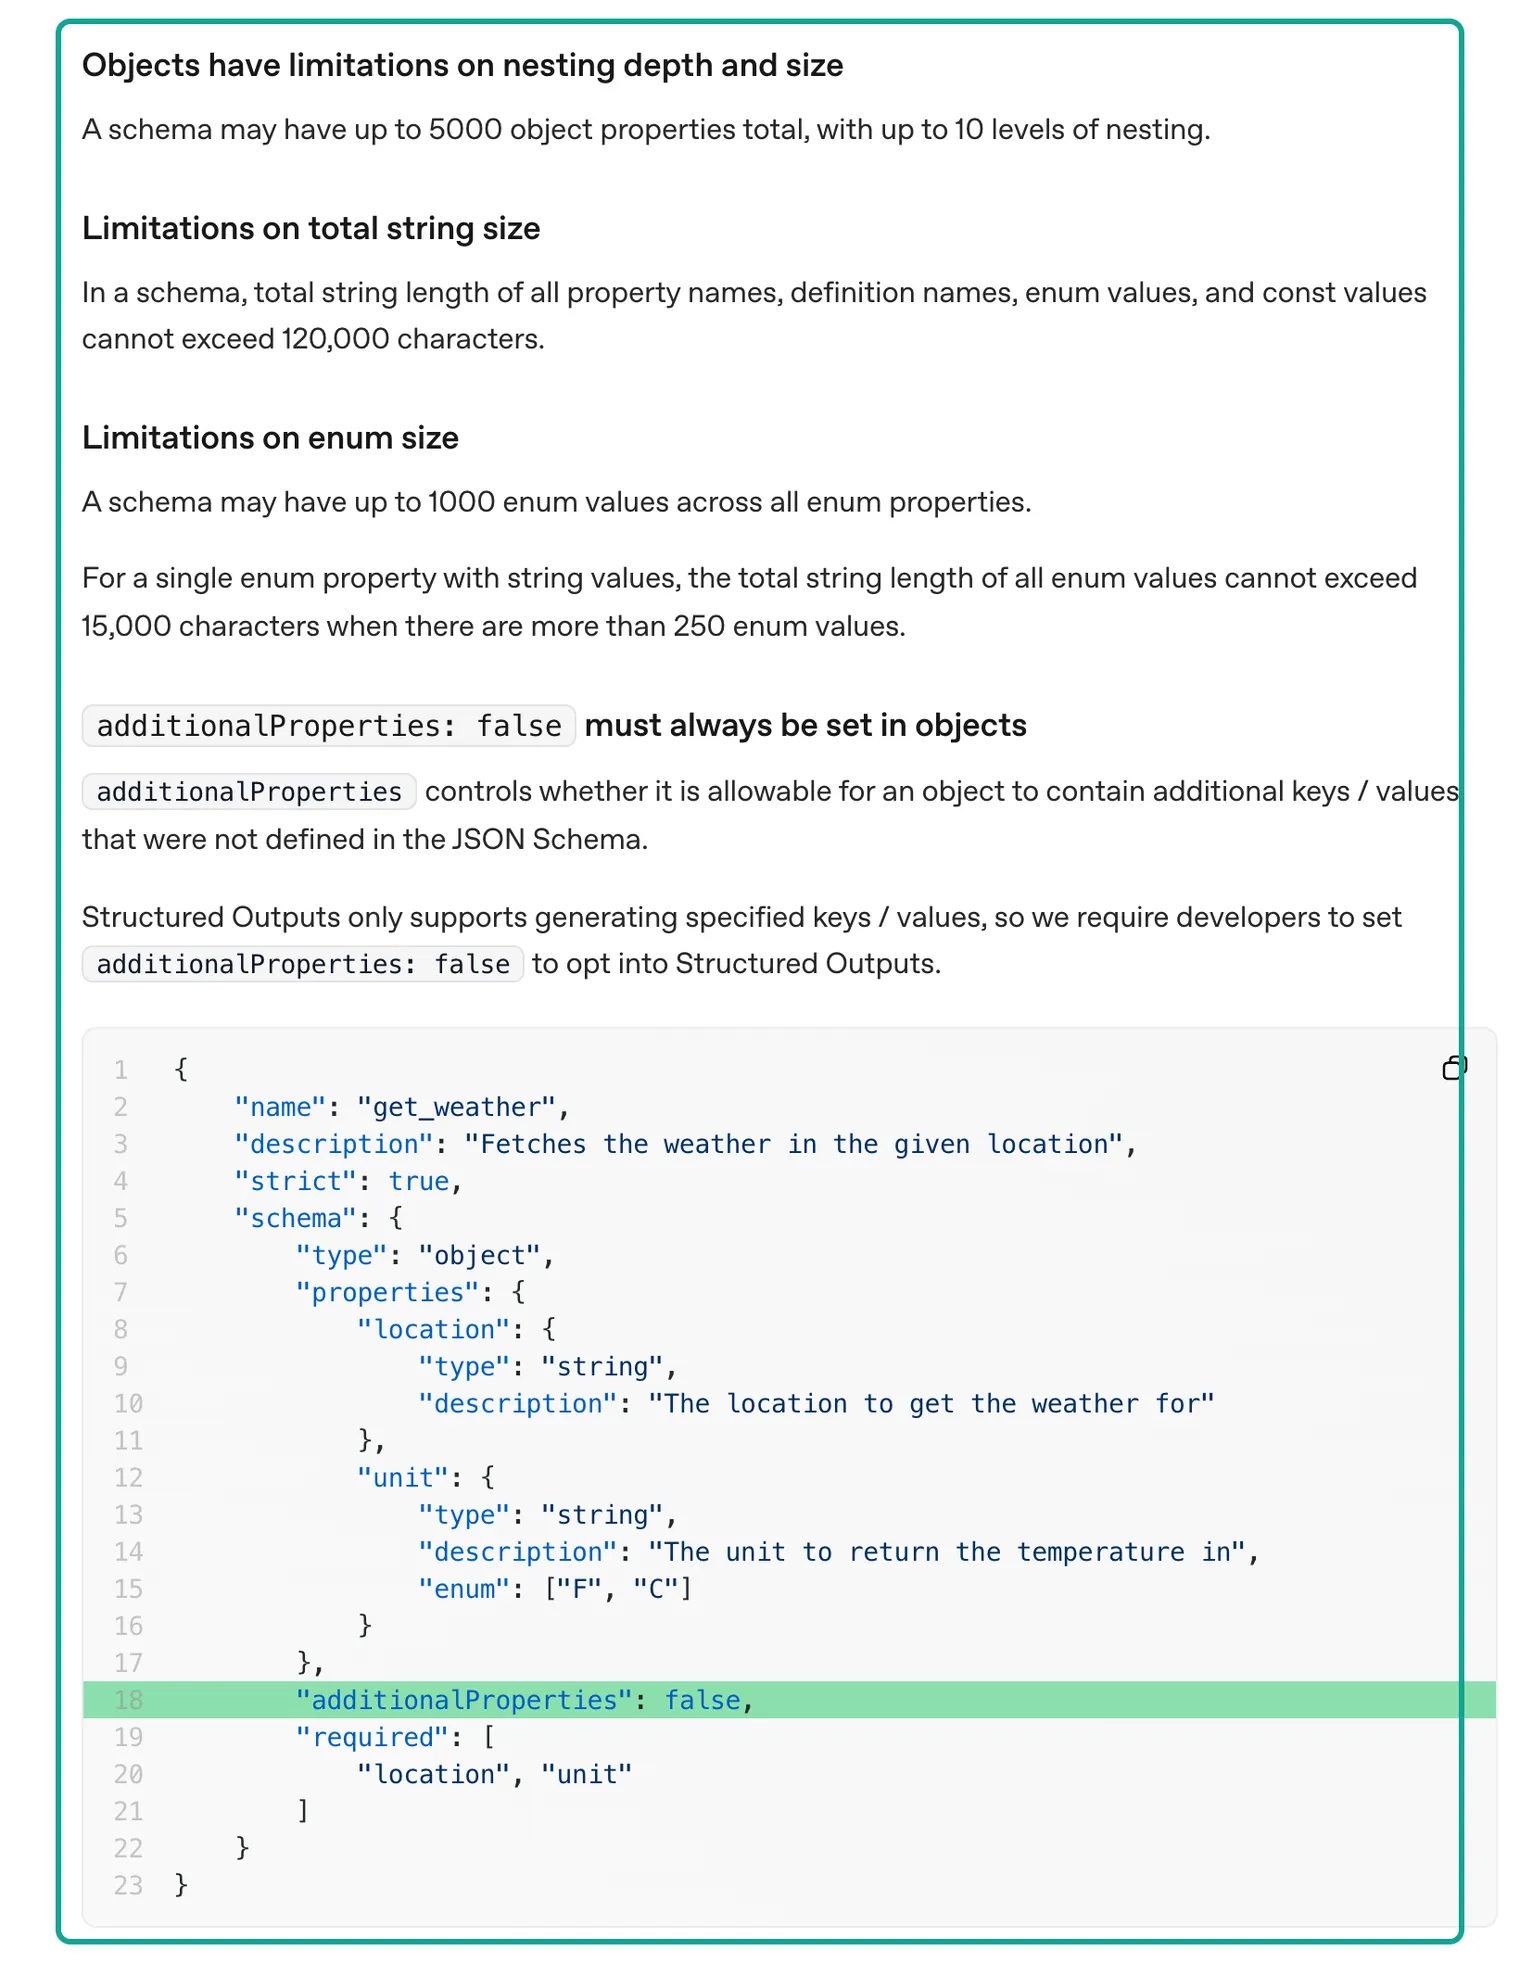
Las cuatro partes del recuadro son límites de tamaño. Fuera del recuadro, la guía fija más reglas de escritura:
- La raíz debe ser un objeto, no un
anyOf. - Todos los campos de cada objeto deben estar en
required. Para un campo opcional, use un tipo como["string","null"]. - La guía no admite
allOf,not,dependentRequired,dependentSchemas,if,thennielse. - En cadenas, la guía solo lista
patternyformat.formatacepta nueve valores:date-time,time,date,duration,email,hostname,ipv4,ipv6yuuid. - Los arrays admiten
minItemsymaxItems. Se admiten$defsy referencias recursivas.
La guía añade que la primera solicitud con un esquema nuevo tiene una latencia extra de procesamiento. Las siguientes con el mismo esquema no la tienen.
| Regla (apartado de la guía) | Límite o requisito | Nuestro esquema | Esquema roto de prueba |
|---|---|---|---|
| Propiedades de objeto en total | ≤ 5000 | 9 | 8 |
| Niveles de anidación | ≤ 10 | 1 | 1 |
| Valores enum en total | ≤ 1000 | 31 | 31 |
| Caracteres en nombres y valores enum | ≤ 120.000 | 416 | 408 |
additionalProperties: false | Obligatorio en cada objeto | Sí | Raíz en true: error |
Todos los campos en required | Obligatorio | 9 de 9 | required incluye un campo que no existe |
| Palabras clave no admitidas | allOf, if, then y otras | 0 | 3 |
| Palabras clave fuera de la lista admitida | Solo aviso | 0 | minLength, 1 |
El script da 0 problemas y 0 avisos para el esquema de una reseña y para el de 25. Para el esquema roto, da 5 problemas y 1 aviso. Ese esquema no es aleatorio. Nace de una idea natural: «si mentions_competitor es true, competitors debe tener al menos un elemento». En JSON Schema esa regla se escribe con allOf e if/then, y el modo estricto no lo admite. Un esquema no puede imponer una relación entre dos campos. Hay que comprobarla con código cuando vuelven los resultados.
Una nota sobre minLength. La guía solo nombra minLength y maxLength como no admitidos para modelos ajustados, pero su lista de palabras clave admitidas en cadenas solo tiene pattern y format. Por eso el script da un aviso y nuestro esquema no la usa. El límite de 20 palabras para las acciones va en description y en el prompt, y luego se mide con código.
Este es nuestro esquema de etiquetas para una reseña. Tiene nueve campos, todos obligatorios. other_brand_name y action_item pueden ser null.
{
  "name": "review_label",
  "strict": true,
  "schema": {
    "type": "object",
    "properties": {
      "item_id": {"type": "string", "description": "Copy the item_id of the input item."},
      "sentiment": {"type": "string", "enum": ["positive", "negative", "mixed", "neutral"]},
      "issue_categories": {"type": "array", "minItems": 1, "maxItems": 3,
        "items": {"type": "string", "enum": ["app_connectivity", "account_login", "mapping_navigation",
          "suction_cleaning", "mopping", "dock_self_empty", "battery_charging", "hardware_defect",
          "firmware_update", "customer_service_warranty", "price_value", "noise", "app_usability", "other", "none"]}},
      "mentions_competitor": {"type": "boolean"},
      "competitors": {"type": "array", "maxItems": 5,
        "items": {"type": "string", "enum": ["roborock", "irobot_roomba", "ecovacs_deebot", "dreame", "eufy",
          "shark", "narwal", "mova", "dyson", "samsung", "xiaomi", "other_brand"]}},
      "other_brand_name": {"type": ["string", "null"]},
      "action_item": {"type": ["string", "null"], "description": "One concrete action, 20 words or fewer, or null."},
      "evidence": {"type": "string", "description": "Up to 15 words copied from the text."},
      "language": {"type": "string", "description": "ISO 639-1 code."}
    },
    "required": ["item_id", "sentiment", "issue_categories", "mentions_competitor", "competitors",
                 "other_brand_name", "action_item", "evidence", "language"],
    "additionalProperties": false
  }
}
La versión de 25 reseñas añade una capa: la raíz tiene un único campo, el array labels, y cada elemento apunta con $ref al mismo objeto en $defs. La anidación pasa de 1 a 2 niveles, lejos del límite de 10. El orden de los campos también cuenta. Según la guía, la salida sigue el orden de las claves del esquema. Por eso item_id va primero y action_item y evidence van al final: el modelo necesita leer la reseña entera para escribirlos. Si una salida se corta, el ID y el sentimiento ya están al principio.
Cómo diseñar las etiquetas: cuatro preguntas, nueve campos
Antes de diseñar etiquetas, decida quién las va a usar. El equipo de la app de una marca de robots aspiradores quiere saber de cortes de wifi, inicios de sesión fallidos y mapas perdidos. El equipo de soporte busca quejas de garantía. El equipo de producto quiere saber con qué otras marcas comparan los usuarios.
Por eso las etiquetas salen de cuatro preguntas. ¿Qué tono tiene? ¿Qué tipo de problema describe? ¿Nombra otra marca? ¿Se puede convertir en una mejora concreta? La categoría del problema es un enum fijo de 15 valores. La competencia es un enum de 12 valores con other_brand como salida.
La categoría fue lo que más tiempo llevó. Primero leímos las 412 reseñas de las llamadas reales y agrupamos las quejas en 13 tipos; luego añadimos other y none. Muchas reseñas de iRobot con pocas estrellas dicen que «los comandos no llegan» o que «no conecta con la nube de iRobot»: van a app_connectivity. «No llega el código de verificación» va a account_login. Muchas reseñas de Roborock dicen que «el mapa se rompió tras la actualización», que es a la vez firmware_update y mapping_navigation. Por eso una reseña puede tener hasta 3 categorías.
El prompt de sistema tiene una línea de guía por categoría. Esa parte ocupa más de la mitad del prompt y explica por qué el prefijo fijo de la cuenta de tokens tiene 645 tokens.
El sentimiento tiene cuatro valores: positive, negative, mixed y neutral. El prompt dice: «No juzgue el sentimiento solo por las estrellas». Estrellas y texto a menudo no coinciden. Una reseña de Roborock de 1 estrella empieza con «App is very good» y solo después dice que el mapa falla. Una de 3 estrellas elogia la app y luego dice que los botones inferiores no funcionan en un móvil plegable de Samsung. Estas se etiquetan como mixed. Los comentarios de TikTok no tienen estrellas; una pregunta como «¿Cuál es el mejor?» va como neutral.
action_item es la etiqueta más difícil de revisar, así que tiene los límites más estrictos: una frase en inglés de 20 palabras o menos, o null. evidence copia hasta 15 palabras de la reseña, en el idioma original. Con estos dos campos, una persona revisa una etiqueta en segundos sin leer la reseña entera.
Escribimos a mano salidas de ejemplo para 12 reseñas reales con este esquema. Sirven para estimar los tokens de salida y para mostrar cómo queda cada campo. La tabla muestra 4. El texto está recortado y sin datos de autor. Estos 12 ejemplos los escribió una persona: no son salida de GPT-6.1 Sol.
| Fuente | Estrellas | Fragmento | Sentimiento | Categorías | Competencia |
|---|---|---|---|---|---|
| App Roborock | 2 | «You ruined my robot after your last update! The map is all messed up…» | negative | firmware_update, mapping_navigation | ninguna |
| App Roborock | 3 | «…it doesn't support the Samsung Z Fold 8's screen aspect ratio…» | mixed | app_usability | ninguna (Samsung es el móvil) |
| App iRobot | 1 | «every 2nd vacuum I have a connection issue. I will never buy another Roomba» | negative | app_connectivity | ninguna |
| Comentario de TikTok | — | «How about the Dreame X60 Pro Ultra?…» | neutral | none | dreame |
Bajar reseñas con EveryInfra: una llamada real de ida y vuelta
Para obtener las reseñas usamos el endpoint de datos de EveryInfra, POST /api/v1/social. El cuerpo indica la plataforma, la acción y los parámetros. Antes de la primera llamada leímos el catálogo de capacidades, que es gratuito, a las 00:15 hora de Singapur del 2026-11-06. Comprobamos precio, parámetros y campos de respuesta de cada capacidad de reseñas:
google_play/reviewscuesta 0,001389 USD por llamada. Una llamada síncrona devuelve hasta 200 filas. Aceptalanguageysort.tiktok/commentscuesta 0,000556 USD por llamada. Recibe la URL de un vídeo.amazon/reviewscuesta 0,001389 USD por llamada. El catálogo dice que cada sitio de Amazon solo muestra las reseñas destacadas de la página del producto, normalmente una docena.trustpilot/reviewscuesta 0,001389 USD por llamada.
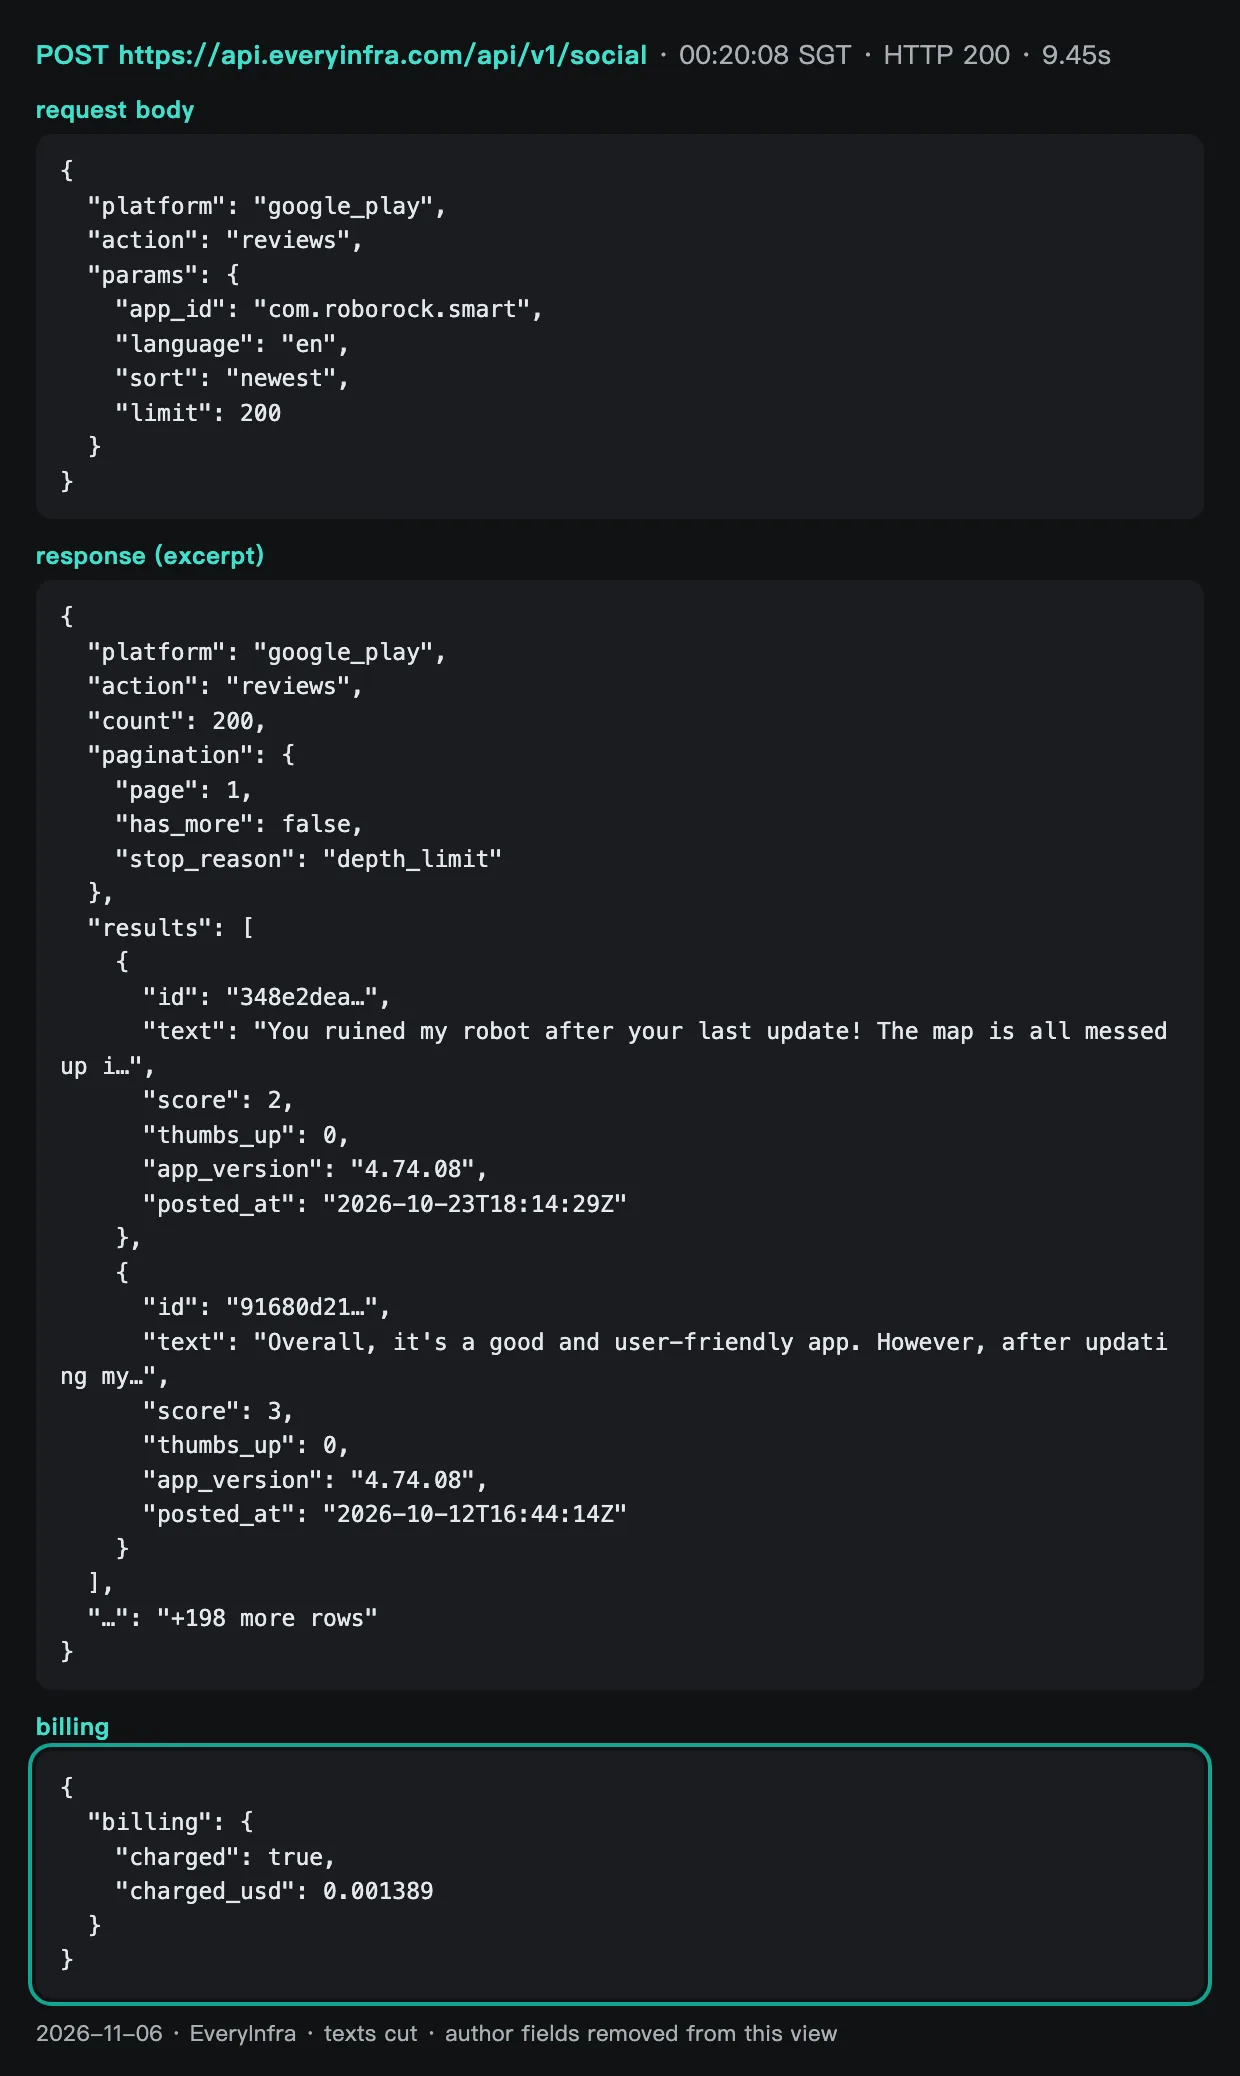
Esta es la solicitud completa de Google Play:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"google_play","action":"reviews",
       "params":{"app_id":"com.roborock.smart","language":"en","sort":"newest","limit":200}}'
La enviamos a las 00:20:08 hora de Singapur del 2026-11-06. Devolvió HTTP 200 en 9,45 segundos, con count 200, pagination.stop_reason igual a depth_limit y has_more en false. El cargo fue de 0,001389 USD. Cada reseña trae campos como id, text, score, thumbs_up, reply_text, reply_at, app_version y posted_at, iguales a la lista response_fields del catálogo. La respuesta también trae nombre y avatar del autor; no hacen falta para etiquetar y los quitamos antes de armar las solicitudes al modelo.
Hicimos 7 llamadas en total, de las 00:16:42 a las 00:24:27 hora de Singapur. La tabla las lista. Una llamada síncrona a tiktok/comments tardó 90,21 segundos y devolvió HTTP 200 con 12 filas. Dos llamadas síncronas, a amazon/reviews y a trustpilot/reviews con limit 200, pasaron de 85 segundos y devolvieron un timeout 503 sin cargo. El mensaje de error recomendaba "mode":"async" o un limit menor. Dos tareas asíncronas de amazon/reviews, con dos productos de Roborock, terminaron bien pero con 0 filas, y el cargo se devolvió.
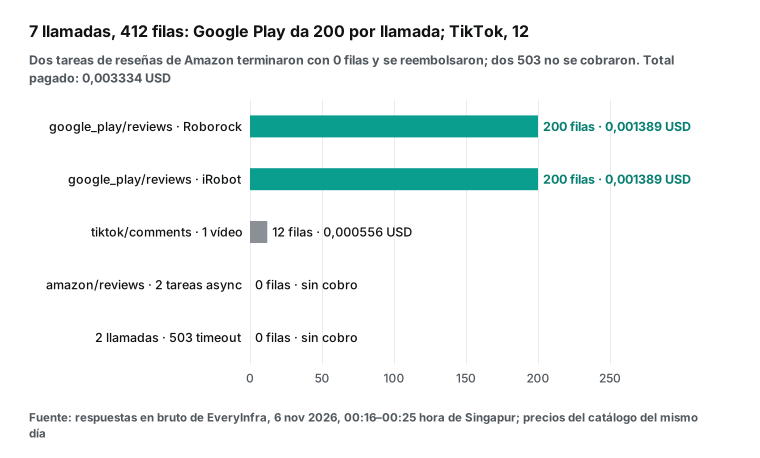
| Hora (Singapur) | Capacidad | Resultado | Tiempo medido por nosotros | Filas | Cargo |
|---|---|---|---|---|---|
| 00:16:42 | amazon/reviews síncrona | Timeout 503 | 89,91 s | 0 | 0 USD |
| 00:18:21 → 00:19:57 | amazon/reviews async | Correcta, 0 filas, reembolsada | Envío 2,08 s, fin en unos 96 s | 0 | 0 USD (cobrada y devuelta) |
| 00:18:26 | tiktok/comments síncrona | 200 | 90,21 s | 12 | 0,000556 USD |
| 00:20:08 | google_play/reviews Roborock | 200 | 9,45 s | 200 | 0,001389 USD |
| 00:20:25 | google_play/reviews iRobot | 200 | 9,24 s | 200 | 0,001389 USD |
| 00:20:34 → 00:24:18 | amazon/reviews async | Correcta, 0 filas, reembolsada | Envío 2,04 s, fin en unos 224 s | 0 | 0 USD (cobrada y devuelta) |
| 00:24:27 | trustpilot/reviews síncrona | Timeout 503 | 88,2 s | 0 | 0 USD |
Un tiempo merece una nota. La llamada a tiktok/comments tardó 90,21 segundos, más que los dos timeouts 503 (89,91 s y 88,2 s), y aun así devolvió 200 con 12 filas. Los dos mensajes de error 503 dicen «request timed out after 85s»: 85 segundos es el límite de espera del servidor. Nuestros tiempos van desde que enviamos la solicitud hasta que recibimos la respuesta completa, así que incluyen red y cola. La respuesta no trae el tiempo del servidor, de modo que no podemos saber cuánto tardó allí la llamada de TikTok; solo que quedó muy cerca del límite y que la misma solicitud, en otro momento, podría devolver un 503. Para descargas por lotes de capacidades lentas como los comentarios de TikTok, use el modo asíncrono.
Esta tabla ya es un hallazgo. Solo 3 de las 7 llamadas trajeron datos, pero las 4 sin datos no costaron nada. Las dos 503 muestran charged_usd: 0 en la respuesta. Las dos tareas vacías se cobraron al enviarlas y el cargo volvió al terminar. En un etiquetado por lotes, una descarga fallida cuesta tiempo, no dinero. El riesgo real es otro: escribir «0 filas» en un informe como si fuera «0 reseñas negativas».
Cómo son las 412 reseñas
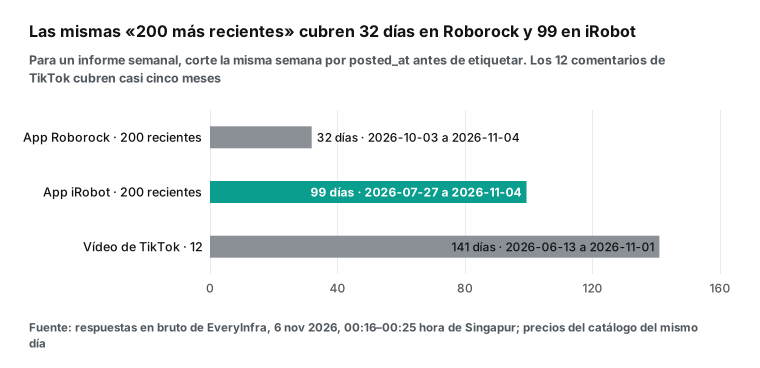
Antes de enviar nada al modelo, mire los datos. Cada app nos dio sus 200 reseñas en inglés más recientes. La cantidad es la misma; el periodo, no. Las 200 de Roborock van del 2026-10-03 al 2026-11-04, es decir, 32 días. Las 200 de iRobot van del 2026-07-27 al 2026-11-04: 99 días. Por el mismo 0,001389 USD, la llamada de Roborock muestra el último mes y la de iRobot, más de tres meses. Si un informe semanal toma «las 200 más recientes», el lado de iRobot mete problemas de julio en esta semana.
Las estrellas difieren todavía más. En iRobot, 100 reseñas son de 1 estrella y 26 de 2: 126 reseñas, el 63 %. En Roborock son 46 más 22: 68 reseñas, el 34 %. Las respuestas del desarrollador también cambian: 100 de 200 en iRobot tienen reply_text, frente a 49 en Roborock.
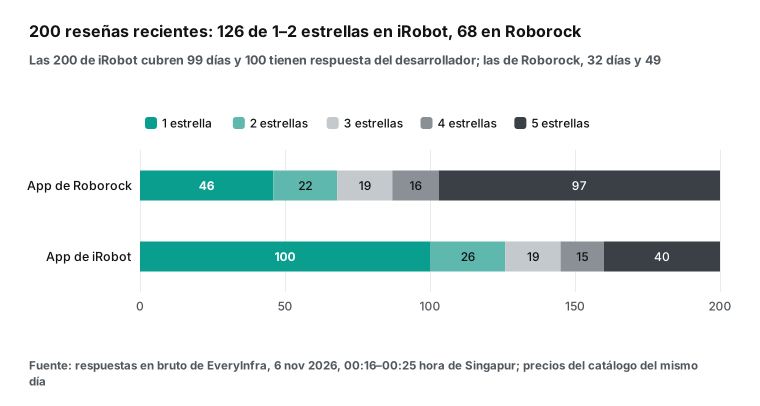
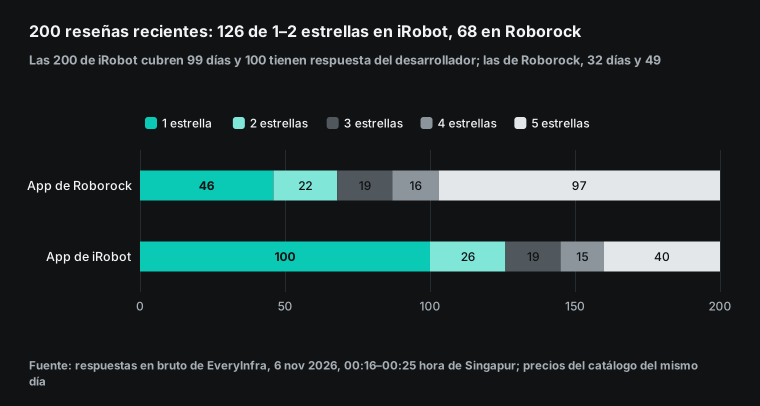
Estas cifras describen solo estas 200 reseñas, no la reputación de cada producto. Las mostramos porque condicionan las etiquetas: la mayor parte del conjunto de iRobot caerá en negative y app_connectivity.
La longitud manda en la cuenta de tokens. La mediana es de 94,5 caracteres en Roborock y 128,5 en iRobot. La reseña más larga de cada lado tiene justo 500 caracteres, el límite de Google Play; un usuario de la comunidad de ayuda de Google Play preguntó por ese límite de 500 caracteres. Hay 35 reseñas de menos de 20 caracteres en Roborock y 24 en iRobot, como «Great robovac great» o «iRobot is awful».
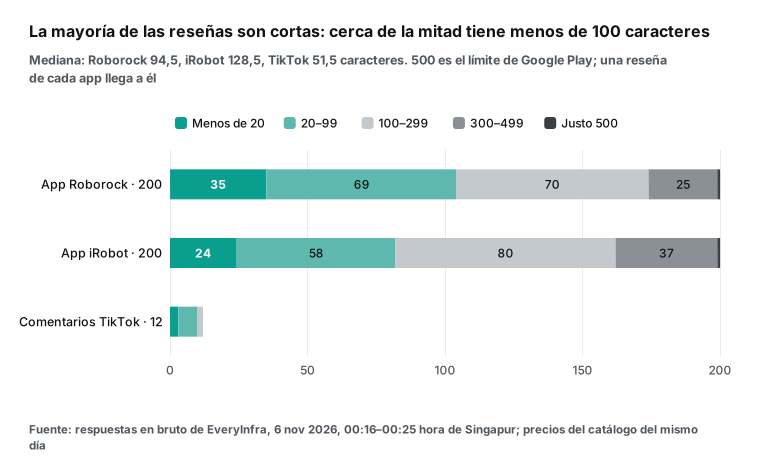
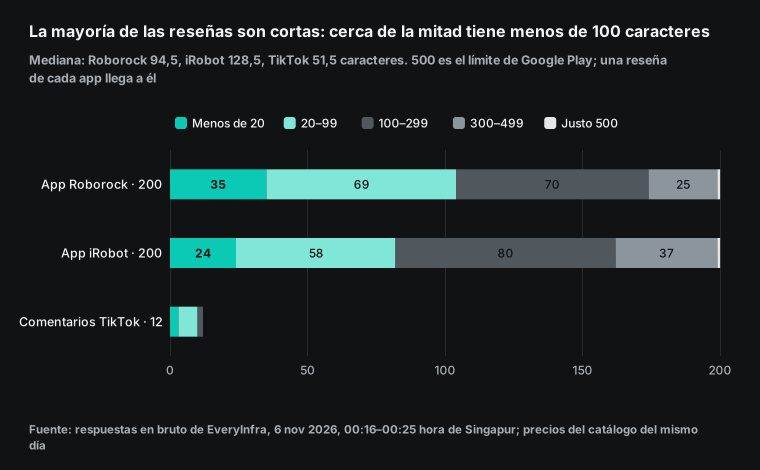
Los 12 comentarios de TikTok tienen una mediana de 51,5 caracteres y casi todos son preguntas. Van del 2026-06-13 al 2026-11-01, casi cinco meses: cuando un vídeo deja de estar de moda, pocos comentan. Por eso una llamada devolvió solo 12 filas. La idea es sencilla: una reseña puede tener unas pocas decenas de tokens, y si cada una lleva cientos de tokens de instrucciones, casi todo el dinero se va en las instrucciones.
Un detalle más. Pedimos language: "en", pero el conjunto de Roborock trae reseñas en chino y en eslovaco. El catálogo aclara que language es el idioma de la consulta, no una garantía para cada reseña. Por eso el esquema tiene un campo language y evidence queda en el idioma original.
«Menciona a la competencia»: hasta dónde llega una regla de palabras clave
De las cuatro etiquetas, «menciona a la competencia» parece la mejor candidata para una regla, que no cuesta nada en modelo. La probamos en las 412 reseñas con una expresión regular de 29 marcas de robots aspiradores y electrodomésticos, sin contar la marca de la propia app. Encontró 17 reseñas. Luego leímos las 17 para ver si de verdad mencionaban otra marca de robot.
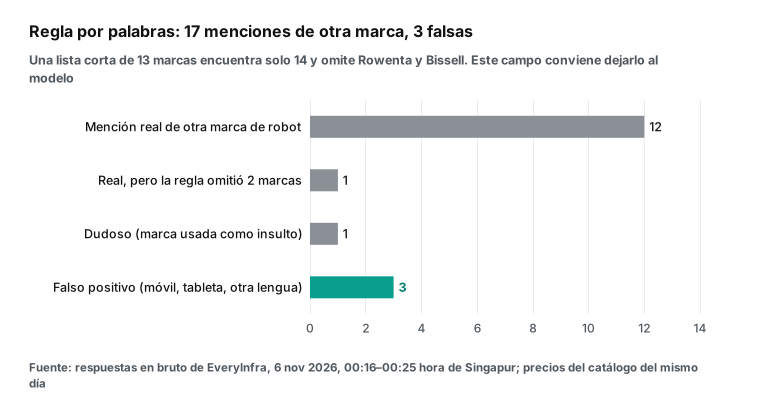
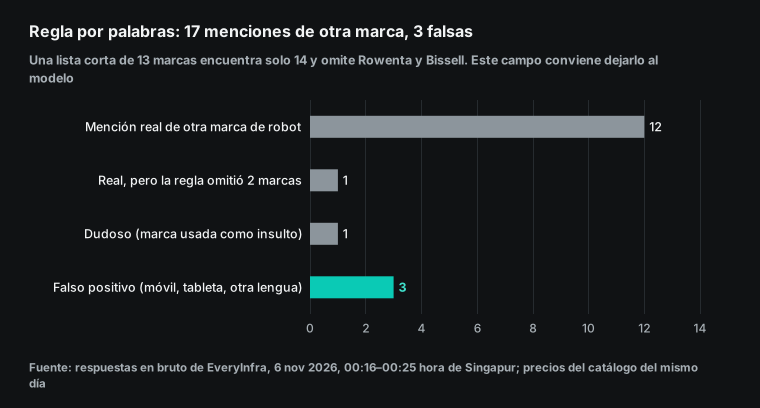
Trece de las 17 son reales. En la app de Roborock, 5 reseñas la comparan con iRobot, Roomba, Shark o Bissell: 4 tienen 5 estrellas, como «a great upgrade from the iRobot», y la quinta, de 1 estrella, dice que Roomba era mejor hace cinco años. En la app de iRobot, 5 reseñas recomiendan comprar Roborock, Shark, Rowenta o Ecovacs; las 5 tienen 1 o 2 estrellas. Las 3 de TikTok preguntan por modelos de Dreame, Roborock y Mova.
Tres son falsos positivos. Una habla de la pantalla de un móvil Samsung Z Fold 8. Otra dice que la app no se instala en una tableta Samsung. La tercera es la palabra eslovaca «mi» («me»), que la regla tomó por Xiaomi. La última es dudosa: llama «click bait» a la nueva página «Explore» de la app y habla de un marketing «typical xiaomi». Nombra una marca, pero no compara robots.
Lo que la regla no vio también cuenta. Una reseña de 5 estrellas nombra «Sharks, Bissell's, iRomba's» y la regla solo encontró Bissell: ni el plural ni la errata coincidieron. Con solo las 13 marcas más comunes, las coincidencias bajan a 14 y se pierden Rowenta y Bissell.
La conclusión es clara. Una regla de palabras clave sirve como primer filtro, no como etiqueta. Los falsos positivos vienen de móviles con el mismo nombre y de palabras de otros idiomas; los fallos, de plurales, erratas y marcas fuera de la lista. Por eso el esquema usa el enum competitors más other_brand y deja esta columna al modelo. El booleano mentions_competitor se puede deducir de si competitors está vacío; lo mantenemos solo para filtrar la hoja con facilidad.
Cómo estimar los tokens: el prefijo fijo es el 92 %
Sin clave de OpenAI, solo podemos estimar el coste del modelo. Mostramos cada paso para que ponga sus propios números. OpenAI no ha publicado el tokenizador de GPT-6.1 Sol. Usamos la codificación pública más reciente, o200k_base, de la biblioteca de código abierto tiktoken de OpenAI, versión 0.14.0 en PyPI. El prompt, el esquema y el formato de entrada son archivos reales; las reseñas son las 412 filas reales. La salida sale de la media de las 12 etiquetas de ejemplo. Los tokens de razonamiento son un supuesto aparte.
La facturación real sigue el objeto usage de cada respuesta. Antes de una ejecución completa, envíe 20 reseñas de prueba, lea input_tokens, output_tokens y output_tokens_details.reasoning_tokens y corrija la tabla.
| Parte | Tokens (o200k_base) | Nota |
|---|---|---|
| Prompt de sistema (guía de categorías y reglas) | 645 | Va en cada solicitud |
| Esquema de una reseña | 322 | Contado como JSON compacto; OpenAI decide cómo se factura |
| Esquema de 25 reseñas | 362 | Una capa más con el array labels |
| Prefijo fijo (una / 25 reseñas) | 967 / 1.007 | Ambos por debajo del mínimo de caché de 1.024 |
| Una reseña como entrada (con ID, fuente y estrellas) | Media 81,1; mediana 73,5; máximo 205 | 412 reseñas reales |
| Solo el texto de la reseña | Media 32,6 | Más de la mitad de los tokens van al formato |
| Una etiqueta como salida | Media 87,3 (de 65 a 107) | 12 ejemplos escritos a mano |
Multiplique por 1.000 reseñas y la diferencia salta a la vista. Con 1 reseña por solicitud, 1.000 solicitudes necesitan unos 1.056.100 tokens de entrada. El prefijo fijo son 967 tokens más 8 de formato de mensaje en cada solicitud: 975.000 tokens, el 92,3 % de la entrada. Con 25 reseñas por solicitud bastan 40 solicitudes. El prefijo baja a 40.600 tokens y la entrada total, a unos 121.700: un 88,5 % menos. Los 81.100 tokens de contenido son iguales en ambos casos. Todo el ahorro viene de no repetir las mismas instrucciones.
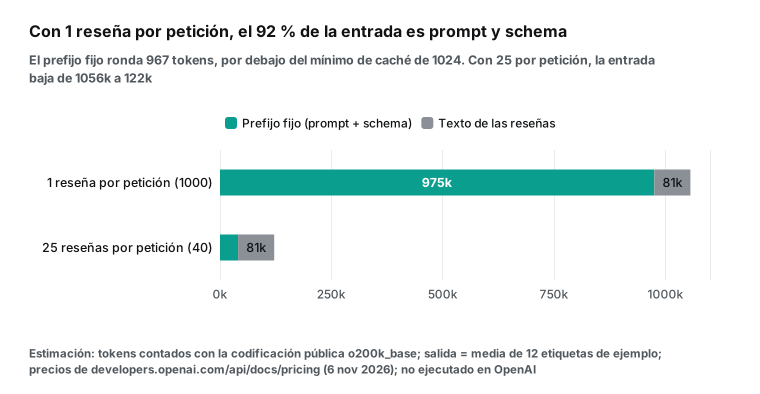
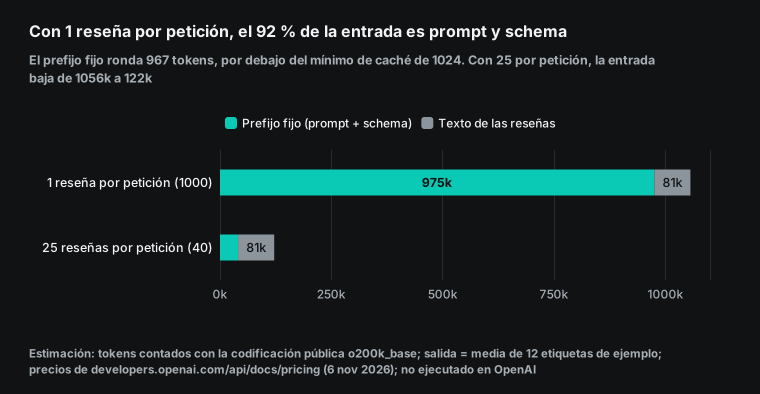
Quizá piense que la caché resolverá la repetición. La guía de caché de prompts dice que, desde GPT-5.6, el prefijo mínimo que se puede guardar es de 1.024 tokens de entrada visibles, sin contar el contenido de sistema oculto que añade OpenAI. En GPT-6.1 Sol, leer de la caché cuesta 0,05 veces el precio de entrada; escribir cuesta 1,25 veces (30 minutos) o 2,5 veces (12 horas).
Nuestro prefijo tiene 967 tokens en o200k_base, 57 por debajo del mínimo. Si OpenAI convierte el esquema en contenido de sistema oculto, la parte visible baja a 645 tokens. En ambos casos, este prefijo no entra en la caché: «1 reseña por solicitud más caché» no funciona con este tamaño de prompt.
Si su prompt ya supera los 1.024 tokens, la caché sí puede ayudar. En un caso hipotético con todo el prefijo leído a precio de caché, 1 reseña por solicitud en Batch costaría unos 0,57 USD por 1.000, casi lo mismo que 0,56 USD con 25 por solicitud, y sin contar la primera escritura. Pero 25 por solicitud no depende de aciertos de caché ni obliga a inflar el prompt. Por eso armamos el archivo Batch con 25 reseñas por solicitud.
Flujo con la Batch API: JSONL, subida y descarga
La guía de la Batch API es clara. Cada solicitud es una línea de un archivo .jsonl con un custom_id único, un method, una url y un body igual al del endpoint síncrono. Un archivo solo puede usar un modelo. Se sube con purpose igual a batch. Al crear el lote, completion_window solo puede ser 24h. El precio es un 50 % menor y Batch tiene sus propios límites, más altos.
La guía también fija tres límites que un etiquetado va a encontrar. Un lote admite hasta 50.000 solicitudes y el archivo de entrada, hasta 200 MB. Se pueden crear hasta 2.000 lotes por hora. El archivo de salida no conserva el orden de entrada, así que hay que casar los resultados por custom_id.
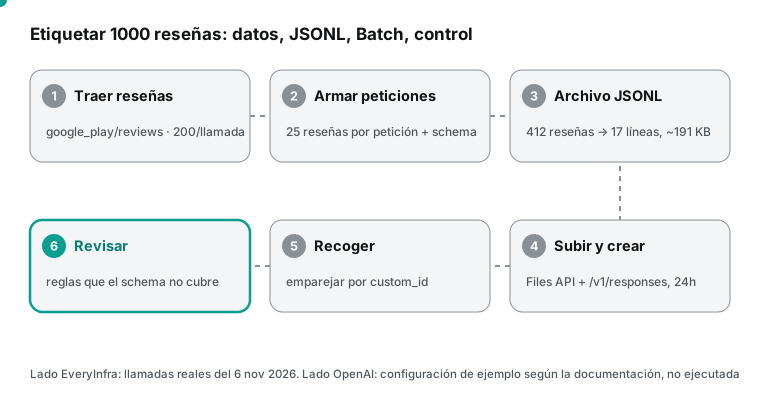
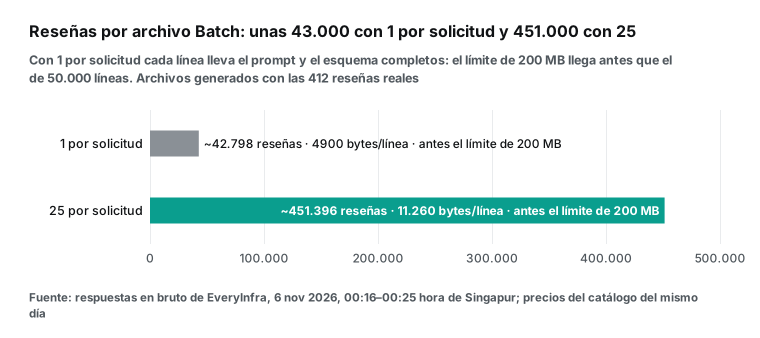
Armamos dos archivos Batch con las 412 reseñas reales para ver su tamaño. El de 1 reseña por solicitud tiene 412 líneas y 2.018.830 bytes: unos 4900 bytes por línea, porque cada línea lleva el prompt y el esquema completos. El de 25 reseñas tiene 17 líneas y 191.412 bytes, unos 11.260 bytes por línea. Con el límite de 200 MB, el primero admite unas 42.798 reseñas y choca con el tamaño antes que con las 50.000 líneas. El segundo admite unas 451.000 reseñas por tamaño. Para 1.000 reseñas no hay problema, pero con decenas de miles el formato de 1 por solicitud llega a 200 MB antes de lo que parece.
Si no usa Batch y va por el endpoint síncrono, una tanda grande puede chocar con el límite de tokens por minuto. El 2026-10-06, OpenAI redujo los niveles de uso a tres: Build, Launch y Grow (guía de límites); la página de Sol da al nivel Build 1.000.000 de tokens por minuto. Batch tiene sus propios límites, más altos y separados de la cuota síncrona. Revise su página de límites antes de una tanda grande.
Esta es la primera línea del archivo de 25 reseñas, con saltos de línea añadidos y el prompt y el esquema recortados, seguida del código Python para subirlo y crear el lote. Es un ejemplo de configuración según la documentación; no lo ejecutamos en OpenAI.
# Una línea JSONL (recortada):
# {"custom_id": "chunk-000", "method": "POST", "url": "/v1/responses",
#  "body": {"model": "gpt-6.1-sol", "reasoning": {"effort": "low"}, "max_output_tokens": 12000, "store": false,
#           "input": [{"role": "developer", "content": "You label customer reviews ..."},
#                     {"role": "user", "content": "item_id: 56a3b9f4-...\nsource: google_play/reviews app=com.roborock.smart\nrating: 5/5\ntext: ..."}],
#           "text": {"format": {"type": "json_schema", "name": "review_labels", "strict": true, "schema": {...}}}}}
from openai import OpenAI
client = OpenAI()  # lee OPENAI_API_KEY del entorno
f = client.files.create(file=open("x25.jsonl", "rb"), purpose="batch")
batch = client.batches.create(input_file_id=f.id, endpoint="/v1/responses", completion_window="24h",
                              metadata={"job": "review-tagging-2026-11-06"})
print(batch.id, batch.status)  # validating -> in_progress -> finalizing -> completed
Ponga un max_output_tokens suficiente. Veinticinco etiquetas de unos 87 tokens suman unos 2.200, más el razonamiento; nosotros pusimos 12.000. Si se queda corto, la salida estructurada se corta a mitad. La guía de Structured Outputs cubre este caso: el estado es incomplete con motivo max_output_tokens, y el JSON está incompleto. Trátelo como un fallo.
store: false pide a OpenAI que no guarde la respuesta para uso posterior. Pero las preguntas frecuentes de la Batch API dicen que la retención cero de datos no se aplica a Batch: los archivos de entrada, salida y error siguen las reglas de retención de Batch y Files. Si las reseñas contienen datos personales, quítelos antes. Nosotros quitamos nombre, avatar y URL de cada reseña y dejamos solo ID, fuente, estrellas y texto.
Al descargar, el estado pasa por validating, in_progress, finalizing y completed. Un lote que no termina en 24 horas pasa a expired: recibe y paga la parte terminada, y lo pendiente va al archivo de errores con el código batch_expired. Los archivos de salida se borran 30 días después; descárguelos a tiempo. La referencia de Batch y la referencia de Files listan cada campo. Si prefiere precio bajo con respuesta síncrona, Flex cobra como Batch, a cambio de respuestas más lentas y algún error 429 que no se factura.
Coste por 1.000 reseñas: datos más modelo
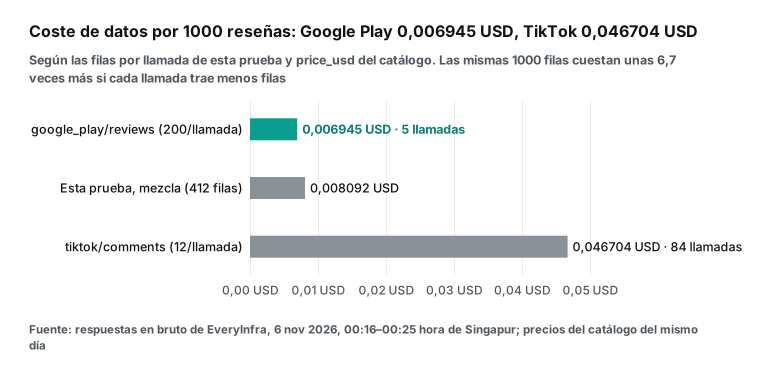
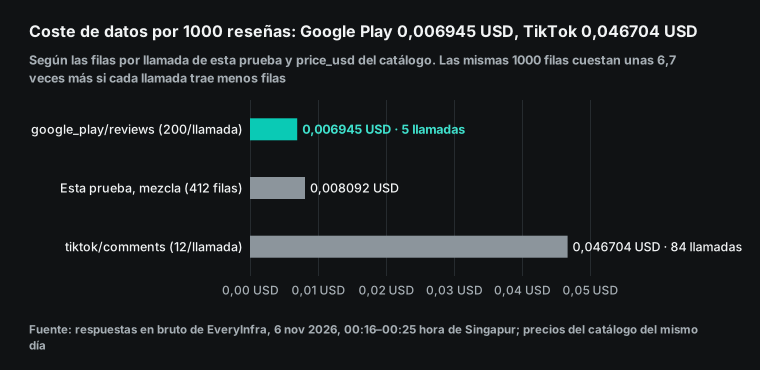
Ahora junte las dos partidas. La tarifa de datos sale de las filas observadas por llamada y del precio del catálogo. Google Play devuelve 200 filas por llamada: 1.000 reseñas son 5 llamadas, 0,006945 USD. Este vídeo de TikTok devolvió 12 filas: 1.000 reseñas serían 84 llamadas, 0,046704 USD, 6,7 veces más. Nuestro conjunto mixto de 412 reseñas costó 0,003334 USD, es decir, 0,008092 USD por 1.000. Un vídeo popular devuelve más filas por llamada y el coste baja mucho: la tarifa por 1.000 depende de cuántas filas trae cada llamada, no solo del precio unitario.
El coste del modelo sale de los precios públicos de OpenAI del 2026-11-06 y de los tokens de arriba. Usamos tres niveles de razonamiento por reseña: 0, 50 y 200. El 0 es un suelo que Sol no alcanza, porque su mínimo es low. Todos los valores son USD por 1.000 reseñas, sin la tarifa de datos.
| Configuración (por 1.000 reseñas) | Razonamiento 0 (suelo) | 50 por reseña (supuesto) | 200 por reseña (supuesto) |
|---|---|---|---|
| Sol estándar, 1 por solicitud | 2,99 USD | 3,49 USD | 4,99 USD |
| Sol Batch, 1 por solicitud | 1,49 USD | 1,74 USD | 2,49 USD |
| Sol Batch, 1 por solicitud, prefijo a precio de caché (hipotético, prefijo bajo 1.024) | 0,57 USD | 0,82 USD | 1,57 USD |
| Sol Batch, 25 por solicitud | 0,56 USD | 0,81 USD | 1,56 USD |
Terra Batch, 25 por solicitud, none | 0,28 USD | n/a | n/a |
Luna Batch, 25 por solicitud, none | 0,028 USD | n/a | n/a |
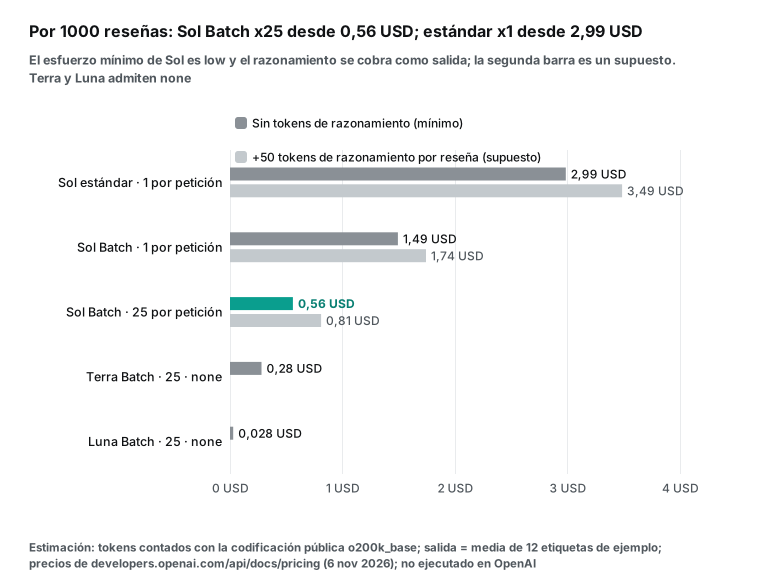
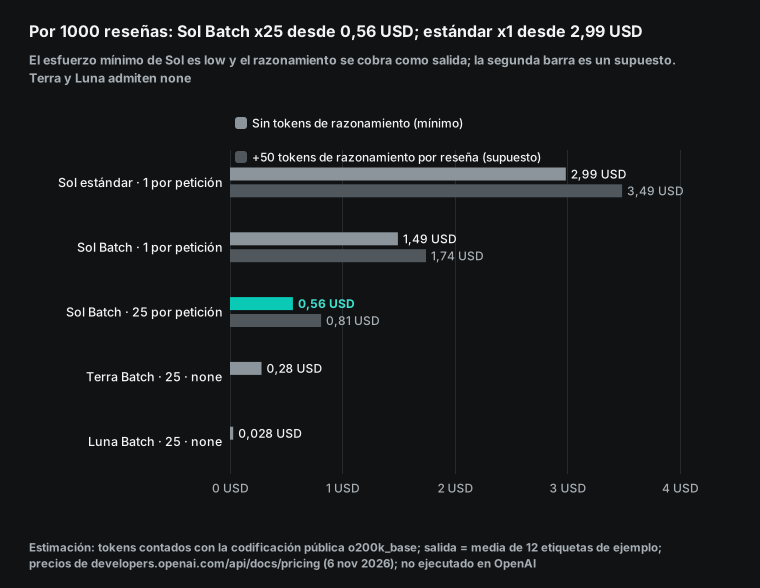
La tabla se lee de tres maneras. Primero: con el mismo modelo y el mismo prompt, pasar de «estándar, 1 por solicitud» a «Batch, 25 por solicitud» baja el suelo de 2,99 a 0,56 USD, 5,3 veces menos. Segundo: con 25 por solicitud, casi todo el dinero va a la salida: 0,44 de los 0,56 USD, un 78 %. Cada 50 tokens de razonamiento por reseña suman 0,25 USD (50 × 1.000 × 5 USD ÷ 1.000.000). La factura final depende de cuántos tokens genera low con sus reseñas, y eso solo lo mide una prueba. Tercero: los datos pesan poco. Google Play (0,006945 USD) más Sol Batch con 25 por solicitud (0,56 USD) suman unos 0,566 USD; los datos son el 1,2 %. Con la tarifa de TikTok, siguen siendo solo el 7,7 %.
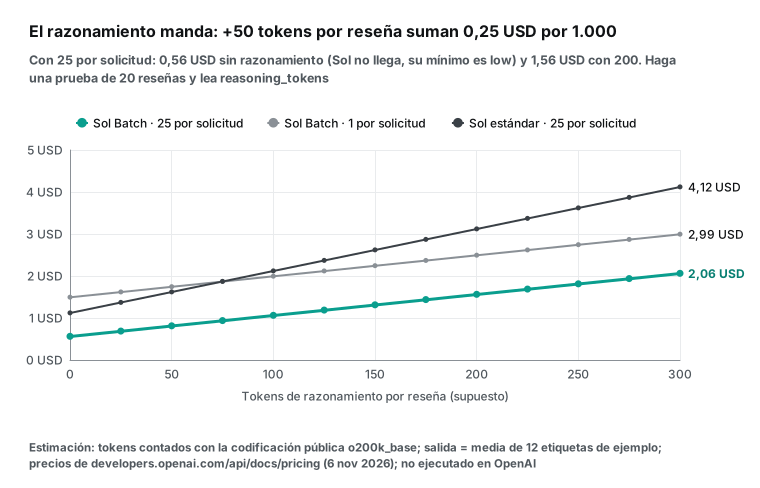
Para usar sus propios números necesita cuatro valores: P, los tokens del prefijo fijo; x, la entrada media por reseña; y, la salida media por etiqueta; y r, el razonamiento por reseña. Con k reseñas por solicitud a precio Batch, el coste por 1.000 reseñas es, aproximadamente, (1.000 ÷ k × P + 1.000 × x) × 1 USD ÷ 1.000.000 más 1.000 × (y + r) × 5 USD ÷ 1.000.000. Aquí, P es 967 o 1.007, x es 81,1, y es 87,3 y r es desconocido. Con reseñas largas, x crece y k importa menos. Con un prompt largo, P crece y k importa más. La fórmula no incluye el recargo de más de 272K tokens: con 25 por solicitud, cada una ronda los 3.000 tokens.
Como referencia externa, Gilardi y otros publicaron en 2023 ChatGPT Outperforms Crowd-Workers for Text-Annotation Tasks, con menos de 0,003 USD por anotación en 2.382 tuits. Nuestro suelo con Sol Batch y 25 por solicitud es de unos 0,00056 USD por reseña, o 0,00081 USD con 50 tokens de razonamiento. Un número es una medición publicada en un artículo; el otro es nuestra estimación, sin ejecutar en OpenAI, y las tareas y los modelos son distintos. Úselo solo como orden de magnitud: no prueba cuánto bajaron los precios ni dice nada de precisión.
Sol, Terra, Luna y la Decisions API: cuándo no usar Sol
Las dos últimas filas de la tabla están ahí a propósito. GPT-6.1 Terra salió el 2026-10-26. Su anuncio dice que su precio estándar es un 50 % menor que el de Sol y que sirve para trabajo documental de gran volumen. Admite none y en Batch cuesta 0,50 USD de entrada y 2,50 USD de salida. OpenAI presenta GPT-6 Luna como su modelo eficiente para tareas concretas de gran volumen; también admite none y en Batch cuesta 0,05 y 0,25 USD. Con la misma estimación, Terra cuesta 0,28 USD por 1.000 reseñas y Luna 0,028 USD, la mitad y una veinteava parte del suelo de Sol, y sin la incógnita del razonamiento.
¿Cuándo usar Sol? Cuando la etiqueta necesita razonar, por ejemplo «¿causó este fallo la última versión del firmware?», o cuando action_item debe sonar escrito por un responsable de producto. También cuando una revisión de una pasada con Luna o Terra muestra muchos errores en ciertos grupos, como el sentimiento mixed: repita solo esa parte con Sol. Para etiquetas que se leen casi literalmente, el razonamiento de Sol se desperdicia.
OpenAI tiene además una vía pensada para clasificar. La Decisions API salió en beta el 2026-10-06 y quedó disponible para todos el 2026-10-22. Hoy solo admite gpt-6-luna. No hace que el modelo escriba JSON: devuelve respuestas tipadas a sus preguntas. predicate da una probabilidad de 0 a 1; choice elige una opción y da la probabilidad de cada una; score puntúa en una escala de 2 a 10 puntos. Una solicitud admite hasta 400 preguntas, y OpenAI dice que es unas 10 veces más rápida que la Responses API. La guía marca el reparto: Decisions para probabilidades, elección única o puntuaciones; Structured Outputs para generar un objeto que cumpla su esquema. Sentimiento, categoría y mención de la competencia pueden ser preguntas de Decisions con nivel de confianza; action_item y evidence siguen necesitando Structured Outputs.
| Opción | Ideal para | Coste del modelo por 1.000 (estimado) | Límite principal |
|---|---|---|---|
| GPT-6.1 Sol + Structured Outputs + Batch | Etiquetas que requieren razonar, acciones redactadas, repeticiones de calidad | Desde 0,56 USD, más 0,25 USD por cada 50 tokens de razonamiento por reseña | No se puede desactivar el razonamiento; entrega en 24 horas |
| GPT-6.1 Terra + Structured Outputs + Batch | Gran volumen, campos claros, una frase redactada | Unos 0,28 USD (none) | Peor que Sol en juicios difíciles |
| GPT-6 Luna + Structured Outputs + Batch | Clasificación pura a muy gran escala | Unos 0,028 USD (none) | Revise la calidad de las acciones redactadas |
| Decisions API (Luna) | Sentimiento, categoría y competencia con nivel de confianza | No estimado aquí | Sin texto libre; solo Luna |
Lo que el esquema no puede imponer: comprobaciones posteriores
El modo estricto garantiza la forma: todos los campos están, los tipos son correctos y cada valor enum es válido. No garantiza que el contenido sea correcto ni que dos campos no se contradigan. Lo probamos con la biblioteca de Python jsonschema: cambiamos la etiqueta escrita a mano del comentario de TikTok a competitors: ["dreame"] y mentions_competitor: false. Los dos campos chocan, pero la etiqueta pasó la validación del esquema. La propia guía de Structured Outputs avisa de que la salida estructurada aún puede contener errores. Cuando lleguen los resultados, ejecute al menos esta comprobación:
def check(label, item):
    errs = []
    if label["mentions_competitor"] != bool(label["competitors"]):
        errs.append("mentions_competitor no coincide con competitors")
    if ("other_brand" in label["competitors"]) != (label["other_brand_name"] is not None):
        errs.append("other_brand no coincide con other_brand_name")
    if "none" in label["issue_categories"] and len(label["issue_categories"]) > 1:
        errs.append("none no puede ir con otras categorías")
    if label["action_item"] and len(label["action_item"].split()) > 20:
        errs.append("action_item supera las 20 palabras")
    if label["evidence"] and label["evidence"].lower()[:30] not in item["text"].lower():
        errs.append("evidence no es una cita del texto")
    if label["item_id"] != item["id"]:
        errs.append("item_id no coincide")
    return errs
Cada comprobación cubre una regla que el esquema no puede expresar: dos campos que deben ser ciertos o falsos a la vez, valores enum que se excluyen, un límite de palabras y una cita que debe salir del texto original. La última es la más útil, porque detecta «citas» inventadas por el modelo. Una solicitud de 25 reseñas necesita un control más: el array labels debe tener 25 elementos y cada item_id debe casar con una entrada. La guía no promete que el array vuelva en el orden de entrada; casar por ID es más seguro que casar por posición.
Dos casos más merecen atención. El primero es la negativa: según la guía, cuando el modelo se niega por seguridad, el contenido es de tipo refusal y no sigue su esquema. Algunas reseñas contienen insultos; una de iRobot que leímos insulta a los desarrolladores con una palabra ofensiva. Esté preparado para recibir refusal. El segundo es la entrada fuera de tema. La guía sugiere que el prompt diga qué devolver cuando la entrada no encaja; la regla 8 de nuestro prompt lo hace: reseñas vacías, anuncios y texto ajeno reciben neutral, none y ninguna marca.
Límites y puntos de atención
Esta vez no llegaron reseñas de Amazon. Las dos tareas asíncronas terminaron con 0 filas y el cargo volvió. El catálogo ya avisa de que cada sitio de Amazon solo muestra las reseñas destacadas del producto, normalmente una docena. Con una docena por llamada, la tarifa supera los 0,08 USD por 1.000 reseñas, más de diez veces la de Google Play. Pruebe unos pocos productos antes de presupuestar Amazon. Nuestra tabla de costes no incluye Amazon.
Las llamadas síncronas tienen un margen de 85 segundos. Esta vez, amazon/reviews y trustpilot/reviews (limit 200) superaron ese margen y devolvieron un timeout 503 sin cargo, con la recomendación de usar "mode":"async" o un limit menor. Ese margen se mide en el servidor: nuestra llamada a tiktok/comments tardó 90,21 segundos de nuestro lado y aun así devolvió 200, así que también rozó el límite. Para descargas por lotes, use el modo asíncrono en las capacidades lentas: recibe un 202 con job_id al instante y luego consulta poll_url. Nuestras dos tareas tardaron 1 minuto 36 segundos y 3 minutos 44 segundos.
«Las 200 más recientes» no es una ventana fija. Para comparar semanas, corte la misma semana por posted_at antes de etiquetar. En modo síncrono, la paginación de Google Play llega a 200 filas; para más profundidad, use el modo asíncrono. Para su propia app, la Reply to Reviews API de Google solo devuelve reseñas de la última semana, hasta 100 por página y 200 consultas GET por hora; las anteriores salen de la descarga en CSV de Play Console. Para la app de un competidor, la API de Google no le da nada.
¿Son reales las reseñas? La norma final de la FTC contra reseñas falsas (agosto de 2024) prohíbe las reseñas falsas generadas por IA. Las etiquetas dicen qué dice una reseña, no si es auténtica. Mire primero cualquier grupo raro de reseñas de 5 o de 1 estrella.
La salida estructurada puede afectar al razonamiento. El artículo Let Me Speak Freely? (2024) encontró que formatos estrictos como JSON pueden empeorar el razonamiento. JSONSchemaBench (2025) probó seis métodos de decodificación restringida, entre ellos el de OpenAI, con 10.000 esquemas reales y halló grandes diferencias. Ambos usaron modelos anteriores, pero respaldan una decisión de este artículo: poner action_item al final del esquema. Si un grupo de etiquetas sale mal, pruebe primero una respuesta libre y conviértala a JSON con un modelo barato.
Mida la precisión con personas, no con el modelo. No ejecutamos el lote en OpenAI, así que no tenemos cifra de precisión. Proponemos esto: tome las 20 reseñas de prueba y 50 al azar de la ejecución completa, y pida a alguien que conozca el producto que compare cada etiqueta con el texto. Cuente errores por categoría y decida qué categorías necesitan otro prompt y cuáles otro modelo. Así revisamos las 17 coincidencias de la regla de palabras clave. La revisión sobre LLM para anotación de datos dedica un apartado a evaluar anotaciones hechas por modelos: la revisión humana es un método; comparar con un conjunto ya etiquetado por personas es otro.
En qué se diferencia de otros artículos sobre reseñas
DeepSeek V4 en Claude Code para limpiar comentarios limpia 695 filas de comentarios de vídeo en una sesión interactiva, y su coste depende de la caché. Claude con uso estricto de herramientas y una API de datos hace estrictos los parámetros de entrada. Un analista de reseñas con Qwen Agent compara precios y lee reseñas en un solo agente. Aquí lo estricto es el formato de salida, el trabajo es un lote único sin conexión y el coste depende de cómo se arman las solicitudes.
Para un informe dentro de ChatGPT, vea GPT-6 Intelligent UI para informes de datos sociales.
Cambios de los últimos 60 días
2026-09-29: GPT-6.1 Sol llega a la API (registro de cambios). Los trabajos estructurados grandes pueden usar un modelo cercano al mejor por una quinta parte del precio de Astra, aunque sin desactivar el razonamiento.
2026-10-06: la Decisions API sale en beta y queda disponible para todos el 2026-10-22 (guía de Decisions). Las etiquetas de elección única tienen una vía con nivel de confianza y sin JSON, de momento solo con Luna.
2026-10-20: caché de prompts de 12 horas en la API, con escrituras a 2,5 veces el precio de entrada (guía de caché). Ayuda si etiqueta varias veces al día con un prompt de más de 1.024 tokens; no ayuda con un prefijo corto.
2026-10-21: límites de niveles de servicio por organización y proyecto en la configuración de la plataforma (registro de cambios). Si su administrador solo permite el nivel por defecto, las solicitudes Flex o de otro nivel no predeterminado fallan con un error de nivel de servicio. Revíselo antes de lanzar el lote.
2026-10-26: sale GPT-6.1 Terra, a mitad de precio que Sol y con none (página de Terra). Hay una opción intermedia que permite desactivar el razonamiento; muchos etiquetados pueden probar Terra primero.
2026-10-28: créditos de API para suscriptores de ChatGPT. Los suscriptores Pro y Business que cumplan los requisitos reciben hasta 500 USD al mes (guía de créditos). Cubren de sobra las pruebas; los créditos no usados caducan cada mes.
Preguntas frecuentes sobre GPT-6.1 Sol y salidas estructuradas
¿Cuál es el gpt 6.1 sol api precio?
La tabla completa está en la primera sección. En resumen, según la página de precios de OpenAI, el precio estándar por millón de tokens es 2 USD de entrada y 10 USD de salida; Batch y Flex cuestan la mitad. Fast cuesta el doble y Ultrafast, 6 veces; ninguno de los dos hace falta para etiquetar por lotes. El razonamiento se cobra como salida. (Origen de la pregunta: sugerencias de Google del 2026-11-06, que en español llegaban a «gpt 6.1 sol api precio colombia».)
¿Cuál es el nombre del modelo en la gpt 6.1 sol api y cómo se usa?
El nombre es gpt-6.1-sol y va en el campo model de una solicitud a la Responses API (página del modelo). Chat Completions también funciona, pero sin llamadas a herramientas; para herramientas, la guía de migración recomienda la Responses API. El razonamiento se fija con reasoning.effort, cuyo mínimo es low.
¿Cómo es un ejemplo de gpt 6.1 structured outputs?
La forma más corta es añadir text: {format: {type: "json_schema", name: "...", strict: true, schema: {...}}} a una solicitud de la Responses API. Cada objeto del esquema necesita additionalProperties: false y todos los campos en required. En Python también puede pasar un modelo de Pydantic a responses.parse del SDK, que genera el esquema por usted (ayudas de openai-python, JSON Schema en Pydantic). Puede copiar y adaptar el esquema de nueve campos de este artículo.
¿Se pueden combinar openai batch api structured output?
Sí. La guía de Structured Outputs dice que Structured Outputs y el modo JSON funcionan con la Batch API. El body de cada línea es igual al de una solicitud síncrona, así que text.format queda igual. Vigile tres cosas: un solo modelo por archivo, un max_output_tokens suficiente para que el JSON no se corte y casar resultados por custom_id, no por orden de línea.
¿Por qué GPT-6.1 Sol con esfuerzo `max` es mucho más lento que GPT-5.6 Sol?
La pregunta viene de un hilo de la comunidad de desarrolladores de OpenAI. Con el mismo prompt, GPT-6.1 Sol con esfuerzo max generó unos 62.708 tokens de salida (52.552 de razonamiento) en 1.846 segundos; GPT-5.6 Sol, unos 31.426 en 373 segundos. Para etiquetar, no use max: low basta, y el doble de razonamiento es el doble de coste de salida.
Primeros pasos
- Cree una clave de API en el inicio rápido de EveryInfra. Lea el catálogo de capacidades, que es gratuito, y revise precio y campos de
google_play/reviews,tiktok/commentsyamazon/reviews. - Pruebe una página de cada fuente en la API de reseñas de Google Play y la API de comentarios de TikTok. Vea cuántas filas trae cada llamada y calcule el presupuesto por 1.000 reseñas. Añada
"mode":"async"en las capacidades lentas. - Adapte el esquema de nueve campos a sus categorías. Revíselo con un script contra las reglas de la guía de Structured Outputs.
- Haga una prueba síncrona de 20 reseñas en OpenAI. Lea los tokens de entrada, salida y razonamiento en
usagey corrija la tabla de costes. Después elija entre Sol, Terra y Luna. - Escriba el JSONL con 25 reseñas por solicitud y use la Batch API. Al recibir los resultados, ejecute la comprobación de coherencia y revise
evidencecontra el texto. - Para consultar reseñas sin código desde Claude, Cursor o ChatGPT, conecte el servidor MCP remoto de EveryInfra. Vea también la API de datos de Google Play, la API de datos de TikTok, la API de datos de Amazon, la API de reseñas de Amazon y la página de precios.
Referencias
- GPT-6.1 Sol Model, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- Introducing GPT-6.1 Sol, OpenAI, 2026-09-29
- API Changelog, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- Pricing, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- Structured model outputs, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- Batch API, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- Prompt caching, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- Using GPT-6 (guía del último modelo), documentación para desarrolladores de OpenAI, leída el 2026-11-06
- Reasoning models, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- Decisions, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- GPT-6.1 Terra Model, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- GPT-6 Luna Model, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- Rate limits, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- Flex processing, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- Function calling, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- Batch API reference, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- Files API reference, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- Ultrafast mode, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- Error codes, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- Your data, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- API credits for ChatGPT subscribers, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- Migrate to the Responses API, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- Prompt cache diagnostics, documentación para desarrolladores de OpenAI, leída el 2026-11-06
- GPT-6.1 Sol system card addendum, OpenAI Deployment Safety Hub, 2026-09-29
- Introducing GPT-6.1 Terra, OpenAI, 2026-10-26
- Batch API FAQ, Centro de ayuda de OpenAI, leída el 2026-11-06
- tiktoken, OpenAI, GitHub
- openai-python helpers, OpenAI, GitHub
- tiktoken 0.14.0, PyPI
- jsonschema, PyPI
- JSON Schema (documentación de Pydantic), Pydantic
- JSON Schema Draft 2020-12, JSON Schema
- RFC 8259: The JSON Data Interchange Format, IETF, 2017-12
- Reply to Reviews, Google Play Developer API, leída el 2026-11-06
- Download and export monthly reports, ayuda de Play Console, leída el 2026-11-06
- Why is there a 500 character limit on Google Play reviews?, comunidad de ayuda de Google Play, 2022-07-31
- Query Video Comments, TikTok for Developers, leída el 2026-11-06
- FTC Announces Final Rule Banning Fake Reviews and Testimonials, Comisión Federal de Comercio de EE. UU., 2024-08-14
- ChatGPT Outperforms Crowd-Workers for Text-Annotation Tasks, Gilardi y otros, arXiv, 2023-03-27
- Let Me Speak Freely? A Study on the Impact of Format Restrictions on Performance of Large Language Models, Tam y otros, arXiv, 2024-08-05
- JSONSchemaBench: A Rigorous Benchmark of Structured Outputs for Language Models, Geng y otros, arXiv, 2025-01-18
- Large Language Models for Data Annotation and Synthesis: A Survey, Tan y otros, arXiv, 2024-02-21
- Why is GPT-6.1 Sol MAX dramatically slower than GPT-5.6 Sol MAX using the same prompt?, comunidad de desarrolladores de OpenAI, leída el 2026-11-06
- Catálogo de capacidades de EveryInfra, EveryInfra, leído el 2026-11-06 a las 00:15 hora de Singapur
- Roborock (página de la app en Google Play), Google Play, leída el 2026-11-06
- iRobot Home (página de la app en Google Play), Google Play, leída el 2026-11-06
- Model Context Protocol Specification, MCP, 2025-06-18
- json — JSON encoder and decoder, documentación de Python
- JSON Lines, jsonlines.org
- Introduction to Structured Outputs (Cookbook), OpenAI Cookbook
Referencia BL-95