GPT-6のIntelligent UIでRedditとXのブランドレポートを作る:MCPの設定例とデータ検証
GPT-6のIntelligent UIは表やグラフで回答できます。ただし、OpenAIはMCPのデータを描画するとは明言していません。3ブランドのレポートにかかったAPI料金は$0.003336でした。
GPT-6は2026年10月7日、Intelligent UIとともにChatGPTのChatタブに登場しました。Intelligent UIでは、回答にテキスト、グラフ、ボタン、フォームのどれを使うかをモデルが判断します(OpenAIの発表記事)。この記事では、ある1つの用途を検証します。EveryInfraのリモートMCPサーバーをChatGPTに接続し、「この3ブランドについて、先週のRedditとXでの投稿量とセンチメントを比較して」と依頼します。安定したインタラクティブなレポートは得られるのでしょうか。
2026年11月5日のシンガポール時間00:18〜00:27に、実際のAPIリクエストを16件実行しました。対象ブランドは、ポータブル電源メーカー3社のEcoFlow、Jackery、BLUETTIです。課金されたのは13件で、合計$0.007228でした。結論は3点です。
第一に、カスタムMCPサーバーが返すデータをIntelligent UIが描画するとは、OpenAIは述べていません。第二に、当社のMCPサーバーはJSON文字列を返すため、モデルがそれを読み取って自分で表を組み立てる必要があります。第三に、生データに含まれる3つの数値は、プロンプトで対処しないとモデルを誤らせます。
この記事は、ChatGPTを扱った他の3本の記事とは内容が異なります。ChatGPT Spacesの競合トラッカーは、チームが毎週更新する共有ページを扱っています。ChatGPT dotsの製品リサーチレーダーは、常時稼働するエージェントとその2種類の権限セットを扱っています。ChatGPTのスケジュール済みタスクによる需要レーダーは、1人に週1回情報を届ける仕組みを扱っています。
本記事で取り上げるのは、単発の回答がインタラクティブな表とグラフになる仕組みの1点だけです。あわせて、モデルが数え間違えないようにデータを設計する方法も紹介します。私たちはChatGPTにログインしていません。ChatGPTの手順はすべてOpenAIのドキュメントに基づくもので、設定例として明記しています。EveryInfraの数値はすべて保存済みの生レスポンスから得たもので、ご自身で再計算できます。
GPT-6のIntelligent UIとは:OpenAIが実際に書いていること
まずは公式の文言を確認します。OpenAIのリリース記事「GPT-6 and Intelligent UI for everyone」では、Intelligent UIをChatGPTにおけるGPT-6の新機能と位置づけています。回答を完全にインタラクティブなインターフェースとして提示し、日常的な質問への回答をより視覚的にしたり、複雑なトピックをより学びやすくしたりできます。ChatGPTは目の前のタスクに合わせた小さなツールを作ることもできます(OpenAIのリリース記事、2026年11月5日閲覧)。
OpenAIは、ストリーミング可能なネイティブコンポーネントのライブラリとコンパイラを構築しました。インターフェースは、モデルが書き進めるにつれて段階的に表示されます。ライブラリが共通のデザイン基盤を提供し、パーツをどう組み合わせるかはモデルが決めます。
ヘルプセンターのページ「Intelligent UI in ChatGPT」には、さらに詳しい説明があります。GPT-6は、テキスト、ビジュアル、インタラクティブな要素を組み合わせて回答を構成するようにトレーニングされています。回答には、グラフィック、タップできるボタン、フォーム、グラフ、インタラクティブな体験をチャット内に含めることができます。形式は質問によって変わり、比較なら左右に並べ、説明ならインタラクティブな図を使うこともあります。
プレーンテキストが最適な回答であれば、プレーンテキストで返ってきます。出典:ヘルプセンター(20001598)、2026年11月5日閲覧。このページには、約14日前に更新された旨が表示されていました。つまり「インタラクティブなコンポーネントはいつ表示されるのか」に対するOpenAIの答えはシンプルで、モデルが質問から判断します。「常にグラフにする」スイッチはありません。
同じページでは、レポート作成で重要になる4つの質問にも答えています。カスタム指示に好みを追加でき、OpenAI自身の例は「選択肢を比較するときは表を使う」です。ただしOpenAIは、こうした好みは回答の方向づけにすぎず、具体的なレイアウトは変わる場合があると補足しています。チェックリストなど一部のコンポーネントは、チャットを再読み込みしても状態が保持されますが、別のチャットには引き継がれません。
Intelligent UIが動作するのはChatのみで、WorkタブやVoiceでは動作しません。Webでは「Personalization」→「Layout and Visuals」→「Simple」の順に選択できます。ただし、その後も一部のビジュアル要素が表示される場合があります。
| 質問 | OpenAIの記述 | 出典 | レポートへの影響 |
|---|---|---|---|
| どんな機能か | モデルがネイティブコンポーネントからテキスト、ビジュアル、ボタン、フォーム、グラフを構成し、コンパイラがレイアウトをストリーミング表示する | リリース記事、ヘルプセンター(20001598) | 表を描くのはモデルで、プラグインが完成済みのウィジェットを渡すわけではない |
| コンポーネントはいつ表示されるか | 質問の種類に応じてモデルが選び、単純な質問にはテキストで答える | ヘルプセンター(20001598) | プロンプトとカスタム指示の両方で表を指定する |
| 特別なプロンプトが必要か | 不要。通常のテキスト回答になることもある | ヘルプセンター(20001354) | 頼まなくてもグラフが表示されることはあるが、レイアウトは変わりうる |
| 専用の利用上限があるか | なし。モデル、ツール、プランの上限が適用される | ヘルプセンター(20001354) | レポートのコストはプラン料金とAPI利用料の合計 |
| プラグインのデータはコンポーネントになるか | 記載は、接続済みのプラグインは「引き続き動作する」という一文のみ | ヘルプセンター(20001598) | 記載なし。コンポーネントになるとは想定しないこと |
| オフにできるか | Web:「Personalization」→「Layout and Visuals」→「Simple」。別のページでは、「設定」で「Layout and visuals」をオフにするとしている | ヘルプセンター(20001598、20001354) | 2つのページでメニュー名が異なる。実際の画面の表示に従う |
オフにする手順には補足が必要です。ヘルプセンターのページ「GPT-6 and other models in ChatGPT」には、Webで設定を開いてLayout and visualsをオフにすると、ビジュアル要素を減らせると書かれています。一方、Intelligent UIのページにはPersonalizationとSimpleと書かれています(ヘルプセンター(20001354))。どちらのページにも、一部のビジュアル要素は引き続き表示される場合があると書かれています。
どちらの方法でも、完全なテキストのみのモードにはなりません。レポートの観点では、レイアウトを完全には制御できないということです。同じプロンプトでも、Simpleを選んだ同僚にはプレーンテキストの表が表示されることがあります。
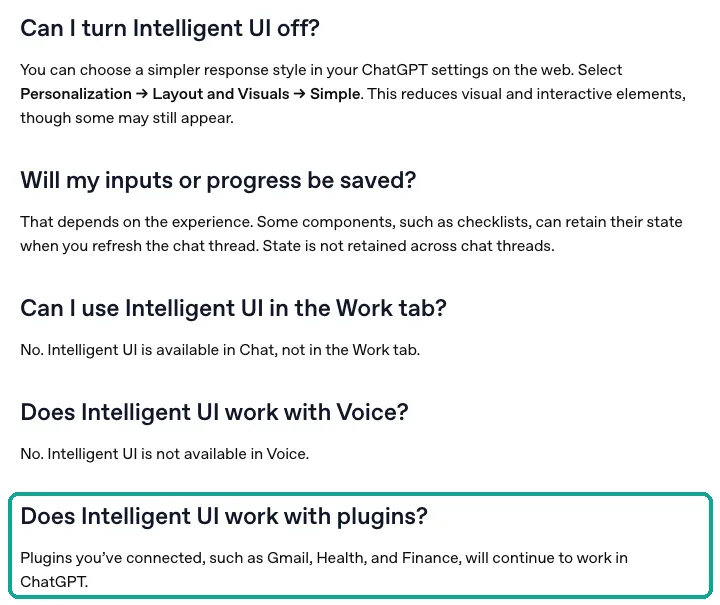
この記事で最も重要なのは、ティール色の枠内の1文です。「引き続き動作する」からわかるのは、プラグインが使えなくなるわけではないということです。プラグインのデータがIntelligent UIのコンポーネントライブラリに渡されるとは書かれていません。開発者向けの情報も確認しました。OpenAIのプラグインのドキュメントには、サーバーが独自のUIテンプレートを提供する別の仕組みが説明されています。
これについては次のセクションで説明します。ヘルプセンター、リリース記事、開発者向けドキュメントのいずれにも、Intelligent UIがMCPツールの結果をグラフとして表示すると述べた文は見つかりませんでした。そのため本記事では「記載なし」とし、「はい」とも「いいえ」とも書いていません。
ChatGPTにおけるGPT-6とIntelligent UI:誰がどこで使えるか
提供スケジュールはリリース記事に記載されています。2026年10月7日、Intelligent UIを備えたGPT-6が、Plus、Pro、Business、Enterpriseを対象に、Chatタブで世界各地に順次提供され始めました。翌日にはFreeとGoにも拡大しました。Enterpriseで利用できるかどうかは管理者の設定によります。
有料プランではGPT-6 Sol、FreeとGoではGPT-6 Lunaが使われ、いずれも日常的なチャット向けに調整されています(OpenAIのリリース記事)。同記事には、WorkとCodexのモデルは変更されていないとも書かれています。OpenAIの開発者コミュニティでの告知も同じ範囲を説明しています。さらに、Web検索を伴う質問に回答し始めるまでの時間が、GPT-6 InstantではGPT-5.6 Instantより平均44%短いと付け加えています(OpenAIコミュニティの告知)。
思考レベルについてはヘルプセンターに明記されています。Intelligent UIはInstantからExtra Highまでで動作します。Proの思考オプションはGPT-6 Astraを使用し、Intelligent UIには対応していません(ヘルプセンター(20001598))。Businessの「models and limits」ページにもAstraの制限が記載されており、Business Standardのシートには月15件のProメッセージが含まれるとあります(ヘルプセンター(12003714))。Businessのリリースノートの2026年10月7日の項目には、対象となるBusinessワークスペースのChatでGPT-6を順次提供中と書かれています。利用できるかどうかは、ワークスペースの設定と対応クライアントによります(Businessのリリースノート)。
| 方式 | ChatでのGPT-6 | Intelligent UI | カスタムMCP |
|---|---|---|---|
| 無料 | GPT-6 Luna(10月8日から) | 可能 | カスタムMCPのページに記載なし |
| Go | GPT-6 Luna(10月8日から) | 可能 | 記載なし |
| Plus | GPT-6 Sol(10月7日から) | 可能 | 開発者モードのページではPlus、プラグインのページではPro、Business、Enterprise/Eduと記載 |
| Pro | GPT-6 Sol。Proの思考レベルはAstra | Solは対応、Astraは非対応 | はい。ただし読み取りと取得の権限付き |
| Business | GPT-6 Sol(ワークスペースごと) | 可能 | 作成・公開できるのは管理者とオーナーのみ |
| Enterprise / Edu | GPT-6 Sol(管理者の設定による) | 可能 | 管理者がロールベースのアクセス制御でメンバーに作成権限を付与可能 |
各プランの料金は、後述の「1件のレポートにかかるAPI費用」セクションに記載しています。EnterpriseとEduのページには、GPT-6は対象となるEnterpriseワークスペースへ順次展開中と書かれています。モデルメニューにGPT-6が表示されない場合、そのワークスペースではまだ利用できません(ヘルプセンター 11165333)。
クライアントも重要です。ヘルプセンターによると、古いバージョンのmacOS版・Windows版デスクトップアプリはIntelligent UIに対応しておらず、Businessの注記にも「対応クライアント」と記載されています。チームメンバーから「グラフが表示されない」と言われたら、まず3点を確認してください。WorkタブではなくChatタブを使っているか。
Proの思考レベルを選んでいないか。デスクトップアプリが古くないか。r/ChatGPTのリリーススレッドでは、ある有料ユーザーがGPT-6 Solは有効になっていたと投稿していました。しかし、リリースページのプロンプトを使っても、回答にビジュアルは表示されなかったそうです。これは段階的な展開またはクライアント側の対応状況による可能性が高いでしょう(r/ChatGPTのリリーススレッド)。
カスタムMCPのデータを表やグラフにできるのか
これが核心となる問いで、方法は2つあります。1つ目はIntelligent UIです。モデルがツールの返した内容を読み取り、ChatGPT独自のコンポーネントで表やグラフを組み立てます。この方法について、OpenAIがプラグインに関して記載しているのは1文だけです。2つ目は、OpenAIのプラグインドキュメントにあるMCP Appsです。
MCPサーバーが独自のUIテンプレートを提供します。ChatGPTはチャット内の分離されたフレームにそのテンプレートを表示し、テンプレートがツールの結果を描画します(開発者ドキュメント:ChatGPT UI)。どちらの方法も、見た目は「チャット内のグラフ」です。しかし、誰が描画するのか、どれだけ安定しているのかは大きく異なります。
開発者ドキュメントでは、2つ目の方法が詳しく説明されています。ツールは_meta.ui.resourceUriでリソースを指し、リソースURIはui://で始まります。リソースタイプはtext/html;profile=mcp-appです。ChatGPTがテンプレートを読み込み、テンプレートはui/で始まるJSON-RPCメッセージでホストとやり取りします。従来の_meta["openai/outputTemplate"]キーも、エイリアスとして引き続き使えます(開発者ドキュメント:Build your MCP server)。
MCP Apps拡張のドキュメントでも、同じモデルが説明されています(MCP Appsドキュメント)。ツールがUIリソースを宣言し、ホストがそれをサンドボックス内でレンダリングします。OpenAIは分離型のパターンも推奨しています。データ用ツールはデータを返し、別のレンダリング用ツールがUIをマウントします。こうすると、「Re-roll」のようなボタンから、UI全体を再マウントせずにデータ用ツールを再度呼び出せます。
| 項目 | Intelligent UI | MCP Apps(サーバーUI) | EveryInfra MCPの現状 |
|---|---|---|---|
| 描画の担い手 | ChatGPTのモデルとコンポーネントライブラリ | MCPサーバーのHTMLテンプレート | テンプレートなし |
| データの渡し方 | モデルがツールのテキストと構造化コンテンツを読み取る | structuredContentがテンプレートに渡される | content[0].type = "text"のJSON文字列1つ |
| ツール結果の描画がドキュメント化されているか | 不要 | はい(それが本来の目的) | 該当なし |
| レイアウトの安定性 | 毎回変わる可能性あり。ユーザーはSimpleを選択可能 | 固定テンプレートで安定 | モデル次第 |
| 構築の担い手 | 構築不要(組み込み済み) | サーバー所有者が構築・レビュー・公開 | テンプレートは提供していません |
| 利用できる場所 | Chat(InstantからExtra Highまで) | プラグインが使える場所 | プラグインと同じ |
MCP仕様は、構造化された結果について明確に定めています。2025-06-18版のツールに関するセクションでは、ツールがoutputSchemaを宣言し、structuredContentでデータを返せます。後方互換性のため、構造化コンテンツを返すツールは、シリアライズしたJSONもTextContentブロックに含めるべきとされています(MCP仕様:Tools)。2026年11月5日、私たちはキーなしでhttps://api.everyinfra.com/mcpにinitializeとtools/listを送信しました。これらは無料です。
サーバーが報告するプロトコルバージョンは2025-06-18です。12個のツールのいずれも、outputSchemaや_metaのUIテンプレートを宣言していません。実際のtools/callの結果にはcontentしかなく、structuredContentはありません。
つまり、ChatGPTでEveryInfraのリモートMCPを使う場合、利用できるのは1つ目の方法だけです。モデルがJSON文字列を読み取り、数え、計算し、表とグラフのどちらを使うかを判断します。これは悪いことばかりではありません。Intelligent UIのコンポーネントはChatGPTのものなので、チャットになじみ、開発も不要です。
ただし、その安定性は2つの点に左右されます。1つは、プロンプトで求める内容を明確に伝えること。もう1つは、データが整っていて、モデルが900 KBのテキストの中で数え間違えない程度に短いことです。次の2つのセクションでは、セットアップとこの2点について説明します。
ChatGPTでEveryInfraのリモートMCPに接続する:個人プランとBusinessの違い
ヘルプセンターのページ「Connecting custom MCP servers in ChatGPT」に最新の手順が記載されています。Pluginsで「+」を選択し、「Add custom MCP server」を選びます。名前、サーバーURL、認証方式を入力します。リスクに関する警告を読んで同意し、「Create as a plugin」を選択します。
現在のPlugins画面では、先にDeveloper Modeを有効にする必要はありません(ヘルプセンター記事12584461、2026年11月5日確認)。同ページによると、サーバーを追加できるのはWebのみで、モバイルからは追加できません。OAuthを使う場合はIDプロバイダーがリフレッシュトークンを発行する必要があるため、スコープにoffline_accessを含めてください。
# Example setup (we did not sign in to ChatGPT; steps follow the Help Center; not run in ChatGPT)
# ChatGPT on the web -> Plugins -> + -> Add custom MCP server
Name:            EveryInfra
MCP server URL:  https://api.everyinfra.com/mcp/all
Authentication:  OAuth
# The consent page sends you to https://auth.everyinfra.com/oidc to sign in to EveryInfra
# Grant at least data:call (data calls) and offline_access (refresh token for ChatGPT)
# Accept the risk warning -> Create as a plugin
# Business workspace: only admins or owners create and publish; members then enable it in Plugins
# Enterprise / Edu: admins can use role-based access control (RBAC) to let chosen members create connectionsなぜ/mcpではなく/mcp/allなのでしょうか。EveryInfraの/mcpエンドポイントは、リクエストヘッダーでキーを受け取ります。これはClaude CodeやCursorのように、ヘッダーを設定できるクライアントに適しています。ChatGPTのカスタムMCPで選べるのは、OAuth、認証なし、混合のいずれかで、「ヘッダーにキーを入れる」という選択肢はありません(開発者向けドキュメント:Developer mode)。/mcp/allはOAuthを使用します。
そのProtected Resource Metadataでは、認可サーバーとしてhttps://auth.everyinfra.com/oidcが指定されており、スコープにはdata:callとoffline_accessが含まれます(EveryInfraのProtected Resource Metadata)。
これはOpenAIの認証ガイドの内容と一致します。リソースサーバーがProtected Resource Metadataを公開し、認可サーバーがOAuthメタデータを公開します。クライアントは、CIMD、動的クライアント登録、または事前定義されたクライアントのいずれかで自身を識別します(開発者向けドキュメント:Authentication)。これはMCP仕様の認可に関する部分に準拠しています(MCP仕様:Authorization)。以前は、認証なしで?key=付きのURLにキーを入れて使っていたユーザーもいましたが、こうした接続は2026年11月4日に動作しなくなりました。その際の401レスポンスはSpacesの記事に記録しています。
個人プランとBusinessの違いは明確です。Businessワークスペースでは、カスタムMCP接続を作成・公開できるのは管理者とオーナーのみです。EnterpriseとEduでは、管理者がロールベースのアクセス制御で選択したメンバーに接続の作成を許可できますが、公開できるのは管理者とオーナーのみです。個人プランについては、FAQ「Are apps and full MCP beta available to Pro users?」に、フルMCPはBusinessとEnterprise/Edu向けであると記載されています。
Proユーザーは、読み取り(read)と取得(fetch)の権限でカスタムMCPサーバーに接続できます。Businessのリリースノートには、プラグイン管理に関する更新も2件記載されています。2026年10月15日から、管理者は複数のプラグインをまとめて管理できるようになりました。2026年10月21日からは、Businessワークスペースの設定はAdmin Consoleで行います(Businessリリースノート)。
| 利用形態 | 追加する人 | データ呼び出し前の確認 | 注意点 |
|---|---|---|---|
| Plus / Pro(個人) | 本人 | あり(everyinfra_call_apiは読み取り専用としてマークされていないため) | Proは「read and fetch」とされていますが、読み取り専用でないツールをProがどう扱うかは不明なため、事前にテストしてください |
| Business | 管理者またはオーナーが作成・公開 | あり(管理者が承認ポリシーを設定可能) | メンバーは追加不可。チーム共有のEveryInfraアカウントで認可してください |
| Enterprise / Edu | 管理者または権限を持つメンバー。公開は管理者 | 可能 | ワークスペースでGPT-6とプラグインを有効にする必要があります |
| Free / Go | 記載なし | 該当なし | Intelligent UIは表示されますが、カスタムMCPについてはドキュメントに記載がありません |
この確認はツールアノテーションによるものです。EveryInfraのtools/listレスポンスでは、データツールeveryinfra_call_apiはreadOnlyHint: false、destructiveHint: true、openWorldHint: trueとなっています。カタログツールeveryinfra_list_capabilitiesは読み取り専用です。Developer modeのドキュメントによると、ChatGPTは読み取り専用のヒントがないツールを書き込みアクションとして扱います。
呼び出しのたびに確認が必要ですが、その会話内では承認を記憶させることもできます(開発者向けドキュメント:Developer mode)。
destructiveHint: trueという値は、必要以上に強い指定です。MCP仕様では、このヒントはツールが環境に対して破壊的な更新を行う可能性があることを意味します。データ呼び出しはRedditとXの公開投稿を読み取るだけで、そこでは何も変更しません。残高への課金も破壊的な更新には当たりません(MCP仕様:Tools)。ただし、ユーザーにとっての結果は同じです。ツールが読み取り専用としてマークされていないため、ChatGPTは呼び出す前に確認を求めます。
実際には、6回呼び出すレポートでも確認は1回です。記憶を選択すれば、そのチャット内の残りの呼び出しでは再度確認されません。
安定した表を出力させる:プロンプトとフィールドの設計
Intelligent UIに特別なプロンプトは必要ありません。ただ、「3つのブランドを投稿量とセンチメントで比較して」という指示はあいまいです。何を投稿量として数えるのか。「先週」とはどの7日間なのか。センチメントは誰の基準で判断するのか。モデルが毎回異なる解釈をする可能性があります。
プロンプトは3つのパートで構成することをおすすめします。取得パートでは、使用する機能とパラメータを指定します。集計パートでは、どの投稿を集計対象にするかを指定します。出力パートでは、どんな表とグラフを作り、表の下にどんな注記を付けるかを指定します。OpenAIのCustom Instructionsの例にある「選択肢を比較するときは表を使う」をプロフィールに設定しておけば、比較のたびにデフォルトで表が出力されます。
# Example prompt (example setup; not run in ChatGPT)
Use @EveryInfra to compare EcoFlow, Jackery and BLUETTI on X and Reddit last week
(UTC 2026-10-26 00:00 to 2026-11-02 00:00): discussion volume and sentiment.
Fetch, once per brand:
1. twitter/search: keyword = "<brand> since:2026-10-26 until:2026-11-02", limit = 200
2. reddit/subreddit_posts: r/Ecoflow_community, r/Jackery, r/bluetti, sort = newest, limit = 100
3. reddit/search: keyword = brand name, sort = newest, limit = 25 (for off-community mentions only, not weekly totals)
Count:
- Count only posts with posted_at inside the week. If X returns exactly 200, or the subreddit list does not reach Monday, write "at least".
- Split X posts by the language field: English, Japanese, other.
- Sentiment means the stance toward the brand, not the tone of the whole post. List posts from brand accounts separately and leave them out of sentiment.
Output:
- One table: brand | X posts | X likes | English / Japanese share | subreddit posts | subreddit comments | note
- One grouped bar chart: X posts and subreddit posts side by side
- One line under the table: how each column was counted, and which numbers are floorsデータ面では、EveryInfraのtwitter/searchの投稿1件には約30のフィールドがあります。カタログには、投稿者のアバター、プロフィール文、フォロワー数、ハッシュタグ、リンクなど、38のフィールドが記載されています(EveryInfraカタログ)。reddit/subreddit_postsは1件あたり14フィールド、reddit/searchは10フィールドです。レポートに必要なのはそのうちの一部だけです。下の表は、実際の結果に基づいて各指標と対応するフィールドを示したものです。プロンプトでこれらのフィールドを指定すれば、モデルが推測する必要はありません。
| 指標 | Xのフィールド | Redditのフィールド | 備考 |
|---|---|---|---|
| 投稿量 | posted_at、id | posted_at、id | 先にposted_atで対象の週に絞り込んでからカウント |
| エンゲージメント | like_count、reply_count、view_count | like_count、comment_count | Redditには閲覧数がないため、両者を合算しない |
| 言語 | language | なし | Reddit投稿の言語はモデルが判定する必要あり |
| ブランドによる投稿 | author_username | author_username | 除外にのみ使用し、個人のユーザー名は表示しない |
| 投稿タイプ | is_reply、is_quote | flair(subreddit投稿のみ)、community | r/Ecoflow_communityのみヘルプ用のフレアを使用 |
| センチメント | text | title、text | センチメントのフィールドはなし。モデルが読み取るか、自前で算出する必要あり |
EveryInfraの前段に、社内のデータサービスなど独自のMCPレイヤーを置いているチームもあります。その場合、MCPの仕様を活用すると動作をより安定させられます。outputSchemaを宣言し、絞り込んだ10個のフィールドをstructuredContentに入れ、同じJSONをテキストとしてTextContentブロックにも入れます。その効果を計測しました。
3ブランド分のXの結果配列を、エスケープ文字なしで改めてシリアライズしたところ、815,904バイトになりました。id、url、posted_at、language、like_count、reply_count、view_count、is_reply、is_quoteと、280文字に切り詰めたtextの10個のフィールドだけに絞ると、292,415バイト、つまり36%になりました。モデルが読む量が3分の2減るため、件数を数え間違えたり行を読み飛ばしたりする可能性も低くなります。
実際の1往復:モデルが送るものと返ってくるもの
プラグインを接続すると、モデルは標準のMCP tools/callを使ってEveryInfraを呼び出します。2026年11月5日 00:25:25(シンガポール時間)に、同じ形式のリクエストをhttps://api.everyinfra.com/mcpに送信しました。今回はヘッダーにAPIキーを指定しましたが、ChatGPTはOAuthトークンを使います。ただし、呼び出すデータツールは同じです。EcoFlowに関する過去1か月のRedditの上位投稿をリクエストしました。実際に送信したリクエストボディは次のとおりです。
{
  "jsonrpc": "2.0",
  "id": 7,
  "method": "tools/call",
  "params": {
    "name": "everyinfra_call_api",
    "arguments": {
      "platform": "reddit",
      "action": "search",
      "params": {"keyword": "EcoFlow", "sort": "top", "limit": 25}
    }
  }
}
サーバーは6.43秒後にHTTP 200で応答し、charged_usdは0.000556でした。result.contentの要素は1つで、typeはtextでした。そのtextは72,067バイトのJSON文字列でした。structuredContentもisErrorもUIテンプレートもありませんでした。文字列の中にはplatform、action、count: 16と16件のデータが入っていました。
各件のフィールドはid、url、title、text、author_username、community、like_count、comment_count、posted_at、platformの10個でした。最後に課金の詳細が続きます。25件を求めて16件が返りました。カタログによると、reddit/searchの対象は直近1か月のみです。上位の投稿が少なければ返る件数も少なくなり、呼び出しあたりの価格は変わりません。
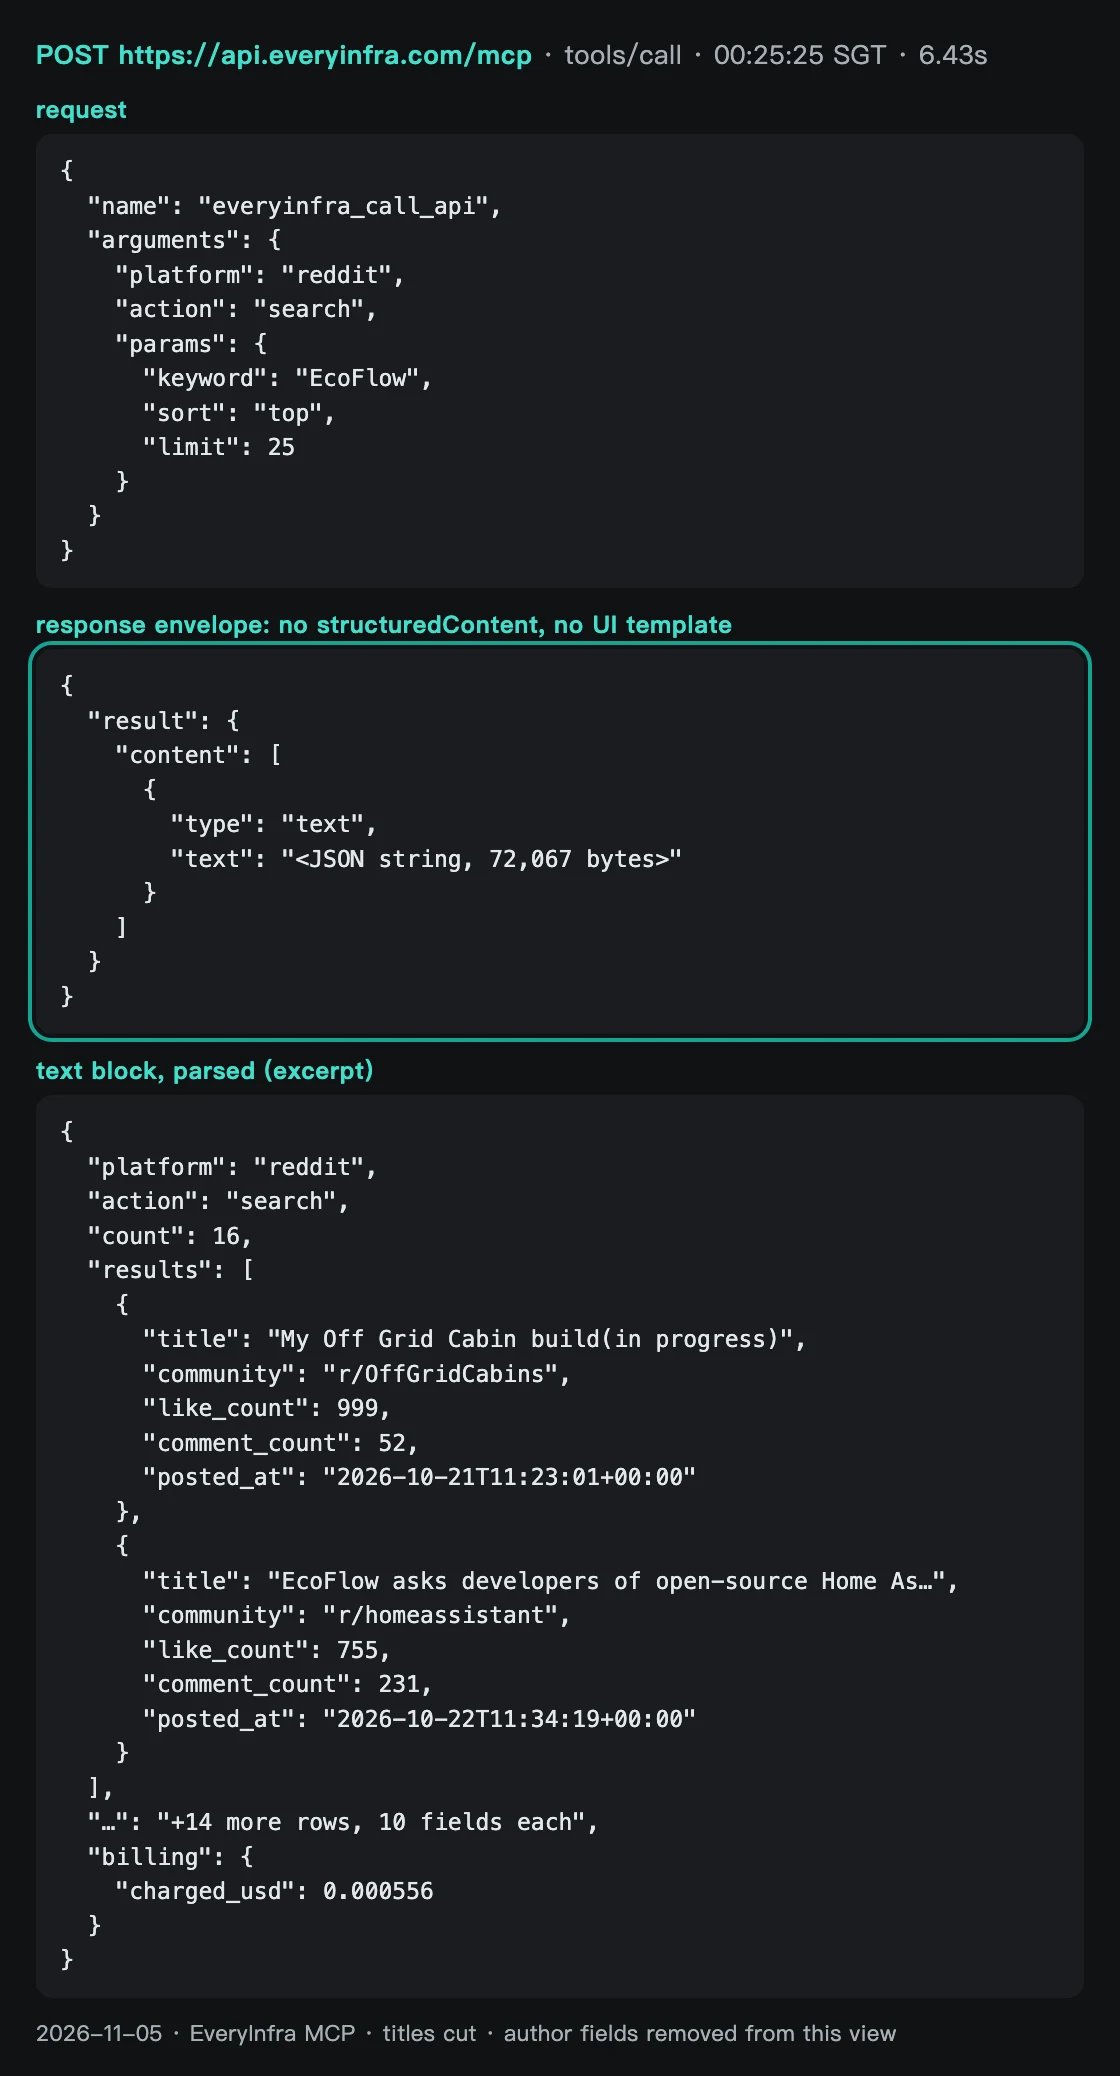
この16件の上位2件を見ると、「ブランドに関する議論」の定義がいかに難しいかがわかります。1件目は、カナダのプリンスエドワード島にあるオフグリッドキャビンの製作記録です。EcoFlowに触れているのは1文だけで、オーナーがEcoFlow Delta Pro、追加バッテリー、495 Wのパネル3枚でキャビンの電力をまかなっているという内容です。それでも999件のいいねを集めました。2件目は、EcoFlowとオープンソースのHome Assistant開発者に関するr/homeassistantのスレッドで、いいね755件、コメント231件です。
こちらはブランドに対する実際の意見を表しています。16件のうち先週の期間に入る投稿は1件もなく、2026年10月5日から11月4日にかけてのものでした。「top」の並び順が答えるのは「今月最も読まれたものは何か」であり、「先週どれだけ話題になったか」には答えられません。


レポート作成を上記の6ステップに分けてみます。最初の3つはChatGPTとAPIの間で行われ、残りの3つはモデルの役割です。APIが保証するのはステップ4より前の部分です。正しいパラメータを指定すれば生データが返り、失敗した呼び出しや結果が空の呼び出しは課金されません。
レポートに誤りが生じるのは、ステップ5の絞り込みと集計です。以下の5つのテストはすべてこのステップに関するものです。モデルがposted_atで絞り込まなかったり、上限で頭打ちになった数を総数として扱ったりすることがあります。そうなると、グラフの見た目は良くても棒の高さが間違っている、ということが起こります。
本記事で実際に行った呼び出しは、すべて以下のログに記録されています。時刻は2026年11月5日のシンガポール時間です。
| 時刻 | 機能 | ブランド | 返された行数 | 課金額 |
|---|---|---|---|---|
| 00:18〜00:19 | reddit/search(newest) | 3 | 16, 24, 24 | 3 x $0.000556 |
| 00:19〜00:21 | twitter/search(先週) | 3 | 200, 200, 167 | 3 x $0.000556 |
| 00:22〜00:24 | reddit/subreddit_posts(newest) | 3(429応答後の再試行2回を含む) | 各100件 | 3 x $0.000556 |
| 00:25 | MCP tools/call、reddit/search(top) | EcoFlow | 16 | $0.000556 |
| 00:25〜00:27 | reddit/search(top) | Jackery、BLUETTI(再試行1回) | 22, 22 | 2 x $0.000556 |
| 00:26 | twitter/search(スペイン語) | 3ブランドを1つのクエリで | 24 | $0.000556 |
テスト1:先週のX検索結果に対象週より後の投稿が含まれていた
Xの検索は日付演算子since:とuntil:に対応しています。EveryInfraのカタログには、twitter/searchのキーワードにプラットフォームの検索構文を含められると記載されています(EveryInfraカタログ)。Xヘルプセンターに書かれているのは、特定の日付より前、後、または期間内の投稿を検索できるということだけです。例として、新年の投稿を探すsince:2013-12-30 until:2014-01-02が挙げられています。
until:の日付が含まれるかどうかや、どのタイムゾーンが適用されるかは書かれていません(Xヘルプセンター:高度な検索)。2026年11月5日 00:19〜00:21(シンガポール時間)に、ブランドごとに1回ずつ検索を実行しました。キーワードは「ブランド名 since:2026-10-26 until:2026-11-02」、limitは200です。
すべての投稿はsince:の日付より後のものでしたが、until:より後の投稿も多数ありました。EcoFlowは200件が返り、そのうち42件のposted_atがUTCで2026年11月2日以降でした。Jackeryは200件中52件、BLUETTIは167件中22件です。余分な投稿の大半は11月2日のもので(EcoFlow 40件、Jackery 48件、BLUETTI 19件)、11月3日のものも2〜4件ありました。モデルがcountをそのまま件数として使うと、EcoFlowは27%、Jackeryは35%多く見積もられます。そのため、プロンプトには「posted_atが週内の投稿のみを数える」という一文を残しておきましょう。
2つ目の問題は上限です。twitter/searchの1回の呼び出しで返る投稿は最大200件です。EcoFlowとJackeryはどちらもちょうど200件が返ったため、週内にはさらに多くの投稿がある可能性があります。158件と148件には「少なくとも」を付けてください。BLUETTIは167件で上限に達していないため、145件がこの検索で取得できた全件です。
カタログによると、XはデフォルトでTop順に並べ、latestでも厳密な時系列順は保証されません。つまり、上限に達した結果は「最新の200件」ではありません。正確に数えるには、週を2つまたは7つの期間に分け、期間ごとに1回ずつ呼び出します。呼び出し回数は増えます。具体的な数字は後述のコストのセクションを参照してください。
テスト2:Redditの1回の検索でカバーできたのは1〜2日分だけだった
reddit/searchが返す投稿は最大25件で、対象は過去1か月のみです。2026年11月5日 00:18と00:19(シンガポール時間)に、ブランドごとにnewestの検索を1回ずつ実行しました。EcoFlowで返ったのは16件だけでした。最も古い投稿はUTCで11月3日の午後のもので、検索がカバーした期間は24.8時間でした。
Jackeryは38.8時間分で24件、BLUETTIは51.0時間分で24件でした。各期間は、最新の投稿から最も古い投稿までの時間です。いずれも先週までは届きませんでした。投稿間の間隔から、サイト全体での言及ペースはそれぞれ1日あたり約15.5件、14.9件、11.3件と推定しています。これは推定値であり、実数ではありません。
サイト全体の検索はノイズも多くなります。EcoFlowの16件は、r/Ecoflow_community(6件)、r/prepping、r/dieselheater、r/overlandingなど約10のコミュニティに分散していました。Jackeryは24件中9件がr/Jackeryで、残りはセール情報の投稿や防災系のコミュニティでした。BLUETTIは24件中r/bluettiの投稿が4件だけでした。
3つの検索に占めるブランドコミュニティの投稿の割合は、それぞれ37.5%、37.5%、16.7%でした。この種のデータからわかるのは、ブランドがどこで言及されているかです。週あたりの総数はわかりません。1回の呼び出しで返るのは25件までなので、話題の多いブランドでは1日分で結果が埋まってしまいます。また、追加の呼び出しごとにどこまで遡れるかも確実にはわかりません。
週ごとの合計を見るなら、各ブランドのコミュニティのほうが信頼できます。シンガポール時間00:22〜00:24に reddit/subreddit_posts で各コミュニティの最新100件の投稿を取得しました。r/Ecoflow_communityの先週の投稿は少なくとも73件、コメントは492件でした。100件を取得しても月曜日の開始時点までは遡れなかった(最も古い投稿はUTCで10月26日16:01)ため、73件は下限値です。r/Jackeryは投稿13件・コメント206件、r/bluettiは投稿20件・コメント93件でした。
今回のラウンドでは、429(レート制限)の応答を2回受けました。60秒待ってから再試行しています。この2回の429応答は課金されていません。
3つのうちフレアを使っているのはr/Ecoflow_communityだけです。先週は「Open Discussion」が29件、「Troubleshooting Help」が26件あり、ほかにDIY、電源バックアップ、レビューなどの投稿が少数ずつありました。「Troubleshooting Help」の26件は、その週の投稿の少なくとも36%を占めます。この数字は品質シグナルとしてそのままレポートに載せられます。
メンバー自身がflairの値を設定しているため、モデルがセンチメントを判定する必要はありません。他の2つのコミュニティにはフレアがないため、モデルがタイトルを分類しなければなりません。同じプロンプトでもブランドによって結果の詳細度が異なるのはこのためです。データそのものの構造が違うのです。
テスト3:投稿の半数が日本語だった
センチメントは、プロンプトが求める2つ目の数値です。簡単なのは英語の投稿だけを読む方法です。しかしXのlanguageフィールドを見ると、先週の言語構成はブランドごとに大きく異なっていました。EcoFlowの投稿は158件で、英語110件、日本語20件、その他の言語(ドイツ語、スペイン語、ウクライナ語、ポルトガル語など)28件でした。
Jackeryは148件で、英語77件、日本語65件でした。BLUETTIは145件で、英語48件、日本語69件と日本語が上回りました。割合で見ると、先週のX投稿に占める日本語の比率はJackeryで44%、BLUETTIで48%です。
日本語の投稿の背景には明確なニュースがあり、その発端は英国です。英国政府は、各家庭に「簡単にできる小さな対策」を取るよう促す、緊急時への備えに関する新たな指針を公表しました(GOV.UKのニュースリリース)。キャンペーンサイトでは3日分の備蓄品が挙げられています(Be Readyサイト)。The Guardianは2026年10月22日、すべての英国民が水と3日分の食料を備えておくよう求められたと報じました(The Guardian)。Reutersも2026年10月23日に報じました(Reuters)。その見出しは、英国が国民に3日分の非常用物資を自宅に備えるよう求めた、というものです。
先週、3ブランド全体で最もいいねを集めた投稿は、このニュースを受けたものでした。日本人の投稿者が2026年10月27日に長いスレッドを投稿しました。日本も英国にならい、全国民に備えを呼びかけるべきだという内容です。そこでは英国の備蓄品として、3日分の水、手回しラジオ、食料、医薬品、身分証明書や保険関係書類の紙のコピーが挙げられています。
スレッドの後半では大容量のモバイルバッテリーを勧め、家族がJackery、EcoFlow、BLUETTIを使ったことがあり、どれも良いと述べています。この投稿は4,406件のいいねと643,989回の表示を獲得しました。米国や英国の読者にとっての教訓は、英語だけのレポートでは、今週の防災に関する議論が実際に行われていた場所を見落とすということです。
この投稿は、言語よりも大きな問題も浮き彫りにしています。3ブランドすべての名前を挙げているのに、この投稿が返ってきたのはBLUETTIの検索だけでした。EcoFlowとJackeryの検索はどちらも上限の200件を返しましたが、どちらにも含まれていませんでした。3つの結果を比べると、どの2ブランドの間でも共通する投稿は1〜8件しかありません。つまり、先週3ブランドすべてについて最もいいねを集めた投稿が、3つのブランドレポートのうち2つには存在しないのです。
理由はレスポンスからはわかりません。200件の上限から漏れたのかもしれませんし、スペースのない日本語テキスト内のブランド名に検索がマッチしないのかもしれません。いずれにせよ、ルールは明確です。上限に達した検索結果は、週全体ではなくサンプルとして扱ってください。本格的なレポートでは、3つの結果を統合して重複を除き、各投稿に、その投稿が言及するすべてのブランドをタグ付けすべきです。
3ブランドは日本でも自ら投稿しています。先週、EcoFlowJapan、jackeryjapan、BLUETTI_JAPANはそれぞれ5回、3回、9回投稿しました。レポートが英語しか読まなければ、BLUETTIの投稿の半数近くがセンチメントスコアの対象から外れ、最もいいねを集めた投稿も除外されます。プロンプトに「Xの投稿を言語別に分ける」という一文があるのは、モデルにまず言語構成を示させるためです。GPT-6は日本語を読めます。しかし、言語別に分けるかどうか、そして各言語に同じルールを適用するかどうかは、プロンプト次第です。
テスト4:センチメントを誰が判定するか、投稿数といいね数のどちらを基準にするか
モデルに依存しない検証をしたかったため、先週の英語の投稿をオープンソースのVADER 3.3.2辞書でスコアリングしました。compoundスコアが0.05以上ならポジティブ、-0.05以下ならネガティブです。VADERはソーシャルメディアのテキスト向けによく使われるルールベースのツールです(VADERリポジトリ)。投稿数ベースでは、ネガティブの割合は近い値です。EcoFlowは17%(110件中19件)、Jackeryは21%(77件中16件)、BLUETTIは19%(48件中9件)でした。いいね数で重み付けすると状況は変わります。英語投稿のいいねのうちネガティブな投稿が占める割合は、EcoFlowで54%、Jackeryで38%、BLUETTIで22%です。
「54%がネガティブ」と聞くと、EcoFlowにとって危機のように思えます。実際はそうではありません。各ブランドについていいねが多い上位15件の英語投稿を読み、ブランドに対するスタンスにラベルを付けました。
ルールは次のとおりです。ブランドへの称賛や推奨、製品の購入、満足して使っている様子を示す投稿はポジティブとし、ブランドによるマーケティング投稿もポジティブとします。ブランドや製品への不満はネガティブです。単に言及するだけの投稿、募金リスト、ニュース、評価を交えずに使用について述べた投稿はニュートラルです。すべてのラベルは記事の筆者が一度の作業で付けており、他の人は確認していません。そのため、これらのラベルはVADERがどこで誤るかを示すためだけに使い、精度スコアとしては使いません。
EcoFlowでは15件中14件がニュートラル、1件がポジティブでした。EcoFlowへの不満は1件もありません。上位の投稿はキーウの停電に関するものでした。
今年最大規模となるロシアのウクライナ電力網への攻撃の後、キーウでは緊急停電と断水が発生しました(Kyiv Independent)。投稿では、停電を乗り切る手段としてEcoFlowの製品が挙げられています。前線への募金リストの中で、EcoFlowが品目の1つとして挙がっている投稿もあります。辞書は「attack」「blackout」「war」といった語を見てネガティブと判定します。しかし、これらの語が指しているのは戦争であり、ブランドではありません。
3ブランドを並べると、問題がよりはっきりします。VADERが筆者の判断と一致したのは、EcoFlowでは15件中わずか1件でした。Jackeryでは6件で、上位の投稿は盛り上がった防災スレッドの中にあるものの、ブランドに対してはニュートラルです。BLUETTIでは11件が一致し、最も良く見えます。
その理由は、15件中11件がbluetti_inc自身によるハロウィンや新製品発表のマーケティング投稿だったことです。ブランドのマーケティングはトーンがポジティブで、ブランドに対しても肯定的なので、辞書と筆者のラベルが一致します。先週はブランドアカウントからの投稿が多く、EcoFlowのアカウントは19回(EcoFlowTech 9回、EcoFlowJapan 5回、その他)、BLUETTIのアカウントは23回(bluetti_inc 14回、BLUETTI_JAPAN 9回)、Jackeryのアカウントは5回投稿していました。これらを除外しなければ、「BLUETTIへのセンチメントが最もポジティブ」という結果の多くは、BLUETTIが自社について語っているにすぎません。
センチメント分析を使わずに結論を変える数字がもう1つあります。いいねの集中度です。先週のBLUETTIの145件の投稿には5,299件のいいねが付きました。そのうち4,406件、つまり83%を前述の日本語スレッドが占めています。上位3件では89%です。EcoFlowとJackeryでは、上位3件の割合は51%と54%でした。
つまり「BLUETTIのエンゲージメントが最も多かった」とは、実際には「BLUETTIに言及した日本語の投稿が1件バズった」という意味です。しかもその投稿は3ブランドすべてに言及しており、拾えたのはBLUETTIの検索だけでした。レポートでは、合計値と並べて表示回数の中央値(EcoFlow 171.5、Jackery 137.5、BLUETTI 191)と上位3件が占める割合を示すべきです。そうすれば、1件の投稿が盛り上がりを左右しているかどうかを読者が判断できます。
これらのテストから、センチメント列について3つのルールが導けます。上記のプロンプトには3つすべてを含めています。ブランドに対するスタンスだけを判定し、ブランドアカウントの投稿は分けて記載してください。また、件数ベースの割合といいね数ベースの割合の両方を示してください。
GPT-6は辞書ベースの手法よりもはるかに的確に全文を読み取れます。ただし、ChatGPTでそのラベル付けは検証していません。それでも、1つ確かなことがあります。プロンプトに「センチメントを分析して」としか書かれていなければ、モデルは投稿全体のトーンを判定します。そうなると、辞書と同じ誤りを犯します。
テスト5:1回のレポートのデータ量はどれくらいか
最後のテストでは、モデルが読み込む必要のあるデータ量を調べました。保存した各レスポンスのサイズを測定したところ、twitter/search 1回(最大200件)は平均約261 KBでした。reddit/search 1回(最大25件)は約50 KB、reddit/subreddit_posts 1回(100件)は約94 KBでした。
MCPのテキストブロックは72 KBでした。ブランドごとにXの呼び出し1回とRedditの検索1回を行う基本レポートは、合計930,618バイトになりました。1トークンあたり約4バイトとすると、約233,000トークンです。subredditの一覧と月間トップ投稿を含むフルレポートは1,395,246バイト、約349,000トークンでした。
OpenAIヘルプセンターには、GPT-6の1つのチャットで扱えるツール出力の量が記載されておらず、ChatGPTでの検証も行っていません。そのため「収まる」とも「収まらない」とも言いません。言えるのは、データ量の大半をXのデータが占めているということです。1投稿あたり約1.3〜1.4 KBあり、投稿者のアバターURL、プロフィール文、メディアの詳細といったフィールドはレポートには役立ちません。
フィールドを10個に絞り、本文を280文字で切り詰めたところ、Xの部分は815,904バイトから292,415バイトに減りました。この2つの数値は、シリアライズした結果配列のサイズです。前述の930,618バイトは保存したファイルのサイズなので、両者を差し引きしないでください。独自のレイヤーを挟まずにEveryInfraのMCPを直接使う場合は、取得量を減らすよう指定できます。Xのlimitを200から100に下げてください。その分、週内の投稿数が実数ではなく下限値としてしか得られないケースが増えます。
レポートの完成イメージ:最初の比較表
上記のルールを、先週(2026年10月26日〜11月1日、UTC)の実データに適用した結果です。プロンプトのルールに従って、生のレスポンスから算出しました。Intelligent UIが理想どおりに機能した場合に描画すべき表です。ChatGPTが実際に何を描画するかは検証していません。
| ブランド | 週内のX投稿数 | Xのいいね数/表示回数の中央値 | 英語/日本語 | 週内のsubreddit投稿数 | subredditのコメント数 | 英語のネガティブ投稿(件数/いいね数) | 備考 |
|---|---|---|---|---|---|---|---|
| EcoFlow | 158件以上 | 4,869 / 171.5 | 110 / 20 | 73件以上(r/Ecoflow_community) | 492 | 17% / 54% | ネガティブ投稿のいいね数は、ブランドへの苦情ではなく、キーウの停電と募金活動に関する投稿によるもの。コミュニティ内のヘルプ投稿は26件 |
| Jackery | 148件以上 | 2,016 / 137.5 | 77 / 65 | 13件(r/Jackery) | 206 | 21% / 38% | 日本語の投稿が44%。上位の投稿は防災関連のスレッドに集中 |
| BLUETTI | 145 | 5,299 / 191 | 48 / 69 | 20件(r/bluetti) | 93 | 19% / 22% | いいねの83%が、3ブランドすべてに言及した日本語の投稿1件に集中。英語の上位投稿はブランドのマーケティング投稿 |
この表から3つの結論が得られます。1つ目に、3ブランドのXでの投稿量はほぼ同じ水準です。2ブランドが200件の上限に達しているため、差はデータの誤差より小さくなっています。
第2に、Redditで最も活発なのは明らかにEcoFlowのコミュニティです。投稿数とコメント数はほかの2社の数倍で、ヘルプのフレアが付いた投稿が26件あります。表に出るのは件数だけです。これらが1つの製品の問題を示しているかどうかは、人が投稿を読んで判断する必要があります。
3つ目に、先週最もいいねを集めた投稿は、停電と防災に関するものでした。3ブランドすべてに言及した日本語の投稿は、英国が呼びかけている3日分の備蓄の話から始まっています。EcoFlowの英語の投稿でいいねが最も多かったのは、キーウの停電に関するものです。
レポート1回あたりのAPI料金
EveryInfraの価格は、2026年11月5日に読んだカタログに基づいています。twitter/search、reddit/search、reddit/subreddit_postsはいずれも1回の呼び出しあたり$0.000556です。失敗した呼び出し、レート制限された呼び出し、空の呼び出しは無料です(EveryInfraカタログ。料金ページでも確認できます)。価格は件数ではなく呼び出し単位です。16件を返すreddit/searchも24件を返すreddit/searchも同じ価格で、200投稿を返すtwitter/searchも1回の呼び出しです。
| レポートの種類 | 呼び出し回数 | API料金 |
|---|---|---|
| 基本:3ブランド、各ブランドでX検索1回とReddit検索1回 | 6 | $0.003336 |
| フル:サブレディットの最新投稿100件とRedditの月間トップ投稿を追加 | 12 | $0.006672 |
| Xの正確な日別件数(3ブランド×7日)にサブレディットを追加 | 24 | $0.013344 |
| フルレポートを週1回作成した場合(月あたり、52週÷12) | 約52 | $0.028912 |
| フルレポートを週1回作成した場合(年あたり) | 624 | $0.346944 |
| 本記事(2026年11月5日 00:18〜00:27、シンガポール時間) | 16リクエスト(課金13件、レート制限3件) | $0.007228 |
ChatGPTでは、レポートごとの料金はかかりません。Intelligent UIには別枠の利用上限がなく、プラグインの呼び出しにも追加料金はかかりません。プラグインの呼び出しはプランの利用枠にカウントされます(ヘルプセンター20001354)。
2026年11月5日時点でヘルプセンターに記載されているプラン料金は次のとおりです。Plusは月額$20です(ヘルプセンター20001493)。Proは月額$100、$200、$500のいずれかです(ヘルプセンター9793128)。Business Standardは1シートあたり月額$25、年払いの場合は1シートあたり月額$20です(ヘルプセンター8792828)。つまり実際のコストは、固定のプラン料金と、ほぼゼロのAPI料金の合計です。フルレポートを1年間で52回作成しても、API料金は$0.35です。
これはPlusの1か月分の約57分の1です。最もコストがかかるのは人の作業時間です。各レポートについて、上限への到達、言語構成、ブランドアカウントによる投稿を誰かが確認する必要があります。
レート制限もコストの1つです。テスト用APIキーでは1分あたり10リクエストまで許可されており、429の応答を3回受けました。レスポンスボディには「10 requests per minute」「retry after 17s」「nothing was charged」と書かれていました。ヘッダーにはretry-after: 17とx-ratelimit-limit-requests: 10が含まれていました。
ChatGPTへの1回の質問で発生する6回の呼び出しなら、通常は上限に達しません。ただし、複数のチームメンバーが1つのEveryInfraアカウントを共有して同時にレポートを実行すると、上限に達する可能性があります。429のテキストはAIが読むことを想定して書かれており、モデルはそれを読んで、たいていは待機してから再試行します。
RedditとHacker Newsの反応
過去1か月間のRedditとHacker Newsで「gpt 6 intelligent ui」を検索しました。探したのは1点だけで、独自のMCPデータをIntelligent UIがグラフとして描画した事例です。事例も反例も見つかりませんでした。ほとんどのスレッドはIntelligent UIそのものについての議論で、引用からはすべてユーザー名を削除しています。r/OpenAIのローンチスレッドでは、最上位のコメントが、コードを書く人だけでなく一般ユーザーの役に立つ久しぶりの機能だと評価していました。Javaアプレットになぞらえるコメントもありました(r/OpenAIのローンチスレッド)。
r/ChatGPTのローンチスレッドでは、他のモデルが作るアーティファクトとどう違うのかを尋ねるユーザーがいました。Chatでのみ動作し、Workでは使えないと指摘するユーザーもいました(r/ChatGPTのローンチスレッド)。r/codexのスレッドでは、以前は不可能だったどんなことができるのかが問われていました(r/codexのスレッド)。Hacker Newsでの批判は、画像と余白が増えて1画面あたりの情報量が減る点に集中していました(Hacker Newsのスレッド)。r/technologyへの転載では、モデルにすべての作業を任せることに懐疑的な声が大半でした(r/technologyのスレッド)。
レポートの観点で最も重要なのは、r/ChatGPTのあるスレッドのタイトルです。Intelligent UIは優れているが、まだインフラではなくスケッチパッドにすぎない、という内容です(r/ChatGPTのスレッド)。この見方は私たちのアドバイスと一致します。Intelligent UIは、質問時の簡易ビューとして使ってください。継続的に追跡する数値は、共有ページか自分のスプレッドシートで管理してください。共有ページについてはSpacesの記事で紹介しています。
制限事項と注意点
| 落とし穴 | 確認した内容 | 対処法 |
|---|---|---|
| 対象週以外の投稿 | Xのuntil:では42件、52件、22件が混入 | posted_atで絞り込む |
| 取得上限 | X投稿200件、サブレディット投稿100件 | 「以上」と明記するか、週を分割する |
| 投稿の取りこぼし | トップ投稿は3ブランドに言及していたが、1回の検索でのみ見つかった | ブランドごとの結果を統合し、重複を除く |
| 言語 | 2ブランドで日本語がそれぞれ44%と48% | 先にlanguageで分ける |
| ブランドアカウント | BLUETTIの英語上位15件のうち11件 | 感情分析とは別に一覧化する |
OpenAIは、Intelligent UIがカスタムMCPの結果を描画することを保証していません。この方法は全体として、モデルがテキストを読み取り、自ら表を組み立てることに依存しています。これは「回答に表やグラフを含められる」というOpenAIの説明の範囲内ですが、個別にドキュメント化された機能ではありません。チームに展開する前に、ご自身のアカウントで同じプロンプトを3回実行してください。レイアウトが安定していることを確認してから利用しましょう。
データツールの呼び出しには確認が求められます。everyinfra_call_apiは読み取り専用としてマークされていないため、開発者モードとプラグインの権限設定により、ChatGPTは呼び出す前に確認を求めます。Businessの管理者は、プラグイン設定で承認ポリシーを変更できます。個人のProについては、OpenAIは「読み取りと取得の権限」と記載しています。Proで読み取り専用でないツールが実行されるのか、確認を求められるのか、ブロックされるのかはドキュメントに記載がなく、私たちもChatGPTでは検証していません。
Intelligent UIの状態はチャットをまたいで引き継がれません。ヘルプセンターによると、チェックリストなどのコンポーネントはページを再読み込みしても状態が保持されますが、新しいチャットでは保持されません。翌週に同じ質問をするとまったく新しいレポートが作られ、前週のトグルやフィルターは引き継がれません。週ごとに比較するには、各表をコピーして保存するか、Spacesのページを使ってください。
Intelligent UIはAPI経由では利用できません。開発者向けドキュメントでは、chat-latestはChatGPTで使われている最新のInstantモデルと説明されています(chat-latestモデルページ)。変更履歴にはそのスナップショットの更新が記録されています(APIの変更履歴)。Intelligent UIのコンポーネントがAPIで提供されるという記述は見つかりませんでした。自社プロダクト内で同じレポートを作るには、グラフを自前で描画してください。
データには落とし穴が3つあります。Xのuntil:は対象週より後の投稿も含むため、posted_atで改めて絞り込んでください。twitter/searchの上限200件とreddit/subreddit_postsの上限100件により、投稿の多いブランドの件数は下限値になります。上限に達した検索では、その週で最も反応の大きい投稿を取りこぼすこともあります。Redditの行には言語フィールドがないため、日本語やスペイン語の投稿はモデル自身が判定する必要があります。上のプロンプトはこの3点すべてに対応しています。各表の下の注記にも同じ内容を記載してください。
RedditとXにはそれぞれ独自の規約があります。EveryInfraは市場調査とブランドモニタリングのために公開投稿を返します。結果を再配布する場合、モデルの学習に使う場合、個人をプロファイリングする場合は、まず各プラットフォームの規約を確認してください。Reddit Data APIのページによると、利用ルールはDeveloper TermsとData API Termsで定められています(Reddit Data API Wiki)。データを再利用する前にReddit Data API Termsをお読みください。本記事は法的助言ではありません。
最近の変更点
| 日付 | 変更内容 |
|---|---|
| 2026年10月7日 | Plus、Pro、Business、Enterprise向けに、ChatでGPT-6とIntelligent UIの提供を開始。同日、Businessのリリースノートにも記載。 |
| 2026年10月8日 | FreeとGoでGPT-6 Lunaが利用可能に。 |
| 2026年10月22日 | The Guardianが英国のBe Ready勧告を報道。2026年10月23日にReutersが続報。 |
| 2026年11月4日 | URLにキーを含むEveryInfra MCP接続が利用不可に。ChatGPTユーザーはOAuthで/mcp/allに移行。 |
| 2026年11月5日 | 当社による実際の呼び出しと、各公式ページの閲覧日。 |
GPT-6 Intelligent UIのよくある質問
無料ユーザーもGPT-6 Intelligent UIを使えますか?
はい。発表記事によると、FreeとGoでは2026年10月8日からGPT-6 Lunaで利用可能になり、ヘルプセンターではLunaがIntelligent UIに対応しているとされています。ただし、カスタムMCPに関するヘルプセンターのページでは、カスタムMCPサーバーを追加できるプランにFreeとGoは含まれていません。つまり、無料アカウントでもIntelligent UIの回答は表示されますが、EveryInfraを接続できるかどうかはOpenAIのドキュメントに記載がありません。出典:OpenAIの発表記事、ヘルプセンター20001598。
Intelligent UIはオフにできますか?
完全にはオフにできず、表示をシンプルにできるだけです。Intelligent UIのページでは、Webで「Personalization」→「Layout and Visuals」→「Simple」と設定するよう案内されています。GPT-6モデルのページでは、設定で「Layout and visuals」をオフにするよう記載されています。どちらのページも一部の視覚要素は表示される場合があるとしており、テキストのみの完全なモードはありません。出典:ヘルプセンター20001598、ヘルプセンター20001354。
開発者はAPIでIntelligent UIを使えますか?
ドキュメントで確認できる範囲ではできません。APIにはchat-latestがあり、ChatGPTで使われている最新のInstantモデルと説明されています。ただし、私たちが確認したAPIドキュメントと変更履歴には、Intelligent UIのコンポーネントがAPIで提供されるという記載はありません。自社アプリでインタラクティブなUIを実現する場合、OpenAIがドキュメントで示している方法は、MCP Appsテンプレートを使ったプラグインです。出典:chat-latestモデルページ、開発者ドキュメント:ChatGPT UI。
Intelligent UIはカスタムMCPのデータを自動でグラフにしますか?
ドキュメントではそのようには説明されていません。プラグインについて、ヘルプセンターには接続済みのプラグインは「引き続き動作します」としか書かれていません。EveryInfra MCPは、structuredContentもUIテンプレートも含まないJSON文字列を返します。モデルがそれを読み取り、Intelligent UIでグラフを作成する必要があります。
グラフが表示されるか、毎回同じ見た目になるかは、プロンプトとデータ量によって変わります。グラフのレイアウトを固定したい場合、ドキュメントで示されている方法はMCP Appsです。出典:ヘルプセンター20001598、MCP仕様:Tools。
チャットにGPT-6 Solと表示されているのに、ビジュアルが出ないのはなぜですか?
次の4点を確認してください。Chatタブを使っていますか?WorkとVoiceは対応していません。思考レベルでProを選んでいませんか?GPT-6 Astraは対応していません。
デスクトップアプリが古いバージョンではありませんか?設定でSimpleを選んでいませんか?提供は段階的に行われており、Redditでは公開から数日たってもビジュアルが表示されない有料ユーザーもいました。出典:ヘルプセンター20001598、r/ChatGPTのローンチスレッド。
始め方
- EveryInfraコンソールで新規登録し、残高をチャージします。無料で閲覧できるカタログで、
twitter/search、reddit/search、reddit/subreddit_postsが利用可能か確認してください。 - curlまたはプレイグラウンドで、各機能を1回ずつ呼び出します。X検索とReddit検索のフィールド、取得上限、日付の書式を確認してください。
- Web版ChatGPTの「Plugins」で、カスタムMCPサーバーとして
https://api.everyinfra.com/mcp/allをOAuthで追加します。リモートMCPのセットアップとMCPサーバーのページを参照してください。Businessの場合は管理者に依頼してください。 - カスタム指示に「選択肢を比較するときは表を使い、各数値の集計方法を明記して」と追加します。上のプロンプトで質問します。最初の呼び出しを承認し、その承認をこのチャット内で記憶する設定を選びます。
- 対象週外の投稿、取得上限、言語という3つの落とし穴に照らして表を確認します。そのうえでチームと共有します。
関連記事
- ChatGPT Spacesで作る競合トラッカー:チームで毎週更新する共有ページ。このレポートの数値をまとめておく場所に適しています。
- ChatGPT dotsで作るプロダクトリサーチレーダー:常時稼働エージェント向けの2種類の権限設定と、有料のデータ呼び出しを割り当てたタスクで行うべき理由。
- ChatGPTのスケジュールタスクで作る需要レーダー:Redditの不満や質問を、毎週1人の担当者にプッシュ通知します。
- RedditデータAPIとXデータAPI:すべての機能、パラメータ、料金。
参考文献
- GPT-6 and Intelligent UI for everyone、OpenAI、2026年11月5日閲覧、https://openai.com/index/gpt-6-for-everyone/
- Intelligent UI in ChatGPT、OpenAIヘルプセンター、2026年11月5日閲覧、https://help.openai.com/en/articles/20001598-intelligent-ui-in-chatgpt
- 「ChatGPTのGPT-6とその他のモデル」、OpenAIヘルプセンター、2026年11月5日閲覧、https://help.openai.com/en/articles/20001354-gpt-6-and-other-models-in-chatgpt
- Connecting custom MCP servers in ChatGPT、OpenAIヘルプセンター、2026年11月5日閲覧、https://help.openai.com/en/articles/12584461-connecting-custom-mcp-servers-in-chatgpt
- ChatGPT Business release notes、OpenAIヘルプセンター、2026年11月5日閲覧、https://help.openai.com/en/articles/11391654-chatgpt-business-release-notes
- ChatGPT release notes、OpenAIヘルプセンター、2026年11月5日閲覧、https://help.openai.com/en/articles/6825453-chatgpt-release-notes
- ChatGPT Enterprise and Edu release notes、OpenAIヘルプセンター、2026年11月5日閲覧、https://help.openai.com/en/articles/10128477-chatgpt-enterprise-and-edu-release-notes
- ChatGPT Business models and limits、OpenAIヘルプセンター、2026年11月5日閲覧、https://help.openai.com/en/articles/12003714-chatgpt-business-models-and-limits
- ChatGPT Enterprise and Edu models and limits、OpenAIヘルプセンター、2026年11月5日閲覧、https://help.openai.com/en/articles/11165333-chatgpt-enterprise-and-edu-models-and-limits
- ChatGPT Business overview、OpenAIヘルプセンター、2026年11月5日閲覧、https://help.openai.com/en/articles/8792828-chatgpt-business-overview
- About ChatGPT Pro tiers、OpenAIヘルプセンター、2026年11月5日閲覧、https://help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers
- 「学生向けChatGPT新学期キャンペーン」(Plusの料金を記載)、OpenAIヘルプセンター、2026年11月5日閲覧、https://help.openai.com/en/articles/20001493-chatgpt-back-to-school-offer-for-students
- Build your MCP server、OpenAI開発者ドキュメント、2026年11月5日閲覧、https://developers.openai.com/plugins/build/mcp-server
- ChatGPT UI、OpenAI開発者ドキュメント、2026年11月5日閲覧、https://developers.openai.com/plugins/build/chatgpt-ui
- Authentication、OpenAI開発者ドキュメント、2026年11月5日閲覧、https://developers.openai.com/plugins/build/auth
- Connect and test in ChatGPT、OpenAI開発者ドキュメント、2026年11月5日閲覧、https://developers.openai.com/plugins/deploy/connect-chatgpt
- Plugins changelog、OpenAI開発者ドキュメント、2026年11月5日閲覧、https://developers.openai.com/plugins/changelog
- ChatGPT Developer mode、OpenAI開発者ドキュメント、2026年11月5日閲覧、https://developers.openai.com/api/docs/guides/developer-mode
- chat-latest、OpenAI開発者ドキュメント、2026年11月5日閲覧、https://developers.openai.com/api/docs/models/chat-latest
- API changelog、OpenAI開発者ドキュメント、2026年11月5日閲覧、https://developers.openai.com/api/docs/changelog
- GPT-6 and Intelligent UI in ChatGPT(告知)、OpenAI Developer Community、2026年11月5日閲覧、https://community.openai.com/t/gpt-6-and-intelligent-ui-in-chatgpt/1404139
- Tools(MCP仕様 2025-06-18)、Model Context Protocol、2026年11月5日閲覧、https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- Authorization(MCP仕様 2025-11-25)、Model Context Protocol、2026年11月5日閲覧、https://modelcontextprotocol.io/specification/2025-11-25/basic/authorization
- MCP Apps、Model Context Protocol、2026年11月5日閲覧、https://modelcontextprotocol.io/docs/extensions/apps
- EveryInfraデータ機能カタログ(無料)、2026年11月5日00時17分(シンガポール時間)閲覧、https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra /mcp/allの保護リソースメタデータ、2026年11月5日閲覧、https://api.everyinfra.com/.well-known/oauth-protected-resource/mcp/all
- EveryInfra MCPサーバー(initialize、tools/list、tools/callの実呼び出し)、2026年11月5日閲覧、https://api.everyinfra.com/mcp
- 「高度な検索の使い方」、Xヘルプセンター、2026年11月5日閲覧、https://help.x.com/en/using-x/x-advanced-search
- Reddit Data API Wiki、Reddit Help、2026年11月5日閲覧、https://support.reddithelp.com/hc/en-us/articles/16160319875092-Reddit-Data-API-Wiki
- Data API Terms、Reddit、2026年11月5日閲覧、https://www.redditinc.com/policies/data-api-terms
- vaderSentiment(VADER 3.3.2)、GitHub、2026年11月5日閲覧、https://github.com/cjhutto/vaderSentiment
- 「緊急時に備え、各家庭に簡単なことから取り組むよう呼びかけ」、GOV.UK、2026年11月5日閲覧、https://www.gov.uk/government/news/households-encouraged-to-take-small-simple-steps-to-stay-prepared-in-an-emergency
- Be ready for emergencies、GOV.UKキャンペーンサイト、2026年11月5日閲覧、https://beready.campaign.gov.uk/
- 「英国、国民に3日分の非常用備蓄を自宅に置くよう要請」、Reuters、2026年10月23日、2026年11月5日閲覧、https://www.reuters.com/business/aerospace-defense/uk-tells-public-keep-three-days-emergency-supplies-home-2026-10-23/
- 「英政府、すべての国民に水と食料の備蓄を勧告」、The Guardian、2026年10月22日、2026年11月5日閲覧、https://www.theguardian.com/politics/2026/oct/22/britain-prepare-infrastructure-attacks-hostile-states-wes-streeting
- 「ロシアによる今年最大のエネルギーインフラ攻撃を受け、キーウで緊急停電と広範囲の断水」、Kyiv Independent、2026年11月5日閲覧、https://kyivindependent.com/kyiv-faces-emergency-power-cuts-widespread-water-outages-after-russias-largest-attack-on-energy-infrastructure-this-year/
- 「EcoFlow、家庭用蓄電池の新シリーズ『Titan』を発表」、ess-news、2026年10月14日、2026年11月5日閲覧、https://www.ess-news.com/2026/10/14/ecoflow-launches-new-residential-storage-series-with-titan-range/
- 「小さなTitan:EcoFlowの新しい家庭用バッテリーシステムは小規模構成から始められる」、electrek、2026年10月18日、2026年11月5日閲覧、https://electrek.co/2026/10/18/tiny-titan-new-residential-battery-system-from-ecoflow-starts-small/
- 「EcoFlowの新しいTITANバッテリーなら、停電中もセントラル空調を動かし続けられる」、PopSci、2026年11月5日閲覧、https://www.popsci.com/gear/ecoflow-titan-5000-home-battery/
- BLUETTI Unveils Early Access for Apex 200: Next-Gen Versatile Power Station(PRNewswireリリース)、Yahoo Finance、2026年10月20日、2026年11月5日閲覧、https://finance.yahoo.com/energy/articles/bluetti-unveils-early-access-apex-160900669.html
- GPT-6 and Intelligent UI for everyone(スレッド)、r/OpenAI、2026年11月5日閲覧、https://www.reddit.com/r/OpenAI/comments/1x045qs/gpt6_and_intelligent_ui_for_everyone/
- GPT-6 and Intelligent UI for everyone(スレッド)、r/ChatGPT、2026年11月5日閲覧、https://www.reddit.com/r/ChatGPT/comments/1x052jr/gpt6_and_intelligent_ui_for_everyone/
- GPT-6's Intelligent UI is genuinely good. It's still a sketchpad, not infrastructure、r/ChatGPT、2026年11月5日閲覧、https://www.reddit.com/r/ChatGPT/comments/1x6crjw/gpt6s_intelligent_ui_is_genuinely_good_its_still/
- What can GPT-6 + Intelligent UI do that wasn't already possible、r/codex、2026年11月5日閲覧、https://www.reddit.com/r/codex/comments/1x04lt9/what_can_gpt6_intelligent_ui_do_that_wasnt/
- OpenAI Introduces "Intelligent UI" For ChatGPT With GPT-6、r/technology、2026年11月5日閲覧、https://www.reddit.com/r/technology/comments/1x04ajv/openai_introduces_intelligent_ui_for_chatgpt_with/
- GPT-6 and Intelligent UI(スレッド)、Hacker News、2026年11月5日閲覧、https://news.ycombinator.com/item?id=49996425
参考資料 BL-90