Le licenze AI per le news passano al pagamento per uso: 8 eventi e un test di ricerca
In 30 giorni Google, Cloudflare e la coalizione di editori SPUR hanno spinto le licenze per le news verso un pagamento per ogni uso da parte dell'AI. Nessuno ha ancora stabilito chi conteggia un uso. Abbiamo testato come tre strumenti di ricerca fanno emergere i documenti originali dietro otto di questi eventi.
Tra il 24 settembre e il 24 ottobre 2026, il denaro tra editori di news e prodotti AI ha iniziato a seguire ogni singolo uso di un articolo. Il 15 ottobre Google ha dichiarato che oltre 400 testate partecipano ora al suo pilota a pagamento News AI (Google). Il 30 settembre Cloudflare ha aperto la beta di Pay Per Use, che addebita agli acquirenti AI ogni uso dichiarato (Cloudflare). Il 2 ottobre la coalizione di editori SPUR ha pubblicato la versione 1.0 del suo Content Telemetry Standard, che definisce come un sistema AI registra di aver recuperato, citato o mostrato un articolo (SPUR). Ma ciascuno dei tre dà una risposta diversa a una domanda: chi conteggia gli usi? Nessuno è ancora sottoposto a un audit indipendente.
Abbiamo anche fatto un test. Il 24 ottobre 2026, dalle 04:30 alle 04:44 UTC (12:30–12:44 ora di Singapore), abbiamo cercato questi otto eventi con le API di ricerca e le API per i dati di X di EveryInfra. Nei primi 10 risultati web, solo per 4 degli 8 eventi compariva il documento originale dell'azienda, del tribunale o del gruppo coinvolto. Per i 4 eventi legali (una sentenza, due cause e un insieme di condizioni di una piattaforma), il testo originale non compariva in nessuna delle 12 liste di risultati dei tre strumenti di ricerca. Tre di questi quattro testi sono pubblici.
In questo articolo, «pagamento per uso» significa che un prodotto AI paga un prezzo concordato ogni volta che usa un articolo. Un uso è un recupero, una risposta basata sull'articolo, una citazione o una visualizzazione a un lettore. Non indica un pagamento per crawl né una licenza una tantum.


Gli otto eventi, in ordine cronologico
Ogni voce si chiude con cosa significa per redazioni e team dati.
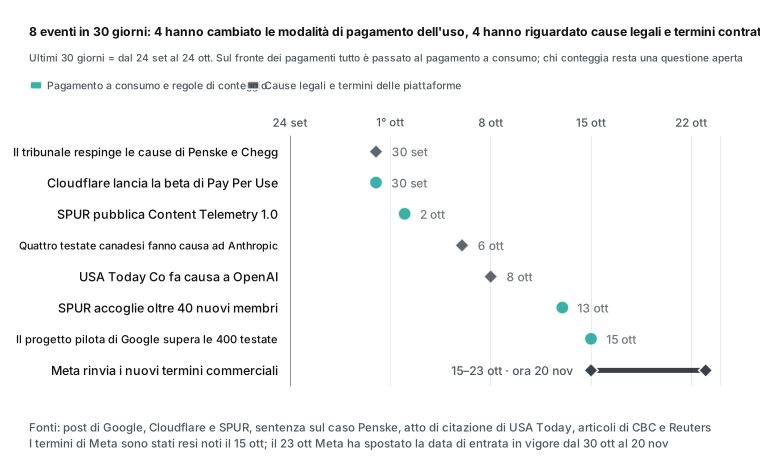
- 30 settembre: un tribunale statunitense ha respinto le cause antitrust di Penske e Chegg contro Google. Il giudice Amit Mehta ha scritto che gli editori avevano solo un'«aspettativa» di traffico. Nella motivazione aggiunge: «un'aspettativa non è un accordo» (Reuters, 1 ott.). Cosa significa: negli Stati Uniti, al momento, il diritto antitrust non obbliga Google a pagare per i riepiloghi AI.
- 30 settembre: Cloudflare ha lanciato la beta di Pay Per Use. Ogni azienda AI definisce l'uso per cui paga e fissa un prezzo. Gli editori accettano o rifiutano le offerte dalla dashboard. L'acquirente dichiara ogni uso e Cloudflare fattura mensilmente (Cloudflare). Lo stesso giorno Cloudflare ha aperto Monetization Gateway, che addebita per richiesta l'accesso ad API e dati (Cloudflare). Cosa significa: i siti piccoli che non possono negoziare una licenza ora hanno un unico posto in cui vedere le offerte.
- 2 ottobre: SPUR ha pubblicato Content Telemetry 1.0. Lo standard suddivide l'uso da parte dell'AI in eventi: recupero, grounding, citazione, presentazione e interazione. Ogni report deve anche dichiarare se la copertura è completa, campionata, aggregata o selezionata (note di rilascio). Cosa significa: gli editori hanno ora un'unità condivisa per le trattative sulle licenze, ma solo se le aziende AI accettano di inviare i report.
- 6 ottobre: quattro organizzazioni giornalistiche canadesi hanno fatto causa ad Anthropic. Postmedia, Torstar, The Globe and Mail e The Canadian Press hanno presentato il ricorso a un tribunale dell'Ontario. Sostengono che Anthropic abbia fatto scraping dei loro siti per sviluppare Claude, aggirando le misure tecniche di protezione. CBC ha dato notizia della causa il 19 ottobre. Le accuse non sono ancora state vagliate da un tribunale (CBC). Cosa significa: le cause delle testate giornalistiche ora coinvolgono altri produttori di modelli oltre a OpenAI.
- 8 ottobre: USA Today Co ha fatto causa a OpenAI. L'atto di citazione, caso 1:26-cv-08892, riguarda 19 testate. Secondo Reuters chiede danni «superiori a 250 milioni di dollari» (Reuters). Cosa significa: un grande gruppo statunitense di informazione locale si è unito alle cause sul copyright già riunite nel Southern District of New York.
- 13 ottobre: SPUR ha aggiunto più di 40 membri. Sono entrati The New York Times, AFP, The Economist e The Atlantic. SPUR conta ora più di 80 membri in oltre 20 paesi (SPUR). Cosa significa: più editori sostengono lo standard, ma nessun acquirente AI ha dichiarato pubblicamente che lo userà.
- 15 ottobre: Google ha introdotto due novità nello stesso giorno. Primo, il pilota News AI è salito a oltre 400 testate. Tra i nuovi partner ci sono CNN, il Financial Times, Axios, Forbes e diverse testate locali statunitensi (Google). Secondo, i link inline in AI Mode e AI Overviews ora compaiono più in alto. I caroselli di articoli (lanciati per la prima volta a maggio) arrivano in più paesi e lingue (Google). Cosa significa: Google paga per i contenuti e rende i link più visibili, ma nessuno dei due post fornisce dati sui clic.
- 15–23 ottobre: Meta ha rinviato le nuove condizioni commerciali. Il 15 ottobre Nieman Lab ha riportato che le condizioni consentono a Meta di fare crawling dei siti «associati» agli account business. Il giorno dopo Meta ha eliminato la parola «train» (addestrare) (Nieman Lab). Il 23 ottobre Meta ha spostato la data di entrata in vigore dal 30 ottobre al 20 novembre (Reuters). Cosa significa: quasi ogni redazione ha un account business su Meta, quindi sarà il testo finale a decidere se Meta potrà fare crawling del suo sito.
Cosa è cambiato davvero: l'unità di pagamento è passata dal crawl all'uso
Prima un sito aveva due scelte: lasciare entrare i crawler e sperare nel traffico dalla ricerca, oppure bloccarli e cercare di firmare una licenza una tantum.
I dati della stessa Cloudflare mostrano perché questa scelta non funziona più. Meno dell'1% dei siti della sua rete blocca i crawler di ricerca, ma il 17% blocca i crawler di addestramento (Cloudflare, 15 set.). Nella primavera del 2025, il 22% delle richieste dei crawler dichiarava l'addestramento come scopo; a giugno 2026 la quota era del 52% (Cloudflare, 30 set.). I siti di news hanno iniziato presto a bloccare: alla fine del 2023, il 48% dei principali siti di news in dieci paesi bloccava i crawler di OpenAI (Reuters Institute). Nel 2025 Pay Per Crawl di Cloudflare addebitava per ogni crawl (Cloudflare, 2025), e Cloudflare Radar mostra il comportamento di ciascun crawler.
I tre nuovi modelli conteggiano tutti gli «eventi di uso». La differenza sta in chi fa il conteggio:
- Conteggia Google. Il pilota News AI paga la fornitura di «contenuti arricchiti». Un portavoce di Google ha detto a Nieman Lab che questo pilota non paga in base al contributo a una risposta AI (Nieman Lab). Un programma separato, l'«AI contribution pilot», paga invece in base al valore. Il 14 settembre Digiday ha riportato che Google paga solo quando ritiene che un contenuto abbia contribuito «in modo significativo» a una risposta in AI Overviews, AI Mode o Gemini. Search Console mostra un importo mensile ma non la formula (Digiday).
- Dichiara l'acquirente. In Pay Per Use, ogni azienda AI dichiara i propri usi come righe di JSON. Cloudflare verifica che ogni record corrisponda a un dominio iscritto, e le condizioni del programma richiedono una rendicontazione completa. Cloudflare lo riassume così: «paga per l'uso, non per il crawl» (Cloudflare).
- Uno standard definisce il report, ma le regole di audit non sono ancora scritte. La bozza di SPUR di giugno prevedeva versioni riviste entro il 10 agosto (avviso sulla bozza SPUR). La versione 1.0 è uscita il 2 ottobre. Digiday ha riportato che il comitato tecnico per «audit e prove» si sarebbe riunito per la prima volta il 15 ottobre (Digiday).
Tutti e tre hanno una lacuna in comune: i dati di utilizzo che un editore vede arrivano da Google o dall'acquirente. Un metodo per verificarli in modo indipendente è ancora in fase di sviluppo, ed è per questo che SPUR indica l'audit come prossimo passo.


Le conclusioni che gli annunci non permettono di trarre
- «400 testate» non significa 400 editori, né pagamento in base al contributo. Google conta le testate. Il suo elenco include sia un singolo marchio come CNN sia un gruppo editoriale come Shaw Media, e il post non spiega come viene contato un gruppo. A giugno la pagina sulle policy di Google parlava di «oltre 200» (Google Public Policy): il numero è raddoppiato in circa quattro mesi. Google non ha reso note le condizioni per nessun partner (Reuters).
- Link più visibili non dimostrano più clic. Il post di Google del 15 ottobre parla di «aumenti continui e sostanziali» dei link inline, ma non fornisce numeri su clic o traffico (Google). Il miglior dato esterno è più vecchio: nei dati di navigazione di marzo 2025, Pew ha rilevato clic su un link all'interno del riepilogo AI solo nell'1% delle visite a queste pagine (Pew). Questi dati precedono il redesign. Sul fronte dei lettori, il sondaggio 2026 del Reuters Institute mostra che l'uso settimanale dei chatbot AI per informarsi è salito dal 7% al 10%. Solo l'1% li considera il proprio canale principale di informazione (Digital News Report 2026).
- Il calo del 40,2% rilevato da Chartbeat non è tutto dovuto all'AI. Il 24 settembre Search Engine Journal ha sintetizzato il 2026 Publisher Playbook di Chartbeat. I referral da Google Search nella rete di Chartbeat sono calati del 40,2% da luglio 2025 a luglio 2026, dopo un calo del 21,9% l'anno precedente. Il campione è sbilanciato verso i siti di news e non indica il numero di siti, né specifica se il dato annuale misuri pageview o quota (SEJ). Lo stesso report stima i referral dai chatbot AI allo 0,01% del traffico. Il Reuters Institute cita un altro dato di Chartbeat: un calo del 33% per oltre 2.500 siti da novembre 2024 a novembre 2025 (come riportato da Reuters). Finestre temporali e campioni sono diversi, quindi non confrontare i due numeri. Il Reuters Institute osserva anche che al momento Google non mostra AI Overviews per le query sulle news (Reuters Institute).
- Il rigetto di una causa antitrust non rende lecito l'uso dei contenuti da parte di Google. Le due cause si basavano sullo Sherman Act e sull'arricchimento senza causa, non sul copyright. La motivazione precisa inoltre che il tribunale non è «insensibile» alle ragioni degli editori (motivazione; sintesi di Press Gazette). Nel Regno Unito, la Competition and Markets Authority (CMA) è intervenuta il 3 giugno: Google deve consentire agli editori di escludere i propri contenuti dalle funzionalità AI della ricerca e ha nove mesi per adeguarsi (CMA, giugno). Il 23 settembre la CMA ha proposto che ogni servizio di ricerca presente nelle sue schermate di scelta debba attribuire chiaramente i contenuti degli editori (CMA, settembre). I due paesi usano strumenti giuridici diversi e ottengono risultati diversi.
- Eliminare «train» e rinviare la data non esclude l'addestramento. Il testo rivisto consente il crawling per «sviluppare» prodotti pubblicitari e business. Il professore di diritto James Grimmelmann ha detto a Nieman Lab che la formulazione è «così ampia da poterci far passare un camion» (Nieman Lab). Al 23 ottobre Meta aveva cambiato solo la data, e le condizioni non contenevano ancora alcun riferimento a robots.txt (Nieman Lab, 23 ott.). La News Media Association britannica (dichiarazione), la News/Media Alliance (dichiarazione) e lo European Publishers Council (dichiarazione) si oppongono pubblicamente. Il 22 ottobre un gruppo ha chiesto alla Commissione europea e alla CMA misure cautelari (Reuters).
- 80 membri di SPUR non significano che le aziende AI usino lo standard. SPUR ha invitato OpenAI, Anthropic, Google, Meta e Microsoft nel suo comitato consultivo. Google ha detto a Digiday soltanto di confrontarsi «spesso» con SPUR e altri gruppi. Gli altri non hanno risposto (Digiday).
- «Fare causa» e «concedere licenze» non sono due schieramenti separati. Abbiamo controllato riga per riga gli elenchi originali di membri e partner. Tutti e quattro i ricorrenti canadesi contro Anthropic figurano nell'elenco dei membri di SPUR. The Canadian Press è entrata come nuovo membro il 13 ottobre, sette giorni dopo il ricorso (elenco SPUR). Il Financial Times, membro fondatore di SPUR, è nell'elenco dei partner di Google del 15 ottobre. The Guardian, del membro fondatore Guardian Media Group, era tra i partner di lancio del pilota di Google a dicembre 2025 (Google, dic. 2025). Delle 17 testate citate nei due post di Google, 2 appartengono a membri fondatori di SPUR. Una stessa organizzazione può fare causa a un'azienda AI, concedere licenze a un'altra e contribuire a scrivere lo standard di conteggio.
Il nostro test: dove mandano le persone gli strumenti di ricerca per queste notizie?
I prodotti AI fanno una ricerca prima di rispondere.
Un paper su arXiv del 10 ottobre ha analizzato 158.099 risposte con 468.037 citazioni. Ogni pagina citata da ChatGPT era stata recuperata dalla sua stessa ricerca. Il recupero spiegava una quota della variazione molto più ampia (32%) rispetto alle caratteristiche delle pagine (2,8%) (arXiv 2610.15033). Il paper riguardava domande commerciali, non news, ma l'ordine è lo stesso: prima la ricerca, poi la citazione.
Abbiamo quindi testato la fase di ricerca. Per ogni evento, quali tipi di siti occupano i primi 10 risultati, e compare il documento originale?
Abbiamo scritto questi criteri prima della prima chiamata (conserviamo l'originale agli atti):
- Quattro classi di siti, definite tramite una allowlist di domini: documento originale, testata giornalistica con articoli firmati, piattaforma social, altro.
- Ipotesi 1: nella ricerca di news, le testate giornalistiche occupano più della metà dei risultati.
- Ipotesi 2: la ricerca web mostra il documento originale per almeno 6 degli 8 eventi.
- Ipotesi 3: la ricerca semantica restituisce una quota di documenti originali più alta rispetto alla ricerca web.
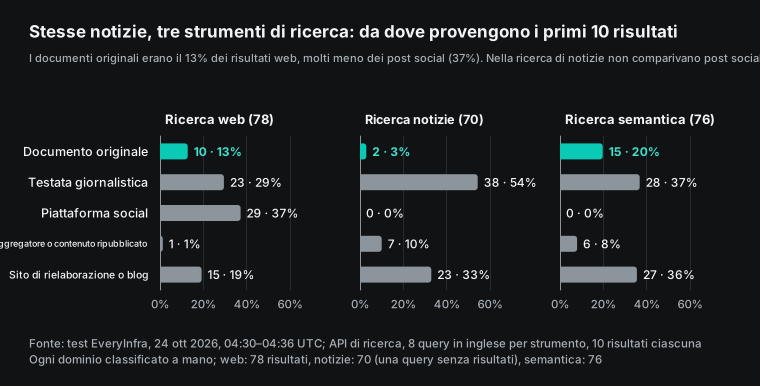
Test 1: quali siti occupano i risultati. Dalle 04:30 alle 04:36 UTC del 24 ottobre abbiamo chiamato tre strumenti dell'API di ricerca di EveryInfra: web, news e semantic. Abbiamo usato una query in inglese per evento e 10 risultati per chiamata, per un totale di 24 chiamate. Su news abbiamo aggiunto 2 query in spagnolo e 2 in cinese. Ogni chiamata costa 0,000694 $ e i risultati vuoti non vengono addebitati.
- Ricerca web: dopo una revisione manuale, 29 risultati su 78 (37%) erano post social da Facebook, Instagram, LinkedIn, Reddit, Threads, YouTube e X. Le testate giornalistiche ne avevano 23 (29%), i documenti originali 10 (13%).
- Ricerca di notizie: nessuno dei 70 risultati era un post social. Con la nostra allowlist predefinita, le testate giornalistiche arrivavano solo al 31%, quindi l'ipotesi 1 non ha retto. L'allowlist non includeva testate come Forbes, Quartz e AdExchanger. Dopo aver esaminato a mano ogni dominio, le testate sono salite al 54% (abbiamo registrato ogni decisione). I siti di riscrittura e i blog personali o di fornitori arrivavano al 33%, gli aggregatori e le ripubblicazioni al 10%.
- La ricerca semantica era in ritardo sugli eventi più recenti. Per «USA Today sues OpenAI», nessuno dei 9 risultati riguardava la causa dell'8 ottobre; i primi risultati erano atti giudiziari di un altro caso del 2025. Per i termini di Meta, 3 risultati su 8 citavano i nuovi termini. Il nostro catalogo degli strumenti di ricerca indica che
semanticha un ritardo di indicizzazione per le pagine molto recenti, e il test lo ha confermato. - Cinese e spagnolo: la query di notizie in cinese ha restituito 1 testata giornalistica, 5 portali o ripubblicazioni e 4 siti di riscrittura. Le 2 query in spagnolo hanno restituito 20 risultati, 10 da testate giornalistiche. In nessuna delle due lingue è comparso un documento originale. Un'altra query in cinese non ha restituito nulla e non è stata addebitata.
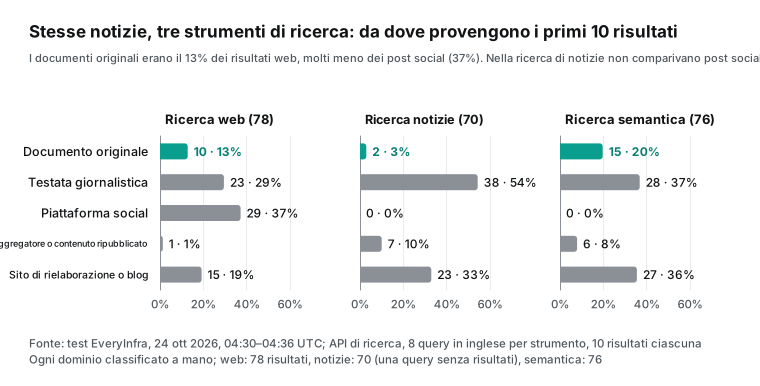
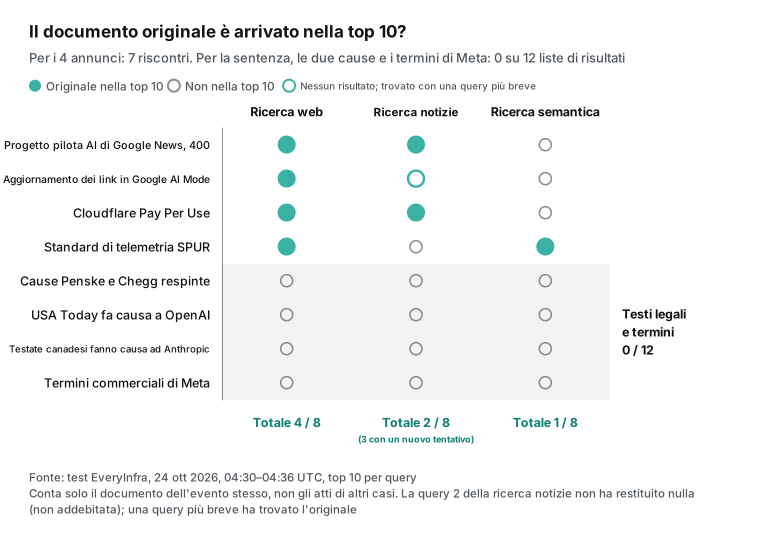
Quante volte il documento originale dell'evento è entrato nei primi 10 (gli atti giudiziari di altri casi non contano):
- Ricerca web: 4 su 8, quindi l'ipotesi 2 non ha retto. I riscontri erano i post di Google, Cloudflare e SPUR.
- Ricerca di notizie: 2 su 8. Una query non ha restituito nulla; con una query più breve, il risultato è stato 3 su 8.
- Ricerca semantica: 1 su 8, e quel riscontro era la pagina della bozza di giugno di SPUR, non la versione 1.0. Come quota complessiva, la ricerca semantica (20%) ha superato quella web (13%), ma i documenti in più erano rapporti governativi del 2025 e altri casi. Contando il documento proprio di ciascun evento, anche l'ipotesi 3 non ha retto.
- La sentenza, le due cause e i termini di Meta: 0 liste di risultati su 12. Il PDF della sentenza e quello dell'atto di citazione di USA Today sono pubblici. Reuters, Forbes e i post social erano posizionati più in alto.
Test 2: un campione di pagine di riscrittura. Dalle 04:43 alle 04:44 UTC abbiamo usato lo strumento read su 6 pagine «altro» dei risultati di notizie. Ogni chiamata costa 0,000694 $. Poi abbiamo controllato ogni pagina a mano.
- 2 pagine dichiarano pubblicamente di essere state scritte da una macchina. Una è attribuita a «Noah Wire Services» e riporta il titolo da cui è stata «ispirata», oltre a citazioni a livello di paragrafo. L'altra ha una biografia dell'autore che lo definisce «un agente di ricerca generato dall'AI».
- 3 pagine rimandano al documento originale dell'evento. Le altre 3 non rimandano né al documento originale né all'articolo di Reuters.
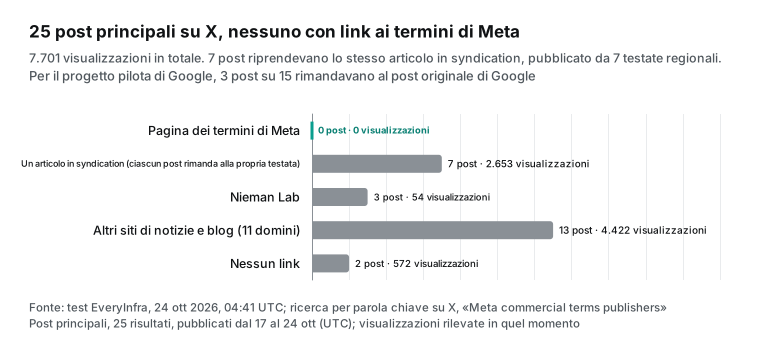
Test 3: diffusione su X. Dalle 04:41 alle 04:42 UTC abbiamo usato la ricerca per parole chiave su X. Per impostazione predefinita, ordina i risultati in base ai post principali e costa 0,000556 $ per chiamata.
- «Meta commercial terms publishers»: 25 post dal 17 al 24 ottobre (UTC). 15 provenivano da account di testate giornalistiche. 7 quotidiani locali hanno pubblicato lo stesso articolo in syndication con lo stesso titolo. Al momento della lettura, i 25 post avevano in totale 7.701 visualizzazioni (mediana 178, massimo 1.013), 7 like, 2 repost e 1 risposta. Nessuno rimandava ai termini di Meta. Nieman Lab era il sito più linkato (3 post).
- «Google "News AI" pilot publishers»: 15 post del 2026 hanno totalizzato 6.052 visualizzazioni. Un solo post di un consulente SEO ne ha raccolto il 57% (3.461). 3 post rimandavano al post originale di Google.
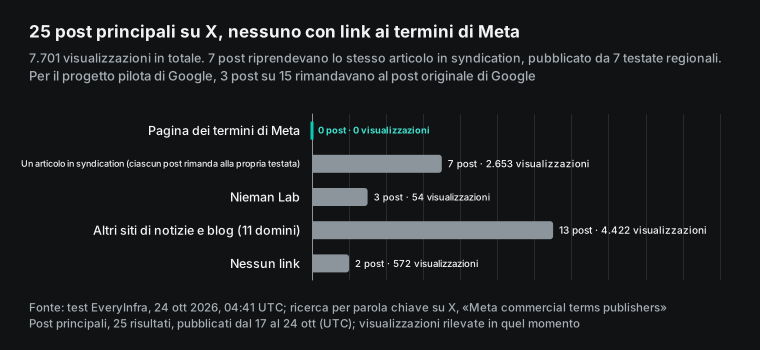
Cosa mostrano i tre test: una redazione o un assistente AI che per questo tipo di notizie si affida solo ai risultati di ricerca ottiene per lo più rielaborazioni. Quanto più un evento è legato a un testo giuridico, tanto più è difficile trovare il documento originale. Limiti: si tratta di un'istantanea del 24 ottobre; i risultati cambiano ogni giorno; abbiamo usato una query per evento; i risultati di X sono i post principali, non tutti i post. Abbiamo anche eseguito 4 query sulla ricerca di Reddit, ma i post coprivano solo l'ultimo giorno, quindi li abbiamo esclusi dalle conclusioni.
Cosa possono fare le redazioni e i team che lavorano con i dati
- Elenca prima i documenti originali. Per ogni evento, annota l'annuncio, la sentenza, l'atto di citazione o la pagina dei termini. Risultato atteso: una tabella di eventi e URL originali.
- Esegui le stesse query ogni giorno. Interroga
webenewsuna volta ciascuno e registra i primi 10 domini. Risultato atteso: due righe per evento al giorno. - Registra due numeri. Il documento originale è nei primi 10? Quanti risultati sono riscritture o aggregatori? Risultato atteso: vedi quali eventi finiscono sepolti sotto le rielaborazioni.
- Leggi direttamente i testi legali. Per sentenze, atti di citazione e termini, usa
readsull'URL originale anziché aspettare i risultati della ricerca. La documentazione di Google indica che le regole di Googlebot e i controlli dell'anteprima comenosnippetsi applicano ad AI Overviews e AI Mode (Google Search Central). Usala per verificare le impostazioni del tuo sito. Risultato atteso: ogni citazione corrisponde a una pagina del documento originale. - Monitora la diffusione. Usa l'API di scraping per X con le stesse parole chiave e registra visualizzazioni e domini linkati. Puoi usare gli stessi termini sulla ricerca di Threads. Risultato atteso: sai quale versione della notizia hanno visto i lettori.
- Riconcilia gli addebiti. Ogni risposta contiene
billing.charged_usde i risultati vuoti riportanoempty_result_refunded. Vedi Riconciliazione della fatturazione API.
Per scegliere tra gli strumenti di ricerca, leggi Strumenti di ricerca per agenti AI. Per decidere cosa aprire ai crawler AI, leggi Crawler AI e robots.txt.
Riproduci il test
Richiesta (ricerca di notizie per il pilota di Google):
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer <API Key>" \
  -H 'Content-Type: application/json' \
  -d '{"tool":"news","params":{"q":"Google News AI pilot 400 publications","num":10}}'
Campi della risposta che ti servono:
results[].url,results[].title,results[].snippet: link, titolo ed estratto.results[].published: data di pubblicazione (lo strumento di ricerca delle notizie restituisce indicazioni temporali relative come «1 week ago»).billing.charged,billing.charged_usd: se la chiamata è stata addebitata e l'importo in USD.billing.reason:empty_result_refundedper un risultato vuoto. L'importo trattenuto viene restituito.id: l'ID della richiesta per la riconciliazione.
Per la ricerca su X, invia POST /api/v1/social con {"platform":"twitter","action":"search","params":{"keyword":"...","limit":25}}. La risposta include view_count, like_count, links e posted_at; consulta il catalogo delle funzionalità per tutti i campi. Per usare gli stessi dati in Claude o Cursor, collega il server MCP remoto. I nuovi utenti possono creare una chiave nella guida rapida.
Errori e addebiti, tutti relativi a questo test:
- Parametri errati (
paramsmancante, nome del campo sbagliato): HTTP 422 con una richiesta di esempio funzionante. Nessun addebito. Abbiamo fatto questo errore 12 volte e pagato 0 $. - Nessun risultato: una lista vuota con
empty_result_refunded. Nessun addebito. È successo 2 volte. - Risultati normali: addebitati al prezzo di catalogo.
Costi
Ai prezzi di catalogo rilevati il 24 ottobre (verifica la pagina dei prezzi), il monitoraggio giornaliero di 8 eventi costa:
- ricerca web + notizie: 8 × 2 = 16 chiamate × 0,000694 $ = 0,011104 $
- lettura di 8 documenti originali: 8 chiamate × 0,000694 $ = 0,005552 $
- ricerca su X per 2 parole chiave: 2 chiamate × 0,000556 $ = 0,001112 $
- totale giornaliero: 0,017768 $, cioè circa 0,53 $ in 30 giorni. I risultati vuoti sono gratuiti, quindi il costo reale è inferiore.
Tutte le chiamate reali per questo articolo: 53 richieste, 0,026238 $ addebitati.
FAQ
Google ora paga i siti di notizie? Alcuni, in due modi. Il pilota News AI paga per i contenuti forniti, non in base al contributo a una risposta, e coinvolge più di 400 testate. Il pilota sul contributo all'AI paga quando Google ritiene che ci sia un contributo «significativo» e mostra un importo mensile in Search Console. Nessuno dei due programmi pubblica le tariffe. (La domanda viene da un post su X, «Google is paying publishers again. Sort of.»)
Le impressioni aumentano ma i clic calano. È colpa di AI Overviews? Un solo numero non basta a rispondere. Da giugno Google ha aperto ad alcuni siti i report sulle impressioni dell'AI generativa in Search Console (Google Search Central). Confronta prima le tue impressioni e i tuoi clic. Poi usa il dato dell'1% di Pew e i dati di rete di Chartbeat, tenendo presente che campioni e date sono diversi. (La domanda viene dal titolo di un post su r/SEO_Experts, «Is Google's AI Search reducing organic traffic, even when impressions…»)
I nuovi termini di Meta entrano in vigore il 30 ottobre? No. Il 23 ottobre Meta ha comunicato a Reuters che la data è slittata al 20 novembre. Nel testo è cambiata solo la data. Se ti preoccupa il crawling, controlla subito il tuo robots.txt e leggi il testo definitivo prima del 20 novembre. (La domanda viene da diversi titoli di risultati come «Meta Terms … Oct. 30.»)
Riferimenti
Documenti primari:
- Google, «400 publications are now partnering with us on our News AI pilot program», 2026-10-15, https://blog.google/products-and-platforms/products/news/news-ai-pilot-update-publishers/
- Google, «AI Mode and AI Overviews updates to explore the web», 2026-10-15, https://blog.google/products-and-platforms/products/search/updates-ai-mode-overviews-explore-web/
- Google, «New Google web ecosystem tools and partnerships», 2025-12, https://blog.google/products-and-platforms/products/search/tools-partnerships-web-ecosystem/
- Google, «How Google Search helps you find original, quality content», 2026-05, https://blog.google/products-and-platforms/products/search/original-high-quality-content-search/
- Google Public Policy, «Google's ongoing commitment to supporting the information ecosystem», 2026-06, https://publicpolicy.google/article/supporting-information-ecosystem/
- Google Search Central, «AI Features and Your Website», aggiornato il 2025-12-10, https://developers.google.com/search/docs/appearance/ai-features
- Google Search Central, «Introducing Search Generative AI performance reports in Search Console», 2026-06-03, https://developers.google.com/search/blog/2026/06/gen-ai-performance-reports
- Cloudflare, «Pay Per Use: when AI uses your work, you should get paid», 2026-09-30, https://blog.cloudflare.com/pay-per-use
- Cloudflare, «The Internet has a second audience», 2026-09-30, https://blog.cloudflare.com/agentic-web
- Cloudflare, «Monetization Gateway beta», 2026-09-30, https://blog.cloudflare.com/monetization-gateway-beta
- Cloudflare, «Have it both ways: stay discoverable in search while disallowing AI training», 2026-09-15, https://blog.cloudflare.com/accountable-mixed-use-ai-crawlers/
- Cloudflare, «Introducing pay per crawl», 2025-07, https://blog.cloudflare.com/introducing-pay-per-crawl/
- Cloudflare Radar, «AI Insights», pagina live, https://radar.cloudflare.com/ai-insights
- SPUR Coalition, «SPUR Content Telemetry Standard v.1 published», 2026-10-02, https://www.spurcoalition.org/updates/spur-content-telemetry-standard-v1-published
- SPUR Coalition, note di rilascio «Content Telemetry 1.0», 2026-10-02, https://github.com/SPUR-Coalition/telemetry/releases/tag/v1.0
- SPUR Coalition, «SPUR Telemetry Standard Published for Public Comment», 2026-06, https://www.spurcoalition.org/updates/spur-telemetry-standard-published-for-public-comment-the-spur-coalition
- SPUR Coalition, «The New York Times, Agence France-Presse, The Economist, and The Atlantic join The SPUR Coalition», 2026-10-13, https://www.spurcoalition.org/updates/the-new-york-times-agence-france-presse-the-economist-and-the-atlantic-join-the-spur-coalition
- Tribunale distrettuale degli Stati Uniti per il Distretto di Columbia, memorandum opinion, Chegg v. Google e Penske Media v. Google, 2026-09-30, https://fingfx.thomsonreuters.com/gfx/legaldocs/byvraqlwbpe/Chegg%20Penske%20order%20-%20Google%20antitrust%2020260930.pdf
- Tribunale distrettuale degli Stati Uniti per il Distretto meridionale di New York, atto di citazione, USA Today Co. v. OpenAI (1:26-cv-08892), 2026-10-08, https://fingfx.thomsonreuters.com/gfx/legaldocs/movarymwypa/USA%20TODAY%20OPENAI%20COPYRIGHT%20lawsuit.pdf
- News Media Association, dichiarazione sui termini di Meta, 2026-10-16, https://newsmediauk.org/blog/2026/10/16/nma-condemns-arrogant-metas-shameless-landgrab-attempt-to-plunder-news-publisher-websites/
- News/Media Alliance, «Statement on Changes to Meta Commercial Terms of Use», 2026-10-16, https://www.newsmediaalliance.org/changes-to-meta-commercial-terms-of-use/
- European Publishers Council, dichiarazione sui termini di Meta, 2026-10-16, https://www.epceurope.eu/post/european-commission-should-be-extremely-concerned-about-meta-s-dilemma-for-european-publishers-hand
- Chartbeat, «The 2026 Publisher Playbook», 2026-09, https://chartbeat.com/resources/general/the-2026-publisher-playbook-9-strategies-to-boost-acquisition-
- UK CMA, «CMA secures fairer deal for publishers and improves Google search services in UK», 2026-06-03, https://www.gov.uk/government/news/cma-secures-fairer-deal-for-publishers-and-improves-google-search-services-in-uk
- UK CMA, «CMA strengthens proposals allowing people choice over their search service», 2026-09-23, https://www.gov.uk/government/news/cma-strengthens-proposals-allowing-people-choice-over-their-search-service
- arXiv 2610.15033, «What Drives AI Citations?», 2026-10-10, https://arxiv.org/abs/2610.15033
- Reuters Institute, «Digital News Report 2026: Emerging uses of AI chatbots for news», 2026-06, https://reutersinstitute.politics.ox.ac.uk/digital-news-report/2026/emerging-uses-ai-chatbots-news-and-what-it-means-journalism
- Reuters Institute, «How many news websites block AI crawlers?», 2024-02-22, https://reutersinstitute.politics.ox.ac.uk/how-many-news-websites-block-ai-crawlers
- Pew Research Center, «Do people click on links in Google AI summaries?», 2025-07-22, https://www.pewresearch.org/short-reads/2025/07/22/google-users-are-less-likely-to-click-on-links-when-an-ai-summary-appears-in-the-results/
- EveryInfra, catalogo degli strumenti di ricerca, consultato il 2026-10-24, https://api.everyinfra.com/api/v1/search/tools
- EveryInfra, catalogo delle funzionalità per i dati, consultato il 2026-10-24, https://api.everyinfra.com/api/v1/social/catalog
Articoli e analisi (fonti secondarie; nel testo, accanto a ciascuna, è indicato il documento originale):
- Reuters, «CNN, Axios and other publishers join Google's AI news program», 2026-10-15, https://www.reuters.com/business/media-telecom/cnn-signs-multi-year-ai-partnership-with-google-2026-10-15/
- Nieman Lab, «Google's News AI pilot expands to over 400 publications», 2026-10-15, https://www.niemanlab.org/2026/10/googles-news-ai-pilot-expands-to-over-400-publications-including-u-s-local-news-outlets/
- Digiday, «Google rolls out pay-per-value AI licensing program to publishers», 2026-09-14, https://digiday.com/media/google-rolls-out-pay-value-ai-licensing-program-to-publishers/
- Digiday, «SPUR publishes AI content tracking standard», 2026-10-02, https://digiday.com/media/spur-publishes-ai-content-tracking-standard-pitches-openai-and-google-to-join-advisory-board/
- Reuters, «Google wins dismissal of Chegg, Penske Media lawsuits over AI overviews», 2026-10-01, https://www.reuters.com/legal/litigation/google-wins-dismissal-chegg-penske-media-lawsuits-over-ai-overviews-2026-10-01/
- Press Gazette, «Penske Google AI Overviews lawsuit dismissed», 2026-10-01, https://pressgazette.co.uk/news/penske-ai-overviews-lawsuit-dismissed-because-no-formal-bargain-struck-with-google/
- Reuters, «USA Today sues OpenAI for copyright infringement over AI training», 2026-10-08, https://www.reuters.com/legal/legalindustry/usa-today-sues-openai-copyright-infringement-over-ai-training-2026-10-08/
- CBC News, «Anthropic sued by major Canadian news publishers», 2026-10-19, https://www.cbc.ca/news/business/anthropic-postmedia-torstar-globe-canadian-press-copyright-lawsuit-9.7387205
- Nieman Lab, «Legal experts warn Meta's new terms still grant broad scraping permissions», 2026-10-17, https://www.niemanlab.org/2026/10/legal-experts-warn-metas-new-terms-still-grant-broad-scraping-permissions-despite-language-changes/
- Nieman Lab, «Meta delays rollout of terms that would allow broad scraping of news sites», 2026-10-23, https://www.niemanlab.org/2026/10/meta-delays-rollout-of-terms-that-would-allow-broad-scraping-of-news-sites-legal-experts-are-still-skeptical/
- Reuters, «Meta to delay new commercial terms criticised by publishers, advertisers», 2026-10-23, https://www.reuters.com/business/media-telecom/meta-delay-new-commercial-terms-criticised-by-publishers-advertisers-2026-10-23/
- Reuters, «Publishers, advertisers call EU, UK antitrust regulators to suspend Meta's new commercial terms», 2026-10-22, https://www.reuters.com/legal/litigation/publishers-advertisers-call-eu-uk-antitrust-regulators-suspend-metas-new-2026-10-22/
- Reuters, «NYT, Economist among publishers joining coalition to curb unpaid AI use», 2026-10-12, https://www.reuters.com/legal/litigation/nyt-economist-among-publishers-joining-coalition-curb-unpaid-ai-use-2026-10-12/
- Search Engine Journal, «Google Search Decline Steepened To 40% YoY For Publishers», 2026-09-24, https://www.searchenginejournal.com/google-search-decline-publishers-chartbeat/590681/
- Reuters Institute, «Life after SEO: How newsrooms are adapting to the AI search shift», 2026-10, https://reutersinstitute.politics.ox.ac.uk/news/life-after-seo-how-newsrooms-are-adapting-ai-search-shift
Letture correlate
- API EverySearch: ricerca web ed evidenze tracciabili
- API di scraping per X (Twitter), API di ricerca per Twitter (X); API di scraping per Reddit, ricerca su Reddit
- Crawler AI e robots.txt: ricerca, addestramento, visite degli utenti
- Strumenti di ricerca per agenti AI: dalla scoperta alle risposte verificate
- Monitoraggio della reputazione multipiattaforma con i dati dei commenti
- Riduci il disallineamento della documentazione API con un catalogo delle funzionalità live
Riferimenti BL-32