Licencias de noticias para IA: ahora se paga por uso
En 30 días, Google, Cloudflare y la coalición de editores SPUR empezaron a cobrar el contenido periodístico por cada uso que hace la IA. Nadie ha resuelto quién cuenta esos usos. Medimos cuántas veces tres buscadores muestran el documento original de ocho de estos hechos.
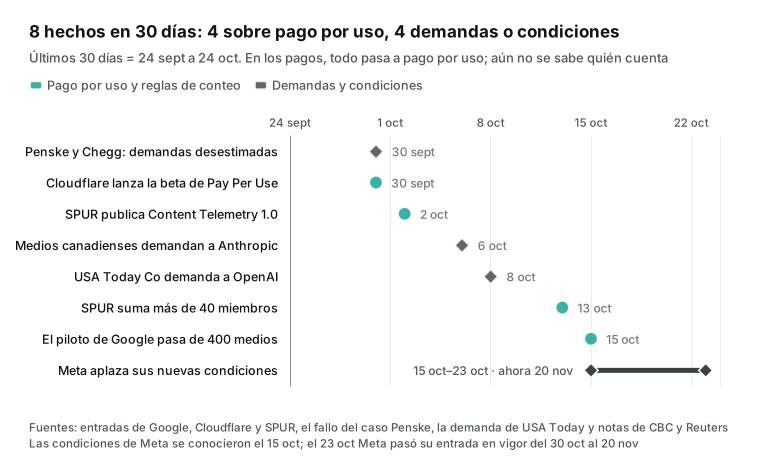
Entre el 24 de septiembre y el 24 de octubre de 2026, el dinero entre los medios y los productos de IA empezó a seguir cada uso de un artículo. El 15 de octubre, Google anunció que más de 400 publicaciones ya participan en su programa piloto de pago News AI (Google). El 30 de septiembre, Cloudflare abrió la beta de Pay Per Use, que factura a los compradores de IA por cada uso declarado (Cloudflare). El 2 de octubre, la coalición de editores SPUR publicó la versión 1.0 de su estándar de telemetría de contenidos, que define cómo un sistema de IA registra que recuperó, citó o mostró un artículo (SPUR). Pero cada uno responde de forma distinta a una pregunta clave: ¿quién cuenta los usos? Ninguno tiene todavía una auditoría independiente.
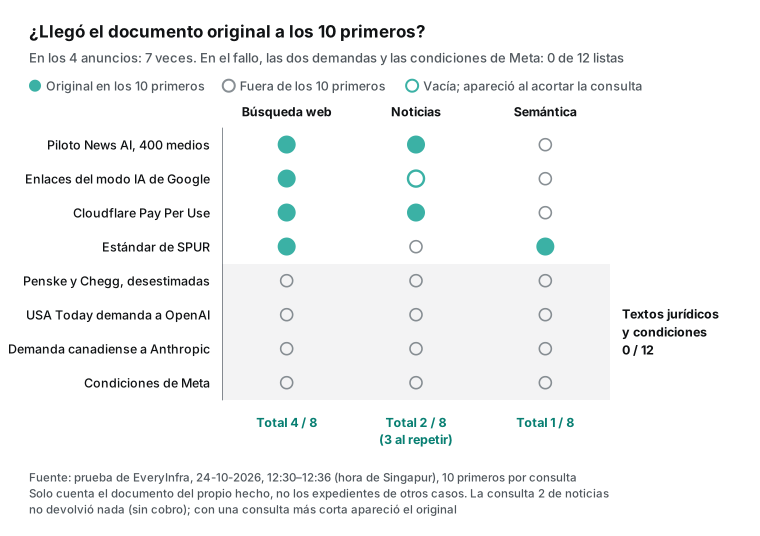
También hicimos una prueba. El 24 de octubre de 2026, de 12:30 a 12:44 (hora de Singapur; 06:30–06:44 en Madrid, 22:30–22:44 del día anterior en Ciudad de México), buscamos estos ocho hechos con las API de búsqueda y de datos de X de EveryInfra. En los 10 primeros resultados web, solo 4 de los 8 hechos mostraron el documento original de la empresa, el tribunal o el grupo implicado. En los 4 hechos jurídicos (un fallo, dos demandas y unas condiciones de uso), el texto original no apareció en ninguna de las 12 listas de resultados de los tres buscadores, aunque 3 de esos textos son públicos.
En este artículo, «pago por uso» significa que un producto de IA paga un precio acordado cada vez que usa un artículo: cuando lo recupera, cuando basa una respuesta en él, cuando lo cita o cuando se lo muestra a un lector. No significa pagar por cada rastreo ni una licencia única.


Los ocho hechos, por fecha
Cada punto termina con lo que significa para redacciones y equipos de datos.
- 30 de septiembre: un tribunal de EE. UU. desestimó las demandas antimonopolio de Penske y Chegg contra Google. El juez Amit Mehta escribió que los editores solo tenían una «expectativa» de tráfico. En el fallo añade que «una expectativa no es un acuerdo» (Reuters, 1 de octubre). Qué significa: en EE. UU., la ley antimonopolio no obliga hoy a Google a pagar por los resúmenes de IA.
- 30 de septiembre: Cloudflare lanzó la beta de Pay Per Use. Cada empresa de IA define qué uso paga y fija un precio. El editor acepta o rechaza la oferta en su panel. El comprador declara cada uso y Cloudflare factura cada mes (Cloudflare). El mismo día abrió Monetization Gateway, que cobra por solicitud a quien consume API y datos (Cloudflare). Qué significa: los sitios pequeños, que no pueden negociar una licencia, tienen por fin un lugar donde ver ofertas.
- 2 de octubre: SPUR publicó Content Telemetry 1.0. El estándar divide el uso en eventos: recuperado, usado como base de una respuesta (grounded), citado, presentado y con interacción. Cada informe debe declarar si su cobertura es completa, por muestreo, agregada o seleccionada (notas de versión). Qué significa: los editores ya tienen una unidad común para negociar, pero solo funciona si las empresas de IA aceptan informar.
- 6 de octubre: cuatro medios canadienses demandaron a Anthropic. Postmedia, Torstar, The Globe and Mail y The Canadian Press presentaron la demanda ante un tribunal de Ontario. Afirman que Anthropic extrajo contenido de sus sitios para desarrollar Claude y eludió medidas técnicas de protección. CBC informó sobre la demanda el 19 de octubre; ningún tribunal ha probado las acusaciones (CBC). Qué significa: las demandas de los medios ya alcanzan a más empresas de modelos, no solo a OpenAI.
- 8 de octubre: USA Today Co demandó a OpenAI. La demanda, caso 1:26-cv-08892, abarca 19 publicaciones. Según Reuters, reclama daños «superiores a 250 millones de dólares» (Reuters). Qué significa: un gran grupo de prensa local de EE. UU. se suma a los casos de derechos de autor que ya se tramitan juntos en Nueva York.
- 13 de octubre: SPUR sumó más de 40 miembros. Entraron The New York Times, AFP, The Economist y The Atlantic, además de asociaciones latinoamericanas como ADEPA (Argentina), la ANJ (Brasil) y la Alianza de Medios (México). La coalición supera los 80 miembros en más de 20 países (SPUR). Qué significa: más editores respaldan el estándar, pero ningún comprador de IA ha dicho en público que lo vaya a usar.
- 15 de octubre: Google hizo dos cambios el mismo día. Primero, el piloto News AI llegó a más de 400 publicaciones; entre los nuevos socios están CNN, el Financial Times, Axios, Forbes y varios medios locales de EE. UU. (Google). Segundo, los enlaces dentro de AI Mode y AI Overviews aparecen más arriba, y los carruseles de artículos (lanzados en mayo) llegan a más países e idiomas (Google). Qué significa: Google paga por contenido y hace los enlaces más visibles, pero ninguna de las dos entradas da datos de clics.
- Del 15 al 23 de octubre: Meta aplazó sus nuevas condiciones comerciales. Nieman Lab informó el 15 de octubre que las condiciones permitían a Meta rastrear los sitios «asociados» a cuentas comerciales. Al día siguiente, Meta quitó la palabra «entrenar» (Nieman Lab). El 23 de octubre movió la entrada en vigor del 30 de octubre al 20 de noviembre (Reuters). Qué significa: casi todas las redacciones tienen una cuenta comercial de Meta, así que el texto final decide si Meta puede rastrear su sitio.
Qué cambió de verdad: se paga por uso, no por rastreo
Antes, un sitio tenía dos opciones: dejar entrar a los rastreadores a cambio de tráfico de búsqueda, o bloquearlos y negociar una licencia única. Los datos de Cloudflare muestran por qué esa elección ya no basta. Menos del 1 % de los sitios de su red bloquea los rastreadores de búsqueda, pero el 17 % bloquea los de entrenamiento (Cloudflare, 15 de septiembre). En la primavera de 2025, el 22 % de las solicitudes de rastreo declaraba el entrenamiento como fin; en junio de 2026 era el 52 % (Cloudflare, 30 de septiembre).
Los medios empezaron antes: a finales de 2023, el 48 % de los principales sitios de noticias de diez países bloqueaba los rastreadores de OpenAI, con apenas un 20 % en México (Reuters Institute). En 2025, Cloudflare cobraba por rastreo con Pay Per Crawl (Cloudflare, 2025), y Cloudflare Radar muestra en público cómo se comporta cada rastreador.
Los tres modelos nuevos cuentan «eventos de uso». La diferencia es quién los cuenta:
- Los cuenta Google. El piloto News AI paga por la entrega de «contenido mejorado». Una portavoz de Google dijo a Nieman Lab que este piloto no paga según lo que aporte cada artículo a una respuesta (Nieman Lab). Otro programa, el «piloto de contribución a la IA», sí paga por valor. Según Digiday (14 de septiembre), Google paga solo cuando considera que el contenido ayudó de forma «significativa» a una respuesta de AI Overviews, AI Mode o Gemini. Search Console muestra un importe mensual, pero no la fórmula (Digiday).
- Los declara el comprador. En Pay Per Use, cada empresa de IA declara sus propios usos, una línea JSON por uso. Cloudflare comprueba que cada registro corresponde a un dominio inscrito, y las condiciones del programa exigen declarar todo. Cloudflare lo resume así: pagar por el uso, no por el rastreo (Cloudflare).
- Un estándar define el informe, pero las reglas de auditoría aún no existen. El borrador de SPUR de junio preveía versiones revisadas antes del 10 de agosto (aviso del borrador). La versión 1.0 salió el 2 de octubre. Según Digiday, el comité técnico de «auditoría y pruebas» tenía prevista su primera reunión para el 15 de octubre (Digiday).
Los tres comparten un hueco. Los datos de uso que ve un editor vienen de Google o del comprador, y el método para comprobarlos por separado aún está en desarrollo. Por eso SPUR pone la auditoría como su siguiente paso.


Conclusiones que no salen de los anuncios
- «400 publicaciones» no son 400 editores, ni significa pago por contribución. Google cuenta publicaciones. Su lista mezcla marcas únicas, como CNN, con grupos de varios diarios, como Shaw Media, y no explica cómo cuenta un grupo. En junio, la página de políticas públicas de Google hablaba de «más de 200» (Google): la cifra se duplicó en unos cuatro meses. Google no ha revelado las condiciones de ningún socio (Reuters).
- Enlaces más visibles no prueban más clics. La entrada de Google del 15 de octubre habla de aumentos «continuos y sustanciales» de enlaces, sin cifras de clics ni de tráfico (Google). El mejor dato externo es anterior: con datos de navegación de marzo de 2025, Pew encontró clics en un enlace del resumen de IA en solo el 1 % de las visitas a esas páginas (Pew). Es anterior al rediseño. Del lado del lector, la encuesta 2026 del Reuters Institute muestra que el uso semanal de chatbots para informarse subió del 7 % al 10 %, y solo el 1 % lo tiene como fuente principal de noticias (Digital News Report 2026).
- La caída del 40,2 % de Chartbeat no se debe solo a la IA. Search Engine Journal resumió el 24 de septiembre el 2026 Publisher Playbook de Chartbeat: las visitas desde Google Search en su red cayeron un 40,2 % entre julio de 2025 y julio de 2026, tras un 21,9 % el año anterior. La muestra se inclina hacia sitios de noticias, no indica cuántos sitios incluye y no aclara si la cifra anual mide páginas vistas o cuota (SEJ). El mismo informe sitúa las visitas desde chatbots en el 0,01 %. El Reuters Institute cita otra cifra de Chartbeat: una caída del 33 % para más de 2.500 sitios entre noviembre de 2024 y noviembre de 2025 (según Reuters). Periodos y muestras distintos: no compares las dos cifras. El Reuters Institute recuerda además que Google no muestra hoy AI Overviews en búsquedas de noticias (Reuters Institute).
- Que se desestime una demanda antimonopolio no hace legal el uso del contenido. Las dos demandas alegaban la Ley Sherman y enriquecimiento injusto, no derechos de autor. El fallo dice además que el tribunal no es ajeno a la situación de los editores (fallo; resumen de Press Gazette). En el Reino Unido, la autoridad de competencia (CMA) decidió el 3 de junio que Google debe permitir a los editores excluir su contenido de las funciones de IA del buscador, con nueve meses de plazo (CMA, junio). El 23 de septiembre, la CMA propuso que todo buscador que aparezca en sus pantallas de elección atribuya con claridad el contenido de los editores (CMA, septiembre). Dos países, dos herramientas jurídicas, dos resultados.
- Quitar «entrenar» y aplazar la fecha no descarta el entrenamiento. El texto revisado permite rastrear para «desarrollar» productos publicitarios y comerciales. El profesor de derecho James Grimmelmann dijo a Nieman Lab que la redacción es tan amplia que «cabe un camión» (Nieman Lab). Al 23 de octubre, Meta solo había cambiado la fecha; las condiciones seguían sin mencionar robots.txt (Nieman Lab, 23 de octubre). La News Media Association británica (comunicado), la News/Media Alliance estadounidense (comunicado) y el European Publishers Council (comunicado) se oponen en público. El 22 de octubre, un grupo pidió medidas cautelares a la Comisión Europea y a la CMA (Reuters).
- 80 miembros de SPUR no significan que las empresas de IA usen el estándar. SPUR invitó a OpenAI, Anthropic, Google, Meta y Microsoft a su consejo asesor. Google solo respondió a Digiday que colabora «con frecuencia» con SPUR y otras asociaciones; las demás no contestaron (Digiday).
- «Demandar» y «licenciar» no son dos bandos. Cotejamos línea por línea las listas originales de miembros y socios. Los cuatro demandantes canadienses contra Anthropic figuran en la lista de SPUR; The Canadian Press entró como miembro nuevo el 13 de octubre, siete días después de presentar la demanda (lista de SPUR). El Financial Times, miembro fundador de SPUR, está en la lista de socios de Google del 15 de octubre. The Guardian, del fundador Guardian Media Group, fue socio inicial del piloto de Google en diciembre de 2025, junto con El País e Infobae (Google, diciembre de 2025). De las 17 publicaciones que nombran las dos entradas de Google, 2 pertenecen a fundadores de SPUR. Una misma organización puede demandar a una empresa de IA, licenciar a otra y ayudar a escribir el estándar de conteo.
Nuestra prueba: ¿adónde llevan los buscadores a quien busca estas noticias?
Los productos de IA buscan antes de responder. Un artículo de arXiv del 10 de octubre analizó 158.099 respuestas con 468.037 citas. Cada página que citó ChatGPT era una que su propia búsqueda había recuperado, y esa búsqueda explicaba mucha más variación (32 %) que las características de la página (2,8 %) (arXiv 2610.15033). El estudio trata preguntas comerciales, no noticias, pero el orden es el mismo: primero se busca y luego se cita.
Por eso medimos el paso de búsqueda: para cada hecho, qué tipo de sitios ocupan los 10 primeros resultados y si aparece el documento original. Antes de la primera llamada escribimos estos criterios (conservamos el original archivado):
- Cuatro clases de sitio, según una lista fija de dominios: documento original, redacción con firma, red social y otros.
- Hipótesis 1: en la búsqueda de noticias, las redacciones ocupan más de la mitad de los resultados.
- Hipótesis 2: la búsqueda web muestra el documento original en al menos 6 de los 8 hechos.
- Hipótesis 3: la búsqueda semántica devuelve más documentos originales que la búsqueda web.
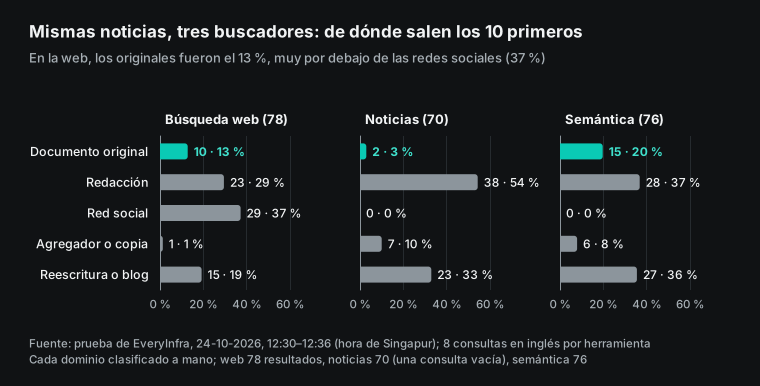
Prueba 1: qué sitios llenan los resultados. El 24 de octubre, de 12:30 a 12:36 (hora de Singapur), llamamos a tres herramientas de la API de EverySearch: web, news y semantic. Usamos una consulta en inglés por hecho y 10 resultados por llamada, 24 llamadas en total, y añadimos 2 consultas en español y 2 en chino en news. Cada llamada cuesta 0,000694 USD y los resultados vacíos no se cobran.
- Búsqueda web: tras una revisión manual, 29 de 78 resultados (37 %) eran publicaciones de Facebook, Instagram, LinkedIn, Reddit, Threads, YouTube y X. Las redacciones sumaron 23 (29 %) y los documentos originales, 10 (13 %).
- Búsqueda de noticias: ninguno de los 70 resultados era de redes sociales. Con la lista fija, las redacciones solo sumaban el 31 %, así que la hipótesis 1 falló. La lista dejaba fuera a medios como Forbes, Quartz o AdExchanger; tras revisar cada dominio a mano, las redacciones llegaban al 54 % (conservamos el registro de cada decisión). Los sitios de reescritura y los blogs personales o de empresas sumaban el 33 %, y los agregadores y reproducciones, el 10 %.
- Búsqueda semántica: se quedó atrás con los hechos más recientes. Con «USA Today sues OpenAI», ninguno de los 9 resultados trataba la demanda del 8 de octubre; arriba aparecían expedientes de otro caso de 2025. Con las condiciones de Meta, 3 de 8 resultados mencionaban las nuevas condiciones. Nuestro catálogo de herramientas de búsqueda indica que
semantictarda en indexar las páginas muy recientes, y la prueba coincidió con esa nota. - Español y chino: las 2 consultas en español devolvieron 20 resultados, 10 de redacciones (entre ellas Infobae, Clarín, Milenio, El Universal y El Economista). La consulta en chino devolvió 1 redacción, 5 portales o reproducciones y 4 sitios de reescritura. En ningún idioma apareció un documento original. Otra consulta en chino no dio resultados y no se cobró.
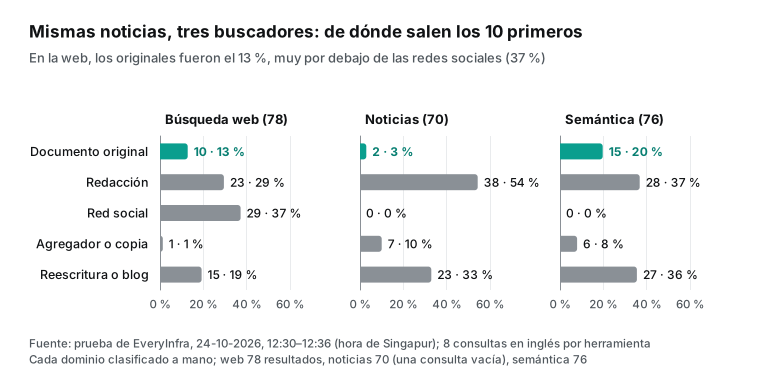
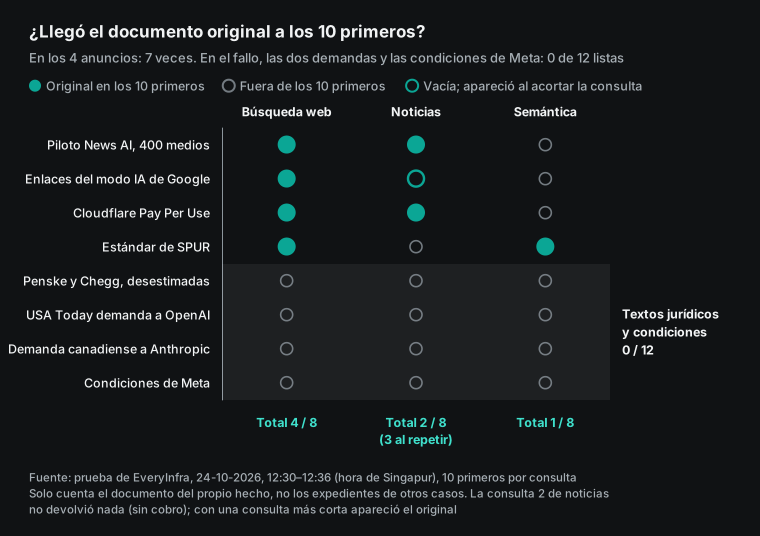
Cuántas veces llegó a los 10 primeros el documento original del propio hecho (los expedientes de otros casos no cuentan):
- Búsqueda web: 4 de 8; la hipótesis 2 falló. Aparecieron las entradas de Google, Cloudflare y SPUR.
- Búsqueda de noticias: 2 de 8. Una consulta no devolvió nada; con una consulta más corta, el resultado fue 3 de 8.
- Búsqueda semántica: 1 de 8, y fue la página del borrador de SPUR de junio, no la versión 1.0. En proporción bruta, la semántica (20 %) superó a la web (13 %), pero lo que sumaba eran informes de gobiernos de 2025 y expedientes de otros casos. Contando solo el documento de cada hecho, la hipótesis 3 también falló.
- El fallo, las dos demandas y las condiciones de Meta: 0 de 12 listas. El PDF del fallo y el de la demanda de USA Today son públicos; por encima quedaron Reuters, Forbes y publicaciones en redes sociales.
Prueba 2: muestra de páginas reescritas. De 12:43 a 12:44, usamos la herramienta read (0,000694 USD por llamada) sobre 6 páginas de la clase «otros» que salieron en la búsqueda de noticias, y después revisamos cada una a mano.
- 2 páginas dicen en público que las escribió una máquina. Una firma como «Noah Wire Services» y lista el titular que la «inspiró» y las referencias de cada párrafo. La otra presenta a su autora como «un agente de investigación generado por IA».
- 3 páginas enlazan el documento original del hecho; las otras 3 no enlazan ni el original ni la nota de Reuters.
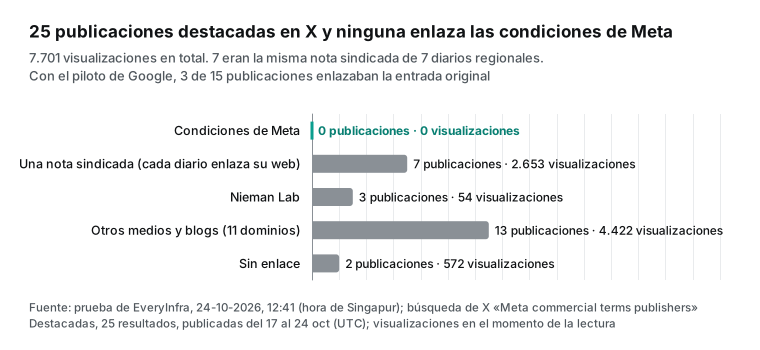
Prueba 3: difusión en X. De 12:41 a 12:42, llamamos a la búsqueda de X por palabra clave, que ordena por publicaciones destacadas por defecto (0,000556 USD por llamada).
- «Meta commercial terms publishers»: 25 publicaciones del 17 al 24 de octubre (UTC). 15 eran de cuentas de medios, y 7 diarios regionales publicaron la misma nota sindicada con el mismo titular. En el momento de la lectura, las 25 sumaban 7.701 visualizaciones (mediana 178, máximo 1.013), 7 «me gusta», 2 republicaciones y 1 respuesta. Ninguna enlazaba las condiciones de Meta; el sitio más enlazado fue Nieman Lab (3 publicaciones).
- «Google "News AI" pilot publishers»: 15 publicaciones de 2026 sumaban 6.052 visualizaciones, y una sola, de un consultor SEO, reunía el 57 % (3.461). 3 publicaciones enlazaban la entrada original de Google.
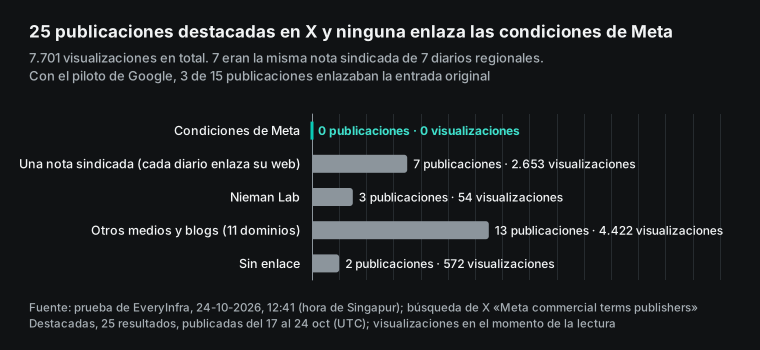
Lo que muestran las tres pruebas: una redacción o un asistente de IA que solo use resultados de búsqueda para este tipo de noticia obtiene sobre todo versiones de segunda mano, y cuanto más jurídico es el hecho, más difícil es llegar al original. Límites: es una sola foto del 24 de octubre; los resultados cambian cada día; usamos una consulta por hecho; los resultados de X son destacados, no todas las publicaciones. También hicimos 4 consultas en la búsqueda de Reddit, pero solo cubrían el último día y no entraron en las conclusiones.
Qué pueden hacer las redacciones y los equipos de datos
- Anota primero los documentos originales. Para cada hecho, apunta el comunicado, el fallo, la demanda o la página de condiciones. Resultado esperado: una tabla de hechos y URL originales.
- Repite las mismas consultas cada día. Consulta
webynewsuna vez cada una y guarda los 10 primeros dominios. Resultado esperado: dos filas por hecho y día. - Registra dos cifras. ¿Está el original entre los 10 primeros? ¿Cuántos resultados son reescrituras o agregadores? Resultado esperado: sabrás qué hechos quedan enterrados bajo versiones de segunda mano.
- Lee los textos jurídicos directamente. Para fallos, demandas y condiciones, usa
readsobre la URL original en lugar de esperar a la búsqueda. La documentación de Google indica que las reglas de Googlebot y controles comonosnippettambién se aplican a AI Overviews y AI Mode (Google Search Central); úsala para revisar la configuración de tu sitio. Resultado esperado: cada cita coincide con una página del original. - Mide la difusión. Usa la API de scraping de X con las mismas palabras y anota visualizaciones y dominios enlazados; puedes repetirlo en la búsqueda de Threads. Resultado esperado: sabrás qué nota vieron los lectores.
- Concilia los cobros. Cada respuesta trae
billing.charged_usd, y los resultados vacíos muestranempty_result_refunded. Consulta Fallos de API, reembolsos y conciliación.
Para elegir entre herramientas de búsqueda, lee Herramientas de búsqueda para agentes de IA. Para decidir qué abrir a los rastreadores de IA, lee Rastreadores de IA: búsqueda, entrenamiento y robots.txt.
Cómo reproducir la prueba
Solicitud (búsqueda de noticias sobre el piloto de Google):
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer <API Key>" \
  -H 'Content-Type: application/json' \
  -d '{"tool":"news","params":{"q":"Google pagará a medios noticias inteligencia artificial","num":10}}'
Campos útiles de la respuesta:
results[].url,results[].title,results[].snippet: enlace, título y extracto.results[].published: fecha de publicación (la herramienta de noticias da tiempos relativos, como «4 days ago»).billing.charged,billing.charged_usd: si la llamada se cobró y el importe en USD.billing.reason:empty_result_refundedcuando no hay resultados; el importe retenido se devuelve.id: identificador de la solicitud para conciliar.
Para buscar en X, envía POST /api/v1/social con {"platform":"twitter","action":"search","params":{"keyword":"...","limit":25}}. La respuesta incluye view_count, like_count, links y posted_at; la lista completa de campos está en el catálogo de capacidades. Para usar los mismos datos en Claude o Cursor, conecta el servidor MCP remoto. Si eres nuevo, crea tu clave en el inicio rápido.
Errores y cobros, todos de esta prueba:
- Parámetros mal escritos (falta
paramso un campo tiene otro nombre): HTTP 422 con un ejemplo de solicitud que funciona. Sin cobro. Nos pasó 12 veces y pagamos 0 USD. - Sin resultados: lista vacía con
empty_result_refunded. Sin cobro. Ocurrió 2 veces. - Resultados normales: se cobran al precio del catálogo.
Cuánto cuesta
Con los precios del catálogo leídos el 24 de octubre (consulta la página de precios), vigilar 8 hechos cada día cuesta:
- búsqueda web + noticias: 8 × 2 = 16 llamadas × 0,000694 USD = 0,011104 USD
- lectura de 8 documentos originales: 8 llamadas × 0,000694 USD = 0,005552 USD
- búsqueda en X de 2 palabras clave: 2 llamadas × 0,000556 USD = 0,001112 USD
- total diario: 0,017768 USD, unos 0,53 USD en 30 días. Los resultados vacíos no se cobran, así que el coste real será menor.
Todas las llamadas reales de este artículo: 53 solicitudes y 0,026238 USD cobrados.
Preguntas frecuentes
¿Google ya paga a los sitios de noticias? A algunos, de dos formas. El piloto News AI paga por el contenido entregado, no por su aporte a cada respuesta, y reúne a más de 400 publicaciones. El piloto de contribución paga cuando Google considera que hubo un aporte «significativo» y muestra un importe mensual en Search Console. Ninguno publica precios. (La pregunta sale de titulares en español como «Google paga a 400 medios por usar sus contenidos en IA», que apareció en nuestra prueba.)
Las impresiones suben pero los clics bajan. ¿Es por AI Overviews? Una sola cifra no lo responde. Desde junio, Google abre a algunos sitios informes de impresiones en funciones de IA en Search Console (Google Search Central). Compara primero tus propias impresiones y clics; después, usa el 1 % de Pew y los datos de Chartbeat, teniendo en cuenta que sus muestras y fechas son distintas. (La pregunta sale de un título de r/SEO_Experts: «Is Google's AI Search reducing organic traffic, even when impressions…».)
¿Las nuevas condiciones de Meta entran en vigor el 30 de octubre? No. Meta dijo a Reuters el 23 de octubre que la fecha pasa al 20 de noviembre, y en el texto solo cambió la fecha. Si te preocupa el rastreo, revisa ya tu robots.txt y lee el texto final antes del 20 de noviembre. (La pregunta sale de varios títulos de resultados como «Meta Terms … Oct. 30».)
Referencias
Documentos originales:
- Google, «400 publications are now partnering with us on our News AI pilot program», 2026-10-15, https://blog.google/products-and-platforms/products/news/news-ai-pilot-update-publishers/
- Google, «AI Mode and AI Overviews updates to explore the web», 2026-10-15, https://blog.google/products-and-platforms/products/search/updates-ai-mode-overviews-explore-web/
- Google, «New Google web ecosystem tools and partnerships», 2025-12, https://blog.google/products-and-platforms/products/search/tools-partnerships-web-ecosystem/
- Google, «How Google Search helps you find original, quality content», 2026-05, https://blog.google/products-and-platforms/products/search/original-high-quality-content-search/
- Google Public Policy, «Google's ongoing commitment to supporting the information ecosystem», 2026-06, https://publicpolicy.google/article/supporting-information-ecosystem/
- Google Search Central, «AI Features and Your Website», actualizado 2025-12-10, https://developers.google.com/search/docs/appearance/ai-features
- Google Search Central, «Introducing Search Generative AI performance reports in Search Console», 2026-06-03, https://developers.google.com/search/blog/2026/06/gen-ai-performance-reports
- Cloudflare, «Pay Per Use: when AI uses your work, you should get paid», 2026-09-30, https://blog.cloudflare.com/pay-per-use
- Cloudflare, «The Internet has a second audience», 2026-09-30, https://blog.cloudflare.com/agentic-web
- Cloudflare, «Monetization Gateway beta», 2026-09-30, https://blog.cloudflare.com/monetization-gateway-beta
- Cloudflare, «Have it both ways: stay discoverable in search while disallowing AI training», 2026-09-15, https://blog.cloudflare.com/accountable-mixed-use-ai-crawlers/
- Cloudflare, «Introducing pay per crawl», 2025-07, https://blog.cloudflare.com/introducing-pay-per-crawl/
- Cloudflare Radar, «AI Insights», página en vivo, https://radar.cloudflare.com/ai-insights
- SPUR Coalition, «SPUR Content Telemetry Standard v.1 published», 2026-10-02, https://www.spurcoalition.org/updates/spur-content-telemetry-standard-v1-published
- SPUR Coalition, notas de versión de «Content Telemetry 1.0», 2026-10-02, https://github.com/SPUR-Coalition/telemetry/releases/tag/v1.0
- SPUR Coalition, «SPUR Telemetry Standard Published for Public Comment», 2026-06, https://www.spurcoalition.org/updates/spur-telemetry-standard-published-for-public-comment-the-spur-coalition
- SPUR Coalition, «The New York Times, Agence France-Presse, The Economist, and The Atlantic join The SPUR Coalition», 2026-10-13, https://www.spurcoalition.org/updates/the-new-york-times-agence-france-presse-the-economist-and-the-atlantic-join-the-spur-coalition
- Tribunal de Distrito de EE. UU. para el Distrito de Columbia, opinión en Chegg v. Google y Penske Media v. Google, 2026-09-30, https://fingfx.thomsonreuters.com/gfx/legaldocs/byvraqlwbpe/Chegg%20Penske%20order%20-%20Google%20antitrust%2020260930.pdf
- Tribunal de Distrito de EE. UU. para el Distrito Sur de Nueva York, demanda USA Today Co. v. OpenAI (1:26-cv-08892), 2026-10-08, https://fingfx.thomsonreuters.com/gfx/legaldocs/movarymwypa/USA%20TODAY%20OPENAI%20COPYRIGHT%20lawsuit.pdf
- News Media Association, comunicado sobre las condiciones de Meta, 2026-10-16, https://newsmediauk.org/blog/2026/10/16/nma-condemns-arrogant-metas-shameless-landgrab-attempt-to-plunder-news-publisher-websites/
- News/Media Alliance, «Statement on Changes to Meta Commercial Terms of Use», 2026-10-16, https://www.newsmediaalliance.org/changes-to-meta-commercial-terms-of-use/
- European Publishers Council, comunicado sobre las condiciones de Meta, 2026-10-16, https://www.epceurope.eu/post/european-commission-should-be-extremely-concerned-about-meta-s-dilemma-for-european-publishers-hand
- Chartbeat, «The 2026 Publisher Playbook», 2026-09, https://chartbeat.com/resources/general/the-2026-publisher-playbook-9-strategies-to-boost-acquisition-
- CMA (Reino Unido), «CMA secures fairer deal for publishers and improves Google search services in UK», 2026-06-03, https://www.gov.uk/government/news/cma-secures-fairer-deal-for-publishers-and-improves-google-search-services-in-uk
- CMA (Reino Unido), «CMA strengthens proposals allowing people choice over their search service», 2026-09-23, https://www.gov.uk/government/news/cma-strengthens-proposals-allowing-people-choice-over-their-search-service
- arXiv 2610.15033, «What Drives AI Citations?», 2026-10-10, https://arxiv.org/abs/2610.15033
- Reuters Institute, «Digital News Report 2026: Emerging uses of AI chatbots for news», 2026-06, https://reutersinstitute.politics.ox.ac.uk/digital-news-report/2026/emerging-uses-ai-chatbots-news-and-what-it-means-journalism
- Reuters Institute, «How many news websites block AI crawlers?», 2024-02-22, https://reutersinstitute.politics.ox.ac.uk/how-many-news-websites-block-ai-crawlers
- Pew Research Center, «Do people click on links in Google AI summaries?», 2025-07-22, https://www.pewresearch.org/short-reads/2025/07/22/google-users-are-less-likely-to-click-on-links-when-an-ai-summary-appears-in-the-results/
- EveryInfra, catálogo de herramientas de búsqueda, leído el 2026-10-24, https://api.everyinfra.com/api/v1/search/tools
- EveryInfra, catálogo de capacidades de datos, leído el 2026-10-24, https://api.everyinfra.com/api/v1/social/catalog
Reportajes y análisis (referencias secundarias; el texto enlaza junto a cada uno el documento original):
- Reuters, «CNN, Axios and other publishers join Google's AI news program», 2026-10-15, https://www.reuters.com/business/media-telecom/cnn-signs-multi-year-ai-partnership-with-google-2026-10-15/
- Nieman Lab, «Google's News AI pilot expands to over 400 publications», 2026-10-15, https://www.niemanlab.org/2026/10/googles-news-ai-pilot-expands-to-over-400-publications-including-u-s-local-news-outlets/
- Digiday, «Google rolls out pay-per-value AI licensing program to publishers», 2026-09-14, https://digiday.com/media/google-rolls-out-pay-value-ai-licensing-program-to-publishers/
- Digiday, «SPUR publishes AI content tracking standard», 2026-10-02, https://digiday.com/media/spur-publishes-ai-content-tracking-standard-pitches-openai-and-google-to-join-advisory-board/
- Reuters, «Google wins dismissal of Chegg, Penske Media lawsuits over AI overviews», 2026-10-01, https://www.reuters.com/legal/litigation/google-wins-dismissal-chegg-penske-media-lawsuits-over-ai-overviews-2026-10-01/
- Press Gazette, «Penske Google AI Overviews lawsuit dismissed», 2026-10-01, https://pressgazette.co.uk/news/penske-ai-overviews-lawsuit-dismissed-because-no-formal-bargain-struck-with-google/
- Reuters, «USA Today sues OpenAI for copyright infringement over AI training», 2026-10-08, https://www.reuters.com/legal/legalindustry/usa-today-sues-openai-copyright-infringement-over-ai-training-2026-10-08/
- CBC News, «Anthropic sued by major Canadian news publishers», 2026-10-19, https://www.cbc.ca/news/business/anthropic-postmedia-torstar-globe-canadian-press-copyright-lawsuit-9.7387205
- Nieman Lab, «Legal experts warn Meta's new terms still grant broad scraping permissions», 2026-10-17, https://www.niemanlab.org/2026/10/legal-experts-warn-metas-new-terms-still-grant-broad-scraping-permissions-despite-language-changes/
- Nieman Lab, «Meta delays rollout of terms that would allow broad scraping of news sites», 2026-10-23, https://www.niemanlab.org/2026/10/meta-delays-rollout-of-terms-that-would-allow-broad-scraping-of-news-sites-legal-experts-are-still-skeptical/
- Reuters, «Meta to delay new commercial terms criticised by publishers, advertisers», 2026-10-23, https://www.reuters.com/business/media-telecom/meta-delay-new-commercial-terms-criticised-by-publishers-advertisers-2026-10-23/
- Reuters, «Publishers, advertisers call EU, UK antitrust regulators to suspend Meta's new commercial terms», 2026-10-22, https://www.reuters.com/legal/litigation/publishers-advertisers-call-eu-uk-antitrust-regulators-suspend-metas-new-2026-10-22/
- Reuters, «NYT, Economist among publishers joining coalition to curb unpaid AI use», 2026-10-12, https://www.reuters.com/legal/litigation/nyt-economist-among-publishers-joining-coalition-curb-unpaid-ai-use-2026-10-12/
- Search Engine Journal, «Google Search Decline Steepened To 40% YoY For Publishers», 2026-09-24, https://www.searchenginejournal.com/google-search-decline-publishers-chartbeat/590681/
- Reuters Institute, «Life after SEO: How newsrooms are adapting to the AI search shift», 2026-10, https://reutersinstitute.politics.ox.ac.uk/news/life-after-seo-how-newsrooms-are-adapting-ai-search-shift
Lecturas relacionadas
- API de EverySearch: búsqueda web y fuentes trazables
- API de scraping de X (Twitter), API de búsqueda de X (Twitter); API de scraping de Reddit, búsqueda de Reddit
- Rastreadores de IA: búsqueda, entrenamiento y robots.txt
- Herramientas de búsqueda para agentes de IA: cómo elegir
- Seguimiento de reputación multiplataforma
- Documentación de API desactualizada: catálogo en tiempo real
Referencia BL-32