Лицензирование новостей для ИИ переходит на оплату за использование: 8 событий и проверка поиска
За 30 дней Google, Cloudflare и коалиция издателей SPUR сдвинули лицензирование новостей к оплате за каждое использование в ИИ. До сих пор не определено, кто учитывает каждое такое использование. Мы проверили, как три поисковых инструмента находят исходные документы восьми таких событий.
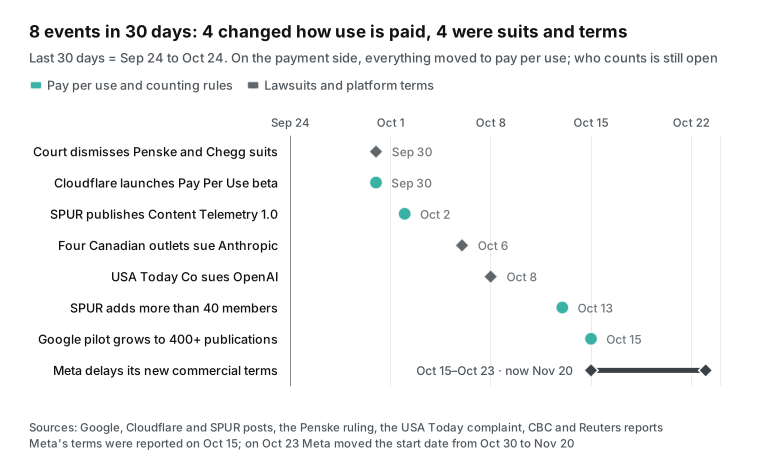
С 24 сентября по 24 октября 2026 года расчёты между новостными издателями и ИИ-продуктами стали учитывать каждое использование статьи. 15 октября в Google сообщили, что в платном пилоте News AI теперь участвуют более 400 изданий (Google). 30 сентября Cloudflare открыл бету Pay Per Use, где ИИ-покупателям выставляют счёт за каждое заявленное использование (Cloudflare). 2 октября коалиция издателей SPUR выпустила версию 1.0 своего стандарта Content Telemetry Standard. Он определяет, как ИИ-система фиксирует, что получила, процитировала или показала статью (SPUR). Но на один вопрос все три отвечают по-разному: кто учитывает каждое использование? Независимого аудита пока нет ни у кого из них.
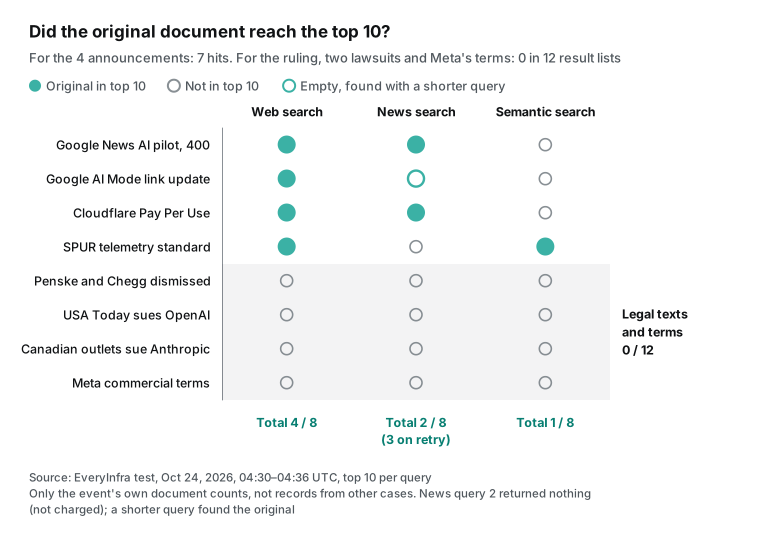
Мы также провели проверку. 24 октября 2026 года, с 04:30 до 04:44 UTC (с 12:30 до 12:44 по сингапурскому времени), мы искали эти восемь событий через API поиска и API данных X от EveryInfra. В топ-10 веб-результатов исходный документ компании, суда или организации нашёлся только для 4 событий из 8. По 4 юридическим событиям (решение суда, два иска и пакет условий платформы) исходный текст не появился ни в одном из 12 списков результатов трёх поисковых инструментов. При этом три из этих четырёх текстов находятся в открытом доступе.
В этой статье «оплата за использование» означает, что ИИ-продукт платит согласованную цену каждый раз, когда использует статью. Использованием считается получение статьи, ответ с опорой на неё, цитата или показ читателю. Оплата за сканирование и разовый лицензионный платёж сюда не относятся.


Восемь событий в хронологическом порядке
В конце каждого пункта мы объясняем, что это значит для редакций и команд по работе с данными.
- 30 сентября: суд США отклонил антимонопольные иски Penske и Chegg против Google. Судья Амит Мехта написал, что у издателей было лишь «ожидание» трафика. В решении он добавляет: «ожидание — не соглашение» (Reuters, 1 октября). Что это значит: в США антимонопольное право сейчас не обязывает Google платить за ИИ-сводки.
- 30 сентября: Cloudflare запустил бету Pay Per Use. Каждая ИИ-компания сама определяет, за какое использование платит, и назначает цену. Издатели принимают или отклоняют предложения в дашборде. Покупатель сообщает о каждом использовании, а Cloudflare выставляет счёт раз в месяц (Cloudflare). В тот же день Cloudflare открыл Monetization Gateway с оплатой за каждый запрос к API и данным (Cloudflare). Что это значит: у небольших сайтов, которые не могут договориться о лицензии, теперь есть одно место, где видны предложения.
- 2 октября: SPUR опубликовала Content Telemetry 1.0. Стандарт разбивает использование в ИИ на события: получение, использование как основы ответа, цитирование, показ и вовлечение. В каждом отчёте также должен указываться тип охвата: полный, выборочный, агрегированный или отобранный (примечания к релизу). Что это значит: у издателей появилась общая единица для переговоров о лицензиях, но только если ИИ-компании согласятся отчитываться.
- 6 октября: четыре канадские новостные организации подали в суд на Anthropic. Postmedia, Torstar, The Globe and Mail и The Canadian Press подали иск в суд Онтарио. По их словам, Anthropic собирала данные с их сайтов для разработки Claude и обходила технические меры защиты. CBC сообщила об иске 19 октября. Суд эти обвинения пока не рассматривал (CBC). Что это значит: новостные иски теперь касаются не только OpenAI, но и других разработчиков моделей.
- 8 октября: USA Today Co подала в суд на OpenAI. Иск по делу 1:26-cv-08892 охватывает 19 изданий. По данным Reuters, истец требует возмещения ущерба «на сумму свыше $250 млн» (Reuters). Что это значит: крупная американская группа местных СМИ присоединилась к делам об авторском праве, которые уже объединены в Южном округе Нью-Йорка.
- 13 октября: в SPUR вступили более 40 новых участников. Среди них The New York Times, AFP, The Economist и The Atlantic. Теперь в SPUR более 80 участников из более чем 20 стран (SPUR). Что это значит: стандарт поддерживает всё больше издателей, но ни один ИИ-покупатель публично не заявил, что будет его использовать.
- 15 октября: Google внёс два изменения в один день. Во-первых, пилот News AI охватил более 400 изданий. Среди новых партнёров CNN, Financial Times, Axios, Forbes и несколько местных изданий США (Google). Во-вторых, встроенные ссылки в AI Mode и AI Overviews теперь показываются выше. Карусели статей (впервые запущенные в мае) стали доступны в большем числе стран и языков (Google). Что это значит: Google платит за контент и делает ссылки заметнее, но ни в одном из двух постов нет данных о кликах.
- 15–23 октября: Meta отложила новые коммерческие условия. 15 октября Nieman Lab сообщил, что условия позволяют Meta сканировать сайты, «связанные с» бизнес-аккаунтами. На следующий день Meta убрала из текста слово «train» («обучать») (Nieman Lab). 23 октября Meta перенесла дату вступления условий в силу с 30 октября на 20 ноября (Reuters). Что это значит: бизнес-аккаунт в Meta есть почти у каждой редакции, поэтому от финального текста зависит, сможет ли Meta сканировать её сайт.
Что на самом деле изменилось: единицей оплаты стало не сканирование, а использование
Раньше у сайта было два варианта: пустить краулеры и надеяться на поисковый трафик или заблокировать их и попытаться заключить разовое лицензионное соглашение.
Собственные данные Cloudflare показывают, почему этот выбор больше не работает. Поисковые краулеры блокируют менее 1% сайтов в сети Cloudflare, а краулеры для обучения блокируют 17% (Cloudflare, 15 сентября). Весной 2025 года обучение указывали в качестве цели 22% запросов краулеров. К июню 2026 года эта доля выросла до 52% (Cloudflare, 30 сентября). Новостные сайты начали блокировать краулеры рано: к концу 2023 года 48% ведущих новостных сайтов в десяти странах блокировали краулеры OpenAI (Reuters Institute). В 2025 году в рамках Pay Per Crawl от Cloudflare плата взималась за каждое сканирование (Cloudflare, 2025), а Cloudflare Radar показывает, как ведёт себя каждый краулер.
Все три новые модели считают «события использования». Разница в том, кто именно считает:
- Считает Google. Пилот News AI платит за предоставление «расширенного контента». Представитель Google сообщил Nieman Lab, что в этом пилоте оплата не зависит от вклада в ответ ИИ (Nieman Lab). Отдельный «пилот по вкладу в ИИ» платит за ценность. 14 сентября Digiday сообщил, что Google платит, только если сам решает, что контент «существенно» помог ответу в AI Overviews, AI Mode или Gemini. Search Console показывает сумму за месяц, но не формулу расчёта (Digiday).
- Отчитывается покупатель. В Pay Per Use каждая ИИ-компания сама передаёт сведения о каждом случае использования в виде отдельной строки JSON. Cloudflare проверяет, что каждая запись относится к подключённому домену, а условия программы требуют полной отчётности. Cloudflare формулирует суть так: «платите за использование, а не за сканирование» (Cloudflare).
- Формат отчёта задаёт стандарт, но правила аудита ещё не написаны. Июньский черновик SPUR предусматривал доработанные версии к 10 августа (уведомление о черновике SPUR). Версия 1.0 вышла 2 октября. По данным Digiday, технический комитет по «аудиту и доказательной базе» должен был впервые собраться 15 октября (Digiday).
У всех трёх моделей один и тот же пробел. Данные об использовании, которые видит издатель, поступают от Google или от покупателя. Способ независимо их проверить ещё разрабатывается, поэтому SPUR называет аудит своим следующим шагом.


Каких выводов из этих анонсов сделать нельзя
- «400 изданий» не означает 400 издателей и не означает оплату за вклад. Google считает издания. В его списке есть и отдельный бренд вроде CNN, и газетная группа вроде Shaw Media. Как считается группа, в посте не сказано. В июне на странице Google о политике говорилось о «более чем 200» изданиях (Google Public Policy). Число удвоилось примерно за четыре месяца. Google не раскрыл условия соглашения ни с одним партнёром (Reuters).
- Более заметные ссылки не доказывают рост кликов. В посте Google от 15 октября говорится о «продолжающемся и существенном увеличении» числа встроенных ссылок. Цифр по кликам или трафику там нет (Google). Наиболее релевантные внешние данные относятся к более раннему периоду. По данным о просмотрах за март 2025 года, Pew зафиксировал клики по ссылке внутри ИИ-сводки лишь в 1% посещений таких страниц (Pew). Эти данные получены до редизайна. Со стороны читателей опрос Reuters Institute 2026 года показывает, что еженедельное использование ИИ-чат-ботов для новостей выросло с 7% до 10%. Лишь 1% называет их основным источником новостей (Digital News Report 2026).
- Падение трафика Chartbeat на 40,2% связано не только с ИИ. 24 сентября Search Engine Journal кратко изложил «2026 Publisher Playbook» от Chartbeat. Переходы из Google Search по сети Chartbeat сократились на 40,2% с июля 2025 по июль 2026 года после падения на 21,9% годом ранее. Выборка смещена в сторону новостных сайтов, а число сайтов не указано. Также не уточняется, измеряет ли годовой показатель просмотры страниц или долю (SEJ). В том же отчёте доля переходов из ИИ-чат-ботов оценивается в 0,01% трафика. Reuters Institute приводит другую цифру Chartbeat: падение на 33% для более чем 2 500 сайтов с ноября 2024 по ноябрь 2025 года (по данным Reuters). Периоды и выборки различаются, поэтому сравнивать эти два числа нельзя. Reuters Institute также отмечает, что сейчас Google не показывает AI Overviews по новостным запросам (Reuters Institute).
- Отклонённый антимонопольный иск не делает использование контента Google законным. Оба иска опирались на Закон Шермана и неосновательное обогащение, а не на авторское право. В решении также сказано, что суд относится к издателям «не без сочувствия» (решение; обзор Press Gazette). В Великобритании Управление по конкуренции и рынкам (CMA) приняло меры 3 июня. Google должен дать издателям возможность исключать контент из ИИ-функций поиска, и на это у него девять месяцев (CMA, июнь). 23 сентября CMA предложило, чтобы каждый поисковый сервис на экранах выбора CMA чётко указывал авторство контента издателей (CMA, сентябрь). Две страны используют разные правовые инструменты и получают разные результаты.
- Удаление слова «train» и перенос даты не исключают обучения. Пересмотренный текст разрешает сканирование для «разработки» рекламных и бизнес-продуктов. Профессор права Джеймс Гриммельманн сказал Nieman Lab, что формулировка «настолько широкая, что через неё проедет грузовик» (Nieman Lab). По состоянию на 23 октября Meta изменила только дату. Положений о robots.txt в условиях по-прежнему не было (Nieman Lab, 23 октября). Британская News Media Association (заявление), News/Media Alliance (заявление) и European Publishers Council (заявление) публично выступают против. 22 октября группа организаций попросила Европейскую комиссию и CMA принять временные меры (Reuters).
- 80 участников SPUR не означают, что ИИ-компании используют стандарт. SPUR пригласила OpenAI, Anthropic, Google, Meta и Microsoft в свой консультативный совет. Google сообщил Digiday лишь, что «часто» взаимодействует со SPUR и другими группами. Остальные не ответили (Digiday).
- Судебные иски и лицензирование — не два отдельных лагеря. Мы построчно сверили исходные списки участников и партнёров. Все четыре канадских истца против Anthropic есть в списке участников SPUR. The Canadian Press вступила в коалицию 13 октября, через семь дней после подачи иска (список SPUR). Financial Times, один из основателей SPUR, есть в списке партнёров Google от 15 октября. The Guardian, которая принадлежит Guardian Media Group, одному из основателей SPUR, стала партнёром Google на старте пилота в декабре 2025 года (Google, декабрь 2025). Из 17 изданий, названных в двух постах Google, 2 принадлежат основателям SPUR. Одна организация может судиться с одной ИИ-компанией, предоставлять лицензию другой и участвовать в написании стандарта учёта.
Наша проверка: на какие источники поисковые инструменты направляют читателей по этим новостям?
Прежде чем ответить, ИИ-продукты выполняют поиск.
В статье на arXiv от 10 октября изучены 158 099 ответов с 468 037 цитатами. Каждую страницу, которую цитировал ChatGPT, до этого нашёл его собственный поиск. Поиск объяснял гораздо большую долю вариации (32%), чем характеристики страниц (2,8%) (arXiv 2610.15033). В статье изучались коммерческие вопросы, а не новости, но порядок тот же: сначала поиск, потом цитирование.
Поэтому мы проверили этап поиска. Какие типы сайтов попадают в топ-10 по каждому событию и появляется ли там исходный документ?
Эти критерии мы записали до первого вызова (оригинал храним у себя):
- Четыре класса сайтов, заданные списком разрешённых доменов: исходный документ, редакционное СМИ с указанием авторства, социальная платформа, прочее.
- Гипотеза 1: в новостном поиске больше половины результатов занимают редакции.
- Гипотеза 2: веб-поиск показывает исходный документ как минимум для 6 событий из 8.
- Гипотеза 3: в семантическом поиске доля исходных документов выше, чем в веб-поиске.
Проверка 1: какие сайты заполняют результаты. С 04:30 до 04:36 UTC 24 октября мы вызывали три инструмента API поиска EveryInfra: web, news и semantic. На каждое событие мы использовали один запрос на английском и 10 результатов на вызов, всего 24 вызова. Для news добавили 2 запроса на испанском и 2 на китайском. Каждый вызов стоит $0,000694, пустые результаты не оплачиваются.
- Веб-поиск: после ручной проверки 29 из 78 результатов (37%) оказались постами в соцсетях: Facebook, Instagram, LinkedIn, Reddit, Threads, YouTube и X. На редакции пришлось 23 результата (29%), на исходные документы 10 (13%).
- Поиск по новостям: ни один из 70 результатов не оказался постом из соцсетей. По нашему заранее заданному списку разрешённых доменов на редакции пришлось лишь 31%, так что гипотеза 1 не подтвердилась. В список не попали такие издания, как Forbes, Quartz и AdExchanger. После того как мы вручную проверили каждый домен, доля редакций составила 54% (каждое решение мы задокументировали). На сайты-рерайтеры, личные блоги и блоги компаний-поставщиков пришлось 33%, на агрегаторы и перепечатки — 10%.
- Семантический поиск отставал на самых свежих событиях. По запросу «USA Today sues OpenAI» ни один из 9 результатов не касался иска от 8 октября; в топе оказались судебные документы по другому делу 2025 года. По запросу о новых условиях Meta они упоминались лишь в 3 из 8 результатов. В нашем каталоге поисковых инструментов указано, что у
semanticесть задержка индексации совсем новых страниц, и тест это подтвердил. - Китайский и испанский: запрос на китайском в поиске по новостям вернул 1 результат от редакции, 5 — от порталов или перепечаток и 4 — от сайтов-рерайтеров. По 2 запросам на испанском пришло 20 результатов, из них 10 — от редакций. Ни на одном из языков оригинальный документ не нашёлся. Ещё один запрос на китайском ничего не вернул, и списания за него не было.
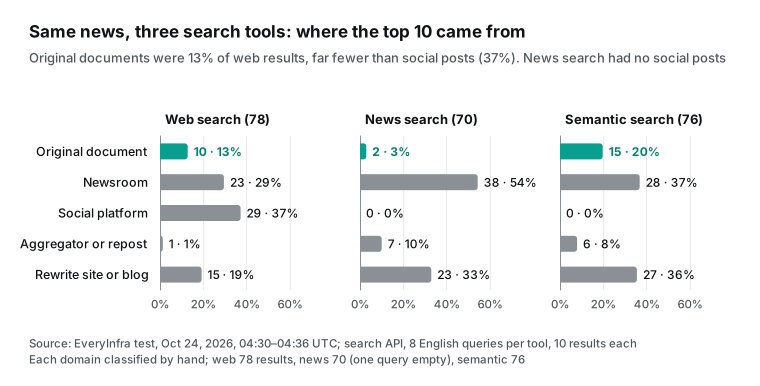
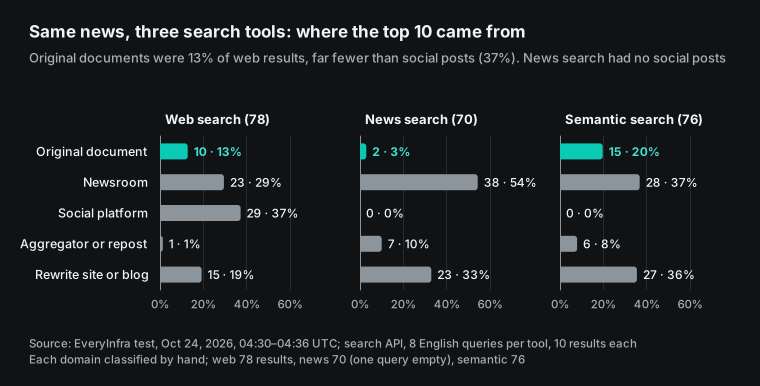
Как часто оригинальный документ самого события попадал в топ-10 (судебные документы по другим делам не учитываются):
- Веб-поиск: 4 из 8, так что гипотеза 2 не подтвердилась. Попаданиями стали публикации Google, Cloudflare и SPUR.
- Поиск по новостям: 2 из 8. Один запрос ничего не вернул; с более коротким запросом результат составил 3 из 8.
- Семантический поиск: 1 из 8, и это была июньская страница черновика SPUR, а не версия 1.0. По общей доле семантический поиск (20%) обошёл веб-поиск (13%), но дополнительные документы оказались правительственными отчётами 2025 года и материалами других дел. Если считать по собственному документу каждого события, гипотеза 3 тоже не подтвердилась.
- Судебное решение, два иска и условия Meta: 0 из 12 списков результатов. PDF решения и PDF иска USA Today находятся в открытом доступе. Reuters, Forbes и посты в соцсетях оказались выше них.
Тест 2: выборка страниц с рерайтами. С 04:43 до 04:44 UTC мы прочитали с помощью инструмента read 6 страниц категории «прочее» из результатов поиска по новостям. Каждый вызов стоит $0,000694. Затем мы вручную проверили каждую страницу.
- На 2 страницах открыто сказано, что их написала машина. Одна подписана «Noah Wire Services»: на ней указан заголовок, которым она «вдохновлена», и ссылки на источники для каждого абзаца. На другой в биографии автора он назван «исследовательским агентом, созданным ИИ».
- 3 страницы ссылаются на оригинальный документ события. Остальные 3 не ссылаются ни на оригинал, ни на материал Reuters.
Тест 3: распространение в X. С 04:41 до 04:42 UTC мы вызывали поиск по ключевым словам в X. По умолчанию он сортирует по топовым постам, вызов стоит $0,000556.
- «Meta commercial terms publishers»: 25 постов с 17 по 24 октября (UTC). 15 из них опубликовали аккаунты редакций. 7 региональных газет разместили один и тот же синдицированный материал с одинаковым заголовком. На момент нашей проверки суммарное число просмотров 25 постов составляло 7 701 (медиана 178, максимум 1 013), также у них было 7 лайков, 2 репоста и 1 ответ. Ни один пост не ссылался на условия Meta. Чаще всего ссылались на Nieman Lab (3 поста).
- «Google „News AI“ pilot publishers»: 15 постов за 2026 год набрали в сумме 6 052 просмотра. На один пост SEO-консультанта пришлось 57% из них (3 461). 3 поста ссылались на исходный пост Google.
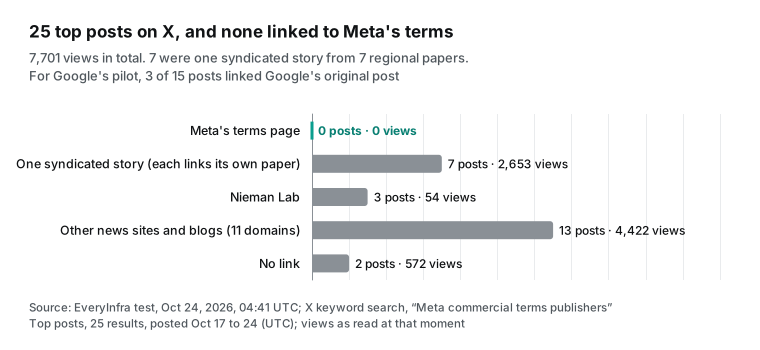
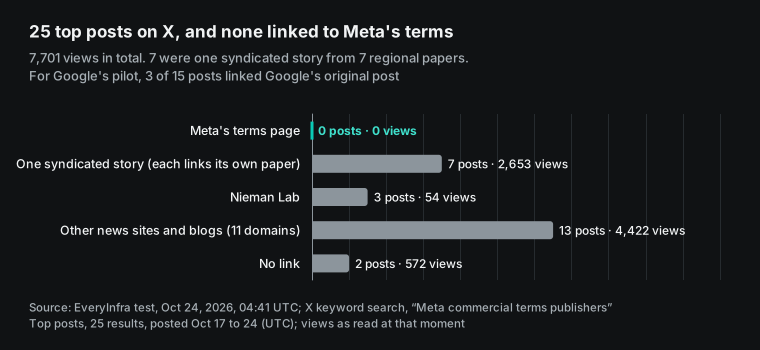
Что показали три теста: если редакция или ИИ-ассистент по таким темам опирается только на поисковую выдачу, то получает в основном пересказы. Чем ближе событие к юридическому тексту, тем труднее найти оригинал. Ограничения: это один срез от 24 октября; результаты меняются ежедневно; мы использовали по одному запросу на событие; результаты X — это топовые посты, а не все посты. Мы также выполнили 4 запроса через поиск Reddit, но посты охватывали только последние сутки, поэтому в выводы мы их не включили.
Что могут сделать редакции и команды по работе с данными
- Сначала составьте список оригинальных документов. Для каждого события запишите анонс, судебное решение, иск или страницу условий. Ожидаемый результат: таблица событий с URL оригиналов.
- Каждый день запускайте одни и те же запросы. Отправляйте по одному запросу в
webиnewsи записывайте домены из топ-10. Ожидаемый результат: две строки на каждое событие в день. - Фиксируйте два числа. Есть ли оригинальный документ в топ-10? Сколько результатов приходится на рерайты или агрегаторы? Ожидаемый результат: вы видите, какие события тонут в пересказах.
- Читайте юридические тексты напрямую. Для судебных решений, исков и условий используйте
readпо URL оригинала, а не ждите, пока его найдёт поиск. В документации Google сказано, что правила для Googlebot и настройки превью, такие какnosnippet, действуют и для AI Overviews и AI Mode (Google Search Central). Сверьтесь с ней, проверяя настройки своего сайта. Ожидаемый результат: каждая цитата соответствует тексту на странице оригинала. - Отслеживайте распространение. Используйте API для парсинга X с теми же ключевыми словами и записывайте просмотры и домены в ссылках. Те же запросы можно выполнить в поиске Threads. Ожидаемый результат: вы знаете, какую версию истории видели читатели.
- Сверяйте списания. В каждом ответе есть
billing.charged_usd, а для пустых результатов указываетсяempty_result_refunded. Подробнее: сверка списаний за вызовы API.
Как выбрать поисковый инструмент, читайте в материале Поисковые инструменты для ИИ-агентов. Что открывать ИИ-краулерам, читайте в материале ИИ-краулеры и robots.txt.
Как воспроизвести тест
Запрос (поиск по новостям о пилоте Google):
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer <API Key>" \
  -H 'Content-Type: application/json' \
  -d '{"tool":"news","params":{"q":"Google News AI pilot 400 publications","num":10}}'
Нужные поля ответа:
results[].url,results[].title,results[].snippet: ссылка, заголовок и фрагмент.results[].published: время публикации (новостной инструмент возвращает относительное время, например «1 week ago»).billing.charged,billing.charged_usd: было ли списание за вызов и его сумма в USD.billing.reason:empty_result_refundedдля пустого результата. Зарезервированная сумма возвращается.id: ID запроса для сверки.
Для поиска в X отправьте POST /api/v1/social с телом {"platform":"twitter","action":"search","params":{"keyword":"...","limit":25}}. В ответе есть view_count, like_count, links и posted_at; все поля описаны в каталоге возможностей. Чтобы использовать те же данные в Claude или Cursor, подключите удалённый MCP-сервер. Новые пользователи могут создать API-ключ в разделе Быстрый старт.
Ошибки и списания (всё по данным этого теста):
- Неверные параметры (нет
params, неверное имя поля): HTTP 422 с рабочим примером запроса. Без списания. Мы допустили эту ошибку 12 раз и заплатили $0. - Нет результатов: пустой список с
empty_result_refunded. Без списания. Так было 2 раза. - Обычные результаты: списание по цене из каталога.
Стоимость
По ценам каталога на 24 октября (актуальные цены — на странице тарифов) ежедневный мониторинг 8 событий стоит:
- веб-поиск + поиск по новостям: 8 × 2 = 16 вызовов × $0,000694 = $0,011104
- чтение 8 оригинальных документов: 8 вызовов × $0,000694 = $0,005552
- поиск в X по 2 ключевым словам: 2 вызова × $0,000556 = $0,001112
- итого в день: $0,017768, или около $0,53 за 30 дней. Пустые результаты бесплатны, поэтому реальная стоимость ниже.
Все реальные вызовы для этой статьи: 53 запроса, списано $0,026238.
FAQ
Платит ли теперь Google новостным сайтам? Некоторым. Есть два способа. Пилот News AI платит за предоставленный контент, а не за вклад в ответ, и охватывает более 400 изданий. Пилот AI contribution платит, когда Google признаёт вклад «значительным», и показывает ежемесячную сумму в Search Console. Ни одна из программ не публикует расценки. (Вопрос взят из поста в X: «Google is paying publishers again. Sort of.»)
Показы растут, а клики падают. Виноваты AI Overviews? Одним числом на это не ответить. С июня Google предоставляет некоторым сайтам доступ к отчётам о показах в генеративном ИИ в Search Console (Google Search Central). Сначала сравните собственные показы и клики. Затем привлеките показатель Pew в 1% и сетевые данные Chartbeat, учитывая, что выборки и даты у них разные. (Вопрос взят из заголовка поста в r/SEO_Experts «Is Google's AI Search reducing organic traffic, even when impressions…»)
Вступают ли новые условия Meta в силу 30 октября? Нет. 23 октября Meta сообщила Reuters, что дата перенесена на 20 ноября. В тексте изменилась только дата. Если вас беспокоит краулинг, проверьте robots.txt уже сейчас и прочитайте окончательный текст до 20 ноября. (Вопрос взят из нескольких заголовков в выдаче, например, «Meta Terms … Oct. 30.»)
Источники
Первичные документы:
- Google, «400 publications are now partnering with us on our News AI pilot program», 2026-10-15, https://blog.google/products-and-platforms/products/news/news-ai-pilot-update-publishers/
- Google, «AI Mode and AI Overviews updates to explore the web», 2026-10-15, https://blog.google/products-and-platforms/products/search/updates-ai-mode-overviews-explore-web/
- Google, «New Google web ecosystem tools and partnerships», 2025-12, https://blog.google/products-and-platforms/products/search/tools-partnerships-web-ecosystem/
- Google, «How Google Search helps you find original, quality content», 2026-05, https://blog.google/products-and-platforms/products/search/original-high-quality-content-search/
- Google Public Policy, «Google's ongoing commitment to supporting the information ecosystem», 2026-06, https://publicpolicy.google/article/supporting-information-ecosystem/
- Google Search Central, «AI Features and Your Website», обновлено 2025-12-10, https://developers.google.com/search/docs/appearance/ai-features
- Google Search Central, «Introducing Search Generative AI performance reports in Search Console», 2026-06-03, https://developers.google.com/search/blog/2026/06/gen-ai-performance-reports
- Cloudflare, «Pay Per Use: when AI uses your work, you should get paid», 2026-09-30, https://blog.cloudflare.com/pay-per-use
- Cloudflare, «The Internet has a second audience», 2026-09-30, https://blog.cloudflare.com/agentic-web
- Cloudflare, «Monetization Gateway beta», 2026-09-30, https://blog.cloudflare.com/monetization-gateway-beta
- Cloudflare, «Have it both ways: stay discoverable in search while disallowing AI training», 2026-09-15, https://blog.cloudflare.com/accountable-mixed-use-ai-crawlers/
- Cloudflare, «Introducing pay per crawl», 2025-07, https://blog.cloudflare.com/introducing-pay-per-crawl/
- Cloudflare Radar, «AI Insights», страница с актуальными данными, https://radar.cloudflare.com/ai-insights
- SPUR Coalition, «SPUR Content Telemetry Standard v.1 published», 2026-10-02, https://www.spurcoalition.org/updates/spur-content-telemetry-standard-v1-published
- SPUR Coalition, примечания к релизу «Content Telemetry 1.0», 2026-10-02, https://github.com/SPUR-Coalition/telemetry/releases/tag/v1.0
- SPUR Coalition, «SPUR Telemetry Standard Published for Public Comment», 2026-06, https://www.spurcoalition.org/updates/spur-telemetry-standard-published-for-public-comment-the-spur-coalition
- SPUR Coalition, «The New York Times, Agence France-Presse, The Economist, and The Atlantic join The SPUR Coalition», 2026-10-13, https://www.spurcoalition.org/updates/the-new-york-times-agence-france-presse-the-economist-and-the-atlantic-join-the-spur-coalition
- Окружной суд США по округу Колумбия, мотивированное решение (memorandum opinion), Chegg v. Google и Penske Media v. Google, 2026-09-30, https://fingfx.thomsonreuters.com/gfx/legaldocs/byvraqlwbpe/Chegg%20Penske%20order%20-%20Google%20antitrust%2020260930.pdf
- Окружной суд США по Южному округу Нью-Йорка, исковое заявление, USA Today Co. v. OpenAI (1:26-cv-08892), 2026-10-08, https://fingfx.thomsonreuters.com/gfx/legaldocs/movarymwypa/USA%20TODAY%20OPENAI%20COPYRIGHT%20lawsuit.pdf
- News Media Association, заявление об условиях Meta, 2026-10-16, https://newsmediauk.org/blog/2026/10/16/nma-condemns-arrogant-metas-shameless-landgrab-attempt-to-plunder-news-publisher-websites/
- News/Media Alliance, «Statement on Changes to Meta Commercial Terms of Use», 2026-10-16, https://www.newsmediaalliance.org/changes-to-meta-commercial-terms-of-use/
- European Publishers Council, заявление об условиях Meta, 2026-10-16, https://www.epceurope.eu/post/european-commission-should-be-extremely-concerned-about-meta-s-dilemma-for-european-publishers-hand
- Chartbeat, «The 2026 Publisher Playbook», 2026-09, https://chartbeat.com/resources/general/the-2026-publisher-playbook-9-strategies-to-boost-acquisition-
- UK CMA, «CMA secures fairer deal for publishers and improves Google search services in UK», 2026-06-03, https://www.gov.uk/government/news/cma-secures-fairer-deal-for-publishers-and-improves-google-search-services-in-uk
- UK CMA, «CMA strengthens proposals allowing people choice over their search service», 2026-09-23, https://www.gov.uk/government/news/cma-strengthens-proposals-allowing-people-choice-over-their-search-service
- arXiv 2610.15033, «What Drives AI Citations?», 2026-10-10, https://arxiv.org/abs/2610.15033
- Reuters Institute, «Digital News Report 2026: Emerging uses of AI chatbots for news», 2026-06, https://reutersinstitute.politics.ox.ac.uk/digital-news-report/2026/emerging-uses-ai-chatbots-news-and-what-it-means-journalism
- Reuters Institute, «How many news websites block AI crawlers?», 2024-02-22, https://reutersinstitute.politics.ox.ac.uk/how-many-news-websites-block-ai-crawlers
- Pew Research Center, «Do people click on links in Google AI summaries?», 2025-07-22, https://www.pewresearch.org/short-reads/2025/07/22/google-users-are-less-likely-to-click-on-links-when-an-ai-summary-appears-in-the-results/
- EveryInfra, каталог поисковых инструментов, дата обращения 2026-10-24, https://api.everyinfra.com/api/v1/search/tools
- EveryInfra, каталог возможностей сбора данных, дата обращения 2026-10-24, https://api.everyinfra.com/api/v1/social/catalog
Публикации и аналитика (вторичные источники; в тексте рядом с каждым приведена ссылка на оригинальный документ):
- Reuters, «CNN, Axios and other publishers join Google's AI news program», 2026-10-15, https://www.reuters.com/business/media-telecom/cnn-signs-multi-year-ai-partnership-with-google-2026-10-15/
- Nieman Lab, «Google's News AI pilot expands to over 400 publications», 2026-10-15, https://www.niemanlab.org/2026/10/googles-news-ai-pilot-expands-to-over-400-publications-including-u-s-local-news-outlets/
- Digiday, «Google rolls out pay-per-value AI licensing program to publishers», 2026-09-14, https://digiday.com/media/google-rolls-out-pay-value-ai-licensing-program-to-publishers/
- Digiday, «SPUR publishes AI content tracking standard», 2026-10-02, https://digiday.com/media/spur-publishes-ai-content-tracking-standard-pitches-openai-and-google-to-join-advisory-board/
- Reuters, «Google wins dismissal of Chegg, Penske Media lawsuits over AI overviews», 2026-10-01, https://www.reuters.com/legal/litigation/google-wins-dismissal-chegg-penske-media-lawsuits-over-ai-overviews-2026-10-01/
- Press Gazette, «Penske Google AI Overviews lawsuit dismissed», 2026-10-01, https://pressgazette.co.uk/news/penske-ai-overviews-lawsuit-dismissed-because-no-formal-bargain-struck-with-google/
- Reuters, «USA Today sues OpenAI for copyright infringement over AI training», 2026-10-08, https://www.reuters.com/legal/legalindustry/usa-today-sues-openai-copyright-infringement-over-ai-training-2026-10-08/
- CBC News, «Anthropic sued by major Canadian news publishers», 2026-10-19, https://www.cbc.ca/news/business/anthropic-postmedia-torstar-globe-canadian-press-copyright-lawsuit-9.7387205
- Nieman Lab, «Legal experts warn Meta's new terms still grant broad scraping permissions», 2026-10-17, https://www.niemanlab.org/2026/10/legal-experts-warn-metas-new-terms-still-grant-broad-scraping-permissions-despite-language-changes/
- Nieman Lab, «Meta delays rollout of terms that would allow broad scraping of news sites», 2026-10-23, https://www.niemanlab.org/2026/10/meta-delays-rollout-of-terms-that-would-allow-broad-scraping-of-news-sites-legal-experts-are-still-skeptical/
- Reuters, «Meta to delay new commercial terms criticised by publishers, advertisers», 2026-10-23, https://www.reuters.com/business/media-telecom/meta-delay-new-commercial-terms-criticised-by-publishers-advertisers-2026-10-23/
- Reuters, «Publishers, advertisers call EU, UK antitrust regulators to suspend Meta's new commercial terms», 2026-10-22, https://www.reuters.com/legal/litigation/publishers-advertisers-call-eu-uk-antitrust-regulators-suspend-metas-new-2026-10-22/
- Reuters, «NYT, Economist among publishers joining coalition to curb unpaid AI use», 2026-10-12, https://www.reuters.com/legal/litigation/nyt-economist-among-publishers-joining-coalition-curb-unpaid-ai-use-2026-10-12/
- Search Engine Journal, «Google Search Decline Steepened To 40% YoY For Publishers», 2026-09-24, https://www.searchenginejournal.com/google-search-decline-publishers-chartbeat/590681/
- Reuters Institute, «Life after SEO: How newsrooms are adapting to the AI search shift», 2026-10, https://reutersinstitute.politics.ox.ac.uk/news/life-after-seo-how-newsrooms-are-adapting-ai-search-shift
Читайте также
- EverySearch API: веб-поиск с источниками, которые можно проверить
- API для парсинга X (Twitter), API поиска Twitter (X); API для парсинга Reddit, поиск Reddit
- ИИ-краулеры и robots.txt: поиск, обучение, визиты пользователей
- Поисковые инструменты для ИИ-агентов: от поиска источников до проверенных ответов
- Мониторинг репутации на нескольких платформах по данным комментариев
- Как живой каталог возможностей помогает документации API не отставать от реальности
Справка BL-32