API Muse Wonder per la due diligence sui creator: test con dati reali e stima dei costi
Crea un agente che verifica i creator di TikTok e YouTube con l'API Muse Wonder di Meta: JSON dei tool, un ciclo completo con dati reali e il costo di una lista di 10 creator.
Il 4 novembre 2026, dalle 11:18 alle 11:42 ET (dalle 00:18 alle 00:42 SGT del 5 novembre), abbiamo verificato tre account di brand: NASA, National Geographic e Notion. Abbiamo usato gli endpoint TikTok e YouTube di EveryInfra e inviato 36 richieste. Trenta richieste sono state addebitate, per un totale di $0,01668. Il dato più utile ci ha sorpreso. National Geographic ha 9,7 milioni di follower su TikTok, ma il suo video mediano ottiene 22.600 visualizzazioni, una copertura dello 0,23%. È il valore più basso tra le sei coppie account-piattaforma che abbiamo controllato.
Lo stesso account continua comunque a registrare un forte coinvolgimento tra chi guarda i video. Il rapporto mediano tra (like + commenti + condivisioni) e le visualizzazioni è dell'8,15%, vicino all'8,97% di NASA, che ha una copertura del 13,25%. National Geographic ha pubblicato 50 TikTok in 30 giorni, quindi ogni video raggiunge una quota più piccola dei suoi follower. Un agente che guarda solo la copertura segnalerebbe come «gonfiato» un account sano. Questo articolo parla proprio di errori di questo tipo.
La domanda a cui risponde questo articolo
Un team di brand o un'agenzia ha una lista di creator. Prima di firmare un contratto, vuole una valutazione preliminare con l'AI che risponda a quattro domande per ogni nome. I follower sono reali? Gli spettatori reagiscono? Il creator ha pubblicato negli ultimi 30 giorni? Di cosa si parla nei commenti? Questa guida costruisce quell'agente con il nuovo modello Muse Wonder di Meta e gli endpoint per i dati di EveryInfra: tiktok/profile, tiktok/user_videos, youtube/profile, youtube/user_posts e due endpoint per i commenti.
Su questa macchina non abbiamo una chiave Meta. La parte Meta (JSON dei tool, loop dell'agente e schema del report) è quindi una configurazione d'esempio. Ogni prezzo, parametro e regola di quella parte rimanda a una pagina di Meta, con la data in cui l'abbiamo consultata. La parte relativa a EveryInfra è stata eseguita dal vivo. Ogni numero nelle tabelle qui sotto proviene dalle risposte grezze di quell'esecuzione, e puoi ricalcolarlo. Quando un numero è una stima, lo diciamo ed elenchiamo i dati di partenza.
Partiamo dal risultato. La tabella applica le nostre quattro regole a tre account su due piattaforme. La sezione sulle regole delle metriche spiega ogni formula, mentre quella sui risultati reali mostra da dove viene ogni numero.
| Account e piattaforma | Follower o iscritti | Copertura (visualizzazioni mediane / follower) | Coinvolgimento mediano per visualizzazione | Post negli ultimi 30 giorni | Composizione dei commenti (basata su regole) |
|---|---|---|---|---|---|
| NASA, TikTok | 2,200,000 | 13.25% | 8.97% | 9, intervallo massimo 6,0 giorni | 16 su 50 sono domande |
| NASA, YouTube | 15,100,000 | 1,80% (ultimi 10) | 1,41% (4 video) | 2 certi | Non recuperati (2 errori, non addebitati) |
| National Geographic, TikTok | 9,700,000 | 0.23% | 8.15% | 50, intervallo massimo 3,1 giorni | 31 pertinenti, 15 di 3 parole o meno |
| National Geographic, YouTube | 26,600,000 | 0.75% | 0,61% (4 video) | 21 certi, 1 incerto | 44 su 50 pertinenti |
| Notion, TikTok | 143,700 | 9,05% (ultimi 15) | 1.48% | 0, il più recente risale a 161,7 giorni fa | 31 pertinenti, 2 solo emoji |
| Notion, YouTube | 350,000 | 0.91% | 0,60% (4 video) | 7 certi, 1 incerto | Solo 2 commenti, nessun giudizio |
Nessuno di questi tre account di brand verificati sembra sospetto. Eppure ognuno ha una metrica che trarrebbe in inganno una regola semplice. L'account TikTok di NASA mostra un created_at del 20 luglio 2026 e ha 2,2 milioni di follower. Una regola sulla crescita potrebbe giudicarla troppo rapida, ma NASA ha la copertura più alta di tutte e sei le coppie.
La copertura del 9,05% di Notion su TikTok sembra ottima, ma il suo video più recente è del 26 maggio 2026. Con una regola a 30 giorni, il TikTok di Notion risulta inattivo. La soluzione è la stessa in ogni caso: prima metti per iscritto la regola, poi lascia che il modello legga i numeri.
Cos'è l'API Muse Wonder: 10 fatti dalle pagine di Meta
Meta ha annunciato Muse Wonder e Muse Wonder Full il 12 ottobre 2026. Secondo Meta, Muse Wonder era disponibile quel giorno stesso tramite Meta Model API e Muse Code (Meta Newsroom, 12 ottobre 2026). Il blog di ricerca dello stesso giorno lo definisce un modello di frontiera per agenti personali e professionali. Mette in evidenza Active Memory e Active Focus, il nome che Meta dà alla capacità di restare sul compito e di riprendersi dagli errori (blog di ricerca di Meta). La pagina del prodotto descrive attività di diverse ore in cui il modello pianifica, affida parti del lavoro a sotto-agenti e chiama tool in parallelo (pagina del prodotto Muse Wonder).
I testi di prodotto sono una cosa. A uno sviluppatore servono i parametri che la documentazione fissa davvero. Il 5 novembre 2026 abbiamo letto la documentazione di dev.meta.ai, il centro assistenza e le pagine legali. La tabella qui sotto riporta solo i fatti che Meta mette per iscritto.
| Dato | Cosa dice la pagina di Meta | Fonte (consultata il 5 novembre 2026) |
|---|---|---|
| ID del modello | muse-wonder-1.0. La home della documentazione dice «Muse Wonder is in preview» | «Overview» |
| Contesto | 1.048.576 token. L'input può essere testo, immagine, video, audio o PDF | «Models» |
| Ragionamento | reasoning.effort va da minimal a max. max non ti fa passare a Wonder Full | «Models» |
| Wonder Full | Solo negli abbonamenti Muse Code, con i piani Power Usage e Maximum Usage | «Models» |
| Formati dell'API | Responses, Chat Completions e Anthropic Messages, con lo stesso prezzo e la stessa autenticazione | «Overview» |
| Tool calling | Le funzioni le definisci ed esegui tu. tool_choice supporta solo auto. Il nome di una funzione può contenere al massimo un punto | «Tool calling» |
| Attività lunghe | Con background: true, i job vengono eseguiti in modo asincrono, fino a 600 nuovi job per team al minuto. Le chiamate lunghe senza streaming possono restituire 504 | «Responses API» |
| Limiti di frequenza delle richieste | 3.000 richieste e 4 milioni di token al minuto per muse-wonder-1.0, per team, non per chiave | «Pricing and rate limits» |
| Aree geografiche | Cina, Hong Kong e Macao sono soggette a restrizioni. Muse Wonder non è disponibile nemmeno in Corea del Sud | «Geographic Use Policy» |
| Uso per l'addestramento | La modalità Standard non usa i tuoi contenuti per l'addestramento. Wonder non offre la modalità Contributor con il piano pay-as-you-go | «Models» |
Due righe determinano la progettazione di un agente di verifica. La prima è tool_choice. Le linee guida di Meta dicono che "none", "required" e una funzione indicata per nome restituiscono tutti HTTP 400 (Tool calling guidelines). Non puoi obbligare il modello a chiamare un tool in un dato turno. Il tuo loop deve gestire due esiti a ogni turno: una chiamata a un tool oppure testo semplice. Il tuo codice dovrebbe anche verificare che ogni creator abbia tutti e quattro i dati e inviare un altro turno quando ne manca uno.
La seconda riga riguarda le aree geografiche. La policy di Meta limita l'uso in Cina, Hong Kong e Macao. Vieta anche di offrire un prodotto integrato agli utenti di quelle aree o di aggirare il blocco (Geographic Use Policy, sezioni 2.1 e 3). La maggior parte dei team statunitensi non avrà questo problema. Un'agenzia statunitense con personale o clienti a Hong Kong dovrebbe verificarlo prima di scegliere questo modello.
Chiave API di Muse Wonder: quattro passaggi e tre trappole
Il centro assistenza AI Developer di Meta spiega come ottenere una chiave in quattro passaggi. Non abbiamo creato un account Meta, quindi la tabella segue il testo del centro assistenza, non una registrazione dello schermo.
| Passaggio | Cosa dice il centro assistenza | Fonte |
|---|---|---|
| 1. Registrati | Fai clic su «Start building» sul sito di Model API. Scegli Individual, poi accedi con email, telefono, Facebook, Google o GitHub. Devi avere almeno 18 anni e trovarti in un'area supportata | «How do I sign up» |
| 2. Configura la fatturazione | Un amministratore aggiunge un metodo di pagamento nella pagina Billing, insieme a un nome legale e a un indirizzo | «Set up billing» |
| 3. Crea la chiave | Nella pagina API keys, fai clic su «Create API key», assegnale un nome e copiala. La chiave appartiene al team | «Create an API key» |
| 4. Imposta una variabile d'ambiente | Usa export MODEL_API_KEY="..." e leggila nel codice. Non inserirla nel codice front-end e non farne il commit | «Quickstart» |
La prima trappola è che la spesa non ha un limite vincolante. Il centro assistenza dice che Meta Model API non offre un limite di spesa che blocchi l'utilizzo. Puoi solo impostare un'email di avviso mensile, e l'utilizzo oltre quella soglia lo paghi comunque (Spend limit alert). Un agente chiama i tool in un loop, quindi un bug può tenerlo in esecuzione tutta la notte. Per questo il nostro codice del loop qui sotto imposta un proprio limite di turni e un budget di token.
La seconda trappola riguarda i tempi di addebito e i rimborsi. Meta addebita l'importo sulla tua carta quando l'utilizzo raggiunge una soglia di pagamento, e addebita il resto il primo di ogni mese (How am I billed). Il centro assistenza dice anche che Model API non concede rimborsi (Refunds). Fai un test con due creator prima di eseguire una lista completa.
La terza trappola è quella che conta di più per le agenzie. Le chiavi appartengono a un team, e il centro assistenza dice che condividere una chiave fuori dal tuo team viola i termini (Can I share my API key). Anche la sezione 10.1 dei Termini di servizio di Model API vieta la rivendita del servizio a terzi senza autorizzazione scritta di Meta. Il divieto include le chiavi e l'accesso al modello (Terms of Service, aggiornati il 9 ottobre 2026). Se verifichi creator per diversi brand tuoi clienti, tieni la chiave all'interno del tuo team. Ai clienti dai i report, non le chiavi.
Lato EveryInfra, registrati tramite la guida rapida e crea una chiave nella console. Tieni anche questa in una variabile d'ambiente. Le due chiavi hanno compiti diversi. La chiave Meta chiama il modello, mentre la chiave EveryInfra recupera i dati. Il codice dei tool gira sul tuo server, quindi il modello non vede mai nessuna delle due chiavi.
Prezzi dell'API Meta Muse Wonder: $4 e $20, più altri tre prezzi
La pagina dei prezzi di Meta indica tre cifre per Muse Wonder, per milione di token: $4,00 per l'input, $0,20 per l'input in cache e $20,00 per l'output. La colonna della modalità Contributor riporta «Not available» (Pricing and rate limits). Il post di lancio di Meta for Developers del 12 ottobre 2026 riporta la stessa cifra, «$4/$20 per million tokens» (post di Meta for Developers).
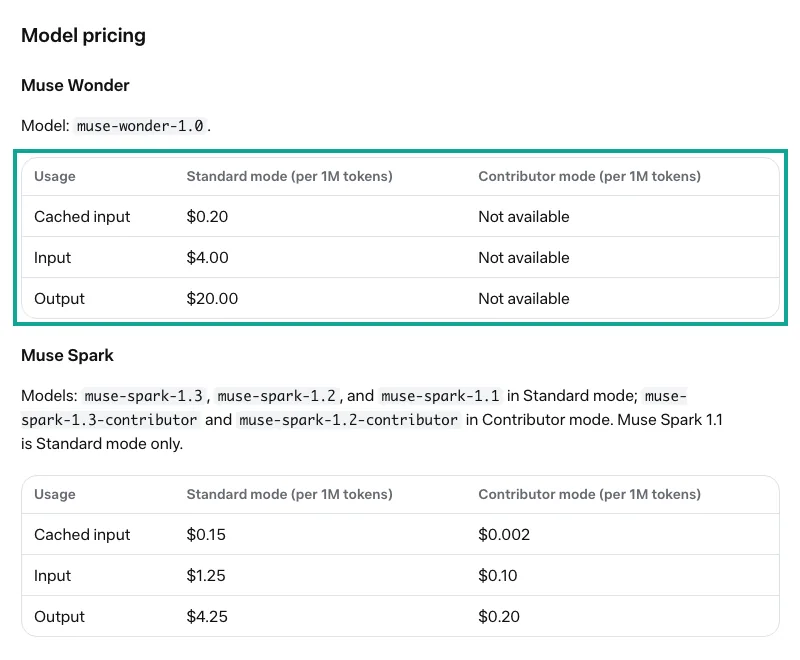
Un agente di verifica può imbattersi in altri tre prezzi. Il primo è la ricerca web. Il tool integrato web_search costa $2,50 in più ogni 1.000 ricerche. Cerca nelle pagine web e non può restituire dati per singolo video, quindi lo lasciamo disattivato (Search grounding).
Il secondo è Muse Spark. Il modello muse-spark-1.3 costa $1,25 per l'input e $4,25 per l'output, per milione di token. La sua versione Contributor costa $0,10 e $0,20, ma la modalità Contributor usa i tuoi contenuti per addestrare i modelli di Meta. La sezione 6.2 dei termini vieta inoltre di inviare informazioni sensibili, riservate o personali ai servizi Contributor (Terms of Service, sezione 6). Il nostro input include testi di commenti scritti da utenti comuni, quindi usiamo solo la modalità Standard.
Il terzo è la cache. Meta mette automaticamente in cache i prefissi identici dei prompt, e i token in cache costano $0,20 per milione (Prompt caching). Metti per primi il system prompt e le definizioni dei tool e cambia solo la lista dei creator alla fine. In un batch di 10 creator, la maggior parte del prefisso fisso viene così servita dalla cache.
| Voce | Muse Wonder | Muse Spark 1.3 | Muse Spark 1.3 Contributor |
|---|---|---|---|
| Input (per milione di token) | $4.00 | $1.25 | $0.10 |
| Input in cache | $0.20 | $0.15 | $0.002 |
| Output | $20.00 | $4.25 | $0.20 |
| Addestra sui tuoi contenuti | No (Standard) | No (Standard) | Sì |
| Richieste e token al minuto, per team | 3.000 e 4 milioni | 3.000 e 4 milioni | 150 e 3 milioni |
| Ruolo adatto in un agente di verifica | Loop principale: leggere, confrontare, scrivere il report | Attività secondarie come l'etichettatura dei commenti | Non adatto ad attività con testo dei commenti |
I limiti di frequenza delle richieste vengono dalla stessa pagina. Meta calcola i limiti per team, quindi tutte le chiavi di un team condividono un unico budget, e ogni modello ha il proprio (Rate limits). Una lista di 10 creator non si avvicina nemmeno a 3.000 richieste al minuto. Il vero limite di velocità sta dal lato dei dati. La nostra chiave di test consente 10 richieste al minuto, e la sezione dei risultati reali mostra l'effetto sul tempo totale di esecuzione.
Perché solo TikTok e YouTube: ambito e termini d'uso di Muse
I brand lavorano di solito con due tipi di creator: creator di video brevi e creator di video lunghi. Questa guida usa una piattaforma per ciascun tipo: TikTok per i video brevi e YouTube per quelli lunghi.
I dati delle due piattaforme sono molto diversi. Il feed di TikTok mostra i video anche a chi non segue l'account, quindi le visualizzazioni possono superare un decimo dei follower. Un grande canale YouTube conserva molti iscritti degli anni passati, quindi di solito la sua copertura è bassa. Insieme, le due piattaforme illustrano un punto su cui questa guida torna più volte: confronta le metriche solo all'interno della stessa piattaforma. Le altre piattaforme sono fuori ambito. Puoi usare le stesse quattro regole e lo stesso schema di tool, ma prima verifica i campi su ciascun endpoint.
Anche sul lato del modello vigono regole per i dati che gli invii. Questa sezione cita solo le pagine legali di Muse (dev.meta.ai/legal). Non è una consulenza legale. Leggi tu stesso i termini e verifica la legge locale e i tuoi accordi con ciascuna piattaforma di dati.
In base alla sezione 4.1 dei Termini di servizio di Meta Model API (aggiornati il 9 ottobre 2026), sei responsabile dei dati che fornisci al servizio, compresa la loro accuratezza e validità. Il punto (vii) della sezione 10.1 vieta di usare il servizio per violare in qualsiasi modo i diritti di terzi. La sezione 10.3 stabilisce che Meta può monitorare il tuo utilizzo tramite revisione automatica o umana (Terms of Service). La pagina Data Commitments dice che Meta non usa i contenuti dei servizi Standard per addestrare i suoi modelli. Meta può comunque elaborare quei contenuti per individuare e gestire le violazioni della policy d'uso o dei termini (Data Commitments).
| Regola | Ambito | Testo chiave (parafrasato) | Effetto su un agente di verifica |
|---|---|---|---|
| Termini di Model API, 4.1 | Dati che invii | Sei responsabile dell'accuratezza e della validità dei dati | Ogni numero deve essere riconducibile a una risposta grezza |
| Termini di Model API, 10.1 (vii) e 10.3 | Come usi il servizio | Nessun uso che violi i diritti di terzi. Meta può monitorare l'utilizzo | Leggi prima i termini. Verifica le fonti dei dati e lo scopo |
| Data Commitments | Contenuti nei servizi Standard | Non usati per l'addestramento. Possono essere elaborati per gestire le violazioni | Invia il testo dei commenti solo in modalità Standard |
| Model API Acceptable Use Policy | Output e scopo | Nessuna deduzione di tratti personali sensibili. Nessuna valutazione delle persone in base al comportamento sociale se può causare loro danni | Valuta i dati di business dell'account, mai la persona |
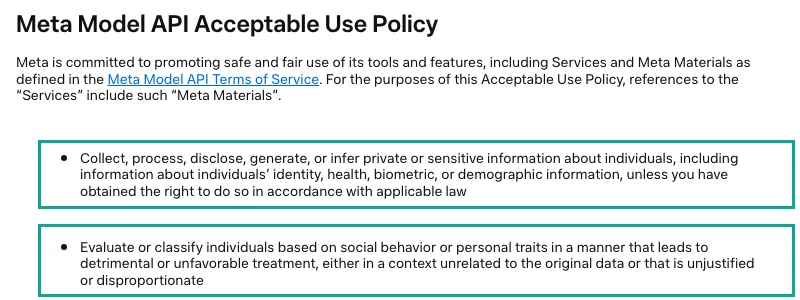
L'ultima riga è facile da trascurare. La Meta Model API Acceptable Use Policy (aggiornata il 12 ottobre 2026) contiene due punti che si applicano direttamente alla valutazione dei creator. Il primo vieta di raccogliere, elaborare, divulgare, generare o dedurre informazioni private o sensibili sulle persone senza averne il diritto legale, per esempio dati identificativi, sanitari, biometrici o demografici. Il secondo vieta di valutare o classificare le persone in base al comportamento sociale o ai tratti personali in due casi: quando ciò porta a un trattamento pregiudizievole e quando l'uso avviene fuori contesto (Acceptable Use Policy).
La verifica dei creator è un passaggio normale prima di un accordo a pagamento. Un brand considera l'account come un canale media. Le visualizzazioni sono stabili? Il coinvolgimento è in linea con il numero di follower? Il creator pubblica con regolarità? I commenti parlano dei contenuti? Si tratta di metriche di business relative all'account.
Le domande rischiose sono altre. Una è chiedere al modello di indovinare età, etnia, salute o orientamento politico di un creator. Un'altra è usare i commenti di utenti comuni per etichettare una persona.
Il nostro codice dei tool fa due cose per rispettare questi limiti. Invia al modello solo il testo del commento, il numero di like, il numero di risposte e l'orario, senza lo username di chi ha commentato. Il system prompt dice inoltre al modello di giudicare solo le prestazioni dei contenuti e di non dedurre tratti personali. Questo rende il report più credibile, perché afferma solo ciò che i dati possono dimostrare.
Le quattro metriche: prima fissa le regole, poi lascia che il modello legga i numeri
Il problema peggiore in un report di verifica è una parola che significa cose diverse per persone diverse. Alcuni dividono il coinvolgimento per i follower, altri per le visualizzazioni. Alcuni giudicano i «follower reali» dai commenti, altri usano i like per follower. Se cambi la formula, il giudizio può ribaltarsi. Per questo inseriamo le quattro formule nel system prompt prima di recuperare qualsiasi dato. Il modello legge i numeri, li confronta e scrive il giudizio. Il metodo non lo inventa lui.
| Metrica | Formula in questa guida | Campi usati | Cosa può e non può mostrare |
|---|---|---|---|
| Autenticità dei follower (indicatore indiretto) | Copertura = visualizzazioni mediane dei video non fissati in alto pubblicati da 3 a 30 giorni fa, divise per i follower. Inoltre rapporto tra media e mediana e quota del video migliore | follower_count, view_count, posted_at, is_pinned | Mostra quanti follower guardano ancora. Non può dimostrare che un singolo follower sia falso |
| Tasso di coinvolgimento | Per ogni video, (like + commenti + condivisioni) / visualizzazioni, poi la mediana. TikTok usa lo stesso campione della copertura (video non fissati in alto pubblicati da 3 a 30 giorni fa). YouTube usa (like + commenti) / visualizzazioni | like_count, comment_count, share_count, view_count | Mostra se gli spettatori reagiscono. Non distingue le persone reali dal coinvolgimento a pagamento |
| Frequenza di pubblicazione negli ultimi 30 giorni | Video non fissati in alto in 30 giorni, intervallo massimo, intervallo mediano, giorni trascorsi dal video più recente | posted_at | Mostra se l'account è attivo. Non dice nulla sulla qualità |
| Composizione dei commenti | Ogni commento riceve una di cinque etichette basate su regole: pertinente (4+ parole), domanda, 3 parole o meno, solo emoji, nessun testo. Vengono contati anche i duplicati esatti | text, is_reply | Mostra se i commenti rispondono al video. Non dice nulla su chi li ha scritti |
Perché usare la copertura invece di una «percentuale di follower falsi»? I dati pubblici non possono dirti se un dato follower è una persona, e un'attività di verifica non dovrebbe accedere all'elenco dei follower. Quello che puoi misurare è il divario tra i follower e le visualizzazioni attuali. La copertura ha senso solo se confronti account di dimensioni simili sulla stessa piattaforma, quindi questa guida non fissa una soglia minima.
Tutte le metriche usano le mediane, perché pochi video di successo possono alzare la media. TechBullion ha riportato un piccolo studio su 675 video di 52 creator TikTok. Per il 73% di quei creator, le visualizzazioni medie erano almeno 1,5 volte la mediana (TechBullion, ottobre 2026). È una fonte secondaria basata su un campione ridotto. La usiamo solo per mostrare che la media può trarre in inganno, non come scala di riferimento.
Dividiamo il coinvolgimento per le visualizzazioni, non per i follower, perché il calcolo basato sui follower incorpora anche la copertura. Un account con molti follower e una copertura bassa sembra debole per follower e può sembrare normale per visualizzazione. Le due versioni rispondono a due domande diverse. Una chiede se i follower ci sono ancora. L'altra chiede se agli spettatori interessa. Le riportiamo entrambe, separatamente.
YouTube richiede due precisazioni. I conteggi pubblici delle condivisioni non sono disponibili, quindi il coinvolgimento su YouTube usa solo like e commenti. YouTube ha inoltre cambiato il conteggio pubblico delle visualizzazioni il 27 agosto 2026. Ora una visualizzazione conta dal primo fotogramma di riproduzione, mentre la monetizzazione e la maggior parte delle analisi usano ancora le visualizzazioni coinvolte (engaged views) (YouTube Data API revision history; YouTube Help). Non confrontare direttamente le visualizzazioni precedenti e successive a quella data.
Definizioni dei tool: il JSON di cinque tool
Il centro assistenza di Meta dice che Model API supporta il tool calling, quindi il modello può chiamare tool esterni e fonti di dati che definisci tu (Can the models call tools?).
Il formato è molto simile a quello di OpenAI. Meta consiglia la Responses API, con i campi della funzione piatti al primo livello di ogni tool: type, name, description, parameters e un strict facoltativo (Tool calling). strict vale false per impostazione predefinita, e in quel caso lo schema viene accettato così com'è. Con true, il server verifica lo schema rispetto a un sottoinsieme più restrittivo. Ogni proprietà deve comparire in required e l'oggetto deve avere "additionalProperties": false, altrimenti la chiamata restituisce HTTP 400 (Strict tool schemas). Tutti e cinque i nostri tool usano strict: true, perché hanno pochi parametri e così gli errori di schema emergono prima del lancio.
La vera questione di design è come suddividere i tool. L'opzione più semplice è un unico tool generico con platform, action e params, come everyinfra_call_api nel server MCP di EveryInfra. Il modello può così chiamare qualsiasi endpoint, ma deve costruire i parametri ogni volta, e ogni errore costa un turno. Un'attività di verifica ha passaggi fissi, quindi usiamo cinque tool specifici, uno per endpoint. Ogni descrizione segnala una trappola, per esempio «i video fissati in alto vengono per primi, scartali prima di calcolare le mediane».
I nomi delle funzioni usano underscore, non punti. Meta consente al massimo un punto nel nome di una funzione, e un nome con due punti restituisce 400. I nomi in stile MCP composti da più parti devono invece usare un tool namespace (Function name rules). Con cinque tool non serve la tool search di Meta. Quella funzionalità è pensata per agenti con centinaia di tool. Trattiene gli schemi dei parametri finché il modello non ne ha bisogno, così si risparmiano token di input e il prefisso in cache resta intatto (Tool search).
[
  {
    "type": "function",
    "name": "tiktok_videos",
    "description": "List the newest public videos of one TikTok account with views, likes, comments, shares, saves, posted_at, is_pinned and is_ad. Calls EveryInfra tiktok/user_videos. Pinned videos come first; drop them before you compute medians.",
    "strict": true,
    "parameters": {
      "type": "object",
      "properties": {
        "username": { "type": "string", "description": "TikTok handle without @" },
        "limit": { "type": "integer", "description": "1 to 50. Use 50 for a 30-day window." }
      },
      "required": ["username", "limit"],
      "additionalProperties": false
    }
  },
  {
    "type": "function",
    "name": "video_comments",
    "description": "Read public comments of one video. Returns comment text, like and reply counts and time only, never the commenter's name. Calls EveryInfra tiktok/comments or youtube/comments.",
    "strict": true,
    "parameters": {
      "type": "object",
      "properties": {
        "platform": { "type": "string", "enum": ["tiktok", "youtube"] },
        "video_url": { "type": "string", "description": "Full URL of one video" },
        "limit": { "type": "integer", "description": "1 to 50" }
      },
      "required": ["platform", "video_url", "limit"],
      "additionalProperties": false
    }
  }
]
Il blocco mostra due dei cinque tool. Gli altri tre sono tiktok_profile per tiktok/profile, youtube_channel per youtube/profile e youtube_videos per youtube/user_posts. Abbiamo verificato ciascuno rispetto ai response_fields nel catalogo di quel giorno. L'ultima colonna elenca il sottoinsieme che il nostro codice dei tool restituisce al modello, non la risposta completa. Un video TikTok grezzo ha 34 campi, tra cui immagine di copertina, musica e bio dell'autore. A un'attività di verifica non servono e costano token, quindi il codice li scarta.
| Strumento | Endpoint | Prezzo di listino per chiamata | Campi restituiti al modello |
|---|---|---|---|
tiktok_profile | tiktok/profile | $0.000556 | username, display_name, follower_count, following_count, like_count, video_count, is_verified, created_at |
tiktok_videos | tiktok/user_videos | $0.000556 | id, url, posted_at, view_count, like_count, comment_count, share_count, collect_count, is_pinned, is_ad, duration_sec |
youtube_channel | youtube/profile | $0.000556 | name, url, subscriber_count, video_count, view_count, is_verified, created_at |
youtube_videos | youtube/user_posts | $0.000556 | id, url, title, posted_at, view_count, like_count, comment_count, duration, is_paid_partnership |
video_comments | tiktok/comments o youtube/comments | $0.000556 | text (troncato a 200 caratteri), like_count, reply_count, is_reply, posted_at |
Il loop dell'agente: lo schema di Meta più tre modifiche
La documentazione di Meta sul tool calling mostra un loop minimo. Invii una richiesta con tools e cerchi gli elementi function_call in output. Esegui ciascuno di essi e rimandi un function_call_output con previous_response_id, mentre il server conserva la cronologia (Tool calling). Abbiamo mantenuto questo schema e apportato tre modifiche. Il codice qui sotto è un esempio di configurazione: la parte Meta non l'abbiamo eseguita.
# Example setup: Muse Wonder (Responses API) + EveryInfra tools. The Meta side was not run here.
import json, os
from openai import OpenAI
from ei_tools import run  # tool layer: calls EveryInfra, trims the response

meta = OpenAI(base_url="https://api.meta.ai/v1", api_key=os.environ["MODEL_API_KEY"])
TOOLS = json.load(open("tools.json"))
SYSTEM = open("system_prompt.txt").read()   # fixed prefix first, so it hits the cache
MAX_TURNS, MAX_TOKENS = 40, 400_000          # Meta has no hard spend cap; set your own

def due_diligence(creators: list[dict]) -> str:
    resp = meta.responses.create(model="muse-wonder-1.0", reasoning={"effort": "medium"},
                                 instructions=SYSTEM, tools=TOOLS, input=json.dumps(creators))
    used = resp.usage.total_tokens
    for _ in range(MAX_TURNS):
        calls = [i for i in resp.output if i.type == "function_call"]
        if not calls:                     # tool_choice is auto only: the model may just answer
            return resp.output_text
        outputs = []
        for c in calls:                   # one turn can hold several parallel calls
            body, code, raw, secs, out = run(c.name, json.loads(c.arguments))
            outputs.append({"type": "function_call_output", "call_id": c.call_id,
                            "output": json.dumps(out, ensure_ascii=False)})
        resp = meta.responses.create(model="muse-wonder-1.0", previous_response_id=resp.id,
                                     tools=TOOLS, input=outputs)
        used += resp.usage.total_tokens
        if used > MAX_TOKENS:
            raise RuntimeError(f"token budget exceeded: {used}")
    raise RuntimeError("too many turns")
La prima modifica gestisce più chiamate per turno. Le linee guida di Meta dicono che il modello può restituire più di una tool call in un turno e che devi rispondere a ciascuna. parallel_tool_calls è true per impostazione predefinita (Guidelines). Dieci creator con cinque chiamate ciascuno possono generare una dozzina di chiamate in contemporanea. Il tuo livello dei tool deve metterle in coda, perché la nostra chiave API di test EveryInfra consente 10 richieste al minuto.
La seconda modifica aggiunge limiti tuoi. max_tool_calls limita solo i tool integrati come web_search, quindi non può fermare le tue funzioni. Meta suggerisce parallel_tool_calls: false o un limite di turni nel loop. Visto che manca anche un tetto di spesa, ti servono sia un limite di turni sia un budget di token.
La terza modifica riduce i risultati prima di rimandarli. Tutto ciò che sta in function_call_output conta come token di input al turno successivo. Il rapporto di riduzione è la variabile più grande nella stima dei costi, quindi ha una sezione dedicata più avanti.
Blocca il formato del report con lo structured output. La documentazione di Meta dice che con json_schema la decodifica stessa segue lo schema, quindi l'output vi corrisponde sempre (Structured output). Nella Responses API lo imposti in text.format, e funziona insieme alle tool call.
Il nostro schema ha una riga per creator. Ogni riga contiene i quattro valori delle metriche, la dimensione del campione dietro ogni valore e un verdetto di una riga. C'è anche un array missing che elenca ogni numero che l'agente non è riuscito a recuperare o che è tornato arrotondato. Con questo array il modello non ha motivo di inventare un numero per riempire un campo.
Job lunghi: usa la modalità background per una lista di 50 creator
Una lista di 10 creator si completa in pochi minuti, e le richieste normali vanno bene. Per 50 creator, o per più pagine di video per creator, usa lo schema di Meta per i job lunghi. La documentazione della Responses API indica tre limiti (Responses API). Una richiesta non in streaming ha un limite di tempo lato server e restituisce 504 se dura troppo.
Con background: true la chiamata restituisce subito status: "queued", e puoi interrogarne lo stato tramite ID, ricevere il risultato in streaming o annullarla. Il corpo di una richiesta in background può essere al massimo di 1 MiB, e uno più grande restituisce 413. La pagina dei prezzi aggiunge che ogni team può creare fino a 600 job in background al minuto (Background responses).
Il limite di 1 MiB è un vincolo concreto per questo lavoro. Nella nostra esecuzione live, la risposta grezza per 50 video TikTok di un account era di circa 114-116 KB. Se metti il JSON grezzo di dieci account in un'unica richiesta in background, superi il limite. Se il livello dei tool riduce prima i dati, il problema sparisce.
EveryInfra ha una propria modalità asincrona. Aggiungi "mode": "async" a qualsiasi corpo della richiesta e la risposta restituisce subito un job_id. Poi leggi il risultato con GET /api/v1/jobs/{job_id}. Il budget sincrono è di 85 secondi, e la colonna async_mode del catalogo riporta il valore attuale. La soluzione più sicura usa l'asincrono su entrambi i lati. Il modello invia le chiamate, e il tuo codice le mette in coda e recupera i dati al ritmo consentito. Il codice rimanda i risultati solo quando sono arrivati tutti.
Attenzione a un'altra impostazione. Se il tuo team attiva la zero data retention (ZDR), il centro assistenza di Meta dice che diverse funzionalità vengono rifiutate. Tra queste ci sono le richieste stateful che fanno riferimento a una risposta precedente, le richieste in background, il caricamento di file e la ricerca web (articolo di assistenza sulla ZDR). Il nostro loop usa previous_response_id. Con la ZDR attiva devi inviare l'intera conversazione a ogni turno, il che aggiunge molti token.
L'altra strada: Claude Agent SDK su Muse Wonder con il server MCP di EveryInfra
Puoi fare a meno del livello dei tool personalizzato. Meta documenta una seconda strada, in cui il Claude Agent SDK esegue il loop dell'agente e punta al modello di Meta. La pagina sui framework per agenti dice che l'SDK si collega a Model API tramite il formato Anthropic Messages. Imposta ANTHROPIC_BASE_URL su https://api.meta.ai (senza /v1) e inserisci la tua chiave Meta in ANTHROPIC_AUTH_TOKEN. Il loop principale usa muse-wonder-1.0, e i subagent possono passare al più economico muse-spark-1.3. La stessa pagina avverte di dichiarare solo server MCP di cui ti fidi (Agent frameworks).
Con questa configurazione puoi collegare il server MCP remoto di EveryInfra. La specifica MCP dice che i server elencano i tool con tools/list e li eseguono con tools/call (MCP specification: Tools). Il modello vede così tool già pronti come everyinfra_call_api, e non devi scrivere alcun JSON dei tool.
# Example setup: Claude Agent SDK with Muse Wonder as the model and the EveryInfra remote MCP server. Not run here.
import os, anyio
from claude_agent_sdk import query, ClaudeAgentOptions, ResultMessage

options = ClaudeAgentOptions(
    model="muse-wonder-1.0",
    system_prompt=open("system_prompt.txt").read(),
    mcp_servers={"everyinfra": {"type": "http", "url": "https://api.everyinfra.com/mcp",
                                "headers": {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}}},
    allowed_tools=["mcp__everyinfra__everyinfra_call_api", "mcp__everyinfra__everyinfra_get_job"],
    setting_sources=[],
    env={**os.environ,
         "ANTHROPIC_BASE_URL": "https://api.meta.ai",
         "ANTHROPIC_AUTH_TOKEN": os.environ["MODEL_API_KEY"],
         "ANTHROPIC_MODEL": "muse-wonder-1.0",
         "ANTHROPIC_DEFAULT_OPUS_MODEL": "muse-wonder-1.0",
         "ANTHROPIC_DEFAULT_SONNET_MODEL": "muse-spark-1.3",
         "ANTHROPIC_DEFAULT_HAIKU_MODEL": "muse-spark-1.3",
         "CLAUDE_CODE_SUBAGENT_MODEL": "muse-spark-1.3"},
)

async def main():
    async for m in query(prompt="Review these creators: natgeo, nasa, notionhq", options=options):
        if isinstance(m, ResultMessage):
            print(m.result, m.usage)

anyio.run(main)
Il compromesso è semplice. Un JSON dei tool personalizzato ti permette di controllare cosa legge il modello: quali campi, quanto è lungo il testo e se includere i nomi di chi commenta. La strada MCP fa risparmiare codice. Il prezzo è che everyinfra_call_api restituisce la risposta completa, quindi un video TikTok porta nel contesto tutti i suoi 34 campi. Entrano anche i nomi utente di chi commenta. Lo abbiamo misurato in una chiamata MCP live, e i numeri sono nella sezione sul round trip.
allowed_tools elenca solo il tool di recupero e quello dei job, in linea con il consiglio di Meta di dare a un agente solo i tool di cui ha bisogno. Il server MCP di EveryInfra ha anche tool per i ticket di assistenza e i dati dell'account, che a un agente di valutazione non servono.
Un round trip live: il modello chiede, il nostro codice recupera i dati
Il JSON dei tool e il loop qui sopra sono un esempio di configurazione. Questa sezione descrive la metà che abbiamo davvero eseguito. Abbiamo scritto il livello dei tool come file a sé. Riceve gli stessi argomenti function_call che invierebbe Muse Wonder e associa ogni nome di funzione a un endpoint EveryInfra. Poi invia la richiesta, conserva i campi necessari, elimina i nomi di chi commenta e incapsula il risultato in un function_call_output.
Il lato modello invia sempre e solo un nome di funzione e una stringa JSON. Il nostro lato riceve lo stesso input, quindi il recupero e il risultato sono identici a quelli che si avrebbero con Muse Wonder nel loop.
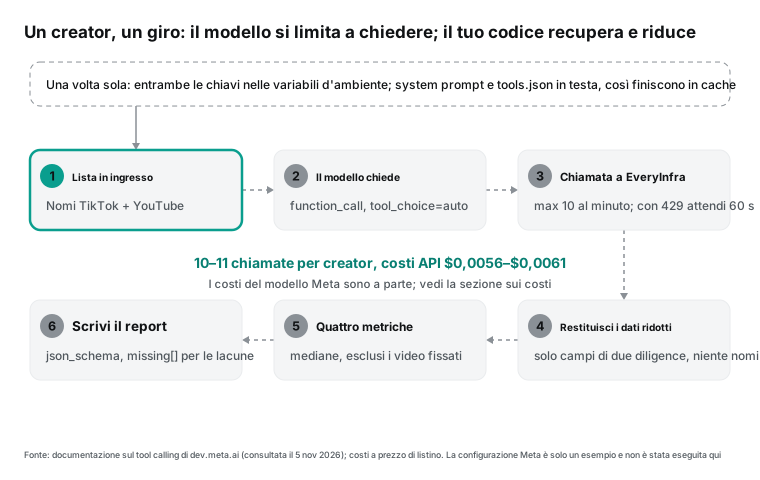
Ecco quattro chiamate per NASA in ordine cronologico. Ogni riga è una richiesta reale. L'ora è quella di invio della richiesta, in SGT, con accanto l'ora della costa est degli Stati Uniti. La durata va dall'invio all'ultimo byte. "Grezzo" è la dimensione del corpo della risposta, e "Al modello" è la dimensione dopo la riduzione operata dal livello dei tool.
| Ora (SGT, 5 novembre) | Ora (ET, 4 novembre) | Tool ed endpoint | Durata | Grezzo | Al modello | Addebitate |
|---|---|---|---|---|---|---|
| 00:18 SGT | 11:18 ET | tiktok_profile, tiktok/profile | 11.35 s | 1,587 B | 287 B | $0.000556 |
| 00:22 SGT | 11:22 ET | tiktok_videos, tiktok/user_videos (50 video) | 35.81 s | 116,106 B | 14,206 B | $0.000556 |
| 00:25 SGT | 11:25 ET | youtube_channel, youtube/profile | 8.96 s | 1,797 B | 299 B | $0.000556 |
| 00:28 SGT | 11:28 ET | video_comments, tiktok/comments (50 commenti) | 58.22 s | 16,761 B | 7,805 B | $0.000556 |
Ecco la richiesta e la risposta della prima chiamata. Abbiamo rimosso un campo lungo, l'URL dell'avatar, e lasciato il resto così com'era. follower_count sembra esatto a 2.200.000, ma è un valore arrotondato, come spiega la sezione dei risultati.
POST https://api.everyinfra.com/api/v1/social
{"platform":"tiktok","action":"profile","params":{"username":"nasa"}}

200 OK, 00:18:46 SGT, 11.35 s, billed $0.000556
{"user_id":"7664638705177150477","username":"nasa","display_name":"NASA",
 "bio":"Making the seemingly impossible, possible.✨","url":"https://www.tiktok.com/@nasa",
 "follower_count":2200000,"following_count":23,"like_count":11500000,"video_count":62,
 "friend_count":17,"is_verified":true,"is_private":false,
 "created_at":"2026-07-20T15:55:49+00:00","platform":"tiktok"}
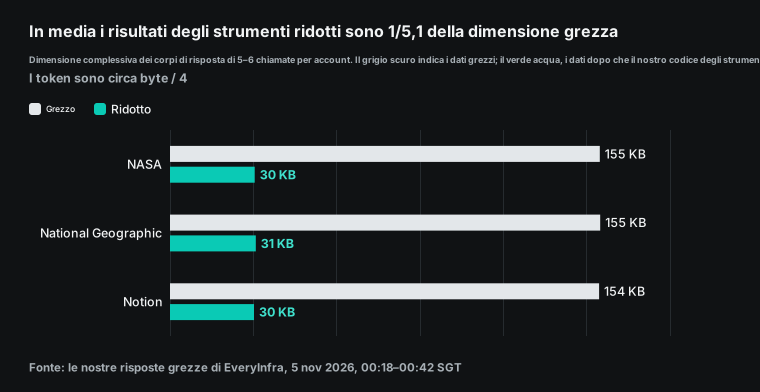
La copia per il modello conserva 8 campi e occupa 287 byte. Ridurre un profilo fa risparmiare poco. Il grosso del risparmio è nella lista dei video. Cinquanta video TikTok grezzi occupano 116.106 byte, con 34 campi ciascuno, tra cui copertine, musica, dati dell'autore e diversi URL. Il lavoro di valutazione ne richiede 11, quindi la copia ridotta occupa 14.206 byte, circa un ottavo della dimensione grezza.
L'immagine qui sotto mette a confronto le due metà del round trip dei commenti. Il blocco in alto è la chiamata che il modello invierebbe, con argomenti presi dall'esecuzione live. Il blocco in basso mostra i primi due dei 50 commenti a un video TikTok di National Geographic, esattamente come li ha restituiti il nostro livello dei tool. Abbiamo accorciato il testo dei commenti per l'immagine, e il codice dei tool aveva già rimosso i nomi di chi commenta.
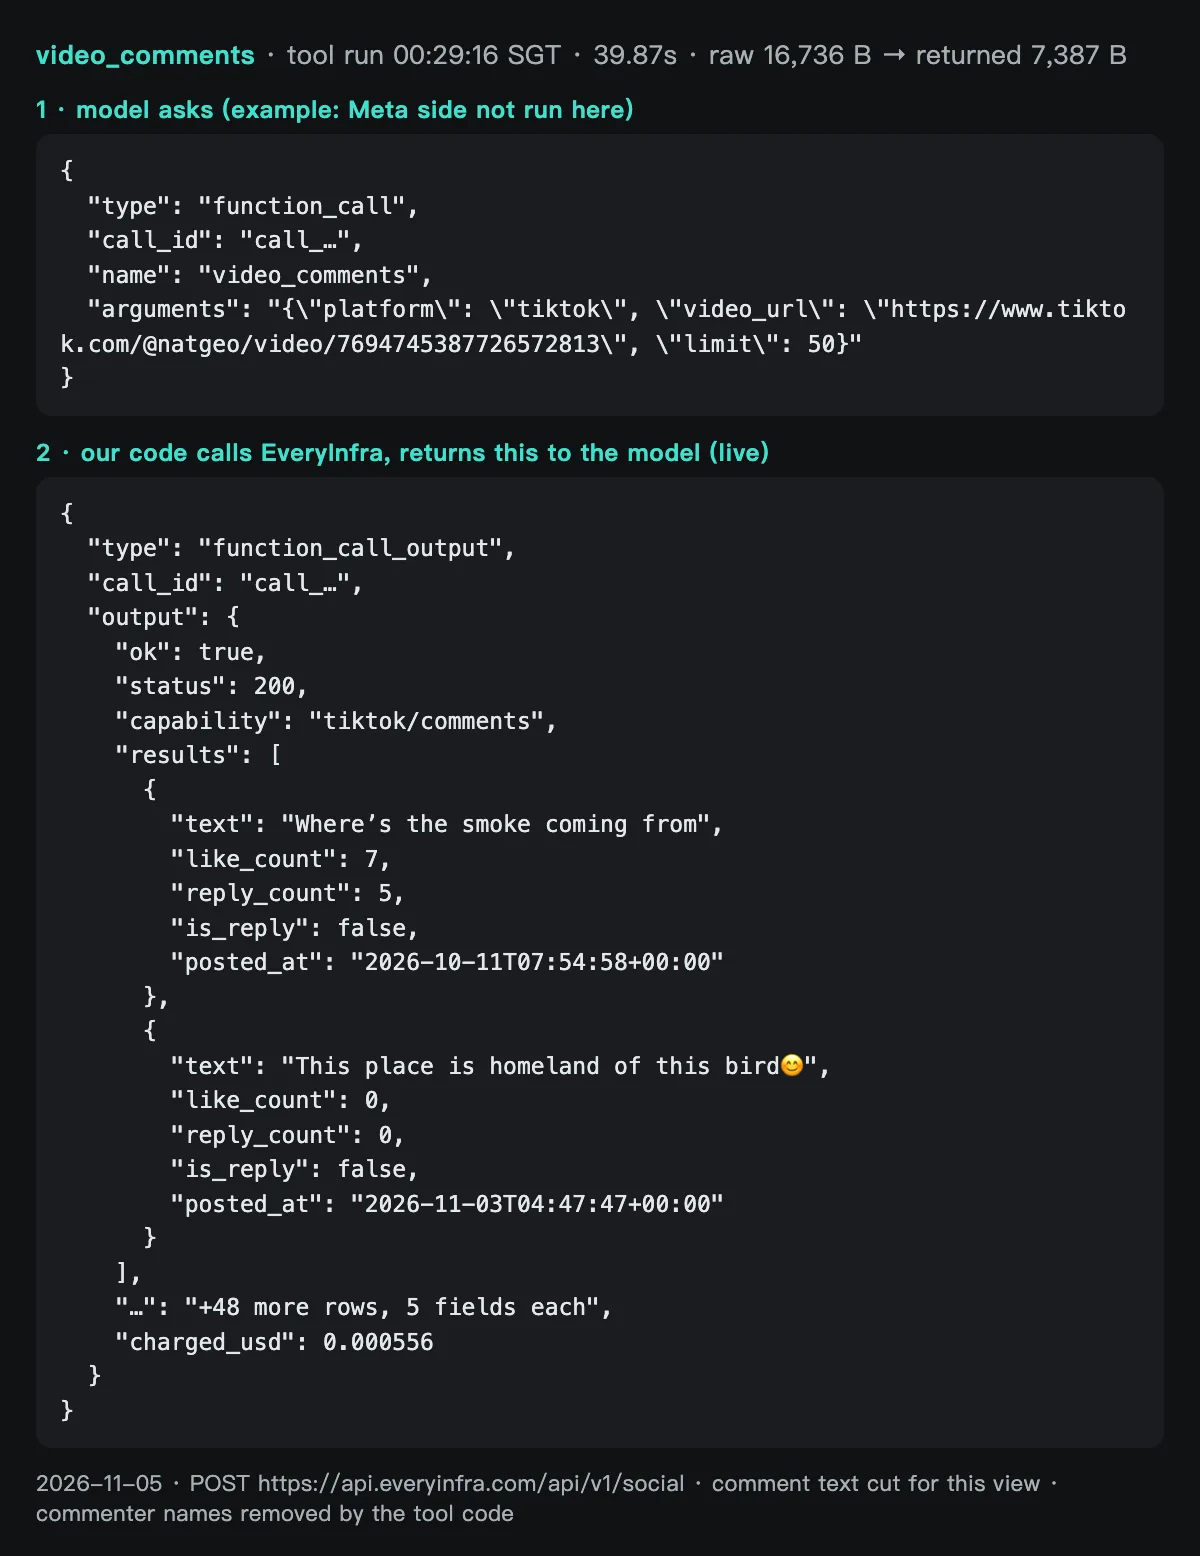
Tramite MCP gli stessi dati costano circa il doppio dei token. Alle 00:38 SGT (11:38 ET) abbiamo usato everyinfra_call_api sul server MCP remoto di EveryInfra per recuperare 50 commenti da un video YouTube di National Geographic. La chiamata ha richiesto 16,74 secondi, con un addebito di $0,000556. Il testo che passa al modello è di 18.198 byte, con 8 campi per commento, tra cui author_name. La nostra whitelist di campi ridurrebbe gli stessi 50 commenti a 9.516 byte, senza nomi.
MCP ti fa risparmiare codice, ma raddoppia i token per chiamata. Inoltre non puoi rimuovere i nomi di chi commenta prima che il modello li legga. Per un report destinato a un cliente conta di più il secondo punto, perché la policy d'uso citata sopra riguarda le inferenze sulle persone.
Abbiamo registrato anche gli errori. I commenti YouTube di NASA hanno restituito 503 due volte, alle 00:37 e alle 00:40 SGT. Il corpo dell'errore riportava retryable: true e retry_after: 20, con billing.charged impostato a false e uno stato del rimborso succeeded.
Al terzo errore di quell'endpoint entro 10 minuti, il messaggio è cambiato. Diceva al chiamante di inviare una volta la richiesta di esempio e spiegava che, se l'esempio funziona, il problema riguarda il target. È lo stile di errore che il nostro livello dei tool cerca. Il modello può leggere quanto aspettare, se fare un nuovo tentativo e cosa controllare dopo.
Per Notion, la nostra prima scelta è stata un video del 27 ottobre 2026 con comment_count pari a 0. L'endpoint ha restituito 200 con un array vuoto e il motivo empty_result_refunded, quindi non è costato nulla. Siamo passati a un video del 23 ottobre 2026 con 5 commenti e ne abbiamo ricevuti 2. Nell'esecuzione, sei richieste non hanno restituito dati: 2 hanno ricevuto 429, 3 hanno ricevuto 503 e 1 era vuota. Nessuna è stata addebitata.
Risultati live: quattro metriche su tre account e sei trappole nei dati
Questa sezione analizza ogni metrica. Tutti i grafici derivano dalle stesse risposte grezze e usano la tabella delle regole riportata sopra. Dopo i numeri elenchiamo le trappole in cui siamo incappati. Queste trappole vanno inserite nel tuo system prompt.
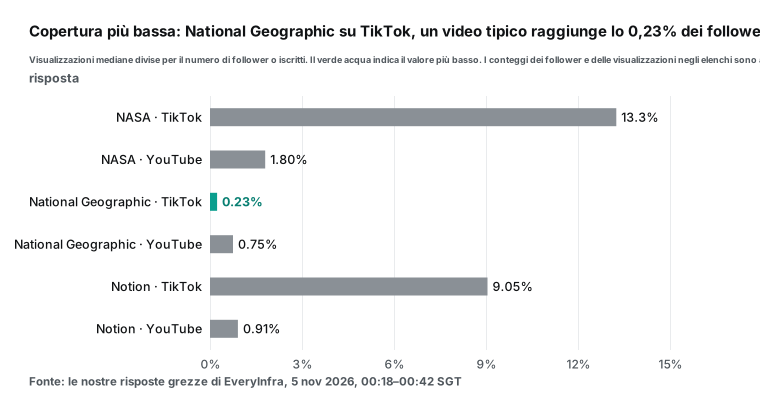
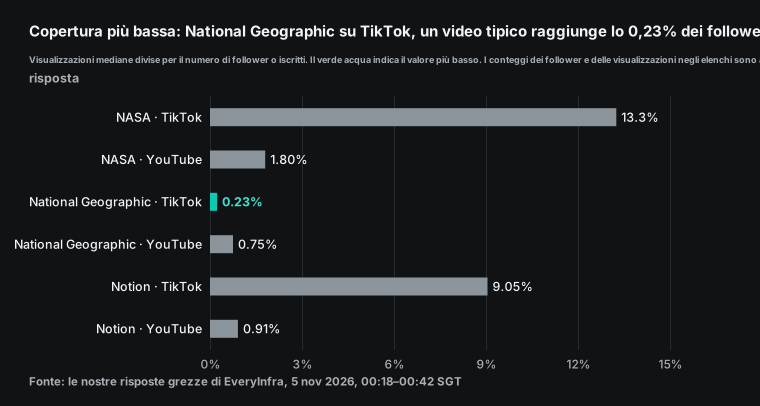
Non confrontare la copertura tra TikTok e YouTube. Il feed di TikTok propone i video anche a chi non ti segue, quindi le visualizzazioni possono superare un decimo dei follower. Un grande canale YouTube ha molti iscritti di anni fa che ormai guardano di rado, quindi la sua copertura è bassa. Confronta solo all'interno della stessa piattaforma. Su TikTok NASA ha il 13,25%, Notion il 9,05% e National Geographic lo 0,23%, uno scarto di oltre 50 volte. Basandosi solo sulla copertura, un agente scriverebbe "follower e visualizzazioni non corrispondono".
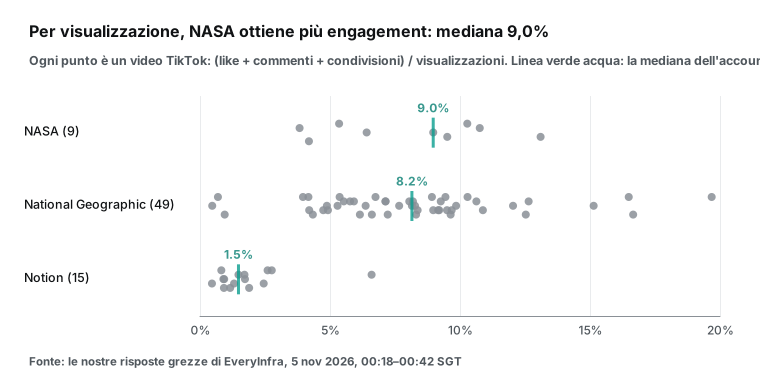
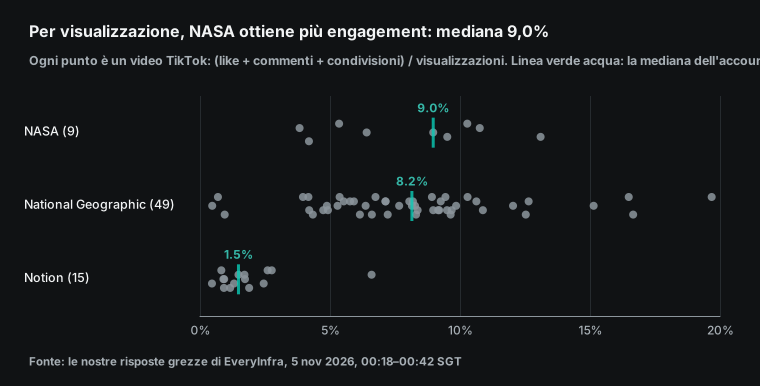
Il grafico dell'engagement ribalta metà di quel verdetto. L'engagement mediano per visualizzazione di National Geographic è dell'8,15%, a meno di un punto dall'8,97% di NASA. Notion è all'1,48%. Chi vede un video di National Geographic mette like e lo condivide più o meno con la stessa frequenza di chi vede un video di NASA.
Una copertura bassa con un engagement normale indica un account che pubblica molto, per cui ogni video raggiunge solo una parte del pubblico. Non indica follower comprati. I follower comprati non guardano e non mettono like, quindi entrambi i numeri calerebbero insieme.
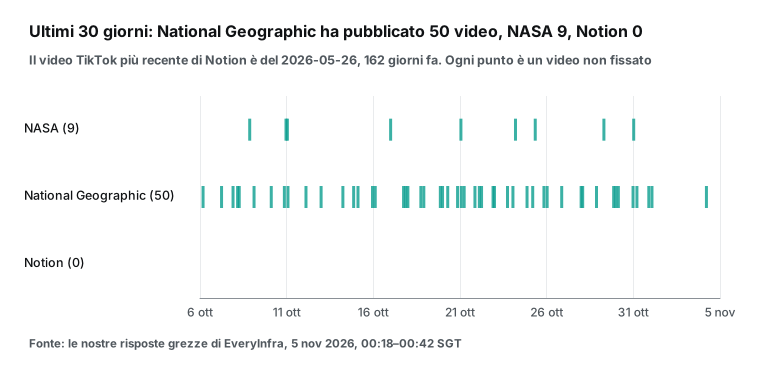
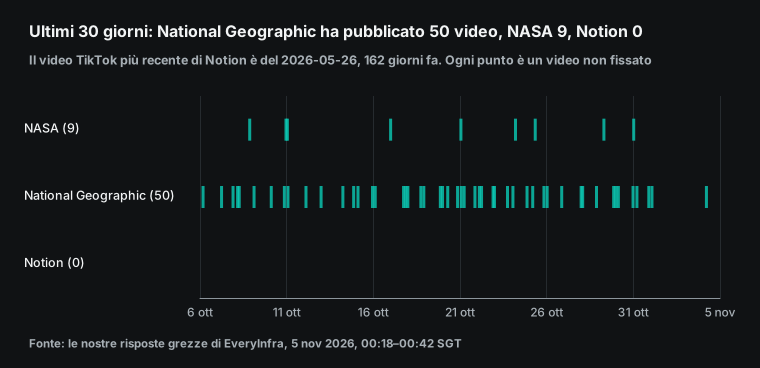
La frequenza di pubblicazione spiega lo schema. National Geographic ha pubblicato 50 TikTok non fissati in 30 giorni, e il più recente è del 3 novembre 2026. L'intervallo mediano è di 0,62 giorni e il più lungo di 3,1 giorni. NASA ne ha pubblicati 9. Il più recente è del 30 ottobre 2026, l'intervallo mediano è di 2,62 giorni e il più lungo di 6,0 giorni.
Quando gli stessi follower ricevono uno o due nuovi video al giorno, ogni video ne raggiunge una quota minore. Se l'agente legge insieme frequenza di pubblicazione e copertura, può scrivere la frase corretta: "pubblica spesso, bassa copertura per video, engagement normale".
La riga di Notion è vuota. Il suo TikTok più recente è del 26 maggio 2026, cioè di 161,7 giorni prima della nostra raccolta. La sua copertura del 9,05% deriva dagli ultimi 15 video, tutti vecchi. Per decidere su un accordo il mese prossimo, quel numero non ti dice nulla.
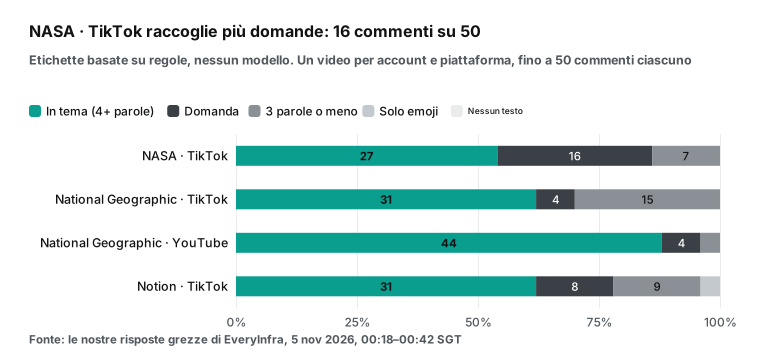
Non abbiamo usato il modello per etichettare i commenti. Abbiamo usato cinque regole fisse: nessun testo, solo emoji o punteggiatura, un punto interrogativo, 3 parole o meno, e in tema per tutto il resto. Le regole sono approssimative, ma chiunque può ricalcolarle, e non interpretano mai un commento in modo creativo.
I commenti TikTok di NASA includono 16 domande, per lo più su ciò che mostra il video, un buon segnale per un creator di divulgazione scientifica. I commenti TikTok di National Geographic includono 15 commenti brevi e 16 con lettere non inglesi o accenti, il che suggerisce un pubblico globale. Su YouTube, 44 dei 50 commenti del brand sono in tema, con una lunghezza mediana di 77 caratteri. Confronta la qualità dei commenti solo all'interno della stessa piattaforma.
C'è un altro tipo di commento a cui prestare attenzione. Il 30 settembre 2026 la YouTube Data API ha aggiunto snippet.imageUrl ai commenti, quindi un commento può contenere un'immagine o una GIF. L'accesso si apre a tutti gli utenti a novembre 2026 (YouTube Data API revision history). Un lettore che considera solo il testo perde i commenti composti solo da un'immagine, quindi le nostre regole contano a parte i commenti senza testo.
| # | Trappola | Cosa abbiamo osservato | Cosa deve fare l'agente |
|---|---|---|---|
| 1 | I conteggi di TikTok sono arrotondati | Ogni video con 10.000 o più visualizzazioni ha un numero di visualizzazioni multiplo di 100. I follower sono 2.200.000, 9.700.000 e 143.700 | Scrivi "circa" nel report. Evita due decimali su campioni piccoli |
| 2 | 50 video potrebbero non coprire 30 giorni | La prima pagina di 50 video di National Geographic copriva solo 28,8 giorni. Una seconda pagina con until ha completato la finestra | Controlla la data più vecchia. Recupera un'altra pagina se il periodo coperto è inferiore a 30 giorni |
| 3 | I video fissati compaiono per primi | NASA e National Geographic hanno ciascuno un video fissato, molto più vecchio degli altri | Escludi gli elementi is_pinned prima di calcolare mediane e intervalli |
| 4 | Le liste di YouTube usano date relative | youtube/user_posts restituisce "2w ago" o "1mo ago", visualizzazioni arrotondate alle migliaia e nessun like o commento | Chiama youtube/video per i video vicini al limite dei 30 giorni, così ottieni ora e visualizzazioni esatte |
| 5 | Anche i like di YouTube sono arrotondati | Un video NASA del 14 ottobre 2026 ha 684.881 visualizzazioni e 11.000 like. Tutti e 4 i video NASA mostrano comment_count 0 | Segna i like come arrotondati. Salta il verdetto sui commenti quando il conteggio è 0 |
| 6 | Un account nuovo non indica una crescita falsa | Il created_at dell'account TikTok di NASA è il 20 luglio 2026, con 2,2 milioni di follower, eppure la sua copertura del 13,25% è la più alta dei sei | Valuta la crescita insieme a copertura ed engagement. Non giudicare mai da un solo numero |
Le trappole 2 e 4 sono quelle che costano più chiamate. Un account TikTok molto attivo richiede due chiamate per i video per coprire 30 giorni. Un canale YouTube richiede, dopo la lista, alcune chiamate per singolo video per ottenere like e date esatte. Abbiamo recuperato 4 video per canale, come compromesso tra una mediana utilizzabile e il costo aggiuntivo. Quelle 4 chiamate costano $0,0022, cioè il 40% del costo dei dati per un creator. Se la tua lista è composta soprattutto da creator TikTok, puoi saltarle e valutare YouTube solo in base a iscritti e frequenza di pubblicazione.
La trappola 5 ha un ulteriore dettaglio. YouTube ha cambiato il conteggio delle visualizzazioni il 27 agosto 2026. Tutti i 12 singoli video che abbiamo controllato sono stati pubblicati dopo quella data, quindi i nostri numeri di engagement su YouTube non la attraversano. Se i video recenti di un creator sono a cavallo di quella data, il report dovrebbe segnalarlo.
Costo dell'API Muse Wonder: il conto per una lista di 10 creator
Questa sezione risponde a una domanda: quanto costa una lista di 10 creator? Il conto ha due parti. I costi dei dati EveryInfra sono il prezzo di listino moltiplicato per le chiamate, quindi questa parte è esatta. I costi del modello Meta sono il prezzo di listino moltiplicato per i token. Non avevamo una chiave Meta e non abbiamo eseguito il modello, quindi questa parte è una stima. Elenchiamo ogni input, così puoi sostituirli con i tuoi valori.
| Chiamate per creator | Conteggio | Prezzo di listino | Subtotale |
|---|---|---|---|
Profilo TikTok, tiktok/profile | 1 | $0.000556 | $0.000556 |
Video TikTok, tiktok/user_videos (seconda pagina per gli account molto attivi) | Da 1 a 2 | $0.000556 | Da $0,000556 a $0,001112 |
Commenti TikTok, tiktok/comments | 1 | $0.000556 | $0.000556 |
Canale YouTube, youtube/profile | 1 | $0.000556 | $0.000556 |
Lista dei video YouTube, youtube/user_posts | 1 | $0.000556 | $0.000556 |
Singolo video YouTube, youtube/video | 4 | $0.000556 | $0.002224 |
Commenti YouTube, youtube/comments | 1 | $0.000556 | $0.000556 |
| Totale | Da 10 a 11 | Da $0,00556 a $0,00612 |
Dieci creator significano da 100 a 110 chiamate e da $0,0556 a $0,0612 di costi dei dati. Errori, timeout e risultati vuoti non vengono addebitati, quindi si tratta di un tetto massimo. Nella nostra esecuzione sono state addebitate 30 richieste su 36. I prezzi seguono il catalogo del giorno (pagina dei prezzi), e puoi consultare il catalogo gratuitamente senza chiave.
La stima del modello si basa su quattro ipotesi. Primo, ogni creator ha una propria conversazione di 3 turni. Il turno 1 invia 4 chiamate per i dati, il turno 2 invia le chiamate per i commenti e il turno 3 scrive il report. Secondo, il prefisso fisso (system prompt più cinque definizioni di tool) è di 1.500 token.
Terzo, i risultati dei tool si convertono in token dividendo i byte per 4. Il centro assistenza di Meta dice che un token corrisponde a circa 3-4 caratteri di testo inglese, e che altre lingue e il codice ne usano di più (How am I billed). Quindi 4 è una stima al ribasso. Ogni turno successivo rilegge i risultati precedenti. Quarto, output e reasoning ammontano a 4.000 token per creator.
Nei nostri dati live, i risultati ridotti per creator sono in media di 30.541 byte, e quelli grezzi di 154.694 byte.
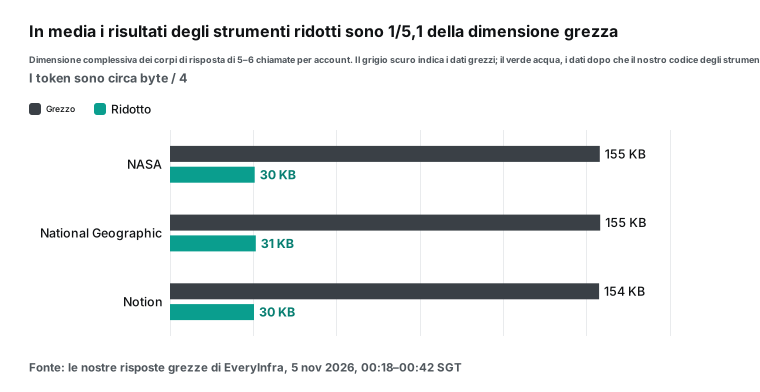
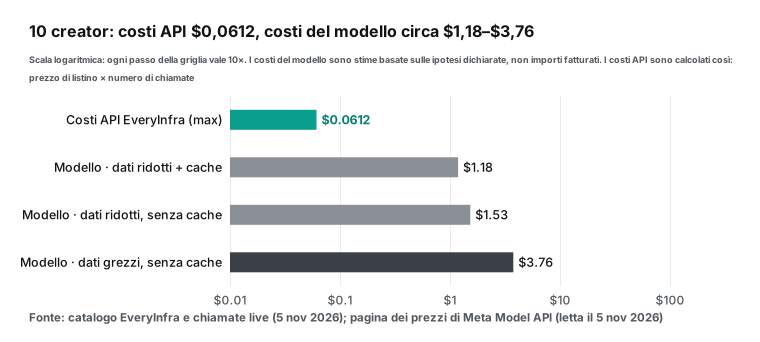
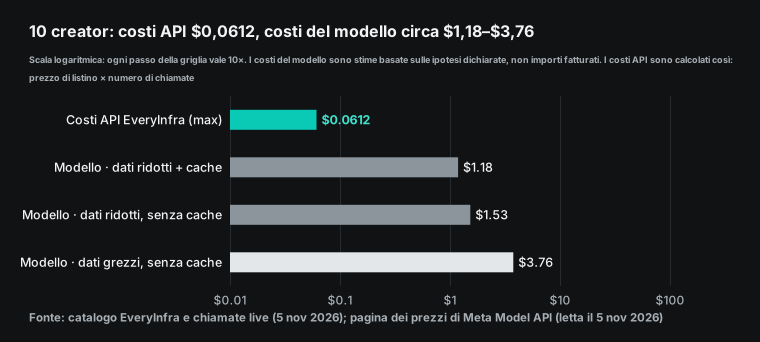
Con questi input, i tre turni di ogni creator sommano circa 18.243 token di input con i dati ridotti, o 74.112 con quelli grezzi. Ai prezzi di Muse Wonder, un'esecuzione con dati ridotti senza cache costa $0,153 per creator, di cui $0,08 di output. Un'esecuzione con dati ridotti e cache hit sui token riletti costa $0,118 per creator. Un'esecuzione con dati grezzi senza cache costa $0,376. Moltiplica per 10 per ottenere i tre totali del grafico.
| Lista di 10 creator | Costi dei dati | Costi del modello (stima) | Totale | Costi del modello / costi dei dati |
|---|---|---|---|---|
| Dati ridotti con cache | $0.0612 | $1.18 | $1.25 | 19x |
| Dati ridotti, senza cache | $0.0612 | $1.53 | $1.59 | 25x |
| Dati grezzi, senza cache | $0.0612 | $3.76 | $3.82 | 61x |
La tabella mostra due cose. Primo, il risparmio è sul lato del modello, non su quello dei dati. I costi dei dati sono identici in tutte e tre le righe, mentre i costi del modello variano di oltre tre volte a causa della dimensione dei risultati.
Secondo, dopo la riduzione l'output diventa la voce di costo più alta. Dei $0,118 per creator nella riga più economica, $0,08 sono i 4.000 token di output. L'output di Muse Wonder costa cinque volte l'input, e i token di reasoning vengono addebitati come output. Quindi per questo report non ti serve il reasoning high. Meta ti permette di impostare l'effort da minimal a max, e medium o low bastano per leggere numeri, confrontarli e scrivere quattro righe.
Prima di un'esecuzione reale puoi contare i token con POST /v1/responses/input_tokens di Meta. La documentazione dice che questo endpoint esegue solo la tokenizzazione, non genera nulla e non registra l'utilizzo. Meta consiglia di usarlo per verificare che l'input stia nel contesto, non per stimare la fatturazione (Token counting). Durante l'esecuzione, leggi usage da ogni turno e sostituisci le nostre stime con i conteggi reali dei token.
Conta anche il tempo. Muse Wonder consente 3.000 richieste al minuto, quindi il lato modello non ti rallenterà. Il lato dati sì. La nostra chiave di test consente 10 richieste al minuto ed era condivisa con altri job. Le nostre 36 richieste sono state eseguite dalle 00:18:46 alle 00:42:08 SGT (dalle 11:18 alle 11:42 ET), cioè in 23 minuti e 22 secondi. Due richieste hanno ricevuto una risposta 429 e hanno atteso 60 secondi ciascuna.
Una lista di 10 creator con 110 chiamate richiede almeno 11 minuti a 10 chiamate al minuto. Sulle 30 chiamate addebitate, la durata mediana è stata di 22,2 secondi e la più lenta di 78,2 secondi. Includendo le sei chiamate che non hanno restituito dati, la più lenta ha richiesto 89,6 secondi. Il tuo livello dei tool dovrebbe mettere in coda le chiamate ed eseguirne alcune in parallelo senza superare il limite al minuto.
Limiti di questo test
| Limite | Effetto | Come colmare la lacuna |
|---|---|---|
| Non abbiamo eseguito il lato Meta | Il JSON dei tool, il loop e lo schema seguono la documentazione di Meta. Non abbiamo misurato come il modello suddivide le chiamate né quanti token di reasoning usa | Esegui prima due creator e leggi usage |
| Solo tre account di brand | Sono tutti grandi brand verificati e non rappresentano i piccoli creator | Aggiungi come controllo due o tre creator che conosci bene |
| I costi del modello sono stime | Byte diviso 4, 3 turni e 4.000 token di output sono ipotesi | Ricalcola con i valori reali di usage |
| Commenti di un solo video per piattaforma | Il mix di commenti descrive un solo video | Campiona altri due o tre video per i creator principali |
| Etichette dei commenti basate su regole | I commenti sarcastici o in più lingue possono finire in "in tema" | Usa le regole come primo filtro e rivedi gli elementi segnalati |
| Lacune nei commenti YouTube | NASA ha fallito due volte e Notion ha restituito solo 2 commenti | Registra le lacune in missing e non giudicare mai da dati vuoti |
Il secondo limite è quello che più probabilmente cambia un verdetto. Tutti e tre i brand hanno più di 100.000 follower, quindi l'arrotondamento alle centinaia o alle migliaia incide poco. Con un creator da 8.000 follower, arrotondamento, campioni piccoli e un singolo video virale pesano di più. Aggiungi al system prompt una regola per i campioni piccoli: con meno di 5 video nella finestra o meno di 10.000 follower, riporta i quattro numeri e non dare alcun verdetto.
FAQ
Quanto costa l'API Muse Wonder e come viene addebitata?
L'addebito è per token, senza canone mensile né minimo: $4,00 per l'input, $0,20 per l'input in cache e $20,00 per l'output, per milione di token. I token di reasoning contano come output (Pricing and rate limits; Quickstart). Meta dice anche che i contenuti di sistema e di steering che inserisce non vengono addebitati e non compaiono in usage. Un'esecuzione di valutazione ha due conti: il costo del modello di Meta e il costo dei dati per chiamata di EveryInfra. La sezione sui costi qui sopra li stima entrambi per 10 creator.
Dove ottengo una chiave API di Muse Wonder, e un collega può usarla?
Registrati sul sito di Model API e apri la pagina delle chiavi API. Poi fai clic sul pulsante Create API key. La chiave appartiene al tuo team, quindi chiunque nel team può usarla (Create an API key). Chi è fuori dal team non può. Il centro assistenza dice che condividere una chiave al di fuori del team viola i termini (Can I share my API key).
Controlla la tua area geografica prima di registrarti. Il centro assistenza dice che Model API è disponibile nella maggior parte dei luoghi in cui sono disponibili Meta AI e la fatturazione. La fonte definitiva è la policy sulle aree geografiche (Supported countries). Cina, Hong Kong e Macao sono soggette a restrizioni (Geographic Use Policy).
Posso chiamare Muse Wonder Full tramite API?
No. La pagina dei modelli di Meta dice che Wonder Full è incluso solo negli abbonamenti Muse Code con i piani Power Usage e Maximum Usage. Impostare il reasoning effort su max nell'API non fa passare a Full (Models). Un commentatore su Hacker News ha fatto la stessa osservazione il giorno del lancio. Secondo questa lettura, il modello Full in testa ai benchmark è riservato agli abbonati, e l'API offre solo Muse Wonder (commento su Hacker News). Un abbonamento Muse Code funziona solo nel suo strumento a riga di comando, non per le chiamate API (Muse Code subscriptions).
Alcuni sviluppatori dicono che l'API Muse Wonder a volte dà errori. Come dovrebbe comportarsi un agente di valutazione?
Poco dopo il lancio, un commentatore su Hacker News l'ha definita vicina al meglio ma troppo costosa, e ha detto che l'API ogni tanto fallisce (commento su Hacker News). È la segnalazione di una sola persona, e non l'abbiamo riprodotta. La documentazione sugli errori di Meta elenca gli errori per cui è previsto un nuovo tentativo. Un errore di parsing dell'output del modello restituisce 500. Un backend sovraccarico restituisce service_overloaded con Retry-After: 60, e in caso di 429 bisogna attendere secondo Retry-After (Error handling).
Gestisci i nuovi tentativi su due livelli. Sul livello Meta, attendi come indica la documentazione. Sul livello EveryInfra, errori e risultati vuoti non vengono addebitati, e in caso di 429 il nostro codice dei tool attende 60 secondi.
Per iniziare: da zero al tuo primo report di valutazione
Ogni piattaforma ha una pagina di panoramica con tutti gli endpoint e i prezzi attuali: l'API di TikTok e l'API di YouTube. Sul lato EveryInfra servono tre passaggi. Primo, registrati tramite la guida rapida e crea una chiave. Poi verifica nel catalogo che tiktok/user_videos, tiktok/comments e youtube/comments siano disponibili quel giorno. Infine esegui il codice dei tool su un account che conosci e confronta i conteggi di follower e visualizzazioni con quelli dell'app.
Il catalogo è consultabile gratuitamente senza chiave: GET /api/v1/social/catalog. Per provare le chiamate nel browser, usa la console di test nel marketplace dei dati. Per collegare direttamente uno strumento di AI, consulta la guida alla configurazione dell'MCP remoto. Per rimborsi e riconciliazione delle chiamate non riuscite o vuote, consulta riconciliazione dei rimborsi per errori. Per permettere a un agente di correggere da solo i parametri dopo un errore 422, consulta errori API con auto-correzione.
Sul lato Meta servono quattro passaggi: registrazione, configurazione della fatturazione, creazione di una chiave e impostazione della variabile d'ambiente, come spiega la sezione sulla chiave. Inserisci tools.json e il system prompt nel tuo progetto. Per provare i tool senza codice, apri il Playground, vai su Advanced e poi su Tools, e seleziona Add tool. Incolla ogni definizione da tools.json. Nel Playground è il modello a decidere quando chiamare un tool (Using tools in the Playground). Esegui prima due creator, poi passa a dieci. Dopo l'esecuzione, leggi usage da ogni turno e sostituisci le nostre stime con i conteggi reali dei token.
Riferimenti
- «Introducing Muse Wonder and Muse Wonder Full: Frontier Models for Agents», Meta Newsroom, 12 ottobre 2026, <https://about.fb.com/news/2026/10/introducing-muse-wonder-models/>
- «Muse Wonder: A Frontier Model For Personal & Professional AI Agents», blog di ricerca di Meta, 12 ottobre 2026, <https://research.meta.ai/blog/muse-wonder>
- Pagina prodotto di Muse Wonder, Meta, consultata il 5 novembre 2026, <https://dev.meta.ai/models/muse-wonder>
- «Get started with Meta Model API and Muse Code», documentazione per sviluppatori di Meta, consultata il 5 novembre 2026, <https://dev.meta.ai/docs/overview>
- «Models», documentazione per sviluppatori di Meta, consultata il 5 novembre 2026, <https://dev.meta.ai/docs/models>
- «Pricing and rate limits», documentazione per sviluppatori di Meta, consultata il 5 novembre 2026, <https://dev.meta.ai/docs/pricing-rate-limits>
- «Quickstart», documentazione per sviluppatori di Meta, consultata il 5 novembre 2026, <https://dev.meta.ai/docs/quickstart>
- «Tool calling», documentazione per sviluppatori di Meta, consultata il 5 novembre 2026, <https://dev.meta.ai/docs/tool-calling>
- «Responses API», documentazione per sviluppatori di Meta, consultata il 5 novembre 2026, <https://dev.meta.ai/docs/protocols/responses>
- «Structured output», documentazione per sviluppatori di Meta, consultata il 5 novembre 2026, <https://dev.meta.ai/docs/structured-output>
- «Prompt caching», documentazione per sviluppatori di Meta, consultata il 5 novembre 2026, <https://dev.meta.ai/docs/prompt-caching>
- «Tool search», documentazione per sviluppatori di Meta, consultata il 5 novembre 2026, <https://dev.meta.ai/docs/tool-search>
- «Agent frameworks», documentazione per sviluppatori di Meta, consultata il 5 novembre 2026, <https://dev.meta.ai/docs/agent-frameworks>
- «Error handling», documentazione per sviluppatori di Meta, consultata il 5 novembre 2026, <https://dev.meta.ai/docs/error-handling>
- «Muse Code subscriptions», documentazione per sviluppatori di Meta, consultata il 5 novembre 2026, <https://dev.meta.ai/docs/muse-code/subscriptions>
- «Search grounding», documentazione per sviluppatori di Meta, consultata il 5 novembre 2026, <https://dev.meta.ai/docs/search-grounding>
- «How do I sign up for Model API?», centro assistenza Meta AI Developer, consultato il 5 novembre 2026, <https://dev.meta.ai/help/accounts-and-login/sign-up>
- «How do I create an API key?», centro assistenza Meta AI Developer, consultato il 5 novembre 2026, <https://dev.meta.ai/help/api-keys/create-api-key>
- «Can I share my API key?», centro assistenza Meta AI Developer, consultato il 5 novembre 2026, <https://dev.meta.ai/help/api-keys/sharing-api-keys>
- «How can I set up billing for Meta Model API?», centro assistenza Meta AI Developer, consultato il 5 novembre 2026, <https://dev.meta.ai/help/billing/set-up-billing>
- «How am I billed for Model API?», centro assistenza Meta AI Developer, consultato il 5 novembre 2026, <https://dev.meta.ai/help/billing/api-bill>
- «How do I set a spend limit alert?», centro assistenza Meta AI Developer, consultato il 5 novembre 2026, <https://dev.meta.ai/help/billing/spend-limit-alert>
- «How do I request a refund for Meta Model API?», centro assistenza Meta AI Developer, consultato il 5 novembre 2026, <https://dev.meta.ai/help/billing/refunds>
- «Does Model API support Zero Data Retention (ZDR)?», centro assistenza Meta AI Developer, consultato il 5 novembre 2026, <https://dev.meta.ai/help/policies-and-privacy/zero-data-retention>
- «Meta Model API Terms of Service», Meta, aggiornato il 9 ottobre 2026, <https://dev.meta.ai/legal/terms-of-service>
- «Meta Model API Acceptable Use Policy», Meta, aggiornato il 12 ottobre 2026, <https://dev.meta.ai/legal/acceptable-use-policy>
- «Meta Model API Model Designation and Geographic Use Policy», Meta, aggiornato il 12 ottobre 2026, <https://dev.meta.ai/legal/geographic-use-policy>
- «Muse Wonder is available today on Meta Model API and in Muse Code», Meta for Developers (post su Facebook), 12 ottobre 2026, <https://www.facebook.com/MetaforDevelopers/posts/muse-wonder-is-available-today-on-meta-model-api-and-in-muse-code-and-muse-wonde/1552628546897475/>
- «YouTube Data API Revision History», Google for Developers, aggiornato il 3 novembre 2026, <https://developers.google.com/youtube/v3/revision_history>
- «Understand your YouTube content performance», Guida di YouTube, consultata il 5 novembre 2026, <https://support.google.com/youtube/answer/12220281>
- «Tools», specifica del Model Context Protocol (2025-06-18), <https://modelcontextprotocol.io/specification/2025-06-18/server/tools>
- «The Average Views Lie: What We Learned From 675 TikTok Creator Videos», TechBullion, ottobre 2026, <https://techbullion.com/average-views-lie-learned-675-tiktok-creator-videos/>
- Commento nel thread di Hacker News su Muse Wonder (nome utente nascosto), Hacker News, ottobre 2026, <https://news.ycombinator.com/item?id=50065098>
- Commento nel thread di Hacker News su Muse Wonder (nome utente nascosto), Hacker News, ottobre 2026, <https://news.ycombinator.com/item?id=50061435>
- Catalogo dati di EveryInfra (consultabile gratuitamente), EveryInfra, consultato il 5 novembre 2026, <https://api.everyinfra.com/api/v1/social/catalog>
- «Token counting», documentazione per sviluppatori di Meta, consultata il 5 novembre 2026, <https://dev.meta.ai/docs/token-counting>
- «Meta Model API Data Commitments», Meta, consultato il 5 novembre 2026, <https://dev.meta.ai/legal/commitments>
- «What countries and territories is Model API available in?», centro assistenza Meta AI Developer, consultato il 5 novembre 2026, <https://dev.meta.ai/help/accounts-and-login/supported-countries>
- «Can the models call tools?», centro assistenza Meta AI Developer, consultato il 5 novembre 2026, <https://dev.meta.ai/help/about-model-api/tool-calling>
- «How do I use tools in the Playground?», centro assistenza Meta AI Developer, consultato il 5 novembre 2026, <https://dev.meta.ai/help/playground/using-tools-in-the-playground>
Riferimenti BL-89