クリエイターの審査にMuse Wonder APIを使う:実データでの検証とコスト試算
MetaのMuse Wonder APIでTikTokとYouTubeのクリエイター審査エージェントを構築します。ツールのJSON、ライブデータのラウンドトリップ、クリエイター10人のリストにかかるコストを紹介します。
2026年11月4日の11:18〜11:42(ET)、シンガポール時間では11月5日の00:18〜00:42に、NASA、National Geographic、Notionの三つのブランドアカウントを対象にクリエイターチェックを行いました。EveryInfraのTikTokとYouTubeのエンドポイントを使い、36件のリクエストを送信しました。課金されたのはそのうち三十件で、合計$0.01668です。最も参考になった数字は意外なものでした。National GeographicはTikTokで9.7百万人のフォロワーを抱えていますが、動画の再生回数の中央値は22,600回で、リーチ率は0.23%にとどまります。今回確認した六つのアカウントとプラットフォームの組み合わせの中で最も低い値です。
それでも、このアカウントは実際に視聴した人から高いエンゲージメントを得ています。再生あたりの(いいね+コメント+シェア)の中央値は8.15%で、NASAの8.97%に近く、NASAのリーチは13.25%です。National Geographicは30日間で50本のTikTok動画を投稿しているため、動画1本が届くフォロワーの割合は小さくなります。リーチだけを見るエージェントは、健全なアカウントを「水増し」と判定してしまいます。この記事で扱うのは、こうした誤りです。
この記事で答える問い
ブランドチームや代理店がクリエイターのリストを持っているとします。契約を結ぶ前に、各クリエイターについて4つの問いに答えるAIチェックを行いたいと考えています。フォロワーは本物か。視聴者は反応しているか。直近30日間に投稿しているか。コメントでは何が話題になっているか。このガイドでは、Metaの新しいMuse WonderモデルとEveryInfraのデータエンドポイント(tiktok/profile、tiktok/user_videos、youtube/profile、youtube/user_posts、および2つのコメント用エンドポイント)を使って、このエージェントを構築します。
このマシンにはMetaのキーがありません。そのため、Meta側(ツールのJSON、エージェントループ、レポートスキーマ)は設定例です。Meta側の料金、パラメータ、ルールにはすべて、参照したMetaのページへのリンクと閲覧日を付けています。EveryInfra側は実際に実行したものです。以下の表の数値はすべてその実行で得た生のレスポンスに基づいており、どれも再計算できます。推定値にはその旨を明記し、入力値を示しています。
まず結果を示します。この表は、2つのプラットフォーム上の3つのアカウントに4つのルールを適用したものです。各計算式は指標ルールのセクションで、各数値の出どころはライブ結果のセクションで説明しています。
| アカウントとプラットフォーム | フォロワー数または登録者数 | リーチ(再生数の中央値/フォロワー数) | 再生あたりのエンゲージメントの中央値 | 直近30日間の投稿数 | コメントの内訳(ルールベース) |
|---|---|---|---|---|---|
| NASA、TikTok | 2,200,000 | 13.25% | 8.97% | 9件、最長間隔6.0日 | 50件中16件が質問 |
| NASA、YouTube | 15,100,000 | 1.80%(最新10件) | 1.41%(動画4本) | 2件は確実 | 取得できず(失敗2件、課金なし) |
| National Geographic、TikTok | 9,700,000 | 0.23% | 8.15% | 50件、最長間隔3.1日 | 関連31件、3語以下15件 |
| National Geographic、YouTube | 26,600,000 | 0.75% | 0.61%(動画4本) | 確実21件、可能性あり1件 | 50件中44件が関連 |
| Notion、TikTok | 143,700 | 9.05%(最新15本) | 1.48% | 0件、最新は161.7日前 | 関連31件、絵文字のみ2件 |
| Notion、YouTube | 350,000 | 0.91% | 0.60%(動画4本) | 確実7件、可能性あり1件 | コメントが2件のみのため判定なし |
三つの認証済みブランドアカウントに、不審な点は見当たりません。それでも、どのアカウントにも単純なルールを誤らせる指標があります。NASAのTikTokアカウントのcreated_atは2026年7月20日で、フォロワーは2.2百万人です。成長率のルールでは急成長すぎると判定されかねませんが、NASAのリーチ率は六つの組み合わせの中で最も高くなっています。
NotionのTikTokのリーチは9.05%と好調に見えますが、最新の動画は2026年5月26日のものです。30日ルールでは、NotionのTikTokは休眠状態と判定されます。対処法はどのケースも同じです。まずルールを書き出し、それからモデルに数値を読ませます。
Muse Wonder APIとは:Meta自身のページから読み取れる10の事実
Metaは2026年10月12日にMuse WonderとMuse Wonder Fullを発表しました。Metaによると、Muse Wonderは同日からMeta Model APIとMuse Codeで利用可能になりました(Meta Newsroom、2026年10月12日)。同日公開の研究ブログでは、個人用および業務用エージェント向けのフロンティアモデルと位置づけています。特に取り上げているのはActive MemoryとActive Focusで、Active Focusはタスクから外れずに作業を続け、エラーから回復する能力を指すMetaの呼び名です(Metaの研究ブログ)。製品ページでは、モデルが計画を立て、作業の一部をサブエージェントに任せ、ツールを並列で呼び出しながら数時間に及ぶタスクをこなす様子が説明されています(Muse Wonder製品ページ)。
製品紹介の文言と、ドキュメントで実際に定められているパラメータは別物です。開発者に必要なのは後者です。2026年11月5日にdev.meta.aiのドキュメント、ヘルプセンター、法務関連ページを確認しました。以下の表には、Metaが文書で明記している事実のみを記載しています。
| 事実 | Metaのページの記載内容 | 出典(2026年11月5日に確認) |
|---|---|---|
| モデルID | muse-wonder-1.0。ドキュメントのトップページには「Muse Wonderはプレビュー段階」と記載 | 概要 |
| コンテキスト | 1,048,576トークン。入力にはテキスト、画像、動画、音声、PDFを使用可能 | モデル |
| 推論 | reasoning.effortはminimalからmaxまで指定可能。maxにしてもWonder Fullには切り替わらない | モデル |
| Wonder Full | Muse Codeのサブスクリプションのみ(Power UsageプランとMaximum Usageプラン) | モデル |
| APIフォーマット | Responses、Chat Completions、Anthropic Messages。料金と認証は共通 | 概要 |
| ツール呼び出し | 関数の定義と実行はユーザー側で行う。tool_choiceはautoのみ対応。関数名に含められるドットは1つまで | ツール呼び出し |
| 長時間ジョブ | background: trueで非同期実行。新規ジョブはチームあたり毎分600件まで。ストリーミングなしの長時間呼び出しでは504が返ることがある | Responses API |
| レート制限 | muse-wonder-1.0は1分あたり3,000リクエスト、4百万トークン。キー単位ではなくチーム単位 | 料金とレート制限 |
| リージョン | 中国、香港、マカオでは利用が制限される。Muse Wonderは韓国でも利用不可 | 地理的利用ポリシー |
| 学習への利用 | Standardモードでは、ユーザーのコンテンツは学習に使用されません。従量課金では、WonderのContributorモードは提供されていません。 | モデル |
表のうち2つの行が、審査エージェントの設計に影響します。1つ目はtool_choiceです。Metaのガイドラインによると、"none"、"required"、特定の関数の指定はいずれもHTTP 400を返します(ツール呼び出しのガイドライン)。特定のターンでモデルにツールの呼び出しを強制することはできません。そのため、ループでは毎ターン、ツール呼び出しとプレーンテキストの2通りの結果を処理する必要があります。また、各クリエイターについて4つのデータポイントがすべて揃っているかを自前のコードで確認し、不足があれば次のターンを送信するようにします。
2つ目は利用地域に関する行です。Metaのポリシーは中国、香港、マカオでの利用を制限しています。また、これらの地域のユーザーに統合製品を提供することや、制限を回避することも禁止しています(地理的利用ポリシー、セクション2.1および3)。米国のチームの多くはこの制限に該当しません。ただし、香港にスタッフやクライアントがいる米国の代理店は、このモデルを選ぶ前に確認が必要です。
Muse Wonder APIキー:4つの手順と3つの落とし穴
MetaのAI Developerヘルプセンターでは、キーの取得方法を4つのステップで説明しています。私たちはMetaアカウントを作成していないため、下の表は画面録画による検証ではなく、ヘルプセンターの記載に基づいています。
| ステップ | ヘルプセンターの記載 | 出典 |
|---|---|---|
| 1. 新規登録 | Model APIサイトで「Start building」をクリックします。Individualを選び、メール、電話番号、Facebook、Google、GitHubのいずれかでログインします。18歳以上で、対応地域にいる必要があります | 新規登録の方法 |
| 2. 支払い情報の登録 | 管理者がBillingページで支払い方法を追加し、あわせて正式な氏名と住所を登録します | 支払い情報を設定する |
| 3. キーの作成 | API keysページで「Create API key」をクリックし、名前を付けてコピーします。キーはチームに属します | APIキーを作成する |
| 4. 環境変数の設定 | export MODEL_API_KEY="..."で設定し、コードから読み込みます。フロントエンドのコードに含めたり、コミットしたりしないでください | クイックスタート |
1つ目の落とし穴は、支出に強制的な上限を設定できないことです。ヘルプセンターによると、Meta Model APIには利用を停止する支出上限の機能がありません。設定できるのは月間利用額のアラートメールだけで、設定額を超えた分についても支払いが必要です(支出上限アラート)。エージェントはツールをループで呼び出すため、バグがあると一晩中動き続けることがあります。そのため、後述のループコードでは独自にターン数の上限とトークン予算を設定しています。
2つ目の落とし穴は、課金のタイミングと返金です。Metaは利用額が支払いしきい値に達した時点でカードに請求し、残りは毎月1日に請求します(請求の仕組み)。ヘルプセンターには、Model APIでは返金を行わないとも書かれています(返金)。全リストを実行する前に、2人のクリエイターでテストしてください。
3つ目の落とし穴は、代理店にとって最も重要です。キーはチームに属し、ヘルプセンターによるとチーム外でキーを共有することは規約違反になります(APIキーを共有できますか)。また、Model API利用規約の第10.1条では、Metaの書面による許可なくサービスを第三者に再販することを禁じています。これにはキーやモデルへのアクセスも含まれます(利用規約、2026年10月9日更新)。複数のブランドクライアントのためにクリエイターを審査する場合も、キーはチーム内にとどめてください。クライアントにはキーではなくレポートを渡します。
EveryInfra側では、クイックスタートから新規登録し、コンソールでキーを作成します。こちらも環境変数に保存してください。2つのキーは役割が異なります。Metaのキーはモデルを呼び出し、EveryInfraのキーはデータを取得します。ツールのコードは自社のサーバーで実行されるため、モデルがどちらのキーを目にすることもありません。
Meta Muse Wonder APIの料金:$4と$20、さらに3つの価格
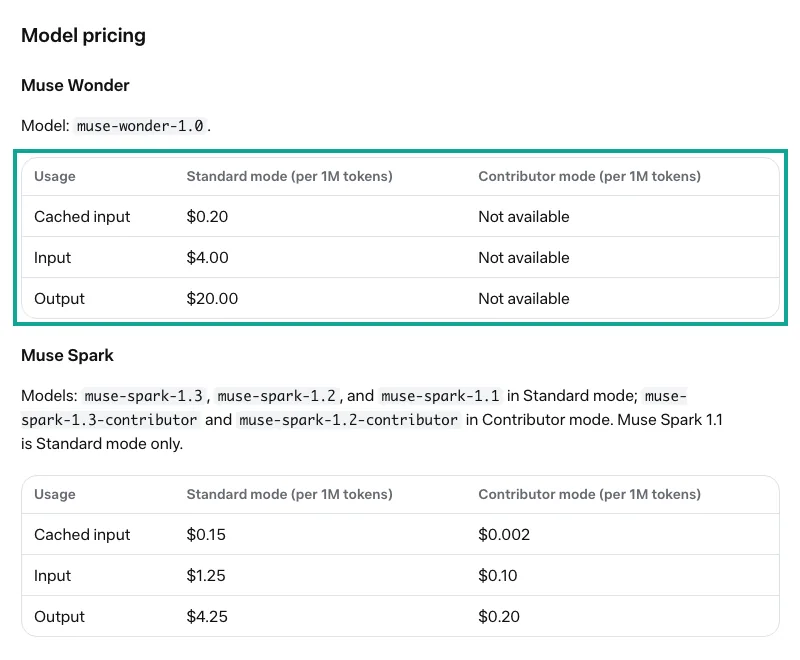
Metaの料金ページには、Muse Wonderの100万トークンあたりの価格として、入力$4.00、キャッシュ入力$0.20、出力$20.00の3つが記載されています。Contributorモードの列は「Not available」となっています(料金とレート制限)。2026年10月12日のMeta for Developersのリリース投稿にも、同じ「100万トークンあたり$4/$20」という数字が示されています(Meta for Developersの投稿)。
審査エージェントでは、さらに3つの価格が関わることがあります。1つ目はWeb検索です。組み込みのweb_searchツールには、1,000回の検索あたり$2.50の追加料金がかかります。このツールはWebページを検索するもので、動画ごとのデータは返せないため、今回は使用しません(検索グラウンディング)。
2つ目はMuse Sparkです。muse-spark-1.3モデルの料金は、100万トークンあたり入力$1.25、出力$4.25です。Contributor版は$0.10と$0.20ですが、ContributorモードではユーザーのコンテンツがMetaのモデルの学習に使用されます。また、規約の第6.2条では、機微情報、機密情報、個人情報をContributorサービスに送信することを禁じています(利用規約、第6条)。私たちの入力には一般ユーザーのコメント本文が含まれるため、Standardモードのみを使用します。
3つ目はキャッシュです。Metaは同一のプロンプトプレフィックスを自動的にキャッシュし、キャッシュされたトークンは100万トークンあたり$0.20です(プロンプトキャッシュ)。システムプロンプトとツール定義を先頭に置き、末尾のクリエイターリストだけを変更してください。こうすると、10人のクリエイターのバッチでは、固定のプレフィックスの大部分がキャッシュにヒットします。
| 項目 | Muse Wonder | Muse Spark 1.3 | Muse Spark 1.3 Contributor |
|---|---|---|---|
| 入力(100万トークンあたり) | $4.00 | $1.25 | $0.10 |
| キャッシュ入力 | $0.20 | $0.15 | $0.002 |
| 出力 | $20.00 | $4.25 | $0.20 |
| ユーザーのコンテンツを学習に使用 | いいえ(Standard) | いいえ(Standard) | 可能 |
| チームごとの1分あたりのリクエスト数とトークン数 | 3,000/4百万 | 3,000/4百万 | 150/3百万 |
| 審査エージェントに適している | メインループ:読み取り、比較、レポート作成 | コメントのラベル付けなどの補助タスク | コメント本文を扱うタスクには不向き |
レート制限も同じページに記載されています。Metaは制限をチーム単位で計算するため、チーム内のすべてのキーが1つの枠を共有し、モデルごとに別の枠があります(レート制限)。10人のクリエイターのリストなら、1分あたり3,000リクエストに近づくことはありません。実際に速度を制約するのはデータ側です。私たちのテスト用キーは1分あたり10リクエストまでで、それによって全体の実行時間がどうなるかは、実行結果のセクションで示します。
TikTokとYouTubeに絞る理由:対象範囲とMuseの利用規約
ブランドが組むクリエイターは、主にショート動画のクリエイターと長尺動画のクリエイターの2種類です。このガイドでは、それぞれ1つのプラットフォームを使います。ショート動画の代表がTikTok、長尺動画の代表がYouTubeです。
2つのプラットフォームのデータは大きく異なります。TikTokのフィードはアカウントをフォローしていない人にも動画を表示するため、再生数がフォロワー数の10分の1を超えることがあります。大規模なYouTubeチャンネルは過去何年分もの登録者を抱えているため、リーチは通常低くなります。この2つを並べると、本ガイドで繰り返し述べる点がよくわかります。指標の比較は同じプラットフォーム内に限ってください。その他のプラットフォームは対象外です。同じ4つのルールと同じツールパターンを使えますが、まず各エンドポイントのフィールドを確認してください。
モデル側にも、送信するデータに関するルールがあります。このセクションでは、Muse自身の法的文書(dev.meta.ai/legal)のみを引用しています。法的助言ではありません。規約はご自身で確認し、現地の法律や各データプラットフォームとの契約もあわせて確認してください。
Meta Model API利用規約(2026年10月9日更新)の第4.1条では、サービスに提供するデータについては利用者が責任を負うとしています。これにはデータの正確性と有効性も含まれます。第10.1条(vii)は、第三者の権利を侵害するなど、その権利を害する目的でサービスを利用することを禁じています。第10.3条には、Metaが自動レビューまたは人によるレビューを通じて利用状況を監視する場合があると書かれています(利用規約)。Data Commitmentsページには、MetaはStandardサービスのコンテンツをモデルのトレーニングに使用しないと記載されています。ただし、利用ポリシーや規約への違反を検出して対応するために、Metaがそのコンテンツを処理することはあります(データに関する取り組み)。
| 規定 | 対象範囲 | 主な内容(要約) | 審査エージェントへの影響 |
|---|---|---|---|
| Model API利用規約第4.1条 | 送信するデータ | データの正確性と有効性は利用者の責任 | すべての数値を生のレスポンスまでたどれるようにする |
| Model API利用規約第10.1条(vii)および第10.3条 | サービスの利用方法 | 第三者の権利を侵害する利用は禁止。Metaは利用状況を監視する場合がある | まず規約を読む。データソースと目的を確認する |
| データに関する取り組み | Standardサービス内のコンテンツ | 学習には使われない。違反への対応のために処理されることがある | コメント本文はStandardモードでのみ送信する |
| Model API利用ポリシー | 出力と目的 | センシティブな個人属性の推測は禁止。社会的行動に基づいて人をスコアリングし、不利益につなげることも禁止 | スコアリングの対象はアカウントのビジネスデータに限り、本人は対象にしない |
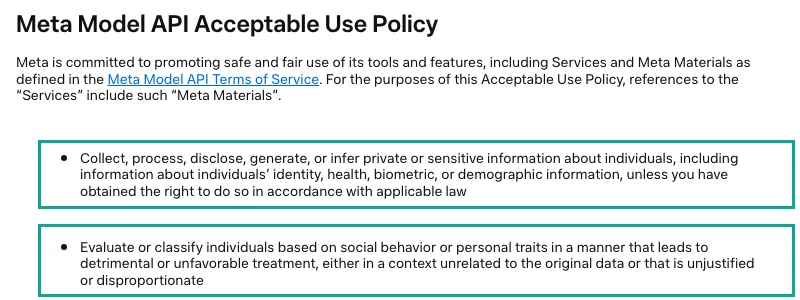
最後の行は見落としがちです。Meta Model API利用ポリシー(2026年10月12日更新)には、クリエイターのスコアリングに直接関わる項目が2つあります。1つは、法的な権利なしに個人に関する私的またはセンシティブな情報を収集、処理、開示、生成、推測することの禁止です。例としては、身元、健康、生体情報、人口統計データが挙げられます。もう1つは、社会的行動や個人的特性によって人を評価・分類することを、2つのケースで禁止するものです。1つは不利益な扱いにつながる場合、もう1つは本来の文脈から外れた利用の場合です(利用ポリシー)。
クリエイターの審査は、有償案件を進める前に行う一般的な手順です。ブランドはアカウントをメディアチャネルとして見ます。再生数は安定していますか? エンゲージメントはフォロワー数に見合っていますか? クリエイターは定期的に投稿していますか? コメントはコンテンツについて語っていますか? これらはアカウントに関するビジネス上の数値です。
一方、リスクがあるのは別の質問です。1つは、クリエイターの年齢、民族、健康状態、政治的立場をモデルに推測させることです。もう1つは、一般ユーザーのコメントを使って人にラベルを付けることです。
私たちのツールコードは、規約の範囲内に収まるように2つのことをしています。モデルに送るのはコメント本文、いいね数、返信数、投稿時刻だけで、コメント投稿者のユーザー名は送りません。また、システムプロンプトで、コンテンツのパフォーマンスだけを判断し、個人の特性は推測しないようモデルに指示しています。データで証明できることだけを述べるため、レポートの信頼性も高まります。
4つの指標:先にルールを決め、それからモデルに読ませる
審査レポートで最も厄介なのは、人によって意味が異なる言葉です。エンゲージメントをフォロワー数で割る人もいれば、再生数で割る人もいます。「本物のフォロワー」をコメントから判断する人もいれば、フォロワーあたりのいいね数を使う人もいます。計算式を変えると、判定が逆転することもあります。そこで、データを取得する前に4つの計算式をシステムプロンプトに入れました。モデルは数値を読み、比較し、判定を書きます。手法を考え出すことはしません。
| 指標 | このガイドでの計算式 | 使用するフィールド | わかること・わからないこと |
|---|---|---|---|
| フォロワーの真正性(代理指標) | リーチ = 3〜30日前に投稿された、ピン留めされていない動画の再生数の中央値をフォロワー数で割った値。あわせて平均値と中央値の比、最多再生動画の占める割合も見る | follower_count、view_count、posted_at、is_pinned | フォロワーのうちどれだけが今も視聴しているかがわかる。個々のフォロワーが偽物であることは証明できない |
| エンゲージメント率 | 動画ごとに(いいね + コメント + シェア)/ 再生数を求め、その中央値をとる。TikTokはリーチと同じサンプル(3〜30日前に投稿された、ピン留めされていない動画)を使う。YouTubeは(いいね + コメント)/ 再生数を使う | like_count, comment_count, share_count, view_count | 視聴者の反応があるかはわかりますが、実際のユーザーによるものか、有償で得たエンゲージメントかは区別できません |
| 30日間の投稿頻度 | 30日間のピン留めされていない動画数、最長の投稿間隔、投稿間隔の中央値、最新動画からの経過日数 | posted_at | アカウントが活動中かどうかがわかります。質については判断できません |
| コメントの内訳 | 各コメントに、ルールに基づいて5種類のラベルのいずれかを付けます。ラベルは、内容に沿ったもの(4語以上)、質問、3語以下、絵文字のみ、テキストなしです。完全に同一のコメントも数えます | text, is_reply | コメントが動画に反応しているかがわかります。誰が書いたかはわかりません |
なぜ「偽フォロワー率」ではなくリーチを使うのでしょうか。公開データでは、あるフォロワーが実在の人物かどうかはわかりません。また、審査でフォロワーリストを扱うべきでもありません。測定できるのは、フォロワー数と現在の再生数の差です。リーチは同じプラットフォーム上の同規模のアカウントと比較して初めて意味を持つため、このガイドでは固定の合格ラインを設けていません。
少数のヒット動画が平均値を押し上げることがあるため、すべての指標で中央値を使います。TechBullionは、TikTokクリエイター52人の動画675本を対象にした小規模な調査を報じました。そのうち73%のクリエイターで、平均再生数が中央値の1.5倍以上でした(TechBullion、2026年10月)。これは小規模なサンプルに基づく二次情報です。平均値が誤解を招きうることを示すためだけに使い、基準としては使いません。
エンゲージメントはフォロワー数ではなく再生数で割ります。フォロワー数で割ると、リーチの要素が混ざるためです。フォロワーが多くリーチが低いアカウントは、フォロワーあたりで見ると弱く見え、再生数あたりで見ると普通に見えることがあります。2つの計算方法は、別々の問いに答えます。1つはフォロワーがまだ残っているか、もう1つは視聴者が関心を持っているかです。私たちは両方を分けて報告します。
YouTubeには注意点が2つあります。シェア数は公開されていないため、YouTubeのエンゲージメントはいいねとコメントのみで計算します。また、YouTubeは2026年8月27日に、一般公開される再生回数のカウント方法を変更しました。現在は動画が最初のフレームから再生された時点で1回の視聴としてカウントされますが、収益化とほとんどのアナリティクスでは引き続きエンゲージドビューが使われます(YouTube Data APIの改訂履歴、YouTubeヘルプ)。この日付の前後の再生数を直接比較しないでください。
ツール定義:5つのツールを定義するJSON
Metaのヘルプセンターによると、Model APIはツール呼び出しに対応しており、モデルはユーザーが定義した外部ツールやデータソースを呼び出せます(モデルはツールを呼び出せますか?)。
形式はOpenAIのものとよく似ています。MetaはResponses APIを推奨しており、各ツールのトップレベルにフラットな関数フィールドを置きます。フィールドはtype、name、description、parameters、任意のstrictです(ツール呼び出し)。strictのデフォルトはfalseで、スキーマをそのまま受け付けます。trueにすると、サーバーがスキーマを厳格なサブセットに照らしてチェックします。すべてのプロパティをrequiredに含め、オブジェクトに"additionalProperties": falseを指定する必要があり、満たさない場合はHTTP 400が返ります(厳格なツールスキーマ)。私たちの5つのツールはすべてstrict: trueを使っています。パラメータが少なく、公開前にスキーマのミスを検出できるからです。
実際の設計上の論点は、ツールをどう分けるかです。最もシンプルなのは、EveryInfra MCPサーバーのeveryinfra_call_apiのように、platform、action、paramsを持つ汎用ツールを1つ用意する方法です。この場合、モデルはどのエンドポイントでも呼び出せますが、呼び出すたびにパラメータを組み立てる必要があり、ミスのたびに1ターンを消費します。審査は手順が決まっているため、エンドポイントごとに1つ、計5つの用途を限定したツールを使います。各ツールの説明には、「ピン留めされた動画が先頭に来るため、中央値を計算する前に除外すること」のような注意点を1つ明記しています。
関数名にはドットではなくアンダースコアを使います。Metaでは関数名に使えるドットは1つまでで、2つ含めると400が返ります。複数のパーツからなるMCP形式の名前には、代わりにnamespaceツールを使う必要があります(関数名のルール)。ツールが5つなら、Metaのツール検索は不要です。この機能は数百のツールを持つエージェント向けです。モデルが必要とするまでパラメータのスキーマを渡さないことで、入力トークンを節約し、キャッシュのプレフィックスを維持します(ツール検索)。
[
  {
    "type": "function",
    "name": "tiktok_videos",
    "description": "List the newest public videos of one TikTok account with views, likes, comments, shares, saves, posted_at, is_pinned and is_ad. Calls EveryInfra tiktok/user_videos. Pinned videos come first; drop them before you compute medians.",
    "strict": true,
    "parameters": {
      "type": "object",
      "properties": {
        "username": { "type": "string", "description": "TikTok handle without @" },
        "limit": { "type": "integer", "description": "1 to 50. Use 50 for a 30-day window." }
      },
      "required": ["username", "limit"],
      "additionalProperties": false
    }
  },
  {
    "type": "function",
    "name": "video_comments",
    "description": "Read public comments of one video. Returns comment text, like and reply counts and time only, never the commenter's name. Calls EveryInfra tiktok/comments or youtube/comments.",
    "strict": true,
    "parameters": {
      "type": "object",
      "properties": {
        "platform": { "type": "string", "enum": ["tiktok", "youtube"] },
        "video_url": { "type": "string", "description": "Full URL of one video" },
        "limit": { "type": "integer", "description": "1 to 50" }
      },
      "required": ["platform", "video_url", "limit"],
      "additionalProperties": false
    }
  }
]このブロックは5つのツールのうち2つを示しています。残りの3つは、tiktok/profile 用のtiktok_profile、youtube/profile 用のyoutube_channel、youtube/user_posts 用のyoutube_videosです。それぞれ、その日のカタログのresponse_fieldsと照合しました。最後の列は、レスポンス全体ではなく、ツールコードがモデルに返すサブセットです。TikTokの動画の生データには、カバー画像、音楽、投稿者のプロフィール文などを含む34のフィールドがあります。審査には不要でトークンも消費するため、コードで除外しています。
| ツール | エンドポイント | 呼び出し1回あたりの定価 | モデルに返すフィールド |
|---|---|---|---|
tiktok_profile | tiktok/profile | $0.000556 | username, display_name, follower_count, following_count, like_count, video_count, is_verified, created_at |
tiktok_videos | tiktok/user_videos | $0.000556 | id, url, posted_at, view_count, like_count, comment_count, share_count, collect_count, is_pinned, is_ad, duration_sec |
youtube_channel | youtube/profile | $0.000556 | name, url, subscriber_count, video_count, view_count, is_verified, created_at |
youtube_videos | youtube/user_posts | $0.000556 | id, url, title, posted_at, view_count, like_count, comment_count, duration, is_paid_partnership |
video_comments | tiktok/commentsまたはyoutube/comments | $0.000556 | text(200文字に切り詰め), like_count, reply_count, is_reply, posted_at |
エージェントループ:Metaのパターンへの3つの変更
Metaのツール呼び出しのドキュメントには、最小構成のループが示されています。toolsを付けてリクエストを送り、output内のfunction_callアイテムを探します。それぞれを実行して、previous_response_idを付けたfunction_call_outputを返すと、履歴はサーバー側で保持されます(ツール呼び出し)。私たちはこのパターンを踏襲し、3つの変更を加えました。以下のコードは設定例で、Meta側は実行していません。
# Example setup: Muse Wonder (Responses API) + EveryInfra tools. The Meta side was not run here.
import json, os
from openai import OpenAI
from ei_tools import run  # tool layer: calls EveryInfra, trims the response

meta = OpenAI(base_url="https://api.meta.ai/v1", api_key=os.environ["MODEL_API_KEY"])
TOOLS = json.load(open("tools.json"))
SYSTEM = open("system_prompt.txt").read()   # fixed prefix first, so it hits the cache
MAX_TURNS, MAX_TOKENS = 40, 400_000          # Meta has no hard spend cap; set your own

def due_diligence(creators: list[dict]) -> str:
    resp = meta.responses.create(model="muse-wonder-1.0", reasoning={"effort": "medium"},
                                 instructions=SYSTEM, tools=TOOLS, input=json.dumps(creators))
    used = resp.usage.total_tokens
    for _ in range(MAX_TURNS):
        calls = [i for i in resp.output if i.type == "function_call"]
        if not calls:                     # tool_choice is auto only: the model may just answer
            return resp.output_text
        outputs = []
        for c in calls:                   # one turn can hold several parallel calls
            body, code, raw, secs, out = run(c.name, json.loads(c.arguments))
            outputs.append({"type": "function_call_output", "call_id": c.call_id,
                            "output": json.dumps(out, ensure_ascii=False)})
        resp = meta.responses.create(model="muse-wonder-1.0", previous_response_id=resp.id,
                                     tools=TOOLS, input=outputs)
        used += resp.usage.total_tokens
        if used > MAX_TOKENS:
            raise RuntimeError(f"token budget exceeded: {used}")
raise RuntimeError("too many turns")1つ目の変更は、1ターンに複数の呼び出しが返る場合への対応です。Metaのガイドラインによると、モデルは1ターンに複数のツール呼び出しを返すことがあり、そのすべてに応答する必要があります。parallel_tool_callsのデフォルトはtrueです(ガイドライン)。クリエイター10人に対してそれぞれ5回の呼び出しがあると、一度に十数件の呼び出しが発生することがあります。私たちが使用したEveryInfraのテスト用APIキーでは1分あたり10リクエストまでしか送れないため、ツールレイヤーで呼び出しをキューに入れる必要があります。
2つ目の変更は、独自の上限を設けることです。max_tool_callsが制限するのはweb_searchなどの組み込みツールだけで、独自の関数は止められません。Metaは、parallel_tool_calls: falseを使うか、ループ内でターン数に上限を設けることを推奨しています。支出上限がないことと合わせて考えると、ターン数の上限とトークン予算の両方が必要です。
3つ目の変更は、結果を返す前に削ることです。function_call_outputに含めた内容はすべて、次のターンで入力トークンとして数えられます。削減率はコスト見積もりで最も大きな変数なので、後ほど独立したセクションで扱います。
構造化出力でレポートの形式を固定します。Metaのドキュメントによると、json_schemaを使うとデコード自体がスキーマに従うため、出力は必ずスキーマに一致します(構造化出力)。Responses APIではtext.formatで設定し、ツール呼び出しと併用できます。
このスキーマでは、クリエイター1人につき1件のレコードを持ちます。各レコードには、4つの指標値、各値の元になったサンプル数、1行の判定が入ります。さらにmissing配列があり、エージェントが取得できなかった数値や丸められて返ってきた数値を列挙します。この配列があるので、モデルがフィールドを埋めるために数値をでっち上げる理由がなくなります。
長時間のジョブ:50人のクリエイターリスト向けバックグラウンドモード
10人のリストなら数分で終わるため、通常のリクエストで問題ありません。50人を対象にする場合や、クリエイターごとに動画を複数ページ取得する場合は、Metaの長時間ジョブ向けのパターンを使います。Responses APIのドキュメントには3つの制限が記載されています(Responses API)。ストリーミングしないリクエストにはサーバー側の時間制限があり、時間がかかりすぎると504が返ります。
background: trueを指定すると、呼び出しはすぐにstatus: "queued"を返し、IDによるポーリング、結果のストリーミング、キャンセルができます。バックグラウンドリクエストのリクエストボディは最大1 MiBで、これを超えると413が返ります。料金ページには、チームごとに1分あたり最大600件のバックグラウンドジョブを作成できることも記載されています(Background responses)。
このジョブでは、1 MiBの上限が実際に問題になります。私たちの実際の実行では、1アカウントのTikTok動画50件分の生レスポンスは約114〜116 KBでした。10アカウント分の生JSONを1つのバックグラウンドリクエストに入れると、上限を超えます。ツールレイヤーで先に削っておけば、この問題はなくなります。
EveryInfraにも独自の非同期モードがあります。任意のリクエストボディに"mode": "async"を追加すると、レスポンスはすぐにjob_idを返します。その後、GET /api/v1/jobs/{job_id}で結果を取得します。同期処理の時間枠は85秒で、最新の値はカタログのasync_mode列で確認できます。最も安全なのは、両側で非同期を使う設計です。モデルが呼び出しを送り、コード側でそれをキューに入れて、許可されたレートで取得します。すべての結果がそろってから初めて、コードがモデルに結果を返します。
もう1つ注意すべき設定があります。Metaのヘルプセンターによると、チームでゼロデータ保持(ZDR)を有効にすると、いくつかの機能を利用したリクエストは拒否されます。対象には、以前のレスポンスを参照するステートフルなリクエスト、バックグラウンドリクエスト、ファイルのアップロード、Web検索が含まれます(ZDR help article)。私たちのループはprevious_response_idを使っています。ZDRを有効にした場合は毎ターン会話全体を送る必要があり、トークンが大幅に増えます。
もう1つの方法:Muse Wonderを使うClaude Agent SDKとEveryInfra MCPサーバー
独自のツールレイヤーは省略することもできます。Metaは2つ目の方法として、Claude Agent SDKでエージェントループを実行し、Metaのモデルに接続する構成をドキュメントで案内しています。エージェントフレームワークのページによると、SDKはAnthropic Messages形式でModel APIに接続します。ANTHROPIC_BASE_URLをhttps://api.meta.ai(/v1なし)に設定し、MetaのAPIキーをANTHROPIC_AUTH_TOKENに入れます。メインループにはmuse-wonder-1.0を使い、サブエージェントはより安価なmuse-spark-1.3に切り替えられます。同じページでは、信頼できるMCPサーバーだけを宣言するよう注意を促しています(Agent frameworks)。
この構成なら、EveryInfraのリモートMCPサーバーを接続できます。MCPの仕様では、サーバーはtools/listでツールの一覧を返し、tools/callでツールを実行します(MCP specification: Tools)。モデルにはeveryinfra_call_apiなどの用意済みツールが提示されるため、ツールJSONを書く必要はありません。
# Example setup: Claude Agent SDK with Muse Wonder as the model and the EveryInfra remote MCP server. Not run here.
import os, anyio
from claude_agent_sdk import query, ClaudeAgentOptions, ResultMessage

options = ClaudeAgentOptions(
    model="muse-wonder-1.0",
    system_prompt=open("system_prompt.txt").read(),
    mcp_servers={"everyinfra": {"type": "http", "url": "https://api.everyinfra.com/mcp",
                                "headers": {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}}},
    allowed_tools=["mcp__everyinfra__everyinfra_call_api", "mcp__everyinfra__everyinfra_get_job"],
    setting_sources=[],
    env={**os.environ,
         "ANTHROPIC_BASE_URL": "https://api.meta.ai",
         "ANTHROPIC_AUTH_TOKEN": os.environ["MODEL_API_KEY"],
         "ANTHROPIC_MODEL": "muse-wonder-1.0",
         "ANTHROPIC_DEFAULT_OPUS_MODEL": "muse-wonder-1.0",
         "ANTHROPIC_DEFAULT_SONNET_MODEL": "muse-spark-1.3",
         "ANTHROPIC_DEFAULT_HAIKU_MODEL": "muse-spark-1.3",
         "CLAUDE_CODE_SUBAGENT_MODEL": "muse-spark-1.3"},
)

async def main():
    async for m in query(prompt="Review these creators: natgeo, nasa, notionhq", options=options):
        if isinstance(m, ResultMessage):
            print(m.result, m.usage)

anyio.run(main)トレードオフは単純です。独自のツールJSONなら、どのフィールドを渡すか、テキストをどの長さにするか、コメント投稿者の名前を含めるかなど、モデルが読む内容を制御できます。MCPを使う方法では、コードを書く量を減らせます。その代わり、everyinfra_call_apiはレスポンス全体を返すため、TikTok動画1件につき34個のフィールドすべてがコンテキストに入ります。コメント投稿者のユーザー名も含まれます。これは実際のMCP呼び出し1回で計測したもので、数値は往復のセクションに掲載しています。
allowed_toolsには取得用ツールとジョブ用ツールだけを指定しています。これは、エージェントには必要なツールだけを与えるというMetaの推奨に沿ったものです。EveryInfra MCPサーバーにはサポートチケットやアカウントデータ用のツールもありますが、審査用のエージェントには不要です。
実際の1往復:モデルからのリクエストとコードによる取得
上記のツールJSONとループは設定例です。このセクションでは、そのうち実際に動かした部分を扱います。ツールレイヤーは独立したファイルとして作成しました。このファイルは、Muse Wonderが送るのと同じfunction_callの引数を受け取り、関数名ごとにEveryInfraのエンドポイントに対応付けます。そしてリクエストを送り、必要なフィールドを残し、コメント投稿者の名前を削除して、結果をfunction_call_outputの形にまとめます。
モデル側が送るのは、常に関数名とJSON文字列だけです。私たちの側は同じ入力を受け取るため、取得処理と結果は、Muse Wonderをループに組み込んだ場合と同じになります。
NASAに対する4回の呼び出しを時系列で示します。各行は実際のリクエスト1件です。時刻はリクエストを送信した時点のSGTで、横に米国東部時間を併記しています。所要時間は、送信から最後のバイトを受信するまでの時間です。「生データ」はレスポンスボディのサイズ、「モデル入力」はツールレイヤーで削った後のサイズです。
| 時刻(SGT、11月5日) | 時刻(ET、11月4日) | ツールとエンドポイント | 所要時間 | 生データ | モデル入力 | 課金額 |
|---|---|---|---|---|---|---|
| 00:18 SGT | 11:18 ET | tiktok_profile、tiktok/profile | 11.35 s | 1,587 B | 287 B | $0.000556 |
| 00:22 SGT | 11:22 ET | tiktok_videos、tiktok/user_videos(動画50件) | 35.81 s | 116,106 B | 14,206 B | $0.000556 |
| 00:25 SGT | 11:25 ET | youtube_channel、youtube/profile | 8.96 s | 1,797 B | 299 B | $0.000556 |
| 00:28 SGT | 11:28 ET | video_comments、tiktok/comments(コメント50件) | 58.22 s | 16,761 B | 7,805 B | $0.000556 |
以下は1回目の呼び出しのリクエストとレスポンスです。長いアバターURLのフィールドだけを削除し、それ以外は受け取ったままにしています。follower_countは2,200,000と正確な値に見えますが、結果のセクションで説明するとおり、これは丸められた値です。
POST https://api.everyinfra.com/api/v1/social
{"platform":"tiktok","action":"profile","params":{"username":"nasa"}}

200 OK, 00:18:46 SGT, 11.35 s, billed $0.000556
{"user_id":"7664638705177150477","username":"nasa","display_name":"NASA",
 "bio":"Making the seemingly impossible, possible.✨","url":"https://www.tiktok.com/@nasa",
 "follower_count":2200000,"following_count":23,"like_count":11500000,"video_count":62,
 "friend_count":17,"is_verified":true,"is_private":false,
 "created_at":"2026-07-20T15:55:49+00:00","platform":"tiktok"}
モデルに渡すコピーには8つのフィールドがあり、287バイトです。プロフィールデータを絞り込んでも、削減量はわずかです。大きく削減できるのは動画リストです。TikTok動画50件の生データは116,106バイトあり、各動画にはカバー画像、音楽、投稿者データ、複数のURLなど34個のフィールドがあります。審査ジョブに必要なのはそのうち11個なので、絞り込み後のコピーは14,206バイトで、生データの約8分の1になります。
下の画像は、コメント取得の往復を並べて示したものです。上のブロックはモデルが送信することになる呼び出しの例で、引数はライブ実行時のものです。下のブロックは、National GeographicのTikTok動画1本に付いた50件のコメントのうち最初の2件を、私たちのツールレイヤーが返したままの形で示しています。画像用にコメント本文は短くしています。コメント投稿者の名前は、ツールのコードの段階ですでに削除されています。
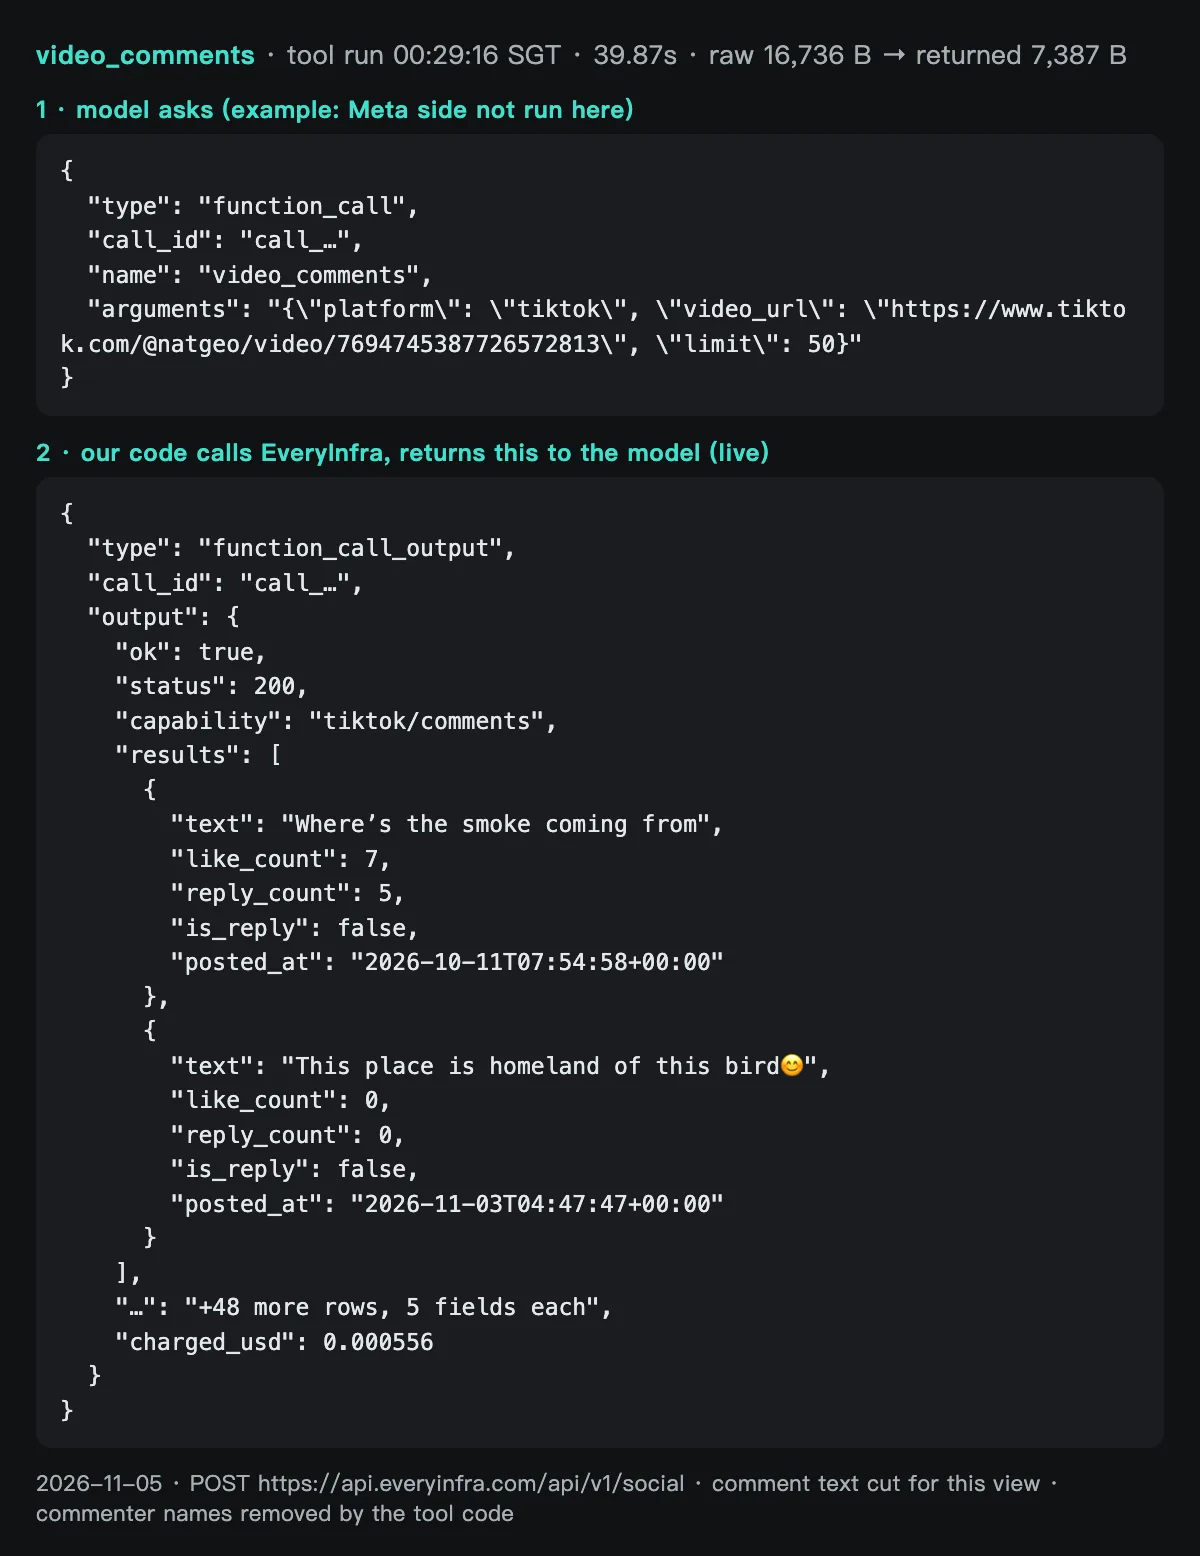
同じデータでも、MCP経由ではトークン数が約2倍になります。00:38 SGT(11:38 ET)に、EveryInfraのリモートMCPサーバーでeveryinfra_call_apiを使い、National GeographicのYouTube動画1本から50件のコメントを取得しました。呼び出しには16.74秒かかり、課金額は$0.000556でした。モデルに渡されるテキストは18,198バイトで、コメント1件あたりauthor_nameを含む8つのフィールドがあります。私たちのフィールドホワイトリストを使えば、同じ50件のコメントを名前なしの9,516バイトまで削減できます。
MCPを使えばコードを書く手間は省けますが、呼び出しごとのトークン数は2倍になります。また、モデルが読む前にコメント投稿者の名前を削除することもできません。クライアントが読むレポートでは、2点目のほうが重要です。前述の利用ポリシーは、人物に関する推論も対象としているためです。
失敗も記録しました。NASAのYouTubeコメントは、00:37 SGTと00:40 SGTの2回、503を返しました。エラーボディにはretryable: trueとretry_after: 20が含まれ、billing.chargedはfalse、返金ステータスはsucceededでした。
同じエンドポイントが10分以内に3回目の失敗をすると、メッセージが変わりました。呼び出し元にサンプルリクエストを一度送るよう促し、サンプルが成功するなら問題は対象側にあると説明する内容です。当社のツール層が求めているのは、こうしたエラーの書き方です。モデルは、どれだけ待つべきか、再試行すべきか、次に何を確認すべきかを読み取れます。
Notionについては、最初に選んだ2026年10月27日の動画のcomment_countが0でした。エンドポイントは200と空の配列を返し、理由がempty_result_refundedだったため、費用はかかりませんでした。そこで、コメントが5件ある2026年10月23日の動画に切り替えたところ、2件が返ってきました。この実行でデータが返らなかったリクエストは6件で、内訳は429が2件、503が3件、空の結果が1件です。いずれも課金されませんでした。
実測結果:3アカウントの4指標と6つのデータ上の落とし穴
このセクションでは、各指標を詳しく見ていきます。すべてのグラフは同じ生のレスポンスから作成し、上のルール表に従っています。数値の後には、実際に遭遇した落とし穴をまとめます。これらの落とし穴は、システムプロンプトに入れておくべきものです。
TikTokとYouTubeの間でリーチを比較してはいけません。TikTokのフィードはフォローしていない人にも動画を表示するため、再生数がフォロワー数の10分の1を超えることがあります。大規模なYouTubeチャンネルには、何年も前に登録して今はほとんど視聴しない登録者が多いため、リーチは低くなります。比較は同じプラットフォーム内に限ってください。TikTokでは、NASAが13.25%、Notionが9.05%、National Geographicが0.23%で、50倍以上の差があります。リーチだけを見ると、エージェントは「フォロワー数と再生数が釣り合っていない」と書いてしまうでしょう。
エンゲージメントのグラフを見ると、この判断の半分が覆ります。National Geographicの再生あたりエンゲージメントの中央値は8.15%で、NASAの8.97%との差は1ポイント未満です。Notionは1.48%です。National Geographicの動画を見た人は、NASAの動画を見た人とほぼ同じ頻度でいいねやシェアをしています。
リーチが低くてもエンゲージメントが通常の水準であれば、投稿数が多いために各動画がオーディエンスの一部にしか届いていないアカウントだと考えられます。フォロワーの購入を示すものではありません。購入されたフォロワーは視聴もいいねもしないため、両方の数値がそろって下がるはずです。
このパターンは投稿頻度で説明できます。National Geographicは30日間に固定されていないTikTokを50本投稿しており、最新は2026年11月3日のものです。投稿間隔の中央値は0.62日、最長は3.1日です。NASAは9本で、最新は2026年10月30日のもの、間隔の中央値は2.62日、最長は6.0日です。
同じフォロワーに1日1〜2本の新しい動画が届くと、各動画が届くフォロワーの割合は小さくなります。エージェントが投稿頻度とリーチを併せて読めば、「投稿頻度が高く、動画あたりのリーチは低いが、エンゲージメントは通常の水準」という正確な一文を書けます。
Notionの行は空です。最新のTikTokは2026年5月26日のもので、データ取得時点で161.7日が経過していました。9.05%というリーチは、直近とはいえ古い動画15本から算出されたものです。来月の案件について判断するうえで、この数値は何の参考にもなりません。
コメントのラベル付けにはモデルを使いませんでした。使ったのは、テキストなし、絵文字または句読点のみ、疑問符を含む、3語以下、それ以外はすべてトピックに沿ったもの、という5つの固定ルールです。大まかなルールですが、誰でも再計算でき、コメントを恣意的に解釈することもありません。
NASAのTikTokコメントには質問が16件あり、そのほとんどは動画の内容に関するものです。科学系クリエイターにとっては良い兆候です。National GeographicのTikTokコメントには、短いものが15件、英語以外の文字やアクセント記号を含むものが16件あり、オーディエンスが世界中にいることがうかがえます。YouTubeでは、同ブランドのコメント50件中44件がトピックに沿っており、長さの中央値は77文字です。コメントの質の比較も、同じプラットフォーム内に限ってください。
もう1つ注意が必要なコメントの種類があります。2026年9月30日、YouTube Data APIはコメントにsnippet.imageUrlを追加し、コメントに画像やGIFを含められるようになりました。2026年11月には全ユーザーが利用できるようになります(YouTube Data APIの改訂履歴)。テキストだけを読む仕組みでは画像のみのコメントを見落とすため、当社のルールではテキストなしのコメントを別に数えています。
| # | 落とし穴 | 確認した内容 | エージェントがすべきこと |
|---|---|---|---|
| 1 | TikTokの数値は丸められている | 再生数が10,000以上の動画は、すべて再生数が100の倍数です。フォロワー数は2,200,000、9,700,000、143,700です | レポートには「約」と書く。少ないサンプルで小数点以下2桁は避ける |
| 2 | 50本では30日間をカバーできないことがある | National Geographicの最初のページ(50本)は28.8日分しかありませんでした。untilを指定した2ページ目で期間を埋めました | 最も古い日付を確認し、30日未満なら次のページを取得する |
| 3 | 固定された動画が先頭に来る | NASAとNational Geographicにはそれぞれ固定された動画が1本あり、ほかの動画よりはるかに古いものです | 中央値や間隔を計算する前にis_pinnedの項目を除外する |
| 4 | YouTubeの一覧は相対日付を使う | youtube/user_postsは「2w ago」や「1mo ago」といった日付と千単位で丸めた再生数を返し、いいね数やコメント数は返しません | 30日の境界付近の動画はyoutube/videoを呼び出し、正確な日時と再生数を取得する |
| 5 | YouTubeのいいね数も丸められている | 2026年10月14日のNASAの動画は、再生数が684,881、いいね数が11,000です。NASAの動画4本はすべてcomment_countが0です | いいね数は丸めた値であると明記する。件数が0ならコメントの評価は行わない |
| 6 | アカウントが新しいだけでは、不正な成長とは判断できない | NASAのTikTokのcreated_atは2026年7月20日、フォロワーは2.2百万人ですが、リーチ率13.25%は六つの中で最高です | 成長はリーチやエンゲージメントと併せて読む。1つの数値だけで判断しない |
落とし穴2と4では、呼び出し回数が最も多くなりました。投稿の多いTikTokアカウントでは、30日分をカバーするために動画取得の呼び出しを2回行う必要があります。YouTubeチャンネルでは、いいね数と正確な投稿日を取得するため、一覧取得後に個別動画の呼び出しを数回行う必要があります。今回は、実用に足る中央値と追加コストのバランスを取り、チャンネルごとに4本の動画を取得しました。この4回の呼び出しにかかった費用は$0.0022で、クリエイター1人分のデータ料金の40%に相当します。リストの大半がTikTokクリエイターであれば、個別動画の呼び出しを省き、YouTubeは登録者数と投稿頻度だけで判断できます。
落とし穴5には、もう1つ注意点があります。YouTubeは2026年8月27日に再生回数のカウント方法を変更しました。今回確認した12本の個別動画はすべてその日以降に投稿されているため、YouTubeのエンゲージメントの数値は変更日の前後にまたがっていません。クリエイターの最近の動画の投稿日がこの日をまたぐ場合は、その旨をレポートに明記してください。
Muse Wonder APIのコスト:クリエイター10人のリストにかかる費用
このセクションでは、クリエイター10人のリストにいくらかかるのか、という1つの問いに答えます。費用は2つに分かれます。EveryInfraのデータ料金は定価×呼び出し回数なので、正確な値です。Metaのモデル料金は定価×トークン数です。MetaのAPIキーがなく、モデルを実行していないため、こちらは推定値です。すべての入力値を記載しているので、ご自身の値に置き換えて計算できます。
| クリエイターあたりの呼び出し | 件数 | 定価 | 小計 |
|---|---|---|---|
TikTokプロフィール、tiktok/profile | 1 | $0.000556 | $0.000556 |
TikTok動画、tiktok/user_videos(投稿の多いアカウントは2ページ目も取得) | 1〜2 | $0.000556 | $0.000556〜$0.001112 |
TikTokコメント、tiktok/comments | 1 | $0.000556 | $0.000556 |
YouTubeチャンネル、youtube/profile | 1 | $0.000556 | $0.000556 |
YouTube動画一覧、youtube/user_posts | 1 | $0.000556 | $0.000556 |
YouTube単一動画、youtube/video | 4 | $0.000556 | $0.002224 |
YouTubeコメント、youtube/comments | 1 | $0.000556 | $0.000556 |
| 合計 | 10〜11 | $0.00556〜$0.00612 |
クリエイター10人では呼び出しが100〜110回となり、データ料金は$0.0556〜$0.0612です。失敗、タイムアウト、空の結果は課金されないため、これは上限値です。今回の実行では、36件のリクエストのうち30件が課金されました。料金は当日のカタログ(料金ページ)に基づきます。カタログはAPIキーなしで無料で参照できます。
モデル料金の推定は、4つの前提に基づいています。1つ目は、クリエイターごとに3ターンの独立した会話を行うことです。ターン1で4回のデータ呼び出しを行い、ターン2でコメント取得の呼び出しを行い、ターン3でレポートを書きます。2つ目は、固定のプレフィックス(システムプロンプトと5つのツール定義)が1,500トークンであることです。
3つ目に、ツールの結果はバイト数÷4でトークンに換算します。Metaのヘルプセンターによると、1トークンは英語テキストで約3〜4文字に相当し、他の言語やコードではより多くのトークンを消費します(How am I billed)。そのため、4で割るのは低めの見積もりです。後のターンでは、それ以前の結果を再度読み込みます。4つ目に、出力と推論の合計はクリエイターあたり4,000トークンです。
実際のデータでは、クリエイターあたりの結果はトリミング後で平均30,541バイト、未加工で平均154,694バイトでした。
これらの入力値では、各クリエイターの3ターン分の入力トークンは、トリミング後で約18,243、未加工で74,112になります。Muse Wonderの料金では、キャッシュなしのトリミング後の実行はクリエイターあたり$0.153で、そのうち$0.08が出力です。再読み込み時のトークンがキャッシュにヒットする場合、トリミング後の実行はクリエイターあたり$0.118です。キャッシュなしの未加工の実行は$0.376です。これらを10倍すると、グラフの3つの合計になります。
| クリエイター10人のリスト | データ料金 | モデル料金(推定) | 合計 | モデル料金÷データ料金 |
|---|---|---|---|---|
| トリミング後・キャッシュあり | $0.0612 | $1.18 | $1.25 | 19x |
| トリミング後・キャッシュなし | $0.0612 | $1.53 | $1.59 | 25x |
| 未加工・キャッシュなし | $0.0612 | $3.76 | $3.82 | 61x |
この表からわかることは2つです。第1に、削減できるのはデータ側ではなくモデル側です。データ料金は3行すべてで同じで、モデル料金は結果のサイズによって3倍を超える差があります。
第2に、結果を絞り込んだ後は出力が最大のコストになります。最も安い行では、クリエイター1人あたり$0.118のうち$0.08が4,000出力トークンの分です。Muse Wonderの出力は入力の5倍の料金で、推論トークンも出力として課金されます。そのため、このレポートにhighの推論は必要ありません。Metaではeffortをminimalからmaxまで設定でき、数値を読んで比較し4行書くだけならmediumかlowで十分です。
本番の実行前に、MetaのPOST /v1/responses/input_tokensでトークン数を数えられます。ドキュメントによると、このエンドポイントはトークン化のみを行い、生成はせず、使用量も記録しません。Metaは、課金額の見積もりではなく、コンテキストに収まるかの確認に使うよう案内しています(Token counting)。実行中は各ターンのusageを読み取り、今回の推定値を実際のトークン数に置き換えてください。
時間も重要です。Muse Wonderは毎分3,000リクエストまで対応しているため、モデル側がボトルネックになることはありません。ボトルネックになるのはデータ側です。今回のテスト用APIキーは毎分10リクエストまでで、他のジョブとも共有していました。36件のリクエストは00:18:46から00:42:08 SGT(11:18から11:42 ET)まで実行され、所要時間は23分22秒でした。2件のリクエストが429レスポンスを受け、それぞれ60秒待機しました。
呼び出しが110回あるクリエイター10人のリストでは、毎分10回の制限で最低11分かかります。課金された30回の呼び出しでは、中央値が22.2秒、最も遅いもので78.2秒でした。データが返らなかった6回を含めると、最も遅いもので89.6秒でした。ツール層では呼び出しをキューに入れ、毎分の上限を超えない範囲で数件ずつ並行実行してください。
このテストの制約
| 制約 | 影響 | 補い方 |
|---|---|---|
| Meta側は実行していない | ツールのJSON、ループ、スキーマはMetaのドキュメントに沿っている。モデルが呼び出しをどう分割するか、推論トークンをどれだけ使うかは測定していない | まず2人のクリエイターで実行し、usageを確認する |
| ブランドアカウントは3つのみ | いずれも大手の認証済みブランドで、小規模なクリエイターを代表していない | よく知っているクリエイターを2〜3人、対照群として追加する |
| モデル料金は推定値 | バイト数÷4、3ターン、出力4,000トークンは前提値 | 実際のusageで再計算する |
| コメントは各プラットフォームで動画1本分のみ | コメントの傾向は動画1本についてのもの | 主要なクリエイターについては、さらに2〜3本の動画をサンプリングする |
| ルールベースのコメント分類 | 皮肉や複数言語が混在するコメントが「話題に沿ったもの」に分類される可能性がある | ルールで一次チェックし、フラグが付いた項目をレビューする |
| YouTubeコメントの欠損 | NASAでは2回失敗し、Notionではコメントが2件しか返されなかった | 欠損はmissingに記録し、空のデータからは判定しない |
2つ目の制約は、判定を最も左右しやすいものです。3ブランドはいずれもフォロワーが100,000人を超えているため、百単位または千単位に丸めても、ほとんど影響しません。フォロワー8,000人のクリエイターの場合、数値の丸め、サンプル数の少なさ、1本のバイラル動画の影響がいずれも大きくなります。そこで、サンプル数が少ない場合のルールをシステムプロンプトに1つ追加します。ルールは次のとおりです。対象期間内の動画が5本未満、またはフォロワーが10,000人未満の場合は、4つの数値を報告し、判定は出しません。
FAQ
Muse Wonder APIの料金と課金方法は?
トークン単位の課金で、月額料金や最低利用額はありません。100万トークンあたり、入力$4.00、キャッシュ済み入力$0.20、出力$20.00です。推論トークンは出力として計上されます(Pricing and rate limits、Quickstart)。Metaによると、Metaが挿入するシステムコンテンツとステアリングコンテンツは課金されず、usageにも表示されません。審査を1回実行すると、Metaのモデル料金とEveryInfraのリクエストごとのデータ料金という2種類の料金が発生します。上記のコストセクションでは、クリエイター10人分について両方を見積もっています。
Muse Wonder APIのAPIキーはどこで取得でき、同僚も使えますか?
Model APIのサイトで新規登録し、「API keys」ページを開きます。次に「Create API key」ボタンをクリックします。APIキーはチームに属するため、チームのメンバーなら誰でも使えます(Create an API key)。チーム外の人は使えません。ヘルプセンターによると、チーム外の人とAPIキーを共有することは利用規約に違反します(Can I share my API key)。
新規登録の前に、利用地域を確認してください。ヘルプセンターによると、Model APIはMeta AIと課金を利用できるほとんどの地域で使えます。最終的な基準は地域ポリシーです(Supported countries)。中国、香港、マカオでは利用が制限されています(Geographic Use Policy)。
Muse Wonder FullはAPIから呼び出せますか?
いいえ。Metaのモデルページによると、Wonder FullはPower UsageプランとMaximum UsageプランのMuse Codeサブスクリプションでのみ使えます。APIでreasoning effortをmaxに設定しても、Fullには切り替わりません(Models)。ローンチ当日には、Hacker Newsのコメント投稿者も同じ点を指摘していました。その投稿者によれば、ベンチマークで首位のFullモデルはサブスクリプション利用者向けで、APIで使えるのはMuse Wonderだけです(Hacker Newsのコメント)。Muse Codeサブスクリプションは専用のコマンドラインツールでのみ使え、API呼び出しには使えません(Muse Code subscriptions)。
Muse Wonder APIはときどき失敗するという開発者もいます。審査エージェントではどう対処すべきですか?
ローンチ直後、Hacker Newsのコメント投稿者は、最高水準に近いものの高すぎると評し、APIがときどき失敗するとも書いていました(Hacker Newsのコメント)。これは1人の報告で、私たちは再現していません。Metaのエラードキュメントには、リトライ可能なエラーが記載されています。モデル出力のパースに失敗すると500が返ります。バックエンドが混雑していると、Retry-After: 60付きでservice_overloadedが返ります。429の場合はRetry-Afterに従ってバックオフします(Error handling)。
リトライは2層に分けて実装します。Meta側では、ドキュメントの指示に従ってバックオフします。EveryInfra側では、失敗した呼び出しと空の結果は課金されません。また、429が返された場合、本記事のツールコードは60秒待機します。
はじめに:ゼロから最初の審査レポートまで
各プラットフォームには、すべてのエンドポイントと現在の料金をまとめた概要ページがあります(TikTok API、YouTube API)。EveryInfra側の手順は3つです。まず、クイックスタートから新規登録してAPIキーを作成します。次に、tiktok/user_videos、tiktok/comments、youtube/commentsがその日に利用可能かをカタログで確認します。最後に、よく知っているアカウント1つでツールコードを実行し、フォロワー数と再生数をアプリの表示と照合します。
カタログはAPIキーなしで無料で閲覧できます(GET /api/v1/social/catalog)。ブラウザで呼び出しを試すには、データマーケットのテストコンソールを使います。AIツールを直接接続する方法は、リモートMCPセットアップガイドを参照してください。失敗した呼び出しや空の結果に対する返金と照合については、失敗時の返金と照合を参照してください。422エラーの後にエージェントが自らパラメータを修正できるようにするには、APIエラーの自己修復を参照してください。
Meta側の手順は4つです。APIキーのセクションで説明したとおり、新規登録、課金設定、APIキーの作成、環境変数の設定を行います。tools.jsonとシステムプロンプトをプロジェクトに配置します。コードを書かずにツールを試すには、Playgroundを開き、「Advanced」、「Tools」の順に進んで「Add tool」を選択します。tools.jsonの各定義を貼り付けます。Playgroundでは、ツールを呼び出すタイミングをモデルが判断します(Using tools in the Playground)。まずクリエイター2人で実行し、その後10人に広げます。実行後は各ターンのusageを確認し、私たちの見積もりを実際のトークン数に置き換えてください。
参考文献
- Introducing Muse Wonder and Muse Wonder Full: Frontier Models for Agents、Meta Newsroom、2026年10月12日、<https://about.fb.com/news/2026/10/introducing-muse-wonder-models/>
- Muse Wonder: A Frontier Model For Personal & Professional AI Agents、Metaリサーチブログ、2026年10月12日、<https://research.meta.ai/blog/muse-wonder>
- Muse Wonder製品ページ、Meta、2026年11月5日閲覧、<https://dev.meta.ai/models/muse-wonder>
- Get started with Meta Model API and Muse Code、Meta開発者ドキュメント、2026年11月5日閲覧、<https://dev.meta.ai/docs/overview>
- Models、Meta開発者ドキュメント、2026年11月5日閲覧、<https://dev.meta.ai/docs/models>
- Pricing and rate limits、Meta開発者ドキュメント、2026年11月5日閲覧、<https://dev.meta.ai/docs/pricing-rate-limits>
- Quickstart、Meta開発者ドキュメント、2026年11月5日閲覧、<https://dev.meta.ai/docs/quickstart>
- Tool calling、Meta開発者ドキュメント、2026年11月5日閲覧、<https://dev.meta.ai/docs/tool-calling>
- Responses API、Meta開発者ドキュメント、2026年11月5日閲覧、<https://dev.meta.ai/docs/protocols/responses>
- Structured output、Meta開発者ドキュメント、2026年11月5日閲覧、<https://dev.meta.ai/docs/structured-output>
- Prompt caching、Meta開発者ドキュメント、2026年11月5日閲覧、<https://dev.meta.ai/docs/prompt-caching>
- Tool search、Meta開発者ドキュメント、2026年11月5日閲覧、<https://dev.meta.ai/docs/tool-search>
- Agent frameworks、Meta開発者ドキュメント、2026年11月5日閲覧、<https://dev.meta.ai/docs/agent-frameworks>
- Error handling、Meta開発者ドキュメント、2026年11月5日閲覧、<https://dev.meta.ai/docs/error-handling>
- Muse Code subscriptions、Meta開発者ドキュメント、2026年11月5日閲覧、<https://dev.meta.ai/docs/muse-code/subscriptions>
- Search grounding、Meta開発者ドキュメント、2026年11月5日閲覧、<https://dev.meta.ai/docs/search-grounding>
- How do I sign up for Model API?、Meta AI Developerヘルプセンター、2026年11月5日閲覧、<https://dev.meta.ai/help/accounts-and-login/sign-up>
- How do I create an API key?、Meta AI Developerヘルプセンター、2026年11月5日閲覧、<https://dev.meta.ai/help/api-keys/create-api-key>
- Can I share my API key?、Meta AI Developerヘルプセンター、2026年11月5日閲覧、<https://dev.meta.ai/help/api-keys/sharing-api-keys>
- How can I set up billing for Meta Model API?、Meta AI Developerヘルプセンター、2026年11月5日閲覧、<https://dev.meta.ai/help/billing/set-up-billing>
- How am I billed for Model API?、Meta AI Developerヘルプセンター、2026年11月5日閲覧、<https://dev.meta.ai/help/billing/api-bill>
- 「利用額上限アラートを設定するにはどうすればよいですか?」、Meta AI Developerヘルプセンター、2026年11月5日閲覧、<https://dev.meta.ai/help/billing/spend-limit-alert>
- 「Meta Model APIの返金を申請するにはどうすればよいですか?」、Meta AI Developerヘルプセンター、2026年11月5日閲覧、<https://dev.meta.ai/help/billing/refunds>
- 「Model APIはZero Data Retention(ZDR)に対応していますか?」、Meta AI Developerヘルプセンター、2026年11月5日閲覧、<https://dev.meta.ai/help/policies-and-privacy/zero-data-retention>
- Meta Model API利用規約、Meta、2026年10月9日更新、<https://dev.meta.ai/legal/terms-of-service>
- Meta Model API利用規定、Meta、2026年10月12日更新、<https://dev.meta.ai/legal/acceptable-use-policy>
- Meta Model APIのモデル指定および地理的利用に関するポリシー、Meta、2026年10月12日更新、<https://dev.meta.ai/legal/geographic-use-policy>
- Muse Wonderが本日よりMeta Model APIとMuse Codeで利用可能に、Meta for Developers(Facebook投稿)、2026年10月12日、<https://www.facebook.com/MetaforDevelopers/posts/muse-wonder-is-available-today-on-meta-model-api-and-in-muse-code-and-muse-wonde/1552628546897475/>
- YouTube Data APIの改訂履歴、Google for Developers、2026年11月3日更新、<https://developers.google.com/youtube/v3/revision_history>
- YouTubeコンテンツのパフォーマンスを把握する、YouTubeヘルプ、2026年11月5日閲覧、<https://support.google.com/youtube/answer/12220281>
- ツール、Model Context Protocol仕様(2025-06-18)、<https://modelcontextprotocol.io/specification/2025-06-18/server/tools>
- 平均再生回数は嘘をつく:TikTokクリエイターの動画675本から得た知見、TechBullion、2026年10月、<https://techbullion.com/average-views-lie-learned-675-tiktok-creator-videos/>
- Muse Wonderに関するHacker Newsスレッドのコメント(ユーザー名非表示)、Hacker News、2026年10月、<https://news.ycombinator.com/item?id=50065098>
- Muse Wonderに関するHacker Newsスレッドのコメント(ユーザー名非表示)、Hacker News、2026年10月、<https://news.ycombinator.com/item?id=50061435>
- EveryInfraデータカタログ(無料で閲覧可能)、EveryInfra、2026年11月5日閲覧、<https://api.everyinfra.com/api/v1/social/catalog>
- トークンのカウント、Meta開発者ドキュメント、2026年11月5日閲覧、<https://dev.meta.ai/docs/token-counting>
- Meta Model APIのデータに関する確約事項、Meta、2026年11月5日閲覧、<https://dev.meta.ai/legal/commitments>
- 「Model APIはどの国と地域で利用できますか?」、Meta AI Developerヘルプセンター、2026年11月5日閲覧、<https://dev.meta.ai/help/accounts-and-login/supported-countries>
- 「モデルはツールを呼び出せますか?」、Meta AI Developerヘルプセンター、2026年11月5日閲覧、<https://dev.meta.ai/help/about-model-api/tool-calling>
- 「Playgroundでツールを使用するにはどうすればよいですか?」、Meta AI Developerヘルプセンター、2026年11月5日閲覧、<https://dev.meta.ai/help/playground/using-tools-in-the-playground>
参考資料 BL-89