Muse Wonder API 做达人尽调:取数实测与成本估算
Muse Wonder API 做达人尽调:tools JSON、真实取数往返、10 人接口费实测和模型费估算,以及四项指标里会碰到的数据坑。
我们在 2026-11-05 00:18–00:42(新加坡时间)用 EveryInfra 接口给 NASA、National Geographic、Notion 三个品牌账号各跑了一遍 TikTok 和 YouTube 尽调,共 36 次请求,扣费 30 次,合计 $0.01668。最反直觉的一个数是:National Geographic 的 TikTok 有 970 万粉丝,一条视频的播放中位数只有 22,600,触达率 0.23%,是六组里最低的;但看过视频的人里,(赞 + 评 + 转)÷ 播放的中位数是 8.15%,和触达率 13.25% 的 NASA(8.97%)几乎一样。它 30 天发了 50 条,播放被摊薄了,粉丝并没有「不在」。如果尽调 agent 只看触达率,会把一个运营正常的大号误判成「粉丝有水分」。
这篇文章回答一个具体问题:品牌或代理公司手里有一份达人名单,想让 AI 先过一遍,给每个人出一份尽调摘要,看四件事:粉丝真不真、看的人有没有反应、最近 30 天还发不发、评论区在聊什么。模型选 Meta 新出的 Muse Wonder,数据用 EveryInfra 的 tiktok/profile、tiktok/user_videos、youtube/profile、youtube/user_posts 和两个评论能力。本机没有 Meta 的 Key,所以 Meta 一侧的 tools JSON、agent 循环和报告格式都写成配置示例,价格、参数和条款全部引 Meta 自己的页面并写明读取日期;EveryInfra 一侧的每个数都来自当天真调的原始返回,可以复算。
先说结论。下面这张表是三个账号、两个平台按本文四条规则算出来的结果,数字的算法在「四个指标怎么定义」一节,每个数的来历在「实测」一节。
| 账号 · 平台 | 粉丝或订阅 | 触达率(播放中位 ÷ 粉丝) | 互动率中位(÷ 播放) | 近 30 天发帖 | 评论区(规则分类) |
|---|---|---|---|---|---|
| NASA · TikTok | 2,200,000 | 13.25% | 8.97% | 9 条,最长间隔 6.0 天 | 50 条里 16 条是提问 |
| NASA · YouTube | 15,100,000 | 1.80%(最新 10 条) | 1.41%(4 条视频) | 确定的 2 条 | 没取到(两次失败,未扣费) |
| National Geographic · TikTok | 9,700,000 | 0.23% | 8.15% | 50 条,最长间隔 3.1 天 | 31 条聊内容,15 条 3 词以内 |
| National Geographic · YouTube | 26,600,000 | 0.75% | 0.61%(4 条视频) | 确定的 21 条,另 1 条待定 | 50 条里 44 条聊内容 |
| Notion · TikTok | 143,700 | 9.05%(最新 15 条) | 1.48% | 0 条,最新一条在 161.7 天前 | 31 条聊内容,2 条只有表情 |
| Notion · YouTube | 350,000 | 0.91% | 0.60%(4 条视频) | 确定的 7 条,另 1 条待定 | 只取到 2 条,不下结论 |
这张表本身就是一份尽调报告的骨架。三个账号都是认证过的品牌号,选它们是因为数据公开、名字可以直接写,结论也容易核对:没有一个账号「有问题」,但每个账号都有一项指标会把粗糙的规则带偏。NASA 的 TikTok 账号,接口返回的创建时间是 2026-07-20,三个多月 220 万粉丝,看上去像「涨粉太快」,但它的触达率是六组里最高的;Notion 的 TikTok 触达率 9.05% 很好看,可最新一条视频停在 2026-05-26,按「近 30 天」规则它是停更账号。这些都要靠规则写死、再让模型读数,才不会被一个漂亮的数字带走。
Muse Wonder API 是什么:Meta 原文能确认的 10 件事
Meta 在 2026 年 10 月 12 日发布 Muse Wonder 和 Muse Wonder Full 两个模型,新闻稿原话是 Muse Wonder 当天起可以通过 Meta Model API 和 Muse Code 使用(Meta Newsroom,2026-10-12)。同一天的研究博客把它定位成「面向个人和专业 agent 的前沿模型」,主打两样能力:Active Memory(跨对话记住与你有关的事)和 Active Focus(任务卡住时换路子、出错后恢复、做重要动作前先确认)(Meta 研究博客,2026-10-12)。产品页的写法更具体:把多步任务交给它连续跑几个小时,它会规划、把部分工作分派给子代理、并行调用工具,出错后自己恢复(Muse Wonder 产品页)。这两样是产品层面的说法,落到开发者手里,真正有用的是文档里写死的参数。我们在 2026-11-05 逐页读了 dev.meta.ai 的文档、帮助中心和法律页,下面这张表只收原文写明了的事实,原文没写的不填。
| 事实 | 原文怎么写 | 出处(2026-11-05 读取) |
|---|---|---|
| 模型名 | muse-wonder-1.0;文档首页注明「Muse Wonder is in preview」 | Overview |
| 上下文 | 1,048,576 token;输入文本、图片、视频、音频、PDF,输出文本 | Models |
| 推理强度 | reasoning.effort 从 minimal 到 max;设成 max 也不会换成 Wonder Full | Models |
| Wonder Full | 只在 Muse Code 订阅里,Power Usage 和 Maximum Usage 两档 | Models |
| 接口格式 | Responses、Chat Completions、Anthropic Messages 三种,同价同鉴权 | Overview |
| 工具调用 | 你定义函数、你执行;tool_choice 只支持 auto;函数名最多一个点 | Tool calling |
| 长任务 | background: true 异步跑,每队每分钟最多建 600 个;非流式请求太久会回 504 | Responses API |
| 限速 | muse-wonder-1.0 每分钟 3,000 次请求、400 万 token,按团队算,不按 Key 算 | Pricing and rate limits |
| 地区 | 中国内地、香港、澳门在受限地区名单里;Muse Wonder 另在韩国不可用 | Geographic Use Policy、Models |
| 训练用途 | Standard 模式不拿你的内容训练模型;Wonder 在按量付费下没有 Contributor 模式 | Models |
这张表里有两条对本文的做法影响最大。第一条是 tool_choice 只能是 auto:你不能强制模型「这一轮必须调某个函数」,文档原话是 "none"、"required" 和指定函数名都会返回 HTTP 400,所以 agent 循环要同时处理「模型调了工具」和「模型直接回了一段话」两种情况(Tool calling,Guidelines 一节)。尽调任务有固定的取数步骤,换在别家模型上我们会用强制调用保证每个达人都取齐数据;在 Muse Wonder 上只能靠提示词写清楚,再在自己的代码里检查每个达人是否四项数据都到齐,缺了就再发一轮。第二条是地区限制:本站的中文读者里有不少人在中国内地和香港,按 Meta 的地区政策这些地方既不能直接使用,也不能把集成了它的产品提供给当地用户,还不能用技术手段绕开(Geographic Use Policy 第 2.1、3 节)。所以本文把 Meta 一侧写成配置示例,团队所在地不在可用范围内的,可以照同样的工具定义换一个模型跑,EveryInfra 这一侧不受影响。
Muse Wonder API Key:拿 Key 的 4 步和 3 个容易忽略的地方
拿 Key 的流程写在 Meta 的 AI Developer 帮助中心里,一共四步,我们照原文排成下表。我们没有注册 Meta 的账号,下面每一步都是按帮助中心原文整理的,不是截图实录。
| 步骤 | 原文写法 | 出处 |
|---|---|---|
| 1 注册 | 在 Model API 网站点「Start building」,个人选 Individual,可以用邮箱、手机号,或者 Facebook、Google、GitHub 账号;要满 18 岁、在支持的国家或地区 | How do I sign up |
| 2 绑卡 | 管理员在 Billing 页添加付款方式,再填法定名称和地址(不是注册公司就填个人姓名和邮寄地址) | Set up billing |
| 3 建 Key | API keys 页点「Create API key」,起个名字,复制保存;Key 属于团队,团队里谁都能用 | Create an API key |
| 4 设环境变量 | export MODEL_API_KEY="...",代码里读环境变量,不要写死在前端或提交进仓库 | Quickstart |
第一个容易忽略的地方是花费没有硬上限。帮助中心原话是 Meta Model API 目前不提供「对用量设硬上限」的支出限制,只能在 Billing 页设一个月度提醒,到了金额发邮件,超出部分照样要付(Spend limit alert)。agent 跑长任务时会自己多轮调用工具,一个写错的循环可能整晚不停,所以本文后面的代码在自己这一侧设了轮数上限和 token 预算。第二个是扣款方式:用量累计到「付款门槛」就扣一次卡,剩余的在每月 1 日扣,按时付款后门槛可能逐步提高(How am I billed),另外帮助中心写明 Model API 不退款(Refunds)。第三个是 Key 不能外借:Key 按团队划分,「在团队以外共享 API Key 违反服务条款」(Can I share my API key),服务条款第 10.1 条还写明,除非 Meta 书面授权,不能把服务(包括模型和 Key)转卖或单独提供给第三方(Terms of Service,2026-10-09 更新)。如果你是代理公司,要给多个品牌客户跑尽调,Key 应该留在你自己的团队里,交付给客户的是报告,不是 Key。
EveryInfra 这一侧的 Key 按快速上手注册后在控制台里建,同样只放环境变量。两边的 Key 分开管:Meta 的 Key 只用来调模型,EveryInfra 的 Key 只用来取数,工具执行代码在你自己的服务器上跑,模型看不到任何一把 Key。
Meta Muse Wonder API Pricing:$4 / $20 之外还有 3 个价
Meta 定价页把 Muse Wonder 的价格写成一张三行的表:每百万 token 输入 $4.00、缓存命中的输入 $0.20、输出 $20.00,Contributor 模式一栏写的是「Not available」(Pricing and rate limits)。Meta for Developers 在发布当天的帖子里也写了「$4/$20 per million tokens」(Meta for Developers,2026-10-12)。
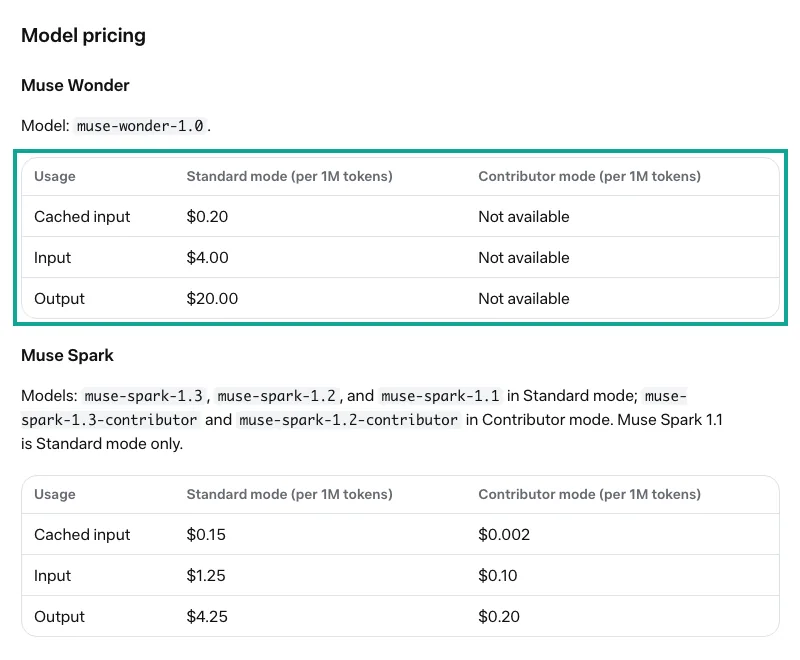
除了这三项,做尽调 agent 还会碰到三个价。第一是搜索:模型自带的 web_search 每 1,000 次另收 $2.50,它搜的是网页,取不到逐条视频数据,本文不开(Search grounding)。第二是 Muse Spark:同样的请求格式,muse-spark-1.3 每百万 token 输入 $1.25、输出 $4.25,Contributor 版本输入 $0.10、输出 $0.20,但 Contributor 模式会把你的内容拿去训练 Meta 的模型,服务条款第 6.2 条还写明不能往 Contributor 服务里提交敏感、机密或个人信息(Terms of Service 第 6 节)。达人尽调的输入里有评论原文,评论是普通用户写的,所以本文只用 Standard 模式。第三是缓存:Meta 会自动缓存相同的提示词前缀,命中部分按 $0.20 计,不用开关(Prompt caching);把系统提示词和工具定义放在请求最前面、每个达人只换后面的名单,10 个人的批次里大部分固定前缀都能命中缓存。
| 项 | Muse Wonder | Muse Spark 1.3 | Muse Spark 1.3 Contributor |
|---|---|---|---|
| 输入(每百万 token) | $4.00 | $1.25 | $0.10 |
| 缓存输入 | $0.20 | $0.15 | $0.002 |
| 输出 | $20.00 | $4.25 | $0.20 |
| 内容会不会被拿去训练 | 不会(Standard) | 不会(Standard) | 会 |
| 每分钟请求 / token(按团队) | 3,000 / 400 万 | 3,000 / 400 万 | 150 / 300 万 |
| 适合尽调里的哪一步 | 主循环:读数、下结论、写报告 | 子任务:评论分类 | 不建议用于含评论原文的任务 |
表里的限速数字也来自同一页。Meta 写明限速按团队算,团队里所有 Key 共用一个额度,每个模型各算各的(Rate limits)。对 10 人名单来说 3,000 次每分钟远远用不完,真正卡住速度的是取数这一侧:我们这把测试 Key 每分钟只放 10 次请求,后面实测一节会写到它怎么影响整批的耗时。
为什么只用 TikTok 和 YouTube:本文的范围和 Muse 的使用条款
品牌做达人合作,最常碰到两类达人:发短视频的和做长视频的。本文各取一个平台做代表,TikTok 看短视频,YouTube 看长视频。两类账号的数据形态差别很大:TikTok 的推荐流会把视频推给不关注你的人,播放可以远超粉丝的十分之一;YouTube 的订阅数里沉淀了多年的老订阅者,大频道的触达率普遍偏低。放在一起,正好能说明后面反复强调的一点:指标只能在同一个平台里横比。其他平台不在本文范围内,同样的四条规则和工具写法可以照搬,字段要按各自的接口重新对一遍。
选好平台,还要看模型这一侧对「你交给它处理的数据」怎么规定。这一节只摆 Muse 自己法律页(dev.meta.ai/legal)的原文,不构成法律意见;你所在地的法律、你和数据所在平台之间的协议,要自己读、自己判断。Meta Model API 服务条款(2026-10-09 更新)第 4.1 条写明,你要对自己提供给服务的信息、数据和其他内容的准确性与有效性负责;第 10.1 条第 (vii) 项禁止用这项服务「从事或协助任何侵犯、盗用或以其他方式违反第三方权利的行为」;第 10.3 条写明 Meta 可以通过自动或人工审核监控你的使用是否合规(Terms of Service)。数据承诺页写明,Standard 服务里的内容不会被用来训练 Meta 的模型,但 Meta 可以为发现和处理违反合理使用政策或服务条款的行为而处理这些内容(Data Commitments)。
| 条款 | 管什么 | 关键原文(意译) | 对尽调 agent 的影响 |
|---|---|---|---|
| Model API Terms 4.1 | 你交给模型的内容 | 你对提供给服务的信息和数据的准确性、有效性负责 | 每个数字都要能回到原始返回 |
| Model API Terms 10.1 (vii)、10.3 | 使用方式 | 不得用于侵犯第三方权利;Meta 可监控使用 | 用前自己读条款,确认数据来源和用途 |
| Data Commitments | Standard 服务的内容 | 不用于训练模型;可为处理违规行为而处理 | 评论原文只走 Standard 模式 |
| Model API 合理使用政策 | 输出和用途 | 不得推断个人敏感信息;不得按社交行为给个人打分并导致不利对待 | 报告只评账号的商业数据,不推断个人属性 |
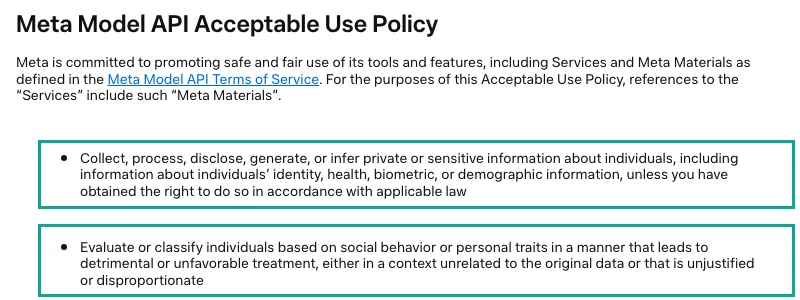
表里最后一行最容易被忽略。Meta Model API 合理使用政策(2026-10-12 更新)有两条直接落在「给人打分」这件事上:一条禁止在没有合法权利时「收集、处理、披露、生成或推断」个人的私密或敏感信息,包括身份、健康、生物特征或人口统计信息;另一条禁止「基于社交行为或个人特征对个人进行评估或分类」,且这种评估导致不利对待,或者用在与原始数据无关的场景、不合理或不成比例(Acceptable Use Policy)。
达人尽调本身是商业合作前的常规动作,品牌看的是账号作为一个媒体渠道的表现:播放是否稳定、互动是否和粉丝量匹配、发帖是否规律、评论区是不是在聊内容。这些都是账号层面的公开商业数据。容易越界的是另外两类问题:让模型去猜达人的年龄、民族、健康状况、政治立场,或者把评论区里普通用户的言论拿来给某个人贴标签。本文的工具执行代码因此做了两件事:交给模型的评论只有正文、点赞数和时间,不带评论者的用户名;系统提示词写明只评估账号的内容表现,不推断任何个人属性。这样做也让报告更可信,因为它只说数据能证明的事。
四个指标怎么定义:先写死规则,再让模型读数
尽调报告最怕的是同一个词在不同人手里算法不同。「互动率」有人除以粉丝、有人除以播放,「真实粉丝」有人看评论、有人看点赞粉丝比,换个算法结论就反过来。所以我们在动手取数之前,先把四个指标的算法写进系统提示词,模型只负责按规则读数、对比和写结论,不负责发明算法。下表是本文用的规则,每一条都能在真实返回里算出来。
| 指标 | 本文的算法 | 用到的字段 | 它能说明什么、不能说明什么 |
|---|---|---|---|
| 粉丝真实度(代理指标) | 触达率 = 近 30 天、发布满 3 天的非置顶视频播放中位数 ÷ 粉丝数;辅以平均 / 中位比值、单条最高播放占比 | follower_count、view_count、posted_at、is_pinned | 能看出粉丝里有多少人还在看;不能证明某个粉丝是假的 |
| 互动率 | 每条视频(赞 + 评 + 转)÷ 播放,取中位数;TikTok 的样本同触达率(近 30 天、发布满 3 天的非置顶视频);YouTube 是(赞 + 评)÷ 播放 | like_count、comment_count、share_count、view_count | 看过的人有没有反应;不能区分真人和刷量 |
| 近 30 天发帖节奏 | 30 天内的非置顶视频条数、最长间隔天数、间隔中位数;距最后一条的天数 | posted_at | 账号还在不在运营;不能说明内容质量 |
| 评论区画风 | 每条评论按规则归为五类:聊内容(4 词以上)、提问、3 词以内、只有表情、没有文字;另计完全重复的评论 | text、is_reply | 评论是不是在回应视频本身;不能判断评论者是谁 |
为什么用触达率代替「假粉比例」:从公开数据里根本算不出某个粉丝是不是真人,粉丝名单本身也不是尽调该碰的东西。能做的是看「粉丝数」和「现在的播放」差多远。触达率只在同一个平台、量级相近的账号之间横比才有意义,本文不设统一的判定线。指标一律取中位数,是因为少数爆款会把平均数拉高:TechBullion 转述了一项 52 个 TikTok 达人、675 条视频的小样本研究,73% 的达人平均播放至少是中位数的 1.5 倍(TechBullion,2026 年 10 月)。这是二手报道、样本小,我们只拿它说明「平均数会骗人」,不拿它当刻度。
互动率选「除以播放」而不是「除以粉丝」,是因为除以粉丝会把触达率的差异混进来:粉丝多、触达低的账号,按粉丝算互动率会显得很差,按播放算可能完全正常。两种算法回答的是两个问题,前者问「粉丝还在不在」,后者问「看到的人在不在乎」,我们分开报。YouTube 这一侧要注意,公开的分享数拿不到,所以只算赞和评;而且 YouTube 在 2026-08-27 改了公开播放的计数方式,视频从第一帧开始播放就算一次播放,变现和大部分分析指标仍按「有效播放」算(YouTube Data API 修订记录、YouTube 帮助中心)。所以 8 月 27 日前后的播放数不能直接比,跨这个日期的互动率也会有台阶。
函数定义:5 个 tools 的 JSON 怎么写
Meta 帮助中心写明 Model API 支持工具调用,模型可以调用你定义的外部工具和数据源(Can the models call tools?)。写法和 OpenAI 基本一致,Meta 文档推荐用 Responses API,函数定义平铺在 tool 对象顶层:type、name、description、parameters,外加一个可选的 strict(Tool calling)。Meta 文档写明 strict 默认是 false,这时 schema 原样接受;设成 true 后服务端会按「严格子集」校验 schema,比如每个属性都要列进 required、要有 "additionalProperties": false,不合格就返回 HTTP 400(Strict tool schemas)。我们的 5 个函数都设了 strict: true,因为参数少、全部必填,写起来不费事,还能在上线前就把写错的 schema 挡住。
函数怎么切,是这一节真正要想的事。最省事的做法是只给模型一个通用函数,参数是 platform、action、params,和 EveryInfra MCP 里的 everyinfra_call_api 一样。这样模型能调任何能力,但它每次都要自己拼参数,拼错了就多一轮。尽调任务的取数步骤是固定的,所以我们按步骤切成 5 个窄函数,每个只对应一项能力,参数名就是能力本身要的参数,描述里写清楚「置顶视频排在最前面,算中位数前先去掉」这类坑。函数名用下划线,不用点:Meta 规定函数名最多只能有一个点,两个点会直接返回 400,MCP 风格的多段名字要改用 namespace 工具(Function name rules)。5 个函数用不上 Meta 的 tool search:它是给几百个工具准备的,把函数的参数 schema 推迟到模型需要时再加载,省输入 token,也不破坏缓存前缀(Tool search);如果你把 EveryInfra 几十项能力都做成函数,可以把它们按平台放进 namespace,再给里面的函数设 defer_loading: true。
[
  {
    "type": "function",
    "name": "tiktok_videos",
    "description": "List the newest public videos of one TikTok account with views, likes, comments, shares, saves, posted_at, is_pinned and is_ad. Calls EveryInfra tiktok/user_videos. Pinned videos come first; drop them before you compute medians.",
    "strict": true,
    "parameters": {
      "type": "object",
      "properties": {
        "username": { "type": "string", "description": "TikTok handle without @" },
        "limit": { "type": "integer", "description": "1 to 50. Use 50 for a 30-day window." }
      },
      "required": ["username", "limit"],
      "additionalProperties": false
    }
  },
  {
    "type": "function",
    "name": "video_comments",
    "description": "Read public comments of one video. Returns comment text, like and reply counts and time only, never the commenter's name. Calls EveryInfra tiktok/comments or youtube/comments.",
    "strict": true,
    "parameters": {
      "type": "object",
      "properties": {
        "platform": { "type": "string", "enum": ["tiktok", "youtube"] },
        "video_url": { "type": "string", "description": "Full URL of one video" },
        "limit": { "type": "integer", "description": "1 to 50" }
      },
      "required": ["platform", "video_url", "limit"],
      "additionalProperties": false
    }
  }
]
上面只放了 5 个里的 2 个,另外 3 个是 tiktok_profile(对应 tiktok/profile)、youtube_channel(对应 youtube/profile)和 youtube_videos(对应 youtube/user_posts),写法相同。每个函数背后对应哪项能力、交回模型哪些字段,我们按当天目录的 response_fields 逐个对过,见下表。表里「交回模型的字段」是我们的工具执行代码挑出来的子集,不是接口的全部字段:TikTok 视频一条原样有 34 个字段,封面图、音乐、作者简介这些对尽调没用,又很占 token,全部在交回模型前去掉。
| 函数 | 调的能力 | 目录价(每次) | 交回模型的字段 |
|---|---|---|---|
tiktok_profile | tiktok/profile | $0.000556 | username、display_name、follower_count、following_count、like_count、video_count、is_verified、created_at |
tiktok_videos | tiktok/user_videos | $0.000556 | id、url、posted_at、view_count、like_count、comment_count、share_count、collect_count、is_pinned、is_ad、duration_sec |
youtube_channel | youtube/profile | $0.000556 | name、url、subscriber_count、video_count、view_count、is_verified、created_at |
youtube_videos | youtube/user_posts | $0.000556 | id、url、title、posted_at、view_count、like_count、comment_count、duration、is_paid_partnership |
video_comments | tiktok/comments 或 youtube/comments | $0.000556 | text(截到 200 字)、like_count、reply_count、is_reply、posted_at |
agent 循环:Meta 文档的写法加 3 处改动
Meta 的工具调用文档给了一个最小循环:发请求带 tools,在返回的 output 里找 function_call,本地执行后用 function_call_output 和 previous_response_id 交回去,服务端会自己接上历史(Tool calling,Responses 示例)。我们照这个写法做了三处改动,代码如下,这是配置示例,没有在本机跑过 Meta 一侧。
# 配置示例:Muse Wonder(Responses API)+ EveryInfra 工具。Meta 一侧没有在本机运行。
import json, os
from openai import OpenAI
from ei_tools import run  # 工具执行层:调 EveryInfra,压缩返回

meta = OpenAI(base_url="https://api.meta.ai/v1", api_key=os.environ["MODEL_API_KEY"])
TOOLS = json.load(open("tools.json"))
SYSTEM = open("system_prompt.txt").read()   # 固定前缀放最前面,命中缓存
MAX_TURNS, MAX_TOKENS = 40, 400_000          # Meta 没有硬性花费上限,自己设

def due_diligence(creators: list[dict]) -> str:
    resp = meta.responses.create(model="muse-wonder-1.0", reasoning={"effort": "medium"},
                                 instructions=SYSTEM, tools=TOOLS, input=json.dumps(creators))
    used = resp.usage.total_tokens
    for _ in range(MAX_TURNS):
        calls = [i for i in resp.output if i.type == "function_call"]
        if not calls:                     # tool_choice 只能是 auto:模型也可能直接回话
            return resp.output_text
        outputs = []
        for c in calls:                   # 一轮里可能有多个并行调用,逐个执行
            body, code, raw, secs, out = run(c.name, json.loads(c.arguments))
            outputs.append({"type": "function_call_output", "call_id": c.call_id,
                            "output": json.dumps(out, ensure_ascii=False)})
        resp = meta.responses.create(model="muse-wonder-1.0", previous_response_id=resp.id,
                                     tools=TOOLS, input=outputs)
        used += resp.usage.total_tokens
        if used > MAX_TOKENS:
            raise RuntimeError(f"token budget exceeded: {used}")
    raise RuntimeError("too many turns")
第一处是一轮可能有多个调用。Meta 文档写明模型可以在一轮里返回多个工具调用,要逐个执行、每个都交回一个结果,parallel_tool_calls 默认是 true(Guidelines)。10 个达人、每人 5 次调用,模型很可能一次发出十几个调用,我们的执行代码要能排队,因为 EveryInfra 这把测试 Key 每分钟只放 10 次请求。第二处是自己设上限。max_tool_calls 只限制 web_search 这类内置工具,管不住你自己定义的函数,文档建议用 parallel_tool_calls: false 或者在自己的循环里限轮数;加上前面说的没有硬性花费上限,轮数和 token 两道闸都要自己写。第三处是交回的内容先压缩。function_call_output 里的内容会全部算进下一轮的输入 token,压缩比是这篇文章成本账里最大的一个变量,后面单独算。
报告格式用结构化输出锁住。Meta 文档写明设了 json_schema 之后,解码过程本身受 schema 约束,输出一定符合 schema,不是事后修补(Structured output);Responses API 里写在 text.format,和工具调用可以一起用。我们的 schema 每个达人一行,字段是四个指标的数值、每个数值的样本量、一句话结论,外加一个 missing 数组,专门列「哪个数没取到、哪个数是取整的」。有了这个数组,模型就不用为了填满字段去编数。
长任务:50 人名单要用 background 模式
10 个人的名单,一轮跑完大概几分钟,用普通请求就行。名单到 50 人、或者每人要翻好几页视频时,就要考虑 Meta 的长任务写法。Responses API 文档写了三条限制:非流式请求有服务端时限,跑太久会返回 504;background: true 可以异步跑,立即返回 status: "queued",之后按 id 轮询、流式取回或取消;background 请求体最大 1 MiB,超过返回 413(Responses API)。定价页另写了 background 每个团队每分钟最多新建 600 个(Background responses)。
1 MiB 这个上限对尽调 agent 是实际的约束。后面的实测里,一个 TikTok 账号最新 50 条视频的原始返回约 114–116 KB,如果把原始 JSON 原样塞进一个 background 请求的输入里,十个账号就超了。工具执行代码先压缩、只交回尽调要的字段,这个问题就不存在。EveryInfra 这一侧也有自己的异步写法:任何能力都可以在请求体里加 "mode": "async",立即拿到 job_id,再用 GET /api/v1/jobs/{job_id} 取结果,同步请求的预算是 85 秒(以当天目录 async_mode 一栏为准)。还有一个容易撞上的限制:如果你的团队开了零数据保留(ZDR),Meta 帮助中心写明引用服务端历史的有状态请求、background 异步请求、文件上传和网页搜索都不可用,请求会被拒绝(ZDR 说明)。本文的循环靠 previous_response_id 接上历史,开了 ZDR 就要改成每轮把完整对话带上,token 会多出不少。两边都异步时,最稳的做法是 agent 循环自己不等:模型发出调用,你的代码把调用丢进队列、按每分钟的限速慢慢取,取齐了再交回模型。
另一条路:Claude Agent SDK 接 Muse Wonder,再挂 EveryInfra MCP
如果你不想自己写工具执行层,Meta 文档给了另一条路:用 Claude Agent SDK 跑 agent 循环,把模型指向 Meta。Agent frameworks 一页写明,SDK 通过 Anthropic Messages 格式连 Model API,环境变量 ANTHROPIC_BASE_URL 设成 https://api.meta.ai(不带 /v1),ANTHROPIC_AUTH_TOKEN 填 Meta 的 Key,主循环用 muse-wonder-1.0,子代理可以压到更便宜的 muse-spark-1.3;同一页还提醒「只声明你信任的 MCP 服务器」(Agent frameworks)。这样 EveryInfra 的远程 MCP 就能直接挂上去,工具按 MCP 规范用 tools/list 列出、tools/call 调用(MCP 规范:Tools),模型看到的是 everyinfra_call_api 这类现成工具,不用你写 tools JSON。
# 配置示例:Claude Agent SDK 用 Muse Wonder 作模型,挂 EveryInfra 远程 MCP。没有在本机运行。
import os, anyio
from claude_agent_sdk import query, ClaudeAgentOptions, ResultMessage

options = ClaudeAgentOptions(
    model="muse-wonder-1.0",
    system_prompt=open("system_prompt.txt").read(),
    mcp_servers={"everyinfra": {"type": "http", "url": "https://api.everyinfra.com/mcp",
                                "headers": {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}}},
    allowed_tools=["mcp__everyinfra__everyinfra_call_api", "mcp__everyinfra__everyinfra_get_job"],
    setting_sources=[],
    env={**os.environ,
         "ANTHROPIC_BASE_URL": "https://api.meta.ai",
         "ANTHROPIC_AUTH_TOKEN": os.environ["MODEL_API_KEY"],
         "ANTHROPIC_MODEL": "muse-wonder-1.0",
         "ANTHROPIC_DEFAULT_OPUS_MODEL": "muse-wonder-1.0",
         "ANTHROPIC_DEFAULT_SONNET_MODEL": "muse-spark-1.3",
         "ANTHROPIC_DEFAULT_HAIKU_MODEL": "muse-spark-1.3",
         "CLAUDE_CODE_SUBAGENT_MODEL": "muse-spark-1.3"},
)

async def main():
    async for m in query(prompt="Review these creators: natgeo, nasa, notionhq", options=options):
        if isinstance(m, ResultMessage):
            print(m.result, m.usage)

anyio.run(main)
两条路的取舍很直接。自己写 tools JSON 的好处是能控制交回模型的内容:哪些字段、截多长、评论者的名字去不去掉,都在你的代码里。挂 MCP 的好处是省代码,坏处是 everyinfra_call_api 交回的是接口的完整返回,一条 TikTok 视频 34 个字段原样进上下文,token 多出好几倍,而且评论者的用户名也会进去。我们在 MCP 那次真调里量了返回体的大小,放在后面的成本一节。allowed_tools 只放取数和查任务两个工具,是按 Meta「只给 agent 需要的工具」的建议做的,EveryInfra MCP 里还有建工单、查账户等工具,尽调用不上。
一次真实往返:模型发出调用,我们的代码去取数
前面的 tools JSON 和 agent 循环是配置示例,这一节是真跑的那一半。我们把工具执行层单独写成一个文件,它接收的就是 Muse Wonder 会发来的 function_call 参数,按函数名找到对应的 EveryInfra 能力,发请求、挑字段、去掉评论者名字,再把结果包成 function_call_output 的样子。Meta 一侧没有跑,但模型那一侧交来的只是一个函数名和一串 JSON 参数,我们这一侧拿到同样的参数,执行和返回的过程与接上 Muse Wonder 时完全一样。
下面是 NASA 这个账号的 4 次调用,按时间排。每一行都是一次真实请求,时刻是请求发出的新加坡时间,耗时是从发出到收完的秒数,「原样」是接口返回体的字节数,「交回模型」是工具执行层挑完字段后的字节数。
| 新加坡时间 | 函数 → 能力 | 耗时 | 原样 | 交回模型 | 扣费 |
|---|---|---|---|---|---|
| 2026-11-05 00:18 | tiktok_profile → tiktok/profile | 11.35 秒 | 1,587 B | 287 B | $0.000556 |
| 2026-11-05 00:22 | tiktok_videos → tiktok/user_videos(50 条) | 35.81 秒 | 116,106 B | 14,206 B | $0.000556 |
| 2026-11-05 00:25 | youtube_channel → youtube/profile | 8.96 秒 | 1,797 B | 299 B | $0.000556 |
| 2026-11-05 00:28 | video_comments → tiktok/comments(50 条) | 58.22 秒 | 16,761 B | 7,805 B | $0.000556 |
第一次调用的请求和返回如下。返回体我们只删掉了头像地址这一个很长的字段,其余照原样;follower_count 是 2,200,000 这种整数,看上去精确,其实是取整过的,后面「实测」一节会说到。
POST https://api.everyinfra.com/api/v1/social
{"platform":"tiktok","action":"profile","params":{"username":"nasa"}}

200 OK,00:18:46(新加坡时间),11.35 秒,扣费 $0.000556
{"user_id":"7664638705177150477","username":"nasa","display_name":"NASA",
 "bio":"Making the seemingly impossible, possible.✨","url":"https://www.tiktok.com/@nasa",
 "follower_count":2200000,"following_count":23,"like_count":11500000,"video_count":62,
 "friend_count":17,"is_verified":true,"is_private":false,
 "created_at":"2026-07-20T15:55:49+00:00","platform":"tiktok"}
交回模型的那一份只剩 8 个字段:username、display_name、follower_count、following_count、like_count、video_count、is_verified、created_at,287 字节。一个资料页这样压缩省得不多,真正的大头在视频列表:50 条 TikTok 视频原样 116,106 字节,每条 34 个字段,里面有封面图、音乐、作者信息、各种地址;尽调要的只有 11 个,压完是 14,206 字节,约原来的 1/8。
评论那一次的往返,我们把模型会发出的调用和工具执行层真实交回的内容并排放在下面这张图里。左边是示例(参数取自真调),右边是 National Geographic 一条 TikTok 视频 50 条评论里的前两条,评论文字截短了,评论者名字在工具代码里就去掉了。
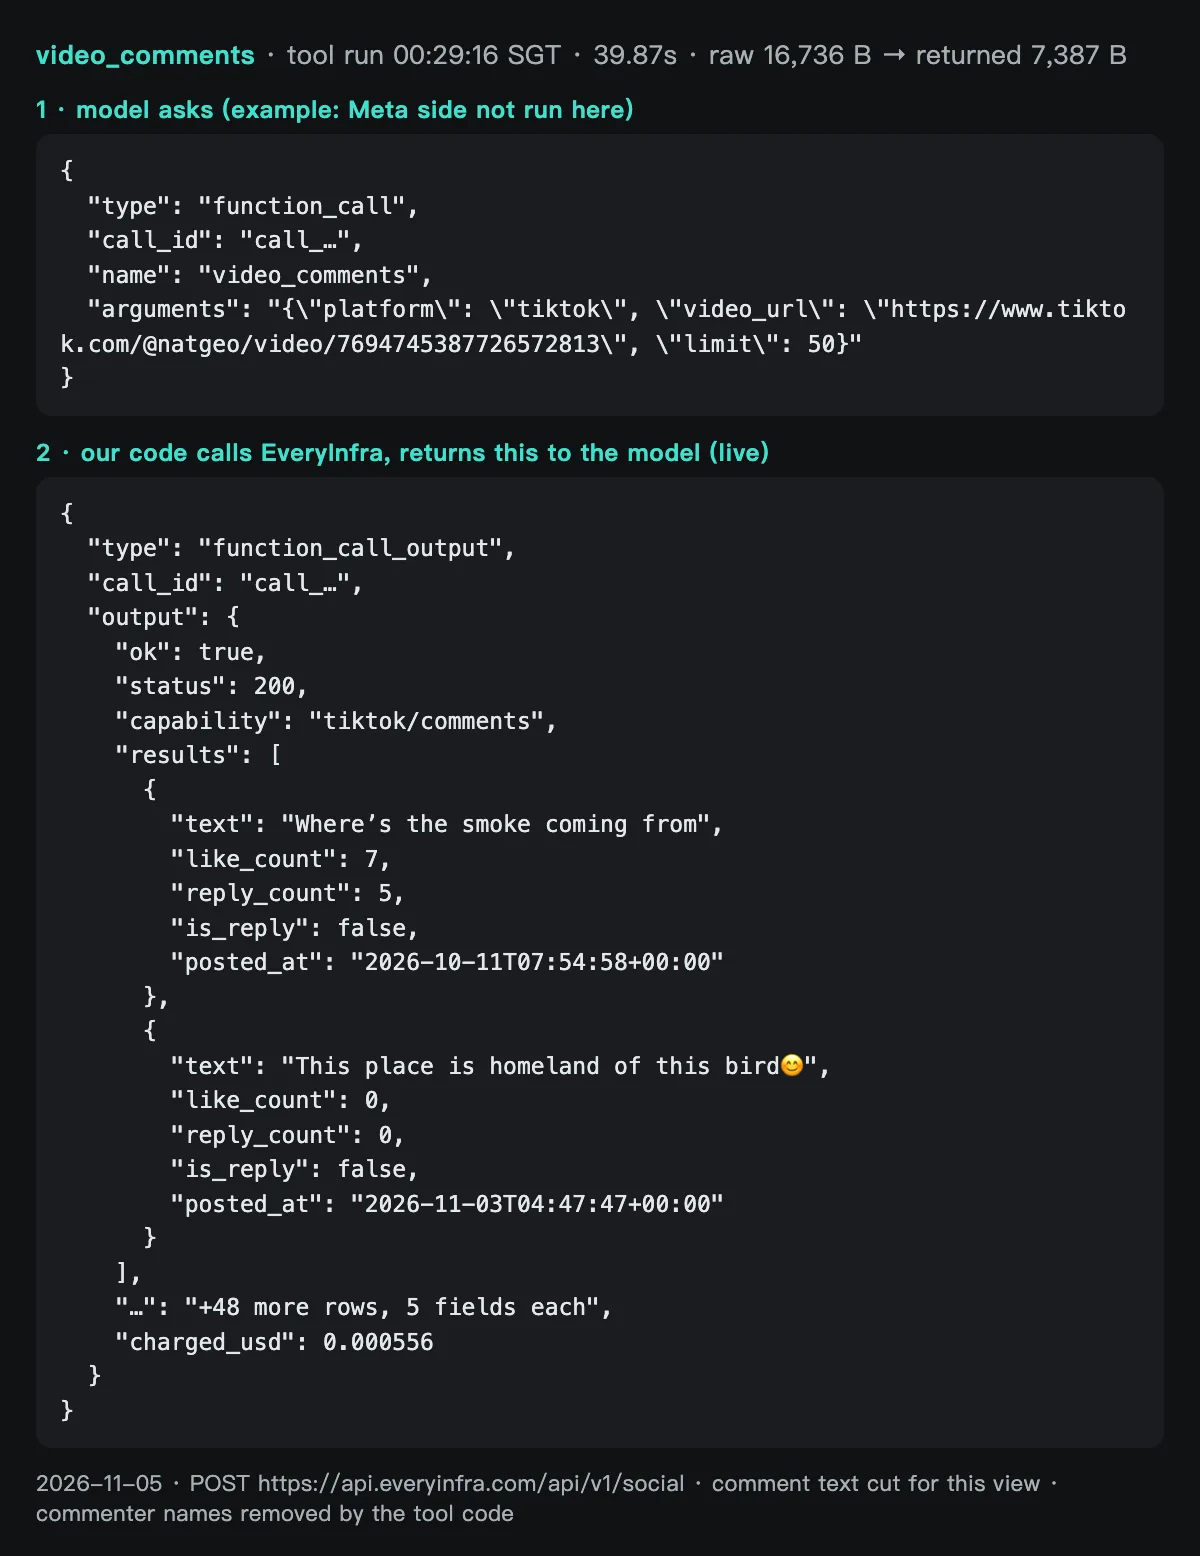
同一类数据如果走 MCP,交回模型的内容会大一倍多。我们在 00:38(新加坡时间)用 EveryInfra 远程 MCP 的 everyinfra_call_api 取了 National Geographic 一条 YouTube 视频的 50 条评论,耗时 16.74 秒,扣费 $0.000556,交给模型的文本是 18,198 字节,每条评论 8 个字段,包括 author_name。同样 50 条评论按本文的字段白名单压缩,是 9,516 字节,而且不带任何人的名字。MCP 省的是你写代码的时间,代价是每次调用多出一倍左右的 token,外加你没法在模型看到数据之前把评论者的名字拿掉。对一份要交给客户的尽调报告,后一点比前一点更要紧,因为前面那条合理使用政策管的就是「对个人的推断」。
失败的调用我们也照实记下。NASA 的 YouTube 评论在 00:37 和 00:40(新加坡时间)连着两次返回 503,错误体写着 retryable: true、retry_after: 20,billing.charged 是 false,退款状态 succeeded;同一能力 10 分钟内第三次失败时,提示改成了「先发一次示例请求,如果示例能取到数据,问题出在这个目标」。这正是本文工具执行层要的写法:错误文案告诉 agent 该等多久、该不该再试、下一步查什么,模型可以照着做,不用你写一堆特殊处理。Notion 那一侧,我们先选的是 2026-10-27 发布的一条视频,comment_count 是 0,接口回了 200 和空数组,reason 是 empty_result_refunded,没扣钱;换一条 2026-10-23 发布、有 5 条评论的视频重取,拿到 2 条。前后 6 次请求没有结果(2 次 429、3 次 503、1 次空结果),都没有扣费。
实测:三个账号的四项指标,和数据里的 6 个坑
这一节把四项指标逐项摊开。每张图的数都由同一份原始返回现算,规则就是前面那张定义表;看完数,再看我们踩到的坑,这些坑才是尽调 agent 真正要写进系统提示词的东西。
触达率这一项,TikTok 和 YouTube 不能放在一起比。TikTok 的推荐流会把视频推给不关注你的人,所以播放可以超过粉丝的十分之一;YouTube 的订阅数里有大量多年前订阅、现在不常看的人,大频道的触达率普遍低。这里有意义的是同平台之间的比较:同在 TikTok,NASA 13.25%、Notion 9.05%、National Geographic 0.23%,差了 50 多倍。单看这一项,agent 会写「粉丝和播放严重不匹配」。
互动率这张图把上面那句结论推翻了一半。National Geographic 每条视频的(赞 + 评 + 转)÷ 播放,中位数 8.15%,和 NASA 的 8.97% 只差不到一个百分点;Notion 是 1.48%。也就是说,看到 National Geographic 视频的人,和看到 NASA 视频的人一样愿意点赞和转发。触达率低、互动率正常,这种组合更像是「发得太多、每条只推给一部分粉丝」,而不是「粉丝是买来的」。买来的粉丝不会看视频,也不会点赞,两项会一起低。
发帖节奏解释了这个组合。National Geographic 近 30 天在 TikTok 发了 50 条非置顶视频,最新一条是 2026-11-03 发的,间隔中位数 0.62 天,最长一次间隔 3.1 天;NASA 是 9 条,最新一条是 2026-10-30 发的,间隔中位数 2.62 天,最长 6.0 天。同样一群粉丝,每天收到一两条推送,单条的播放自然被摊薄。把发帖数和触达率一起看,agent 才能写出「高频发布、单条触达低、互动正常」这样准确的一句话。Notion 那一行是空的,它的 TikTok 最新一条视频停在 2026-05-26,到我们取数时已经 161.7 天;它 9.05% 的触达率是用最新 15 条老视频算的,对一份「现在要不要合作」的尽调没有意义。
评论区这一项我们故意不用模型分类,而是用 5 条写死的规则:没有文字、只有表情或标点、带问号、3 个词以内、其余算「聊内容」。规则粗,但可以复算,也不会把某条评论「理解」成别的意思。NASA 的 TikTok 评论里 16 条是提问,多是在问视频里的现象,这对科普类达人是好信号;National Geographic 的 TikTok 评论有 15 条在 3 个词以内,另有 16 条含非英文字母或带重音的字,说明观众来自很多语言;同一个品牌在 YouTube 上的评论,50 条里 44 条在聊内容,长度中位数 77 个字符。评论区「水不水」,只能在同一个平台里横比。还有一类评论要单独留意:YouTube Data API 在 2026-09-30 给评论加了 snippet.imageUrl,评论可以带图片或动图,2026 年 11 月对所有用户开放(YouTube Data API 修订记录);只读文字会漏掉「只发了张图」的评论,所以规则把没有文字的评论单独计数,好让这类情况露出来。
| # | 坑 | 我们看到的 | 尽调 agent 该怎么处理 |
|---|---|---|---|
| 1 | TikTok 数字是取整的 | 三个账号所有播放过万的视频,播放数都是 100 的整数倍;粉丝数是 2,200,000、9,700,000、143,700 | 报告里写「约」,样本小时不要算到小数点后两位 |
| 2 | 50 条盖不满 30 天 | National Geographic 第一页 50 条只盖了 28.8 天,用 until 翻第二页才凑齐 30 天 | 先看最老一条的日期,不够 30 天就翻页 |
| 3 | 置顶视频排在最前 | NASA 和 National Geographic 各有 1 条置顶,发布时间远早于其他视频 | 算中位数和发帖间隔前先去掉 is_pinned |
| 4 | YouTube 列表只有相对时间 | youtube/user_posts 返回「2w ago」「1mo ago」,播放取整到千位,没有点赞和评论数 | 30 天边界上的视频另查 youtube/video,那里有精确时间和播放 |
| 5 | YouTube 单条视频的点赞也取整 | NASA 一条 2026-10-14 发布的视频播放 684,881,点赞 11,000;4 条视频的 comment_count 都是 0 | 互动率写成区间或标「点赞为取整值」;评论数为 0 时不判断评论区 |
| 6 | 新账号不等于刷粉 | NASA 的 TikTok 账号 created_at 是 2026-07-20,三个多月 220 万粉丝,但触达率 13.25% 是六组最高 | 涨粉速度要和触达率、互动率一起看,单项不下结论 |
第 2 条和第 4 条最费调用次数。一个高频的 TikTok 账号要两次视频调用才能盖住 30 天,一个 YouTube 频道除了列表还要查几条单条视频,才能拿到点赞数和精确的发布时间。我们给每个 YouTube 频道查了 4 条视频,是在「够算一个中位数」和「每人多花多少钱」之间取的折中:4 次单条视频调用是 $0.0022,占一个达人全部接口费的四成。如果你的名单以 TikTok 为主,YouTube 只看订阅数和发帖节奏,可以省掉这 4 次。第 5 条也值得单独记一笔:YouTube 在 2026-08-27 改了公开播放的计数方式,我们查的 12 条单条视频都发在这之后,所以本文的 YouTube 互动率不用跨日期比较;名单里要是有人近期的视频横跨这个日期,报告里要写一句。
Muse Wonder API Cost:10 人名单的账
这一节回答「跑一份 10 人名单要花多少钱」。账分两份:EveryInfra 的接口费按目录价乘调用次数,是确定的数;Meta 的模型费按 Meta 公开价乘 token 数,本机没有 Meta Key、没有真跑,所以是估算,下面把每个假设都写出来,你可以换成自己的数。
| 每个达人的调用 | 次数 | 单价(目录) | 小计 |
|---|---|---|---|
TikTok 资料页 tiktok/profile | 1 | $0.000556 | $0.000556 |
TikTok 视频 tiktok/user_videos(高频账号翻一页) | 1–2 | $0.000556 | $0.000556–$0.001112 |
TikTok 评论 tiktok/comments | 1 | $0.000556 | $0.000556 |
YouTube 频道 youtube/profile | 1 | $0.000556 | $0.000556 |
YouTube 视频列表 youtube/user_posts | 1 | $0.000556 | $0.000556 |
YouTube 单条视频 youtube/video | 4 | $0.000556 | $0.002224 |
YouTube 评论 youtube/comments | 1 | $0.000556 | $0.000556 |
| 合计 | 10–11 | $0.00556–$0.00612 |
10 个达人就是 100–110 次调用,接口费 $0.0556–$0.0612。失败、超时和空结果不扣费,所以这是上限;我们这次实测 36 次请求只扣了 30 次。价格以当天目录为准(定价页),目录本身可以不带 Key 免费读取。
模型费的估算用了四个假设。第一,每个达人单独一段 3 轮对话:第 1 轮发出 4 个取数调用,第 2 轮读完再发出评论调用,第 3 轮写报告。第二,固定前缀(系统提示词加 5 个工具定义)按 1,500 token 算。第三,工具结果按字节数 ÷ 4 换成 token,Meta 帮助中心说英文大约 3–4 个字符一个 token,非英文和代码会更多(How am I billed),取 4 是偏少的估计;工具结果交回后,后面每一轮都会再读一遍。第四,输出加推理按每人 4,000 token 算。按实测,压缩后每个达人交回模型的内容平均 30,541 字节,原样是 154,694 字节。
按这四个假设,每个达人 3 轮的输入合计约 18,243 token(压缩后)或 74,112 token(原样)。用 Muse Wonder 的价格算:压缩后、不算缓存,每人 $0.153,其中输出就占了 $0.08;压缩后再加上缓存命中(后面几轮重读的部分按 $0.20),每人 $0.118;原样交回、不算缓存,每人 $0.376。乘以 10,就是下图的三档。
| 10 人名单 | 接口费 | 模型费(估算) | 合计 | 模型费 ÷ 接口费 |
|---|---|---|---|---|
| 压缩 + 缓存 | $0.0612 | $1.18 | $1.25 | 19 倍 |
| 压缩、无缓存 | $0.0612 | $1.53 | $1.59 | 25 倍 |
| 原样、无缓存 | $0.0612 | $3.76 | $3.82 | 61 倍 |
这张表说明两件事。第一,做尽调 agent 时,省钱的地方在模型那一侧,不在取数那一侧:接口费在三档里都是同一个数,模型费因为交回内容大小差了 3 倍多。第二,压缩到一定程度以后,输出成了大头:压缩加缓存那一档每人 $0.118 里,$0.08 是 4,000 token 的输出。Muse Wonder 的输出价是输入的 5 倍,推理 token 也按输出计,所以报告的推理强度不必开到 high。Meta 文档写明推理强度从 minimal 到 max 可调,读数、对比、写四行结论这种活,medium 或 low 就够;真跑之前,可以先用 Meta 的 POST /v1/responses/input_tokens 数一下一个达人的完整输入有多少 token;文档写明它只做分词、不生成、不记用量,用来核上下文装不装得下,不用来估账单(Token counting)。真跑时读每一轮返回里的 usage,用真实 token 数替换本文的估算。
时间也算一笔。Muse Wonder 每分钟 3,000 次请求,模型那一侧不会卡;卡住的是取数。我们这把测试 Key 每分钟只放 10 次,而且同时有别的任务在用,36 次请求从 00:18:46 跑到 00:42:08(新加坡时间),23 分 22 秒,其中碰到 2 次 429,各等了 60 秒。10 人名单 110 次调用,按每分钟 10 次算至少 11 分钟;扣费的 30 次调用耗时中位数 22.2 秒、最长 78.2 秒(算上没结果的 6 次,最长一次 89.6 秒),所以工具执行层要能排队、能并发几路,又不超过每分钟的限额。
本文的局限
| 局限 | 影响 | 怎么补 |
|---|---|---|
| Meta 一侧没有真跑 | tools JSON、循环和报告格式是按 Meta 文档写的配置示例,模型实际会怎么拆调用、写多少推理 token 没有实测 | 拿到 Key 后先用 2 个达人试跑,读 usage |
| 只测了 3 个品牌号 | 都是认证过的大品牌,不代表中小达人的数据形态 | 名单里先放 2–3 个你熟悉的达人做对照 |
| 模型费是估算 | 字节 ÷ 4、3 轮、每人 4,000 token 输出都是假设 | 按真实 usage 重算 |
| 每个平台只抽一条视频的评论 | 评论区画风只代表一条视频 | 对重点达人多抽 2–3 条,按视频分别报 |
| 评论分类用规则 | 讽刺、反话、多语言混写的评论会被分进「聊内容」 | 规则只做初筛,可疑的再给模型或人看 |
| YouTube 评论有缺口 | NASA 两次失败、Notion 只取到 2 条 | 报告里用 missing 写明,不拿空值下结论 |
这些局限里,最可能让结论出错的是第二条。三个品牌号的粉丝都在十万以上,TikTok 的数字取整到百位、千位,对它们影响很小;换成一个 8,000 粉丝的小达人,取整、样本少、单条爆款的影响都会放大。尽调 agent 的系统提示词里应该写一条:样本少于 5 条、或者粉丝少于 1 万时,四项指标只报数、不下结论。
常见问题
Muse Wonder API cost 到底怎么算?
按 token 算,没有月费和最低消费:每百万 token 输入 $4.00、缓存输入 $0.20、输出 $20.00,推理 token 计入输出(Pricing and rate limits、Quickstart)。Meta 还写明它注入的系统提示词和引导内容不计费,也不算进 usage。做尽调时你的账单分两份:Meta 的模型费,加上 EveryInfra 按调用次数收的取数费,本文的 10 人名单两份加起来的估算见上面的成本一节。
Muse Wonder API key 在哪里拿,能不能给同事用?
在 Model API 网站注册后,进 API keys 页点「Create API key」;Key 属于团队,同一个团队里的人都能用(Create an API key)。团队以外的人不能用:帮助中心写明在团队以外共享 Key 违反服务条款(Can I share my API key)。注册前先确认所在地区可用:帮助中心说 Model API 在大多数 Meta AI 可用、支持计费的国家和地区开放,以地区政策为准(Supported countries);中国内地、香港、澳门在受限名单里(Geographic Use Policy)。
Muse Wonder Full 能不能用 API 调?
不能。Meta 的模型页写明 Wonder Full 只在 Muse Code 订阅里,Power Usage 和 Maximum Usage 两档才有,API 上把推理强度设成 max 也不会换成 Full(Models)。Hacker News 上有开发者在发布当天就指出这一点,原话的意思是「评测里领先的 Full 只给订阅用户,API 上只有 Muse Wonder」(Hacker News 评论)。Muse Code 的订阅只能在它自己的命令行工具里用,不能拿去调 API(Muse Code subscriptions)。
有人说 Muse Wonder 的 API 偶尔会失败,尽调 agent 要怎么防?
发布后不久 Hacker News 上有开发者评价它「接近最好,但太贵,而且 API 目前偶尔失败」(Hacker News 评论),这是个人体验,我们没有复现。Meta 的错误处理文档列了几类可以重试的错误:模型输出解析失败返回 500,后端满载返回 service_overloaded 并带 Retry-After: 60,429 要按 Retry-After 退避(Error handling)。尽调 agent 里最省事的做法是把重试放在两层:Meta 那一层按文档退避;EveryInfra 那一层,失败和空结果不扣费,429 等 60 秒再发,本文的工具执行代码就是这么写的。
上手:从零到第一份尽调报告
两个平台各有一页总览,列出全部能力和当天价格:TikTok 数据接口、YouTube 数据接口。EveryInfra 一侧三步:按快速上手注册并建 Key;在目录里确认 tiktok/user_videos、tiktok/comments、youtube/comments 当天可用;先用一个你熟悉的账号跑一次本文的工具执行代码,核对返回的粉丝数、播放数和你在 App 里看到的是否对得上。目录本身免费读取,不用 Key:GET /api/v1/social/catalog。想先在浏览器里点一点,可以去数据市场的试用台;想直接接 AI 工具,看远程 MCP 接入说明。失败和空结果怎么退费、怎么对账,见失败退费对账;422 错误怎么让 agent 自己改参数,见错误自愈。价格以定价页为准。
Meta 一侧四步:注册、绑卡、建 Key、设环境变量,按前面「拿 Key」一节的表做;把 tools.json 和系统提示词放进项目;想先不写代码看看模型怎么调工具,可以在 Playground 的 Advanced → Tools 里点 Add tool,把 tools.json 里的定义逐个贴进去,Playground 里由模型自己决定何时调用(Using tools in the Playground);先用 2 个达人跑通,再放大到 10 个;跑完读每轮返回里的 usage,用真实 token 数替换本文的估算。
参考资料
- Introducing Muse Wonder and Muse Wonder Full: Frontier Models for Agents,Meta Newsroom,2026-10-12,<https://about.fb.com/news/2026/10/introducing-muse-wonder-models/>
- Muse Wonder: A Frontier Model For Personal & Professional AI Agents,Meta 研究博客,2026-10-12,<https://research.meta.ai/blog/muse-wonder>
- Muse Wonder 产品页,Meta,2026-11-05 读取,<https://dev.meta.ai/models/muse-wonder>
- Get started with Meta Model API and Muse Code,Meta 开发者文档,2026-11-05 读取,<https://dev.meta.ai/docs/overview>
- Models,Meta 开发者文档,2026-11-05 读取,<https://dev.meta.ai/docs/models>
- Pricing and rate limits,Meta 开发者文档,2026-11-05 读取,<https://dev.meta.ai/docs/pricing-rate-limits>
- Quickstart,Meta 开发者文档,2026-11-05 读取,<https://dev.meta.ai/docs/quickstart>
- Tool calling,Meta 开发者文档,2026-11-05 读取,<https://dev.meta.ai/docs/tool-calling>
- Responses API,Meta 开发者文档,2026-11-05 读取,<https://dev.meta.ai/docs/protocols/responses>
- Structured output,Meta 开发者文档,2026-11-05 读取,<https://dev.meta.ai/docs/structured-output>
- Prompt caching,Meta 开发者文档,2026-11-05 读取,<https://dev.meta.ai/docs/prompt-caching>
- Tool search,Meta 开发者文档,2026-11-05 读取,<https://dev.meta.ai/docs/tool-search>
- Agent frameworks,Meta 开发者文档,2026-11-05 读取,<https://dev.meta.ai/docs/agent-frameworks>
- Error handling,Meta 开发者文档,2026-11-05 读取,<https://dev.meta.ai/docs/error-handling>
- Muse Code subscriptions,Meta 开发者文档,2026-11-05 读取,<https://dev.meta.ai/docs/muse-code/subscriptions>
- Search grounding,Meta 开发者文档,2026-11-05 读取,<https://dev.meta.ai/docs/search-grounding>
- How do I sign up for Model API?,Meta AI Developer 帮助中心,2026-11-05 读取,<https://dev.meta.ai/help/accounts-and-login/sign-up>
- How do I create an API key?,Meta AI Developer 帮助中心,2026-11-05 读取,<https://dev.meta.ai/help/api-keys/create-api-key>
- Can I share my API key?,Meta AI Developer 帮助中心,2026-11-05 读取,<https://dev.meta.ai/help/api-keys/sharing-api-keys>
- How can I set up billing for Meta Model API?,Meta AI Developer 帮助中心,2026-11-05 读取,<https://dev.meta.ai/help/billing/set-up-billing>
- How am I billed for Model API?,Meta AI Developer 帮助中心,2026-11-05 读取,<https://dev.meta.ai/help/billing/api-bill>
- How do I set a spend limit alert?,Meta AI Developer 帮助中心,2026-11-05 读取,<https://dev.meta.ai/help/billing/spend-limit-alert>
- How do I request a refund for Meta Model API?,Meta AI Developer 帮助中心,2026-11-05 读取,<https://dev.meta.ai/help/billing/refunds>
- Does Model API support Zero Data Retention (ZDR)?,Meta AI Developer 帮助中心,2026-11-05 读取,<https://dev.meta.ai/help/policies-and-privacy/zero-data-retention>
- Meta Model API Terms of Service,Meta,2026-10-09 更新,<https://dev.meta.ai/legal/terms-of-service>
- Meta Model API Acceptable Use Policy,Meta,2026-10-12 更新,<https://dev.meta.ai/legal/acceptable-use-policy>
- Meta Model API Model Designation and Geographic Use Policy,Meta,2026-10-12 更新,<https://dev.meta.ai/legal/geographic-use-policy>
- Muse Wonder is available today on Meta Model API and in Muse Code,Meta for Developers(Facebook 帖子),2026-10-12,<https://www.facebook.com/MetaforDevelopers/posts/muse-wonder-is-available-today-on-meta-model-api-and-in-muse-code-and-muse-wonde/1552628546897475/>
- YouTube Data API Revision History,Google for Developers,2026-11-03 更新,<https://developers.google.com/youtube/v3/revision_history>
- Understand your YouTube content performance,YouTube 帮助中心,2026-11-05 读取,<https://support.google.com/youtube/answer/12220281>
- Tools,Model Context Protocol 规范(2025-06-18 版),<https://modelcontextprotocol.io/specification/2025-06-18/server/tools>
- The Average Views Lie: What We Learned From 675 TikTok Creator Videos,TechBullion,2026 年 10 月,<https://techbullion.com/average-views-lie-learned-675-tiktok-creator-videos/>
- Hacker News 讨论《Muse Wonder》中的评论(用户名已隐去),Hacker News,2026 年 10 月,<https://news.ycombinator.com/item?id=50065098>
- Hacker News 讨论《Muse Wonder》中的评论(用户名已隐去),Hacker News,2026 年 10 月,<https://news.ycombinator.com/item?id=50061435>
- EveryInfra 数据能力目录(免费读取),EveryInfra,2026-11-05 读取,<https://api.everyinfra.com/api/v1/social/catalog>
- Token counting,Meta 开发者文档,2026-11-05 读取,<https://dev.meta.ai/docs/token-counting>
- Meta Model API Data Commitments,Meta,2026-11-05 读取,<https://dev.meta.ai/legal/commitments>
- What countries and territories is Model API available in?,Meta AI Developer 帮助中心,2026-11-05 读取,<https://dev.meta.ai/help/accounts-and-login/supported-countries>
- Can the models call tools?,Meta AI Developer 帮助中心,2026-11-05 读取,<https://dev.meta.ai/help/about-model-api/tool-calling>
- How do I use tools in the Playground?,Meta AI Developer 帮助中心,2026-11-05 读取,<https://dev.meta.ai/help/playground/using-tools-in-the-playground>
引用编号 BL-89