Muse Wonder API для проверки блогеров: тест на живых данных и оценка стоимости
Создайте агента для проверки блогеров TikTok и YouTube с помощью Muse Wonder API от Meta: JSON с описанием инструментов, полный цикл запроса на живых данных и стоимость проверки списка из 10 блогеров.
4 ноября 2026 года с 11:18 до 11:42 ET (с 00:18 до 00:42 SGT 5 ноября) мы проверили три аккаунта брендов: NASA, National Geographic и Notion. Мы использовали эндпоинты EveryInfra для TikTok и YouTube и отправили 36 запросов. Плата была начислена за 30 запросов, на общую сумму $0,01668. Самым полезным оказался неожиданный показатель. У National Geographic 9,7 млн подписчиков в TikTok, но медианное число просмотров видео составляет 22 600, что соответствует охвату 0,23%. Это самый низкий показатель среди шести проверенных пар «аккаунт — платформа».
При этом его видео всё равно активно вовлекают тех, кто их смотрит. Медианное отношение суммы лайков, комментариев и репостов к числу просмотров составляет 8,15% — почти столько же, сколько у NASA (8,97%), а охват NASA составляет 13,25%. National Geographic опубликовал 50 роликов в TikTok за 30 дней, поэтому каждый ролик охватывает меньшую долю подписчиков. Агент, который смотрит только на охват, пометил бы аккаунт с нормальными показателями как «накрученный». Именно такой ошибке посвящена эта статья.
На какой вопрос отвечает эта статья
У команды бренда или агентства есть список блогеров. Прежде чем кто-либо подпишет контракт, команда хочет провести проверку с помощью ИИ и получить по каждому блогеру ответы на четыре вопроса. Настоящие ли у него подписчики? Реагируют ли зрители? Публиковал ли блогер что-либо за последние 30 дней? О чём пишут в комментариях? В этом руководстве мы создаём такого агента с помощью новой модели Muse Wonder от Meta и эндпоинтов данных EveryInfra: tiktok/profile, tiktok/user_videos, youtube/profile, youtube/user_posts и двух эндпоинтов для комментариев.
На этой машине у нас нет API-ключа Meta. Поэтому компоненты на стороне Meta — JSON-описания инструментов, цикл агента и схема отчёта — приведены как пример настройки. Для каждой цены, каждого параметра и каждого правила на этой стороне дана ссылка на страницу Meta с указанием даты обращения. Часть на стороне EveryInfra работает с реальными данными. Каждое число в таблицах ниже взято из необработанных ответов этого запуска, и его можно пересчитать. Если число является оценкой, мы прямо это отмечаем и перечисляем исходные данные.
Сначала результат. В таблице наши четыре правила применены к трём аккаунтам на двух платформах. В разделе о правилах метрик объясняется каждая формула, а в разделе с живыми результатами показано, откуда взялось каждое число.
| Аккаунт и платформа | Подписчики | Охват (медианное число просмотров / число подписчиков) | Медианная вовлечённость на просмотр | Публикации за последние 30 дней | Состав комментариев (по правилам) |
|---|---|---|---|---|---|
| NASA, TikTok | 2,200,000 | 13.25% | 8.97% | 9, максимальный перерыв 6,0 дня | 16 из 50 — вопросы |
| NASA, YouTube | 15,100,000 | 1,80% (по 10 последним видео) | 1,41% (4 видео) | 2 — точно | Не получены (2 ошибки, без списания) |
| National Geographic, TikTok | 9,700,000 | 0.23% | 8.15% | 50, максимальный перерыв 3,1 дня | 31 по теме, 15 — не длиннее 3 слов |
| National Geographic, YouTube | 26,600,000 | 0.75% | 0,61% (4 видео) | 21 — точно, 1 — возможно | 44 из 50 по теме |
| Notion, TikTok | 143,700 | 9,05% (по 15 последним видео) | 1.48% | 0, последнее видео опубликовано 161,7 дня назад | 31 комментарий по теме, 2 содержат только эмодзи |
| Notion, YouTube | 350,000 | 0.91% | 0,60% (4 видео) | 7 — точно, 1 — возможно | Всего 2 комментария, без вывода |
Ни один из этих трёх верифицированных аккаунтов брендов не выглядит подозрительно. Тем не менее у каждого есть показатель, из-за которого простое правило дало бы неверный результат. В поле created_at аккаунта NASA в TikTok указано 20 июля 2026 года, а подписчиков у него 2,2 млн. Правило оценки роста могло бы счесть такой рост слишком быстрым, но у пары NASA и TikTok самый высокий охват из всех шести.
Охват аккаунта Notion в TikTok на уровне 9,05% выглядит отлично, но самое новое видео опубликовано 26 мая 2026 года. По правилу, учитывающему последние 30 дней, аккаунт Notion в TikTok считается неактивным. Решение во всех случаях одно: сначала сформулируйте правило, а затем передайте модели числа.
Что такое Muse Wonder API: 10 фактов со страниц самой Meta
Meta анонсировала Muse Wonder и Muse Wonder Full 12 октября 2026 года. По словам Meta, Muse Wonder стала доступна в тот же день через Meta Model API и Muse Code (Meta Newsroom, 12 октября 2026 года). В исследовательском блоге от того же дня её называют передовой моделью для личных и рабочих агентов. В нём выделены Active Memory и Active Focus — так Meta называет способность не отвлекаться от задачи и восстанавливаться после ошибок (исследовательский блог Meta). На странице продукта описаны многочасовые задачи, в которых модель строит план, передаёт части работы субагентам и вызывает инструменты параллельно (страница продукта Muse Wonder).
Маркетинговые тексты — одно, а разработчику нужны параметры, которые действительно закреплены в документации. 5 ноября 2026 года мы изучили документацию, справочный центр и юридические страницы dev.meta.ai. В таблице ниже только факты, которые Meta указывает письменно.
| Факт | Что сказано на странице Meta | Источник (дата обращения: 5 ноября 2026 года) |
|---|---|---|
| ID модели | muse-wonder-1.0. На главной странице документации сказано: «Muse Wonder is in preview» | Overview |
| Контекст | 1 048 576 токенов. На вход можно подавать текст, изображения, видео, аудио или PDF | Models |
| Рассуждение | reasoning.effort принимает значения от minimal до max. max не переключает на Wonder Full | Models |
| Wonder Full | Только в подписках Muse Code, на тарифах Power Usage и Maximum Usage | Models |
| Форматы API | Responses, Chat Completions и Anthropic Messages, с одинаковой ценой и авторизацией | Overview |
| Вызов инструментов | Функции определяете и выполняете вы. tool_choice поддерживает только auto. В имени функции может быть не больше одной точки | Tool calling |
| Долгие задачи | background: true запускает задачу асинхронно, до 600 новых задач на команду в минуту. Долгие вызовы без стриминга могут вернуть 504 | Responses API |
| Лимиты запросов | 3 000 запросов и 4 млн токенов в минуту для muse-wonder-1.0: лимит действует на команду, а не на ключ | Pricing and rate limits |
| Регионы | Ограничения действуют для Китая, Гонконга и Макао. Кроме того, Muse Wonder недоступна в Южной Корее | Geographic Use Policy |
| Использование для обучения | В стандартном режиме модели на вашем контенте не обучаются. У Wonder нет режима Contributor при оплате по факту использования | Models |
Две строки таблицы определяют устройство агента для проверки. Первая относится к tool_choice. В рекомендациях Meta сказано, что "none", "required" и указание конкретной функции возвращают HTTP 400 (Tool calling guidelines). Заставить модель вызвать инструмент на определённом шаге нельзя. На каждом шаге цикл должен обрабатывать два возможных исхода: вызов инструмента или обычный текст. Ваш код также должен проверять, что для каждого блогера собраны все четыре показателя, и отправлять модели ещё один запрос, если одного из них не хватает.
Вторая строка касается регионов. Политика Meta ограничивает использование в Китае, Гонконге и Макао. Она также запрещает предлагать там интегрированный продукт пользователям или обходить блокировку (Geographic Use Policy, разделы 2.1 и 3). Большинство американских команд с этим не столкнутся. Американскому агентству с сотрудниками или клиентами в Гонконге стоит проверить этот пункт, прежде чем выбирать модель.
API-ключ Muse Wonder: четыре шага и три ловушки
В справочном центре Meta AI Developer описано, как получить ключ за четыре шага. Мы не создавали аккаунт Meta, поэтому таблица основана на тексте справочного центра, а не на записи экрана.
| Шаг | Что сказано в справочном центре | Источник |
|---|---|---|
| 1. Регистрация | Нажмите «Start building» на сайте Model API. Выберите Individual, затем войдите через email, телефон, Facebook, Google или GitHub. Вам должно быть не меньше 18 лет, и вы должны находиться в поддерживаемом регионе | How do I sign up |
| 2. Настройка оплаты | Администратор добавляет способ оплаты на странице Billing, а также полное имя по документам и адрес | Set up billing |
| 3. Создание ключа | На странице API keys нажмите «Create API key», задайте имя и скопируйте ключ. Ключ принадлежит команде | Create an API key |
| 4. Настройка переменной окружения | Выполните export MODEL_API_KEY="..." и читайте значение в коде. Не размещайте ключ во фронтенд-коде и не коммитьте его | Quickstart |
Первая ловушка: жёсткого лимита расходов нет. В справочном центре сказано, что Meta Model API не позволяет задать лимит расходов, при достижении которого использование прекращается. Можно настроить только ежемесячное уведомление по электронной почте, а расходы сверх указанной суммы всё равно придётся оплатить (Spend limit alert). Агент вызывает инструменты в цикле, поэтому из-за ошибки он может работать всю ночь. По этой причине наш код цикла ниже задаёт собственный лимит шагов и бюджет токенов.
Вторая ловушка связана со сроками списания и возвратом средств. Meta списывает деньги с карты, когда расходы достигают порога оплаты, а оставшуюся сумму — первого числа каждого месяца (How am I billed). В справочном центре также сказано, что Model API не возвращает средства (Refunds). Прежде чем запускать полный список, проверьте всё на двух блогерах.
Третья ловушка важнее всего для агентств. Ключи принадлежат команде, а в справочном центре сказано, что передача ключа за пределы вашей команды нарушает условия (Can I share my API key). Раздел 10.1 Условий использования Model API также запрещает перепродавать сервис третьим лицам без письменного разрешения Meta. Это касается как ключей, так и доступа к модели (Terms of Service, обновлено 9 октября 2026 года). Если вы проверяете блогеров для нескольких брендов, храните ключ внутри своей команды. Ваши клиенты получают отчёты, а не ключи.
На стороне EveryInfra зарегистрируйтесь по инструкции в разделе Быстрый старт и создайте API-ключ в консоли. Его тоже храните в переменной окружения. У двух API-ключей разные задачи: API-ключ Meta используется для обращения к модели, а API-ключ EveryInfra — для получения данных. Код инструментов выполняется на вашем сервере, поэтому модель не видит ни одного из ключей.
Цены на Meta Muse Wonder API: $4 и $20, а также ещё три расценки
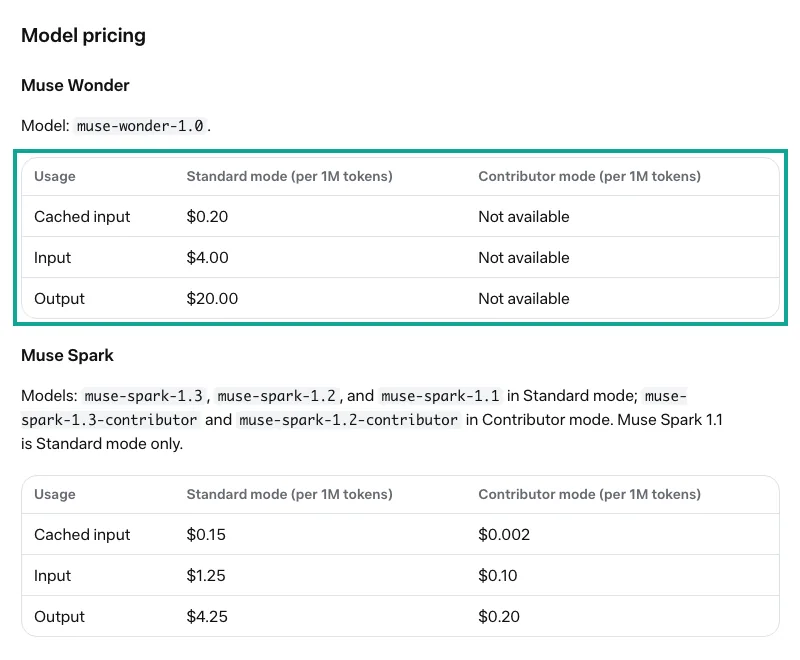
На странице цен Meta для Muse Wonder указаны три расценки за миллион токенов: $4,00 за ввод, $0,20 за кешированный ввод и $20,00 за вывод. В столбце режима Contributor написано «Not available» (Pricing and rate limits). В анонсе Meta for Developers от 12 октября 2026 года приведены те же расценки: «$4/$20 per million tokens» (пост Meta for Developers).
Агент для проверки может столкнуться ещё с тремя статьями расходов. Первая из них — веб-поиск. Встроенный инструмент web_search стоит дополнительно $2.50 за 1 000 поисковых запросов. Он ищет по веб-страницам и не может возвращать данные по отдельным видео, поэтому мы его не используем (Search grounding).
Вторая статья расходов — Muse Spark. Для модели muse-spark-1.3 входные токены стоят $1,25, а выходные — $4,25 за миллион токенов. В режиме Contributor они стоят соответственно $0,10 и $0,20, но ваш контент используется для обучения моделей Meta. Раздел 6.2 условий также запрещает отправлять в сервисы Contributor чувствительную, конфиденциальную или персональную информацию (Terms of Service, раздел 6). Наши входные данные содержат тексты комментариев обычных пользователей, поэтому мы используем только режим Standard.
Третья — кеширование. Meta сама кеширует одинаковые префиксы промптов, а кешированные токены стоят $0,20 за миллион (Prompt caching). Ставьте системный промпт и определения инструментов в начало и меняйте только список блогеров в конце. Тогда в пакете из 10 блогеров большая часть неизменного префикса попадает в кеш.
| Пункт | Muse Wonder | Muse Spark 1.3 | Muse Spark 1.3 Contributor |
|---|---|---|---|
| Ввод (за миллион токенов) | $4.00 | $1.25 | $0.10 |
| Кешированный ввод | $0.20 | $0.15 | $0.002 |
| Вывод | $20.00 | $4.25 | $0.20 |
| Обучение на вашем контенте | Нет (Standard) | Нет (Standard) | Да |
| Запросы и токены в минуту на команду | 3 000 и 4 млн | 3 000 и 4 млн | 150 и 3 млн |
| Для чего подходит в агенте проверки | Основной цикл: чтение, сравнение, написание отчёта | Вспомогательные задачи, например разметка комментариев | Не для задач с текстами комментариев |
Лимиты запросов взяты с той же страницы. Meta считает лимиты на команду, поэтому все ключи команды делят общий бюджет, а у каждой модели он свой (Rate limits). Списку из 10 авторов до 3 000 запросов в минуту очень далеко. Реальное ограничение скорости находится на стороне данных. Наш тестовый ключ допускает 10 запросов в минуту, а в разделе с реальными результатами показано, как это влияет на общее время выполнения.
Почему только TikTok и YouTube: рамки статьи и условия использования Muse
Бренды обычно работают с двумя типами авторов: теми, кто снимает короткие видео, и теми, кто снимает длинные. В этом руководстве для каждого типа выбрана одна платформа: TikTok для коротких видео, YouTube — для длинных.
Данные двух платформ сильно различаются. Лента TikTok показывает видео людям, которые не подписаны на аккаунт, поэтому просмотры могут превышать десятую часть числа подписчиков. У крупного YouTube-канала часто остаётся много подписчиков, пришедших в прошлые годы, поэтому его охват обычно невысок. Вместе эти платформы иллюстрируют мысль, к которой руководство возвращается снова и снова: сравнивайте метрики только в пределах одной платформы. Другие платформы в статье не рассматриваются. Для них можно использовать те же четыре правила и ту же схему инструментов, но сначала проверьте поля каждого эндпоинта.
К данным, которые вы отправляете модели, тоже применяются правила. В этом разделе цитируются только юридические страницы самой Muse (dev.meta.ai/legal). Это не юридическая консультация. Самостоятельно прочитайте условия, проверьте требования местного законодательства и свои соглашения с каждой платформой, откуда вы получаете данные.
Согласно разделу 4.1 Условий использования Meta Model API (обновлены 9 октября 2026 года), вы отвечаете за данные, которые передаёте сервису, в том числе за их точность и достоверность. Пункт (vii) раздела 10.1 запрещает использовать сервис для нарушения или иного ущемления прав третьих лиц. В разделе 10.3 сказано, что Meta может контролировать использование вами сервиса посредством автоматической проверки или проверки человеком (Terms of Service). На странице Data Commitments сказано, что Meta не использует контент из сервисов Standard для обучения своих моделей. При этом Meta может обрабатывать этот контент, чтобы выявлять нарушения правил использования или условий и реагировать на них (Data Commitments).
| Правило | Область действия | Суть текста (пересказ) | Что это значит для агента проверки |
|---|---|---|---|
| Условия Model API, п. 4.1 | Данные, которые вы отправляете | Вы отвечаете за точность и достоверность данных | Каждое число должно подтверждаться исходным ответом |
| Условия Model API, п. 10.1 (vii) и 10.3 | Как вы используете сервис | Запрещено использование, нарушающее права третьих лиц. Meta может отслеживать использование | Сначала прочитайте условия. Проверьте источники данных и цель |
| Data Commitments | Контент в сервисах Standard | Не используется для обучения. Может обрабатываться для выявления нарушений и реагирования на них | Отправляйте тексты комментариев только в режиме Standard |
| Model API Acceptable Use Policy | Результат и цель | Запрещено делать выводы о чувствительных личных характеристиках. Запрещено оценивать людей по социальному поведению, если это приводит к вреду | Оценивайте бизнес-показатели аккаунта, но не человека |
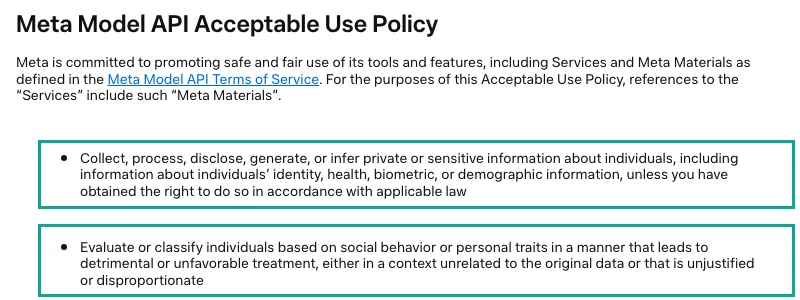
Последнюю строку легко упустить. В Правилах допустимого использования Meta Model API (обновлены 12 октября 2026 года) есть два пункта, которые напрямую касаются оценки блогеров. Первый запрещает без законных оснований собирать, обрабатывать, раскрывать, генерировать или выводить частную или чувствительную информацию о людях, например данные, позволяющие установить личность, сведения о здоровье, биометрические или демографические данные. Второй запрещает оценивать или классифицировать людей по социальному поведению или личным характеристикам в двух случаях: если это приводит к неблагоприятному обращению с ними или если такая оценка используется вне исходного контекста (Acceptable Use Policy).
Проверка блогера — обычный шаг перед платным сотрудничеством. Бренд оценивает аккаунт как медиаканал. Стабильны ли просмотры? Соответствует ли вовлечённость числу подписчиков? Публикует ли блогер контент регулярно? Обсуждают ли в комментариях сам контент? Всё это бизнес-показатели аккаунта.
Риск представляют другие вопросы. Например, просьба к модели угадать возраст, этническую принадлежность, состояние здоровья или политические взгляды блогера. Ещё один пример — использование комментариев обычных пользователей, чтобы навесить на человека ярлык.
Чтобы не выйти за допустимые рамки, наш код инструментов делает две вещи. Он отправляет модели только текст комментария, число лайков, число ответов и время, без имени комментатора. Кроме того, системный промпт велит модели оценивать только эффективность контента и не делать выводов о личных характеристиках. Это делает отчёт убедительнее, потому что в нём только то, что подтверждают данные.
Четыре метрики: сначала зафиксируйте правила, затем дайте модели проанализировать данные
Худшее, что может быть в отчёте о проверке, — слово, которое разные люди понимают по-разному. Одни делят вовлечённость на число подписчиков, другие — на просмотры. Одни судят о «настоящих подписчиках» по комментариям, другие — по лайкам на подписчика. Стоит поменять формулу, и вывод может стать противоположным. Поэтому мы прописываем четыре формулы в системном промпте ещё до получения данных. Модель читает числа, сравнивает их и пишет вывод, но не придумывает методику.
| Метрика | Формула в этом руководстве | Используемые поля | Что можно и чего нельзя узнать |
|---|---|---|---|
| Подлинность подписчиков (косвенная оценка) | Охват = медиана просмотров незакреплённых видео, опубликованных от 3 до 30 дней назад, делённая на число подписчиков. Также отношение среднего к медиане и доля самого популярного видео | follower_count, view_count, posted_at, is_pinned | Показывает, какая часть подписчиков всё ещё смотрит. Не доказывает, что какой-то конкретный подписчик фейковый |
| Коэффициент вовлечённости | Для каждого видео (лайки + комментарии + репосты) / просмотры, затем медиана. Для TikTok берётся та же выборка, что и для охвата (незакреплённые видео, опубликованные от 3 до 30 дней назад). Для YouTube считается (лайки + комментарии) / просмотры | like_count, comment_count, share_count, view_count | Показывает, реагируют ли зрители. Не позволяет отличить активность реальных зрителей от купленной активности |
| Частота публикаций за 30 дней | Число незакреплённых видео за 30 дней, самый длинный перерыв, медианный перерыв, число дней с последнего видео | posted_at | Показывает, активен ли аккаунт. Ничего не говорит о качестве |
| Состав комментариев | Каждый комментарий получает одну из пяти меток по правилам: по теме (от 4 слов), вопрос, 3 слова и меньше, только эмодзи, без текста. Точные дубликаты тоже подсчитываются | text, is_reply | Показывает, отвечают ли комментарии на содержание видео. Ничего не говорит о том, кто их написал |
Почему охват, а не «процент фейковых подписчиков»? По публичным данным нельзя определить, является ли конкретный подписчик реальным человеком, а список подписчиков не следует использовать при проверке блогеров. Измерить можно разрыв между числом подписчиков и текущими просмотрами. Охват имеет смысл только при сравнении аккаунтов похожего размера на одной платформе, поэтому в этом руководстве нет фиксированного проходного порога.
Все метрики считаются по медиане, потому что несколько хитов могут завысить среднее. TechBullion описал небольшое исследование: 675 видео от 52 авторов TikTok. У 73 % из них среднее число просмотров было как минимум в 1,5 раза выше медианы (TechBullion, октябрь 2026). Это вторичный источник с небольшой выборкой. Мы приводим его только как пример того, что среднее может вводить в заблуждение, а не как шкалу для оценки.
Мы делим вовлечённость на просмотры, а не на подписчиков, потому что в варианте с подписчиками к ней примешивается охват. Аккаунт с большим числом подписчиков и низким охватом выглядит слабым в пересчёте на подписчика и может выглядеть нормально в пересчёте на просмотр. Эти два варианта отвечают на разные вопросы. Первый: продолжают ли подписчики смотреть контент. Второй: интересен ли контент зрителям. Мы указываем оба показателя отдельно.
По YouTube нужны два уточнения. Публичное число репостов недоступно, поэтому вовлечённость на YouTube считается только по лайкам и комментариям. Кроме того, 27 августа 2026 года YouTube изменил подсчёт публичных просмотров. Теперь просмотр засчитывается с первого кадра воспроизведения, а монетизация и большая часть аналитики по-прежнему используют вовлечённые просмотры (engaged views) (YouTube Data API revision history; YouTube Help). Не сравнивайте напрямую просмотры до и после этой даты.
Определения инструментов: JSON для пяти инструментов
В справочном центре Meta сказано, что Model API поддерживает вызов инструментов (tool calling): модель может вызывать внешние инструменты и источники данных, которые вы определите (Can the models call tools?).
Формат очень похож на формат OpenAI. Meta рекомендует Responses API, где поля функции находятся непосредственно на верхнем уровне каждого инструмента: type, name, description, parameters и необязательное поле strict (Tool calling). По умолчанию strict имеет значение false, и схема принимается как есть. При значении true сервер проверяет, соответствует ли схема строгому подмножеству. Каждое свойство должно входить в required, а объект должен содержать "additionalProperties": false, иначе вызов вернёт HTTP 400 (Strict tool schemas). Во всех пяти наших инструментах используется strict: true: у них мало параметров, и это позволяет выявить ошибки в схеме до запуска.
Основной вопрос проектирования — как разделить инструменты. Самый простой вариант — один универсальный инструмент с platform, action и params, как everyinfra_call_api в MCP-сервере EveryInfra. Тогда модель может вызывать любой эндпоинт, но ей приходится каждый раз формировать параметры, а каждая ошибка требует дополнительного шага. Процесс проверки авторов состоит из фиксированных шагов, поэтому мы используем пять специализированных инструментов, по одному на каждый эндпоинт. В описании каждого указана одна из ловушек, например: «Закреплённые видео идут первыми, исключите их перед расчётом медиан».
В именах функций используются подчёркивания, а не точки. Meta разрешает использовать в имени функции не более одной точки; две точки приводят к ошибке 400. Для составных имён в стиле MCP вместо этого нужен инструмент с пространством имён (namespace tool) (Function name rules). Для пяти инструментов поиск инструментов Meta (tool search) не нужен. Эта возможность предназначена для агентов с сотнями инструментов. Она не передаёт схемы параметров, пока они не понадобятся модели, что экономит входные токены и сохраняет префикс кеша неизменным (Tool search).
[
  {
    "type": "function",
    "name": "tiktok_videos",
    "description": "List the newest public videos of one TikTok account with views, likes, comments, shares, saves, posted_at, is_pinned and is_ad. Calls EveryInfra tiktok/user_videos. Pinned videos come first; drop them before you compute medians.",
    "strict": true,
    "parameters": {
      "type": "object",
      "properties": {
        "username": { "type": "string", "description": "TikTok handle without @" },
        "limit": { "type": "integer", "description": "1 to 50. Use 50 for a 30-day window." }
      },
      "required": ["username", "limit"],
      "additionalProperties": false
    }
  },
  {
    "type": "function",
    "name": "video_comments",
    "description": "Read public comments of one video. Returns comment text, like and reply counts and time only, never the commenter's name. Calls EveryInfra tiktok/comments or youtube/comments.",
    "strict": true,
    "parameters": {
      "type": "object",
      "properties": {
        "platform": { "type": "string", "enum": ["tiktok", "youtube"] },
        "video_url": { "type": "string", "description": "Full URL of one video" },
        "limit": { "type": "integer", "description": "1 to 50" }
      },
      "required": ["platform", "video_url", "limit"],
      "additionalProperties": false
    }
  }
]
В блоке показаны два инструмента из пяти. Остальные три: tiktok_profile для tiktok/profile, youtube_channel для youtube/profile и youtube_videos для youtube/user_posts. Каждый из них мы сверили с response_fields в каталоге по состоянию на тот день. В последнем столбце указано подмножество полей, которое наш код инструментов возвращает модели, а не полный ответ. В исходном ответе TikTok для видео 34 поля, включая обложку, музыку и описание профиля автора. Для проверки блогера они не нужны, но расходуют токены, поэтому код их отбрасывает.
| Инструмент | Эндпоинт | Цена за вызов в каталоге | Поля, возвращаемые модели |
|---|---|---|---|
tiktok_profile | tiktok/profile | $0.000556 | username, display_name, follower_count, following_count, like_count, video_count, is_verified, created_at |
tiktok_videos | tiktok/user_videos | $0.000556 | id, url, posted_at, view_count, like_count, comment_count, share_count, collect_count, is_pinned, is_ad, duration_sec |
youtube_channel | youtube/profile | $0.000556 | name, url, subscriber_count, video_count, view_count, is_verified, created_at |
youtube_videos | youtube/user_posts | $0.000556 | id, url, title, posted_at, view_count, like_count, comment_count, duration, is_paid_partnership |
video_comments | tiktok/comments или youtube/comments | $0.000556 | text (обрезается до 200 символов), like_count, reply_count, is_reply, posted_at |
Цикл агента: схема Meta и три изменения
В документации Meta по вызову инструментов показан минимальный цикл. Вы отправляете запрос с tools и ищете элементы function_call в output. Каждый из них вы выполняете и отправляете обратно function_call_output с previous_response_id, а историю хранит сервер (Tool calling). Мы сохранили эту схему и внесли три изменения. Код ниже приведён как пример настройки; часть на стороне Meta мы не запускали.
# Example setup: Muse Wonder (Responses API) + EveryInfra tools. The Meta side was not run here.
import json, os
from openai import OpenAI
from ei_tools import run  # tool layer: calls EveryInfra, trims the response

meta = OpenAI(base_url="https://api.meta.ai/v1", api_key=os.environ["MODEL_API_KEY"])
TOOLS = json.load(open("tools.json"))
SYSTEM = open("system_prompt.txt").read()   # fixed prefix first, so it hits the cache
MAX_TURNS, MAX_TOKENS = 40, 400_000          # Meta has no hard spend cap; set your own

def due_diligence(creators: list[dict]) -> str:
    resp = meta.responses.create(model="muse-wonder-1.0", reasoning={"effort": "medium"},
                                 instructions=SYSTEM, tools=TOOLS, input=json.dumps(creators))
    used = resp.usage.total_tokens
    for _ in range(MAX_TURNS):
        calls = [i for i in resp.output if i.type == "function_call"]
        if not calls:                     # tool_choice is auto only: the model may just answer
            return resp.output_text
        outputs = []
        for c in calls:                   # one turn can hold several parallel calls
            body, code, raw, secs, out = run(c.name, json.loads(c.arguments))
            outputs.append({"type": "function_call_output", "call_id": c.call_id,
                            "output": json.dumps(out, ensure_ascii=False)})
        resp = meta.responses.create(model="muse-wonder-1.0", previous_response_id=resp.id,
                                     tools=TOOLS, input=outputs)
        used += resp.usage.total_tokens
        if used > MAX_TOKENS:
            raise RuntimeError(f"token budget exceeded: {used}")
    raise RuntimeError("too many turns")
Первое изменение касается нескольких вызовов за ход. В рекомендациях Meta сказано, что модель может вернуть больше одного вызова инструмента за ход, и ответить нужно на каждый. По умолчанию parallel_tool_calls равно true (Guidelines). Десять блогеров по пять вызовов могут дать дюжину вызовов сразу. Слой инструментов должен ставить их в очередь, потому что наш тестовый ключ EveryInfra допускает 10 запросов в минуту.
Второе изменение добавляет собственные ограничения. max_tool_calls ограничивает только встроенные инструменты, такие как web_search, поэтому ваши собственные функции он не остановит. Meta предлагает parallel_tool_calls: false или лимит ходов в вашем цикле. С учётом отсутствия лимита расходов вам нужны и лимит ходов, и бюджет токенов.
Третье изменение обрезает результаты до отправки обратно. Всё содержимое function_call_output на следующем ходе считается входными токенами. Степень обрезки сильнее всего влияет на оценку стоимости, поэтому ей посвящён отдельный раздел ниже.
Зафиксируйте формат отчёта с помощью структурированного вывода. В документации Meta сказано, что с json_schema схеме следует само декодирование, поэтому вывод всегда ей соответствует (Structured output). В Responses API формат задаётся в text.format и работает вместе с вызовами инструментов.
В нашей схеме одна запись на автора. В каждой записи четыре значения метрик, размер выборки для каждого значения и вердикт в одну строку. Есть и массив missing, где перечислены все числа, которые агент не смог получить или которые пришли округлёнными. С таким массивом у модели нет причин выдумывать число, чтобы заполнить поле.
Долгие задачи: фоновый режим для списка из 50 авторов
Список из 10 авторов обрабатывается за несколько минут, и обычных запросов достаточно. Для 50 авторов или нескольких страниц видео на каждого используйте схему Meta для долгих задач. В документации Responses API перечислены три ограничения (Responses API). У запроса без стриминга есть серверный лимит времени, и при слишком долгом выполнении он возвращает 504.
С background: true вызов сразу возвращает status: "queued", после чего задачу можно опрашивать по ID, результат — получать потоком, а саму задачу — отменить. Тело фонового запроса не может превышать 1 MiB; при большем размере возвращается 413. На странице с ценами уточняется, что каждая команда может создавать до 600 фоновых задач в минуту (Background responses).
Лимит в 1 MiB для этой задачи вполне реален. Во время реального запуска сырой ответ с данными о 50 видео TikTok из одного аккаунта занимал примерно 114–116 КБ. Если поместить сырой JSON по десяти аккаунтам в один фоновый запрос, лимит будет превышен. Если сначала обрезать данные в слое инструментов, проблема исчезает.
У EveryInfra есть собственный асинхронный режим. Добавьте "mode": "async" в тело любого запроса, и ответ сразу вернёт job_id. Затем получите результат через GET /api/v1/jobs/{job_id}. На синхронный режим отводится 85 секунд, актуальное значение указано в столбце async_mode каталога. Надёжнее всего использовать асинхронность на обеих сторонах. Модель отправляет вызовы, а ваш код ставит их в очередь и получает результаты с допустимой частотой. Код отправляет их обратно только после того, как получит все.
Обратите внимание ещё на одну настройку. Если ваша команда включит нулевое хранение данных (zero data retention, ZDR), то, согласно справочному центру Meta, ряд функций будет отклоняться. Это запросы с сохранением состояния, ссылающиеся на предыдущий ответ, фоновые запросы, загрузка файлов и веб-поиск (ZDR help article). Наш цикл использует previous_response_id. С включённым ZDR придётся на каждом ходе отправлять весь диалог, а это много дополнительных токенов.
Другой путь: Claude Agent SDK с моделью Muse Wonder и MCP-сервером EveryInfra
Собственный слой инструментов можно не писать. Meta описывает второй путь: цикл агента выполняет Claude Agent SDK, работающий с моделью Meta. На странице об агентных фреймворках сказано, что SDK подключается к Model API через формат Anthropic Messages. Задайте ANTHROPIC_BASE_URL равным https://api.meta.ai (без /v1) и укажите ключ Meta в ANTHROPIC_AUTH_TOKEN. Основной цикл использует muse-wonder-1.0, а субагенты могут перейти на более дешёвую muse-spark-1.3. На той же странице предупреждают, что подключать стоит только MCP-серверы, которым вы доверяете (Agent frameworks).
При такой настройке можно подключить удалённый MCP-сервер EveryInfra. По спецификации MCP серверы перечисляют инструменты через tools/list и выполняют их через tools/call (MCP specification: Tools). Модель видит готовые инструменты, например everyinfra_call_api, и JSON инструментов писать не нужно.
# Example setup: Claude Agent SDK with Muse Wonder as the model and the EveryInfra remote MCP server. Not run here.
import os, anyio
from claude_agent_sdk import query, ClaudeAgentOptions, ResultMessage

options = ClaudeAgentOptions(
    model="muse-wonder-1.0",
    system_prompt=open("system_prompt.txt").read(),
    mcp_servers={"everyinfra": {"type": "http", "url": "https://api.everyinfra.com/mcp",
                                "headers": {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}}},
    allowed_tools=["mcp__everyinfra__everyinfra_call_api", "mcp__everyinfra__everyinfra_get_job"],
    setting_sources=[],
    env={**os.environ,
         "ANTHROPIC_BASE_URL": "https://api.meta.ai",
         "ANTHROPIC_AUTH_TOKEN": os.environ["MODEL_API_KEY"],
         "ANTHROPIC_MODEL": "muse-wonder-1.0",
         "ANTHROPIC_DEFAULT_OPUS_MODEL": "muse-wonder-1.0",
         "ANTHROPIC_DEFAULT_SONNET_MODEL": "muse-spark-1.3",
         "ANTHROPIC_DEFAULT_HAIKU_MODEL": "muse-spark-1.3",
         "CLAUDE_CODE_SUBAGENT_MODEL": "muse-spark-1.3"},
)

async def main():
    async for m in query(prompt="Review these creators: natgeo, nasa, notionhq", options=options):
        if isinstance(m, ResultMessage):
            print(m.result, m.usage)

anyio.run(main)
Компромисс простой. Собственный JSON инструментов позволяет контролировать, что читает модель: какие поля, какой длины текст и попадают ли туда имена комментаторов. Путь через MCP экономит код. Его недостаток в том, что everyinfra_call_api возвращает полный ответ, поэтому одно видео TikTok добавляет в контекст все 34 поля. Туда же попадают и имена пользователей, оставивших комментарии. Мы измерили это во время одного реального вызова через MCP; цифры приведены в разделе о цикле обмена данными.
В allowed_tools указаны только инструмент получения данных и инструмент для работы с задачами. Это соответствует совету Meta давать агенту только нужные ему инструменты. У MCP-сервера EveryInfra есть также инструменты для обращений в поддержку и данных аккаунта, а агенту для проверки авторов они не нужны.
Один реальный цикл обмена данными: модель запрашивает, наш код получает
JSON инструментов и цикл выше приведены как пример настройки. В этом разделе описана та часть схемы, которую мы действительно запустили. Слой инструментов мы написали отдельным файлом. Он принимает те же аргументы function_call, что отправила бы Muse Wonder, и сопоставляет каждое имя функции с эндпоинтом EveryInfra. Затем он отправляет запрос, оставляет нужные поля, убирает имена комментаторов и оборачивает результат в function_call_output.
Модель всегда отправляет только имя функции и JSON-строку. Наша сторона получает тот же вход, поэтому получение данных и результат такие же, как с Muse Wonder в цикле.
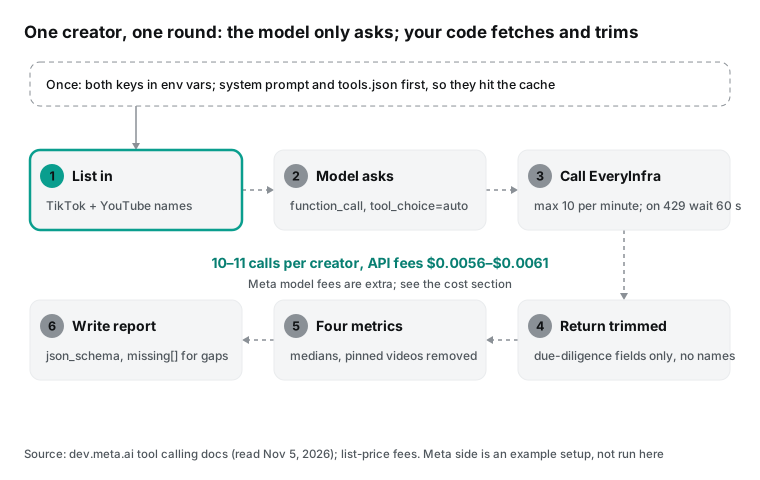
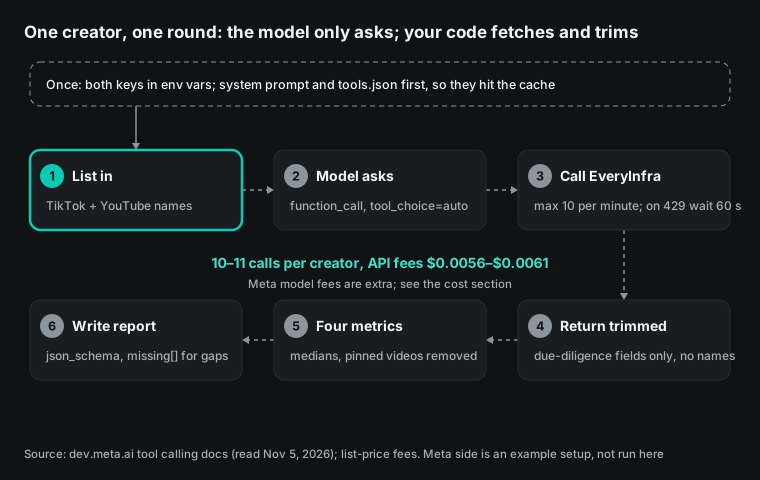
Ниже четыре вызова для NASA в хронологическом порядке. Каждая строка соответствует одному реальному запросу. Время указано на момент отправки запроса по SGT, рядом приведено восточное время США. Длительность измеряется от отправки до последнего байта. «Сырой ответ» означает размер тела ответа, «Передано модели» означает размер после обрезки слоем инструментов.
| Время (SGT, 5 ноября) | Время (ET, 4 ноября) | Инструмент и эндпоинт | Длительность | Сырой ответ | Передано модели | Оплачено |
|---|---|---|---|---|---|---|
| 00:18 SGT | 11:18 ET | tiktok_profile, tiktok/profile | 11.35 s | 1,587 B | 287 B | $0.000556 |
| 00:22 SGT | 11:22 ET | tiktok_videos, tiktok/user_videos (50 видео) | 35.81 s | 116,106 B | 14,206 B | $0.000556 |
| 00:25 SGT | 11:25 ET | youtube_channel, youtube/profile | 8.96 s | 1,797 B | 299 B | $0.000556 |
| 00:28 SGT | 11:28 ET | video_comments, tiktok/comments (50 комментариев) | 58.22 s | 16,761 B | 7,805 B | $0.000556 |
Ниже запрос и ответ первого вызова. Мы убрали одно длинное поле, URL аватара, а остальное оставили как пришло. Значение follower_count, 2 200 000, выглядит точным, но оно округлено, как объясняется в разделе с результатами.
POST https://api.everyinfra.com/api/v1/social
{"platform":"tiktok","action":"profile","params":{"username":"nasa"}}

200 OK, 00:18:46 SGT, 11.35 s, billed $0.000556
{"user_id":"7664638705177150477","username":"nasa","display_name":"NASA",
 "bio":"Making the seemingly impossible, possible.✨","url":"https://www.tiktok.com/@nasa",
 "follower_count":2200000,"following_count":23,"like_count":11500000,"video_count":62,
 "friend_count":17,"is_verified":true,"is_private":false,
 "created_at":"2026-07-20T15:55:49+00:00","platform":"tiktok"}
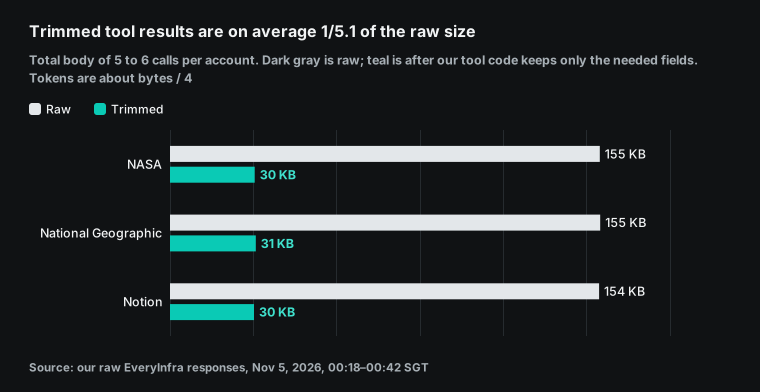
Копия для модели содержит 8 полей и занимает 287 байт. Обрезка профиля экономит немного. Основная экономия приходится на список видео. Пятьдесят сырых видео TikTok занимают 116 106 байт, по 34 поля в каждом, включая обложки, музыку, данные автора и несколько URL. Для проверки нужно 11 из этих полей, поэтому обрезанная копия занимает 14 206 байт, примерно восьмую часть исходного размера.
На изображении ниже рядом показаны запрос и ответ для комментариев. Верхний блок содержит вызов, который отправила бы модель, с аргументами из реального запуска. Нижний блок показывает первые два из 50 комментариев к одному видео National Geographic в TikTok ровно в том виде, в каком их вернул наш слой инструментов. Текст комментариев для изображения мы обрезали, а имена комментаторов код инструментов удалил ещё раньше.
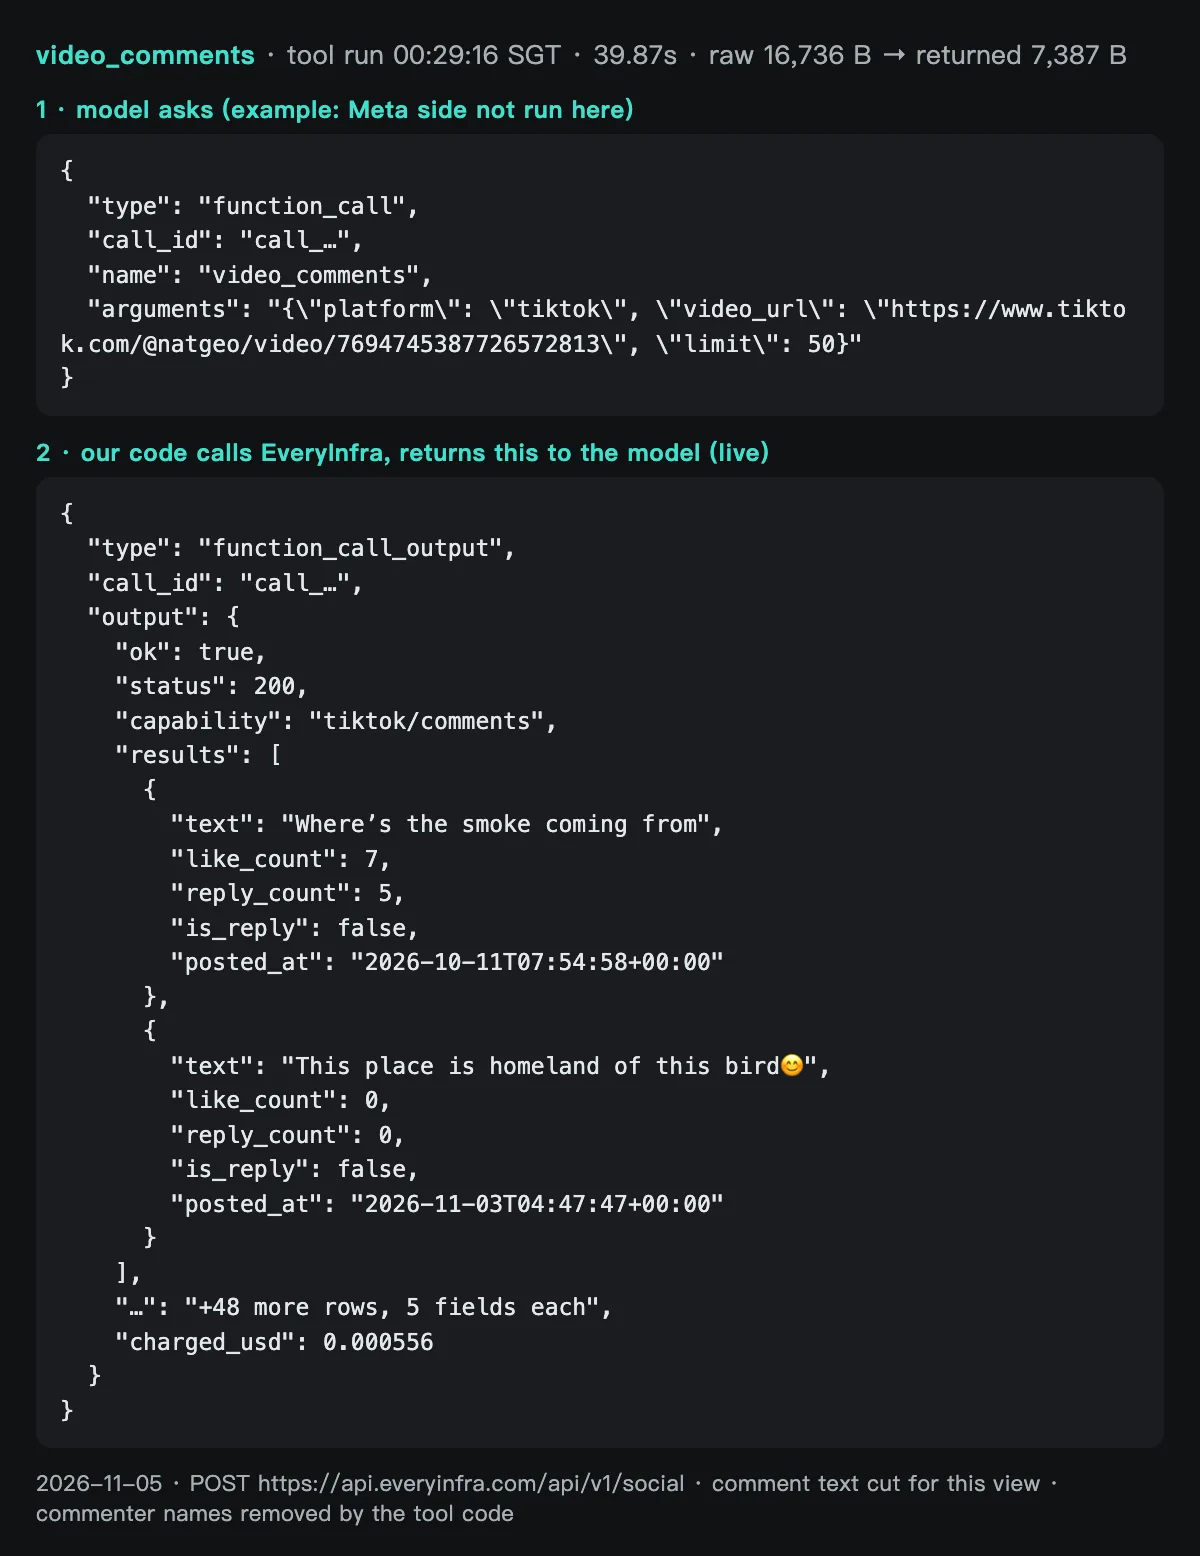
При работе через MCP те же данные требуют примерно вдвое больше токенов. В 00:38 SGT (11:38 ET) мы вызвали everyinfra_call_api на удалённом MCP-сервере EveryInfra и получили 50 комментариев к одному видео National Geographic на YouTube. Вызов занял 16,74 секунды, списано $0,000556. Модели передаётся текст объёмом 18 198 байт, по 8 полей на комментарий, включая author_name. Наш список разрешённых полей сократил бы те же 50 комментариев до 9 516 байт, без имён.
MCP экономит код, но удваивает число токенов на вызов. Кроме того, вы не можете убрать имена комментаторов до того, как их прочитает модель. Для отчёта, который будет читать клиент, важнее второй пункт, потому что упомянутая выше политика использования распространяется на выводы о людях.
Сбои мы тоже записали. Запросы комментариев NASA на YouTube дважды вернули ошибку 503: в 00:37 и 00:40 SGT. В теле ошибки были retryable: true и retry_after: 20; поле billing.charged имело значение false, а статус возврата средств — succeeded.
При третьем сбое этого эндпоинта за 10 минут сообщение изменилось. В нём предлагалось один раз отправить запрос из примера и говорилось, что если пример работает, проблема на стороне целевого ресурса. Именно такой формат ошибок нужен нашему слою инструментов. Из сообщения модель может узнать, сколько ждать, стоит ли делать повторную попытку и что проверить дальше.
Для Notion мы сначала выбрали видео от 27 октября 2026 года с comment_count, равным 0. Эндпоинт вернул 200 с пустым массивом и причиной empty_result_refunded, так что запрос ничего не стоил. Мы перешли на видео от 23 октября 2026 года с 5 комментариями и получили 2. Шесть запросов за прогон не вернули данных: для 2 вернулся код 429, для 3 — 503, ещё 1 дал пустой результат. Ни за один из них плата не списывалась.
Результаты реального запуска: четыре метрики по трём аккаунтам и шесть ловушек в данных
В этом разделе каждая метрика разобрана подробно. Все графики построены по одним и тем же сырым ответам по правилам из таблицы выше. После цифр мы перечисляем ловушки, на которые наткнулись. Им место в вашем системном промпте.
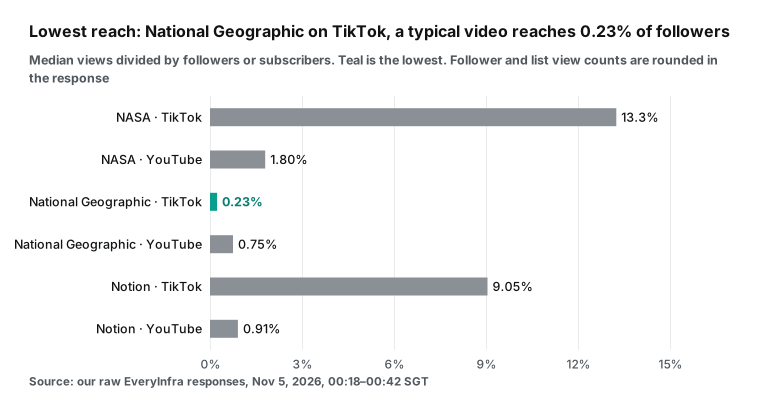
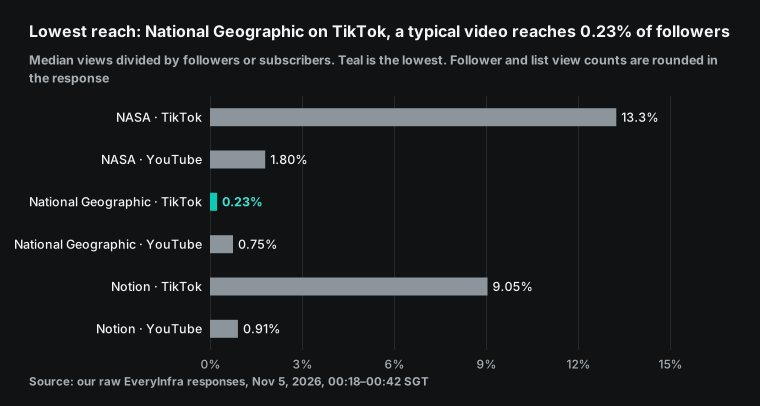
Не сравнивайте охват в TikTok и YouTube. Лента TikTok показывает видео и тем, кто на вас не подписан, поэтому число просмотров может превышать десятую часть числа подписчиков. У крупного канала YouTube много людей, подписавшихся много лет назад и теперь редко смотрящих видео, поэтому охват низкий. Сравнивайте аккаунты только внутри одной платформы. В TikTok у NASA 13,25%, у Notion 9,05%, а у National Geographic 0,23%: разрыв более чем в 50 раз. Только по охвату агент сделал бы вывод: «число подписчиков не соответствует числу просмотров».
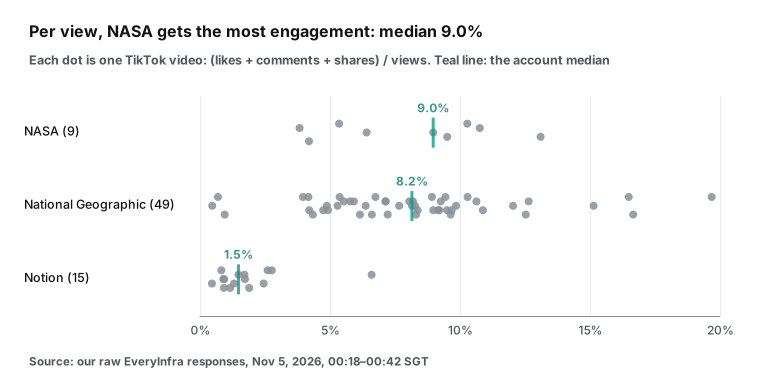
График вовлечённости опровергает половину этого вердикта. Медианная вовлечённость на просмотр у National Geographic составляет 8,15%, а у NASA — 8,97%; разница менее одного процентного пункта. У Notion она равна 1,48%. Зрители видео National Geographic ставят лайки и делятся ими примерно так же часто, как зрители видео NASA.
Низкий охват при нормальной вовлечённости указывает на аккаунт, который много публикует, поэтому каждое видео доходит лишь до части аудитории. На купленных подписчиков это не указывает. Купленные подписчики не смотрят и не ставят лайки, поэтому оба показателя упали бы вместе.
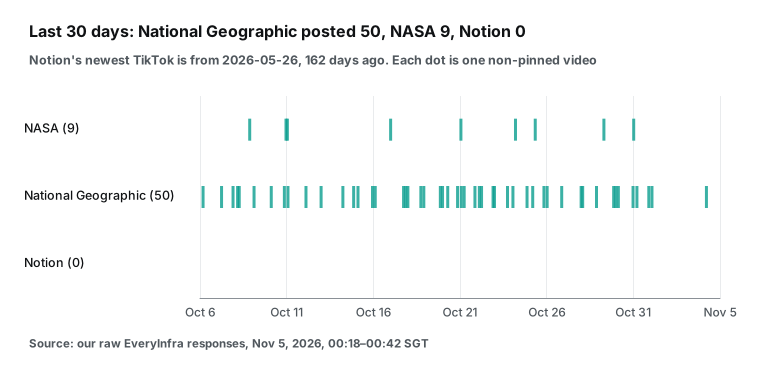
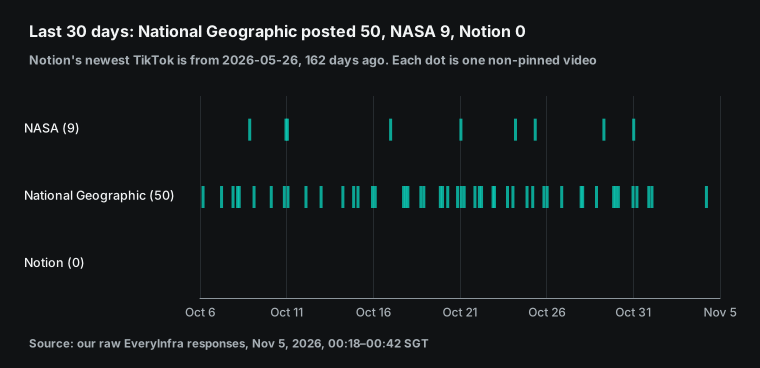
Частота публикаций объясняет эту картину. У National Geographic за 30 дней вышло 50 незакреплённых видео в TikTok, самое новое опубликовано 3 ноября 2026 года. Медианный интервал между публикациями составляет 0,62 дня, а самый длинный — 3,1 дня. У NASA за тот же период вышло 9 видео. Самое новое опубликовано 30 октября 2026 года, медианный интервал между публикациями составляет 2,62 дня, а самый длинный — 6,0 дня.
Когда одним и тем же подписчикам показывают одно-два новых видео в день, на каждое видео приходится меньшая доля аудитории. Если агент анализирует частоту публикаций вместе с охватом, он может сформулировать точный вывод: «публикует часто; охват каждого видео низкий, вовлечённость нормальная».
Строка Notion пустая. Последнее видео Notion в TikTok опубликовано 26 мая 2026 года, и на момент выгрузки ему было 161,7 дня. Охват 9,05% получен по последним 15 старым видео. Для решения о сделке в следующем месяце это число ничего не говорит.
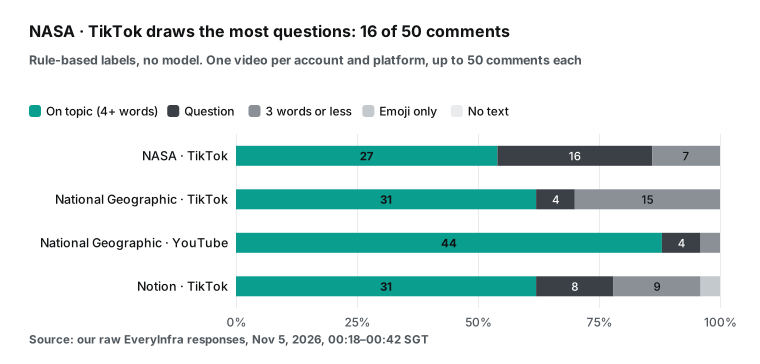
Для разметки комментариев мы не использовали модель. Мы применили пять фиксированных правил: без текста, только эмодзи или знаки препинания, есть вопросительный знак, 3 слова и меньше, и «по теме» для всего остального. Правила грубые, но любой может пересчитать результат, и они никогда не толкуют комментарий творчески.
В комментариях NASA в TikTok 16 вопросов, в основном о том, что показано в видео, и для научного автора это хороший знак. Среди комментариев National Geographic в TikTok 15 коротких и 16 с неанглийскими буквами или диакритическими знаками, что может указывать на международную аудиторию. На YouTube 44 из 50 комментариев бренда по теме, медианная длина составляет 77 символов. Качество комментариев сравнивайте только в рамках одной платформы.
Ещё один тип комментариев требует внимания. 30 сентября 2026 года в YouTube Data API для комментариев добавили поле snippet.imageUrl, поэтому комментарий может содержать изображение или GIF. Доступ откроется для всех пользователей в ноябре 2026 года (YouTube Data API revision history). Инструмент, считывающий только текст, пропустит комментарии, содержащие только изображение, поэтому наши правила выделяют комментарии без текста в отдельную категорию.
| # | Ловушка | Что мы увидели | Что должен делать агент |
|---|---|---|---|
| 1 | Количественные показатели TikTok округлены | У каждого видео с 10 000 и более просмотров число просмотров кратно 100. Число подписчиков: 2 200 000, 9 700 000 и 143 700 | Писать в отчёте «около». Не указывать два знака после запятой при малых выборках |
| 2 | 50 видео могут не покрывать 30 дней | Первая страница из 50 видео National Geographic охватила только 28,8 дня. Вторая страница с until позволила охватить весь период | Проверять самую старую дату. Если охвачено меньше 30 дней, запрашивать ещё одну страницу |
| 3 | Закреплённые видео идут первыми | У NASA и National Geographic по одному закреплённому видео, намного старше остальных | Исключать записи с is_pinned перед расчётом медиан и интервалов между публикациями |
| 4 | В списках YouTube даты указаны в относительном формате | youtube/user_posts возвращает «2w ago» или «1mo ago»; число просмотров округлено до тысяч, а данные о лайках и комментариях отсутствуют | Для видео у границы 30-дневного периода вызывать youtube/video, чтобы получить точное время публикации и число просмотров |
| 5 | Лайки на YouTube тоже округлены | У видео NASA от 14 октября 2026 года 684 881 просмотр и 11 000 лайков. У всех 4 видео NASA comment_count равно 0 | Помечать лайки как округлённые. Не делать выводов о комментариях, если их число равно 0 |
| 6 | Новый аккаунт не означает накрутку | У TikTok-аккаунта NASA в created_at указано 20 июля 2026 года; у него 2,2 млн подписчиков, однако охват в 13,25% — самый высокий из всех шести | Оценивать рост вместе с охватом и вовлечённостью. Никогда не судить по одному числу |
Больше всего вызовов требуют ловушки 2 и 4. Для активного аккаунта TikTok нужны два вызова, чтобы получить видео за 30 дней. Для канала YouTube после получения списка видео нужно сделать несколько вызовов для отдельных видео, чтобы узнать число лайков и точные даты публикации. Мы запрашивали по 4 видео на канал как компромисс между достаточно надёжной медианой и дополнительными расходами. Эти 4 вызова стоят $0,0022, то есть 40% платы за данные по одному автору. Если в вашем списке в основном авторы из TikTok, эти вызовы можно пропустить, а авторов YouTube оценивать только по числу подписчиков и частоте публикаций.
У ловушки 5 есть ещё одна особенность. 27 августа 2026 года YouTube изменил метод подсчёта просмотров. Все 12 отдельных видео, которые мы проверили, опубликованы после этой даты, поэтому наши показатели вовлечённости на YouTube не охватывают период до изменения. Если среди недавних видео автора есть опубликованные как до, так и после этой даты, это нужно указать в отчёте.
Стоимость Muse Wonder API: счёт за список из 10 авторов
Этот раздел отвечает на один вопрос: сколько стоит список из 10 авторов? Счёт состоит из двух частей. Плата за данные EveryInfra равна цене из прайс-листа, умноженной на число вызовов, поэтому эта часть точная. Плата за модель Meta равна цене из прайс-листа, умноженной на число токенов. Ключа Meta у нас не было, и модель мы не запускали, поэтому эта часть является оценкой. Мы приводим все исходные данные, чтобы вы могли подставить свои.
| Число вызовов на автора | Количество | Обычная цена | Промежуточный итог |
|---|---|---|---|
Профиль TikTok, tiktok/profile | 1 | $0.000556 | $0.000556 |
Видео TikTok, tiktok/user_videos (вторая страница для активных аккаунтов) | от 1 до 2 | $0.000556 | от $0,000556 до $0,001112 |
Комментарии TikTok, tiktok/comments | 1 | $0.000556 | $0.000556 |
Канал YouTube, youtube/profile | 1 | $0.000556 | $0.000556 |
Список видео YouTube, youtube/user_posts | 1 | $0.000556 | $0.000556 |
Отдельное видео YouTube, youtube/video | 4 | $0.000556 | $0.002224 |
Комментарии YouTube, youtube/comments | 1 | $0.000556 | $0.000556 |
| Итого | от 10 до 11 | от $0,00556 до $0,00612 |
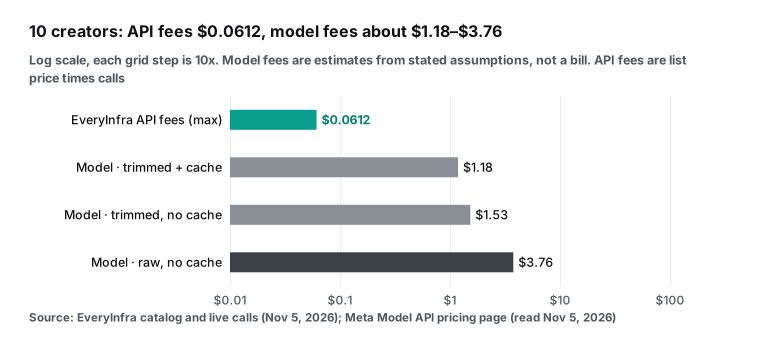
Десять авторов — это от 100 до 110 вызовов и от $0,0556 до $0,0612 платы за данные. Сбои, тайм-ауты и пустые результаты не оплачиваются, поэтому это верхняя граница. В нашем прогоне оплачено 30 запросов из 36. Цены взяты из каталога за день проведения теста (страница тарифов); каталог доступен бесплатно и без ключа.
Оценка для модели строится на четырёх допущениях. Первое: для каждого автора ведётся отдельный диалог из 3 ходов. На ходе 1 отправляются 4 вызова за данными, на ходе 2 — вызовы за комментариями, на ходе 3 модель пишет отчёт. Второе: фиксированный префикс (системный промпт и пять определений инструментов) занимает 1 500 токенов.
Третье: число токенов в результатах инструментов рассчитывается делением числа байт на 4. В справочном центре Meta указано, что один токен соответствует примерно 3–4 символам английского текста, а для других языков и кода токенов требуется больше (How am I billed). Поэтому деление на 4 даёт заниженную оценку. На каждом следующем ходу модель снова читает все полученные ранее результаты. Четвёртое: на вывод и рассуждения приходится 4 000 токенов на автора.
В данных, полученных во время теста, результаты после обрезки для одного автора занимают в среднем 30 541 байт, а исходные — 154 694 байта.
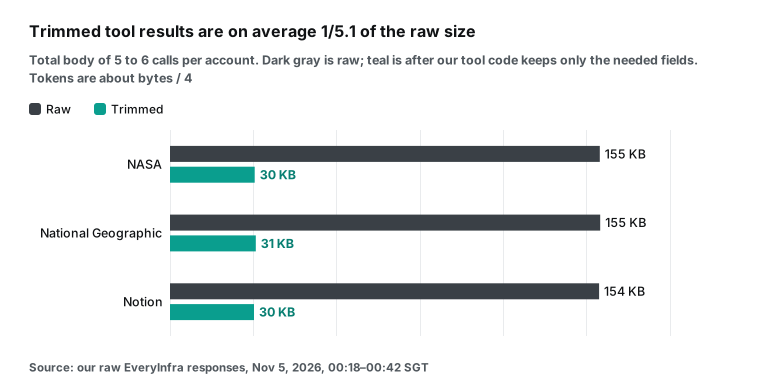
С этими исходными данными три хода для каждого автора в сумме дают около 18 243 входных токенов после обрезки результатов или 74 112 токенов без неё. По ценам Muse Wonder прогон с обрезкой без кэша стоит $0,153 на автора, из которых $0,08 приходится на вывод. Прогон с обрезкой, при котором повторно считываемые токены попадают в кэш, стоит $0,118 на автора. Прогон с исходными результатами без кэша стоит $0,376. Умножьте эти значения на 10, чтобы получить три итоговые суммы на графике.
| Список из 10 авторов | Плата за данные | Плата за модель (оценка) | Итого | Плата за модель / плата за данные |
|---|---|---|---|---|
| С обрезкой и кэшем | $0.0612 | $1.18 | $1.25 | 19x |
| С обрезкой, без кэша | $0.0612 | $1.53 | $1.59 | 25x |
| Сырые данные, без кэша | $0.0612 | $3.76 | $3.82 | 61x |
Из таблицы следуют два вывода. Первый: экономия возникает на стороне модели, а не данных. Плата за данные одинакова во всех трёх строках, а плата за модель различается более чем в три раза из-за размера результатов.
Второе: после обрезки главной статьёй расходов становится вывод. Из $0,118 на автора в самой дешёвой строке $0,08 приходится на 4 000 выходных токенов. Вывод Muse Wonder стоит в пять раз дороже ввода, а токены рассуждений тарифицируются как вывод. Поэтому для этого отчёта не нужен уровень рассуждений high. Meta позволяет задавать его от minimal до max; medium или low достаточно, чтобы проанализировать числа, сравнить их и написать четыре строки.
Перед реальным прогоном токены можно подсчитать с помощью POST /v1/responses/input_tokens от Meta. Согласно документации, этот эндпоинт только выполняет токенизацию, ничего не генерирует и не регистрирует использование. Meta советует использовать его, чтобы проверить, помещаются ли входные данные в контекст, а не для оценки стоимости (Token counting). Во время прогона считывайте usage на каждом ходу, а затем замените наши оценки фактическим числом токенов.
Важно и время. Muse Wonder допускает 3 000 запросов в минуту, поэтому обработка моделью вас не задержит. Узким местом станет получение данных. Наш тестовый API-ключ допускает 10 запросов в минуту, и его параллельно использовали другие задачи. Наши 36 запросов выполнялись с 00:18:46 до 00:42:08 SGT (с 11:18 до 11:42 ET), то есть 23 минуты 22 секунды. Два запроса получили ответ 429, после чего каждый ждал 60 секунд.
Список из 10 авторов со 110 вызовами при 10 запросах в минуту займёт не меньше 11 минут. Среди 30 оплаченных вызовов медианная длительность составила 22,2 секунды, а самый медленный занял 78,2 секунды. С учётом шести вызовов без данных самый медленный занял 89,6 секунды. Код работы с инструментами должен ставить вызовы в очередь и выполнять несколько параллельно, не превышая лимит запросов в минуту.
Ограничения теста
| Ограничение | Последствие | Как устранить пробелы |
|---|---|---|
| Модель Meta мы не запускали | JSON с описаниями инструментов, цикл и схема соответствуют документации Meta. Мы не измеряли, как модель распределяет вызовы и сколько токенов рассуждений она расходует | Сначала проверьте двух авторов и посмотрите usage |
| Только три аккаунта брендов | Все они представляют собой крупные верифицированные бренды и не дают представления о небольших авторах | Добавьте для контроля двух-трёх хорошо знакомых вам авторов |
| Размер платы за модель указан приблизительно | Деление числа байт на 4, 3 хода и 4 000 выходных токенов — это допущения | Пересчитайте по реальному usage |
| Комментарии только к одному видео на каждой платформе | Распределение комментариев по категориям относится только к одному видео | Для ключевых авторов возьмите ещё два-три видео |
| Метки комментариев по правилам | Сарказм и комментарии на смеси языков могут быть отнесены к категории «по теме» | Используйте правила для первичной проверки и просматривайте помеченные записи |
| Пробелы в данных о комментариях YouTube | У NASA дважды произошёл сбой, а для Notion удалось получить только 2 комментария | Фиксируйте недостающие данные в missing и никогда не делайте выводов по пустым данным |
Именно второе ограничение с наибольшей вероятностью может изменить вердикт. У всех трёх брендов больше 100 000 подписчиков, поэтому округление до сотен или тысяч на них почти не влияет. Для автора с 8 000 подписчиков округление, малые выборки и одно вирусное видео значат больше. Добавьте в системный промпт одно правило для малых выборок: если за анализируемый период меньше 5 видео или у автора меньше 10 000 подписчиков, выводите четыре числа и не выносите вердикт.
FAQ
Сколько стоит Muse Wonder API и как он оплачивается?
Оплата идёт за токены, без абонентской платы и минимального платежа: $4,00 за миллион входных токенов, $0,20 за миллион кэшированных входных токенов и $20,00 за миллион выходных токенов. Токены рассуждений считаются выходными (Pricing and rate limits; Quickstart). Meta также сообщает, что добавляемый ею системный и управляющий контент не оплачивается и не отображается в usage. У прогона проверки две статьи расходов: плата Meta за модель и оплата EveryInfra за каждый запрос данных. Обе части оценены для 10 авторов в разделе о стоимости выше.
Где получить API-ключ Muse Wonder и может ли им пользоваться коллега?
Зарегистрируйтесь на сайте Model API и откройте страницу «API keys». Затем нажмите кнопку «Create API key». Ключ принадлежит вашей команде, поэтому пользоваться им может любой её участник (Create an API key). Люди вне команды этого делать не могут. В справочном центре сказано, что передача ключа за пределы команды нарушает условия использования (Can I share my API key).
Перед регистрацией проверьте свой регион. В справочном центре сказано, что Model API доступен в большинстве стран, где доступны Meta AI и оплата. Окончательным источником служит региональная политика (Supported countries). Для Китая, Гонконга и Макао действуют ограничения (Geographic Use Policy).
Можно ли вызвать Muse Wonder Full через API?
Нет. На странице моделей Meta сказано, что Wonder Full доступна только по подписке Muse Code на тарифах Power Usage и Maximum Usage. Если задать в API уровень рассуждений max, переключения на Full не произойдёт (Models). Комментатор на Hacker News в день запуска отметил то же самое. По его мнению, модель Full, лидирующая в бенчмарках, предназначена для подписчиков, а в API есть только Muse Wonder (Hacker News comment). Подписка Muse Code действует только в инструменте командной строки Muse Code и не подходит для вызовов API (Muse Code subscriptions).
Некоторые разработчики говорят, что Muse Wonder API временами сбоит. Как с этим справляться агенту для проверки авторов?
Вскоре после запуска комментатор на Hacker News назвал Muse Wonder почти лучшей моделью, но слишком дорогой, и написал, что API время от времени сбоит (Hacker News comment). Это сообщение одного человека; мы сами такой сбой не воспроизводили. В документации Meta по ошибкам перечислены ошибки, допускающие повторную попытку. Сбой разбора вывода модели возвращает 500. Перегруженный бэкенд возвращает service_overloaded с Retry-After: 60, а при ответе 429 нужно выдерживать паузу согласно Retry-After (Error handling).
Делайте повторные попытки на двух уровнях. На уровне Meta выдерживайте паузы, как сказано в документации. На уровне EveryInfra сбои и пустые результаты не оплачиваются, а при ответе 429 наш код работы с инструментами ждёт 60 секунд.
Начало работы: от нуля до первого отчёта о проверке
У каждой платформы есть обзорная страница со всеми эндпоинтами и актуальными ценами: TikTok API и YouTube API. На стороне EveryInfra нужно три шага. Сначала зарегистрируйтесь по инструкции из раздела Быстрый старт и создайте ключ. Затем проверьте в каталоге, что tiktok/user_videos, tiktok/comments и youtube/comments доступны в этот день. После этого запустите код инструментов на одном знакомом вам аккаунте и сверьте число подписчиков и просмотров с приложением.
Каталог можно читать бесплатно и без ключа: GET /api/v1/social/catalog. Чтобы попробовать вызовы в браузере, используйте тестовую консоль в Infra Marketplace. Чтобы подключить ИИ-инструмент напрямую, см. руководство по настройке удалённого MCP-сервера. О возврате средств и сверке по неудачным и пустым вызовам читайте в руководстве по сверке возвратов за неудачные или пустые вызовы. Чтобы агент сам исправлял параметры после ошибки 422, см. самовосстановление после ошибок API.
На стороне Meta нужно выполнить четыре шага: зарегистрироваться, подключить оплату, создать ключ и задать переменную окружения, как описано в разделе о ключе. Поместите tools.json и системный промпт в проект. Чтобы попробовать инструменты без кода, откройте песочницу (Playground), перейдите в Advanced, затем в Tools и выберите Add tool. Вставьте каждое определение из tools.json. В песочнице модель сама решает, когда вызвать инструмент (Using tools in the Playground). Сначала проверьте двух авторов, затем расширьте список до десяти. После прогона посмотрите usage каждого хода и замените наши оценки фактическим числом токенов.
Источники
- «Introducing Muse Wonder and Muse Wonder Full: Frontier Models for Agents», Meta Newsroom, 12 октября 2026 г., <https://about.fb.com/news/2026/10/introducing-muse-wonder-models/>
- «Muse Wonder: A Frontier Model For Personal & Professional AI Agents», исследовательский блог Meta, 12 октября 2026 г., <https://research.meta.ai/blog/muse-wonder>
- Страница продукта Muse Wonder, Meta, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/models/muse-wonder>
- «Get started with Meta Model API and Muse Code», документация Meta для разработчиков, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/docs/overview>
- «Models», документация Meta для разработчиков, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/docs/models>
- «Pricing and rate limits», документация Meta для разработчиков, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/docs/pricing-rate-limits>
- «Quickstart», документация Meta для разработчиков, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/docs/quickstart>
- «Tool calling», документация Meta для разработчиков, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/docs/tool-calling>
- «Responses API», документация Meta для разработчиков, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/docs/protocols/responses>
- «Structured output», документация Meta для разработчиков, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/docs/structured-output>
- «Prompt caching», документация Meta для разработчиков, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/docs/prompt-caching>
- «Tool search», документация Meta для разработчиков, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/docs/tool-search>
- «Agent frameworks», документация Meta для разработчиков, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/docs/agent-frameworks>
- «Error handling», документация Meta для разработчиков, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/docs/error-handling>
- «Muse Code subscriptions», документация Meta для разработчиков, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/docs/muse-code/subscriptions>
- «Search grounding», документация Meta для разработчиков, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/docs/search-grounding>
- «How do I sign up for Model API?», справочный центр Meta AI Developer, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/help/accounts-and-login/sign-up>
- «How do I create an API key?», справочный центр Meta AI Developer, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/help/api-keys/create-api-key>
- «Can I share my API key?», справочный центр Meta AI Developer, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/help/api-keys/sharing-api-keys>
- «How can I set up billing for Meta Model API?», справочный центр Meta AI Developer, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/help/billing/set-up-billing>
- «How am I billed for Model API?», справочный центр Meta AI Developer, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/help/billing/api-bill>
- «How do I set a spend limit alert?», справочный центр Meta AI Developer, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/help/billing/spend-limit-alert>
- «How do I request a refund for Meta Model API?», справочный центр Meta AI Developer, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/help/billing/refunds>
- «Does Model API support Zero Data Retention (ZDR)?», справочный центр Meta AI Developer, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/help/policies-and-privacy/zero-data-retention>
- «Meta Model API Terms of Service», Meta, обновлено 9 октября 2026 г., <https://dev.meta.ai/legal/terms-of-service>
- «Meta Model API Acceptable Use Policy», Meta, обновлено 12 октября 2026 г., <https://dev.meta.ai/legal/acceptable-use-policy>
- «Meta Model API Model Designation and Geographic Use Policy», Meta, обновлено 12 октября 2026 г., <https://dev.meta.ai/legal/geographic-use-policy>
- «Muse Wonder is available today on Meta Model API and in Muse Code», Meta for Developers (пост в Facebook), 12 октября 2026 г., <https://www.facebook.com/MetaforDevelopers/posts/muse-wonder-is-available-today-on-meta-model-api-and-in-muse-code-and-muse-wonde/1552628546897475/>
- «YouTube Data API Revision History», Google for Developers, обновлено 3 ноября 2026 г., <https://developers.google.com/youtube/v3/revision_history>
- «Understand your YouTube content performance», YouTube Help, дата обращения: 5 ноября 2026 г., <https://support.google.com/youtube/answer/12220281>
- «Tools», спецификация Model Context Protocol (2025-06-18), <https://modelcontextprotocol.io/specification/2025-06-18/server/tools>
- «The Average Views Lie: What We Learned From 675 TikTok Creator Videos», TechBullion, октябрь 2026 г., <https://techbullion.com/average-views-lie-learned-675-tiktok-creator-videos/>
- Комментарий в треде Hacker News о Muse Wonder (имя пользователя скрыто), Hacker News, октябрь 2026 г., <https://news.ycombinator.com/item?id=50065098>
- Комментарий в треде Hacker News о Muse Wonder (имя пользователя скрыто), Hacker News, октябрь 2026 г., <https://news.ycombinator.com/item?id=50061435>
- Каталог данных EveryInfra (доступен бесплатно), EveryInfra, дата обращения: 5 ноября 2026 г., <https://api.everyinfra.com/api/v1/social/catalog>
- «Token counting», документация для разработчиков Meta, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/docs/token-counting>
- «Meta Model API Data Commitments», Meta, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/legal/commitments>
- «What countries and territories is Model API available in?», справочный центр Meta AI Developer, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/help/accounts-and-login/supported-countries>
- «Can the models call tools?», справочный центр Meta AI Developer, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/help/about-model-api/tool-calling>
- «How do I use tools in the Playground?», справочный центр Meta AI Developer, дата обращения: 5 ноября 2026 г., <https://dev.meta.ai/help/playground/using-tools-in-the-playground>
Справка BL-89