Muse Wonder API para analizar creadores: datos reales y coste estimado
Un agente con Muse Wonder API de Meta que revisa creadores de TikTok y YouTube: tools JSON, una llamada real de ida y vuelta y el coste de 10 perfiles.
El 5 de noviembre de 2026, entre las 00:18 y las 00:42 hora de Singapur (entre las 17:18 y las 17:42 del día 4 en Madrid), revisamos tres cuentas de marca con los endpoints de TikTok y YouTube de EveryInfra: NASA, National Geographic y Notion. Fueron 36 peticiones, de las que se cobraron 30, por un total de 0,01668 USD. El dato que más nos sorprendió es este: National Geographic tiene 9,7 millones de seguidores en TikTok, pero la mediana de visualizaciones por vídeo es de 22.600. Eso da un alcance del 0,23 %, el más bajo de las seis combinaciones de cuenta y plataforma.
Y, sin embargo, quien ve sus vídeos reacciona. La mediana de (me gusta + comentarios + compartidos) por visualización es del 8,15 %, casi igual que el 8,97 % de NASA, que tiene un alcance del 13,25 %. National Geographic publicó 50 vídeos en 30 días, así que cada uno llega a una parte más pequeña de su audiencia. Un agente que solo mirase el alcance marcaría como «inflada» una cuenta que funciona bien. De ese tipo de error va este artículo.
Qué problema resuelve este artículo
Una marca o una agencia tiene una lista de creadores. Antes de firmar nada, quiere que una IA haga una primera revisión de cada nombre y responda a cuatro preguntas. ¿Los seguidores son reales? ¿La gente que ve los vídeos reacciona? ¿Ha publicado en los últimos 30 días? ¿De qué se habla en los comentarios? Para montarlo usamos el nuevo modelo Muse Wonder de Meta y estos endpoints de EveryInfra: tiktok/profile, tiktok/user_videos, youtube/profile, youtube/user_posts y dos de comentarios.
No tenemos clave de Meta en este equipo. Por eso la parte de Meta (tools JSON, bucle del agente y formato del informe) es un ejemplo de configuración, y cada precio, parámetro y norma enlaza a una página de Meta con la fecha en que la leímos. La parte de EveryInfra sí es real: cada cifra de las tablas sale de las respuestas en bruto de esa sesión y se puede volver a calcular. Cuando un número es una estimación, lo decimos y explicamos de dónde sale.
Empezamos por el resultado. La tabla aplica nuestras cuatro reglas a tres cuentas en dos plataformas. Las fórmulas están en la sección de métricas y el origen de cada cifra, en la de resultados.
| Cuenta y plataforma | Seguidores o suscriptores | Alcance (mediana de vistas / seguidores) | Interacción mediana por vista | Publicaciones en 30 días | Comentarios (por reglas) |
|---|---|---|---|---|---|
| NASA, TikTok | 2.200.000 | 13,25 % | 8,97 % | 9; hueco máximo de 6,0 días | 16 de 50 son preguntas |
| NASA, YouTube | 15.100.000 | 1,80 % (últimos 10) | 1,41 % (4 vídeos) | 2 seguras | Sin datos (2 fallos, sin cobro) |
| National Geographic, TikTok | 9.700.000 | 0,23 % | 8,15 % | 50; hueco máximo de 3,1 días | 31 sobre el tema; 15 de 3 palabras o menos |
| National Geographic, YouTube | 26.600.000 | 0,75 % | 0,61 % (4 vídeos) | 21 seguras y 1 dudosa | 44 de 50 sobre el tema |
| Notion, TikTok | 143.700 | 9,05 % (últimos 15) | 1,48 % | 0; el último tiene 161,7 días | 31 sobre el tema; 2 solo emojis |
| Notion, YouTube | 350.000 | 0,91 % | 0,60 % (4 vídeos) | 7 seguras y 1 dudosa | Solo 2 comentarios; sin conclusión |
Ninguna de estas tres cuentas verificadas parece sospechosa, pero cada una tiene una métrica que engañaría a una regla simple. La cuenta de TikTok de NASA devuelve un created_at del 2026-07-20 y ya tiene 2,2 millones de seguidores: una regla de «crecimiento demasiado rápido» saltaría, y aun así es la cuenta con más alcance de las seis. El 9,05 % de alcance de Notion en TikTok parece estupendo, pero su vídeo más reciente es del 2026-05-26. Con una regla de 30 días, esa cuenta está parada. La solución es siempre la misma: fijar la regla por escrito y dejar que el modelo solo lea los números.
Qué es Muse Wonder API: 10 datos sacados de las páginas de Meta
Meta presentó Muse Wonder y Muse Wonder Full el 12 de octubre de 2026 y anunció que Muse Wonder estaba disponible ese mismo día en Meta Model API y en Muse Code (Meta Newsroom, 2026-10-12). El blog de investigación lo describe como un modelo puntero para agentes personales y profesionales, con dos bazas: Active Memory, que recuerda lo relevante entre conversaciones, y Active Focus, que cambia de enfoque cuando una tarea se atasca (blog de investigación de Meta). La página del producto habla de tareas de varias horas en las que el modelo planifica, reparte trabajo entre subagentes y llama a herramientas en paralelo (página de Muse Wonder).
Para quien desarrolla, lo útil son los parámetros que la documentación deja fijados. Leímos la documentación, el centro de ayuda y las páginas legales de dev.meta.ai el 5 de noviembre de 2026. La tabla solo recoge lo que Meta dice por escrito.
| Dato | Qué dice la página de Meta | Fuente (leída el 2026-11-05) |
|---|---|---|
| Identificador | muse-wonder-1.0; la portada de la documentación indica «Muse Wonder is in preview» | Overview |
| Contexto | 1.048.576 tokens; admite texto, imagen, vídeo, audio y PDF | Models |
| Razonamiento | reasoning.effort va de minimal a max; max no activa Wonder Full | Models |
| Wonder Full | Solo en las suscripciones de Muse Code, planes Power Usage y Maximum Usage | Models |
| Formatos | Responses, Chat Completions y Anthropic Messages, con el mismo precio y la misma autenticación | Overview |
| Herramientas | Tú defines y ejecutas las funciones; tool_choice solo admite auto; el nombre admite como mucho un punto | Tool calling |
| Tareas largas | background: true ejecuta en segundo plano, hasta 600 por equipo y minuto; las peticiones largas sin streaming pueden dar 504 | Responses API |
| Límites | 3000 peticiones y 4 millones de tokens por minuto para muse-wonder-1.0, por equipo y no por clave | Pricing and rate limits |
| Regiones | China, Hong Kong y Macao, restringidos; Muse Wonder tampoco está en Corea del Sur | Geographic Use Policy |
| Entrenamiento | El modo Standard no entrena con tu contenido; Wonder no tiene modo Contributor en pago por uso | Models |
Dos filas condicionan el diseño del agente. La primera es tool_choice: según las pautas de Meta, "none", "required" o el nombre de una función devuelven un error HTTP 400 (pautas de Tool calling). No puedes obligar al modelo a llamar a una herramienta en un turno concreto, así que el bucle tiene que aceptar dos salidas en cada turno: una llamada o un texto. Además, tu propio código debe comprobar que cada creador tiene las cuatro métricas y lanzar otro turno si falta alguna.
La segunda fila es la de regiones, y aquí hay un matiz que interesa a quien lee desde España o Latinoamérica. La política geográfica de Meta restringe China, Hong Kong y Macao, y Muse Wonder no está en Corea del Sur (Geographic Use Policy); España no aparece en esa lista. Otra cosa es la app de consumo: según Notebookcheck, la app Muse solo funciona en Estados Unidos y Canadá y Meta no ha dado fecha para Europa (Notebookcheck, octubre de 2026). Para este caso de uso eso da igual, porque el agente funciona por API y no necesita la app.
Muse Wonder API key: cuatro pasos y tres trampas
El centro de ayuda de Meta explica cómo conseguir la clave en cuatro pasos. No creamos cuenta en Meta, así que la tabla resume el texto del centro de ayuda; no son capturas de un registro real.
| Paso | Qué dice el centro de ayuda | Fuente |
|---|---|---|
| 1. Registro | Pulsa «Start building» en la web de Model API, elige Individual y entra con correo, teléfono, Facebook, Google o GitHub; hay que tener 18 años y estar en una región admitida | How do I sign up |
| 2. Facturación | Un administrador añade un método de pago en Billing, con nombre legal y dirección | Set up billing |
| 3. Clave | En API keys, pulsa «Create API key», ponle nombre y cópiala; la clave pertenece al equipo | Create an API key |
| 4. Variable de entorno | export MODEL_API_KEY="..." y léela desde el código; nunca en el front ni en el repositorio | Quickstart |
La primera trampa es que el gasto no tiene tope. El centro de ayuda dice que Meta Model API no ofrece un límite que corte el uso: solo puedes configurar un aviso mensual por correo y pagas igualmente lo que pase de ahí (Spend limit alert). Un agente llama a herramientas en bucle, y un fallo puede dejarlo funcionando toda la noche. Por eso nuestro bucle lleva su propio límite de turnos y de tokens.
La segunda tiene que ver con los cobros. Meta carga la tarjeta cuando el uso alcanza un umbral y cobra el resto el día 1 de cada mes (How am I billed). Además, el centro de ayuda deja claro que Model API no hace reembolsos (Refunds). Prueba con dos creadores antes de lanzar la lista completa.
La tercera es la que más afecta a las agencias. La clave es del equipo y compartirla fuera de él incumple las condiciones (Can I share my API key). El apartado 10.1 de las condiciones de Model API prohíbe además revender el servicio, incluidas las claves y el acceso al modelo, o ponerlo a disposición de terceros sin autorización escrita de Meta (Terms of Service, actualizadas el 2026-10-09). Si trabajas para varias marcas, la clave se queda en tu equipo y al cliente le entregas el informe.
En EveryInfra, te registras desde la guía rápida y creas la clave en la consola; también va en una variable de entorno. Cada clave tiene su papel: la de Meta llama al modelo y la de EveryInfra trae los datos. El código de herramientas se ejecuta en tu servidor, así que el modelo no ve ninguna de las dos.
Meta Muse Wonder API pricing: 4 y 20 USD, y tres precios más
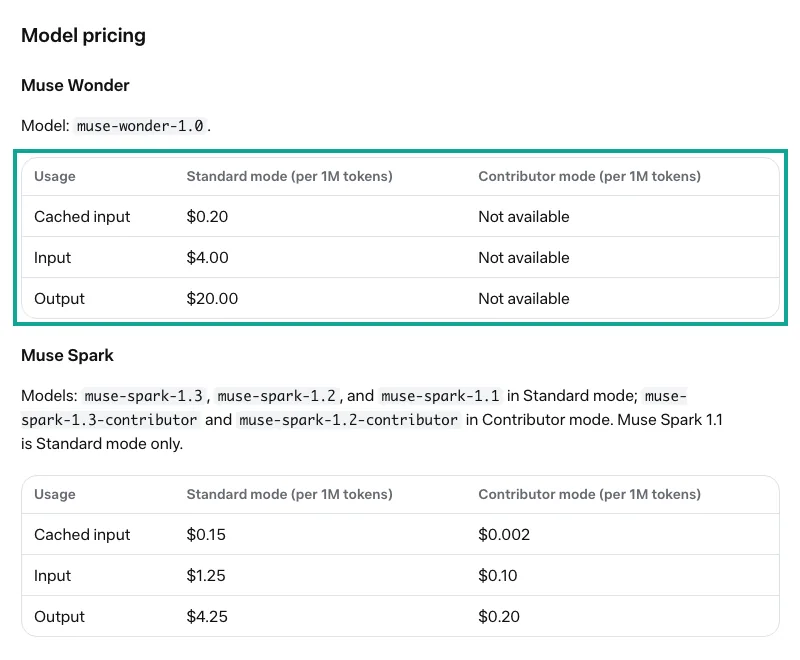
La página de precios de Meta da tres cifras por millón de tokens para Muse Wonder: 4,00 USD de entrada, 0,20 USD de entrada en caché y 20,00 USD de salida. La columna del modo Contributor dice «Not available» (Pricing and rate limits). La publicación de Meta for Developers del día del lanzamiento repite el «$4/$20 per million tokens» (publicación de Meta for Developers).
Un agente de este tipo puede toparse con otros tres precios. El primero es la búsqueda web: web_search cobra aparte 2,50 USD por cada 1000 búsquedas, busca en páginas web y no devuelve datos vídeo a vídeo, así que la dejamos apagada (Search grounding).
El segundo es Muse Spark. muse-spark-1.3 cuesta 1,25 USD de entrada y 4,25 USD de salida por millón de tokens, y su variante Contributor, 0,10 y 0,20 USD. Pero el modo Contributor usa tu contenido para entrenar los modelos de Meta, y el apartado 6.2 de las condiciones prohíbe enviarle información sensible, confidencial o personal (Terms of Service, apartado 6). Como aquí el modelo lee comentarios escritos por usuarios corrientes, usamos solo el modo Standard.
El tercero es la caché. Meta guarda automáticamente los prefijos de prompt idénticos y cobra esos tokens a 0,20 USD por millón (Prompt caching). Pon al principio el prompt de sistema y las definiciones de herramientas, y cambia solo la lista de creadores al final. En un lote de 10 creadores, casi todo el prefijo fijo saldrá de la caché.
| Concepto | Muse Wonder | Muse Spark 1.3 | Muse Spark 1.3 Contributor |
|---|---|---|---|
| Entrada (por millón de tokens) | 4,00 USD | 1,25 USD | 0,10 USD |
| Entrada en caché | 0,20 USD | 0,15 USD | 0,002 USD |
| Salida | 20,00 USD | 4,25 USD | 0,20 USD |
| ¿Entrena con tu contenido? | No (Standard) | No (Standard) | Sí |
| Peticiones y tokens por minuto, por equipo | 3000 y 4 millones | 3000 y 4 millones | 150 y 3 millones |
| Dónde encaja en el agente | Bucle principal: leer, comparar y redactar | Tareas auxiliares, como clasificar comentarios | No para tareas con texto de comentarios |
Los límites salen de la misma página: se cuentan por equipo, todas las claves del equipo comparten cupo y cada modelo tiene el suyo (Rate limits). Una lista de 10 creadores no se acerca ni de lejos a 3000 peticiones por minuto. El cuello de botella está en los datos: nuestra clave de pruebas admite 10 peticiones por minuto, y en la sección de resultados se ve qué supone eso para el tiempo total.
Por qué solo TikTok y YouTube: el alcance del artículo y las condiciones de Muse
Las marcas suelen trabajar con dos tipos de creadores: los de vídeo corto y los de vídeo largo. Aquí usamos una plataforma para cada uno: TikTok para el vídeo corto y YouTube para el largo. Los datos de las dos se parecen poco. El feed de TikTok enseña vídeos a quien no sigue la cuenta, así que las visualizaciones pueden superar con holgura una décima parte de los seguidores; un canal grande de YouTube acumula suscriptores de hace años y su alcance suele ser bajo. Juntas, sirven para ilustrar una idea que el artículo repite varias veces: las métricas solo se comparan dentro de la misma plataforma. Otras plataformas quedan fuera del artículo; las cuatro reglas y el patrón de herramientas valen igual, pero hay que revisar los campos de cada endpoint.
Elegidas las plataformas, queda ver qué dice el lado del modelo sobre los datos que le envías. Esta sección solo cita las páginas legales del propio Muse (dev.meta.ai/legal) y no es asesoramiento jurídico: lee tú las condiciones y valora la ley que te aplica y lo que hayas pactado con cada plataforma de datos. Según el apartado 4.1 de las condiciones de Meta Model API (actualizadas el 9 de octubre de 2026), respondes de la exactitud y la validez de la información y los datos que aportas al servicio. El punto (vii) del apartado 10.1 veta usar el servicio para infringir o vulnerar derechos de terceros, y el apartado 10.3 permite a Meta supervisar tu uso con revisión automática o humana (Terms of Service). La página de compromisos sobre datos dice que Meta no usa el contenido de los servicios Standard para entrenar sus modelos, aunque puede procesarlo para detectar y atender infracciones de la política de uso o de las condiciones (Data Commitments).
| Norma | Qué regula | Idea clave (parafraseada) | Qué implica para el agente |
|---|---|---|---|
| Condiciones de Model API, 4.1 | Los datos que envías | Respondes de su exactitud y validez | Cada cifra tiene que poder rastrearse hasta la respuesta original |
| Condiciones de Model API, 10.1 (vii) y 10.3 | Cómo usas el servicio | Nada que vulnere derechos de terceros; Meta puede supervisar | Lee las condiciones antes; confirma el origen y el uso de los datos |
| Data Commitments | Contenido de los servicios Standard | No se usa para entrenar; puede procesarse para atender infracciones | El texto de los comentarios solo pasa por el modo Standard |
| Política de uso aceptable | Resultados y finalidad | No inferir rasgos personales sensibles; no puntuar a personas por su conducta social con perjuicio | Se evalúan datos comerciales de la cuenta, nunca a la persona |
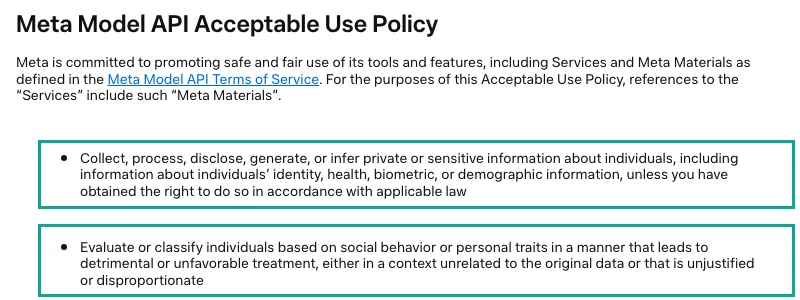
La última fila es la que más se pasa por alto. La política de uso aceptable de Meta Model API (actualizada el 12 de octubre de 2026) tiene dos puntos que tocan de lleno la evaluación de creadores. Uno prohíbe recopilar, procesar, revelar, generar o inferir información privada o sensible de personas sin base legal, como identidad, salud, datos biométricos o demográficos. El otro prohíbe evaluar o clasificar a personas por su conducta social o sus rasgos cuando eso lleva a un trato perjudicial o se usa fuera de contexto (Acceptable Use Policy).
Revisar a un creador antes de una campaña es una práctica normal. La marca mira la cuenta como un canal de medios: si las visualizaciones son estables, si la interacción cuadra con los seguidores, si publica con regularidad y si los comentarios hablan del contenido. Todo eso son datos comerciales de la cuenta. Lo delicado es otra cosa: pedirle al modelo que adivine la edad, el origen, la salud o la ideología del creador, o usar comentarios de usuarios corrientes para etiquetar a alguien. Nuestro código hace dos cosas para no cruzar esa línea. Al modelo solo le llega el texto del comentario, los me gusta, las respuestas y la hora, sin nombre de usuario. Y el prompt de sistema le pide evaluar únicamente el rendimiento del contenido, sin inferir rasgos personales.
En España: el umbral de «usuario de especial relevancia»
Si trabajas con creadores en España, hay una cifra más que el agente puede ayudarte a vigilar. El Real Decreto 444/2024, de 30 de abril, concreta cuándo alguien es «usuario de especial relevancia» de plataformas de intercambio de vídeos, en desarrollo del artículo 94 de la Ley 13/2022, General de Comunicación Audiovisual (BOE, Real Decreto 444/2024). Esa condición obliga, entre otras cosas, a inscribirse en el Registro estatal que prevé la ley.
El decreto fija dos requisitos cuantitativos. El artículo 3 habla de ingresos significativos: 300.000 euros brutos o más en el año natural anterior, procedentes solo de la actividad en estas plataformas. El artículo 4 habla de audiencia significativa: 1.000.000 de seguidores o más en una sola plataforma, o 2.000.000 o más sumando todas, en algún momento del año anterior, y al menos 24 vídeos publicados en ese año (BOE, texto del Real Decreto 444/2024).
| Requisito del RD 444/2024 | Umbral | ¿Se ve en datos públicos? | Qué puede hacer el agente |
|---|---|---|---|
| Ingresos (art. 3) | 300.000 euros brutos o más en el año anterior | No | Nada; solo lo sabe el propio creador |
| Seguidores (art. 4.a) | 1.000.000 en una plataforma o 2.000.000 sumando todas | Sí, el dato actual y redondeado | Sumar seguidores de TikTok y YouTube y marcar si se acerca |
| Vídeos (art. 4.b) | 24 o más en el año natural anterior | Sí, contando vídeos con fecha | Paginar hasta cubrir el año anterior y contar |
Dos advertencias. La primera: el agente solo ve el número de seguidores de hoy, no el máximo del año anterior, y además redondeado. Puede servir de alerta («supera el millón en TikTok»), no de prueba. La segunda: para contar los vídeos de todo 2025 hacen falta bastantes más páginas que las que usamos aquí, porque 50 vídeos de TikTok no cubrieron ni 30 días en el caso de National Geographic. Esto no es asesoramiento jurídico. Si el agente marca a un creador, la conversación sobre sus obligaciones es con él y con quien os asesore.
Las cuatro métricas: primero la regla, después el modelo
Lo peor que le puede pasar a un informe de este tipo es que una misma palabra signifique cosas distintas. Hay quien divide la interacción entre seguidores y quien la divide entre visualizaciones; hay quien juzga la «autenticidad» por los comentarios y quien usa me gusta por seguidor. Cambia la fórmula y cambia el veredicto. Por eso escribimos las cuatro fórmulas en el prompt de sistema antes de pedir un solo dato: el modelo lee, compara y redacta, pero no inventa el método.
| Métrica | Fórmula de este artículo | Campos | Qué demuestra y qué no |
|---|---|---|---|
| Autenticidad de seguidores (indicador) | Alcance = mediana de visualizaciones de vídeos no fijados publicados hace entre 3 y 30 días, dividida entre seguidores; también media/mediana y peso del vídeo más visto | follower_count, view_count, posted_at, is_pinned | Cuántos seguidores siguen viendo; no prueba que un seguidor concreto sea falso |
| Tasa de interacción | Por vídeo, (me gusta + comentarios + compartidos) / visualizaciones, y luego la mediana; en TikTok, con la misma muestra que el alcance (vídeos no fijados de entre 3 y 30 días); en YouTube, (me gusta + comentarios) / visualizaciones | like_count, comment_count, share_count, view_count | Si quien ve reacciona; no distingue personas de interacción comprada |
| Ritmo en 30 días | Vídeos no fijados en 30 días, hueco más largo, hueco mediano y días desde el último | posted_at | Si la cuenta sigue activa; nada sobre la calidad |
| Tono de los comentarios | Cinco etiquetas por reglas: sobre el tema (4 palabras o más), pregunta, 3 palabras o menos, solo emojis, sin texto; más duplicados exactos | text, is_reply | Si los comentarios responden al vídeo; nada sobre quién los escribe |
¿Por qué el alcance y no un «porcentaje de seguidores falsos»? Porque con datos públicos no hay forma de saber si un seguidor es una persona, y la lista de seguidores no es algo que una revisión deba tocar. Lo que sí se puede medir es la distancia entre seguidores y visualizaciones actuales. El alcance solo tiene sentido entre cuentas de tamaño parecido en la misma plataforma, así que no fijamos un umbral único. Todas las métricas usan la mediana porque unos pocos vídeos virales inflan la media: TechBullion recoge un estudio pequeño de 675 vídeos de 52 creadores de TikTok en el que, para el 73 % de ellos, la media de visualizaciones era al menos 1,5 veces la mediana (TechBullion, octubre de 2026). Es una fuente secundaria con una muestra pequeña; la usamos solo para mostrar que la media engaña, no como escala.
La interacción la dividimos entre visualizaciones, no entre seguidores, porque la segunda opción mezcla el alcance. Una cuenta con muchos seguidores y poco alcance sale mal parada por seguidor y puede estar perfectamente por visualización. Son dos preguntas distintas: si los seguidores siguen ahí y si a quien ve le importa. Las damos por separado. En YouTube hay dos detalles. Los compartidos no son públicos, así que solo contamos me gusta y comentarios. Y YouTube cambió el recuento público de visualizaciones el 27 de agosto de 2026: ahora cuenta desde el primer fotograma, mientras que la monetización y casi toda la analítica siguen con las visualizaciones con interacción (historial de YouTube Data API; ayuda de YouTube). No compares visualizaciones de antes y después de esa fecha.
Las herramientas: el JSON de cinco funciones
El centro de ayuda de Meta confirma que Model API admite llamadas a herramientas: el modelo puede usar herramientas y fuentes de datos externas que tú defines (Can the models call tools?). El formato se parece mucho al de OpenAI. Meta recomienda la Responses API, con los campos de la función en el primer nivel: type, name, description, parameters y, si quieres, strict (Tool calling). strict es false por defecto; con true, el servidor valida el esquema contra un subconjunto estricto en el que todas las propiedades van en required y el objeto lleva "additionalProperties": false, y si no cumple devuelve 400 (Strict tool schemas). Las cinco nuestras usan strict: true: tienen pocos parámetros y así los errores de esquema salen antes de producción.
Lo que de verdad hay que pensar es cómo partir las herramientas. Lo más cómodo sería una sola herramienta genérica con platform, action y params, como everyinfra_call_api en el servidor MCP de EveryInfra; el modelo podría llamar a cualquier cosa, pero tendría que montar los parámetros cada vez y cada fallo costaría un turno. Como la revisión sigue siempre los mismos pasos, preferimos cinco funciones estrechas, una por endpoint, y en cada descripción avisamos de una trampa, por ejemplo que los vídeos fijados salen primero. Los nombres llevan guiones bajos: Meta admite como mucho un punto y con dos devuelve 400 (Function name rules). Con cinco funciones tampoco hace falta la búsqueda de herramientas de Meta, que está pensada para cientos de herramientas y retrasa la carga de los esquemas hasta que el modelo los necesita (Tool search).
[
  {
    "type": "function",
    "name": "tiktok_videos",
    "description": "List the newest public videos of one TikTok account with views, likes, comments, shares, saves, posted_at, is_pinned and is_ad. Calls EveryInfra tiktok/user_videos. Pinned videos come first; drop them before you compute medians.",
    "strict": true,
    "parameters": {
      "type": "object",
      "properties": {
        "username": { "type": "string", "description": "TikTok handle without @" },
        "limit": { "type": "integer", "description": "1 to 50. Use 50 for a 30-day window." }
      },
      "required": ["username", "limit"],
      "additionalProperties": false
    }
  },
  {
    "type": "function",
    "name": "video_comments",
    "description": "Read public comments of one video. Returns comment text, like and reply counts and time only, never the commenter's name. Calls EveryInfra tiktok/comments or youtube/comments.",
    "strict": true,
    "parameters": {
      "type": "object",
      "properties": {
        "platform": { "type": "string", "enum": ["tiktok", "youtube"] },
        "video_url": { "type": "string", "description": "Full URL of one video" },
        "limit": { "type": "integer", "description": "1 to 50" }
      },
      "required": ["platform", "video_url", "limit"],
      "additionalProperties": false
    }
  }
]
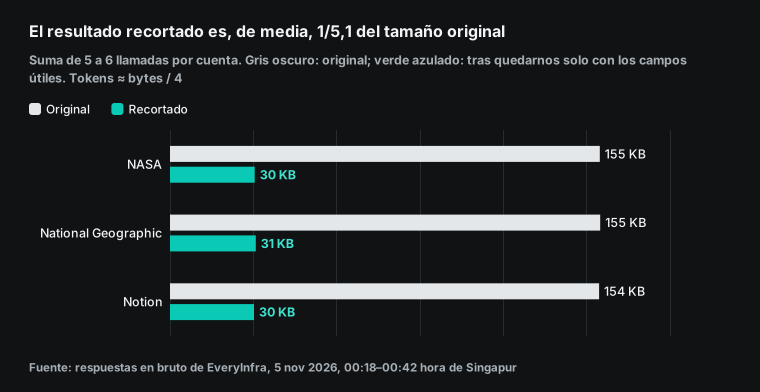
El bloque muestra dos de las cinco. Las otras tres son tiktok_profile para tiktok/profile, youtube_channel para youtube/profile y youtube_videos para youtube/user_posts. Dejamos las descripciones en inglés a propósito: es el idioma en el que mejor rinden los modelos al elegir herramientas y no lo ve ningún usuario final. La última columna de la tabla es el subconjunto que nuestro código devuelve al modelo. Un vídeo de TikTok en bruto trae 34 campos, con portada, música y biografía del autor; para revisar no sirven y cuestan tokens.
| Función | Endpoint | Precio por llamada | Campos que recibe el modelo |
|---|---|---|---|
tiktok_profile | tiktok/profile | 0,000556 USD | username, display_name, follower_count, following_count, like_count, video_count, is_verified, created_at |
tiktok_videos | tiktok/user_videos | 0,000556 USD | id, url, posted_at, view_count, like_count, comment_count, share_count, collect_count, is_pinned, is_ad, duration_sec |
youtube_channel | youtube/profile | 0,000556 USD | name, url, subscriber_count, video_count, view_count, is_verified, created_at |
youtube_videos | youtube/user_posts | 0,000556 USD | id, url, title, posted_at, view_count, like_count, comment_count, duration, is_paid_partnership |
video_comments | tiktok/comments o youtube/comments | 0,000556 USD | text (hasta 200 caracteres), like_count, reply_count, is_reply, posted_at |
El bucle del agente: el patrón de Meta con tres cambios
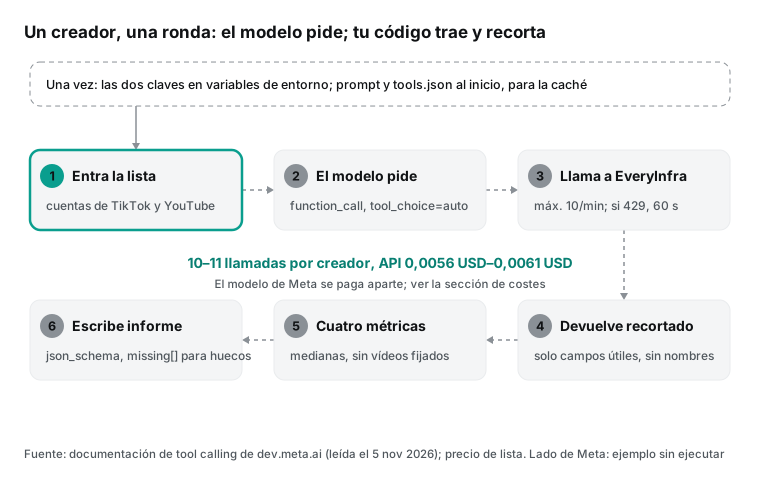
La documentación de Meta propone un bucle mínimo: envías la petición con tools, buscas elementos function_call en output, los ejecutas y devuelves cada resultado como function_call_output junto con previous_response_id, y el servidor conserva el historial (Tool calling). Mantuvimos ese patrón con tres cambios. Es un ejemplo de configuración: la parte de Meta no se ejecutó.
# Ejemplo de configuración: Muse Wonder (Responses API) + herramientas de EveryInfra. La parte de Meta no se ejecutó.
import json, os
from openai import OpenAI
from ei_tools import run  # capa de herramientas: llama a EveryInfra y recorta la respuesta

meta = OpenAI(base_url="https://api.meta.ai/v1", api_key=os.environ["MODEL_API_KEY"])
TOOLS = json.load(open("tools.json"))
SYSTEM = open("system_prompt.txt").read()   # prefijo fijo al principio para aprovechar la caché
MAX_TURNS, MAX_TOKENS = 40, 400_000          # Meta no tiene tope de gasto: pon el tuyo

def due_diligence(creators: list[dict]) -> str:
    resp = meta.responses.create(model="muse-wonder-1.0", reasoning={"effort": "medium"},
                                 instructions=SYSTEM, tools=TOOLS, input=json.dumps(creators))
    used = resp.usage.total_tokens
    for _ in range(MAX_TURNS):
        calls = [i for i in resp.output if i.type == "function_call"]
        if not calls:                     # tool_choice solo admite auto: el modelo puede contestar sin llamar
            return resp.output_text
        outputs = []
        for c in calls:                   # un turno puede traer varias llamadas en paralelo
            body, code, raw, secs, out = run(c.name, json.loads(c.arguments))
            outputs.append({"type": "function_call_output", "call_id": c.call_id,
                            "output": json.dumps(out, ensure_ascii=False)})
        resp = meta.responses.create(model="muse-wonder-1.0", previous_response_id=resp.id,
                                     tools=TOOLS, input=outputs)
        used += resp.usage.total_tokens
        if used > MAX_TOKENS:
            raise RuntimeError(f"token budget exceeded: {used}")
    raise RuntimeError("too many turns")
Primer cambio: varias llamadas por turno. Las pautas de Meta dicen que el modelo puede devolver más de una llamada a la vez y que hay que responder a todas; parallel_tool_calls viene en true (pautas). Con 10 creadores y cinco llamadas cada uno, pueden llegar una docena de golpe, y tu código tiene que ponerlas en cola, porque nuestra clave de pruebas de EveryInfra admite 10 por minuto. Segundo cambio: límites propios. max_tool_calls solo limita herramientas integradas como web_search, no tus funciones; junto con la falta de tope de gasto, eso obliga a poner un límite de turnos y otro de tokens. Tercer cambio: recortar antes de devolver. Todo lo que va en function_call_output cuenta como entrada en el turno siguiente, y la proporción de recorte es la variable que más pesa en el coste.
El formato del informe se fija con salida estructurada. Según Meta, con json_schema la propia decodificación sigue el esquema, así que la salida siempre lo cumple (Structured output); en la Responses API va en text.format y convive con las herramientas. Nuestro esquema tiene una fila por creador con las cuatro métricas, el tamaño de muestra de cada una y una frase de conclusión, más una lista missing con lo que no se pudo obtener o llegó redondeado. Con esa lista el modelo no tiene excusa para inventarse un número.
Tareas largas y la otra vía: Claude Agent SDK con el MCP de EveryInfra
Diez creadores se revisan en pocos minutos con peticiones normales. Para 50, o si cada creador exige varias páginas, conviene el modo de tareas largas. La documentación de la Responses API marca tres límites: una petición sin streaming tiene tiempo máximo y devuelve 504 si se pasa; con background: true recibes status: "queued" al momento y luego consultas, recibes por streaming o cancelas; y el cuerpo de una petición en segundo plano no puede superar 1 MiB, o devuelve 413 (Responses API). La página de precios añade que cada equipo puede crear hasta 600 tareas en segundo plano por minuto (Background responses). El límite de 1 MiB importa: 50 vídeos de TikTok de una sola cuenta ocupaban en bruto unos 114 a 116 KB, así que diez cuentas sin recortar no caben.
EveryInfra también tiene modo asíncrono: añade "mode": "async" a cualquier petición, recibes un job_id y lees el resultado con GET /api/v1/jobs/{job_id}; el presupuesto síncrono es de 85 segundos. Un último aviso: si tu equipo activa la retención cero de datos (ZDR), el centro de ayuda de Meta indica que se rechazan las peticiones con estado que remiten a una respuesta anterior, las de segundo plano, la subida de archivos y la búsqueda web (ZDR). Nuestro bucle usa previous_response_id; con ZDR tendrías que reenviar la conversación entera en cada turno.
Si no quieres escribir la capa de herramientas, Meta documenta otra vía: el Claude Agent SDK lleva el bucle y apunta al modelo de Meta mediante el formato Anthropic Messages. Basta con ANTHROPIC_BASE_URL en https://api.meta.ai (sin /v1) y la clave de Meta en ANTHROPIC_AUTH_TOKEN; el bucle principal usa muse-wonder-1.0 y los subagentes pueden bajar a muse-spark-1.3. La misma página pide declarar solo servidores MCP de confianza (Agent frameworks). Así puedes conectar el servidor MCP remoto de EveryInfra, que expone sus herramientas con tools/list y tools/call, tal como manda la especificación MCP (especificación MCP: Tools).
# Ejemplo de configuración: Claude Agent SDK con Muse Wonder y el servidor MCP remoto de EveryInfra. No se ejecutó.
import os, anyio
from claude_agent_sdk import query, ClaudeAgentOptions, ResultMessage

options = ClaudeAgentOptions(
    model="muse-wonder-1.0",
    system_prompt=open("system_prompt.txt").read(),
    mcp_servers={"everyinfra": {"type": "http", "url": "https://api.everyinfra.com/mcp",
                                "headers": {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}}},
    allowed_tools=["mcp__everyinfra__everyinfra_call_api", "mcp__everyinfra__everyinfra_get_job"],
    setting_sources=[],
    env={**os.environ,
         "ANTHROPIC_BASE_URL": "https://api.meta.ai",
         "ANTHROPIC_AUTH_TOKEN": os.environ["MODEL_API_KEY"],
         "ANTHROPIC_MODEL": "muse-wonder-1.0",
         "ANTHROPIC_DEFAULT_OPUS_MODEL": "muse-wonder-1.0",
         "ANTHROPIC_DEFAULT_SONNET_MODEL": "muse-spark-1.3",
         "ANTHROPIC_DEFAULT_HAIKU_MODEL": "muse-spark-1.3",
         "CLAUDE_CODE_SUBAGENT_MODEL": "muse-spark-1.3"},
)

async def main():
    async for m in query(prompt="Review these creators: natgeo, nasa, notionhq", options=options):
        if isinstance(m, ResultMessage):
            print(m.result, m.usage)

anyio.run(main)
El intercambio es sencillo. Con tu propio tools JSON decides qué lee el modelo: qué campos, cuánto texto y si entran o no los nombres de quienes comentan. Con MCP te ahorras código, pero everyinfra_call_api devuelve la respuesta completa, con los 34 campos de cada vídeo y los nombres de usuario de los comentarios. En allowed_tools dejamos solo la herramienta de datos y la de tareas, siguiendo el consejo de Meta de dar al agente solo lo que necesita; el servidor MCP de EveryInfra tiene más, como tickets de soporte o datos de cuenta, y aquí no hacen falta.
Una ida y vuelta real: el modelo pide y nuestro código trae los datos
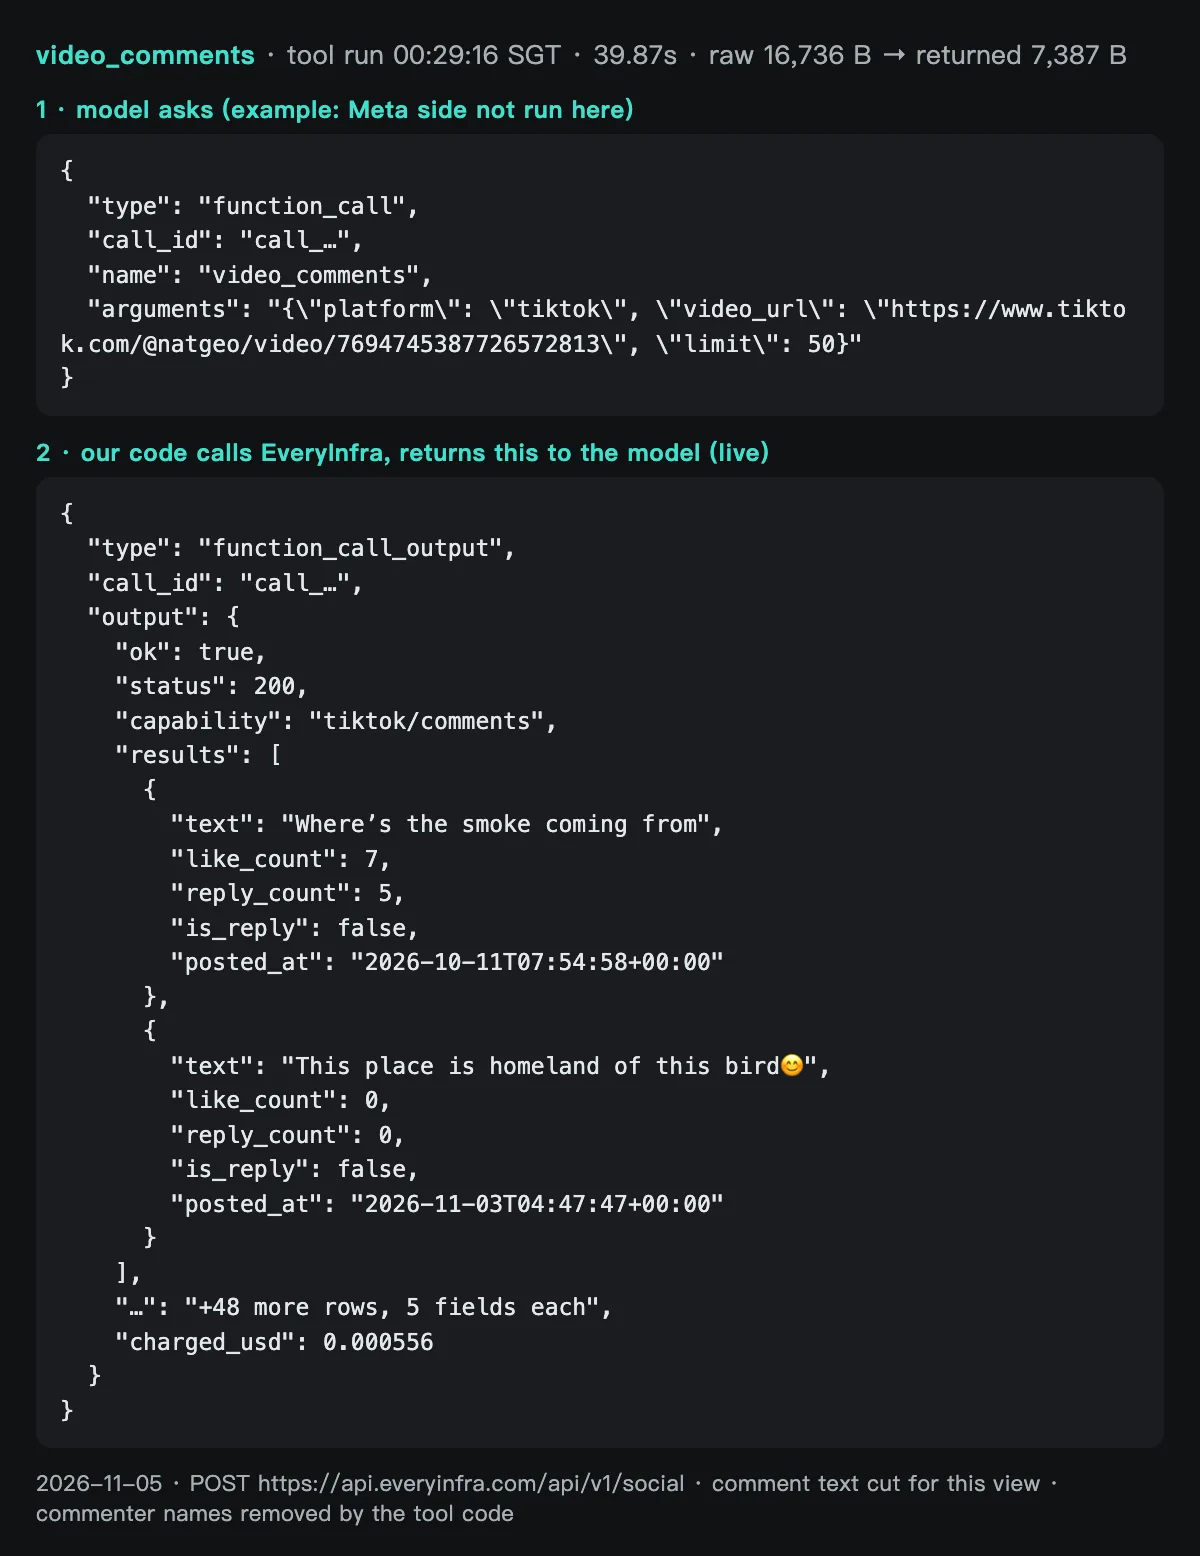
El tools JSON y el bucle de antes son un ejemplo. Esta sección cuenta la parte que sí ejecutamos. Escribimos la capa de herramientas como un archivo aparte: recibe los mismos argumentos de function_call que mandaría Muse Wonder, busca el endpoint de EveryInfra que corresponde a cada función, hace la petición, se queda con los campos útiles, quita los nombres de quienes comentan y lo envuelve como un function_call_output. Del lado del modelo solo llegan un nombre de función y una cadena JSON; con esa misma entrada, lo que hace nuestro código y lo que devuelve es idéntico a lo que pasaría con Muse Wonder conectado.
Estas son cuatro llamadas reales para NASA, en orden. La hora es la de salida de la petición, en Singapur y en Madrid; la duración va del envío al último byte; «bruto» es el tamaño de la respuesta y «al modelo», lo que queda tras el recorte.
| Hora de Singapur (5 nov.) | Hora de Madrid (4 nov.) | Función y endpoint | Duración | Bruto | Al modelo | Cobro |
|---|---|---|---|---|---|---|
| 00:18 hora de Singapur | 17:18 | tiktok_profile, tiktok/profile | 11,35 s | 1587 B | 287 B | 0,000556 USD |
| 00:22 hora de Singapur | 17:22 | tiktok_videos, tiktok/user_videos (50 vídeos) | 35,81 s | 116.106 B | 14.206 B | 0,000556 USD |
| 00:25 hora de Singapur | 17:25 | youtube_channel, youtube/profile | 8,96 s | 1797 B | 299 B | 0,000556 USD |
| 00:28 hora de Singapur | 17:28 | video_comments, tiktok/comments (50 comentarios) | 58,22 s | 16.761 B | 7805 B | 0,000556 USD |
Esta es la primera petición con su respuesta. Solo quitamos un campo muy largo, la URL del avatar. Ojo con follower_count: 2200000 parece exacto, pero es un valor redondeado, como veremos en los resultados.
POST https://api.everyinfra.com/api/v1/social
{"platform":"tiktok","action":"profile","params":{"username":"nasa"}}

200 OK, 00:18:46 hora de Singapur, 11,35 s, cobro 0,000556 USD
{"user_id":"7664638705177150477","username":"nasa","display_name":"NASA",
 "bio":"Making the seemingly impossible, possible.✨","url":"https://www.tiktok.com/@nasa",
 "follower_count":2200000,"following_count":23,"like_count":11500000,"video_count":62,
 "friend_count":17,"is_verified":true,"is_private":false,
 "created_at":"2026-07-20T15:55:49+00:00","platform":"tiktok"}
La copia para el modelo se queda en 8 campos y 287 bytes. En un perfil se ahorra poco; donde se nota es en la lista de vídeos. Cincuenta vídeos de TikTok en bruto ocupan 116.106 bytes, con 34 campos cada uno; la revisión necesita 11, y la versión recortada pesa 14.206 bytes, más o menos una octava parte. La imagen siguiente muestra la ida y vuelta de comentarios: arriba, la llamada que haría el modelo, con los argumentos de la sesión real; abajo, los dos primeros de 50 comentarios de un vídeo de National Geographic en TikTok, tal como los devolvió nuestro código, con el texto acortado para la imagen y sin nombres.
Por MCP, los mismos datos cuestan más o menos el doble de tokens. A las 00:38 hora de Singapur (17:38 en Madrid) pedimos con everyinfra_call_api, en el servidor MCP remoto de EveryInfra, 50 comentarios de un vídeo de National Geographic en YouTube. Tardó 16,74 segundos y costó 0,000556 USD. El texto que recibe el modelo ocupa 18.198 bytes, con 8 campos por comentario, author_name incluido. Con nuestra lista de campos, esos 50 comentarios se quedan en 9516 bytes y sin un solo nombre. MCP ahorra código, pero dobla los tokens y no te deja quitar los nombres antes de que el modelo los lea; en un informe que va a leer un cliente, lo segundo pesa más.
También apuntamos los fallos. Los comentarios de YouTube de NASA devolvieron 503 dos veces, a las 00:37 y a las 00:40 hora de Singapur. El cuerpo del error decía retryable: true y retry_after: 20, con billing.charged en false y el reembolso en succeeded. Al tercer fallo del mismo endpoint en 10 minutos, el mensaje cambió: pedía enviar una vez la petición de ejemplo y explicaba que, si el ejemplo funciona, el problema está en el objetivo. Es el tipo de error que conviene a un agente, porque le dice cuánto esperar, si reintentar y qué comprobar. En Notion, el primer vídeo elegido (publicado el 2026-10-27) tenía comment_count 0; la respuesta fue un 200 con lista vacía y motivo empty_result_refunded, sin cobro. Con otro vídeo del 2026-10-23, que tenía 5 comentarios, obtuvimos 2. En total, seis peticiones no trajeron datos (dos 429, tres 503 y una vacía) y ninguna se cobró.
Resultados: cuatro métricas, tres cuentas y seis trampas
Cada gráfico sale de las mismas respuestas en bruto y de la tabla de reglas. Después de los números vienen las trampas que encontramos, que son justo lo que debe ir en el prompt de sistema.
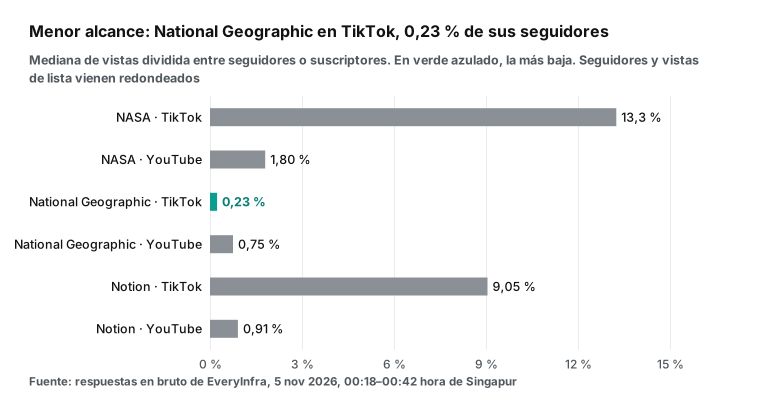
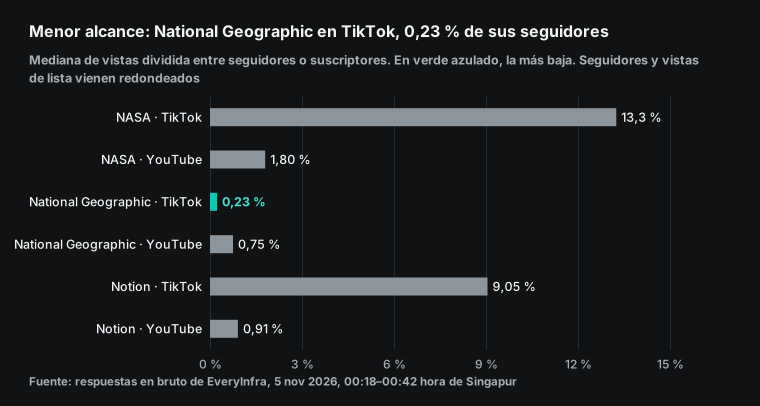
El alcance no se compara entre TikTok y YouTube. El feed de TikTok enseña vídeos a quien no te sigue, así que las visualizaciones pueden superar con holgura una décima parte de los seguidores; un canal grande de YouTube arrastra suscriptores de hace años que ya casi no ven nada. Dentro de TikTok, NASA tiene un 13,25 %, Notion un 9,05 % y National Geographic un 0,23 %: más de 50 veces de diferencia. Mirando solo esto, el agente escribiría que seguidores y visualizaciones no cuadran.
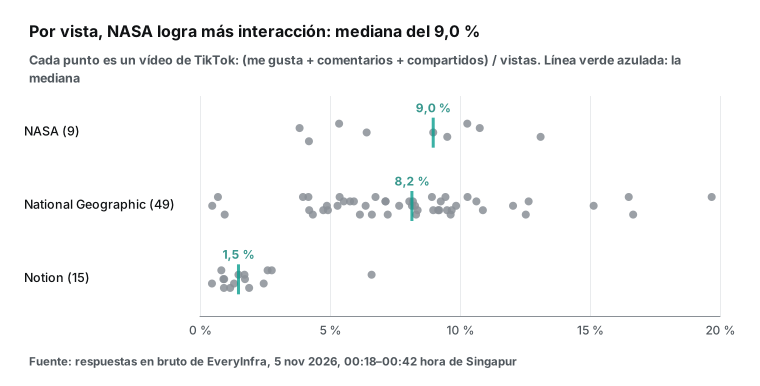
La interacción desmonta media conclusión. La mediana de National Geographic es del 8,15 %, a menos de un punto del 8,97 % de NASA; Notion se queda en el 1,48 %. Quien ve un vídeo de National Geographic da me gusta y comparte casi tanto como quien ve uno de NASA. Poco alcance con interacción normal apunta a una cuenta que publica mucho, de modo que cada vídeo llega solo a una parte de su audiencia, no a seguidores comprados: esos ni ven ni reaccionan, y las dos cifras caerían a la vez.
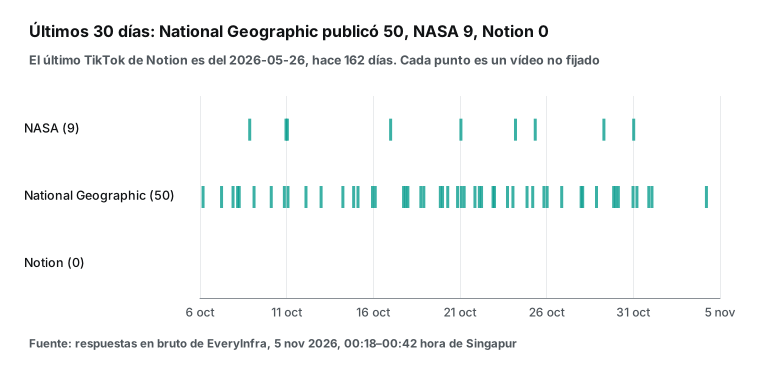
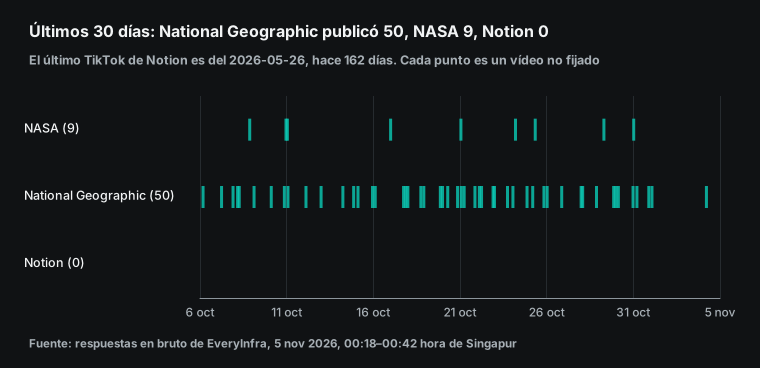
El ritmo lo explica. National Geographic publicó 50 vídeos no fijados en 30 días, el último el 2026-11-03, con un hueco mediano de 0,62 días y uno máximo de 3,1; NASA publicó 9, el último el 2026-10-30, con 2,62 días de hueco mediano y 6,0 de máximo. Si los mismos seguidores reciben uno o dos vídeos nuevos al día, cada uno se reparte entre menos gente. Leyendo ritmo y alcance juntos, el agente puede escribir la frase correcta: publica mucho, poco alcance por vídeo, interacción normal. La fila de Notion está vacía: su último TikTok es del 2026-05-26, con 161,7 días de antigüedad cuando hicimos la consulta, y su 9,05 % sale de los últimos 15 vídeos antiguos. Para decidir una campaña el mes que viene, ese número no dice nada.
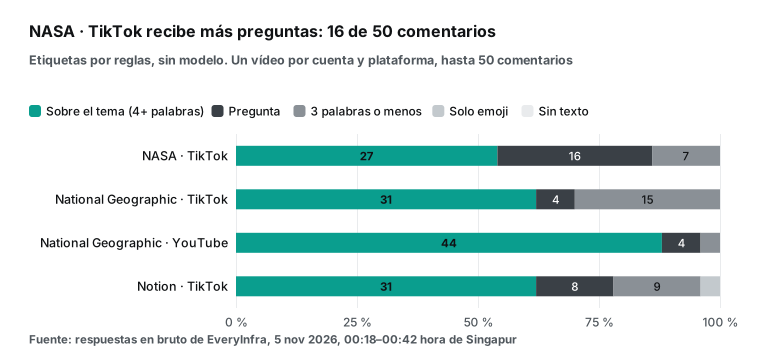
Para los comentarios no usamos el modelo, sino cinco reglas fijas: sin texto, solo emojis o signos, con interrogación, 3 palabras o menos y, el resto, sobre el tema. Son reglas toscas, pero cualquiera puede repetir el cálculo y no hacen interpretaciones creativas. En TikTok, NASA recibe 16 preguntas, casi todas sobre lo que sale en el vídeo, buena señal para divulgación científica. National Geographic tiene 15 comentarios cortos y 16 con letras no inglesas o tildes, lo que sugiere una audiencia muy internacional; para una marca española que busca público hispanohablante, ese dato pide mirar en qué idiomas comentan. En YouTube, 44 de 50 comentarios de la misma marca hablan del contenido, con una longitud mediana de 77 caracteres. La calidad de los comentarios solo se compara dentro de cada plataforma. Hay además un tipo de comentario que conviene vigilar: el 30 de septiembre de 2026, YouTube Data API añadió snippet.imageUrl a los comentarios, que pueden llevar imagen o GIF, con acceso para todos en noviembre de 2026 (historial de cambios de YouTube Data API). Quien solo lee el texto se pierde los comentarios que son solo una imagen; por eso nuestras reglas cuentan aparte los comentarios sin texto.
| # | Trampa | Qué vimos | Qué debe hacer el agente |
|---|---|---|---|
| 1 | TikTok redondea | Todos los vídeos con 10.000 o más visualizaciones tienen cifras múltiplos de 100; seguidores de 2.200.000, 9.700.000 y 143.700 | Escribir «unos» y no dar dos decimales con muestras pequeñas |
| 2 | 50 vídeos no siempre cubren 30 días | La primera página de National Geographic cubría 28,8 días; hizo falta una segunda con until | Mirar la fecha del más antiguo y paginar si no llega |
| 3 | Los vídeos fijados van primero | NASA y National Geographic tienen uno fijado cada una, mucho más antiguo | Quitar los is_pinned antes de medianas y huecos |
| 4 | La lista de YouTube usa fechas relativas | youtube/user_posts devuelve «2w ago» o «1mo ago», vistas redondeadas a miles y sin me gusta ni comentarios | Pedir youtube/video para los vídeos cerca del límite de 30 días |
| 5 | En YouTube también se redondean los me gusta | Un vídeo de NASA del 2026-10-14 tiene 684.881 vistas y 11.000 me gusta; los 4 vídeos de NASA marcan comment_count 0 | Marcar los me gusta como redondeados y no juzgar comentarios si no hay |
| 6 | Cuenta nueva no es crecimiento falso | El created_at de NASA en TikTok es del 2026-07-20, con 2,2 millones de seguidores, y aun así su alcance es el más alto | Cruzar crecimiento con alcance e interacción; nunca juzgar por un solo dato |
Las trampas 2 y 4 son las que más llamadas cuestan. Una cuenta de TikTok muy activa necesita dos llamadas para cubrir 30 días, y un canal de YouTube necesita varias consultas de vídeo sueltas para tener me gusta y fechas exactas. Nosotros pedimos 4 vídeos por canal: 0,0022 USD, el 40 % del coste de datos de un creador. Si tu lista es sobre todo de TikTok, puedes saltártelas y valorar YouTube solo por suscriptores y ritmo. Sobre la trampa 5: los 12 vídeos sueltos que miramos se publicaron después del cambio de recuento del 27 de agosto, así que nuestras cifras no lo cruzan. Si los vídeos de un creador sí lo cruzan, el informe debe decirlo.
Muse Wonder API cost: la factura de una lista de 10 creadores
La factura tiene dos partes. Los datos de EveryInfra son precio de catálogo por número de llamadas, así que esa cifra es exacta. El modelo de Meta es precio público por tokens; como no lo ejecutamos, es una estimación, y explicamos cada supuesto para que pongas los tuyos.
| Llamadas por creador | Número | Precio de catálogo | Subtotal |
|---|---|---|---|
Perfil de TikTok, tiktok/profile | 1 | 0,000556 USD | 0,000556 USD |
Vídeos de TikTok, tiktok/user_videos (segunda página en cuentas activas) | 1 o 2 | 0,000556 USD | 0,000556 a 0,001112 USD |
Comentarios de TikTok, tiktok/comments | 1 | 0,000556 USD | 0,000556 USD |
Canal de YouTube, youtube/profile | 1 | 0,000556 USD | 0,000556 USD |
Lista de vídeos de YouTube, youtube/user_posts | 1 | 0,000556 USD | 0,000556 USD |
Vídeo suelto de YouTube, youtube/video | 4 | 0,000556 USD | 0,002224 USD |
Comentarios de YouTube, youtube/comments | 1 | 0,000556 USD | 0,000556 USD |
| Total | 10 u 11 | 0,00556 a 0,00612 USD |
Diez creadores son entre 100 y 110 llamadas, es decir, entre 0,0556 y 0,0612 USD en datos. Los fallos, los tiempos agotados y las respuestas vacías no se cobran, así que eso es un techo: en nuestra sesión se cobraron 30 de 36 peticiones. Los precios son los del catálogo del día (página de precios), que se puede leer gratis y sin clave.
Para el modelo partimos de cuatro supuestos. Uno: cada creador tiene su propia conversación de 3 turnos (datos, comentarios e informe). Dos: el prefijo fijo, con prompt de sistema y cinco funciones, ocupa 1500 tokens. Tres: los resultados se pasan a tokens dividiendo los bytes entre 4. El centro de ayuda de Meta dice que un token son unos 3 o 4 caracteres de texto en inglés y que otros idiomas y el código usan más (How am I billed), así que 4 se queda corto; y cada turno posterior vuelve a leer lo anterior. Cuatro: la salida con razonamiento suma 4000 tokens por creador. En nuestros datos, lo recortado de cada creador ocupa de media 30.541 bytes y lo bruto, 154.694.
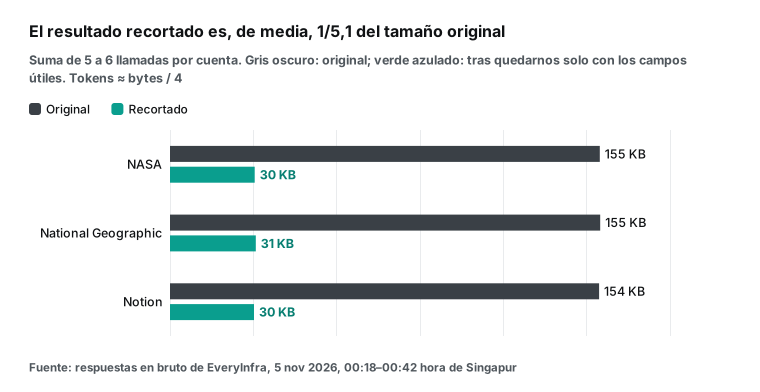
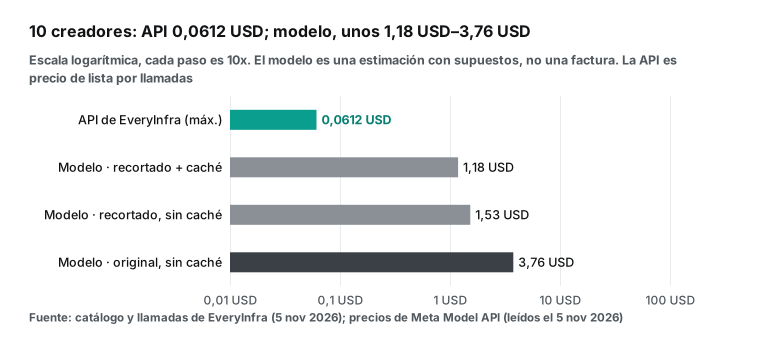
Con esos supuestos, los tres turnos de un creador suman unos 18.243 tokens de entrada recortados, o 74.112 en bruto. A precios de Muse Wonder, recortado y sin caché sale por 0,153 USD por creador, de los que 0,08 USD son salida; recortado y con caché en lo que se relee, 0,118 USD; en bruto y sin caché, 0,376 USD. Multiplica por 10 y tienes las tres barras del gráfico.
| Lista de 10 creadores | Datos | Modelo (estimación) | Total | Modelo / datos |
|---|---|---|---|---|
| Recortado con caché | 0,0612 USD | 1,18 USD | 1,25 USD | 19 veces |
| Recortado sin caché | 0,0612 USD | 1,53 USD | 1,59 USD | 25 veces |
| En bruto sin caché | 0,0612 USD | 3,76 USD | 3,82 USD | 61 veces |
De aquí salen dos ideas. La primera: el ahorro está en el modelo, no en los datos; los datos cuestan lo mismo en las tres filas y el modelo varía más del triple según el tamaño de lo que lee. La segunda: una vez recortado, lo que más pesa es la salida. De los 0,118 USD de la fila más barata, 0,08 USD son los 4000 tokens de salida, porque en Muse Wonder la salida cuesta cinco veces la entrada y el razonamiento se cobra como salida. Para leer cifras y escribir cuatro líneas no hace falta high; con medium o low basta. Antes de lanzar, Meta ofrece POST /v1/responses/input_tokens para contar tokens de entrada; solo tokeniza, no genera ni registra uso, y Meta lo recomienda para comprobar si cabe en el contexto, no para estimar la factura (Token counting). Durante la ejecución, lee usage en cada turno y sustituye nuestras estimaciones.
Queda el tiempo. Muse Wonder admite 3000 peticiones por minuto; el freno está en los datos. Nuestra clave de pruebas permite 10 por minuto y la compartían otras tareas: las 36 peticiones fueron de las 00:18:46 a las 00:42:08 hora de Singapur (de 17:18 a 17:42 en Madrid), 23 minutos y 22 segundos, con dos respuestas 429 y 60 segundos de espera en cada una. Una lista de 10 creadores, con 110 llamadas, tarda como mínimo 11 minutos a ese ritmo. Entre las 30 llamadas cobradas, la mediana tardó 22,2 segundos y la más lenta 78,2 (contando las 6 sin resultado, la más lenta llegó a 89,6), así que la capa de herramientas debe hacer cola y lanzar varias a la vez sin pasarse del límite.
Límites de esta prueba
| Límite | Efecto | Cómo cubrirlo |
|---|---|---|
| No ejecutamos la parte de Meta | Tools JSON, bucle y esquema siguen la documentación; no medimos cómo reparte el modelo las llamadas ni cuánto razona | Probar con dos creadores y leer usage |
| Solo tres cuentas de marca | Grandes y verificadas; no representan a creadores pequeños | Añadir dos o tres creadores que conozcas como control |
| El coste del modelo es una estimación | Bytes entre 4, 3 turnos y 4000 tokens de salida son supuestos | Recalcular con usage real |
| Comentarios de un solo vídeo por plataforma | El tono describe un vídeo | Muestrear dos o tres más en creadores clave |
| Etiquetas por reglas | La ironía o la mezcla de idiomas pueden caer en «sobre el tema» | Usar las reglas como primer filtro y revisar lo marcado |
| Huecos en comentarios de YouTube | NASA falló dos veces y Notion devolvió 2 | Anotarlo en missing y no concluir con datos vacíos |
El segundo límite es el que más puede cambiar una conclusión. Las tres marcas superan los 100.000 seguidores, así que el redondeo apenas les afecta; con un creador de 8000 seguidores, el redondeo, las muestras pequeñas y un solo vídeo viral pesan mucho más. Añade una regla al prompt: con menos de 5 vídeos en la ventana o menos de 10.000 seguidores, el informe da las cuatro cifras y no saca conclusión.
Preguntas frecuentes
Muse Wonder API cost: ¿cuánto cuesta y cómo se cobra?
Se cobra por tokens, sin cuota mensual ni mínimo: 4,00 USD de entrada, 0,20 USD de entrada en caché y 20,00 USD de salida por millón, y los tokens de razonamiento cuentan como salida (Pricing and rate limits; Quickstart). Meta añade que el contenido de sistema que inyecta no se cobra ni aparece en usage. En una revisión pagas dos cosas: el modelo a Meta y los datos por llamada a EveryInfra; la sección de coste estima ambas para 10 creadores.
Muse Wonder API key: ¿dónde se consigue y puede usarla un compañero?
Te registras en la web de Model API, entras en API keys y pulsas «Create API key». La clave es del equipo, así que cualquiera del equipo puede usarla (Create an API key); fuera del equipo, no, porque compartirla incumple las condiciones (Can I share my API key). Antes de registrarte, revisa la política geográfica. El centro de ayuda dice que Model API está disponible en la mayoría de los países y territorios donde lo está Meta AI y se admite la facturación, y que la referencia es la política geográfica (Supported countries). España no está entre las regiones restringidas, que son China, Hong Kong y Macao (Geographic Use Policy).
¿Puedo usar Muse Wonder Full por API?
No. La página de modelos dice que Wonder Full solo está en las suscripciones de Muse Code, planes Power Usage y Maximum Usage, y que poner el razonamiento en max no activa Full (Models). Un comentario en Hacker News lo señaló el día del lanzamiento: el Full que lidera las pruebas es para suscriptores y en la API solo está Muse Wonder (comentario en Hacker News). La suscripción de Muse Code solo funciona en su propia herramienta de línea de comandos, no para llamar a la API (Muse Code subscriptions).
Hay quien dice que la API de Muse Wonder falla a veces. ¿Cómo se protege el agente?
Poco después del lanzamiento, un comentario en Hacker News la describía como casi de lo mejor, pero cara y con fallos ocasionales de la API (comentario en Hacker News); es una experiencia personal y no la reprodujimos. La documentación de errores de Meta marca qué se puede reintentar: un fallo al interpretar la salida devuelve 500, un servidor saturado devuelve service_overloaded con Retry-After: 60 y ante un 429 hay que esperar lo que diga Retry-After (Error handling). Pon los reintentos en dos capas: en Meta, según su documentación; en EveryInfra, los fallos y las respuestas vacías no se cobran y nuestro código espera 60 segundos ante un 429.
Cómo empezar: de cero a tu primer informe
Cada plataforma tiene una página general con todos los endpoints y sus precios: la API de TikTok y la API de YouTube. En EveryInfra son tres pasos: regístrate con la guía rápida y crea la clave; comprueba en el catálogo que tiktok/user_videos, tiktok/comments y youtube/comments están disponibles ese día; y ejecuta el código de herramientas con una cuenta que conozcas para comparar seguidores y visualizaciones con lo que ves en la app. El catálogo se lee gratis y sin clave: GET /api/v1/social/catalog. Para probar desde el navegador, usa la consola del mercado de datos; para conectar directamente una herramienta de IA, sigue la guía de MCP remoto. Los reembolsos y la conciliación de llamadas fallidas o vacías están en conciliación de reembolsos, y cómo hacer que el agente corrija solo sus parámetros tras un error 422, en errores que se corrigen solos.
En Meta son cuatro pasos, los de la sección de la clave: registro, facturación, clave y variable de entorno. Mete tools.json y el prompt de sistema en tu proyecto. Si quieres ver cómo llama el modelo a las herramientas sin escribir código, en el Playground abre Advanced, luego Tools, pulsa Add tool y pega cada definición de tools.json; allí es el modelo quien decide cuándo llamar (Using tools in the Playground). Después prueba con dos creadores, amplía a diez y, al terminar, lee usage en cada turno para sustituir nuestras estimaciones por cifras reales.
Referencias
- Introducing Muse Wonder and Muse Wonder Full: Frontier Models for Agents, Meta Newsroom, 2026-10-12, <https://about.fb.com/news/2026/10/introducing-muse-wonder-models/>
- Muse Wonder: A Frontier Model For Personal & Professional AI Agents, blog de investigación de Meta, 2026-10-12, <https://research.meta.ai/blog/muse-wonder>
- Página de producto de Muse Wonder, Meta, leída el 2026-11-05, <https://dev.meta.ai/models/muse-wonder>
- Get started with Meta Model API and Muse Code, documentación de Meta, leída el 2026-11-05, <https://dev.meta.ai/docs/overview>
- Models, documentación de Meta, leída el 2026-11-05, <https://dev.meta.ai/docs/models>
- Pricing and rate limits, documentación de Meta, leída el 2026-11-05, <https://dev.meta.ai/docs/pricing-rate-limits>
- Quickstart, documentación de Meta, leída el 2026-11-05, <https://dev.meta.ai/docs/quickstart>
- Tool calling, documentación de Meta, leída el 2026-11-05, <https://dev.meta.ai/docs/tool-calling>
- Responses API, documentación de Meta, leída el 2026-11-05, <https://dev.meta.ai/docs/protocols/responses>
- Structured output, documentación de Meta, leída el 2026-11-05, <https://dev.meta.ai/docs/structured-output>
- Prompt caching, documentación de Meta, leída el 2026-11-05, <https://dev.meta.ai/docs/prompt-caching>
- Tool search, documentación de Meta, leída el 2026-11-05, <https://dev.meta.ai/docs/tool-search>
- Agent frameworks, documentación de Meta, leída el 2026-11-05, <https://dev.meta.ai/docs/agent-frameworks>
- Error handling, documentación de Meta, leída el 2026-11-05, <https://dev.meta.ai/docs/error-handling>
- Muse Code subscriptions, documentación de Meta, leída el 2026-11-05, <https://dev.meta.ai/docs/muse-code/subscriptions>
- Search grounding, documentación de Meta, leída el 2026-11-05, <https://dev.meta.ai/docs/search-grounding>
- Token counting, documentación de Meta, leída el 2026-11-05, <https://dev.meta.ai/docs/token-counting>
- How do I sign up for Model API?, centro de ayuda de Meta AI Developer, leída el 2026-11-05, <https://dev.meta.ai/help/accounts-and-login/sign-up>
- How do I create an API key?, centro de ayuda de Meta AI Developer, leída el 2026-11-05, <https://dev.meta.ai/help/api-keys/create-api-key>
- Can I share my API key?, centro de ayuda de Meta AI Developer, leída el 2026-11-05, <https://dev.meta.ai/help/api-keys/sharing-api-keys>
- How can I set up billing for Meta Model API?, centro de ayuda de Meta AI Developer, leída el 2026-11-05, <https://dev.meta.ai/help/billing/set-up-billing>
- How am I billed for Model API?, centro de ayuda de Meta AI Developer, leída el 2026-11-05, <https://dev.meta.ai/help/billing/api-bill>
- How do I set a spend limit alert?, centro de ayuda de Meta AI Developer, leída el 2026-11-05, <https://dev.meta.ai/help/billing/spend-limit-alert>
- How do I request a refund for Meta Model API?, centro de ayuda de Meta AI Developer, leída el 2026-11-05, <https://dev.meta.ai/help/billing/refunds>
- Does Model API support Zero Data Retention (ZDR)?, centro de ayuda de Meta AI Developer, leída el 2026-11-05, <https://dev.meta.ai/help/policies-and-privacy/zero-data-retention>
- Meta Model API Terms of Service, Meta, actualizadas el 2026-10-09, <https://dev.meta.ai/legal/terms-of-service>
- Meta Model API Acceptable Use Policy, Meta, actualizada el 2026-10-12, <https://dev.meta.ai/legal/acceptable-use-policy>
- Meta Model API Model Designation and Geographic Use Policy, Meta, actualizada el 2026-10-12, <https://dev.meta.ai/legal/geographic-use-policy>
- Muse Wonder is available today on Meta Model API and in Muse Code, Meta for Developers (publicación en Facebook), 2026-10-12, <https://www.facebook.com/MetaforDevelopers/posts/muse-wonder-is-available-today-on-meta-model-api-and-in-muse-code-and-muse-wonde/1552628546897475/>
- YouTube Data API Revision History, Google for Developers, actualizada el 2026-11-03, <https://developers.google.com/youtube/v3/revision_history>
- Understand your YouTube content performance, ayuda de YouTube, leída el 2026-11-05, <https://support.google.com/youtube/answer/12220281>
- Real Decreto 444/2024, de 30 de abril (usuarios de especial relevancia), BOE, <https://www.boe.es/eli/es/rd/2024/04/30/444>
- Texto del Real Decreto 444/2024 (BOE-A-2024-8716), BOE, <https://www.boe.es/diario_boe/txt.php?id=BOE-A-2024-8716>
- Tools, especificación de Model Context Protocol (2025-06-18), <https://modelcontextprotocol.io/specification/2025-06-18/server/tools>
- Meta Muse Wonder: Developers get it now, the Muse app skips Europe, Notebookcheck, octubre de 2026, <https://www.notebookcheck.net/Meta-Muse-Wonder-Developers-get-it-now-the-Muse-app-skips-Europe.1422810.0.html>
- The Average Views Lie: What We Learned From 675 TikTok Creator Videos, TechBullion, octubre de 2026, <https://techbullion.com/average-views-lie-learned-675-tiktok-creator-videos/>
- Comentario en el hilo de Hacker News sobre Muse Wonder (usuario oculto), Hacker News, octubre de 2026, <https://news.ycombinator.com/item?id=50065098>
- Comentario en el hilo de Hacker News sobre Muse Wonder (usuario oculto), Hacker News, octubre de 2026, <https://news.ycombinator.com/item?id=50061435>
- Catálogo de datos de EveryInfra (lectura gratuita), EveryInfra, leído el 2026-11-05, <https://api.everyinfra.com/api/v1/social/catalog>
- Meta Model API Data Commitments, Meta, leída el 2026-11-05, <https://dev.meta.ai/legal/commitments>
- What countries and territories is Model API available in?, centro de ayuda de Meta AI Developer, leída el 2026-11-05, <https://dev.meta.ai/help/accounts-and-login/supported-countries>
- Can the models call tools?, centro de ayuda de Meta AI Developer, leída el 2026-11-05, <https://dev.meta.ai/help/about-model-api/tool-calling>
- How do I use tools in the Playground?, centro de ayuda de Meta AI Developer, leída el 2026-11-05, <https://dev.meta.ai/help/playground/using-tools-in-the-playground>
Referencia BL-89