Muse Wonder API로 크리에이터 사전 검증하기: 실데이터 테스트와 비용 추정
Meta의 Muse Wonder API로 TikTok·YouTube 크리에이터 검증 에이전트를 만듭니다. tools JSON, 실데이터 왕복 호출, 크리에이터 10명 목록의 비용까지 다룹니다.
2026년 11월 4일 미국 동부 시간 11:18~11:42(싱가포르 시간 11월 5일 00:18~00:42)에 NASA, National Geographic, Notion 세 브랜드 계정을 대상으로 크리에이터 점검을 진행했습니다. EveryInfra의 TikTok 및 YouTube 엔드포인트로 요청 36건을 보냈고, 그중 서른 건이 과금되어 총 비용은 $0.01668였습니다. 가장 유용한 수치는 예상 밖이었습니다. National Geographic의 TikTok 팔로워는 9.7백만 명이지만 동영상 조회수 중앙값은 22,600회로, 도달률이 0.23%에 그칩니다. 점검한 계정·플랫폼 조합 여섯 개 중 가장 낮은 수치입니다.
그래도 이 계정은 실제로 시청한 사람들에게서 높은 참여를 얻습니다. 조회 1회당 (좋아요 + 댓글 + 공유) 중앙값은 8.15%로, NASA의 8.97%에 가깝습니다. NASA의 도달률은 13.25%입니다. National Geographic은 30일 동안 TikTok 영상을 50개 올렸기 때문에 영상 하나가 닿는 팔로워 비율이 작습니다. 도달률만 보는 에이전트라면 정상적인 계정을 “팔로워 수가 부풀려진 계정”으로 표시할 것입니다. 이 글은 바로 이런 실수를 다룹니다.
이 글이 답하는 질문
브랜드 팀이나 에이전시가 크리에이터 목록을 갖고 있습니다. 계약 전에 각 크리에이터에 대해 AI로 네 가지 질문의 답을 얻고자 합니다. 팔로워가 진짜인가? 시청자가 반응하는가? 최근 30일 안에 게시했는가? 댓글에서는 무슨 이야기를 하는가? 이 가이드는 Meta의 새 Muse Wonder 모델과 EveryInfra 데이터 엔드포인트인 tiktok/profile, tiktok/user_videos, youtube/profile, youtube/user_posts, 그리고 댓글 엔드포인트 2개로 이 에이전트를 만듭니다.
이 머신에는 Meta 키가 없습니다. 그래서 Meta 쪽(tools JSON, 에이전트 루프, 보고서 스키마)은 예시 구성입니다. 해당 부분의 가격, 파라미터, 규칙은 모두 확인 날짜와 함께 Meta 페이지로 연결해 두었습니다. EveryInfra 쪽은 실제로 실행했습니다. 아래 표의 모든 수치는 그 실행의 원본 응답에서 나왔으며, 각각 다시 계산해 볼 수 있습니다. 추정치인 경우에는 추정치라고 밝히고 입력값을 함께 적었습니다.
결과부터 보겠습니다. 아래 표는 두 플랫폼의 세 계정에 네 가지 규칙을 적용한 결과입니다. 지표 규칙 섹션에서 각 공식을 설명하고, 실데이터 결과 섹션에서 각 수치의 출처를 보여 드립니다.
| 계정 및 플랫폼 | 팔로워 또는 구독자 | 도달률(조회수 중앙값 / 팔로워) | 조회당 참여율 중앙값 | 최근 30일 게시물 수 | 댓글 구성(규칙 기반) |
|---|---|---|---|---|---|
| NASA, TikTok | 2,200,000 | 13.25% | 8.97% | 9개, 최장 공백 6.0일 | 50개 중 16개가 질문 |
| NASA, YouTube | 15,100,000 | 1.80%(최근 10개) | 1.41%(영상 4개) | 확실 2개 | 가져오지 못함(실패 2건, 과금 없음) |
| National Geographic, TikTok | 9,700,000 | 0.23% | 8.15% | 50개, 최장 공백 3.1일 | 주제 관련 31개, 3단어 이하 15개 |
| National Geographic, YouTube | 26,600,000 | 0.75% | 0.61%(영상 4개) | 확실 21개, 불확실 1개 | 50개 중 44개가 주제 관련 |
| Notion, TikTok | 143,700 | 9.05%(최근 15개) | 1.48% | 0개, 최신 영상은 161.7일 전 | 주제 관련 31개, 이모지로만 된 댓글 2개 |
| Notion, YouTube | 350,000 | 0.91% | 0.60%(영상 4개) | 확실 7개, 불확실 1개 | 댓글 2개뿐이라 판단 보류 |
인증된 브랜드 계정 세 곳 모두 의심스러운 점은 없습니다. 그래도 각 계정에는 단순한 규칙으로 판단하면 오해를 부를 만한 지표가 하나씩 있습니다. NASA의 TikTok 계정은 created_at이 2026년 7월 20일로 표시되는데 팔로워는 2.2백만 명입니다. 성장 속도 규칙이라면 지나치게 빠르다고 판단할 수 있지만, NASA는 여섯 개 조합 중 도달률이 가장 높습니다.
Notion의 TikTok 도달률 9.05%는 훌륭해 보이지만 최신 영상은 2026년 5월 26일에 올라온 것입니다. 30일 규칙으로 보면 Notion의 TikTok은 휴면 상태입니다. 해법은 모든 경우에 같습니다. 규칙을 먼저 정해 두고, 그다음에 모델이 수치를 읽게 하세요.
Muse Wonder API란: Meta 공식 페이지로 확인한 10가지 사실
Meta는 2026년 10월 12일 Muse Wonder와 Muse Wonder Full을 발표했습니다. Meta는 Muse Wonder를 당일부터 Meta Model API와 Muse Code에서 사용할 수 있다고 밝혔습니다(Meta Newsroom, 2026년 10월 12일). 같은 날 공개된 리서치 블로그는 이 모델을 개인 및 업무용 에이전트를 위한 프런티어 모델이라고 소개합니다. 특히 Active Memory와 Active Focus를 강조하는데, Active Focus는 작업에 집중하고 오류에서 복구하는 능력을 가리키는 Meta의 명칭입니다(Meta 리서치 블로그). 제품 페이지는 모델이 계획을 세우고, 일부 작업을 하위 에이전트에 넘기고, 도구를 병렬로 호출하면서 몇 시간씩 이어지는 작업을 수행한다고 설명합니다(Muse Wonder 제품 페이지).
제품 소개 문구는 참고일 뿐입니다. 개발자에게 필요한 것은 문서에 실제로 명시된 파라미터입니다. 2026년 11월 5일에 dev.meta.ai 문서, 고객센터, 법률 페이지를 확인했습니다. 아래 표에는 Meta가 문서로 명시한 사실만 담았습니다.
| 항목 | Meta 페이지 내용 | 출처(2026년 11월 5일 확인) |
|---|---|---|
| 모델 ID | muse-wonder-1.0. 문서 홈에 “Muse Wonder is in preview”(프리뷰 단계)라고 명시 | Overview |
| 컨텍스트 | 1,048,576 토큰. 입력은 텍스트, 이미지, 동영상, 오디오, PDF 가능 | Models |
| 추론 | reasoning.effort는 minimal부터 max까지. max로 설정해도 Wonder Full로 전환되지 않음 | Models |
| Wonder Full | Muse Code 구독의 Power Usage 및 Maximum Usage 요금제에서만 제공 | Models |
| API 형식 | Responses, Chat Completions, Anthropic Messages 지원, 가격과 인증 방식 동일 | Overview |
| 도구 호출 | 함수 정의와 실행은 사용자가 담당. tool_choice는 auto만 지원. 함수 이름에는 점을 최대 1개까지 사용 가능 | Tool calling |
| 장시간 작업 | background: true로 비동기 실행, 팀당 분당 신규 작업 최대 600개. 오래 걸리는 비스트리밍 호출은 504를 반환할 수 있음 | Responses API |
| 요청 속도 제한 | muse-wonder-1.0 기준 분당 요청 3,000건, 토큰 4백만 개(키 단위가 아닌 팀 단위) | Pricing and rate limits |
| 지역 | 중국, 홍콩, 마카오는 사용 제한. Muse Wonder는 한국에서도 제공되지 않음 | Geographic Use Policy |
| 학습 사용 | Standard 모드는 사용자 콘텐츠로 학습하지 않음. 종량제에서 Wonder는 Contributor 모드 없음 | Models |
검증 에이전트 설계에 영향을 주는 행은 두 개입니다. 첫째는 tool_choice입니다. Meta 가이드라인에 따르면 "none", "required", 특정 함수 지정은 모두 HTTP 400을 반환합니다(Tool calling guidelines). 특정 턴에 모델이 도구를 호출하도록 강제할 수 없습니다. 따라서 루프는 매 턴 도구 호출과 일반 텍스트라는 두 가지 결과를 모두 처리해야 합니다. 또한 코드에서 각 크리에이터의 데이터 포인트 네 가지가 모두 있는지 확인하고, 빠진 것이 있으면 턴을 한 번 더 보내야 합니다.
두 번째 행은 지역에 관한 것입니다. Meta 정책은 중국, 홍콩, 마카오에서의 사용을 제한합니다. 해당 지역 사용자에게 통합 제품을 제공하거나 차단을 우회하는 것도 금지합니다(Geographic Use Policy, 섹션 2.1 및 3). 미국 팀 대부분은 해당되지 않습니다. 홍콩에 직원이나 고객이 있는 미국 에이전시라면 이 모델을 고르기 전에 확인해야 합니다.
Muse Wonder API 키 발급: 4단계와 주의할 함정 3가지
Meta AI Developer 고객센터는 키를 받는 방법을 4단계로 설명합니다. Meta 계정을 만들지 않았으므로, 아래 표는 화면 녹화가 아니라 고객센터 문서 내용을 따릅니다.
| 단계 | 고객센터 설명 | 출처 |
|---|---|---|
| 1. 회원가입 | Model API 사이트에서 “Start building” 클릭. Individual 선택 후 이메일, 전화번호, Facebook, Google, GitHub로 로그인. 18세 이상이며 지원 지역에 있어야 함 | How do I sign up |
| 2. 결제 정보 추가 | 관리자가 Billing 페이지에서 결제 수단과 법적 이름, 주소를 추가 | Set up billing |
| 3. 키 생성 | API keys 페이지에서 “Create API key” 클릭 후 이름을 지정하고 복사. 키는 팀 소유 | Create an API key |
| 4. 환경 변수 설정 | export MODEL_API_KEY="..."로 설정하고 코드에서 읽음. 프런트엔드 코드에 넣거나 커밋하지 말 것 | Quickstart |
첫 번째 함정은 지출에 강제 상한이 없다는 점입니다. 고객센터에 따르면 Meta Model API는 사용을 중단시키는 지출 한도를 제공하지 않습니다. 월별 알림 이메일만 설정할 수 있고, 그 금액을 넘긴 사용분도 그대로 청구됩니다(Spend limit alert). 에이전트는 루프로 도구를 호출하므로 버그가 있으면 밤새 실행될 수 있습니다. 그래서 아래 루프 코드는 자체 턴 제한과 토큰 예산을 둡니다.
두 번째 함정은 청구 시점과 환불입니다. Meta는 사용량이 결제 임계값에 도달하면 카드로 청구하고, 나머지는 매월 1일에 청구합니다(How am I billed). 고객센터는 Model API가 환불을 제공하지 않는다고도 밝힙니다(Refunds). 전체 목록을 실행하기 전에 크리에이터 2명으로 먼저 테스트하세요.
세 번째 함정은 에이전시에 가장 중요합니다. 키는 팀 소유이며, 고객센터는 팀 외부에 키를 공유하면 약관 위반이라고 안내합니다(Can I share my API key). Model API Terms of Service 10.1항도 Meta의 서면 허가 없이 서비스를 제3자에게 재판매하는 것을 금지합니다. 여기에는 키와 모델 접근 권한이 포함됩니다(Terms of Service, 2026년 10월 9일 개정). 여러 브랜드 고객을 위해 크리에이터를 검증한다면 키는 팀 안에만 두세요. 고객에게는 키가 아니라 보고서를 전달합니다.
EveryInfra 쪽은 빠른 시작에 따라 회원가입하고 콘솔에서 키를 만듭니다. 이 키도 환경 변수에 보관하세요. 두 키는 역할이 다릅니다. Meta 키는 모델을 호출하고, EveryInfra 키는 데이터를 가져옵니다. 도구 코드는 자체 서버에서 실행되므로 모델은 어느 키도 볼 수 없습니다.
Meta Muse Wonder API 요금: $4와 $20, 그리고 추가로 확인할 가격 3가지
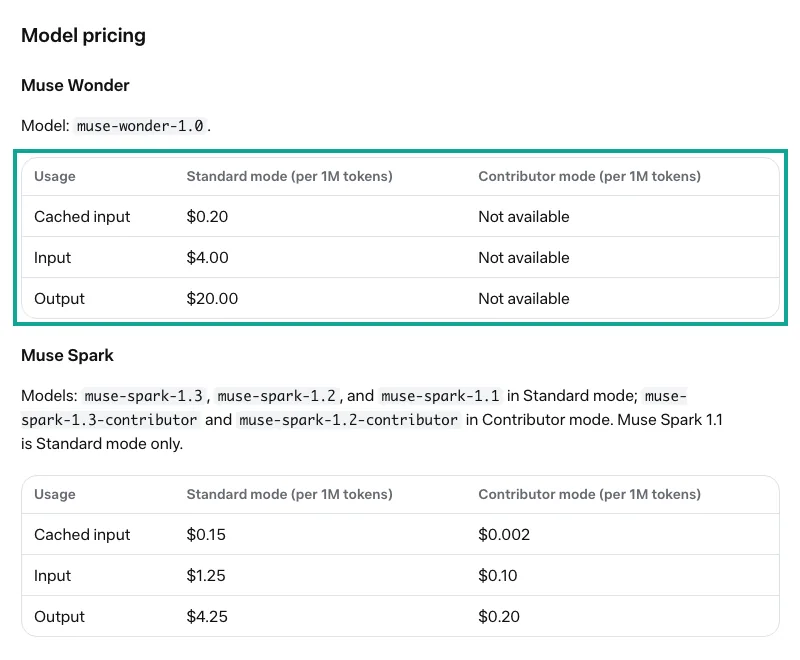
Meta 요금 페이지는 Muse Wonder의 100만 토큰당 가격으로 입력 $4.00, 캐시된 입력 $0.20, 출력 $20.00의 세 가지를 제시합니다. Contributor mode 열에는 “Not available”로 표시되어 있습니다(Pricing and rate limits). 2026년 10월 12일 Meta for Developers 출시 게시물도 같은 “$4/$20 per million tokens” 수치를 제시합니다(Meta for Developers 게시물).
검증 에이전트에는 세 가지 추가 비용이 들 수 있습니다. 첫째는 웹 검색입니다. 내장 web_search 도구는 검색 1,000회당 $2.50가 추가됩니다. 이 도구는 웹 페이지를 검색할 뿐 영상별 데이터는 반환하지 못하므로 사용하지 않습니다(Search grounding).
둘째는 Muse Spark입니다. muse-spark-1.3 모델은 100만 토큰당 입력 $1.25, 출력 $4.25입니다. Contributor 버전은 $0.10과 $0.20이지만, Contributor 모드는 사용자 콘텐츠를 Meta 모델 학습에 사용합니다. 약관 6.2항은 민감 정보, 기밀 정보, 개인정보를 Contributor 서비스로 보내는 것도 금지합니다(Terms of Service, 6항). 이 글의 입력에는 일반 사용자의 댓글 텍스트가 포함되므로 Standard 모드만 사용합니다.
셋째는 캐싱입니다. Meta는 동일한 프롬프트 접두부를 자동으로 캐시하며, 캐시된 토큰은 100만 개당 $0.20입니다(Prompt caching). 시스템 프롬프트와 도구 정의를 앞에 두고 끝의 크리에이터 목록만 바꾸세요. 그러면 크리에이터 10명 배치에서 고정된 접두부 대부분이 캐시에 적중합니다.
| 항목 | Muse Wonder | Muse Spark 1.3 | Muse Spark 1.3 Contributor |
|---|---|---|---|
| 입력(100만 토큰당) | $4.00 | $1.25 | $0.10 |
| 캐시된 입력 | $0.20 | $0.15 | $0.002 |
| 출력 | $20.00 | $4.25 | $0.20 |
| 사용자 콘텐츠로 학습 | 아니요(Standard) | 아니요(Standard) | 예 |
| 팀당 분당 요청 수 및 토큰 수 | 3,000건, 4백만 개 | 3,000건, 4백만 개 | 150건, 3백만 개 |
| 검증 에이전트에서 적합한 용도 | 메인 루프: 읽기, 비교, 보고서 작성 | 댓글 라벨링 같은 보조 작업 | 댓글 텍스트가 포함된 작업에는 부적합 |
요청 속도 제한도 같은 페이지에 나옵니다. Meta는 제한을 팀 단위로 계산하므로 한 팀의 모든 키가 하나의 한도를 공유하며, 모델마다 한도가 따로 있습니다(Rate limits). 크리에이터 10명 목록으로는 분당 3,000건에 근접하지도 않습니다. 실제 병목은 데이터 쪽의 요청 속도 제한입니다. 테스트 키의 요청 속도 제한은 분당 10건이며, 실데이터 결과 섹션에서 이 제한이 전체 실행 시간에 미치는 영향을 보여 드립니다.
TikTok과 YouTube만 다룬 이유: 범위와 Muse 이용약관
브랜드는 보통 숏폼 크리에이터와 롱폼 크리에이터, 두 유형과 협업합니다. 이 가이드는 유형마다 플랫폼을 하나씩 사용합니다. TikTok은 숏폼, YouTube는 롱폼을 대표합니다.
두 플랫폼의 데이터는 매우 다릅니다. TikTok 피드는 계정을 팔로우하지 않는 사람에게도 영상을 보여 주므로 조회수가 팔로워의 10분의 1을 넘을 수 있습니다. 대형 YouTube 채널은 과거 몇 년간 쌓인 구독자가 많아 도달률이 대체로 낮습니다. 두 플랫폼을 함께 보면 이 가이드가 거듭 강조하는 점이 드러납니다. 지표는 같은 플랫폼 안에서만 비교해야 합니다. 다른 플랫폼은 범위에서 제외했습니다. 같은 네 가지 규칙과 같은 도구 패턴을 쓸 수 있지만, 먼저 각 엔드포인트의 필드를 확인하세요.
모델 쪽에도 모델에 보내는 데이터에 관한 규칙이 있습니다. 이 섹션은 Muse의 자체 법률 페이지(dev.meta.ai/legal)만 인용하며, 법률 자문이 아닙니다. 약관을 직접 읽고, 현지 법률과 각 데이터 플랫폼과의 계약도 확인하세요.
Meta Model API Terms of Service(2026년 10월 9일 개정) 4.1항에 따르면 서비스에 제공하는 데이터의 정확성과 유효성을 포함한 책임은 사용자에게 있습니다. 10.1항 (vii)은 제3자의 권리를 침해하거나 위반하는 방식으로 서비스를 사용하는 것을 금지합니다. 10.3항은 Meta가 자동 검토 또는 사람의 검토를 통해 서비스 사용을 모니터링할 수 있다고 명시합니다(Terms of Service). Data Commitments 페이지에 따르면 Meta는 Standard 서비스의 콘텐츠를 모델 학습에 사용하지 않습니다. 다만 사용 정책이나 약관 위반을 찾아 대응하기 위해 해당 콘텐츠를 처리할 수는 있습니다(Data Commitments).
| 규칙 | 범위 | 주요 내용(요약) | 검증 에이전트에 미치는 영향 |
|---|---|---|---|
| Model API Terms 4.1항 | 사용자가 보내는 데이터 | 데이터의 정확성과 유효성은 사용자 책임 | 모든 수치는 원본 응답까지 추적 가능해야 함 |
| Model API Terms 10.1항 (vii) 및 10.3항 | 서비스 사용 방식 | 제3자 권리를 침해하는 사용 금지. Meta가 사용을 모니터링할 수 있음 | 약관을 먼저 읽고 데이터 출처와 목적을 확인 |
| Data Commitments | Standard 서비스의 콘텐츠 | 학습에 사용하지 않음. 위반 대응을 위해 처리될 수 있음 | 댓글 텍스트는 Standard 모드로만 전송 |
| Model API Acceptable Use Policy | 출력과 목적 | 민감한 개인 특성 추론 금지. 사회적 행동으로 사람을 평가해 피해를 주는 행위 금지 | 사람이 아닌 계정의 비즈니스 데이터만 평가 |
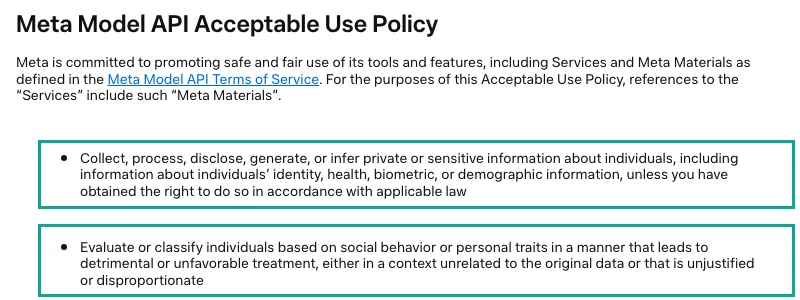
마지막 행은 놓치기 쉽습니다. Meta Model API Acceptable Use Policy(2026년 10월 12일 개정)에는 크리에이터 평가에 직접 적용되는 항목이 두 개 있습니다. 하나는 법적 권리 없이 사람에 관한 사적 정보나 민감 정보를 수집, 처리, 공개, 생성, 추론하는 것을 금지합니다. 신원, 건강, 생체, 인구통계 데이터가 그 예입니다. 다른 하나는 두 가지 경우에 사회적 행동이나 개인 특성으로 사람을 평가하거나 분류하는 것을 금지합니다. 불리한 대우로 이어지는 경우와 맥락을 벗어나 사용하는 경우입니다(Acceptable Use Policy).
크리에이터 검증은 유료 협업 전에 거치는 일반적인 절차입니다. 브랜드는 계정을 하나의 미디어 채널로 봅니다. 조회수가 꾸준한가? 참여도가 팔로워 수에 걸맞은가? 일정하게 게시하는가? 댓글이 콘텐츠에 관해 이야기하는가? 모두 계정에 관한 비즈니스 수치입니다.
위험한 질문은 이와 다릅니다. 하나는 모델에게 크리에이터의 나이, 민족, 건강, 정치 성향을 추측하게 하는 것입니다. 다른 하나는 일반 사용자의 댓글을 근거로 사람에게 꼬리표를 붙이는 것입니다.
이 글의 도구 코드는 규칙을 지키기 위해 두 가지 조치를 취합니다. 모델에는 댓글 텍스트, 좋아요 수, 답글 수, 작성 시간만 보내고 댓글 작성자의 사용자 이름은 보내지 않습니다. 또한 시스템 프롬프트로 콘텐츠 성과만 판단하고 개인 특성은 추론하지 말라고 지시합니다. 보고서에 데이터로 입증할 수 있는 내용만 담기므로 신뢰도도 높아집니다.
네 가지 지표: 규칙을 먼저 정하고 모델에게 읽게 하기
검증 보고서에서 가장 큰 문제는 사람마다 다르게 이해하는 용어입니다. 어떤 사람은 참여 수를 팔로워로 나누고, 어떤 사람은 조회수로 나눕니다. 어떤 사람은 댓글로 “진짜 팔로워”를 판단하고, 어떤 사람은 팔로워당 좋아요 수를 봅니다. 공식이 바뀌면 판정이 뒤집힐 수 있습니다. 그래서 데이터를 가져오기 전에 네 가지 공식을 시스템 프롬프트에 넣었습니다. 모델은 수치를 읽고 비교해 판정을 작성할 뿐, 방법을 지어내지 않습니다.
| 지표 | 이 가이드의 공식 | 사용 필드 | 알 수 있는 것과 알 수 없는 것 |
|---|---|---|---|
| 팔로워 진정성(대리 지표) | 도달률 = 3~30일 전에 게시된 고정되지 않은 동영상의 조회수 중앙값 ÷ 팔로워 수. 평균/중앙값 비율과 상위 동영상 비중도 함께 산출 | follower_count, view_count, posted_at, is_pinned | 팔로워 중 얼마나 많은 사람이 아직 시청하는지 보여 줍니다. 특정 팔로워가 가짜인지는 증명할 수 없습니다 |
| 참여율 | 동영상별로 (좋아요 + 댓글 + 공유) / 조회수를 구한 뒤 중앙값을 냅니다. TikTok은 도달률과 같은 표본(3~30일 전에 게시된 고정되지 않은 동영상)을 사용합니다. YouTube는 (좋아요 + 댓글) / 조회수를 사용합니다 | like_count, comment_count, share_count, view_count | 시청자가 반응하는지 보여 줍니다. 실제 사람의 반응과 유료 참여는 구별할 수 없습니다 |
| 30일 게시 주기 | 30일간 고정되지 않은 동영상 수, 최장 간격, 간격 중앙값, 최신 동영상 이후 경과 일수 | posted_at | 계정이 활동 중인지 보여 줍니다. 품질에 대해서는 알려 주지 않습니다 |
| 댓글 구성 | 각 댓글에 다섯 가지 규칙 라벨 중 하나를 붙입니다: 주제 관련(4단어 이상), 질문, 3단어 이하, 이모지만, 텍스트 없음. 완전히 동일한 중복 댓글도 따로 셉니다 | text, is_reply | 댓글이 동영상 내용에 반응하는지 보여 줍니다. 누가 작성했는지는 알려 주지 않습니다 |
왜 “가짜 팔로워 비율” 대신 도달률을 쓸까요? 공개 데이터로는 특정 팔로워가 실제 사람인지 알 수 없고, 팔로워 목록은 검증 작업에서 건드릴 대상이 아닙니다. 측정할 수 있는 것은 팔로워 수와 현재 조회수 사이의 차이입니다. 도달률은 같은 플랫폼에서 비슷한 규모의 계정끼리 비교할 때만 의미가 있으므로, 이 가이드는 고정된 합격선을 두지 않습니다.
모든 지표는 중앙값을 사용합니다. 소수의 히트 동영상이 평균을 끌어올릴 수 있기 때문입니다. TechBullion은 TikTok 크리에이터 52명의 동영상 675개를 대상으로 한 소규모 연구를 보도했습니다. 이 크리에이터 중 73%는 평균 조회수가 중앙값의 1.5배 이상이었습니다(TechBullion, 2026년 10월). 표본이 작은 2차 보도이므로, 평균이 오해를 부를 수 있다는 점을 보여 주는 용도로만 쓰고 기준으로 삼지는 않습니다.
참여도는 팔로워가 아니라 조회수로 나눕니다. 팔로워로 나누면 도달률이 섞이기 때문입니다. 팔로워가 많고 도달률이 낮은 계정은 팔로워 기준으로는 약해 보이지만 조회수 기준으로는 정상으로 보일 수 있습니다. 두 방식은 서로 다른 질문에 답합니다. 하나는 팔로워가 아직 남아 있는지를 묻고, 다른 하나는 시청자가 관심을 보이는지를 묻습니다. 저희는 두 값을 따로 보고합니다.
YouTube에는 두 가지 주의 사항이 있습니다. 공개 공유 수를 얻을 수 없으므로 YouTube 참여율은 좋아요와 댓글만 사용합니다. 또한 YouTube는 2026년 8월 27일에 공개 조회수 집계 방식을 변경했습니다. 이제 재생 첫 프레임부터 조회로 집계되지만, 수익 창출과 대부분의 분석은 여전히 참여 조회수(engaged views)를 사용합니다(YouTube Data API revision history; YouTube Help). 이 날짜 전후의 조회수를 직접 비교하지 마세요.
도구 정의: 다섯 가지 도구의 JSON
Meta 고객센터에 따르면 Model API는 도구 호출을 지원하므로, 모델이 사용자가 정의한 외부 도구와 데이터 소스를 호출할 수 있습니다(Can the models call tools?).
형식은 OpenAI와 매우 비슷합니다. Meta는 Responses API를 권장하며, 각 도구의 최상위에 type, name, description, parameters와 선택 필드인 strict를 직접 둡니다(Tool calling). strict의 기본값은 false이며, 이 경우 스키마를 그대로 허용합니다. true로 설정하면 서버가 스키마가 엄격한 하위 집합 요건을 충족하는지 검사합니다. 모든 속성을 required에 포함하고 객체에 "additionalProperties": false를 지정해야 하며, 그렇지 않으면 호출 시 HTTP 400이 반환됩니다(Strict tool schemas). 저희 도구 다섯 개는 모두 strict: true를 사용합니다. 파라미터가 적은 데다 출시 전에 스키마 오류를 잡을 수 있기 때문입니다.
진짜 설계 문제는 도구를 어떻게 나누느냐입니다. 가장 간단한 방법은 EveryInfra MCP 서버의 everyinfra_call_api처럼 platform, action, params를 받는 범용 도구 하나를 두는 것입니다. 그러면 모델이 어떤 엔드포인트든 호출할 수 있지만, 매번 파라미터를 직접 구성해야 하고 실수할 때마다 턴 하나를 잃습니다. 검증 작업은 단계가 정해져 있으므로, 엔드포인트마다 하나씩 범위가 좁은 도구 다섯 개를 사용합니다. 각 설명에는 “고정된 동영상이 먼저 나오므로 중앙값을 계산하기 전에 제외하세요” 같은 함정을 명시합니다.
함수 이름에는 점이 아니라 밑줄을 사용합니다. Meta는 함수 이름에 점을 최대 하나까지 허용하며, 점이 두 개면 400을 반환합니다. 여러 부분으로 된 MCP 스타일 이름에는 네임스페이스 도구를 대신 써야 합니다(Function name rules). 도구가 다섯 개라면 Meta의 도구 검색 기능은 필요 없습니다. 이 기능은 도구가 수백 개인 에이전트용입니다. 모델이 필요로 할 때까지 파라미터 스키마를 보내지 않아 입력 토큰을 아끼고 캐시 접두부를 그대로 유지합니다(Tool search).
[
  {
    "type": "function",
    "name": "tiktok_videos",
    "description": "List the newest public videos of one TikTok account with views, likes, comments, shares, saves, posted_at, is_pinned and is_ad. Calls EveryInfra tiktok/user_videos. Pinned videos come first; drop them before you compute medians.",
    "strict": true,
    "parameters": {
      "type": "object",
      "properties": {
        "username": { "type": "string", "description": "TikTok handle without @" },
        "limit": { "type": "integer", "description": "1 to 50. Use 50 for a 30-day window." }
      },
      "required": ["username", "limit"],
      "additionalProperties": false
    }
  },
  {
    "type": "function",
    "name": "video_comments",
    "description": "Read public comments of one video. Returns comment text, like and reply counts and time only, never the commenter's name. Calls EveryInfra tiktok/comments or youtube/comments.",
    "strict": true,
    "parameters": {
      "type": "object",
      "properties": {
        "platform": { "type": "string", "enum": ["tiktok", "youtube"] },
        "video_url": { "type": "string", "description": "Full URL of one video" },
        "limit": { "type": "integer", "description": "1 to 50" }
      },
      "required": ["platform", "video_url", "limit"],
      "additionalProperties": false
    }
  }
]
이 블록에는 다섯 도구 중 두 개가 나와 있습니다. 나머지 세 개는 tiktok/profile용 tiktok_profile, youtube/profile용 youtube_channel, youtube/user_posts용 youtube_videos입니다. 각 도구는 당일 카탈로그의 response_fields와 대조해 확인했습니다. 마지막 열은 전체 응답이 아니라 저희 도구 코드가 모델에 돌려보내는 필드 일부입니다. TikTok 원본 동영상 데이터에는 커버 이미지, 음악, 작성자 소개를 포함해 34개 필드가 있습니다. 검증 작업에는 필요 없고 토큰만 소모하므로 코드에서 제거합니다.
| 도구 | 엔드포인트 | 호출당 정가 | 모델에 다시 전달되는 필드 |
|---|---|---|---|
tiktok_profile | tiktok/profile | $0.000556 | username, display_name, follower_count, following_count, like_count, video_count, is_verified, created_at |
tiktok_videos | tiktok/user_videos | $0.000556 | id, url, posted_at, view_count, like_count, comment_count, share_count, collect_count, is_pinned, is_ad, duration_sec |
youtube_channel | youtube/profile | $0.000556 | name, url, subscriber_count, video_count, view_count, is_verified, created_at |
youtube_videos | youtube/user_posts | $0.000556 | id, url, title, posted_at, view_count, like_count, comment_count, duration, is_paid_partnership |
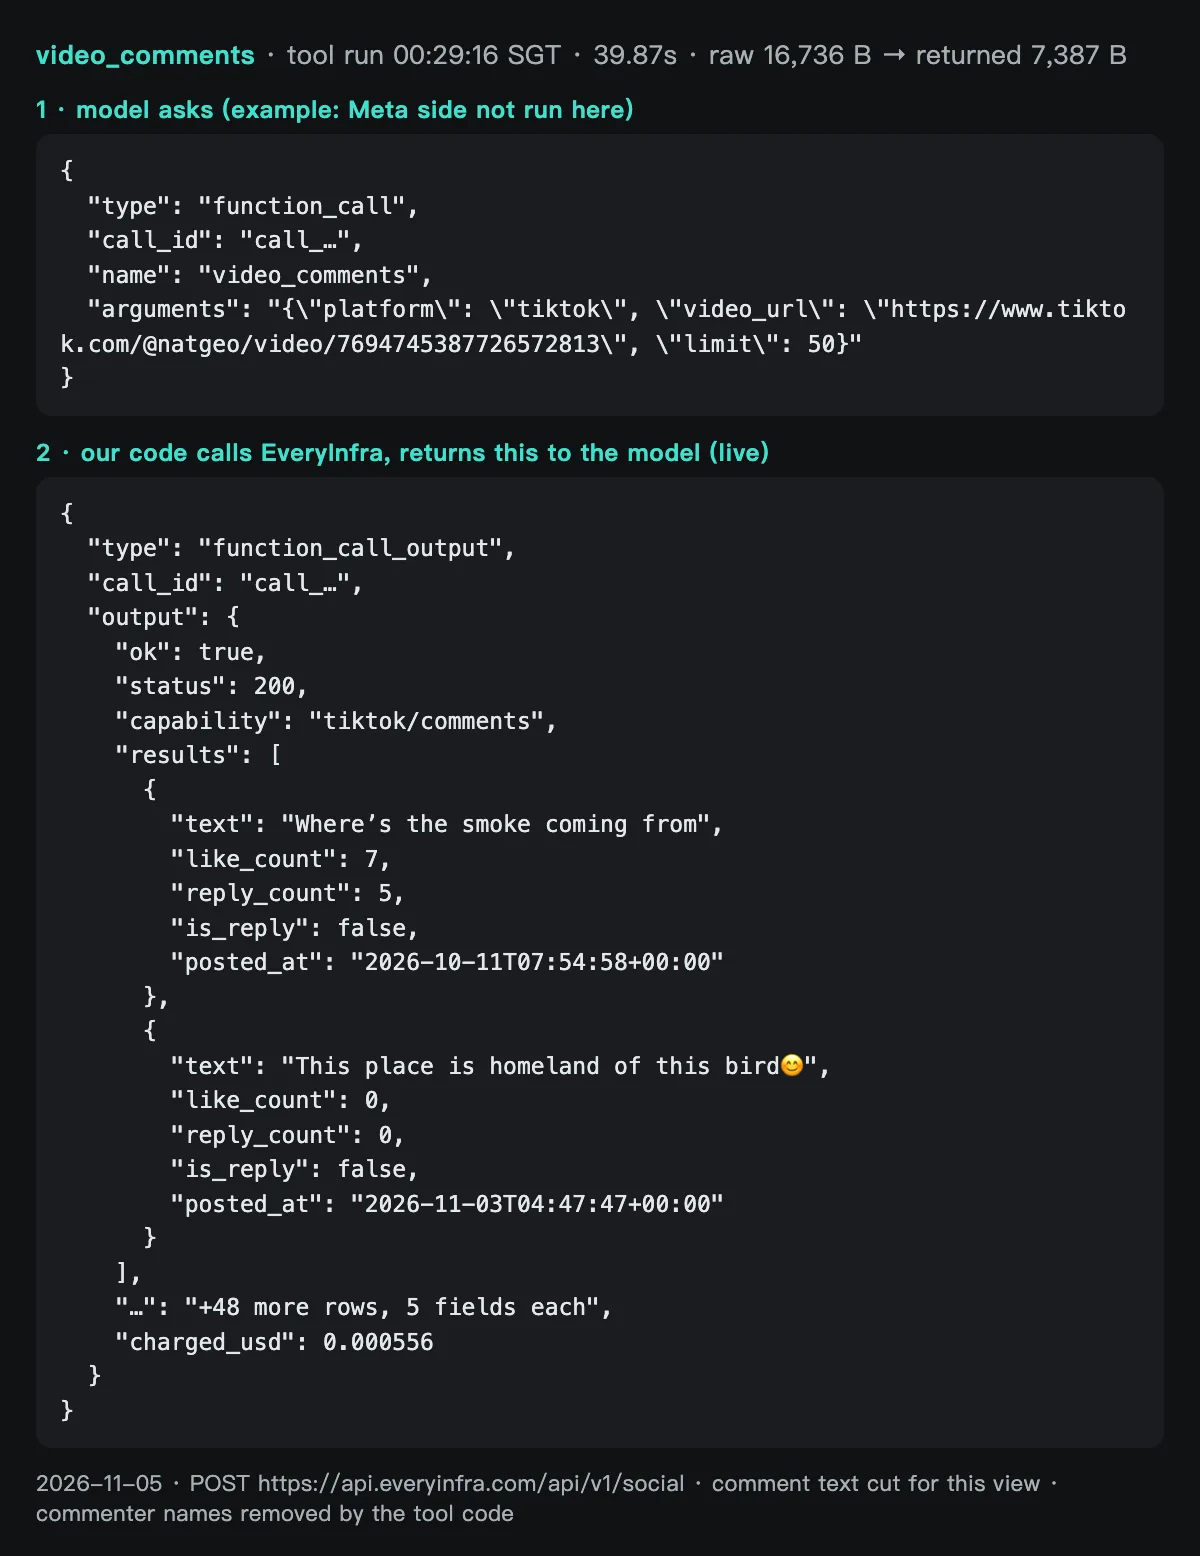
video_comments | tiktok/comments 또는 youtube/comments | $0.000556 | text(200자로 잘라냄), like_count, reply_count, is_reply, posted_at |
에이전트 루프: Meta 패턴에서 세 가지를 바꿨습니다
Meta의 도구 호출 문서는 최소한의 루프를 보여 줍니다. tools를 포함해 요청을 보내고 output에서 function_call 항목을 찾습니다. 각 항목을 실행한 뒤 previous_response_id와 함께 function_call_output을 보내면 서버가 대화 기록을 유지합니다(Tool calling). 저희는 이 패턴을 유지하면서 세 가지를 바꿨습니다. 아래 코드는 예시 구성이며, Meta 쪽은 실행하지 않았습니다.
# Example setup: Muse Wonder (Responses API) + EveryInfra tools. The Meta side was not run here.
import json, os
from openai import OpenAI
from ei_tools import run  # tool layer: calls EveryInfra, trims the response

meta = OpenAI(base_url="https://api.meta.ai/v1", api_key=os.environ["MODEL_API_KEY"])
TOOLS = json.load(open("tools.json"))
SYSTEM = open("system_prompt.txt").read()   # fixed prefix first, so it hits the cache
MAX_TURNS, MAX_TOKENS = 40, 400_000          # Meta has no hard spend cap; set your own

def due_diligence(creators: list[dict]) -> str:
    resp = meta.responses.create(model="muse-wonder-1.0", reasoning={"effort": "medium"},
                                 instructions=SYSTEM, tools=TOOLS, input=json.dumps(creators))
    used = resp.usage.total_tokens
    for _ in range(MAX_TURNS):
        calls = [i for i in resp.output if i.type == "function_call"]
        if not calls:                     # tool_choice is auto only: the model may just answer
            return resp.output_text
        outputs = []
        for c in calls:                   # one turn can hold several parallel calls
            body, code, raw, secs, out = run(c.name, json.loads(c.arguments))
            outputs.append({"type": "function_call_output", "call_id": c.call_id,
                            "output": json.dumps(out, ensure_ascii=False)})
        resp = meta.responses.create(model="muse-wonder-1.0", previous_response_id=resp.id,
                                     tools=TOOLS, input=outputs)
        used += resp.usage.total_tokens
        if used > MAX_TOKENS:
            raise RuntimeError(f"token budget exceeded: {used}")
    raise RuntimeError("too many turns")
첫 번째 변경은 한 턴에 여러 호출을 처리하는 것입니다. Meta 가이드라인에 따르면 모델은 한 턴에 도구 호출을 둘 이상 반환할 수 있으며, 각각에 응답해야 합니다. parallel_tool_calls의 기본값은 true입니다(Guidelines). 크리에이터 10명에 각각 호출 5건이면 한 번에 십여 건의 호출이 생길 수 있습니다. 저희 EveryInfra 테스트 키는 분당 10건의 요청만 허용하므로, 도구 레이어에서 호출을 대기열에 넣어야 합니다.
두 번째 변경은 자체 제한을 추가하는 것입니다. max_tool_calls는 web_search 같은 내장 도구만 제한하므로 직접 정의한 함수는 막지 못합니다. Meta는 parallel_tool_calls: false를 쓰거나 루프에 턴 제한을 두라고 제안합니다. 지출 상한이 없다는 점까지 고려하면 턴 제한과 토큰 예산이 모두 필요합니다.
세 번째 변경은 결과를 돌려보내기 전에 줄이는 것입니다. function_call_output에 들어간 모든 내용은 다음 턴의 입력 토큰으로 계산됩니다. 축소 비율은 비용 추정에서 가장 큰 변수이므로 아래에서 별도 섹션으로 다룹니다.
구조화된 출력으로 리포트 형식을 고정하세요. Meta 문서에 따르면 json_schema를 사용하면 디코딩 자체가 스키마를 따르므로 출력이 항상 스키마와 일치합니다(Structured output). Responses API에서는 text.format에 설정하며, 도구 호출과 함께 동작합니다.
저희 스키마는 크리에이터마다 행 하나를 둡니다. 각 행에는 네 가지 지표 값, 각 값의 표본 크기, 한 줄 판정이 들어갑니다. 또한 에이전트가 가져오지 못했거나 반올림된 채 반환된 수치를 나열하는 missing 배열이 있습니다. 이 배열이 있으면 모델이 필드를 채우려고 숫자를 지어낼 이유가 없습니다.
긴 작업: 크리에이터 50명 목록은 백그라운드 모드로 처리하세요
크리에이터 10명 목록은 몇 분 안에 끝나므로 일반 요청으로 충분합니다. 크리에이터가 50명이거나 크리에이터마다 동영상을 여러 페이지 가져와야 한다면 Meta의 장시간 작업 패턴을 사용하세요. Responses API 문서는 세 가지 제한을 안내합니다(Responses API). 스트리밍이 아닌 요청에는 서버 시간 제한이 있어, 너무 오래 걸리면 504를 반환합니다.
background: true로 설정하면 호출이 즉시 status: "queued"를 반환하며, ID로 폴링하거나 결과를 스트리밍하거나 취소할 수 있습니다. 백그라운드 요청 본문은 최대 1 MiB이며, 이보다 크면 413을 반환합니다. 요금 페이지에는 팀마다 분당 최대 600개의 백그라운드 작업을 만들 수 있다는 내용이 추가로 나와 있습니다(Background responses).
1 MiB 상한은 이 작업에서 실제로 걸리는 제한입니다. 실제 실행에서 한 계정의 TikTok 동영상 50개에 대한 원본 응답은 약 114~116 KB였습니다. 계정 10개의 원본 JSON을 백그라운드 요청 하나에 넣으면 상한을 넘습니다. 도구 레이어에서 먼저 축소하면 이 문제는 사라집니다.
EveryInfra에도 자체 비동기 모드가 있습니다. 어떤 요청 본문에든 "mode": "async"를 추가하면 응답이 즉시 job_id를 반환합니다. 그다음 GET /api/v1/jobs/{job_id}로 결과를 읽습니다. 동기 처리 시간 한도는 85초이며, 현재 값은 카탈로그의 async_mode 열에서 확인할 수 있습니다. 가장 안전한 설계는 양쪽 모두 비동기를 쓰는 것입니다. 모델이 호출을 보내면 코드가 이를 대기열에 넣고 허용된 속도로 결과를 가져옵니다. 결과가 모두 모였을 때만 코드가 결과를 돌려보냅니다.
설정 하나를 더 확인하세요. Meta 도움말 센터에 따르면 팀에서 데이터 미보존(ZDR, zero data retention)을 켜면 여러 기능을 사용할 수 없습니다. 이전 응답을 참조하는 상태 유지 요청, 백그라운드 요청, 파일 업로드, 웹 검색이 여기에 포함됩니다(ZDR 도움말 문서). 저희 루프는 previous_response_id를 사용합니다. ZDR을 켜면 매 턴마다 전체 대화를 보내야 하므로 토큰이 크게 늘어납니다.
또 다른 방법: Muse Wonder에서 Claude Agent SDK와 EveryInfra MCP 서버 사용하기
직접 만든 도구 레이어를 생략할 수도 있습니다. Meta는 두 번째 방법도 문서화했는데, Claude Agent SDK가 에이전트 루프를 실행하면서 Meta의 모델을 사용하는 방식입니다. 에이전트 프레임워크 페이지에 따르면 SDK는 Anthropic Messages 형식으로 Model API에 연결합니다. ANTHROPIC_BASE_URL을 https://api.meta.ai(/v1 없이)로 설정하고 Meta 키를 ANTHROPIC_AUTH_TOKEN에 넣으세요. 메인 루프는 muse-wonder-1.0을 사용하고, 서브에이전트는 더 저렴한 muse-spark-1.3으로 낮출 수 있습니다. 같은 페이지는 신뢰하는 MCP 서버만 선언하라고 경고합니다(Agent frameworks).
이렇게 설정하면 EveryInfra 원격 MCP 서버를 연결할 수 있습니다. MCP 사양에 따르면 서버는 tools/list로 도구 목록을 제공하고 tools/call로 도구를 실행합니다(MCP specification: Tools). 그러면 모델이 everyinfra_call_api 같은 기성 도구를 바로 사용할 수 있으므로, 도구 JSON을 직접 작성할 필요가 없습니다.
# Example setup: Claude Agent SDK with Muse Wonder as the model and the EveryInfra remote MCP server. Not run here.
import os, anyio
from claude_agent_sdk import query, ClaudeAgentOptions, ResultMessage

options = ClaudeAgentOptions(
    model="muse-wonder-1.0",
    system_prompt=open("system_prompt.txt").read(),
    mcp_servers={"everyinfra": {"type": "http", "url": "https://api.everyinfra.com/mcp",
                                "headers": {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}}},
    allowed_tools=["mcp__everyinfra__everyinfra_call_api", "mcp__everyinfra__everyinfra_get_job"],
    setting_sources=[],
    env={**os.environ,
         "ANTHROPIC_BASE_URL": "https://api.meta.ai",
         "ANTHROPIC_AUTH_TOKEN": os.environ["MODEL_API_KEY"],
         "ANTHROPIC_MODEL": "muse-wonder-1.0",
         "ANTHROPIC_DEFAULT_OPUS_MODEL": "muse-wonder-1.0",
         "ANTHROPIC_DEFAULT_SONNET_MODEL": "muse-spark-1.3",
         "ANTHROPIC_DEFAULT_HAIKU_MODEL": "muse-spark-1.3",
         "CLAUDE_CODE_SUBAGENT_MODEL": "muse-spark-1.3"},
)

async def main():
    async for m in query(prompt="Review these creators: natgeo, nasa, notionhq", options=options):
        if isinstance(m, ResultMessage):
            print(m.result, m.usage)

anyio.run(main)
트레이드오프는 단순합니다. 도구 JSON을 직접 작성하면 모델이 읽는 내용, 즉 어떤 필드를 넣을지, 텍스트를 얼마나 길게 둘지, 댓글 작성자 이름을 넣을지를 제어할 수 있습니다. MCP 방식은 코드를 줄여 줍니다. 대신 everyinfra_call_api는 전체 응답을 반환하므로 TikTok 동영상 하나를 가져오면 34개 필드가 모두 컨텍스트에 들어갑니다. 댓글 작성자의 사용자 이름도 함께 들어갑니다. 실제 MCP 호출 한 번으로 이를 측정했으며, 수치는 왕복 섹션에 있습니다.
allowed_tools에는 데이터 조회 도구와 작업 도구만 나열합니다. 에이전트에는 필요한 도구만 주라는 Meta의 권고를 따른 것입니다. EveryInfra MCP 서버에는 지원 티켓과 계정 데이터용 도구도 있지만, 검증 에이전트에는 필요 없습니다.
실제 왕복 1회: 모델이 요청하고, 코드가 데이터를 가져옵니다
위의 도구 JSON과 루프는 예시 구성입니다. 이 섹션에서는 저희가 실제로 실행한 나머지 절반을 다룹니다. 도구 레이어는 별도 파일로 작성했습니다. 이 파일은 Muse Wonder가 보낼 것과 같은 function_call 인수를 받아 각 함수 이름을 EveryInfra 엔드포인트에 매핑합니다. 그다음 요청을 보내고, 필요한 필드만 남기고, 댓글 작성자 이름을 제거한 뒤, 결과를 function_call_output으로 감쌉니다.
모델 쪽은 함수 이름과 JSON 문자열만 보냅니다. 저희 쪽도 같은 입력을 받으므로, 데이터 조회와 그 결과는 Muse Wonder가 루프에 있을 때와 같습니다.
다음은 NASA에 대한 호출 네 건을 시간순으로 정리한 것입니다. 각 행은 실제 요청 하나입니다. 시간은 요청을 보낸 시각으로 SGT 기준이며, 옆에 미국 동부 시간을 함께 적었습니다. 소요 시간은 전송부터 마지막 바이트 수신까지입니다. “원본”은 응답 본문 크기이고, “모델 전달분”은 도구 레이어가 축소한 뒤의 크기입니다.
| 시간(SGT, 11월 5일) | 시간(ET, 11월 4일) | 도구 및 엔드포인트 | 소요 시간 | 원본 | 모델 전달분 | 과금 |
|---|---|---|---|---|---|---|
| 00:18 SGT | 11:18 ET | tiktok_profile, tiktok/profile | 11.35 s | 1,587 B | 287 B | $0.000556 |
| 00:22 SGT | 11:22 ET | tiktok_videos, tiktok/user_videos(동영상 50개) | 35.81 s | 116,106 B | 14,206 B | $0.000556 |
| 00:25 SGT | 11:25 ET | youtube_channel, youtube/profile | 8.96 s | 1,797 B | 299 B | $0.000556 |
| 00:28 SGT | 11:28 ET | video_comments, tiktok/comments(댓글 50개) | 58.22 s | 16,761 B | 7,805 B | $0.000556 |
다음은 첫 번째 호출의 요청과 응답입니다. 긴 필드인 아바타 URL 하나만 제거하고 나머지는 받은 그대로 두었습니다. follower_count는 2,200,000으로 정확한 값처럼 보이지만, 결과 섹션에서 설명하듯 반올림된 값입니다.
POST https://api.everyinfra.com/api/v1/social
{"platform":"tiktok","action":"profile","params":{"username":"nasa"}}

200 OK, 00:18:46 SGT, 11.35 s, billed $0.000556
{"user_id":"7664638705177150477","username":"nasa","display_name":"NASA",
 "bio":"Making the seemingly impossible, possible.✨","url":"https://www.tiktok.com/@nasa",
 "follower_count":2200000,"following_count":23,"like_count":11500000,"video_count":62,
 "friend_count":17,"is_verified":true,"is_private":false,
 "created_at":"2026-07-20T15:55:49+00:00","platform":"tiktok"}
모델에 전달되는 사본은 필드 8개, 287바이트입니다. 프로필은 축소해도 절약 효과가 작습니다. 큰 절약은 동영상 목록에서 나옵니다. TikTok 원본 동영상 50개는 116,106바이트이며, 각각 커버, 음악, 작성자 데이터, 여러 URL을 포함한 34개 필드가 있습니다. 검증 작업에 필요한 필드는 그중 11개이므로, 축소한 사본은 14,206바이트로 원본의 약 8분의 1입니다.
아래 이미지는 댓글 왕복을 나란히 보여 줍니다. 위쪽 블록은 모델이 보낼 호출이며, 인수는 실제 실행에서 가져왔습니다. 아래쪽 블록은 National Geographic TikTok 동영상 하나에 달린 댓글 50개 중 처음 2개를 도구 레이어가 반환한 그대로 보여 줍니다. 이미지에서는 댓글 텍스트를 잘랐으며, 댓글 작성자 이름은 도구 코드가 이미 제거한 상태입니다.
같은 데이터라도 MCP를 거치면 토큰이 약 두 배 듭니다. 00:38 SGT(11:38 ET)에 EveryInfra 원격 MCP 서버의 everyinfra_call_api로 National Geographic YouTube 동영상 하나의 댓글 50개를 가져왔습니다. 호출에는 16.74초가 걸렸고 $0.000556이 과금되었습니다. 모델에 전달되는 텍스트는 18,198바이트이며, 댓글마다 author_name을 포함한 필드 8개가 있습니다. 저희 필드 화이트리스트를 쓰면 같은 댓글 50개가 이름 없이 9,516바이트로 줄어듭니다.
MCP는 코드를 줄여 주지만 호출당 토큰을 두 배로 늘립니다. 또한 모델이 읽기 전에 댓글 작성자 이름을 제거할 수 없습니다. 고객이 읽을 리포트라면 두 번째 문제가 더 중요합니다. 앞서 다룬 이용 정책이 사람에 대한 추론을 규율하기 때문입니다.
실패도 기록했습니다. NASA의 YouTube 댓글은 00:37 SGT와 00:40 SGT에 두 번 503을 반환했습니다. 오류 본문에는 retryable: true와 retry_after: 20이 있었고, billing.charged는 false, 환불 상태는 succeeded였습니다.
같은 엔드포인트가 10분 안에 세 번째로 실패하자 메시지가 바뀌었습니다. 호출자에게 예시 요청을 한 번 보내 보라고 안내하면서, 예시가 정상 동작하면 문제는 대상 쪽에 있다고 알려 줬습니다. 저희 도구 레이어가 원하는 것이 바로 이런 오류 형식입니다. 모델이 얼마나 기다릴지, 재시도할지, 다음에 무엇을 확인할지 읽어 낼 수 있습니다.
Notion의 경우, 처음 고른 동영상은 comment_count가 0인 2026년 10월 27일 게시물이었습니다. 엔드포인트는 빈 배열과 함께 empty_result_refunded 사유로 200을 반환했고, 비용은 들지 않았습니다. 댓글이 5개인 2026년 10월 23일 동영상으로 바꾸자 2개가 반환되었습니다. 이번 실행에서 데이터 없이 끝난 요청은 6건으로, 429가 2건, 503이 3건, 빈 결과가 1건이었습니다. 어느 요청도 과금되지 않았습니다.
실제 결과: 세 계정에 대한 네 가지 지표와 여섯 가지 데이터 함정
이 섹션에서는 각 지표를 자세히 살펴봅니다. 모든 차트는 같은 원본 응답에서 만들었으며 위의 규칙 표를 따릅니다. 수치 다음에는 실제로 마주친 함정을 정리합니다. 이 함정들은 시스템 프롬프트에 넣어야 합니다.
TikTok과 YouTube 사이에서 도달률을 비교하지 마세요. TikTok 피드는 팔로우하지 않은 사람에게도 동영상을 노출하므로 조회수가 팔로워의 10분의 1을 넘을 수 있습니다. 대형 YouTube 채널에는 몇 년 전에 구독했지만 지금은 거의 시청하지 않는 구독자가 많아 도달률이 낮습니다. 비교는 같은 플랫폼 안에서만 하세요. TikTok에서 NASA는 13.25%, Notion은 9.05%, National Geographic은 0.23%로 50배 넘게 차이가 납니다. 도달률만 보면 에이전트는 “팔로워와 조회수가 맞지 않는다”고 쓸 것입니다.
참여율 차트는 그 판정의 절반을 뒤집습니다. National Geographic의 조회당 참여율 중앙값은 8.15%로, NASA의 8.97%와 1%포인트 이내입니다. Notion은 1.48%입니다. National Geographic 동영상을 본 사람도 NASA 동영상을 본 사람과 비슷한 빈도로 좋아요를 누르고 공유합니다.
도달률은 낮은데 참여율이 정상이라면, 게시물을 많이 올려서 동영상마다 오디언스 일부에게만 도달하는 계정이라는 뜻입니다. 팔로워를 구매했다는 신호는 아닙니다. 구매한 팔로워는 시청하지도, 좋아요를 누르지도 않으므로 두 수치가 함께 떨어집니다.
게시 주기가 이 패턴을 설명합니다. National Geographic은 30일 동안 고정되지 않은 TikTok 동영상 50개를 게시했고, 최신 동영상은 2026년 11월 3일 게시물입니다. 간격 중앙값은 0.62일, 최장 간격은 3.1일입니다. NASA는 9개를 게시했습니다. 최신 동영상은 2026년 10월 30일 게시물이며, 간격 중앙값은 2.62일, 최장 간격은 6.0일입니다.
같은 팔로워에게 하루 한두 개씩 새 동영상이 올라가면, 동영상 하나가 닿는 팔로워 비율은 줄어듭니다. 에이전트가 게시 주기와 도달률을 함께 읽으면 “게시 빈도 높음, 동영상당 도달률 낮음, 참여율 정상”이라는 정확한 판정을 쓸 수 있습니다.
Notion 행은 비어 있습니다. 최신 TikTok 동영상은 2026년 5월 26일 게시물로, 데이터를 가져온 시점에 게시된 지 161.7일이 지난 상태였습니다. 9.05%라는 도달률은 최신 동영상 15개에서 계산했지만, 모두 오래된 동영상입니다. 다음 달 계약을 결정하는 데에는 아무 의미가 없는 수치입니다.
댓글 라벨링에는 모델을 쓰지 않았습니다. 고정된 규칙 다섯 가지를 사용했습니다: 텍스트 없음, 이모지나 문장 부호만, 물음표 포함, 3단어 이하, 그리고 나머지는 모두 주제 관련. 규칙은 거칠지만 누구나 다시 계산할 수 있고, 댓글을 자의적으로 해석하는 일이 없습니다.
NASA의 TikTok 댓글에는 질문이 16개 있으며 대부분 동영상 내용에 관한 것으로, 과학 크리에이터에게는 좋은 신호입니다. National Geographic의 TikTok 댓글에는 짧은 댓글이 15개, 영어 외 문자나 악센트가 들어간 댓글이 16개 있어 전 세계 시청자층을 짐작하게 합니다. YouTube에서는 이 브랜드의 댓글 50개 중 44개가 주제 관련이며, 길이 중앙값은 77자입니다. 댓글 품질도 같은 플랫폼 안에서만 비교하세요.
주의할 댓글 유형이 하나 더 있습니다. 2026년 9월 30일 YouTube Data API가 댓글에 snippet.imageUrl을 추가해, 댓글에 이미지나 GIF를 넣을 수 있게 되었습니다. 2026년 11월에 모든 사용자에게 공개됩니다(YouTube Data API revision history). 텍스트만 읽으면 이미지만 있는 댓글을 놓치므로, 저희 규칙은 텍스트 없는 댓글을 따로 셉니다.
| # | 함정 | 확인한 내용 | 에이전트가 할 일 |
|---|---|---|---|
| 1 | TikTok 수치는 반올림됨 | 조회수가 10,000 이상인 모든 동영상의 조회수가 100의 배수입니다. 팔로워 수는 2,200,000, 9,700,000, 143,700입니다 | 리포트에 “약”이라고 쓰세요. 표본이 작을 때는 소수점 둘째 자리까지 쓰지 마세요 |
| 2 | 동영상 50개로 30일을 다 채우지 못할 수 있음 | National Geographic의 첫 페이지(50개)는 28.8일만 포함했습니다. until로 두 번째 페이지를 가져와 기간을 채웠습니다 | 가장 오래된 날짜를 확인하세요. 30일 미만이면 페이지를 하나 더 가져오세요 |
| 3 | 고정 동영상이 먼저 반환됨 | NASA와 National Geographic에는 각각 고정된 동영상이 하나씩 있으며, 나머지보다 훨씬 오래되었습니다 | 중앙값과 간격을 계산하기 전에 is_pinned 항목을 제외하세요 |
| 4 | YouTube 목록은 상대 날짜를 사용함 | youtube/user_posts는 “2w ago”나 “1mo ago” 같은 날짜와 천 단위로 반올림된 조회수를 반환하며, 좋아요와 댓글 수는 없습니다 | 30일 경계 부근의 동영상은 youtube/video를 호출해 정확한 시각과 조회수를 가져오세요 |
| 5 | YouTube 좋아요 수도 반올림됨 | 2026년 10월 14일 NASA 동영상은 조회수 684,881회, 좋아요 11,000개입니다. NASA 동영상 4개 모두 comment_count가 0으로 표시됩니다 | 좋아요 수는 반올림된 값으로 표시하세요. 댓글 수가 0이면 댓글 판정은 건너뛰세요 |
| 6 | 새 계정이라는 사실만으로 가짜 성장이라 볼 수 없음 | NASA TikTok 계정의 created_at은 2026년 7월 20일이고 팔로워는 2.2백만 명이지만, 도달률은 13.25%로 여섯 개 중 가장 높습니다 | 성장세는 도달률, 참여율과 함께 읽으세요. 숫자 하나로 판단하지 마세요 |
호출이 가장 많이 드는 함정은 2번과 4번입니다. 활동이 많은 TikTok 계정은 30일을 채우려면 동영상 호출이 두 번 필요합니다. YouTube 채널은 목록을 가져온 뒤 좋아요와 정확한 날짜를 얻으려면 단일 동영상 호출이 몇 번 더 필요합니다. 저희는 쓸 만한 중앙값과 추가 비용 사이의 균형을 고려해 채널마다 동영상 4개를 가져왔습니다. 이 4건의 호출 비용은 $0.0022로, 크리에이터 한 명 데이터 요금의 40%입니다. 목록이 대부분 TikTok 크리에이터라면 이 호출을 생략하고 YouTube는 구독자 수와 게시 주기만으로 판단해도 됩니다.
5번 함정에는 세부 사항이 하나 더 있습니다. YouTube는 2026년 8월 27일에 조회수 집계 방식을 변경했습니다. 저희가 확인한 단일 동영상 12개는 모두 그 이후에 게시되었으므로, YouTube 참여율 수치는 이 날짜를 걸치지 않습니다. 크리에이터의 최근 동영상이 이 날짜 전후에 걸쳐 있다면 리포트에 그 사실을 밝혀야 합니다.
Muse Wonder API 비용: 크리에이터 10명 목록의 청구 금액은?
이 섹션은 크리에이터 10명 목록의 비용이 얼마인지라는 한 가지 질문에 답합니다. 청구 금액은 두 부분으로 나뉩니다. EveryInfra 데이터 요금은 정가 × 호출 수이므로 정확한 값입니다. Meta 모델 요금은 정가 × 토큰 수입니다. Meta 키가 없어 모델을 실행하지 않았으므로 이 부분은 추정치입니다. 직접 값을 바꿔 넣을 수 있도록 모든 입력값을 나열합니다.
| 크리에이터당 호출 | 개수 | 정가 | 소계 |
|---|---|---|---|
TikTok 프로필, tiktok/profile | 1 | $0.000556 | $0.000556 |
TikTok 동영상, tiktok/user_videos(활동이 많은 계정은 두 번째 페이지 포함) | 1~2 | $0.000556 | $0.000556~$0.001112 |
TikTok 댓글, tiktok/comments | 1 | $0.000556 | $0.000556 |
YouTube 채널, youtube/profile | 1 | $0.000556 | $0.000556 |
YouTube 동영상 목록, youtube/user_posts | 1 | $0.000556 | $0.000556 |
YouTube 단일 동영상, youtube/video | 4 | $0.000556 | $0.002224 |
YouTube 댓글, youtube/comments | 1 | $0.000556 | $0.000556 |
| 합계 | 10~11 | $0.00556~$0.00612 |
크리에이터 10명이면 호출 100~110건, 데이터 요금 $0.0556~$0.0612입니다. 실패, 타임아웃, 빈 결과는 과금되지 않으므로 이 금액은 상한입니다. 저희 실행에서는 요청 36건 중 30건이 과금되었습니다. 가격은 당일 카탈로그 기준이며(요금 페이지), 카탈로그는 키 없이 무료로 조회할 수 있습니다.
모델 비용 추정에는 네 가지 가정을 사용합니다. 첫째, 크리에이터마다 3턴짜리 대화를 따로 진행합니다. 1턴에서 데이터 호출 4건, 2턴에서 댓글 호출을 보내고, 3턴에서 리포트를 작성합니다. 둘째, 고정 접두사(시스템 프롬프트와 도구 정의 다섯 개)는 1,500토큰입니다.
셋째, 도구 결과는 바이트 수 ÷ 4로 토큰 수를 환산합니다. Meta 도움말 센터에 따르면 토큰 하나는 영어 텍스트 약 3~4자이며, 다른 언어와 코드는 토큰을 더 많이 사용합니다(How am I billed). 따라서 4는 낮게 잡은 추정치입니다. 이후 턴마다 이전 결과를 다시 읽습니다. 넷째, 출력과 추론을 합쳐 크리에이터당 4,000토큰입니다.
실제 데이터에서 크리에이터당 축소된 결과는 평균 30,541바이트, 원본 결과는 평균 154,694바이트입니다.
이 입력값으로 계산하면 크리에이터 한 명의 3턴 입력 토큰은 축소 시 약 18,243개, 원본 시 74,112개입니다. Muse Wonder 요금 기준으로, 캐시 없이 축소해 실행하면 크리에이터당 $0.153이며 그중 $0.08이 출력 비용입니다. 다시 읽는 토큰이 캐시에 적중하는 축소 실행은 크리에이터당 $0.118입니다. 캐시 없는 원본 실행은 $0.376입니다. 여기에 10을 곱하면 차트의 세 합계가 됩니다.
| 크리에이터 10명 목록 | 데이터 요금 | 모델 요금(추정) | 합계 | 모델 요금 / 데이터 요금 |
|---|---|---|---|---|
| 축소, 캐시 사용 | $0.0612 | $1.18 | $1.25 | 19x |
| 축소, 캐시 미사용 | $0.0612 | $1.53 | $1.59 | 25x |
| 원본, 캐시 미사용 | $0.0612 | $3.76 | $3.82 | 61x |
이 표에서 알 수 있는 점은 두 가지입니다. 첫째, 절약은 데이터 쪽이 아니라 모델 쪽에서 일어납니다. 데이터 요금은 세 행 모두 같지만, 모델 요금은 결과 크기 때문에 세 배 넘게 차이 납니다.
둘째, 축소한 뒤에는 출력이 가장 큰 비용이 됩니다. 가장 저렴한 행의 크리에이터당 $0.118 중 $0.08이 출력 토큰 4,000개의 비용입니다. Muse Wonder의 출력 단가는 입력의 다섯 배이며, 추론 토큰은 출력으로 과금됩니다. 따라서 이 리포트에는 high 추론이 필요 없습니다. Meta에서는 effort를 minimal부터 max까지 설정할 수 있으며, 숫자를 읽고 비교해 네 줄을 쓰는 데는 medium이나 low로 충분합니다.
실제 실행 전에 Meta의 POST /v1/responses/input_tokens로 토큰 수를 셀 수 있습니다. 문서에 따르면 이 엔드포인트는 토큰화만 하며, 생성하지 않고 사용량도 기록하지 않습니다. Meta는 이를 비용 추정이 아니라 컨텍스트에 들어가는지 확인하는 용도로 쓰라고 안내합니다(Token counting). 실행 중에는 각 턴의 usage를 읽어 저희 추정치를 실제 토큰 수로 바꾸세요.
시간도 고려해야 합니다. Muse Wonder는 분당 3,000건의 요청을 허용하므로 모델 쪽이 속도를 늦추지는 않습니다. 속도를 늦추는 것은 데이터 쪽입니다. 저희 테스트 키는 분당 10건만 허용했고, 다른 작업과 공유되었습니다. 요청 36건은 00:18:46부터 00:42:08 SGT(11:18~11:42 ET)까지 23분 22초 동안 실행되었습니다. 두 요청은 429 응답을 받고 각각 60초를 기다렸습니다.
호출 110건인 크리에이터 10명 목록은 분당 10건 기준으로 최소 11분이 걸립니다. 과금된 호출 30건의 소요 시간 중앙값은 22.2초, 가장 느린 호출은 78.2초였습니다. 데이터 없이 끝난 호출 6건까지 포함하면 가장 느린 호출은 89.6초였습니다. 도구 레이어는 호출을 대기열에 넣고, 분당 제한을 넘지 않는 범위에서 몇 건씩 동시에 실행해야 합니다.
이번 테스트의 한계
| 한계 | 영향 | 보완 방법 |
|---|---|---|
| Meta 쪽은 실행하지 않음 | 도구 JSON, 루프, 스키마는 Meta 문서를 따랐습니다. 모델이 호출을 어떻게 나누는지, 추론 토큰을 얼마나 쓰는지는 측정하지 않았습니다 | 먼저 크리에이터 2명으로 실행하고 usage를 확인하세요 |
| 브랜드 계정 3개뿐 | 모두 인증된 대형 브랜드로, 소규모 크리에이터를 대표하지 않습니다 | 잘 아는 크리에이터 2~3명을 대조군으로 추가하세요 |
| 모델 요금은 추정치 | 바이트 수 ÷ 4, 3턴, 출력 토큰 4,000개는 모두 가정입니다 | 실제 usage로 다시 계산하세요 |
| 플랫폼별로 동영상 하나의 댓글만 사용 | 댓글 구성은 동영상 하나에 대한 결과입니다 | 주요 크리에이터는 동영상 2~3개를 더 샘플링하세요 |
| 규칙 기반 댓글 라벨 | 반어적 표현이나 여러 언어가 섞인 댓글이 “주제 관련”으로 분류될 수 있습니다 | 규칙은 1차 분류로 쓰고, 표시된 항목은 직접 검토하세요 |
| YouTube 댓글 누락 | NASA는 두 번 실패했고 Notion은 댓글 2개만 반환했습니다 | 누락은 missing에 기록하고, 빈 데이터로는 절대 판정하지 마세요 |
판정을 바꿀 가능성이 가장 큰 한계는 두 번째입니다. 세 브랜드 모두 팔로워가 100,000명이 넘으므로 백 단위나 천 단위 반올림의 영향이 작습니다. 팔로워가 8,000명인 크리에이터라면 반올림, 작은 표본, 바이럴 동영상 하나가 모두 더 크게 작용합니다. 작은 표본에 대한 규칙 하나를 시스템 프롬프트에 추가하세요. 규칙은 다음과 같습니다: 기간 내 동영상이 5개 미만이거나 팔로워가 10,000명 미만이면 네 가지 수치만 보고하고 판정은 내리지 않습니다.
FAQ
Muse Wonder API의 비용은 얼마이고, 어떻게 과금되나요?
월 요금이나 최소 결제 금액 없이 토큰 단위로 과금됩니다: 100만 토큰당 입력 $4.00, 캐시된 입력 $0.20, 출력 $20.00입니다. 추론 토큰은 출력으로 계산됩니다(Pricing and rate limits; Quickstart). 또한 Meta는 자체적으로 삽입하는 시스템 및 조정(steering) 콘텐츠는 과금하지 않으며 usage에도 나타나지 않는다고 밝혔습니다. 검증 실행에는 Meta의 모델 요금과 EveryInfra의 호출당 데이터 요금, 두 가지 청구가 발생합니다. 위의 비용 섹션에서 크리에이터 10명 기준으로 둘 다 추정했습니다.
Muse Wonder API 키는 어디서 받고, 동료도 사용할 수 있나요?
Model API 사이트에서 회원가입한 뒤 API 키 페이지를 여세요. 그다음 Create API key 버튼을 클릭합니다. 키는 팀에 속하므로 팀원이라면 누구나 사용할 수 있습니다(Create an API key). 팀 외부 사람은 사용할 수 없습니다. 도움말 센터에 따르면 팀 외부와 키를 공유하는 것은 약관 위반입니다(Can I share my API key).
회원가입 전에 지역을 확인하세요. 도움말 센터에 따르면 Model API는 Meta AI와 결제를 이용할 수 있는 대부분의 지역에서 제공됩니다. 최종 기준은 지역 정책입니다(Supported countries). 중국, 홍콩, 마카오는 이용이 제한됩니다(Geographic Use Policy).
API로 Muse Wonder Full을 호출할 수 있나요?
아니요. Meta 모델 페이지에 따르면 Wonder Full은 Muse Code 구독의 Power Usage 및 Maximum Usage 요금제에서만 제공됩니다. API에서 추론 effort를 max로 설정해도 Full로 바뀌지 않습니다(Models). 출시 당일 한 Hacker News 댓글 작성자도 같은 점을 지적했습니다. 그 의견에 따르면 벤치마크 선두인 Full 모델은 구독자용이고, API에서는 Muse Wonder만 쓸 수 있습니다(Hacker News 댓글). Muse Code 구독은 자체 명령줄 도구에서만 동작하며, API 호출에는 쓸 수 없습니다(Muse Code subscriptions).
Muse Wonder API가 가끔 실패한다는 개발자들이 있습니다. 검증 에이전트는 어떻게 대응해야 하나요?
출시 직후 한 Hacker News 댓글 작성자는 최고 수준에 가깝지만 너무 비싸고, API가 가끔 실패한다고 말했습니다(Hacker News 댓글). 한 사람의 보고이며, 저희는 재현하지 않았습니다. Meta의 오류 문서는 재시도 가능한 오류를 나열합니다. 모델 출력 파싱에 실패하면 500을 반환합니다. 백엔드가 과부하 상태면 Retry-After: 60과 함께 service_overloaded를 반환하며, 429를 받으면 Retry-After에 따라 백오프해야 합니다(Error handling).
재시도를 두 계층에 구현하세요. Meta 계층에서는 문서대로 백오프합니다. EveryInfra 계층에서는 실패와 빈 결과가 과금되지 않으며, 429가 발생하면 저희 도구 코드가 60초를 기다립니다.
시작하기: 처음부터 첫 검증 리포트까지
각 플랫폼에는 모든 엔드포인트와 현재 가격을 정리한 개요 페이지가 있습니다: TikTok API와 YouTube API. EveryInfra 쪽은 세 단계면 됩니다. 먼저 빠른 시작에서 회원가입하고 키를 만드세요. 다음으로 tiktok/user_videos, tiktok/comments, youtube/comments를 당일 사용할 수 있는지 카탈로그에서 확인하세요. 그런 다음 잘 아는 계정 하나로 도구 코드를 실행해 팔로워 수와 조회수를 앱과 대조해 보세요.
카탈로그는 키 없이 무료로 조회할 수 있습니다: GET /api/v1/social/catalog. 브라우저에서 호출을 시험하려면 데이터 마켓의 테스트 콘솔을 사용하세요. AI 도구를 직접 연결하려면 원격 MCP 설정 가이드를 참고하세요. 실패하거나 빈 결과가 나온 호출의 환불과 정산은 실패 환불 정산을 참고하세요. 422 오류 후 에이전트가 파라미터를 스스로 고치게 하려면 스스로 복구하는 API 오류를 참고하세요.
Meta 쪽은 키 섹션에서 설명한 대로 회원가입, 결제 수단 추가, 키 생성, 환경 변수 설정의 네 단계가 필요합니다. 프로젝트에 tools.json과 시스템 프롬프트를 넣으세요. 코드 없이 도구를 시험하려면 Playground를 열고 Advanced, Tools로 차례로 이동한 뒤 Add tool을 선택하세요. tools.json의 각 정의를 붙여 넣습니다. Playground에서는 모델이 도구 호출 시점을 직접 결정합니다(Using tools in the Playground). 먼저 크리에이터 2명으로 실행한 뒤 10명으로 늘리세요. 실행 후에는 각 턴의 usage를 읽어 저희 추정치를 실제 토큰 수로 바꾸세요.
참고 자료
- “Introducing Muse Wonder and Muse Wonder Full: Frontier Models for Agents”, Meta Newsroom, 2026년 10월 12일, <https://about.fb.com/news/2026/10/introducing-muse-wonder-models/>
- “Muse Wonder: A Frontier Model For Personal & Professional AI Agents”, Meta 리서치 블로그, 2026년 10월 12일, <https://research.meta.ai/blog/muse-wonder>
- Muse Wonder 제품 페이지, Meta, 2026년 11월 5일 확인, <https://dev.meta.ai/models/muse-wonder>
- “Get started with Meta Model API and Muse Code”, Meta 개발자 문서, 2026년 11월 5일 확인, <https://dev.meta.ai/docs/overview>
- “Models”, Meta 개발자 문서, 2026년 11월 5일 확인, <https://dev.meta.ai/docs/models>
- “Pricing and rate limits”, Meta 개발자 문서, 2026년 11월 5일 확인, <https://dev.meta.ai/docs/pricing-rate-limits>
- “Quickstart”, Meta 개발자 문서, 2026년 11월 5일 확인, <https://dev.meta.ai/docs/quickstart>
- “Tool calling”, Meta 개발자 문서, 2026년 11월 5일 확인, <https://dev.meta.ai/docs/tool-calling>
- “Responses API”, Meta 개발자 문서, 2026년 11월 5일 확인, <https://dev.meta.ai/docs/protocols/responses>
- “Structured output”, Meta 개발자 문서, 2026년 11월 5일 확인, <https://dev.meta.ai/docs/structured-output>
- “Prompt caching”, Meta 개발자 문서, 2026년 11월 5일 확인, <https://dev.meta.ai/docs/prompt-caching>
- “Tool search”, Meta 개발자 문서, 2026년 11월 5일 확인, <https://dev.meta.ai/docs/tool-search>
- “Agent frameworks”, Meta 개발자 문서, 2026년 11월 5일 확인, <https://dev.meta.ai/docs/agent-frameworks>
- “Error handling”, Meta 개발자 문서, 2026년 11월 5일 확인, <https://dev.meta.ai/docs/error-handling>
- “Muse Code subscriptions”, Meta 개발자 문서, 2026년 11월 5일 확인, <https://dev.meta.ai/docs/muse-code/subscriptions>
- “Search grounding”, Meta 개발자 문서, 2026년 11월 5일 확인, <https://dev.meta.ai/docs/search-grounding>
- “How do I sign up for Model API?”, Meta AI Developer 도움말 센터, 2026년 11월 5일 확인, <https://dev.meta.ai/help/accounts-and-login/sign-up>
- “How do I create an API key?”, Meta AI Developer 도움말 센터, 2026년 11월 5일 확인, <https://dev.meta.ai/help/api-keys/create-api-key>
- “Can I share my API key?”, Meta AI Developer 도움말 센터, 2026년 11월 5일 확인, <https://dev.meta.ai/help/api-keys/sharing-api-keys>
- “How can I set up billing for Meta Model API?”, Meta AI Developer 도움말 센터, 2026년 11월 5일 확인, <https://dev.meta.ai/help/billing/set-up-billing>
- “How am I billed for Model API?”, Meta AI Developer 도움말 센터, 2026년 11월 5일 확인, <https://dev.meta.ai/help/billing/api-bill>
- “How do I set a spend limit alert?”, Meta AI Developer 도움말 센터, 2026년 11월 5일 확인, <https://dev.meta.ai/help/billing/spend-limit-alert>
- “How do I request a refund for Meta Model API?”, Meta AI Developer 도움말 센터, 2026년 11월 5일 확인, <https://dev.meta.ai/help/billing/refunds>
- “Does Model API support Zero Data Retention (ZDR)?”, Meta AI Developer 도움말 센터, 2026년 11월 5일 확인, <https://dev.meta.ai/help/policies-and-privacy/zero-data-retention>
- “Meta Model API Terms of Service”, Meta, 2026년 10월 9일 업데이트, <https://dev.meta.ai/legal/terms-of-service>
- “Meta Model API Acceptable Use Policy”, Meta, 2026년 10월 12일 업데이트, <https://dev.meta.ai/legal/acceptable-use-policy>
- “Meta Model API Model Designation and Geographic Use Policy”, Meta, 2026년 10월 12일 업데이트, <https://dev.meta.ai/legal/geographic-use-policy>
- “Muse Wonder is available today on Meta Model API and in Muse Code”, Meta for Developers(Facebook 게시물), 2026년 10월 12일, <https://www.facebook.com/MetaforDevelopers/posts/muse-wonder-is-available-today-on-meta-model-api-and-in-muse-code-and-muse-wonde/1552628546897475/>
- “YouTube Data API Revision History”, Google for Developers, 2026년 11월 3일 업데이트, <https://developers.google.com/youtube/v3/revision_history>
- “Understand your YouTube content performance”, YouTube 고객센터, 2026년 11월 5일 확인, <https://support.google.com/youtube/answer/12220281>
- “Tools”, Model Context Protocol 사양(2025-06-18), <https://modelcontextprotocol.io/specification/2025-06-18/server/tools>
- “The Average Views Lie: What We Learned From 675 TikTok Creator Videos”, TechBullion, 2026년 10월, <https://techbullion.com/average-views-lie-learned-675-tiktok-creator-videos/>
- Muse Wonder 관련 Hacker News 스레드의 댓글(사용자명 비공개), Hacker News, 2026년 10월, <https://news.ycombinator.com/item?id=50065098>
- Muse Wonder 관련 Hacker News 스레드의 댓글(사용자명 비공개), Hacker News, 2026년 10월, <https://news.ycombinator.com/item?id=50061435>
- EveryInfra 데이터 카탈로그(무료 열람), EveryInfra, 2026년 11월 5일 확인, <https://api.everyinfra.com/api/v1/social/catalog>
- “Token counting”, Meta 개발자 문서, 2026년 11월 5일 확인, <https://dev.meta.ai/docs/token-counting>
- “Meta Model API Data Commitments”, Meta, 2026년 11월 5일 확인, <https://dev.meta.ai/legal/commitments>
- “What countries and territories is Model API available in?”, Meta AI Developer 도움말 센터, 2026년 11월 5일 확인, <https://dev.meta.ai/help/accounts-and-login/supported-countries>
- “Can the models call tools?”, Meta AI Developer 도움말 센터, 2026년 11월 5일 확인, <https://dev.meta.ai/help/about-model-api/tool-calling>
- “How do I use tools in the Playground?”, Meta AI Developer 도움말 센터, 2026년 11월 5일 확인, <https://dev.meta.ai/help/playground/using-tools-in-the-playground>
참고 BL-89