Kimi K3.1 Pro Research: confronta il sentiment su Weibo con i risultati trimestrali
Come confrontare i post di Weibo e Reddit con i documenti finanziari trimestrali di Tesla e BYD usando Kimi K3.1 Pro: tempistica dei commenti, verifiche voce per voce, configurazione MCP e costi.
Tesla ha pubblicato i risultati del terzo trimestre il 21 ottobre 2026. Undici giorni dopo, alle 00:18 SGT del 2 novembre, abbiamo cercato su Weibo i post sui risultati di Tesla. Abbiamo ottenuto 17 post. Solo 3 parlavano dei risultati di Tesla.
Solo 1 era precedente al 22 ottobre. La stessa ricerca su Reddit ha collocato 7 post su 8 tra il 21 e il 22 ottobre. Questa differenza è la prima lezione. Una ricerca sui social mostra il momento in cui la esegui, non la finestra dei risultati trimestrali.
La seconda lezione viene da BYD, la casa automobilistica cinese che ha pubblicato i risultati il 29 ottobre. Sotto un popolare post di Weibo sul report di BYD abbiamo raccolto 31 commenti. La somma dei loro like è zero, e undici sono arrivati negli stessi 18 secondi. Un secondo post lungo sullo stesso report aveva 36 commenti, distribuiti su più di due giorni, con non più di 1 ogni 20 secondi.
La terza lezione è che la discussione e il documento finanziario guardano numeri diversi. Tre voci sono cambiate più delle altre nel documento di BYD dall'inizio dell'anno. Le rimanenze sono salite del 60,08%, i crediti del 52,61% e la liquidità è scesa del 58,92%.
Il documento spiega ogni variazione, per esempio più scorte per le vendite di auto all'estero. Nessun commento del set cita queste voci. Questo non dice chi abbia ragione. Dice che un riepilogo di ricerca non può basarsi solo sui commenti.
Questo articolo mostra come costruire quel confronto con Kimi K3.1 Pro di Moonshot AI. Il modello legge i post social e le tabelle finanziarie in un unico contesto lungo e scrive un riepilogo di una pagina con una fonte per ogni riga. EveryInfra fornisce i dati grezzi tramite weibo/search, weibo/comments, yahoo_finance/financials e altre funzionalità. Il tuo codice fa i conteggi prima che il modello inizi a scrivere.
Questo articolo riguarda i metodi di analisi dei dati e la configurazione degli strumenti. Non è una consulenza in materia di investimenti. Non dice che un titolo vada comprato o venduto. I numeri finanziari compaiono solo per mostrare come verificare un'affermazione social rispetto a una fonte primaria. L'esito di ogni verifica indica solo se un numero compare nella discussione, non se sia positivo o negativo.
Questo articolo è stato scritto dal team di EveryInfra. Tutti i conteggi sono stati fatti da script, e nessun analista finanziario abilitato lo ha revisionato. Per qualsiasi valutazione su una società, affidati ai suoi documenti ufficiali e a professionisti abilitati.
Non avevamo una chiave Kimi, quindi non abbiamo usato Kimi. Tutto il codice Kimi qui è un esempio di configurazione basato sui documenti di Moonshot consultati il 2 novembre 2026. Tutti i numeri di EveryInfra provengono da richieste reali e dalle relative risposte grezze.
Il task: un confronto di una pagina tra social e risultati trimestrali
Partiamo da un task chiaro, perché tutti i numeri di configurazione e di costo che seguono dipendono da questo. L'input è una società quotata e la data del suo ultimo report trimestrale. La fase di raccolta dei dati recupera quattro cose. Ci sono i post di Weibo sul report e i commenti sotto i post più attivi. Ci sono anche le tabelle trimestrali recenti e i prezzi giornalieri intorno alla data del report. L'output è un riepilogo di una pagina con una struttura fissa.
Il riepilogo risponde a cinque domande. Cosa sostengono i post social? Cosa dice il documento finanziario su ciascuna affermazione? Quali affermazioni non corrispondono?
Quali post o commenti non sembrano una discussione spontanea? Quali sono i limiti di questo riepilogo? Ogni risposta deve rimandare a un campo grezzo o a una pagina del documento finanziario. Così il lettore può verificare ogni riga senza doversi fidare del modello.
Questo task si adatta a un modello a contesto lungo con chiamate ai tool per tre motivi. Primo, il materiale grezzo ha quattro forme diverse. Post, commenti, tabelle finanziarie e righe di prezzo non si allineano facilmente a mano. Un modello può leggerli tutti insieme e scrivere in un unico formato. Secondo, la regola del confronto è semplice da formulare.
Per ogni affermazione finanziaria in un commento, trova il campo corrispondente nella tabella oppure segnalalo come non trovato. È un lavoro riga per riga, in cui i modelli a contesto lungo sono efficaci. Terzo, il giudizio finale resta a una persona. Il modello produce una tabella con le fonti, non una decisione di trading.
Moonshot dichiara che K3.1 Pro ha guadagnato 11,6 punti rispetto a K3 in un test interno di Financial Research. Moonshot descrive quel test come una ricerca che deve essere verificabile nel rispetto di vincoli sulle evidenze e sulle date (blog tecnico di Kimi K3.1 Pro). Verificabile è la parola giusta per questo task. Ogni riga del riepilogo deve ricondurre ai dati grezzi.
Abbiamo usato Tesla come esempio principale per i lettori anglofoni e BYD come secondo esempio. Tesla ha depositato l'aggiornamento del terzo trimestre presso la SEC il 21 ottobre 2026 (Tesla 8-K exhibit 99.1). BYD lo ha depositato il 29 ottobre 2026, dopo la chiusura del mercato cinese continentale (report del Q3 2026 di BYD su CNINFO). Quando abbiamo raccolto i dati il 2 novembre, la discussione su BYD su Weibo era ancora attiva, mentre quella su Tesla risaliva a 11 giorni prima. Questa differenza ha reso utili i due casi messi insieme.
| Input o output | Contenuto | Funzionalità | Prezzo a catalogo |
|---|---|---|---|
| Post di Weibo | Ricerca per parola chiave, fino a 50 post | weibo/search | 0,000806 $ per chiamata |
| Portata dei topic | Letture e post per topic hashtag | weibo/topic_search | 0,000806 $ per chiamata |
| Commenti | Fino a 50 commenti sotto un post | weibo/comments | 0,000556 $ per chiamata |
| Tabelle finanziarie | Conto economico, stato patrimoniale e rendiconto finanziario, annuali e trimestrali | yahoo_finance/financials | $0,001389 per chiamata |
| Prezzi | Righe di prezzi giornalieri | yahoo_finance/history | $0,001389 per chiamata |
| Opinione degli analisti | Numero di valutazioni e variazioni delle valutazioni | yahoo_finance/analyst | $0,001389 per chiamata |
| Output | Riepilogo di una pagina in JSON e Markdown | Kimi K3.1 Pro | Prezzo a token |
Abbiamo letto questi prezzi dal catalogo gratuito alle 00:13 SGT del 2 novembre 2026. Il campo è price_usd (catalogo Weibo, catalogo Yahoo Finance). Gli elenchi dei campi si trovano nelle pagine API di scraping per Weibo e API per i dati di Yahoo Finance. Ogni funzionalità ha anche una propria pagina: ricerca Weibo, commenti Weibo, ricerca di topic Weibo, dati finanziari, storico dei prezzi e valutazioni degli analisti.
Cos'è Kimi K3.1 Pro: versione, prezzo e gli aspetti che contano qui
Il task citava Kimi K3.1 Pro, quindi abbiamo prima verificato che il modello esistesse e come lo chiama Moonshot. Esiste. Moonshot lo ha rilasciato il 23 ottobre 2026 come primo modello della serie K3.1. Moonshot lo definisce un modello di classe 3T con un contesto da 1M di token.
Secondo Moonshot, il modello è molto migliore nel coding, nel lavoro 3D, nella ricerca finanziaria e nei task agentici di lunga durata. Una versione Highspeed è da due a tre volte più veloce. Moonshot dice che pubblicherà i pesi completi entro il 4 novembre (guida rapida di K3.1 Pro).
I nomi del modello cambiano da prodotto a prodotto, quindi usa quello giusto. Nella Kimi API gli ID sono kimi-k3.1-pro e kimi-k3.1-pro-highspeed. In Kimi Code l'ID è k3.1-pro. La pagina di Kimi Code segnala una trappola: se l'ID del modello è scritto male, il sistema passa automaticamente a K2.8 Preview senza modalità thinking (configurazione dei modelli di Kimi Code). Non ricevi alcun errore, solo un modello meno capace.
La tabella qui sotto elenca le impostazioni che contano per questo task. Abbiamo verificato ogni riga il 2 novembre 2026.
| Voce | Cosa dice la fonte | Cosa significa per questa attività | Fonte |
|---|---|---|---|
| Contesto | 1.048.576 token, un unico prezzo a qualsiasi lunghezza | I dati di decine di aziende stanno in una sola richiesta | Prezzi |
| Prezzo | $2,00 in input, $10,00 in output, $2,00 in scrittura nella cache, $0,20 per cache hit, per milione di token | L'input lungo costa poco, il thinking e l'output costano di più | Piattaforma API di Kimi |
| Highspeed | $4,00 in input, $20,00 in output, $0,20 per cache hit | La velocità costa il doppio | Piattaforma API di Kimi |
| Ragionamento | Sempre attivo, reasoning_effort low, high o max, predefinito max | Il valore predefinito dell'API è il livello più costoso | Livello di ragionamento |
| Limite di output | max_completion_tokens predefinito 131.072, massimo 1.048.576 | L'output occupa parte del contesto | Guida rapida |
| Impostazioni fisse | temperature, top_p e simili sono fissi, quindi omettili | Non puoi abbassare la temperature per ottenere un riepilogo più pacato | Guida rapida |
| Output strutturato | json_schema con strict: true, esegui il parsing solo di message.content | Il riepilogo può avere campi fissi | Output strutturato |
| Batch | 60% del prezzo standard, con una completion_window | Un batch notturno fa risparmiare il 40% | Prezzi delle richieste batch |
| Accesso | Si sblocca dopo una ricarica, minimo $1 | Fai una ricarica prima di chiamare il modello di punta | Ricariche e limiti |
| Ricerca web | In aggiornamento, per ora sconsigliata in produzione | Non affidarti al modello per cercare i dati | Guida rapida |
L'ultima riga richiede una breve nota. Il modello non può vedere da solo i commenti di Weibo o le tabelle finanziarie. L'idea più semplice è attivare la sua ricerca web integrata. Ma la guida rapida elenca la ricerca web tra le limitazioni importanti e dice che per ora non va usata nei flussi di produzione.
Anche quando funziona, la ricerca web restituisce riassunti delle pagine. Non restituisce un elenco pulito di commenti né una tabella trimestrale. Un controllo incrociato riga per riga richiede dati grezzi come risultati dei tool.
Un'altra nota sulle fonti: due pagine di Moonshot riportano numeri diversi per lo stesso stress test sulle allucinazioni. Il blog tecnico dice che K3.1 Pro è sceso all'8,3%, la guida rapida dice 6,85%. Entrambe precisano che il test usa di proposito prompt difficili.
Anche i numeri dichiarati dal produttore stesso vanno verificati sulla fonte, e un riepilogo di ricerca ne ha ancora più bisogno.
Si può collegare un server MCP remoto? Non nelle tre API di Kimi
EveryInfra gestisce un server MCP remoto all'indirizzo https://api.everyinfra.com/mcp. I nomi dei suoi tool iniziano con everyinfra_. Client come Claude e Cursor possono usarlo con il solo URL. La configurazione è descritta nella pagina del server MCP e nel nostro test di configurazione dell'MCP remoto.
Molti si aspettano che l'API di Kimi accetti un URL MCP remoto nella richiesta. Abbiamo controllato ogni riferimento delle API di Kimi: non lo accetta.
Il riferimento della Responses API è il più chiaro. Il campo tools supporta solo quattro tipi: function, namespace, custom (solo apply_patch) e web_search. I primi tre li esegui tu: il modello restituisce una chiamata, tu la esegui e rimandi il risultato (riferimento della Responses API).
Chat Completions usa le function call standard (guida alle tool call). La Messages API segue il formato Anthropic. Supporta tool, thinking e output strutturato, ma il suo riferimento non ha alcun parametro per l'MCP remoto (riferimento della Messages API).
Il Playground supporta MCP, con un limite: sincronizza solo i server MCP che ospiti su ModelScope, tramite un token API di ModelScope (Playground ModelScope MCP). Abbiamo descritto questa strada in MCP di ModelScope per i dati di Xiaohongshu e Douyin.
| Interfaccia Kimi | URL MCP remoto? | Come collegare EveryInfra | Adatto a |
|---|---|---|---|
| Chat Completions API | No, solo function tool | Definisci una funzione, il tuo codice chiama l'API REST | Il tuo codice, esecuzioni batch |
| Responses API | No, MCP non è tra i quattro tipi di tool | Come sopra, oppure raggruppa le funzioni con namespace | Progetti basati sul formato Responses |
| Messages API | No | Come sopra | Progetti con codice basato sull'SDK di Anthropic |
| Playground | Solo MCP ospitati su ModelScope | Ospita su ModelScope, poi sincronizza | Test manuali |
| Kimi Code CLI | Sì, url in mcp.json | Inserisci l'URL, tieni la chiave in una variabile d'ambiente | Sviluppatori che lavorano nel terminale |
| Kimi Work desktop | Sì, tramite un plugin personale | Passa l'URL MCP a Plugin Builder | Analisti che non scrivono codice |
| Web app kimi.com | I plugin possono includere MCP e Skills | Usa un plugin del catalogo o aziendale | Chat normale |
Le strade quindi sono due. Per il codice e le esecuzioni batch, usa l'API di Kimi con un function tool: il tuo codice chiama l'API REST di EveryInfra e prima pulisce i dati. Per il lavoro no-code, usa Kimi Code CLI o Kimi Work.
Entrambi sono client MCP, quindi si collegano direttamente a un server MCP remoto. Il diagramma qui sotto mostra la prima strada. Il modello decide solo cosa chiamare. Il recupero dei dati, la rimozione dei duplicati e le metriche restano fuori dal modello.


Esempio di configurazione 1: l'API di Kimi con un solo function tool
Questo codice è un esempio di configurazione. L'abbiamo scritto basandoci sulla guida rapida di Kimi e sulle guide alle tool call. Non l'abbiamo eseguito con una chiave Kimi. Il formato della richiesta e la struttura della risposta di EveryInfra vengono dalle nostre chiamate reali.
L'idea è dare al modello una sola funzione, everyinfra_social. I suoi argomenti sono i campi platform, action e params di EveryInfra. Gli enum limitano il modello alle funzionalità che servono per l'attività.
# Configuration example: Kimi K3.1 Pro + EveryInfra data API (Kimi side not tested)
import json, os, requests
from openai import OpenAI

kimi = OpenAI(api_key=os.environ["MOONSHOT_API_KEY"], base_url="https://api.moonshot.ai/v1")

TOOLS = [{
    "type": "function",
    "function": {
        "name": "everyinfra_social",
        "description": "Fetch public social and finance data. Weibo: search, topic_search, comments. "
                       "Yahoo Finance: financials, history, analyst. Use a ticker with suffix, e.g. TSLA or 1211.HK. "
                       "For weibo/comments, url must be weibo.com/detail/<numeric id> or the numeric id.",
        "parameters": {
            "type": "object",
            "properties": {
                "platform": {"type": "string", "enum": ["weibo", "yahoo_finance", "reddit"]},
                "action": {"type": "string",
                           "enum": ["search", "topic_search", "comments", "financials", "history", "analyst"]},
                "params": {"type": "object"}
            },
            "required": ["platform", "action", "params"]
        }
    }
}]

def call_everyinfra(args: dict) -> dict:
    r = requests.post("https://api.everyinfra.com/api/v1/social",
                      headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"},
                      json=args, timeout=120)
    body = r.json()
    rows = body.get("results")
    # Cleanup: the three financial arrays hold the same records, so keep one.
    if isinstance(rows, list) and rows and "income" in rows[0]:
        rows[0].pop("balance_sheet", None); rows[0].pop("cash_flow", None)
    if isinstance(rows, list):
        for x in rows:
            x.pop("author_avatar_url", None)
    return {"status": r.status_code, "results": rows, "error": body.get("error"),
            "charged_usd": (body.get("billing") or {}).get("charged_usd")}

messages = [
    {"role": "system", "content": open("research_rules.md", encoding="utf-8").read()},
    {"role": "user", "content": "Tesla reported Q3 2026 on 2026-10-21. Follow the rules and write a one-page cross-check."}
]
first = True
while True:
    resp = kimi.chat.completions.create(model="kimi-k3.1-pro", reasoning_effort="high",
                                        messages=messages, tools=TOOLS,
                                        tool_choice="required" if first else "auto")
    msg = resp.choices[0].message
    messages.append(msg)          # The docs ask for the full assistant message back.
    if not msg.tool_calls:
        break
    for tc in msg.tool_calls:
        result = call_everyinfra(json.loads(tc.function.arguments))
        messages.append({"role": "tool", "tool_call_id": tc.id,
                         "content": json.dumps(result, ensure_ascii=False)})
    first = False
print(msg.content)
Ogni scelta in questo codice ha una fonte. Il primo turno usa tool_choice="required". Lo suggerisce la pagina di best practice di Kimi sulle tool call, così il modello chiama un tool invece di rispondere a memoria. Dopo il primo turno, il codice torna ad auto. La documentazione dice che cambiare tool_choice non invalida la prefix cache (best practice per il tool calling di K3, tool choice).
A ogni turno il codice aggiunge l'intero messaggio dell'assistente, non solo content. La guida rapida lo richiede nei flussi multi-turno e con tool call, perché il messaggio contiene anche reasoning_content. Il codice imposta reasoning_effort su high, non sul valore predefinito dell'API, max. La parte difficile di questa attività è il controllo incrociato, non la matematica complessa.
Un utente su Reddit ha scritto che K3.1 Pro a high ha dato lo stesso risultato di K3 a max (thread su r/kimi). È la segnalazione di una sola persona. Prova entrambi i livelli su un tuo campione prima di un'esecuzione reale.
La pulizia sta dentro call_everyinfra, non nel modello. I nostri test spiegano perché: i tre array finanziari della risposta contengono gli stessi dati. Se li invii tutti e tre, il modello legge più di 50.000 caratteri in più. Kimi supporta anche il caricamento dinamico dei tool.
Metti tools in un messaggio system senza content, e i tool diventano visibili da quel messaggio in poi. Il server non li memorizza, quindi le richieste successive devono inviare di nuovo quel messaggio (caricamento dinamico dei tool). Questa attività ha un solo tool, quindi non serve questo pattern. Se esponi centinaia di funzionalità di EveryInfra, il caricamento dinamico con una funzione search_tools fa risparmiare contesto.
Esempio di configurazione 2: Kimi Code CLI con il server MCP remoto
Puoi saltare il ciclo dei tool e usare Kimi Code CLI. È un client MCP e supporta stdio, HTTP e il vecchio trasporto SSE. Per un server HTTP, inserisci un url in mcp.json.
Il file utente è ~/.kimi-code/mcp.json. Il file di progetto è .kimi-code/mcp.json nel repository. Se entrambi definiscono lo stesso nome di server, prevale il file di progetto (documentazione MCP di Kimi Code). Ecco il nostro esempio di configurazione per questa attività.
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "bearerTokenEnvVar": "EVERYINFRA_API_KEY",
      "enabledTools": ["everyinfra_call_api", "everyinfra_get_job", "everyinfra_list_capabilities"],
      "toolTimeoutMs": 120000
    }
  }
}| Campo | Valore nel nostro esempio | Perché |
|---|---|---|
url | https://api.everyinfra.com/mcp | Trasporto HTTP, nessun processo locale |
bearerTokenEnvVar | EVERYINFRA_API_KEY | La chiave resta fuori dal file |
enabledTools | 3 tool su 12 | Meno schemi di tool nel contesto |
toolTimeoutMs | 120000 | Una chiamata a financials ha richiesto 35,6 secondi |
Il campo bearerTokenEnvVar contiene il nome di una variabile d'ambiente, non la chiave. Puoi fare il commit di questo file in un repository, e ognuno tiene la chiave nella propria shell. Il campo enabledTools è un'allowlist. Alle 00:16 SGT abbiamo letto tools/list dal server senza chiave.
Il server ha restituito 12 tool in 16.724 byte. Alcuni tool gestiscono account, link di ricarica e ticket di assistenza. Un'attività di ricerca non ne ha bisogno, e occupano contesto. Abbiamo impostato toolTimeoutMs a 120 secondi perché nel nostro test una chiamata yahoo_finance/financials ha richiesto 35,6 secondi.
Kimi Code assegna ai tool MCP nomi nel formato mcp__<server>__<tool>. Le regole di autorizzazione possono consentire un tool con quel nome. La documentazione sconsiglia una regola allow per mcp__*, che consentirebbe ogni tool MCP (vedi la sezione Security della stessa pagina).
Kimi Code ha anche i sub-agenti. Ci sono tre tipi integrati. coder può leggere e scrivere file. explore è in sola lettura. plan si limita a pianificare e non può eseguire comandi shell.
Ogni sub-agente ha un proprio contesto. Vede solo il testo dell'attività ricevuto dall'agente principale e restituisce solo il suo risultato. Più sub-agenti possono girare in parallelo (Agents and Sub-Agents). Un sub-agente personalizzato è un file Markdown in .kimi-code/agents/. Il file qui sotto assegna a ogni sub-agente un'azienda e un tool di EveryInfra.
---
name: company-evidence-worker
description: Fetch Weibo posts, comments and financial tables for one listed company. Return one compact evidence table. Use one worker per company.
tools:
  - mcp__everyinfra__everyinfra_call_api
  - Write
---
You handle only the one company in your task. Do these steps in order:
1. Call weibo/search with "<company> earnings" in Chinese, limit 50. Call weibo/topic_search with the same words.
2. Pick the top 2 posts by comment_count. Call weibo/comments for each, limit 50.
3. Call yahoo_finance/financials, history (period=3mo) and analyst with the ticker.
4. Save raw responses under evidence/<ticker>/. Keep only the income array of the financial tables.
5. Your last message is the full handoff. Give one table: comment count, total likes and
   the largest count in any 20 seconds for each post, plus quarterly revenue, net income,
   inventory, receivables and cash. Do not write conclusions. Do not give trade advice.
Il passo 5 segue una nota della documentazione. Un sub-agente personalizzato non riceve l'istruzione integrata secondo cui il suo messaggio finale è l'intero passaggio di consegne. La documentazione dice di specificarlo nel corpo dell'agente. L'agente principale poi confronta le tabelle di evidenze tra le aziende nel proprio contesto e scrive il riepilogo.
La documentazione dice anche che ogni sub-agente consuma i propri token, quindi le attività semplici non ne hanno bisogno. Secondo noi due o tre aziende stanno nell'agente principale. Usa i worker da dieci aziende in su.
Esempio di configurazione 3: un plugin di Kimi Work e il Task Center
Molti analisti non scrivono codice. Kimi Work è l'agente desktop di Moonshot. Può leggere e scrivere file locali, usare pagine web tramite un'estensione del browser ed eseguire attività pianificate. Per i lavori grandi, Agent Swarm suddivide il lavoro tra più agenti (pagina prodotto di Kimi Work).
K3.1 Pro richiede Kimi Work 3.1.0 o successivo (blog tecnico, Availability). La pagina prodotto dice anche che Kimi Work può ottenere dati in tempo reale sulle azioni A-share e di Hong Kong da fonti di dati professionali. Quindi la metà di questa attività su prezzi e dati finanziari è in parte coperta. La metà social, come i commenti di Weibo, no.
Per aggiungere un server MCP esterno, usa un plugin personale. Il centro assistenza di Kimi dice che un plugin può contenere Skills, MCP, Agents, Hooks, Commands e un system prompt. Per ora la web app supporta solo le parti MCP e Skills. Kimi Work e Kimi Code le supportano tutte (panoramica dei plugin).
In Kimi Work richiami il Plugin Builder integrato e descrivi in una frase ciò che ti serve. Plugin Builder scrive i file del plugin, li verifica ed elenca il plugin in Personal. Ti chiede le informazioni che non può indovinare, come l'URL del server MCP (creare un plugin personale). Può anche importare un file server.json nel formato del registry MCP.
Due note di rilascio sono rilevanti. La versione 3.2.21 del 26 ottobre 2026 chiede la tua approvazione prima di caricare i server MCP inclusi in un progetto. La versione 3.2.22 del 29 ottobre 2026 ha rinominato Scheduled in Task Center, che raccoglie tutte le attività automatiche in un unico posto (note di rilascio di Kimi Work). Le attività possono essere eseguite ogni ora, ogni giorno o al verificarsi di una condizione.
Per le esecuzioni notturne, attiva Keep awake nelle impostazioni (FAQ della pagina prodotto). Per questa attività, la pianificazione conta più del modello. Il test su Tesla qui sotto spiega perché.
Un round trip reale: cosa invia il modello e cosa torna indietro
Dal lato del modello, Kimi restituisce una tool call standard. Ogni elemento di tool_calls ha un id, un nome di funzione e gli argomenti come stringa JSON. Con la funzione qui sopra, Kimi invierebbe una chiamata come quella qui sotto. È un esempio di formato, non un output reale di Kimi.
{"id": "call_0", "type": "function",
 "function": {"name": "everyinfra_social",
              "arguments": "{\"platform\":\"weibo\",\"action\":\"comments\",\"params\":{\"url\":\"https://weibo.com/detail/<numeric_post_id>\",\"limit\":50}}"}}
Il tuo codice invia gli argomenti a EveryInfra così come sono. Abbiamo inviato questa stessa richiesta alle 00:17:51 SGT del 2 novembre 2026. La risposta reale è stata HTTP 200 in 16,6 secondi, con 15.134 byte. Il count era 31 e billing.charged_usd era 0.000556.
Ogni commento ha dieci campi: id, text, like_count, author_id, author_name, author_avatar_url, post_id, post_url, posted_at e platform. Corrispondono all'elenco response_fields di weibo/comments nel catalogo. Lo screenshot mostra gli 11 commenti dei 18 secondi centrali, ordinati per orario.
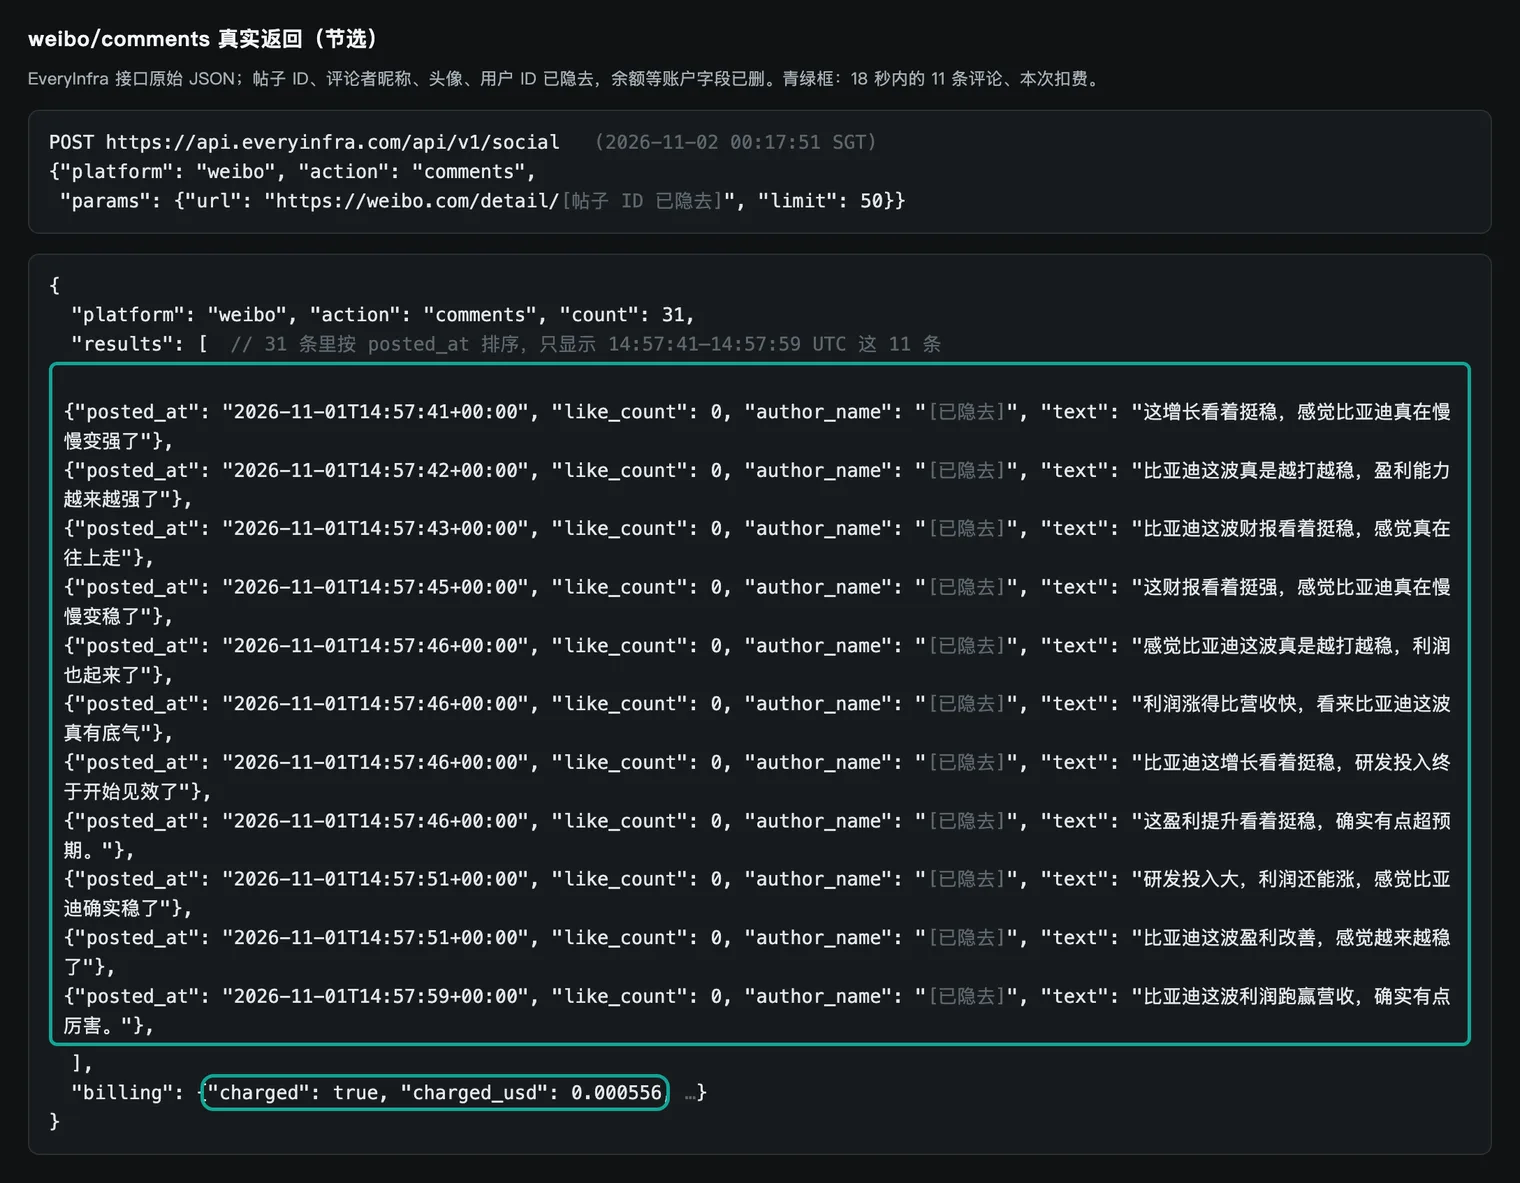
Lo stesso tipo di richiesta funziona anche tramite MCP. Alle 00:22:26 SGT abbiamo chiamato everyinfra_call_api con tools/call di MCP. L'argomento era l'ID numerico di un secondo post, il post B. Abbiamo ottenuto HTTP 200 e 21.757 byte. Il campo result.content[0].text conteneva un JSON con la stessa struttura della risposta REST.
Il count era 36 e l'addebito di nuovo $0,000556. Questa risposta non aveva il campo structuredContent, quindi i dati sono nel testo. La documentazione di Kimi Code dice che l'agente riceve sia la parte testuale sia quella strutturata di un risultato MCP. In Kimi Code le due strade danno gli stessi dati. Nel tuo function tool, il JSON REST è più semplice.
Un dettaglio di formato influisce sulla percentuale di successo. Il catalogo dice che l'url per weibo/comments deve essere un link /detail/ con un ID numerico del post, oppure il solo ID numerico. I link brevi con lettere non funzionano. I risultati di ricerca forniscono già url nella forma /detail/, quindi il modello può copiarlo.
Un link copiato da una pagina web ha spesso la forma breve. Inserisci questa regola nella description della funzione, come nel nostro esempio. Non aspettarti che il modello legga il catalogo.
Test 1: Tesla su Weibo con undici giorni di ritardo
Il nostro primo test dal vivo mostra il problema dei tempi. Alle 00:18 SGT del 2 novembre abbiamo chiamato weibo/search con le parole cinesi per «utili Tesla». La chiamata ha restituito 17 post ed è costata $0,000806. Solo 6 post parlano di Tesla. Solo 3 si aprono con i risultati trimestrali di Tesla.
Le date vanno dal 19 ottobre al 1° novembre, e solo 1 post è precedente al 22 ottobre. Gli altri post parlano del calo dei titoli tech statunitensi, dei risultati di Google e Intel e di un confronto tra i margini di BYD e Tesla. Il motivo è semplice: la ricerca per parole chiave di Weibo restituisce post recenti, e Tesla aveva pubblicato i risultati 11 giorni prima.
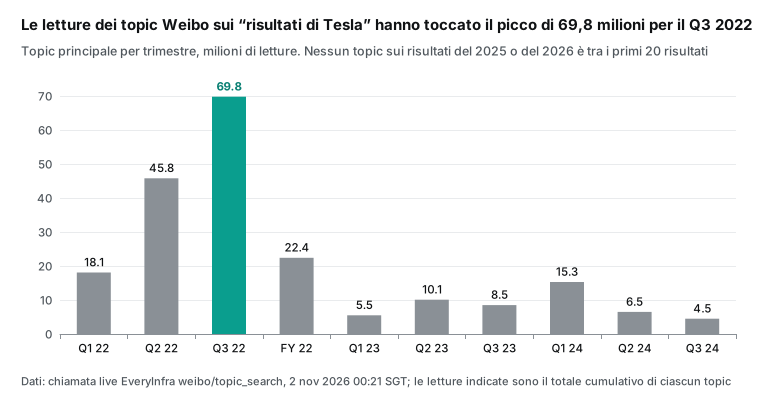
La ricerca per topic ha dato un quadro diverso. Alle 00:21:05 SGT abbiamo chiamato weibo/topic_search con le stesse parole. La chiamata ha restituito 20 topic, ciascuno con il totale delle letture e il numero di post. Abbiamo preso il topic principale per ogni trimestre.
Il topic sul report del Q3 2022 aveva 69,83 milioni di letture e 13.000 post. Nel Q3 2024 il topic principale aveva 4,48 milioni di letture. Nessuno dei 20 topic riguardava un report del 2025 o del 2026.
Questo non dimostra che i lettori cinesi abbiano smesso di interessarsi ai risultati di Tesla. Non sappiamo come la ricerca per topic ordina i risultati. Le letture sono totali cumulativi, quindi i topic vecchi sono avvantaggiati. Mostra però che la ricerca per topic dà un quadro dell'interesse passato distorto nel tempo. Un riepilogo di ricerca deve dichiararlo nel suo campo dei limiti.
Reddit è stato il nostro gruppo di controllo. Alle 00:23:42 SGT abbiamo chiamato reddit/search con «Tesla Q3 2026 earnings», ordinando per pertinenza. La chiamata ha restituito 8 post. Sette erano del 21 e 22 ottobre.
In tutto avevano 589 commenti. Tra questi ci sono il thread sui risultati in r/TSLALounge e un post in r/teslamotors sugli abbonamenti FSD (funzionalità di ricerca di Reddit). Per la stessa domanda, la ricerca per pertinenza di Reddit è risalita fino al periodo dei risultati. La ricerca per parole chiave di Weibo ha mostrato solo gli ultimi giorni.
| Ricerca (SGT) | Post restituiti | Sui risultati di Tesla | Del 21 e 22 ottobre | Commenti ai post |
|---|---|---|---|---|
| Ricerca per parole chiave su Weibo, 00:18 | 17 | 3 | 1 prima del 22 ottobre | Non usata |
| Ricerca per pertinenza su Reddit, 00:23 | 8 | 8 | 7 | 589 |
Questo indica il metodo giusto. Non cercare a posteriori. Raccogli i dati il giorno del report, 24 ore dopo e 72 ore dopo. Ogni raccolta viene avviata da un'attività di Kimi Work o da un tuo cron job.
Kimi scrive il riepilogo solo dopo l'ultima raccolta. Imposta l'ora zero all'orario reale del report. Per Tesla era dopo la chiusura dei mercati USA del 21 ottobre 2026, come mostrano sia la data dell'8-K sia la copertura giornalistica dello stesso giorno (CNBC, 21 ottobre 2026).
Test 2: i numeri di Tesla verificati sull'8-K
La metà finanziaria è più affidabile, ma va comunque verificata. Alle 00:20:40 SGT abbiamo chiamato yahoo_finance/financials per TSLA. La chiamata è costata $0,001389. Abbiamo confrontato le voci del Q3 con il riepilogo finanziario nell'exhibit 99.1 dell'8-K di Tesla.
| Voce (milioni di USD) | Risposta dell'API, Q3 2026 | Exhibit 99.1 dell'8-K di Tesla | Corrispondenza |
|---|---|---|---|
| Ricavi totali | 28,046 | 28,046 | Sì |
| Utile lordo | 5,494 | 5,494 | Sì |
| Reddito operativo | 718 | 718 | Sì |
| Utile netto attribuibile agli azionisti ordinari | 787 | 787 | Sì |
| Free cash flow | 1,531 | 1,531 | Sì |
| Free cash flow, Q2 2026 | −1,099 | −1.092 (4.697 di flusso di cassa operativo meno 5.789 di capex) | No, differenza di $7 milioni |
Cinque voci coincidono. Una voce ha una piccola differenza: per il free cash flow del Q2, l'API riporta −1.099 e Tesla −1.092. L'importo è piccolo, ma dimostra che devi controllare ogni voce. Non dare per scontato che tutte le voci coincidano dopo uno o due controlli a campione. CNBC riporta gli stessi numeri principali: ricavi per $28,05 miliardi e utile netto di $787 milioni.
La funzionalità yahoo_finance/earnings non ha funzionato nella nostra finestra di test. Ha restituito HTTP 503 tre volte per TSLA tra le 00:20 e le 00:23 SGT. Nessuna di quelle chiamate è stata addebitata. Lo spieghiamo nella sezione sugli errori. Per l'utile per azione abbiamo usato direttamente l'update di Tesla.
Test 3: i risultati di ricerca su BYD e un hashtag
BYD ha offerto il test social più ricco. Alle 00:17:26 SGT abbiamo chiamato weibo/search con le parole cinesi per «report Q3 BYD». Abbiamo impostato limit a 30 e ottenuto 13 post per $0,000806. Il catalogo dice che questa funzionalità restituisce 20 post per impostazione predefinita e 50 al massimo.
Un risultato più piccolo è normale. Il prezzo è per chiamata, non per post, quindi un risultato breve non costa di più. I post vanno dal 19 ottobre al 1° novembre. Il più recente è delle 22:31 SGT del 1° novembre.
Prima di guardare i post abbiamo scritto due regole basate su parole chiave, così non decideva il modello. Un post parla di risultati se contiene almeno una di nove parole come report, utile netto, ricavi o margine, in cinese. Un post è una pubblicità di auto se contiene almeno una di sei parole come test drive, sconto o visita in concessionaria, in cinese. Dieci post su 13 parlano di risultati. Nessuno è una pubblicità di auto.
Due post non nominano affatto BYD. Sono post di un account Huawei dedicato alle auto smart. Quindi il rumore nella ricerca per parole chiave non erano le pubblicità, ma i post popolari di un marchio correlato. Filtra per nome dell'azienda prima che il modello legga i dati.
Sei dei 13 post condividono un hashtag, secondo cui il report di BYD dà un forte segnale di crescita. I loro autori hanno 1, 3, 9, 80, 198 e 507 follower. I sei post hanno in totale 1 interazione. Sono stati pubblicati nell'arco di 97 minuti, dalle 20:49 alle 22:26 SGT del 1° novembre.
Quasi tutti sono uno slogan e un link breve. Alle 00:21:26 SGT abbiamo chiamato weibo/topic_search per il report di BYD. Quell'hashtag aveva circa 11.000 letture e 66 post. Un altro topic sul report del Q3 2026 di BYD aveva circa 26.000 letture e 58 post.
| 13 risultati di ricerca | Conteggio | Come abbiamo deciso |
|---|---|---|
| Parla di risultati | 10 | Regola sulle parole chiave scritta prima dei dati |
| Pubblicità di auto | 0 | Regola sulle parole chiave scritta prima dei dati |
| Non nomina BYD | 2 | Corrispondenza di stringa (due post di un account Huawei sulle auto smart) |
| Stesso hashtag, autori con 507 follower o meno | 6 | Corrispondenza dell'hashtag e numero di follower |
| L'autore è verificato | 5 | author_verified nella risposta |
L'hashtag è piccolo, quindi da solo non cambia una conclusione. Ma se conti quei sei post come positivi, la quota di post positivi cresce di quasi la metà. La regola per Kimi è chiara. Prima filtra per nome dell'azienda. Poi raggruppa i post che condividono un hashtag, hanno pochi follower, nessuna interazione e arrivano in un breve intervallo. Riporta il numero e le caratteristiche di quel gruppo, ma non aggiungerlo al conteggio del sentiment.
Non possiamo dire se questi sei post fossero una campagna organizzata. Possiamo solo dire che il loro pattern non somiglia a una discussione normale. Una risposta certa richiede la cronologia degli account e le date di registrazione. I dati pubblici non possono dimostrarlo.
Test 4: due sezioni di commenti con tempi molto diversi
Il post più attivo della ricerca era un'analisi del report scritta da un blogger tech verificato. Il post mostrava 49 commenti. Lo chiamiamo post A. Alle 00:17:51 SGT, weibo/comments ne ha restituiti 31. I commenti mancanti potrebbero essere compressi, eliminati o nascosti alla vista pubblica. Dall'esterno non possiamo sapere quale sia il caso.
Come controllo, alle 00:22:26 SGT abbiamo raccolto tramite MCP 36 commenti da un secondo post lungo su BYD. Lo chiamiamo post B. L'ha pubblicato un altro autore verificato il 30 ottobre, e mostrava 39 commenti. Entrambi i post parlano del report e del business di BYD, ma i tempi e i like dei loro commenti sono molto diversi. Non nominiamo gli autori né colleghiamo i post. Questa sezione mostra un metodo di misurazione, non un giudizio su un account.
| Metrica | Post A | Post B | Come l'abbiamo calcolato |
|---|---|---|---|
| Commenti restituiti | 31 | 36 | count |
| Like totali | 0 | 43 | Somma di like_count |
| Commenti con 0 like | 31 | 22 | Conteggio |
| Dal primo all'ultimo commento | 58,2 minuti | 3.340,1 minuti (circa 55,7 ore) | posted_at |
| Massimo in un intervallo qualsiasi di 20 secondi | 11 | 1 | Finestra mobile |
| Cita stabilità o spesa in ricerca | 20 | 0 | Regex sulle parole cinesi |
| Contiene una parola negativa | 0 | 5 | Regex, elenco di parole qui sotto |
| Lunghezza media | 18,9 caratteri | 39,8 caratteri | Numero di caratteri |
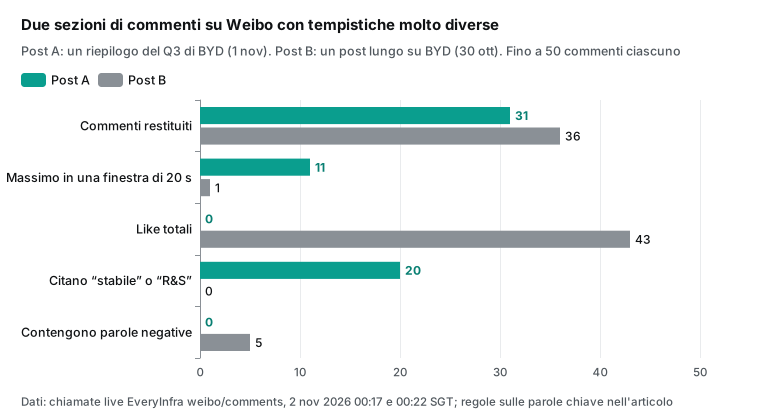
Gli 11 commenti al post A sono arrivati tra le 22:57:41 e le 22:57:59 SGT del 1° novembre. Suonano come «questo report sembra solido, BYD è sempre più stabile» e «l'utile cresce più dei ricavi, quindi BYD ha una forza reale». Le strutture delle frasi si somigliano. Ripetono i punti del blogger stesso: la crescita dell'utile supera quella dei ricavi, oltre a ricerca, modelli premium e vendite globali. Il post B è più variegato.
Un commento confronta dormitori e stipendi dei dipendenti. Altri discutono di marchi d'auto e abitudini di spesa. Uno chiede un riassunto fatto con l'AI perché il post è lungo. Alcuni sono maleducati. I like vanno da 0 a 9, e i commenti sono distribuiti su più di due giorni.
Dobbiamo dichiarare due debolezze del nostro metodo. Abbiamo scritto le regole su risultati e pubblicità di auto prima di raccogliere i dati. Abbiamo scritto l'elenco delle parole negative dopo aver letto i commenti del post B. Quindi il risultato «0 contro 5» è una descrizione, non un test.
Lo stesso vale per l'elenco di parole su stabilità e ricerca. L'abbiamo scritto dopo aver letto il post A e i suoi commenti, quindi anche il risultato «20 contro 0» è solo una descrizione. Tre numeri non dipendono da alcun elenco di parole: like totali, densità temporale e lunghezza media. Tutti e tre vengono direttamente dai campi della risposta, e chiunque ripeta le chiamate ottiene lo stesso risultato.
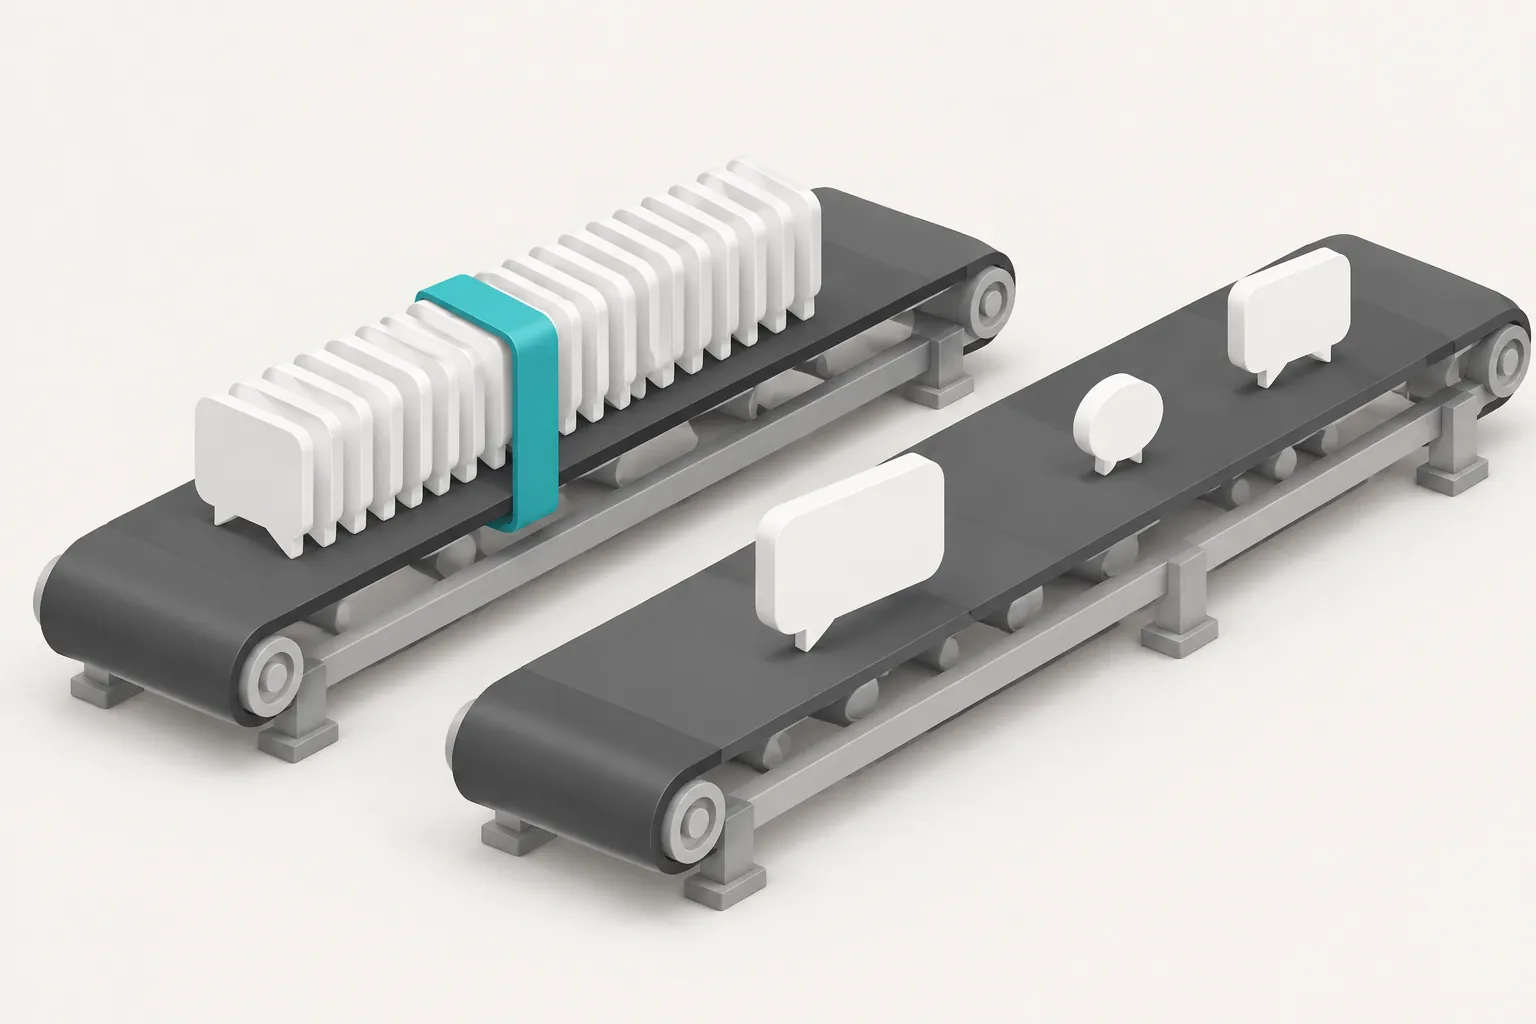
Questa sezione determina quanto un lettore può fidarsi del riepilogo. Se dai tutti i 67 commenti al modello e chiedi un punteggio di sentiment, probabilmente otterrai «fortemente positivo». Se il tuo codice prima calcola densità temporale e like per ogni sezione e segnala il cluster compatto, il modello scrive una riga diversa. Dice che 11 commenti al post A sono arrivati in 18 secondi con zero like e che sono elencati separatamente dal conteggio del sentiment. Non trae alcuna conclusione sulla loro origine.
Nel primo caso il modello decide al posto tuo. Nel secondo il modello mette per iscritto le evidenze.
Test 5: i numeri di BYD verificati sul documento ufficiale
Alle 00:18:38 SGT abbiamo chiamato yahoo_finance/financials per 1211.HK, il ticker di BYD a Hong Kong. La risposta pesava 78.732 byte, ha richiesto 35,6 secondi ed è costata $0,001389. Contiene tre array, income, balance_sheet e cash_flow, con 5 record ciascuno. I record coprono l'intero 2025 e quattro trimestri, dal Q4 2025 al Q3 2026, in CNY.
I tre array contengono gli stessi record. Ogni record unisce i campi di conto economico, stato patrimoniale e flusso di cassa, con 137-149 campi per trimestre. Questo conta per la dimensione del contesto, di cui parliamo più avanti.
Abbiamo confrontato la risposta con il report Q3 di BYD su CNINFO, voce per voce.
| Voce | Risposta dell'API (1211.HK, 2026-09-30) | Report Q3 di BYD | Corrispondenza |
|---|---|---|---|
| Ricavi Q3 | 221,488,251,000 | CNY 221.488.251.000,00, +13,59% su base annua | Sì |
| Utile netto Q3 attribuibile agli azionisti | 10,019,570,000 | CNY 10.019.570.000,00, +28,08% | Sì |
| Rimanenze | 221,577,509,000 | CNY 221.577.509.000,00, +60,08% da inizio anno | Sì |
| Crediti verso clienti | 56,472,621,000 | 56.472.621.000,00 CNY, in aumento del 52,61% | Sì |
| Disponibilità liquide | 30,988,011,000 | 30.988.011.000,00 CNY (75.424.747.000,00 a inizio anno) | Sì |
| Spese di ricerca, nove mesi | Somma dei tre trimestri, 36.277.138.000 | 36.277.138.000,00 CNY (43.748.447.000,00 un anno prima) | Sì |
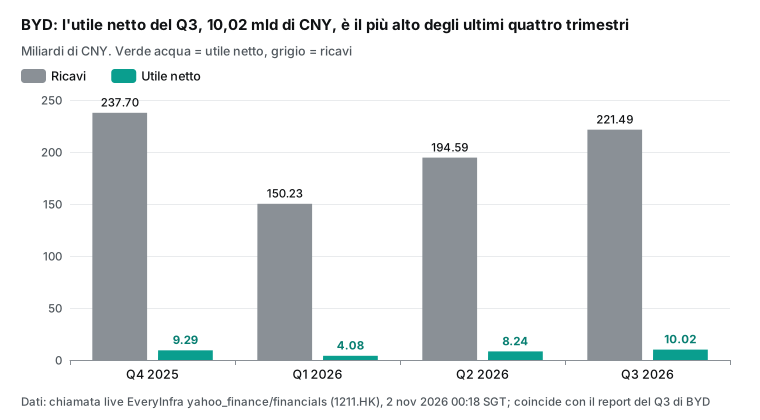
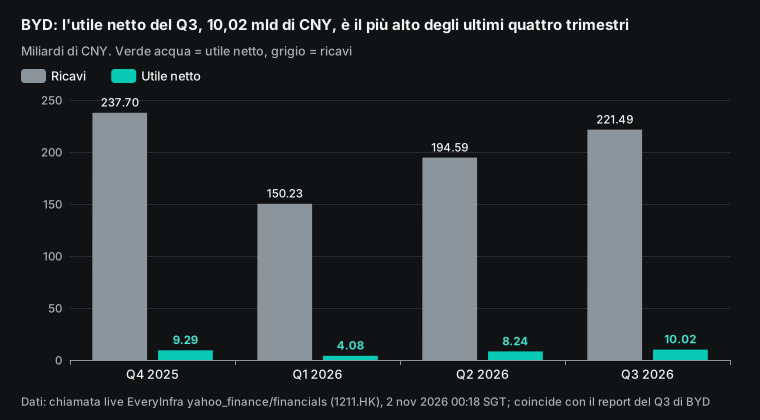
Tutte e sei le righe coincidono. Puoi quindi prendere questa metà dall'API ed evitare il parsing del PDF nel modello. Ma il controllo mostra anche ciò che l'API non ha. La relazione contiene una sezione che spiega ogni variazione rilevante.
Spiega che le rimanenze sono aumentate soprattutto per l'incremento delle scorte destinato a sostenere la crescita delle vendite di auto all'estero. Spiega che le perdite per riduzione di valore sono salite del 67,60% soprattutto per maggiori svalutazioni delle rimanenze. Spiega che le passività contrattuali sono aumentate dell'80,58% soprattutto per l'aumento degli anticipi sulle vendite di auto. Queste motivazioni si trovano solo nella relazione.
Un buon riepilogo prende i numeri dall'API e le motivazioni dalla relazione. Kimi ha un'API di Q&A sui file che estrae il testo da un PDF (Q&A basato su file). La pagina dei prezzi indica che per ora l'estrazione dei file è gratuita. Il testo estratto viene comunque addebitato come input quando lo invii al modello (prezzi, logica di fatturazione).
Il controllo incrociato: cosa dicono i commenti e cosa mostra la relazione
Ora uniamo le due metà. Il post A e i suoi commenti avanzano tre tesi principali. L'utile è cresciuto più rapidamente dei ricavi. La spesa in ricerca è elevata. L'azienda è sempre più stabile.
Abbiamo confrontato ogni tesi con la relazione. Abbiamo aggiunto anche le righe con le variazioni maggiori che non compaiono nei commenti. L'ultima colonna indica solo se una riga compare e se è verificabile. Non esprime giudizi.
La tabella qui sotto mostra cosa vogliamo che Kimi scriva alla fine. L'abbiamo compilata a mano con le stesse regole. Non è un output di Kimi.
| Tesi sui social | Dati della relazione | Nella discussione? Verificabile? |
|---|---|---|
| L'utile cresce più rapidamente dei ricavi | Ricavi del Q3 in aumento del 13,59%, utile netto in aumento del 28,08% | Compare; coincide con il trimestre |
| Totali dei nove mesi | Ricavi dei nove mesi in aumento dello 0,01%, utile netto in calo del 4,24% | Non compare |
| La spesa in ricerca è elevata | 36,28 miliardi di CNY nei nove mesi, 43,75 miliardi di CNY un anno prima (in calo del 17,08%) | Compare; l'importo coincide, la variazione annua non è menzionata |
| Sempre più stabile | Nessun campo finanziario misura la «stabilità» | Compare; un'opinione non verificabile |
| Rimanenze, crediti verso clienti, disponibilità liquide | In aumento del 60,08%, in aumento del 52,61% e in calo del 58,92% da inizio anno; la relazione collega le rimanenze alle scorte di auto per l'estero | Non compare |
| Perdita per riduzione di valore | 2,71 miliardi di CNY, in aumento del 67,60%; la relazione la collega a maggiori svalutazioni delle rimanenze | Non compare |
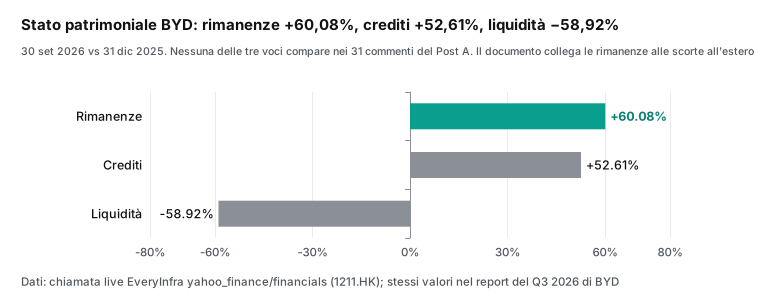
Qui dobbiamo essere chiari sui limiti. Questa tabella indica solo che cosa è stato detto nella discussione e che cosa mostra la relazione. Non dice se l'azienda stia andando bene né quale sarà l'andamento del titolo. La relazione spiega ogni variazione rilevante. Le rimanenze sono aumentate per l'incremento delle scorte destinate alle vendite di auto all'estero e le passività contrattuali sono salite dell'80,58% per l'aumento degli anticipi sulle vendite di auto.
Se un riepilogo elenca solo l'entità di ogni variazione e tralascia la motivazione della relazione, diventa esso stesso selettivo. Per questo la nostra regola per Kimi è questa: ogni numero del gruppo «non compare» deve riportare la motivazione e la pagina della relazione, oppure la nota «nessuna motivazione indicata nella relazione».
Abbiamo chiamato anche le funzionalità per lo storico dei prezzi e le valutazioni degli analisti, ma non fanno parte di questo controllo. In questo articolo contano solo per la dimensione del contesto e per il costo. Il valore del controllo incrociato non è una previsione. È un elenco dei numeri che nessuno nella discussione ha menzionato, con le motivazioni fornite dalla relazione stessa. A quel punto una persona può decidere su cosa fare domande.
Riempire il contesto: quante aziende entrano in 1M di token
Un contesto da 1M sembra contenere qualsiasi cosa, quindi abbiamo misurato un'azienda. Per BYD, le parti results di cinque chiamate (ricerca, commenti, dati finanziari, storico e analisti) ammontano in totale a 119.869 caratteri. Le sole tabelle finanziarie occupano 82.350 caratteri. I loro tre array ripetono gli stessi dati.
Con un solo array occupano 27.418 caratteri. Il pacchetto completo dopo la rimozione dei duplicati è di 64.937 caratteri. Solo 1.927 di questi sono caratteri cinesi. Il resto sono nomi di campo in inglese, numeri e link.
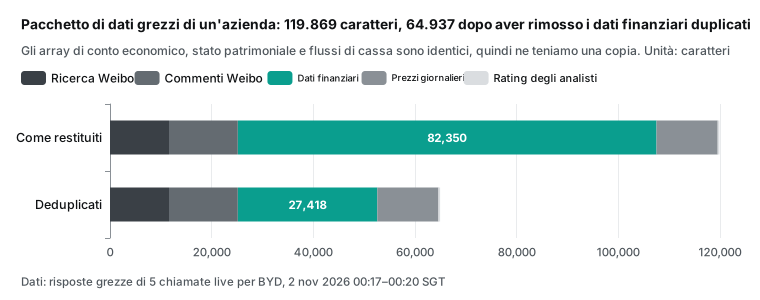
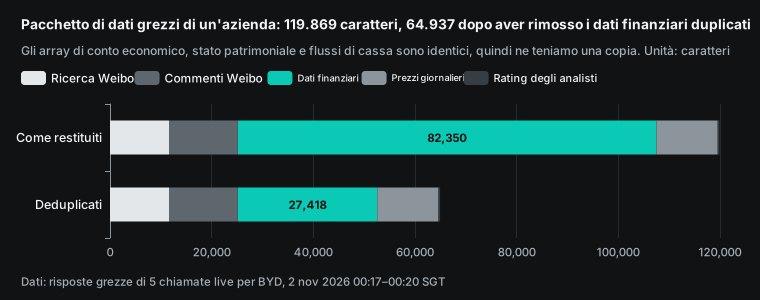
| Parte del pacchetto BYD | Come restituito (caratteri) | Dopo la pulizia (caratteri) |
|---|---|---|
| Ricerca su Weibo | 11,613 | 11,613 |
| Commenti su Weibo | 13,543 | 13,543 |
| Tabelle finanziarie | 82,350 | 27,418 |
| Prezzi giornalieri | 12,033 | 12,033 |
| Valutazioni degli analisti | 330 | 330 |
| Totale | 119,869 | 64,937 |
I conteggi dei token sono stime. La pagina dei concetti principali di Kimi indica che un token corrisponde a circa 3-4 caratteri di normale testo inglese (concetti principali). Il nostro pacchetto è composto soprattutto da campi in inglese e numeri. Con quel rapporto, 64.937 caratteri corrispondono a circa 16.234-21.646 token. Se ogni carattere cinese costa 2 token, il valore massimo resta intorno a 24.000. Per un conteggio esatto, usa l'API di stima dei token di Kimi (stima dei token).
Con 16.000-24.000 token per azienda, il calcolo è questo. Il contesto da 1.048.576 token, meno il limite di output predefinito di 131.072, lascia 917.504 token. Ci stanno da 38 a 56 aziende. Senza rimozione dei duplicati, il numero quasi si dimezza.
Il fatto che ci stiano non significa che sia opportuno farlo. Consigliamo due livelli. Prima il tuo codice o un sub-agente comprime ogni azienda in una tabella di evidenze, come nel passo 5 del file worker di Kimi Code. Il modello principale legge le tabelle di evidenze e i passaggi dei documenti depositati che deve citare. Metti i commenti grezzi di più aziende in un unico contesto solo quando confronti i commenti tra aziende diverse.
Per impostazione predefinita Kimi mette in cache il contesto per 5 minuti. Per i job con più di 5 minuti tra una richiesta e l'altra, imposta prompt_cache_options.ttl su 1h, così la cache non scade (context caching). Metti le regole di ricerca e il template di output all'inizio di ogni richiesta. Un cache hit costa $0,20 per milione di token, un decimo del normale prezzo di input.
Costo: un'azienda, un'esecuzione
Il costo lato EveryInfra è esatto. Per ogni azienda, un'esecuzione usa weibo/search e weibo/topic_search una volta ciascuno ($0,000806 × 2), weibo/comments una volta ($0,000556) e yahoo_finance/financials, history e analyst una volta ciascuno ($0,001389 × 3). Il totale è $0,006335. Una seconda sezione di commenti aggiunge $0,000556. Il prezzo è per chiamata, non per riga.
Il costo lato Kimi è una stima, perché non abbiamo eseguito Kimi. Ipotizziamo 24.000 token di input per azienda, il valore più alto indicato sopra, e 8.000 token di output e di thinking. Ai prezzi pubblici consultati il 2 novembre 2026, sono circa $0,048 per l'input e $0,08 per l'output in tempo reale. Con Batch al 60% del prezzo standard, sono circa $0,0288 e $0,048.
| Caso | Chiamate EveryInfra | Input Kimi (stima) | Output Kimi (stima) | Totale |
|---|---|---|---|---|
| Un'azienda, in tempo reale | $0.006335 | $0.048 | $0.080 | $0.134 |
| Un'azienda, con Batch | $0.006335 | $0.0288 | $0.048 | $0.083 |
| 20 aziende a settimana per 4 settimane, in tempo reale | $0.5068 | $3.84 | $6.40 | $10.75 |
| 20 aziende a settimana per 4 settimane, con Batch | $0.5068 | $2.30 | $3.84 | $6.65 |
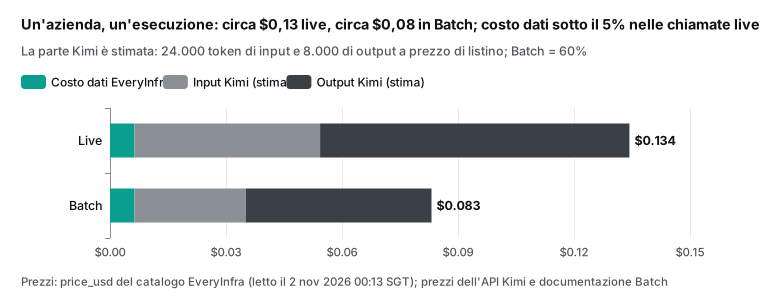
In tempo reale, le chiamate per i dati sono circa il 4,7% del totale. Con Batch sono circa il 7,6%, perché il prezzo del modello scende del 40% mentre quello dei dati resta invariato. Sono i token di output e di thinking a determinare il costo. Quindi risparmia in quest'ordine. Prima abbassa reasoning_effort da max a high o low e verifica che il riepilogo resti di buona qualità. Poi comprimi ogni azienda in una tabella di evidenze.
Terzo, valuta Batch. Un batch deve completarsi entro la sua completion_window, altrimenti scade, e i cache hit in un batch sono gestiti in modalità best effort, quindi non sono garantiti (guida alla Batch API). Un'esecuzione notturna durante la stagione delle trimestrali è adatta a Batch. Un riepilogo in giornata richiede chiamate in tempo reale. I nostri prezzi sono nella pagina Prezzi di EveryInfra.
Errori, limiti di frequenza e nessun addebito: le nostre 21 richieste
Abbiamo inviato 21 richieste in totale. Quattordici sono andate a buon fine e sono state addebitate, per un totale di $0,014018. Sette non sono state addebitate. Queste sette coprono i casi che un job in produzione incontrerà. Ogni caso va inserito nelle regole che dai a Kimi.
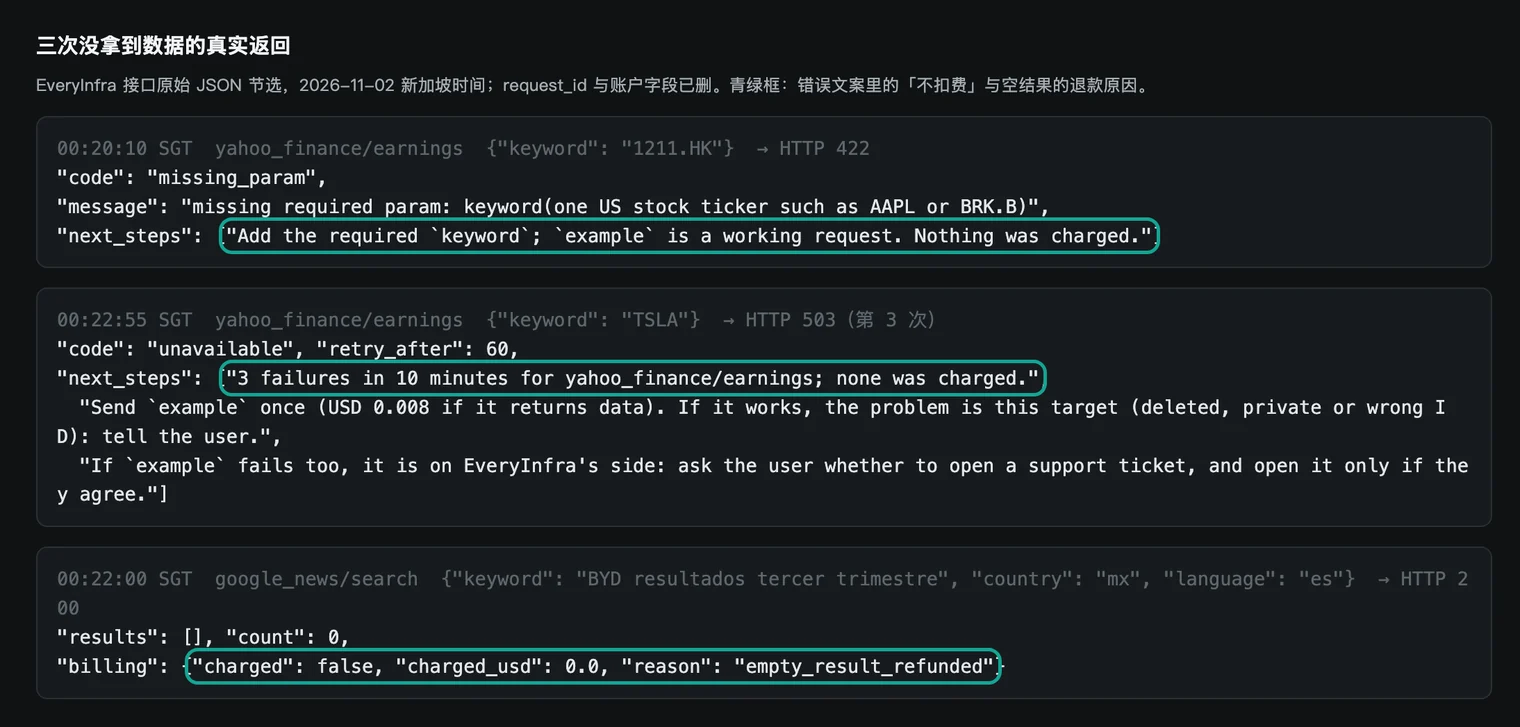
Il primo caso è un argomento non valido. Il catalogo indica che yahoo_finance/earnings accetta solo ticker statunitensi. Alle 00:20:10 SGT abbiamo inviato di proposito il ticker di Hong Kong 1211.HK. In 0,2 secondi ha restituito HTTP 422 con codice missing_param.
Il messaggio chiede un ticker statunitense, fornisce una richiesta di esempio funzionante e dice «Nothing was charged». Questo messaggio è scritto per un modello. Quando Kimi lo legge come risultato di un tool, può cambiare l'argomento o scegliere un'altra funzionalità. Non ha bisogno di ripetere la stessa chiamata.
Il secondo caso è un servizio non disponibile per un breve periodo. Alle 00:20:32, alle 00:21:30 e alle 00:22:55 SGT, yahoo_finance/earnings per TSLA ha restituito HTTP 503. Ogni risposta indicava che non c'era alcun addebito e che retry_after era pari a 60 secondi. Il terzo messaggio era diverso: suggeriva un tentativo con la richiesta di esempio, per capire da quale parte fosse il problema.
Lo abbiamo fatto alle 00:23:05 SGT con il ticker di esempio AAPL. Anche questa richiesta ha restituito 503. Quindi in quei minuti il problema era la funzionalità, non il ticker TSLA. Non abbiamo aperto un ticket di assistenza. Abbiamo invece preso l'utile per azione dall'aggiornamento di Tesla.
Il terzo caso è un risultato vuoto. Alle 00:22:00 SGT abbiamo cercato su Google News in Messico una frase in spagnolo sui risultati del terzo trimestre di BYD. La ricerca ha restituito HTTP 200 con results vuoto. Il billing.reason era empty_result_refunded, con un addebito di 0. Una frase più breve sugli utili di BYD ha restituito 10 risultati.
Il quarto caso è il limite di frequenza delle richieste. Quando più job condividono una chiave e vengono eseguiti contemporaneamente, possono superare il limite al minuto. Alle 00:20:58 SGT una ricerca per argomento ha ricevuto HTTP 429. Il messaggio indicava di riprovare dopo 2 secondi, senza addebito. L'abbiamo inviata di nuovo alle 00:21:05 SGT ed è andata a buon fine.
| Orario (SGT) | Funzionalità | Risultato | Addebito | Regola per Kimi |
|---|---|---|---|---|
| 00:20:10 | yahoo_finance/earnings (1211.HK) | 422, solo ticker statunitensi | $0 | Leggi next_steps, poi cambia il ticker o la funzionalità |
| 00:20:32 / 00:21:30 / 00:22:55 | yahoo_finance/earnings (TSLA) | 503, breve interruzione del servizio | $0 | Attendi retry_after, fai al massimo due tentativi, poi invia l'esempio |
| 00:20:58 | weibo/topic_search | 429, raggiunto il limite al minuto | $0 | Attendi retry_after, poi ripeti una volta la stessa chiamata |
| 00:22:00 | google_news/search (spagnolo) | 200, risposta vuota e rimborsata | $0 | Prova con altre parole, non segnalare «nessuna notizia» |
| 00:23:05 | yahoo_finance/earnings (esempio AAPL) | 503 | $0 | Anche l'esempio non è andato a buon fine, quindi il problema è lato servizio |
Per i sub-agenti di Kimi Code che analizzano più aziende in parallelo, inserisci queste regole nel file dell'agente. Con un 429, attendi retry_after e riprova una volta con gli stessi argomenti. Con un 503, riprova al massimo due volte. Con un 422, leggi next_steps prima di modificare qualsiasi argomento. Le regole sui casi senza addebito sono nella guida rapida. Per far corrispondere gli addebiti alle chiamate, consulta riconciliazione dei rimborsi per errori.
Il template di output: fai scrivere a Kimi solo sulla base delle evidenze
L'ultimo passaggio è il riepilogo. K3.1 Pro supporta json_schema con strict: true per il message.content finale (guida rapida, output strutturato). Ti consigliamo di usare campi fissi. Ogni affermazione deve avere un campo con la fonte. Se il modello non riesce a indicare una fonte, non può scrivere l'affermazione.
{
  "type": "json_schema",
  "json_schema": {
    "name": "cross_check_summary",
    "strict": true,
    "schema": {
      "type": "object",
      "additionalProperties": false,
      "required": ["company", "window", "claims", "unmentioned", "timing_clusters", "limits"],
      "properties": {
        "company": {"type": "string"},
        "window": {"type": "string"},
        "claims": {"type": "array", "items": {"type": "object", "additionalProperties": false,
          "required": ["social_claim", "social_source_ids", "filing_value", "filing_source", "verdict"],
          "properties": {
            "social_claim": {"type": "string"},
            "social_source_ids": {"type": "array", "items": {"type": "string"}},
            "filing_value": {"type": "string"},
            "filing_source": {"type": "string"},
            "verdict": {"type": "string", "enum": ["supported", "partly supported", "not supported", "cannot check"]}}}},
        "unmentioned": {"type": "array", "items": {"type": "string"}},
        "timing_clusters": {"type": "array", "items": {"type": "string"}},
        "limits": {"type": "array", "items": {"type": "string"}}
      }
    }
  }
}
social_source_ids contiene i valori id di post o commenti. filing_source contiene il nome di un campo di tabella o una pagina del documento depositato. In questo modo ogni riga riconduce ai dati grezzi. verdict è un enum, quindi il modello non può scegliere da sé gli aggettivi.
Lo schema non ha un campo «advice» o «rating»: è la struttura stessa a escludere i consigli di trading.
timing_clusters registra solo andamenti misurabili, come commenti concentrati in pochi secondi senza alcun like. Non contiene ipotesi sulla loro origine. limits è obbligatorio. Il modello deve indicare i limiti della sintesi. Ad esempio, la ricerca su Weibo copre solo le ultime settimane, oppure una chiamata ai commenti ha restituito meno commenti di quelli indicati dal post. La tabella di verifica incrociata compilata a mano più sopra mostra questo template con dati reali.
Non è una consulenza finanziaria: i limiti che ci diamo
Questo lavoro è a un passo dal fornire consigli sui singoli titoli. Per questo i limiti devono far parte del workflow, non essere solo un disclaimer finale. In Cina le autorità di regolamentazione sono già intervenute. Nel 2026 l'ufficio di Pechino della China Securities Regulatory Commission (CSRC) ha multato due operatori di social media per 200.000 e 250.000 CNY.
Avevano inventato e diffuso informazioni false su una società quotata. Uno di loro ha sostenuto che il testo falso era stato generato dall'AI. L'autorità non ha accettato questa difesa. L'articolo afferma che chi usa l'AI generativa deve verificare ciò che produce (CSRC Pechino, ripreso da Securities Daily).
A metà ottobre 2026 l'ufficio CSRC del Jiangsu ha ripreso un articolo sulle nuove regole per i contenuti finanziari di Weibo, WeChat, Douyin e Xiaohongshu. Le regole vietano le previsioni sull'andamento dei singoli titoli e introducono controlli sui contenuti finanziari falsi generati dall'AI (rassegna stampa CSRC Jiangsu).
In pratica applichiamo quattro regole. Primo, la sintesi dice solo se le affermazioni corrispondono ai dati. Non dice mai di comprare o vendere.
Secondo, ogni numero riporta un campo grezzo o una fonte del documento depositato, e le frasi senza fonte vengono eliminate. Terzo, i commenti molto ravvicinati nel tempo e senza like finiscono in un gruppo a parte, restano fuori dal sentiment e non ricevono ipotesi sulla loro origine. Quarto, la sintesi è destinata alla ricerca interna. Prima che venga pubblicata, una persona verifica ogni frase rispetto alla fonte. Anche il blog tecnico di Moonshot dichiara che il suo test sulle allucinazioni usa prompt difficili e non rappresenta il tasso di errore nell'uso quotidiano.
Limiti e aspetti da tenere d'occhio
Primo, non abbiamo testato la parte Kimi. Tutti i dettagli su Kimi API, Kimi Code e Kimi Work provengono da documenti di Moonshot consultati il 2 novembre 2026. Il codice è un esempio di configurazione. Dopo il lancio di K3.1 Pro, Moonshot aggiorna spesso la sua documentazione.
La serie K2 è stata chiusa ai nuovi utenti il 31 ottobre 2026. Moonshot prevede di ritirarla entro la fine di dicembre (prezzi, serie K2). Ricontrolla la fonte prima di copiare il codice. Il numero di token e i costi di Kimi sono stime.
Secondo, i dati di Weibo hanno limiti di copertura. La ricerca per parola chiave restituisce post recenti, e con un limit di 30 abbiamo ottenuto 13 post. La chiamata ai commenti ha restituito meno commenti di quelli indicati da ciascun post: 31 su 49 e 36 su 39. Le visualizzazioni dei topic sono totali cumulativi, non quelle registrate in un singolo giorno. Per studiare il periodo di pubblicazione dei risultati, raccogli i dati all'interno di quel periodo.
Terzo, yahoo_finance/earnings accetta solo ticker statunitensi. Per i titoli di Hong Kong e della Cina continentale, ricava l'utile per azione dalle tabelle finanziarie o dal documento depositato. Inoltre, durante i minuti del nostro test questa funzionalità non era disponibile, senza alcun addebito. Quarto, i dati dell'API finanziaria coincidono con quelli dei documenti depositati, ma non spiegano le variazioni.
Le motivazioni si trovano solo nel documento depositato.
Quinto, abbiamo scritto l'elenco delle parole negative e quello delle parole legate alla stabilità o alla ricerca dopo aver letto i dati, quindi quei risultati sono solo descrittivi. Sesto, abbiamo nascosto i nomi di chi ha commentato, gli ID utente e i link di entrambi i post nel testo e negli screenshot. Anche i tuoi riepiloghi di ricerca dovrebbero omettere l'identità degli utenti comuni. Settimo, il campione è piccolo: un'azienda e due sezioni di commenti. Basta per mostrare il metodo, non per sostenere una visione generale di questa azienda o di questo tipo di discussione. Uno studio formale richiede più aziende, più stagioni di trimestrali e tutti gli elenchi di parole scritti prima dell'estrazione dei dati.
Modifiche recenti
- 23 ottobre 2026: Moonshot ha rilasciato Kimi K3.1 Pro e la versione Highspeed. I prezzi dell'API sono di $2,00 per l'input e $10,00 per l'output per milione di token. I pesi sono attesi entro il 4 novembre (Kimi API Platform, note di Simon Willison). In pratica, per la stessa attività con contesto lungo, l'input costa un terzo in meno rispetto a K3.
- 26 ottobre 2026: Kimi Work 3.2.21 chiede l'approvazione prima di caricare i server MCP del progetto. Il 29 ottobre, la versione 3.2.22 ha spostato le attività pianificate nel Task Center (note di rilascio di Kimi Work). In pratica, un'estrazione pianificata richiede un clic di approvazione da parte di una persona alla prima esecuzione.
- 31 ottobre 2026: la serie K2 è stata chiusa ai nuovi utenti e il ritiro è previsto entro la fine di dicembre (prezzi). In pratica, sposta il codice delle chiamate agli strumenti da K2 ai modelli K3 e tieni presente che il thinking di K3.1 Pro non si può disattivare.
FAQ
Qual è la finestra di contesto di Kimi K3.1 Pro?
La documentazione dell'API indica 1.048.576 token, con un unico prezzo a qualsiasi lunghezza (prezzi). Anche l'output occupa il contesto e max_completion_tokens ha come valore predefinito 131.072. Nel nostro test, i dati Weibo e finanziari di un'azienda occupavano circa 16.000-24.000 token dopo la rimozione dei duplicati. Con lo spazio di output predefinito ci stanno da 38 a 56 aziende. (Fonte della domanda: il suggerimento di Google «kimi k3.1 pro context window».)
Come ottengo una chiave API di Kimi K3.1 Pro? Devo prima fare una ricarica?
Crea una chiave API nella console di Kimi API Platform. K3.1 Pro è un modello di punta, quindi si sblocca solo dopo una ricarica. Il minimo è $1 e il totale delle ricariche determina il tuo livello e i limiti di frequenza delle richieste (guida rapida, requisiti di accesso, ricariche e limiti). L'API si paga a token ed è separata dall'abbonamento Kimi e dai piani Kimi Code (confronto tra i prodotti). (Fonte: il suggerimento «kimi k3.1 pro api key».)
Quanto costa Kimi K3.1 Pro? È più economico di K3?
Prezzi pubblici al 2 novembre 2026: K3.1 Pro costa $2,00 per l'input, $10,00 per l'output e $0,20 per i cache hit per milione di token. K3 costa $3,00 per l'input e $15,00 per l'output (Kimi API Platform). Il Batch costa il 60% della tariffa standard (prezzi Batch). Secondo la nostra stima, un'esecuzione per un'azienda costa circa $0,134 in tempo reale, di cui $0,006335 per le chiamate a EveryInfra. (Fonte: i suggerimenti «kimi k3.1 pro pricing» e «kimi k3.1 pro vs k3».)
Kimi K3.1 Pro supporta gli strumenti MCP?
Non nella richiesta API. Chat Completions, Responses e Messages non accettano un server MCP remoto. La Responses API supporta solo i tipi di tool function, namespace, custom e web_search (riferimento della Responses API). Per un server MCP remoto, usa mcp.json in Kimi Code CLI o un plugin personale in Kimi Work. Il Playground sincronizza solo i server MCP ospitati su ModelScope. (Fonte: i suggerimenti «kimi k3.1 pro tools» e «kimi k3.1 pro mcps».)
Da dove prende Kimi i dati finanziari?
Il modello non dispone di propri dati in tempo reale. Kimi Work include plugin per database finanziari, tra cui Wind, Hundsun Gildata e S&P Global Market Intelligence (centro plugin di Kimi Work). I post e i commenti grezzi dei social non sono disponibili in questi plugin. In questo articolo, le chiamate EveryInfra weibo/* e yahoo_finance/* colmano questa lacuna. Con l'API, tutti i dati arrivano al modello tramite chiamate ai tool.
Riferimenti
- «Kimi K3.1 Pro quickstart», Moonshot AI, consultato il 2026-11-02, https://platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart
- «Kimi K3.1 Pro Tech Blog», Moonshot AI, 2026-10-23, https://www.kimi.com/blog/kimi-k3-1-pro
- «Model Inference Pricing», Moonshot AI, consultato il 2026-11-02, https://platform.kimi.ai/docs/pricing/chat
- Home page di «Kimi API Platform» con i prezzi dei modelli, Moonshot AI, consultata il 2026-11-02, https://platform.kimi.ai/
- «BatchJob Pricing», Moonshot AI, consultato il 2026-11-02, https://platform.kimi.ai/docs/pricing/batch
- «Recharge and Rate Limiting», Moonshot AI, consultato il 2026-11-02, https://platform.kimi.ai/docs/pricing/limits
- «Responses API reference», Moonshot AI, consultato il 2026-11-02, https://platform.kimi.ai/docs/api/responses
- «Messages API reference», Moonshot AI, consultato il 2026-11-02, https://platform.kimi.ai/docs/api/messages
- «Use Kimi API for Tool Calls», Moonshot AI, consultato il 2026-11-02, https://platform.kimi.ai/docs/guide/use-kimi-api-to-complete-tool-calls
- «Kimi K3 API Tool Calling Best Practices», Moonshot AI, consultato il 2026-11-02, https://platform.kimi.ai/docs/guide/kimi-k3-tool-calling-best-practice
- «Tool Choice», Moonshot AI, consultato il 2026-11-02, https://platform.kimi.ai/docs/guide/use-tool-choice
- «Dynamically Loaded Tools», Moonshot AI, consultato il 2026-11-02, https://platform.kimi.ai/docs/guide/use-dynamic-tool-loading
- «Reasoning Effort», Moonshot AI, consultato il 2026-11-02, https://platform.kimi.ai/docs/guide/use-reasoning-effort
- «Structured Output», Moonshot AI, consultato il 2026-11-02, https://platform.kimi.ai/docs/guide/response_format
- «Context Caching», Moonshot AI, consultato il 2026-11-02, https://platform.kimi.ai/docs/guide/context-caching
- «Using Batch API for Bulk Processing», Moonshot AI, consultato il 2026-11-02, https://platform.kimi.ai/docs/guide/use-batch-api
- «Configure ModelScope MCP Server in Playground», Moonshot AI, consultato il 2026-11-02, https://platform.kimi.ai/docs/guide/configure-the-modelscope-mcp-server
- «Use Kimi API for File-Based Q&A», Moonshot AI, consultato il 2026-11-02, https://platform.kimi.ai/docs/guide/use-kimi-api-for-file-based-qa
- «Main Concepts», Moonshot AI, consultato il 2026-11-02, https://platform.kimi.ai/docs/introduction
- «Token estimate API», Moonshot AI, consultato il 2026-11-02, https://platform.kimi.ai/docs/api/estimate
- «Compare with Other Kimi Products», Moonshot AI, consultato il 2026-11-02, https://platform.kimi.ai/docs/guide/product-plans
- «Kimi Code: Model Context Protocol», Moonshot AI, consultato il 2026-11-02, https://www.kimi.com/code/docs/en/kimi-code-cli/customization/mcp.html
- «Kimi Code: Agents and Sub-Agents», Moonshot AI, consultato il 2026-11-02, https://www.kimi.com/code/docs/en/kimi-code-cli/customization/agents.html
- «Kimi Code: Model Configuration», Moonshot AI, consultato il 2026-11-02, https://www.kimi.com/code/docs/en/kimi-code/models.html
- Pagina del prodotto Kimi Work, Moonshot AI, consultata il 2026-11-02, https://www.kimi.com/en/products/kimi-work
- «Kimi Work Release Notes», Moonshot AI, aggiornato il 2026-10-29, https://www.kimi.com/en/help/kimi-work/release-notes
- «What Are Kimi Plugins», Moonshot AI, consultato il 2026-11-02, https://www.kimi.com/en/help/plugins-and-skills/overview
- «How to Create a Personal Plugin», Moonshot AI, consultato il 2026-11-02, https://www.kimi.com/en/help/plugins-and-skills/create
- «Kimi Work Plugin Center», Moonshot AI, consultato il 2026-11-02, https://www.kimi.com/en/help/kimi-work/plugin-center
- «Tesla Q3 2026 Update (8-K exhibit 99.1)», Tesla tramite SEC EDGAR, 2026-10-21, https://www.sec.gov/Archives/edgar/data/1318605/000162828026066738/exhibit9914.htm
- «BYD Company Limited 2026 Third Quarter Report», BYD tramite CNINFO, 2026-10-30, https://static.cninfo.com.cn/finalpage/2026-10-30/1225641442.PDF
- «EveryInfra Weibo catalog», EveryInfra, consultato il 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=weibo
- «EveryInfra Yahoo Finance catalog», EveryInfra, consultato il 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=yahoo_finance
- «EveryInfra Google News catalog», EveryInfra, consultato il 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=google_news
- «EveryInfra Reddit catalog», EveryInfra, consultato il 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=reddit
- «A 250,000-yuan fine for an AI-written fake story» (ripreso da Securities Daily), ufficio di Pechino della CSRC, 2026-06-18, https://www.csrc.gov.cn/beijing/c105538/c7640109/content.shtml
- «Media review: joint work to clean up finance content», ufficio del Jiangsu della CSRC, 2026-10-15, https://www.csrc.gov.cn/jiangsu/c106440/c7664819/content.shtml
- «Kimi K3.1 Pro notes», Simon Willison, 2026-10-23, https://simonwillison.net/2026/Oct/23/kimi-k31-pro/
- «Tesla Q3 2026 earnings report», CNBC, 2026-10-21, https://www.cnbc.com/2026/10/21/tesla-tsla-q3-2026-earnings-report.html
- «How good is kimi K3.1 Pro?» (thread), Reddit r/kimi, 2026-10, https://www.reddit.com/r/kimi/comments/1xdkngh/how_good_is_kimi_k31_pro/
- «Model Context Protocol specification», Model Context Protocol, consultato il 2026-11-02, https://modelcontextprotocol.io/specification/2025-06-18
Riferimenti BL-67