Kimi K3.1 Pro ResearchでWeiboのセンチメントを決算と照らし合わせる
Kimi K3.1 Proを使って、WeiboとRedditの投稿をTeslaとBYDの決算書類と照合する方法。コメントのタイミング、項目ごとの照合、MCPのセットアップ、コストを解説します。
Teslaは2026年10月21日に第3四半期決算を発表しました。その11日後、11月2日00:18(SGT)に、WeiboでTeslaの決算に関する投稿を検索しました。返ってきた投稿は17件で、そのうちTeslaの決算に関するものは3件だけでした。
10月22日より前の投稿は1件だけでした。Redditで同じ検索を行うと、8件中7件が10月21日から22日の投稿でした。この差が1つ目の教訓です。ソーシャル検索が映すのは検索を実行した時点の状況であり、決算発表前後の期間ではありません。
2つ目の教訓は、10月29日に決算を発表した中国の自動車メーカーBYDから得られました。BYDの決算に関するWeiboの人気投稿の1つから、コメントを31件取得しました。いいねの合計は0で、そのうち11件はわずか18秒の間に投稿されていました。同じ決算に関する別の長文投稿には36件のコメントがありました。これらは2日以上にわたって分散しており、どの20秒間を見てもコメントは最大1件でした。
3つ目の教訓は、議論と開示資料では見ている数字が違うということです。BYDの開示資料で、年初から変化が最も大きかったのは次の3項目です。在庫は60.08%増、売掛金は52.61%増、現金は58.92%減でした。
開示資料には、海外向け自動車販売のための在庫増加など、各変化の理由が説明されています。取得したコメントの中に、これらの項目に触れたものはありません。これはどちらが正しいかを示すものではありません。リサーチの要約をコメントだけに頼ることはできない、ということを示しています。
この記事では、Moonshot AIのKimi K3.1 Proを使ってこの照合を構築する方法を紹介します。モデルはソーシャル投稿と財務表を1つの長いコンテキストで読み込み、各行に出典を付けた1ページの要約を書きます。EveryInfraはweibo/search、weibo/comments、yahoo_finance/financialsなどの機能を通じて生データを提供します。集計は、モデルが書き始める前に自分のコードで行います。
この記事では、データの扱い方とツールの設定方法を解説します。投資助言ではありません。特定の銘柄の売買を推奨するものでもありません。財務の数値は、SNS上の主張を一次情報と照らし合わせて確認する方法を示すためにのみ掲載しています。各確認の結果が示すのは、その数値が議論の中に出てくるかどうかだけで、数値の良し悪しは示しません。
この記事はEveryInfraチームが執筆しました。集計はすべてスクリプトで行っており、有資格の金融アナリストによるレビューは受けていません。企業に関する判断は、その企業の開示資料と有資格の専門家を頼りにしてください。
KimiのAPIキーを持っていなかったため、Kimiは実行していません。ここに掲載したKimiのコードはすべて、2026年11月2日に参照したMoonshotのドキュメントに基づく設定例です。EveryInfraの数値はすべて、実際のリクエストとその生のレスポンスから得たものです。
タスク:SNSと決算を照合した1ページの要約
以下の設定やコストの数値はすべてタスクの内容によって変わるため、まずタスクを明確にします。入力は、ある上場企業とその最新の決算発表日です。データ収集の段階では4つのデータを集めます。決算に関するWeiboの投稿と、特に反応の多い投稿に付いたコメントです。さらに、直近の四半期の財務表と、決算発表日前後の日次株価も含みます。出力は、決まった構成の1ページの要約です。
要約は5つの問いに答えます。SNSの投稿は何を主張しているか。開示資料はそれぞれの主張について何と述べているか。食い違っている主張はどれか。
自然な議論に見えない投稿やコメントはどれか。この要約の限界は何か。すべての回答は、生データのフィールドか開示資料のページを示す必要があります。そうすれば読者は、モデルを信用しなくても各行を検証できます。
このタスクが、ツール呼び出しに対応した長文コンテキストモデルに向いている理由は3つあります。1つ目は、元データの形式が4種類あることです。投稿、コメント、財務表、株価の行は、手作業では突き合わせられません。モデルならすべてを一度に読み込み、1つの形式で書き出せます。2つ目は、照合のルールを簡単に言い表せることです。
コメント内の財務に関する主張ごとに、財務表の該当フィールドを探し、なければ「見つからない」と記録します。これは1行ずつ確認していく作業で、長文コンテキストモデルが得意とするものです。3つ目は、最終的な判断を人が担うことです。モデルが作るのは出典付きの表であり、売買の判断ではありません。
Moonshotによると、K3.1 Proは社内のFinancial Researchテストで、K3より11.6ポイント向上しました。Moonshotはこのテストを、根拠と日付の制約のもとで監査可能でなければならないリサーチと説明しています(Kimi K3.1 Proテックブログ)。このタスクには、まさに「監査可能」という言葉が当てはまります。要約の各行は、生データまでたどれる必要があります。
英語圏の読者向けにTeslaを主な例とし、BYDを2つ目の例としました。Teslaは2026年10月21日に第3四半期のアップデートをSECに提出しました(Tesla 8-K exhibit 99.1)。BYDは2026年10月29日、中国本土市場の取引終了後に提出しました(CNINFO掲載のBYD 2026年第3四半期報告書)。11月2日にデータを取得した時点で、WeiboではBYDに関する議論がまだ活発でした。一方、Teslaに関する議論は11日前のものでした。この違いがあるため、2つの事例を並べると有用でした。
| 入力・出力 | 内容 | 機能 | カタログ価格 |
|---|---|---|---|
| Weiboの投稿 | キーワード検索、最大50件の投稿 | weibo/search | 1回の呼び出しあたり$0.000806 |
| トピックのリーチ | ハッシュタグトピックごとの閲覧数と投稿数 | weibo/topic_search | 1回の呼び出しあたり$0.000806 |
| コメント | 1件の投稿に付いたコメントを最大50件 | weibo/comments | 1回の呼び出しあたり$0.000556 |
| 財務表 | 年次・四半期の損益計算書、貸借対照表、キャッシュフロー計算書 | yahoo_finance/financials | 1回の呼び出しあたり$0.001389 |
| 株価 | 日次株価の行データ | yahoo_finance/history | 1回の呼び出しあたり$0.001389 |
| アナリストの見解 | レーティング数とレーティングの変更 | yahoo_finance/analyst | 1回の呼び出しあたり$0.001389 |
| 出力 | JSON形式とMarkdown形式の1ページの要約 | Kimi K3.1 Pro | トークン単位で課金 |
これらの価格は、2026年11月2日00:13(SGT)に無料のカタログから取得しました。フィールドはprice_usdです(Weiboカタログ、Yahoo Financeカタログ)。フィールド一覧はWeiboスクレイピングAPIとYahoo FinanceデータAPIのページにあります。機能ごとの個別ページもあります。Weibo検索、Weiboコメント、Weiboトピック検索、財務情報、株価履歴、アナリストレーティングです。
Kimi K3.1 Proとは:バージョン、料金、このタスクで重要な点
タスクでKimi K3.1 Proが指定されていたため、まずモデルが実在するか、Moonshotがどう命名しているかを確認しました。モデルは実在します。Moonshotは2026年10月23日、K3.1シリーズの最初のモデルとしてリリースしました。Moonshotは、1Mトークンのコンテキストを持つ3T級のモデルとしています。
コーディング、3D作業、金融リサーチ、長時間のエージェントタスクで大きく性能が向上したとしています。Highspeed版は2〜3倍高速に動作します。Moonshotは11月4日までに重みをすべて公開するとしています(K3.1 Proクイックスタート)。
モデル名は製品ごとに異なるため、正しいものを使ってください。Kimi APIでのIDはkimi-k3.1-proとkimi-k3.1-pro-highspeedです。Kimi CodeでのIDはk3.1-proです。Kimi Codeのページでは、落とし穴が1つ注意喚起されています。モデルIDを打ち間違えると、思考なしのK2.8 Previewにフォールバックします(Kimi Codeのモデル設定)。エラーは出ず、性能の低いモデルが使われるだけです。
以下の表に、このタスクで重要な設定をまとめます。各行は2026年11月2日に確認しました。
| 項目 | 情報源の記載内容 | このタスクにとっての意味 | 出典 |
|---|---|---|---|
| コンテキスト | 1,048,576トークン、長さによらず同一価格 | 数十社分のデータを1回のリクエストに収められる | 料金 |
| 料金 | 100万トークンあたり入力$2.00、出力$10.00、キャッシュ書き込み$2.00、キャッシュヒット$0.20 | 長い入力は安価、思考と出力は割高 | Kimi API Platform |
| Highspeed | 入力$4.00、出力$20.00、キャッシュヒット$0.20 | 高速化するとコストは2倍 | Kimi API Platform |
| 思考 | 常時有効。reasoning_effortはlow、high、maxから選択(デフォルトはmax) | APIのデフォルトが最もコストの高いレベルです | 推論の深さ |
| 出力上限 | max_completion_tokensはデフォルト131,072、最大1,048,576 | 出力はコンテキストの一部を消費します | クイックスタート |
| 固定の設定 | temperature、top_pなどは固定のため、指定しないでください | temperatureを下げて、ばらつきの少ない要約にすることはできません | クイックスタート |
| 構造化出力 | json_schemaとstrict: trueを使い、message.contentのみをパース | 要約のフィールドを固定できます | 構造化出力 |
| バッチ | 標準価格の60%、completion_windowを指定 | 夜間バッチなら40%節約できます | バッチ料金 |
| 利用条件 | チャージ後に利用可能(最低$1) | フラッグシップモデルを呼び出す前にチャージしてください | チャージと制限 |
| Web検索 | 更新中のため、現時点では本番環境での利用は非推奨 | データの検索をモデルに任せないでください | クイックスタート |
最後の行には短い補足が必要です。モデルは単独ではWeiboのコメントや財務データの表を参照できません。手軽な方法は組み込みのWeb検索を有効にすることです。しかし、クイックスタートではWeb検索が重要な制限事項として挙げられており、当面は本番環境のフローで使用すべきではないとされています。
仮に動作したとしても、Web検索が返すのはページの要約です。整ったコメント一覧や四半期の表は返しません。1行ずつクロスチェックするには、ツールの結果として生データが必要です。
情報源についてもう1点補足します。Moonshotの2つのページで、同じハルシネーションのストレステストの数値が異なります。技術ブログではK3.1 Proが8.3%まで下がったとしていますが、クイックスタートでは6.85%となっています。どちらのページも、このテストでは意図的に難しいプロンプトを使っていると説明しています。
開発元が自ら公表する数値でさえ情報源との照合が必要であり、リサーチの要約ならなおさらです。
リモートMCPサーバーに接続できるのか:Kimiの3つのAPIでは不可
EveryInfraはhttps://api.everyinfra.com/mcpでリモートMCPサーバーを提供しています。ツール名はeveryinfra_で始まります。ClaudeやCursorなどのクライアントは、URLを指定するだけで利用できます。設定方法はMCPサーバーのページとリモートMCPのセットアップ検証で紹介しています。
Kimi APIではリクエスト内でリモートMCPのURLを指定できると思う人は多いでしょう。Kimiの各APIリファレンスを確認しましたが、対応していません。
最も明確なのはResponses APIのリファレンスです。toolsフィールドがサポートするのはfunction、namespace、custom(apply_patchのみ)、web_searchの4種類だけです。最初の3つは利用者側で実行します。モデルが呼び出しを返し、それを実行して結果を送り返す仕組みです(Responses APIリファレンス)。
Chat Completionsは標準的な関数呼び出しを使用します(ツール呼び出しガイド)。Messages APIはAnthropic形式に準拠しており、ツール、思考、構造化出力をサポートしていますが、リファレンスにリモートMCPのパラメータはありません(Messages APIリファレンス)。
PlaygroundではMCPを利用できますが、制限が1つあります。ModelScope APIトークン経由で同期できるのは、ModelScope上でホストしたMCPサーバーのみです(Playground ModelScope MCP)。この方法についてはModelScope MCPでXiaohongshuとDouyinのデータを取得するで解説しています。
| Kimiの提供形態 | リモートMCPのURLに対応 | EveryInfraの接続方法 | 用途 |
|---|---|---|---|
| Chat Completions API | 不可。関数ツールのみ | 関数を1つ定義し、自分のコードからREST APIを呼び出す | 独自のコード、バッチ実行 |
| Responses API | 不可。MCPは4種類のツールタイプに含まれない | 同上、またはnamespaceで関数をグループ化 | Responses形式のプロジェクト |
| Messages API | 不要 | 同上 | Anthropic SDKのコードを使うプロジェクト |
| Playground | ModelScopeでホストされたMCPのみ | ModelScopeでホストしてから同期 | 手動テスト |
| Kimi Code CLI | はい、mcp.jsonのurlで指定 | URLを設定し、APIキーは環境変数に保存 | ターミナルで作業する開発者 |
| Kimi Workデスクトップ版 | はい、個人用プラグイン経由で | Plugin BuilderにMCPのURLを指定 | コードを書かないアナリスト |
| kimi.comのWebアプリ | プラグインにMCPとスキルを含められる | 公開済みまたは社内のプラグインを使用 | 通常のチャット |
つまり、ルートは2つあります。コードやバッチ実行には、Kimi APIと関数ツールを使います。コード側でEveryInfraのREST APIを呼び出し、先にデータをクリーンアップします。ノーコードで作業する場合は、Kimi Code CLIかKimi Workを使います。
どちらもMCPクライアントなので、リモートMCPサーバーに直接接続できます。下の図は1つ目のルートを示しています。モデルが決めるのは何を呼び出すかだけです。データ取得、重複の除去、指標の計算はモデルの外で行います。


設定例1:Kimi APIで関数ツールを1つ使用
このコードは設定例です。Kimiのクイックスタートとツール呼び出しガイドをもとに作成したもので、KimiのAPIキーを使った実行はしていません。EveryInfraのリクエスト形式とレスポンス構造は、実際の呼び出し結果に基づいています。
考え方としては、モデルにeveryinfra_socialという関数を1つだけ渡します。引数はEveryInfraのplatform、action、paramsフィールドです。enumを使って、モデルが選べる機能をタスクに必要なものだけに絞ります。
# Configuration example: Kimi K3.1 Pro + EveryInfra data API (Kimi side not tested)
import json, os, requests
from openai import OpenAI

kimi = OpenAI(api_key=os.environ["MOONSHOT_API_KEY"], base_url="https://api.moonshot.ai/v1")

TOOLS = [{
    "type": "function",
    "function": {
        "name": "everyinfra_social",
        "description": "Fetch public social and finance data. Weibo: search, topic_search, comments. "
                       "Yahoo Finance: financials, history, analyst. Use a ticker with suffix, e.g. TSLA or 1211.HK. "
                       "For weibo/comments, url must be weibo.com/detail/<numeric id> or the numeric id.",
        "parameters": {
            "type": "object",
            "properties": {
                "platform": {"type": "string", "enum": ["weibo", "yahoo_finance", "reddit"]},
                "action": {"type": "string",
                           "enum": ["search", "topic_search", "comments", "financials", "history", "analyst"]},
                "params": {"type": "object"}
            },
            "required": ["platform", "action", "params"]
        }
    }
}]

def call_everyinfra(args: dict) -> dict:
    r = requests.post("https://api.everyinfra.com/api/v1/social",
                      headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"},
                      json=args, timeout=120)
    body = r.json()
    rows = body.get("results")
    # Cleanup: the three financial arrays hold the same records, so keep one.
    if isinstance(rows, list) and rows and "income" in rows[0]:
        rows[0].pop("balance_sheet", None); rows[0].pop("cash_flow", None)
    if isinstance(rows, list):
        for x in rows:
            x.pop("author_avatar_url", None)
    return {"status": r.status_code, "results": rows, "error": body.get("error"),
            "charged_usd": (body.get("billing") or {}).get("charged_usd")}

messages = [
    {"role": "system", "content": open("research_rules.md", encoding="utf-8").read()},
    {"role": "user", "content": "Tesla reported Q3 2026 on 2026-10-21. Follow the rules and write a one-page cross-check."}
]
first = True
while True:
    resp = kimi.chat.completions.create(model="kimi-k3.1-pro", reasoning_effort="high",
                                        messages=messages, tools=TOOLS,
                                        tool_choice="required" if first else "auto")
    msg = resp.choices[0].message
    messages.append(msg)          # The docs ask for the full assistant message back.
    if not msg.tool_calls:
        break
    for tc in msg.tool_calls:
        result = call_everyinfra(json.loads(tc.function.arguments))
        messages.append({"role": "tool", "tool_call_id": tc.id,
                         "content": json.dumps(result, ensure_ascii=False)})
    first = False
print(msg.content)このコードの各選択には根拠があります。最初のターンではtool_choice="required"を使います。Kimiのツール呼び出しのベストプラクティスのページで推奨されている方法で、モデルが記憶から答えずにツールを呼び出すようになります。最初のターンの後は、autoに戻します。ドキュメントによると、tool_choiceを変更してもプレフィックスキャッシュは無効になりません(K3のツール呼び出しのベストプラクティス、ツール選択)。
各ターンでは、contentだけでなくassistantメッセージ全体を追加します。メッセージにはreasoning_contentも含まれるため、クイックスタートではマルチターンやツール呼び出しのフローでこうするよう求めています。コードではreasoning_effortを、APIのデフォルトであるmaxではなくhighに設定しています。このタスクで難しいのは深い計算ではなく、クロスチェックだからです。
Redditのあるユーザーは、K3.1 Proのhighで、K3のmaxと同じ結果が得られたと述べています(r/kimiのスレッド)。これは1人の報告にすぎません。本番の実行前に、自分のサンプルで両方のレベルを試してください。
クリーンアップはモデル内ではなく、call_everyinfra内で行います。理由はテスト結果に表れています。レスポンス内にある財務データの3つの配列には、同じデータが入っています。3つすべてを送ると、モデルは50,000文字超のデータを余分に読むことになります。Kimiは動的なツール読み込みにも対応しています。
contentのないsystemメッセージにtoolsを入れると、モデルはそのメッセージ以降、ツールを利用できるようになります。サーバーにはツールの定義が保存されないため、後続のリクエストでもそのメッセージを再送する必要があります(動的なツール読み込み)。このタスクで使うツールは1つだけなので、このパターンは不要です。EveryInfraの機能を数百種類公開する場合は、search_tools関数を使った動的なツール読み込みで、コンテキストの使用量を抑えられます。
設定例2:Kimi Code CLIとリモートMCPサーバー
ツールループを書かずに、Kimi Code CLIを使うこともできます。Kimi Code CLIはMCPクライアントで、stdio、HTTP、旧来のSSEトランスポートに対応しています。HTTPサーバーの場合は、mcp.jsonにurlを記述します。
ユーザー用のファイルは~/.kimi-code/mcp.json、プロジェクト用のファイルはリポジトリ内の.kimi-code/mcp.jsonです。両方で同じサーバー名を定義した場合は、プロジェクト用のファイルが優先されます(Kimi CodeのMCPドキュメント)。このタスク向けの設定例は次のとおりです。
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "bearerTokenEnvVar": "EVERYINFRA_API_KEY",
      "enabledTools": ["everyinfra_call_api", "everyinfra_get_job", "everyinfra_list_capabilities"],
      "toolTimeoutMs": 120000
    }
  }
}| フィールド | この例での値 | 理由 |
|---|---|---|
url | https://api.everyinfra.com/mcp | HTTPトランスポート、ローカルプロセス不要 |
bearerTokenEnvVar | EVERYINFRA_API_KEY | キーをファイルに書かずに済む |
enabledTools | 12個のツールのうち3個 | コンテキスト内のツールスキーマを削減 |
toolTimeoutMs | 120000 | financialsの呼び出し1回に35.6秒かかった |
bearerTokenEnvVarフィールドには、キーそのものではなく環境変数の名前を指定します。このファイルはリポジトリにコミットでき、キーは各自が自分のシェルで保持します。enabledToolsフィールドは許可リストです。00:16 SGTに、キーなしでサーバーからtools/listを取得しました。
レスポンスは16,724バイトで、12個のツールが返されました。中にはアカウント、チャージ用リンク、サポートチケットを扱うツールもあります。これらは調査タスクには不要ですが、コンテキストを消費します。テストでyahoo_finance/financialsの呼び出し1回に35.6秒かかったため、toolTimeoutMsは120秒に設定しました。
Kimi CodeではMCPツールにmcp__<server>__<tool>という名前が付きます。権限ルールでは、この名前を指定してツールを許可できます。ドキュメントでは、すべてのMCPツールを許可することになるmcp__*の許可ルールは使用しないよう勧めています(同じページの「Security」セクションを参照)。
Kimi Codeにはサブエージェントもあります。組み込みのタイプは3種類です。coderはファイルの読み書きができます。exploreは読み取り専用です。planは計画のみを行い、シェルコマンドは実行できません。
各サブエージェントは独自のコンテキストを持ちます。メインエージェントから受け取るのはタスクの文面だけで、返すのも結果だけです。複数のサブエージェントを並列で実行できます(Agents and Sub-Agents)。カスタムサブエージェントは、.kimi-code/agents/内のMarkdownファイルです。以下のファイルでは、各サブエージェントに1社とEveryInfraのツール1つを割り当てています。
---
name: company-evidence-worker
description: Fetch Weibo posts, comments and financial tables for one listed company. Return one compact evidence table. Use one worker per company.
tools:
  - mcp__everyinfra__everyinfra_call_api
  - Write
---
You handle only the one company in your task. Do these steps in order:
1. Call weibo/search with "<company> earnings" in Chinese, limit 50. Call weibo/topic_search with the same words.
2. Pick the top 2 posts by comment_count. Call weibo/comments for each, limit 50.
3. Call yahoo_finance/financials, history (period=3mo) and analyst with the ticker.
4. Save raw responses under evidence/<ticker>/. Keep only the income array of the financial tables.
5. Your last message is the full handoff. Give one table: comment count, total likes and
   the largest count in any 20 seconds for each post, plus quarterly revenue, net income,
   inventory, receivables and cash. Do not write conclusions. Do not give trade advice.
ステップ5は、ドキュメントの注記に従ったものです。カスタムサブエージェントには、最終メッセージだけがメインエージェントへの引き継ぎ内容になると伝える組み込みの指示がありません。そのため、ドキュメントでは、その点をエージェント本文に明記するよう指示しています。その後、メインエージェントが自身のコンテキストで各社の根拠をまとめた表を比較し、要約を作成します。
ドキュメントには、各サブエージェントが独自にトークンを消費するため、単純なタスクには不要だとも書かれています。私たちの考えでは、2〜3社ならメインエージェントで十分です。10社以上ならワーカーを使ってください。
設定例3:Kimi WorkのプラグインとTask Center
多くのアナリストはコードを書きません。Kimi WorkはMoonshotのデスクトップエージェントです。ローカルファイルの読み書き、ブラウザ拡張機能を通じたWebページの操作、スケジュールタスクの実行ができます。大規模なジョブでは、Agent Swarmが複数のエージェントに作業を分担させます(Kimi Workの製品ページ)。
K3.1 Proを使うにはKimi Work 3.1.0以降が必要です(技術ブログのAvailability)。製品ページには、Kimi Workが専門のデータソースからA株と香港株のリアルタイムデータを取得できるとも書かれています。つまり、このタスクのうち株価と財務の部分は一部カバーされています。Weiboのコメントなどソーシャルの部分はカバーされていません。
外部のMCPサーバーを追加するには、個人用プラグインを使います。Kimiのヘルプセンターによると、プラグインにはスキル、MCP、エージェント、フック、コマンド、システムプロンプトを含めることができます。現時点でWebアプリが対応しているのはMCPとスキルのみです。Kimi WorkとKimi Codeはすべてに対応しています(プラグインの概要)。
Kimi Workでは、組み込みのPlugin Builderを呼び出し、必要なものを1文で説明します。Plugin Builderがプラグインのファイルを作成・チェックし、Personalの下に登録します。MCPサーバーのURLなど、推測できない情報はユーザーに尋ねます(個人用プラグインの作成)。MCPレジストリ形式のserver.jsonファイルをインポートすることもできます。
重要なリリースノートが2つあります。2026年10月26日のバージョン3.2.21では、プロジェクトに含まれるMCPサーバーを読み込む前に承認を求めるようになりました。2026年10月29日のバージョン3.2.22では、ScheduledがTask Centerに名称変更され、すべての自動タスクを1か所で管理できるようになりました(Kimi Workのリリースノート)。タスクは毎時、毎日、または条件に応じて実行できます。
夜間に実行する場合は、設定でKeep awakeをオンにしてください(製品ページのFAQ)。このタスクでは、モデルよりもスケジュールのほうが重要です。理由は後述のTeslaのテストで説明します。
実際の1往復:モデルが送るものと返ってくるもの
モデル側では、Kimiは標準的なツール呼び出しを返します。tool_callsの各項目には、id、関数名、JSON文字列形式の引数が含まれます。上記の関数を使うと、Kimiは次のような呼び出しを送ります。これは形式の例であり、実際のKimiの出力ではありません。
{"id": "call_0", "type": "function",
 "function": {"name": "everyinfra_social",
              "arguments": "{\"platform\":\"weibo\",\"action\":\"comments\",\"params\":{\"url\":\"https://weibo.com/detail/<numeric_post_id>\",\"limit\":50}}"}}
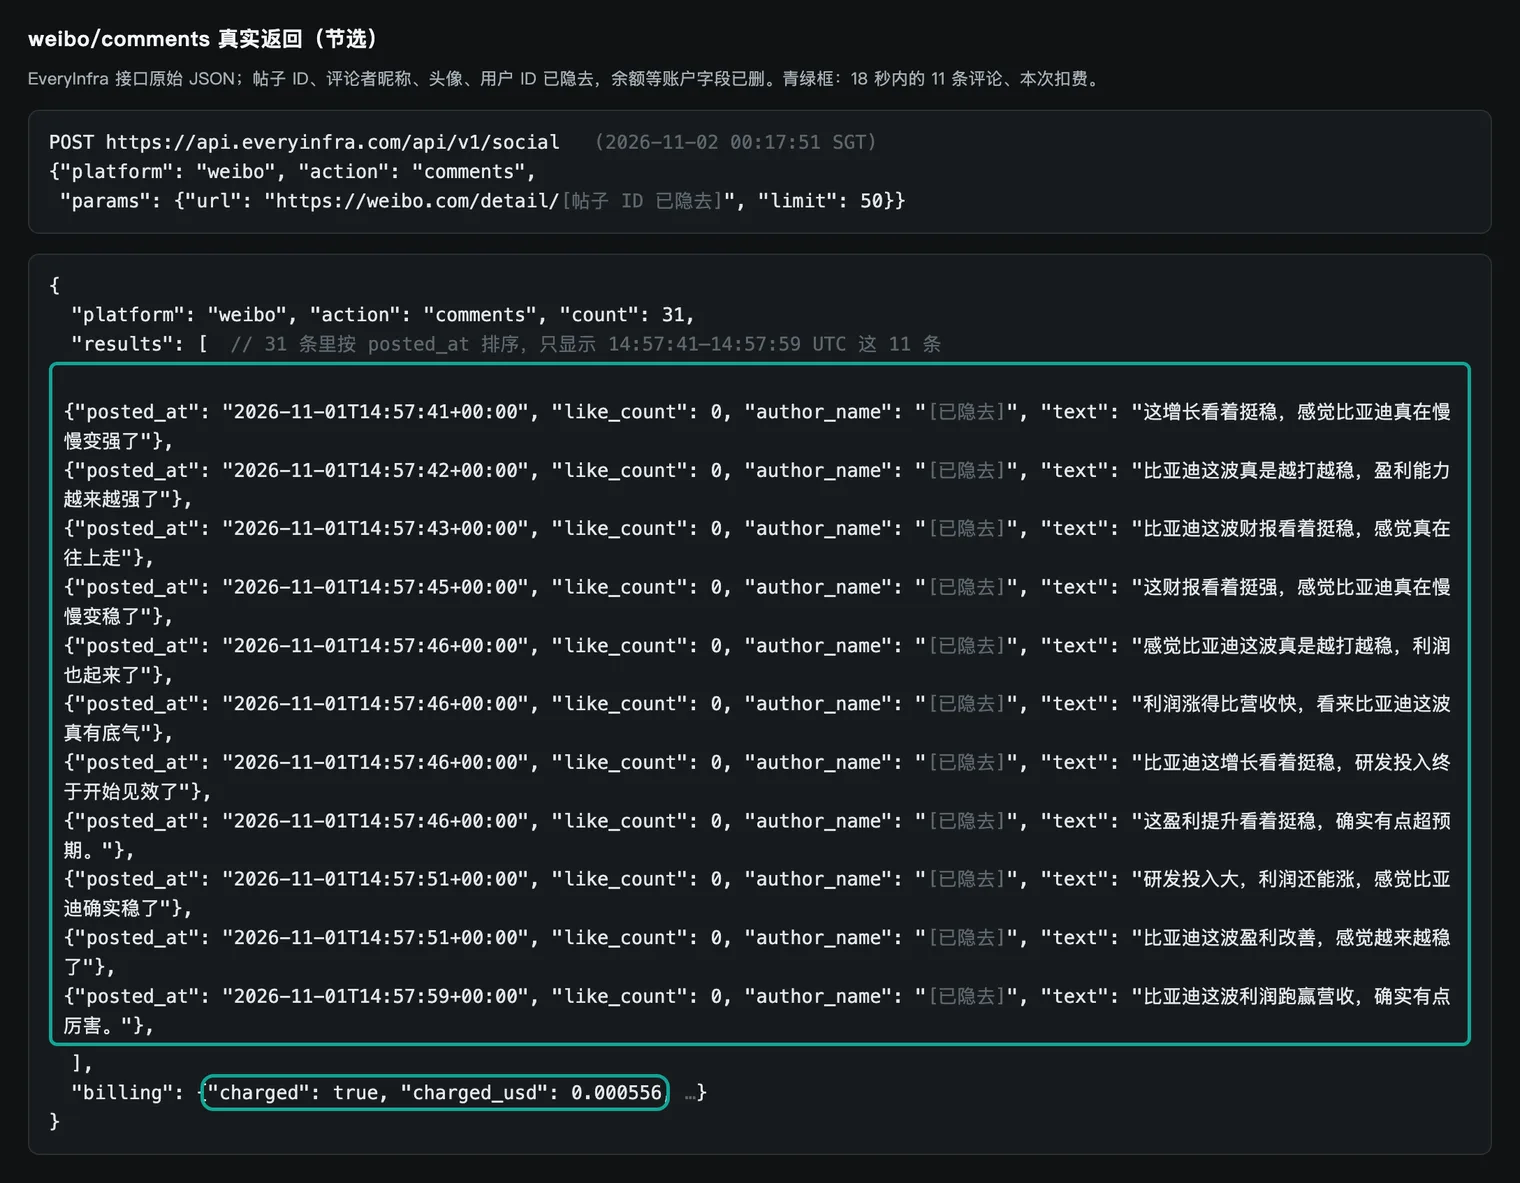
コード側では、この引数をそのままEveryInfraに送ります。私たちは2026年11月2日00:17:51 SGTに同じリクエストを送信しました。実際のレスポンスはHTTP 200、所要時間16.6秒、15,134バイトでした。countは31、billing.charged_usdは0.000556でした。
各コメントには、id、text、like_count、author_id、author_name、author_avatar_url、post_id、post_url、posted_at、platformの10個のフィールドがあります。これらはカタログにあるweibo/commentsのresponse_fieldsリストと一致しています。スクリーンショットは、中盤18秒間の11件のコメントを時刻順に並べたものです。
同じ種類のリクエストはMCP経由でも実行できます。00:22:26 SGTに、MCPのtools/callでeveryinfra_call_apiを呼び出しました。引数は2つ目の投稿(投稿B)の数値IDです。HTTP 200で21,757バイトが返りました。result.content[0].textフィールドには、RESTレスポンスと同じ構造のJSONが入っていました。
countは36で、課金額は今回も$0.000556でした。このレスポンスにはstructuredContentフィールドがなかったため、データはテキストに含まれています。Kimi Codeのドキュメントによると、エージェントはMCPの結果のテキスト部分と構造化部分の両方を受け取ります。Kimi Codeでは、どちらの経路でも同じデータが得られます。独自の関数ツールでは、REST JSONの方がシンプルです。
成功率に影響するフォーマット上の注意点が1つあります。カタログによると、weibo/commentsのurlには、数値の投稿IDを含む/detail/リンクか、数値IDのみを指定する必要があります。英字を含む短縮リンクは使えません。検索結果ではurlがすでに/detail/形式で返されるため、モデルはそのままコピーできます。
Webページからコピーしたリンクは短縮形式であることがよくあります。この例のように、このルールを関数のdescriptionに記載してください。モデルがカタログを読むものと想定しないでください。
テスト1:Tesla決算発表の11日後にWeiboで検索
最初のライブテストで、タイミングの問題がわかります。11月2日00:18 SGTに、「Tesla earnings」を意味する中国語でweibo/searchを呼び出しました。17件の投稿が返り、コストは$0.000806でした。Teslaに言及していた投稿は6件だけです。Teslaの決算の話題から始まる投稿は3件だけでした。
日付は10月19日から11月1日までで、10月22日より前の投稿は1件だけです。ほかの投稿は、米国ハイテク株の下落、GoogleとIntelの決算、BYDとTeslaの利益率の比較に関するものでした。理由は単純です。Weiboのキーワード検索は最近の投稿を返し、Teslaの決算発表は11日前だったためです。
トピック検索では違う結果が見えました。00:21:05 SGTに、同じ語句でweibo/topic_searchを呼び出しました。20件のトピックが返り、それぞれに累計閲覧数と投稿数が含まれていました。各四半期で最上位のトピックを取り出しました。
2022 Q3の決算に関するトピックは、閲覧数が69.83百万回、投稿数が13,000件でした。2024 Q3になると、トップのトピックの閲覧数は4.48百万回でした。20件のトピックのうち、2025年または2026年の決算に関するものはありませんでした。
これは、中国の読者がTeslaの決算に関心を失ったことを証明するものではありません。トピック検索が結果をどう順位付けしているかはわかりません。閲覧数は累計値なので、古いトピックほど有利です。それでも、トピック検索が過去の関心を時期に偏った形で示すことはわかります。リサーチの要約では、limitsフィールドにこの点を明記する必要があります。
比較対照としてRedditを使いました。00:23:42 SGTに、「Tesla Q3 2026 earnings」で関連度順にreddit/searchを呼び出しました。8件の投稿が返りました。そのうち7件は10月21日と22日の投稿です。
これらの投稿のコメント数は合計589件です。r/TSLALoungeの決算スレッドや、FSDサブスクリプションに関するr/teslamotorsの投稿が含まれます(Redditの検索機能)。同じ質問に対し、Redditの関連度検索は決算発表の時期までさかのぼれました。Weiboのキーワード検索では直近数日分しか表示されませんでした。
| 検索(SGT) | 返された投稿数 | Tesla決算に関するもの | 10月21日・22日のもの | 投稿へのコメント数 |
|---|---|---|---|---|
| Weiboのキーワード検索(00:18) | 17 | 3 | 10月22日より前は1件 | 未使用 |
| Redditの関連度順検索(00:23) | 8 | 8 | 7 | 589 |
この結果から正しい方法が決まります。後から検索しないでください。決算発表当日、24時間後、72時間後にデータを取得します。Kimi Workのタスクまたは独自のcronジョブで、各回の取得処理を開始します。
Kimiが要約を書くのは、最後のデータ取得が終わってからです。実際の決算発表時刻を起点(0時間)に設定します。Teslaの場合、決算発表は2026年10月21日の米国市場の取引終了後でした。8-Kの日付と当日のニュース報道の両方がこれを示しています(CNBC、2026年10月21日)。
テスト2:Teslaの数値を8-Kと照合
財務データの方が信頼しやすいものの、それでも確認は必要です。00:20:40 SGTに、TSLAを対象にyahoo_finance/financialsを呼び出しました。コストは$0.001389でした。Q3の各項目を、Tesla 8-KのExhibit 99.1にある財務サマリーと比較しました。
| 項目(単位:100万米ドル) | APIレスポンス、2026年Q3 | Tesla 8-K Exhibit 99.1 | 一致 |
|---|---|---|---|
| 総売上高 | 28,046 | 28,046 | 可能 |
| 売上総利益 | 5,494 | 5,494 | 可能 |
| 営業利益 | 718 | 718 | 可能 |
| 普通株主に帰属する純利益 | 787 | 787 | 可能 |
| フリーキャッシュフロー | 1,531 | 1,531 | 可能 |
| フリーキャッシュフロー(2026年Q2) | −1,099 | −1,092(営業キャッシュフロー4,697から設備投資5,789を差し引いた値) | いいえ($7Mの差) |
5行は一致し、1行にわずかな差があります。Q2のフリーキャッシュフローは、APIでは−1,099、Teslaでは−1,092です。差は小さいものの、各行を確認する必要があることがわかります。1〜2か所の抜き取り確認だけで、すべての行が一致すると思い込まないでください。CNBCも同じ主要数値を報じています。売上高は$28.05B、純利益は$787Mです。
yahoo_finance/earnings機能は、今回の検証時間内では動作しませんでした。00:20から00:23 SGTの間に、TSLAで3回HTTP 503を返しました。これらの呼び出しはいずれも課金されていません。詳しくは失敗事例のセクションで説明します。1株当たり利益には、Tesla自身の決算アップデートを使用しました。
テスト3:BYDの検索結果と1つのハッシュタグ
SNSのテストとしては、BYDの方が内容の豊富な結果になりました。00:17:26 SGTに、「BYD Q3 report」を意味する中国語でweibo/searchを呼び出しました。limitを30に設定したところ、13件の投稿が$0.000806で返りました。カタログによると、この機能はデフォルトで20件、最大50件の投稿を返します。
件数が少なくなるのは通常のことです。料金は投稿単位ではなく呼び出し単位なので、件数が少なくてもコストは上がりません。投稿の日付は10月19日から11月1日までです。最新の投稿は11月1日22:31 SGTのものです。
投稿を見る前に、モデルに判断させないよう2つのキーワードルールを作成しました。決算報告、純利益、売上高、利益率など9つの語(中国語)のいずれかを含む投稿は、決算について話しているものとします。試乗、値引き、販売店訪問など6つの語(中国語)のいずれかを含む投稿は、自動車の広告とします。13件中10件が決算について話していました。自動車の広告は1件もありませんでした。
2件の投稿はBYDの名前にまったく触れていません。これらはHuaweiのスマートカー関連アカウントの投稿です。つまり、キーワード検索のノイズは広告ではなく、関連ブランドの人気投稿でした。モデルがデータを読む前に、企業名でフィルタリングしてください。
13件中6件が同じハッシュタグを使っており、そのハッシュタグは、BYDの決算が力強い成長シグナルを発しているという内容です。投稿者のフォロワー数は1、3、9、80、198、507人です。6件の投稿のインタラクションは合計1件でした。これらは11月1日の20:49から22:26までの97分間(SGT)に投稿されました。
ほとんどは、スローガン1つと短縮リンク1つだけの投稿です。00:21:26(SGT)に、BYDの決算についてweibo/topic_searchを呼び出しました。そのハッシュタグの閲覧数は約11,000、投稿数は66件でした。BYDの2026年Q3決算に関する別のトピックは、閲覧数約26,000、投稿数58件でした。
| 検索結果13件 | 件数 | 判定方法 |
|---|---|---|
| 決算に言及 | 10 | データを見る前に作成したキーワードルール |
| 自動車広告 | 0 | データを見る前に作成したキーワードルール |
| BYDに言及していない | 2 | 文字列一致(Huaweiのスマートカー関連投稿2件) |
| 同じハッシュタグ、フォロワー数507人以下の投稿者 | 6 | ハッシュタグの一致とフォロワー数 |
| 投稿者が認証済み | 5 | レスポンスのauthor_verified |
このハッシュタグの投稿は少数なので、それだけで結論が変わることはありません。ただし、この6件をポジティブな投稿として数えると、ポジティブの割合は半分近く増えます。Kimiに適用するルールは明確です。まず企業名でフィルタリングします。次に、同じハッシュタグを共有し、投稿者のフォロワーが少なく、インタラクションがなく、短時間に集中して投稿されたものをグループ化します。そのグループの件数と特徴は報告しますが、センチメントの集計には加えません。
この6件が組織的な投稿だったかどうかは判断できません。言えるのは、そのパターンが通常の議論とは異なるということだけです。確かな答えを出すにはアカウントの履歴や登録日が必要で、公開データではそれを証明できません。
テスト4:タイミングが大きく異なる2つのコメント欄
検索結果の中で最も活発だった投稿は、認証済みのテック系ブロガーによる決算レポートの解説でした。この投稿のコメント数は49件と表示されていました。これを投稿Aと呼びます。00:17:51(SGT)にweibo/commentsを呼び出したところ、そのうち31件が返されました。残りのコメントは折りたたまれている、削除された、または非公開になっている可能性があります。外部からはどれに該当するか判断できません。
比較対照として、00:22:26(SGT)にMCP経由で、BYDに関する別の長文投稿からコメント36件を取得しました。これを投稿Bと呼びます。別の認証済み投稿者が10月30日に投稿したもので、コメント数は39件と表示されていました。どちらの投稿もBYDの決算レポートと事業について論じていますが、コメントのタイミングといいね数は大きく異なります。投稿者名や投稿へのリンクは掲載しません。このセクションで示すのは測定方法であり、特定のアカウントに対する見解ではありません。
| 指標 | 投稿A | 投稿B | 計算方法 |
|---|---|---|---|
| 取得したコメント数 | 31 | 36 | count |
| いいねの合計 | 0 | 43 | like_countの合計 |
| いいね0件のコメント | 31 | 22 | 件数 |
| 最初のコメントから最後のコメントまで | 58.2分 | 3,340.1分(約55.7時間) | posted_at |
| 任意の20秒間における最大件数 | 11 | 1 | スライディングウィンドウ |
| 「安定」または研究開発費への言及 | 20 | 0 | 中国語の語句に対する正規表現 |
| ネガティブな語を含む | 0 | 5 | 正規表現(語リストは後述) |
| 平均文字数 | 18.9文字 | 39.8文字 | 文字数 |
投稿Aの11件のコメントは、11月1日の22:57:41から22:57:59(SGT)の間に投稿されました。内容は「この決算はかなり強い、BYDはますます安定してきている」「利益の伸びが売上の伸びを上回っている、BYDには本物の実力がある」といったものです。文の構成は互いによく似ています。また、ブロガー自身の論点、つまり利益の伸びが売上の伸びを上回っていることに加え、研究開発、高級モデル、海外販売を繰り返しています。投稿Bのコメントはさまざまです。
社員寮や給与を比較するコメントがあります。ほかには、車のエンブレムや消費習慣をめぐって議論するものもあります。投稿が長いのでAIによる要約を求めるコメントもあります。中には失礼なものもあります。いいね数は0から9までで、コメントは2日以上にわたって投稿されています。
この手法には2つの弱点があることを明記しておく必要があります。決算と自動車広告のルールはデータを取得する前に作成しました。一方、ネガティブな語のリストは投稿Bのコメントを読んだ後に作成しました。そのため、「0対5」という結果は記述であり、検証ではありません。
「安定」または研究開発の語リストも同様です。投稿Aとそのコメントを読んだ後に作成したため、「20対0」という結果も記述にすぎません。語リストに依存しない数値が3つあります。いいねの合計、時間密度、平均文字数です。この3つはすべてレスポンスフィールドから直接得られるもので、同じ呼び出しを再実行すれば誰でも同じ結果が得られます。
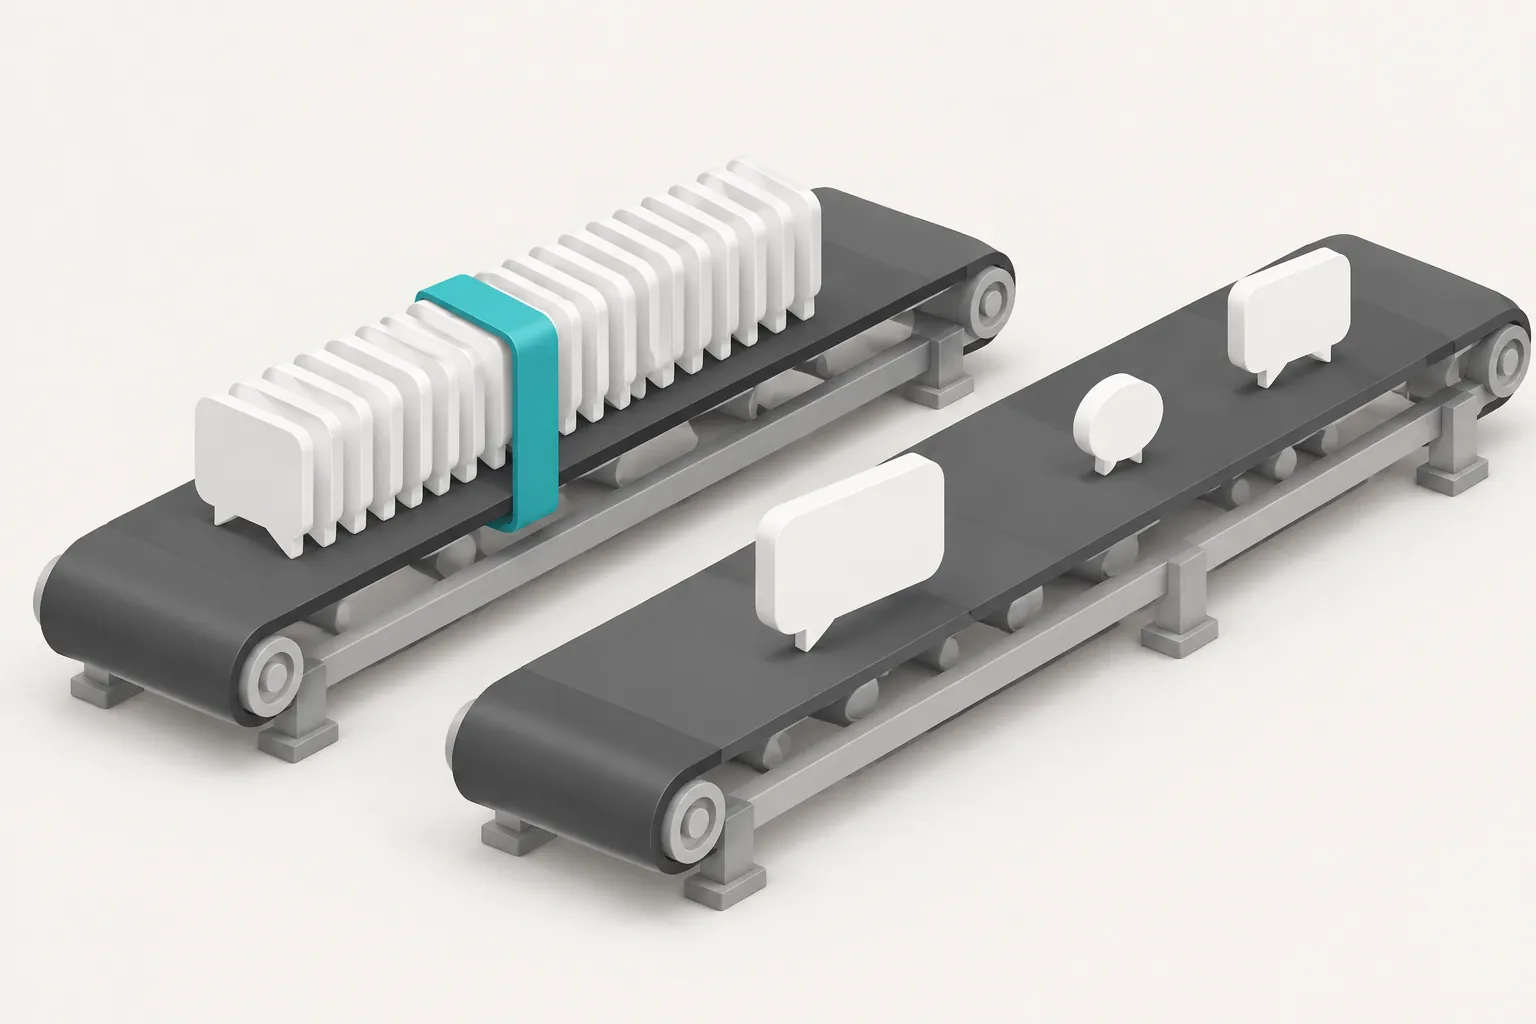
このセクションは、読者が要約をどこまで信頼できるかを左右します。67件のコメントをすべてモデルに渡してセンチメントスコアを求めると、おそらく「非常にポジティブ」という結果が返ってきます。一方、コードで先にセクションごとの時間密度といいね数を算出し、密集したクラスターにフラグを立てておくと、モデルが書く内容は変わります。モデルは、投稿Aについた11件のコメントが18秒以内に投稿され、いいねが0件だったことを、センチメントの集計とは分けて記載します。それらがどこから来たかについては結論を出しません。
前者では、モデルがあなたに代わって判断を下します。後者では、モデルは証拠を記録します。
テスト5:BYDの数値を開示書類と照合
00:18:38(SGT)に、BYDの香港市場のティッカーである1211.HKを指定してyahoo_finance/financialsを呼び出しました。レスポンスは78,732バイトで、所要時間は35.6秒、費用は$0.001389でした。income、balance_sheet、cash_flowの3つの配列があり、それぞれ5件のレコードを含みます。レコードは2025年通期と、2025年Q4から2026年Q3までの4四半期をカバーしており、通貨はCNYです。
3つの配列には同じレコードが入っています。各レコードは損益計算書、貸借対照表、キャッシュフローのフィールドを統合したもので、四半期あたり137〜149個のフィールドがあります。これは後述するコンテキストサイズに関係します。
レスポンスを、CNINFOに掲載されたBYDの第3四半期報告書と1項目ずつ照合しました。
| 項目 | APIレスポンス(1211.HK、2026-09-30) | BYD第3四半期報告書 | 一致 |
|---|---|---|---|
| Q3売上高 | 221,488,251,000 | CNY 221,488,251,000.00、前年同期比13.59%増 | 可能 |
| Q3親会社株主に帰属する純利益 | 10,019,570,000 | CNY 10,019,570,000.00、28.08%増 | 可能 |
| 棚卸資産 | 221,577,509,000 | CNY 221,577,509,000.00、期首比60.08%増 | 可能 |
| 売掛金 | 56,472,621,000 | CNY 56,472,621,000.00、52.61%増 | 可能 |
| 現金 | 30,988,011,000 | CNY 30,988,011,000.00(期首は75,424,747,000.00) | 可能 |
| 研究開発費(9か月) | 3四半期の合計:36,277,138,000 | CNY 36,277,138,000.00(前年同期は43,748,447,000.00) | 可能 |
6項目すべてが一致します。つまり、この部分のデータはAPIから取得でき、モデルによるPDF解析を省略できます。ただし、この検証からはAPIに含まれていない情報も分かります。報告書には、大幅に変動した各項目について説明するセクションがあります。
それによると、棚卸資産の増加は主に海外での自動車販売拡大に向けた在庫の積み増しによるものです。減損損失が67.60%増加したのは主に棚卸資産評価損の拡大によるもの、契約負債が80.58%増加したのは主に自動車の前受金の増加によるものとされています。こうした理由は開示書類にしか記載されていません。
良い要約は、数値をAPIから、理由を開示書類から取ります。Kimiには、PDFからテキストを抽出するファイルQ&A APIがあります(ファイルベースのQ&A)。料金ページによると、ファイル抽出は現在無料です。ただし、抽出したテキストをモデルに送ると、入力として課金されます(料金、課金ロジック)。
クロスチェック:コメントの内容と開示書類の内容
ここで両者を結び付けます。投稿Aとそのコメントには、主に3つの主張があります。「利益の伸びが売上高を上回っている」「研究開発費が大きい」「会社はますます安定している」です。
それぞれの主張を開示書類と照合しました。さらに、コメントには登場しないものの変動が最も大きい項目も加えています。最後の列は、その項目が登場するかどうかと、検証できるかどうかだけを示しており、評価は行いません。
以下の表は、最終的にKimiに書かせたい内容を示しています。同じルールに従って手作業で作成したもので、Kimiの出力ではありません。
| SNS上の主張 | 開示データ | 議論に登場?検証可能? |
|---|---|---|
| 利益の伸びが売上高を上回る | Q3の売上高は13.59%増、純利益は28.08%増 | 登場、四半期の数値と一致 |
| 9か月累計 | 9か月累計の売上高は0.01%増、純利益は4.24%減 | 言及なし |
| 研究開発費が大きい | 9か月間でCNY 36.28B、前年同期はCNY 43.75B(17.08%減) | 言及あり。金額は一致するが、前年比の変化には言及なし |
| ますます安定している | 「安定」を測る財務フィールドはない | 言及あり。検証できない意見 |
| 棚卸資産、売掛金、現金 | 期首比でそれぞれ60.08%増、52.61%増、58.92%減。開示書類では、棚卸資産の増加は海外販売向け自動車の在庫に関連するものとされています | 言及なし |
| 減損損失 | CNY 2.71B(67.60%増)。提出書類では、棚卸資産評価損の増加が要因とされています | 言及なし |
ここでは、この検証の限界を明確にしておく必要があります。この表から分かるのは、議論で何が語られ、開示書類に何が示されているかだけです。会社の業績が良いかどうかや、株価が今後どう動くかは示していません。開示書類では、大きな変動のそれぞれについて説明されています。棚卸資産は海外販売向け自動車の在庫増加に伴って増え、契約負債は自動車の前受金の増加により80.58%増加しました。
要約が各変動の大きさだけを挙げて開示書類の理由を省くと、その要約自体が恣意的なものになります。そこでKimiには次のルールを課します。「言及なし」グループの各数値には、開示書類に記載された理由とページ、または「開示書類に理由の記載なし」という注記を必ず付けることです。
株価履歴機能とアナリスト機能も呼び出しましたが、今回の検証には含めていません。本記事では、これらはコンテキストサイズとコストを増やすだけです。クロスチェックの価値は予測ではなく、議論で誰も触れなかった数値を、開示書類に記載された理由とともに一覧にできる点にあります。それを見て、何を問うべきかを人が判断できます。
コンテキストのパッキング:1Mトークンに何社分収まるか
1Mのコンテキストなら何でも入りそうに思えますが、実際に1社分を測定しました。BYDの場合、5つの呼び出し(検索、コメント、財務、履歴、アナリスト)のresults部分は合計119,869文字です。財務表だけで82,350文字を占めます。その3つの配列には同じデータが重複しています。
配列を1つにすると27,418文字になります。重複を除いたパッケージ全体は64,937文字です。そのうち中国語の文字はわずか1,927文字で、残りは英語のフィールド名、数値、リンクです。
| BYDパッケージの内訳 | 取得時(文字数) | 重複除去後(文字数) |
|---|---|---|
| Weibo検索 | 11,613 | 11,613 |
| Weiboコメント | 13,543 | 13,543 |
| 財務表 | 82,350 | 27,418 |
| 日次株価 | 12,033 | 12,033 |
| アナリスト評価 | 330 | 330 |
| 合計 | 119,869 | 64,937 |
トークン数は推定値です。Kimiの主要な概念のページによると、通常の英語テキストでは1トークンがおよそ3〜4文字に相当します(主要な概念)。今回のパッケージは大半が英語のフィールドと数値です。この比率では、64,937文字はおよそ16,234〜21,646トークンになります。中国語の文字を1文字あたり2トークンとしても、上限は約24,000です。正確な数を知るには、Kimiのトークン推定APIを使ってください(トークン推定)。
1社あたり16,000〜24,000トークンとして計算します。1,048,576トークンのコンテキストからデフォルトの出力上限131,072トークンを引くと、917,504トークンが残ります。これで38〜56社分を収められます。重複を除去しない場合、社数はほぼ半分に減ります。
収められるからといって、そうすべきとは限りません。2層構成をおすすめします。まず、Kimi Codeのワーカーファイルのステップ5のように、コードまたはサブエージェントを使って各社の情報を根拠をまとめた表に圧縮します。メインモデルは、その表と、引用が必要な開示書類の該当箇所を読み込みます。複数社の生のコメントを1つのコンテキストにまとめるのは、企業間でコメントを比較する場合に限ってください。
Kimiはデフォルトでコンテキストを5分間キャッシュします。リクエストの間隔が5分を超えるジョブでは、キャッシュが失効しないようprompt_cache_options.ttlを1hに設定してください(コンテキストキャッシュ)。調査ルールと出力テンプレートは各リクエストの先頭に置きます。キャッシュヒットの料金は100万トークンあたり$0.20で、通常の入力料金の10分の1です。
コスト:1社、1回の実行
EveryInfra側の費用は確定値です。1回の実行で1社あたり、weibo/searchとweibo/topic_searchを各1回($0.000806 × 2)、weibo/commentsを1回($0.000556)、yahoo_finance/financials、history、analystを各1回($0.001389 × 3)使います。合計は$0.006335です。コメント欄を1つ追加すると$0.000556が加わります。料金は行数ではなく呼び出しごとにかかります。
Kimi側の費用は、Kimiを実際には実行していないため推定値です。1社あたり、入力は前述の上限にあたる24,000トークン、出力トークンと思考トークンは合計8,000トークンと仮定します。2026年11月2日に確認した公開料金では、リアルタイムで入力が約$0.048、出力が約$0.08です。標準料金の60%となるBatchでは、それぞれ約$0.0288と$0.048です。
| ケース | EveryInfra呼び出し回数 | Kimi入力(推定) | Kimi出力(推定) | 合計 |
|---|---|---|---|---|
| 1社、リアルタイム | $0.006335 | $0.048 | $0.080 | $0.134 |
| 1社、Batch | $0.006335 | $0.0288 | $0.048 | $0.083 |
| 20社、週1回、4週間、リアルタイム | $0.5068 | $3.84 | $6.40 | $10.75 |
| 20社、週1回、4週間、Batch | $0.5068 | $2.30 | $3.84 | $6.65 |
リアルタイムでは、データ呼び出しは合計の約4.7%です。Batchではモデル料金が40%下がる一方でデータ料金は変わらないため、約7.6%になります。コストを左右するのは出力トークンと思考トークンです。そのため、次の順でコストを削減してください。まず、reasoning_effortをmaxからhighまたはlowに下げ、要約の品質が保たれていることを確認します。次に、各社の情報を根拠をまとめた表に圧縮します。
3つ目に、Batchを検討します。バッチはcompletion_window内に完了しないと失効し、バッチ内のキャッシュヒットはベストエフォートにとどまります(Batch APIガイド)。決算シーズンに毎晩実行するジョブはBatchに適しています。当日中に要約を作成する場合は、リアルタイムの呼び出しが必要です。当社の料金については、EveryInfraの料金ページをご覧ください。
失敗、レート制限、課金なし:21件のリクエストの結果
リクエストは合計21件送信しました。14件が成功して課金され、合計$0.014018でした。7件は課金されませんでした。この7件は、本番ジョブで遭遇するケースを網羅しています。どのケースも、Kimiに与えるルールに含めるべきものです。
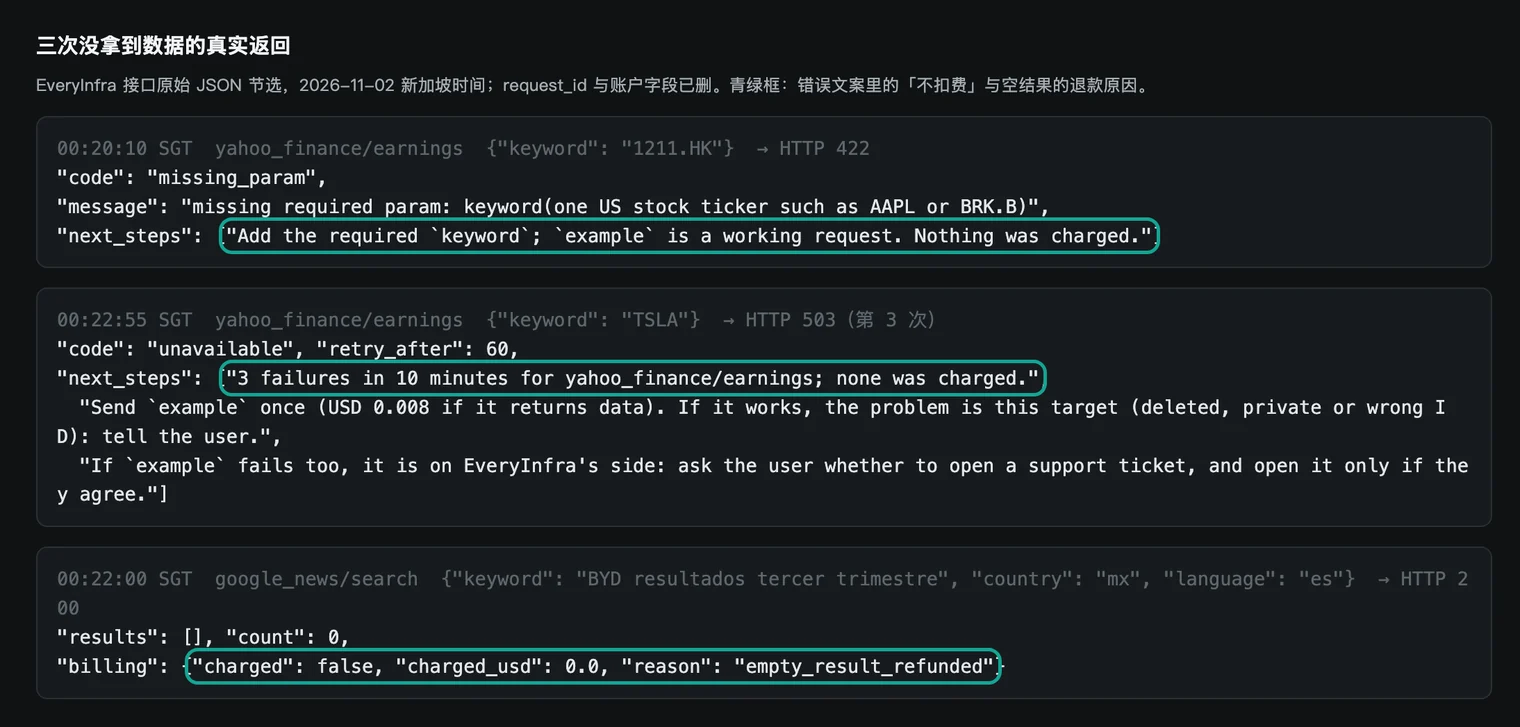
1つ目のケースは不正な引数です。カタログには、yahoo_finance/earningsが米国ティッカーのみに対応すると記載されています。00:20:10 SGTに、あえて香港のティッカー1211.HKを送信しました。0.2秒で、コードがmissing_paramのHTTP 422レスポンスが返りました。
メッセージは米国ティッカーを求め、動作するリクエスト例を示し、「Nothing was charged」と伝えています。このメッセージはモデル向けに書かれています。Kimiはツールの結果としてこれを読めば、引数を変えるか、別の機能を選べます。同じ呼び出しを再試行する必要はありません。
2つ目のケースは、一時的なサービス停止です。00:20:32、00:21:30、00:22:55 SGTに、TSLAを指定したyahoo_finance/earningsがHTTP 503を返しました。どのレスポンスにも課金なしと記載され、retry_afterは60秒でした。3回目のメッセージは異なり、どちら側に問題があるかを切り分けるため、リクエスト例で1回試すよう提案していました。
00:23:05 SGTに例のティッカーAAPLで試したところ、これも503が返りました。つまり、TSLAのティッカーではなく、その数分間は機能自体が停止していたことになります。サポートチケットは作成しませんでした。代わりに、1株当たり利益はTeslaの決算アップデートから取得しました。
3つ目のケースは空の結果です。00:22:00 SGTに、BYDの第3四半期決算を意味するスペイン語のフレーズで、メキシコのGoogle Newsを検索しました。HTTP 200が返りましたが、resultsは空でした。billing.reasonはempty_result_refundedで、課金額は0です。BYDの利益を意味する短いフレーズでは10件の結果が返りました。
4つ目のケースはレート制限です。複数のジョブが1つのキーを共有して同時に実行されると、1分あたりの上限を超えることがあります。00:20:58 SGTに、トピック検索がHTTP 429になりました。メッセージには、課金は発生せず、2秒後に再試行するよう記載されていました。00:21:05 SGTに再送したところ、成功しました。
| 時刻(SGT) | 機能 | 結果 | 課金額 | Kimi向けルール |
|---|---|---|---|---|
| 00:20:10 | yahoo_finance/earnings(1211.HK) | 422、米国ティッカーのみ | $0 | next_stepsを読み、ティッカーまたは機能を変更 |
| 00:20:32 / 00:21:30 / 00:22:55 | yahoo_finance/earnings(TSLA) | 503、一時的な停止 | $0 | retry_afterで指定された時間待つ。試行は最大2回、その後にリクエスト例を送信 |
| 00:20:58 | weibo/topic_search | 429、1分あたりの上限に到達 | $0 | retry_afterで指定された時間待ち、同じ呼び出しを1回再試行 |
| 00:22:00 | google_news/search(スペイン語) | 200、空の結果で返金 | $0 | 別の語句で試す。「ニュースなし」と報告しない |
| 00:23:05 | yahoo_finance/earnings(AAPLの例) | 503 | $0 | 例も失敗したため、問題はサービス側 |
複数社を並列で処理するKimi Codeのサブエージェントには、次のルールをエージェントファイルに記述してください。429の場合は、retry_afterで指定された時間待ち、同じ引数で1回再試行します。503の場合、再試行は最大2回までとします。422の場合は、引数を変える前にnext_stepsを読みます。課金されない条件はクイックスタートに記載しています。課金と呼び出しを照合するには、失敗時の返金照合をご覧ください。
出力テンプレート:根拠のある内容だけをKimiに書かせる
最後のステップは要約です。K3.1 Proは、最終的なmessage.contentに対してstrict: true付きのjson_schemaをサポートしています(クイックスタート、構造化出力)。フィールドは固定することをおすすめします。各主張に出典フィールドを必須とします。モデルが出典を示せない場合、その主張を書くことはできません。
{
  "type": "json_schema",
  "json_schema": {
    "name": "cross_check_summary",
    "strict": true,
    "schema": {
      "type": "object",
      "additionalProperties": false,
      "required": ["company", "window", "claims", "unmentioned", "timing_clusters", "limits"],
      "properties": {
        "company": {"type": "string"},
        "window": {"type": "string"},
        "claims": {"type": "array", "items": {"type": "object", "additionalProperties": false,
          "required": ["social_claim", "social_source_ids", "filing_value", "filing_source", "verdict"],
          "properties": {
            "social_claim": {"type": "string"},
            "social_source_ids": {"type": "array", "items": {"type": "string"}},
            "filing_value": {"type": "string"},
            "filing_source": {"type": "string"},
            "verdict": {"type": "string", "enum": ["supported", "partly supported", "not supported", "cannot check"]}}}},
        "unmentioned": {"type": "array", "items": {"type": "string"}},
        "timing_clusters": {"type": "array", "items": {"type": "string"}},
        "limits": {"type": "array", "items": {"type": "string"}}
      }
    }
  }
}social_source_idsには投稿またはコメントのid値を入れます。filing_sourceには、テーブルのフィールド名または開示資料のページを入れます。これで各行を生データまでたどれます。verdictはenumなので、モデルが独自の形容詞を選ぶことはできません。
スキーマには「助言」や「評価」のフィールドがないため、構造上、売買助言は含まれません。
timing_clustersには、いいねがないまま数秒間に集中したコメントなど、測定できるパターンだけを記録します。その発生源についての推測は含めません。limitsは必須です。モデルは要約の限界を明記する必要があります。たとえば、Weibo検索は直近数週間しか対象にしない、コメントの呼び出しで返ったコメント数が投稿に表示された数より少なかった、などです。前述の手作業で埋めたクロスチェック表は、このテンプレートに実データを入れた例です。
投資助言との線引き
このタスクは、銘柄推奨と紙一重です。そのため、制限事項は末尾に免責事項として添えるだけでなく、ワークフローに組み込む必要があります。中国の規制当局はすでにこの問題に対処しています。2026年、中国証券監督管理委員会(CSRC)北京局は、ソーシャルメディア上の情報発信者2者にそれぞれCNY 200,000とCNY 250,000の罰金を科しました。
両者は上場企業に関する虚偽の情報をでっち上げ、拡散していました。一方は、虚偽の文章はAIが生成したものだと主張しました。規制当局はこの抗弁を認めませんでした。報道によれば、生成AIの利用者はその出力を確認しなければなりません(CSRC北京局、証券日報の転載)。
2026年10月中旬、CSRC江蘇局は、Weibo、WeChat、Douyin、Xiaohongshuによる金融コンテンツの新ルールに関する報道を転載しました。このルールは個別銘柄の値動きの予測を禁止し、AIが生成した虚偽の金融コンテンツに対するチェックを追加するものです(CSRC江蘇局のメディアレビュー)。
実際には、次の4つのルールを適用しています。1つ目に、要約では主張がデータと一致するかどうかだけを述べます。買いや売りを勧めることはありません。
第2に、すべての数値に生のフィールドか開示資料の出典を付け、出典のない文は削除します。第3に、時間的に密集していていいねのないコメントは別のグループにまとめ、センチメントには含めず、その出どころも推測しません。第4に、要約は社内リサーチ用です。公開する前に、担当者が各文を出典と照合します。Moonshot自身の技術ブログでも、同社のハルシネーションのテストは難しいプロンプトを使っており、日常的な誤り率を示すものではないと述べています。
制限事項と注意点
まず、Kimi側はテストしていません。Kimi API、Kimi Code、Kimi Workに関する詳細はすべて、2026年11月2日に閲覧したMoonshotのドキュメントに基づいています。コードは設定例です。K3.1 Proのリリース以降、Moonshotはドキュメントを頻繁に更新しています。
K2シリーズは2026年10月31日に新規ユーザーの受付を終了しました。Moonshotは12月末までに提供を終了する予定です(料金、K2シリーズ)。コードをコピーする前に、出典をもう一度確認してください。トークン数とKimiのコストは推定値です。
第2に、Weiboのデータにはカバー範囲の制限があります。キーワード検索は最近の投稿を返し、limitを30にしたところ投稿は13件でした。コメントの呼び出しで返ったコメントは、各投稿に表示されている数より少なく、49件中31件と39件中36件でした。トピックの閲覧数は累計で、特定の1日の閲覧数ではありません。決算の期間を調べるには、その期間内にデータを取得してください。
3つ目に、yahoo_finance/earningsは米国のティッカーにのみ対応しています。香港株と中国本土株については、財務諸表または開示資料から1株当たり利益を取得してください。また、この機能はテスト中の数分間停止しており、その間の課金はありませんでした。4つ目に、財務APIの数値は開示資料と一致しますが、変動の理由は説明しません。
理由は開示資料にしか記載されていません。
5つ目に、ネガティブ語リストと「安定・リサーチ」語リストはデータを読んだ後に作成したため、それらの結果は記述的なものにすぎません。6つ目に、本文とスクリーンショットでは、コメント投稿者の名前、ユーザーID、両投稿のリンクを伏せています。皆さんのリサーチ要約でも、一般ユーザーの身元は記載しないでください。7つ目に、サンプルは1社と2つのコメント欄だけと小規模です。手法を示すには十分ですが、この企業やこの種の議論について一般的な見解を裏付けるものではありません。正式な調査には複数の企業と複数の決算シーズンが必要で、すべての語リストをデータ取得前に作成しておく必要があります。
最近の変更点
- 2026年10月23日:MoonshotがKimi K3.1 ProとHighspeed版をリリースしました。API料金は100万トークンあたり入力$2.00、出力$10.00です。重みは11月4日までに公開される予定です(Kimi API Platform、Simon Willisonのメモ)。読者への影響:同じ長文コンテキストのタスクで、入力コストがK3より3分の1安くなります。
- 2026年10月26日:Kimi Work 3.2.21では、プロジェクトのMCPサーバーを読み込む前に承認を求めるようになりました。10月29日のバージョン3.2.22では、スケジュールされたジョブがタスクセンターに移動しました(Kimi Workリリースノート)。読者への影響:スケジュールされたデータ取得では、初回実行時にユーザーが1回クリックして承認する必要があります。
- 2026年10月31日:K2シリーズが新規ユーザーの受付を終了し、12月末までに提供終了が予定されています(料金)。読者への影響:K2のツール呼び出しコードはK3モデルに移行してください。なお、K3.1 Proの思考(thinking)はオフにできません。
FAQ
kimi k3.1 proのコンテキストウィンドウはどれくらいですか?
APIドキュメントによると1,048,576トークンで、長さにかかわらず料金は一律です(料金)。出力もコンテキストを消費し、max_completion_tokensのデフォルトは131,072です。今回のテストでは、1社分のWeiboデータと財務データは重複除去後に約16,000〜24,000トークンでした。デフォルトの出力枠を確保した場合、38〜56社分が収まります。(質問の出典:Googleのサジェスト「kimi k3.1 pro context window」)
kimi k3.1 proのAPIキーはどう取得しますか?先にチャージが必要ですか?
Kimi API Platformのコンソールでキーを作成します。K3.1 Proはフラッグシップモデルのため、チャージ後にのみ利用できます。最低チャージ額は$1で、チャージ総額によってティアとレート制限が決まります(クイックスタート、利用要件、チャージと制限)。APIはトークン単位の従量課金で、KimiのメンバーシップやKimi Codeのプランとは別です(製品比較)。(出典:サジェスト「kimi k3.1 pro api key」)
kimi k3.1 proの料金は?K3より安いですか?
2026年11月2日時点の公開料金:K3.1 Proは100万トークンあたり入力$2.00、出力$10.00、キャッシュヒット$0.20です。K3は入力$3.00、出力$15.00です(Kimi API Platform)。Batchは標準料金の60%です(Batchの料金)。1回の実行で1社を処理する場合の推定コストはリアルタイムで約$0.134で、そのうち$0.006335がEveryInfraの呼び出し分です。(出典:サジェスト「kimi k3.1 pro pricing」と「kimi k3.1 pro vs k3」)
kimi k3.1 proはMCPツールに対応していますか?
APIリクエストでは対応していません。Chat Completions、Responses、MessagesはいずれもリモートMCPサーバーを受け付けません。Responses APIがサポートするツールタイプはfunction、namespace、custom、web_searchのみです(Responses APIリファレンス)。リモートMCPを使うには、Kimi Code CLIのmcp.jsonか、Kimi Workの個人用プラグインを使用してください。Playgroundで同期できるのは、ModelScopeでホストされているMCPサーバーだけです。(出典:サジェスト「kimi k3.1 pro tools」と「kimi k3.1 pro mcps」)
Kimiは財務データをどこから取得していますか?
モデル自体はライブデータを持っていません。Kimi Workには、Wind、Hundsun Gildata、S&P Global Market Intelligenceなどの金融データベースプラグインが用意されています(Kimi Workプラグインセンター)。ただし、これらのプラグインにはソーシャルメディアの生の投稿やコメントは含まれていません。本記事では、EveryInfraのweibo/*とyahoo_finance/*の呼び出しでその不足を補っています。APIを使う場合、すべてのデータはツール呼び出しを通じてモデルに渡されます。
参考文献
- Kimi K3.1 Proクイックスタート、Moonshot AI、2026-11-02閲覧、https://platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart
- Kimi K3.1 Pro Tech Blog、Moonshot AI、2026-10-23、https://www.kimi.com/blog/kimi-k3-1-pro
- Model Inference Pricing、Moonshot AI、2026-11-02閲覧、https://platform.kimi.ai/docs/pricing/chat
- Kimi API Platformトップページ(モデル料金)、Moonshot AI、2026-11-02閲覧、https://platform.kimi.ai/
- BatchJob Pricing、Moonshot AI、2026-11-02閲覧、https://platform.kimi.ai/docs/pricing/batch
- Recharge and Rate Limiting、Moonshot AI、2026-11-02閲覧、https://platform.kimi.ai/docs/pricing/limits
- Responses APIリファレンス、Moonshot AI、2026-11-02閲覧、https://platform.kimi.ai/docs/api/responses
- Messages APIリファレンス、Moonshot AI、2026-11-02閲覧、https://platform.kimi.ai/docs/api/messages
- Use Kimi API for Tool Calls、Moonshot AI、2026-11-02閲覧、https://platform.kimi.ai/docs/guide/use-kimi-api-to-complete-tool-calls
- Kimi K3 API Tool Calling Best Practices、Moonshot AI、2026-11-02閲覧、https://platform.kimi.ai/docs/guide/kimi-k3-tool-calling-best-practice
- Tool Choice、Moonshot AI、2026-11-02閲覧、https://platform.kimi.ai/docs/guide/use-tool-choice
- Dynamically Loaded Tools、Moonshot AI、2026-11-02閲覧、https://platform.kimi.ai/docs/guide/use-dynamic-tool-loading
- Reasoning Effort、Moonshot AI、2026-11-02閲覧、https://platform.kimi.ai/docs/guide/use-reasoning-effort
- Structured Output、Moonshot AI、2026-11-02閲覧、https://platform.kimi.ai/docs/guide/response_format
- Context Caching、Moonshot AI、2026-11-02閲覧、https://platform.kimi.ai/docs/guide/context-caching
- Using Batch API for Bulk Processing、Moonshot AI、2026-11-02閲覧、https://platform.kimi.ai/docs/guide/use-batch-api
- Configure ModelScope MCP Server in Playground、Moonshot AI、2026-11-02閲覧、https://platform.kimi.ai/docs/guide/configure-the-modelscope-mcp-server
- Use Kimi API for File-Based Q&A、Moonshot AI、2026-11-02閲覧、https://platform.kimi.ai/docs/guide/use-kimi-api-for-file-based-qa
- Main Concepts、Moonshot AI、2026-11-02閲覧、https://platform.kimi.ai/docs/introduction
- Token estimate API、Moonshot AI、2026-11-02閲覧、https://platform.kimi.ai/docs/api/estimate
- Compare with Other Kimi Products、Moonshot AI、2026-11-02閲覧、https://platform.kimi.ai/docs/guide/product-plans
- Kimi Code: Model Context Protocol、Moonshot AI、2026-11-02閲覧、https://www.kimi.com/code/docs/en/kimi-code-cli/customization/mcp.html
- Kimi Code: Agents and Sub-Agents、Moonshot AI、2026-11-02閲覧、https://www.kimi.com/code/docs/en/kimi-code-cli/customization/agents.html
- Kimi Code: Model Configuration、Moonshot AI、2026-11-02閲覧、https://www.kimi.com/code/docs/en/kimi-code/models.html
- Kimi Work製品ページ、Moonshot AI、2026-11-02閲覧、https://www.kimi.com/en/products/kimi-work
- Kimi Work Release Notes、Moonshot AI、2026-10-29更新、https://www.kimi.com/en/help/kimi-work/release-notes
- What Are Kimi Plugins、Moonshot AI、2026-11-02閲覧、https://www.kimi.com/en/help/plugins-and-skills/overview
- 個人用プラグインの作成方法、Moonshot AI、2026-11-02閲覧、https://www.kimi.com/en/help/plugins-and-skills/create
- Kimi Workプラグインセンター、Moonshot AI、2026-11-02閲覧、https://www.kimi.com/en/help/kimi-work/plugin-center
- Tesla 2026年第3四半期アップデート(8-K別紙99.1)、Tesla(SEC EDGAR経由)、2026-10-21、https://www.sec.gov/Archives/edgar/data/1318605/000162828026066738/exhibit9914.htm
- BYD Company Limited 2026年第3四半期報告書、BYD(CNINFO経由)、2026-10-30、https://static.cninfo.com.cn/finalpage/2026-10-30/1225641442.PDF
- EveryInfra Weiboカタログ、EveryInfra、2026-11-02閲覧、https://api.everyinfra.com/api/v1/social/catalog?platform=weibo
- EveryInfra Yahoo Financeカタログ、EveryInfra、2026-11-02閲覧、https://api.everyinfra.com/api/v1/social/catalog?platform=yahoo_finance
- EveryInfra Google Newsカタログ、EveryInfra、2026-11-02閲覧、https://api.everyinfra.com/api/v1/social/catalog?platform=google_news
- EveryInfra Redditカタログ、EveryInfra、2026-11-02閲覧、https://api.everyinfra.com/api/v1/social/catalog?platform=reddit
- AIが書いた虚偽記事に250,000元の罰金(証券日報からの転載)、中国証券監督管理委員会(CSRC)北京監管局、2026-06-18、https://www.csrc.gov.cn/beijing/c105538/c7640109/content.shtml
- メディアレビュー:金融コンテンツ浄化に向けた共同の取り組み、CSRC江蘇監管局、2026-10-15、https://www.csrc.gov.cn/jiangsu/c106440/c7664819/content.shtml
- Kimi K3.1 Proに関するメモ、Simon Willison、2026-10-23、https://simonwillison.net/2026/Oct/23/kimi-k31-pro/
- Tesla 2026年第3四半期決算報告、CNBC、2026-10-21、https://www.cnbc.com/2026/10/21/tesla-tsla-q3-2026-earnings-report.html
- Kimi K3.1 Proの性能は?(スレッド)、Reddit r/kimi、2026-10、https://www.reddit.com/r/kimi/comments/1xdkngh/how_good_is_kimi_k31_pro/
- Model Context Protocol仕様、Model Context Protocol、2026-11-02閲覧、https://modelcontextprotocol.io/specification/2025-06-18
参考資料 BL-67