Kimi K3.1 Pro 리서치: 웨이보 여론을 실적 자료와 대조하기
Kimi K3.1 Pro로 웨이보와 Reddit 게시물을 테슬라·BYD 실적 공시와 대조하는 방법을 소개합니다. 댓글 시점, 항목별 대조, MCP 설정, 비용까지 다룹니다.
테슬라는 2026년 10월 21일에 3분기 실적을 발표했습니다. 11일 뒤인 11월 2일 00:18(SGT)에 웨이보에서 테슬라 실적 관련 게시물을 검색했습니다. 게시물 17건이 반환되었지만, 그중 테슬라 실적을 다룬 것은 3건뿐이었습니다.
10월 22일 이전 게시물은 1건뿐이었습니다. 같은 검색을 Reddit에서 하자 8건 중 7건이 10월 21~22일 게시물이었습니다. 이 차이가 첫 번째 교훈입니다. 소셜 검색은 실적 발표 시기가 아니라 검색을 실행한 시점의 모습을 보여 줍니다.
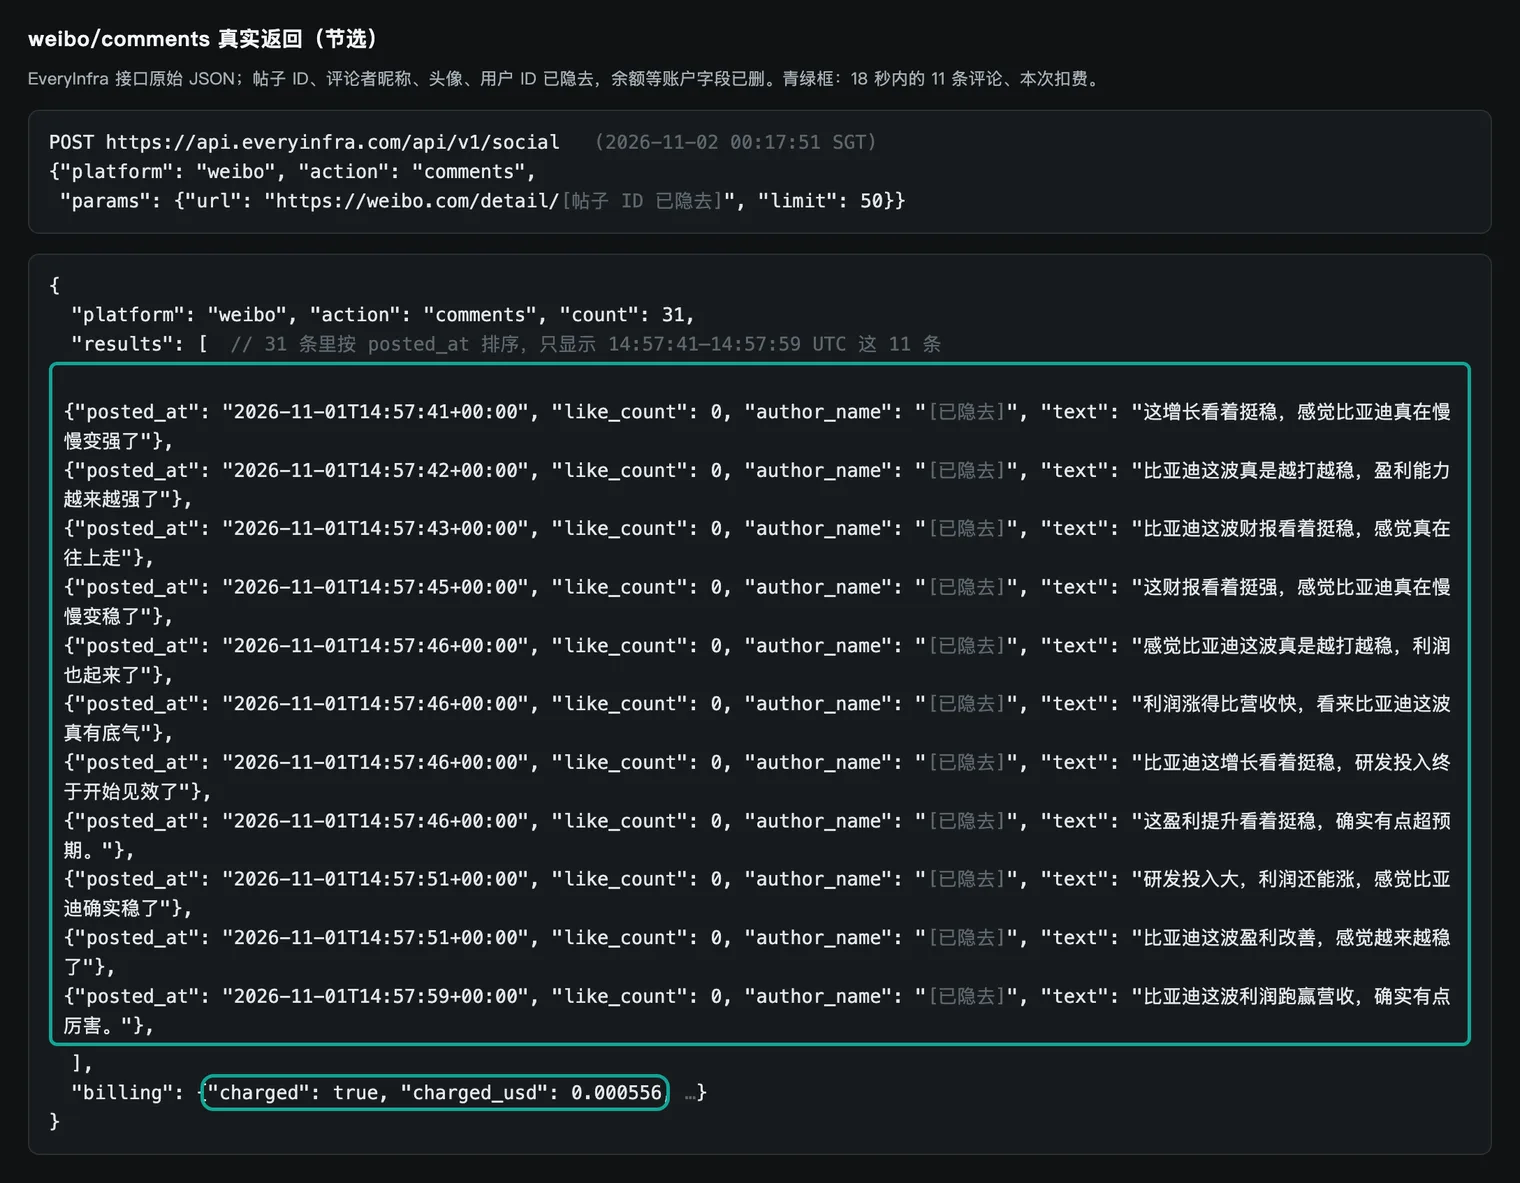
두 번째 교훈은 10월 29일에 실적을 발표한 중국 자동차 제조사 BYD에서 얻었습니다. BYD 실적을 다룬 인기 웨이보 게시물 하나에서 댓글 31개를 수집했습니다. 이 댓글들의 좋아요 수 합계는 0이었고, 그중 11개는 같은 18초 안에 달렸습니다. 같은 실적을 다룬 또 다른 장문 게시물에는 댓글 36개가 있었습니다. 이 댓글들은 이틀 넘게 분산되어 있었고, 어느 20초 구간에도 1개를 넘지 않았습니다.
세 번째 교훈은 토론과 공시가 서로 다른 숫자를 본다는 점입니다. BYD 공시에서 연초 대비 가장 크게 변한 항목은 세 가지였습니다. 재고자산은 60.08% 늘고, 매출채권은 52.61% 늘었으며, 현금은 58.92% 줄었습니다.
공시에는 해외 차량 판매를 위한 재고 확대처럼 각 변화의 이유가 설명되어 있습니다. 수집한 댓글 중 이 항목을 언급한 것은 하나도 없었습니다. 이것으로 누가 옳은지 알 수는 없습니다. 다만 리서치 요약이 댓글에만 의존할 수 없다는 점은 분명합니다.
이 글에서는 Moonshot AI의 Kimi K3.1 Pro로 이런 대조 작업을 구성하는 방법을 소개합니다. 모델은 하나의 긴 컨텍스트에서 소셜 게시물과 재무표를 함께 읽고, 각 줄에 출처를 단 1페이지 요약을 작성합니다. EveryInfra는 weibo/search, weibo/comments, yahoo_finance/financials 등의 기능으로 원본 데이터를 제공합니다. 집계는 모델이 작성을 시작하기 전에 직접 작성한 코드가 처리합니다.
이 글은 데이터 활용 방법과 도구 설정을 다룹니다. 투자 조언이 아니며, 특정 종목의 매수나 매도를 권하지 않습니다. 재무 수치는 소셜에서 나온 주장을 1차 자료와 대조하는 방법을 보여 주기 위해서만 사용합니다. 각 대조 결과는 해당 수치가 토론에 등장하는지 여부만 나타내며, 그 수치가 좋은지 나쁜지는 판단하지 않습니다.
이 글은 EveryInfra 팀이 작성했습니다. 모든 집계는 스크립트로 처리했으며, 공인 재무 분석가의 검토는 받지 않았습니다. 기업에 대해 판단할 때는 해당 기업의 공시와 공인 전문가의 의견을 근거로 하십시오.
저희는 Kimi API 키가 없어 Kimi를 실행하지 않았습니다. 이 글의 Kimi 코드는 모두 2026년 11월 2일에 확인한 Moonshot 문서를 바탕으로 작성한 설정 예시입니다. EveryInfra 관련 수치는 모두 실제 요청과 원본 응답에서 나온 것입니다.
과제: 소셜 반응과 실적을 대조하는 1페이지 요약
먼저 과제를 명확히 정합니다. 아래의 설정과 비용 수치가 모두 이 과제를 기준으로 하기 때문입니다. 입력은 상장 기업 1곳과 최근 실적 발표일입니다. 데이터 단계에서는 네 가지를 수집합니다. 실적 관련 웨이보 게시물과 반응이 가장 활발한 게시물의 댓글, 그리고 최근 분기 재무표와 실적 발표일 전후의 일별 주가입니다. 출력은 구조가 고정된 1페이지 요약입니다.
요약은 다섯 가지 질문에 답합니다. 소셜 게시물은 무엇을 주장하는가? 각 주장에 대해 공시는 무엇이라고 하는가? 어떤 주장이 일치하지 않는가?
어떤 게시물이나 댓글이 자연스러운 토론으로 보이지 않는가? 이 요약의 한계는 무엇인가? 모든 답은 원본 필드나 공시의 특정 페이지를 가리켜야 합니다. 그래야 독자가 모델을 믿지 않고도 각 줄을 직접 확인할 수 있습니다.
이 과제가 도구 호출을 지원하는 긴 컨텍스트 모델에 맞는 이유는 세 가지입니다. 첫째, 원본 자료의 형태가 네 가지로 서로 다릅니다. 게시물, 댓글, 재무표, 주가 행은 수작업으로 맞추기 어렵습니다. 모델은 이를 한꺼번에 읽고 하나의 형식으로 작성할 수 있습니다. 둘째, 대조 규칙을 간단히 정의할 수 있습니다.
댓글에 나온 재무 관련 주장마다 표에서 해당 필드를 찾고, 없으면 '찾을 수 없음'으로 표시합니다. 긴 컨텍스트 모델이 잘하는 한 줄씩 대조하는 작업입니다. 셋째, 최종 판단은 사람이 내립니다. 모델은 거래 결정을 내리지 않고 출처가 달린 표를 만듭니다.
Moonshot은 내부 Financial Research 테스트에서 K3.1 Pro가 K3보다 11.6점 높았다고 밝혔습니다. Moonshot은 이 테스트를 근거와 날짜 제한 아래에서 검증 가능해야 하는 리서치라고 설명합니다(Kimi K3.1 Pro 기술 블로그). 이 과제에도 '검증 가능'이라는 표현이 정확히 들어맞습니다. 요약의 각 줄은 원본 데이터로 거슬러 올라갈 수 있어야 합니다.
영어권 독자를 위해 테슬라를 주 예시로, BYD를 두 번째 예시로 사용했습니다. 테슬라는 2026년 10월 21일 SEC에 3분기 실적 자료를 제출했습니다(Tesla 8-K exhibit 99.1). BYD는 2026년 10월 29일 중국 본토 장 마감 후 공시했습니다(CNINFO의 BYD 2026년 3분기 보고서). 11월 2일 데이터를 수집했을 때 웨이보의 BYD 관련 토론은 여전히 활발했지만, 테슬라 관련 토론은 이미 11일이 지난 상태였습니다. 이 차이 덕분에 두 사례를 함께 볼 의미가 있었습니다.
| 입력/출력 | 내용 | 기능 | 카탈로그 가격 |
|---|---|---|---|
| 웨이보 게시물 | 키워드 검색, 최대 50건 | weibo/search | 호출당 $0.000806 |
| 토픽 도달 범위 | 해시태그 토픽별 조회 수와 게시물 수 | weibo/topic_search | 호출당 $0.000806 |
| 댓글 | 게시물 1건당 댓글 최대 50개 | weibo/comments | 호출당 $0.000556 |
| 재무 테이블 | 연간·분기 손익계산서, 재무상태표, 현금흐름표 | yahoo_finance/financials | 호출당 $0.001389 |
| 주가 | 일별 주가 행 | yahoo_finance/history | 호출당 $0.001389 |
| 애널리스트 의견 | 투자의견별 집계와 투자의견 변경 | yahoo_finance/analyst | 호출당 $0.001389 |
| 출력 | JSON 및 Markdown 형식의 1페이지 요약 | Kimi K3.1 Pro | 토큰 단위 과금 |
이 가격은 2026년 11월 2일 00:13(SGT)에 무료 카탈로그에서 확인했습니다. 해당 필드는 price_usd입니다(웨이보 카탈로그, Yahoo Finance 카탈로그). 필드 목록은 웨이보 스크래핑 API와 Yahoo Finance 데이터 API 페이지에 있습니다. 기능별 페이지도 있습니다. 웨이보 검색, 웨이보 댓글, 웨이보 토픽 검색, 재무제표, 주가 이력, 애널리스트 투자의견입니다.
Kimi K3.1 Pro란: 버전, 가격, 이 과제에 중요한 부분
과제에서 Kimi K3.1 Pro를 지정했으므로, 먼저 이 모델이 실제로 있는지와 Moonshot이 어떻게 부르는지 확인했습니다. 모델은 실제로 있습니다. Moonshot은 2026년 10월 23일 K3.1 시리즈의 첫 모델로 이 모델을 출시했습니다. Moonshot은 이를 1M 토큰 컨텍스트를 갖춘 3T급 모델이라고 소개합니다.
Moonshot에 따르면 이 모델은 코딩, 3D 작업, 재무 리서치, 장시간 에이전트 작업에서 크게 향상되었습니다. Highspeed 버전은 2~3배 빠르게 실행됩니다. Moonshot은 11월 4일까지 전체 가중치를 공개하겠다고 밝혔습니다(K3.1 Pro 빠른 시작).
모델 이름은 제품마다 다르므로 정확한 이름을 써야 합니다. Kimi API에서는 kimi-k3.1-pro와 kimi-k3.1-pro-highspeed이고, Kimi Code에서는 k3.1-pro입니다. Kimi Code 페이지는 함정 하나를 경고합니다. 모델 ID를 잘못 입력하면 추론 기능이 없는 K2.8 Preview로 대체됩니다(Kimi Code 모델 설정). 오류는 발생하지 않고 성능이 낮은 모델로 바뀔 뿐입니다.
아래 표는 이 과제에 중요한 설정을 정리한 것입니다. 각 항목은 2026년 11월 2일에 확인했습니다.
| 항목 | 출처 내용 | 이 과제에서의 의미 | 출처 |
|---|---|---|---|
| 컨텍스트 | 1,048,576 토큰, 길이와 관계없이 단일 가격 | 요청 1건에 수십 개 기업의 데이터를 담을 수 있음 | 요금 |
| 요금 | 100만 토큰당 입력 $2.00, 출력 $10.00, 캐시 쓰기 $2.00, 캐시 히트 $0.20 | 긴 입력은 저렴하지만 추론과 출력에는 비용이 더 많이 듦 | Kimi API Platform |
| Highspeed | 입력 $4.00, 출력 $20.00, 캐시 히트 $0.20 | 속도를 높이면 비용이 2배 | Kimi API Platform |
| 추론(Thinking) | 항상 켜짐, reasoning_effort는 low, high, max 중 선택, 기본값 max | API 기본값이 가장 비싼 단계 | 추론 강도 |
| 출력 한도 | max_completion_tokens 기본값 131,072, 최대 1,048,576 | 출력도 컨텍스트 일부를 차지함 | 빠른 시작 |
| 고정 설정 | temperature, top_p 등은 고정값이므로 생략 | temperature를 낮춰 더 차분한 요약을 얻을 수 없음 | 빠른 시작 |
| 구조화된 출력 | json_schema에 strict: true 지정, message.content만 파싱 | 요약에 고정 필드를 둘 수 있음 | 구조화된 출력 |
| 배치 | 표준 가격의 60%, completion_window 지정 | 야간 배치로 40% 절감 | 배치 요금 |
| 이용 조건 | 충전 후 이용 가능, 최소 $1 | 플래그십 모델 호출 전 충전 필요 | 충전 및 한도 |
| 웹 검색 | 업데이트 중, 현재 프로덕션 사용 비권장 | 데이터 검색을 모델에 맡기지 말 것 | 빠른 시작 |
마지막 항목은 짧은 설명이 필요합니다. 모델은 웨이보 댓글이나 재무표를 스스로 볼 수 없습니다. 내장 웹 검색을 켜면 된다고 생각하기 쉽습니다. 하지만 빠른 시작 문서는 웹 검색을 주요 제한 사항에 포함하고, 당분간 프로덕션 흐름에서 사용하지 말라고 안내합니다.
웹 검색이 동작하더라도 결과는 페이지 요약입니다. 깔끔한 댓글 목록이나 분기 재무표는 반환하지 않습니다. 한 줄씩 대조하려면 도구 결과로 원본 데이터를 받아야 합니다.
출처에 관해 하나 더 짚어 둡니다. Moonshot의 두 페이지가 같은 환각 스트레스 테스트에 대해 서로 다른 수치를 제시합니다. 기술 블로그는 K3.1 Pro가 8.3%로 낮아졌다고 하고, 빠른 시작 문서는 6.85%라고 합니다. 두 문서 모두 이 테스트가 의도적으로 어려운 프롬프트를 사용한다고 설명합니다.
모델 제공사가 직접 발표한 수치도 출처와 대조해야 하며, 리서치 요약이라면 더욱 그렇습니다.
원격 MCP 서버를 연결할 수 있을까? Kimi API 3종에서는 불가능
EveryInfra는 https://api.everyinfra.com/mcp에서 원격 MCP 서버를 운영합니다. 도구 이름은 everyinfra_로 시작합니다. Claude, Cursor 같은 클라이언트는 URL만으로 이 서버를 사용할 수 있습니다. 설정 방법은 MCP 서버 페이지와 원격 MCP 설정 테스트에 있습니다.
많은 사람이 Kimi API가 요청에서 원격 MCP URL을 받을 것이라고 기대합니다. Kimi API 레퍼런스를 하나씩 확인한 결과, 지원하지 않습니다.
가장 명확한 것은 Responses API 레퍼런스입니다. tools 필드는 function, namespace, custom(apply_patch만 해당), web_search 네 가지 유형만 지원합니다. 앞의 세 가지는 사용자 측에서 실행합니다. 모델이 호출을 반환하면 직접 실행한 뒤 결과를 다시 보냅니다(Responses API 레퍼런스).
Chat Completions는 표준 함수 호출을 사용합니다(도구 호출 가이드). Messages API는 Anthropic 형식을 따릅니다. 도구, 추론, 구조화된 출력을 지원하지만 레퍼런스에 원격 MCP 파라미터는 없습니다(Messages API 레퍼런스).
플레이그라운드에는 MCP가 있지만 제한이 하나 있습니다. ModelScope API 토큰을 통해 ModelScope에 호스팅한 MCP 서버만 동기화합니다(플레이그라운드 ModelScope MCP). 이 방법은 Xiaohongshu·Douyin 데이터를 위한 ModelScope MCP에서 다뤘습니다.
| Kimi 제품 | 원격 MCP URL 지원 | EveryInfra 연결 방법 | 적합한 용도 |
|---|---|---|---|
| Chat Completions API | 불가, 함수 도구만 지원 | 함수 1개 정의, 직접 작성한 코드가 REST 호출 | 자체 코드, 배치 실행 |
| Responses API | 불가, MCP는 4가지 도구 유형에 없음 | 동일, 또는 namespace로 함수 묶기 | Responses 형식 기반 프로젝트 |
| Messages API | 아니요 | 위와 같음 | Anthropic SDK 코드를 쓰는 프로젝트 |
| 플레이그라운드 | ModelScope 호스팅 MCP만 | ModelScope에 호스팅한 뒤 동기화 | 수동 테스트 |
| Kimi Code CLI | 가능, mcp.json의 url | URL 입력, 키는 환경 변수에 보관 | 터미널을 쓰는 개발자 |
| Kimi Work 데스크톱 | 가능, 개인 플러그인 사용 | Plugin Builder에 MCP URL 입력 | 코드를 작성하지 않는 애널리스트 |
| kimi.com 웹 앱 | 플러그인에 MCP와 스킬 포함 가능 | 공개 플러그인 또는 회사 플러그인 사용 | 일반 채팅 |
따라서 방법은 두 가지입니다. 코드와 배치 실행에는 Kimi API와 함수 도구를 사용합니다. 직접 작성한 코드가 EveryInfra REST API를 호출하고 데이터를 먼저 정리합니다. 코드 없이 작업하려면 Kimi Code CLI나 Kimi Work를 사용합니다.
두 도구 모두 MCP 클라이언트이므로 원격 MCP 서버에 직접 연결됩니다. 아래 다이어그램은 첫 번째 방법을 보여 줍니다. 모델은 무엇을 호출할지만 결정합니다. 데이터 가져오기, 중복 제거, 지표 계산은 모델 밖에서 처리합니다.


설정 예시 1: 함수 도구 1개로 Kimi API 사용하기
이 코드는 설정 예시입니다. Kimi 빠른 시작 문서와 도구 호출 가이드를 바탕으로 작성했으며, Kimi API 키로 실행하지는 않았습니다. EveryInfra 요청 형식과 응답 구조는 실제 호출에서 가져왔습니다.
핵심은 모델에 everyinfra_social 함수 하나를 제공하는 것입니다. 인수는 EveryInfra의 platform, action, params 필드입니다. enum으로 모델이 과제에 필요한 기능만 쓰도록 제한합니다.
# Configuration example: Kimi K3.1 Pro + EveryInfra data API (Kimi side not tested)
import json, os, requests
from openai import OpenAI

kimi = OpenAI(api_key=os.environ["MOONSHOT_API_KEY"], base_url="https://api.moonshot.ai/v1")

TOOLS = [{
    "type": "function",
    "function": {
        "name": "everyinfra_social",
        "description": "Fetch public social and finance data. Weibo: search, topic_search, comments. "
                       "Yahoo Finance: financials, history, analyst. Use a ticker with suffix, e.g. TSLA or 1211.HK. "
                       "For weibo/comments, url must be weibo.com/detail/<numeric id> or the numeric id.",
        "parameters": {
            "type": "object",
            "properties": {
                "platform": {"type": "string", "enum": ["weibo", "yahoo_finance", "reddit"]},
                "action": {"type": "string",
                           "enum": ["search", "topic_search", "comments", "financials", "history", "analyst"]},
                "params": {"type": "object"}
            },
            "required": ["platform", "action", "params"]
        }
    }
}]

def call_everyinfra(args: dict) -> dict:
    r = requests.post("https://api.everyinfra.com/api/v1/social",
                      headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"},
                      json=args, timeout=120)
    body = r.json()
    rows = body.get("results")
    # Cleanup: the three financial arrays hold the same records, so keep one.
    if isinstance(rows, list) and rows and "income" in rows[0]:
        rows[0].pop("balance_sheet", None); rows[0].pop("cash_flow", None)
    if isinstance(rows, list):
        for x in rows:
            x.pop("author_avatar_url", None)
    return {"status": r.status_code, "results": rows, "error": body.get("error"),
            "charged_usd": (body.get("billing") or {}).get("charged_usd")}

messages = [
    {"role": "system", "content": open("research_rules.md", encoding="utf-8").read()},
    {"role": "user", "content": "Tesla reported Q3 2026 on 2026-10-21. Follow the rules and write a one-page cross-check."}
]
first = True
while True:
    resp = kimi.chat.completions.create(model="kimi-k3.1-pro", reasoning_effort="high",
                                        messages=messages, tools=TOOLS,
                                        tool_choice="required" if first else "auto")
    msg = resp.choices[0].message
    messages.append(msg)          # The docs ask for the full assistant message back.
    if not msg.tool_calls:
        break
    for tc in msg.tool_calls:
        result = call_everyinfra(json.loads(tc.function.arguments))
        messages.append({"role": "tool", "tool_call_id": tc.id,
                         "content": json.dumps(result, ensure_ascii=False)})
    first = False
print(msg.content)
이 코드의 각 선택에는 근거가 있습니다. 첫 턴에서는 tool_choice="required"를 사용합니다. Kimi 도구 호출 모범 사례 페이지가 권장하는 방식으로, 모델이 기억에 의존해 답하지 않고 도구를 호출하게 합니다. 첫 턴 이후에는 다시 auto로 돌아갑니다. 문서에 따르면 tool_choice를 바꿔도 프리픽스 캐시는 깨지지 않습니다(K3 도구 호출 모범 사례, 도구 선택).
각 턴에서는 content만이 아니라 assistant 메시지 전체를 추가합니다. 메시지에 reasoning_content도 들어 있기 때문에, 빠른 시작 문서는 멀티턴과 도구 호출 흐름에서 이렇게 하라고 안내합니다. 코드는 reasoning_effort를 API 기본값인 max가 아니라 high로 설정합니다. 이 과제에서 어려운 부분은 복잡한 수학이 아니라 대조 작업이기 때문입니다.
Reddit의 한 사용자는 K3.1 Pro를 high로 썼을 때 K3를 max로 쓴 것과 같은 결과가 나왔다고 했습니다(r/kimi 스레드). 한 사람의 경험담일 뿐입니다. 실제로 실행하기 전에 자체 샘플로 두 단계를 모두 테스트하십시오.
데이터 정리는 모델이 아니라 call_everyinfra 안에서 처리합니다. 테스트 결과를 보면 그 이유를 알 수 있습니다. 응답에 포함된 세 개의 재무 배열은 같은 데이터를 담고 있습니다. 세 배열을 모두 보내면 모델이 50,000자 이상을 추가로 읽게 됩니다. Kimi는 동적 도구 로딩도 지원합니다.
content가 없는 system 메시지에 tools를 넣으면, 그 메시지 이후부터 도구가 보이게 됩니다. 서버는 도구를 저장하지 않으므로 이후 요청에서도 그 메시지를 다시 보내야 합니다(동적 도구 로딩). 이 과제는 도구가 1개라 이 패턴이 필요 없습니다. EveryInfra 기능 수백 개를 노출한다면 search_tools 함수와 동적 로딩을 함께 써서 컨텍스트를 아낄 수 있습니다.
설정 예시 2: 원격 MCP 서버로 Kimi Code CLI 사용하기
도구 호출 루프를 직접 만들지 않고 Kimi Code CLI를 쓸 수도 있습니다. Kimi Code CLI는 MCP 클라이언트이며 stdio, HTTP와 이전 방식인 SSE 전송을 지원합니다. HTTP 서버는 mcp.json에 url을 넣으면 됩니다.
사용자 파일은 ~/.kimi-code/mcp.json이고, 프로젝트 파일은 저장소의 .kimi-code/mcp.json입니다. 두 파일이 같은 서버 이름을 정의하면 프로젝트 파일이 우선합니다(Kimi Code MCP 문서). 이 과제를 위한 설정 예시는 다음과 같습니다.
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "bearerTokenEnvVar": "EVERYINFRA_API_KEY",
      "enabledTools": ["everyinfra_call_api", "everyinfra_get_job", "everyinfra_list_capabilities"],
      "toolTimeoutMs": 120000
    }
  }
}| 필드 | 예시 값 | 이유 |
|---|---|---|
url | https://api.everyinfra.com/mcp | HTTP 전송, 로컬 프로세스 불필요 |
bearerTokenEnvVar | EVERYINFRA_API_KEY | 키를 파일에 넣지 않음 |
enabledTools | 도구 12개 중 3개 | 컨텍스트에 들어가는 도구 스키마 감소 |
toolTimeoutMs | 120000 | financials 호출 1건에 35.6초 소요 |
bearerTokenEnvVar 필드에는 키가 아니라 환경 변수의 이름을 넣습니다. 따라서 이 파일을 저장소에 커밋할 수 있고, 키는 각자 자신의 셸에 보관합니다. enabledTools 필드는 허용 목록입니다. 00:16(SGT)에 키 없이 서버의 tools/list를 조회했습니다.
도구 12개가 16,724바이트로 반환되었습니다. 일부 도구는 계정, 충전 링크, 지원 티켓을 처리합니다. 리서치 작업에는 필요 없고 컨텍스트만 차지합니다. 테스트에서 yahoo_finance/financials 호출 1건에 35.6초가 걸렸기 때문에 toolTimeoutMs를 120초로 설정했습니다.
Kimi Code는 MCP 도구 이름을 mcp__<server>__<tool> 형식으로 붙입니다. 권한 규칙에서 이 이름으로 도구를 허용할 수 있습니다. 문서는 모든 MCP 도구를 허용하게 되는 mcp__* 허용 규칙을 쓰지 말라고 권고합니다(같은 페이지의 Security 항목 참고).
Kimi Code에는 서브 에이전트도 있습니다. 내장 유형은 세 가지입니다. coder는 파일을 읽고 쓸 수 있습니다. explore는 읽기 전용입니다. plan은 계획만 세우며 셸 명령을 실행할 수 없습니다.
각 서브 에이전트는 별도의 컨텍스트를 가집니다. 메인 에이전트가 넘긴 작업 텍스트만 보고, 결과만 반환합니다. 여러 서브 에이전트를 병렬로 실행할 수 있습니다(Agents and Sub-Agents). 사용자 정의 서브 에이전트는 .kimi-code/agents/에 있는 Markdown 파일입니다. 아래 파일은 서브 에이전트마다 기업 1곳과 EveryInfra 도구 1개를 할당합니다.
---
name: company-evidence-worker
description: Fetch Weibo posts, comments and financial tables for one listed company. Return one compact evidence table. Use one worker per company.
tools:
  - mcp__everyinfra__everyinfra_call_api
  - Write
---
You handle only the one company in your task. Do these steps in order:
1. Call weibo/search with "<company> earnings" in Chinese, limit 50. Call weibo/topic_search with the same words.
2. Pick the top 2 posts by comment_count. Call weibo/comments for each, limit 50.
3. Call yahoo_finance/financials, history (period=3mo) and analyst with the ticker.
4. Save raw responses under evidence/<ticker>/. Keep only the income array of the financial tables.
5. Your last message is the full handoff. Give one table: comment count, total likes and
   the largest count in any 20 seconds for each post, plus quarterly revenue, net income,
   inventory, receivables and cash. Do not write conclusions. Do not give trade advice.
5단계는 문서의 안내를 따른 것입니다. 사용자 정의 서브 에이전트에는 마지막 메시지가 전달 내용의 전부라는 내장 지침이 들어가지 않습니다. 문서는 이를 에이전트 본문에 명시하라고 안내합니다. 그러면 메인 에이전트가 자신의 컨텍스트에서 기업별 근거 표를 비교하고 요약을 작성합니다.
문서는 서브 에이전트마다 토큰을 따로 사용하므로 간단한 작업에는 필요 없다고도 설명합니다. 저희가 보기에 기업 2~3곳은 메인 에이전트로 충분합니다. 10곳 이상이면 워커를 사용하십시오.
설정 예시 3: Kimi Work 플러그인과 Task Center 활용하기
많은 애널리스트는 코드를 작성하지 않습니다. Kimi Work는 Moonshot의 데스크톱 에이전트입니다. 로컬 파일을 읽고 쓰고, 브라우저 확장 프로그램으로 웹 페이지를 다루며, 예약 작업을 실행할 수 있습니다. 대규모 작업은 Agent Swarm이 여러 에이전트에 나눠 처리합니다(Kimi Work 제품 페이지).
K3.1 Pro를 쓰려면 Kimi Work 3.1.0 이상이 필요합니다(기술 블로그의 Availability 항목). 제품 페이지에 따르면 Kimi Work는 전문 데이터 소스에서 A주와 홍콩 주식의 실시간 데이터를 가져올 수 있습니다. 따라서 이 과제 중 주가와 재무 부분은 어느 정도 해결됩니다. 웨이보 댓글 같은 소셜 부분은 해결되지 않습니다.
외부 MCP 서버를 추가하려면 개인 플러그인을 사용합니다. Kimi 도움말 센터에 따르면 플러그인에는 스킬, MCP, 에이전트, 훅, 명령, 시스템 프롬프트를 담을 수 있습니다. 현재 웹 앱은 MCP와 스킬 부분만 지원하고, Kimi Work와 Kimi Code는 모든 구성 요소를 지원합니다(플러그인 개요).
Kimi Work에서는 내장 Plugin Builder를 불러 필요한 내용을 한 문장으로 설명합니다. Plugin Builder는 플러그인 파일을 작성하고 검사한 뒤 Personal 아래에 플러그인을 등록합니다. MCP 서버 URL처럼 추측할 수 없는 정보는 사용자에게 묻습니다(개인 플러그인 만들기). MCP 레지스트리 형식의 server.json 파일도 가져올 수 있습니다.
릴리스 노트 두 건이 중요합니다. 2026년 10월 26일의 3.2.21 버전부터는 프로젝트에 포함된 MCP 서버를 불러오기 전에 승인을 요청합니다. 2026년 10월 29일의 3.2.22 버전은 Scheduled의 이름을 Task Center로 바꿨으며, 모든 자동 작업을 한곳에서 관리합니다(Kimi Work 릴리스 노트). 작업은 매시간, 매일 또는 특정 조건에서 실행할 수 있습니다.
야간에 실행하려면 설정에서 Keep awake를 켜십시오(제품 페이지 FAQ). 이 과제에서는 모델보다 실행 일정이 더 중요합니다. 그 이유는 아래 테슬라 테스트에서 확인할 수 있습니다.
실제 왕복 한 번: 모델이 보내는 요청과 돌아오는 응답
모델 쪽에서 Kimi는 표준 도구 호출을 반환합니다. tool_calls의 각 항목에는 id, 함수 이름, JSON 문자열 형태의 인수가 있습니다. 위 함수를 쓰면 Kimi는 아래와 같은 호출을 보냅니다. 실제 Kimi 출력이 아닌 형식 예시입니다.
{"id": "call_0", "type": "function",
 "function": {"name": "everyinfra_social",
              "arguments": "{\"platform\":\"weibo\",\"action\":\"comments\",\"params\":{\"url\":\"https://weibo.com/detail/<numeric_post_id>\",\"limit\":50}}"}}
코드는 이 인수를 그대로 EveryInfra에 보냅니다. 같은 요청을 2026년 11월 2일 00:17:51(SGT)에 보냈습니다. 실제 응답은 HTTP 200이었고, 16.6초 만에 15,134바이트가 반환되었습니다. count는 31, billing.charged_usd는 0.000556이었습니다.
각 댓글에는 id, text, like_count, author_id, author_name, author_avatar_url, post_id, post_url, posted_at, platform의 10개 필드가 있습니다. 이 필드는 카탈로그에 있는 weibo/comments의 response_fields 목록과 일치합니다. 스크린샷은 가운데 18초 동안 달린 댓글 11개를 시간순으로 보여 줍니다.
같은 종류의 요청은 MCP로도 동작합니다. 00:22:26(SGT)에 MCP tools/call로 everyinfra_call_api를 호출했습니다. 인수는 두 번째 게시물인 게시물 B의 숫자 ID였습니다. HTTP 200과 21,757바이트가 반환되었습니다. result.content[0].text 필드에는 REST 응답과 같은 구조의 JSON이 들어 있었습니다.
count는 36이었고 요금은 이번에도 $0.000556이었습니다. 이 응답에는 structuredContent 필드가 없었으므로 데이터는 텍스트에 들어 있습니다. Kimi Code 문서에 따르면 에이전트는 MCP 결과의 텍스트와 구조화된 부분을 모두 받습니다. Kimi Code에서는 두 방법 모두 같은 데이터를 제공합니다. 직접 만든 함수 도구에서는 REST JSON이 더 간단합니다.
성공률에 영향을 주는 형식 규칙이 하나 있습니다. 카탈로그에 따르면 weibo/comments의 url은 숫자 게시물 ID가 포함된 /detail/ 링크이거나 숫자 ID 자체여야 합니다. 문자가 섞인 짧은 링크는 동작하지 않습니다. 검색 결과는 이미 /detail/ 형식의 url을 제공하므로 모델이 그대로 복사하면 됩니다.
웹 페이지에서 복사한 링크는 짧은 형식인 경우가 많습니다. 예시처럼 이 규칙을 함수 description에 넣으십시오. 모델이 카탈로그를 읽을 것이라고 기대하지 마십시오.
테스트 1: 11일 늦게 검색한 웨이보의 테슬라 반응
첫 실시간 테스트에서 타이밍 문제가 드러났습니다. 11월 2일 00:18(SGT)에 "테슬라 실적"을 뜻하는 중국어로 weibo/search를 호출했습니다. 게시물 17건이 반환되었고 비용은 $0.000806이었습니다. 테슬라를 언급한 게시물은 6건뿐이었고, 첫머리에서 테슬라 실적을 다룬 게시물은 3건뿐이었습니다.
날짜는 10월 19일부터 11월 1일까지였고, 10월 22일 이전 게시물은 1건뿐이었습니다. 나머지 게시물은 미국 기술주 하락, Google과 Intel 실적, BYD와 테슬라의 마진 비교를 다뤘습니다. 이유는 간단합니다. 웨이보 키워드 검색은 최근 게시물을 반환하는데, 테슬라는 11일 전에 실적을 발표했습니다.
토픽 검색은 다른 모습을 보여 줬습니다. 00:21:05(SGT)에 같은 검색어로 weibo/topic_search를 호출했습니다. 토픽 20개가 반환되었고, 각 토픽에는 누적 조회 수와 게시물 수가 있었습니다. 분기별로 상위 토픽을 하나씩 골랐습니다.
2022년 Q3 보고서 관련 토픽은 조회 69.83M회, 게시물 13,000건을 기록했습니다. 2024년 Q3에는 1위 토픽의 조회수가 4.48M회였습니다. 20개 토픽 중 2025년이나 2026년 보고서를 다룬 토픽은 하나도 없었습니다.
이것으로 중국 독자가 테슬라 실적에 관심을 잃었다고 단정할 수는 없습니다. 토픽 검색의 순위 기준을 알 수 없기 때문입니다. 조회 수는 누적값이라 오래된 토픽이 유리합니다. 다만 토픽 검색이 과거 관심도를 시기적으로 치우친 모습으로 보여 준다는 점은 분명합니다. 리서치 요약은 이 점을 한계 필드에 밝혀야 합니다.
Reddit은 대조군이었습니다. 00:23:42(SGT)에 "Tesla Q3 2026 earnings"로 관련도순 reddit/search를 호출했습니다. 게시물 8건이 반환되었고, 그중 7건이 10월 21~22일 게시물이었습니다.
이 게시물들의 댓글은 모두 589개였습니다. r/TSLALounge의 실적 스레드와 FSD 구독을 다룬 r/teslamotors 게시물이 포함되어 있습니다(Reddit 검색 기능). 같은 질문에 대해 Reddit 관련도 검색은 실적 발표 시기까지 거슬러 올라갔지만, 웨이보 키워드 검색은 최근 며칠만 보여 줬습니다.
| 검색(SGT) | 반환된 게시물 | 테슬라 실적 관련 | 10월 21~22일 게시물 | 게시물 댓글 수 |
|---|---|---|---|---|
| 웨이보 키워드 검색, 00:18 | 17 | 3 | 10월 22일 이전 1건 | 사용 안 함 |
| Reddit 관련도 검색, 00:23 | 8 | 8 | 7 | 589 |
이에 따라 올바른 수집 방법이 정해집니다. 사후에 검색하지 마세요. 실적 발표 당일, 24시간 후, 72시간 후에 데이터를 수집합니다. 각 수집은 Kimi Work 작업이나 직접 설정한 cron 작업으로 시작합니다.
Kimi는 마지막 수집이 끝난 뒤에만 요약을 작성합니다. 실제 발표 시각을 0시간으로 잡으세요. Tesla의 경우 2026년 10월 21일 미국 장 마감 이후였습니다. 8-K 제출일과 당일 뉴스 보도가 모두 이를 보여 줍니다(CNBC, 2026년 10월 21일).
테스트 2: Tesla 수치를 8-K와 대조하다
재무 쪽은 더 믿을 만하지만 그래도 확인해야 합니다. SGT 00:20:40에 TSLA로 yahoo_finance/financials를 호출했습니다. 비용은 $0.001389였습니다. 3분기 항목을 Tesla 8-K 첨부 자료(exhibit) 99.1의 재무 요약과 비교했습니다.
| 항목(단위: 백만 달러) | API 응답, 2026년 3분기 | Tesla 8-K 첨부 자료 99.1 | 일치 |
|---|---|---|---|
| 총매출 | 28,046 | 28,046 | 예 |
| 매출총이익 | 5,494 | 5,494 | 예 |
| 영업이익 | 718 | 718 | 예 |
| 보통주주 귀속 순이익 | 787 | 787 | 예 |
| 잉여현금흐름 | 1,531 | 1,531 | 예 |
| 잉여현금흐름, 2026년 2분기 | −1,099 | −1,092(영업현금흐름 4,697 − 설비투자 5,789) | 아니요, $7 million 차이 |
다섯 개 행은 일치하고, 한 행에서 작은 차이가 있습니다. 2분기 잉여현금흐름은 API 기준 −1,099, Tesla 기준 −1,092입니다. 금액은 작지만, 모든 행을 하나씩 확인해야 한다는 점을 보여 줍니다. 한두 번 표본 확인만으로 모든 행이 일치한다고 가정해서는 안 됩니다. CNBC도 매출 $28.05 billion, 순이익 $787 million으로 같은 주요 수치를 제시합니다.
yahoo_finance/earnings 기능은 테스트 시간대에 작동하지 않았습니다. SGT 00:20~00:23 사이 TSLA 요청에 HTTP 503을 세 번 반환했습니다. 이 호출은 모두 과금되지 않았습니다. 자세한 내용은 실패 사례 섹션에서 설명합니다. 주당순이익은 Tesla 실적 자료에서 직접 가져왔습니다.
테스트 3: BYD 검색 결과와 해시태그 하나를 들여다보다
소셜 테스트는 BYD 쪽이 더 풍부했습니다. SGT 00:17:26에 “BYD 3분기 실적 보고서”를 뜻하는 중국어 검색어로 weibo/search를 호출했습니다. limit을 30으로 설정했고, $0.000806에 게시물 13개를 받았습니다. 카탈로그에 따르면 이 기능은 기본 20개, 최대 50개 게시물을 반환합니다.
결과가 이보다 적은 것은 정상입니다. 요금은 게시물 단위가 아니라 호출 단위이므로 결과가 적다고 비용이 더 들지는 않습니다. 게시물은 10월 19일부터 11월 1일까지에 걸쳐 있습니다. 가장 최근 게시물은 11월 1일 SGT 22:31에 올라왔습니다.
게시물을 보기 전에 키워드 규칙 두 가지를 먼저 작성해, 모델이 판단하지 않도록 했습니다. 보고서, 순이익, 매출, 마진 등 중국어 단어 9개 중 하나라도 있으면 실적을 다루는 게시물로 봅니다. 시승, 할인, 판매점 방문 등 중국어 단어 6개 중 하나라도 있으면 자동차 광고로 봅니다. 13개 중 10개가 실적을 다뤘습니다. 자동차 광고는 하나도 없었습니다.
게시물 2개는 BYD를 전혀 언급하지 않습니다. Huawei 스마트카 계정의 게시물입니다. 즉 키워드 검색의 노이즈는 광고가 아니라 관련 브랜드의 인기 게시물이었습니다. 모델이 데이터를 읽기 전에 회사명으로 필터링하세요.
13개 중 6개 게시물이 같은 해시태그를 달고 있으며, 이 해시태그는 BYD 실적이 강한 성장 신호를 보낸다는 내용입니다. 작성자의 팔로워 수는 각각 1, 3, 9, 80, 198, 507명입니다. 6개 게시물의 상호작용은 모두 합쳐 1건입니다. 게시 시간은 11월 1일 SGT 20:49부터 22:26까지 97분 안에 몰려 있습니다.
대부분은 슬로건 하나와 짧은 링크 하나로 이뤄져 있습니다. SGT 00:21:26에 BYD 실적 보고서로 weibo/topic_search를 호출했습니다. 해당 해시태그는 조회수 약 11,000회, 게시물 66개였습니다. BYD 2026년 3분기 실적 보고서에 관한 다른 토픽은 조회수 약 26,000회, 게시물 58개였습니다.
| 검색 결과 13건 | 개수 | 판단 방법 |
|---|---|---|
| 실적 언급 | 10 | 데이터 수집 전에 작성한 키워드 규칙 |
| 자동차 광고 | 0 | 데이터 수집 전에 작성한 키워드 규칙 |
| BYD 미언급 | 2 | 문자열 일치(Huawei 스마트카 게시물 2개) |
| 동일 해시태그, 팔로워 507명 이하 작성자 | 6 | 해시태그 일치 및 팔로워 수 |
| 인증된 작성자 | 5 | 응답의 author_verified |
이 해시태그는 규모가 작아 그것만으로 결론이 바뀌지는 않습니다. 하지만 이 6개 게시물을 긍정 게시물로 세면 긍정 비율이 절반 가까이 늘어납니다. Kimi에 줄 규칙은 분명합니다. 먼저 회사명으로 필터링합니다. 그다음 해시태그가 같고, 팔로워가 적고, 상호작용이 없고, 짧은 시간에 몰려 올라온 게시물을 하나의 그룹으로 묶습니다. 이 그룹의 개수와 특징은 보고하되 감성 집계에는 넣지 않습니다.
이 6개 게시물이 조직적으로 올라온 것인지는 알 수 없습니다. 패턴이 일반적인 논의와 다르다는 것까지만 말할 수 있습니다. 확실한 답을 얻으려면 계정 이력과 가입일이 필요합니다. 공개 데이터로는 이를 증명할 수 없습니다.
테스트 4: 댓글 타이밍이 확연히 다른 두 댓글란
검색 결과에서 가장 활발한 게시물은 인증된 테크 블로거의 실적 분석 글이었습니다. 이 게시물에는 댓글 49개가 표시되어 있었습니다. 이를 게시물 A라고 부르겠습니다. SGT 00:17:51에 weibo/comments는 그중 31개를 반환했습니다. 누락된 댓글은 접혔거나, 삭제되었거나, 공개 범위에서 숨겨졌을 수 있습니다. 외부에서는 어느 쪽인지 알 수 없습니다.
대조군으로 SGT 00:22:26에 MCP를 통해 BYD에 관한 또 다른 긴 게시물에서 댓글 36개를 수집했습니다. 이를 게시물 B라고 부르겠습니다. 다른 인증 작성자가 10월 30일에 올린 글로, 댓글 39개가 표시되어 있었습니다. 두 게시물 모두 BYD 실적과 사업을 다루지만, 댓글의 타이밍과 좋아요는 크게 다릅니다. 작성자 이름은 밝히지 않으며 게시물 링크도 걸지 않습니다. 이 섹션은 측정 방법을 보여 줄 뿐, 특정 계정에 대한 의견이 아닙니다.
| 지표 | 게시물 A | 게시물 B | 계산 방법 |
|---|---|---|---|
| 반환된 댓글 | 31 | 36 | count |
| 총 좋아요 | 0 | 43 | like_count 합계 |
| 좋아요 0개인 댓글 | 31 | 22 | 개수 |
| 첫 댓글부터 마지막 댓글까지 | 58.2분 | 3,340.1분(약 55.7시간) | posted_at |
| 20초 구간 최대 댓글 수 | 11 | 1 | 슬라이딩 윈도 |
| 안정 또는 연구개발비 언급 | 20 | 0 | 중국어 단어 정규식 |
| 부정어 포함 | 0 | 5 | 정규식, 아래 단어 목록 |
| 평균 길이 | 18.9자 | 39.8자 | 글자 수 |
게시물 A의 댓글 11개는 11월 1일 SGT 22:57:41부터 22:57:59 사이에 달렸습니다. 내용은 “이번 실적은 탄탄해 보이고 BYD는 갈수록 안정되고 있다”, “이익이 매출보다 빠르게 늘었으니 BYD는 진짜 실력이 있다” 같은 식입니다. 문장 구조가 서로 비슷합니다. 이익 성장률이 매출 성장률을 앞선다는 점과 연구개발, 프리미엄 모델, 글로벌 판매라는 블로거 본인의 주장을 그대로 반복합니다. 게시물 B는 반응이 섞여 있습니다.
한 댓글은 직원 기숙사와 급여를 비교합니다. 자동차 엠블럼과 소비 습관을 두고 논쟁하는 댓글도 있습니다. 글이 길어서 AI 요약을 요청하는 댓글도 있습니다. 무례한 댓글도 있습니다. 좋아요는 0~9개이며, 댓글은 이틀이 넘는 기간에 걸쳐 달렸습니다.
방법론의 약점 두 가지를 밝혀야 합니다. 실적 규칙과 자동차 광고 규칙은 데이터를 수집하기 전에 작성했습니다. 부정어 목록은 게시물 B의 댓글을 읽은 뒤에 작성했습니다. 따라서 “0 대 5” 결과는 검증이 아니라 현상을 기술한 것입니다.
안정 또는 연구개발 단어 목록도 마찬가지입니다. 게시물 A와 그 댓글을 읽은 뒤에 작성했으므로 “20 대 0” 결과도 기술에 불과합니다. 단어 목록과 무관한 수치는 총 좋아요, 시간 밀도, 평균 길이 세 가지입니다. 세 수치 모두 응답 필드에서 바로 나오므로, 누가 호출을 다시 실행해도 같은 결과를 얻습니다.
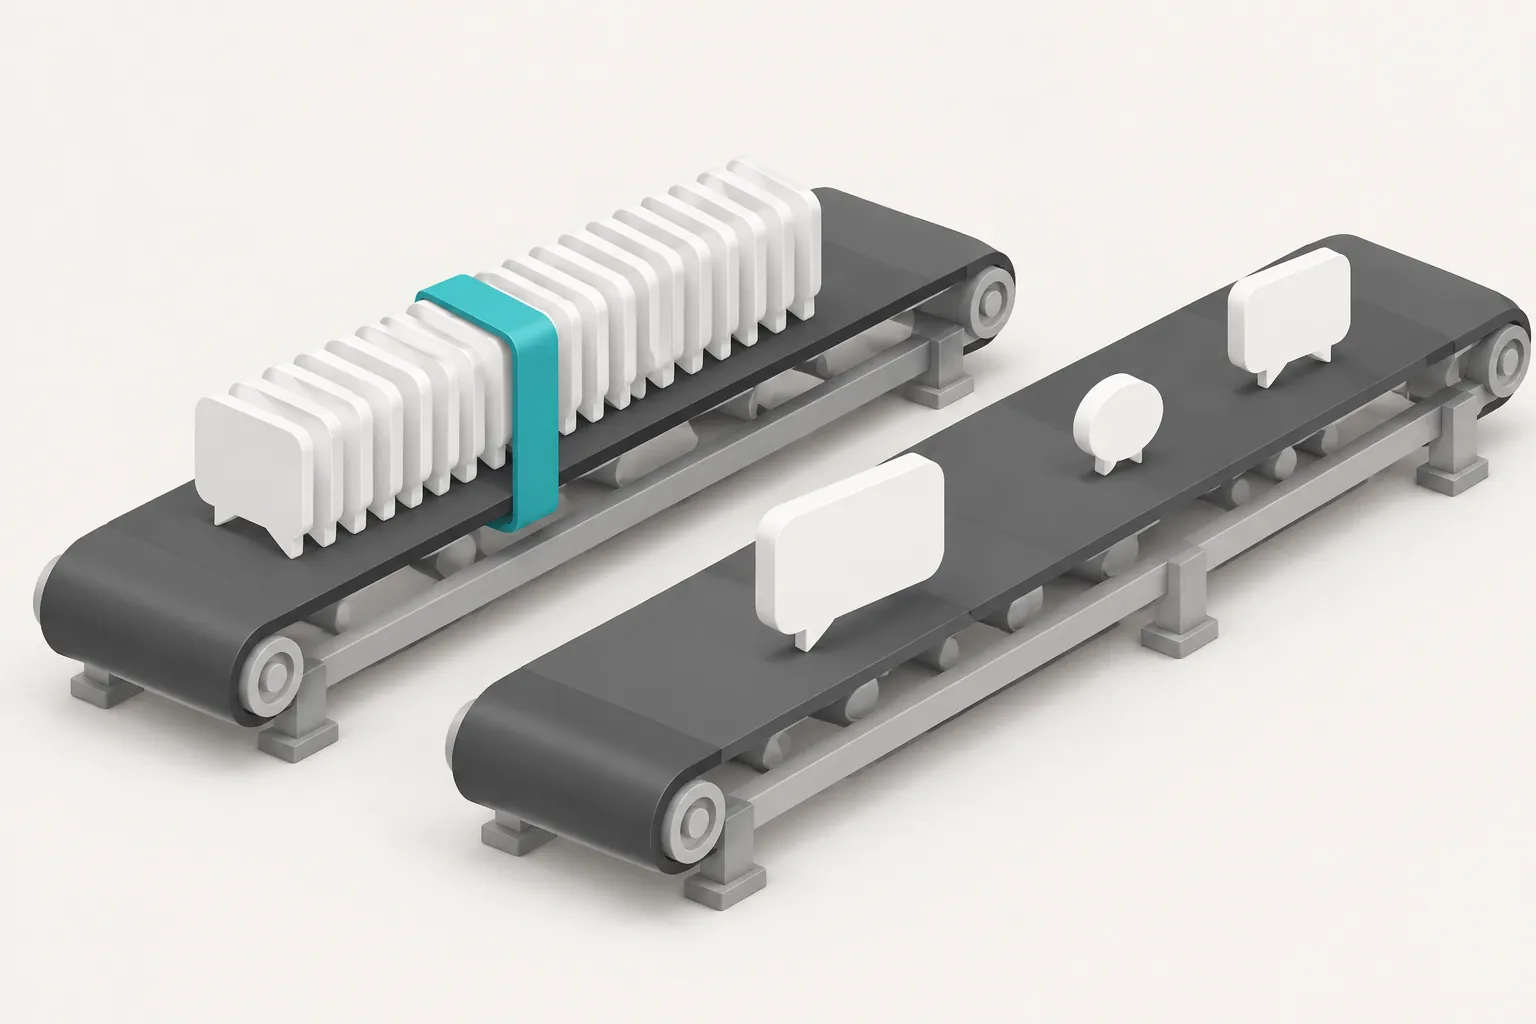
이 섹션이 독자가 요약을 얼마나 신뢰할 수 있는지를 결정합니다. 댓글 67개를 모두 모델에 넘기고 감성 점수를 요청하면 “매우 긍정적”이라는 답이 나올 가능성이 큽니다. 코드가 먼저 댓글란별 시간 밀도와 좋아요를 계산하고 촘촘한 클러스터를 표시하면, 모델은 다른 문장을 씁니다. 게시물 A의 댓글 11개가 18초 안에 좋아요 0개로 달렸으며, 감성 집계와 별도로 분류했다고 씁니다. 이 댓글들의 출처에 대해서는 어떤 결론도 내리지 않습니다.
첫 번째 경우에는 모델이 대신 판단합니다. 두 번째 경우에는 모델이 증거를 기록합니다.
테스트 5: BYD 수치를 공시와 대조하다
SGT 00:18:38에 BYD의 홍콩 티커인 1211.HK로 yahoo_finance/financials를 호출했습니다. 응답 크기는 78,732바이트, 소요 시간은 35.6초, 비용은 $0.001389였습니다. 응답에는 income, balance_sheet, cash_flow 세 배열이 있고, 각각 레코드 5개가 들어 있습니다. 레코드는 2025년 연간 실적과 2025년 4분기부터 2026년 3분기까지 4개 분기를 CNY 기준으로 담고 있습니다.
세 배열에는 같은 레코드가 들어 있습니다. 각 레코드는 손익계산서, 재무상태표, 현금흐름표 필드를 합친 것으로, 분기당 필드 수는 137~149개입니다. 이는 아래의 컨텍스트 크기 계산에 영향을 줍니다.
응답을 CNINFO에 게시된 BYD 3분기 보고서와 항목별로 대조했습니다.
| 항목 | API 응답(1211.HK, 2026-09-30) | BYD 3분기 보고서 | 일치 |
|---|---|---|---|
| 3분기 매출 | 221,488,251,000 | CNY 221,488,251,000.00, 전년 동기 대비 13.59% 증가 | 예 |
| 3분기 주주 귀속 순이익 | 10,019,570,000 | CNY 10,019,570,000.00, 28.08% 증가 | 예 |
| 재고자산 | 221,577,509,000 | CNY 221,577,509,000.00, 연초 대비 60.08% 증가 | 예 |
| 매출채권 | 56,472,621,000 | CNY 56,472,621,000.00, 52.61% 증가 | 예 |
| 현금 | 30,988,011,000 | CNY 30,988,011,000.00(연초 75,424,747,000.00) | 예 |
| 연구개발비, 9개월 누적 | 3개 분기 합계, 36,277,138,000 | CNY 36,277,138,000.00(전년 동기 43,748,447,000.00) | 예 |
6개 항목이 모두 일치합니다. 따라서 이 부분은 API에서 가져오고, 모델에서 PDF를 파싱하는 과정은 생략해도 됩니다. 하지만 이 대조는 API에 없는 것도 보여 줍니다. 보고서에는 큰 변동마다 이유를 설명하는 섹션이 있습니다.
보고서는 재고자산 증가가 주로 해외 자동차 사업 성장에 대비한 재고 확충 때문이라고 설명합니다. 손상차손이 67.60% 늘어난 것은 주로 재고자산 평가손실이 커졌기 때문이라고 합니다. 계약부채가 80.58% 늘어난 것은 주로 차량 선수금이 늘었기 때문이라고 합니다. 이런 이유는 공시에만 있습니다.
좋은 요약은 수치는 API에서, 이유는 공시에서 가져옵니다. Kimi에는 PDF에서 텍스트를 추출하는 파일 Q&A API가 있습니다(파일 기반 Q&A). 요금 페이지에 따르면 파일 추출은 현재 무료입니다. 다만 추출한 텍스트를 모델에 보내면 입력으로 과금됩니다(요금, 과금 방식).
교차 검증: 댓글이 말하는 것과 공시가 보여 주는 것
이제 두 부분을 합칩니다. 게시물 A와 그 댓글의 핵심 주장은 세 가지입니다. 이익이 매출보다 빠르게 늘었다는 것, 연구개발비 규모가 크다는 것, 회사가 갈수록 안정적이 되고 있다는 것입니다.
각 주장을 공시와 연결했습니다. 댓글에 등장하지 않는 항목 중 변동 폭이 가장 큰 항목도 추가했습니다. 마지막 열은 해당 항목이 언급되었는지, 검증할 수 있는지만 나타냅니다. 판단은 하지 않습니다.
아래 표는 Kimi가 최종적으로 작성하기를 바라는 결과물입니다. 같은 규칙으로 직접 채운 것이며 Kimi 출력이 아닙니다.
| 소셜 게시물의 주장 | 공시 데이터 | 논의에 등장? 검증 가능? |
|---|---|---|
| 이익이 매출보다 빠르게 증가 | 3분기 매출 13.59% 증가, 순이익 28.08% 증가 | 언급됨, 분기 수치와 일치 |
| 9개월 누적 | 9개월 매출 0.01% 증가, 순이익 4.24% 감소 | 언급되지 않음 |
| 연구개발비 규모가 큼 | 아홉 달 누적 CNY 36.28 billion, 전년 동기 CNY 43.75 billion(17.08% 감소) | 언급됨, 금액은 일치하나 전년 대비 변동은 언급 없음 |
| 갈수록 안정적 | “안정”을 측정하는 재무 필드 없음 | 언급됨, 검증할 수 없는 의견 |
| 재고자산, 매출채권, 현금 | 연초 대비 각각 60.08% 증가, 52.61% 증가, 58.92% 감소. 공시는 재고자산 증가를 해외 판매용 차량 재고와 연결 | 언급되지 않음 |
| 손상차손 | CNY 2.71 billion, 67.60% 증가. 공시 자료는 이를 재고자산 평가손실 확대와 연결 짓습니다 | 언급되지 않음 |
여기서 한계를 분명히 해야 합니다. 이 표는 논의에서 무엇이 언급되었고 공시가 무엇을 보여 주는지에만 답합니다. 회사 실적이 좋은지, 주가가 어디로 갈지는 말하지 않습니다. 공시는 큰 변동마다 이유를 설명합니다. 재고자산은 해외 판매용 차량 재고와 함께 늘었고, 계약부채는 차량 선수금 증가와 함께 80.58% 늘었습니다.
요약이 각 변동의 크기만 나열하고 공시상의 이유를 빼면 요약 자체가 선택적인 내용이 됩니다. 그래서 Kimi에 주는 규칙은 다음과 같습니다. “언급되지 않음” 그룹의 모든 수치에는 공시상의 이유와 페이지를 함께 적거나, “공시에 이유가 제시되지 않음”이라고 표기해야 합니다.
주가 이력과 애널리스트 기능도 호출했지만 이번 대조에는 포함하지 않았습니다. 이 글에서는 컨텍스트 크기와 비용 계산에만 반영했습니다. 교차 검증의 가치는 예측이 아닙니다. 논의에서 아무도 언급하지 않은 수치를 공시 자체의 이유와 함께 정리한 목록입니다. 그러면 사람이 무엇을 물어볼지 정할 수 있습니다.
컨텍스트 패킹: 1M 토큰에 몇 개 회사가 들어갈까
1M 컨텍스트라면 무엇이든 담을 수 있을 것 같아서, 회사 하나를 기준으로 측정했습니다. BYD의 경우 다섯 번의 호출(검색, 댓글, 재무, 주가 이력, 애널리스트)의 results 부분을 합치면 119,869자입니다. 재무 테이블만 82,350자를 차지합니다. 세 배열이 같은 데이터를 반복하기 때문입니다.
배열 하나만 남기면 27,418자입니다. 중복을 제거한 전체 패키지는 64,937자입니다. 이 중 중국어 문자는 1,927자뿐입니다. 나머지는 영어 필드명, 숫자, 링크입니다.
| BYD 패키지 구성 | 반환 원본(글자 수) | 정리 후(글자 수) |
|---|---|---|
| Weibo 검색 | 11,613 | 11,613 |
| Weibo 댓글 | 13,543 | 13,543 |
| 재무 테이블 | 82,350 | 27,418 |
| 일별 주가 | 12,033 | 12,033 |
| 애널리스트 평가 | 330 | 330 |
| 합계 | 119,869 | 64,937 |
토큰 수는 추정치입니다. Kimi 주요 개념 페이지에 따르면 일반 영어 텍스트 기준 토큰 1개는 약 3~4자입니다(주요 개념). 이 패키지는 대부분 영어 필드와 숫자입니다. 이 비율이면 64,937자는 약 16,234~21,646토큰입니다. 중국어 문자 하나에 2토큰이 든다고 해도 상한은 약 24,000토큰입니다. 정확한 수치는 Kimi 토큰 추정 API로 확인하세요(토큰 추정).
회사당 16,000~24,000토큰으로 계산하면 다음과 같습니다. 1,048,576토큰 컨텍스트에서 기본 출력 한도 131,072토큰을 빼면 917,504토큰이 남습니다. 여기에 38~56개 회사가 들어갑니다. 중복을 제거하지 않으면 이 수가 거의 절반으로 줄어듭니다.
들어간다고 해서 다 넣어야 하는 것은 아닙니다. 2단계 구성을 권장합니다. 먼저 코드나 서브 에이전트가 각 회사를 증거 테이블로 압축합니다. Kimi Code 워커 파일의 5단계와 같은 방식입니다. 메인 모델은 증거 테이블과 인용해야 할 공시 구절을 읽습니다. 여러 회사의 원본 댓글을 한 컨텍스트에 넣는 것은 회사 간 댓글을 비교할 때만 하세요.
Kimi는 기본적으로 컨텍스트를 5분간 캐시합니다. 요청 간격이 5분을 넘는 작업에서는 캐시가 만료되지 않도록 prompt_cache_options.ttl을 1h로 설정하세요(컨텍스트 캐싱). 리서치 규칙과 출력 템플릿은 각 요청의 맨 앞에 두세요. 캐시 적중 비용은 100만 토큰당 $0.20으로, 일반 입력 가격의 10분의 1입니다.
비용: 회사 하나를 1회 실행하면 얼마일까
EveryInfra 측 비용은 정확합니다. 회사 하나를 1회 실행할 때 weibo/search와 weibo/topic_search를 각 1회($0.000806 × 2), weibo/comments를 1회($0.000556), yahoo_finance/financials, history, analyst를 각 1회($0.001389 × 3) 호출합니다. 합계는 $0.006335입니다. 댓글란을 하나 더 수집하면 $0.000556이 추가됩니다. 요금은 행 단위가 아니라 호출 단위입니다.
Kimi 측은 직접 실행하지 않았으므로 추정치입니다. 회사당 입력 토큰 24,000개(위에서 계산한 상한)와 출력 및 추론 토큰 8,000개를 가정했습니다. 2026년 11월 2일에 확인한 공개 가격 기준으로 실시간 호출 시 입력 약 $0.048, 출력 약 $0.08입니다. 표준 가격의 60%인 Batch를 쓰면 각각 약 $0.0288, $0.048입니다.
| 사례 | EveryInfra 호출 수 | Kimi 입력(추정) | Kimi 출력(추정) | 합계 |
|---|---|---|---|---|
| 회사 1개, 실시간 | $0.006335 | $0.048 | $0.080 | $0.134 |
| 회사 1개, Batch | $0.006335 | $0.0288 | $0.048 | $0.083 |
| 회사 20개, 주 1회 4주간, 실시간 | $0.5068 | $3.84 | $6.40 | $10.75 |
| 회사 20개, 주 1회 4주간, Batch | $0.5068 | $2.30 | $3.84 | $6.65 |
실시간 기준 데이터 호출은 전체의 약 4.7%입니다. Batch를 쓰면 모델 가격은 40% 내려가고 데이터 가격은 그대로이므로 약 7.6%가 됩니다. 출력 및 추론 토큰이 비용을 좌우합니다. 따라서 다음 순서로 절감하세요. 첫째, reasoning_effort를 max에서 high나 low로 낮추고 요약 품질이 유지되는지 확인합니다. 둘째, 각 회사를 증거 테이블로 압축합니다.
셋째, Batch를 검토합니다. 배치는 completion_window 안에 끝나야 하며, 그렇지 않으면 만료됩니다. 배치 내 캐시 적중은 베스트 에포트 방식으로만 제공됩니다(Batch API 가이드). 실적 시즌의 야간 실행은 Batch와 잘 맞습니다. 당일 요약에는 실시간 호출이 필요합니다. EveryInfra 요금은 EveryInfra 요금 페이지에서 확인할 수 있습니다.
실패, 요청 속도 제한, 미과금: 21건의 요청에서 확인한 것
총 21건의 요청을 보냈습니다. 14건이 성공해 과금되었고, 합계는 $0.014018입니다. 7건은 과금되지 않았습니다. 이 7건은 프로덕션 작업에서 마주칠 사례를 보여 줍니다. 각 사례는 Kimi에 주는 규칙에 반영해야 합니다.
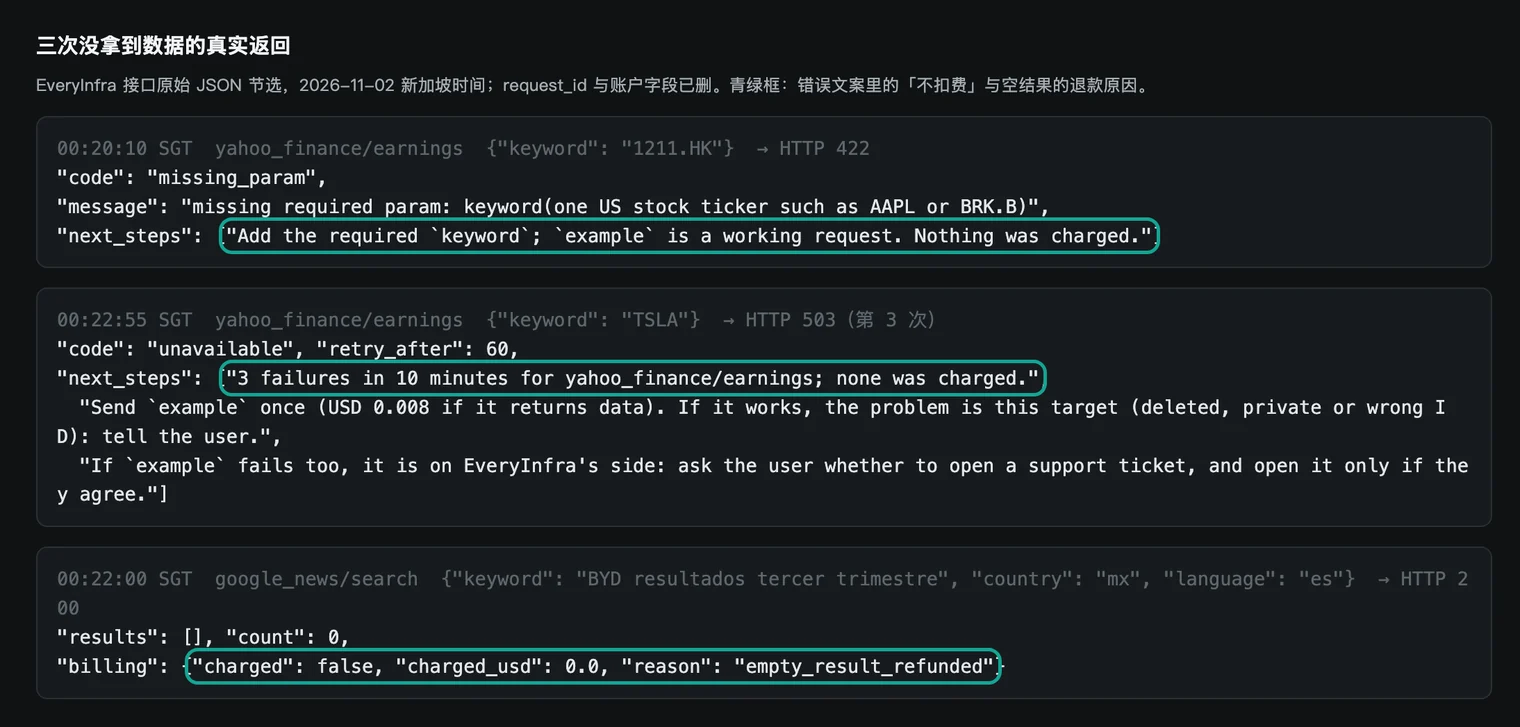
첫 번째는 잘못된 인수입니다. 카탈로그에 따르면 yahoo_finance/earnings는 미국 티커만 받습니다. SGT 00:20:10에 일부러 홍콩 티커 1211.HK를 보냈습니다. 0.2초 만에 코드 missing_param과 함께 HTTP 422가 반환되었습니다.
메시지는 미국 티커를 요구하고, 작동하는 예시 요청을 제시하며, “Nothing was charged”라고 알립니다. 이 메시지는 모델이 읽도록 작성되어 있습니다. Kimi가 이를 도구 결과로 읽으면 인수를 바꾸거나 다른 기능을 고를 수 있습니다. 같은 호출을 재시도할 필요가 없습니다.
두 번째는 서비스의 일시적 중단입니다. SGT 00:20:32, 00:21:30, 00:22:55에 TSLA로 호출한 yahoo_finance/earnings가 HTTP 503을 반환했습니다. 응답마다 과금이 없다고 알리고 retry_after를 60초로 제시했습니다. 세 번째 메시지는 달랐습니다. 어느 쪽에 문제가 있는지 확인할 수 있도록 예시 요청으로 한 번 시도해 보라고 제안했습니다.
SGT 00:23:05에 예시 티커 AAPL로 그렇게 해 봤습니다. 역시 503이 반환되었습니다. 즉 문제는 TSLA 티커가 아니라, 그 몇 분 동안 기능 자체가 중단된 것이었습니다. 지원 티켓은 열지 않았습니다. 대신 주당순이익을 Tesla 실적 자료에서 가져왔습니다.
세 번째는 빈 결과입니다. SGT 00:22:00에 BYD 3분기 실적을 뜻하는 스페인어 문구로 멕시코 Google News를 검색했습니다. 빈 results와 함께 HTTP 200이 반환되었습니다. billing.reason은 empty_result_refunded였고, 과금액은 0이었습니다. BYD 이익을 뜻하는 더 짧은 문구로는 결과 10건이 반환되었습니다.
네 번째는 요청 속도 제한입니다. 여러 작업이 키 하나를 공유하며 동시에 실행되면 분당 한도를 넘을 수 있습니다. SGT 00:20:58에 토픽 검색이 HTTP 429를 받았습니다. 메시지는 과금 없이 2초 후 재시도하라고 안내했습니다. SGT 00:21:05에 다시 보내자 성공했습니다.
| 시각(SGT) | 기능 | 결과 | 과금 | Kimi 규칙 |
|---|---|---|---|---|
| 00:20:10 | yahoo_finance/earnings (1211.HK) | 422, 미국 티커만 지원 | $0 | next_steps를 읽은 뒤 티커나 기능 변경 |
| 00:20:32 / 00:21:30 / 00:22:55 | yahoo_finance/earnings (TSLA) | 503, 일시적 중단 | $0 | retry_after만큼 대기, 최대 2회 시도 후 예시 요청 전송 |
| 00:20:58 | weibo/topic_search | 429, 분당 한도 도달 | $0 | retry_after만큼 대기 후 같은 호출 1회 재시도 |
| 00:22:00 | google_news/search (스페인어) | 200, 빈 결과, 환불됨 | $0 | 다른 검색어로 시도, “뉴스 없음”으로 보고하지 않음 |
| 00:23:05 | yahoo_finance/earnings (AAPL 예시) | 503 | $0 | 예시 요청도 실패했으므로 서비스 측 문제 |
여러 회사를 병렬로 처리하는 Kimi Code 서브 에이전트라면 이 규칙을 에이전트 파일에 넣으세요. 429에서는 retry_after만큼 기다린 뒤 같은 인수로 한 번 재시도합니다. 503에서는 최대 두 번까지 재시도합니다. 422에서는 인수를 바꾸기 전에 next_steps를 읽습니다. 미과금 규칙은 빠른 시작에 있습니다. 과금 내역과 호출을 맞춰 보려면 실패 건 환불 대조를 참고하세요.
출력 템플릿: Kimi가 증거로만 쓰게 하는 법
마지막 단계는 요약입니다. K3.1 Pro는 최종 message.content에 대해 strict: true를 지정한 json_schema를 지원합니다(빠른 시작, 구조화된 출력). 고정 필드를 권장합니다. 모든 주장에는 출처 필드가 있어야 합니다. 모델이 출처를 제시하지 못하면 그 주장은 쓸 수 없습니다.
{
  "type": "json_schema",
  "json_schema": {
    "name": "cross_check_summary",
    "strict": true,
    "schema": {
      "type": "object",
      "additionalProperties": false,
      "required": ["company", "window", "claims", "unmentioned", "timing_clusters", "limits"],
      "properties": {
        "company": {"type": "string"},
        "window": {"type": "string"},
        "claims": {"type": "array", "items": {"type": "object", "additionalProperties": false,
          "required": ["social_claim", "social_source_ids", "filing_value", "filing_source", "verdict"],
          "properties": {
            "social_claim": {"type": "string"},
            "social_source_ids": {"type": "array", "items": {"type": "string"}},
            "filing_value": {"type": "string"},
            "filing_source": {"type": "string"},
            "verdict": {"type": "string", "enum": ["supported", "partly supported", "not supported", "cannot check"]}}}},
        "unmentioned": {"type": "array", "items": {"type": "string"}},
        "timing_clusters": {"type": "array", "items": {"type": "string"}},
        "limits": {"type": "array", "items": {"type": "string"}}
      }
    }
  }
}social_source_ids에는 게시물 또는 댓글의 id 값이 들어갑니다. filing_source에는 테이블 필드명이나 공시의 페이지가 들어갑니다. 그래서 각 행을 원시 데이터까지 거슬러 추적할 수 있습니다. verdict는 enum이므로 모델이 형용사를 마음대로 고를 수 없습니다.
스키마에 “조언”이나 “평가” 필드가 없으므로 구조 자체가 매매 조언을 배제합니다.
timing_clusters에는 좋아요 없이 몇 초 안에 몰린 댓글처럼 측정할 수 있는 형태만 기록합니다. 출처에 대한 추측은 담지 않습니다. limits는 필수입니다. 모델은 요약의 한계를 밝혀야 합니다. 예를 들어 Weibo 검색은 최근 몇 주만 다룬다거나, 댓글 호출이 게시물에 표시된 수보다 적은 댓글을 반환했다는 점입니다. 위에서 직접 채운 교차 검증 표가 이 템플릿에 실제 데이터를 넣은 모습입니다.
투자 조언이 아닙니다: 우리가 그은 선
이 작업은 종목 추천과 한 걸음 거리에 있습니다. 그래서 한계는 마지막 면책 문구에만 둘 것이 아니라 워크플로의 일부가 되어야 합니다. 중국 규제 당국은 이미 이 문제에 조치를 취했습니다. 2026년 중국증권감독관리위원회(CSRC) 베이징 사무소는 소셜 미디어 운영자 2명에게 각각 CNY 200,000과 CNY 250,000의 벌금을 부과했습니다.
이들은 상장사에 관한 허위 정보를 지어내 퍼뜨렸습니다. 한 명은 AI가 허위 텍스트를 생성했다고 주장했습니다. 규제 당국은 이 항변을 받아들이지 않았습니다. 보도에 따르면 생성형 AI 사용자는 AI가 만든 결과물을 검토해야 합니다(CSRC 베이징, 증권일보 기사 전재).
2026년 10월 중순 CSRC 장쑤 사무소는 Weibo, WeChat, Douyin, Xiaohongshu의 새 금융 콘텐츠 규칙에 관한 보도를 전재했습니다. 이 규칙은 개별 종목의 주가 움직임 예측을 금지하고, AI가 만든 허위 금융 콘텐츠에 대한 검사를 추가합니다(CSRC 장쑤 언론 보도 모음).
실무에서는 네 가지 규칙을 적용합니다. 첫째, 요약은 주장이 데이터와 일치하는지만 말합니다. 매수나 매도는 절대 언급하지 않습니다.
둘째, 모든 수치에는 원시 필드나 공시 출처를 붙이고, 출처가 없는 문장은 삭제합니다. 셋째, 좋아요가 없고 짧은 시간에 몰린 댓글은 별도 그룹으로 분리해 감성 집계에서 제외하며, 어디서 비롯됐는지도 추측하지 않습니다. 넷째, 요약은 내부 리서치용입니다. 이를 공개하기 전에는 사람이 모든 문장을 출처와 대조해야 합니다. Moonshot의 자체 기술 블로그도 자사 환각 테스트에는 고난도 프롬프트가 사용되며 일반적인 사용 환경의 오류율을 보여 주는 것은 아니라고 밝힙니다.
한계와 주의할 점
첫째, Kimi 측은 테스트하지 않았습니다. Kimi API, Kimi Code, Kimi Work에 관한 모든 내용은 2026년 11월 2일에 확인한 Moonshot 문서에 근거합니다. 코드는 구성 예시입니다. Moonshot은 K3.1 Pro 출시 이후 문서를 자주 업데이트합니다.
K2 시리즈는 2026년 10월 31일부터 신규 사용자를 받지 않습니다. Moonshot은 12월 말까지 이 시리즈의 서비스를 종료할 계획입니다(요금, K2 시리즈). 코드를 복사하기 전에 출처를 다시 확인하세요. 토큰 수와 Kimi 비용은 추정치입니다.
둘째, Weibo 데이터에는 수집 범위의 한계가 있습니다. 키워드 검색은 최근 게시물을 반환하며, limit 30으로 13개를 받았습니다. 댓글 호출은 각 게시물에 표시된 수보다 적은 댓글을 반환했습니다. 49개 중 31개, 39개 중 36개입니다. 토픽 조회수는 특정일의 조회수가 아니라 누적 총계입니다. 실적 발표 기간을 분석하려면 그 기간 안에 데이터를 수집하세요.
셋째, yahoo_finance/earnings는 미국 티커만 받습니다. 홍콩 및 중국 본토 종목은 재무 테이블이나 공시에서 주당순이익을 가져오세요. 또한 이 기능은 테스트하던 몇 분 동안 중단되었으며, 과금은 없었습니다. 넷째, 재무 API는 공시와 일치하지만 변동의 이유는 설명하지 않습니다.
이유는 공시에만 있습니다.
다섯째, 부정어 목록과 안정 또는 연구개발 단어 목록은 데이터를 읽은 뒤에 작성했으므로 해당 결과는 기술에 불과합니다. 여섯째, 본문과 스크린샷에서 댓글 작성자 이름, 사용자 ID, 두 게시물의 링크를 가렸습니다. 여러분의 리서치 요약에서도 일반 사용자의 신원은 빼야 합니다. 일곱째, 표본이 작습니다. 회사 하나와 댓글란 두 개뿐입니다. 방법을 보여 주기에는 충분하지만, 이 회사나 이런 유형의 논의에 대한 일반적인 견해를 뒷받침하기에는 부족합니다. 정식 연구라면 여러 회사와 여러 실적 시즌이 필요하며, 모든 단어 목록을 데이터 수집 전에 작성해야 합니다.
최근 변경 사항
- 2026년 10월 23일: Moonshot이 Kimi K3.1 Pro와 Highspeed 버전을 출시했습니다. API 가격은 100만 토큰당 입력 $2.00, 출력 $10.00입니다. 가중치는 11월 4일까지 공개될 예정입니다(Kimi API Platform, Simon Willison의 노트). 독자에게 미치는 영향: 같은 롱 컨텍스트 작업의 입력 비용이 K3보다 3분의 1 낮습니다.
- 2026년 10월 26일: Kimi Work 3.2.21부터 프로젝트 MCP 서버를 불러오기 전에 승인을 요청합니다. 10월 29일 버전 3.2.22에서는 예약 작업이 Task Center로 옮겨졌습니다(Kimi Work 릴리스 노트). 독자에게 미치는 영향: 예약 수집은 첫 실행 때 사람이 한 번 클릭해야 합니다.
- 2026년 10월 31일: K2 시리즈가 신규 사용자를 받지 않게 되었으며, 12월 말까지 서비스 종료가 예정되어 있습니다(요금). 독자에게 미치는 영향: K2 도구 호출 코드를 K3 모델로 옮기세요. K3.1 Pro의 thinking은 끌 수 없다는 점에 유의하세요.
FAQ
Kimi K3.1 Pro의 컨텍스트 윈도는 얼마인가요?
API 문서에 따르면 1,048,576토큰이며, 길이와 관계없이 가격은 같습니다(요금). 출력도 컨텍스트를 사용하며, max_completion_tokens 기본값은 131,072입니다. 테스트에서 회사 하나의 Weibo 및 재무 데이터는 중복 제거 후 약 16,000~24,000토큰이었습니다. 기본 출력 공간을 확보하면 38~56개 회사가 들어갑니다. (질문 출처: Google 추천 검색어 “kimi k3.1 pro context window”)
Kimi K3.1 Pro API 키는 어떻게 받나요? 먼저 충전해야 하나요?
Kimi API Platform 콘솔에서 키를 생성하세요. K3.1 Pro는 플래그십 모델이므로 충전 후에만 사용할 수 있습니다. 최소 충전액은 $1이며, 누적 충전액에 따라 등급과 요청 속도 제한이 정해집니다(빠른 시작, 이용 요건, 충전 및 한도). API는 토큰당 과금되며, Kimi 멤버십 및 Kimi Code 요금제와는 별개입니다(제품 비교). (출처: 추천 검색어 “kimi k3.1 pro api key”)
Kimi K3.1 Pro 요금은 얼마이고, K3보다 저렴한가요?
2026년 11월 2일 기준 공개 가격: K3.1 Pro는 100만 토큰당 입력 $2.00, 출력 $10.00, 캐시 적중 $0.20입니다. K3는 입력 $3.00, 출력 $15.00입니다(Kimi API Platform). Batch는 표준 가격의 60%입니다(Batch 요금). 회사 하나를 1회 실행할 때의 추정 비용은 실시간 기준 약 $0.134이며, 그중 EveryInfra 호출이 $0.006335입니다. (출처: 추천 검색어 “kimi k3.1 pro pricing”, “kimi k3.1 pro vs k3”)
Kimi K3.1 Pro는 MCP 도구를 지원하나요?
API 요청에서는 지원하지 않습니다. Chat Completions, Responses, Messages는 원격 MCP 서버를 받지 않습니다. Responses API는 function, namespace, custom, web_search 도구 유형만 지원합니다(Responses API 레퍼런스). 원격 MCP를 쓰려면 Kimi Code CLI의 mcp.json이나 Kimi Work의 개인 플러그인을 사용하세요. Playground는 ModelScope에 호스팅된 MCP 서버만 동기화합니다. (출처: 추천 검색어 “kimi k3.1 pro tools”, “kimi k3.1 pro mcps”)
Kimi는 재무 데이터를 어디서 가져오나요?
모델 자체에는 실시간 데이터가 없습니다. Kimi Work에는 Wind, Hundsun Gildata, S&P Global Market Intelligence 등 금융 데이터베이스 플러그인이 기본 제공됩니다(Kimi Work 플러그인 센터). 원시 소셜 게시물과 댓글은 이 플러그인에 없습니다. 이 글에서는 EveryInfra의 weibo/* 및 yahoo_finance/* 호출이 그 공백을 메웁니다. API를 쓰면 모든 데이터가 도구 호출을 통해 모델에 전달됩니다.
참고 자료
- “Kimi K3.1 Pro quickstart”, Moonshot AI, 2026-11-02 열람, https://platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart
- “Kimi K3.1 Pro Tech Blog”, Moonshot AI, 2026-10-23, https://www.kimi.com/blog/kimi-k3-1-pro
- “Model Inference Pricing”, Moonshot AI, 2026-11-02 열람, https://platform.kimi.ai/docs/pricing/chat
- 모델 가격이 표시된 Kimi API Platform 홈페이지, Moonshot AI, 2026-11-02 열람, https://platform.kimi.ai/
- “BatchJob Pricing”, Moonshot AI, 2026-11-02 열람, https://platform.kimi.ai/docs/pricing/batch
- “Recharge and Rate Limiting”, Moonshot AI, 2026-11-02 열람, https://platform.kimi.ai/docs/pricing/limits
- “Responses API reference”, Moonshot AI, 2026-11-02 열람, https://platform.kimi.ai/docs/api/responses
- “Messages API reference”, Moonshot AI, 2026-11-02 열람, https://platform.kimi.ai/docs/api/messages
- “Use Kimi API for Tool Calls”, Moonshot AI, 2026-11-02 열람, https://platform.kimi.ai/docs/guide/use-kimi-api-to-complete-tool-calls
- “Kimi K3 API Tool Calling Best Practices”, Moonshot AI, 2026-11-02 열람, https://platform.kimi.ai/docs/guide/kimi-k3-tool-calling-best-practice
- “Tool Choice”, Moonshot AI, 2026-11-02 열람, https://platform.kimi.ai/docs/guide/use-tool-choice
- “Dynamically Loaded Tools”, Moonshot AI, 2026-11-02 열람, https://platform.kimi.ai/docs/guide/use-dynamic-tool-loading
- “Reasoning Effort”, Moonshot AI, 2026-11-02 열람, https://platform.kimi.ai/docs/guide/use-reasoning-effort
- “Structured Output”, Moonshot AI, 2026-11-02 열람, https://platform.kimi.ai/docs/guide/response_format
- “Context Caching”, Moonshot AI, 2026-11-02 열람, https://platform.kimi.ai/docs/guide/context-caching
- “Using Batch API for Bulk Processing”, Moonshot AI, 2026-11-02 열람, https://platform.kimi.ai/docs/guide/use-batch-api
- “Configure ModelScope MCP Server in Playground”, Moonshot AI, 2026-11-02 열람, https://platform.kimi.ai/docs/guide/configure-the-modelscope-mcp-server
- “Use Kimi API for File-Based Q&A”, Moonshot AI, 2026-11-02 열람, https://platform.kimi.ai/docs/guide/use-kimi-api-for-file-based-qa
- “Main Concepts”, Moonshot AI, 2026-11-02 열람, https://platform.kimi.ai/docs/introduction
- “Token estimate API”, Moonshot AI, 2026-11-02 열람, https://platform.kimi.ai/docs/api/estimate
- “Compare with Other Kimi Products”, Moonshot AI, 2026-11-02 열람, https://platform.kimi.ai/docs/guide/product-plans
- “Kimi Code: Model Context Protocol”, Moonshot AI, 2026-11-02 열람, https://www.kimi.com/code/docs/en/kimi-code-cli/customization/mcp.html
- “Kimi Code: Agents and Sub-Agents”, Moonshot AI, 2026-11-02 열람, https://www.kimi.com/code/docs/en/kimi-code-cli/customization/agents.html
- “Kimi Code: Model Configuration”, Moonshot AI, 2026-11-02 열람, https://www.kimi.com/code/docs/en/kimi-code/models.html
- “Kimi Work product page”, Moonshot AI, 2026-11-02 열람, https://www.kimi.com/en/products/kimi-work
- “Kimi Work Release Notes”, Moonshot AI, 2026-10-29 업데이트, https://www.kimi.com/en/help/kimi-work/release-notes
- “What Are Kimi Plugins”, Moonshot AI, 2026-11-02 열람, https://www.kimi.com/en/help/plugins-and-skills/overview
- “How to Create a Personal Plugin”, Moonshot AI, 2026-11-02 열람, https://www.kimi.com/en/help/plugins-and-skills/create
- “Kimi Work Plugin Center”, Moonshot AI, 2026-11-02 열람, https://www.kimi.com/en/help/kimi-work/plugin-center
- “Tesla Q3 2026 Update (8-K exhibit 99.1)”, Tesla(SEC EDGAR 게재), 2026-10-21, https://www.sec.gov/Archives/edgar/data/1318605/000162828026066738/exhibit9914.htm
- “BYD Company Limited 2026 Third Quarter Report”, BYD(CNINFO 게재), 2026-10-30, https://static.cninfo.com.cn/finalpage/2026-10-30/1225641442.PDF
- “EveryInfra Weibo catalog”, EveryInfra, 2026-11-02 열람, https://api.everyinfra.com/api/v1/social/catalog?platform=weibo
- “EveryInfra Yahoo Finance catalog”, EveryInfra, 2026-11-02 열람, https://api.everyinfra.com/api/v1/social/catalog?platform=yahoo_finance
- “EveryInfra Google News catalog”, EveryInfra, 2026-11-02 열람, https://api.everyinfra.com/api/v1/social/catalog?platform=google_news
- “EveryInfra Reddit catalog”, EveryInfra, 2026-11-02 열람, https://api.everyinfra.com/api/v1/social/catalog?platform=reddit
- “A 250,000-yuan fine for an AI-written fake story (reprint of Securities Daily)”, CSRC 베이징 감독국, 2026-06-18, https://www.csrc.gov.cn/beijing/c105538/c7640109/content.shtml
- “Media review: joint work to clean up finance content”, CSRC 장쑤 감독국, 2026-10-15, https://www.csrc.gov.cn/jiangsu/c106440/c7664819/content.shtml
- “Kimi K3.1 Pro notes”, Simon Willison, 2026-10-23, https://simonwillison.net/2026/Oct/23/kimi-k31-pro/
- “Tesla Q3 2026 earnings report”, CNBC, 2026-10-21, https://www.cnbc.com/2026/10/21/tesla-tsla-q3-2026-earnings-report.html
- “How good is kimi K3.1 Pro?”(스레드), Reddit r/kimi, 2026-10, https://www.reddit.com/r/kimi/comments/1xdkngh/how_good_is_kimi_k31_pro/
- “Model Context Protocol specification”, Model Context Protocol, 2026-11-02 열람, https://modelcontextprotocol.io/specification/2025-06-18
참고 BL-67