Исследование с Kimi K3.1 Pro: как сверить настроения в Weibo с финансовой отчётностью
Как сверить посты в Weibo и Reddit с финансовой отчётностью Tesla и BYD с помощью Kimi K3.1 Pro: время публикации комментариев, построчная проверка, настройка MCP и стоимость.
Tesla отчиталась за третий квартал 21 октября 2026 года. Через одиннадцать дней, 2 ноября в 00:18 по SGT, мы выполнили в Weibo поиск постов об отчётности Tesla. Поиск вернул 17 постов. Только 3 из них были посвящены отчётности Tesla.
Лишь 1 из них был опубликован до 22 октября. Тот же поиск в Reddit дал 7 из 8 постов за 21 и 22 октября. Этот разрыв и есть первый урок. Поиск по соцсетям показывает картину на момент запуска, а не на период публикации отчётности.
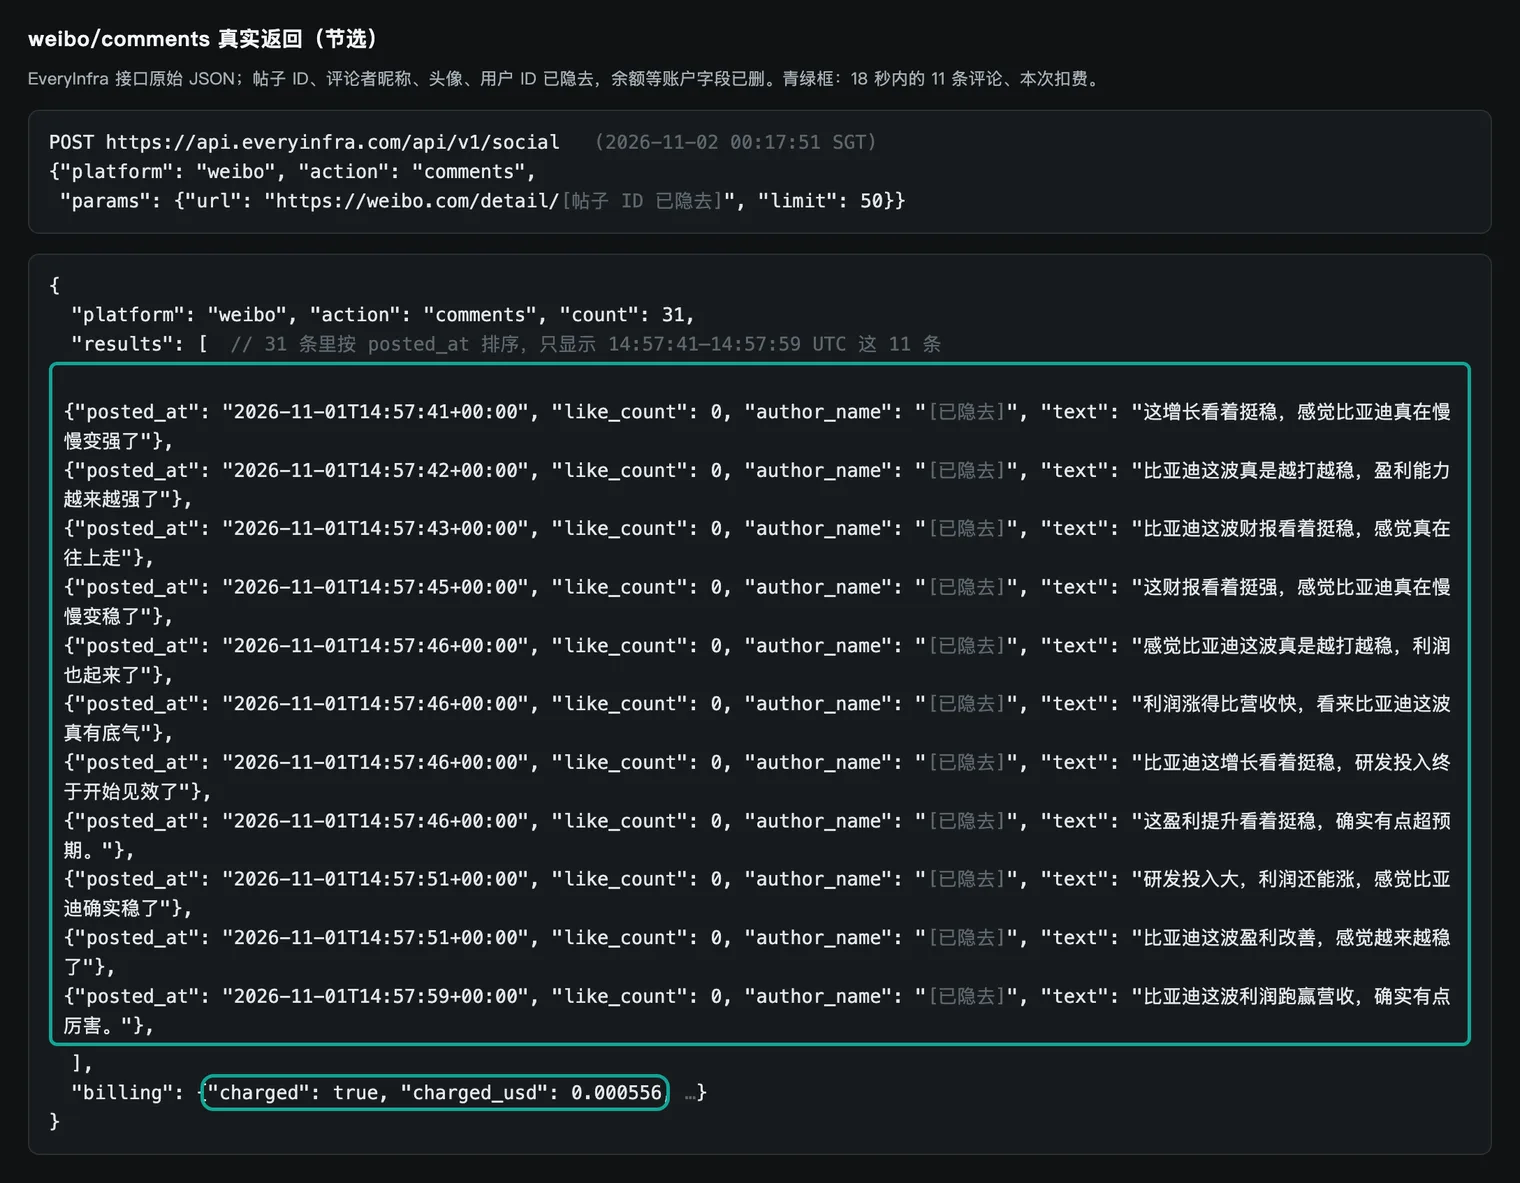
Второй урок дала BYD, китайский автопроизводитель, отчитавшийся 29 октября. Под одним популярным постом в Weibo об отчёте BYD мы собрали 31 комментарий. Сумма их лайков равна нулю, а одиннадцать из них появились в пределах одних и тех же 18 секунд. Под вторым длинным постом о том же отчёте было 36 комментариев. Они распределились более чем на два дня, и ни в какие 20 секунд не попадало больше 1.
Третий урок: в обсуждении и отчётности рассматриваются разные цифры. С начала года в отчётности BYD сильнее всего изменились три строки. Запасы выросли на 60,08%, дебиторская задолженность выросла на 52,61%, а денежные средства сократились на 58,92%.
Отчётность объясняет каждое изменение: например, запасы выросли для обеспечения зарубежных продаж автомобилей. Ни один комментарий в выборке не упоминает эти строки. Это не показывает, кто прав. Это лишь показывает, что исследовательская сводка не может опираться только на комментарии.
В этой статье показано, как построить такую сверку с Kimi K3.1 Pro от Moonshot AI. Модель читает посты из соцсетей и финансовые таблицы в одном длинном контексте. Она пишет сводку на одну страницу с источником для каждой строки. EveryInfra предоставляет исходные данные через weibo/search, weibo/comments, yahoo_finance/financials и другие возможности. Все подсчёты выполняет ваш собственный код до того, как модель начнёт писать.
Эта статья посвящена методам работы с данными и настройке инструментов. Она не является инвестиционной рекомендацией. В ней не утверждается, что какую-либо акцию стоит покупать или продавать. Финансовые показатели приводятся только для того, чтобы показать, как сверить утверждение из соцсетей с первичным источником. Результат каждой проверки говорит лишь о том, встречается ли число в обсуждении, а не о том, хорошее оно или плохое.
Эту статью написала команда EveryInfra. Все подсчёты выполнены скриптами, а лицензированный финансовый аналитик статью не проверял. Для любых выводов о компании опирайтесь на её отчётность и на мнение лицензированных специалистов.
У нас не было ключа Kimi, поэтому мы не запускали Kimi. Весь код для Kimi в статье представляет собой пример конфигурации на основе документации Moonshot, которую мы прочитали 2 ноября 2026 года. Все цифры EveryInfra получены из реальных запросов и их исходных ответов.
Задача: сверка соцсетей и отчётности на одной странице
Начнём с чёткой постановки задачи, потому что от неё зависят все приведённые ниже настройки и расчёты стоимости. На входе — одна компания, чьи акции торгуются на бирже, и дата её последнего отчёта о финансовых результатах. На этапе сбора получают четыре вида данных: посты в Weibo об отчёте, комментарии под самыми активными постами, последние квартальные таблицы и дневные котировки вблизи даты отчёта. На выходе получается сводка на одну страницу с фиксированной структурой.
Сводка отвечает на пять вопросов. Что утверждают посты в соцсетях? Что говорит отчётность о каждом утверждении? Какие утверждения не совпадают с ней?
Какие посты или комментарии не похожи на естественное обсуждение? Каковы ограничения этой сводки? Каждый ответ должен указывать на исходное поле или страницу отчётности. Тогда читатель сможет проверить каждую строку, не доверяя модели на слово.
Эта задача подходит для модели с длинным контекстом и вызовами инструментов по трём причинам. Во-первых, исходные материалы бывают четырёх разных видов. Посты, комментарии, финансовые таблицы и строки с ценами вручную не сопоставить. Модель может прочитать их все сразу и записать результат в одном формате. Во-вторых, правило сверки легко сформулировать.
Для каждого финансового утверждения в комментарии найдите соответствующее поле в таблице или отметьте, что оно не найдено. Это построчная работа, с которой модели с длинным контекстом справляются хорошо. В-третьих, окончательное суждение остаётся за человеком. Модель составляет таблицу с источниками, а не принимает торговое решение.
По данным Moonshot, K3.1 Pro набрала на 11,6 балла больше, чем K3, во внутреннем тесте Financial Research. Moonshot описывает этот тест как исследование, которое должно допускать проверку с учётом ограничений по доказательной базе и датам (технический блог Kimi K3.1 Pro). Для этой задачи точнее всего подходит слово «проверяемость». Каждая строка сводки должна вести к исходным данным.
Основным примером для англоязычных читателей мы взяли Tesla, вторым примером стала BYD. Tesla подала в SEC отчёт за третий квартал 21 октября 2026 года (Tesla 8-K, приложение 99.1). BYD подала отчёт 29 октября 2026 года, после закрытия рынка материкового Китая (отчёт BYD за Q3 2026 на CNINFO). Когда мы собирали данные 2 ноября, обсуждение BYD в Weibo ещё продолжалось. Обсуждению Tesla было уже 11 дней. Из-за этой разницы два случая полезно рассматривать вместе.
| Входные или выходные данные | Содержимое | Возможность | Цена по каталогу |
|---|---|---|---|
| Посты в Weibo | Поиск по ключевым словам, до 50 постов | weibo/search | $0,000806 за вызов |
| Охват темы | Просмотры и посты по каждой теме с хештегом | weibo/topic_search | $0,000806 за вызов |
| Комментарии | До 50 комментариев под одним постом | weibo/comments | $0,000556 за вызов |
| Финансовые таблицы | Годовые и квартальные отчёты о прибылях и убытках, бухгалтерские балансы и отчёты о движении денежных средств | yahoo_finance/financials | $0,001389 за вызов |
| Цены | Дневные котировки | yahoo_finance/history | $0,001389 за вызов |
| Мнение аналитиков | Число рейтингов и их изменения | yahoo_finance/analyst | $0,001389 за вызов |
| Вывод | Сводка на одну страницу в JSON и Markdown | Kimi K3.1 Pro | Оплата за токены |
Мы взяли эти цены из бесплатного каталога 2 ноября 2026 года в 00:13 по SGT. Нужное поле называется price_usd (каталог Weibo, каталог Yahoo Finance). Списки полей приведены на страницах API для парсинга Weibo и API данных Yahoo Finance. У каждой возможности также есть своя страница: поиск по Weibo, комментарии Weibo, поиск тем Weibo, финансовые показатели, история цен и рейтинги аналитиков.
Что такое Kimi K3.1 Pro: версия, цена и то, что важно для этой задачи
В задаче была указана Kimi K3.1 Pro, поэтому сначала мы проверили, существует ли такая модель и как её называет Moonshot. Она существует. Moonshot выпустила её 23 октября 2026 года как первую модель серии K3.1. Moonshot называет её моделью класса 3T с контекстом 1M токенов.
По словам компании, модель заметно лучше справляется с программированием, 3D-задачами, финансовыми исследованиями и длительными агентными задачами. Версия Highspeed работает в два-три раза быстрее. Moonshot обещает опубликовать полные веса к 4 ноября (Быстрый старт K3.1 Pro).
Названия модели различаются в зависимости от продукта, поэтому используйте правильное. В Kimi API идентификаторы модели: kimi-k3.1-pro и kimi-k3.1-pro-highspeed. В Kimi Code идентификатор k3.1-pro. На странице Kimi Code есть предупреждение об одной ловушке. При опечатке в идентификаторе система без предупреждения переключается на K2.8 Preview без режима рассуждений (настройка моделей Kimi Code). Сообщения об ошибке не будет, вы лишь получите более слабую модель.
В таблице ниже перечислены параметры, важные для этой задачи. Каждую строку мы проверили 2 ноября 2026 года.
| Пункт | Что говорит источник | Что это значит для задачи | Источник |
|---|---|---|---|
| Контекст | 1 048 576 токенов, единая цена при любой длине контекста | Данные по десяткам компаний помещаются в один запрос | Тарифы |
| Цена | За миллион токенов: вход $2,00, выход $10,00, запись в кэш $2,00, попадание в кэш $0,20 | Длинный вход обходится дёшево, рассуждения и вывод стоят дороже | Kimi API Platform |
| Highspeed | Вход $4,00, выход $20,00, попадание в кэш $0,20 | Скорость стоит вдвое дороже | Kimi API Platform |
| Рассуждения | Всегда включены, reasoning_effort: low, high или max, по умолчанию max | По умолчанию в API выбран самый дорогой уровень | Уровень рассуждений |
| Лимит вывода | max_completion_tokens: по умолчанию 131 072, максимум 1 048 576 | Вывод занимает часть контекста | Быстрый старт |
| Фиксированные параметры | temperature, top_p и подобные параметры зафиксированы, поэтому не передавайте их | Понизить temperature ради более сдержанной сводки нельзя | Быстрый старт |
| Структурированный вывод | json_schema со strict: true, разбирайте только message.content | У сводки могут быть фиксированные поля | Структурированный вывод |
| Batch | 60% стандартной цены, с параметром completion_window | Ночной пакетный запуск экономит 40% | Тарифы Batch |
| Доступ | Открывается после пополнения баланса, минимум $1 | Пополните баланс до вызова флагманской модели | Пополнение и лимиты |
| Веб-поиск | Обновляется, пока не рекомендуется для продакшена | Не полагайтесь на то, что модель сама найдёт данные | Быстрый старт |
Последняя строка требует короткого пояснения. Сама по себе модель не видит комментарии Weibo или финансовые таблицы. Самое простое решение: включить встроенный веб-поиск. Но в Быстром старте веб-поиск указан среди важных ограничений, и там сказано, что пока его не стоит использовать в продакшен-сценариях.
Даже когда веб-поиск работает, он возвращает краткое содержание страниц. Он не возвращает чистый список комментариев или квартальную таблицу. Для построчной сверки нужны исходные данные в виде результатов инструментов.
Ещё одно замечание об источниках: на двух страницах Moonshot приведены разные цифры для одного и того же стресс-теста на галлюцинации. В техническом блоге сказано, что у K3.1 Pro показатель снизился до 8,3%, а в Быстром старте указано 6,85%. Обе страницы уточняют, что в тесте намеренно используются сложные промпты.
Даже собственные цифры разработчика модели нужно сверять с источником, а исследовательскую сводку тем более.
Можно ли подключить удалённый MCP-сервер? Ни к одному из трёх API Kimi
EveryInfra предоставляет удалённый MCP-сервер по адресу https://api.everyinfra.com/mcp. Названия его инструментов начинаются с everyinfra_. Такие клиенты, как Claude и Cursor, могут подключиться к нему, указав только URL. Настройка описана на странице MCP-сервера и в нашем тесте настройки удалённого MCP.
Многие ожидают, что Kimi API примет URL удалённого MCP прямо в запросе. Мы проверили справочник каждого API Kimi. Такой возможности нет.
Яснее всего это видно в справочнике Responses API. Поле tools поддерживает только четыре типа: function, namespace, custom (только apply_patch) и web_search. Первые три выполняются на вашей стороне. Модель возвращает вызов, вы его выполняете и отправляете результат обратно (справочник Responses API).
Chat Completions использует стандартные вызовы функций (руководство по вызову инструментов). Messages API следует формату Anthropic. Он поддерживает инструменты, рассуждения и структурированный вывод, но в его справочнике нет параметра для удалённого MCP (справочник Messages API).
В песочнице поддержка MCP есть, но с одним ограничением. Она синхронизирует только MCP-серверы, размещённые в ModelScope, через API-токен ModelScope (MCP ModelScope в песочнице). Об этом варианте мы писали в статье MCP ModelScope для данных Xiaohongshu и Douyin.
| Продукт Kimi | URL удалённого MCP? | Как подключить EveryInfra | Для чего подходит |
|---|---|---|---|
| Chat Completions API | Нет, только инструменты-функции | Определите одну функцию, а ваш код вызывает REST API | Собственный код, пакетные запуски |
| Responses API | Нет, MCP не входит в четыре типа инструментов | Так же, либо сгруппируйте функции через namespace | Проекты, использующие формат Responses |
| Messages API | Нет | То же | Проекты на базе Anthropic SDK |
| Песочница | Только MCP-серверы, размещённые в ModelScope | Разместите в ModelScope, затем синхронизируйте | Ручные тесты |
| Kimi Code CLI | Да, url в mcp.json | Укажите URL, ключ храните в переменной окружения | Разработчики в терминале |
| Десктопное приложение Kimi Work | Да, через личный плагин | Передайте URL MCP в Plugin Builder | Аналитики, которые не пишут код |
| Веб-приложение kimi.com | Плагины могут содержать компоненты MCP и Skill | Используйте плагин из каталога или корпоративный плагин | Обычный чат |
Итак, есть два пути. Для кода и пакетных запусков используйте Kimi API с инструментом-функцией. Ваш код вызывает REST API EveryInfra и очищает данные, прежде чем передать их модели. Для работы без кода используйте Kimi Code CLI или Kimi Work.
Оба продукта являются MCP-клиентами, поэтому подключаются к удалённому MCP-серверу напрямую. На схеме ниже показан первый путь. Модель только решает, что вызвать. Получение данных, удаление дубликатов и расчёт метрик выполняются вне модели.


Пример настройки 1: Kimi API с одним инструментом-функцией
Этот код является примером конфигурации. Мы написали его по Быстрому старту Kimi и руководствам по вызову инструментов. С ключом Kimi мы его не запускали. Формат запроса к EveryInfra и структура ответа взяты из наших реальных вызовов.
Идея в том, чтобы дать модели одну функцию, everyinfra_social. Её аргументы соответствуют полям EveryInfra platform, action и params. Перечисления (enum) ограничивают модель теми возможностями, которые нужны для задачи.
# Configuration example: Kimi K3.1 Pro + EveryInfra data API (Kimi side not tested)
import json, os, requests
from openai import OpenAI

kimi = OpenAI(api_key=os.environ["MOONSHOT_API_KEY"], base_url="https://api.moonshot.ai/v1")

TOOLS = [{
    "type": "function",
    "function": {
        "name": "everyinfra_social",
        "description": "Fetch public social and finance data. Weibo: search, topic_search, comments. "
                       "Yahoo Finance: financials, history, analyst. Use a ticker with suffix, e.g. TSLA or 1211.HK. "
                       "For weibo/comments, url must be weibo.com/detail/<numeric id> or the numeric id.",
        "parameters": {
            "type": "object",
            "properties": {
                "platform": {"type": "string", "enum": ["weibo", "yahoo_finance", "reddit"]},
                "action": {"type": "string",
                           "enum": ["search", "topic_search", "comments", "financials", "history", "analyst"]},
                "params": {"type": "object"}
            },
            "required": ["platform", "action", "params"]
        }
    }
}]

def call_everyinfra(args: dict) -> dict:
    r = requests.post("https://api.everyinfra.com/api/v1/social",
                      headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"},
                      json=args, timeout=120)
    body = r.json()
    rows = body.get("results")
    # Cleanup: the three financial arrays hold the same records, so keep one.
    if isinstance(rows, list) and rows and "income" in rows[0]:
        rows[0].pop("balance_sheet", None); rows[0].pop("cash_flow", None)
    if isinstance(rows, list):
        for x in rows:
            x.pop("author_avatar_url", None)
    return {"status": r.status_code, "results": rows, "error": body.get("error"),
            "charged_usd": (body.get("billing") or {}).get("charged_usd")}

messages = [
    {"role": "system", "content": open("research_rules.md", encoding="utf-8").read()},
    {"role": "user", "content": "Tesla reported Q3 2026 on 2026-10-21. Follow the rules and write a one-page cross-check."}
]
first = True
while True:
    resp = kimi.chat.completions.create(model="kimi-k3.1-pro", reasoning_effort="high",
                                        messages=messages, tools=TOOLS,
                                        tool_choice="required" if first else "auto")
    msg = resp.choices[0].message
    messages.append(msg)          # The docs ask for the full assistant message back.
    if not msg.tool_calls:
        break
    for tc in msg.tool_calls:
        result = call_everyinfra(json.loads(tc.function.arguments))
        messages.append({"role": "tool", "tool_call_id": tc.id,
                         "content": json.dumps(result, ensure_ascii=False)})
    first = False
print(msg.content)
У каждого решения в этом коде есть источник. В первом ходе используется tool_choice="required". Так советует страница лучших практик вызова инструментов Kimi: модель вызывает инструмент, а не отвечает по памяти. После первого хода код возвращается к auto. В документации сказано, что изменение tool_choice не ломает кэш префикса (лучшие практики вызова инструментов K3, tool choice).
На каждом ходе в историю добавляется полное сообщение ассистента, а не только content. Быстрый старт требует этого в многоходовых сценариях и при вызове инструментов, потому что сообщение также содержит reasoning_content. Код задаёт reasoning_effort равным high, а не значению API по умолчанию max. Главная сложность этой задачи — сверка, а не глубокие математические вычисления.
Один пользователь Reddit написал, что K3.1 Pro на уровне high дала тот же результат, что и K3 на уровне max (ветка r/kimi). Это мнение одного человека. Перед реальным запуском проверьте оба уровня на собственной выборке.
Очистка выполняется внутри call_everyinfra, а не внутри модели. Наши тесты показывают почему. Три финансовых массива в ответе содержат одни и те же данные. Если отправить все три, модель прочитает более 50 000 лишних символов. Kimi также поддерживает динамическую загрузку инструментов.
Вы помещаете tools в сообщение system без content, и инструменты становятся видимыми начиная с этого сообщения. Сервер их не хранит, поэтому в последующих запросах это сообщение нужно отправлять снова (динамическая загрузка инструментов). В этой задаче всего один инструмент, поэтому такой подход не нужен. Если вы открываете модели сотни возможностей EveryInfra, динамическая загрузка с функцией search_tools экономит контекст.
Пример настройки 2: Kimi Code CLI с удалённым MCP-сервером
Можно обойтись без цикла вызова инструментов и использовать Kimi Code CLI. Это MCP-клиент. Он поддерживает stdio, HTTP и более старый транспорт SSE. Для HTTP-сервера достаточно указать url в mcp.json.
Пользовательская конфигурация хранится в ~/.kimi-code/mcp.json, а конфигурация проекта в файле .kimi-code/mcp.json в репозитории. Если в обоих файлах определён сервер с одинаковым именем, приоритет у файла проекта (документация Kimi Code по MCP). Вот наш пример конфигурации для этой задачи.
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "bearerTokenEnvVar": "EVERYINFRA_API_KEY",
      "enabledTools": ["everyinfra_call_api", "everyinfra_get_job", "everyinfra_list_capabilities"],
      "toolTimeoutMs": 120000
    }
  }
}| Поле | Значение в нашем примере | Почему |
|---|---|---|
url | https://api.everyinfra.com/mcp | HTTP-транспорт, без локального процесса |
bearerTokenEnvVar | EVERYINFRA_API_KEY | Ключ не хранится в файле |
enabledTools | 3 из 12 инструментов | Меньше схем инструментов в контексте |
toolTimeoutMs | 120000 | Один вызов financials занял 35,6 секунды |
Поле bearerTokenEnvVar содержит имя переменной окружения, а не сам ключ. Этот файл можно закоммитить в репозиторий, а каждый участник хранит ключ в переменной окружения своей командной оболочки. Поле enabledTools задаёт список разрешённых инструментов. В 00:16 по SGT мы запросили у сервера tools/list без ключа.
Сервер вернул 12 инструментов в ответе размером 16 724 байта. Некоторые инструменты отвечают за аккаунты, ссылки на пополнение баланса и обращения в поддержку. Исследовательской задаче они не нужны, но занимают место в контексте. Мы задали toolTimeoutMs равным 120 секундам, потому что в нашем тесте один вызов yahoo_finance/financials занял 35,6 секунды.
Kimi Code называет MCP-инструменты по схеме mcp__<server>__<tool>. Правила разрешений позволяют разрешить отдельный инструмент по этому имени. Документация не рекомендует создавать разрешающее правило для mcp__*, поскольку оно откроет доступ ко всем MCP-инструментам (см. раздел «Security» на той же странице).
В Kimi Code есть и субагенты. Встроенных типов три. coder может читать и записывать файлы. explore работает только на чтение. plan только планирует и не может выполнять команды оболочки.
У каждого субагента собственный контекст. Он видит только текст задачи от главного агента и возвращает только свой результат. Несколько субагентов могут работать параллельно (Агенты и субагенты). Пользовательский субагент описывается Markdown-файлом в .kimi-code/agents/. Файл ниже назначает каждому субагенту одну компанию и один инструмент EveryInfra.
---
name: company-evidence-worker
description: Fetch Weibo posts, comments and financial tables for one listed company. Return one compact evidence table. Use one worker per company.
tools:
  - mcp__everyinfra__everyinfra_call_api
  - Write
---
You handle only the one company in your task. Do these steps in order:
1. Call weibo/search with "<company> earnings" in Chinese, limit 50. Call weibo/topic_search with the same words.
2. Pick the top 2 posts by comment_count. Call weibo/comments for each, limit 50.
3. Call yahoo_finance/financials, history (period=3mo) and analyst with the ticker.
4. Save raw responses under evidence/<ticker>/. Keep only the income array of the financial tables.
5. Your last message is the full handoff. Give one table: comment count, total likes and
   the largest count in any 20 seconds for each post, plus quarterly revenue, net income,
   inventory, receivables and cash. Do not write conclusions. Do not give trade advice.
Шаг 5 следует указанию из документации. Пользовательский субагент не получает встроенной инструкции о том, что его итоговое сообщение и есть весь передаваемый результат. Документация советует прописать это в теле агента. Затем главный агент сравнивает таблицы доказательств по всем компаниям в своём контексте и пишет сводку.
В документации также сказано, что каждый субагент расходует собственные токены, поэтому для простых задач они не нужны. По нашему мнению, с двумя-тремя компаниями главный агент справится сам. Для десяти и более компаний используйте воркеры.
Пример настройки 3: плагин Kimi Work и Task Center
Многие аналитики не пишут код. Kimi Work представляет собой десктопного агента Moonshot. Он умеет читать и записывать локальные файлы, работать с веб-страницами через расширение браузера и выполнять задачи по расписанию. Для крупных задач Agent Swarm распределяет работу между агентами (страница Kimi Work).
Для K3.1 Pro нужна Kimi Work версии 3.1.0 или новее (технический блог, раздел Availability). На странице продукта также сказано, что Kimi Work получает данные по китайским акциям класса A и акциям Гонконга в реальном времени из профессиональных источников данных. Значит, данные о ценах и финансовых показателях для этой задачи уже частично доступны. Данных из соцсетей, например комментариев Weibo, там нет.
Чтобы добавить внешний MCP-сервер, используйте личный плагин. В справочном центре Kimi сказано, что плагин может содержать компоненты Skill и MCP, агентов, хуки, команды и системный промпт. Веб-приложение пока поддерживает только компоненты MCP и Skill. Kimi Work и Kimi Code поддерживают все компоненты (обзор плагинов).
В Kimi Work вы вызываете встроенный Plugin Builder и одним предложением описываете, что вам нужно. Он создаёт файлы плагина, проверяет их и добавляет плагин в раздел Personal. Сведения, которые он не может угадать, например URL MCP-сервера, он запрашивает у вас (создание личного плагина). Он также умеет импортировать файл server.json в формате реестра MCP.
Важны две записи из истории изменений. Версия 3.2.21 от 26 октября 2026 года запрашивает ваше подтверждение перед загрузкой MCP-серверов, которые поставляются вместе с проектом. В версии 3.2.22 от 29 октября 2026 года раздел Scheduled переименован в Task Center, где собраны все автоматические задачи (история изменений Kimi Work). Задачи можно запускать ежечасно, ежедневно или по условию.
Для ночных запусков включите Keep awake в настройках (FAQ на странице продукта). В этой задаче расписание важнее модели. Это видно из приведённого ниже теста с Tesla.
Один реальный цикл: что отправляет модель и что приходит в ответ
На стороне модели Kimi возвращает стандартный вызов инструмента. Каждый элемент tool_calls содержит id, имя функции и аргументы в виде JSON-строки. С функцией выше Kimi отправила бы вызов, как показано ниже. Это пример формата, а не реальный вывод Kimi.
{"id": "call_0", "type": "function",
 "function": {"name": "everyinfra_social",
              "arguments": "{\"platform\":\"weibo\",\"action\":\"comments\",\"params\":{\"url\":\"https://weibo.com/detail/<numeric_post_id>\",\"limit\":50}}"}}
Ваш код передаёт аргументы в EveryInfra без изменений. Мы отправили этот же запрос 2 ноября 2026 года в 00:17:51 по SGT. Реальный ответ пришёл с кодом HTTP 200 за 16,6 секунды, размер 15 134 байта. Значение count было 31, а billing.charged_usd равно 0.000556.
У каждого комментария десять полей: id, text, like_count, author_id, author_name, author_avatar_url, post_id, post_url, posted_at и platform. Они совпадают со списком response_fields для weibo/comments в каталоге. На скриншоте показаны 11 комментариев, опубликованных за 18 секунд в середине выборки и отсортированных по времени.
Такой же запрос работает и через MCP. В 00:22:26 по SGT мы вызвали everyinfra_call_api через MCP tools/call. Аргументом был числовой ID второго поста, поста B. Мы получили HTTP 200 и 21 757 байт. Поле result.content[0].text содержало JSON той же структуры, что и ответ REST.
Значение count было 36, и снова было списано $0,000556. В этом ответе не было поля structuredContent, поэтому данные находятся в тексте. В документации Kimi Code сказано, что агент получает и текстовую, и структурированную часть результата MCP. В Kimi Code оба пути дают одинаковые данные. В собственном инструменте-функции проще работать с JSON из REST.
Одна деталь формата влияет на долю успешных запросов. В каталоге сказано, что url для weibo/comments должен быть ссылкой вида /detail/ с числовым ID поста или самим числовым ID. Короткие ссылки с буквами не работают. Результаты поиска уже содержат url в форме /detail/, поэтому модель может его просто скопировать.
Ссылка, скопированная с веб-страницы, часто имеет короткую форму. Пропишите это правило в description функции, как в нашем примере. Не рассчитывайте, что модель прочитает каталог.
Тест 1: Tesla в Weibo с опозданием на одиннадцать дней
Первый тест на реальных данных показывает проблему со временем. 2 ноября в 00:18 по SGT мы вызвали weibo/search с китайским запросом «отчётность Tesla». Он вернул 17 постов и стоил $0,000806. Tesla упоминается только в 6 постах. Только 3 поста с самого начала посвящены отчётности Tesla.
Даты охватывают период с 19 октября по 1 ноября, и только 1 пост опубликован до 22 октября. Остальные посты посвящены падению американских техноакций, результатам Google и Intel и сравнению маржи BYD и Tesla. Причина простая. Поиск по ключевым словам в Weibo возвращает свежие посты, а Tesla отчиталась 11 днями ранее.
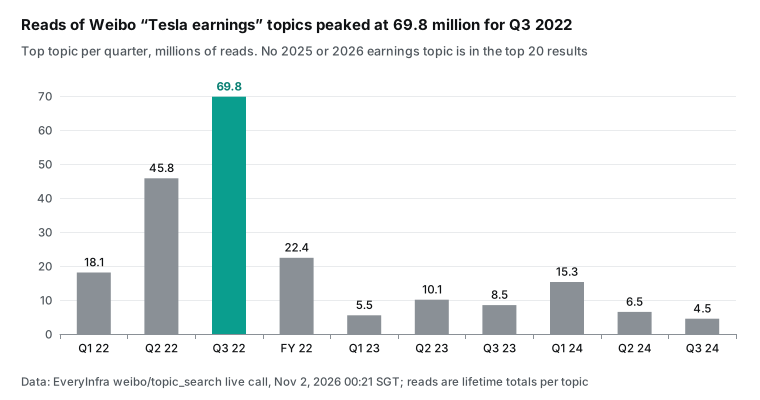
Поиск по темам дал другую картину. В 00:21:05 по SGT мы вызвали weibo/topic_search с тем же запросом. Он вернул 20 тем, для каждой указаны общее число просмотров и постов. Для каждого квартала мы взяли самую популярную тему.
У темы об отчёте за Q3 2022 было 69,83 млн просмотров и 13 000 постов. К Q3 2024 у самой популярной темы было 4,48 млн просмотров. Ни одна из 20 тем не касалась отчётов за 2025 или 2026 год.
Это не доказывает, что китайские читатели перестали интересоваться результатами Tesla. Мы не знаем, как поиск по темам ранжирует результаты. Просмотры считаются за всё время, поэтому у старых тем есть преимущество. Но это показывает, что поиск по темам даёт искажённое временным фактором представление о прошлом интересе. Исследовательская сводка должна указать это в поле ограничений.
Контрольной площадкой был Reddit. В 00:23:42 по SGT мы вызвали reddit/search с запросом «Tesla Q3 2026 earnings» и сортировкой по релевантности. Он вернул 8 постов. Семь из них были опубликованы 21 и 22 октября.
Вместе у этих постов было 589 комментариев. Среди самих постов были ветка об отчётности в r/TSLALounge и публикация в r/teslamotors о подписках на FSD (возможность поиска по Reddit). По тому же вопросу поиск по релевантности в Reddit охватил период публикации отчётности. Поиск по ключевым словам в Weibo показал только последние дни.
| Поиск (SGT) | Найдено постов | Об отчётности Tesla | За 21 и 22 октября | Комментарии к постам |
|---|---|---|---|---|
| Поиск по ключевым словам в Weibo, 00:18 | 17 | 3 | 1 до 22 октября | Не используется |
| Поиск по релевантности в Reddit, 00:23 | 8 | 8 | 7 | 589 |
Отсюда и правильный метод: не искать задним числом. Собирайте данные в день отчёта, через 24 часа и через 72 часа. Каждую выгрузку запускает задача Kimi Work или ваше собственное cron-задание.
Kimi пишет сводку только после последней выгрузки. Нулевой час ставьте на фактическое время публикации отчёта. Для Tesla это было после закрытия торгов в США 21 октября 2026 года. Это подтверждают и дата формы 8-K, и новости в тот же день (CNBC, 21 октября 2026 г.).
Тест 2: сверяем цифры Tesla с формой 8-K
Финансовой половине доверять проще, но проверять её всё равно нужно. В 00:20:40 SGT мы вызвали yahoo_finance/financials для TSLA. Вызов стоил $0,001389. Строки за 3-й квартал мы сравнили с финансовой сводкой в приложении 99.1 к форме 8-K Tesla.
| Строка (млн долл. США) | Ответ API, 3-й кв. 2026 | Приложение 99.1 к форме 8-K Tesla | Совпадает |
|---|---|---|---|
| Общая выручка | 28,046 | 28,046 | Да |
| Валовая прибыль | 5,494 | 5,494 | Да |
| Операционная прибыль | 718 | 718 | Да |
| Чистая прибыль, относящаяся к держателям обыкновенных акций | 787 | 787 | Да |
| Свободный денежный поток | 1,531 | 1,531 | Да |
| Свободный денежный поток, 2-й кв. 2026 | −1,099 | −1 092 (операционный денежный поток 4 697 минус капитальные затраты 5 789) | Нет, расхождение составляет $7 млн |
Пять строк совпадают. В одной есть небольшое расхождение: по свободному денежному потоку за 2-й квартал API даёт −1 099, а Tesla — −1 092. Расхождение невелико, но оно показывает, что проверять нужно каждую строку. После одной-двух выборочных проверок не считайте, что совпадают все строки. CNBC приводит те же ключевые цифры: выручка — $28,05 млрд, чистая прибыль — $787 млн.
В течение выбранного нами временного окна возможность yahoo_finance/earnings не работала. С 00:20 до 00:23 SGT она трижды вернула HTTP 503 для TSLA. Ни за один из этих вызовов средства не списали. Подробнее об этом в разделе о сбоях. Данные о прибыли на акцию мы взяли из самого обновления Tesla.
Тест 3: результаты поиска по BYD и один хештег
Для проверки соцсетей BYD дал больше материала. В 00:17:26 SGT мы вызвали weibo/search с китайским запросом «отчёт BYD за 3-й квартал». Мы задали limit равным 30 и получили 13 постов за $0,000806. Согласно каталогу, эта возможность по умолчанию возвращает 20 постов, максимум 50.
Меньшее число результатов — это нормально. Оплата взимается за вызов API, а не за пост, поэтому короткая выдача не стоит дороже. Посты охватывают период с 19 октября по 1 ноября. Самый свежий опубликован в 22:31 SGT 1 ноября.
Ещё до просмотра постов мы записали два правила по ключевым словам, чтобы решение принимала не модель. Пост считается обсуждением отчётности, если в нём есть хотя бы одно из девяти китайских слов, например «отчёт», «чистая прибыль», «выручка» или «маржа». Пост считается рекламой автомобиля, если в нём есть хотя бы одно из шести китайских слов, например «тест-драйв», «скидка» или «визит в дилерский центр». Об отчётности говорят 10 из 13 постов. Рекламы нет ни в одном.
Два поста вообще не упоминают BYD. Это посты из аккаунта Huawei, посвящённого умным автомобилям. Значит, шумом в поиске по ключевым словам оказалась не реклама, а популярные посты смежного бренда. Фильтруйте по названию компании до того, как данные прочитает модель.
Шесть из 13 постов используют один и тот же хештег, который утверждает, что отчёт BYD подаёт сильный сигнал роста. У их авторов 1, 3, 9, 80, 198 и 507 подписчиков. На шесть постов в сумме приходится 1 взаимодействие. Все они опубликованы за 97 минут, с 20:49 до 22:26 SGT 1 ноября.
Большинство из них состоит из одного слогана и короткой ссылки. В 00:21:26 SGT мы вызвали weibo/topic_search по отчёту BYD. У этого хештега было около 11 000 прочтений и 66 постов. У другой темы, об отчёте BYD за 3-й квартал 2026 года, было около 26 000 прочтений и 58 постов.
| 13 результатов поиска | Количество | Как определяли |
|---|---|---|
| Об отчётности | 10 | Правило по ключевым словам, составленное до сбора данных |
| Реклама автомобиля | 0 | Правило по ключевым словам, составленное до сбора данных |
| Не упоминает BYD | 2 | Поиск по строке (два поста об умных автомобилях Huawei) |
| Один и тот же хештег, у авторов не более 507 подписчиков | 6 | Совпадение хештега и число подписчиков |
| Автор верифицирован | 5 | author_verified в ответе |
Хештег небольшой, поэтому сам по себе вывод не меняет. Но если засчитать эти шесть постов как позитивные, доля позитивных вырастет почти в полтора раза. Правило для Kimi простое. Сначала отфильтруйте по названию компании. Затем объедините в группу посты с общим хештегом, малым числом подписчиков и без взаимодействий, опубликованные за короткое время. Укажите число постов в группе и их признаки, но не включайте её в подсчёт тональности.
Мы не можем сказать, были ли эти шесть постов результатом организованного продвижения. Можно лишь утверждать, что характер их публикации не похож на обычное обсуждение. Для однозначного ответа нужны история аккаунтов и даты регистрации. Публичные данные не позволяют это доказать.
Тест 4: две ветки комментариев с очень разным распределением по времени
Самым активным постом в выдаче оказался разбор отчёта от верифицированного техноблогера. Под постом значилось 49 комментариев. Назовём его постом A. В 00:17:51 SGT weibo/comments вернул 31 из них. Недостающие комментарии могут быть свёрнуты, удалены или скрыты из публичного доступа. По открытым данным нельзя определить, какой из вариантов верен.
Для контроля в 00:22:26 SGT мы выгрузили через MCP 36 комментариев ко второму длинному посту о BYD. Назовём его постом B. Его опубликовал 30 октября другой верифицированный автор, под ним значилось 39 комментариев. Оба поста обсуждают отчёт и бизнес BYD, но время публикации комментариев и лайки под ними сильно различаются. Мы не называем авторов и не даём ссылок на посты. Этот раздел показывает способ измерения, а не мнение о каком-либо аккаунте.
| Метрика | Пост A | Пост B | Как считали |
|---|---|---|---|
| Получено комментариев | 31 | 36 | count |
| Всего лайков | 0 | 43 | Сумма like_count |
| Комментарии с 0 лайков | 31 | 22 | Подсчёт |
| От первого до последнего комментария | 58,2 минуты | 3 340,1 минуты (около 55,7 часа) | posted_at |
| Максимум за любые 20 секунд | 11 | 1 | Скользящее окно |
| Упоминает стабильность или расходы на исследования | 20 | 0 | Регулярное выражение по китайским словам |
| Содержит негативное слово | 0 | 5 | Регулярное выражение, список слов ниже |
| Средняя длина | 18,9 символа | 39,8 символа | Число символов |
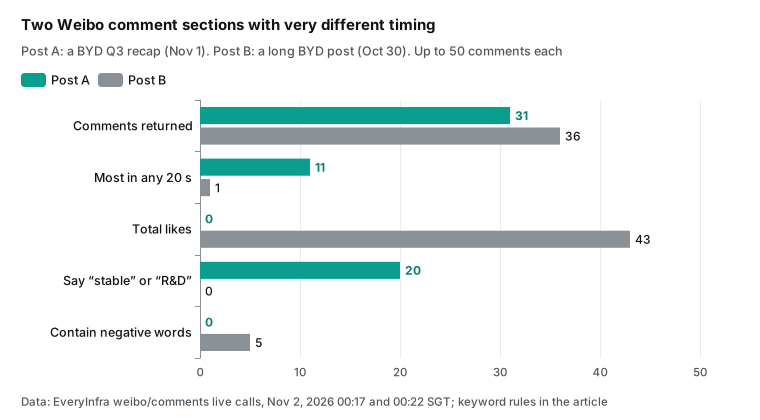
11 комментариев к посту A появились с 22:57:41 по 22:57:59 SGT 1 ноября. Они звучат примерно так: «отчёт выглядит сильным, BYD становится всё стабильнее» и «прибыль растёт быстрее выручки, значит, у BYD реальная сила». Фразы построены очень похоже. Они повторяют тезисы самого блогера: рост прибыли опережает рост выручки, плюс исследования, премиальные модели и продажи по всему миру. В посте B картина смешанная.
Один комментарий сравнивает общежития и зарплаты сотрудников. В других спорят о шильдиках и привычках тратить деньги. В одном просят ИИ-пересказ, потому что пост длинный. Некоторые комментарии грубые. Лайков от 0 до 9, а сами комментарии растянуты более чем на двое суток.
Нужно назвать два слабых места нашего метода. Правила для отчётности и рекламы автомобилей мы составили до сбора данных. А список негативных слов составили после того, как прочитали комментарии к посту B. Поэтому результат «0 против 5» — это описание, а не проверка.
То же относится к списку слов о стабильности и исследованиях. Мы составили его после прочтения поста A и комментариев к нему, так что результат «20 против 0» тоже лишь описание. Три показателя не зависят ни от какого списка слов: общее число лайков, плотность по времени и средняя длина. Все три берутся напрямую из полей ответа, и любой, кто повторит вызовы, получит тот же результат.
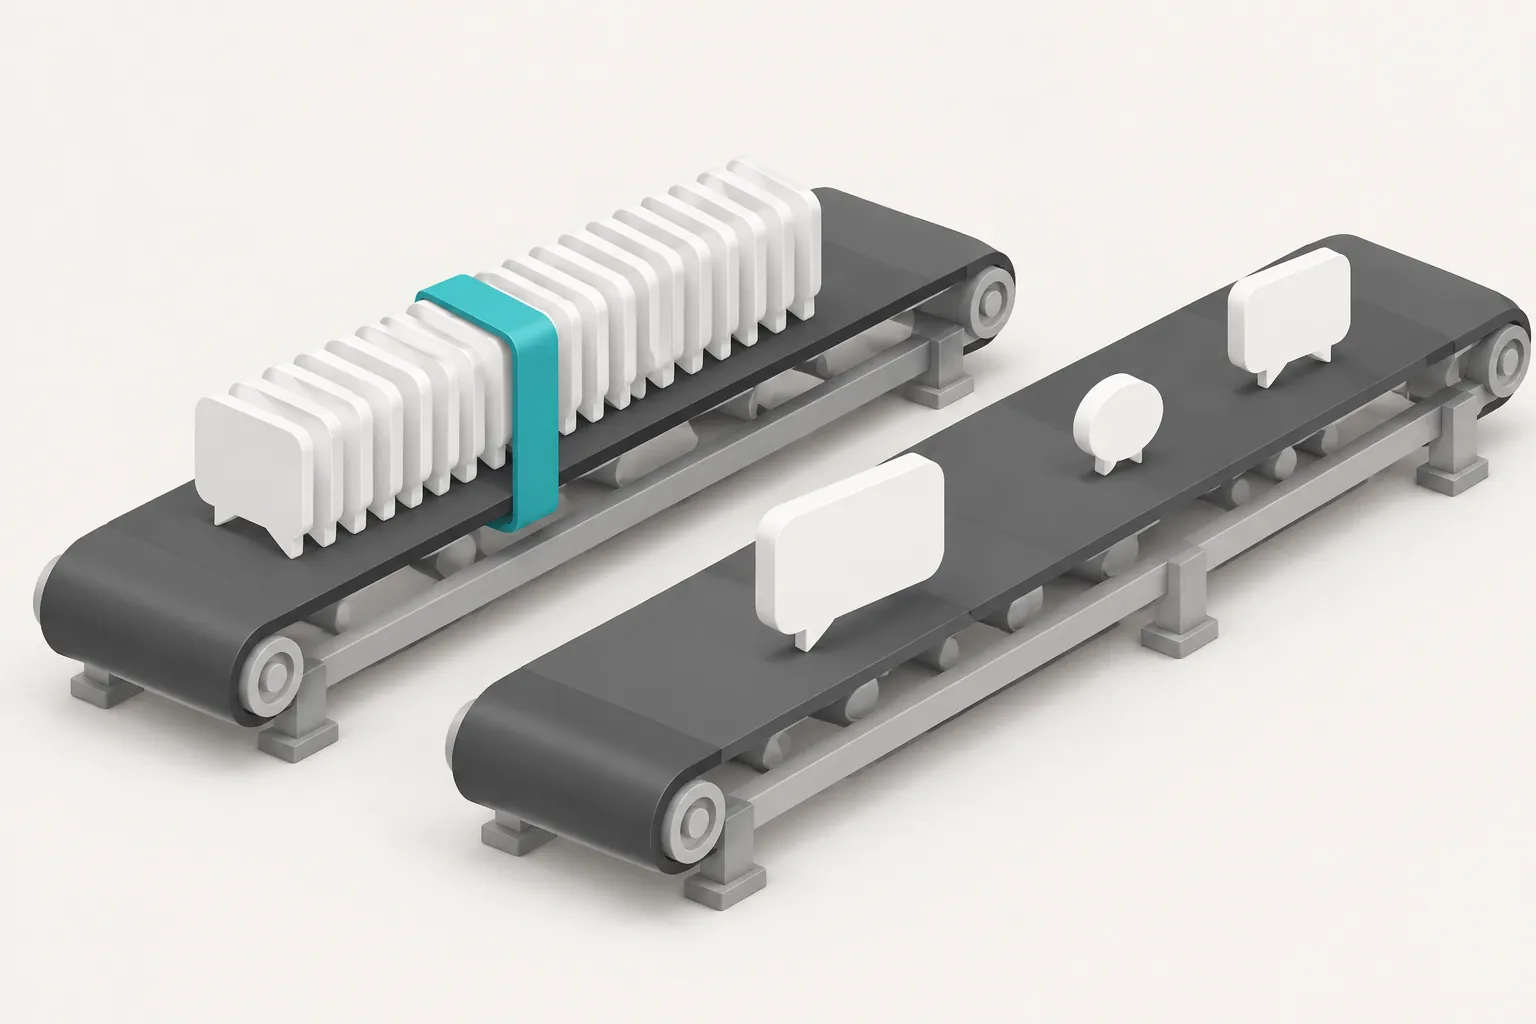
От этого раздела зависит, насколько читатель может доверять сводке. Если передать модели все 67 комментариев и попросить оценить тональность, скорее всего, она назовёт её «явно положительной». Если же ваш код сначала рассчитает плотность по времени и количество лайков для каждой ветки и пометит плотный кластер, модель сформулирует вывод иначе. Она укажет, что 11 комментариев к посту A появились за 18 секунд и не получили ни одного лайка, и вынесет их за рамки подсчёта тональности. Выводов об их происхождении она делать не будет.
В первом случае решение за вас принимает модель. Во втором она фиксирует доказательства.
Тест 5: сверяем цифры BYD с отчётностью
В 00:18:38 SGT мы вызвали yahoo_finance/financials для 1211.HK, гонконгского тикера BYD. Размер ответа составил 78 732 байта, его получение заняло 35,6 секунды, а вызов стоил $0,001389. В ответе три массива: income, balance_sheet и cash_flow, по 5 записей в каждом. Записи охватывают весь 2025 год и четыре квартала с 4-го квартала 2025 по 3-й квартал 2026 года, суммы указаны в CNY.
Все три массива содержат одни и те же записи. Каждая запись объединяет поля отчёта о прибылях и убытках, бухгалтерского баланса и отчёта о движении денежных средств и содержит от 137 до 149 полей на квартал. Это важно для расчёта размера контекста ниже.
Мы построчно сверили ответ с отчётом BYD за 3-й квартал на CNINFO.
| Строка | Ответ API (1211.HK, 2026-09-30) | Отчёт BYD за 3-й кв. | Совпадает |
|---|---|---|---|
| Выручка за 3-й кв. | 221,488,251,000 | CNY 221 488 251 000,00, +13,59% год к году | Да |
| Чистая прибыль, относящаяся к акционерам, за 3-й кв. | 10,019,570,000 | CNY 10 019 570 000,00, +28,08% | Да |
| Запасы | 221,577,509,000 | CNY 221 577 509 000,00, +60,08% с начала года | Да |
| Дебиторская задолженность | 56,472,621,000 | CNY 56 472 621 000,00, +52,61% | Да |
| Денежные средства | 30,988,011,000 | CNY 30 988 011 000,00 (75 424 747 000,00 на начало года) | Да |
| Расходы на исследования, девять месяцев | Сумма за три квартала: 36 277 138 000 | CNY 36 277 138 000,00 (43 748 447 000,00 годом ранее) | Да |
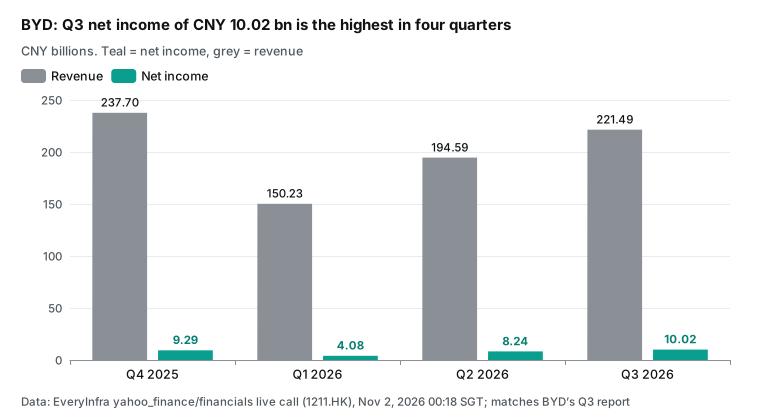
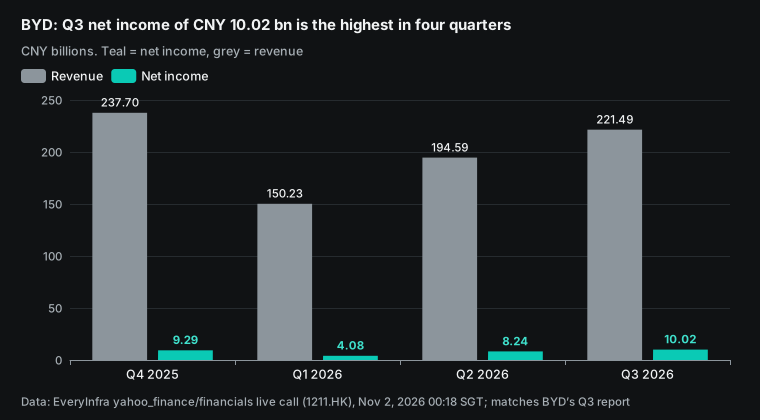
Все шесть строк совпадают. Значит, эту половину можно брать из API и не заставлять модель разбирать PDF. Но проверка показывает и то, чего в API нет. В отчёте есть раздел, который объясняет каждое крупное изменение.
По данным отчёта, запасы выросли в основном из-за наращивания складских остатков под рост зарубежных продаж автомобилей. Убытки от обесценения выросли на 67,60% в основном из-за более крупных списаний запасов. Обязательства по договорам выросли на 80,58% в основном за счёт роста авансов за автомобили. Эти причины есть только в отчётности.
Хорошая сводка берёт цифры из API, а причины из отчётности. У Kimi есть API для вопросов и ответов по файлам, который извлекает текст из PDF (вопросы и ответы по файлам). На странице тарифов сказано, что извлечение из файлов пока бесплатно. Но извлечённый текст всё равно оплачивается как входные токены, когда вы отправляете его модели (тарифы, логика списания).
Перекрёстная проверка: что говорят комментарии и что показывает отчётность
Теперь соединим две половины. Пост A и комментарии к нему содержат три основных утверждения. Прибыль выросла быстрее выручки. Расходы на исследования велики. Компания становится всё стабильнее.
Каждое утверждение мы сопоставили с отчётностью. Также мы добавили строки с наибольшими изменениями, которых нет в комментариях. Последний столбец сообщает только, упоминается ли строка и можно ли её проверить. Оценок он не даёт.
Таблица ниже показывает, что мы хотим получить от Kimi в итоге. Мы заполнили её вручную по тем же правилам. Это не вывод Kimi.
| Утверждение в соцсетях | Данные отчётности | Есть в обсуждении? Можно проверить? |
|---|---|---|
| Прибыль растёт быстрее выручки | Выручка за 3-й кв. +13,59%, чистая прибыль +28,08% | Упоминается; совпадает с данными за квартал |
| Итоги за девять месяцев | Выручка за девять месяцев +0,01%, чистая прибыль −4,24% | Не упоминается |
| Расходы на исследования велики | CNY 36,28 млрд за девять месяцев, CNY 43,75 млрд годом ранее (−17,08%) | Упоминается; сумма совпадает, изменение год к году не упоминается |
| Всё стабильнее | Ни одно финансовое поле не измеряет «стабильность» | Упоминается; мнение, которое нельзя проверить |
| Запасы, дебиторская задолженность, денежные средства | +60,08%, +52,61% и −58,92% с начала года; в отчётности рост запасов связан с остатками автомобилей для зарубежных рынков | Не упоминается |
| Убыток от обесценения | CNY 2,71 млрд, +67,60%; в отчётности это связано с более крупными списаниями запасов | Не упоминается |
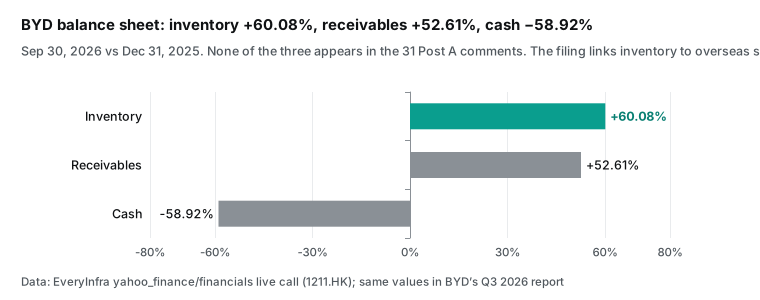
Здесь важно чётко обозначить границы. Эта таблица показывает только, что говорилось в обсуждении и что указано в отчётности. Она не оценивает положение компании и не прогнозирует цену её акций. В отчётности объясняется каждое крупное изменение. Рост запасов связан с увеличением складских остатков для зарубежных продаж автомобилей, а рост обязательств по договорам на 80,58% — с увеличением авансов за автомобили.
Если сводка приводит только величину каждого изменения и опускает объяснение из отчётности, она сама становится избирательной. Поэтому наше правило для Kimi такое: каждая цифра из группы «не упоминается» должна сопровождаться объяснением из отчётности и номером страницы либо пометкой «в отчётности причина не указана».
Мы также вызывали возможности истории цен и аналитиков, но в эту проверку они не входят. В этой статье они влияют только на размер контекста и стоимость. Ценность перекрёстной проверки не в прогнозе. Она даёт список цифр, которые никто в обсуждении не упомянул, вместе с объяснениями из самой отчётности. Дальше человек сам решает, о чём спрашивать.
Упаковка контекста: сколько компаний помещается в 1 млн токенов
Контекст в 1M кажется безразмерным, поэтому мы измерили одну компанию. Для BYD части results пяти вызовов (поиск, комментарии, финансы, история и аналитики) в сумме дают 119 869 символов. Одни только финансовые таблицы занимают 82 350 символов. Их три массива повторяют одни и те же данные.
С одним массивом они занимают 27 418 символов. Весь пакет после удаления дубликатов занимает 64 937 символов. Из них только 1 927 приходится на китайские иероглифы. Остальное — английские имена полей, числа и ссылки.
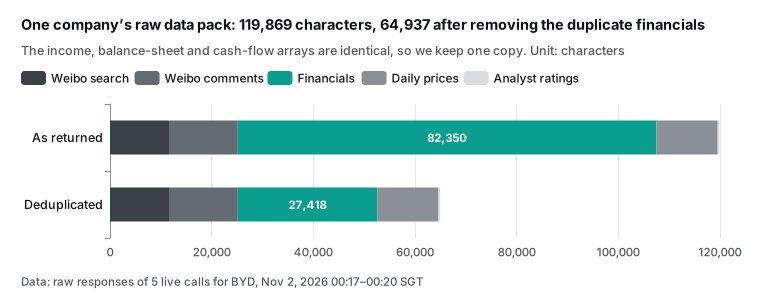
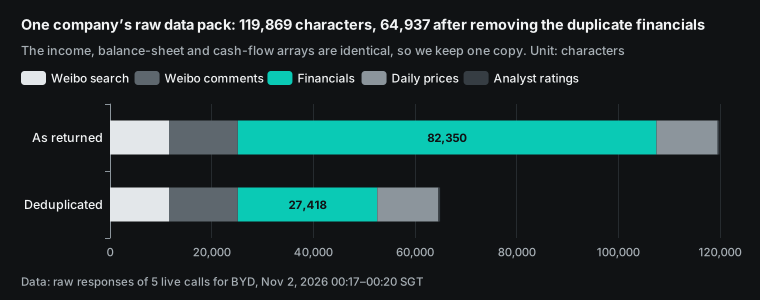
| Часть пакета BYD | В исходном виде (символы) | После очистки (символы) |
|---|---|---|
| Поиск Weibo | 11,613 | 11,613 |
| Комментарии Weibo | 13,543 | 13,543 |
| Финансовые таблицы | 82,350 | 27,418 |
| Дневные цены | 12,033 | 12,033 |
| Рейтинги аналитиков | 330 | 330 |
| Итого | 119,869 | 64,937 |
Число токенов — оценка. На странице основных понятий Kimi сказано, что один токен соответствует примерно 3–4 символам обычного английского текста (основные понятия). Наш пакет в основном состоит из английских полей и чисел. При таком соотношении 64 937 символов — это примерно 16 234–21 646 токенов. Если каждый китайский иероглиф стоит 2 токена, верхняя граница всё равно составит около 24 000. Для точного подсчёта используйте API оценки токенов Kimi (оценка токенов).
При 16 000–24 000 токенов на компанию расчёт такой. Контекст в 1 048 576 токенов минус лимит вывода по умолчанию в 131 072 токена оставляет 917 504 токена. В них помещается от 38 до 56 компаний. Без удаления дубликатов это число падает почти вдвое.
То, что они помещаются, не значит, что так нужно делать. Мы предлагаем два уровня. Сначала ваш код или субагент сжимает данные каждой компании в таблицу доказательств, как в шаге 5 файла воркера Kimi Code. Основная модель читает таблицы доказательств и фрагменты отчётности, которые ей нужно цитировать. Сырые комментарии по нескольким компаниям помещайте в один контекст, только когда сравниваете комментарии между компаниями.
По умолчанию Kimi кеширует контекст на 5 минут. Если между запросами в задании проходит больше 5 минут, задайте prompt_cache_options.ttl равным 1h, чтобы кеш не истекал (кеширование контекста). Размещайте правила исследования и шаблон вывода в начале каждого запроса. Попадание в кеш стоит $0,20 за миллион токенов, это десятая часть обычной цены входных токенов.
Стоимость: одна компания, один запуск
Расходы на стороне EveryInfra известны точно. Один запуск по одной компании включает по одному вызову weibo/search и weibo/topic_search ($0,000806 × 2), один вызов weibo/comments ($0,000556) и по одному вызову yahoo_finance/financials, history и analyst ($0,001389 × 3). Итого $0,006335. Вторая ветка комментариев добавляет $0,000556. Оплата берётся за вызов, а не за запись.
Расходы на стороне Kimi — оценка, потому что Kimi мы не запускали. Мы исходим из 24 000 входных токенов на компанию (верхняя граница из расчёта выше) и 8 000 токенов вывода и рассуждений. По публичным ценам, которые мы смотрели 2 ноября 2026 года, это около $0,048 за вход и $0,08 за вывод в режиме реального времени. В Batch по цене 60% от стандартной это около $0,0288 и $0,048.
| Сценарий | Вызовы EveryInfra | Вход Kimi (оценка) | Вывод Kimi (оценка) | Итого |
|---|---|---|---|---|
| Одна компания, реальное время | $0.006335 | $0.048 | $0.080 | $0.134 |
| Одна компания, Batch | $0.006335 | $0.0288 | $0.048 | $0.083 |
| 20 компаний еженедельно в течение 4 недель, реальное время | $0.5068 | $3.84 | $6.40 | $10.75 |
| 20 компаний еженедельно в течение 4 недель, Batch | $0.5068 | $2.30 | $3.84 | $6.65 |
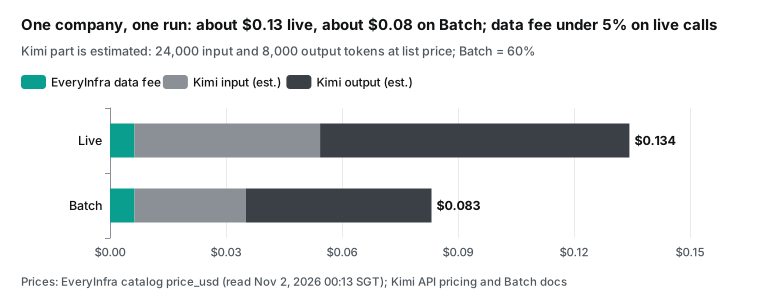
В режиме реального времени вызовы данных составляют около 4,7% общей суммы. В Batch около 7,6%, потому что цена модели падает на 40%, а цена данных не меняется. Основную часть стоимости дают токены вывода и рассуждений. Поэтому экономьте в таком порядке. Во-первых, снизьте reasoning_effort с max до high или low и убедитесь, что качество сводки не падает. Во-вторых, сжимайте данные каждой компании в таблицу доказательств.
В-третьих, рассмотрите Batch. Пакет должен завершиться в пределах completion_window, иначе он истекает, а попадания в кеш внутри пакета не гарантируются (руководство по Batch API). Ночной запуск в сезон отчётности хорошо подходит для Batch. Для сводки в тот же день нужны вызовы в реальном времени. Наши цены указаны на странице тарифов EveryInfra.
Сбои, лимиты запросов и отсутствие списаний: разбираем наш 21 запрос
Всего мы отправили 21 запрос. Четырнадцать завершились успешно, и за них списали в общей сложности $0,014018. За остальные семь средства не списывались. Эти запросы охватывают ситуации, с которыми столкнётся задача в рабочей среде. Каждую из них стоит прописать в правилах, которые вы даёте Kimi.
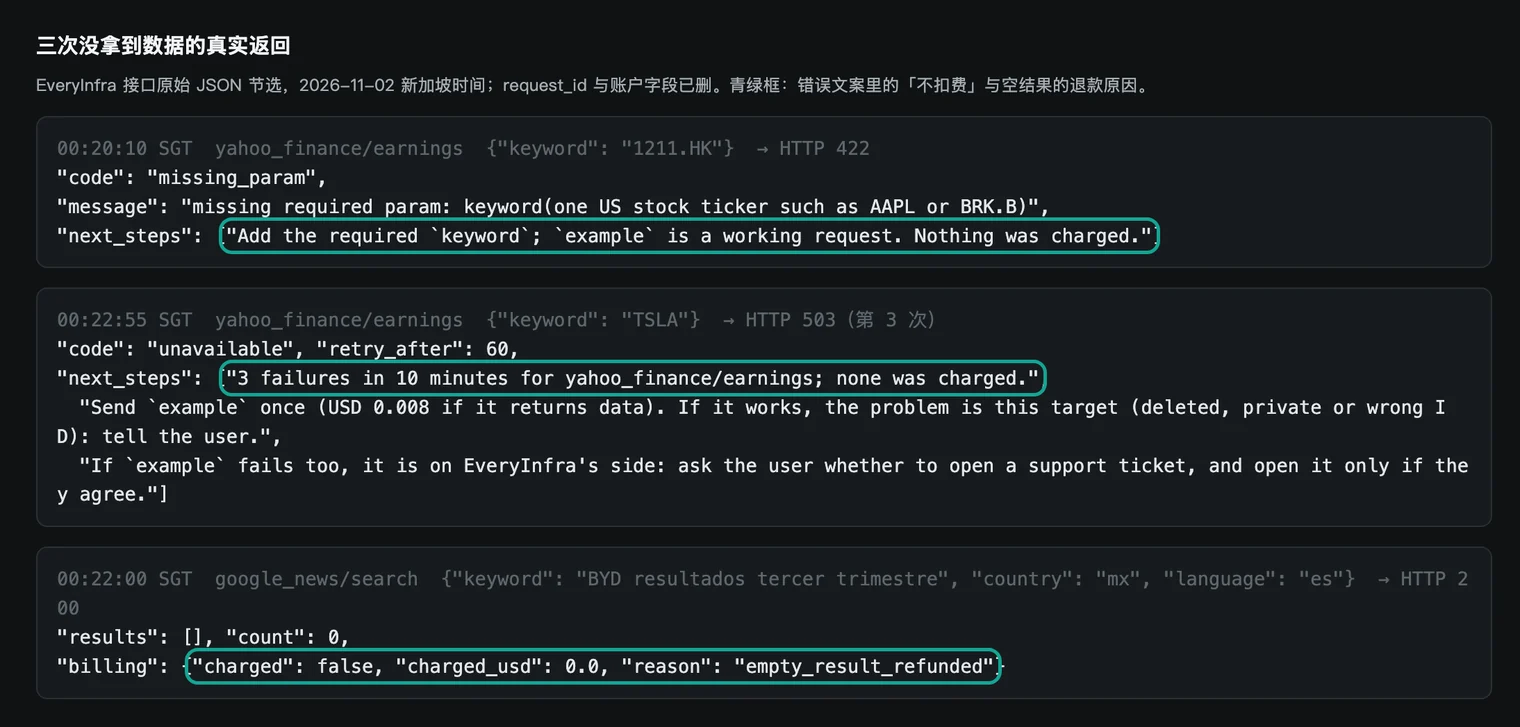
Первый случай — некорректный аргумент. Согласно каталогу, yahoo_finance/earnings принимает только американские тикеры. В 00:20:10 SGT мы намеренно отправили гонконгский тикер 1211.HK. Через 0,2 секунды пришёл ответ HTTP 422 с кодом missing_param.
Сообщение просит указать американский тикер, приводит рабочий пример запроса и говорит «Nothing was charged». Это сообщение написано для модели. Прочитав его как результат инструмента, Kimi может изменить аргумент или выбрать другую возможность. Повторять тот же вызов не нужно.
Второй случай — кратковременная недоступность сервиса. В 00:20:32, 00:21:30 и 00:22:55 SGT yahoo_finance/earnings для TSLA вернул HTTP 503. В каждом ответе говорилось, что средства не списаны, а retry_after был равен 60 секундам. Третье сообщение отличалось: оно предлагало один раз попробовать пример запроса, чтобы понять, на чьей стороне проблема.
Мы сделали это в 00:23:05 SGT с тикером из примера AAPL. Он тоже вернул 503. Значит, в эти минуты не работала сама возможность, а не тикер TSLA. Обращение в поддержку мы не открывали. Вместо этого данные о прибыли на акцию взяли из обновления Tesla.
Третий случай — пустой результат. В 00:22:00 SGT мы выполнили поиск в Google News для Мексики по испанской фразе о результатах BYD за третий квартал. Ответ пришёл с HTTP 200 и пустым results. В billing.reason было empty_result_refunded, списание составило 0. Более короткая фраза о прибыли BYD вернула 10 результатов.
Четвёртый случай — лимит запросов. Если несколько заданий одновременно используют один API-ключ, они могут превысить поминутный лимит. В 00:20:58 SGT поиск по темам получил HTTP 429. В сообщении говорилось, что средства не списаны и запрос можно повторить через 2 секунды. Мы отправили его снова в 00:21:05 SGT, и он прошёл.
| Время (SGT) | Возможность | Результат | Списание | Правило для Kimi |
|---|---|---|---|---|
| 00:20:10 | yahoo_finance/earnings (1211.HK) | 422, только американские тикеры | $0 | Прочитать next_steps, затем сменить тикер или возможность |
| 00:20:32 / 00:21:30 / 00:22:55 | yahoo_finance/earnings (TSLA) | 503, кратковременный сбой | $0 | Дождаться retry_after, не более двух попыток, затем отправить пример |
| 00:20:58 | weibo/topic_search | 429, достигнут поминутный лимит | $0 | Дождаться retry_after, затем один раз повторить тот же вызов |
| 00:22:00 | google_news/search (на испанском) | 200, пусто, средства возвращены | $0 | Попробовать другие слова, не сообщать «новостей нет» |
| 00:23:05 | yahoo_finance/earnings (пример с AAPL) | 503 | $0 | Пример тоже не сработал, значит, проблема на стороне сервиса |
Для субагентов Kimi Code, которые обрабатывают несколько компаний параллельно, пропишите эти правила в файле агента. При 429 дождитесь retry_after и повторите вызов один раз с теми же аргументами. При 503 делайте не более двух повторных попыток. При 422 прочитайте next_steps, прежде чем менять какой-либо аргумент. Правила, по которым средства не списываются, описаны в разделе Быстрый старт. Чтобы сопоставить списания с вызовами, см. сверку возвратов средств за сбои.
Шаблон вывода: как заставить Kimi писать только на основе доказательств
Последний шаг — сводка. K3.1 Pro поддерживает json_schema со strict: true для итогового message.content (Быстрый старт: структурированный вывод). Мы советуем фиксированные поля. Каждое утверждение должно содержать поле с источником. Если модель не может указать источник, она не может написать утверждение.
{
  "type": "json_schema",
  "json_schema": {
    "name": "cross_check_summary",
    "strict": true,
    "schema": {
      "type": "object",
      "additionalProperties": false,
      "required": ["company", "window", "claims", "unmentioned", "timing_clusters", "limits"],
      "properties": {
        "company": {"type": "string"},
        "window": {"type": "string"},
        "claims": {"type": "array", "items": {"type": "object", "additionalProperties": false,
          "required": ["social_claim", "social_source_ids", "filing_value", "filing_source", "verdict"],
          "properties": {
            "social_claim": {"type": "string"},
            "social_source_ids": {"type": "array", "items": {"type": "string"}},
            "filing_value": {"type": "string"},
            "filing_source": {"type": "string"},
            "verdict": {"type": "string", "enum": ["supported", "partly supported", "not supported", "cannot check"]}}}},
        "unmentioned": {"type": "array", "items": {"type": "string"}},
        "timing_clusters": {"type": "array", "items": {"type": "string"}},
        "limits": {"type": "array", "items": {"type": "string"}}
      }
    }
  }
}
social_source_ids содержит значения id постов или комментариев. filing_source содержит имя поля таблицы или страницу отчётности. Так каждая строка ведёт к исходным данным. verdict — это enum, поэтому модель не может подбирать собственные эпитеты.
В схеме нет поля «совет» или «рейтинг», поэтому торговые рекомендации исключены самой структурой.
timing_clusters фиксирует только измеримые закономерности, например комментарии, уложенные в несколько секунд и не получившие лайков. Догадок об их происхождении там нет. Поле limits обязательно: модель должна указать ограничения сводки. Например, поиск Weibo охватывает только последние недели или вызов для получения комментариев вернул меньше комментариев, чем указано под постом. Наша заполненная вручную таблица перекрёстной проверки выше показывает, как этот шаблон выглядит с реальными данными.
Не инвестиционная рекомендация: где мы проводим границы
От этой задачи один шаг до биржевых советов. Поэтому ограничения должны быть частью рабочего процесса, а не только дисклеймером в конце. Регуляторы в Китае уже принимали меры. В 2026 году пекинское управление Комиссии по регулированию ценных бумаг Китая (CSRC) оштрафовало двух операторов аккаунтов в соцсетях на CNY 200 000 и CNY 250 000.
Они выдумали и распространяли ложную информацию о публичной компании. Один из них заявил, что ложный текст сгенерировал ИИ. Регулятор этот довод не принял. В сообщении сказано, что пользователи генеративного ИИ обязаны проверять то, что он создаёт (пекинское управление CSRC, перепечатка Securities Daily).
В середине октября 2026 года управление CSRC в провинции Цзянсу перепечатало материал о новых правилах для финансового контента в Weibo, WeChat, Douyin и Xiaohongshu. Правила запрещают прогнозировать изменение цены отдельных акций и предусматривают проверку ложного финансового контента, созданного ИИ (обзор СМИ от управления CSRC в Цзянсу).
На практике мы следуем четырём правилам. Первое: сводка говорит только о том, совпадают ли утверждения с данными. Она никогда не советует покупать или продавать.
Второе: у каждой цифры есть исходное поле или источник в отчётности, а предложения без источника удаляются. Третье: комментарии, плотно сгруппированные по времени и без лайков, выносятся в отдельную группу, не учитываются в тональности и не сопровождаются догадками об их происхождении. Четвёртое: сводка предназначена для внутренних исследований. Перед публикацией человек сверяет каждое предложение с источником. Moonshot в собственном техническом блоге тоже пишет, что её тест на галлюцинации использует сложные промпты и не отражает частоту ошибок в повседневной работе.
Ограничения и важные моменты
Во-первых, сторону Kimi мы не тестировали. Все сведения об API Kimi, Kimi Code и Kimi Work взяты из документации Moonshot, которую мы читали 2 ноября 2026 года. Код — это пример конфигурации. После запуска K3.1 Pro Moonshot часто обновляет документацию.
Серия K2 закрыта для новых пользователей с 31 октября 2026 года. Moonshot планирует вывести её из эксплуатации до конца декабря (тарифы, серия K2). Прежде чем копировать код, перечитайте источник. Число токенов и расходы на Kimi — оценки.
Во-вторых, у данных Weibo есть ограничения по охвату. Поиск по ключевым словам возвращает недавние посты, а при limit, равном 30, мы получили 13 постов. Вызов комментариев вернул меньше комментариев, чем значилось под каждым постом: 31 из 49 и 36 из 39. Прочтения темы — это суммарные значения за всё время, а не за один день. Чтобы изучать окно отчётности, собирайте данные внутри этого окна.
В-третьих, yahoo_finance/earnings принимает только американские тикеры. Для акций Гонконга и материкового Китая берите прибыль на акцию из финансовых таблиц или отчётности. Кроме того, во время нашего теста эта возможность несколько минут не работала, средства при этом не списывались. В-четвёртых, финансовый API совпадает с отчётностью, но не объясняет изменения.
Причины есть только в отчётности.
В-пятых, список негативных слов и список слов о стабильности и исследованиях мы составили после прочтения данных, поэтому эти результаты — лишь описания. В-шестых, мы скрыли имена комментаторов, ID пользователей и ссылки на оба поста в тексте и на скриншотах. Ваши исследовательские сводки тоже не должны раскрывать личности обычных пользователей. В-седьмых, выборка мала: одна компания и две ветки комментариев. Этого достаточно, чтобы показать метод, но недостаточно для общих выводов об этой компании или о таком типе обсуждений. Для полноценного исследования нужны несколько компаний, несколько сезонов отчётности и все списки слов, составленные до сбора данных.
Последние изменения
- 23 октября 2026 года: Moonshot выпустила Kimi K3.1 Pro и версию Highspeed. Цены API составляют $2,00 за вход и $10,00 за вывод за миллион токенов. Веса обещают опубликовать до 4 ноября (Kimi API Platform, заметки Саймона Уиллисона). Что это значит для читателей: вход для той же задачи с длинным контекстом стоит на треть меньше, чем на K3.
- 26 октября 2026 года: Kimi Work 3.2.21 запрашивает подтверждение перед загрузкой MCP-серверов проекта. 29 октября версия 3.2.22 перенесла запланированные задания в Task Center (примечания к выпуску Kimi Work). Что это значит для читателей: при первом запуске запланированной выгрузки человек должен подтвердить её одним кликом.
- 31 октября 2026 года: серия K2 закрыта для новых пользователей, вывод из эксплуатации запланирован до конца декабря (тарифы). Что это значит для читателей: перенесите код вызова инструментов с K2 на модели K3 и учтите, что режим рассуждений в K3.1 Pro отключить нельзя.
FAQ
Какое контекстное окно у kimi k3.1 pro?
В документации API указано 1 048 576 токенов, с единой ценой при любой длине (тарифы). Вывод тоже занимает контекст, а max_completion_tokens по умолчанию равен 131 072. В нашем тесте данные Weibo и финансовые данные по одной компании после удаления дубликатов заняли примерно 16 000–24 000 токенов. С местом под вывод по умолчанию помещается от 38 до 56 компаний. (Источник вопроса: подсказка Google «kimi k3.1 pro context window».)
Как получить API-ключ kimi k3.1 pro и нужно ли сначала пополнить баланс?
Создайте API-ключ в консоли Kimi API Platform. K3.1 Pro — флагманская модель, поэтому она становится доступна только после пополнения баланса. Минимальная сумма составляет $1, а общая сумма пополнений определяет ваш уровень и лимиты запросов (Быстрый старт: требования к доступу, пополнение и лимиты). API оплачивается за токены. Оплата API не связана с подпиской Kimi и тарифами Kimi Code (сравнение продуктов). (Источник: подсказка «kimi k3.1 pro api key».)
Сколько стоит kimi k3.1 pro и дешевле ли она, чем K3?
Публичные цены на 2 ноября 2026 года: K3.1 Pro стоит $2,00 за вход, $10,00 за вывод и $0,20 за попадание в кеш за миллион токенов. K3 стоит $3,00 за вход и $15,00 за вывод (Kimi API Platform). Batch стоит 60% от стандартной цены (цены Batch). По нашей оценке, одна компания за запуск обходится примерно в $0,134 в реальном времени, из них $0,006335 приходится на вызовы EveryInfra. (Источник: подсказки «kimi k3.1 pro pricing» и «kimi k3.1 pro vs k3».)
Поддерживает ли kimi k3.1 pro инструменты MCP?
В запросе к API — нет. Chat Completions, Responses и Messages не принимают удалённый MCP-сервер. Responses API поддерживает только типы инструментов function, namespace, custom и web_search (справочник Responses API). Для удалённого MCP используйте mcp.json в Kimi Code CLI или личный плагин в Kimi Work. Песочница синхронизирует только MCP-серверы, размещённые на ModelScope. (Источник: подсказки «kimi k3.1 pro tools» и «kimi k3.1 pro mcps».)
Откуда Kimi берёт финансовые данные?
Собственных актуальных данных у модели нет. В Kimi Work есть плагины финансовых баз данных, включая Wind, Hundsun Gildata и S&P Global Market Intelligence (центр плагинов Kimi Work). Исходных постов и комментариев из соцсетей в этих плагинах нет. В этой статье этот пробел закрывают вызовы EveryInfra weibo/* и yahoo_finance/*. При работе через API все данные попадают в модель через вызовы инструментов.
Источники
- «Kimi K3.1 Pro quickstart», Moonshot AI, дата обращения: 2026-11-02, https://platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart
- «Kimi K3.1 Pro Tech Blog», Moonshot AI, 2026-10-23, https://www.kimi.com/blog/kimi-k3-1-pro
- «Model Inference Pricing», Moonshot AI, дата обращения: 2026-11-02, https://platform.kimi.ai/docs/pricing/chat
- Главная страница Kimi API Platform с ценами моделей, Moonshot AI, дата обращения: 2026-11-02, https://platform.kimi.ai/
- «BatchJob Pricing», Moonshot AI, дата обращения: 2026-11-02, https://platform.kimi.ai/docs/pricing/batch
- «Recharge and Rate Limiting», Moonshot AI, дата обращения: 2026-11-02, https://platform.kimi.ai/docs/pricing/limits
- «Responses API reference», Moonshot AI, дата обращения: 2026-11-02, https://platform.kimi.ai/docs/api/responses
- «Messages API reference», Moonshot AI, дата обращения: 2026-11-02, https://platform.kimi.ai/docs/api/messages
- «Use Kimi API for Tool Calls», Moonshot AI, дата обращения: 2026-11-02, https://platform.kimi.ai/docs/guide/use-kimi-api-to-complete-tool-calls
- «Kimi K3 API Tool Calling Best Practices», Moonshot AI, дата обращения: 2026-11-02, https://platform.kimi.ai/docs/guide/kimi-k3-tool-calling-best-practice
- «Tool Choice», Moonshot AI, дата обращения: 2026-11-02, https://platform.kimi.ai/docs/guide/use-tool-choice
- «Dynamically Loaded Tools», Moonshot AI, дата обращения: 2026-11-02, https://platform.kimi.ai/docs/guide/use-dynamic-tool-loading
- «Reasoning Effort», Moonshot AI, дата обращения: 2026-11-02, https://platform.kimi.ai/docs/guide/use-reasoning-effort
- «Structured Output», Moonshot AI, дата обращения: 2026-11-02, https://platform.kimi.ai/docs/guide/response_format
- «Context Caching», Moonshot AI, дата обращения: 2026-11-02, https://platform.kimi.ai/docs/guide/context-caching
- «Using Batch API for Bulk Processing», Moonshot AI, дата обращения: 2026-11-02, https://platform.kimi.ai/docs/guide/use-batch-api
- «Configure ModelScope MCP Server in Playground», Moonshot AI, дата обращения: 2026-11-02, https://platform.kimi.ai/docs/guide/configure-the-modelscope-mcp-server
- «Use Kimi API for File-Based Q&A», Moonshot AI, дата обращения: 2026-11-02, https://platform.kimi.ai/docs/guide/use-kimi-api-for-file-based-qa
- «Main Concepts», Moonshot AI, дата обращения: 2026-11-02, https://platform.kimi.ai/docs/introduction
- «Token estimate API», Moonshot AI, дата обращения: 2026-11-02, https://platform.kimi.ai/docs/api/estimate
- «Compare with Other Kimi Products», Moonshot AI, дата обращения: 2026-11-02, https://platform.kimi.ai/docs/guide/product-plans
- «Kimi Code: Model Context Protocol», Moonshot AI, дата обращения: 2026-11-02, https://www.kimi.com/code/docs/en/kimi-code-cli/customization/mcp.html
- «Kimi Code: Agents and Sub-Agents», Moonshot AI, дата обращения: 2026-11-02, https://www.kimi.com/code/docs/en/kimi-code-cli/customization/agents.html
- «Kimi Code: Model Configuration», Moonshot AI, дата обращения: 2026-11-02, https://www.kimi.com/code/docs/en/kimi-code/models.html
- «Kimi Work product page», Moonshot AI, дата обращения: 2026-11-02, https://www.kimi.com/en/products/kimi-work
- «Kimi Work Release Notes», Moonshot AI, обновлено 2026-10-29, https://www.kimi.com/en/help/kimi-work/release-notes
- «What Are Kimi Plugins», Moonshot AI, дата обращения: 2026-11-02, https://www.kimi.com/en/help/plugins-and-skills/overview
- «How to Create a Personal Plugin», Moonshot AI, дата обращения: 2026-11-02, https://www.kimi.com/en/help/plugins-and-skills/create
- «Kimi Work Plugin Center», Moonshot AI, дата обращения: 2026-11-02, https://www.kimi.com/en/help/kimi-work/plugin-center
- «Tesla Q3 2026 Update (8-K exhibit 99.1)», Tesla через SEC EDGAR, 2026-10-21, https://www.sec.gov/Archives/edgar/data/1318605/000162828026066738/exhibit9914.htm
- «BYD Company Limited 2026 Third Quarter Report», BYD через CNINFO, 2026-10-30, https://static.cninfo.com.cn/finalpage/2026-10-30/1225641442.PDF
- «EveryInfra Weibo catalog», EveryInfra, дата обращения: 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=weibo
- «EveryInfra Yahoo Finance catalog», EveryInfra, дата обращения: 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=yahoo_finance
- «EveryInfra Google News catalog», EveryInfra, дата обращения: 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=google_news
- «EveryInfra Reddit catalog», EveryInfra, дата обращения: 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=reddit
- «A 250,000-yuan fine for an AI-written fake story (reprint of Securities Daily)», пекинское отделение CSRC, 2026-06-18, https://www.csrc.gov.cn/beijing/c105538/c7640109/content.shtml
- «Media review: joint work to clean up finance content», отделение CSRC в провинции Цзянсу, 2026-10-15, https://www.csrc.gov.cn/jiangsu/c106440/c7664819/content.shtml
- «Kimi K3.1 Pro notes», Simon Willison, 2026-10-23, https://simonwillison.net/2026/Oct/23/kimi-k31-pro/
- «Tesla Q3 2026 earnings report», CNBC, 2026-10-21, https://www.cnbc.com/2026/10/21/tesla-tsla-q3-2026-earnings-report.html
- «How good is kimi K3.1 Pro?» (тред), Reddit r/kimi, 2026-10, https://www.reddit.com/r/kimi/comments/1xdkngh/how_good_is_kimi_k31_pro/
- «Model Context Protocol specification», Model Context Protocol, дата обращения: 2026-11-02, https://modelcontextprotocol.io/specification/2025-06-18
Справка BL-67