GLM 5.3 in Claude Code: uno script per analizzare un tema su Zhihu e Weibo
Come usare GLM 5.3 in Claude Code con una chiave Z.ai o BigModel e fargli scrivere uno script che confronta le risposte di Zhihu e i commenti di Weibo, con i costi reali.
Se segui gli strumenti di AI in Cina, due siti ti dicono quasi tutto quello che pensano gli sviluppatori. Zhihu è un sito di domande e risposte dove si scrivono risposte lunghe e si fanno i conti. Weibo è un microblog dove si reagisce in poche parole. Leggendoli insieme vedi sia l'umore sia le ragioni che lo motivano.
Questo articolo mette alla prova una configurazione per questo lavoro. Configuriamo Claude Code per usare GLM-5.3 o GLM-5.3-Flash di Zhipu. GLM scrive poi uno script, topic_pulse.py, che recupera tramite EveryInfra le risposte di Zhihu e i commenti di Weibo su un tema. Infine GLM legge l'output e scrive un breve confronto.
Il tema che usiamo è «aumento di prezzo del Coding Plan». Il 2026-07-30 Zhipu è passata a un sistema a crediti per il suo Coding Plan, e gli sviluppatori su entrambi i siti ne discutono ancora. È quindi un buon test: il tema è circoscritto, tecnico e strettamente legato allo strumento che usiamo.
Ecco cosa è reale e cosa no. Sulla macchina di test non abbiamo un account Zhipu. Perciò tutti i passaggi in cui Claude Code usa GLM sono esempi di configurazione, basati sulla documentazione di Z.ai e BigModel letta il 2026-11-04. Non abbiamo eseguito GLM dentro Claude Code. La parte dei dati è reale.
Tra le 00:16 e le 02:08 SGT del 2026-11-04 abbiamo inviato 52 richieste all'API di EveryInfra. Di queste, 34 hanno restituito dati e sono state addebitate, per un totale di $0,020404. Le altre 18 sono fallite o non hanno restituito risultati; nessuna è stata addebitata. Una delle 52 è passata dal metodo MCP tools/call.
Abbiamo eseguito lo script completo tre volte. La seconda esecuzione ha letto anche il testo completo delle risposte, ha fatto 12 richieste ed è costata $0,00581. La terza esecuzione ha usato lo script finale: 7 richieste, tutte riuscite, per $0,004142.
1. Cosa può fare qui una configurazione GLM 5.3 + Claude Code
Il lavoro ha due metà: l'API recupera i dati e GLM li legge. La prima metà richiede record strutturati, una riga per risposta o commento. Ogni riga contiene il numero di like, una data e la domanda o il post a cui appartiene. Uno script può contare e ordinare queste righe senza alcun modello.
La seconda metà consiste nella lettura dei dati. Devi stabilire quali commenti sono costituiti solo da emoji, quali si ripetono, quali si lamentano del prezzo e quali fanno i conti della quota. Questa parte richiede un modello.
Claude Code collega le due metà. Descrivi il lavoro in una frase. Il modello scrive lo script, lo esegue, legge l'output e ti restituisce i risultati. Abbiamo scelto GLM-5.3 perché Zhipu pubblica una guida per Claude Code e i suoi prezzi per token sono pubblici (le sezioni da 2 a 4 citano ogni pagina). Per chi non è in Cina, il sito Z.ai vende gli stessi modelli in USD.
La tabella seguente elenca ogni funzionalità che abbiamo invocato e il relativo risultato. «Righe» indica il numero di elementi in ogni risposta. Il prezzo è quello del catalogo EveryInfra per richiesta. Le richieste fallite e i risultati vuoti non vengono addebitati.
| Funzionalità | Chiamate del 2026-11-04 | Prezzo a catalogo | Dati restituiti |
|---|---|---|---|
weibo/search | 6 (una tramite MCP) | $0.000806 | 20 post ogni volta |
weibo/comments | 9 con dati, 1 vuota | $0.000556 | da 2 a 43 commenti per post |
zhihu/search | 5 | $0.000556 | 20 risposte con estratti da 51 a 86 caratteri |
zhihu/content_comments | 7 | $0.000556 | da 3 a 26 commenti per risposta |
zhihu/content_detail (facoltativo) | 7 con dati, 1 soggetta a un limite di frequenza delle richieste | $0.000556 | testo completo della risposta, fino a 756 caratteri |
Lo script finale usa solo le prime quattro righe. Su Zhihu parte da zhihu/search, che restituisce già titolo della domanda, link alla risposta, estratto e numero di like. Poi zhihu/content_comments legge i commenti sotto le risposte migliori. Se ti serve il testo completo di una risposta, aggiungi una chiamata a zhihu/content_detail. La tabella non ha righe per GLM, perché quella parte non l'abbiamo eseguita.
2. GLM-5.3 e GLM-5.3-Flash in breve
GLM-5.3 è il modello di testo di punta di Zhipu. È stato rilasciato sulla piattaforma BigModel il 2026-08-19. La pagina del modello indica che accetta solo testo, ha una finestra di contesto di 1M di token e restituisce fino a 128K token di output (pagina del modello GLM-5.3). Il ragionamento (thinking) è sempre attivo. Puoi scegliere low, high o max, e max è il valore predefinito. Non puoi disattivare il ragionamento.
GLM-5.3-Flash è arrivato il 2026-08-26. È un modello multimodale che combina attenzione lineare e sparsa (note di rilascio di BigModel). Ha 320B parametri totali e 18B parametri attivi. Secondo Zhipu richiede molta meno potenza di calcolo e cache KV rispetto a GLM-5.3.
Le impostazioni consigliate sono temperature a 1, top_p a 0,95 e reasoning_effort impostato su max (pagina del modello GLM-5.3-Flash). Per uno script che elabora dati, la differenza principale è il costo. Nella sezione 11, Flash costa circa un nono di GLM-5.3 per la stessa sessione.
| Voce | GLM-5.3 | GLM-5.3-Flash | Fonte, consultata il 2026-11-04 |
|---|---|---|---|
| Data di rilascio | 2026-08-19 | 2026-08-26 | note di rilascio di BigModel |
| Input | solo testo | testo e immagini | pagine dei modelli |
| Finestra di contesto | 1M di token | 1M di token con l'impostazione [1m] | pagina del modello, guida al cambio di modello |
| Ragionamento | sempre attivo: low, high o max | sempre attivo, con max come valore consigliato | pagine dei modelli |
| Prezzo Z.ai per 1M di token | $1,4 in input, $0,26 in cache, $4,4 in output | $0,15 in input, $0,03 in cache, $0,50 in output | pagina dei prezzi di Z.ai |
| Prezzo BigModel per 1M di token | CNY 8 in input, CNY 2 in cache, CNY 28 in output | CNY 0,8 in input, CNY 0,23 in cache, CNY 2,8 in output | pagina dei prezzi di BigModel |
| Fattori di credito del Coding Plan | 6.9, 1.7, 24 | 2.3, 0.56, 8 | panoramica del Coding Plan |
I prezzi Z.ai provengono dalla pagina dei prezzi di Z.ai. I prezzi in CNY provengono dalla pagina dei prezzi di BigModel. Quella pagina indica anche che lo storage della cache è gratuito per un periodo limitato. Indica inoltre che un token corrisponde a circa 1,6 caratteri cinesi.
Usiamo questo rapporto per tutte le stime del numero di token riportate di seguito. Al tasso di parità centrale del 2026-11-03, pari a 6,7150 CNY per USD, CNY 8 corrispondono a circa $1,19 (pagina dei tassi di cambio SAFE). I due siti applicano quindi prezzi simili.
I due siti usano URL di base diversi. Su Z.ai, Claude Code comunica con https://api.z.ai/api/anthropic (guida a Claude Code di Z.ai). Su BigModel, l'URL compatibile con Anthropic è https://open.bigmodel.cn/api/anthropic. BigModel indica anche https://open.bigmodel.cn/api/v1 per Codex e https://open.bigmodel.cn/api/coding/paas/v4 per gli altri strumenti di coding compatibili con OpenAI. L'API standard a consumo si trova su https://open.bigmodel.cn/api/paas/v4. Non confonderli. Solo gli URL per il coding attingono alla quota del piano.
| Strumento | URL di base | Usa la quota del piano | Consultato il |
|---|---|---|---|
| Claude Code su Z.ai | https://api.z.ai/api/anthropic | yes | 2026-11-04 |
| Claude Code su BigModel | https://open.bigmodel.cn/api/anthropic | yes | 2026-11-04 |
| Codex su BigModel | https://open.bigmodel.cn/api/v1 | yes | 2026-11-04 |
| Altri strumenti di coding compatibili con OpenAI | https://open.bigmodel.cn/api/coding/paas/v4 | yes | 2026-11-04 |
| API standard a consumo | https://open.bigmodel.cn/api/paas/v4 | no | 2026-11-04 |
Abbiamo anche trovato una discrepanza tra due pagine di Zhipu. La guida a Claude Code di BigModel mostra ancora glm-5.2[1m] come modello principale e glm-4.7 come modello piccolo. La più recente guida al cambio di modello usa glm-5.3-flash[1m] per tutti e tre gli slot dei modelli. Indica inoltre di essere stata verificata su Claude Code 2.1.140.
La panoramica del Coding Plan spiega perché il vecchio esempio funziona ancora. Le chiamate a GLM-5.2 o GLM-5.1 vanno a GLM-5.3. Le chiamate a GLM-5-Turbo o GLM-4.7 vanno a GLM-5.3-Flash. La vecchia configurazione quindi funziona, ma il modello in uso non è quello che pensi.
Le due pagine mappano anche i livelli di effort in modo diverso. Fidati della pagina più recente: il valore predefinito è max, e in Claude Code digiti /effort e scegli high per rendere ogni turno più breve ed economico.
3. Livelli del Coding Plan, crediti e orari di punta
Il Coding Plan è un abbonamento mensile per strumenti di coding. Dal 2026-07-30 conteggia l'utilizzo in crediti. La documentazione di Z.ai dice che i piani partono «da soli 18 USD al mese» (panoramica del Coding Plan di Z.ai). La pagina dei piani di Z.ai non veniva visualizzata nel nostro browser headless, quindi non possiamo riportare il prezzo in USD di ogni livello.
Sul sito cinese, la pagina del GLM Coding Plan mostrava i prezzi mensili il 2026-11-04. Lite costava CNY 118, Pro CNY 538 e Max CNY 1078. A 6,7150 CNY per USD, sono circa $17,57, $80,12 e $160,54. La fatturazione trimestrale applica uno sconto del 20% e quella annuale del 30%.
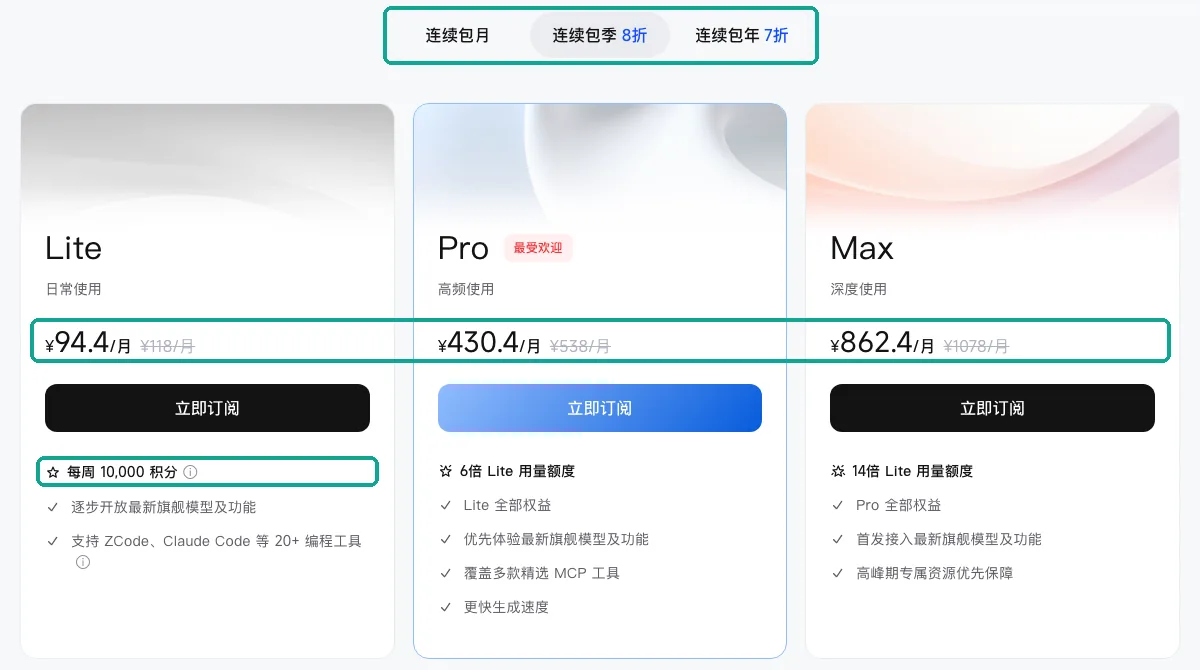
Ogni piano ha due limiti: uno ogni 5 ore e uno settimanale. Lite offre 2.000 crediti ogni 5 ore e 10.000 a settimana. Pro ne offre 12.000 e 60.000. Max ne offre 28.000 e 140.000.
La finestra di 5 ore si rinnova 5 ore dopo ogni utilizzo. La finestra settimanale dura 7 giorni dalla data dell'ordine. Quando esaurisci i crediti, devi aspettare. Il piano non addebita nulla sul tuo saldo.
La formula dei crediti è pubblica. I crediti del modello sono pari ai token di input per il fattore di input, più i token in cache per il fattore di cache, più i token di output per il fattore di output. Il totale si divide poi per 10.000. Ogni chiamata MCP per ricerca web, lettura di pagine web o lettura di repository costa 1,2 crediti.
Fuori dagli orari di punta le chiamate ai modelli costano la metà. Gli orari di punta vanno dalle 14:00 alle 18:00 SGT, dal lunedì al venerdì, secondo la documentazione di Z.ai. La documentazione di BigModel indica gli stessi orari in UTC+8. Se lavori da Singapore, evita le sessioni lunghe nel pomeriggio.
| Livello | Prezzo mensile al 2026-11-04 | USD (circa) | Crediti ogni 5 h | Crediti a settimana | Sessioni GLM-5.3 a settimana in orario di punta |
|---|---|---|---|---|---|
| Lite | CNY 118 | $17.57 | 2,000 | 10,000 | circa 48 |
| Pro | CNY 538 | $80.12 | 12,000 | 60,000 | circa 288 |
| Max | CNY 1078 | $160.54 | 28,000 | 140,000 | circa 673 |
L'ultima colonna usa la sessione di esempio della sezione 11. Quella sessione costa circa 207,8 crediti su GLM-5.3 e 68,7 crediti su Flash. Fuori dagli orari di punta, il numero raddoppia. Considera questi numeri come un ordine di grandezza, non come una garanzia.
Quando sviluppi uno script per l'elaborazione dei dati, contano tre regole. Primo, il piano funziona solo negli strumenti supportati. Le chiamate API fatte da qualsiasi altra parte non usano la quota del piano. Le norme d'uso di Z.ai lo dicono in cinque parole: «Use limited to supported tools» (norme d'uso di Z.ai).
Le FAQ di BigModel aggiungono che le tue app, i tuoi siti, i tuoi bot e i tuoi prodotti SaaS richiedono l'API standard (FAQ del Coding Plan). In secondo luogo, dal 2026-10-16 le chiavi API standard e le chiavi del piano sono separate. Una chiave standard in uno strumento di coding non usa la quota del piano (avviso sulle chiavi API). In terzo luogo, i piani non prevedono rimborsi e non puoi condividere un account (note d'uso).
La prima regola determina tutto il progetto. Un'idea allettante è fare in modo che topic_pulse.py chiami direttamente GLM per etichettare i commenti. Così lo script potrebbe girare a orari prefissati senza nessun intervento umano. Con le regole del piano, però, quelle chiamate a GLM non conterebbero come utilizzo del piano. Pagheresti i prezzi dell'API standard.
Il nostro script quindi fa solo due cose. Recupera i dati e calcola statistiche semplici che non richiedono un modello. La lettura e il riepilogo avvengono dentro Claude Code, dove si applica il piano. In più, lo script funziona su qualsiasi macchina, anche su una senza accesso a un modello.
4. Come usare GLM 5.3 in Claude Code: un esempio di configurazione
Ecco un esempio di ~/.claude/settings.json per Z.ai. Segue la guida a Claude Code di Z.ai e la documentazione di riferimento sulle variabili d'ambiente di Claude Code. Non l'abbiamo eseguito, perché non abbiamo un account Z.ai. Le chiavi sono segnaposto.
{
  "env": {
    "ANTHROPIC_AUTH_TOKEN": "your-zai-coding-plan-key",
    "ANTHROPIC_BASE_URL": "https://api.z.ai/api/anthropic",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "glm-5.3[1m]",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "glm-5.3[1m]",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "glm-5.3-flash[1m]",
    "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000",
    "API_TIMEOUT_MS": "3000000",
    "CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC": "1",
    "EVERYINFRA_API_KEY": "your-everyinfra-key"
  }
}
Claude Code invia ANTHROPIC_AUTH_TOKEN come Bearer token nell'header Authorization (variabili d'ambiente di Claude Code). Qui usa la chiave del Coding Plan, non una chiave API standard. I tre valori ANTHROPIC_DEFAULT_*_MODEL indicano a Claude Code quale modello reale si trova dietro i suoi alias opus, sonnet e haiku. Z.ai mette GLM-5.3 dietro opus e sonnet, e Flash dietro haiku. La pagina più recente di BigModel mette Flash dietro tutti e tre. Seguiamo Z.ai, perché per scrivere script serve il modello più potente. Le attività in background possono usare Flash per risparmiare crediti.
Mantieni il suffisso [1m]. Claude Code non conosce l'ID glm-5.3. Per un ID sconosciuto, la documentazione sulla configurazione dei modelli dice che presume 200K token e mostra un avviso all'avvio (configurazione dei modelli di Claude Code). Con [1m] nell'ID, presume una finestra da 1M, che corrisponde a GLM-5.3. Senza il suffisso, Claude Code compatta la conversazione troppo presto. Lo noti soprattutto quando il modello legge risultati lunghi.
CLAUDE_CODE_AUTO_COMPACT_WINDOW stabilisce quanto può riempirsi il contesto prima della compattazione. Accetta valori da 100.000 a 1.000.000. API_TIMEOUT_MS a 3.000.000 millisecondi è il valore consigliato da Zhipu, perché GLM con effort massimo può ragionare a lungo. CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC disattiva la telemetria e le altre richieste facoltative.
L'ultima riga, EVERYINFRA_API_KEY, serve allo script. I processi figli avviati da Claude Code possono leggerla, quindi lo script la legge da os.environ. La chiave non finisce mai nel codice.
| Variabile | Valore nel nostro esempio | Scopo | Fonte, consultata il 2026-11-04 |
|---|---|---|---|
ANTHROPIC_BASE_URL | https://api.z.ai/api/anthropic | invia le richieste a Z.ai | guida a Claude Code di Z.ai |
ANTHROPIC_AUTH_TOKEN | chiave del piano | Bearer token | riferimento delle variabili d'ambiente di Claude Code |
ANTHROPIC_DEFAULT_OPUS_MODEL | glm-5.3[1m] | modello principale | guida a Claude Code di Z.ai |
ANTHROPIC_DEFAULT_HAIKU_MODEL | glm-5.3-flash[1m] | piccole attività in background | guida a Claude Code di Z.ai |
CLAUDE_CODE_AUTO_COMPACT_WINDOW | 1000000 | soglia di compattazione | riferimento delle variabili d'ambiente di Claude Code |
API_TIMEOUT_MS | 3000000 | timeout delle richieste | guida a Claude Code di BigModel |
Un fatto va detto chiaramente. La documentazione sui gateway di Claude Code dice che funziona qualsiasi gateway con un formato API supportato. Dice anche che Anthropic «non supporta l'instradamento di Claude Code verso modelli non Claude tramite alcun gateway» (gateway LLM di Claude Code). Quindi Claude Code su GLM funziona perché Zhipu ha realizzato un endpoint compatibile.
Se qualcosa non funziona, il riferimento sono la documentazione e il supporto di Zhipu. Il 2026-11-04 la release più recente di Claude Code era la 2.1.317 del 2026-11-03 (changelog di Claude Code). La pagina di Zhipu è stata verificata sulla 2.1.140. Tra queste due versioni ci sono molte release, quindi controlla entrambi i changelog quando vedi un errore strano.
Se preferisci una configurazione guidata, Zhipu offre uno strumento interattivo, npx @z_ai/coding-helper (pacchetto npm). Al termine della configurazione, apri un nuovo terminale ed esegui claude. Poi digita /status. L'origine delle impostazioni deve puntare al tuo ~/.claude/settings.json. La riga del modello deve mostrare glm-5.3 o glm-5.3[1m].
5. Due set di strumenti MCP fianco a fianco
MCP sta per Model Context Protocol, un protocollo aperto che consente a un modello di chiamare strumenti esterni (specifica MCP). Il Coding Plan include i propri strumenti MCP. Il 2026-11-04 la documentazione elencava la ricerca web (webSearchPrime), la lettura web (webReader), un lettore di repository chiamato zread e un server di visione. Il server zread ha tre strumenti: search_doc, get_repo_structure e read_file. Il server di visione viene eseguito in locale come pacchetto npm @z_ai/mcp-server. La sua ultima versione, la 0.1.6, è uscita il 2026-10-29 (pacchetto npm).
Le pagine sulla ricerca web e sul lettore web condividono una frase. Con il Coding Plan in Claude Code, entrambi gli strumenti sono integrati nel servizio del modello (MCP per la ricerca web, MCP per la lettura web). Non devi installarli. Li aggiungi a mano solo se vuoi usarli con un altro modello.
| Strumento integrato | Cosa restituisce | Crediti per chiamata | Versione o data |
|---|---|---|---|
webSearchPrime | titolo, URL, riepilogo, nome del sito, icona | 1.2 | documentazione consultata il 2026-11-04 |
webReader | titolo, testo principale, metadati, link | 1.2 | documentazione consultata il 2026-11-04 |
| zread | search_doc, get_repo_structure, read_file | 1.2 | documentazione consultata il 2026-11-04 |
| server di visione | analisi di immagini e video, in esecuzione locale | conteggiato come Flash | 0.1.6 del 2026-10-29 |
La documentazione descrive anche cosa restituisce ciascuno strumento. La ricerca web restituisce titolo della pagina, URL, riepilogo, nome del sito e icona del sito. Il lettore web recupera un URL e restituisce titolo, testo principale, metadati e un elenco di link. È adatto al lavoro di programmazione. Puoi cercare una libreria, leggere una discussione su un errore o aprire un README.
Uno script di analisi del sentiment ha bisogno di dati con una forma diversa. Gli serve una riga per ogni risposta o commento, con like, risposte, data e la domanda o il post a cui appartiene. Con queste righe, uno script può ordinare, eliminare il rumore e calcolare le mediane. La tabella seguente confronta i campi restituiti da ciascun tipo di strumento. La colonna degli strumenti integrati si basa solo sulla documentazione di Zhipu, perché non abbiamo un account Zhipu. La colonna EveryInfra mostra i campi restituiti dalle nostre chiamate reali del 2026-11-04.
| Cosa ti serve | Ricerca o lettore integrati (documentazione Zhipu) | Campi EveryInfra (chiamate reali, 2026-11-04) | Verificato |
|---|---|---|---|
| Risposte di Zhihu su un argomento | titolo della pagina, URL, riepilogo, nome del sito | zhihu/search: titolo della domanda, link alla risposta, estratto, like, commenti, salvataggi, data (20 per chiamata) | 2026-11-04 |
| Testo completo di una risposta | titolo della pagina, testo principale, metadati, link | zhihu/content_detail: testo completo con like, commenti, salvataggi | 2026-11-04 |
| Commenti a una risposta | una pagina di testo principale | zhihu/content_comments: una riga per commento con text, like_count, reply_count (da 3 a 26 righe) | 2026-11-04 |
| Ricerca per parola chiave su Weibo | titolo della pagina, URL, riepilogo | weibo/search: id, url, text, posted_at, numero di commenti, repost e like (20 per chiamata) | 2026-11-04 |
| Commenti su Weibo | come sopra | weibo/comments: una riga per commento (da 2 a 43 righe) | 2026-11-04 |
| Notizie, documentazione, GitHub | adatto | non è lo scopo di queste funzionalità | 2026-11-04 |
Entrambi i siti gestiscono anche proprie piattaforme per sviluppatori. Fanno al caso tuo se ti servono solo i dati del tuo account o se ti integri tramite l'autorizzazione della piattaforma stessa. La ricerca della piattaforma dati di Zhihu usa un token Bearer e un header con timestamp. Il valore massimo di Count è 10, ContentText è un estratto e HasMore è sempre false (documentazione per sviluppatori Zhihu: ricerca). La sua skill per la classifica dei contenuti più popolari accetta un limit da 1 a 30 (documentazione per sviluppatori Zhihu: classifica dei contenuti più popolari).
Su Weibo, l'endpoint comments/show restituisce i commenti dell'utente autorizzato (API di Weibo: comments/show). L'endpoint search/topics è un'API avanzata che restituisce i 200 elementi più recenti (API di Weibo: search/topics).
Quindi i due set MCP si dividono il lavoro. Gli strumenti integrati di Zhipu coprono documentazione, notizie e pagine pubbliche, a 1,2 crediti per chiamata. Il server MCP o l'API di EveryInfra coprono i dati strutturati all'interno delle piattaforme, con un prezzo in USD per richiesta. Entrambi possono restare connessi nella stessa sessione di Claude Code, e il modello sceglie in base alla descrizione dello strumento. Ecco come aggiungere il server MCP remoto di EveryInfra. Abbiamo eseguito initialize e tools/list sul server, che ha elencato 12 strumenti.
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer $EVERYINFRA_API_KEY"

# Check the connection: the list must show everyinfra and its tools
claude mcp list
Uno script per un argomento usa solo 2 dei 12 strumenti. everyinfra_list_capabilities elenca piattaforme, funzionalità e parametri. everyinfra_call_api esegue una funzionalità. Alle 00:23 SGT abbiamo chiamato weibo/search tramite tools/call di MCP con la parola chiave “Zhipu Coding Plan” in cinese. Ha restituito 20 post e ha avuto un costo di $0,000806, lo stesso di una chiamata diretta. Il risultato testuale aveva 15.103 caratteri.
Questa dimensione conta. Claude Code mostra un avviso quando un singolo risultato MCP supera i 10.000 token, e il limite predefinito è di 25.000 token. Puoi modificare il limite con MAX_MCP_OUTPUT_TOKENS. I risultati testuali oltre i 50.000 caratteri vengono salvati in un file anziché nel contesto (documentazione MCP di Claude Code).
Venti post ci stanno senza problemi. Ma se il modello recupera 50 commenti e 20 risposte tramite MCP una chiamata alla volta, il contesto si riempie in fretta. Per questo abbiamo fatto scrivere uno script a GLM. Lo script raccoglie decine di chiamate in un unico piccolo file JSON, e il modello legge solo quel file.
Un altro dettaglio riguarda i gateway. Claude Code attiva la ricerca degli strumenti per impostazione predefinita, quindi gli strumenti MCP vengono caricati su richiesta. Le richieste contengono quindi campi defer_loading e blocchi tool_reference. Dietro ANTHROPIC_BASE_URL, Claude Code si aspetta che il gateway li inoltri senza modifiche.
Dalla versione 2.1.305, se il gateway risponde con 400 o 422, Claude Code ritenta una volta senza la ricerca degli strumenti e carica subito tutti gli strumenti MCP. Non abbiamo potuto verificare se l'endpoint di Zhipu accetta questi campi. Se il contesto sembra già pieno all'inizio di una sessione con molti server MCP, la causa potrebbe essere questa.
6. Il flusso di un confronto


L'intero lavoro segue una linea retta. Primo, dai a Claude Code una sola frase. Per esempio: “Scrivi uno script che confronti come Zhihu e Weibo parlano dell'aumento di prezzo del Coding Plan, poi spiegami la differenza.” Secondo, GLM legge la richiesta. Chiama everyinfra_list_capabilities o legge la documentazione dell'API per conoscere i parametri, poi scrive topic_pulse.py.
Terzo, Claude Code esegue lo script. Lo script chiama in sequenza la ricerca di Weibo, i commenti di Weibo, la ricerca di Zhihu e i commenti di Zhihu. Scrive i risultati e il costo di ogni chiamata in un unico file JSON. Quarto, GLM legge quel file e scrive il riepilogo.
Su questa linea spiccano due numeri. Il primo è la compressione. Nella seconda esecuzione, il JSON grezzo dell'API aveva 50.859 caratteri, circa 14.543 token. Lo script ha tenuto solo i campi di testo, lasciando 4.315 caratteri, circa 2.207 token. Così si elimina l'85% dell'input. GLM rilegge il contesto a ogni turno, quindi questo risparmio si ripete molte volte nella stessa sessione.
Il secondo numero è il tempo. La seconda esecuzione è andata dalle 00:33:55 alle 00:37:01 SGT, poco più di 3 minuti. Gran parte di quel tempo era attesa prevista. Lo script distanzia le chiamate per restare sotto le 10 richieste al minuto. Ha anche atteso dopo una risposta HTTP 429.
7. Lo script che GLM deve scrivere
Questo è il prompt che daremmo a Claude Code. Puoi usarlo così com'è.
Scrivi uno script Python, topic_pulse.py, usando solo la libreria standard. Riceve una parola chiave sull'argomento. Chiama l'API di EveryInfra con POST https://api.everyinfra.com/api/v1/social usando la chiave della variabile d'ambiente EVERYINFRA_API_KEY. Cerca 20 post su Weibo con weibo/search. Tiene i post che contengono una determinata parola e hanno almeno 3 commenti, e legge 50 commenti per post con weibo/comments.
Cerca 20 risposte su Zhihu con zhihu/search e le raggruppa per domanda. Tiene le domande il cui titolo corrisponde a un determinato pattern. Per le prime 3 domande, legge 50 commenti sotto la risposta con più like usando zhihu/content_comments.
Attende 6,5 secondi tra una chiamata e l'altra. In caso di 429 o 503 attende retry_after e riprova. Quando recent_failures arriva a 3, smette di chiamare quella funzionalità. Scarta i commenti composti solo da emoji, ripetuti, molto brevi e quelli dei bot. Scrive un unico file JSON con i conteggi, le lunghezze mediane, i 5 commenti principali e ogni chiamata con il relativo stato HTTP e charged_usd.
Ogni riga ha un motivo. Usare solo la libreria standard significa che lo script funziona ovunque senza installare nulla. L'intervallo di 6,5 secondi mantiene lo script sotto il limite predefinito di 10 richieste al minuto.
Le regole sui nuovi tentativi e la regola su recent_failures sono nate dopo la prima esecuzione, che ha richiesto più di 7 minuti. Il filtro sul titolo è arrivato dopo la seconda. La sezione 9 spiega entrambe le cose. La regola sui bot esiste perché Weibo ha un assistente di ricerca automatico che risponde all'interno delle discussioni nei commenti. Le sue risposte lunghe falserebbero le statistiche.
Di seguito trovi il nucleo della terza versione. L'abbiamo scritta a partire dal prompt qui sopra e l'abbiamo eseguita. Il file completo ha circa 120 righe, e questo estratto mostra solo la logica di chiamata, dei nuovi tentativi e di Zhihu.
API = "https://api.everyinfra.com/api/v1/social"
KEY = os.environ["EVERYINFRA_API_KEY"]
GAP = 6.5            # seconds between calls: stay under 10 requests per minute
DOWN = set()         # capabilities that failed 3 times in 10 minutes

def call(platform, action, params, tries=3):
    if f"{platform}/{action}" in DOWN:
        return None
    body = json.dumps({"platform": platform, "action": action, "params": params}).encode()
    for attempt in range(tries):
        req = urllib.request.Request(API, data=body, method="POST", headers={
            "Authorization": f"Bearer {KEY}", "Content-Type": "application/json"})
        try:
            with urllib.request.urlopen(req, timeout=120) as r:
                code, d = r.status, json.load(r)
        except urllib.error.HTTPError as e:
            code, d = e.code, json.loads(e.read() or b"{}")
        log(platform, action, code, d)       # rows and billing.charged_usd
        time.sleep(GAP)
        err = d.get("error") or {}
        if code == 200:
            return d
        if (err.get("recent_failures") or 0) >= 3:   # the error says: stop retrying
            DOWN.add(f"{platform}/{action}")
            return None
        if code in (429, 503) and err.get("retryable") and attempt < tries - 1:
            time.sleep(min(err.get("retry_after", 30), 60))
            continue
        return None

# Zhihu: search, group by question, keep matching titles, read comments of the top answer
for q in top_questions:
    answers += by_q[q]                   # search rows: question title, link, excerpt, likes
    best = max(by_q[q], key=lambda x: x.get("like_count") or 0)
    zcomments += rows(call("zhihu", "content_comments", {"url": best["url"], "limit": 50}))
La parte chiave è il modo in cui lo script legge gli errori. Un errore di EveryInfra è un oggetto JSON con dei campi, non un semplice messaggio. fault indica di chi è il problema. retryable e retry_after indicano se riprovare e quanto attendere. recent_failures indica quante volte questa funzionalità ha fallito di recente.
next_steps dice al chiamante, in linguaggio semplice, cosa fare dopo. example fornisce una richiesta che funziona di sicuro. Uno script che legge questi campi fa scelte migliori di uno che conta solo i codici HTTP. GLM può leggere gli stessi campi in Claude Code e cambiare piano senza entrare in un ciclo di nuovi tentativi. Nella seconda esecuzione è arrivato un HTTP 429 alle 00:35:34 SGT. Lo script ha atteso come indicato dalla risposta, e il nuovo tentativo 33 secondi dopo è andato a buon fine senza addebito.
Le regole sul rumore sono semplici. Prima di tutto, lo script rimuove da ogni commento il prefisso “risposta a qualcuno”. Un commento di 4 caratteri o meno conta come breve. Un commento che contiene solo tag emoji, spazi, cifre, “sì” o risate conta come emoji o ripetizione. Un commento di un autore il cui nome contiene il tag dell'assistente di ricerca di Weibo conta come bot.
Abbiamo scritto queste regole dopo aver letto il primo lotto reale, non prima. Non sono perfette. Per esempio, anche un “vero” di due caratteri viene scartato come breve. Per rispondere alla domanda “quante persone dicono qualcosa di concreto”, funzionano abbastanza bene.
8. Un giro completo reale su entrambi i siti
Prima di scrivere lo script, abbiamo chiamato ogni funzionalità a mano per verificare i parametri e la struttura delle risposte. La tabella elenca le chiamate principali in ordine. Tutti gli orari sono SGT del 2026-11-04.
| Orario (SGT) | Funzionalità | Target | HTTP | Righe | Addebitato |
|---|---|---|---|---|---|
| 00:16:49 | weibo/search | parola chiave “aumento di prezzo del Coding Plan” | 200 | 20 | $0.000806 |
| 00:17:03 | zhihu/search | stessa parola chiave | 200 | 20 | $0.000556 |
| 00:21:42 | zhihu/content_detail | una risposta con 47 like | 200 | 1 | $0.000556 |
| 00:21:56 | zhihu/content_comments | stessa risposta | 200 | 7 | $0.000556 |
| 00:22:20 | weibo/comments | un post su quattro strategie di prezzo | 200 | 11 | $0.000556 |
| 00:22:57 | weibo/comments | un codice breve alfabetico anziché un ID numerico | 200 | 0 | $0, risultato vuoto rimborsato |
Weibo ha funzionato bene. Ogni post di weibo/search ha id, url, text, posted_at e i conteggi di commenti, repost e like. I 20 post per la nostra parola chiave andavano dal 2026-08-17 al 2026-10-26. Una ricerca di “GLM-5.3” alle 00:21 SGT ha restituito post più recenti, dal 2026-10-30 al 2026-11-03. weibo/comments accetta un ID numerico o un link con l'ID numerico.
Alle 00:22:20 SGT abbiamo letto 11 commenti sotto un post che confrontava quattro strategie di prezzo. Un lettore ha scritto che “costo più margine, poi tariffe di picco e fuori picco” è più facile da capire di un prezzo unico. Un altro ha detto che Kimi andava bene “ma è caro e lento”, quindi sarebbe rimasto su DeepSeek. L'unica trappola era il formato del link.
Abbiamo inviato di proposito un codice breve alfabetico. L'API ha restituito 200 con zero righe e il motivo empty_result_refunded, senza alcun addebito. Se usi il campo id dei risultati di ricerca, non incontri mai questo problema.
Anche la ricerca su Zhihu ha funzionato. Ha restituito 20 risposte con titolo della domanda, link alla risposta, estratto, like, commenti, salvataggi e data. Basta per due passaggi. Lo script raggruppa le risposte in base all'ID della domanda presente in ogni link. Poi sceglie la risposta con più like in ogni gruppo. zhihu/content_comments riceve il link di una risposta e restituisce i suoi commenti di primo livello, ciascuno con testo, like e risposte.
La risposta che abbiamo letto con zhihu/content_detail alle 00:21:42 SGT era di un utente che aveva rinnovato un piano Max. Diceva che il prezzo trimestrale era di 422 CNY al mese il giorno prima e di “otto o novecento” il giorno dopo. Aveva 47 like e 28 commenti, e alle 00:21:56 SGT ne abbiamo letti 7. zhihu/content_detail ti serve solo quando l'estratto non basta, con una richiesta per ogni risposta.
9. Tre esecuzioni dello script: parola chiave fuori tema, limiti di frequenza delle richieste e un filtro sul titolo
La prima esecuzione usava la parola chiave “Zhipu Coding Plan” in cinese. È durata dalle 00:24:58 alle 00:32:37 SGT, cioè 7 minuti e 39 secondi. Ha inviato 15 richieste, di cui 6 addebitate, per $0,003586. Le altre 9 sono fallite e non sono state addebitate. L'esecuzione era lenta perché questa versione attendeva 60 secondi dopo ogni errore e non leggeva recent_failures.
Inoltre la parola chiave è andata fuori tema. Su Weibo, il post con più commenti era un post di vendita in livestream. Non aveva alcun legame con l'argomento, ma lo script ne ha letto i commenti.
| Esecuzione | Keyword | Orario (SGT) | Richieste | Addebitato | Costo |
|---|---|---|---|---|---|
| Prima | Zhipu Coding Plan | dalle 00:24:58 alle 00:32:37 | 15 | 6 | $0.003586 |
| Seconda | aumento di prezzo del Coding Plan | dalle 00:33:55 alle 00:37:01 | 12 | 10 | $0.00581 |
| Terza, finale | stessa parola chiave, con un filtro sui titoli di Zhihu | dalle 02:06:32 alle 02:08:22 | 7 | 7 | $0.004142 |
La seconda esecuzione ha corretto tre cose. Ha aggiunto la regola su recent_failures. Ha aggiunto anche --must "coding plan", così un post di Weibo deve contenere quella frase. Abbiamo sostituito la parola chiave con quella più specifica “aumento di prezzo del Coding Plan”. Questa versione leggeva anche il testo completo delle risposte con zhihu/content_detail.
L'esecuzione è andata dalle 00:33:55 alle 00:37:01 SGT, cioè 3 minuti e 6 secondi. Ha inviato 12 richieste, di cui 10 addebitate, per un costo di $0,00581. Tra le due richieste gratuite c'era il 429 delle 00:35:34 SGT. I numeri del confronto nella sezione 10 usano questa esecuzione più le chiamate manuali.
La seconda esecuzione era più pulita, ma ha rivelato un difetto nella scelta delle domande in base ai like. Delle 20 risposte di Zhihu, 8 avevano titoli che citavano Zhipu o GLM. Una chiedeva perché il piano di Zhipu costa di più in Cina che all'estero. Un'altra chiedeva cosa si pensa dell'“aumento di prezzo dello Zhipu Coding Plan”. Lo script ha scelto le 3 domande con più like in totale.
Una chiedeva perché OpenAI ha sospeso il suo piano Pro da $200, con 523 like. Un'altra chiedeva dove comprare oggi un coding plan conveniente, con 378 like. La terza, con 235 like, parlava di Alibaba Cloud che ha interrotto i rinnovi del suo piano Lite. Tutte e tre parlano dei prezzi dei coding plan, ma nessuna riguarda Zhipu.
Se vuoi sapere “cosa pensa la gente dell'aumento di Zhipu”, aggiungi un filtro sul titolo, per esempio un titolo che citi Zhipu o GLM. È un compito adatto a Claude Code. Leggi il primo riepilogo e scrivi “solo domande su Zhipu”. GLM cambia una riga e riesegue lo script per meno di un centesimo.
Su Weibo lo stesso problema era ancora più evidente. Dei 20 post per “aumento di prezzo del Coding Plan”, solo 7 citano il coding plan nel testo. Solo 2 di questi hanno 3 o più commenti. Uno è di un utente che ha disdetto un altro piano e ha provato delle alternative.
L'altro dice che GLM 5.3 è migliorato molto, ma il prezzo è salito troppo. Insieme hanno raccolto solo 5 commenti. Gli altri 13 post includono repost di notizie, riepiloghi giornalieri e notizie sui videogiochi. Il post con più commenti, 50, era un post tematico sui prezzi di DeepSeek.
Quindi gli argomenti tecnici di nicchia vengono poco discussi su Weibo, e la maggior parte delle opinioni si trova su Zhihu. Per avere un campione equo, abbiamo unito 4 set di commenti di Weibo scelti a mano (73 commenti) ai 5 della seconda esecuzione. Il totale è di 78 commenti su Weibo. Su Zhihu abbiamo unito 71 commenti della seconda esecuzione a 7 della fase manuale, arrivando sempre a 78. Con lo stesso numero di commenti, le percentuali sono facili da confrontare.
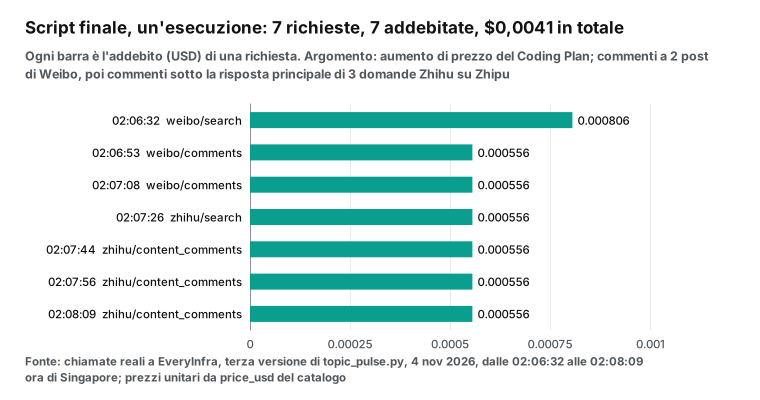
La terza esecuzione ha aggiunto il filtro sul titolo ed è lo script finale di questo articolo. Abbiamo eliminato il passaggio del testo completo e mantenuto quattro funzionalità. Abbiamo aggiunto --zhihu-title con un pattern per Zhipu, GLM e un soprannome diffuso di Zhipu. L'esecuzione è andata dalle 02:06:32 alle 02:08:22 SGT del 2026-11-04, cioè 1 minuto e 50 secondi. Tutte e 7 le richieste hanno restituito 200 e sono state addebitate, per $0,004142.
Su Weibo ha letto gli stessi 2 post e 5 commenti della seconda esecuzione. Su Zhihu, tutte e 3 le domande ora riguardavano Zhipu. Una chiedeva cosa si pensa del passaggio ai crediti del 2026-07-30 (risposta principale: 47 like, 28 commenti). Una chiedeva dove abbonarsi al coding plan di GLM-5 e perché il modello è così popolare (36 like). Una chiedeva perché lo Zhipu Coding Plan costa così tanto (7 like).
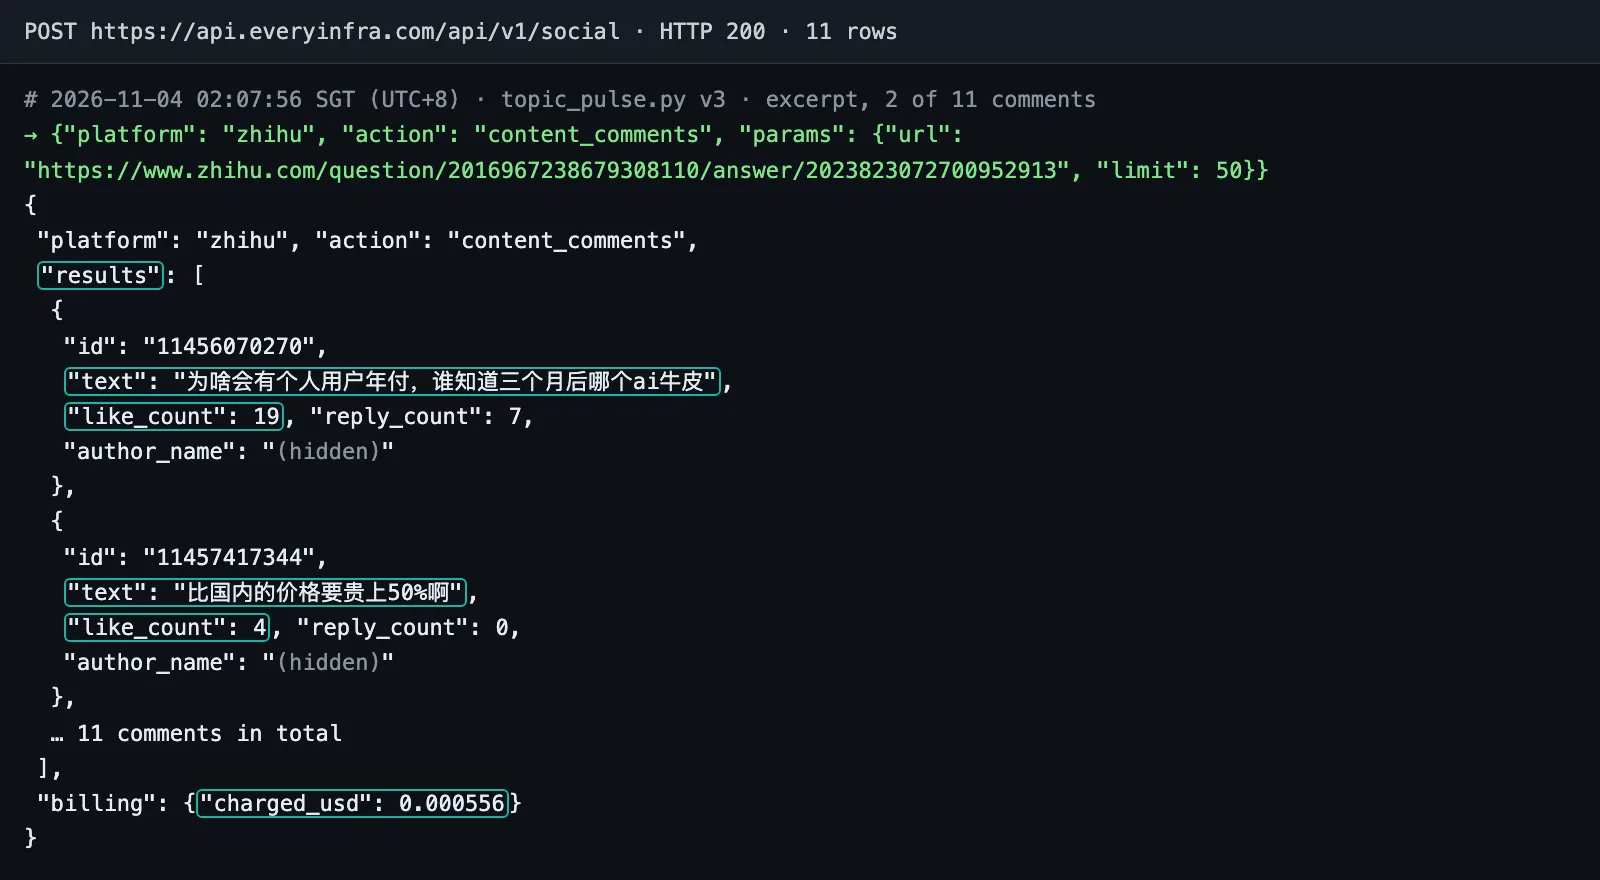
Sotto queste tre risposte lo script ha letto 7, 11 e 3 commenti, 21 in totale. Le regole sul rumore non ne hanno eliminato nessuno, e la lunghezza mediana era di 26 caratteri. Il commento principale, con 19 like, chiedeva perché qualcuno paghi un anno intero quando nessuno sa quale AI sarà in testa tra tre mesi. Un altro, con 4 like, diceva che il piano internazionale costa “il 50% in più del prezzo nazionale”.
10. Cosa si dice su Zhihu e su Weibo
Questa sezione mostra cosa dovrebbe scrivere GLM dopo aver letto i risultati. Per evitare che il modello valuti sé stesso, analysis.py calcola ogni numero dalle risposte grezze, senza alcun modello. Il testo è un nostro esempio basato su quei numeri.
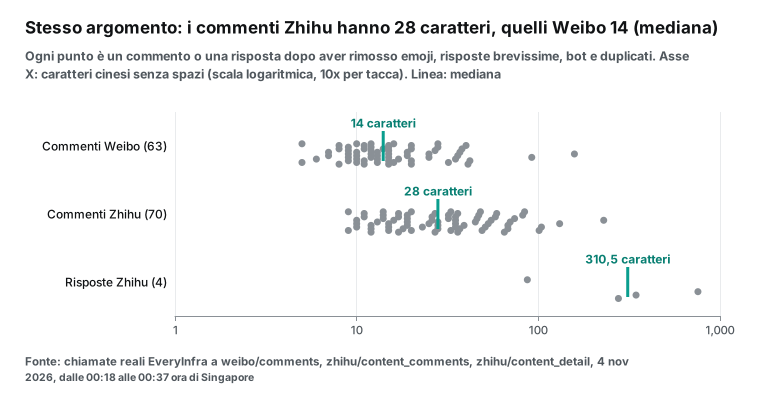
Partiamo dalla lunghezza. Dopo la rimozione del rumore, il commento mediano su Weibo ha 14 caratteri. Nove commenti su dieci di Weibo hanno 36 caratteri o meno, e il più lungo ne ha 158. Il commento mediano su Zhihu ha 28 caratteri, nove su dieci ne hanno 70 o meno, e il più lungo ne ha 229.
Le quattro risposte di Zhihu hanno una mediana di 310,5 caratteri e un massimo di 756. Quindi un commento su Zhihu è lungo il doppio di uno su Weibo, e una risposta su Zhihu è a sua volta dieci volte più lunga. Se leggi solo Weibo, cogli l'umore. Per le motivazioni ti servono le risposte di Zhihu.
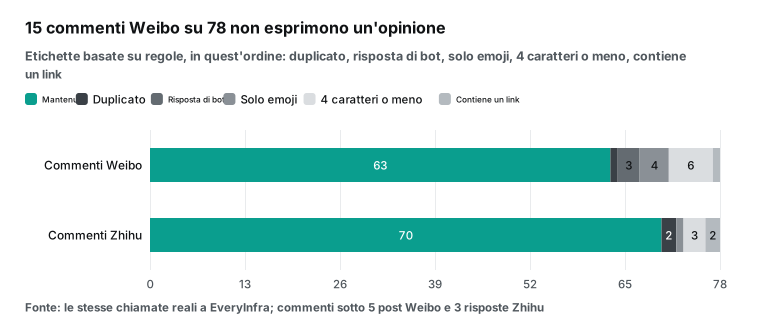
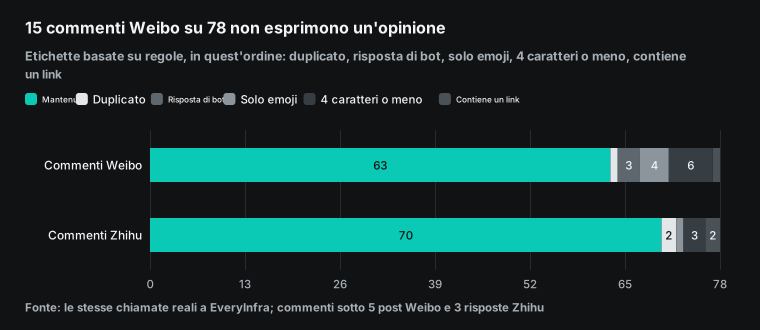
Poi, il rumore. Su 78 commenti di Weibo, le regole ne hanno eliminati 15. Sei avevano 4 caratteri o meno, come “sì”. Quattro erano solo emoji.
Tre erano risposte dell'assistente di ricerca di Weibo. Uno era una ripetizione e uno era solo un link. Su 78 commenti di Zhihu, le regole ne hanno eliminati 8: 3 troppo brevi, 2 solo link, 2 ripetizioni e 1 solo emoji. La quota di rumore è del 19% su Weibo e del 10% su Zhihu.
Le risposte dei bot meritano una nota. Gli utenti di Weibo possono taggare l'assistente di ricerca in un commento e chiedere, per esempio, “di quanto ha aumentato i prezzi DeepSeek”. L'assistente pubblica una risposta lunga, e queste risposte si piazzano in alto per numero di like. Senza la regola sui bot, riporteresti come opinione delle persone ciò che ha detto l'assistente.
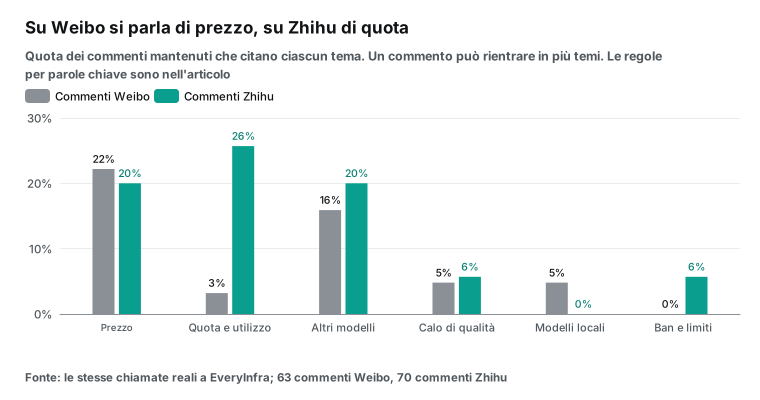
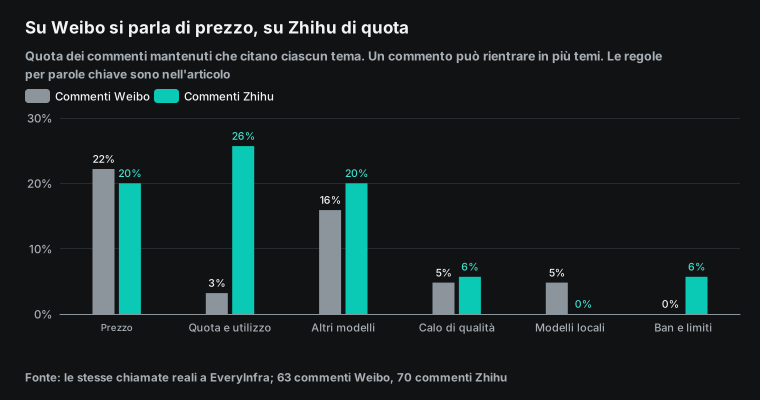
Poi, i temi. Abbiamo scritto un elenco di parole chiave per ciascuno dei sei temi. Prezzo comprende le parole per aumento, caro, quanto costa, CNY e dollari. Quota comprende quota, utilizzo, esaurito, 5 ore, settimana, crediti e reset. Qualità comprende “instupidito” e quantizzato.
Concorrenti comprende DeepSeek, Kimi, Codex, Claude, Qwen e MiniMax. Installazione locale comprende locale, VRAM e deploy. Ban comprende ban, controllo dei rischi e limiti di frequenza delle richieste. Un commento può rientrare in più di un tema.
Dei 63 commenti di Weibo rimasti, il 22,2% parla di prezzo e il 15,9% fa confronti con i concorrenti. Qualità e installazione locale hanno il 4,8% ciascuna, e la quota solo il 3,2%. Dei 70 commenti di Zhihu rimasti, il 25,7% parla di quota. Prezzo e concorrenti hanno il 20% ciascuno. Qualità e ban hanno il 5,7% ciascuno, e l'installazione locale nessuno.
| Misura | Weibo, 78 commenti | Zhihu, 78 commenti e 4 risposte | Come leggerlo | Data di raccolta |
|---|---|---|---|---|
| Rimasti dopo le regole sul rumore | 63 | 70 | Weibo ha il doppio della quota di rumore | 2026-11-04 |
| Lunghezza mediana | 14 caratteri | 28 per i commenti, 310,5 per le risposte | le motivazioni stanno su Zhihu | 2026-11-04 |
| Like sugli elementi rimasti | 112 | 349 sui commenti, 1.183 sulle risposte | su Zhihu i like si concentrano su poche risposte | 2026-11-04 |
| Tema principale | prezzo, 22,2% | quota, 25,7% | “è troppo caro?” contro “basta?” | 2026-11-04 |
| Tema presente su un solo sito | installazione locale, 4,8% | ban, 5,7% | campione piccolo, solo un indizio | 2026-11-04 |
In base a questi numeri, un riepilogo di GLM potrebbe essere così. È un nostro testo di esempio, non un output del modello.
Entrambi i siti parlano di prezzo, ma in modo diverso. Su Weibo le persone danno un giudizio in una riga, come “i prezzi sono sempre più assurdi”, e raramente spiegano perché. Circa un commento su sei cita un altro fornitore. Su Zhihu le persone fanno i conti. La risposta principale sostiene che qualsiasi piano con uno sconto sull'API superiore a 15 volte va in perdita quando un utente lo sfrutta per intero.
I commenti principali riguardano la quota. Uno con 74 like dice che l'utilizzo è sceso a circa la metà di prima “dopo la distribuzione delle card di reset”. Su Zhihu il 5,7% dei commenti parla di ban e controllo dei rischi, mentre su Weibo nessuno. Alcuni utenti di Weibo chiedono se un'installazione locale possa sostituire un piano, mentre in questo gruppo di Zhihu nessuno lo fa. Il campione è piccolo, con 78 commenti per sito, e le risposte di Zhihu provengono dalle domande con più like.
Citiamo solo il testo pubblico dei commenti, senza nomi utente. I conteggi dei like vengono dal campo like_count. Un limite va ribadito. Si tratta di un solo argomento, una sola notte e 78 commenti per sito.
Le regole sui temi sono elenchi di parole chiave scritti da noi. GLM potrebbe classificare i commenti con più precisione, oppure sbagliare. Il risultato risponde alla domanda “in che modo questi due siti discutono l'argomento in modo diverso”. Non risponde alla domanda “quale percentuale di persone sostiene l'aumento di prezzo”.
11. Costi: dati, token di GLM e crediti del piano
Partiamo dai dati. La seconda esecuzione ha inviato 12 richieste. weibo/search è costata $0,000806, e ciascuna delle altre 9 richieste riuscite $0,000556. Le due richieste fallite, una delle quali era un 429, sono state gratuite. Il totale è stato di $0,00581. L'esecuzione ha restituito 79 righe di testo (5 commenti di Weibo, 3 risposte di Zhihu e 71 commenti di Zhihu) più 40 righe di ricerca. Il costo è di $0,0735 per 1.000 righe di testo.
Lo script finale elimina il passaggio del testo completo. Un'esecuzione invia 7 richieste per $0,004142 e restituisce 5 commenti di Weibo, 21 commenti di Zhihu e 40 righe di ricerca. Un'esecuzione giornaliera delle dimensioni della nostra seconda esecuzione costa $0,1743 al mese, mentre lo script finale costa $0,12426 al mese.
| Scenario | Richieste | USD | Base |
|---|---|---|---|
| Seconda esecuzione, con testo completo | 12 inviate, 10 addebitate | $0.00581 | charged_usd |
| Terza esecuzione, script finale | 7 inviate, 7 addebitate | $0.004142 | charged_usd |
| Per 1.000 righe di testo | n/a | $0.0735 | 79 righe |
| Ogni giorno per 30 giorni | 360 | $0.1743 | 30 × $0.00581 |
| Lettura del riepilogo con Flash su Z.ai | 1 | $0.001081 | 3.707 token |
Poi, il modello. Senza un account non potevamo misurare una sessione reale. Prendiamo quindi in prestito una sessione di esempio dalla documentazione sui costi di Claude Code. Ha 1,2k token di input, 5,3k token di output, 940k letture dalla cache e 50k scritture nella cache.
Questo profilo si avvicina a “scrivi uno script di 100 righe, eseguilo due volte, correggilo una volta”. Le letture dalla cache prevalgono, perché a ogni turno si rilegge il contesto. Zhipu non ha un prezzo separato per le scritture nella cache, quindi le calcoliamo come input normale.
| Modello e sito | Sessione di esempio | USD (circa) | Una lettura del riepilogo | Crediti del piano in orario di picco |
|---|---|---|---|---|
| GLM-5.3 su Z.ai | $0.3394 | $0.3394 | $0.00969 | 207.8 |
| GLM-5.3 su BigModel | CNY 2,438 | $0.3631 | $0.008884 | 207.8 |
| GLM-5.3-Flash su Z.ai | $0.0385 | $0.0385 | $0.001081 | 68.7 |
| GLM-5.3-Flash su BigModel | CNY 0,272 | $0.0405 | $0.000888 | 68.7 |
| Un'esecuzione di raccolta dei dati su EveryInfra | n/a | $0.00581 | n/a | n/a |
La colonna “Una lettura del riepilogo” presuppone 2.207 token di input (il testo ripulito della seconda esecuzione) e 1.500 token di output. È il costo aggiuntivo giornaliero, una volta che lo script esiste, per far leggere a GLM i dati aggiornati. I valori in CNY usano il cambio del 2026-11-03, pari a 6,7150.
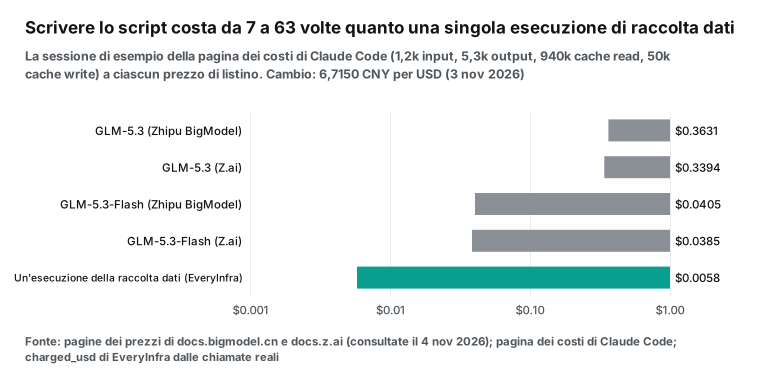
Il grafico mostra una cosa sola. In questo tipo di attività, la maggior parte della spesa va nella scrittura e nella correzione del codice, non nel recupero dei dati. Una sessione di scrittura dello script su GLM-5.3 costa circa 60 volte i dati. Su Flash costa circa 7 volte. Una volta che lo script esiste, il costo giornaliero è dato dai dati più una lettura del riepilogo. Con Flash su Z.ai, si resta sotto $0,007 al giorno.
Con un Coding Plan, il costo del modello si trasforma in crediti. Lite offre 10.000 crediti a settimana. Bastano per circa 48 sessioni come il nostro esempio su GLM-5.3, o circa 145 su Flash, tutte in orario di picco. Fuori picco, entrambi i numeri raddoppiano. La ricerca web integrata costa 1,2 crediti per chiamata, quindi qualche consultazione della documentazione incide appena sulla quota.
C'è un altro costo facile da trascurare: passare al modello la risposta grezza dell'API. Il JSON grezzo della seconda esecuzione aveva circa 14.543 token. Al prezzo di input di GLM-5.3 su Z.ai, $1,4 per milione, una lettura costa circa $0,02, più di tre volte il costo dei dati. Ogni turno in più lo rilegge. Fai comprimere prima i dati allo script, così il modello legge solo circa 2.207 token. È il risparmio singolo più grande di questa configurazione.
12. Limiti
Primo, zhihu/question_answers, che legge tutte le risposte a una domanda, non era disponibile durante i nostri test, e le richieste fallite non sono state addebitate. Per questo lo script parte da zhihu/search e legge, per ogni domanda, solo le risposte trovate dalla ricerca e i relativi commenti.
Secondo, non abbiamo testato nulla lato Zhipu. La configurazione segue la documentazione consultata il 2026-11-04, che si contraddice in due punti. Non abbiamo dati su quale script scriverebbe GLM-5.3, su quante correzioni servirebbero o su quanti token userebbe. Il costo del modello è una stima basata su una sessione di esempio della documentazione di Claude Code, non una misurazione.
Terzo, il campione è piccolo. Ogni sito ha 78 commenti. Su Weibo, 73 provengono da post scelti da noi a mano, non dallo script. Zhihu ha solo 4 risposte. Le regole sui temi sono elenchi di parole chiave, e parole brevi come “settimana” possono corrispondere per caso. Usa i risultati come indizi, non come percentuali di opinione.
Quarto, la quota del piano funziona solo negli strumenti supportati. Un timer che esegue lo script e chiede a GLM di fare il riepilogo, senza intervento umano, non rientra nel piano. Richiederebbe l'API standard. Nel nostro schema, il timer esegue solo lo script. Il riepilogo aspetta che tu apra Claude Code e chieda a GLM di leggere il file più recente.
Quinto, i commenti di Weibo ottenuti con weibo/comments non hanno un campo con la località IP. Le risposte all'interno di una discussione arrivano da weibo/comment_replies, che costa $0,000806 per chiamata e include la località. Se ti serve una vista per regione, aggiungi quella chiamata.
13. Le novità recenti su GLM-5.3 e sul Coding Plan
Sul fronte del modello, il 2026-10-12 QbitAI ha riportato che Zhipu ha aggiunto GLM-5.3-Highspeed a ZCode 3.15.1. Un utente ha misurato circa 490 token al secondo (QbitAI). Per ora quel modello è disponibile solo in ZCode, e la documentazione del Coding Plan non lo elenca per Claude Code. Il pacchetto MCP di visione è passato alla versione 0.1.6 il 2026-10-29.
Sul fronte della sicurezza, il 2026-09-29 Anthropic ha pubblicato una ricerca. Secondo la ricerca, GLM-5.3 è in grado di costruire da solo exploit informatici end-to-end ed è stato rilasciato senza solide protezioni (ricerca di Anthropic). Il 2026-10-30, Help Net Security ha riportato una valutazione di Irregular.
GLM-5.3 non ha rifiutato nessuno dei 13 scenari, e i valutatori consigliano di testare le restrizioni prima di concedergli più autonomia (Help Net Security). Per questa configurazione, significa privilegi minimi. Quando GLM lavora in Claude Code, lo script ha bisogno di una cartella e di un'API, nient'altro.
Sul fronte dei prezzi, il 2026-10-16 Zhipu ha separato le chiavi standard da quelle del piano. Il 2026-10-23, 36Kr ha riportato che Zhipu era tra i pochi fornitori con un vero sconto per il Singles' Day. La card mensile Lite è scesa da CNY 118 a CNY 115 (36Kr). A fine ottobre, la community BAAI ha riferito che alcuni utenti del piano avevano ricevuto card di reset della quota come compensazione per un calo di qualità (BAAI Hub). Questo coincide con il commento su Zhihu sull'utilizzo “dopo la distribuzione delle card di reset”. Nella documentazione di Zhipu non abbiamo trovato regole su queste card.
| Data | Modifica | Fonte |
|---|---|---|
| 2026-09-29 | Ricerca di Anthropic sulle capacità cyber di GLM-5.3 | Anthropic |
| 2026-10-12 | GLM-5.3-Highspeed in ZCode 3.15.1 | QbitAI |
| 2026-10-16 | separazione tra chiavi standard e chiavi del piano | Avviso di BigModel |
| 2026-10-23 | Card mensile Lite da CNY 118 a CNY 115 | 36Kr |
| 2026-10-29 | @z_ai/mcp-server 0.1.6 | npm |
| 2026-10-30 | Valutazione di GLM-5.3 da parte di Irregular | Help Net Security |
| 2026-11-03 | Claude Code 2.1.317 | Changelog di Claude Code |
14. Come iniziare
I passaggi da 1 a 3 sono un esempio di configurazione. I passaggi da 4 a 6 li abbiamo eseguiti noi.
- Abbonati a un Coding Plan su Z.ai e crea una chiave del piano.
- Modifica
~/.claude/settings.jsoncome nella sezione 4. - Apri un nuovo terminale, esegui
claudee digita/statusper verificare il modello. - Ottieni una chiave EveryInfra dalla guida rapida e aggiungila come
EVERYINFRA_API_KEY. - Dai a Claude Code il prompt della sezione 7. Inizia in piccolo con
--weibo-posts 2 --zhihu-questions 2e--zhihu-title. - Chiedi a GLM di leggere il JSON e scrivere il riepilogo, poi aggiungi un filtro sul titolo ed esegui di nuovo.
I parametri e i campi di ogni funzionalità sono nella pagina dell'API di Zhihu e nella pagina dell'API di Weibo. Consulta ricerca su Zhihu, commenti di Zhihu e la funzionalità facoltativa dettaglio dei contenuti di Zhihu. Per Weibo, consulta ricerca su Weibo e commenti di Weibo. L'elenco degli strumenti MCP remoti è nella pagina del server MCP, e i prezzi del catalogo sono nella pagina dei prezzi.
Letture correlate: per vedere come se la cavano i modelli nella fase di pulizia e quanto costa, leggi DeepSeek V4 in Claude Code per la pulizia dei commenti. Il JSON di topic_pulse.py può alimentare direttamente quel flusso. Per un altro schema di raccolta dei dati con Claude Code, consulta workflow dinamici di Claude Code per i commenti di Xiaohongshu. Per la distorsione introdotta dalla “scelta in base ai like”, consulta integrità del campione nella ricerca sui social media, e per i rimborsi delle chiamate fallite, consulta riconciliazione dei rimborsi per le chiamate fallite.
FAQ
Come si usa GLM 5.3 in Claude Code e a cosa serve il suffisso [1m]?
Imposta i valori nel blocco env di ~/.claude/settings.json, come mostrato nella sezione 4. Il passaggio che molti saltano è il suffisso [1m]. Claude Code non conosce l'ID glm-5.3, quindi senza il suffisso presume una finestra di 200K e compatta il contesto troppo presto. Dopo la modifica, apri un nuovo terminale e verifica la riga del modello con /status. Origine della domanda: suggerimenti di ricerca per “how to use glm 5.3 in claude code” e “glm 5.3 claude code”, verificati il 2026-11-04. Fonti: guida Claude Code di Z.ai, configurazione del modello in Claude Code.
Il mio script può usare la quota del Coding Plan?
No. Il piano funziona solo negli strumenti supportati. Le chiamate dalle tue app, dai tuoi siti, bot o prodotti SaaS richiedono l'API standard. Dal 2026-10-16 i due tipi di chiave sono anche separati. Per questo il nostro script si limita a recuperare i dati, e il riepilogo lo scrive GLM in Claude Code. Origine della domanda: suggerimenti di ricerca per “glm coding plan limits”, verificati il 2026-11-04. Fonti: norme di utilizzo di Z.ai, panoramica del Coding Plan.
Quali sono il base URL e l'endpoint del GLM Coding Plan per Claude Code?
Su Z.ai usa https://api.z.ai/api/anthropic. Su BigModel usa https://open.bigmodel.cn/api/anthropic. Codex e gli altri strumenti compatibili con OpenAI hanno i propri URL dedicati al coding. L'URL dell'API normale non attinge alla quota del piano. Origine della domanda: suggerimenti di ricerca per “glm coding plan base url” e “glm coding plan endpoint”, verificati il 2026-11-04. Fonti: guida al cambio di modello di BigModel, guida rapida di Z.ai.
Per scrivere lo script conviene GLM-5.3-Flash o GLM-5.3?
Su Z.ai, l'input di Flash costa circa un nono di quello di GLM-5.3, e lo stesso vale per l'output. Secondo la nostra stima, una sessione di scrittura dello script costa circa $0,04 su Flash e $0,34 su GLM-5.3. Per uno script di dati di 100 righe, parti da Flash e passa a GLM-5.3 solo se Flash non riesce a correggere un bug. Origine della domanda: suggerimenti di ricerca per “glm 5.3 flash vs glm 5.3” e “glm 5.3 flash cost”, verificati il 2026-11-04. Fonti: prezzi di Z.ai.
Cosa può restituire la ricerca web integrata nel Coding Plan?
Secondo la documentazione di Zhipu, la ricerca web restituisce titoli, URL, riepiloghi, nomi dei siti e icone, e il lettore web restituisce titolo, testo principale, metadati e link. È adatta a documentazione e notizie. Uno script per un argomento ha bisogno di una riga per ogni risposta o commento con like e date, e per questo usiamo zhihu/search, zhihu/content_comments, weibo/search e weibo/comments. Non abbiamo un account Zhipu, quindi non abbiamo testato gli strumenti integrati. Origine della domanda: suggerimenti di ricerca per “glm coding plan web search”, verificati il 2026-11-04. Fonti: MCP per la ricerca web, MCP per la lettura web.
Zhihu ha un'API?
Sì. La piattaforma dati di Zhihu offre endpoint di ricerca e di classifica dei contenuti più popolari. La ricerca restituisce al massimo 10 estratti per chiamata con commenti in evidenza e usa un token Bearer con un header di timestamp. È adatta al lavoro che passa per l'autorizzazione della piattaforma stessa.
Il nostro script usa zhihu/search per ottenere 20 risposte per chiamata e zhihu/content_comments per i commenti. Il 2026-11-04 l'esecuzione finale ha letto 21 commenti di Zhihu, e la parte su Zhihu è costata $0,002224. Origine della domanda: suggerimenti di ricerca per “zhihu com api”, verificati il 2026-11-04. Fonti: documentazione per sviluppatori Zhihu: ricerca, pagina della funzionalità di ricerca di Zhihu.
Riferimenti
- Z.ai: guida a Claude Code
- Documentazione Z.ai: «Coding Plan overview»
- Documentazione Z.ai: «Switch to the latest model»
- Documentazione Z.ai: «Usage policy»
- Documentazione Z.ai: «Quick start»
- Documentazione Z.ai: «Pricing»
- Blog di Z.ai: «GLM-5.3»
- BigModel: guida al cambio di modello, consultata il 2026-11-04
- Documentazione BigModel: «Claude Code guide»
- Documentazione BigModel: «Claude Code introduction»
- Documentazione BigModel: «Coding Plan overview»
- Documentazione BigModel: «Coding Plan quick start»
- Documentazione BigModel: «Coding Plan usage notes»
- Documentazione BigModel: «Coding Plan FAQ»
- Documentazione BigModel: «Plan revision notice»
- Documentazione BigModel: «API key notice», 2026-10-16
- Documentazione BigModel: «MCP for web search»
- BigModel: MCP per la lettura del web
- BigModel: MCP zread
- BigModel: MCP per la visione
- BigModel: strumenti supportati
- BigModel: pagina del modello GLM-5.3
- BigModel: pagina del modello GLM-5.3-Flash
- BigModel: prezzi
- BigModel: note di rilascio
- BigModel: domande sui costi
- BigModel: domande sulle API
- Pagina del GLM Coding Plan, prezzi consultati il 2026-11-04
- Claude Code: gateway LLM
- Claude Code: configurazione del modello
- Claude Code: variabili d'ambiente
- Claude Code: documentazione su MCP
- Claude Code: impostazioni
- Claude Code: costi
- Claude Code: changelog, 2.1.317 del 2026-11-03
- Changelog del repository di Claude Code
- Specifica MCP, 2026-07-28
- Zhipu glm-cookbook: esempio con Claude Code
- «npm: @z_ai/mcp-server»
- «npm: @z_ai/coding-helper»
- Piattaforma dati di Zhihu
- Piattaforma dati di Zhihu: ricerca
- Piattaforma dati di Zhihu: Skill per la classifica dei contenuti più popolari
- CLI della piattaforma aperta di Weibo
- Guida rapida della CLI di Weibo
- API di Weibo: comments/show
- API di Weibo: search/topics
- API di Weibo: limiti di frequenza delle richieste
- Catalogo delle funzionalità di EveryInfra, consultato il 2026-11-04
- SAFE: tassi di parità centrale del RMB
- Anthropic, «GLM-5.3 and the spread of advanced cyber capabilities», 2026-09-29
- Help Net Security: la valutazione di GLM-5.3 condotta da Irregular, 2026-10-30
- QbitAI: GLM-5.3-Highspeed a 490 token al secondo, 2026-10-12
- 36Kr: i piani a token per il Singles' Day, 2026-10-23
- BAAI Hub: calo di qualità e card di reset
Riferimenti BL-81