Claude Code에서 GLM 5.3으로 Zhihu·Weibo 비교 스크립트
Z.ai 또는 BigModel 키로 Claude Code에서 GLM 5.3을 사용하고, Zhihu 답변과 Weibo 댓글을 비교하는 스크립트를 작성하게 하는 방법을 실제 비용과 함께 소개합니다.
중국의 AI 도구 동향을 살펴본다면, 개발자들의 생각은 대부분 두 사이트에서 알 수 있습니다. Zhihu는 사람들이 긴 답변을 쓰고 직접 계산까지 해 보이는 질의응답 사이트입니다. Weibo는 몇 마디로 반응을 남기는 마이크로블로그입니다. 두 사이트를 함께 읽으면 분위기와 그 이유를 모두 파악할 수 있습니다.
이 글에서는 그 작업을 위한 설정 하나를 테스트합니다. Claude Code가 Zhipu의 GLM-5.3 또는 GLM-5.3-Flash를 사용하도록 설정합니다. 그러면 GLM이 한 주제에 대한 Zhihu 답변과 Weibo 댓글을 EveryInfra로 가져오는 topic_pulse.py 스크립트를 작성합니다. 마지막으로 GLM이 출력을 읽고 짧은 비교 글을 씁니다.
사용한 주제는 “Coding Plan 가격 인상”입니다. Zhipu는 2026-07-30에 Coding Plan을 크레딧 방식으로 바꿨고, 두 사이트의 개발자들은 지금도 이를 두고 논쟁하고 있습니다. 주제가 좁고 기술적이며 우리가 쓰는 도구와 밀접하다는 점에서 좋은 테스트 대상입니다.
실제로 실행한 것과 그렇지 않은 것을 구분해 두겠습니다. 테스트 머신에는 Zhipu 계정이 없습니다. 따라서 Claude Code를 GLM으로 실행하는 단계는 모두 2026-11-04에 확인한 Z.ai 및 BigModel 문서를 바탕으로 한 설정 예시입니다. Claude Code 안에서 GLM을 실행하지는 않았습니다. 데이터 쪽은 실제로 실행한 결과입니다.
2026-11-04 SGT 00:16부터 02:08까지 EveryInfra API에 요청 52건을 보냈습니다. 그중 34건이 데이터를 반환해 과금되었고, 합계는 $0.020404였습니다. 나머지 18건은 실패하거나 빈 결과를 반환했으며, 모두 과금되지 않았습니다. 52건 중 1건은 MCP tools/call 메서드로 보냈습니다.
전체 스크립트는 세 번 실행했습니다. 두 번째 실행에서는 답변 전문까지 읽어 요청 12건에 $0.00581이 들었습니다. 세 번째 실행이 최종 스크립트로, 요청 7건이 모두 성공했고 비용은 $0.004142였습니다.
1. GLM-5.3 Claude Code 설정으로 할 수 있는 일
이 작업은 두 부분으로 나뉩니다. API가 데이터를 가져오고 GLM이 그 데이터를 읽습니다. 앞부분에는 답변이나 댓글 하나당 한 행으로 구성된 구조화된 레코드가 필요합니다. 각 행에는 좋아요 수, 날짜, 그리고 해당 답변이나 댓글이 속한 질문 또는 게시물 정보가 들어 있습니다. 이런 행은 모델 없이 스크립트만으로 세고 정렬할 수 있습니다.
뒷부분은 데이터를 읽는 일입니다. 어떤 댓글이 이모지인지, 어떤 댓글이 반복되는지, 어떤 댓글이 가격에 불만을 제기하는지, 어떤 댓글이 할당량을 계산하는지 판단해야 합니다. 이 부분에는 모델이 필요합니다.
두 부분을 잇는 것이 Claude Code입니다. 작업을 한 문장으로 설명하면 모델이 스크립트를 작성하고, 실행하고, 출력을 읽고, 결과를 보고합니다. GLM-5.3을 고른 이유는 Zhipu가 Claude Code용 가이드를 공개하고 있고 토큰당 가격도 공개되어 있기 때문입니다(2~4장에서 각 페이지를 인용합니다). 중국 밖의 독자는 Z.ai 사이트에서 같은 모델을 USD로 구매할 수 있습니다.
아래 표는 호출한 모든 기능과 반환된 결과를 정리한 것입니다. “행”은 각 응답에 담긴 항목 수입니다. 가격은 EveryInfra 카탈로그의 요청당 가격입니다. 실패한 요청과 빈 결과는 과금되지 않습니다.
| 기능 | 2026-11-04 호출 수 | 카탈로그 가격 | 반환 결과 |
|---|---|---|---|
weibo/search | 6(1건은 MCP 경유) | $0.000806 | 매번 게시물 20개 |
weibo/comments | 데이터 있음 9, 빈 결과 1 | $0.000556 | 게시물당 댓글 2~43개 |
zhihu/search | 5 | $0.000556 | 답변 20개, 발췌 51~86자 |
zhihu/content_comments | 7 | $0.000556 | 답변당 댓글 3~26개 |
zhihu/content_detail(선택) | 데이터 있음 7, 요청 속도 제한 적용 1 | $0.000556 | 답변 전문, 최대 756자 |
최종 스크립트는 처음 네 행만 사용합니다. Zhihu에서는 zhihu/search로 시작하며, 이 기능은 질문 제목, 답변 링크, 발췌, 좋아요 수를 이미 반환합니다. 이어서 zhihu/content_comments로 상위 답변의 댓글을 읽습니다. 답변 하나의 전문이 필요하면 zhihu/content_detail 호출을 한 번 추가하세요. GLM 쪽은 실행하지 않았으므로 표에 GLM 행은 없습니다.
2. GLM-5.3과 GLM-5.3-Flash 한눈에 보기
GLM-5.3은 Zhipu의 플래그십 텍스트 모델입니다. 2026-08-19에 BigModel 플랫폼에 출시되었습니다. 모델 페이지에 따르면 텍스트만 입력받고, 컨텍스트 창은 1M 토큰이며, 출력 토큰은 최대 128K입니다(GLM-5.3 모델 페이지). 추론(thinking) 기능은 항상 켜져 있습니다. low, high, max 중에서 고를 수 있고 기본값은 max입니다. 추론 기능을 끌 수는 없습니다.
GLM-5.3-Flash는 2026-08-26에 뒤이어 출시되었습니다. 선형 어텐션과 희소 어텐션을 함께 쓰는 멀티모달 모델입니다(BigModel 릴리스 노트). 전체 파라미터는 320B, 활성 파라미터는 18B입니다. Zhipu에 따르면 GLM-5.3보다 연산량과 KV 캐시가 훨씬 적게 듭니다.
권장 설정은 temperature 1, top_p 0.95, reasoning_effort max입니다(GLM-5.3-Flash 모델 페이지). 데이터 스크립트에서 가장 큰 차이는 비용입니다. 11장에서 보듯 같은 세션 기준으로 Flash의 비용은 GLM-5.3의 약 9분의 1입니다.
| 항목 | GLM-5.3 | GLM-5.3-Flash | 출처(2026-11-04 확인) |
|---|---|---|---|
| 출시일 | 2026-08-19 | 2026-08-26 | BigModel 릴리스 노트 |
| 입력 | 텍스트만 | 텍스트 및 이미지 | 모델 페이지 |
| 컨텍스트 윈도우 | 1M 토큰 | [1m] 설정 시 1M 토큰 | 모델 페이지, 모델 전환 가이드 |
| 추론(Thinking) | 항상 켜짐, low·high·max | 항상 켜짐, max 권장 | 모델 페이지 |
| Z.ai 1M 토큰당 가격 | 입력 $1.4, 캐시 $0.26, 출력 $4.4 | 입력 $0.15, 캐시 $0.03, 출력 $0.50 | Z.ai 요금 페이지 |
| BigModel 1M 토큰당 가격 | 입력 CNY 8, 캐시 CNY 2, 출력 CNY 28 | 입력 CNY 0.8, 캐시 CNY 0.23, 출력 CNY 2.8 | BigModel 요금 페이지 |
| Coding Plan 크레딧 계수 | 6.9, 1.7, 24 | 2.3, 0.56, 8 | Coding Plan 개요 |
Z.ai 가격은 Z.ai 요금 페이지에서, CNY 가격은 BigModel 요금 페이지에서 가져왔습니다. BigModel 페이지에는 캐시 저장이 한시적으로 무료라는 내용도 있습니다. 또한 토큰 1개가 중국어 약 1.6자에 해당한다고 설명합니다.
아래의 모든 토큰 추정치에는 이 비율을 적용합니다. 2026-11-03 위안화 기준환율인 USD당 6.7150 CNY로 계산하면 CNY 8은 약 $1.19입니다(SAFE 환율 페이지). 즉, 두 사이트의 요금은 비슷합니다.
두 사이트는 기본 URL이 다릅니다. Z.ai에서 Claude Code는 https://api.z.ai/api/anthropic에 연결합니다(Z.ai Claude Code 가이드). BigModel에서 Anthropic 호환 URL은 https://open.bigmodel.cn/api/anthropic입니다. BigModel은 Codex용으로 https://open.bigmodel.cn/api/v1, 기타 OpenAI 호환 코딩 도구용으로 https://open.bigmodel.cn/api/coding/paas/v4도 안내합니다. 일반 종량제 API는 https://open.bigmodel.cn/api/paas/v4입니다. 이 URL들을 혼동하지 마세요. 요금제 할당량이 차감되는 것은 코딩용 URL뿐입니다.
| 도구 | 기본 URL | 요금제 할당량 사용 | 기준 |
|---|---|---|---|
| Z.ai의 Claude Code | https://api.z.ai/api/anthropic | yes | 2026-11-04 |
| BigModel의 Claude Code | https://open.bigmodel.cn/api/anthropic | yes | 2026-11-04 |
| BigModel의 Codex | https://open.bigmodel.cn/api/v1 | yes | 2026-11-04 |
| 기타 OpenAI 호환 코딩 도구 | https://open.bigmodel.cn/api/coding/paas/v4 | yes | 2026-11-04 |
| 일반 종량제 API | https://open.bigmodel.cn/api/paas/v4 | no | 2026-11-04 |
Zhipu의 두 페이지 사이에 차이가 있다는 점도 발견했습니다. BigModel Claude Code 가이드는 여전히 메인 모델에 glm-5.2[1m], 소형 모델에 glm-4.7을 표시합니다. 더 최신인 모델 전환 가이드는 세 모델 슬롯 모두에 glm-5.3-flash[1m]을 사용합니다. 이 가이드는 Claude Code 2.1.140에서 검증했다고도 밝힙니다.
Coding Plan 개요를 보면 예전 예시가 여전히 동작하는 이유를 알 수 있습니다. GLM-5.2나 GLM-5.1 호출은 GLM-5.3으로, GLM-5-Turbo나 GLM-4.7 호출은 GLM-5.3-Flash로 전달됩니다. 따라서 예전 설정도 동작하지만, 실제로 사용되는 모델은 예상한 모델과 다릅니다.
두 페이지는 추론 수준(effort level)을 서로 다르게 매핑합니다. 더 최신 페이지를 따르세요. 기본값은 max이며, Claude Code에서 /effort를 입력하고 high를 고르면 턴마다 응답이 짧아지고 비용도 줄어듭니다.
3. Coding Plan 등급, 크레딧, 피크 시간대
Coding Plan은 코딩 도구용 월 구독 상품입니다. 2026-07-30부터는 사용량을 크레딧으로 계산합니다. Z.ai 문서에는 요금제가 “월 18 USD부터” 시작한다고 적혀 있습니다(Z.ai Coding Plan 개요). Z.ai 요금제 페이지가 저희 헤드리스 브라우저에서 렌더링되지 않아 등급별 USD 가격은 인용할 수 없습니다.
중국 사이트의 GLM Coding Plan 페이지에는 2026-11-04 기준 월 요금이 표시되어 있었습니다. Lite는 CNY 118, Pro는 CNY 538, Max는 CNY 1078입니다. USD당 6.7150 CNY로 환산하면 각각 약 $17.57, $80.12, $160.54입니다. 분기 결제는 20%, 연간 결제는 30% 할인됩니다.
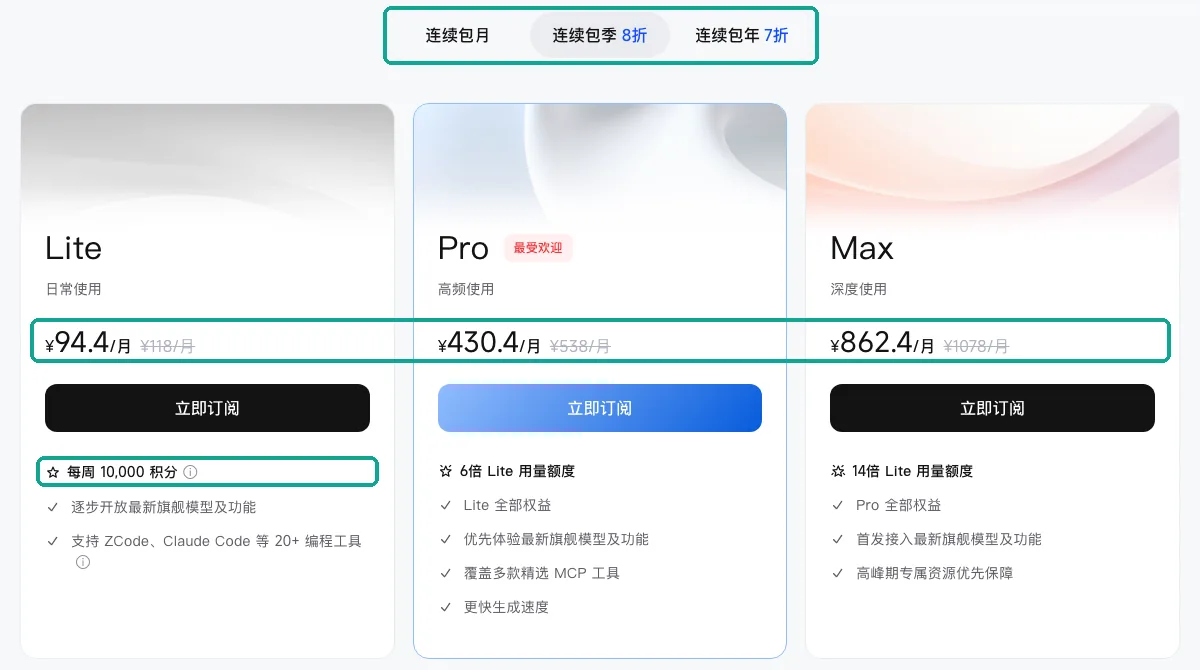
각 요금제에는 5시간당 한도와 주간 한도가 있습니다. Lite는 5시간당 2,000크레딧, 주당 10,000크레딧을 제공합니다. Pro는 12,000과 60,000, Max는 28,000과 140,000입니다.
5시간 한도는 사용할 때마다 5시간 뒤에 갱신됩니다. 주간 한도는 주문일로부터 7일 단위로 적용됩니다. 한도를 다 쓰면 기다려야 합니다. 요금제는 잔액에서 요금을 차감하지 않습니다.
크레딧 계산식은 공개되어 있습니다. 모델 크레딧은 입력 토큰 × 입력 계수, 캐시 토큰 × 캐시 계수, 출력 토큰 × 출력 계수를 모두 더한 뒤 10,000으로 나눈 값입니다. 웹 검색, 웹 읽기, 저장소 읽기용 MCP 호출은 1회에 1.2크레딧입니다.
피크 시간 외에는 모델 호출에 드는 크레딧이 절반으로 줄어듭니다. Z.ai 문서에 따르면 피크 시간은 월요일부터 금요일까지 SGT 14:00~18:00입니다. BigModel 문서도 같은 시간대를 UTC+8로 표기합니다. 싱가포르에서 작업한다면 오후에는 긴 세션을 피하세요.
| 등급 | 월 요금(2026-11-04) | USD(근사치) | 5시간당 크레딧 | 주당 크레딧 | 피크 시간 기준 주당 GLM-5.3 세션 수 |
|---|---|---|---|---|---|
| Lite | CNY 118 | $17.57 | 2,000 | 10,000 | 약 48 |
| Pro | CNY 538 | $80.12 | 12,000 | 60,000 | 약 288 |
| Max | CNY 1078 | $160.54 | 28,000 | 140,000 | 약 673 |
마지막 열은 11절의 예시 세션을 기준으로 합니다. 이 세션에는 GLM-5.3에서 약 207.8크레딧, Flash에서 68.7크레딧이 듭니다. 피크 시간 외에는 세션 수가 두 배가 됩니다. 이 수치는 보장된 값이 아니라 대략적인 규모를 가늠하는 참고치로만 보십시오.
데이터 스크립트를 만들 때 중요한 규칙이 세 가지 있습니다. 첫째, 요금제는 지원되는 도구에서만 적용됩니다. 그 밖의 곳에서 보낸 API 호출은 요금제 할당량을 쓰지 않습니다. Z.ai 이용 정책은 이를 다섯 단어로 정리합니다. “Use limited to supported tools”(Z.ai 이용 정책).
BigModel FAQ는 직접 만든 앱, 사이트, 봇, SaaS 제품에는 표준 API를 써야 한다고 덧붙입니다(Coding Plan FAQ). 둘째, 2026-10-16부터 표준 API 키와 요금제 키가 분리되었습니다. 코딩 도구에 표준 키를 넣으면 요금제 할당량을 쓰지 않습니다(API 키 공지). 셋째, 요금제는 환불되지 않으며 계정을 공유할 수 없습니다(이용 안내).
첫 번째 규칙이 전체 설계를 좌우합니다. topic_pulse.py가 직접 GLM을 호출해 댓글에 라벨을 붙이게 하고 싶을 수 있습니다. 그러면 사람 없이 타이머로 스크립트를 실행할 수 있습니다. 하지만 요금제 규칙상 이런 GLM 호출은 요금제 사용량으로 인정되지 않으므로 표준 API 가격을 내야 합니다.
그래서 저희 스크립트는 두 가지만 합니다. 데이터를 가져오고, 모델이 필요 없는 간단한 통계를 계산합니다. 읽고 요약하는 일은 요금제가 적용되는 Claude Code 안에서 처리합니다. 덤으로 이 스크립트는 모델에 접근할 수 없는 머신을 포함해 어떤 머신에서든 실행됩니다.
4. Claude Code에서 GLM 5.3을 사용하는 방법: 설정 예시
아래는 Z.ai용 ~/.claude/settings.json 예시입니다. Z.ai Claude Code 가이드와 Claude Code 환경 변수 레퍼런스를 따랐습니다. Z.ai 계정이 없어 직접 실행하지는 않았습니다. 키는 자리 표시자입니다.
{
  "env": {
    "ANTHROPIC_AUTH_TOKEN": "your-zai-coding-plan-key",
    "ANTHROPIC_BASE_URL": "https://api.z.ai/api/anthropic",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "glm-5.3[1m]",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "glm-5.3[1m]",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "glm-5.3-flash[1m]",
    "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000",
    "API_TIMEOUT_MS": "3000000",
    "CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC": "1",
    "EVERYINFRA_API_KEY": "your-everyinfra-key"
  }
}
Claude Code는 ANTHROPIC_AUTH_TOKEN을 Authorization 헤더의 Bearer 토큰으로 보냅니다(Claude Code environment variables). 여기에는 표준 API 키가 아니라 Coding Plan 키를 사용하십시오. ANTHROPIC_DEFAULT_*_MODEL 값 세 개는 Claude Code의 opus, sonnet, haiku 별칭 뒤에 실제로 어떤 모델이 있는지 지정합니다. Z.ai는 opus와 sonnet에 GLM-5.3을, haiku에 Flash를 연결합니다. 더 최신인 BigModel 페이지는 세 별칭 모두에 Flash를 연결합니다. 스크립트 작성에는 더 강한 모델이 필요하므로 저희는 Z.ai 방식을 따릅니다. 백그라운드 작업은 Flash로 처리해 크레딧을 아낄 수 있습니다.
[1m] 접미사는 그대로 두십시오. Claude Code는 glm-5.3 ID를 인식하지 못합니다. 모델 설정 문서에 따르면 Claude Code는 알 수 없는 ID의 컨텍스트 창을 200K 토큰으로 간주하고 시작할 때 경고를 표시합니다(Claude Code model configuration). ID에 [1m]을 붙이면 GLM-5.3과 일치하는 1M 컨텍스트 창으로 간주합니다. 접미사가 없으면 Claude Code가 대화를 너무 일찍 압축합니다. 모델이 긴 결과를 읽을 때 특히 눈에 띕니다.
CLAUDE_CODE_AUTO_COMPACT_WINDOW는 컨텍스트가 얼마나 찼을 때 압축할지 정합니다. 100,000부터 1,000,000까지의 값을 받습니다. API_TIMEOUT_MS를 3,000,000밀리초로 설정하는 것은 Zhipu의 권장 사항입니다. GLM은 추론 강도가 max일 때 오래 사고할 수 있기 때문입니다. CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC은 텔레메트리 등 필수가 아닌 요청을 막습니다.
마지막 줄의 EVERYINFRA_API_KEY는 스크립트용입니다. Claude Code가 실행한 자식 프로세스가 이 값을 읽을 수 있으므로 스크립트는 os.environ에서 키를 읽습니다. 키는 코드에 절대 들어가지 않습니다.
| 변수 | 예시 값 | 용도 | 출처(2026-11-04 확인) |
|---|---|---|---|
ANTHROPIC_BASE_URL | https://api.z.ai/api/anthropic | Z.ai로 요청 전송 | Z.ai Claude Code 가이드 |
ANTHROPIC_AUTH_TOKEN | 요금제 키 | Bearer 토큰 | Claude Code 환경 변수 레퍼런스 |
ANTHROPIC_DEFAULT_OPUS_MODEL | glm-5.3[1m] | 메인 모델 | Z.ai Claude Code 가이드 |
ANTHROPIC_DEFAULT_HAIKU_MODEL | glm-5.3-flash[1m] | 소규모 백그라운드 작업 | Z.ai Claude Code 가이드 |
CLAUDE_CODE_AUTO_COMPACT_WINDOW | 1000000 | 압축 임계값 | Claude Code 환경 변수 레퍼런스 |
API_TIMEOUT_MS | 3000000 | 요청 타임아웃 | BigModel Claude Code 가이드 |
한 가지 사실은 분명히 짚어 둡니다. Claude Code 게이트웨이 문서에 따르면 지원되는 API 형식을 갖춘 게이트웨이라면 어떤 것이든 동작합니다. 동시에 Anthropic은 “어떤 게이트웨이를 통해서도 Claude Code를 Claude가 아닌 모델로 라우팅하는 것은 지원하지 않는다”고 밝힙니다(Claude Code LLM gateway). 즉, Claude Code에서 GLM을 사용할 수 있는 것은 Zhipu가 호환 엔드포인트를 만들었기 때문입니다.
문제가 생기면 Zhipu 문서를 확인하거나 지원팀에 문의하십시오. 2026-11-04 기준 최신 Claude Code 릴리스는 2026-11-03에 나온 2.1.317이었습니다(Claude Code changelog). Zhipu 페이지는 2.1.140에서 검증되었습니다. 두 버전 사이에 릴리스가 많으므로 예상치 못한 오류가 발생하면 양쪽 변경 내역을 모두 확인하십시오.
안내에 따라 설정하고 싶다면 Zhipu의 대화형 도구 npx @z_ai/coding-helper를 쓸 수 있습니다(npm 패키지). 설정이 끝나면 새 터미널을 열고 claude를 실행한 뒤 /status를 입력하십시오. 설정 소스는 ~/.claude/settings.json을 가리켜야 하고, 모델 줄에는 glm-5.3 또는 glm-5.3[1m]이 표시되어야 합니다.
5. 두 MCP 도구 세트 비교
MCP는 Model Context Protocol의 약자로, 모델이 외부 도구를 호출할 수 있게 하는 개방형 프로토콜입니다(MCP specification). Coding Plan에는 자체 MCP 도구가 포함되어 있습니다. 2026-11-04 기준 문서에는 웹 검색(webSearchPrime), 웹 읽기(webReader), zread라는 저장소 리더, 비전 서버가 나와 있었습니다. zread 서버에는 search_doc, get_repo_structure, read_file의 세 가지 도구가 있습니다. 비전 서버는 @z_ai/mcp-server npm 패키지로 로컬에서 실행됩니다. 최신 버전 0.1.6은 2026-10-29에 나왔습니다(npm 패키지).
웹 검색 페이지와 웹 읽기 페이지에는 같은 문장이 있습니다. Claude Code에서 Coding Plan을 쓰면 두 도구가 모델 서비스에 내장되어 있다는 내용입니다(웹 검색 MCP, 웹 읽기 MCP). 따로 설치할 필요가 없습니다. 다른 모델에서 쓰고 싶을 때만 직접 추가하면 됩니다.
| 기본 제공 도구 | 반환 내용 | 호출당 크레딧 | 버전 또는 날짜 |
|---|---|---|---|
webSearchPrime | 제목, URL, 요약, 사이트 이름, 아이콘 | 1.2 | 2026-11-04 문서 확인 기준 |
webReader | 제목, 본문 텍스트, 메타데이터, 링크 | 1.2 | 2026-11-04 문서 확인 기준 |
| zread | search_doc, get_repo_structure, read_file | 1.2 | 2026-11-04 문서 확인 기준 |
| 비전 서버 | 이미지·동영상 분석, 로컬 실행 | Flash로 집계 | 0.1.6(2026-10-29) |
문서에는 각 도구가 무엇을 반환하는지도 나와 있습니다. 웹 검색은 페이지 제목, URL, 요약, 사이트 이름, 사이트 아이콘을 반환합니다. 웹 리더는 URL 하나를 가져와 제목, 본문 텍스트, 메타데이터, 링크 목록을 반환합니다. 코딩 작업에는 잘 맞습니다. 라이브러리를 찾아보거나, 오류 관련 스레드를 읽거나, README를 열어 볼 수 있습니다.
감성 분석 스크립트에는 형태가 다른 데이터가 필요합니다. 답변이나 댓글마다 한 행씩, 좋아요 수, 답글 수, 날짜, 그리고 그 답변이나 댓글이 속한 질문 또는 게시물이 있어야 합니다. 이런 행이 있으면 스크립트로 정렬하고, 노이즈를 걸러 내고, 중앙값을 계산할 수 있습니다. 아래 표는 각 도구 유형이 반환하는 필드를 비교합니다. Zhipu 계정이 없어 기본 제공 도구 열은 Zhipu 문서만을 근거로 작성했습니다. EveryInfra 열은 2026-11-04에 실제로 호출해 받은 필드입니다.
| 필요 사항 | 기본 제공 검색 또는 리더(Zhipu 문서 기준) | EveryInfra 필드(실제 호출, 2026-11-04) | 확인 |
|---|---|---|---|
| 특정 주제의 Zhihu 답변 | 페이지 제목, URL, 요약, 사이트 이름 | zhihu/search: 질문 제목, 답변 링크, 발췌문, 좋아요, 댓글, 저장 수, 날짜(호출당 20건) | 2026-11-04 |
| 답변 하나의 전문 | 페이지 제목, 본문 텍스트, 메타데이터, 링크 | zhihu/content_detail: 좋아요, 댓글, 저장 수를 포함한 전문 | 2026-11-04 |
| 답변에 달린 댓글 | 본문 텍스트 한 페이지 | zhihu/content_comments: 댓글당 한 행, text, like_count, reply_count 포함(3~26행) | 2026-11-04 |
| Weibo 키워드 검색 | 페이지 제목, URL, 요약 | weibo/search: id, url, text, posted_at, 댓글·리포스트·좋아요 수(호출당 20건) | 2026-11-04 |
| Weibo 댓글 | 위와 동일 | weibo/comments: 댓글당 한 행(2~43행) | 2026-11-04 |
| 뉴스, 문서, GitHub | 적합 | 이 기능의 용도가 아님 | 2026-11-04 |
두 사이트 모두 자체 개발자 플랫폼도 운영합니다. 본인 계정의 데이터만 필요하거나 플랫폼 자체 인증으로 연동한다면 이쪽이 맞습니다. Zhihu 데이터 플랫폼 검색은 Bearer 토큰과 타임스탬프 헤더를 사용합니다. Count 최댓값은 10이고, ContentText는 발췌문이며, HasMore는 항상 false입니다(Zhihu 개발자 문서: search). 인기 목록 스킬은 1~30 범위의 limit을 받습니다(Zhihu 개발자 문서: hot list).
Weibo에서 comments/show 엔드포인트는 인증한 사용자의 댓글을 반환합니다(Weibo API: comments/show). search/topics 엔드포인트는 최신 항목 200개를 반환하는 고급 API입니다(Weibo API: search/topics).
따라서 두 MCP 세트는 역할을 나눕니다. Zhipu 기본 제공 도구는 문서, 뉴스, 공개 페이지를 다루며 호출당 1.2크레딧이 듭니다. EveryInfra MCP 서버나 API는 플랫폼 내부의 구조화된 데이터를 제공하며 요청당 미국 달러(USD)로 과금됩니다. 두 세트를 한 Claude Code 세션에 함께 연결해 둘 수 있으며, 모델은 도구 설명을 보고 어느 쪽을 쓸지 고릅니다. EveryInfra 원격 MCP 서버는 아래와 같이 추가합니다. 이 서버에 initialize와 tools/list를 실행했더니 도구 12개가 나열되었습니다.
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer $EVERYINFRA_API_KEY"

# Check the connection: the list must show everyinfra and its tools
claude mcp list
주제 스크립트에는 12개 도구 중 2개만 있으면 됩니다. everyinfra_list_capabilities는 플랫폼, 기능, 파라미터를 나열합니다. everyinfra_call_api는 기능을 실행합니다. SGT 00:23에 MCP tools/call로 중국어 키워드 "Zhipu Coding Plan"을 넣어 weibo/search를 호출했습니다. 게시물 20건이 반환되었고, 비용은 직접 호출과 같은 $0.000806이었습니다. 텍스트 결과는 15,103자였습니다.
이 크기가 중요합니다. Claude Code는 MCP 결과 하나가 10,000토큰을 넘으면 경고하며, 기본 상한은 25,000토큰입니다. 상한은 MAX_MCP_OUTPUT_TOKENS로 바꿀 수 있습니다. 50,000자를 넘는 텍스트 결과는 컨텍스트 대신 파일로 저장됩니다(Claude Code MCP 문서).
게시물 20건은 여유 있게 들어갑니다. 하지만 모델이 MCP로 댓글 50개와 답변 20개를 한 번에 하나씩 가져오면 컨텍스트가 금세 찹니다. 그래서 GLM에게 스크립트를 작성하게 했습니다. 스크립트가 수십 번의 호출 결과를 작은 JSON 파일 하나로 모으고, 모델은 그 파일만 읽습니다.
게이트웨이에 영향을 주는 세부 사항이 하나 더 있습니다. Claude Code는 도구 검색을 기본으로 활성화하므로 MCP 도구는 필요할 때 로드됩니다. 이때 요청에는 defer_loading 필드와 tool_reference 블록이 포함됩니다. Claude Code는 ANTHROPIC_BASE_URL로 지정된 게이트웨이가 이를 그대로 전달할 것으로 기대합니다.
버전 2.1.305부터는 게이트웨이가 400 또는 422로 응답하면 Claude Code가 도구 검색 없이 한 번 재시도하고 모든 MCP 도구를 처음부터 불러옵니다. Zhipu 엔드포인트가 이 필드를 받아들이는지는 확인하지 못했습니다. MCP 서버를 많이 연결한 상태에서 세션을 시작하자마자 컨텍스트가 가득 차 보인다면 이것이 원인일 수 있습니다.
6. 비교 작업 한 번은 이렇게 흘러갑니다


전체 작업은 한 줄로 이어집니다. 첫째, Claude Code에 한 문장을 입력합니다. 예: "Zhihu와 Weibo가 Coding Plan 가격 인상을 어떻게 이야기하는지 비교하는 스크립트를 작성하고, 차이를 알려 줘." 둘째, GLM이 요청을 읽습니다. everyinfra_list_capabilities를 호출하거나 API 문서를 읽어 파라미터를 파악한 뒤 topic_pulse.py를 작성합니다.
셋째, Claude Code가 스크립트를 실행합니다. 스크립트는 Weibo 검색, Weibo 댓글, Zhihu 검색, Zhihu 댓글을 차례로 호출하고, 결과와 호출별 비용을 JSON 파일 하나에 기록합니다. 넷째, GLM이 그 파일을 읽고 요약을 작성합니다.
이 흐름에서 눈에 띄는 숫자가 두 가지 있습니다. 첫째는 압축률입니다. 두 번째 실행에서 API가 반환한 원본 JSON은 50,859자, 약 14,543토큰이었습니다. 스크립트가 텍스트 필드만 남기자 4,315자, 약 2,207토큰이 되었습니다. 입력이 85% 줄어든 것입니다. GLM은 턴마다 컨텍스트를 다시 읽으므로 한 세션에서 이 절감 효과가 여러 번 반복됩니다.
두 번째 숫자는 시간입니다. 두 번째 실행은 SGT 00:33:55부터 00:37:01까지, 3분 남짓 걸렸습니다. 그중 대부분은 의도한 대기 시간이었습니다. 스크립트는 분당 10회 요청을 넘지 않도록 호출 간격을 둡니다. HTTP 429 응답을 한 번 받은 뒤에도 대기했습니다.
7. GLM이 작성해야 할 스크립트
Claude Code에 입력할 프롬프트는 다음과 같습니다. 그대로 사용해도 됩니다.
표준 라이브러리만 사용하는 Python 스크립트 topic_pulse.py를 작성하십시오. 스크립트는 주제 키워드 하나를 입력받습니다. EVERYINFRA_API_KEY 환경 변수에서 키를 읽어 EveryInfra API의 POST 엔드포인트(https://api.everyinfra.com/api/v1/social)를 호출합니다. weibo/search로 Weibo 게시물 20건을 검색합니다. 지정한 단어가 들어 있고 댓글이 3개 이상인 게시물만 남기고, weibo/comments로 게시물마다 댓글 50개를 읽습니다.
zhihu/search로 Zhihu 답변 20건을 검색하고 질문별로 묶습니다. 제목이 지정한 패턴과 일치하는 질문만 남깁니다. 상위 3개 질문에 대해 좋아요가 가장 많은 답변의 댓글 50개를 zhihu/content_comments로 읽습니다.
호출 사이에 6.5초를 기다립니다. 429 또는 503을 받으면 retry_after만큼 기다린 뒤 다시 시도합니다. recent_failures가 3에 도달하면 해당 기능 호출을 중단합니다. 이모지만 있는 댓글, 반복 댓글, 너무 짧은 댓글, 봇 댓글은 제외합니다. 건수, 길이 중앙값, 상위 댓글 5개, 그리고 HTTP 상태와 charged_usd를 포함한 호출별 기록을 JSON 파일 하나에 씁니다.
각 줄에는 이유가 있습니다. 표준 라이브러리만 쓰면 아무것도 설치하지 않고 어디서나 스크립트를 실행할 수 있습니다. 6.5초 간격은 기본 요청 속도 제한인 분당 10회를 넘지 않기 위한 것입니다.
재시도 규칙과 recent_failures 규칙은 7분 넘게 걸린 첫 번째 실행 이후에 추가했습니다. 제목 필터는 두 번째 실행 이후에 추가했습니다. 두 가지 모두 9절에서 설명합니다. 봇 규칙은 Weibo에 댓글 스레드 안에서 답글을 다는 자동 검색 어시스턴트가 있어서 만들었습니다. 이 어시스턴트의 긴 답글이 통계를 왜곡하기 때문입니다.
아래는 세 번째 버전의 핵심 부분입니다. 위 프롬프트를 바탕으로 직접 작성해 실행했습니다. 전체 파일은 약 120줄이며, 이 발췌본에는 호출, 재시도, Zhihu 로직만 담았습니다.
API = "https://api.everyinfra.com/api/v1/social"
KEY = os.environ["EVERYINFRA_API_KEY"]
GAP = 6.5            # seconds between calls: stay under 10 requests per minute
DOWN = set()         # capabilities that failed 3 times in 10 minutes

def call(platform, action, params, tries=3):
    if f"{platform}/{action}" in DOWN:
        return None
    body = json.dumps({"platform": platform, "action": action, "params": params}).encode()
    for attempt in range(tries):
        req = urllib.request.Request(API, data=body, method="POST", headers={
            "Authorization": f"Bearer {KEY}", "Content-Type": "application/json"})
        try:
            with urllib.request.urlopen(req, timeout=120) as r:
                code, d = r.status, json.load(r)
        except urllib.error.HTTPError as e:
            code, d = e.code, json.loads(e.read() or b"{}")
        log(platform, action, code, d)       # rows and billing.charged_usd
        time.sleep(GAP)
        err = d.get("error") or {}
        if code == 200:
            return d
        if (err.get("recent_failures") or 0) >= 3:   # the error says: stop retrying
            DOWN.add(f"{platform}/{action}")
            return None
        if code in (429, 503) and err.get("retryable") and attempt < tries - 1:
            time.sleep(min(err.get("retry_after", 30), 60))
            continue
        return None

# Zhihu: search, group by question, keep matching titles, read comments of the top answer
for q in top_questions:
    answers += by_q[q]                   # search rows: question title, link, excerpt, likes
    best = max(by_q[q], key=lambda x: x.get("like_count") or 0)
    zcomments += rows(call("zhihu", "content_comments", {"url": best["url"], "limit": 50}))
핵심은 스크립트가 오류를 읽는 방식입니다. EveryInfra 오류는 메시지 한 줄이 아니라 필드가 담긴 JSON 객체입니다. fault는 누구 쪽 문제인지 알려 줍니다. retryable과 retry_after는 재시도 여부와 대기 시간을 알려 줍니다. recent_failures는 이 기능이 최근 몇 번 실패했는지 알려 줍니다.
next_steps는 다음에 무엇을 해야 하는지 호출자에게 쉬운 말로 알려 줍니다. example은 동작이 확인된 요청을 보여 줍니다. 이 필드를 읽는 스크립트는 HTTP 코드만 세는 스크립트보다 더 나은 판단을 내립니다. Claude Code 안의 GLM도 같은 필드를 읽고, 재시도를 반복하지 않고 계획을 바꿀 수 있습니다. 두 번째 실행에서는 SGT 00:35:34에 HTTP 429가 한 번 발생했습니다. 스크립트는 응답에 나온 대로 기다렸고, 33초 뒤 재시도는 과금 없이 성공했습니다.
노이즈 규칙은 단순합니다. 먼저 스크립트는 각 댓글에서 "OO님에게 답글" 접두어를 제거합니다. 4자 이하인 댓글은 짧은 댓글로 분류합니다. 이모지 태그, 공백, 숫자, "네"나 웃음만 있는 댓글은 이모지 또는 반복으로 분류합니다. 작성자 이름에 Weibo 검색 어시스턴트 태그가 들어 있으면 봇으로 분류합니다.
이 규칙은 실제 데이터를 처음 한 묶음 읽어 본 뒤에 만들었습니다. 완벽하지는 않습니다. 예를 들어 두 글자짜리 "진짜"도 짧은 댓글로 걸러집니다. 그래도 "실제로 의견을 말하는 사람이 몇 명인가"라는 질문에는 충분히 쓸 만합니다.
8. 두 사이트에서 실제로 한 바퀴 돌려 보기
스크립트를 만들기 전에 각 기능을 직접 호출해 파라미터와 응답 형태를 확인했습니다. 표에 주요 호출을 순서대로 정리했습니다. 모든 시각은 2026-11-04 SGT 기준입니다.
| 시각(SGT) | 기능 | 대상 | HTTP | 행 | 과금액 |
|---|---|---|---|---|---|
| 00:16:49 | weibo/search | 키워드 "Coding Plan 가격 인상" | 200 | 20 | $0.000806 |
| 00:17:03 | zhihu/search | 같은 키워드 | 200 | 20 | $0.000556 |
| 00:21:42 | zhihu/content_detail | 좋아요 47개인 답변 | 200 | 1 | $0.000556 |
| 00:21:56 | zhihu/content_comments | 같은 답변 | 200 | 7 | $0.000556 |
| 00:22:20 | weibo/comments | 네 가지 가격 전략을 다룬 게시물 | 200 | 11 | $0.000556 |
| 00:22:57 | weibo/comments | 숫자 ID 대신 문자로 된 단축 코드 | 200 | 0 | $0, 빈 결과로 환불 처리 |
Weibo는 잘 동작했습니다. weibo/search가 반환한 각 게시물에는 id, url, text, posted_at과 댓글·리포스트·좋아요 수가 있습니다. 저희 키워드로 받은 게시물 20건의 작성일은 2026-08-17부터 2026-10-26까지였습니다. SGT 00:21에 "GLM-5.3"으로 검색하자 2026-10-30부터 2026-11-03까지의 더 최근 게시물이 반환되었습니다. weibo/comments는 숫자 ID 또는 숫자 ID가 들어 있는 링크를 받습니다.
SGT 00:22:20에 네 가지 가격 전략을 비교한 게시물의 댓글 11개를 읽었습니다. 한 독자는 "원가에 마진을 더한 뒤 피크 시간대와 비피크 시간대로 나누는" 방식이 하나의 일률적인 요금보다 이해하기 쉽다고 썼습니다. 다른 독자는 Kimi도 괜찮지만 "비싸고 느리다"며 DeepSeek을 계속 쓰겠다고 했습니다. 유일하게 주의할 점은 링크 형식이었습니다.
일부러 문자로 된 단축 코드를 보내 보았습니다. API는 0행과 empty_result_refunded라는 사유를 담아 HTTP 200 응답을 반환했으며, 과금하지 않았습니다. 검색 결과의 id 필드를 쓰면 이 문제를 겪지 않습니다.
Zhihu 검색도 잘 동작했습니다. 질문 제목, 답변 링크, 발췌문, 좋아요, 댓글, 저장 수, 날짜가 담긴 답변 20건을 반환했습니다. 두 단계를 처리하기에 충분한 정보입니다. 스크립트는 각 링크에 들어 있는 질문 ID로 답변을 묶습니다. 그런 다음 묶음마다 좋아요가 가장 많은 답변을 고릅니다. zhihu/content_comments는 답변 링크를 받아 최상위 댓글을 반환하며, 각 댓글에는 텍스트, 좋아요 수, 답글 수가 있습니다.
SGT 00:21:42에 zhihu/content_detail로 읽은 답변은 Max 플랜을 갱신한 사용자가 쓴 글이었습니다. 전날에는 분기 요금이 월 422 CNY였는데 다음 날에는 "800~900 CNY"가 되었다고 했습니다. 이 답변은 좋아요 47개, 댓글 28개였고, SGT 00:21:56에 그중 댓글 7개를 읽었습니다. zhihu/content_detail은 발췌문으로 부족할 때만 쓰면 되며, 답변마다 요청 1건이 듭니다.
9. 스크립트 세 번 실행: 키워드 이탈, 요청 속도 제한, 제목 필터
첫 번째 실행에서는 중국어 키워드 "Zhipu Coding Plan"을 사용했습니다. SGT 00:24:58부터 00:32:37까지 7분 39초가 걸렸습니다. 요청 15건 중 6건이 과금되어 $0.003586이 나왔습니다. 나머지 9건은 실패했고 과금되지 않았습니다. 이 버전은 실패할 때마다 60초를 기다렸고 recent_failures를 읽지 않았기 때문에 느렸습니다.
키워드도 주제에서 벗어났습니다. Weibo에서 댓글이 가장 많은 게시물은 라이브커머스 판매 게시물이었습니다. 주제와 아무 관련이 없었지만 스크립트는 그 댓글을 읽었습니다.
| 실행 | 키워드 | 시각(SGT) | 요청 | 과금액 | 비용 |
|---|---|---|---|---|---|
| 첫 번째 | Zhipu Coding Plan | 00:24:58~00:32:37 | 15 | 6 | $0.003586 |
| 두 번째 | Coding Plan 가격 인상 | 00:33:55~00:37:01 | 12 | 10 | $0.00581 |
| 세 번째(최종) | 같은 키워드, Zhihu 제목 필터 추가 | 02:06:32~02:08:22 | 7 | 7 | $0.004142 |
두 번째 실행에서는 세 가지를 고쳤습니다. recent_failures 규칙을 추가했습니다. --must "coding plan"도 추가해 Weibo 게시물에 이 문구가 반드시 들어 있도록 했습니다. 키워드는 범위가 더 좁은 "Coding Plan 가격 인상"으로 바꿨습니다. 이 버전은 zhihu/content_detail로 답변 전문도 읽었습니다.
실행 시간은 SGT 00:33:55부터 00:37:01까지, 3분 6초였습니다. 요청 12건 중 10건이 과금되어 비용은 $0.00581이었습니다. 무료였던 2건에는 SGT 00:35:34의 429가 포함됩니다. 10절의 비교 수치는 이 실행 결과와 수동 호출 결과를 합친 것입니다.
두 번째 실행은 더 깔끔했지만, 좋아요 수로 질문을 고르는 방식의 결함이 드러났습니다. Zhihu 답변 20건 중 8건은 제목에 Zhipu나 GLM이 들어 있었습니다. 하나는 Zhipu 플랜이 해외보다 중국에서 더 비싼 이유를 물었습니다. 다른 하나는 "Zhipu Coding Plan 가격 인상"을 어떻게 보는지 물었습니다. 그런데 스크립트는 좋아요 합계가 가장 많은 질문 3개를 골랐습니다.
하나는 OpenAI가 $200 Pro 플랜을 일시 중단한 이유를 묻는 질문으로, 좋아요 523개였습니다. 하나는 지금 가성비 좋은 코딩 플랜을 어디서 사야 하는지 묻는 질문으로, 좋아요 378개였습니다. 세 번째는 좋아요 235개로, Alibaba Cloud가 Lite 플랜 갱신을 중단한 일에 관한 질문이었습니다. 세 질문 모두 코딩 플랜 가격을 다루지만 Zhipu에 관한 질문은 없습니다.
"Zhipu 가격 인상을 사람들이 어떻게 생각하는지" 알고 싶다면 제목 필터를 추가하세요. 예를 들어 제목에 Zhipu나 GLM이 들어간 질문만 고르는 식입니다. 이런 작업은 Claude Code에 잘 맞습니다. 첫 요약을 읽고 "Zhipu에 관한 질문만"이라고 말하면 됩니다. GLM이 한 줄을 고치고 1센트도 안 되는 비용으로 다시 실행합니다.
Weibo에서는 같은 문제가 더 심하게 나타났습니다. "Coding Plan 가격 인상"으로 받은 게시물 20건 중 본문에 coding plan을 언급한 것은 7건뿐입니다. 그중 댓글이 3개 이상인 것은 2건뿐입니다. 하나는 다른 플랜을 해지하고 대안을 써 본 사용자의 게시물입니다.
다른 하나는 GLM 5.3이 많이 좋아졌지만 가격이 너무 많이 올랐다는 내용입니다. 두 게시물을 합쳐도 댓글은 5개뿐이었습니다. 나머지 13건에는 뉴스 리포스트, 일간 요약, 게임 뉴스가 섞여 있습니다. 댓글이 50개로 가장 많았던 게시물은 DeepSeek 가격에 관한 토픽 게시물이었습니다.
즉 틈새 기술 주제는 Weibo에서 논의가 적고, 의견은 대부분 Zhihu에 모입니다. 공정한 표본을 얻기 위해 Weibo에서 직접 고른 댓글 묶음 4개(댓글 73개)와 두 번째 실행의 댓글 5개를 합쳐 Weibo 댓글 78개를 만들었습니다. Zhihu에서는 두 번째 실행의 댓글 71개와 수동 단계의 댓글 7개를 합쳐 역시 78개로 맞췄습니다. 개수가 같으면 비율을 비교하기 쉽습니다.
세 번째 실행에서는 제목 필터를 추가했으며, 이것이 이 글의 최종 스크립트입니다. 전문 조회 단계를 빼고 기능 4개만 남겼습니다. Zhipu, GLM, 그리고 Zhipu를 부르는 흔한 별칭을 담은 패턴으로 --zhihu-title을 추가했습니다. 실행 시간은 2026-11-04 SGT 02:06:32부터 02:08:22까지, 1분 50초였습니다. 요청 7건이 모두 200을 반환하고 과금되어 비용은 $0.004142였습니다.
Weibo에서는 두 번째 실행과 같은 게시물 2건과 댓글 5개를 읽었습니다. Zhihu에서는 이번에 질문 3개가 모두 Zhipu에 관한 것이었습니다. 하나는 2026-07-30의 크레딧 방식 전환을 어떻게 보는지 묻는 질문이었습니다(최고 답변: 좋아요 47개, 댓글 28개). 하나는 GLM-5 코딩 플랜을 어디서 구독하는지, 이 모델이 왜 그렇게 인기 있는지 묻는 질문이었습니다(좋아요 36개). 나머지 하나는 Zhipu Coding Plan이 왜 그렇게 비싼지 묻는 질문이었습니다(좋아요 7개).
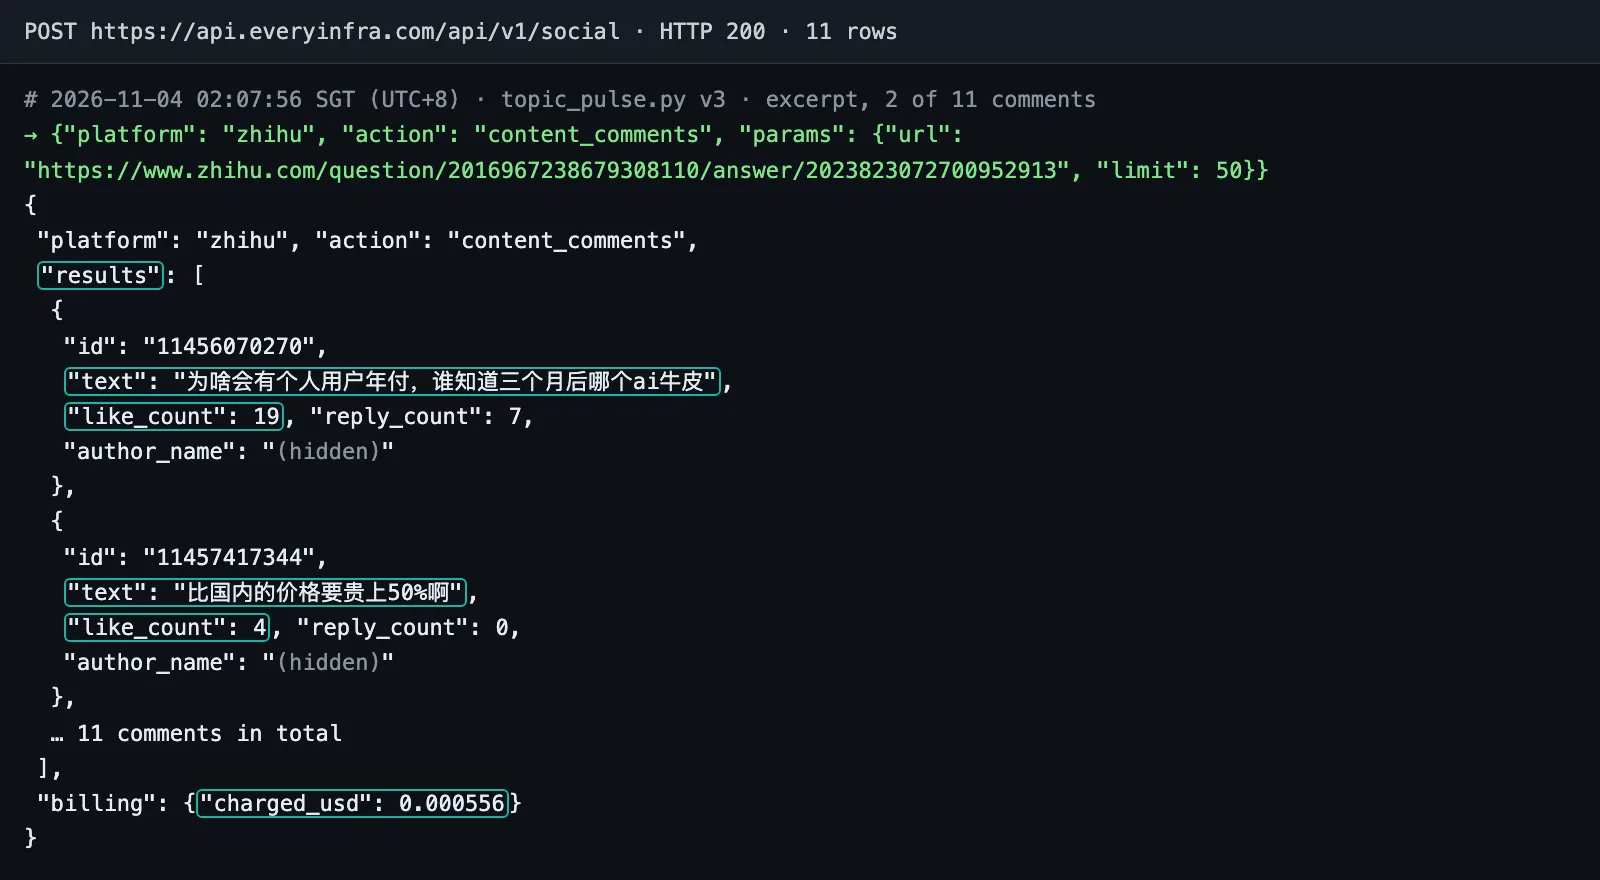
스크립트는 세 답변 아래에서 댓글을 각각 7개, 11개, 3개, 총 21개 읽었습니다. 노이즈 규칙으로 제거된 댓글은 없었고, 길이 중앙값은 26자였습니다. 좋아요 19개로 가장 위에 오른 댓글은 석 달 뒤 어떤 AI가 앞서 있을지 아무도 모르는데 왜 1년 치를 결제하느냐고 물었습니다. 좋아요 4개를 받은 다른 댓글은 해외 플랜이 "국내 가격보다 50% 비싸다"고 했습니다.
10. Zhihu와 Weibo는 무엇을 말하는가
이 절에서는 GLM이 결과를 읽은 뒤 작성해야 할 내용을 보여 줍니다. 모델이 자기 결과를 스스로 채점하지 않도록, analysis.py가 모델 없이 원본 응답에서 모든 수치를 계산합니다. 본문은 이 수치를 바탕으로 저희가 직접 작성한 예시입니다.
먼저 길이입니다. 노이즈를 제거한 뒤 Weibo 댓글의 길이 중앙값은 14자입니다. Weibo 댓글 10개 중 9개는 36자 이하이며, 가장 긴 댓글은 158자입니다. Zhihu 댓글의 중앙값은 28자이고, 10개 중 9개는 70자 이하이며, 가장 긴 댓글은 229자입니다.
Zhihu 답변 4개의 길이 중앙값은 310.5자, 최댓값은 756자입니다. 즉 Zhihu 댓글은 Weibo 댓글보다 두 배 길고, Zhihu 답변은 거기서 다시 열 배 깁니다. Weibo만 읽으면 분위기를 알 수 있습니다. 이유를 알려면 Zhihu 답변을 읽어야 합니다.
다음은 노이즈입니다. Weibo 댓글 78개 중 규칙에 따라 15개를 제거했습니다. 6개는 "네"처럼 4자 이하였습니다. 4개는 이모지만 있었습니다.
3개는 Weibo 검색 어시스턴트의 답글이었습니다. 1개는 반복, 1개는 링크만 있는 댓글이었습니다. Zhihu 댓글 78개 중에서는 8개를 제거했습니다. 너무 짧은 댓글 3개, 링크만 있는 댓글 2개, 반복 2개, 이모지만 있는 댓글 1개입니다. 노이즈 비율은 Weibo 19%, Zhihu 10%입니다.
봇 답글은 따로 짚어 둘 만합니다. Weibo 사용자는 댓글에서 검색 어시스턴트를 태그해 "DeepSeek이 가격을 얼마나 올렸어?" 같은 질문을 할 수 있습니다. 어시스턴트는 긴 답을 달고, 이런 답글은 좋아요 순으로 상위에 오릅니다. 봇 규칙이 없으면 어시스턴트가 한 말을 사람들의 의견으로 보고하게 됩니다.
그다음은 테마입니다. 테마 여섯 개마다 키워드 목록을 만들었습니다. 가격에는 인상, 비싸다, 얼마, CNY, 달러를 뜻하는 단어가 들어갑니다. 쿼터에는 쿼터, 사용량, 다 씀, 5시간, 주, 크레딧, 초기화가 들어갑니다. 품질에는 "멍청해졌다"와 양자화가 들어갑니다.
경쟁사에는 DeepSeek, Kimi, Codex, Claude, Qwen, MiniMax가 들어갑니다. 로컬에는 로컬, VRAM, 배포가 들어갑니다. 차단에는 차단, 리스크 관리, 요청 속도 제한이 들어갑니다. 댓글 하나가 여러 테마에 해당할 수 있습니다.
남은 Weibo 댓글 63개 중 22.2%는 가격을, 15.9%는 경쟁사 비교를 다룹니다. 품질과 로컬 구성은 각각 4.8%이고, 쿼터는 3.2%에 그칩니다. 남은 Zhihu 댓글 70개 중 25.7%는 쿼터를 다룹니다. 가격과 경쟁사는 각각 20%입니다. 품질과 차단은 각각 5.7%이고, 로컬 구성은 없습니다.
| 지표 | Weibo, 댓글 78개 | Zhihu, 댓글 78개·답변 4개 | 해석 | 데이터 기준일 |
|---|---|---|---|---|
| 노이즈 규칙 적용 후 남은 수 | 63 | 70 | Weibo의 노이즈 비율이 두 배 | 2026-11-04 |
| 길이 중앙값 | 14자 | 댓글 28자, 답변 310.5자 | 이유는 Zhihu에 있음 | 2026-11-04 |
| 남은 항목의 좋아요 수 | 112 | 댓글의 좋아요 349개, 답변의 좋아요 1,183개 | Zhihu 좋아요는 소수 답변에 집중 | 2026-11-04 |
| 주요 테마 | 가격, 22.2% | 쿼터, 25.7% | "너무 비싼가" 대 "충분한가" | 2026-11-04 |
| 한쪽에서만 나온 테마 | 로컬 구성, 4.8% | 차단, 5.7% | 표본이 작아 단서로만 활용 | 2026-11-04 |
이 수치를 바탕으로 한 GLM 요약은 다음과 같을 수 있습니다. 모델 출력이 아니라 저희가 작성한 예시입니다.
두 사이트 모두 가격을 이야기하지만 방식이 다릅니다. Weibo에서는 "가격이 갈수록 터무니없다"처럼 한 줄로 평가하고 이유는 거의 대지 않습니다. 댓글 여섯 개 중 하나꼴로 다른 업체를 언급합니다. Zhihu에서는 직접 계산합니다. 최고 답변은 API 대비 할인 폭이 15배를 넘는 플랜은 사용자가 쿼터를 전부 쓰면 손해라고 말합니다.
상위 댓글은 쿼터에 관한 것입니다. 좋아요 74개를 받은 댓글은 "초기화 카드 배포 이후" 사용량이 예전의 절반 정도로 줄었다고 말합니다. Zhihu 댓글의 5.7%는 계정 차단과 리스크 관리를 이야기하며, Weibo에는 이런 댓글이 없습니다. 일부 Weibo 사용자는 로컬 구성으로 플랜을 대체할 수 있는지 묻는데, 이번 Zhihu 데이터에는 이런 댓글이 없습니다. 표본은 사이트당 댓글 78개로 작고, Zhihu 답변은 좋아요가 가장 많은 질문에서 가져왔습니다.
공개된 댓글 텍스트만 인용했으며 사용자 이름은 싣지 않았습니다. 좋아요 수는 like_count 필드에서 가져왔습니다. 한계 하나는 다시 강조할 만합니다. 이 결과는 주제 하나, 하룻밤, 사이트당 댓글 78개를 기준으로 합니다.
테마 규칙은 저희가 작성한 키워드 목록입니다. GLM이 댓글을 더 정확하게 분류할 수도 있고, 틀릴 수도 있습니다. 이 결과는 "두 사이트가 이 주제를 어떻게 다르게 논의하는가"에 답합니다. "가격 인상을 지지하는 사람의 비율은 얼마인가"에는 답하지 않습니다.
11. 비용: 데이터, GLM 토큰, 플랜 크레딧
먼저 데이터입니다. 두 번째 실행에서는 요청 12건을 보냈습니다. weibo/search는 $0.000806, 나머지 성공한 요청 9건은 각각 $0.000556이었습니다. 실패한 요청 2건(그중 1건은 429)은 무료였습니다. 합계는 $0.00581입니다. 이 실행은 텍스트 79행(Weibo 댓글 5개, Zhihu 답변 3개, Zhihu 댓글 71개)과 검색 결과 40행을 반환했습니다. 텍스트 1,000행당 $0.0735입니다.
최종 스크립트는 전문 조회 단계를 뺍니다. 한 번 실행하면 요청 7건에 $0.004142가 들고, Weibo 댓글 5개, Zhihu 댓글 21개, 검색 결과 40행을 반환합니다. 두 번째 실행 규모로 매일 실행하면 월 $0.1743, 최종 스크립트는 월 $0.12426입니다.
| 시나리오 | 요청 | USD | 근거 |
|---|---|---|---|
| 두 번째 실행(전문 포함) | 12건 전송, 10건 과금 | $0.00581 | charged_usd |
| 세 번째 실행(최종 스크립트) | 7건 전송, 7건 과금 | $0.004142 | charged_usd |
| 텍스트 1,000행당 | n/a | $0.0735 | 79행 |
| 30일간 매일 | 360 | $0.1743 | 30 × $0.00581 |
| Z.ai에서 Flash로 요약 1회 읽기 | 1 | $0.001081 | 3,707 토큰 |
다음은 모델입니다. 계정이 없어 실제 세션을 측정할 수 없었습니다. 그래서 Claude Code 비용 문서의 예시 세션을 빌려 왔습니다. 입력 1.2k 토큰, 출력 5.3k 토큰, 캐시 읽기 940k, 캐시 쓰기 50k입니다.
이 구성은 "100줄짜리 스크립트를 작성하고, 두 번 실행하고, 한 번 고치는" 작업과 비슷합니다. 턴마다 컨텍스트를 다시 읽으므로 캐시 읽기가 대부분을 차지합니다. Zhipu에는 캐시 쓰기 요금이 따로 없어 일반 입력 요금으로 계산했습니다.
| 모델과 사이트 | 예시 세션 | USD(근사치) | 요약 1회 읽기 | 피크 시간 플랜 크레딧 |
|---|---|---|---|---|
| Z.ai의 GLM-5.3 | $0.3394 | $0.3394 | $0.00969 | 207.8 |
| BigModel의 GLM-5.3 | CNY 2.438 | $0.3631 | $0.008884 | 207.8 |
| Z.ai의 GLM-5.3-Flash | $0.0385 | $0.0385 | $0.001081 | 68.7 |
| BigModel의 GLM-5.3-Flash | CNY 0.272 | $0.0405 | $0.000888 | 68.7 |
| EveryInfra 데이터 실행 1회 | n/a | $0.00581 | n/a | n/a |
"요약 1회 읽기" 열은 입력 2,207 토큰(두 번째 실행에서 정리한 텍스트)과 출력 1,500 토큰을 가정합니다. 스크립트가 만들어진 뒤 GLM이 새 데이터를 읽는 데 매일 추가로 드는 비용입니다. CNY 값은 2026-11-03 환율 6.7150을 적용했습니다.
이 차트가 보여 주는 점은 하나입니다. 이런 작업에서는 비용 대부분이 데이터 수집이 아니라 코드 작성과 수정에 들어갑니다. GLM-5.3으로 스크립트 세션을 한 번 진행하면 데이터 비용의 약 60배가 듭니다. Flash에서는 약 7배입니다. 스크립트가 만들어진 뒤 하루 비용은 데이터 비용에 요약 1회 읽기 비용을 더한 금액입니다. Z.ai에서 Flash를 쓰면 하루 $0.007 미만입니다.
Coding Plan에서는 모델 비용이 크레딧으로 바뀝니다. Lite는 주당 10,000 크레딧을 제공합니다. 모두 피크 시간 기준으로, 예시와 같은 세션을 GLM-5.3으로는 약 48회, Flash로는 약 145회 진행할 수 있습니다. 비피크 시간에는 두 수치 모두 두 배가 됩니다. 기본 제공 웹 검색은 호출당 1.2 크레딧이므로 문서를 몇 번 찾아보는 정도로는 쿼터가 거의 줄지 않습니다.
놓치기 쉬운 비용이 하나 더 있습니다. API 원본 응답을 모델에 그대로 넣는 비용입니다. 두 번째 실행의 원본 JSON은 약 14,543 토큰이었습니다. Z.ai GLM-5.3 입력 가격인 100만 토큰당 $1.4로 계산하면 한 번 읽는 데 약 $0.02가 들며, 이는 데이터 비용의 세 배가 넘습니다. 턴이 추가될 때마다 다시 읽습니다. 스크립트가 먼저 압축하게 하면 모델은 약 2,207 토큰만 읽습니다. 이 구성에서 가장 크게 절약되는 부분입니다.
12. 한계
첫째, 질문 아래의 모든 답변을 읽는 zhihu/question_answers는 테스트 기간에 사용할 수 없었고, 실패한 요청은 과금되지 않았습니다. 그래서 스크립트는 zhihu/search에서 시작해, 질문마다 검색으로 찾은 답변과 그 아래 댓글만 읽습니다.
둘째, Zhipu 쪽은 아무것도 테스트하지 않았습니다. 설정은 2026-11-04에 읽은 문서를 따랐으며, 그 문서들은 두 군데에서 서로 맞지 않습니다. GLM-5.3이 어떤 스크립트를 작성할지, 수정이 몇 번 필요할지, 토큰을 얼마나 쓸지에 대한 데이터는 없습니다. 모델 비용은 측정값이 아니라 Claude Code 문서의 예시 세션으로 추정한 값입니다.
셋째, 표본이 작습니다. 사이트마다 댓글이 78개입니다. 그중 Weibo 댓글 73개는 스크립트가 아니라 저희가 직접 고른 게시물에서 나왔습니다. Zhihu 답변은 4개뿐입니다. 테마 규칙은 키워드 목록이어서 "주" 같은 짧은 단어가 우연히 일치할 수 있습니다. 결과는 의견 비율이 아니라 단서로 활용하세요.
넷째, 플랜 쿼터는 지원되는 도구에서만 쓸 수 있습니다. 사람이 개입하지 않고 타이머로 스크립트를 실행해 GLM에게 요약을 시키는 방식은 플랜 범위를 벗어나며, 표준 API가 필요합니다. 저희 설계에서는 타이머로 스크립트만 실행합니다. 요약은 사용자가 Claude Code를 열고 GLM에게 최신 파일을 읽어 달라고 요청할 때 작성됩니다.
다섯째, weibo/comments로 받은 Weibo 댓글에는 IP 위치 필드가 없습니다. 스레드 안의 답글은 weibo/comment_replies로 가져오며, 호출당 $0.000806이고 위치 정보가 포함됩니다. 지역별로 보려면 이 호출을 추가하세요.
13. GLM-5.3과 Coding Plan, 최근 무엇이 바뀌었나
모델 쪽에서는 QbitAI가 2026-10-12에 Zhipu가 ZCode 3.15.1에 GLM-5.3-Highspeed를 추가했다고 보도했습니다. 한 사용자는 초당 약 490 토큰을 측정했습니다(QbitAI). 이 모델은 현재 ZCode에서만 제공되며, Coding Plan 문서에는 Claude Code용으로 나와 있지 않습니다. 비전 MCP 패키지는 2026-10-29에 버전 0.1.6으로 업데이트되었습니다.
안전성 측면에서는 Anthropic이 2026-09-29에 연구 결과를 발표했습니다. GLM-5.3이 엔드투엔드 사이버 익스플로잇을 스스로 만들 수 있으며, 강력한 안전장치 없이 출시되었다는 내용입니다(Anthropic 연구). 2026-10-30에는 Help Net Security가 Irregular의 평가를 보도했습니다.
GLM-5.3은 시나리오 13개 중 어느 것도 거부하지 않았으며, 평가팀은 더 많은 자율성을 주기 전에 제한 장치를 테스트하라고 권고합니다(Help Net Security). 이 구성에서는 최소 권한을 지키라는 뜻입니다. Claude Code에서 GLM을 실행할 때 스크립트에 필요한 것은 폴더 하나와 API 하나뿐이며, 그 이상은 필요하지 않습니다.
가격 쪽에서는 Zhipu가 2026-10-16에 표준 키와 플랜 키를 분리했습니다. 2026-10-23에 36Kr은 Zhipu가 광군제(Singles' Day)에 실제로 할인을 제공한 몇 안 되는 업체 중 하나라고 보도했습니다. Lite 월간 카드는 CNY 118에서 CNY 115로 내려갔습니다(36Kr). 10월 말에는 BAAI 커뮤니티가 일부 플랜 사용자가 품질 저하 보상으로 쿼터 초기화 카드를 받았다고 전했습니다(BAAI Hub). 이는 "초기화 카드 배포 이후" 사용량을 언급한 Zhihu 댓글과 맞아떨어집니다. Zhipu 문서에서 이 카드에 관한 규정은 찾지 못했습니다.
| 날짜 | 변경 사항 | 출처 |
|---|---|---|
| 2026-09-29 | GLM-5.3 사이버 역량에 관한 Anthropic 연구 | Anthropic |
| 2026-10-12 | ZCode 3.15.1에 GLM-5.3-Highspeed 추가 | QbitAI |
| 2026-10-16 | 표준 키와 플랜 키 분리 | BigModel 공지 |
| 2026-10-23 | Lite 월간 카드 CNY 118에서 CNY 115로 인하 | 36Kr |
| 2026-10-29 | @z_ai/mcp-server 0.1.6 | npm |
| 2026-10-30 | Irregular의 GLM-5.3 평가 | Help Net Security |
| 2026-11-03 | Claude Code 2.1.317 | Claude Code 변경 내역 |
14. 시작하기: 단계별 안내
1~3단계는 설정 예시입니다. 4~6단계는 저희가 직접 실행했습니다.
- Z.ai에서 Coding Plan을 구독하고 플랜 키를 생성합니다.
- 4절과 같이
~/.claude/settings.json을 수정합니다. - 새 터미널을 열고
claude를 실행한 뒤/status를 입력해 모델을 확인합니다. - 빠른 시작에서 EveryInfra 키를 발급받아
EVERYINFRA_API_KEY로 추가합니다. - 7절의 프롬프트를 Claude Code에 입력합니다.
--weibo-posts 2 --zhihu-questions 2와--zhihu-title로 작게 시작하세요. - GLM에게 JSON을 읽고 요약을 작성하게 한 뒤, 제목 필터를 추가해 다시 실행합니다.
각 기능의 파라미터와 필드는 Zhihu API 페이지와 Weibo API 페이지에 있습니다. Zhihu 검색, Zhihu 댓글, 선택 사항인 Zhihu 콘텐츠 상세를 참고하세요. Weibo는 Weibo 검색과 Weibo 댓글을 참고하세요. 원격 MCP 도구 목록은 MCP 서버 페이지에, 카탈로그 가격은 요금 페이지에 있습니다.
함께 읽을 글: 정리 단계에서 모델별 성능과 비용이 궁금하다면 Claude Code에서 DeepSeek V4로 댓글 정리하기를 읽어 보세요. topic_pulse.py가 만든 JSON을 그 흐름에 바로 넣을 수 있습니다. Claude Code를 활용한 다른 데이터 패턴은 Xiaohongshu 댓글을 위한 Claude Code 동적 워크플로를 참고하세요. "좋아요 순으로 고르기"가 만드는 편향은 소셜 미디어 연구의 표본 무결성을, 실패한 호출의 환불은 실패 요청 환불 정산을 참고하세요.
FAQ
Claude Code에서 GLM 5.3은 어떻게 쓰고, [1m] 접미사는 왜 필요한가요?
4절처럼 ~/.claude/settings.json의 env 블록에 값을 설정합니다. 많은 사람이 놓치는 단계는 [1m] 접미사입니다. Claude Code는 glm-5.3 ID를 모르기 때문에 접미사가 없으면 컨텍스트 창을 200K로 가정하고 일찍 압축합니다. 변경한 뒤 새 터미널을 열고 /status로 모델 줄을 확인하세요. 질문 출처: "how to use glm 5.3 in claude code", "glm 5.3 claude code" 검색 추천어, 2026-11-04 확인. 근거: Z.ai Claude Code 가이드, Claude Code 모델 설정.
직접 만든 스크립트에서도 Coding Plan 쿼터를 쓸 수 있나요?
아니요. 플랜은 지원되는 도구에서만 쓸 수 있습니다. 직접 만든 앱, 사이트, 봇, SaaS 제품에서 호출하려면 표준 API가 필요합니다. 2026-10-16부터는 두 키 유형도 분리되었습니다. 그래서 저희 스크립트는 데이터만 가져오고, 요약은 Claude Code 안의 GLM이 작성합니다. 질문 출처: "glm coding plan limits" 검색 추천어, 2026-11-04 확인. 근거: Z.ai 사용 정책, Coding Plan 개요.
Claude Code용 GLM Coding Plan의 기본 URL과 엔드포인트는 무엇인가요?
Z.ai에서는 https://api.z.ai/api/anthropic을, BigModel에서는 https://open.bigmodel.cn/api/anthropic을 사용합니다. Codex 등 OpenAI 호환 도구에는 별도의 코딩용 URL이 있습니다. 일반 API URL로 호출하면 플랜 쿼터가 차감되지 않습니다. 질문 출처: "glm coding plan base url", "glm coding plan endpoint" 검색 추천어, 2026-11-04 확인. 근거: BigModel 모델 전환 가이드, Z.ai 빠른 시작.
스크립트 작성에는 GLM-5.3-Flash와 GLM-5.3 중 무엇을 골라야 하나요?
Z.ai에서 Flash는 입력 비용과 출력 비용 모두 GLM-5.3의 약 9분의 1입니다. 저희 추정으로는 스크립트 세션 1회에 Flash는 약 $0.04, GLM-5.3은 약 $0.34가 듭니다. 100줄짜리 데이터 스크립트라면 Flash로 시작하고, Flash가 버그를 고치지 못할 때만 GLM-5.3으로 바꾸세요. 질문 출처: "glm 5.3 flash vs glm 5.3", "glm 5.3 flash cost" 검색 추천어, 2026-11-04 확인. 근거: Z.ai 요금.
Coding Plan 기본 제공 웹 검색은 무엇을 반환하나요?
Zhipu 문서에 따르면 웹 검색은 제목, URL, 요약, 사이트 이름, 아이콘을 반환하고, 웹 리더는 제목, 본문 텍스트, 메타데이터, 링크를 반환합니다. 문서와 뉴스에 적합합니다. 주제 스크립트에는 좋아요 수와 날짜가 담긴 답변·댓글당 한 행의 데이터가 필요하며, 저희는 이를 위해 zhihu/search, zhihu/content_comments, weibo/search, weibo/comments를 사용합니다. Zhipu 계정이 없어 기본 제공 도구는 테스트하지 않았습니다. 질문 출처: "glm coding plan web search" 검색 추천어, 2026-11-04 확인. 근거: 웹 검색용 MCP, 웹 읽기용 MCP.
Zhihu에는 API가 있나요?
네. Zhihu 데이터 플랫폼은 검색과 인기 목록 엔드포인트를 제공합니다. 검색은 호출당 최대 10개의 발췌문을 추천 댓글과 함께 반환하며, Bearer 토큰과 타임스탬프 헤더를 사용합니다. 플랫폼 자체 인증을 거치는 작업에 적합합니다.
저희 스크립트는 호출당 답변 20건을 받는 zhihu/search와 댓글을 받는 zhihu/content_comments를 사용합니다. 2026-11-04 최종 실행에서는 Zhihu 댓글 21개를 읽었고, Zhihu 부분 비용은 $0.002224였습니다. 질문 출처: "zhihu com api" 검색 추천어, 2026-11-04 확인. 근거: Zhihu 개발자 문서: 검색, Zhihu 검색 기능 페이지.
참고 자료
- Z.ai: Claude Code 가이드
- Z.ai: Coding Plan 개요
- Z.ai: 최신 모델로 전환
- Z.ai: 사용 정책
- Z.ai: 빠른 시작
- Z.ai: 요금
- Z.ai 블로그: GLM-5.3
- BigModel: 모델 전환 가이드, 2026-11-04 확인
- BigModel: Claude Code 가이드
- BigModel: Claude Code 소개
- BigModel: Coding Plan 개요
- BigModel: Coding Plan 빠른 시작
- BigModel: Coding Plan 사용 참고 사항
- BigModel: Coding Plan FAQ
- BigModel: 플랜 개정 공지
- BigModel: API 키 공지, 2026-10-16
- BigModel: 웹 검색용 MCP
- BigModel: 웹 읽기용 MCP
- BigModel: zread MCP
- BigModel: 비전 MCP
- BigModel: 지원 도구
- BigModel: GLM-5.3 모델 페이지
- BigModel: GLM-5.3-Flash 모델 페이지
- BigModel: 요금
- BigModel: 릴리스 노트
- BigModel: 요금 관련 질문
- BigModel: API 관련 질문
- GLM Coding Plan 페이지, 2026-11-04 기준 가격
- Claude Code: LLM 게이트웨이
- Claude Code: 모델 설정
- Claude Code: 환경 변수
- Claude Code: MCP
- Claude Code: settings
- Claude Code: costs
- Claude Code: changelog, 2026-11-03 2.1.317
- Claude Code repository changelog
- MCP specification, 2026-07-28
- Zhipu glm-cookbook: Claude Code example
- npm: @z_ai/mcp-server
- npm: @z_ai/coding-helper
- Zhihu data platform
- Zhihu data platform: search
- Zhihu data platform: hot list skill
- Weibo open platform CLI
- Weibo CLI quick start
- Weibo API: comments/show
- Weibo API: search/topics
- Weibo API: rate limits
- EveryInfra 기능 카탈로그, 2026-11-04 확인
- SAFE: RMB central parity rates
- Anthropic: GLM-5.3 and the spread of advanced cyber capabilities, 2026-09-29
- Help Net Security: Irregular evaluation of GLM-5.3, 2026-10-30
- QbitAI: GLM-5.3-Highspeed at 490 tokens per second, 2026-10-12
- 36Kr: token plans on Singles' Day, 2026-10-23
- BAAI Hub: quality drop and reset cards
참고 BL-81