Campioni per la ricerca sui social media: ripeti la stessa ricerca e metà dei risultati cambia
Prima di usare i risultati di ricerca sui social media come campione di ricerca, verifica che il campione sia stabile. Il 24 ottobre 2026 abbiamo ripetuto le stesse query dopo due minuti. Su X, YouTube e TikTok coincideva solo circa la metà dei risultati. L'articolo tratta anche cancellazioni, duplicati, finestre temporali e lo stato dell'articolo 40 del DSA.
Una ricerca per parole chiave su una piattaforma social non ti dà un campione fisso. Il 24 ottobre 2026 (in questo articolo usiamo l'ora di Singapore, UTC+8) abbiamo inviato di nuovo le stesse quattro query dopo circa due minuti. Ogni volta abbiamo preso 25 risultati. Su X, YouTube e TikTok, la sovrapposizione di Jaccard tra le due esecuzioni era solo di 0,47–0,56. Tutti gli elementi «nuovi» della seconda esecuzione erano stati pubblicati prima della prima.
Una terza esecuzione due ore dopo ha dato una sovrapposizione con la prima di 0,52 su X e 0,22 su TikTok, ma di 0,92 su YouTube. Quindi registra l'ora della query, i parametri completi e la risposta grezza. Raccogli ogni query più di una volta e riporta la sovrapposizione. Altrimenti gli altri ricercatori non possono riprodurre il tuo campione, e nemmeno tu potrai farlo domani.
Questo articolo è pensato per i team di ricerca che usano dati dei social media o dei motori di ricerca. Tra gli ambiti interessati ci sono gli studi sulla comunicazione, la sanità pubblica, le scienze politiche, le scienze sociali computazionali e le unità di fact-checking. Descriviamo metodi di lavoro sui dati e numeri che puoi verificare. Non forniamo consulenza legale. Per i termini delle piattaforme e il Digital Services Act (DSA) dell'UE, leggi i testi originali e consulta il tuo comitato etico e l'ufficio legale per il tuo progetto.
Perché verificare il tuo campione adesso
Negli ultimi due mesi sono cambiati diversi canali di accesso ai dati delle piattaforme:
- Reddit ha fissato le date per chiudere la sua Data API pubblica. Reddit ha pubblicato le date su r/redditdev il 30 settembre 2026. Dal 31 ottobre non accetta più nuove richieste all'API pubblica. Dal 12 gennaio 2027 inizia a revocare l'accesso alle app che non si sono registrate. A marzo 2027 l'accesso pubblico viene chiuso per tutte le app rimanenti. TechCrunch ha riportato lo stesso giorno che sono coinvolti anche strumenti usati dai ricercatori.
- La Regola 8 di Reddit vieta l'uso dei contenuti eliminati. Il 24 ottobre abbiamo letto la pagina dell'Assistenza Reddit «Don't break the site». Indica che le app non devono «continuare a usare o mostrare contenuti pubblici eliminati dagli utenti o rimossi per violazioni delle Regole di Reddit». Elenca inoltre lo scraping «senza un accordo autorizzato» come possibile violazione.
- Le domande ai sensi dell'articolo 40 del DSA sono aperte, ma non c'è ancora nessun esito positivo pubblico. Oliver Marsh lavora per la ONG tedesca AlgorithmWatch. Il 2 ottobre ha scritto su DSA Observatory che a luglio 2026 erano state presentate 77 domande ai sensi dell'articolo 40, paragrafo 4. Nessuna risultava accolta. L'autorità irlandese Coimisiún na Meán ha pubblicato la sua relazione annuale 2025 il 7 ottobre. A pagina 81 si legge che la disposizione è entrata in vigore il 29 ottobre 2025 e che sono arrivate le prime domande.
- Reddit è ora una piattaforma online di dimensioni molto grandi. Il 31 agosto la Commissione europea ha designato Reddit e Roblox come piattaforme online di dimensioni molto grandi (VLOP). ChatGPT è diventato un motore di ricerca online di dimensioni molto grandi (VLOSE). Hanno quattro mesi, fino a gennaio 2027, per adeguarsi agli obblighi aggiuntivi delle VLOP, tra cui l'accesso ai dati previsto dall'articolo 40. Così la fine dell'API pubblica di Reddit e l'inizio dei suoi obblighi verso la ricerca ai sensi del DSA cadono nello stesso trimestre.
Quando i canali di accesso ai dati si restringono, i ricercatori devono dimostrare quanto sono completi i propri campioni. Il test che segue è un modo economico per farlo.
Il test: una query, tre esecuzioni
Abbiamo fissato prima i criteri. Abbiamo stabilito questa regola prima della terza esecuzione. Se due esecuzioni della stessa query hanno una sovrapposizione di Jaccard di 0,9 o più, per quell'endpoint basta una sola esecuzione. Se la sovrapposizione è inferiore a 0,9, raccogli più esecuzioni e riporta l'unione e la sovrapposizione. Se un nuovo elemento è stato pubblicato prima della prima esecuzione, lo consideriamo una differenza di ranking o di campionamento, non un nuovo post.
Configurazione. Quattro piattaforme, quattro endpoint, gli stessi parametri in tutte le esecuzioni, 25 risultati per chiamata:
- API di ricerca per Reddit (
reddit/search): parola chiaveDigital Services Act,sort=newest. - API di ricerca per Twitter (X) (
twitter/search): parola chiave tra virgolette,"Digital Services Act",sort=latest. - API di ricerca per YouTube (
youtube/search): parola chiaveDigital Services Act, ordinamento predefinito per pertinenza. - API di ricerca per TikTok (
tiktok/search): parola chiaveclimate change,content_type=video.
L'esecuzione A si è svolta dalle 12:13 alle 12:15, la B dalle 12:16 alle 12:17 e la C dalle 14:15 alle 14:18. Abbiamo confrontato gli ID degli elementi, non i titoli.


Risultati.
- X: le esecuzioni A e B avevano in comune 18 elementi su 25. La sovrapposizione di Jaccard era 0,56 e 7 dei primi 10 coincidevano. I 7 nuovi elementi dell'esecuzione B erano stati pubblicati tra aprile 2022 e agosto 2026. Nessuno era stato pubblicato tra le due esecuzioni. L'esecuzione C aveva un Jaccard di 0,52 con A e di 0,43 con B. Nelle tre esecuzioni sono comparsi 39 elementi diversi, e solo 14 erano presenti in tutte e tre. Il più recente dei 7 nuovi elementi dell'esecuzione C era stato pubblicato il 20 ottobre.
- YouTube: 16 elementi in comune, Jaccard 0,47, e solo 4 dei primi 10 coincidevano. I 9 elementi nuovi dell'esecuzione B erano stati pubblicati nel periodo 2022–2025. L'esecuzione C aveva un Jaccard di 0,92 con l'esecuzione A (differiva solo 1 elemento) ma di 0,43 con l'esecuzione B. L'esecuzione B sembra un insieme di risultati diverso, scomparso di nuovo due ore dopo. Nelle tre esecuzioni sono comparsi 35 elementi diversi, e 15 erano presenti in tutte e tre.
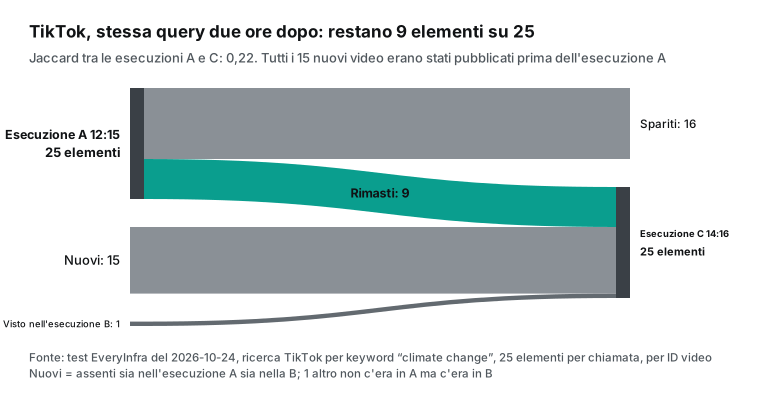
- TikTok: 16 elementi in comune, Jaccard 0,47. Però 9 dei primi 10 coincidevano, quindi la maggior parte dei cambiamenti si concentrava oltre la 12ª posizione. Il più recente dei 9 nuovi elementi era stato pubblicato alle 00:11 UTC del 24 ottobre, prima dell'esecuzione A. Dopo due ore la differenza era maggiore. L'esecuzione C aveva un Jaccard di 0,22 con A e di 0,19 con B. Nelle tre esecuzioni sono comparsi 49 elementi diversi, e solo 7 erano presenti in tutte e tre. Il più recente dei 15 nuovi elementi dell'esecuzione C era stato pubblicato alle 23:50 UTC del 23 ottobre, anch'esso prima dell'esecuzione A.
- Reddit (dal più recente): le esecuzioni A e B hanno restituito gli stessi 25 elementi nello stesso ordine. Nell'esecuzione C, due ore dopo, tutti i 25 elementi erano nuovi post pubblicati tra le 05:15 e le 06:12 UTC. Una finestra ordinata dal più recente avanza con il tempo. È proprio questo il significato di «newest», quindi non lo consideriamo instabilità.
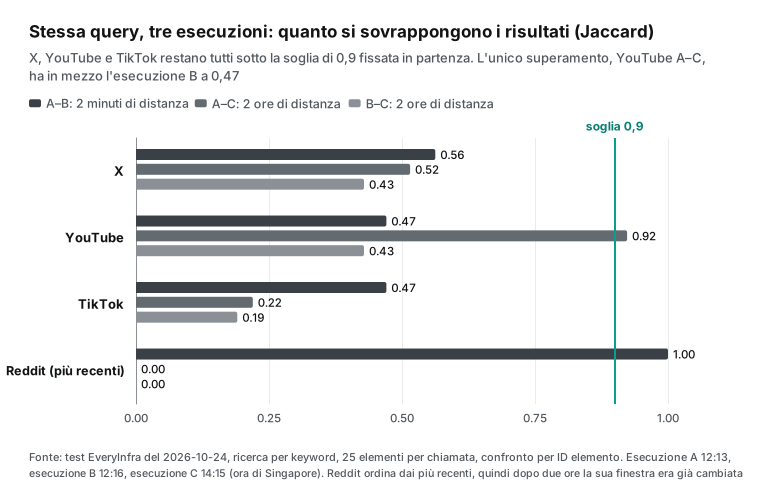
In base alla nostra stessa regola, le ricerche per parole chiave su X, YouTube e TikTok non forniscono un campione riproducibile con una sola esecuzione. L'unica coppia sopra 0,9 era quella delle esecuzioni A e C di YouTube, ma l'esecuzione B tra le due era a 0,47. Quindi un'unica sovrapposizione alta tra due esecuzioni non dimostra nulla.
Non è un difetto dello strumento. Il catalogo delle funzionalità di EveryInfra indica che X restituisce per impostazione predefinita i risultati «Top» e che latest non garantisce un ordine cronologico rigoroso. La documentazione ufficiale della YouTube Data API di Google dice che totalResults «è un'approssimazione e potrebbe non rappresentare un valore esatto». Una ricerca ordinata per pertinenza non è un elenco fisso.
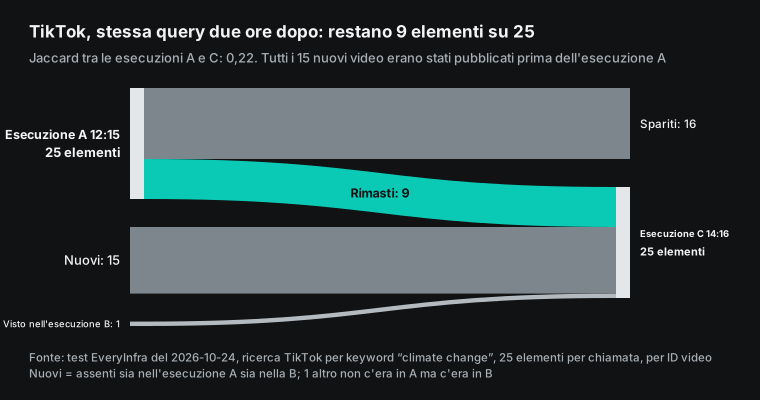
Limiti di questo risultato: abbiamo testato 4 query, 25 elementi ciascuna, con tre esecuzioni in un solo giorno. Non applicarlo ad archivi completi o a periodi più lunghi. Il risultato stabile di Reddit vale per l'ordinamento dal più recente su due minuti. Non dimostra che l'ordinamento per pertinenza su Reddit sia stabile.
La corrispondenza delle parole chiave è più ampia di quanto pensi
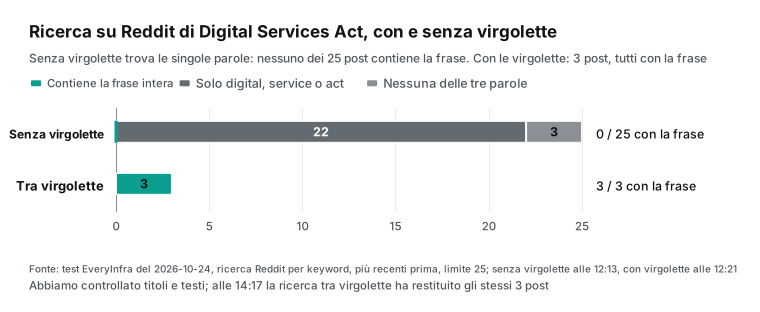
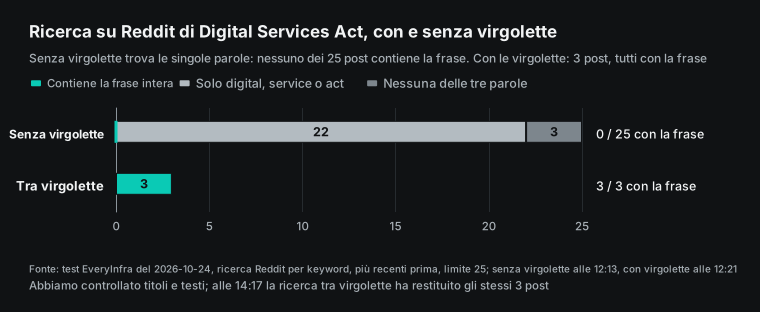
Lo stesso test ha mostrato un secondo problema. Su Reddit, una parola chiave composta da più parole senza virgolette trova le singole parole, non la frase.
- Nell'esecuzione A,
Digital Services Actsenza virgolette (dal più recente) ha restituito 25 post. Nessuno conteneva la frase completa nel titolo o nel testo. 22 contenevano almeno una delle parole (digital, service, act). I post erano pubblicità di casinò, consigli sentimentali e scambi di giochi. - Alle 12:21 abbiamo inviato
"Digital Services Act"tra virgolette, sempre dal più recente. La ricerca ha restituito 3 post, e tutti e 3 contenevano la frase completa. Erano un ricorso relativo a un account Instagram, un avviso su siti di incontri truffaldini e un post in tedesco su una truffa d'affitto. Il catalogo indica che questo endpoint cerca nell'ultimo mese, quindi questi 3 post sono tutto ciò che la ricerca dal più recente fornisce per quel mese. Alle 14:17 abbiamo ottenuto di nuovo gli stessi 3 post.
Anche il controllo di pertinenza può dare risultati errati. Per l'insieme di TikTok, abbiamo prima contato i post il cui testo conteneva «climate change». Ne corrispondevano solo 4 su 25. Poi abbiamo rimosso # e gli spazi dagli hashtag e rifatto il confronto. Ora ne corrispondevano 23 su 25. I 19 video che ci erano sfuggiti avevano solo #climatechange.
Cosa significa per uno studio: controlla a mano un campione per parole chiave e riporta la quota di elementi non pertinenti. Il corpus ISAAC (arXiv:2609.27059), pubblicato il 22 settembre, ha selezionato oltre 527 milioni di post di Reddit. I suoi autori hanno usato un filtro in più fasi, verificato da persone, per mantenere i contenuti non pertinenti sotto il 10%, e riportano questa quota per ogni gruppo. Senza un passaggio simile, un campione di «discussioni su Reddit sul DSA» può essere composto in gran parte da pubblicità di casinò.
Lo stesso elemento, due endpoint, due conteggi
Gli studi usano spesso like, visualizzazioni o commenti come variabili di esito o come pesi. Tra le 12:16 e le 12:21 del 24 ottobre abbiamo confrontato i conteggi nei risultati di ricerca con quelli degli endpoint per singolo elemento:
- YouTube: per un video pubblicato a giugno 2026, la ricerca indicava 4.650 like. Alle 12:19 l'API dei dettagli dei video di YouTube ne indicava 4.600. Visualizzazioni (48.406) e commenti (590) coincidevano e non erano cambiati alle 14:18. La differenza nei like dipende dalla precisione di visualizzazione, non da una variazione reale.
- TikTok: per un video sul clima pubblicato da The Guardian il 23 ottobre, la ricerca alle 12:17 mostrava 671.900 visualizzazioni, 90.300 like e 3.068 commenti. Alle 12:19 l'API dei dettagli dei video di TikTok mostrava 673.500, 90.500 e 3.074. Le visualizzazioni sono aumentate di 1.600 in due minuti e mezzo. Per questo video, visualizzazioni e like erano arrotondati alle centinaia, mentre i commenti erano esatti. Alle 14:17 abbiamo ricontrollato: 767.600 visualizzazioni, 101.600 like e 3.402 commenti. Le visualizzazioni erano cresciute di circa il 14% in due ore.
- X: abbiamo controllato il post della Commissione europea del 31 agosto sulle designazioni. La ricerca e l'API dei dettagli dei post di X (Twitter) indicavano entrambe 6.523.789 visualizzazioni e 4.668 like. Alle 14:17 le visualizzazioni erano 6.523.800 e i like ancora 4.668. Le ultime due cifre sono diventate 0. Può trattarsi di un arrotondamento o di 11 visualizzazioni in più. Un solo elemento non basta a capirlo, quindi registra anche la precisione di ogni conteggio.
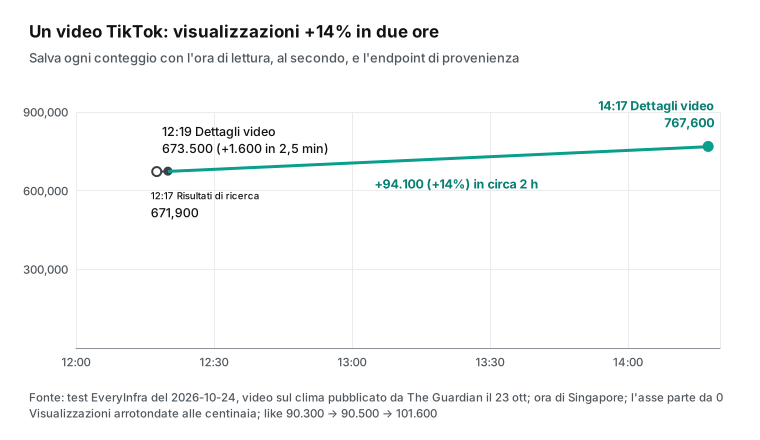
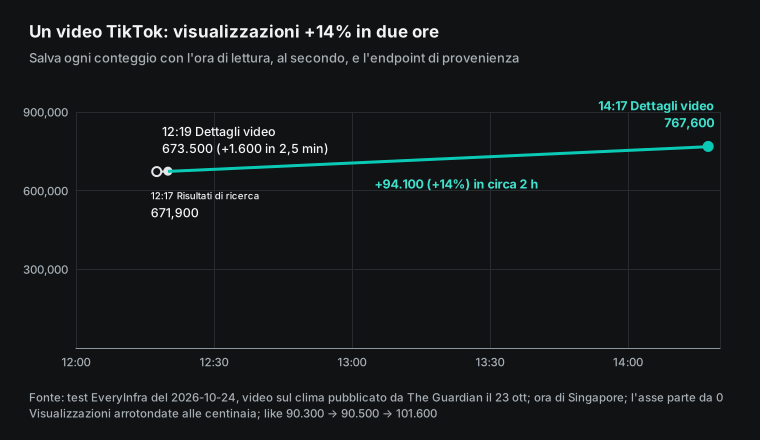
Quindi, per ogni conteggio, salva due informazioni: l'ora della rilevazione, con precisione al secondo, e l'endpoint che ha fornito il conteggio. I nuovi post crescono rapidamente nei primi giorni. Non confrontare un conteggio del mattino con uno del pomeriggio dello stesso giorno come se fossero equivalenti.
Duplicati e repost: un account, quattro post in nove minuti
Tra i 25 post non pertinenti di Reddit, 4 provenivano da un unico account. L'account li ha pubblicati in 4 community diverse nell'arco di 9 minuti (03:39–03:48 UTC). I testi erano quasi identici: la similarità di Jaccard degli shingle di 5 parole era 0,93–0,99. Un altro account ha pubblicato 3 pubblicità di casinò in 3 community non correlate.
Se la tua domanda è «quante persone discutono di questo tema», conta questi 4 post come una sola voce. Se la tua domanda è «come si diffondono i contenuti tra le community», questi post sono proprio il segnale da conservare. Suggeriamo questo metodo:
- Normalizza il testo: rimuovi link e punteggiatura e converti tutto in minuscolo.
- Segna come quasi duplicate le coppie con un Jaccard sugli shingle di 5 parole pari o superiore a 0,6.
- Usa l'autore e una finestra temporale (ad esempio, lo stesso autore entro 1 ora) per distinguere repost, cross-post e spam.
- Riporta la dimensione del campione prima e dopo la rimozione dei duplicati.
La stessa logica vale per i record delle attività commerciali su Google Maps: un ID di piattaforma ti dice che un record esiste. Non ti dice che il record è una voce o un'entità indipendente.
Cancellazioni e visibilità: i campioni si riducono
Anche i contenuti spariscono. Gli autori eliminano i post, le piattaforme li rimuovono e gli account vengono chiusi o diventano privati.
- Il dataset PoliTok-DE (arXiv:2509.15860) di Ruiz e colleghi contiene oltre 930.000 post di TikTok relativi a due elezioni tedesche. Oltre 330.000 sono stati successivamente eliminati: il 18,7% del campione della Sassonia e il 39,7% del campione federale. Nel campione federale, circa due terzi delle cancellazioni erano opera dei creator.
- Zubiaga (2018, JASIST) ha raccolto di nuovo 30 dataset di Twitter con oltre 147 milioni di tweet. Più un dataset era vecchio, minore era la quota ancora disponibile. Anche i metadati, come il numero di follower, sono diventati meno rappresentativi nel tempo.
Allo stesso tempo, i termini delle piattaforme impongono ai ricercatori di eliminare i dati:
- I TikTok Research Tools Terms si applicano dal 22 gennaio 2026. Devi aggiornare i dati di ricerca almeno ogni 30 giorni. A ogni aggiornamento, devi eliminare i dati non più disponibili. I ricercatori abilitati ai sensi del DSA possono spiegare nella loro richiesta perché queste regole bloccherebbero la loro ricerca.
- La X Developer Policy stabilisce che i contenuti di X archiviati devono corrispondere al loro stato attuale su X. Quando un contenuto cambia su X, modifica anche la tua copia. Fallo non appena ragionevolmente possibile, o entro 24 ore da una richiesta. I ricercatori accademici possono condividere gli ID dei post per ricerche non commerciali approvate per iscritto da X, o per la peer review.
- La Regola 8 di Reddit, citata sopra, vieta alle app di continuare a usare contenuti pubblici eliminati.
Ne nasce un conflitto: la riproducibilità richiede il campione originale, ma termini e privacy richiedono la cancellazione.
Una rassegna del 2026 su Political Communication indica i «limiti alla condivisione dei dati per la replicazione» tra le prime sfide dell'articolo 40. Un approccio praticabile: pubblica l'elenco degli ID, i parametri delle query, gli orari di raccolta e le statistiche aggregate. Conserva il testo completo solo in un ambiente controllato ed eliminalo come richiesto dai termini. A ogni nuova raccolta, riporta la quota che riesci ancora a recuperare. Tratta il tasso di cancellazione come un risultato del tuo articolo. Non sostituire il campione in silenzio.
Bias di campionamento: anche le interfacce per la ricerca mostrano solo una parte
Molti pensano che l'interfaccia per la ricerca di una piattaforma fornisca i dati completi. Gli audit recenti non lo confermano:
- In arXiv:2601.12390, Bekavac e Mayer hanno ricostruito i feed completi di due account di test sotto il loro controllo durante le elezioni. Hanno confrontato questi feed con i dati che TikTok Research API e Meta Content Library restituiscono per gli stessi post. Le interfacce per la ricerca escludevano fino a circa il 50% dei contenuti visti dagli utenti. Rimuovevano fino a circa l'83% dei metadati di contesto. Uno dei limiti era di non più di circa 1.000 richieste a settimana.
- La pagina di Meta Content Library fissa un limite per gli account personali. Ne include i post solo se l'account è verificato o ha almeno 100 follower. I piccoli account personali sono esclusi per scelta progettuale.
- WhichTok (arXiv:2608.09917), pubblicato il 10 agosto, ha confrontato tre strumenti di raccolta per TikTok: la TikTok Research API e due strumenti basati sul web. Le ricerche per hashtag e per parole chiave hanno mostrato le differenze maggiori. Solo l'endpoint utente ha dato risultati coerenti in tutti e tre.
- Nel 2025 arXiv:2506.09746 ha testato video provenienti da donazioni di dati. La TikTok Research API non ha restituito metadati per circa un video su otto, compresi video e annunci di TikTok stessa.
- Il problema non è nuovo. Morstatter e colleghi (2013) hanno confrontato la Streaming API campionata di Twitter con il Firehose completo. In Pfeffer e colleghi (2023), 80 studiosi hanno raccolto tutti i 375 milioni di tweet delle 24 ore a partire dal 21 settembre 2022. Il dataset è un riferimento per le ricerche successive.
Quindi, per ogni canale di accesso ai dati, annota cosa lascia fuori. Se possibile, verifica parte del campione con un secondo canale indipendente. Il nostro confronto tra ricerca e dettagli descritto sopra è un esempio economico.
Finestre temporali: «recente» non significa sempre la stessa cosa
L'intervallo temporale di una ricerca per parole chiave spesso non lo scegli tu:
- Il catalogo indica che la ricerca per parole chiave su Reddit copre l'ultimo mese, e l'ordinamento non cambia questo intervallo.
- La nostra esecuzione A su X usava
latest, ma i 25 post erano stati pubblicati tra agosto 2024 e ottobre 2026 (5 nel 2024, 11 nel 2025, 9 nel 2026). - I 25 risultati di YouTube in ordine di pertinenza erano stati pubblicati tra il 2020 e il 2026.
Per una serie temporale, non usare una ricerca per pertinenza come se rappresentasse «tutta la discussione in un periodo». Raccogli per community, account o canale e filtra per posted_at. Oppure usa la sintassi per le date della piattaforma nella parola chiave di X (la nota del catalogo per twitter/search riporta sintassi come since:). Nella sezione sui metodi, indica le date effettive di inizio e fine coperte dai tuoi dati.
Articolo 40 del DSA: a che punto siamo dopo un anno
L'articolo 40 del Digital Services Act offre ai ricercatori due strade:
- Articolo 40, paragrafo 12: dati pubblici. VLOP e VLOSE devono consentire l'accesso «senza indebito ritardo» ai dati pubblicamente accessibili nella loro interfaccia, «compresi, ove tecnicamente possibile, i dati in tempo reale». Il testo include i ricercatori «affiliati a organismi, organizzazioni e associazioni senza scopo di lucro». Il 5 dicembre 2025 la Commissione ha inflitto la sua prima sanzione ai sensi del DSA, di 120 milioni di euro, a X. Una delle violazioni era «la mancata concessione ai ricercatori dell'accesso ai dati pubblici». Tech Policy Press riassume la decisione. X vietava l'accesso ai ricercatori indipendenti, anche tramite scraping. Le quote e i periodi di accesso previsti erano troppo limitati.
- Articolo 40(4), dati non pubblici. I ricercatori abilitati presentano domanda tramite il Coordinatore dei servizi digitali (DSC) del proprio paese. Le regole sono nel Regolamento delegato (UE) 2025/2050, che si applica dal 29 ottobre 2025. Le domande passano dal portale di accesso ai dati del DSA. I DSC hanno fino a 80 giorni lavorativi per emettere una richiesta motivata. Le piattaforme devono pubblicare e aggiornare i cataloghi dei dati. La pagina dell'atto delegato della Commissione riporta il testo completo. Il DSC irlandese ha pubblicato la versione 2 delle sue linee guida a maggio 2026.
Lo stato attuale, secondo fonti dirette recenti:
- La richiesta di AlgorithmWatch è stata respinta dal DSC irlandese 80 giorni lavorativi dopo l'invio. I motivi: dettagli insufficienti su archiviazione dei dati e cybersecurity, e nessuna spiegazione del perché la quantità di dati fosse proporzionata. Dopo averla ripresentata, AlgorithmWatch ha dovuto aspettare altri 80 giorni lavorativi. Ai sensi dell'articolo 40(12), circa 20 organizzazioni hanno chiesto a sei piattaforme i 1.000 post più visti in ogni Stato membro ogni sei ore. Le trattative sono iniziate a ottobre 2025 e finora nessuna piattaforma ha accettato (DSA Observatory, 2 ottobre).
- Il paper di ICWSM 2026 The Great Data Standoff individua il problema di fondo. I ricercatori devono indicare i dati di cui hanno bisogno, ma non possono sapere quali dati detengano le piattaforme. Taylor Annabell della Cardiff University analizza i cataloghi dei dati pubblicati in Media, Technology and Governance (2026). Sostiene che le piattaforme restringono il concetto di «dati» a dataset predefiniti e aggregati.
- Smart Data Research UK ha finanziato la Social Platforms Data Access Taskforce. Il suo rapporto finale è uscito il 9 settembre ed è stato depositato nel repository il 6 ottobre. Raccoglie un anno di evidenze sugli ostacoli che incontrano i ricercatori.
- Anche i dati di trasparenza delle piattaforme hanno dei limiti. arXiv:2610.26226 (19 ottobre) riporta che oltre il 99,8% delle decisioni nel DSA Transparency Database cita i termini della piattaforma stessa, non una disposizione di legge.
Cosa significa per il disegno dello studio: l'articolo 40 è una strada che vale la pena percorrere, ma richiede anni, non settimane. Nell'attesa, gli studi basati su dati pubblici devono descrivere la completezza in modo ancora più chiaro. I revisori chiederanno quanto il tuo campione si discosta dal feed reale della piattaforma.
Etica della ricerca e termini delle piattaforme
Questi sono aspetti di metodo, non consulenza legale:
- Richiedi prima una valutazione etica. Le AoIR Internet Research Ethical Guidelines 3.0 sono il riferimento comune in questo campo. I dati pubblici non sono automaticamente liberi da usare. Valuta nel contesto il rischio per gli autori, soprattutto per salute, sessualità e opinioni politiche.
- Raccogli solo ciò che ti serve. Conserva solo i campi necessari alla tua domanda di ricerca. Sostituisci i nomi utente degli account personali con hash unidirezionali prima dell'analisi. Non citare frasi che un lettore può cercare per risalire al post originale. Questo articolo non nomina alcun account personale.
- Elimina quando i termini lo richiedono. Imposta raccolte ed eliminazioni periodiche e registra quanto hai eliminato.
- Leggi l'ambito di applicazione di ciascuna serie di condizioni. Le condizioni per la ricerca limitano l'area geografica, la finalità e chi può presentare domanda. Entrambi i percorsi previsti dall'articolo 40 del DSA sono limitati alla ricerca sui rischi sistemici nell'UE. Indica nella sezione sui metodi il percorso e le condizioni che hai utilizzato.
- Pubblica ciò che altri possono verificare. Di solito puoi pubblicare elenchi di ID, parametri delle query, orari di raccolta, risultati aggregati e codice. Gestisci il testo integrale come previsto dalle condizioni applicabili.
Una checklist per creare un campione verificabile da altri


- Scrivi i criteri. Prima di raccogliere, fissa la soglia di sovrapposizione e la quota massima di elementi non pertinenti. Decidi come riportare le eliminazioni.
- Fissa i parametri. Metti parola chiave, ordinamento, numero di elementi, lingua e regione in un file di configurazione. Tienilo sotto controllo di versione.
- Salva le risposte grezze. Conserva il JSON completo di ogni chiamata con l'ID della richiesta. Aggiungi un timestamp di lettura con precisione al secondo e il relativo fuso orario.
- Raccogli più di una volta. Esegui ogni query almeno due volte. Riporta unione, intersezione e sovrapposizione di Jaccard. Per gli endpoint instabili, usa l'unione come campione.
- Verifica la pertinenza a mano. Etichetta 50–100 elementi casuali e riporta la quota di elementi non pertinenti. Normalizza gli hashtag prima del confronto testuale.
- Rimuovi i duplicati. Usa testo normalizzato, similarità tra shingle, autore e finestra temporale. Riporta la dimensione del campione prima e dopo.
- Verifica i conteggi incrociandoli. Ricontrolla alcuni elementi con un endpoint per singolo elemento. Annota da quale endpoint e in quale momento proviene ogni conteggio.
- Raccogli di nuovo ed elimina. Ripeti la raccolta secondo la cadenza fissata dalle condizioni. Registra la quota ancora disponibile ed elimina i contenuti non più visibili.
Riproduci questo test con EveryInfra
Questa è la richiesta dell'esecuzione A per X. Sostituisci <API Key> con la tua chiave (vedi la guida rapida):
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer <API Key>" \
  -H "Content-Type: application/json" \
  -d '{"platform":"twitter","action":"search","params":{"keyword":"\"Digital Services Act\"","sort":"latest","limit":25}}'
La risposta contiene id (l'ID della richiesta), count, results e billing al primo livello. Questi campi dei risultati sono utili per un test di riproducibilità (il catalogo delle funzionalità è il riferimento per i nomi dei campi):
id: l'ID dell'elemento sulla piattaforma. Usalo per la sovrapposizione e la deduplicazione.url: il link al post originale, per nuove raccolte e controlli manuali.posted_at: l'orario di pubblicazione (UTC). Usalo per stabilire se un nuovo elemento è davvero un nuovo post.text,title: corpo e titolo (Reddit e YouTube prevedono un titolo), per i controlli di pertinenza e il rilevamento dei quasi duplicati.hashtags: includili nei controlli di pertinenza per TikTok e X.like_count,view_count,comment_count: conteggi. Salvali sempre insieme al timestamp di lettura.author_username: l'autore, usato per la finestra temporale per autore nella deduplicazione. Calcolane l'hash prima dell'analisi.community: il nome della community di Reddit, per individuare i cross-post.search_rank: la posizione nella ricerca di YouTube, per la sovrapposizione nella top 10.
Nei client AI come Claude o Cursor, puoi accedere agli stessi dati tramite MCP. A quel punto l'assistente può eseguire la checklist qui sopra. Per altri client, consulta la pagina del server MCP remoto:
export EVERYINFRA_API_KEY="<API Key>"
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope user \
  --header 'Authorization: Bearer ${EVERYINFRA_API_KEY}'
Poi chiama everyinfra_call_api con gli stessi parametri della richiesta curl. Usa everyinfra_requests per vedere l'addebito associato a ogni ID della richiesta.
Errori e addebiti:
unauthorized: chiave assente o non valida. Nessun addebito.unknown_paramo valore non valido: nome di parametro o valore enum errato. La risposta elenca i parametri validi e un esempio. Nessun addebito.- Risultato vuoto: per esempio, una parola chiave tra virgolette senza post corrispondenti questo mese. Ricevi un elenco vuoto e il preaddebito viene rimborsato.
- Funzionalità temporaneamente non disponibile: la risposta lo indica. Nessun addebito.
Per verificare i rimborsi uno per uno, vedi riconciliazione della fatturazione API. Per capire perché il catalogo in tempo reale è il riferimento per funzionalità e parametri, vedi il catalogo delle funzionalità in tempo reale.
Costo: un mese di monitoraggio della stabilità
Secondo il catalogo delle funzionalità consultato il 24 ottobre, reddit/search, twitter/search, youtube/search e tiktok/search costano $0,000556 per chiamata. Anche gli endpoint per singolo elemento youtube/video, tiktok/video e twitter/post costano $0,000556 per chiamata (il riferimento è la pagina Prezzi):
- 4 piattaforme, 5 parole chiave per piattaforma, una chiamata ogni 6 ore, 25 elementi per chiamata, per 30 giorni: 4 × 5 × 4 × 30 = 2.400 chiamate × $0,000556 = $1,33.
- Ogni settimana, ricontrolla i conteggi di 100 elementi con gli endpoint per singolo elemento, per 4 settimane: 400 chiamate × $0,000556 = $0,22.
- Totale: circa $1,56. I risultati vuoti e le chiamate non riuscite non vengono addebitati, quindi il costo reale può solo essere inferiore.
Tutte le chiamate live per questo articolo (tre esecuzioni di ricerca, i controlli per singolo elemento, la ricerca Reddit tra virgolette e quattro ricerche web che non abbiamo usato nel testo) sono costate in totale $0,015008 (26 chiamate).
Novità recenti (settembre–ottobre 2026)
- 30 settembre: Reddit pubblica il calendario di chiusura della sua API pubblica per i dati (r/redditdev). Per i ricercatori: gli script che usano l'API pubblica di Reddit devono passare al programma per ricercatori di Reddit, stipulare un accordo commerciale oppure seguire il percorso previsto dal DSA prima di marzo 2027. Documenta subito i campioni che hai già.
- 1° ottobre: Reddit aggiorna la sua pagina sul DSA (Reddit Help). Nel primo semestre 2026, Reddit ha avuto non più di 57,2 milioni di destinatari attivi mensili medi nell'UE. Per i ricercatori: gli obblighi di Reddit come VLOP partono a gennaio 2027, quindi puoi preparare già ora una richiesta ai sensi dell'articolo 40(12).
- **1° ottobre: Pote, Flammini e Menczer pubblicano arXiv:2610.02591.** Hanno studiato i metadati delle app di 43 operazioni di influenza rimosse da X. Le API fanno parte dell'infrastruttura della manipolazione coordinata. Hanno anche rilevato che la rimozione dei metadati a livello di app da parte di X ha eliminato un importante strumento di rilevamento. Per i ricercatori: quando una piattaforma rimuove un campo, un intero filone di ricerca può diventare impossibile da riprodurre. Conserva le risposte grezze.
- **29 settembre: arXiv:2609.38571 analizza le etichette AI su quattro piattaforme.** Ha raccolto 10.722 post con parole chiave legate ai rischi sistemici e all'AI. Solo il 33% dei deepfake identificati dagli esperti aveva un'etichetta della piattaforma. Per i ricercatori: anche questa è una quota che deriva da un campione per parole chiave, quindi è l'elenco delle parole chiave a determinare il denominatore.
- 2–6 ottobre: nuovi studi usano ampi campioni dalle piattaforme. arXiv:2610.09082 monitora i danni dell'AI in 5,7 milioni di riassunti di post Reddit nell'arco di 18 mesi. Due studi sulle alluvioni in Irlanda (arXiv:2610.03334, arXiv:2610.06330) usano query per parole chiave in Meta Content Library. Per i ricercatori: più è dettagliata la descrizione del campione, più i risultati reggono.
- **21 ottobre: un'analisi di Tech Policy Press.** Jen Rosiere Reynolds sostiene che la ricerca sui rischi dell'AI ha ora lo stesso problema di accesso ai dati della ricerca sui social media.
FAQ
Posso ancora usare l'API di Reddit per la ricerca accademica? (suggerimento di Google: «reddit api for academic research») Il post di Reddit del 30 settembre indica due date. Il termine per le nuove richieste di accesso all'API pubblica è il 31 ottobre 2026. L'accesso pubblico termina a marzo 2027. Nei commenti, uno sviluppatore suggerisce a chi non ha accesso all'API di verificare se Devvit o il programma per ricercatori sono adatti al proprio caso. Reddit ora è una VLOP, quindi da gennaio 2027 dovrà garantire ai ricercatori l'accesso ai dati ai sensi dell'articolo 40 del DSA. Se hai un progetto in corso, metti subito a punto la descrizione del campione e i log di raccolta.
Alcuni post del mio dataset di ricerca sono stati eliminati. Cosa devo fare? (suggerimento di Google: «deleted tweets research dataset») Di solito le condizioni delle piattaforme richiedono che li elimini anche tu. TikTok richiede un aggiornamento almeno ogni 30 giorni, con l'eliminazione dei dati non più disponibili. X richiede di eliminare o aggiornare la tua copia poco dopo una modifica. Per garantire la riproducibilità, pubblica gli ID, i parametri e le statistiche aggregate; quando ripeti la raccolta, indica la quota ancora recuperabile. Riporta il tasso di eliminazione tra i risultati.
Chi può presentare domanda ai sensi dell'articolo 40 del DSA? (suggerimento di Google: «dsa article 40 researchers») L'articolo 40(4) è rivolto ai ricercatori affiliati a un organismo di ricerca e indipendenti da interessi commerciali. Devono rispettare requisiti di sicurezza e riservatezza dei dati. Presentano domanda tramite un Coordinatore dei servizi digitali.
L'articolo 40(12), per i dati pubblici, include esplicitamente i ricercatori affiliati a enti, organizzazioni e associazioni senza scopo di lucro. Entrambi i percorsi valgono solo per la ricerca sui rischi sistemici nell'UE. AlgorithmWatch riferisce che una semplice richiesta quantitativa da parte di una ONG può superare il primo controllo. Devi però spiegare perché la quantità di dati è proporzionata. Verifica con il tuo istituto se hai i requisiti.
Letture correlate
- Scraping dei commenti di Reddit: MoreComments e replace_more di PRAW
- API dei commenti di YouTube senza risposte: la paginazione a due livelli
- Pagine delle piattaforme: API di scraping per Reddit, API di scraping per X (Twitter), API di scraping per YouTube, API di scraping per TikTok
Riferimenti
- «Moving Data API Apps to the Developer Platform: migration dates and next steps». Reddit (r/redditdev), 2026-09-30 (fonte primaria). https://www.reddit.com/r/redditdev/comments/1wubcvf/moving_data_api_apps_to_the_developer_platform/
- «Reddit is killing RSS feeds, ending public API access because of AI bots». TechCrunch, 2026-09-30 (fonte secondaria). https://techcrunch.com/2026/09/30/reddit-is-killing-rss-feeds-ending-public-api-access-because-of-ai-bots/
- «Don't break the site» (regola 8). Reddit Help, consultato il 2026-10-24 (fonte primaria). https://support.reddithelp.com/hc/en-us/articles/360043512931-Don-t-break-the-site
- «Two Stories of DSA Data (Non)-Access from an NGO perspective». DSA Observatory (Oliver Marsh, AlgorithmWatch), 2026-10-02 (fonte secondaria). https://dsa-observatory.eu/2026/10/02/two-stories-of-dsa-data-non-access-from-an-ngo-perspective/
- «Annual Report 2025». Coimisiún na Meán, 2026-10-07 (fonte primaria). https://www.cnam.ie/app/uploads/Coimisiun-na-Mean-Annual-Report-2025.pdf
- «Commission designates ChatGPT, Reddit, Roblox under DSA» (IP/26/1772). Commissione europea, 2026-08-31 (fonte primaria). https://ec.europa.eu/commission/presscorner/detail/en/ip_26_1772
- «Social data capability catalog». EveryInfra, consultato il 2026-10-24 (fonte primaria). https://api.everyinfra.com/api/v1/social/catalog
- «Search: list» (YouTube Data API). Google for Developers, consultato il 2026-10-24 (fonte primaria). https://developers.google.com/youtube/v3/docs/search/list
- «The Illinois Social Attitudes Aggregate Corpus (ISAAC)» (arXiv:2609.27059). Hemmatian et al., 2026-09-22 (fonte primaria). https://arxiv.org/abs/2609.27059
- «PoliTok-DE: A Multimodal Dataset of Political TikToks and Deletions From Germany» (arXiv:2509.15860). Ruiz et al., 2025-09-19 (fonte primaria). https://arxiv.org/abs/2509.15860
- «A longitudinal assessment of the persistence of Twitter datasets» (JASIST). Zubiaga, 2018 (fonte primaria). https://doi.org/10.1002/asi.24026
- «TikTok Research Tools Terms of Service». TikTok, 2026-01-22 (fonte primaria). https://www.tiktok.com/legal/page/global/terms-of-service-research-api/en
- «Developer Policy». X, consultato il 2026-10-24 (fonte primaria). https://developer.x.com/en/developer-terms/policy
- «Finally, Access: How Article 40 DSA Changes Platform Research in Practice» (Political Communication). Taylor & Francis, 2026 (fonte primaria). https://doi.org/10.1080/10584609.2026.2664157
- «Platforms' Research API Data Access: What Users See vs. What Researchers can Retrieve» (arXiv:2601.12390). Bekavac, Mayer, 2026-01-18 (fonte primaria). https://arxiv.org/abs/2601.12390
- «Meta Content Library and API». Meta Transparency Center, consultato il 2026-10-24 (fonte primaria). https://transparency.meta.com/researchtools/meta-content-library/
- «WhichTok? Comparing Three TikTok Data Acquisition Tools» (arXiv:2608.09917). Jeon et al., 2026-08-10 (fonte primaria). https://arxiv.org/abs/2608.09917
- «TikTok's Research API: Problems Without Explanations» (arXiv:2506.09746). arXiv, 2025-06-11 (fonte primaria). https://arxiv.org/abs/2506.09746
- «Is the Sample Good Enough? Comparing Data from Twitter's Streaming API with Twitter's Firehose» (arXiv:1306.5204). Morstatter et al., 2013-06-21 (fonte primaria). https://arxiv.org/abs/1306.5204
- «Just Another Day on Twitter: A Complete 24 Hours of Twitter Data» (arXiv:2301.11429). Pfeffer, Matter, Jaidka et al., 2023-01-26 (fonte primaria). https://arxiv.org/abs/2301.11429
- «Regulation (EU) 2022/2065 (Digital Services Act)». EUR-Lex, 2022-10-19 (fonte primaria). https://eur-lex.europa.eu/eli/reg/2022/2065/oj
- «Commission fines X €120 million under the Digital Services Act». Commissione europea, 2025-12-05 (fonte primaria). https://digital-strategy.ec.europa.eu/en/news/commission-fines-x-eu120-million-under-digital-services-act
- «What the X Fine Reveals About Data Access Under Article 40 of the Digital Services Act». Tech Policy Press, 2026-02-12 (fonte secondaria). https://www.techpolicy.press/what-the-x-fine-reveals-about-data-access-under-article-40-of-the-digital-services-act/
- «Digital Services Act – sharing platform and search engine data with vetted researchers» (sintesi del Regolamento delegato (UE) 2025/2050). EUR-Lex, 2026-01-28 (fonte primaria). https://eur-lex.europa.eu/EN/legal-content/summary/digital-services-act-sharing-platform-and-search-engine-data-with-vetted-researchers.html
- «DSA data access portal». Commissione europea, consultato il 2026-10-24 (fonte primaria). https://data-access.dsa.ec.europa.eu/
- «Delegated act on data access under the Digital Services Act (DSA)». Commissione europea, 2025-07-02 (fonte primaria). https://digital-strategy.ec.europa.eu/en/library/delegated-act-data-access-under-digital-services-act-dsa
- «DSA Article 40(4)–(11) Data Access Guidance, V2». Coimisiún na Meán, 2026-05 (fonte primaria). https://www.cnam.ie/app/uploads/2026/05/DSA-Article-40-4-11-Data-Access_Guidance_V2_-.pdf
- «The Great Data Standoff: Researchers vs. Platforms Under the Digital Services Act» (ICWSM 2026). Goanta et al., 2026 (fonte primaria). https://ojs.aaai.org/index.php/ICWSM/article/view/42671
- «Regulating a Floating Signifier: Interpretations of "Data" in the DSA Researcher Access Provision» (Media, Technology and Governance). Annabell, 2026 (fonte primaria). https://doi.org/10.1177/29777984261486601
- «Social Platforms Data Access Taskforce: Final Report». Smart Data Research UK / University of Sheffield, 2026-09-09 (depositato il 2026-10-06) (fonte primaria). https://eprints.whiterose.ac.uk/id/eprint/246345/
- «Towards More Granular Reasoning: Mapping the DSA Transparency Database Taxonomy to Platform Terms and Conditions» (arXiv:2610.26226). Ranucci, Leijten, Graus, 2026-10-19 (fonte primaria). https://arxiv.org/abs/2610.26226
- «Internet Research: Ethical Guidelines 3.0». Association of Internet Researchers (AoIR), 2019 (fonte primaria). https://aoir.org/reports/ethics3.pdf
- «Digital Services Act (DSA): Information for EU users». Reddit Help, 2026-10-01 (fonte primaria). https://support.reddithelp.com/hc/en-us/articles/23595536875796-Digital-Services-Act-DSA-Information-for-EU-users
- «Information Operations Exploit APIs to Manipulate Social Media» (arXiv:2610.02591). Pote, Flammini, Menczer, 2026-10-01 (fonte primaria). https://arxiv.org/abs/2610.02591
- «Drowning in AI Slop: How Social Media Platforms (Do Not) Label AI and Deepfake Content under EU law» (arXiv:2609.38571). Rijsbosch et al., 2026-09-29 (fonte primaria). https://arxiv.org/abs/2609.38571
- «Move Fast and Mend Things: Keeping Up with Evolving AI Harms Using Social Media Commentary» (arXiv:2610.09082). Rowe et al., 2026-10-06 (fonte primaria). https://arxiv.org/abs/2610.09082
- «A population-level assessment framework for flood-related wellbeing from public discourse in Ireland» (arXiv:2610.03334). Luo, Morrissey, 2026-10-02 (fonte primaria). https://arxiv.org/abs/2610.03334
- «Assessing flood-related wellbeing from public discourse in Ireland using large language model as judge, 2012–2025» (arXiv:2610.06330). Luo, Morrissey, 2026-10-05 (fonte primaria). https://arxiv.org/abs/2610.06330
- «You Can't Solve AI Risk Without Solving the AI Evidence Problem». Tech Policy Press (Jen Rosiere Reynolds), 2026-10-21 (fonte secondaria). https://www.techpolicy.press/you-cant-solve-ai-risk-without-solving-the-ai-evidence-problem
Riferimenti BL-33