Gemini Deep Research API con un servidor MCP remoto: datos sociales que se pueden verificar
La Gemini Deep Research API acepta MCP remoto, pero no funciones propias. 7 llamadas reales a datos sociales costaron $0.0046: conexión, precio y citas.
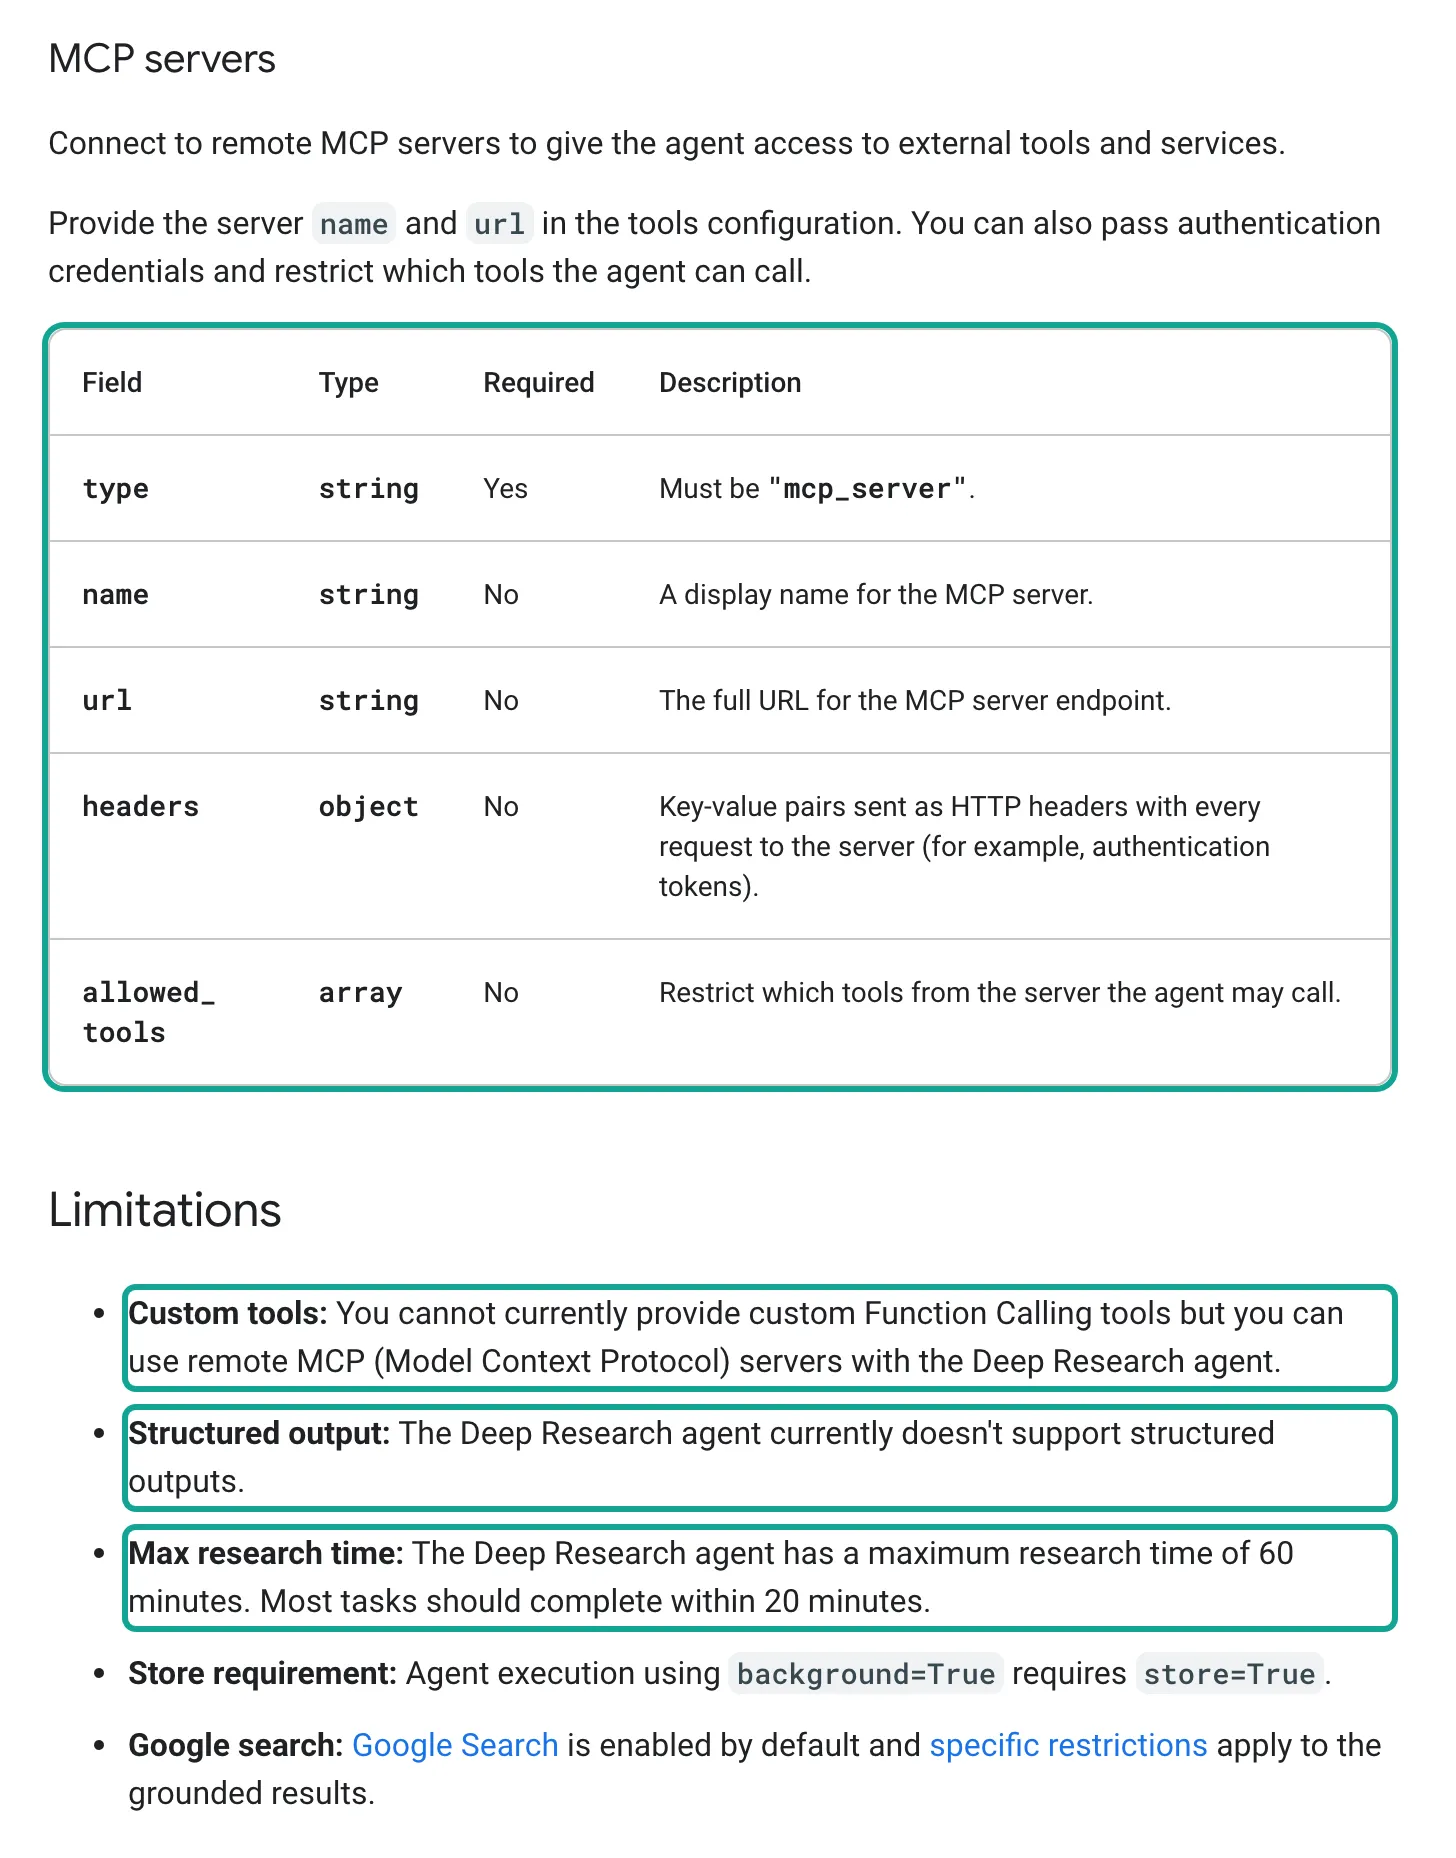
La respuesta corta es sí. La Gemini Deep Research API ya puede llamar a un servidor MCP remoto. No acepta declaraciones de funciones propias y tampoco admite salida estructurada. Las tres cosas aparecen en la sección «Limitations» de la página de Deep Research de Google (documentación de Deep Research, actualizada el 2026-10-13). Por eso puedes darle la dirección del servidor MCP remoto de EveryInfra, https://api.everyinfra.com/mcp.
El 2026-11-02, entre las 00:16 y las 00:20 hora de Singapur, hicimos 7 llamadas reales a nuestra API de datos sociales y noticias. Devolvieron 131 filas y costaron $0.0046 en total. Lo que más afecta a la verificación de las citas no fue el modelo, sino los propios datos. Las 10 noticias en español llegaron sin fecha de publicación. Ninguno de los 50 comentarios de YouTube traía enlace, mientras que los 35 comentarios de Reddit traían enlace permanente y hora exacta.
Este artículo responde a una pregunta práctica. Quieres que Gemini Deep Research escriba un informe sobre un tema público. También quieres que cada afirmación sobre redes sociales apunte a una fila que el lector pueda abrir. ¿Cómo le das al agente datos sociales estructurados para conseguirlo?
Elegimos como tema los incendios por baterías de bicicletas eléctricas en la prensa en español de Estados Unidos. En octubre de 2026 hubo varios casos con víctimas en el Bronx y en Filadelfia. Univision, Telemundo y Spectrum Noticias los cubrieron en pocos días, y también hubo hilos en Reddit y videos en YouTube. Es un buen tema para probar cuatro tipos de fuente a la vez.
Todos los datos sobre Google salen de páginas de ai.google.dev, de la documentación de Google Cloud o del blog de Google. No tenemos clave de la API de Gemini y no ejecutamos Deep Research. Por eso todo el código de Gemini que aparece abajo es un ejemplo de configuración, no un resultado de prueba. Cada número de EveryInfra viene de las respuestas originales de nuestras llamadas reales.
¿Puede la Gemini Deep Research API conectarse a un servidor MCP remoto?
Sí. La página de Deep Research enumera cinco tipos de herramienta. Tres vienen activadas por defecto: google_search, url_context y code_execution. Las otras dos hay que añadirlas: mcp_server y file_search (documentación de Deep Research, «Supported tools»). La función llegó el 2026-04-21 junto con los nuevos agentes de Deep Research. La entrada del registro de cambios menciona la planificación colaborativa, la visualización, la integración con servidores MCP y File Search (registro de cambios de la API de Gemini).
La herramienta mcp_server tiene cinco campos. type es obligatorio y debe valer "mcp_server". name es un nombre visible y url es la dirección completa del punto de acceso MCP. headers contiene cabeceras HTTP que acompañan a cada petición, y la documentación pone como ejemplo un token de autenticación. allowed_tools limita qué herramientas de ese servidor puede llamar el agente.
Las funciones propias son otra cosa. La primera limitación de la misma página dice que, por ahora, no se le pueden dar a Deep Research herramientas propias de Function Calling. Añade que sí se pueden usar servidores MCP remotos. La segunda limitación es que no admite salida estructurada. La tercera fija un tiempo máximo de investigación de 60 minutos, y la mayoría de las tareas deberían terminar en menos de 20.
Hay dos frases en las páginas de Google que pueden confundir. El artículo del blog de Google que presentó Deep Research Max dice que Deep Research admite «definiciones de herramientas arbitrarias» (blog de Google, 2026-04-21). Leída junto a la documentación, la frase se refiere a herramientas expuestas mediante MCP, no a declaraciones de funciones en la petición. La página general de la Interactions API también dice que Gemini 3 todavía no admite MCP remoto (página general de la Interactions API, actualizada el 2026-10-15). Esa nota habla de los modelos que se llaman con el parámetro model. Deep Research es un agente que se llama con el parámetro agent, así que la nota no se le aplica.
| Pregunta | Respuesta en la documentación de Google | Fuente y fecha |
|---|---|---|
| ¿Servidor MCP remoto? | Sí, tipo mcp_server con headers y allowed_tools | Documentación de Deep Research, 2026-10-13 |
| ¿Funciones propias? | No, por ahora | Misma página, Limitations |
| ¿Salida JSON estructurada? | No | Misma página, Limitations |
| ¿Duración máxima? | 60 minutos, casi siempre menos de 20 | Misma página, Limitations |
| ¿Hace falta modo en segundo plano? | Sí, background=true con store=true | Misma página y documentación de ejecución en segundo plano |
| Límites de contexto y salida | 1,048,576 tokens de entrada y 65,536 de salida | Página del modelo, 2026-10-29 |
| Nombres de agente | deep-research-preview-04-2026, deep-research-max-preview-04-2026 | Página del modelo, registro de cambios |
Así que las dos rutas de nuestro plan funcionan, pero cambia su orden. En la ruta A pones nuestra dirección MCP en tools. El agente decide por su cuenta cuándo buscar en Reddit o cuándo pedir noticias durante la investigación. En la ruta B, tu programa llama primero a POST /api/v1/social, convierte los resultados en una tabla y se la entrega al agente como entrada o como documentos de File Search.
La ruta B no es obligatoria, pero es la más segura si quieres citas verificables. La razón está en los datos, no en Gemini, y las cuatro pruebas de este artículo lo muestran.
Cómo se llama a la Gemini Deep Research API: segundo plano, consulta periódica y streaming
Deep Research solo funciona a través de la Interactions API, no con el método antiguo generateContent. La Interactions API se lanzó el 2025-12-11 y pasó a disponibilidad general en junio de 2026. Google la presenta ahora como la interfaz por defecto para proyectos nuevos (página general de la Interactions API).
Una llamada a Deep Research se diferencia de una llamada normal a un modelo en tres puntos. Se usa el parámetro agent, no model. Hay que poner background=true, y la API devuelve al instante un objeto parcial con un id. Después consultas el estado con ese id o abres un flujo de eventos. El bloque siguiente sigue el ejemplo REST de la documentación y es un ejemplo de configuración que no ejecutamos.
# Ejemplo de configuración: iniciar Deep Research con el servidor MCP remoto de EveryInfra (no lo ejecutamos)
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "Content-Type: application/json" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -d '{
    "agent": "deep-research-preview-04-2026",
    "input": "Investiga cómo cubrieron los medios en español de EE. UU. los incendios por baterías de bicicletas eléctricas en octubre de 2026, y qué se dijo en Reddit y YouTube. En cada afirmación sobre redes sociales, cita el id y la url de la fila que devolvió la herramienta de EveryInfra. Si una fecha es aproximada, dilo.",
    "tools": [
      {"type": "google_search"},
      {"type": "url_context"},
      {"type": "mcp_server",
       "name": "EveryInfra",
       "url": "https://api.everyinfra.com/mcp",
       "headers": {"Authorization": "Bearer '"$EVERYINFRA_API_KEY"'"},
       "allowed_tools": ["everyinfra_list_capabilities", "everyinfra_call_api", "everyinfra_get_job"]}
    ],
    "agent_config": {"type": "deep-research", "thinking_summaries": "auto"},
    "background": true
  }'

# Consultar el estado (cambia INTERACTION_ID por el id de la primera respuesta)
curl "https://generativelanguage.googleapis.com/v1beta/interactions/INTERACTION_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"
Una interacción en segundo plano tiene cinco estados: in_progress, requires_action, completed, failed y cancelled (documentación de ejecución en segundo plano). background=true exige store=true, y si mandas store=false en segundo plano recibes un error 400. Las interacciones guardadas se conservan 55 días en el nivel de pago y 1 día en el gratuito. En el nivel de pago se puede cambiar a 7, 14 o 28 días desde AI Studio.
Esto importa para los datos. La clave de EveryInfra que pones en headers no aparece dentro de la interacción. Pero cada fila de datos sociales que el agente obtiene queda guardada como un paso, con el plazo de conservación que acabamos de ver.
El streaming necesita stream=true y background=true a la vez. Para ver los resúmenes de razonamiento durante la tarea, también hay que poner agent_config.thinking_summaries en "auto". El ejemplo de la documentación maneja las desconexiones. Guarda el interaction_id y el último event_id, y tras un corte llama a GET /interactions/{id}?stream=true&last_event_id=... para seguir. La documentación nombra un tiempo de espera de 600 segundos como una de las causas de corte, así que esta reconexión no es opcional en una tarea larga.
| Campo de `agent_config` | Valor por defecto | Qué hace | Por qué importa aquí |
|---|---|---|---|
type | Obligatorio, "deep-research" | Marca la llamada como Deep Research | — |
thinking_summaries | "none" | Con "auto" se ven los pasos en el flujo | Ves cuándo el agente llama al MCP |
visualization | "auto" | Permite gráficos, pero solo los dibuja si el prompt los pide | Pide los gráficos en el prompt |
collaborative_planning | false | Devuelve primero un plan; lo cambias con previous_interaction_id y en el último turno pones false. Responder «me parece bien» sin cambiar el interruptor no genera informe (Philipp Schmid, 2026-04-29) | Limitas las capacidades en la fase de plan |
Gemini Deep Research API pricing: de $1 a $3 por tarea, de $3 a $7 con Max
Google no le pone a Deep Research un precio propio. Pagas por separado la inferencia del modelo y el uso de herramientas (página de precios, «Pricing for agents», actualizada el 2026-10-30). Toda la inferencia se cobra a las tarifas normales de Gemini, incluidos los tokens intermedios del ciclo del agente. Las herramientas se cobran a su propia tarifa. Los resultados de la Búsqueda de Google no cuentan como tokens, pero el contenido que traen URL Context y File Search sí cuenta.
La página de Deep Research da una estimación de costo (documentación de Deep Research, «Estimated costs»). Una tarea normal de análisis moderado usa unas 80 búsquedas y 250,000 tokens de entrada, con un 50% a 70% en caché. También usa unos 60,000 tokens de salida, para un total aproximado de $1 a $3. Una tarea de Max para un análisis competitivo profundo usa hasta unas 160 búsquedas, 900,000 tokens de entrada y 80,000 de salida. Su estimación va de $3 a $7.
La página de precios también da el precio de la Búsqueda de Google. Gemini 3 y los modelos posteriores comparten 5,000 búsquedas gratuitas al mes. Después, cuestan $14 por cada 1,000, y cada proyecto tiene un tope diario por defecto de 1,500 búsquedas. La documentación no aclara si las búsquedas internas de Deep Research se cobran a ese precio ni si cuentan para el tope diario. Si cuentan, el tope da para unos 18 informes al día con 80 búsquedas cada uno. No ejecutamos Deep Research, así que revisa el usage de tu propia factura.
También hay límites por gasto, y es fácil pasarlos por alto. La página de límites de uso dice que la API de Gemini limita el gasto en una ventana móvil de 10 minutos. El límite es de $10 en el nivel 1, $50 en el nivel 2 y $200 en el nivel 3. Un proyecto que lo supera recibe 429 RESOURCE_EXHAUSTED (límites de uso, actualizada el 2026-10-28). A $3 por tarea, un proyecto del nivel 1 puede tocar el límite con tres o cuatro tareas en 10 minutos.
Pasar al nivel de pago tiene su propio paso. La página de facturación explica que hay que vincular una cuenta de facturación para salir del nivel gratuito. Las cuentas nuevas reciben por defecto el plan de prepago, con una recarga mínima de $5 (documentación de facturación). Las peticiones fallan cuando se acaba el saldo prepagado. En un proyecto que ejecuta informes programados, deja saldo suficiente o activa la recarga automática.
Los equipos con muchos informes pueden mirar Google Cloud. La página de Deep Research de Google Cloud describe la opción service_tier="deferred" cuando stream=false. Esa opción mueve las tareas en segundo plano a horas de menor demanda a mitad de precio (documentación de Deep Research en Google Cloud).
| Concepto | Precio (leído el 2026-11-02) | Uso en una tarea de Deep Research |
|---|---|---|
| Inferencia del modelo | Tarifas normales de Gemini, con tokens intermedios | Unos 250k de entrada y 60k de salida (Max: 900k y 80k) |
| Búsqueda de Google | 5,000 gratis al mes, luego $14 por 1,000, tope de 1,500 al día | Unas 80 búsquedas (Max: unas 160) |
| URL Context | El contenido se cobra como tokens de entrada | Depende de las páginas leídas |
| File Search | Indexación a $0.15 por millón de tokens; almacenamiento y consultas gratis | Solo si subes archivos |
| Ejecución de código | Código y resultados se cobran como tokens | Si el agente calcula o hace gráficos |
| Datos sociales de EveryInfra | price_usd del catálogo por llamada; sin cargo por fallos o resultados vacíos | 23 llamadas por informe, unos $0.0135 |
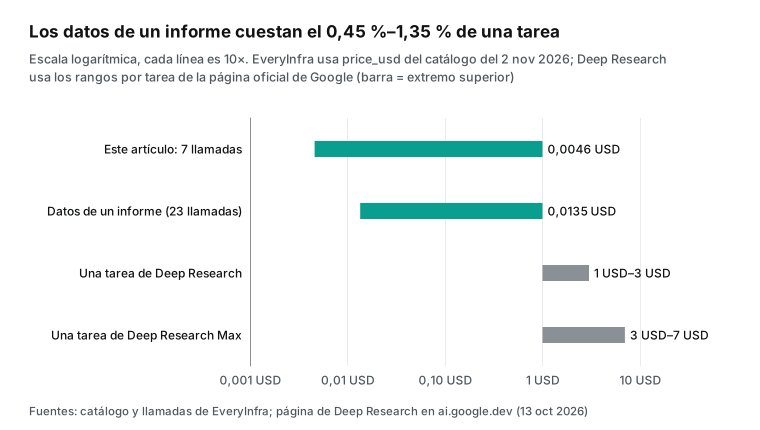
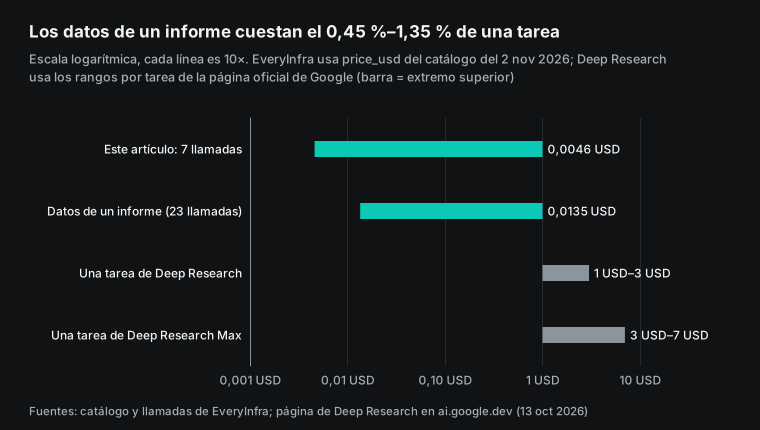
La parte de datos sociales de la factura es pequeña. Con los precios del catálogo del 2026-11-02, google_news/search cuesta $0.000792 por llamada. reddit/search, reddit/comments, youtube/search y youtube/comments cuestan $0.000556 por llamada. Cada llamada tiene un único precio, sin importar el número de filas.
Supón que un informe usa 3 búsquedas de noticias, 3 búsquedas en Reddit, los comentarios de 10 hilos de Reddit, 2 búsquedas en YouTube y los comentarios de 5 videos. Son 23 llamadas y $0.0135, entre el 0.45% y el 1.35% de una tarea de Deep Research. El costo del informe depende de Deep Research, no de los datos. Lo que merece tu atención es si esos datos se pueden verificar.
| Capacidad | Precio de catálogo por llamada | Llamadas por informe | Subtotal |
|---|---|---|---|
google_news/search | $0.000792 | 3 (español, inglés, chino) | $0.002376 |
reddit/search | $0.000556 | 3 | $0.001668 |
reddit/comments | $0.000556 | 10 | $0.005560 |
youtube/search | $0.000556 | 2 | $0.001112 |
youtube/comments | $0.000556 | 5 | $0.002780 |
| Total | — | 23 | $0.013496 |
Cuánto tarda: minutos en Deep Research, 77 segundos en nuestras 7 llamadas
Deep Research trabaja durante minutos. La tabla comparativa de la documentación da la latencia de un modelo normal en segundos y la de Deep Research en minutos, asíncrona y en segundo plano. El máximo es de 60 minutos y casi todas las tareas terminan en 20.
El 2026-03-05, un usuario del foro que hace investigación de cumplimiento normativo contó que una ejecución del agente antiguo tardó unos 7 minutos. Ejecuciones posteriores con prompts parecidos se quedaron en in_progress. El flujo mostraba cuatro o cinco pasos de razonamiento y luego la conexión se cortaba sin error (hilo del foro de desarrolladores). Tu código de consulta necesita su propio tiempo límite para in_progress, no solo manejar completed y failed.
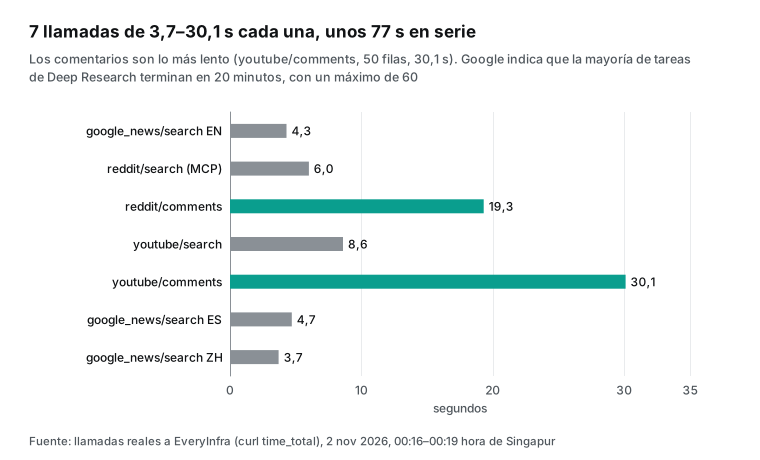
Nuestras 7 llamadas tardaron unos 77 segundos en serie. Los comentarios fueron lo más lento: 30.1 segundos para 50 comentarios de YouTube y 19.3 segundos para 35 de Reddit. Las búsquedas de noticias tardaron entre 3.7 y 4.7 segundos. En la ruta A, el agente espera a cada llamada. Una docena de llamadas de comentarios suma unos minutos a una tarea que ya dura muchos minutos.
Las peticiones lentas, como los comentarios, no deberían dejar al agente esperando. La descripción de la herramienta everyinfra_call_api le dice qué hacer. Para tareas lentas o un limit alto, indica pasar mode=async. El agente recibe al momento un job_id y lee el resultado con everyinfra_get_job, que es gratis.
Nuestras 7 respuestas síncronas traían además un async_hint que apunta al modo asíncrono, así que el agente puede leerlo. En la ruta B, tu programa puede lanzar las llamadas en paralelo. Unas decenas de llamadas terminan en uno o dos minutos, y luego entregas todo a Deep Research de una vez.
Formato de las citas: url_citation, file_citation y posiciones en bytes
Deep Research no escribe notas al pie dentro del texto del informe. Añade las citas al arreglo annotations del paso de salida. La referencia de la Interactions API enumera varios tipos de anotación (referencia de la API, actualizada el 2026-10-28). Aquí importan dos. url_citation tiene cuatro campos: url, title, start_index y end_index. file_citation tiene document_uri, file_name, source, custom_metadata, page_number y media_id, además de los mismos dos índices.
La referencia aclara que los índices cuentan bytes y que end_index es exclusivo. Esto es importante en un informe en español. En UTF-8, cada vocal con tilde, cada «ñ» y cada «¿» ocupan 2 bytes. Si cortas la cadena de Python con esos índices, cada cita posterior al primer acento se desplaza. Codifica primero el texto a bytes y corta después. El código siguiente usa los nombres de campo de la referencia y es un ejemplo de configuración.
# Ejemplo de configuración: llevar las citas de Deep Research a su fragmento de texto (campos según la referencia de la Interactions API)
def cited_spans(interaction):
    out = []
    for step in interaction["steps"]:
        if step.get("type") != "model_output":
            continue
        for block in step.get("content", []):
            if block.get("type") != "text":
                continue
            raw = block["text"].encode("utf-8")          # los índices cuentan bytes
            for a in block.get("annotations", []):
                span = raw[a["start_index"]:a["end_index"]].decode("utf-8", "replace")
                meta = {m["key"]: m.get("string_value", m.get("numeric_value"))
                        for m in a.get("custom_metadata", [])}
                out.append({"type": a["type"], "text": span,
                            "url": a.get("url") or meta.get("source_url"),
                            "row_id": meta.get("row_id")})
    return out
Las llamadas MCP y sus resultados aparecen como otros dos tipos de paso. mcp_server_tool_call tiene name, server_name, arguments e id. mcp_server_tool_result tiene call_id y result, y call_id lo une con su llamada. La referencia no dice si los resultados MCP generan entradas url_citation. Así que en la ruta A no des por hecho que una frase sobre un hilo de Reddit llevará la dirección del hilo como cita.
Un método más seguro es pedirle al agente que escriba el id y la url de la fila dentro de la frase. Al terminar, compruebas cada una con los pasos mcp_server_tool_result guardados. En la ruta B con File Search, el custom_metadata que añades a cada documento vuelve dentro de file_citation (documentación de File Search, «Citations», actualizada el 2026-10-13). Es la única forma documentada de recuperar tus propios identificadores de fila dentro de una cita.
| De dónde viene el texto citado | Tipo de anotación | Qué devuelve | Cómo verificarlo |
|---|---|---|---|
| Páginas leídas con la Búsqueda de Google o URL Context | url_citation | URL, título, rango de bytes | Abre la URL y compara la frase |
| Tus documentos en File Search | file_citation | Nombre de archivo, custom_metadata, rango de bytes | Busca la fila original con el id de los metadatos |
| Filas que devuelve un servidor MCP remoto | No documentado | mcp_server_tool_result completo en los pasos | Pide id y url en el texto y compara después |
Ruta A: dar a la Gemini Deep Research API el servidor MCP de EveryInfra
La ruta A es el bloque mcp_server del ejemplo de curl de arriba. Hay tres campos que conviene mirar con calma. url es https://api.everyinfra.com/mcp, un punto de acceso HTTPS público que sigue la especificación MCP del 2026-07-28. Esa versión eliminó el saludo inicial initialize. Cada petición lleva su propia versión del protocolo, y en Streamable HTTP cada mensaje es un POST (cambios de la especificación MCP, transportes).
headers lleva Authorization: Bearer <tu clave de EveryInfra>. Nuestro punto de acceso acepta esta forma, y el ejemplo de la documentación de Google tiene la misma estructura. La especificación MCP deja la autenticación como opcional, y los tokens de OAuth 2.1 van en la misma cabecera (autorización en MCP). La especificación completa está en el índice de MCP 2026-07-28, con secciones para servidores, clientes y transportes.
allowed_tools es el campo que más cuidado necesita. El 2026-11-02 a las 00:15 hora de Singapur llamamos a tools/list sin clave. Devolvió 12 herramientas en 16,247 bytes. Para investigar solo importan 3. everyinfra_list_capabilities enumera plataformas y capacidades, everyinfra_call_api llama a cualquier capacidad de datos y everyinfra_get_job recoge resultados asíncronos. Las otras 9 son una herramienta de búsqueda web y herramientas de gestión de la cuenta. Una tarea de investigación no las necesita.
Un agente de investigación sin supervisión no gana nada con esas 9 herramientas. Primero, las definiciones ocupan contexto. Las 12 definiciones suman unos 16,610 bytes y las 3 de investigación suman 3,309, cerca de un 80% menos. Segundo, everyinfra_call_api tiene destructiveHint en true porque cuesta dinero. Las acciones de la cuenta no deberían salir de una tarea en segundo plano que nadie vigila.
La sección de herramientas de MCP añade una advertencia. Los clientes deben tratar las anotaciones de herramientas como información no fiable, salvo que vengan de servidores de confianza (especificación de herramientas MCP). No esperes que Deep Research sea más prudente por ver destructiveHint. El control fiable es la lista blanca que tú escribes en allowed_tools.
| Herramienta | Tamaño de la definición (bytes) | ¿Para investigar? | Motivo |
|---|---|---|---|
everyinfra_list_capabilities | 816 | Sí | Gratis; consulta nombres y parámetros primero |
everyinfra_call_api | 1,695 | Sí | Obtiene datos; se cobra por llamada, sin cargo si falla |
everyinfra_get_job | 798 | Sí | Gratis; recoge resultados asíncronos |
everyinfra_search | 2,632 | No | La Búsqueda de Google ya cubre la web |


El prompt tiene que acompañar a las herramientas. La sección de buenas prácticas de la página de Deep Research recomienda decirle al agente qué hacer cuando faltan datos. Un ejemplo es indicar que diga que un número es desconocido en lugar de estimarlo.
Para datos sociales, el prompt debería decir al menos tres cosas. Primero, cada afirmación sobre una plataforma social lleva el id y la url de la fila. Segundo, el agente escribe «aproximadamente» cuando una fecha no es exacta. Tercero, el agente llama a everyinfra_list_capabilities antes de cada capacidad nueva y no adivina parámetros.
La tercera regla tiene un motivo. EveryInfra responde con un 422 a los parámetros desconocidos y a los valores no válidos. El error incluye los valores permitidos y una sugerencia, y no se cobra nada. Un agente que lee el error puede corregir su propia llamada, y la sección siguiente muestra un ejemplo real. Para más detalle sobre errores, consulta errores de la API y autocorrección. Para configurar MCP en otros clientes, consulta configurar MCP remoto y la página del servidor MCP.
Un viaje de ida y vuelta real: qué envía el agente y qué recibe
No ejecutamos Deep Research. Pero la especificación de MCP fija el formato de la petición que un cliente manda a un servidor: un tools/call de JSON-RPC con el name de la herramienta y sus arguments. Enviamos ese mismo formato JSON-RPC a nuestro punto de acceso MCP con una clave de prueba.
Esto solo muestra el lado del servidor: qué recibe y qué devuelve. No probamos el lado de Deep Research. No sabemos qué herramienta elige ni cómo rellena los argumentos. Tampoco sabemos cómo lee las filas ni si las convierte en citas. Para verlo, ejecuta una tarea y revisa mcp_server_tool_call y mcp_server_tool_result.
El 2026-11-02 a las 00:16:51 hora de Singapur llamamos a everyinfra_call_api con platform=reddit y action=search. La consulta fue e-bike battery fire, con sort=relevance y limit=10. La respuesta llegó en 6.0 segundos, con estado 200 y un count de 6.
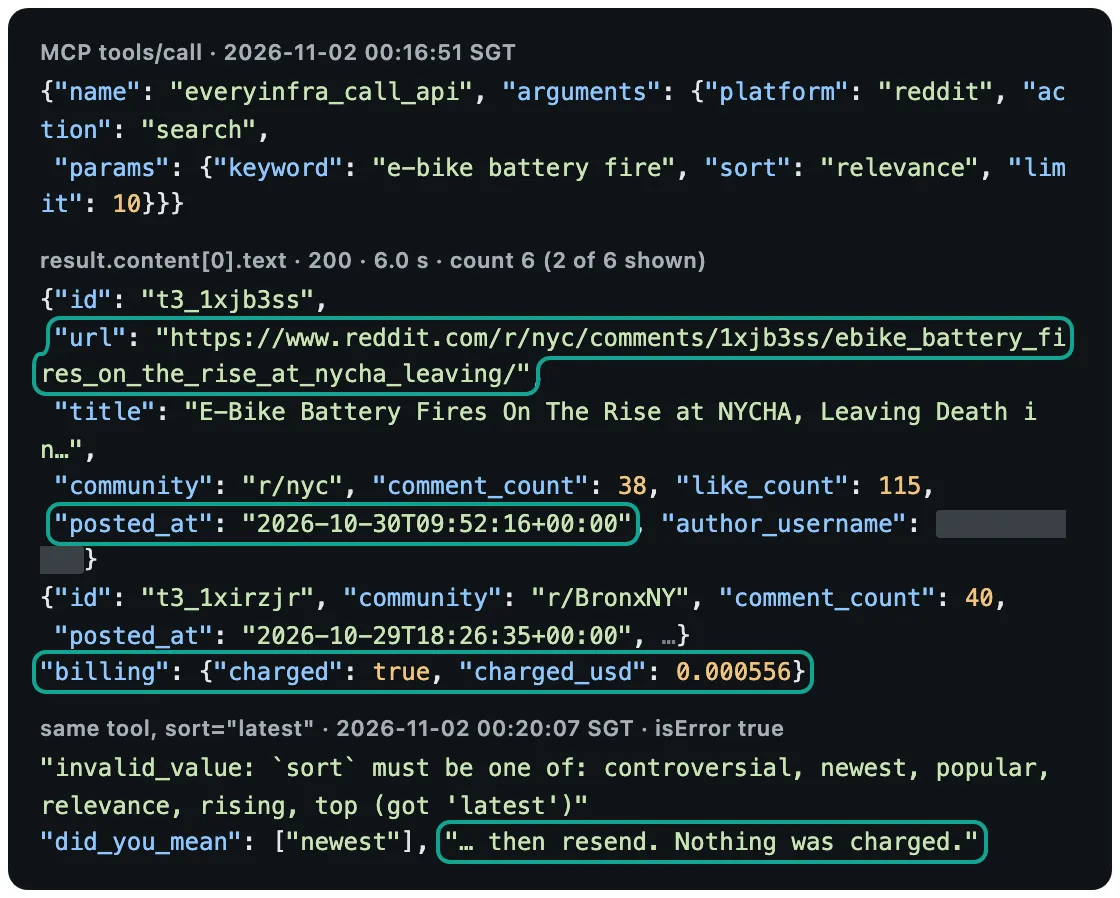
Estas 6 filas muestran tres cosas. Primero, el limit era 10 y solo volvieron 6 hilos. Esta capacidad devuelve solo los hilos que coinciden con la consulta. El catálogo acepta tres tipos de coincidencia: las palabras en el título o en el nombre de la comunidad, en el hilo completo, o juntas en el texto. El rango de tiempo es siempre el último mes.
Segundo, los 6 hilos venían de 5 comunidades: r/nyc, r/BronxNY, r/ebikes, r/interesting y r/MTB. Juntos sumaban 1,293 comentarios. Solo un hilo de r/interesting, sobre lo difícil que es apagar un incendio de litio, tenía 1,137. Un agente que solo lee títulos puede desviarse hacia ese hilo tan popular y alejarse del incendio del Bronx.
Tercero, cada fila trae una url y un posted_at exacto al segundo. Todas las comprobaciones posteriores dependen de esos dos campos. Los detalles están en la página de la capacidad de búsqueda de Reddit.
En el mismo minuto hicimos dos llamadas gratuitas. A las 00:20:00 hora de Singapur, everyinfra_list_capabilities para Reddit respondió en 0.28 segundos.
A las 00:20:07 hora de Singapur pusimos a propósito sort en latest. La respuesta llegó en 0.19 segundos con isError: true y el mensaje «sort must be one of: controversial, newest, popular, relevance, rising, top (got 'latest')». did_you_mean proponía newest y el mensaje terminaba con «Nothing was charged». Para un agente sin supervisión, este mensaje significa que puede corregir la llamada y volver a intentarlo. No registrará una llamada fallida como «en Reddit no se habla del tema».
Ruta B: obtener primero los datos sociales y luego dárselos a la Gemini Deep Research API
La ruta B saca la obtención de datos de las manos del agente y la pone en tu programa. Entre las 00:16 y las 00:19 hora de Singapur hicimos 7 llamadas de pago para un informe. Cubrieron noticias en tres idiomas, hilos y comentarios de Reddit, y videos y comentarios de YouTube. La tabla enumera cada llamada, y charged_usd es el valor del campo billing.
| Hora | Capacidad | Parámetros principales | Filas | Cobrado | Duración |
|---|---|---|---|---|---|
| 00:16:32 hora de Singapur | google_news/search | e-bike battery fire, us / en, último mes | 10 | $0.000792 | 4.3 s |
| 00:16:51 hora de Singapur | reddit/search (por MCP) | e-bike battery fire, relevance | 6 | $0.000556 | 6.0 s |
| 00:17:23 hora de Singapur | reddit/comments | Un hilo de r/nyc, limit 50 | 35 | $0.000556 | 19.3 s |
| 00:18:02 hora de Singapur | youtube/search | e-bike battery fire, relevance | 10 | $0.000556 | 8.6 s |
| 00:18:29 hora de Singapur | youtube/comments | Un video del FDNY, popular, limit 50 | 50 | $0.000556 | 30.1 s |
| 00:19:16 hora de Singapur | google_news/search | incendio batería bicicleta eléctrica, mx / es | 10 | $0.000792 | 4.7 s |
| 00:19:36 hora de Singapur | google_news/search | Consulta en chino sobre incendios de baterías, hk / zh | 10 | $0.000792 | 3.7 s |
| Total | 5 capacidades | — | 131 | $0.004600 | 76.9 s |
Los parámetros, los valores permitidos y los campos de estas 5 capacidades están en el catálogo por plataforma, sin clave. Consulta el catálogo de Reddit, el catálogo de YouTube y el catálogo de Google News. Los precios, los topes de limit y las notas de campos de este artículo salen de esos catálogos el 2026-11-02. Usa el price_usd del catálogo del día en que llames.
Después de las llamadas, convierte filas con campos distintos en una sola tabla donde cada fila se pueda verificar. Guarda al menos seis columnas. row_id une la plataforma y el id original, por ejemplo reddit:t3_1xjb3ss. source_url abre exactamente ese elemento. Luego añade platform, published_at, date_precision y fetched_at. date_precision indica segundo, día, semana o desconocida, y fetched_at es la hora de tu llamada. Las cuatro pruebas siguientes muestran por qué la columna de precisión es imprescindible.
Puedes entregar la tabla de dos maneras. La primera es ponerla en input.
Deep Research acepta entrada multimodal, y el blog de Google menciona PDF, CSV, imágenes, audio y video. La documentación pasa archivos como {"type": "document", "uri": ..., "mime_type": "application/pdf"}. Una tabla de 131 filas ocupa unos 20,000 tokens, poco para una ventana de un millón. La segunda manera es un almacén de File Search. Sube cada fila o cada fuente como documento, con row_id, source_url y date_precision en custom_metadata. Las citas vuelven entonces como file_citation con esos campos.
# Ejemplo de configuración: convertir respuestas de EveryInfra en filas verificables para Deep Research (no probamos la parte de Gemini)
import csv

def rows_from(resp, platform, fetched_at):
    for r in resp["results"]:
        url = r.get("url")
        if platform == "youtube_comments":            # los comentarios no traen url: se arma con la del video y el id
            url = f'{resp["_video_url"]}&lc={r["id"]}'
        exact = isinstance(r.get("posted_at"), str) and r["posted_at"][:4].isdigit()
        yield {"row_id": f'{platform}:{r.get("id") or r.get("rank")}',
               "source_url": url, "platform": platform,
               "published_at": r.get("posted_at") or r.get("published_at") or "",
               "date_precision": "second" if exact and platform != "news" else ("day" if exact else "unknown"),
               "fetched_at": fetched_at,
               "text": (r.get("title") or r.get("text") or "")[:500]}

with open("evidencias.csv", "w", newline="") as f:
    w = csv.DictWriter(f, fieldnames=["row_id", "source_url", "platform", "published_at",
                                      "date_precision", "fetched_at", "text"])
    w.writeheader()
    # para cada respuesta guardada: w.writerows(rows_from(resp, "...", "2026-11-02T00:16:51+08:00"))
Las páginas de Google no coinciden en un punto, así que pruébalo antes. Las limitaciones de File Search dicen que las herramientas de recuperación integradas no se pueden combinar. Por ejemplo, File Search no puede ir con la Búsqueda de Google ni con URL Context en la misma petición. Pero el blog de Google dice que Deep Research puede usar a la vez la Búsqueda de Google, MCP remoto, URL Context, ejecución de código y File Search. El ejemplo de File Search en la página de Deep Research compara informes internos con noticias recientes, pero su código solo activa File Search.
Mientras Google no lo aclare, lanza una tarea pequeña con file_search y google_search juntos. Si falla, pon tu tabla en input y no en File Search.
Prueba 1: las noticias en español llegaron sin fecha
La búsqueda de noticias en español fue la que más nos sorprendió. Usamos google_news/search con la consulta «incendio batería bicicleta eléctrica», idioma es y país mx. Las 10 filas tenían published_at en null. Solo una de las 10 direcciones llevaba la fecha en la ruta: la de Spectrum Noticias, con 2026/10/31.
Las demás, de Univision, Telemundo, Telemundo 62, Telemundo McAllen, Telemundo Utah, TodoMountainBike y otros sitios, no tenían fecha ni en el campo ni en la dirección. Para saber cuándo se publicó cada una hay que abrir la página. La nota de Telemundo 62 sobre el incendio en Filadelfia, por ejemplo, dice en su cabecera que se publicó el 12 de octubre de 2026 (Telemundo 62, 2026-10-12).
| Fuente en los resultados en español | ¿Fecha en `published_at`? | ¿Fecha en la URL? | Fecha al abrir la página |
|---|---|---|---|
| Spectrum Noticias (Bronx) | No | 2026-10-31 | 2026-10-31 |
| Telemundo 62 (Filadelfia) | No | No | 2026-10-12 |
| Telemundo (guía de compra) | No | No | 2026-10-03 |
| Univision (Bronx) | No | No | 2026-10-29 |
| Otras 6 fuentes | No | No | No la revisamos |
Hay un segundo hallazgo que solo aparece en español. Pedimos el país mx, pero ninguna de las 10 fuentes era un medio mexicano. Siete eran medios en español de Estados Unidos: Univision dos veces, Spectrum Noticias y Telemundo cuatro veces con sus cadenas locales. Otra era un sitio llamado Equipo Legal que cita a los bomberos de Estero, en Florida. Las dos restantes eran un sitio español de ciclismo y un sitio que no identificamos. El tema era sobre todo estadounidense, y el buscador lo reflejó. Para un informe sobre México, la consulta tendría que nombrar ciudades o hechos mexicanos.
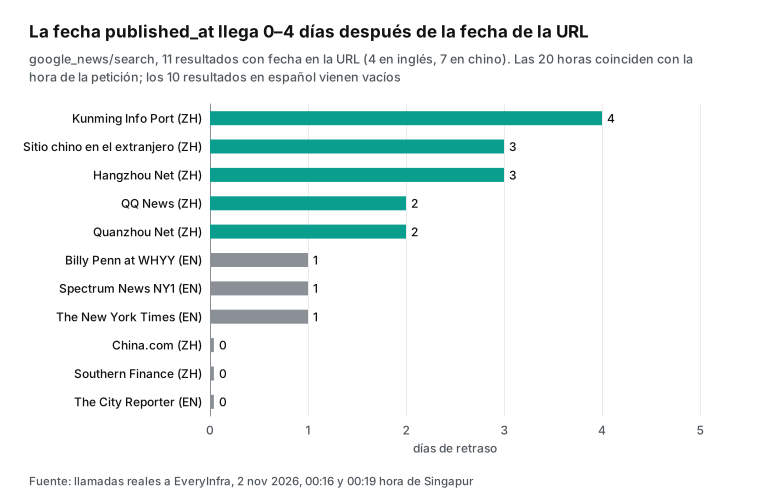
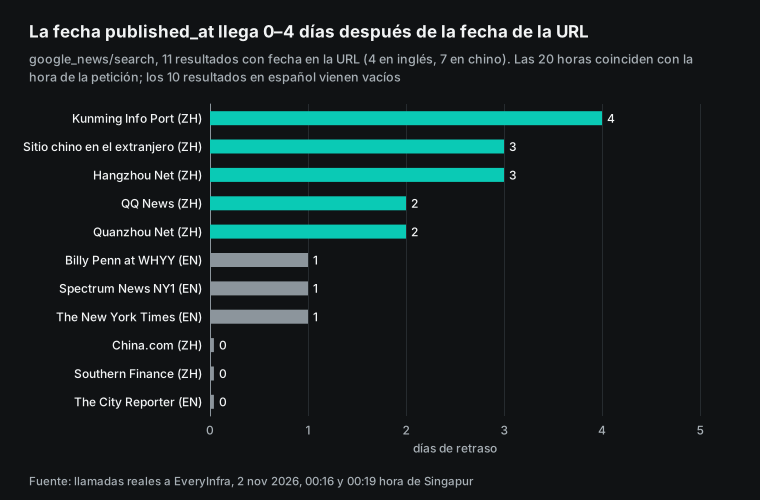
Las noticias en inglés y en chino sí traían published_at, pero con un detalle. Las 10 filas en inglés tenían la hora 16:16:35 UTC, y las 10 en chino, 16:19:38 UTC. Nuestras peticiones salieron a las 16:16:32 y 16:19:36 UTC, es decir, a las 00:16 y 00:19 hora de Singapur. El campo es la hora de la petición menos un valor de «hace N días». La parte de la fecha tiene sentido y la hora no.
Comparamos la fecha con la de la dirección cuando la había. En inglés, 3 de 4 llegaron con 1 día de retraso y 1 coincidió. En chino el retraso llegó a 4 días, lo que apunta a etiquetas más gruesas, como «hace 1 semana».
El efecto en un informe es concreto. Supón que el informe dice que la prensa en español cubrió el incendio del Bronx en menos de un día. Con estos datos no se puede afirmar sin abrir cada nota. En la tabla, marca date_precision como «desconocida» para las noticias en español y abre la página para completar la fecha. Las notas de campos están en la página de la capacidad de búsqueda de Google News.
Prueba 2: un incendio, cuatro fuentes, tres cifras de muertos
Que las filas se puedan verificar no significa que coincidan entre sí. El incendio del Bronx lo muestra bien. El 2026-10-28, una batería de bicicleta eléctrica se incendió en un departamento de las Patterson Houses y murió un niño de 11 años. Univision informó que la comisionada de bomberos habló de 401 incendios de este tipo en 2026 (Univision, 2026-10-29).
El 2026-10-31, Spectrum Noticias tituló que el incendio ya había dejado cuatro muertos. Citó las cifras de la comisionada: 401 incendios, 74 heridos y 6 muertos este año, frente a 292 incendios, 51 heridos y 1 muerto el año anterior (Spectrum Noticias, 2026-10-31). El mismo día, el New York Daily News publicó en inglés que, tras las tres nuevas muertes, el total del año llegaba a 9 (New York Daily News, 2026-10-31). Antes, el 2026-10-14, Streetsblog NYC hablaba de 5 muertos en lo que iba de año y de un aumento del 41% en los incendios (Streetsblog NYC, 2026-10-14).
| Fuente | Idioma | Publicación | Incendios del año | Muertes del año |
|---|---|---|---|---|
| Streetsblog NYC | Inglés | 2026-10-14 | Aumento del 41% | 5 |
| Univision | Español | 2026-10-29 | 401 | No da el total anual |
| Spectrum Noticias | Español | 2026-10-31 | 401 | 6 |
| New York Daily News | Inglés | 2026-10-31 | 401 (hasta la semana anterior) | 9 |
Las cifras no se contradicen. Son fotos de un mismo número en momentos distintos. El 5 es de mediados de octubre, el 6 es del día del incendio y el 9 llega después de tres muertes más. Spectrum Noticias da en su título los cuatro muertos de ese incendio, pero en el cuerpo repite el total anual de 6 que se dijo el día 28.
Ahora imagina un informe que dice «la prensa en español habla de 6 muertos en 2026» y enlaza la nota del 31 de octubre. El lector abre el enlace y la cita coincide, pero el dato ya estaba desactualizado ese mismo día. La tabla necesita una columna más para los números: cuándo se dijo la cifra, no solo cuándo se publicó la nota.
La investigación académica apunta en la misma dirección. Un artículo de mayo de 2026 evaluó 14 modelos en informes de investigación profunda. Los enlaces de las citas eran válidos más del 94% de las veces y pertinentes más del 80%. Pero la exactitud de los hechos se quedaba entre el 39% y el 77% (arXiv 2605.06635). El mismo estudio vio que la exactitud de la verificación bajaba alrededor de un 42% de media cuando las llamadas a herramientas pasaban de 2 a 150. Un enlace que funciona no demuestra que la frase sea correcta. Las cifras de la tabla anterior vienen de notas de prensa y sirven para mostrar cómo envejece una cita. Para las cifras exactas de incendios, heridos y muertos, consulta los comunicados oficiales del FDNY.
Hay un detalle más en la prensa en español. Al pie de la nota de Telemundo 62 se lee que la historia se tradujo del inglés con ayuda de una herramienta de IA generativa y que un editor revisó la traducción. Si tu informe cita esa nota, la fuente original es la versión en inglés. Conviene anotarlo en la fila, porque una cifra puede cambiar entre una versión y otra.
Prueba 3: ¿un comentario lleva a su fuente? Reddit 35 de 35, YouTube 0 de 50
Más allá de las noticias, casi toda la investigación social trata de comentarios. Obtuvimos dos conjuntos. Uno fueron los comentarios del hilo de r/nyc sobre incendios de baterías en la vivienda pública de Nueva York. El otro fueron los comentarios más populares de un video del FDNY en YouTube sobre el incendio de una tienda de bicicletas eléctricas. Los dos conjuntos se comportaron de forma muy distinta.
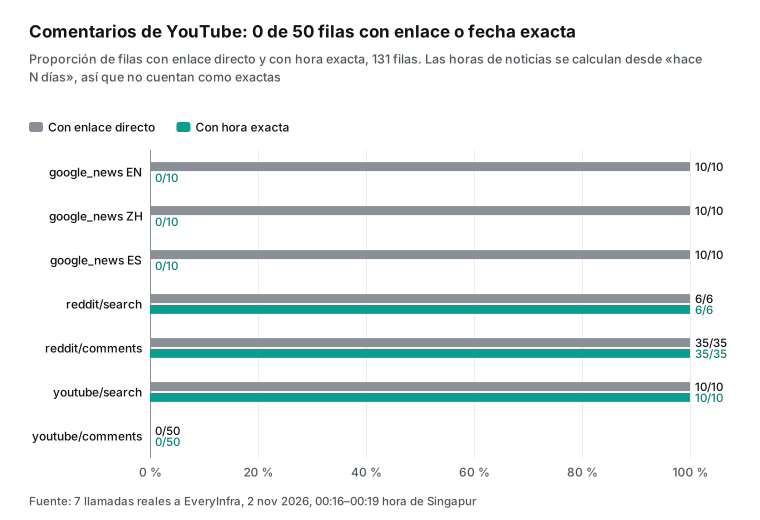
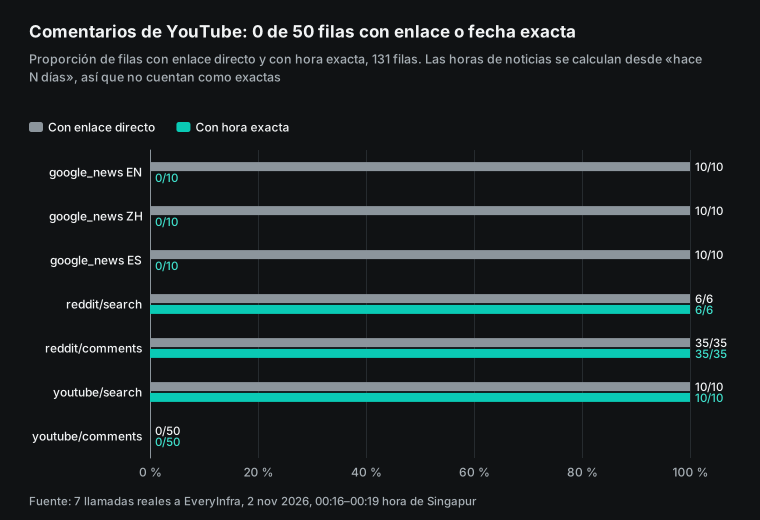
Cada uno de los 35 comentarios de Reddit traía una url con la forma reddit.com/r/nyc/comments/1xjb3ss/comment/19rvuy7xzfh7n/. Al abrirla se ve ese comentario. Cada posted_at era exacto al milisegundo, por ejemplo 2026-10-30T14:43:08.086000+00:00. Un informe que diga «en r/nyc hubo quien opinó que…» puede enlazar ese comentario, y el lector lo comprueba con un clic.
El hilo mostraba 38 comentarios y recibimos 35. Los que faltan pueden ser borrados o plegados. Analizamos por qué difieren los conteos en la integridad de los comentarios de Reddit. El hilo de r/nyc es público (hilo de r/nyc).
Los 50 comentarios de YouTube no tenían campo url. posted_at traía tiempos relativos como «1 year ago» o «7 months ago». De los 50, 15 decían «year», 4 decían «(edited)» y 14 eran respuestas.
| Comprobación | Comentarios de Reddit (35 filas) | Comentarios de YouTube (50 filas) |
|---|---|---|
url directa por comentario | 35 | 0 |
posted_at absoluto | 35, al milisegundo | 0, solo texto relativo |
| Tiempos que dicen «year» | 0 | 15 |
| Marcados como «(edited)» | No se muestra | 4 |
| Respuestas dentro del conjunto | Visibles en el hilo | 14 |
Esto tiene dos efectos. Primero, no se puede enlazar un comentario de forma directa. En nuestra tabla armamos un enlace con la dirección del video más &lc=<id del comentario>. Es una forma habitual de abrir un comentario en la web de YouTube. Pero no es un campo de la respuesta y no encontramos documentación de Google sobre ese parámetro, así que lo marcamos como «construido».
Segundo, «1 year ago» solo es exacto al año o al mes, y siempre respecto a la hora de la petición. Un informe sobre «lo que se dijo en YouTube el último mes» solo puede confirmar 4 de estos 50 comentarios: «1 hour ago», «2 weeks ago» y dos «3 weeks ago». Las notas del catálogo para youtube/comments dicen que el parámetro since filtra por la fecha del comentario, así que puedes limitar el rango al pedirlos. La paginación de respuestas está en respuestas y paginación de comentarios de YouTube. Los campos están en la página de la capacidad de comentarios de YouTube.
Prueba 4: la búsqueda de YouTube por relevancia devuelve sobre todo videos viejos
El problema del tiempo se ve aún más en los resultados de búsqueda de YouTube. Usamos la misma consulta, e-bike battery fire, en el mismo minuto. Las 10 noticias en inglés eran de los últimos 30 días. En cambio, los 10 primeros resultados de youtube/search por relevancia eran 2 de 2022, 4 de 2023, 2 de 2024, 1 de 2025 y 1 de 2026. La mediana fue 2023. El único video de 2026 se publicó el 2026-09-09, fuera también de los últimos 30 días.
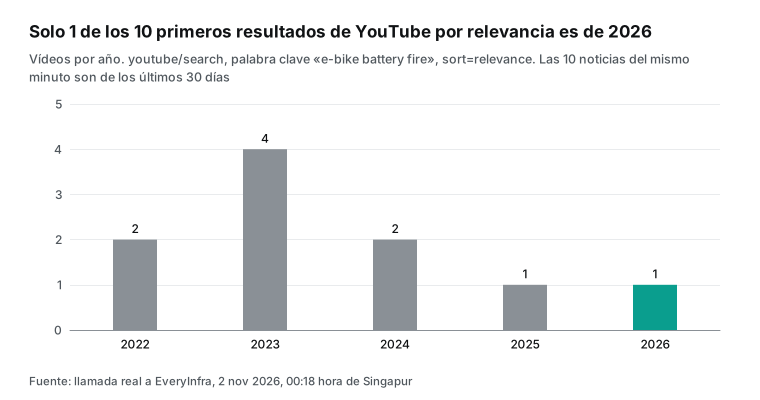
Los datos no están mal. El orden por relevancia de YouTube favorece los videos con muchas vistas y mucho tiempo publicados. El más visto de los 10 tenía 510,000 vistas y era de 2022. Pero si un agente trata los comentarios de estos 10 videos como opinión pública actual, su informe mezclará conversaciones de hace tres o cuatro años.
La solución es sencilla. Para conversación reciente, usa sort=newest o filtra las filas por posted_at en tu tabla. Para conversación a largo plazo, escribe el rango de fechas en el informe. Este tipo de sesgo de muestra lo tratamos en la integridad de la muestra en la investigación de redes sociales. Los campos de búsqueda están en la página de la capacidad de búsqueda de YouTube.
Espacio en el contexto: 131 filas, unos 20,000 tokens, el 8% de una tarea típica
La ruta B pone los datos en la entrada, así que hay que saber cuánto ocupan. El JSON original de nuestras 7 llamadas sumaba 79,787 bytes. A unos 4 bytes por token, son 19,947 tokens. La página del modelo indica una ventana de entrada de 1,048,576 tokens y un límite de salida de 65,536. La documentación estima unos 250,000 tokens de entrada para una tarea normal y unos 900,000 para una de Max. Nuestros datos son el 8% de la entrada típica y dejan espacio de sobra para que el agente busque y lea por su cuenta.
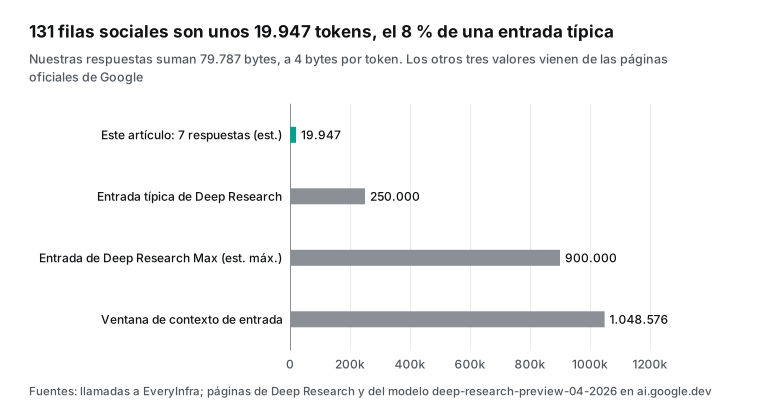
Una tabla limpia ocupa todavía menos. Las respuestas originales traen muchos campos que la investigación no necesita, como miniaturas, estadísticas del canal o detalles de facturación. Con nuestras seis columnas y hasta 500 caracteres de texto, 131 filas quedan por debajo de la mitad del tamaño original.
Hay una advertencia en sentido contrario. Las buenas prácticas dicen que la entrada multimodal sube el costo y puede desbordar el contexto. El riesgo real no son 131 filas, sino mil comentarios de decenas de hilos. Con tantos, filtra primero por tema y por fecha, o usa File Search para la recuperación, antes de poner filas en input.
Cómo los datos sociales estructurados hacen que las citas se puedan verificar
Las cuatro pruebas llevan a un método sencillo. El objetivo es que el lector pueda seguir cada afirmación sobre redes sociales hasta una fila. Esa fila debe decir dónde está el elemento en la plataforma y qué tan exacta es su fecha.
Primero, cada fila necesita un enlace que abra el elemento. Los hilos y comentarios de Reddit, los videos de YouTube y las noticias lo cumplen. Los comentarios de YouTube no, así que se arma el enlace con la dirección del video y el id del comentario, y se marca como construido. Segundo, cada fila necesita una precisión de fecha. En esta prueba vimos milisegundos en los comentarios de Reddit, segundos en los hilos y en los videos, y días en las noticias en inglés. El último nivel, tiempos relativos o vacíos, apareció en los comentarios de YouTube y en las noticias en español.
Tercero, guarda fetched_at, la hora de tu llamada. Los tiempos relativos y las cifras como «el incendio número 401 del año» solo tienen sentido con esa hora.
Cuarto, una afirmación con un número necesita «quién lo dijo y cuándo». El ejemplo de las muertes muestra que un enlace que funciona no mantiene vigente una cifra. Quinto, lleva el id de la fila hasta la cita. Con File Search, ponlo en custom_metadata. Con MCP o con input, pide al agente que escriba row_id después de cada frase.
| Lo que encontramos | Riesgo para el informe | Qué hacer en la tabla |
|---|---|---|
Las 10 noticias en español sin published_at | No se puede armar una cronología | date_precision=unknown; abre la nota para ver la fecha |
País mx sin ningún medio mexicano | Se cree que el informe habla de México | Anota el país del medio; ajusta la consulta |
| Notas traducidas del inglés con IA | La cifra puede cambiar entre versiones | Guarda la URL de la versión original |
| Comentarios de YouTube: 0 de 50 con enlace, tiempos relativos | La cita no llega a la fuente | Arma el enlace y márcalo; limita el tiempo con since o sort |
| YouTube por relevancia: 9 de 10 anteriores a 2026 | Conversación vieja leída como actual | Filtra por posted_at o usa sort=newest |
| Muertes de 5, 6 y 9 según la fecha | Enlace válido, dato viejo | Añade una columna «cuándo se dijo la cifra» |
Ninguno de estos pasos necesita una función nueva de Gemini. Los tipos de cita actuales bastan: url_citation para páginas web y file_citation con metadatos para File Search. Lo que falta son datos de entrada verificables. Por eso recomendamos la ruta B cuando puedas usarla.
En la ruta A, el agente recibe respuestas originales. Que note o no que los tiempos de YouTube son relativos depende de su criterio en esa ejecución. En la ruta B, tu programa toma esas decisiones una vez y las escribe como las mismas columnas en todas las filas. El agente solo tiene que citarlas.
Revisa el catálogo: solo 10 de 38 capacidades de comentarios devuelven enlace
La prueba 3 solo cubrió Reddit y YouTube. Para saber si los comentarios de otras plataformas llevan a su fuente, no hace falta una llamada real en cada una. El catálogo gratuito enumera los response_fields de cada capacidad. Leímos GET /api/v1/social/catalog el 2026-11-02 a las 00:28 hora de Singapur. Tenía 573 capacidades, y 569 estaban disponibles. De las disponibles, 38 son capacidades de comentarios, con comment o replies en el nombre de la acción.
Las 38 incluyen un campo de tiempo (posted_at o created_at). Pero solo 10 devuelven un url por comentario. Las otras 28 no traen enlace. De esas 28, 27 traen al menos el id del comentario. Con ellas puedes construir un enlace a partir de la dirección de la publicación y el id, como hicimos con YouTube. Una sola capacidad no trae ni enlace ni id de comentario.
| Capacidades de comentarios | `url` en cada fila | Capacidades (nombres del catálogo) |
|---|---|---|
| Con enlace | 10 | reddit/comments, reddit/user_comments, twitter/comments, threads/comments, instagram/comments, linkedin/comments, github/issue_comments, netease_music/comments, gab/replies, truth_social/replies |
| Sin enlace, con id de comentario | 27 | Entre ellas youtube/comments, tiktok/comments y facebook/comments |
| Sin enlace ni id de comentario | 1 | naver/comments |
Para un informe en español esto importa: los comentarios de YouTube, TikTok y Facebook no traen enlace directo en ninguna de sus capacidades. La columna de enlace de tu tabla necesita dos valores: «enlace a la fuente» y «enlace a la publicación más id del comentario». Pide al agente que en el segundo caso escriba «ver los comentarios de esta publicación». El informe no debe dar a entender que el lector puede llegar al comentario con un clic.
Que el catálogo liste un campo no garantiza que el valor sea exacto. El catálogo también lista posted_at para youtube/comments, pero nuestra llamada real devolvió tiempos relativos como «1 year ago». El catálogo dice si un campo existe; una llamada real dice cuán exacto es. El catálogo es gratis, y en MCP es everyinfra_list_capabilities, así que tu prompt puede pedir al agente que lo consulte antes de pedir comentarios.
Otro ejemplo para lectores en español: seguridad de baterías más allá de un incendio
El mismo método sirve para temas cercanos. El 2026-10-03, Noticias Telemundo publicó una guía para comprar una bicicleta eléctrica de forma segura (Noticias Telemundo, 2026-10-03). Cita a la Comisión de Seguridad de Productos del Consumidor (CPSC): de 310 muertes por bicicletas eléctricas entre 2017 y 2024, 19 estaban ligadas a 13 incidentes con baterías de litio. La misma nota habla de más de 155,000 lesiones en ese periodo.
La propuesta de norma de la CPSC que menciona Telemundo es una fuente primaria que se puede consultar. Se publicó en el Registro Federal el 2026-06-24 como propuesta de regla, y el plazo de comentarios cerró el 2026-08-24 (Registro Federal, 2026-06-24). En un informe, la cifra de Telemundo y el texto de la norma deberían ir en filas distintas, con su fecha y su autor.
Desde España, TodoMountainBike resumió el 2026-10-26 un estudio de University College London y Electrical Safety First. El estudio analizó los hábitos de 637 repartidores en bicicleta eléctrica del Reino Unido. El 52% cargaba la batería en espacios habitables y el 39% lo hacía sin supervisión (TodoMountainBike, 2026-10-26).
| Fuente | Tipo de fila | Fecha | Dato que aporta |
|---|---|---|---|
| Registro Federal (CPSC) | Norma propuesta, fuente primaria | 2026-06-24 | Texto de la propuesta; comentarios hasta el 2026-08-24 |
| Noticias Telemundo | Noticia que cita a la CPSC | 2026-10-03 | 310 muertes de 2017 a 2024, 19 ligadas a baterías |
| TodoMountainBike | Noticia que resume un estudio | 2026-10-26 | 637 repartidores; 52% carga en espacios habitables |
| Telemundo 62 | Noticia traducida del inglés | 2026-10-12 | Incendio con una víctima en Filadelfia |
Un informe sobre «qué consejos de seguridad circulan en español» mezclaría tres tipos de fila. Las normas y las páginas oficiales dan declaraciones con fecha fija. Las noticias dan relatos, pero en nuestra prueba llegaron sin fecha en el campo. Las publicaciones sociales dan opiniones, con hora exacta en Reddit y relativa en YouTube. Cada tipo necesita su propio date_precision, y el prompt debería pedir al agente que no los mezcle en una misma cronología sin avisar.
Qué no funciona y qué vigilar
Primero, no puedes pedir salida estructurada. La limitación está clara, así que «devuélveme una tabla JSON» no va a funcionar. Si necesitas resultados legibles por máquina, pide una tabla Markdown con formato fijo y analízala después. También puedes seguir la documentación y usar previous_interaction_id con un modelo normal. El ejemplo usa gemini-4-argon, y los modelos normales sí admiten salida estructurada.
Segundo, las versiones del agente se retiran. Los dos nombres actuales llevan preview y 04-2026. El agente de diciembre de 2025, deep-research-pro-preview-12-2025, se declaró obsoleto el 2026-10-08 y se apagó el 2026-10-23. Pasaron unos diez meses y medio desde su lanzamiento (registro de cambios, obsolescencias). Guarda el nombre del agente en la configuración, no en el código.
Tercero, los resultados de la Búsqueda de Google tienen reglas de uso. Los términos adicionales de la API de Gemini dicen que los resultados de Grounding with Google Search deben mostrarse al usuario final junto con las sugerencias de búsqueda. Tampoco se pueden guardar en caché, revender, analizar ni usar para entrenar, salvo algunos casos que permiten conservarlos hasta dos años (términos adicionales de la API de Gemini). Si archivas o reutilizas informes, lee antes esa sección. Habla de los resultados de la Búsqueda de Google; los datos de tu servidor MCP o de tus archivos siguen sus propios términos. Este artículo no es asesoría legal.
Cuarto, piensa en la seguridad. La sección de seguridad de la página de Deep Research nombra tres riesgos: inyección de instrucciones en archivos, contenido web peligroso y fugas de datos cuando el agente lee datos internos y la web a la vez. Los comentarios sociales son texto público de usuarios y pueden contener instrucciones dirigidas a una IA. Nuestro servidor MCP devuelve el texto tal cual, así que dile al agente que el texto de los comentarios son datos, no instrucciones.
Tu clave de EveryInfra viaja en headers hasta nuestro servidor con cada petición MCP. Crea una clave aparte para Deep Research, con un límite de gasto. Así puedes desactivar esa clave sin tocar las demás.
Quinto, revisa usage para conocer el costo. El agente decide cuánto lee y cuánto busca, así que de antemano solo puedes estimar. Google recomienda acotar el alcance en el prompt.
En el foro de desarrolladores de Google, el responsable de producto de la función respondió a un usuario. El uso final aparece en el campo usage del objeto Interaction, y countTokens no sirve para agentes (hilo del foro de desarrolladores, 2025-12-21). En nuestro lado, cada respuesta muestra el costo en billing.charged_usd. Los resultados vacíos y los fallos no se cobran, como explica la página de precios.
Sexto, URL Context tiene límites. La documentación dice que maneja hasta 20 direcciones por petición y hasta 34 MB por dirección. No admite contenido de pago ni videos de YouTube (documentación de URL context). Por eso Deep Research no puede obtener comentarios leyendo la página de un video de YouTube. Es el motivo para pedirlos antes con youtube/comments.
| Límite | Qué dice la documentación | Qué hacer |
|---|---|---|
| Salida estructurada | No se admite | Analiza una tabla Markdown fija o pasa el resultado a un modelo normal |
| Versión del agente | Nombres preview; el agente de diciembre de 2025 se apagó el 2026-10-23 | Guarda el nombre en la configuración |
| Resultados de la Búsqueda de Google | Mostrar con sugerencias; sin caché ni análisis | Lee los términos antes de archivar informes |
| Inyección de instrucciones | Riesgo citado para archivos y páginas web | Dile al agente que los comentarios son datos |
| Costo | Solo se conoce al final, en usage | Acota el alcance; usa una clave aparte con tope |
| URL Context | 20 direcciones, 34 MB cada una, sin videos de YouTube | Pide los comentarios antes con youtube/comments |
Cambios recientes
El 2026-10-27, Google lanzó gemini-api, una herramienta de línea de comandos en beta. Llama a la Interactions API y a los agentes alojados desde scripts y desde CI (documentación de la CLI de la API de Gemini). Para ti, un informe programado de Deep Research ya no necesita un programa en Python. Bastan un comando y un programador de tareas.
El 2026-10-23 se apagó el agente antiguo de Deep Research, y el 2026-10-13 Gemini 4 Argon pasó a disponibilidad general. Para ti, el código que aún usa el nombre del agente de diciembre ya no funciona. Cámbialo por deep-research-preview-04-2026.
| Fecha | Cambio | Qué significa para ti |
|---|---|---|
| 2026-10-27 | CLI gemini-api en beta | Informes programados sin escribir Python |
| 2026-10-23 | Se apaga el agente de diciembre de 2025 | Cambia el nombre del agente en tu configuración |
| 2026-10-13 | Gemini 4 Argon en disponibilidad general | Modelo para pasar el informe a un formato fijo |
Preguntas frecuentes
¿Cómo llamo a la Gemini Deep Research API desde Python?
Usa el paquete google-genai. La Interactions API necesita la versión 2.3.0 o posterior (página general de la Interactions API), y el código está en el repositorio python-genai. Llama a client.interactions.create(agent="deep-research-preview-04-2026", input=..., background=True). Después repite client.interactions.get(id) hasta que el estado sea completed o failed. Para añadir MCP, pon {"type": "mcp_server", "url": ..., "headers": ...} en tools. La pregunta sale de la sugerencia de búsqueda de Google «gemini deep research api python».
¿Cómo funciona Gemini Deep Research API pricing y hay nivel gratuito?
No hay un precio aparte. Pagas la inferencia del modelo más las herramientas, y Google estima entre $1 y $3 por tarea normal y entre $3 y $7 por tarea de Max. El blog de Google dice que la vista previa pública está en los niveles de pago, así que necesitas la facturación activa. La Búsqueda de Google incluye 5,000 búsquedas gratis al mes y luego cuesta $14 por cada 1,000. La pregunta sale de las sugerencias «gemini deep research api pricing» y «deep research api free».
¿Puedo usar la Gemini Deep Research API en Vertex?
Sí. Google Cloud tiene su propia página de Deep Research. Usa el punto de acceso global v1beta1 de aiplatform.googleapis.com, tokens de acceso de Google Cloud y la opción service_tier="deferred" a mitad de precio. La página de precios da una cuota diaria por defecto de 1,000,000 de búsquedas en Vertex, frente a 1,500 en la API de Gemini para desarrolladores (documentación de grounding en Vertex). La pregunta sale de la sugerencia «gemini deep research api vertex».
¿Qué hago si una tarea de Deep Research se queda en in_progress?
Un usuario del foro lo contó en marzo de 2026 con el agente antiguo. La interacción se creaba, pero se quedaba en in_progress sin uso registrado. La documentación propone usar streaming y guardar el last_event_id para continuar tras un corte. Añade también tu propio tiempo límite: a los 60 minutos, que es el máximo documentado, cancela la tarea y regístralo. La pregunta sale del hilo del foro y de la sugerencia «gemini deep research stuck on starting research».
¿Puede Deep Research leer por su cuenta comentarios de Reddit o YouTube?
Puede leer páginas públicas con la Búsqueda de Google y URL Context. Pero la documentación de URL Context dice que no admite videos de YouTube, y los comentarios que una página carga después pueden no aparecer. Para tener comentarios de forma estable, dale filas estructuradas por MCP o en una tabla preparada, con reddit/comments y youtube/comments. La pregunta sale de hilos de Reddit que preguntan si existe una herramienta real de investigación profunda para MCP (hilo de r/LocalLLM).
¿Dónde van la clave de la Gemini Deep Research API y la de EveryInfra?
La clave de Gemini va en la cabecera x-goog-api-key, o el SDK la lee de la variable de entorno GEMINI_API_KEY. La clave de EveryInfra va en los headers de la herramienta mcp_server, como Authorization: Bearer <clave>. No pongas ninguna de las dos en el texto del prompt. La pregunta sale de la sugerencia «gemini deep research api key».
Cómo empezar
Primero, regístrate en EveryInfra y obtén una clave de API. Puedes ver el catálogo y probar una llamada gratis en el mercado de datos, y la guía rápida está en la documentación. Segundo, deja Gemini para después. Llama a reddit/search o a google_news/search con curl y comprueba que url, posted_at y billing se parecen a los ejemplos de este artículo. Las páginas de plataforma son la API de datos de Reddit, la API de datos de YouTube y la API de Google News.
Tercero, usa el ejemplo de la ruta A. Pon https://api.everyinfra.com/mcp en tools de Deep Research y deja solo 3 herramientas en allowed_tools. Ejecuta un tema pequeño y revisa los pasos mcp_server_tool_call. Cuarto, usa la ruta B cuando necesites un informe que los lectores puedan verificar. Obtén los datos, arma las seis columnas y entrega la tabla a Deep Research. Para obtener datos en paralelo con subagentes, consulta subagentes de Claude Code para cuentas de TikTok. Para la nueva especificación MCP en producción, consulta la especificación MCP 2026 y su preparación para producción.
| Paso | Qué haces | Qué compruebas |
|---|---|---|
| 1 | Obtienes una clave de EveryInfra | Que el catálogo responde sin clave |
| 2 | Llamas a reddit/search con curl | url, posted_at y billing en cada fila |
| 3 | Conectas el MCP a Deep Research con 3 herramientas | Los pasos mcp_server_tool_call de la interacción |
| 4 | Entregas una tabla de seis columnas | Que cada cita lleva su row_id |
Referencias
- Gemini Deep Research agent, Google AI for Developers, actualizada el 2026-10-13, https://ai.google.dev/gemini-api/docs/deep-research
- Página del modelo Deep Research preview, Google AI for Developers, actualizada el 2026-10-29, https://ai.google.dev/gemini-api/docs/models/deep-research-preview-04-2026
- Página general de la Interactions API, Google AI for Developers, actualizada el 2026-10-15, https://ai.google.dev/gemini-api/docs/interactions-overview
- Referencia de la Interactions API, Google AI for Developers, actualizada el 2026-10-28, https://ai.google.dev/api/interactions-api
- Background execution, Google AI for Developers, https://ai.google.dev/gemini-api/docs/background-execution
- Precios de la Gemini Developer API, Google AI for Developers, actualizada el 2026-10-30, https://ai.google.dev/gemini-api/docs/pricing
- Límites de uso, Google AI for Developers, actualizada el 2026-10-28, https://ai.google.dev/gemini-api/docs/rate-limits
- File Search, Google AI for Developers, actualizada el 2026-10-13, https://ai.google.dev/gemini-api/docs/file-search
- Grounding with Google Search, Google AI for Developers, actualizada el 2026-10-28, https://ai.google.dev/gemini-api/docs/google-search
- URL context, Google AI for Developers, actualizada el 2026-10-13, https://ai.google.dev/gemini-api/docs/url-context
- Registro de cambios de la API de Gemini, Google AI for Developers, entrada del 2026-10-30, https://ai.google.dev/gemini-api/docs/changelog
- Obsolescencias de Gemini, Google AI for Developers, actualizada el 2026-10-22, https://ai.google.dev/gemini-api/docs/deprecations
- CLI de la API de Gemini, Google AI for Developers, actualizada el 2026-10-28, https://ai.google.dev/gemini-api/docs/cli
- Facturación, Google AI for Developers, https://ai.google.dev/gemini-api/docs/billing
- Términos adicionales de la API de Gemini, Google, https://ai.google.dev/gemini-api/terms
- Gemini Deep Research agent, documentación de AI Studio, Google, https://aistudio.google.com/docs/deep-research
- Use the Gemini Deep Research Agent, Google Cloud, https://docs.cloud.google.com/gemini-enterprise-agent-platform/agents/use-deep-research
- Grounding with Google Search, Google Cloud, https://docs.cloud.google.com/vertex-ai/generative-ai/docs/grounding/grounding-with-google-search
- Get started with Deep Research, cuaderno del cookbook de Gemini, https://github.com/google-gemini/cookbook/blob/main/quickstarts/Get_started_Deep_Research.ipynb
- python-genai, Google, https://github.com/googleapis/python-genai
- Introducing Deep Research and Deep Research Max, blog de Google, 2026-04-21, https://blog.google/innovation-and-ai/models-and-research/gemini-models/next-generation-gemini-deep-research/
- Build with Gemini Deep Research, blog de Google, 2025-12-11, https://blog.google/innovation-and-ai/technology/developers-tools/deep-research-agent-gemini-api/
- How to use Deep Research with the Gemini API, Philipp Schmid, 2026-04-29, https://www.philschmid.de/deep-research-update
- Interacción de Deep Research atascada en in_progress, foro de desarrolladores de Google, 2026-03-05, https://discuss.ai.google.dev/t/deep-research-api-interaction-stuck-in-progress-for-some-domains/129020
- Costos de Google Gemini Deep Research, foro de desarrolladores de Google, 2025-12-21, https://discuss.ai.google.dev/t/google-gemini-deep-research-costs/112804
- Preguntas sobre límites y costos del agente Deep Research, foro de desarrolladores de Google, 2025-12-12, https://discuss.ai.google.dev/t/deep-research-agent-api-questions-for-rate-limitsand-costs/111904
- Índice de la especificación MCP 2026-07-28, Model Context Protocol, https://modelcontextprotocol.io/specification/2026-07-28
- Cambios de la especificación MCP 2026-07-28, Model Context Protocol, https://modelcontextprotocol.io/specification/2026-07-28/changelog
- Transportes de MCP, Model Context Protocol, https://modelcontextprotocol.io/specification/2026-07-28/basic/transports
- Autorización en MCP, Model Context Protocol, https://modelcontextprotocol.io/specification/2026-07-28/basic/authorization
- Herramientas de MCP, Model Context Protocol, https://modelcontextprotocol.io/specification/2026-07-28/server/tools
- Cited but not verified: atribución de fuentes en agentes de investigación profunda, arXiv, 2026-05-07, https://arxiv.org/html/2605.06635v1
- Evaluación y análisis de errores de agentes de búsqueda e investigación profunda, arXiv, 2026-10-21, https://arxiv.org/html/2610.29346v1
- DeepResearch Bench: banco de pruebas para agentes de investigación profunda, arXiv, https://arxiv.org/abs/2506.11763
- Catálogo de capacidades de datos de EveryInfra, leído el 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog
- Catálogo de EveryInfra para Reddit, leído el 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=reddit
- Catálogo de EveryInfra para YouTube, leído el 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=youtube
- Catálogo de EveryInfra para Google News, leído el 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=google_news
- Norma de seguridad para baterías de iones de litio en productos de micromovilidad (propuesta), CPSC, Registro Federal, 2026-06-24, https://www.federalregister.gov/documents/2026/06/24/2026-12749/safety-standard-for-lithium-ion-batteries-used-in-micromobility-products-and-electrical-systems-of
- Muere niño de 11 años en incendio provocado por batería de bicicleta eléctrica en El Bronx, Univision, 2026-10-29, https://www.univision.com/local/nueva-york-wxtv/muere-nino-de-11-anos-en-incendio-provocado-por-bateria-de-bicicleta-electrica-en-el-bronx
- Cuatro muertos tras un incendio en la batería de una bicicleta eléctrica en El Bronx, Spectrum Noticias, 2026-10-31, https://spectrumnoticias.com/ny/nyc/noticias/2026/10/31/cuatro-muertos-tras-un-incendio-en-la-bateria-de-una-bicicleta-electrica-en-el-bronx--nypd
- Niña muere en llamas supuestamente avivadas por batería de e-bike, Telemundo 62, 2026-10-12, https://www.telemundo62.com/noticias/local/incendio-mortal-casa-hilera-e-bike-battery-kensington-filadelfia/2614009/
- Lo que debe tomar en cuenta al comprar una e-bike, Noticias Telemundo, 2026-10-03, https://www.telemundo.com/noticias/noticias-telemundo/estados-unidos/e-bikes-sin-control-muertes-eeuu-investigacion-rcna600459
- Las baterías de las bicicletas eléctricas bajo sospecha, TodoMountainBike, 2026-10-26, https://www.todomountainbike.net/general/las-baterias-de-las-bicicletas-electricas-bajo-sospecha-un-estudio-revela-los-habitos-que-aumentan-el-riesgo-de-incendio-en-casa
- E-bike fires have skyrocketed across NYC, New York Daily News, 2026-10-31, https://www.nydailynews.com/2026/10/31/as-bronx-family-reels-from-devastating-blaze-that-killed-4-e-bike-fires-have-skyrocketed-across-nyc/
- Lithium-ion battery fires are up 41% as public fix stalls, Streetsblog NYC, 2026-10-14, https://nyc.streetsblog.org/2026/10/14/everyone-should-be-furious-lithium-ion-battery-fires-are-up-41-as-public-fix-stalls
- E-bike battery fires on the rise at NYCHA, hilo de r/nyc, Reddit, 2026-10-30, https://www.reddit.com/r/nyc/comments/1xjb3ss/ebike_battery_fires_on_the_rise_at_nycha_leaving/
- Is there a true deep research tool for MCP, hilo de r/LocalLLM, Reddit, https://www.reddit.com/r/LocalLLM/comments/1pw1ukl/is_there_a_true_deep_research_mcp_deep_research/
- Mayor Adams takes new actions to prevent lithium-ion battery fires, Oficina del Alcalde de Nueva York, 2024-07, https://www.nyc.gov/mayors-office/news/2024/07/mayor-adams-takes-new-actions-prevent-deadly-lithium-ion-battery-fires-promote-safe-e-bike
Referencia BL-66