Alternativa allo scraper LinkedIn di Apify: quanto costano 1.000 risultati, con test reali
1.000 profili LinkedIn costano $4,00 con lo scraper Apify più usato e $0,556 con EveryInfra. Le offerte di lavoro costano $0,0033 per 1.000. Test live, nov. 2026.
Ti servono 1.000 profili LinkedIn. Lo scraper di profili più usato su Apify Store è LinkedIn Profile Scraper di harvestapi, con 15.718 utenti negli ultimi 30 giorni. Il suo prezzo pubblico è di $4,00 per 1.000 profili sui livelli Free e Starter, $3,20 su Business e $10,00 con la ricerca delle email. Il 5 novembre 2026 abbiamo testato linkedin/person_profile di EveryInfra. Una chiamata restituisce un profilo e costa $0,000556, quindi 1.000 profili costano $0,556.
È 7,2 volte meno caro rispetto al livello Free. Il divario è molto più ampio per i dati restituiti una pagina alla volta. A Singapore, 11 ricerche linkedin/jobs hanno restituito 1.853 offerte di lavoro uniche per $0,006116 in totale, cioè $0,0033 per 1.000. È 606 volte meno caro dello scraper di offerte di lavoro più usato sul livello Free.
C'è anche l'altra faccia della medaglia. Un'API per profili sullo Store con soli 132 utenti costa $0,02 per 1.000 profili. Per i singoli profili costa 27,8 volte meno di noi. Il nostro linkedin/job_detail ha restituito 503 in tutte e cinque le chiamate di test, senza addebiti. Per i dettagli delle singole offerte di lavoro, oggi Apify è la scelta migliore.
In questo articolo, "prezzo per 1.000" indica quanto una chiamata ha addebitato davvero (charged_usd nella risposta), diviso per le righe uniche restituite e moltiplicato per 1.000. Risponde a una domanda: quanto costano 1.000 risultati utilizzabili? EveryInfra addebita per richiesta. Una richiesta costa uguale che restituisca 1 riga o 200 righe.
La maggior parte degli scraper LinkedIn su Apify Store addebita per risultato, quindi ogni riga in più aggiunge un costo. I due modelli si possono confrontare solo con lo stesso denominatore. Per Apify abbiamo usato solo materiale pubblico. Abbiamo letto le pagine dello Store, la pagina dei prezzi, la documentazione e l'endpoint pubblico api.apify.com/v2/acts/<owner>~<name>.
Non abbiamo creato un account Apify e non abbiamo eseguito alcun actor (il termine di Apify per un programma di scraping in cloud). Quindi ogni numero Apify qui riportato è un prezzo unitario pubblico, non un addebito misurato. Ogni numero EveryInfra proviene da una chiamata live.
apify linkedin scraper vs EveryInfra: la tabella riepilogativa
Questa tabella contiene solo due tipi di numeri. Il primo è costituito dai prezzi unitari pubblici di Apify Store. Li abbiamo letti tra le 00:16 e le 00:40 ora di Singapore del 2026-11-05, e il livello è indicato in ogni cella. Il secondo è il nostro risultato live: ora di Singapore, funzionalità, righe e charged_usd. I livelli di Apify dipendono dal piano mensile.
Il piano Free offre $5 di utilizzo al mese senza sconti sullo Store. Starter costa $19 al mese e corrisponde a Bronze. Scale costa $199 e corrisponde a Silver. Business costa $999 e corrisponde a Gold. Platinum e Diamond sono contratti personalizzati più grandi.
| Dati | Scraper Apify (utenti a 30 giorni) | Apify per 1.000: Free / Diamond | Funzionalità EveryInfra | Test live (ora di Singapore, righe, addebito) | EveryInfra per 1.000 | Divario (Apify Free / noi) |
|---|---|---|---|---|---|---|
| Profilo | LinkedIn Profile Scraper, harvestapi (15.718) | $4.00 / $2.20 | linkedin/person_profile | 00:14-00:18, 5 chiamate, 1 riga ciascuna, $0,000556 ciascuna | $0.556 | 7.2x |
| Profilo + email | Idem, modalità di ricerca dell'email | $10.00 / $10.00 | linkedin/person_profile (campo email) | Idem, 3 righe su 5 con email | $0.556 | 18x |
| Azienda | LinkedIn Company Details Scraper, harvestapi (8.071) | $4.00 / $1.20 | linkedin/company_profile | 00:14-00:22, 4 chiamate, 1 riga ciascuna | $0.556 | 7.2x |
| Elenco offerte di lavoro | Linkedin Jobs Scraper, curious_coder (15.193) | $2.00 / $1.00 | linkedin/jobs | 00:14-00:53, 11 chiamate, 1.853 righe uniche, $0,006116 | $0.0033 | 606x |
| Elenco offerte di lavoro (più economico) | Rapid Linkedin Jobs Scraper in modalità quick, worldunboxer (632) | $0.10 / $0.10 | linkedin/jobs | Come sopra | $0.0033 | 30.3x |
| Dettaglio di una singola offerta | Idem, modalità detailed | $0.35 / $0.30 | linkedin/job_detail | 00:25-01:10, 5 chiamate, tutte 503, $0 | Prezzo di listino $1,194 (non ha funzionato nel test di oggi) | Apify 3,4 volte più economico |
| Ricerca di persone | LinkedIn Profile Search Scraper, harvestapi (8.094) | modalità short $4,00 / $1,00 | linkedin/profile_search | 00:26, 1 chiamata asincrona, 78 persone, $0,000556 | $0.0071 | 561x |
| Dipendenti di un'azienda | LinkedIn Company Employees Scraper, harvestapi (6.420) | modalità short $3,00 / $1,15, più $0,02 per avvio | linkedin/employees | 00:22, 1 chiamata, 200 persone, $0,000556 | $0.0028 | 1,079x |
| Profilo (più economico) | LinkedIn Profile API, johnvc (132) | $0.02 / $0.02 | linkedin/person_profile | Come la riga 1 | $0.556 | Apify 27,8 volte più economico |
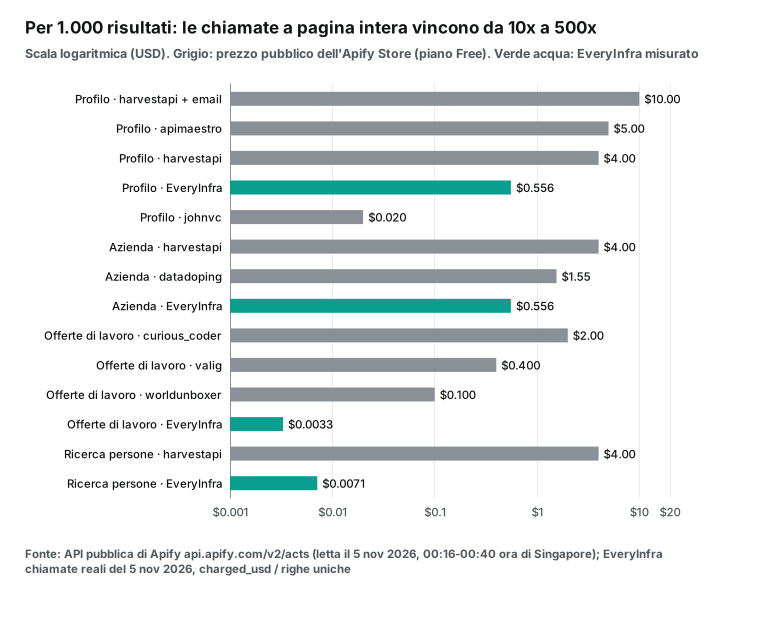
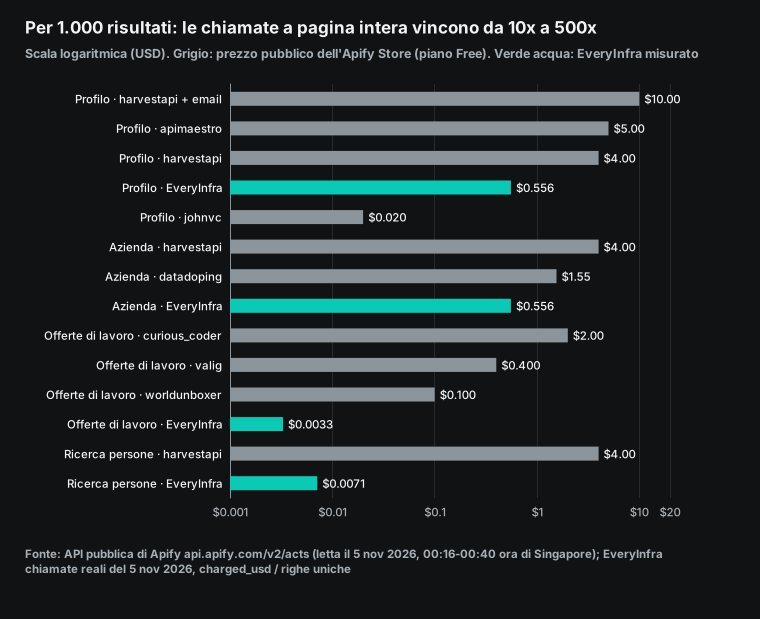
Questa tabella viene fraintesa in tre modi. Primo: i campi sono diversi da una parte e dall'altra. Una differenza di prezzo indica il costo di un risultato. Non indica che i due risultati contengano gli stessi dati.
Per questo ogni sezione di test qui sotto riporta i tassi di compilazione che abbiamo misurato separatamente dai campi descritti nelle pagine di Apify. Non diciamo mai che le due parti siano equivalenti. Secondo: un prezzo Apify è il prezzo unitario dello Store moltiplicato per 1.000. La fattura reale dipende anche da risultati minimi, costi di avvio, riesecuzioni fallite e dal limite di run del piano Free.
Dal nostro lato dividiamo gli addebiti reali per le righe reali, quindi le chiamate vuote e fallite restano nel costo. Terzo: tutte le differenze più grandi vengono da funzionalità che restituiscono una pagina per chiamata. Per singoli profili e aziende la differenza è solo di 7,2 volte. Rispetto allo scraper di terze parti più economico dello Store, costiamo di più.
Come abbiamo eseguito i test e fatto i calcoli
Abbiamo eseguito tutte le chiamate effettive nelle prime ore del 5 novembre 2026, dalle 00:14 alle 01:17 ora di Singapore. Abbiamo usato un'unica chiave di test condivisa con un limite di 10 richieste al minuto. Altri autori usavano la stessa chiave nello stesso momento, quindi abbiamo atteso 8 secondi tra una chiamata e l'altra. In caso di 429 (troppe richieste), abbiamo atteso 62 secondi e inviato di nuovo la chiamata.
Non abbiamo contato i tentativi con 429 come risultati.
Profili, aziende e offerte di lavoro hanno avuto ciascuno almeno cinque chiamate. Abbiamo testato cinque profili pubblici e uno username inesistente. Abbiamo testato quattro aziende e un nome inesistente. Tre chiamate sulle aziende (Microsoft, Grab e Santander) hanno ricevuto prima un 429, e la tabella conta solo il nuovo tentativo. Abbiamo eseguito 11 ricerche di offerte a Singapore con 10 keyword, perché abbiamo cercato data engineer due volte.
Abbiamo eseguito anche quattro chiamate di dettaglio offerta, una ricerca di persone sincrona e una asincrona e un elenco di dipendenti. Solo la ricerca di persone asincrona ha funzionato. Questi ultimi tre campioni sono piccoli, quindi considerali solo indicativi. Altre due chiamate erano senza chiave o con un parametro scritto male, per vedere se gli errori costano.
Ogni prezzo per 1.000 usa la stessa formula: totale addebitato, diviso per le righe uniche, moltiplicato per 1.000. Le chiamate vuote e fallite restano al numeratore. Le loro righe non entrano nel denominatore. Quindi una chiamata poco produttiva può solo far sembrare più alto il nostro prezzo.
Abbiamo deduplicato le offerte per id e le persone per URL del profilo. Per Apify abbiamo letto pricingInfos e stats di ogni actor dall'endpoint pubblico. pricingInfos indica il prezzo di ogni evento di addebito per ciascun livello. stats indica utenti, run e tassi di successo degli ultimi 30 giorni.
Abbiamo preso il prezzo dell'evento principale per risultato e lo abbiamo moltiplicato per 1.000. Alcuni actor addebitano anche per avvio o per pagina di ricerca. In questi casi abbiamo distribuito il costo sulla dimensione di pagina indicata nella pagina dell'actor, e lo segnaliamo in tabella.
Abbiamo fissato il criterio di selezione prima di scrivere l'articolo. Per ogni tipo di dato abbiamo preso l'actor con più utenti negli ultimi 30 giorni. Abbiamo preso anche l'actor più economico sul livello Free tra quelli con almeno 100 utenti. Questo criterio ci impedisce di scegliere di proposito un concorrente debole. Ha anche fatto emergere l'unico caso in cui Apify ci batte con ampio margine.
| Scenario | Chiamate | Chiamate con dati | Righe restituite | Totale addebitato | Ora di Singapore |
|---|---|---|---|---|---|
linkedin/person_profile | 7 | 5 | 5 | $0.002780 | 00:14-00:25 |
linkedin/company_profile | 5 (più 3 tentativi con risposta 429 non conteggiati) | 4 (1 chiamata vuota è stata addebitata) | 4 | $0.002780 | 00:14-00:22 |
linkedin/jobs | 12 | 11 | 1.970 (1.853 uniche) | $0.006116 | 00:14-00:53 |
linkedin/job_detail | 4 | 0 | 0 | $0 | 00:25-00:28 |
linkedin/profile_search | 2 | 1 | 78 | $0.000556 | 00:23-00:26 |
linkedin/employees | 1 | 1 | 200 | $0.000556 | 00:22 |
| Round aggiuntivo: 3 ricerche di offerte (USA, Madrid, Città del Messico), 2 aziende (BBVA, Mercado Libre), 1 ricerca di persone (Madrid), 1 nuovo tentativo di dettaglio offerta | 7 | 6 | 657 | $0.003336 | 00:56-01:10 |
| Tramite MCP (1 con chiave, 2 senza) | 3 | 1 | 1 | $0.000556 | 01:02-01:17 |
| Totale | 41 | 29 | 2,915 | $0.016680 | 00:14-01:17 |
In totale, le chiamate effettive eseguite per questo articolo sono costate $0,016680. L'importo è inferiore al limite di $0,10 che avevamo fissato prima del test. Due illustrazioni provenivano da un servizio di immagini e sono costate circa $0,03 ciascuna. Non abbiamo ripetuto le chiamate per ottenere numeri migliori.
La prima ricerca di persone sincrona è andata in timeout dopo 89 secondi con un 503 e nessun addebito. Abbiamo tenuto quel risultato. Poi abbiamo seguito il suggerimento dell'errore e rieseguito la stessa ricerca in modalità asincrona.
apify linkedin scraper: quanto costa e come leggere i prezzi dello Store
Il 5 novembre 2026, alle 00:17 ora di Singapore, abbiamo cercato "linkedin" su Apify Store. La ricerca ha restituito 370 risultati. Li abbiamo letti tutti e 370 tramite l'API pubblica. Di questi, 109 avevano almeno 100 utenti negli ultimi 30 giorni.
Di questi 109, 78 riportano "No cookies", "No login" o simili nel titolo o nella descrizione. Quindi non devi fornire la tua sessione LinkedIn.
Anche i modelli di prezzo sono diversi. Dei 370, 31 usano "pay per event + usage". Con questo modello paghi per risultato e paghi anche compute, proxy e storage. Dei 109 actor con 100+ utenti, solo 4 usano questo modello. Gli altri 105 usano solo pay per event.
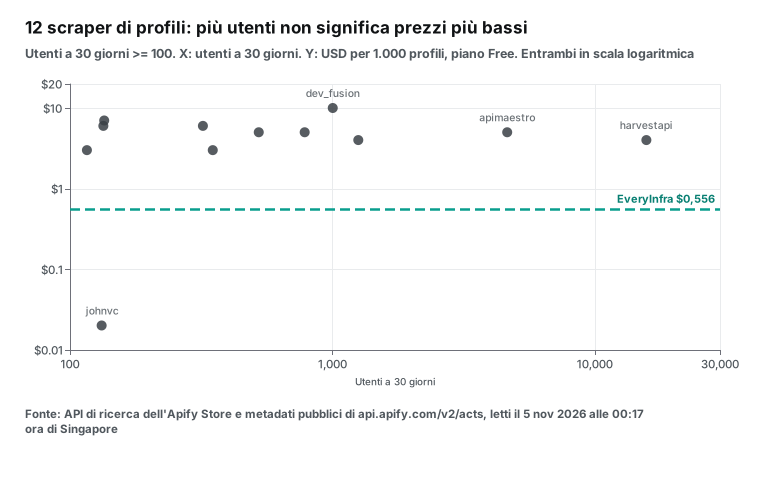
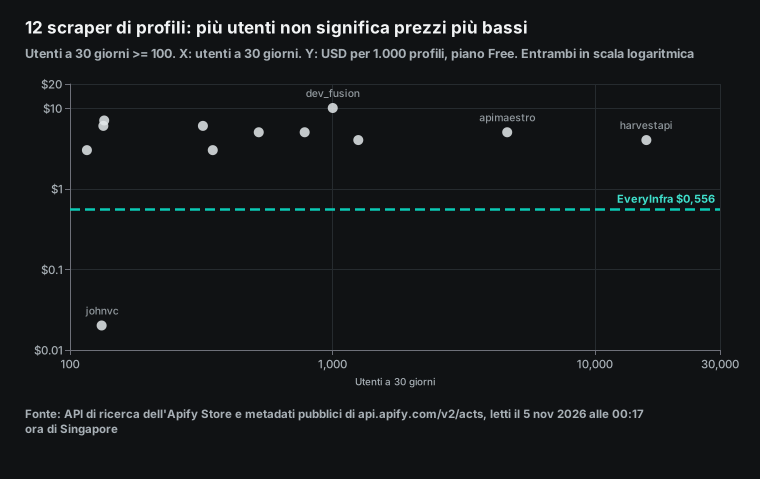
Abbiamo poi preso i 12 scraper di profili con almeno 100 utenti. Il loro prezzo mediano sul livello Free è $5,00 per 1.000 profili. Il più basso è $0,02 e il più alto $10,00 (con email).
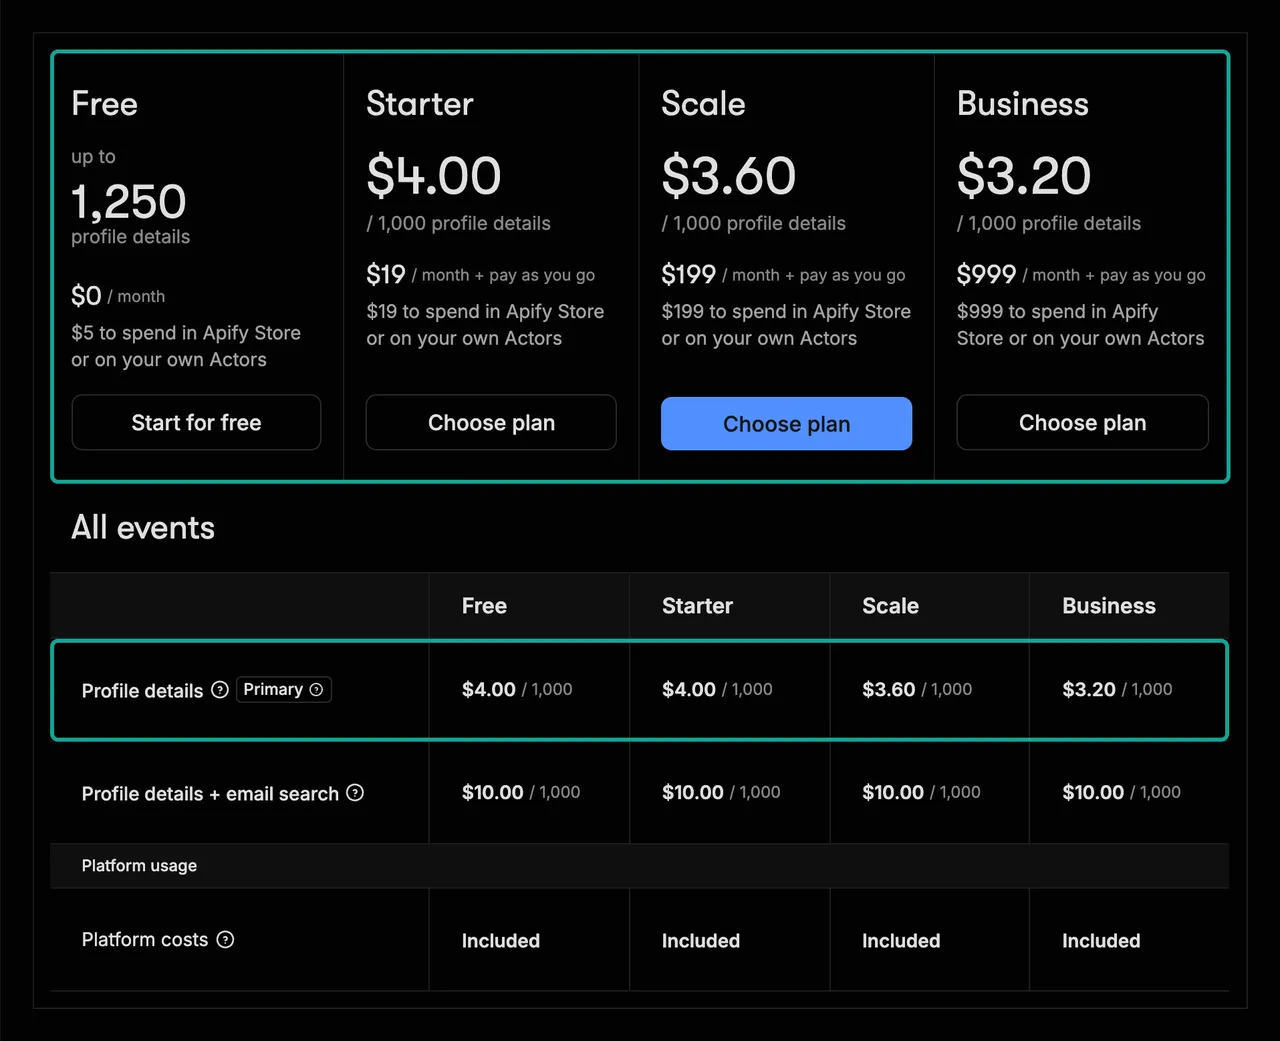
I prezzi Apify nascondono quattro trappole. La prima è il livello. La pagina dei prezzi di Apify dice che il piano Free offre $5 al mese con "No Apify Store discount". I piani a pagamento sbloccano i livelli di sconto Bronze, Silver e Gold. Ogni proprietario di actor fissa lo sconto per ciascun livello. Lo scraper di profili di harvestapi costa $4,00 su Free e Bronze, $3,60 su Silver, $3,20 su Gold, $2,60 su Platinum e $2,20 su Diamond.
Lo scraper di offerte di curious_coder costa $2,00 su Free e $1,00 su tutti i livelli a pagamento, quindi sul livello Free paghi il doppio. Per lo stesso actor, un utente singolo e un cliente Business possono vedere prezzi che differiscono di quasi 2 volte. Controlla il tuo livello prima di confrontare.
| Piano Apify | Canone mensile | Utilizzo incluso | Livello di sconto dello Store | Prezzo per compute unit |
|---|---|---|---|---|
| Gratis | $0 | $5 | Nessuno | $0,2 per CU |
| Starter | $19 | $19 | Bronze | $0,2 per CU |
| Scale | $199 | $199 | Silver | $0,16 per CU |
| Business | $999 | $999 | Gold | $0,13 per CU |
| Enterprise | Personalizzato | Personalizzato | Personalizzato | Personalizzato |
Questa tabella viene dalla pagina dei prezzi di Apify, consultata alle 00:39 ora di Singapore del 2026-11-05. Esaurito l'utilizzo incluso, paghi a consumo e puoi impostare un limite. Una compute unit (CU) corrisponde a 1 GB di memoria per 1 ora. Gli actor pay-per-event di solito non aggiungono costi in CU. I 31 actor "pay per event + usage" tra i 370 invece sì. Solo 4 di loro hanno 100+ utenti.
La seconda trappola è il prezzo in evidenza. Alcuni actor mettono un prezzo basso nel titolo o nella descrizione, e spesso è il prezzo di un livello alto. Lo scraper di profili di datadoping dice "For just $3 per 1,000 profiles".
L'API pubblica mostra $4,00 su Free, $3,50 su Bronze e $3,00 solo da Gold in su. Il suo scraper di aziende dice "$1.2 per 1,000 companies", ma su Free costa $1,55. La pagina di curious_coder dice "Pricing from $1.00 / 1,000 results". Quel "from" indica il livello Bronze o uno superiore.
Gli utenti del piano Free pagano $2,00. Non è un errore dei proprietari: devi solo leggere quel "from" con attenzione.
La terza trappola sono i costi per avvio e per pagina. Lo scraper di dipendenti di harvestapi addebita $0,02 per avvio. Il suo scraper per la ricerca di persone addebita $0,10 per pagina di ricerca, con un massimo di 25 persone per pagina. La pagina dice che il costo si applica "regardless of how many profiles were found on the page". Abbiamo distribuito il costo di pagina su una pagina piena da 25, ottenendo $4,00 per 1.000 persone, il caso migliore per Apify.
Una ricerca mirata con poche persone per pagina costa di più. Lo scraper di offerte di valig addebita $0,001 per avvio. L'API di fantastic-jobs addebita $0,01 per avvio su Free. Per una sola run da qualche migliaio di righe, questi costi sono piccoli. Molti flussi n8n però avviano una run per ogni lead. Con questa struttura, i costi di avvio possono diventare la voce di spesa principale.
La quarta trappola è il limite di run del piano Free. La pagina dello scraper di profili di harvestapi dice "Users on free-tier plans are limited to 50 runs in total". Con i $5 inclusi nel piano Free puoi ottenere 1.250 profili a $4,00 per 1.000. Da qui deriva il "fino a 1.250" dello screenshot. Su r/n8n un utente ha condiviso un flusso "gratuito" che trova i post di LinkedIn sulle assunzioni. Il flusso fa scraping dei post LinkedIn sul livello Free di Apify.
Una risposta diceva "the apify $5 just went away in a few minutes". La stessa risposta riportava che una run era costata più di $1. In un altro thread, due utenti consigliavano lo scraper di offerte di curious_coder, sostenendo che il suo livello Free dà circa 5.000 offerte al mese. Non possiamo verificare quelle fatture.
Al prezzo Free attuale di curious_coder, $2,00 per 1.000, con $5 ottieni solo 2.500 offerte. Il prezzo attuale è in vigore dal 2026-08-14, quindi il post potrebbe citare un prezzo vecchio. I prezzi dello Store cambiano: controlla la scheda Pricing prima di fidarti di qualsiasi resoconto.
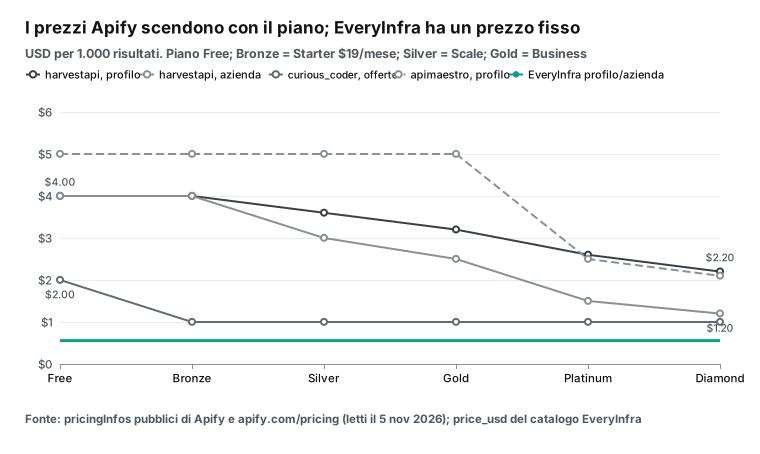
EveryInfra non ha livelli. Su LinkedIn, person_profile, company_profile, jobs, profile_search e employees costano ciascuno $0,000556 per chiamata. job_detail costa $0,001194 e person_posts $0,004. Non ci sono piani né canoni mensili.
Paghi solo quello che usi. Per provare, metti una stella a due repository GitHub di EveryInfra e ricevi $1 di credito di prova valido 24 ore. Le ricariche a pagamento partono da $10. Ogni pagina di funzionalità mostra il proprio prezzo, ad esempio l'API per i profili LinkedIn e l'API per le offerte di lavoro LinkedIn.
| Funzionalità LinkedIn di EveryInfra | Prezzo per chiamata | Righe massime per chiamata | Per 1.000 (pagine piene) |
|---|---|---|---|
linkedin/person_profile | $0.000556 | 1 | $0.556 |
linkedin/company_profile | $0.000556 | 1 | $0.556 |
linkedin/followers (conteggio) | $0.000556 | 1 | $0.556 |
linkedin/job_detail | $0.001194 | 1 | $1.194 |
linkedin/search (post) | $0.000556 | 50 | $0.011 |
linkedin/profile_search | $0.000556 | 100 | $0.0056 |
linkedin/jobs | $0.000556 | 200 | $0.0028 |
linkedin/employees | $0.000556 | 200 | $0.0028 |
linkedin/comments | $0.000556 | 200 | $0.0028 |
linkedin/company_posts | $0.002319 | 50 | $0.046 |
linkedin/person_posts | $0.004 | 50 | $0.080 |
L'ultima colonna presume che ogni chiamata restituisca una pagina piena. Le chiamate reali spesso restituiscono meno. In questo test le ricerche di offerte hanno restituito in media 179 righe per chiamata, quindi il prezzo reale è stato $0,0033, non $0,0028. La ricerca di persone ha restituito 78 persone invece di 100, quindi il prezzo reale è stato $0,0071, non $0,0056. Con l'addebito per richiesta, il prezzo reale dipende da quante righe restituisce ogni chiamata.
Test 1: 1.000 profili LinkedIn
Per prima cosa abbiamo chiamato linkedin/person_profile per cinque persone con ruoli professionali pubblici: Satya Nadella di Microsoft, il cofondatore di LinkedIn Reid Hoffman, Bill Gates, l'ex CEO di LinkedIn Jeff Weiner e il dirigente di LinkedIn Ryan Roslansky. Il parametro username accetta l'handle preso dal percorso del profilo oppure l'URL completo del profilo. Nella terza chiamata abbiamo inviato l'URL completo, con lo stesso risultato. Tutte e cinque le chiamate hanno restituito 200 e addebitato $0,000556 ciascuna.
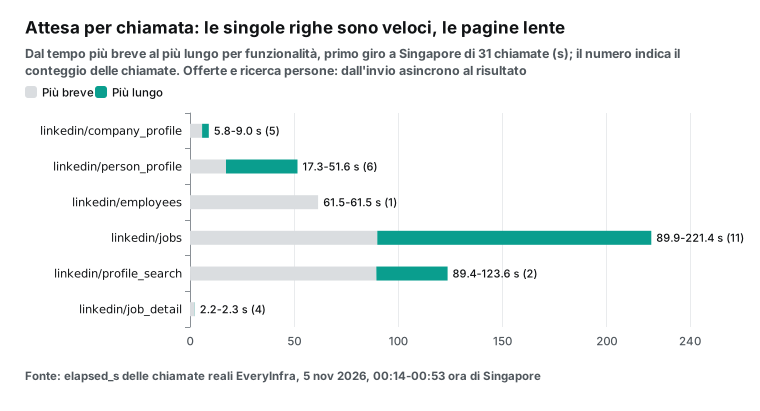
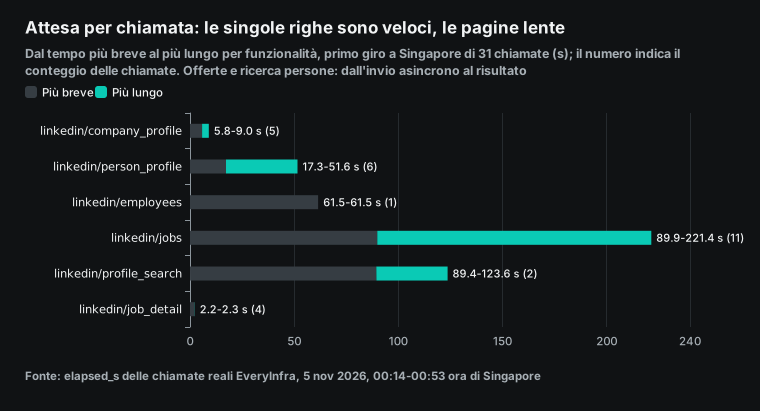
Hanno impiegato da 17,3 a 51,6 secondi. Il risultato della chiamata più lenta, effettuata alle 00:18 ora di Singapore, non conteneva esperienze lavorative né formazione. Il catalogo spiega questo caso: quando la fonte principale non è disponibile, risponde una fonte di riserva e alcuni campi possono restare vuoti.
| Campo | Righe con un valore (su 5) | Nota |
|---|---|---|
| headline, about, location, current_company | 5 / 5 | Testo pubblico del profilo |
| follower_count, connection_count | 5 / 5 | Follower e collegamenti |
| experience | 4 / 5 | 5, 5, 3 e 7 voci |
| education | 4 / 5 | 2, 2, 2 e 1 voci |
| 3 / 5 | Catalogo: email di lavoro dedotta da dati pubblici e verificata | |
| open_to_work, account_created_at | 4 / 5 | Può essere vuoto con la fonte di riserva |
| top_skills | 0 / 5 | Vuoto in tutti e cinque |
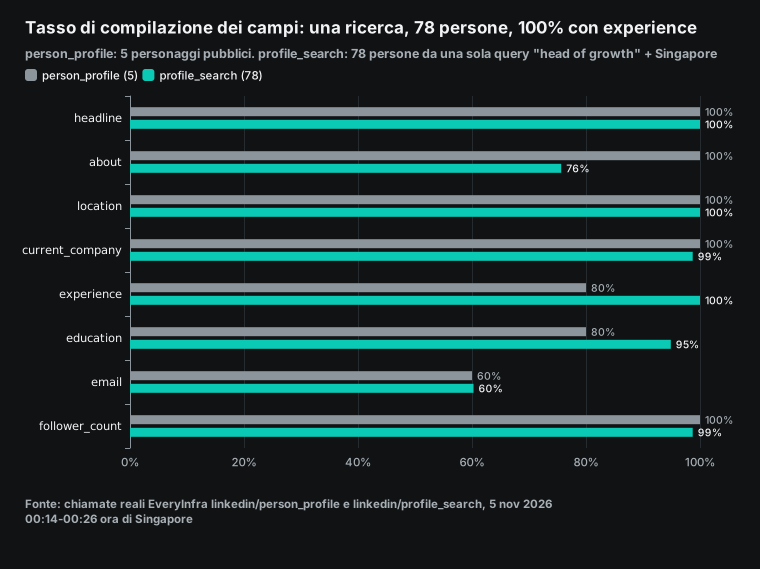
Poi abbiamo inviato uno username inesistente alle 00:19 ora di Singapore. Dopo 32 secondi l'API ha restituito 503 con il codice unavailable. Il blocco di fatturazione riportava charged false e reason request_failed_refunded. L'addebito è stato $0. Quindi una persona inesistente risulta "non disponibile al momento" e non come un 200 vuoto.
Non paghi nulla. Ma da una sola risposta non puoi capire se la persona non esiste o se la chiamata è fallita questa volta. Il campo next_steps dice "Not charged" e ti indica di riprovare dopo retry_after secondi. Al terzo errore indica cosa controllare.
Apify offre la scelta più ampia di scraper di profili. Il più usato, di harvestapi, costa $4,00 per 1.000, o $10,00 con la ricerca dell'email. La sua pagina dice "No cookies or account required". Accetta username, URL dei profili o ID interni.
La modalità email esegue verifiche SMTP. Se un profilo ha troppo pochi dati per una ricerca dell'email, la pagina dice che la ricerca non viene addebitata. Il Profile Details Scraper di apimaestro costa $5,00 per 1.000 e $2,10 su Diamond. Ha avuto 4.636 utenti in 30 giorni e un tasso di successo delle run del 100%.
Il più economico è LinkedIn Profile API di johnvc. Addebita $0,00001 per profilo più $0,00001 per elemento del dataset, quindi $0,02 per 1.000. Ogni avvio costa altri $0,00001. Ha solo 132 utenti e un tasso di successo delle run del 91,12% in 30 giorni. Quello di harvestapi è del 99,97%.
Solo sul prezzo, questo actor costa 27,8 volte meno della nostra chiamata per singolo profilo. Non lo abbiamo eseguito, quindi non sappiamo quanto siano compilati i suoi campi. La sua pagina elenca nome, headline, località, azienda attuale, esperienze, formazione e numero di follower.
Per i singoli profili, quindi, il risultato è misto. Costiamo da 7 a 9 volte meno degli scraper più usati dello Store. Costiamo più di quello più economico. Ti serve solo arricchire ogni giorno un elenco di URL di profili e puoi accettare un tasso di successo più basso? Allora prova prima quell'actor da $0,02.
Se ti servono anche ricerca di persone, offerte di lavoro e dati aziendali, un solo account e una sola chiave ti fanno risparmiare tempo sulla fatturazione e sulla gestione di più actor. Puoi anche partire dalla ricerca di persone. Una ricerca restituisce decine di persone con l'intera storia lavorativa, a un costo per persona molto più basso. I numeri sono nel Test 4.
Test 2: 1.000 pagine aziendali LinkedIn
Abbiamo chiamato linkedin/company_profile per quattro aziende: Stripe, Microsoft, Grab e Santander (inviata come URL completo). Tutte e quattro hanno restituito 200 in 6-9 secondi e addebitato $0,000556 ciascuna. Stripe mostra 16.694 dipendenti, un employee_count_range di 5001-10000 e 14 sedi. Microsoft mostra 231.125 dipendenti, 29.447.391 follower e 45 sedi. Grab mostra 58.341 dipendenti, la sede centrale a Singapore e il 2012 come anno di fondazione. Santander mostra 131.291 dipendenti e la sede centrale a Boadilla del Monte, vicino a Madrid.
Nota che employee_count e employee_count_range possono non coincidere. Il primo conta i membri LinkedIn che indicano l'azienda come lavoro attuale. Il secondo è la fascia dimensionale scelta dall'azienda. Per Stripe e Grab il numero di membri supera la fascia. Se fai lead scoring, tieni separati i due campi.
| Azienda | employee_count | employee_count_range | follower_count | Sede centrale | Sedi |
|---|---|---|---|---|---|
| Stripe | 16,694 | 5001-10000 | 1,805,161 | South San Francisco, Stati Uniti | 14 |
| Microsoft | 231,125 | 10001+ | 29,447,391 | Redmond, Stati Uniti | 45 |
| Grab | 58,341 | 5001-10000 | 1,056,756 | Singapore | 16 |
| Santander | 131,291 | 10001+ | 2,240,169 | Boadilla del Monte, Spagna | 3 |
Tutte e quattro le righe avevano description, website, industries, headquarters e offices. Solo due avevano founded_year. Nessuna aveva crunchbase_url o latest_funding_round. Il catalogo dice che la fonte di riserva può omettere finanziamenti, link a Crunchbase e coordinate sulla mappa. Se acquisti dati aziendali soprattutto per i round di finanziamento, non contare su questi due campi da parte nostra.
Dobbiamo segnalare un problema in questo test. Alle 00:20 ora di Singapore abbiamo inviato il nome di un'azienda inesistente. L'API ha restituito HTTP 200 con stringhe vuote in ogni campo e ha addebitato $0,000556. La nostra stessa regola dice che i risultati vuoti sono gratuiti. Quindi è un nostro bug, e lo abbiamo segnalato ai nostri ingegneri.
Finché la correzione non viene rilasciata, controlla l'elenco delle aziende prima di inviarlo. Puoi anche registrare le chiamate in cui results.name è vuoto insieme al loro request_id e chiederci di verificarle. Includendo questa chiamata vuota, il costo reale di queste cinque chiamate è $0,695 per 1.000 aziende. È il 25% in più dei $0,556 calcolati sulle sole righe valide.
Su Apify l'actor per aziende più usato è LinkedIn Company Details Scraper di harvestapi, con 8.071 utenti. Costa $4,00 per 1.000 su Free e $1,20 su Diamond, più $0,00005 per avvio. La sua pagina dice "No cookies or account required". Può anche trovare in blocco gli URL delle aziende a partire dai nomi. Il più economico è Linkedin Company Details Scraper di datadoping, a $1,55 su Free e $1,20 da Gold in su.
Aveva 116 utenti e un tasso di successo del 99,99%. Costiamo 2,8 volte meno di datadoping e 7,2 volte meno di harvestapi. Con un'azienda per chiamata la differenza resta piccola: le differenze grandi vengono dalle chiamate che restituiscono una pagina. Puoi provare questa funzionalità nella pagina dell'API per le aziende LinkedIn.
Test 3: 1.000 offerte di lavoro (apify linkedin scraper jobs)
Le offerte di lavoro sono il dato LinkedIn più richiesto. Mostrano anche la differenza maggiore tra i due modelli di addebito. linkedin/jobs accetta tre parametri. keyword è il termine di ricerca, oppure l'URL completo di una ricerca di offerte su LinkedIn.
location è il luogo. limit arriva fino a 200. Abbiamo eseguito una ricerca per ciascuna di 10 keyword a Singapore, ognuna con limit 200. In seguito abbiamo ripetuto data engineer, per un totale di 11 ricerche. Le keyword erano data engineer, software engineer, product manager, data scientist, data analyst, marketing manager, account executive, business analyst, devops engineer e finance manager.
Le ricerche grandi sono lente. La prima chiamata sincrona ha impiegato 89,9 secondi. Da lì in poi abbiamo aggiunto "mode": "async". L'API ha restituito subito un job_id e abbiamo interrogato poll_url ogni 8 secondi.
Tutte le 11 ricerche sono andate a buon fine. Le keyword erano 10, e abbiamo ripetuto data engineer 39 minuti dopo. Ogni ricerca ha addebitato $0,000556, per un totale di $0,006116. Ognuna ha restituito da 102 a 200 righe, per un totale di 1.970 righe.
Dopo aver rimosso i duplicati per ID offerta sono rimaste 1.853 righe, quindi il prezzo è $0,0033 per 1.000. I job asincroni hanno impiegato da 115 a 221 secondi dall'invio al risultato. Dopo la settima ricerca avevamo già 1.193 offerte uniche. Quindi 1.000 offerte uniche a Singapore ci sono costate solo 7 richieste e $0,003892.
La maggior parte dei duplicati veniva dalla ricerca ripetuta. Alle 00:14 ora di Singapore, la ricerca sincrona per data engineer ha restituito solo 102 righe. Alle 00:53, la ricerca asincrona per la stessa keyword ne ha restituite 198, di cui 101 coincidevano con la prima chiamata. Tra keyword diverse c'erano solo 14 duplicati. Venivano da data analyst e business analyst, due ruoli che si sovrappongono ad altre keyword.
Abbiamo eseguito anche ricerche fuori da Singapore. Alle 00:56, software engineer negli Stati Uniti ha restituito 198 offerte in 180,7 secondi per $0,000556. Ma quelle 198 offerte venivano da sole 31 aziende: Affirm da sola ne aveva 100, AWS 32 e JPMorganChase 20. Una keyword generica su un intero paese si riempie di pochi grandi inserzionisti, quindi per una visione del mercato cerca per città.
Le ricerche per città sono andate meglio. Analista de datos a Madrid ha restituito 199 offerte da 165 aziende. Data analyst a Città del Messico ha restituito 158 offerte da 126 aziende. Ogni chiamata è costata $0,000556. Solo 3 e 10 di quelle righe, rispettivamente, avevano salary.
| Keyword | Ora di Singapore | Righe | Nuovi unici | Totale cumulativo di offerte uniche | Secondi |
|---|---|---|---|---|---|
| data engineer (sincrona) | 00:14 | 102 | 102 | 102 | 89.9 |
| software engineer | 00:29 | 194 | 194 | 296 | 131.9 |
| product manager | 00:31 | 200 | 200 | 496 | 221.4 |
| data scientist | 00:35 | 196 | 196 | 692 | 140.4 |
| data analyst | 00:37 | 198 | 192 | 884 | 156.6 |
| marketing manager | 00:40 | 189 | 189 | 1,073 | 164.2 |
| account executive | 00:43 | 120 | 120 | 1,193 | 115.4 |
| business analyst | 00:45 | 199 | 191 | 1,384 | 197.3 |
| devops engineer | 00:48 | 200 | 200 | 1,584 | 149.4 |
| finance manager | 00:51 | 174 | 174 | 1,758 | 123.9 |
| data engineer (ripetuta) | 00:53 | 198 | 95 | 1,853 | 156.1 |
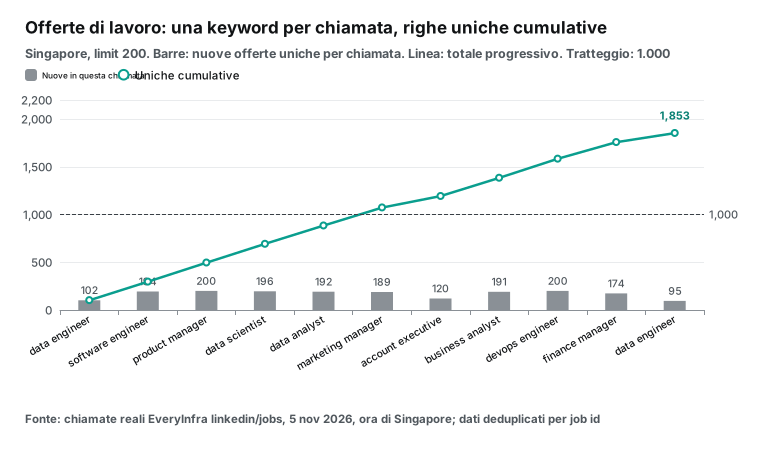
Per i campi abbiamo esaminato le prime 102 offerte. title, text (la descrizione completa), company_name, company_url, location, employment_type, seniority, applicant_count e posted_at erano presenti in tutte e 102. La descrizione mediana era lunga 3.567 caratteri. Solo 4 offerte avevano salary, perché la maggior parte degli annunci a Singapore non indica la retribuzione. Quanto alle date, 64 delle 102 erano state pubblicate a ottobre 2026 e 25 nei primi giorni di novembre.
Su tutte le 1.970 righe delle 11 ricerche, solo 66 (3,4%) avevano salary, sempre come fascia mensile o annuale in dollari di Singapore. Del totale, 1.884 righe avevano full-time come employment_type e 1.046 avevano Not Applicable come seniority. Il valore mediano di applicant_count era 101,5.
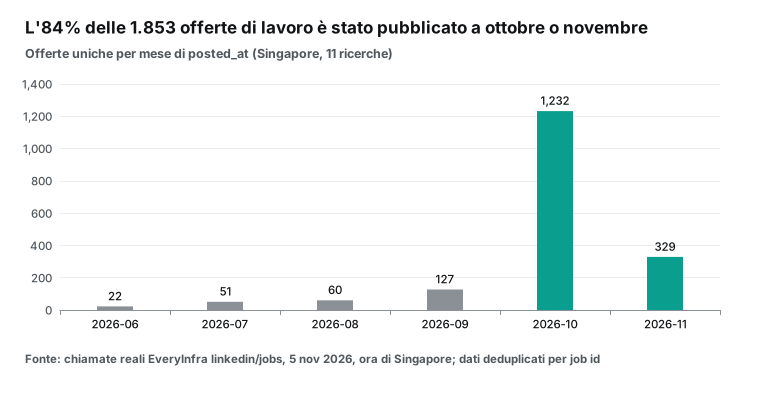
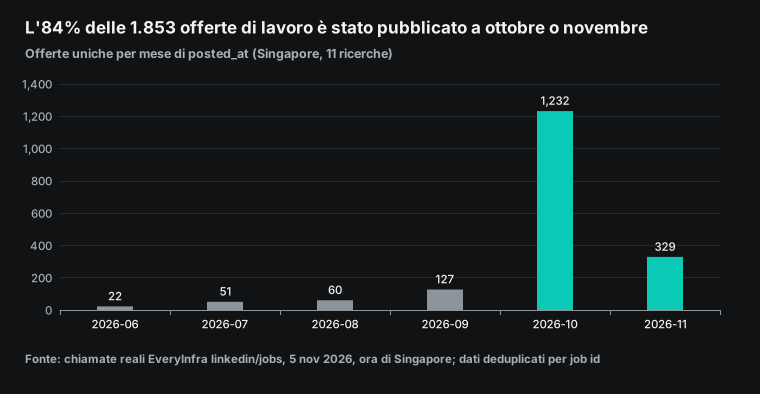
Le 1.853 offerte uniche venivano da 817 aziende. Le prime tre erano OCBC con 35 offerte e GovTech Singapore e Shopee con 33 ciascuna. Per mese di pubblicazione, 1.232 delle 1.853 offerte erano di ottobre e 329 dei primi giorni di novembre, l'84% in totale.
L'annuncio più vecchio era di agosto 2024. Quindi i risultati di ricerca possono includere alcuni annunci vecchi ancora aperti. Per gli avvisi sulle nuove offerte, filtra di nuovo per posted_at.
Apify ha il maggior numero di scraper di offerte di lavoro. Il più usato è Linkedin Jobs Scraper di curious_coder, con 15.193 utenti. Costa $2,00 per 1.000 su Free e $1,00 da Bronze in su. La sua pagina dice che può aggiungere i dettagli di chi ha pubblicato l'offerta e dell'azienda.
La pagina indica anche un limite di LinkedIn: "Linkedin limits number of jobs per search to 1000". Per ottenere più offerte attivi "Split search urls by location". L'actor esegue allora una ricerca per città e rimuove i duplicati. LinkedIn Jobs Scraper di valig, con 8.091 utenti, costa $0,40 per 1.000 più $0,001 per avvio. cheap_scraper dice "No login or cookies needed" e costa $0,70.
Rapid Linkedin Jobs Scraper di worldunboxer costa $0,10 per 1.000 in modalità quick e $0,35 in modalità detailed. La sua pagina elenca "cron schedules, webhooks and MCP for AI agents". Advanced LinkedIn Job Search API di fantastic-jobs è un prodotto di tipo diverso: si presenta come un database con oltre 10 milioni di nuove offerte al mese, dati sui recruiter e campi AI. Costa $5,00 per 1.000 su Free e $1,50 da Gold in su.
In confronto, il nostro linkedin/jobs costa $0,0033 per 1.000: 606 volte meno di curious_coder su Free, 121 volte meno di valig e 30,3 volte meno dell'opzione più economica da $0,10. Il dettaglio della singola offerta va nella direzione opposta. linkedin/job_detail ha un prezzo di listino di $0,001194 per chiamata, cioè $1,194 per 1.000.
Tutte e cinque le chiamate di test hanno restituito 503 e sono costate $0. Abbiamo provato due ID di offerte reali, un ID inesistente e l'ID di esempio indicato nel suggerimento dell'errore. Alle 01:10 abbiamo provato un terzo ID reale preso dalla nostra ricerca data engineer, e anche questo ha restituito 503. La modalità detailed di worldunboxer costa $0,35 per 1.000, 3,4 volte meno del nostro prezzo di listino. Il nostro campo text contiene già la descrizione completa, quindi alla maggior parte dei progetti la chiamata di dettaglio non serve. Se ti servono link di candidatura o benefit, che compaiono solo nella pagina di dettaglio, per ora Apify è la scelta migliore.
Test 4: ricerca di persone ed elenchi dei dipendenti di un'azienda
linkedin/profile_search trova persone per ruolo attuale e località. keyword è il ruolo, location è il luogo e limit arriva fino a 100. Abbiamo cercato "head of growth" a "Singapore" con limit 100. La prima chiamata sincrona ha restituito 503 timeout dopo 89,4 secondi, senza addebito.
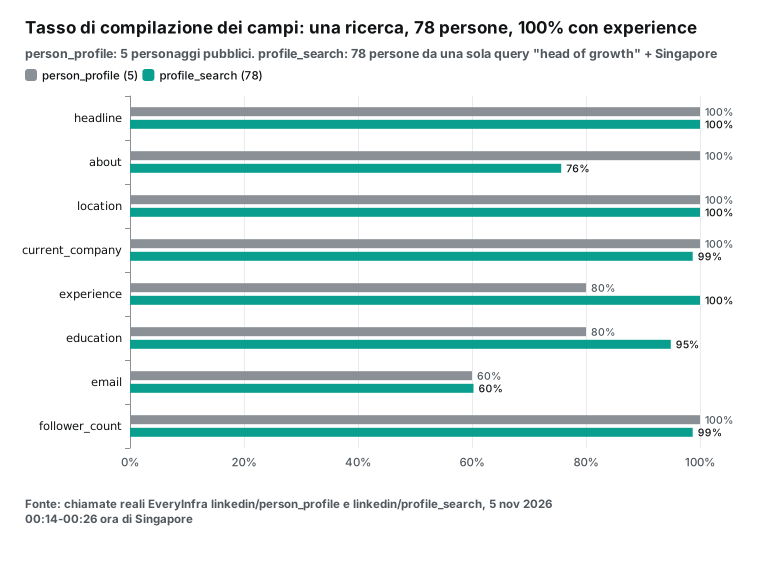
Il suggerimento nella risposta indicava di aggiungere "mode":"async" per limiti elevati. Alle 00:26 ora di Singapore abbiamo inviato la versione asincrona. Circa due minuti dopo avevamo 78 persone per $0,000556, cioè $0,0071 per 1.000.
Tutte le 78 persone avevano experience, con una mediana di 7 voci. 74 avevano education, 59 about e 47 email. 27 avevano is_premium impostato a true. Quindi una sola ricerca restituisce profili completi con la storia lavorativa. Per persona, costa circa 78 volte meno delle singole chiamate a person_profile.
Attenzione a un dettaglio: location non significa "vive ora in questa città". Delle 78 persone, solo 27 avevano Singapore in location. Le altre erano a Sydney, New York, nella San Francisco Bay Area, a Mumbai, Londra, Hong Kong, Parigi e altrove. Però 48 dei 78 record citavano Singapore da qualche parte, quindi sembrano corrispondere anche persone che ci hanno lavorato in passato.
Alle 01:06 lo abbiamo verificato di nuovo con data scientist a Madrid e limit 100. Dopo 229,4 secondi avevamo 100 persone per $0,000556. Di queste, 55 avevano Madrid in location e 77 citavano Madrid da qualche parte nel record. E 94 avevano data scien in headline. Se ti servono persone che si trovano ora in quella città, filtra tu i risultati su location. Con queste percentuali, circa metà delle persone restituite è utilizzabile.
linkedin/employees elenca le persone di un'azienda. Abbiamo chiesto Stripe con limit 200. In 61,5 secondi l'API ha restituito 200 persone per $0,000556, cioè $0,0028 per 1.000. Tutte le 200 avevano headline e location.
Nessuna aveva email, perché secondo il catalogo le email dei dipendenti compaiono solo se la persona le rende pubbliche. Delle 200, 106 avevano is_premium impostato a true. Queste due chiamate restituiscono nomi e ruoli di persone private, quindi in questo articolo non mostriamo né i loro nomi né le loro email.
Su Apify, LinkedIn Profile Search Scraper di harvestapi (8.094 utenti) ha una modalità short che costa $0,10 per pagina, con un massimo di 25 persone. Se ogni pagina contiene 25 persone, il costo è di $4,00 per 1.000. La modalità full aggiunge $0,004 per persona, per un totale di $8,00 per 1.000. La ricerca dell'email costa di più.
Il suo punto di forza sono i filtri. La pagina elenca filtri per azienda, settore, scuola e anni di esperienza, e harvestapi ha un actor separato che cerca per nome. Company Employees Scraper di harvestapi costa $3,00 per 1.000 in modalità short, più $0,02 per avvio, e $8,00 in modalità full. La sua pagina dice "This actor can try to find contact emails".
Rispetto alla modalità short, la nostra ricerca di persone costa 561 volte meno e il nostro elenco dei dipendenti 1.079 volte meno. Però offriamo solo due filtri, ruolo e località, e employees filtra solo per azienda. Non abbiamo filtri per settore, scuola o anzianità. Per elenchi di persone con criteri molto specifici, quegli actor Apify sono più adatti.
Un unico paniere: 1.000 profili, 1.000 aziende e 1.000 offerte di lavoro
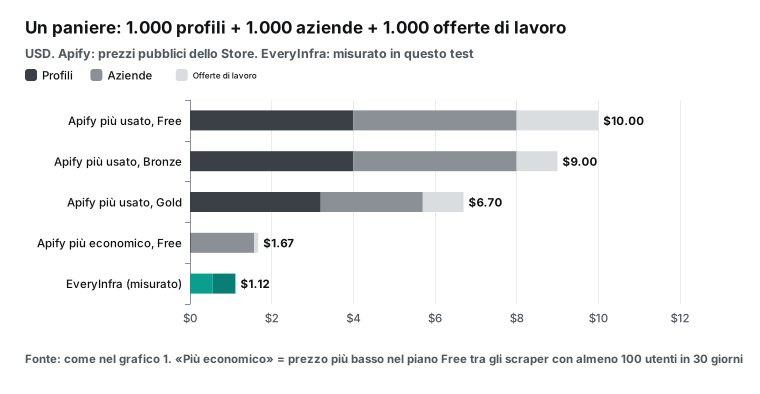
Ora mettiamo le tre esigenze più comuni in un unico paniere. Il risultato dipende da come scegli gli actor su Apify. Con l'actor più usato per ogni tipo, il livello Free costa $4,00 + $4,00 + $2,00 = $10,00. Starter (Bronze) costa $9,00 e Business (Gold) $6,70.
Il piano Free offre solo $5 al mese, quindi non basta per questo paniere. Serve almeno il piano Starter da $19. Con l'actor più economico sul livello Free per ogni tipo (100+ utenti), il costo è johnvc $0,02 + datadoping $1,55 + worldunboxer $0,10 = $1,67. Il nostro costo è $0,556 + $0,556 + $0,0033 = $1,12.
| Opzione | Profili | Aziende | Offerte di lavoro | Totale | Differenza rispetto a EveryInfra |
|---|---|---|---|---|---|
| Actor Apify più usati, Free | $4.00 | $4.00 | $2.00 | $10.00 | 9.0x |
| Idem, Starter (Bronze) | $4.00 | $4.00 | $1.00 | $9.00 | 8.1x |
| Idem, Business (Gold) | $3.20 | $2.50 | $1.00 | $6.70 | 6.0x |
| Actor Apify più economici per tipo, Free | $0.02 | $1.55 | $0.10 | $1.67 | 1.5x |
| EveryInfra (misurato) | $0.556 | $0.556 | $0.0033 | $1.12 | - |
L'ultima riga Apify è solo 1,5 volte sopra il nostro totale. Il motivo è semplice: l'actor per profili più economico costa 27,8 volte meno di noi e annulla gran parte del nostro vantaggio sulle offerte di lavoro. Se il tuo paniere è fatto soprattutto di profili, la strategia "più economico per tipo" su Apify può farti risparmiare. Il prezzo da pagare è la gestione di tre actor con proprietari, input e tassi di successo diversi. Se il tuo paniere è fatto soprattutto di offerte di lavoro, ricerche di persone o elenchi di dipendenti, l'addebito per richiesta prevale con un margine mensile maggiore.
Vediamo più da vicino una routine quotidiana. Un team di recruiting o di vendite esegue un job al giorno per 30 giorni. Cerca offerte per 10 keyword, aggiorna 50 aziende target e arricchisce 20 profili di candidati. Per entrambe le parti usiamo le 179 righe per ricerca di offerte misurate in questo test. Cambia solo il modello di addebito.
| Attività giornaliera | EveryInfra (al mese) | Actor Apify più usati, Free (al mese) | Idem, Starter o Bronze (al mese) | Actor Apify più economici, Free (al mese) |
|---|---|---|---|---|
| 10 ricerche di offerte, circa 1.790 righe | $0.17 | $107.42 | $53.72 | $5.39 |
| 50 pagine aziendali | $0.83 | $6.00 | $6.00 | $2.33 |
| 20 profili | $0.33 | $2.40 | $2.40 | $0.01 |
| Totale | $1.33 | $115.82 | $62.12 | $7.72 |
La tabella mostra una cosa: quando una routine include dati restituiti a pagine intere, sono questi dati a determinare il costo con la fatturazione per risultato. Con gli actor più usati il credito di $19 dello Starter non basta, e paghi circa $43 in più a consumo. Con gli actor più economici il mese costa circa $8. Con noi il costo mensile è di $1,33, cioè 5,8 volte meno. I costi di avvio per ogni run sono inclusi e sono contenuti.
apify linkedin scraper api a confronto con l'API di EveryInfra
Tutti gli actor Apify funzionano tramite la stessa REST API. La chiamata più comune esegue un actor e restituisce il suo dataset in un'unica richiesta. L'endpoint è POST https://api.apify.com/v2/acts/<owner>~<name>/run-sync-get-dataset-items. Il corpo della richiesta è l'input di quell'actor, e ogni actor ha i propri campi di input, che trovi nella scheda Input della sua pagina sullo Store. I parametri di query includono timeout, memory, maxItems e maxTotalChargeUsd.
Secondo la documentazione di Apify, maxItems fissa il numero massimo di elementi che paghi. Non garantisce che l'actor restituisca solo quel numero. maxTotalChargeUsd limita il costo totale di una run, con qualsiasi modello di prezzo. Questi due controlli sono un vero punto di forza di Apify.
Noi non abbiamo un limite di costo per run, perché ogni nostra richiesta ha un prezzo fisso. Il blocco qui sotto è un esempio di configurazione Apify. Non lo abbiamo eseguito, e devi compilare il file di input per l'actor che scegli.
# Configuration example (not run): run an Apify LinkedIn jobs actor, pay for at most 1,000 items, spend at most $2
curl -X POST \
  "https://api.apify.com/v2/acts/curious_coder~linkedin-jobs-scraper/run-sync-get-dataset-items?maxItems=1000&maxTotalChargeUsd=2" \
  -H "Authorization: Bearer $APIFY_TOKEN" \
  -H "Content-Type: application/json" \
  -d @input.json   # input fields come from the actor's Input tab
EveryInfra usa un solo URL per tutte le piattaforme: POST https://api.everyinfra.com/api/v1/social. Il corpo contiene sempre tre chiavi: platform, action e params. Per cambiare piattaforma o funzionalità cambi solo questi valori. Per le richieste lente aggiungi "mode": "async". L'API restituisce subito un job_id e un poll_url, che interroghi con GET.
La prima risposta mostra già l'addebito. Se il job fallisce, lo stesso addebito viene rimborsato. Questa è la chiamata che abbiamo usato nel test. La chiave viene da una variabile d'ambiente.
# Live test call: search data scientist jobs in Singapore, async, up to 200 rows
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"linkedin","action":"jobs","mode":"async",
       "params":{"keyword":"data scientist","location":"Singapore","limit":200}}'
# 202: {"job_id":"...","status":"running","poll_url":"/api/v1/jobs/...","billing":{"charged_usd":0.000556,...}}
curl -s "https://api.everyinfra.com/api/v1/jobs/<job_id>" -H "Authorization: Bearer $EVERYINFRA_API_KEY"
# poll until status=succeeded; results holds the job array
Anche gli errori funzionano in modo diverso sulle due piattaforme. Alle 00:25 ora di Singapore abbiamo scritto di proposito location come locaton. In 0,1 secondi l'API ha restituito 422 con il codice unknown_param. L'errore elencava i parametri supportati e diceva "did you mean location".
L'addebito è stato di 0 $. Anche una chiamata senza chiave ha restituito 401 missing_key, sempre a 0 $. Abbiamo scritto questi messaggi pensando ai client AI. Un modello che legge il 422 può correggere il parametro e inviare di nuovo la chiamata.
Su Apify, ogni proprietario definisce l'input dell'actor con un JSON Schema. La piattaforma controlla i tipi e i campi obbligatori prima che l'esecuzione parta. Il modo in cui un actor gestisce i campi in più dipende dall'actor. Questa parte non l'abbiamo testata.
Apify offre anche client ufficiali per JavaScript e Python, una CLI e integrazioni con n8n, Make e Zapier. Dispone di Schedules per le esecuzioni programmate e Webhooks per le callback. EveryInfra offre un file OpenAPI, un file llms.txt, semplici nodi HTTP Request in n8n e il server MCP remoto descritto più avanti. Se pensi di migrare un flusso n8n, leggi la nostra guida alternativa ad Apify per n8n. Spiega come modificare ogni nodo.
Ti servono un login o i tuoi cookie?
LinkedIn mostra la maggior parte dei dati del profilo solo agli iscritti che hanno effettuato l'accesso. Per questo la prima domanda da porsi su qualsiasi scraper LinkedIn è: devi cedere i tuoi cookie? La nostra risposta è semplice. Tutte le funzionalità LinkedIn di EveryInfra usano solo la tua chiave API EveryInfra. Non richiedono, e non accettano, il tuo account LinkedIn, la tua password o i tuoi cookie. Nessun parametro chiede un login.
Su Apify, la maggior parte degli actor più popolari che abbiamo esaminato dichiara nel titolo di non richiedere cookie. Tutti e quattro gli actor di harvestapi (profile, company, search ed employees) riportano «No cookies or account required». apimaestro riporta «No Cookies» e «No login required». cheap_scraper riporta «No login or cookies needed».
worldunboxer riporta «without login cookies» e lergassy «No account at risk». Le pagine di curious_coder e valig che abbiamo letto non lo indicano. Per questi due scriviamo «non indicato nella pagina».
Nello Store ci sono anche actor che chiedono il tuo cookie li_at. Dei 109 actor con almeno 100 utenti, 31 non dichiarano «no cookies» né nel titolo né nella descrizione. Controllali uno per uno prima di usarli.
| Scraper | Testo della pagina | Serve il cookie LinkedIn? |
|---|---|---|
| harvestapi: profilo, azienda, ricerca, dipendenti | No cookies or account required | No |
| apimaestro: profilo, dipendenti | No Cookies; No login required | No |
| cheap_scraper: offerte di lavoro | No login or cookies needed | No |
| worldunboxer: offerte di lavoro | without login cookies | No |
| lergassy: profilo | No account at risk | No |
| curious_coder: offerte di lavoro; valig: offerte di lavoro | Non indicato nella pagina | Non indicato |
| EveryInfra, tutte le funzionalità LinkedIn | Solo la chiave API EveryInfra | No, e non viene accettato |
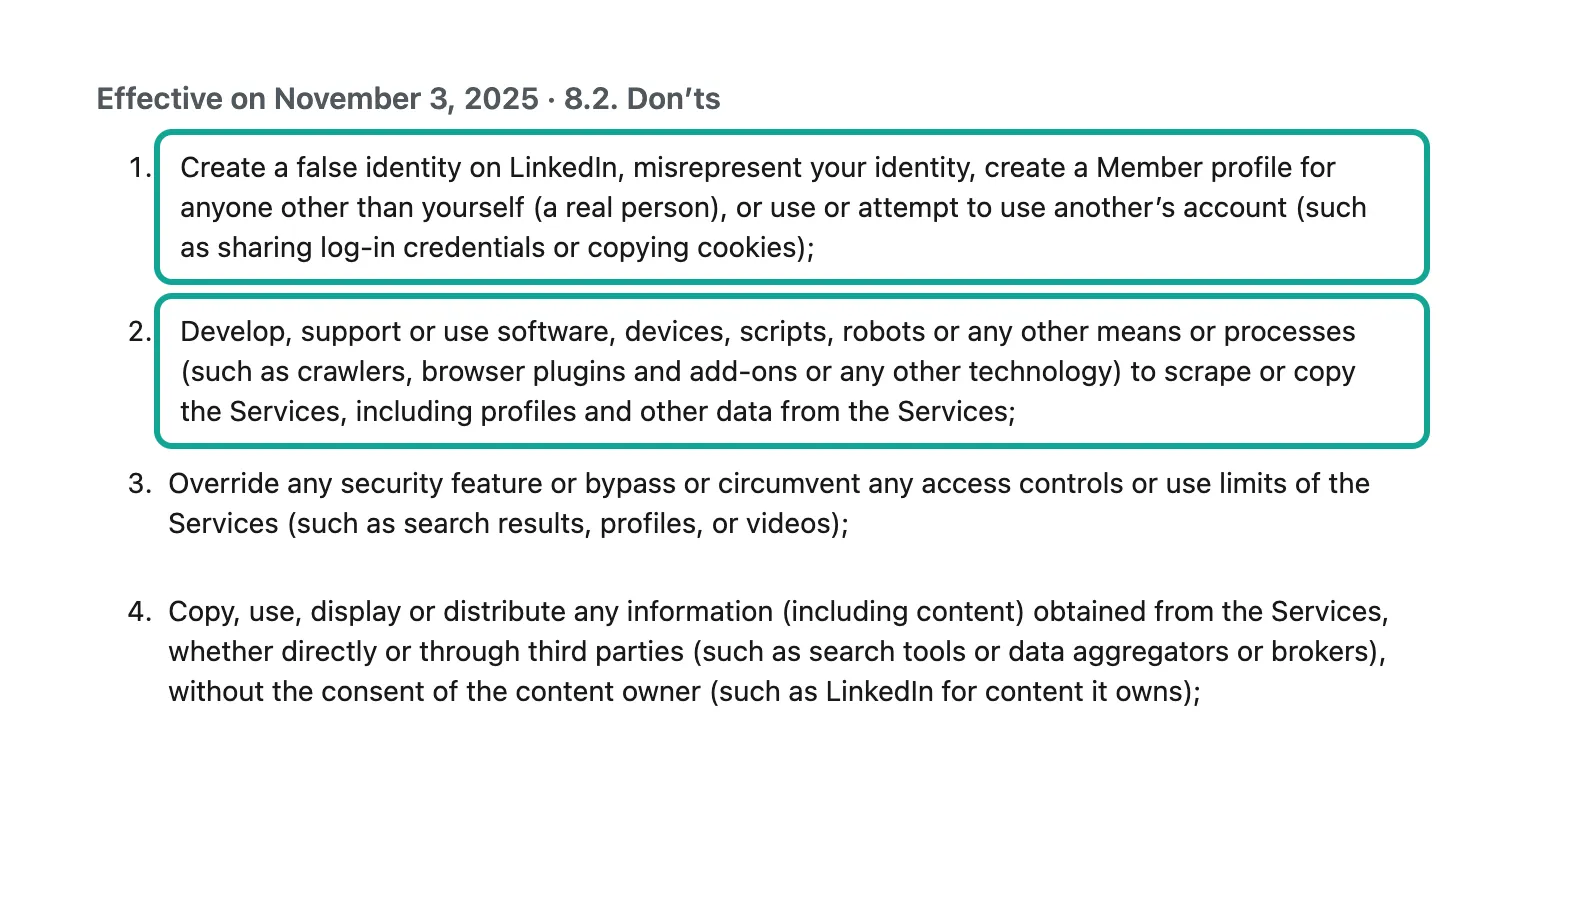
Perché è importante? Il punto 2 della sezione 8.2 dello User Agreement di LinkedIn vieta crawler, script e plugin del browser che fanno scraping o copiano i Servizi. Lo riportiamo nella sezione successiva. Se dai il tuo cookie a uno strumento di terze parti, lo scraping avviene con il tuo account. Quindi, se LinkedIn limita o banna quell'account, la perdita è tua.
Con il cookie di un'altra persona violi anche il punto 1, secondo cui non devi «use or attempt to use another's account (such as sharing log-in credentials or copying cookies)».
Cosa dice lo User Agreement di LinkedIn sullo scraping
Abbiamo letto la versione attuale su linkedin.com/legal/user-agreement. La pagina riporta «Effective on November 3, 2025». La parte più rilevante è la sezione 8.2, «Don'ts». Sotto «You agree that you will not», il punto 2 riguarda software, dispositivi, script, robot, crawler, plugin e componenti aggiuntivi del browser.
Il punto stabilisce che non devi usarli «to scrape or copy the Services, including profiles and other data from the Services». Il punto 3 vieta di aggirare i controlli di accesso o i limiti di utilizzo, ad esempio sui risultati di ricerca o sui profili. Un altro punto vieta di copiare o condividere dati dei Servizi tramite terze parti e cita espressamente «data aggregators or brokers». La sezione 5 stabilisce che la sezione 8.2 resta in vigore anche dopo la fine del contratto.
Questi termini vincolano chi usa LinkedIn e accetta il contratto. Per anni i tribunali statunitensi hanno discusso delle visite a pagine pubbliche senza login. Uno dei casi è hiQ Labs v. LinkedIn. La Corte d'appello del Nono Circuito si è pronunciata il 18 aprile 2022. Ha ritenuto che lo scraping di profili visibili pubblicamente probabilmente non avvenga «without authorization» ai sensi del Computer Fraud and Abuse Act (CFAA) statunitense.
La corte ha emesso quella decisione dopo la sentenza Van Buren del 2021 della Corte Suprema sul concetto di «exceeds authorized access». Più avanti nel 2022, il tribunale distrettuale della California settentrionale ha stabilito che hiQ aveva violato lo User Agreement. Il caso si è poi chiuso con un accordo transattivo.
Il 24 gennaio 2025 LinkedIn ha fatto causa a Nubela, la società dietro Proxycurl, presso il Northern District of California (causa 3:25-cv-00828). Secondo LinkedIn, Proxycurl usava centinaia di migliaia di account falsi per fare scraping dei dati degli iscritti. Proxycurl ha annunciato la chiusura il 4 luglio 2025. Nell'ottobre 2025 LinkedIn ha fatto causa a ProAPIs e Netswift.
Secondo LinkedIn, le due società usavano milioni di account falsi per fare scraping dei dati e rivenderli. The Record riporta che in seguito il tribunale ha approvato una sentenza concordata tra le parti. Le società devono smettere di fare scraping, vendere e trasferire i dati degli iscritti, smettere di usare account falsi ed eliminare i dati raccolti. In tutti questi casi, le contestazioni riguardavano account falsi o un modo per aggirare il login wall.
LinkedIn pubblica anche i Crawling Terms (ultima revisione 25 maggio 2017) e un file robots.txt. Entrambi stabiliscono che il crawling automatizzato senza autorizzazione non è consentito, salvo per i motori di ricerca elencati. La documentazione ufficiale delle API di LinkedIn su Microsoft Learn rende disponibili alla maggior parte degli sviluppatori solo pochi permessi: l'accesso (sign-in), il proprio profilo di base e la propria email e la pubblicazione di post per conto di un iscritto.
La ricerca di persone e i profili completi di altri iscritti richiedono programmi partner come Sales Navigator o Talent Solutions, previa revisione. Quindi LinkedIn non offre un accesso aperto per leggere in blocco i dati pubblici. È per questo che esiste un mercato per gli scraper di terze parti.
Non forniamo consulenza legale. Se e come usare questi dati dipende dalla tua attività, dal luogo in cui operi e dal tuo scopo. Rivolgiti a un avvocato della tua giurisdizione. Ecco i fatti che possiamo affermare. Le funzionalità LinkedIn di EveryInfra descritte in questo articolo restituiscono solo dati mostrati da pagine pubbliche e non richiedono un tuo account LinkedIn.
In person_profile e profile_search, il campo email contiene un'email di lavoro dedotta da dati pubblici e verificata. In employees, un'email compare solo se la persona l'ha resa pubblica. Tratta i dati personali secondo la legge locale, ad esempio il California Consumer Privacy Act (CCPA) o il GDPR dell'UE. Verifica il consenso prima di usarli per il marketing.
Errori e risultati vuoti si pagano?
Le regole sugli errori determinano quanto costa una giornata storta. In questo test abbiamo visto quattro tipi di errore.
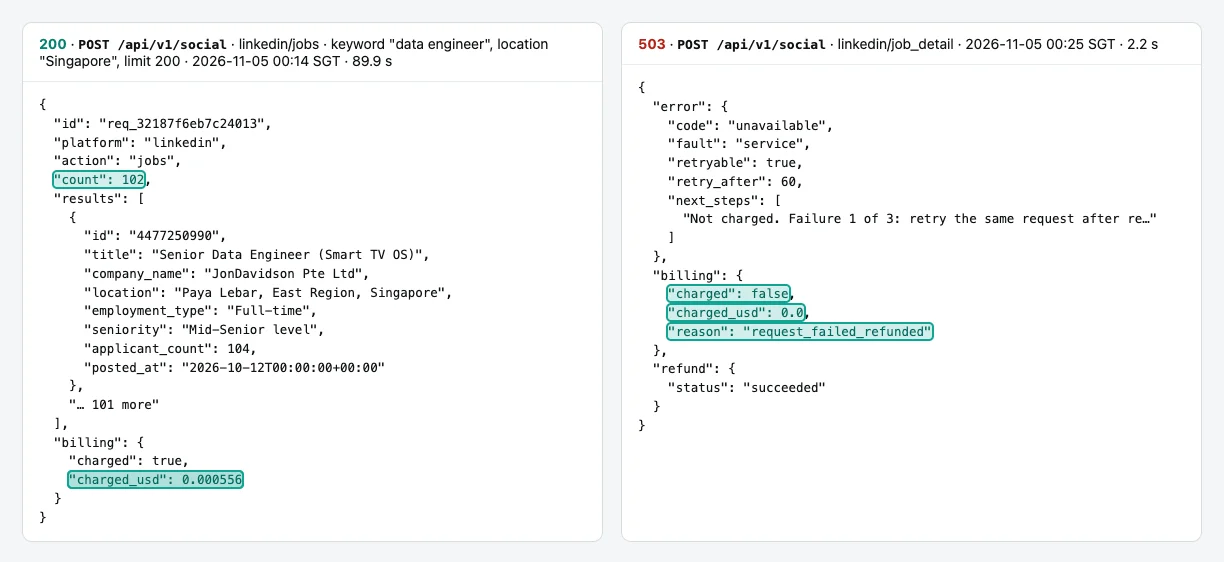
| Caso | Ora di Singapore | HTTP | Codice di errore | Addebito EveryInfra | Regola pubblica di Apify |
|---|---|---|---|---|---|
| Nessuna chiave API | 00:25 | 401 | missing_key | $0 | Senza token, nessuna esecuzione |
Parametro scritto male (locaton) | 00:25 | 422 | unknown_param | $0 | Controllo dello schema di input; dipende dall'actor |
| Persona sconosciuta | 00:19 | 503 | unavailable | $0 | Pay per event: nessun evento di risultato, nessuna tariffa per risultato; la tariffa di avvio si applica comunque |
| Dettaglio offerta non disponibile (5 chiamate) | 00:25-01:10 | 503 | unavailable | $0 | Come sopra |
| Timeout della ricerca sincrona di persone | 00:23 | 503 | timeout | $0 | Il tuo timeout termina l'esecuzione; gli eventi registrati fino a quel momento vengono addebitati |
| Azienda sconosciuta | 00:20 | 200 | none | 0,000556 $ (un nostro bug) | - |
La nostra regola è questa. Quando confermiamo un errore o un risultato vuoto, rimborsiamo lo stesso charge_id sullo stesso portafoglio. Quando l'esito è incerto, manteniamo lo stato reale e lo verifichiamo prima. L'unica chiamata che ha violato questa regola è stata il 200 vuoto per un'azienda sconosciuta, come detto sopra. Con il modello pay per event di Apify, secondo la documentazione un actor addebita ogni volta che il suo codice segnala un evento.
Nessun risultato significa nessun evento di risultato. Gli eventi di avvio come «Actor start» però si applicano comunque, così come quelli per pagina come «search page». L'actor di ricerca di harvestapi addebita 0,10 $ per pagina «regardless of how many profiles were found». La sua modalità email dichiara di non addebitare la ricerca dell'email se il profilo è troppo scarno. Quindi su Apify è ogni proprietario a decidere quanto costa un errore. Controlla ogni actor.
MCP e strumenti AI
Entrambi supportano MCP (Model Context Protocol, uno standard che permette ai client AI di chiamare strumenti esterni). Il server MCP di Apify si trova su https://mcp.apify.com. Secondo la documentazione di Apify, la prima connessione apre un browser per l'accesso OAuth. Puoi anche usare un Bearer token.
Di default carica gli strumenti per cercare actor, eseguirli e consultare la documentazione. Puoi aggiungere ?tools= all'URL per caricare solo alcuni actor. Senza account funzionano solo strumenti come la ricerca di actor e la consultazione della documentazione. Per sicurezza, gli actor che richiedono permessi completi sono esclusi da MCP.
Il server supporta anche gli «agentic payments» per richiesta, solo per gli actor pay per event. Il 5 novembre 2026 abbiamo chiamato https://mcp.apify.com senza token e ha restituito 401, in linea con la documentazione.
Il server MCP remoto di EveryInfra si trova su https://api.everyinfra.com/mcp. Il 5 novembre 2026, tools/list ha restituito 12 strumenti, tutti con nome everyinfra_*. everyinfra_list_capabilities elenca funzionalità e prezzi. everyinfra_call_api chiama qualsiasi funzionalità della piattaforma.
everyinfra_get_job legge i job asincroni. everyinfra_get_account mostra il tuo saldo. Alle 01:02 ora di Singapore del 2026-11-05 abbiamo inviato una tools/call MCP a everyinfra_call_api con {"platform":"linkedin","action":"company_profile","params":{"company":"openai"}}. La risposta è arrivata in 6,4 secondi.
Il testo di content conteneva lo stesso JSON della REST API, circa 3.300 caratteri. Per OpenAI risultavano un employee_count di 11.489, una fascia dimensionale 1001-5000 e 12.126.872 follower. L'addebito è stato di 0,000556 $, lo stesso della REST API. In Claude Code lo aggiungi con un solo blocco:
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}| Voce | Apify MCP | EveryInfra MCP |
|---|---|---|
| URL | https://mcp.apify.com | https://api.everyinfra.com/mcp |
| Autenticazione | Accesso OAuth di default, oppure Bearer token | Chiave API (Bearer) |
| Una chiamata a uno strumento | Avvia un'esecuzione dell'actor e restituisce il dataset | Una richiesta API, restituisce JSON |
| Fatturazione | Regole dell'actor che esegui (per lo più per risultato) | Per richiesta, per lo più 0,000556 $ per LinkedIn |
| Senza credenziali | Solo ricerca di actor e documentazione | Testato alle 01:04 e alle 01:17: isError, codice unauthorized, «Nothing was charged» |
| Questo test | 401 senza token | Chiamata sull'azienda alle 01:02, 6,4 secondi, 0,000556 $ |
In un client AI, la domanda chiave è quanto restituisce una singola chiamata a uno strumento. Una chiamata MCP di Apify avvia un'esecuzione dell'actor e restituisce il suo dataset al termine. Una chiamata MCP di EveryInfra è una richiesta API e restituisce il JSON visto sopra. Per un agente, «cerca offerte di lavoro e ottieni 200 righe» è da noi una sola chiamata a uno strumento da 0,000556 $. Su Apify è un'esecuzione dell'actor, addebitata per risultato. Consulta la pagina del server MCP di EveryInfra per configurare il client.
Quando Apify è la scelta migliore
Questa sezione elenca ciò che Apify offre e noi no, e i casi in cui Apify costa meno. Il primo riguarda i singoli profili. La LinkedIn Profile API di johnvc costa 0,02 $ per 1.000, un prezzo 27,8 volte inferiore al nostro. Il suo tasso di successo è del 91,12%, ma alle righe con errore non viene applicata alcuna tariffa per risultato, quindi resta più economica per riga valida. Se il tuo unico compito è arricchire URL di profili, provala per prima.
Il secondo caso riguarda i dettagli delle singole offerte di lavoro. Il nostro linkedin/job_detail ha restituito 503 in tutte e cinque le chiamate di test e il suo prezzo di listino è 1,194 $ per 1.000. La modalità detailed di worldunboxer costa 0,35 $ e funziona.
Il terzo caso riguarda i filtri dettagliati. Gli actor di harvestapi per la ricerca e per i dipendenti filtrano per azienda, settore, scuola e anzianità, e un actor cerca per nome. Il nostro profile_search filtra solo per ruolo e località, e employees solo per azienda. Il quarto caso riguarda la ricerca di email. La modalità email di harvestapi con verifiche SMTP e le funzioni «verified email» e «phone number» di dev_fusion sono prodotti dedicati.
Da noi l'email è solo un campo del profilo. In questo test era presente in 3 profili pubblici su 5 e in 47 risultati di ricerca su 78.
Il quinto caso riguarda un grande database di offerte di lavoro già pronto. fantastic-jobs dichiara di aggiungere oltre 10 milioni di nuove offerte al mese, con dati sui recruiter e campi AI. Per l'analisi del mercato del lavoro, il suo modello dati è più adatto. Il sesto caso riguarda i controlli sulle esecuzioni. maxTotalChargeUsd fissa un tetto al costo di una singola esecuzione.
Gli Schedules eseguono gli actor a orari programmati. I Webhooks inviano callback. I Datasets salvano i risultati ed esportano in CSV o Excel. Noi non abbiamo queste funzioni di piattaforma, quindi devi realizzarle con cron e un database.
Il settimo punto è l'ampiezza dell'offerta. Lo Store elenca 370 actor per LinkedIn, con strumenti separati per post aziendali, eventi, gruppi e Sales Navigator. Noi abbiamo 11 funzionalità LinkedIn.
| Caso d'uso | Più adatto | Motivo |
|---|---|---|
| Solo arricchire un elenco di URL di profili | Apify (johnvc) | 0,02 $ per 1.000, un prezzo 27,8 volte inferiore al nostro |
| Dettagli di singole offerte e link per candidarsi | Apify (worldunboxer detailed) | 0,35 $ per 1.000; le nostre 5 chiamate di test hanno ricevuto 503 |
| Restringere gli elenchi per settore, scuola o anzianità | Apify (harvestapi search) | Filtriamo solo per ruolo e località |
| Ricerca di email con verifiche SMTP | Apify (harvestapi, dev_fusion) | Restituiamo solo il campo email nel profilo |
| Molte offerte, persone o dipendenti per chiamata | EveryInfra | Da 0,0028 $ a 0,0071 $ per 1.000, differenze di 100 volte e oltre |
| Molte piattaforme con una sola chiave, prezzo fisso nei client AI | EveryInfra | Un unico formato di richiesta, prezzo fisso per chiamata |
In altri casi siamo noi la scelta migliore. Il primo riguarda i casi in cui una chiamata restituisce molte righe, come per le offerte di lavoro, la ricerca di persone, gli elenchi di dipendenti e i commenti. Lì la differenza va da 10 a 1.000 volte. Il secondo caso è un progetto che richiede LinkedIn insieme ad altre piattaforme come Instagram, TikTok o X.
Usi una sola chiave, un solo formato di richiesta e un solo account. Il terzo caso è l'uso di MCP nei client AI, dove ogni chiamata a uno strumento ha un prezzo fisso e il costo non può crescere con la dimensione dei risultati. Il quarto caso è quando non vuoi gestire più actor con proprietari e input diversi e prezzi che cambiano. In questo test, tutti e quattro gli actor di harvestapi avevano nuovi prezzi dal 2026-10-27; per apimaestro i nuovi prezzi erano in vigore dal 2026-11-02 e per worldunboxer dal 2026-10-29. Per cheap_scraper era previsto un nuovo prezzo a partire dal 2026-11-07.
In cosa questo articolo si differenzia dagli altri nostri articoli su Apify
Abbiamo altri articoli su Apify, ognuno dedicato a un argomento. Come funzionano i prezzi di Apify tratta piani, compute unit e pay per event, per chi non conosce ancora Apify. Alternative ad Apify elenca le opzioni per piattaforma. Alternativa allo scraper Twitter di Apify e Alternativa allo scraper Reddit di Apify confrontano i prezzi per X e Reddit. Questo articolo tratta solo LinkedIn.
Aggiunge tre elementi che gli altri non hanno. Mostra la differenza di prezzo tra le chiamate LinkedIn che restituiscono una sola riga e quelle che restituiscono una pagina di risultati. Tratta i cookie e lo User Agreement. Indica anche per nome l'actor dello Store per i profili che costa meno di noi. Tutte le pagine di confronto sono su /alternatives.
Modifiche recenti
Per la tua scelta contano due tipi di cambiamento. Il primo riguarda LinkedIn. Il Centro assistenza di LinkedIn spiega che, da settembre, la ricerca di lavoro basata sull'AI sta sostituendo gradualmente quella classica. Descrivi con parole tue il lavoro che cerchi. Questo cambiamento può influire sui risultati delle ricerche di lavoro per parola chiave. Se monitori un mercato con linkedin/jobs o con un actor di Apify per le offerte, controlla di tanto in tanto il numero di righe per parole chiave fisse.
Il secondo riguarda Apify. Gli actor LinkedIn più popolari hanno cambiato spesso prezzo nell'ultimo mese (vedi la tabella). Controlla la scheda Pricing prima di fidarti di un prezzo riportato in un vecchio articolo o post. Il 2026-10-30 il blog dell'Agentic AI Foundation ha pubblicato un articolo del team MCP di Apify. Il team ha provato per 30 giorni il formato TOON, pensato per risparmiare token, sul server MCP di Apify. Non avendo notato un guadagno costante, è tornato a JSON. Inoltre la pagina dei prezzi di Apify ora riporta «We're live on x402», quindi gli agenti AI possono pagare per singola esecuzione.
| Data | Evento | Fonte |
|---|---|---|
| 2026-10-07 | Entra in vigore il prezzo attuale della LinkedIn Profile API di johnvc | API pubblica di Apify |
| 2026-10-15 | Entra in vigore il prezzo attuale dell'actor per i profili di lergassy | API pubblica di Apify |
| 2026-10-22 | Entra in vigore il prezzo attuale dell'actor per i dipendenti aziendali di johnvc | API pubblica di Apify |
| 2026-10-27 | Nuovi prezzi per quattro actor LinkedIn di harvestapi | API pubblica di Apify |
| 2026-10-29 | Nuovo prezzo per l'actor delle offerte di lavoro di worldunboxer | API pubblica di Apify |
| 2026-10-30 | Il team MCP di Apify rimuove TOON dopo 30 giorni | Agentic AI Foundation |
| 2026-11-02 | Nuovi prezzi per gli actor di apimaestro per profili e aziende | API pubblica di Apify |
FAQ
Quanto costa lo scraper LinkedIn di Apify?
Prezzi pubblici dello Store al 5 novembre 2026: gli scraper di profili costano da 0,02 $ a 10,00 $ per 1.000. Il più usato, quello di harvestapi, costa 4,00 $ sul piano Free e 10,00 $ con l'email. Gli scraper di aziende costano da 1,55 $ a 5,00 $. Gli scraper di offerte di lavoro costano da 0,10 $ a 5,00 $, e il più usato, quello di curious_coder, costa 2,00 $ sul piano Free e 1,00 $ sui piani a pagamento.
Il costo reale dipende anche dal tuo livello, dalle tariffe di avvio e da quelle per pagina. Le chiamate LinkedIn di EveryInfra costano 0,000556 $ l'una (0,001194 $ per il dettaglio di un'offerta). Per 1.000 righe significa 0,556 $ per profili e aziende, 0,0033 $ per le offerte di lavoro e 0,0071 $ per la ricerca di persone.
Come faccio a chiamare l'API dello scraper LinkedIn di Apify?
Ogni actor di Apify si esegue con POST /v2/acts/<owner>~<name>/run-sync-get-dataset-items, che lo avvia e restituisce i risultati. Compila i campi di input in base alla scheda Input dell'actor. Puoi aggiungere maxItems e maxTotalChargeUsd per limitare il costo. Apify offre anche client per JavaScript e Python. EveryInfra usa un solo URL, POST /api/v1/social, con platform, action e params nel corpo della richiesta.
Quanti risultati può restituire per ricerca uno scraper di offerte LinkedIn su Apify?
Secondo la pagina di curious_coder, LinkedIn limita ogni ricerca di offerte di lavoro a 1.000 risultati. Per ottenerne di più, suddivide la ricerca per città ed elimina i duplicati. Il nostro linkedin/jobs accetta un limit fino a 200 per chiamata. In questo test, 11 ricerche a Singapore hanno restituito in media 179 righe per chiamata. Secondo il catalogo, la fonte di riserva restituisce al massimo 25 righe per chiamata.
Esiste uno scraper LinkedIn gratuito?
Il piano Free di Apify offre 5 $ al mese. A 4,00 $ per 1.000, bastano per circa 1.250 profili, ma harvestapi indica che gli utenti del piano Free hanno solo 50 esecuzioni in totale. Su GitHub esistono anche script open source per lo scraping di LinkedIn. Login, proxy e modifiche alle pagine devi gestirli tu.
Se li esegui con il tuo account, lo User Agreement si applica comunque. La prova di EveryInfra offre 1 $ per 24 ore quando aggiungi una stella a due repository GitHub. A 0,000556 $ per chiamata, sono circa 1.798 richieste.
LinkedIn consente lo scraping?
La sezione 8.2 dello User Agreement di LinkedIn vieta di usare crawler, script o strumenti simili per fare scraping o copiare i Servizi. Vieta anche di copiare cookie per usare un altro account. I Crawling Terms di LinkedIn stabiliscono che il crawling automatizzato senza autorizzazione non è consentito. I tribunali si sono pronunciati in modi diversi sulle pagine pubbliche visualizzate senza login.
LinkedIn continua a fare causa alle società che fanno scraping con account falsi. Questo articolo non costituisce consulenza legale, quindi rivolgiti a un avvocato del tuo paese.
Quanto costa l'API ufficiale di LinkedIn?
LinkedIn non pubblica un listino con prezzi per chiamata per i dati degli iscritti. La maggior parte degli sviluppatori può usare solo l'accesso (sign-in), il proprio profilo di base e l'email, e la pubblicazione di post per conto di un iscritto. La ricerca di persone e i profili completi di altri iscritti richiedono programmi partner come Sales Navigator o Talent Solutions. I partner approvati pagano secondo contratto.
Come lo uso in n8n o in Claude?
In n8n, usa un nodo HTTP Request per chiamare POST /api/v1/social. Apify ha un proprio nodo n8n. Nei client MCP come Claude Code o Claude Desktop, aggiungi https://api.everyinfra.com/mcp o https://mcp.apify.com. Il nostro usa una chiave API. Apify usa di default l'accesso OAuth.
Per iniziare
Passo 1: ottieni una chiave API. Aggiungi una stella a due repository EveryInfra su GitHub per ricevere 1 $ di credito di prova valido 24 ore. Le ricariche a pagamento partono da 10 $, che bastano per circa 17.986 richieste LinkedIn a 0,000556 $ l'una (guida rapida, prezzi). Passo 2: apri la pagina di una funzionalità ed esegui una chiamata nel suo box di test.
Prova ricerca di offerte di lavoro LinkedIn, ricerca di persone, profili, pagine aziendali o dipendenti di un'azienda. Passo 3: leggi charged_usd e il numero di righe nella risposta. Dividi l'addebito per il numero di righe e moltiplica per 1.000 per ottenere il tuo prezzo per 1.000. Poi confrontalo con quanto paghi oggi.
Tutte le 11 funzionalità LinkedIn sono nella pagina API per i dati di LinkedIn. La stessa chiave funziona anche con l'API per i dati di TikTok e l'API per i dati di Instagram. Puoi esplorare tutte le piattaforme nel marketplace dei dati.
Se migri da Apify, la tabella mostra cosa cambiare. Con l'addebito per richiesta, più righe per chiamata significano un prezzo per riga più basso. Quindi accumula un batch, poi esegui una sola ricerca.
| Su Apify | Su EveryInfra |
|---|---|
| Ogni actor ha i propri campi di input | Tre chiavi fisse: platform, action, params |
| Esegui l'actor, attendi, poi leggi il dataset | Una richiesta sincrona, oppure "mode": "async" e polling di poll_url |
maxItems e maxTotalChargeUsd limitano il costo | Ogni richiesta ha un prezzo fisso, quindi conta le richieste |
| Un'esecuzione per ogni nuovo lead | Accumula un batch, poi esegui una sola ricerca |
| Schedules e Webhooks | Un tuo cron job o una pianificazione n8n |
Riferimenti
- «LinkedIn Profile Scraper» (pagina dello Store e scheda Pricing), Apify / harvestapi, screenshot del 5 novembre 2026, 00:28 ora di Singapore. https://apify.com/harvestapi/linkedin-profile-scraper
- «LinkedIn Profile Scraper», metadati pubblici (pricingInfos, stats), API di Apify, consultato il 5 novembre 2026, 00:16 ora di Singapore. https://api.apify.com/v2/acts/harvestapi~linkedin-profile-scraper
- «LinkedIn Company Details Scraper», Apify / harvestapi, consultato il 5 novembre 2026. https://apify.com/harvestapi/linkedin-company
- «LinkedIn Profile Search Scraper» (25 per pagina, 0,10 $ per pagina), Apify / harvestapi. https://apify.com/harvestapi/linkedin-profile-search
- «LinkedIn Company Employees Scraper», Apify / harvestapi. https://apify.com/harvestapi/linkedin-company-employees
- «Profile Details Scraper for LinkedIn + EMAIL», Apify / apimaestro. https://apify.com/apimaestro/linkedin-profile-detail
- «LinkedIn Profile API», Apify / johnvc. https://apify.com/johnvc/linkedin-profile-api
- «Linkedin Profile Scraper with Email and Company Data», Apify / datadoping. https://apify.com/datadoping/linkedin-profile-scraper
- «Linkedin Company Details Scraper», Apify / datadoping. https://apify.com/datadoping/linkedin-company-scraper
- «Linkedin Jobs Scraper» (limite di 1.000 offerte per ricerca), Apify / curious_coder. https://apify.com/curious_coder/linkedin-jobs-scraper
- «LinkedIn Jobs Scraper», Apify / valig. https://apify.com/valig/linkedin-jobs-scraper
- «Rapid Linkedin Jobs Scraper», Apify / worldunboxer. https://apify.com/worldunboxer/rapid-linkedin-scraper
- «LinkedIn Jobs Scraper», Apify / cheap_scraper. https://apify.com/cheap_scraper/linkedin-job-scraper
- «Advanced LinkedIn Job Search API», Apify / fantastic-jobs. https://apify.com/fantastic-jobs/advanced-linkedin-job-search-api
- Pagina dei prezzi di Apify (Free 5 $, Starter 19 $, Scale 199 $, Business 999 $, livelli di sconto dello Store), consultata il 5 novembre 2026, 00:39 ora di Singapore. https://apify.com/pricing
- «Run Actor synchronously and get dataset items» (maxItems, maxTotalChargeUsd), documentazione API di Apify. https://docs.apify.com/api/v2/act-run-sync-get-dataset-items-post
- «Get Actor», documentazione API di Apify. https://docs.apify.com/api/v2/act-get
- «Get list of Actors in Store», documentazione API di Apify. https://docs.apify.com/api/v2/store-get
- «Actors in Store» (i proprietari fissano gli sconti per livello), documentazione di Apify. https://docs.apify.com/platform/actors/running/actors-in-store
- «Monetize your Actor» (regole del pay per event), documentazione di Apify. https://docs.apify.com/platform/actors/publishing/monetize
- «Usage and resources», documentazione Apify. https://docs.apify.com/platform/actors/running/usage-and-resources
- «Apify MCP server», documentazione di Apify, consultata il 5 novembre 2026. https://docs.apify.com/platform/integrations/mcp
- «apify-mcp-server», GitHub. https://github.com/apify/apify-mcp-server
- «Schedules», documentazione Apify. https://docs.apify.com/platform/schedules
- «Webhooks», documentazione Apify. https://docs.apify.com/platform/integrations/webhooks
- «Dataset», documentazione di Apify. https://docs.apify.com/platform/storage/dataset
- «Limits», documentazione di Apify. https://docs.apify.com/platform/limits
- «n8n integration», documentazione Apify. https://docs.apify.com/platform/integrations/n8n
- «Zapier integration», documentazione di Apify. https://docs.apify.com/platform/integrations/zapier
- «Apify API client for JavaScript», documentazione di Apify. https://docs.apify.com/api/client/js
- «Apify CLI», documentazione di Apify. https://docs.apify.com/cli
- «LinkedIn User Agreement» (Effective on November 3, 2025, sezione 8.2), screenshot del 5 novembre 2026. https://www.linkedin.com/legal/user-agreement
- «LinkedIn Crawling Terms and Conditions». https://www.linkedin.com/legal/crawling-terms
- «LinkedIn Privacy Policy». https://www.linkedin.com/legal/privacy-policy
- «LinkedIn Cookie Policy». https://www.linkedin.com/legal/cookie-policy
- «LinkedIn Professional Community Policies». https://www.linkedin.com/legal/professional-community-policies
- «LinkedIn API Terms of Use». https://www.linkedin.com/legal/l/api-terms-of-use
- «Getting Access to LinkedIn APIs», Microsoft Learn. https://learn.microsoft.com/en-us/linkedin/shared/authentication/getting-access
- «Sign In with LinkedIn using OpenID Connect», Microsoft Learn. https://learn.microsoft.com/en-us/linkedin/consumer/integrations/self-serve/sign-in-with-linkedin-v2
- «LinkedIn Sales Navigator developer docs», Microsoft Learn. https://learn.microsoft.com/en-us/linkedin/sales/
- «Job Posting API overview», Microsoft Learn. https://learn.microsoft.com/en-us/linkedin/talent/job-postings/api/overview
- «API rate limiting», Microsoft Learn. https://learn.microsoft.com/en-us/linkedin/shared/api-guide/concepts/rate-limits
- «LinkedIn Developer Solutions». https://developer.linkedin.com/
- «hiQ Labs v. LinkedIn Corp.», Corte d'appello degli Stati Uniti per il Nono Circuito, 18 aprile 2022. https://cdn.ca9.uscourts.gov/datastore/opinions/2022/04/18/17-16783.pdf
- «Van Buren v. United States», Corte Suprema degli Stati Uniti, 2021. https://www.supremecourt.gov/opinions/20pdf/19-783_k53l.pdf
- «hiQ v. LinkedIn Wrapped Up: Web Scraping Lessons Learned», ZwillGen. https://www.zwillgen.com/alternative-data/hiq-v-linkedin-wrapped-up-web-scraping-lessons-learned
- Atto di citazione «LinkedIn Corp. v. ProAPIs», Northern District of California (CourtListener). https://storage.courtlistener.com/recap/gov.uscourts.cand.457309/gov.uscourts.cand.457309.1.0.pdf
- «LinkedIn wins court order blocking mass scraping of user data», The Record. https://therecord.media/linkedin-wins-court-order-blocking-mass-scraping
- «Proxycurl Shuts Down», Nubela, 4 luglio 2025. https://nubela.co/blog/goodbye-proxycurl/
- «California Consumer Privacy Act (CCPA)», California Attorney General. https://oag.ca.gov/privacy/ccpa
- «General Data Protection Regulation (GDPR)», EUR-Lex. https://eur-lex.europa.eu/eli/reg/2016/679/oj
- Catalogo LinkedIn di EveryInfra (price_usd, response_fields, field_note), consultato il 5 novembre 2026, 00:12 ora di Singapore. https://api.everyinfra.com/api/v1/social/catalog
- llms.txt di EveryInfra. https://api.everyinfra.com/llms.txt
- OpenAPI di EveryInfra. https://api.everyinfra.com/openapi.json
- MCP remoto di EveryInfra (tools/list), consultato il 5 novembre 2026. https://api.everyinfra.com/mcp
- «Model Context Protocol introduction». https://modelcontextprotocol.io/introduction
- «Connect Claude Code to tools via MCP», documentazione di Claude Code. https://code.claude.com/docs/en/mcp
- «HTTP Request node», documentazione n8n. https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.httprequest/
- «TOON (Token-Oriented Object Notation)», GitHub. https://github.com/toon-format/toon
- «We Added TOON to Our MCP Server, Then Removed It», Agentic AI Foundation, 30 ottobre 2026. https://aaif.io/blog/we-added-toon-to-our-mcp-server-then-removed-it
- «AI-powered job search» (la ricerca di lavoro classica viene dismessa gradualmente da settembre), LinkedIn Help. https://www.linkedin.com/help/linkedin/answer/a6889044
- r/n8n: flusso gratuito per lo scraping delle offerte di lavoro su LinkedIn e la risposta «$5 in a few minutes» (nomi utente nascosti). https://www.reddit.com/r/n8n/comments/1t4lk7a/i_built_a_100_free_linkedin_job_scraper_using_n8n/
- r/n8n: richiesta di aiuto su un workflow di scraping delle offerte di lavoro su LinkedIn (nomi utente nascosti). https://www.reddit.com/r/n8n/comments/1t9trjv/n8n_linkedin_job_scraper_workflow_help/
- «LinkedIn Copyright Policy». https://www.linkedin.com/legal/copyright-policy
- «LinkedIn User Agreement Summary». https://www.linkedin.com/legal/user-agreement-summary
- «LinkedIn California Privacy Disclosure». https://www.linkedin.com/legal/california-privacy-disclosure
- «LinkedIn Talent Solutions», documentazione per sviluppatori, Microsoft Learn. https://learn.microsoft.com/en-us/linkedin/talent/
- «LinkedIn Marketing API», documentazione, Microsoft Learn. https://learn.microsoft.com/en-us/linkedin/marketing/
- «Runs and builds», documentazione Apify. https://docs.apify.com/platform/actors/running/runs-and-builds
- «Billing», documentazione Apify. https://docs.apify.com/platform/console/billing
- «Apify API client for Python», documentazione Apify. https://docs.apify.com/api/client/python
- «Make integration», documentazione Apify. https://docs.apify.com/platform/integrations/make
- «Apify Proxy», documentazione Apify. https://docs.apify.com/platform/proxy
Riferimenti BL-91