Datos de redes sociales para investigar: repite la búsqueda y la mitad cambia
Antes de usar resultados de búsqueda en redes sociales como muestra de investigación, comprueba si la muestra se mantiene. El 24 de octubre de 2026 repetimos las mismas consultas a los dos minutos: en X, YouTube y TikTok solo coincidió cerca de la mitad. Además: publicaciones borradas, duplicados, ventanas temporales y el estado del artículo 40 de la DSA.
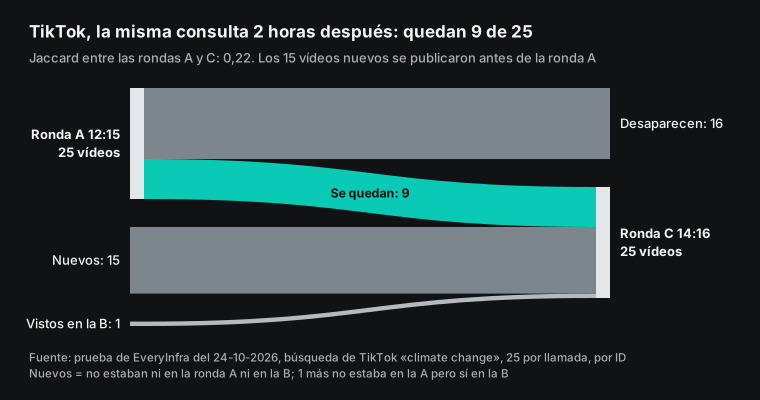
Una búsqueda por palabra clave en una red social no devuelve una muestra fija. El 24 de octubre de 2026 (hora de Singapur, UTC+8, en todo el texto) repetimos las mismas cuatro consultas con unos dos minutos de diferencia y 25 resultados por llamada. En X, YouTube y TikTok, la coincidencia de Jaccard entre las dos rondas fue de apenas 0,47–0,56, y todos los elementos «nuevos» de la segunda ronda se habían publicado antes de la primera. Una tercera ronda, dos horas después, dio una coincidencia con la primera de 0,52 en X y de 0,22 en TikTok, pero de 0,92 en YouTube. Por eso conviene guardar la hora de la consulta, los parámetros completos y la respuesta original, repetir cada consulta e informar del grado de coincidencia. Si no, nadie podrá reproducir la muestra, ni siquiera tú al día siguiente.
Este artículo está pensado para equipos que trabajan con datos de redes sociales o de buscadores: comunicación, salud pública, ciencia política, ciencias sociales computacionales y unidades de verificación de datos. Explicamos métodos y cifras que se pueden comprobar; no damos asesoramiento jurídico. Para las condiciones de cada plataforma y la Ley de Servicios Digitales de la UE (DSA), consulta los textos originales y el comité de ética y la asesoría jurídica de tu institución.
Por qué revisar la muestra ahora
En los últimos dos meses cambiaron varias vías de acceso a datos de plataformas:
- Reddit fijó el calendario para cerrar su Data API pública. En una publicación del 30 de septiembre de 2026 en r/redditdev, Reddit anunció que desde el 31 de octubre no acepta nuevas solicitudes de acceso a la API pública, que a partir del 12 de enero de 2027 empieza a retirar el acceso a las apps no registradas y que en marzo de 2027 cierra el acceso público para todas. TechCrunch informó ese mismo día de que las herramientas que usan los investigadores también se ven afectadas.
- La regla 8 de Reddit prohíbe seguir usando contenido borrado. La página de ayuda «Don't break the site», tal como la leímos el 24 de octubre, indica que las apps no deben seguir usando ni mostrando contenido público que el usuario haya borrado o que se haya retirado por infringir las normas, y menciona el scraping «sin un acuerdo autorizado» como posible infracción.
- El artículo 40 de la DSA ya admite solicitudes, pero no hay éxitos públicos. Oliver Marsh, de la ONG alemana AlgorithmWatch, escribió en el DSA Observatory el 2 de octubre que, a julio de 2026, había 77 solicitudes al amparo del artículo 40(4) y ningún éxito conocido. El regulador irlandés Coimisiún na Meán confirma en la página 81 de su informe anual de 2025, publicado el 7 de octubre, que la disposición entró en vigor el 29 de octubre de 2025 y que entonces llegaron las primeras solicitudes.
- Reddit ya es una plataforma en línea de muy gran tamaño. El 31 de agosto, la Comisión Europea designó a Reddit y Roblox como plataformas de muy gran tamaño (VLOP) y a ChatGPT como motor de búsqueda de muy gran tamaño (VLOSE). Tienen cuatro meses, hasta enero de 2027, para cumplir las obligaciones adicionales, entre ellas el acceso a datos para investigadores del artículo 40. El cierre de la API pública de Reddit y el inicio de sus obligaciones de la DSA coinciden en el mismo trimestre.
Cuando las vías de acceso se estrechan, cada equipo tiene que demostrar hasta qué punto su propia muestra está completa. La prueba que sigue es una forma barata de hacerlo.
La prueba: una consulta, tres rondas
Primero fijamos el criterio. Antes de la tercera ronda establecimos esta regla: si dos rondas de la misma consulta tienen una coincidencia de Jaccard de 0,9 o más, basta con una sola recogida para ese punto de acceso; por debajo de 0,9, hay que recoger varias rondas e informar de la unión y la coincidencia. Si un elemento nuevo se publicó antes de la primera ronda, lo contamos como diferencia de orden o de muestreo, no como publicación nueva.
Configuración. Cuatro plataformas, cuatro puntos de acceso, los mismos parámetros en todas las rondas y 25 resultados por llamada:
- API de búsqueda de Reddit (
reddit/search): palabra claveDigital Services Act,sort=newest. - API de búsqueda de X (Twitter) (
twitter/search): palabra clave entre comillas,"Digital Services Act",sort=latest. - API de búsqueda de YouTube (
youtube/search): palabra claveDigital Services Act, orden por relevancia. - API de búsqueda de TikTok (
tiktok/search): palabra claveclimate change,content_type=video.
La ronda A fue a las 12:13–12:15, la B a las 12:16–12:17 y la C a las 14:15–14:18. Comparamos los ID de los elementos, no los títulos.


Resultados.
- X: las rondas A y B compartieron 18 de 25 elementos; Jaccard 0,56 y 7 de los 10 primeros iguales. Los 7 elementos nuevos de la ronda B se publicaron entre abril de 2022 y agosto de 2026; ninguno apareció entre las dos rondas. La ronda C tuvo un Jaccard de 0,52 con la A y de 0,43 con la B; en las tres rondas aparecieron 39 elementos distintos y solo 14 estuvieron en las tres. El más reciente de los 7 nuevos de la ronda C se publicó el 20 de octubre.
- YouTube: 16 elementos compartidos, Jaccard 0,47 y solo 4 de los 10 primeros iguales. Los 9 elementos nuevos de la ronda B son de 2022–2025. La ronda C tuvo un Jaccard de 0,92 con la A (solo cambió 1 elemento), pero de 0,43 con la B: la ronda B parece un conjunto distinto de resultados que dos horas después volvió a desaparecer. En las tres rondas aparecieron 35 elementos distintos y 15 estuvieron en las tres.
- TikTok: 16 elementos compartidos, Jaccard 0,47, pero 9 de los 10 primeros iguales, así que los cambios se concentran a partir del puesto 12. El más reciente de los 9 nuevos se publicó el 24 de octubre a las 00:11 UTC, antes de la ronda A. Dos horas después la diferencia fue mayor: la ronda C tuvo un Jaccard de 0,22 con la A y de 0,19 con la B; en las tres rondas aparecieron 49 elementos distintos y solo 7 estuvieron en las tres. El más reciente de los 15 nuevos de la ronda C se publicó el 23 de octubre a las 23:50 UTC, también antes de la ronda A.
- Reddit (más recientes primero): las rondas A y B devolvieron los mismos 25 elementos en el mismo orden. En la ronda C, dos horas después, los 25 elementos eran publicaciones nuevas de entre las 05:15 y las 06:12 UTC. Una ventana ordenada por «más recientes» avanza con el tiempo; eso es lo que significa «más recientes», así que no lo contamos como inestabilidad.
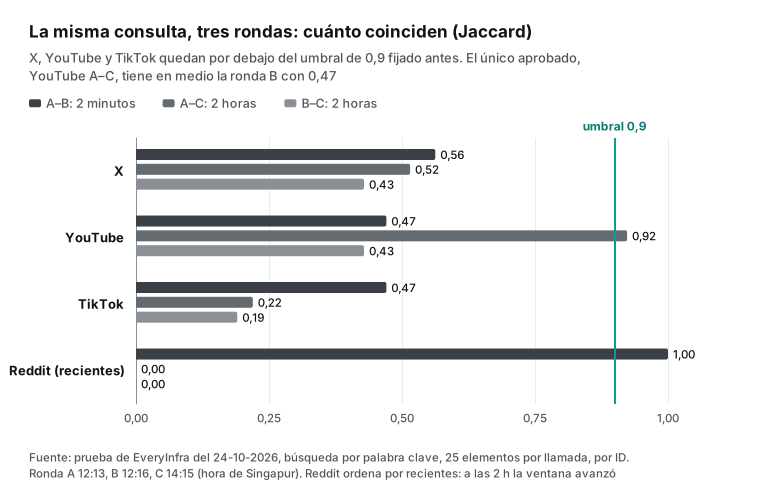
Según nuestra propia regla, las búsquedas por palabra clave en X, YouTube y TikTok no dan una muestra reproducible con una sola recogida. El único par por encima de 0,9 fue el de las rondas A y C de YouTube, pero la ronda B, entre ambas, se quedó en 0,47: una coincidencia alta en una sola comparación no demuestra nada. No es un fallo de la herramienta: el catálogo de capacidades de EveryInfra indica que X devuelve por defecto los resultados «Top» y que latest no garantiza un orden cronológico estricto, y la documentación de la Data API de YouTube advierte que totalResults es una aproximación y puede no ser un valor exacto. Una búsqueda ordenada por relevancia no es una lista fija.
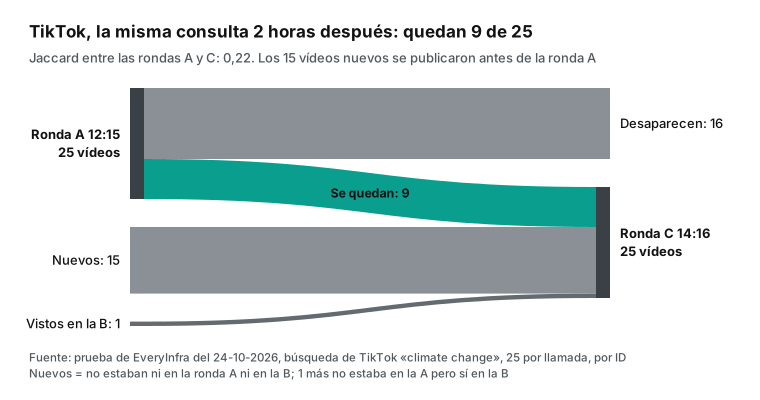
Límites de este resultado: probamos 4 consultas, con 25 elementos cada una y tres rondas en un mismo día; no se puede extrapolar a archivos completos ni a periodos largos. La estabilidad de Reddit vale para el orden «más recientes» durante dos minutos; no demuestra que el orden por relevancia sea estable.
La coincidencia por palabras es más amplia de lo que parece
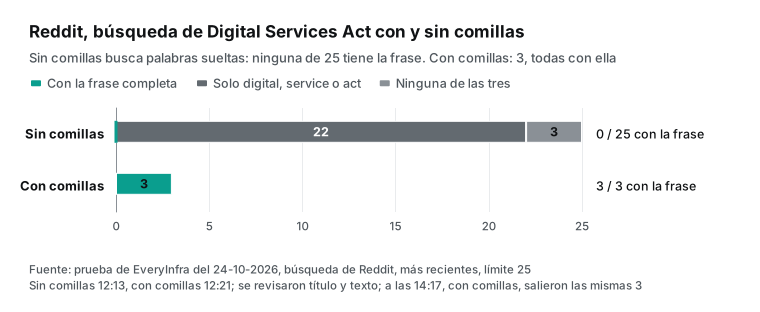
La misma prueba mostró otro problema: en Reddit, una palabra clave de varias palabras sin comillas busca palabras sueltas, no la frase.
- En la ronda A,
Digital Services Actsin comillas (más recientes primero) devolvió 25 publicaciones. Ninguna contenía la frase completa en el título o el texto; 22 tenían al menos una de las palabras (digital, service, act). Eran anuncios de casinos, consultas sentimentales y compraventas de videojuegos. - A las 12:21 enviamos
"Digital Services Act"entre comillas, también por más recientes. La búsqueda devolvió 3 publicaciones y las 3 contenían la frase: una apelación por una cuenta de Instagram, un aviso sobre webs de citas fraudulentas y una publicación en alemán sobre una estafa de alquiler vacacional. Según el catálogo, este punto de acceso busca en el último mes, así que esas 3 son todo lo que ofrece la búsqueda por más recientes para ese mes; a las 14:17 volvimos a obtener las mismas 3.
La comprobación de relevancia también puede fallar. En el conjunto de TikTok contamos primero los textos que contenían «climate change»: solo 4 de 25. Luego quitamos # y espacios de las etiquetas y volvimos a comparar: 23 de 25. Los 19 vídeos que se nos escapaban solo llevaban #climatechange.
La consecuencia para un estudio es concreta: revisa a mano una muestra por palabra clave e informa del porcentaje de elementos irrelevantes. El corpus ISAAC (arXiv:2609.27059), publicado el 22 de septiembre, seleccionó más de 527 millones de publicaciones de Reddit; sus autores aplicaron un filtro en varias fases, auditado por personas, para dejar el contenido irrelevante por debajo del 10 %, y publican esa proporción por categoría. Sin un paso así, una muestra de «debate en Reddit sobre la DSA» puede estar formada sobre todo por anuncios de casinos.
El mismo contenido, dos puntos de acceso, dos cifras
Muchos estudios usan «me gusta», reproducciones o comentarios como variable o como peso. Entre las 12:16 y las 12:21 del 24 de octubre comparamos las cifras de los resultados de búsqueda con las de los puntos de acceso de detalle:
- YouTube: en un vídeo publicado en junio de 2026, la búsqueda dio 4.650 «me gusta» y, a las 12:19, la API de detalles del video de YouTube dio 4.600. Las reproducciones (48.406) y los comentarios (590) coincidían y seguían igual a las 14:18. La diferencia en «me gusta» se debe a la precisión con que se muestra la cifra, no a un cambio real.
- TikTok: en un vídeo sobre el clima que The Guardian publicó el 23 de octubre, la búsqueda de las 12:17 mostraba 671.900 reproducciones, 90.300 «me gusta» y 3.068 comentarios; a las 12:19, la API de detalles del video de TikTok daba 673.500, 90.500 y 3.074. En dos minutos y medio, las reproducciones subieron 1.600. En este vídeo, reproducciones y «me gusta» eran centenas redondas, mientras que los comentarios eran exactos. A las 14:17 volvimos a consultar: 767.600 reproducciones, 101.600 «me gusta» y 3.402 comentarios. En dos horas, las reproducciones crecieron cerca de un 14 %.
- X: en la publicación de la Comisión Europea del 31 de agosto sobre las designaciones de ChatGPT y Reddit, la búsqueda y la API de detalles de la publicación de X (Twitter) coincidían: 6.523.789 visualizaciones y 4.668 «me gusta». A las 14:17, las visualizaciones eran 6.523.800 y los «me gusta» seguían en 4.668. Las dos últimas cifras pasaron a ser 0: puede ser un redondeo o 11 visualizaciones más, y con un solo elemento no se puede saber; por eso conviene registrar también la precisión de cada cifra.
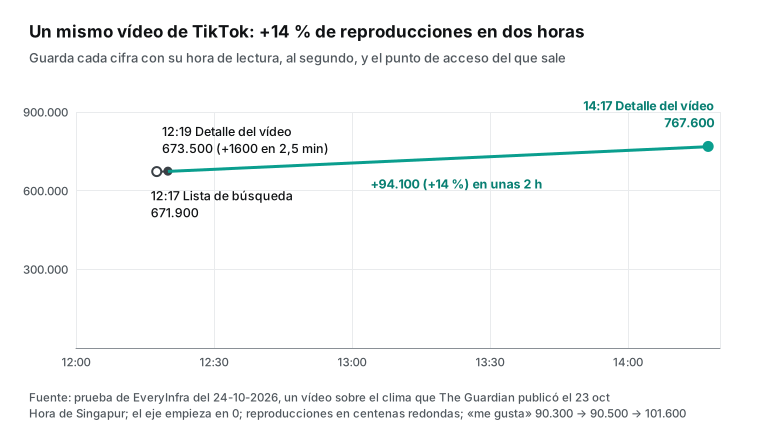
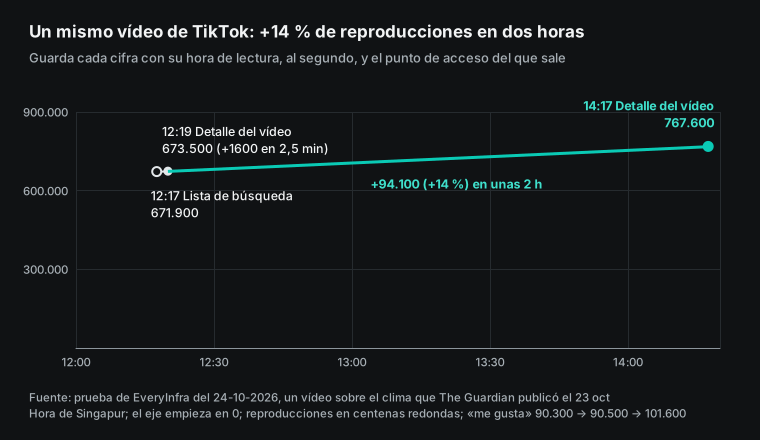
Por tanto, cada cifra debe guardarse con dos datos: la hora de lectura, al segundo, y el punto de acceso del que procede. El contenido nuevo crece rápido en sus primeros días; no compares una cifra de la mañana con otra de la tarde como si fueran equivalentes.
Duplicados y reenvíos: una cuenta, cuatro publicaciones en nueve minutos
De las 25 publicaciones de Reddit sin relación con el tema, 4 venían de la misma cuenta, que las envió a 4 comunidades distintas en 9 minutos (03:39–03:48 UTC). Los textos eran casi idénticos: la similitud de Jaccard con fragmentos de 5 palabras iba de 0,93 a 0,99. Otra cuenta publicó 3 anuncios de casino en 3 comunidades que no tenían nada que ver entre sí.
Si tu pregunta es «cuántas personas hablan de este tema», esas 4 publicaciones cuentan como una sola voz. Si tu pregunta es «cómo se difunde el contenido entre comunidades», son justo la señal que quieres conservar. Proponemos este método:
- Normaliza el texto: quita enlaces y signos de puntuación y pásalo a minúsculas.
- Marca como casi duplicados los pares cuyo índice de Jaccard con fragmentos de 5 palabras sea de 0,6 o más.
- Usa el autor y una ventana temporal (por ejemplo, el mismo autor en menos de 1 hora) para separar reenvíos, publicaciones cruzadas y spam.
- Informa del tamaño de la muestra antes y después de quitar duplicados.
Es la misma lógica que la de deduplicar negocios de Google Maps: el ID de la plataforma dice que existe un registro, no que ese registro sea una voz o una entidad independiente.
Borrados y visibilidad: la muestra encoge sola
El contenido también desaparece: los autores borran, las plataformas retiran y las cuentas se cierran o pasan a privadas.
- El conjunto de datos PoliTok-DE (arXiv:2509.15860), de Ruiz y sus colegas, reúne más de 930.000 publicaciones de TikTok de dos elecciones alemanas. Más de 330.000 se borraron después: el 18,7 % de la muestra de Sajonia y el 39,7 % de la muestra federal. En la federal, cerca de dos tercios de los borrados los hicieron los propios creadores.
- Zubiaga (2018, JASIST) volvió a recoger 30 conjuntos de datos de Twitter con más de 147 millones de tuits: cuanto más antiguo era el conjunto, menor la proporción todavía disponible, y metadatos como el número de seguidores perdían representatividad con el tiempo.
Al mismo tiempo, las condiciones de las plataformas obligan a borrar:
- Las condiciones de las herramientas de investigación de TikTok (vigentes desde el 22 de enero de 2026) exigen actualizar los datos al menos cada 30 días y borrar los que ya no estén disponibles en cada actualización. Los investigadores autorizados por la DSA pueden explicar en su solicitud por qué esas normas impedirían su investigación.
- La política para desarrolladores de X exige que el contenido guardado coincida con su estado actual en X: si se borra o se modifica allí, hay que borrar o modificar la copia lo antes posible o en 24 horas tras una solicitud. Los investigadores académicos pueden compartir ID de publicaciones para investigación no comercial aprobada por escrito por X o para revisión por pares.
- La regla 8 de Reddit, citada más arriba, prohíbe a las apps seguir usando contenido público borrado.
Esto crea una tensión: la reproducibilidad necesita la muestra original, y las condiciones y la privacidad exigen borrar. Una revisión de 2026 en Political Communication cita los límites para compartir datos con fines de replicación entre los retos iniciales del artículo 40. Una solución práctica: publicar la lista de ID, los parámetros de consulta, las horas de recogida y las estadísticas agregadas; guardar el texto completo solo en un entorno controlado y borrarlo cuando lo exijan las condiciones; y, en cada nueva recogida, informar de la proporción que sigue disponible. La tasa de borrado es un resultado del estudio, no algo que se corrige en silencio cambiando la muestra.
Sesgo de muestreo: las interfaces de investigación también recortan
Mucha gente cree que la interfaz de investigación de la propia plataforma da todos los datos. Las auditorías recientes no lo confirman:
- En arXiv:2601.12390, Bekavac y Mayer reconstruyeron los feeds completos de dos cuentas de prueba durante periodos electorales y los compararon con lo que devuelven la Research API de TikTok y Meta Content Library para las mismas publicaciones. Las interfaces de investigación dejaban fuera hasta cerca del 50 % del contenido que veían los usuarios, eliminaban hasta cerca del 83 % de los metadatos de contexto y, en un caso, permitían solo unas 1.000 peticiones por semana.
- La página de Meta Content Library indica que, de las cuentas personales, solo incluye publicaciones de cuentas verificadas o con 100 seguidores o más. Las cuentas personales pequeñas quedan fuera por diseño.
- WhichTok (arXiv:2608.09917), publicado el 10 de agosto, comparó tres herramientas para recoger datos de TikTok: la Research API de TikTok y dos herramientas basadas en la web. Las búsquedas por etiqueta y por palabra clave fueron las que más difirieron; solo la consulta por usuario dio resultados coherentes en las tres.
- En 2025, arXiv:2506.09746 halló que la Research API de TikTok no devolvía metadatos de aproximadamente uno de cada ocho vídeos procedentes de donaciones de datos, incluidos vídeos de la propia TikTok y anuncios.
- El problema no es nuevo. Morstatter y sus colegas (2013) compararon la Streaming API de muestreo de Twitter con el Firehose completo, y Pfeffer y sus colegas (2023), un equipo de 80 investigadores, recogieron los 375 millones de tuits de un periodo de 24 horas a partir del 21 de septiembre de 2022 como referencia para estudios posteriores.
Así que, para cada vía de acceso, deja por escrito qué deja fuera y, si puedes, contrasta parte de la muestra con una segunda vía independiente. Nuestra comparación entre búsqueda y detalle es un ejemplo barato.
Ventanas temporales: «reciente» no significa lo mismo en todas partes
El rango temporal de una búsqueda por palabra clave a menudo no lo decides tú:
- Según el catálogo, la búsqueda por palabra clave de Reddit cubre el último mes y el orden no cambia ese rango.
- En nuestra ronda A de X usamos
latest, pero las 25 publicaciones abarcaban de agosto de 2024 a octubre de 2026 (5 de 2024, 11 de 2025 y 9 de 2026). - Los 25 resultados de YouTube ordenados por relevancia iban de 2020 a 2026.
Para una serie temporal, no uses una búsqueda por relevancia como si fuera «todo lo que se dijo en un periodo». Recoge por comunidad, cuenta o canal y filtra por posted_at, o usa la sintaxis de fechas de la propia plataforma en la palabra clave de X (la nota del catálogo para twitter/search menciona sintaxis como since:). En la sección de métodos, indica las fechas reales de inicio y fin que cubren tus datos.
Artículo 40 de la DSA: dónde estamos tras un año
El artículo 40 de la Ley de Servicios Digitales ofrece dos vías:
- Artículo 40(12), datos públicos. Las VLOP y los VLOSE deben dar acceso sin demora indebida a los datos públicamente accesibles en su interfaz, incluidos datos en tiempo real cuando sea técnicamente posible. El texto incluye expresamente a investigadores vinculados a organismos, organizaciones y asociaciones sin ánimo de lucro. El 5 de diciembre de 2025, la Comisión impuso su primera multa de la DSA, de 120 millones de euros, a X; uno de los incumplimientos fue no dar acceso a datos públicos a los investigadores. Tech Policy Press señala que la decisión concluyó que X prohibía el acceso de investigadores independientes, también mediante scraping, y que sus cuotas y plazos eran demasiado limitados.
- Artículo 40(4), datos no públicos. Los investigadores autorizados lo solicitan a través del coordinador de servicios digitales (DSC) de su país. Las normas están en el Reglamento Delegado (UE) 2025/2050, aplicable desde el 29 de octubre de 2025: las solicitudes pasan por el portal de acceso a datos de la DSA, los DSC tienen hasta 80 días hábiles para emitir una solicitud motivada y las plataformas deben publicar y actualizar catálogos de datos. La página del acto delegado de la Comisión tiene el texto completo, y el regulador irlandés publicó en mayo de 2026 la versión 2 de su guía.
La situación actual, según fuentes recientes de primera mano:
- El regulador irlandés rechazó la solicitud de AlgorithmWatch 80 días hábiles después de presentarla, por falta de detalle sobre almacenamiento y ciberseguridad y por no justificar que la cantidad de datos fuera proporcionada; tras volver a presentarla, la organización debe esperar otros 80 días hábiles. Por la vía del artículo 40(12), unas 20 organizaciones pidieron a seis plataformas las 1.000 publicaciones más vistas de cada Estado miembro cada seis horas; las conversaciones empezaron en octubre de 2025 y ninguna plataforma ha aceptado (DSA Observatory, 2 de octubre).
- El artículo de ICWSM 2026 The Great Data Standoff describe el bloqueo de fondo: los investigadores deben especificar qué datos necesitan, pero no pueden saber qué datos guardan las plataformas. En Media, Technology and Governance (2026), Taylor Annabell, de la Universidad de Cardiff, analiza los catálogos de datos publicados y sostiene que las plataformas reducen los «datos» a conjuntos agregados y predefinidos.
- El informe final del Social Platforms Data Access Taskforce, financiado por Smart Data Research UK, se publicó el 9 de septiembre y se depositó el 6 de octubre; recoge un año de pruebas sobre los obstáculos que encuentran los investigadores.
- Los datos de transparencia de las plataformas también tienen límites: arXiv:2610.26226 (19 de octubre) indica que más del 99,8 % de las decisiones de la base de datos de transparencia de la DSA citan las condiciones de la propia plataforma y no una disposición legal.
Qué supone para el diseño de un estudio: el artículo 40 merece la pena, pero los plazos se miden en años, no en semanas. Mientras tanto, los estudios con datos públicos deben describir su completitud con aún más cuidado, porque los revisores preguntarán cuánto se aleja la muestra del feed real.
Ética de la investigación y condiciones de uso
Son pautas de método, no asesoramiento jurídico:
- Solicita primero la revisión del comité de ética. Las Internet Research Ethical Guidelines 3.0 de la AoIR son la referencia habitual: que algo sea público no significa que pueda usarse sin más; hay que valorar el riesgo para los autores según el contexto, sobre todo en temas de salud, sexualidad u opinión política.
- Recoge solo lo necesario. Guarda solo los campos que exige tu pregunta, sustituye los nombres de usuario de cuentas personales por hashes irreversibles antes del análisis y no cites frases que permitan encontrar la publicación original con un buscador. Este artículo no nombra ninguna cuenta personal.
- Borra cuando lo pidan las condiciones. Programa recogidas periódicas y borrados, y registra cuánto borraste.
- Comprueba el alcance de cada conjunto de condiciones. Las condiciones de investigación de TikTok, X y Reddit limitan la región, la finalidad (sin ánimo de lucro, interés público) y quién puede solicitarlas; las dos vías del artículo 40 se limitan a investigar riesgos sistémicos en la UE. Indica en los métodos la vía y las condiciones que usaste.
- Publica lo que otros puedan comprobar. Listas de ID, parámetros de consulta, horas de recogida, resultados agregados y código suelen poder publicarse; el texto completo se trata según las condiciones.
Lista de comprobación para una muestra verificable


- Fija los criterios. Antes de recoger, define el umbral de coincidencia, el máximo de elementos irrelevantes y cómo informarás de los borrados.
- Fija los parámetros. Guarda la palabra clave (con comillas), el orden, el número de elementos, el idioma y la región en un archivo de configuración con control de versiones.
- Guarda las respuestas originales. Conserva el JSON completo de cada llamada con el ID de la petición y la hora de lectura, al segundo y con zona horaria.
- Recoge más de una vez. Lanza cada consulta al menos dos veces e informa de la unión, la intersección y el índice de Jaccard. En los puntos de acceso inestables, usa la unión como muestra.
- Revisa la relevancia a mano. Etiqueta 50–100 elementos al azar e informa del porcentaje irrelevante. Normaliza las etiquetas antes de buscar texto.
- Quita duplicados. Usa texto normalizado, similitud de fragmentos, autor y ventana temporal, e informa del tamaño antes y después.
- Contrasta las cifras. Revisa parte de los elementos con un punto de acceso de detalle e indica de qué punto de acceso y de qué hora sale cada cifra.
- Vuelve a recoger y borra. Repite la recogida con la frecuencia que fijen las condiciones, registra la proporción todavía disponible y borra lo que ya no es visible.
Reproduce la prueba con EveryInfra
Esta es la petición de la ronda A en X. Sustituye <API Key> por tu clave (consulta el inicio rápido):
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer <API Key>" \
  -H "Content-Type: application/json" \
  -d '{"platform":"twitter","action":"search","params":{"keyword":"\"Digital Services Act\"","sort":"latest","limit":25}}'
La respuesta incluye en el nivel superior id (ID de la petición), count, results y billing. Estos campos de cada resultado sirven para una prueba de reproducibilidad (los nombres de referencia están en el catálogo de capacidades):
id: ID del elemento en la plataforma, para la coincidencia y la deduplicación.url: enlace a la publicación original, para volver a consultarla y revisarla a mano.posted_at: hora de publicación (UTC), para saber si un elemento nuevo es una publicación nueva.text,title: texto y título (Reddit y YouTube tienen título), para revisar la relevancia y detectar casi duplicados.hashtags: etiquetas; inclúyelas al valorar la relevancia en TikTok y X.like_count,view_count,comment_count: cifras; guárdalas siempre con la hora de lectura.author_username: autor, para la ventana por autor al deduplicar; conviértelo en hash antes del análisis.community: nombre de la comunidad de Reddit, para detectar publicaciones cruzadas.search_rank: puesto en la búsqueda de YouTube, para la coincidencia en los 10 primeros.
En clientes de IA como Claude o Cursor puedes conectar los mismos datos por MCP y pedir al asistente que siga la lista anterior (otras formas de conexión en el servidor MCP remoto):
export EVERYINFRA_API_KEY="<API Key>"
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope user \
  --header 'Authorization: Bearer ${EVERYINFRA_API_KEY}'
Después llama a everyinfra_call_api con los mismos parámetros que en curl; everyinfra_requests muestra el cargo de cada ID de petición.
Errores y cargos:
unauthorized: falta la clave o no es válida. Sin cargo.unknown_paramo valor no válido: parámetro o valor de enumeración incorrecto; la respuesta indica los parámetros válidos y un ejemplo. Sin cargo.- Resultado vacío: por ejemplo, una palabra clave entre comillas sin publicaciones este mes. Se devuelve una lista vacía y se reembolsa el cargo previo.
- Capacidad no disponible temporalmente: la respuesta lo indica. Sin cargo.
Para revisar los reembolsos uno a uno, consulta fallos de API, reembolsos y conciliación del cargo neto; para saber por qué el catálogo en tiempo real es la referencia, consulta el catálogo de capacidades en tiempo real.
Cuánto cuesta un mes de seguimiento de estabilidad
Según el catálogo de capacidades leído el 24 de octubre, reddit/search, twitter/search, youtube/search y tiktok/search cuestan $0.000556 por llamada, y los puntos de acceso de detalle youtube/video, tiktok/video y twitter/post también cuestan $0.000556 por llamada (la referencia es la página de precios):
- 4 plataformas, 5 palabras clave por plataforma, una llamada cada 6 horas con 25 elementos, durante 30 días: 4 × 5 × 4 × 30 = 2.400 llamadas × $0.000556 = $1.33.
- Cada semana, revisar las cifras de 100 elementos con los puntos de acceso de detalle, durante 4 semanas: 400 llamadas × $0.000556 = $0.22.
- Total: unos $1.56. Los resultados vacíos y las llamadas fallidas no se cobran, así que el coste real solo puede ser menor.
Todas las llamadas reales de este artículo (tres rondas de búsqueda, las comprobaciones de detalle, la búsqueda de Reddit entre comillas y cuatro búsquedas web que no usamos en el texto) costaron $0.015008 (26 llamadas) en total.
Cambios recientes (septiembre–octubre de 2026)
- 30 de septiembre: Reddit publica el calendario de cierre de su Data API pública (r/redditdev). Para investigadores: los scripts que usan la API pública de Reddit tendrán que pasar al programa de investigación de Reddit, a un acuerdo comercial o a la vía de la DSA antes de marzo de 2027. Documenta ya tus muestras actuales.
- 1 de octubre: Reddit actualiza su página sobre la DSA, que indica no más de 57,2 millones de destinatarios activos mensuales de media en la UE en el primer semestre de 2026 (Ayuda de Reddit). Para investigadores: las obligaciones de Reddit como VLOP empiezan en enero de 2027, así que ya se puede preparar una solicitud por el artículo 40(12).
- **1 de octubre: Pote, Flammini y Menczer publican arXiv:2610.02591**, con metadatos de apps de 43 operaciones de influencia retiradas; muestran que las API forman parte de la infraestructura de la manipulación coordinada y que la eliminación de los metadatos de apps por parte de X suprimió una herramienta importante de detección. Para investigadores: si una plataforma elimina un campo, toda una línea de investigación puede dejar de ser reproducible; conserva las respuestas originales.
- **29 de septiembre: arXiv:2609.38571 audita las etiquetas de IA en cuatro plataformas** con 10.722 publicaciones recogidas por palabras clave de riesgo sistémico y de IA; solo el 33 % de los deepfakes identificados por expertos llevaba etiqueta de la plataforma. Para investigadores: es otra proporción calculada sobre una muestra por palabras clave, así que la lista de palabras fija el denominador.
- 2–6 de octubre: nuevos estudios con grandes muestras de plataformas. arXiv:2610.09082 sigue los daños de la IA en 5,7 millones de resúmenes de publicaciones de Reddit durante 18 meses, y dos estudios sobre inundaciones en Irlanda (arXiv:2610.03334, arXiv:2610.06330) usan consultas por palabras clave en Meta Content Library. Para investigadores: cuanto más detallada sea la descripción de la muestra, mejor resisten los resultados una revisión.
- **21 de octubre: Tech Policy Press publica una tribuna de Jen Rosiere Reynolds** según la cual la investigación sobre riesgos de la IA repite el problema de acceso a datos que ya vivió la investigación sobre redes sociales.
Preguntas frecuentes
¿Se puede seguir usando la API de Reddit para investigación académica? (sugerencia de Google: «reddit api for academic research») La publicación de Reddit del 30 de septiembre indica que las nuevas solicitudes de API pública se cierran el 31 de octubre de 2026 y que el acceso público termina en marzo de 2027; en los comentarios, un desarrollador sugiere comprobar si Devvit o el programa para investigadores encajan con cada caso. Como Reddit ya es una VLOP, desde enero de 2027 debe dar acceso a datos a investigadores según el artículo 40 de la DSA. Si tienes un proyecto en marcha, fija ya la descripción de la muestra y los registros de recogida.
Se borraron publicaciones de mi conjunto de datos. ¿Qué hago? (sugerencia de Google: «deleted tweets research dataset») Las condiciones de las plataformas suelen obligarte a borrarlas también: TikTok exige actualizar al menos cada 30 días y borrar lo que ya no está disponible, y X exige borrar o actualizar la copia poco después del cambio. Para la reproducibilidad, publica los ID, los parámetros y las estadísticas agregadas, e informa de la proporción que sigue disponible al volver a recoger. La tasa de borrado es un resultado.
¿Quién puede solicitar datos por el artículo 40 de la DSA? (sugerencia de Google: «dsa article 40 researchers») El artículo 40(4) está pensado para investigadores vinculados a una organización de investigación, independientes de intereses comerciales y capaces de cumplir requisitos de seguridad y confidencialidad; lo solicitan a través de un coordinador de servicios digitales. El artículo 40(12), para datos públicos, incluye expresamente a investigadores vinculados a organismos, organizaciones y asociaciones sin ánimo de lucro. Las dos vías se limitan a investigar riesgos sistémicos en la UE. Según AlgorithmWatch, una solicitud cuantitativa sencilla de una ONG puede superar el primer filtro, pero hay que justificar por qué la cantidad de datos es proporcionada. Aquí solo describimos el texto y casos públicos; consulta tu caso con tu institución.
Lecturas relacionadas
- Comentarios de Reddit incompletos: MoreComments y PRAW
- API de comentarios de YouTube: por qué faltan respuestas
- Páginas de plataforma: API de scraping de Reddit, API de scraping de X (Twitter), API de scraping de YouTube, API de scraping de TikTok
Referencias
- Moving Data API Apps to the Developer Platform: migration dates and next steps. Reddit (r/redditdev), 2026-09-30 (fuente primaria). https://www.reddit.com/r/redditdev/comments/1wubcvf/moving_data_api_apps_to_the_developer_platform/
- Reddit is killing RSS feeds, ending public API access because of AI bots. TechCrunch, 2026-09-30 (fuente secundaria). https://techcrunch.com/2026/09/30/reddit-is-killing-rss-feeds-ending-public-api-access-because-of-ai-bots/
- Don't break the site (Rule 8). Reddit Help, consultado el 2026-10-24 (fuente primaria). https://support.reddithelp.com/hc/en-us/articles/360043512931-Don-t-break-the-site
- Two Stories of DSA Data (Non)-Access from an NGO perspective. DSA Observatory (Oliver Marsh, AlgorithmWatch), 2026-10-02 (fuente secundaria). https://dsa-observatory.eu/2026/10/02/two-stories-of-dsa-data-non-access-from-an-ngo-perspective/
- Annual Report 2025. Coimisiún na Meán, 2026-10-07 (fuente primaria). https://www.cnam.ie/app/uploads/Coimisiun-na-Mean-Annual-Report-2025.pdf
- Commission designates ChatGPT, Reddit, Roblox under DSA (IP/26/1772). European Commission, 2026-08-31 (fuente primaria). https://ec.europa.eu/commission/presscorner/detail/en/ip_26_1772
- Social data capability catalog. EveryInfra, consultado el 2026-10-24 (fuente primaria). https://api.everyinfra.com/api/v1/social/catalog
- Search: list (YouTube Data API). Google for Developers, consultado el 2026-10-24 (fuente primaria). https://developers.google.com/youtube/v3/docs/search/list
- The Illinois Social Attitudes Aggregate Corpus (ISAAC) (arXiv:2609.27059). Hemmatian et al., 2026-09-22 (fuente primaria). https://arxiv.org/abs/2609.27059
- PoliTok-DE: A Multimodal Dataset of Political TikToks and Deletions From Germany (arXiv:2509.15860). Ruiz et al., 2025-09-19 (fuente primaria). https://arxiv.org/abs/2509.15860
- A longitudinal assessment of the persistence of Twitter datasets (JASIST). Zubiaga, 2018 (fuente primaria). https://doi.org/10.1002/asi.24026
- TikTok Research Tools Terms of Service. TikTok, 2026-01-22 (fuente primaria). https://www.tiktok.com/legal/page/global/terms-of-service-research-api/en
- Developer Policy. X, consultado el 2026-10-24 (fuente primaria). https://developer.x.com/en/developer-terms/policy
- Finally, Access: How Article 40 DSA Changes Platform Research in Practice (Political Communication). Taylor & Francis, 2026 (fuente primaria). https://doi.org/10.1080/10584609.2026.2664157
- Platforms' Research API Data Access: What Users See vs. What Researchers can Retrieve (arXiv:2601.12390). Bekavac, Mayer, 2026-01-18 (fuente primaria). https://arxiv.org/abs/2601.12390
- Meta Content Library and API. Meta Transparency Center, consultado el 2026-10-24 (fuente primaria). https://transparency.meta.com/researchtools/meta-content-library/
- WhichTok? Comparing Three TikTok Data Acquisition Tools (arXiv:2608.09917). Jeon et al., 2026-08-10 (fuente primaria). https://arxiv.org/abs/2608.09917
- TikTok's Research API: Problems Without Explanations (arXiv:2506.09746). arXiv, 2025-06-11 (fuente primaria). https://arxiv.org/abs/2506.09746
- Is the Sample Good Enough? Comparing Data from Twitter's Streaming API with Twitter's Firehose (arXiv:1306.5204). Morstatter et al., 2013-06-21 (fuente primaria). https://arxiv.org/abs/1306.5204
- Just Another Day on Twitter: A Complete 24 Hours of Twitter Data (arXiv:2301.11429). Pfeffer, Matter, Jaidka et al., 2023-01-26 (fuente primaria). https://arxiv.org/abs/2301.11429
- Regulation (EU) 2022/2065 (Digital Services Act). EUR-Lex, 2022-10-19 (fuente primaria). https://eur-lex.europa.eu/eli/reg/2022/2065/oj
- Commission fines X €120 million under the Digital Services Act. European Commission, 2025-12-05 (fuente primaria). https://digital-strategy.ec.europa.eu/en/news/commission-fines-x-eu120-million-under-digital-services-act
- What the X Fine Reveals About Data Access Under Article 40 of the Digital Services Act. Tech Policy Press, 2026-02-12 (fuente secundaria). https://www.techpolicy.press/what-the-x-fine-reveals-about-data-access-under-article-40-of-the-digital-services-act/
- Digital Services Act – sharing platform and search engine data with vetted researchers (summary of Delegated Regulation (EU) 2025/2050). EUR-Lex, 2026-01-28 (fuente primaria). https://eur-lex.europa.eu/EN/legal-content/summary/digital-services-act-sharing-platform-and-search-engine-data-with-vetted-researchers.html
- DSA data access portal. European Commission, consultado el 2026-10-24 (fuente primaria). https://data-access.dsa.ec.europa.eu/
- Delegated act on data access under the Digital Services Act (DSA). European Commission, 2025-07-02 (fuente primaria). https://digital-strategy.ec.europa.eu/en/library/delegated-act-data-access-under-digital-services-act-dsa
- DSA Article 40(4)–(11) Data Access Guidance, V2. Coimisiún na Meán, 2026-05 (fuente primaria). https://www.cnam.ie/app/uploads/2026/05/DSA-Article-40-4-11-Data-Access_Guidance_V2_-.pdf
- The Great Data Standoff: Researchers vs. Platforms Under the Digital Services Act (ICWSM 2026). Goanta et al., 2026 (fuente primaria). https://ojs.aaai.org/index.php/ICWSM/article/view/42671
- Regulating a Floating Signifier: Interpretations of "Data" in the DSA Researcher Access Provision (Media, Technology and Governance). Annabell, 2026 (fuente primaria). https://doi.org/10.1177/29777984261486601
- Social Platforms Data Access Taskforce: Final Report. Smart Data Research UK / University of Sheffield, 2026-09-09 (depositado 2026-10-06) (fuente primaria). https://eprints.whiterose.ac.uk/id/eprint/246345/
- Towards More Granular Reasoning: Mapping the DSA Transparency Database Taxonomy to Platform Terms and Conditions (arXiv:2610.26226). Ranucci, Leijten, Graus, 2026-10-19 (fuente primaria). https://arxiv.org/abs/2610.26226
- Internet Research: Ethical Guidelines 3.0. Association of Internet Researchers (AoIR), 2019 (fuente primaria). https://aoir.org/reports/ethics3.pdf
- Digital Services Act (DSA): Information for EU users. Reddit Help, 2026-10-01 (fuente primaria). https://support.reddithelp.com/hc/en-us/articles/23595536875796-Digital-Services-Act-DSA-Information-for-EU-users
- Information Operations Exploit APIs to Manipulate Social Media (arXiv:2610.02591). Pote, Flammini, Menczer, 2026-10-01 (fuente primaria). https://arxiv.org/abs/2610.02591
- Drowning in AI Slop: How Social Media Platforms (Do Not) Label AI and Deepfake Content under EU law (arXiv:2609.38571). Rijsbosch et al., 2026-09-29 (fuente primaria). https://arxiv.org/abs/2609.38571
- Move Fast and Mend Things: Keeping Up with Evolving AI Harms Using Social Media Commentary (arXiv:2610.09082). Rowe et al., 2026-10-06 (fuente primaria). https://arxiv.org/abs/2610.09082
- A population-level assessment framework for flood-related wellbeing from public discourse in Ireland (arXiv:2610.03334). Luo, Morrissey, 2026-10-02 (fuente primaria). https://arxiv.org/abs/2610.03334
- Assessing flood-related wellbeing from public discourse in Ireland using large language model as judge, 2012–2025 (arXiv:2610.06330). Luo, Morrissey, 2026-10-05 (fuente primaria). https://arxiv.org/abs/2610.06330
- You Can't Solve AI Risk Without Solving the AI Evidence Problem. Tech Policy Press (Jen Rosiere Reynolds), 2026-10-21 (fuente secundaria). https://www.techpolicy.press/you-cant-solve-ai-risk-without-solving-the-ai-evidence-problem
Referencia BL-33