scraperapi alternatives: precio por cada 1.000 resultados según la tarea
ScraperAPI frente a ZenRows, Bright Data, Firecrawl, Apify y EveryInfra: cuánto cuestan 1.000 páginas de Amazon, búsquedas de Google y posts sociales.
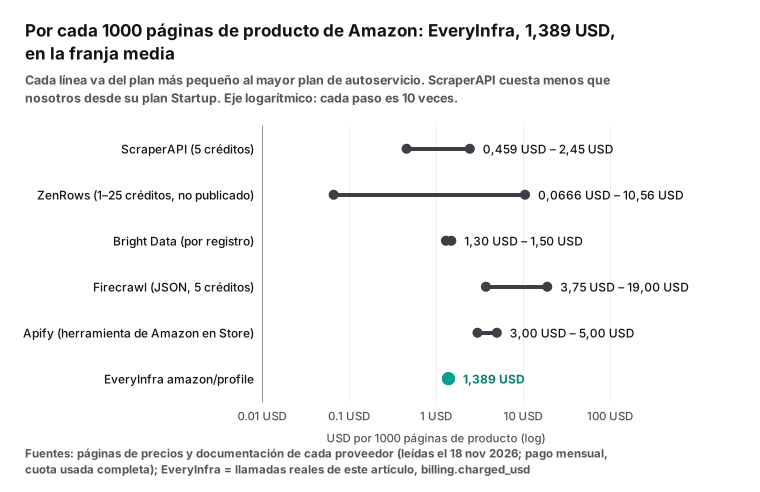
Quien busca scraperapi alternatives casi siempre tiene la misma duda: ¿pago de más por lo que hago? La respuesta depende de la tarea. Leímos las listas de precios públicas el 18 de noviembre de 2026 (2026-11-18). Con esos precios, 1.000 páginas de producto de Amazon cuestan en ScraperAPI entre 0,46 y 2,45 dólares, porque cada página gasta 5 créditos. Desde el plan Startup de 149 dólares, eso es más barato que los 1,389 dólares que nos cobró EveryInfra en nuestras propias llamadas.
Con Google pasa lo contrario. ScraperAPI gasta 25 créditos por búsqueda, así que 1.000 búsquedas cuestan entre 2,30 y 12,25 dólares. Es de 3,3 a 17,7 veces lo que pagamos nosotros por la misma tarea: 0,694 dólares.
En redes sociales la distancia es todavía mayor. Bright Data cobra entre 1,30 y 1,50 dólares por cada 1.000 registros, y las herramientas de TikTok e Instagram de la Apify Store cobran entre 1,00 y 3,70. Una sola petición a EveryInfra devuelve de 20 a 30 publicaciones, de modo que 1.000 publicaciones salen entre 0,0185 y 0,0278 dólares. En TikTok es 47 veces menos que Bright Data, la más barata de las dos; en Instagram, 54 veces menos que el precio más bajo de la herramienta de publicaciones de Apify.
Antes de comparar: cuánto gastas hoy en ScraperAPI
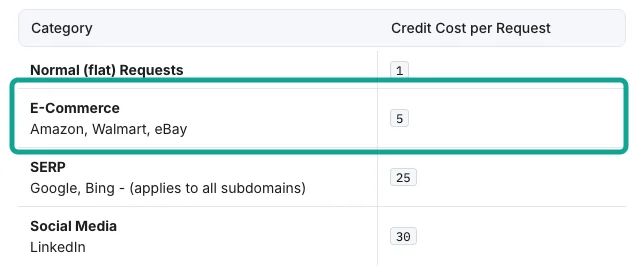
ScraperAPI vende créditos. Le envías una URL, y el servicio cambia de proxy, resuelve los bloqueos, ejecuta JavaScript si hace falta y te devuelve la página o un JSON ya procesado. Una petición normal gasta 1 crédito. Las tiendas como Amazon, Walmart y eBay gastan 5. Las búsquedas de Google y Bing gastan 25, y LinkedIn 30 (costes de créditos).
Encima de eso se suman los parámetros. premium=true cuesta 10, render=true cuesta 10 y los dos juntos cuestan 25. ultra_premium=true cuesta 30, y con renderizado llega a 75. La misma página de Amazon puede gastar 5 créditos o 25, según cómo la pidas. El precio por cada 1.000 páginas cambia hasta cinco veces.
Por eso el primer paso de cualquier cambio de proveedor es medir tu multiplicador real. ScraperAPI da tres herramientas para eso. La cabecera de respuesta sa-credit-cost dice cuántos créditos gastó cada petición. El parámetro max_cost pone un tope: si una petición lo supera, devuelve 403 y no se ejecuta. El endpoint /account/urlcost te dice cuánto costará una URL sin hacer la petición (control de costes).
En junio de 2026 ScraperAPI publicó además un estimador de créditos por dominio (nota de versión). Pasa por urlcost la lista de URLs que usaste el mes pasado. Con eso sabrás tu multiplicador medio y podrás compararlo con las cifras de esta guía.
Esta guía no repite el cálculo completo de créditos por plan. Ese desglose está en nuestro artículo sobre los precios de ScraperAPI, y la página de alternativas a ScraperAPI da un resumen. Aquí tomamos cuatro tareas frecuentes y ponemos seis servicios en la misma unidad: dólares por cada 1.000 resultados.
Los precios de los competidores salen de sus páginas de precios y su documentación pública. Los leímos el 18 de noviembre de 2026 entre las 00:17 y las 00:40, hora de Singapur. Usamos precios mensuales y suponemos que se gasta todo el saldo del plan. No incluimos descuentos anuales ni contratos a medida.
Nuestros precios salen del campo charged_usd de las respuestas a nuestras llamadas de prueba. Enviamos 20 peticiones entre las 00:15 y las 00:41, hora de Singapur. Se cobraron 18, por 0,017474 dólares en total. Diecisiete importes salen de charged_usd; la tarea asíncrona de Instagram no muestra importe, así que la contamos al precio del catálogo, 0,000556 dólares; una respuesta 429 por límite de velocidad y una 422 fueron gratis. Cada cargo coincide con el price_usd de nuestro catálogo gratuito GET /api/v1/social/catalog de ese día.
Los seis servicios devuelven nombres de campo, límites de filas y paginación distintos, así que esta guía compara solo dinero y reglas de cobro.
La tabla de scraperapi alternatives: unidad de cobro, fallos, plan gratuito y herramientas de IA
| Servicio | Unidad de cobro | 1.000 páginas de producto de Amazon | 1.000 búsquedas de Google | Fallos o resultados vacíos | Entrada de pago más baja | Plan gratuito | Herramientas de IA |
|---|---|---|---|---|---|---|---|
| ScraperAPI | Créditos con multiplicador por tipo | 0,46–2,45 (5 créditos) | 2,30–12,25 (25 créditos) | Cobra solo 200 y 404, y lo que canceles antes de 70 segundos | Hobby, 49 al mes | Prueba de 7 días con 5.000 créditos; luego 1.000 al mes | MCP remoto, 22 herramientas |
| ZenRows | Créditos: 1 simple, 5 JS, 10 proxy premium, 25 sitio protegido | 0,07–10,56 (no publica el coste por sitio) | Mismo rango | Los fallos no se cobran; 404 y 410 cuentan como éxito | Build, 19 al mes | 5.000 créditos al mes | MCP remoto |
| Bright Data | Por registro o petición entregada | 1,30–1,50 | 1,31–1,50 | No cobra entregas fallidas | Pago por uso, sin cuota | 5.000 registros al mes | MCP, 5.000 peticiones gratis al mes |
| Firecrawl | Créditos: 1 por página, 4 más por JSON | JSON 3,75–19,00; solo Markdown 0,75–3,80 | 1,50–7,60 (2 créditos por 10 resultados) | Sin resultado no cobra; páginas 403 o 404 devueltas cuestan 1 | Hobby, 19 al mes | 1.000 créditos al mes | MCP v3 |
| Apify | Por evento, un cargo por resultado, más barato en planes altos | 3,00–5,00 | 1,80–4,50 (por página) | Lo escrito antes de un fallo se cobra | Starter, 19 al mes | 5 dólares de uso al mes | MCP remoto |
| EveryInfra | Por petición, precio fijo | 1,389 (amazon/profile, cobrado) | 0,694 (herramienta web, cobrado) | Fallos y vacíos no se cobran; parámetro ausente da 422 | Primera recarga de 10, el saldo no caduca | 1 dólar de prueba por dar estrella a dos repositorios de GitHub, 24 horas | MCP remoto |
Cada rango va del plan de autoservicio más caro al más barato por crédito. Todas las cifras están en dólares. En ScraperAPI, Hobby cuesta 49 dólares por 100.000 créditos, es decir, 0,49 por cada 1.000. Advanced cuesta 1.975 dólares por 21,5 millones de créditos, es decir, 0,0919 por cada 1.000 (precios de ScraperAPI).
| Plan de ScraperAPI | Precio al mes | Créditos al mes | Por 1.000 créditos | Hilos simultáneos | Regiones |
|---|---|---|---|---|---|
| Gratuito | 0 | 1.000 | Gratis | 5 | No indicado |
| Hobby | 49 | 100.000 | 0,49 | 20 | EE. UU. y UE |
| Startup | 149 | 1.000.000 | 0,149 | 50 | EE. UU. y UE |
| Business | 299 | 3.000.000 | 0,0997 | 100 | Por país |
| Scaling | 475 | 5.000.000 | 0,095 | 200 | Por país |
| Professional | 975 | 10.500.000 | 0,0929 | 300 | Por país |
| Advanced | 1.975 | 21.500.000 | 0,0919 | 500 | Por país |
En ZenRows, el plan Build cuesta 19 dólares por 45.000 créditos, y el mayor plan de autoservicio cuesta 2.999 dólares por 45 millones (precios de ZenRows). En Firecrawl, Hobby cuesta 19 dólares por 5.000 créditos y Scale 749 dólares por 1 millón (precios de Firecrawl).
La Web Scraper API de Bright Data cuesta 1,50 dólares por cada 1.000 registros en pago por uso. Su plan Scale cuesta 499 dólares al mes e incluye 384.000 registros (precios de Web Scraper API). La SERP API cuesta 1,50 dólares por cada 1.000 peticiones, y su plan Scale incluye 380.000 (precios de SERP API). Los precios de Apify salen de la página de cada herramienta en la Apify Store, con cuatro niveles según el plan: Free, Starter, Scale y Business (precios de Apify, cobro en la Store).
Cómo se multiplican los créditos, y dónde se contradice ScraperAPI con Walmart
ZenRows y Firecrawl también venden créditos, pero cada uno multiplica de otra forma. Esta tabla pone los tres lado a lado.
| Tipo de petición | ScraperAPI (créditos) | ZenRows (créditos) | Firecrawl (créditos) |
|---|---|---|---|
| Página estática simple | 1 | 1 | 1 |
| Renderizar JavaScript | 10 | 5 | 1 (sin recargo) |
| Proxy premium | 10 | 10 | No indicado |
| Sitio con protección fuerte | 30 (ultra_premium), 75 con renderizado | 25 | No indicado |
| Amazon, Walmart, eBay | 5 | Según la configuración que funcionó; no publicado por sitio | 1, y 4 más por JSON estructurado |
| Búsqueda en Google | 25 | Según la configuración que funcionó | 2 por cada 10 resultados |
ZenRows, con mode=auto, solo cobra la configuración que al final funcionó. Pero no publica qué configuración necesita cada sitio, así que hay que probarlo (referencia de la API de ZenRows).
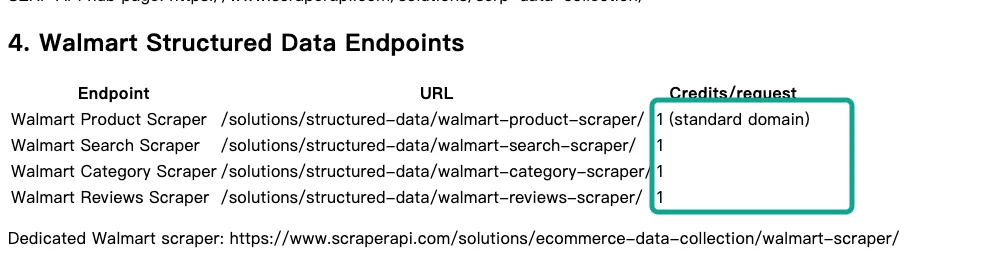
Al revisar el precio de Walmart encontramos que dos documentos de ScraperAPI no coinciden. La página de créditos de arriba mete a Walmart en el grupo de comercio electrónico, a 5 créditos. ScraperAPI publica además una página de datos estructurados pensada para herramientas de IA. Esa página dice primero que un endpoint estructurado cuesta lo mismo que la API principal en el mismo dominio. Pero su tabla de Walmart pone a 1 crédito los cuatro endpoints: producto, búsqueda, categoría y reseñas (página de datos estructurados).
En el plan Hobby, 1 crédito equivale a 0,49 dólares por cada 1.000 peticiones y 5 créditos a 2,45. Es una diferencia de cinco veces. No tenemos cuenta en ScraperAPI, así que no podemos confirmar el cargo real. Si extraes Walmart en volumen, lanza unas cuantas URLs reales y mira la cabecera sa-credit-cost antes de firmar. Guarda una copia del resultado.
Ese mismo día buscamos «wireless earbuds» con la capacidad walmart/search de EveryInfra. A las 00:27, hora de Singapur, devolvió 20 productos y cobró 0,001389 dólares. Son 0,0695 dólares por cada 1.000 productos.
El endpoint de búsqueda de Walmart en ScraperAPI devuelve una página de resultados, pero la documentación no dice cuántos productos trae. Si suponemos 20, el coste queda entre 0,0046 y 0,0245 dólares por cada 1.000 productos a 1 crédito, o entre 0,023 y 0,12 a 5 créditos. Para tareas pequeñas por páginas, ScraperAPI tiene un precio razonable en Walmart. Antes, averigua cuál de las dos cifras es la correcta. La página de la plataforma Walmart muestra todas nuestras capacidades y precios.
Tarea 1: páginas de producto de Amazon, donde ScraperAPI gana desde Startup
La tarea más común es revisar cada día el precio, la valoración y el número de reseñas de una lista de ASIN. El endpoint estructurado de Amazon en ScraperAPI cuesta 5 créditos, igual que la API principal. Devuelve título, precio, valoración, número de reseñas, ASIN, disponibilidad, imágenes, descripción, especificaciones y datos del vendedor.
En los seis planes de ScraperAPI, 1.000 páginas de producto cuestan desde 2,45 dólares en Hobby hasta 0,459 en Advanced. En Startup, de 149 dólares, cuestan 0,745. Eso ya es menos que nuestro precio.
Nosotros pedimos un producto por llamada con amazon/profile, a 0,001389 dólares según el catálogo. A las 00:15, hora de Singapur, pedimos el ASIN B09FT58QQP. La llamada devolvió los auriculares TOZO A1 a 19,99 dólares, con una valoración de 4,3 sobre 119.343 valoraciones. Tardó 53,3 segundos y costó 0,001389 dólares.
A las 00:29, hora de Singapur, pedimos los AirPods Pro 2 (B0BDHWDR12). La respuesta trajo un precio de 265,77 dólares y una valoración de 4,7 sobre 57.993 valoraciones. Tardó 58,3 segundos y también costó 0,001389. Las dos llamadas se cobraron al precio del catálogo: 1,389 dólares por cada 1.000 páginas de producto.
Un solo producto tardó casi un minuto. Si construyes un comparador de precios en vivo, cuenta con esa espera. ScraperAPI no publica el tiempo medio de sus endpoints estructurados, así que prueba los dos servicios con tus propios ASIN.
El resultado cambia si buscas por palabra clave. Nuestra capacidad amazon/search cuesta 0,002236 dólares por petición y devuelve una página de resultados. A las 00:16, hora de Singapur, «wireless earbuds» devolvió 18 productos. A las 00:31, hora de Singapur, «running shoes» devolvió 20. La media sale a 0,1177 dólares por cada 1.000 productos.
El endpoint de búsqueda de Amazon en ScraperAPI también cuesta 5 créditos por petición. El número de productos por página cambia con la palabra clave. Si suponemos 20 por página, el coste queda entre 0,023 y 0,12 dólares por cada 1.000 productos, cerca del nuestro.
Bright Data cobra entre 1,30 y 1,50 dólares por cada 1.000 registros. La herramienta de productos de Amazon de Apify cobra por resultado: 5,00 en Free, 4,00 en Starter, 3,50 en Scale y 3,00 en Business (herramienta de Amazon). Para listas de productos, los tres servicios que cobran por página o por petición salen unas diez veces más baratos que los dos que cobran por registro.
| Tarea en Amazon | ScraperAPI | ZenRows | Bright Data | Firecrawl | Apify | EveryInfra |
|---|---|---|---|---|---|---|
| Ficha de un producto, por 1.000 | 0,459–2,45 | 0,0666–10,56 | 1,30–1,50 | 3,75–19,00 (JSON) | 3,00–5,00 | 1,389 (cobrado) |
| Búsqueda por palabra clave, por 1.000 páginas | 0,459–2,45 | 0,0666–10,56 | Cobra por registro | 0,75–3,80 | Cobra por resultado | 2,236 (cobrado) |
| Búsqueda por palabra clave, por 1.000 productos | Unos 0,023–0,12 (suponiendo 20 por página) | No publicado | 1,30–1,50 | No publicado | 3,00–5,00 | 0,1177 (cobrado, 38 productos) |
También probamos un ASIN que esperábamos que fallara. A las 00:30, hora de Singapur, pedimos B000000000. Amazon llevó ese número a un producto real, una bolsa de patatas fritas. La llamada devolvió datos normales y costó 0,001389 dólares.
Un ASIN inventado en Amazon no siempre da un resultado vacío. Limpia tu lista de ASIN antes de lanzar un lote grande. El fallo de verdad lo probamos aparte, en la sección de peticiones fallidas.
Esta es una petición completa para un producto. Cambia $EVERYINFRA_API_KEY por tu clave:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"amazon","action":"profile","params":{"url":"https://www.amazon.com/dp/B0BDHWDR12"}}' \
  | jq '{title: .results.title, price: .results.price, rating: .results.rating, rating_count: .results.rating_count, charged: .billing.charged_usd}'
Tarea 2: búsquedas de Google, donde 25 créditos por búsqueda encarecen ScraperAPI de 3,3 a 17,7 veces
La búsqueda en Google tiene uno de los multiplicadores más altos de ScraperAPI. Cada búsqueda gasta 25 créditos, y los endpoints estructurados de búsqueda, compras y noticias de Google usan la misma tarifa (página de datos estructurados). En Hobby, 1.000 búsquedas cuestan 12,25 dólares. En Advanced siguen costando 2,30. Nosotros cobramos 0,694 por cada 1.000, así que todos los planes de ScraperAPI salen de 3,3 a 17,7 veces más caros en esta tarea.
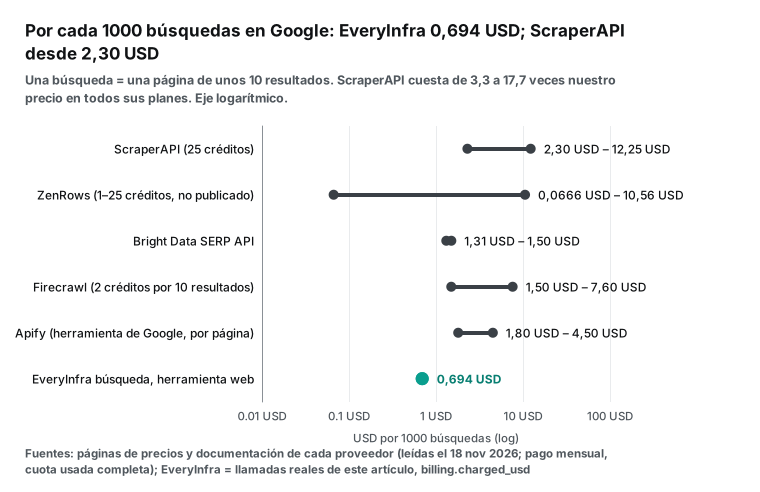
La SERP API de Bright Data cuesta 1,50 dólares por cada 1.000 peticiones en pago por uso y 1,31 en su plan Scale. La búsqueda de Firecrawl gasta 2 créditos por cada 10 resultados, así que una búsqueda de 10 resultados sale entre 1,50 y 7,60 por cada 1.000. La herramienta de búsqueda de Google de Apify cobra por página de resultados (herramienta de Google): 4,50 en Free, 2,50 en Starter, 1,95 en Scale y 1,80 en Business. ZenRows no publica qué multiplicador aplica a Google con su API general.
Nuestra búsqueda usa POST /api/v1/search con la herramienta web. La lista de herramientas en /api/v1/search/tools se puede leer gratis. Hicimos tres búsquedas.
| Hora (Singapur) | Consulta | Resultados | Segundos | Cobrado (dólares) | Pertinente |
|---|---|---|---|---|---|
| 00:17 | scraperapi alternatives | 10 | 1,8 | 0,000694 | No, todos ajenos |
| 00:31 | best running shoes | 9 | 2,7 | 0,000694 | Sí |
| 00:41 | scraperapi competitors | 10 | 1,9 | 0,000694 | Sí |
A las 00:31, hora de Singapur, «best running shoes» devolvió 9 resultados en 2,7 segundos. A las 00:41, hora de Singapur, «scraperapi competitors» devolvió 10 resultados en 1,9 segundos. Entre los diez primeros estaban el artículo de alternativas de Firecrawl, la página comparativa de la propia ScraperAPI y varias páginas de alternativas de otras empresas del sector.
A las 00:17, hora de Singapur, la búsqueda «scraperapi alternatives» también devolvió 10 resultados y costó 0,000694 dólares. Pero los 10 eran sitios sin relación que llevan «alternatives» en el título: un servicio juvenil, una cooperativa de crédito y una página sobre un comando de Linux. Al cambiar a «scraperapi competitors», los resultados fueron correctos. Si buscas una marca junto a una palabra común, pon la marca entre comillas o usa términos más concretos.
Para seguir posiciones también importa la ubicación. Los endpoints de Google en ScraperAPI pueden devolver resultados por país. Pero los planes Hobby y Startup solo salen por EE. UU. y la UE, y la selección por país empieza en Business. Nuestra herramienta web usa el parámetro location. Admite el nombre del país o su código de dos letras, y si le das una ciudad usa el país de esa ciudad. También admite filtro por sitio, ventana de fechas y paginación.
El número de resultados por búsqueda también cambia el precio por resultado. En estas pruebas, nuestras búsquedas devolvieron entre 9 y 10 resultados orgánicos. La SERP API de Bright Data devuelve la página completa ya procesada, con anuncios y búsquedas relacionadas. El endpoint de Google de ScraperAPI también trae anuncios, fragmentos destacados y el panel de conocimiento. Si solo necesitas los diez primeros enlaces, los cuatro servicios dan una cantidad de datos parecida. Si necesitas anuncios y cajas de respuesta, lee antes la lista de campos de cada uno. Nuestra prueba de alternativas de API SERP compara este grupo con más detalle.
Tarea 3: TikTok e Instagram, donde cobrar por registro sale de 47 a 54 veces más caro
La página de créditos de ScraperAPI pone LinkedIn a 30 créditos. Su página de soluciones trata TikTok como una página simple de 1 crédito que devuelve HTML, así que tendrás que procesarlo tú. Instagram no aparece.
ZenRows y Firecrawl también cobran por página y no publican cuántos vídeos trae una página de búsqueda de TikTok. Solo tres servicios se pueden comparar por cada 1.000 publicaciones. Bright Data y Apify cobran por registro, y EveryInfra cobra por petición con un número de filas conocido.
Del lado de ScraperAPI solo podemos estimar. Una página de TikTok gasta 1 crédito, entre 0,092 y 0,49 dólares por cada 1.000 páginas, de Advanced a Hobby. Si una página da 20 vídeos, como nuestra llamada, salen unos 0,0046 a 0,0245 dólares por cada 1.000 vídeos, en el mismo orden que nuestros 0,0278. Si la página necesita render=true para mostrar el contenido, cada página gasta 10 créditos: unos 0,046 a 0,245 dólares por cada 1.000 vídeos.
ScraperAPI no publica cuántos vídeos trae una página, y el procesado lo escribes tú. Lanza unas cuantas páginas con tus propias palabras clave antes de decidir. Instagram no aparece en la página de soluciones de ScraperAPI; a 1 crédito por página simple también tendrías que procesar la página y contar las filas tú mismo, así que no estimamos un precio por cada 1.000 publicaciones.
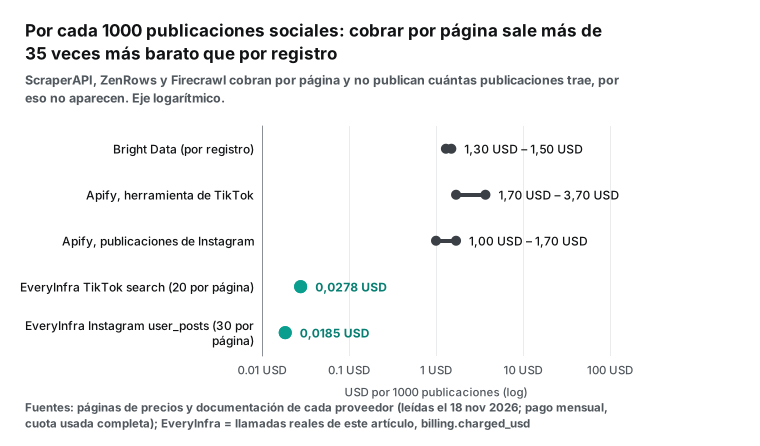
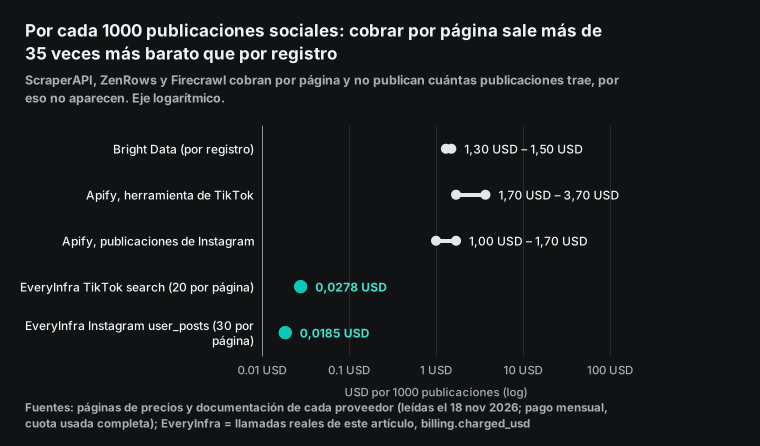
Probamos tiktok/search tres veces con un límite de 20, a 0,000556 dólares por llamada según el catálogo. A las 00:17, hora de Singapur, «wireless earbuds review» devolvió 20 vídeos en 11,4 segundos. A las 00:31, hora de Singapur, «running shoes review» devolvió 20 vídeos en 22,6 segundos.
A las 00:40, hora de Singapur, buscamos la cadena aleatoria «qzxvjkw9931plmnbt». Tras 62,6 segundos, la llamada devolvió 20 vídeos de todos modos y se cobró. La búsqueda de TikTok devuelve vídeos parecidos para cualquier palabra y no da una lista vacía. Si la usas para vigilar una marca, filtra los resultados por título o etiqueta. Las tres llamadas trajeron 60 vídeos: 0,0278 dólares por cada 1.000.
Para Instagram usamos instagram/user_posts con la cuenta de la NASA y un límite de 30. Esta capacidad opera como una tarea asíncrona. A las 00:27, hora de Singapur, enviamos la petición. A los 14,1 segundos recibimos un identificador de tarea. El estado pasó de running a finalizing y luego a succeeded, con 30 publicaciones y billing_state en charged.
El resultado de la tarea asíncrona no muestra el importe. Usamos el precio del catálogo, 0,000556 dólares por llamada, que da 0,0185 por cada 1.000 publicaciones. Se pueden pedir hasta 200 publicaciones, y cada página cuenta como una llamada.
| Tarea social | Bright Data | Apify | EveryInfra |
|---|---|---|---|
| Vídeos de TikTok, por 1.000 | 1,50 en pago por uso, 1,30 en Scale | Herramienta de TikTok: Free 3,70, Starter 3,00, Scale 2,30, Business 1,70 | 0,0278 (cobrado, 20 por llamada) |
| Publicaciones de Instagram, por 1.000 | 1,50 en pago por uso, 1,30 en Scale | Herramienta de publicaciones: Free 1,70, Starter 1,50, Scale 1,30, Business 1,00. Herramienta general 1,50–2,70 | 0,0185 (precio de catálogo, 30 por llamada) |
| Unidad de cobro | Cada registro entregado | Cada resultado escrito en el dataset | Cada petición |
Los datos sociales también tardan más que una página web. Nuestras tres búsquedas de TikTok tardaron 11,4, 22,6 y 62,6 segundos, y la palabra aleatoria fue la más lenta. Instagram fue asíncrono y dio el identificador a los 14 segundos. En Bright Data, las peticiones sociales de «descubrir por palabra clave» también se procesan como tareas asíncronas. En Apify, cada petición es una ejecución completa que tarda de decenas de segundos a varios minutos. Para un producto en vivo, recoge los datos sociales en segundo plano y muestra resultados en caché.
Los precios de Apify salen de la página de cada herramienta (herramienta de TikTok, herramienta de publicaciones de Instagram). Cada herramienta fija su propio precio. La página de TikTok se actualizó el 2026-11-17, así que conviene releerlas cada mes.
Si tu trabajo en ScraperAPI es sobre todo de redes sociales, una API estructurada que cobra por registro o por petición te ahorra el procesado del HTML. La página de TikTok y la página de Instagram muestran todos los campos y precios que ofrecemos.
Tarea 4: cualquier página web y JavaScript, donde ScraperAPI y ZenRows son los más baratos a volumen
Las tres primeras tareas usan datos de plataformas. Si tu lista tiene miles de webs distintas y necesitas el HTML completo o el texto, ScraperAPI juega en su terreno. Una página simple gasta 1 crédito: 0,49 dólares por cada 1.000 en Hobby y 0,092 en Advanced.
ZenRows también cobra 1 crédito por página simple, entre 0,067 y 0,42 dólares por cada 1.000. Para renderizar JavaScript, ZenRows cobra 5 créditos y ScraperAPI 10. Firecrawl cobra 1 crédito por página, maneja contenido generado con JavaScript y devuelve Markdown, entre 0,75 y 3,80 dólares por cada 1.000. Firecrawl encaja bien cuando la página va directa a un modelo de lenguaje.
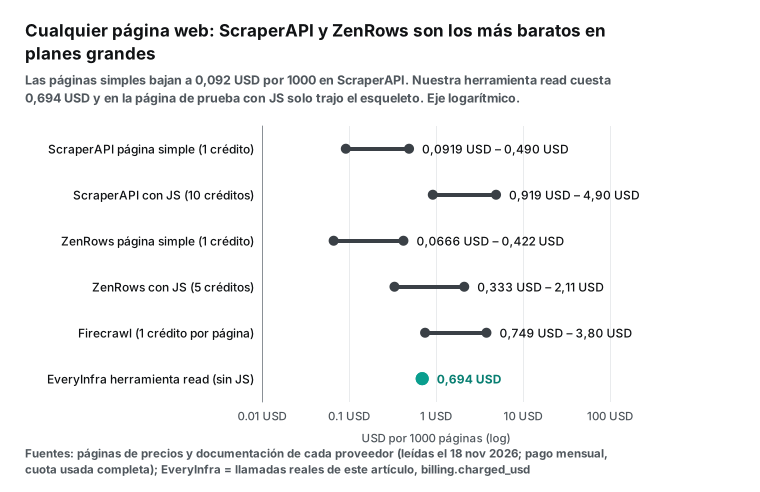
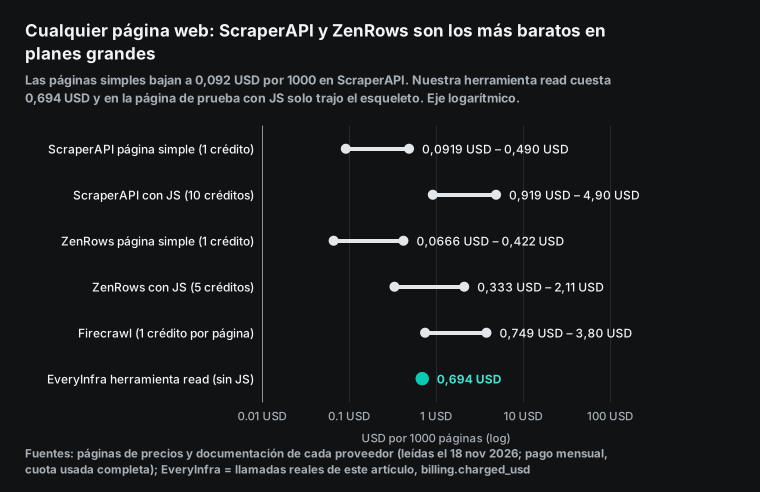
Nuestra herramienta read cuesta 0,000694 dólares por llamada, es decir, 0,694 por cada 1.000 páginas. Es más que el precio de página simple de ScraperAPI y ZenRows en sus planes grandes. A las 00:27, hora de Singapur, la usamos con quotes.toscrape.com/js/, una página de prueba que construye su contenido con JavaScript. Respondió en 0,76 segundos y costó 0,000694. El texto solo traía el título, un enlace de acceso y un enlace a la página siguiente. No traía ninguna de las citas.
En esta prueba, nuestra herramienta read no ejecutó los scripts de la página. Hay páginas que son aplicaciones de una sola página, otras que deben esperar a que aparezca un elemento y otras que necesitan captura. Para esas, usa render=true y wait_for_selector en ScraperAPI, o js_render en ZenRows.
Con un proxy general pasa lo mismo. ScraperAPI también ofrece un modo de puerto proxy: funciona como un proxy HTTP que rota la salida. Se conecta a un script de Scrapy o Playwright que ya tengas, sin tocar el código que procesa las páginas. Los parámetros country_code y session_number fijan el país y la sesión.
EveryInfra vende APIs y datos estructurados, no proxies. Si ya tienes tus propios rastreadores y solo te falta esquivar bloqueos, quedarte en ScraperAPI o pasar a ZenRows es un cambio menor que pasar a nosotros.
Simultaneidad, regiones y velocidad: tres límites que la tabla de precios no muestra
Dos servicios con el mismo precio por cada 1.000 pueden comportarse muy distinto. Las razones son el límite de peticiones simultáneas, las regiones disponibles y el tiempo por petición. La tabla de planes de ScraperAPI de arriba muestra sus hilos: de 5 en el plan gratuito a 500 en Advanced. Si te pasas del límite, recibes un 429 y no se gastan créditos. Si necesitas precios locales de Alemania, Japón o Brasil, necesitas como mínimo Business, de 299 dólares.
Firecrawl da más detalle. Los navegadores simultáneos son 2 en Free, 5 en Hobby, 25 en Standard, 50 en Growth y 100 en Scale. Las peticiones por minuto a /scrape y /search van de 10 en Free a 10.000 en Scale (precios de Firecrawl).
La Scraper API de Bright Data hace las búsquedas por palabra clave como tareas asíncronas. Una petición síncrona por URL que pase de un minuto devuelve 202 con un snapshot_id y sigue como tarea asíncrona (peticiones síncronas y asíncronas). Apify arranca una ejecución completa en cada petición, así que encaja mejor con lotes programados que con consultas de una fila en vivo.
| Nuestra llamada de prueba | Capacidad | Tiempo (segundos) | Filas | Cobrado (dólares) |
|---|---|---|---|---|
| 00:15 un producto de Amazon | amazon/profile | 53,3 | 1 | 0,001389 |
| 00:16 búsqueda en Amazon | amazon/search | 55,7 | 18 | 0,002236 |
| 00:17 búsqueda en TikTok | tiktok/search | 11,4 | 20 | 0,000556 |
| 00:27 búsqueda en Walmart | walmart/search | 35,8 | 20 | 0,001389 |
| 00:27 leer una página con JavaScript | herramienta read | 0,8 | 1 (solo el armazón) | 0,000694 |
| 00:31 búsqueda en Google | herramienta web | 2,7 | 9 | 0,000694 |
| 00:40 TikTok con palabra aleatoria | tiktok/search | 62,6 | 20 | 0,000556 |
Todas las horas de esta tabla son hora de Singapur del 2026-11-18. La búsqueda y la lectura de páginas respondieron en menos de tres segundos. Los datos de plataformas tardaron entre diez segundos y un minuto.
ScraperAPI cobra también las peticiones que canceles antes de 70 segundos, lo que indica que cuenta con que algunas tarden decenas de segundos. Nuestras respuestas síncronas incluyen un campo async_hint, que sugiere añadir "mode":"async" al cuerpo de la petición en tareas lentas. Para una interfaz de chat donde alguien espera, envía las peticiones de plataforma como tareas asíncronas y lee el resultado con el identificador. Consultar el estado es gratis. En lotes de fondo, el tiempo importa menos que la simultaneidad y las peticiones por minuto.
Cuántas páginas de Amazon da cada plan gratuito
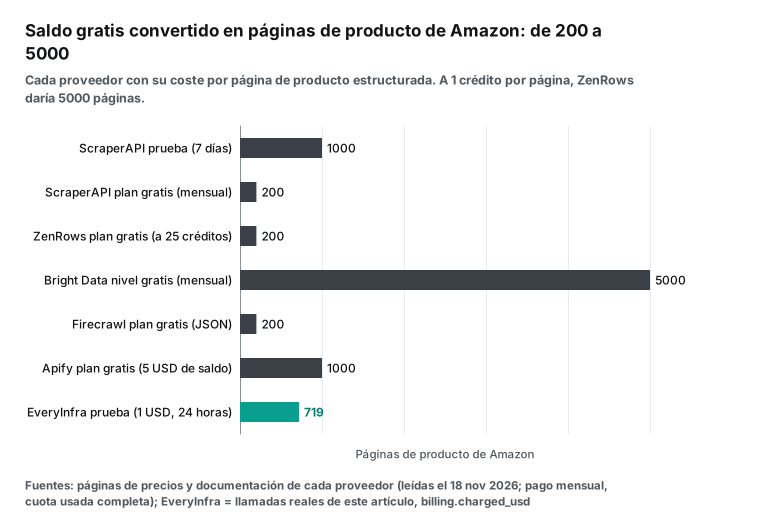
Convertimos el plan gratuito de cada servicio en una sola unidad: páginas de producto de Amazon.
| Plan gratuito | Saldo | Páginas de producto de Amazon | Límites |
|---|---|---|---|
| Prueba de ScraperAPI | 5.000 créditos, 7 días | 1.000 | Caduca a los 7 días |
| Plan gratuito de ScraperAPI | 1.000 créditos al mes | 200 | 5 hilos simultáneos |
| Plan gratuito de ZenRows | 5.000 créditos al mes | De 200 (a 25 créditos) a 5.000 (a 1 crédito) | El coste por sitio hay que probarlo |
| Plan gratuito de Bright Data | 5.000 registros al mes | 5.000 | Cobra por registro |
| Plan gratuito de Firecrawl | 1.000 créditos al mes | 200 (JSON) | 2 navegadores simultáneos |
| Plan gratuito de Apify | 5 dólares de uso al mes | 1.000 | Sin descuento de plan |
| Prueba de EveryInfra | 1 dólar, 24 horas | 719 | Se obtiene dando estrella a dos repositorios de GitHub |
En esta unidad, el plan gratuito de Bright Data es el mayor, con 5.000 registros al mes. La prueba de ScraperAPI dura solo 7 días. Después, el plan gratuito da 1.000 créditos al mes, que alcanzan para solo 200 páginas de producto a 5 créditos cada una. Nuestra prueba equivale a 719 páginas de producto. Si la usas con amazon/search a 20 productos por llamada, 1 dólar da unas 8.900 filas de producto. La página de precios explica cómo pedirla.
Peticiones fallidas, resultados vacíos y tiempos de espera: quién cobra
La tabla de precios solo muestra media factura. La otra mitad son las peticiones fallidas.
ScraperAPI cobra solo los códigos 200 y 404. También cobra una petición que canceles antes de 70 segundos, porque el trabajo ya empezó (documentación de créditos). Una petición por encima de tu límite de simultaneidad devuelve 429 y es gratis. ZenRows dice en su página de precios que nunca cobra las peticiones fallidas, y cuenta 404 y 410 como resultados correctos.
Firecrawl dice que una extracción sin resultado no se cobra. Pero si la página de destino responde 403 o 404, te la entrega igual y cuesta 1 crédito (documentación de cobro). Bright Data cobra por registro entregado. Apify cobra por evento, así que los resultados escritos en el dataset antes de que falle una ejecución se cobran.
| Caso | ScraperAPI | ZenRows | Firecrawl | Bright Data | Apify | EveryInfra |
|---|---|---|---|---|---|---|
| El destino devuelve 404 | Se cobra | Se cobra (cuenta como éxito) | 1 crédito | Sin registro, sin cargo | Depende de la herramienta | Gratis |
| Bloqueo o tiempo agotado | Gratis | Gratis | Gratis | Gratis | Se cobra lo escrito hasta ese momento | Gratis, reembolso con el mismo identificador de cargo |
| Parámetro incorrecto | Gratis | Gratis | Gratis | Gratis | Puede aplicar un cargo de arranque | 422, gratis |
| Cancelas la petición | Se cobra antes de 70 segundos | No indicado | No indicado | No indicado | Se cobra el uso hasta ese momento | No probado |
A las 00:40, hora de Singapur, enviamos amazon/profile con un parámetro equivocado: asin en lugar del url que pide. A los 0,13 segundos llegó un 422 missing_param. La respuesta nombraba el parámetro necesario, daba una petición de ejemplo que funciona y decía «Nothing was charged». El campo charged_usd venía vacío.
En la misma ronda, la búsqueda aleatoria de TikTok devolvió 20 vídeos y se cobró como un resultado normal. En las peticiones lentas retenemos el cargo primero. Si el resultado falla o llega vacío, lo devolvemos con el mismo identificador de cargo. Nuestra guía de conciliación de reembolsos explica cómo comprobarlo en tus propios registros.
Mide tu propia tasa de fallos: el coste por página buena
Una tabla de precios da el coste por cada 1.000 peticiones. Tu factura es el coste por cada 1.000 páginas que puedes usar. La diferencia son los fallos y los reintentos.
Para la prueba, toma entre 100 y 200 URLs al azar de tu lista, de los cinco o seis dominios que más extraes. Lánzalas en cada servicio y anota tres datos por URL: el código de estado, el cargo y si puedes sacar los campos que necesitas. Luego divide el coste total entre las páginas que salieron bien y multiplica por 1.000. La prueba de ScraperAPI dura 7 días y la nuestra 24 horas, así que lanza las mismas entradas en todos los servicios mientras las pruebas coinciden.
Un ejemplo. Un servicio cuesta 0,49 dólares por cada 1.000 peticiones. De 200 URLs, 170 salen bien. Las otras 30 devuelven una página de verificación o una página vacía, y el servicio las cobra porque responden con estado 200. El coste real es 0,49 × 200 ÷ 170 = 0,576 dólares por cada 1.000 páginas buenas, un 18 % más que el precio de lista.
| Ejemplo con 200 URLs | Servicio A | Servicio B |
|---|---|---|
| Precio de lista por 1.000 peticiones | 0,49 | 0,60 |
| Páginas buenas | 170 | 170 |
| ¿Cobra las 30 fallidas? | Sí (responden 200) | No |
| Coste real por 1.000 páginas buenas | 0,576 | 0,60 |
Un segundo servicio anuncia 0,60 y no cobra los fallos, así que su coste real es 0,60. La diferencia queda en un 4 %, y un grupo de dominios más difícil puede darle la vuelta. En EveryInfra, el campo billing.charged_usd de cada respuesta da el cargo en dólares, y los fallos marcan cero. En ScraperAPI, mira la cabecera sa-credit-cost. En ZenRows y Firecrawl, mira el registro de uso del panel.
Aplicamos el mismo método a las 20 llamadas de esta guía. Cuatro grupos de llamadas respondieron HTTP 200 y se cobraron, pero parte de las filas no nos servía. Los 10 resultados de «scraperapi alternatives» no tenían relación con el tema. Los 20 vídeos de TikTok para la palabra aleatoria no sirven para seguir una marca. El ASIN equivocado devolvió una bolsa de patatas fritas. Si quitamos esas filas, el precio por cada 1.000 filas útiles queda en torno a un 50 % por encima del precio de lista. Las dos llamadas a amazon/search trajeron 38 filas y no 40, y la cifra de 0,1177 ya usa las filas recibidas.
| Llamadas de esta guía | Coste (USD) | Filas recibidas | Filas útiles | Precio de lista por 1.000 filas | Precio por 1.000 filas útiles |
|---|---|---|---|---|---|
Tres búsquedas web | 0,002082 | 29 | 19 | 0,0718 | 0,1096 |
Tres llamadas a tiktok/search | 0,001668 | 60 | 40 | 0,0278 | 0,0417 |
Tres llamadas a amazon/profile | 0,004167 | 3 | 2 | 1,389 | 2,08 |
Dos llamadas a amazon/search | 0,004472 | 38 | 38 | 0,1177 | 0,1177 |
Todos los servicios cobran alguna respuesta 200 que no puedes usar: ScraperAPI cobra el 200, ZenRows cuenta el 404 como éxito y Firecrawl cobra 1 crédito por las páginas 403 y 404. Compara los servicios con el precio sin filas inútiles, porque se parece más a tu factura del mes.
La regla de filtrado depende de la plataforma. En resultados de búsqueda, comprueba que el título o la URL contengan la marca. En vídeos de TikTok, revisa la descripción y las etiquetas. En productos de Amazon, compara el título recibido con el nombre del producto de tu lista y cuenta como fallo cualquier diferencia. Pon estas reglas en tu script de prueba y aplica las mismas a todos los servicios. No las cambies entre una ronda y otra, o no podrás comparar los resultados.
Un mes de uso: tres cargas de trabajo, seis facturas
El tamaño de los planes también cambia la factura. Para tres cargas típicas elegimos el plan mensual más pequeño que cubre el uso, o el precio de pago por uso si existe.
| Carga mensual | ScraperAPI | ZenRows | Bright Data | Firecrawl | Apify | EveryInfra |
|---|---|---|---|---|---|---|
| A: 30.000 páginas de producto de Amazon + 3.000 búsquedas de Google | Startup 149 (225.000 créditos) | Launch 99 (a 10 créditos, tramo de 500.000) a Growth 199 (a 25, tramo de 1,2 millones) | 49,50 en pago por uso | Standard 99 + 140 extra, 239 en total | 127,50 a precios de Starter | 43,75 |
| B: 100.000 vídeos de TikTok + 30.000 publicaciones de Instagram | No publica filas por página | Igual | 195 en pago por uso | Igual | 345 a precios de Starter | 3,34 (6.000 peticiones) |
| C: 2 millones de páginas simples | Business 299 | Growth 279 (tramo de 2 millones) | Sin calcular | Scale 749 + 1.000 extra, 1.749 en total | No encaja | 1.388 (read, sin JavaScript) |
En la carga A, una mezcla de productos y búsquedas, EveryInfra y el pago por uso de Bright Data son lo más barato. Las 3.000 búsquedas de Google gastan 75.000 créditos de ScraperAPI, a 25 cada una, y eso empuja la cuenta al plan Startup de 149 dólares.
En la carga B, datos sociales, cobrar por petición sale unas 100 veces más barato que cobrar por registro. A 20 vídeos por llamada, 100.000 vídeos de TikTok necesitan solo 5.000 peticiones.
En la carga C, muchas páginas simples, ScraperAPI y ZenRows cuestan menos de 0,15 dólares por cada 1.000 páginas en sus planes grandes: 0,10 en el plan Business de ScraperAPI y 0,14 en el tramo de 279 dólares de Growth en ZenRows. La factura de nuestra herramienta read es de cuatro a cinco veces mayor y no renderiza JavaScript. No te recomendamos que traslades esta carga a nosotros.
Estos son los supuestos. En ScraperAPI y ZenRows tomamos el plan mensual más pequeño que cubre los créditos. El plan Growth de ZenRows tiene tres tramos: 199, 279 y 399 dólares al mes por 1,2, 2 y 3 millones de créditos; las filas A y C usan tramos distintos. ZenRows no publica sus multiplicadores para Amazon y Google, así que damos el resultado a 10 y a 25 créditos. En Firecrawl usamos 5 créditos por página de producto estructurada. Los créditos extra cuestan 5 dólares por cada 2.000 en Standard y por cada 5.000 en Scale. En Apify usamos los precios de Starter y contamos la cuota de 19 dólares como uso prepagado. Si tus multiplicadores son otros, cambia los precios unitarios y vuelve a calcular.
# Calcula un mes con tu propio uso y tus multiplicadores
amazon_pages, google_searches = 30_000, 3_000
scraperapi_credits = amazon_pages * 5 + google_searches * 25      # 225,000
everyinfra_usd = amazon_pages * 0.001389 + google_searches * 0.000694
print(scraperapi_credits, round(everyinfra_usd, 2))               # 225000 43.75
Topes de gasto y excesos: qué pasa cuando se acaba el saldo
La factura también depende de lo que ocurre cuando se acaban los créditos. Los planes Hobby, Startup y Business de ScraperAPI no pueden comprar créditos extra. Cuando se acaban, esperas al mes siguiente o activas antes la subida automática de plan. De Hobby a Startup, la cuota pasa de 49 a 149 dólares. El pago por uso solo existe desde Scaling, con un tope mensual que fijas tú (precios de ScraperAPI). Los créditos no pasan al mes siguiente (preguntas sobre planes y cobro).
| Regla de exceso | ScraperAPI | ZenRows | Firecrawl | Bright Data | Apify | EveryInfra |
|---|---|---|---|---|---|---|
| Comprar créditos extra | Solo desde Scaling | No indicado | Todos los planes de pago, en pasos de 5 dólares | Pago por uso | La cuota es uso prepagado | Recarga cuando quieras |
| Créditos sin usar pasan al mes siguiente | No | No indicado | Solo Scale, un mes | No aplica | No indicado | El saldo no caduca |
| Tope de gasto | max_cost por petición, tope en pago por uso | Límite de créditos por clave | Límite mensual de pago por uso | No indicado | Límite por ejecución | El saldo prepagado es el tope |
| Descuento anual | 10 % | 2 meses gratis | 16,7 % a 20 % | No aplica | No indicado | Sin suscripción |
Todos los planes de pago de Firecrawl pueden comprar créditos extra en pasos de 5 dólares: 1.000 créditos en Hobby, 2.000 en Standard, 2.500 en Growth y 5.000 en Scale. Fijas un límite mensual, o pones 0 para desactivarlo. Los créditos comprados a mano caducan si cancelas la suscripción. ZenRows añadió a principios de octubre un límite de créditos por clave, útil cuando entregas una clave a un agente de IA.
Nuestro saldo prepagado no caduca y no tiene cuota mensual. Con la carga A, 30.000 páginas de producto y 3.000 búsquedas, la factura es de 43,75 dólares al mes; si el uso baja a la mitad, la factura también, sin saltar a otro plan.
Conectar herramientas de IA: MCP en los seis servicios
Los seis servicios ofrecen MCP. MCP es el Model Context Protocol, que permite a herramientas de IA como Claude o Cursor llamar a APIs externas (introducción al protocolo). Las diferencias están en el diseño de las herramientas y en el cobro.
| Servicio | Dirección o repositorio MCP | Notas |
|---|---|---|
| ScraperAPI | https://mcp.scraperapi.com/mcp | Servidor remoto con 22 herramientas en la documentación, mismas reglas de créditos (documentación MCP, repositorio) |
| ZenRows | https://mcp.zenrows.com/mcp | Servidor remoto con un saldo de créditos compartido (documentación MCP, repositorio) |
| Bright Data | Remoto o local | 5.000 peticiones gratis al mes (preguntas MCP, repositorio) |
| Firecrawl | Remoto o local | Versión 3 publicada el 2026-11-12 (documentación MCP, repositorio) |
| Apify | https://mcp.apify.com | Busca y ejecuta herramientas de la Store (documentación MCP, repositorio) |
| EveryInfra | https://api.everyinfra.com/mcp | Cobro por petición; las tareas lentas devuelven un identificador (página de MCP) |
Antes de dar una clave a una herramienta de IA, fija un tope de gasto. En ScraperAPI, el parámetro max_cost frena con un 403 cualquier petición que lo supere; en ZenRows, desde octubre puedes poner un límite de créditos por clave. Nosotros cobramos por petición, y la llamada más cara de esta guía fue amazon/search, a 0,002236 dólares: cien llamadas de un modelo cuestan 0,22 dólares, así que conoces el máximo antes de empezar. Esta es nuestra configuración:
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
ZenRows tiene además una vía de compra para agentes de IA: el agente paga sus créditos solo, a 0,50 dólares por cada 1.000 (pagos de agentes). Es algo más que los 0,42 del plan Build, pero nadie tiene que abrir una suscripción.
Qué scraperapi alternative encaja con tu equipo
Las cuatro tareas y las tres facturas dan la tabla de decisión siguiente. «Primera opción» es el servicio más barato, o el que pide menos cambios, para el mismo uso, con los precios públicos y las pruebas de esta guía. Tus multiplicadores, regiones y necesidades de simultaneidad pueden cambiar la respuesta.
| Tarea principal | Primera opción | Segunda opción | Motivo |
|---|---|---|---|
| HTML completo de miles de webs, más de 1 millón de páginas al mes | ScraperAPI o ZenRows | Firecrawl | 1 crédito por página simple, menos de 0,15 por cada 1.000 en planes grandes |
| Aplicaciones de una sola página con JavaScript y capturas | ZenRows | ScraperAPI | ZenRows renderiza por 5 créditos, ScraperAPI por 10 |
| Precio y valoración de cientos de miles de ASIN | ScraperAPI desde Startup | Bright Data | 0,46–0,75 por cada 1.000 |
| Listas de productos de Amazon o Walmart por palabra clave | EveryInfra | ScraperAPI | 20 filas por llamada, 0,07–0,12 por cada 1.000 productos |
| Seguimiento de miles de palabras clave en Google al día | EveryInfra | Bright Data | 0,694 por cada 1.000; ScraperAPI gasta 25 créditos por búsqueda |
| Seguimiento de TikTok e Instagram | EveryInfra | Apify | Cobro por petición, 0,02–0,03 por cada 1.000 publicaciones |
| Páginas en Markdown para un modelo de lenguaje | Firecrawl | read de EveryInfra | Firecrawl devuelve Markdown a 1 crédito por página |
| Scripts de Scrapy o Playwright que solo necesitan proxy | ScraperAPI | ZenRows | Modo de puerto proxy, sin cambiar el procesado |
Para un desarrollador en solitario o un equipo pequeño, el primer paso suele ser una prueba. La prueba de ScraperAPI da 5.000 créditos durante 7 días, suficientes para 1.000 páginas de producto de Amazon o 200 búsquedas de Google. El plan gratuito de Bright Data da 5.000 registros cada mes y es el que más dura. Nuestra prueba de 1 dólar vale 24 horas y cubre 1.440 búsquedas de Google o 1.798 búsquedas de TikTok.
Cuándo ScraperAPI es mejor opción entre los scraperapi competitors
En estos casos sale más barato o más cómodo quedarse en ScraperAPI.
| Caso en que ScraperAPI encaja mejor | Coste en ScraperAPI | Comparación |
|---|---|---|
| 2 millones de páginas simples al mes | 299 (Business) | read de EveryInfra 1.388, Firecrawl 1.749, ZenRows 279 |
| Páginas con JavaScript, esperas y capturas | 10 créditos por página renderizada | Nuestro read solo devolvió el armazón |
| Rastreadores propios que necesitan proxy | Modo de puerto proxy | EveryInfra no vende proxies |
| Productos sueltos de Amazon a volumen | 0,459–0,745 por cada 1.000 (desde Startup) | EveryInfra 1,389 por cada 1.000 |
El primer caso es el HTML completo de muchas webs a volumen. Una página simple gasta 1 crédito, 0,092 dólares por cada 1.000 en los planes grandes. Dos millones de páginas al mes cuestan 299 dólares, frente a 1.388 con nuestro cobro por petición y 1.749 con Firecrawl. ZenRows se acerca mucho aquí, con 279 dólares por 2 millones de créditos en el segundo tramo de Growth y un multiplicador menor para JavaScript.
El segundo caso son las aplicaciones de una sola página que necesitan renderizado, espera a un elemento o captura. En nuestra prueba de las 00:27, hora de Singapur, la herramienta read solo devolvió el armazón de la página. render=true con wait_for_selector en ScraperAPI espera al contenido antes de responder. Si traes estas páginas a nosotros, no obtendrás los datos.
El tercer caso son los rastreadores propios que solo necesitan proxies y manejo de bloqueos. En octubre de 2026, ScraperAPI hizo automático el desbloqueo de sitios protegidos con Akamai, y ya no hace falta premium para ellos (nota de versión).
El cuarto caso es un gran volumen de productos sueltos de Amazon desde Startup. A 0,459–0,745 dólares por cada 1.000, ScraperAPI sale más barato que nuestros 1,389. En julio, además, su servicio de lotes DataPipeline quitó el multiplicador de 5 (nota de versión).
En otros tres casos ScraperAPI sale claramente más caro: Google gasta 25 créditos por búsqueda, los datos sociales piden tu propio procesado del HTML y la búsqueda de productos se cobra por página sin un número fijo de filas. Para esas tres tareas mira Bright Data, Apify o EveryInfra. Nuestras guías de alternativas a Bright Data, alternativas a Firecrawl, precios de ZenRows y Apify vs Firecrawl comparan el mercado desde esos ángulos.
Qué cambiar en tu código al salir de ScraperAPI
Un cambio desde ScraperAPI toca tres partes del código. La primera es el formato de la petición. ScraperAPI usa los parámetros de consulta api_key y url, y sus endpoints estructurados usan rutas distintas. Nosotros usamos un cuerpo JSON con platform, action y params, y la clave va en la cabecera Authorization. El catálogo muestra los parámetros necesarios y un ejemplo para cada capacidad.
La segunda parte son los nombres de campo, que obligan a escribir una capa de mapeo. La tercera son las tareas lentas: algunas de nuestras capacidades, como instagram/user_posts, siempre van como tareas asíncronas y devuelven un identificador, que se lee con GET /api/v1/jobs/{job_id} sin coste.
| Dato | Endpoint estructurado de ScraperAPI (según su documentación) | `amazon/profile` de EveryInfra (campos reales) |
|---|---|---|
| Título | Title | title |
| Precio | Price | price, currency |
| Valoración y número | Rating, review count | rating, rating_scale, rating_count |
| Identificador | ASIN | asin |
| Existencias | Availability | in_stock |
| Imágenes | Images | image_url, images |
| Vendedor | Seller info | seller_name |
| Descripción y puntos clave | Description | features |
| Especificaciones | Product specifications | Sin campo propio |
| Marca y categoría | No indicado | brand, category, is_amazon_choice |
La columna de EveryInfra usa los campos reales de nuestra llamada a amazon/profile de las 00:29, hora de Singapur. La búsqueda por palabra clave añade description y bestseller_ranks. Para controlar el gasto, guarda en tu sistema el campo billing.charged_usd de cada respuesta síncrona, o billing_state en las asíncronas, y podrás cuadrar el mes sin entrar al panel.
Cambios recientes en ScraperAPI y en el mercado
Antes de cambiar, mira hacia dónde va ScraperAPI. En mayo de 2026 añadió dos planes por encima de Scaling: Professional, de 975 dólares por 10,5 millones de créditos, y Advanced, de 1.975 dólares por 21,5 millones, con créditos de regalo por tiempo limitado y 300 y 500 hilos (nota de versión). En julio quitó el multiplicador extra de DataPipeline, en junio lanzó el estimador por dominio y en octubre automatizó Akamai.
Los cambios de los últimos 30 días en el resto del mercado:
- 2026-11-17: Firecrawl anunció su primera oficina fuera de San Francisco, en Toronto, y recordó su ronda Serie B de 75 millones de dólares de septiembre (nota de Business Wire). Para el lector: Firecrawl se centra en fuentes de datos para agentes de IA, y sus precios de extracción no cambiaron.
- 2026-11-13: el registro de cambios de Firecrawl dice que sus datos de empresas en Alexandria ya cubren más de 75 millones de compañías (registro de cambios). Para el lector: hay una fuente más, por créditos, para datos de empresas.
- 2026-11-12: Firecrawl publicó la versión 3 de su MCP, con límites de velocidad 60 veces mayores y 4 veces más uso. Para el lector: sus créditos gratuitos rinden más en herramientas de IA.
- 2026-11-16 y 2026-11-17: se actualizaron cuatro de las cinco páginas de herramientas de la Apify Store usadas en esta guía; la de publicaciones de Instagram no muestra fecha. Para el lector: los precios de Apify cambian por herramienta, conviene releerlos cada mes.
- 2026-10-30: Firecrawl se integró en eve, el marco abierto de agentes de Vercel; el 2026-10-22 había añadido un índice de documentos públicos y legales. Para el lector: Firecrawl avanza hacia conjuntos de datos ya preparados.
- Octubre de 2026: ZenRows añadió un endpoint de rastreo y el límite de créditos por clave (registro de cambios de ZenRows). Para el lector: si das una clave a un agente, ahora puedes acotar su gasto.
Qué dicen los vídeos de YouTube y los foros sobre scraperapi alternatives
Usamos la capacidad youtube/search de EveryInfra para buscar «scraperapi alternatives». A las 00:17, hora de Singapur, devolvió 10 vídeos por 0,000778 dólares. Sacamos la transcripción de los tres más pertinentes con youtube/transcript, a las 00:26, hora de Singapur, por 0,000556 cada una.
| Vídeo | Subido | Vistas | Idea principal | Qué no muestra |
|---|---|---|---|---|
| ScraperAPI Alternative Same Pages Lower Cost 2026 Benchmark | 2026-10-26 | 9 | Más de 2 dólares por 1.000 páginas estándar en la prueba de ScraperAPI | URLs y multiplicadores usados |
| Scraper API Review: Best Web Scraper Tool in 2026? | 2026-06-02 | 59 | Los créditos se acaban rápido con renderizado y anti-bots | Cómo medir el coste por sitio |
| Best Web Scraping API: five-provider comparison | 2026-10-19 | 175 | Cada tipo de petición gasta créditos distintos | Ningún precio por 1.000 resultados |
El primer vídeo es un anuncio de 30 segundos de otra empresa del sector. Dice que en la prueba de ScraperAPI su test costó más de 2 dólares por cada 1.000 páginas estándar. Con precios públicos, una página simple gasta 1 crédito, como mucho 0,49 dólares por cada 1.000. Pasar de 2 dólares implica 5 créditos o más por página. El vídeo no da sus URLs ni sus multiplicadores, así que no podemos comprobarlo.
El segundo vídeo es una reseña. Su idea central es que los créditos se acaban rápido con JavaScript y con el desbloqueo anti-bots, y recomienda calcular costes antes de contratar un plan grande. El tercero compara cinco servicios y concluye que hay que estimar el coste con los sitios que de verdad vas a extraer.
Los tres vídeos tienen cero comentarios, así que los puntos de dolor solo salen de las transcripciones. Los tres dicen «estima el coste por sitio», pero ninguno enseña cómo. Ninguno usa /account/urlcost, la cabecera sa-credit-cost, el tope max_cost ni el estimador por dominio. La sección de créditos de esta guía muestra esas herramientas.
En Reddit, un hilo de r/WebScrapingInsider pregunta qué API usar para tiendas en línea. Una respuesta aconseja comparar el coste por página buena en cada dominio y cita una prueba externa en la que 100.000 páginas de Amazon cuestan entre 20 y 300 dólares al mes según el proveedor. En un hilo de r/scrapingtheweb, quien publica cuenta que los servicios por créditos se los comían con JavaScript y proxies premium, y que acabó en Firecrawl. Son testimonios sueltos sin verificación externa; úsalos como lista de pruebas propias.
Límites legales
Los seis servicios recogen datos de páginas públicas. Tú respondes de las condiciones del sitio de destino y de la ley local. Si las reseñas o publicaciones que recoges contienen datos personales de personas en la UE, aplica el RGPD. Esta guía compara precios y reglas de cobro. No dice si un sitio concreto se puede extraer y no es asesoría legal.
Primeros pasos: comprueba las cifras con tu propia lista
- Abre la guía de inicio rápido y crea tu cuenta.
- Pide la prueba de 1 dólar como explica la página de precios; vale 24 horas.
- Abre la página de Amazon, la página de TikTok o el mercado de datos.
- Lanza tus propios ASIN y palabras clave en el panel de prueba.
- Anota las filas y el
charged_usdde cada llamada. - Mira el multiplicador de ScraperAPI para las mismas URLs con
/account/urlcost. - Mete los dos precios en el ejemplo de Python de arriba para obtener tu factura mensual.
Preguntas frecuentes
¿Cuáles son las scraperapi alternatives más baratas?
(Fuente: sugerencias de Google «scraperapi free alternative» y «scraperapi competitors») Depende de la tarea. Con los precios públicos del 2026-11-18, somos los más baratos en búsquedas de Google, a 0,694 dólares por cada 1.000, frente a 2,30–12,25 de ScraperAPI. En publicaciones sociales cobramos 0,0185–0,0278 por cada 1.000, al menos 47 veces menos que Bright Data y Apify. Para HTML completo de cualquier web, ScraperAPI y ZenRows bajan de 0,15 por cada 1.000 páginas en planes grandes, más barato que nosotros.
¿Cómo elegir entre scraperapi vs firecrawl?
(Fuente: sugerencia de Google «scraperapi vs firecrawl») Para HTML completo, proxies y manejo de bloqueos, elige ScraperAPI, a 0,092–0,49 dólares por cada 1.000 páginas simples. Para convertir páginas en Markdown para un modelo de lenguaje, elige Firecrawl, a 1 crédito por página o 0,75–3,80 por cada 1.000. El JSON estructurado cuesta 4 créditos más por página en Firecrawl, así que Amazon supera los 3,75 por cada 1.000.
¿Qué sale más barato, ZenRows o ScraperAPI?
(Fuente: sugerencia de Google «zenrows vs scraperapi») En páginas simples están cerca, y los planes grandes de ZenRows quedan algo por debajo, a 0,067 dólares por cada 1.000 créditos. Para renderizar JavaScript, ZenRows gasta 5 créditos y ScraperAPI 10, la mitad. ZenRows no publica su coste para Amazon o Google; ScraperAPI sí (5 y 25), lo que facilita el presupuesto. Los dos dicen que no cobran los fallos.
scraperapi vs apify: ¿cuál sirve mejor para redes sociales?
(Fuente: sugerencia de Google «scraperapi vs apify») La Apify Store tiene herramientas listas para TikTok e Instagram que cobran por resultado, entre 1,00 y 3,70 dólares por cada 1.000, y devuelven JSON estructurado. ScraperAPI trata TikTok como página simple y devuelve HTML que debes procesar, y no menciona Instagram. Para solo redes sociales, Apify ahorra desarrollo. EveryInfra cobra por petición y devuelve 20 a 30 publicaciones por llamada, unos 0,02 dólares por cada 1.000.
¿Hay alguna scraperapi alternative de pago por uso, sin suscripción?
(Fuente: sugerencia de Google «scraperapi free alternative» y las quejas sobre créditos del hilo de r/scrapingtheweb) Sí, tres. El pago por uso de Bright Data no tiene cuota y cuesta 1,50 dólares por cada 1.000 registros. Firecrawl vende créditos extra solo en planes de pago. EveryInfra usa saldo prepagado, con una primera recarga de 10 dólares que no caduca; cada petición se cobra al precio del catálogo y los fallos y vacíos son gratis. ScraperAPI solo ofrece pago por uso desde Scaling.
¿ScraperAPI tiene plan gratuito y qué pasa cuando se acaba?
(Fuente: sugerencias de Google «scraperapi free tier» y «scraperapi free plan») Sí. Una cuenta nueva tiene 7 días de prueba con 5.000 créditos. Después, el plan gratuito da 1.000 créditos al mes con 5 hilos. Los créditos no pasan al mes siguiente y los planes por debajo de Scaling no compran extra. A 5 créditos por página de Amazon, el plan gratuito cubre solo 200 páginas al mes. El plan gratuito de Bright Data da 5.000 registros al mes, el mayor en esta unidad.
¿Es seguro y legal usar ScraperAPI?
(Fuente: sugerencias de Google «is scraperapi legit» y «is scraperapi legal») ScraperAPI es un servicio comercial consolidado, con precios públicos, una ventana de reembolso de 7 días y reglas de cobro documentadas. Que tu uso sea legal depende de los sitios que extraigas y de cómo uses los datos, igual que con cualquier proveedor. Respeta las condiciones de cada sitio y trata los datos personales según la ley del lugar donde operas.
Referencias
- Precios de ScraperAPI, leído el 2026-11-18, https://www.scraperapi.com/pricing/
- Credits and Requests Costs, documentación de ScraperAPI, leído el 2026-11-18, https://docs.scraperapi.com/getting-started/quick-start/credits-and-requests-costs
- Plans and Billing FAQ, documentación de ScraperAPI, leído el 2026-11-18, https://docs.scraperapi.com/resources/faq/plans-and-billing
- Cost Control, documentación de ScraperAPI, leído el 2026-11-18, https://docs.scraperapi.com/control-and-optimization/cost-control
- MCP Server, documentación de ScraperAPI, leído el 2026-11-18, https://docs.scraperapi.com/integrations/llm-integrations/mcp-server
- Repositorio scraperapi-mcp, GitHub, leído el 2026-11-18, https://github.com/scraperapi/scraperapi-mcp
- Structured Data (versión para IA), ScraperAPI, leído el 2026-11-18, https://www.scraperapi.com/docs/ai/structured-data
- Pricing (versión para IA), ScraperAPI, leído el 2026-11-18, https://www.scraperapi.com/docs/ai/pricing
- Akamai-protected sites now unblocked automatically, notas de versión de ScraperAPI, octubre de 2026, https://docs.scraperapi.com/resources/release-notes/october-2026/akamai-protected-sites-now-unblocked-automatically
- DataPipeline is now up to 80% cheaper, notas de versión de ScraperAPI, julio de 2026, https://docs.scraperapi.com/resources/release-notes/july-2026/datapipeline-is-now-up-to-80-cheaper
- New Domain Credit Cost Estimator, notas de versión de ScraperAPI, junio de 2026, https://docs.scraperapi.com/resources/release-notes/june-2026/new-domain-credit-cost-estimator
- More credits, higher limits: new growth plans, notas de versión de ScraperAPI, mayo de 2026, https://docs.scraperapi.com/resources/release-notes/may-2026/more-credits-higher-limits-introducing-new-growth-plans-on-scraperapi
- Índice de documentación de ScraperAPI (llms.txt), leído el 2026-11-18, https://docs.scraperapi.com/llms.txt
- Precios de ZenRows, leído el 2026-11-18, https://www.zenrows.com/pricing
- Universal Scraper API reference, documentación de ZenRows, leído el 2026-11-18, https://docs.zenrows.com/fetch/api-reference
- Agentic payments, documentación de ZenRows, leído el 2026-11-18, https://docs.zenrows.com/first-steps/agentic-payments
- MCP integrations, documentación de ZenRows, leído el 2026-11-18, https://docs.zenrows.com/integrations/mcp/mcp-integrations
- Repositorio zenrows-mcp, GitHub, leído el 2026-11-18, https://github.com/ZenRows/zenrows-mcp
- Registro de cambios de ZenRows, leído el 2026-11-18, https://docs.zenrows.com/changelog
- Página de extracción de ASIN de Amazon, ZenRows, leído el 2026-11-18, https://www.zenrows.com/scrape/amazon-asin
- Precios de Bright Data, leído el 2026-11-18, https://brightdata.com/pricing
- Precios de Web Scraper API, Bright Data, leído el 2026-11-18, https://brightdata.com/pricing/web-scraper
- Precios de SERP API, Bright Data, leído el 2026-11-18, https://brightdata.com/pricing/serp
- SERP API introduction, documentación de Bright Data, leído el 2026-11-18, https://docs.brightdata.com/scraping-automation/serp-api/introduction
- MCP Server FAQs, documentación de Bright Data, leído el 2026-11-18, https://docs.brightdata.com/products/mcp-server/faqs
- Repositorio brightdata-mcp, GitHub, leído el 2026-11-18, https://github.com/brightdata/brightdata-mcp
- Sync vs async requests, documentación de Bright Data, leído el 2026-11-18, https://docs.brightdata.com/concepts/sync-vs-async
- Precios de Firecrawl, leído el 2026-11-18, https://www.firecrawl.dev/pricing
- Billing, documentación de Firecrawl, leído el 2026-11-18, https://docs.firecrawl.dev/billing
- Scrape, documentación de Firecrawl, leído el 2026-11-18, https://docs.firecrawl.dev/features/scrape
- Search, documentación de Firecrawl, leído el 2026-11-18, https://docs.firecrawl.dev/features/search
- MCP Server, documentación de Firecrawl, leído el 2026-11-18, https://docs.firecrawl.dev/mcp-server
- Repositorio firecrawl-mcp-server, GitHub, leído el 2026-11-18, https://github.com/firecrawl/firecrawl-mcp-server
- Registro de cambios de Firecrawl, leído el 2026-11-18, https://www.firecrawl.dev/changelog
- Firecrawl Brings Its Library for the World's Knowledge to Toronto, Business Wire, 2026-11-17, https://www.businesswire.com/news/home/20261117386615/en/Firecrawl-Brings-Its-Library-for-the-Worlds-Knowledge-to-Toronto
- Precios de Apify, leído el 2026-11-18, https://apify.com/pricing
- Actors in Store, documentación de Apify, leído el 2026-11-18, https://docs.apify.com/platform/actors/running/actors-in-store
- Apify MCP server, documentación de Apify, leído el 2026-11-18, https://docs.apify.com/platform/integrations/mcp
- Repositorio apify-mcp-server, GitHub, leído el 2026-11-18, https://github.com/apify/apify-mcp-server
- Amazon Product Scraper, Apify Store, leído el 2026-11-18, https://apify.com/junglee/amazon-crawler
- Google Search Results Scraper, Apify Store, leído el 2026-11-18, https://apify.com/apify/google-search-scraper
- TikTok Scraper, Apify Store, leído el 2026-11-18, https://apify.com/clockworks/tiktok-scraper
- Instagram Post Scraper, Apify Store, leído el 2026-11-18, https://apify.com/apify/instagram-post-scraper
- What is the Model Context Protocol, documentación de MCP, leído el 2026-11-18, https://modelcontextprotocol.io/docs/getting-started/intro
- Catálogo de capacidades de EveryInfra, leído el 2026-11-18 a las 00:14, https://api.everyinfra.com/api/v1/social/catalog
- Catálogo de herramientas de búsqueda de EveryInfra, leído el 2026-11-18, https://api.everyinfra.com/api/v1/search/tools
- Which is the best web scraping API for e-commerce sites?, Reddit r/WebScrapingInsider, leído el 2026-11-18, https://www.reddit.com/r/WebScrapingInsider/comments/1vsd1ot/which_is_the_best_web_scraping_api_for_ecommerce/
- I'm looking for ScrapingBee Alternatives in 2026, Reddit r/scrapingtheweb, leído el 2026-11-18, https://www.reddit.com/r/scrapingtheweb/comments/1v85plc/im_looking_for_scrapingbee_alternatives_in_2026/
- ScraperAPI Alternative Same Pages Lower Cost 2026 Benchmark, YouTube, 2026-10-26, https://www.youtube.com/watch?v=PkaI1bDWhAw
- Scraper API Review: Best Web Scraper Tool in 2026?, YouTube, 2026-06-02, https://www.youtube.com/watch?v=niOu3F7fVlw
- Best Web Scraping API: five-provider comparison, YouTube, 2026-10-19, https://www.youtube.com/watch?v=hvmfHAYxgLQ
- Reglamento (UE) 2016/679 (RGPD), EUR-Lex, https://eur-lex.europa.eu/eli/reg/2016/679/oj
Referencia BL-183