Subagentes de Claude Code: Haiku para cuentas de TikTok
Una cuenta de marca de TikTok ocupa unos 9700 tokens en bruto; un subagente Haiku 5.5 devuelve un resumen de 95 tokens. 98 llamadas reales, errores 429 y el costo de 50 cuentas.
El 26 de octubre de 2026, entre las 17:25 y las 17:48 (hora de Singapur), descargamos con la API de EveryInfra el perfil, los 10 videos más recientes y los comentarios de un video de 18 cuentas de marca en TikTok. Cada cuenta devolvió en promedio 38.794 bytes en bruto, unos 9700 tokens según la proporción que da la página de precios de Anthropic (10 kB son unos 2500 tokens). El resumen de esa misma cuenta ocupa unos 382 bytes, unos 95 tokens: unas 100 veces menos. Eso es lo que ahorran los subagentes de Claude Code en el contexto principal. Hay un segundo resultado que pasa desapercibido: nuestra clave de prueba la limitamos a 10 solicitudes por minuto (la cuenta trae 60 por defecto), y con seis trabajadores en paralelo recibimos 20 errores 429 en 56 solicitudes, mientras que cuatro trabajadores con un tope propio obtuvieron más de un 50 % más de resultados por minuto.
Este artículo responde una pregunta práctica. Tienes una lista de varias decenas de cuentas de marca en TikTok: competidores, posibles aliados o tus propias cuentas por país. Quieres que Claude Code descargue perfiles, videos recientes y comentarios, y que arme una tabla comparativa. ¿Cómo repartes el trabajo entre subagentes? ¿Qué modelo y qué herramientas recibe cada uno? ¿Qué llamadas de datos hace, cuánto cuesta y qué pasa cuando el límite de la API lo frena?
La configuración de Claude Code que verás aquí sale de la documentación oficial y del registro de cambios. No ejecutamos el subagente en nuestra máquina, así que esa parte aparece como ejemplo de configuración. Cada número de EveryInfra sale de las respuestas en bruto de llamadas reales.
El trabajo: 50 cuentas de marca, una tabla comparativa
Primero definimos el trabajo, porque todos los números posteriores dependen de él. La entrada es una lista de nombres de usuario de TikTok. De cada cuenta queremos tres cosas. La primera es el perfil: seguidores, número de videos y si la cuenta está verificada. La segunda son los 10 videos más recientes: vistas, me gusta, comentarios y fecha de publicación. La tercera son hasta 50 comentarios del video con más comentarios entre esos 10. La salida es una tabla con una fila por cuenta: seguidores, mediana de vistas, tasa de interacción, publicaciones por semana y comentarios muestreados, más una nota breve.
Este trabajo tiene tres rasgos que coinciden con el propósito de los subagentes. Las cuentas no dependen unas de otras: descargar Zara no necesita el resultado de Bershka, así que todo puede ir en paralelo. Se lee mucho más de lo que se conserva: cada cuenta devuelve decenas de kilobytes, pero la tabla guarda una fila. Y los pasos son fijos y las decisiones son simples, de modo que basta un modelo pequeño y barato.
La documentación de Claude Code describe los subagentes en los mismos términos. Dice que conviene usar uno cuando una tarea lateral llenaría la conversación principal de resultados de búsqueda, registros o contenido de archivos que no volverás a consultar. El subagente hace ese trabajo en su propio contexto y solo devuelve el resumen (documentación de subagentes de Claude Code).
Probamos 24 nombres de usuario en tres grupos. El grupo de marcas en español tuvo 8: Zara, Bershka, Real Madrid, Telcel y Pull&Bear, más tres nombres que dedujimos de las marcas Mercado Libre, OXXO y Bimbo. El grupo de ropa deportiva de Estados Unidos tuvo 8: Nike, Adidas, Gymshark, lululemon, Under Armour, New Balance, PUMA y HOKA. El grupo de marcas chinas tuvo SHEIN, Temu, DJI, OnePlus y EcoFlow, más tres nombres deducidos para Anker, Insta360 y Xiaomi. Las seis deducciones fallaron, y la sección de errores explica por qué eso importa. Las 18 cuentas verificadas restantes son la base de todos los datos de tamaño, costo y velocidad, que escalamos a 50 donde lo indicamos.


¿Conviene dividir? Lo que dice la guía de Anthropic del 22 de octubre
Antes de configurar nada, mira el consejo contrario. El 22 de octubre de 2026, Anthropic publicó una guía larga titulada «When to fold subagents into your main agent loop» (guía de Anthropic). Sostiene que la mayoría de los agentes debería usar menos subagentes: un modelo, una ventana de contexto y un bucle de herramientas abierto por defecto. Los procedimientos del dominio van a Skills, y las consultas y los límites duros van a herramientas. Un resumen en Reddit cuenta que el bucle único de un cliente fue unas 2 veces más rápido que su sistema multiagente.
El kit que acompaña la guía, single-agent-loop-kit, es prudente con esa afirmación. Su README dice que el kit no da por hecho que un bucle único siempre gane: mide cada cambio con la misma evaluación antes y después. El mismo README enumera buenas razones para conservar un subagente: investigación en paralelo con contextos nuevos, verificación independiente y trabajo que lee mucho más de lo que el agente principal necesita después.
Descargar 50 cuentas de TikTok es justo el último caso. Cada cuenta trae unos 9700 tokens y la sesión principal necesita una fila de 95. Según The Decoder, Anthropic pone tres condiciones para conservar subagentes: pérdida de calidad medible por el crecimiento del contexto, tareas en paralelo con contextos separados o problemas para elegir herramientas. Nuestro trabajo cumple las dos primeras.
| Motivo para conservar un subagente (kit de Anthropic) | ¿Se cumple aquí? | Dato de este artículo |
|---|---|---|
| Investigación en paralelo con contextos nuevos | Sí | Las cuentas no dependen entre sí |
| Trabajo que lee mucho más de lo que se necesita después | Sí | Unos 9700 tokens leídos frente a 95 devueltos por cuenta |
| Verificación independiente | En parte | Un trabajador nuevo puede repetir una cuenta y comparar |
| Problemas con demasiadas herramientas | Sí, si no filtras | 25 herramientas MCP frente a 2 permitidas |
Nuestra decisión es dividir, pero solo un nivel y solo en el paso de «descargar y resumir». La tabla, la elección de qué cuentas merecen una segunda mirada y la decisión de lanzar otra ronda se quedan en la sesión principal, porque necesitan ver todas las cuentas a la vez. No es el patrón de «un subagente por equipo» contra el que advierte la guía. Nuestros trabajadores no tienen un rol: cada uno tiene una lista fija de pasos y una cuenta.
Subagentes de Claude Code: el archivo, el campo model y la lista de herramientas permitidas
Un subagente de Claude Code es un archivo Markdown. Empieza con metadatos en YAML (la documentación los llama frontmatter) y el cuerpo se convierte en el prompt de sistema del subagente. Los subagentes de proyecto van en .claude/agents/ y puedes subirlos al repositorio para tu equipo; los de usuario van en ~/.claude/agents/. La documentación dice que solo name y description son obligatorios. Los nombres de campo usan camelCase, y Claude Code ignora en silencio un campo mal escrito (referencia de frontmatter). Este es nuestro ejemplo de configuración para el trabajo; los párrafos siguientes explican cada decisión.
---
name: tiktok-account-worker
description: Descarga una cuenta de TikTok (perfil, videos recientes, comentarios de un video) y devuelve un resumen JSON de una línea. Usa uno por cada cuenta de la lista.
model: claude-haiku-5-5
effort: low
tools: mcp__everyinfra__everyinfra_call_api, mcp__everyinfra__everyinfra_get_job
mcpServers:
  - everyinfra:
      type: http
      url: https://api.everyinfra.com/mcp
      headers:
        Authorization: "Bearer ${EVERYINFRA_API_KEY}"
maxTurns: 8
omitClaudeMd: true
---

Trabaja solo con el nombre de usuario de TikTok de tu tarea. Sigue estos pasos en orden:
1. Llama a everyinfra_call_api con platform=tiktok, action=profile, params={username}.
   Si is_verified es false y follower_count < 1000, detente y devuelve {"username":..., "flag":"lookalike"}.
2. Llama a action=user_videos con params={username, limit:10}. Excluye los videos con is_pinned=true de medianas y tasas.
3. Toma el video con más comment_count del paso 2 y llama a action=comments con params={url, limit:50}.
4. Ante un 429, espera retry_after segundos y reintenta una vez. No cambies los parámetros.
5. Devuelve solo una línea JSON: username, verified, followers, median_views, engagement_pct,
   posts_per_week, comments_fetched y una nota de 25 palabras como máximo. No devuelvas datos en bruto.
La línea model usa el identificador completo del modelo y no el alias haiku; la siguiente sección explica por qué. La línea tools es una lista de herramientas permitidas. Según la documentación, un subagente con tools solo puede usar esas herramientas, y uno sin esa lista hereda todas las de la conversación principal (herramientas disponibles).
El servidor MCP remoto de EveryInfra devuelve 25 herramientas en tools/list. Dos sirven para obtener datos: everyinfra_call_api y everyinfra_get_job. Las demás gestionan la cuenta, las claves, los tickets de soporte y los webhooks. Una herramienta como everyinfra_key_delete no tiene lugar en un trabajo por lotes que un modelo pequeño ejecuta 50 veces. La lista de permitidas deja dos herramientas y elimina ese riesgo desde el origen.
La línea mcpServers es la que más contexto ahorra. La documentación explica que un servidor MCP definido dentro del subagente se conecta cuando el subagente arranca y se desconecta cuando termina. Para que un servidor MCP no entre en la conversación principal, ni sus descripciones ocupen contexto allí, defínelo aquí y no en .mcp.json (limitar servidores MCP a un subagente).
Medimos la respuesta tools/list de EveryInfra: 30.682 bytes, unos 7670 tokens. La respuesta de initialize añade 3924 caracteres de instrucciones del servidor. Las dos herramientas permitidas ocupan 2505 bytes, unos 626 tokens. La documentación también fija una regla de confianza: Claude Code solo carga un servidor MCP definido en un archivo de .claude/agents/ del proyecto después de que confías en esa carpeta. Las versiones anteriores a v2.1.238 no lo comprobaban.
omitClaudeMd: true arranca el subagente sin los archivos CLAUDE.md de usuario, de proyecto y locales. Por defecto, un subagente carga cada nivel de CLAUDE.md que carga la conversación principal (qué se carga al arrancar). Un trabajador que hace tres llamadas a una API no necesita la mayoría de esas reglas, y cada uno de los 50 cargaría su propia copia. Este campo requiere Claude Code v2.1.271 o posterior. maxTurns: 8 fija un límite de turnos; al alcanzarlo, Claude Code marca la salida como parcial y la sesión principal puede reanudar al trabajador (desde v2.1.246).
La clave usa expansión de variables de entorno. La documentación de MCP de Claude Code dice que .mcp.json y las entradas MCP de los subagentes admiten ${VAR}, así que un equipo comparte un archivo y cada persona usa su propia clave. Pero ciertos nombres de credenciales siempre se leen vacíos en la url y los headers de un servidor remoto: ANTHROPIC_API_KEY, las credenciales del proveedor de nube o NPM_TOKEN, entre otros (documentación de MCP, variables de entorno). Esa regla evita que un archivo del proyecto envíe tus credenciales a un servidor que el propio archivo nombra. Usa un nombre propio, como EVERYINFRA_API_KEY.
Si prefieres no poner el servidor en el archivo del subagente, agrégalo al proyecto con un comando y luego nómbralo en mcpServers:
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope project --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"
Queda un ajuste que puede detener el trabajo. En tools/list, everyinfra_call_api lleva readOnlyHint: false y destructiveHint: true, porque cada llamada cuesta dinero. La documentación indica que, cuando un subagente en segundo plano necesita permiso para usar una herramienta, Claude Code muestra la solicitud en la sesión principal y nombra al subagente (primer plano y segundo plano). Cincuenta trabajadores pueden significar cincuenta solicitudes. Antes de empezar, permite mcp__everyinfra__everyinfra_call_api en permissions.allow de tu configuración (documentación de permisos), y solo esa herramienta.
La tabla resume cada campo, su función y la fuente oficial con la versión que exige.
| Campo | Valor en este ejemplo | Qué hace | Fuente (versión) |
|---|---|---|---|
model | claude-haiku-5-5 | Fija el modelo del subagente; también admite alias como haiku o inherit | Documentación de subagentes, «Choose a model» |
tools | Solo dos herramientas MCP | Lista de permitidas; sin ella, hereda todas | Documentación de subagentes, «Available tools» |
mcpServers | Servidor de EveryInfra definido dentro | Las descripciones solo se cargan en el subagente | Documentación; control de confianza desde v2.1.238 |
effort | low | Nivel de esfuerzo del subagente | Documentación, «Choose an effort level» |
maxTurns | 8 | Límite de turnos; salida marcada como parcial | Marca parcial desde v2.1.246 |
omitClaudeMd | true | No carga los CLAUDE.md | Desde v2.1.271 |
Claude Code subagents model selection: cuatro pasos y la trampa del alias haiku
El modelo en el que corre un subagente es lo que más influye en el costo de este trabajo, y es una de las dudas más frecuentes: las sugerencias de Google incluyen «claude code subagents model selection», «claude code subagent model default» y «claude_code_subagent_model force». La documentación da un orden de cuatro pasos. Primero, el parámetro model que pasa la sesión principal al lanzar el subagente. Segundo, el campo model del archivo del subagente, donde inherit significa usar el modelo principal. Tercero, la variable de entorno CLAUDE_CODE_SUBAGENT_MODEL. Cuarto, el modelo de la conversación principal (Choose a model).
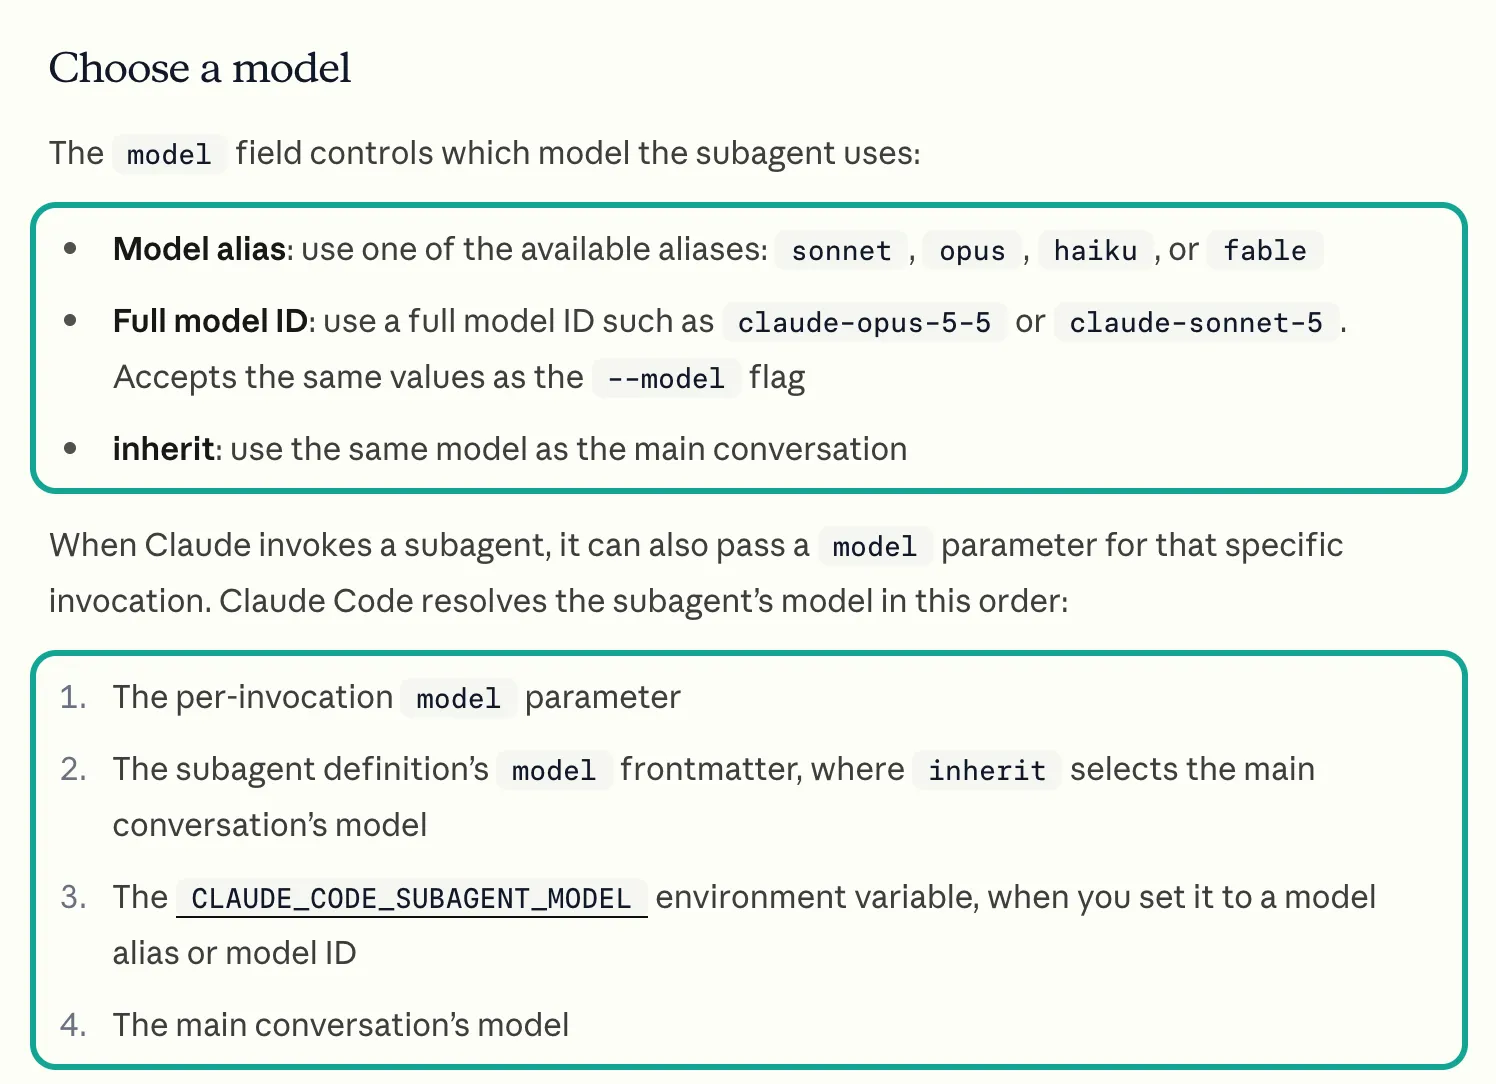
De ese orden salen dos consecuencias. La primera: un subagente sin campo model hereda el modelo principal. Si tu sesión principal usa Opus 5.5, un pequeño trabajador de datos también factura a precio de Opus. Un hilo de Reddit con 736 votos lanzó la misma advertencia: el subagente integrado Explore ya no corre siempre en Haiku y sigue a la sesión principal (hilo de r/ClaudeCode).
La segunda: la variable de entorno va después del archivo, así que solo es un valor por defecto. Para imponer un modelo a todos los subagentes, la documentación pide definir también CLAUDE_CODE_SUBAGENT_MODEL_FORCE=1; con esa marca, Claude Code ignora el campo model de los archivos. Una publicación anterior de la comunidad pone la variable en primer lugar (hilo de r/claude). Ese orden no coincide con la documentación actual; sigue la documentación.
Usamos el identificador completo y no haiku porque el alias apunta a modelos distintos según el proveedor. La documentación de configuración de modelos de Claude Code trae una tabla: en la API de Anthropic, haiku es Haiku 5.5; en Claude Platform on AWS, Amazon Bedrock, Google Cloud y Microsoft Foundry, haiku sigue siendo Haiku 4.5 (configuración de modelos). Haiku 4.5 cuesta 1 USD por millón de tokens de entrada y 5 USD por millón de salida, 10 veces el precio de Haiku 5.5 (tabla de precios del lanzamiento de Haiku 5.5).
El mismo archivo de subagente en Bedrock puede costar diez veces más sin mostrar ningún error. El registro de cambios de Claude Code indica que Haiku 5.5 pasó a ser el modelo Haiku por defecto en la API de Anthropic con la v2.1.293, el 2026-10-07 (registro de cambios de Claude Code).
| Proveedor | El alias `haiku` apunta a | Entrada / salida por millón de tokens | Qué hacer |
|---|---|---|---|
| API de Anthropic | Haiku 5.5 | 0,10 / 0,50 USD (prompts de hasta 100.000) | Alias o identificador completo |
| Claude Platform on AWS | Haiku 4.5 | 1 / 5 USD | Identificador completo |
| Amazon Bedrock, Google Cloud | Haiku 4.5 | Precios del proveedor | Identificador del proveedor |
| Microsoft Foundry | Haiku 4.5 | Precios de Azure | Identificador completo |
¿Por qué Haiku 5.5 y no Sonnet? La página de lanzamiento del 7 de octubre de 2026 lo dice claro: tareas de gran volumen y sensibles al costo, como resúmenes, compactación, consultas a bases de datos y clasificación, y añade que combina bien con Opus 5.5 y Sonnet 5.5 como subagente. La misma página aclara que Sonnet 5.5 y Opus 5.5 siguen siendo mejores para programación agéntica compleja y que Haiku 5.5 rinde mejor en tareas acotadas (lanzamiento de Haiku 5.5).
Nuestro trabajador hace tres cosas: llama a la API en orden, elige el video con más comentarios y calcula unas medianas. Un script puede comprobar cada salida: es una tarea acotada. La experiencia de la comunidad coincide. Un usuario probó Haiku 5.5 en 7 tareas pequeñas y acotadas y obtuvo 140 de 140 aceptadas, igual que Opus 5.5, aunque avisó de que con un archivo y una comprobación funciona bien y con trabajo abierto se desvía (hilo de r/ClaudeAI).
Haiku 5.5 también cambia algunos comportamientos de la API. La guía de migración indica que no acepta temperature, top_p ni top_k; que un thinking con budget_tokens devuelve un error 400 y hay que usar {"type": "adaptive"}; y que ya no admite el prellenado del turno del asistente (guía de migración a Haiku 5.5). Claude Code gestiona esos parámetros por ti; si escribes trabajadores con el Agent SDK o la API, revísalos.
Las tres llamadas de EveryInfra que hace cada trabajador
Las tres capacidades salen del catálogo de EveryInfra (GET /api/v1/social/catalog, gratis y sin clave), que leímos y guardamos el 26 de octubre de 2026 a las 17:22, hora de Singapur. Las tres están en el nivel de TikTok con price_usd de 0.000556, es decir, 0,000556 USD por llamada. Una llamada cuesta lo mismo sin importar cuántas filas devuelva: user_videos devuelve hasta 50 filas por llamada y comments hasta 200 (catálogo de TikTok). Las páginas de cada capacidad son tiktok/profile, tiktok/user_videos y tiktok/comments; la visión general está en la API de datos de TikTok.
| Capacidad | Parámetro obligatorio | Uso en este artículo | Precio por llamada | Campos usados (coinciden con response_fields del catálogo) |
|---|---|---|---|---|
tiktok/profile | username | 1 llamada por cuenta | 0,000556 USD | username, display_name, follower_count, video_count, like_count, is_verified |
tiktok/user_videos | username | limit: 10 | 0,000556 USD | url, view_count, like_count, comment_count, posted_at, is_pinned |
tiktok/comments | url | limit: 50 | 0,000556 USD | id, like_count, reply_count, is_reply, posted_at |
tiktok/search | keyword | content_type: profile para hallar el usuario correcto | 0,000556 USD por cuenta devuelta | author_username, author_is_verified, author_follower_count |
La última fila merece una nota. En el catálogo, tiktok/search tiene un campo rows_per_unit_when que indica que, con content_type igual a profile, cada fila devuelta cuenta como una unidad. Lo usamos para encontrar el usuario correcto de tres marcas con limit: 5, y cada llamada costó 0,002778 USD, exactamente 5 × 0,000556 USD. Una búsqueda de videos cuesta una unidad por llamada; una búsqueda de cuentas, una unidad por cuenta. Esa diferencia se escapa con facilidad al hacer un presupuesto.
Así queda el primer paso del trabajador por REST. La clave solo sale de una variable de entorno; el campo billing.charged_usd de la respuesta muestra el cobro real de la llamada.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"tiktok","action":"user_videos","params":{"username":"zara","limit":10}}'
Dos detalles de los campos cambian la tabla. Primero, user_videos ordena por lo más reciente, pero los videos fijados (is_pinned: true) aparecen primero. Siete de las 18 cuentas tenían videos fijados entre sus 10 más recientes; Bershka, SHEIN, DJI y Gymshark tenían 3 cada una, y Telcel y Real Madrid, 2. Un video fijado puede tener meses: el más antiguo de Telcel era del 14 de abril. Sin el filtro, los «últimos 10 videos» de Real Madrid incluyen dos de enero y la frecuencia de publicación sale mal.
Segundo, usa el número de comentarios que devuelve la llamada, no el comment_count del video. El video de Telcel mostraba 10 comentarios y la llamada devolvió 5; el de Pull&Bear mostraba 3 y devolvió 2. El catálogo también dice que cada comentario principal trae como máximo dos respuestas y que el hilo completo no está garantizado.
Un viaje MCP real: qué envía el modelo y qué vuelve
Un subagente que llama a la API por MCP usa el transporte Streamable HTTP de la especificación MCP: primero initialize, después notifications/initialized, luego tools/list y por último tools/call (transportes de MCP 2025-06-18, ciclo de vida).
Lo hicimos a mano a las 17:30, hora de Singapur, del 26 de octubre de 2026. initialize devolvió 200 con la versión de protocolo 2025-06-18. La respuesta no traía el encabezado Mcp-Session-Id, así que este servidor no exige identificador de sesión. notifications/initialized devolvió 202 con el cuerpo vacío, como indica nuestra guía de configuración del MCP remoto. tools/list devolvió 25 herramientas.
A las 17:45:05, hora de Singapur, enviamos un tools/call a everyinfra_call_api para los comentarios de un video de Nike con limit: 200. Es la misma llamada que haría un trabajador Haiku desde Claude Code. La API respondió 200 tras 92,6 segundos. La respuesta HTTP completa tenía 61.653 bytes, y su campo content[0].text, 54.819 caracteres con 177 comentarios y billing.charged_usd: 0.000556.
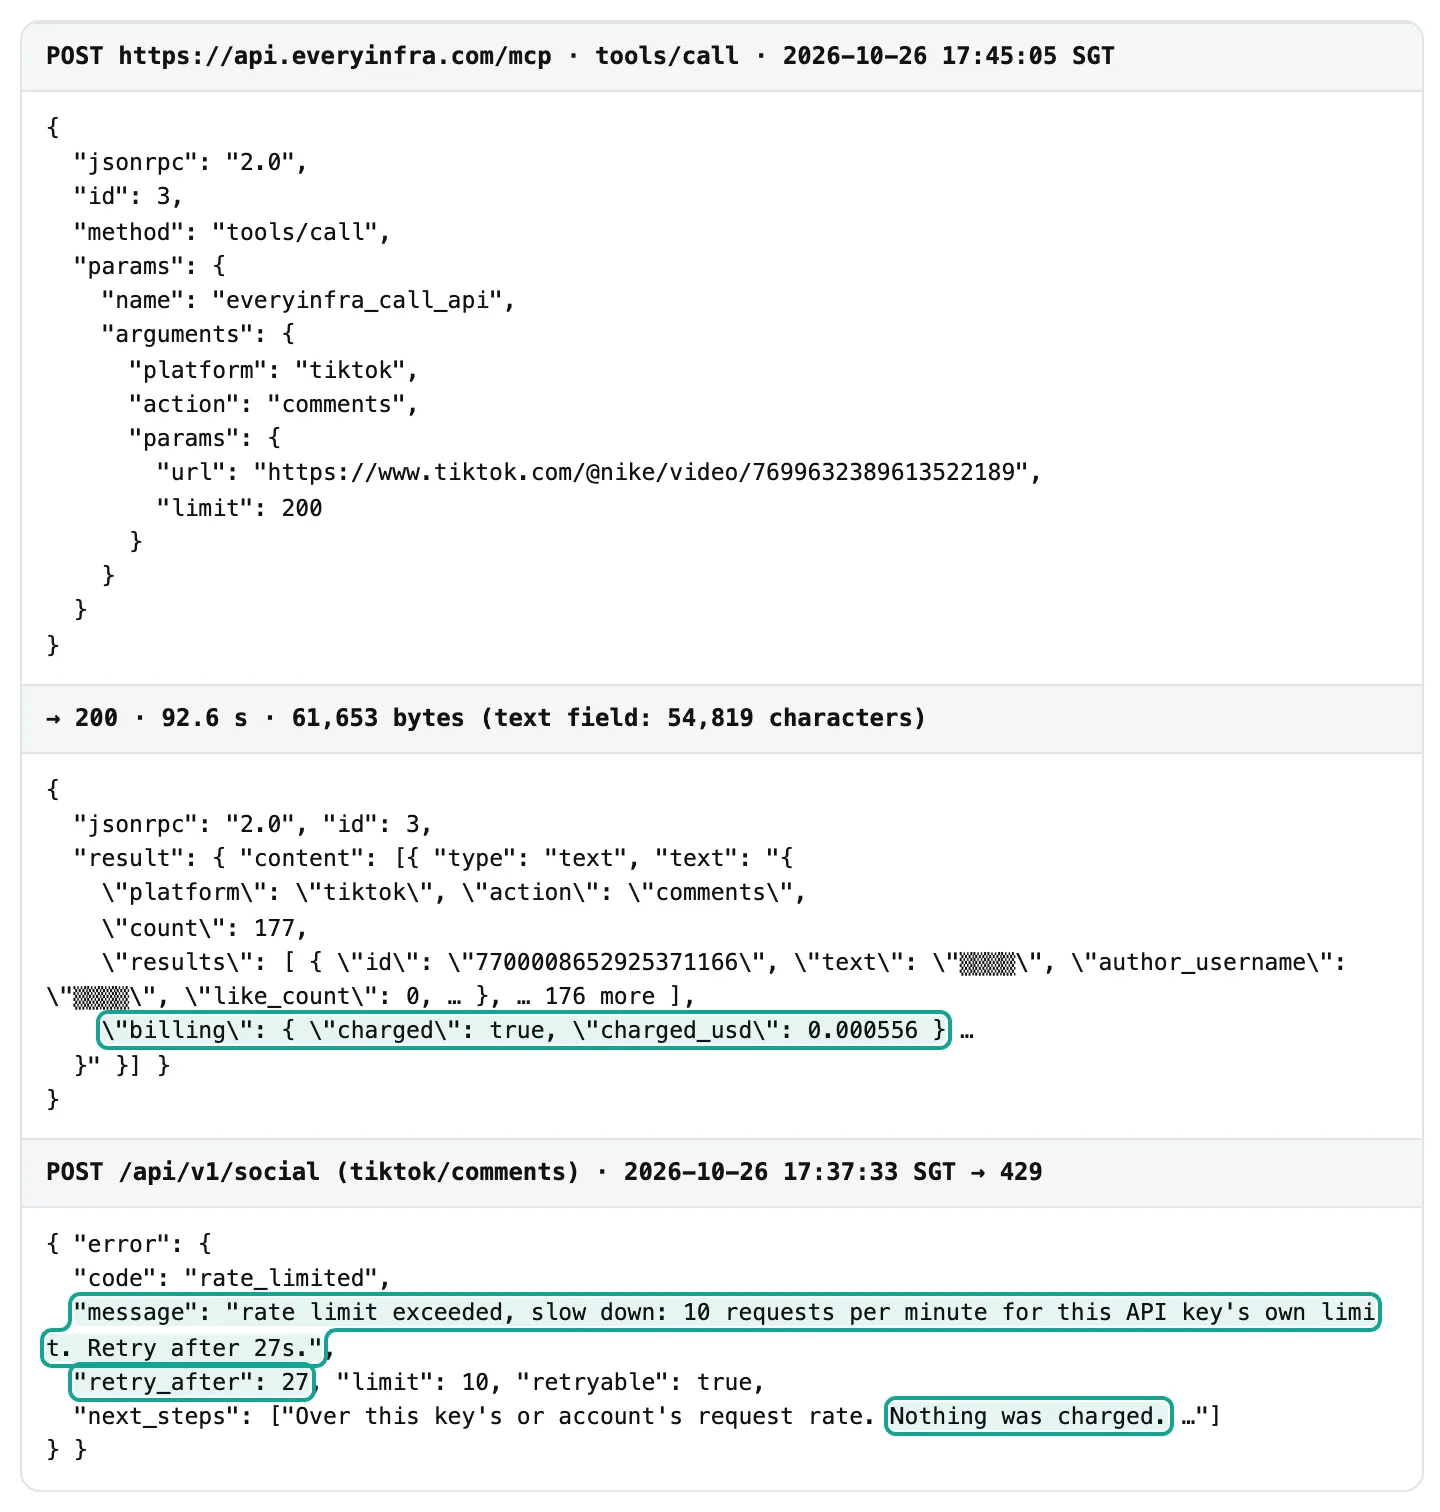
Compara esos 54.819 caracteres con tres límites de Claude Code. La documentación de MCP dice que Claude Code muestra un aviso cuando la salida de una herramienta MCP supera 10.000 tokens. El límite por defecto es de 25.000 tokens y se puede subir con MAX_MCP_OUTPUT_TOKENS. Además, si la herramienta no declara anthropic/maxResultSizeChars, Claude Code guarda en un archivo todo resultado de texto correcto de más de 50.000 caracteres y en la conversación solo deja una referencia al archivo (límites de salida de MCP).
| Límite de Claude Code para resultados MCP | Valor en la documentación | Resultado medido | ¿Lo supera? |
|---|---|---|---|
| Aviso | 10.000 tokens | 200 comentarios: unos 13.865 tokens | Sí |
Límite por defecto (MAX_MCP_OUTPUT_TOKENS) | 25.000 tokens | 200 comentarios: unos 13.865 tokens | No |
Guardar en archivo (sin anthropic/maxResultSizeChars) | 50.000 caracteres | 200 comentarios: 54.819 caracteres | Sí |
| Guardar en archivo | 50.000 caracteres | 50 comentarios: 24.749 caracteres como máximo | No |
| Guardar en archivo | 50.000 caracteres | 10 videos: 29.156 caracteres como máximo | No |
Revisamos la respuesta de tools/list y las herramientas de EveryInfra no llevan esa anotación. Así que una llamada de 200 comentarios supera el aviso de 10.000 tokens (unos 13.865 a 4 bytes por token) y Claude Code guarda el resultado en disco. El trabajador necesita entonces una llamada Read para leer ese archivo: un turno más y más contexto.
La solución es sencilla: pide los comentarios con limit: 50. Nuestras 18 respuestas de 50 comentarios promediaron 14.106 caracteres de JSON y la más larga tuvo 24.749, todas por debajo de 50.000. La respuesta más larga de 10 videos tuvo 29.156 caracteres, también por debajo. Si necesitas 200 comentarios, usa mode: "async", toma el job_id y léelo con everyinfra_get_job; la descripción de la herramienta dice que leer un trabajo es gratis y no cuenta para el límite por minuto. El modelo no ve esa línea: solo da un paso más después de que el resultado se guarda.
Prueba uno: ¿cuánto ocupa una cuenta en bruto?
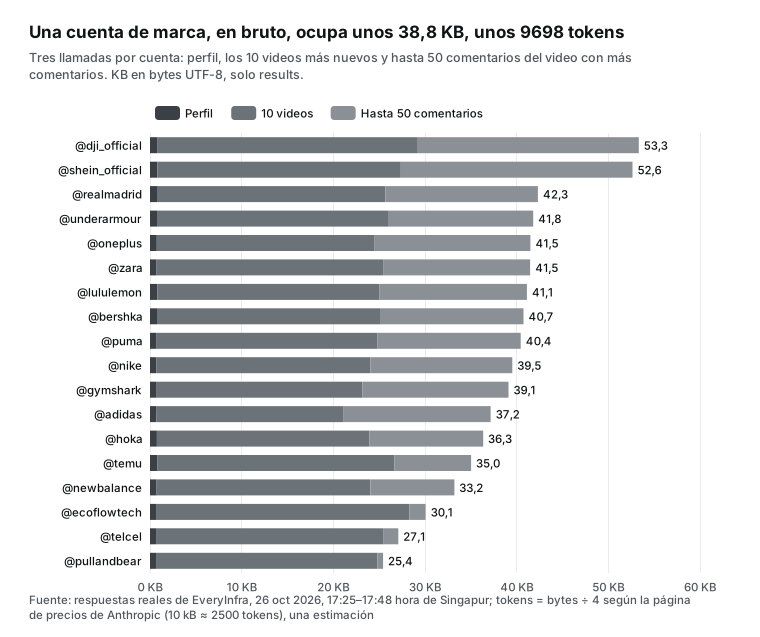
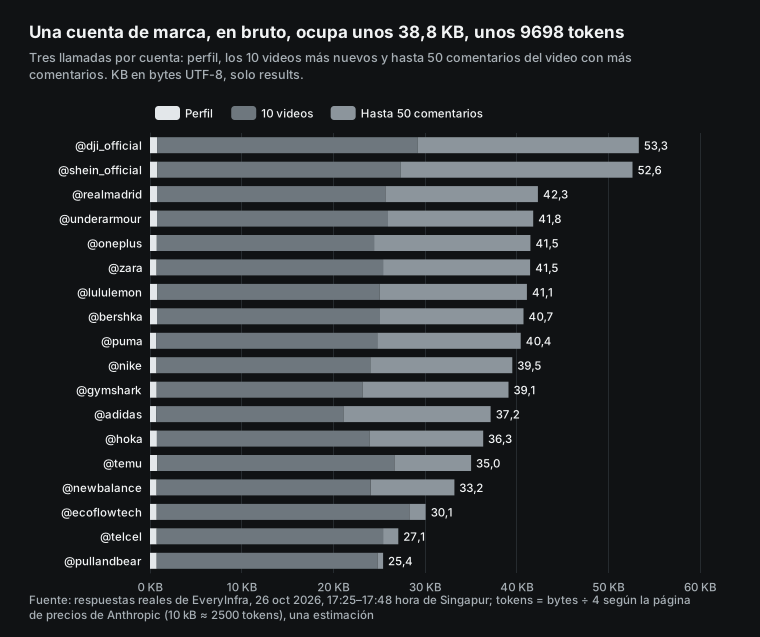
El gráfico muestra el tamaño de las tres llamadas de cada una de las 18 cuentas de marca. Contamos solo los bytes UTF-8 del campo results y dejamos fuera la facturación y el saldo. El promedio es de 38.794 bytes por cuenta y la mediana, de 39.983. La más pequeña es Pull&Bear, con 25.426 bytes, porque su video tenía solo 2 comentarios. La más grande es DJI, con 53.324 bytes. El perfil es pequeño: 740 bytes en promedio. Los 10 videos son la mayor parte, con 24.514 bytes, y los comentarios promedian 13.540 bytes.
| Parte de una cuenta | Bytes promedio | Tokens estimados (÷ 4) | Con el tokenizador nuevo (× 1,3) |
|---|---|---|---|
| Perfil | 740 | 185 | 240 |
| 10 videos más recientes | 24.514 | 6128 | 7967 |
| Hasta 50 comentarios | 13.540 | 3385 | 4400 |
| Total | 38.794 | 9698 | 12.608 |
| Resumen que devuelve el trabajador | 382 | 95 | 124 |
¿Por qué pesan tanto los videos? Cada registro de video trae la URL de la portada, la del avatar y la de la música, y cada una lleva parámetros firmados de CDN de trescientos o cuatrocientos caracteres. Quitamos todos los campos que terminan en _url, salvo la url del propio video, y el promedio bajó a 25.175 bytes: las URL son el 35,1 % de los bytes. Una tabla comparativa no necesita ninguna.
Por eso el trabajador devuelve un resumen y no «los datos limpios». Incluso sin URL, la sesión principal recibiría 25 KB por cuenta; con nuestro formato de resumen, recibe 382 bytes.
Para pasar de bytes a tokens usamos el ejemplo de la página de precios de Anthropic: una página web promedio de 10 kB son unos 2500 tokens, es decir, 4 bytes por token (precios de Anthropic, web fetch). La misma página dice que los modelos Claude 4.7 y posteriores usan un tokenizador nuevo que produce un 30 % más de tokens con el mismo texto. Todos los tokens de este artículo son estimaciones, y damos ambas cifras: «4 bytes por token» y «un 30 % más». Si necesitas cifras exactas, usa el endpoint de conteo de tokens, que según su documentación es gratis y solo está limitado por solicitudes por minuto (conteo de tokens).
Por qué el ahorro de contexto es real: las tres capas de un claude code haiku subagent
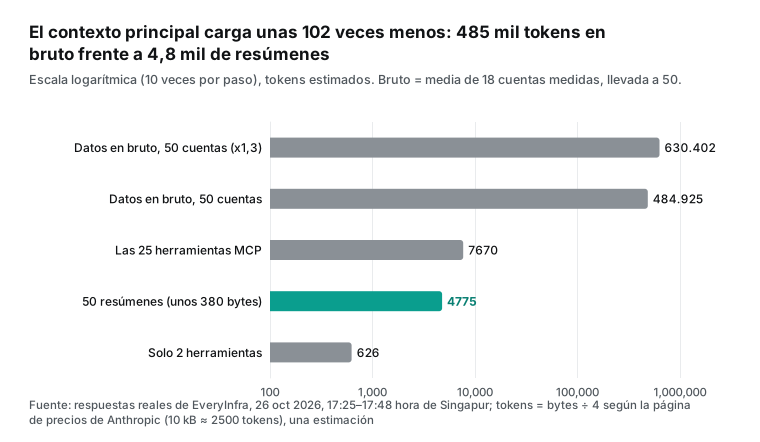
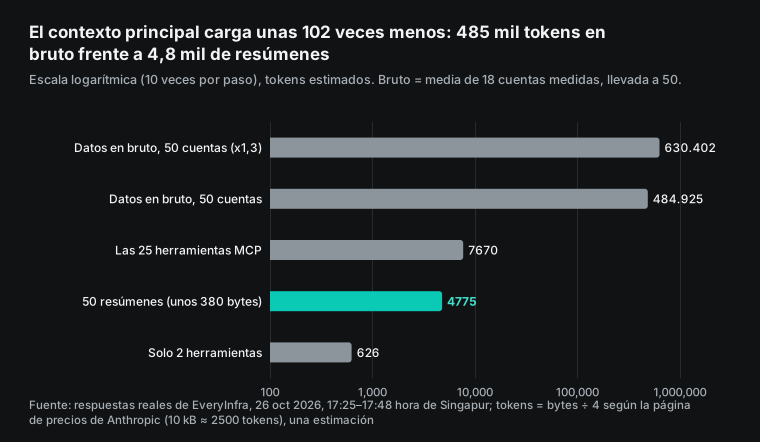
Con el tamaño de una cuenta ya medido, podemos contar lo que ahorran los subagentes. La primera capa es el contexto principal. Escaladas a 50 cuentas, las respuestas en bruto suman unos 1,94 millones de bytes, unos 485.000 tokens (unos 630.000 con el tokenizador nuevo): entre la mitad y dos tercios del contexto de 1 millón de tokens de Opus 5.5. Como resúmenes, las 50 cuentas ocupan unos 4800 tokens, unas 102 veces menos.
Las descripciones de las 25 herramientas de EveryInfra añaden unos 7670 tokens más. Con un mcpServers dentro del subagente y la lista de permitidas, bajan a 626 tokens y solo viven dentro del trabajador.
La segunda capa es el contexto de cada trabajador, y tiene una línea de precio que suele pasarse por alto. La página de precios de Anthropic explica que Haiku 5.5 cobra según la longitud del prompt. Una solicitud con un prompt de más de 100.000 tokens, contando lecturas y escrituras de caché, paga 0,50 USD por millón de tokens de entrada en lugar de 0,10 USD, y la salida pasa de 0,50 a 2,50 USD por millón; además, toda la solicitud paga el precio alto (precios por contexto largo).
Cada cuenta extra añade unos 9700 tokens a un trabajador. Suma unos 3600 tokens de prompt y descripciones de herramientas: los 626 de las herramientas son medidos y los 3000 de prompt y tarea son una suposición nuestra. Con esas cifras, un trabajador admite 9 cuentas; con el 30 % extra del tokenizador nuevo, 7. A partir de ahí, cada solicitud cuesta 5 veces más.
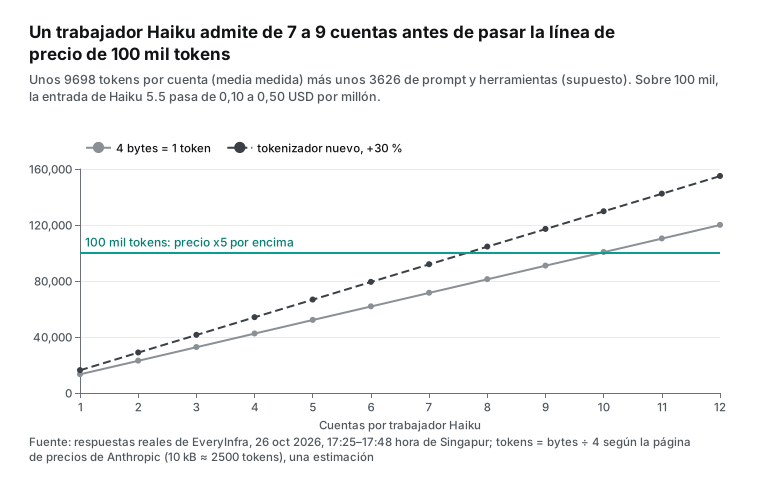
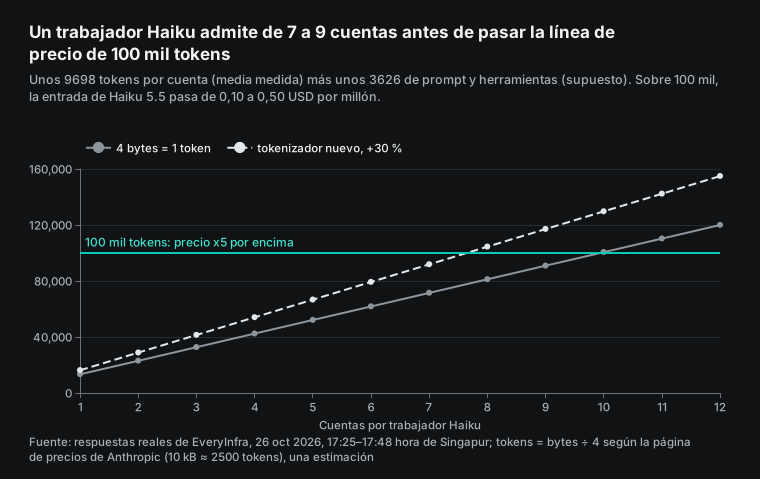
La tercera capa es el dinero. La documentación de costos de Claude Code explica por qué las sesiones largas se encarecen: cada solicitud envía la conversación completa, y cada uso de herramienta envía otra solicitud con sus resultados; con caché de prompts, el historial se vuelve a leer a precio de caché (costos de Claude Code). Por eso los datos en bruto en la sesión principal no se pagan una vez, sino en cada solicitud posterior. Esta es nuestra estimación con precios públicos; las suposiciones van debajo de la tabla:
| Esquema | Partes principales | Costo estimado para 50 cuentas |
|---|---|---|
| Con subagentes | 50 trabajadores Haiku 5.5, unos 0,134 USD; API de EveryInfra, 0,0834 USD; Opus 5.5 lee los resúmenes, unos 0,043 USD | Unos 0,26 USD |
| Sin dividir, todo en la sesión principal | API de EveryInfra, 0,0834 USD; Opus 5.5 guarda unos 485.000 tokens y los relee en 20 solicitudes posteriores, unos 4,36 USD | Unos 4,45 USD |
Las suposiciones: cada trabajador envía 4 solicitudes (3 llamadas a herramientas y 1 respuesta final) con unos 400 tokens de salida cada una. Usamos los precios públicos de Haiku 5.5 por millón de tokens: entrada 0,10 USD, escritura en caché 0,125 USD, lectura de caché 0,01 USD y salida 0,50 USD, con caché de 5 minutos. Para la sesión principal usamos Opus 5.5: entrada 4 USD, escritura en caché 5 USD (1,25 veces), lectura de caché 0,20 USD. Tras recibir los datos, la sesión principal envía 20 solicitudes más.
Los precios de Opus 5.5 salen de la vista general de modelos de Anthropic, y el de lectura de caché, de la sección de caché de la página de precios. Si usas un plan Pro o Max, Claude Code no cobra estos importes: consume los límites de tu plan. La proporción se mantiene, y meter los datos en bruto en la sesión principal agota tus límites más de diez veces más rápido. La documentación de costos también aclara que las solicitudes de los subagentes cuentan para los mismos límites (documentación de costos).
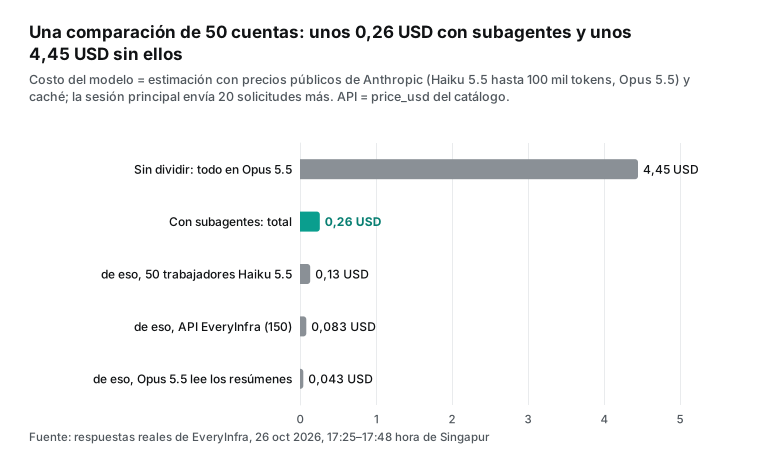
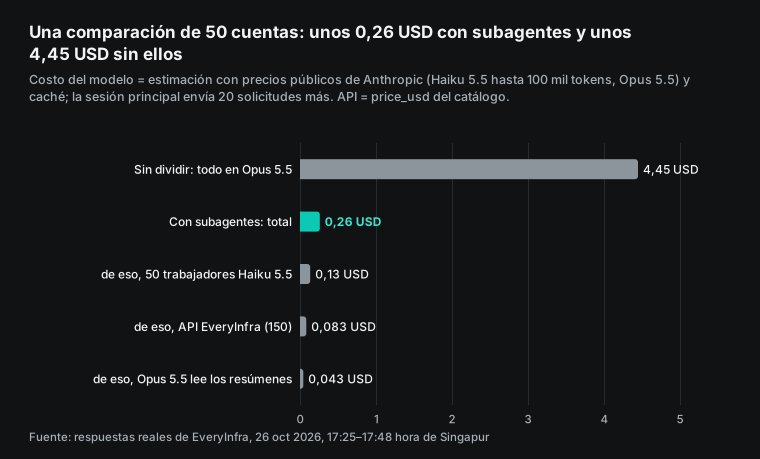
Esta estimación tiene límites. No cuenta la planificación ni la redacción de la tabla en la sesión principal, que cuestan más o menos lo mismo en ambos esquemas. Las 20 solicitudes posteriores son una suposición: cuanto más larga la sesión, más cara la fila «sin dividir». Claude Code también compacta la sesión principal cuando el contexto se llena, y esa compactación es en sí una solicitud grande que no incluimos. Además, 485.000 tokens son casi la mitad del contexto de 1 millón de Haiku 5.5: una sesión principal en Haiku también cruzaría la línea de 100.000 tokens.
Prueba dos: ¿cuántos trabajadores en paralelo?
Los subagentes pueden ir en paralelo, pero la API marca el ritmo. Nuestra clave de prueba admite 10 solicitudes por minuto y por encima devuelve 429. Ese tope lo fijamos nosotros en esta clave, y el 429 lo dice con reason: key_limit; el valor por defecto de la cuenta es de 60 solicitudes por minuto, compartidas entre todas las claves, y sube a 180, 600 y 1.800 con 50, 150 y 750 USD recargados en total (página de precios). Recalcule los trabajadores con su propio límite: con unos 25 segundos por llamada, 60 por minuto mantienen ocupados a unos 25 trabajadores, más que el tope por defecto de Claude Code de 20 subagentes a la vez. Hicimos tres rondas y medimos los tiempos reales.
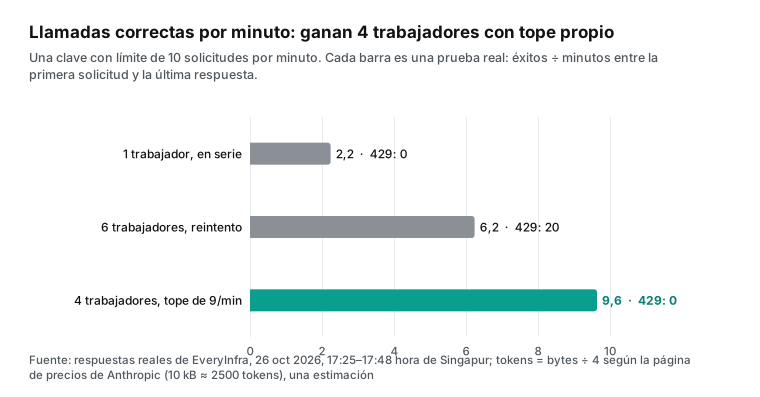
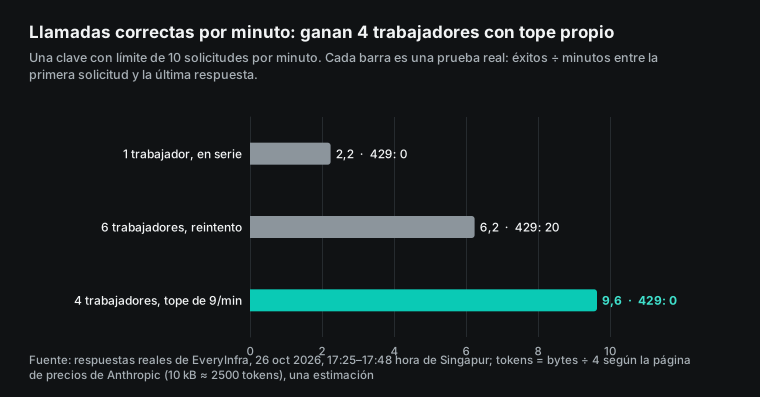
La primera ronda fue de 17:25 a 17:37, hora de Singapur. Un trabajador descargó 24 perfiles en serie: 24 respuestas en 10,72 minutos, 2,24 por minuto, con una mediana de 18,2 segundos por llamada. Ninguna recibió 429, pero casi todo el tiempo se fue en esperar respuestas.
La segunda ronda fue de 17:37 a 17:43, hora de Singapur. Seis trabajadores descargaron videos y comentarios de 18 cuentas, dos llamadas por cuenta, y ante un 429 cada uno esperaba retry_after y reintentaba. De 56 solicitudes, 36 tuvieron éxito y 20 recibieron 429. La ronda duró 5,77 minutos: 6,24 éxitos por minuto.
La tercera ronda fue de 17:46 a 17:48, hora de Singapur. Cuatro trabajadores compartieron un limitador propio que permite como máximo 9 solicitudes nuevas por minuto de reloj, y descargaron los videos populares (sort: popular) de 12 cuentas. Las 12 llamadas tuvieron éxito, sin ningún 429. La ronda duró 1,25 minutos: 9,64 éxitos por minuto.
| Ronda | Hora (Singapur) | Trabajadores y regla | Solicitudes | Éxitos | 429 | Éxitos por minuto | Mediana por llamada |
|---|---|---|---|---|---|---|---|
| 1 | 17:25–17:37 | 1 trabajador en serie | 24 | 24 | 0 | 2,24 | 18,2 s |
| 2 | 17:37–17:43 | 6 trabajadores, reintento tras 429 | 56 | 36 | 20 | 6,24 | 26,1 s |
| 3 | 17:46–17:48 | 4 trabajadores, tope de 9 por minuto | 12 | 12 | 0 | 9,64 | 19,6 s |
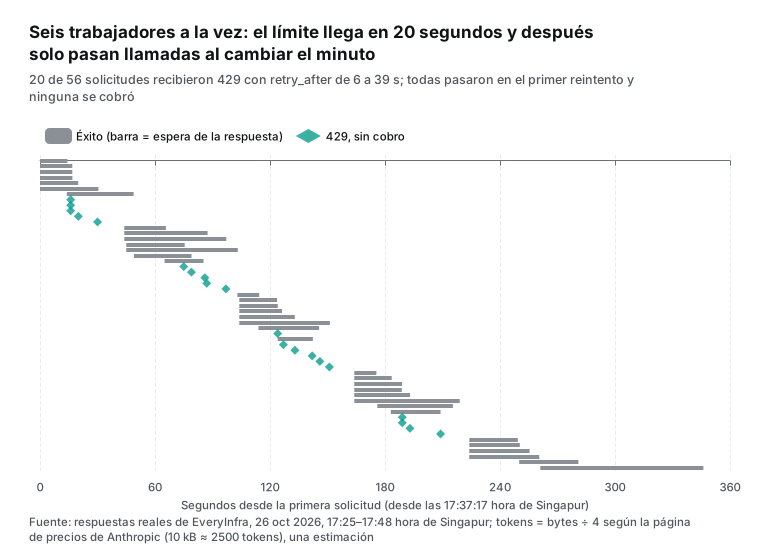
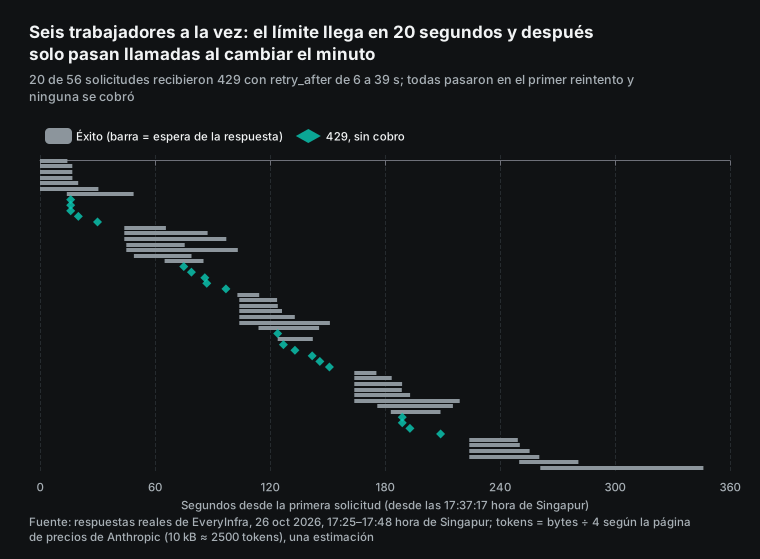
La línea de tiempo de la segunda ronda muestra por qué los 429 frenaron todo. Cada fila es una solicitud: una barra gris es la espera de la respuesta y un rombo verde azulado es un 429. Los seis trabajadores gastaron el cupo del minuto en los primeros 16 segundos y las solicitudes siguientes fallaron. Cada trabajador rechazado esperó al siguiente minuto completo y luego todos volvieron a intentarlo juntos.
Los valores de retry_after fueron de 6 a 39 segundos y todos apuntaban al inicio del siguiente minuto de reloj, lo que indica que esta clave reinicia su cuenta en cada minuto de reloj. El resultado es una avalancha al comienzo de cada minuto y un hueco largo después.
De aquí sale un techo sencillo. El número útil de trabajadores en paralelo es, más o menos, el límite por minuto multiplicado por la duración media de una llamada en segundos y dividido entre 60. La duración media de todas las llamadas correctas de las tres rondas fue de 25,1 segundos, así que 10 × 25,1 ÷ 60 ≈ 4,2. Con menos de 4 trabajadores queda cupo sin usar; con más de 4, los sobrantes solo generan 429.
Con este cálculo, 150 llamadas para 50 cuentas tardan como mínimo 15 minutos con una clave de 10 solicitudes por minuto, o 2,5 minutos con los 60 por defecto de la cuenta; en serie, unos 63 minutos. Claude Code permite por defecto 20 subagentes a la vez; el número 21 devuelve «Concurrent subagent limit reached», y CLAUDE_CODE_MAX_CONCURRENT_SUBAGENTS cambia ese límite (límite de subagentes simultáneos). El valor por defecto de 20 está muy por encima de 4, así que indícale claramente a la sesión principal que use como máximo 4 trabajadores a la vez.
Estas rondas son pequeñas: la tercera tuvo solo 12 llamadas, todas de una misma capacidad (tiktok/user_videos), y los tiempos cambian según la hora y la cuenta. No copies el 4,2 tal cual: vuelve a calcularlo con tu propio límite y tu propia duración media. GET /api/v1/account (en MCP, everyinfra_account) muestra el límite por minuto, y según la documentación de la API esa consulta es gratis y no cuenta para el límite.
Cómo manejar el 429: la respuesta real y un patrón de espera
Así se ve un 429 real. A las 17:37:33, hora de Singapur, la solicitud de comentarios del trabajador de Nike falló. El cuerpo traía code: rate_limited, retry_after: 27, limit: 10, retryable: true y max_retries: 3, y en next_steps decía «Nothing was charged». Revisamos los 20 errores: ninguno se cobró y todos pasaron en el primer reintento tras la espera. El estándar HTTP define el 429 como demasiadas solicitudes en un periodo dado, y permite incluir Retry-After para indicar cuánto esperar (RFC 6585, sección 4; RFC 9110, Retry-After).
Manéjalo en tres capas. Primera capa: no choques. Limita cuántos trabajadores corren a la vez desde la sesión principal y añade un limitador compartido en las llamadas; por eso la tercera ronda no tuvo ningún 429. Segunda capa: si chocas, espera. Espera exactamente retry_after y suma un pequeño retraso aleatorio, para que un grupo de trabajadores no reintente en el mismo segundo.
Un artículo de AWS lo explica bien: si la carga causa los errores y todos los clientes reintentan a la vez, los reintentos empeoran la carga, así que hay que añadir tiempo aleatorio para repartir las solicitudes (Amazon Builders' Library). Tercera capa: no repitas una llamada ya cobrada. 429, 422 y 401 ocurren antes de cualquier cobro, así que reintentar es seguro; lo que no debes hacer es reenviar una llamada que ya devolvió 200 porque el trabajador perdió la cuenta. Nuestras guías sobre errores de API que se corrigen solos y conciliación de reembolsos explican cómo verificarlo por identificador de solicitud.
Este es el núcleo del limitador de la tercera ronda. Usa el grupo de hilos de la biblioteca estándar de Python (documentación de concurrent.futures). En Claude Code puedes pedir a la sesión principal que reparta a los trabajadores con la misma regla, o poner esta lógica en un script que los trabajadores llamen.
import threading, time, random
lock = threading.Lock(); state = {"minute": None, "n": 0}
def acquire(per_min=9):            # como máximo per_min inicios por minuto de reloj
    while True:
        with lock:
            m = int(time.time() // 60)
            if state["minute"] != m:
                state["minute"], state["n"] = m, 0
            if state["n"] < per_min:
                state["n"] += 1
                return
        time.sleep(0.5)
def on_429(err):                    # err es el objeto error de la respuesta
    time.sleep(err["retry_after"] + random.uniform(0.5, 2.0))
El tope es 9 y no 10. Así queda un hueco por minuto para otras llamadas de la sesión principal, como consultar el saldo o leer el catálogo.
Fallos y cobros: 422, resultados vacíos y usuarios equivocados
Además de los 429, provocamos o encontramos varios fallos en la misma hora, y cada uno afecta de forma distinta a un trabajo por lotes. Cada fila de la tabla corresponde a una respuesta real.
| Caso | Hora (Singapur) | HTTP y respuesta | Cobro | Qué debe hacer el trabajador |
|---|---|---|---|---|
Parámetro mal escrito usernme | 17:43:20 | 422, missing_param, «usernme is not a parameter here», con un ejemplo que funciona | 0 USD | Corregir el parámetro y reenviar |
| Sin clave | 17:43:20 | 401, missing_key | 0 USD | Detenerse y avisar del problema de configuración |
| Demasiado rápido | 17:37:33 y 19 más | 429, retry_after de 6 a 39 s | 0 USD | Esperar y reintentar |
| El usuario no existe | 17:33:34 y 17:34:49 | 200, resultado vacío, reason: empty_result_refunded | 0 USD (se cobra y se devuelve) | Marcar «no encontrado» y no reintentar |
| El usuario existe pero no es la marca | 17:31:16 y 3 más | 200, sin verificar, de 4 a 222 seguidores | 0,000556 USD como siempre | Marcar «posible imitación» y dejar que decida la sesión principal |
La respuesta 422 está escrita para que la lea un modelo. Dice que falta username, aclara que usernme no es un parámetro válido aquí y trae una solicitud de ejemplo que funciona; un modelo pequeño como Haiku puede corregir la llamada con ese texto. Los dos resultados vacíos, nuestras deducciones para Mercado Libre y OXXO, devolvieron 200 con charged_usd en 0 y el motivo empty_result_refunded: no costaron nada.
La última fila es la que más importa. Los cuatro nombres que dedujimos de las marcas (uno para Anker, otro para Insta360, otro para Xiaomi y otro para Bimbo) existen, pero son cuentas personales comunes. Ninguna está verificada; tienen 4, 121, 222 y 14 seguidores y entre 0 y 8 videos. La API devolvió sus datos correctamente, así que las llamadas se cobraron. La API no puede detectar este error: lo tiene que detectar el trabajador. De ahí sale la regla del paso 1 del ejemplo: detente y marca toda cuenta sin verificar con menos de 1000 seguidores.
| Marca | Lo que devolvió el usuario deducido | Cuenta verificada encontrada con `tiktok/search` | Seguidores |
|---|---|---|---|
| Insta360 | Cuenta personal sin verificar, 121 seguidores | insta360_official | 2,4 millones |
| Xiaomi | Cuenta personal sin verificar, 222 seguidores | xiaomi.official | 8,3 millones |
| Anker | Cuenta personal sin verificar, 4 seguidores | ankercharging | 803.600 |
| Mercado Libre, OXXO | Resultado vacío, reembolsado | No buscamos | — |
El usuario correcto se puede buscar con tiktok/search por cuentas. Hicimos tres búsquedas entre las 17:43 y las 17:44, hora de Singapur, y encontramos las cuentas verificadas insta360_official (2,4 millones de seguidores), xiaomi.official (8,3 millones) y ankercharging (803.600), a 0,002778 USD cada búsqueda. El origen de tu lista decide si la tabla está bien desde el principio.
La cuenta: tarifa de la API según el número de cuentas
El lado de EveryInfra es fácil de calcular: solo depende del número de llamadas, no de cuántas filas vuelven ni de qué modelo usa el trabajador.
| Tamaño | Llamadas | Tarifa con `price_usd` 0,000556 USD | Tiempo mínimo a 10 por minuto |
|---|---|---|---|
| 1 cuenta | 3 | 0,001668 USD | 18 segundos |
| 50 cuentas | 150 | 0,0834 USD | 15 minutos |
| 50 cuentas, cada semana, durante un mes | unas 650 | unos 0,361 USD | 15 minutos por ronda |
| 500 cuentas | 1500 | 0,834 USD | 150 minutos |
La tabla supone que la lista es correcta. Si antes necesitas tiktok/search para encontrar un usuario, suma unos 0,002778 USD por cuenta (limit: 5). Toda nuestra prueba usó 98 solicitudes: 97 por REST y 1 tools/call por MCP, más 3 mensajes gratuitos de inicio de MCP. Se cobraron 74 solicitudes, por un total de 0,04781 USD. Las 24 sin cobro fueron 20 errores 429, 2 resultados vacíos, 1 error 422 y 1 error 401, y cada una cuadra con el billing o el cuerpo de error de su respuesta. Para empezar, la guía rápida muestra los tres pasos de REST y la página del servidor MCP trae la configuración de cada cliente.
Cómo elegir el formato del resumen: esa línea decide qué puede hacer la sesión principal
Lo que devuelve el trabajador es el paso que merece más cuidado. Nuestra regla tiene dos partes: el resumen solo lleva los números que la sesión principal necesita para decidir, y un script puede calcular cada uno a partir de la respuesta en bruto. Eso trae dos ventajas.
La primera es que la sesión principal puede verificar por muestreo: elige cualquier cuenta, pide a un trabajador nuevo que la repita y compara los números, sin fiarse de la «interpretación» de ningún trabajador. La segunda es que el tamaño queda bajo control. Nuestro formato tiene 15 campos; los 18 resúmenes promedian 382 bytes de JSON y el más largo, el de Real Madrid, ocupa solo 398, porque sus cifras tienen más dígitos.
No dejes que los trabajadores devuelvan «lo que les parezca importante». Los resúmenes abiertos varían de longitud: algunos trabajadores devuelven media página y otros copian comentarios enteros, y el contexto principal vuelve a crecer. Además, dos trabajadores pueden entender «importante» de forma distinta, y entonces las filas no encajan en una tabla.
Ten especial cuidado con los comentarios. El texto de los comentarios incluye nombres de usuario y opiniones personales de gente común, y si llega a la sesión principal puede acabar copiado en el informe final. Nuestro formato solo devuelve cuántos comentarios hay y cuántos tienen respuestas. Si quieres analizar sentimiento o temas, clasifica dentro del trabajador y devuelve solo cuántos hay en cada clase.
La instrucción para la sesión principal cabe en tres frases. Entrega cada usuario de la lista a tiktok-account-worker, como máximo 4 a la vez. Cuando vuelvan todos, une los resúmenes en una tabla y marca las cuentas con flag lookalike. Para las 3 primeras y las 3 últimas cuentas por mediana de vistas e interacción, escribe una frase de explicación para cada una. Las dos primeras frases son reparto de trabajo; solo la tercera necesita el criterio de un modelo grande, y es justo el tipo de trabajo que la guía de Anthropic deja en el bucle principal.
Lo que recibe la sesión principal: la tabla de marcas en español
Esta es la tabla que la sesión principal arma con los resúmenes de las marcas en español. Para que el tamaño se pueda reproducir, un script calculó estos resúmenes a partir de las respuestas en bruto con las mismas reglas del ejemplo; no los escribió Haiku, y una nota escrita por Haiku añadiría unas decenas de bytes a cada resumen. La mediana de vistas y la tasa de interacción (mediana de me gusta entre vistas) excluyen los videos fijados.
| Cuenta | Seguidores | Mediana de vistas, videos recientes | Interacción | Publicaciones por semana | Comentarios muestreados |
|---|---|---|---|---|---|
| Zara | 14,9 millones | 2.250.000 | 1,11 % | 2,9 | 50 |
| Bershka | 4,8 millones | 76.400 | 1,68 % | 7,0 | 50 |
| Real Madrid | 78,6 millones | 4.050.000 | 20,61 % | 466,0 | 50 |
| Telcel | 625.400 | 1147 | 1,74 % | 10,4 | 5 |
| Pull&Bear | 1 millón | 4489 | 1,15 % | 10,7 | 2 |
Esta tabla muestra por qué el criterio se queda en la sesión principal. Las «466 publicaciones por semana» de Real Madrid no son un error: sus 10 videos más recientes salieron el mismo día, el 2026-10-25, y al pasar esa tasa diaria a semanas sale una cifra enorme. Zara tiene una mediana de 2,25 millones de vistas con solo 2,9 publicaciones por semana, mientras que Pull&Bear y Telcel publican más de 10 por semana y no llegan a 5000 vistas de mediana. Bershka y Telcel tenían videos fijados entre sus 10 más recientes; sin el filtro, sus tasas mezclarían publicaciones viejas y nuevas.
Estas comparaciones necesitan ver todas las filas a la vez y algo de sentido común. Es tarea del modelo grande de la sesión principal, no de cada trabajador por separado. Fuera de este grupo, Gymshark muestra la misma lección desde otro ángulo: tiene la mitad de seguidores que Adidas, pero una tasa de interacción del 14,07 %, más de cinco veces la de Adidas.
El mismo trabajador en otras plataformas: Instagram y YouTube
Si tu lista también incluye cuentas de marca en Instagram y YouTube, el trabajador conserva su estructura. Cambia tres cosas: la plataforma, la acción y el nombre del parámetro. La tabla sale del mismo catálogo (leído el 26 oct 2026 a las 17:22, hora de Singapur). No hicimos llamadas reales en estas dos plataformas, así que solo muestra precios y parámetros del catálogo; mide tú una vez el tamaño de las respuestas. Las visiones generales son la API de datos de Instagram y la API de datos de YouTube.
| Plataforma | Perfil | Publicaciones recientes | Comentarios | Precio por llamada | Nota |
|---|---|---|---|---|---|
| TikTok (medido aquí) | profile, parámetro username | user_videos, hasta 50 | comments, hasta 200 | 0,000556 USD | Los videos fijados van primero |
profile, parámetro username | user_posts, hasta 200 | comments, hasta 100 | 0,000556 USD | reels no está disponible por ahora | |
| YouTube | profile, el parámetro es la url del canal | user_posts, url del canal, hasta 50 | comments, hasta 100 | 0,000556 USD | Los Shorts usan la acción shorts |
Estas tres capacidades cuestan lo mismo en las tres plataformas: tres llamadas por cuenta son 0,001668 USD, y 50 cuentas, 0,0834 USD en cada plataforma. Los parámetros sí cambian: el perfil y la lista de videos de YouTube piden la URL del canal, no el usuario, así que el paso 1 del trabajador debe obtener primero esa URL.
Los tamaños de respuesta también cambian. Los registros de publicaciones de Instagram, igual que los de TikTok, traen muchas URL de imágenes. Por lo que vimos en TikTok, mide primero los datos en bruto de una cuenta y luego decide cuántas cuentas por trabajador y cuántos comentarios por llamada. Si ya usaste MCP con estas plataformas en otro editor, nuestro artículo sobre datos de TikTok, Instagram y Amazon en Cursor trae tiempos medidos que ayudan a dimensionar el número de trabajadores.
Límites y puntos de atención
Primero, las condiciones de la plataforma. Los Términos de Servicio de TikTok en Estados Unidos dicen que no puedes raspar, rastrear, exportar ni extraer datos de la plataforma con un sistema automatizado salvo aprobación por escrito de TikTok USDS Joint Venture (Términos de Servicio de TikTok). Los investigadores académicos y las organizaciones sin fines de lucro pueden solicitar las herramientas de investigación de TikTok, y la aprobación suele tardar unas 4 semanas (TikTok Research Tools, diccionario de datos). Decide según tu país y tu caso si tu uso es adecuado; este artículo solo trata el método de datos.
Hay un punto que confunde. El 5 de octubre de 2026, TikTok anunció que su TikTok for Business MCP ya es un conector en Claude y otras plataformas de IA (sala de prensa de TikTok). Ese MCP trabaja sobre tu propia cuenta publicitaria: campañas, creatividades y resultados (blog de TikTok for Business). No lee los perfiles ni los comentarios públicos de otras marcas.
Segundo, los comentarios no están completos. comments devuelve como máximo dos respuestas por comentario principal, y la cantidad puede ser menor que la que muestra el video. En 5 de nuestras 18 llamadas volvieron menos de 50 comentarios, porque esos videos tenían pocos. Si analizas sentimiento, incluye el tamaño de la muestra en el resumen.
Tercero, más subagentes no siempre es mejor. Además del límite de la API, Claude Code tiene sus propios límites: los subagentes se anidan hasta tres niveles por defecto (CLAUDE_CODE_MAX_SUBAGENT_SPAWN_DEPTH lo cambia), y el tamaño del contexto de un trabajador depende del modelo del trabajador, no del principal (documentación de subagentes). Para listas de miles de cuentas, la documentación remite a los flujos dinámicos: Claude escribe un script de JavaScript que reparte a los agentes, con hasta 16 a la vez por defecto, y CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS lo sube hasta 256 (flujos dinámicos). El cupo por minuto de la API no crece por eso.
Cuarto, lo que no probamos. No ejecutamos este subagente en Claude Code. No tenemos datos medidos sobre la calidad de los resúmenes que escribe Haiku 5.5, sobre cuánto respeta la regla de is_pinned ni sobre el tiempo real de 50 trabajadores. Los datos de tamaño, cobro, 429 y velocidad son medidos; los costos de modelo son estimaciones con precios públicos. Antes de confiar en esto, prueba primero con 10 cuentas, revisa en /tasks el modelo real de cada subagente y consulta en /usage cuánto consumen los subagentes.
Cambios recientes
2026-10-07: Anthropic lanzó Claude Haiku 5.5, a 0,10 USD por millón de tokens de entrada y 0,50 USD por millón de salida para prompts de hasta 100.000 tokens, y citó el trabajo de subagente entre sus usos principales (lanzamiento). Ese mismo día, Claude Code v2.1.293 lo convirtió en el modelo Haiku por defecto en la API de Anthropic (registro de cambios). Qué significa para ti: un trabajador de datos cuesta ahora una décima parte que hace un mes, pero comprueba a qué modelo apunta haiku en tu proveedor.
2026-10-16: Claude Code v2.1.302 hizo que la aplicación de escritorio y VS Code ejecuten siempre en segundo plano los subagentes de la conversación principal, como ya hacía la terminal; los subagentes fork pasaron a estar activos por defecto en claude -p, el Agent SDK, la aplicación de escritorio y VS Code (registro de cambios). Qué significa para ti: los trabajadores en segundo plano envían sus solicitudes de permiso a la sesión principal, así que permite de antemano la única herramienta que necesitan.
2026-10-19 y 2026-10-21: la v2.1.304 mejoró la velocidad con muchos subagentes a la vez y corrigió subagentes que olvidaban su trabajo reciente al recibir un mensaje justo al terminar; la v2.1.307 hizo que cada subagente fork de un grupo sepa cuál es su propio lanzamiento, para que no tomen el trabajo de otro (registro de cambios). Qué significa para ti: los trabajadores en paralelo son más estables que hace un mes; este artículo usa subagentes normales, no fork.
2026-10-22: Anthropic publicó «When to fold subagents into your main agent loop». Recomienda que la mayoría de los agentes use menos subagentes y los conserve solo ante crecimiento medible del contexto, contextos desechables en paralelo o demasiadas herramientas (guía, kit). Qué significa para ti: antes de dividir, confirma que tu trabajo lee mucho, guarda poco y tiene partes independientes; si no, déjalo en la sesión principal con Skills.
2026-10-05: en la Advertising Week de Nueva York, TikTok anunció que su MCP para anuncios es un conector en Claude, Kimi, Perplexity y otras plataformas (sala de prensa de TikTok). Qué significa para ti: úsalo para gestionar tus propios anuncios; para ver cómo rinden en público otras cuentas de marca sigues necesitando una API de datos públicos.
Preguntas frecuentes
¿Los subagentes de Claude Code pueden usar otro modelo?
Sí. Define model en el archivo del subagente: acepta un alias (sonnet, opus, haiku, fable), un identificador completo como claude-haiku-5-5 o inherit. El orden es: el parámetro al lanzarlo, luego el campo model, luego CLAUDE_CODE_SUBAGENT_MODEL y por último el modelo principal. (Origen de la pregunta: sugerencias de Google «claude code subagents different model» y «claude code subagents model selection»; respuesta: documentación de subagentes)
¿Qué modelo usa por defecto un subagente de Claude Code?
Sin campo model, el orden anterior termina en el modelo principal: el subagente lo hereda. El subagente integrado Explore tampoco corre ya siempre en Haiku. Para poner todos los subagentes en un modelo, define a la vez CLAUDE_CODE_SUBAGENT_MODEL y CLAUDE_CODE_SUBAGENT_MODEL_FORCE=1. (Origen: sugerencias «claude code subagent model default» y «claude_code_subagent_model force»; respuesta: documentación de subagentes, hilo de r/ClaudeCode)
**¿Por qué mi claude code haiku subagent sigue saliendo caro con model: haiku?**
Hay dos causas habituales. En Bedrock, Google Cloud, Foundry o Claude Platform on AWS, el alias haiku es Haiku 4.5, que cuesta 10 veces más que Haiku 5.5. O tienes definida CLAUDE_CODE_SUBAGENT_MODEL_FORCE y Claude Code ignora el campo model. /tasks muestra el modelo real de cada subagente. (Origen: sugerencias «claude code subagent model=haiku» y «claude code use haiku for subagents»; respuesta: configuración de modelos, documentación de subagentes)
¿Qué diferencia hay entre subagentes y agent teams en Claude Code?
Un subagente devuelve su resultado al agente principal y los subagentes no hablan entre sí. Los miembros de un agent team comparten una lista de tareas y pueden escribirse mensajes, lo que sirve para trabajos que necesitan debate y coordinación. La documentación dice que los agent teams son experimentales, vienen desactivados y gastan bastantes más tokens. Para un lote de cuentas independientes, bastan los subagentes. (Origen: sugerencia «claude code subagents vs agent teams»; respuesta: documentación de agent teams)
¿Cuántos subagentes puede ejecutar Claude Code a la vez?
Por defecto, 20 a la vez; el número 21 devuelve «Concurrent subagent limit reached». CLAUDE_CODE_MAX_CONCURRENT_SUBAGENTS lo cambia desde la v2.1.217, y el total en una sesión no tiene límite. Para trabajadores que llaman a una API externa, el límite real es el cupo de la API: con las 10 solicitudes por minuto de nuestra clave de prueba y unos 25 segundos por llamada, más de 4 trabajadores solo producen 429; con las 60 por minuto por defecto de la cuenta, unos 25. (Origen: sugerencia «claude code run subagents in parallel»; respuesta: límite de subagentes simultáneos y nuestra prueba)
¿Qué hace Claude Code con un resultado MCP muy grande?
Avisa por encima de 10.000 tokens y el límite por defecto es de 25.000 tokens (MAX_MCP_OUTPUT_TOKENS lo cambia). Si la herramienta no declara anthropic/maxResultSizeChars, un resultado correcto de más de 50.000 caracteres va a un archivo. Nuestro resultado de 200 comentarios de TikTok tuvo 54.819 caracteres, así que se guardaría; el más largo de 50 comentarios tuvo 24.749, así que no. (Origen: nuestra prueba; respuesta: límites de salida de MCP)
Referencias
- Create custom subagents, documentación de Claude Code, Anthropic, leído el 2026-10-26, https://code.claude.com/docs/en/sub-agents
- Connect Claude Code to tools via MCP, documentación de Claude Code, Anthropic, leído el 2026-10-26, https://code.claude.com/docs/en/mcp
- Claude Code changelog (v2.1.293 a v2.1.310), Anthropic, del 2026-10-07 al 2026-10-23, https://code.claude.com/docs/en/changelog
- Manage costs effectively, documentación de Claude Code, Anthropic, leído el 2026-10-26, https://code.claude.com/docs/en/costs
- Model configuration, documentación de Claude Code, Anthropic, leído el 2026-10-26, https://code.claude.com/docs/en/model-config
- Environment variables, documentación de Claude Code, Anthropic, leído el 2026-10-26, https://code.claude.com/docs/en/env-vars
- Agent teams, documentación de Claude Code, Anthropic, leído el 2026-10-26, https://code.claude.com/docs/en/agent-teams
- Orchestrate subagents at scale with dynamic workflows, documentación de Claude Code, Anthropic, leído el 2026-10-26, https://code.claude.com/docs/en/workflows
- Explore the context window, documentación de Claude Code, Anthropic, leído el 2026-10-26, https://code.claude.com/docs/en/context-window
- Permissions, documentación de Claude Code, Anthropic, leído el 2026-10-26, https://code.claude.com/docs/en/permissions
- Settings, documentación de Claude Code, Anthropic, leído el 2026-10-26, https://code.claude.com/docs/en/settings
- Run Claude Code programmatically, documentación de Claude Code, Anthropic, leído el 2026-10-26, https://code.claude.com/docs/en/headless
- Skills, documentación de Claude Code, Anthropic, leído el 2026-10-26, https://code.claude.com/docs/en/skills
- Prompt caching, documentación de Claude Code, Anthropic, leído el 2026-10-26, https://code.claude.com/docs/en/prompt-caching
- CHANGELOG.md, anthropics/claude-code, GitHub, leído el 2026-10-26, https://github.com/anthropics/claude-code/blob/main/CHANGELOG.md
- Introducing Claude Haiku 5.5, Anthropic, 2026-10-07, https://www.anthropic.com/claude-haiku-5-5
- Claude Haiku 5.5 System Card, Anthropic, 2026-10-07, https://www.anthropic.com/claude-haiku-5-5-system-card
- Pricing, documentación de Claude Platform, Anthropic, leído el 2026-10-26, https://platform.claude.com/docs/en/about-claude/pricing
- Models overview, documentación de Claude Platform, Anthropic, leído el 2026-10-26, https://platform.claude.com/docs/en/about-claude/models/overview
- Migrating to Claude Haiku 5.5, documentación de Claude Platform, Anthropic, leído el 2026-10-26, https://platform.claude.com/docs/en/models/haiku-5-5/migration-guide
- Prompt caching, documentación de Claude Platform, Anthropic, leído el 2026-10-26, https://platform.claude.com/docs/en/build-with-claude/prompt-caching
- Token counting, documentación de Claude Platform, Anthropic, leído el 2026-10-26, https://platform.claude.com/docs/en/build-with-claude/token-counting
- Rate limits, documentación de Claude Platform, Anthropic, leído el 2026-10-26, https://platform.claude.com/docs/en/api/rate-limits
- Release notes, documentación de Claude Platform, Anthropic, leído el 2026-10-26, https://platform.claude.com/docs/en/release-notes/overview
- Tool search tool, documentación de Claude Platform, Anthropic, leído el 2026-10-26, https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- Tool use overview, documentación de Claude Platform, Anthropic, leído el 2026-10-26, https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview
- Claude pricing (Pro, Max, Team), Anthropic, leído el 2026-10-26, https://claude.com/pricing
- Building agents: When to fold subagents into your main agent loop, Anthropic, 2026-10-22, https://claude.com/resources/articles/building-agents-when-to-fold-subagents-into-your-main-agent-loop
- single-agent-loop-kit, anthropics, GitHub, leído el 2026-10-26, https://github.com/anthropics/single-agent-loop-kit
- Transports (2025-06-18), especificación de Model Context Protocol, https://modelcontextprotocol.io/specification/2025-06-18/basic/transports
- Tools (2025-06-18), especificación de Model Context Protocol, https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- Lifecycle (2025-06-18), especificación de Model Context Protocol, https://modelcontextprotocol.io/specification/2025-06-18/basic/lifecycle
- RFC 6585: Additional HTTP Status Codes (429), IETF, abril de 2012, https://www.rfc-editor.org/rfc/rfc6585
- RFC 9110: HTTP Semantics (Retry-After), IETF, junio de 2022, https://www.rfc-editor.org/rfc/rfc9110
- Timeouts, retries, and backoff with jitter, Amazon Builders' Library, 2019-12-05, https://aws.amazon.com/builders-library/timeouts-retries-and-backoff-with-jitter/
- concurrent.futures, documentación de Python, leído el 2026-10-26, https://docs.python.org/3/library/concurrent.futures.html
- TikTok Research Tools: Access and Eligibility, TikTok for Developers, leído el 2026-10-26, https://developers.tiktok.com/products/research-api/
- Research API Codebook, TikTok for Developers, leído el 2026-10-26, https://developers.tiktok.com/doc/research-api-codebook
- TikTok Unveils AI-Powered Updates for Advertisers, sala de prensa de TikTok, 2026-10-05, https://newsroom.tiktok.com/tiktok-unveils-ai-powered-updates-for-advertisers-driving-discovery-action-and-measurable-business-outcomes?lang=en
- Evolving TikTok for Business MCP, blog de TikTok for Business, 2026-06-30, https://ads.tiktok.com/business/en-US/blog/tiktok-agentic-hub-ai-agents-skills-mcp
- TikTok Terms of Service (EE. UU.), TikTok, leído el 2026-10-26, https://www.tiktok.com/legal/page/us/terms-of-service/en
- Catálogo de datos de EveryInfra, EveryInfra, leído el 2026-10-26 a las 17:22 hora de Singapur, https://api.everyinfra.com/api/v1/social/catalog
- Catálogo de TikTok de EveryInfra, EveryInfra, leído el 2026-10-26, https://api.everyinfra.com/api/v1/social/catalog?platform=tiktok
- Haiku 5.5 is 40x cheaper than Opus 5.5. Your Explore subagent is probably still running on Opus, Reddit r/ClaudeCode, 2026-10-08, https://www.reddit.com/r/ClaudeCode/comments/1x0kzbh/haiku_55_is_40x_cheaper_than_opus_55_your_explore/
- PSA: Claude Code subagents inherit your session model now, Reddit r/claude, leído el 2026-10-26, https://www.reddit.com/r/claude/comments/1v7iqqy/psa_claude_code_subagents_inherit_your_session/
- How much more effective is using Opus 5.5 with Haiku subagents, Reddit r/ClaudeAI, leído el 2026-10-26, https://www.reddit.com/r/ClaudeAI/comments/1x1buac/how_much_more_effectivebetter_is_using_opus_55/
- Anthropic's new guide (Oct 22) argues most agents should have fewer subagents, Reddit r/ClaudeAI, 2026-10-24, https://www.reddit.com/r/ClaudeAI/comments/1xdwquj/anthropics_new_guide_oct_22_argues_most_agents/
- Anthropic says one AI agent beats many subagents, The Decoder, 2026-10-25, https://the-decoder.com/anthropic-says-one-ai-agent-beats-many-subagents-now-that-models-can-handle-complexity-alone/
Referencia BL-53