openai agent builder shut down:迁到 Agents SDK 接社媒数据
Agent Builder 11月30日停服,社媒数据 agent 迁到 Agents SDK:MCP 审批与流式实测,每天100问月费$11.78起。
OpenAI 定在 2026 年 11 月 30 日停掉 Agent Builder,工作流的代码导出只能在停服前做(OpenAI 弃用页)。我们把一个调社媒数据的 agent 迁到 Agents SDK 0.24.0 实跑了一遍,最容易错的两处都不在迁移文档里:审批函数读的工具注解字段名跟着 MCP Python SDK 大版本变,写错时 12 个工具全被拦下审批;客户端默认 5 秒超时,会把一次服务端已完成、已扣费的调用显示成失败。按 11 月 8 日的公开价,每天 100 个问题一个月 $11.78 起(gpt-6-luna),最贵一档 gpt-6-astra 是 $682.28。
这篇要回答的问题是:你在 Agent Builder 里搭了一个回答「大家最近怎么评价某个产品」的 agent,它通过 MCP 节点去拉 Reddit 和 YouTube 的帖子、评论,11 月 30 日之后怎么继续跑。OpenAI 给的两条正路是 Agents SDK 和 ChatGPT Workspace Agents(迁移指南),本文主要写前一条,也写直接用 Responses API 的写法。OpenAI 一侧的字段名和默认值都来自 developers.openai.com 和 Agents SDK 文档原文,我们 11 月 8 日逐条打开核对过;因为没有调用 OpenAI 的模型,凡是需要 OpenAI 服务端参与的部分(HostedMCPTool、Responses API 的审批往返)一律写成「配置示例」。本机测试在 11 月 8 日 00:16–00:30(新加坡时间)完成:审批、拒绝、流式、异步都是真实运行,只有「模型说什么」用 SDK 自带的脚本模型写死。EveryInfra 一侧的每个数字都来自实际调用的原始返回;整场测试共有 15 次扣费的数据调用,每次 $0.000556,合计约 $0.0083;另有 2 次被限速的请求没有扣费,列工具、读注解、查请求记录这些调用都不收费。
openai agent builder shut down:OpenAI 原文写了什么
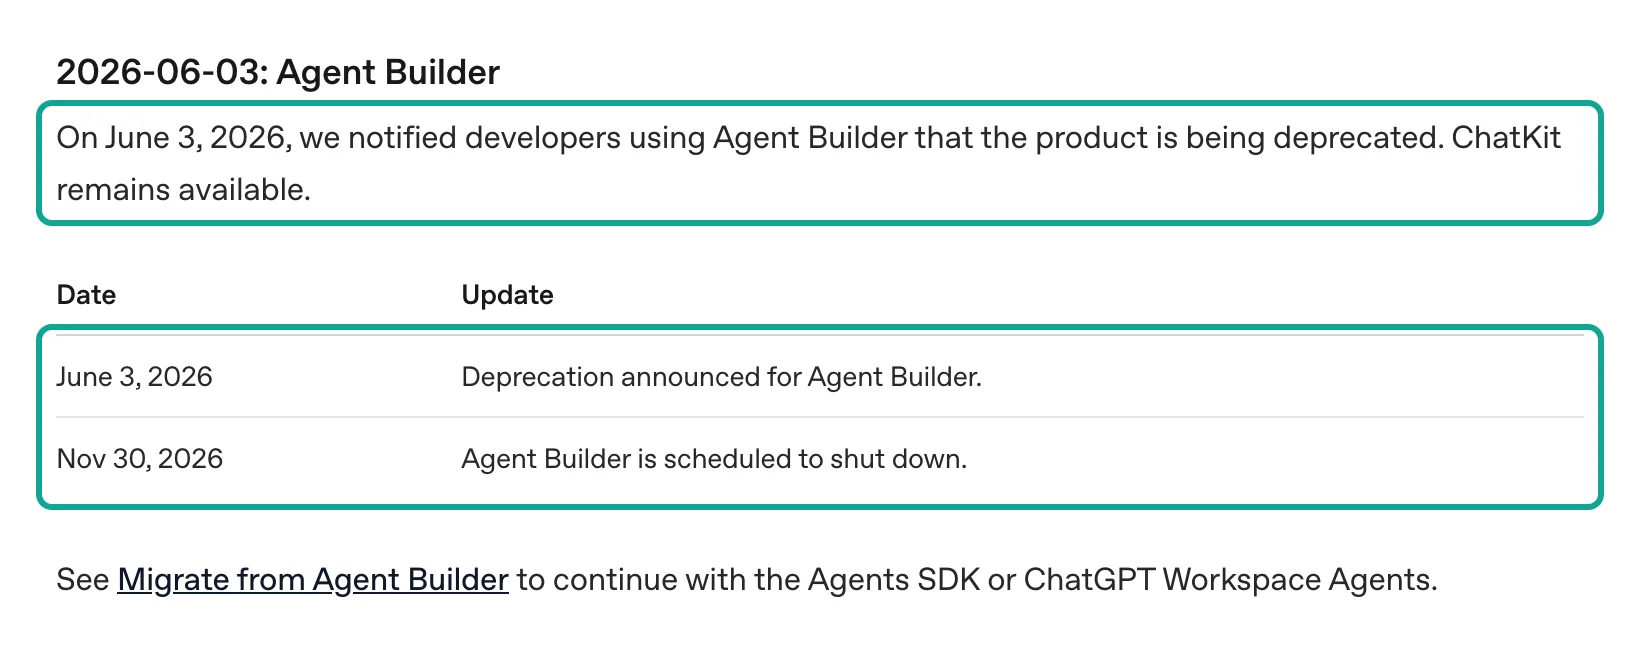
先把日期和范围钉死,后面的工作量都按它排。OpenAI 弃用页「2026-06-03: Agent Builder」一节原文是:6 月 3 日通知使用 Agent Builder 的开发者该产品正在弃用,ChatKit 继续提供;表格里只有两行,6 月 3 日宣布弃用,11 月 30 日计划停服,并指向迁移指南,说可以继续用 Agents SDK 或 ChatGPT Workspace Agents(OpenAI 弃用页)。同一页还有两条同一天公布、同一天停的:可复用 prompt 对象和 v1/prompts 接口 11 月 30 日停(弃用页:Reusable prompts),Evals 平台已有的评测 10 月 31 日起只读、11 月 30 日停(弃用页:Evals platform)。Agent Builder 的说明页和节点参考页顶部现在都挂着同一段话:现有用户在过渡期内还能继续用,产品计划 11 月 30 日停服,ChatKit 保留(Agent Builder 指南;节点参考)。
这三条要一起看,原因很具体:一个在 Agent Builder 里搭出来的工作流,指令常常存在 prompt 对象里,回归测试常常放在 Evals 里,三样东西 11 月 30 日一起没了。OpenAI 对 prompt 对象的迁移建议是把提示词内容搬进应用代码,用 git 提交和代码评审来管版本,并且把静态内容放前面、动态内容放后面,以保住提示词缓存的命中(Migrate from prompt objects);对 Evals 给的是一份迁到 Promptfoo 的 cookbook(Moving from OpenAI Evals to Promptfoo)。社区里有人 10 月 30 日把这几个日期整理成了一张清单,并提醒 ChatKit 保留不等于背后的 Agent Builder 工作流还能用(OpenAI 社区:Nov 30 shutdown checklist);弃用公告帖里另有人提醒了一个更具体的坑:别把工作流提示词搬进 prompt 对象,那也是 11 月 30 日停,否则要搬两次(OpenAI 社区:Deprecation notice: Agent Builder)。
| 日期 | 事件 | 对一个社媒数据 agent 意味着什么 | 出处 |
|---|---|---|---|
| 2026-06-03 | 通知 Agent Builder、prompt 对象、Evals 弃用 | 开始倒计时;导出代码要趁画布还能打开 | 弃用页 |
| 2026-10-15 | openai-agents 0.24.0 发布,转换后的 MCP 工具带上注解 | 迁移时可以按工具注解写审批规则 | PyPI;GitHub Releases |
| 2026-10-31 | 已有 Evals 变成只读 | 回归测试集要先导出 | 弃用页 |
| 2026-11-30 | Agent Builder、v1/prompts、Evals 停服 | 画布、托管工作流、prompt 对象一起没了 | 弃用页 |
| 2026-12-11 | GPT-5、o3 一批旧快照下线 | 导出代码里写死的旧模型名也要换 | 弃用页 |
最后一行容易被忽略。Agent Builder 导出的代码里,模型名是你当初在画布上选的那一个;弃用页 6 月 11 日那一节写明,gpt-5、gpt-5-mini、o3 等快照 12 月 11 日下线,推荐换成 gpt-5.6-sol、gpt-5.6-terra 等(弃用页:GPT-5 and o3)。也就是说,11 月 30 日把代码搬出来之后,12 月 11 日还可能再坏一次。弃用页同时给了一个能用程序盯住这件事的办法:GET /v1/models 返回的模型对象里有可选的 shutdown_date 字段,有日期就说明已经排了下线(弃用页开头)。迁移时顺手把这个检查做成定时任务,比每个月去翻一次公告可靠。
受影响的到底是什么:画布、托管工作流和 ChatKit 的那条「推荐接法」
「ChatKit 保留」这句话很容易被读成「我前端用的 ChatKit 不受影响」。ChatKit 文档现在写的是两条路:一条是在自己的服务器上跑 ChatKit,连任何代理服务,包括用 Agents SDK 写的;另一条是「已有的 Agent Builder 托管接法」,原文是如果你已经在用 Agent Builder 工作流驱动 ChatKit,可以在过渡期内继续用这个托管工作流(ChatKit 文档)。第二条的前提是 Agent Builder 还在。ChatKit 的高级接法文档也写了,新的 ChatKit 应用应该基于你自己的服务端代理实现来搭,用 ChatKit SDK 加 Agents SDK(Advanced integrations with ChatKit)。
OpenAI 社区的弃用公告帖里,一位给多个客户做 ChatKit 的开发者 6 月 4 日贴出了旧文档的「推荐接法」截图,问这是否意味着 ChatKit 推荐接法也不能用了;回帖里有人的说法是:ChatKit 本身留着,但依赖 Agent Builder 托管后端的那条推荐接法实际上没有了,剩下的是 ChatKit 前端加你自己的后端(OpenAI 社区:Deprecation notice: Agent Builder)。这是社区成员的理解,不是 OpenAI 的表态;Forkast 在 11 月初的分析里也指出,官方文档没有说清已发布的工作流 ID 在 11 月 30 日之后还能不能通过 ChatKit 执行(Forkast)。在没有新的官方说法之前,稳妥的做法是按「工作流 ID 会失效」来排期。
还有一件事只能在停服前做:导出。迁移指南的步骤是在 Agent Builder 里打开工作流,点顶部的 Code,在弹窗里选 Agents SDK,再选 TypeScript 或 Python,复制完整导出(迁移指南)。同一页写得很直接:这个过程不会转换你的工作流图,也不保证每个行为原样迁移;Workspace Agents 那条路需要 ChatGPT Business、Enterprise 或 Edu 工作区,而且「核心是强确定性逻辑的工作流」可能无法忠实地迁到 Workspace Agent(迁移指南)。一个按固定顺序调三次数据接口、再按规则拼答案的社媒 agent,正好属于强确定性那一类,所以本文选 Agents SDK。
三条去路怎么选:Agents SDK、直接调 Responses API、Workspace Agents
三条路的差别不在「能不能调 MCP」,三条都能;差别在代理循环跑在谁那里、审批交给谁、Key 放在哪。下表按官方文档原文整理,最后一列是对一个每天要回答上百个社媒问题的 agent 的判断。
| 去路 | 代理循环在哪 | 连 MCP 的一方 | 审批怎么做 | 适合 | 出处 |
|---|---|---|---|---|---|
Agents SDK + MCPServerStreamableHttp | 你的进程 | 你的进程 | require_approval,可以是函数;暂停后 RunState 恢复 | 要自己记日志、控制花费、换模型的团队 | SDK MCP 文档 |
Agents SDK + HostedMCPTool | 你的进程 | OpenAI 的服务 | tool_config 里的 require_approval 加 on_approval_request 回调 | 服务器公网可达、想少写连接代码 | SDK MCP 文档 |
直接调 Responses API 的 mcp 工具 | 你的进程(自己写循环) | OpenAI 的服务 | 默认 always;收到 mcp_approval_request 后回 mcp_approval_response | 已经有自己的循环,只差一个工具 | Responses MCP 指南 |
| ChatGPT Workspace Agents | ChatGPT | ChatGPT 的应用和连接 | 在 ChatGPT 里单独配权限 | 给团队用自然语言维护的 agent | 迁移指南 |
走 Agents SDK 这条路,版本要钉在 PyPI 上的 openai-agents==0.24.0(上传于 2026 年 10 月 15 日,PyPI:openai-agents),别装 GitHub 上同名的 0.24.0-alpha.6。原因是那个预览版只通过 GitHub Releases 分发,发布说明里写了公开接口的改动,例如一次性调用改用 Agent.run()、去掉了多余的 Runner 别名(openai-agents-python Releases),而 Agent Builder 导出的代码用的正是 Runner.run;装错版本,导出代码第一次运行就可能报错,你还会误以为是导出本身有问题。Python 和 Node.js 的版本要求放在文末「上手步骤」第 2 步。
OpenAI 另有一个托管的 Agents API,代理循环跑在 OpenAI 那边(Agents API 概览),但迁移指南没有把它列为 Agent Builder 的去处,本文也不走这条路;它连 MCP 的配置见站内的 openai agents api 口碑巡检。
节点对照:Agent Builder 的每个节点在 Agents SDK 里是什么
迁移指南说导出不转换工作流图,那图里的每个节点就要在代码里有个落点。下表左列是节点参考页列出的全部节点(节点参考),右列是 Agents SDK 里对应的写法,来自 SDK 文档;中间一列写社媒数据 agent 最常用到的那一种情况。
| Agent Builder 节点 | 在社媒数据 agent 里通常做什么 | Agents SDK 里的写法 |
|---|---|---|
Start(input_as_text) | 接住用户的问题 | Runner.run(agent, input) 的 input |
| Agent | 决定先搜 Reddit 还是 YouTube,最后写答案 | Agent(name, instructions, model, tools, mcp_servers) |
| MCP | 调 EveryInfra 的 everyinfra_call_api | MCPServerStreamableHttp 或 HostedMCPTool |
| Human approval | 花钱的调用前问一句 | MCP 的 require_approval,暂停后 result.interruptions → state.approve() / state.reject() |
| If/else、While(CEL 表达式) | 结果为空就换关键词再搜一次 | 普通的 Python 或 TypeScript 判断和循环 |
| Guardrails | 拦截个人信息、越狱 | SDK 的输入、输出护栏和工具护栏,失败时抛异常,由你决定结束还是重试(SDK 护栏文档) |
| (画布自动保存的对话历史) | 用户连着问几个问题 | SDK 的会话(Sessions),恢复审批时传同一个会话(SDK 会话文档) |
| Transform、Set state | 把搜索结果整理成固定结构 | output_type 结构化输出、运行上下文 |
| File search | 查自己上传的资料 | FileSearchTool |
| Note | 画布上的注释 | 代码注释 |
这张表里最值得花时间的是两行。MCP 节点在画布上只是「选一个服务器、填一下授权」,到了代码里要决定由谁去连、带哪个头、只开哪几个工具、超时多长,见「远程 MCP 两种接法」和「默认 5 秒超时」两节。Human approval 节点在画布上是一个独立的框,到了 SDK 里分散在三处:工具配置里的审批规则、运行结果里的 interruptions、以及能序列化保存的 RunState(SDK 人工审批文档),见「工具审批」和「拒绝一次调用之后」两节。其余节点照表替换即可,If/else 在画布上要写的 CEL 表达式(节点参考)到代码里一个 if 就够。
Agent 节点的指令怎么改写:把画布上的隐含规则写成文字
画布上有很多规则是靠「连线」表达的:结果为空就走 If/else 的另一支,审批没过就回到上一个 Agent 节点。搬进代码后,循环和判断可以写成 Python,但模型那一侧要知道的规则必须写进 instructions。迁移指南建议在 Workspace Agent 那条路上逐项检查控制流、触发条件、工具和权限(迁移指南);走 SDK 这条路同样要做,只是检查的对象变成了你自己写的指令。下面这段是我们按本次实际调用的结果写的指令示例,每一条都对应一个实测里碰到的情况:
You answer questions about what people say online, using EveryInfra tools only.
1. Call everyinfra_call_api with platform "reddit", action "search", limit 10,
   and platform "youtube", action "search", limit 5, in the same turn.
2. "Agent Builder" is also a Microsoft Copilot product. Drop results that do not
   mention OpenAI before you count anything.
3. Call youtube/comments (limit 20, sort "newest") only for the first relevant video.
4. YouTube comment posted_at can be relative ("2 weeks ago"). Do not convert it
   into an exact date. Say "about 2 weeks ago".
5. If a tool returns 0 rows, say "no matching posts in the last month". Do not say
   "nobody talks about it".
6. If an error has retryable true, wait retry_after seconds once. Never call the
   same arguments twice after a timeout; use mode "async" for limit > 50.
7. Quote the post or video URL for every claim.
第 2 条来自 reddit/search 和 youtube/search 的实测:两个关键词都搜出了微软 Copilot 的同名功能。第 4 条来自 youtube/comments 的 posted_at 是相对时间。第 5 条来自 reddit/search 的目录说明:它只搜最近一个月、只返回对得上关键词的帖子,一条都没有时按空结果退款(目录:reddit)。第 6 条来自后文的超时实测:超时之后照原参数再调一次,会再扣一次费。这些规则写在画布上时分散在连线和节点设置里,迁移时最容易丢;写成编号的文字后,也方便你用同一组真实问题做回归测试,取代 11 月 30 日一起停掉的 Evals。OpenAI 的 Agent Builder 安全指南提醒过,代理工作流有提示注入和数据泄露的风险(Safety in building agents);社媒帖子和评论正是不可信的外部文本,所以第 7 条要求每个结论都引用原链接,方便人工复核,而不是让模型把评论里的话当成指令。
远程 MCP 两种接法:HostedMCPTool 和 MCPServerStreamableHttp
Agents SDK 的 MCP 文档开头有一张选择表:要让 OpenAI 的 Responses API 替模型去调一个公网可达的 MCP 服务器,用 HostedMCPTool;要自己管网络连接、连本地或远程的 Streamable HTTP 服务器,用 MCPServerStreamableHttp(SDK MCP 文档)。EveryInfra 的 MCP 地址 https://api.everyinfra.com/mcp 是公网的,两种都能用,区别在于请求从哪里发出、Key 经过谁、出错时你能看到什么。


先看我们本机实跑通过的这种:MCPServerStreamableHttp。下面是 2026 年 11 月 8 日 00:18(新加坡时间)跑审批测试时用的配置,只把 Key 换成了环境变量名。headers 里放 Authorization: Bearer,这是 SDK 文档推荐的放法,两种 MCP Python SDK 大版本都能用(SDK MCP 文档);tool_filter 只放两个工具;client_session_timeout_seconds 我们调到 120 秒,原因在后面「默认 5 秒超时」一节。
import os
from agents import Agent, Runner
from agents.mcp import MCPServerStreamableHttp, create_static_tool_filter

def read_only_hint(tool):
    ann = getattr(tool, "annotations", None)
    if ann is None:
        return None
    for name in ("read_only_hint", "readOnlyHint"):  # MCP Python SDK v2 / v1
        if hasattr(ann, name):
            return getattr(ann, name)
    return None

def needs_approval(run_context, agent, tool):
    return read_only_hint(tool) is not True  # 只读工具放行,其余都要审批

everyinfra = MCPServerStreamableHttp(
    name="everyinfra",
    params={
        "url": "https://api.everyinfra.com/mcp",
        "headers": {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"},
        "timeout": 30,
        "sse_read_timeout": 120,
    },
    tool_filter=create_static_tool_filter(
        allowed_tool_names=["everyinfra_call_api", "everyinfra_get_job"]),
    require_approval=needs_approval,
    cache_tools_list=True,
    client_session_timeout_seconds=120,
)
为什么只开两个工具?00:18(新加坡时间)我们用这个客户端列了一次工具:EveryInfra MCP 一共 12 个工具,工具定义压成 JSON 是 16,275 字节;只留 everyinfra_call_api 和 everyinfra_get_job 是 2,449 字节。按 OpenAI 帮助中心「英文约 4 个字符合 1 个 token」的换算,约 4,069 和 612 token(OpenAI 帮助中心:token)。工具定义每一轮都要进上下文,一个问题按三轮算,差的就是每题约 1.04 万 token。另外 12 个工具里还有对话、验证码、工单、充值链接这类和社媒问答无关的工具,不开就不会被模型误调。SDK 文档对 cache_tools_list 的说明是每次运行都会对每个 MCP 服务器调一次 list_tools(),远程服务器会带来明显延迟,打开缓存可以省掉(SDK MCP 文档:Caching)。
再看 HostedMCPTool。它把整个工具往返交给 OpenAI:SDK 只把服务器标签和配置转给 Responses API,模型列工具、调工具都不再回调你的 Python 进程;tool_config 和你发给 REST 接口的 JSON 一样(SDK MCP 文档:Hosted MCP server tools)。下面是配置示例,我们没有用 OpenAI 账号跑过。Responses API 参考里 mcp 工具的 headers 是「发给 MCP 服务器的可选 HTTP 头」,authorization 是「可用于远程 MCP 服务器的 OAuth 访问令牌」,allowed_tools 可以是工具名数组,也可以是带 read_only 和 tool_names 的过滤对象(Responses API 参考:create)。EveryInfra 的 Key 是 Bearer 形式的 API Key,不是 OAuth 令牌,所以示例放在 headers 里。SDK 仓库的 examples/hosted_mcp 目录有流式、审批和连接器三种完整样例,可以对照着改(openai-agents-python 示例);如果你的 MCP 服务器在内网、不想暴露到公网,OpenAI 给的办法是 Secure MCP Tunnel,用 tunnel_id 代替 server_url(Secure MCP Tunnel)。
from agents import Agent, HostedMCPTool, MCPToolApprovalRequest

def approve(request: MCPToolApprovalRequest):
    args = request.data.arguments or "{}"
    if '"limit":100' in args.replace(" ", ""):
        return {"approve": False, "reason": "Use limit 20 for a single question."}
    return {"approve": True}

agent = Agent(
    name="Social listening agent",
    model="gpt-6-luna",
    instructions="Answer with data from EveryInfra tools. Quote post URLs.",
    tools=[HostedMCPTool(
        tool_config={
            "type": "mcp",
            "server_label": "everyinfra",
            "server_url": "https://api.everyinfra.com/mcp",
            "headers": {"Authorization": "Bearer <EVERYINFRA_API_KEY>"},
            "allowed_tools": ["everyinfra_call_api", "everyinfra_get_job"],
            "require_approval": {
                "always": {"tool_names": ["everyinfra_call_api"]},
                "never": {"tool_names": ["everyinfra_get_job"]},
            },
        },
        on_approval_request=approve,
    )],
)
两种接法在三件事上不一样。第一,Key 经过谁:Hosted 方式下 Key 跟着每次请求发给 OpenAI,再由 OpenAI 转给 MCP 服务器;Responses MCP 指南写明 authorization 字段的值不会被存储,也不会出现在返回的 Response 对象里,所以每次请求都要重新带上(Responses MCP 指南);headers 是否同样处理,文档没有写,我们也没有核到。第二,护栏:SDK 文档写明,挂在本地 MCP 服务器对象上的工具输入、输出护栏不会作用到 HostedMCPTool,因为后者由 Responses API 作为托管工具执行(SDK MCP 文档)。第三,数据驻留:OpenAI 说 MCP 工具兼容零数据保留和数据驻留,但发到 MCP 服务器的数据受该服务器自己的保留和驻留政策约束(Responses MCP 指南)。对社媒公开数据来说,第三条影响不大;对要在发给数据接口之前先做脱敏、记日志的团队,第一、二条决定了只能用本地接法。
一次完整往返:模型发出什么,EveryInfra 回了什么
本机没有调用 OpenAI 的模型。Agents SDK 0.24.0 自带一个 agents.testing.ScriptedModel,源码说明写的是「用于测试代理工作流的确定性、与模型提供方无关的模型」,每一步返回你预先写好的输出(openai-agents-python 源码:testing/model.py)。我们让它在第一轮发出两个并行的工具调用,第二轮写一句答案;除了「模型说什么」是写死的,其余全部是 SDK 的真实代码在跑:工具清单、审批中断、RunState 序列化、恢复、流式事件、MCP 调用和返回。
模型第一轮发出的两个调用,就是 everyinfra_call_api 的入参:
[{"name":"everyinfra_call_api","arguments":{"platform":"reddit","action":"search","params":{"keyword":"Agents SDK","sort":"newest","limit":10}}},
 {"name":"everyinfra_call_api","arguments":{"platform":"youtube","action":"comments","params":{"url":"https://www.youtube.com/watch?v=ug0UziXU3-Q","sort":"newest","limit":50}}}]
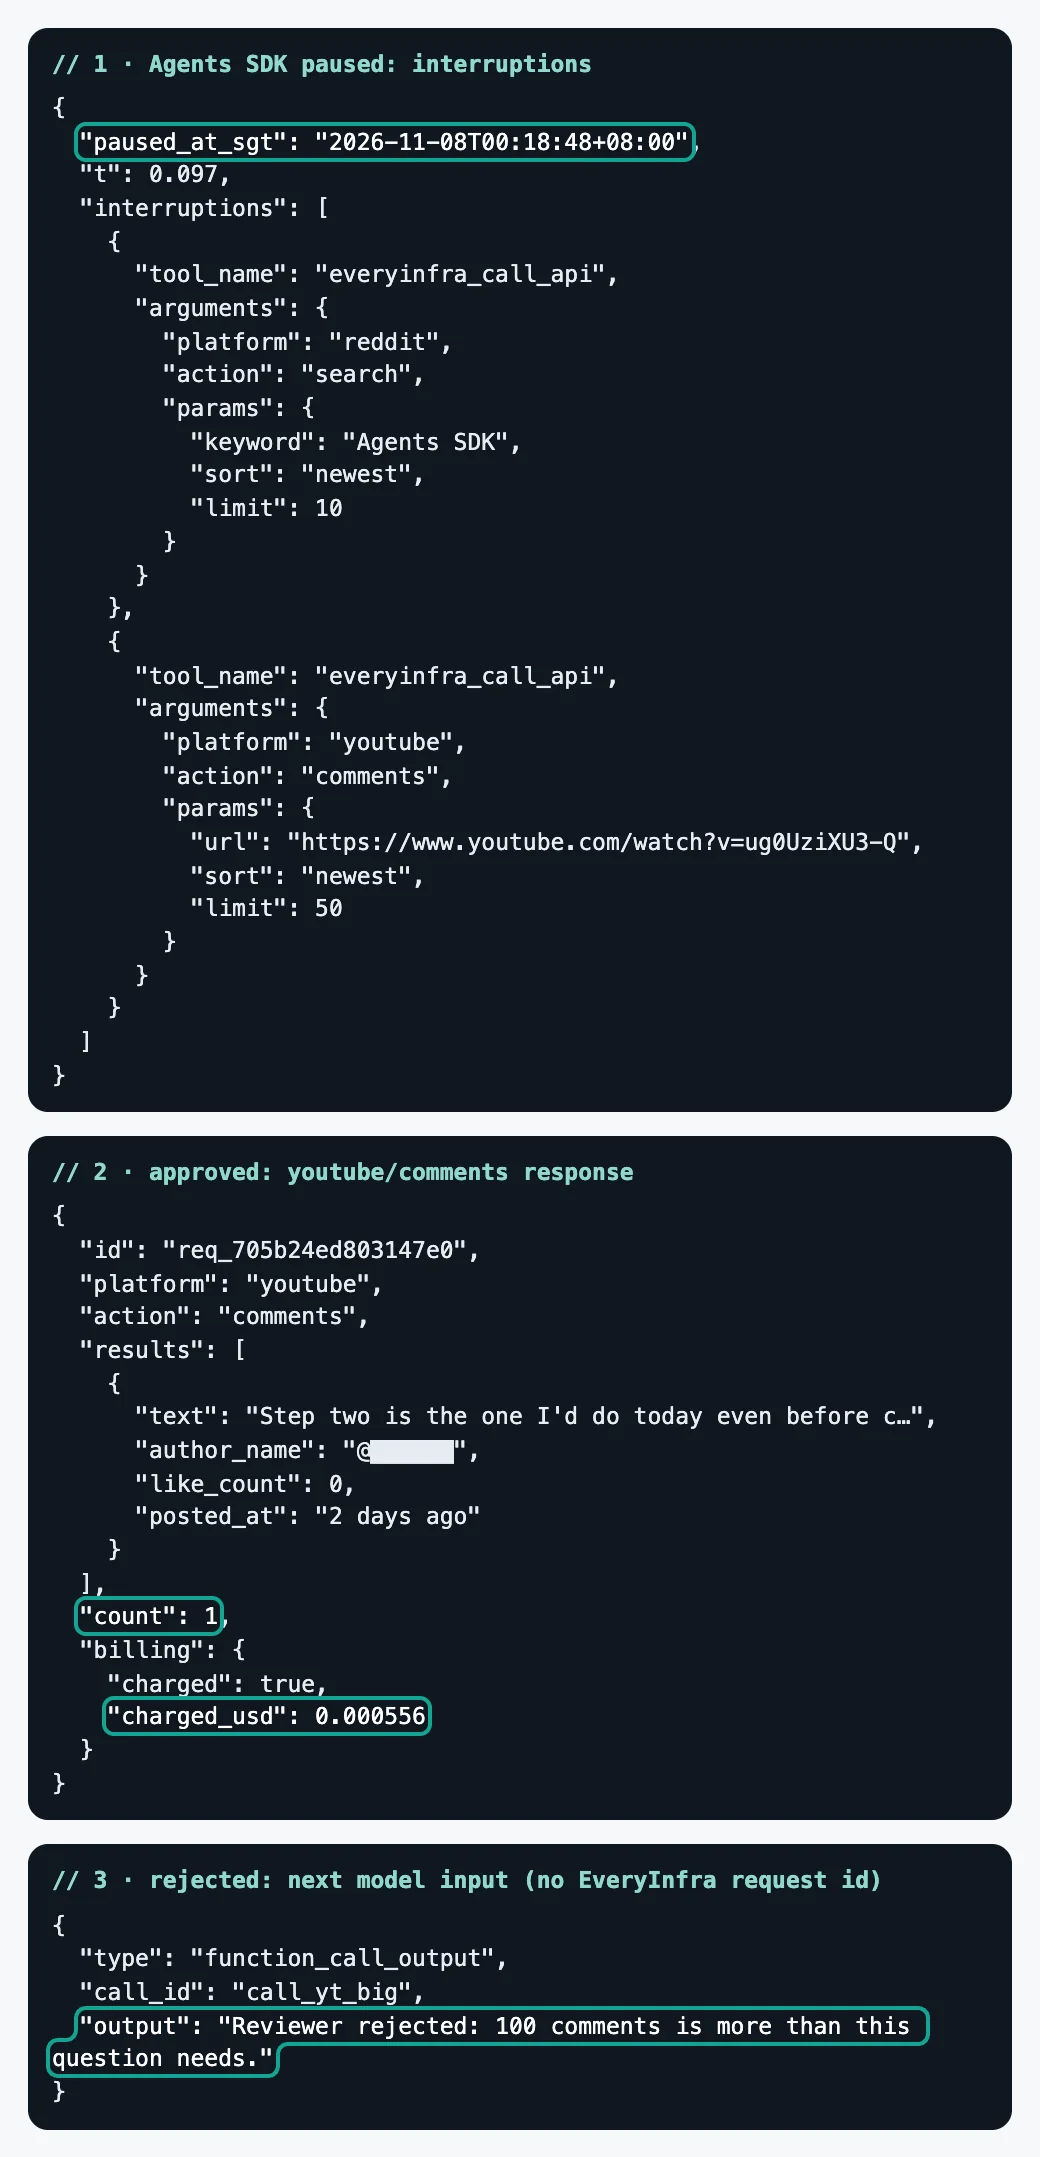
2026 年 11 月 8 日 00:18:48(新加坡时间),运行在第 0.097 秒暂停,result.interruptions 里是这两个调用,tool_name 都是 everyinfra_call_api,参数和上面一字不差。这时还没有任何请求发到 EveryInfra。我们把暂停时的状态用 state.to_string() 存下来,一共 25,739 字节,这就是你可以写进数据库、等人在后台点「批准」之后再取出来恢复的那一份。批准两个调用、用 Runner.run_streamed(agent, state) 恢复后,第 15.07 秒两个工具结果同时回来:reddit/search 回了 5 条帖子,MCP 返回的文本 13,835 个字符;youtube/comments 回了 1 条评论,1,689 个字符;两次的 billing.charged_usd 都是 0.000556,和目录里这两项的 price_usd 一致(目录:reddit;目录:youtube)。
那条唯一的评论来自 YouTube 上一个 11 月 2 日发布的停服提醒视频,原文开头是「Step two is the one I'd do today even before choosing where to migrate: click Code, copy it」,意思是先别急着选去哪,今天就点 Code 把导出复制下来,再把提示词、工具、护栏和条件用纯文字写下来(YouTube 视频)。后半句正好是下文「把画布上的隐含规则写成文字」要做的事。这条评论的字段是 id、text、author_name、like_count、reply_count、posted_at、is_reply、platform 8 个;它是顶层评论,所以没有 reply_to_id,回复类评论才另带这个字段(00:17 拉的 100 条里有 2 条回复带了它)。合起来和目录 youtube/comments 的 response_fields 9 个字段对得上;评论人名字我们在正文和截图里都隐去了。
reddit/search 就不是这样。这次 5 条帖子、以及 00:16 另外两次搜索的 19 条帖子,都只返回 10 个字段:id、url、title、text、author_username、community、like_count、comment_count、posted_at、platform。目录给这项能力列了 15 个字段,flair、domain、external_link、thumbnail_url、image_urls 这 5 个三次都没返回。目录的 field_note 写明,其他来源不可用时由末位来源返回结果,它不带 flair、thumbnail_url 和 image_urls(目录:reddit);domain 和 external_link 不在这句说明里,是我们这次实测另外看到缺的。对 agent 的影响很直接:如果你的指令让模型按 flair 区分「求助帖」和「讨论帖」,在这种情况下它拿到的是空字段,要在指令里写明字段缺失时怎么处理,而不是让模型猜。
返回里有两样东西是模型用不上、却会照样进上下文的:billing 和 quota。每次调用的返回都带着这次扣了多少、账户还剩多少,五六百字节。对单个问题无所谓,但在每天几百次的循环里,它们会被模型一遍遍重读。Agents SDK 的 MCP 服务器类有一个 custom_data_extractor 参数,可以把工具输出里的数据另存给你的程序(SDK MCP 文档);更直接的做法是用工具输出护栏在交给模型前删掉这两个字段,同时把扣费写进你自己的账本。后一种写法我们没有在本机跑过,这里只作建议。
工具审批:三种写法和一个字段名的坑
Agent Builder 里的 Human approval 是一个节点,画上去就生效。搬到代码里,审批的默认值在三个地方不一样,这是迁移时第一个要对齐的地方。Responses API 参考里 require_approval 的默认值是 always(Responses API 参考:create),MCP 指南也说默认会在把任何数据发给远程 MCP 服务器之前请求你批准(Responses MCP 指南);JavaScript 版 Agents SDK 的 hostedMcpTool 选项表里,requireApproval 写的是默认 'never'(Agents SDK JS:MCP);Python 版的 HostedMCPTool 则是把 tool_config 原样转给 REST 接口,不写就按 Responses API 的默认走(SDK MCP 文档)。同一个导出工作流,TypeScript 版不写审批就不审批,Python 版不写审批就每次都审批,跑起来的行为相反。
本地 MCP 服务器的 require_approval 支持五种写法:"always" 或 "never"、True 或 False、按工具名的映射、{"always": {"tool_names": [...]}} 这种分组对象,以及一个签名为 (run_context, agent, tool) 的函数;函数能拿到原始的 MCP Tool 对象,包括 tool.annotations,但拿不到这一次调用的参数和调用编号(SDK MCP 文档:Approval policies)。文档同时提醒,服务器给的注解只是建议,只有在你信任服务器的分类时才用它来跳过审批。按注解写审批很自然:MCP 规范把 annotations 定义为描述工具行为的可选属性(MCP 规范:Tools),EveryInfra 给 everyinfra_call_api 标的是 readOnlyHint: false、destructiveHint: true,因为它会花钱;给 everyinfra_get_job 标的是 readOnlyHint: true,因为读异步结果不收费。00:24(新加坡时间)我们直接请求 tools/list 看了原始 JSON,12 个工具里 7 个是 readOnlyHint: true,逐个列在下表。
| 工具 | `readOnlyHint` | `destructiveHint` | 按注解要不要审批 | 和社媒问答有没有关系 |
|---|---|---|---|---|
everyinfra_call_api | false | true | 要 | 有,所有数据调用都走它 |
everyinfra_get_job | true | false | 不要 | 有,读异步结果 |
everyinfra_list_capabilities | true | false | 不要 | 间接,查能力和参数 |
everyinfra_list_requests | true | false | 不要 | 间接,对账、查超时后的真实结果 |
everyinfra_get_account | true | false | 不要 | 无 |
everyinfra_get_topup_link | true | false | 不要 | 无 |
everyinfra_list_captcha_types | true | false | 不要 | 无 |
everyinfra_get_ticket | true | false | 不要 | 无 |
everyinfra_search | false | true | 要 | 无(网页搜索) |
everyinfra_chat | false | true | 要 | 无 |
everyinfra_solve_captcha | false | true | 要 | 无 |
everyinfra_create_ticket | false | false | 要 | 无 |
这张表也说明了前面为什么用 tool_filter 只开两个:要审批的 5 个里,有 4 个和社媒问答无关,开着它们只会让审批队列里多出模型误调的请求。everyinfra_create_ticket 是个特例,它不只读、但也不标「破坏性」,按「不是只读就审批」的写法它会被拦下,这正是我们想要的,因为开工单会通知到人。
坑就在这里。原始 JSON 里字段名是规范写的驼峰 readOnlyHint,但 Agents SDK 0.24.0 在今天默认装上的是 MCP Python SDK 2.3.0,它把这个字段暴露成 read_only_hint。我们第一次写审批函数时照规范名写 tool.annotations.readOnlyHint,用 getattr 取不到就当「不是只读」,结果 12 个工具全部判成要审批,连免费的 everyinfra_get_job 也要人点一下。为了确认不是我们写错,我们另建一个环境装 openai-agents==0.24.0 加 mcp<2,装上的是 1.30.0,在这个版本里字段名又是 readOnlyHint,read_only_hint 取不到。SDK 文档写明它同时支持 mcp>=1.19.0,<3 两个大版本,并会自动适配连接方式(SDK MCP 文档:MCP Python SDK v1 and v2),但注解对象的属性名跟着装上的 MCP 包走,这一点文档没有提。
| 环境(同一个服务器、同一份 `tools/list`) | `tool.annotations.readOnlyHint` | `tool.annotations.read_only_hint` | 只按规范名写,要审批的工具 | 两个名字都读,要审批的工具 |
|---|---|---|---|---|
| openai-agents 0.24.0 + mcp 2.3.0(默认安装) | 不存在 | 有值 | 12 / 12 | 5 / 12 |
openai-agents 0.24.0 + mcp 1.30.0(mcp<2) | 有值 | 不存在 | 5 / 12 | 5 / 12 |
这个坑往哪边错,取决于你的默认值怎么写。我们的写法是取不到就要审批,错在保守一侧:多弹几次审批,无人值守的定时任务会卡住,但不会多花钱。反过来,如果默认值写成「取不到就当只读」,在另一个大版本下就会让所有会花钱的调用都免审批。按 Responses API 或 HostedMCPTool 那条路走就没有这个问题,因为过滤是 OpenAI 服务端按 JSON 字段做的,JavaScript 版文档也写了 requireApproval 的对象形式可以按只读注解选工具(Agents SDK JS:MCP)。修法也简单:像上面配置里那样两个名字都读,再在部署前跑一次 list_tools(),断言要审批的工具数等于你期望的数。我们的期望值是 5,来自服务器原始 JSON 里 readOnlyHint 不为 true 的工具个数,不是来自审批函数自己。
拒绝一次调用之后发生了什么
批准之外,还要确认拒绝真的拦住了。00:19(新加坡时间)我们让脚本模型请求从 OpenAI 官方的 Agent Builder 介绍视频拉 100 条热门评论,运行同样在审批处暂停;这次我们调用 state.reject(item, rejection_message="Reviewer rejected: 100 comments is more than this question needs."),再恢复运行。模型第二轮收到的输入里,这个调用对应的 function_call_output 正是那句拒绝说明,没有 EveryInfra 的请求编号,也没有扣费记录。SDK 文档对拒绝的说法是:被拒绝的工具调用默认把 SDK 的标准拒绝文字交回运行,可以用 RunConfig.tool_error_formatter 改全局文字,也可以在 state.reject() 里用 rejection_message 单独改一次(SDK 人工审批文档:Custom rejection messages)。
拒绝说明要写成模型能照着改的话。只写「被拒绝了」,模型多半会原样再试一次;写清「100 条超出这个问题的需要」,模型下一轮就有理由把 limit 改小。这和 EveryInfra 自己的错误返回是同一个思路:参数写错时接口回 422,带支持的参数、允许值和建议的改法,并写明没有扣费,让客户的 AI 能自己改正。审批还有一个容易误用的开关:state.approve(item, always_approve=True) 会让同一个工具之后的调用都自动通过,而且这个决定会跟着 RunState 一起被序列化保存(SDK 人工审批文档)。对会花钱的数据调用,我们建议只做逐次批准,或者干脆用函数按参数判断,比如 limit 超过 20 就拦下。
| 审批动作 | 是否发到 EveryInfra | 是否扣费 | 模型下一轮读到什么 | 本机记录 |
|---|---|---|---|---|
| 批准(逐次) | 是 | 是,$0.000556 / 次 | 真实返回的 JSON 文本 | 00:18:48 暂停,15.07 秒后返回 |
拒绝,带 rejection_message | 否 | 否 | 那句拒绝说明 | 00:19:03 |
批准并 always_approve=True | 之后同名工具不再暂停 | 是 | 真实返回 | 本机没跑,按文档 |
流式:暂停时流里有什么,恢复后 15 秒才有结果
Agent Builder 的预览窗口会一格一格点亮正在执行的节点,用户看得到进度。搬到 SDK 之后,进度要你自己从流式事件里拼出来。SDK 的流式文档把事件分成两层:raw_response_event 是模型原始的 Responses API 事件,run_item_stream_event 是更高层的「某一项生成完了」,名字是固定的一组,其中和 MCP 有关的是 tool_called、tool_output、mcp_approval_requested、mcp_approval_response、mcp_list_tools(SDK 流式文档)。文档还写了:如果有工具需要审批,stream_events() 会结束,待审批的项出现在 interruptions 里,要转成 RunState、批准后再用 Runner.run_streamed() 接着流(SDK 流式文档:Streaming and approvals)。
我们把 00:18 那次运行的每个事件都记了下来。暂停前一共 14 个事件,全部挤在头 0.095 秒里:1 个 agent_updated_stream_event,11 个原始事件(response.created、两组 response.output_item.added 和 response.function_call_arguments.done 等),最后是 2 个 tool_called。恢复后 13 个事件,头一个在第 0.024 秒,然后整整 15 秒什么都没有,第 15.07 秒两个 tool_output 一起到,再跟着模型写答案的 9 个原始事件和 1 个 message_output_created。也就是说,用户点了「批准」之后,有 15 秒流里是空的。两个工具并行执行,结果是一起交回的,先完成的那个也要等慢的那个。
这 15 秒怎么填,取决于你走哪条路。走本地 MCP 时,SDK 的 tool_called 事件在暂停前就发出了,你可以在 tool_called 到 tool_output 之间自己显示「正在拉 Reddit 和 YouTube 的数据」。走 Responses API 托管 MCP 时,OpenAI 的流式事件参考里专门有 8 个 MCP 事件:response.mcp_list_tools.in_progress、.completed、.failed,response.mcp_call_arguments.delta、.done,以及 response.mcp_call.in_progress、.completed、.failed(Responses 流式事件参考),前端可以直接按 mcp_call.in_progress 显示进度。如果前端仍用 ChatKit,它的服务端有 ProgressUpdateEvent,长时间运行的工具可以往界面推进度(Advanced integrations with ChatKit)。还有一条容易漏:SDK 文档提醒,事件消费者中途退出时,后台运行可能还在继续调模型和工具;要中途停下,得显式调用 result.cancel()(SDK 流式文档)。对每次调用都扣费的数据工具,这一条直接关系到账单。
默认 5 秒超时:客户端说失败,服务端已经扣费
这是本次测试里最贵的一个发现,虽然只花了 $0.000556。SDK 文档写明,MCPServerStdio、MCPServerSse、MCPServerStreamableHttp 的 client_session_timeout_seconds 默认是 5 秒(SDK MCP 文档)。而社媒数据的同步调用经常超过 5 秒。00:19–00:21(新加坡时间)按「算账」一节的固定配方跑的两个问题,6 次调用里有 4 次超过 5 秒:
| 问题 | 能力 | `limit` | 返回条数 | 耗时(秒) | 默认 5 秒超时下 |
|---|---|---|---|---|---|
| Notion AI | reddit/search | 10 | 7 | 4.70 | 勉强赶上 |
| Notion AI | youtube/search | 5 | 5 | 7.95 | 超时 |
| Notion AI | youtube/comments | 20 | 20 | 21.43 | 超时 |
| Cursor pricing | reddit/search | 10 | 1 | 4.93 | 勉强赶上 |
| Cursor pricing | youtube/search | 5 | 5 | 10.04 | 超时 |
| Cursor pricing | youtube/comments | 20 | 20 | 12.11 | 超时 |
这 6 次跑的时候客户端的等待时间长于 5 秒,所以都拿到了结果;换成默认值,每个问题只有 Reddit 搜索那一步能回来,YouTube 的两步都会在你这边报错、在服务端照样扣费。两次 reddit/search 都卡在 4.7–4.9 秒,离 5 秒只差几百毫秒,网络稍慢一点也会掉进去。00:29:20(新加坡时间),我们用默认超时的客户端调了一次 youtube/comments,对象是一个 2025 年 10 月的 Agent Builder 课程视频,limit 100。客户端在 5.0 秒抛出 MCPError: Request 'tools/call' timed out。
45 秒后(00:30:05)我们用 everyinfra_list_requests(只读、不收费)查这把 Key 的请求记录,看到一条 youtube.comments,状态 200,latency_ms 28,442,items 100,charged 为 true,扣了 $0.000556,完成时间是 UTC 16:29:48,也就是新加坡时间 00:29:48,正好是发出时间加 28.4 秒。请求列表不返回参数,所以我们是按发出时间和耗时对上的,同一把测试 Key 那几分钟也有别的任务在用。结论很明确:客户端放弃等待,不等于服务端取消;数据已经拿到、钱已经扣了,你这边却只看到一个超时错误。如果你还按 SDK 文档给连接加了 max_retry_attempts(它会自动重试 call_tool()),模型或 SDK 再试一次就会再扣一次。
修法有两种,可以一起用。一是把 client_session_timeout_seconds 调到比最慢的能力更长,我们用的是 120 秒;EveryInfra 同步调用自己的等待上限是 85 秒,目录的 async_mode 说明里写着,慢任务或大 limit 用异步模式,而不是等同步的 85 秒(目录)。二是对已知的慢能力直接走 mode: "async"。00:25(新加坡时间)我们经 MCP 发了一次异步的 youtube/comments:2.53 秒拿到 status: running 和 job_id,之后每 3 秒用 everyinfra_get_job 查一次,6 次 running、4 次 finalizing,第 11 次 succeeded,从提交到拿到结果 38.58 秒。everyinfra_get_job 的工具说明写明它免费、不占每分钟的次数,所以轮询不加钱;扣费只在提交那一次,$0.000556。对 agent 来说,异步模式把「一次长等待」变成了「几次短调用」,每次都远低于 5 秒,也更容易在界面上显示进度。
| 调用方式 | 客户端看到 | 服务端结果 | 扣费 | 时间(新加坡) |
|---|---|---|---|---|
| 同步,默认 5 秒超时 | 5.0 秒 MCPError 超时 | 28.4 秒后完成,100 条 | $0.000556 | 00:29:20 |
| 同步,超时 120 秒 | 15.07 秒拿到结果 | 1 条(另一个视频,limit 50) | $0.000556 / 次 | 00:18:48 |
异步 mode: async + 轮询 | 2.53 秒拿到 job_id,38.58 秒拿到结果 | 2 条 | $0.000556(轮询免费) | 00:25:01 |
实测:「开发者怎么看 Agent Builder 停服」这个问题能拿到什么
迁移完了,这个 agent 要回答真实的问题。我们拿它最该会答的一个问题试:开发者怎么看 Agent Builder 停服?00:16(新加坡时间)先用 reddit/search 搜「agent builder」,按最新排序,回了 10 条,全部是搜索前 7 个多小时内发的帖子(新加坡时间 11 月 7 日 17:01 到 11 月 8 日 00:14),没有一条和 OpenAI 有关,有一条是在比较微软 Copilot Studio 里的同名功能。换成「OpenAI Agent Builder」按相关性排序,回了 9 条,时间从 2026 年 10 月 20 日到 2026 年 11 月 7 日;其中只有 2 条和 OpenAI 有关(一条问 Agents API,一条讲 OpenAI 托管代理的 Kubernetes operator),2 条又是微软 Copilot 的「agent builder」,没有一条提到停服。reddit/search 的目录说明写明,搜索范围固定为最近一个月,只返回对得上关键词的帖子,条数可能少于 limit(目录:reddit)。
「Agent Builder」这个名字本身就有歧义,微软也有一个,所以 agent 的指令里要写清楚:搜到的结果先按是否提到 OpenAI 过滤,再统计。同一个问题去 YouTube 搜,信号就清楚多了。00:16:36(新加坡时间)用 youtube/search 搜「openai agent builder shut down」,20 条结果里 8 条是专门讲停服的视频,发布时间从 9 月 3 日到 11 月 2 日,播放量合计 472 次;另有 6 条是 2025 年 10 月到 12 月的 Agent Builder 教程,包括 OpenAI 自己的介绍视频,播放量合计 2,118,658 次,是停服视频的约 4,489 倍;剩下 6 条和题目无关,其中又有一条是微软 Copilot 的 Agent Builder 教程。
这个差距说明一件事:大量照着教程搭过 Agent Builder 工作流的人,很可能还没看到停服的消息。OpenAI 介绍视频下面的评论也印证了这一点。00:17(新加坡时间)用 youtube/comments 按最新排序拉了 100 条,只有 2 条提到弃用:一条大约 3 个月前写「Now is deprecated!」,一条大约 2 周前问「Is this still a thing?」。100 条里有 19 条是和别的评论一字不差的重复,像是刷出来的;最新的 100 条一直往回排到「10 months ago」,有 55 条落在那个时间段。还要注意 posted_at 在这里是「2 weeks ago」这样的相对时间,不是日期,agent 要按日期筛选就得自己换算,而且只能精确到它给的粒度。对一个要统计「最近一个月」的 agent,这一条必须写进指令。
这类观察是数据接口在迁移场景里真正的用处:不是替代 Agent Builder,而是帮你判断「我的用户里有多少人还不知道要搬」。如果你维护的是一个基于 Agent Builder 的模板、课程或插件,可以照这个配方每周跑一次,看停服相关视频和评论的增长,用来决定要不要给老用户再发一次提醒。站内的 YouTube 评论接口说明 和 Reddit 搜索接口说明 列了全部参数;同样的做法也能换到 YouTube 搜索 和 Reddit 评论。
算账:每天 100 个问题,一个月多少钱
成本分两块:数据接口费和模型费。数据接口费最好算。每个问题按固定配方调 3 次:reddit/search 取 10 条、youtube/search 取 5 条、对搜索到的第一个视频调 youtube/comments 取 20 条,目录里三项的 price_usd 都是 0.000556,按次计费、和返回条数无关(目录)。每题 $0.001668,每天 100 题、一个月 30 天共 3,000 题,接口费 $5.004。失败和空结果按目录说明退款,所以这是上限。
模型费要从真实返回的大小算。00:19–00:21(新加坡时间)我们用这个配方跑了两个问题。「Notion AI」:reddit/search 回 7 条、11,318 字节,youtube/search 回 5 条、16,689 字节,youtube/comments 回 20 条、6,525 字节,合计 34,532 字节。「Cursor pricing」:reddit/search 只回 1 条、1,372 字节(关键词匹配很严),youtube/search 8,411 字节,youtube/comments 7,652 字节,合计 17,435 字节。两题平均每题 25,984 字节,按 4 字节约 1 个 token 算约 6,496 token。
关键在于代理循环会重读。第一轮模型只读指令、工具定义和问题,约 1,052 token(指令按 400 token、问题按 40 token 假设,工具定义 612 token 是实测);它发出两个搜索调用。第二轮要把两个搜索结果一起读进来,约 5,896 token;它再发出评论调用。第三轮要把前面所有内容加上评论结果再读一遍,约 7,728 token,然后写答案。三轮输入合计 14,676 token,是「只读一遍工具返回」的 2 倍左右。输出按每个调用参数 60 token、答案 500 token、每轮推理 300 token 假设,合计 1,580 token。一个月 3,000 题,输入约 4,403 万 token,输出约 474 万 token。
再乘上 OpenAI 定价页 11 月 8 日的标准价(每百万 token,输入 / 输出):gpt-6-luna $0.10 / $0.50,gpt-6.1-terra $1.00 / $5.00,gpt-6.1-sol $2.00 / $10.00,gpt-6-astra $10.00 / $50.00(OpenAI 定价页)。Responses MCP 指南写明用 MCP 工具只按导入工具定义和调用工具用掉的 token 计费,每次工具调用不另收费(Responses MCP 指南);Agents SDK 本身是开源库,不收费。下表没有算提示词缓存,也没有算你自己托管 SDK 进程的服务器费;定价页另写了数据驻留端点对 2026 年 3 月 5 日及之后发布的模型加收 10%(OpenAI 定价页)。
| 模型 | 模型费 / 月 | 接口费 / 月 | 合计 / 月 | 每题 | 接口费占比 |
|---|---|---|---|---|---|
| gpt-6-luna | $6.77 | $5.00 | $11.78 | $0.00393 | 42.5% |
| gpt-6.1-terra | $67.73 | $5.00 | $72.73 | $0.02424 | 6.9% |
| gpt-6.1-sol | $135.46 | $5.00 | $140.46 | $0.04682 | 3.6% |
| gpt-6-astra | $677.28 | $5.00 | $682.28 | $0.22743 | 0.7% |
这张表有两个读法。第一,选模型对账单的影响比选数据源大得多:最便宜和最贵两档模型的单价正好差 100 倍,月成本从 $11.78 到 $682.28。第二,用最便宜的 gpt-6-luna 时,数据接口费占到 42.5%,这时候省钱要从调用次数下手:比如先用 youtube/search 的结果判断够不够,不够再调评论,或者把 limit 从 20 降到 10。我们也算了两种敏感性:如果你的问题平均返回大一倍(工具输出 ×2),四档月成本变成 $15.14、$106.39、$207.78、$1,018.88;如果推理 token 从每轮 300 涨到 1,000,变成 $14.93、$104.23、$203.46、$997.28。推理 token 我们没有实测,是假设里最不确定的一项;上线前用你自己的真实问题跑一周、看账单,是唯一可靠的办法。
拿官方接口做同样的事,难点不在钱。YouTube Data API 的配额说明写明,默认每个项目每天 100 次 search.list,单独计配额,其余接口合计每天 10,000 单位(YouTube Data API 配额计算器),页面最后更新于 2026 年 11 月 3 日;commentThreads.list 每次 1 单位(commentThreads: list)。也就是说,每天 100 个问题、每题一次 YouTube 搜索,正好用完默认的搜索配额,第 101 次或任何一次重试都会失败。Reddit 的免费 Data API 限制是每个 OAuth 客户端每分钟 100 次(按 10 分钟平均),并要求删除已在 Reddit 上删除的内容,建议 48 小时内清理存储的用户数据(Reddit Data API Wiki;Reddit Data API Terms)。这些规则对 agent 同样适用:如果你把拉回来的帖子存进向量库长期复用,删除义务也跟着过来。
| 做同一件事 | 每天 100 题够不够 | 要准备什么 | 出处 |
|---|---|---|---|
| YouTube Data API(默认配额) | 搜索刚好 100 次,没有余量 | Google Cloud 项目、API Key,超额要申请 | 配额计算器 |
| Reddit Data API(免费档) | 次数够,每分钟 100 次 | 注册 OAuth 应用、写规定格式的 User-Agent | Reddit Data API Wiki |
| EveryInfra MCP | 每题 3 次,$0.001668 | 一把 Key;本文用的测试 Key 被单独设了每分钟 10 次的上限,不是默认值 | 目录 |
最后一行的限速是本次实测里遇到的:00:16:55(新加坡时间)我们同时发了两个评论请求,都回了 429,retry_after 5 秒,next_steps 写着没有扣费;隔 16 秒和 39 秒重发都成功。这把测试 Key 被单独限到每分钟 10 次,那几分钟另有几个任务也在用。每天 100 题平均每分钟 0.2 题,限速只在集中提问时才会碰到;碰到时按 retry_after 等就行。
做不了或要注意的地方
导出不是迁移。迁移指南说得很清楚,导出不转换工作流图,也不保证行为不变(迁移指南)。我们没有拿到一个真实的 Agent Builder 导出文件来逐行对照,本文的节点对照表来自节点参考页和 SDK 文档;你拿到自己的导出后,要用原工作流的典型输入逐个对比输出,至少覆盖「结果为空」「被限速」「审批被拒」三种情况。导出代码默认会尝试把追踪数据发给 OpenAI,我们本机运行时没有设 OPENAI_API_KEY,SDK 打出「skipping trace export」并跳过;SDK 的追踪文档写了怎么关闭或换成你自己的追踪处理器(SDK 追踪文档)。
OpenAI 一侧我们没有跑。HostedMCPTool 和 Responses API 的 mcp_approval_request / mcp_approval_response 往返都需要真实的 OpenAI 账号和模型,本文里这两段都是配置示例;Responses API 的审批是每次调用一个请求,回复时要用 previous_response_id 把新请求和产生审批请求的那次连起来(Responses MCP 指南)。另外,connector_id 方式对 9 月 1 日之后发布的模型已经弃用,要用 server_url 或 tunnel_id(Responses MCP 指南);如果你在 Agent Builder 的 MCP 节点里用的是 OpenAI 内置的连接器,迁移时换新模型就要换接法。
托管成本要自己算。Agent Builder 和 ChatKit 托管工作流时,你不用管服务器;搬到 SDK 后,进程、存储、冷启动都归你。社区帖里有开发者贴出的实测是:用 AWS Lambda 容器加 Lambda Web Adapter 跑 ChatKit 后端,20 次并发健康检查的冷启动初始化 2.5–3.4 秒;另一位说常驻虚拟机一个月要 15–30 美元(OpenAI 社区:Deprecation notice: Agent Builder)。这些是个人报告,不是我们的实测,只说明这笔钱和数据接口费、模型费是同一个量级,算总账时别漏。
数据一侧的边界:reddit/search 只搜最近一个月的帖子标题和正文,不搜评论全文;youtube/comments 的 posted_at 可能是相对时间;主来源不可用时,部分字段会是空的,例如 youtube/comments 可能缺 like_count 和 reply_count,reddit/search 本次就没返回 flair 和缩略图,目录 field_note 写明了每项能力会缺哪些字段(目录)。agent 的指令里要写明这几条,避免模型把「没有返回」说成「没有人讨论」。
最近的变化
- 2026-10-14:OpenAI 通知 GPT-4o、GPT-4.1 系列 2027 年 1 月 14 日下线,推荐换
gpt-6-luna(弃用页)。对读者意味着:老工作流里常见的gpt-4.1-mini也要换,DevPro Journal 引 The New Stack 指出这次只给了三个月(DevPro Journal)。 - 2026 年 10 月:Agents API 加了自动审批(
review: "auto_review"),由模型按对话意图和风险批准或拒绝工具请求,另计 token(OpenAI 更新日志)。对读者意味着:托管那条路的审批可以交给模型,自己跑 SDK 的这条路要自己写。
常见问题
openai agent builder shut down automatically 是什么意思,到期会自动停吗?
会。弃用页写的是 11 月 30 日「计划停服」,停服后产品不再可用(OpenAI 弃用页);弃用页对术语的说明是,停服(shut down)指不再可以访问。你不需要做任何操作它也会停,所以要在这之前导出代码。
chatkit after agent builder not working:Agent Builder 停服后 ChatKit 还能用吗?
ChatKit 保留,但由 Agent Builder 托管的工作流只在过渡期内可用(ChatKit 文档);新应用和迁移要走 ChatKit 的高级接法,后端换成你自己的 Agents SDK 服务(Advanced integrations with ChatKit)。已发布的工作流 ID 停服后是否还能执行,官方没有写明,社区和 Forkast 都把它当作未决问题(Forkast)。
openai agent builder replacement:官方推荐的替代是什么?
迁移指南只列了两条:Agents SDK(用代码搭)和 ChatGPT Workspace Agents(用自然语言搭、和团队共享,需要 Business、Enterprise 或 Edu 工作区)(迁移指南)。社区回帖里也有人建议直接在 Responses API 上写一层自己的薄封装(OpenAI 社区清单帖)。
openai hosted mcp tool approvals:托管 MCP 的审批怎么关、怎么只关一部分?
在 require_approval 里写 "never" 关掉全部,或写 {"never": {"tool_names": [...]}} 只对列出的工具免审批(Responses MCP 指南);Python SDK 里还可以用 on_approval_request 回调在代码里自动判断(SDK MCP 文档)。对会扣费的数据工具,建议只对免费的只读工具免审批。
上手步骤
- 在 11 月 30 日之前打开每个工作流,点 Code → Agents SDK → Python 或 TypeScript,把导出存进代码仓库;同时导出 prompt 对象里的提示词和 Evals 里的测试集。
- 装 PyPI 上的
openai-agents==0.24.0(Python 3.10 以上,见 PyPI;导出的是 TypeScript 就装@openai/agents,要求 Node.js 22 以上,见 npm),照 Agents SDK quickstart 跑通第一次运行,再把模型名换成弃用页推荐的新模型。 - 在 EveryInfra 控制台 拿一把 Key,放进环境变量
EVERYINFRA_API_KEY;远程 MCP 接入说明 和 MCP 服务页 有各客户端的配置。 - 把 MCP 节点换成上文的
MCPServerStreamableHttp配置:只开两个工具、超时 120 秒、审批函数两个字段名都读。 - 跑一次
list_tools(),断言要审批的工具数是 5;再用三个真实问题对比原工作流的输出。 - 查一下 Reddit 数据接口 和 YouTube 数据接口 的能力页,按你的问题挑能力和
limit;价格见 定价页,也可以在 市场 里直接试调。
参考资料
- Deprecations,OpenAI,2026-11-08 读取,<https://developers.openai.com/api/docs/deprecations>
- Migrate from Agent Builder,OpenAI,2026-11-08 读取,<https://developers.openai.com/api/docs/guides/agent-builder/migrate-from-agent-builder>
- Agent Builder,OpenAI,2026-11-08 读取,<https://developers.openai.com/api/docs/guides/agent-builder>
- Node reference,OpenAI,2026-11-08 读取,<https://developers.openai.com/api/docs/guides/node-reference>
- Migrate from prompt objects,OpenAI,2026-11-08 读取,<https://developers.openai.com/api/docs/guides/prompting/migrate-from-prompt-object>
- Moving from OpenAI Evals to Promptfoo,OpenAI Cookbook,2026-11-08 读取,<https://developers.openai.com/cookbook/examples/evaluation/moving-from-openai-evals-to-promptfoo>
- Nov 30 shutdown checklist: Agent Builder, Evals, prompt objects,OpenAI 开发者社区,2026-10-30,<https://community.openai.com/t/nov-30-shutdown-checklist-agent-builder-evals-prompt-objects-evals-go-read-only-oct-31/1411075>
- ChatKit,OpenAI,2026-11-08 读取,<https://developers.openai.com/api/docs/guides/chatkit>
- Advanced integrations with ChatKit,OpenAI,2026-11-08 读取,<https://developers.openai.com/api/docs/guides/custom-chatkit>
- Deprecation notice: Agent Builder,OpenAI 开发者社区,2026-06 起,<https://community.openai.com/t/deprecation-notice-agent-builder/1382650>
- OpenAI Agent Builder's Nov. 30 shutdown puts migration on a code-and-validation path,Forkast,2026-11,<https://forkast.news/openai-agent-builders-nov-30-shutdown-puts-migration-on-a-code-and-validation-path/>
- Model context protocol (MCP),OpenAI Agents SDK(Python)文档,2026-11-08 读取,<https://openai.github.io/openai-agents-python/mcp/>
- MCP servers(Responses API),OpenAI,2026-11-08 读取,<https://developers.openai.com/api/docs/guides/tools-connectors-mcp>
- openai-agents 0.24.0,PyPI,2026-10-15,<https://pypi.org/project/openai-agents/>
- @openai/agents,npm,2026-11-08 读取,<https://www.npmjs.com/package/@openai/agents>
- Releases · openai/openai-agents-python,GitHub,2026-10-15 起,<https://github.com/openai/openai-agents-python/releases>
- Agents API overview,OpenAI,2026-11-08 读取,<https://developers.openai.com/api/docs/guides/agents-api/overview>
- Human-in-the-loop,OpenAI Agents SDK(Python)文档,2026-11-08 读取,<https://openai.github.io/openai-agents-python/human_in_the_loop/>
- What are tokens and how to count them,OpenAI 帮助中心,2026-11-08 读取,<https://help.openai.com/en/articles/4936856-what-are-tokens-and-how-to-count-them>
- Responses API reference: Create a model response,OpenAI,2026-11-08 读取,<https://developers.openai.com/api/reference/resources/responses/methods/create>
- src/agents/testing/model.py,openai/openai-agents-python,GitHub,2026-11-08 读取,<https://github.com/openai/openai-agents-python/blob/main/src/agents/testing/model.py>
- EveryInfra 数据目录:reddit,EveryInfra,2026-11-08 00:15 读取,<https://api.everyinfra.com/api/v1/social/catalog?platform=reddit>
- EveryInfra 数据目录:youtube,EveryInfra,2026-11-08 00:15 读取,<https://api.everyinfra.com/api/v1/social/catalog?platform=youtube>
- OpenAI Agent Builder Is Shutting Down Do This Before November 30,YouTube,2026-11-02,<https://www.youtube.com/watch?v=ug0UziXU3-Q>
- Model Context Protocol (MCP),OpenAI Agents SDK(JavaScript)文档,2026-11-08 读取,<https://openai.github.io/openai-agents-js/guides/mcp/>
- Tools,Model Context Protocol 规范 2025-11-25,2026-11-08 读取,<https://modelcontextprotocol.io/specification/2025-11-25/server/tools>
- Streaming,OpenAI Agents SDK(Python)文档,2026-11-08 读取,<https://openai.github.io/openai-agents-python/streaming/>
- Responses streaming events,OpenAI API 参考,2026-11-08 读取,<https://developers.openai.com/api/reference/resources/responses/streaming-events>
- EveryInfra 数据目录(全部能力,含 async_mode 说明),EveryInfra,2026-11-08 00:15 读取,<https://api.everyinfra.com/api/v1/social/catalog>
- Pricing,OpenAI,2026-11-08 读取,<https://developers.openai.com/api/docs/pricing>
- Quota Calculator,YouTube Data API,Google for Developers,页面更新于 2026-11-03,<https://developers.google.com/youtube/v3/determine_quota_cost>
- CommentThreads: list,YouTube Data API,Google for Developers,2026-11-08 读取,<https://developers.google.com/youtube/v3/docs/commentThreads/list>
- Reddit Data API Wiki,Reddit Help,2026-11-08 读取,<https://support.reddithelp.com/hc/en-us/articles/16160319875092-Reddit-Data-API-Wiki>
- Data API Terms,Reddit,2026-11-08 读取,<https://www.redditinc.com/policies/data-api-terms>
- Tracing,OpenAI Agents SDK(Python)文档,2026-11-08 读取,<https://openai.github.io/openai-agents-python/tracing/>
- AI model deprecation is coming. Is your product ready?,DevPro Journal,2026-11,<https://www.devprojournal.com/technology-trends/ai/ai-model-deprecation-is-coming-is-your-product-ready/>
- Changelog,OpenAI,2026-11-08 读取,<https://developers.openai.com/api/docs/changelog>
- Safety in building agents,OpenAI,2026-11-08 读取,<https://developers.openai.com/api/docs/guides/agent-builder-safety>
- Secure MCP Tunnel,OpenAI,2026-11-08 读取,<https://developers.openai.com/api/docs/guides/secure-mcp-tunnels>
- Agents SDK quickstart,OpenAI,2026-11-08 读取,<https://developers.openai.com/api/docs/guides/agents/quickstart>
- Guardrails,OpenAI Agents SDK(Python)文档,2026-11-08 读取,<https://openai.github.io/openai-agents-python/guardrails/>
- Sessions,OpenAI Agents SDK(Python)文档,2026-11-08 读取,<https://openai.github.io/openai-agents-python/sessions/>
- examples/hosted_mcp,openai/openai-agents-python,GitHub,2026-11-08 读取,<https://github.com/openai/openai-agents-python/tree/main/examples/hosted_mcp>
引用编号 BL-108