OpenAI Agent Builder shut down: cómo pasar un agente de datos sociales al Agents SDK
Agent Builder cierra el 30 de noviembre. Pasa tu agente de Reddit y YouTube al Agents SDK con MCP, aprobaciones y streaming, desde 11,78 USD al mes.
OpenAI cierra Agent Builder el 30 de noviembre de 2026, y el código de los flujos solo se puede exportar antes de esa fecha (página de obsolescencias de OpenAI). Al pasar un agente de Reddit y YouTube al Agents SDK 0.24.0 encontramos dos fallos que la guía de migración no cuenta: el nombre de la pista de solo lectura de MCP cambia según la versión de MCP Python SDK, y el tiempo de espera de 5 segundos convierte una llamada cobrada en un «error». Con 100 preguntas al día, el coste total arranca en 11,78 USD al mes con gpt-6-luna y llega a 682,28 USD con gpt-6-astra.
Si trabajas en español, es fácil que no te hayas enterado del cierre. El 8 de noviembre de 2026, a las 00:36 hora de Singapur, buscamos en YouTube «OpenAI Agent Builder cierre migrar Agents SDK». De los 20 vídeos devueltos, ninguno estaba en español y ninguno trataba del cierre. Cuatro estaban en portugués y dos en ruso. La documentación del Agents SDK tampoco ayuda: existe en inglés, japonés, coreano y chino, pero no en español.
Este artículo es la guía que faltaba. Entre las 00:16 y las 00:30 hora de Singapur reconstruimos el agente con el servidor MCP remoto de EveryInfra. La pausa de aprobación, el rechazo, el streaming y la tarea asíncrona se ejecutaron de verdad en nuestra máquina; solo el modelo era un sustituto programado que trae el propio SDK.
El caso es concreto. Montaste en Agent Builder un agente que responde «¿qué dice la gente de este producto?». Su nodo MCP trae publicaciones de Reddit, vídeos de YouTube y comentarios de YouTube. ¿Cómo lo mantienes vivo después del 30 de noviembre? OpenAI propone dos caminos: el Agents SDK y los Workspace Agents de ChatGPT (Migrate from Agent Builder). Aquí cubrimos el Agents SDK y la Responses API sin SDK.
Cada nombre de campo y cada valor por defecto de OpenAI sale de developers.openai.com o de la documentación del Agents SDK, que abrimos el 8 de noviembre. No llamamos a ningún modelo de OpenAI. Por eso, todo lo que depende del servicio de OpenAI aparece como «ejemplo de configuración». Cada cifra de EveryInfra sale de una respuesta real.
| Parte del artículo | Estado | De dónde sale |
|---|---|---|
| Fechas y alcance del cierre | Leído en páginas de OpenAI el 8 de noviembre | Página de obsolescencias y guía de migración |
MCPServerStreamableHttp, pausa, rechazo y streaming | Ejecutado en nuestra máquina | Agents SDK 0.24.0 con un modelo programado |
| Llamadas y cobros de EveryInfra | Ejecutado en vivo | Respuestas reales con charged_usd |
HostedMCPTool y aprobaciones de la Responses API | Ejemplo de configuración | Solo documentación de OpenAI |
| Coste mensual | Calculado | Tamaños reales y precios públicos de OpenAI |
OpenAI Agent Builder shut down: qué dice el aviso de OpenAI
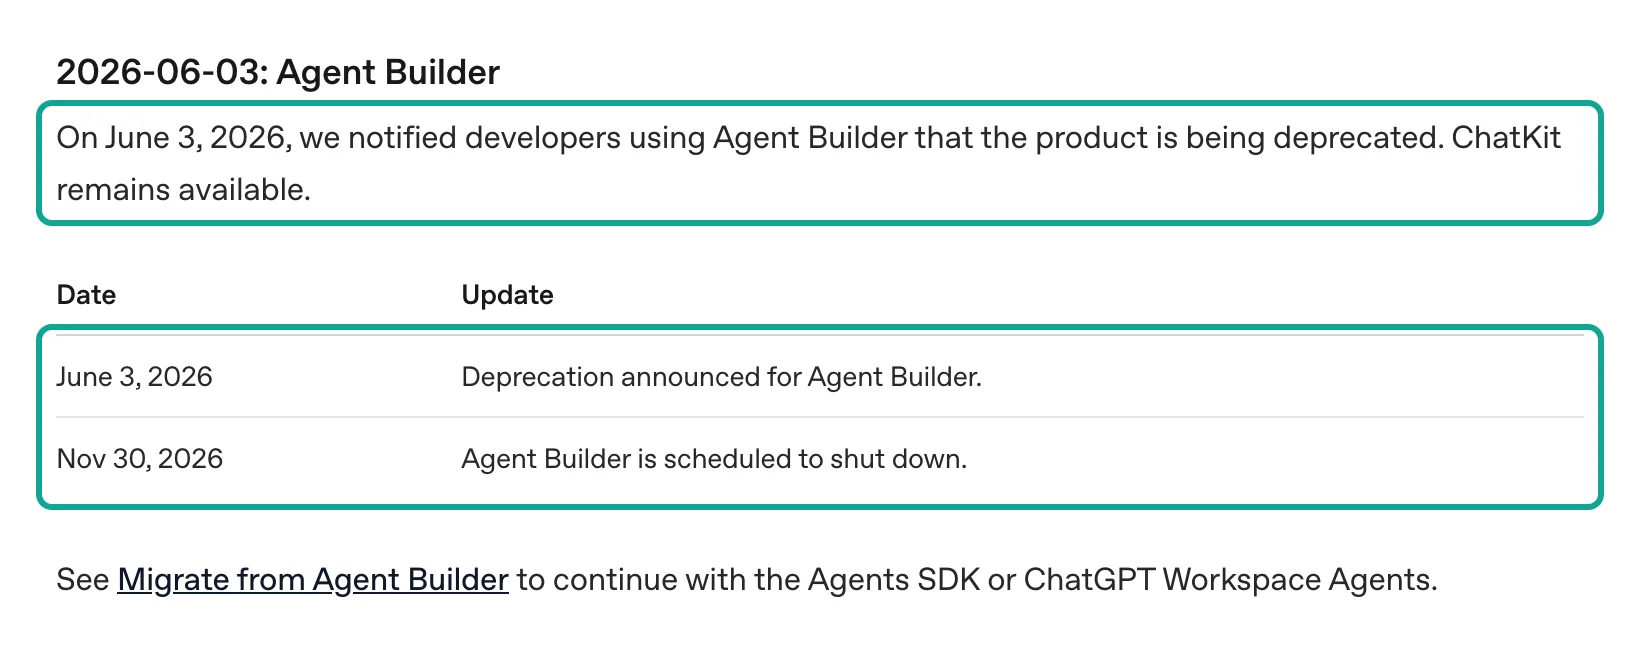
Primero, las fechas, porque todo el plan depende de ellas. La página de obsolescencias tiene una sección titulada «2026-06-03: Agent Builder». Dice que OpenAI avisó el 3 de junio a quienes usan Agent Builder de que el producto queda obsoleto, y que ChatKit sigue disponible. La tabla de esa sección tiene dos filas: el aviso del 3 de junio de 2026 y el cierre previsto del 30 de noviembre de 2026 (página de obsolescencias de OpenAI).
La misma página anuncia otros dos cierres para el mismo día. Los objetos de prompt reutilizables y la API v1/prompts dejan de funcionar el 30 de noviembre. Las evaluaciones existentes pasaron a solo lectura el 31 de octubre, y el panel y la API de Evals cierran también el 30 de noviembre (página de obsolescencias de OpenAI). La guía de Agent Builder y la referencia de nodos muestran el mismo aviso (guía de Agent Builder; referencia de nodos).
Conviene leer los tres cierres juntos. Un flujo típico guarda las instrucciones en un objeto de prompt y las pruebas en Evals, y las tres piezas desaparecen el mismo día. Para los prompts, OpenAI da un camino claro: pasar el texto al código, versionarlo en git y poner primero el texto estático para no perder la caché de prompts (Migrate from prompt objects). Para las evaluaciones, remite a un cookbook que las lleva a Promptfoo (Moving from OpenAI Evals to Promptfoo).
En el foro de OpenAI, un usuario reunió todas las fechas en una lista de comprobación el 30 de octubre y avisó de que el hecho de que ChatKit siga no significa que el flujo de Agent Builder que hay detrás siga funcionando (lista del foro de OpenAI). En el hilo original del aviso, otra respuesta da un consejo más concreto: no muevas los prompts de tus flujos a objetos de prompt, que también se apagan el 30 de noviembre, porque tendrías que migrar dos veces (hilo del aviso en el foro de OpenAI).
| Fecha | Qué pasa | Qué significa para un agente de datos sociales | Fuente |
|---|---|---|---|
| 2026-06-03 | Agent Builder, objetos de prompt y Evals quedan obsoletos | Empieza la cuenta atrás; exporta mientras el lienzo abra | Deprecations |
| 2026-10-15 | openai-agents 0.24.0 expone las anotaciones MCP en las herramientas | Puedes escribir reglas de aprobación con las pistas de cada herramienta | PyPI; GitHub |
| 2026-10-31 | Las evaluaciones existentes pasan a solo lectura | Exporta antes tus conjuntos de prueba | Deprecations |
| 2026-11-30 | Cierran Agent Builder, v1/prompts y Evals | Desaparecen el lienzo, los flujos alojados y los prompts guardados | Deprecations |
| 2026-12-11 | Cierran instantáneas antiguas de GPT-5 y o3 | Los nombres de modelo antiguos del código exportado vuelven a romperse | Deprecations |
La última fila es la que más se pasa por alto. El código exportado conserva el nombre de modelo que elegiste en el lienzo. La página dice que gpt-5, gpt-5-mini, o3 y otras instantáneas cierran el 11 de diciembre de 2026, con gpt-5.6-sol y gpt-5.6-terra como sustitutos (página de obsolescencias de OpenAI). Un código migrado el 30 de noviembre puede romperse otra vez once días después.
La misma página da una forma de vigilarlo desde el código. La respuesta de GET /v1/models incluye un campo opcional shutdown_date, y si trae una fecha, hay un cierre programado (página de obsolescencias de OpenAI). Mete esa comprobación en una tarea programada mientras dure la migración.
Por qué casi no hay nada en español sobre el cierre
Antes de seguir con el código, una observación que solo tiene sentido para quien lee en español. A las 00:36 hora de Singapur lanzamos youtube/search con la consulta «OpenAI Agent Builder cierre migrar Agents SDK». La llamada costó 0,000556 USD y devolvió 20 vídeos.
| Idioma del título | Vídeos | Sobre el cierre de Agent Builder | Ejemplo de tema |
|---|---|---|---|
| Inglés | 14 | 0 | Cursos del Agents SDK, la presentación oficial de Agent Builder |
| Portugués | 4 | 0 | Tutoriales completos de Agent Builder de octubre de 2025 |
| Ruso | 2 | 0 | Agent Builder frente a n8n, reseña del SDK |
| Español | 0 | 0 | — |
El buscador entendió la consulta, porque devolvió el vídeo oficial «Intro to Agent Builder» (1.752.612 visualizaciones) y la presentación de la Agents API (295.865). Pero no encontró nada en español. A las 00:36 lanzamos también reddit/search con «Agent Builder OpenAI español». Devolvió 2 publicaciones, ninguna de OpenAI: un creador de agentes de código abierto y una comparación de tres herramientas de automatización.
La documentación va en la misma línea. El 8 de noviembre comprobamos los selectores de idioma de las dos webs del Agents SDK. La de Python ofrece inglés, japonés, coreano y chino (Agents SDK Python). La de JavaScript, lo mismo (Agents SDK JS). La ruta /es/ devuelve 404 en las dos. Las sugerencias de búsqueda de Google cuentan algo parecido: con «agent builder openai cierre» no salió ninguna sugerencia en español, y con «agents sdk openai español» salieron «docs», «github» y «pdf», es decir, gente buscando documentación que no existe.
Para un equipo de Ciudad de México, Bogotá o Madrid, esto tiene una consecuencia práctica. Si montaste el flujo con un tutorial en portugués o en inglés de finales de 2025, nadie en tu idioma te va a recordar la fecha. Apunta el 30 de noviembre en el calendario hoy mismo.
Qué se apaga: el lienzo, los flujos alojados y la configuración «recomendada» de ChatKit
«ChatKit sigue disponible» se lee fácilmente como «mi interfaz de ChatKit está a salvo». La guía de ChatKit describe ahora dos caminos. El primero ejecuta ChatKit en tu propio servidor y lo conecta con cualquier servicio de agentes, por ejemplo uno hecho con el Agents SDK. El segundo es la integración alojada en Agent Builder, que la guía permite usar solo durante el periodo de transición (guía de ChatKit). La guía avanzada dice que las apps nuevas deben usar un agente propio en el servidor (Advanced integrations with ChatKit).
El 4 de junio, un desarrollador que mantiene ChatKit para varios clientes preguntó en el foro si la configuración «recomendada» también se apagaba. Una respuesta explicó que ChatKit sigue, pero que la configuración recomendada dependía de un backend alojado en Agent Builder. Solo queda la configuración «avanzada» con backend propio (hilo del aviso en el foro de OpenAI). Es una lectura del foro, no una declaración de OpenAI.
Un análisis de Forkast de principios de noviembre añade que la documentación no aclara si los ID de flujos publicados seguirán funcionando con ChatKit después del 30 de noviembre (Forkast). Mientras OpenAI no diga otra cosa, planifica como si el ID dejara de funcionar.
La exportación también tiene fecha límite. La guía de migración da cuatro pasos: abrir el flujo, elegir Code en la barra superior, elegir Agents SDK y, por último, TypeScript o Python y copiar el resultado (Migrate from Agent Builder). La misma página advierte que el proceso no convierte el grafo del flujo ni garantiza que todo el comportamiento se mantenga igual.
El camino de Workspace Agents exige un espacio de ChatGPT Business, Enterprise o Edu. Además, la guía avisa de que los flujos muy deterministas pueden no pasar bien a un agente de espacio de trabajo. Un agente que hace tres llamadas de datos en un orden fijo es justo ese caso, así que usamos el Agents SDK.
Tres caminos: Agents SDK, Responses API o Workspace Agents
Los tres caminos pueden llamar a herramientas MCP. Cambian en dónde corre el bucle del agente, quién aprueba cada llamada y por dónde pasa la clave. La tabla sale de la documentación oficial; la columna «Encaja con» es nuestra opinión para un agente que responde unos cientos de preguntas al día.
| Camino | Dónde corre el bucle | Quién conecta con el MCP | Cómo se aprueba | Encaja con | Fuente |
|---|---|---|---|---|---|
Agents SDK + MCPServerStreamableHttp | Tu proceso | Tu proceso | require_approval, también como función; se reanuda desde RunState | Equipos que registran todo, controlan el gasto y cambian de modelo | MCP en el SDK |
Agents SDK + HostedMCPTool | Tu proceso | OpenAI | require_approval en tool_config más on_approval_request | Servidores públicos, menos código de conexión | MCP en el SDK |
Herramienta mcp de la Responses API | Tu propio bucle | OpenAI | Por defecto always; responder a mcp_approval_request con mcp_approval_response | Quien ya tiene un bucle propio | Guía MCP de Responses |
| Workspace Agents de ChatGPT | ChatGPT | Apps de ChatGPT | Se configura en ChatGPT | Agentes de equipo en lenguaje natural | Guía de migración |
Si eliges el Agents SDK, fija openai-agents==0.24.0 desde PyPI, la versión subida el 15 de octubre de 2026 (PyPI: openai-agents), y no instales la 0.24.0-alpha.6 de GitHub. Esa vista previa solo se publica en GitHub Releases y sus notas listan cambios en la API pública: por ejemplo, las llamadas de un solo paso pasan a Agent.run() y desaparecen los alias de Runner (releases de openai-agents-python). El código exportado usa Runner.run, así que con la versión equivocada la primera ejecución puede fallar y parecerá que la exportación está mal cuando no lo está. Las versiones de Python y Node.js que hacen falta están en el paso 3 de «Cómo empezar».
OpenAI tiene además una Agents API alojada, en la que el bucle corre en sus servidores (Agents API overview), pero la guía de migración no la nombra como destino y este artículo no la usa. Su configuración MCP está en nuestro agente de reseñas con la Agents API de OpenAI.
Nodo a nodo: dónde va cada nodo de Agent Builder en el Agents SDK
Como la exportación no convierte el grafo, cada nodo necesita un sitio en el código. La columna izquierda recoge todos los nodos de la referencia oficial (referencia de nodos). La derecha es la pieza equivalente del SDK.
| Nodo de Agent Builder | Uso habitual en un agente de datos sociales | Equivalente en el Agents SDK |
|---|---|---|
Start (input_as_text) | Recibe la pregunta | El input de Runner.run(agent, input) |
| Agent | Elige Reddit o YouTube y redacta la respuesta | Agent(name, instructions, model, tools, mcp_servers) |
| MCP | Llama a everyinfra_call_api | MCPServerStreamableHttp o HostedMCPTool |
| Human approval | Pide permiso antes de una llamada de pago | require_approval del MCP, luego result.interruptions y state.approve() o state.reject() |
| If/else, While (CEL) | Repite la búsqueda con otra palabra si no hay resultados | Python o TypeScript normal |
| Guardrails | Bloquea datos personales o intentos de jailbreak | Guardrails de entrada, salida y herramienta |
| (Historial de chat que guarda el lienzo) | El usuario hace varias preguntas seguidas | Una sesión del SDK |
| Transform, Set state | Da forma fija a los resultados | output_type y el contexto de ejecución |
| File search | Busca en tus archivos | FileSearchTool |
| Note | Comentario en el lienzo | Comentario en el código |
Las dos filas que más trabajo dan son MCP y Human approval. Los nodos If/else y While usan expresiones CEL en el lienzo, y en código basta un if. El nodo MCP es otra cosa: en el lienzo eliges un servidor y pegas un token; en código decides quién conecta, en qué cabecera va la clave, qué herramientas quedan activas y cuánto se espera.
El nodo Human approval es una sola caja en el lienzo. En el SDK se divide en tres piezas: la regla de aprobación en la configuración de la herramienta, la lista interruptions en el resultado de la ejecución y un RunState que puedes guardar y recuperar (human-in-the-loop en el SDK). Las secciones de aprobación y de rechazo desarrollan esas tres piezas. Para el resto de filas basta la tabla: un guardrail del SDK que falla dispara una alarma y deja la decisión a tu código (guardrails en el SDK), y con una sesión solo hay que pasar la misma al reanudar después de una aprobación (sesiones en el SDK).
Reescribir las instrucciones del nodo Agent: poner por escrito las reglas escondidas en el lienzo
En el lienzo, muchas reglas viven en las flechas. Un resultado vacío va a la otra rama de un If/else; una aprobación rechazada vuelve al nodo Agent anterior. En código puedes escribir el bucle y los controles en Python. Pero el modelo sigue necesitando las reglas que afectan a sus decisiones, y esas van en instructions.
La guía de migración pide a quien use Workspace Agents que revise flujo de control, disparadores, herramientas y permisos (Migrate from Agent Builder). El camino del SDK necesita la misma revisión. Estas son las instrucciones que escribimos a partir de la prueba; cada línea responde a algo que vimos en una llamada real. Las dejamos en inglés porque el modelo las sigue igual de bien y así coinciden con los nombres de campo.
You answer questions about what people say online, using EveryInfra tools only.
1. Call everyinfra_call_api with platform "reddit", action "search", limit 10,
   and platform "youtube", action "search", limit 5, in the same turn.
2. "Agent Builder" is also a Microsoft Copilot product. Drop results that do not
   mention OpenAI before you count anything.
3. Call youtube/comments (limit 20, sort "newest") only for the first relevant video.
4. YouTube comment posted_at can be relative ("2 weeks ago"). Do not convert it
   into an exact date. Say "about 2 weeks ago".
5. If a tool returns 0 rows, say "no matching posts in the last month". Do not say
   "nobody talks about it".
6. If an error has retryable true, wait retry_after seconds once. Never call the
   same arguments twice after a timeout; use mode "async" for limit > 50.
7. Quote the post or video URL for every claim.| Regla | Llamada real que la motivó | Qué vimos |
|---|---|---|
| 2 | reddit/search y youtube/search, 00:16 hora de Singapur | Resultados de Microsoft Copilot con el mismo nombre |
| 4 | youtube/comments, 00:17 hora de Singapur | Fechas como «2 weeks ago» |
| 5 | Nota del catálogo para reddit/search | Solo el último mes; los resultados vacíos se reembolsan |
| 6 | Prueba de tiempo de espera, 00:29 hora de Singapur | Una llamada cobrada que el cliente vio como error |
La regla 5 sale de la nota del catálogo para reddit/search: busca solo en el último mes, devuelve solo publicaciones que contienen la palabra clave y reembolsa un resultado vacío (catálogo de EveryInfra: reddit). La regla 6 sale de la prueba de tiempo de espera que contamos más abajo: repetir la llamada con los mismos argumentos habría costado un segundo cobro.
Estas reglas estaban repartidas entre flechas y ajustes de nodos, y se pierden con facilidad. Escritas y numeradas, además, sirven como prueba de regresión: pasa las mismas preguntas reales antes y después de cada cambio, y así sustituyes las Evals que cierran el 30 de noviembre. La guía de seguridad de Agent Builder avisa de la inyección de prompts y de las fugas de datos (Safety in building agents). Las publicaciones y los comentarios son texto externo no fiable. La regla 7 obliga a citar un enlace por afirmación, de modo que una persona puede comprobarla y el modelo no toma el texto de un comentario como una orden.
Dos formas de conectar un MCP remoto
La documentación MCP del SDK empieza con una tabla de elección. HostedMCPTool sirve cuando quieres que la Responses API de OpenAI llame a un MCP público por el modelo. MCPServerStreamableHttp sirve cuando prefieres gestionar tú la conexión, sea local o remota (MCP en el SDK). La dirección MCP de EveryInfra, https://api.everyinfra.com/mcp, es pública, así que valen las dos. La diferencia está en desde dónde sale la petición, quién ve la clave y qué ves tú cuando una llamada falla.


Empezamos por la opción que probamos, MCPServerStreamableHttp. Esta es la configuración exacta de la prueba de aprobación de las 00:18 hora de Singapur del 8 de noviembre; solo cambiamos la clave por una variable de entorno. La clave va en la cabecera Authorization: Bearer, que la documentación del SDK recomienda porque funciona con las dos versiones principales de MCP Python SDK (MCP en el SDK). El tool_filter deja solo dos herramientas, y client_session_timeout_seconds sube a 120 por lo que explicamos en la sección del tiempo de espera.
import os
from agents import Agent, Runner
from agents.mcp import MCPServerStreamableHttp, create_static_tool_filter

def read_only_hint(tool):
    ann = getattr(tool, "annotations", None)
    if ann is None:
        return None
    for name in ("read_only_hint", "readOnlyHint"):  # MCP Python SDK v2 / v1
        if hasattr(ann, name):
            return getattr(ann, name)
    return None

def needs_approval(run_context, agent, tool):
    return read_only_hint(tool) is not True  # free read-only tools pass

everyinfra = MCPServerStreamableHttp(
    name="everyinfra",
    params={
        "url": "https://api.everyinfra.com/mcp",
        "headers": {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"},
        "timeout": 30,
        "sse_read_timeout": 120,
    },
    tool_filter=create_static_tool_filter(
        allowed_tool_names=["everyinfra_call_api", "everyinfra_get_job"]),
    require_approval=needs_approval,
    cache_tools_list=True,
    client_session_timeout_seconds=120,
)
¿Por qué solo dos herramientas? A las 00:18 hora de Singapur listamos las herramientas con este cliente. El MCP de EveryInfra tiene 12, y sus definiciones ocupan 16.275 bytes de JSON. Con solo everyinfra_call_api y everyinfra_get_job se quedan en 2449 bytes. OpenAI calcula que un token equivale a unos 4 caracteres de texto en inglés (OpenAI: qué son los tokens), así que pasamos de unos 4069 tokens a 612.
Las definiciones entran en el contexto en cada turno. Con tres turnos por pregunta, el filtro ahorra unos 10.400 tokens por pregunta. Las otras diez herramientas son de chat, tickets o recargas, y un agente de investigación social no las necesita; además, el modelo no puede llamar a lo que no ve. El SDK llama a list_tools() en cada ejecución, y cache_tools_list elimina ese retraso en un servidor remoto (MCP en el SDK: caché).
Ahora la opción alojada. Con HostedMCPTool, todo el ida y vuelta de la herramienta queda en manos de OpenAI. El SDK envía la etiqueta del servidor y la configuración a la Responses API, y el modelo lista y llama herramientas sin volver a tu proceso de Python. El tool_config es el mismo JSON que mandarías a la API REST (MCP en el SDK: herramientas alojadas). El código siguiente es un ejemplo de configuración; no lo ejecutamos con una cuenta de OpenAI.
from agents import Agent, HostedMCPTool, MCPToolApprovalRequest

def approve(request: MCPToolApprovalRequest):
    args = request.data.arguments or "{}"
    if '"limit":100' in args.replace(" ", ""):
        return {"approve": False, "reason": "Use limit 20 for a single question."}
    return {"approve": True}

agent = Agent(
    name="Social listening agent",
    model="gpt-6-luna",
    instructions="Answer with data from EveryInfra tools. Quote post URLs.",
    tools=[HostedMCPTool(
        tool_config={
            "type": "mcp",
            "server_label": "everyinfra",
            "server_url": "https://api.everyinfra.com/mcp",
            "headers": {"Authorization": "Bearer <EVERYINFRA_API_KEY>"},
            "allowed_tools": ["everyinfra_call_api", "everyinfra_get_job"],
            "require_approval": {
                "always": {"tool_names": ["everyinfra_call_api"]},
                "never": {"tool_names": ["everyinfra_get_job"]},
            },
        },
        on_approval_request=approve,
    )],
)
La referencia de la Responses API describe los campos de la herramienta mcp (referencia de la Responses API). headers es un mapa de cabeceras HTTP opcionales. authorization es un token de acceso OAuth para un MCP remoto. allowed_tools acepta una lista de nombres o un filtro con read_only y tool_names. La clave de EveryInfra es una clave Bearer, no un token OAuth, y por eso el ejemplo la pone en headers. El repositorio del SDK tiene ejemplos alojados de streaming, aprobaciones y conectores en examples/hosted_mcp (ejemplos de openai-agents-python). Para servidores que no pueden estar en internet, OpenAI ofrece Secure MCP Tunnel, con tunnel_id en lugar de server_url (Secure MCP Tunnel).
| Diferencia | `HostedMCPTool` | `MCPServerStreamableHttp` | Fuente |
|---|---|---|---|
| Quién manda la clave al MCP | OpenAI, en cada petición | Tu proceso | Guía MCP de Responses |
| Guardrails de herramienta en tu lado | No se aplican | Se aplican | MCP en el SDK |
| Aprobación por defecto | always en la Responses API | La decides tú | Referencia de la Responses API |
| Qué ves en una llamada lenta | Eventos de streaming de OpenAI | Tu propio tiempo de espera y tus errores | MCP en el SDK |
Sobre la clave: la guía MCP dice que la Responses API no guarda el valor de authorization ni lo muestra en el objeto Response, así que hay que enviarlo en cada petición (guía MCP de Responses). No dice lo mismo de headers, y no lo comprobamos. Sobre los guardrails: la documentación del SDK aclara que los guardrails de herramienta de un MCP local no se aplican a HostedMCPTool, porque la Responses API lo ejecuta como herramienta alojada. Sobre los datos: OpenAI dice que la herramienta MCP es compatible con Zero Data Retention y residencia de datos, pero lo que llega al servidor MCP sigue las reglas de ese servidor. Si tu equipo tiene que limpiar o registrar cada petición antes de que salga, necesita la opción local.
Una ida y vuelta completa: qué envió el modelo y qué devolvió EveryInfra
No llamamos a ningún modelo de OpenAI. Agents SDK 0.24.0 trae agents.testing.ScriptedModel, que su código fuente describe como un modelo determinista y neutral respecto al proveedor para probar flujos de agentes (código de testing/model.py). Cada paso devuelve una salida escrita de antemano. Le pedimos dos llamadas en paralelo en el primer turno y una frase en el segundo. El texto del modelo era fijo; todo lo demás era código real del SDK: la lista de herramientas, la pausa de aprobación, el guardado del RunState, la reanudación, los eventos de streaming, las llamadas MCP y las respuestas.
Estas son las dos llamadas del primer turno, como argumentos de everyinfra_call_api:
[{"name":"everyinfra_call_api","arguments":{"platform":"reddit","action":"search","params":{"keyword":"Agents SDK","sort":"newest","limit":10}}},
 {"name":"everyinfra_call_api","arguments":{"platform":"youtube","action":"comments","params":{"url":"https://www.youtube.com/watch?v=ug0UziXU3-Q","sort":"newest","limit":50}}}]
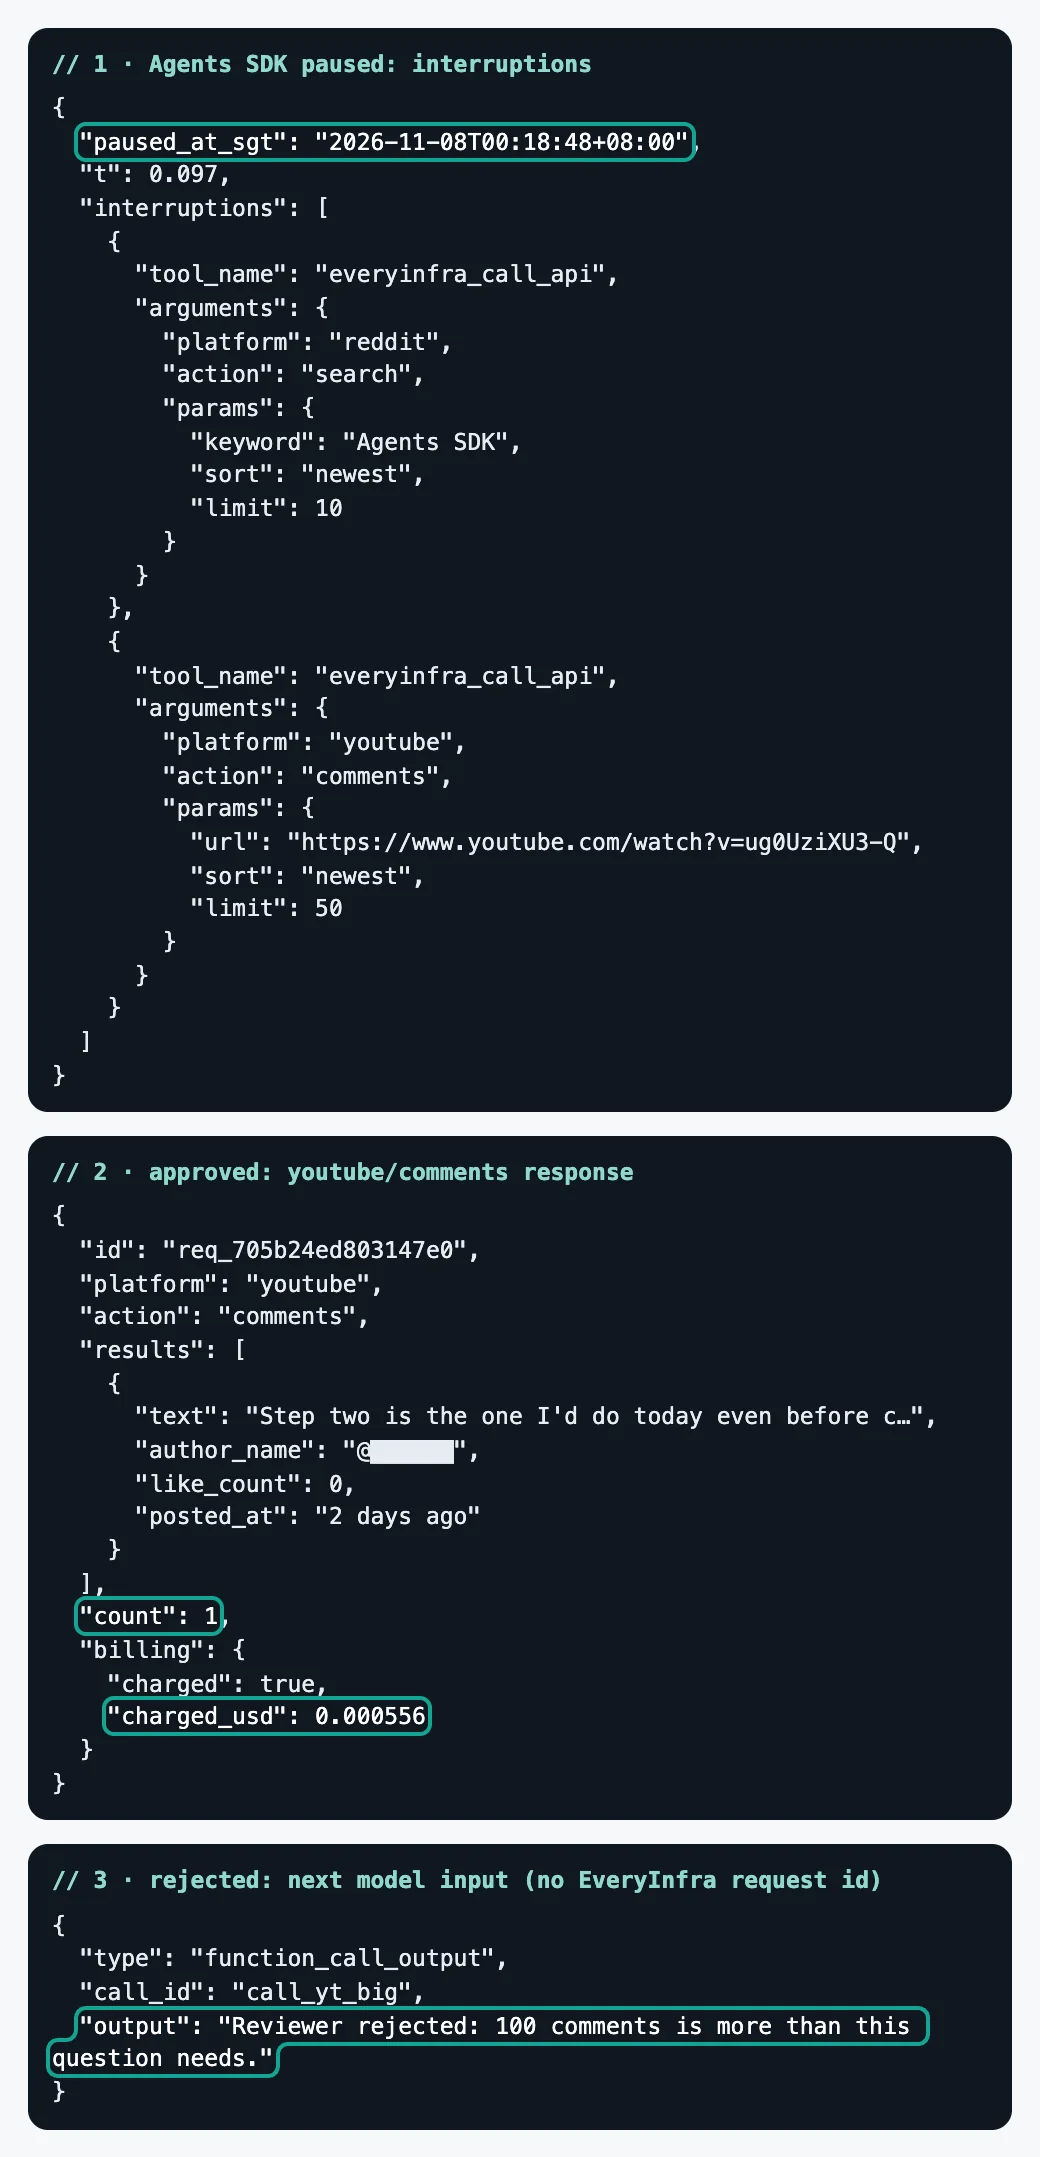
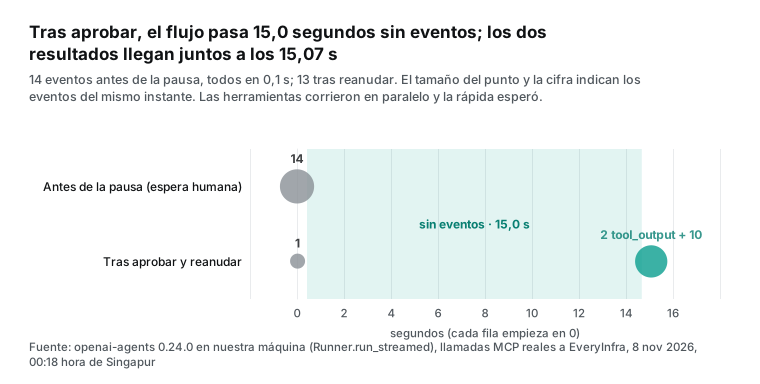
A las 00:18:48 hora de Singapur del 8 de noviembre, la ejecución se detuvo a los 0,097 segundos. result.interruptions contenía las dos llamadas con sus argumentos exactos, y todavía no había salido ninguna petición hacia EveryInfra. Guardamos el estado con state.to_string(): 25.739 bytes. Ese registro puede ir a una base de datos mientras alguien decide desde un panel de administración. Aprobamos las dos llamadas, reanudamos con Runner.run_streamed(agent, state) y los dos resultados llegaron a los 15,07 segundos.
| Llamada | Filas | Tamaño del texto MCP | `charged_usd` | Campos devueltos |
|---|---|---|---|---|
reddit/search, palabra clave «Agents SDK» | 5 | 13.835 caracteres | 0,000556 | 10 campos: id, url, title, text, author_username, community, like_count, comment_count, posted_at, platform |
youtube/comments, un vídeo | 1 | 1689 caracteres | 0,000556 | 8 campos: id, text, author_name, like_count, reply_count, posted_at, is_reply, platform |
Los dos cobros coinciden con el price_usd del catálogo para cada capacidad (catálogo de EveryInfra: reddit; (catálogo de EveryInfra: youtube). Quitamos los nombres de quienes comentan, tanto del texto como de la captura.
Los campos del comentario encajan con el catálogo de youtube/comments, que lista 9. El noveno, reply_to_id, solo viene en las respuestas a otro comentario; este era un comentario de primer nivel y no lo traía. En los 100 comentarios que sacamos a las 00:17, las 2 respuestas sí lo tenían.
Con Reddit no pasa lo mismo. El catálogo lista 15 campos para reddit/search, pero estas 5 publicaciones y las 19 de nuestras dos búsquedas de las 00:16 traían solo 10: faltaban flair, domain, external_link, thumbnail_url e image_urls. El field_note del catálogo explica una parte: cuando las demás fuentes no están disponibles responde una fuente de último recurso que no devuelve flair, thumbnail_url ni image_urls (catálogo de EveryInfra: reddit). La nota no menciona domain ni external_link; que faltaran es lo que vimos en esta prueba. Si tus instrucciones piden al modelo clasificar publicaciones por flair, ese campo puede llegar vacío, así que dile qué hacer cuando falte.
El único comentario está bajo un vídeo del 2 de noviembre de 2026 que recuerda el cierre (vídeo de YouTube). Traducido, dice que el segundo paso es el que haría hoy mismo, antes incluso de decidir adónde migrar: pulsar Code, copiar el código y poner por escrito, en texto plano, los prompts, las herramientas, los guardrails y las condiciones. La segunda mitad es justo lo que hace nuestra sección sobre reescribir las instrucciones del nodo Agent.
Cada respuesta trae además dos bloques que el modelo no necesita: billing y quota, con el cobro y el saldo de la cuenta. Suman unos quinientos o seiscientos bytes por llamada. En una pregunta es poco, pero en un bucle de cientos de llamadas al día el modelo los vuelve a leer una y otra vez. Las clases de servidor MCP del SDK tienen la opción custom_data_extractor, que pasa los datos de la salida a tu programa (MCP en el SDK). Un guardrail de salida de herramienta también podría quitar esos dos campos antes de que lleguen al modelo, mientras tu código anota el cobro en tu propia contabilidad. No probamos ese guardrail; tómalo como sugerencia.
Aprobación de herramientas: tres valores por defecto y un nombre de atributo
En Agent Builder, Human approval es un nodo y funciona en cuanto lo colocas. En código, el valor por defecto cambia según el sitio. La referencia de la Responses API fija require_approval en always (referencia de la Responses API), y la guía MCP dice que OpenAI pide tu aprobación antes de enviar datos a un MCP remoto (guía MCP de Responses). En el Agents SDK de JavaScript, en cambio, la tabla de opciones de hostedMcpTool pone requireApproval en 'never' (MCP en el SDK de JS).
| Dónde corre el agente | Valor si no indicas la aprobación | Fuente |
|---|---|---|
Herramienta mcp de la Responses API | always | Referencia de la Responses API |
HostedMCPTool de Python | always, heredado de la API REST | MCP en el SDK |
hostedMcpTool de JavaScript | 'never' | MCP en el SDK de JS |
El HostedMCPTool de Python envía tool_config tal cual a la API REST, así que se aplica el valor de la Responses API. Dicho de otro modo: el mismo flujo, exportado a TypeScript, no pide aprobación; exportado a Python, la pide en cada llamada.
Para los MCP locales, require_approval admite cinco formas (MCP en el SDK: políticas de aprobación): "always" o "never", True o False, un mapa de nombres de herramienta, un objeto agrupado como {"always": {"tool_names": [...]}} o una función con la firma (run_context, agent, tool). La función recibe la Tool original de MCP con sus tool.annotations, pero no los argumentos ni el ID de la llamada. La documentación añade que las anotaciones son pistas y que solo conviene fiarse de ellas si te fías del servidor.
Una regla basada en anotaciones es lo natural. La especificación MCP define annotations como propiedades opcionales que describen el comportamiento de una herramienta (especificación MCP: Tools). EveryInfra marca everyinfra_call_api con readOnlyHint: false y destructiveHint: true, porque cada llamada cuesta dinero, y marca everyinfra_get_job con readOnlyHint: true, porque leer un resultado asíncrono es gratis. A las 00:24 hora de Singapur leímos el JSON original de tools/list: 7 de las 12 herramientas tenían readOnlyHint: true.
Aquí está la trampa. El JSON usa el nombre de la especificación, readOnlyHint, en camelCase. Pero Agents SDK 0.24.0 instala hoy MCP Python SDK 2.3.0, y esa versión expone el campo como read_only_hint. Nuestra primera función leía tool.annotations.readOnlyHint y trataba la ausencia como «no es de solo lectura». Resultado: las 12 herramientas pedían aprobación, incluida la gratuita everyinfra_get_job.
Para descartar un error nuestro, creamos un segundo entorno con openai-agents==0.24.0 y mcp<2, que instaló la 1.30.0. Ahí el nombre vuelve a ser readOnlyHint y read_only_hint no existe. La documentación del SDK dice que admite las dos versiones principales con mcp>=1.19.0,<3 (MCP en el SDK: MCP Python SDK v1 y v2). Lo que no dice es que el nombre de los atributos de anotación depende del paquete MCP instalado.
| Entorno (mismo servidor, mismo `tools/list`) | `tool.annotations.readOnlyHint` | `tool.annotations.read_only_hint` | A aprobación, leyendo solo el nombre de la especificación | A aprobación, leyendo los dos nombres |
|---|---|---|---|---|
| openai-agents 0.24.0 + mcp 2.3.0 (instalación por defecto) | No existe | Existe | 12 de 12 | 5 de 12 |
openai-agents 0.24.0 + mcp 1.30.0 (mcp<2) | Existe | No existe | 5 de 12 | 5 de 12 |
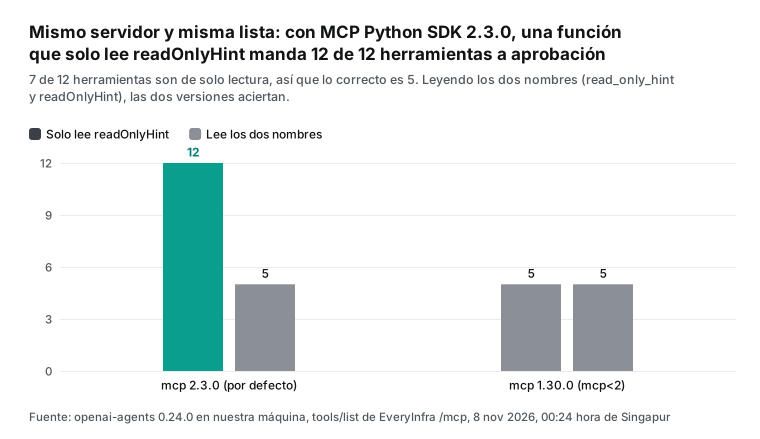
El sentido del error depende de tu valor por defecto. La nuestra manda a aprobación todo lo que no tiene pista, así que falla del lado seguro: más avisos de aprobación y una tarea desatendida que se queda parada, pero ningún gasto extra. Con el criterio opuesto, «sin pista es solo lectura», la otra versión principal dejaría pasar todas las llamadas de pago sin aprobar. El camino de la Responses API y HostedMCPTool no tiene este problema, porque OpenAI filtra con el campo del JSON en su lado. La documentación de JavaScript también dice que la forma de objeto de requireApproval puede seleccionar herramientas por su anotación de solo lectura (MCP en el SDK de JS).
La solución es corta: lee los dos nombres, como en la configuración de arriba. Y antes de cada despliegue, ejecuta list_tools() una vez y comprueba que el número de herramientas que piden aprobación es el esperado. Nuestro valor esperado es 5 y sale del JSON original del servidor, no de la propia función de aprobación.
Qué pasa cuando rechazas una llamada
También hace falta comprobar que un rechazo detiene de verdad la llamada. A las 00:19 hora de Singapur, el modelo programado pidió los 100 comentarios principales del vídeo oficial de presentación de Agent Builder. La ejecución se detuvo de nuevo para aprobar. Esta vez usamos state.reject() con el mensaje «Reviewer rejected: 100 comments is more than this question needs.» y reanudamos. En la siguiente entrada del modelo, la salida de esa llamada era el mensaje de rechazo. No hubo ID de petición de EveryInfra ni cobro.
La documentación del SDK explica el texto del rechazo (human-in-the-loop: mensajes de rechazo). Por defecto, una llamada rechazada devuelve un texto estándar. RunConfig.tool_error_formatter lo cambia para toda la ejecución, y rejection_message en state.reject() lo cambia para una sola llamada. Escribe el mensaje pensando en lo que debe hacer el modelo después. Un «rechazado» a secas suele provocar que lo intente igual. «100 comentarios es más de lo que pide esta pregunta» le da un motivo para bajar el limit. Los errores de EveryInfra siguen la misma idea: un parámetro incorrecto devuelve 422 con los parámetros admitidos, los valores permitidos, una sugerencia de corrección y la indicación de que no se cobró nada.
Una opción de aprobación pide cuidado: state.approve(item, always_approve=True) aprueba también las llamadas siguientes a la misma herramienta, y esa decisión queda guardada dentro del RunState (human-in-the-loop en el SDK). Con llamadas de datos de pago, aprueba de una en una, o usa una función que revise los argumentos, por ejemplo que bloquee cualquier limit por encima de 20.
| Acción | ¿Sale hacia EveryInfra? | ¿Se cobra? | Qué lee el modelo después | Nuestro registro |
|---|---|---|---|---|
| Aprobar una llamada | Sí | Sí, 0,000556 USD por llamada | La respuesta JSON real | Pausa a las 00:18:48, resultados 15,07 s después |
Rechazar con rejection_message | No | No | El mensaje de rechazo | 00:19:03 |
Aprobar con always_approve=True | Las siguientes llamadas a esa herramienta ya no se detienen | Sí | La respuesta real | No probado; según la documentación |
Streaming: qué muestra el flujo durante una pausa y 15 segundos de silencio
La vista previa de Agent Builder ilumina cada nodo mientras se ejecuta, y así el usuario ve el progreso. En el SDK, ese progreso se construye con eventos de streaming. La documentación describe dos capas (streaming en el SDK). Un raw_response_event envuelve un evento original de la Responses API. Un run_item_stream_event avisa de un elemento terminado, con nombres fijos; los relacionados con MCP son tool_called, tool_output, mcp_approval_requested, mcp_approval_response y mcp_list_tools.
Cuando una herramienta necesita aprobación, stream_events() termina y los elementos pendientes aparecen en interruptions. Conviertes el resultado en RunState, apruebas y reanudas con Runner.run_streamed() (streaming y aprobaciones). Registramos todos los eventos de la ejecución de las 00:18.
| Fase | Eventos | Momento | Qué eran |
|---|---|---|---|
| Antes de la pausa | 14 | De 0 a 0,095 s | 1 agent_updated_stream_event, 11 eventos originales, 2 tool_called |
| Esperando a una persona | 0 | Hasta la aprobación | El flujo ya terminó |
| Tras reanudar, inicio | 1 | 0,024 s | Un evento original |
| Tras reanudar, resultados | 2 | 15,07 s | 2 tool_output, juntos |
| Tras reanudar, respuesta | 10 | Desde 15,07 s | 9 eventos originales y 1 message_output_created |
Después de que alguien pulse «aprobar», el flujo se queda vacío 15 segundos. Las dos herramientas corrieron en paralelo y sus resultados llegaron juntos, de modo que la más rápida esperó a la más lenta.
Cómo rellenar esos 15 segundos depende del camino. Con un MCP local, el SDK emite tool_called antes de la pausa, y tu interfaz puede mostrar «buscando datos de Reddit y YouTube» desde tool_called hasta tool_output. Con MCP alojado, la referencia de streaming lista 8 eventos MCP: tres de response.mcp_list_tools, dos de response.mcp_call_arguments y tres de response.mcp_call (eventos de streaming de Responses). Tu interfaz puede enseñar el progreso a partir de response.mcp_call.in_progress. Si mantienes ChatKit como interfaz, su servidor tiene un ProgressUpdateEvent para que las herramientas largas envíen avances (Advanced integrations with ChatKit).
Un detalle que se olvida: si tu consumidor de eventos sale antes de tiempo, la ejecución en segundo plano puede seguir llamando al modelo y a las herramientas. Para pararla, llama a result.cancel() y vacía el flujo (streaming en el SDK). Con una herramienta de datos que cobra por llamada, esa advertencia afecta a tu factura.
El tiempo de espera de 5 segundos: el cliente dice «error» y el servidor ya cobró
Fue el hallazgo más caro de la prueba, aunque solo costó 0,000556 USD. La documentación del SDK dice que client_session_timeout_seconds vale 5 segundos por defecto en MCPServerStdio, MCPServerSse y MCPServerStreamableHttp (MCP en el SDK). Muchas llamadas síncronas de datos sociales tardan más. Entre las 00:19 y las 00:21 hora de Singapur ejecutamos la receta fija de la sección de costes para dos preguntas, y 4 de las 6 llamadas pasaron de 5 segundos:
| Pregunta | Capacidad | `limit` | Filas | Segundos | Con la espera por defecto de 5 s |
|---|---|---|---|---|---|
| Notion AI | reddit/search | 10 | 7 | 4,70 | Llega por poco |
| Notion AI | youtube/search | 5 | 5 | 7,95 | Error de espera |
| Notion AI | youtube/comments | 20 | 20 | 21,43 | Error de espera |
| Cursor pricing | reddit/search | 10 | 1 | 4,93 | Llega por poco |
| Cursor pricing | youtube/search | 5 | 5 | 10,04 | Error de espera |
| Cursor pricing | youtube/comments | 20 | 20 | 12,11 | Error de espera |
En esas 6 llamadas el cliente esperaba más de 5 segundos, así que todas devolvieron resultados. Con el valor por defecto, de cada pregunta solo volvería el paso de Reddit; los dos de YouTube darían error en tu lado y el servidor los cobraría igual. Las dos reddit/search tardaron entre 4,7 y 4,9 segundos, a unos cientos de milisegundos del límite, así que una red algo más lenta también las tumba.
A las 00:29:20 hora de Singapur llamamos a youtube/comments con el tiempo de espera por defecto, sobre un vídeo-curso de Agent Builder de octubre de 2025 y con limit 100. El cliente lanzó MCPError: Request 'tools/call' timed out a los 5,0 segundos. Cuarenta y cinco segundos después, a las 00:30:05, consultamos everyinfra_list_requests, una herramienta gratuita de solo lectura que muestra el registro de peticiones de la clave.
El registro mostraba una petición youtube.comments con estado 200 y latency_ms 28.442: 100 elementos, charged verdadero y 0,000556 USD. Terminó a las 00:29:48 hora de Singapur, 28,4 segundos después del envío. El registro no muestra los parámetros, así que emparejamos la petición por hora de envío y duración; en esos minutos, otras tareas también usaban esta clave de prueba.
La conclusión es clara: cuando el cliente deja de esperar, el servidor no cancela. Consiguió los datos y los cobró, y tu lado solo vio un error. Si además activas max_retry_attempts, que reintenta call_tool() automáticamente, el SDK o el modelo pueden repetir la llamada y pagar dos veces.
| Forma de llamar | Qué vio el cliente | Resultado en el servidor | Cobro | Hora (Singapur) |
|---|---|---|---|---|
| Síncrona, 5 s por defecto | MCPError a los 5,0 s | Terminada 28,4 s después, 100 filas | 0,000556 USD | 00:29:20 |
| Síncrona, 120 s | Resultados a los 15,07 s | 1 fila (otro vídeo, limit 50) | 0,000556 USD por llamada | 00:18:48 |
Asíncrona mode: async + consultas | job_id a los 2,53 s, resultados a los 38,58 s | 2 filas | 0,000556 USD (consultas gratis) | 00:25:01 |
Hay dos remedios y puedes usar ambos. El primero: sube client_session_timeout_seconds por encima de tu capacidad más lenta. Nosotros usamos 120 segundos, porque una llamada síncrona de EveryInfra espera hasta 85 segundos y la nota async_mode del catálogo recomienda el modo asíncrono para tareas lentas o límites grandes (catálogo de EveryInfra). El segundo: manda las capacidades lentas con mode: "async".
A las 00:25 hora de Singapur enviamos por MCP un youtube/comments asíncrono. A los 2,53 segundos teníamos status: running y un job_id. Luego consultamos everyinfra_get_job cada 3 segundos: 6 veces running, 4 veces finalizing y, en la consulta 11, succeeded, a los 38,58 segundos del envío. Según su descripción, everyinfra_get_job es gratis y no cuenta para el límite por minuto, así que consultar no añade coste. El cobro fue único, 0,000556 USD, en el envío. Para un agente, el modo asíncrono convierte una espera larga en varias llamadas cortas, todas muy por debajo de 5 segundos, y el progreso es más fácil de mostrar.
Prueba real: qué encuentra el agente sobre «¿qué opinan los desarrolladores del cierre?»
Tras la migración, el agente tiene que responder preguntas reales. Probamos la que mejor debería contestar: ¿qué opinan los desarrolladores del cierre de Agent Builder? A las 00:16 hora de Singapur lanzamos dos búsquedas en Reddit.
| Consulta (hora de Singapur) | Orden | Filas | Sobre OpenAI | Sobre Microsoft Copilot | Sobre el cierre |
|---|---|---|---|---|---|
| «agent builder», 00:16:14 | Más recientes | 10 | 0 | 1 | 0 |
| «OpenAI Agent Builder», 00:16:31 | Relevancia | 9 | 2 | 2 | 0 |
La primera devolvió 10 publicaciones, todas de las 8 horas anteriores a la búsqueda (de las 17:01 del 7 de noviembre a las 00:14 del 8, hora de Singapur) y ninguna sobre OpenAI. La segunda devolvió 9, publicadas entre el 2026-10-20 y el 2026-11-07 (UTC); solo 2 trataban de OpenAI (una pregunta sobre la Agents API y un operador de Kubernetes para agentes gestionados) y ninguna mencionaba el cierre. La nota del catálogo lo explica en parte: reddit/search solo busca en el último mes y solo devuelve publicaciones que contienen la palabra clave (catálogo de EveryInfra: reddit). Además, «Agent Builder» es un nombre ambiguo, porque Microsoft tiene uno. Por eso la regla 2 obliga a quedarse solo con resultados que mencionan OpenAI.
YouTube dio una señal mucho más clara. A las 00:16:36 hora de Singapur, youtube/search con «openai agent builder shut down» devolvió 20 vídeos. Ocho trataban del cierre, publicados entre el 3 de septiembre y el 2 de noviembre de 2026, con 472 visualizaciones en total. Seis eran tutoriales de Agent Builder de finales de 2025, entre ellos el vídeo oficial de presentación, con 2.118.658 visualizaciones: unas 4489 veces más. Los otros 6 no venían al caso, y uno era un tutorial del Agent Builder de Microsoft Copilot.
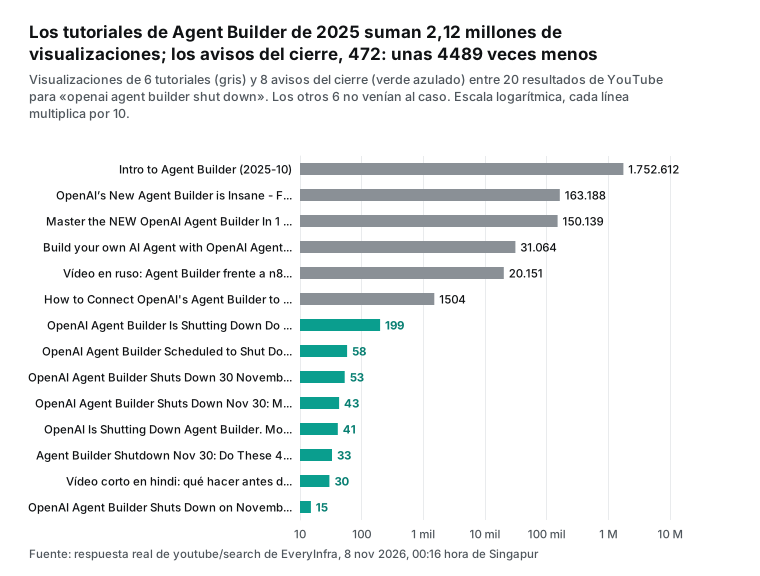
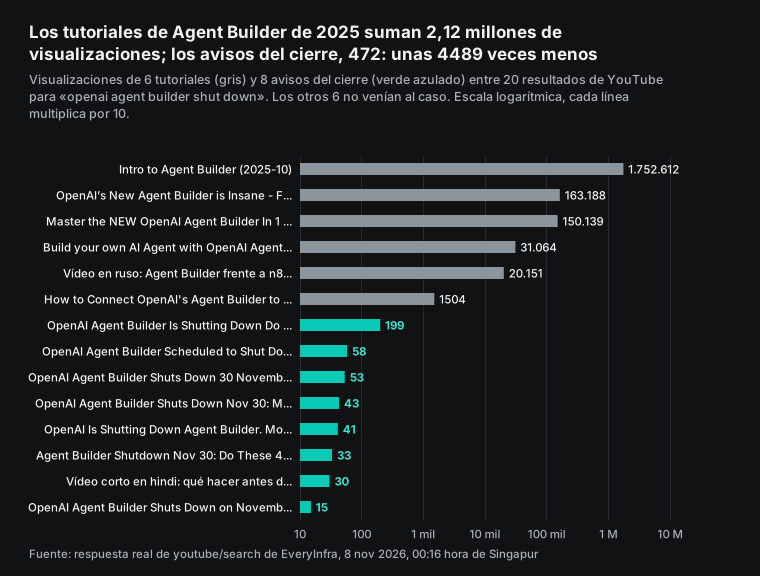
La diferencia sugiere que mucha gente que montó flujos con esos tutoriales no se ha enterado del cierre, y los comentarios del vídeo oficial apuntan en la misma dirección. A las 00:17 hora de Singapur, youtube/comments devolvió los 100 comentarios más recientes.
| Medida, 100 comentarios más recientes del vídeo oficial | Valor |
|---|---|
| Comentarios únicos | 81 |
| Repeticiones exactas de otro comentario | 19 |
| Respuestas | 2 |
| Comentarios que mencionan la obsolescencia | 2 |
| Comentarios en el grupo «hace 10 meses» | 55 |
Uno de los dos, de hace unos 3 meses, dice que ya está obsoleto; el otro, de hace unas 2 semanas, pregunta si esto sigue existiendo. Las 19 repeticiones parecen spam. Y posted_at es un texto relativo como «2 weeks ago», no una fecha, así que un agente que filtra por fecha solo puede ser tan preciso como ese texto.
Aquí es donde una API de datos ayuda en una migración. No sustituye a Agent Builder: te dice cuántos de tus propios usuarios no saben que tienen que moverse. Si mantienes una plantilla, un curso o un plugin de Agent Builder, ejecuta esta receta una vez por semana, sigue los vídeos y comentarios sobre el cierre y decide con esa cifra si mandas otro recordatorio. Y si tu público habla español, la búsqueda de arriba demuestra que ese recordatorio tendrás que escribirlo tú. Las páginas de la API de comentarios de YouTube y de la API de búsqueda de Reddit describen todos los parámetros; lo mismo sirve con la búsqueda de YouTube y los comentarios de Reddit.
El coste: 100 preguntas al día durante un mes
El coste tiene dos partes: la API de datos y el modelo. Los datos son fáciles de calcular. Cada pregunta usa una receta fija de 3 llamadas: reddit/search con 10 filas, youtube/search con 5 y youtube/comments con 20. Las tres cuestan 0,000556 USD por llamada según el price_usd del catálogo, sin importar el número de filas (catálogo de EveryInfra). Son 0,001668 USD por pregunta y 5,004 USD al mes con 100 preguntas diarias durante 30 días. Las llamadas fallidas y los resultados vacíos se reembolsan, así que es un máximo.
El coste del modelo depende de cuánto texto vuelve. Entre las 00:19 y las 00:21 hora de Singapur ejecutamos la receta con dos preguntas.
| Pregunta | `reddit/search` | `youtube/search` | `youtube/comments` | Bytes totales |
|---|---|---|---|---|
| «Notion AI» | 7 filas, 11.318 bytes | 5 filas, 16.689 bytes | 20 filas, 6525 bytes | 34.532 |
| «Cursor pricing» | 1 fila, 1372 bytes | 8411 bytes | 7652 bytes | 17.435 |
| Media | 25.984 |
«Cursor pricing» solo trajo 1 fila de Reddit porque la coincidencia de palabras es estricta. La media es de 25.984 bytes por pregunta, unos 6496 tokens a 4 bytes por token.
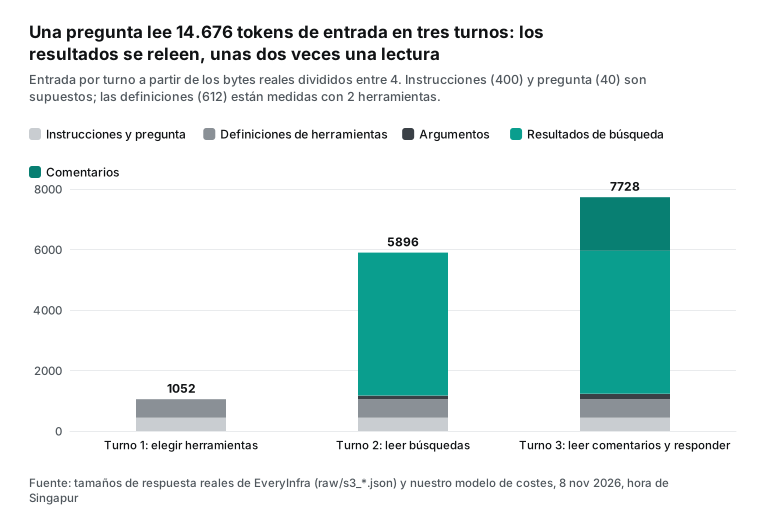
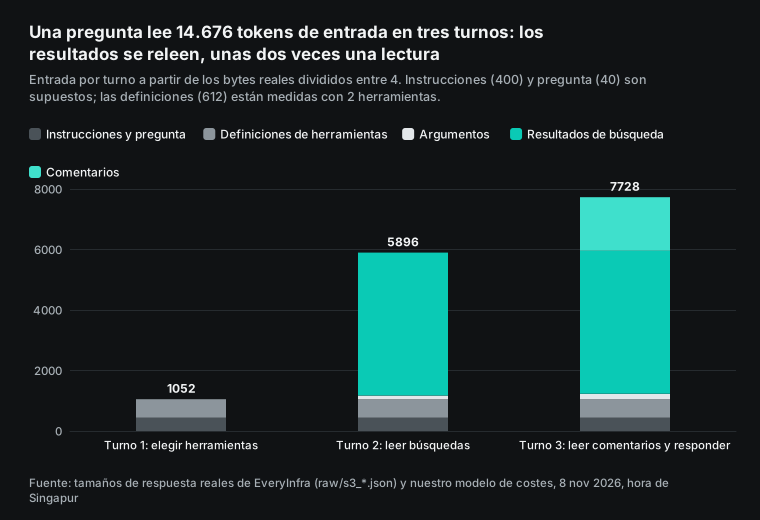
La clave está en que el bucle del agente relee el mismo texto. En el turno 1, el modelo lee las instrucciones, las definiciones de herramientas y la pregunta: unos 1052 tokens (400 de instrucciones y 40 de pregunta son supuestos; los 612 de definiciones están medidos). Luego hace las dos búsquedas. En el turno 2 lee todo eso más los dos resultados, unos 5896 tokens, y pide los comentarios. En el turno 3 lo lee todo otra vez más los comentarios, unos 7728 tokens, y escribe la respuesta. En total, 14.676 tokens de entrada, más o menos el doble de una sola lectura de los resultados. Para la salida suponemos 60 tokens por llamada, 500 para la respuesta y 300 de razonamiento por turno: 1580 tokens por pregunta. Con 3000 preguntas al mes salen unos 44,03 millones de tokens de entrada y 4,74 millones de salida.
Aplicamos los precios estándar de la página de precios de OpenAI del 8 de noviembre, por millón de tokens de entrada y de salida (precios de OpenAI): gpt-6-luna 0,10 y 0,50 USD; gpt-6.1-terra 1,00 y 5,00 USD; gpt-6.1-sol 2,00 y 10,00 USD; gpt-6-astra 10,00 y 50,00 USD. La guía MCP dice que solo se pagan los tokens, sin tarifa por llamada a herramienta (guía MCP de Responses), y el Agents SDK es gratuito. La tabla no incluye la caché de prompts ni el servidor donde corre tu proceso. La página de precios añade que los endpoints con residencia de datos cuestan un 10 % más para los modelos publicados a partir del 5 de marzo de 2026 (precios de OpenAI).
| Modelo | Modelo / mes | Datos / mes | Total / mes | Por pregunta | Peso de los datos |
|---|---|---|---|---|---|
| gpt-6-luna | 6,77 USD | 5,00 USD | 11,78 USD | 0,00393 USD | 42,5 % |
| gpt-6.1-terra | 67,73 USD | 5,00 USD | 72,73 USD | 0,02424 USD | 6,9 % |
| gpt-6.1-sol | 135,46 USD | 5,00 USD | 140,46 USD | 0,04682 USD | 3,6 % |
| gpt-6-astra | 677,28 USD | 5,00 USD | 682,28 USD | 0,22743 USD | 0,7 % |
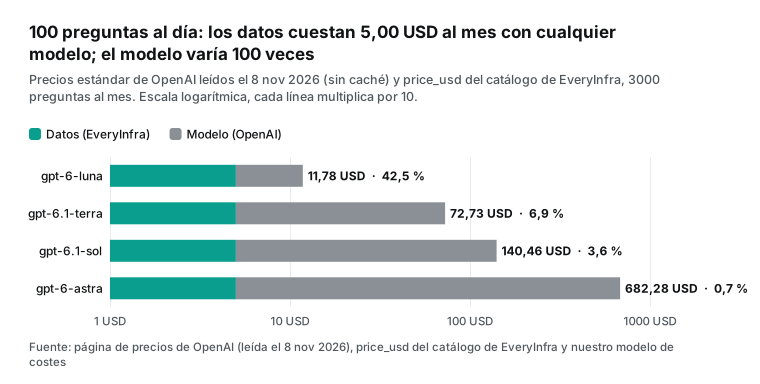
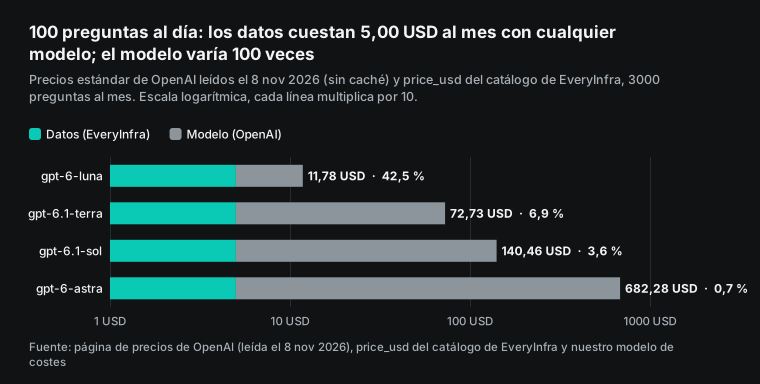
La tabla se lee de dos maneras. Primero, el modelo pesa mucho más que los datos: entre el más barato y el más caro hay exactamente 100 veces de diferencia en precio unitario, y el total mensual va de 11,78 a 682,28 USD. Segundo, con gpt-6-luna los datos son el 42,5 % del total, y ahí sí compensa hacer menos llamadas: revisa primero los resultados de youtube/search y pide comentarios solo cuando hagan falta, o baja el limit de 20 a 10.
Probamos también dos variaciones. Si tus respuestas traen el doble de texto, los cuatro totales pasan a 15,14, 106,39, 207,78 y 1018,88 USD. Si el razonamiento sube de 300 a 1000 tokens por turno, pasan a 14,93, 104,23, 203,46 y 997,28 USD. No medimos tokens de razonamiento, así que ese es el supuesto más débil. Antes de lanzar, pasa tus preguntas reales durante una semana y mira la factura.
Con las API de las propias plataformas, el problema no es el dinero. Cada proyecto de YouTube Data API tiene por defecto 100 llamadas diarias a search.list, en un cupo aparte, más 10.000 unidades diarias para el resto de métodos (calculadora de cuota de YouTube Data API); la página se actualizó el 3 de noviembre de 2026. Una llamada a commentThreads.list cuesta 1 unidad (commentThreads: list). Con 100 preguntas diarias y una búsqueda cada una, el cupo por defecto se agota justo, y la pregunta 101 o cualquier reintento falla.
La API de datos de Reddit gratuita permite 100 consultas por minuto por ID de cliente OAuth, de media en 10 minutos (Reddit Data API Wiki). Además obliga a borrar lo que los usuarios hayan borrado en Reddit y recomienda eliminar los datos de usuario guardados en 48 horas (Reddit Data API Terms). Eso también vale para agentes: si guardas publicaciones en una base vectorial, la obligación de borrar viene con ellas.
| Mismo trabajo | ¿Llega a 100 preguntas al día? | Qué hay que montar | Fuente |
|---|---|---|---|
| YouTube Data API (cuota por defecto) | Justo 100 búsquedas, sin margen | Proyecto de Google Cloud, clave de API, solicitud de más cuota | Calculadora de cuota |
| Reddit Data API (gratuita) | Sí, 100 por minuto | App OAuth y User-Agent con el formato exigido | Reddit Data API Wiki |
| MCP de EveryInfra | 3 llamadas por pregunta, 0,001668 USD | Una clave; la nuestra de prueba tiene un límite propio de 10 llamadas por minuto, que no es el valor por defecto | Catálogo de EveryInfra |
Durante la prueba sí chocamos con un límite de ritmo. A las 00:16:55 hora de Singapur enviamos dos peticiones de comentarios a la vez y las dos devolvieron 429 con retry_after de 5 segundos; next_steps indicaba que no se había cobrado nada. Las repetimos 16 y 39 segundos después y funcionaron. Nuestra clave de prueba admite 10 llamadas por minuto y otras tareas la usaban en esos minutos. Con 100 preguntas al día, la media es de 0,2 preguntas por minuto: solo llegarás al límite en ráfagas, y entonces basta con esperar retry_after.
Límites y puntos a vigilar
Exportar no es migrar. La guía dice que la exportación no convierte el grafo ni garantiza el mismo comportamiento, y nosotros no teníamos una exportación real para comparar línea a línea; la tabla de nodos sale de la referencia y de la documentación del SDK. Cuando tengas tu exportación, compara su salida con la del flujo antiguo en entradas típicas, y cubre al menos tres casos: resultado vacío, límite de ritmo y aprobación rechazada.
El SDK intenta enviar trazas a OpenAI por defecto. En nuestra máquina no había OPENAI_API_KEY, y el SDK avisó de que se saltaba la exportación de trazas. La documentación explica cómo desactivarlas o usar tu propio procesador (tracing en el SDK).
No probamos el lado de OpenAI. HostedMCPTool y el ida y vuelta de aprobación de la Responses API necesitan una cuenta y un modelo reales, así que aquí son ejemplos de configuración. En la Responses API, cada aprobación cubre una sola llamada, y la respuesta usa previous_response_id para enlazar con la petición que la pidió (guía MCP de Responses). Además, connector_id queda obsoleto para los modelos lanzados después del 1 de septiembre de 2026; usa server_url o tunnel_id. Si tu nodo MCP usaba un conector integrado de OpenAI, un modelo nuevo implica otra forma de conectar.
El alojamiento pasa a ser cosa tuya. Con Agent Builder y ChatKit alojado no tenías servidor; con el SDK, el proceso, el almacenamiento y los arranques en frío son tuyos. En el hilo del foro, un desarrollador montó el backend de ChatKit en un contenedor de AWS Lambda y midió arranques en frío de 2,5 a 3,4 segundos con 20 comprobaciones en paralelo. Otro calculó entre 15 y 30 USD al mes por una máquina virtual siempre encendida (hilo del aviso en el foro de OpenAI). Son experiencias personales, no pruebas nuestras, pero muestran que el alojamiento está en el mismo orden que los datos y el modelo.
Los datos también tienen límites. reddit/search solo busca en títulos y cuerpos de publicaciones del último mes, no en comentarios. El posted_at de youtube/comments puede ser relativo. Algunos campos pueden venir vacíos cuando la fuente principal no está disponible (por ejemplo, youtube/comments puede llegar sin like_count ni reply_count, y reddit/search no devolvió flair ni miniaturas en esta prueba), y el field_note del catálogo indica cuáles faltan en cada capacidad (catálogo de EveryInfra). Pon esos límites en las instrucciones para que el modelo no convierta «sin filas» en «nadie habla de esto».
Cambios recientes
- 2026-10-14: OpenAI avisa de que GPT-4o y GPT-4.1 se retiran el 14 de enero de 2027, con
gpt-6-lunacomo sustituto (página de obsolescencias de OpenAI). DevPro Journal, citando a The New Stack, señala que ese aviso solo dio tres meses (DevPro Journal). - Octubre de 2026: la Agents API añade revisión automática con
review: "auto_review", en la que un modelo aprueba o deniega las peticiones de herramientas con coste extra de tokens (changelog de OpenAI). Qué hacer: en el camino del SDK, esa regla la escribes tú.
Preguntas frecuentes
¿Qué significa la «openai agent builder deprecation» y cuándo deja de funcionar?
Significa que Agent Builder está obsoleto desde el aviso del 3 de junio de 2026 y que el cierre está previsto para el 30 de noviembre de 2026. La página de obsolescencias define el cierre como «ya no accesible» (página de obsolescencias de OpenAI). No tienes que hacer nada para que se apague, así que exporta tu código antes de esa fecha.
¿Cuál es el sustituto de OpenAI Agent Builder?
La guía de migración nombra dos: el Agents SDK, para código, y los Workspace Agents de ChatGPT, para agentes de equipo en lenguaje natural, que exigen un espacio Business, Enterprise o Edu (Migrate from Agent Builder). En el foro, una respuesta propone además un envoltorio propio y ligero sobre la Responses API (lista del foro de OpenAI).
¿Cuánto cuesta lo que hacía Agent Builder una vez migrado?
El Agents SDK es gratuito y OpenAI cobra solo los tokens del modelo, sin tarifa por llamada MCP (guía MCP de Responses). En nuestra receta de 100 preguntas al día, el total va de 11,78 USD al mes con gpt-6-luna a 682,28 USD con gpt-6-astra, con 5,00 USD de datos en todos los casos. A eso súmale el alojamiento, que antes no pagabas.
¿Me conviene pasarme a n8n en lugar del Agents SDK?
Es un debate que también aparece en un vídeo ruso de nuestra búsqueda en español. La guía de OpenAI no menciona n8n; sus destinos son el Agents SDK y los Workspace Agents (Migrate from Agent Builder). Si tu equipo prefiere un lienzo visual, cualquier herramienta que admita un MCP remoto por HTTP puede conectar con https://api.everyinfra.com/mcp, pero no probamos n8n para este artículo. La lógica de aprobación y los tiempos de espera que describimos valen igual.
¿Hay documentación del Agents SDK en español?
No, a 8 de noviembre de 2026. Las webs del SDK de Python y de JavaScript ofrecen inglés, japonés, coreano y chino, y la ruta /es/ devuelve 404 (Agents SDK Python; Agents SDK JS). Los nombres de campo de este artículo están en inglés, tal como aparecen en la documentación original.
Cómo empezar
- Antes del 30 de noviembre, abre cada flujo y elige Code, Agents SDK y Python o TypeScript. Guarda la exportación en tu repositorio.
- Exporta el texto de los objetos de prompt y los conjuntos de prueba de Evals.
- Instala
openai-agents==0.24.0desde PyPI, que necesita Python 3.10 o posterior (PyPI); si exportaste TypeScript, instala@openai/agents, que pide Node.js 22 o posterior (npm: @openai/agents). Haz una primera ejecución con la guía de inicio rápido del Agents SDK y sustituye los nombres de modelo antiguos por los de la página de obsolescencias. - Consigue una clave en el inicio rápido de EveryInfra y guárdala en la variable de entorno
EVERYINFRA_API_KEY. La guía de configuración del MCP remoto y la página del servidor MCP muestran la configuración para cada cliente. - Sustituye el nodo MCP por la configuración
MCPServerStreamableHttpde arriba: dos herramientas, 120 segundos de espera y una función de aprobación que lee los dos nombres. - Ejecuta
list_tools()una vez y comprueba que 5 herramientas piden aprobación. Después compara tres preguntas reales con el flujo antiguo. - Elige capacidades y límites en la API de datos de Reddit y la API de datos de YouTube. Los precios están en la página de precios y puedes probar llamadas en el mercado.
Referencias
- Deprecations, OpenAI, leído el 2026-11-08, <https://developers.openai.com/api/docs/deprecations>
- Migrate from Agent Builder, OpenAI, leído el 2026-11-08, <https://developers.openai.com/api/docs/guides/agent-builder/migrate-from-agent-builder>
- Agent Builder, OpenAI, leído el 2026-11-08, <https://developers.openai.com/api/docs/guides/agent-builder>
- Node reference, OpenAI, leído el 2026-11-08, <https://developers.openai.com/api/docs/guides/node-reference>
- Migrate from prompt objects, OpenAI, leído el 2026-11-08, <https://developers.openai.com/api/docs/guides/prompting/migrate-from-prompt-object>
- Moving from OpenAI Evals to Promptfoo, OpenAI Cookbook, leído el 2026-11-08, <https://developers.openai.com/cookbook/examples/evaluation/moving-from-openai-evals-to-promptfoo>
- Nov 30 shutdown checklist: Agent Builder, Evals, prompt objects, OpenAI Developer Community, 2026-10-30, <https://community.openai.com/t/nov-30-shutdown-checklist-agent-builder-evals-prompt-objects-evals-go-read-only-oct-31/1411075>
- Deprecation notice: Agent Builder, OpenAI Developer Community, desde 2026-06, <https://community.openai.com/t/deprecation-notice-agent-builder/1382650>
- OpenAI Agents SDK (Python), selector de idiomas, leído el 2026-11-08, <https://openai.github.io/openai-agents-python/>
- OpenAI Agents SDK (JavaScript), selector de idiomas, leído el 2026-11-08, <https://openai.github.io/openai-agents-js/>
- ChatKit, OpenAI, leído el 2026-11-08, <https://developers.openai.com/api/docs/guides/chatkit>
- Advanced integrations with ChatKit, OpenAI, leído el 2026-11-08, <https://developers.openai.com/api/docs/guides/custom-chatkit>
- OpenAI Agent Builder's Nov. 30 shutdown puts migration on a code-and-validation path, Forkast, 2026-11, <https://forkast.news/openai-agent-builders-nov-30-shutdown-puts-migration-on-a-code-and-validation-path/>
- Model context protocol (MCP), documentación del Agents SDK (Python), leído el 2026-11-08, <https://openai.github.io/openai-agents-python/mcp/>
- MCP servers (Responses API), OpenAI, leído el 2026-11-08, <https://developers.openai.com/api/docs/guides/tools-connectors-mcp>
- openai-agents 0.24.0, PyPI, 2026-10-15, <https://pypi.org/project/openai-agents/>
- Agents SDK quickstart, OpenAI, leído el 2026-11-08, <https://developers.openai.com/api/docs/guides/agents/quickstart>
- @openai/agents, npm, leído el 2026-11-08, <https://www.npmjs.com/package/@openai/agents>
- Releases, openai/openai-agents-python, GitHub, desde 2026-10-15, <https://github.com/openai/openai-agents-python/releases>
- Agents API overview, OpenAI, leído el 2026-11-08, <https://developers.openai.com/api/docs/guides/agents-api/overview>
- Human-in-the-loop, documentación del Agents SDK (Python), leído el 2026-11-08, <https://openai.github.io/openai-agents-python/human_in_the_loop/>
- Guardrails, documentación del Agents SDK (Python), leído el 2026-11-08, <https://openai.github.io/openai-agents-python/guardrails/>
- Sessions, documentación del Agents SDK (Python), leído el 2026-11-08, <https://openai.github.io/openai-agents-python/sessions/>
- Catálogo de EveryInfra: reddit, EveryInfra, leído el 2026-11-08 a las 00:15 SGT, <https://api.everyinfra.com/api/v1/social/catalog?platform=reddit>
- Safety in building agents, OpenAI, leído el 2026-11-08, <https://developers.openai.com/api/docs/guides/agent-builder-safety>
- What are tokens and how to count them, OpenAI Help Center, leído el 2026-11-08, <https://help.openai.com/en/articles/4936856-what-are-tokens-and-how-to-count-them>
- Responses API reference: create a model response, OpenAI, leído el 2026-11-08, <https://developers.openai.com/api/reference/resources/responses/methods/create>
- examples/hosted_mcp, openai/openai-agents-python, GitHub, leído el 2026-11-08, <https://github.com/openai/openai-agents-python/tree/main/examples/hosted_mcp>
- Secure MCP Tunnel, OpenAI, leído el 2026-11-08, <https://developers.openai.com/api/docs/guides/secure-mcp-tunnels>
- src/agents/testing/model.py, openai/openai-agents-python, GitHub, leído el 2026-11-08, <https://github.com/openai/openai-agents-python/blob/main/src/agents/testing/model.py>
- Catálogo de EveryInfra: youtube, EveryInfra, leído el 2026-11-08 a las 00:15 SGT, <https://api.everyinfra.com/api/v1/social/catalog?platform=youtube>
- OpenAI Agent Builder Is Shutting Down Do This Before November 30, YouTube, 2026-11-02, <https://www.youtube.com/watch?v=ug0UziXU3-Q>
- Model Context Protocol (MCP), documentación del Agents SDK (JavaScript), leído el 2026-11-08, <https://openai.github.io/openai-agents-js/guides/mcp/>
- Tools, especificación de Model Context Protocol 2025-11-25, leído el 2026-11-08, <https://modelcontextprotocol.io/specification/2025-11-25/server/tools>
- Streaming, documentación del Agents SDK (Python), leído el 2026-11-08, <https://openai.github.io/openai-agents-python/streaming/>
- Responses streaming events, referencia de la API de OpenAI, leído el 2026-11-08, <https://developers.openai.com/api/reference/resources/responses/streaming-events>
- Catálogo de EveryInfra (todas las capacidades, con async_mode), EveryInfra, leído el 2026-11-08 a las 00:15 SGT, <https://api.everyinfra.com/api/v1/social/catalog>
- Pricing, OpenAI, leído el 2026-11-08, <https://developers.openai.com/api/docs/pricing>
- Quota Calculator, YouTube Data API, Google for Developers, actualizado el 2026-11-03, <https://developers.google.com/youtube/v3/determine_quota_cost>
- CommentThreads: list, YouTube Data API, Google for Developers, leído el 2026-11-08, <https://developers.google.com/youtube/v3/docs/commentThreads/list>
- Reddit Data API Wiki, Reddit Help, leído el 2026-11-08, <https://support.reddithelp.com/hc/en-us/articles/16160319875092-Reddit-Data-API-Wiki>
- Data API Terms, Reddit, leído el 2026-11-08, <https://www.redditinc.com/policies/data-api-terms>
- Tracing, documentación del Agents SDK (Python), leído el 2026-11-08, <https://openai.github.io/openai-agents-python/tracing/>
- AI model deprecation is coming. Is your product ready?, DevPro Journal, 2026-11, <https://www.devprojournal.com/technology-trends/ai/ai-model-deprecation-is-coming-is-your-product-ready/>
- Changelog, OpenAI, leído el 2026-11-08, <https://developers.openai.com/api/docs/changelog>
Referencia BL-108