Snowflake Cortex Agents MCP:社媒差评和退货怎么进一张表
Snowflake MCP 连接器只认 OAuth;给出外部访问集成、四张表和周视图的配置示例与月费估算,实测 12 次接口调用,亚马逊评论当晚未取到。
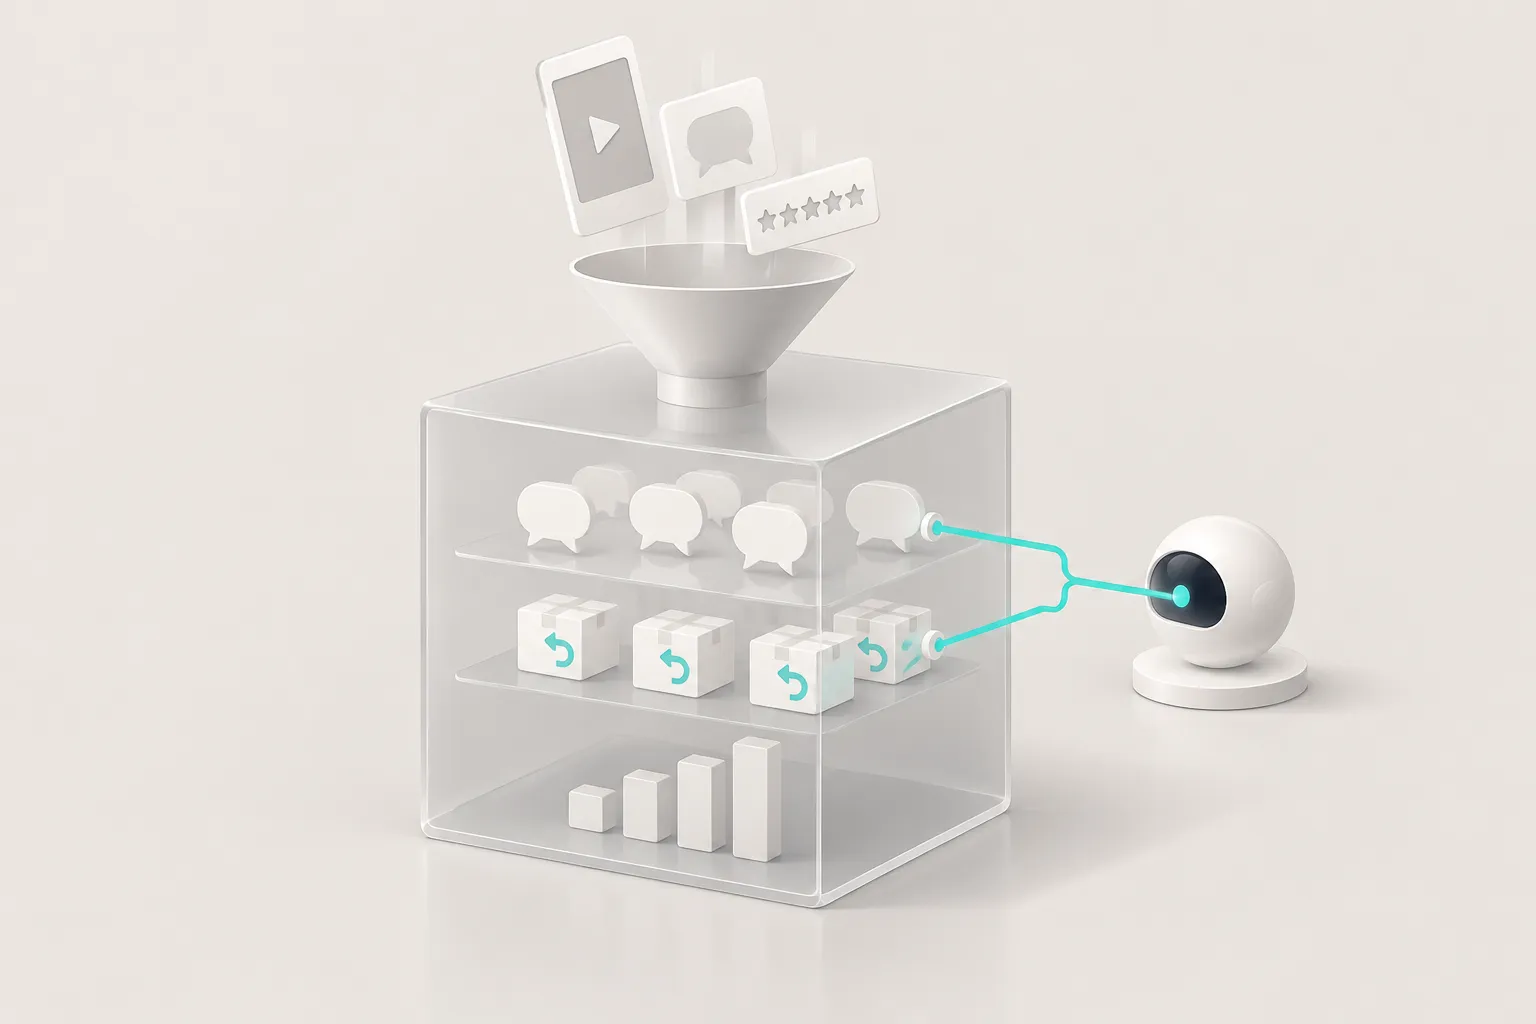
Snowflake 在 2026-11-03 的 Expedition 2026 大会上发布了 CoWork(原来的 Snowflake Intelligence)和一组 Cortex Agents 的新能力,其中最受关注的是 MCP 连接器:智能体可以经 MCP 去调外部系统的工具(Snowflake 新闻稿,MCP 连接器文档)。做消费品的团队马上会想到一个用法:把亚马逊评论、Reddit 帖子、TikTok 评论这些「顾客在外面怎么说」的数据放进 Snowflake,和销量、退货表并排,直接问智能体「哪条差评主题和退货率一起涨」。退货是实打实的钱:美国零售联合会 2025 年 10 月的报告估计,2025 年美国消费者退货总额约 8,499 亿美元,网购的退货率是 19.3%(NRF 新闻稿)。这篇文章回答三件事:能不能用 MCP 连接器接、接不了怎么办、每月要花多少钱。
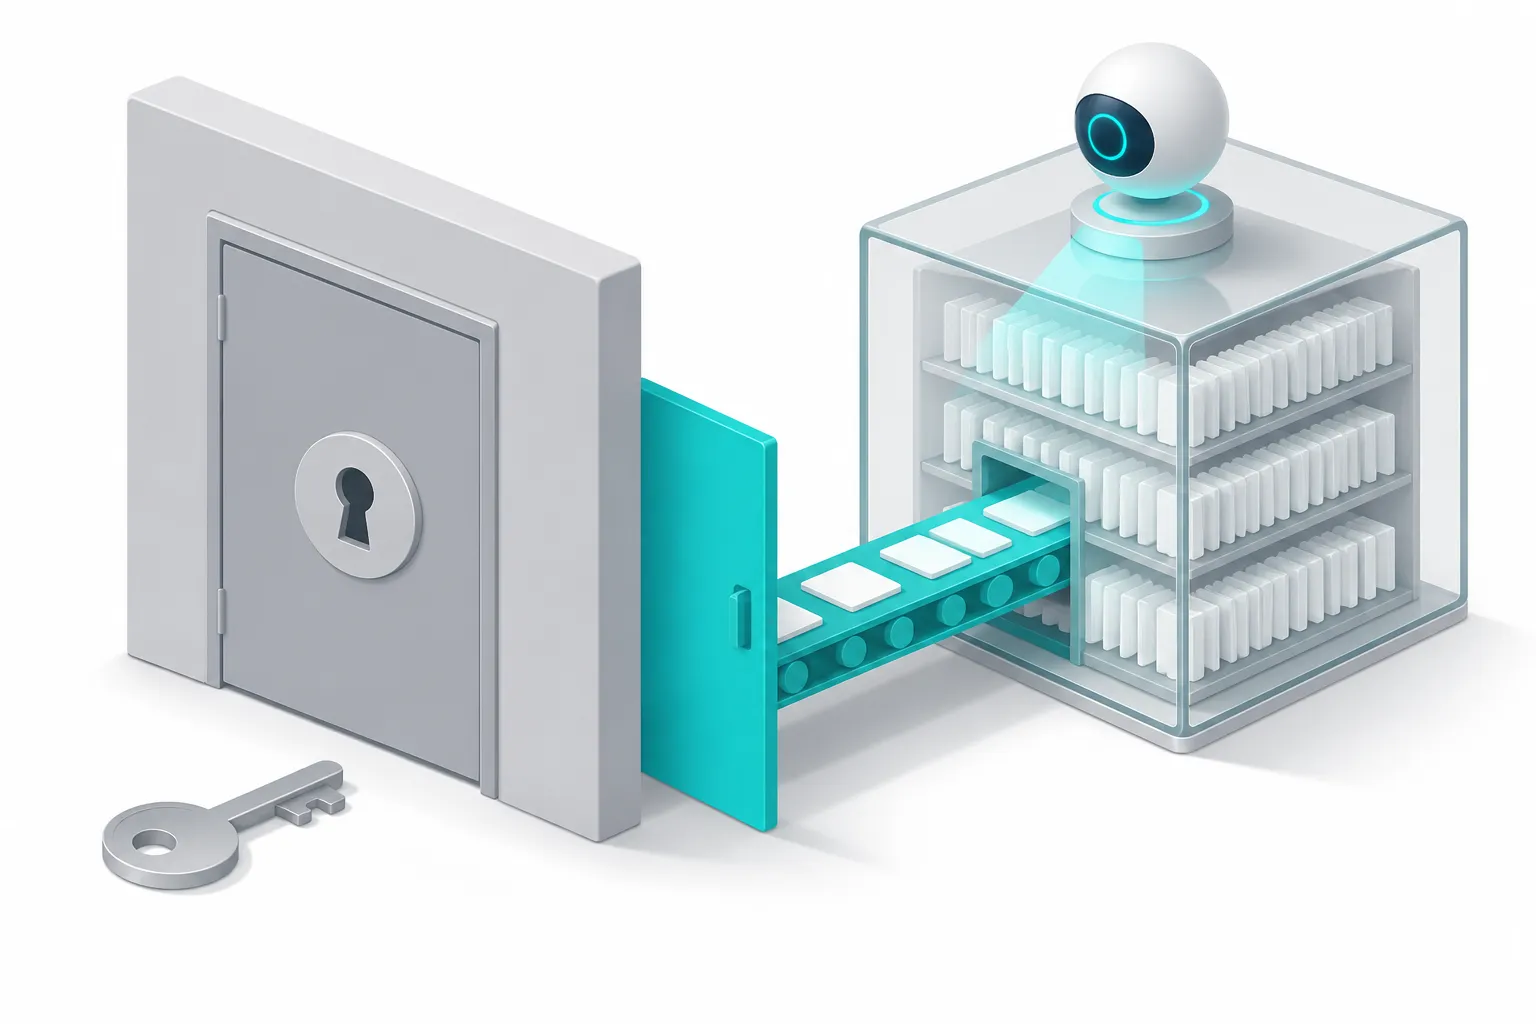
先说结论:今天不能把 EveryInfra 直接加成 Snowflake 的 MCP 连接器,能用的路线是 Snowflake 的外部访问集成。连接器只接受 OAuth,而且要么对方支持动态客户端注册,要么你在对方那里登记一个带 Snowflake 回调地址的客户端(连接器文档「Key considerations」);EveryInfra 的完整 MCP 入口有标准的 OAuth 发现,但授权服务器没有开放动态注册,公开文档里也没有让客户自助登记 OAuth 客户端的入口。就算能加,连接器也只是让智能体在对话里临时调工具,数据不会落进表里,没法和退货表做关联。外部访问集成的做法是:一个只放行 api.everyinfra.com 的网络规则、一个存 API Key 的密钥对象、一个 Python 存储过程,由定时任务每天把评论写进表。有三点要先交代:Snowflake 一侧全文都是配置示例,本机没有 Snowflake 账户,我们没有在 Snowflake 里跑过;亚马逊评论当晚 5 次都没取到;退货表本文只给结构、没有数据,所以本文给的是「怎么搭、花多少」,不是「哪条差评和退货相关」的结论。数据接口一侧的每个数字都来自 2026-11-06 凌晨的真实调用。EveryInfra 与 Snowflake 没有合作关系,文中 Snowflake 的内容都来自它的公开文档和新闻稿。
snowflake cowork 和 Cortex Agents:Expedition 2026 发布了什么
Snowflake CoWork 是这次大会的主角。新闻稿把它说成面向业务人员的智能体工作台,网址是 ai.snowflake.com,前身是 Snowflake Intelligence;同一天发布的 Cortex Code(简称 CoCo)面向开发和数据工程师(Expedition 2026 新闻稿,CoWork 产品页)。同一天的另一份新闻稿发布了 Business Ontology 和 Cortex AI Gateway,前者给智能体一层业务名词和指标的定义,后者统一管理智能体能调用的模型和外部工具(Business Ontology 与 AI Gateway 新闻稿)。
对本文的问题来说,CoWork 是「谁来问」,Cortex Agents 是「谁来答」。CoWork 里的每一个助手背后都是一个 Cortex Agent 对象,智能体能用的工具在它的规格里写死:用 Cortex Analyst 按语义视图把问题翻译成 SQL,用 Cortex Search 搜文本,用代码执行工具跑 Python,用自定义工具调存储过程或函数,再加上这次的 MCP 连接器和网页搜索(Cortex Agents 概览,创建和管理智能体)。所以「差评主题和退货率」这个问题,答案的质量几乎完全取决于表里有什么、语义视图怎么写;智能体本身只负责把一句话翻译成正确的 SQL,并把结果讲清楚。
下表是我们在 2026-11-06 读到的、和本文直接有关的两项功能的状态。
| 功能 | 状态(2026-11-06 读取) | 出处 |
|---|---|---|
| CoWork Automations(定时让助手跑一遍、发邮件) | 原文未写正式或预览 | Automations 文档 |
| Cortex Agents MCP 连接器(外部 MCP 服务器) | 连接器文档未写状态,CoWork 博客把连接器列为正式可用;只支持 OAuth | 连接器文档 |
CoWork 的博客还提到一项预览中的「分析型搜索」,举的例子正是「上个月哪些客户问题出现得最多」:先用 Cortex Search 缩小范围,再用 AI 函数和 SQL 去数和比较(CoWork 博客)。它面对的是已经在 Snowflake 里的文档,本文要先把站外的评论搬进来。Automations 的限制和权限细节放在后面「每周发一封报告」那一节。
snowflake cortex agents mcp 能不能直接连 EveryInfra
这是读完新闻稿最自然的想法:EveryInfra 本来就有远程 MCP 服务器(EveryInfra MCP 服务器说明),Cortex Agents 也能接外部 MCP,那把地址填进去不就行了?我们把 Snowflake 的要求和 EveryInfra 的实际情况逐条对了一遍,答案是今天还不行,卡在 OAuth 客户端的登记方式上。
Snowflake 的连接器文档写得很直接:MCP 服务器连接只支持 OAuth(原文 Snowflake supports only OAuth for MCP server connections),管理员先建一个 API_PROVIDER = external_mcp 的 API 集成,里面放 OAuth 的配置,再建一个引用它的外部 MCP 服务器对象(连接器文档)。OAuth 配置有两种写法。第一种叫标准 OAuth:你在对方的授权服务器上先登记一个应用,拿到客户端 ID(可以带密钥,也可以是不带密钥的公开客户端),并把回调地址 https://identity.snowflake.com/oauth2/callback 登记进去。第二种是动态客户端注册,Snowflake 自己去对方的注册端点要一个客户端 ID,这要求对方实现 RFC 7591(RFC 7591)。文档里预置好的连接器有 Atlassian、GitHub、Glean、Linear、Salesforce 五家,其中 Atlassian 的示例用的就是动态注册。
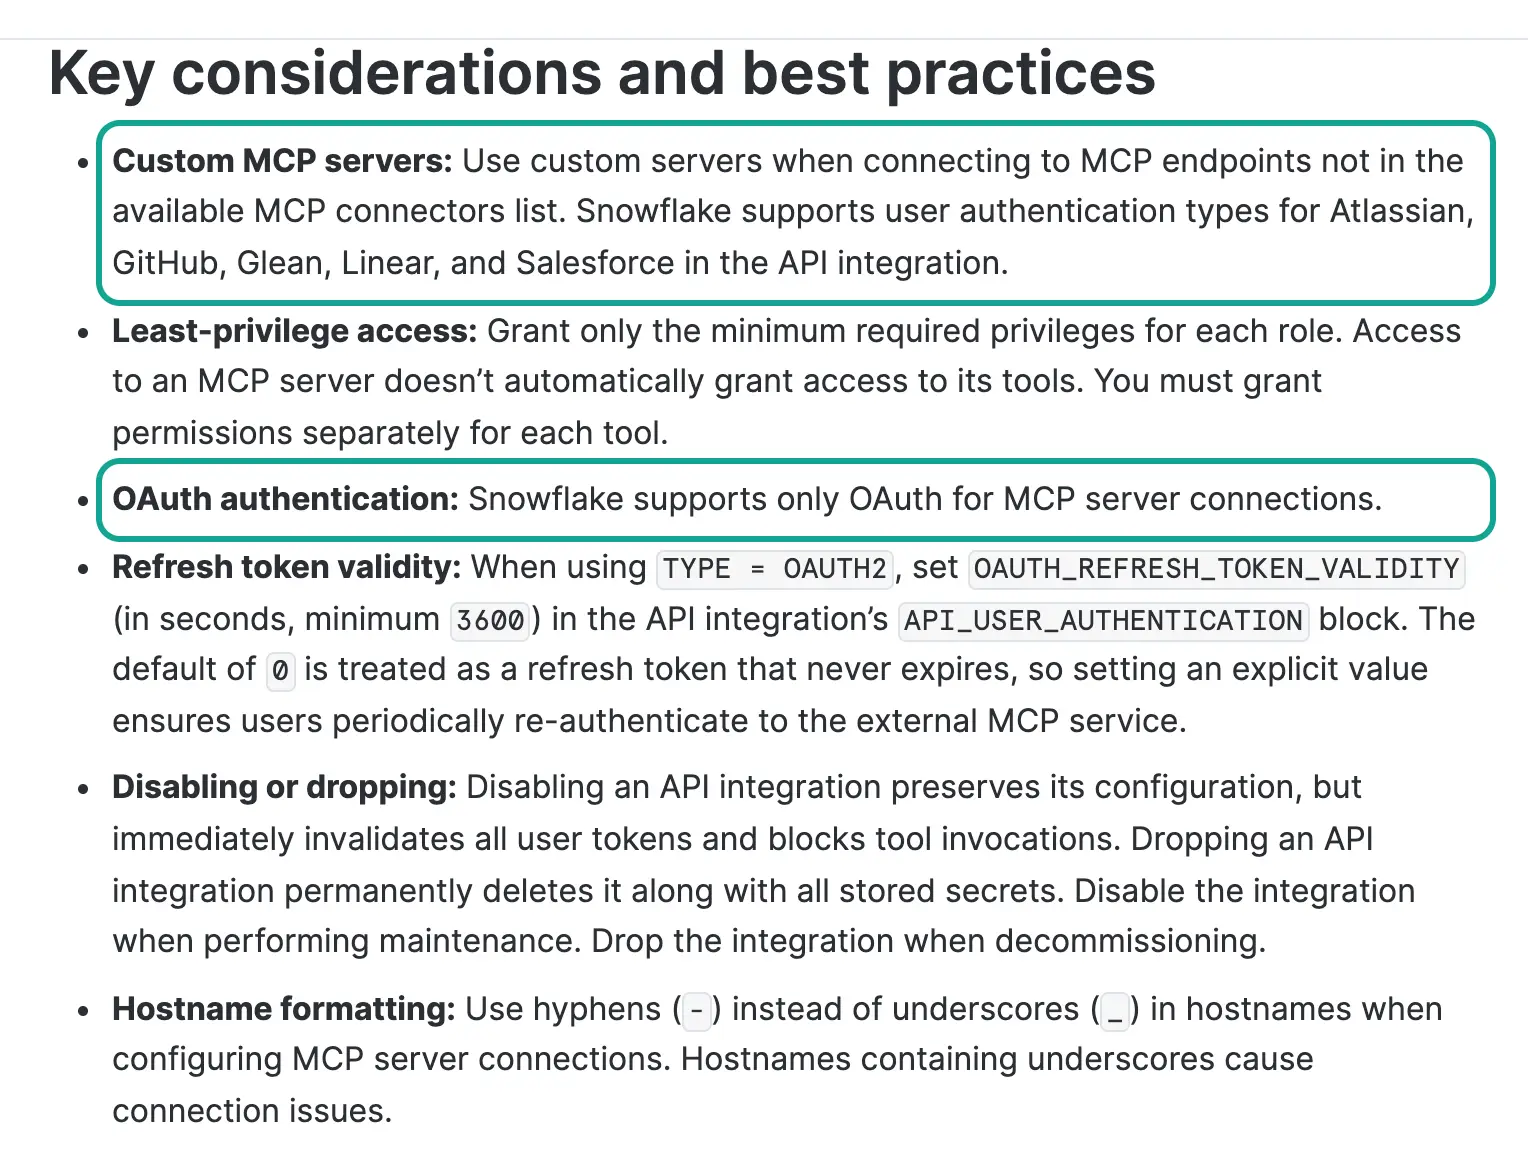
EveryInfra 这边有两个 MCP 地址。常用的 https://api.everyinfra.com/mcp 用 API Key 鉴权,在请求头里写 Bearer 加 Key;我们在新加坡时间 2026-11-06 00:43 请求它的受保护资源说明 /.well-known/oauth-protected-resource 和授权服务器说明 /.well-known/oauth-authorization-server,都是 404,也就是说这个地址不做 OAuth 发现。完整入口 https://api.everyinfra.com/mcp/all 不一样:同一分钟不带凭据去请求,返回 401,WWW-Authenticate 头里指向一份按 RFC 9728 写的资源说明,说明里的授权服务器是 auth.everyinfra.com/oidc;再读这台授权服务器的元数据,它支持 PKCE(S256)和不带密钥的公开客户端,但 registration_endpoint 这一项是空的,没有动态注册(RFC 9728,RFC 8414)。
| Snowflake 要的 | EveryInfra `/mcp`(API Key) | EveryInfra `/mcp/all`(2026-11-06 00:43 实测) |
|---|---|---|
| 只接受 OAuth | 不满足:用 Bearer API Key | 满足:401 并给出 RFC 9728 资源说明 |
| 动态客户端注册(RFC 7591) | 不适用 | 不满足:授权服务器元数据里没有注册端点 |
| 标准 OAuth:登记回调地址的客户端 ID | 不适用 | 公开文档没有自助登记入口 |
| 只用 MCP 的 tools 能力 | 满足:工具都是 tools | 满足 |
| 主机名不能有下划线 | 满足 | 满足 |
MCP 规范本身没有要求服务器必须做 OAuth:2025-06-18 版写的是授权是可选的,做了的话要按 RFC 9728 和 RFC 8414 发布说明,动态注册是「应该」而不是「必须」(MCP 授权规范 2025-06-18)。所以 EveryInfra 用 API Key 是合规的做法,Snowflake 只认 OAuth 也是它自己的选择,两边都没有错,只是对不上。Snowflake 的 AI Gateway 里另有一种「自定义 MCP 服务器」,文档写明同样要 OAuth、地址要以 /mcp 结尾、只有 ACCOUNTADMIN 能加(AI Gateway 自定义应用);EveryInfra 有 OAuth 发现的是 /mcp/all,以 /mcp 结尾的那个又只认 Key,两个条件凑不到同一个地址上。
退一步说,就算客户端登记的问题解决了,MCP 连接器也不适合本文的问题。连接器的工作方式是:每个用户在 CoWork 里点「连接」,跳到对方的登录页授权,之后智能体在对话里按需调用对方的工具,结果只存在于这一次对话(连接器文档「Use MCP connectors in Snowflake CoWork」)。这意味着每个提问的人都要有自己的 EveryInfra 账户,钱从各自余额里扣;更重要的是评论数据不会落进表里,智能体没法拿它和三个月的退货记录做按周关联。「差评主题和退货率一起涨」是一个需要历史的问题,历史要在表里。连接器适合的是另一类问题,比如「帮我看看这条视频下面大家在吵什么」,一次性、不用存。
连接 Snowflake 和外部数据接口,我们能找到四种做法,按「数据会不会进表」和「要不要 OAuth」排一下:
| 做法 | 数据进表 | 要 OAuth | 适合 | 出处 |
|---|---|---|---|---|
| MCP 连接器(外部 MCP 服务器对象) | 否,只在对话里 | 要 | 一次性提问 | 连接器文档 |
| 外部访问集成 + 存储过程 + 任务 | 是 | 不要,Key 存进密钥对象 | 每天定时入表,本文推荐 | 外部网络访问 |
| Snowflake 外面跑采集,再用 Snowpipe 入表 | 是 | 不要 | 已经有采集程序的团队 | Snowpipe |
| Cortex Code Agent SDK 里配外部 MCP | 否,除非自己写回表 | 不要,可以写请求头 | 开发者在代码里试 | Agent SDK 自定义工具 |
第四种路线里,Snowflake 的开发工具允许在请求头里写 Key(Agent SDK 文档),但它在开发者的代码里,不在 CoWork 的业务界面里。本文接下来按第二种写,因为它能把数据放进表、按时间表更新,而且全部在 Snowflake 的权限体系里管。
推荐做法:外部访问集成加存储过程(配置示例)
整条数据流可以用一张图说清楚:EveryInfra 接口负责把亚马逊、Reddit、TikTok 上的公开评论取回来;Snowflake 里的定时任务每天调一次存储过程,存储过程经外部访问集成去调接口,把原始返回写进一张原样保存的表,再展开成按平台分好的评论表;你自己的销量和 FBA 退货报告照常进另外两张表;最上面一层是语义视图和 Cortex Agent,业务人员在 CoWork 里提问。


外部访问集成是 Snowflake 让存储过程和函数访问外网的标准办法,由三个对象组成:网络规则写明允许访问哪些主机和端口,密钥对象保存凭据,外部访问集成把前两者绑在一起,再授权给具体的角色使用(外部网络访问概览,创建和使用外部网络访问)。网络规则只放行 api.everyinfra.com 一个主机,存储过程即使被人改了代码,也访问不了别的地址;Key 存在密钥对象里,代码里读不到明文,执行存储过程的角色也看不到它。下面这段是配置示例,voc 是我们给示例库起的名字,意思是「顾客的声音」。
-- 1. 只放行 EveryInfra 接口一个主机(出站)
CREATE OR REPLACE NETWORK RULE voc.raw.everyinfra_egress
  MODE = EGRESS
  TYPE = HOST_PORT
  VALUE_LIST = ('api.everyinfra.com');

-- 2. 把 API Key 存进密钥对象;建议在 EveryInfra 控制台单独建一把,设每分钟次数上限
CREATE OR REPLACE SECRET voc.raw.everyinfra_key
  TYPE = GENERIC_STRING
  SECRET_STRING = '<EveryInfra API Key>';

-- 3. 外部访问集成:把规则和密钥绑在一起
CREATE OR REPLACE EXTERNAL ACCESS INTEGRATION everyinfra_access
  ALLOWED_NETWORK_RULES = (voc.raw.everyinfra_egress)
  ALLOWED_AUTHENTICATION_SECRETS = (voc.raw.everyinfra_key)
  ENABLED = TRUE;

-- 4. 只授给负责入表的角色
GRANT USAGE ON INTEGRATION everyinfra_access TO ROLE voc_loader;
GRANT READ ON SECRET voc.raw.everyinfra_key TO ROLE voc_loader;
这几条语句的写法都来自 Snowflake 的 SQL 参考(CREATE NETWORK RULE,CREATE SECRET,CREATE EXTERNAL ACCESS INTEGRATION)。创建外部访问集成需要账户级的权限,一般由管理员做一次;之后入表的角色只要有这个集成的使用权和密钥的读取权。Snowflake 的示例页还给了用密钥调外部接口的完整例子,可以对照着看(外部网络访问示例)。
存储过程这一步有一个影响成本的设计选择:同步等结果,还是异步提交、过一会儿再收。EveryInfra 的接口两种都支持。同步调用时,请求一直挂着直到数据回来,我们这次实测最慢的一次亚马逊评论请求挂了 67 秒;异步调用时,请求体里加一个 "mode": "async",接口在两秒内回 202 和一个任务编号,之后用 GET /api/v1/jobs/{任务编号} 去取结果(文档)。在 Snowflake 里这个差别直接变成钱:存储过程在仓库上运行,仓库按运行时间计费,同步等待的每一秒仓库都开着。所以我们把入表拆成两个存储过程、两个任务:一个只负责提交,几秒就结束;另一个隔一段时间去收已经完成的任务。
CREATE OR REPLACE PROCEDURE voc.raw.submit_pulls()
  RETURNS VARIANT
  LANGUAGE PYTHON
  RUNTIME_VERSION = '3.11'
  PACKAGES = ('snowflake-snowpark-python', 'requests')
  HANDLER = 'run'
  EXTERNAL_ACCESS_INTEGRATIONS = (everyinfra_access)
  SECRETS = ('ei' = voc.raw.everyinfra_key)
AS
$$
import json, requests, _snowflake

API = "https://api.everyinfra.com/api/v1/social"

def run(session):
    key = _snowflake.get_generic_secret_string("ei")
    headers = {"Authorization": f"Bearer {key}", "Content-Type": "application/json"}
    # watchlist:要盯的商品链接、视频链接和关键词,一行一个请求
    rows = session.sql(
        "SELECT watch_id, platform, action, params FROM voc.raw.watchlist WHERE active"
    ).collect()
    submitted = 0
    for r in rows:
        body = {"platform": r["PLATFORM"], "action": r["ACTION"],
                "params": json.loads(r["PARAMS"]), "mode": "async"}
        resp = requests.post(API, headers=headers, json=body, timeout=30)
        payload = resp.json()
        session.sql(
            """INSERT INTO voc.raw.jobs
               (watch_id, job_id, http_status, charged_usd, first_payload, submitted_at)
               SELECT ?, ?, ?, ?, PARSE_JSON(?), CURRENT_TIMESTAMP()""",
            params=[r["WATCH_ID"], payload.get("job_id"), resp.status_code,
                    (payload.get("billing") or {}).get("charged_usd"), json.dumps(payload)],
        ).collect()
        submitted += 1
    return {"submitted": submitted}
$$;
提交过程的写法参考了 Snowflake 的 Python 存储过程文档:SECRETS 子句把密钥对象映射成一个名字,代码里用 _snowflake.get_generic_secret_string 按这个名字取值,PACKAGES 里声明要用的第三方包(Python 存储过程概览)。有两处细节值得照抄。第一,提交时把第一次返回整份存下来,返回里写着这次实际扣了多少美元,月底和 EveryInfra 控制台的账单逐条对账就靠它。第二,接口在参数不对、目标暂时不可用、返回为空的时候都不扣费,返回里也会写原因,所以不要在存储过程里自动重试同一个目标,让第二天的任务再试一次就好;我们这次亚马逊评论的 503 返回里就写着「立刻重试同一个商品大概率没用」。
收结果的过程结构一样,区别是它读 voc.raw.jobs 里还没收的任务编号,逐个去问状态:还在跑(running)或正在收尾(finalizing)的跳过,完成了的把整份结果原样写进 voc.raw.api_responses,再标记为已收。我们实测时第一次只把 running 当作「还在跑」,结果把一个正在收尾的任务当成了完成,后来才补上 finalizing,这个坑写在这里提醒一下。两个任务的定时可以这样设:提交每天新加坡时间凌晨 2 点跑一次;收结果在 2 点 20 分和 3 点 20 分各跑一次,第一次没完成的留给第二次。收结果不要设成每几分钟跑一次:仓库每次恢复最少按 60 秒计费,跑得越密,空转越多。仓库的自动挂起时间也建议设成 60 秒,而不是默认的 10 分钟。
CREATE OR REPLACE TASK voc.raw.t_submit
  WAREHOUSE = voc_xs_wh
  SCHEDULE = 'USING CRON 0 2 * * * Asia/Singapore'
AS
  CALL voc.raw.submit_pulls();

CREATE OR REPLACE TASK voc.raw.t_collect
  WAREHOUSE = voc_xs_wh
  SCHEDULE = 'USING CRON 20 2,3 * * * Asia/Singapore'
AS
  CALL voc.raw.collect_results();

ALTER TASK voc.raw.t_collect RESUME;
ALTER TASK voc.raw.t_submit RESUME;
任务的写法见 CREATE TASK 和 任务概览。如果不想自己管仓库,也可以去掉 WAREHOUSE 改用无服务器任务,Snowflake 按实际用到的计算量计费;服务用量表里无服务器任务的计算倍数是 0.9(服务用量表 PDF)。
四张表:评论、社媒提及、销量、退货
表结构的原则是:原始返回原样存一份,展开后的表只放分析要用的字段,个人信息能不存就不存。EveryInfra 的接口会返回评论作者的用户名和头像,做「差评主题和退货率」的分析完全用不到,展开时直接丢掉,既省存储,也少一层合规上的麻烦。下面是四张核心表加一张对照表的定义,销量表和退货表的数据来自你自己的系统,这里只给结构。
-- 原始返回:一行一次接口返回,VARIANT 原样保存
CREATE TABLE IF NOT EXISTS voc.raw.api_responses (
  job_id        STRING,
  platform      STRING,
  action        STRING,
  fetched_at    TIMESTAMP_TZ,
  payload       VARIANT
);

-- 亚马逊评论(amazon/reviews 展开)
CREATE TABLE IF NOT EXISTS voc.core.reviews (
  review_id            STRING PRIMARY KEY,
  asin                 STRING,
  country              STRING,
  rating               NUMBER(3,1),
  title                STRING,
  body                 STRING,
  posted_at            TIMESTAMP_TZ,
  is_verified_purchase BOOLEAN,
  helpful_count        NUMBER,
  variant              STRING,
  fetched_at           TIMESTAMP_TZ
);

-- 社媒提及:TikTok 评论、Reddit 帖子放在一张表
CREATE TABLE IF NOT EXISTS voc.core.social_mentions (
  platform      STRING,          -- tiktok / reddit
  source_id     STRING,          -- 评论或帖子的编号
  source_url    STRING,          -- 视频链接或帖子链接
  community     STRING,          -- Reddit 版块,TikTok 为空
  product_key   STRING,          -- 对照表里的商品编号
  body          STRING,
  like_count    NUMBER,
  reply_count   NUMBER,
  is_reply      BOOLEAN,
  posted_at     TIMESTAMP_TZ,
  fetched_at    TIMESTAMP_TZ,
  themes        ARRAY,           -- AI_CLASSIFY 打的主题
  PRIMARY KEY (platform, source_id)
);

-- 每日销量(来自你自己的订单系统)
CREATE TABLE IF NOT EXISTS voc.core.sales_daily (
  sale_date     DATE,
  sku           STRING,
  asin          STRING,
  units_ordered NUMBER,
  PRIMARY KEY (sale_date, sku)
);

-- FBA 退货报告(GET_FBA_FULFILLMENT_CUSTOMER_RETURNS_DATA)
CREATE TABLE IF NOT EXISTS voc.core.fba_returns (
  return_date          TIMESTAMP_TZ,
  order_id             STRING,
  sku                  STRING,
  asin                 STRING,
  fnsku                STRING,
  quantity             NUMBER,
  fulfillment_center_id STRING,
  detailed_disposition STRING,
  reason               STRING,
  status               STRING,
  customer_comments    STRING,
  return_themes        ARRAY
);

-- 商品对照:一个商品对应哪些 ASIN、SKU、视频和关键词
CREATE TABLE IF NOT EXISTS voc.core.product_map (
  product_key   STRING,
  asin          STRING,
  sku           STRING,
  tiktok_urls   ARRAY,
  reddit_terms  ARRAY
);
退货表的字段直接照亚马逊 SP-API 的 FBA 退货报告:报告类型是 GET_FBA_FULFILLMENT_CUSTOMER_RETURNS_DATA,字段有退货日期、订单号、SKU、ASIN、FNSKU、商品名、数量、仓库编号、处置结果、退货原因、状态、license plate 编号和顾客留言,文档写明每天更新(SP-API FBA 报告类型)。其中「顾客留言」这一列对本文特别重要:它和社媒评论一样是一段自由文字,用同一套主题去分类,两边就能按主题对上。退货原因那一列是亚马逊给的固定选项,粒度比「杯盖漏」这种主题粗得多,单靠它回答不了「哪个主题」。
接口返回的字段到表的列,对照如下。左边的字段名来自 EveryInfra 目录 GET /api/v1/social/catalog 在 2026-11-06 的返回(目录)。
| 能力 | 接口字段 | 写进哪一列 | 说明 |
|---|---|---|---|
amazon/reviews | review_id、product_asin、country | reviews.review_id、asin、country | 按评论编号去重 |
amazon/reviews | rating、title、text、posted_at | rating、title、body、posted_at | 星级是 1 到 5 |
amazon/reviews | is_verified_purchase、helpful_count、variant | 同名列 | 颜色、容量等款式在 variant |
amazon/reviews | author_name、author_id、author_avatar_url | 不存 | 分析用不到的个人信息 |
tiktok/comments | id、text、like_count、reply_count、is_reply、posted_at | social_mentions 同义列 | 每条一级评论最多带 2 条回复 |
tiktok/comments | author_username、author_id | 不存 | 同上 |
reddit/search | id、url、title+text、community、like_count、comment_count | source_id、source_url、body、community、like_count、reply_count | 标题和正文拼成一段 |
reddit/search | author_username | 不存 | 同上 |
展开这一步用 SQL 就能做,不用再写 Python:从 api_responses 里按平台挑出行,用 LATERAL FLATTEN 把 payload:results 展成一行一条,再 MERGE 进目标表,按编号去重。重复拉同一条视频时,旧评论的点赞数会更新,新评论会追加进来;后面会看到,这种「隔几个月再拉一次同一条视频」恰恰是这个场景里最有价值的动作。
一次真实往返:REST、异步和 MCP
Snowflake 一侧我们没法实跑,但存储过程里发出去的请求和收回来的返回,和我们在本机发的是同一个接口、同一个格式。2026-11-06 新加坡时间 00:16 到 00:36,我们用一把测试 Key 一共调了 12 次,覆盖本文要用的三项能力,外加两次帮助选题的搜索。每一次的请求、开始和结束时间、HTTP 状态、耗时和扣费都原样存了下来。
| # | 新加坡时间 | 能力 | 方式 | 结果 | 耗时 | 扣费 |
|---|---|---|---|---|---|---|
| 1 | 00:16:52 | amazon/search 关键词 portable blender | 同步 | 10 条商品,9 条是 Ninja | 42.14 秒 | $0.002236 |
| 2 | 00:17:41 | amazon/reviews 商品 B0C2FF4JD1 | 同步 | 503,暂时不可用(不扣费) | 60.12 秒 | $0 |
| 3 | 00:18:41 | amazon/reviews 商品 B0CN3S2SW2 | 同步 | 503 | 58.57 秒 | $0 |
| 4 | 00:19:47 | amazon/reviews 商品 B09B8V1LZ3 | 同步 | 0 条,空结果退款 | 67.25 秒 | $0 |
| 5 | 00:20:55 | reddit/search 关键词 portable blender,按最新 | 同步 | 14 条帖子 | 6.56 秒 | $0.000556 |
| 6 | 00:21:13 | tiktok/search 关键词 ninja blast portable blender review | 同步 | 10 条视频 | 3.78 秒 | $0.000556 |
| 7 | 00:21:21 | tiktok/comments 对比测评视频 | 同步 | 200 条评论 | 52.30 秒 | $0.000556 |
| 8 | 00:22:13 | walmart/reviews 商品页 | 同步 | 0 条,空结果退款 | 54.34 秒 | $0 |
| 9 | 00:24:22 | amazon/reviews 商品 B0D2YYHN1B | 同步 | 503 | 19.48 秒 | $0 |
| 10 | 00:25:26 | reddit/search 关键词 ninja blast | MCP | 7 条帖子 | 7.62 秒 | $0.000556 |
| 11 | 00:27:36 | tiktok/comments 单品上手视频 | 异步 | 202 后约 100 秒完成,73 条 | 提交 1.95 秒 | $0.000556 |
| 12 | 00:36:23 | amazon/reviews 商品 B0C2FF4JD1 再试 | 同步 | 503 | 38.42 秒 | $0 |
12 次里 6 次扣费,合计 $0.005016;另外 6 次是 503 或空结果,全部没扣。第 8 次的沃尔玛商品链接是我们按商品名猜的,空结果不奇怪,算我们自己的失误;它在这里的意义是确认了「空结果不扣费」这条规则对沃尔玛评论(沃尔玛评论接口)同样生效。
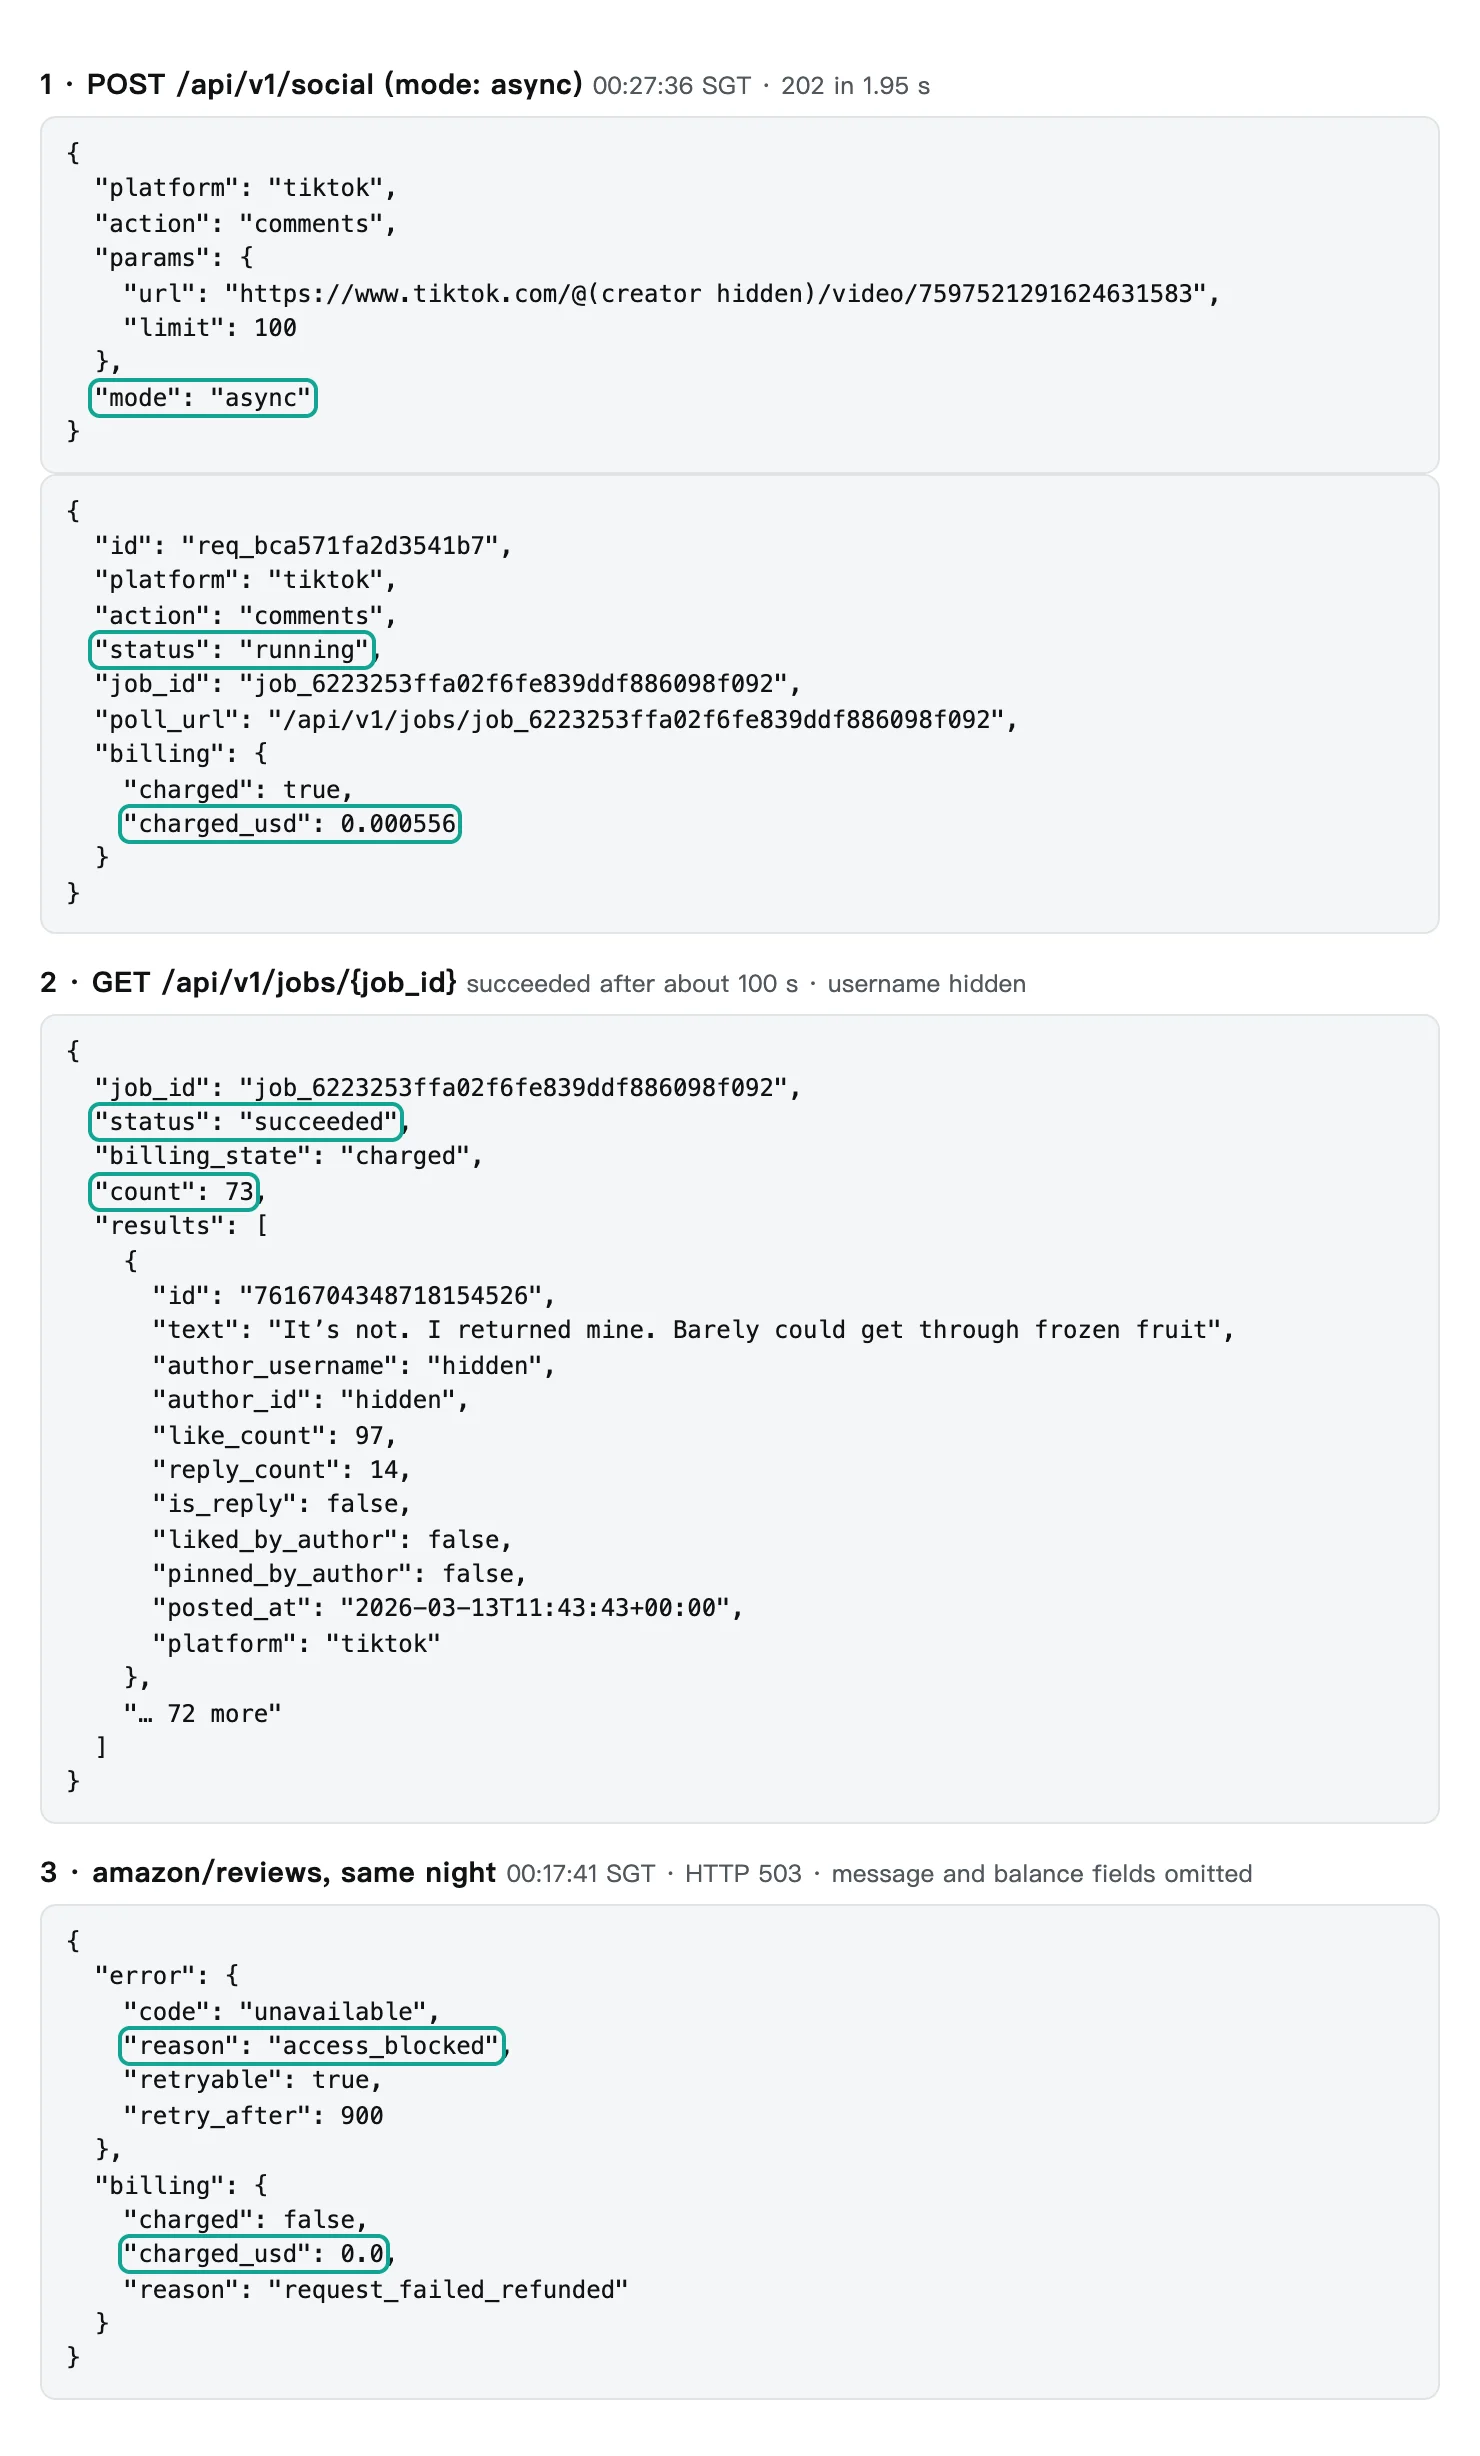
图里第一段就是 Snowflake 提交过程会拿到的东西:1.95 秒返回 202,带任务编号,扣费在提交时就发生,返回里写明是 $0.000556。第二段是收结果的过程会拿到的东西,状态从 running 走到 finalizing 再到 succeeded,我们隔 8 秒左右问一次,一共问了 12 次,从提交到完成大约 100 秒。第三段是失败的样子:HTTP 503,原因 access_blocked,建议 900 秒后再试,扣费为 0。存储过程只要按状态码和这几个字段分支,就不需要任何特殊处理。
MCP 那一次(第 10 次)是为了对比:同样的 Reddit 搜索,经 MCP 的 everyinfra_call_api 工具调用,7.62 秒返回 7 条帖子,返回的工具结果是一段 18,619 个字符的文本,整个响应 19,490 字节。如果是 Cortex Agent 在对话里经 MCP 连接器调用,这 1.9 万个字符会作为工具结果进入模型的上下文,按输入 token 计费;同样的数据走存储过程进表,智能体之后只读它需要的几行。这也是为什么我们倾向于「先进表、再提问」,而不是让智能体每次现取。
耗时这张图决定了 Snowflake 一侧的成本结构。按数据量算,三项能力都很轻:一次 TikTok 评论 200 条是 71,228 字节,一次 Reddit 搜索约 3 万字节;按等待时间算,同步的评论类请求动辄 50 到 70 秒。仓库按秒计费、每次恢复最少算 60 秒(仓库概览,计算成本说明),同步调用时仓库绝大部分时间是在等网络,没有在算任何东西。后面的成本一节会把这一点算成具体的美元。
实测一:TikTok 评论里有多少是在说产品问题
我们选了一个所有人都熟悉的品类做例子:便携搅拌机。第 1 次调用 amazon/search 搜 portable blender,前 10 个结果里 9 个是 Ninja,价格从 $19.95 到 $59.99(亚马逊数据接口,亚马逊搜索)。于是第 6 次调用用 tiktok/search 搜 ninja blast portable blender review,在返回的 10 条视频里挑了两条评论最多的,分别用 tiktok/comments 拉评论(TikTok 数据接口,TikTok 评论接口,TikTok 搜索接口)。第一条是 2025-07-27 发的「便宜和贵的搅拌机对比测评」,到我们拉取时 2,586,703 次播放、251 条评论,我们拿到 200 条(这项能力单次上限 200);第二条是 2026-01-20 发的单品上手视频,208,916 次播放、98 条评论,我们拿到 73 条,其中 17 条是回复。两条视频的作者名在本文里都不写。
拿到评论之后,我们先用最常见的做法试了一遍:写一组关键词,电池、漏、坏、退货、贵、太小,命中就算差评。第一条视频的 200 条评论里命中了 42 条。然后我们一条一条人工读,只有 4 条真是在说这台搅拌机出了问题,关键词规则的准确率只有 9.5%。漏判的原因一看就懂:对比测评视频的评论区大部分在接梗,「cheap vs expensive」这个格式引来了上百条「下次测便宜和贵的某某」的玩笑;命中「贵」的 30 条里,7 条是在说价格不值,其余是在说别的东西贵。这说明在 Snowflake 里做这件事,主题分类必须交给模型,而且要先写清楚「什么算产品问题」。
人工标注的规则我们定成这样:只算明确在说本产品出了问题的评论,包括杯盖和漏洒、电池不耐用、打不动冰或冻水果、收到时缺配件、难清洗、用不久就坏、笼统的「不值、退了」;价格抱怨、和别的品牌比较、玩笑和表情都不算。按这个规则,两条视频的结果差别很大:
播放量大十倍的那条视频,产品问题只占 2.0%;播放量小的单品上手视频,产品问题占 17.8%。原因不难理解:对比测评吸引来的是看热闹的人,单品上手视频吸引来的是买了或者正想买的人,后者才会在评论里说「我的也漏了」。对 Snowflake 里的设计来说,这意味着 product_map 里挑哪些视频比拉多少条评论更要紧:同样花 $0.000556 拉一次,单品上手类视频的有效信号密度高将近 9 倍。挑视频这一步本身也可以自动化:先用 tiktok/search 按关键词搜,把视频描述里有「review」「trying」「honest」这类词、评论数在几十到几百之间的视频放进观察名单。
两条视频合计 273 条评论,17 条在说产品问题,按主题分是这样:
| 主题 | 条数 | 例子(原文,作者隐去) | 点赞 |
|---|---|---|---|
| 杯盖、漏洒 | 6 | The way I just gasped when it spilled. Were you supposed to open it from the top instead? | 79 |
| 电池 | 3 | the batteries do not last long enough to make a full smoothie | 9 |
| 笼统差评、已退货 | 2 | Not worth it, returned after a week | 0 |
| 打不动冰果 | 2 | It's not. I returned mine. Barely could get through frozen fruit | 97 |
| 缺配件 | 2 | ours both didn't come with the blade cap | 0 |
| 用不久 | 1 | they are shit, lasts 2 spins | 1 |
| 难清洗 | 1 | Hard to wash | 0 |
杯盖和漏洒是最大的一类,而且点赞最多的那条(79 个赞)是在问「是不是应该从上面打开」,另一条说「我第一次用也洒了,没想到要用那个盖子」,还有一条 2026-01-22 的评论提醒别人「千万别用盖子上的按钮开,会坏,而且买不到替换件」。这一类问题的性质和电池、马力不同:它更像说明书、包装或者商品页图片能改的问题,改了以后退货率有可能马上下来。这正是「差评主题和退货率一起涨」这个问题想抓的东西,因为一旦确认这个主题和某个时间段的退货有关,行动方案是很具体的。
点赞数也要进表。同样是「打不动冰果」,一条 97 个赞的「我退了」和一条 0 个赞的抱怨,代表的人数显然不一样。我们建议在 social_mentions 里保留 like_count,在语义视图里同时给出「条数」和「按点赞加权的条数」两个指标,让智能体回答时两个都报。
在 Snowflake 里,这一步可以用 AI_CLASSIFY 做:把上面七个主题加一个「不是产品问题」作为类别,用多标签模式,给一段任务说明,写清价格抱怨和玩笑不算;文档建议类别不要超过 20 个左右,可以给示例,也可以用 output_mode 设成多标签(AI_CLASSIFY 文档)。文档的使用说明里有一句要注意:输入最好是英文,其他语言效果可能变差。TikTok 和亚马逊美国站的评论大多是英文,问题不大;如果你同时盯西语或中文市场,先在一小批人工标好的评论上核对一遍分类结果,再放开跑全量。任务说明和类别也会算进每一行的 token,所以每行的实际 token 数会比评论本身多。
UPDATE voc.core.social_mentions
SET themes = AI_CLASSIFY(
      body,
      ['lid_or_spill', 'battery', 'weak_on_ice', 'missing_part',
       'breaks_quickly', 'hard_to_clean', 'general_negative', 'not_a_product_issue'],
      {'output_mode': 'multi',
       'task_description': 'Label only comments that report a problem with this blender. Price complaints, jokes and brand comparisons are not_a_product_issue.'}
    ):labels
WHERE themes IS NULL;
同一段分类也用在退货表的 customer_comments 列上,写进 return_themes。这样两边用的是同一套主题、同一个模型、同一段说明,按主题对比才有意义。AI_SENTIMENT 也能给每条评论打正负情绪分(AI_SENTIMENT 文档),但对本文的问题帮助有限:我们要的是「哪类问题」,不是「多不高兴」。
实测二:Reddit 搜索拿到的是什么
Reddit 常被当作「真实用户讨论」的来源,我们也想看看它能不能补 TikTok 的不足。第 5 次调用用 reddit/search 搜 portable blender、按最新排序,返回 14 条帖子;第 10 次经 MCP 搜 ninja blast,返回 7 条(Reddit 数据接口,Reddit 搜索接口)。这项能力固定搜最近一个月,单次最多 25 条,我们实际拿到的 14 条只覆盖 2026-10-30 到 2026-11-05(UTC),7 条只覆盖 11 月 3 日到 5 日。
逐条看下来,21 条帖子里没有一条在讨论搅拌机好不好用。portable blender 的 14 条里,10 条是折扣帖,大部分发在 r/priceglitch 这类比价版块,标题就是「Ninja Blast Max Portable Blender, Twist & Go, 22oz」加颜色和价格,2026-10-31、2026-11-01、2026-11-05 各有一两条;另外 2026-11-02 和 2026-11-03 有几条是每日亚马逊折扣汇总。剩下 4 条和搅拌机无关,比如一位用户在问哪款 ThinkPad 便于携带,还有两条是 3D 软件 Blender 版块里问笔记本配置的。ninja blast 的 7 条里,4 条是折扣帖,3 条撞了词:一条是游戏讨论,两条是乐高动画 Ninjago 的版块。
这不说明 Reddit 没用,说明「按最新排序搜一个短词」这个用法不对。在 Snowflake 里落地时,Reddit 这一路有三个调整。第一,判断相关性只看标题,并且要求「搅拌机」前面跟着便携、个人、奶昔或品牌名;我们一开始用正文匹配 blender,把 3D 软件的帖子都算了进来。第二,把折扣帖单独分一类存下来,它们本身是有用的数据:一个月里同一款搅拌机在比价版块出现了多少次、标价多少,可以和你的销量表对着看促销对退货的影响。第三,真正的产品讨论更可能在某几个固定版块里,比如做奶昔和健身饮食的版块,可以换成 reddit/comments 去拉那几个版块里相关帖子的评论,而不是全站搜。
实测三:亚马逊评论 503,而且不扣费
本文最想要的数据其实是亚马逊评论:它和退货发生在同一个平台、同一批买家身上。但这次 5 次 amazon/reviews 调用一条评论都没拿到(亚马逊评论接口)。00:17、00:18、00:24 新加坡时间三个不同的 Ninja 和 Hamilton Beach 商品各试一次,都是 503,原因 access_blocked,表示这个商品的评论暂时不可用(不扣费),建议 900 秒后再试;00:19 换了一个更早的商品,返回 200 但 0 条,按空结果退款;00:36 隔了 19 分钟再试第一个商品,仍然是 503。5 次全部没扣费,返回里的 charged_usd 都是 0。
我们把这个结果原样写出来,因为它就是你在 Snowflake 里每天跑任务时会遇到的情况。按 EveryInfra 的规则,暂时不可用、需要登录这类情况一律回 503,不会当成「没有评论」回一个空的 200,返回里也写明了原因和建议的重试时间。这对入表的程序很重要:503 意味着「今天没拿到,明天再试」,空结果意味着「这里确实没有」。如果存储过程把两者混在一起,语义视图里就会出现某些天某个商品「零差评」的假象,智能体会据此得出错误的结论。我们的建议是在 jobs 表里单独存 HTTP 状态和原因,展开时只处理 200,并在语义视图里加一个「数据缺失的天数」,让智能体在回答时说明哪几天没有数据。
目录里写明 amazon/reviews 只返回商品页上展示的精选评论,通常每个商品十几条,单次最多 100 条,支持 11 个亚马逊站点。所以即使今天能拿到,它也不是一个商品的全部评论,而是亚马逊挑出来放在商品页上的那一批;用来看「最显眼的差评说了什么」够用,用来统计差评总量不够。对差评总量,亚马逊卖家后台和 FBA 退货报告里的顾客留言是更完整的数据,后者正好就是上面 fba_returns 表的来源。
让 Cortex Agent 回答「哪条差评主题和退货率一起涨」
表准备好以后,先建一个按周汇总的视图,把每个商品、每个主题、每一周的社媒提及数,和同一周的退货件数、销量放在一行。退货率用「退货件数除以销量」,按周对齐;主题来自上面那段分类。
CREATE OR REPLACE VIEW voc.core.theme_returns_weekly AS
WITH mentions AS (
  SELECT s.product_key,
         DATE_TRUNC('week', s.posted_at)::DATE AS week_start,
         t.value::STRING AS theme,
         COUNT(*) AS mentions,
         SUM(1 + COALESCE(s.like_count, 0)) AS weighted_mentions
  FROM voc.core.social_mentions s,
       LATERAL FLATTEN(input => s.themes) t
  WHERE t.value::STRING <> 'not_a_product_issue'
  GROUP BY 1, 2, 3
),
returns AS (
  SELECT pm.product_key,
         DATE_TRUNC('week', f.return_date)::DATE AS week_start,
         COALESCE(t.value::STRING, 'unclassified') AS theme,
         SUM(f.quantity) AS returned_units
  FROM voc.core.fba_returns f
  JOIN (SELECT DISTINCT product_key, asin FROM voc.core.product_map) pm
    ON pm.asin = f.asin,
       LATERAL FLATTEN(input => f.return_themes, OUTER => TRUE) t
  GROUP BY 1, 2, 3
),
sales AS (
  SELECT pm.product_key,
         DATE_TRUNC('week', d.sale_date)::DATE AS week_start,
         SUM(d.units_ordered) AS units_sold
  FROM voc.core.sales_daily d
  JOIN (SELECT DISTINCT product_key, asin FROM voc.core.product_map) pm
    ON pm.asin = d.asin
  GROUP BY 1, 2
),
theme_weeks AS (
  SELECT COALESCE(m.product_key, r.product_key) AS product_key,
         COALESCE(m.week_start, r.week_start) AS week_start,
         COALESCE(m.theme, r.theme) AS theme,
         COALESCE(m.mentions, 0) AS mentions,
         COALESCE(m.weighted_mentions, 0) AS weighted_mentions,
         COALESCE(r.returned_units, 0) AS returned_units
  FROM mentions m
  FULL OUTER JOIN returns r
    ON r.product_key = m.product_key
   AND r.week_start = m.week_start
   AND r.theme = m.theme
)
SELECT tw.product_key, tw.week_start, tw.theme,
       tw.mentions, tw.weighted_mentions, tw.returned_units,
       s.units_sold,
       tw.returned_units / NULLIF(s.units_sold, 0) AS theme_return_rate
FROM theme_weeks tw
LEFT JOIN sales s
  ON s.product_key = tw.product_key AND s.week_start = tw.week_start;
这个视图有三处写法是为了不漏算退货。第一,社媒提及和退货先按商品、周、主题做全外连接,再按商品和周去配销量:某一周社媒里只出现了杯盖问题,同一周电池主题的退货件数也会单独成一行,不会被丢掉。第二,没写留言、分不出主题的退货用 OUTER => TRUE 保留下来,记成 unclassified。第三,对照表里一个 ASIN 可能对应几个 SKU,先去重再关联,否则退货和销量会被成倍放大。还要注意,一条留言可能打上两个主题,各主题的退货件数加起来会大于实际退货件数;看总退货率时直接对 fba_returns 求和,不要把各主题的行相加。
然后在这个视图上建语义视图,告诉 Cortex Analyst 每一列是什么意思、哪些是指标(语义视图概览,CREATE SEMANTIC VIEW)。至少要定义四个指标:主题提及数、按点赞加权的提及数、按主题的退货件数、按主题的退货率;维度是商品、主题和周。语义视图里还可以写同义词,比如把「漏」「洒」「盖子」都指向 lid_or_spill,业务人员用中文提问时智能体更容易对上。
智能体的规格用 YAML 写,最少只要一个 Cortex Analyst 工具指向这个语义视图;我们再加一个自定义工具,让它在需要时读某个主题下点赞最多的几条原文。下面是配置示例,格式照 CREATE AGENT 的结构写;自定义工具的参数不能用对象类型,这是 Cortex Agents 文档里写明的限制(Cortex Agents 概览)。
models:
  orchestration: claude-sonnet-5-5
orchestration:
  budget:
    seconds: 120
    tokens: 40000
instructions:
  orchestration: >
    For questions about complaint themes and returns, use VocAnalyst on weekly data.
    Compare each theme's mentions with the same week and the next 1 to 4 weeks of
    theme_return_rate. Report weeks with missing review data. Never treat a missing
    week as zero complaints.
  response: >
    Answer in the user's language. Give the theme, the weeks, both raw and
    like-weighted mention counts, and the return rate change. Quote at most two
    comments from TopComments, without author names.
  sample_questions:
    - question: "哪条差评主题和退货率一起涨?"
    - question: "Ninja Blast 最近四周的杯盖问题和退货有关系吗?"
tools:
  - tool_spec:
      type: cortex_analyst_text_to_sql
      name: VocAnalyst
      description: Weekly social complaint themes, returns and sales by product.
  - tool_spec:
      type: generic
      name: TopComments
      description: Returns the most liked comments for one product and one theme.
      input_schema:
        type: object
        properties:
          product_key: {type: string, description: Product key from product_map}
          theme: {type: string, description: One theme label}
        required: [product_key, theme]
tool_resources:
  VocAnalyst:
    semantic_view: voc.core.voc_returns
  TopComments:
    type: procedure
    identifier: voc.core.top_comments
    execution_environment:
      type: warehouse
      warehouse: voc_xs_wh
「一起涨」要说清楚是哪种一起涨。我们在说明里让智能体比较同一周和之后 1 到 4 周的退货率,因为数据本身告诉我们差评和退货之间有时间差。下面这张图是 17 条产品问题评论按月份的分布:对比测评视频发于 2025-07-27,它的 4 条产品问题评论分别出现在 6 天、44 天和 245 天后;单品上手视频发于 2026-01-20,它的 13 条里只有 2 条出现在第一周,其余分布在 3 月到 9 月。两条明确写了「退货」的评论都在 2026 年 3 月,一条是视频发出 245 天后,一条是 52 天后。
这张图对 Snowflake 里的设计有两个直接影响。第一,同一条视频不能只拉一次:如果我们只在视频发出一周内拉评论,第一条视频会漏掉 3 条产品问题,第二条会漏掉 11 条。所以 watchlist 里的视频要按周或按月重复拉,MERGE 去重后新评论自然追加进来。第二,把差评和退货按「同一周」对齐很可能什么都看不出来,因为买家先用了一段时间才在评论里抱怨、再去退货,两边的时间差需要用数据去找,而不是预设。
还要坦白一点:两条视频 14 个月里一共只有 17 条产品问题评论,按周算大部分周是 0。用这样稀疏的数据算相关系数没有意义。要让智能体的回答站得住,一个商品至少要盯二三十条单品上手类视频,再加上亚马逊评论和退货留言本身;粒度也先按月,等数据够了再按周。这不是 Snowflake 的限制,是数据量的限制,换任何工具都一样。我们在智能体说明里写「报告数据缺失的周」也是这个原因:宁可让它说「这几周数据太少,看不出」,也不要让它在 3 条评论上编出一个趋势。
每月要花多少钱:接口费和 Snowflake 费用
先定一个具体的使用计划,再算钱。假设一个品牌盯 20 个 ASIN 和 20 条 TikTok 视频,每天各拉一次评论;5 个 Reddit 关键词每天搜一次;5 个 TikTok 关键词每周搜一次找新视频。一个月按 30 天,共 1,370 次接口调用。接口费按 2026-11-06 读取的目录价算,是实价;Snowflake 的部分全部是估算,方法写在表里,价格取 Snowflake 服务用量表(2026-11-04 生效)和价格页的美东标准版按需价:普通 credit $2.00,AI credit 全球 $2.00(服务用量表,价格页,Cortex AI 计费说明)。
| 项目 | 怎么算 | 每月 |
|---|---|---|
| EveryInfra 接口费 | 600 次 amazon/reviews × $0.001389 + 600 次 tiktok/comments × $0.000556 + 150 次 reddit/search × $0.000556 + 20 次 tiktok/search × $0.000556 | $1.26 |
| 仓库等接口返回(同步、串行) | 每次按本文实测耗时:亚马逊评论 67.25 秒(取 5 次里最慢的一次,那次是空结果;若按 503 那几次的 19.48 到 60.12 秒算,这一项是 $24.61 到 $38.16)、TikTok 评论 52.3 秒、Reddit 7.62 秒、TikTok 搜索 3.78 秒,合计 20.27 小时 × XS 仓库每小时 1 credit × $2 | $40.54 |
| 仓库等接口返回(同步、10 路并发) | 同上除以 10 | $4.05 |
| 仓库(异步两段式) | 每天提交约 46 次 × 2 秒 + 收结果 2 次、每次按 60 秒最低计费,再加 3 次运行后各 60 秒自动挂起前的空转;每天约 392 秒,一个月约 3.3 小时 | 约 $6.5 |
AI_CLASSIFY 打主题 | 每月 1 万条评论 × 每条约 150 token = 150 万 token × 1.62 AI credit/百万 × $2 | $4.86 |
| Cortex Agent 提问(Sonnet 5.5) | 每月 50 个问题 × 每个 2 万输入、1,500 输出 token;输入 1.30、输出 6.50 AI credit/百万 | $3.58 |
| Cortex Agent 提问(Haiku 5.5) | 同上,输入 0.065、输出 0.325 AI credit/百万 | $0.18 |
| 智能体生成的 SQL 在仓库上跑 | 50 次 × 每次按 60 秒最低计费 × $2 | $1.67 |
| 存储 | 1 GB × 每 TB 每月 $23 | 约 $0.02 |
关键在第二行。接口本身一个月只要 $1.26,但如果存储过程用最直接的写法,一个接一个同步调用、等每次返回,Snowflake 仓库一个月要开 20 多个小时,约 $40.54,是接口费的 32 倍。改成 10 路并发或者异步两段式,这一项能降到 $4 到 $7。并发写法在估算里最省,但要在 Python 里自己管线程和超时;异步两段式多花两三美元,换来的是单次请求不会因为等太久被掐断,失败的任务第二天自然重试,我们更推荐后者。全部加起来,串行写法一个月约 $51.93,并发写法约 $15.44;在新加坡区域,标准版普通 credit 是 $2.50,仓库相关的几项要乘以 1.25。如果你的账户是企业版,美东按需价是每 credit $3.00,同样按比例放大。
模型选择是第二个变量。Cortex Agent 的编排按 token 计费,服务用量表里 CoWork 和 Agents 的模型价差很大:同样 50 个问题,Sonnet 5.5 约 $3.58,Haiku 5.5 约 $0.18,Opus 5.5 输入 2.60、输出 13.00 AI credit/百万,会是 Sonnet 的两倍。每个问题 2 万输入 token 是我们的假设,包括语义视图的定义、说明文字和一两轮工具结果;如果智能体在一次对话里多轮调工具,或者把大段原文评论读进上下文,实际 token 会更多。上线后看 CORTEX_AGENT_USAGE_HISTORY 视图就能拿到真实数,CoWork 里的提问则记在 SNOWFLAKE_COWORK_USAGE_HISTORY,两个视图互不包含对方的请求(Cortex Agent 用量视图,CoWork 用量视图)。
下表是服务用量表里和本文有关的几项单价,单位是每百万 token 多少个 AI credit;AI 函数一栏不分输入输出,按处理的 token 总数计。
| 模型或函数 | 输入 | 输出 | 本文用在哪里 |
|---|---|---|---|
| claude-sonnet-5-5(CoWork、Agents) | 1.30 | 6.50 | 智能体编排,成本表的默认值 |
| claude-haiku-5-5(CoWork、Agents) | 0.065 | 0.325 | 便宜的编排选择 |
| claude-opus-5-5(CoWork、Agents) | 2.60 | 13.00 | 本文不推荐用于例行报告 |
| openai-gpt-6.1-sol(CoWork、Agents) | 1.30 | 6.50 | 和 Sonnet 同价 |
AI_CLASSIFY | 1.62(合计) | 给评论和退货留言打主题 | |
AI_SENTIMENT | 1.60(合计) | 情绪分,可选 | |
AI_AGG | 1.85(合计) | 按主题汇总原文,可选 |
存储过程访问外网的每一次请求,记在 EXTERNAL_ACCESS_HISTORY 视图里,文档写明这个视图最多有 3 小时延迟(外部访问历史)。把它和 voc.raw.jobs 里存的 charged_usd 按时间对一下,就能每月核一次两边的次数和花费。Snowflake 也提供智能体级别的预算控制:可以给单个智能体设资源预算,也可以按用户设配额,超了就停(Cortex Agents 资源预算)。EveryInfra 这边可以给这把 Key 单独设每分钟次数上限,两边都有闸,就不会出现某个任务写错了一晚上调几万次的情况。
服务用量表里还有一行容易看错:「Cortex Tools」写的是第三方智能体访问非 Snowflake 端点,每 1,000 次工具调用 8 个 AI credit,访问 Snowflake 自己的端点不收费。本文的做法里,调 EveryInfra 接口的是 Snowflake 的存储过程,不是智能体,智能体只读 Snowflake 里的表,所以我们没有把这一行算进去。如果你改走 MCP 连接器、让智能体在对话里直接调外部工具,这一行是否适用、怎么计次,原文未写,上线前最好问一下 Snowflake 的客户经理。新账户可以先用试用 credit 跑一遍:价格页写的是 30 天、$400 的 credit。
用 snowflake cowork 自动化每周发一封报告
数据和智能体都准备好以后,最后一步是让结果按时出现在该看的人面前。Snowflake CoWork 的 Automations 正好做这件事:在 CoWork 里把一个问题设成定时运行,比如每周一早上 9 点问一次「过去四周哪条差评主题和退货率一起涨,给出商品、主题、周和两条原文」,结果发到邮箱(Automations 文档)。文档写明的限制要先知道:最密每小时一次,结果只发邮件,收件人要先在 Snowflake 里验证邮箱;运行记录保留 60 天;自动化按创建者的权限执行,所以创建者能看到的表,邮件里都可能出现。
这几条限制对本文的场景都不构成问题。差评和退货本来就是按周看的,每小时一次绰绰有余;只发邮件意味着不能直接推到 Slack,但同一份新闻稿里提到 Snowflake for Slack 已经进入公开预览(Expedition 2026 新闻稿)。真正要注意的是权限:EXECUTE AGENT TASK 默认授给了 PUBLIC,账户里的任何人都能给自己建自动化;而自动化按创建者的权限跑,如果某个人能看到全部销售数据,他建的自动化就会把这些数据发到他填的邮箱。管理员如果不希望这样,需要收回 PUBLIC 上的这项权限,再按角色授。
局限和注意事项
本文的 Snowflake 部分全部是配置示例,我们没有 Snowflake 账户,没有跑过这些 SQL、存储过程和智能体规格。写法都按 2026-11-06 读取的 docs.snowflake.com 原文,但 Snowflake 这个月刚发了大版本,语法和限制可能还会变;上线前请在自己的账户里逐段执行。成本表里只有接口费是实价,Snowflake 的每一项都是按公开价格和我们的假设算出来的估计值,最大的不确定在两处:每条评论分类时的实际 token 数,以及每个智能体问题的实际 token 数。
数据这一侧,亚马逊评论这次 5 次都没拿到,本文关于主题和退货的分析只用了 TikTok 的 273 条评论,人工标注是作者一个人按上面的规则做的,没有第二个人复核。17 条产品问题评论的主题分布可以说明「杯盖和漏洒值得盯」,不足以说明这款产品的真实问题比例。销量表和退货表本文只给了结构,没有任何真实或虚构的数字,「哪条差评主题和退货率一起涨」的答案要等你的数据进来才有。
还有一条和 EveryInfra 自己有关:我们的 MCP 目前不能直接加成 Snowflake 的连接器,原因上面已经写清楚了。外部访问集成这条路不受影响,也是我们推荐的做法;但如果你的团队更想在 CoWork 里点一下就连上,现在做不到,我们会在本文发布时再核一次这个状态。
和我们以前几篇的区别
EveryInfra 博客以前几篇读评论的文章,比如《Claude Cowork 定时任务:每周竞品价格评论表》、《Claude Managed Agents 每晚巡检门店差评》、《Qwen Agent MCP 实战:淘宝京东闲鱼比价评论员》和《DeepSeek V4 Claude Code 洗评论》,评论数据都停在智能体或一份文件里,回答的是「最近大家在抱怨什么」;这一篇把评论放进公司的数据仓库,和销量、退货放在同一个权限体系、同一套语义定义下,回答的是「哪个抱怨真的在花我们的钱」。代价是多了一层仓库成本和一套表结构,前面算过,一个品牌一个月十几美元。
最近的变化
2026-11-04,Snowflake 新版服务用量表生效,CoWork 和 Cortex Agents 的模型价、Cortex AI 函数价和「Cortex Tools」一行都按这一版算(服务用量表)。同一天的版本说明给 Snowflake 托管的 MCP 服务器加了后台运行:CORTEX_AGENT_RUN 和 CODING_AGENT 两类工具多了一个 background 参数,设为真时立刻返回一个句柄;有这两类工具的 MCP 服务器会自动多出 ASYNC_AGENT_RUN_STATUS、ASYNC_AGENT_RUN_CANCEL、AGENT_RUN_RESULT 三个辅助工具,用来查状态、取消和读结果;新的 content_cel_filter 参数让客户端先要一份提纲,再只读需要的部分(2026-11-04 版本说明)。
snowflake cortex agents mcp 常见问题
snowflake cortex agents mcp server 和 MCP 连接器是一回事吗?
不是,方向正好相反。来源:Google 联想词「snowflake cortex agents mcp server」。Snowflake 托管的 MCP 服务器是把 Snowflake 当作服务器,让 Claude、Cursor 这类外部客户端经 MCP 调用你在 Snowflake 里的智能体、Cortex Search、Cortex Analyst 和 SQL,工具类型有 CORTEX_AGENT_RUN、CODING_AGENT、CORTEX_SEARCH_SERVICE_QUERY、CORTEX_ANALYST_MESSAGE、SYSTEM_EXECUTE_SQL 和 GENERIC,文档建议客户端用 OAuth 而不是写死令牌(Snowflake 托管 MCP 服务器,CREATE MCP SERVER)。MCP 连接器则是把 Snowflake 当作客户端,让 Cortex Agents 和 CoWork 去调外部的 MCP 服务器,只支持 OAuth(连接器文档)。本文要的是后一个方向,而且最终选了不经 MCP 的外部访问集成。
snowflake cowork 和 CoCo(Cortex Code)有什么区别?
来源:Google 联想词「snowflake cowork vs coco」。按 2026-11-03 的新闻稿,CoWork 面向业务人员,在 ai.snowflake.com 用自然语言提问、看看板、设自动化;CoCo 面向开发者和数据工程师,用来写代码、建数据对象,分析师也可以对它描述需求来建看板(Expedition 2026 新闻稿,Cortex Code 文档)。放到本文的场景里,表、存储过程和语义视图是数据工程师用 CoCo 或普通 SQL 建的,提问和每周报告是业务人员在 CoWork 里做的。
不用 OAuth,Cortex Agents 能用 API Key 调外部接口吗?
能,但不是经 MCP 连接器。来源:Snowflake 连接器文档里「只支持 OAuth」那一条引出的延伸问题。用外部访问集成把 Key 存进 GENERIC_STRING 类型的密钥对象,写一个 Python 存储过程去调接口,再把这个存储过程作为自定义工具加进智能体;智能体调用它时在仓库上执行,按仓库时间计费(外部网络访问,Cortex Agents 概览)。本文更推荐让定时任务调存储过程把数据写进表,智能体只读表,这样每次提问不用等接口。
评论不是英文,AI_CLASSIFY 还能用吗?
能用,但要先核对。来源:Snowflake AI_CLASSIFY 文档的使用说明。文档写明输入最好用英文,其他语言的效果可能下降(AI_CLASSIFY 文档)。如果你同时盯西语或中文市场,先人工标 100 条左右,拿 AI_CLASSIFY 的结果对一遍;对不上的类别,把任务说明和示例写得更具体,或者改用 Cortex Agents 里更强的模型逐条判断,成本会高一些。
EveryInfra 接口失败或者没数据会扣费吗?
不会。来源:本文 12 次真调的返回。参数错误、暂时不可用(503)、返回空结果都不扣费,每次扣费的返回里都写明了实扣金额;本文 6 次没拿到数据的调用,charged_usd 全部是 0。异步模式在提交时扣费,任务最后失败会按同一笔退回。
上手步骤
- 在 EveryInfra 注册并充值,按 快速开始 建一把只给 Snowflake 用的 API Key,设好每分钟次数上限。
- 先在本机用
curl对你要盯的商品链接、视频链接和关键词各调一次,核对返回字段和条数,把能用的目标写进watchlist表。 - 在 Snowflake 里按上面的配置示例建网络规则、密钥、外部访问集成,再建提交和收结果两个存储过程、两个任务,仓库自动挂起设成 60 秒。
- 跑几天后建按周汇总的视图和语义视图,用
AI_CLASSIFY给社媒评论和退货留言打同一套主题,先人工核对一批。 - 建 Cortex Agent,在 CoWork 里先手动问几次,确认回答会报告数据缺失的周,再设成每周一封的 Automation。
需要的数据能力都在 EveryInfra 能力目录 里,远程 MCP 的说明在 MCP 服务器,按次价格在 价格页。
参考资料
- Snowflake 新闻稿《Expedition 2026:CoCo 与 CoWork》,2026-11-06 读取:https://www.snowflake.com/en/news/press-releases/expedition-2026-coco-cowork/
- Snowflake 新闻稿《Business Ontology 与 Cortex AI Gateway》,2026-11-06 读取:https://www.snowflake.com/en/news/press-releases/expedition-2026-business-ontology-ai-gateway/
- Snowflake 博客《AI agents, governed data and business context》,2026-11-06 读取:https://www.snowflake.com/en/blog/ai-agents-governed-data-business-context/
- Snowflake 博客《Snowflake CoWork Adds Profiles, Dashboards & Automations》,2026-11-06 读取:https://www.snowflake.com/en/blog/snowflake-cowork-profiles-automations-dashboards
- Snowflake 博客《Snowflake CoCo:云端智能体与自动化》,2026-11-06 读取:https://www.snowflake.com/en/blog/snowflake-coco-cloud-agents-automations/
- Snowflake CoWork 产品页,2026-11-06 读取:https://www.snowflake.com/en/product/snowflake-cowork/
- Snowflake 价格页,2026-11-06 读取:https://www.snowflake.com/en/pricing-options/
- Snowflake 服务用量表(Service Consumption Table,2026-11-04 生效),2026-11-06 读取:https://www.snowflake.com/legal-files/CreditConsumptionTable.pdf
- Snowflake 文档《Cortex Agents MCP connectors》,2026-11-06 读取:https://docs.snowflake.com/en/user-guide/snowflake-cortex/cortex-agents-mcp-connectors
- Snowflake 文档《Cortex Agents MCP connectors》限制一节,2026-11-06 读取:https://docs.snowflake.com/en/user-guide/snowflake-cortex/cortex-agents-mcp-connectors#limitations
- Snowflake 文档《Cortex Agents》,2026-11-06 读取:https://docs.snowflake.com/en/user-guide/snowflake-cortex/cortex-agents
- Snowflake 文档《Create and manage agents》,2026-11-06 读取:https://docs.snowflake.com/en/user-guide/snowflake-cortex/cortex-agents-manage
- Snowflake 文档《CREATE AGENT》,2026-11-06 读取:https://docs.snowflake.com/en/sql-reference/sql/create-agent
- Snowflake 文档《Cortex Agents Run API》,2026-11-06 读取:https://docs.snowflake.com/en/user-guide/snowflake-cortex/cortex-agents-run
- Snowflake 文档《Cortex Agents resource budgets》,2026-11-06 读取:https://docs.snowflake.com/en/user-guide/snowflake-cortex/cortex-agents-resource-budgets
- Snowflake 文档《Cortex Agents code execution tool》,2026-11-06 读取:https://docs.snowflake.com/en/user-guide/snowflake-cortex/cortex-agents-code-execution-tool
- Snowflake 文档《Snowflake-managed MCP server》,2026-11-06 读取:https://docs.snowflake.com/en/user-guide/snowflake-cortex/cortex-agents-mcp
- Snowflake 文档《CREATE MCP SERVER》,2026-11-06 读取:https://docs.snowflake.com/en/sql-reference/sql/create-mcp-server
- Snowflake 版本说明《November 4, 2026: Background runs and additional supplementary tools for agents》,2026-11-06 读取:https://docs.snowflake.com/en/release-notes/2026/other/2026-11-04-mcp-async-agent-tools
- Snowflake 文档《Cortex AI Gateway:自定义应用与 MCP 服务器》,2026-11-06 读取:https://docs.snowflake.com/en/user-guide/snowflake-cortex/cortex-ai-gateway/tools/admin-custom-apps
- Snowflake 文档《Cortex Code Agent SDK:MCP 与自定义工具》,2026-11-06 读取:https://docs.snowflake.com/en/user-guide/cortex-code-agent-sdk/mcp-custom-tools
- Snowflake 文档《Cortex Code》,2026-11-06 读取:https://docs.snowflake.com/en/user-guide/cortex-code/cortex-code
- Snowflake 文档《Snowflake CoWork》,2026-11-06 读取:https://docs.snowflake.com/en/user-guide/snowflake-cortex/snowflake-cowork
- Snowflake 文档《CoWork Automations》,2026-11-06 读取:https://docs.snowflake.com/en/user-guide/snowflake-cortex/snowflake-cowork/automations
- Snowflake 文档《Cortex AI 计费》,2026-11-06 读取:https://docs.snowflake.com/en/user-guide/snowflake-cortex/pricing
- Snowflake 文档《Cortex AI Functions(AISQL)》,2026-11-06 读取:https://docs.snowflake.com/en/user-guide/snowflake-cortex/aisql
- Snowflake 文档《AI_CLASSIFY》,2026-11-06 读取:https://docs.snowflake.com/en/sql-reference/functions/ai_classify
- Snowflake 文档《AI_SENTIMENT》,2026-11-06 读取:https://docs.snowflake.com/en/sql-reference/functions/ai_sentiment
- Snowflake 文档《Semantic views overview》,2026-11-06 读取:https://docs.snowflake.com/en/user-guide/views-semantic/overview
- Snowflake 文档《CREATE SEMANTIC VIEW》,2026-11-06 读取:https://docs.snowflake.com/en/sql-reference/sql/create-semantic-view
- Snowflake 文档《External network access overview》,2026-11-06 读取:https://docs.snowflake.com/en/developer-guide/external-network-access/external-network-access-overview
- Snowflake 文档《Creating and using an external access integration》,2026-11-06 读取:https://docs.snowflake.com/en/developer-guide/external-network-access/creating-using-external-network-access
- Snowflake 文档《External network access examples》,2026-11-06 读取:https://docs.snowflake.com/en/developer-guide/external-network-access/external-network-access-examples
- Snowflake 文档《CREATE NETWORK RULE》,2026-11-06 读取:https://docs.snowflake.com/en/sql-reference/sql/create-network-rule
- Snowflake 文档《CREATE SECRET》,2026-11-06 读取:https://docs.snowflake.com/en/sql-reference/sql/create-secret
- Snowflake 文档《CREATE EXTERNAL ACCESS INTEGRATION》,2026-11-06 读取:https://docs.snowflake.com/en/sql-reference/sql/create-external-access-integration
- Snowflake 文档《Writing stored procedures in Python》,2026-11-06 读取:https://docs.snowflake.com/en/developer-guide/stored-procedure/python/procedure-python-overview
- Snowflake 文档《CREATE TASK》,2026-11-06 读取:https://docs.snowflake.com/en/sql-reference/sql/create-task
- Snowflake 文档《Introduction to tasks》,2026-11-06 读取:https://docs.snowflake.com/en/user-guide/tasks-intro
- Snowflake 文档《Snowpipe》,2026-11-06 读取:https://docs.snowflake.com/en/user-guide/data-load-snowpipe-intro
- Snowflake 文档《Overview of warehouses》,2026-11-06 读取:https://docs.snowflake.com/en/user-guide/warehouses-overview
- Snowflake 文档《Understanding compute cost》,2026-11-06 读取:https://docs.snowflake.com/en/user-guide/cost-understanding-compute
- Snowflake 文档《CORTEX_AGENT_USAGE_HISTORY view》,2026-11-06 读取:https://docs.snowflake.com/en/sql-reference/account-usage/cortex_agent_usage_history
- Snowflake 文档《SNOWFLAKE_COWORK_USAGE_HISTORY view》,2026-11-06 读取:https://docs.snowflake.com/en/sql-reference/account-usage/snowflake_cowork_usage_history_view
- Snowflake 文档《EXTERNAL_ACCESS_HISTORY view》,2026-11-06 读取:https://docs.snowflake.com/en/sql-reference/account-usage/external_access_history
- MCP 规范《Authorization》2025-06-18 版,2026-11-06 读取:https://modelcontextprotocol.io/specification/2025-06-18/basic/authorization
- IETF RFC 9728《OAuth 2.0 Protected Resource Metadata》,2026-11-06 读取:https://datatracker.ietf.org/doc/html/rfc9728
- IETF RFC 8414《OAuth 2.0 Authorization Server Metadata》,2026-11-06 读取:https://datatracker.ietf.org/doc/html/rfc8414
- IETF RFC 7591《OAuth 2.0 Dynamic Client Registration Protocol》,2026-11-06 读取:https://datatracker.ietf.org/doc/html/rfc7591
- 亚马逊 SP-API 文档《FBA report type values》,2026-11-06 读取:https://developer-docs.amazon/sp-api/docs/report-type-values-fba
- 美国零售联合会新闻稿《Consumers expected to return nearly $850 billion in merchandise in 2025》,2026-11-06 读取:https://nrf.com/media-center/press-releases/consumers-expected-to-return-nearly-850-billion-in-merchandise-in-2025
- Analytics India Magazine《Snowflake introduces Business Ontology, Cortex AI Gateway》,2026-11-06 读取:https://analyticsindiamag.com/ai-news/snowflake-introduces-business-ontology-cortex-ai-gateway-to-bring-ai-agents-into-enterprise-workflows
- EveryInfra 能力目录
GET /api/v1/social/catalog,2026-11-06 读取:https://api.everyinfra.com/api/v1/social/catalog - EveryInfra 远程 MCP 地址,2026-11-06 实测:https://api.everyinfra.com/mcp
- EveryInfra 完整 MCP 入口的受保护资源说明,2026-11-06 实测:https://api.everyinfra.com/.well-known/oauth-protected-resource/mcp/all
引用编号 BL-97