GPT-6 Intelligent UI 社媒报告:数据实测
GPT-6 Intelligent UI 能把回答做成表和图,原文没写会画 MCP 数据;三品牌报告接口费 $0.003336,X 混进 42 条界外帖。
GPT-6 在 2026-10-07 进入 ChatGPT 的 Chat,同时带来 Intelligent UI:模型自己决定一条回答里放文字、图表、按钮还是表单(OpenAI 发布文)。本文要回答的问题很具体:在 ChatGPT 里接上 EveryInfra 远程 MCP,问一句「对比这 3 个品牌上周在 Reddit 和 X 上的讨论量和情绪」,能不能稳定地得到一份可交互的报告。我们在 2026-11-05 00:18–00:27(新加坡时间)给 EcoFlow、Jackery、BLUETTI 三个便携电源品牌真调了 16 次接口,13 次付费,合计 $0.007228。结论分三层:OpenAI 的原文没有写自定义 MCP 返回的数据会被 Intelligent UI 画成图;接口回来的是一段 JSON 文本,表和图要靠模型读完再算;而算之前,有三个数会先骗你。
这篇和站内三篇 ChatGPT 文章的分工不同。ChatGPT Spaces 竞品社媒追踪页讲多人共同维护、每周更新一次的共享页面;ChatGPT dots 选品雷达讲常驻智能体的两套权限和指派任务;ChatGPT 定时任务做需求雷达讲一个人每周收一条推送。本篇只看一件事:一次性提问的回答怎样被做成可交互的表和图,数据字段怎样设计才不让模型算错。ChatGPT 一侧我们没有登录操作,所有步骤来自 OpenAI 帮助中心和开发者文档的原文,写成「配置示例」;EveryInfra 一侧的每个数都来自真调的原始返回,能复算。
GPT-6 Intelligent UI 是什么:OpenAI 原文怎么写
先把名字和边界说准。OpenAI 的发布文《GPT-6 and Intelligent UI for everyone》把 Intelligent UI 写成 GPT-6 在 ChatGPT 里的一种新能力:回答可以是完整的可交互界面,让日常回答更直观、让复杂话题更容易学,也能当场做一个解决手头任务的小工具(OpenAI 发布文,2026-11-05 读取)。实现上,OpenAI 做了一个原生、可流式输出的组件库,加一个编译器,模型一边生成,界面一边按顺序出现;组件库给每个回答一个统一的设计底子,组件怎么组合由模型决定。
帮助中心的专页《Intelligent UI in ChatGPT》说得更细:GPT-6 被训练成用文字、图像和交互元素组织回答,回答里可以有图形、可点的按钮、表单、图表和能直接在对话里用的交互体验;格式取决于你问什么,比较类问题可能并排放,解释类问题可能用交互图,简单的文字回答最合适时就只给文字(帮助中心 20001598,2026-11-05 读取,页面显示约 14 天前更新)。也就是说,「什么时候出可交互组件」这个问题,原文的答案是:由模型按问题判断,用户没有一个「必须出图」的开关。
同一页还回答了几件和报告直接有关的事。第一,偏好可以写进 Custom Instructions,帮助中心给的例子正好是「use tables when comparing options」(比较选项时用表格),但原文也写了这些偏好只是引导,具体版式会变。第二,部分组件(例子是清单)在刷新对话时能保留状态,换一个对话就不保留。第三,Intelligent UI 只在 Chat 里有,Work 标签和 Voice 都没有。第四,可以调成更简单的回答风格,网页版路径是 Personalization → Layout and Visuals → Simple,调了以后仍可能出现部分视觉元素。
| 问题 | 原文怎么写 | 出处 | 对报告的意思 |
|---|---|---|---|
| Intelligent UI 是什么 | 模型用原生组件库拼出文字、图像、按钮、表单、图表和交互元素,编译器让界面边生成边出现 | 发布文、帮助中心 20001598 | 表和图是模型自己拼的,不是插件交来的现成组件 |
| 什么时候出组件 | 按问题决定;比较可能并排,解释可能用交互图,简单问题只给文字 | 帮助中心 20001598 | 想要表格,提示词和 Custom Instructions 里写明「比较时用表格」 |
| 要不要特殊提示词 | 不要;普通文字回答仍然会有 | 帮助中心 20001354 | 不写也可能出图,但不保证每次版式一样 |
| 有没有单独额度 | 没有;模型、工具和套餐原有额度照常算 | 帮助中心 20001354 | 报告的成本只有套餐和接口费两块 |
| 插件返回的数据会不会被画成组件 | 只写「已连接的插件(如 Gmail、Health、Finance)会照常工作」 | 帮助中心 20001598 | 原文没写,不能当成会自动出图 |
| 能不能关 | 网页版 Personalization → Layout and Visuals → Simple;另一页写 Settings 里关掉 Layout and visuals | 帮助中心 20001598、20001354 | 两页菜单名不一致,以你界面上实际看到的为准 |
关掉的路径要单独说。帮助中心《GPT-6 and other models in ChatGPT》写的减少视觉元素的路径是在网页版 Settings 里关掉 Layout and visuals,而 Intelligent UI 专页写的是 Personalization 里选 Simple(帮助中心 20001354)。两处都说关了以后仍可能出现部分视觉元素,也都没说能切回纯文字的经典模式。对做报告的人来说,这意味着「回答长什么样」不完全受你控制:同一个提示词,在同事的账号上可能因为他选了 Simple 而只出文字表格。
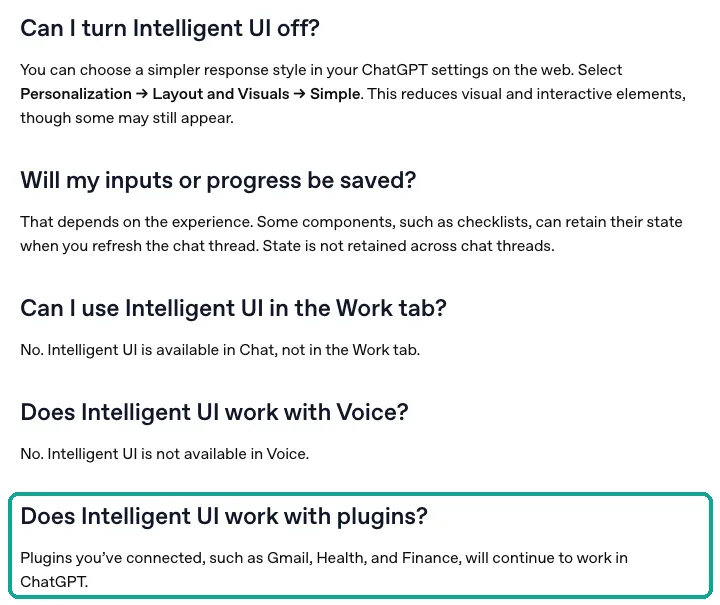
截图里青绿框那一句是本文最要紧的原文。「插件会照常工作」只说明接了插件不会坏,没说插件交回来的数据会进入 Intelligent UI 的组件库。我们也查了开发者一侧:OpenAI 的插件开发文档讲的是另一套机制,服务器自己提供界面模板,这在下一节「自定义 MCP 返回的数据能不能变成表格和图表」里展开。在帮助中心、发布文和开发者文档里,我们都没有找到一句话说「Intelligent UI 会把 MCP 工具结果渲染成图表」,所以本文把它写成「原文没写」,不写成「会」,也不写成「不会」。
GPT-6 和 Intelligent UI:谁能用、在哪能用
发布文写的上线节奏是:2026-10-07 先在 Chat 标签里向全球的 Plus、Pro、Business、Enterprise 推送,第二天扩到 Free 和 Go;Enterprise 能不能用取决于工作区管理员的设置。付费档背后的模型是 GPT-6 Sol,Free 和 Go 是 GPT-6 Luna,两个都按日常对话调过(OpenAI 发布文)。发布文也写了这次更新只改 Chat,Work 和 Codex 背后的模型不变。OpenAI 开发者社区的公告帖重复了同样的范围,并补充 GPT-6 Instant 回答需要联网搜索的问题时,开始作答的时间平均比 GPT-5.6 Instant 早 44%(OpenAI 社区公告)。
帮助中心把思考档位的边界写得很清楚:Intelligent UI 从 Instant 到 Extra High 都能用;Pro 思考档用的是 GPT-6 Astra,不支持 Intelligent UI(帮助中心 20001598)。Business 的《models and limits》一页同样写了 Pro 思考档不支持 Intelligent UI,并写 Business Standard 席位每月含 15 条 Pro 消息(帮助中心 12003714)。Business 发布说明在 2026-10-07 那一条写,GPT-6 在 Chat 里向符合条件的 Business 工作区推送,能不能用取决于工作区权限和客户端是否支持(Business 发布说明)。
| 套餐 | Chat 里的 GPT-6 | Intelligent UI | 能不能接自定义 MCP |
|---|---|---|---|
| Free | GPT-6 Luna,2026-10-08 起 | 能用 | 帮助中心自定义 MCP 一页没列 Free |
| Go | GPT-6 Luna,2026-10-08 起 | 能用 | 同上,没列 |
| Plus | GPT-6 Sol,2026-10-07 起 | 能用 | 开发者模式写了 Plus;Plugins 直接加的那一页只点名 Pro、Business、Enterprise/Edu |
| Pro | GPT-6 Sol;Pro 思考档是 Astra | Sol 能用,Astra 不能 | 能接,但原文写的是带读取和取数权限 |
| Business | GPT-6 Sol,按工作区开 | 能用 | 只有管理员和所有者能建、能发布 |
| Enterprise / Edu | GPT-6 Sol,看管理员设置 | 能用 | 管理员可用角色权限把建连接的权限给别的成员 |
各套餐的价格放在后面「一份报告的接口费」一节。Enterprise 与 Edu 的《models and limits》写 GPT-6 正在向符合条件的 Enterprise 工作区推送,模型菜单里没有 GPT-6 就说明你的工作区还没开(帮助中心 11165333)。
还有一个容易漏的条件:客户端。帮助中心说旧版的 macOS 和 Windows 桌面应用不支持 Intelligent UI,Business 发布说明也写了「supported clients」。如果团队里有人说「我这儿没有图」,先看三件事:是不是在 Chat 标签而不是 Work;思考档是不是选了 Pro;桌面应用是不是旧版。Reddit 的发布讨论里就有付费用户说模型已经显示 GPT-6 Sol,用发布页上的提示词也没出可视化,这类情况多半是推送还没到这个账号或客户端(r/ChatGPT 发布讨论)。
自定义 MCP 返回的数据能不能变成表格和图表
这是本文最想回答的问题,答案分两条路看。第一条路是 Intelligent UI:模型读完工具返回的内容,再用 ChatGPT 自己的组件库拼出表和图。这条路的原文只有「插件照常工作」一句,没有承诺。第二条路是 OpenAI 插件开发文档里的 MCP Apps:MCP 服务器自己带一个界面模板,ChatGPT 把它放进对话里的一个隔离框(iframe)里显示,工具结果交给这个模板去画(开发者文档《ChatGPT UI》)。两条路做出来的东西看起来都像「对话里的图表」,但谁负责画、画得稳不稳,完全不同。
开发者文档的写法是:工具在描述里用 _meta.ui.resourceUri 指向一个 ui:// 开头的资源,资源的类型是 text/html;profile=mcp-app;ChatGPT 加载这个模板,模板和宿主之间用 ui/* 开头的 JSON-RPC 消息通信;为了兼容旧写法,_meta["openai/outputTemplate"] 仍然能用(开发者文档《Build your MCP server》)。MCP 官方的 Apps 扩展文档描述的是同一套模型:工具声明界面资源,宿主在沙箱里渲染(MCP Apps 文档)。OpenAI 还推荐一种「拆开」的写法:取数工具只管返回数据,另一个渲染工具只管挂界面,这样界面里的「重新生成」之类操作可以直接调取数工具,不用重新挂载整个组件。
| 对比项 | Intelligent UI | MCP Apps(服务器自带界面) | EveryInfra MCP 现在的样子 |
|---|---|---|---|
| 谁来画 | ChatGPT 的模型和组件库 | MCP 服务器提供的 HTML 模板 | 不带模板 |
| 数据怎么交 | 模型读工具返回的文字和结构化内容 | 工具结果的 structuredContent 交给模板 | 只有 content[0].type = "text" 的 JSON 字符串 |
| 原文有没有写会画工具结果 | 没写 | 写了,这是它的用途 | 不适用 |
| 版式稳不稳 | 模型每次可能不一样;用户可选 Simple | 模板固定,稳 | 取决于模型 |
| 要谁开发 | 不用开发 | 服务器方写模板、做审核和发布 | 我们没有提供模板 |
| 在哪能用 | Chat,Instant 到 Extra High | 插件能用的地方 | 同插件 |
MCP 规范本身对「结构化结果」有明确的写法。2025-06-18 版的工具一节规定,工具可以声明 outputSchema,返回时把结构化数据放进 structuredContent;为了向后兼容,返回结构化内容的工具「应该」同时在一个 TextContent 块里放一份序列化后的 JSON(MCP 规范:Tools)。我们在 2026-11-05 对 https://api.everyinfra.com/mcp 发了不带 Key 的 initialize 和 tools/list(免费):服务器报的协议版本是 2025-06-18,12 个工具里没有一个声明 outputSchema,也没有 _meta 界面模板。一次真实的 tools/call 返回里只有 content,没有 structuredContent。
所以在 ChatGPT 里接 EveryInfra 远程 MCP 做报告,走的只能是第一条路:模型读一段 JSON 文本,自己数、自己算、自己决定用不用表格和图。这不一定是坏事。Intelligent UI 的组件是 ChatGPT 自己的,样式和对话一致,不用任何开发;但它的稳定性取决于两件事,一是提示词把要什么写得够清楚,二是返回的数据够干净、够短,模型不会在 90 万字节的文本里数错。下面两节分别讲接法和这两件事。
在 ChatGPT 里接 EveryInfra 远程 MCP:个人和 Business 不一样
帮助中心《Connecting custom MCP servers in ChatGPT》写的现行步骤是:在 Plugins 里点「+」,选 Add custom MCP server,填名称、服务器地址和认证方式,阅读并勾选风险提示,再点 Create as a plugin;在现在的 Plugins 界面里,加自定义 MCP 服务器不用先打开开发者模式(帮助中心 12584461,2026-11-05 读取)。这一页还写了只能在网页版上加,手机上不行;用 OAuth 时,身份提供方要能发 refresh token,也就是授权范围里要有 offline_access。
# 配置示例(本机没有登录 ChatGPT,以下按帮助中心原文整理,未在 ChatGPT 里运行)
# ChatGPT 网页版 → Plugins → + → Add custom MCP server
Name:            EveryInfra
MCP server URL:  https://api.everyinfra.com/mcp/all
Authentication:  OAuth
# 授权页跳到 https://auth.everyinfra.com/oidc 登录 EveryInfra 账号
# 授权范围至少要 data:call(取数)和 offline_access(让 ChatGPT 拿 refresh token)
# 勾选风险提示 → Create as a plugin
# Business 工作区:只有管理员或所有者能建、能发布;发布后成员在 Plugins 里启用
# Enterprise / Edu:管理员可以用角色权限(RBAC)把「建连接」的权限给指定成员
为什么地址是 /mcp/all 而不是 /mcp:EveryInfra 的 /mcp 用请求头里的 Key 认证,适合 Claude Code、Cursor 这类能自己写请求头的客户端;ChatGPT 的自定义 MCP 只给 OAuth、不认证和混合三种选项,没有「填一个 Key 放进请求头」的选项(开发者文档《Developer mode》)。/mcp/all 走 OAuth:我们读到它公布的受保护资源元数据,授权服务器是 https://auth.everyinfra.com/oidc,支持的授权范围里有 data:call 和 offline_access(EveryInfra 受保护资源元数据)。OpenAI 的认证文档要求的正是这一套:资源服务器公布受保护资源元数据,授权服务器公布 OAuth 配置,客户端用 CIMD、动态注册或预置客户端标明身份(开发者文档《Authentication》),对应的是 MCP 规范的授权一节(MCP 规范:Authorization)。以前有人把 Key 写进地址的 ?key= 里、认证选「不认证」,这种连接 2026-11-04 起已经停用,站内Spaces 那篇记了当时的 401 返回。
个人和 Business 的差别,帮助中心写得很直接。Business 工作区里只有管理员和所有者能建自定义 MCP 连接、能发布给工作区;Enterprise 和 Edu 的管理员可以用角色权限把建连接的权限给选定成员,但发布仍然只能由管理员和所有者做。个人套餐里,常见问题「Are apps and full MCP beta available to Pro users?」的答案是:完整 MCP 目前只给 Business 和 Enterprise/Edu,Pro 用户能接带读取和取数(read/fetch)权限的自定义 MCP 服务器。Business 发布说明还记了两条和插件管理有关的更新:2026-10-15 起管理员可以一次管理多个插件,2026-10-21 起 Business 工作区的设置可以在 Admin Console 里管(Business 发布说明)。
| 场景 | 谁来加 | 取数时会不会先确认 | 要注意的地方 |
|---|---|---|---|
| Plus / Pro 个人 | 自己 | 会;取数工具 everyinfra_call_api 标的是非只读 | Pro 原文写「读取和取数权限」,非只读工具在 Pro 上的表现原文没写清,要先试 |
| Business | 管理员或所有者建、发布 | 会;管理员可在插件权限里设确认策略 | 成员不能自己加;用团队共用的 EveryInfra 账号授权 |
| Enterprise / Edu | 管理员,或被授权的成员建;管理员发布 | 会 | 工作区要先开 GPT-6 和插件 |
| Free / Go | 帮助中心没列 | 不适用 | 能看到 Intelligent UI,但接自定义 MCP 原文没写 |
确认这一步来自工具标注。我们读到的 tools/list 里,取数用的 everyinfra_call_api 标的是 readOnlyHint: false、destructiveHint: true、openWorldHint: true;列能力的 everyinfra_list_capabilities 标的是只读。开发者模式文档写,没有标只读的工具会被当成写操作,调用前要用户确认,用户可以选择在这个对话里记住这次批准(开发者文档《Developer mode》)。这里的 destructiveHint: true 标得过重:MCP 规范里这个标注表示工具可能对环境做破坏性的更新,而取数只读 Reddit 和 X 的公开帖子,不改任何东西,扣费也不属于这一类(MCP 规范:Tools)。对用户来说,标注的效果都一样:工具没有标只读,所以调用前要确认。实际效果是:一份 6 次调用的报告,第一次会先弹确认,选了记住以后,同一个对话里后面几次不再问。
让模型稳定出表:提示词和返回字段设计
Intelligent UI 不需要专门的提示词,但「对比三个品牌的讨论量和情绪」这句话太松:讨论量按什么算,上周是哪七天,情绪按谁的标准,模型每次可能理解得不一样。我们的建议是把提示词写成三段:取数(调哪几项能力、参数是什么)、计数(哪些帖子算、哪些不算)、输出(要一张什么样的表、一张什么样的图、表下面写什么说明)。帮助中心给的 Custom Instructions 例子「比较选项时用表格」可以放进个人设置里,让每次对比类问题都默认出表。
# 提示词示例(配置示例,未在 ChatGPT 里运行)
用 @EveryInfra 对比 EcoFlow、Jackery、BLUETTI 上周(UTC 2026-10-26 00:00 到 2026-11-02 00:00)在 X 和 Reddit 上的讨论量和情绪。
取数,每个品牌各一次:
1. twitter/search:keyword = "<品牌> since:2026-10-26 until:2026-11-02",limit = 200
2. reddit/subreddit_posts:r/Ecoflow_community、r/Jackery、r/bluetti,sort = newest,limit = 100
3. reddit/search:keyword = 品牌名,sort = newest,limit = 25(只用来看站外讨论,不用来算周总数)
计数:
- 只算 posted_at 落在这一周里的帖子;返回刚好 200 条或社区 100 条还没翻到周一的,写「至少」
- X 按 language 分成英文、日文、其他三栏
- 情绪只看对品牌本身的态度,不看整条帖子的语气;品牌自己账号发的帖子单列,不算进情绪
输出:
- 一张表:品牌 | X 帖数 | X 点赞 | 英文 / 日文占比 | 品牌社区帖数 | 社区评论数 | 说明
- 一张并排柱图:X 帖数和品牌社区帖数
- 表下面一句话写每一列怎么数的,哪些数是下限
返回字段这一侧,EveryInfra 的 twitter/search 每条帖子有 30 个左右字段,目录里列的可返回字段有 38 个,包括作者头像、简介、粉丝数、话题标签和外链(EveryInfra 目录);reddit/subreddit_posts 每条 14 个字段,reddit/search 每条 10 个。做报告用得上的只有一小部分。下面这张表是我们按真调结果整理的「哪个指标用哪个字段」,提示词里把这些字段名写出来,模型就不会去猜。
| 指标 | X 用哪个字段 | Reddit 用哪个字段 | 要注意 |
|---|---|---|---|
| 讨论量 | posted_at、id | posted_at、id | 先按 posted_at 筛出这一周,再数 |
| 互动 | like_count、reply_count、view_count | like_count、comment_count | Reddit 没有浏览数,两边不能直接加 |
| 语言 | language | 没有 | Reddit 的帖子要模型自己判断语言 |
| 品牌自己发的 | author_username | author_username | 只用来排除,报告里不展示个人用户名 |
| 帖子类型 | is_reply、is_quote | flair(只有社区帖有)、community | r/Ecoflow_community 用了求助类 flair,另两个社区没用 |
| 情绪 | text | title、text | 返回里没有情绪字段,要模型读或另外算 |
如果你在自己的服务里再包一层 MCP(比如公司内部的数据服务转发 EveryInfra 的结果),可以按 MCP 规范把这件事做得更稳:声明 outputSchema,把筛好的 10 个字段放进 structuredContent,同时在 TextContent 里放同一份 JSON 的序列化版本。我们算过,把三家品牌 X 返回里的结果数组重新序列化(不含转义),原样是 815,904 字节,只留 id、url、posted_at、language、like_count、reply_count、view_count、is_reply、is_quote 和截到 280 字的 text 以后是 292,415 字节,只剩 36%。模型要读的东西少了三分之二,数错和漏读的机会也跟着少。
一次真实往返:模型发出什么,接口回了什么
ChatGPT 接上插件以后,模型调 EveryInfra 的方式就是一次标准的 MCP tools/call。我们在 2026-11-05 00:25:25(新加坡时间)用同样的请求格式直接调了一次 https://api.everyinfra.com/mcp(请求头带 Key,和 ChatGPT 用 OAuth 拿到的令牌走同一个取数工具),拉 EcoFlow 在 Reddit 上近一个月的热门帖。下面是请求体原样:
{
  "jsonrpc": "2.0",
  "id": 7,
  "method": "tools/call",
  "params": {
    "name": "everyinfra_call_api",
    "arguments": {
      "platform": "reddit",
      "action": "search",
      "params": {"keyword": "EcoFlow", "sort": "top", "limit": 25}
    }
  }
}
接口 6.43 秒后返回 HTTP 200,charged_usd 是 0.000556。返回的结构是 result.content 里只有一个元素,type 是 text,text 是一段 72,067 字节的 JSON 字符串;没有 structuredContent,没有 isError,也没有任何界面模板。把这段字符串解开,里面是 platform、action、count: 16 和 16 条结果,每条 10 个字段:id、url、title、text、author_username、community、like_count、comment_count、posted_at、platform,最后是计费信息。要了 25 条只回了 16 条,按目录的说明,reddit/search 的时间范围固定是最近一个月,热门帖不够 25 条就有多少回多少,不够也照一次收费。
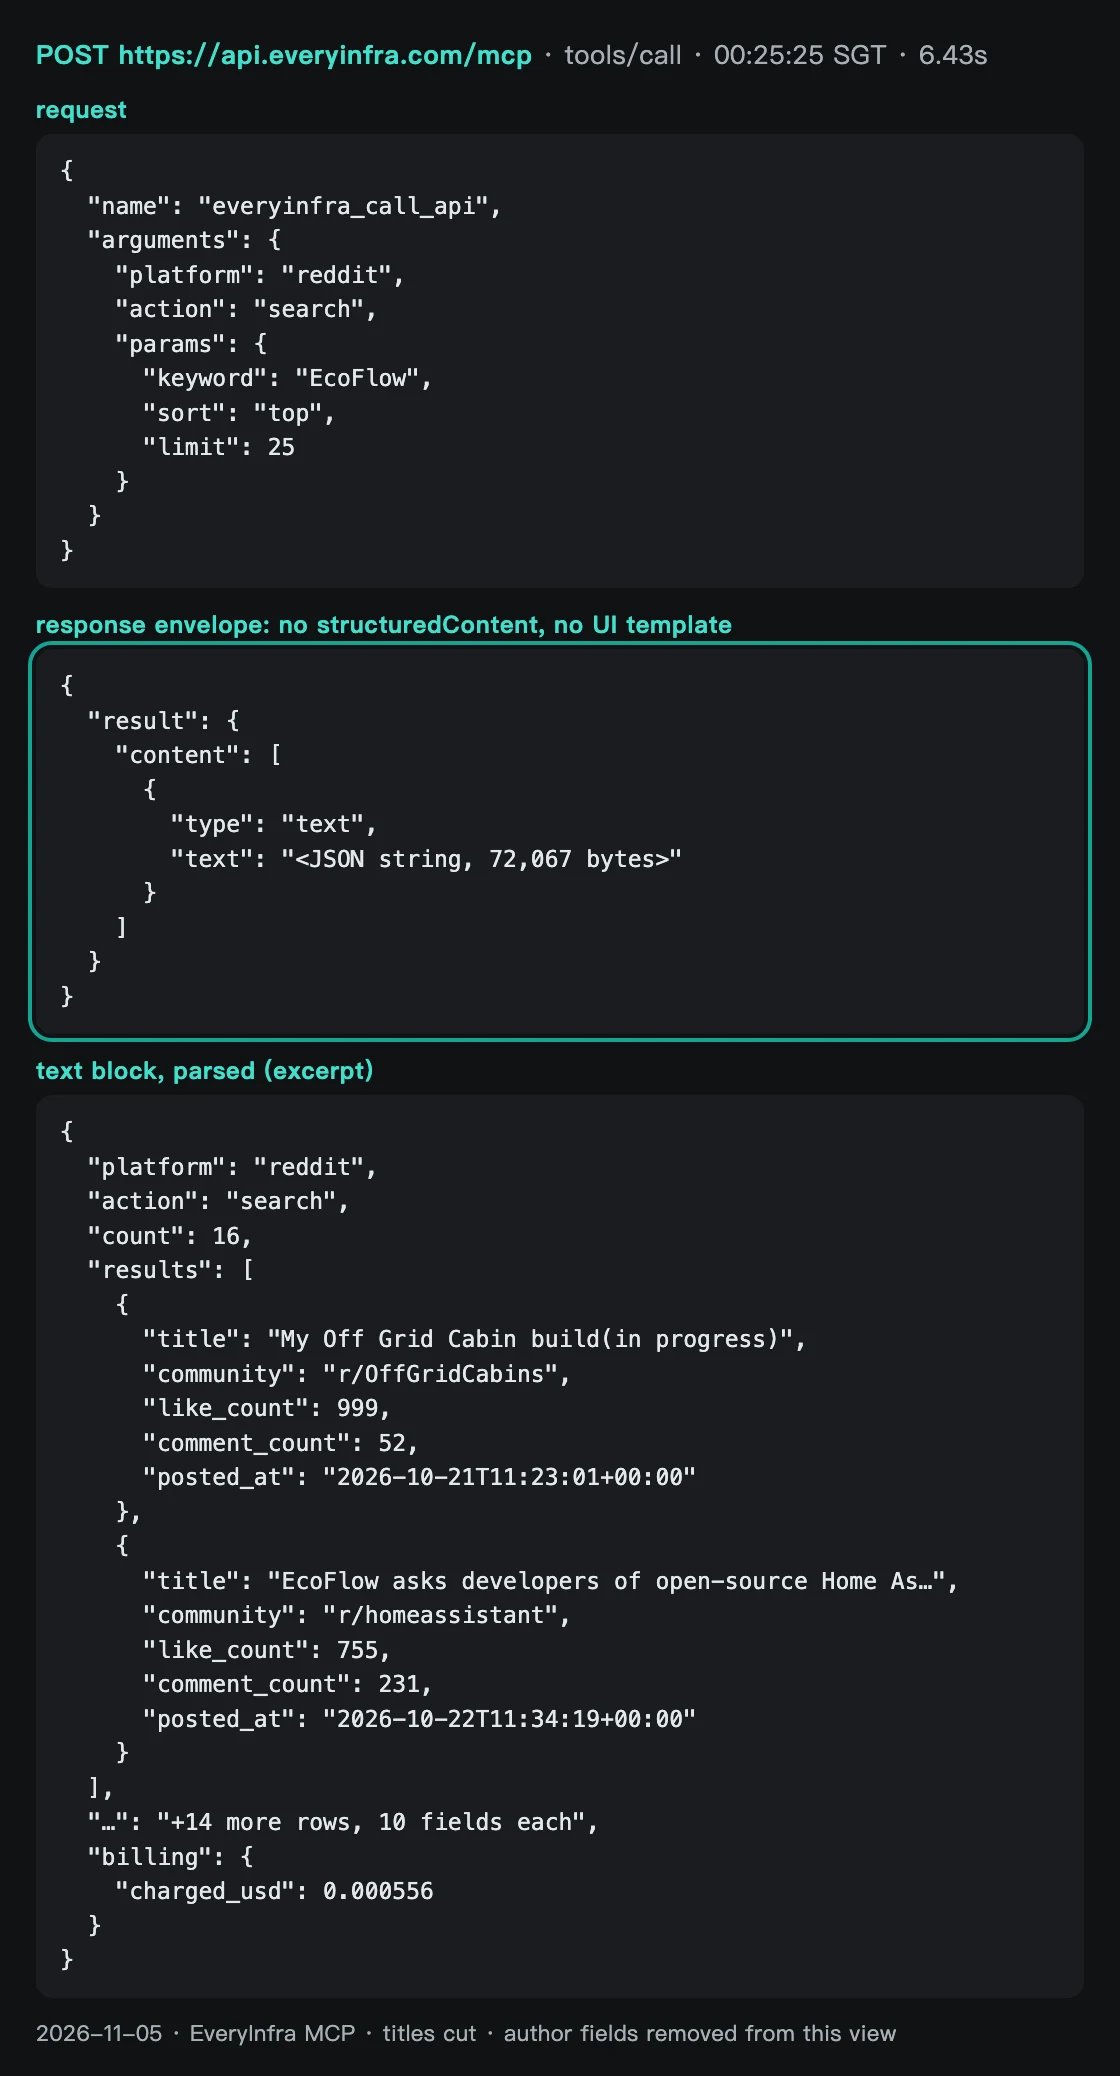
这 16 条里最热的两条正好说明「品牌讨论量」这件事有多难定义。第一条是一个人在加拿大爱德华王子岛盖离网小屋的进度帖,正文里只有一句提到用 EcoFlow Delta Pro 加一块扩展电池和三块 495 瓦的板子供电,却拿了 999 个赞;第二条是 r/homeassistant 里关于 EcoFlow 和开源 Home Assistant 开发者的讨论,755 个赞、231 条评论,这才是对品牌本身有态度的帖子。16 条里没有一条落在上周之内,最新的一条是 2026-11-04,最早的是 2026-10-05。也就是说,「热门」排序回答的是「这一个月大家最爱看哪几条」,回答不了「上周讨论了多少」。


把一份报告拆成上面六步看,前三步是 ChatGPT 和接口之间的事,后三步是模型自己的事。接口能保证的是第四步之前:参数对了就回原始数据,失败和空结果不扣钱。第五步的筛选和计数是整份报告最容易出错的地方,下面五个实测都发生在这一步:如果模型不按 posted_at 筛,或者把被截断的数当成总数,Intelligent UI 画得再漂亮,柱子的高度也是错的。
实测一:X 的「上周」里混进了 11 月 2 日之后的帖子
X 的搜索支持 since: 和 until: 两个日期运算符,EveryInfra 目录对 twitter/search 的 keyword 说明里也写了可以带平台搜索语法(EveryInfra 目录)。X 帮助中心对日期筛选只写了「某日期之前、之后或某个范围内的帖子」,例子是用 since:2013-12-30 until:2014-01-02 找新年前后的帖子,没写 until: 那一天算不算、按哪个时区算(X 帮助中心:高级搜索)。我们在 2026-11-05 00:19–00:21(新加坡时间)给三个品牌各调了一次,关键词写「品牌名 since:2026-10-26 until:2026-11-02」,limit 200。
返回的帖子全部晚于 since: 那一天,但都超出了 until::EcoFlow 返回 200 条,其中 42 条的 posted_at 在 UTC 2026-11-02 当天或之后;Jackery 200 条里 52 条;BLUETTI 167 条里 22 条。按日期看,越界的帖子集中在 11 月 2 日(EcoFlow 40 条、Jackery 48 条、BLUETTI 19 条),11 月 3 日各有两三条。如果模型直接拿 count 当讨论量,EcoFlow 会多算 27%,Jackery 多算 35%。所以提示词里「只算 posted_at 落在这一周里的帖子」这一句不能省。
第二个问题是上限。twitter/search 一次最多 200 条,EcoFlow 和 Jackery 都刚好返回 200 条,说明这一周的帖子可能不止这些,158 和 148 只能写成「至少」。BLUETTI 返回 167 条,没碰到上限,145 才可以当成这次搜索能看到的全部。目录里对排序的说明是「X 默认按热门返回,传 latest 也不保证严格按时间排列」,所以碰到上限时也不能假设拿到的是最新的 200 条。要数准,就把一周拆成两段或七段,每段各调一次,代价是调用次数翻倍,后面成本一节会算。
实测二:Reddit 搜索一次只盖住 1 到 2 天
reddit/search 一次最多 25 条,时间范围固定是最近一个月。我们在 2026-11-05 00:18–00:19(新加坡时间)按 newest 排序给三个品牌各调了一次:EcoFlow 只回了 16 条,最早一条是 UTC 11月3日下午,一共只盖住 24.8 小时;Jackery 24 条盖住 38.8 小时;BLUETTI 24 条盖住 51.0 小时(都按最新一条到最旧一条之间的时间算)。三次都没有翻到上周。按每条的时间间隔粗估,三个品牌在全站的提及速度大约是每天 15.5、14.9 和 11.3 条,这是估计值,不是计数。
全站搜索还有噪音。EcoFlow 那 16 条分布在 r/Ecoflow_community(6 条)、r/prepping、r/dieselheater、r/overlanding 等十来个社区,Jackery 24 条里 9 条在 r/Jackery、其余散在折扣帖和备灾社区,BLUETTI 24 条里只有 4 条在 r/bluetti。品牌社区帖在三家的搜索结果里分别只占 37.5%、37.5% 和 16.7%。这类分散提及适合看「品牌在哪些圈子里被提到」,不适合数周总量:一次 25 条,热闹的品牌一天就用完了,想用全站搜索盖住一整周,要连调好几次,而且每次能往回翻多远并不确定。
要数周总量,更稳的办法是看品牌自己的社区。我们在 00:22–00:24(新加坡时间)用 reddit/subreddit_posts 拉了三个社区最新的 100 条帖子:r/Ecoflow_community 上周至少 73 条帖子、492 条评论,而且 100 条还没翻到周一(最早一条是 UTC 10月26日 16:01),所以 73 是下限;r/Jackery 上周 13 条、206 条评论;r/bluetti 上周 20 条、93 条评论。这一轮中间碰到两次 429 限速,等了 60 秒重试,限速的两次没有扣费。
r/Ecoflow_community 是三个社区里唯一用 flair 分类的:上周的帖子里 29 条是 Open Discussion,26 条是 Troubleshooting Help,另外还有 DIY、备用电源、评测等小类。26 条求助帖占了上周至少 36%,这是一个可以直接放进报告的「讨论质量」指标,而且不需要模型判断情绪,flair 字段本身就是社区成员自己打的标签。另两个社区没有 flair,同样的指标只能靠模型读标题去分。这也说明了为什么同一个提示词在三个品牌上会得到粒度不同的结果:数据本身的结构就不一样。
实测三:日语帖占了一半,只读英文会漏掉谁
情绪是这份报告要的第二个数。最省事的做法是只读英文帖,但 X 的 language 字段显示,上周三个品牌的帖子语言很不一样:EcoFlow 158 条里英文 110 条、日文 20 条、其他语言 28 条(德、西、乌克兰、葡等十几种);Jackery 148 条里英文 77 条、日文 65 条;BLUETTI 145 条里英文 48 条、日文 69 条,日文比英文还多。换成比例,Jackery 和 BLUETTI 上周的 X 讨论里日文分别占 44% 和 48%。
日文帖多,背后有一条具体的新闻线。上周三个品牌里点赞最多的一条帖子,是一位日本博主 2026-10-27 发的长帖:开头说继英国政府之后日本也该提醒全民做准备,接着列出英国建议备的东西,三天的饮用水、手摇应急收音机、几天的食物、常用药,以及打印出来的证件和保险单据;后半段推荐备大容量电源,写家里人用过 Jackery、EcoFlow 和 BLUETTI,三家都不错。这条帖子拿了 4,406 个赞、643,989 次浏览。它对应的是英国政府的应急准备宣传:政府新闻稿鼓励家庭采取「小而简单」的步骤准备紧急情况(GOV.UK 新闻稿),配套网站给出备三天物资的清单(Be Ready 网站),《卫报》2026-10-22 报道每个英国人都被建议囤水和三天的食物(The Guardian),路透社 2026-10-23 的报道标题就是英国让公众在家备三天应急物资(路透社)。
这条帖子还暴露了一个比语言更大的问题:它同时点名了三个品牌,却只出现在 BLUETTI 的搜索结果里。EcoFlow 和 Jackery 的两次搜索都返回了满额的 200 条,里面没有它;三家的结果两两重合的帖子只有 1 到 8 条。也就是说,上周和三个品牌都有关、热度最高的一条讨论,在两家品牌的报告里根本不存在。原因我们无法从返回里判断(可能是 200 条上限截掉了,也可能是日文正文里品牌名紧挨着假名,搜索没有匹配上),但结论很清楚:碰到上限的搜索结果不能当成「这一周的全部讨论」,一份严肃的报告至少要把三家的结果合在一起去重,再按每条帖子提到了哪些品牌重新归类。
对监测海外讨论的市场团队来说,这个结果比情绪分本身更有用。三家都有日本官方账号(EcoFlowJapan、jackeryjapan、BLUETTI_JAPAN 上周分别发了 5 条、3 条和 9 条)。如果报告只读英文,BLUETTI 上周近一半的讨论、以及点赞最多的那条帖子都不会进情绪分。提示词里「X 按 language 分成英文、日文、其他三栏」这一句,就是为了让模型先把语言摊开,再决定每一栏怎么判断。GPT-6 本身能读日文,但它会不会主动分语言、分了以后会不会用同一个标准,要靠提示词写明。
实测四:情绪谁来算,按条数还是按点赞
为了有一个模型以外的判据,我们用开源的 VADER 3.3.2 词典给上周的英文帖打了分(复合分 ≥0.05 算正面,≤-0.05 算负面),它是社交媒体文本常用的规则情绪工具(VADER 开源仓库)。按条数算,三家的负面占比很接近:EcoFlow 17%(110 条里 19 条),Jackery 21%(77 条里 16 条),BLUETTI 19%(48 条里 9 条)。按点赞加权,结果完全变了:EcoFlow 的负面帖拿走了英文帖全部点赞的 54%,Jackery 38%,BLUETTI 22%。
EcoFlow 按点赞算「54% 负面」,听上去像是出了公关危机,读原文才知道不是。我们逐条读了每个品牌点赞最多的 15 条英文帖,按「对品牌本身的态度」重新判读。规则是:夸、推荐、选用或高兴地晒出算正面(品牌自己发的营销帖也算正面),抱怨品牌或产品算负面,只是提到、募捐清单、新闻、只说在用而不评价都算中性;判读由本文作者一次读完给出,没有第二人复核,所以这组数只用来说明 VADER 偏在哪里,不当成准确率。结果是EcoFlow 的 15 条里 14 条是中性,1 条正面,没有一条在抱怨 EcoFlow。点赞最多的几条讲的是基辅停电:俄罗斯对乌克兰能源设施发动了今年规模最大的一轮攻击,基辅出现紧急停电和大面积停水(Kyiv Independent),帖子里提到 EcoFlow 电源是用来撑过停电的东西;另一批是给前线募捐的清单,EcoFlow 只是清单里的一项。词典看到「attack」「blackout」「war」就判负面,可这些负面词说的是战争和停电,不是品牌。
三家对比更能看出问题。EcoFlow 的 15 条里 VADER 只对了 1 条;Jackery 对了 6 条,它的热门帖多在备灾话题里,语气激动但对品牌是中性;BLUETTI 对了 11 条,看上去最准,原因却是这 15 条里有 11 条是 bluetti_inc 自己发的万圣节和新品营销帖,语气正面、对品牌也正面,词典和逐条判读当然一致。品牌自己账号上周的量也不小:EcoFlow 系账号 19 条(EcoFlowTech 9 条、EcoFlowJapan 5 条等),BLUETTI 系 23 条(bluetti_inc 14 条、BLUETTI_JAPAN 9 条),Jackery 系 5 条。不把这些排除,「BLUETTI 情绪最正面」这个结论有一大半是它自己说的。
还有一个和情绪无关、但同样会改变报告结论的数:点赞的集中度。BLUETTI 上周 145 条帖子一共 5,299 个赞,其中 4,406 个在前面说的那一条日文长帖上,占 83%;前三条占 89%。而那条帖子同时点名了三家,只是恰好只被 BLUETTI 的搜索收进来。EcoFlow 和 Jackery 的前三条也分别占了 51% 和 54%。所以「BLUETTI 上周互动最高」这句话,准确的说法是「有一条和 BLUETTI 有关的日文帖火了」。报告里与其给一个点赞总数,不如同时给中位数浏览量(EcoFlow 171.5、Jackery 137.5、BLUETTI 191)和前三条占比,让读的人自己判断热度是不是来自个别帖子。
这些实测合起来,给「情绪」一栏定了三条规则,都写进了前面的提示词:只判断对品牌本身的态度;品牌自己账号的帖子单列;同时给按条数和按点赞两种比例。GPT-6 读全文的能力比词典强得多,我们没有在 ChatGPT 里测它的判断,但可以确定一点:如果提示词只说「分析情绪」,模型会按整条帖子的语气判,和词典犯一样的错。
实测五:一份报告的返回有多大
最后一个实测关心的是模型要读多少。我们把每次返回存下来量了字节数:一次 twitter/search(200 条以内)平均约 261 KB,一次 reddit/search(25 条以内)约 50 KB,一次 reddit/subreddit_posts(100 条)约 94 KB,那次 MCP 返回的文本块 72 KB。一份基础报告(三家各一次 X、一次 Reddit 搜索)合计 930,618 字节,按每 4 个字节约 1 个 token 粗估是 23 万 token;加上品牌社区和 Reddit 月榜的完整版是 1,395,246 字节,约 35 万 token。
OpenAI 的帮助中心没有写 Chat 里 GPT-6 一次对话能装多少工具返回,我们也没有在 ChatGPT 里测,所以这里不下「装得下」或「装不下」的结论。能确定的是:X 的返回占了大头,每条帖子约 1.3 到 1.4 KB,其中作者头像地址、简介、媒体信息这些字段在报告里完全用不上。只留 10 个字段、正文截到 280 字以后,X 部分(按结果数组重新序列化计)从 815,904 字节降到 292,415 字节;上面 930,618 字节用的是存盘文件的大小,两个数不能直接相减。如果你只用 EveryInfra 的 MCP 而不自己包一层,能做的是在提示词里少要一点:X 的 limit 从 200 降到 100,代价是周内帖数更容易变成「至少」。
报告长什么样:第一版对比表
把上面的规则用在真调数据上,三家品牌上周(UTC 2026-10-26 到 2026-11-01)的对比表是下面这样。这是我们用原始返回按提示词里的规则算出来的结果,也就是 Intelligent UI 在理想情况下应该画出来的那张表;ChatGPT 实际会画成什么样,我们没有测。
| 品牌 | X 周内帖数 | X 点赞 / 中位浏览 | 英文 / 日文 | 品牌社区周内帖数 | 社区评论 | 英文负面(条数 / 点赞) | 说明 |
|---|---|---|---|---|---|---|---|
| EcoFlow | ≥158 | 4,869 / 171.5 | 110 / 20 | ≥73(r/Ecoflow_community) | 492 | 17% / 54% | 负面点赞多来自基辅停电和募捐帖,不是抱怨品牌;社区里 26 条求助帖 |
| Jackery | ≥148 | 2,016 / 137.5 | 77 / 65 | 13(r/Jackery) | 206 | 21% / 38% | 日文帖占 44%;热门帖多在备灾话题 |
| BLUETTI | 145 | 5,299 / 191 | 48 / 69 | 20(r/bluetti) | 93 | 19% / 22% | 83% 的点赞在一条同时点名三家的日文帖上;热门英文帖多是品牌自己发的 |
这张表能直接给出的判断有三条。第一,三家在 X 上的周讨论量是同一个量级,差别小于数据本身的误差(两家碰到了 200 条上限)。第二,Reddit 上 EcoFlow 的社区明显最活跃,帖子数和评论数都是另两家的几倍,其中 26 条带求助类 flair;这些帖子是不是指向同一个产品问题,要有人读完才知道,表里只能给出条数。第三,上周点赞最多的几条帖子都和停电备灾有关:那条点名三家的日文帖从英国的三天物资宣传说起,EcoFlow 点赞最多的英文帖讲的是基辅停电。
一份报告的接口费
EveryInfra 一侧的价格按 2026-11-05 读到的目录:twitter/search、reddit/search、reddit/subreddit_posts 都是每次 $0.000556,失败、限速和空结果不扣费(EveryInfra 目录,价格也可以在定价页核对)。按次收费,和返回多少条无关:reddit/search 回 16 条和回 24 条收一样的钱,twitter/search 回 200 条也是一次。
| 报告版本 | 调用 | 接口费 |
|---|---|---|
| 基础版:3 个品牌 × X 一次 + Reddit 搜索一次 | 6 次 | $0.003336 |
| 完整版:再加品牌社区最新 100 条 + Reddit 月榜 | 12 次 | $0.006672 |
| X 按天拆开数准(3 个品牌 × 7 天)+ 品牌社区 | 24 次 | $0.013344 |
| 每周一份完整版,按月(52 周 ÷ 12) | 约 52 次 | $0.028912 |
| 每周一份完整版,一年 | 624 次 | $0.346944 |
| 本文实际:2026-11-05 00:18–00:27(新加坡时间) | 16 次请求,13 次付费,3 次 429 | $0.007228 |
ChatGPT 一侧没有按报告收费:Intelligent UI 没有单独额度,调插件也不另外收钱,算在你的套餐里(帮助中心 20001354)。套餐价按帮助中心 2026-11-05 的页面:Plus 每月 $20(帮助中心 20001493),Pro 每月 $100、$200、$500 三档(帮助中心 9793128),Business Standard 每席每月 $25、年付 $20(帮助中心 8792828)。所以真实的成本结构是一份固定的套餐费,加上几乎可以忽略的接口费。一年 52 份完整报告的接口费 $0.35,只有一个月 Plus 订阅费的约五十七分之一。真正贵的是人的时间:每份报告都要有人核一遍上限、语言和品牌自发帖这三件事。
限速也算一种成本。这把测试 Key 每分钟 10 次,我们这一轮碰到 3 次 429,返回体写明「每分钟 10 次」「17 秒后重试」「没有扣费」,响应头里有 retry-after: 17 和 x-ratelimit-limit-requests: 10。ChatGPT 里一次提问连发 6 次调用,正常不会碰到;如果几位同事同时用同一个 EveryInfra 账号跑报告,就可能碰到,模型会看到 429 的说明,通常会等一下再试。错误文字本身就是写给 AI 读的,告诉它多久以后再来。
Reddit 和 Hacker News 上的讨论
我们在 Reddit 和 Hacker News 上搜了「gpt 6 intelligent ui」近一个月的讨论,想找有没有人贴出「自定义 MCP 返回的数据被 Intelligent UI 画成图」的实例。结果是没有找到,也没有找到反例。其余讨论大多在评价 Intelligent UI 本身,引用时去掉了用户名:r/OpenAI 的发布帖里,最高赞的评论认为这是很久以来第一次「给普通用户而不是只给写代码的人」的功能,也有人把它比作当年的 Java applet(r/OpenAI 发布讨论)。
r/ChatGPT 的发布帖里有人问这和其他模型早就会生成的 artifact 有什么区别,也有人指出它只在 Chat 里、不在 Work 里(r/ChatGPT 发布讨论);r/codex 有一帖问它能做什么以前做不到的(r/codex 讨论)。Hacker News 的批评集中在图片和留白变多、信息密度下降(Hacker News 讨论),r/technology 的转帖多是对「模型替人做完所有事」的怀疑(r/technology 讨论)。r/ChatGPT 另一帖的标题对做报告最有参考意义:Intelligent UI 确实好用,但它还是一块草稿板,不是基础设施(r/ChatGPT 讨论)。对照这个判断,本文的建议是:把 Intelligent UI 当成每次提问时快速看一眼的界面,要长期留存、多人对照的数字,放进Spaces 那篇讲的共享页面或自己的表格里。
做不了或要注意的地方
第一,原文没有承诺 Intelligent UI 会渲染自定义 MCP 的结果。本文的整套做法依赖模型读文本再自己出表,这在原文的「回答可以包含表格和图表」范围内,但不是一项单独写明的功能。哪天你在团队里推这个做法,先在自己的账号上用同一个提示词跑三次,看版式是否稳定,再决定要不要依赖它。
第二,取数工具会先要确认。everyinfra_call_api 标的是非只读,开发者模式和插件权限都会让 ChatGPT 在调用前问你;Business 管理员可以在插件权限里调确认策略。个人 Pro 的原文写的是「读取和取数权限」,非只读工具在 Pro 上是能调、要确认还是不能调,原文没写清,我们也没在 ChatGPT 里试过。
第三,Intelligent UI 的状态不跨对话保存。帮助中心写清单这类组件刷新后能保留状态,换一个对话就不保留;下周你再问一次,是一份全新的报告,上周的切换按钮和筛选不会带过来。要每周对比,就把每次的表复制出来存档,或者用 Spaces 的页面。
第四,API 里拿不到 Intelligent UI。开发者文档里 chat-latest 的说明是「ChatGPT 里使用的最新 Instant 模型」,更新日志也记了这个快照的更新(chat-latest 模型页、API 更新日志),但我们没有在 API 文档里找到 Intelligent UI 组件可以经 API 输出的说法。想在自己的产品里复刻同样的报告,要自己画图。
第五,数据侧的三个陷阱:X 的 until: 会混进界外帖,要按 posted_at 再筛;twitter/search 200 条、reddit/subreddit_posts 100 条的上限会让热闹品牌的数变成下限;Reddit 返回没有语言字段,日语、西语讨论要模型自己判断。这些都写进了上面的提示词,也写在了每张表下面的说明里。
第六,Reddit 和 X 自己的规则。EveryInfra 返回的是公开帖子,用来做市场研究和品牌监测;把结果再分发、拿去训练模型或做针对个人的画像,要先读平台条款。Reddit 帮助中心的 Data API 说明写明,使用规则以 Developer Terms 和 Data API Terms 为准(Reddit Data API Wiki、Reddit Data API Terms)。本文不构成法律意见。
最近的变化
- 2026-10-07:GPT-6 和 Intelligent UI 在 Chat 里向 Plus、Pro、Business、Enterprise 推送;Business 发布说明同日记录。
- 2026-10-08:扩到 Free 和 Go,模型是 GPT-6 Luna。
- 2026-10-22:《卫报》报道英国政府的 Be Ready 指引,建议每个家庭备三天的水和食物;2026-10-23 路透社跟进报道。
- 2026-11-04:EveryInfra 地址里带 Key 的 MCP 连接停用,ChatGPT 改接
/mcp/all并用 OAuth。 - 2026-11-05:本文真调,读取全部官方页面。
GPT-6 Intelligent UI 常见问题
免费用户能用 GPT-6 Intelligent UI 吗?
能。发布文写 2026-10-08 起扩到 Free 和 Go,背后是 GPT-6 Luna,帮助中心写 Luna 同样支持 Intelligent UI。但帮助中心的自定义 MCP 一页没有把 Free 和 Go 列进能加自定义 MCP 服务器的套餐,所以免费账号能看到 Intelligent UI 的回答,接 EveryInfra 做报告这一步原文没写能不能做。出处:OpenAI 发布文、帮助中心 20001598。
Intelligent UI 能关掉吗?
不能完全关,只能调简单。Intelligent UI 专页写网页版 Personalization → Layout and Visuals → Simple;GPT-6 模型页写在 Settings 里关掉 Layout and visuals。两页都说调了以后仍可能有部分视觉元素,也没有切回纯文字模式的选项。出处:帮助中心 20001598、帮助中心 20001354。
开发者能在 API 里用 Intelligent UI 吗?
原文没写能。API 里有 chat-latest,说明是 ChatGPT 里使用的最新 Instant 模型,但我们读到的 API 文档和更新日志都没有说 Intelligent UI 的组件可以经 API 输出。想在自己的应用里出交互界面,OpenAI 文档给的路是做插件并用 MCP Apps 提供界面模板。出处:chat-latest 模型页、开发者文档《ChatGPT UI》。
Intelligent UI 会把自定义 MCP 返回的数据自动画成图吗?
原文没写会。帮助中心对插件只写「已连接的插件会照常工作」。EveryInfra 的 MCP 返回一段 JSON 文本,没有 structuredContent 和界面模板,图表要靠模型读完再用 Intelligent UI 拼;能不能出、每次是否一样,取决于提示词和数据量。要固定版式的图,文档里的做法是 MCP Apps。出处:帮助中心 20001598、MCP 规范:Tools。
模型显示 GPT-6 Sol,为什么回答里没有可视化?
先看四件事:是不是在 Chat 标签(Work 和 Voice 都不支持);思考档是不是选了 Pro(GPT-6 Astra 不支持);桌面应用是不是旧版;设置里是不是选了 Simple。推送是分批的,Reddit 上有付费用户在发布后几天仍没看到。出处:帮助中心 20001598、r/ChatGPT 发布讨论。
上手步骤
- 在 EveryInfra 控制台 注册并充值,用免费的目录接口确认
twitter/search、reddit/search、reddit/subreddit_posts都是可用状态。 - 用 curl 或试用台把这三项能力各调一次,看清 X 搜索和 Reddit 搜索的返回字段、条数上限和日期写法。
- 在 ChatGPT 网页版 Plugins 里加自定义 MCP:
https://api.everyinfra.com/mcp/all,认证选 OAuth,接法细节见远程 MCP 接入和 MCP 服务器说明;Business 让管理员加。 - 在 Custom Instructions 里加一句「比较选项时用表格,数字下面写怎么数的」,再用上面的提示词问一次,第一次调用时确认并选择在这个对话里记住。
- 拿回答里的表对照本文的三个陷阱核一遍:界外帖、上限、语言;没问题再分享给团队。
相关阅读
- ChatGPT Spaces 竞品社媒追踪页:多人维护、每周更新的共享页面,适合长期留存本篇报告里的数字。
- ChatGPT dots 选品雷达:常驻智能体的两套权限,扣费取数为什么要放进指派任务。
- ChatGPT 定时任务做需求雷达:一个人每周一收一条 Reddit 抱怨和提问的推送。
- Reddit 数据接口 和 X 数据接口:全部能力、参数和价格。
参考资料
- GPT-6 and Intelligent UI for everyone,OpenAI,2026-11-05 读取,https://openai.com/index/gpt-6-for-everyone/
- Intelligent UI in ChatGPT,OpenAI 帮助中心,2026-11-05 读取,https://help.openai.com/en/articles/20001598-intelligent-ui-in-chatgpt
- GPT-6 and other models in ChatGPT,OpenAI 帮助中心,2026-11-05 读取,https://help.openai.com/en/articles/20001354-gpt-6-and-other-models-in-chatgpt
- Connecting custom MCP servers in ChatGPT,OpenAI 帮助中心,2026-11-05 读取,https://help.openai.com/en/articles/12584461-connecting-custom-mcp-servers-in-chatgpt
- ChatGPT Business release notes,OpenAI 帮助中心,2026-11-05 读取,https://help.openai.com/en/articles/11391654-chatgpt-business-release-notes
- ChatGPT release notes,OpenAI 帮助中心,2026-11-05 读取,https://help.openai.com/en/articles/6825453-chatgpt-release-notes
- ChatGPT Enterprise and Edu release notes,OpenAI 帮助中心,2026-11-05 读取,https://help.openai.com/en/articles/10128477-chatgpt-enterprise-and-edu-release-notes
- ChatGPT Business models and limits,OpenAI 帮助中心,2026-11-05 读取,https://help.openai.com/en/articles/12003714-chatgpt-business-models-and-limits
- ChatGPT Enterprise and Edu models and limits,OpenAI 帮助中心,2026-11-05 读取,https://help.openai.com/en/articles/11165333-chatgpt-enterprise-and-edu-models-and-limits
- ChatGPT Business overview,OpenAI 帮助中心,2026-11-05 读取,https://help.openai.com/en/articles/8792828-chatgpt-business-overview
- About ChatGPT Pro tiers,OpenAI 帮助中心,2026-11-05 读取,https://help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers
- ChatGPT back-to-school offer for students(含 Plus 原价),OpenAI 帮助中心,2026-11-05 读取,https://help.openai.com/en/articles/20001493-chatgpt-back-to-school-offer-for-students
- Build your MCP server,OpenAI 开发者文档,2026-11-05 读取,https://developers.openai.com/plugins/build/mcp-server
- ChatGPT UI,OpenAI 开发者文档,2026-11-05 读取,https://developers.openai.com/plugins/build/chatgpt-ui
- Authentication,OpenAI 开发者文档,2026-11-05 读取,https://developers.openai.com/plugins/build/auth
- Connect and test in ChatGPT,OpenAI 开发者文档,2026-11-05 读取,https://developers.openai.com/plugins/deploy/connect-chatgpt
- Plugins changelog,OpenAI 开发者文档,2026-11-05 读取,https://developers.openai.com/plugins/changelog
- ChatGPT Developer mode,OpenAI 开发者文档,2026-11-05 读取,https://developers.openai.com/api/docs/guides/developer-mode
- chat-latest,OpenAI 开发者文档,2026-11-05 读取,https://developers.openai.com/api/docs/models/chat-latest
- API changelog,OpenAI 开发者文档,2026-11-05 读取,https://developers.openai.com/api/docs/changelog
- GPT-6 and Intelligent UI in ChatGPT(公告帖),OpenAI 开发者社区,2026-11-05 读取,https://community.openai.com/t/gpt-6-and-intelligent-ui-in-chatgpt/1404139
- Tools(MCP 规范 2025-06-18),Model Context Protocol,2026-11-05 读取,https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- Authorization(MCP 规范 2025-11-25),Model Context Protocol,2026-11-05 读取,https://modelcontextprotocol.io/specification/2025-11-25/basic/authorization
- MCP Apps,Model Context Protocol,2026-11-05 读取,https://modelcontextprotocol.io/docs/extensions/apps
- EveryInfra 数据能力目录(免费接口),2026-11-05 00:17(新加坡时间)读取,https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra /mcp/all 受保护资源元数据,2026-11-05 读取,https://api.everyinfra.com/.well-known/oauth-protected-resource/mcp/all
- EveryInfra MCP 服务器(initialize、tools/list、tools/call 真调),2026-11-05 读取,https://api.everyinfra.com/mcp
- How to use advanced search,X 帮助中心,2026-11-05 读取,https://help.x.com/en/using-x/x-advanced-search
- Reddit Data API Wiki,Reddit 帮助中心,2026-11-05 读取,https://support.reddithelp.com/hc/en-us/articles/16160319875092-Reddit-Data-API-Wiki
- Data API Terms,Reddit,2026-11-05 读取,https://www.redditinc.com/policies/data-api-terms
- vaderSentiment(VADER 3.3.2),GitHub,2026-11-05 读取,https://github.com/cjhutto/vaderSentiment
- Households encouraged to take small, simple steps to stay prepared in an emergency,GOV.UK,2026-11-05 读取,https://www.gov.uk/government/news/households-encouraged-to-take-small-simple-steps-to-stay-prepared-in-an-emergency
- Be ready for emergencies,GOV.UK 宣传网站,2026-11-05 读取,https://beready.campaign.gov.uk/
- UK tells public to keep three days of emergency supplies at home,路透社,2026-10-23,2026-11-05 读取,https://www.reuters.com/business/aerospace-defense/uk-tells-public-keep-three-days-emergency-supplies-home-2026-10-23/
- Every Briton should stockpile water and food supplies, government advises,The Guardian,2026-10-22,2026-11-05 读取,https://www.theguardian.com/politics/2026/oct/22/britain-prepare-infrastructure-attacks-hostile-states-wes-streeting
- Kyiv faces emergency power cuts, widespread water outages after Russia's largest attack on energy infrastructure this year,Kyiv Independent,2026-11-05 读取,https://kyivindependent.com/kyiv-faces-emergency-power-cuts-widespread-water-outages-after-russias-largest-attack-on-energy-infrastructure-this-year/
- EcoFlow launches new residential storage series with Titan range,ess-news,2026-10-14,2026-11-05 读取,https://www.ess-news.com/2026/10/14/ecoflow-launches-new-residential-storage-series-with-titan-range/
- Tiny Titan: new residential battery system from EcoFlow starts small,electrek,2026-10-18,2026-11-05 读取,https://electrek.co/2026/10/18/tiny-titan-new-residential-battery-system-from-ecoflow-starts-small/
- EcoFlow's new TITAN batteries can keep your central air running through a blackout,PopSci,2026-11-05 读取,https://www.popsci.com/gear/ecoflow-titan-5000-home-battery/
- BLUETTI Unveils Early Access for Apex 200: Next-Gen Versatile Power Station(PRNewswire 新闻稿转载),Yahoo Finance,2026-10-20,2026-11-05 读取,https://finance.yahoo.com/energy/articles/bluetti-unveils-early-access-apex-160900669.html
- GPT-6 and Intelligent UI for everyone(讨论),r/OpenAI,2026-11-05 读取,https://www.reddit.com/r/OpenAI/comments/1x045qs/gpt6_and_intelligent_ui_for_everyone/
- GPT-6 and Intelligent UI for everyone(讨论),r/ChatGPT,2026-11-05 读取,https://www.reddit.com/r/ChatGPT/comments/1x052jr/gpt6_and_intelligent_ui_for_everyone/
- GPT-6's Intelligent UI is genuinely good. It's still a sketchpad, not infrastructure,r/ChatGPT,2026-11-05 读取,https://www.reddit.com/r/ChatGPT/comments/1x6crjw/gpt6s_intelligent_ui_is_genuinely_good_its_still/
- What can GPT-6 + Intelligent UI do that wasn't already possible,r/codex,2026-11-05 读取,https://www.reddit.com/r/codex/comments/1x04lt9/what_can_gpt6_intelligent_ui_do_that_wasnt/
- OpenAI Introduces "Intelligent UI" For ChatGPT With GPT-6,r/technology,2026-11-05 读取,https://www.reddit.com/r/technology/comments/1x04ajv/openai_introduces_intelligent_ui_for_chatgpt_with/
- GPT-6 and Intelligent UI(讨论),Hacker News,2026-11-05 读取,https://news.ycombinator.com/item?id=49996425
引用编号 BL-90