API de datos de Douyin: 672 publicaciones en 34 páginas
Leímos la cuenta de Douyin de un museo: perfil, 34 páginas (672 publicaciones, sin duplicados), detalle de vídeo y comentarios. La lista costó 0,0189 USD.
El 14 de noviembre de 2026 (2026-11-14) leímos con la biblioteca requests de Python una cuenta pública de Douyin: la del Museo Nacional de China. Llamamos al perfil, a la lista de publicaciones, al detalle de un vídeo, a los comentarios, a las respuestas de un comentario y a una transcripción. La lista de publicaciones ocupó 34 páginas y devolvió 672 elementos. Tras quitar duplicados por el id de la publicación, quedaron los mismos 672: ningún duplicado. Recorrer la lista entera costó 0,018904 USD, unos 0,028 USD por cada mil elementos.
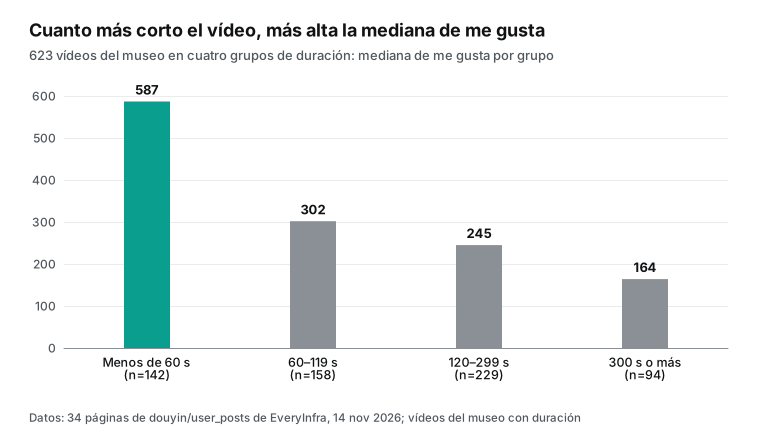
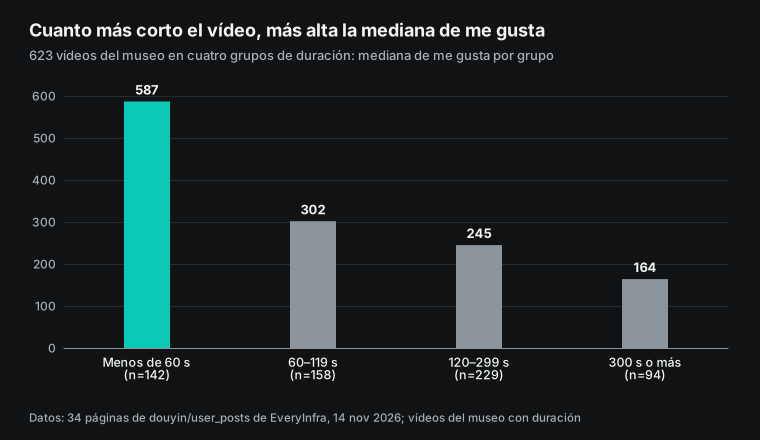
De los 672, 655 tienen al museo como autor. Los otros 17 son publicaciones en colaboración iniciadas por otras 10 cuentas. La mediana de me gusta de esas 17 es 8.810; la de las publicaciones propias del museo es 281. El museo tiene 623 vídeos con duración. Los de menos de 60 segundos tienen una mediana de 587 me gusta; los de 300 segundos o más, solo 164.
Leímos un mismo vídeo tres veces en 48 minutos. Las tres veces, el detalle del vídeo trajo tres campos que la lista no tenía: el ID de Douyin del autor, la biografía del autor y el total de me gusta del autor. Los me gusta del vídeo pasaron de 8.691 a 8.703.
API del perfil de usuario de Douyin: tres vías y quién puede leer qué
La API oficial solo lee las cuentas que autorizaron su aplicación. En la plataforma abierta de Douyin, los endpoints de cuentas y de vídeos usan un access_token que un usuario autorizó. El documento obtener información pública del usuario indica el ámbito user_info y que requiere consentimiento del usuario. Dice que el endpoint devuelve la información pública del usuario de Douyin: apodo, avatar, sexo y región. El ejemplo de respuesta incluye además open_id y union_id.
La lista de vídeos de la cuenta autorizada exige una cabecera access-token, y el documento aclara que «este token requiere autorización del usuario». El mismo documento dice que todavía no admite filtrar por fecha. Así que la vía oficial encaja con una institución que quiere los datos de su propia cuenta. Para leer otro museo o una cuenta de divulgación científica, primero tiene que pedir a esa cuenta que autorice su aplicación.
Los scripts de código abierto pueden leer perfiles públicos. Pero necesitan una sesión iniciada en la web, o que usted calcule las firmas de las peticiones. El README de DouK-Downloader dice que el proyecto ya no mantiene su código de parámetros cifrados, por cumplimiento legal. Cuando una actualización de la plataforma rompe una función, el usuario debe aportar ese código. MediaCrawler mantiene la sesión con Playwright y, por defecto, se conecta por CDP a un Chrome con la sesión iniciada en su equipo (Chrome 144 o posterior). Su aviso legal prohíbe el uso comercial.
La tercera vía es una API de pago por llamada. Usted envía el secUid de una cuenta o el enlace de un vídeo y recibe JSON estructurado. No necesita el consentimiento de la otra cuenta ni desplegar o mantener scripts. A cambio, paga por llamada y el proveedor de la API decide los campos.
| Aspecto | Plataforma abierta de Douyin | Scripts de código abierto en GitHub | API de pago por llamada (EveryInfra en esta prueba) |
|---|---|---|---|
| Qué perfiles y publicaciones | Solo cuentas que autorizaron su aplicación | Perfiles públicos; la mayoría de proyectos necesita sesión iniciada | Perfiles públicos; basta el secUid |
| Acceso | Solicitud por capacidad con revisión de la plataforma; los datos de interacción son solo para organizaciones | Sin filtro de acceso; usted lo despliega | Registro y clave |
| Campos del perfil | user_info devuelve apodo, avatar, sexo y región | Depende del proyecto; los nombres siguen a los endpoints web | 24 campos en el catálogo; 16 con valor en esta prueba |
| Lista de publicaciones | Vídeos de la cuenta autorizada; páginas por cursor; sin filtro por fecha | La mayoría la admite; un README avisa de que puede traer pocas publicaciones | 20 elementos por página en esta prueba; se pagina hasta que desaparece next_page_token |
| Mantenimiento | Actualizar el certificado del servidor antes del 31 de octubre de 2026 | Firmas, sesiones, controles de riesgo; una incidencia reciente informa de que no llegan detalles tras volver a iniciar sesión | Lo mantiene el proveedor de la API |
| Precio | La capacidad es gratuita; el personal y la revisión van aparte | Usted paga servidores y proxies | 0,000556 USD por llamada; comentarios y respuestas, 0,000556 USD por cada 20 elementos |
Fuentes de la columna oficial: la página de datos de interacción de usuarios, la página de información pública del usuario y el aviso del certificado. La columna de código abierto viene de los README e incidencias que citamos más abajo. Los precios de la columna de pago por llamada vienen del catálogo de capacidades de EveryInfra, consultado el 14 de noviembre de 2026 a las 13:05, hora de Singapur.
La plataforma abierta oficial de Douyin: primero el consentimiento
La plataforma abierta de Douyin separa los datos de cuentas y los datos de vídeos en capacidades distintas. Cada una se solicita y se revisa por su cuenta. La página de la capacidad de datos de vídeo dice que, con el consentimiento del usuario, se pueden consultar datos de vídeo. Eso incluye la información básica (título, portada, si está fijado, fecha de creación) y los recuentos oficiales de me gusta, reproducciones, compartidos y comentarios. Su caso de uso es combinarla con la capacidad de «publicar en Douyin» y mostrar la ventana de consentimiento cuando el usuario publica un vídeo.
El documento de consulta de datos de un vídeo dice que solo devuelve datos de vídeos públicos y que los datos son en tiempo real. Si un vídeo es privado, el registro trae una fecha de creación de 0. El objeto statistics del ejemplo tiene seis recuentos: me gusta, descargas, reproducciones, compartidos, reenvíos y comentarios. El recuento de reproducciones play_count es uno de ellos y se puede leer tras el consentimiento del titular. Para la propia cuenta de una institución, ese es el uso más directo de la vía oficial.
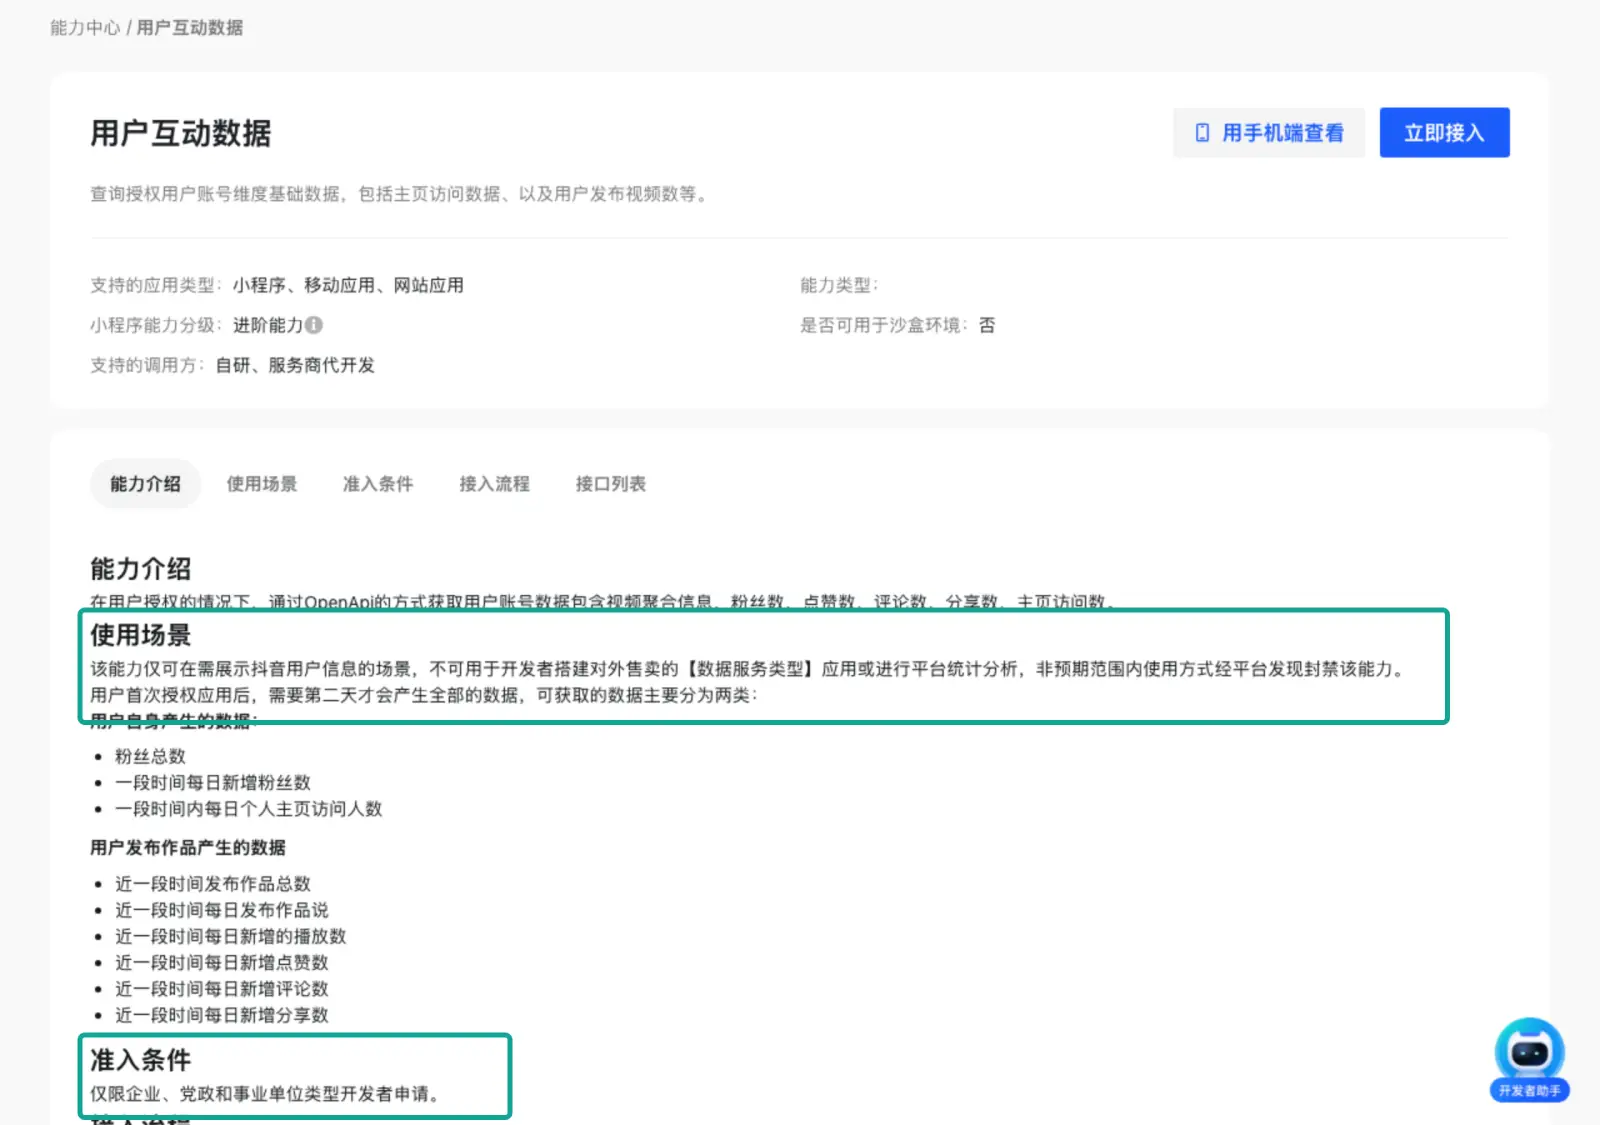
El producto de datos de interacción de usuarios lee el total de seguidores, los seguidores nuevos por día y los visitantes del perfil. También lee, por publicación, las reproducciones, los me gusta, los comentarios y los compartidos nuevos de cada día. El apartado de casos de uso dice que no puede usarse para crear productos de servicios de datos para la venta ni para estadísticas de la plataforma. La condición de acceso dice que solo pueden solicitarlo empresas, organismos públicos e instituciones públicas. La página añade que, tras el primer consentimiento, los datos completos aparecen al día siguiente.
Para el equipo de redes sociales de un museo, esta vía encaja bien: es su propia cuenta, ellos dan el consentimiento y obtienen recuentos completos, reproducciones incluidas. Un investigador que quiera comparar las publicaciones públicas de 50 museos necesita el consentimiento de los 50. Además, la página de la capacidad dice que estos datos no admiten estadísticas de la plataforma.
Guarde el token de consentimiento con cuidado. El documento obtener access_token dice que un token guardado en el cliente puede ser robado y recomienda guardarlo en el servidor. Una nota indica que, tras obtener el access_token, no se debe volver a usar el código temporal de autorización, porque eso hace caducar el código anterior. Una tarea programada debe tratar «el token caduca pronto y el titular debe autorizar de nuevo» como un evento que avisa a una persona.
Otro cambio entra en vigor en noviembre. La plataforma actualizó su aviso de certificados el 23 de marzo de 2026. Dice que, desde noviembre de 2026, usará certificados sin raíz con firma cruzada. Cambian tres dominios: open.douyin.com, v.douyin.com y www.iesdouyin.com. Los desarrolladores tenían que actualizar antes del 31 de octubre de 2026. Para revisar su sistema, use la columna G2 de la tabla de compatibilidad de certificados raíz de DigiCert.
Las preguntas frecuentes del aviso dicen que solo algunos sistemas antiguos y versiones antiguas de Java necesitan la actualización. La actualización es gratuita. Un programa que actualiza después del plazo vuelve a funcionar tras la actualización.
La parte de miniprogramas tiene una versión con consentimiento comercial. La consulta de datos de un vídeo con consentimiento comercial exige primero vincular una cuenta de marca, de empleado o de socio. Después, el usuario de Douyin debe aprobar la relación comercial. Aun así, solo se pueden consultar los vídeos que subió el titular del token.
Comparación con las API oficiales de TikTok
TikTok usa el mismo diseño. La guía de inicio de Display API pide a la aplicación dos ámbitos, user.info.basic y video.list. En el endpoint de lista de vídeos, max_count vale 10 por defecto y 20 como máximo. El cursor de paginación es una marca de tiempo en milisegundos, así que se pueden pedir los vídeos publicados antes de un momento dado.
La Research API lee datos públicos para instituciones de investigación. TikTok dice que la respuesta suele llegar en un plazo de 4 semanas, y que un doctorando debe enviar además una carta de aval de un profesor. En las dos plataformas, la API oficial pregunta primero quién le dio el consentimiento y después qué puede leer.
| Aspecto | Plataforma abierta de Douyin | TikTok for Developers |
|---|---|---|
| Leer su propia cuenta | Sí, con consentimiento del usuario | Display API con user.info.basic y video.list |
| Paginación de vídeos | Páginas por cursor; sin filtro por fecha | Hasta 20 vídeos por página; el cursor es una marca de tiempo |
| Datos públicos para investigación | No figura en los documentos que leímos | Research API; respuesta en unas 4 semanas |
| Límites de acceso | Algunos productos solo para organizaciones | Research API para investigadores; los doctorandos necesitan una carta |
El tipo de desarrollador también decide qué capacidades puede solicitar. La página de tipos de usuario y permisos tiene dos tipos: desarrolladores propios y proveedores de servicios. Cualquier usuario registrado puede elegir el tipo propio y recibe los permisos básicos tras la revisión. Los proveedores de servicios reciben además permisos de servicios locales. Los dos tipos pueden verificarse como cuenta de empresa, lo que añade un grupo de capacidades empresariales. Junto con la captura de arriba, esto significa que los datos de interacción se abren por tipo de organización, y que una institución debe solicitar ella misma los recuentos completos.
Scripts de código abierto: lo que dicen sus README e incidencias
Douyin_TikTok_Download_API, en su versión 5, crea identidades de invitado con un navegador sin interfaz y mantiene su propio grupo de identidades. Su tabla de capacidades marca «perfil del autor» y «publicaciones del autor» para Douyin. También dice que las listas de seguidores y seguidos de Douyin solo están abiertas a sesiones iniciadas, así que no registra esos dos endpoints. La búsqueda y los feeds de etiquetas igual: un invitado no puede leerlos.
El 31 de octubre de 2026, en la incidencia #805, el mantenedor respondió a un usuario. El enlace directo del vídeo lleva en su ruta una hora de caducidad en hexadecimal, y caduca unas tres horas después de firmarse. Una vez caducado, cualquier dominio devuelve 403. El mantenedor recomienda el endpoint de descarga de la instancia, que vuelve a analizar la publicación cuando un enlace guardado caduca.
El README en chino de douyin-downloader es directo. Dice que los controles de seguridad de Douyin bloquean ahora la versión de línea de comandos para vídeos sueltos y publicaciones de imágenes, colecciones, música, me gusta y favoritos. Para las publicaciones de un perfil, se puede probar la automatización del navegador, pero sin garantía. La primera pregunta frecuente es por qué un perfil devuelve pocas publicaciones. La respuesta es abrir un navegador, desactivar el modo sin interfaz y superar la verificación a mano.
Su lista de incidencias tiene estos títulos en los últimos 30 días. El 26 de octubre, la #258 dice que el control de seguridad solo deja pasar las peticiones hechas desde la propia página web, y que ni reintentar ni volver a iniciar sesión sirve. El 9 de noviembre, la #263 dice que Douyin no devolvió los detalles de la publicación. El usuario había vuelto a iniciar sesión con cookies nuevas, la herramienta funcionaba unas semanas antes y la aplicación de escritorio iba bien. Una incidencia anterior, la #253 del 9 de octubre, dice que al descargar sus propios favoritos todos los apodos de autor salían como «self».
f2 marca «información del usuario», «publicaciones del perfil» y «publicación suelta» de Douyin como disponibles con o sin sesión. Pero, por defecto, las peticiones usan su firma «ab» de código abierto. El título de la incidencia #350 dice que las descargas fallan al fijar el intervalo en fechas concretas. El registro de la incidencia muestra 20 elementos por petición y un rango de fechas del 2025-03-01 al 2025-07-06.
El README de douyin-cli divide el acceso en dos líneas. La búsqueda web, las publicaciones del perfil y las publicaciones sueltas usan cookies del navegador. La información oficial del usuario y los endpoints de comentarios usan un access token de OAuth. Dice que una cookie web no sustituye a un token de OpenAPI, y que un token de OAuth no sustituye a una cookie web.
| Proyecto | Cómo lee Douyin | Lo que dice su propio texto | Incidencia pública reciente |
|---|---|---|---|
| Douyin_TikTok_Download_API | Identidades de invitado con un navegador sin interfaz | Listas de seguidores, búsqueda y etiquetas requieren sesión | #805, 2026-10-31: los enlaces directos caducan en unas 3 horas |
| douyin-downloader | Cookies; automatización del navegador para perfiles | Los controles de seguridad bloquean la descarga de vídeos sueltos por línea de comandos | #263, 2026-11-09: sin detalles tras volver a iniciar sesión |
| f2 | Su propia firma «ab» | Publicaciones del perfil con o sin sesión | #350: falla la descarga por rango de fechas |
| douyin-cli | Cookies del navegador y un token de OAuth | Un tipo de credencial no sustituye al otro | Ninguna citada |
| MediaCrawler | Playwright con un Chrome con sesión iniciada por CDP | Solo para estudio e investigación; sin uso comercial | Ninguna citada |
Cuatro de los cinco proyectos necesitan una sesión iniciada o un navegador. Douyin_TikTok_Download_API crea identidades de invitado con un navegador sin interfaz; douyin-downloader y douyin-cli usan cookies; MediaCrawler se conecta a un Chrome con la sesión iniciada. Solo f2 dice que lee publicaciones del perfil sin sesión, y para eso lleva su propio código de firma. El coste de la vía de código abierto está en tres frentes: las sesiones caducan, el código de firma cambia y los controles de riesgo web detienen las peticiones de línea de comandos.
En sus avisos legales, la mayoría de mantenedores devuelve la responsabilidad legal al usuario. No ejecutamos estos proyectos: todo lo que dice esta sección sale solo de su texto público.
La API de datos de Douyin de pago por llamada: cinco pasos para leer una cuenta
Probamos nosotros mismos la tercera vía. El catálogo de EveryInfra tiene seis capacidades de cuentas y publicaciones de Douyin: douyin/profile, douyin/user_posts (lista de publicaciones), douyin/video (detalle de un vídeo), douyin/comments, douyin/comment_replies y douyin/transcript. Perfil, lista, detalle y transcripción cuestan 0,000556 USD por llamada. Comentarios y respuestas se cobran por bloques de 20 elementos, a 0,000556 USD el bloque, y un bloque sin elementos no se cobra. Cada capacidad tiene su página dentro de la API de scraping de Douyin, por ejemplo perfil, publicaciones de usuario, detalle de vídeo, comentarios y transcripción.
Use el secUid para localizar una cuenta. El catálogo dice que user_id es el secUid del usuario de Douyin, que suele empezar por MS4w, y que no es el apodo ni el ID corto de Douyin. Puede tomarlo de la dirección del perfil web, tras douyin.com/user/, o del author_id de los resultados de búsqueda. El perfil web del museo es douyin.com/user/MS4wLjABAAAAH26VW7w8VFw_GxiN0TNSb0HyDLcHkQQdzE2EmUHEJJQ y su ID de Douyin es chnmuseum. Son dos cosas distintas: el ID de Douyin es un nombre corto que elige el usuario, y el secUid es la cadena larga de la dirección web.
El código usa la biblioteca requests de Python, versión 2.34.2 en nuestro equipo. Abajo va una versión simplificada. La clave sale solo de una variable de entorno. Ante una respuesta 429, el código espera lo que indique la cabecera Retry-After; si no la hay, espera cada vez un poco más.
import os, time, requests

API = "https://api.everyinfra.com/api/v1/social"
HEAD = {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}

def call(action, params):
    for attempt in range(5):
        r = requests.post(API, headers=HEAD, timeout=180,
                          json={"platform": "douyin", "action": action, "params": params})
        if r.status_code == 429:          # límite de ritmo: Retry-After o espera creciente
            time.sleep(float(r.headers.get("Retry-After", 2 ** attempt * 5)))
            continue
        r.raise_for_status()
        return r.json()
    raise RuntimeError("429 retries exhausted")

SEC = "MS4wLjABAAAAH26VW7w8VFw_GxiN0TNSb0HyDLcHkQQdzE2EmUHEJJQ"   # Museo Nacional de China

profile = call("profile", {"user_id": SEC})["results"]

posts, token = [], ""                     # página 1: cadena vacía
while True:
    page = call("user_posts", {"user_id": SEC, "page_token": token})
    posts += page["results"]
    token = page.get("next_page_token")
    if not token:                         # sin next_page_token: última página
        break

seen = {}
for p in posts:                           # quitar duplicados por id
    seen.setdefault(p["id"], p)
own = [p for p in seen.values() if p["author_id"] == SEC]   # solo las de la propia cuenta

url = max(own, key=lambda p: p["posted_at"])["url"]   # la más reciente por posted_at
video = call("video", {"url": url})["results"]
comments = call("comments", {"url": url, "page_token": ""})
transcript = call("transcript", {"url": url})["results"]
print(profile["follower_count"], len(seen), len(own), video["like_count"])
Con curl, la misma llamada queda así. A partir de la página 2, ponga en page_token el next_page_token de la página anterior sin cambiarlo y deje igual el resto de parámetros. Si los cambia, el token deja de valer y la API devuelve 422; entonces vuelva a empezar por la página 1.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"douyin","action":"user_posts",
       "params":{"user_id":"MS4wLjABAAAAH26VW7w8VFw_GxiN0TNSb0HyDLcHkQQdzE2EmUHEJJQ","page_token":""}}'
Si usa herramientas de IA, las mismas capacidades están en el servidor MCP remoto, en https://api.everyinfra.com/mcp; vea la guía de configuración de MCP. Para tareas diarias y llamadas que se reintentan solas, use REST y envíe la cabecera Idempotency-Key: una repetición con la misma clave no se cobra dos veces. Vea reintentos con clave de idempotencia.
Prueba 1: el perfil, 24 campos del catálogo en una llamada
El primer momento de prueba fue de 13:07 a 13:18, hora de Singapur, del 14 de noviembre de 2026. Enviamos douyin/profile a las 13:07:15. Devolvió 1.067.081 seguidores, 26 seguidos, 3.001.617 me gusta en total y 659 publicaciones. El texto de verificación era «cuenta oficial de Douyin del Museo Nacional»; is_verified era true e is_live, false. En las tres llamadas al perfil, la mediana de tiempo fue de 1,62 segundos.
El catálogo enumera 24 campos de perfil, y en esta prueba 16 tenían valor. Los 8 vacíos eran sexo, ubicación IP, país, idioma, me gusta dados, tienda, edad y series (gender, ip_location, country, language, likes_given_count, has_shop, age, has_series). Una institución no rellena sexo ni edad, y el perfil web no muestra la ubicación IP, así que tiene sentido. Esos 8 campos pueden tener valor en cuentas personales. Nuestra muestra solo tiene una cuenta institucional, así que solo podemos decir «vacío en esta muestra».
Use los datos del perfil como una instantánea. Seguidores, me gusta totales y número de publicaciones son totales acumulados: léalos una vez al día y podrá dibujar una curva de crecimiento. El número de publicaciones es la cifra que muestra la plataforma. Para contar cuántas publicaciones hizo la cuenta, use la tabla de publicaciones filtrada por author_id. Una llamada cuesta 0,000556 USD; leer 50 cuentas institucionales una vez al día cuesta al mes 50 × 30 × 0,000556 = 0,834 USD.
Prueba 2: la lista hasta la última página, con 17 elementos en colaboración
Recorrimos la lista de publicaciones de 13:07:26 a 13:16:57, hora de Singapur: 34 páginas en total. En esta prueba, cada página devolvió 20 elementos; las páginas 14 y 33 trajeron 19 cada una y la última, 14. El total es 672. Tras quitar duplicados por id, siguen siendo 672: ningún duplicado. En la página 34, la respuesta ya no traía next_page_token y pagination.has_more era false. Las 34 llamadas costaron 0,018904 USD.
Mire el tiempo en dos partes. Leímos la página 1 una vez en cada uno de los tres momentos y la mediana fue de 13,08 segundos (3 llamadas). Las páginas 2 a 34 tuvieron una mediana de 2,29 segundos (33 llamadas). Ajuste el tiempo máximo de espera de una tarea programada a la página 1, que es más lenta.
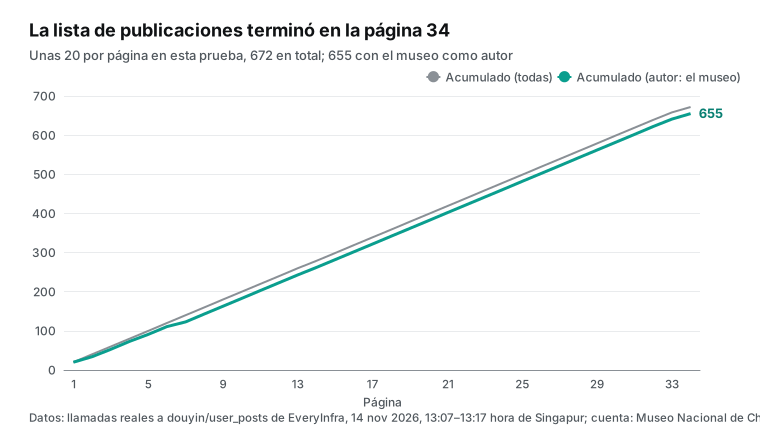
De los 672 elementos, 655 tienen un author_id igual al secUid del museo. Los otros 17 vienen de 10 cuentas distintas: la tienda oficial de una editorial, las cuentas oficiales de ByteDance y de Doubao, y algunos creadores particulares (no damos sus nombres). Son publicaciones en colaboración de Douyin: las inició la otra cuenta y el museo figura como cocreador, por eso aparecen en la lista del museo.
Las publicaciones en colaboración reciben muchos más me gusta que las propias del museo. Las 17 tienen una mediana de 8.810 y la mayor llega a 225.867; las 655 propias del museo tienen una mediana de 281.
| Grupo | Publicaciones | Mediana de me gusta | Máximo |
|---|---|---|---|
| En colaboración | 17 | 8.810 | 225.867 |
| Propias del museo | 655 | 281 | 180.091 |
La mayoría de las cuentas que las iniciaron son cuentas de plataforma con más seguidores, y la publicación aparece en los dos perfiles. Esa diferencia se debe a la audiencia de la otra cuenta y no debe contarse como resultado del contenido propio del museo. Para «cuántas publicaciones hizo esta cuenta» y «cómo le va a su propio contenido», use solo los 655 elementos filtrados por author_id. Para «qué contenido aparece en este perfil», use los 672.
| Concepto | Valor | Cómo se obtuvo |
|---|---|---|
| Páginas | 34 | Desde page_token="" hasta que no hay next_page_token |
| Elementos devueltos | 672 | 20 por página; 19 en las páginas 14 y 33; 14 en la 34 |
Tras quitar duplicados por id | 672 | 0 duplicados |
| Autor: el museo | 655 | author_id igual al secUid del museo |
| Publicaciones en colaboración | 17 elementos / 10 cuentas | El autor es otra cuenta |
| Mediana de me gusta, colaboración | 8.810 | like_count de los 17 elementos |
| Mediana de me gusta, propias | 281 | like_count de los 655 elementos |
| Vídeo / imágenes | 640 / 32 | media_type |
| Cobrado | 0,018904 USD | 34 × 0,000556 USD |
| Por cada mil elementos | 0,0281 USD | 0,018904 ÷ 672 × 1.000 |
La publicación más antigua es del 15 de mayo de 2018 (UTC). La más reciente es el vídeo de la exposición sobre la «corona de nueve dragones y nueve fénix», del 10 de noviembre de 2026 a las 12:00, hora de Pekín. El catálogo dice que la paginación no filtra por since: para leer un intervalo de fechas, hay que recorrer la lista entera y filtrar usted por posted_at. La lista oficial de vídeos tampoco filtra por fecha.
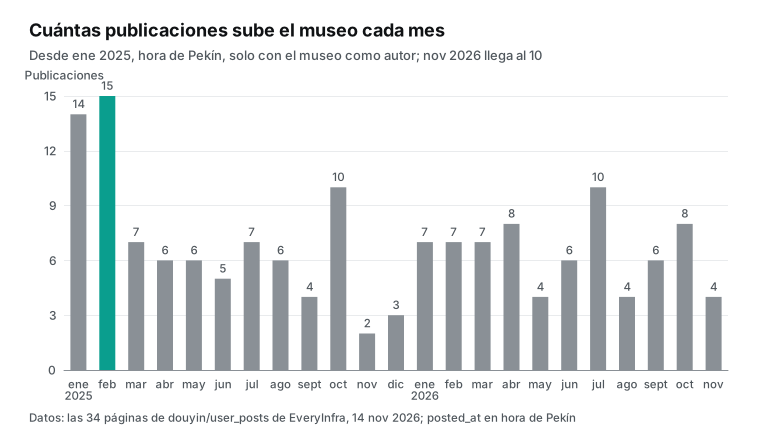
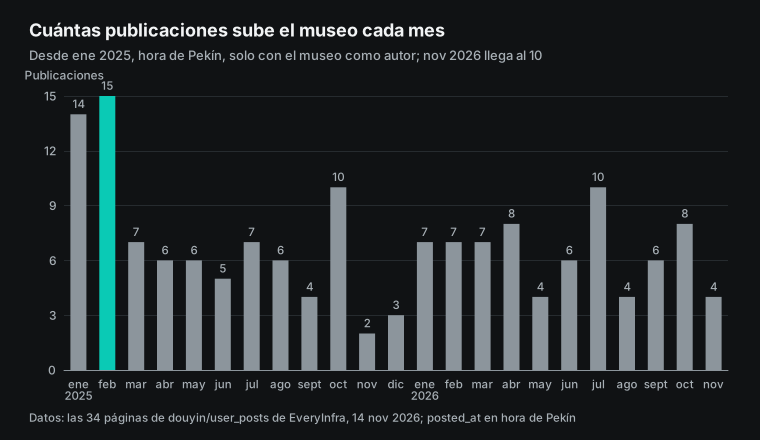
Para las actualizaciones diarias, vuelva a leer la página 1 cada cierto tiempo y fusiónela con su tabla por el id de la publicación: inserte los id nuevos y actualice los recuentos de los que ya tiene. El museo publica de 2 a 15 veces al mes, así que los 20 elementos de la página 1, una vez al día, cubren las publicaciones nuevas. Es 1 llamada por cuenta y día.
Prueba 3: lo que añade la API de detalle de vídeo de Douyin
Enviamos la primera llamada de detalle a las 13:17:45, hora de Singapur. Usamos la publicación más reciente de la lista: el vídeo de la exposición «Ritos y esplendor Ming: la corona de nueve dragones y nueve fénix de la emperatriz Xiaoduan», publicado el 10 de noviembre de 2026 (2026-11-10). La organiza el Museo Nacional. Un reportaje de CCTV del 10 de noviembre dice que abrió al público el 4 de noviembre de 2026 (2026-11-04), en la sala Norte 16 del museo, como exposición temática de larga duración.
Un avance del museo del 30 de octubre de 2026 (2026-10-30) dice que la corona dejó la galería «China antigua» desde el 2 de noviembre de 2026 (2026-11-02). La página de la exposición dice que la corona salió de la tumba de Dingling, en Changping (Pekín), en 1957. Mide 48,5 cm de alto, pesa 2.320 g y lleva 115 gemas y 4.414 perlas. Xinhua publicó ese mismo día fotos de la sala tomadas el 9 de noviembre.
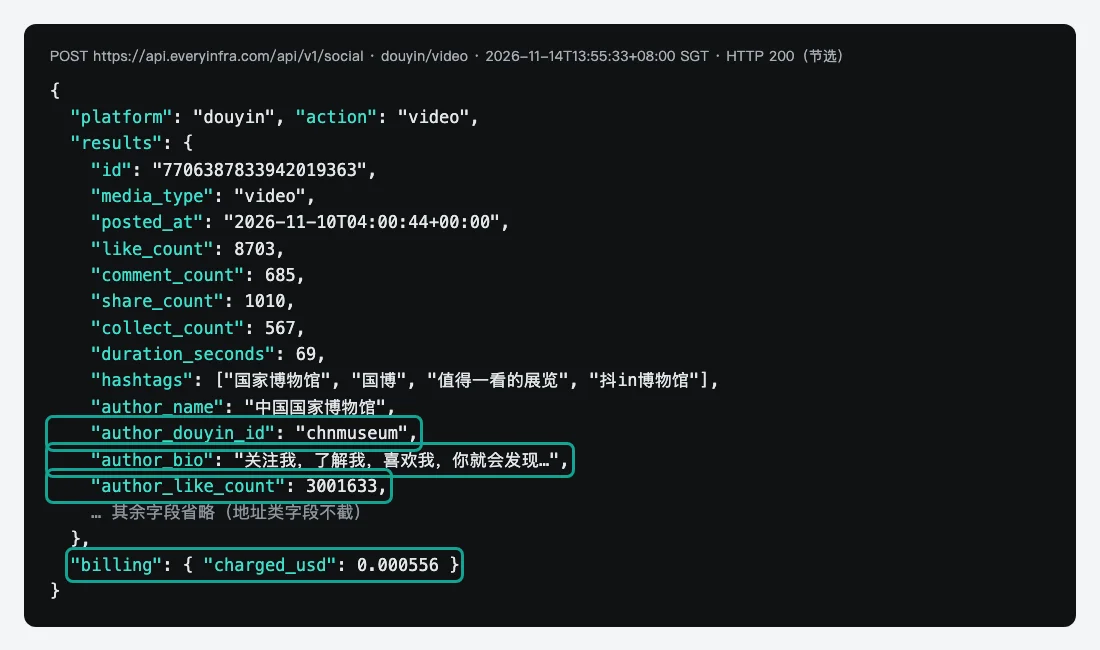
Para el mismo vídeo, leímos la página 1 de la lista y el detalle una vez en cada uno de los tres momentos. Solo contamos los campos que tuvieron un valor útil las tres veces; vacío, 0 o «unknown» no cuentan. La lista tuvo 27 de esos campos para este vídeo y el detalle, 29. Las tres veces, el detalle añadió tres campos de instantánea del autor: author_douyin_id (chnmuseum), author_bio (la biografía de la cuenta) y author_like_count (el total de me gusta de la cuenta, 3.001.633 a las 13:55).
Las dos llamadas comparten 26 campos con los datos de la publicación y los datos básicos del autor. Los de la publicación son id, enlace, texto, etiquetas, duración, ancho y alto, y hora de publicación. Además están la portada, la portada animada, la música de fondo, los cuatro recuentos, is_pinned e is_ad. Los del autor son nombre, avatar, uid y verificación.
Por eso, llamar al detalle solo para los recuentos de me gusta, comentarios, compartidos y guardados es pagar dos veces: la página 1 de la lista ya los trae. Use el detalle para obtener el ID de Douyin, la biografía y el total de me gusta del autor sin una llamada aparte al perfil. Encaja cuando parte del enlace de un vídeo y necesita localizar al autor.
Los response_fields del catálogo para el detalle de vídeo enumeran también etiquetas de contenido, ciudad, niveles de calidad, permisos y la hora de caducidad de la dirección. El catálogo los describe así. video_tags son etiquetas de categoría que la plataforma pone a una publicación. city es la ciudad donde se publicó, escrita en pinyin. video_bitrates son las direcciones de reproducción de cada nivel de calidad. permissions son los permisos de comentar, descargar, hacer dúos y otros que fija el autor, y solo contienen lo que da la plataforma. video_url_expires_at es la hora a la que caducan las direcciones de reproducción y descarga, tras la cual hay que leerlas de nuevo.
De estos campos solo repetimos el texto del catálogo y no sacamos conclusiones. Si piensa usarlos para clasificar o para comprobar si se puede descargar, mida antes en su propia muestra con qué frecuencia traen valor.
Trate los campos de dirección como lo hacen los proyectos de código abierto. En la incidencia #805, el mantenedor calculó que un enlace directo web caduca unas tres horas después de firmarse. El catálogo también dice que las direcciones de video_bitrates van firmadas y caducan. En su archivo, guarde solo el id del vídeo y el enlace de la publicación. Antes de reproducir o descargar, vuelva a leer el detalle por id. No guarde una dirección como campo permanente.
Sobre las reproducciones, el catálogo dice que view_count no es un recuento real de reproducciones y que Douyin no publica las reproducciones de los vídeos. Para medir el alcance, use me gusta, comentarios, compartidos y guardados. Para obtener reproducciones, use la capacidad oficial de datos de vídeo con el consentimiento del titular. Para un investigador, esos cuatro recuentos son las métricas comparables: están en la lista y en el detalle y, en nuestras tres lecturas, subieron de forma coherente con el tiempo (vea los tres momentos más abajo).
| Grupo de campos | Lista `user_posts` (las tres lecturas) | Detalle `video` (las tres lecturas) | Uso |
|---|---|---|---|
| Recuentos: me gusta, comentarios, compartidos, guardados | Sí | Sí | Seguimiento diario con la página 1 |
| Publicación: id, enlace, texto, etiquetas, duración, hora | Sí | Sí | El núcleo de la tabla de publicaciones |
| Portada, portada animada, música de fondo | Sí | Sí | Mostrar y quitar duplicados |
| Nombre, avatar, uid y verificación del autor | Sí | Sí | Marcar publicaciones en colaboración |
ID de Douyin del autor author_douyin_id | No | Sí | Localizar la cuenta desde un vídeo |
Biografía del autor author_bio | No | Sí | Perfil de la cuenta |
Me gusta totales del autor author_like_count | No | Sí | Me gusta totales sin llamar al perfil |
Reproducciones view_count | — | — | El catálogo dice que no son reproducciones reales |
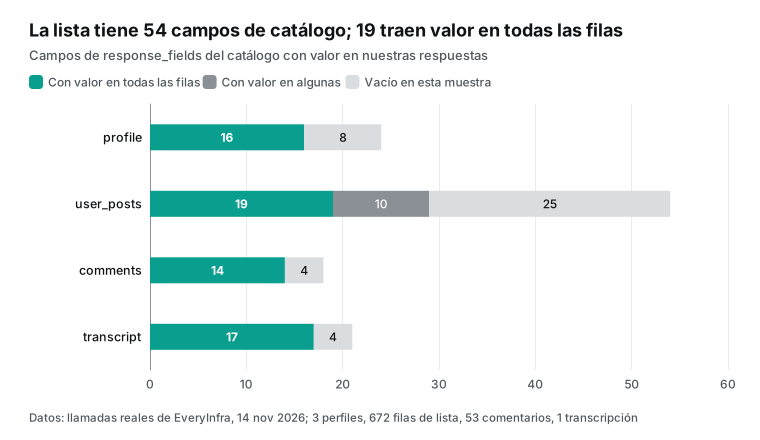
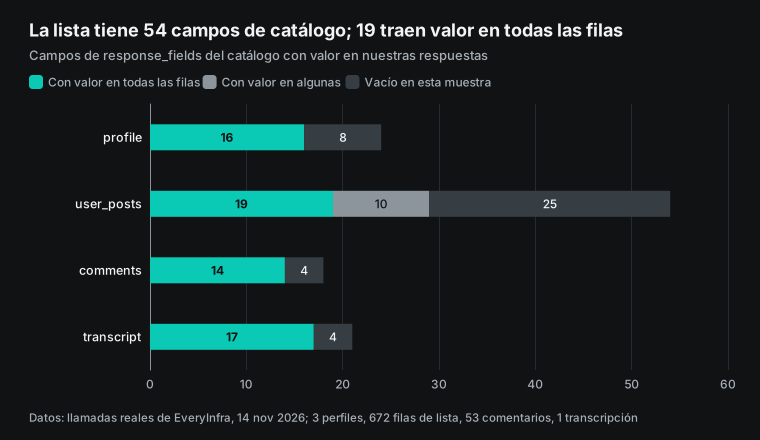
La fila de la lista en el gráfico tiene 10 campos con valor en algunas filas. image_urls solo tiene valor en las 32 publicaciones de imágenes. video_url y duration_seconds solo lo tienen en los vídeos (95,2 %). region tiene valor en el 21,6 % de las publicaciones, title en el 20,4 % y hashtags en el 79,3 %. Estos porcentajes dependen del tipo de publicación y del año, así que no son cifras fijas.
Trate la lista como el índice y el detalle como el expediente. Recorrer entera una cuenta cuesta menos de 2 centavos de dólar. El detalle cuesta 0,000556 USD por publicación, así que úselo solo en las publicaciones en las que necesite los datos del autor o mirar más a fondo.
Prueba 4: comentarios, respuestas y transcripción del vídeo
Enviamos la llamada de comentarios a las 13:18:12, hora de Singapur, con page_token vacío. Devolvió 20 comentarios de primer nivel y un token para la página siguiente, y costó un bloque, 0,000556 USD. El catálogo enumera 18 campos de comentario (sin contar el token), y en esta prueba 14 tenían valor. Estaban ip_location (por ejemplo Henan, Zhejiang o Pekín), reply_count y liked_by_author; is_hot, reply_to_id, images y mentioned_users salieron vacíos en esta muestra. El comentario de primer nivel con más me gusta tenía 244 me gusta y 15 respuestas. Los autores de los comentarios son usuarios particulares: en el análisis solo usamos recuentos y regiones, y no guardamos apodos.
En el segundo momento, a las 13:37, hora de Singapur, usamos douyin/comment_replies para leer las respuestas a ese comentario. Enviamos el enlace del vídeo, el id del comentario y un page_token vacío. Devolvió 15 respuestas, que coinciden con el reply_count de 15 del comentario; pagination.has_more era false y costó un bloque, 0,000556 USD. Dos de las 15 respuestas traen reply_to_reply_id y reply_to_author_name, es decir, son respuestas a respuestas, y tres traen mentioned_users.
En ese mismo minuto, usamos el token de la página 1 para leer la página 2 de comentarios: devolvió 13 comentarios y también costó un bloque. Las 15 respuestas suman 50 me gusta y la mayor tiene 30, un orden de magnitud por debajo del comentario de primer nivel. Por eso conviene contar por separado los comentarios de primer nivel y las respuestas.
| Llamada | Hora (Singapur) | Elementos devueltos | Cobrado |
|---|---|---|---|
douyin/comments, página 1 | 13:18:12 | 20 | 0,000556 USD |
douyin/comments, página 2 | 13:36:55 | 13 | 0,000556 USD |
douyin/comment_replies | 13:37:07 | 15 | 0,000556 USD |
douyin/transcript | 13:18:23 | 9 segmentos | 0,000556 USD |
Enviamos la llamada de transcripción a las 13:18:23. Tardó 18,92 segundos (1 llamada) y dividió el vídeo de 69 segundos en 9 frases con hora de inicio y de fin. La transcripción sale del reconocimiento de voz, así que las palabras que suenan igual pueden salir mal. La página de la exposición del museo tiene una expresión de cuatro caracteres que significa «el oro y el azul martín pescador brillan juntos», y en la transcripción dos de esos caracteres son homófonos equivocados. En otro punto, la transcripción tiene mal el primer carácter de la palabra «polvo fino», algo que se deduce del contexto. Si busca palabras clave en las transcripciones, busque también en el título y las etiquetas.
Tres momentos: cómo cambian los recuentos de un mismo vídeo
Los tres momentos de prueba fueron de 13:07 a 13:18, de 13:36 a 13:37 y a las 13:55, todos en hora de Singapur. De la primera petición a la última pasaron 48 minutos y 39 segundos. En cada momento leímos una vez el perfil, la página 1 de la lista y el detalle del vídeo de la corona. En el segundo momento leímos además la página 2 de comentarios y las respuestas; en el tercero, otra vez la página 1 de comentarios.
| Momento (Singapur) | Me gusta del vídeo | Comentarios del vídeo | Compartidos del vídeo | Guardados del vídeo | Seguidores | Me gusta de la cuenta |
|---|---|---|---|---|---|---|
| Primero: lista 13:07, detalle 13:17, perfil 13:07 | 8.691 (lista) / 8.696 (detalle) | 684 | 1.009 | 566 | 1.067.081 | 3.001.617 |
| Segundo: 13:36 | 8.700 | 685 | 1.010 | 567 | 1.067.087 | 3.001.631 |
| Tercero: 13:55 | 8.703 | 685 | 1.010 | 567 | 1.067.087 | 3.001.632 |
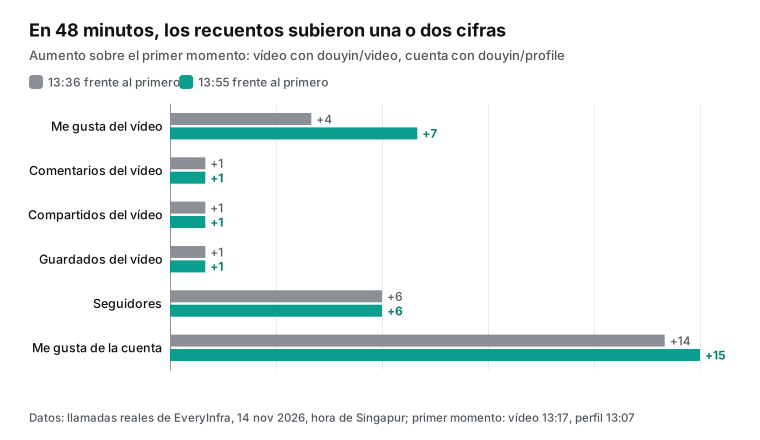
En 48 minutos, este vídeo de la exposición, con 4 días de vida, ganó 12 me gusta: de 8.691 en la lista a las 13:07 a 8.703 a las 13:55. Comentarios, compartidos y guardados ganaron 1 cada uno. La cuenta ganó 6 seguidores y 15 me gusta totales. En un mismo momento, las dos fuentes coinciden: en el segundo, la lista a las 13:36:13 y el detalle a las 13:36:35 marcan 8.700; en el tercero, 13:55:11 y 13:55:33 marcan 8.703. En el primero, lista y detalle difieren en 5 me gusta porque las dos peticiones se hicieron con 10 minutos de diferencia. De las otras 19 publicaciones de la página 1, solo 1 cambió (+1) entre el primer y el segundo momento, y ninguna entre el segundo y el tercero.
Fije la frecuencia de seguimiento según la antigüedad de la publicación. En la cuenta de un museo, los recuentos de las publicaciones que no son las más recientes apenas se mueven en una hora, así que basta con leer la página 1 una vez al día. Para seguir la difusión tras la apertura de una gran exposición, suba la frecuencia solo en las dos o tres publicaciones más nuevas. Por ejemplo, llame a douyin/video una vez por hora: 24 llamadas por publicación y día, 0,0133 USD. Medianas de tiempo en los tres momentos: perfil 1,62 segundos (3 llamadas), detalle de vídeo 11,71 segundos (3 llamadas), página 1 de la lista 13,08 segundos (3 llamadas).
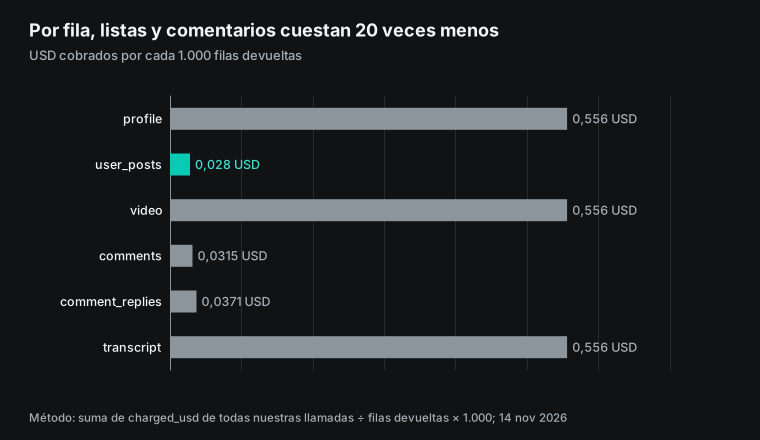
Coste por cada mil elementos: unos 0,028 USD en listas y 0,556 USD en llamadas de un elemento
Agrupamos por capacidad todas las llamadas reales de este artículo. Para cada una, dividimos lo cobrado entre los elementos devueltos y multiplicamos por 1.000. En las capacidades que devuelven una página por llamada, el tamaño de la página reparte el precio unitario. En las que devuelven un elemento por llamada, el coste por cada mil es 1.000 × 0,000556 USD.
| Capacidad | Llamadas | Elementos devueltos | Cobrado | Por cada mil | Mediana de tiempo (muestras) |
|---|---|---|---|---|---|
douyin/profile | 3 | 3 | 0,001668 USD | 0,556 USD | 1,62 s (3) |
douyin/user_posts | 36 | 716 | 0,020016 USD | 0,0280 USD | 2,37 s (36) |
douyin/video | 3 | 3 | 0,001668 USD | 0,556 USD | 11,71 s (3) |
douyin/comments | 3 | 53 | 0,001668 USD | 0,0315 USD | 1,99 s (3) |
douyin/comment_replies | 1 | 15 | 0,000556 USD | 0,0371 USD | 2,50 s (1) |
douyin/transcript | 1 | 1 | 0,000556 USD | 0,556 USD | 18,92 s (1) |
| Total | 47 | 791 | 0,026132 USD | — | — |
Los 716 elementos de la lista son la suma de lo devuelto por 36 llamadas: las 34 de la paginación más la página 1 del segundo y del tercer momento. La página 1 del primer momento es también la página 1 de la paginación, así que una misma publicación puede contarse más de una vez. Solo para la paginación completa, son 34 llamadas, 672 elementos y 0,0281 USD por cada mil. Los 53 comentarios salen de tres llamadas (20, 13 y 20 elementos), y cada una costó un bloque.
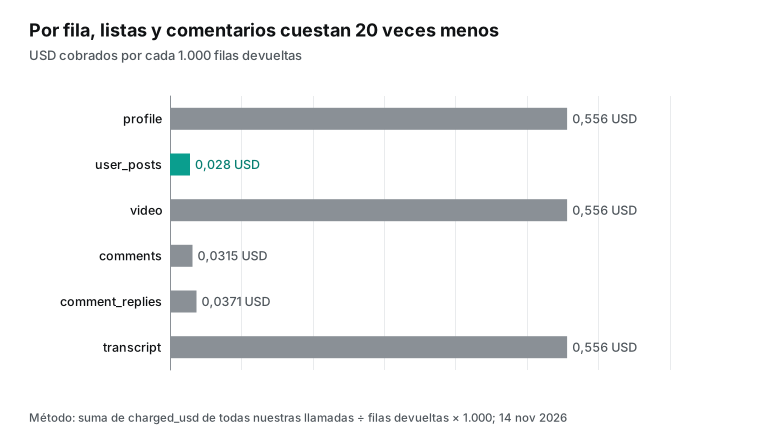
Tres casos con este precio unitario. Primero, una institución sigue su propia cuenta cada día: 1 llamada al perfil y 1 a la página 1 de la lista. Son 0,001112 USD al día y 0,033 USD al mes. Segundo, un investigador lee por primera vez 50 cuentas institucionales. Si cada una tiene un tamaño parecido al del museo (34 páginas), la primera pasada cuesta unos 50 × 35 × 0,000556 = 0,973 USD. Después, 2 llamadas por cuenta y día cuestan 50 × 2 × 30 × 0,000556 = 1,668 USD al mes. Tercero, leer el detalle y la página 1 de comentarios de 500 publicaciones clave: 500 × 2 × 0,000556 = 0,556 USD. Cada fórmula muestra sus supuestos, así que puede poner sus propios números de cuentas y publicaciones.
| Caso | Llamadas | Coste |
|---|---|---|
| Una institución sigue su propia cuenta | 2 al día | 0,001112 USD al día, 0,033 USD al mes |
| Primera paginación de 50 cuentas | 50 × 35 | 0,973 USD una vez |
| Seguimiento diario de 50 cuentas | 50 × 2 × 30 | 1,668 USD al mes |
| Detalle y una página de comentarios de 500 publicaciones | 500 × 2 | 0,556 USD |
Guardar los datos: tres tablas y actualización diaria
Juntas, las pruebas anteriores dan tres tablas. La primera es una tabla de instantáneas de cuenta, con una fila por cuenta y día. Guarda seguidores, seguidos, me gusta totales y número de publicaciones de douyin/profile, con clave secUid más fecha. En nuestras tres llamadas al perfil en 48 minutos, los seguidores pasaron de 1.067.081 a 1.067.087 y los me gusta totales de 3.001.617 a 3.001.632.
La segunda es una tabla de publicaciones, con una fila por publicación y clave en su id. Guarda author_id, posted_at, media_type, is_pinned, etiquetas y duración. Al crear la tabla, recorra la lista entera. Después, vuelva a leer la página 1 cada cierto tiempo y fusione toda la página por id: inserte los id nuevos y, en los que ya tiene, actualice solo los recuentos e is_pinned. La tercera es una tabla de recuentos, con una fila por id de publicación y fecha, que guarda me gusta, comentarios, compartidos y guardados, también desde la página 1 diaria. Para seguir una publicación más antigua, llame a douyin/video cuando lo necesite.
Tres reglas más. Primera: no guarde direcciones de vídeo ni de portada; léalas por id cuando las necesite, por lo que dicen la incidencia #805 y el catálogo. Segunda: añada a la tabla de publicaciones una marca «el autor es esta cuenta». Quite las publicaciones en colaboración cuando cuente la producción propia de la institución y déjelas cuando cuente «el contenido de este perfil». En el ejemplo del museo, las 17 en colaboración llevan el total de me gusta de 1.392.825 a 2.051.983, casi la mitad más, y la cuota de las 10 primeras del 52,1 % al 57,3 %. Tercera: de los comentarios guarde solo recuentos, regiones y horas, no apodos ni avatares; si necesita enlazar comentarios de una misma persona, guarde un hash con sal.
Con este diseño, una institución necesita 2 llamadas fijas al día y 50 instituciones, 100; el coste mensual está más arriba. Para 50 instituciones, la primera carga son unas 34.000 filas (a 672 por cuenta). Después se añaden unas 3.750 filas al año (a razón de las 75 publicaciones del museo en los últimos 12 meses). Un portátil normal puede con eso.
Un ejemplo de cultura pública: lo que muestran los datos de un museo
Las 34 páginas de la lista contienen 655 publicaciones con el museo como autor, y con ellas se puede medir cómo trabaja un museo en Douyin. La duración mediana de los vídeos es de 124 segundos (623 vídeos con duración; cuartiles de 63 y 205 segundos), y el más largo dura 2.714 segundos. De las 655 publicaciones, 516 llevan etiquetas. Las más frecuentes son «Museo Nacional» 154 veces, el nombre corto del museo 126 veces, «reliquias culturales» 104 veces y «exposición» 102 veces. Por año de publicación, 2021 es el que más tiene, 125; 2025 tiene 85 y 2026, hasta el 10 de noviembre, 71 (años en UTC).
Los me gusta están muy concentrados. Las 655 publicaciones suman 1.392.825 me gusta, una media de 2.126 por publicación, pero una mediana de solo 281, y las 10 más populares concentran el 52,1 %. Seis de esas 10 son de la serie «Feliz cumpleaños, patria» de septiembre y octubre de 2019. Dos son avances de visitas virtuales de la serie «Visite el museo desde casa» de febrero de 2020; la mayor tiene 180.091 me gusta. Las otras dos son de «Que las reliquias se muevan», de enero de 2019, y de «Venga al museo a ver China», de enero de 2023. Unos pocos picos de difusión suben la media; informe la mediana y la cuota de las 10 primeras juntas, porque se acercan más al alcance habitual del museo.
La mediana de me gusta cambia mucho según el año. No compare con una media publicaciones de años distintos de una misma cuenta:
| Año de publicación (UTC) | Publicaciones | Mediana de me gusta |
|---|---|---|
| 2018 | 17 | 2.430 |
| 2019 | 64 | 728,5 |
| 2020 | 46 | 796,5 |
| 2021 | 125 | 181 |
| 2022 | 94 | 312,5 |
| 2023 | 68 | 437,5 |
| 2024 | 85 | 230 |
| 2025 | 85 | 157 |
| 2026 (hasta el 10 de nov.) | 71 | 281 |
Si deja fuera 2018, que solo tiene 17 publicaciones, la mediana anual va de 157 a 797. El año más alto, 2020, es unas 5 veces el más bajo, 2025. 2021 tiene más publicaciones que ningún otro (125), pero una mediana de solo 181. Las 75 publicaciones de los últimos 12 meses (desde el 2025-11-14) tienen una mediana de 283. Así que, para juzgar «cómo le fue este año al contenido del museo», compare publicaciones del mismo año o del mismo intervalo. Una tabla completa, fruto de una paginación entera, se lo permite.
La duración y los me gusta muestran un patrón claro. Dividimos los 623 vídeos en cuatro grupos por duración. Menos de 60 segundos: 142 vídeos, mediana de 587 me gusta. De 60 a 119 segundos: 158 vídeos, 302. De 120 a 299 segundos: 229 vídeos, 245. 300 segundos o más: 94 vídeos, 164. Cuanto más largo el vídeo, más baja la mediana: el grupo más corto multiplica por unas 3,6 al más largo.
| Duración del vídeo | Vídeos | Mediana de me gusta |
|---|---|---|
| Menos de 60 s | 142 | 587 |
| 60–119 s | 158 | 302 |
| 120–299 s | 229 | 245 |
| 300 s o más | 94 | 164 |
Más de la mitad de los vídeos del museo (323) duran 2 minutos o más. Muchos son conferencias, visitas guiadas a exposiciones y fragmentos de directos. Menos me gusta no significa menos espectadores, y para ellos guardados y comentarios pueden ser mejor medida. Las 32 publicaciones de imágenes tienen una mediana de 269,5 me gusta, cerca de los 282 de los vídeos.
Las etiquetas y las horas de publicación también dan cifras. Las 139 publicaciones sin etiquetas tienen una mediana de 314 me gusta. Las 69 con «historia» tienen 412; las 104 con «reliquias», 375; las 154 con la etiqueta más frecuente, «Museo Nacional», solo 222. Más etiquetas no significan más me gusta: las publicaciones con etiquetas de contenido (historia, reliquias) tienen medianas más altas que las que llevan el nombre del museo como etiqueta.
| Etiqueta | Publicaciones | Mediana de me gusta |
|---|---|---|
| Sin etiquetas | 139 | 314 |
| «historia» | 69 | 412 |
| «reliquias» | 104 | 375 |
| «Museo Nacional» | 154 | 222 |
En hora de Pekín, el museo publica sobre todo los viernes (140 publicaciones) y menos los sábados (62). Por horas, las 16:00 y las 17:00 tienen 89 publicaciones cada una y las 10:00, 76; después de las 21:00 solo hay 20. El museo publica, por tanto, sobre todo en días y horas laborables.
| Día (hora de Pekín) | Lun | Mar | Mié | Jue | Vie | Sáb | Dom |
|---|---|---|---|---|---|---|---|
| Publicaciones | 80 | 104 | 84 | 115 | 140 | 62 | 70 |
Las 655 publicaciones suman 99.934 comentarios; la mediana por publicación es de 21 comentarios, 37 compartidos y 23 guardados.
¿Por qué deberían mirar estas cifras las instituciones culturales públicas? Un comentario del periódico China Archives News, publicado el 26 de octubre y reproducido por la web de archivos de Fuzhou el 4 de noviembre, dice que Weibo, WeChat Channels y Douyin son ahora el lugar principal donde la gente se informa. Pide a los archivos contenido distinto según la lógica y el público de cada plataforma. Un museo que se pregunta «¿alguien ve nuestros vídeos cortos y qué contenido ve?» necesita esta tabla base: la tabla completa de su propia cuenta y otra equivalente de instituciones parecidas.
Deje claros los límites del método. Me gusta y comentarios dependen de las recomendaciones de la plataforma y no equivalen a la opinión del público sobre la exposición. Marque aparte las publicaciones en colaboración. Las reproducciones no están disponibles, así que no se pueden calcular tasas de finalización ni de interacción.
Cargos: paga por lo que vuelve
En esta prueba hicimos 47 llamadas. El cargo total fue de 0,026132 USD, la suma de billing.charged_usd de cada respuesta. Perfil, lista, detalle de vídeo y transcripción cuestan 0,000556 USD por llamada. Comentarios y respuestas se cobran por bloques de 20 elementos; nuestras 3 llamadas de comentarios y la de respuestas devolvieron un bloque o menos cada una, así que cada una costó un bloque. El catálogo dice que un bloque sin elementos no se cobra.
Un token de página vale 24 horas y solo sirve para la misma cuenta y los mismos parámetros. Si cambian los parámetros, la API devuelve 422 y se vuelve a empezar por la página 1. En las tareas programadas que se reintentan solas, envíe un Idempotency-Key para que una repetición de la misma petición no se cobre dos veces.
| Caso | Resultado | Cobrado | Fuente |
|---|---|---|---|
| Perfil, página de lista, detalle de vídeo, transcripción | Una llamada | 0,000556 USD | Nuestras 47 llamadas |
| Comentarios o respuestas, de 1 a 20 elementos | Un bloque | 0,000556 USD | Nuestras 47 llamadas |
| Bloque de comentarios sin elementos | Sin datos en ese bloque | 0 USD | Regla del catálogo |
| Token antiguo con parámetros cambiados | 422; volver a la página 1 | — | Regla del catálogo |
Cuándo encajan mejor las otras dos vías
La plataforma abierta oficial encaja con instituciones que gestionan sus propias cuentas. Reproducciones, visitantes del perfil y seguidores nuevos por día solo están disponibles con el consentimiento del titular. La página de la capacidad fija los usos permitidos, y una institución que usa los datos para su propia presentación y revisión está dentro de ellos.
Los scripts de código abierto encajan con equipos técnicos con poco volumen de datos, que mantienen su propio código y quieren controlar cada petición. Encajan sobre todo cuando necesita el archivo de vídeo en sí, o listas que solo ve un usuario con sesión iniciada, como me gusta y favoritos. Para eso, la lista de funciones de DouK-Downloader es más amplia que una API de datos.
Una API de pago por llamada encaja cuando lee muchas cuentas públicas, no quiere desplegar ni mantener scripts y necesita campos JSON estables. Puede usar las tres: la vía oficial para su cuenta, una API de pago por llamada para compararse con otras y una herramienta de código abierto cuando necesite el archivo original.
| Su objetivo | Vía adecuada | Por qué |
|---|---|---|
| Reproducciones y visitantes del perfil de su propia cuenta | Plataforma abierta oficial | Solo el consentimiento del titular da acceso a esas cifras |
| El archivo de vídeo original, o listas con sesión iniciada | Herramienta de código abierto | Una API de datos devuelve campos y direcciones que caducan |
| Comparar a diario muchas cuentas públicas | API de pago por llamada | Sin consentimiento; nada que desplegar ni mantener |
| Localizar al autor desde un vídeo | douyin/video de pago por llamada | Las tres lecturas trajeron ID de Douyin, biografía y me gusta del autor; 0,000556 USD por llamada |
Cumplimiento normativo y límites
Leer perfiles públicos también tiene reglas. El artículo 18 del Reglamento de Gestión de la Seguridad de los Datos en Red trata de las herramientas automáticas que acceden a datos en red y los recogen. Exige evaluar el efecto sobre el servicio, no entrar ilegalmente en redes ajenas y no alterar el funcionamiento normal del servicio. El artículo 24 dice que, si la recogida automática no puede evitar datos personales innecesarios, hay que borrarlos o anonimizarlos.
La Ley contra la Competencia Desleal está en vigor desde el 15 de octubre de 2025. Su artículo 13 dice que una empresa no puede obtener ni usar datos que otra empresa posee legalmente mediante fraude, coacción, o eludiendo o rompiendo medidas técnicas. El artículo 13 de la Ley de Protección de la Información Personal incluye un caso permitido: tratar, dentro de un alcance razonable, datos personales que la persona hizo públicos o que se hicieron públicos legalmente.
Nuestra práctica es esta. Solo leemos perfiles y publicaciones públicos. No guardamos apodos ni avatares de los comentarios, o los anonimizamos. Mantenemos el ritmo de llamadas dentro del límite de la API y no eludimos el inicio de sesión ni las verificaciones de la plataforma. En los análisis nombramos las cuentas institucionales y omitimos los nombres de los creadores particulares. El robots.txt de Douyin impide a los rastreadores de buscadores que enumera acceder a /follow y a las páginas con el parámetro enter_from=. Esta sección describe un método de datos; no es asesoramiento jurídico.
Límites de la muestra: probamos una cuenta institucional, y el detalle y los comentarios de un vídeo. Los tres momentos de prueba cupieron en 60 minutos. «Vacío en esta muestra» solo vale para esta muestra; las cuentas personales, las de tiendas y las que publican sobre todo imágenes pueden ser distintas. El análisis por año, duración, etiquetas y horas usa solo las 655 publicaciones del museo.
Novedades del sector
- Noviembre de 2026: según su aviso, la plataforma abierta de Douyin pasa a certificados sin raíz con firma cruzada. Los sistemas antiguos que no actualizaron antes del 31 de octubre reciben errores al llamar a
open.douyin.com, y el aviso dice que actualizar lo resuelve. Qué significa para usted: si tiene programas Java antiguos que llaman a la API oficial, revise el certificado este mes. - 9 de noviembre de 2026: la #263 de douyin-downloader informa de que no llegan detalles de publicaciones tras volver a iniciar sesión, mientras la aplicación de escritorio funciona. Qué significa para usted: en esta incidencia, volver a iniciar sesión no lo arregló, así que los scripts basados en cookies necesitan otras comprobaciones.
- 4 de noviembre de 2026: la exposición de la corona del Museo Nacional abrió al público. A las 13:07 del 14 de noviembre, el vídeo de la exposición publicado el 10 de noviembre tenía 8.691 me gusta: 27,7 veces la mediana (314) de las otras 19 publicaciones de los 3 meses anteriores. Qué significa para usted: los picos de las cuentas institucionales siguen a las exposiciones presenciales, así que ponga las fechas de las exposiciones en su calendario de seguimiento.
- 31 de octubre de 2026: el mantenedor de Douyin_TikTok_Download_API explica en la #805 que los enlaces directos de vídeo caducan en unas tres horas. Qué significa para usted: guarde solo el
iddel vídeo y lea la dirección cuando la necesite. - 26 de octubre de 2026: el título de la #258 de douyin-downloader dice que el control de seguridad solo deja pasar peticiones hechas desde la página web, y que ni reintentar ni volver a iniciar sesión sirve. Qué significa para usted: si construye su propia herramienta, prevea el coste de la automatización del navegador.
Preguntas frecuentes
¿Douyin tiene una API oficial?
Sí: la plataforma abierta de Douyin. Los endpoints de cuentas y vídeos requieren que el titular autorice su aplicación. user_info devuelve apodo, avatar, sexo y región. El producto de datos de interacción de usuarios solo está abierto a empresas, organismos públicos e instituciones públicas. Para leer otras cuentas públicas, necesita scripts de código abierto o una API de pago por llamada.
¿Qué campos devuelve una API del perfil de usuario de Douyin?
El documento oficial de /oauth/userinfo/ enumera apodo, avatar, sexo y región, y el ejemplo incluye además open_id y union_id; requiere consentimiento del usuario. El catálogo de douyin/profile, de pago por llamada, enumera 24 campos, y en el Museo Nacional 16 tenían valor. Entre ellos están seguidores, seguidos, me gusta totales, número de publicaciones, texto de verificación, avatar e imagen de cabecera.
¿Qué diferencia hay entre uid y sec_uid en Douyin?
uid es un ID numérico; el del museo es 92744920981. sec_uid es la parte que va tras douyin.com/user/ en la dirección del perfil web y empieza por MS4w. La API de pago por llamada usa sec_uid para localizar una cuenta. El ID corto de Douyin, chnmuseum en el caso del museo, es un tercer identificador: lo elige la cuenta y no sirve como secUid. El campo author_douyin_id del detalle de vídeo devuelve el ID de Douyin del autor, así que puede usarlo para comprobarlo.
¿Hay una API de datos de Douyin gratuita?
Las capacidades de la plataforma abierta son gratuitas, pero exigen una organización acreditada, una revisión y el consentimiento del titular. Los proyectos de código abierto de GitHub son gratuitos, pero usted paga servidores, proxies y mantenimiento. Con la API de pago por llamada, recorrer entera la lista del museo devolvió 672 elementos y costó 0,018904 USD.
¿Siguen funcionando los proyectos de API de Douyin de GitHub?
Algunos sí, pero lea antes las incidencias recientes. El README de douyin-downloader dice que los controles de seguridad bloquean ahora la descarga de vídeos sueltos en la versión de línea de comandos. El 9 de noviembre de 2026, un usuario informó de que no recibía detalles de publicaciones ni tras volver a iniciar sesión. Douyin_TikTok_Download_API lee autores y publicaciones con un grupo de identidades de invitado, pero las listas de seguidores y la búsqueda requieren sesión.
¿Una API de Douyin devuelve las reproducciones?
La consulta oficial de datos de vídeo puede devolver play_count, pero requiere el consentimiento del titular y solo lee los vídeos de la cuenta autorizada. El catálogo de pago por llamada dice que view_count no es un recuento real de reproducciones, porque Douyin no publica las reproducciones de los vídeos. Para medir el alcance, use me gusta, comentarios, compartidos y guardados.
Primeros pasos
- Abra la guía rápida de EveryInfra, regístrese y obtenga una clave de API. Guárdela en la variable de entorno
EVERYINFRA_API_KEY. - Abra la cuenta que le interesa en Douyin web y copie el secUid que va tras
douyin.com/user/en la dirección. - Póngalo en
SECen el código Python de arriba. Ejecute primero el perfil y la página 1 y compruebe los recuentos. Consulte la página de precios y el catálogo de capacidades para ver los precios vigentes. - Para recorrer la lista entera, repita hasta que no haya
next_page_tokeny luego quite las publicaciones en colaboración porauthor_id. Para las actualizaciones diarias, vuelva a leer la página 1 cada cierto tiempo y fusione toda la página con su tabla por elidde la publicación. - Llame a
douyin/videoydouyin/commentssolo en las publicaciones en las que necesite los datos del autor o mirar más a fondo. - Para buscar por palabras clave y ver el flujo completo de la búsqueda a las respuestas, vea la prueba de la API de Douyin con Python. Para comparar precios unitarios de dos formas de comprar datos de Douyin, lea la comparación de precios de la API de Douyin. Para otras plataformas, vea la API de scraping de TikTok y la API de scraping de Xiaohongshu.
Referencias
- Plataforma abierta de Douyin: página de datos de interacción de usuarios (en chino), consultado el 2026-11-14
- Plataforma abierta de Douyin: página de datos de vídeo (en chino), consultado el 2026-11-14
- Plataforma abierta de Douyin: página de información pública del usuario (en chino), consultado el 2026-11-14
- Plataforma abierta de Douyin: documento de información pública del usuario (en chino), consultado el 2026-11-14
- Plataforma abierta de Douyin: lista de vídeos de la cuenta autorizada (en chino), consultado el 2026-11-14
- Plataforma abierta de Douyin: consulta de datos de un vídeo (en chino), consultado el 2026-11-14
- Plataforma abierta de Douyin: obtener access_token (en chino), consultado el 2026-11-14
- Plataforma abierta de Douyin: consulta de datos de un vídeo con consentimiento comercial (en chino), consultado el 2026-11-14
- Plataforma abierta de Douyin: tipos de usuario y permisos (en chino), consultado el 2026-11-14
- Plataforma abierta de Douyin: aviso de certificados del servidor, actualizado el 2026-03-23 (en chino), consultado el 2026-11-14
- DigiCert: compatibilidad de los certificados raíz de DigiCert, consultado el 2026-11-14
- TikTok for Developers: guía de inicio de Display API, consultado el 2026-11-14
- TikTok for Developers: endpoint de lista de vídeos, consultado el 2026-11-14
- TikTok for Developers: Research API, consultado el 2026-11-14
- GitHub: README de Douyin_TikTok_Download_API, consultado el 2026-11-14
- GitHub: incidencia #805 de Douyin_TikTok_Download_API, respuesta del 2026-10-31, consultado el 2026-11-14
- GitHub: README de douyin-downloader, consultado el 2026-11-14
- GitHub: README en chino de douyin-downloader, consultado el 2026-11-14
- GitHub: lista de incidencias de douyin-downloader, consultado el 2026-11-14
- GitHub: incidencia #258 de douyin-downloader, 2026-10-26, consultado el 2026-11-14
- GitHub: incidencia #263 de douyin-downloader, 2026-11-09, consultado el 2026-11-14
- GitHub: incidencia #253 de douyin-downloader, 2026-10-09, consultado el 2026-11-14
- GitHub: README de DouK-Downloader (TikTokDownloader), consultado el 2026-11-14
- GitHub: README de MediaCrawler, consultado el 2026-11-14
- GitHub: README de f2, consultado el 2026-11-14
- GitHub: incidencia #350 de f2, consultado el 2026-11-14
- GitHub: README de douyin-cli, consultado el 2026-11-14
- PyPI: requests, consultado el 2026-11-14
- Catálogo de capacidades de EveryInfra, consultado a las 13:05 hora de Singapur, consultado el 2026-11-14
- Douyin: perfil web del Museo Nacional de China, consultado el 2026-11-14
- robots.txt de Douyin, consultado el 2026-11-14
- CCTV: reportaje sobre la exposición de la corona, 2026-11-10 (en chino), consultado el 2026-11-14
- Museo Nacional de China: avance de la exposición de la corona, 2026-10-30 (en chino), consultado el 2026-11-14
- Museo Nacional de China: página de la exposición de la corona (en chino), consultado el 2026-11-14
- Xinhua: reportaje fotográfico de la sala, 2026-11-10 (en chino), consultado el 2026-11-14
- Web de archivos de Fuzhou: comentario de China Archives News, 2026-11-04 (en chino), consultado el 2026-11-14
- Reglamento de Gestión de la Seguridad de los Datos en Red, texto completo (en chino), consultado el 2026-11-14
- Ley contra la Competencia Desleal de China, texto completo (en chino), consultado el 2026-11-14
- Ley de Protección de la Información Personal de China, texto completo (en chino), consultado el 2026-11-14
- Plataforma abierta de Douyin: centro de documentación (en chino), consultado el 2026-11-14
Referencia BL-154