Claude Code Code Mode 接数据 MCP:30 个仓库真调,脚本按 Code Mode 写法模拟
Claude Code Code Mode 接 EveryInfra MCP:30 个仓库真调回 295 万字符,模拟脚本只回 1,687 字符。
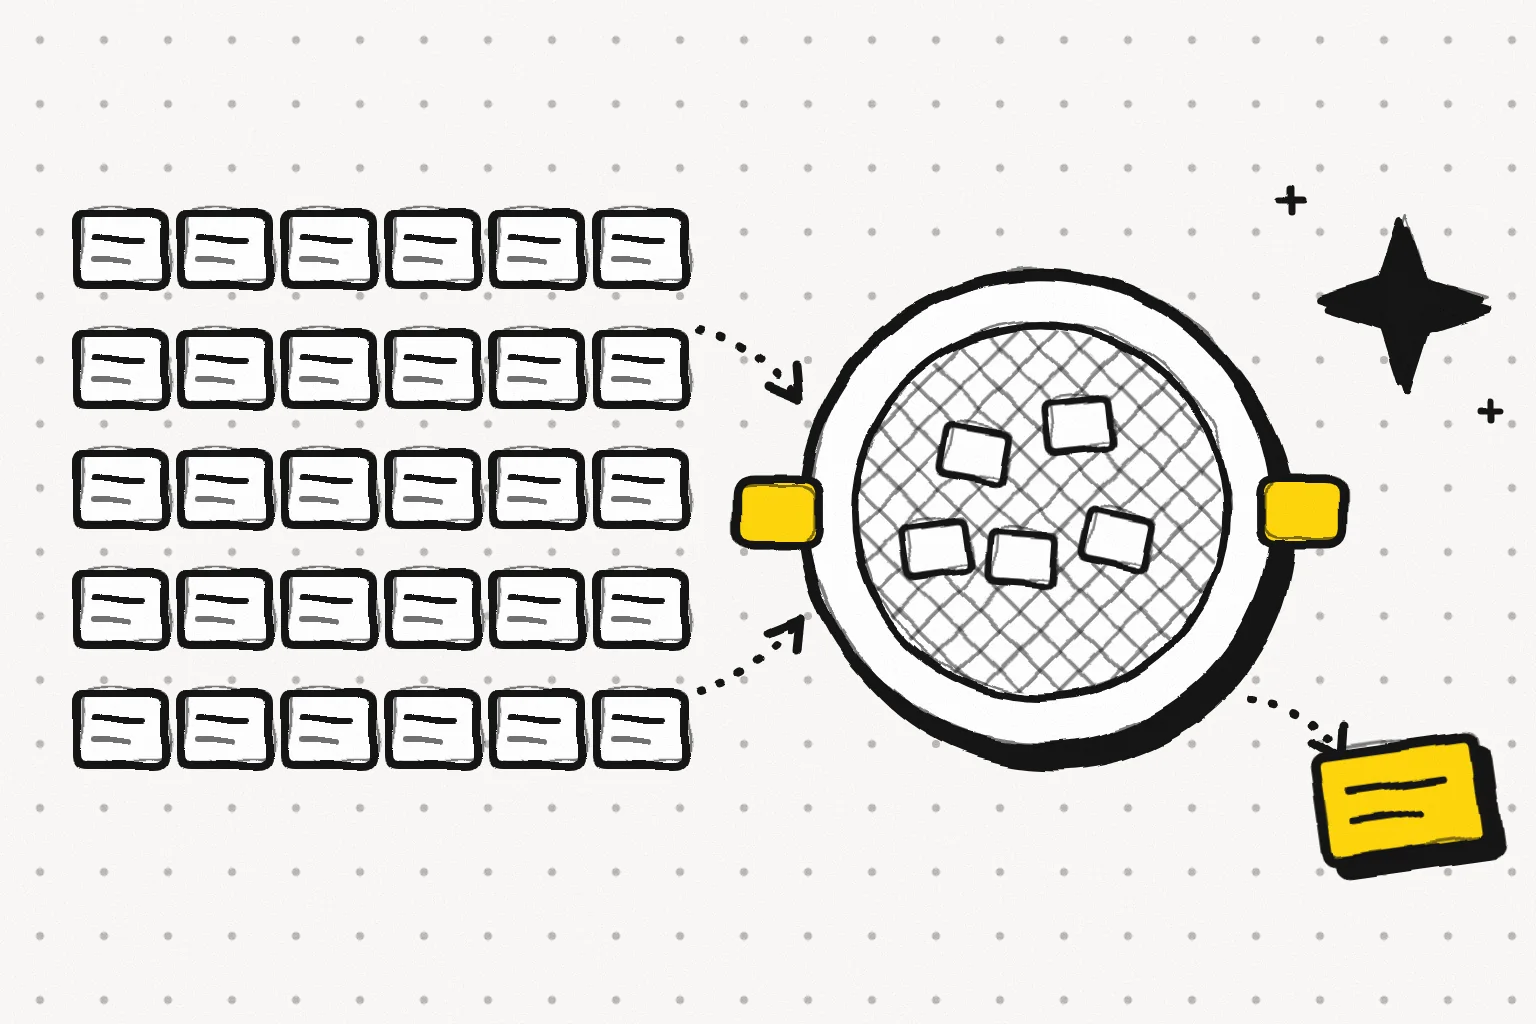
先说清哪部分是真调、哪部分是模拟。真调的是 EveryInfra 数据接口这一侧:2026 年 11 月 22 日 12:43–12:51(新加坡时间),我们经 EveryInfra 远程 MCP 把 30 个常用开源依赖的最新 issue 逐个拉了一遍,30 次 github/repository_issues 调用的工具返回合计 2,953,102 个字符,按 Anthropic 公开的分词比例估算约 110 万 token,比 Opus 5.5 的 100 万 token 上下文窗口还大,其中 28 次单次返回超过 Claude Code 的 5 万字符落盘线;之后两段脚本又发了 66 次调用,原始返回和扣费记录都留着。模拟的是 Claude Code 这一侧:Code Mode 本身这次没有开起来(本机 claude -p 报「Not logged in」,而 Code Mode 只支持交互终端),文中的「Code Mode 式脚本」是我们按 Code Mode 文档的写法手写、在 Node.js 里跑的 JavaScript,不是 Claude 在 Code Mode 下写出来的;模型会读到多少 token、要几轮,都是按字符数估算或按做法推算,没有实测。在这个前提下,12:51–12:55 的脚本在本地读完 25 个仓库的 250 万字符,按「7 天内、不是 PR、标题或标签含 regression、crash、security 等词」筛完,最后交回的对象只有 1,687 个字符(约 630 token,估算),是同样 25 个仓库逐次调用返回量的 0.067%。EveryInfra 一侧两种做法都按成功条数扣费,每个仓库 $0.000958,失败和限速的那几次都没扣钱。
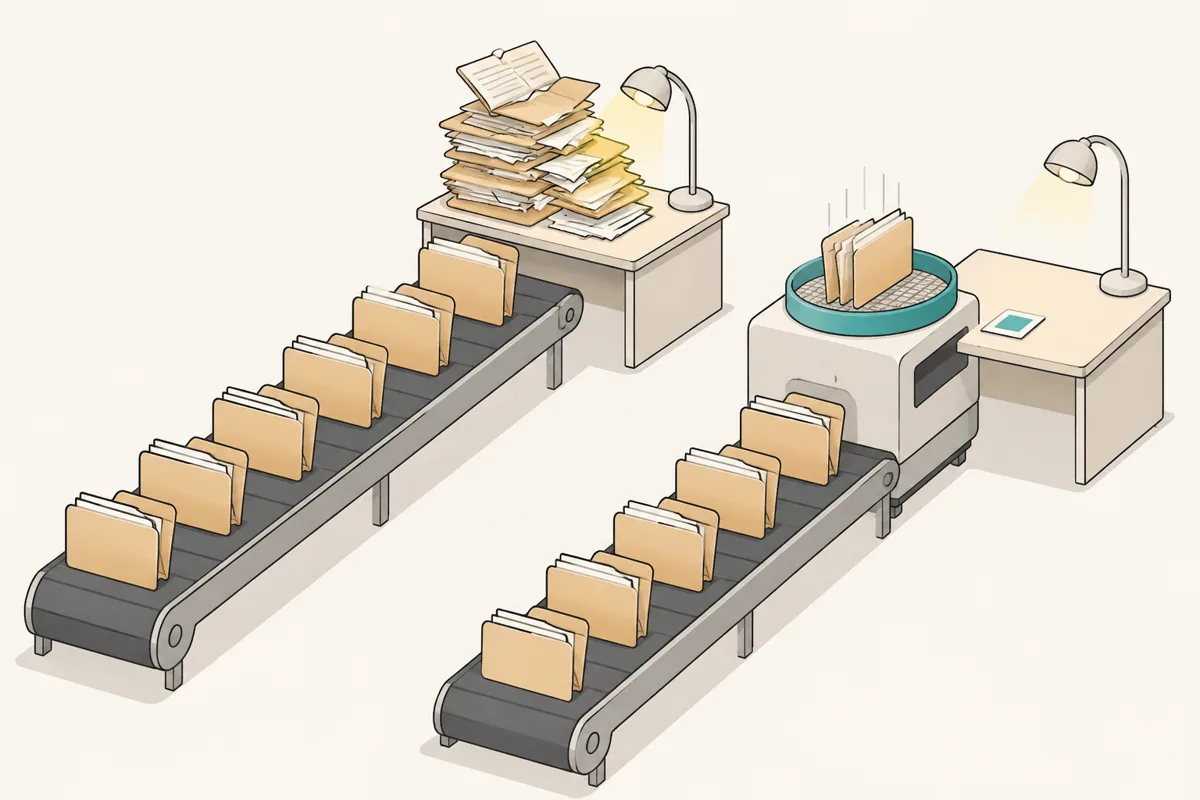
claude code code mode 是什么:一段 JavaScript 替模型调工具
Claude Code 默认的工作方式是一问一答式地调工具:模型发出一个 Bash、Read、Edit 或 MCP 工具调用,Claude Code 执行,把结果原样放回对话,模型读完再决定下一步。Code Mode 文档写的是另一条路:模型写一段 JavaScript,由这段代码去调工具,代码可以并行发命令、把前一个结果喂给下一个调用,最后只返回模型需要读的那一部分。在对话里你看到的仍是工具调用和改动的 diff,代码本身要按 Ctrl+O 打开对话记录查看器,展开折叠的 Code 行才看得到。
这个开关是在 Claude Code v2.1.323 加进来的,更新日志里那一条写的是「实验性、需要主动打开,Claude 写 JavaScript 来调用它的工具」。npm 上 2.1.323 的发布时间是 2026-11-12 20:29 UTC(新加坡时间 11 月 13 日凌晨),我们 11 月 22 日读到的最新版是 2.1.330(11 月 20 日)。11 月 12 日到 20 日之间连发了 2.1.325、2.1.326、2.1.327、2.1.328、2.1.329 五个版本,每一版的更新日志里都有 Code Mode 的修复:2.1.326 支持和 agent teams 一起开,2.1.328 让等待权限确认的时间不计入 10 分钟上限,2.1.329 允许在开着 OpenTelemetry 事件和指标时启动,2.1.330 修了脚本读几百个文件后的长时间停顿。11 月 22 日核对时它仍标着 experimental,没有改名,也没有转正。
| 项目 | 2026-11-22 核对的原文 | 出处 |
|---|---|---|
| 最低版本 | v2.1.323;和 agent teams 同开要 v2.1.326 | Code Mode 文档、更新日志 |
| 怎么打开 | 环境变量 CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1,写在 shell 或 ~/.claude/settings.json 的 env 里;项目级设置不认 | Code Mode 文档 |
| 账号 | Claude 订阅或 Console 账号;不走网关、Bedrock、Google Cloud、Foundry | Code Mode 文档 |
| 模型 | Opus 5.5、Sonnet 5.5、Haiku 5.5、Fable 5.2 | Code Mode 文档 |
| 在哪能用 | 只在终端里的交互式 claude 会话;VS Code 面板、Desktop 应用、云端会话不行 | Code Mode 文档 |
| 时长 | 等待中的代码 10 分钟停;auto 或 bypassPermissions 模式下放后台最长 2 小时 | Code Mode 文档 |
| 关掉 | 变量设成 0,任一处的 0 优先;组织可在受管设置里统一关 | Code Mode 文档 |
哪些是真调,哪些是模拟
派这篇稿时我们想在本机真跑一次对照:同一批 30 个目标,Code Mode 关和开各跑一遍,记模型的输入输出 token、请求次数和用时。本机装的是 Claude 应用,里面带着一份 Claude Code 2.1.328 的可执行文件。11 月 22 日 12:40 我们用它跑了一次 claude -p(带 CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1),返回的是「Not logged in · Please run /login」,初始化消息里列出的工具也没有运行代码的 REPL。这和文档一致:Code Mode 只支持交互终端,-p 和 Desktop 应用都不在名单里;wmedia 的实测也贴出了 -p 下的提示「for now it only works in the interactive terminal」。这次没有登录交互会话,所以 Code Mode 开和关的对照没有做成。
EveryInfra 接口一侧全部是真调,30 个仓库的原始返回都留着;Claude Code 一侧(模型发出什么、读到什么)用两种方法补。第一,按 Code Mode 写法手写的脚本在 Node.js 里跑,脚本里调工具的那一行换成直连 MCP 端点的小函数;按文档,开着 Code Mode 时模型读到的就是脚本最后那个对象,所以这个对象的字符数是实测的,但它是我们写的脚本的输出,不是 Claude 写的脚本的输出;第二,模型侧的 token 数没有实测,按 Anthropic 术语表的说法换算:旧分词器约 3.5 个英文字符一个 token,Claude 4.7 及以后的分词器同样文本多出约 30% 的 token,所以本文按每 2.69 个字符一个 token 估算,表里一律标「估算」。想要精确数,token 计数接口是免费的,拿你自己的模型 ID 数一遍就有。
| 环节 | 这次怎么做的 | 留下的证据 |
|---|---|---|
30 个仓库的 github/repository_issues 调用 | 真调,经 EveryInfra 远程 MCP,41 次尝试、30 次成功 | 每次的原始返回和 charged_usd |
| 两段脚本里的 66 次调用 | 真调;发调用的脚本是我们手写的,在 Node.js 里跑 | 运行记录和原始返回 |
Code Mode 开关和 REPL 工具 | 没开起来,claude -p 报「Not logged in」 | 初始化消息里的工具列表 |
| 脚本交回的 1,687 和 908 字符 | 字符数是实测,但脚本不是 Claude 写的 | 脚本最后那个对象 |
| 模型读到的 token、模型轮数 | 估算(每 2.69 字符一个 token)或按做法推算 | 没有,要自己跑开和关的对照 |
| 模型费 | 按定价页单价估算 | Claude API 定价页 |
这次的活:30 个依赖仓库,一周内谁报了 regression
我们挑了一件 Claude Code 用户常做、又正好需要很多次相关调用的活:给项目的依赖做一次 issue 体检。名单是 30 个常见的 JavaScript 和 Python 依赖仓库,从 React、Next.js、Vite、TypeScript、ESLint 到 Flask、FastAPI、Requests、Pydantic、pandas。每个仓库拉最新 30 条 issue,找出 7 天内新开的、不是 PR、标题或标签里带 regress、breaking、crash、security、CVE、memory leak、hang、fails 这类词的条目,按评论数排序,再给评论最多的前 3 条拉最近的评论。这件活有三个特点:仓库之间互不依赖,可以并行;每个仓库读进来几万到几十万字符,留下来的只有几行;第二步拉评论要用第一步的结果,属于「用一个结果决定下一个调用」。Code Mode 文档列出的三类适用场景(重复的改动、要先筛再读的搜索、可以同时跑的独立命令)这件活占了后两类。
数据来自 EveryInfra 的 GitHub 数据接口,用了两个能力:github/repository_issues 按仓库网址取最新 issue,github/issue_comments 按 issue 网址取评论。12:38:05 读的免费目录(GET /api/v1/social/catalog,当时 714 项能力里 683 项可用)写着两项都是同步返回,每次 $0.000958,repository_issues 默认 30 条、最多 100 条。目录里 response_fields 列出的字段有 number、title、text、state、is_pull_request、labels、comment_count、posted_at、updated_at 等 20 多个,text 是 issue 正文全文,返回体大小主要由它决定。
技术目标:脚本回给模型的数据量不超过逐次调用的 10%,模型轮数不超过 3 轮(轮数按做法推算)。
claude code mcp code mode 怎么配:接 EveryInfra 远程 MCP
Code Mode 里的脚本能调哪些工具,取决于会话里接了哪些工具,MCP 服务器照常用 claude mcp add 加。EveryInfra 的远程 MCP 地址是 https://api.everyinfra.com/mcp,走 HTTP 传输,Key 放在 Authorization 头里。Claude Code 的 MCP 文档给的写法如下,Key 用环境变量传进去,不写进项目文件:
# 1) Key 只放在环境变量里(例如写进 ~/.zshrc 引用的 env 文件)
export EVERYINFRA_API_KEY=ei_xxx   # 换成控制台里新建的 Key

# 2) 加远程 MCP,用户级作用域,不进项目仓库
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope user --header 'Authorization: Bearer ${EVERYINFRA_API_KEY}'

# 3) 打开 Code Mode(只对这一次会话)
CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1 claude
第 2 步的单引号是故意的:配置里存的是 ${EVERYINFRA_API_KEY} 这串字面量,Claude Code 每次连接时再展开。MCP 文档专门写了一条:远程服务器的 url 和 headers 里,某些凭据类变量(例如 ANTHROPIC_AUTH_TOKEN)会被读成空值,防止项目里的 .mcp.json 把你的 Claude 凭据发给它点名的服务器。EVERYINFRA_API_KEY 不在那张名单上,可以正常展开;如果连接时报 401,先按文档用 claude --debug-file 查有没有「never expanded toward a remote server」那一行。
要长期开着 Code Mode,把变量写进用户级设置的 env 块。Code Mode 文档写明项目级设置不能打开它,所以你克隆别人的仓库,对方没法替你开:
{
  "env": { "CLAUDE_CODE_EXPERIMENTAL_CODE_MODE": "1" },
  "permissions": {
    "allow": ["mcp__everyinfra__everyinfra_call_api", "mcp__everyinfra__everyinfra_list_capabilities"],
    "deny": ["mcp__everyinfra__everyinfra_create_ticket", "mcp__everyinfra__everyinfra_get_topup_link"]
  }
}
权限规则这一段在 Code Mode 下更要写。权限文档规定 MCP 工具的规则名是 mcp__<服务器>__<工具>,Code Mode 文档写明脚本里的每一次工具调用都按工具原名过你的 deny 和 ask 规则和 PreToolUse 钩子。但 auto 模式的分类器只在脚本运行前审一次代码,看不到运行时才算出来的值(比如从上一个结果里取出的网址),所以要严格管住的调用要靠规则和钩子,不能指望分类器。EveryInfra 的 MCP 在 12:42 的 tools/list 里列出 12 个工具,读数据只用得到 everyinfra_call_api、everyinfra_list_capabilities 和 everyinfra_get_job 三个;建工单、拿充值链接这类会产生外部动作的,在这件活里直接 deny。
逐次调用:30 轮,每轮回来几万到几十万字符
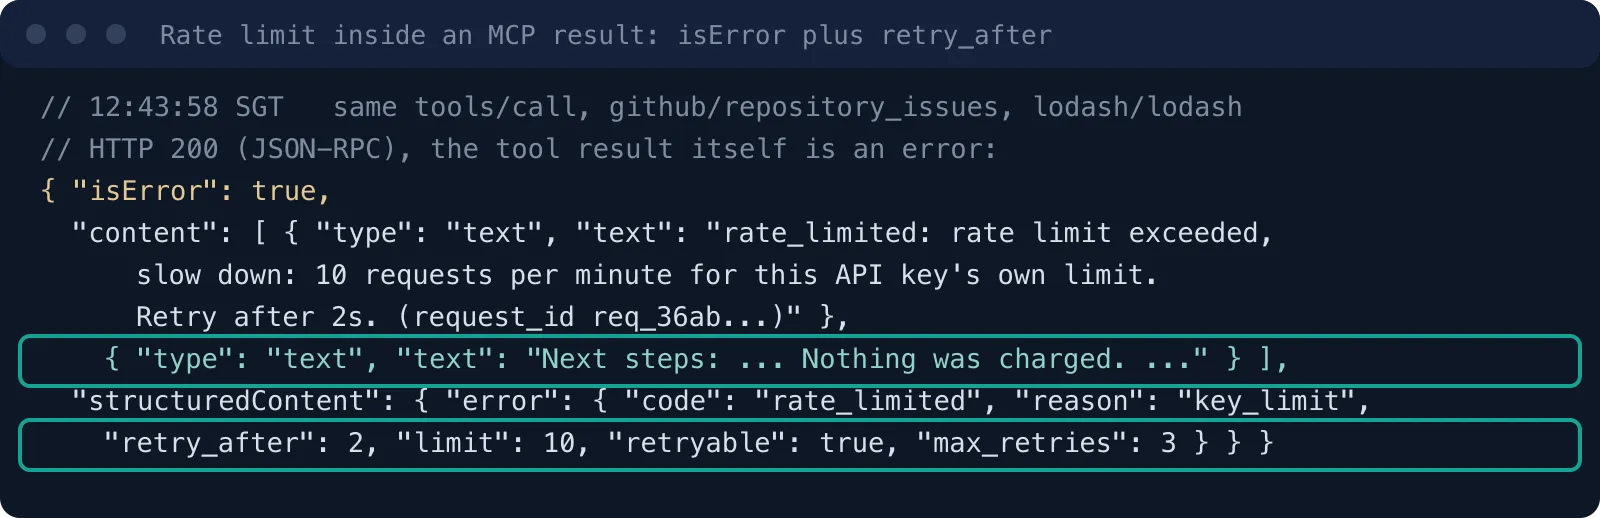
第一轮我们模拟不开 Code Mode 时模型会做的事:对 30 个仓库逐个发 tools/call,每次调 everyinfra_call_api,参数是 {"platform":"github","action":"repository_issues","params":{"url":"https://github.com/<仓库>"}}。每个调用的返回都存了原文,下图是其中一次(Vite,12:43:37)的请求和返回。
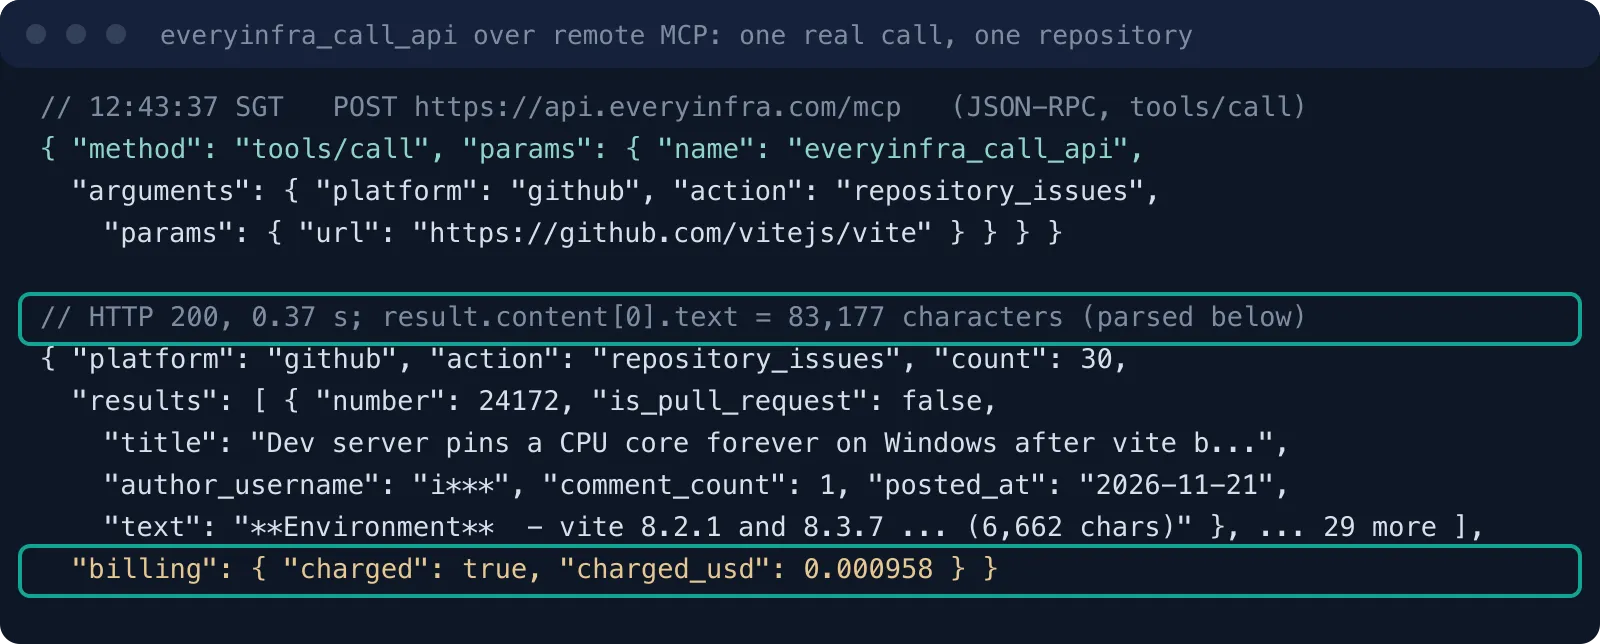
30 个仓库的返回文本合计 2,953,102 个字符,中位数 84,740,最大的是 TanStack/query 的 323,135 个字符(单条 issue 正文就很长),最小的是 pmndrs/zustand 的 4,538 个字符(它只返回了 5 条,其中 3 条是 PR)。按每 2.69 个字符一个 token 估算,合计约 109.7 万 token。逐次调用的时候,这些字符要全部经过模型:要么直接进上下文,要么先落盘再由模型去读。
Claude Code 对大的 MCP 返回有两道闸。MCP 文档的「输出上限」一节写着:单个 MCP 工具输出超过 10,000 token 时在对话记录里给出警告;默认上限 25,000 token,可以用 MAX_MCP_OUTPUT_TOKENS 改;没有声明自己上限的工具,文本结果超过 50,000 个字符时,无论 token 数多少,Claude Code 都会把它存成文件,在对话里换成一条写着文件路径的消息。我们的 30 次返回里有 28 次越过 5 万字符这条线,按估算有 22 次越过 25,000 token。也就是说,在不开 Code Mode 的会话里,这件活多半会变成「30 次 MCP 调用 + 28 个落盘文件 + 若干次 Read」:Read 工具一次最多返回 25,000 token,整个文件超过 256 KB 会被拒绝、要分页读,TanStack/query 那份 323,135 字符的文件就得分好几页。
Bicameral 在 Reddit 上的回复里说过:文件类的活 Claude 本来就会写 shell 脚本处理,差别大的地方在 MCP 调用,因为 shell 脚本够不着 MCP 工具,每个结果都会先落进对话。落盘让这一点松动了一些:超过 5 万字符的结果不在对话里,shell 能读到文件,也可以让 Claude 对落盘文件跑 jq 筛选;5 万字符以下的那些,每一次都整份进上下文。
| 指标 | 逐次调用(12:43–12:51) | 说明 |
|---|---|---|
| 仓库数 / 成功 | 30 / 30 | 41 次尝试里 11 次被限速挡回,按 retry_after 重试后成功 |
| 工具返回合计 | 2,953,102 字符 | 每次 result.content[0].text 的长度相加 |
| 约合 token | 约 109.7 万(估算) | 每 2.69 字符一个 token |
| 超过 5 万字符、会落盘 | 28 次 | MCP 文档的字符上限 |
| 超过 25,000 token(估算) | 22 次 | MCP 文档的默认 token 上限 |
| 单次接口用时中位数 | 0.94 秒 | 30 次合计 30.12 秒 |
| 接口费 | $0.02874 | 30 × $0.000958,逐条 charged_usd 相加 |
| 返回里 PR 的占比 | 625 / 849,73.6% | GitHub 把 PR 也算作 issue |
GitHub 的 issues 接口文档写明每个 pull request 都是 issue,但不是每个 issue 都是 PR,列表接口会把两者一起返回。我们 30 个仓库拉回的 849 条里有 625 条是 PR,占 73.6%。如果你要的只是用户报的问题,接近四分之三的字节都是要丢掉的,这类数据适合在脚本里先筛掉,不让模型读。
模拟的 Code Mode 式脚本:在 Node.js 里跑,回 1,687 个字符
第二轮从 12:51:56 开始。Code Mode 没开起来,我们就按 Code Mode 文档描述的写法自己写了一段脚本,在 Node.js 里跑;它不是 Claude 在 Code Mode 下写出的代码,Claude 实际写出的脚本可能更好,也可能更差。下面是脚本的主体,完整版和运行记录都存着。它做四件事:一个最多 3 路并发、两次开始至少隔 7 秒的小并发池;遇到 rate_limited 按返回里的 retry_after 等;30 个仓库的结果留在脚本的变量里,按规则筛完;命中的前 3 条再拉评论,最后一个表达式就是模型能看到的全部内容。
// Code Mode 里,callTool 是会话里现成的函数(调的是 mcp__everyinfra__everyinfra_call_api);
// 我们在 Node.js 里用一个直连 MCP 端点的小函数代替,其余代码不变。
const since = Date.now() - 7 * 864e5;
const RX = /regress|breaking|crash|segfault|security|vulnerab|CVE|memory leak|hang|broken|not working|fails?\b/i;

async function api(platform, action, params) {
  for (let i = 0; i < 6; i++) {
    const res = await callTool("everyinfra_call_api", { platform, action, params });
    if (res.isError) {
      const e = res.structuredContent?.error ?? {};
      if (e.code === "rate_limited") { await sleep(((e.retry_after ?? 10) + 2) * 1000); continue; }
      return { error: e.code ?? "error", charged_usd: 0 };
    }
    const j = JSON.parse(res.content[0].text);
    return { results: j.results ?? [], charged_usd: j.billing?.charged_usd ?? 0 };
  }
  return { error: "gave_up", charged_usd: 0 };
}

const pages = await pool(repos, 3, 7000, rp =>
  api("github", "repository_issues", { url: `https://github.com/${rp}` }));
const hits = [];
pages.forEach((p, i) => (p.results || []).forEach(x => {
  if (x.is_pull_request || Date.parse(x.posted_at) < since) return;
  if (!RX.test(x.title + " " + (x.labels || []).join(" "))) return;
  hits.push({ repo: repos[i], number: x.number, title: x.title.slice(0, 90),
              comments: x.comment_count, url: x.url, posted: x.posted_at.slice(0, 10) });
}));
hits.sort((a, b) => b.comments - a.comments);
const top = hits.slice(0, 3);
const threads = await pool(top, 3, 7000, h => api("github", "issue_comments", { url: h.url }));
top.forEach((h, k) => { h.last_comments = (threads[k].results || []).slice(-3)
  .map(c => (c.text || "").replace(/\s+/g, " ").slice(0, 200)); });
({ repos: repos.length, failed: pages.map((p, i) => p.error ? repos[i] : null).filter(Boolean),
   hits: hits.length, top, other_hits: hits.slice(3, 15).map(h => `${h.repo}#${h.number} ${h.title}`) });
这段脚本跑了 194 秒,共发 42 次调用:25 次成功,9 次被每分钟 10 次的限额挡回(按 retry_after 重试后有的成功了),8 次返回 unavailable。失败的集中在最后 5 个 Python 仓库(psf/requests、pydantic、encode/httpx、sqlalchemy、pandas)和第二步的 3 次拉评论,它们在第一轮 12:50 前后都是成功的。unavailable 的返回里 billing.charged_usd 是 0、reason 是 request_failed_refunded,structuredContent.error 里写着 retryable: true、retry_after: 60。第一版脚本只对 rate_limited 重试,把 unavailable 当成终局错误,于是这 8 次直接进了 failed。
脚本在本地读进了 25 个仓库的 2,502,282 个字符,最后交回的对象序列化后是 1,687 个字符,约 630 token(估算)。里面有 30 个仓库里 7 天内命中规则的 10 条 issue:评论最多的是 eslint/eslint #21556(6 条评论),另外有 microsoft/TypeScript #65600(「7.0 regression」开头)、vitest-dev/vitest #11976(Node 27 下截图断言失败)、jestjs/jest #16565 等;failed 字段列出了 5 个没拿到的仓库。开着 Code Mode 时,模型读到的就是这 1,687 个字符,从中能看出下一步该补哪 5 个仓库、该看哪几条 issue。
第二段脚本:只补失败的 5 个仓库
Code Mode 的一个用法是:第一段脚本的返回里带着 failed,模型读完再写一段只补这几个的脚本。Claude Code 的会话里,前一段脚本的变量在下一段还能用,wmedia 的实测提到「variables survive from one script to the next」,更新日志 2.1.328 也修过「上一段失败的脚本没设的顶层变量被当成 undefined」的问题。我们在 12:56 照这个做法、同样在 Node.js 里跑了第二段:把 unavailable 这类 retryable: true 的错误也按 retry_after 等一次(最多 60 秒),只对 5 个失败仓库重拉,再把两段的命中合起来,给评论最多的前 3 条拉评论。
第二段脚本 12:56:18 开始、13:02:36 结束,跑了 378 秒,共发 24 次调用:5 个仓库各试 3 次(首次加两次重试,每次按 retry_after 等 60 秒),给评论最多的前 3 条拉评论也各试 3 次。24 次全部返回 unavailable,charged_usd 合计 0。脚本交回的对象是 908 个字符:failed 里仍是那 5 个仓库,hits 是 0,top 是两段合并后评论最多的 3 条,每条的 last_comments 都是空数组。
补跑 24 次全部 unavailable。读这 908 个字符能知道两件事:补跑没补上,评论也没拉到。如果脚本只交回 top,三条命中的评论都是空的,模型很可能把它读成「这几条没人讨论」,再据此告诉你不用急。所以交回值里要始终带着 failed 和每一步的成功数,空结果和没拿到结果要分开写。另外,378 秒离 10 分钟的上限已经不远:如果名单再长一倍、每个失败都等两次 60 秒,脚本就会被截断,这时要么在 auto 模式下放到后台,要么让脚本先交回已拿到的部分。
脚本筛错了,模型看不出来:10 条命中里 5 条是误报
省下 99.9% 的上下文是有代价的:被脚本丢掉的 250 万字符,模型一个字都没看见。我们事后拿第一轮的原始返回逐条复核了脚本的命中,发现规则本身有一个错:正则里的 hang(本意是「卡死」)会命中 change、changes、changed 里的那四个字母。10 条命中里有 5 条是这么来的:vitejs/vite #24143 和 #24138、eslint/eslint #21556、vitest-dev/vitest #12022 和 #11971,标题里都只是出现了 change 一类的词,内容是功能请求、文档或构建行为,和 regression 无关。eslint #21556 评论最多(6 条),排在第一位,第二段脚本照着这个排序去给它拉了评论。
剩下 5 条是规则想找的东西:microsoft/TypeScript #65600 标题直接写「7.0 regression」;vitest-dev/vitest #11976 是 Node 27 下截图断言失败;jestjs/jest #16565 是 watchman 出错时 Jest 不跑测试却以 0 退出;reduxjs/redux-toolkit #5618 是特定编译选项下类型声明报错;facebook/react #38335 报的是用 memo 包表单时界面崩溃,标签还是「Status: Unconfirmed」。第一轮落下的 5 个 Python 仓库里,离线复算还能再找到 2 条:psf/requests #7651(解析摘要认证头时没去空格,导致认证失败)和 pandas-dev/pandas #72256(一条带「crash」字样的功能建议,严格说也算误报)。30 个仓库最近 30 条里,不是 PR 的 issue 一共 224 条,7 天内新开的 96 条,规则从中挑出 12 条,其中能算 regression 或故障报告的约 6 条。
这类错误在逐次调用时比较容易被发现:模型读到 eslint #21556 的原文,会看出它是功能请求。在 Code Mode 下,模型只看到脚本交回的标题和评论数,判断全靠规则写得对不对。我们的改法有三条:正则用词边界(\bhang(s|ing)?\b);交回结果里带上每条命中的「命中词」,让模型能一眼看出是哪个词触发的;再随机抽 5 条被丢掉的条目一起交回,给模型一个检查规则的机会。三条加起来,估计交回的数据从 1,687 字符增加到 2,000 多字符(改后的脚本没有重跑),仍是逐次调用的千分之一量级。Bicameral 的测试也报告过类似的风险:在「读记录再判断」那一类里,3 次判错都出在 Haiku 5.5 上,作者推测是脚本借着记录的固定句式跳过了重复的段落。
两种做法并排:上下文、轮数、用时、接口费
回进模型的工具结果相差约 1,100 倍(2,953,102 字符对 1,687 + 908 字符),模型轮数按做法推算是 30 轮以上对 2 段脚本;接口费、接口用时几乎一样。表里接口一侧的数字是实测,模型一侧是推算或估算。
| 指标 | 逐次调用 | 模拟的 Code Mode 式脚本 | 依据 |
|---|---|---|---|
| 模型发出的工具调用请求 | 30 次 MCP 调用 + 落盘后的若干次 Read | 2 段脚本 | 按做法推算,模型侧没有实测;Read 次数视模型怎么读而定 |
| 回进上下文的工具结果 | 2,953,102 字符(约 110 万 token,估算) | 1,687 + 908 字符(约 965 token,估算) | 原始返回现算;token 为估算 |
| 超过 5 万字符落盘的返回 | 28 次 | 0 次 | MCP 文档的字符上限 |
| 接口调用次数(含重试) | 41 次尝试,30 次成功 | 42 + 24 次尝试,25 次成功 | 运行记录 |
| EveryInfra 接口费 | $0.02874 | $0.02395 + $0 | 逐条 charged_usd |
| 失败是否扣费 | 限速 11 次,$0 | 限速 9 次、unavailable 32 次,$0 | 返回里的 billing |
用时这一项要分开看。接口本身很快,单次中位数 0.94 秒;两轮的墙钟时间(第一轮约 7 分半,第二轮 194 秒)几乎全花在等限额上:这把测试 Key 被我们单独设成每分钟 10 次,还和同一时段的其他写作任务共用。在每分钟 10 次的 Key 上,30 次调用最快也要 3 分钟,脚本开再多并发也只是更早撞上 rate_limited。逐次调用省不下的是模型一侧的时间:每一次工具调用都要模型完整推理一次,Anthropic 介绍程序化工具调用时写的是「五个工具的流程就是五次推理」(Advanced tool use)。30 个仓库就是 30 次以上,每次还要带着越来越长的对话发出去。
钱怎么算:接口费按条,模型费看读进多少
EveryInfra 一侧的账很简单,和用不用 Code Mode 无关:github/repository_issues 每次 $0.000958,30 个仓库每天体检一次是 $0.02874,一个月 30 天约 $0.86;命中的前 3 条再拉评论,每天多 $0.002874。失败不扣钱是写在返回里的:被限速挡回的那些返回文字直接写「Nothing was charged」,unavailable 那些的 billing 里 charged_usd 是 0、reason 是 request_failed_refunded,退款状态 succeeded。三轮里两项 GitHub 能力的 charged_usd 加起来是 $0.05269,正好等于 55 次成功 × $0.000958;所有失败和限速的请求,charged_usd 都是 0。
模型一侧的钱取决于读进了多少 token。按 Claude API 定价页 11 月 22 日的价格,Opus 5.5 基础输入每百万 token $4、输出 $20、缓存命中 $0.20;Sonnet 5.5 输入 $2;Haiku 5.5 在 10 万 token 以内输入 $0.10,超过 10 万的请求按 $0.50 算。只算「把工具结果读进来一次」的输入费,逐次调用约 110 万 token,在 Opus 5.5 上约 $4.39,在 Sonnet 5.5 上约 $2.19;Code Mode 式脚本的约 630 token 在 Opus 5.5 上不到一美分(约 $0.0025)。这个估算偏低估了逐次调用的成本:对话里早先的内容每一轮都会随请求重发,虽然大部分会按缓存价计费;它也忽略了 Code Mode 自己的开销,比如写脚本的输出 token。用 Claude 订阅时这些钱不直接扣,但会算进用量额度。
| 30 个仓库体检一次 | 逐次调用 | 模拟的 Code Mode 式脚本 | 依据 |
|---|---|---|---|
| EveryInfra 接口费 | $0.02874 | $0.02395(实扣,25 个仓库成功;30 个都成功时是 $0.02874) | 目录单价 × 成功条数 |
| 模型读入的工具结果 | 约 109.7 万 token | 两段脚本合计约 965 token | 估算,每 2.69 字符一个 token |
| Opus 5.5 读一次的输入费 | 约 $4.39 | 约 $0.0039 | $4 / 百万 token |
| Sonnet 5.5 读一次的输入费 | 约 $2.19 | 约 $0.0019 | $2 / 百万 token |
| 能否装进一个会话 | 超过 Opus 5.5 的 100 万 token 窗口,要压缩或分批 | 能 | 定价页「1M token context window」 |
放大到每天、100 个和 300 个仓库
把这件活变成每天早上的定时体检,账要按名单长度和 Key 的限额一起算。接口费是线性的:每个仓库每天一次 github/repository_issues,30 个仓库每天 $0.02874,100 个 $0.0958,300 个 $0.2874;一个月按 30 天算分别约 $0.86、$2.87、$8.62。拉评论的条数取决于命中多少,按每天前 3 条算再加 $0.002874。
时间由限额决定。我们这把测试 Key 每分钟 10 次,300 个仓库至少要 30 分钟;账户默认的限额更高(Claude Code 子代理那篇里实测过账户默认是每分钟 60 次),300 个仓库约 5 分钟能拉完。Code Mode 等待中的代码 10 分钟就停,所以 300 个仓库的活要在 auto 或 bypassPermissions 模式下放后台跑(最长 2 小时),或者拆成每段 100 个仓库的几段脚本。
模型一侧,逐次调用的上下文随名单线性增长:30 个仓库已经约 110 万 token,100 个约 370 万,任何一个会话都装不下,只能靠落盘、分页和多次压缩维持;Code Mode 式脚本交回的是命中条目,大小取决于命中数,100 个仓库按本文的平均值线性外推(1,687 字符 ÷ 25 个仓库 × 100),约 6,700 字符、约 2,500 token(估算);按 30 个仓库 12 条命中、约 6 条有效的比例,100 个仓库约 40 条命中、约 20 条有效(估算)。
| 名单长度 | 接口费 / 天 | 接口费 / 月(30 天) | 每分钟 10 次的 Key 最少用时 | 每分钟 60 次的 Key 最少用时 | 逐次调用的工具结果(估算) |
|---|---|---|---|---|---|
| 30 个仓库 | $0.02874 | $0.86 | 3 分钟 | 30 秒 | 约 110 万 token |
| 100 个仓库 | $0.0958 | $2.87 | 10 分钟 | 100 秒 | 约 370 万 token |
| 300 个仓库 | $0.2874 | $8.62 | 30 分钟 | 5 分钟 | 约 1,100 万 token |
有人会问:既然只是拉 GitHub 的 issue,为什么不直接调 GitHub 的 REST 接口?可以,GitHub 限速文档写的是未认证请求每小时 60 次、用个人令牌每小时 5,000 次。用 EveryInfra 的理由在于同一把 Key、同一个 MCP 工具还能取 Reddit、YouTube、X 等 106 个平台的数据(目录 11 月 22 日的数字),返回字段统一成 posted_at、comment_count 这类名字,失败不扣费;只查 GitHub 的话,自己的令牌就够了。
别人的测量:Bicameral、wmedia 和 Flavio Copes
我们的数是一件活、一组仓库、一种筛选规则。11 月 13 日到 18 日之间,另有三份公开测量可以对照,它们都在 Claude Code 里真跑了模型。
Bicameral 的基准仓库最系统:6 个测试,Opus 5.5、Sonnet 5.5、Haiku 5.5、Fable 5.2 四个模型,每格开关各跑两次,共 96 次运行,在 Claude Code 2.1.326 上做,数字全部取自 Claude Code 存下的对话记录。和我们这件活最接近的是「经一个 MCP 工具取 120 条记录并求和」,四个模型的处理 token 少了 62%–77%;「读记录再判断」少了 40%–68%;Claude 本来就会写脚本的文件类活,三个模型少 15%–54%,Haiku 5.5 反而多用了 9%;每个 Code Mode 会话开头固定少约 13,000 token。作者在回复里补了按模式拆开的费用:MCP 类的活,求和那项处理 token 少 68%、记录下来的费用少 73%;文件类的活在 Opus 上费用反而高 15%。
wmedia 11 月 13 日的测试是另一种活:读 40 个订单 JSON 文件、找出消费最多的 3 个客户,Opus 5.5 medium,两边都是 4 次请求,第一次请求的输入 token 从 36,404 降到 22,233,含缓存的总输入从 150,364 降到 94,659,但用时从 15 秒变成 37 秒;/context 显示系统工具从 24.6k token 降到 11.1k,因为 Code Mode 下模型只看到 REPL 和 Poll 两个工具,其余工具以更短的说明写在 REPL 里。Flavio Copes 11 月 18 日在一个 8 个 Markdown 文件的 Astro 项目上测:找坏链接从 35 秒降到 15 秒,三条独立检查从 17 秒降到 14 秒,100 次构建计时是一段脚本里的 101 条命令。
| 测量 | 活 | Code Mode 的变化 | 运行次数 | 日期 |
|---|---|---|---|---|
| 本文 | 30 个仓库 issue 体检,经 EveryInfra MCP | 回给模型的字符少 99.93%(同 25 个仓库) | 接口 3 轮真调;Code Mode 未开,脚本在 Node.js 里模拟 | 11-22 |
| Bicameral | 经 MCP 取 120 条记录求和 | 处理 token 少 62%–77% | 4 模型 × 2 次 × 2 档 | 11-17 |
| Bicameral | 读记录再判断 | 处理 token 少 40%–68% | 同上 | 11-17 |
| Bicameral | 文件里查找和修改 | 三个模型少 15%–54%,Haiku 多 9% | 同上 | 11-17 |
| wmedia | 40 个 JSON 文件求前 3 名 | 总输入 token 少 37%,用时 15 秒变 37 秒 | 各 1 次 | 11-13 |
| Flavio Copes | 找坏链接 | 35 秒变 15 秒 | 各 1 次 | 11-18 |
| Better Stack | 53 个文件、166 处 console 调用的迁移 | 平均快约 80%,模型往返少 28%,费用持平 | 各 3 次 | 11-20 |
| Ray Amjad | 真实开源项目上的问题 | 输入 token 约一半,总费用是普通模式的 71% | 视频未写 | 11-16 |
工具结果越大、越需要先筛,Code Mode 省得越多;对模型本来就能用 shell 脚本处理的文件,省下的主要是会话开头那一截。我们这件活的 99.9% 比 Bicameral 的 62%–77% 高得多,原因在统计范围上:我们只比「工具结果进模型的字符数」,没有算系统提示、工具定义和模型自己写的代码,Bicameral 算的是全部处理 token。把这些固定开销加回来,真实的节省比例会低于 99.9%,但量级仍在百倍以上,因为单是工具结果就有约 110 万 token。
限速、失败和重试:脚本里要自己处理的三件事
逐次调用时,遇到错误由模型读完返回再决定怎么办;Code Mode 下,错误先到脚本手里,脚本没写怎么处理,模型就只能看到一个 failed 列表。
第一种是限速。EveryInfra 的限速在 MCP 里表现为工具结果的 isError: true,JSON-RPC 层仍是 HTTP 200;返回里有两段文字和一个 structuredContent.error 对象,字段有 code: "rate_limited"、reason: "key_limit"、retry_after、limit、retryable: true、max_retries: 3。MCP 规范的工具一节把工具执行错误放在结果的 isError 里,而不是协议层错误,所以脚本要看 isError,不能只看 HTTP 状态码。我们的脚本按 retry_after 多等 2 秒再试,三轮的限速全部重试成功。
第二种是暂时不可用。12:54 前后 5 个 Python 仓库和 3 次拉评论连续返回 unavailable,fault 是 service,retryable: true,retry_after: 60。返回的第三段文字给了下一步:先用 structuredContent 里的示例请求试一次,示例也失败就是服务端的问题,再问用户要不要开工单。第一版脚本没有对这类错误重试,于是交回了一个有 5 个缺口的结果;第二版按 retry_after 每次等 60 秒、最多再试两次,5 个仓库和 3 次拉评论在 12:56 到 13:02 之间的 24 次请求仍然全部返回 unavailable,都没有扣费。脚本把这 5 个仓库原样写进了 failed,模型读完知道名单还缺哪几项,可以过一会儿再让它补。
第三种是目标本身不存在。第三轮最后,我们在 13:02:55 故意请求了一个不存在的仓库 everyinfra-test/this-repo-does-not-exist-2026,想看「目标不存在」时返回什么。返回的是 HTTP 503 和同样的 unavailable,recent_failures 是 22,第一条 next_steps 写着「22 failures in 10 minutes for github/repository_issues; none was charged」。第二条给了一个区分办法:用返回里自带的 example(拉 facebook/react 的 issue)发一次,示例成功说明是你这个目标的问题(删了、私有或写错),示例也失败就是 EveryInfra 一侧的问题,再问用户要不要开工单。我们 13:08:34 照做,示例也返回 503、没扣费;按这条指引,这次是服务端的问题,开工单要先问用户,这次是测试,我们没有开。
还有第四种我们是无意中碰到的:参数写错。13:05:24 我们给 youtube/comments 传了 sort: "top",返回 HTTP 422,code 是 invalid_value,allowed 列出 newest 和 popular,did_you_mean 是 popular,并写明「Nothing was charged」。改成 popular 重发,13:05:31 返回 20 条评论,扣 $0.000556。这类错误在脚本里最好处理:读 allowed 或 did_you_mean,改一个参数重发一次;模型甚至不用知道发生过。
| 返回的情况 | 返回里的信号 | 脚本该怎么做 | 本次次数 |
|---|---|---|---|
| 限速 | isError: true,code: rate_limited,retry_after,retryable: true | 等 retry_after 再试,不超过 max_retries | 20 次,全部重试成功 |
| 暂时不可用 | HTTP 503 或 isError,fault: service,retry_after: 60,带 example | 等 60 秒重试,最多 2 次;还失败就发一次 example,再写进 failed | 34 次 |
| 参数错 | HTTP 422,allowed,did_you_mean | 换成建议值重发一次 | 2 次,改后成功 |
| 目标不存在 | retryable: false | 不重试,写进返回值 | 这次没测出 |
安全和审计:Key、钩子、沙盒各管什么
Key 的位置。我们的 Key 只在 MCP 配置的 headers 里以 ${EVERYINFRA_API_KEY} 展开,脚本调用工具时不经手 Key,模型也看不到它。不要让模型在脚本里自己用 fetch 带着 Key 去调 REST 接口:那样 Key 会出现在脚本代码里,会写进对话记录。Code Mode 文档写明 JavaScript 本身和它发起的文件、网络、MCP 调用都在沙盒之外运行,沙盒只管它启动的 shell 命令;要把整个会话隔离,就放进容器或虚拟机。
钩子。想在脚本跑之前看代码,给 REPL 这个工具加 ask 规则,或者写一个匹配 REPL 的 PreToolUse 钩子,从 tool_input.code 里读 JavaScript;想在模型读之前处理脚本的输出(比如去掉数据里的邮箱),写匹配 REPL 的 PostToolUse 钩子,返回改过的 updatedToolOutput。文档特别写了:v2.1.328 起 UserPromptSubmit 钩子收不到脚本输出,原来靠它检查输出的要搬到 PostToolUse。
审计。脚本里的每个工具调用仍按工具原名过权限规则,所以 mcp__everyinfra__everyinfra_call_api 的 allow 和对建工单、充值链接的 deny 照样生效。权限模式文档列出的那些「任何模式都不自动批准」的操作,在脚本里也会弹出确认。EveryInfra 一侧,每次调用都有 request_id,控制台的调用记录和 MCP 的 everyinfra_list_requests 工具都能按它查到扣费和退款。
视频里演示、文档没写的几步
Code Mode 发布后一周,YouTube 上的几条讲解视频比文字教程多演示了几个操作细节。我们在 11 月 22 日 13:02(新加坡时间)用 EveryInfra 的 youtube/search 按「claude code code mode」搜了一次,取搜索结果的前 3 条,13:04 用 youtube/transcript 拿到了它们的英文文稿,13:05 又用 youtube/comments 拉了后两条视频的热门评论。三条视频是 JeredBlu 的《Claude Code Finally Got MCP Code Mode (Setup + Test)》(11 月 16 日,6 分 46 秒)、Better Stack 的《I Tested Claude Code's New Code Mode 6 Times》(11 月 20 日,9 分 21 秒,约 10.4 万次播放)和 Ray Amjad 的《Code Mode Makes Claude Code Smarter & Cheaper》(11 月 16 日,14 分 55 秒,约 22.3 万次播放)。
先确认它真的开了。Ray Amjad 的做法最直接:启动后问一句「你有哪些工具」,Code Mode 下模型会回答只有 REPL 和 Poll 两个;Poll 用来查看已经转到后台的长脚本。这和 wmedia 用 /context 看到的「系统工具从 24.6k 降到 11.1k token」是同一件事的两个侧面。他第一次启动时还碰到了提示说 Code Mode 没有开成,原因是他装了一个用到 Claude Code 钩子的界面扩展,停用后才开成;JeredBlu 第一次没开成,是因为同时开着 agent teams(他用的是早于 2.1.326 的版本)。所以开不成时,先看启动提示里点名的是哪个设置或扩展。
再用 /context 看会话开头的大小。JeredBlu 在同一个仓库里并排开了两个会话:开 Code Mode 的一开始是 19.6k token,没开的是 29.7k,差约 1 万 token,和 Bicameral 测到的「每个会话固定少约 13,000 token」接近。接着他让两边各用 YouTube 的 MCP 查自己表现最好的视频:没开的那边对话消息占了 44.8k token,开了的那边 23.5k,用时多了几秒。另一组用一个模型目录的 MCP 找最便宜的长上下文模型,Code Mode 39 秒、上下文 5%,普通模式 44 秒、上下文 14%。
看脚本要按两次键。Better Stack 演示的是先按 Ctrl+O 打开对话记录,再按 Ctrl+E 展开某一行 Code,才能看到完整的 JavaScript;文档只写了 Ctrl+O。他的另一个发现对审计有用:不开 Code Mode 时,Claude 在三次运行里都自己写了 Python 脚本从 shell 改文件,/cost 报告的增删行数是 0,因为 Claude Code 只看到一条 shell 命令;开了 Code Mode 以后,改动走 Claude Code 自己的 Edit,/cost 报告新增 224 行、删除 171 行,53 个文件都进了文件历史,每处改动都能看到 diff。
会话恢复和远程控制。JeredBlu 的截图里,Code Mode 会话启动时直接提示:这个会话只能在开着 Code Mode 时恢复,远程控制不可用,要用就退出后不带 Code Mode 重开。Ray Amjad 视频下点赞较多的评论里也有人说「失去远程控制太痛了」。这和文档的限制一致,但视频把提示原文放到了你眼前:要用手机远程看会话的人,开之前先想好。
评论区里点赞最多的担心是护栏。Ray Amjad 视频下一条 29 个赞的评论问:让模型随便写代码,以后怎么给工具调用加护栏,钩子是不是不管用了?文档的回答是钩子和权限规则照样逐次检查:脚本里每次调用都按工具原名过 PreToolUse 钩子和 deny 规则,只有 auto 模式的分类器改成在运行前看一次整段代码。Better Stack 的视频专门演示了后一点的风险:脚本先搜文件、再删搜到的文件,分类器批准的是计划,看不到最后删了哪些。他的结论是别把 auto 模式当成唯一的保险,要挡的命令写成规则或钩子。
自己补上模型侧的数字:开和关各跑一次
本文缺的是模型侧的实测,这一步要在已登录的交互终端里做,读者可以照公开的测法自己补。2026 年 11 月 17 日公开的 Bicameral 基准和 2026 年 11 月 16 日 JeredBlu 的视频用的是同一个办法:同一个仓库目录、同一句提示,开两个交互会话,一个用 CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1 claude 启动,一个直接用 claude 启动,两边接同一个 EveryInfra MCP、同一套 allow 和 deny 规则,仓库名单和提示词也一字不改,否则差别说不清是从哪来的。
开跑前各看一次 /context,记下会话开头的大小;JeredBlu 测到开 Code Mode 的一边开头是 19.6k token,没开的是 29.7k。然后给两边同一件活,例如「拉这 30 个仓库最近的 issue,只告诉我 7 天内的 regression,按评论数排序」,跑完再看一次 /context,记下对话消息和工具结果各占多少;Better Stack 还用了 /cost,看费用和增删行数。每种至少跑两次,因为模型每次写的脚本都不一样;Bicameral 每格跑两次、共 96 次,数字取自 Claude Code 存下的对话记录,不靠界面上的读数。
要拿精确的 token 数,把对话记录里的工具结果交给免费的 token 计数接口数一遍,模型 ID 填你实际用的那个。Code Mode 一侧还要看脚本本身:按 Ctrl+O 打开对话记录、再按 Ctrl+E 展开 Code 行,核对模型写的筛选规则,本文正则里的 hang 误中 change 就是这一类错,只看交回的结果发现不了。EveryInfra 一侧不用另外记:两边的每次调用都带 request_id 和 charged_usd,控制台的调用记录能逐条对上,接口费应当等于目录单价乘成功条数,限速和 unavailable 的那几次不扣钱。从 2.1.329(2026 年 11 月 19 日)起,开着 OpenTelemetry 事件和指标时也能启动 Code Mode,脚本里的每次工具调用都会单独发事件,用 OpenTelemetry 记用量的团队可以直接从事件里取每次调用的记录。
什么时候不用 Code Mode
目标接口本身支持批量。EveryInfra 有些能力一次收一组目标,按条数计费,例如 reddit/posts_batch、twitter/posts_batch、instagram/profiles_batch 收 urls 或 usernames 数组;这类能力一次调用就把几十个目标的结果带回来,脚本的并发池用不上,剩下的是筛选。github/repository_issues 一次只收一个仓库,所以这件活适合脚本。
结果本来就小。只查一个仓库、只要几个字段,一次调用回来几千字符,逐次调用和脚本没有差别;Bicameral 的「一个问题、一个文件」对照组,两种模式记录的费用一样。
筛选规则说不清的活。脚本只能按写得出来的规则筛,像「这条是不是 regression」这种要读正文才能判断的事,正则既会误报也会漏报:本文 12 条命中里 5 条是 hang 误中了 change。这类活可以让脚本只做粗筛和去重,把候选条目的标题和正文前几百字交回,由模型来判;12 条候选各带 500 字符也只有约 6,000 字符,仍比逐次调用小两个数量级以上(估算)。
要在中途看人意见的活。脚本一旦跑起来,模型要等它结束才读到结果;如果每一步都要你确认(例如逐条决定要不要开工单),逐次调用更合适。还有平台限制:要在 Claude Desktop 应用、VS Code 面板或 claude -p 的定时任务里跑,目前都开不了 Code Mode,这时可以退回到「MCP 返回落盘 + 让 Claude 用 jq 筛文件」的做法,或者直接写一段调 REST 接口的定时脚本,不经模型。
站内相关的几篇:动态工作流分类小红书评论把 500 条评论分给并行的工人;子代理并行拉 TikTok 品牌号把原始数据关在子代理各自的上下文里;Responses API WebSocket换传输方式省等待;依赖 issue 体检也可以接到漏洞情报做成修复队列的流程里。Anthropic 10 月 22 日的《When to fold subagents into your main agent loop》主张默认一个模型、一个上下文、一个工具循环;Code Mode 是在单循环里减少上下文的办法,可以先试它,再考虑拆子代理。
常见问题
claude code code mode 是什么?
它是 Claude Code 从 v2.1.323 起的实验开关:打开后模型不再一次发一个工具调用,而是写一段 JavaScript,由代码去调 Bash、Read、Edit 和 MCP 工具,只把代码的返回值交给模型。默认关闭,用 CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1 claude 启动。
claude code mcp code mode:Code Mode 能调 MCP 工具吗?
能。Code Mode 文档写明脚本里的每个工具调用都按工具原名过权限规则,原名包括 mcp__<服务器>__<工具> 这种 MCP 工具名;更新日志 2.1.328 修过「脚本调不到上一段脚本运行期间才连上的 MCP 服务器」,2.1.329 修过「MCP 表单等待时脚本被 10 分钟上限截断」。我们没有在 Claude Code 里真跑,但 EveryInfra 的 MCP 工具结果格式(content、isError、structuredContent)和脚本里的处理方式都是按真实返回写的。
code mode vs mcp:Code Mode 会取代 MCP 吗?
两者在不同层:MCP 定义工具怎么暴露、怎么鉴权、怎么返回;Code Mode 改的是模型怎么用这些工具。Cloudflare 2025 年 9 月的原文也写到,MCP 的价值在于提供统一的连接、鉴权和文档方式,代码调用照样依赖它。你接上的 MCP 服务器不用改,打开 Code Mode 以后,它的工具变成脚本里可调的函数。同一思路此前也出现在 Anthropic 2025 年 11 月的《Code execution with MCP》和 Claude API 的程序化工具调用里,后者在 Anthropic 的沙盒里跑 Python;Code Mode 的脚本在你自己的会话里执行。
Code Mode 能省多少 token,省多少钱?
看活的类型。工具结果大、需要筛的活省得最多:我们的 30 个仓库,交给模型的字符少了 99.9%;Bicameral 经 MCP 取记录求和的测试少了 62%–77% 的处理 token、73% 的记录费用。文件类的活主要省会话开头约 13,000 token,费用上可能持平甚至略高。EveryInfra 接口费不变,按成功条数算。
Code Mode 和子代理、skills 一起用有没有改进?
v2.1.326 起可以和 agent teams 同开,队友在默认的进程内模式里用 Code Mode,分屏模式下不用;2.1.329 修了只读子代理被提供 write()、edit() 的问题。子代理解决的是「原始数据留在别的上下文」,Code Mode 解决的是「原始数据留在脚本里」,两者可以叠加:子代理里也可以写脚本。
上手步骤
- 在 EveryInfra 控制台新建一把 API Key,放进环境变量
EVERYINFRA_API_KEY,不要写进项目文件。 - 运行
claude --version,低于 2.1.323 就claude update。 - 按上面的命令加远程 MCP(MCP 接入说明),在
~/.claude/settings.json里写好 allow 和 deny 规则。 - 用
CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1 claude启动,问一句「你有哪些工具」或看/context,只剩REPL和Poll两个工具就说明开成了。 - 给它一件要很多次相关调用的活,例如「拉这 30 个仓库最近的 issue,只告诉我 7 天内的 regression」,按
Ctrl+O看它写的脚本;单价在价格页和各能力页(github/repository_issues、YouTube 数据接口、youtube/transcript)都能查到。
参考资料
- Code Mode,Claude Code 文档,2026-11-22 读取
- Changelog,Claude Code 文档,2026-11-22 读取
- CHANGELOG.md, 2.1.323 to 2.1.330,Anthropic,GitHub,2026-11-22 读取
- @anthropic-ai/claude-code release times,npm registry,2026-11-22 读取
- Connect Claude Code to tools via MCP,Claude Code 文档,2026-11-22 读取
- Tools reference,Claude Code 文档,2026-11-22 读取
- Configure permissions,Claude Code 文档,2026-11-22 读取
- Hooks reference,Claude Code 文档,2026-11-22 读取
- Sandboxing,Claude Code 文档,2026-11-22 读取
- Permission modes,Claude Code 文档,2026-11-22 读取
- Claude Code settings,Claude Code 文档,2026-11-22 读取
- Environment variables,Claude Code 文档,2026-11-22 读取
- Managed settings,Claude Code 文档,2026-11-22 读取
- Manage costs effectively,Claude Code 文档,2026-11-22 读取
- Context window,Claude Code 文档,2026-11-22 读取
- Prompt caching in Claude Code,Claude Code 文档,2026-11-22 读取
- Run Claude Code programmatically,Claude Code 文档,2026-11-22 读取
- Agent teams,Claude Code 文档,2026-11-22 读取
- Subagents,Claude Code 文档,2026-11-22 读取
- Interactive mode,Claude Code 文档,2026-11-22 读取
- Set up Claude Code,Claude Code 文档,2026-11-22 读取
- Monitoring (OpenTelemetry),Claude Code 文档,2026-11-22 读取
- Pricing,Claude Platform 文档,2026-11-22 读取
- Glossary,Claude Platform 文档,2026-11-22 读取
- Token counting,Claude Platform 文档,2026-11-22 读取
- Prompt caching,Claude Platform 文档,2026-11-22 读取
- Programmatic tool calling,Claude Platform 文档,2026-11-22 读取
- Specification 2025-06-18: Tools,Model Context Protocol,2026-11-22 读取
- claude-code-mode-benchmark,Bicameral,GitHub,2026-11-17,2026-11-22 读取
- REST API endpoints for issues,GitHub Docs,2026-11-22 读取
- Rate limits for the REST API,GitHub Docs,2026-11-22 读取
- Data API catalog,EveryInfra,2026-11-22 读取
- Code execution with MCP,Anthropic 工程博客,2025-11,2026-11-22 读取
- Introducing advanced tool use,Anthropic 工程博客,2026-11-22 读取
- Building agents: When to fold subagents into your main agent loop,Anthropic,2026-10-22,2026-11-22 读取
- Code Mode: the better way to use MCP,Cloudflare 博客,2025-09,2026-11-22 读取
- I benchmarked Claude Code's Code Mode across 4 models,Reddit r/ClaudeAI,2026-11-17,2026-11-22 读取
- Claude Code Code Mode: how to turn it on,wmedia,2026-11-13,2026-11-22 读取
- Claude Code Code Mode,Flavio Copes,2026-11-18,2026-11-22 读取
- Claude Code Finally Got MCP Code Mode (Setup + Test),JeredBlu,YouTube,2026-11-16,2026-11-22 读取
- I Tested Claude Code's New Code Mode 6 Times,Better Stack,YouTube,2026-11-20,2026-11-22 读取
- Code Mode Makes Claude Code Smarter & Cheaper,Ray Amjad,YouTube,2026-11-16,2026-11-22 读取
引用编号 BL-207