Claude Code Code Mode con un MCP de datos: 30 repos reales, script simulado
Claude Code Code Mode con el MCP de EveryInfra: 30 llamadas reales a repos dieron 2,95 millones de caracteres; un script simulado en Node.js, 1.687.
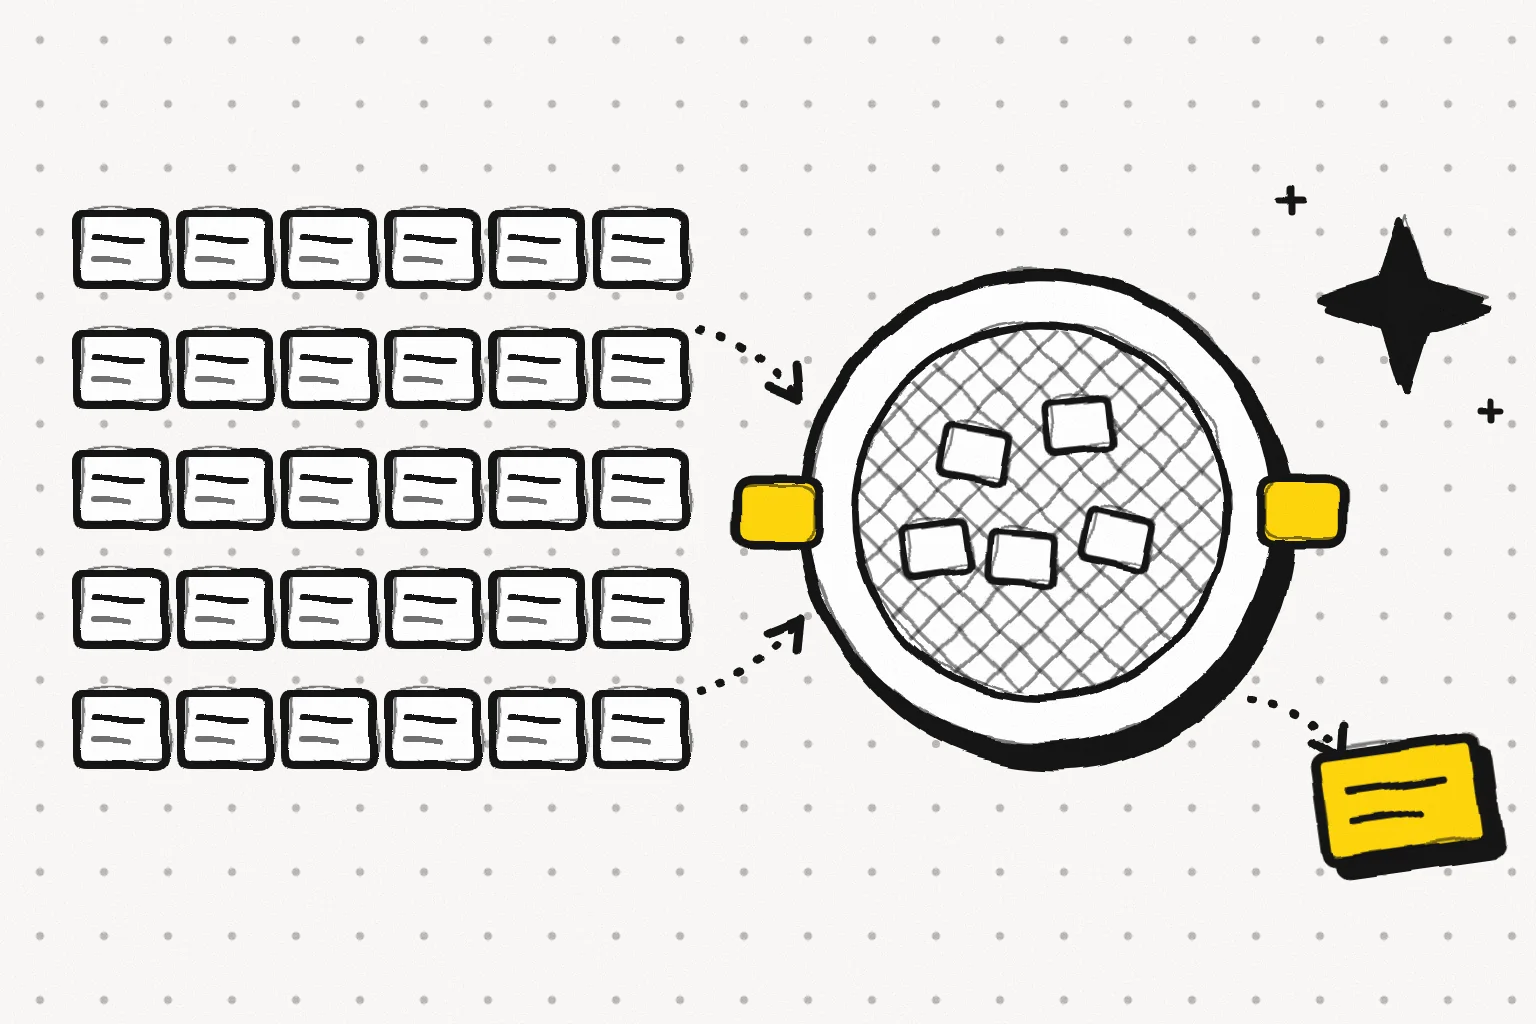
Primero, qué es real y qué es simulado. El lado de la API de datos es real. El 22 de noviembre de 2026, entre las 12:43 y las 12:51 hora de Singapur (SGT), pedimos los issues más recientes de 30 repositorios de código abierto a través del MCP remoto de EveryInfra, con una llamada a github/repository_issues por repositorio. Los 30 resultados sumaron 2.953.102 caracteres. Con la proporción de tokens que publica Anthropic, son unos 1,1 millones de tokens (estimación), más que la ventana de contexto de 1 millón de Opus 5.5. En 28 de las 30 llamadas, el resultado superó los 50.000 caracteres, el límite a partir del cual Claude Code guarda un resultado MCP en un archivo. Después, dos scripts hicieron 66 llamadas reales más, y guardamos cada resultado en bruto y cada cobro.
El lado de Claude Code es simulado. Code Mode no llegó a activarse en esta prueba: claude -p en este equipo respondió «Not logged in», y además Code Mode solo funciona en la terminal interactiva. El «script al estilo de Code Mode» de este artículo es JavaScript que escribimos a mano siguiendo la documentación de Code Mode y que ejecutamos en Node.js; Claude no lo escribió dentro de Code Mode. Los tokens y los turnos del modelo son estimaciones a partir de los caracteres o deducciones a partir de cómo funciona cada método; no se midieron.
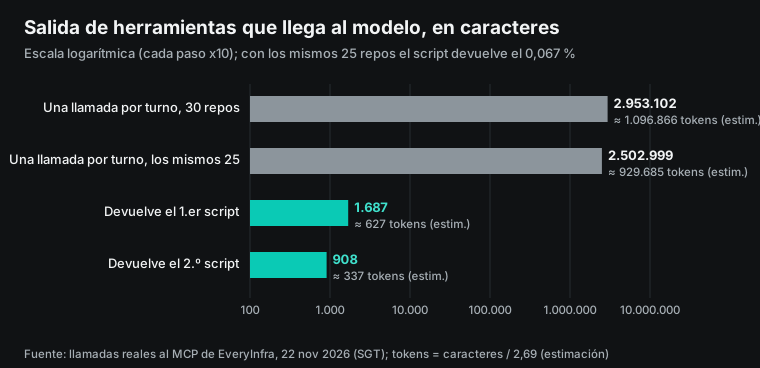
Con esa salvedad, entre las 12:51 y las 12:55 SGT el script leyó en local 2.502.282 caracteres de 25 repositorios y se quedó solo con los issues de los últimos 7 días que no son pull requests y que contienen palabras como regression, crash o security. El objeto que devolvió tenía 1.687 caracteres, unos 627 tokens (estimación): el 0,067 % del volumen por llamada para los mismos 25 repositorios. En EveryInfra, los dos métodos cuestan lo mismo: 0,000958 USD por llamada correcta. Las llamadas limitadas por frecuencia o fallidas no costaron nada.
Qué es claude code code mode
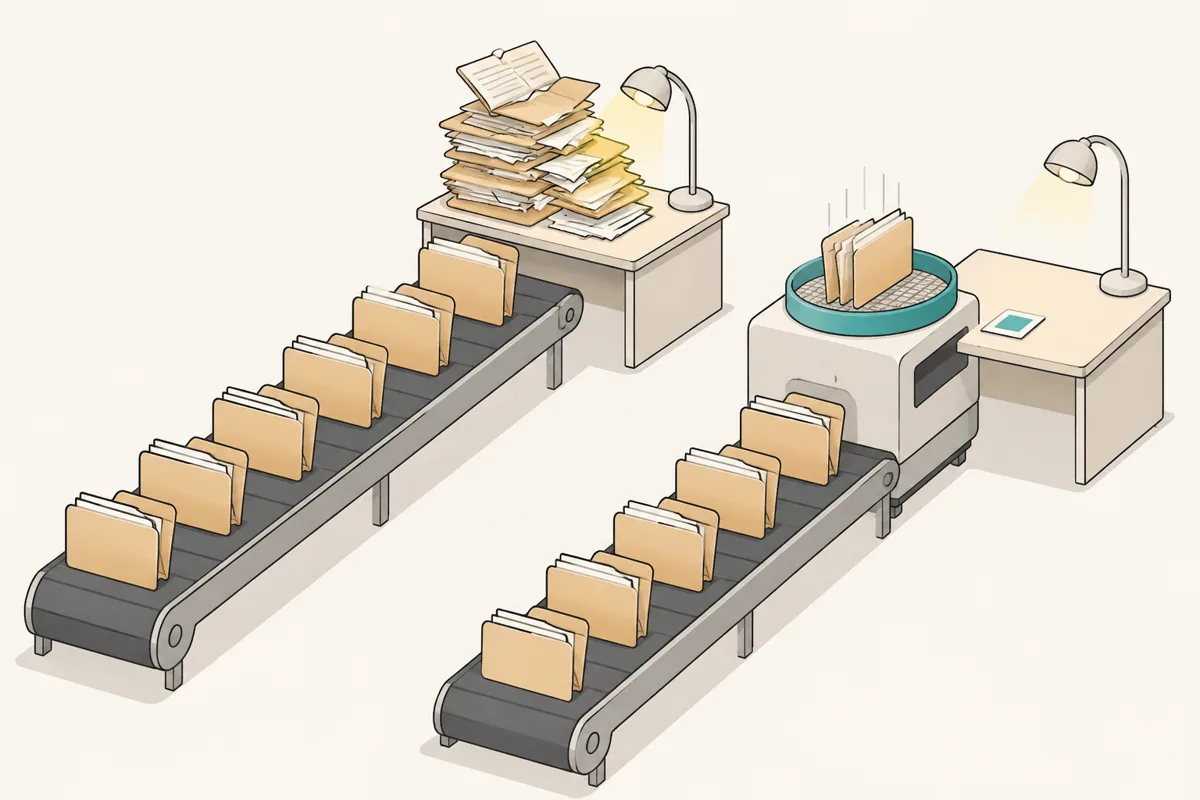
Por defecto, Claude Code usa las herramientas de una en una. El modelo envía una llamada a Bash, Read, Edit o a una herramienta MCP; Claude Code la ejecuta y devuelve el resultado completo a la conversación; el modelo lo lee y decide el siguiente paso. La documentación de Code Mode describe otro bucle: el modelo escribe un bloque de JavaScript y ese código llama a las herramientas. El código puede lanzar comandos en paralelo, pasar un resultado a la siguiente llamada y devolver al final solo lo que el modelo necesita leer.
En la conversación sigues viendo las llamadas y los diffs de cada edición. Para ver el código, pulsa Ctrl+O, que abre el visor de la transcripción, y despliega la fila Code.
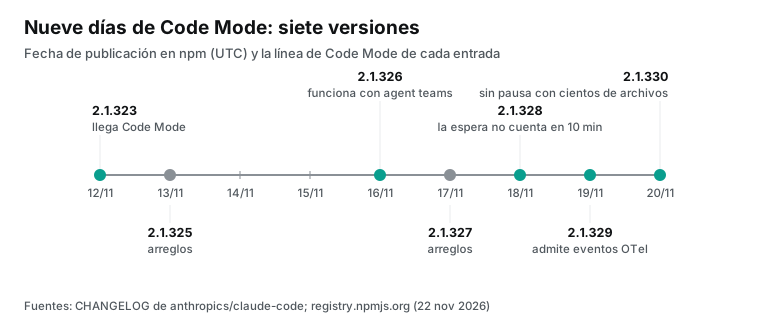
El interruptor llegó en Claude Code v2.1.323. La entrada del changelog lo describe como experimental y opcional: Claude escribe JavaScript para llamar a sus herramientas. El registro de npm muestra la 2.1.323 publicada el 2026-11-12 a las 20:29 UTC. El 2026-11-22, la versión más reciente era la 2.1.330, del 2026-11-20. Cada una de las cinco versiones intermedias trae al menos un arreglo de Code Mode.
Algunos arreglos cambian cómo lo usas. En la 2.1.326, Code Mode funciona junto con agent teams. En la 2.1.328, el tiempo que pasas ante una petición de permiso deja de contar para el límite de 10 minutos. En la 2.1.329, Code Mode arranca con los eventos y métricas de OpenTelemetry activos. En la 2.1.330 desaparece una pausa larga después de leer cientos de archivos. El 2026-11-22 la función seguía marcada como experimental.
| Punto | Qué decía la fuente el 2026-11-22 | Fuente |
|---|---|---|
| Versión mínima | v2.1.323; v2.1.326 para usarlo con agent teams | Docs de Code Mode, changelog |
| Cómo activarlo | CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1 en la shell o en el bloque env de ~/.claude/settings.json; la configuración del proyecto no cuenta | Docs de Code Mode |
| Cuenta | Suscripción de Claude o cuenta de Console; no vale con gateway, Bedrock, Google Cloud ni Foundry | Docs de Code Mode |
| Modelos | Opus 5.5, Sonnet 5.5, Haiku 5.5, Fable 5.2 | Docs de Code Mode |
| Dónde funciona | Solo en la sesión interactiva de claude en una terminal; no en el panel de VS Code, la app de escritorio ni las sesiones en la nube | Docs de Code Mode |
| Límite de tiempo | El código que Claude espera se detiene a los 10 minutos; en modo auto o bypassPermissions puede seguir en segundo plano hasta 2 horas | Docs de Code Mode |
| Cómo desactivarlo | Asigna 0 a la variable; un 0 en cualquier nivel prevalece; los administradores pueden desactivarlo con managed settings | Docs de Code Mode |
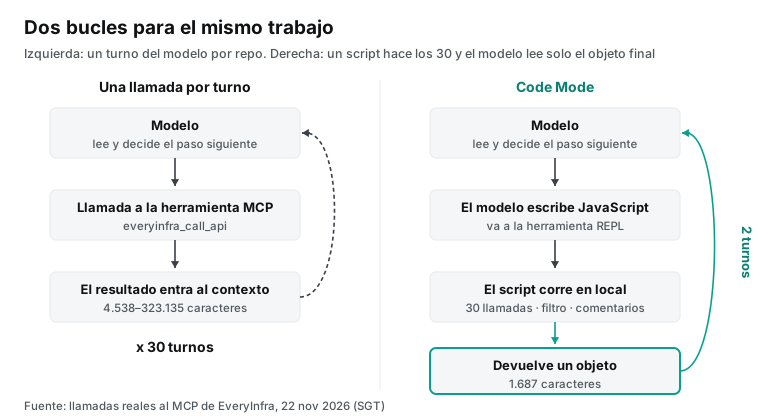
Qué es real y qué es simulado
Queríamos una prueba A/B real dentro de Claude Code: los mismos 30 objetivos, Code Mode apagado y encendido, con tokens, peticiones y tiempo de cada pasada. Este equipo tiene la app de escritorio de Claude, que incluye un binario de Claude Code 2.1.328. A las 12:40 SGT del 2026-11-22 ejecutamos claude -p con CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1. La respuesta fue «Not logged in · Please run /login», y la lista de herramientas del mensaje inicial no incluía REPL, que es la herramienta que ejecuta el código.
Encaja con la documentación: Code Mode solo admite la terminal interactiva, y -p y la app de escritorio no están en la lista. La prueba de wmedia muestra el mensaje que da -p: «for now it only works in the interactive terminal». No iniciamos sesión en una terminal interactiva, así que la comparación con Code Mode encendido y apagado no se hizo.
En el lado de EveryInfra, cada cifra sale de llamadas reales y guardamos los 30 resultados en bruto. En el lado de Claude Code, cubrimos el hueco de dos maneras. Primero, escribimos a mano un script al estilo de Code Mode y lo ejecutamos en Node.js, con una pequeña función en lugar de la llamada a la herramienta. Según la documentación, con Code Mode activo el modelo lee el objeto final del script, así que el tamaño de ese objeto está medido; pero es la salida de nuestro script, no de un script escrito por Claude.
Los tokens del modelo no los medimos: los estimamos con el glosario de Anthropic. Da unos 3,5 caracteres ingleses por token en los tokenizadores antiguos, y dice que los de Claude 4.7 en adelante producen alrededor de un 30 % más de tokens para el mismo texto. Usamos 2,69 caracteres por token y marcamos estas cifras como estimaciones. El endpoint de conteo de tokens da el número exacto gratis.
| Parte | Qué hicimos | Pruebas guardadas |
|---|---|---|
30 llamadas a github/repository_issues | Reales, con el MCP remoto de EveryInfra; 41 intentos, 30 correctos | Cada resultado en bruto y su charged_usd |
| 66 llamadas dentro de los dos scripts | Reales; el script que las hizo lo escribimos nosotros y corrió en Node.js | Registros y resultados en bruto |
Interruptor de Code Mode y herramienta REPL | No se activó; claude -p respondió «Not logged in» | Lista de herramientas del mensaje inicial |
| Los 1.687 y 908 caracteres que devolvieron los scripts | Medidos, pero el script no lo escribió Claude | El objeto final de cada script |
| Tokens y turnos del modelo | Estimados (2,69 caracteres por token) o deducidos | Ninguna; haz tu propia comparación |
| Coste del modelo | Estimado con precios de lista | Página de precios de la API de Claude |
El trabajo: 30 repos de dependencias y una semana de regresiones
Elegimos un trabajo habitual en Claude Code que necesita muchas llamadas relacionadas: revisar los issues de las dependencias de un proyecto. La lista tiene 30 repositorios comunes de JavaScript y Python, desde React, Next.js, Vite, TypeScript y ESLint hasta Flask, FastAPI, Requests, Pydantic y pandas. De cada uno pedimos los 30 issues más recientes y nos quedamos con los abiertos en los últimos 7 días, que no sean pull requests y cuyo título o etiquetas incluyan palabras como regress, breaking, crash, security, CVE, memory leak, hang o fails.
Después ordenamos por número de comentarios y pedimos los últimos comentarios de los 3 primeros. El trabajo tiene tres rasgos útiles. Los repositorios no dependen entre sí, así que las llamadas pueden ir en paralelo. Cada repositorio devuelve decenas o cientos de miles de caracteres y solo unas líneas valen la pena. Y el segundo paso usa el resultado del primero. La documentación de Code Mode cita tres buenos casos: el mismo cambio en muchos archivos, una búsqueda que filtra antes de leer y comandos independientes. Este trabajo encaja en los dos últimos.
Los datos vienen de la API de datos de GitHub de EveryInfra, con dos capacidades. github/repository_issues recibe la URL de un repositorio y devuelve sus issues más recientes. github/issue_comments recibe la URL de un issue y devuelve sus comentarios. Leímos el catálogo gratuito (GET /api/v1/social/catalog) a las 12:38:05 SGT: tenía 714 capacidades, 683 disponibles. Las dos son síncronas y cuestan 0,000958 USD por llamada. repository_issues devuelve 30 elementos por defecto y 100 como máximo.
El resultado trae más de 20 campos, como title, text, is_pull_request, labels, comment_count y posted_at. El campo text lleva el cuerpo completo del issue y decide casi todo el tamaño.
Objetivos técnicos: lo que el script devuelve al modelo debe ser como mucho el 10 % del volumen por llamada, y el trabajo no debe pasar de 3 turnos del modelo (los turnos son deducidos, no medidos).
claude code mcp code mode: conecta el MCP remoto de EveryInfra
En Code Mode, el script puede llamar a las herramientas que tenga tu sesión. Los servidores MCP se añaden con claude mcp add, como siempre. El MCP remoto de EveryInfra está en https://api.everyinfra.com/mcp, usa transporte HTTP y la clave va en la cabecera Authorization. La documentación MCP de Claude Code da este patrón. Guarda tu clave en una variable de entorno, no en un archivo del proyecto.
# 1) Keep the key only in an environment variable (for example, an env file that ~/.zshrc reads)
export EVERYINFRA_API_KEY=ei_xxx   # use a key that you create in the console

# 2) Add the remote MCP at user scope, so it stays out of the project repo
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope user --header 'Authorization: Bearer ${EVERYINFRA_API_KEY}'

# 3) Turn on Code Mode for this session only
CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1 claude
Las comillas simples del paso 2 son a propósito: la configuración guarda el texto literal ${EVERYINFRA_API_KEY} y Claude Code lo expande cada vez que conecta. La documentación MCP tiene una regla especial para servidores remotos: en url y headers, algunas variables de credenciales como ANTHROPIC_AUTH_TOKEN se expanden a vacío. Así un .mcp.json de proyecto no puede mandar tus credenciales de Claude a un servidor que él elija. EVERYINFRA_API_KEY no está en esa lista y se expande con normalidad. Si la conexión da 401, ejecuta claude --debug-file y busca una línea «never expanded toward a remote server».
Para dejar Code Mode siempre activo, pon la variable en el bloque env de tu configuración de usuario. La documentación dice que la configuración de proyecto no puede activarlo, así que un repositorio ajeno que clones no puede encenderlo por ti.
{
  "env": { "CLAUDE_CODE_EXPERIMENTAL_CODE_MODE": "1" },
  "permissions": {
    "allow": ["mcp__everyinfra__everyinfra_call_api", "mcp__everyinfra__everyinfra_list_capabilities"],
    "deny": ["mcp__everyinfra__everyinfra_create_ticket", "mcp__everyinfra__everyinfra_get_topup_link"]
  }
}
Las reglas de permisos importan más en Code Mode. La documentación de permisos nombra las herramientas MCP como mcp__<servidor>__<herramienta>. Según la documentación de Code Mode, cada llamada dentro del script pasa por tus reglas deny y ask y por tus hooks PreToolUse con el nombre habitual de la herramienta. Pero el clasificador del modo auto revisa el script una sola vez, antes de ejecutarlo, y no ve los valores que el script calcula en marcha, como una URL sacada de un resultado anterior.
Por eso los límites estrictos van en reglas y hooks, no en el clasificador. A las 12:42 SGT, tools/list del MCP de EveryInfra mostraba 12 herramientas. Para leer datos, este trabajo solo necesita tres: everyinfra_call_api, everyinfra_list_capabilities y everyinfra_get_job. Las que provocan acciones externas, como abrir un ticket o pedir un enlace de recarga, quedan en deny.
Una llamada por turno: 30 turnos de decenas de miles de caracteres
En la primera ronda copiamos lo que hace el modelo con Code Mode apagado: un tools/call por repositorio a everyinfra_call_api con {"platform":"github","action":"repository_issues","params":{"url":"https://github.com/<repo>"}}. Guardamos cada resultado en bruto. La captura muestra uno, el de Vite a las 12:43:37 SGT.
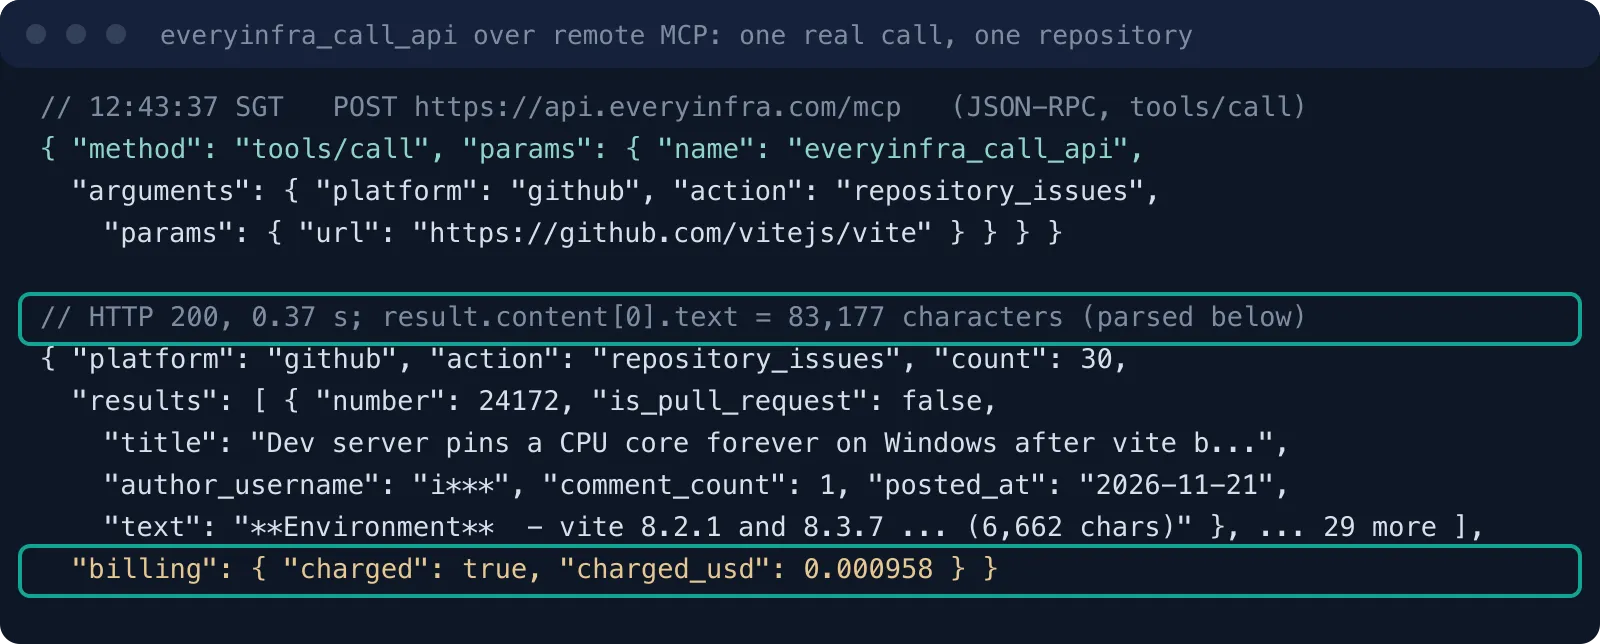
Los 30 resultados sumaron 2.953.102 caracteres, con una mediana de 84.740. El mayor fue TanStack/query, con 323.135 caracteres, porque algunos cuerpos de issue son muy largos. El menor fue pmndrs/zustand, con 4.538, porque solo devolvió 5 elementos, 3 de ellos pull requests. A 2,69 caracteres por token, el total ronda los 1,097 millones de tokens (estimación). Con una llamada por turno, todos esos caracteres pasan por el modelo: o entran al contexto o van a un archivo que el modelo lee después.
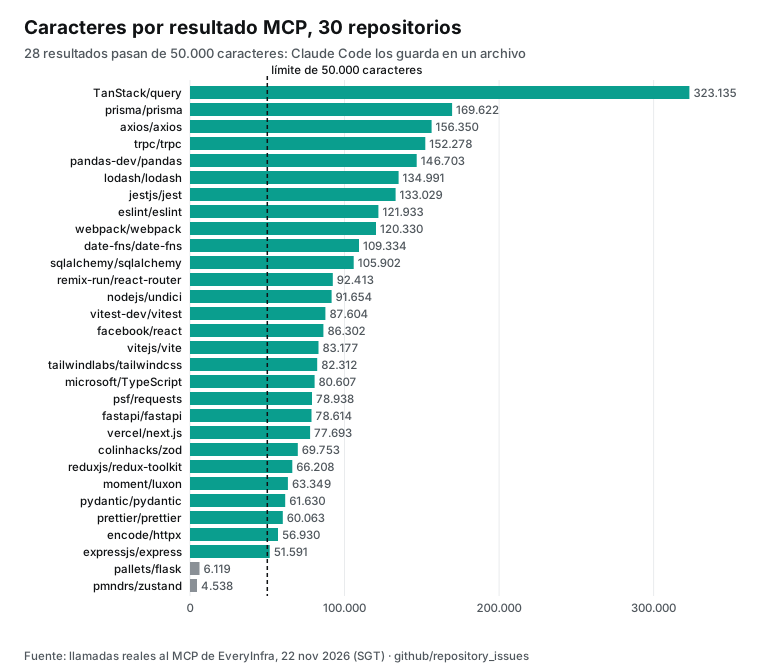
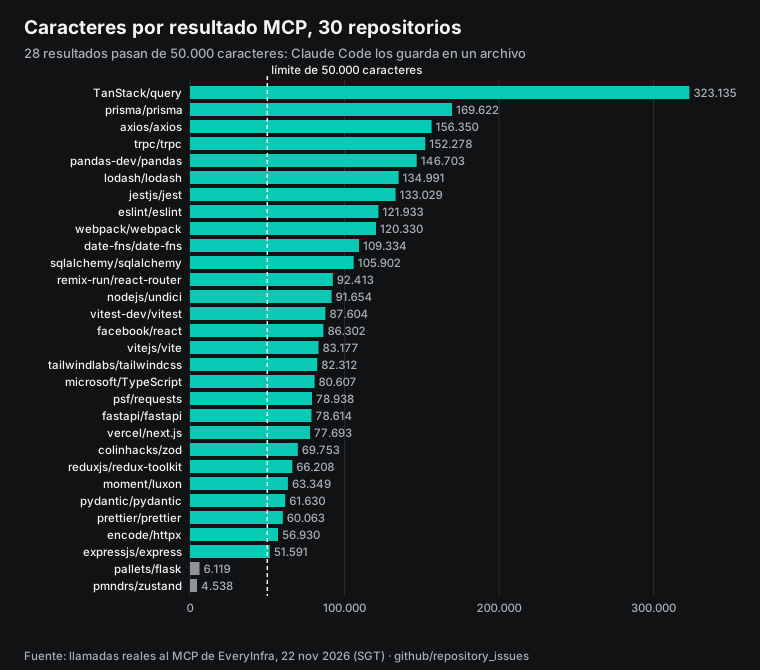
Claude Code tiene dos límites para los resultados MCP grandes. La sección de límites de salida MCP dice que aparece un aviso cuando un resultado pasa de 10.000 tokens. El máximo por defecto es 25.000 tokens y se cambia con MAX_MCP_OUTPUT_TOKENS. Para herramientas que no declaran su propio límite, un resultado de texto de más de 50.000 caracteres va a un archivo, tenga los tokens que tenga, y la conversación recibe un mensaje con la ruta.
En nuestra prueba, 28 de 30 resultados cruzaron la línea de 50.000 caracteres y unos 22 pasaron de 25.000 tokens (estimación). Con Code Mode apagado, el trabajo se convierte en 30 llamadas MCP, 28 archivos guardados y varias lecturas con Read. La herramienta Read devuelve como mucho 25.000 tokens por llamada y rechaza un archivo entero de más de 256 KB, así que el modelo tiene que leerlo por páginas.
Con Code Mode apagado, el modelo aún puede ejecutar jq sobre los archivos guardados y leer menos. Bicameral lo comentó en una respuesta en Reddit: para trabajo con archivos, Claude ya escribe scripts de shell, y Code Mode ahorra sobre todo el coste fijo del arranque. La gran diferencia está en las llamadas MCP, porque un script de shell no puede llamar a herramientas MCP. Cada resultado por debajo de 50.000 caracteres sigue entrando entero al contexto.
| Métrica | Una llamada por turno (12:43 a 12:51 SGT) | Nota |
|---|---|---|
| Repositorios / éxitos | 30 / 30 | 11 de 41 intentos fueron limitados y se repitieron con retry_after |
| Salida total de la herramienta | 2.953.102 caracteres | Suma de la longitud de cada result.content[0].text |
| Tokens | unos 1,097 millones (estimación) | 2,69 caracteres por token |
| Resultados de más de 50.000 caracteres | 28 | Límite de caracteres de la documentación de MCP |
| Resultados de más de 25.000 tokens (estimación) | 22 | Límite de tokens por defecto |
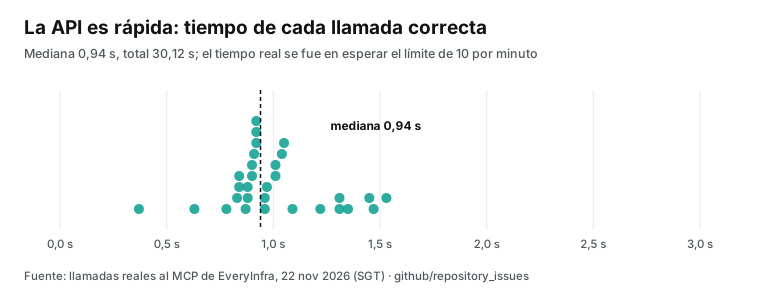
| Mediana de tiempo de API por llamada | 0,94 segundos | 30,12 segundos en total |
| Tarifa de API | 0,02874 USD | 30 × 0,000958 USD, suma de charged_usd |
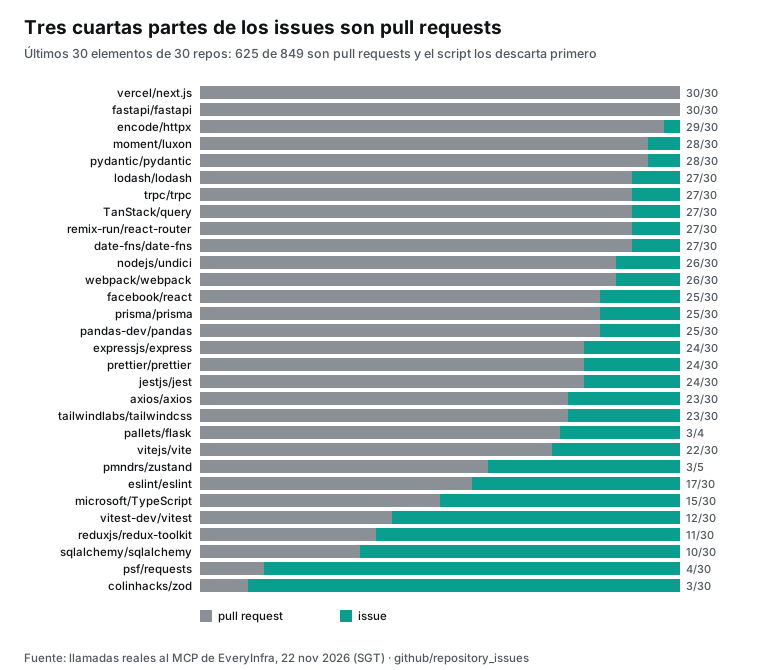
| Pull requests en los resultados | 625 de 849, 73,6 % | GitHub cuenta los pull requests como issues |
La documentación REST de issues de GitHub dice que todo pull request es un issue, así que los listados devuelven ambos. De nuestros 849 elementos, 625 eran pull requests (73,6 %). Si solo quieres los informes de usuarios, son datos que conviene descartar en un script antes de que el modelo lea nada.
Un script simulado al estilo Code Mode: en Node.js, 1.687 caracteres devueltos
La segunda ronda empezó a las 12:51:56 SGT. Como Code Mode no se activó, escribimos a mano un script con el estilo que describe la documentación de Code Mode y lo ejecutamos en Node.js. Claude no escribió este código, y un script escrito por Claude podría salir mejor o peor; abajo está la parte principal, y guardamos la versión completa con su registro. Hace cuatro cosas: un pequeño grupo de concurrencia (pool) con 3 llamadas en vuelo como máximo y al menos 7 segundos entre arranques; ante rate_limited, espera el valor retry_after del resultado; guarda los 30 resultados en variables y los filtra; y pide comentarios de las 3 primeras coincidencias. La expresión final es todo lo que ve el modelo.
// In Code Mode, callTool is a ready-made function in the session (it calls mcp__everyinfra__everyinfra_call_api).
// In Node.js we replaced it with a small function that calls the MCP endpoint. The rest is unchanged.
const since = Date.now() - 7 * 864e5;
const RX = /regress|breaking|crash|segfault|security|vulnerab|CVE|memory leak|hang|broken|not working|fails?\b/i;

async function api(platform, action, params) {
  for (let i = 0; i < 6; i++) {
    const res = await callTool("everyinfra_call_api", { platform, action, params });
    if (res.isError) {
      const e = res.structuredContent?.error ?? {};
      if (e.code === "rate_limited") { await sleep(((e.retry_after ?? 10) + 2) * 1000); continue; }
      return { error: e.code ?? "error", charged_usd: 0 };
    }
    const j = JSON.parse(res.content[0].text);
    return { results: j.results ?? [], charged_usd: j.billing?.charged_usd ?? 0 };
  }
  return { error: "gave_up", charged_usd: 0 };
}

const pages = await pool(repos, 3, 7000, rp =>
  api("github", "repository_issues", { url: `https://github.com/${rp}` }));
const hits = [];
pages.forEach((p, i) => (p.results || []).forEach(x => {
  if (x.is_pull_request || Date.parse(x.posted_at) < since) return;
  if (!RX.test(x.title + " " + (x.labels || []).join(" "))) return;
  hits.push({ repo: repos[i], number: x.number, title: x.title.slice(0, 90),
              comments: x.comment_count, url: x.url, posted: x.posted_at.slice(0, 10) });
}));
hits.sort((a, b) => b.comments - a.comments);
const top = hits.slice(0, 3);
const threads = await pool(top, 3, 7000, h => api("github", "issue_comments", { url: h.url }));
top.forEach((h, k) => { h.last_comments = (threads[k].results || []).slice(-3)
  .map(c => (c.text || "").replace(/\s+/g, " ").slice(0, 200)); });
({ repos: repos.length, failed: pages.map((p, i) => p.error ? repos[i] : null).filter(Boolean),
   hits: hits.length, top, other_hits: hits.slice(3, 15).map(h => `${h.repo}#${h.number} ${h.title}`) });
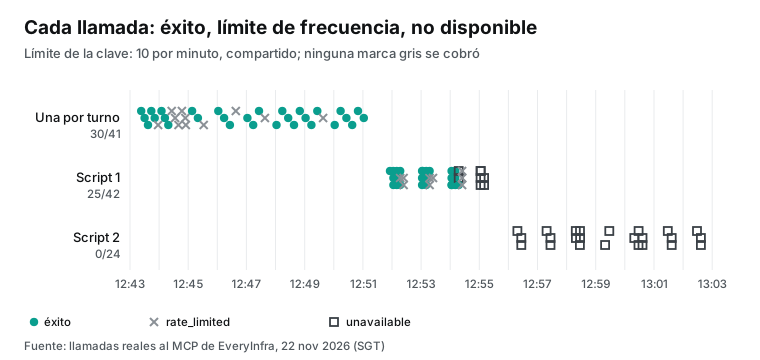
El script duró 194 segundos e hizo 42 llamadas: 25 correctas, 9 frenadas por el límite de 10 por minuto (algunas salieron bien al repetir) y 8 que devolvieron unavailable. Fallaron los 5 últimos repositorios de Python (psf/requests, pydantic, encode/httpx, sqlalchemy y pandas) y las 3 llamadas de comentarios. Los cinco repositorios habían funcionado en la primera ronda, hacia las 12:50 SGT.
Cada unavailable traía billing.charged_usd 0 y reason request_failed_refunded, y su structuredContent.error indicaba retryable: true y retry_after: 60. Nuestro primer script solo repetía rate_limited y trataba unavailable como definitivo, así que esas 8 llamadas fueron directas a failed.
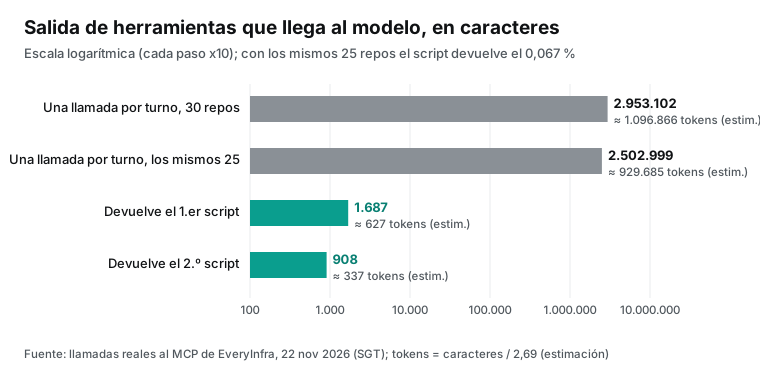
El script leyó en local 2.502.282 caracteres de 25 repositorios y devolvió un objeto de 1.687, unos 627 tokens (estimación). Contenía los 10 issues de los últimos 7 días que cumplían la regla. El primero por comentarios era eslint/eslint #21556, con 6. Entre los demás estaban microsoft/TypeScript #65600 (su título empieza por «7.0 regression»), vitest-dev/vitest #11976 (una aserción de captura falla en Node 27) y jestjs/jest #16565. El campo failed listaba los 5 repositorios que faltaban. Con Code Mode activo, esos 1.687 caracteres serían lo que lee el modelo, y muestran qué repetir y qué issues leer.
El segundo script: solo los cinco fallos
Un patrón posible en Code Mode es un segundo script: el primero devuelve failed, el modelo lo lee y escribe un script corto solo para esos elementos. En una sesión de Claude Code, las variables de un script siguen disponibles en el siguiente; wmedia lo resume como «variables survive from one script to the next».
A las 12:56 SGT ejecutamos un segundo script de ese estilo, también en Node.js. Además de rate_limited, espera ante errores con retryable: true, como unavailable, el tiempo de retry_after con un tope de 60 segundos. Solo pide los 5 repositorios fallidos, une las coincidencias de los dos scripts y pide comentarios de las 3 primeras.
Empezó a las 12:56:18 SGT y terminó a las 13:02:36 SGT: 378 segundos y 24 llamadas en total, 3 intentos por cada uno de los 5 repositorios y por cada una de las 3 llamadas de comentarios, con 60 segundos de espera antes de cada repetición. Las 24 devolvieron unavailable y el charged_usd total fue 0. El script devolvió 908 caracteres: failed seguía con los mismos 5 repositorios, hits valía 0 y top tenía las 3 coincidencias unidas con más comentarios, cada una con last_comments vacío.
Las 24 repeticiones devolvieron unavailable. Esos 908 caracteres muestran la repetición no cubrió el hueco y que no llegaron comentarios. Si el script devolviera solo top, el modelo podría leer los comentarios vacíos como «nadie habla de estos issues» y decirte que no hay prisa. Por eso el valor devuelto debe llevar siempre failed y un recuento de éxitos por paso: un resultado vacío y un resultado que falta son cosas distintas.
Además, 378 segundos ya se acercan al límite de 10 minutos. Con una lista el doble de larga y dos esperas de 60 segundos por fallo, el script se cortaría antes de acabar. En ese caso, ejecútalo en segundo plano en modo auto o deja que devuelva lo que ya tiene.
El filtro del script se equivocó y el modelo no podía verlo
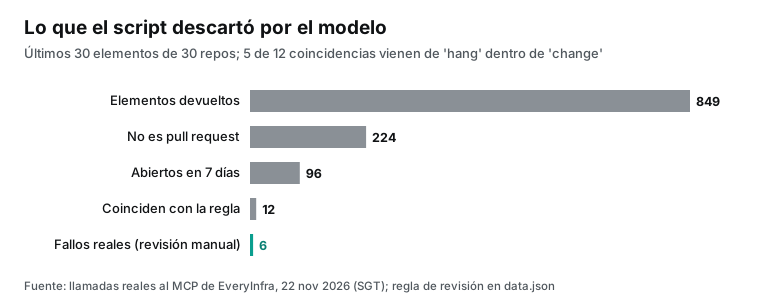
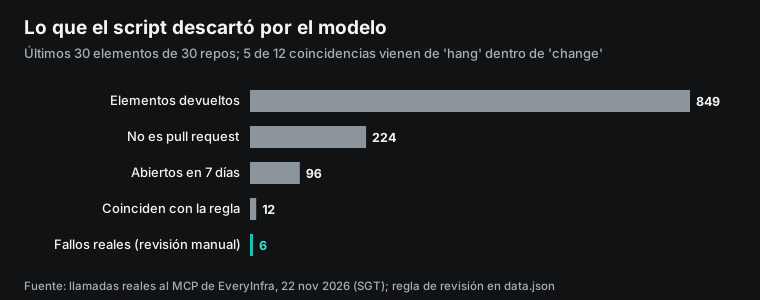
Recortar el contexto un 99,9 % tiene un precio: el modelo no vio nada de los 2,5 millones de caracteres que el script descartó. Después de la prueba revisamos cada coincidencia contra los datos en bruto de la primera ronda y encontramos un fallo en la regla. El término hang de la regex (pensado para «la app se cuelga») también coincide con las cuatro letras dentro de change, changes y changed.
Cinco de las 10 coincidencias salieron de ahí: vitejs/vite #24143 y #24138, eslint/eslint #21556 y vitest-dev/vitest #12022 y #11971. Sus títulos solo contienen una palabra como «change»; son peticiones de funciones, documentación o comportamiento de compilación, no regresiones. eslint #21556 tenía más comentarios (6), así que quedó el primero, y el segundo script fue a pedir sus comentarios.
Las otras 5 eran justo lo que buscaba la regla. microsoft/TypeScript #65600 lleva «7.0 regression» en el título. vitest-dev/vitest #11976 es una aserción de captura que falla en Node 27. jestjs/jest #16565 es Jest saliendo con código 0 sin ejecutar pruebas cuando falla watchman. reduxjs/redux-toolkit #5618 es un error de declaración de tipos con una opción del compilador. facebook/react #38335 informa de un fallo de la interfaz con memo alrededor de un formulario, aún con la etiqueta «Status: Unconfirmed».
Para los 5 repositorios de Python que faltaron, una revisión sin conexión sobre los datos de la primera ronda encuentra 2 más: psf/requests #7651, un fallo de autenticación porque una cabecera digest no se recorta, y pandas-dev/pandas #72256, una idea de función con la palabra «crash» que también es un falso positivo. Entre los 30 elementos más recientes de 30 repositorios había 224 issues que no eran pull requests; 96 se abrieron en los últimos 7 días; la regla eligió 12, y unos 6 eran regresiones o fallos reales.
Con una llamada por turno, este error se detecta antes: el modelo lee el texto de eslint #21556 y ve una petición de función. En Code Mode, el modelo solo ve los títulos y los recuentos que devuelve el script, así que el resultado vale lo que vale la regla. Hicimos tres cambios. La regex usa límites de palabra (\bhang(s|ing)?\b). Cada coincidencia devuelta incluye la palabra que la activó, para que el modelo vea el disparador de un vistazo. Y el script añade 5 elementos descartados al azar, para que el modelo tenga una muestra con la que comprobar la regla.
Con los tres cambios, estimamos que el valor devuelto pasa de 1.687 a algo más de 2.000 caracteres (no volvimos a ejecutar el script corregido): sigue siendo alrededor de una milésima del volumen por llamada. El benchmark de Bicameral describe un riesgo parecido: en su tarea de «leer registros y juzgar», los 3 errores fueron de Haiku 5.5, y el autor cree que el script usó la redacción fija de los registros para saltarse partes repetidas.
Lado a lado: contexto, turnos, tiempo y tarifa
La salida que llega al modelo difiere unas 1.100 veces (2.953.102 caracteres frente a 1.687 + 908). Los turnos del modelo, deducidos de cada método, son 30 o más frente a 2 scripts. La tarifa y el tiempo de la API son casi iguales. Las cifras de la API de la tabla están medidas; las del modelo son deducidas o estimadas.
| Métrica | Una llamada por turno | Script simulado estilo Code Mode | Base |
|---|---|---|---|
| Peticiones de herramientas del modelo | 30 llamadas MCP más lecturas de archivos guardados | 2 scripts | Deducido de cada método, sin medir en el lado del modelo; las lecturas dependen de cómo lea el modelo |
| Salida que entra al contexto | 2.953.102 caracteres (unos 1,1 M de tokens, estimación) | 1.687 + 908 caracteres (unos 965 tokens, estimación) | Contado sobre resultados en bruto; los tokens son estimaciones |
| Resultados guardados en archivo (más de 50.000 caracteres) | 28 | 0 | Límite de la documentación MCP |
| Intentos de API, con repeticiones | 41 intentos, 30 éxitos | 42 + 24 intentos, 25 éxitos | Registros de ejecución |
| Tarifa de EveryInfra | 0,02874 USD | 0,02395 USD + 0 USD | Suma de charged_usd |
| Cobro por fallos | 11 limitadas, 0 USD | 9 limitadas y 32 unavailable, 0 USD | billing de cada resultado |
El tiempo merece una mirada aparte. La API es rápida: mediana de 0,94 segundos por llamada. Las dos rondas pasaron casi todo su tiempo real esperando al límite de frecuencia: la primera unos 7,5 minutos y la segunda 194 segundos. Esta clave de prueba tiene un límite de 10 llamadas por minuto y la compartían otros trabajos a la vez. Con ese límite, 30 llamadas tardan al menos 3 minutos, y más paralelismo en el script solo hace que choque antes con rate_limited.
Lo que una llamada por turno no ahorra es tiempo de modelo. Cada llamada necesita una inferencia completa. En el artículo advanced tool use, Anthropic dice que un flujo de cinco herramientas son cinco pasadas de inferencia. Con 30 repositorios son al menos 30, y cada una envía una conversación más larga que la anterior.
Coste: la API cobra por llamada y el modelo por lo que lee
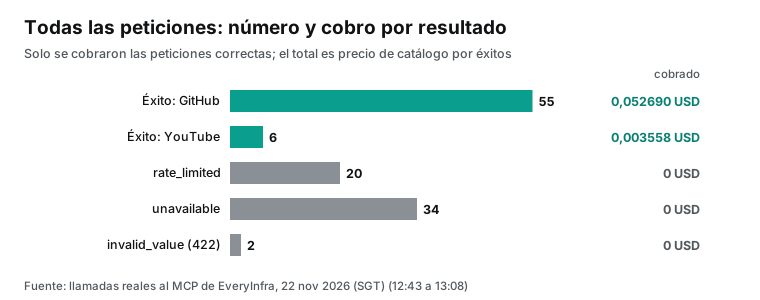
El lado de EveryInfra es sencillo y no depende de Code Mode. github/repository_issues cuesta 0,000958 USD por llamada; revisar 30 repositorios al día cuesta 0,02874 USD, unos 0,86 USD en un mes de 30 días, y los comentarios de las 3 primeras coincidencias suman 0,002874 USD al día. Las respuestas dicen cuándo un fallo es gratis: cada resultado limitado indica «Nothing was charged», y cada unavailable trae charged_usd 0, reason request_failed_refunded y un reembolso en estado succeeded. En las tres rondas, los charged_usd de las dos capacidades de GitHub suman 0,05269 USD: exactamente 55 éxitos × 0,000958 USD.
El lado del modelo depende de cuántos tokens lea. Estos son los precios de la API de Claude del 2026-11-22: Opus 5.5 cuesta 4 USD por millón de tokens de entrada, 20 USD por millón de salida y 0,20 USD por millón en caché; Sonnet 5.5 cuesta 2 USD por millón de entrada; Haiku 5.5, 0,10 USD por millón hasta 100.000 tokens por petición y 0,50 USD por encima.
Con una sola lectura, una llamada por turno lee unos 1,1 millones de tokens: unos 4,39 USD en Opus 5.5. La salida del script cuesta menos de un céntimo. La estimación deja fuera el contexto que se reenvía en cada turno (casi todo a precio de caché) y los tokens de salida del propio script. Con una suscripción de Claude no pagas estas cifras directamente, pero cuentan para tus límites de uso.
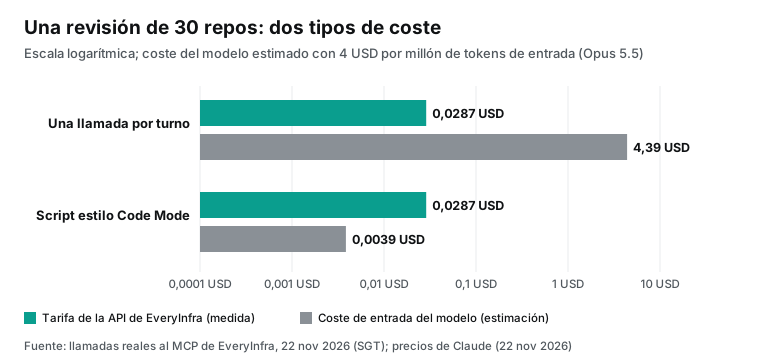
| Una revisión de 30 repositorios | Una llamada por turno | Script simulado estilo Code Mode | Base |
|---|---|---|---|
| Tarifa de EveryInfra | 0,02874 USD | 0,02395 USD cobrados (25 repositorios correctos); 0,02874 USD si salen los 30 | Precio de catálogo × éxitos |
| Salida que lee el modelo | unos 1,097 millones de tokens | unos 965 tokens entre los dos scripts | Estimación, 2,69 caracteres por token |
| Entrada en Opus 5.5, una lectura | unos 4,39 USD | unos 0,0039 USD | 4 USD por millón de tokens |
| Entrada en Sonnet 5.5, una lectura | unos 2,19 USD | unos 0,0019 USD | 2 USD por millón de tokens |
| Cabe en una sesión | No, supera la ventana de 1 M de Opus 5.5 | Sí | Página de precios, ventana de 1 M |
A escala: cada día, 100 y 300 repositorios
Como revisión diaria, el coste depende de la longitud de la lista y del límite de la clave. La tarifa crece en línea recta: una llamada a github/repository_issues por repositorio y día cuesta 0,02874 USD con 30 repositorios, 0,0958 USD con 100 y 0,2874 USD con 300; en un mes de 30 días, unos 0,86, 2,87 y 8,62 USD.
El límite de la clave marca el tiempo. Nuestra clave de prueba admite 10 llamadas por minuto, así que 300 repositorios necesitan al menos 30 minutos. Las claves de cuenta tienen un límite por defecto mayor: en nuestra prueba de subagentes de Claude Code medimos 60 llamadas por minuto, y 300 repositorios tardan unos 5 minutos. Como el código que Claude espera se corta a los 10 minutos, un trabajo de 300 repositorios debe ir en segundo plano en modo auto o bypassPermissions (hasta 2 horas), o en varios scripts de 100.
En el lado del modelo, una llamada por turno crece con la lista: 30 repositorios ya son unos 1,1 millones de tokens y 100 son unos 3,7 millones. Ninguna sesión lo aguanta, así que el modelo depende de archivos guardados, lecturas por páginas y muchas compactaciones. Un script estilo Code Mode devuelve las coincidencias, y su tamaño depende de cuántas haya. Una extrapolación lineal desde nuestra media (1.687 caracteres ÷ 25 repositorios × 100) da unos 6.700 caracteres, unos 2.500 tokens, para 100 repositorios. Con nuestra tasa de 12 coincidencias y unas 6 reales por cada 30 repositorios, 100 repositorios darían unas 40 coincidencias y unas 20 reales (estimación).
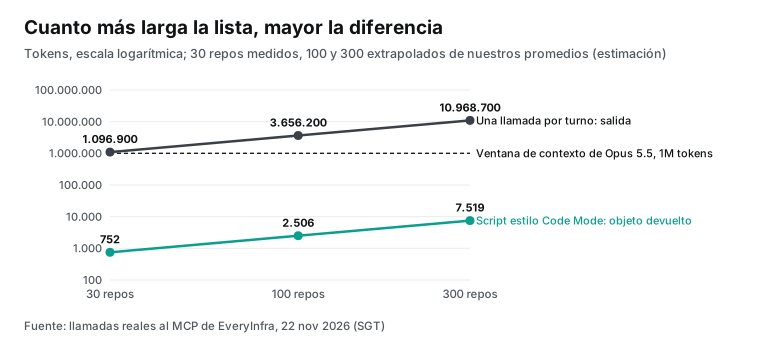
| Longitud de la lista | Tarifa por día | Tarifa por mes (30 días) | Tiempo mínimo a 10 por minuto | Tiempo mínimo a 60 por minuto | Salida por llamada (estimación) |
|---|---|---|---|---|---|
| 30 repositorios | 0,02874 USD | 0,86 USD | 3 minutos | 30 segundos | unos 1,1 M de tokens |
| 100 repositorios | 0,0958 USD | 2,87 USD | 10 minutos | 100 segundos | unos 3,7 M de tokens |
| 300 repositorios | 0,2874 USD | 8,62 USD | 30 minutos | 5 minutos | unos 11 M de tokens |
¿Y llamar directamente a la API REST de GitHub? Puedes: la documentación de límites de GitHub permite 60 peticiones por hora sin token y 5.000 por hora con un token personal. La ventaja de EveryInfra es que la misma clave y la misma herramienta MCP llegan también a Reddit, YouTube, X y más (106 plataformas en el catálogo del 2026-11-22), con los mismos nombres de campo, como posted_at y comment_count, y sin cobro en los fallos. Si solo necesitas GitHub, tu propio token basta.
Otras mediciones: Bicameral, wmedia y Flavio Copes
Entre el 2026-11-13 y el 2026-11-18, otras tres pruebas públicas ejecutaron el modelo dentro de Claude Code.
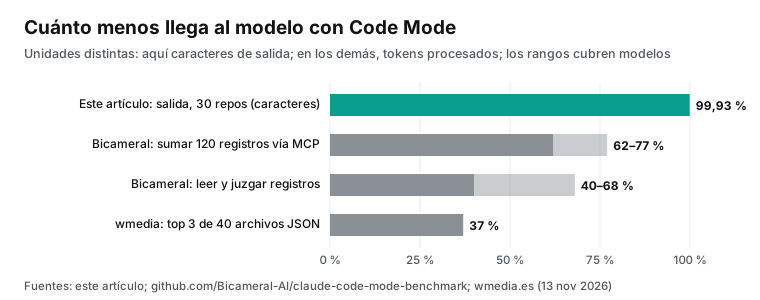
El repositorio de benchmark de Bicameral es el más completo: 6 pruebas, 4 modelos (Opus 5.5, Sonnet 5.5, Haiku 5.5 y Fable 5.2) y dos pasadas por celda y modo, 96 en total sobre Claude Code 2.1.326, con cifras sacadas de las transcripciones. La prueba más parecida a la nuestra suma 120 registros de una herramienta MCP: los tokens procesados bajaron entre un 62 % y un 77 %. «Leer registros y juzgar» bajó entre un 40 % y un 68 %.
En trabajo con archivos, donde Claude ya escribe scripts, tres modelos bajaron entre un 15 % y un 54 % y Haiku 5.5 gastó un 9 % más. Cada sesión con Code Mode arrancó unos 13.000 tokens más pequeña. En una respuesta, el autor añadió el coste: en la suma vía MCP, el coste registrado bajó un 73 %; en archivos con Opus subió un 15 %.
La prueba de wmedia del 2026-11-13 leyó 40 archivos JSON de pedidos y buscó los 3 clientes que más gastan, con Opus 5.5 en esfuerzo medio. Los dos modos hicieron 4 peticiones. La entrada de la primera petición bajó de 36.404 a 22.233 tokens y la entrada total con caché de 150.364 a 94.659, pero el tiempo pasó de 15 a 37 segundos. /context mostró que las herramientas del sistema bajaban de 24,6k a 11,1k tokens, porque en Code Mode el modelo solo ve dos herramientas, REPL y Poll.
Flavio Copes probó el 2026-11-18 con un proyecto Astro de 8 archivos Markdown: buscar enlaces rotos pasó de 35 a 15 segundos y tres comprobaciones independientes de 17 a 14.
| Prueba | Trabajo | Cambio con Code Mode | Pasadas | Fecha |
|---|---|---|---|---|
| Este artículo | Revisión de issues de 30 repositorios con el MCP de EveryInfra | 99,93 % menos caracteres de vuelta al modelo (mismos 25) | 3 rondas reales de API; Code Mode sin activar, script simulado en Node.js | 2026-11-22 |
| Bicameral | Sumar 120 registros vía MCP | Entre 62 % y 77 % menos tokens procesados | 4 modelos × 2 × 2 modos | 2026-11-17 |
| Bicameral | Leer registros y juzgar | Entre 40 % y 68 % menos | Igual | 2026-11-17 |
| Bicameral | Buscar y cambiar texto en archivos | Entre 15 % y 54 % menos en tres modelos; Haiku, 9 % más | Igual | 2026-11-17 |
| wmedia | Top 3 de 40 archivos JSON | 37 % menos entrada; de 15 a 37 segundos | 1 cada uno | 2026-11-13 |
| Flavio Copes | Buscar enlaces rotos | De 35 a 15 segundos | 1 cada uno | 2026-11-18 |
| Better Stack | Migrar 166 llamadas a console en 53 archivos | Un 80 % más rápido de media, 28 % menos idas y vueltas al modelo, mismo coste | 3 cada uno | 2026-11-20 |
| Ray Amjad | Issues de un proyecto real de código abierto | Más o menos la mitad de tokens de entrada, 71 % del coste | No lo dice | 2026-11-16 |
Cuanto más grande la salida de las herramientas, más ahorra Code Mode. Nuestro 99,9 % supera el 62–77 % de Bicameral porque solo contamos la salida que llega al modelo, mientras que Bicameral cuenta todos los tokens procesados, incluidos el prompt del sistema, las definiciones de herramientas y el propio código. Con eso sumado, nuestro recorte baja del 99,9 %, pero sigue por encima de un factor de 100.
Límites, fallos y reintentos: lo que el script debe manejar
Con una llamada por turno, el modelo lee cada error y decide. En Code Mode, el error llega antes al script; si el script no tiene una regla, el modelo solo ve una lista failed.
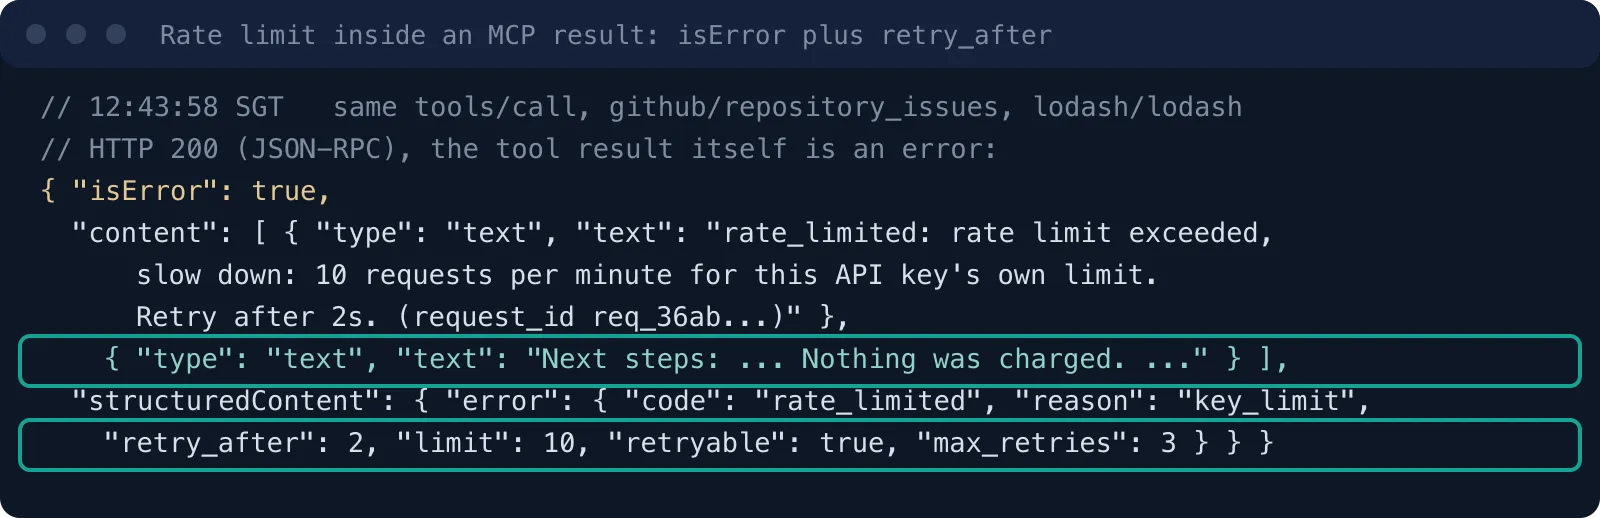
El primero es el límite de frecuencia. En el MCP de EveryInfra es un resultado con isError: true mientras la capa JSON-RPC sigue en HTTP 200. Trae dos bloques de texto y un objeto structuredContent.error con code: "rate_limited", reason: "key_limit", retry_after, limit, retryable: true y max_retries: 3. La especificación de herramientas MCP coloca los errores de ejecución en isError, no en errores de protocolo, así que el script tiene que mirar isError y no solo el estado HTTP. Nuestro script esperó retry_after más 2 segundos y repitió; todos los límites de las tres rondas salieron bien al repetir.
El segundo es una indisponibilidad temporal. Hacia las 12:54 SGT, los 5 repositorios de Python y las 3 llamadas de comentarios devolvieron unavailable una y otra vez, con fault: "service", retryable: true y retry_after: 60. El tercer bloque de texto daba los pasos: enviar una vez la petición de ejemplo de structuredContent; si el ejemplo también falla, el problema es del servicio, y hay que preguntar al usuario antes de abrir un ticket. El primer script no repetía este error y devolvió 5 huecos. El segundo esperó 60 segundos por intento, con dos repeticiones como máximo, y entre las 12:56 y las 13:02 SGT las 24 peticiones siguieron en unavailable, sin cobro. El script escribió los 5 repositorios en failed, así que el modelo sabía qué faltaba.
El tercero es un objetivo que no existe. A las 13:02:55 SGT pedimos a propósito el repositorio everyinfra-test/this-repo-does-not-exist-2026 para ver la respuesta de «no encontrado». Llegó un HTTP 503 con el mismo unavailable y recent_failures 22. La primera línea de next_steps decía «22 failures in 10 minutes for github/repository_issues; none was charged». La segunda explicaba cómo distinguir los casos: enviar una vez el example de la respuesta, que pide los issues de facebook/react. Si el ejemplo funciona, el problema es tu objetivo (borrado, privado o mal escrito); si también falla, es del lado de EveryInfra, y hay que preguntar al usuario antes de abrir un ticket.
A las 13:08:34 SGT seguimos ese paso. El ejemplo también devolvió 503, sin cobro, así que según esa regla el problema era del servicio. Un ticket necesita el permiso del usuario y esto era una prueba, así que no abrimos ninguno. Esta vez no vimos el caso de «no encontrado».
El cuarto lo encontramos sin querer: un parámetro mal puesto. A las 13:05:24 SGT enviamos sort: "top" a youtube/comments. La respuesta fue HTTP 422 con code invalid_value, allowed con newest y popular, did_you_mean igual a popular y el aviso «Nothing was charged». Enviamos popular y a las 13:05:31 SGT llegaron 20 comentarios por 0,000556 USD. Es el error más fácil para un script: lee allowed o did_you_mean, cambia un parámetro y repite una vez.
| Resultado | Señal en la respuesta | Qué hace el script | Veces en esta prueba |
|---|---|---|---|
| Límite de frecuencia | isError: true, code: rate_limited, retry_after, retryable: true | Espera retry_after y repite, hasta max_retries | 20, todas bien al repetir |
| No disponible | HTTP 503 o isError, fault: service, retry_after: 60, un example | Espera 60 segundos y repite hasta 2 veces; luego envía el example y añade el elemento a failed | 34 |
| Parámetro erróneo | HTTP 422, allowed, did_you_mean | Repite una vez con el valor sugerido | 2, corregidas al repetir |
| Objetivo inexistente | retryable: false | No repite; lo pone en el valor devuelto | No apareció en esta prueba |
Seguridad y auditoría: clave, hooks y sandbox
Mantén la clave fuera del código. Nuestra clave solo existe en los headers del MCP, donde se expande ${EVERYINFRA_API_KEY}. Cuando el script llama a una herramienta, no toca la clave y el modelo nunca la ve. No dejes que el modelo llame a la API REST con fetch y la clave dentro del script: la clave aparecería en el código y acabaría en la transcripción. La documentación de Code Mode dice que el JavaScript y sus llamadas de archivos, red y MCP corren fuera del sandbox; el sandbox solo cubre los comandos de shell que lanza el script. Para aislar la sesión entera, usa un contenedor o una máquina virtual.
Revisa el código y su salida con hooks. Para ver un script antes de que corra, añade una regla ask para REPL; un hook PreToolUse también puede leer tool_input.code. Para cambiar la salida antes de que la lea el modelo, escribe un hook PostToolUse que devuelva un updatedToolOutput modificado. Desde la v2.1.328, los hooks UserPromptSubmit ya no reciben la salida del script: si comprobabas la salida ahí, pasa esa comprobación a PostToolUse.
Audita cada llamada. Cada llamada dentro del script sigue pasando por las reglas de permisos con el nombre habitual, así que la regla allow de mcp__everyinfra__everyinfra_call_api y las deny de tickets y recargas siguen valiendo. La documentación de modos de permiso lista acciones que ningún modo aprueba sin preguntar, y también preguntan dentro de un script. En EveryInfra, cada llamada tiene un request_id; el registro de llamadas de la consola y la herramienta MCP everyinfra_list_requests encuentran con él el cobro y cualquier reembolso.
Lo que muestran los vídeos y no dicen las guías
A las 13:02 SGT del 2026-11-22 buscamos «claude code code mode» en YouTube con la capacidad youtube/search de EveryInfra y tomamos los 3 primeros resultados. A las 13:04 SGT sacamos sus transcripciones en inglés con youtube/transcript, y a las 13:05 SGT los comentarios más votados de dos de ellos con youtube/comments. Los vídeos son de JeredBlu (2026-11-16), Better Stack (2026-11-20, unas 104.000 visualizaciones) y Ray Amjad (2026-11-16, unas 223.000).
Comprueba que Code Mode está activo de verdad. Ray Amjad pregunta al modelo qué herramientas tiene, y en Code Mode solo nombra REPL y Poll; Poll consulta un script que pasó a segundo plano. En su primer arranque recibió un aviso de que Code Mode no se había activado: la causa era una extensión de interfaz que usa hooks de Claude Code, y al quitarla arrancó. El primer arranque de JeredBlu también falló, porque tenía agent teams activo con una versión anterior a la 2.1.326. Si Code Mode no arranca, lee el mensaje de inicio: nombra el ajuste o la extensión que lo impide.
Compara el arranque con /context. JeredBlu abrió dos sesiones en el mismo repositorio: la de Code Mode empezó con 19,6k tokens y la otra con 29,7k, una diferencia de unos 10.000, cerca de los 13.000 que midió Bicameral. Después, las dos usaron un MCP de YouTube para la misma pregunta: los mensajes ocuparon 44,8k tokens sin Code Mode y 23,5k con él.
Pulsa dos teclas para ver el script. Better Stack muestra que hay que pulsar Ctrl+O para abrir la transcripción y luego Ctrl+E para desplegar una fila Code; la documentación solo menciona Ctrl+O. Su segundo hallazgo ayuda en auditorías. Sin Code Mode, en las tres pasadas Claude escribió un script de Python que cambiaba archivos desde la shell, y /cost mostró 0 líneas añadidas y 0 borradas, porque Claude Code solo vio un comando de shell. Con Code Mode, las ediciones pasaron por la herramienta Edit de Claude Code: /cost mostró 224 líneas añadidas y 171 borradas, los 53 archivos entraron en el historial y cada edición tenía su diff.
Piensa en la reanudación y el control remoto. En la captura de JeredBlu, la sesión avisa al arrancar de que solo se puede reanudar con Code Mode activo y de que Remote Control no está disponible.
Los límites de seguridad son la mayor preocupación en los comentarios. Uno bajo el vídeo de Ray Amjad, con 29 «me gusta», pregunta cómo poner barreras a las llamadas y si los hooks seguirán funcionando. La documentación responde: hooks y reglas siguen revisando cada llamada del script con el nombre habitual; solo cambia el clasificador del modo auto, que ahora revisa el script entero una vez antes de ejecutarlo. Better Stack enseña el riesgo: un script busca archivos y luego borra lo encontrado; el clasificador aprueba el plan, pero nunca ve qué archivos se borraron. Su consejo es poner en reglas o hooks los comandos que debes bloquear y no confiar solo en el modo auto.
Consigue tú las cifras del modelo: una pasada encendido y otra apagado
A este artículo le falta la medición del lado del modelo. Ese paso necesita una terminal interactiva con sesión iniciada, y puedes añadirlo con el método público. El benchmark de Bicameral publicado el 2026-11-17 y el vídeo de JeredBlu del 2026-11-16 usan la misma preparación: la misma carpeta de repositorio y el mismo prompt en dos sesiones interactivas, una arrancada con CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1 claude y otra con claude a secas. Las dos se conectan al mismo MCP de EveryInfra con las mismas reglas allow y deny, y la lista de repositorios y el prompt no cambian ni una palabra, para que cualquier diferencia tenga una causa clara.
Ejecuta /context en cada sesión antes de empezar y apunta el tamaño inicial; JeredBlu vio 19,6k tokens con Code Mode y 29,7k sin él. Después da a las dos sesiones el mismo trabajo, por ejemplo «trae los issues más recientes de estos 30 repositorios y dime solo las regresiones de los últimos 7 días, ordenadas por comentarios». Al terminar, vuelve a ejecutar /context y apunta cuánto ocupan los mensajes y los resultados de herramientas; Better Stack usó también /cost para el coste y las líneas cambiadas. Haz al menos dos pasadas por modo, porque el modelo escribe un script distinto cada vez. Bicameral hizo dos pasadas por celda, 96 en total, y sacó las cifras de las transcripciones que guarda Claude Code, no de la pantalla.
Para un recuento exacto de tokens, envía los resultados de herramientas de la transcripción al endpoint gratuito de conteo de tokens con el ID del modelo que usaste. En el lado de Code Mode, lee también el propio script: pulsa Ctrl+O para la transcripción y Ctrl+E para desplegar la fila Code, y revisa la regla de filtrado. Nuestra regex hang que coincidía con change es ese tipo de fallo, y el resultado devuelto por sí solo no lo muestra. En el lado de EveryInfra no hay nada extra que registrar: cada llamada de las dos sesiones tiene request_id y charged_usd, el registro de llamadas de la consola las cuadra una a una, y la tarifa debe ser el precio de catálogo por el número de éxitos, con las limitadas y las unavailable a 0 USD. Desde la 2.1.329 (2026-11-19), Code Mode también arranca con eventos y métricas de OpenTelemetry activos, y cada llamada de un script envía su propio evento, así que los equipos que miden el uso con OpenTelemetry pueden sacar de ahí el registro de cada llamada.
Cuándo no usar Code Mode
La API ya acepta lotes. Algunas capacidades de EveryInfra reciben una lista de objetivos y cobran por elemento, como reddit/posts_batch, twitter/posts_batch o instagram/profiles_batch, que aceptan un array urls o usernames. github/repository_issues recibe un repositorio por llamada, y por eso este trabajo encaja con un script.
El resultado es pequeño. Si revisas un repositorio y necesitas pocos campos, una llamada devuelve unos miles de caracteres, y los dos métodos dan lo mismo. En la prueba de control de Bicameral con una pregunta y un archivo, los dos modos registraron el mismo coste.
La regla de filtrado no está clara. Un script solo filtra con una regla que puedas escribir. Saber si un issue es una regresión suele exigir leer el cuerpo, y una regex falla por exceso y por defecto: 5 de nuestras 12 coincidencias salieron de hang dentro de change. Para esos trabajos, deja que el script haga un filtro grueso y quite duplicados, y que devuelva el título y los primeros cientos de caracteres de cada candidato para que juzgue el modelo. 12 candidatos con 500 caracteres cada uno son unos 6.000 caracteres, todavía más de dos órdenes de magnitud por debajo de una llamada por turno (estimación).
Quieres decidir tú a mitad de camino. Cuando un script arranca, el modelo espera a que termine, así que una llamada por turno encaja mejor si quieres aprobar cada paso. Además, la app de escritorio, el panel de VS Code y los trabajos programados con claude -p no pueden usar Code Mode hoy; ahí, deja que Claude filtre con jq los resultados MCP guardados, o programa un script que llame a la API REST sin el modelo.
Artículos relacionados del sitio: dynamic workflows para comentarios de Xiaohongshu reparte 500 comentarios entre trabajadores en paralelo; subagentes para cuentas de TikTok guarda los datos en bruto en el contexto de cada subagente; la prueba de Responses API WebSocket ahorra espera con otro transporte; y la revisión de issues de dependencias puede alimentar el flujo de avisos de vulnerabilidades convertidos en cola de arreglos. El 2026-10-22, Anthropic publicó When to fold subagents into your main agent loop, que recomienda por defecto un modelo, un contexto y un bucle de herramientas. Code Mode recorta contexto dentro de un solo bucle, así que pruébalo antes de repartir el trabajo en subagentes.
Preguntas frecuentes
¿Qué es claude code code mode?
Es un interruptor experimental de Claude Code desde la v2.1.323: con él activo, el modelo no envía una llamada cada vez, sino que escribe JavaScript y ese código llama a Bash, Read, Edit y a las herramientas MCP. Solo el valor que devuelve el código llega al modelo. Viene apagado; arráncalo con CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1 claude.
¿Code Mode puede llamar a herramientas MCP?
Sí. La documentación dice que cada llamada del script pasa por las reglas de permisos con el nombre habitual, y eso incluye nombres MCP como mcp__<servidor>__<herramienta>. Nuestro script maneja el formato real de resultados del MCP de EveryInfra (content, isError y structuredContent), aunque no ejecutamos el modelo dentro de Claude Code.
Code Mode frente a MCP: ¿Code Mode sustituye a MCP?
Trabajan en capas distintas: MCP define cómo se exponen, autentican y devuelven las herramientas; Code Mode cambia cómo las usa el modelo. Tus servidores MCP no cambian: con Code Mode activo, sus herramientas pasan a ser funciones que un script puede llamar. El artículo de Cloudflare de septiembre de 2025 dice lo mismo: MCP sigue dando una forma común de conectar, autenticar y documentar herramientas. La misma idea apareció en el artículo de Anthropic de noviembre de 2025 Code execution with MCP y en la llamada programática de herramientas de la API de Claude, que ejecuta Python en un sandbox de Anthropic; Code Mode ejecuta el script en tu propia sesión.
¿Cuántos tokens y cuánto dinero ahorra Code Mode?
Depende del trabajo. Los trabajos con salidas grandes que hay que filtrar ahorran más: en nuestros 30 repositorios, los caracteres de vuelta al modelo bajaron un 99,9 %, y en la suma vía MCP de Bicameral los tokens procesados bajaron entre un 62 % y un 77 % y el coste un 73 %. En trabajo con archivos se ahorran sobre todo los 13.000 tokens del arranque, y el coste puede quedar igual o algo más alto. La tarifa de EveryInfra no cambia, porque cuenta llamadas correctas.
¿Code Mode funciona con subagentes y skills?
Desde la v2.1.326 funciona con agent teams: los compañeros usan Code Mode en el modo integrado por defecto, no en el de paneles divididos. Puedes combinar ambos: un subagente también puede escribir un script.
Cómo empezar
- Crea una clave de API en el inicio rápido de EveryInfra y guárdala en
EVERYINFRA_API_KEY, no en un archivo del proyecto. - Ejecuta
claude --versiony, si es anterior a la 2.1.323, ejecutaclaude update. - Añade el MCP remoto con el comando de arriba (mira la página de configuración MCP) y escribe las reglas
allowydenyen~/.claude/settings.json. - Arranca con
CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1 claude. Pregunta qué herramientas tiene o ejecuta/context: si solo quedanREPLyPoll, Code Mode está activo. - Dale un trabajo con muchas llamadas relacionadas, como los issues más recientes de 30 repositorios, y pulsa
Ctrl+Opara ver el script. Los precios están en la página de precios y en cada página de capacidad, por ejemplogithub/repository_issues, YouTube yyoutube/transcript.
Referencias
- Code Mode, documentación de Claude Code, consultado el 22 nov 2026
- Changelog, documentación de Claude Code, consultado el 22 nov 2026
- CHANGELOG.md, 2.1.323 to 2.1.330, Anthropic, GitHub, consultado el 22 nov 2026
- @anthropic-ai/claude-code release times, npm registry, consultado el 22 nov 2026
- Connect Claude Code to tools via MCP, documentación de Claude Code, consultado el 22 nov 2026
- Tools reference, documentación de Claude Code, consultado el 22 nov 2026
- Configure permissions, documentación de Claude Code, consultado el 22 nov 2026
- Hooks reference, documentación de Claude Code, consultado el 22 nov 2026
- Sandboxing, documentación de Claude Code, consultado el 22 nov 2026
- Permission modes, documentación de Claude Code, consultado el 22 nov 2026
- Claude Code settings, documentación de Claude Code, consultado el 22 nov 2026
- Environment variables, documentación de Claude Code, consultado el 22 nov 2026
- Managed settings, documentación de Claude Code, consultado el 22 nov 2026
- Manage costs effectively, documentación de Claude Code, consultado el 22 nov 2026
- Context window, documentación de Claude Code, consultado el 22 nov 2026
- Prompt caching in Claude Code, documentación de Claude Code, consultado el 22 nov 2026
- Run Claude Code programmatically, documentación de Claude Code, consultado el 22 nov 2026
- Agent teams, documentación de Claude Code, consultado el 22 nov 2026
- Subagents, documentación de Claude Code, consultado el 22 nov 2026
- Interactive mode, documentación de Claude Code, consultado el 22 nov 2026
- Set up Claude Code, documentación de Claude Code, consultado el 22 nov 2026
- Monitoring (OpenTelemetry), documentación de Claude Code, consultado el 22 nov 2026
- Pricing, documentación de Claude Platform, consultado el 22 nov 2026
- Glossary, documentación de Claude Platform, consultado el 22 nov 2026
- Token counting, documentación de Claude Platform, consultado el 22 nov 2026
- Prompt caching, documentación de Claude Platform, consultado el 22 nov 2026
- Programmatic tool calling, documentación de Claude Platform, consultado el 22 nov 2026
- Specification 2025-06-18: Tools, Model Context Protocol, consultado el 22 nov 2026
- claude-code-mode-benchmark, Bicameral, GitHub, 17 nov 2026, consultado el 22 nov 2026
- REST API endpoints for issues, GitHub Docs, consultado el 22 nov 2026
- Rate limits for the REST API, GitHub Docs, consultado el 22 nov 2026
- Data API catalog, EveryInfra, consultado el 22 nov 2026
- Code execution with MCP, Anthropic Engineering, nov 2025, consultado el 22 nov 2026
- Introducing advanced tool use, Anthropic Engineering, consultado el 22 nov 2026
- Building agents: When to fold subagents into your main agent loop, Anthropic, 22 oct 2026, consultado el 22 nov 2026
- Code Mode: the better way to use MCP, blog de Cloudflare, sep 2025, consultado el 22 nov 2026
- I benchmarked Claude Code's Code Mode across 4 models, Reddit r/ClaudeAI, 17 nov 2026, consultado el 22 nov 2026
- Claude Code Code Mode: how to turn it on, wmedia, 13 nov 2026, consultado el 22 nov 2026
- Claude Code Code Mode, Flavio Copes, 18 nov 2026, consultado el 22 nov 2026
- Claude Code Finally Got MCP Code Mode (Setup + Test), JeredBlu, YouTube, 16 nov 2026, consultado el 22 nov 2026
- I Tested Claude Code's New Code Mode 6 Times, Better Stack, YouTube, 20 nov 2026, consultado el 22 nov 2026
- Code Mode Makes Claude Code Smarter & Cheaper, Ray Amjad, YouTube, 16 nov 2026, consultado el 22 nov 2026
Referencia BL-207