GPT-6 Intelligent UI per un report sui brand da Reddit e X: esempio di configurazione MCP e test sui dati
GPT-6 Intelligent UI può rispondere con tabelle e grafici. OpenAI non dice che Intelligent UI rappresenti graficamente i dati MCP. Il nostro report su 3 brand ha generato costi API pari a 0,003336 $.
GPT-6 è arrivato nella scheda Chat di ChatGPT il 7 ottobre 2026, insieme a Intelligent UI. Con Intelligent UI è il modello a decidere se una risposta contiene testo, grafici, pulsanti o un modulo (post di lancio di OpenAI). Questo articolo mette alla prova un caso d'uso preciso. Colleghi il server MCP remoto di EveryInfra a ChatGPT e chiedi: «Confronta questi 3 brand su Reddit e X la settimana scorsa, per volume e sentiment». Riesci a ottenere un report interattivo e stabile?
Il 5 novembre 2026, tra le 00:18 e le 00:27 ora di Singapore, abbiamo eseguito 16 richieste API reali. I brand erano EcoFlow, Jackery e BLUETTI, tre produttori di power station portatili. Tredici richieste sono state addebitate, per un totale di 0,007228 $. La risposta ha tre parti.
Primo: OpenAI non dice che Intelligent UI disegni i dati restituiti da un server MCP personalizzato. Secondo: il nostro server MCP restituisce una stringa JSON, quindi il modello deve leggerla e costruire la tabella da solo. Terzo: tre numeri nei dati grezzi trarranno in inganno il modello se il prompt non li gestisce.
Questo articolo è diverso dagli altri tre che abbiamo dedicato a ChatGPT. Il tracker dei concorrenti con ChatGPT Spaces tratta una pagina condivisa che un team aggiorna ogni settimana. Il radar per la ricerca prodotto con ChatGPT dots tratta un agente sempre attivo e i suoi due insiemi di permessi. Il radar della domanda con le attività pianificate di ChatGPT tratta un unico invio settimanale a una persona.
Qui guardiamo una cosa sola: come una risposta una tantum diventa una tabella e un grafico interattivi. Mostriamo anche come strutturare i dati perché il modello non sbagli i conteggi. Non abbiamo effettuato l'accesso a ChatGPT. Ogni passaggio in ChatGPT viene dalla documentazione di OpenAI ed è indicato come configurazione di esempio. Ogni numero di EveryInfra viene da una risposta grezza salvata, che puoi ricalcolare.
Che cos'è GPT-6 Intelligent UI: cosa ha scritto davvero OpenAI
Partiamo dalle parole ufficiali. Il post di lancio di OpenAI «GPT-6 and Intelligent UI for everyone» definisce Intelligent UI una nuova funzionalità di GPT-6 in ChatGPT. Le risposte possono essere interfacce completamente interattive, che rendono più visive le risposte di tutti i giorni e più facili da capire gli argomenti complessi. ChatGPT può anche costruire un piccolo strumento adatto all'attività che stai svolgendo (post di lancio di OpenAI, consultato il 5 novembre 2026).
OpenAI ha creato una libreria di componenti nativi che supportano lo streaming e un compilatore. L'interfaccia compare passo dopo passo mentre il modello scrive. La libreria fornisce una base di design comune e il modello decide come combinare le parti.
La pagina dell'Help Center «Intelligent UI in ChatGPT» entra più nel dettaglio. GPT-6 è stato addestrato a comporre risposte con testo, elementi visivi ed elementi interattivi. Una risposta può includere grafica, pulsanti da toccare, moduli, grafici ed esperienze interattive dentro la chat. Il formato dipende dalla domanda: un confronto può essere presentato fianco a fianco, una spiegazione può usare un diagramma interattivo.
Quando la risposta migliore è il testo semplice, ottieni testo semplice. Fonte: Help Center 20001598, consultato il 5 novembre 2026. La pagina indicava di essere stata aggiornata circa 14 giorni prima. Quindi la risposta di OpenAI a «quando compaiono i componenti interattivi?» è semplice: decide il modello in base alla domanda. Non esiste un interruttore «sempre un grafico».
La stessa pagina risponde a quattro domande importanti per un report. Puoi aggiungere preferenze nelle Custom Instructions, e l'esempio della stessa OpenAI è «usa tabelle quando confronti delle opzioni». OpenAI aggiunge che queste preferenze orientano soltanto la risposta e che il layout esatto può cambiare. Alcuni componenti, come le checklist, mantengono il loro stato quando aggiorni la chat, ma non da una chat all'altra.
Intelligent UI funziona solo in Chat, non nella scheda Work né in Voice. Sul web puoi scegliere Personalization, poi Layout and Visuals, poi Simple. Anche dopo, alcuni elementi visivi possono comparire comunque.
| Domanda | Cosa ha scritto OpenAI | Fonte | Cosa significa per un report |
|---|---|---|---|
| Che cos'è | Il modello costruisce testo, elementi visivi, pulsanti, moduli e grafici con componenti nativi; un compilatore trasmette il layout in streaming | Post di lancio, Help Center 20001598 | La tabella viene creata dal modello; un plugin non fornisce un widget già pronto |
| Quando compaiono i componenti | Il modello sceglie in base al tipo di domanda; alle domande semplici risponde con testo | Help Center 20001598 | Chiedi una tabella nel prompt e nelle Custom Instructions |
| Serve un prompt speciale | No; le normali risposte in testo restano possibili | Help Center 20001354 | Puoi ottenere un grafico senza chiederlo, ma il layout può cambiare |
| Quota di utilizzo separata | No; valgono i limiti del modello, degli strumenti e del piano | Help Center 20001354 | Il costo del report è il tuo piano più i costi API |
| I dati dei plugin diventano componenti | Solo: i plugin collegati «continueranno a funzionare» | Help Center 20001598 | Non documentato; non darlo per scontato |
| Si può disattivare | Web: Personalization, Layout and Visuals, Simple; un'altra pagina dice di disattivare Layout and visuals in Settings | Help Center 20001598, 20001354 | Le due pagine usano nomi di menu diversi; segui quello che vedi sullo schermo |
Il percorso per disattivarla richiede una precisazione. La pagina dell'Help Center «GPT-6 and other models in ChatGPT» dice che puoi ridurre gli elementi visivi aprendo Settings sul web e disattivando Layout and visuals. La pagina su Intelligent UI indica invece Personalization e Simple (Help Center 20001354). Entrambe le pagine dicono che alcuni elementi visivi possono comparire comunque.
Nessuna delle due offre una vera modalità solo testo. Per un report, questo significa che non controlli del tutto il layout. Lo stesso prompt può restituire una tabella in solo testo a un collega che ha scelto Simple.
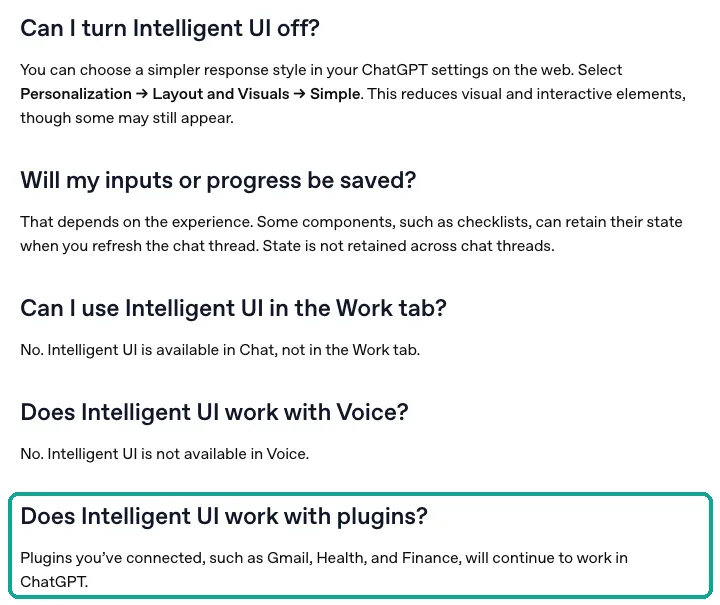
La frase nel riquadro verde acqua è il testo più importante per questo articolo. «Continueranno a funzionare» ti dice che i plugin non si rompono. Non ti dice che i dati dei plugin finiscano nella libreria di componenti di Intelligent UI. Abbiamo controllato anche il lato sviluppatori. La documentazione dei plugin di OpenAI descrive un meccanismo diverso, in cui è il server a fornire il proprio template di UI.
Ne parliamo nella prossima sezione. Nell'Help Center, nel post di lancio e nella documentazione per sviluppatori non abbiamo trovato nessuna frase secondo cui Intelligent UI rende i risultati degli strumenti MCP sotto forma di grafici. Per questo scriviamo «non documentato». Non scriviamo «sì» e non scriviamo «no».
GPT-6 e Intelligent UI in ChatGPT: per chi sono disponibili e dove
Il post di lancio descrive il rilascio. Il 7 ottobre 2026 GPT-6 con Intelligent UI ha iniziato a essere distribuito in tutto il mondo agli utenti Plus, Pro, Business ed Enterprise nella scheda Chat. Il giorno dopo è stato esteso a Free e Go. Per Enterprise, l'accesso dipende dalle impostazioni dell'amministratore.
I piani a pagamento usano GPT-6 Sol, mentre Free e Go usano GPT-6 Luna; entrambi sono ottimizzati per la chat di tutti i giorni (post di lancio di OpenAI). Il post dice anche che i modelli di Work e Codex non sono cambiati. L'annuncio nella community per sviluppatori di OpenAI ripete questo perimetro. Aggiunge che GPT-6 Instant inizia a rispondere alle domande con ricerca web in media il 44% più rapidamente rispetto a GPT-5.6 Instant (annuncio nella OpenAI Community).
L'Help Center è chiaro sui livelli di ragionamento. Intelligent UI funziona da Instant fino a Extra High. L'opzione di ragionamento Pro usa GPT-6 Astra e non supporta Intelligent UI (Help Center 20001598). La pagina «models and limits» di Business ripete il limite di Astra e dice che una licenza Business Standard include 15 messaggi Pro al mese (Help Center 12003714). Nelle note di rilascio di Business, la voce del 7 ottobre 2026 dice che GPT-6 è in fase di distribuzione in Chat per i workspace Business idonei. L'accesso dipende dalle impostazioni del workspace e dai client supportati (note di rilascio di Business).
| Piano | GPT-6 in Chat | Intelligent UI | MCP personalizzato |
|---|---|---|---|
| Gratis | GPT-6 Luna, dall'8 ottobre | Sì | Non indicato nella pagina sugli MCP personalizzati |
| Go | GPT-6 Luna, dall'8 ottobre | Sì | Non indicato |
| Plus | GPT-6 Sol, dal 7 ottobre | Sì | La pagina sulla Developer mode indica Plus; la pagina Plugins cita Pro, Business ed Enterprise/Edu |
| Pro | GPT-6 Sol; il ragionamento Pro usa Astra | Sol sì, Astra no | Sì, ma con permessi read e fetch |
| Business | GPT-6 Sol, in base al workspace | Sì | Solo amministratori e proprietari creano e pubblicano |
| Enterprise / Edu | GPT-6 Sol, in base alle impostazioni dell'amministratore | Sì | Gli amministratori possono concedere la creazione ai membri tramite accesso basato sui ruoli |
I prezzi dei piani sono nella sezione «Costi API per un report» più avanti. La pagina su Enterprise ed Edu dice che GPT-6 è in fase di distribuzione nei workspace Enterprise idonei. Se GPT-6 non compare nel menu dei modelli, il tuo workspace non lo ha ancora (Help Center 11165333).
Contano anche i client. L'Help Center dice che le vecchie versioni delle app desktop per macOS e Windows non supportano Intelligent UI, e le note di Business parlano di «client supportati». Se un collega ti dice «non vedo grafici», controlla prima tre cose. È nella scheda Chat e non in Work?
Ha scelto il livello di ragionamento Pro? La sua app desktop è vecchia? Nel thread di lancio su r/ChatGPT, un utente a pagamento ha detto che GPT-6 Sol era attivo. Le risposte però non avevano elementi visivi, nemmeno con i prompt della pagina di lancio. Molto probabilmente si tratta di un rilascio non ancora completo o di un limite del client (thread di lancio su r/ChatGPT).
I dati di un MCP personalizzato possono diventare tabelle e grafici?
Questa è la domanda centrale, e le strade sono due. La prima è Intelligent UI. Il modello legge ciò che restituisce lo strumento e costruisce una tabella o un grafico con i componenti di ChatGPT. Per questa strada, OpenAI offre solo quella frase sui plugin. La seconda è quella delle MCP Apps, descritte nella documentazione dei plugin di OpenAI.
Il server MCP fornisce il proprio template di UI. ChatGPT mostra il template in un frame isolato dentro la chat, e il template genera la visualizzazione del risultato dello strumento (documentazione per sviluppatori: ChatGPT UI). Entrambe le strade producono quello che sembra «un grafico nella chat», ma differiscono molto per chi lo genera e per la stabilità.
La documentazione per sviluppatori descrive la seconda strada nel dettaglio. Uno strumento punta a una risorsa con _meta.ui.resourceUri, e l'URI della risorsa inizia con ui://. Il tipo della risorsa è text/html;profile=mcp-app. ChatGPT carica il template, e il template comunica con l'host tramite messaggi JSON-RPC che iniziano con ui/. La vecchia chiave _meta["openai/outputTemplate"] funziona ancora come alias (documentazione per sviluppatori: Build your MCP server).
La documentazione dell'estensione MCP Apps descrive lo stesso modello (documentazione di MCP Apps). Lo strumento dichiara una risorsa di UI e l'host ne esegue il rendering in una sandbox. OpenAI consiglia anche uno schema disaccoppiato: gli strumenti per i dati restituiscono dati e uno strumento di rendering separato monta l'interfaccia. Così un pulsante come «Re-roll» può richiamare uno strumento per i dati senza rimontare tutto.
| Voce | Intelligent UI | MCP Apps (UI del server) | MCP di EveryInfra oggi |
|---|---|---|---|
| Chi genera l'interfaccia | Il modello e la libreria di componenti di ChatGPT | Un template HTML del server MCP | Nessun template |
| Come arrivano i dati | Il modello legge il testo e il contenuto strutturato dello strumento | structuredContent va al template | Un'unica stringa JSON content[0].type = "text" |
| Visualizzazione documentata dei risultati degli strumenti | No | Sì, è il suo scopo | Non applicabile |
| Stabilità del layout | Può cambiare ogni volta; gli utenti possono scegliere Simple | Template fisso, stabile | Dipende dal modello |
| Chi lo sviluppa | Nessuno; è integrato | Il proprietario del server lo sviluppa, lo verifica e lo pubblica | Non forniamo un template |
| Dove funziona | Chat, da Instant a Extra High | Dove funzionano i plugin | Come i plugin |
La specifica MCP è esplicita sui risultati strutturati. La sezione sugli strumenti della versione 2025-06-18 consente a uno strumento di dichiarare un outputSchema e di restituire dati in structuredContent. Per la retrocompatibilità, uno strumento che restituisce contenuto strutturato dovrebbe inserire anche il JSON serializzato in un blocco TextContent (specifica MCP: Tools). Il 5 novembre 2026 abbiamo inviato initialize e tools/list a https://api.everyinfra.com/mcp senza chiave, un'operazione gratuita.
Il server indica la versione del protocollo 2025-06-18. Nessuno dei suoi 12 strumenti dichiara un outputSchema o un template di UI in _meta. Un risultato reale di tools/call contiene solo content, senza structuredContent.
Quindi, con l'MCP remoto di EveryInfra in ChatGPT, è percorribile solo la prima strada. Il modello legge una stringa JSON, conta, calcola e decide se usare una tabella o un grafico. Non è del tutto uno svantaggio. I componenti di Intelligent UI appartengono a ChatGPT, quindi si integrano con la chat e non richiedono sviluppo.
La loro stabilità però dipende da due cose. Il prompt deve dire chiaramente cosa vuoi. I dati devono essere puliti e abbastanza brevi da non far sbagliare i conteggi al modello in mezzo a 900 KB di testo. Le prossime due sezioni trattano la configurazione e questi due aspetti.
Collegare l'MCP remoto di EveryInfra in ChatGPT: piani personali e Business a confronto
La pagina dell'Help Center «Connecting custom MCP servers in ChatGPT» riporta i passaggi attuali. In Plugins, seleziona «+» e poi Add custom MCP server. Inserisci un nome, l'URL del server e il tipo di autenticazione. Leggi e accetta l'avviso sui rischi, poi seleziona Create as a plugin.
Nell'attuale esperienza Plugins non devi attivare prima la Developer Mode (Help Center 12584461, consultato il 5 novembre 2026). La pagina dice anche che puoi aggiungere server solo dal web, non da mobile. Con OAuth, il tuo provider di identità deve emettere refresh token, quindi gli scope devono includere offline_access.
# Example setup (we did not sign in to ChatGPT; steps follow the Help Center; not run in ChatGPT)
# ChatGPT on the web -> Plugins -> + -> Add custom MCP server
Name:            EveryInfra
MCP server URL:  https://api.everyinfra.com/mcp/all
Authentication:  OAuth
# The consent page sends you to https://auth.everyinfra.com/oidc to sign in to EveryInfra
# Grant at least data:call (data calls) and offline_access (refresh token for ChatGPT)
# Accept the risk warning -> Create as a plugin
# Business workspace: only admins or owners create and publish; members then enable it in Plugins
# Enterprise / Edu: admins can use role-based access control (RBAC) to let chosen members create connections
Perché /mcp/all e non /mcp? L'endpoint /mcp di EveryInfra riceve una chiave API in un header della richiesta. È adatto ai client che possono impostare header, come Claude Code o Cursor. L'MCP personalizzato di ChatGPT offre OAuth, nessuna autenticazione oppure una modalità mista. Non ha un'opzione per inserire una chiave API in un header (documentazione per sviluppatori: Developer mode). /mcp/all usa OAuth.
I suoi metadati della risorsa protetta indicano https://auth.everyinfra.com/oidc come server di autorizzazione, e i suoi scope includono data:call e offline_access (metadati della risorsa protetta di EveryInfra).
Questo corrisponde alla guida all'autenticazione di OpenAI. Il server delle risorse pubblica i metadati della risorsa protetta e il server di autorizzazione pubblica i metadati OAuth. Il client si identifica con CIMD, registrazione dinamica o un client predefinito (documentazione per sviluppatori: Authentication). È lo schema previsto dalla parte sull'autorizzazione della specifica MCP (specifica MCP: Authorization). In passato alcuni utenti inserivano la chiave in un URL ?key= senza autenticazione. Queste connessioni hanno smesso di funzionare il 4 novembre 2026; il nostro articolo su Spaces riporta la risposta 401.
La differenza tra piani personali e Business è netta. In un workspace Business solo amministratori e proprietari possono creare connessioni MCP personalizzate e pubblicarle. Gli amministratori di Enterprise ed Edu possono usare l'accesso basato sui ruoli per consentire ad alcuni membri di creare connessioni, ma a pubblicarle sono solo amministratori e proprietari. Per i piani personali, la FAQ «Are apps and full MCP beta available to Pro users?» dice che l'MCP completo è riservato a Business ed Enterprise/Edu.
Gli utenti Pro possono collegare server MCP personalizzati con permessi read e fetch. Le note di rilascio di Business elencano anche due aggiornamenti per l'amministrazione dei plugin. Dal 15 ottobre 2026 gli amministratori possono gestire più plugin contemporaneamente. Dal 21 ottobre 2026 le impostazioni dei workspace Business si trovano in Admin Console (note di rilascio di Business).
| Configurazione | Chi lo aggiunge | Conferma prima di una chiamata allo strumento per i dati | Attenzione a |
|---|---|---|---|
| Plus / Pro personali | Tu | Sì; everyinfra_call_api non è contrassegnato come di sola lettura | Per Pro si parla di «read and fetch»; non è chiaro come Pro gestisca uno strumento non di sola lettura, quindi fai prima una prova |
| Business | Lo crea e lo pubblica un amministratore o un proprietario | Sì; gli amministratori possono impostare il criterio di approvazione | I membri non possono aggiungerlo; autorizza con un account EveryInfra condiviso dal team |
| Enterprise / Edu | Un amministratore, o un membro autorizzato; pubblica l'amministratore | Sì | Il workspace deve abilitare GPT-6 e i plugin |
| Free / Go | Non indicato | Non applicabile | Intelligent UI è presente, ma l'MCP personalizzato non è documentato |
La conferma dipende dalle annotazioni degli strumenti. Nella nostra risposta a tools/list, lo strumento per i dati everyinfra_call_api ha readOnlyHint: false, destructiveHint: true e openWorldHint: true. Lo strumento del catalogo everyinfra_list_capabilities è di sola lettura. La documentazione sulla developer mode dice che ChatGPT tratta gli strumenti senza indicazione di sola lettura come azioni di scrittura.
Devi confermare prima di ogni chiamata, e puoi scegliere di ricordare l'approvazione per quella conversazione (documentazione per sviluppatori: Developer mode).
Il valore destructiveHint: true è più forte del necessario. Nella specifica MCP questo hint indica che lo strumento può apportare modifiche distruttive al proprio ambiente. Una chiamata ai dati legge soltanto post pubblici su Reddit e X e lì non modifica nulla. Un addebito sul tuo saldo non è una modifica distruttiva (specifica MCP: Tools). Per te il risultato è lo stesso: lo strumento non è contrassegnato come di sola lettura, quindi ChatGPT chiede conferma prima di chiamarlo.
In pratica, un report da 6 chiamate chiede conferma una volta. Se scegli di ricordare l'approvazione, le altre chiamate in quella chat non la richiedono più.
Ottenere tabelle stabili: come progettare prompt e campi
Intelligent UI non richiede un prompt speciale. Ma «confronta i tre brand per volume e sentiment» è vago. Che cosa conta come volume? Quali sette giorni sono «la settimana scorsa»? Con quale criterio si valuta il sentiment? Il modello può interpretarlo in modo diverso ogni volta.
Suggeriamo un prompt in tre parti. La parte di recupero dice quali funzionalità e parametri usare. La parte di conteggio dice quali post contano. La parte di output dice quale tabella, quale grafico e quale nota mettere sotto la tabella. L'esempio di Custom Instructions di OpenAI, «usa tabelle quando confronti delle opzioni», può andare nel tuo profilo, così ogni confronto riceve una tabella per impostazione predefinita.
# Example prompt (example setup; not run in ChatGPT)
Use @EveryInfra to compare EcoFlow, Jackery and BLUETTI on X and Reddit last week
(UTC 2026-10-26 00:00 to 2026-11-02 00:00): discussion volume and sentiment.
Fetch, once per brand:
1. twitter/search: keyword = "<brand> since:2026-10-26 until:2026-11-02", limit = 200
2. reddit/subreddit_posts: r/Ecoflow_community, r/Jackery, r/bluetti, sort = newest, limit = 100
3. reddit/search: keyword = brand name, sort = newest, limit = 25 (for off-community mentions only, not weekly totals)
Count:
- Count only posts with posted_at inside the week. If X returns exactly 200, or the subreddit list does not reach Monday, write "at least".
- Split X posts by the language field: English, Japanese, other.
- Sentiment means the stance toward the brand, not the tone of the whole post. List posts from brand accounts separately and leave them out of sentiment.
Output:
- One table: brand | X posts | X likes | English / Japanese share | subreddit posts | subreddit comments | note
- One grouped bar chart: X posts and subreddit posts side by side
- One line under the table: how each column was counted, and which numbers are floors
Lato dati, ogni post di twitter/search di EveryInfra ha circa 30 campi. Il catalogo elenca 38 campi possibili, tra cui avatar dell'autore, bio, numero di follower, hashtag e link (catalogo di EveryInfra). Ogni riga di reddit/subreddit_posts ha 14 campi e ogni riga di reddit/search ne ha 10. A un report ne servono pochi. La tabella qui sotto associa ogni metrica ai suoi campi, in base ai nostri risultati reali. Se il prompt nomina questi campi, il modello non deve tirare a indovinare.
| Metrica | Campo di X | Campo di Reddit | Nota |
|---|---|---|---|
| Volume | posted_at, id | posted_at, id | Prima filtra i dati in base a posted_at per limitarti alla settimana, poi conta i post |
| Engagement | like_count, reply_count, view_count | like_count, comment_count | Reddit non ha il numero di visualizzazioni, quindi non sommare i due valori |
| Lingua | language | Nessuno | Il modello deve stabilire la lingua dei post di Reddit |
| Post pubblicati dal brand | author_username | author_username | Da usare solo per escludere; non mostrare i nomi utente personali |
| Tipo di post | is_reply, is_quote | flair (solo post dei subreddit), community | r/Ecoflow_community usa flair di assistenza; gli altri due no |
| Sentiment | text | title, text | Nessun campo per il sentiment: il modello deve leggere i post, oppure devi calcolarlo tu |
Alcuni team gestiscono un proprio livello MCP davanti a EveryInfra, ad esempio un servizio dati interno. Possono usare la specifica MCP per rendere il risultato più stabile. Dichiara un outputSchema. Metti i 10 campi filtrati in structuredContent e lo stesso JSON come testo in un blocco TextContent. Abbiamo misurato l'effetto.
Abbiamo serializzato di nuovo gli array dei risultati di X per i tre brand, senza caratteri di escape. Il totale era di 815.904 byte. Tenendo solo id, url, posted_at, language, like_count, reply_count, view_count, is_reply, is_quote e text troncato a 280 caratteri, si scendeva a 292.415 byte, cioè il 36%. Il modello legge due terzi in meno, quindi ha meno occasioni di sbagliare i conteggi o saltare righe.
Un round trip reale: cosa invia il modello e cosa torna indietro
Una volta collegato il plugin, il modello chiama EveryInfra con un tools/call MCP standard. Il 5 novembre 2026 alle 00:25:25 ora di Singapore abbiamo inviato lo stesso formato di richiesta a https://api.everyinfra.com/mcp. Abbiamo usato una chiave API nell'header; ChatGPT usa un token OAuth, ma chiama lo stesso strumento per i dati. Abbiamo chiesto i post Reddit più popolari dell'ultimo mese su EcoFlow. Questo è il corpo della richiesta così come è stato inviato:
{
  "jsonrpc": "2.0",
  "id": 7,
  "method": "tools/call",
  "params": {
    "name": "everyinfra_call_api",
    "arguments": {
      "platform": "reddit",
      "action": "search",
      "params": {"keyword": "EcoFlow", "sort": "top", "limit": 25}
    }
  }
}
Il server ha risposto dopo 6,43 secondi con HTTP 200 e charged_usd pari a 0,000556. result.content conteneva un solo elemento, con type impostato su text. Il suo text era una stringa JSON di 72.067 byte. Non c'erano structuredContent, isError né un template di UI. Nella stringa c'erano platform, action, count: 16 e 16 righe.
Ogni riga aveva 10 campi: id, url, title, text, author_username, community, like_count, comment_count, posted_at e platform. In fondo c'erano i dettagli di fatturazione. Avevamo chiesto 25 righe e ne abbiamo ricevute 16. Il catalogo dice che reddit/search copre solo l'ultimo mese. Se ci sono meno post popolari, ricevi meno righe e il prezzo per chiamata non cambia.
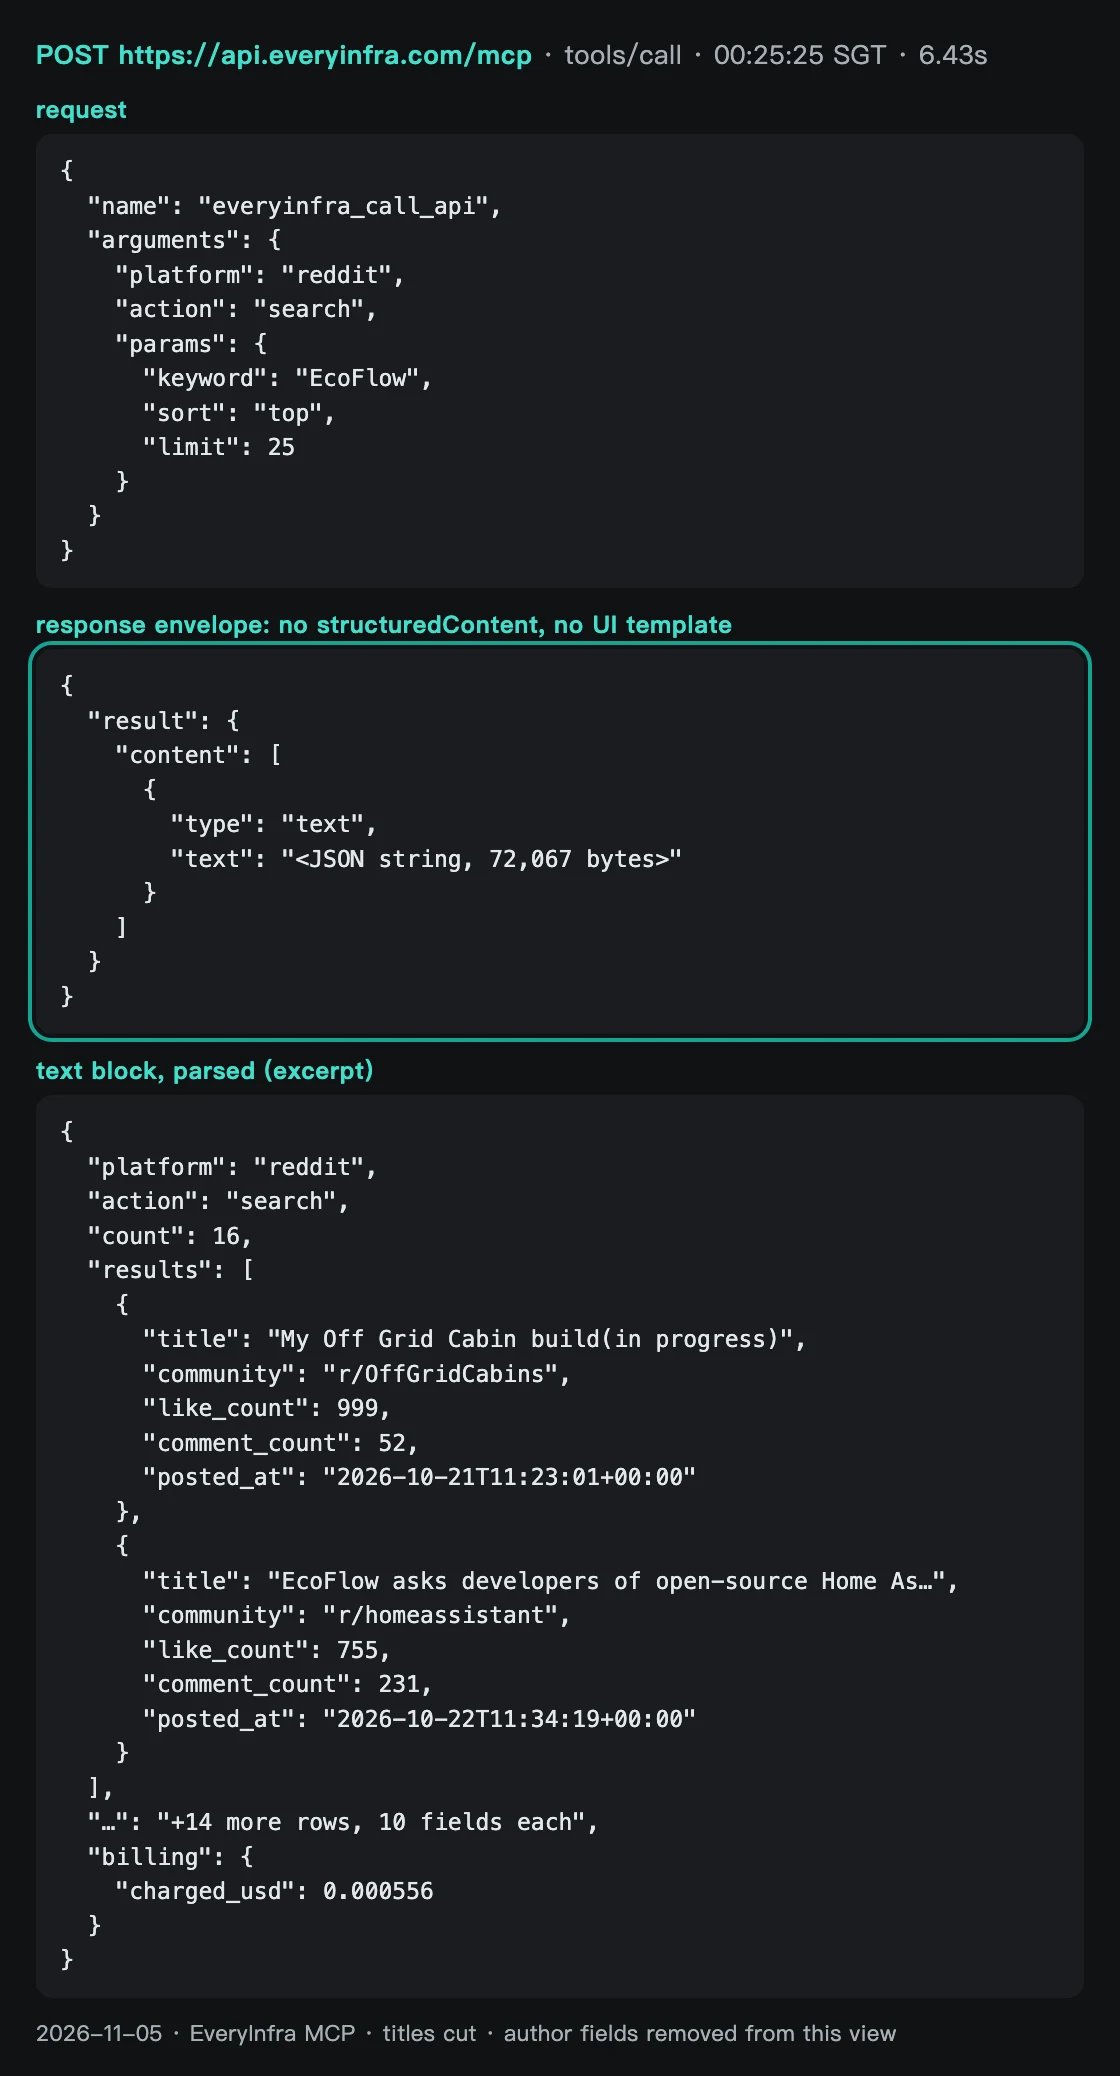
I primi due di quei 16 post mostrano quanto sia difficile definire una «discussione sul brand». Il primo è il diario di costruzione di una baita off-grid sull'Isola del Principe Edoardo, in Canada. Solo una frase cita EcoFlow: il proprietario alimenta la baita con una EcoFlow Delta Pro, una batteria aggiuntiva e tre pannelli da 495 W. Ha comunque ottenuto 999 like. Il secondo è un thread in r/homeassistant su EcoFlow e gli sviluppatori open source di Home Assistant, con 755 like e 231 commenti.
Questo thread esprime un'opinione reale sul brand. Nessuno dei 16 post rientrava nella settimana scorsa: andavano dal 5 ottobre al 4 novembre 2026. L'ordinamento «top» risponde a «cosa ha letto di più la gente questo mese». Non può rispondere a «quanto se n'è parlato la settimana scorsa».


Dividi un report nei sei passaggi qui sopra. I primi tre avvengono tra ChatGPT e l'API. Gli ultimi tre spettano al modello. L'API garantisce i passaggi che precedono il quarto: con i parametri corretti restituisce i dati grezzi, e le chiamate non riuscite o vuote sono gratuite.
Il quinto passaggio, filtrare e contare, è quello in cui possono introdursi errori nei report. Tutti e cinque i test qui sotto riguardano questo passaggio. Il modello potrebbe non filtrare per posted_at, oppure scambiare per un totale un numero fermo a un limite massimo. In quel caso il grafico può sembrare corretto e avere comunque barre di altezza sbagliata.
Tutte le chiamate reali di questo articolo sono nel log qui sotto. Gli orari si riferiscono al 5 novembre 2026 e sono espressi nell'ora di Singapore.
| Tempo | Funzionalità | Brand | Righe restituite | Addebitate |
|---|---|---|---|---|
| Dalle 00:18 alle 00:19 | reddit/search (più recenti) | 3 | 16, 24, 24 | 3 x $0.000556 |
| Dalle 00:19 alle 00:21 | twitter/search, settimana scorsa | 3 | 200, 200, 167 | 3 x $0.000556 |
| Dalle 00:22 alle 00:24 | reddit/subreddit_posts (più recenti) | 3 (2 nuovi tentativi dopo un 429) | 100 ciascuno | 3 x $0.000556 |
| 00:25 | MCP tools/call, reddit/search (top) | EcoFlow | 16 | $0.000556 |
| Dalle 00:25 alle 00:27 | reddit/search (top) | Jackery, BLUETTI (1 nuovo tentativo) | 22, 22 | 2 x $0.000556 |
| 00:26 | twitter/search in spagnolo | Tutti e 3 in una sola query | 24 | $0.000556 |
Test 1: i risultati X della settimana scorsa includevano post pubblicati dopo la fine della settimana
La ricerca di X supporta gli operatori di data since: e until:. Il catalogo EveryInfra indica che la parola chiave di twitter/search può includere la sintassi di ricerca della piattaforma (catalogo EveryInfra). L'Help Center di X dice solo che puoi trovare post prima di una data, dopo una data o in un intervallo. Il suo esempio usa since:2013-12-30 until:2014-01-02 per i post di Capodanno.
Non dice se il giorno di until: è incluso né quale fuso orario si applica (Help Center di X: ricerca avanzata). Il 5 novembre 2026, dalle 00:19 alle 00:21 ora di Singapore, abbiamo eseguito una ricerca per brand. La parola chiave era «brand since:2026-10-26 until:2026-11-02» e il limite era 200.
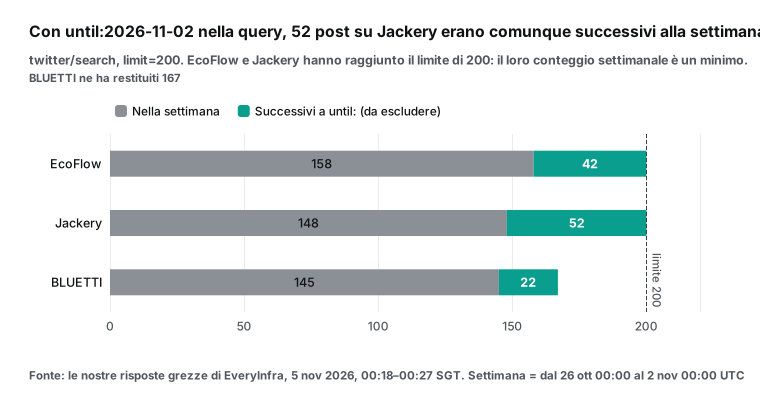
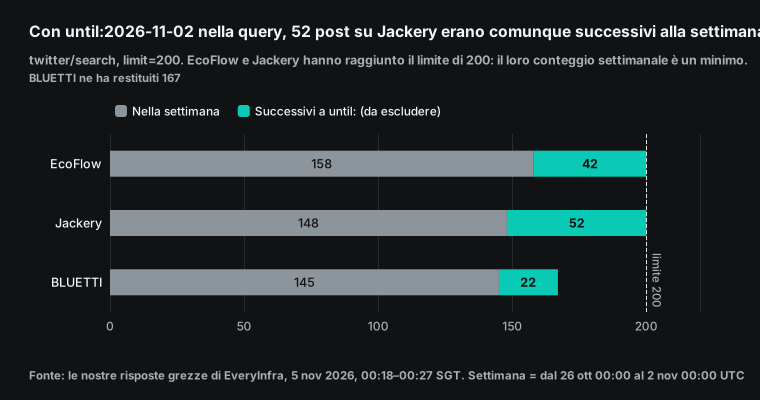
Tutti i post erano successivi alla data di since:, ma molti erano successivi a until:. EcoFlow ha restituito 200 post, e 42 avevano un posted_at uguale o successivo al 2 novembre 2026 UTC. Jackery ne aveva 52 su 200, BLUETTI 22 su 167. La maggior parte dei post in più era del 2 novembre (EcoFlow 40, Jackery 48, BLUETTI 19), con da due a quattro post del 3 novembre. Se il modello usa count come volume, il dato di EcoFlow risulta più alto del 27% e quello di Jackery del 35%. Quindi mantieni nel prompt la riga «conta solo i post con posted_at all'interno della settimana».
Il secondo problema è il limite massimo. Una chiamata twitter/search restituisce al massimo 200 post. EcoFlow e Jackery ne hanno restituiti esattamente 200, quindi la settimana potrebbe contenerne di più. Scrivi 158 e 148 come «almeno». BLUETTI ne ha restituiti 167 senza raggiungere il limite, quindi 145 è tutto ciò che questa ricerca poteva vedere.
Il catalogo indica che X ordina per Top come impostazione predefinita, e latest non garantisce un ordine cronologico rigoroso. Quindi un risultato che raggiunge il limite non corrisponde ai «200 più recenti». Per un conteggio accurato, dividi la settimana in due o sette parti ed esegui una chiamata per parte. Il numero di chiamate aumenta; trovi i numeri nella sezione sui costi più avanti.
Test 2: una ricerca Reddit copriva solo uno o due giorni
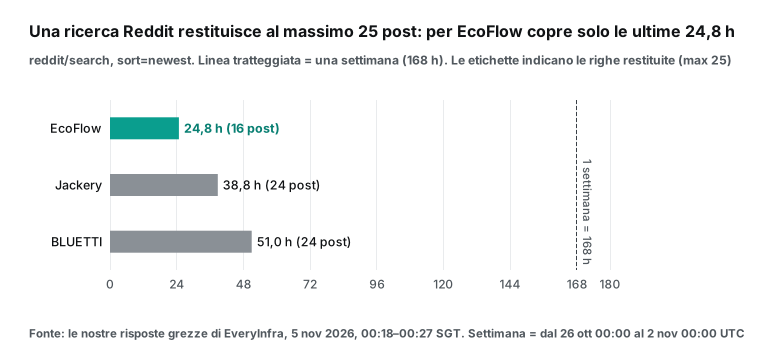
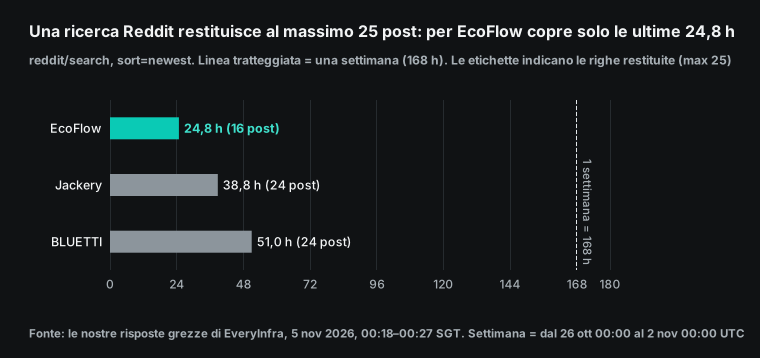
reddit/search restituisce al massimo 25 post e copre solo l'ultimo mese. Il 5 novembre 2026, alle 00:18 e alle 00:19 ora di Singapore, abbiamo eseguito una ricerca newest per brand. EcoFlow ha restituito solo 16 post. Il più vecchio era del pomeriggio del 3 novembre UTC, quindi la ricerca copriva 24,8 ore.
Jackery ha restituito 24 post in 38,8 ore, BLUETTI 24 post in 51,0 ore. Ogni intervallo è il tempo che separa il post più recente da quello più vecchio. Nessuna ricerca arrivava alla settimana scorsa. Dagli intervalli tra un post e l'altro stimiamo frequenze di menzione sull'intero sito di circa 15,5, 14,9 e 11,3 post al giorno. Sono stime, non conteggi.
Anche la ricerca sull'intero sito è rumorosa. I 16 post di EcoFlow erano distribuiti su una decina di community, come r/Ecoflow_community (6 post), r/prepping, r/dieselheater e r/overlanding. Jackery ne aveva 9 su 24 in r/Jackery; il resto erano post di offerte e community sulla preparazione alle emergenze. BLUETTI ne aveva solo 4 su 24 in r/bluetti.
I post nelle community dei brand erano il 37,5%, il 37,5% e il 16,7% delle tre ricerche. Questo tipo di dati mostra dove viene menzionato un brand. Non fornisce un totale settimanale. Con 25 post per chiamata, un brand molto citato riempie il risultato in un giorno. Inoltre non puoi sapere con certezza quanto indietro arriva ogni chiamata aggiuntiva.
Per i totali settimanali, la community del brand è più affidabile. Dalle 00:22 alle 00:24 ora di Singapore abbiamo recuperato i 100 post più recenti di ogni community con reddit/subreddit_posts. r/Ecoflow_community aveva almeno 73 post e 492 commenti la settimana scorsa. I 100 post non risalivano fino all'inizio di lunedì (il più vecchio era del 26 ottobre alle 16:01 UTC), quindi 73 è un valore minimo. r/Jackery aveva 13 post e 206 commenti, mentre r/bluetti aveva 20 post e 93 commenti.
In questo giro abbiamo ricevuto due risposte 429 per il limite di frequenza delle richieste. Abbiamo aspettato 60 secondi e riprovato. Le due risposte 429 non sono state addebitate.
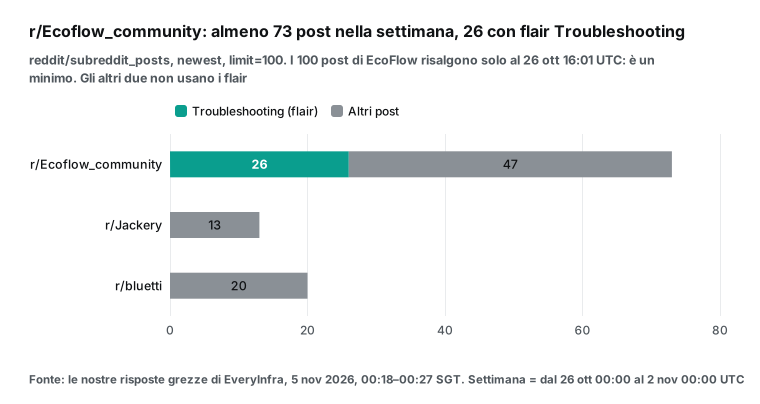
r/Ecoflow_community è l'unica delle tre a usare i flair. La settimana scorsa aveva 29 post Open Discussion e 26 post Troubleshooting Help, più piccoli gruppi come DIY, power backup e recensioni. I 26 post di aiuto sono almeno il 36% della settimana. Puoi inserire questo dato direttamente in un report come segnale di qualità.
Il modello non deve giudicare il sentiment, perché sono i membri stessi a impostare il valore flair. Le altre due community non hanno flair, quindi il modello deve classificare i titoli. Ecco perché lo stesso prompt dà risultati con un livello di dettaglio diverso per ogni brand: sono i dati stessi ad avere una struttura diversa.
Test 3: metà dei post era in giapponese
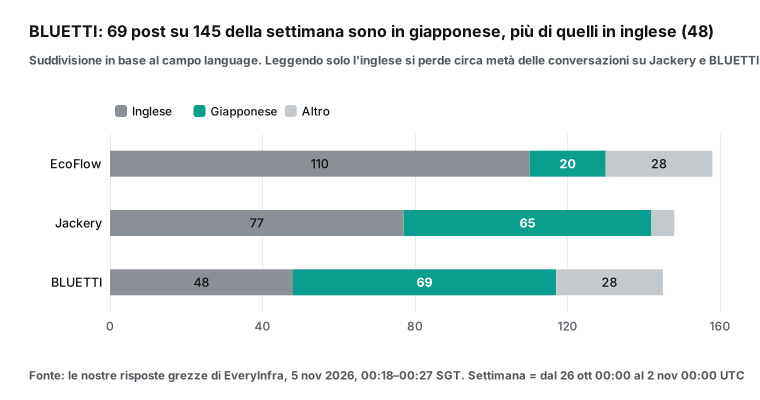
Il sentiment è il secondo numero che il prompt chiede. La strada più facile è leggere solo i post in inglese. Ma il campo language di X mostra mix di lingue molto diversi per la settimana scorsa. EcoFlow aveva 158 post: 110 in inglese, 20 in giapponese e 28 in altre lingue, come tedesco, spagnolo, ucraino e portoghese.
Jackery aveva 148 post: 77 in inglese e 65 in giapponese. BLUETTI aveva 145 post: 48 in inglese e 69 in giapponese, quindi prevaleva il giapponese. In percentuale, la settimana scorsa il giapponese rappresentava il 44% dei post X di Jackery e il 48% di quelli di BLUETTI.
Dietro i post in giapponese c'è una notizia precisa, e parte dal Regno Unito. Il governo britannico ha lanciato nuove indicazioni sulla preparazione alle emergenze che invitano le famiglie a compiere «piccoli, semplici passi» (comunicato GOV.UK). Il sito della campagna elenca le scorte per 3 giorni (sito Be Ready). Il 22 ottobre 2026 The Guardian ha riportato che ogni britannico era invitato a tenere in casa acqua e cibo per tre giorni (The Guardian). Reuters ha ripreso la notizia il 23 ottobre 2026 (Reuters). Il suo titolo: il Regno Unito ha chiesto alla popolazione di tenere in casa scorte di emergenza per tre giorni.
Il post con più like della settimana scorsa tra i tre brand nasce da quella notizia. Un autore giapponese ha pubblicato un lungo thread il 27 ottobre 2026. Dice che il Giappone dovrebbe seguire il Regno Unito e chiedere a tutti di prepararsi. Elenca le scorte raccomandate nel Regno Unito: acqua per tre giorni, una radio a manovella, cibo, medicinali e copie stampate di documenti d'identità e polizze assicurative.
Più avanti consiglia power bank di grande capacità e dice che in famiglia hanno usato Jackery, EcoFlow e BLUETTI, e che tutti e tre sono validi. Il post ha ottenuto 4.406 like e 643.989 visualizzazioni. Per i lettori statunitensi e britannici, la lezione è che un report solo in inglese non vede dove si è svolta davvero la discussione di questa settimana sulla preparazione alle emergenze.
Quel post mostra anche un problema più grande della lingua. Nomina tutti e tre i brand, ma solo la ricerca BLUETTI lo ha restituito. Le ricerche EcoFlow e Jackery hanno entrambe restituito tutti i 200 post, e il post non compariva in nessuna delle due. Tra i tre risultati, due brand qualsiasi hanno in comune solo da 1 a 8 post. Quindi il post con più like della settimana scorsa sui tre brand non esiste in due dei tre report di brand.
Dalla risposta non possiamo capire perché. Può averlo escluso il limite di 200, oppure la ricerca potrebbe non riconoscere i nomi dei brand dentro un testo giapponese senza spazi. La regola resta comunque chiara. Tratta una ricerca che raggiunge il limite come un campione, non come l'intera settimana. Un report serio deve unire i tre risultati, rimuovere i duplicati e taggare ogni post con tutti i brand che nomina.
Anche i tre brand pubblicano direttamente in Giappone. EcoFlowJapan, jackeryjapan e BLUETTI_JAPAN hanno pubblicato rispettivamente 5, 3 e 9 volte la settimana scorsa. Se il report considera solo i post in inglese, quasi la metà dei post di BLUETTI resta fuori dal punteggio di sentiment, così come il post con più like. La riga del prompt «dividi i post X per lingua» serve a fare in modo che il modello mostri prima il mix linguistico. GPT-6 sa leggere il giapponese. Ma il fatto che suddivida i post per lingua e applichi la stessa regola a ciascuna lingua dipende dal prompt.
Test 4: chi valuta il sentiment, e in base al numero di post o ai like
Volevamo una verifica che non provenisse da un modello, quindi abbiamo valutato i post in inglese della settimana scorsa con il lessico open source VADER 3.3.2. Un punteggio compound pari o superiore a 0,05 è positivo, uno pari o inferiore a -0,05 è negativo. VADER è uno strumento basato su regole molto usato per i testi dei social media (repository VADER). Per numero di post, le quote negative sono vicine: EcoFlow 17% (19 su 110), Jackery 21% (16 su 77) e BLUETTI 19% (9 su 48). Ponderando per like, il quadro cambia. I post negativi raccolgono il 54% dei like in inglese di EcoFlow, il 38% di quelli di Jackery e il 22% di quelli di BLUETTI.
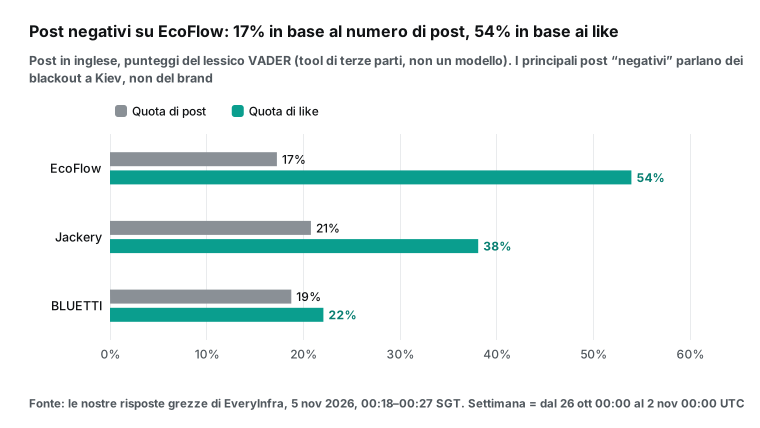
«54% negativo» sembra una crisi per EcoFlow. Non lo è. Abbiamo letto i 15 post in inglese con più like per ogni brand e classificato l'atteggiamento espresso nei confronti del brand.
La regola è questa: lodi, raccomandazioni, acquisti ed esperienze d'uso positive sono segnali positivi; anche il marketing del brand è positivo. Una lamentela sul brand o sul prodotto è negativa. Una semplice menzione, una lista per una raccolta fondi, una notizia o un uso senza giudizio sono neutri. L'autore dell'articolo ha assegnato tutte le etichette in un solo passaggio e nessun'altra persona le ha controllate. Per questo usiamo queste etichette solo per mostrare dove VADER sbaglia, non come misura di accuratezza.
Per EcoFlow, 14 post su 15 erano neutri e 1 positivo. Nessuno si lamentava di EcoFlow. I post principali parlavano dei blackout a Kiev.
Dopo il più grande attacco russo dell'anno alla rete energetica ucraina, Kiev ha subito interruzioni di corrente d'emergenza e diffuse interruzioni dell'erogazione idrica (Kyiv Independent). I post citano i dispositivi EcoFlow come soluzione usata dalle persone per affrontare i blackout. Altri sono liste per raccolte fondi destinate al fronte, nelle quali EcoFlow è una delle voci. Il lessico rileva «attack», «blackout» e «war» e assegna un punteggio negativo. Quelle parole riguardano la guerra, non il brand.
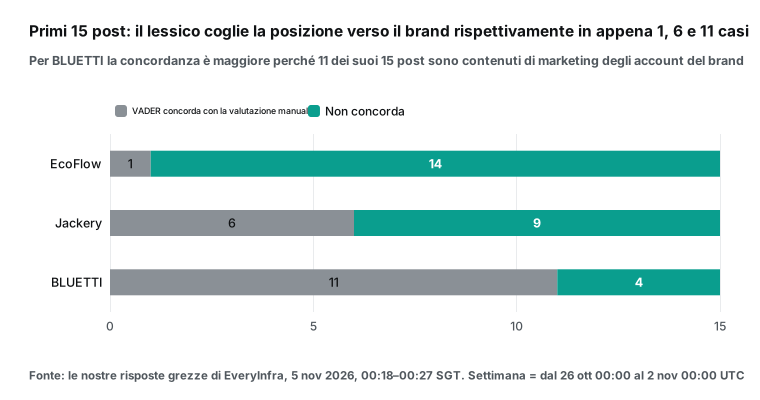
Il confronto tra i tre brand rende il problema più chiaro. VADER concordava con la nostra lettura solo per 1 dei 15 post di EcoFlow. Concordava per 6 post di Jackery, i cui post con più like compaiono in thread entusiasti sulla preparazione alle emergenze ma sono neutri nei confronti del brand. Concordava per 11 post di BLUETTI, che sembra quindi il risultato migliore.
Il motivo è che 11 di quei 15 post provenivano dall'account bluetti_inc ed erano contenuti di marketing per Halloween e per il lancio di prodotti. Il marketing del brand ha un tono positivo ed è positivo nei confronti del brand, quindi il lessico e le nostre etichette concordano. Gli account dei brand hanno pubblicato molto la settimana scorsa: gli account EcoFlow 19 volte (EcoFlowTech 9, EcoFlowJapan 5 e altri), gli account BLUETTI 23 volte (bluetti_inc 14, BLUETTI_JAPAN 9) e gli account Jackery 5 volte. Se non li escludi, l'affermazione «BLUETTI ha il sentiment migliore» dipende in larga parte da BLUETTI che parla di sé.
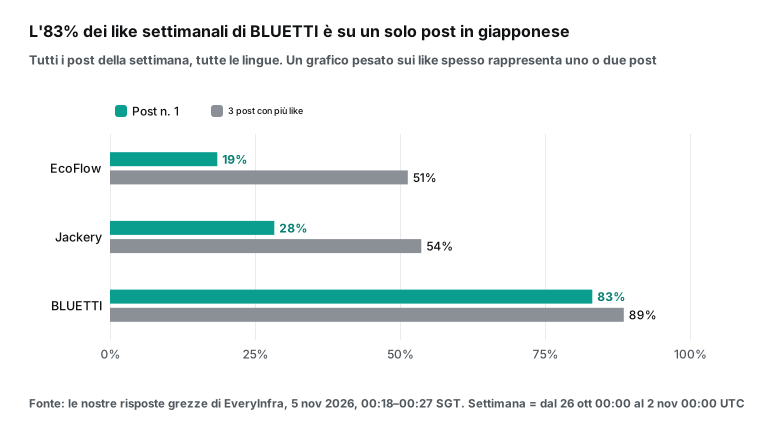
Un altro numero cambia la conclusione senza bisogno del sentiment: quanto sono concentrati i like. I 145 post di BLUETTI della settimana scorsa hanno raccolto 5.299 like. Il thread giapponese citato sopra ne aveva 4.406, cioè l'83%. I tre post principali ne avevano l'89%. Per EcoFlow e Jackery, i tre post principali avevano il 51% e il 54%.
Quindi «BLUETTI ha avuto più engagement» significa in realtà «un post giapponese che nomina BLUETTI è diventato virale». E quel post nomina tutti e tre i brand; solo la ricerca BLUETTI l'ha intercettato. Un report deve mostrare le visualizzazioni mediane accanto ai totali (EcoFlow 171,5, Jackery 137,5, BLUETTI 191) e la quota dei tre post principali. Così i lettori possono capire se l'attenzione dipende da un solo post.
Questi test danno tre regole per la colonna del sentiment, e il prompt sopra le include tutte. Valuta solo l'atteggiamento nei confronti del brand. Elenca a parte i post degli account dei brand. Mostra sia la quota per numero di post sia la quota per like.
GPT-6 legge il testo completo molto meglio di un lessico. Non abbiamo testato le sue etichette in ChatGPT. Ma una cosa è certa. Se il prompt dice solo «analizza il sentiment», il modello giudicherà il tono dell'intero post. E farà lo stesso errore del lessico.
Test 5: qual è il volume di dati di un report?
L'ultimo test misura quanto deve leggere il modello. Abbiamo misurato ogni risposta salvata. Una twitter/search (fino a 200 post) pesava in media circa 261 KB. Una reddit/search (fino a 25 post) circa 50 KB, e una reddit/subreddit_posts (100 post) circa 94 KB.
Il blocco di testo MCP era di 72 KB. Un report base, con una chiamata X e una ricerca Reddit per brand, arrivava a 930.618 byte. A circa 4 byte per token, sono circa 233.000 token. Il report completo, con gli elenchi dei subreddit e i post top del mese, arrivava a 1.395.246 byte, circa 349.000 token.
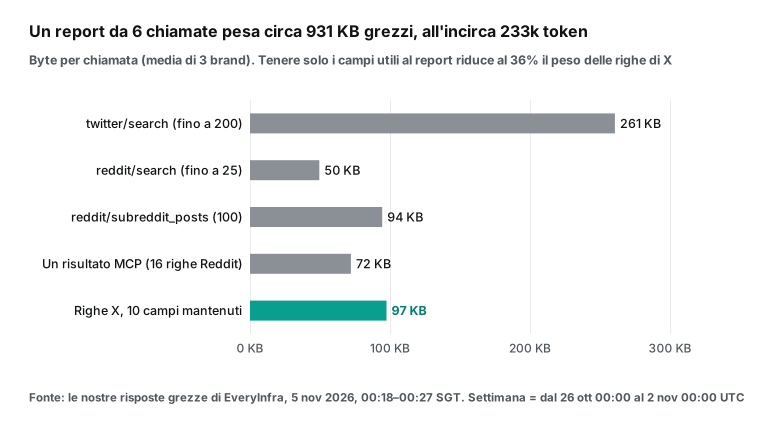
L'Help Center di OpenAI non dice quanto output degli strumenti può contenere una chat GPT-6, e non l'abbiamo testato in ChatGPT. Quindi non diciamo né «ci sta» né «non ci sta». Possiamo dire che i dati X sono la parte più pesante. Ogni post pesa circa 1,3-1,4 KB, e campi come l'URL dell'avatar dell'autore, la bio e i dettagli dei media non servono a un report.
Con 10 campi e il testo tagliato a 280 caratteri, la parte X è scesa da 815.904 a 292.415 byte. Questi due numeri si basano sugli array dei risultati serializzati. I 930.618 byte citati sopra si basano sulle dimensioni dei file salvati, quindi non sottrarre gli uni dagli altri. Se usi direttamente l'MCP di EveryInfra, senza un tuo livello intermedio, puoi chiedere meno dati: abbassa il limit di X da 200 a 100. Il compromesso è che i conteggi nella settimana diventano più spesso valori minimi.
Com'è fatto il report: la prima tabella di confronto
Ecco le regole sopra applicate ai dati reali, per la settimana scorsa (dal 26 ottobre al 1° novembre 2026, UTC). Abbiamo calcolato la tabella dalle risposte grezze con le regole del prompt. È la tabella che Intelligent UI dovrebbe disegnare nel caso migliore. Non abbiamo testato cosa disegna davvero ChatGPT.
| Brand | Post X nella settimana | Like su X / visualizzazioni mediane | Inglese / giapponese | Post nel subreddit nella settimana | Commenti nel subreddit | Quota negativa in inglese (numero di post / like) | Nota |
|---|---|---|---|---|---|---|---|
| EcoFlow | 158 o più | 4,869 / 171.5 | 110 / 20 | 73 o più (r/Ecoflow_community) | 492 | 17% / 54% | I like dei post classificati come negativi provengono dai post sui blackout di Kiev e sulle raccolte fondi, non da lamentele sul brand; 26 post di aiuto nella community |
| Jackery | 148 o più | 2,016 / 137.5 | 77 / 65 | 13 (r/Jackery) | 206 | 21% / 38% | Giapponese al 44%; i post principali compaiono in thread sulla preparazione alle emergenze |
| BLUETTI | 145 | 5,299 / 191 | 48 / 69 | 20 (r/bluetti) | 93 | 19% / 22% | 83% dei like su un solo post giapponese che nomina tutti e tre i brand; i post principali in inglese sono marketing del brand |
La tabella supporta tre conclusioni. Primo, il volume su X dei tre brand è nello stesso ordine di grandezza. La differenza è inferiore all'errore nei dati, perché due brand hanno raggiunto il limite di 200.
Secondo, la community Reddit di EcoFlow è chiaramente la più attiva. Ha un numero di post e commenti più volte superiore alle altre due, e 26 post hanno un flair di richiesta di aiuto. La tabella mostra solo il conteggio. Una persona deve leggere questi post per capire se indicano un unico problema di prodotto.
Terzo, i post con più like della settimana scorsa riguardavano blackout e preparazione alle emergenze. Il post giapponese che nomina tutti e tre i brand parte dall'indicazione britannica sulle scorte per tre giorni. I post in inglese con più like di EcoFlow parlano dei blackout a Kiev.
Costi API per un report
I prezzi EveryInfra vengono dal catalogo che abbiamo letto il 5 novembre 2026. twitter/search, reddit/search e reddit/subreddit_posts costano ciascuno $0,000556 per chiamata. Le chiamate non riuscite, vuote o soggette a un limite di frequenza delle richieste sono gratuite (catalogo EveryInfra; puoi anche consultare la pagina dei prezzi). Il prezzo è per chiamata, non per riga. Una reddit/search che restituisce 16 righe costa quanto una che ne restituisce 24, e una twitter/search con 200 post resta una sola chiamata.
| Versione del report | Chiamate | Costi API |
|---|---|---|
| Base: 3 brand, una ricerca X e una ricerca Reddit ciascuno | 6 | $0.003336 |
| Completo: aggiunge i 100 post più recenti del subreddit e i post top del mese su Reddit | 12 | $0.006672 |
| Conteggi X accurati per giorno (3 brand x 7 giorni) più i subreddit | 24 | $0.013344 |
| Un report completo a settimana, al mese (52 settimane / 12) | circa 52 | $0.028912 |
| Un report completo a settimana, all'anno | 624 | $0.346944 |
| Questo articolo, 5 novembre 2026, dalle 00:18 alle 00:27 ora di Singapore | 16 richieste, 13 addebitate, 3 soggette a un limite di frequenza delle richieste | $0.007228 |
ChatGPT non addebita costi per report. Intelligent UI non ha una quota separata e le chiamate ai plugin non hanno costi aggiuntivi; rientrano nel tuo piano (Help Center 20001354).
Prezzi dei piani sull'Help Center al 5 novembre 2026: Plus costa $20 al mese (Help Center 20001493). Pro costa $100, $200 o $500 al mese (Help Center 9793128). Business Standard costa $25 per postazione al mese, oppure $20 per postazione al mese con fatturazione annuale (Help Center 8792828). Quindi il costo reale è un canone fisso del piano più costi API vicini allo zero. Un anno di 52 report completi costa $0,35 di costi API.
Cioè circa 1/57 di un mese di Plus. La parte costosa è il tempo delle persone. Qualcuno deve verificare in ogni report se è stato raggiunto il limite massimo, controllare il mix linguistico e individuare i post degli account dei brand.
Anche i limiti di frequenza delle richieste sono un costo. La nostra chiave di test consente 10 richieste al minuto, e abbiamo ricevuto tre risposte 429. Il corpo diceva «10 requests per minute», «retry after 17s» e «nothing was charged». Gli header contenevano retry-after: 17 e x-ratelimit-limit-requests: 10.
Sei chiamate generate da una sola domanda in ChatGPT normalmente non raggiungono il limite. Se più colleghi condividono un account EveryInfra ed eseguono report nello stesso momento, possono raggiungerlo. Il modello vede il testo del 429, scritto per essere letto da un'AI, e di solito aspetta e riprova.
Cosa dicono Reddit e Hacker News
Abbiamo cercato «gpt 6 intelligent ui» su Reddit e Hacker News nell'ultimo mese. Cercavamo una cosa sola: un esempio di dati MCP personalizzati che Intelligent UI avesse disegnato come grafico. Non abbiamo trovato né esempi né controesempi. La maggior parte dei thread parla di Intelligent UI in sé, e abbiamo rimosso i nomi utente da tutte le citazioni. Nel thread di lancio su r/OpenAI, il commento più votato la definiva la prima funzionalità da molto tempo che aiuta gli utenti normali, non solo chi programma. Un altro commento la paragonava alle applet Java (thread di lancio su r/OpenAI).
Nel thread di lancio su r/ChatGPT, un utente chiedeva in cosa si differenzi dagli artifact creati da altri modelli. Un altro faceva notare che funziona solo in Chat, non in Work (thread di lancio su r/ChatGPT). Un thread su r/codex chiedeva cosa permetta di fare che prima non fosse possibile (thread su r/codex). Le critiche su Hacker News riguardavano più immagini e più spazi vuoti, quindi meno informazioni per schermata (thread su Hacker News). Il repost su r/technology era per lo più scettico sull'idea che i modelli facciano tutto il lavoro (thread su r/technology).
Per i report conta soprattutto il titolo di un thread su r/ChatGPT. Dice che Intelligent UI è valida ma resta un ambiente per creare bozze, non un'infrastruttura (thread su r/ChatGPT). Questa opinione è in linea con il nostro consiglio. Usa Intelligent UI per una visione rapida nel momento in cui fai la domanda. Tieni i numeri che monitori nel tempo in una pagina condivisa o in un tuo foglio di calcolo. Il nostro articolo su Spaces mostra la pagina condivisa.
Limiti e aspetti da tenere d'occhio
| Trappola | Cosa abbiamo osservato | Cosa fare |
|---|---|---|
| Post fuori settimana | until: di X ha lasciato passare 42, 52 e 22 post | Filtra per posted_at |
| Limiti massimi | 200 post X, 100 post del subreddit | Scrivi «almeno» o dividi la settimana |
| Post non rilevati | Il post principale nominava 3 brand ed è stato trovato da 1 ricerca | Unisci i risultati dei brand e rimuovi i duplicati |
| Lingua | Giapponese al 44% e al 48% per due brand | Dividi prima per language |
| Account dei brand | 11 dei 15 post in inglese con più like di BLUETTI | Elencali separatamente dal sentiment |
OpenAI non garantisce che Intelligent UI visualizzi i risultati provenienti da server MCP personalizzati. L'intero metodo dipende dal fatto che il modello legga il testo e costruisca la tabella da solo. Rientra nella dichiarazione di OpenAI secondo cui le risposte possono includere tabelle e grafici, ma non è una funzionalità documentata a parte. Prima di estenderlo a un team, esegui lo stesso prompt tre volte sul tuo account. Verifica che il layout sia stabile prima di farci affidamento.
Lo strumento per i dati chiede conferma. everyinfra_call_api non è contrassegnato come di sola lettura, quindi con la modalità sviluppatore e i permessi dei plugin ChatGPT chiede conferma prima di chiamarlo. Gli admin di Business possono cambiare la policy di approvazione nelle impostazioni dei plugin. Per Pro personale, OpenAI parla di «read and fetch permissions». La documentazione non dice se su Pro uno strumento non di sola lettura viene eseguito, chiede conferma o viene bloccato, e non l'abbiamo testato in ChatGPT.
Lo stato di Intelligent UI non passa da una chat all'altra. L'Help Center dice che componenti come le checklist mantengono lo stato dopo un aggiornamento della pagina, ma non in una nuova chat. La domanda della settimana prossima produce un report completamente nuovo, senza i toggle e i filtri della settimana scorsa. Per confrontare una settimana con l'altra, copia ogni tabella altrove o usa una pagina di Spaces.
Non puoi ottenere Intelligent UI tramite l'API. La documentazione per sviluppatori descrive chat-latest come l'ultimo modello Instant usato in ChatGPT (pagina del modello chat-latest). Il changelog registra gli aggiornamenti dei suoi snapshot (changelog dell'API). Non abbiamo trovato alcuna dichiarazione secondo cui i componenti di Intelligent UI arrivino tramite l'API. Per creare lo stesso report nel tuo prodotto, disegna i grafici tu stesso.
Ci sono tre trappole nei dati. until: di X lascia passare post successivi alla settimana, quindi filtra di nuovo per posted_at. I limiti di 200 per twitter/search e di 100 per reddit/subreddit_posts trasformano i conteggi dei brand più citati in valori minimi. Una ricerca che raggiunge il limite può anche perdere il post più importante della settimana. Le righe di Reddit non hanno un campo per la lingua, quindi il modello deve riconoscere da solo i post in giapponese o in spagnolo. Il prompt sopra copre tutte e tre le trappole, e la nota sotto ogni tabella dovrebbe ripeterle.
Reddit e X hanno regole proprie. EveryInfra restituisce post pubblici per ricerche di mercato e monitoraggio dei brand. Se ridistribuisci i risultati, li usi per addestrare modelli o per profilare persone, leggi prima i termini della piattaforma. La pagina della Reddit Data API dice che le regole d'uso sono stabilite dai Developer Terms e dai Data API Terms (Reddit Data API Wiki). Leggi i Reddit Data API Terms prima di riutilizzare i dati. Questo articolo non costituisce consulenza legale.
Modifiche recenti
| Data | Modifica |
|---|---|
| 7 ottobre 2026 | GPT-6 e Intelligent UI arrivano in Chat per Plus, Pro, Business ed Enterprise; le note di rilascio di Business lo registrano lo stesso giorno. |
| 8 ottobre 2026 | Free e Go ottengono GPT-6 Luna. |
| 22 ottobre 2026 | The Guardian riporta le indicazioni britanniche Be Ready; Reuters riprende la notizia il 23 ottobre 2026. |
| 4 novembre 2026 | Le connessioni al server MCP di EveryInfra che includono una chiave nell'URL smettono di funzionare; gli utenti ChatGPT passano a /mcp/all con OAuth. |
| 5 novembre 2026 | le nostre chiamate reali e la data di lettura di ogni pagina ufficiale. |
FAQ su GPT-6 Intelligent UI
Gli utenti gratuiti possono usare GPT-6 Intelligent UI?
Sì. Il post di lancio dice che Free e Go l'hanno ricevuta dall'8 ottobre 2026, con GPT-6 Luna, e l'Help Center dice che Luna supporta Intelligent UI. Però la pagina dell'Help Center sugli MCP personalizzati non elenca Free né Go tra i piani che possono aggiungere server MCP personalizzati. Quindi un account gratuito vede risposte con Intelligent UI, ma OpenAI non documenta se possa collegare EveryInfra. Fonti: post di lancio di OpenAI, Help Center 20001598.
Posso disattivare Intelligent UI?
Non del tutto; puoi solo semplificarla. Sul web, la pagina di Intelligent UI indica Personalization, poi Layout and Visuals, poi Simple. La pagina dei modelli GPT-6 dice di disattivare Layout and visuals in Settings. Entrambe le pagine dicono che alcuni elementi visivi possono comunque comparire, e non esiste una vera modalità solo testo. Fonti: Help Center 20001598, Help Center 20001354.
Gli sviluppatori possono usare Intelligent UI nell'API?
Non secondo la documentazione. L'API offre chat-latest, descritto come l'ultimo modello Instant usato in ChatGPT. Ma la documentazione e il changelog dell'API che abbiamo letto non dicono che i componenti di Intelligent UI arrivino tramite l'API. Per una UI interattiva nella tua app, la strada documentata da OpenAI è un plugin con un template MCP Apps. Fonti: pagina del modello chat-latest, documentazione per sviluppatori: ChatGPT UI.
Intelligent UI disegna automaticamente i dati MCP personalizzati?
Non secondo la documentazione. Per quanto riguarda i plugin, l'Help Center dice solo che quelli collegati «continueranno a funzionare». Il server MCP di EveryInfra restituisce una stringa JSON senza structuredContent e senza template di UI. Il modello deve leggerla e costruire un grafico con Intelligent UI.
Se compare un grafico, e se ha lo stesso aspetto ogni volta, dipende dal prompt e dalla dimensione dei dati. Per un layout di grafico fisso, la strada documentata è MCP Apps. Fonti: Help Center 20001598, specifica MCP: Tools.
Perché la mia chat mostra GPT-6 Sol ma nessun elemento visivo?
Controlla quattro cose. Sei nella scheda Chat? Work e Voice non la supportano. Hai scelto il livello di ragionamento Pro? GPT-6 Astra non la supporta.
La tua app desktop non è aggiornata? Hai scelto Simple nelle impostazioni? Il rilascio è stato graduale, e alcuni utenti paganti su Reddit non vedevano ancora elementi visivi giorni dopo il lancio. Fonti: Help Center 20001598, thread di lancio su r/ChatGPT.
Per iniziare
- Registrati ed effettua una ricarica nella console EveryInfra. Usa il catalogo gratuito per verificare che
twitter/search,reddit/searchereddit/subreddit_postssiano disponibili. - Esegui una chiamata a ogni funzionalità con curl o dal playground. Controlla campi, limiti massimi e sintassi delle date per la ricerca X e la ricerca Reddit.
- In ChatGPT sul web, aggiungi un server MCP personalizzato in Plugins:
https://api.everyinfra.com/mcp/allcon OAuth. Consulta la configurazione dell'MCP remoto e la pagina del server MCP. Su Business, chiedi a un admin. - Aggiungi una Custom Instruction: «Usa tabelle quando confronti opzioni e indica come è stato contato ogni numero». Fai la domanda con il prompt sopra. Conferma la prima chiamata e scegli di ricordare la scelta per la chat.
- Verifica la tabella rispetto alle tre trappole: post fuori settimana, limiti massimi e lingua. Poi condividila con il tuo team.
Letture correlate
- Tracker dei concorrenti con ChatGPT Spaces: una pagina condivisa che il team aggiorna ogni settimana, il posto giusto per i numeri di questo report.
- Radar di ricerca prodotto con ChatGPT dots: due set di permessi per un agente sempre attivo, e perché le chiamate API a pagamento per i dati vanno nelle attività assegnate.
- Radar della domanda con le attività pianificate di ChatGPT: una persona riceve ogni settimana una raccolta di lamentele e domande da Reddit.
- API per i dati di Reddit e API per i dati di X: tutte le funzionalità, i parametri e i prezzi.
Riferimenti
- «GPT-6 and Intelligent UI for everyone», OpenAI, letto il 5 novembre 2026, https://openai.com/index/gpt-6-for-everyone/
- «Intelligent UI in ChatGPT», OpenAI Help Center, letto il 5 novembre 2026, https://help.openai.com/en/articles/20001598-intelligent-ui-in-chatgpt
- «GPT-6 and other models in ChatGPT», OpenAI Help Center, letto il 5 novembre 2026, https://help.openai.com/en/articles/20001354-gpt-6-and-other-models-in-chatgpt
- «Connecting custom MCP servers in ChatGPT», OpenAI Help Center, letto il 5 novembre 2026, https://help.openai.com/en/articles/12584461-connecting-custom-mcp-servers-in-chatgpt
- «ChatGPT Business release notes», OpenAI Help Center, letto il 5 novembre 2026, https://help.openai.com/en/articles/11391654-chatgpt-business-release-notes
- «ChatGPT release notes», OpenAI Help Center, letto il 5 novembre 2026, https://help.openai.com/en/articles/6825453-chatgpt-release-notes
- «ChatGPT Enterprise and Edu release notes», OpenAI Help Center, letto il 5 novembre 2026, https://help.openai.com/en/articles/10128477-chatgpt-enterprise-and-edu-release-notes
- «ChatGPT Business models and limits», OpenAI Help Center, letto il 5 novembre 2026, https://help.openai.com/en/articles/12003714-chatgpt-business-models-and-limits
- «ChatGPT Enterprise and Edu models and limits», OpenAI Help Center, letto il 5 novembre 2026, https://help.openai.com/en/articles/11165333-chatgpt-enterprise-and-edu-models-and-limits
- «ChatGPT Business overview», OpenAI Help Center, letto il 5 novembre 2026, https://help.openai.com/en/articles/8792828-chatgpt-business-overview
- «About ChatGPT Pro tiers», OpenAI Help Center, letto il 5 novembre 2026, https://help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers
- «ChatGPT back-to-school offer for students» (indica il prezzo di Plus), OpenAI Help Center, letto il 5 novembre 2026, https://help.openai.com/en/articles/20001493-chatgpt-back-to-school-offer-for-students
- «Build your MCP server», documentazione per sviluppatori OpenAI, letto il 5 novembre 2026, https://developers.openai.com/plugins/build/mcp-server
- «ChatGPT UI», documentazione per sviluppatori OpenAI, letto il 5 novembre 2026, https://developers.openai.com/plugins/build/chatgpt-ui
- «Authentication», documentazione per sviluppatori OpenAI, letto il 5 novembre 2026, https://developers.openai.com/plugins/build/auth
- «Connect and test in ChatGPT», documentazione per sviluppatori OpenAI, letto il 5 novembre 2026, https://developers.openai.com/plugins/deploy/connect-chatgpt
- «Plugins changelog», documentazione per sviluppatori OpenAI, letto il 5 novembre 2026, https://developers.openai.com/plugins/changelog
- «ChatGPT Developer mode», documentazione per sviluppatori OpenAI, letto il 5 novembre 2026, https://developers.openai.com/api/docs/guides/developer-mode
- «chat-latest», documentazione per sviluppatori OpenAI, letto il 5 novembre 2026, https://developers.openai.com/api/docs/models/chat-latest
- «API changelog», documentazione per sviluppatori OpenAI, letto il 5 novembre 2026, https://developers.openai.com/api/docs/changelog
- «GPT-6 and Intelligent UI in ChatGPT» (annuncio), OpenAI Developer Community, letto il 5 novembre 2026, https://community.openai.com/t/gpt-6-and-intelligent-ui-in-chatgpt/1404139
- «Tools» (specifica MCP 2025-06-18), Model Context Protocol, letto il 5 novembre 2026, https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- «Authorization» (specifica MCP 2025-11-25), Model Context Protocol, letto il 5 novembre 2026, https://modelcontextprotocol.io/specification/2025-11-25/basic/authorization
- «MCP Apps», Model Context Protocol, letto il 5 novembre 2026, https://modelcontextprotocol.io/docs/extensions/apps
- «EveryInfra data capability catalog» (gratuito), letto il 5 novembre 2026 alle 00:17 ora di Singapore, https://api.everyinfra.com/api/v1/social/catalog
- «EveryInfra /mcp/all protected resource metadata», letto il 5 novembre 2026, https://api.everyinfra.com/.well-known/oauth-protected-resource/mcp/all
- «EveryInfra MCP server» (chiamate reali a initialize, tools/list e tools/call), letto il 5 novembre 2026, https://api.everyinfra.com/mcp
- «How to use advanced search», X Help Center, letto il 5 novembre 2026, https://help.x.com/en/using-x/x-advanced-search
- «Reddit Data API Wiki», Reddit Help, letto il 5 novembre 2026, https://support.reddithelp.com/hc/en-us/articles/16160319875092-Reddit-Data-API-Wiki
- «Data API Terms», Reddit, letto il 5 novembre 2026, https://www.redditinc.com/policies/data-api-terms
- «vaderSentiment» (VADER 3.3.2), GitHub, letto il 5 novembre 2026, https://github.com/cjhutto/vaderSentiment
- «Households encouraged to take small, simple steps to stay prepared in an emergency», GOV.UK, letto il 5 novembre 2026, https://www.gov.uk/government/news/households-encouraged-to-take-small-simple-steps-to-stay-prepared-in-an-emergency
- «Be ready for emergencies», sito della campagna GOV.UK, letto il 5 novembre 2026, https://beready.campaign.gov.uk/
- «UK tells public to keep three days' emergency supplies at home», Reuters, 23 ottobre 2026, letto il 5 novembre 2026, https://www.reuters.com/business/aerospace-defense/uk-tells-public-keep-three-days-emergency-supplies-home-2026-10-23/
- «Every Briton should stockpile water and food supplies, government advises», The Guardian, 22 ottobre 2026, letto il 5 novembre 2026, https://www.theguardian.com/politics/2026/oct/22/britain-prepare-infrastructure-attacks-hostile-states-wes-streeting
- «Kyiv faces emergency power cuts, widespread water outages after Russia's largest attack on energy infrastructure this year», Kyiv Independent, letto il 5 novembre 2026, https://kyivindependent.com/kyiv-faces-emergency-power-cuts-widespread-water-outages-after-russias-largest-attack-on-energy-infrastructure-this-year/
- «EcoFlow launches new residential storage series with Titan range», ess-news, 14 ottobre 2026, letto il 5 novembre 2026, https://www.ess-news.com/2026/10/14/ecoflow-launches-new-residential-storage-series-with-titan-range/
- «Tiny Titan: new residential battery system from EcoFlow starts small», electrek, 18 ottobre 2026, letto il 5 novembre 2026, https://electrek.co/2026/10/18/tiny-titan-new-residential-battery-system-from-ecoflow-starts-small/
- «EcoFlow's new TITAN batteries can keep your central air running through a blackout», PopSci, letto il 5 novembre 2026, https://www.popsci.com/gear/ecoflow-titan-5000-home-battery/
- «BLUETTI Unveils Early Access for Apex 200: Next-Gen Versatile Power Station» (comunicato PRNewswire), Yahoo Finance, 20 ottobre 2026, letto il 5 novembre 2026, https://finance.yahoo.com/energy/articles/bluetti-unveils-early-access-apex-160900669.html
- «GPT-6 and Intelligent UI for everyone» (thread), r/OpenAI, letto il 5 novembre 2026, https://www.reddit.com/r/OpenAI/comments/1x045qs/gpt6_and_intelligent_ui_for_everyone/
- «GPT-6 and Intelligent UI for everyone» (thread), r/ChatGPT, letto il 5 novembre 2026, https://www.reddit.com/r/ChatGPT/comments/1x052jr/gpt6_and_intelligent_ui_for_everyone/
- «GPT-6's Intelligent UI is genuinely good. It's still a sketchpad, not infrastructure», r/ChatGPT, letto il 5 novembre 2026, https://www.reddit.com/r/ChatGPT/comments/1x6crjw/gpt6s_intelligent_ui_is_genuinely_good_its_still/
- «What can GPT-6 + Intelligent UI do that wasn't already possible», r/codex, letto il 5 novembre 2026, https://www.reddit.com/r/codex/comments/1x04lt9/what_can_gpt6_intelligent_ui_do_that_wasnt/
- «OpenAI Introduces "Intelligent UI" For ChatGPT With GPT-6», r/technology, letto il 5 novembre 2026, https://www.reddit.com/r/technology/comments/1x04ajv/openai_introduces_intelligent_ui_for_chatgpt_with/
- «GPT-6 and Intelligent UI» (thread), Hacker News, letto il 5 novembre 2026, https://news.ycombinator.com/item?id=49996425
Riferimenti BL-90