GPT-6 Intelligent UI para un informe de marcas en Reddit y X: ejemplo de configuración MCP y pruebas con datos reales
GPT-6 Intelligent UI responde con tablas y gráficos, pero OpenAI no dice que dibuje datos de MCP. Un informe de 3 marcas costó 0,003336 USD en la API.
GPT-6 llegó a la pestaña Chat de ChatGPT el 2026-10-07 junto con Intelligent UI. Con esta función, el modelo decide si una respuesta lleva texto, gráficos, botones o un formulario (artículo de OpenAI). Este artículo prueba un trabajo concreto. Conectas el servidor MCP remoto de EveryInfra a ChatGPT y preguntas: «Compara estas 3 marcas en Reddit y X la semana pasada, por volumen de conversación y sentimiento». ¿Sale un informe interactivo y estable?
El 2026-11-05, entre las 00:18 y las 00:27 (hora de Singapur), hicimos 16 solicitudes reales a la API. Las marcas fueron EcoFlow, Jackery y BLUETTI, tres fabricantes de estaciones de energía portátiles. Se cobraron 13 solicitudes, en total 0,007228 USD. La respuesta tiene tres partes. Primero, OpenAI no dice que Intelligent UI dibuje los datos que devuelve un servidor MCP personalizado. Segundo, nuestro MCP devuelve una cadena JSON, así que el modelo tiene que leerla y armar la tabla por su cuenta. Tercero, hay tres números en los datos que engañan al modelo si el prompt no los controla.
Este artículo es distinto de nuestros otros tres sobre ChatGPT. El de ChatGPT Spaces para seguir a la competencia trata una página compartida que un equipo actualiza cada semana. El del radar de productos con ChatGPT dots trata un agente siempre activo y sus dos grupos de permisos. El del radar de demanda con tareas programadas trata un aviso semanal para una sola persona. Aquí miramos una sola cosa: cómo una pregunta suelta se convierte en una tabla y un gráfico interactivos. También explicamos cómo diseñar los datos para que el modelo no cuente mal. No iniciamos sesión en ChatGPT: cada paso de ChatGPT sale de la documentación de OpenAI y está marcado como ejemplo de configuración. Cada número de EveryInfra sale de una respuesta real guardada que se puede recalcular.
Qué es GPT-6 Intelligent UI: lo que OpenAI escribió de verdad
Empecemos por el texto oficial. El artículo de OpenAI «GPT-6 and Intelligent UI for everyone» presenta Intelligent UI como una capacidad nueva de GPT-6 en ChatGPT. Las respuestas pueden ser interfaces totalmente interactivas que hacen más visuales las respuestas diarias y más fáciles los temas complejos. ChatGPT también puede crear en el momento una pequeña herramienta para la tarea que tienes delante (artículo de OpenAI, leído el 2026-11-05). OpenAI construyó una biblioteca de componentes nativos que se transmiten por partes, más un compilador. La interfaz aparece poco a poco mientras el modelo escribe. La biblioteca da una base de diseño común y el modelo decide cómo encajan las piezas.
La página del Centro de ayuda «Intelligent UI in ChatGPT» da más detalle. GPT-6 se entrenó para componer respuestas con texto, imágenes y elementos interactivos. Una respuesta puede incluir gráficos, botones, formularios y experiencias interactivas dentro del chat. El formato depende de la pregunta: una comparación puede ir lado a lado y una explicación puede usar un diagrama interactivo. Cuando el texto simple es la mejor respuesta, recibes texto simple. Fuente: Centro de ayuda 20001598, leído el 2026-11-05; la página mostraba una actualización de unos 14 días antes. Así que la respuesta de OpenAI a «¿cuándo aparecen componentes interactivos?» es sencilla: el modelo decide según la pregunta. No hay un interruptor de «siempre con gráfico».
La misma página responde varias preguntas útiles para un informe. Puedes añadir preferencias en las instrucciones personalizadas (Custom Instructions); el ejemplo de OpenAI es usar tablas al comparar opciones, aunque el diseño exacto puede cambiar. Las listas de verificación conservan su estado al recargar el chat, pero no entre chats. Intelligent UI solo funciona en Chat, no en Work ni en Voice.
| Pregunta | Lo que escribió OpenAI | Fuente | Qué significa para un informe |
|---|---|---|---|
| Qué es | El modelo arma texto, imágenes, botones, formularios y gráficos con componentes nativos; un compilador los muestra por partes | Artículo de lanzamiento, Centro de ayuda 20001598 | La tabla la dibuja el modelo; el plugin no entrega un componente terminado |
| Cuándo aparecen componentes | El modelo decide según el tipo de pregunta; las preguntas simples reciben texto | Centro de ayuda 20001598 | Pide la tabla en el prompt y en las instrucciones personalizadas |
| Hace falta un prompt especial | No; las respuestas de texto siguen existiendo | Centro de ayuda 20001354 | Puede salir un gráfico sin pedirlo, pero el diseño puede variar |
| Cuota de uso propia | No; se aplican los límites del modelo, las herramientas y el plan | Centro de ayuda 20001354 | El coste del informe es el plan más la API |
| Los datos de un plugin se convierten en componentes | Solo dice que los plugins conectados «seguirán funcionando» | Centro de ayuda 20001598 | No está documentado; no lo des por hecho |
| Se puede desactivar | Web: Personalization, Layout and Visuals, Simple; otra página dice desactivar Layout and visuals en Settings | Centro de ayuda 20001598 y 20001354 | Las dos páginas usan menús distintos; sigue lo que veas en pantalla |
La forma de desactivarlo merece una nota. La página «GPT-6 and other models in ChatGPT» habla de Settings y Layout and visuals; la de Intelligent UI, de Personalization y Simple (Centro de ayuda 20001354). Ninguna ofrece un modo solo texto. Así que no controlas del todo el diseño: el mismo prompt puede dar una tabla de texto plano a un compañero que eligió Simple.
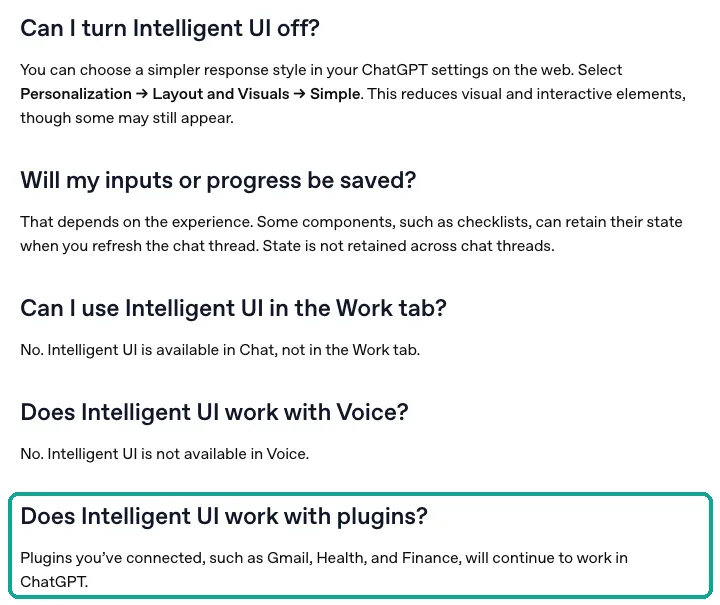
La frase del recuadro es el texto más importante de este artículo. «Seguirán funcionando» indica que los plugins no se rompen. No indica que los datos del plugin entren en la biblioteca de componentes de Intelligent UI. También revisamos la parte para desarrolladores. La documentación de plugins de OpenAI describe otro mecanismo, en el que el servidor aporta su propia plantilla de interfaz; lo vemos en la siguiente sección. Ni en el Centro de ayuda, ni en el artículo de lanzamiento, ni en la documentación para desarrolladores encontramos una frase que diga que Intelligent UI muestra como gráficos los resultados de una herramienta MCP. Por eso escribimos «no documentado». No escribimos «sí» ni escribimos «no».
GPT-6 e Intelligent UI en ChatGPT: quién lo tiene y dónde
El artículo de lanzamiento da el calendario. El 2026-10-07, GPT-6 con Intelligent UI empezó a llegar en todo el mundo a Plus, Pro, Business y Enterprise en la pestaña Chat. Al día siguiente llegó a Free y Go. En Enterprise depende de la configuración del administrador. Los planes de pago usan GPT-6 Sol y Free y Go usan GPT-6 Luna; los dos están ajustados para la conversación diaria (artículo de OpenAI). El artículo también dice que los modelos de Work y Codex no cambiaron. El anuncio en la comunidad de desarrolladores de OpenAI repite este alcance. Añade que GPT-6 Instant empieza a responder preguntas con búsqueda web un 44 % antes, de media, que GPT-5.6 Instant (anuncio en la comunidad de OpenAI).
El Centro de ayuda es claro sobre los niveles de razonamiento. Intelligent UI funciona desde Instant hasta Extra High. La opción de razonamiento Pro usa GPT-6 Astra y no admite Intelligent UI (Centro de ayuda 20001598). La página de modelos y límites de Business repite el límite de Astra. También dice que un puesto Business Standard incluye 15 mensajes Pro al mes (Centro de ayuda 12003714). La nota de versión de Business del 2026-10-07 dice que GPT-6 llega a Chat en los espacios de trabajo Business que cumplen los requisitos. El acceso depende de la configuración del espacio de trabajo y de los clientes compatibles (notas de versión de Business).
| Plan | GPT-6 en Chat | Intelligent UI | MCP personalizado |
|---|---|---|---|
| Free | GPT-6 Luna, desde el 2026-10-08 | Sí | No aparece en la página de MCP personalizado |
| Go | GPT-6 Luna, desde el 2026-10-08 | Sí | No aparece |
| Plus | GPT-6 Sol, desde el 2026-10-07 | Sí | El modo desarrollador incluye Plus; la página de Plugins nombra Pro, Business y Enterprise/Edu |
| Pro | GPT-6 Sol; el razonamiento Pro es Astra | Sol sí, Astra no | Sí, pero con permisos de lectura y consulta |
| Business | GPT-6 Sol, por espacio de trabajo | Sí | Solo administradores y propietarios crean y publican |
| Enterprise / Edu | GPT-6 Sol, según el administrador | Sí | El administrador puede dar permiso de creación a miembros con control de acceso por roles |
Los precios de cada plan están más abajo, en «Costo de API de un informe». La página de Enterprise y Edu dice que GPT-6 está llegando a los espacios Enterprise que cumplen los requisitos. Si GPT-6 no aparece en tu menú de modelos, tu espacio de trabajo todavía no lo tiene (Centro de ayuda 11165333).
El cliente también cuenta. El Centro de ayuda dice que las versiones antiguas de la app de escritorio para macOS y Windows no admiten Intelligent UI, y las notas de Business hablan de «clientes compatibles». Si alguien del equipo dice «a mí no me salen gráficos», revisa tres cosas. ¿Está en la pestaña Chat y no en Work? ¿Eligió el nivel de razonamiento Pro? ¿Su app de escritorio es antigua? En el hilo de lanzamiento de r/ChatGPT, un usuario de pago dijo que tenía GPT-6 Sol activo. Pero sus respuestas no traían elementos visuales, ni siquiera con los prompts de la página de lanzamiento. Lo más probable es que el despliegue o el cliente todavía no hubieran llegado (hilo de lanzamiento en r/ChatGPT).
¿Los datos de un MCP personalizado pueden convertirse en tablas y gráficos?
Esta es la pregunta central y hay dos caminos. El primero es Intelligent UI. El modelo lee lo que devuelve la herramienta y arma una tabla o un gráfico con los componentes de ChatGPT. Para este camino, OpenAI solo tiene la frase sobre los plugins. El segundo es MCP Apps, de la documentación de plugins de OpenAI. El servidor MCP trae su propia plantilla de interfaz. ChatGPT la muestra en un marco aislado dentro del chat y la plantilla dibuja el resultado de la herramienta (documentación: ChatGPT UI). Los dos caminos parecen «un gráfico en el chat». Pero quién lo dibuja y qué tan estable es cambian por completo.
La documentación describe el segundo camino con detalle. Una herramienta apunta a un recurso con _meta.ui.resourceUri, y la dirección del recurso empieza por ui://. El tipo del recurso es text/html;profile=mcp-app. ChatGPT carga la plantilla, y la plantilla habla con el anfitrión mediante mensajes JSON-RPC que empiezan por ui/. La clave antigua _meta["openai/outputTemplate"] sigue funcionando como alias (documentación: Build your MCP server). La documentación de la extensión MCP Apps describe el mismo modelo (documentación de MCP Apps). La herramienta declara un recurso de interfaz y el anfitrión lo muestra en un entorno aislado. OpenAI recomienda además separar funciones. Las herramientas de datos devuelven datos y otra herramienta monta la interfaz. Así, un botón como «Volver a generar» puede llamar otra vez a la herramienta de datos sin montar todo de nuevo.
| Aspecto | Intelligent UI | MCP Apps (interfaz del servidor) | MCP de EveryInfra hoy |
|---|---|---|---|
| Quién dibuja | El modelo y la biblioteca de componentes de ChatGPT | Una plantilla HTML del servidor MCP | Sin plantilla |
| Cómo llegan los datos | El modelo lee el texto y el contenido estructurado de la herramienta | structuredContent va a la plantilla | Una cadena JSON en content[0].type = "text" |
| Documentado para dibujar resultados de herramientas | No | Sí, para eso existe | No aplica |
| Estabilidad del diseño | Puede cambiar cada vez; el usuario puede elegir Simple | Plantilla fija, estable | Depende del modelo |
| Quién lo desarrolla | Nadie; viene integrado | El dueño del servidor lo crea, lo revisa y lo publica | No ofrecemos plantilla |
| Dónde funciona | Chat, de Instant a Extra High | Donde funcionan los plugins | Igual que los plugins |
La especificación MCP es clara sobre los resultados estructurados. La sección de herramientas de la versión 2025-06-18 permite que una herramienta declare un outputSchema y devuelva datos en structuredContent. Por compatibilidad, una herramienta que devuelve contenido estructurado debería poner también el JSON serializado en un bloque TextContent (especificación MCP: Tools). El 2026-11-05 enviamos initialize y tools/list a https://api.everyinfra.com/mcp sin clave, lo cual es gratis. El servidor declara la versión de protocolo 2025-06-18. Ninguna de sus 12 herramientas declara outputSchema ni una plantilla _meta. Un tools/call real solo trae content, sin structuredContent.
Así que, con el MCP remoto de EveryInfra en ChatGPT, solo queda el primer camino. El modelo lee una cadena JSON, cuenta, calcula y decide si usar una tabla o un gráfico. No todo es malo. Los componentes de Intelligent UI son de ChatGPT, encajan con el chat y no hay que desarrollar nada. Pero su estabilidad depende de dos cosas. El prompt tiene que decir con claridad qué quieres. Los datos tienen que ser limpios y lo bastante cortos para que el modelo no se equivoque al contar dentro de 900 KB de texto. Las dos secciones siguientes tratan la conexión y estas dos cosas.
Conectar el MCP remoto de EveryInfra en ChatGPT: planes personales y Business
La página del Centro de ayuda «Connecting custom MCP servers in ChatGPT» da los pasos actuales. En Plugins, pulsa «+» y luego Add custom MCP server. Escribe un nombre, la dirección del servidor y el tipo de autenticación. Lee y acepta el aviso de riesgo y pulsa Create as a plugin. En la experiencia actual de Plugins no hace falta activar antes el modo desarrollador (Centro de ayuda 12584461, leído el 2026-11-05). La página también dice que los servidores solo se añaden en la web, no en el móvil. Con OAuth, el proveedor de identidad debe emitir tokens de actualización, así que los permisos deben incluir offline_access.
# Ejemplo de configuración (no iniciamos sesión en ChatGPT; pasos según el Centro de ayuda; no ejecutado en ChatGPT)
# ChatGPT en la web -> Plugins -> + -> Add custom MCP server
Name:            EveryInfra
MCP server URL:  https://api.everyinfra.com/mcp/all
Authentication:  OAuth
# La pantalla de permiso te lleva a https://auth.everyinfra.com/oidc para entrar en EveryInfra
# Concede al menos data:call (llamadas de datos) y offline_access (token de actualizacion para ChatGPT)
# Acepta el aviso de riesgo -> Create as a plugin
# Espacio Business: solo administradores o propietarios crean y publican; luego los miembros lo activan en Plugins
# Enterprise / Edu: el administrador puede usar control de acceso por roles (RBAC) para que ciertos miembros creen conexiones
¿Por qué /mcp/all y no /mcp? El punto /mcp de EveryInfra recibe la clave en una cabecera de la solicitud. Eso sirve para clientes que pueden poner cabeceras, como Claude Code o Cursor. El MCP personalizado de ChatGPT ofrece OAuth, sin autenticación o mixto. No tiene la opción de «poner una clave en una cabecera» (documentación: Developer mode). /mcp/all usa OAuth. Sus metadatos de recurso protegido nombran https://auth.everyinfra.com/oidc como servidor de autorización, y sus permisos incluyen data:call y offline_access (metadatos de recurso protegido de EveryInfra).
Esto coincide con la guía de autenticación de OpenAI. El servidor de recursos publica metadatos de recurso protegido y el servidor de autorización publica metadatos OAuth. El cliente se identifica con CIMD, registro dinámico o un cliente predefinido (documentación: Authentication). Todo sigue la parte de autorización de la especificación MCP (especificación MCP: Authorization). Antes, algunos usuarios ponían la clave en la dirección con ?key= y elegían «sin autenticación». Esas conexiones dejaron de funcionar el 2026-11-04; nuestro artículo de Spaces recoge la respuesta 401.
La diferencia entre planes personales y Business es directa. En un espacio Business, solo los administradores y propietarios pueden crear conexiones MCP personalizadas y publicarlas. En Enterprise y Edu, el administrador puede usar control de acceso por roles para que ciertos miembros creen conexiones, pero solo administradores y propietarios publican. Para planes personales, la pregunta frecuente «Are apps and full MCP beta available to Pro users?» dice que el MCP completo es para Business y Enterprise/Edu. Los usuarios Pro pueden conectar servidores MCP personalizados con permisos de lectura y consulta. Las notas de Business recogen dos cambios de administración de plugins. Desde el 2026-10-15, el administrador puede gestionar varios plugins a la vez. Desde el 2026-10-21, la configuración del espacio Business está en Admin Console (notas de versión de Business).
| Escenario | Quién lo añade | Confirmación antes de una llamada de datos | Qué vigilar |
|---|---|---|---|
| Plus / Pro personal | Tú | Sí; everyinfra_call_api no está marcado como de solo lectura | Pro dice «lectura y consulta»; no está claro cómo trata una herramienta que no es de solo lectura, así que pruébalo primero |
| Business | El administrador o propietario crea y publica | Sí; el administrador puede fijar la política de aprobación | Los miembros no pueden añadirlo; autoriza con una cuenta de EveryInfra del equipo |
| Enterprise / Edu | El administrador, o un miembro con permiso; el administrador publica | Sí | El espacio debe tener activados GPT-6 y los plugins |
| Free / Go | No aparece | No aplica | Se ve Intelligent UI, pero el MCP personalizado no está documentado |
La confirmación viene de las anotaciones de las herramientas. En nuestra respuesta de tools/list, la herramienta de datos everyinfra_call_api tiene readOnlyHint: false, destructiveHint: true y openWorldHint: true. La herramienta de catálogo everyinfra_list_capabilities es de solo lectura. La documentación del modo desarrollador dice que ChatGPT trata las herramientas sin marca de solo lectura como acciones de escritura. Hay que confirmar antes de cada llamada, y se puede elegir recordar la aprobación en esa conversación (documentación: Developer mode). El valor destructiveHint: true es más fuerte de lo necesario. En la especificación MCP, esta marca indica que la herramienta puede hacer cambios destructivos en su entorno. Una llamada de datos solo lee publicaciones públicas de Reddit y X y no cambia nada allí; descontar saldo no es un cambio destructivo (especificación MCP: Tools). Para el usuario el efecto es el mismo: la herramienta no está marcada como de solo lectura, así que ChatGPT pide confirmación. En la práctica, un informe de 6 llamadas pregunta una vez. Si eliges recordar, el resto de llamadas de ese chat ya no pregunta.
Tablas estables: diseño del prompt y de los campos
Intelligent UI no necesita un prompt especial. Pero «compara las tres marcas por volumen y sentimiento» es una frase floja. ¿Qué cuenta como volumen? ¿Qué siete días son «la semana pasada»? ¿Sentimiento según qué regla? El modelo puede entenderlo distinto cada vez. Proponemos un prompt en tres partes. La parte de datos dice qué capacidades y parámetros usar. La parte de conteo dice qué publicaciones cuentan. La parte de salida dice qué tabla, qué gráfico y qué nota va debajo de la tabla. El ejemplo de OpenAI para las instrucciones personalizadas, usar tablas al comparar opciones, puede ir en tu perfil para que cada comparación tenga tabla por defecto.
# Ejemplo de prompt (ejemplo de configuracion; no ejecutado en ChatGPT)
Usa @EveryInfra para comparar EcoFlow, Jackery y BLUETTI en X y Reddit la semana pasada
(UTC 2026-10-26 00:00 a 2026-11-02 00:00): volumen de conversacion y sentimiento.
Datos, una vez por marca:
1. twitter/search: keyword = "<marca> since:2026-10-26 until:2026-11-02", limit = 200
2. reddit/subreddit_posts: r/Ecoflow_community, r/Jackery, r/bluetti, sort = newest, limit = 100
3. reddit/search: keyword = nombre de la marca, sort = newest, limit = 25 (solo menciones fuera de la comunidad, no totales semanales)
4. twitter/search en espanol: keyword = "(EcoFlow OR Jackery OR Bluetti) lang:es since:2026-10-26 until:2026-11-02"
Conteo:
- Cuenta solo publicaciones con posted_at dentro de la semana. Si X devuelve 200 justas, o la comunidad no llega al lunes, escribe "al menos".
- Separa X por el campo language: ingles, japones, espanol, otros.
- Sentimiento = postura hacia la marca, no el tono de toda la publicacion. Pon aparte las publicaciones de cuentas de la marca.
Salida:
- Una tabla: marca | posts en X | me gusta en X | reparto por idioma | posts en la comunidad | comentarios | nota
- Un grafico de barras agrupadas: posts en X y posts en la comunidad
- Una linea bajo la tabla: como se conto cada columna y que numeros son minimos
Del lado de los datos, cada publicación de twitter/search en EveryInfra tiene unos 30 campos. El catálogo lista 38 campos posibles, entre ellos avatar del autor, biografía, seguidores, etiquetas y enlaces (catálogo de EveryInfra). Cada fila de reddit/subreddit_posts tiene 14 campos y cada fila de reddit/search, 10. Un informe solo necesita unos pocos. La tabla siguiente asigna cada métrica a sus campos, según nuestros resultados reales. Si el prompt nombra estos campos, el modelo no tiene que adivinar.
| Métrica | Campo en X | Campo en Reddit | Nota |
|---|---|---|---|
| Volumen | posted_at, id | posted_at, id | Filtra primero la semana por posted_at y luego cuenta |
| Interacción | like_count, reply_count, view_count | like_count, comment_count | Reddit no tiene vistas; no sumes las dos cosas |
| Idioma | language | No hay | El modelo debe juzgar el idioma en Reddit |
| Publicaciones de la marca | author_username | author_username | Úsalo solo para excluir; no muestres nombres de usuarios particulares |
| Tipo de publicación | is_reply, is_quote | flair (solo en comunidades), community | r/Ecoflow_community usa etiquetas de ayuda; las otras dos no |
| Sentimiento | text | title, text | No hay campo de sentimiento; el modelo lo lee o lo calculas aparte |
Algunos equipos ponen su propia capa MCP delante de EveryInfra, por ejemplo un servicio interno de datos. Pueden usar la especificación MCP para que todo sea más estable. Declaran un outputSchema, ponen los 10 campos filtrados en structuredContent y repiten el mismo JSON como texto en un bloque TextContent. Medimos el efecto. Volvimos a serializar los arreglos de resultados de X de las tres marcas, sin caracteres de escape, y ocupaban 815.904 bytes. Con solo id, url, posted_at, language, like_count, reply_count, view_count, is_reply, is_quote y text recortado a 280 caracteres, quedaron en 292.415 bytes, el 36 %. El modelo lee dos tercios menos y tiene menos ocasiones de contar mal o saltarse filas.
Una ida y vuelta real: qué envía el modelo y qué vuelve
Con el plugin conectado, el modelo llama a EveryInfra con un tools/call MCP estándar. El 2026-11-05 a las 00:25:25 (hora de Singapur) enviamos el mismo formato de solicitud a https://api.everyinfra.com/mcp. Usamos una clave en la cabecera; ChatGPT usa un token OAuth, pero llama a la misma herramienta de datos. Pedimos las publicaciones más populares de EcoFlow en Reddit del último mes. Este es el cuerpo de la solicitud tal como se envió:
{
  "jsonrpc": "2.0",
  "id": 7,
  "method": "tools/call",
  "params": {
    "name": "everyinfra_call_api",
    "arguments": {
      "platform": "reddit",
      "action": "search",
      "params": {"keyword": "EcoFlow", "sort": "top", "limit": 25}
    }
  }
}
El servidor respondió en 6,43 segundos con HTTP 200 y charged_usd 0.000556. result.content tenía un solo elemento, con type igual a text. Su text era una cadena JSON de 72.067 bytes. No había structuredContent, ni isError, ni plantilla de interfaz. Dentro de la cadena venían platform, action, count: 16 y 16 filas. Cada fila tenía 10 campos: id, url, title, text, author_username, community, like_count, comment_count, posted_at y platform. Al final venían los datos de cobro. Pedimos 25 filas y llegaron 16. El catálogo dice que reddit/search solo cubre el último mes. Si hay menos publicaciones populares, llegan menos filas y el precio por llamada no cambia.
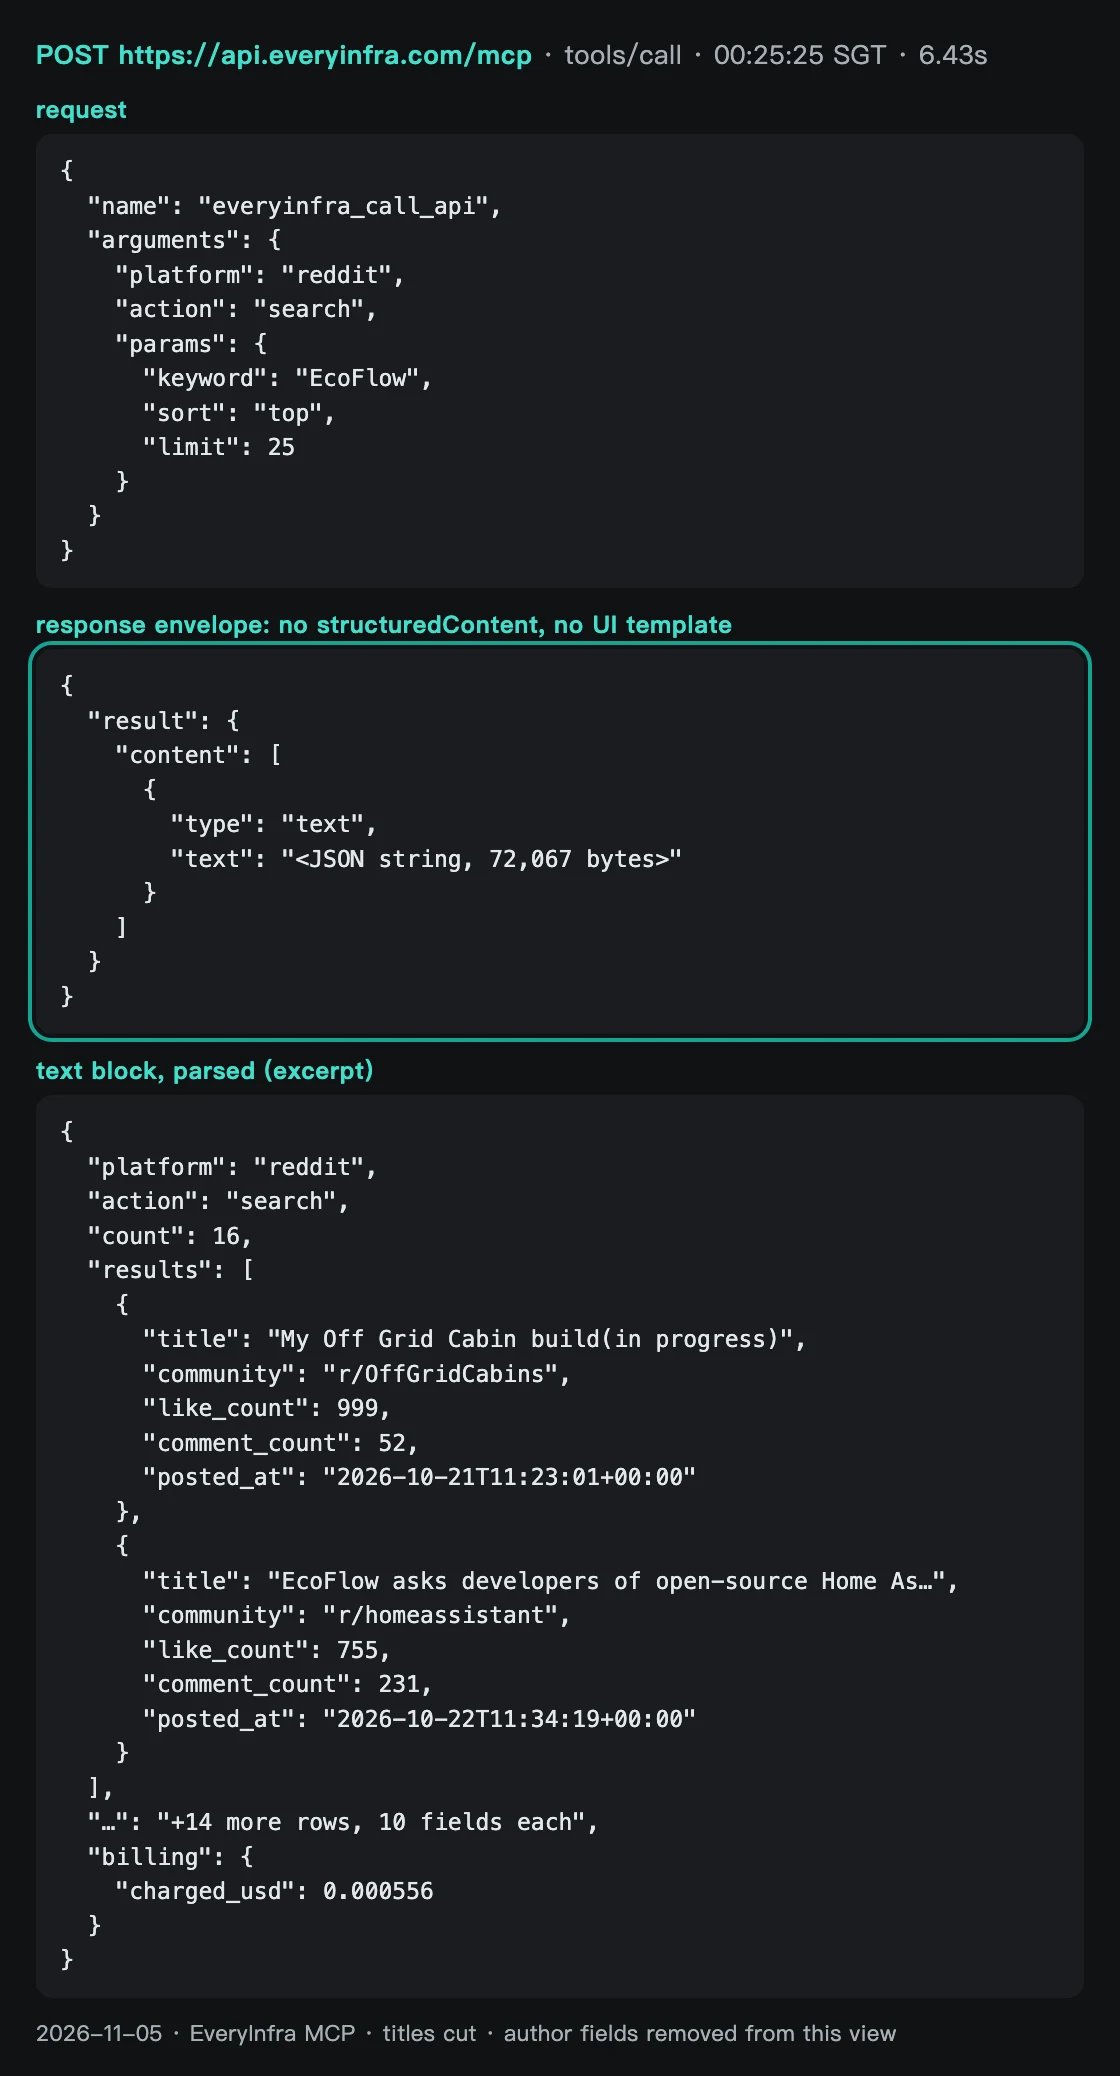
Las dos primeras de esas 16 publicaciones muestran lo difícil que es definir «conversación sobre la marca». La primera es el diario de obra de una cabaña sin conexión a la red en la Isla del Príncipe Eduardo, en Canadá. Solo una frase menciona EcoFlow: el dueño alimenta la cabaña con un EcoFlow Delta Pro, una batería extra y tres paneles de 495 W. Aun así sumó 999 votos. La segunda es un hilo de r/homeassistant sobre EcoFlow y los desarrolladores de Home Assistant, con 755 votos y 231 comentarios. Esa sí expresa una opinión sobre la marca. Ninguna de las 16 cae en la semana pasada; van del 2026-10-05 al 2026-11-04. El orden «top» responde a «qué fue lo más leído del mes». No responde a «cuánto se habló la semana pasada».


Divide un informe en los seis pasos de arriba. Los tres primeros ocurren entre ChatGPT y la API. Los tres últimos son trabajo del modelo. La API garantiza lo que pasa antes del paso cuatro: con parámetros correctos devuelve datos, y las llamadas fallidas o vacías no se cobran. El paso cinco, filtrar y contar, es donde los informes fallan. Las cinco pruebas siguientes ocurren en ese paso. Puede que el modelo no filtre por posted_at o que tome un número con tope como total. Entonces el gráfico se ve bien y aun así las barras tienen la altura equivocada.
Todas las llamadas reales de este artículo están en este registro. Las horas son de Singapur, el 2026-11-05.
| Hora | Capacidad | Marcas | Filas devueltas | Cobro |
|---|---|---|---|---|
| 00:18 a 00:19 | reddit/search newest | 3 | 16, 24, 24 | 3 x 0,000556 USD |
| 00:19 a 00:21 | twitter/search semana pasada | 3 | 200, 200, 167 | 3 x 0,000556 USD |
| 00:22 a 00:24 | reddit/subreddit_posts newest | 3 (2 reintentos tras 429) | 100 cada una | 3 x 0,000556 USD |
| 00:25 | MCP tools/call, reddit/search top | EcoFlow | 16 | 0,000556 USD |
| 00:25 a 00:27 | reddit/search top | Jackery, BLUETTI (1 reintento) | 22, 22 | 2 x 0,000556 USD |
| 00:26 | twitter/search en español | Las 3 en una consulta | 24 | 0,000556 USD |
Prueba 1: la «semana pasada» de X incluía publicaciones posteriores
La búsqueda de X admite los operadores de fecha since: y until:. El catálogo de EveryInfra dice que la palabra clave de twitter/search puede llevar sintaxis de búsqueda de la plataforma (catálogo de EveryInfra). La ayuda de X solo dice que puedes buscar publicaciones antes de una fecha, después de una fecha o dentro de un rango. Su ejemplo usa since:2013-12-30 until:2014-01-02 para publicaciones de Año Nuevo. No dice si el día de until: se incluye ni qué zona horaria se aplica (ayuda de X: búsqueda avanzada). El 2026-11-05, de 00:19 a 00:21 (hora de Singapur), hicimos una búsqueda por marca. La palabra clave fue «marca since:2026-10-26 until:2026-11-02» y el límite, 200.
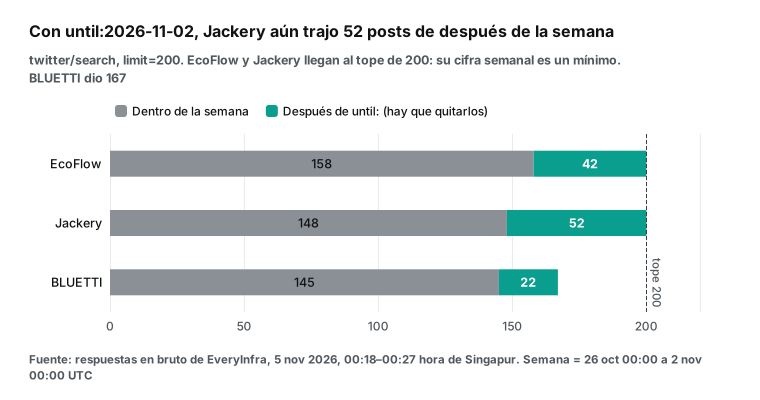
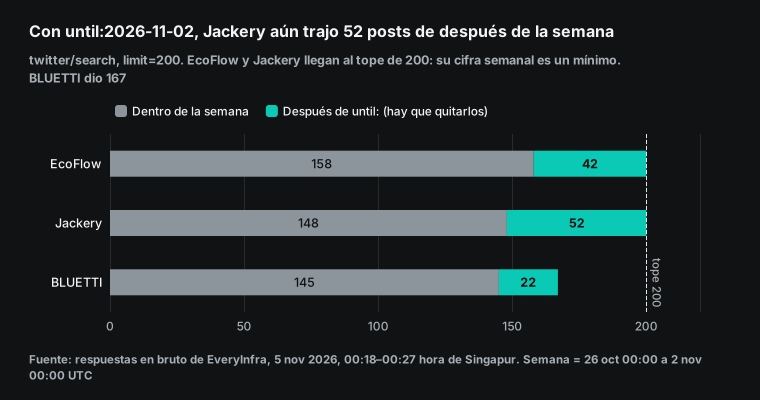
Todas las publicaciones eran posteriores a la fecha de since:, pero muchas pasaban de until:. EcoFlow devolvió 200, y 42 tenían posted_at del 2026-11-02 UTC o después. Jackery tuvo 52 de 200 y BLUETTI, 22 de 167. La mayoría de las sobrantes eran del 2 de noviembre (EcoFlow 40, Jackery 48, BLUETTI 19), con dos a cuatro del día 3. Si el modelo usa count como volumen, EcoFlow sale un 27 % alto y Jackery un 35 %. Por eso hay que mantener en el prompt la línea «cuenta solo publicaciones con posted_at dentro de la semana».
El segundo problema es el tope. Una llamada a twitter/search devuelve como máximo 200 publicaciones. EcoFlow y Jackery devolvieron 200 justas, así que la semana puede tener más. Escribe 158 y 148 como «al menos». BLUETTI devolvió 167 y no llegó al tope, así que 145 es todo lo que esta búsqueda podía ver. El catálogo dice que X ordena por relevancia (Top) por defecto, y que latest no garantiza un orden estricto por fecha. Un resultado con tope no es «las 200 más nuevas». Para contar bien, divide la semana en dos o siete tramos y haz una llamada por tramo. Las llamadas suben; la sección de costes trae las cifras.
Prueba 2: una búsqueda en Reddit cubrió solo uno o dos días
reddit/search devuelve como máximo 25 publicaciones y solo cubre el último mes. El 2026-11-05, a las 00:18 y 00:19 (hora de Singapur), hicimos una búsqueda newest por marca. EcoFlow devolvió solo 16. La más antigua era de la tarde del 3 de noviembre UTC, así que cubrió 24,8 horas. Jackery devolvió 24 en 38,8 horas y BLUETTI, 24 en 51,0 horas. Cada lapso va de la publicación más reciente a la más antigua. Ninguna llegó a la semana pasada. Por los intervalos entre publicaciones, estimamos unas 15,5, 14,9 y 11,3 menciones al día en todo el sitio. Son estimaciones, no conteos.
| Marca | Filas | Horas cubiertas | En la comunidad de la marca |
|---|---|---|---|
| EcoFlow | 16 | 24,8 | 37,5 % |
| Jackery | 24 | 38,8 | 37,5 % |
| BLUETTI | 24 | 51,0 | 16,7 % |
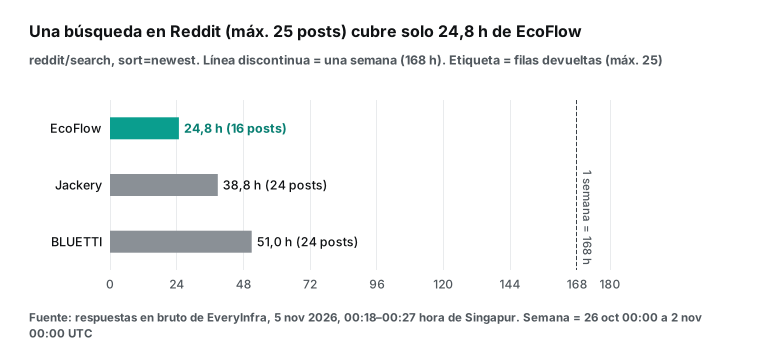
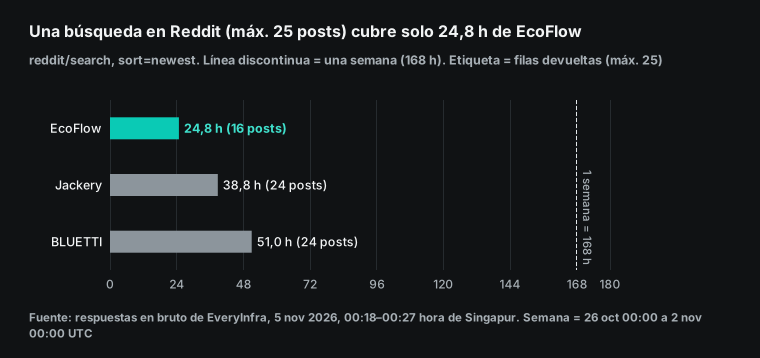
La búsqueda en todo el sitio también tiene ruido. Las 16 de EcoFlow estaban repartidas en unas diez comunidades, como r/Ecoflow_community (6), r/prepping, r/dieselheater y r/overlanding. Jackery tenía 9 de 24 en r/Jackery; el resto eran ofertas y comunidades de preparación para emergencias. BLUETTI tenía solo 4 de 24 en r/bluetti. Las publicaciones de la comunidad de la marca fueron el 37,5 %, 37,5 % y 16,7 % de las tres búsquedas. Estos datos muestran dónde se menciona una marca. No dan un total semanal. Con 25 publicaciones por llamada, una marca activa llena el resultado en un día. Además, no se sabe hasta dónde llega cada llamada extra.
Para totales semanales, la comunidad de la marca es más fiable. De 00:22 a 00:24 (hora de Singapur) pedimos las 100 publicaciones más nuevas de cada comunidad con reddit/subreddit_posts. r/Ecoflow_community tuvo al menos 73 publicaciones y 492 comentarios la semana pasada. Las 100 no llegaron al lunes (la más antigua era del 26 de octubre a las 16:01 UTC), así que 73 es un mínimo. r/Jackery tuvo 13 publicaciones y 206 comentarios; r/bluetti, 20 publicaciones y 93 comentarios.
En esta ronda recibimos dos respuestas 429 por límite de velocidad. Esperamos 60 segundos y lo intentamos de nuevo. Las dos respuestas 429 no se cobraron.
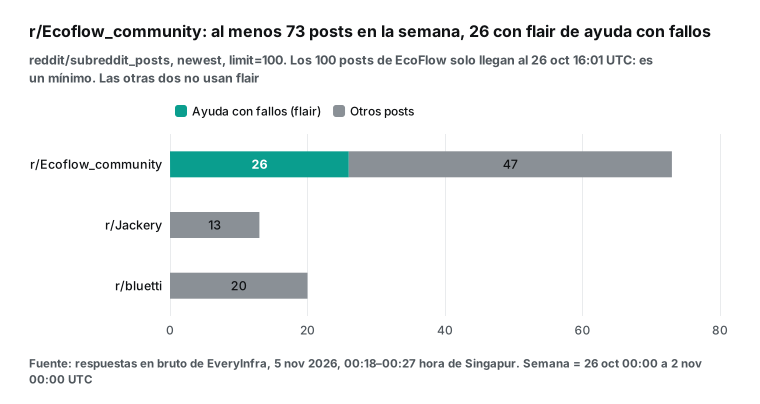
r/Ecoflow_community es la única de las tres que usa etiquetas (flair). La semana pasada tuvo 29 publicaciones Open Discussion y 26 Troubleshooting Help, además de grupos pequeños como bricolaje, respaldo eléctrico y reseñas. Las 26 de ayuda son al menos el 36 % de la semana. Ese dato puede ir directo a un informe como señal de calidad. El modelo no tiene que juzgar sentimiento, porque el valor de flair lo ponen los propios miembros. Las otras dos comunidades no tienen etiquetas, así que el modelo tiene que clasificar los títulos. Por eso el mismo prompt da resultados con distinto detalle para cada marca: los datos tienen otra estructura.
Prueba 3: la mitad de las publicaciones estaba en japonés y el español hablaba de Cuba
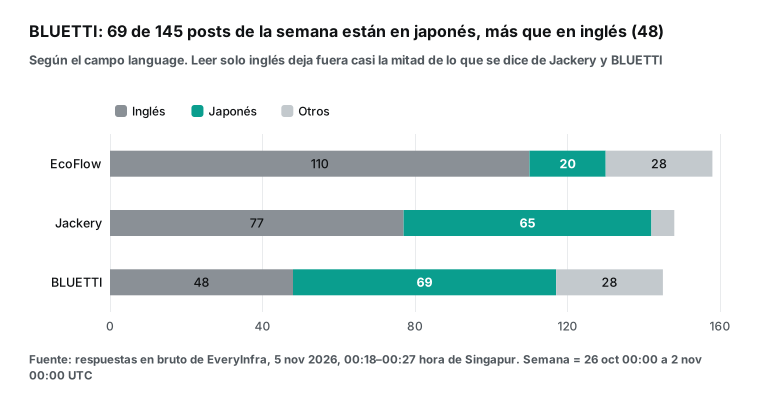
El sentimiento es el segundo número que pide el prompt. Lo fácil es leer solo las publicaciones en inglés. Pero el campo language de X muestra mezclas de idiomas muy distintas la semana pasada. EcoFlow tuvo 158 publicaciones: 110 en inglés, 20 en japonés y 28 en otros idiomas, como alemán, español, ucraniano y portugués. Jackery tuvo 148: 77 en inglés y 65 en japonés. BLUETTI tuvo 145: 48 en inglés y 69 en japonés, así que el japonés iba primero. En porcentaje, el japonés fue el 44 % en Jackery y el 48 % en BLUETTI.
La publicación con más «me gusta» de las tres marcas salió de una noticia británica. El gobierno del Reino Unido publicó una guía que anima a los hogares a dar «pasos pequeños y sencillos» para prepararse ante emergencias (nota de GOV.UK). La web de la campaña lista provisiones para 3 días (web Be Ready). The Guardian informó el 2026-10-22 que se pedía a cada británico guardar agua y comida para tres días (The Guardian), y Reuters lo siguió el 2026-10-23 (Reuters). El 2026-10-27, un autor japonés publicó un hilo largo: Japón debería seguir al Reino Unido. Recomienda baterías grandes y dice que su familia usó Jackery, EcoFlow y BLUETTI, y que las tres son buenas. Sumó 4.406 «me gusta» y 643.989 vistas.
Esa publicación muestra un problema más grande que el idioma. Nombra a las tres marcas, pero solo la búsqueda de BLUETTI la devolvió. Las búsquedas de EcoFlow y Jackery devolvieron las 200 completas y no la incluían. Entre los tres resultados, dos marcas cualesquiera comparten solo de 1 a 8 publicaciones. Así que la publicación más popular de la semana sobre las tres marcas no existe en dos de los tres informes. La respuesta no dice por qué. Quizá el tope de 200 la dejó fuera, o quizá la búsqueda no encuentra nombres de marca dentro de texto japonés sin espacios. La regla es clara de todos modos. Un resultado con tope es una muestra, no la semana entera. Un informe serio debe juntar los tres resultados, quitar duplicados y etiquetar cada publicación con todas las marcas que nombra.
Para el público hispanohablante hicimos una consulta aparte. A las 00:26 (hora de Singapur) buscamos «(EcoFlow OR Jackery OR Bluetti) lang:es» en la misma semana. Llegaron 24 publicaciones, sin tope, y 17 caían dentro de la semana. De esas 17, 16 nombran a EcoFlow, 2 a BLUETTI (una compara las dos marcas) y ninguna a Jackery. Sumaron 141 «me gusta» y 26.978 vistas, poco al lado del inglés o del japonés. Pero el contenido es muy distinto. Al menos 5 de las 17 hablan de Cuba de forma explícita: robos de un EcoFlow en Cienfuegos, un policlínico de Ciego de Ávila que sigue atendiendo gracias a un EcoFlow, y una queja desde Matanzas sobre transformadores que se dañan por sobrecarga, «en parte por equipos como ecoflow».
| Tema de la publicación en español | Cuántas de 17 | Ejemplo, sin nombres de usuario |
|---|---|---|
| Cuba: apagones, robos, transformadores | 5 | Robo de dinero y un EcoFlow en Cienfuegos; transformadores dañados en Matanzas |
| Ofertas, precios y comparativas | 5 | Una BLUETTI de 288 Wh rebajada en una tienda de Chile; una comparativa EcoFlow RIVER 2 contra BLUETTI EB3A |
| Bromas y quejas por el precio | 4 | «Cómprate un ecoflow», responde alguien a quien se queja de los cortes de luz |
| Uso diario y reseñas | 3 | Un corte de luz desde las 10:45 en Barcelona, Anzoátegui; una prueba de laboratorio de la DELTA 2 Max |
El contexto cubano tiene fecha y cifras. El 2026-10-21, la Unión Eléctrica estimó una disponibilidad de 1.017 MW frente a una demanda máxima de 2.950 MW en el Sistema Eléctrico Nacional, un déficit de 1.933 MW (Cubadebate). El 2026-10-27, la central Antonio Guiteras, la mayor de la isla con 316 MW, volvió a salir de línea por una avería (CiberCuba). En ese contexto, «el ecoflow» funciona casi como nombre común: 9 de las 17 publicaciones lo escriben con artículo, como «un ecoflow» o «el ecoflow», a menudo en minúscula. Para un equipo de marketing en Latinoamérica es una buena y una mala noticia. La marca es sinónimo de la categoría, pero también carga con las quejas de la categoría.
Esto cambia el prompt para el público hispano. Un modelo que solo lee inglés no ve nada de esto. Un modelo que lee español pero mide «sentimiento hacia EcoFlow» puede contar como negativa una publicación que se queja del precio de «un ecoflow» cualquiera, o del apagón. La línea del prompt «sentimiento = postura hacia la marca» sirve aquí igual que en inglés. Y la consulta lang:es aparte es barata: una llamada, 0,000556 USD. Las cuentas japonesas de las marcas también publicaron: EcoFlowJapan 5 veces, jackeryjapan 3 y BLUETTI_JAPAN 9. Las marcas cuidan Japón; en español, la conversación la llevan los usuarios.
Prueba 4: quién mide el sentimiento, por número o por «me gusta»
Queríamos una referencia que no viniera de un modelo, así que puntuamos las publicaciones en inglés de la semana con el léxico de código abierto VADER 3.3.2. Una puntuación compuesta de 0,05 o más es positiva y de -0,05 o menos, negativa. VADER es una herramienta común basada en reglas para texto de redes sociales (repositorio de VADER). Por número de publicaciones, las proporciones negativas se parecen: EcoFlow 17 % (19 de 110), Jackery 21 % (16 de 77) y BLUETTI 19 % (9 de 48). Ponderado por «me gusta», el cuadro cambia. Las publicaciones negativas reúnen el 54 % de los «me gusta» en inglés de EcoFlow, el 38 % de Jackery y el 22 % de BLUETTI.
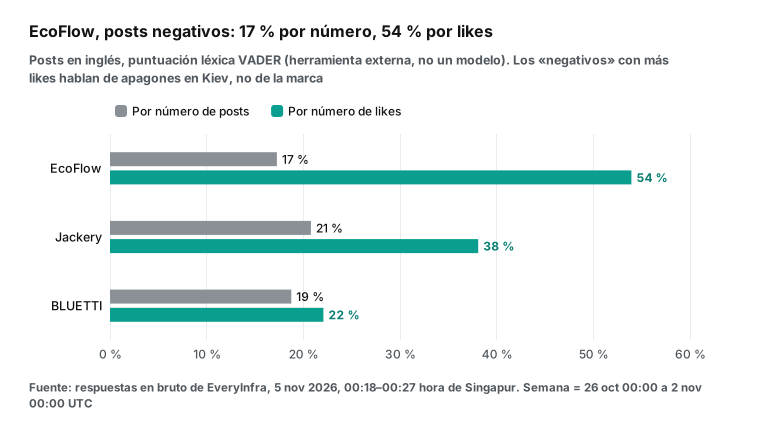
«54 % negativo» suena a crisis para EcoFlow. No lo es. Leímos las 15 publicaciones en inglés con más «me gusta» de cada marca y anotamos la postura hacia la marca. La regla: elogiar, recomendar, elegir o mostrar con gusto el producto es positivo, y el marketing de la propia marca también. Quejarse de la marca o del producto es negativo. Solo mencionarla, una lista de donaciones, una noticia o contar que se usa sin juzgar es neutral. El autor del artículo hizo todas las etiquetas en una sola pasada y nadie más las revisó. Por eso las usamos solo para ver dónde se equivoca VADER, no como una tasa de acierto.
En EcoFlow, 14 de 15 eran neutrales y 1 positiva. Ninguna se quejaba de EcoFlow. Las más populares hablaban de los cortes de luz en Kiev. Tras el mayor ataque ruso del año contra la red eléctrica de Ucrania, Kiev tuvo cortes de emergencia y falta de agua (Kyiv Independent). Las publicaciones mencionan los equipos EcoFlow como la forma de pasar los cortes. Otras son listas de donaciones para el frente, donde EcoFlow es un artículo más. El léxico ve «attack», «blackout» y «war» y puntúa negativo. Esas palabras hablan de la guerra, no de la marca.
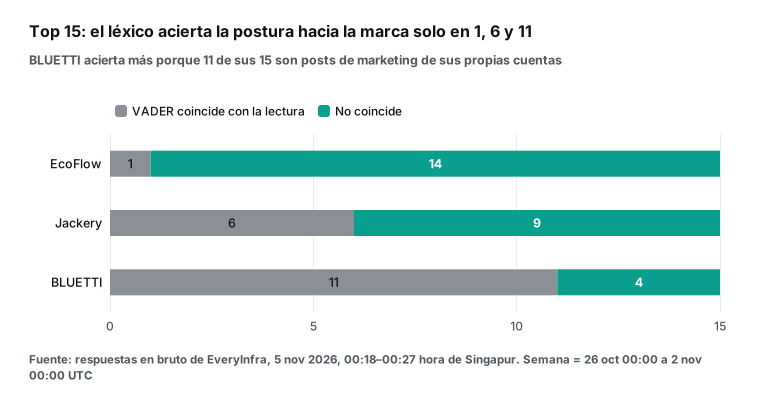
Las tres marcas juntas aclaran el problema. VADER coincidió con nuestra lectura en solo 1 de las 15 de EcoFlow. Coincidió en 6 de Jackery, cuyas publicaciones populares están en hilos agitados sobre preparación para emergencias, pero son neutrales con la marca. Coincidió en 11 de BLUETTI, que parece la mejor. La razón es que 11 de esas 15 eran de bluetti_inc, con marketing de Halloween y de lanzamientos. El marketing de una marca es positivo en tono y positivo con la marca, así que el léxico y nuestras etiquetas coinciden. Las cuentas de las marcas publicaron mucho la semana pasada: las de EcoFlow 19 veces (EcoFlowTech 9, EcoFlowJapan 5 y otras), las de BLUETTI 23 (bluetti_inc 14, BLUETTI_JAPAN 9) y las de Jackery 5. Si no se quitan, buena parte de «BLUETTI tiene el mejor sentimiento» es BLUETTI hablando de sí misma.
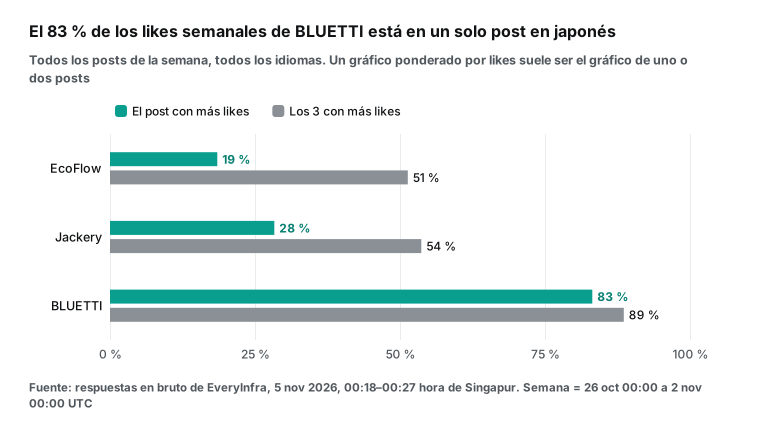
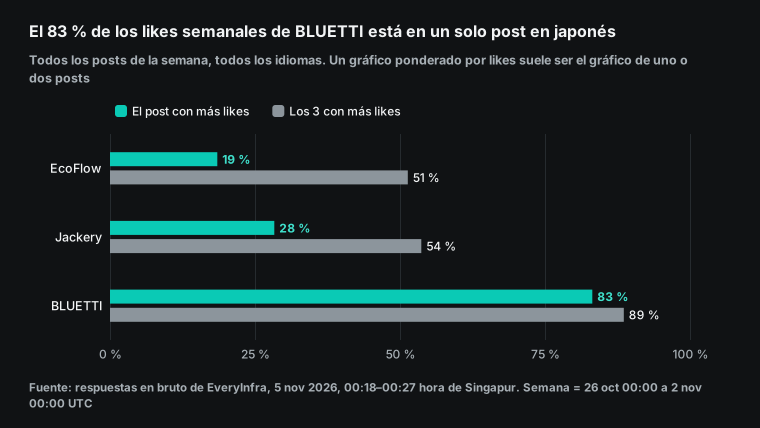
Otro número cambia la conclusión sin hablar de sentimiento: qué tan concentrados están los «me gusta». Las 145 publicaciones de BLUETTI de la semana sumaron 5.299 «me gusta». El hilo japonés tenía 4.406, el 83 %. Las tres primeras tenían el 89 %. En EcoFlow y Jackery, las tres primeras tenían el 51 % y el 54 %. Así que «BLUETTI tuvo la mayor interacción» quiere decir «una publicación japonesa que nombra a BLUETTI se hizo viral». Y esa publicación nombra a las tres marcas; solo la búsqueda de BLUETTI la atrapó. Un informe debe mostrar la mediana de vistas junto a los totales (EcoFlow 171,5, Jackery 137,5, BLUETTI 191) y la parte de las tres primeras. Así el lector ve si una sola publicación explica el calor.
| Marca | VADER coincide con la lectura (de 15) | Publicaciones de la propia marca (de 15) | Parte de los me gusta en la publicación principal |
|---|---|---|---|
| EcoFlow | 1 | 0 | 19 % |
| Jackery | 6 | 2 | 28 % |
| BLUETTI | 11 | 11 | 83 % |
Estas pruebas dan tres reglas para la columna de sentimiento, y el prompt de arriba incluye las tres. Mide la postura hacia la marca, no el tono. Pon aparte las publicaciones de cuentas de la marca. Muestra la proporción por número y por «me gusta». GPT-6 lee texto completo mucho mejor que un léxico. No probamos sus etiquetas en ChatGPT. Pero algo es seguro. Si el prompt dice solo «analiza el sentimiento», el modelo juzgará el tono de toda la publicación. Entonces comete el mismo error que el léxico.
Prueba 5: cuánto pesan los datos de un informe
La última prueba mide cuánto tiene que leer el modelo. Medimos cada respuesta guardada. Una llamada a twitter/search (hasta 200 publicaciones) pesó unos 261 KB de media. Una a reddit/search (hasta 25) unos 50 KB, y una a reddit/subreddit_posts (100) unos 94 KB. El bloque de texto del MCP pesó 72 KB. Un informe básico, con una llamada de X y una búsqueda de Reddit por marca, sumó 930.618 bytes. A unos 4 bytes por token, son unos 233.000 tokens. El informe completo, con comunidades y lo más popular del mes, sumó 1.395.246 bytes, unos 349.000 tokens.
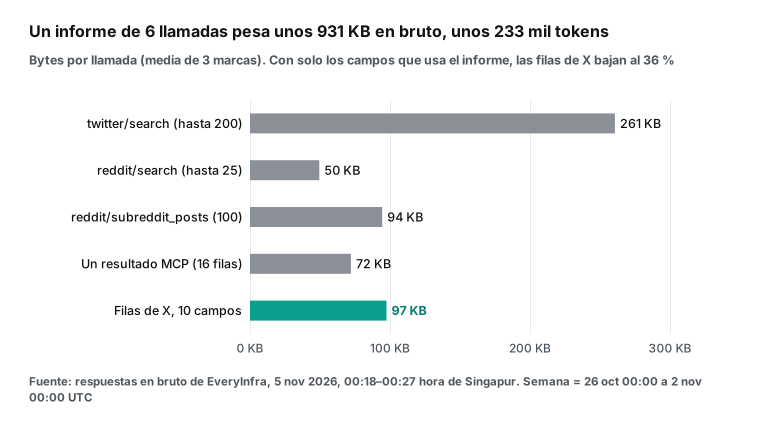
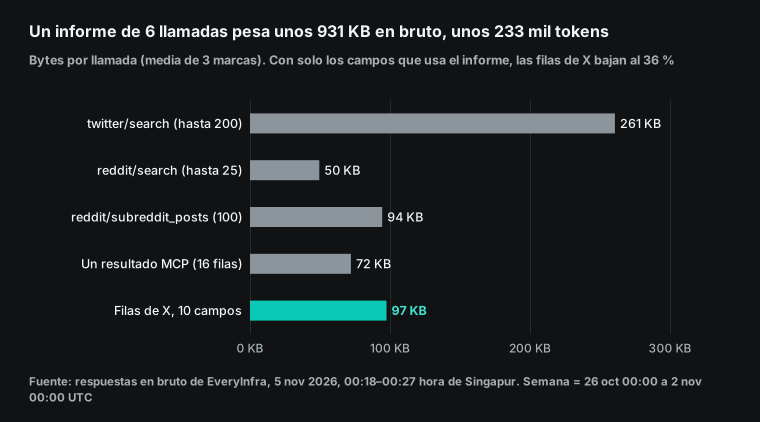
El Centro de ayuda de OpenAI no dice cuánta salida de herramientas cabe en un chat de GPT-6, y no lo probamos en ChatGPT. Por eso no decimos «cabe» ni «no cabe». Lo que sí podemos decir es que X es la mayor parte del peso. Cada publicación ocupa unos 1,3 a 1,4 KB, y campos como el avatar del autor, la biografía o los detalles de medios no sirven para un informe. Con 10 campos y el texto recortado a 280 caracteres, la parte de X bajó de 815.904 a 292.415 bytes (medido con los arreglos de resultados serializados). Los 930.618 bytes de arriba son el tamaño de los archivos guardados, así que no conviene restar una cifra de la otra. Si usas el MCP de EveryInfra directamente, sin capa propia, puedes pedir menos: baja el limit de X de 200 a 100. A cambio, los conteos de la semana quedarán como mínimos más a menudo.
Cómo se ve el informe: la primera tabla comparativa
Estas son las reglas anteriores aplicadas a los datos reales de la semana pasada (UTC, del 2026-10-26 al 2026-11-01). Lo calculamos desde las respuestas guardadas con las reglas del prompt. Es la tabla que Intelligent UI debería dibujar en el mejor caso. No probamos lo que dibuja ChatGPT en la práctica.
| Marca | Posts en X | Me gusta / vistas medianas | Inglés / japonés | Posts en la comunidad | Comentarios | Negativo en inglés (número / me gusta) | Nota |
|---|---|---|---|---|---|---|---|
| EcoFlow | 158 o más | 4.869 / 171,5 | 110 / 20 | 73 o más (r/Ecoflow_community) | 492 | 17 % / 54 % | Lo negativo viene de cortes en Kiev y donaciones, no de quejas; 26 pedidos de ayuda; 16 de 17 posts en español |
| Jackery | 148 o más | 2.016 / 137,5 | 77 / 65 | 13 (r/Jackery) | 206 | 21 % / 38 % | El japonés es el 44 %; ningún post en español en la semana |
| BLUETTI | 145 | 5.299 / 191 | 48 / 69 | 20 (r/bluetti) | 93 | 19 % / 22 % | El 83 % de los me gusta en un post japonés que nombra a las tres; lo popular en inglés es marketing propio |
La tabla permite tres conclusiones. Primera, el volumen en X de las tres marcas está en el mismo rango. La diferencia es menor que el error de los datos, porque dos marcas tocaron el tope de 200. Segunda, la comunidad de EcoFlow en Reddit es claramente la más activa. Tiene varias veces las publicaciones y comentarios de las otras dos, y 26 publicaciones llevan una etiqueta de ayuda. La tabla solo da el número; alguien tiene que leerlas para saber si apuntan a un mismo problema de producto. Tercera, las publicaciones con más «me gusta» de la semana hablaban de cortes de luz y de preparación: la publicación japonesa que nombra a las tres marcas parte de la guía británica de tres días, las más populares de EcoFlow en inglés tratan de los cortes en Kiev y, en español, de los apagones de Cuba.
Costo de API de un informe
Los precios de EveryInfra salen del catálogo que leímos el 2026-11-05. twitter/search, reddit/search y reddit/subreddit_posts cuestan 0,000556 USD por llamada cada una. Las llamadas fallidas, limitadas por velocidad o vacías no se cobran (catálogo de EveryInfra; también puedes ver la página de precios). El precio es por llamada, no por fila. Una reddit/search con 16 filas cuesta lo mismo que una con 24, y una twitter/search con 200 publicaciones sigue siendo una llamada.
| Versión del informe | Llamadas | Costo de API |
|---|---|---|
| Básica: 3 marcas, una búsqueda en X y una en Reddit por marca | 6 | 0,003336 USD |
| Completa: más las 100 publicaciones nuevas de cada comunidad y lo más popular del mes | 12 | 0,006672 USD |
| Completa más la consulta en español | 13 | 0,007228 USD |
| Conteo exacto de X por día (3 marcas x 7 días) más comunidades | 24 | 0,013344 USD |
| Un informe completo por semana, por mes (52 semanas / 12) | unas 52 | 0,028912 USD |
| Un informe completo por semana, por año | 624 | 0,346944 USD |
| Este artículo, 2026-11-05, de 00:18 a 00:27 (hora de Singapur) | 16 solicitudes, 13 cobradas, 3 limitadas | 0,007228 USD |
ChatGPT no cobra por informe. Intelligent UI no tiene cuota propia, y las llamadas a plugins no tienen cargo extra; cuentan dentro del plan (Centro de ayuda 20001354). Precios del Centro de ayuda leídos el 2026-11-05: Plus cuesta 20 USD al mes (Centro de ayuda 20001493); Pro, 100, 200 o 500 USD al mes (Centro de ayuda 9793128); Business Standard, 25 USD por puesto al mes o 20 USD con pago anual (Centro de ayuda 8792828). El coste real es una cuota fija del plan más un costo de API casi nulo. Un año de 52 informes completos cuesta 0,35 USD en la API, cerca de 1/57 de un solo mes de Plus. Lo caro es el tiempo de las personas. Alguien tiene que revisar cada informe por el tope, la mezcla de idiomas y las cuentas de la marca.
Los límites de velocidad también cuestan. Nuestra clave de prueba permite 10 solicitudes por minuto y recibimos tres respuestas 429. El cuerpo decía «10 requests per minute», «retry after 17s» y «nothing was charged». Las cabeceras traían retry-after: 17 y x-ratelimit-limit-requests: 10. Seis llamadas desde una pregunta de ChatGPT no suelen tocar el límite. Si varias personas comparten una cuenta de EveryInfra y lanzan informes a la vez, sí pueden. El modelo ve el texto del 429, escrito para que lo lea una IA, y normalmente espera y vuelve a intentar.
Qué dicen en Reddit y Hacker News
Buscamos «gpt 6 intelligent ui» en Reddit y Hacker News en el último mes con una pregunta concreta: ¿alguien mostró datos de un MCP personalizado dibujados por Intelligent UI? No encontramos ningún ejemplo, ni tampoco un contraejemplo. Casi todos los hilos opinan sobre Intelligent UI en sí, y quitamos los nombres de usuario de las citas. En el hilo de lanzamiento de r/OpenAI, el comentario más votado dijo que era la primera función en mucho tiempo pensada para el usuario normal y no solo para programadores; otro lo comparó con los applets de Java (hilo en r/OpenAI).
En el hilo de lanzamiento de r/ChatGPT, un usuario preguntó en qué se diferencia de los artifacts de otros modelos y otro señaló que solo funciona en Chat y no en Work (hilo de lanzamiento en r/ChatGPT). Un hilo en r/codex preguntó qué puede hacer que antes no se pudiera (hilo en r/codex). En Hacker News, las críticas fueron más imágenes y espacio en blanco (hilo en Hacker News), y en r/technology casi todos dudaban de los modelos que hacen todo el trabajo (hilo en r/technology).
Para un informe, lo más útil es el título de otro hilo de r/ChatGPT: Intelligent UI es bueno de verdad, pero todavía es un borrador, no infraestructura (hilo en r/ChatGPT). Esa idea encaja con nuestro consejo. Usa Intelligent UI como vista rápida al preguntar. Guarda los números que sigues en el tiempo en una página compartida o en tu propia hoja de cálculo. Nuestro artículo de Spaces explica la página compartida.
Límites y puntos a vigilar
| Trampa | Qué vimos | Qué hacer |
|---|---|---|
| Publicaciones fuera de la semana | until: de X dejó pasar 42, 52 y 22 | Filtrar por posted_at |
| Topes | 200 en X, 100 en comunidades | Escribir «al menos» o dividir la semana |
| Publicaciones perdidas | La más popular nombraba a 3 marcas y salió en 1 búsqueda | Juntar resultados y quitar duplicados |
| Idioma | Japonés 44 % y 48 % en dos marcas; Cuba domina el español | Separar por language primero |
| Cuentas de la marca | 11 de las 15 más populares de BLUETTI en inglés | Ponerlas aparte del sentimiento |
OpenAI no promete que Intelligent UI muestre los resultados de un MCP personalizado. Todo este método depende de que el modelo lea texto y arme la tabla. Eso cabe en lo que dice OpenAI, que las respuestas pueden incluir tablas y gráficos, pero no es una función documentada por separado. Antes de llevarlo a un equipo, ejecuta el mismo prompt tres veces en tu cuenta. Comprueba que el diseño es estable antes de depender de él.
La herramienta de datos pide confirmación. everyinfra_call_api no está marcada como de solo lectura, así que el modo desarrollador y los permisos de plugins hacen que ChatGPT pregunte antes de llamar. El administrador de Business puede cambiar la política de aprobación. En Pro personal, OpenAI habla de «permisos de lectura y consulta». La documentación no dice si en Pro una herramienta que no es de solo lectura se ejecuta, pregunta o se bloquea, y no lo probamos en ChatGPT.
El estado de Intelligent UI no pasa de un chat a otro. El Centro de ayuda dice que componentes como las listas conservan su estado al recargar, pero no en un chat nuevo. La pregunta de la semana que viene da un informe nuevo, sin los interruptores ni filtros de esta semana. Para comparar semana a semana, copia cada tabla o usa una página de Spaces.
Intelligent UI no está en la API. La documentación describe chat-latest como el último modelo Instant usado en ChatGPT (página de chat-latest). El registro de cambios recoge sus actualizaciones (registro de cambios de la API). No encontramos ninguna frase que diga que los componentes de Intelligent UI salen por la API. Para crear el mismo informe en tu propio producto, dibuja tú los gráficos.
Reddit y X tienen sus propias reglas. EveryInfra devuelve publicaciones públicas para estudios de mercado y seguimiento de marca. Si vas a redistribuir resultados, entrenar modelos con ellos o perfilar a personas, lee antes las condiciones de cada plataforma. La página de la Data API de Reddit dice que las reglas de uso están en sus Developer Terms y Data API Terms (Reddit Data API Wiki). Lee las Data API Terms de Reddit antes de reutilizar datos. Este artículo no es asesoría legal.
Cambios recientes
| Fecha | Cambio |
|---|---|
| 2026-10-07 | GPT-6 e Intelligent UI llegan a Chat en Plus, Pro, Business y Enterprise; las notas de Business lo recogen el mismo día |
| 2026-10-08 | Free y Go reciben GPT-6 Luna |
| 2026-10-21 | En Cuba, déficit previsto de 1.933 MW |
| 2026-10-22 | The Guardian informa de la guía británica Be Ready; Reuters la sigue el 2026-10-23 |
| 2026-10-27 | La central Antonio Guiteras vuelve a salir de línea en Cuba |
| 2026-11-04 | Las conexiones MCP de EveryInfra con la clave en la dirección dejan de funcionar; en ChatGPT se usa /mcp/all con OAuth |
| 2026-11-05 | Nuestras llamadas reales y la fecha de lectura de todas las páginas oficiales |
Preguntas frecuentes sobre GPT-6 Intelligent UI
¿Los usuarios gratuitos tienen GPT-6 Intelligent UI?
Sí. El artículo de lanzamiento dice que Free y Go lo recibieron desde el 2026-10-08, con GPT-6 Luna, y el Centro de ayuda dice que Luna admite Intelligent UI. Pero la página de MCP personalizado no incluye Free ni Go entre los planes que pueden añadir servidores MCP. Una cuenta gratuita ve respuestas con Intelligent UI, pero OpenAI no documenta si puede conectar EveryInfra. Fuentes: artículo de OpenAI, Centro de ayuda 20001598.
¿Se puede desactivar Intelligent UI?
No del todo; solo se puede simplificar. La página de Intelligent UI dice Personalization, Layout and Visuals y Simple, en la web. La página de modelos GPT-6 dice desactivar Layout and visuals en Settings. Las dos dicen que algunos elementos visuales pueden seguir apareciendo, y no hay modo solo texto. Fuentes: Centro de ayuda 20001598, Centro de ayuda 20001354.
¿Pueden los desarrolladores usar Intelligent UI en la API?
No según la documentación. La API tiene chat-latest, descrito como el último modelo Instant usado en ChatGPT. Pero la documentación y el registro de cambios que leímos no dicen que los componentes de Intelligent UI salgan por la API. Para una interfaz interactiva en tu propia app, la vía documentada por OpenAI es un plugin con plantilla de MCP Apps. Fuentes: página de chat-latest, documentación: ChatGPT UI.
¿Intelligent UI dibuja por sí solo los datos de un MCP personalizado?
No según la documentación. Sobre los plugins, el Centro de ayuda solo dice que los plugins conectados «seguirán funcionando». El MCP de EveryInfra devuelve una cadena JSON sin structuredContent ni plantilla. El modelo tiene que leerla y armar el gráfico con Intelligent UI. Que salga un gráfico, y que salga igual cada vez, depende del prompt y del tamaño de los datos. Para un gráfico con diseño fijo, la vía documentada es MCP Apps. Fuentes: Centro de ayuda 20001598, especificación MCP: Tools.
¿Por qué veo GPT-6 Sol pero no aparecen elementos visuales?
Revisa cuatro cosas. ¿Estás en la pestaña Chat? Work y Voice no lo admiten. ¿Elegiste el nivel de razonamiento Pro? GPT-6 Astra no lo admite. ¿Tu app de escritorio es una versión antigua? ¿Elegiste Simple en la configuración? El despliegue fue gradual, y en Reddit algunos usuarios de pago seguían sin elementos visuales días después. Fuentes: Centro de ayuda 20001598, hilo de lanzamiento en r/ChatGPT.
Primeros pasos
- Regístrate y recarga saldo en la consola de EveryInfra. Usa el catálogo gratuito para comprobar que
twitter/search,reddit/searchyreddit/subreddit_postsestán disponibles. - Llama una vez a cada capacidad con curl o en el área de pruebas. Revisa campos, topes y fechas de la búsqueda en X y la búsqueda en Reddit.
- En ChatGPT web, añade un servidor MCP en Plugins:
https://api.everyinfra.com/mcp/allcon OAuth. Consulta la configuración de MCP remoto y la página del servidor MCP. En Business, pídeselo a un administrador. - Añade una instrucción personalizada: «Usa tablas al comparar opciones y di cómo se contó cada número». Pregunta con el prompt de arriba y confirma la primera llamada.
- Revisa la tabla contra las trampas: semana, topes, idioma y cuentas de la marca. Luego compártela con tu equipo.
Lecturas relacionadas
- ChatGPT Spaces para seguir a la competencia: una página compartida que el equipo actualiza cada semana, buen lugar para guardar estos números.
- Radar de productos con ChatGPT dots: dos grupos de permisos para un agente siempre activo, y por qué las llamadas de pago van en tareas asignadas.
- Radar de demanda con tareas programadas de ChatGPT: una persona recibe cada semana las quejas y preguntas de Reddit.
- API de datos de Reddit y API de datos de X: todas las capacidades, parámetros y precios.
Referencias
- GPT-6 and Intelligent UI for everyone, OpenAI, leído el 2026-11-05, https://openai.com/index/gpt-6-for-everyone/
- Intelligent UI in ChatGPT, Centro de ayuda de OpenAI, leído el 2026-11-05, https://help.openai.com/en/articles/20001598-intelligent-ui-in-chatgpt
- GPT-6 and other models in ChatGPT, Centro de ayuda de OpenAI, leído el 2026-11-05, https://help.openai.com/en/articles/20001354-gpt-6-and-other-models-in-chatgpt
- Connecting custom MCP servers in ChatGPT, Centro de ayuda de OpenAI, leído el 2026-11-05, https://help.openai.com/en/articles/12584461-connecting-custom-mcp-servers-in-chatgpt
- ChatGPT Business release notes, Centro de ayuda de OpenAI, leído el 2026-11-05, https://help.openai.com/en/articles/11391654-chatgpt-business-release-notes
- ChatGPT release notes, Centro de ayuda de OpenAI, leído el 2026-11-05, https://help.openai.com/en/articles/6825453-chatgpt-release-notes
- ChatGPT Enterprise and Edu release notes, Centro de ayuda de OpenAI, leído el 2026-11-05, https://help.openai.com/en/articles/10128477-chatgpt-enterprise-and-edu-release-notes
- ChatGPT Business models and limits, Centro de ayuda de OpenAI, leído el 2026-11-05, https://help.openai.com/en/articles/12003714-chatgpt-business-models-and-limits
- ChatGPT Enterprise and Edu models and limits, Centro de ayuda de OpenAI, leído el 2026-11-05, https://help.openai.com/en/articles/11165333-chatgpt-enterprise-and-edu-models-and-limits
- ChatGPT Business overview, Centro de ayuda de OpenAI, leído el 2026-11-05, https://help.openai.com/en/articles/8792828-chatgpt-business-overview
- About ChatGPT Pro tiers, Centro de ayuda de OpenAI, leído el 2026-11-05, https://help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers
- ChatGPT back-to-school offer for students (indica el precio de Plus), Centro de ayuda de OpenAI, leído el 2026-11-05, https://help.openai.com/en/articles/20001493-chatgpt-back-to-school-offer-for-students
- Build your MCP server, documentación para desarrolladores de OpenAI, leído el 2026-11-05, https://developers.openai.com/plugins/build/mcp-server
- ChatGPT UI, documentación para desarrolladores de OpenAI, leído el 2026-11-05, https://developers.openai.com/plugins/build/chatgpt-ui
- Authentication, documentación para desarrolladores de OpenAI, leído el 2026-11-05, https://developers.openai.com/plugins/build/auth
- Connect and test in ChatGPT, documentación para desarrolladores de OpenAI, leído el 2026-11-05, https://developers.openai.com/plugins/deploy/connect-chatgpt
- Plugins changelog, documentación para desarrolladores de OpenAI, leído el 2026-11-05, https://developers.openai.com/plugins/changelog
- ChatGPT Developer mode, documentación para desarrolladores de OpenAI, leído el 2026-11-05, https://developers.openai.com/api/docs/guides/developer-mode
- chat-latest, documentación para desarrolladores de OpenAI, leído el 2026-11-05, https://developers.openai.com/api/docs/models/chat-latest
- API changelog, documentación para desarrolladores de OpenAI, leído el 2026-11-05, https://developers.openai.com/api/docs/changelog
- GPT-6 and Intelligent UI in ChatGPT (anuncio), comunidad de desarrolladores de OpenAI, leído el 2026-11-05, https://community.openai.com/t/gpt-6-and-intelligent-ui-in-chatgpt/1404139
- Tools (especificación MCP 2025-06-18), Model Context Protocol, leído el 2026-11-05, https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- Authorization (especificación MCP 2025-11-25), Model Context Protocol, leído el 2026-11-05, https://modelcontextprotocol.io/specification/2025-11-25/basic/authorization
- MCP Apps, Model Context Protocol, leído el 2026-11-05, https://modelcontextprotocol.io/docs/extensions/apps
- Catálogo de capacidades de datos de EveryInfra (gratuito), leído el 2026-11-05 a las 00:17 (hora de Singapur), https://api.everyinfra.com/api/v1/social/catalog
- Metadatos de recurso protegido de /mcp/all de EveryInfra, leído el 2026-11-05, https://api.everyinfra.com/.well-known/oauth-protected-resource/mcp/all
- Servidor MCP de EveryInfra (initialize, tools/list y tools/call reales), leído el 2026-11-05, https://api.everyinfra.com/mcp
- How to use advanced search, ayuda de X, leído el 2026-11-05, https://help.x.com/en/using-x/x-advanced-search
- Reddit Data API Wiki, ayuda de Reddit, leído el 2026-11-05, https://support.reddithelp.com/hc/en-us/articles/16160319875092-Reddit-Data-API-Wiki
- Data API Terms, Reddit, leído el 2026-11-05, https://www.redditinc.com/policies/data-api-terms
- vaderSentiment (VADER 3.3.2), GitHub, leído el 2026-11-05, https://github.com/cjhutto/vaderSentiment
- Households encouraged to take small, simple steps to stay prepared in an emergency, GOV.UK, leído el 2026-11-05, https://www.gov.uk/government/news/households-encouraged-to-take-small-simple-steps-to-stay-prepared-in-an-emergency
- Be ready for emergencies, web de campaña de GOV.UK, leído el 2026-11-05, https://beready.campaign.gov.uk/
- UK tells public to keep three days' emergency supplies at home, Reuters, 2026-10-23, leído el 2026-11-05, https://www.reuters.com/business/aerospace-defense/uk-tells-public-keep-three-days-emergency-supplies-home-2026-10-23/
- Every Briton should stockpile water and food supplies, government advises, The Guardian, 2026-10-22, leído el 2026-11-05, https://www.theguardian.com/politics/2026/oct/22/britain-prepare-infrastructure-attacks-hostile-states-wes-streeting
- Kyiv faces emergency power cuts, widespread water outages after Russia's largest attack on energy infrastructure this year, Kyiv Independent, leído el 2026-11-05, https://kyivindependent.com/kyiv-faces-emergency-power-cuts-widespread-water-outages-after-russias-largest-attack-on-energy-infrastructure-this-year/
- Unión Eléctrica prevé afectaciones de 1 963 MW en el horario pico de este miércoles, Cubadebate, 2026-10-21, leído el 2026-11-05, http://www.cubadebate.cu/noticias/2026/10/21/deficit-de-generacion-electrica-alcanzara-los-1-933-mw-en-el-horario-pico-de-este-miercoles/
- La Guiteras vuelve a salir por avería y deja al SEN al borde del colapso, CiberCuba, 2026-10-27, leído el 2026-11-05, https://www.cibercuba.com/noticias/2026-10-27-u1-e74-s27061-nid343949-guiteras-vuelve-salir-averia-deja-al-sen-al-borde
- EcoFlow launches new residential storage series with Titan range, ess-news, 2026-10-14, leído el 2026-11-05, https://www.ess-news.com/2026/10/14/ecoflow-launches-new-residential-storage-series-with-titan-range/
- Tiny Titan: new residential battery system from EcoFlow starts small, electrek, 2026-10-18, leído el 2026-11-05, https://electrek.co/2026/10/18/tiny-titan-new-residential-battery-system-from-ecoflow-starts-small/
- EcoFlow's new TITAN batteries can keep your central air running through a blackout, PopSci, leído el 2026-11-05, https://www.popsci.com/gear/ecoflow-titan-5000-home-battery/
- BLUETTI Unveils Early Access for Apex 200: Next-Gen Versatile Power Station (nota de prensa de PRNewswire), Yahoo Finance, 2026-10-20, leído el 2026-11-05, https://finance.yahoo.com/energy/articles/bluetti-unveils-early-access-apex-160900669.html
- GPT-6 and Intelligent UI for everyone (hilo), r/OpenAI, leído el 2026-11-05, https://www.reddit.com/r/OpenAI/comments/1x045qs/gpt6_and_intelligent_ui_for_everyone/
- GPT-6 and Intelligent UI for everyone (hilo), r/ChatGPT, leído el 2026-11-05, https://www.reddit.com/r/ChatGPT/comments/1x052jr/gpt6_and_intelligent_ui_for_everyone/
- GPT-6's Intelligent UI is genuinely good. It's still a sketchpad, not infrastructure, r/ChatGPT, leído el 2026-11-05, https://www.reddit.com/r/ChatGPT/comments/1x6crjw/gpt6s_intelligent_ui_is_genuinely_good_its_still/
- What can GPT-6 + Intelligent UI do that wasn't already possible, r/codex, leído el 2026-11-05, https://www.reddit.com/r/codex/comments/1x04lt9/what_can_gpt6_intelligent_ui_do_that_wasnt/
- OpenAI Introduces "Intelligent UI" For ChatGPT With GPT-6, r/technology, leído el 2026-11-05, https://www.reddit.com/r/technology/comments/1x04ajv/openai_introduces_intelligent_ui_for_chatgpt_with/
- GPT-6 and Intelligent UI (hilo), Hacker News, leído el 2026-11-05, https://news.ycombinator.com/item?id=49996425
Referencia BL-90