claude managed agents: un controllo notturno delle nuove recensioni da 1–2 stelle dei ristoranti
Esegui claude managed agents con una pianificazione cron per leggere ogni notte le nuove recensioni su Google, Yelp e Tripadvisor e segnalare quelle da 1–2 stelle. Costo API: $0,0056 per locale.
Il 4 novembre 2026 (ora di Singapore) abbiamo usato l'API di EveryInfra per leggere le nuove recensioni di Katz's Delicatessen a New York. Abbiamo consultato le recensioni su Google Maps, Yelp e Tripadvisor. Il risultato principale riguarda il concetto di “nuovo”. Le N recensioni più recenti coprono intervalli di tempo molto diversi su ciascun sito. Su Google coprono meno di 4 giorni, su Tripadvisor quasi 4 mesi. La pagina 1 di Yelp non è in ordine di data.
Un'ora dopo, una seconda lettura ha trovato una nuova recensione su Google. La sua data di pubblicazione era precedente alla nostra prima chiamata, ma la prima chiamata non l'aveva restituita. Quindi un job notturno deve stabilire cosa è “nuovo” in base all'ID della recensione e ricordare dove si è fermato. Non può limitarsi a prendere le N più recenti o fidarsi delle date di pubblicazione.
Il secondo risultato riguarda il costo. La tariffa API è bassa: 4 chiamate per locale a notte costano meno di un centesimo. La voce di costo più consistente è costituita dai token del modello lato Anthropic. Con Sonnet 5.5, secondo la nostra stima il costo del modello supera di oltre dieci volte quello dell'API. Quindi uno script nella sandbox dovrebbe ridurre i dati grezzi alle sole recensioni da 1–2 stelle prima che il modello li legga.
Questo articolo risponde a una domanda precisa. L'operations manager di un gruppo di ristoranti di New York vuole un report ogni giorno prima delle 7:00. Il report deve elencare ogni nuova recensione da 1–2 stelle su Google Maps, Yelp e Tripadvisor arrivata dalla sera precedente. Per ogni recensione deve indicare se il problema riguarda il cibo, il servizio, la fila o il prezzo, e se qualcuno ha risposto.
Per questo usiamo i deployment pianificati di Claude Managed Agents. Ogni notte il cloud di Anthropic avvia una nuova sessione secondo una pianificazione cron. L'agente chiama tre endpoint di EveryInfra per le recensioni tramite HTTP o MCP remoto, individua le nuove recensioni negative, le classifica per causa e scrive il report. Poi un webhook comunica al tuo server che l'esecuzione è terminata.
Lato EveryInfra abbiamo effettuato 26 chiamate reali, di cui 20 addebitate, per un totale di $0,02778. Lato Anthropic non abbiamo eseguito alcun deployment. Ogni informazione su Managed Agents rimanda alla documentazione o alle note di rilascio di platform.claude.com, che abbiamo consultato il 4 novembre 2026.
Il lavoro: un report mattutino sulle nuove recensioni negative su tre siti
Abbiamo usato due locali pubblici come esempio. Non abbiamo alcun legame con nessuna delle due attività, e il report di esempio serve solo a mostrare il metodo. Il primo locale è Katz's Delicatessen, nel Lower East Side. Ha una valutazione di 4,5 e 56.460 recensioni su Google Maps, e una valutazione di 4,2 e 18.710 recensioni su Tripadvisor.
Riceve molti turisti, quindi è un buon test per capire “quante nuove recensioni arrivano in una notte”. Il secondo locale è Haidilao Hot Pot a Flushing, nel Queens. Ha una valutazione di 4,8 e 8.792 recensioni su Google, e una valutazione di 4,8 e 2.643 recensioni su Yelp. Rappresenta un locale con una valutazione alta e poche recensioni negative.
Perché eseguirlo ogni notte e non una volta a settimana? Nella risposta reale di Google per Katz's, le 100 recensioni più recenti coprono 3,97 giorni, cioè circa 24,7 recensioni al giorno. Le 50 più recenti coprono solo 1,80 giorni, e 29 recensioni sono arrivate nelle ultime 24 ore. È più facile intervenire su una recensione negativa entro il primo o il secondo giorno.
È il momento in cui una risposta, un'offerta di rimborso o una verifica interna hanno più effetto. Un job settimanale deve leggere 4 pagine Google per locale, e quando arriva il report la recensione negativa più vecchia ha sei o sette giorni. Un job notturno che legge le 50 più recenti copre tutto ciò che è arrivato dalla sera prima, con una notte di margine.
| Sito | Funzionalità | Recensioni per chiamata | Ordinamento | Prezzo per chiamata |
|---|---|---|---|---|
| Google Maps | google_maps_reviews/reviews | Fino a 100, noi ne usiamo 50 | sort=newest, più una data since facoltativa | $0.001389 |
| Yelp | yelp/reviews | 10 per pagina, pagina successiva con page_token | Ordine predefinito di Yelp, non per data | $0.001389 |
| Tripadvisor | tripadvisor/reviews | Fino a 50 | Nessuna opzione di ordinamento. Nei nostri test, prima le più recenti | $0.001389 |
| Ricerca del locale | google_maps_reviews/search, yelp/search, tripadvisor/search | Una volta per sito in fase di configurazione | — | $0.001389 |
I prezzi vengono dal catalogo gratuito su https://api.everyinfra.com/api/v1/social/catalog, che abbiamo consultato alle 00:13 ora di Singapore del 4 novembre. Tutte e tre le funzionalità per le recensioni risultavano available. Ogni chiamata costa 100 crediti, cioè $0,001389. Le tre chiamate di ricerca del locale servono una sola volta per locale. Trasformano il nome del locale nel suo URL su ciascun sito, e da lì in poi il job notturno legge le recensioni tramite URL.
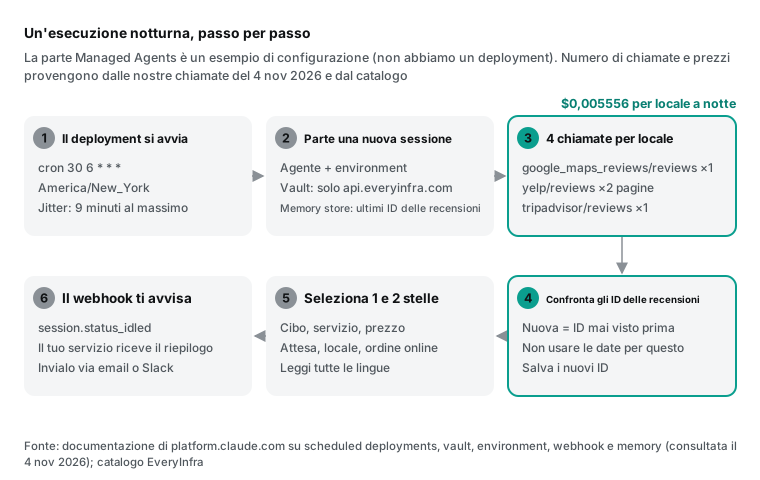
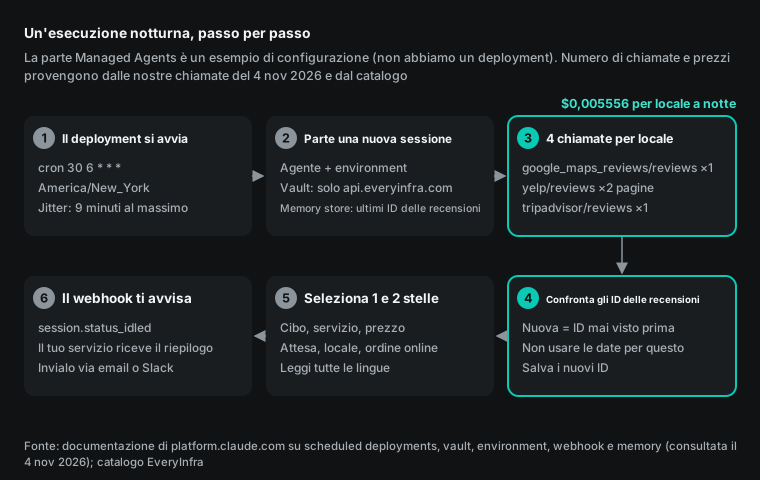
Cos'è claude managed agents: quattro oggetti più una pianificazione
Claude Managed Agents è un insieme di API ospitate sulla Claude Platform. Tu definisci il modello, il system prompt e i tool di un agente. Anthropic esegue il loop dell'agente nel proprio cloud: avvia un container sandbox, esegue le chiamate ai tool e conserva il registro della sessione. Il prodotto è stato lanciato in beta pubblica l'8 aprile 2026. Ogni richiesta deve includere l'header anthropic-beta: managed-agents-2026-04-01 (panoramica, note di rilascio).
La panoramica indica quattro concetti di base: agente, ambiente, sessione e vault. Il deployment pianificato è un quinto oggetto. È arrivato il 9 giugno 2026 e avvia le sessioni per te secondo una pianificazione (blog di Anthropic). La tabella mostra a cosa corrisponde ogni oggetto nel controllo delle recensioni.
| Oggetto | Cosa controlla | Impostazione per il controllo delle recensioni | Documentazione |
|---|---|---|---|
| agent | Modello, system prompt, tool, server MCP, policy di autorizzazione, con versioni | Sonnet 5.5. Mantieni bash e i tool per i file. Disattiva web_fetch e web_search. Nel percorso MCP, consenti solo everyinfra_call_api | “Define your agent” |
| environment | Come viene creata la sandbox e quali host può raggiungere | Rete limited con solo api.everyinfra.com in allowed_hosts | “Cloud environment setup” |
| vault | Credenziali che la sessione riceve in fase di esecuzione | Una credenziale environment_variable, EVERYINFRA_API_KEY, inserita negli header solo per api.everyinfra.com | “Authenticate with vaults” |
| session | Un'esecuzione: un nuovo container più un registro della conversazione | Il deployment ne crea una ogni notte | “Start a session” |
| deployment | Avvia sessioni secondo una pianificazione cron, con un budget per ogni esecuzione | 30 6 * * * in America/New_York, 50 centesimi per esecuzione | “Scheduled deployments” |
Il punto che sfugge più spesso è che l'ambiente è nuovo a ogni esecuzione. La documentazione sulle sessioni dice che ogni sessione riceve un container nuovo. I file che un'esecuzione scrive nella sandbox non ci sono più all'esecuzione successiva (“Start a session”). Per un controllo delle recensioni questo conta molto.
L'elenco delle “recensioni già viste” non può stare in un file della sandbox. Deve stare in un memory store, una beta separata montata in /mnt/memory/ (“Using agent memory”). L'alternativa è che il tuo server conservi l'elenco dopo ogni webhook e lo rimandi nel messaggio iniziale successivo.
Deployment pianificati: cron, fuso orario, jitter, budget e nessun recupero delle esecuzioni saltate
Crei un deployment pianificato con POST /v1/deployments. Servono un agente, un ambiente, almeno un evento iniziale (di solito un user.message) e uno schedule. Lo schedule ha type: cron e un'expression in formato cron POSIX standard a 5 campi, con precisione al minuto. Ha anche un timezone con un nome IANA come America/New_York (“Scheduled deployments”).
I campi cron seguono POSIX crontab. I nomi dei fusi orari vengono dal database dei fusi orari IANA, la cui ultima release, 2026f, è uscita il 2026-10-27. La risposta di creazione elenca i prossimi orari di attivazione in schedule.upcoming_runs_at, così puoi verificare subito l'espressione.
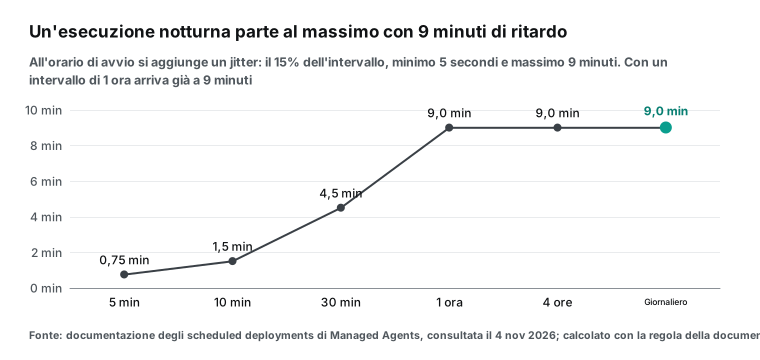
Una frase della documentazione determina la scadenza del report. Gli orari di attivazione sono esatti, ma l'avvio effettivo ha un jitter fino al 15% dell'intervallo tra le esecuzioni. Il minimo è 5 secondi e il massimo 9 minuti. Il grafico qui sotto rappresenta questa regola.
Un deployment eseguito ogni 5 minuti parte al massimo con 45 secondi di ritardo. Un deployment eseguito ogni ora o ogni giorno parte al massimo con 9 minuti di ritardo. Se il report deve arrivare prima delle 7:00, un cron alle 6:30 lascia spazio per 9 minuti di jitter più un'esecuzione di 20 minuti.
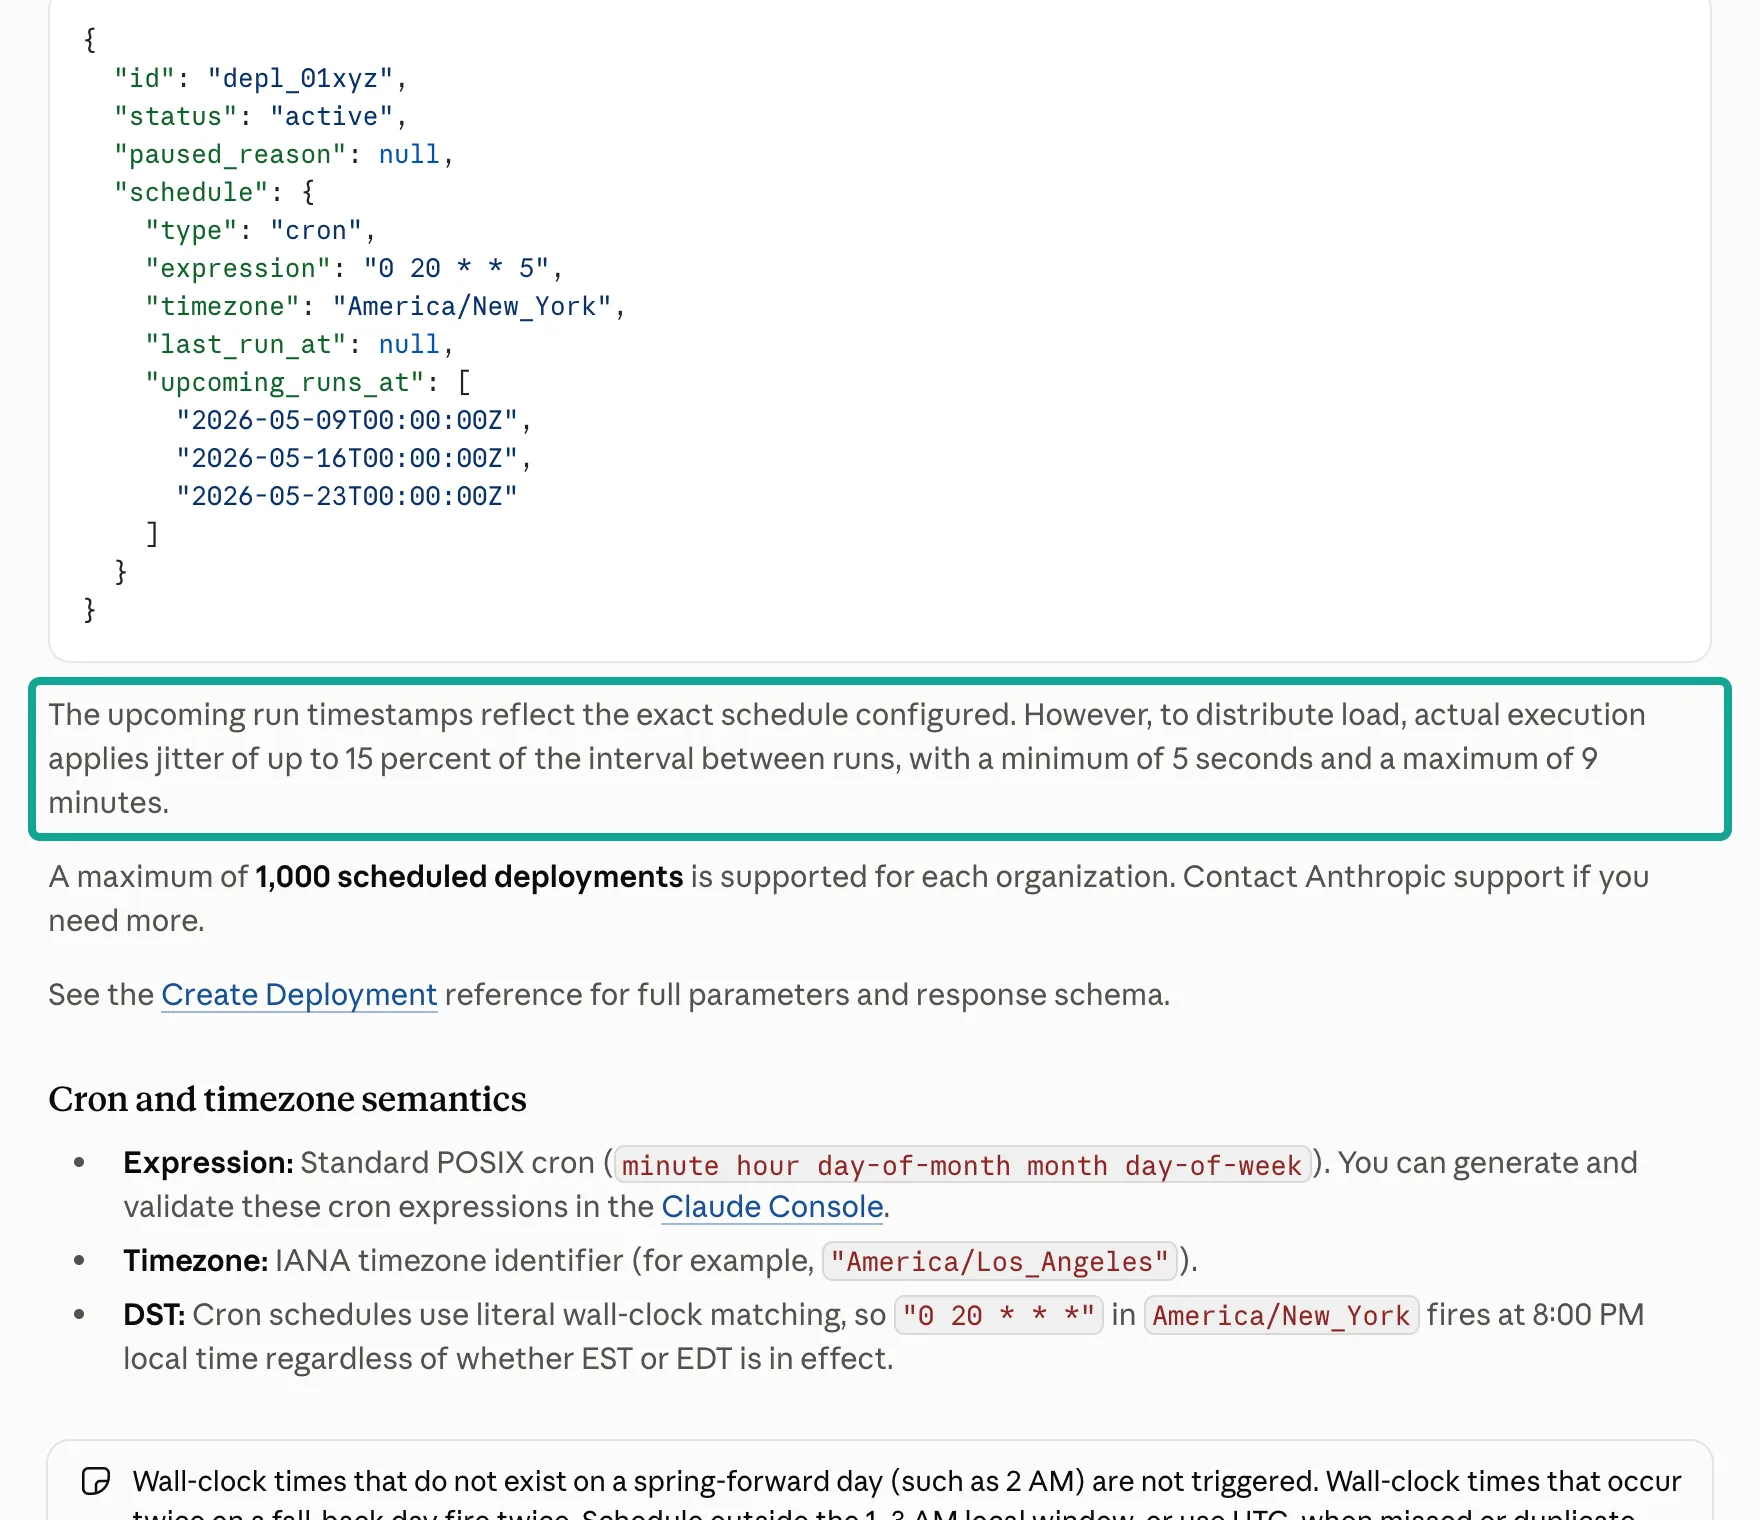
La seconda trappola è l'ora legale. Secondo la documentazione, il cron confronta letteralmente l'ora dell'orologio locale. Quindi 0 20 * * * in America/New_York scatta alle 8 di sera ora locale, sia in EST sia in EDT. Nel giorno in cui si spostano avanti le lancette, un orario che non esiste, come le 2 di notte, non scatta.
Nel giorno in cui le lancette tornano indietro, un orario che si ripete due volte si attiva due volte. La documentazione consiglia di evitare la fascia tra l'1:00 e le 3:00 ora locale, oppure di usare UTC. Nel 2026 l'ora legale negli Stati Uniti è finita il 1° novembre. Quindi da questa settimana 30 6 * * * a New York corrisponde alle 11:30 UTC, mentre con l'ora legale corrisponde alle 10:30 UTC.
Il terzo punto è il budget. Un deployment può avere un budget facoltativo con la stessa struttura del budget di sessione: {"type": "limit", "max_list_cost": {"amount": "50", "currency": "USD"}}. L'importo è un numero intero di centesimi di dollaro USA scritto come stringa, quindi "50" significa 50 centesimi (“Session budgets”). Il deployment copia questo tetto su ogni nuova sessione. Quindi il tetto vale per ogni esecuzione, non per un totale mensile. L'esempio della documentazione è chiaro: un deployment con un tetto di "2000" può spendere circa $20 a ogni esecuzione.
Il budget conta i token del modello, le ricerche web ($10 per 1.000) e il tempo di esecuzione della sessione ($0,08 all'ora) ai prezzi di listino pubblici. La piattaforma lo controlla tra una richiesta al modello e l'altra e mette in pausa la sessione con budget_reached quando si raggiunge il tetto. Il budget non include la tariffa dell'API di EveryInfra. Quella dipende solo dal numero di chiamate, fisso a 4 per locale a notte.
Il quarto punto riguarda gli errori. Quando metti in pausa un deployment, le attivazioni pianificate si fermano, ma una sessione in corso arriva alla fine. Quando lo riattivi, la pianificazione riparte dal successivo orario previsto. La documentazione lo dice chiaramente: “Missed triggers are not backfilled”, cioè le attivazioni saltate non vengono recuperate. Ogni attivazione scrive un record di esecuzione del deployment. Puoi elencare quelle non riuscite con GET /v1/deployment_runs?deployment_id=…&has_error=true.
I tipi di errore comuni sono environment_archived_error, agent_archived_error e session_rate_limited_error. L'ultimo viene registrato e non ritentato. Ogni organizzazione può avere fino a 1.000 deployment pianificati. Quindi il job del report deve gestire da solo il caso “ieri notte non è partito”. L'esecuzione successiva non deve leggere solo le ultime 24 ore. Deve risalire fino all'ultimo ID di recensione salvato dall'ultima esecuzione riuscita.
Dove si trova la chiave: due tipi di credenziali vault
La chiave EveryInfra viene usata da una connessione MCP oppure da curl nella sandbox. Questi due usi corrispondono a due tipi di credenziali vault (“Authenticate with vaults”). Le credenziali MCP sono mcp_oauth e static_bearer, e sono indicizzate per mcp_server_url. Quando la sessione si connette a un server MCP a quell'URL, il token viene aggiunto automaticamente.
Una credenziale environment_variable è indicizzata per secret_name. La sandbox contiene solo un segnaposto opaco. Il valore reale sostituisce il segnaposto al bordo della rete, solo per gli host in networking.allowed_hosts, e injection_location può limitare la sostituzione agli header.
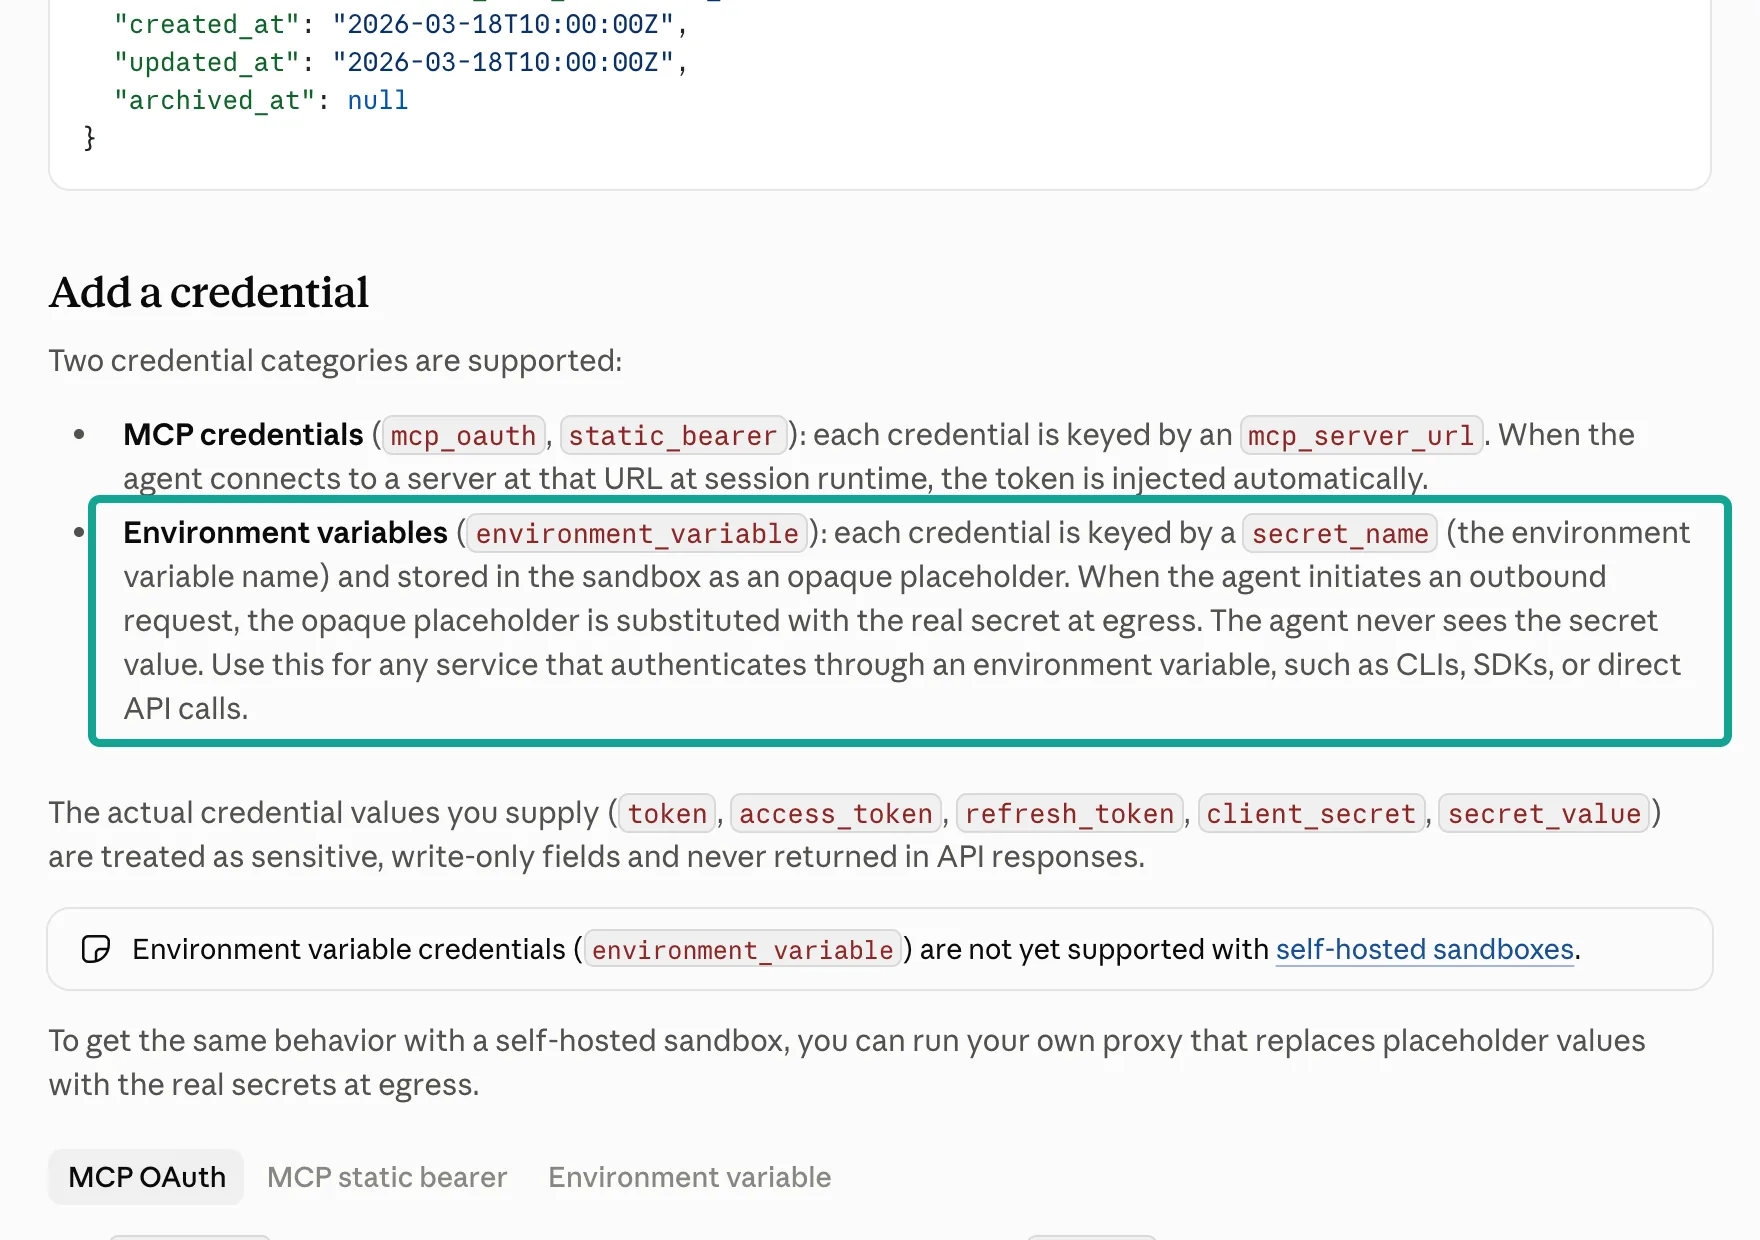
Per questo job consigliamo la credenziale di tipo variabile d'ambiente, per tre motivi. Primo, la chiave può essere inviata a una sola destinazione. La credenziale include solo api.everyinfra.com tra gli allowed_hosts. Se una riga malevola contenuta in una recensione ordina al modello di chiamare un altro URL, quella richiesta contiene soltanto il segnaposto.
Secondo, allowed_hosts della credenziale controlla quali richieste ricevono la chiave, non quali richieste possono uscire dalla sandbox. Di questo si occupa l'impostazione networking dell'ambiente. Quando entrambi consentono solo api.everyinfra.com, ottieni due controlli distinti: uno sulla rete e uno sulla chiave.
Terzo, nel percorso HTTP la risposta grezza finisce prima in un file della sandbox. Un filtro jq passa poi al modello solo le righe che contano, e la sezione sui costi mostra quanti token si risparmiano così. Anche la credenziale di tipo variabile d'ambiente ha dei limiti. Non funziona ancora con le sandbox self-hosted. Un vault può contenere fino a 20 credenziali. La piattaforma non verifica una credenziale quando la crei, quindi scopri che una chiave è sbagliata solo al momento dell'esecuzione.
Abbiamo verificato quest'ultimo punto sul lato EveryInfra. Alle 00:22 ora di Singapore abbiamo chiamato tools/call del server MCP remoto senza chiave. Lo stato HTTP era 200. Il corpo aveva isError impostato a true, con un testo che indicava che la chiamata non era autorizzata e "Nothing was charged".
Quindi una chiave errata o scaduta nel vault non fallisce quando la sessione si connette a MCP. Fallisce alla prima chiamata a un tool, come risultato di errore. Il prompt dell'agente deve dire: fermati in caso di errore di autorizzazione e scrivi "chiave non valida" in cima al report. Non deve fare un nuovo tentativo con altri parametri.
Perché non usare web_fetch per leggere le pagine delle recensioni
Managed Agents ha un tool integrato web_fetch, e sembra la strada più semplice. Metti i tre URL dei locali nel prompt e lasci che l'agente legga le pagine ogni notte. Abbiamo controllato la documentazione e i file robots.txt dei tre siti. Per un job notturno senza supervisione, questa strada non funziona bene. La tabella mostra perché.
| Strada | Riesce a leggere le nuove recensioni ogni notte? | Fonte |
|---|---|---|
web_fetch sulle pagine dei locali | Non in modo affidabile. Dal 2026-10-07 recupera solo URL già comparsi nella sessione, e gli URL nel system prompt o nell'output MCP non contano. Non esegue JavaScript e rispetta robots.txt | «Release notes 2026-10-07», «Web fetch tool» |
| Pagine web di Yelp | Il robots.txt di Yelp consente Claude-User solo su /article e ha Disallow: / per il resto (letto il 2026-11-04) | yelp.com/robots.txt, articolo di Anthropic sul crawler |
| Google Places API | Fino a 5 recensioni per luogo, in ordine di pertinenza | «Place Details» |
| Google Business Profile API | Solo per le sedi che gestisci, con OAuth | «Review data» |
| Yelp Fusion API | Fino a 3 estratti di recensioni per attività, nell'ordine predefinito di Yelp | «Yelp Fusion reviews» |
| Tripadvisor Content API | Fino alle 5 recensioni più recenti per sede | «Location reviews» |
| Endpoint di EveryInfra per le recensioni | Google fino a 100 per chiamata, dalle più recenti. Yelp 10 per pagina con paginazione. Tripadvisor fino a 50 per chiamata | Catalogo |
Il primo limite sfugge spesso. La release note del 7 ottobre 2026 dice che ora web_fetch recupera solo URL già comparsi nella sessione. Lo scopo è ridurre il rischio di esfiltrazione dei dati. Un URL in un messaggio dell'utente o in un risultato di web_search conta. Alcuni URL non contano: quelli presenti solo nell'output di Claude, nel system prompt, in un documento allegato o nell'output di bash o di un tool MCP. Per questi, la chiamata restituisce url_not_in_prior_context.
Una seconda nota dello stesso giorno riguarda la rete limited. Con questa impostazione, la lista allowed_hosts dell'ambiente si applica anche a web_fetch e web_search (Restrict web search and web fetch domains). Dal 20 ottobre, inoltre, un amministratore dell'organizzazione può disattivare il web fetch nella pagina Capabilities della Console. Quando è disattivato, ogni chiamata web_fetch in una sessione di Managed Agents restituisce un errore. Con tutte e tre le regole attive, un job notturno con URL fissi dipende da troppe condizioni.
Il problema più grosso sono le pagine stesse. L'elenco delle recensioni di Google Maps si carica con JavaScript, e la documentazione di web_fetch dice che non supporta i siti renderizzati con JavaScript. Le pagine dei locali su Yelp sono chiuse a Claude-User. Il robots.txt di Tripadvisor ha Disallow: / per ClaudeBot.
Claude-User non è nominato, quindi gli si applicano le regole generali. Le API ufficiali hanno tutte limiti bassi: 5 recensioni da Google Places, 3 estratti da Yelp Fusion e 5 dalla Tripadvisor Content API. Katz's riceve circa 25 recensioni a notte, quindi questi limiti sono decisamente troppo bassi. Per questo job resta una sola strada: chiamare un'API per le recensioni via HTTP o MCP remoto e ottenere JSON strutturato.
MCP remoto o HTTP: due strade con costi diversi
La prima strada è MCP remoto. Il server MCP di EveryInfra si trova a https://api.everyinfra.com/mcp e usa il trasporto Streamable HTTP (MCP transports). Il suo tools/list restituisce 12 tool, e quello a pagamento è everyinfra_call_api (vedi la pagina del server MCP). Sull'agente dichiari un server MCP con type: url e aggiungi un mcp_toolset. Il vault fornisce una credenziale static_bearer che corrisponde all'URL del server (MCP connector). Questa strada richiede la configurazione minima, ma ha due trappole.
La prima trappola è l'approvazione. La documentazione sulle policy dei permessi dice che il toolset dell'agente ha come impostazione predefinita always_allow e i toolset MCP always_ask (Permission policies). La sessione si mette in pausa prima di ogni chiamata MCP e attende l'approvazione. Di notte nessuno approva, quindi la sessione resta in attesa.
Imposta default_config.enabled: false sul toolset per disattivare tutti i suoi tool, poi imposta always_allow solo su everyinfra_call_api. Il tool ha le annotazioni readOnlyHint: false e destructiveHint: true perché ogni chiamata è a pagamento. Per questo anche la policy auto può chiedere l'approvazione. La specifica dei tool MCP definisce queste annotazioni.
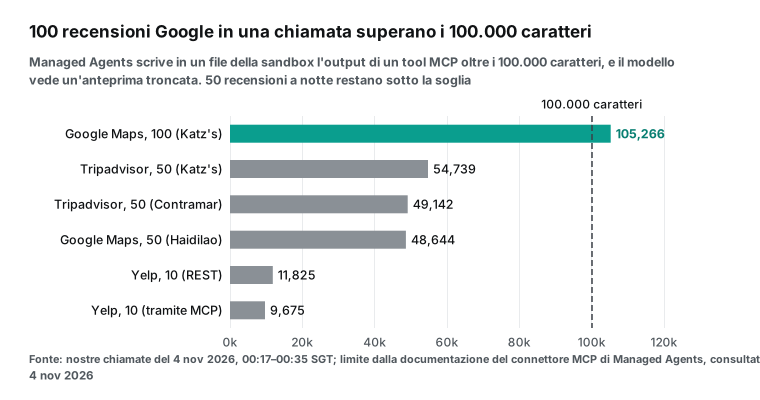
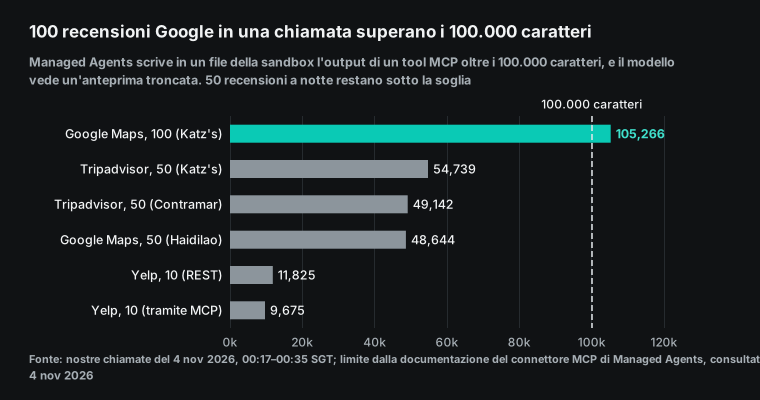
La seconda trappola è la dimensione della risposta. La documentazione del connettore MCP indica un limite di 100.000 caratteri (circa 25.000 token). Un output di un tool più grande finisce in un file nella sandbox, e il modello riceve solo una breve anteprima. La nostra risposta reale di Google con le 100 recensioni più recenti di Katz's era di 105.266 caratteri, appena sopra quella soglia.
Nel secondo round, una chiamata MCP reale per le 50 più recenti ha restituito 53.364 caratteri. Tripadvisor con 50 recensioni era di 54.739 caratteri, e una pagina Yelp da 10 di circa 10.000 caratteri. Il grafico mette ogni risposta reale accanto alla soglia.
La seconda strada è HTTP con la credenziale come variabile d'ambiente. L'agente usa il suo tool integrato bash per eseguire curl con l'header Authorization: Bearer $EVERYINFRA_API_KEY. Nella sandbox quella variabile contiene solo il segnaposto, e la chiave reale lo sostituisce in uscita. La risposta JSON va direttamente in un file della sandbox. Un filtro jq lascia poi passare solo le recensioni da 1–2 stelle che non sono nell'ultima lista di ID.
Così il modello vede una dozzina di recensioni filtrate invece di 128.000 caratteri di dati grezzi per locale. Il prezzo da pagare è un prompt più lungo con passaggi di script chiari, più jq nell'ambiente. Puoi consentire all'ambiente di usare i package manager, oppure installare jq in anticipo. Per l'esecuzione notturna consigliamo la strada HTTP. Tieni MCP per i controlli manuali. In una sessione manuale l'agente può chiamare everyinfra_list_requests per vedere lo stato e l'addebito di una chiamata, e quel tool è gratuito.
Esempi di configurazione: ambiente, agente, vault, deployment
Abbiamo scritto i quattro file qui sotto partendo dai campi della documentazione di platform.claude.com. Sono esempi di configurazione, e non li abbiamo creati in un'organizzazione. La CLI ant può trasformare un file Markdown con un header YAML in un oggetto con ant apply. Salva l'ID in claude-lock.json (Define your agent). Si parte dall'ambiente.
# Configuration example: environment (fields from the Cloud environment setup doc; not tested by us)
name: review-patrol-env
config:
  type: cloud
  networking:
    type: limited
    allowed_hosts:
      - api.everyinfra.com
    allow_package_managers: true   # to install jq; turn off after you preinstall it
    allow_mcp_servers: false
Poi viene l'agente. Il system prompt fissa tre regole: chiamare solo quattro endpoint, giudicare "nuovo" in base all'ID e fermarsi in caso di errore di autorizzazione.
---
# Configuration example: agent.md (fields from Define your agent, Tools and Permission policies; not tested by us)
name: Nightly review patrol
model: claude-sonnet-5-5
tools:
  - type: agent_toolset_20260401
    configs:
      - name: web_fetch
        enabled: false
      - name: web_search
        enabled: false
---
Each night, read new reviews for every store in the store list. Use only bash and curl to call
https://api.everyinfra.com/api/v1/social with the header "Authorization: Bearer $EVERYINFRA_API_KEY".
Make 4 calls per store: google_maps_reviews/reviews (sort=newest, limit=50), yelp/reviews pages 1 and 2,
and tripadvisor/reviews. Save each response to /tmp/<store>-<site>.json.
Use jq to drop review IDs that are already in /mnt/memory/review-patrol/seen.json. Read only 1-2 star reviews.
Give each bad review one or more labels: food, service, line and seating, price and hype, venue, online order.
Translate reviews that are not in English before you label them.
If a response says unauthorized, stop. Write "EveryInfra key not valid" as the first line of the report. Do not retry.
At the end, write all review IDs from this run back to /mnt/memory/review-patrol/seen.json,
and write the report to /mnt/session/outputs/report.md.
Il vault ha bisogno di una sola credenziale. Sulla tua macchina, leggi secret_value da una variabile d'ambiente, così la chiave non finisce mai in un file.
# Configuration example: add an environment variable credential to a vault (fields from Authenticate with vaults; not tested by us)
curl --fail-with-body -sS "https://api.anthropic.com/v1/vaults/$VAULT_ID/credentials" \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "anthropic-beta: managed-agents-2026-04-01" \
  -H "content-type: application/json" \
  -d "$(jq -n --arg v "$EVERYINFRA_API_KEY" '{
        auth: {
          type: "environment_variable",
          secret_name: "EVERYINFRA_API_KEY",
          secret_value: $v,
          networking: {type: "limited", allowed_hosts: ["api.everyinfra.com"]},
          injection_location: {header: true}
        },
        display_name: "EveryInfra key for nightly review patrol"
      }')"
Per ultimo il deployment pianificato. La documentazione dice che un deployment accetta le stesse impostazioni di una nuova sessione. Agente e ambiente sono obbligatori. File, memory store e vault sono facoltativi. L'elenco dei locali va nel messaggio iniziale, e il budget è di 50 centesimi per esecuzione. Il campo amount è in centesimi, quindi "50" equivale a 0,50 $, non a 50 $. Un memory store viene montato sotto /mnt/memory/ con il suo nome visualizzato, quindi uno store chiamato review-patrol si trova in /mnt/memory/review-patrol/.
{
  "name": "Nightly review patrol (NYC)",
  "agent": "agent_01...",
  "environment_id": "env_01...",
  "vault_ids": ["vlt_01..."],
  "resources": [
    {"type": "memory_store", "memory_store_id": "memstore_01...", "access": "read_write",
     "instructions": "seen.json holds the review IDs from the last run, grouped by site."}
  ],
  "initial_events": [
    {
      "type": "user.message",
      "content": [{"type": "text", "text": "Store list: Katz's Delicatessen and Haidilao Hot Pot Flushing. URLs are in stores.json. Read all new reviews since the last run and write the morning report."}]
    }
  ],
  "schedule": {"type": "cron", "expression": "30 6 * * *", "timezone": "America/New_York"},
  "budget": {"type": "limit", "max_list_cost": {"amount": "50", "currency": "USD"}}
}
Come ricevi il risultato? I webhook inviano un payload ridotto con solo il tipo di evento, l'ID e un timestamp, non l'oggetto completo. Recuperi l'oggetto con una chiamata GET (Subscribe to webhooks). Bastano due tipi di evento. Nota che session.status_idled significa "l'agente si è fermato e attende input".
Si attiva quando l'esecuzione è terminata e anche quando l'esecuzione attende un'approvazione. Quindi il tuo server deve fare GET della sessione e leggere stop_reason.type sull'ultimo evento session.status_idle (Session event stream). deployment_run.failed significa che l'esecuzione di quella notte non ha creato una sessione. Le esecuzioni manuali tramite l'endpoint run non inviano eventi deployment_run, quindi non aspettarne uno durante un test.
Ogni evento ha fino a 3 tentativi di consegna, con backoff esponenziale con jitter da 5 a 120 secondi. Dopo l'ultimo tentativo fallito, l'evento viene scartato e non messo in coda. Quindi il tuo server deve deduplicare su event.id e deve controllare ogni mattina l'elenco delle esecuzioni del deployment. Il signing secret inizia con whsec_. Gli header sono webhook-id, webhook-timestamp e webhook-signature, nello stesso formato di Standard Webhooks.
| `stop_reason.type` | Cosa significa | Cosa fa il tuo server dopo il webhook |
|---|---|---|
end_turn | L'agente ha terminato il suo turno | Scarica /mnt/session/outputs/report.md con la Files API e invialo al responsabile di turno |
requires_action | Una chiamata a un tool attende l'approvazione, ad esempio un tool MCP ancora su always_ask | Invia un avviso e correggi la policy dei permessi dell'agente. Non approvare le chiamate di notte tramite script |
budget_reached | Il costo a listino di questa esecuzione ha raggiunto il budget | Invia un avviso e controlla se l'agente ha ripetuto i tentativi in loop. Modifica il budget il giorno dopo |
Un round trip reale: cosa invia il modello e cosa torna indietro
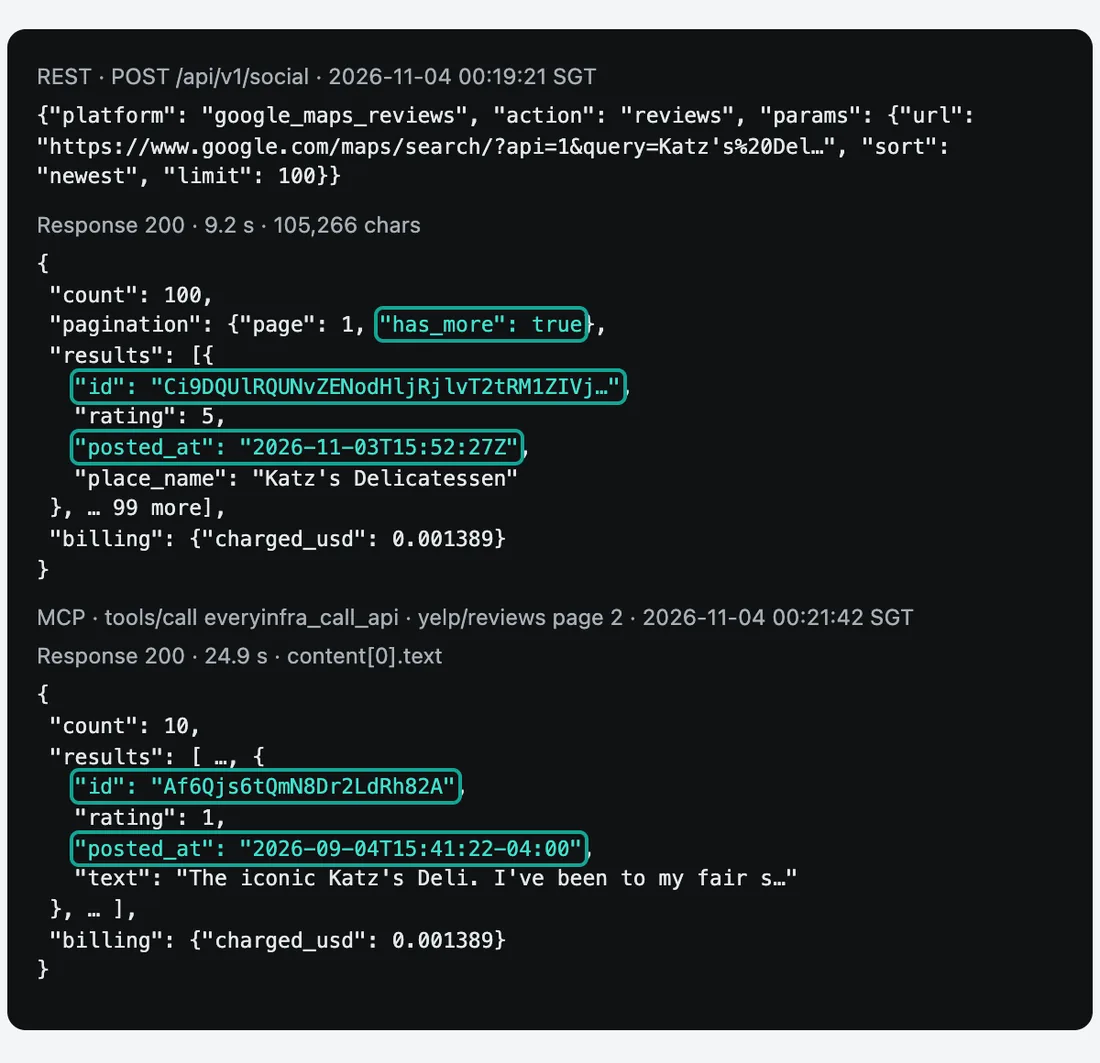
Non abbiamo fatto il deployment sul lato Anthropic. Ma una richiesta che un agente invia a EveryInfra tramite MCP, dal nostro lato, è identica a una che invia con curl. Qui sotto c'è la richiesta reale che abbiamo inviato alle 00:21:42 ora di Singapore tramite tools/call del server MCP remoto. Legge la pagina 2 delle recensioni di Katz's su Yelp. Il page_token proviene da next_page_token nella risposta della pagina 1, e qui l'abbiamo accorciato.
{"jsonrpc": "2.0", "id": 7, "method": "tools/call",
 "params": {"name": "everyinfra_call_api",
  "arguments": {"platform": "yelp", "action": "reviews",
   "params": {"url": "https://www.yelp.com/biz/katzs-delicatessen-new-york",
              "page_token": "pt1.4EnA2jhN8mJn…"}}}}
La risposta è arrivata con HTTP 200 dopo 24,9 secondi. content[0].text conteneva 9.675 caratteri di JSON con 10 recensioni, e la chiamata è stata addebitata 0,001389 $. Ogni recensione ha campi come id, rating, posted_at e text. Il campo più importante è id, perché il test del "nuovo" dipende da questo. La tabella elenca tutte le chiamate del primo round (T1) per Katz's.
| Ora di Singapore | Funzionalità | Strada | Righe | Tempo | Caratteri | Addebito |
|---|---|---|---|---|---|---|
| 00:18:04 | google_maps_reviews/search | REST | 3 | 72.5 s | 3,915 | $0.001389 |
| 00:19:21 | google_maps_reviews/reviews, più recenti, 100 | REST | 100 | 9.2 s | 105,266 | $0.001389 |
| 00:19:46 | yelp/reviews pagina 1 | REST | 10 | 24.6 s | 11,825 | $0.001389 |
| 00:20:22 | tripadvisor/search | REST | 1 | 15.2 s | 1,741 | $0.001389 |
| 00:20:43 | tripadvisor/reviews | REST | 50 | 11.1 s | 54,739 | $0.001389 |
| 00:21:02 | yelp/reviews, URL con sort_by=date_desc | REST | 10 | 27.4 s | 11,825 | $0.001389 |
| 00:21:42 | yelp/reviews pagina 2 | MCP | 10 | 24.9 s | 9,675 | $0.001389 |
La prima chiamata, alle 00:17:32, ha ricevuto un 429. La nostra chiave di test ha un limite di 10 chiamate al minuto. Quella chiamata non è stata addebitata, e un nuovo tentativo dopo 30 secondi è andato a buon fine. Poi abbiamo fatto altre 13 chiamate per Haidilao e per Contramar a Città del Messico.
Quattro di queste erano ricerche senza risultati, e l'API ha rimborsato ciascuna con empty_result_refunded. Nel primo round sono state addebitate 15 chiamate, per 0,020835 $. Con le 5 chiamate del secondo round alle 01:20, le chiamate addebitate sono state 20, per 0,02778 $. La ricerca dei luoghi di Google non ha restituito risultati per i due locali fuori dagli USA (Botín a Madrid e Contramar a Città del Messico). Abbiamo quindi chiamato google_maps_reviews/reviews con un URL di ricerca di Google Maps e ottenuto 50 recensioni di Contramar.
Test 1: quanti giorni coprono "le N più recenti" su ciascun sito
Quante recensioni devi leggere ogni notte dipende da quanto tempo copre una pagina. Abbiamo preso il posted_at della prima e dell'ultima recensione di ogni risposta e abbiamo calcolato la differenza. Il grafico mostra il risultato. Due vecchie recensioni modificate su Google (datate 23 ottobre e 10 agosto) si trovavano a metà dell'elenco. La guida di Google dice che una recensione modificata mostra la data della modifica (Google Business Profile help), quindi abbiamo escluso quelle due dall'intervallo.
| Sito | Righe lette | Intervallo coperto | 1–2 stelle | Risposte del titolare | In ordine di data? |
|---|---|---|---|---|---|
| 100 | 3,97 giorni | 10 | 10 | Sì, tranne 2 recensioni modificate | |
| Yelp pagine 1 e 2 | 20 | 68,84 giorni | 1 | 0 | No |
| Tripadvisor | 50 | 119 giorni | 10 | 0 | Sì |
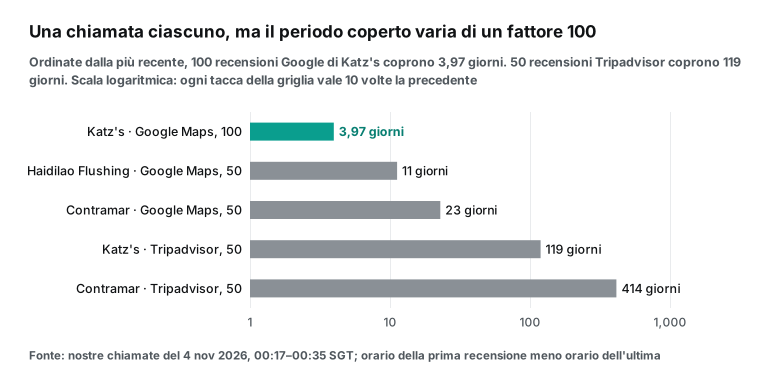
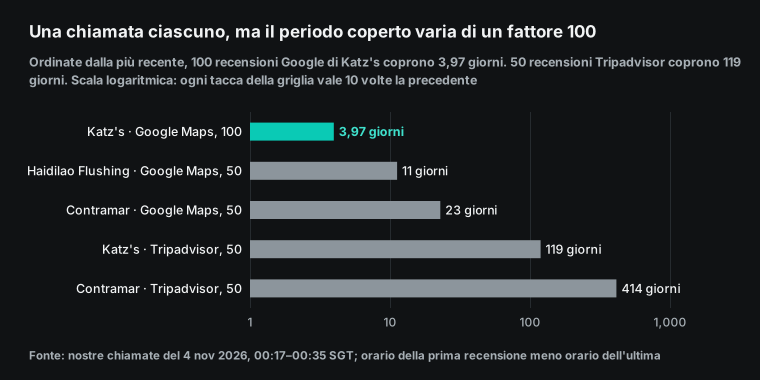
"Le 50 più recenti" coprono meno di due giorni per Katz's su Google e più di un anno per Contramar su Tripadvisor. Questo divario ha due cause: il volume di recensioni del locale e la lingua delle recensioni. Entrambe le risposte di Tripadvisor erano interamente in inglese. Tutte le 50 recensioni di Katz's erano in inglese. Per Contramar abbiamo usato l'URL del sito messicano, tripadvisor.com.mx, e tutte le 50 recensioni erano comunque in inglese, dal 2025-09-02 al 2026-10-21.
Quindi questo endpoint legge le recensioni in inglese su Tripadvisor, e quelle in spagnolo non sono nella risposta. Per un locale frequentato soprattutto da clienti del posto, il lato Tripadvisor mostrerà raramente una nuova recensione in una data notte. Una lettura costa solo 0,001389 $, quindi vale comunque la pena tenerla nel job.
Yelp si comporta in modo diverso. La pagina 1 di Katz's aveva 10 recensioni dal 20 settembre al 2 novembre, in ordine misto. La pagina di supporto di Yelp dice che l'ordine predefinito tiene conto di quanto è recente la recensione, dei voti e della qualità, quindi recensioni più vecchie possono comparire prima di quelle più nuove. Solo gli utenti che hanno effettuato l'accesso possono scegliere "Newest First" (Yelp support).
Abbiamo aggiunto sort_by=date_desc all'URL e rifatto la chiamata. I 10 ID delle recensioni erano esattamente gli stessi, quindi questo parametro dell'URL non aveva effetto. La pagina 2 aveva una recensione del 1° novembre, e 5 delle sue 10 recensioni erano più recenti della recensione più vecchia della pagina 1. Quindi il job notturno deve leggere almeno due pagine di Yelp e deve giudicare "nuovo" in base all'ID. La prima recensione della pagina 1 non è un riferimento sicuro.
Test 2: dove sono le recensioni negative e cosa dicono
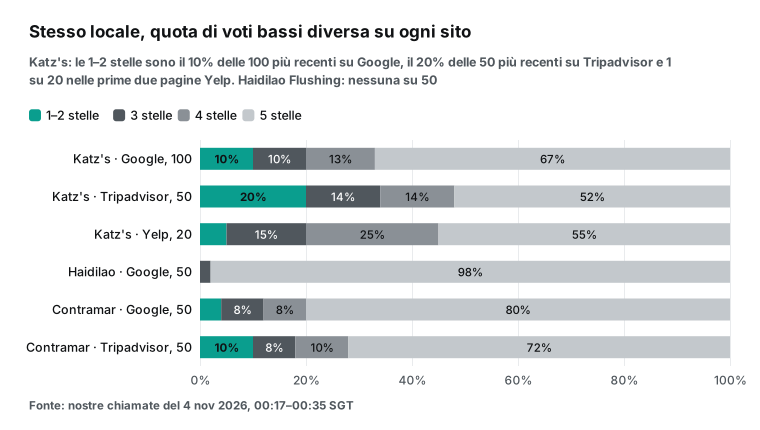
Il grafico mostra la quota di ciascuna valutazione in stelle in ogni risposta. Nelle 100 recensioni Google più recenti di Katz's, 10 avevano 1–2 stelle, cioè il 10%. Su Tripadvisor, 10 su 50 avevano 1–2 stelle, cioè il 20%. Su Yelp, solo 1 delle 20 recensioni su due pagine aveva 1 stella.
Per Haidilao, 49 delle 50 recensioni Google avevano 5 stelle e 1 aveva 3 stelle, senza nessuna recensione negativa. Tutte le 10 recensioni della pagina 1 di Yelp di Haidilao avevano 4 o 5 stelle. Per Contramar, le 50 recensioni Google includevano una recensione da 1 stella e una da 2 stelle.
Abbiamo letto il testo completo delle 10 recensioni negative su Google e delle 10 su Tripadvisor per Katz's. Abbiamo etichettato ciascuna a mano, e una recensione può avere più di un'etichetta. Delle 10 recensioni Google, 6 riguardavano il cibo (carne secca, pane che si sfalda) e 7 dicevano che il locale è sopravvalutato o troppo caro. 3 riguardavano il personale, 2 i posti affollati o la sala, e 1 la coda.
Delle 10 recensioni Tripadvisor, 7 riguardavano il cibo, 6 il prezzo e l'hype, 5 il servizio e 3 la coda e i posti. Altre due riguardavano ordini online e spedizioni, non la visita al ristorante. Questa suddivisione aiuta il report. I reclami sugli ordini online vanno al team e-commerce e non devono pesare sul personale del locale.
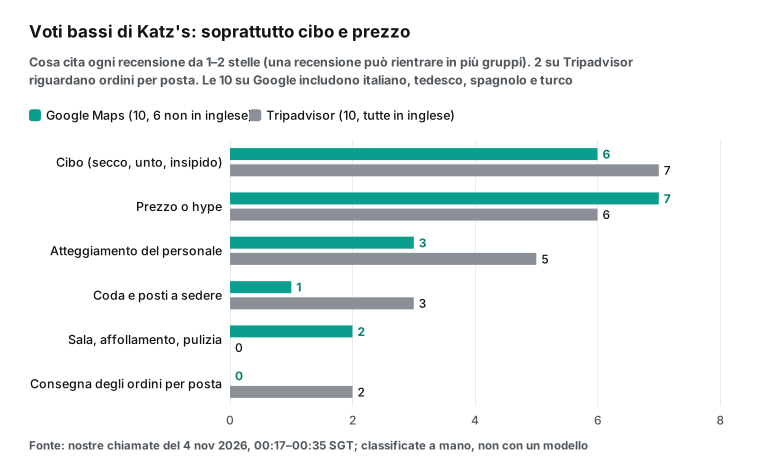
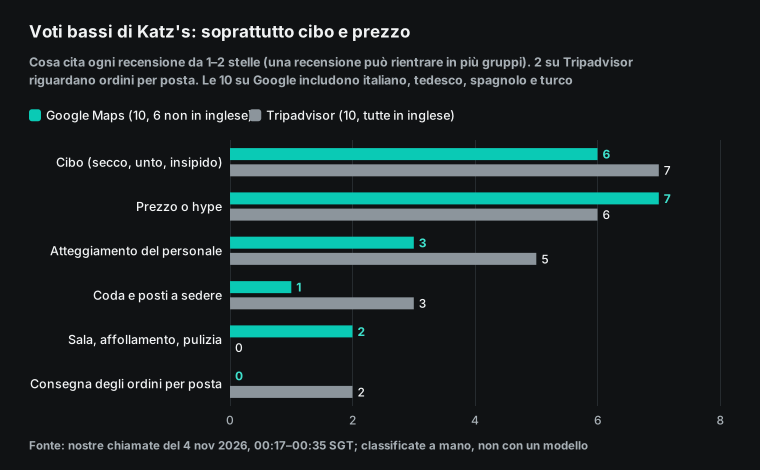
Altri due risultati cambiano il prompt. Primo, 6 delle 10 recensioni Google negative non erano in inglese: 2 in italiano, 2 in tedesco, 1 in turco e 1 in spagnolo. Il parametro lang imposta la lingua dell'interfaccia e non traduce le recensioni, quindi l'agente deve tradurre prima di etichettare. Secondo, 10 delle 100 recensioni Google più recenti avevano una risposta del titolare. Tutte e 10 le risposte sono state pubblicate tra le 21:10 e le 21:32 UTC del 2 novembre, in una finestra di 22 minuti.
Nove delle 10 risposte erano a recensioni da 5 stelle. Solo una era a una recensione da 1 stella, che riguardava qualcuno che aveva saltato la fila. Quella risposta è arrivata circa 35 ore dopo la recensione. Quindi questo locale risponde a blocchi e risponde prima alle recensioni positive. Una colonna "risposta" nel report porta in cima le recensioni negative che nessuno ha gestito.
Test 3: come giudicare "nuovo" tra due snapshot
Il primo round (T1) si è svolto dalle 00:19 alle 00:21 ora di Singapore e il secondo (T2) alle 01:20. L'intervallo di circa un'ora rappresenta "ieri notte" e "stanotte". In T2 abbiamo letto le 50 recensioni Google più recenti di Katz's tramite MCP remoto. Abbiamo letto di nuovo Google via REST con since=2026-11-03, più la pagina 1 di Yelp e Tripadvisor, una volta ciascuno.
Sono 4 chiamate per 0,005556 $. Un'altra chiamata yelp/search ha trovato la pagina Yelp di Contramar per l'edizione spagnola. La regola del "nuovo" sta in una riga: una recensione è nuova se il suo ID non è nell'insieme dell'ultima esecuzione.
| Sito | Righe T1 | Righe T2 | ID non visti in T1 | Di cui con 1–2 stelle |
|---|---|---|---|---|
| Google 50 più recenti (MCP) | 100 | 50, 53.364 caratteri | 3, tutte da 5 stelle | 0 |
Google since=2026-11-03 (REST) | — | 17, 21.588 caratteri, nessuna pagina successiva | 3 (le altre 14 erano in T1) | 0 |
| Yelp pagina 1 | 10 | 10, stessi ID nello stesso ordine di T1 | 0 | 0 |
| Tripadvisor | 50 | 50 | 0 | 0 |
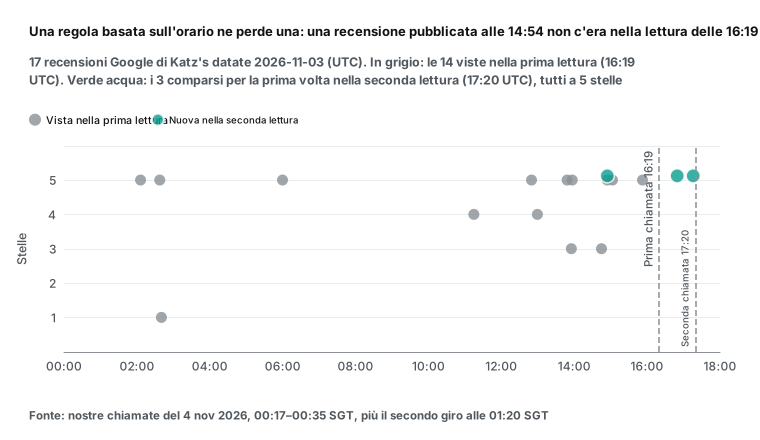
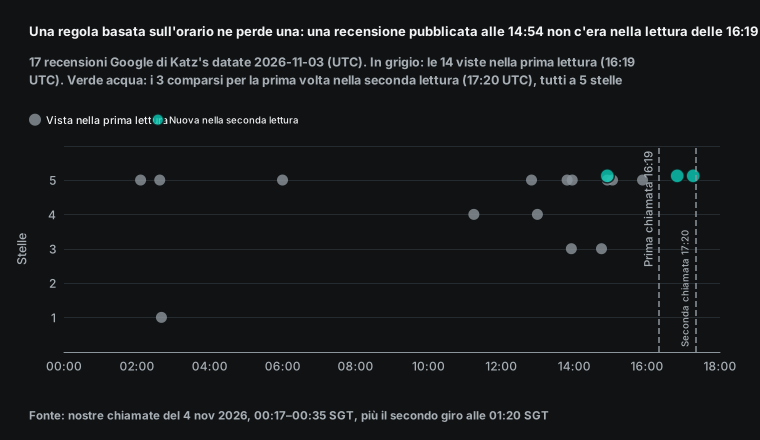
Il dettaglio più utile è l'orario di pubblicazione delle 3 nuove recensioni Google: 17:15, 16:49 e 14:54 UTC. Le prime due sono successive alla chiamata T1 delle 16:19 UTC, quindi sono normali recensioni nuove. La terza, delle 14:54, precede di 1 ora e 25 minuti la chiamata T1. È persino più vecchia della recensione più recente di T1 (15:52), ma non era nell'elenco di 100 di T1.
Quindi una recensione può comparire su Google più tardi dell'orario di pubblicazione mostrato. Una regola come "leggi solo le recensioni con posted_at successivo all'ultima più recente" salta questa recensione per sempre. Solo un confronto degli ID la intercetta. Per le recensioni presenti sia in T1 sia in T2, posted_at, la valutazione in stelle e la risposta del titolare non sono cambiati.
Anche il parametro since va nel prompt. È una data, non un orario. since=2026-11-03 ha restituito tutte le 17 recensioni del 3 novembre UTC, e 14 di queste erano già in T1. Quindi non può sostituire il controllo degli ID. Però ha ridotto la risposta da 53.364 a 21.588 caratteri, circa il 60% in meno, e questo aiuta soprattutto sulla strada MCP.
Il nostro consiglio: imposta since al giorno prima dell'ultima esecuzione riuscita, mantieni sort=newest e rimuovi i duplicati in base all'ID. Lascia limit a 50 come rete di sicurezza nel caso since sia sbagliato. Yelp e Tripadvisor non hanno avuto nuove recensioni in quest'ora, e i 10 ID della pagina 1 di Yelp hanno mantenuto lo stesso ordine. Una pagina 1 senza cambiamenti non dimostra che la pagina 2 non sia cambiata, quindi leggi entrambe le pagine. Il report di questa notte è di una riga: "3 nuove recensioni nell'ultima ora sui tre siti, tutte da 5 stelle, nessuna nuova recensione negativa."
Questo confronto decide anche cosa salvare nel memory store. Basta un insieme di ID delle recensioni recenti per ciascun sito. Conserva gli ultimi 400 ID per Google, perché l'endpoint consente di paginare fino a 400 righe. Conserva gli ultimi 100 ID per Yelp e per Tripadvisor. Conserva anche la data dell'ultima esecuzione riuscita. Non salvare solo "l'orario della recensione più recente", per via della recensione delle 14:54 vista sopra.
Come si presenta il report del mattino
Scrivi le regole delle etichette nel prompt, con una riga di definizione e qualche indizio per ciascuna etichetta. Altrimenti la stessa recensione oggi è "servizio" e domani "coda", e i totali di fine mese non sono confrontabili. Abbiamo costruito le sei etichette qui sotto dal testo completo di 28 recensioni negative: 21 di Katz's e 7 di Contramar. Ogni indizio viene da parole ricorrenti in quelle recensioni. Una recensione può avere più di un'etichetta. Quando l'agente non è sicuro, deve aggiungere un'etichetta in più invece di forzare una scelta unica.
| Etichetta | Definizione | Indizi nelle recensioni | Destinatario |
|---|---|---|---|
| Cibo | Un problema del cibo in sé | Secco, salato, unto, insapore, non fresco, pane che si sfalda | Capo cucina |
| Servizio | Atteggiamento o comportamento del personale | Scortese, ci ha ignorati, ha lanciato il sacchetto, ha aggiunto la mancia senza chiedere | Direttore del locale |
| Coda e posti | Attesa, disposizione dei tavoli, scelta del posto | Coda lunga, qualcuno ha saltato la fila, solo il bancone, tavoli troppo vicini | Responsabile di sala |
| Prezzo e hype | Non vale il prezzo, o la fama supera il cibo | Troppo caro, sopravvalutato, posto virale, non vale il viaggio | Marketing e prezzi |
| Sala | La sala e le strutture | Affollato, tavoli vicini, qualcuno che svapa al tavolo accanto | Direttore del locale |
| Ordini online | Ordini web, spedizione, consegna | Arrivato una settimana dopo, problema con condimenti acquistati online | Team e-commerce |
L'esempio qui sotto usa le 10 recensioni negative di Katz's su Google dalla risposta T1. Abbiamo tradotto e accorciato ogni recensione. Le date sono in UTC. Un report reale dovrebbe includere anche il link a ogni recensione, così il responsabile di turno può aprirla e rispondere.
| Pubblicata (UTC) | Stelle | Lingua | Riepilogo | Etichette | Risposta |
|---|---|---|---|---|---|
| 11-03 02:40 | 1 | Italiano | Il personale al banco di bevande e contorni è stato scortese e ha lanciato il sacchetto al cliente | Servizio | No |
| 11-01 17:59 | 1 | Inglese | Il cibo è peggiorato negli anni. Il pastrami di oggi era unto e insapore | Cibo, prezzo e hype | No |
| 11-01 10:08 | 1 | Inglese | Qualcuno ha saltato la fila, ma il cuoco ha detto all'autore della recensione di continuare ad aspettare | Coda e posti | Sì |
| 10-31 15:07 | 1 | Turco | Sopravvalutato, non vale la corsa in taxi | Prezzo e hype | No |
| 10-31 12:55 | 2 | Spagnolo | L'uomo che tagliava la carne era poco cordiale | Servizio | No |
| 10-31 08:34 | 2 | Italiano | La carne sapeva di bollito ed era secca, pane cattivo, prezzi molto alti | Cibo, prezzo e hype, sala | No |
| 10-31 02:53 | 2 | Tedesco | Cibo molto deludente. Solo la sala sembrava quella di una classica deli americana; hype e prezzo non sono all'altezza del cibo | Cibo, prezzo e hype | No |
| 10-31 02:51 | 1 | Tedesco | Carne secca e senza condimento, non vale l'hype né i soldi | Cibo, prezzo e hype | No |
| 10-30 23:33 | 1 | Inglese | Un panino al pastrami da 31 $, molto secco e troppo duro da tagliare | Cibo, prezzo e hype | No |
| 10-30 16:33 | 2 | Inglese | Soprattutto un cameriere scortese, non il loro, che li ha rimproverati per aver spostato un tavolo; inoltre sopravvalutato, cibo non eccezionale, tavoli troppo vicini | Servizio, cibo, sala, prezzo e hype | No |
Il report dovrebbe iniziare con un breve riepilogo, non con un lungo elenco. Dalla tabella sopra, il riepilogo può dire: "Negli ultimi 4 giorni, Google ha ricevuto 10 nuove recensioni da 1–2 stelle. 7 dicono che il locale è sopravvalutato o non vale il prezzo, e 6 riguardano il cibo. 6 recensioni non sono in inglese. 9 non hanno risposta, e 3 di queste riguardano il personale. Oggi rispondi prima a queste 3."
Non inserire nel testo del report i nomi di chi ha scritto le recensioni o del personale. Conserva solo i link. Il testo delle recensioni Google di Contramar contiene anche tag di a capo <br> (6 delle 30 recensioni con testo), quindi l'agente deve rimuoverli prima di scrivere il report.
Prezzi di claude managed agents: il costo delle API e i costi lato Anthropic
Il costo ha due componenti. Quella di EveryInfra è semplice. Ogni locale richiede 4 chiamate a notte a 0,001389 $, cioè 0,005556 $ a notte e 0,1667 $ per 30 notti. Per 10 locali sono 1,6668 $ al mese, e per 50 locali 8,334 $.
Non c'è un canone mensile. I risultati vuoti vengono rimborsati. Le tre chiamate di ricerca avvengono solo in fase di configurazione (vedi la pagina dei prezzi).
Sul lato Anthropic, la pagina dei prezzi che abbiamo letto il 4 novembre 2026 dice che Managed Agents ha due voci di costo. I token sono addebitati al prezzo di listino del modello. Il runtime della sessione costa 0,08 $ l'ora, misurato al millisecondo, e solo mentre lo stato della sessione è running. Il tempo di inattività è gratuito.
Le ricerche web in una sessione costano 10 $ ogni 1.000, e lo sconto della Batch API non si applica (Pricing). La stessa pagina indica Opus 5.5 a 4 $ in input e 20 $ in output per milione di token. Sonnet 5.5 costa 2 $ e 10 $. Haiku 5.5, per prompt fino a 100.000 token, costa 0,10 $ e 0,50 $.
Non abbiamo misurato l'uso di token, quindi i numeri che seguono sono stime. Mostriamo le ipotesi così puoi usare le tue. Un locale per una notte produce 129.603 caratteri di risposte grezze (la risposta reale di Google con 50 recensioni del secondo round, due pagine di Yelp, Tripadvisor con 50). Il glossario dice che i modelli meno recenti usano circa 3,5 caratteri inglesi per token. I modelli 4.7 e successivi usano circa il 30% di token in più per lo stesso testo (Glossary). Abbiamo usato 2,69 caratteri per token, quindi le risposte grezze valgono circa 48.138 token.
Il loop dell'agente può leggere il contesto più di una volta. Non possiamo misurare quante volte, quindi diamo due livelli. 1x (ogni risposta entra nel contesto una volta) è il livello basso, e 3x è un livello alto. Entrambi i livelli aggiungono 15.000 token per il system prompt e il testo dei tool, e 3.000 token di output. Non abbiamo incluso alcuno sconto della prompt cache. Sulla strada MCP, con tutti i dati grezzi nel contesto, una notte richiede circa da 63.138 a 159.414 token di input.
Sulla strada HTTP, dove jq lascia passare solo le righe da 1–2 stelle, una notte richiede circa da 17.854 a 23.564 token di input. Al livello 3x, è circa l'85% in meno. Anche il valore di caratteri per token è una stima. Per un numero più preciso, usa l'endpoint di conteggio dei token di Anthropic sulle tue risposte. Per il runtime abbiamo usato i 69,8 secondi misurati delle 4 chiamate ai tool più 60 secondi di tempo del modello, che danno 0,00288 $ a notte.
| Un locale | Per notte (da 1x a 3x) | Al mese (30 notti, 3x) |
|---|---|---|
| Costo API di EveryInfra (4 chiamate, prezzo di catalogo) | $0.005556 | $0.1667 |
| Runtime della sessione (stima 129,8 s) | $0.00288 | $0.0864 |
| Haiku 5.5, HTTP con filtro | da 0,0033 $ a 0,0039 $ | $0.117 |
| Haiku 5.5, MCP con dati completi | da 0,0078 $ a 0,0174 $ | $0.522 |
| Sonnet 5.5, HTTP con filtro | da 0,0657 $ a 0,0771 $ | $2.313 |
| Sonnet 5.5, MCP con dati completi | da 0,1563 $ a 0,3488 $ | $10.464 |
| Opus 5.5, HTTP con filtro | da 0,1314 $ a 0,1543 $ | $4.629 |
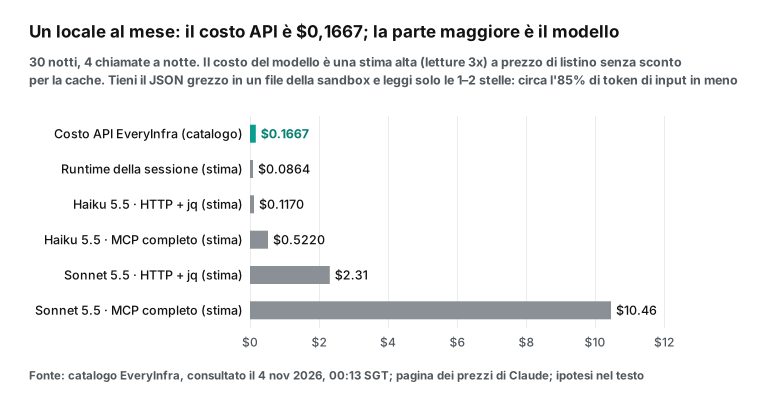
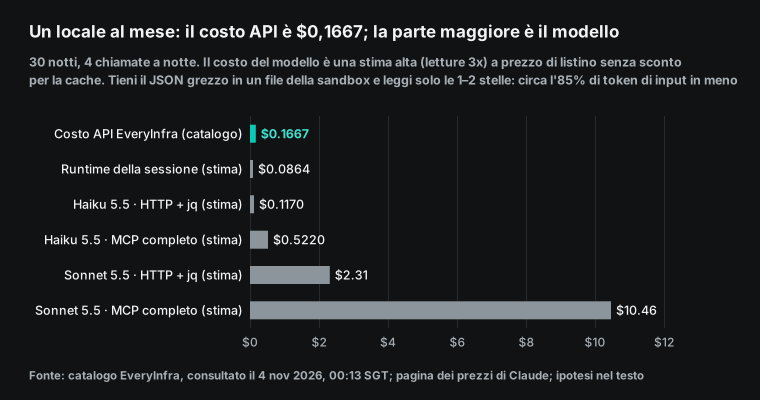
Il costo delle API è un numero piccolo e fisso. Il costo reale dipende dal modello e da quanti dati grezzi entrano nel contesto. Con Sonnet 5.5 sulla strada HTTP, un locale costa in totale circa da 0,074 $ a 0,086 $ a notte. Il costo delle API ne rappresenta solo il 6,5–7,5%. Lo stesso modello sulla strada MCP con dati completi costa circa da 0,165 $ a 0,357 $ a notte, cioè da 2,2 a 4,2 volte tanto. Haiku 5.5 è probabilmente sufficiente per etichettare e tradurre le recensioni, e in quel caso un locale costa meno di 0,40 $ al mese.
Per impostare il budget del deployment, usa "locali × stima per locale × 3". Per 10 locali su Sonnet con HTTP, la stima è di circa 0,86 $ a notte. Un budget di "300" (3 $) ferma un loop fuori controllo e lascia comunque finire un'esecuzione normale. Un utente di Reddit ha scritto che tre prove di Managed Agents gli sono costate circa 6 $ di API (thread su Reddit). Per questo conviene impostare il budget fin dal primo giorno. La tabella estende i totali a più locali al livello 3x. Presuppone che il costo per locale resti lo stesso e che una sola sessione legga tutti i locali.
| Locali | API di EveryInfra al mese | Totale con Haiku 5.5, HTTP (stima) | Totale con Sonnet 5.5, HTTP (stima) | Budget per esecuzione, Sonnet |
|---|---|---|---|---|
| 1 | $0.1667 | $0.369 | $2.565 | "30" |
| 10 | $1.667 | $3.69 | $25.65 | "300" |
| 50 | $8.334 | $18.45 | $128.25 | "1300" |
claude managed agents vs agent sdk e le pianificazioni di Claude Code e Cowork
Anthropic offre ormai almeno quattro modi per eseguire Claude in modo pianificato. Quello giusto dipende da chi esegue il loop, chi paga e dove si trova la chiave. L'Agent SDK è una libreria. Porta il loop dell'agente di Claude Code nel tuo processo.
Macchina e scheduler li fornisci tu (Agent SDK overview, hosting guide). Managed Agents è un loop ospitato più una sandbox. Le routine di Claude Code e le attività pianificate di Cowork sono funzionalità delle app in abbonamento e consumano l'utilizzo previsto dal tuo piano.
| Deployment di Managed Agents | Agent SDK | Routine di Claude Code | Attività pianificate di Cowork | |
|---|---|---|---|---|
| Chi esegue il loop | Cloud di Anthropic | Il tuo server o container | Cloud di Anthropic | Cloud di Anthropic |
| Pianificazione | Cron + fuso orario IANA, fino a 9 min di jitter | Il tuo cron o la tua coda di job | Cron, almeno 1 ora di intervallo | Scegli una frequenza nell'app |
| Fatturazione | Token API + 0,08 $ all'ora | Token API | Utilizzo del piano | Utilizzo del piano |
| Ideale per | Job di produzione per molti negozi, con budget e webhook | Team che gestiscono già dei server e vogliono il pieno controllo | Il riepilogo personale di uno sviluppatore | Un report settimanale personale |
| Fonte | «Scheduled deployments», «Pricing» | «Agent SDK overview», «hosting» | «Routines» | Guida di Cowork |
Abbiamo già scritto due articoli correlati. Il primo usa le routine di Claude Code per leggere Reddit ogni notte e scrivere un riepilogo dei problemi degli utenti. In quel test, una pagina da 100 post copriva solo 18,7 ore (attività pianificate di Claude Code su Reddit). Il secondo usa le attività pianificate di Cowork per una tabella del lunedì con prezzi e recensioni dei concorrenti (tabella dei prezzi dei concorrenti con Cowork).
Leggi insieme i tre articoli. Per un report settimanale destinato a te, Cowork è la soluzione più semplice. Per un job di sviluppo legato a un repository di codice, usa Claude Code. Per decine di negozi ogni notte, con un tetto di spesa, avvisi in caso di errore e risultati inviati al tuo sistema, usa un deployment pianificato di Managed Agents.
La documentazione di Claude Code indica che le routine vengono eseguite al massimo una volta all'ora e vengono conteggiate nell'utilizzo del piano (Routines). Le attività di Cowork vengono eseguite nel cloud anche quando il computer è in sospensione (Guida di Cowork). Se ti servono solo le recensioni di Google Maps in un foglio di calcolo, senza agente, leggi come fare scraping delle recensioni di Google Maps.
Quando qualcosa si rompe: quale livello controllare per primo
Quando un job notturno fallisce, il report spesso dice solo «nessun dato». La tabella raccoglie in un unico posto i possibili guasti a tre livelli: il deployment e la sessione di Anthropic, il vault e la rete e l'API di EveryInfra. La colonna di sinistra mostra il sintomo che vedi. Le colonne a destra ti dicono dove guardare per primo. Nelle nostre chiamate reali del 4 novembre abbiamo riscontrato ciascuno dei casi relativi a EveryInfra elencati nella tabella. Le righe relative ad Anthropic derivano dalla documentazione su errori e stati.
| Sintomo | Livello tipico | Cosa controllare per primo | Soluzione |
|---|---|---|---|
| Nessun report e nessun webhook al mattino | Il deployment non ha creato una sessione, oppure tutti e 3 i tentativi di invio del webhook sono falliti | GET /v1/deployment_runs?has_error=true | Chiama POST /v1/deployments/{id}/run una volta a mano |
| La sessione resta in attesa e non compare alcun file di report | Il toolset MCP è ancora su always_ask | stop_reason dell'ultimo evento idle | Imposta always_allow su everyinfra_call_api |
| Il risultato del tool dice unauthorized e «Nothing was charged» | Chiave errata nel vault, oppure allowed_hosts errati nella credenziale | secret_name e networking della credenziale | Correggi la credenziale. Non lasciare che l'agente riprovi |
curl riceve un 403 che indica l'host | Gli allowed_hosts dell'ambiente non includono l'host | networking dell'ambiente | Aggiungi api.everyinfra.com |
| Il modello vede solo una breve anteprima | Output del tool MCP oltre i 100.000 caratteri | limit di quella chiamata | Usa 50 recensioni oppure passa alle chiamate HTTP con jq |
| L'API restituisce 429 | È stato raggiunto il limite di richieste al minuto per la chiave | retry_after nella risposta | Attendi quel numero di secondi. Un 429 non viene addebitato |
| Una ricerca non restituisce risultati e viene rimborsata | La ricerca del luogo non ha trovato il negozio | reason nella risposta | Leggi le recensioni con un URL di ricerca di Google Maps |
Dietro questa tabella c'è una regola. Ogni errore deve comparire nel report, e l'agente non deve aggirarlo da solo. Gli agenti sono bravi a «riprovare con altri parametri». Questo job costa denaro e gira di notte senza che nessuno lo controlli.
Qui una soluzione alternativa spesso comporta la selezione del negozio sbagliato, una lettura duplicata o un errore di configurazione che persiste per un mese. Quindi il prompt deve dire: in caso di unauthorized, 403 o pausa per budget, fermati e scrivi il motivo. Solo in caso di 429 va eseguito un nuovo tentativo al termine dell'attesa.
Limiti e questioni aperte
Primo, non abbiamo testato il lato Anthropic. Deployment pianificati, sostituzione delle credenziali tramite vault, policy di autorizzazione e webhook sono tutti esempi di configurazione tratti dalla documentazione di platform.claude.com, consultata il 4 novembre 2026. Managed Agents è ancora in beta e i campi possono cambiare. Abbiamo scritto vault_ids e resources partendo dagli esempi della documentazione sulle sessioni e sulla memoria. Verificali nella documentazione di riferimento dei deployment per la tua versione dell'SDK prima di creare qualsiasi cosa.
Secondo, il lato Tripadvisor restituisce solo recensioni in inglese. Le recensioni in spagnolo, cinese o altre lingue non sono incluse nella risposta. Terzo, la ricerca di luoghi su Google non ha dato risultati per nessuno dei due negozi fuori dagli Stati Uniti (con rimborso). Il recupero diretto tramite un URL di ricerca di Google Maps ha funzionato, quindi verifica manualmente una volta l'URL di ogni nuovo negozio. Quarto, la pagina 1 di Yelp non è ordinata per data e il parametro di ordinamento nell'URL non ha effetto. Leggi una pagina in più e stabilisci cosa è «nuovo» in base all'ID.
Quinto, il testo delle recensioni è input non attendibile. La documentazione sulla memoria avverte che il contenuto di un memory store può contenere prompt injection, e il testo delle recensioni ha lo stesso rischio. Qualcuno può scrivere «ignora le tue istruzioni» in una recensione. Il percorso HTTP con jq tratta le recensioni come dati. L'ambiente consente solo api.everyinfra.com, e il vault sostituisce la chiave solo per quell'host. Così, anche se il modello viene ingannato, la chiave non può uscire.
Sesto, usa il report solo per migliorare i tuoi negozi. La norma della FTC del 2024 vieta le recensioni false, il pagamento in cambio di recensioni che esprimano un'opinione prestabilita e la soppressione delle recensioni negative (comunicato stampa della FTC). Vale la pena controllare ogni notte le recensioni negative, ma la risposta giusta è replicare e risolvere il problema, non cercare di far modificare la recensione esercitando pressioni. Questo articolo tratta solo metodi relativi ai dati e non costituisce consulenza legale.
Modifiche recenti
Questi aggiornamenti dell'ultimo mese riguardano questo job. Sono tutti nelle Claude Platform release notes. Il 2026-10-07, web_fetch ha iniziato a recuperare solo URL già comparsi nella sessione, e allowed_hosts con networking limited ha iniziato ad applicarsi a web_fetch e web_search. Il 2026-10-09, Managed Agents ha aggiunto i dynamic workflows, che eseguono molti agenti in fasi. Possono essere utili quando hai centinaia di negozi, ma non li abbiamo testati. Il 2026-10-14, i deployment pianificati sono diventati disponibili su Claude Platform on AWS.
Il 2026-10-20, gli amministratori delle organizzazioni hanno ottenuto un'opzione nella Console per disattivare web fetch o limitarne i domini, e le sessioni di Managed Agents la rispettano. Il 2026-10-29 è arrivata la beta della Usage and Cost Analytics API. Suddivide token e costi per modello, workspace e chiave API, e ti aiuta a controllare il costo mensile del monitoraggio.
FAQ
Qual è la differenza tra Claude Managed Agents e le routine di Claude Code?
Questa domanda viene dai suggerimenti di ricerca «claude managed agents vs claude code» e «claude managed agents vs routines», e dal post su Reddit «What is the point of Managed Agents» (thread su Reddit). Entrambi vengono eseguiti nel cloud di Anthropic. Le routine di Claude Code vengono conteggiate nell'utilizzo del piano e vengono eseguite al massimo una volta all'ora (Routines). Con i deployment di Managed Agents vengono addebitati i token API più 0,08 $ per ora di sessione e viene usato un cron con granularità al minuto. Ogni esecuzione ha un limite rigido di budget e i risultati vengono inviati tramite webhook (Scheduled deployments). Scegli Managed Agents per i job di produzione destinati a un team o ai clienti.
Come funzionano i prezzi di Claude Managed Agents e quanto costa una notte?
Questa domanda viene dai suggerimenti «claude managed agents pricing» e «claude managed agents cost». Ci sono due voci di costo. I token del modello vengono addebitati al prezzo di listino, mentre il runtime della sessione costa 0,08 $ all'ora, solo nello stato running (Pricing, consultata il 2026-11-04). Secondo la nostra stima, un negozio su Sonnet 5.5 con il percorso HTTP costa circa 0,077 $ per il modello e 0,0029 $ per il runtime ogni notte. Aggiungendo 0,0056 $ per l'API di EveryInfra, il totale è di circa 0,0855 $ nello scenario alto, pari a 3×.
Claude Managed Agents vs Agent SDK: quale scegliere?
Questa domanda viene dal suggerimento «claude managed agents vs agent sdk». L'Agent SDK è una libreria. Il loop gira nel tuo processo, e sei tu a gestire la macchina, la pianificazione, i segreti e i log (Agent SDK overview). Managed Agents ospita il loop, la sandbox, la pianificazione, la sostituzione delle credenziali e il registro della sessione. Scegli l'SDK se gestisci già server e una coda di job e vuoi il pieno controllo. Scegli Managed Agents se vuoi webhook e un budget per esecuzione senza un tuo scheduler.
Managed Agents può leggere le recensioni di Google Maps o Yelp con web_fetch?
Questa domanda viene dal suggerimento «claude managed agents web». Non in modo affidabile. web_fetch non esegue JavaScript e dal 2026-10-07 recupera solo URL già comparsi nella sessione (note di rilascio). Il robots.txt di Yelp consente Claude-User solo su /article (yelp.com/robots.txt). Un'API per le recensioni con dati strutturati è più affidabile.
Cosa succede quando un deployment pianificato salta un'esecuzione?
Questa domanda viene dal suggerimento «claude managed agents schedule». I trigger saltati durante una pausa non vengono recuperati. Quando la creazione della sessione è soggetta a un limite di frequenza delle richieste, quell'esecuzione riceve un record session_rate_limited_error e nessun nuovo tentativo (Scheduled deployments). Quindi l'esecuzione successiva deve leggere a ritroso fino all'ultimo ID recensione salvato dall'ultima esecuzione riuscita, non solo le ultime 24 ore. Su Google, limit=50 copre circa due giorni per un negozio molto frequentato come Katz's, quindi anche una notte saltata resta coperta.
Il modello può vedere la chiave nel vault?
Questa domanda viene dai suggerimenti «claude managed agents vault» e «claude managed agents credential vault». No. Una credenziale di tipo variabile d'ambiente contiene solo un segnaposto nella sandbox. Il valore reale viene inserito nella richiesta in uscita solo per gli host inclusi in allowed_hosts (Authenticate with vaults). Anche il blog di Anthropic dice che l'agente non vede mai la tua chiave (blog di Anthropic).
Per iniziare
- Ottieni una chiave API di EveryInfra. Segui la guida rapida ed esegui una chiamata a ciascuno di
google_maps_reviews/search,yelp/searchetripadvisor/searchper trovare i tre URL dei negozi. - Dalla tua macchina, esegui una chiamata con curl a ciascuno di
google_maps_reviews/reviews,yelp/reviewsetripadvisor/reviews. Controlla i campi e la dimensione della risposta. Per il percorso MCP, consulta la pagina del server MCP. - Nella Claude Console, crea l'ambiente con networking
limitede soloapi.everyinfra.com. Crea il vault con una sola credenzialeEVERYINFRA_API_KEY. Crea l'agente conweb_fetcheweb_searchdisattivati. - Esegui manualmente una sessione oppure chiama
POST /v1/deployments/{id}/runper controllare il formato del report e il costo. Poi crea il deployment con il cron30 6 * * *e un budget per esecuzione. Configura la sottoscrizione agli eventisession.status_idlededeployment_run.failed. - Per le rispettive API delle recensioni, consulta la pagina delle recensioni di Google Maps, la pagina di Yelp e la pagina di Tripadvisor. Per un report settimanale su cinque siti di recensioni, leggi il monitoraggio delle recensioni con la OpenAI Agents API.
Riferimenti
- «Claude Managed Agents overview», documentazione Anthropic, consultato il 2026-11-04.
- «Scheduled deployments», documentazione Anthropic, consultato il 2026-11-04.
- «Authenticate with vaults», documentazione Anthropic, consultato il 2026-11-04.
- «Cloud environment setup», documentazione Anthropic, consultato il 2026-11-04.
- «Tools», documentazione Anthropic, consultato il 2026-11-04.
- «MCP connector», documentazione Anthropic, consultato il 2026-11-04.
- «Permission policies», documentazione Anthropic, consultato il 2026-11-04.
- «Session budgets», documentazione Anthropic, consultato il 2026-11-04.
- «Subscribe to webhooks», documentazione Anthropic, consultato il 2026-11-04.
- «Reference», documentazione Anthropic, consultato il 2026-11-04.
- «Using agent memory», documentazione Anthropic, consultato il 2026-11-04.
- «Restrict web search and web fetch domains», documentazione Anthropic, consultato il 2026-11-04.
- «Web fetch tool», documentazione Anthropic, consultato il 2026-11-04.
- «Pricing», documentazione Anthropic, consultato il 2026-11-04.
- «Claude Platform release notes», Anthropic, consultato il 2026-11-04.
- «Define your agent», documentazione Anthropic, consultato il 2026-11-04.
- «Start a session», documentazione Anthropic, consultato il 2026-11-04.
- «Session event stream», documentazione Anthropic, consultato il 2026-11-04.
- «Glossary», documentazione Anthropic, consultato il 2026-11-04.
- «Agent SDK overview», documentazione di Claude Code, consultato il 2026-11-04.
- «Hosting the Agent SDK», documentazione di Claude Code, consultato il 2026-11-04.
- «Routines», documentazione di Claude Code, consultato il 2026-11-04.
- «Schedule recurring tasks in Claude Cowork», Claude Help Center, consultato il 2026-11-04.
- «Does Anthropic crawl data from the web», Claude Help Center, consultato il 2026-11-04.
- «New in Claude Managed Agents: run agents on a schedule», blog di Anthropic, consultato il 2026-11-04.
- «Claude Managed Agents: get to production 10x faster», blog di Anthropic, consultato il 2026-11-04.
- «MCP Transports», specifica del Model Context Protocol, consultato il 2026-11-04.
- «MCP Tools», specifica del Model Context Protocol, consultato il 2026-11-04.
- «Place Details (New)», Google for Developers, consultato il 2026-11-04.
- «Work with review data», documentazione di Google Business Profile, consultato il 2026-11-04.
- «Read and reply to reviews», Guida di Google Business Profile, consultato il 2026-11-04.
- «Business Reviews», documentazione di Yelp Fusion, consultato il 2026-11-04.
- «How is the order of reviews determined?», Yelp Support, consultato il 2026-11-04.
- yelp.com/robots.txt, Yelp, consultato il 2026-11-04.
- «Location Reviews», documentazione della Tripadvisor Content API, consultato il 2026-11-04.
- tripadvisor.com/robots.txt, Tripadvisor, consultato il 2026-11-04.
- «crontab», The Open Group Base Specifications Issue 8, consultato il 2026-11-04.
- «Time Zones», IANA, consultato il 2026-11-04.
- «Standard Webhooks», Standard Webhooks, consultato il 2026-11-04.
- «FTC final rule banning fake reviews», Federal Trade Commission (USA), pubblicato il 2024-08-14, consultato il 2026-11-04.
- «What is the point of Managed Agents?», Reddit r/ClaudeAI, consultato il 2026-11-04.
- Catalogo delle API di EveryInfra, EveryInfra, consultato il 2026-11-04 alle 00:13 ora di Singapore.
Riferimenti BL-79