claude managed agentsで、星1〜2の新着飲食店レビューを毎晩パトロールする
claude managed agentsをcronスケジュールで実行し、Google、Yelp、Tripadvisorの新着レビューを毎晩読み取り、星1〜2のレビューを検出します。API費用は1店舗あたり$0.0056です。
2026年11月4日(シンガポール時間)、EveryInfra APIを使ってニューヨークのKatz's Delicatessenの新着レビューを読み取りました。対象はGoogle Maps、Yelp、Tripadvisorです。主な発見は「新着」の扱いに関するものです。最新N件のレビューがカバーする期間は、サイトごとに大きく異なります。Googleでは4日未満、Tripadvisorでは約4か月です。Yelpの1ページ目は日付順ではありません。
1時間後に2回目の読み取りを行うと、Googleで新しいレビューが1件見つかりました。投稿時刻は1回目の呼び出しより前でしたが、1回目の呼び出しでは返されていませんでした。そのため夜間ジョブでは「新着」をレビューIDで判定し、どこまで読んだかを記録しておく必要があります。最新N件を取得するだけ、あるいは投稿時刻を信頼するだけでは不十分です。
2つ目の発見はコストに関するものです。API費用はわずかで、1店舗あたり1晩4回の呼び出しで1セント未満です。コストの大半を占めるのは、Anthropic側のモデルトークン料金です。Sonnet 5.5の場合、私たちの見積もりではモデル費用がAPI費用の10倍以上になります。そのため、モデルが読む前に、サンドボックス内のスクリプトで生データを星1〜2のレビューだけに絞り込むべきです。
この記事では、ある具体的な問いに答えます。ニューヨークのレストラングループのオペレーションマネージャーが、毎日午前7時までにレポートを受け取りたいと考えています。レポートには、前夜以降にGoogle Maps、Yelp、Tripadvisorに投稿された星1〜2の新着レビューをすべて掲載する必要があります。各レビューについて、問題が料理、接客、行列、価格のどれなのか、そして誰かが返信したかどうかを示す必要があります。
ここではClaude Managed Agentsのスケジュールデプロイメントを使います。毎晩、Anthropicのクラウドがcronスケジュールに従って新しいセッションを開始します。エージェントはHTTPまたはリモートMCP経由でEveryInfraの3つのレビューエンドポイントを呼び出し、新着の低評価レビューを抽出して原因別に分類し、レポートを作成します。その後、Webhookでサーバーに実行完了を通知します。
EveryInfra側では実際に26回の呼び出しを行い、そのうち20回が課金され、合計$0.02778でした。Anthropic側ではデプロイしていません。Managed Agentsに関する記述はすべて、2026年11月4日に確認したplatform.claude.comのドキュメントまたはリリースノートへのリンクを付けています。
やりたいこと:3サイトの新着低評価レビューを1本の朝のレポートにまとめる
公開されている2つの店舗をサンプルとして使いました。どちらの店舗とも関係はなく、サンプルレポートは手法を示すためのものです。1つ目はロウアー・イースト・サイドのKatz's Delicatessenです。Google Mapsでは評価4.5、レビュー56,460件、Tripadvisorでは評価4.2、レビュー18,710件です。
観光客が多いため、「1晩に何件の新着レビューが届くか」を試すのに適しています。2つ目はクイーンズ区フラッシングのHaidilao Hot Potです。Googleでは評価4.8、レビュー8,792件、Yelpでは評価4.8、レビュー2,643件です。評価が高く、低評価レビューが少ない店舗の代表例です。
なぜ週1回ではなく毎晩実行するのでしょうか。Katz'sのGoogleの実レスポンスでは、最新100件のレビューが3.97日分で、1日あたり約24.7件です。最新50件はわずか1.80日分で、直近24時間に29件が投稿されていました。低評価レビューに最も対処しやすいのは、投稿から1〜2日以内です。
返信、返金の申し出、社内確認が最も効果を発揮するのもこの時期です。週次ジョブでは1店舗あたりGoogleを4ページ読む必要があり、レポートが届く時点で最も古い低評価レビューは6〜7日前のものになります。最新50件を読む夜間ジョブなら前夜以降のすべてをカバーでき、さらに1晩分の余裕があります。
| サイト | 機能 | 1回あたりのレビュー数 | 並び順 | 1回あたりの料金 |
|---|---|---|---|---|
| Google Maps | google_maps_reviews/reviews | 最大100件、本記事では50件を使用 | sort=newest、任意でsinceに日付も指定可能 | $0.001389 |
| Yelp | yelp/reviews | 1ページ10件、次ページはpage_tokenで取得 | Yelpのデフォルト順(日付順ではない) | $0.001389 |
| Tripadvisor | tripadvisor/reviews | 最大50件 | ソートオプションなし。テストでは新しい順 | $0.001389 |
| 店舗の検索 | google_maps_reviews/search、yelp/search、tripadvisor/search | セットアップ時に各サイト1回 | — | $0.001389 |
料金は無料のカタログhttps://api.everyinfra.com/api/v1/social/catalogから取得したもので、11月4日00:13(シンガポール時間)に確認しました。3つのレビュー機能はいずれもavailableでした。1回の呼び出しは100クレジット、つまり$0.001389です。3つの検索呼び出しは1店舗につき1回だけ必要です。店舗名を各サイトの店舗URLに変換するためのもので、以降の夜間ジョブはURLでレビューを読み取ります。
claude managed agentsとは:4つのオブジェクトとスケジュール
Claude Managed Agentsは、Claude Platform上のホスト型APIのセットです。エージェントのモデル、システムプロンプト、ツールを定義すると、Anthropicが自社クラウドでエージェントループを実行します。サンドボックスコンテナを起動し、ツール呼び出しを実行し、セッションの記録を保持します。2026年4月8日にパブリックベータとして提供開始されました。すべてのリクエストにヘッダーanthropic-beta: managed-agents-2026-04-01が必要です(概要、リリースノート)。
概要では、エージェント、環境、セッション、Vaultの4つをコアコンセプトとして挙げています。スケジュールされたデプロイメントは5つ目のオブジェクトです。2026年6月9日に追加され、スケジュールに従って自動でセッションを開始します(Anthropicブログ)。各オブジェクトとレビュー巡回の対応は以下の表のとおりです。
| オブジェクト | 制御する内容 | レビュー巡回での設定 | ドキュメント |
|---|---|---|---|
| agent | モデル、システムプロンプト、ツール、MCPサーバー、権限ポリシー(バージョン管理付き) | Sonnet 5.5。bashとファイルツールは残し、web_fetchとweb_searchはオフにする。MCP経由の場合はeveryinfra_call_apiのみ許可 | エージェントを定義する |
| environment | サンドボックスの構成と、アクセス可能なホスト | allowed_hostsにapi.everyinfra.comのみを指定したlimitedネットワーク | クラウド環境のセットアップ |
| vault | 実行時にセッションが受け取る認証情報 | environment_variable認証情報EVERYINFRA_API_KEYを1つ用意し、api.everyinfra.com宛てのヘッダーにのみ差し替え | Vaultで認証する |
| session | 1回の実行:新しいコンテナと会話記録 | デプロイメントが毎晩1つ作成 | セッションを開始する |
| deployment | cronスケジュールでセッションを開始し、実行ごとに予算を設定 | America/New_Yorkで30 6 * * *、1回の実行につき50セント | スケジュールされたデプロイメント |
最も見落とされやすいのは、環境が実行のたびに新しくなるという点です。セッションのドキュメントによると、各セッションには新しいコンテナが割り当てられます。ある実行でサンドボックスに書き込んだファイルは、次の実行では消えています(セッションを開始する)。レビュー巡回では、この点が非常に重要です。
「確認済みのレビュー」のリストは、サンドボックスのファイルには保存できません。/mnt/memory/にマウントされる別のベータ機能であるメモリストアに保存する必要があります(エージェントメモリの使用)。もう1つの方法は、Webhookを受け取るたびに自社サーバーでリストを保持し、次回の初期メッセージで送り返すことです。
スケジュールされたデプロイメント:cron、タイムゾーン、ジッター、予算、バックフィルなし
スケジュールされたデプロイメントはPOST /v1/deploymentsで作成します。エージェント、環境、少なくとも1つの初期イベント(通常はuser.message)、そしてscheduleが必要です。scheduleにはtype: cronと、分単位の精度を持つ標準的な5フィールドのPOSIX cron形式のexpressionを指定します。さらに、America/New_YorkなどのIANAタイムゾーン名をtimezoneに指定します(スケジュールされたデプロイメント)。
cronのフィールドはPOSIX crontabに準拠します。タイムゾーン名はIANAタイムゾーンデータベースに由来し、その最新リリースである2026fは2026-10-27に公開されました。作成時のレスポンスでは次回以降の起動時刻がschedule.upcoming_runs_atに一覧表示されるため、式をすぐに確認できます。
レポートの締め切りを左右するのは、ドキュメントのある一文です。スケジュール上の起動時刻は正確ですが、実際の開始には実行間隔の最大15%のジッターが加わります。最小は5秒、最大は9分です。下のグラフはこのルールをプロットしたものです。
5分ごとに実行するデプロイメントは、最大45秒遅れて開始します。1時間ごとや1日ごとに実行するデプロイメントは、最大9分遅れて開始します。レポートを7:00より前に届ける必要がある場合、6:30のcronなら9分のジッターと20分の実行時間を見込む余裕があります。
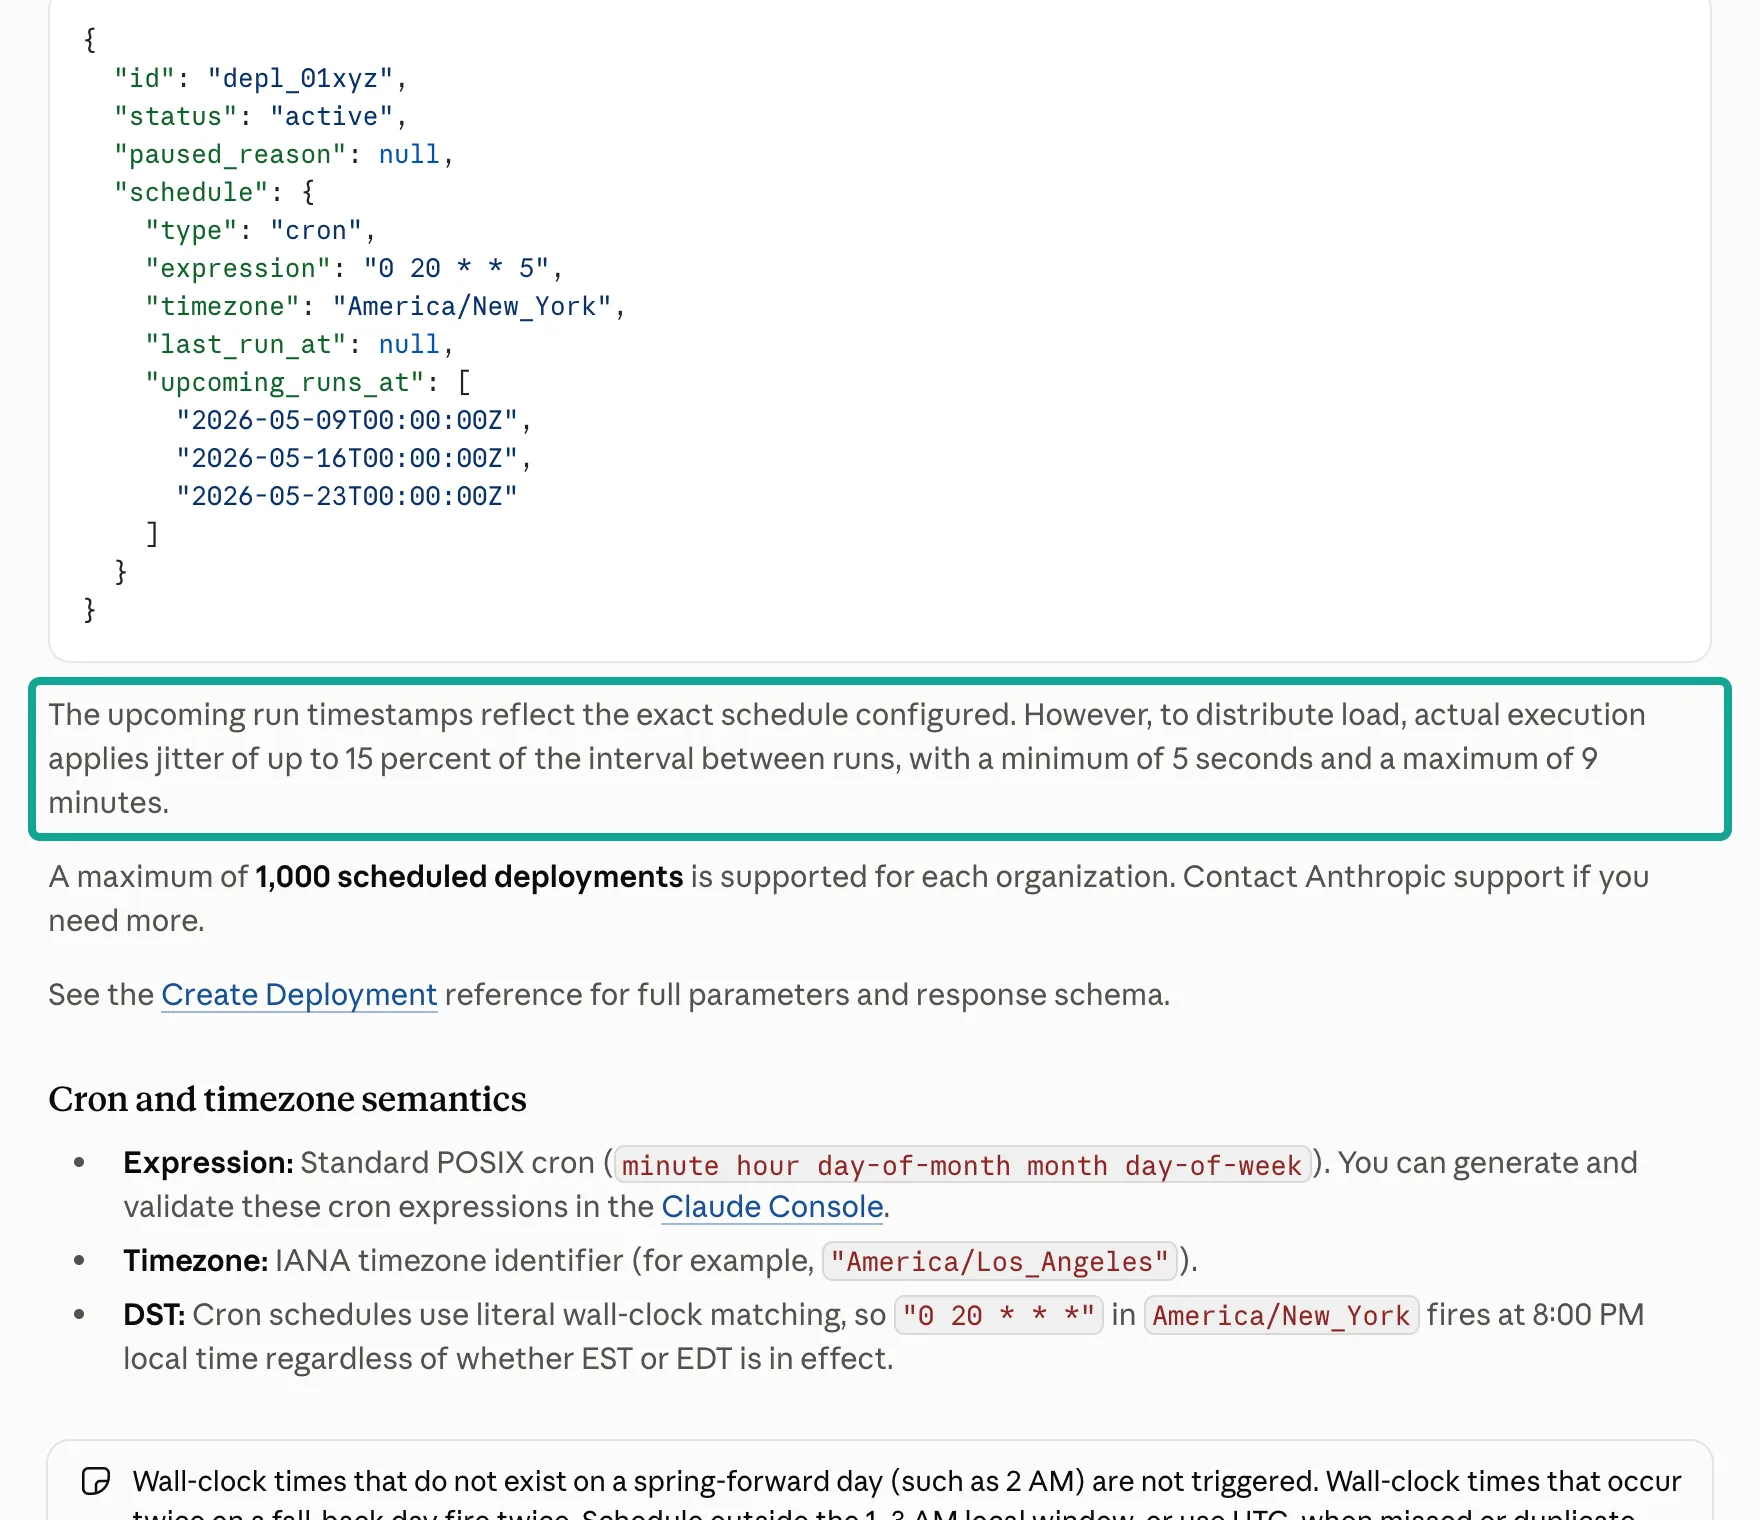
2つ目の落とし穴は夏時間です。ドキュメントによると、cronは指定したタイムゾーンの時計上の時刻を文字どおり照合します。そのため、America/New_Yorkの0 20 * * *は、ESTとEDTのどちらでも現地時間の午後8時に起動します。夏時間の開始日には、午前2時のように存在しない時刻では起動しません。
夏時間の終了日には、2回現れる時刻で2回起動します。ドキュメントでは、現地時間の午前1時から3時を避けるか、UTCを使うよう求めています。2026年、米国の夏時間は11月1日に終了しました。そのため今週からは、ニューヨークの30 6 * * *はUTCの11:30になり、夏時間中はUTCの10:30です。
3つ目は予算です。デプロイメントには、セッション予算と同じ形式の任意のbudgetを設定できます。形式は{"type": "limit", "max_list_cost": {"amount": "50", "currency": "USD"}}です。金額は米国セントの整数を文字列で表したもので、"50"は50セントを意味します(セッション予算)。デプロイメントはこの上限を新しいセッションごとにコピーします。つまり上限は月間の合計ではなく、実行ごとに適用されます。ドキュメントの例が明確に示しているとおり、上限が"2000"のデプロイメントは実行のたびに約$20を使う可能性があります。
予算には、モデルのトークン、Web検索(1,000回あたり$10)、セッションの実行時間(1時間あたり$0.08)が公開定価で計上されます。プラットフォームはモデルリクエストの合間に予算を確認し、上限に達するとセッションをbudget_reachedで一時停止します。この予算にはEveryInfra APIの料金は含まれません。この料金は呼び出し回数のみで決まり、1店舗あたり毎晩4回に固定されています。
4つ目は失敗時の挙動です。デプロイメントを一時停止するとスケジュールによるトリガーは止まりますが、実行中のセッションは最後まで実行されます。再開すると、次の予定時刻からスケジュールが再び始まります。ドキュメントには「実行されなかったトリガーはバックフィルされません」とあります。トリガーごとにデプロイメント実行レコードが書き込まれます。失敗したものはGET /v1/deployment_runs?deployment_id=…&has_error=trueで一覧表示できます。
よくあるエラータイプはenvironment_archived_error、agent_archived_error、session_rate_limited_errorです。最後のものは記録されるだけで、再試行されません。各組織で作成できるスケジュールされたデプロイメントは最大1,000件です。したがって、レポートジョブは「昨夜実行されなかった」場合に自ら対処する必要があります。次の実行では直近24時間分だけを読むのではなく、前回正常に完了した実行が保存した最後のレビューIDまでさかのぼって読む必要があります。
キーの保管場所:2種類のVault認証情報
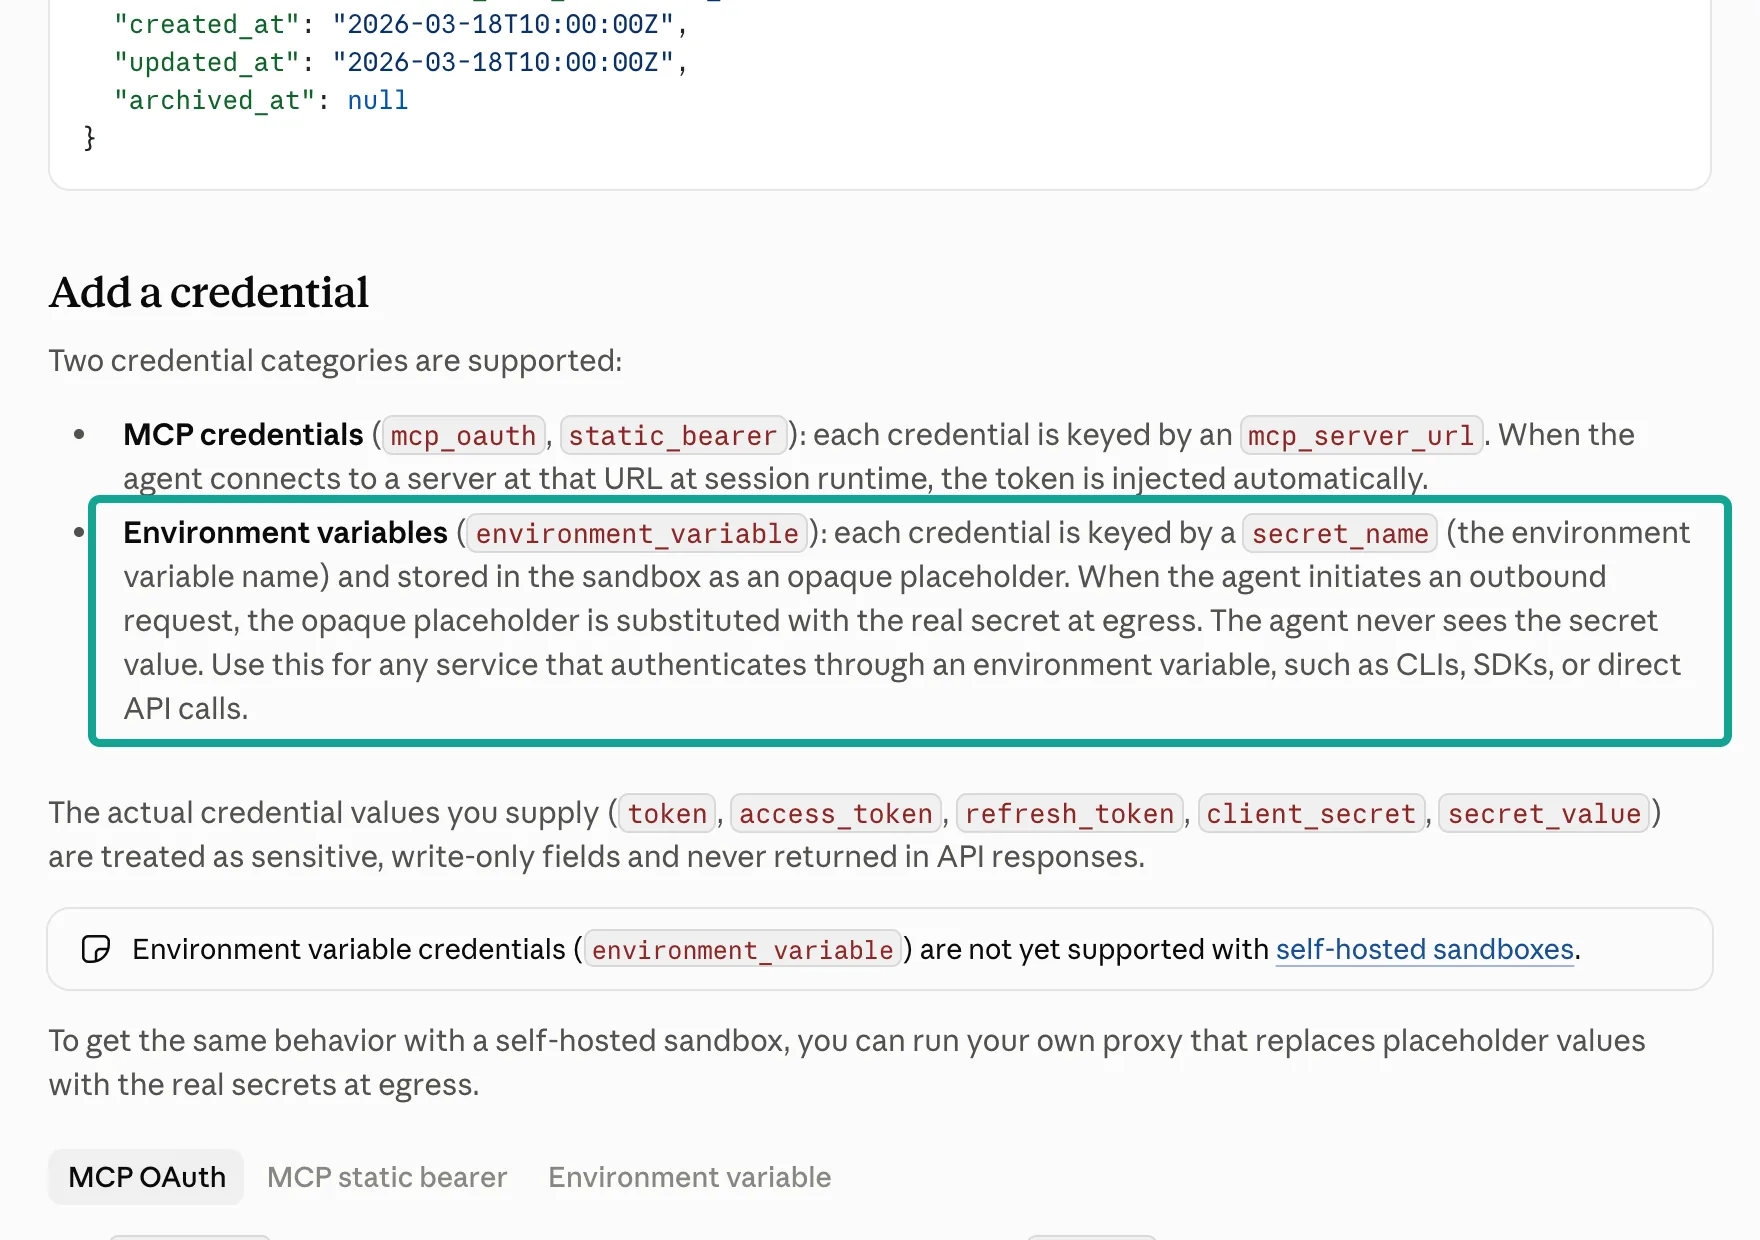
EveryInfraのキーは、MCP接続か、サンドボックス内のcurlのいずれかで使われます。この2つの用途は、2種類のVault認証情報に対応しています(Vaultで認証する)。MCP用の認証情報はmcp_oauthとstatic_bearerで、mcp_server_urlをキーとして管理されます。セッションがそのURLのMCPサーバーに接続すると、トークンが自動で付与されます。
environment_variable認証情報はsecret_nameをキーとして管理されます。サンドボックスが保持するのは不透明なプレースホルダーだけです。実際の値は、networking.allowed_hostsに含まれるホストに対してのみ、ネットワークエッジでプレースホルダーと置き換えられます。また、injection_locationで置き換え先をヘッダーに限定できます。
このジョブには、次の3つの理由から環境変数の認証情報をおすすめします。1つ目に、キーの送信先を1か所に限定できます。この認証情報のallowed_hostsにはapi.everyinfra.comのみを指定します。レビュー内の悪意ある一文がモデルに別のURLを呼び出すよう指示しても、そのリクエストにはプレースホルダーしか含まれません。
第2に、認証情報のallowed_hostsが制御するのは、どのリクエストにキーが付与されるかであり、どのリクエストがサンドボックスの外に出られるかではありません。後者は環境のnetworking設定で制御します。両方にapi.everyinfra.comだけを指定すれば、ネットワークとキーの両方に鍵をかけられます。
3つ目に、HTTP経由の場合、生のレスポンスはまずサンドボックス内のファイルに保存されます。その後jqフィルターで必要な行だけをモデルに渡します。これでどれだけトークンを節約できるかは、コストのセクションで示します。環境変数の認証情報にも制限があります。セルフホスト型のサンドボックスにはまだ対応していません。1つのVaultに保存できる認証情報は最大20件です。また、プラットフォームは作成時に認証情報を検証しないため、キーが誤っていることは実行時に初めてわかります。
この最後の点をEveryInfra側で検証しました。シンガポール時間の00:22に、キーなしでリモートMCPのtools/callを呼び出しました。HTTPステータスは200でした。ボディではisErrorがtrueになっており、呼び出しが認可されていないことと「Nothing was charged」という旨のテキストが含まれていました。
つまり、Vault内のキーが誤っていたり期限切れだったりしても、セッションがMCPに接続した時点では失敗しません。最初のツール呼び出しで、エラー結果として失敗します。エージェントのプロンプトには、認可エラーが出たら処理を止め、レポートの冒頭に「キーが無効」と書くよう明記する必要があります。別のパラメータで再試行させてはいけません。
レビューページの取得にweb_fetchを使わない理由
Managed Agentsには組み込みのweb_fetchツールがあり、一見すると手軽な方法に見えます。3店舗のURLをプロンプトに入れ、エージェントに毎晩ページを読ませるだけです。私たちはドキュメントと3サイトのrobots.txtを確認しました。無人で動かす夜間ジョブでは、この方法はうまく機能しません。理由は表のとおりです。
| 方法 | 毎晩新しいレビューを読めるか | 出典 |
|---|---|---|
店舗ページへのweb_fetch | 確実ではありません。2026-10-07以降、セッション内にすでに登場したURLのみを取得し、システムプロンプトやMCPの出力に含まれるURLは対象外です。JavaScriptは実行せず、robots.txtに従います | リリースノート(2026-10-07)、Web fetchツール |
| YelpのWebページ | Yelpのrobots.txtはClaude-Userに/articleのみを許可し、それ以外はDisallow: /です(2026-11-04に確認) | yelp.com/robots.txt、Anthropicのクローラーに関する記事 |
| Google Places API | 1施設あたり最大5件のレビュー(関連度順) | Place Details |
| Google Business Profile API | OAuthを使い、自分が管理するロケーションのみ | レビューデータ |
| Yelp Fusion API | 1ビジネスあたり最大3件のレビュー抜粋(Yelpのデフォルト順) | Yelp Fusionのレビュー |
| Tripadvisor Content API | 1ロケーションあたり最新のレビュー最大5件 | ロケーションのレビュー |
| EveryInfraのレビューエンドポイント | Googleは1回の呼び出しで最大100件(新しい順)。Yelpは1ページ10件でページング可能。Tripadvisorは1回の呼び出しで最大50件 | カタログ |
見落とされがちなのが1つ目の制限です。2026年10月7日のリリースノートによると、web_fetchはセッション内にすでに登場したURLのみを取得するようになりました。データ流出のリスクを減らすのが目的です。ユーザーメッセージやweb_searchの結果に含まれるURLは対象になります。一方、対象にならないURLもあります。Claude自身の出力、システムプロンプト、添付ドキュメント、bashやMCPツールの出力にのみ含まれるURLです。これらに対する呼び出しはurl_not_in_prior_contextを返します。
同日の2つ目のノートはlimitedネットワーキングに関するものです。これを使うと、環境のallowed_hostsリストがweb_fetchとweb_searchにも適用されます(Web検索とWeb fetchのドメインを制限する)。さらに10月20日以降、組織の管理者はコンソールのCapabilitiesページでWeb fetchを無効にできます。無効にすると、Managed Agentsセッション内のすべてのweb_fetch呼び出しがエラーを返します。この3つのルールが重なると、固定URLを使う夜間ジョブは依存する条件が多くなりすぎます。
さらに大きな問題はページそのものです。Google MapsのレビューリストはJavaScriptで読み込まれますが、web_fetchのドキュメントにはJavaScriptでレンダリングされるサイトには対応していないと書かれています。Yelpの店舗ページはClaude-Userに対して閉じられています。Tripadvisorのrobots.txtは、ClaudeBotに対してDisallow: /を指定しています。
Claude-Userは名指しされていないため、一般ルールが適用されます。公式APIはいずれも取得件数の上限が低く、Google Placesは5件、Yelp Fusionは抜粋3件、Tripadvisor Content APIは5件です。Katz'sには一晩で約25件のレビューが付くため、これらの上限ではまったく足りません。そのため、このジョブで残る手段は、HTTPまたはリモートMCP経由でレビューAPIを呼び出し、構造化されたJSONを取得する方法だけです。
リモートMCPかHTTPか:コストの異なる2つの方法
1つ目の方法はリモートMCPです。EveryInfraのMCPサーバーはhttps://api.everyinfra.com/mcpにあり、Streamable HTTPトランスポートを使用します(MCP transports)。tools/listは12個のツールを返し、そのうち課金対象はeveryinfra_call_apiです(MCPサーバーのページを参照)。エージェント側ではtype: urlでMCPサーバーを宣言し、mcp_toolsetを追加します。Vaultは、サーバーのURLに一致するstatic_bearer認証情報を提供します(MCP connector)。この方法はセットアップが最小限で済みますが、2つの落とし穴があります。
1つ目の落とし穴は承認です。権限ポリシーのドキュメントによると、エージェントのツールセットはデフォルトでalways_allow、MCPツールセットはデフォルトでalways_askです(Permission policies)。セッションはMCP呼び出しのたびに一時停止し、承認を待ちます。夜間は誰も承認しないため、セッションは待ち続けることになります。
ツールセットにdefault_config.enabled: falseを設定してすべてのツールを無効にし、everyinfra_call_apiだけにalways_allowを設定します。このツールは呼び出しごとに課金されるため、readOnlyHint: falseとdestructiveHint: trueのアノテーションが付いています。そのため、autoポリシーでも承認を求められることがあります。これらのアノテーションはMCP tools specで定義されています。
2つ目の落とし穴はレスポンスサイズです。MCP connectorのドキュメントでは、サイズ上限は100,000文字(約25,000トークン)とされています。これを超えるツール出力はサンドボックス内のファイルに書き出され、モデルには短いプレビューしか渡されません。Katz'sの最新レビュー100件を取得した実際のGoogleのレスポンスは105,266文字で、この上限をわずかに超えていました。
2回目の検証では、最新50件を取得する実際のMCP呼び出しが53,364文字を返しました。Tripadvisorの50件は54,739文字、Yelpの1ページ10件は約10,000文字でした。グラフでは、実際の各レスポンスを上限ラインと並べて示しています。
2つ目は、環境変数の認証情報を使うHTTP経由の方法です。エージェントは組み込みのbashツールで、ヘッダーAuthorization: Bearer $EVERYINFRA_API_KEYを付けてcurlを実行します。サンドボックス内ではこの変数にプレースホルダーしか入っておらず、送信時に実際のキーに置き換えられます。JSONレスポンスはそのままサンドボックス内のファイルに保存されます。続いてjqフィルターで、前回のIDリストにない星1〜2のレビューだけを抽出します。
そのため、モデルが目にするのは店舗あたり128,000文字の生データではなく、絞り込まれた十数件のレビューです。その代わり、スクリプトの手順を明記した長めのプロンプトと、環境内のjqが必要になります。環境でパッケージマネージャーを使えるようにするか、事前にjqをインストールしておいてください。夜間の実行にはHTTPの方法をおすすめします。MCPは手動での確認用に残しておきましょう。手動セッションでは、エージェントがeveryinfra_list_requestsを呼び出して1回の呼び出しのステータスと課金額を確認でき、このツールは無料です。
設定例:環境、エージェント、Vault、デプロイメント
以下の4つのファイルは、platform.claude.comのドキュメントに記載されたフィールドをもとに作成しました。あくまで設定例であり、実際の組織で作成したものではありません。ant CLIでは、YAMLヘッダー付きのMarkdownファイルをant applyでオブジェクトに変換できます。IDはclaude-lock.jsonに保存されます(Define your agent)。まずは環境です。
# Configuration example: environment (fields from the Cloud environment setup doc; not tested by us)
name: review-patrol-env
config:
  type: cloud
  networking:
    type: limited
    allowed_hosts:
      - api.everyinfra.com
    allow_package_managers: true   # to install jq; turn off after you preinstall it
    allow_mcp_servers: false
次はエージェントです。システムプロンプトでは、4つのエンドポイントのみを呼び出す、「新着」はIDで判定する、認可エラーが出たら停止する、という3つのルールを定めます。
---
# Configuration example: agent.md (fields from Define your agent, Tools and Permission policies; not tested by us)
name: Nightly review patrol
model: claude-sonnet-5-5
tools:
  - type: agent_toolset_20260401
    configs:
      - name: web_fetch
        enabled: false
      - name: web_search
        enabled: false
---
Each night, read new reviews for every store in the store list. Use only bash and curl to call
https://api.everyinfra.com/api/v1/social with the header "Authorization: Bearer $EVERYINFRA_API_KEY".
Make 4 calls per store: google_maps_reviews/reviews (sort=newest, limit=50), yelp/reviews pages 1 and 2,
and tripadvisor/reviews. Save each response to /tmp/<store>-<site>.json.
Use jq to drop review IDs that are already in /mnt/memory/review-patrol/seen.json. Read only 1-2 star reviews.
Give each bad review one or more labels: food, service, line and seating, price and hype, venue, online order.
Translate reviews that are not in English before you label them.
If a response says unauthorized, stop. Write "EveryInfra key not valid" as the first line of the report. Do not retry.
At the end, write all review IDs from this run back to /mnt/memory/review-patrol/seen.json,
and write the report to /mnt/session/outputs/report.md.Vaultに必要な認証情報は1つです。キーがファイルに残らないよう、手元のマシンではsecret_valueを環境変数から読み込みます。
# Configuration example: add an environment variable credential to a vault (fields from Authenticate with vaults; not tested by us)
curl --fail-with-body -sS "https://api.anthropic.com/v1/vaults/$VAULT_ID/credentials" \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "anthropic-beta: managed-agents-2026-04-01" \
  -H "content-type: application/json" \
  -d "$(jq -n --arg v "$EVERYINFRA_API_KEY" '{
        auth: {
          type: "environment_variable",
          secret_name: "EVERYINFRA_API_KEY",
          secret_value: $v,
          networking: {type: "limited", allowed_hosts: ["api.everyinfra.com"]},
          injection_location: {header: true}
        },
        display_name: "EveryInfra key for nightly review patrol"
}')"最後はスケジュール実行のデプロイメントです。ドキュメントによると、デプロイメントには新しいセッションと同じ設定を指定します。エージェントと環境は必須で、ファイル、メモリストア、Vaultは任意です。店舗リストは最初のメッセージに含め、予算は1回の実行あたり50セントとします。amountフィールドの単位はセントなので、"50"は$50ではなく$0.50です。メモリストアは表示名で/mnt/memory/配下にマウントされるため、review-patrolという名前のストアは/mnt/memory/review-patrol/に配置されます。
{
  "name": "Nightly review patrol (NYC)",
  "agent": "agent_01...",
  "environment_id": "env_01...",
  "vault_ids": ["vlt_01..."],
  "resources": [
    {"type": "memory_store", "memory_store_id": "memstore_01...", "access": "read_write",
     "instructions": "seen.json holds the review IDs from the last run, grouped by site."}
  ],
  "initial_events": [
    {
      "type": "user.message",
      "content": [{"type": "text", "text": "Store list: Katz's Delicatessen and Haidilao Hot Pot Flushing. URLs are in stores.json. Read all new reviews since the last run and write the morning report."}]
    }
  ],
  "schedule": {"type": "cron", "expression": "30 6 * * *", "timezone": "America/New_York"},
  "budget": {"type": "limit", "max_list_cost": {"amount": "50", "currency": "USD"}}
}結果はどのように受け取るのでしょうか。Webhookが送るのは、イベントタイプ、ID、タイムスタンプだけを含む軽量なペイロードで、オブジェクト全体は含まれません。オブジェクトはGET呼び出しで取得します(Subscribe to webhooks)。必要なイベントタイプは2つです。なお、session.status_idledは「エージェントが停止し、入力を待っている」ことを意味します。
このイベントは、実行が完了したときだけでなく、実行が承認待ちになったときにも発火します。そのため、サーバー側でセッションをGETし、最新のsession.status_idleイベントのstop_reason.typeを確認する必要があります(Session event stream)。deployment_run.failedは、その夜の実行でセッションが作成されなかったことを意味します。実行エンドポイントによる手動実行ではdeployment_runイベントは送信されないため、テストではこのイベントを待たないでください。
各イベントの配信は最大3回まで試行され、5〜120秒のジッター付き指数バックオフで再試行されます。最後の試行が失敗すると、イベントは破棄され、キューには残りません。そのため、サーバー側でevent.idによる重複排除を行い、毎朝デプロイメントの実行一覧を確認する必要があります。署名シークレットはwhsec_で始まります。ヘッダーはwebhook-id、webhook-timestamp、webhook-signatureで、Standard Webhooksと同じ形式です。
| `stop_reason.type` | 意味 | Webhook受信後のサーバー側の処理 |
|---|---|---|
end_turn | エージェントがターンを終了しました | Files APIで/mnt/session/outputs/report.mdを取得し、当番のマネージャーに送信します |
requires_action | ツール呼び出しが承認待ちです(例:まだalways_askのままのMCPツール) | アラートを送信し、エージェントの権限ポリシーを修正します。夜間にスクリプトで呼び出しを承認しないでください |
budget_reached | この実行の定価ベースのコストが予算に達しました | アラートを送信し、エージェントがループでリトライしていないか確認します。予算の変更は翌日に行います |
実際の1往復:モデルが送るものと返ってくるもの
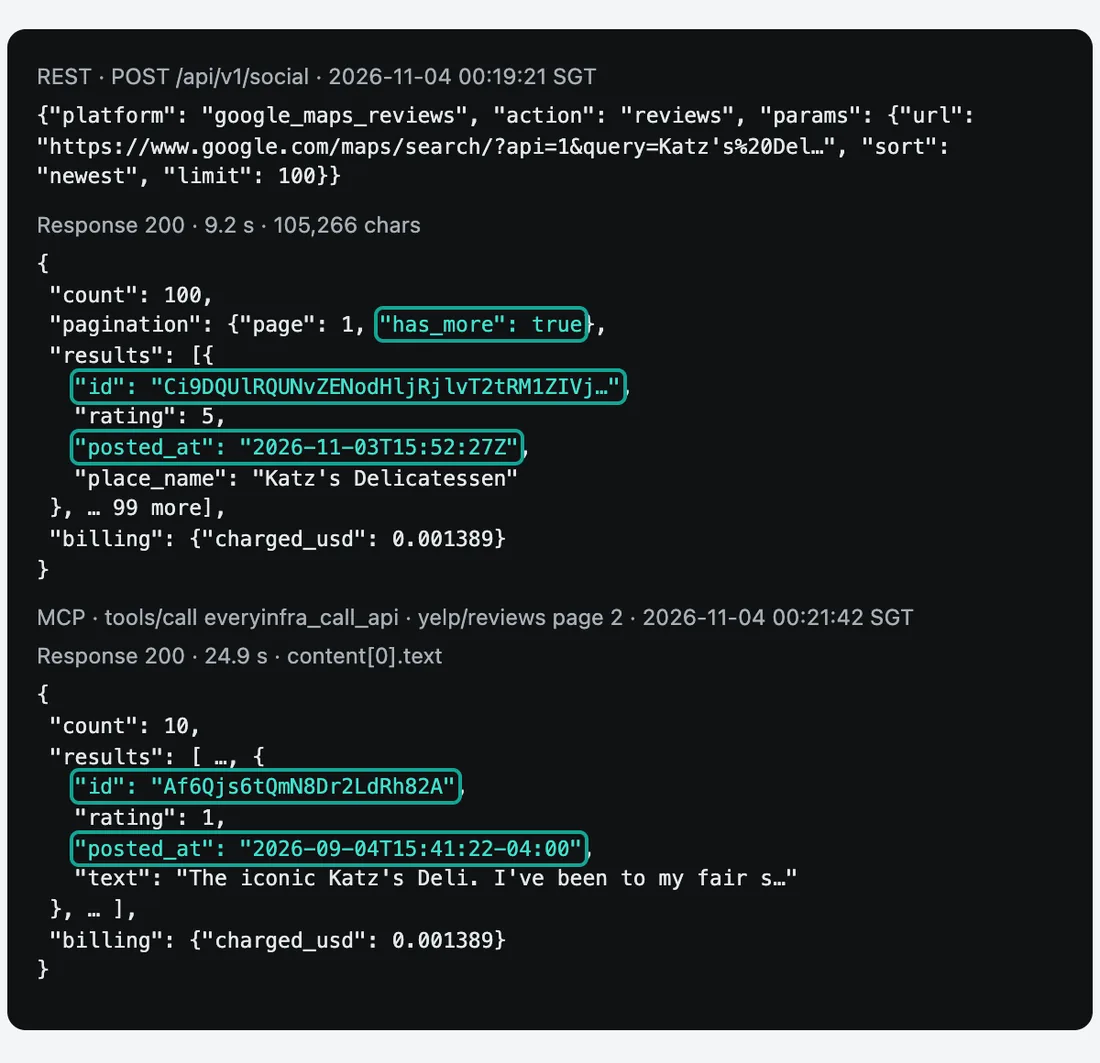
Anthropic側でのデプロイは行っていません。ただし、エージェントがMCP経由でEveryInfraに送るリクエストは、こちら側から見るとcurlで送るリクエストと変わりません。以下は、シンガポール時間00:21:42にリモートMCPのtools/callで実際に送信したリクエストです。YelpにあるKatz'sのレビューの2ページ目を読み込みます。page_tokenは1ページ目のレスポンスのnext_page_tokenから取得したもので、ここでは短縮しています。
{"jsonrpc": "2.0", "id": 7, "method": "tools/call",
 "params": {"name": "everyinfra_call_api",
  "arguments": {"platform": "yelp", "action": "reviews",
   "params": {"url": "https://www.yelp.com/biz/katzs-delicatessen-new-york",
              "page_token": "pt1.4EnA2jhN8mJn…"}}}}
レスポンスは24.9秒後にHTTP 200で返ってきました。content[0].textには10件のレビューを含む9,675文字のJSONが入っており、この呼び出しの課金額は$0.001389でした。各レビューにはid、rating、posted_at、textなどのフィールドがあります。最も重要なのはidで、「新着」の判定はこれに依存します。表には、Katz'sについて行った1回目(T1)の呼び出しをすべて示します。
| シンガポール時間 | 機能 | 方法 | 件数 | 時刻 | 文字数 | 課金額 |
|---|---|---|---|---|---|---|
| 00:18:04 | google_maps_reviews/search | REST | 3 | 72.5 s | 3,915 | $0.001389 |
| 00:19:21 | google_maps_reviews/reviews、新しい順、100件 | REST | 100 | 9.2 s | 105,266 | $0.001389 |
| 00:19:46 | yelp/reviews 1ページ目 | REST | 10 | 24.6 s | 11,825 | $0.001389 |
| 00:20:22 | tripadvisor/search | REST | 1 | 15.2 s | 1,741 | $0.001389 |
| 00:20:43 | tripadvisor/reviews | REST | 50 | 11.1 s | 54,739 | $0.001389 |
| 00:21:02 | yelp/reviews、sort_by=date_desc付きURL | REST | 10 | 27.4 s | 11,825 | $0.001389 |
| 00:21:42 | yelp/reviews 2ページ目 | MCP | 10 | 24.9 s | 9,675 | $0.001389 |
00:17:32の最初の呼び出しは429になりました。テスト用キーのレート制限は1分あたり10回です。この呼び出しは課金されず、30秒後のリトライで成功しました。続いて、Haidilaoとメキシコシティのコントラマー(Contramar)に対してさらに13回呼び出しました。
そのうち4回は結果のない検索で、APIはそれぞれempty_result_refundedとして返金しました。1回目で課金された呼び出しは15回、計$0.020835です。01:20の2回目の5回を合わせると、課金された呼び出しは20回、計$0.02778でした。Googleの店舗検索では、米国外の2店舗(マドリードのBotínとメキシコシティのContramar)について結果が返りませんでした。そこでGoogle Mapsの検索URLを指定してgoogle_maps_reviews/reviewsを呼び出し、Contramarのレビューを50件取得しました。
テスト1:各サイトの「最新N件」が何日分をカバーするか
毎晩何件のレビューを読む必要があるかは、1ページがどれだけの期間をカバーするかで決まります。各レスポンスの最初と最後のレビューのposted_atを取り、その差を求めました。結果はグラフのとおりです。Googleでは、編集された古いレビュー2件(10月23日付と8月10日付)がリストの途中に含まれていました。Googleのヘルプによると、編集されたレビューには編集日が表示されます(Googleビジネスプロフィール ヘルプ)。そのため、この2件は期間の計算から除外しました。
| サイト | 読み込んだ件数 | リストの期間 | 星1〜2 | オーナーの返信 | 日付順 |
|---|---|---|---|---|---|
| 100 | 3.97日 | 10 | 10 | はい(編集済みレビュー2件を除く) | |
| Yelpの1・2ページ目 | 20 | 68.84日 | 1 | 0 | 不要 |
| Tripadvisor | 50 | 119日 | 10 | 0 | 可能 |
「最新50件」がカバーする期間は、GoogleのKatz'sでは2日未満、TripadvisorのContramarでは1年以上です。この差を生む要因は、店舗のレビュー数とレビューの言語の2つです。Tripadvisorのレスポンスは2件ともすべて英語でした。Katz'sの50件はすべて英語でした。Contramarではメキシコのサイトであるtripadvisor.com.mxのURLを使いましたが、50件はやはりすべて英語で、期間は2025-09-02から2026-10-21でした。
つまり、このエンドポイントはTripadvisorの英語レビューを読み込むもので、スペイン語のレビューはレスポンスに含まれません。地元客が中心の店舗では、Tripadvisorで一晩のうちに新着レビューが見つかることはまれです。それでも1回の読み込みはわずか$0.001389なので、ジョブに残しておく価値はあります。
Yelpは挙動が異なります。Katz'sの1ページ目には9月20日から11月2日までのレビュー10件が、順不同で並んでいました。Yelpのサポートページによると、デフォルトの並び順は新しさ、投票、レビューの質に基づくため、古いレビューが新しいレビューより先に表示されることがあります。「Newest First」を選べるのはログインしたユーザーだけです(Yelpサポート)。
URLにsort_by=date_descを追加して再度呼び出しました。10件のレビューIDはまったく同じで、このURLパラメータには効果がありませんでした。2ページ目には11月1日のレビューがあり、10件中5件は1ページ目の最も古いレビューより新しいものでした。そのため、夜間ジョブではYelpを少なくとも2ページ読み込み、「新規」をIDで判定する必要があります。1ページ目の先頭のレビューは、目印として信頼できません。
テスト2:低評価レビューはどこにあり、何が書かれているか
グラフは、各レスポンスにおける星評価ごとの割合を示しています。Katz'sのGoogleの最新100件では、星1〜2が10件で10%でした。Tripadvisorでは50件中10件が星1〜2で、20%でした。Yelpでは、2ページ分20件のうち星1は1件だけでした。
Haidilaoでは、Googleレビュー50件のうち49件が星5、1件が星3で、低評価レビューはありませんでした。HaidilaoのYelpの1ページ目の10件はすべて星4または星5でした。ContramarのGoogleレビュー50件には、星1と星2のレビューが1件ずつ含まれていました。
Katz'sの低評価レビューについて、Googleの10件とTripadvisorの10件の全文を読みました。各レビューには手作業でラベルを付けており、1件に複数のラベルが付く場合もあります。Googleの10件のうち、6件は料理(パサついた肉、崩れるパン)に関するもので、7件は評判倒れ・割高だという内容でした。スタッフに関するものが3件、混雑した席や店内に関するものが2件、行列に関するものが1件です。
Tripadvisorの10件のうち、料理が7件、価格や過大評価に関するものが6件、サービスが5件、行列・席が3件でした。ほかの2件は来店についてではなく、オンライン注文と配送に関するものでした。この分類はレポートに役立ちます。オンライン注文への苦情はEC担当チームに回し、店舗スタッフの評価には含めないようにします。
プロンプトを見直す必要がある点が、さらに2つ見つかりました。第1に、Googleの低評価レビュー10件のうち6件は英語以外で、内訳はイタリア語2件、ドイツ語2件、トルコ語1件、スペイン語1件でした。langパラメータはインターフェースの言語を設定するもので、レビュー自体は翻訳しません。そのため、エージェントはラベル付けの前にレビューを翻訳する必要があります。第2に、Googleの最新レビュー100件のうち10件にオーナーからの返信がありました。10件の返信はすべて、11月2日の21:10から21:32(UTC)までの22分間に投稿されました。
10件の返信のうち9件は星5のレビューへのものでした。星1のレビューへの返信は1件だけで、割り込みをした人についてのレビューでした。その返信はレビュー投稿の約35時間後です。つまりこの店舗はまとめて返信し、しかも高評価のレビューから先に返信しています。レポートに「返信済み」列を設けると、誰も対応していない低評価レビューが上位に表示されます。
テスト3:2つのスナップショット間で「新規」をどう判定するか
1回目(T1)はシンガポール時間00:19〜00:21、2回目(T2)は01:20に実行しました。約1時間の間隔は「昨夜」と「今夜」に見立てたものです。T2では、リモートMCP経由でKatz'sのGoogle最新レビュー50件を読み込みました。さらにREST経由でsince=2026-11-03を指定してGoogleを再度読み込み、Yelpの1ページ目とTripadvisorもそれぞれ1回ずつ読み込みました。
合計4回の呼び出しで$0.005556です。さらにyelp/searchを1回呼び出し、スペイン語版のためにContramarのYelpページを見つけました。「新規」のルールは1行だけです。前回の実行時のIDセットに含まれていないIDのレビューを新規とします。
| サイト | T1の件数 | T2の件数 | T1になかったID | うち星1〜2 |
|---|---|---|---|---|
| Google最新50件(MCP) | 100 | 50件、53,364文字 | 3件、すべて星5 | 0 |
Google since=2026-11-03(REST) | — | 17件、21,588文字、次ページなし | 3件(残り14件はT1に含まれていた) | 0 |
| Yelpの1ページ目 | 10 | 10件、IDと順序はT1と同じ | 0 | 0 |
| Tripadvisor | 50 | 50 | 0 | 0 |
最も有用なのは、Googleの新規レビュー3件の投稿時刻です。17:15、16:49、14:54 UTCでした。最初の2件は16:19 UTCのT1呼び出しより後なので、通常の新規レビューです。3件目の14:54は、T1呼び出しより1時間25分前です。T1の最新レビュー(15:52)よりも古いにもかかわらず、T1の100件のリストには含まれていませんでした。
つまりGoogleでは、レビューが表示上の投稿時刻より遅れて現れることがあります。「前回の最新レビューより後のposted_atを持つレビューだけを読む」といったルールでは、このレビューはいつまでも取りこぼされます。検出できるのはIDの比較だけです。T1とT2の両方に含まれるレビューでは、posted_at、星の評価、オーナーの返信に変化はありませんでした。
sinceパラメータもプロンプトに含めるべきです。これは時刻ではなく日付です。since=2026-11-03は11月3日(UTC)のレビュー17件をすべて返し、そのうち14件はすでにT1に含まれていました。そのため、IDチェックの代わりにはなりません。ただしレスポンスは53,364文字から21,588文字へと約60%減り、特にMCP経由で効果があります。
おすすめの設定は次のとおりです。sinceを前回の正常な実行の前日に設定し、sort=newestを維持し、IDで重複を除去します。sinceが誤っていた場合の安全策として、limitは50のままにします。この1時間、YelpとTripadvisorには新規レビューがなく、Yelpの1ページ目の10件のIDも同じ順序のままでした。1ページ目に変化がなくても2ページ目に変化がないとは限らないため、両方のページを読んでください。この夜のレポートは1行です。「直近1時間に3サイト全体で新規レビュー3件、すべて星5、新たな低評価レビューなし。」
この比較から、メモリストアに何を保存するかも決まります。サイトごとの最近のレビューIDのセットがあれば十分です。Googleはエンドポイントが最大400件までページングするため、直近400件のIDを保持します。YelpとTripadvisorは、それぞれ直近100件のIDを保持します。前回の正常な実行の日付も保持してください。前述の14:54のレビューがあるため、「最新レビューの時刻」だけを保存するのは避けてください。
朝のレポートのイメージ
ラベルのルールはプロンプトに書き込み、各ラベルに1行の定義といくつかの手がかりを添えます。そうしないと、同じレビューが今日は「サービス」、明日は「行列」と分類され、月末の集計を比較できなくなります。以下の6つのラベルは、低評価レビュー28件(Katz'sが21件、Contramarが7件)の全文をもとに作成しました。各手がかりは、それらのレビューで繰り返し出てきた言葉に基づいています。1件のレビューに複数のラベルを付けても構いません。エージェントが判断に迷う場合は、無理に1つに絞らず、ラベルをもう1つ追加するようにします。
| ラベル | 定義 | レビュー中の手がかり | 担当 |
|---|---|---|---|
| 料理 | 料理そのものの問題 | パサパサ、しょっぱい、脂っこい、味がない、新鮮でない、パンが崩れる | 厨房責任者 |
| 接客 | スタッフの態度や行動 | 失礼、無視された、袋を投げられた、断りなくチップを加算された | 店長 |
| 行列・席 | 待ち時間、席の配置、席の選び方 | 長い行列、割り込みされた、バー席しかない、テーブルの間隔が狭い | フロアマネージャー |
| 価格・評判 | 価格に見合わない、または料理より評判が先行している | 高すぎる、過大評価、話題になっただけの店、わざわざ行く価値なし | マーケティング・価格設定担当 |
| 店内環境 | 店内と設備 | 混雑、テーブルの間隔が狭い、隣のテーブルで電子タバコ | 店長 |
| オンライン注文 | Web注文、配送、デリバリー | 1週間後に届いた、オンラインで購入した調味料の問題 | EC担当チーム |
以下のサンプルでは、T1のレスポンスに含まれるKatz'sのGoogle低評価レビュー10件を使用しています。各レビューは翻訳し、要約しています。日付はUTCです。実際のレポートでは、当番のマネージャーがすぐに開いて返信できるよう、各レビューへのリンクも付けてください。
| 投稿日時(UTC) | スター数 | 言語 | 要約 | ラベル | 返信済み |
|---|---|---|---|---|---|
| 11-03 02:40 | 1 | イタリア語 | ドリンク・サイドメニューのカウンターのスタッフが失礼な態度で、客に袋を投げつけた | 接客 | 不要 |
| 11-01 17:59 | 1 | 英語 | 料理の質が何年も落ち続けている。今日のパストラミは脂っぽく、味がなかった | 料理、価格・評判 | 不要 |
| 11-01 10:08 | 1 | 英語 | 割り込みがあったのに、調理担当者は投稿者にそのまま待つよう言った | 行列・席 | 可能 |
| 10-31 15:07 | 1 | トルコ語 | 評判倒れで、タクシーで行く価値はない | 価格・評判 | 不要 |
| 10-31 12:55 | 2 | スペイン語 | 肉を切る男性スタッフが無愛想だった | 接客 | 不要 |
| 10-31 08:34 | 2 | イタリア語 | 肉は茹でたような味でパサパサ、パンもまずく、価格が非常に高い | 料理、価格・評判、店内 | 不要 |
| 10-31 02:53 | 2 | ドイツ語 | 料理にはとてもがっかり。昔ながらのアメリカンデリらしいのは店内だけで、評判と価格に料理が見合っていない | 料理、価格・評判 | 不要 |
| 10-31 02:51 | 1 | ドイツ語 | 肉はパサパサで味付けがなく、評判にも値段にも見合わない | 料理、価格・評判 | 不要 |
| 10-30 23:33 | 1 | 英語 | $31のパストラミサンドイッチは非常にパサパサで、硬すぎて切れない | 料理、価格・評判 | 不要 |
| 10-30 16:33 | 2 | 英語 | 主な不満は、担当ではない店員が失礼な態度で、テーブルを動かしたことを責めてきたこと。ほかに過大評価、料理がいまひとつ、テーブル同士が近すぎるとの指摘も | 接客、料理、店内、価格・評判 | 不要 |
レポートは長いリストではなく、短い要約から始めます。上の表からは、次のような要約が書けます。「直近4日間で、Googleに星1〜2の新しいレビューが10件ありました。7件は評判倒れ、または価格に見合わないという内容で、6件は料理に関するものです。6件は英語以外のレビューです。9件は未返信で、そのうち3件はスタッフに関するものです。今日はまずこの3件に返信してください。」
レポート本文には投稿者やスタッフの名前を入れず、リンクだけを残します。また、ContramarのGoogleレビュー本文には改行タグ<br>が含まれている(本文のある30件のレビューのうち6件)ため、エージェントはレポートを書く前にこれを取り除く必要があります。
Claude Managed Agentsの料金:API料金とAnthropic側の費用
費用は2つに分かれます。EveryInfra側はシンプルです。1店舗あたり1晩に4回の呼び出しが必要で、1回$0.001389なので、1晩で$0.005556、30晩で$0.1667です。10店舗なら月額$1.6668、50店舗なら$8.334です。
月額料金はありません。結果が空の場合は返金されます。3回のルックアップ呼び出しは初期設定時にのみ発生します(料金ページを参照)。
Anthropic側については、2026年11月4日に確認した料金ページによると、Managed Agentsには2種類の課金があります。トークンはモデルの定価で課金されます。セッション実行料金は1時間あたり$0.08で、実行時間はミリ秒単位で計測され、セッションのステータスがrunningの間のみ課金されます。アイドル時間は無料です。
セッション内のWeb検索は1,000回あたり$10で、Batch APIの割引は適用されません(料金)。同じページでは、Opus 5.5は100万トークンあたり入力$4、出力$20です。Sonnet 5.5は$2と$10です。Haiku 5.5は、100,000トークン以下のプロンプトで$0.10と$0.50です。
トークン使用量は計測していないため、以下の数値は推定です。ご自身の前提で計算できるよう、前提条件も示します。1店舗・1晩分の生のレスポンスは129,603文字です(2回目に取得した実際のGoogle 50件のレスポンス、Yelp 2ページ分、Tripadvisor 50件)。用語集によると、旧モデルでは英語約3.5文字が1トークンにあたります。4.7以降のモデルでは、同じテキストでもトークン数が約30%多くなります(用語集)。ここでは1トークンあたり2.69文字として計算したため、生のレスポンスは約48,138トークンです。
エージェントループはコンテキストを複数回読み込むことがあります。その回数は計測できないため、2つの水準を示します。1x(各レスポンスがコンテキストに1回だけ入る)が下限、3xが上限の目安です。どちらの水準でも、システムプロンプトとツールのテキスト分として15,000トークン、出力として3,000トークンを加えています。プロンプトキャッシュの割引は含めていません。生データをすべてコンテキストに入れるMCP経由の場合、1晩あたり約63,138〜159,414入力トークンが必要です。
jqで星1〜2の行だけを渡すHTTP経由の場合、1晩あたり約17,854〜23,564入力トークンで済みます。3xの水準では約85%の削減です。1トークンあたりの文字数も推定値です。より正確な数値が必要な場合は、ご自身のレスポンスに対してAnthropicのトークンカウント用エンドポイントを実行してください。実行時間には、4回のツール呼び出しの実測値69.8秒にモデルの処理時間60秒を加えた値を使い、1晩あたり$0.00288となりました。
| 1店舗 | 1晩あたり(1x〜3x) | 月額(30晩、3x) |
|---|---|---|
| EveryInfra API料金(4回の呼び出し、カタログ価格) | $0.005556 | $0.1667 |
| セッション実行時間(推定129.8秒) | $0.00288 | $0.0864 |
| Haiku 5.5、HTTP(フィルターあり) | $0.0033〜$0.0039 | $0.117 |
| Haiku 5.5、MCP(全データ) | $0.0078〜$0.0174 | $0.522 |
| Sonnet 5.5、HTTP(フィルターあり) | $0.0657〜$0.0771 | $2.313 |
| Sonnet 5.5、MCP(全データ) | $0.1563〜$0.3488 | $10.464 |
| Opus 5.5、HTTP(フィルターあり) | $0.1314〜$0.1543 | $4.629 |
API料金は少額で、金額も一定です。実際のコストは、モデルと、コンテキストに入れる生データの量で決まります。Sonnet 5.5をHTTP経由で使う場合、1店舗あたり、1晩の合計コストは約$0.074〜$0.086です。そのうちAPI料金は6.5%〜7.5%にすぎません。同じモデルをMCP経由で全データを渡して使う場合、1晩あたり約$0.165〜$0.357となり、2.2〜4.2倍のコストがかかります。レビューのラベル付けと翻訳にはおそらくHaiku 5.5で十分で、その場合、1店舗あたりの月額は$0.40未満です。
デプロイの予算は「店舗数 × 1店舗あたりの推定額 × 3」で設定します。SonnetをHTTP経由で使用して10店舗を処理する場合、推定額は1晩あたり約$0.86です。予算を"300"($3)にしておけば、暴走したループを止めながら、通常の実行は最後まで完了できます。あるRedditユーザーは、Managed Agentsを3回試しただけでAPI料金が約$6かかったと報告しています(Redditのスレッド)。そのため、予算は初日に設定してください。下の表は、推定額を3倍した水準で、店舗数に応じた合計額を示しています。1店舗あたりのコストは変わらず、1つのセッションですべての店舗を読み込む前提で計算しています。
| 店舗数 | EveryInfra API(月額) | 合計:Haiku 5.5、HTTP(推定) | 合計:Sonnet 5.5、HTTP(推定) | 1回あたりの予算(Sonnet) |
|---|---|---|---|---|
| 1 | $0.1667 | $0.369 | $2.565 | "30" |
| 10 | $1.667 | $3.69 | $25.65 | "300" |
| 50 | $8.334 | $18.45 | $128.25 | "1300" |
Claude Managed Agents、Agent SDK、Claude CodeとCoworkのスケジュール機能の比較
現在Anthropicでは、Claudeをスケジュール実行する方法が少なくとも4つあります。どれが適切かは、誰がループを実行するか、誰が費用を負担するか、キーをどこに置くかで決まります。Agent SDKはライブラリで、Claude Codeのエージェントループを自分のプロセス内で動かします。
マシンとスケジューラーは自分で用意します(Agent SDKの概要、ホスティングガイド)。Managed Agentsは、ホスト型のループとサンドボックスを提供します。Claude CodeのルーティンとCoworkのスケジュールタスクは、サブスクリプションで利用するアプリの機能で、プランの利用枠を消費します。
| Managed Agentsのデプロイ | Agent SDK | Claude Codeのルーティン | Coworkのスケジュールタスク | |
|---|---|---|---|---|
| ループの実行主体 | Anthropicのクラウド | 自前のサーバーまたはコンテナ | Anthropicのクラウド | Anthropicのクラウド |
| スケジュール | Cron+IANAタイムゾーン、最大9分のジッター | 自前のcronまたはジョブキュー | Cron、実行間隔は1時間以上 | アプリで頻度を選択 |
| 課金 | APIのトークン料金+1時間あたり$0.08 | APIのトークン料金 | プランの使用量 | プランの使用量 |
| 最適な用途 | 多数の店舗を処理する、予算設定とWebhookを備えた本番ジョブ | すでにサーバーを運用していて、すべてを自分で制御したいチーム | 開発者個人のダイジェスト | 個人用の週次レポート |
| 出典 | スケジュールデプロイ、料金 | Agent SDKの概要、ホスティング | ルーティン | Coworkヘルプ |
以前、関連する記事を2本公開しました。1本目は、Claude Codeのルーティンで毎晩Redditを読み込み、ペインポイントのダイジェストを作成するものです。このテストでは、100件の投稿を含む1ページで18.7時間分しかカバーできませんでした(RedditでのClaude Codeスケジュールタスク)。2本目は、Coworkのスケジュールタスクで毎週月曜に競合の価格とレビューの表を作成するものです(Coworkによる競合価格表)。
3本をあわせて読んでください。自分で読む週次レポートなら、Coworkが最も手軽です。コードリポジトリに紐づく開発者向けジョブなら、Claude Codeを使います。数十店舗を毎晩処理し、予算の上限設定、失敗時のアラート、自社システムへの結果送信が必要なら、Managed Agentsのスケジュールデプロイを使います。
Claude Codeのドキュメントによると、ルーティンの実行は最大で1時間に1回で、プランの使用量を消費します(ルーティン)。Coworkのタスクはクラウドで実行されるため、コンピューターがスリープ中でも動作します(Coworkヘルプ)。エージェントは不要で、Google Mapsのレビューをスプレッドシートにまとめたいだけなら、Google Mapsのレビューをスクレイピングする方法をご覧ください。
障害発生時:最初に確認すべきレイヤー
夜間ジョブが失敗しても、レポートには「データなし」としか表示されないことがよくあります。下の表では、Anthropicのデプロイとセッション、シークレット保管庫とネットワーク、EveryInfra APIという3つのレイヤーで起こりやすい障害をまとめています。左の列は実際に見える症状、右側の列はまず確認すべき箇所です。EveryInfraの各行は、11月4日に実際の呼び出しで発生したものです。Anthropicの各行は、エラーと状態に関するドキュメントの記述に基づいています。
| 症状 | 主な原因レイヤー | 最初に確認する箇所 | 対処法 |
|---|---|---|---|
| 朝になってもレポートもWebhookも届かない | デプロイメントがセッションを作成しなかったか、Webhookの3回の試行がすべて失敗した | GET /v1/deployment_runs?has_error=true | POST /v1/deployments/{id}/runを手動で1回呼び出す |
| セッションが待機したままで、レポートファイルが作成されない | MCPツールセットがalways_askのままになっている | 最後のアイドルイベントのstop_reason | everyinfra_call_apiにalways_allowを設定する |
| ツールの結果にunauthorizedと「Nothing was charged」が表示される | Vault内のキーが誤っている、または認証情報のallowed_hostsが誤っている | 認証情報のsecret_nameとnetworking | 認証情報を修正する。エージェントに再試行させない |
curlで、ホスト名が明記された403が返される | 環境のallowed_hostsにそのホストが含まれていない | 環境のnetworking | api.everyinfra.comを追加する |
| モデルには短いプレビューしか見えない | MCPツールの出力が100,000文字を超えている | その呼び出しのlimit | レビューを50件にするか、jqを使うHTTP方式に切り替える |
| APIが429を返す | キーの1分あたりのレート制限に達した | レスポンスのretry_after | その秒数だけ待つ。429は課金されない |
| 検索で結果が返されず、返金される | プレイス検索で店舗が見つからなかった | レスポンスのreason | Googleマップの検索URLでレビューを取得する |
この表には1つの原則があります。各エラーは必ずレポートに記載し、エージェントが自分で回避してはいけません。エージェントは「別のパラメータで再試行する」のが得意です。しかし、このジョブはコストがかかり、誰も監視していない夜間に実行されます。
ここで回避を試みると、多くの場合、誤った店舗を取得したり、二重に読み込んだり、設定ミスが1か月も残ったりします。そのため、プロンプトには次のように明記する必要があります。unauthorized、403、予算による一時停止の場合は停止し、理由を記録すること。待機後に1回だけ再試行してよいのは429のみです。
制限事項と未解決の点
1つ目に、Anthropic側はテストしていません。スケジュールされたデプロイメント、Vaultによるキーの置き換え、権限ポリシー、Webhookは、いずれも2026年11月4日に参照したplatform.claude.comのドキュメントにある設定例です。Managed Agentsはまだベータ版のため、フィールドが変更される可能性があります。vault_idsとresourcesは、セッションのドキュメントとメモリのドキュメントにある例をもとに記述しました。何かを作成する前に、お使いのSDKバージョンのデプロイメントリファレンスと照らし合わせて確認してください。
第2に、Tripadvisor側は英語のレビューしか返しません。スペイン語や中国語など、ほかの言語のレビューはレスポンスに含まれません。第3に、Googleの場所検索では、米国外の2店舗はどちらも結果が得られませんでした(返金済み)。Google Mapsの検索URLを使った直接読み込みは成功したので、新しい店舗のURLは一度ずつ手作業で確認してください。第4に、Yelpの1ページ目は日付順ではなく、URLのsortパラメータも効きません。もう1ページ読み込み、「新しいかどうか」はIDで判断してください。
5つ目に、レビュー本文は信頼できない入力です。メモリのドキュメントでは、メモリストア内のコンテンツにプロンプトインジェクションが含まれうると警告されており、レビュー本文にも同じリスクがあります。レビューに「指示を無視せよ」と書くことは誰にでもできます。HTTPとjqによる方式では、レビューはデータとして扱われます。環境で許可されているのはapi.everyinfra.comのみで、Vaultはそのホストに対してのみキーを置き換えます。そのため、たとえモデルが誘導されても、キーが外部に漏れることはありません。
6つ目に、レポートは自社店舗の改善にのみ使用してください。2024年のFTC規則は、偽のレビュー、特定の意見を条件としたレビューへの対価の支払い、否定的なレビューの抑制を禁止しています(FTCプレスリリース)。低評価のレビューは毎晩確認する価値がありますが、適切な対応は返信と改善であり、レビュー投稿者に圧力をかけることではありません。本記事はデータ手法のみを扱うもので、法的助言ではありません。
最近の変更点
過去1か月の以下のアップデートがこのジョブに影響します。いずれもClaude Platformのリリースノートに記載されています。2026-10-07に、web_fetchはセッション内ですでに登場したURLのみを取得するようになり、limitedネットワーキングのallowed_hostsがweb_fetchとweb_searchにも適用されるようになりました。2026-10-09に、Managed Agentsに動的ワークフローが追加されました。これは多数のエージェントをフェーズごとに実行する機能です。店舗が数百ある場合に役立つ可能性がありますが、テストはしていません。2026-10-14に、Claude Platform on AWSでスケジュールされたデプロイメントが利用可能になりました。
2026-10-20に、組織の管理者はコンソールでweb fetchを無効化したり、対象ドメインを制限したりできるスイッチを利用できるようになり、Managed Agentsのセッションもこの設定に従います。2026-10-29に、Usage and Cost Analytics APIのベータ版が公開されました。トークンとコストをモデル、ワークスペース、APIキーごとに分けて確認できるため、巡回の月額コストのチェックに役立ちます。
FAQ
claude managed agentsとClaude Codeのroutinesの違いは何ですか?
この質問は、検索候補の「claude managed agents vs claude code」と「claude managed agents vs routines」、およびRedditの投稿「What is the point of Managed Agents」(Redditスレッド)から来ています。どちらもAnthropicのクラウドで実行されます。Claude Codeのroutinesはプランの使用量を消費し、実行は最大で1時間に1回です(Routines)。Managed Agentsのデプロイメントは、APIトークンに加えて1セッション時間あたり$0.08が課金され、分単位のcronで実行されます。各実行には厳密な予算上限を設定でき、結果はWebhookで送信されます(Scheduled deployments)。チーム向けやクライアント向けの本番ジョブには後者を使用してください。
claude managed agentsの料金体系はどうなっていて、1晩あたりいくらかかりますか?
この質問は、検索候補の「claude managed agents pricing」と「claude managed agents cost」から来ています。料金は2種類あります。モデルのトークンは定価で、セッションの実行時間はrunning状態の間のみ1時間あたり$0.08です(Pricing、2026-11-04に参照)。当社の試算では、Sonnet 5.5でHTTP方式を使う場合、1店舗あたり1晩でモデル料金が約$0.077、実行時間料金が約$0.0029です。EveryInfra APIの$0.0056を加えると、高めに見積もった3倍の水準で合計約$0.0855になります。
claude managed agentsとagent sdk、どちらを選ぶべきですか?
この質問は、検索候補の「claude managed agents vs agent sdk」から来ています。Agent SDKはライブラリです。ループは自分のプロセス内で実行され、マシン、スケジュール、シークレット、ログは自分で管理します(Agent SDK overview)。Managed Agentsは、ループ、サンドボックス、スケジュール、認証情報の置き換え、セッション記録をホストします。すでにサーバーとジョブキューを運用していて、完全に制御したい場合はSDKを選んでください。独自のスケジューラーなしで、Webhookと実行ごとの予算を使いたい場合はManaged Agentsを選んでください。
Managed Agentsはweb_fetchでGoogleマップやYelpのレビューを取得できますか?
この質問は、検索候補の「claude managed agents web」から来ています。確実にはできません。web_fetchはJavaScriptを実行せず、2026-10-07以降はセッション内ですでに登場したURLしか取得しません(リリースノート)。Yelpのrobots.txtは、Claude-Userに/articleのみを許可しています(yelp.com/robots.txt)。構造化されたレビューAPIのほうが確実です。
スケジュールされたデプロイメントが予定どおり実行されなかった場合はどうなりますか?
この質問は、検索候補の「claude managed agents schedule」から来ています。一時停止中に実行されなかったトリガーは、後から補完されません。セッション作成がレート制限を受けた場合、その実行にはsession_rate_limited_errorの記録が残り、再試行は行われません(Scheduled deployments)。そのため、次回の実行では直近24時間分だけでなく、最後に成功した実行が保存した最後のレビューIDまで遡って取得する必要があります。Googleでは、Katz'sのような人気店ならlimit=50で約2日分をカバーできるため、1晩の実行漏れがあっても対応できます。
モデルはVault内のキーを見られますか?
この質問は、検索候補の「claude managed agents vault」と「claude managed agents credential vault」に基づいています。いいえ。認証情報を環境変数として設定しても、サンドボックス内で保持されるのはプレースホルダーだけです。外部への送信時にプレースホルダーが実際の値に置き換えられますが、対象はallowed_hostsに含まれるホストに限られます(Authenticate with vaults)。Anthropicのブログでも、エージェントがキーの実際の値を参照することはないと説明されています(Anthropicブログ)。
始め方
- EveryInfraのAPIキーを取得します。クイックスタートの手順に従い、
google_maps_reviews/search、yelp/search、tripadvisor/searchをそれぞれ1回実行して、3つの店舗URLを特定します。 - 自分のマシンで
google_maps_reviews/reviews、yelp/reviews、tripadvisor/reviewsをcurlで1回ずつ呼び出します。フィールドとレスポンスサイズを確認してください。MCP方式についてはMCPサーバーのページを参照してください。 - Claudeコンソールで、ネットワーク設定を
limitedにし、api.everyinfra.comのみを許可した環境を作成します。EVERYINFRA_API_KEYという認証情報を1つ登録したVaultを作成します。web_fetchとweb_searchを無効にしたエージェントを作成します。 - 手動でセッションを1回実行するか、
POST /v1/deployments/{id}/runを呼び出して、レポートの形式とコストを確認します。次に、cron30 6 * * *と実行ごとの予算を設定してデプロイメントを作成します。session.status_idledとdeployment_run.failedをサブスクライブします。 - 各レビューAPIについては、Google Mapsレビューのページ、Yelpのページ、Tripadvisorのページをご覧ください。5つのレビューサイトを横断する週次レポートについては、OpenAI Agents APIによるレビュー巡回をご覧ください。
参考文献
- Claude Managed Agents overview、Anthropicドキュメント、2026-11-04閲覧。
- Scheduled deployments、Anthropicドキュメント、2026-11-04閲覧。
- Authenticate with vaults、Anthropicドキュメント、2026-11-04閲覧。
- Cloud environment setup、Anthropicドキュメント、2026-11-04閲覧。
- Tools、Anthropicドキュメント、2026-11-04閲覧。
- MCP connector、Anthropicドキュメント、2026-11-04閲覧。
- Permission policies、Anthropicドキュメント、2026-11-04閲覧。
- Session budgets、Anthropicドキュメント、2026-11-04閲覧。
- Subscribe to webhooks、Anthropicドキュメント、2026-11-04閲覧。
- Reference、Anthropicドキュメント、2026-11-04閲覧。
- Using agent memory、Anthropicドキュメント、2026-11-04閲覧。
- Web検索とWebフェッチのドメインを制限する、Anthropicドキュメント、2026-11-04閲覧。
- Web fetch tool、Anthropicドキュメント、2026-11-04閲覧。
- Pricing、Anthropicドキュメント、2026-11-04閲覧。
- Claude Platform release notes、Anthropic、2026-11-04閲覧。
- Define your agent、Anthropicドキュメント、2026-11-04閲覧。
- Start a session、Anthropicドキュメント、2026-11-04閲覧。
- Session event stream、Anthropicドキュメント、2026-11-04閲覧。
- Glossary、Anthropicドキュメント、2026-11-04閲覧。
- Agent SDK overview、Claude Codeドキュメント、2026-11-04閲覧。
- Hosting the Agent SDK、Claude Codeドキュメント、2026-11-04閲覧。
- Routines、Claude Codeドキュメント、2026-11-04閲覧。
- Schedule recurring tasks in Claude Cowork、Claudeヘルプセンター、2026-11-04閲覧。
- Anthropicはウェブからデータをクロールしていますか、Claudeヘルプセンター、2026-11-04閲覧。
- New in Claude Managed Agents: run agents on a schedule、Anthropicブログ、2026-11-04閲覧。
- Claude Managed Agents: get to production 10x faster、Anthropicブログ、2026-11-04閲覧。
- MCP Transports、Model Context Protocol仕様、2026-11-04閲覧。
- MCP Tools、Model Context Protocol仕様、2026-11-04閲覧。
- Place Details (New)、Google for Developers、2026-11-04閲覧。
- Work with review data、Googleビジネスプロフィールのドキュメント、2026-11-04閲覧。
- クチコミを閲覧して返信する、Googleビジネスプロフィールヘルプ、2026-11-04閲覧。
- Business Reviews、Yelp Fusionドキュメント、2026-11-04閲覧。
- レビューの表示順はどのように決まりますか?、Yelpサポート、2026-11-04閲覧。
- yelp.com/robots.txt、Yelp、2026-11-04閲覧。
- Location Reviews、Tripadvisor Content APIドキュメント、2026-11-04閲覧。
- tripadvisor.com/robots.txt、Tripadvisor、2026-11-04閲覧。
- crontab、The Open Group Base Specifications Issue 8、2026-11-04閲覧。
- Time Zones、IANA、2026-11-04閲覧。
- Standard Webhooks、Standard Webhooks、2026-11-04閲覧。
- 偽レビューを禁止するFTCの最終規則、米国連邦取引委員会、2024-08-14公開、2026-11-04閲覧。
- What is the point of Managed Agents?、Reddit r/ClaudeAI、2026-11-04閲覧。
- EveryInfra APIカタログ、EveryInfra、2026-11-04 00:13(シンガポール時間)閲覧。
参考資料 BL-79