claude managed agents: revisión nocturna de reseñas negativas de restaurantes
Con claude managed agents y un cron, lee cada noche las reseñas nuevas de Google, Yelp y Tripadvisor y separa las de 1 y 2 estrellas: 0,0056 USD por local.
El 4 de noviembre de 2026 (hora de Singapur) consultamos con la API de EveryInfra las reseñas de Contramar, en la colonia Roma de la Ciudad de México, y de Katz's Delicatessen, en Nueva York, en Google Maps, Yelp y Tripadvisor. El hallazgo que más cambia el diseño es que «las N más recientes» cubren lapsos muy distintos en cada sitio: en Contramar, 50 reseñas de Google cubren unas tres semanas y 50 de Tripadvisor, más de un año; en Katz's, 100 de Google no llegan a 4 días, y la primera página de Yelp ni siquiera viene en orden de fecha. Además, una segunda lectura una hora después trajo una reseña de Google con hora de publicación anterior a la primera llamada, que esa llamada no había traído; por eso la tarea nocturna tiene que comparar por identificador de reseña y recordar dónde se quedó, no limitarse a «traer las N más recientes» ni fiarse de la hora.
El segundo hallazgo es de costos: la tarifa de la API es pequeña, porque 4 llamadas por local y por noche cuestan menos de un centavo de dólar, y lo grande está en los tokens del modelo del lado de Anthropic. Con Sonnet 5.5, según nuestra estimación, el costo del modelo supera más de diez veces el de la API, así que conviene que un script dentro del sandbox deje solo las reseñas de 1 y 2 estrellas antes de pasarlas al modelo.
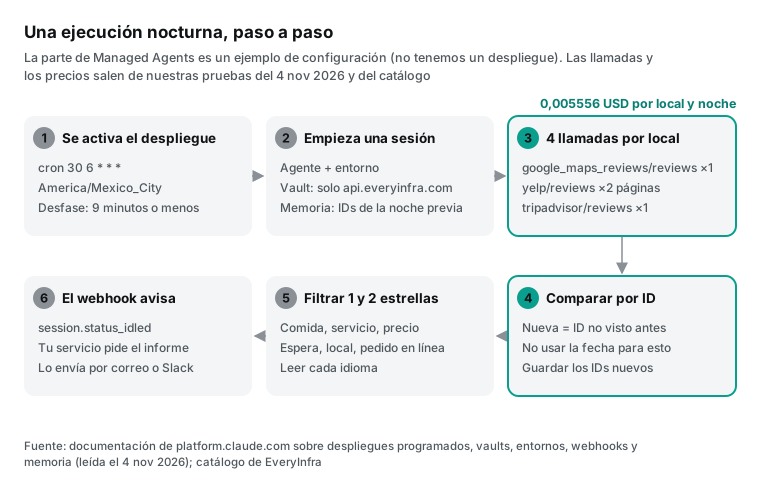
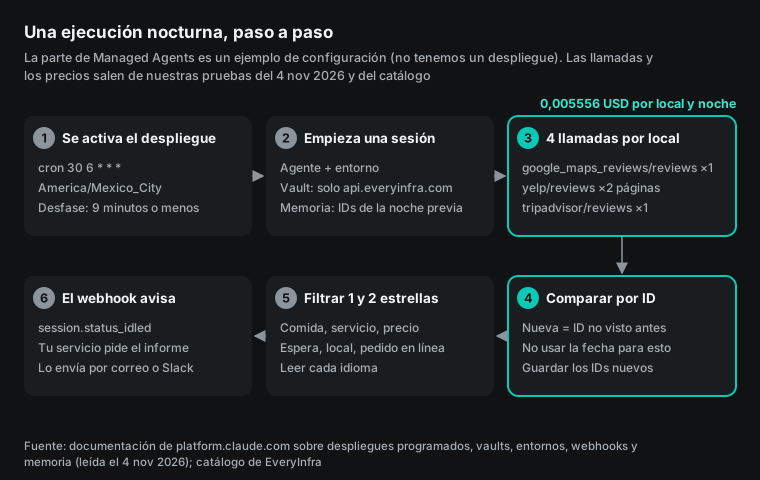
Este artículo responde una pregunta concreta. La gerente de operaciones de un grupo de restaurantes en la Ciudad de México quiere recibir, antes de las 7 de la mañana, un reporte con todas las reseñas nuevas de 1 y 2 estrellas desde la noche anterior en Google Maps, Yelp y Tripadvisor. Para cada reseña quiere saber si el problema es la comida, el servicio, la espera, el precio o la propina, y si alguien ya respondió. Para eso usamos los despliegues programados (scheduled deployments) de Claude Managed Agents: cada noche, la nube de Anthropic abre una sesión nueva según un cron; el agente llama a tres endpoints de reseñas de EveryInfra por HTTP o por MCP remoto, separa las reseñas negativas nuevas, las clasifica y escribe el reporte; al terminar, un webhook avisa a tu servidor.
Del lado de EveryInfra hicimos 26 llamadas reales, de las cuales 20 se cobraron, por 0,02778 USD en total. Del lado de Anthropic no desplegamos nada: cada dato sobre Managed Agents enlaza a la documentación o a las notas de versión de platform.claude.com, que leímos el 4 de noviembre de 2026.
La tarea: un reporte matutino de reseñas negativas en tres sitios
Usamos tres locales públicos como muestra. No tenemos ninguna relación con ellos y el reporte de ejemplo solo sirve para explicar el método. El principal es Contramar, la marisquería de la calle Durango en la Roma Norte: en Tripadvisor tiene 4,5 de calificación y 1728 opiniones, y en Google 40 de sus 50 reseñas más nuevas son de cinco estrellas. El segundo es Katz's Delicatessen, en Nueva York, con 4,5 y 56.460 reseñas en Google; lo usamos como caso extremo de volumen. El tercero, Haidilao en Flushing, Nueva York, tiene 4,8 en Google con 8792 reseñas y representa a un local con muy pocas quejas.
¿Por qué cada noche y no una vez por semana? Depende del volumen. En la respuesta real de Google para Katz's, las 100 reseñas más nuevas abarcan 3,97 días, unas 24,7 reseñas al día, y en las últimas 24 horas llegaron 29. Para Contramar, las 50 más nuevas de Google abarcan 22,86 días, poco más de dos reseñas al día. Una reseña negativa se atiende mejor en el primer o segundo día: es cuando una respuesta, una disculpa o una revisión interna tienen más efecto. Con una tarea semanal, en un local como Katz's habría que leer 4 páginas de Google y la queja más vieja llegaría al reporte con seis o siete días. Con una tarea nocturna basta leer las 50 más nuevas, con margen de sobra para Contramar y de casi dos noches para Katz's.
| Sitio | Capacidad | Reseñas por llamada | Orden | Precio por llamada |
|---|---|---|---|---|
| Google Maps | google_maps_reviews/reviews | Hasta 100; usamos 50 | sort=newest, con filtro opcional since por fecha | 0,001389 USD |
| Yelp | yelp/reviews | 10 por página; la siguiente con page_token | Orden propio de Yelp, no por fecha | 0,001389 USD |
| Tripadvisor | tripadvisor/reviews | Hasta 50 | Sin parámetro de orden; en nuestras pruebas, de la más nueva a la más vieja | 0,001389 USD |
| Buscar el local | google_maps_reviews/search, yelp/search, tripadvisor/search | Una vez por sitio al configurar | — | 0,001389 USD |
Los precios vienen del catálogo gratuito https://api.everyinfra.com/api/v1/social/catalog, que leímos a las 00:13 (hora de Singapur) del 4 de noviembre. Las tres capacidades de reseñas aparecían como available y cada llamada cuesta 100 créditos, es decir, 0,001389 USD. Las tres búsquedas solo hacen falta la primera vez: convierten el nombre del local en su dirección en cada sitio, y desde entonces la tarea nocturna lee las reseñas directamente con esa dirección.
Qué es claude managed agents: cuatro objetos y un horario
Claude Managed Agents es un conjunto de API alojadas en Claude Platform. Tú defines el modelo, las instrucciones de sistema y las herramientas del agente; Anthropic ejecuta el ciclo del agente en su propia nube, abre un contenedor aislado (sandbox), corre las llamadas a herramientas y guarda el registro de la sesión. Salió como beta pública el 8 de abril de 2026 y cada petición necesita el encabezado anthropic-beta: managed-agents-2026-04-01 (descripción general, notas de versión).
La documentación habla de cuatro conceptos centrales: agente (agent), entorno (environment), sesión (session) y vault. El despliegue programado (deployment) es un quinto objeto que llegó el 9 de junio de 2026 y abre sesiones por ti según un horario (blog de Anthropic). La tabla muestra cómo se usa cada uno en la revisión nocturna.
| Objeto | Qué controla | Ajuste para la revisión de reseñas | Documento |
|---|---|---|---|
| agente | Modelo, instrucciones, herramientas, servidores MCP y permisos, con versiones | Sonnet 5.5; solo bash y archivos; web_fetch y web_search apagados; en la ruta MCP, solo everyinfra_call_api permitido | Define your agent |
| entorno | Cómo se crea el sandbox y a qué hosts puede conectarse | Red limited con solo api.everyinfra.com en allowed_hosts | Cloud environment setup |
| vault | Credenciales que la sesión recibe al ejecutarse | Una credencial environment_variable, EVERYINFRA_API_KEY, que solo se sustituye en encabezados hacia api.everyinfra.com | Authenticate with vaults |
| sesión | Una ejecución: un contenedor nuevo y un registro de conversación | La crea el despliegue cada noche | Start a session |
| despliegue | Abre sesiones con un cron y una zona horaria, con presupuesto por ejecución | 30 6 * * * en America/Mexico_City, 50 centavos de dólar por ejecución | Scheduled deployments |
Lo que más se pasa por alto es que el entorno es nuevo en cada ejecución. La documentación de sesiones dice que cada sesión recibe un contenedor recién creado, y los archivos que escribió la ejecución anterior ya no están (Start a session). Para revisar reseñas esto importa mucho: la lista de «reseñas que ya vimos» no puede vivir en un archivo del sandbox. Tiene que estar en un almacén de memoria (memory store), otra beta que se monta bajo /mnt/memory/ (Using agent memory), o en tu propio servidor, que la guarda al recibir el webhook y la devuelve en el mensaje inicial de la noche siguiente.
Despliegues programados: cron, zona horaria, retraso, presupuesto y sin recuperación
Un despliegue programado se crea con POST /v1/deployments. Necesita un agente, un entorno, al menos un evento inicial (normalmente un user.message) y un schedule con type: cron, una expression en formato cron POSIX de 5 campos con precisión de minutos y una timezone con nombre IANA, por ejemplo America/Mexico_City (Scheduled deployments). Los campos del cron siguen la norma POSIX crontab y los nombres de zona vienen de la base de datos de zonas horarias de IANA, cuya versión más reciente, 2026f, salió el 2026-10-27. La respuesta de creación trae schedule.upcoming_runs_at con las próximas horas de disparo, para que compruebes la expresión en el momento.
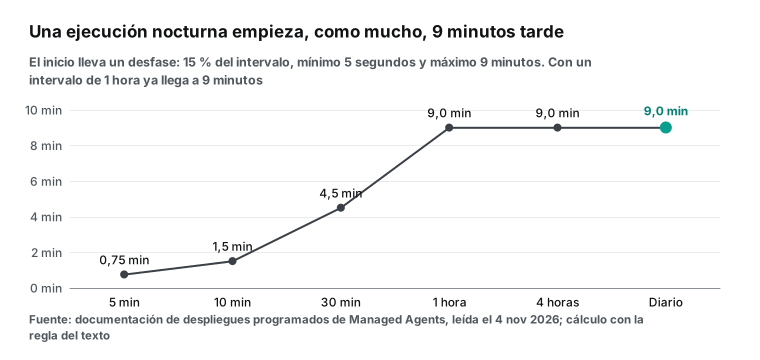
Hay una frase de la documentación que define la hora límite del reporte. Las horas de disparo son exactas, pero la ejecución real lleva un retraso aleatorio (jitter) de hasta el 15 % del intervalo entre ejecuciones, con un mínimo de 5 segundos y un máximo de 9 minutos. La gráfica dibuja esa regla: un despliegue cada 5 minutos arranca como mucho 45 segundos tarde; uno cada hora o cada día, como mucho 9 minutos tarde. Si el reporte tiene que llegar antes de las 7:00, un cron a las 6:30 deja espacio para esos 9 minutos más unos 20 minutos de ejecución.
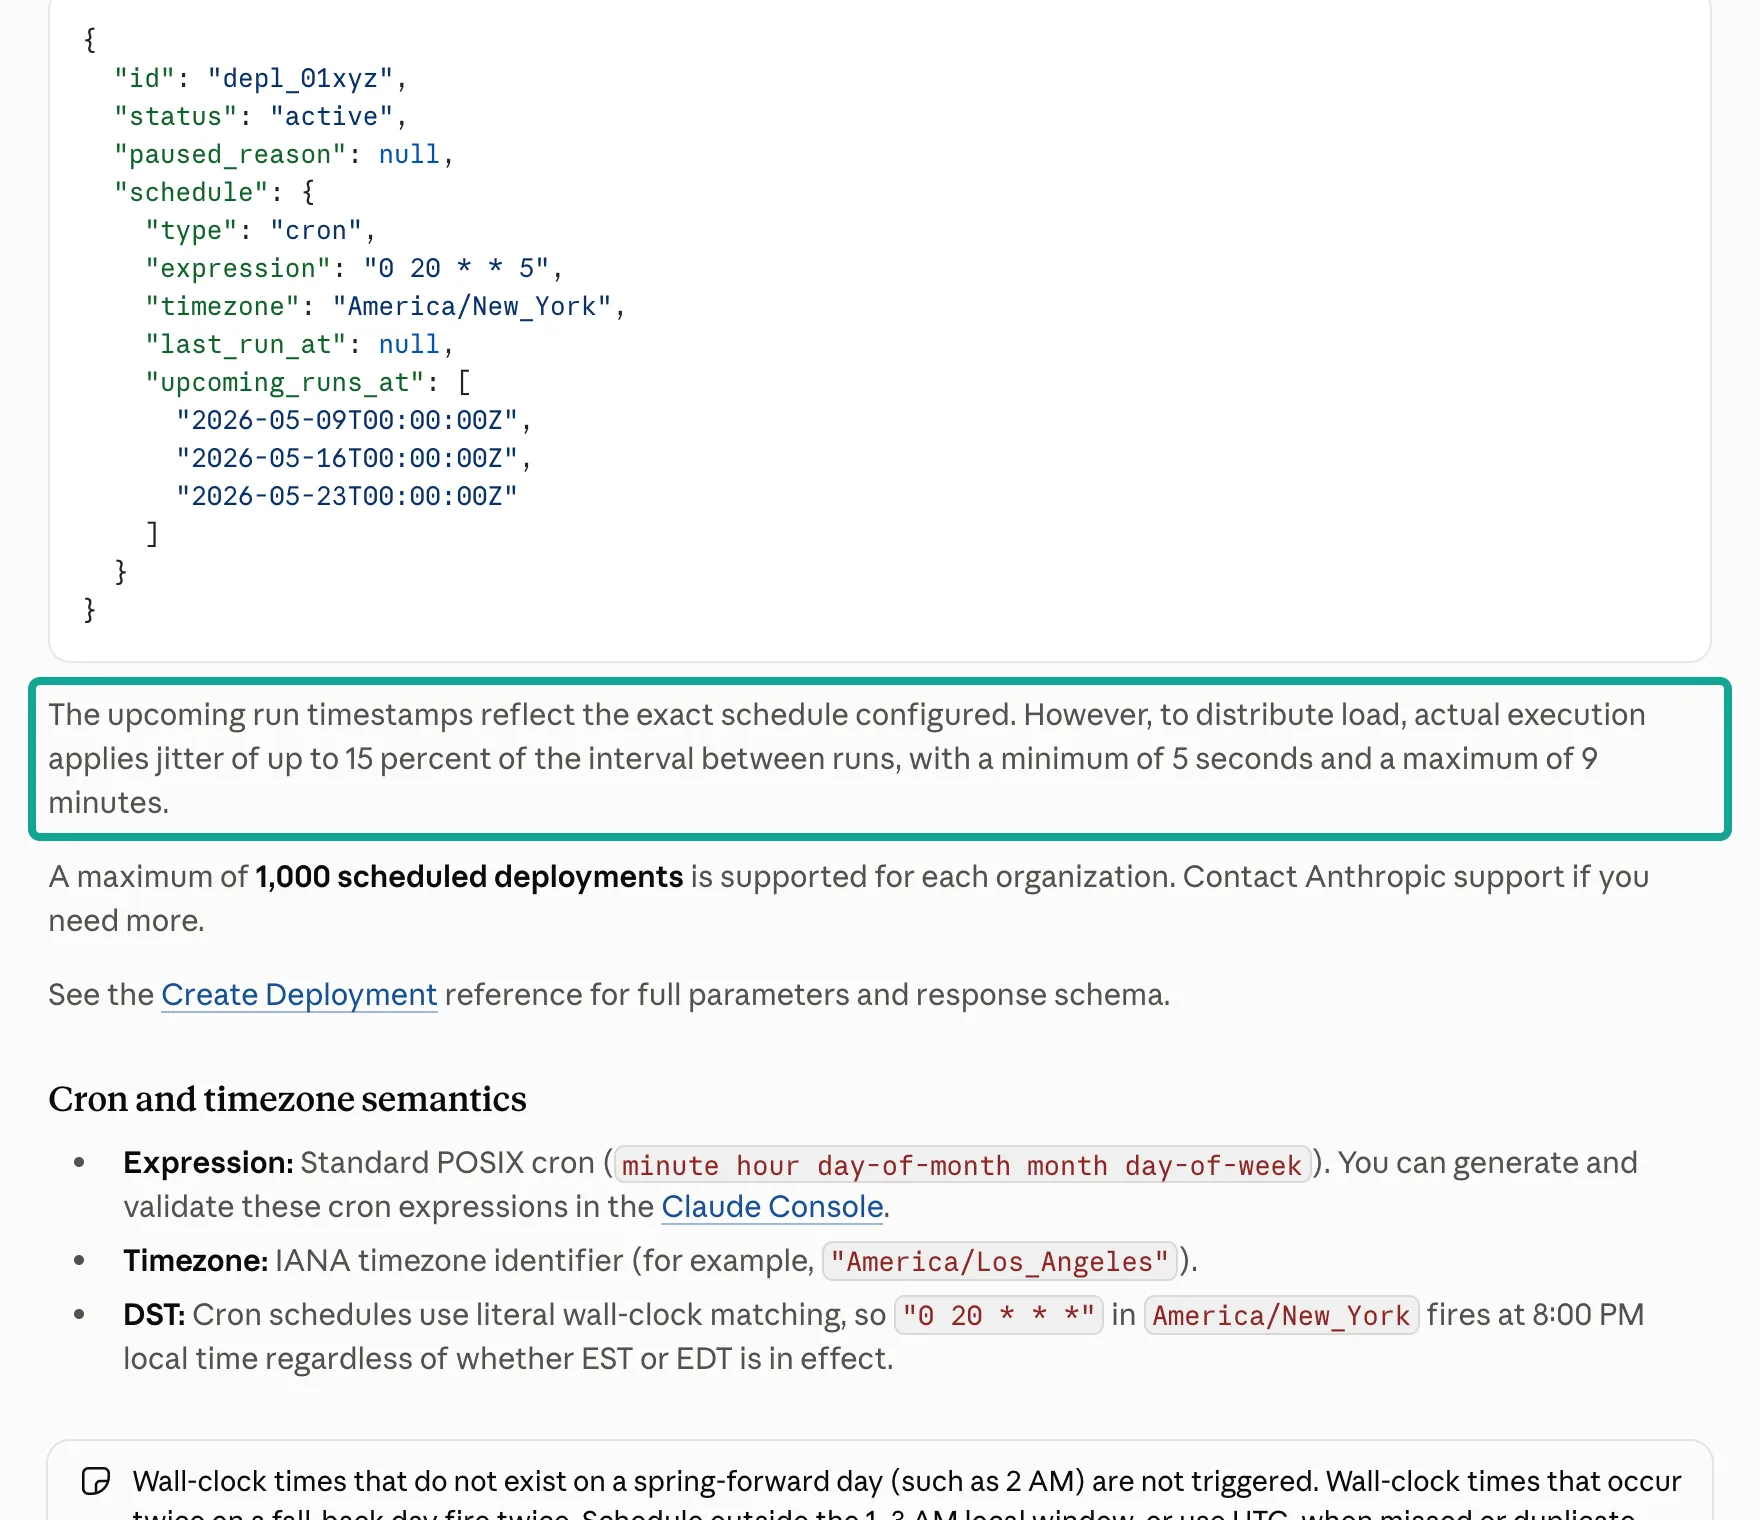
El horario de verano es la segunda trampa, y aquí México tiene una ventaja. La documentación dice que el cron compara la hora de reloj literal: 0 20 * * * en America/New_York se dispara a las 8 de la noche local tanto en horario estándar como en horario de verano; el día en que se adelanta el reloj, una hora que no existe (por ejemplo, las 2 de la mañana) no se dispara, y el día en que se atrasa, una hora repetida se dispara dos veces. La recomendación es evitar la franja de 1 a 3 de la mañana o usar UTC. En la mayor parte de México esto ya no aplica: la Ley de los Husos Horarios, publicada en el Diario Oficial de la Federación el 28 de octubre de 2022, eliminó el horario de verano salvo en la franja fronteriza norte (Secretaría de Energía). Así, 30 6 * * * en America/Mexico_City es siempre 12:30 UTC. Si el grupo tiene locales en Tijuana o en Nuevo Laredo, conviene un despliegue aparte con la zona correcta, porque esos municipios sí cambian la hora.
| Zona IANA | Dónde aplica | ¿Cambia la hora? | `30 6 * * *` en UTC |
|---|---|---|---|
America/Mexico_City | Ciudad de México, Guadalajara y la mayor parte del país | No, desde 2022 | 12:30 todo el año |
America/Cancun | Quintana Roo | No | 11:30 todo el año |
America/Tijuana | Baja California | Sí, del segundo domingo de marzo al primer domingo de noviembre | 14:30 en invierno, 13:30 en verano |
America/Matamoros | Municipios fronterizos de Coahuila, Nuevo León y Tamaulipas | Sí, con las mismas fechas | 12:30 en invierno, 11:30 en verano |
America/New_York | Nueva York | Sí; en 2026 terminó el 1 de noviembre | 11:30 desde el 1 de noviembre, 10:30 en verano |
El tercer punto es el presupuesto. Un despliegue puede llevar un budget opcional con la misma forma que el presupuesto de una sesión: {"type": "limit", "max_list_cost": {"amount": "50", "currency": "USD"}}. El monto es un número entero de centavos de dólar escrito como texto, así que "50" son 50 centavos (Session budgets). El despliegue copia ese tope en cada sesión nueva, de modo que limita cada ejecución y no el total del mes; el ejemplo de la documentación lo dice claro: con un tope de "2000", cada ejecución puede gastar unos 20 USD. El presupuesto suma, a precio de lista, los tokens del modelo, las búsquedas web (10 USD por cada 1000) y el tiempo de sesión (0,08 USD por hora). Se revisa entre una petición al modelo y la siguiente, y al llegar al tope la sesión se pausa con budget_reached. No incluye la tarifa de EveryInfra, que depende solo del número de llamadas: 4 por local y por noche.
El cuarto punto son las fallas. Al pausar un despliegue se detienen los disparos programados, pero la sesión que ya estaba corriendo termina. Al reanudarlo, el horario sigue desde la siguiente hora programada; la documentación lo dice así: «Missed triggers are not backfilled», es decir, los disparos perdidos no se recuperan. Cada disparo deja un registro de ejecución (deployment run) y puedes listar los que fallaron con GET /v1/deployment_runs?deployment_id=…&has_error=true. Los errores más comunes son environment_archived_error, agent_archived_error y session_rate_limited_error; este último se registra y no se reintenta. Cada organización puede tener hasta 1000 despliegues programados. Por eso la tarea tiene que resolver sola el caso «anoche no corrió»: la ejecución siguiente no debe leer solo las últimas 24 horas, sino hasta el último identificador de reseña que guardó la última ejecución buena.
Dónde va la clave: dos tipos de credenciales en el vault
La clave de EveryInfra la usa o bien una conexión MCP, o bien curl dentro del sandbox, y cada uso corresponde a un tipo de credencial del vault (Authenticate with vaults). Las credenciales MCP son mcp_oauth y static_bearer, y se asocian a un mcp_server_url: cuando la sesión se conecta a un servidor MCP con esa dirección, el token se agrega solo. La credencial environment_variable se asocia a un secret_name; en el sandbox solo hay un valor de relleno opaco, y el valor real lo sustituye la red al salir la petición, solo para los hosts de networking.allowed_hosts. Con injection_location se puede limitar la sustitución a los encabezados.
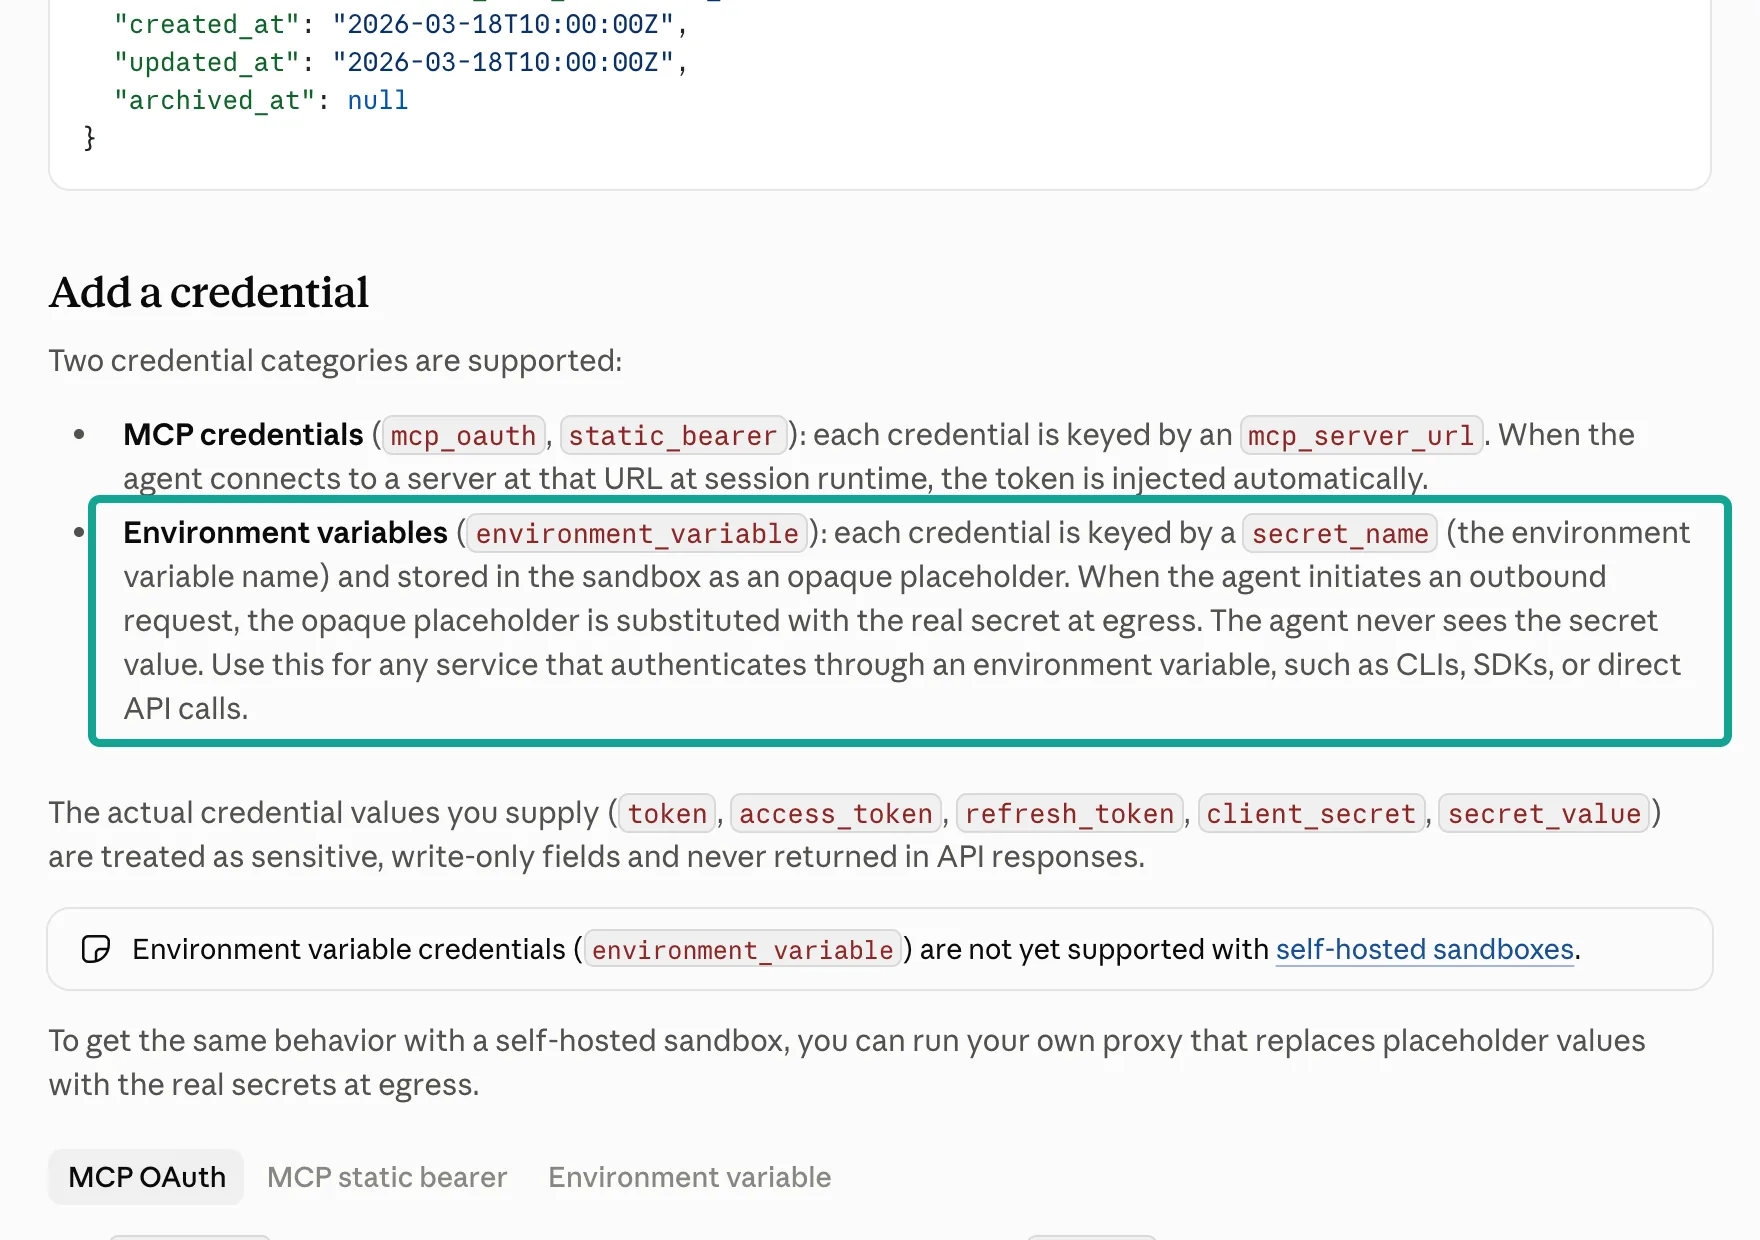
Para esta tarea recomendamos la credencial de variable de entorno, por tres razones. Primero, la clave solo puede ir a un lugar: la credencial lista únicamente api.everyinfra.com en allowed_hosts, así que si una reseña maliciosa le pide al modelo que llame a otra dirección, esa petición solo lleva el valor de relleno. Segundo, el allowed_hosts de la credencial decide qué peticiones reciben la clave, no qué peticiones pueden salir; eso lo decide el networking del entorno. Si ambos listan solo api.everyinfra.com, hay un candado en la red y otro en la clave. Tercero, en la ruta HTTP la respuesta cruda se guarda primero en un archivo del sandbox y un filtro con jq le pasa al modelo solo lo que importa; en la sección de costos se ve cuántos tokens ahorra esto.
La credencial de variable de entorno también tiene límites: todavía no funciona con sandboxes alojados por ti mismo (self-hosted), un vault admite hasta 20 credenciales y la plataforma no prueba la credencial al crearla, así que un error en la clave solo aparece durante la ejecución. Este último punto lo probamos del lado de EveryInfra. A las 00:22 (hora de Singapur) llamamos a tools/call del MCP remoto sin clave. El estado HTTP fue 200 y la respuesta traía isError en verdadero, con un texto que decía que la llamada no estaba autorizada y «Nothing was charged», es decir, que no se cobró nada. Por eso una clave equivocada o vencida en el vault no hace fallar la conexión MCP: falla en la primera llamada a una herramienta, como un resultado de error. Las instrucciones del agente tienen que decir: ante un error de autorización, detente y escribe «clave no válida» al inicio del reporte; no reintentes con otros parámetros.
Por qué no usar web_fetch para leer las páginas de reseñas
Managed Agents trae la herramienta web_fetch, y parece el camino fácil: pones las tres direcciones del local en las instrucciones y dejas que el agente lea las páginas cada noche. Revisamos la documentación y el archivo robots.txt de los tres sitios, y para una tarea nocturna sin supervisión este camino no es confiable. La tabla explica por qué.
| Ruta | ¿Lee reseñas nuevas cada noche? | Fuente |
|---|---|---|
web_fetch sobre la página del local | No de forma confiable. Desde el 2026-10-07 solo descarga direcciones que ya aparecieron en la sesión; las que están en las instrucciones de sistema o en la salida de MCP no cuentan. No ejecuta JavaScript y respeta robots.txt | Notas de versión, 2026-10-07, Web fetch tool |
| Páginas de Yelp | El robots.txt de Yelp solo deja pasar a Claude-User en /article y pone Disallow: / en lo demás (leído el 2026-11-04) | yelp.com/robots.txt, artículo de Anthropic sobre sus rastreadores |
| API de Google Places | Hasta 5 reseñas por lugar, ordenadas por relevancia | Place Details |
| API de Perfil de Negocio de Google | Solo para los locales que tú administras, con OAuth | Review data |
| API Yelp Fusion | Hasta 3 fragmentos de reseña por negocio, en el orden de Yelp | Yelp Fusion reviews |
| Tripadvisor Content API | Hasta 5 reseñas recientes por lugar | Location reviews |
| Endpoints de reseñas de EveryInfra | Google hasta 100 por llamada, de la más nueva a la más vieja; Yelp 10 por página con paginación; Tripadvisor hasta 50 por llamada | Catálogo |
El primer límite es el que más se ignora. La nota del 7 de octubre de 2026 dice que, para reducir el riesgo de fuga de datos, web_fetch solo descarga direcciones que ya aparecieron en la sesión, como las de un mensaje del usuario o las de un resultado de web_search. Una dirección que solo aparece en la salida del propio Claude, en las instrucciones de sistema, en un documento adjunto o en la salida de bash o de una herramienta MCP no cuenta, y la llamada devuelve url_not_in_prior_context. Otra nota del mismo día dice que, con red limited, la lista allowed_hosts del entorno también se aplica a web_fetch y a web_search (Restrict web search and web fetch domains). Y desde el 20 de octubre, quien administra la organización puede apagar web fetch en la página Capabilities de la consola; con eso, cualquier web_fetch dentro de una sesión de Managed Agents devuelve un error. Con las tres reglas juntas, una tarea nocturna con direcciones fijas depende de demasiadas condiciones.
El problema de fondo son las páginas. La lista de reseñas de Google Maps se carga con JavaScript, y la documentación de web_fetch dice que no admite sitios que se generan con JavaScript. Las páginas de Yelp están cerradas para Claude-User. El robots.txt de Tripadvisor pone Disallow: / para ClaudeBot, y Claude-User no aparece por nombre, así que le aplican las reglas generales. Las API oficiales tienen topes pequeños: 5 reseñas en Google Places, 3 fragmentos en Yelp Fusion y 5 en la Content API de Tripadvisor. Para un local que recibe decenas de reseñas a la semana no alcanza. Queda una sola ruta: llamar a una API de reseñas por HTTP o por MCP remoto y recibir JSON estructurado.
MCP remoto o HTTP: dos rutas con costos distintos
La primera ruta es el MCP remoto. El servidor MCP de EveryInfra está en https://api.everyinfra.com/mcp y usa el transporte Streamable HTTP (transportes de MCP); su tools/list devuelve 12 herramientas y la que cobra es everyinfra_call_api (ver la página del servidor MCP). En el agente se declara un servidor MCP con type: url y se añade un mcp_toolset; el vault aporta una credencial static_bearer asociada a esa dirección (MCP connector). Es la ruta con menos configuración, pero tiene dos trampas.
La primera trampa es la aprobación. La documentación de permisos dice que las herramientas propias del agente vienen con always_allow y los conjuntos MCP con always_ask (Permission policies): la sesión se pausa antes de cada llamada MCP y espera una aprobación. De madrugada nadie aprueba y la sesión se queda esperando. Hay que poner default_config.enabled: false en el conjunto para apagar todas sus herramientas y luego always_allow solo en everyinfra_call_api. Esa herramienta tiene las anotaciones readOnlyHint: false y destructiveHint: true, porque cada llamada se cobra, así que incluso con la política auto puede pedir confirmación; las anotaciones están definidas en la especificación de herramientas de MCP.
La segunda trampa es el tamaño de la respuesta. La documentación del conector MCP dice que una salida de herramienta de más de 100.000 caracteres (unos 25.000 tokens) se guarda en un archivo del sandbox y el modelo solo recibe un fragmento. Nuestra respuesta real de Google con las 100 reseñas más nuevas de Katz's midió 105.266 caracteres, justo por encima de esa línea. Las 50 reseñas de Contramar en Google midieron 48.082 caracteres y las 50 de Tripadvisor, 49.142; una página de Yelp con 10 reseñas ronda los 10.000. La gráfica pone cada respuesta real junto a esa línea.
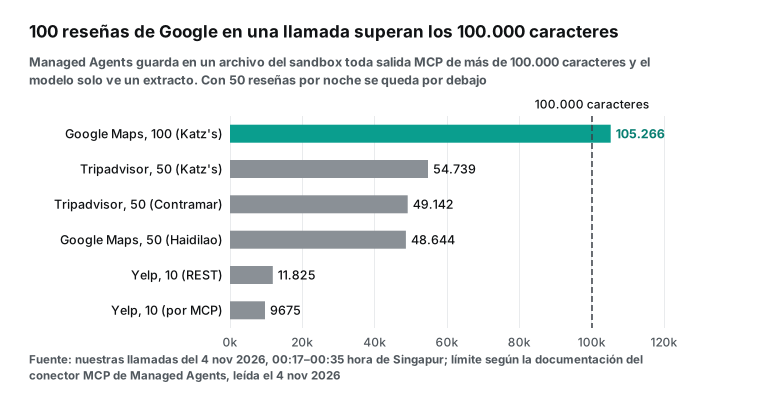
La segunda ruta es HTTP con la credencial de variable de entorno. El agente usa su herramienta bash para correr curl con el encabezado Authorization: Bearer $EVERYINFRA_API_KEY; dentro del sandbox esa variable solo tiene el valor de relleno, y la clave real se pone al salir. La respuesta JSON se guarda directo en un archivo, y un filtro con jq le pasa al modelo solo las reseñas de 1 y 2 estrellas que no estaban en la lista de la noche anterior. Así el modelo ve una docena de reseñas filtradas y no más de 100.000 caracteres de datos crudos por local. El costo es escribir unas instrucciones más largas, con los pasos del script, y tener jq en el entorno: puedes permitir los gestores de paquetes o dejarlo instalado de antemano. Recomendamos la ruta HTTP para la ejecución nocturna y dejar MCP para las revisiones manuales: en una sesión manual, el agente puede usar everyinfra_list_requests para ver el estado y el cobro de una llamada, y esa herramienta es gratuita.
Ejemplos de configuración: entorno, agente, vault y despliegue
Los cuatro archivos siguientes se escribieron con los campos de la documentación de platform.claude.com. Son ejemplos de configuración: no los creamos en ninguna organización. La línea de comandos ant puede convertir un archivo Markdown con encabezado YAML en un objeto con ant apply, y guarda el identificador en claude-lock.json (Define your agent). Primero, el entorno:
# Ejemplo de configuración: entorno (campos de Cloud environment setup; no lo probamos)
name: review-patrol-env
config:
  type: cloud
  networking:
    type: limited
    allowed_hosts:
      - api.everyinfra.com
    allow_package_managers: true   # para instalar jq; apágalo si lo dejas preinstalado
    allow_mcp_servers: false
Después, el agente. Las instrucciones fijan tres reglas: llamar solo a cuatro endpoints, decidir qué es nuevo por identificador y detenerse ante un error de autorización.
---
# Ejemplo de configuración: agent.md (campos de Define your agent, Tools y Permission policies; no lo probamos)
name: Revisión nocturna de reseñas
model: claude-sonnet-5-5
tools:
  - type: agent_toolset_20260401
    configs:
      - name: web_fetch
        enabled: false
      - name: web_search
        enabled: false
---
Cada noche, lee las reseñas nuevas de cada local de la lista. Usa solo bash y curl para llamar a
https://api.everyinfra.com/api/v1/social con el encabezado "Authorization: Bearer $EVERYINFRA_API_KEY".
Haz 4 llamadas por local: google_maps_reviews/reviews (sort=newest, limit=50), yelp/reviews páginas 1 y 2
y tripadvisor/reviews. Guarda cada respuesta en /tmp/<local>-<sitio>.json.
Con jq, quita los identificadores que ya están en /mnt/memory/review-patrol/seen.json y lee solo 1 y 2 estrellas.
Clasifica cada reseña negativa en una o varias categorías: comida, servicio, espera y mesas, precio y propina, ambiente.
Traduce al español las reseñas que estén en otro idioma antes de clasificarlas. Quita etiquetas <br> del texto.
Si una respuesta dice unauthorized, detente, escribe "Clave de EveryInfra no válida" en la primera línea y no reintentes.
Al final, guarda todos los identificadores vistos en /mnt/memory/review-patrol/seen.json
y escribe el reporte en /mnt/session/outputs/reporte.md.
El vault necesita una sola credencial. En tu propia máquina, secret_value se lee de una variable de entorno para que la clave nunca quede en un archivo:
# Ejemplo de configuración: credencial de variable de entorno en el vault (campos de Authenticate with vaults; no lo probamos)
curl --fail-with-body -sS "https://api.anthropic.com/v1/vaults/$VAULT_ID/credentials" \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "anthropic-beta: managed-agents-2026-04-01" \
  -H "content-type: application/json" \
  -d "$(jq -n --arg v "$EVERYINFRA_API_KEY" '{
        auth: {
          type: "environment_variable",
          secret_name: "EVERYINFRA_API_KEY",
          secret_value: $v,
          networking: {type: "limited", allowed_hosts: ["api.everyinfra.com"]},
          injection_location: {header: true}
        },
        display_name: "EveryInfra key for nightly review patrol"
      }')"
Al final, el despliegue programado. La documentación dice que un despliegue acepta la misma configuración que una sesión nueva: agente y entorno obligatorios; archivos, almacenes de memoria y vaults opcionales. La lista de locales va en el mensaje inicial y el presupuesto es de 50 centavos por ejecución: el campo amount va en centavos, así que "50" son 0,50 USD y no 50 USD. Un almacén de memoria se monta bajo /mnt/memory/ con su nombre visible, así que uno llamado review-patrol queda en /mnt/memory/review-patrol/.
{
  "name": "Revisión nocturna de reseñas (CDMX)",
  "agent": "agent_01...",
  "environment_id": "env_01...",
  "vault_ids": ["vlt_01..."],
  "resources": [
    {"type": "memory_store", "memory_store_id": "memstore_01...", "access": "read_write",
     "instructions": "seen.json guarda los identificadores de reseñas de la última ejecución, por sitio."}
  ],
  "initial_events": [
    {
      "type": "user.message",
      "content": [{"type": "text", "text": "Locales: Contramar (Roma Norte) y los demás de stores.json. Lee las reseñas nuevas desde la última ejecución y escribe el reporte matutino en español."}]
    }
  ],
  "schedule": {"type": "cron", "expression": "30 6 * * *", "timezone": "America/Mexico_City"},
  "budget": {"type": "limit", "max_list_cost": {"amount": "50", "currency": "USD"}}
}
¿Cómo llega el resultado? Los webhooks envían una carga mínima: tipo de evento, identificador y hora, sin el objeto completo; tú lo pides después con un GET (Subscribe to webhooks). Bastan dos tipos de evento. Ojo: session.status_idled significa «el agente se detuvo y espera algo», y llega tanto cuando terminó como cuando se quedó esperando una aprobación. Por eso tu servidor debe pedir la sesión con un GET y leer stop_reason.type en el último evento session.status_idle (Session event stream). deployment_run.failed indica que esa noche ni siquiera se creó la sesión. Las ejecuciones manuales con el endpoint run no envían eventos deployment_run, así que no los esperes en una prueba. Cada evento tiene hasta 3 intentos de entrega, con espera exponencial de 5 a 120 segundos; si el último falla, el evento se descarta y no queda en cola. Por eso tu servidor debe eliminar duplicados por event.id y revisar cada mañana la lista de ejecuciones del despliegue. El secreto de firma empieza con whsec_ y los encabezados son webhook-id, webhook-timestamp y webhook-signature, con el mismo formato que Standard Webhooks.
| `stop_reason.type` | Qué significa | Qué hace tu servidor al recibir el webhook |
|---|---|---|
end_turn | El agente terminó su turno | Descarga /mnt/session/outputs/reporte.md con la Files API y lo envía a la gerente de turno |
requires_action | Una llamada a herramienta espera aprobación, por ejemplo una herramienta MCP que sigue en always_ask | Envía una alerta y corrige la política de permisos; no apruebes llamadas de madrugada con un script |
budget_reached | El costo de lista de esta ejecución llegó al presupuesto | Envía una alerta y revisa si el agente se quedó reintentando; ajusta el presupuesto al día siguiente |
Una ida y vuelta real: qué envía el modelo y qué regresa
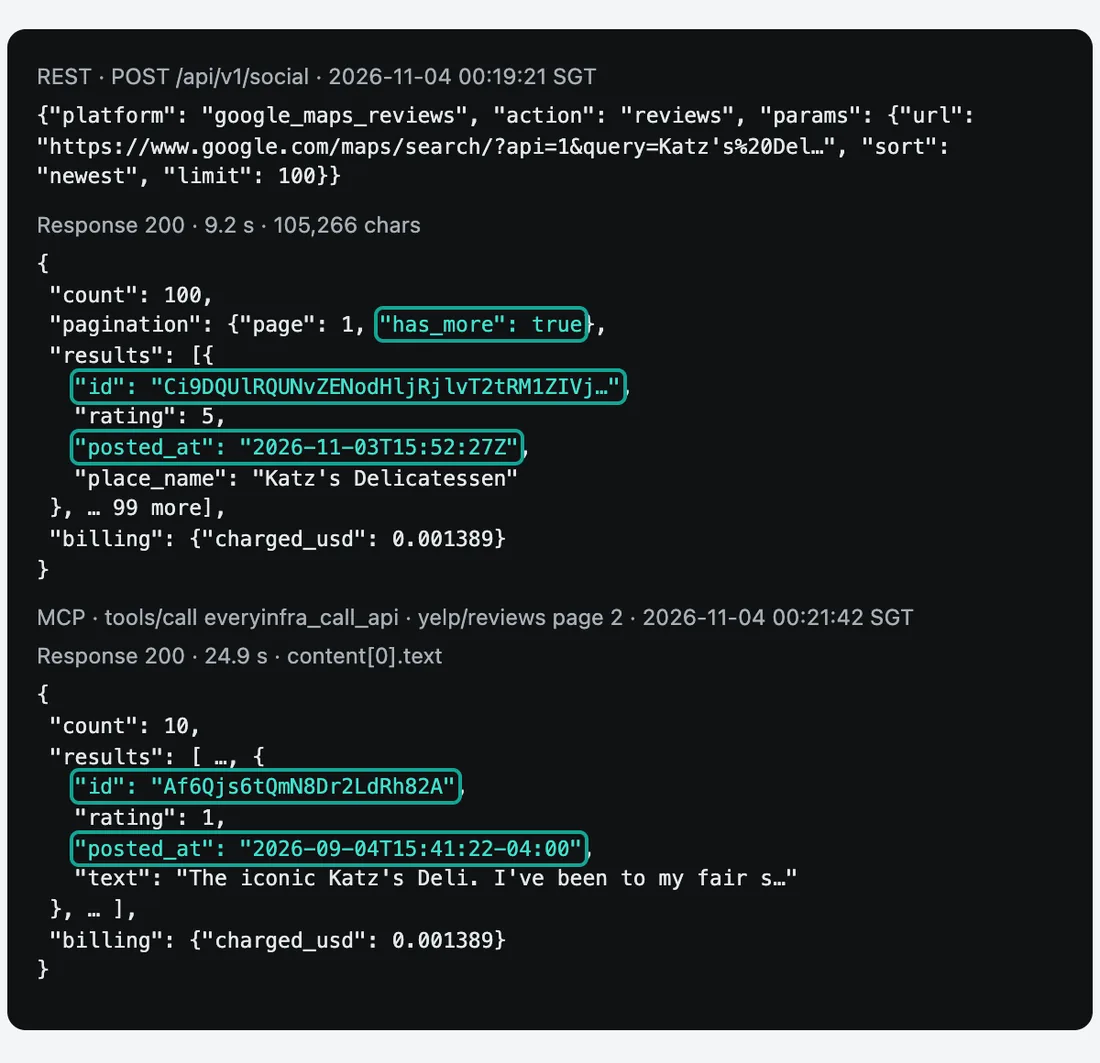
Del lado de Anthropic no desplegamos nada, pero la petición que un agente manda a EveryInfra por MCP es igual, para nosotros, a la que mandaría con curl. Abajo está la petición real que enviamos a las 00:21:42 (hora de Singapur) por tools/call del MCP remoto para leer la página 2 de reseñas de Katz's en Yelp. El page_token viene del next_page_token de la página 1 y aquí está recortado:
{"jsonrpc": "2.0", "id": 7, "method": "tools/call",
 "params": {"name": "everyinfra_call_api",
  "arguments": {"platform": "yelp", "action": "reviews",
   "params": {"url": "https://www.yelp.com/biz/katzs-delicatessen-new-york",
              "page_token": "pt1.4EnA2jhN8mJn…"}}}}
La respuesta llegó con HTTP 200 en 24,9 segundos. content[0].text traía 9675 caracteres de JSON con 10 reseñas, y la llamada se cobró a 0,001389 USD. Cada reseña trae campos como id, rating, posted_at y text; el que más importa es id, porque de él depende decidir qué es nuevo. La tabla resume las llamadas reales a Contramar y las de Google que fallaron fuera de Estados Unidos.
| Hora de Singapur | Capacidad | Ruta | Filas | Tiempo | Caracteres | Cobro |
|---|---|---|---|---|---|---|
| 00:30:12 | google_maps_reviews/search, Botín (Madrid) | REST | 0 | 83,6 s | 988 | reembolsado |
| 00:31:45 | google_maps_reviews/search, Botín, otra consulta | REST | 0 | 67,3 s | 989 | reembolsado |
| 00:33:00 | google_maps_reviews/search, Contramar | REST | 0 | 65,9 s | 989 | reembolsado |
| 00:34:13 | tripadvisor/search, Contramar | REST | 1 | 19,5 s | 1624 | 0,001389 USD |
| 00:34:39 | tripadvisor/reviews, Contramar | REST | 50 | 13,6 s | 49.142 | 0,001389 USD |
| 00:35:03 | google_maps_reviews/reviews, Contramar, con dirección de búsqueda | REST | 50 | 25,1 s | 48.082 | 0,001389 USD |
La primera llamada de la noche, a las 00:17:32, recibió un 429: la clave de prueba que usamos tiene un límite de 10 llamadas por minuto. No se cobró, y el reintento medio minuto después funcionó. En la primera ronda hicimos 21 llamadas: 15 se cobraron, por 0,020835 USD, y 4 búsquedas sin resultado se reembolsaron solas con el motivo empty_result_refunded. Con las 5 de la segunda ronda, a la 01:20, fueron 20 llamadas cobradas por 0,02778 USD. Lo que muestra la tabla es útil para quien opera en México o en España: la búsqueda de lugares de Google devolvió cero resultados para Botín y para Contramar, pero al llamar a google_maps_reviews/reviews con una dirección de búsqueda de Google Maps («Contramar Durango 200 Roma Norte Ciudad de Mexico») llegaron 50 reseñas. Al dar de alta un local nuevo, conviene revisar a mano esa dirección una vez.
Prueba 1: cuántos días cubren «las N más recientes» en cada sitio
Cuántas reseñas hay que leer cada noche depende del tiempo que cubre una página. Restamos el posted_at de la primera y de la última reseña de cada respuesta, y el resultado está en la gráfica. En Google, dos reseñas viejas editadas (con fechas del 23 de octubre y del 10 de agosto) aparecían a mitad de la lista de Katz's. La ayuda de Google dice que una reseña editada muestra la fecha de la edición (ayuda del Perfil de Negocio de Google), así que no las contamos en el rango.
| Sitio (Katz's) | Filas leídas | Rango de la lista | 1 y 2 estrellas | Respuestas del local | ¿En orden de fecha? |
|---|---|---|---|---|---|
| 100 | 3,97 días | 10 | 10 | Sí, salvo 2 reseñas editadas | |
| Yelp, páginas 1 y 2 | 20 | 68,84 días | 1 | 0 | No |
| Tripadvisor | 50 | 119 días | 10 | 0 | Sí |
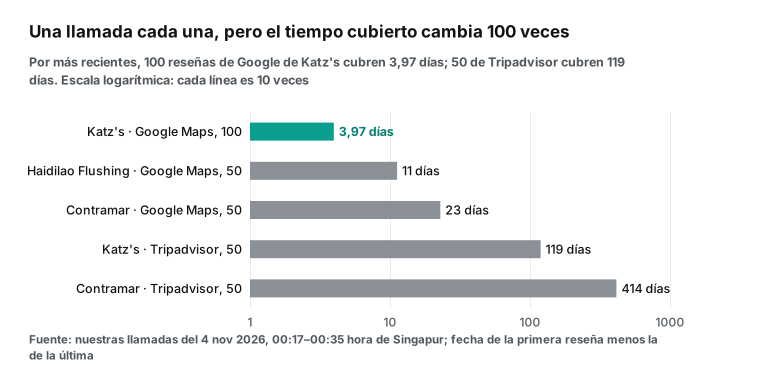
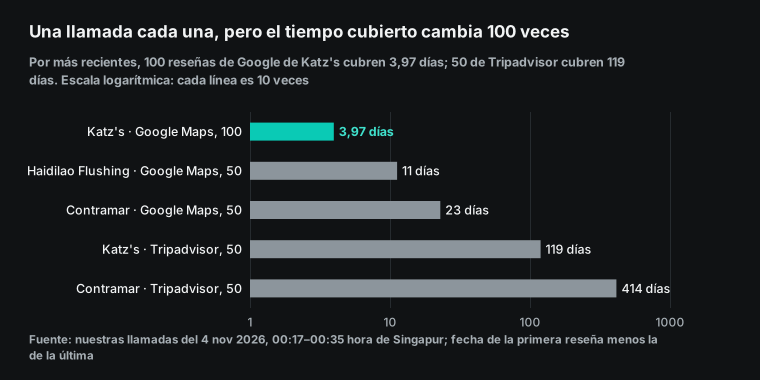
«Las 50 más recientes» son menos de dos días para Katz's en Google y más de un año para Contramar en Tripadvisor. La diferencia tiene dos causas: el volumen de reseñas del local y el idioma. Las dos respuestas de Tripadvisor estaban completamente en inglés. Para Contramar usamos la dirección del sitio mexicano, tripadvisor.com.mx, y aun así las 50 reseñas eran en inglés, del 2025-09-02 al 2026-10-21.
| Sitio | Reseñas leídas | Rango de fechas | Idioma | 1 y 2 estrellas | Con respuesta del local |
|---|---|---|---|---|---|
| 50 | 2026-10-11 a 2026-11-03 (22,86 días) | 30 con texto; unas 10 en español | 2 | 0 | |
| Tripadvisor | 50 | 2025-09-02 a 2026-10-21 (414 días) | 50 en inglés | 5 | 0 |
Es decir, este endpoint lee las reseñas en inglés de Tripadvisor, y las reseñas en español no vienen en la respuesta. Para un restaurante con clientela sobre todo local, Tripadvisor casi nunca tendrá algo nuevo en una noche, pero sí refleja la opinión de los turistas, y leerlo cuesta solo 0,001389 USD.
En Google pasa lo contrario: de las 30 reseñas de Contramar con texto, unas 10 estaban en español y el resto en inglés, de visitantes extranjeros. Además, 6 de esas 30 traían etiquetas <br> en medio del texto, que hay que limpiar antes de escribir el reporte. El parámetro lang del endpoint define el idioma de la interfaz, no traduce las reseñas, así que el agente debe traducir al español las que lleguen en inglés, italiano o alemán antes de clasificarlas.
Yelp funciona de otra manera, y lo vimos con Katz's. Su primera página traía 10 reseñas del 20 de septiembre al 2 de noviembre, en desorden. La página de soporte de Yelp explica que el orden predeterminado combina antigüedad, votos y calidad de la reseña, así que una reseña vieja puede aparecer antes que una nueva; solo los usuarios con sesión iniciada pueden elegir «Newest First» (soporte de Yelp). Agregamos sort_by=date_desc a la dirección y volvimos a llamar: los 10 identificadores fueron exactamente los mismos, así que ese parámetro no tuvo efecto. La página 2 traía una reseña del 1 de noviembre y 5 reseñas más nuevas que la más vieja de la página 1. Por eso la tarea tiene que leer al menos dos páginas de Yelp y decidir por identificador.
Prueba 2: dónde están las reseñas negativas y qué dicen
La gráfica muestra la proporción de cada calificación en cada respuesta. En las 50 reseñas más nuevas de Contramar en Google hubo una de 1 estrella y una de 2, es decir, el 4,0 %; en Tripadvisor hubo 3 de 1 estrella y 2 de 2 estrellas, el 10,0 %. Katz's tuvo el 10,0 % de reseñas negativas en Google y el 20,0 % en Tripadvisor. Haidilao, en Flushing, tuvo 49 reseñas de 5 estrellas y una de 3 en 50, sin ninguna negativa.
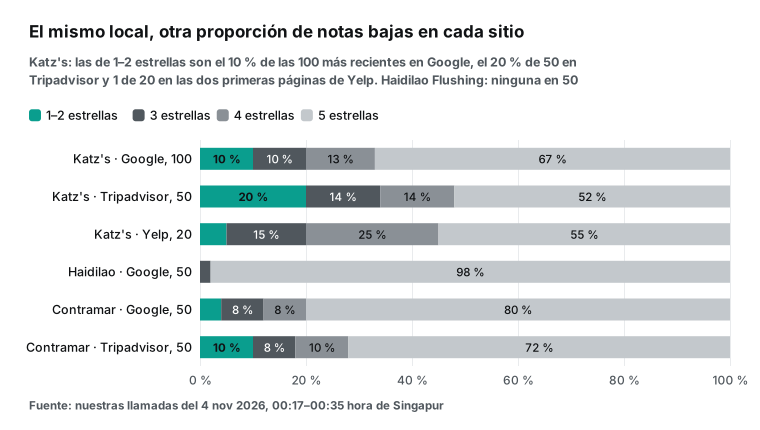
Leímos el texto completo de las 7 reseñas negativas de Contramar. Las 2 de Google, ambas en inglés y de finales de octubre, hablan de precio: una dice que la comida y el servicio estaban bien, pero que el precio de unos tacos era excesivo; la otra, que el pescado estaba salado y poco fresco para lo que cuesta. Las 5 de Tripadvisor, que van de septiembre de 2025 a julio de 2026, hablan casi todas del trato en la entrada y en el salón: mesas apartadas para grupos grandes mientras a parejas las mandan a la barra, la impresión de que se favorece a los clientes locales, meseros que ignoran la mesa y una propina del 15 % agregada a la cuenta sin pedirla. Ninguna de las 100 reseñas de Contramar tenía respuesta del local.
Para comparar con un local de mucho volumen, también leímos y etiquetamos a mano las 10 reseñas negativas de Katz's en Google y las 10 de Tripadvisor; una reseña puede tener varias etiquetas. En Google, 6 hablan de la comida, 7 de que «no vale lo que cuesta» o de que la fama es exagerada, 3 del servicio, 2 del ambiente y 1 de la fila. En Tripadvisor, 7 de la comida, 6 del precio, 5 del servicio, 3 de la fila y las mesas, y 2 de pedidos en línea y envíos, que no tienen que ver con el restaurante. Esa separación sirve: las quejas de pedidos en línea van al equipo de comercio electrónico y no cuentan contra el personal del local.
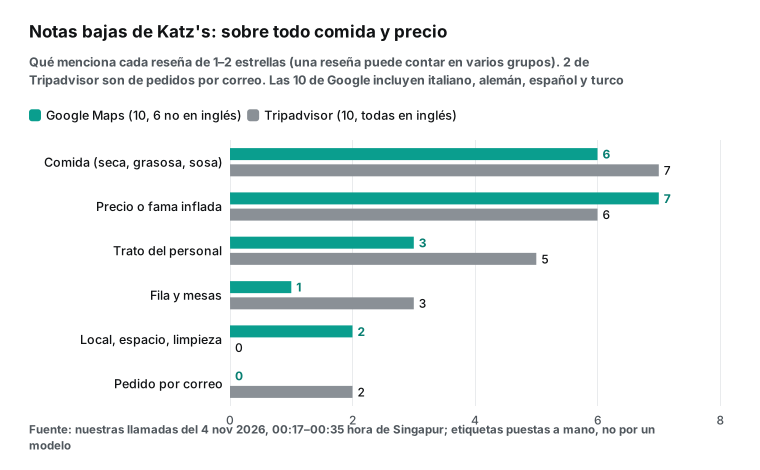
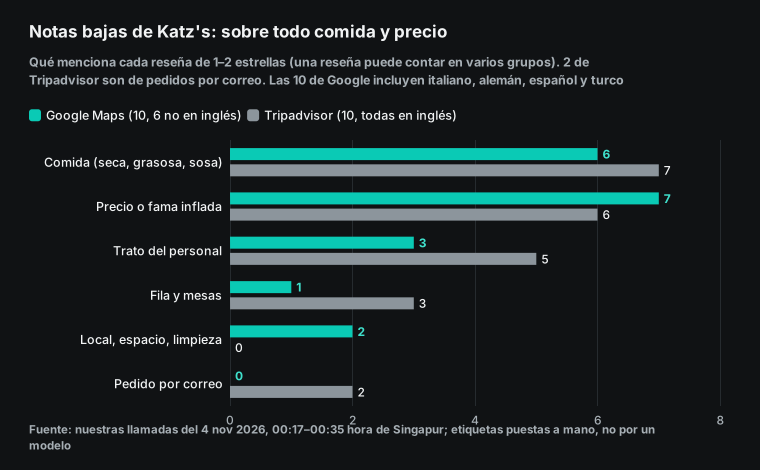
Dos hallazgos más cambian las instrucciones del agente. Primero, 6 de las 10 reseñas negativas de Katz's en Google no estaban en inglés: 2 en italiano, 2 en alemán, 1 en turco y 1 en español. Segundo, las 10 respuestas del dueño entre las 100 reseñas más nuevas de Katz's se publicaron entre las 21:10 y las 21:32 UTC del 2 de noviembre, en una ventana de 22 minutos; 9 fueron a reseñas de 5 estrellas y solo 1 a una de 1 estrella, unas 35 horas después de publicada. Es decir, ese local responde por lotes y empieza por las buenas. Una columna «¿respondida?» en el reporte pone arriba las reseñas negativas que nadie ha atendido.
Prueba 3: cómo decidir qué es nuevo entre dos lecturas
La primera lectura (T1) fue entre las 00:19 y las 00:21 (hora de Singapur) y la segunda (T2) a la 01:20, con una hora de diferencia: hace las veces de «la noche anterior» y «esta noche». En T2 leímos por MCP remoto las 50 reseñas más nuevas de Katz's en Google, repetimos Google por REST con since=2026-11-03 y leímos una vez la página 1 de Yelp y Tripadvisor: 4 llamadas, 0,005556 USD. Una llamada más a yelp/search encontró la página de Contramar en Yelp: 4,5 estrellas y 951 reseñas, en https://www.yelp.com/biz/contramar-ciudad-de-m%C3%A9xico. La regla para decidir qué es nuevo cabe en una línea: una reseña es nueva si su identificador no está en el conjunto de la ejecución anterior.
| Sitio | Filas en T1 | Filas en T2 | Identificadores que T1 no vio | De esos, 1 y 2 estrellas |
|---|---|---|---|---|
| Google, 50 más nuevas (MCP) | 100 | 50, con 53.364 caracteres | 3, todas de 5 estrellas | 0 |
Google con since=2026-11-03 (REST) | — | 17, con 21.588 caracteres y sin página siguiente | 3 (las otras 14 ya estaban en T1) | 0 |
| Yelp, página 1 | 10 | 10, mismos identificadores y mismo orden que T1 | 0 | 0 |
| Tripadvisor | 50 | 50 | 0 | 0 |
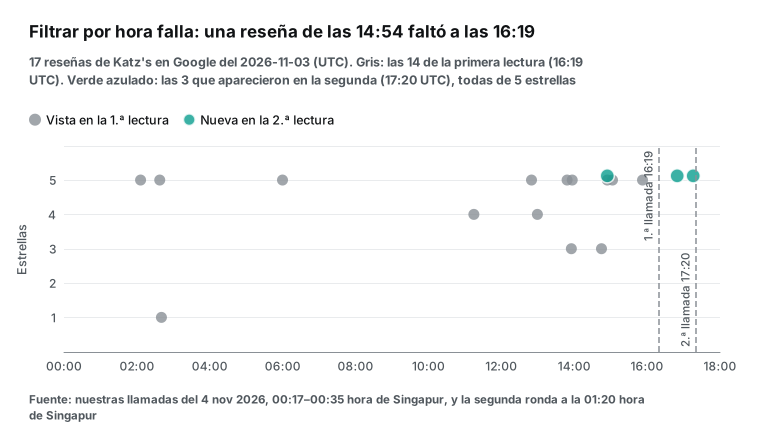
El dato más útil es la hora de publicación de las 3 reseñas nuevas de Google: 17:15, 16:49 y 14:54 (UTC). Las dos primeras son posteriores a la llamada de T1 (16:19 UTC), así que son reseñas nuevas normales. La tercera, de las 14:54, es 1 hora y 25 minutos anterior a la llamada de T1, e incluso anterior a la reseña más nueva de T1 (15:52), pero no estaba entre las 100 de T1. Es decir, una reseña puede aparecer en Google después de la hora de publicación que muestra. Con una regla como «leer solo las reseñas con posted_at posterior a la más nueva de la vez anterior», esa reseña se saltaría para siempre; solo la comparación por identificador la atrapa. En las reseñas que aparecen en T1 y en T2, ni posted_at, ni la calificación, ni la respuesta del local cambiaron.
El parámetro since también merece una línea en las instrucciones. Es una fecha, no una hora: since=2026-11-03 devolvió las 17 reseñas del 3 de noviembre en UTC, y 14 ya estaban en T1, así que no reemplaza la comparación por identificador. Pero redujo la respuesta de 53.364 a 21.588 caracteres, cerca de un 60 % menos, y eso ayuda sobre todo en la ruta MCP. Nuestra recomendación: pon en since el día anterior a la última ejecución buena, deja sort=newest, compara por identificador y mantén limit en 50 como respaldo por si since está mal. Yelp y Tripadvisor no tuvieron reseñas nuevas en esa hora, y los 10 identificadores de la página 1 de Yelp ni siquiera cambiaron de orden; que la página 1 no cambie no garantiza que la 2 tampoco, así que hay que leer las dos. El reporte de esa noche tendría una sola línea: «En la última hora hubo 3 reseñas nuevas en los tres sitios, todas de 5 estrellas; ninguna negativa.»
Esta comparación también define qué se guarda en el almacén de memoria. Basta un conjunto de identificadores recientes por sitio: los últimos 400 de Google (el endpoint pagina hasta 400 filas), los últimos 100 de Yelp y de Tripadvisor, y la fecha de la última ejecución buena. No guardes solo «la hora de la reseña más nueva», por la reseña de las 14:54.
Cómo se ve el reporte matutino
Las reglas de clasificación tienen que ir escritas en las instrucciones, con una definición de una línea y algunas pistas para cada categoría; si no, la misma reseña hoy queda como «servicio» y mañana como «espera», y a fin de mes no hay forma de comparar. Armamos las categorías de abajo con el texto completo de 28 reseñas negativas, 21 de Katz's y 7 de Contramar, y cada pista sale de expresiones que se repiten en esas reseñas. Una reseña puede tener varias categorías; si el agente duda, es mejor que agregue una más y no que fuerce una sola.
| Categoría | Definición | Pistas en las reseñas | A quién se envía |
|---|---|---|---|
| Comida | Un problema con lo que se comió | Seco, salado, grasoso, sin sabor, poco fresco, el pan se deshace | Jefe de cocina |
| Servicio | La actitud o lo que hizo el personal | Grosero, nos ignoraron, aventó la bolsa, agregaron propina sin pedirla | Gerente del local |
| Espera y mesas | La fila, el reparto de mesas, el lugar asignado | Fila larga, alguien se metió, solo nos dieron barra, mesas muy juntas | Responsable de piso |
| Precio y propina | No vale lo que cuesta, o la fama es mayor que la comida | Muy caro, sobrevalorado, lugar de moda, no vale el viaje | Mercadotecnia y precios |
| Ambiente | El salón y las instalaciones | Lleno, mesas juntas, vapeaban en la mesa de al lado | Gerente del local |
| Pedido en línea | Pedidos por internet, envíos, entregas | Llegó una semana después, problemas con productos comprados en línea | Comercio electrónico |
El ejemplo usa las 7 reseñas negativas de Contramar de la primera lectura. Resumimos y tradujimos cada reseña, y las fechas están en UTC. Un reporte real también debe llevar el enlace de cada reseña para que el gerente de turno la abra y responda. No pongas en el reporte los nombres de quien escribe ni del personal mencionado: deja solo el enlace.
| Publicada | Estrellas | Sitio | Idioma original | Resumen | Categoría | ¿Respondida? |
|---|---|---|---|---|---|---|
| 2026-10-29 | 2 | inglés | Comida y servicio bien, pero los tacos de camarón y de pescado, demasiado caros | Precio y propina | No | |
| 2026-10-27 | 1 | inglés | El pescado salado y poco fresco no corresponde al precio; el taco de atún, bueno | Comida, precio y propina | No | |
| 2026-07-07 | 1 | Tripadvisor | inglés | Al volver de una salida breve, no le dejaron agregar una silla a su mesa ni le dieron otra opción | Servicio, espera y mesas | No |
| 2026-04-28 | 1 | Tripadvisor | inglés | Apartan mesas para grupos grandes, a las parejas las mandan a la barra y es demasiado caro para lo que dan | Espera y mesas, precio y propina | No |
| 2026-03-10 | 1 | Tripadvisor | inglés | Sintió que se favorecía a los clientes locales sobre los extranjeros | Servicio, espera y mesas | No |
| 2026-02-27 | 2 | Tripadvisor | inglés | Buena comida, pero dejaron vapear en la mesa de al lado | Ambiente | No |
| 2025-09-02 | 2 | Tripadvisor | inglés | Los meseros los ignoraron y agregaron un 15 % de propina sin pedirla | Servicio, precio y propina | No |
El reporte debe empezar con un resumen corto y no con la lista completa. Con la tabla anterior, el resumen diría algo así: «En las últimas tres semanas, Google recibió 2 reseñas nuevas de 1 o 2 estrellas, las dos sobre precio y en inglés; ninguna tiene respuesta. En Tripadvisor no hay reseñas negativas nuevas desde julio.» En una noche normal, para un local como Contramar, lo más probable es que el reporte diga «sin reseñas negativas nuevas», y eso también es información útil para la gerente.
claude managed agents pricing: la tarifa de la API y el lado de Anthropic
El costo tiene dos lados. El de EveryInfra es sencillo: 4 llamadas por local y por noche a 0,001389 USD son 0,005556 USD por noche y 0,1667 USD en 30 noches; 10 locales cuestan 1,6668 USD al mes y 50 locales, 8,334 USD. No hay cuota mensual, los resultados vacíos se reembolsan y las tres búsquedas del local solo se pagan al configurar (ver la página de precios).
Del lado de Anthropic, la página de precios que leímos el 4 de noviembre de 2026 dice que Managed Agents cobra dos cosas: los tokens, al precio de lista del modelo, y el tiempo de sesión, a 0,08 USD por hora, medido en milisegundos y solo mientras la sesión está en estado running; el tiempo en espera no se cobra. Las búsquedas web dentro de la sesión cuestan 10 USD por cada 1000, y el descuento de la Batch API no aplica (Pricing). En esa misma página, Opus 5.5 cuesta 4 USD por millón de tokens de entrada y 20 USD de salida; Sonnet 5.5, 2 USD y 10 USD; Haiku 5.5, con instrucciones de hasta 100.000 tokens, 0,10 USD y 0,50 USD.
No medimos el consumo de tokens, así que lo que sigue es una estimación; dejamos los supuestos a la vista para que pongas los tuyos. Un local en una noche produce 129.603 caracteres de respuestas crudas (tomando a Katz's: la respuesta real de Google con 50 reseñas de la segunda ronda, Yelp dos páginas y Tripadvisor 50). El glosario dice que los modelos anteriores usan unos 3,5 caracteres en inglés por token y que los modelos 4.7 y posteriores usan cerca de un 30 % más de tokens para el mismo texto (Glossary); usamos 2,69 caracteres por token, así que las respuestas crudas son unos 48.138 tokens. El ciclo del agente puede volver a leer el contexto varias veces; no podemos medir cuántas, así que damos dos niveles: 1 vez (cada respuesta entra una sola vez al contexto) como mínimo y 3 veces como máximo alto. Los dos suman 15.000 tokens de instrucciones y descripción de herramientas y 3000 tokens de salida, sin descuento por caché. En la ruta MCP con todos los datos en el contexto, una noche necesita entre 63.138 y 159.414 tokens de entrada; en la ruta HTTP, donde jq solo pasa las reseñas de 1 y 2 estrellas, entre 17.854 y 23.564; con el nivel de 3 veces, cerca de un 85 % menos. La relación de caracteres por token también es una estimación: el endpoint de conteo de tokens de Anthropic, usado sobre tus propias respuestas, da una cifra mejor. Para el tiempo de sesión sumamos los 69,8 segundos medidos de las 4 llamadas y 60 segundos de modelo: 0,00288 USD por noche.
| Un local | Por noche (1 a 3 lecturas) | Por mes (30 noches, 3 lecturas) |
|---|---|---|
| Tarifa de EveryInfra (4 llamadas, precio del catálogo) | 0,005556 USD | 0,1667 USD |
| Tiempo de sesión (estimado, 129,8 s) | 0,00288 USD | 0,0864 USD |
| Haiku 5.5, HTTP con filtro | 0,0033 a 0,0039 USD | 0,117 USD |
| Haiku 5.5, MCP con todos los datos | 0,0078 a 0,0174 USD | 0,522 USD |
| Sonnet 5.5, HTTP con filtro | 0,0657 a 0,0771 USD | 2,313 USD |
| Sonnet 5.5, MCP con todos los datos | 0,1563 a 0,3488 USD | 10,464 USD |
| Opus 5.5, HTTP con filtro | 0,1314 a 0,1543 USD | 4,629 USD |
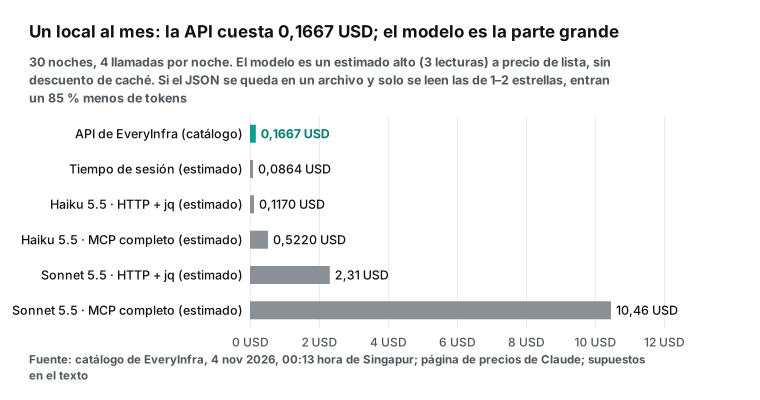
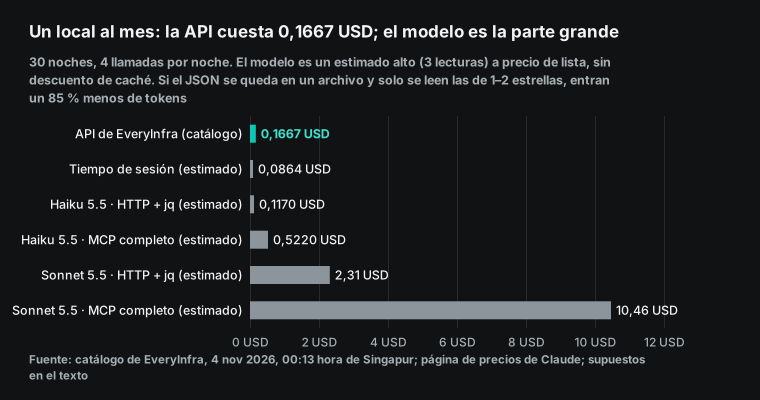
La conclusión es directa: la tarifa de la API es una cifra pequeña y fija; lo que decide el costo es el modelo y cuántos datos crudos entran al contexto. Con Sonnet 5.5 por la ruta HTTP, un local cuesta entre 0,074 y 0,086 USD por noche en total y la tarifa de la API es apenas del 6,5 % al 7,5 %; el mismo modelo por MCP con todos los datos cuesta entre 0,165 y 0,357 USD por noche, de 2,2 a 4,2 veces más. Para clasificar y traducir reseñas, Haiku 5.5 probablemente basta, y entonces un local cuesta menos de 0,40 USD al mes.
Para fijar el presupuesto del despliegue, usa «locales × estimación por local × 3». Con 10 locales en Sonnet por HTTP, la estimación es de unos 0,86 USD por noche, y un presupuesto de "300" (3 USD) frena un ciclo descontrolado sin cortar una ejecución normal. Una persona contó en Reddit que tres intentos con Managed Agents le costaron unos 6 USD de API (hilo de Reddit); por eso el presupuesto va desde el primer día. La tabla lleva los totales a más locales con el nivel de 3 lecturas, suponiendo que el costo por local no cambia y que una sola sesión lee todos los locales.
| Locales | API de EveryInfra al mes | Total con Haiku 5.5 por HTTP (estimado) | Total con Sonnet 5.5 por HTTP (estimado) | Presupuesto por ejecución con Sonnet |
|---|---|---|---|---|
| 1 | 0,1667 USD | 0,369 USD | 2,565 USD | "30" |
| 10 | 1,667 USD | 3,69 USD | 25,65 USD | "300" |
| 50 | 8,334 USD | 18,45 USD | 128,25 USD | "1300" |
claude managed agents vs agent sdk, Claude Code y Cowork
Anthropic ofrece hoy al menos cuatro formas de poner a Claude a trabajar con horario. La correcta depende de quién corre el ciclo, quién paga y dónde vive la clave. El Agent SDK es una biblioteca que lleva el ciclo de agente de Claude Code a tu propio proceso; tú pones la máquina y el programador de tareas (Agent SDK overview, guía de alojamiento). Managed Agents es un ciclo alojado con sandbox incluido. Las rutinas de Claude Code y las tareas programadas de Cowork son funciones de las aplicaciones por suscripción y consumen el uso de tu plan.
| Despliegue de Managed Agents | Agent SDK | Rutinas de Claude Code | Tareas programadas de Cowork | |
|---|---|---|---|---|
| Quién corre el ciclo | Nube de Anthropic | Tu servidor o contenedor | Nube de Anthropic | Nube de Anthropic |
| Horario | Cron + zona IANA, hasta 9 min de retraso | Tu propio cron o cola de tareas | Cron, mínimo cada hora | Frecuencia elegida en la aplicación |
| Cobro | Tokens de la API + 0,08 USD por hora | Tokens de la API | Uso del plan | Uso del plan |
| Para qué sirve más | Tareas de producción para muchos locales, con presupuesto y webhooks | Equipos con servidores propios que quieren control total | Resúmenes para el propio desarrollador | Un reporte semanal personal |
| Fuente | Scheduled deployments, Pricing | Agent SDK overview, alojamiento | Routines | ayuda de Cowork |
Ya escribimos dos artículos relacionados. En uno, una rutina de Claude Code lee Reddit cada noche y arma un resumen de quejas; una página de 100 publicaciones cubría solo 18,7 horas (tareas programadas de Claude Code con Reddit). En el otro, una tarea programada de Cowork arma cada lunes una tabla de precios y reseñas de la competencia (tabla semanal con Cowork). Leídos juntos: para un reporte semanal que lees tú, Cowork es lo más sencillo; para un desarrollador que trabaja junto a su repositorio, Claude Code; para decenas de locales cada noche, con tope de gasto, alertas de falla y resultados que llegan a tu propio sistema, un despliegue programado de Managed Agents. La documentación de Claude Code dice que las rutinas corren como mucho una vez por hora y consumen el uso del plan (Routines); las tareas de Cowork corren en la nube aunque tu computadora esté dormida (ayuda de Cowork). Si solo necesitas las reseñas de Google Maps en una hoja de cálculo, sin agente, mira cómo extraer reseñas de Google Maps.
Cuando algo falla: qué capa revisar primero
Cuando una tarea nocturna falla, el reporte suele decir solo «no hay datos». La tabla junta las fallas probables de tres capas: el despliegue y la sesión de Anthropic, el vault y la red, y la API de EveryInfra. A la izquierda está el síntoma que vas a ver; a la derecha, dónde mirar primero. Las filas de EveryInfra las vivimos en las llamadas reales del 4 de noviembre; las de Anthropic vienen de lo que dice la documentación sobre errores y estados.
| Síntoma | Capa habitual | Qué revisar primero | Qué hacer |
|---|---|---|---|
| En la mañana no hay reporte ni webhook | El despliegue no creó la sesión, o los 3 intentos del webhook fallaron | GET /v1/deployment_runs?has_error=true | Llamar una vez a mano a POST /v1/deployments/{id}/run |
| La sesión se queda quieta y no aparece el reporte | El conjunto MCP sigue en always_ask | El stop_reason del último evento de espera | Poner always_allow en everyinfra_call_api |
| La herramienta dice no autorizado y «Nothing was charged» | Clave equivocada en el vault, o allowed_hosts mal puesto en la credencial | secret_name y networking de la credencial | Corregir la credencial; que el agente no reintente |
curl recibe un 403 que nombra el host | El allowed_hosts del entorno no incluye ese host | networking del entorno | Agregar api.everyinfra.com |
| El modelo solo ve un fragmento recortado | Salida de MCP de más de 100.000 caracteres | El limit de esa llamada | Bajar a 50 reseñas o pasar a HTTP con jq |
| La API devuelve 429 | Se agotó el límite por minuto de la clave | retry_after en la respuesta | Esperar esos segundos; un 429 no se cobra |
| Una búsqueda no devuelve nada y se reembolsa | La búsqueda de lugares no encontró el local | reason en la respuesta | Leer las reseñas con una dirección de búsqueda de Google Maps |
Detrás de la tabla hay una regla: cada error tiene que aparecer en el reporte, y el agente no debe rodearlo por su cuenta. Los agentes son buenos para «intentar otra vez con otros parámetros», pero en una tarea que cuesta dinero y corre de madrugada sin nadie mirando, rodear un error suele significar leer el local equivocado, leer dos veces o dejar un problema de configuración sin arreglar durante un mes. Por eso las instrucciones deben decir: ante no autorizado, 403 o pausa por presupuesto, detente y escribe la causa; solo un 429 merece un reintento después de esperar.
Límites y puntos abiertos
Primero, no probamos el lado de Anthropic. Despliegues programados, sustitución de credenciales del vault, políticas de permisos y webhooks son ejemplos de configuración tomados de la documentación de platform.claude.com, leída el 4 de noviembre de 2026. Managed Agents sigue en beta y los campos pueden cambiar; vault_ids y resources los escribimos según los ejemplos de las páginas de sesiones y de memoria, así que revísalos con la referencia de despliegues de tu versión del SDK antes de crear nada. Segundo, del lado de Tripadvisor solo llegan reseñas en inglés: las que están en español no vienen en la respuesta, aunque uses la dirección de tripadvisor.com.mx. Tercero, la búsqueda de lugares de Google no encontró ninguno de los dos locales fuera de Estados Unidos (se reembolsó), y la lectura directa con una dirección de búsqueda de Google Maps sí funcionó. Cuarto, la primera página de Yelp no viene en orden de fecha y el parámetro de orden de la dirección no tiene efecto.
Quinto, el texto de una reseña es una entrada no confiable. La documentación de memoria advierte que lo que se guarda en un almacén de memoria puede traer inyección de instrucciones (prompt injection), y con las reseñas pasa lo mismo: alguien puede escribir «ignora tus instrucciones» en una reseña. La ruta HTTP con jq trata las reseñas solo como datos; el entorno solo deja salir hacia api.everyinfra.com y el vault solo pone la clave para ese host, así que aunque el modelo se confunda, la clave no sale. Sexto, usa el reporte solo para mejorar tus propios locales. En Estados Unidos, la regla de 2024 de la Comisión Federal de Comercio prohíbe las reseñas falsas, pagar por reseñas con una opinión determinada y suprimir las negativas (comunicado de la FTC). Las reseñas negativas merecen una revisión cada noche, pero la respuesta correcta es contestar y corregir, no presionar sobre la reseña. Aquí solo hablamos de métodos de datos; no es asesoría legal.
Cambios recientes
Estas novedades del último mes afectan a esta tarea, y todas están en las notas de versión de Claude Platform. El 2026-10-07, web_fetch empezó a descargar solo direcciones ya vistas en la sesión, y allowed_hosts con red limited empezó a aplicarse también a web_fetch y web_search. El 2026-10-09, Managed Agents agregó los flujos dinámicos (dynamic workflows), que corren varios agentes por fases; pueden servir cuando hay cientos de locales, pero no los probamos. El 2026-10-14, los despliegues programados llegaron también a Claude Platform on AWS. El 2026-10-20, quien administra la organización puede apagar web fetch o limitar sus dominios desde la consola, y las sesiones de Managed Agents respetan ese ajuste. El 2026-10-29 salió la beta de la API de análisis de uso y costos, que separa tokens y gasto por modelo, espacio de trabajo y clave de API, útil para revisar cada mes cuánto cuesta la revisión nocturna.
Preguntas frecuentes
¿Qué diferencia hay entre claude managed agents y las rutinas de Claude Code?
La pregunta sale de las sugerencias de búsqueda «claude managed agents vs claude code» y «claude managed agents vs routines», y de la publicación de Reddit «What is the point of Managed Agents» (hilo de Reddit). Las dos corren en la nube de Anthropic. Las rutinas de Claude Code consumen el uso del plan y corren como mucho una vez por hora (Routines). Los despliegues de Managed Agents cobran tokens de la API más 0,08 USD por hora de sesión, aceptan un cron con precisión de minutos, limitan cada ejecución con un presupuesto y envían el resultado por webhook (Scheduled deployments). Para tareas de producción de un equipo o de clientes, conviene lo segundo.
¿Cómo funciona claude managed agents pricing y cuánto cuesta una noche?
La pregunta sale de las sugerencias «claude managed agents pricing» y «claude managed agents cost». Hay dos cobros: los tokens del modelo a precio de lista y el tiempo de sesión a 0,08 USD por hora, solo en estado running (Pricing, leído el 2026-11-04). Con nuestra estimación, un local en Sonnet 5.5 por la ruta HTTP cuesta unos 0,077 USD de modelo y 0,0029 USD de tiempo de sesión por noche; con los 0,0056 USD de EveryInfra, el total ronda los 0,0855 USD con el nivel alto de 3 lecturas.
claude managed agents vs agent sdk: ¿cuál elijo?
La pregunta sale de la sugerencia «claude managed agents vs agent sdk». El Agent SDK es una biblioteca: el ciclo corre en tu propio proceso y tú te encargas de la máquina, el horario, los secretos y los registros (Agent SDK overview). Managed Agents aloja el ciclo, el sandbox, el horario, la sustitución de credenciales y el registro de sesión. Elige el SDK si ya tienes servidores y una cola de tareas y quieres control total; elige Managed Agents si no quieres mantener un programador de tareas y necesitas webhooks y un presupuesto por ejecución.
¿Puede Managed Agents leer reseñas de Google Maps o de Yelp con web_fetch?
La pregunta sale de la sugerencia «claude managed agents web». No de forma confiable: web_fetch no ejecuta JavaScript y, desde el 2026-10-07, solo descarga direcciones que ya aparecieron en la sesión (notas de versión). El robots.txt de Yelp solo deja pasar a Claude-User en /article (yelp.com/robots.txt). Una API de reseñas estructurada es más confiable.
¿Qué pasa si un despliegue programado se salta una ejecución?
La pregunta sale de la sugerencia «claude managed agents schedule». Los disparos perdidos durante una pausa no se recuperan; si la creación de la sesión choca con un límite de frecuencia, esa ejecución queda registrada con session_rate_limited_error y no se reintenta (Scheduled deployments). Por eso la ejecución siguiente debe leer hasta el último identificador que guardó la última ejecución buena, y no solo las últimas 24 horas. Para un local como Contramar, las 50 reseñas más nuevas de Google cubren más de tres semanas, así que una noche perdida no deja huecos.
¿El modelo puede ver la clave guardada en el vault?
La pregunta sale de las sugerencias «claude managed agents vault» y «claude managed agents credential vault». No. Una credencial de variable de entorno solo guarda un valor de relleno en el sandbox; el valor real lo pone la red al salir la petición, y solo para los hosts de allowed_hosts (Authenticate with vaults). El blog de Anthropic también dice que el agente nunca ve tu clave (blog de Anthropic).
Primeros pasos
- Consigue una clave de API de EveryInfra y sigue la guía de inicio rápido. Corre una vez
google_maps_reviews/search,yelp/searchytripadvisor/searchpara obtener las direcciones del local; si la búsqueda de Google no encuentra un local fuera de Estados Unidos, usa una dirección de búsqueda de Google Maps con el nombre y la calle. - Llama una vez con curl, desde tu máquina, a
google_maps_reviews/reviews,yelp/reviewsytripadvisor/reviews. Revisa los campos y el tamaño de la respuesta. Para la ruta MCP, mira la página del servidor MCP. - En la consola de Claude, crea el entorno con red
limitedy soloapi.everyinfra.com, el vault con una credencialEVERYINFRA_API_KEYy el agente conweb_fetchyweb_searchapagados. - Corre una sesión a mano, o llama a
POST /v1/deployments/{id}/run, para revisar el formato del reporte y el costo. Después crea el despliegue con el cron30 6 * * *enAmerica/Mexico_Cityy un presupuesto por ejecución, y suscríbete asession.status_idledydeployment_run.failed. - Para ver qué devuelve cada API de reseñas, abre la página de reseñas de Google Maps, la página de Yelp y la página de Tripadvisor. Para un reporte semanal de cinco sitios de reseñas, mira la revisión de reseñas con openai agents api.
Referencias
- Claude Managed Agents overview, documentación de Anthropic, leído el 2026-11-04.
- Scheduled deployments, documentación de Anthropic, leído el 2026-11-04.
- Authenticate with vaults, documentación de Anthropic, leído el 2026-11-04.
- Cloud environment setup, documentación de Anthropic, leído el 2026-11-04.
- Tools, documentación de Anthropic, leído el 2026-11-04.
- MCP connector, documentación de Anthropic, leído el 2026-11-04.
- Permission policies, documentación de Anthropic, leído el 2026-11-04.
- Session budgets, documentación de Anthropic, leído el 2026-11-04.
- Subscribe to webhooks, documentación de Anthropic, leído el 2026-11-04.
- Reference, documentación de Anthropic, leído el 2026-11-04.
- Using agent memory, documentación de Anthropic, leído el 2026-11-04.
- Restrict web search and web fetch domains, documentación de Anthropic, leído el 2026-11-04.
- Web fetch tool, documentación de Anthropic, leído el 2026-11-04.
- Pricing, documentación de Anthropic, leído el 2026-11-04.
- Claude Platform release notes, Anthropic, leído el 2026-11-04.
- Define your agent, documentación de Anthropic, leído el 2026-11-04.
- Start a session, documentación de Anthropic, leído el 2026-11-04.
- Session event stream, documentación de Anthropic, leído el 2026-11-04.
- Glossary, documentación de Anthropic, leído el 2026-11-04.
- Agent SDK overview, documentación de Claude Code, leído el 2026-11-04.
- Hosting the Agent SDK, documentación de Claude Code, leído el 2026-11-04.
- Routines, documentación de Claude Code, leído el 2026-11-04.
- Schedule recurring tasks in Claude Cowork, centro de ayuda de Claude, leído el 2026-11-04.
- Does Anthropic crawl data from the web, centro de ayuda de Claude, leído el 2026-11-04.
- New in Claude Managed Agents: run agents on a schedule, blog de Anthropic, leído el 2026-11-04.
- Claude Managed Agents: get to production 10x faster, blog de Anthropic, leído el 2026-11-04.
- MCP Transports, especificación de Model Context Protocol, leído el 2026-11-04.
- MCP Tools, especificación de Model Context Protocol, leído el 2026-11-04.
- Place Details (New), Google for Developers, leído el 2026-11-04.
- Work with review data, documentación del Perfil de Negocio de Google, leído el 2026-11-04.
- Read and reply to reviews, ayuda del Perfil de Negocio de Google, leído el 2026-11-04.
- Business Reviews, documentación de Yelp Fusion, leído el 2026-11-04.
- How is the order of reviews determined?, soporte de Yelp, leído el 2026-11-04.
- yelp.com/robots.txt, Yelp, leído el 2026-11-04.
- Location Reviews, documentación de Tripadvisor Content API, leído el 2026-11-04.
- tripadvisor.com/robots.txt, Tripadvisor, leído el 2026-11-04.
- crontab, The Open Group Base Specifications Issue 8, leído el 2026-11-04.
- Time Zones, IANA, leído el 2026-11-04.
- Standard Webhooks, Standard Webhooks, leído el 2026-11-04.
- Decreto por el que se expide la Ley de los Husos Horarios en los Estados Unidos Mexicanos, Diario Oficial de la Federación, publicado el 2022-10-28, leído el 2026-11-04.
- En la República Mexicana ya no hay Horario de Verano, Secretaría de Energía, leído el 2026-11-04.
- FTC final rule banning fake reviews, Comisión Federal de Comercio de Estados Unidos, publicado el 2024-08-14, leído el 2026-11-04.
- What is the point of Managed Agents?, Reddit r/ClaudeAI, leído el 2026-11-04.
- Catálogo de la API de EveryInfra, EveryInfra, leído el 2026-11-04 a las 00:13, hora de Singapur.
Referencia BL-79