claude managed agents: 새로 올라온 별점 1~2점 레스토랑 리뷰를 매일 밤 점검하기
claude managed agents를 cron 일정으로 실행해 매일 밤 Google, Yelp, Tripadvisor의 새 리뷰를 읽고 별점 1~2점 리뷰를 표시합니다. API 비용은 매장당 $0.0056입니다.
2026년 11월 4일(싱가포르 시간), EveryInfra API로 뉴욕 Katz's Delicatessen의 새 리뷰를 읽었습니다. 대상은 Google Maps, Yelp, Tripadvisor였습니다. 핵심 발견은 "새 리뷰"의 의미에 관한 것입니다. 최신 리뷰 N개가 포괄하는 기간은 사이트마다 크게 다릅니다. Google에서는 4일 미만, Tripadvisor에서는 거의 4개월입니다. Yelp의 1페이지는 날짜순이 아닙니다.
1시간 뒤 다시 읽었을 때 Google에서 새 리뷰가 하나 발견되었습니다. 이 리뷰의 게시 시각은 첫 호출보다 앞섰지만, 첫 호출에서는 반환되지 않았습니다. 따라서 야간 작업은 리뷰 ID로 "새 리뷰"를 판단하고 어디까지 읽었는지 기억해야 합니다. 최신 N개만 가져오거나 게시 시각을 그대로 믿어서는 안 됩니다.
두 번째 발견은 비용에 관한 것입니다. API 요금은 적습니다. 매장 하나당 하룻밤 4회 호출에 1센트도 들지 않습니다. 비용의 대부분은 Anthropic 측의 모델 토큰입니다. Sonnet 5.5 기준으로 추정하면 모델 요금이 API 요금의 10배가 넘습니다. 따라서 샌드박스의 스크립트가 원시 데이터를 별점 1~2점 리뷰로 걸러 낸 뒤 모델에 넘겨야 합니다.
이 글은 구체적인 질문 하나에 답합니다. 뉴욕의 한 레스토랑 그룹 운영 매니저가 매일 오전 7시 전에 보고서를 받고 싶어 합니다. 보고서에는 어젯밤 이후 Google Maps, Yelp, Tripadvisor에 새로 올라온 별점 1~2점 리뷰가 모두 담겨야 합니다. 리뷰마다 문제가 음식, 서비스, 대기 줄, 가격 중 무엇인지, 그리고 누군가 답글을 달았는지도 표시해야 합니다.
이를 위해 Claude Managed Agents의 예약 배포를 사용합니다. 매일 밤 Anthropic 클라우드가 cron 일정에 따라 새 세션을 시작합니다. 에이전트는 HTTP 또는 원격 MCP로 EveryInfra 리뷰 엔드포인트 세 개를 호출하고, 새 부정 리뷰를 골라 원인별로 분류한 뒤 보고서를 작성합니다. 그런 다음 웹훅이 서버에 실행 완료를 알립니다.
EveryInfra 측에서는 실제 호출을 26회 했고, 그중 20회가 과금되어 총 $0.02778이 나왔습니다. Anthropic 측에는 배포하지 않았습니다. Managed Agents에 관한 모든 사실은 2026년 11월 4일에 확인한 platform.claude.com 문서나 릴리스 노트에 링크되어 있습니다.
과제: 세 사이트의 새 부정 리뷰를 아침 보고서 하나로 받기
공개된 매장 두 곳을 샘플로 사용했습니다. 두 업체와는 아무 관계가 없으며, 샘플 보고서는 방법을 보여 주기 위한 것일 뿐입니다. 첫 번째 매장은 Lower East Side의 Katz's Delicatessen입니다. Google Maps에서 평점 4.5에 리뷰 56,460개, Tripadvisor에서 평점 4.2에 리뷰 18,710개입니다.
관광객이 많이 찾는 곳이라 "하룻밤에 새 리뷰가 몇 개 올라오는가"를 시험하기 좋습니다. 두 번째 매장은 Queens Flushing의 Haidilao Hot Pot입니다. Google에서 평점 4.8에 리뷰 8,792개, Yelp에서 평점 4.8에 리뷰 2,643개입니다. 평점이 높고 부정 리뷰가 적은 매장의 사례입니다.
왜 주 1회가 아니라 매일 밤 실행할까요? Katz's의 실제 Google 응답에서 최신 리뷰 100개는 3.97일에 걸쳐 있으며, 하루 약 24.7개꼴입니다. 최신 50개는 1.80일에 불과하고, 최근 24시간 동안 29개가 올라왔습니다. 부정 리뷰는 처음 하루 이틀 안에 대응하기가 가장 쉽습니다.
답글, 환불 제안, 내부 점검이 가장 큰 효과를 내는 시점도 이때입니다. 주간 작업은 매장마다 Google 페이지 4개를 읽어야 하고, 보고서가 도착할 때면 가장 오래된 부정 리뷰는 이미 6~7일이 지나 있습니다. 최신 50개를 읽는 야간 작업은 어젯밤 이후의 리뷰를 모두 포괄하며, 하룻밤 분량의 여유도 있습니다.
| 사이트 | 기능 | 호출당 리뷰 수 | 정렬 순서 | 호출당 가격 |
|---|---|---|---|---|
| Google Maps | google_maps_reviews/reviews | 최대 100개, 50개 사용 | sort=newest, 선택적으로 since 날짜 지정 | $0.001389 |
| Yelp | yelp/reviews | 페이지당 10개, 다음 페이지는 page_token으로 조회 | Yelp 기본 순서, 날짜순 아님 | $0.001389 |
| Tripadvisor | tripadvisor/reviews | 최대 50개 | 정렬 옵션 없음. 테스트에서는 최신순 | $0.001389 |
| 매장 조회 | google_maps_reviews/search, yelp/search, tripadvisor/search | 설정 시 사이트당 1회 | — | $0.001389 |
가격은 무료 카탈로그 https://api.everyinfra.com/api/v1/social/catalog에서 가져왔으며, 11월 4일 싱가포르 시간 00:13에 확인했습니다. 세 리뷰 기능 모두 available 상태였습니다. 호출 1회는 100크레딧, 즉 $0.001389입니다. 조회 호출 3회는 매장당 한 번만 필요합니다. 이 호출은 매장 이름을 각 사이트의 매장 URL로 바꿔 주며, 그 뒤 야간 작업은 URL로 리뷰를 읽습니다.
claude managed agents란 무엇인가: 객체 네 개와 일정 하나
Claude Managed Agents는 Claude Platform의 호스팅 API 모음입니다. 에이전트의 모델, 시스템 프롬프트, 도구를 정의하면 Anthropic이 자체 클라우드에서 에이전트 루프를 실행합니다. 샌드박스 컨테이너를 시작하고, 도구 호출을 실행하고, 세션 기록을 보관합니다. 이 제품은 2026년 4월 8일 공개 베타로 출시되었습니다. 모든 요청에는 anthropic-beta: managed-agents-2026-04-01 헤더가 필요합니다(개요, 릴리스 노트).
개요 문서는 핵심 개념으로 에이전트, 환경, 세션, 볼트 네 가지를 꼽습니다. 예약 배포는 다섯 번째 객체입니다. 2026년 6월 9일에 추가되었으며, 일정에 따라 세션을 대신 시작해 줍니다(Anthropic 블로그). 아래 표는 각 객체가 리뷰 점검 작업에서 어떻게 쓰이는지 보여 줍니다.
| 객체 | 제어 대상 | 리뷰 점검 설정 | 문서 |
|---|---|---|---|
| agent | 모델, 시스템 프롬프트, 도구, MCP 서버, 권한 정책(버전 관리 포함) | Sonnet 5.5. bash와 파일 도구는 유지. web_fetch와 web_search는 끔. MCP 경로에서는 everyinfra_call_api만 허용 | 에이전트 정의 |
| environment | 샌드박스 구성 방식과 접근 가능한 호스트 | limited 네트워킹, allowed_hosts에는 api.everyinfra.com만 지정 | 클라우드 환경 설정 |
| vault | 세션이 실행 시점에 받는 자격 증명 | environment_variable 자격 증명 1개(EVERYINFRA_API_KEY), 실제 값은 api.everyinfra.com 요청 헤더에만 삽입됨 | 볼트로 인증 |
| session | 실행 1회: 새 컨테이너와 대화 기록 | 배포가 매일 밤 하나씩 생성 | 세션 시작 |
| deployment | cron 일정에 따라 세션을 시작하며, 실행마다 예산 적용 | America/New_York 기준 30 6 * * *, 실행당 50센트 | 예약 배포 |
가장 많이 놓치는 점은 환경이 실행마다 새로 만들어진다는 것입니다. 세션 문서에 따르면 세션마다 새 컨테이너가 할당됩니다. 한 실행에서 샌드박스에 쓴 파일은 다음 실행에서 사라집니다(세션 시작). 리뷰 점검에서는 이 점이 매우 중요합니다.
"이미 본 리뷰" 목록은 샌드박스 파일에 둘 수 없습니다. /mnt/memory/ 아래에 마운트되는 별도 베타 기능인 메모리 스토어에 두어야 합니다(에이전트 메모리 사용). 다른 방법은 웹훅을 받을 때마다 자체 서버에 목록을 보관하고 다음 초기 메시지에 다시 넣어 보내는 것입니다.
예약 배포: cron, 시간대, 지터, 예산, 그리고 소급 실행 없음
예약 배포는 POST /v1/deployments로 생성합니다. 에이전트, 환경, 초기 이벤트 하나 이상(보통 user.message), schedule이 필요합니다. schedule에는 type: cron과 분 단위 정밀도의 표준 5필드 POSIX cron expression이 들어갑니다. America/New_York 같은 IANA 이름의 timezone도 들어갑니다(예약 배포).
cron 필드는 POSIX crontab을 따릅니다. 시간대 이름은 IANA 시간대 데이터베이스에서 가져오며, 최신 릴리스인 2026f는 2026-10-27에 나왔습니다. 생성 응답의 schedule.upcoming_runs_at에 다음 실행 시각이 나오므로 표현식을 바로 확인할 수 있습니다.
문서의 한 문장이 보고서 마감 시각을 좌우합니다. 실행 예정 시각은 정확하지만, 실제 시작에는 실행 간격의 최대 15%만큼 지터가 붙습니다. 최솟값은 5초, 최댓값은 9분입니다. 아래 차트는 이 규칙을 나타냅니다.
5분마다 실행되는 배포는 최대 45초 늦게 시작합니다. 매시간 또는 매일 실행되는 배포는 최대 9분 늦게 시작합니다. 보고서가 7:00 전에 도착해야 한다면 6:30 cron으로 9분의 지터와 20분의 실행 시간을 감당할 여유가 생깁니다.
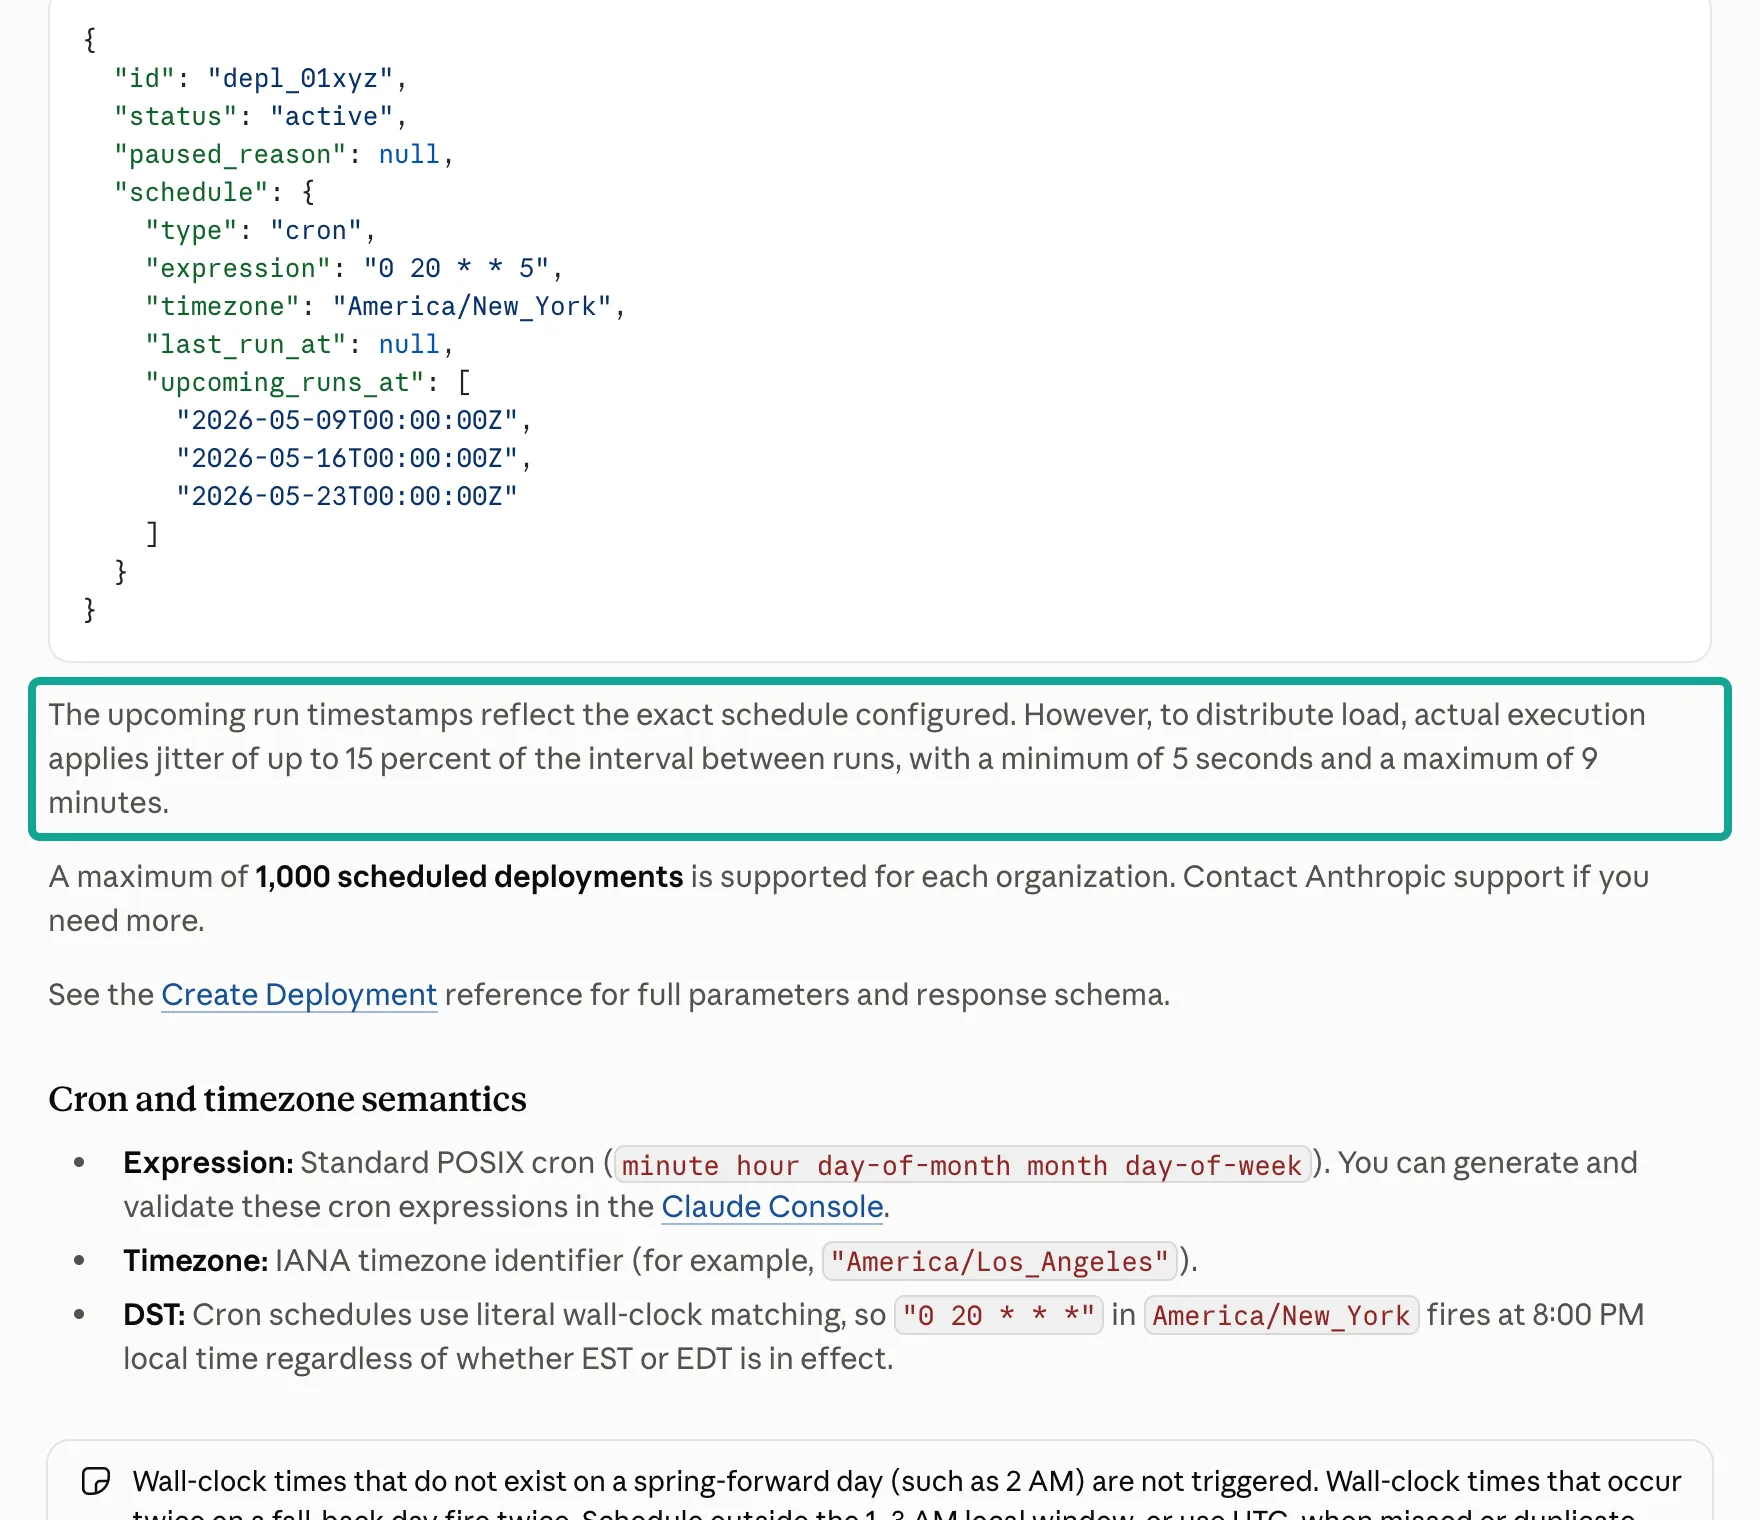
두 번째 함정은 서머타임입니다. 문서에 따르면 cron은 지정된 현지 시각과 실제 현지 시각이 일치할 때 실행됩니다. 따라서 America/New_York의 0 20 * * *는 EST와 EDT 모두 현지 시각 오후 8시에 실행됩니다. 서머타임이 시작되는 날에는 오전 2시처럼 존재하지 않는 시각에는 실행되지 않습니다.
서머타임이 끝나는 날에는 같은 현지 시각이 두 번 발생하면 작업도 두 번 실행됩니다. 문서는 현지 시각 오전 1~3시를 피하거나 UTC를 쓰라고 권합니다. 2026년 미국 서머타임은 11월 1일에 끝났습니다. 따라서 이번 주부터 뉴욕의 30 6 * * *는 11:30 UTC이고, 서머타임 기간에는 10:30 UTC입니다.
세 번째는 예산입니다. 배포에는 세션 예산과 같은 형태의 선택 항목 budget을 지정할 수 있으며, 형식은 {"type": "limit", "max_list_cost": {"amount": "50", "currency": "USD"}}입니다. 금액은 미국 센트 단위의 정수를 문자열로 쓴 값이므로 "50"은 50센트입니다(세션 예산). 배포는 이 상한을 새 세션마다 복사합니다. 따라서 상한은 월 합계가 아니라 실행마다 적용됩니다. 문서 예시가 이를 분명히 보여 줍니다. "2000" 상한을 둔 배포는 실행할 때마다 약 $20를 쓸 수 있습니다.
예산에는 모델 토큰, 웹 검색(1,000회당 $10), 세션 실행 시간(시간당 $0.08)이 공개 정가 기준으로 포함됩니다. 플랫폼은 모델 요청 사이마다 예산을 확인하고, 상한에 도달하면 budget_reached로 세션을 일시 중지합니다. EveryInfra API 요금은 예산에 포함되지 않습니다. 이 요금은 호출 횟수로만 정해지며, 호출 횟수는 매장당 하룻밤 4회로 고정되어 있습니다.
네 번째는 실패입니다. 배포를 일시 중지하면 예약 트리거는 멈추지만 실행 중인 세션은 끝까지 진행됩니다. 일시 중지를 해제하면 다음 예정 시각부터 일정이 다시 시작됩니다. 문서에는 놓친 트리거는 소급 실행되지 않는다("Missed triggers are not backfilled")고 적혀 있습니다. 트리거마다 배포 실행 레코드가 남습니다. 실패한 레코드는 GET /v1/deployment_runs?deployment_id=…&has_error=true로 조회할 수 있습니다.
흔한 오류 유형은 environment_archived_error, agent_archived_error, session_rate_limited_error입니다. 마지막 오류는 기록만 되고 재시도되지 않습니다. 조직당 예약 배포는 최대 1,000개까지 만들 수 있습니다. 따라서 "어젯밤 실행되지 않음" 상황은 보고서 작업이 스스로 처리해야 합니다. 다음 실행은 최근 24시간만 읽어서는 안 되며, 마지막으로 성공한 실행이 저장한 리뷰 ID까지 거슬러 올라가 읽어야 합니다.
키는 어디에 둘까: 두 종류의 볼트 자격 증명
EveryInfra 키는 MCP 연결 또는 샌드박스의 curl에서 사용됩니다. 이 두 용도는 두 종류의 볼트 자격 증명에 대응합니다(볼트로 인증). MCP 자격 증명은 mcp_oauth와 static_bearer이며 mcp_server_url을 키로 합니다. 세션이 해당 URL의 MCP 서버에 연결하면 토큰이 자동으로 추가됩니다.
environment_variable 자격 증명은 secret_name을 키로 합니다. 샌드박스에는 불투명한 자리 표시자만 있습니다. 실제 값은 네트워크 경계에서 networking.allowed_hosts에 있는 호스트에 대해서만 자리 표시자를 대체하며, injection_location으로 교체 위치를 헤더로 제한할 수 있습니다.
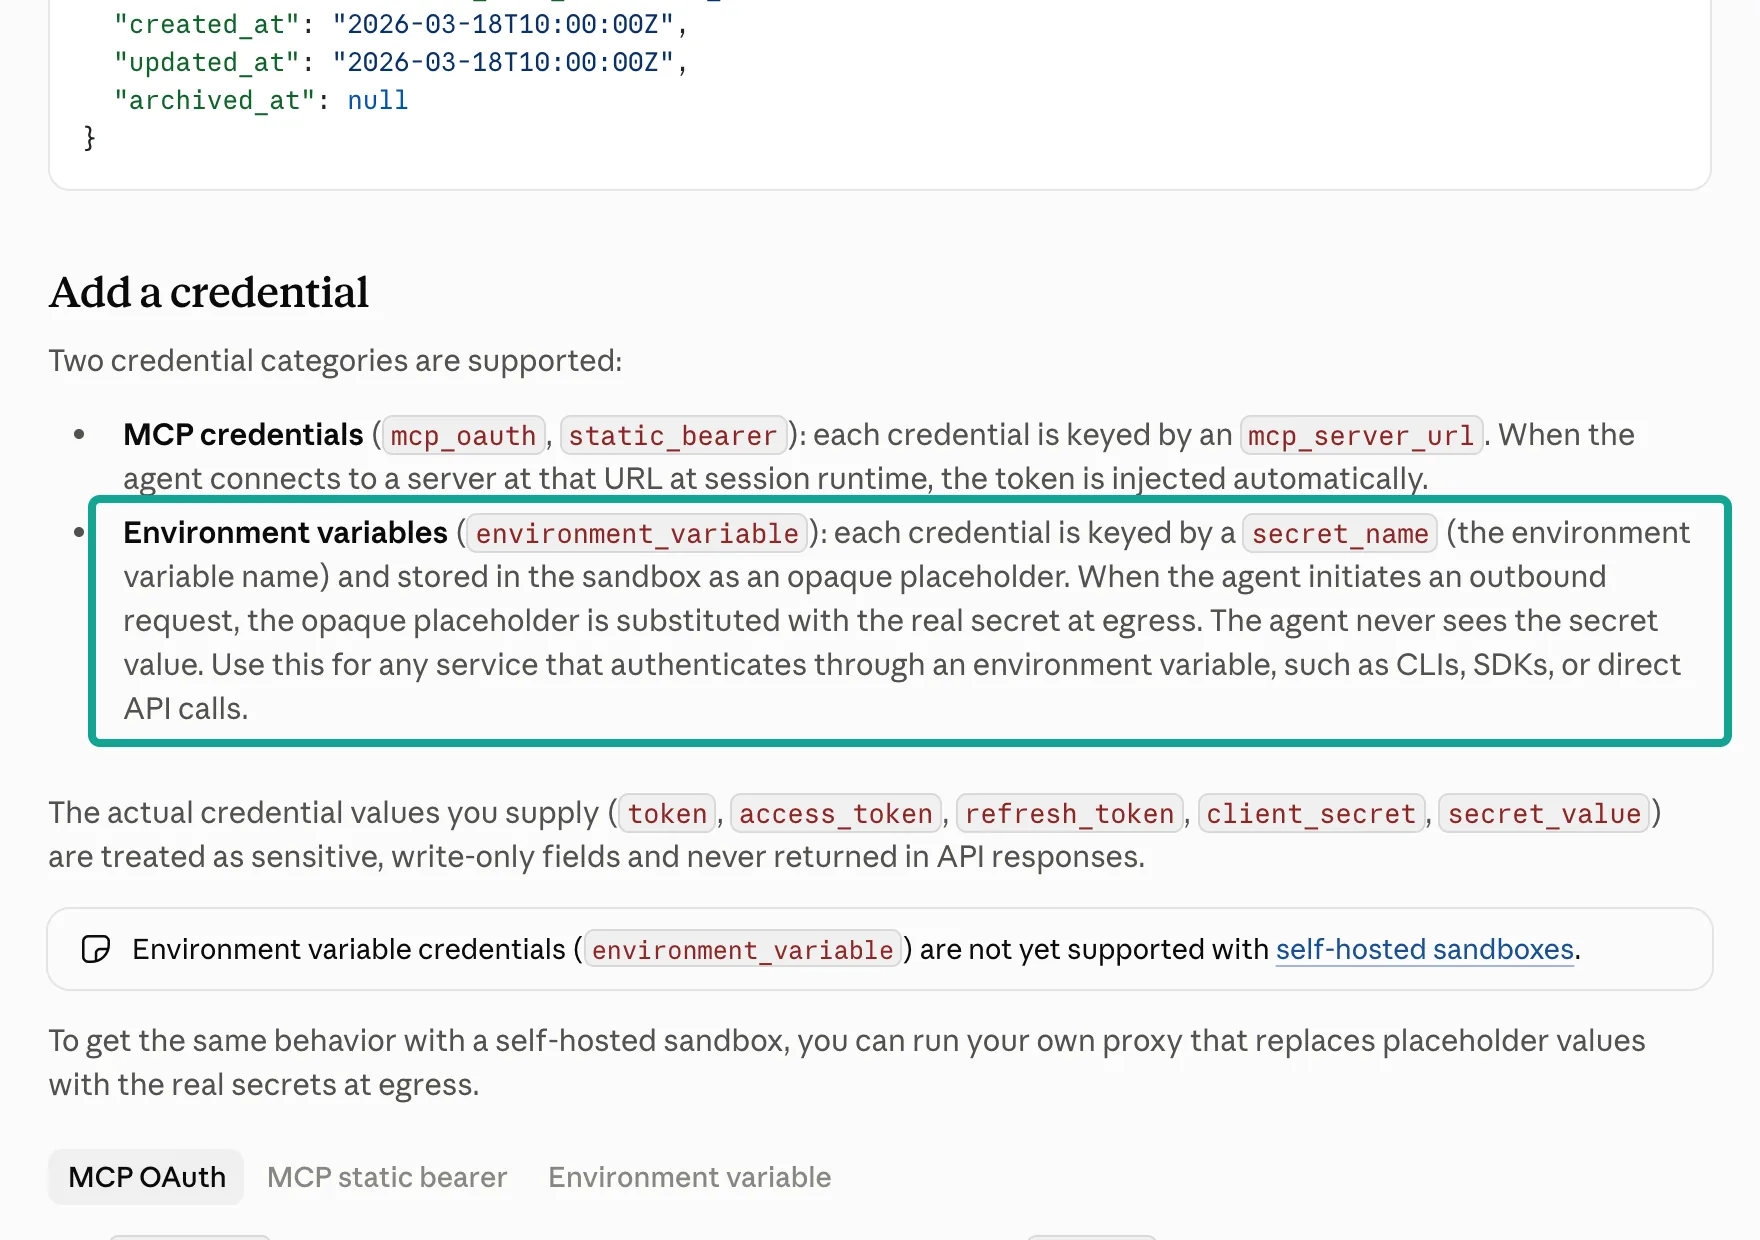
이 작업에는 세 가지 이유로 환경 변수 자격 증명을 권장합니다. 첫째, 키가 한 곳으로만 갈 수 있습니다. 자격 증명의 allowed_hosts에는 api.everyinfra.com만 들어 있습니다. 리뷰에 포함된 악의적인 문장이 모델에게 다른 URL을 호출하라고 지시해도 그 요청에는 자리 표시자만 실립니다.
둘째, 자격 증명의 allowed_hosts가 제어하는 것은 어떤 요청이 키를 받는지이며, 어떤 요청이 샌드박스 밖으로 나갈 수 있는지는 제어하지 않습니다. 후자는 환경의 networking 설정이 제어합니다. 두 설정 모두 api.everyinfra.com만 허용하면 네트워크와 키에 각각 잠금이 하나씩 걸립니다.
셋째, HTTP 경로에서는 원시 응답이 먼저 샌드박스 파일에 저장됩니다. 그런 다음 jq 필터가 필요한 행만 모델에 넘기며, 이로써 절약되는 토큰 수는 비용 섹션에서 다룹니다. 환경 변수 자격 증명에도 제약이 있습니다. 아직 자체 호스팅 샌드박스에서는 작동하지 않습니다. 볼트 하나에는 자격 증명을 최대 20개까지 넣을 수 있습니다. 플랫폼은 자격 증명을 생성할 때 검증하지 않으므로, 키가 잘못되었다는 사실은 실행 시점에야 알 수 있습니다.
마지막 사항은 EveryInfra 측에서 테스트했습니다. 싱가포르 시간 00:22에 키 없이 원격 MCP tools/call을 호출했습니다. HTTP 상태는 200이었습니다. 본문에는 isError가 true로 설정되어 있었고, 호출 권한이 없으며 "Nothing was charged"(과금되지 않음)라는 텍스트가 들어 있었습니다.
따라서 볼트에 잘못되었거나 만료된 키가 있어도 세션이 MCP에 연결할 때는 실패하지 않습니다. 첫 도구 호출에서 오류 결과로 실패합니다. 에이전트 프롬프트에는 다음 지시가 있어야 합니다. 인증 오류가 나면 중단하고 보고서 맨 위에 "키가 유효하지 않음"이라고 쓸 것. 다른 파라미터로 재시도하지 말 것.
web_fetch로 리뷰 페이지를 읽지 않는 이유
Managed Agents에는 기본 제공 web_fetch 도구가 있어 쉬운 방법처럼 보입니다. 프롬프트에 매장 URL 세 개를 넣고 에이전트가 매일 밤 페이지를 읽게 하면 됩니다. 문서와 세 사이트의 robots.txt를 확인해 보니, 사람이 지켜보지 않는 야간 작업에는 이 방법이 잘 맞지 않았습니다. 이유는 아래 표와 같습니다.
| 경로 | 매일 밤 새 리뷰를 읽을 수 있는가? | 출처 |
|---|---|---|
매장 페이지에 web_fetch 사용 | 안정적으로는 불가. 2026-10-07부터 세션에 이미 등장한 URL만 가져오며, 시스템 프롬프트나 MCP 출력에 있는 URL은 이미 등장한 URL로 인정되지 않음. JavaScript를 실행하지 않으며 robots.txt를 따름 | 릴리스 노트 2026-10-07, Web fetch tool |
| Yelp 웹 페이지 | Yelp robots.txt는 Claude-User에 /article만 허용하고 나머지는 Disallow: /로 지정(2026-11-04 확인) | yelp.com/robots.txt, Anthropic 크롤러 안내 문서 |
| Google Places API | 장소당 리뷰 최대 5개, 관련성순 | Place Details |
| Google Business Profile API | 직접 관리하는 위치만 가능, OAuth 필요 | Review data |
| Yelp Fusion API | 업체당 리뷰 발췌문 최대 3개, Yelp 기본 순서 | Yelp Fusion reviews |
| Tripadvisor Content API | 위치당 최신 리뷰 최대 5개 | Location reviews |
| EveryInfra 리뷰 엔드포인트 | Google은 호출당 최대 100개, 최신순. Yelp는 페이지당 10개, 페이지네이션 지원. Tripadvisor는 호출당 최대 50개 | 카탈로그 |
첫 번째 제한은 놓치기 쉽습니다. 2026년 10월 7일 릴리스 노트에 따르면 이제 web_fetch는 세션에 이미 등장한 URL만 가져옵니다. 데이터 유출 위험을 줄이기 위한 조치입니다. 사용자 메시지나 web_search 결과에 나온 URL은 인정됩니다. 인정되지 않는 URL도 있습니다. Claude 자신의 출력, 시스템 프롬프트, 첨부 문서, bash 또는 MCP 도구 출력에만 있는 URL입니다. 이런 URL을 요청하면 호출이 url_not_in_prior_context를 반환합니다.
같은 날 나온 두 번째 릴리스 노트는 limited 네트워킹에 관한 것입니다. 이 설정을 쓰면 환경의 allowed_hosts 목록이 web_fetch와 web_search에도 적용됩니다(Restrict web search and web fetch domains). 10월 20일부터는 조직 관리자가 콘솔의 기능 페이지에서 웹 페치를 끌 수도 있습니다. 꺼져 있으면 Managed Agents 세션의 모든 web_fetch 호출이 오류를 반환합니다. 세 규칙이 모두 적용되면 고정 URL을 쓰는 야간 작업은 너무 많은 조건에 좌우됩니다.
더 큰 문제는 페이지 자체입니다. Google Maps 리뷰 목록은 JavaScript로 로드되는데, web_fetch 문서에는 JavaScript로 렌더링되는 사이트를 지원하지 않는다고 나와 있습니다. Yelp 매장 페이지는 Claude-User의 접근을 막고 있습니다. Tripadvisor의 robots.txt에는 ClaudeBot에 대해 Disallow: /가 설정되어 있습니다.
Claude-User는 명시되어 있지 않으므로 일반 규칙이 적용됩니다. 공식 API는 모두 제공량 상한이 낮습니다. Google Places는 리뷰 5개, Yelp Fusion은 발췌문 3개, Tripadvisor Content API는 리뷰 5개까지만 제공합니다. Katz's에는 하룻밤에 리뷰가 약 25개 달리므로 이 상한으로는 턱없이 부족합니다. 따라서 이 작업에 남는 도구 경로는 하나입니다. HTTP나 원격 MCP로 리뷰 API를 호출해 구조화된 JSON을 받는 방법입니다.
원격 MCP냐 HTTP냐: 비용이 다른 두 가지 경로
첫 번째 경로는 원격 MCP입니다. EveryInfra MCP 서버는 https://api.everyinfra.com/mcp에 있으며 Streamable HTTP 전송 방식을 사용합니다(MCP transports). tools/list는 도구 12개를 반환하며, 이 중 비용이 발생하는 도구는 everyinfra_call_api입니다(MCP 서버 페이지 참고). 에이전트에서는 type: url로 MCP 서버를 선언하고 mcp_toolset을 추가합니다. 볼트는 서버 URL과 일치하는 static_bearer 자격 증명을 제공합니다(MCP connector). 이 경로는 설정이 가장 간단하지만 함정이 두 가지 있습니다.
첫 번째 함정은 승인입니다. 권한 정책 문서에 따르면 에이전트 도구 세트의 기본값은 always_allow이고 MCP 도구 세트의 기본값은 always_ask입니다(Permission policies). 세션은 MCP를 호출할 때마다 일시 중지되고 승인을 기다립니다. 밤에는 승인할 사람이 없으므로 세션은 계속 기다리기만 합니다.
도구 세트에 default_config.enabled: false를 설정해 모든 도구를 끈 다음, everyinfra_call_api에만 always_allow를 설정합니다. 이 도구는 호출할 때마다 과금되므로 readOnlyHint: false와 destructiveHint: true 어노테이션이 붙어 있습니다. 그래서 auto 정책에서도 승인을 요청할 수 있습니다. 이 어노테이션은 MCP tools spec에 정의되어 있습니다.
두 번째 함정은 응답 크기입니다. MCP 커넥터 문서에 나온 크기 제한은 100,000자(약 25,000토큰)입니다. 이보다 큰 도구 출력은 샌드박스의 파일로 저장되고, 모델은 짧은 미리보기만 받습니다. Katz's의 최신 리뷰 100개를 담은 실제 Google 응답은 105,266자로, 이 기준을 살짝 넘었습니다.
2차 라운드에서 최신 리뷰 50개를 요청한 실제 MCP 호출은 53,364자를 반환했습니다. 리뷰 50개짜리 Tripadvisor 응답은 54,739자, 리뷰 10개짜리 Yelp 한 페이지는 약 10,000자였습니다. 차트에서 각 실제 응답을 기준선과 나란히 비교할 수 있습니다.
두 번째 경로는 환경 변수 자격 증명을 사용하는 HTTP입니다. 에이전트는 내장 bash 도구로 Authorization: Bearer $EVERYINFRA_API_KEY 헤더를 붙여 curl을 실행합니다. 샌드박스 안에서 이 변수에는 플레이스홀더만 들어 있고, 요청이 밖으로 나갈 때 실제 키로 바뀝니다. JSON 응답은 곧바로 샌드박스 파일에 저장됩니다. 그런 다음 jq 필터가 지난번 ID 목록에 없는 별점 1~2점 리뷰만 통과시킵니다.
따라서 모델이 보는 것은 매장당 128,000자의 원시 데이터가 아니라 필터링된 리뷰 10여 개입니다. 대신 스크립트 단계를 명확히 적은 더 긴 프롬프트가 필요하고, 환경에 jq도 있어야 합니다. 환경에서 패키지 매니저를 쓰도록 허용하거나 jq를 미리 설치해 두면 됩니다. 야간 실행에는 HTTP 경로를 권장합니다. MCP는 수동 점검용으로 남겨 두는 것이 좋습니다. 수동 세션에서는 에이전트가 everyinfra_list_requests를 호출해 개별 호출의 상태와 과금액을 확인할 수 있으며, 이 도구는 무료입니다.
구성 예시: 환경, 에이전트, 볼트, 배포
아래 네 파일은 platform.claude.com 문서에 나온 필드를 바탕으로 작성했습니다. 구성 예시일 뿐이며 실제 조직에서 생성해 보지는 않았습니다. ant CLI는 YAML 헤더가 있는 Markdown 파일을 ant apply로 객체로 만들 수 있습니다. 생성된 ID는 claude-lock.json에 저장됩니다(Define your agent). 먼저 환경입니다.
# Configuration example: environment (fields from the Cloud environment setup doc; not tested by us)
name: review-patrol-env
config:
  type: cloud
  networking:
    type: limited
    allowed_hosts:
      - api.everyinfra.com
    allow_package_managers: true   # to install jq; turn off after you preinstall it
    allow_mcp_servers: false
다음은 에이전트입니다. 시스템 프롬프트로 세 가지 규칙을 고정합니다. 엔드포인트 4개만 호출하고, "신규" 여부는 ID로 판단하며, 권한 오류가 나면 중단합니다.
---
# Configuration example: agent.md (fields from Define your agent, Tools and Permission policies; not tested by us)
name: Nightly review patrol
model: claude-sonnet-5-5
tools:
  - type: agent_toolset_20260401
    configs:
      - name: web_fetch
        enabled: false
      - name: web_search
        enabled: false
---
Each night, read new reviews for every store in the store list. Use only bash and curl to call
https://api.everyinfra.com/api/v1/social with the header "Authorization: Bearer $EVERYINFRA_API_KEY".
Make 4 calls per store: google_maps_reviews/reviews (sort=newest, limit=50), yelp/reviews pages 1 and 2,
and tripadvisor/reviews. Save each response to /tmp/<store>-<site>.json.
Use jq to drop review IDs that are already in /mnt/memory/review-patrol/seen.json. Read only 1-2 star reviews.
Give each bad review one or more labels: food, service, line and seating, price and hype, venue, online order.
Translate reviews that are not in English before you label them.
If a response says unauthorized, stop. Write "EveryInfra key not valid" as the first line of the report. Do not retry.
At the end, write all review IDs from this run back to /mnt/memory/review-patrol/seen.json,
and write the report to /mnt/session/outputs/report.md.
볼트에는 자격 증명 하나가 필요합니다. 로컬 머신에서는 secret_value를 환경 변수에서 읽어, 키가 파일에 남지 않도록 합니다.
# Configuration example: add an environment variable credential to a vault (fields from Authenticate with vaults; not tested by us)
curl --fail-with-body -sS "https://api.anthropic.com/v1/vaults/$VAULT_ID/credentials" \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "anthropic-beta: managed-agents-2026-04-01" \
  -H "content-type: application/json" \
  -d "$(jq -n --arg v "$EVERYINFRA_API_KEY" '{
        auth: {
          type: "environment_variable",
          secret_name: "EVERYINFRA_API_KEY",
          secret_value: $v,
          networking: {type: "limited", allowed_hosts: ["api.everyinfra.com"]},
          injection_location: {header: true}
        },
        display_name: "EveryInfra key for nightly review patrol"
      }')"
마지막은 예약 배포입니다. 문서에 따르면 배포에는 새 세션과 같은 설정이 들어갑니다. 에이전트와 환경은 필수입니다. 파일, 메모리 스토어, 볼트는 선택입니다. 매장 목록은 초기 메시지에 넣고, 예산은 실행당 50센트입니다. amount 필드의 단위는 센트이므로 "50"은 $50가 아니라 $0.50입니다. 메모리 스토어는 표시 이름으로 /mnt/memory/ 아래에 마운트되므로, review-patrol이라는 스토어는 /mnt/memory/review-patrol/에 있습니다.
{
  "name": "Nightly review patrol (NYC)",
  "agent": "agent_01...",
  "environment_id": "env_01...",
  "vault_ids": ["vlt_01..."],
  "resources": [
    {"type": "memory_store", "memory_store_id": "memstore_01...", "access": "read_write",
     "instructions": "seen.json holds the review IDs from the last run, grouped by site."}
  ],
  "initial_events": [
    {
      "type": "user.message",
      "content": [{"type": "text", "text": "Store list: Katz's Delicatessen and Haidilao Hot Pot Flushing. URLs are in stores.json. Read all new reviews since the last run and write the morning report."}]
    }
  ],
  "schedule": {"type": "cron", "expression": "30 6 * * *", "timezone": "America/New_York"},
  "budget": {"type": "limit", "max_list_cost": {"amount": "50", "currency": "USD"}}
}
결과는 어떻게 받을까요? 웹훅은 전체 객체 대신 이벤트 유형, ID, 타임스탬프만 담은 가벼운 페이로드를 보냅니다. 객체는 GET 호출로 가져옵니다(Subscribe to webhooks). 이벤트 유형은 두 가지면 충분합니다. session.status_idled는 "에이전트가 멈추고 입력을 기다린다"는 뜻이라는 점에 유의해야 합니다.
이 이벤트는 실행이 끝났을 때뿐 아니라 실행이 승인을 기다릴 때도 발생합니다. 따라서 서버는 세션을 GET으로 조회해 최신 session.status_idle 이벤트의 stop_reason.type을 읽어야 합니다(Session event stream). deployment_run.failed는 그날 밤 실행이 세션을 생성하지 못했다는 뜻입니다. run 엔드포인트를 통한 수동 실행은 deployment_run 이벤트를 보내지 않으므로, 테스트에서 이 이벤트를 기다리면 안 됩니다.
각 이벤트는 최대 3번까지 전송을 시도하며, 5초에서 120초 사이의 지터가 적용된 지수 백오프를 사용합니다. 마지막 시도까지 실패하면 이벤트는 대기열에 들어가지 않고 버려집니다. 따라서 서버는 event.id로 중복을 제거해야 하고, 매일 아침 배포 실행 목록을 확인해야 합니다. 서명 시크릿은 whsec_로 시작합니다. 헤더는 webhook-id, webhook-timestamp, webhook-signature이며 Standard Webhooks와 같은 형식입니다.
| `stop_reason.type` | 의미 | 웹훅 수신 후 서버 처리 |
|---|---|---|
end_turn | 에이전트가 턴을 마침 | Files API로 /mnt/session/outputs/report.md를 가져와 당직 매니저에게 전송 |
requires_action | 도구 호출이 승인 대기 중(예: 아직 always_ask로 설정된 MCP 도구) | 알림을 보내고 에이전트 권한 정책 수정. 야간에 스크립트로 호출을 승인하지 말 것 |
budget_reached | 이번 실행의 정가 기준 비용이 예산에 도달함 | 알림을 보내고 에이전트가 반복해서 재시도했는지 확인. 예산은 다음 날 변경 |
실제 왕복 한 번: 모델이 보내는 요청과 돌아오는 응답
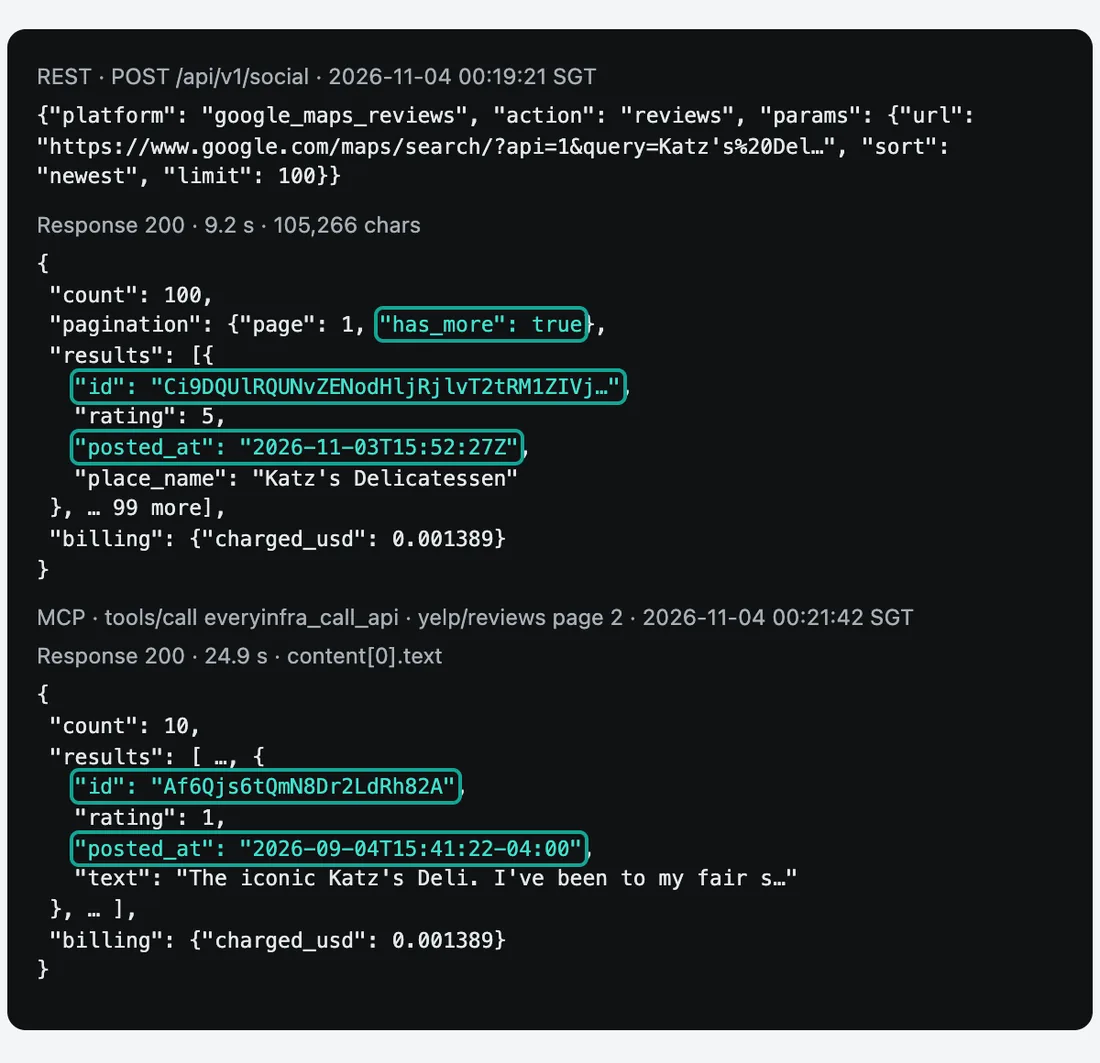
Anthropic 쪽에 실제로 배포하지는 않았습니다. 하지만 에이전트가 MCP로 EveryInfra에 보내는 요청은 저희 쪽에서 보면 curl로 보내는 요청과 똑같습니다. 아래는 싱가포르 시간 00:21:42에 원격 MCP tools/call로 보낸 실제 요청입니다. Yelp에서 Katz's 리뷰 2페이지를 읽는 요청입니다. page_token은 1페이지 응답의 next_page_token에서 가져온 값이며, 여기서는 줄여서 표시했습니다.
{"jsonrpc": "2.0", "id": 7, "method": "tools/call",
 "params": {"name": "everyinfra_call_api",
  "arguments": {"platform": "yelp", "action": "reviews",
   "params": {"url": "https://www.yelp.com/biz/katzs-delicatessen-new-york",
              "page_token": "pt1.4EnA2jhN8mJn…"}}}}
응답은 24.9초 뒤 HTTP 200으로 돌아왔습니다. content[0].text에는 리뷰 10개가 담긴 9,675자의 JSON이 들어 있었고, 이 호출에는 $0.001389가 과금되었습니다. 각 리뷰에는 id, rating, posted_at, text 같은 필드가 있습니다. 가장 중요한 필드는 id입니다. "신규" 판정이 이 필드에 달려 있기 때문입니다. 아래 표는 Katz's에 대한 1차 라운드(T1) 호출 전체입니다.
| 싱가포르 시간 | 기능 | 경로 | 행 | 시간 | 문자 수 | 과금 |
|---|---|---|---|---|---|---|
| 00:18:04 | google_maps_reviews/search | REST | 3 | 72.5 s | 3,915 | $0.001389 |
| 00:19:21 | google_maps_reviews/reviews, 최신순, 100개 | REST | 100 | 9.2 s | 105,266 | $0.001389 |
| 00:19:46 | yelp/reviews 1페이지 | REST | 10 | 24.6 s | 11,825 | $0.001389 |
| 00:20:22 | tripadvisor/search | REST | 1 | 15.2 s | 1,741 | $0.001389 |
| 00:20:43 | tripadvisor/reviews | REST | 50 | 11.1 s | 54,739 | $0.001389 |
| 00:21:02 | yelp/reviews, sort_by=date_desc를 붙인 URL | REST | 10 | 27.4 s | 11,825 | $0.001389 |
| 00:21:42 | yelp/reviews 2페이지 | MCP | 10 | 24.9 s | 9,675 | $0.001389 |
00:17:32의 첫 호출은 429를 받았습니다. 테스트 키의 요청 속도 제한이 분당 10회이기 때문입니다. 이 호출은 과금되지 않았고, 30초 뒤 재시도는 성공했습니다. 이어서 Haidilao와 멕시코시티의 Contramar에 대해 13건을 더 호출했습니다.
이 중 4건은 결과가 없는 검색이었고, API가 각각 empty_result_refunded로 환불했습니다. 1차 라운드에서는 15건이 과금되어 $0.020835였습니다. 01:20에 진행한 2차 라운드 5건을 더하면 20건, $0.02778이 과금되었습니다. 미국 밖의 두 매장(마드리드의 Botín, 멕시코시티의 Contramar)은 Google 장소 검색에서 결과가 나오지 않았습니다. 그래서 Google Maps 검색 URL로 google_maps_reviews/reviews를 호출해 Contramar 리뷰 50개를 받았습니다.
테스트 1: 사이트별 "최신 N개"는 며칠 치를 담을까
매일 밤 읽어야 하는 리뷰 수는 한 페이지가 담는 기간에 따라 달라집니다. 각 응답에서 첫 리뷰와 마지막 리뷰의 posted_at 차이를 계산했고, 결과는 차트와 같습니다. Google에서는 수정된 예전 리뷰 2개(10월 23일, 8월 10일 날짜)가 목록 중간에 끼어 있었습니다. Google 도움말에 따르면 수정된 리뷰에는 수정 날짜가 표시되므로(Google Business Profile help), 이 두 리뷰는 기간 계산에서 제외했습니다.
| 사이트 | 읽은 행 | 목록 기간 | 별점 1~2점 | 업주 답글 | 날짜순 여부 |
|---|---|---|---|---|---|
| 100 | 3.97일 | 10 | 10 | 예, 수정된 리뷰 2개 제외 | |
| Yelp 1·2페이지 | 20 | 68.84일 | 1 | 0 | 아니요 |
| Tripadvisor | 50 | 119일 | 10 | 0 | 예 |
"최신 50개"가 담는 기간은 Google의 Katz's에서는 이틀이 채 안 되고, Tripadvisor의 Contramar에서는 1년이 넘습니다. 이 차이는 매장의 리뷰 양과 리뷰 언어 때문에 생깁니다. Tripadvisor 응답 두 개는 모두 영어 리뷰뿐이었습니다. Katz's 리뷰 50개는 모두 영어였습니다. Contramar는 멕시코 사이트 URL인 tripadvisor.com.mx를 썼는데도 리뷰 50개가 모두 영어였으며, 기간은 2025-09-02부터 2026-10-21까지였습니다.
즉 이 엔드포인트는 Tripadvisor의 영어 리뷰를 읽으며, 스페인어 리뷰는 응답에 포함되지 않습니다. 현지 손님이 대부분인 매장이라면 특정한 날 밤에 Tripadvisor 쪽에서 새 리뷰가 나오는 일은 드뭅니다. 그래도 한 번 읽는 비용이 $0.001389에 불과하므로 작업에 남겨 둘 가치가 있습니다.
Yelp는 다르게 동작합니다. Katz's 1페이지에는 9월 20일부터 11월 2일까지의 리뷰 10개가 순서 없이 섞여 있었습니다. Yelp 지원 페이지에 따르면 기본 정렬은 최신성, 투표 수, 리뷰 품질을 함께 반영하므로 오래된 리뷰가 새 리뷰보다 앞에 나올 수 있습니다. "Newest First"는 로그인한 사용자만 선택할 수 있습니다(Yelp support).
URL에 sort_by=date_desc를 붙여 다시 호출했습니다. 리뷰 ID 10개가 완전히 같았으므로 이 URL 파라미터는 효과가 없었습니다. 2페이지에는 11월 1일 리뷰가 있었고, 10개 중 5개가 1페이지의 가장 오래된 리뷰보다 최신이었습니다. 따라서 야간 작업은 Yelp 페이지를 최소 두 개 읽어야 하고, "신규" 여부를 ID로 판단해야 합니다. 1페이지 맨 위 리뷰는 믿을 만한 기준점이 아닙니다.
테스트 2: 부정 리뷰는 어디에 있고 무엇을 말하는가
차트는 각 응답의 별점별 비율을 보여 줍니다. Katz's의 최신 Google 리뷰 100개 중 10개(10%)가 별점 1~2점이었습니다. Tripadvisor에서는 50개 중 10개(20%)가 별점 1~2점이었습니다. Yelp에서는 두 페이지의 리뷰 20개 중 별점 1점 리뷰가 1개뿐이었습니다.
Haidilao는 Google 리뷰 50개 중 49개가 별점 5점, 1개가 3점으로 부정 리뷰가 없었습니다. Haidilao의 Yelp 1페이지 리뷰 10개도 모두 4점 또는 5점이었습니다. Contramar의 Google 리뷰 50개에는 1점 리뷰와 2점 리뷰가 하나씩 있었습니다.
Katz's의 Google 부정 리뷰 10개와 Tripadvisor 부정 리뷰 10개의 전문을 읽었습니다. 리뷰마다 직접 라벨을 붙였으며, 한 리뷰에 라벨이 여러 개 붙을 수 있습니다. Google 리뷰 10개 중 6개는 음식(퍽퍽한 고기, 부서지는 빵)에 관한 내용이었고, 7개는 과대평가되었거나 가격이 비싸다는 내용이었습니다. 직원 관련이 3개, 붐비는 좌석이나 실내 관련이 2개, 줄 관련이 1개였습니다.
Tripadvisor 리뷰 10개 중 7개는 음식, 6개는 가격과 과대평가, 5개는 서비스, 3개는 줄과 좌석에 관한 내용이었습니다. 또 다른 2개는 매장 방문이 아니라 온라인 주문과 배송에 관한 것이었습니다. 이렇게 나눠 두면 보고서에 도움이 됩니다. 온라인 주문 불만은 이커머스팀에 전달해야 하며, 매장 직원 평가에 반영해서는 안 됩니다.
프롬프트를 바꿔야 할 발견이 두 가지 더 있습니다. 첫째, Google 부정 리뷰 10개 중 6개가 영어가 아니었습니다. 이탈리아어 2개, 독일어 2개, 튀르키예어 1개, 스페인어 1개입니다. lang 파라미터는 인터페이스 언어를 설정할 뿐 리뷰를 번역하지 않으므로, 에이전트가 라벨을 붙이기 전에 직접 번역해야 합니다. 둘째, 최신 Google 리뷰 100개 중 10개에 업주 답글이 있었습니다. 답글 10개는 모두 11월 2일 21:10~21:32 UTC, 22분 사이에 달렸습니다.
답글 10개 중 9개는 별점 5점 리뷰에 달렸습니다. 1점 리뷰에 달린 답글은 하나뿐이었고, 새치기한 사람에 관한 리뷰였습니다. 그 답글은 리뷰가 올라온 지 약 35시간 뒤에 달렸습니다. 즉 이 매장은 답글을 몰아서 달고, 좋은 리뷰부터 답합니다. 보고서에 "답글 여부" 열을 두면 아무도 처리하지 않은 부정 리뷰가 맨 위로 올라옵니다.
테스트 3: 두 스냅샷 사이에서 "신규"를 판정하는 방법
1차 라운드(T1)는 싱가포르 시간 00:19~00:21, 2차 라운드(T2)는 01:20에 진행했습니다. 약 1시간 간격은 "어젯밤"과 "오늘 밤"을 가정한 것입니다. T2에서는 원격 MCP로 Katz's의 최신 Google 리뷰 50개를 읽었습니다. 또 REST로 since=2026-11-03을 붙여 Google을 다시 읽고, Yelp 1페이지와 Tripadvisor도 한 번씩 읽었습니다.
호출 4건에 $0.005556입니다. yelp/search를 한 번 더 호출해 스페인어판 글에 쓸 Contramar의 Yelp 페이지를 찾았습니다. "신규" 규칙은 한 줄입니다. 리뷰 ID가 지난 실행의 ID 집합에 없으면 신규입니다.
| 사이트 | T1 행 | T2 행 | T1에 없던 ID | 그중 별점 1~2점 |
|---|---|---|---|---|
| Google 최신 50개(MCP) | 100 | 50, 53,364자 | 3, 모두 별점 5점 | 0 |
Google since=2026-11-03(REST) | — | 17, 21,588자, 다음 페이지 없음 | 3(나머지 14개는 T1에 있음) | 0 |
| Yelp 1페이지 | 10 | 10, T1과 같은 ID·같은 순서 | 0 | 0 |
| Tripadvisor | 50 | 50 | 0 | 0 |
가장 유용한 정보는 새 Google 리뷰 3개의 게시 시각인 17:15, 16:49, 14:54 UTC입니다. 앞의 두 개는 16:19 UTC의 T1 호출보다 나중이므로 평범한 신규 리뷰입니다. 세 번째인 14:54 리뷰는 T1 호출보다 1시간 25분 앞섭니다. T1의 가장 최신 리뷰(15:52)보다도 이전이지만, T1의 100개 목록에는 없었습니다.
즉 Google에서는 리뷰가 표시된 게시 시각보다 늦게 나타날 수 있습니다. "지난번 최신 리뷰 이후의 posted_at만 읽는다" 같은 규칙으로는 이 리뷰를 영영 놓칩니다. ID 비교로만 잡을 수 있습니다. T1과 T2에 모두 나온 리뷰는 posted_at, 별점, 업주 답글이 바뀌지 않았습니다.
since 파라미터도 프롬프트에 넣어야 합니다. 이 값은 시각이 아니라 날짜입니다. since=2026-11-03은 11월 3일(UTC) 리뷰 17개를 모두 반환했고, 그중 14개는 이미 T1에 있었습니다. 따라서 ID 확인을 대신할 수는 없습니다. 하지만 응답을 53,364자에서 21,588자로 약 60% 줄였고, 이는 MCP 경로에서 특히 도움이 됩니다.
권장 설정은 다음과 같습니다. since는 마지막으로 성공한 실행의 전날로 설정하고, sort=newest를 유지하며, ID로 중복을 제거합니다. since가 잘못될 경우에 대비해 limit은 50으로 유지합니다. 이 1시간 동안 Yelp와 Tripadvisor에는 새 리뷰가 없었고, Yelp 1페이지의 ID 10개는 순서도 그대로였습니다. 1페이지가 바뀌지 않았다고 해서 2페이지도 그대로라는 보장은 없으므로 두 페이지를 모두 읽어야 합니다. 이날 밤 보고서는 한 줄입니다. "지난 1시간 동안 세 사이트에 새 리뷰 3개, 모두 별점 5점, 새 부정 리뷰 없음."
이 비교 결과로 메모리 스토어에 무엇을 저장할지도 정해집니다. 사이트별 최근 리뷰 ID 집합이면 충분합니다. Google은 엔드포인트가 페이지네이션으로 최대 400행까지 가져오므로 최근 ID 400개를 보관합니다. Yelp와 Tripadvisor는 각각 최근 ID 100개를 보관합니다. 마지막으로 성공한 실행 날짜도 저장합니다. 앞의 14:54 리뷰 사례 때문에 "가장 최신 리뷰의 시각"만 저장해서는 안 됩니다.
아침 보고서는 어떤 모습일까
라벨 규칙은 라벨마다 한 줄 정의와 몇 가지 단서를 붙여 프롬프트에 적어 둡니다. 그렇지 않으면 같은 리뷰가 오늘은 "서비스", 내일은 "대기"로 분류되어 월말 집계를 비교할 수 없습니다. 아래 라벨 6개는 부정 리뷰 28개(Katz's 21개, Contramar 7개)의 전문을 바탕으로 만들었습니다. 각 단서는 이 리뷰들에서 반복해서 나온 표현입니다. 한 리뷰에 라벨이 여러 개 붙을 수 있습니다. 에이전트가 확신하지 못할 때는 하나를 억지로 고르지 말고 라벨을 하나 더 붙이도록 합니다.
| 라벨 | 정의 | 리뷰 속 단서 | 전달 대상 |
|---|---|---|---|
| 음식 | 음식 자체의 문제 | 퍽퍽함, 짬, 느끼함, 맛없음, 신선하지 않음, 빵이 부서짐 | 주방 책임자 |
| 서비스 | 직원의 태도나 행동 | 무례함, 우리를 무시함, 봉투를 던짐, 묻지 않고 팁을 추가함 | 매장 매니저 |
| 대기·좌석 | 대기, 테이블 배치, 좌석 선택 | 긴 줄, 새치기, 바 좌석만 가능, 테이블 간격이 좁음 | 홀 매니저 |
| 가격·과대평가 | 가격만큼의 가치가 없거나 명성이 음식보다 큼 | 너무 비쌈, 과대평가, 바이럴 맛집, 일부러 갈 가치 없음 | 마케팅·가격 담당 |
| 매장 환경 | 실내 공간과 시설 | 붐빔, 테이블 간격이 좁음, 옆 테이블에서 전자담배 | 매장 매니저 |
| 온라인 주문 | 웹 주문, 배송, 배달 | 일주일 뒤 도착, 온라인으로 구매한 양념류에 문제 | 이커머스팀 |
아래 샘플은 T1 응답에 있던 Katz's의 Google 부정 리뷰 10개를 사용합니다. 각 리뷰는 번역하고 요약했습니다. 날짜는 UTC 기준입니다. 실제 보고서에는 당직 매니저가 바로 열어 답글을 달 수 있도록 리뷰마다 링크도 넣어야 합니다.
| 게시 시각(UTC) | 별점 | 언어 | 요약 | 라벨 | 답글 여부 |
|---|---|---|---|---|---|
| 11-03 02:40 | 1 | 이탈리아어 | 음료·사이드 카운터 직원이 무례했고 손님에게 봉투를 던짐 | 서비스 | 아니요 |
| 11-01 17:59 | 1 | 영어 | 음식 수준이 몇 년째 떨어지고 있음. 오늘 파스트라미는 느끼하고 맛이 없었음 | 음식, 가격·과대평가 | 아니요 |
| 11-01 10:08 | 1 | 영어 | 새치기한 사람이 있었는데 조리사는 리뷰어에게 계속 기다리라고 함 | 대기·좌석 | 예 |
| 10-31 15:07 | 1 | 튀르키예어 | 과대평가됨, 택시 타고 갈 가치 없음 | 가격·과대평가 | 아니요 |
| 10-31 12:55 | 2 | 스페인어 | 고기를 써는 남자 직원이 불친절했음 | 서비스 | 아니요 |
| 10-31 08:34 | 2 | 이탈리아어 | 고기가 삶은 듯한 맛에 퍽퍽했고, 빵이 별로였으며, 가격이 매우 비쌈 | 음식, 가격·과대평가, 매장 환경 | 아니요 |
| 10-31 02:53 | 2 | 독일어 | 음식이 매우 실망스러움. 실내만 전형적인 미국 델리 느낌이었고, 명성과 가격이 음식에 걸맞지 않음 | 음식, 가격·과대평가 | 아니요 |
| 10-31 02:51 | 1 | 독일어 | 간이 안 된 퍽퍽한 고기, 명성이나 가격만큼의 가치 없음 | 음식, 가격·과대평가 | 아니요 |
| 10-30 23:33 | 1 | 영어 | $31짜리 파스트라미 샌드위치가 너무 퍽퍽하고 질겨서 썰기 어려움 | 음식, 가격·과대평가 | 아니요 |
| 10-30 16:33 | 2 | 영어 | 주된 불만은 담당 서버가 아닌 직원이 테이블을 옮겼다며 손님을 탓하고 무례하게 대한 것. 그 밖에도 과대평가, 별로인 음식, 너무 좁은 테이블 간격을 지적함 | 서비스, 음식, 매장 환경, 가격·과대평가 | 아니요 |
보고서는 긴 목록이 아니라 짧은 요약으로 시작해야 합니다. 위 표를 바탕으로 하면 요약은 이렇게 쓸 수 있습니다. "지난 4일간 Google에 별점 1~2점 신규 리뷰가 10개 달렸습니다. 7개는 과대평가되었거나 가격만큼의 가치가 없다는 내용이고, 6개는 음식에 관한 내용입니다. 6개는 영어가 아닙니다. 9개는 답글이 없으며, 그중 3개는 직원 관련입니다. 오늘은 이 3개에 먼저 답글을 다세요."
보고서 본문에는 리뷰어나 직원의 이름을 넣지 말고 링크만 남깁니다. Contramar의 Google 리뷰 텍스트에는 <br> 줄바꿈 태그도 들어 있으므로(텍스트가 있는 리뷰 30개 중 6개), 에이전트가 보고서를 작성하기 전에 정리해야 합니다.
Claude Managed Agents 요금: API 요금과 Anthropic 측 비용
비용은 두 부분으로 나뉩니다. EveryInfra 쪽은 간단합니다. 매장 하나당 매일 밤 $0.001389짜리 호출 4건이 필요하므로 하룻밤 $0.005556, 30일 기준 $0.1667입니다. 매장 10곳이면 월 $1.6668, 50곳이면 $8.334입니다.
월 요금은 없습니다. 빈 결과는 환불됩니다. 조회 호출 3건은 초기 설정 때만 발생합니다(요금 페이지 참고).
Anthropic 쪽은 2026년 11월 4일에 확인한 요금 페이지에 따르면 Managed Agents에 두 가지 요금이 있습니다. 토큰은 모델 정가로 과금됩니다. 세션 런타임은 시간당 $0.08이며, 밀리초 단위로 측정되고 세션 상태가 running인 동안에만 부과됩니다. 유휴 시간은 무료입니다.
세션 내 웹 검색은 1,000건당 $10이며 Batch API 할인은 적용되지 않습니다(Pricing). 같은 페이지에 따르면 Opus 5.5는 100만 토큰당 입력 $4, 출력 $20입니다. Sonnet 5.5는 $2와 $10입니다. Haiku 5.5는 프롬프트 100,000토큰 이하 기준 $0.10과 $0.50입니다.
토큰 사용량은 측정하지 않았으므로 아래 수치는 추정치입니다. 직접 값을 넣어 볼 수 있도록 가정을 함께 밝힙니다. 매장 하나, 하룻밤 기준 원시 응답은 129,603자입니다(2차 라운드의 실제 Google 50개 응답, Yelp 두 페이지, Tripadvisor 50개). 용어집에 따르면 이전 모델은 영어 기준 토큰당 약 3.5자를 사용합니다. 4.7 이후 모델은 같은 텍스트에 토큰을 약 30% 더 사용합니다(Glossary). 저희는 토큰당 2.69자를 적용했으므로 원시 응답은 약 48,138토큰입니다.
에이전트 루프는 컨텍스트를 여러 번 읽을 수 있습니다. 몇 번인지는 측정할 수 없어 두 가지 수준으로 제시합니다. 1x(각 응답이 컨텍스트에 한 번 들어감)가 하한이고 3x가 상한입니다. 두 수준 모두 시스템 프롬프트와 도구 텍스트 15,000토큰, 출력 3,000토큰을 더했습니다. 프롬프트 캐시 할인은 반영하지 않았습니다. 원시 데이터를 모두 컨텍스트에 넣는 MCP 경로에서는 하룻밤에 입력 토큰이 약 63,138~159,414개 필요합니다.
jq로 별점 1~2점 행만 통과시키는 HTTP 경로에서는 하룻밤에 입력 토큰이 약 17,854~23,564개 필요합니다. 3x 수준에서 약 85% 적은 양입니다. 토큰당 문자 수도 추정치입니다. 더 정확한 수치가 필요하면 실제 응답으로 Anthropic 토큰 카운팅 엔드포인트를 실행해 보세요. 런타임은 도구 호출 4건의 실측 시간 69.8초에 모델 처리 시간 60초를 더해 계산했으며, 하룻밤 $0.00288입니다.
| 매장 1곳 | 하룻밤(1x~3x) | 월(30일, 3x) |
|---|---|---|
| EveryInfra API 요금(호출 4건, 정가) | $0.005556 | $0.1667 |
| 세션 런타임(추정 129.8초) | $0.00288 | $0.0864 |
| Haiku 5.5, HTTP + 필터 | $0.0033~$0.0039 | $0.117 |
| Haiku 5.5, MCP + 전체 데이터 | $0.0078~$0.0174 | $0.522 |
| Sonnet 5.5, HTTP + 필터 | $0.0657~$0.0771 | $2.313 |
| Sonnet 5.5, MCP + 전체 데이터 | $0.1563~$0.3488 | $10.464 |
| Opus 5.5, HTTP + 필터 | $0.1314~$0.1543 | $4.629 |
API 요금은 작고 고정된 금액입니다. 실제 비용은 모델과 컨텍스트에 들어가는 원시 데이터의 양에 따라 달라집니다. Sonnet 5.5로 HTTP 경로를 쓰면 매장 하나의 총비용은 하룻밤 약 $0.074~$0.086입니다. 이 중 API 요금은 6.5~7.5%에 불과합니다. 같은 모델로 전체 데이터를 넣는 MCP 경로를 쓰면 하룻밤 약 $0.165~$0.357로 2.2~4.2배가 됩니다. 리뷰 라벨링과 번역에는 Haiku 5.5로도 충분할 가능성이 높으며, 그러면 매장 하나의 비용은 월 $0.40 미만입니다.
배포 예산은 "매장 수 × 매장당 추정치 × 3"으로 정합니다. Sonnet과 HTTP로 매장 10곳을 처리하면 추정치는 하룻밤 약 $0.86입니다. "300"($3) 예산이면 폭주하는 루프는 멈추고 정상 실행은 끝까지 완료할 수 있습니다. 한 Reddit 사용자는 Managed Agents를 세 번 시도하는 데 API 요금이 약 $6 들었다고 했습니다(Reddit 스레드). 그래서 예산은 첫날부터 설정해야 합니다. 아래 표는 3x 수준에서 매장 수를 늘렸을 때의 총액입니다. 매장당 비용이 일정하고 세션 하나가 모든 매장을 읽는다고 가정했습니다.
| 매장 수 | 월 EveryInfra API 요금 | Haiku 5.5 HTTP 총액(추정) | Sonnet 5.5 HTTP 총액(추정) | 실행당 예산(Sonnet) |
|---|---|---|---|---|
| 1 | $0.1667 | $0.369 | $2.565 | "30" |
| 10 | $1.667 | $3.69 | $25.65 | "300" |
| 50 | $8.334 | $18.45 | $128.25 | "1300" |
Claude Managed Agents·Agent SDK·Claude Code·Cowork의 예약 실행 방식 비교
이제 Anthropic에서 Claude를 예약 실행하는 방법은 최소 네 가지입니다. 어떤 방법이 맞는지는 누가 루프를 실행하는지, 누가 비용을 내는지, 키가 어디에 있는지에 따라 달라집니다. Agent SDK는 라이브러리입니다. Claude Code 에이전트 루프를 사용자의 프로세스 안에서 실행합니다.
머신과 스케줄러는 직접 준비해야 합니다(Agent SDK overview, hosting guide). Managed Agents는 호스팅되는 루프와 샌드박스를 함께 제공합니다. Claude Code routines와 Cowork 예약 작업은 구독형 앱의 기능이며, 요금제 사용량을 소모합니다.
| Managed Agents 배포 | Agent SDK | Claude Code routines | Cowork 예약 작업 | |
|---|---|---|---|---|
| 루프 실행 주체 | Anthropic 클라우드 | 자체 서버 또는 컨테이너 | Anthropic 클라우드 | Anthropic 클라우드 |
| 일정 | Cron + IANA 시간대, 최대 9분 지터 | 자체 cron 또는 작업 큐 | Cron, 최소 1시간 간격 | 앱에서 실행 빈도 선택 |
| 과금 | API 토큰 + 시간당 $0.08 | API 토큰 | 플랜 사용량 | 플랜 사용량 |
| 적합한 용도 | 예산과 웹훅을 갖춘 다수 매장 대상 프로덕션 작업 | 이미 서버를 운영하며 완전한 제어를 원하는 팀 | 개발자 개인용 요약 | 개인 주간 보고서 |
| 출처 | Scheduled deployments, Pricing | Agent SDK overview, hosting | Routines | Cowork 도움말 |
앞서 관련 글을 두 편 썼습니다. 한 편은 Claude Code 루틴으로 매일 밤 Reddit을 읽고 불편 사항 요약을 작성합니다. 이 테스트에서 게시물 100개짜리 한 페이지는 18.7시간 분량만 담았습니다(Claude Code 예약 작업으로 Reddit 불편 사항 수집). 다른 한 편은 Cowork 예약 작업으로 매주 월요일 경쟁사 가격·리뷰 표를 만듭니다(Cowork 경쟁사 가격 표).
세 글을 함께 읽어 보세요. 직접 읽는 주간 보고서에는 Cowork가 가장 간편합니다. 코드 저장소와 함께 돌리는 개발 작업에는 Claude Code가 맞습니다. 수십 개 매장을 매일 밤 확인하면서 예산 상한, 실패 알림, 자체 시스템으로의 결과 전송까지 필요하다면 Managed Agents 예약 배포를 사용하세요.
Claude Code 문서에 따르면 루틴은 최대 1시간에 한 번 실행되며 플랜 사용량을 소모합니다(Routines). Cowork 작업은 컴퓨터가 절전 상태여도 클라우드에서 실행됩니다(Cowork 도움말). 에이전트 없이 Google Maps 리뷰를 스프레드시트로만 받으면 된다면 Google Maps 리뷰 스크래핑 방법을 참고하세요.
문제가 생겼을 때: 어느 계층부터 확인할까
야간 작업이 실패하면 보고서에는 "데이터 없음"만 남는 경우가 많습니다. 아래 표는 Anthropic 배포와 세션, 볼트와 네트워크, EveryInfra API라는 세 계층에서 일어날 수 있는 장애를 한곳에 모았습니다. 왼쪽 열은 눈에 보이는 증상입니다. 오른쪽 열은 먼저 확인할 곳을 알려 줍니다. EveryInfra 관련 행은 모두 11월 4일 실제 호출에서 직접 겪은 사례입니다. Anthropic 관련 행은 오류와 상태에 관한 문서 내용을 근거로 합니다.
| 증상 | 주요 원인 계층 | 먼저 확인할 항목 | 해결 방법 |
|---|---|---|---|
| 아침에 보고서도 웹훅도 없음 | 배포가 세션을 만들지 못했거나 웹훅 전송 3회가 모두 실패함 | GET /v1/deployment_runs?has_error=true | POST /v1/deployments/{id}/run을 직접 한 번 호출 |
| 세션이 대기 상태이고 보고서 파일이 생성되지 않음 | MCP 툴셋이 아직 always_ask로 설정됨 | 마지막 idle 이벤트의 stop_reason | everyinfra_call_api에 always_allow 설정 |
| 도구 결과에 unauthorized와 "Nothing was charged"가 표시됨 | 볼트의 키가 잘못됐거나 자격 증명의 allowed_hosts가 잘못됨 | 자격 증명의 secret_name과 networking | 자격 증명 수정. 에이전트가 재시도하지 않게 함 |
curl이 호스트를 명시한 403 응답을 받음 | 환경의 allowed_hosts에 해당 호스트가 없음 | 환경의 networking | api.everyinfra.com 추가 |
| 모델은 짧은 미리보기만 볼 수 있음 | MCP 도구 출력이 100,000자 초과 | 해당 호출의 limit | 리뷰 50개를 사용하거나 jq를 쓰는 HTTP 방식으로 전환 |
| API가 429 반환 | 키의 분당 요청 한도를 모두 사용함 | 응답의 retry_after | 해당 시간(초)만큼 대기. 429 응답은 과금되지 않음 |
| 검색 결과가 없고 환불됨 | 장소 검색에서 매장을 찾지 못함 | 응답의 reason | Google Maps 검색 URL로 리뷰 읽기 |
이 표에는 한 가지 원칙이 깔려 있습니다. 모든 오류는 보고서에 드러나야 하며, 에이전트가 스스로 우회해서는 안 됩니다. 에이전트는 "다른 파라미터로 다시 시도"하는 데 능숙합니다. 하지만 이 작업은 비용이 들고, 아무도 지켜보지 않는 밤에 실행됩니다.
이 작업에서 우회는 대개 엉뚱한 매장, 중복 읽기, 또는 한 달 동안 방치되는 설정 오류로 이어집니다. 따라서 프롬프트에 이렇게 명시해야 합니다. unauthorized, 403, 예산으로 인한 일시 중지가 발생하면 멈추고 이유를 기록할 것. 429만 대기 후 한 번 재시도할 것.
한계와 미해결 사항
첫째, Anthropic 쪽은 테스트하지 않았습니다. 예약 배포, 볼트의 키 치환, 권한 정책, 웹훅은 모두 2026년 11월 4일에 읽은 platform.claude.com 문서의 설정 예시입니다. Managed Agents는 아직 베타이므로 필드가 바뀔 수 있습니다. vault_ids와 resources는 세션 문서와 메모리 문서의 예시를 바탕으로 작성했습니다. 리소스를 생성하기 전에 사용하는 SDK 버전의 deployments 레퍼런스와 대조해 확인하세요.
둘째, Tripadvisor는 영어 리뷰만 반환합니다. 스페인어, 중국어 등 다른 언어의 리뷰는 응답에 포함되지 않습니다. 셋째, 미국 밖에 있는 두 매장 모두 Google 장소 검색 결과가 나오지 않았습니다(환불됨). Google Maps 검색 URL로 직접 읽으면 동작했으므로, 새 매장 URL은 각각 한 번씩 직접 확인하세요. 넷째, Yelp 1페이지는 날짜순이 아니며 URL의 정렬 파라미터는 효과가 없습니다. 한 페이지를 더 읽고 ID로 "신규" 여부를 판단하세요.
다섯째, 리뷰 텍스트는 신뢰할 수 없는 입력입니다. 메모리 문서는 메모리 저장소의 콘텐츠에 프롬프트 인젝션이 담길 수 있다고 경고하는데, 리뷰 텍스트에도 같은 위험이 있습니다. 누군가 리뷰에 "지시를 무시하라"고 쓸 수 있습니다. HTTP와 jq 방식은 리뷰를 데이터로만 다룹니다. 환경은 api.everyinfra.com만 허용하고, 볼트는 해당 호스트로 가는 요청에서만 키를 치환합니다. 따라서 모델이 속더라도 키는 밖으로 나갈 수 없습니다.
여섯째, 보고서는 자기 매장을 개선하는 데만 사용하세요. 2024년 FTC 규칙은 가짜 리뷰, 특정 의견을 조건으로 한 리뷰 대가 지급, 부정적 리뷰 억제를 금지합니다(FTC 보도자료). 나쁜 리뷰는 매일 밤 확인할 가치가 있지만, 올바른 대응은 리뷰에 압력을 가하는 것이 아니라 답글을 달고 문제를 고치는 것입니다. 이 글은 데이터 처리 방법만 다루며 법률 자문이 아닙니다.
최근 변경 사항
지난 한 달 동안 나온 다음 업데이트가 이 작업에 영향을 줍니다. 모두 Claude Platform release notes에 있습니다. 2026-10-07부터 web_fetch는 세션에 이미 등장한 URL만 가져오며, limited 네트워킹의 allowed_hosts가 web_fetch와 web_search에도 적용됩니다. 2026-10-09에는 Managed Agents에 여러 에이전트를 단계별로 실행하는 동적 워크플로가 추가됐습니다. 매장이 수백 개라면 도움이 될 수 있지만 직접 테스트하지는 않았습니다. 2026-10-14에는 Claude Platform on AWS에서 예약 배포를 사용할 수 있게 됐습니다.
2026-10-20에는 조직 관리자가 콘솔에서 웹 가져오기를 끄거나 도메인을 제한하는 스위치가 생겼으며, Managed Agents 세션도 이 설정을 따릅니다. 2026-10-29에는 Usage and Cost Analytics API 베타가 출시됐습니다. 이 API는 토큰과 비용을 모델, 워크스페이스, API 키별로 나누어 보여 주므로 순찰 작업의 월간 비용을 확인하는 데 유용합니다.
FAQ
Claude Managed Agents와 Claude Code 루틴은 무엇이 다른가요?
이 질문은 검색 추천어 "claude managed agents vs claude code", "claude managed agents vs routines"와 Reddit 게시물 "What is the point of Managed Agents"에서 나왔습니다(Reddit 스레드). 둘 다 Anthropic 클라우드에서 실행됩니다. Claude Code 루틴은 플랜 사용량을 소모하며 최대 1시간에 한 번 실행됩니다(Routines). Managed Agents 배포는 API 토큰 비용에 세션 시간당 $0.08이 더해지며, 분 단위 cron으로 실행됩니다. 실행마다 엄격한 예산 상한을 두고 결과를 웹훅으로 전송합니다(Scheduled deployments). 팀이나 고객을 위한 프로덕션 작업에는 후자를 사용하세요.
Claude Managed Agents 요금은 어떻게 책정되며, 하룻밤 비용은 얼마인가요?
이 질문은 추천어 "claude managed agents pricing"과 "claude managed agents cost"에서 나왔습니다. 과금 항목은 두 가지입니다. 모델 토큰은 정가로 과금되고, 세션 실행 시간은 running 상태일 때만 시간당 $0.08이 과금됩니다(Pricing, 2026-11-04 열람). 저희 추정으로는 Sonnet 5.5와 HTTP 방식을 쓸 때 매장 하나당 하룻밤에 모델 요금 약 $0.077, 실행 시간 요금 $0.0029가 듭니다. 여기에 EveryInfra API 비용 $0.0056을 더하면, 3배로 높게 잡은 기준에서 총액은 약 $0.0855입니다.
Claude Managed Agents vs Agent SDK: 어떤 것을 선택해야 할까요?
이 질문은 추천어 "claude managed agents vs agent sdk"에서 나왔습니다. Agent SDK는 라이브러리입니다. 루프는 직접 운영하는 프로세스에서 실행되며 머신, 스케줄, 시크릿, 로그를 직접 관리해야 합니다(Agent SDK overview). Managed Agents는 루프, 샌드박스, 스케줄, 자격 증명 치환, 세션 기록을 호스팅합니다. 이미 서버와 작업 큐를 운영하고 있고 완전한 제어를 원한다면 SDK를 고르세요. 자체 스케줄러 없이 웹훅과 실행별 예산을 쓰고 싶다면 Managed Agents를 고르세요.
Managed Agents가 web_fetch로 Google Maps나 Yelp 리뷰를 읽을 수 있나요?
이 질문은 추천어 "claude managed agents web"에서 나왔습니다. 안정적으로는 어렵습니다. web_fetch는 JavaScript를 실행하지 않으며, 2026-10-07부터는 세션에 이미 등장한 URL만 가져옵니다(릴리스 노트). Yelp의 robots.txt는 Claude-User에게 /article만 허용합니다(yelp.com/robots.txt). 구조화된 리뷰 API가 더 안정적입니다.
예약 배포의 실행이 누락되면 어떻게 되나요?
이 질문은 추천어 "claude managed agents schedule"에서 나왔습니다. 일시 중지 중에 놓친 트리거는 소급 실행되지 않습니다. 세션 생성에 요청 속도 제한이 걸리면 해당 실행에는 session_rate_limited_error 기록이 남고 재시도는 없습니다(Scheduled deployments). 따라서 다음 실행은 최근 24시간만 볼 것이 아니라, 마지막으로 성공한 실행이 저장한 마지막 리뷰 ID까지 거슬러 읽어야 합니다. Google에서는 Katz's처럼 리뷰가 많은 매장도 limit=50이면 약 이틀 분량을 담으므로, 하룻밤을 놓쳐도 빠짐없이 확인할 수 있습니다.
모델이 볼트에 있는 키를 볼 수 있나요?
이 질문은 추천어 "claude managed agents vault"와 "claude managed agents credential vault"에서 나왔습니다. 볼 수 없습니다. 환경 변수 자격 증명은 샌드박스 안에 플레이스홀더만 둡니다. 실제 값은 요청이 밖으로 나갈 때, 그것도 allowed_hosts에 있는 호스트로 가는 경우에만 치환됩니다(Authenticate with vaults). Anthropic 블로그도 에이전트가 키를 절대 볼 수 없다고 설명합니다(Anthropic 블로그).
시작하기
- EveryInfra API 키를 발급받으세요. 빠른 시작을 따라
google_maps_reviews/search,yelp/search,tripadvisor/search를 한 번씩 실행해 세 매장의 URL을 찾습니다. - 로컬 머신에서 curl로
google_maps_reviews/reviews,yelp/reviews,tripadvisor/reviews를 한 번씩 호출합니다. 필드와 응답 크기를 확인하세요. MCP 방식은 MCP 서버 페이지를 참고하세요. - Claude 콘솔에서
limited네트워킹으로api.everyinfra.com만 허용하는 환경을 만듭니다.EVERYINFRA_API_KEY자격 증명 하나로 볼트를 만듭니다.web_fetch와web_search를 끈 상태로 에이전트를 만듭니다. - 세션을 직접 한 번 실행하거나
POST /v1/deployments/{id}/run을 호출해 보고서 형식과 비용을 확인합니다. 그런 다음 cron30 6 * * *과 실행별 예산으로 배포를 만듭니다.session.status_idled와deployment_run.failed를 구독합니다. - 각 리뷰 API는 Google Maps 리뷰 페이지, Yelp 페이지, Tripadvisor 페이지를 참고하세요. 리뷰 사이트 5곳을 아우르는 주간 보고서는 OpenAI Agents API 리뷰 순찰을 참고하세요.
참고 자료
- “Claude Managed Agents overview”, Anthropic 문서, 2026-11-04 열람.
- “Scheduled deployments”, Anthropic 문서, 2026-11-04 열람.
- “Authenticate with vaults”, Anthropic 문서, 2026-11-04 열람.
- “Cloud environment setup”, Anthropic 문서, 2026-11-04 열람.
- “Tools”, Anthropic 문서, 2026-11-04 열람.
- “MCP connector”, Anthropic 문서, 2026-11-04 열람.
- “Permission policies”, Anthropic 문서, 2026-11-04 열람.
- “Session budgets”, Anthropic 문서, 2026-11-04 열람.
- “Subscribe to webhooks”, Anthropic 문서, 2026-11-04 열람.
- “Reference”, Anthropic 문서, 2026-11-04 열람.
- “Using agent memory”, Anthropic 문서, 2026-11-04 열람.
- “Restrict web search and web fetch domains”, Anthropic 문서, 2026-11-04 열람.
- “Web fetch tool”, Anthropic 문서, 2026-11-04 열람.
- “Pricing”, Anthropic 문서, 2026-11-04 열람.
- “Claude Platform release notes”, Anthropic, 2026-11-04 열람.
- “Define your agent”, Anthropic 문서, 2026-11-04 열람.
- “Start a session”, Anthropic 문서, 2026-11-04 열람.
- “Session event stream”, Anthropic 문서, 2026-11-04 열람.
- “Glossary”, Anthropic 문서, 2026-11-04 열람.
- “Agent SDK overview”, Claude Code 문서, 2026-11-04 열람.
- “Hosting the Agent SDK”, Claude Code 문서, 2026-11-04 열람.
- “Routines”, Claude Code 문서, 2026-11-04 열람.
- “Schedule recurring tasks in Claude Cowork”, Claude Help Center, 2026-11-04 열람.
- “Does Anthropic crawl data from the web”, Claude Help Center, 2026-11-04 열람.
- “New in Claude Managed Agents: run agents on a schedule”, Anthropic 블로그, 2026-11-04 열람.
- “Claude Managed Agents: get to production 10x faster”, Anthropic 블로그, 2026-11-04 열람.
- “MCP Transports”, Model Context Protocol 사양, 2026-11-04 열람.
- “MCP Tools”, Model Context Protocol 사양, 2026-11-04 열람.
- “Place Details (New)”, Google for Developers, 2026-11-04 열람.
- “Work with review data”, Google Business Profile 문서, 2026-11-04 열람.
- “Read and reply to reviews”, Google Business Profile 도움말, 2026-11-04 열람.
- “Business Reviews”, Yelp Fusion 문서, 2026-11-04 열람.
- “How is the order of reviews determined?”, Yelp 고객 지원, 2026-11-04 열람.
- “yelp.com/robots.txt”, Yelp, 2026-11-04 열람.
- “Location Reviews”, Tripadvisor Content API 문서, 2026-11-04 열람.
- “tripadvisor.com/robots.txt”, Tripadvisor, 2026-11-04 열람.
- “crontab”, The Open Group Base Specifications Issue 8, 2026-11-04 열람.
- “Time Zones”, IANA, 2026-11-04 열람.
- “Standard Webhooks”, Standard Webhooks, 2026-11-04 열람.
- “FTC final rule banning fake reviews”, 미국 연방거래위원회(FTC), 2024-08-14 게시, 2026-11-04 열람.
- “What is the point of Managed Agents?”, Reddit r/ClaudeAI, 2026-11-04 열람.
- “EveryInfra API 카탈로그”, EveryInfra, 2026-11-04 싱가포르 시간 00:13 열람.
참고 BL-79