El plugin de Databricks Genie en el chat, para cotejar reseñas públicas
Los plugins de Databricks Genie llegaron a ChatGPT, Claude, Copilot Cowork y Grok Bot el 2026-11-11. Probamos preguntar métricas internas y traer reseñas públicas en un mismo turno.
Databricks llevó los plugins de Genie a cuatro clientes de chat el 2026-11-11: ChatGPT, Claude, Microsoft Copilot Cowork y Grok Bot. Esos agentes ya pueden consultar los datos internos gobernados de una empresa dentro de Databricks (blog de Databricks, notas de la versión de noviembre en AWS). En el mismo cuadro de chat, también puedes conectar un servidor MCP estándar para traer datos públicos. Hicimos una llamada real el 2026-11-17 a las 00:29 (hora de Singapur, SGT) con el MCP remoto de EveryInfra. Una sola llamada trajo las reseñas más recientes de Notion en la App Store. La respuesta devolvió 20 elementos con un charged_usd de 0,001389 USD. Para el mismo producto, cinco fuentes públicas de reseñas dieron ese día notas de 1,93 a 4,77. Leer solo una fuente apuntaría el "por que" hacia el lado equivocado.
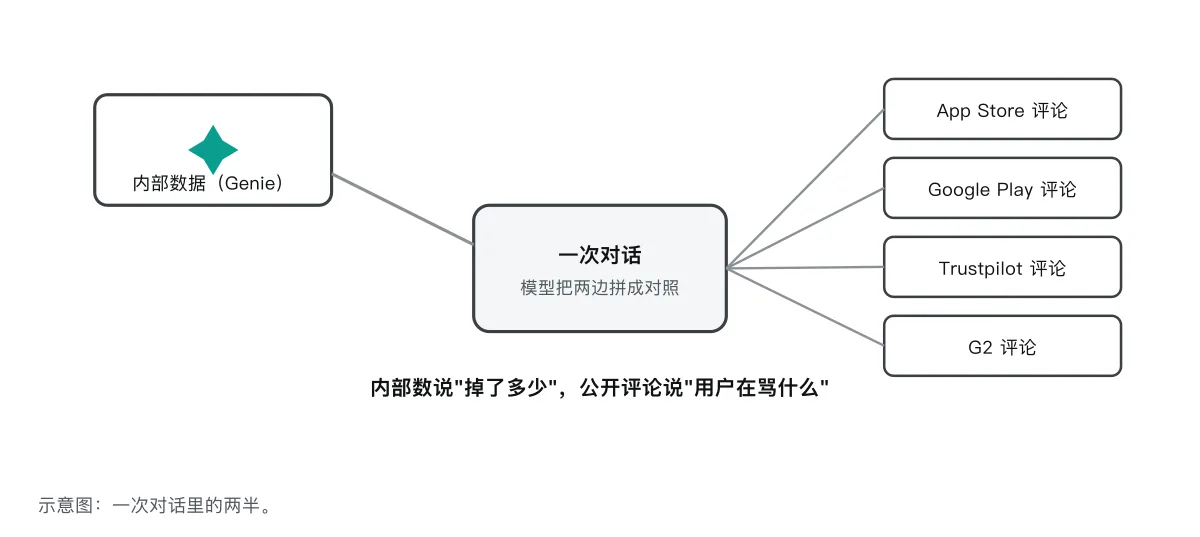
Dicho en una frase: el escritorio de la izquierda tiene los números internos gobernados de la empresa, el de la derecha tiene las reseñas públicas, y un turno del chat une los dos. El número interno responde "cuanto bajo"; las reseñas públicas responden "por que los usuarios están descontentos".
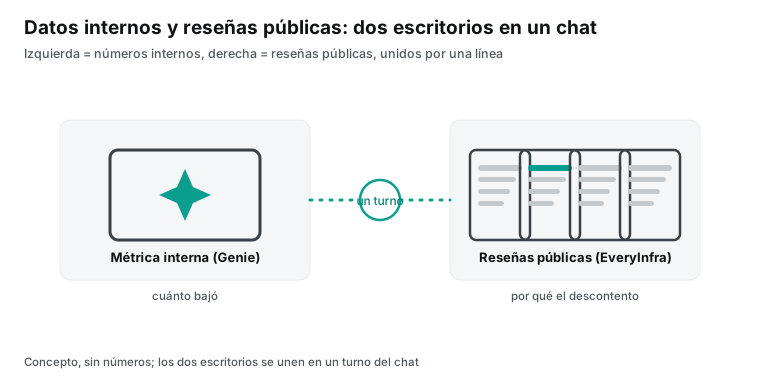
Qué es el plugin de Databricks Genie: cuatro clientes de chat el 2026-11-11
Databricks plantea el problema así. Antes de responder una pregunta de negocio, un agente necesita un mapa del negocio. Sin el mapa, recorre un camino casi aleatorio por las fuentes de datos y llega a la respuesta equivocada (blog de Databricks). Ese mapa es Genie Ontology, la capa semantica gobernada dentro de Databricks que combina definiciones de métricas acordadas con contexto aprendido de los activos de la empresa. Paso a disponibilidad general el 2026-11-11 (GA de Genie Ontology, página de producto). Los plugins de Genie llevan ese mapa a los agentes de chat que un equipo ya usa.
Cada cliente tiene su propia entrada. El plugin de ChatGPT está en la página de plugins de negocio de OpenAI. El conector de Claude está en el marketplace de Claude. El plugin de Grok Bot está en x.ai. El plugin de Microsoft Copilot Cowork está en el marketplace de Microsoft. Las notas de la versión ponen fecha a cada uno. Conectar ChatGPT, conectar Claude y conectar Grok Bot/Cursor llevan fecha 2026-11-11. Permitir ChatGPT y Claude como plataformas asociadas en las politicas de ingreso lleva fecha 2026-11-10 (notas de la versión de noviembre).
Los cuatro plugins se conectan igual. Primero un administrador pública el plugin en el espacio de trabajo. Luego cada usuario hace clic en conectar. Tras una redirección, el usuario inicia sesión con su cuenta de Databricks (documentación de Genie One MCP, sección de plugins). La documentación indica que los plugins usan apps OAuth por defecto, así que el administrador no crea una app OAuth. El plugin de Copilot Cowork en Azure necesita una licencia de Microsoft 365 Copilot y un espacio con Genie One habilitado. El usuario escribe el nombre del host del espacio de trabajo y se autentica con una cuenta de Microsoft Entra ID. Cada usuario mantiene una conexión separada que no se puede compartir (documentación del plugin de Azure Databricks Genie).
Los hechos de este lanzamiento, cada uno comprobado contra la página oficial, están abajo.
| Hecho | Fecha / estado | Fuente oficial |
|---|---|---|
| Plugins de Genie nativos en ChatGPT, Claude, Copilot Cowork, Grok Bot | 2026-11-11 | blog de databricks.com; notas de la versión en AWS |
La capa debajo es Genie One MCP (system.ai.genie_one_mcp, Unity Gateway) | GA; endpoint Beta fin de vida 2026-11-30 | docs.databricks.com genie-mcp |
Herramientas de Genie One MCP: genie_ask, genie_poll_response, genie_get_query_result | GA | docs.databricks.com genie-mcp |
| Vista interactiva de MCP Apps en clientes compatibles | 2026-11 | modelcontextprotocol.io; docs genie-mcp |
| ChatGPT y Claude permitidos como plataformas asociadas en ingreso | 2026-11-10 | docs.databricks.com partner-platforms |
| Genie Ontology en disponibilidad general | 2026-11-11 | databricks.com announcing-ga-genie-ontology |
El paso de conexión por cliente esta abajo.
| Cliente | Lanzado | Quien lo configura | Como se conecta el usuario |
|---|---|---|---|
| ChatGPT | 2026-11-11 | el admin pública desde una plantilla | conectar, iniciar sesión con cuenta de Databricks |
| Claude | 2026-11-11 | el admin del equipo agrega el conector | conectar, iniciar sesión |
| Grok Bot / Cursor | 2026-11-11 | el admin del equipo de Cursor pública | iniciar sesión con cuenta de Databricks |
| Copilot Cowork | 2026-11-11 | requiere licencia M365 Copilot | escribir el host, iniciar sesión con Entra ID |
Esta pieza es distinta de BL-151. Ese articulo cubre Genie como agente residente, que corre en segundo plano y hace la tarea que le das. Esta pieza cubre el lado del plugin de chat. Escribes una pregunta en el cuadro de ChatGPT o Claude. El agente decide que la pregunta es para Genie y se la pasa. Genie corre su propio bucle y devuelve una respuesta con citas. Es el mismo servidor Genie One MCP, con dos usos. Uno es un agente que trabaja por ti; otro es una herramienta que usas dentro de un chat.
El ejemplo de chat que da Databricks encaja con el cotejo de datos. El blog describe a un analista que explica por que los ingresos de una región quedaron 10% por debajo del pronóstico. Claude puede pedir a Genie ingresos, volumen de pedidos y ticket medio con las definiciones de métrica que usa finanzas. Luego hace que Genie busque notas de precios, registros de llamadas de ventas e informes de competidores. Devuelve un análisis con una cita detras de cada afirmacion (blog de Databricks). Genie sostiene bien la mitad de adentro. Lo que falta es la voz de afuera del muro de la empresa: de que se quejan los usuarios en plataformas públicas.
Debajo del plugin está Genie One MCP: cómo fluye una pregunta
El plugin no es un protocolo nuevo. Conecta el servidor Genie One MCP a un cliente de chat. Ese servidor expone a Genie como una herramienta conversacional. Un cliente envia una pregunta en lenguaje natural. Genie busca datos de la empresa, escribe SQL y devuelve una respuesta anclada en Genie Ontology con citas (documentación de Genie One MCP). Usa el transporte MCP Streamable HTTP y lleva un token de Databricks en una cabecera Authorization: Bearer <token>. Aplica permisos de Unity Catalog en cada solicitud, así que un usuario solo lee datos que tiene permitido ver.
Como Genie busca datos y corre SQL, la respuesta es asincrona. El flujo documentado tiene tres pasos. Llama a genie_ask para iniciar una respuesta y obtener un conversation_id y un response_id con estado in_progress. Consulta genie_poll_response, donde aparecen los pasos de progreso. Cuando el estado pasa a completed (o incomplete, o failed), toma la respuesta completa con un enlace profundo "Explore in Databricks" (documentación de Genie One MCP, hacer una pregunta). Para seguir la misma conversación, la pregunta siguiente reutiliza el conversation_id anterior. Cuando el resultado es grande, genie_ask y genie_poll_response devuelven filas truncadas. El agente entonces llama a genie_get_query_result para la tabla completa.
La documentación fija la cadencia de consulta: espera a que termine la consulta previa de genie_poll_response antes de consultar otra vez. Para correr una consulta en un almacén SQL elegido, pasa warehouse_id en los parámetros _meta (las notas). Estos detalles son casi invisibles para quien usa el plugin en el chat, porque el agente los gestiona. Explican por que una respuesta de Genie puede tardar unos segundos. Corre un bucle que busca datos, escribe SQL y revisa fuentes.
Sobre la autenticacion, Genie One MCP acepta cualquier token de Databricks en la cabecera bearer. Eso incluye OAuth de usuario a maquina, de maquina a maquina y tokens de acceso personal. Recomienda OAuth en nombre del usuario, para que el salto a las fuentes de Genie sea fluido (documentación de Genie One MCP, consideraciones). El llamante necesita EXECUTE en system.ai.genie_one_mcp, más USE CATALOG en el catálogo system y USE SCHEMA en el esquema system.ai. Para el plugin de chat, el OAuth del inicio de sesión lleva esto, así que el usuario no lo configura a mano. Significa una cosa. Los datos internos que un usuario alcanza en el chat equivalen exactamente a lo que ese usuario autenticado puede ver en Databricks.
Hay una fecha que conviene recordar. El endpoint Beta https://<workspace-hostname>/api/2.0/mcp/genie está obsoleto y llega a fin de vida el 2026-11-30. Después de esa fecha, las solicitudes fallan. Los equipos deben pasar al generalmente disponible system.ai.genie_one_mcp (documentación de Genie One MCP, acceso por Unity Gateway). Para quien usa el plugin en el chat, el plugin gestiona esta URL. Para un equipo que conecta Genie One MCP en su propio código, la URL y el alcance de OAuth deben cambiar antes de fin de noviembre.
Los clientes compatibles con la extension MCP Apps también reciben una vista interactiva. El servidor Genie One MCP provee una MCP App. En un cliente compatible, el servidor devuelve un panel embebido en la conversación. El panel muestra el progreso de Genie, graficos y la respuesta final con citas de Ontology (documentación de Genie One MCP, MCP App). MCP Apps es una extension oficial del Model Context Protocol. Deja que un servidor devuelva HTML interactivo renderizado en un iframe aislado. Los clientes documentados incluyen Claude, Claude Desktop, VS Code GitHub Copilot y Microsoft 365 Copilot (resumen de MCP Apps).
Por qué traer reseñas públicas en el mismo turno
Genie es bueno conciliando definiciones internas que no coinciden. Databricks plantea el problema con claridad. Los líderes tienen muchos datos, pero aún les cuesta responder "por que cayó 8% el ingreso neto en nuestra mayor cuenta la semana pasada". La respuesta abarca ventas, finanzas, promociones, inventario y datos de cuenta. Cada fuente es correcta por sí sola, pero usa una definición distinta (blog de Genie One MCP). Genie Ontology ancla "ingreso neto" a la definición de métrica acordada. Concilia conflictos por autoridad y certificación, y responde bajo los permisos de cada usuario.
Llévalo un paso más. El número interno puede decir "el ingreso de una región quedó 10% por debajo del pronóstico". Genie puede partir la brecha en volumen de pedidos y tamaño de trato con definiciones acordadas. Puede buscar notas de precios e informes de competidores. Todo eso queda dentro del muro de la empresa. ¿Afuera del muro, que dijeron los usuarios de esa región en plataformas públicas durante esas semanas? ¿Se quejaban de una subida de precio o de una función perdida? Eso no está en los datos internos. Lo que falta es la voz de afuera, y viene de las reseñas públicas.
Las reseñas de afuera del muro también se contradicen, y ninguna Ontology las concilia por ti. Para un mismo producto, las cinco fuentes suelen dar impresiones muy distintas. Una métrica interna te dice "la adopción empresarial cayó la semana pasada", pero el motivo vive en las reseñas públicas. Si traes solo una fuente, puedes traer la que apunta al lado contrario. Por eso el cotejo en el chat debe traer varias fuentes de afuera a la vez y dejar que el modelo las concilie, igual que Genie concilia las definiciones de adentro.
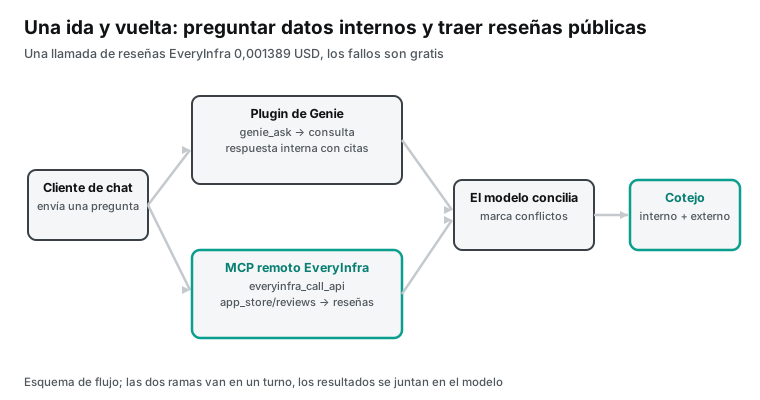
La interfaz de datos de EveryInfra es la capa que trae esas fuentes públicas a la conversación. Es un servidor MCP estándar que puede ir junto al plugin de Genie en cualquier cliente de chat compatible con MCP. En un turno, pides a Genie el número interno de adopción o ingreso. Luego pides a EveryInfra traer las reseñas públicas del mismo producto en la App Store, Google Play, Trustpilot y G2. El modelo cose las dos mitades, y lee el número interno y las reseñas de afuera contra la misma pregunta.
¿Por que en el "mismo turno" y no en dos pasos? Porque el valor de un cotejo es que ambos lados respondan la misma pregunta. En dos pasos, una persona tiene que tender un puente entre la conclusión interna y las reseñas de afuera, y es fácil equivocarse. Ves caer el ingreso y buscas un sitio de reseñas, y ese sitio puede apuntar al lado contrario. En un turno, el modelo retiene la señal concreta de la métrica interna: que cuenta, que semanas, que línea de producto. Trae las fuentes públicas que corresponden a esa señal, sin la conjetura de una persona en medio.
Hay otra capa: la confianza se traslada. La respuesta de Genie lleva fuentes, y el usuario puede abrirlas para ver que definición y que tabla la calcularon. En el lado público, cada reseña que devuelve EveryInfra lleva url, posted_at y rating. La frase "los usuarios se quejan del cobro" se apoya en reseñas reales que se pueden abrir, no en un resumen inventado. Ambos lados se remontan a su fuente. Eso importa para quien toma una decisión: el número interno tiene las fuentes de Genie, la impresion externa tiene los enlaces de las reseñas, y ninguna frase queda en el aire.
Conecta el MCP remoto de EveryInfra al mismo cliente de chat
Los cuatro clientes admiten conectar un servidor MCP externo o un conector, y el paso se parece a agregar el plugin de Genie. ChatGPT y Claude admiten conectores personalizados. Cursor, del lado de Grok Bot, admite servidores MCP. Del lado de Copilot Cowork, un administrador de Microsoft 365 lo agrega en "gestionar plugins, skills y servidores MCP". El propio blog de Databricks indica que los agentes sin plugin nativo pueden alcanzar a Genie por el servidor MCP (blog de Databricks). Bajo el mismo protocolo abierto, el MCP remoto de EveryInfra se conecta igual. Abajo esta el fragmento de configuración para conectar EveryInfra a un cliente que admite MCP remoto. La clave se lee de una variable de entorno y nunca se escribe en el archivo.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
Una vez conectado, el cliente se conecta y lista las herramientas. Recorrimos el saludo a mano el 2026-11-17 a las 00:28:11 SGT. initialize devolvió 200 con la versión de protocolo 2025-06-18 y sin cabecera Mcp-Session-Id, así que el servidor no requiere un identificador de sesión. notifications/initialized devolvió 202 con cuerpo vacío. tools/list devolvió 12 herramientas everyinfra_*. La especificación MCP para Streamable HTTP pide exactamente esto. Cada mensaje JSON-RPC es un nuevo HTTP POST a un mismo endpoint. La cabecera Accept lista application/json y text/event-stream. El servidor devuelve 202 sin cuerpo para una notificacion o una respuesta (transportes MCP 2025-06-18).
De las 12 herramientas, everyinfra_call_api trae datos y everyinfra_get_job lee una tarea asincrona. El resto lista capacidades, busca, consulta la cuenta y crea tickets. En un cliente de chat sueles exponer al modelo solo everyinfra_call_api y dejas el resto fuera. Antes de una llamada, lee una vez el catálogo gratuito GET /api/v1/social/catalog para confirmar nombres de capacidad, parámetros, price_usd y available. Las capacidades de reseñas públicas son app_store/reviews, google_play/reviews, trustpilot/reviews, g2/reviews y capterra/reviews, todas marcadas available: true. Las páginas de capacidad son app_store/reviews, google_play/reviews, trustpilot/reviews y g2/reviews. Las vistas de plataforma están en API de datos de App Store y API de datos de Trustpilot.
El saludo devolvió estos resultados, que coinciden con la especificación de Streamable HTTP.
| Paso | Resultado |
|---|---|
initialize | 200, protocolo 2025-06-18, sin cabecera Mcp-Session-Id |
notifications/initialized | 202, cuerpo vacío |
tools/list | 12 herramientas everyinfra_*, 16 318 bytes |
tools/call (sort malo) | isError, did_you_mean: newest, sin cobro |
tools/call (sort: newest) | 200, 20 reseñas, charged_usd 0,001389 |
Una ida y vuelta real de MCP: que envia el modelo, que devuelve la API
Tras el saludo, un agente que quiere reseñas envia una tools/call. Enviamos una el 2026-11-17 a las 00:29:09 SGT, con el nombre de herramienta everyinfra_call_api, para las 20 reseñas más recientes de Notion en la App Store de EE. UU. Esta es la misma forma que emitiria un modelo dentro de ChatGPT o Claude.
{
  "jsonrpc": "2.0", "id": 4, "method": "tools/call",
  "params": {
    "name": "everyinfra_call_api",
    "arguments": {
      "platform": "app_store", "action": "reviews",
      "params": { "app_id": "1232780281", "country": "us", "limit": 20, "sort": "newest" }
    }
  }
}
La API devolvió 200. Toda la respuesta HTTP fue de 14 646 bytes. El campo content[0].text tenia un JSON de 13 666 caracteres con 20 reseñas y billing.charged_usd: 0.001389. El billing.amount.per_1k.USD fue 1,389. Cada reseña llevaba rating, title, text, app_version y posted_at, iguales a los response_fields del catálogo. Con ese texto, el modelo puede calcular cuántas estrellas hay en las últimas 20 y en que versión se agrupan las quejas.
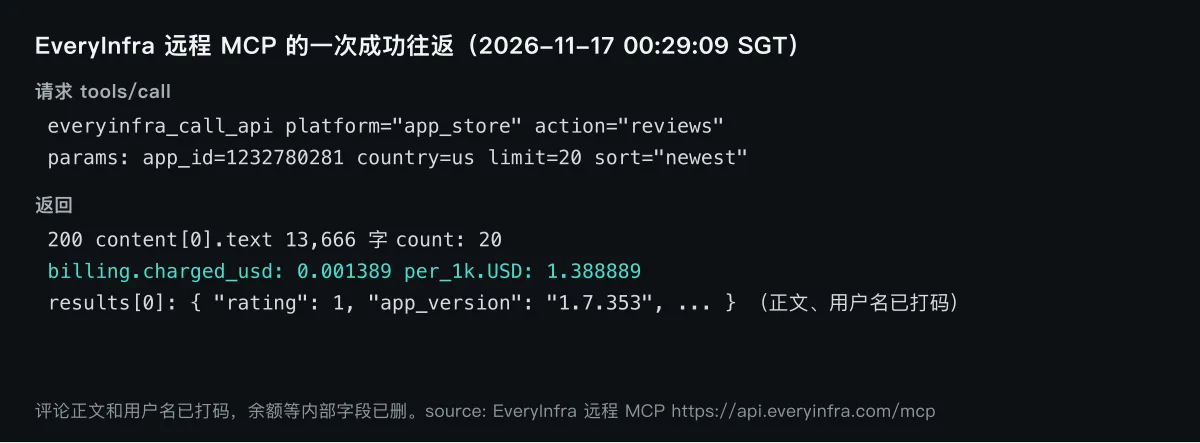
La ida y vuelta exitosa también llevó un objeto de facturación que contaba el costo en detalle. Tenia charged true, credits 100, charged_usd 0,001389, per_1k.USD 1,388889 y rate_source en live. Para un caso de chat que llama a la API de forma automática, ese objeto es útil. Cada traida de reseñas lleva su propio costo. Un bucle principal que quiera un tope de presupuesto puede sumar charged_usd y parar cerca del limite. Los campos internos como el saldo deben quitarse cuando el modelo muestre algo al usuario. Por eso la figura muestra solo charged_usd y el conteo.
El tamaño de esta respuesta vale la pena anotarlo. A unos 4 bytes por token, 13 666 caracteres son unos 3 400 tokens. Eso queda por debajo de la línea de aviso de 10 000 tokens para la salida de herramientas MCP en Claude Code. También por debajo de la línea de 50 000 caracteres que escribe el resultado a un archivo (documentación MCP de Claude Code). Así que una respuesta de 20 reseñas entra directa en la conversación, sin truncar ni escribir a archivo. Para traer cientos de una vez, pon mode en async, obten un job_id y leelo con everyinfra_get_job. Leer una tarea es gratis y no cuenta contra el limite por minuto.
Una ida y vuelta con un parámetro mal: como la API deja que el modelo se corrija
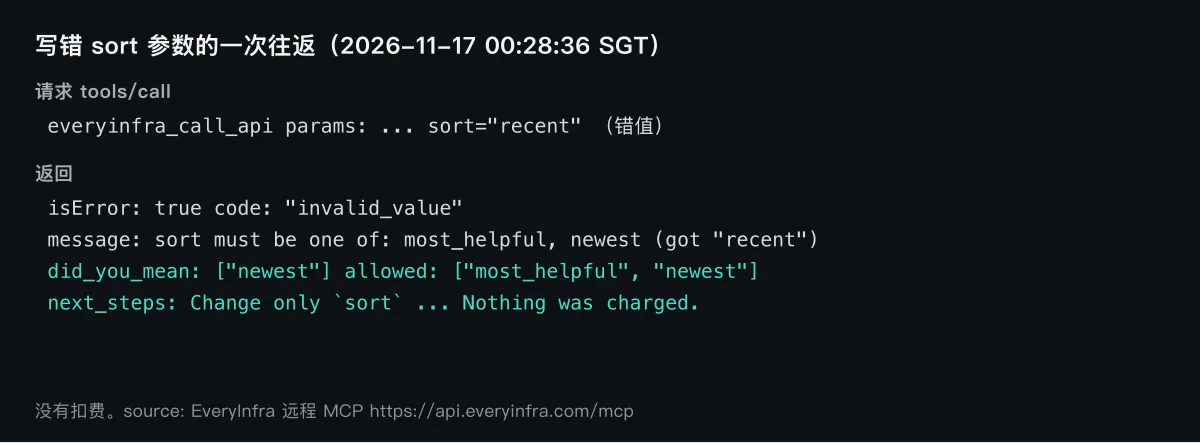
Enviamos la primera llamada con un parámetro de orden mal, sort en recent. La API no lo ignoro en silencio ni cobro igual. Devolvió un error escrito para el modelo. El cuerpo del error tenia code invalid_value y un mensaje "sort must be one of: most_helpful, newest (got 'recent')". Tenia did_you_mean de ["newest"], una lista allowed de dos valores legales e isError true. El next_steps decia "cambia solo sort, luego reenvia. Nothing was charged." El modelo leyó did_you_mean, cambió sort a newest, lo reenvio y obtuvo la respuesta exitosa de arriba.
invalid_value: `sort` must be one of: most_helpful, newest (got 'recent')
did_you_mean: ["newest"]   next_steps: Change only `sort` to a value in `allowed`, then resend. Nothing was charged.
Esto importa para las llamadas automaticas en el chat. Un modelo que arma parámetros en una conversación no tiene a nadie vigilando cada llamada. El texto del error tiene que leerse para el modelo, no solo para una persona que programa. did_you_mean da un valor que puede usar, y allowed lista cada valor legal. next_steps dice que hacer en una línea, así que el modelo cambia un campo y reenvia. Si la API solo respondiera "parámetro invalido", el modelo tendria que adivinar y podria romper otro parámetro que ya estaba bien. Un parámetro mal devuelve 422, y un orden ilegal devuelve la pista did_you_mean. Los dos ocurren antes de cualquier cobro, así que son seguros de reintentar. Explicamos como conectar el MCP remoto y conciliar por identificador de solicitud en las notas de conexión.
Prueba real: cuánto divergen cinco sitios públicos para un producto
Usamos un producto público, Notion (una herramienta de notas y colaboracion), para la demostración; el método es igual para cualquier producto. En un caso real, el lado de Genie son los números internos de retención o adopción de tu empresa, y el lado de EveryInfra son las reseñas públicas. Trajimos cinco fuentes públicas el 2026-11-17 entre las 00:20 y las 00:27 SGT, cada una para el mismo producto, y los números salen de las respuestas reales.
| Fuente pública | Nota ese día | Muestra | Ventana | Queja principal |
|---|---|---|---|---|
| App Store (histórico) | 4,77 | 90 724 valoraciones | acumulado | — (incluye solo-estrellas) |
| App Store (reseñas recientes) | 2,34 | 50 | 2026-10-01 a 11-14 | fallos, funciones quitadas, IA |
| Google Play (histórico) | 4,61 | 407 304 valoraciones | acumulado | — |
| Google Play (reseñas recientes) | 3,34 | 50 | 2026-11-10 a 11-15 | fallos, lentitud |
| Trustpilot | 1,93 | 30 | 2026-06-26 a 11-13 | cobros, cuentas bloqueadas |
| G2 | 4,6 | 13 980 | agregado | curva de aprendizaje |
| Capterra | 4,0 | 30 | muestra | limites como back-end |
Las llamadas reales de esta prueba están abajo.
| # | Hora (SGT) | Capacidad | Devolvió | charged_usd |
|---|---|---|---|---|
| 1 | 00:21:10 | trustpilot/reviews | 30 reseñas, promedio 1,93 | 0,001389 |
| 2 | 00:22:39 | app_store/reviews | 50 reseñas, promedio 2,34 | 0,001389 |
| 3 | 00:22:48 | google_play/reviews | 50 reseñas, promedio 3,34 | 0,001389 |
| 4 | 00:26:50 | g2/reviews | agregado 4,6 / 13 980 | 0,001389 |
| 5 | 00:29:09 | app_store/reviews (MCP) | 20 reseñas via tools/call | 0,001389 |
A primera vista, el mismo producto va de 1,93 a 4,77. La diferencia viene de dos lugares. Primero, los públicos difieren. La App Store y Google Play llevan consumidores, G2 y Capterra llevan compradores de empresa, y buena parte de quienes escriben en Trustpilot van a quejarse del cobro. Públicos distintos valoran cosas distintas, así que puntuan el mismo producto muy distinto. Segundo, y más oculto, esta la brecha dentro de una misma tienda. En la App Store, la nota histórica de 4,77 y el promedio de 50 reseñas recientes de 2,34 difieren en más del doble. Un solo número de "nota" puede enganar. Puede ser un agregado de todo el tiempo o el animo de quienes escribieron texto hace poco. Los dos se llaman "nota" en la misma página.
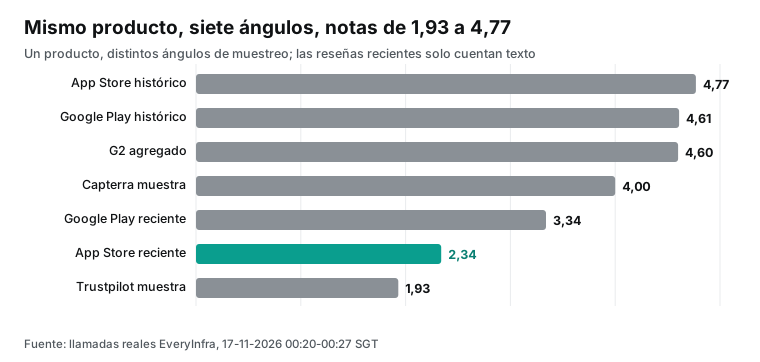
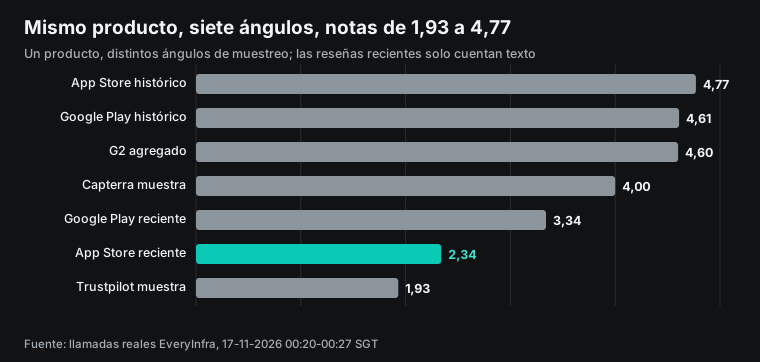
La muestra de 30 de Capterra ese día fue toda de cuatro estrellas, promedio 4,0, una banda estrecha. Eso es probablemente un efecto de muestreo y de orden: las pocas decenas traidas quedaron en cuatro estrellas. No significa que el producto solo tenga reseñas de cuatro estrellas en Capterra. Por eso la fila de Capterra lleva "muestra" y no se toma como el veredicto general de la fuente. Es un recordatorio: el promedio de cada fuente debe leerse con su tamaño de muestra y su método, no sacarse como un solo número. El 4,0 de Capterra solo sugeriria compradores contentos. Pero el agregado de G2, con 13 980 reseñas, lista "curva de aprendizaje empinada" 872 veces. Dos fuentes B2B juntas muestran una satisfaccion que viene con una puesta en marcha dificil.
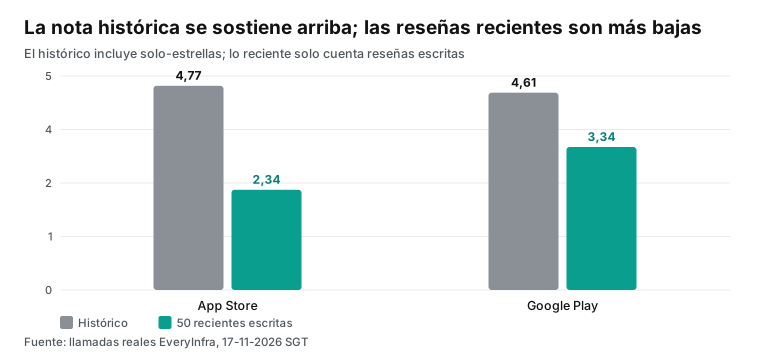
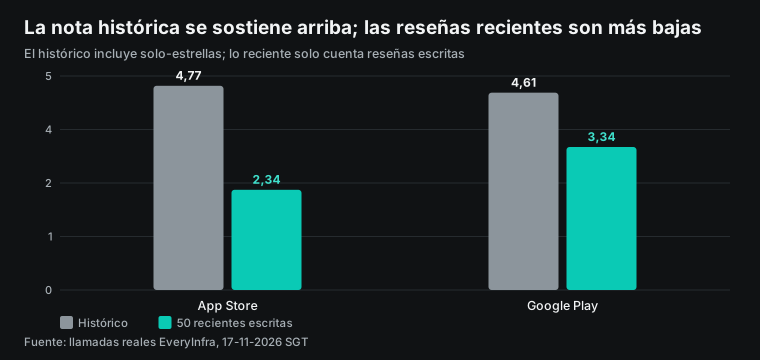
La diferencia entre histórico y reciente escrito no es una pelea; son dos cantidades distintas. La nota histórica cuenta a quienes solo tocaron una estrella y nunca escribieron; son una mayoría silenciosa sin incidente. El promedio reciente escrito cuenta solo reseñas con texto. Algunos de quienes escriben fueron a plantear un problema. También trajimos la "nota de la versión actual" de la App Store, aún 4,77, igual al histórico. Sumar las valoraciones de solo estrellas fuera de las reseñas escritas mantiene el número alto. Mientras tanto, 26 de quienes se sentaron a escribir el último mes dieron una estrella. Para un análisis que explica por que cayó la adopción empresarial, la señal útil son las reseñas escritas. El 4,77 sostenido por la mayoría silenciosa no ayuda.
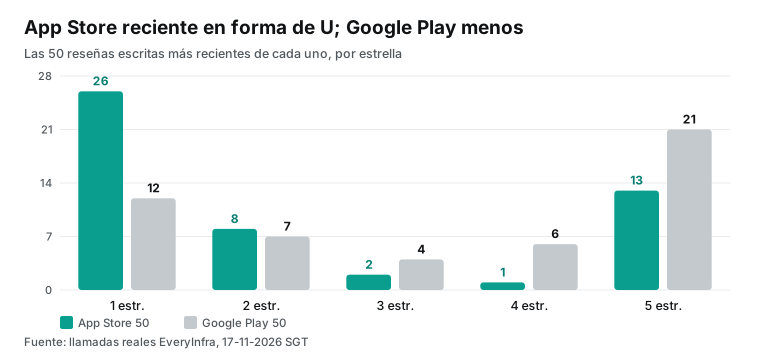
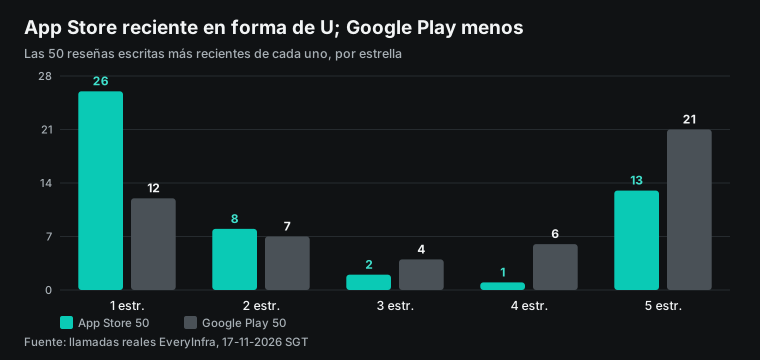
Reparte las 50 recientes de App Store por estrella: 26 de una estrella, 8 de dos, 2 de tres, 1 de cuatro, 13 de cinco. Uno y cinco son grandes y el medio está vacío. Esa forma es común cuando un producto choca con un problema concreto. Los usuarios conformes no escriben, mientras los contentos y los enojados si lo hacen. Las 50 recientes de Google Play son 12 de una estrella, 7 de dos, 4 de tres, 6 de cuatro, 21 de cinco, con el enojo menos concentrado. Dos tiendas, el mismo producto, el mismo periodo, y quienes escriben tienen genios distintos.
Misma nota no significa misma razon: temas negativos lado a lado
Más alla de la nota, lo que importa es de que se quejan las negativas. Agrupamos por palabras clave las reseñas de dos estrellas o menos en tres fuentes, según el titulo y el texto. La regla de agrupado esta fija en el script, y una revision a mano coincidio con la lectura. Siendo todas negativas, las tres fuentes se quejan de cosas distintas.
| Tema negativo | App Store (<=2) | Google Play (<=2) | Trustpilot (<=2) |
|---|---|---|---|
| fallos, lentitud, roto tras actualizar | 19 | 13 | 4 |
| funciones quitadas, peor que antes | 11 | 1 | 4 |
| IA (cupo, forzada) | 9 | 0 | 4 |
| cuenta, acceso, bloqueo | 4 | 4 | 10 |
| cobros, subida de precio, precargo | 1 | 1 | 10 |
En las negativas de App Store, los fallos y "roto tras actualizar" encabezan con 19. Los titulos de una estrella repiten "la última versión se cae", "la actualizacion lo arruino" y "no corre en equipos viejos". Las quejas de IA suman 9. Algunas reseñas de una estrella, en corto (traducidas donde hizo falta, sin nombres de usuario), dicen "usa un poco menos de IA", "se actualiza tan seguido y te deja fuera si no lo haces" y "se cae al abrir en el iOS más reciente, sin problemas en otras apps". Esas apuntan a la versión y la estabilidad; casi nadie menciona el precio.
Trustpilot es otra cara por completo: cobros y cuentas, 10 cada uno. Quienes escriben van a quejarse de precargos, subidas de precio y cuentas bloqueadas. Algunas reseñas de una estrella dicen "practicas de cobro muy abusivas y soporte inexistente", "me cobraron tras borrar mi cuenta" y "una prueba gratis cancelada a mitad sin razon". Mismo producto, mismo periodo: en App Store se quejan de que se cae, en Trustpilot de que cobra de más. Si tu métrica interna muestra "cayó la conversion de pago", traer reseñas de la App Store leeria mal la causa como "la app se cae". Solo Trustpilot muestra "los usuarios se quejan del cobro". Ambas fuentes tienen razon; cada una cuenta la mitad. Por eso un cotejo no puede confiar en una sola fuente. Con solo la pila de App Store, el modelo escribiria un problema de cobro como un problema de estabilidad, y la conversion de pago nunca hallaría su razon.
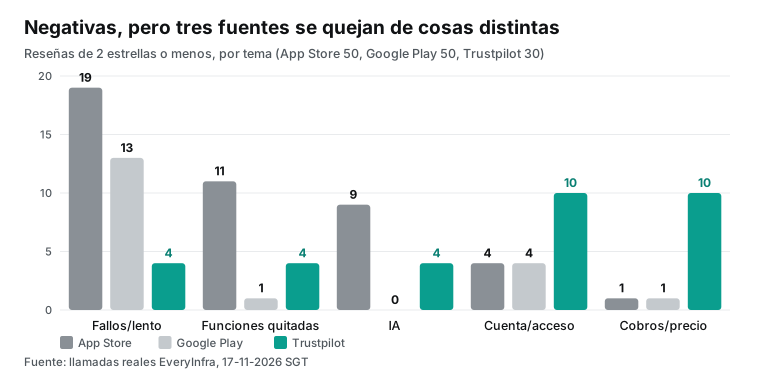
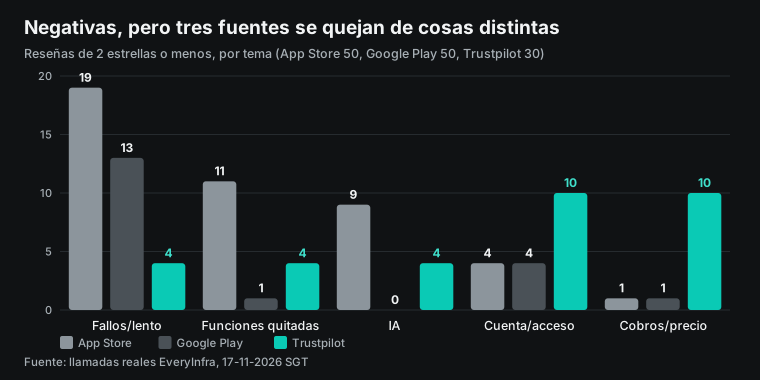
Esta es justo la razon de traer varias fuentes en un turno. El agregado de G2 suma otra capa. Agrupa las quejas de 13 980 reseñas en etiquetas, encabezadas por "curva de aprendizaje empinada" (872 menciones), "espacios grandes lentos" (617), "interfaz confusa" (494), "demasiadas funciones" (469) y "configuración lenta" (441). El lado positivo es "fácil a diario" (2 135) y "espacio flexible" (2 053). Los compradores de empresa valoran el costo de puesta en marcha y el rendimiento a escala, algo distinto de los fallos que los consumidores reportan en la App Store. Trae estas fuentes juntas en el chat, y el modelo arma la cara completa.
El tiempo de las reseñas también importa. Estas 50 de App Store llevan fecha del 2026-10-01 al 2026-11-14. Las 50 de Google Play se agrupan del 2026-11-10 al 2026-11-15. Las 30 de Trustpilot están más dispersas, del 2026-06-26 al 2026-11-13. Ventanas distintas sesgan una comparacion directa de promedios. El 1,93 de Trustpilot mezcla cuentas de medio ano atras, y el 3,34 de Google Play cubre solo los últimos días. Para el cotejo, la correccion es simple. Haz que el modelo traiga con el mismo orden y escriba la ventana en la conclusión, en vez de poner promedios de ventanas distintas lado a lado.
¿Qué métrica interna va con qué fuente externa?
Emparejar cada métrica interna con una fuente de reseñas es el paso que evita que el cotejo se desvie. La métrica interna responde "que número se movió". Fuentes externas distintas responden un "por que" de naturaleza distinta. La tabla de abajo empareja métricas internas comunes con fuentes públicas adecuadas, según las observaciones reales de arriba.
| Métrica interna (lado Genie) | Fuente pública adecuada | El "por qué" que aporta | Evidencia en esta prueba | Observado |
|---|---|---|---|---|
| activos diarios de consumo, caida de retención | App Store, Google Play recientes | fallos, roto tras actualizar, funciones quitadas | negativas de fallos App Store 19, funciones quitadas 11 | 2026-11-17 |
| conversion de pago, caida de renovacion | Trustpilot | cobros, subida de precio, precargo, cuenta bloqueada | Trustpilot cobros 10, cuenta 10 | 2026-11-17 |
| adopción empresarial, lento a escala | G2, Capterra | curva de aprendizaje, rendimiento a escala, limites de back-end | G2 curva 872, lentitud 617 | 2026-11-17 |
| adopción de nueva función | App Store, Google Play recientes + G2 | función forzada, experiencia peor | negativas de IA App Store 9 | 2026-11-17 |
La tabla es un recordatorio, no una regla fija. Ante una señal de que una métrica interna se movió, decide qué clase de "por qué" quieres. Luego decide que fuentes traer. La retención de consumo va con las tiendas de apps, los temas de pago y cuenta con Trustpilot, la adopción empresarial con G2 y Capterra. Trae la fuente equivocada y las reseñas apuntan al lado errado. Trae varias, y el modelo ve que clase de queja está más concentrada en este producto.
¿Cuánto cuesta el cotejo, por mil?
El lado de EveryInfra es fácil de presupuestar. Depende solo del número de llamadas, no de cuántas filas vuelven ni de dónde corre el modelo. Las capacidades de reseñas cuestán casi todas 0,001389 USD por llamada en el catálogo, es decir 1,389 USD por mil (una llamada devuelve una página de reseñas). Los precios de abajo salen del catálogo, los conteos devueltos de esta prueba real.
| Capacidad | Por llamada | Por mil | Esta prueba devolvió | Hora (SGT) |
|---|---|---|---|---|
app_store/reviews | 0,001389 USD | 1,389 USD | 50 / 20 | 00:22:39 / 00:29:09 |
google_play/reviews | 0,001389 USD | 1,389 USD | 50 | 00:22:48 |
trustpilot/reviews | 0,001389 USD | 1,389 USD | 30 | 00:21:10 |
g2/reviews | 0,001389 USD | 1,389 USD | 30 | 00:26:50 |
capterra/reviews | 0,001389 USD | 1,389 USD | 30 | 00:27:04 |
Un cotejo de cinco fuentes cuesta 5 x 0,001389 USD = 0,006945 USD. Traer una ronda al día para un producto, un mes es unos 0,208 USD. Escalalo: un equipo de exito de clientes que vigila los productos de 20 clientes clave, cada uno de cinco fuentes a diario, son 100 llamadas al día, 0,139 USD, unos 4,17 USD al mes. Traer solo cuando una métrica interna alerta, una docena de veces por semana, son unos centavos al mes. Ese costo es pequeño frente a lo que compra. Cuando la métrica interna alerta, el modelo trae las razones de las reseñas públicas con ella, y nadie reabre varios sitios de reseñas a mano.
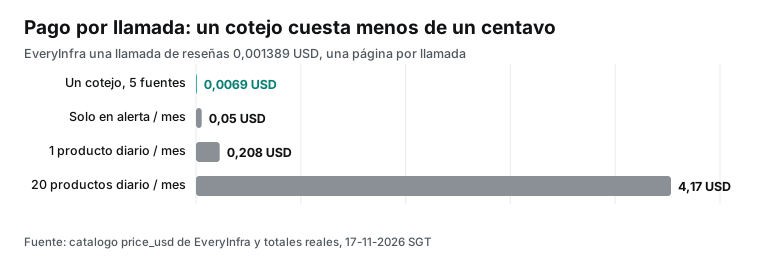
El costo es predecible porque sigue solo el número de llamadas. Una llamada devuelve una página, tenga esa página 20 reseñas o 50. Para traer cientos, usa async, obten un job_id y leelo gratis. Esto se diferencia del cobro por filas devueltas. Con pago por llamada, el presupuesto es "fuentes a traer por rondas", claro de un vistazo. No salta porque un producto tenga muchas reseñas. Para un cotejo dentro de un flujo automático, esa previsibilidad importa más que el precio unitario. El lado de Genie es otro esquema. Genie One MCP usa el consumo propio de Genie, atado al computo del almacén SQL, facturado por la página de precios de Genie de Databricks (precios de Genie, documentación de Genie One MCP, consideraciones), leida el 2026-11-17. No lo convertimos a un precio por llamada, porque depende del tamaño del almacén y de la complejidad de la consulta.
Unir el cotejo a los datos internos de Genie: dos conciliaciones
Lo que Genie Ontology hace adentro es conciliar definiciones en conflicto en una respuesta confiable. La guia práctica de Databricks la divide en capas. Arregla la base de datos, alinea las definiciones de métrica, y Genie ordena el contexto por autoridad, aplica permisos y entrega el contexto más útil a Genie al momento de responder (guia de operacion de Genie Ontology). Dicho de otro modo, cuando "cliente" significa cuentas activas en ventas y toda cuenta en soporte, y el mismo cliente tiene tres identificadores entre sistemas, Genie usa la Ontology para decidir en cual confiar.
El cotejo en el chat lleva la misma conciliacion afuera del muro. Las reseñas públicas también tienen tres identificadores. Para un producto, hay una nota en la App Store, otra en Trustpilot, una tercera en G2, cada una con un público y una ventana distintos. El modelo hace la misma clase de movimiento que Genie hace con las definiciones internas. No toma una fuente como la unica verdad. Pone juntas las evidencias de varias fuentes y marca donde divergen.
Hay una simetria fácil de pasar por alto. Al escribir sobre el costo de conectar datos directo, Databricks dice que dar a un agente fuentes crudas estructuradas y no estructuradas da acceso, no significado de negocio compartido. No le dice al agente que fuentes, definiciones o uniones SQL están aprobadas. Así que el agente sigue inspeccionando esquemas, documentos y relaciones, quemando tokens y tiempo (blog de Genie One MCP). Los datos públicos externos tienen el mismo problema. Suelta una pila de páginas de reseñas crudas sobre un modelo, y tiene que deducir que fila es que producto. También tiene que juzgar que nota confiar y si la ventana coincide. La interfaz de datos de EveryInfra las trae en campos estructurados (rating, posted_at, app_version, iguales al catálogo), una entrada limpia también del lado de afuera. El modelo no escarba entre páginas.
Un punto mantiene honesta la analogia. Genie Ontology es la capa semantica interna, gobernada, con autoridad y certificación. El lado de EveryInfra no gobierna ninguna definición interna; solo trae reseñas públicas en campos uniformes. Conciliar el conflicto entre varias fuentes externas es un juicio que el modelo hace en la conversación, no algo que EveryInfra deja decidido. Así que la frase correcta es esta. Las definiciones internas con autoridad las garantizan Genie y la Ontology. Las varias fuentes externas las trae fielmente la interfaz de datos. Cual es más creible lo juzga el modelo con la evidencia de ambos lados.
Los tres escenarios de chat de Databricks encajan en esta capa. En el escenario de retención del blog, un líder de exito de clientes pregunta a Copilot Cowork que clientes muestran adopción en baja, soporte en alza y riesgo de renovacion. Genie conecta datos gobernados de cliente, uso de producto, soporte y contrato (blog de Databricks). Ahi el número interno te dice "que clientes se escapan". Conectar EveryInfra para traer las reseñas públicas de los productos de esos clientes agrega la razon: "se escapan porque las reseñas públicas se quejan del cobro y los fallos". Los escenarios de finanzas y marketing del blog de Genie One MCP comparten la estructura. Genie ancla la definición interna, y la interfaz de datos aporta la voz de afuera (blog de Genie One MCP).
Limites: muestreo, orden y lo que el plugin no hace
Unos limites evitan que este cotejo parezca más fuerte de lo que es. Primero, las reseñas son una muestra, no un censo. Trajimos de 20 a 50 por fuente, las "recientes escritas" de App Store y Google Play vinieron con el orden por defecto de cada tienda, y las ventanas difieren (App Store abarca del 2026-10-01 al 11-14, Google Play solo del 2026-11-10 al 11-15). Así que un promedio entre fuentes no es "el veredicto general de esa fuente sobre el producto"; es el promedio de las pocas decenas traidas esta vez. Para un resultado más estable, trae de nuevo con el mismo orden, conteo y ventana.
Segundo, la nota histórica y el promedio escrito son dos cantidades; no las mezcles. La primera incluye valoraciones de solo estrellas, la segunda cuenta solo reseñas escritas. Todo "histórico" en esta pieza está marcado como que incluye solo-estrellas. Todo "promedio reciente escrito" está marcado como solo texto. Mezclarlas da una mala lectura como "la nota de App Store se desplomó". En realidad la mayoría silenciosa no cambió y quienes escriben se pusieron más duros.
Tercero, el plugin solo trae a Genie al chat; no cambia el modelo de permisos de Genie. Los permisos de Unity Catalog aplican en cada solicitud. Un usuario en el chat también lee solo los datos internos que tiene permitido ver (documentación de Genie One MCP, consideraciones). Del lado de afuera, EveryInfra trae reseñas visibles al público y no toca ningún dato privado con inicio de sesión. Cada lado guarda su propio limite. Lo que se une es "números internos gobernados" más "voz visible al público", no los datos privados de nadie mezclados.
Cuarto, la entrada para conectar un MCP externo a un cliente de chat cambia con la versión del cliente. Que un administrador la abra es decisión del cliente. Databricks también deja a las empresas una compuerta. Las politicas de ingreso pueden permitir ChatGPT y Claude como plataformas asociadas desde el 2026-11-10, dejando que esos clientes MCP alojados alcancen el espacio de trabajo (documentación de plataformas asociadas). La documentación indica que la regla identifica el trafico por los rangos de IP de salida o la app OAuth del socio, sincronizados cada una o dos semanas. Permite solo el trafico de ese socio, mientras usuarios y principales de servicio siguen autenticandose.
Quinto, la ida y vuelta del plugin tiene latencia; el cotejo no es una operacion instantanea sin costo. El lado de Genie corre un bucle en segundo plano que busca datos y escribe SQL, así que la respuesta es asincrona. La llamada de reseñas de EveryInfra esta vez tardó de cientos de milisegundos a unos segundos por ida y vuelta. Poner ambos en un turno hace que el usuario espere a los dos. Eso está bien para preguntas interactivas. Esta mal para un requisito de menos de un segundo, que encaja con una tarea programada en segundo plano que trae el cotejo y empuja una vista terminada.
Vale la pena anotar una revision externa. Buscamos la palabra "databricks genie plugin chatgpt" en video. Los primeros resultados eran tutoriales generales de Genie, Genie Code y MCP, de 2026-04 a 2026-11. Ninguno demostraba el flujo de conexión de los plugins de chat del 2026-11-11, con publicacion por el admin e inicio de sesión del usuario. El más cercano, un video introductorio del 2026-11-15, cubre conectar un servidor MCP con OAuth, JWT y clave de API, que no es la conexión nativa del marketplace. Los comentarios de ese video no se devolvieron. Así que el flujo de conexión de estos plugins en el chat se apoya sobre todo en la documentación oficial; el lado de los videos está vacío.
Novedades del sector
- 2026-11-11: Databricks lanzó una segunda generación de Genie, un agente de empresa siempre activo y autónomo que delega subagentes y avisa cuando hace falta una decisión (nota de prensa). Para el lector: el plugin de chat es una cara de Genie; el agente residente es otra.
- 2026-11-11: Genie Ontology y Pages pasaron a disponibilidad general, así que las definiciones de negocio gobernadas se pueden organizar por dominio, certificar y retirar (GA de Genie Ontology). Para el lector: cuanto más firmes las definiciones de adentro, más vale enganchar un cotejo.
- 2026-11-10: Genie Search pasó a disponibilidad general, indexando más de 100 fuentes como Google Drive, Jira y Confluence (notas de la versión). Para el lector: cuanto más amplia la búsqueda interna, más marcan los datos públicos la línea adentro-afuera.
- 2026-11-09: La app de Databricks Genie para Slack y la de Microsoft Teams pasaron a disponibilidad general (notas de la versión). Para el lector: Genie entra en más superficies de chat, cada una capaz de llevar junto una interfaz de datos externa.
- 2026-11-12: Genie ZeroOps entró en Beta, vigilando trabajos, pipelines y tablas en segundo plano y proponiendo arreglos cuando haya fallos (notas de la versión). Para el lector: cuanto más se automatiza el monitoreo interno, más destaca que el veredicto de afuera necesita su propia fuente.
Preguntas frecuentes
¿Qué clientes de chat admite el plugin de Databricks Genie, y cuándo salió? (de la sugerencia "databricks genie plugin")
Cuatro de forma nativa: ChatGPT, Claude, Microsoft Copilot Cowork y Grok Bot, salió el 2026-11-11. Los agentes sin plugin nativo pueden alcanzar a Genie por el servidor Genie One MCP (blog de Databricks, notas de la versión).
¿Cómo se conecta el genie chatgpt plugin, y debo crear mi propia app OAuth? (de la sugerencia "genie chatgpt plugin")
Un administrador pública el plugin en el espacio de ChatGPT, cada usuario hace clic en conectar y se autentica con su cuenta de Databricks. El plugin usa apps OAuth por defecto, así que el administrador no crea una (documentación de Genie One MCP).
¿Puede un mismo chat preguntar a Genie y traer reseñas públicas a la vez? (de esta prueba)
Sí. Los clientes de chat admiten conectar un servidor MCP externo o conector, así que el MCP remoto de EveryInfra puede ir junto al plugin de Genie, y un turno puede preguntar el número interno y traer reseñas públicas. Es MCP como protocolo abierto; no significa que haya sociedad.
¿Es gratis el genie chatgpt plugin, y cuánto cuestán las reseñas públicas? (de la sugerencia "genie chatgpt plugin free")
El lado de Genie factura por el consumo de Databricks Genie (precios de Genie). El lado de EveryInfra trae reseñas públicas a 0,001389 USD por llamada, 1,389 USD por mil, con fallos y resultados vacios gratis.
¿Por qué difieren tanto las notas del mismo producto entre sitios? (de la sugerencia "why are app ratings so different")
Públicos y ventanas difieren: App Store y Google Play llevan consumidores, G2 y Capterra compradores de empresa, y muchos de Trustpilot van a quejarse. Las notas históricas incluyen solo estrellas, mientras lo reciente cuenta solo texto, y las dos pueden diferir en más del doble. Por eso hay que traer varias fuentes para cotejar.
¿Cobra un parámetro mal? (de esta prueba)
No. Un parámetro mal devuelve 422 o una pista did_you_mean, ambos antes de cualquier cobro, con "Nothing was charged" en la respuesta. Solo una llamada que devuelve 200 cobra.
Primeros pasos en tres pasos
- Lee una vez el catálogo gratuito
GET https://api.everyinfra.com/api/v1/social/catalogpara confirmar los parámetros yprice_usddeapp_store/reviews,trustpilot/reviewsyg2/reviews. - En tu cliente de chat, conecta el MCP remoto de EveryInfra (
https://api.everyinfra.com/mcp) como conector junto al plugin de Databricks Genie. El fragmento está en la página del servidor MCP, con la conexión remota en las notas. - En una conversación, pide a Genie el número interno. Luego haz que el modelo use
everyinfra_call_apipara traer las reseñas del mismo producto de varias fuentes públicas. Inicio rápido tiene los tres pasos REST. Trabajos relacionados en análisis de reseñas de competidores y auditar reseñas de fichas en ChatGPT.
Referencias
- Databricks, "Bring your business context to ChatGPT, Claude, Microsoft Copilot Cowork and Grok Bot", 2026-11-11, https://www.databricks.com/blog/bring-your-business-context-chatgpt-claude-microsoft-copilot-cowork-and-grok-bot
- Databricks on AWS, "November 2026 release notes", 2026-11, https://docs.databricks.com/aws/en/release-notes/product/2026/november
- Databricks, documentación "Genie One MCP server", 2026-11, https://docs.databricks.com/aws/en/agents/mcp-tools/genie-mcp
- Databricks, documentación "Genie One MCP server", sección Ask a question, https://docs.databricks.com/aws/en/agents/mcp-tools/genie-mcp#ask-a-question
- Databricks, documentación "Genie One MCP server", sección Access through Unity Gateway, https://docs.databricks.com/aws/en/agents/mcp-tools/genie-mcp#access-through-unity-gateway
- Databricks, documentación "Genie One MCP server", sección MCP App, https://docs.databricks.com/aws/en/agents/mcp-tools/genie-mcp#mcp-app
- Databricks, documentación "Genie One MCP server", sección Considerations, https://docs.databricks.com/aws/en/agents/mcp-tools/genie-mcp#considerations
- Databricks, documentación "Genie One MCP server", sección de plugins, https://docs.databricks.com/aws/en/agents/mcp-tools/genie-mcp#databricks-genie-plugins-for-chatgpt-claude-and-grok-botcursor
- Databricks, "Genie One MCP: Give any AI Agent the Right Business Context", 2026, https://www.databricks.com/blog/genie-one-mcp-give-any-ai-agent-right-business-context
- Databricks, "Operationalizing Genie Ontology in Your Data Stack", 2026-09-01, https://www.databricks.com/blog/operationalizing-genie-ontology-your-data-stack
- Databricks, "Announcing GA of Genie Ontology", 2026-11-11, https://www.databricks.com/blog/announcing-ga-genie-ontology
- Databricks, página de producto Genie Ontology, https://www.databricks.com/product/genie/ontology
- Databricks, nota de prensa "Databricks Launches New Always-on Genie: Autonomous AI for Complex Enterprise Work", 2026-11-11, https://www.databricks.com/company/newsroom/press-releases/databricks-launches-new-always-genie-autonomous-ai-complex
- Databricks, página de precios de Genie, https://www.databricks.com/product/pricing/genie
- Databricks, página de producto Genie, https://www.databricks.com/product/genie/
- Databricks on AWS, documentación de Genie Ontology, https://docs.databricks.com/aws/en/genie/genie-ontology/
- Databricks on AWS, "Allow partner platforms in context-based ingress policies", 2026-11-10, https://docs.databricks.com/aws/en/security/network/front-end/partner-platforms
- Databricks on AWS, nota de la app de escritorio de Genie One para Windows (Beta), 2026-11-11, https://docs.databricks.com/aws/en/genie-one/desktop#install-windows
- Databricks on AWS, nota de la extension de Chrome de Genie One (Beta), 2026-11-10, https://docs.databricks.com/aws/en/genie-one/chrome-extension
- Azure Databricks, "Azure Databricks Genie plugin for Microsoft Copilot Cowork", 2026-11, https://learn.microsoft.com/en-us/azure/databricks/integrations/msft-cowork
- Azure Databricks, "November 2026 release notes", 2026-11, https://learn.microsoft.com/en-us/azure/databricks/release-notes/product/2026/november
- OpenAI, página del plugin de negocio de Databricks para ChatGPT, https://openai.com/business/plugins/databricks/
- Claude, conector de Databricks (marketplace de Claude), https://claude.com/marketplace/connectors/databricks
- x.ai, plugin de Databricks para Grok Bot, https://x.ai/bot/plugin/86276802
- Microsoft, plugin de Azure Databricks Genie (marketplace), https://marketplace.microsoft.com/en-us/product/WA200013104
- Model Context Protocol, especificación "Transports (2025-06-18)", https://modelcontextprotocol.io/specification/2025-06-18/basic/transports
- Model Context Protocol, especificación "Lifecycle (2025-06-18)", https://modelcontextprotocol.io/specification/2025-06-18/basic/lifecycle
- Model Context Protocol, resumen "MCP Apps", https://modelcontextprotocol.io/extensions/apps/overview
- Model Context Protocol, matriz de soporte de clientes, https://modelcontextprotocol.io/extensions/client-matrix
- Model Context Protocol, introduccion, https://modelcontextprotocol.io/introduction
- GitHub, modelcontextprotocol/ext-apps, https://github.com/modelcontextprotocol/ext-apps/
- GitHub, modelcontextprotocol/python-sdk, https://github.com/modelcontextprotocol/python-sdk
- Claude Code, documentación MCP (limites de salida), https://code.claude.com/docs/en/mcp
- Databricks on AWS, sección "Connect AI agents to Genie One MCP", https://docs.databricks.com/aws/en/agents/mcp-tools/genie-mcp#connect-ai-agents-to-genie-one-mcp
- Databricks on AWS, documentación de Unity Gateway, https://docs.databricks.com/aws/en/ai-gateway/
- Databricks on AWS, documentación "Govern an MCP", https://docs.databricks.com/aws/en/ai-gateway/govern-mcp-service
- EveryInfra, catálogo de capacidades de datos, https://api.everyinfra.com/api/v1/social/catalog
- Databricks, página de producto Unity Catalog, https://www.databricks.com/product/unity-catalog
- Databricks, página Unity Catalog Semantics, https://www.databricks.com/product/unity-catalog/business-semantics
- Databricks on AWS, documentación Chat in Genie One, https://docs.databricks.com/aws/en/genie-one/chat
- Databricks on AWS, documentación "Supported coding and work agents", https://docs.databricks.com/aws/en/ai-gateway/coding-agent-supported-agents
- Databricks on AWS, documentación "Other MCP clients", https://docs.databricks.com/aws/en/ai-gateway/coding-agent-mcp-skills
- Unite.AI, "Databricks Launches Native Genie Plugins for Four AI Agents", 2026-11-12, https://www.unite.ai/databricks-launches-native-genie-plugins-for-four-ai-agents/
- AlphaSignal, "Databricks Brings Genie Into ChatGPT to Query Company Data Instantly", 2026-11, https://alphasignal.ai/news/databricks-brings-genie-into-chatgpt-to-query-company-data-instantly
Referencia BL-174