zenrows alternatives en 2026: una lista por producto y por tarea
ZenRows frente a ScraperAPI, Bright Data, Firecrawl, Apify y EveryInfra: cuánto cuestan 1.000 páginas, productos de Amazon y búsquedas de Google.
Por 1.000 páginas web estáticas, ZenRows cuesta de 0,067 a 0,42 USD según sus precios públicos del 19 de noviembre de 2026. Es más barato que ScraperAPI, Firecrawl, Bright Data y EveryInfra. Por 1.000 búsquedas en Google, ZenRows baja a 0,067 USD si cada búsqueda usa 1 crédito. Con 5 créditos, las mismas 1.000 búsquedas cuestan de 0,33 a 2,11 USD. En nuestras llamadas de prueba, EveryInfra cobró un precio fijo de 0,694 USD por cada 1.000 búsquedas.
La mayor diferencia está en los datos sociales. Bright Data cobra de 1,30 a 1,50 USD por cada 1.000 registros. La herramienta de Reddit de Apify parte de 3,40 USD por cada 1.000 resultados. En EveryInfra, tiktok/profile cuesta 0,556 USD por cada 1.000 perfiles. Una solicitud de reddit/subreddit_posts devuelve 10 publicaciones, lo que da 0,0556 USD por cada 1.000 publicaciones. Es de 2,3 a 61 veces menos que los dos servicios que cobran por registro. Estos múltiplos suponen una solicitud que devuelve las 10 publicaciones más nuevas: reddit/subreddit_posts no permite fijar el número de publicaciones ni un rango de fechas. Para sacar todas las publicaciones de un subreddit o un número concreto, la herramienta por registro es la unidad comparable, y los dos precios no se comparan directamente.
ZenRows es la mejor opción en tres casos. El primero son las páginas con JavaScript y los sitios con protección antibots: nuestra herramienta read devolvió una página vacía en una prueba y un resultado vacío y reembolsado en la otra. El segundo es el ancho de banda de proxies residenciales. El tercero es un navegador real que hace clic e inicia sesión. EveryInfra no tiene producto para estos tres casos.
ZenRows es una API de datos web que cobra en créditos. Usted le envía una URL. ZenRows decide, según la dificultad de la página, si debe ejecutar JavaScript o usar un proxy residencial. Solo descuenta créditos cuando la solicitud sale bien. Una solicitud estándar cuesta 1 crédito, el renderizado de JavaScript 5, un proxy premium 10 y ambos juntos 25. El ancho de banda residencial cuesta 25.000 créditos por GB, y una sesión de Browser cuesta 25.000 créditos por GB más 5 créditos por minuto (documentación de precios de ZenRows, leída el 19-11-2026).
Nuestra guía de precios de ZenRows convierte cada uno de los 14 planes mensuales en un precio por 1.000. Nuestra página de alternativas a ZenRows da un resumen corto.
Los precios de los proveedores salen de sus páginas de precios y de su documentación pública. Los leímos entre las 00:14 y las 00:30, hora de Singapur, del 19 de noviembre de 2026. Todos usan pago mensual y suponen que se usa toda la cuota. Nuestros precios salen del campo charged_usd de las respuestas a nuestras llamadas reales. También los cotejamos con price_usd en el catálogo GET /api/v1/social/catalog del mismo día. Los seis servicios usan nombres de campo, límites de filas y paginación distintos. Las tablas comparan solo dinero, reglas de cobro y acceso, no campos.
Por línea de producto: ¿qué producto de ZenRows usa?
ZenRows vende ahora cinco piezas. Fetch obtiene una página. Extract convierte la página en JSON estructurado en la misma solicitud. Crawl parte de una URL y sigue los enlaces por todo el sitio. Batch acepta hasta 100.000 URL en un trabajo. Browser da una sesión de navegador real que puede hacer clic e iniciar sesión. ZenRows también vende proxies residenciales aparte (índice de la documentación de ZenRows, versión de noviembre de 2026).
Todo comparte un solo saldo de créditos. La respuesta a «cambiar o quedarse» es distinta para cada producto.
| Su producto de ZenRows | Cómo cobra | Quién sale más barato | Motivo para quedarse |
|---|---|---|---|
| Fetch, páginas estándar | 1 crédito, 0,067–0,42 USD por 1.000 | Casi nadie | El precio más bajo de los seis |
| Fetch con JS o en sitios protegidos | De 5 a 25 créditos | Bright Data Unlocker, 1,30–1,50 USD | El modo adaptativo cobra solo el nivel que funcionó |
| Extract en sitios listos (Amazon, Google, Maps, TikTok, Reddit) | Igual que Fetch, Extract es gratis por ahora | APIs estructuradas por registro o por solicitud | Campos listos para 539 sitios |
| Crawl, Batch | Cada página cobra como Fetch | Crawl de Firecrawl, 1 crédito por página | 100.000 URL por trabajo, horarios y webhooks |
| Browser | 25.000 créditos por GB más 5 por minuto | Browser API de Bright Data | Inicios de sesión, clics y formularios |
| Proxies residenciales | 25.000 créditos por GB, planes antiguos 18.000–54.000 | Residencial de Bright Data | Comparte el saldo de Fetch |
Mire las páginas de ZenRows para Amazon ASIN, Google Search, Google Maps, TikTok y Reddit. Todas usan la misma solicitud: mode=auto más extract=auto. Fetch abre la página en modo adaptativo y Extract devuelve los campos.
Las cinco páginas muestran una solicitud real del 20 de octubre de 2026. Ninguna dice si la página cae en 1, 5, 10 o 25 créditos. La página de precios solo dice que el modo adaptativo empieza por la configuración más ligera y sube cuando la página lo pide (página de precios de ZenRows). Por eso, cada precio de ZenRows para páginas estructuradas en este artículo es un rango de 1 a 25 créditos. Los dos extremos difieren en más de 150 veces.
Cobertura de Extract: revise la lista de dominios antes de cambiar
Si usa Extract, compruebe primero una cosa: ¿su sitio está en la lista de dominios preparados? ZenRows ofrece esa lista como endpoint. GET /v1/extract/domains devuelve todos los dominios que Extract maneja hoy. No obtiene páginas, así que no cuesta créditos. Una solicitud con extract=auto a un dominio fuera de la lista devuelve REQS007. El título dice entonces que el dominio no está preparado (referencia de Extract).
Puede enviar usted mismo un dominio que falte. POST /v1/extract/prepared-domains acepta el dominio y de 1 a 5 URL de ejemplo. ZenRows aprende la forma de las páginas y revisa los campos. Luego el estado pasa a ready, normalmente en unos minutos. Cada cuenta tiene un cupo mensual de envíos, que se reinicia cada mes natural en UTC, y un envío por encima del cupo devuelve 429 (introducción a Extract).
Hay sitios que están en la lista y de los que solo necesita campos estándar, como Amazon, Google, TikTok y Reddit. Para ellos, una API con campos fijos por plataforma es el cambio fácil: las dos partes reciben un ID y devuelven campos, y solo cambian el precio y los nombres. Otros son sitios poco comunes que debe enviar para su preparación. Ahí la preparación de ZenRows es una ventaja, y nuestro catálogo probablemente tampoco cubre esos sitios, así que déjelos en ZenRows.
Nuestra lista de funciones también es pública. GET /api/v1/social/catalog funciona sin clave. El 19 de noviembre de 2026 listaba 612 funciones, cada una con price_usd, params y response_fields (catálogo de EveryInfra). Compare las dos listas y mueva primero los sitios que aparecen en ambas.
| Endpoint | Créditos | Uso |
|---|---|---|
GET /v1/extract/domains | 0 | Lista los dominios que Extract cubre hoy |
POST /v1/extract/prepared-domains | 0, usa un cupo mensual | Pide preparar un dominio nuevo |
GET /v1/extract/prepared-domains/allowance | 0 | Consulta los cupos que quedan este mes |
GET /api/v1/social/catalog (EveryInfra) | 0, sin clave | Lista funciones, precios y campos |
La tabla comparativa: unidad de cobro, fallos, gasto mínimo y MCP
| Servicio | Unidad de cobro | Páginas estándar por 1.000 (USD) | Búsquedas en Google por 1.000 (USD) | Fallos o resultados vacíos | Gasto mínimo | Cuota gratuita | Herramientas de IA |
|---|---|---|---|---|---|---|---|
| ZenRows | Créditos, 1/5/10/25 | 0,067–0,42 | 0,067–10,56 (nivel no publicado) | Fallos gratis, 404 y 410 cuentan como éxito | Build, 19 USD al mes | 5.000 créditos al mes | MCP remoto |
| ScraperAPI | Créditos, multiplicados por dominio y parámetros | 0,092–0,49 | 2,30–12,25 (25 créditos) | Solo cobra 200, 404 y cancelaciones en 70 segundos | Hobby, 49 USD al mes | 5.000 en 7 días, luego 1.000 al mes | MCP remoto |
| Firecrawl | Créditos, 1 por página | 0,75–3,80 | 1,50–7,60 (2 créditos por 10 resultados) | Sin resultado es gratis, 403 y 404 cuestan 1 | Hobby, 19 USD al mes | 1.000 créditos al mes | MCP |
| Bright Data | Por solicitud o registro con éxito | 1,30–1,50 (Unlocker) | 1,31–1,50 | Solo paga el éxito | Pago por uso, sin cuota mensual | 5.000 créditos al mes | MCP, 5.000 solicitudes gratis al mes |
| Apify | Por evento, casi siempre por resultado | No aplica | 1,80–4,50 (por página) | Puede fijar un cargo máximo por ejecución | Starter, 19 USD al mes | 5 USD al mes | MCP remoto |
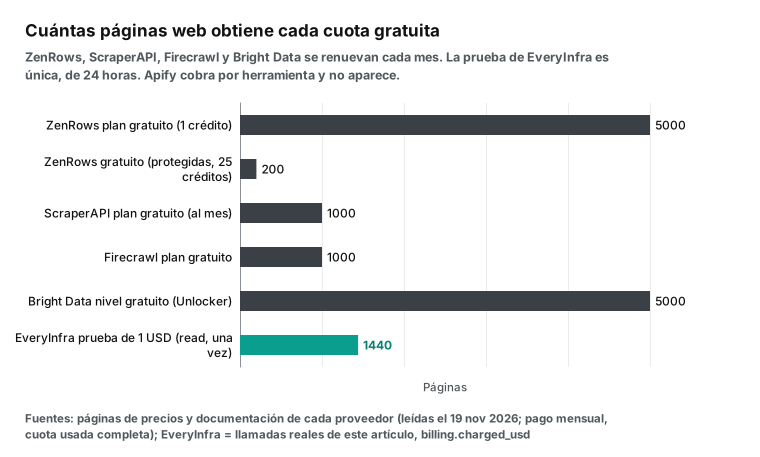
| EveryInfra | Por solicitud, precio fijo | 0,694 (read, cobrado) | 0,694 (web, cobrado) | Fallos y vacíos gratis, faltan parámetros: 422 | Primera recarga 10 USD, el saldo no caduca | 1 USD por marcar con una estrella dos repositorios de GitHub, 24 horas | MCP remoto |
Cada rango va del plan mensual de autoservicio más barato al más caro, con toda la cuota usada. Build B1 de ZenRows cuesta 19 USD por 45.000 créditos, es decir, 0,422 USD por cada 1.000 créditos. Scale S5 cuesta 2999 USD por 45 millones de créditos, o 0,0666 USD por cada 1.000 (documentación de precios de ZenRows). Hobby de ScraperAPI cuesta 49 USD por 100.000 créditos, y Advanced cuesta 1975 USD por 21,5 millones (precios de ScraperAPI). Hobby de Firecrawl cuesta 19 USD por 5.000 créditos, y Scale 749 USD por 1 millón, con precios vigentes desde el 4 de septiembre de 2026 (precios de Firecrawl).
Web Unlocker de Bright Data cuesta 1,50 USD por cada 1.000 solicitudes en pago por uso. Su paquete Scale cuesta 499 USD e incluye 383.000 solicitudes (precios de Web Unlocker). SERP API cuesta 1,50 USD por cada 1.000 en pago por uso, y su paquete Scale incluye 380.000 (precios de SERP API). El nivel gratuito de Bright Data da 5.000 créditos al mes, y Unlocker, SERP y Web Scraper usan 1 crédito por solicitud o registro (nivel gratuito de Bright Data). Los precios de Apify salen de los niveles públicos de cada herramienta de la Store, que siguen los planes Free, Starter, Scale y Business (precios de Apify, cobro en la Store de Apify).
Multiplicadores de créditos de ZenRows: calcule primero su nivel medio
Antes de cambiar necesita un número: cuántos créditos usan de media sus solicitudes. La documentación de ZenRows fija los multiplicadores. Una solicitud estándar cuesta 1, el renderizado de JavaScript 5, los proxies premium 10 y ambos juntos 25. La documentación dice que estos pesos son fijos e iguales en todos los planes. Entre planes solo cambia la cuota mensual de créditos (documentación de precios de ZenRows).
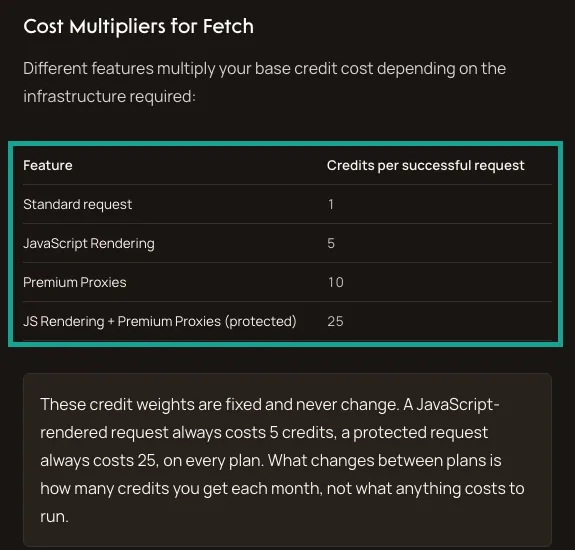
Multiplique el peso por el precio de 1.000 créditos y obtendrá el precio de 1.000 páginas. Estos son cinco de los 14 planes de autoservicio:
| Plan de ZenRows | Precio mensual (USD) | Créditos al mes | Estándar por 1.000 | JS | Proxy premium | Protegida (25) | Residencial por GB |
|---|---|---|---|---|---|---|---|
| Build B1 | 19 | 45.000 | 0,422 | 2,11 | 4,22 | 10,56 | 10,56 |
| Launch L1 | 69 | 250.000 | 0,276 | 1,38 | 2,76 | 6,90 | 6,90 |
| Growth G1 | 199 | 1.200.000 | 0,166 | 0,83 | 1,66 | 4,15 | 4,15 |
| Scale S1 | 549 | 5.000.000 | 0,110 | 0,55 | 1,10 | 2,75 | 2,75 |
| Scale S5 | 2999 | 45.000.000 | 0,067 | 0,33 | 0,67 | 1,67 | 1,67 |
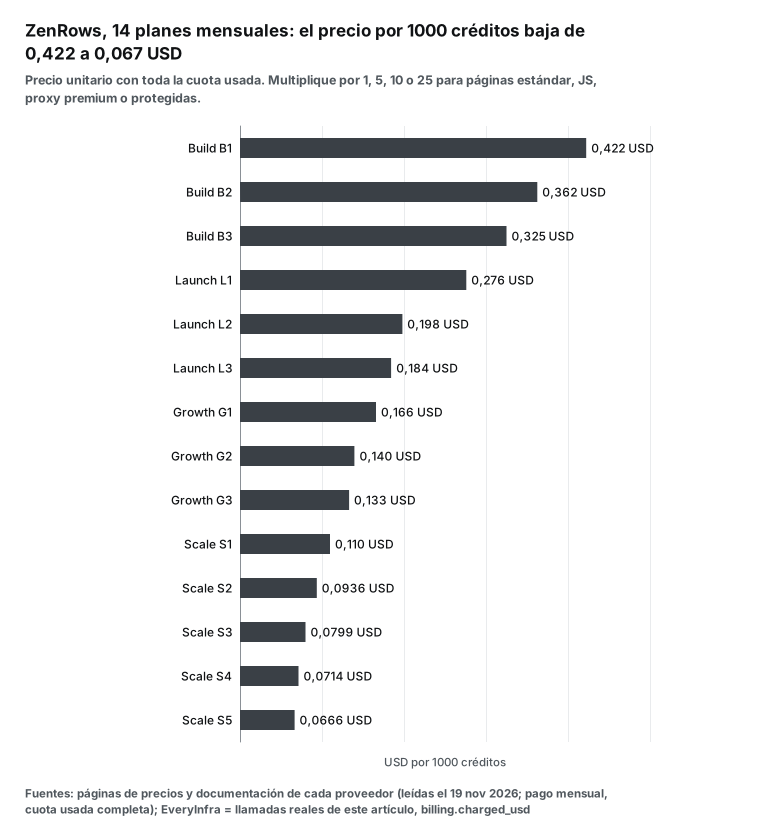
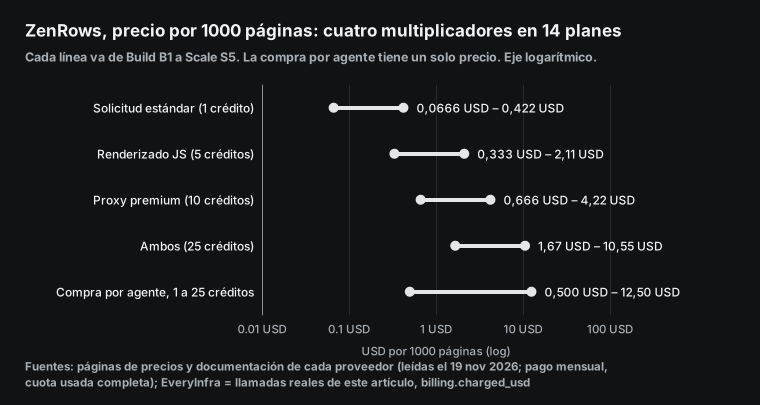
Dos cosas suben su nivel medio real. La primera es una configuración mínima por dominio. La documentación de errores de ZenRows dice que algunos dominios exigen renderizado de JavaScript o proxies premium por su fuerte protección. ZenRows revisa esta regla por dominio o URL antes de obtener la página. Una solicitud con parámetros de menos devuelve REQS002 sin cobro, pero la configuración ligera se rechaza siempre, así que no hay un primer intento barato en esos dominios (códigos de error de ZenRows).
La segunda es el modo adaptativo. mode=auto empieza por la configuración más ligera y sube. Cobra el último nivel que funcionó, así que usted no conoce el nivel antes de la solicitud. La forma más simple de estimarlo es una muestra. Tome 200 URL reales del último mes y páselas con mode=auto. Luego abra el Activity Log del panel, que ZenRows lanzó a finales de julio de 2026. Filtra por producto y URL, con una ventana de 24 horas a 60 días (changelog de ZenRows). Calcule la media de créditos y multiplique por ella los demás precios de este artículo.
ScraperAPI también usa créditos, con otros multiplicadores. Una solicitud estándar cuesta 1, Amazon, Walmart y eBay 5, las búsquedas en Google y Bing 25 y LinkedIn 30. render=true y premium=true cuestan 10 cada uno, y juntos 25. El desbloqueo de Cloudflare, DataDome, PerimeterX y Akamai cuesta 10 por solicitud. ultra_premium=true cuesta 30, y con renderizado 75 (créditos de ScraperAPI).
En octubre de 2026, ScraperAPI empezó a desbloquear los sitios protegidos por Akamai sin parámetro extra (nota de octubre de ScraperAPI). Con el renderizado de JavaScript activado, ScraperAPI usa 10 créditos y ZenRows 5. Una página con JavaScript gasta el doble de créditos en ScraperAPI.
Tarea 1: cualquier página web, donde ZenRows es el más barato en páginas estándar y el más caro en las protegidas
Primero, cualquier página web. Elegimos tres páginas de prueba de ScrapingCourse.com, un sitio público de práctica para scrapers, y obtuvimos cada una una vez con la herramienta read de EveryInfra. La primera es una lista de productos estática. La segunda muestra los productos solo cuando se ejecuta JavaScript. La tercera tiene un desafío antibots.
A las 00:17, hora de Singapur, del 19 de noviembre de 2026, la lista estática scrapingcourse.com/ecommerce/ llegó en 1,28 segundos. El texto traía «Showing 1–16 of 188 results» y 16 productos. Costó 0,000694 USD, es decir, 0,694 USD por 1.000 páginas. En el mismo minuto, la página de prueba de JavaScript scrapingcourse.com/javascript-rendering tardó 11,44 segundos. El texto tenía solo dos líneas, «JS Rendering Challenge» y «Enable JavaScript to see products», sin productos, y aun así costó 0,000694 USD.
Nuestra herramienta read no ejecuta JavaScript, así que en esas páginas devuelve el esqueleto. A las 00:18, la página antibots scrapingcourse.com/antibot-challenge tardó 11,98 segundos. El resultado llegó vacío, la respuesta decía empty_result_refunded y el cobro fue de 0 USD.
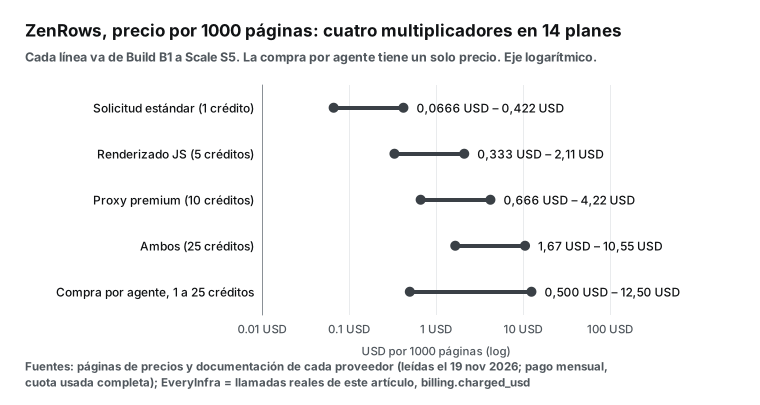
Podemos obtener páginas estáticas, pero nuestro precio es más alto que los planes más bajos de ZenRows y ScraperAPI. No podemos obtener páginas con JavaScript ni páginas protegidas. ZenRows cobra 5 y 25 créditos por esas dos clases de página: de B1 a S5, de 0,33 a 2,11 USD y de 1,67 a 10,56 USD por 1.000. El renderizado de ScraperAPI cuesta 10 créditos, de 0,92 a 4,90 USD por 1.000, y su desbloqueo también 10. Bright Data Web Unlocker cuesta de 1,30 a 1,50 USD con cualquier dificultad. Firecrawl cobra 1 crédito por página con renderizado incluido, de 0,75 a 3,80 USD por 1.000.
La documentación de ZenRows aconseja subir paso a paso. Envíe primero una solicitud estándar. Active el renderizado solo si falta contenido. Active los proxies premium solo si el sitio sigue bloqueando. Combine los dos, a 25 créditos, solo si uno no basta (guía de inicio de ZenRows, parámetros de Fetch).
Use la misma lógica para dividir la migración. Cualquier servicio puede llevar las páginas estáticas, y las páginas con JavaScript o protegidas se quedan en un servicio que renderice. Para saber si una página es estática, mire el texto que devuelve nuestra herramienta read. Si contiene sus campos, es estática. Si solo muestra un aviso como «Enable JavaScript», necesita renderizado.
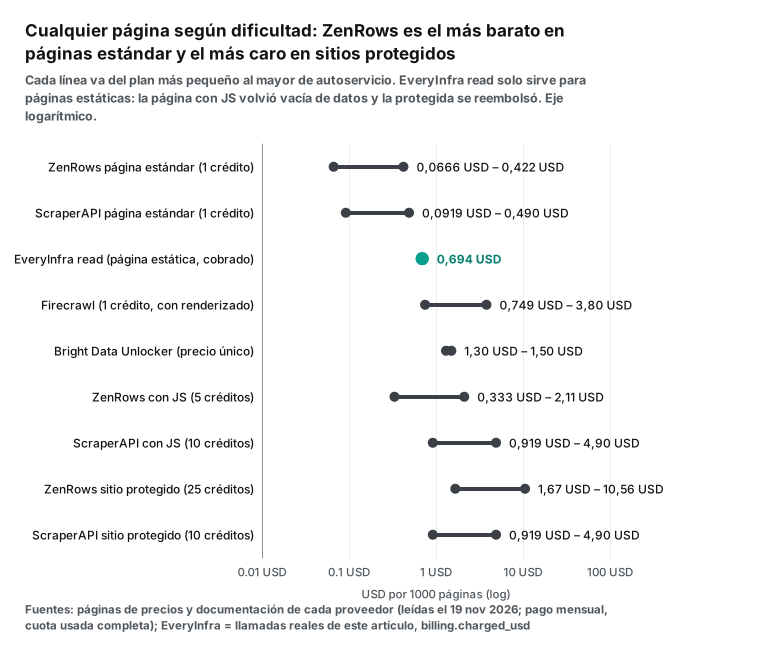
ZenRows es más barato que ScraperAPI en páginas estándar, pero el orden se invierte en sitios protegidos. Los 25 créditos de ZenRows cuestan más que el desbloqueo de 10 créditos de ScraperAPI: en B1 son 10,56 USD por 1.000 páginas, frente a 4,90 USD en el plan Hobby de ScraperAPI. ZenRows da su motivo en su propia prueba, con cuatro sitios protegidos: Zim, Glassdoor, Idealista e Indeed. Cada servicio recibió 100 solicitudes por sitio, 400 en total, a 2 solicitudes por segundo.
ZenRows acertó en el 99,0 % con 9,1 segundos de media, y ScraperAPI en el 49,0 % con 36,0 segundos de media. Las cifras están en una publicación de r/LLMDevs. Su primera línea dice que el autor escribe contenido técnico para ZenRows y que los datos vienen de pruebas internas de ZenRows. La publicación dice que se probaron cinco servicios, pero solo da los resultados de tres; las tablas completas están en el blog de ZenRows. Con esas tasas, cada página buena de ScraperAPI cuesta 1/0,49 veces el precio de lista, unas 2,04 veces. Son cifras de ZenRows: antes de decidir, haga 100 solicitudes por servicio en sus propios sitios protegidos.
Tarea 2: páginas de producto de Amazon, probadas con el ASIN de ejemplo de ZenRows
La página Amazon ASIN de ZenRows usa B0CRMZHDG8 como ejemplo: el vaso STANLEY Quencher H2.0 de 40 oz. La solicitud del 20 de octubre devolvió una valoración media de 4,75 y 206.884 valoraciones, con 34 detalles del producto y 6 imágenes (página Amazon ASIN de ZenRows). A las 00:19, hora de Singapur, del 19 de noviembre, obtuvimos el mismo producto con amazon/profile. Tardó 7,72 segundos.
La respuesta traía el título, la marca STANLEY, un precio de 42,30 USD, una valoración de 4,7, 207.914 valoraciones y la marca de disponibilidad. También traía la categoría, la descripción, las imágenes y los puntos destacados. Costó 0,001389 USD, es decir, 1,389 USD por 1.000 páginas de producto. En los 30 días entre las dos lecturas, el número de valoraciones subió en 1030.
A las 00:34, hora de Singapur, probamos un segundo producto: Apple AirPods Pro de 2.ª generación (B0BDHWDR12). Llegó en 7,56 segundos con un precio de 265,78 USD, una valoración de 4,7, 57.992 valoraciones y el vendedor 6ave. Costó lo mismo, 0,001389 USD: una página de producto tiene un precio por solicitud, y ni la popularidad ni la longitud lo cambian. En el mismo minuto buscamos «stanley tumbler 40 oz» con amazon/search. Devolvió 10 productos en 4,51 segundos, cada uno con ASIN, título, precio, precio de lista, valoración y número de valoraciones. Costó 0,002236 USD, o 2,236 USD por 1.000 búsquedas y 0,2236 USD por 1.000 productos.
Seis de los 10 resultados eran colores del Quencher H2.0. Los seis mostraban 207.914 valoraciones, igual que B0CRMZHDG8, porque Amazon suma las valoraciones de todos los colores. Cinco costaban 22,50 USD con precio de lista de 45,00 USD, y uno no mostraba precio. La versión fucsia que obtuvimos sola costaba 42,30 USD: el mismo producto en otro color costaba casi el doble. ¿Vigila precios de lista y valoraciones sin necesitar el detalle? La búsqueda da 10 productos por solicitud y sale 6,2 veces más barata que una página de producto por artículo.
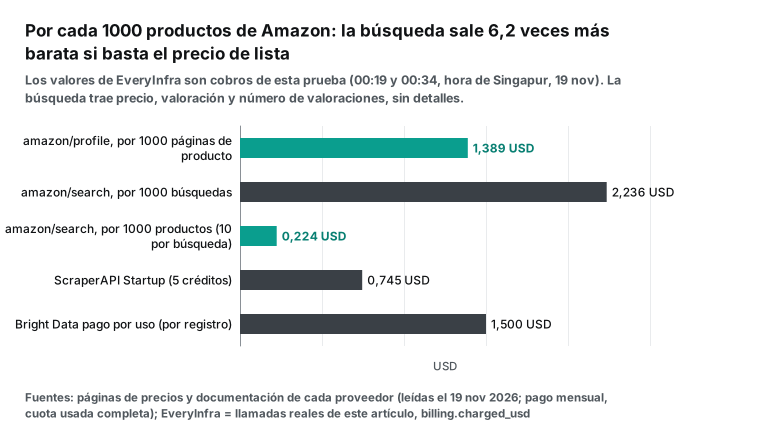
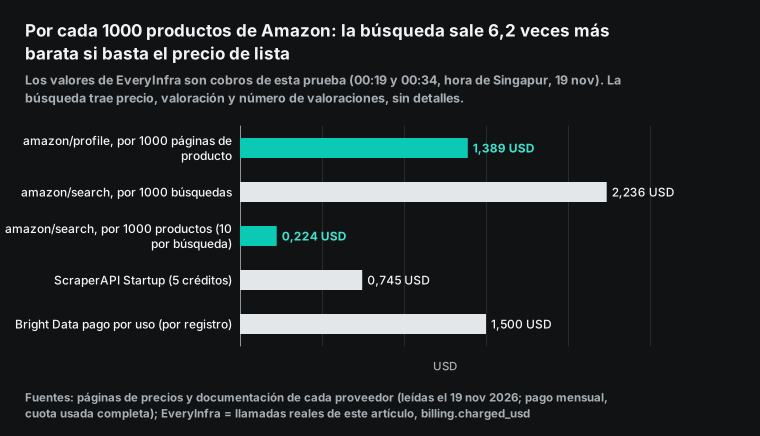
Este es el precio por 1.000 páginas de producto en los demás servicios. ScraperAPI usa 5 créditos por página: 2,45 USD en Hobby y 0,46 USD en Advanced. Web Scraper de Bright Data cobra por registro: 1,50 USD en pago por uso y 1,30 USD en Scale. La herramienta de Amazon de la Store de Apify cuesta de 0,003 a 0,005 USD por resultado, de 3,00 a 5,00 USD por 1.000 (herramienta de Amazon en Apify). Firecrawl con salida JSON usa 1 más 4 créditos por página, de 3,75 a 19,00 USD por 1.000. ZenRows no publica el nivel de Amazon: con 1 a 25 créditos, cuesta de 0,067 a 10,56 USD.
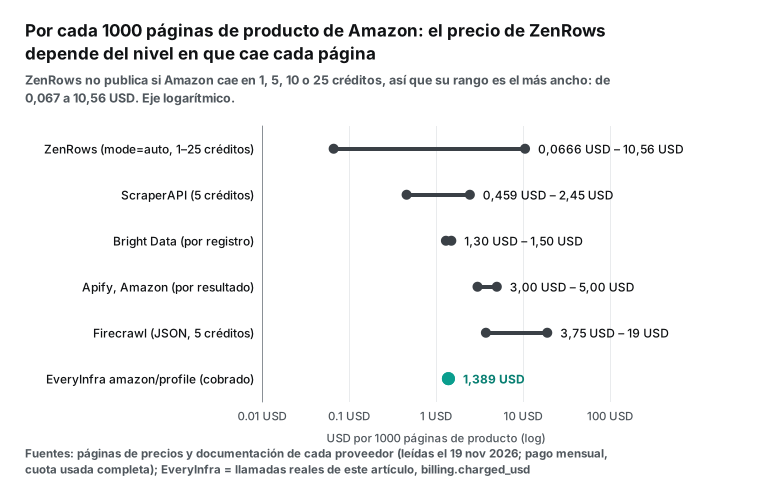
La línea de ZenRows es la más larga, y la respuesta depende del nivel medio de sus solicitudes de Amazon. A 1 crédito, ZenRows cuesta de 0,067 a 0,42 USD por 1.000 páginas y gana a todos. A 5 créditos, de 0,33 a 2,11 USD, cerca de ScraperAPI. A 25 créditos, B1 cuesta 10,56 USD, 7,6 veces nuestro precio. El nivel de Amazon hay que medirlo: pruebe 200 de sus ASIN y lea el Activity Log. El tercer vídeo de YouTube de más abajo da una referencia. El autor abre una página de búsqueda de Amazon en el panel de ZenRows y activa a la vez los proxies premium y el renderizado de JavaScript, y el panel dice que la solicitud cuesta «solo 0.025». El vídeo no da la unidad ni el plan. Con las dos opciones activas, la documentación sitúa la solicitud en el nivel de 25 créditos.
Para equipos de mucho volumen que solo necesitan el detalle del producto, ScraperAPI es más barato que nosotros desde el plan Startup, a 0,745 USD por 1.000 páginas. Para equipos más pequeños que no quieren un plan mensual, la API de Amazon de pago por llamada es más sencilla. amazon/search y amazon/reviews usan el mismo saldo.
Tarea 3: búsqueda en Google y Google Maps, a un precio fijo por búsqueda
El ejemplo de Google Search de ZenRows usa la consulta «best running shoes» (página de Google Search de ZenRows). A las 00:23, hora de Singapur, enviamos la misma consulta con la herramienta web. Devolvió 10 resultados orgánicos en 2,8 segundos, con RunRepeat, Runner's World, el subreddit r/runninglifestyle, Nike, YouTube y la lista de más vendidos de Amazon. Costó 0,000694 USD, es decir, 0,694 USD por 1.000 búsquedas o 0,0694 USD por 1.000 resultados.
A las 00:35, hora de Singapur, buscamos «zenrows alternatives» con la misma herramienta. Devolvió 10 resultados en 1,57 segundos por los mismos 0,000694 USD. El primero era la página de alternativas de la propia ZenRows, y el segundo y el tercero eran páginas «ZenRows alternative» de ScraperAPI y de Apify. Ocho de los 10 venían de proveedores de scraping, uno de un sitio de reseñas de software y uno era un artículo en Medium. Casi todo lo que se lee con esta consulta viene de una parte interesada, y cada proveedor se pone primero. Revise sus páginas de precios y su documentación antes de decidir.
Este es el precio por 1.000 búsquedas en Google en los demás servicios. SERP API de Bright Data cuesta 1,50 USD en pago por uso y 1,31 USD en Scale. Firecrawl usa 2 créditos por cada 10 resultados, de 1,50 a 7,60 USD. La herramienta de Google Search de Apify cobra por página de resultados, de 0,0018 a 0,0045 USD por página, de 1,80 a 4,50 USD por 1.000 (herramienta de Google Search en Apify). ScraperAPI usa 25 créditos por búsqueda, de 2,30 a 12,25 USD.
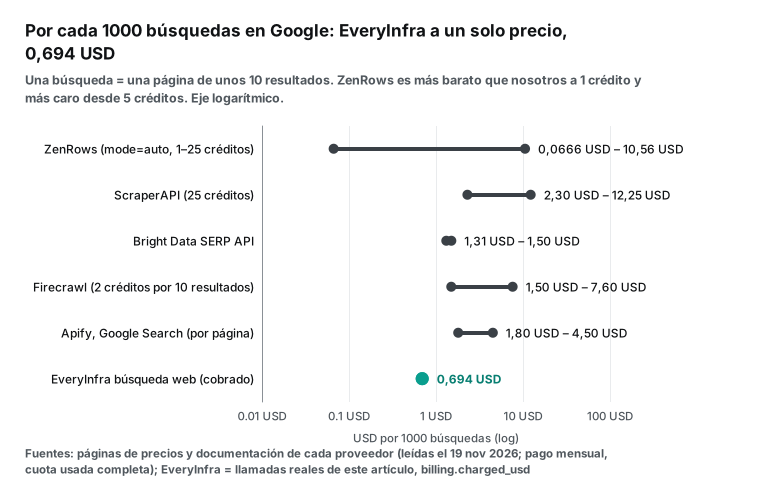
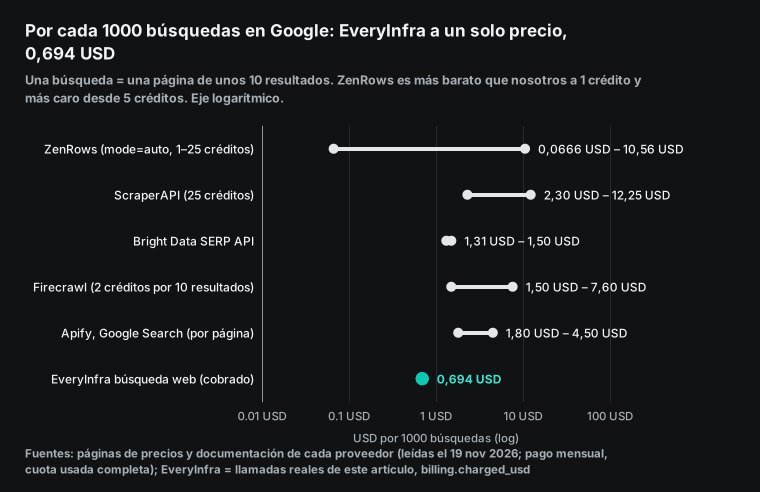
A 1 crédito, ZenRows es más barato que nosotros. Pero ZenRows no muestra ningún ejemplo de página de resultados de Google a 1 crédito: su solicitud de ejemplo usa mode=auto y proxy_country=us. Con una media de 5 créditos, B1 cuesta 2,11 USD por 1.000 búsquedas, 3 veces nuestro precio. Con 25 créditos, B1 cuesta 10,56 USD, 15 veces nuestro precio. Nuestra herramienta web tiene un solo precio para cualquier consulta, sin nivel que adivinar.
Para Google Maps, la consulta de ejemplo de ZenRows es «coffee shops in austin tx». La página dice que el ejemplo muestra solo 3 de los lugares devueltos y no dice cuántos devuelve una búsqueda (página de Google Maps de ZenRows). A las 00:24 enviamos la misma consulta a google_maps_reviews/search. Devolvió un error 503 sin cobro. El mensaje decía que esta función había fallado varias veces en 10 minutos, todas gratis, y que reintentáramos más tarde. Reintentamos a las 00:35 y a las 00:40, con 503 y sin cobro las dos veces. El segundo mensaje incluía una solicitud de ejemplo para comprobar si el problema era el objetivo o el servicio.
Entonces usamos la herramienta places. A las 00:40 buscamos «coffee shops» con la ubicación «Austin, TX». Devolvió 20 lugares en 2,41 segundos, cada uno con nombre, dirección, valoración, número de valoraciones, categoría, teléfono, web, coordenadas, horario y place_id. Costó 0,000694 USD, es decir, 0,0347 USD por 1.000 lugares. Mozart's Coffee Roasters tenía más valoraciones, 11.016 con 4,5, y Trippy Buck Coffee menos, 47 con 4,9. De los 20 lugares, 19 tenían web, 19 horario y 12 teléfono. Los 8 lugares con 4,9 o más tenían como mucho 435 valoraciones cada uno, y los 5 con más de 1000 valoraciones estaban todos entre 4,4 y 4,7. Si ordena una lista por valoración, mire también cuántas valoraciones tiene. La herramienta places no devuelve el texto de las reseñas: para eso hay que esperar a que google_maps_reviews se recupere.
| Lugar (5 de los 20) | Valoración | Valoraciones | Categoría |
|---|---|---|---|
| Jo's Coffee – South Congress | 4,4 | 2013 | Coffee shop |
| Epoch Coffee | 4,5 | 2543 | Coffee shop |
| Terrible Love Coffee | 4,9 | 435 | Coffee shop |
| Mozart's Coffee Roasters | 4,5 | 11.016 | Coffee shop |
| Summer Moon Coffee | 4,6 | 2074 | Coffee shop |
Dos servicios cobran por lugar. Bright Data cobra de 1,30 a 1,50 USD por cada 1.000 registros de Google Maps. La herramienta de Google Maps de Apify cobra de 0,0015 a 0,004 USD por lugar, de 1,50 a 4,00 USD por 1.000 (herramienta de Google Maps en Apify). La Places API de Google cobra por llamada: Text Search devuelve como máximo 60 lugares y Place Details como máximo 5 reseñas (precios de Google Maps Platform).
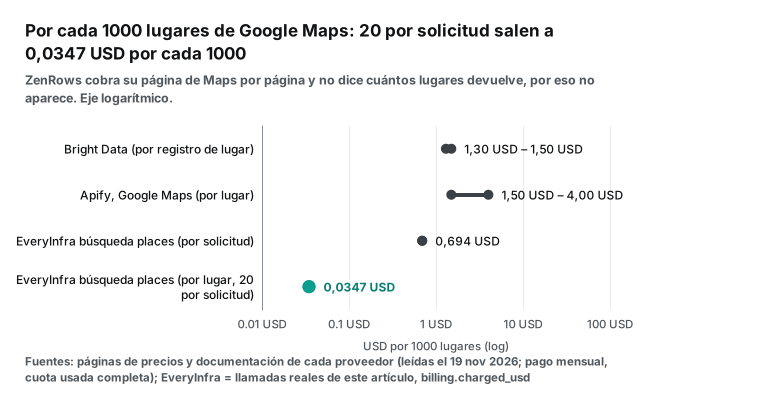
Veinte lugares por solicitud a 0,0347 USD por 1.000 es de 37 a 115 veces menos que los dos servicios que cobran por lugar. La diferencia viene de la unidad de cobro: places cobra por solicitud, con cualquier número de lugares, y Bright Data y Apify cobran por lugar. Estos múltiplos suponen una solicitud con 20 lugares y campos básicos; para fijar el número de lugares, sacar todos los negocios de una ciudad o incluir reseñas, las unidades son distintas y los precios no se comparan directamente. Si saca listas de negocios por categoría en cientos de ciudades, con nombre, teléfono y valoración, places es la opción más barata. Si necesita el texto completo de las reseñas de cada negocio, necesita una herramienta por lugar o la página de Maps de ZenRows.
Tarea 4: perfiles de TikTok y subreddits, donde cobrar por página o por registro cambia el precio en 10 veces o más
La página de TikTok de ZenRows cubre solo perfiles públicos: entra la URL de un perfil y sale un registro. La cuenta de ejemplo es zachking. La solicitud del 20 de octubre mostraba 86.820.822 seguidores, 1.304.199.204 «me gusta» y 619 vídeos (página de TikTok de ZenRows). A las 00:25, hora de Singapur, obtuvimos la misma cuenta con tiktok/profile. Llegó en 1,83 segundos con 86.743.505 seguidores, 1.307.359.332 «me gusta», 622 vídeos, cuenta verificada y pública. Costó 0,000556 USD, es decir, 0,556 USD por 1.000 perfiles. En 30 días, la cuenta perdió 77.317 seguidores, ganó 3.160.128 «me gusta» y publicó 3 vídeos más.
A las 00:35 obtuvimos khaby.lame, una cuenta unas dos veces mayor. Llegó en 1,74 segundos con 162.895.918 seguidores, 2.695.175.517 «me gusta» y 1362 vídeos, y el cobro volvió a ser 0,000556 USD. El tamaño de la cuenta no cambia el precio. La página de TikTok de ZenRows no dice en qué nivel cae un perfil, y su página de escucha social dice que los resultados de búsqueda de TikTok se renderizan en el navegador. La Research API de TikTok solo está abierta a investigadores académicos y organizaciones sin ánimo de lucro aprobados, con respuesta habitual en 4 semanas (Research API de TikTok). Los equipos comerciales no pueden usar esa vía.
En Reddit, la comparación es r/webscraping. La página de Reddit de ZenRows usa este subreddit como ejemplo y devuelve el nombre, la descripción, 22.206 usuarios activos semanales, las reglas y las publicaciones fijadas (página de Reddit de ZenRows). A las 00:25 obtuvimos el mismo subreddit con reddit/subreddit_posts. Devolvió 10 publicaciones en 2,7 segundos, cada una con título, texto, autor, puntuación, comentarios, fecha y etiqueta. La primera era el hilo mensual de autopromoción de octubre, con 166 comentarios. Otra era una publicación de noviembre sobre una caída del 45 % del tráfico residencial tras bloquear fuentes y medios. Costó 0,000556 USD: con 10 publicaciones por solicitud, son 0,0556 USD por 1.000 publicaciones. Aparte del hilo fijado de octubre, las otras 9 publicaciones eran del 15-11-2026 al 18-11-2026 (UTC), así que 10 publicaciones cubrían algo más de tres días. La más votada trataba de una carta de cese y desistimiento que un portal web envió al autor de una biblioteca de código abierto, con 111 votos y 71 comentarios, y otras pedían ayuda con errores 403 constantes en un scraper de eBay o con DataDome en automatización de navegador. En un subreddit con este ritmo, una lectura diaria de publicaciones nuevas no pierde nada.
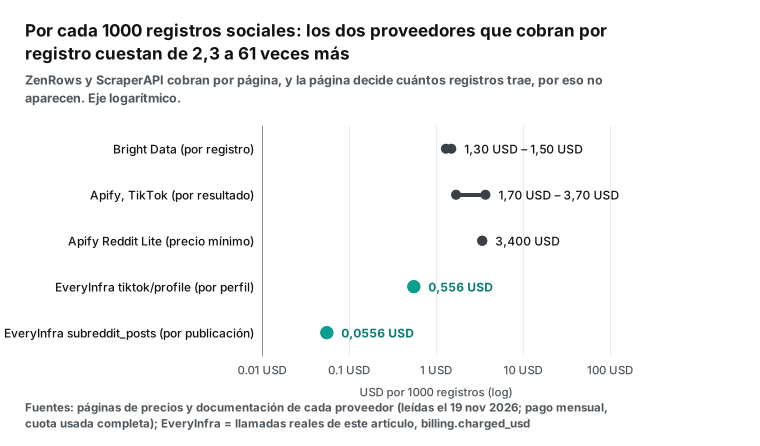
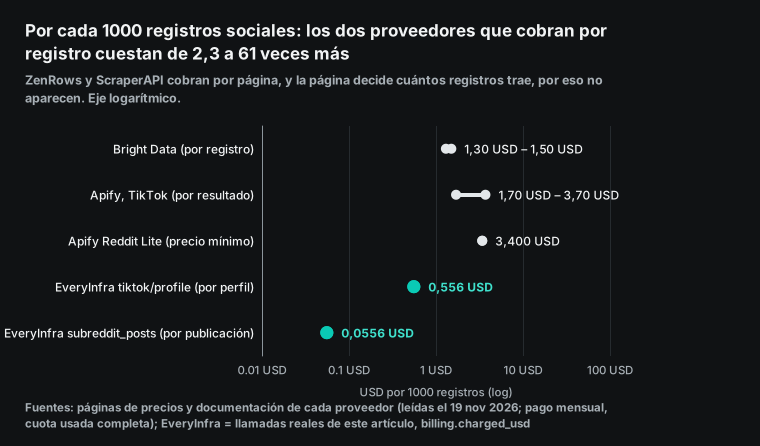
Dos servicios cobran por registro. Bright Data cobra de 1,30 a 1,50 USD por cada 1.000 perfiles de TikTok o publicaciones de Reddit. La herramienta de TikTok de Apify cuesta de 0,0017 a 0,0037 USD por resultado (herramienta de TikTok en Apify), y Reddit Lite parte de 3,40 USD por 1.000 (Reddit Lite en Apify). En perfiles de TikTok, costamos de 2,3 a 2,7 veces menos que Bright Data y de 3,1 a 6,7 veces menos que Apify. En publicaciones de Reddit, Bright Data cuesta de 23 a 27 veces nuestro precio, y Apify 61 veces. ZenRows y ScraperAPI cobran por página, y la página decide cuántas publicaciones trae, así que su precio no se pasa a 1.000 publicaciones. A 1 crédito, una página de subreddit en ZenRows cuesta de 0,000067 a 0,00042 USD, en el mismo orden que nuestros 0,000556 USD por solicitud. Bright Data y Apify cobran cada registro que saque; nuestro lado devuelve las 10 publicaciones más nuevas por solicitud y no permite fijar la cantidad. Estos múltiplos solo valen para una tarea como «revisar las 10 publicaciones más nuevas cada cierto tiempo»; las tareas que sacan todas las publicaciones o un rango de fechas no se comparan así.
El ejemplo de Reddit de ZenRows trae datos del subreddit: descripción, usuarios activos, reglas y fijados. Nuestro reddit/subreddit_posts trae una lista de publicaciones, así que son dos clases de datos distintas. No tenemos una función solo para los datos del subreddit. Nuestro catálogo lista 8 funciones de Reddit: búsqueda, publicaciones del subreddit, detalle de publicación, comentarios, publicaciones de usuario, comentarios de usuario, publicaciones en tendencia y resumen de problemas. Búsqueda y comentarios cuestan 0,000792 USD por solicitud, los comentarios de usuario 0,032403 USD y el resumen de problemas 0,072 USD.
El grupo de TikTok lista 24 funciones, 22 disponibles. Vídeos, comentarios, hashtags, transcripciones, listas de seguidores y búsqueda de productos de TikTok Shop cobran por solicitud, casi todas a 0,000556 USD. La página de TikTok de ZenRows cubre solo perfiles, con los comentarios en otra página. Para un perfil, sus vídeos recientes y los comentarios de cada vídeo, aquí son tres funciones, una llamada a cada una. En ZenRows son tres páginas, cada una cobrada al nivel en que caiga.
| Función | Precio por solicitud (USD) | Qué devuelve |
|---|---|---|
reddit/subreddit_posts | 0,000556 | 10 publicaciones con puntuación, comentarios y etiqueta |
reddit/comments | 0,000792 | Comentarios de una publicación |
reddit/search | 0,000792 | Publicaciones que coinciden con una consulta |
tiktok/profile | 0,000556 | Un perfil con sus contadores |
tiktok/comments | 0,000556 | Comentarios de un vídeo |
tiktok/shop_search | 0,000556 | Productos de TikTok Shop para una consulta |
Proxies residenciales y navegadores: lo que EveryInfra no vende
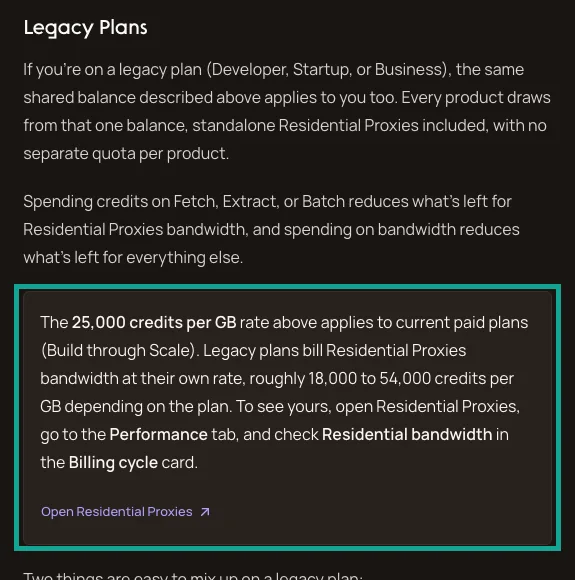
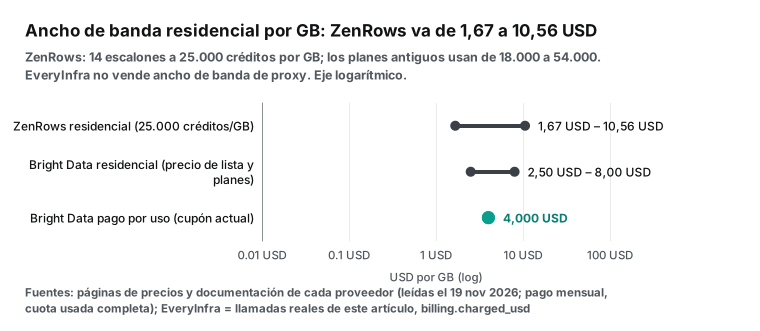
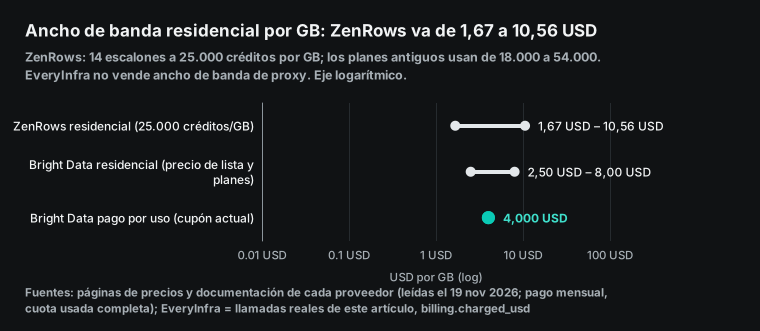
ZenRows cobra el ancho de banda residencial a 25.000 créditos por GB: 10,56 USD por GB en B1 y 1,67 USD en S5. Su regla práctica es que 1 GB equivale a unas 1.000 páginas protegidas (documentación de precios de ZenRows). Las cuentas con planes antiguos pagan otra tarifa: Developer, Startup y Business usan de 18.000 a 54.000 créditos por GB según el plan. Puede ver la suya en la pestaña Performance de la página de proxies residenciales (sección Legacy Plans de la misma página de la documentación).
Bright Data lista sus proxies residenciales a 8 USD por GB en pago por uso. La página muestra un cupón del 50 %, que deja el precio en 4 USD. Sus paquetes cuestan 499 USD por 141 GB (3,54 USD por GB), 999 USD por 332 GB (3,01 USD) y 1999 USD por 798 GB (2,51 USD) (precios residenciales de Bright Data). Antes de usarlos, Bright Data pide una verificación KYC, que puede incluir una videollamada. Web Unlocker no necesita KYC (preguntas frecuentes de la misma página). Los proxies residenciales sueltos de ZenRows no están en el plan gratuito.
EveryInfra no vende ancho de banda de proxy ni navegador remoto para Puppeteer o Playwright. Si usa ZenRows sobre todo para proxies residenciales o Browser, no somos un sustituto. Una sesión de Browser de ZenRows dura como máximo 15 minutos y cuesta 5 créditos por minuto más 25.000 créditos por GB (página de Browser de ZenRows), y el producto equivalente es Browser API de Bright Data. La publicación de Reddit citada da una forma de ahorrar en cualquier proveedor: bloquear fuentes, imágenes y medios bajó el tráfico residencial cerca de un 45 %. Un comentario avisa de que la intercepción de rutas de Playwright desactiva la caché HTTP, así que compare dos pasadas por el mismo dominio antes de fiarse (hilo de r/webscraping).
Una llamada real: solicitud, respuesta y campos
Tras el cambio, cada llamada es una solicitud POST. Usted pone la plataforma y la función en el cuerpo, sin construir una URL de destino ni elegir renderizado o proxy. Esta es la solicitud del perfil de TikTok de las 00:25, tal como la enviamos, con la clave en una variable de entorno:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"tiktok","action":"profile","params":{"username":"zachking"}}'
El objeto results trae los campos del perfil, y billing el cobro de esta llamada. Este es un extracto, sin el enlace del avatar ni la biografía:
{
  "platform": "tiktok", "action": "profile",
  "results": {
    "user_id": "68616495085350913", "username": "zachking", "display_name": "Zach King",
    "follower_count": 86743505, "following_count": 185, "like_count": 1307359332,
    "video_count": 622, "is_verified": true, "is_private": false,
    "created_at": "2016-02-29T07:29:22+00:00", "platform": "tiktok"
  },
  "billing": { "charged": true, "credits": 40, "charged_usd": 0.000556 }
}
Los nombres de campo coinciden con los response_fields de tiktok/profile en el catálogo del mismo día. El ejemplo de TikTok de ZenRows reparte datos parecidos en tres grupos, profile, stats y videos. Las dos estructuras son distintas, así que al cambiar hay que volver a mapear los campos. Para usarlo en una herramienta de IA como Claude o Cursor, añada una dirección MCP remota; todos los nombres de herramienta empiezan por everyinfra_:
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
Nuestras 27 solicitudes: tiempo y cobro de cada una
Entre las 00:17 y las 00:40, hora de Singapur, del 19 de noviembre de 2026, enviamos 27 solicitudes. Otra solicitud a las 00:16 chocó con el límite de velocidad y devolvió 429 sin cobro, y no la contamos. Las 27 cubrieron doce funciones: search/read, search/web, search/places, amazon/profile, amazon/search, tiktok/profile, reddit/subreddit_posts, youtube/search, youtube/comments, youtube/transcript, google_maps_reviews/search y zillow/search. Se cobraron 15, por 0,012598 USD en total. Las otras 12 fueron gratis: 1 resultado vacío reembolsado y 11 errores 503.
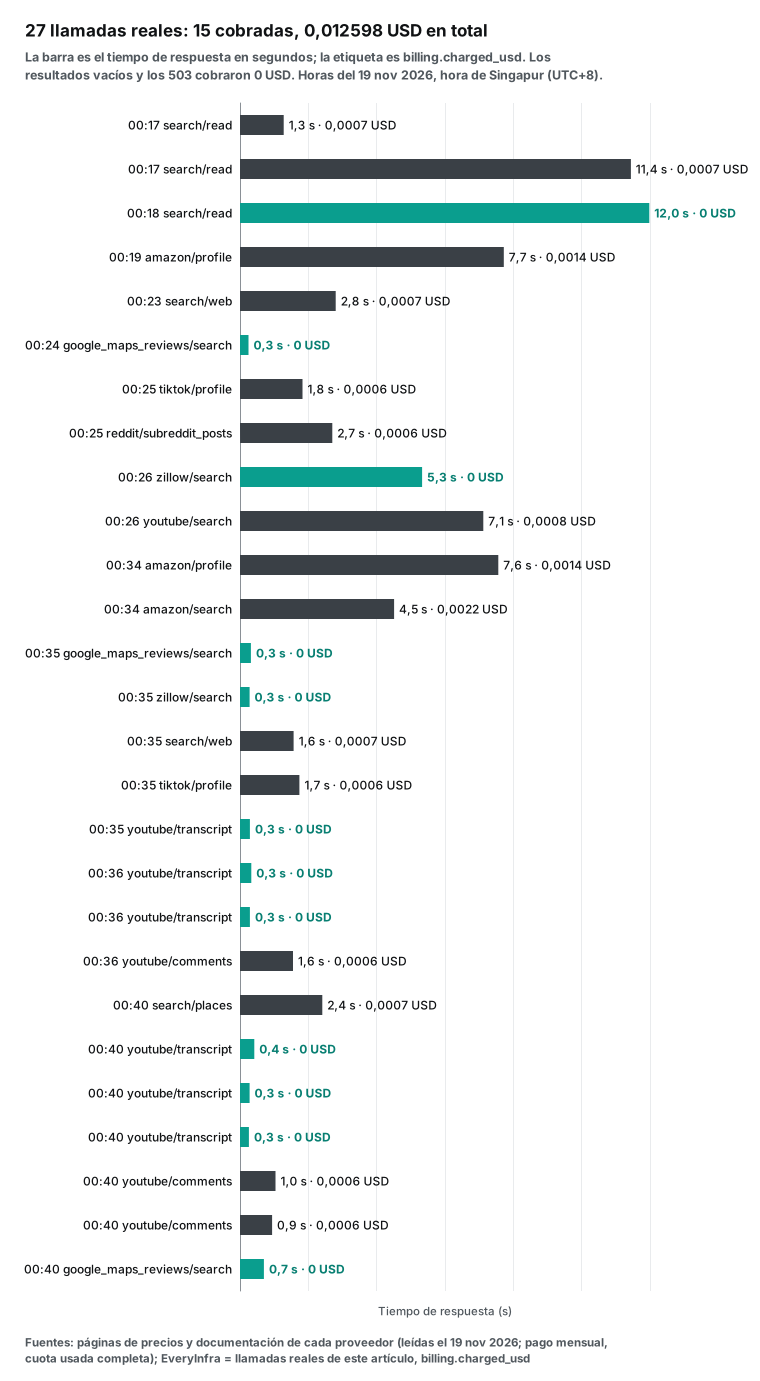
Entre las solicitudes correctas, los perfiles de TikTok, los subreddits, los resultados de búsqueda y los comentarios de YouTube tardaron de 1 a 3 segundos. Las páginas de producto de Amazon tardaron de 7,6 a 7,7 segundos. Read tardó de 11 a 12 segundos en la página con JavaScript y en la antibots, porque ambas esperan a que termine la página de destino. Cada 503 volvió en menos de 1 segundo, con el aviso de que no hubo cobro y un tiempo de espera, así que el cliente no espera un timeout. Las 15 solicitudes cobradas costaron 0,00084 USD de media. A 1 crédito, estas 27 solicitudes gastarían 27 créditos de ZenRows, y a 25 créditos, 675: la cuota gratuita alcanza en los dos casos.
Fallos, resultados vacíos, 503 y 429: quién cobra
La regla de fallos fija el precio real por resultado bueno. ZenRows no cobra los fallos, pero cuenta 404 y 410 como éxitos y los cobra (documentación de precios de ZenRows). Un rechazo REQS002 por faltar parámetros también es gratis (códigos de error de ZenRows). ScraperAPI solo cobra las respuestas 200 y 404 y las solicitudes que usted cancela en 70 segundos, y un 429 por exceso de concurrencia es gratis (precios de ScraperAPI). Firecrawl no cobra cuando no hay resultado, pero cobra 1 crédito si el destino devuelve 403 o 404 (precios de Firecrawl). Bright Data dice que solo se paga el éxito. La mayoría de las herramientas de Apify cobran por resultado, y se puede fijar un cargo máximo por ejecución (cobro en la Store de Apify).
| Qué vimos | Hora (Singapur) | Función | Resultado | Cobro (USD) |
|---|---|---|---|---|
| Límite propio de 10 por minuto de nuestra clave de prueba | 00:16 | read | 429, «Nothing was charged», reintentar en 25 segundos | 0 |
| Página con desafío antibots | 00:18 | read | 200, resultado vacío, empty_result_refunded | 0 |
| Página con JavaScript, solo el esqueleto | 00:17 | read | 200, dos líneas, sin productos | 0,000694 |
| Búsqueda en Google Maps | 00:24 | google_maps_reviews/search | 503, unavailable, «none was charged» | 0 |
| Búsqueda en Zillow | 00:26 | zillow/search | 503, sin cobro | 0 |
| Google Maps, intentos 2 y 3 | 00:35, 00:40 | google_maps_reviews/search | 503 con una solicitud de ejemplo | 0 |
| Transcripciones de YouTube, dos intentos por vídeo | 00:35–00:40 | youtube/transcript | 503, sin cobro | 0 |
| Zillow, segundo intento | 00:35 | zillow/search | 503, «fallo 2 de 3», el tercero dice qué revisar | 0 |
En la fila del esqueleto de JavaScript, la página tenía contenido, dos líneas, así que no era un resultado vacío y se cobró normal. Antes de usar read en un sitio que se renderiza en el navegador, pruebe una o dos URL y mire si el texto trae sus campos. Las respuestas 503 y 429 dicen que no hubo cobro y cuánto esperar, así que el cliente puede esperar retry_after y repetir. Nuestra guía de conciliación de reembolsos explica cómo cuadrar cada cobro con su charge_id.
Un mes de uso: lo que pagan tres tipos de usuario de ZenRows
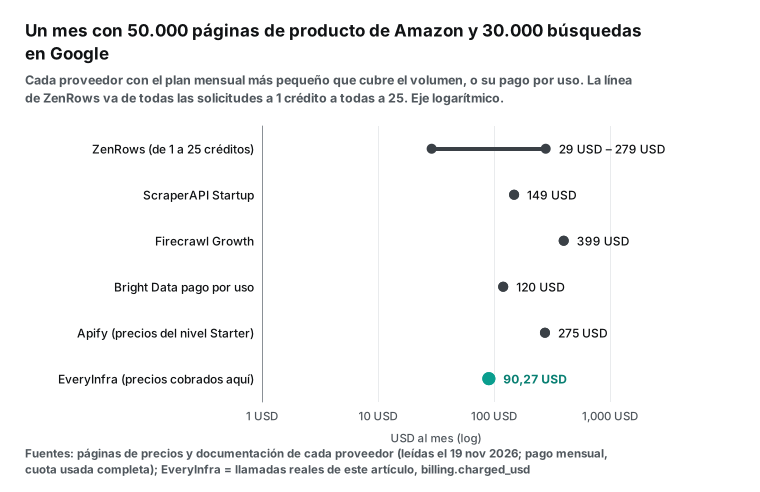
Tomamos tres cargas habituales. Para cada servicio usamos el plan mensual más pequeño que cubre el volumen, o el pago por uso. Para EveryInfra multiplicamos los precios unitarios cobrados en esta prueba:
| Carga mensual | ZenRows | ScraperAPI | Firecrawl | Bright Data | Apify | EveryInfra |
|---|---|---|---|---|---|---|
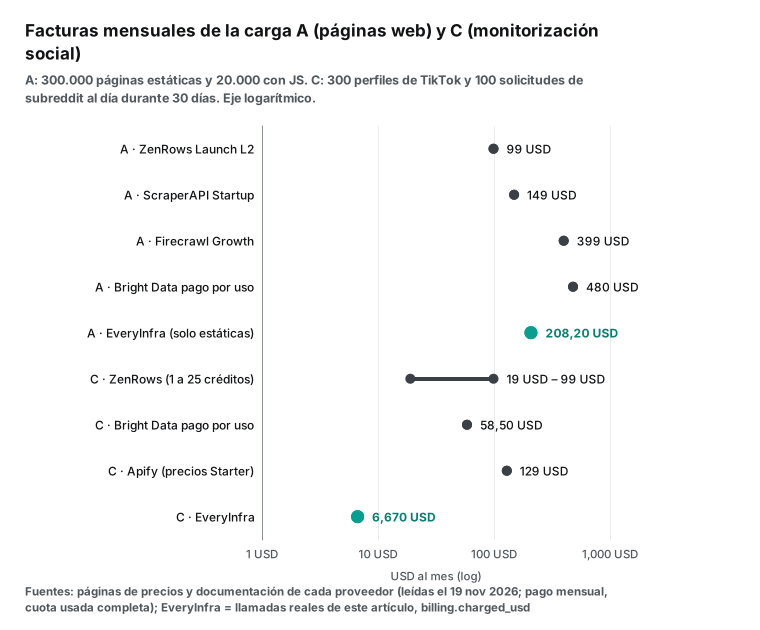
| A: 300.000 páginas estáticas y 20.000 con JS | 99 (Launch L2, 400.000 créditos) | 149 (Startup) | 399 (Growth) | 480 (Unlocker, pago por uso) | No aplica | 208,20 (solo las 300.000 estáticas) |
| B: 50.000 páginas de Amazon y 30.000 búsquedas en Google | De 29 a 279 (todo a 1 crédito o todo a 25) | 149 (Startup, 1 millón de créditos) | 399 (Growth) | 120 (pago por uso) | Unos 275 (precios Starter) | 90,27 |
| C: 300 perfiles de TikTok y 100 solicitudes de subreddit al día | De 19 a 99 (todo a 1 o todo a 25) | Sin multiplicador publicado para TikTok ni Reddit | Sin dato | 58,50 (pago por uso, 39.000 registros) | Unos 129 (precios Starter) | 6,67 |
La carga A es casi toda de páginas estáticas, con algunas de JavaScript. ZenRows es el más barato, con 99 USD, y nosotros cobramos 208,20 USD sin poder hacer las 20.000 páginas con JavaScript: para la carga A, quédese en ZenRows. El resultado de la carga B depende del nivel medio de ZenRows. Si Amazon y Google caen en 1 crédito, ZenRows es el más barato, con 29 USD. Con una media de 5 créditos (400.000 créditos) necesita Launch L2, a 99 USD, y con 25 créditos, 279 USD. Nosotros cobramos 90,27 USD con cualquier nivel.
La carga C es de monitorización social: 9000 perfiles de TikTok y 3000 solicitudes de Reddit de 10 publicaciones cada una, es decir, 30.000 publicaciones. Cobramos 6,67 USD, y Bright Data 58,50 USD por 39.000 registros. Si cada solicitud de ZenRows cae en 1 crédito, basta el plan B1 de 19 USD, unos 12 USD más que nosotros.
# Ponga aquí su volumen mensual: compara ZenRows (por nivel medio) con EveryInfra (por llamada).
ZR = [(19, 45_000), (29, 80_000), (39, 120_000), (69, 250_000), (99, 500_000), (129, 700_000),
      (199, 1_200_000), (279, 2_000_000), (399, 3_000_000), (549, 5_000_000), (749, 8_000_000),
      (999, 12_500_000), (1999, 28_000_000), (2999, 45_000_000)]          # leído el 19-11-2026
EI = {"amazon/profile": 0.001389, "search/web": 0.000694, "search/read": 0.000694,
      "tiktok/profile": 0.000556, "reddit/subreddit_posts": 0.000556}  # cobrado en esta prueba
def zenrows_month(requests, avg_credits):
    need = requests * avg_credits
    return min((p for p, c in ZR if c >= need), default=None)
def everyinfra_month(calls):          # calls = {"amazon/profile": 50_000, ...}
    return round(sum(EI[k] * n for k, n in calls.items()), 2)
print(zenrows_month(80_000, 5), everyinfra_month({"amazon/profile": 50_000, "search/web": 30_000}))
# -> 99 90.27
Concurrencia, topes y presupuesto: cuatro cosas que la tabla de precios no muestra
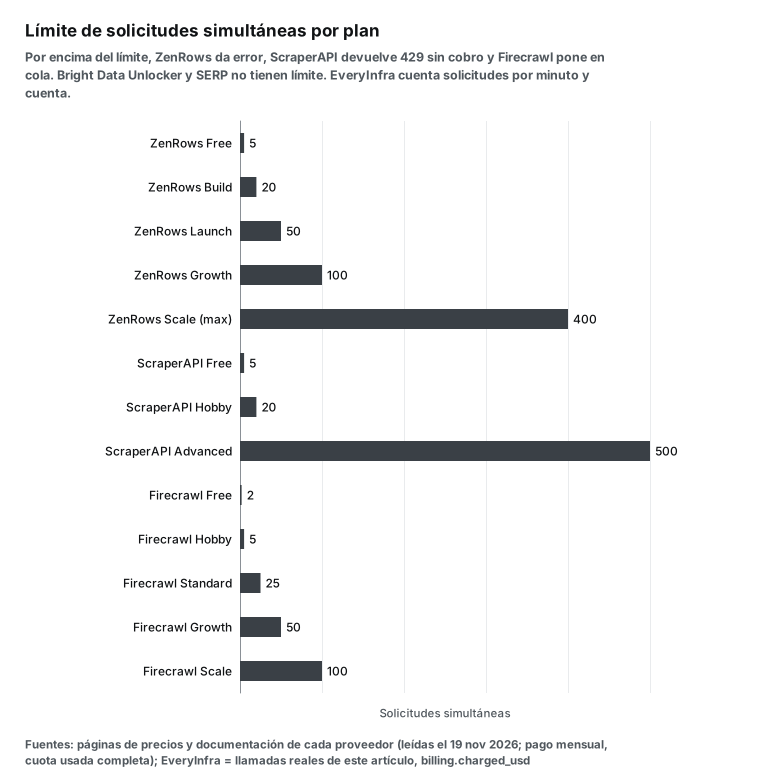
Los límites de concurrencia deciden cuántas páginas termina en una hora. ZenRows los fija por nivel: Free 5, Build 20, Launch 50, Growth 100 y Scale de 200 a 400, y por encima del límite devuelve un error (documentación de precios de ZenRows, concurrencia en ZenRows). ScraperAPI permite 20 en Hobby y hasta 500 en Advanced, con un 429 gratuito por encima. Firecrawl permite 2 navegadores a la vez en Free y 5 en Hobby, y los trabajos en cola cuentan para el timeout (límites de Firecrawl). Bright Data dice que Unlocker y SERP no tienen límite de concurrencia. Nosotros contamos solicitudes por minuto y cuenta, sumando todas las claves, con 60 por minuto por defecto y paquetes de 30 días para subir el límite (precios de EveryInfra). La clave de esta prueba tenía además su propio límite de 10 por minuto, y el 429 de las 00:16 vino de ese límite.
En topes de presupuesto, ZenRows añadió detalle en los dos últimos meses. Desde el 2 de octubre de 2026, cada clave de API puede tener su propio tope de créditos por periodo de facturación, día, semana o mes en UTC. Al llegar al tope solo se detiene esa clave, con avisos al 80 % y al 100 %, y una cuenta puede tener hasta 10 claves (topes por clave en ZenRows). Cuando se agota la cuota, los planes de pago pueden comprar paquetes de recarga, hasta 10 por periodo, y los créditos de recarga sin usar pasan una vez al siguiente periodo. Los créditos del plan no se acumulan y se reinician al renovar.
En ScraperAPI, Hobby, Startup y Business no tienen pago por uso: al agotar los créditos el scraping se detiene, salvo que active la mejora automática. Los planes anuales reciben los créditos de todo el año de golpe (preguntas de facturación de ScraperAPI). Nosotros usamos saldo prepago que no caduca, sin reinicio mensual. Una respuesta de ZenRows puede pesar 5 MB en Free y Build, 10 MB en Launch y Growth y 20 MB en Scale; una mayor devuelve 413 y no se entrega.
Cada respuesta de ZenRows lleva la cabecera X-Request-Cost con los créditos de esa llamada (renderizado de JavaScript en ZenRows). Su documentación aconseja activar primero una sola función y combinar solo si hace falta (proxy premium en ZenRows). ScraperAPI acepta max_cost: si la solicitud fuera a gastar más créditos, devuelve 403 y no hace el scraping (control de costes de ScraperAPI). Firecrawl devuelve por defecto una copia en caché de hasta dos días, y la caché sigue costando 1 crédito (scrape en Firecrawl). Una sesión de Browser de ZenRows dura 3 minutos por defecto y 15 como máximo (duración de sesión en ZenRows).
El cuarto punto es el coste de migrar. Una solicitud de ZenRows es un GET con parámetros: apikey, url, mode, extract y proxy_country. Con nosotros es un POST con un cuerpo JSON: platform, action y params, y además hay que volver a mapear los campos. Mueva una función cada vez, empezando por la más cara y fácil de cuadrar, que suele ser la búsqueda en Google y los datos sociales. Deje Fetch estándar y los sitios protegidos en ZenRows, con los dos saldos en paralelo un tiempo.
Código de migración: los mismos ID en los dos lados
La migración más segura es una pasada en paralelo. Tome un lote de ID de producto o de cuentas, obtenga cada uno en ZenRows y en el nuevo servicio, y compare campos y gasto. El código siguiente pone la solicitud de Amazon de ZenRows junto a nuestro amazon/profile. En ZenRows anota los créditos de la cabecera X-Request-Cost, y en nuestro lado billing.charged_usd:
import os, requests
ZR_KEY, EI_KEY = os.environ["ZENROWS_API_KEY"], os.environ["EVERYINFRA_API_KEY"]
def zenrows(asin):
    r = requests.get("https://api.zenrows.com/v1/", params={
        "apikey": ZR_KEY, "url": f"https://www.amazon.com/dp/{asin}",
        "mode": "auto", "extract": "auto", "proxy_country": "us"}, timeout=120)
    return r.status_code, int(r.headers.get("X-Request-Cost", 0)), r.json() if r.ok else None
def everyinfra(asin):
    r = requests.post("https://api.everyinfra.com/api/v1/social",
        headers={"Authorization": f"Bearer {EI_KEY}"},
        json={"platform": "amazon", "action": "profile", "params": {"url": f"https://www.amazon.com/dp/{asin}"}}, timeout=120)
    body = r.json()
    return r.status_code, body.get("billing", {}).get("charged_usd", 0), body.get("results")
for asin in ["B0CRMZHDG8", "B0BDHWDR12"]:
    zs, credits, _ = zenrows(asin)
    es, usd, res = everyinfra(asin)
    print(asin, "ZenRows", zs, credits, "credits |", "EveryInfra", es, usd, "USD", (res or {}).get("rating_count"))
Herramientas de IA: dirección MCP y cobro en seis servicios
Los seis servicios tienen servidor MCP. ZenRows usa la dirección remota mcp.zenrows.com/mcp, con las herramientas Fetch, Extract, Batch y Browser (página en npm, MCP en ZenRows, código), y su SDK de Python está en PyPI. Para Firecrawl, vea la página en npm y el MCP en Firecrawl.
Bright Data da 5.000 solicitudes MCP gratis al mes por cuenta nueva (página en npm, MCP en Bright Data). Apify usa la dirección remota mcp.apify.com, que busca herramientas en la Store y las llama (página en npm, MCP en Apify). Cuatro de estos servidores tienen el código en GitHub: ZenRows MCP (más una herramienta de línea de comandos), Firecrawl MCP, Bright Data MCP y Apify MCP.
Estos cuatro servidores publican a menudo. En los 30 días del 20 de octubre al 19 de noviembre de 2026, npm muestra 9 versiones estables del MCP de ZenRows (la última, 2.19.0, el 6 de noviembre), 10 de Firecrawl (3.40.0, el 12 de noviembre), 9 de Bright Data (4.8.0, el 10 de noviembre) y 21 de Apify (0.21.12, el 17 de noviembre). Es una versión cada tres o cuatro días, y los nombres de herramienta y los parámetros cambian con ellas: si usa un servidor MCP en producción, fije la versión y lea las notas antes de actualizar.
| Servicio | Dirección MCP | Herramientas | Cobro |
|---|---|---|---|
| ZenRows | mcp.zenrows.com/mcp | Fetch, Extract, Batch, Browser | El mismo saldo de créditos que la API |
| Firecrawl | mcp.firecrawl.dev/v2/mcp | Búsqueda, scraping, rastreo, acciones de navegador | Los mismos créditos que la API |
| Bright Data | Remota o local | Búsqueda, scraping, datos estructurados, navegador | 5.000 solicitudes gratis al mes, luego pago por uso |
| Apify | mcp.apify.com | Herramientas de la Store | Precio por evento de cada herramienta |
| EveryInfra | api.everyinfra.com/mcp | everyinfra_*, por plataforma y función | Igual que la API, precio fijo por llamada |
Un precio fijo por llamada ayuda más cuando el modelo elige las herramientas. El modelo no sabe en qué nivel caerá una página, así que no puede decirle el coste antes. Con precio fijo, 100 llamadas cuestan 100 veces el precio unitario. La respuesta de ZenRows es la compra por agente, lanzada el 5 de octubre de 2026: un agente de IA puede comprar Fetch y Extract en agents.zenrows.com sin cuenta, desde 5 USD, a 0,50 USD por 1.000 créditos y con los mismos multiplicadores (pagos por agente en ZenRows).
Elección rápida: según la tarea que más repite
| Su tarea más frecuente | Mire primero | Por 1.000 (USD) | Por qué |
|---|---|---|---|
| Páginas estáticas en volumen | ZenRows Scale | 0,067–0,110 | El más bajo de los seis |
| Páginas con JavaScript | ZenRows | 0,33–2,11 | 5 créditos, ScraperAPI usa 10 |
| Sitios protegidos de dificultad variable | Bright Data Unlocker | 1,30–1,50 | Un precio con cualquier dificultad |
| Páginas en Markdown para un LLM | Firecrawl | 0,75–3,80 | Renderizado incluido en 1 crédito |
| Detalle de productos de Amazon | EveryInfra, o ScraperAPI en un plan grande | 1,389 / 0,46–2,45 | Un precio fijo, o más bajo con volumen |
| Búsqueda en Google | EveryInfra | 0,694 | No cambia con el nivel |
| Listas de negocios de Google Maps | EveryInfra places | 0,0347 por lugar | 20 lugares por solicitud |
| Perfiles de TikTok, publicaciones de Reddit | EveryInfra | 0,556 / 0,0556 | Cobro por solicitud, no por registro |
| Proxies residenciales, navegador real | ZenRows o Bright Data | 1,67–10,56 / 2,51–8,00 por GB | No los vendemos |
Cuándo ZenRows es la mejor opción
En estos cuatro casos, ZenRows encaja mejor que los demás servicios de este artículo, y mejor que nosotros:
- Scraping general de mucho volumen, con páginas sobre todo estáticas. Las páginas estándar cuestan de 0,067 a 0,42 USD por 1.000, lo más bajo de los seis, y en S5 sale 10 veces más barato que nuestra herramienta read.
- Páginas con JavaScript y sitios protegidos. Nuestra herramienta read devolvió un esqueleto en una página de prueba y un resultado vacío en la otra. El modo adaptativo de ZenRows cobra solo el nivel que funcionó, y un rechazo
REQS002es gratis (códigos de error de ZenRows). - Rastreos de sitios completos y trabajos grandes. Crawl se lanzó el 9 de octubre de 2026 sin tarifa propia: cada página cobra como Fetch, y
max_pageslimita el gasto (Crawl en ZenRows). Un trabajo de Batch acepta 100.000 URL, con horarios y webhooks (Batch en ZenRows). - Proxies residenciales o un navegador real. No vendemos ninguno de los dos.
En otros dos casos encaja mejor otro servicio. Si solo necesita HTML completo y proxies, con más de 5 millones de créditos al mes, los planes Scaling y superiores de ScraperAPI siguen en pago por uso. Si necesita pasar páginas a Markdown para un LLM, Firecrawl cobra 1 crédito por página con renderizado incluido. Bright Data encaja con equipos que quieren proxies, Unlocker, SERP y registros estructurados de un solo proveedor y aceptan el KYC.
Cambios de los últimos 30 días
- El 17 de noviembre de 2026, Firecrawl lanzó UltraSearch para agentes, con fragmentos de datos sobre personas, empresas y acciones en los resultados. El 13 de noviembre de 2026, su base de empresas pasó de 75 millones (changelog de Firecrawl). Los precios del 4 de septiembre no cambiaron, y su precio por página renderizada sigue por encima del nivel JS de ZenRows.
- El 9 de noviembre de 2026, ZenRows actualizó su página de escucha social. Dice que las búsquedas de Reddit, YouTube y TikTok se renderizan en el navegador y necesitan el modo adaptativo (escucha social en ZenRows), así que la búsqueda social en ZenRows probablemente cae en 5 créditos o más.
- El 6 de noviembre de 2026 salió el SDK de Python 1.13.0 de ZenRows. Las notas del SDK describen un cliente de Crawl y una forma de estimar el coste de un Batch antes de enviarlo, y las reglas de reintento son más estrictas: un PUT ya no se reintenta ante 429 o 5xx. Revise su lógica de reintentos al actualizar.
- El 20 de octubre de 2026, ZenRows actualizó los ejemplos de sus páginas listas para Amazon, Google, Maps, TikTok, Reddit y más, todos con solicitudes reales de ese día, y el SDK de Python 1.11.0 salió el mismo día. Eso da una referencia fechada para comparar, y las tareas 2 y 4 la usan.
- En octubre de 2026, ScraperAPI empezó a desbloquear automáticamente los sitios protegidos por Akamai. Ya no hace falta un parámetro, pero cada solicitud sigue costando los 10 créditos del desbloqueo.
Qué dicen YouTube y los foros sobre una zenrows alternative
A las 00:26, hora de Singapur, buscamos «zenrows alternatives» en YouTube con youtube/search. Cinco de los 10 primeros títulos nombran a ZenRows. Los resultados 2 y 7 son dos tutoriales del mismo canal sobre cómo conectar ZenRows dentro de una herramienta de automatización de flujos; se centran en configurar esa herramienta, y no los tomamos. Leímos los resultados 1, 4 y 6, y los tres están ligados a la promoción de ZenRows. El primero es una reseña del 20 de enero de 2026, con 25.533 visualizaciones y 22 comentarios, y su descripción dice que la patrocina ZenRows. El segundo es una comparativa del 4 de junio de 2026, con 13.783 visualizaciones, que promociona una herramienta de huella de navegador. El tercero es un tutorial del 17 de diciembre de 2025, con 25.232 visualizaciones, y su enlace lleva parámetros de promoción pagada. Nuestro youtube/transcript devolvió 503 sin cobro cada vez, así que leímos las transcripciones del texto público de la página de YouTube, y comprobamos cada afirmación de abajo con su marca de tiempo. Los comentarios los sacamos con youtube/comments, tres llamadas por 0,001668 USD.
| Vídeo | Publicado | Visualizaciones | Comentarios leídos | Promoción |
|---|---|---|---|---|
| ZenRows Review - 2026 | 2026-01-20 | 25.533 | 20 | Patrocinado por ZenRows |
| ZenRows: Why It Fails for Real Scraping | 2026-06-04 | 13.783 | 1 | Promociona una herramienta de huella |
| Scrape ANY Website With AI For FREE with ZenRows | 2025-12-17 | 25.232 | 3 | Enlace de promoción pagada |
Los vídeos muestran tres pasos que las páginas web no describen. La reseña patrocinada empieza en el panel: se pega una URL, se pulsa «Add domain», se marcan proxies premium y renderizado, y se elige la salida, que puede ser JSON, Markdown, HTML o una captura. A la derecha se genera código Python, que se puede cambiar a Node, Java, PHP, Go, Ruby, un lenguaje de la familia C y curl, y los ajustes avanzados permiten POST, una cabecera Referer y conservar las cookies entre solicitudes con un ID de sesión. El vídeo usa nombres antiguos, Universal Scraper API y Scraping Browser, que la documentación actual llama Fetch y Browser, así que los menús no coinciden. El tercer vídeo habla de una prueba gratis de 14 días, y la página de precios actual muestra un plan gratuito de 5.000 créditos al mes, sin mencionar 14 días: fíese de la página de precios.
El tercer vídeo usa una página de búsqueda de amazon.co.uk. El autor activa los proxies premium, elige un país, activa el renderizado de JavaScript y elige JSON con análisis automático. Antes de ejecutar, el panel dice que la solicitud cuesta «solo 0.025». Además de JSON, Markdown, HTML y capturas, la salida puede extraer directamente imágenes, enlaces, títulos, correos, teléfonos, metadatos y tablas.
| Lo que muestra el vídeo | Lo que dice la documentación actual |
|---|---|
| Universal Scraper API | Fetch |
| Scraping Browser | Browser |
| Prueba gratis de 14 días | Plan gratuito de 5.000 créditos al mes |
| Cobro por intento, también si falla | Los fallos no se cobran; 404 y 410 sí |
Dos afirmaciones del segundo vídeo no cuadran con la documentación ni con los otros vídeos. La primera es el cobro: dice que ZenRows cobra por intento, incluidos los fallos, y la documentación dice que los fallos son gratis y que 404 y 410 se cobran. La segunda son las sesiones: dice que cada solicitud de ZenRows es independiente y no puede mantener la sesión iniciada ni las cookies, pero el primer vídeo muestra un ID de sesión que conserva las cookies entre solicitudes, y ZenRows vende además sesiones de Browser que inician sesión y hacen clic. La segunda mitad de este vídeo promociona una herramienta de huella de navegador, así que lea sus críticas a ZenRows con eso en mente. El vídeo sí describe una trampa que vale para cualquier proveedor, el «bloqueo suave». El sitio detecta un bot y no da error, sino que devuelve 200 con contenido vacío o falso, y todos los proveedores lo cuentan como éxito y lo cobran. Vimos un caso del mismo tipo en la página con JavaScript de ScrapingCourse: 200, dos líneas de texto y cobro normal.
Los comentarios se centran en el dinero y en las páginas con JavaScript. Bajo la reseña patrocinada, alguien pregunta cuánto cuesta de verdad, otro dice que el coste de los proxies sube rápido con volumen, otro pide un vídeo sobre una tienda con mucho JavaScript y otro avisa de que el scraping puede romper las condiciones de los sitios. Bajo el tercer vídeo, alguien pide una alternativa gratuita. El comentario fijado de los tres vídeos es un enlace con código de descuento o parámetros de promoción.
En los foros, un hilo de r/webscraping de 2023 pregunta por las mejores APIs de scraping y tiene 54 comentarios. El autor cuenta que un plan antiguo devolvía errores 500 a menudo y que otro servicio duplicó su precio. Unas respuestas proponen escribir su propio scraper, y otras dicen que un equipo debe comprar un servicio gestionado si el scraping no es su negocio principal (hilo de r/webscraping). Los moderadores borraron varias respuestas de ese hilo antiguo, y la nota de borrado dice que el subreddit desaconseja hablar de herramientas de pago, también las que tienen prueba gratis, y que la promoción va en el hilo mensual de autopromoción. En la prueba de noviembre de 2026 citada arriba, el autor también lista los casos en que otras herramientas encajan mejor: Bright Data para un control directo y detallado de los proxies y, si ya usa Scrapy, el servicio hecho para Scrapy.
Límites de estas cifras
ZenRows no publica el nivel de sus páginas estructuradas, así que cada precio de ZenRows para Amazon, Google y datos sociales es un rango de 1 a 25 créditos, y sus URL deciden el número real. Los precios de los proveedores son de planes mensuales leídos el 19 de noviembre y suponen toda la cuota usada. Si usa menos, el precio unitario de los planes mensuales sube, y el pago por llamada no cambia. Las tasas de éxito de ZenRows en sitios protegidos vienen de sus propias pruebas. Los precios de EveryInfra son los cobros de esta prueba, y el catálogo del día fija cada precio. Recoja solo datos públicos: los comentarios y los perfiles pueden contener datos personales, así que cumpla la ley donde opere. La página de Google Maps de ZenRows también dice que los nombres de quienes reseñan son datos personales.
Primeros pasos: compruebe las cifras con sus propias URL
- Abra la guía rápida y regístrese. Marque con una estrella dos repositorios de GitHub para recibir 1 USD de prueba, válido 24 horas.
- Abra la consola de prueba de la API de Amazon, la API de TikTok, la API de Reddit o el mercado. Introduzca los productos, cuentas o subreddits de sus 20 URL más frecuentes en ZenRows y anote las filas y
charged_usd. - Abra el Activity Log de ZenRows y lea los créditos de esas mismas URL. Calcule el nivel medio, póngalo en el código Python de arriba y compare un mes de facturas.
Preguntas frecuentes
zenrows vs apify: ¿qué los diferencia?
ZenRows vende la capacidad de obtener cualquier URL y cobra créditos según la dificultad. Apify es una tienda de herramientas: cada autor fija el precio, y la mayoría cobra por resultado. Amazon cuesta de 3,00 a 5,00 USD por 1.000 resultados, y TikTok de 1,70 a 3,70. Para muchos registros estructurados de una plataforma, una herramienta lista de Apify es cómoda. Para páginas arbitrarias, encaja mejor ZenRows.
¿Es zenrows legit y seguro?
El plan empresarial de ZenRows menciona SLA, SOC 2 e ISO 27001. Tiene una página de estado pública y un centro de confianza, y su MCP y su CLI son de código abierto en GitHub (índice de la documentación de ZenRows, condiciones legales de ZenRows). Lo legal depende de qué recoge y cómo lo usa. Las páginas de TikTok y Google Maps de ZenRows indican que solo deben recogerse datos públicos y recuerdan que el RGPD y la CCPA se aplican a los datos personales. Ante la duda, consulte a un abogado.
¿Los créditos de ZenRows sin usar pasan al mes siguiente?
Los créditos del plan no pasan y se reinician al renovar. Los paquetes de recarga de los planes de pago pasan una vez al periodo siguiente. Los planes mensuales de ScraperAPI tampoco acumulan, y sus planes anuales dan los créditos de todo el año de golpe. Firecrawl acumula créditos solo en Scale. Nuestro saldo prepago no caduca ni se reinicia cada mes, así que un volumen irregular no desperdicia cuota.
¿Es fiable la zenrows alternative que se recomienda en Reddit?
Mire quién escribe. La prueba de noviembre de 2026 en cuatro sitios protegidos dice en su primera línea que el autor escribe contenido técnico para ZenRows y que los datos vienen de pruebas internas de ZenRows. Los moderadores de r/webscraping desaconsejan hablar de herramientas de pago, y la promoción va en el hilo mensual de autopromoción. Antes de fiarse de una afirmación, pase sus propias 100 URL por cada servicio y calcule el coste por resultado bueno.
Referencias
- Pricing, ZenRows, leído el 19-11-2026, https://www.zenrows.com/pricing
- Zenrows Pricing (documentación), ZenRows, leído el 19-11-2026, https://docs.zenrows.com/first-steps/pricing
- Changelog, ZenRows, leído el 19-11-2026, https://www.zenrows.com/changelog
- Amazon ASIN scraper, ZenRows, actualizado el 20-10-2026, https://www.zenrows.com/scrape/amazon-asin
- Google Search scraper, ZenRows, actualizado el 20-10-2026, https://www.zenrows.com/scrape/google-search
- Google Maps scraper, ZenRows, actualizado el 20-10-2026, https://www.zenrows.com/scrape/google-maps
- TikTok scraper, ZenRows, actualizado el 20-10-2026, https://www.zenrows.com/scrape/tiktok
- Reddit scraper, ZenRows, actualizado el 20-10-2026, https://www.zenrows.com/scrape/reddit
- API Error Codes, documentación de ZenRows, leído el 19-11-2026, https://docs.zenrows.com/api-error-codes
- Concurrency, documentación de ZenRows, leído el 19-11-2026, https://docs.zenrows.com/fetch/features/concurrency
- API Keys and Credit Caps, documentación de ZenRows, leído el 19-11-2026, https://docs.zenrows.com/first-steps/api-key-credit-caps
- Crawl endpoints, documentación de ZenRows, leído el 19-11-2026, https://docs.zenrows.com/crawl/endpoints
- Batch REST API, documentación de ZenRows, leído el 19-11-2026, https://docs.zenrows.com/batch/developer-guide-restapi
- MCP overview, documentación de ZenRows, leído el 19-11-2026, https://docs.zenrows.com/mcp/overview
- Agentic Payments, documentación de ZenRows, leído el 19-11-2026, https://docs.zenrows.com/first-steps/agentic-payments
- Browser, ZenRows, leído el 19-11-2026, https://www.zenrows.com/products/browser
- Social listening data, ZenRows, actualizado el 09-11-2026, https://www.zenrows.com/use-cases/social-listening
- zenrows-mcp, GitHub, leído el 19-11-2026, https://github.com/ZenRows/zenrows-mcp
- @zenrows/mcp 2.19.0, npm, publicado el 06-11-2026, https://www.npmjs.com/package/@zenrows/mcp
- zenrows 1.13.0, PyPI, publicado el 06-11-2026, https://pypi.org/project/zenrows/
- Pricing, ScraperAPI, leído el 19-11-2026, https://www.scraperapi.com/pricing/
- Credits and Requests Costs, documentación de ScraperAPI, leído el 19-11-2026, https://docs.scraperapi.com/getting-started/quick-start/credits-and-requests-costs
- Akamai-protected sites now unblocked automatically, documentación de ScraperAPI, octubre de 2026, https://docs.scraperapi.com/resources/release-notes/october-2026/akamai-protected-sites-now-unblocked-automatically
- Pricing, Firecrawl, leído el 19-11-2026, https://www.firecrawl.dev/pricing
- Changelog, Firecrawl, actualizado el 17-11-2026, https://www.firecrawl.dev/changelog
- Rate Limits, documentación de Firecrawl, leído el 19-11-2026, https://docs.firecrawl.dev/rate-limits
- MCP Server, documentación de Firecrawl, leído el 19-11-2026, https://docs.firecrawl.dev/mcp-server
- firecrawl-mcp 3.40.0, npm, publicado el 12-11-2026, https://www.npmjs.com/package/firecrawl-mcp
- Web Unlocker Pricing, Bright Data, leído el 19-11-2026, https://brightdata.com/pricing/web-unlocker
- SERP API Pricing, Bright Data, leído el 19-11-2026, https://brightdata.com/pricing/serp
- Residential Proxies Pricing, Bright Data, leído el 19-11-2026, https://brightdata.com/pricing/proxy-network/residential-proxies
- Free tier, documentación de Bright Data, leído el 19-11-2026, https://docs.brightdata.com/general/account/billing-and-pricing/free-tier
- MCP server overview, documentación de Bright Data, leído el 19-11-2026, https://docs.brightdata.com/products/mcp-server/overview
- @brightdata/mcp 4.8.0, npm, publicado el 10-11-2026, https://www.npmjs.com/package/@brightdata/mcp
- Pricing, Apify, leído el 19-11-2026, https://apify.com/pricing
- Actors in Store, documentación de Apify, leído el 19-11-2026, https://docs.apify.com/platform/actors/running/actors-in-store
- Apify MCP server, documentación de Apify, leído el 19-11-2026, https://docs.apify.com/mcp
- @apify/actors-mcp-server 0.21.12, npm, publicado el 17-11-2026, https://www.npmjs.com/package/@apify/actors-mcp-server
- Amazon Product Scraper, Apify Store, leído el 19-11-2026, https://apify.com/junglee/amazon-crawler
- Google Search Results Scraper, Apify Store, leído el 19-11-2026, https://apify.com/apify/google-search-scraper
- Google Maps Scraper, Apify Store, leído el 19-11-2026, https://apify.com/compass/crawler-google-places
- TikTok Scraper, Apify Store, leído el 19-11-2026, https://apify.com/clockworks/tiktok-scraper
- Reddit Scraper Lite, Apify Store, leído el 19-11-2026, https://apify.com/trudax/reddit-scraper-lite
- Google Maps Platform pricing, Google for Developers, leído el 19-11-2026, https://developers.google.com/maps/billing-and-pricing/pricing
- Benchmarking 3 scraping APIs across 4 protected sites, Reddit r/LLMDevs, noviembre de 2026, https://www.reddit.com/r/LLMDevs/comments/1xog8dj/benchmarking_3_scraping_apis_across_4_protected/
- Best web scraping api's at the moment?, Reddit r/webscraping, 2023, https://www.reddit.com/r/webscraping/comments/1016j3l/best_web_scraping_apis_at_the_moment/
- Blocking fonts/media cut our proxy GB usage by 45%, Reddit r/webscraping, noviembre de 2026, https://www.reddit.com/r/webscraping/comments/1xydijg/blocking_fontsmedia_cut_our_proxy_gb_usage_by_45/
- Catálogo de funciones, EveryInfra, leído el 19-11-2026, https://api.everyinfra.com/api/v1/social/catalog
- ZenRows Review - 2026, YouTube (Daniel | Tech & Data), publicado el 20-01-2026, https://www.youtube.com/watch?v=Jn_m5tgol7Y
- ZenRows: Why It Fails for Real Scraping, YouTube (Weblab Media), publicado el 04-06-2026, https://www.youtube.com/watch?v=NZi_50xbtzE
- Scrape ANY Website With AI For FREE with ZenRows, YouTube (The Metaverse Guy), publicado el 17-12-2025, https://www.youtube.com/watch?v=jb5L2ouXQZo
- Introduction to Extract, documentación de ZenRows, leído el 19-11-2026, https://docs.zenrows.com/extract/introduction
- Extract API Reference, documentación de ZenRows, leído el 19-11-2026, https://docs.zenrows.com/extract/endpoints
- JavaScript Rendering, documentación de ZenRows, leído el 19-11-2026, https://docs.zenrows.com/fetch/features/js-rendering
- Premium Proxy, documentación de ZenRows, leído el 19-11-2026, https://docs.zenrows.com/fetch/features/premium-proxy
- Session TTL, documentación de ZenRows, leído el 19-11-2026, https://docs.zenrows.com/browser-sessions/features/session-ttl
- ZenRows CLI, GitHub, leído el 19-11-2026, https://github.com/ZenRows/cli
- firecrawl-mcp-server, GitHub, leído el 19-11-2026, https://github.com/firecrawl/firecrawl-mcp-server
- brightdata-mcp, GitHub, leído el 19-11-2026, https://github.com/brightdata/brightdata-mcp
- apify-mcp-server, GitHub, leído el 19-11-2026, https://github.com/apify/apify-mcp-server
- Scrape (caché y maxAge), documentación de Firecrawl, leído el 19-11-2026, https://docs.firecrawl.dev/features/scrape
- Cost Control, documentación de ScraperAPI, leído el 19-11-2026, https://docs.scraperapi.com/control-and-optimization/cost-control
- Plans & Billing, documentación de ScraperAPI, leído el 19-11-2026, https://docs.scraperapi.com/resources/faq/plans-and-billing
- Research API, TikTok for Developers, leído el 19-11-2026, https://developers.tiktok.com/products/research-api/
- llms.txt, documentación de ZenRows, leído el 19-11-2026, https://docs.zenrows.com/llms.txt
- Legal, ZenRows, leído el 19-11-2026, https://www.zenrows.com/legal
- Getting started guide, documentación de ZenRows, leído el 19-11-2026, https://docs.zenrows.com/first-steps/getting-started-guide
- Fetch API reference, documentación de ZenRows, leído el 19-11-2026, https://docs.zenrows.com/fetch/api-reference
Referencia BL-189