TikHub YouTube API Python 对比:三条路取评论和字幕
Python 取 YouTube 三条路:官方搜索每天 100 次、取不到他人字幕;TikHub 每次 $0.001 起;我们实测 $0.000556 起。
用 Python 取 YouTube 数据,官方 YouTube Data API v3 从 2026 年 6 月 1 日起把搜索单独计数,默认每天只能搜 100 次,每次最多 50 条,而且字幕下载接口要求你对这个视频有编辑权限,别人的公开课字幕取不到(配额计算器、captions.download,2026 年 11 月 13 日读取)。TikHub 的 48 个 YouTube 接口按次计费,搜索、评论、视频详情每次 $0.001,字幕接口 get_video_captions 每次 $0.008,48 个里只有 1 个参加按天折扣、6 个能用注册送的免费额度(公开价目接口,同日 21:32 新加坡时间不带 Key 读取)。EveryInfra 同一条「搜索→视频→评论→字幕」在 2026 年 11 月 13 日 21:35、21:42、21:48(新加坡时间)跑了三轮:搜索每次 $0.000778 回 20 条,视频详情和评论每次 $0.000556,评论两次各返回 40 条,按实扣算每 1,000 条评论 $0.0139;字幕 youtube/transcript 在 22:31 到 22:32 三门课各取到一次,每次扣 $0.000556,其中 15 小时 57 分的 CS50P 全课一次回了 24,851 段、183,775 个英文词。
想看简短结论可以先看 /alternatives/tikhub;TikHub 全平台的账单公式在 TikHub pricing 详解,YouTube 评论回复的两层分页在 YouTube 评论抓取为什么漏回复。YouTube 各项能力的参数、返回字段和单价列在 YouTube 数据接口页。
一张表看完:官方 Data API、tikhub youtube api 和 EveryInfra
表里官方一侧来自 developers.google.com 的文档原文,TikHub 一侧来自它不带 Key 就能读的价目接口、openapi.json、定价页、FAQ 和 YouTube API 介绍页,都在 2026 年 11 月 13 日 21:32 到 21:34(新加坡时间)读取;我们没有注册 TikHub,也没有调用它的付费接口,TikHub 的数都是公开单价。EveryInfra 一侧是同日 21:31 读的能力目录和三轮真调。
| 账单的一项 | YouTube Data API v3(官方) | TikHub YouTube 接口 | EveryInfra `youtube/*` |
|---|---|---|---|
| 计价方式 | 免费,按每天的配额单位记账 | 每次请求一个单价 | 每次请求一个单价 |
| 搜索 | 单独一个桶,每天 100 次,每次最多 50 条 | search_video 每次 $0.001,一页几条没公开 | youtube/search 每次 $0.000778,实测每次 20 条 |
| 视频详情 | videos.list 1 个单位,一次最多 50 个 ID | get_video_info 每次 $0.001 | youtube/video 每次 $0.000556 |
| 评论 | commentThreads.list 1 个单位,一页最多 100 条 | get_video_comments 每次 $0.001,一页几条没公开 | youtube/comments 每次 $0.000556,本次两次各返回 40 条 |
| 字幕 | captions.download 200 个单位,要有视频编辑权限 | get_video_captions 每次 $0.008,没字幕也计费 | youtube/transcript 每次 $0.000556,失败不扣 |
| 免费额度 | 每天 10,000 单位加 100 次搜索 | 注册送 $0.05,YouTube 48 个接口里 6 个能用 | GitHub 点星领 $1,24 小时内有效 |
| 用量折扣 | 无(可申请加配额) | 按天累进最多 5 折,YouTube 只有 1 个接口参加 | 没有按天折扣 |
| 最低充值 | 不用充值 | $5 起,PayPal 付 $5 实扣 $5.55 | 档位 $10 起 |
| AI 工具接入 | 自己写函数 | 每个平台一个 MCP 服务,MCP 页写 YouTube 37 个工具 | 一个远程 MCP 地址,能力用参数选 |
对脚本写法影响最大的是搜索配额和字幕权限。搜索配额的变化来自 Google 自己:2026 年 6 月 1 日的修订记录写着 Data API「转向按方法细分的配额」,先从 videos.insert 和 search.list 开始;今天的 search.list 文档写的是「每天 100 次,每次在 Search Queries 桶里记 1 个单位」。按旧规则,一次搜索记 100 个单位,10,000 个单位一天也只够搜 100 次,上限碰巧一样;差别在于现在搜索不再吃掉评论和视频详情的那 10,000 个单位。TikHub 的 YouTube API 介绍页在 11 月 13 日读取时仍写「a single search burns 100 of them」,这是按旧规则写的。字幕权限那一行:官方接口能下载的只有你自己有编辑权限的视频,做公开课受众分析这类「别人的视频」,这一步官方走不通。
官方 YouTube Data API v3:2026 年起搜索单独算
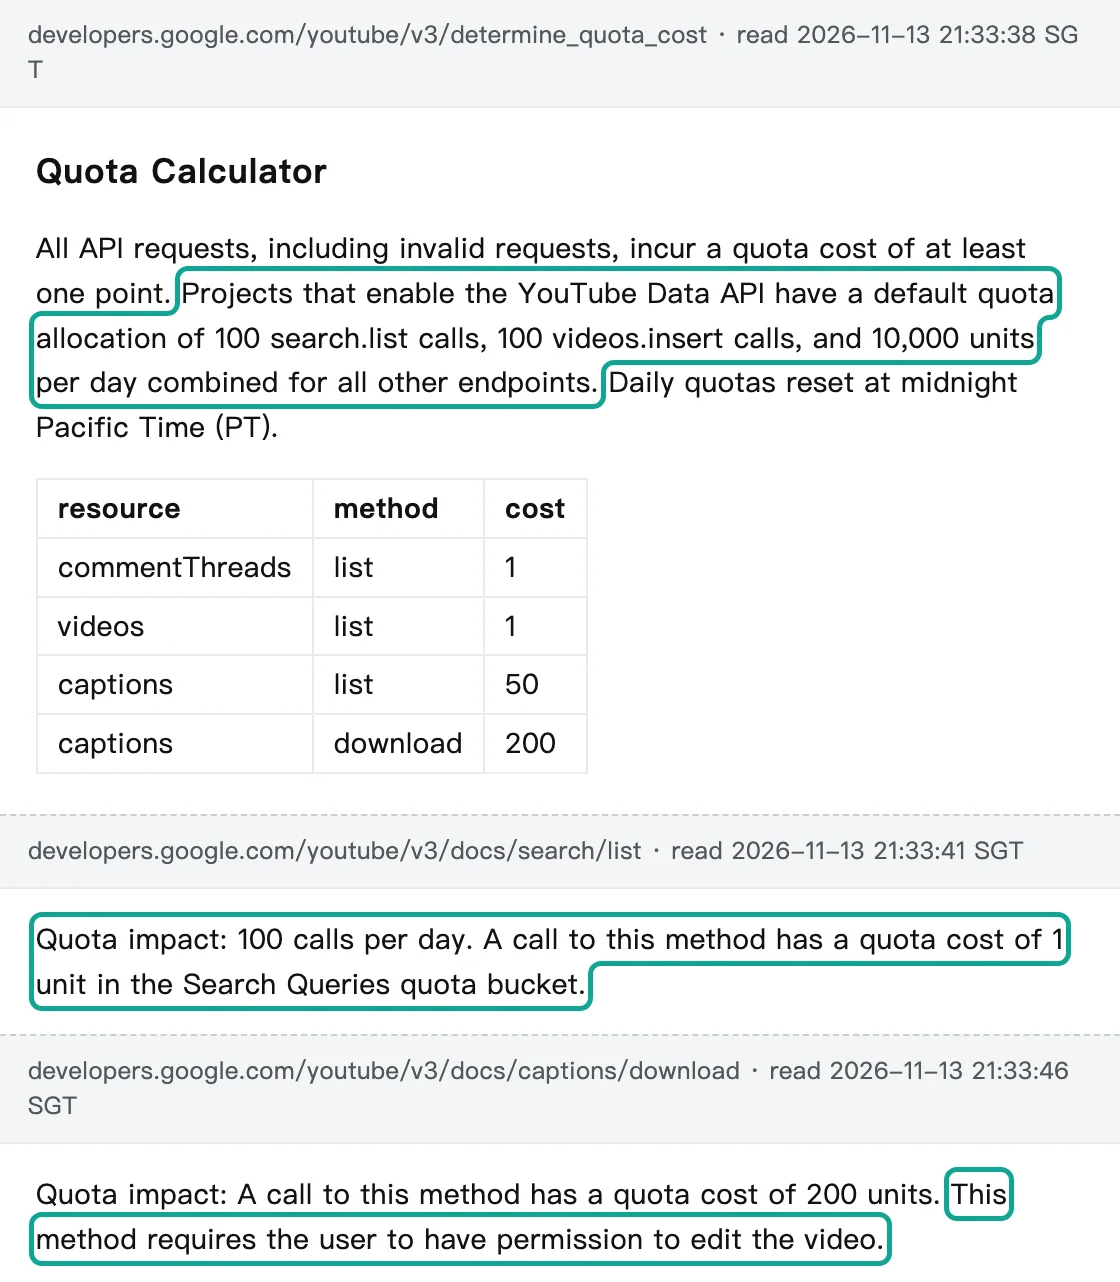
Google 的配额计算器开头一段是这样写的:启用 Data API 的项目默认每天有 100 次 search.list、100 次 videos.insert,其余所有方法合计 10,000 个单位;配额在太平洋时间午夜清零;所有请求,包括写错的请求,至少记 1 个单位。按这一段和各方法页面的单价,可以算出一个 Python 脚本一天最多能取多少条:搜索 100 次乘以每页最多 50 条(search.list),一天 5,000 条;评论线程每页最多 100 条、每页 1 个单位(commentThreads.list),如果 10,000 个单位全给评论,一天最多 100 万条顶层评论;视频详情一次最多 50 个 ID、每次 1 个单位(videos.list),全给它是 50 万个视频。
这三个上限有一个共同前提:每页都取满。search.list 的文档自己写了一句提醒,API 可能因为内部排序或过滤,回的条数少于 maxResults,要以 nextPageToken 为准继续翻页;也就是说 5,000 条是天花板,实际会更少。搜索结果拿到的只是视频 ID 和标题摘要,播放量、点赞数要再调 videos.list,所以真实脚本的配额消耗是「搜索次数」和「单位」两个桶同时在走。
字幕这一项在图里没有柱子,因为它是 0。captions.list 每次 50 个单位,只返回字幕轨道的列表,不含字幕内容;captions.download 每次 200 个单位,文档写明「这个方法要求用户有编辑该视频的权限」,要用 OAuth 以视频主人的身份调。对做课程反馈、竞品视频研究的人来说,官方 API 能给的是标题、简介、统计数和评论,讲师在视频里说了什么,要另找办法。YouTube 帮助中心写过自动字幕是语音识别生成的,质量随口音和录音条件变化(Use automatic captioning),这一点不管走哪条路都一样,拿到字幕后要抽查。
| 官方方法 | 每次单位 | 每页上限 | 用默认配额一天最多 | 能取别人的视频吗 |
|---|---|---|---|---|
search.list | 单独桶,1 次 | 50 条(默认 5) | 100 次 × 50 = 5,000 条 | 能 |
videos.list | 1 | 50 个 ID | 10,000 × 50 = 500,000 个 | 能 |
commentThreads.list | 1 | 100 条(默认 20) | 10,000 × 100 = 1,000,000 条 | 能 |
comments.list(取回复) | 1 | 100 条 | 和上面共用 10,000 单位 | 能 |
captions.list | 50 | 轨道列表 | 200 次 | 只列轨道 |
captions.download | 200 | 一条字幕 | 50 次 | 不能,要编辑权限 |
配额不够时,Google 给的路是填配额扩展申请表,并通过合规审核;审核按开发者政策逐条核你的应用怎么展示、存储数据。政策里有两条和「拿数据做分析」关系最大:一条是没经授权取得的数据,统计数之类最多存 30 天,到期要删除或重新拉取;另一条标题就叫 Scraping,要求 API 客户端不得抓取 YouTube,也不得取得抓取来的 YouTube 数据。后一条约束的是在 Google 那里注册了的 API 客户端本身。你的项目如果同时用官方 API 和第三方数据接口,这一条怎么适用,要拿着你的使用场景读原文,必要时问法务;我们不在这里替你下结论。
tikhub youtube api 价目:48 个接口逐个看
TikHub 的价目接口路径是 /api/v1/tikhub/user/get_all_endpoints_info。我们在 2026 年 11 月 13 日 21:32:42(新加坡时间)不带任何 Key 发了一次 GET,返回 200 和一个 1,482 行的数组,响应里的服务器时间是洛杉矶时间 05:32:42。站内 TikHub pricing 详解 2026 年 11 月 1 日读到的是 1,470 行,TikHub Twitter API 替代 2026 年 11 月 11 日读到 1,481 行,价目一直在加行,所以下面的数只代表 11 月 13 日这一份。
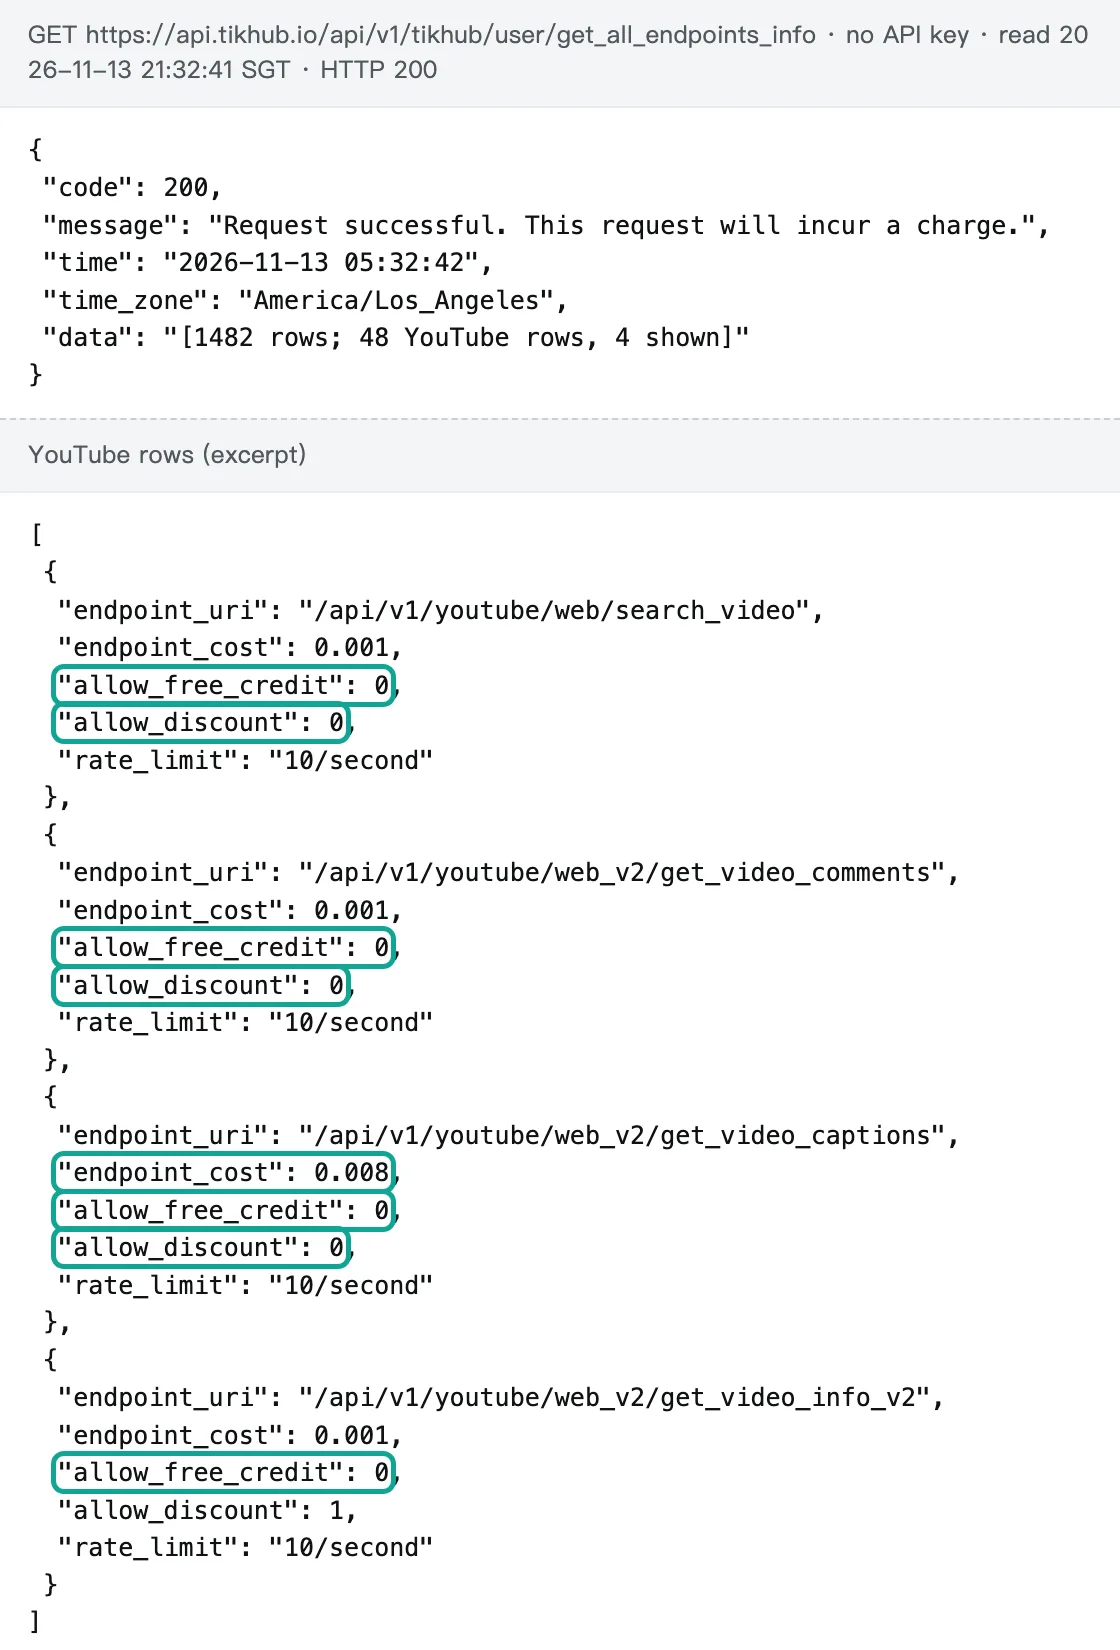
48 行 YouTube 接口分在 /api/v1/youtube/web/ 和 /api/v1/youtube/web_v2/ 两组下。按价目里的四个字段数:单价 endpoint_cost 有 38 个是 $0.001,5 个 $0.002,$0.003、$0.004、$0.008、$0.03 和 $0 各 1 个;速率 rate_limit 46 个是每秒 10 次,get_video_comments_v2 是每秒 4 次,字幕异步结果接口写的是 2;能用免费额度 allow_free_credit 只有 6 个,都是查频道 ID、频道网址、搜索联想词、视频详情 v2 这类辅助接口;能参加阶梯折扣 allow_discount 只有 1 个,是 web_v2/get_video_info_v2。也就是说,定价页上「每天用量到 1,000 次打 9 折、3 万次以上打 5 折」的阶梯,对 YouTube 的搜索、评论和字幕都不生效;注册送的 $0.05 也用不到这三类接口上,想用 Python 试一次 TikHub 的 YouTube 评论,先要充至少 $5,PayPal 付 $5 实扣 $5.55(FAQ 原话「Topping up $5 through PayPal is charged as $5.55」)。
| 用途 | TikHub 接口(价目原名) | 单价 | 免费额度 | 阶梯折扣 | 在公开文档里 |
|---|---|---|---|---|---|
| 搜索视频 | web/search_video | $0.001 | 否 | 否 | 是 |
| 综合搜索 V2(清洗后) | web_v2/get_general_search_v2 | $0.002 | 否 | 否 | 是 |
| 视频详情 | web_v2/get_video_info | $0.001 | 否 | 否 | 是 |
| 视频详情 V2 | web_v2/get_video_info_v2 | $0.001 | 否 | 是 | 是 |
| 一级评论 | web_v2/get_video_comments | $0.001 | 否 | 否 | 是 |
| 二级评论 | web_v2/get_video_comment_replies | $0.001 | 否 | 否 | 是 |
| 字幕 | web_v2/get_video_captions | $0.008 | 否 | 否 | 是 |
| 字幕 V2 | web_v2/get_video_captions_v2 | $0.001 | 否 | 否 | 否 |
| 频道视频 | web_v2/get_channel_videos | $0.001 | 否 | 否 | 是 |
| 频道 Shorts | web_v2/get_channel_shorts | $0.001 | 否 | 否 | 是 |
| 频道邮箱 | web/get_channel_email | $0.03 | 否 | 否 | 否 |
最后一列是我们把价目和 openapi.json(版本 V5.3.2)逐个对出来的:openapi 里 YouTube 路径 34 个,价目里 48 个,有 14 个接口在价目里有单价、公开文档里查不到,包括 $0.001 的 get_video_captions_v2、$0.03 的 get_channel_email 和 v1 那组旧的评论接口。写 Python 时只能照文档里的参数调,表上那个更便宜的字幕 V2,openapi.json 里没有它的参数说明。
字幕接口的文档还有一句要看清:get_video_captions 遇到视频没有字幕时,返回 200 加一句「该视频没有可用字幕」,「且照常计费」,单价 $0.008;视频较大时转成异步任务,要拿 job_id 去轮询免费的 get_video_captions_result。TikHub 的 FAQ 写「只有成功的请求计费,返回 200 就计费,失败的不计费」,两句放在一起看,「没有字幕」算成功。一门课里如果有几讲没开字幕,这几次 $0.008 照付。
tikhub youtube api python:三条路的代码各长什么样
三条路的 Python 代码结构差不多:拿 Key、发请求、翻页、存 JSON。差别在三处:鉴权方式、翻页参数、字幕那一步能不能走通。官方路线用 Google 的 google-api-python-client,2026 年 11 月 10 日刚发了 2.202.0(PyPI);TikHub 有自己的 Python SDK(PyPI 上的 tikhub 2.2.0,2026 年 10 月 3 日),也可以直接用 requests 发 GET;EveryInfra 只有一个 POST 地址,下面的脚本也只用 requests。三段代码里 Key 都从环境变量读(Python 的 os.environ),不写进文件。
官方路线:取一个视频的全部顶层评论。按 Google 的 Python 快速上手,API Key 在 Google Cloud 控制台建(API 密钥说明),翻页靠 nextPageToken(分页说明)。下面这段是配置示例,我们没有在本文的测试里跑它,单位数按文档算。
# 配置示例:官方 YouTube Data API v3(pip install google-api-python-client)
import os
from googleapiclient.discovery import build

yt = build("youtube", "v3", developerKey=os.environ["YOUTUBE_API_KEY"])

def all_top_level_comments(video_id):
    rows, token, units = [], None, 0
    while True:
        resp = yt.commentThreads().list(
            part="snippet", videoId=video_id, maxResults=100,
            order="relevance", textFormat="plainText", pageToken=token,
        ).execute()
        units += 1                      # 每页 1 个单位
        for item in resp["items"]:
            s = item["snippet"]["topLevelComment"]["snippet"]
            rows.append({"text": s["textOriginal"], "likes": s["likeCount"],
                         "published_at": s["publishedAt"]})
        token = resp.get("nextPageToken")
        if not token:
            return rows, units
TikHub 路线:照它 openapi.json 里 get_video_comments 的参数写,翻页参数叫 continuation_token,默认 need_format=true 返回清洗后的字段,published_time 是「1 天前」这样的相对时间。下面同样是配置示例,没有运行(我们不注册对方账号),每次 $0.001 是价目上的单价。
# 配置示例:TikHub web_v2 评论接口(按 openapi.json 的参数写,未运行)
import os, requests

H = {"Authorization": f"Bearer {os.environ['TIKHUB_API_KEY']}"}
URL = "https://api.tikhub.io/api/v1/youtube/web_v2/get_video_comments"

def comments(video_id, pages=5):
    rows, token = [], None
    for _ in range(pages):              # 每页 $0.001,一页几条公开材料没写
        params = {"video_id": video_id, "sort_by": "top", "language_code": "en-US"}
        if token:
            params["continuation_token"] = token
        data = requests.get(URL, headers=H, params=params, timeout=60).json()["data"]
        rows += data.get("comments", [])
        token = data.get("continuation_token")
        if not token:
            break
    return rows
EveryInfra 路线:一条完整的「搜索→视频→评论→字幕」,三轮真调用用的就是这个脚本,每次的原始返回都由它存档(下载用的 Python 依赖 requests 2.34.2,时区用标准库 zoneinfo)。每一步一次 POST,"platform":"youtube" 加能力名,参数放 params 里;慢的请求会回 status: running 和 poll_url,脚本按它轮询;碰到 429 按 Retry-After 等。
"""YouTube search -> video -> comments -> transcript with the EveryInfra API.

Usage:
    export EVERYINFRA_API_KEY=...        # never hard-code the key
    python3 yt_chain.py "cs50 python lecture" out_dir

Each step is one POST /api/v1/social call. The script saves every raw
response to out_dir and prints rows returned and USD charged per step.
"""
import json
import os
import sys
import time
from datetime import datetime
from zoneinfo import ZoneInfo

import requests

API = "https://api.everyinfra.com/api/v1/social"
KEY = os.environ["EVERYINFRA_API_KEY"]
SGT = ZoneInfo("Asia/Singapore")
session = requests.Session()
session.headers.update({"Authorization": f"Bearer {KEY}", "User-Agent": "yt-chain-example/1.0"})

def call(action, params, out_dir, tag):
    body = {"platform": "youtube", "action": action, "params": params}
    for attempt in range(4):
        started = datetime.now(SGT).strftime("%Y-%m-%d %H:%M:%S")
        r = session.post(API, json=body, timeout=120)
        if r.status_code == 429:  # rate limit: wait and try again
            time.sleep(int(r.headers.get("Retry-After", 60)))
            continue
        break
    data = r.json()
    # slow jobs answer with status=running and a poll_url
    while isinstance(data, dict) and data.get("status") == "running" and data.get("poll_url"):
        time.sleep(5)
        poll = data["poll_url"]
        if poll.startswith("/"):
            poll = "https://api.everyinfra.com" + poll
        data = session.get(poll, timeout=60).json()
    with open(os.path.join(out_dir, f"{tag}_{action}.json"), "w", encoding="utf-8") as f:
        json.dump({"sgt": started, "http": r.status_code, "request": body, "response": data}, f, ensure_ascii=False, indent=1)
    results = data.get("results") if isinstance(data, dict) else None
    rows = len(results) if isinstance(results, list) else (1 if isinstance(results, dict) else 0)
    charged = (data.get("billing") or {}).get("charged_usd", 0) if isinstance(data, dict) else 0
    err = (data.get("error") or {}).get("code") if isinstance(data, dict) and isinstance(data.get("error"), dict) else None
    print(f"{started} SGT  youtube/{action:<10} http={r.status_code} rows={rows:<4} charged_usd={charged} error={err}")
    return data, rows, charged

def main():
    keyword, out_dir = sys.argv[1], sys.argv[2]
    tag = sys.argv[3] if len(sys.argv) > 3 else "r"
    os.makedirs(out_dir, exist_ok=True)
    total, rows_total = 0.0, 0

    found, n, c = call("search", {"keyword": keyword, "limit": 20}, out_dir, tag)
    total, rows_total = total + c, rows_total + n
    videos = [v for v in found.get("results", []) if v.get("comment_count")]
    if not videos:
        sys.exit("no video with comments in the search results")
    url = videos[0]["url"]
    time.sleep(7)

    for action, params in (
        ("video", {"url": url}),
        ("comments", {"url": url, "sort": "popular", "limit": 40}),
        ("transcript", {"url": url, "language": "en"}),
    ):
        _, n, c = call(action, params, out_dir, tag)
        total, rows_total = total + c, rows_total + n
        time.sleep(7)

    print(f"video={url} rows={rows_total} total_usd={round(total, 6)}")

if __name__ == "__main__":
    main()
鉴权都是一个 Header,翻页的差别最大:官方给 nextPageToken,TikHub 给 continuation_token,两边都要你写循环、自己数花了几页;EveryInfra 的 youtube/search、youtube/comments 用 limit 一次要够条数(参数范围见目录),没有翻页参数,计费按次,不按页。要取的评论多于一次返回的量,就换 sort(popular 和 newest)各取一次,或用 since 按日期往前切,再按评论 id 去重。
字段对照:同一条评论,三边各回什么
三边一条评论的字段名和格式都不一样。下表按官方 comments 资源、commentThreads 资源、TikHub openapi.json 里 get_video_comments 的返回示例,以及我们目录里 youtube/comments 的 response_fields 逐个对出来。TikHub 那一列来自它文档里的示例,不是我们调出来的。
| 含义 | 官方 Data API | TikHub `get_video_comments`(文档示例) | EveryInfra `youtube/comments` |
|---|---|---|---|
| 评论 ID | id | comment_id | id |
| 正文 | textOriginal、textDisplay | content | text |
| 作者 | authorDisplayName | author.display_name | author_name |
| 发布时间 | publishedAt(ISO 8601) | published_time(相对时间,如「1天前」) | posted_at |
| 点赞数 | likeCount(整数) | like_count(字符串,如 "2") | 热门评论用 sort: popular 取;视频总点赞在 youtube/video |
| 回复数、是不是回复 | totalReplyCount、parentId | reply_count(字符串)、reply_level | is_reply、reply_to_id |
| 评论附图 | imageUrl(2026 年 9 月新增) | 文档未列 | 目录未列 |
时间上,官方给的是精确到秒的 ISO 时间,TikHub 文档示例是「1天前」这类相对时间;做「开课后第几周评论最多」这类时间序列,官方的时间戳更合适。点赞上,官方是整数,TikHub 示例是字符串,要先转成数字。回复上,官方要另调 comments.list 按 parentId 取,两层分页的细节在这篇里实测过;我们这三轮返回的 89 条全部是顶层评论(is_reply 都是 false)。所以做严肃的课程研究,比较稳的组合是:官方 API 取评论正文、时间和点赞,字幕交给能取别人视频的那一路,两边用视频 ID 拼起来。跨路拼接时,官方的评论 id 和我们返回的 id 都是 YouTube 自己的评论编号,可以直接对上;TikHub 的 comment_id 是不是同一套,拼之前抽几条核对。
实测:同一条链在 21:35、21:42、21:48 各跑一轮
三轮用三个不同的公开课关键词,每轮从搜索结果里挑第一个有评论的视频,接着取它的详情、评论和字幕。金额取每次响应里的 billing.charged_usd,条数取 results 的长度,原始返回逐次存档。
| 轮次(新加坡时间) | 关键词 | 选中的视频 | 搜索 | 视频详情 | 评论 | 字幕 |
|---|---|---|---|---|---|---|
| 21:35 | cs50 python lecture | freeCodeCamp 转载的 CS50P 全课,15 小时 57 分,播放 9,529,399,评论 5,433 | 20 条,$0.000778 | 1 个,$0.000556 | 40 条,$0.000556 | 22:32 取到,24,851 段,$0.000556 |
| 21:42 | mit 6.100L python lecture | MIT OCW 6.100L 第 2 讲,1 小时 18 分,播放 411,084,评论 259 | 20 条,$0.000778 | 1 个,$0.000556 | 40 条,$0.000556 | 22:31 取到,1,721 段,$0.000556 |
| 21:48 | khan academy statistics | Khan Academy 统计课总览,1 分 36 秒,播放 33,096,评论 9 | 20 条,$0.000778 | 1 个,$0.000556 | 9 条,$0.000556 | 22:31 取到,47 段,$0.000556 |
三轮的搜索各返回 20 条。第一轮搜 cs50 的 20 条里,cs50 频道的视频占 13 条,其中 11 条是 CS50P 的各讲,freeCodeCamp 转载的两门全课排在第 1 和第 3,第 8 条是 MIT OCW 6.100L 的第 1 讲;第二轮搜 MIT 的 20 条里,mitocw 频道的正式课只有 6 条,另外 14 条来自同一个转载频道,播放都不到 100 次,其中大部分是 2026 年 10 月 28 日集中上传的,所以这 20 条的播放数中位数只有 17 次;第三轮搜 Khan Academy 的 20 条全部来自 khanacademy 频道,上传年份从 2009 年到 2020 年,播放中位数约 104 万。做课程研究时,转载要按 author_username 或 author_id 筛掉,否则同一门课的评论会被拆到两处,样本也会被播放极少的副本稀释。我们的做法是先列出课程官方频道的 author_id,只保留这些频道的视频,其余的另存一份留档。频道订阅数可以用 youtube/profile 取(能力目录写明支持,本次没有实测)。
评论那一列:第三轮的 Khan Academy 视频,youtube/video 回的 comment_count 是 9,youtube/comments 本次返回 9 条,一条不差;前两轮本次各返回 40 条,全部是顶层评论。评论多的视频要取得更全,可以按 popular 和 newest 各取一次,或用 since 按日期分段,合并时按评论 id 去重。
视频详情这一列三轮都成功,每次返回 14 个字段,like_count、comment_count、view_count 都是整数,可以拿来当分母。三门课的互动差别这样一算就出来了:CS50P 全课的点赞数是播放数的 2.5%,每万次播放有 5.7 条评论;MIT 第 2 讲点赞占 1.5%,每万次播放 6.3 条评论;Khan Academy 那条 1 分 36 秒的总览视频点赞只占 0.3%,每万次播放 2.7 条评论。十几个小时的长课,评论密度没有比短视频低,MIT 那一讲反而最高。样本只有三条视频,这组数只能当作「取到数之后先算什么」的例子,不能拿来比较三家机构的教学效果。
搜索返回的 60 条本身也能先做一遍筛选,三轮的分布差别很大。cs50 那一轮时长中位数 99 分钟,20 条里 15 条超过 1 小时,最长一条 24.5 小时,20 条都有评论,合计 16,375 条;MIT 那一轮中位数 63.5 分钟,11 条超过 1 小时,但只有 6 条有评论,前 3 条视频占了这一轮 90.8% 的播放,其余大多是前面说的转载副本;Khan Academy 那一轮中位数 9.1 分钟,没有一条超过 1 小时,18 条有评论,播放最分散,前 3 条只占 40.6%。按有评论的视频算,每万次播放的评论数中位数分别是 5.0、5.9 和 2.1。
| 轮次 | 时长中位数 | 超过 1 小时 | 有评论的视频 | 评论合计 | 播放前 3 条占比 | 每万次播放评论数(中位数) |
|---|---|---|---|---|---|---|
| cs50 python lecture | 99.0 分钟 | 15 / 20 | 20 | 16,375 | 56.2% | 5.0 |
| mit 6.100L python lecture | 63.5 分钟 | 11 / 20 | 6 | 1,719 | 90.8% | 5.9 |
| khan academy statistics | 9.1 分钟 | 0 / 20 | 18 | 5,750 | 40.6% | 2.1 |
这张分布表决定了钱花在哪里更值。字幕按次计费,在 cs50 这类长课上,一次 $0.000556 拿到的是几个小时的讲课;在 Khan 这类几分钟的短视频上,同样的钱只拿到几百个词。按讲次批量取字幕和评论之前,先用搜索结果里的 duration 和 comment_count 排个序,评论为 0 的视频不调 youtube/comments,转载副本整组跳过。MIT 那一轮如果只取有评论的 6 条,评论请求就从 20 次降到 6 次。
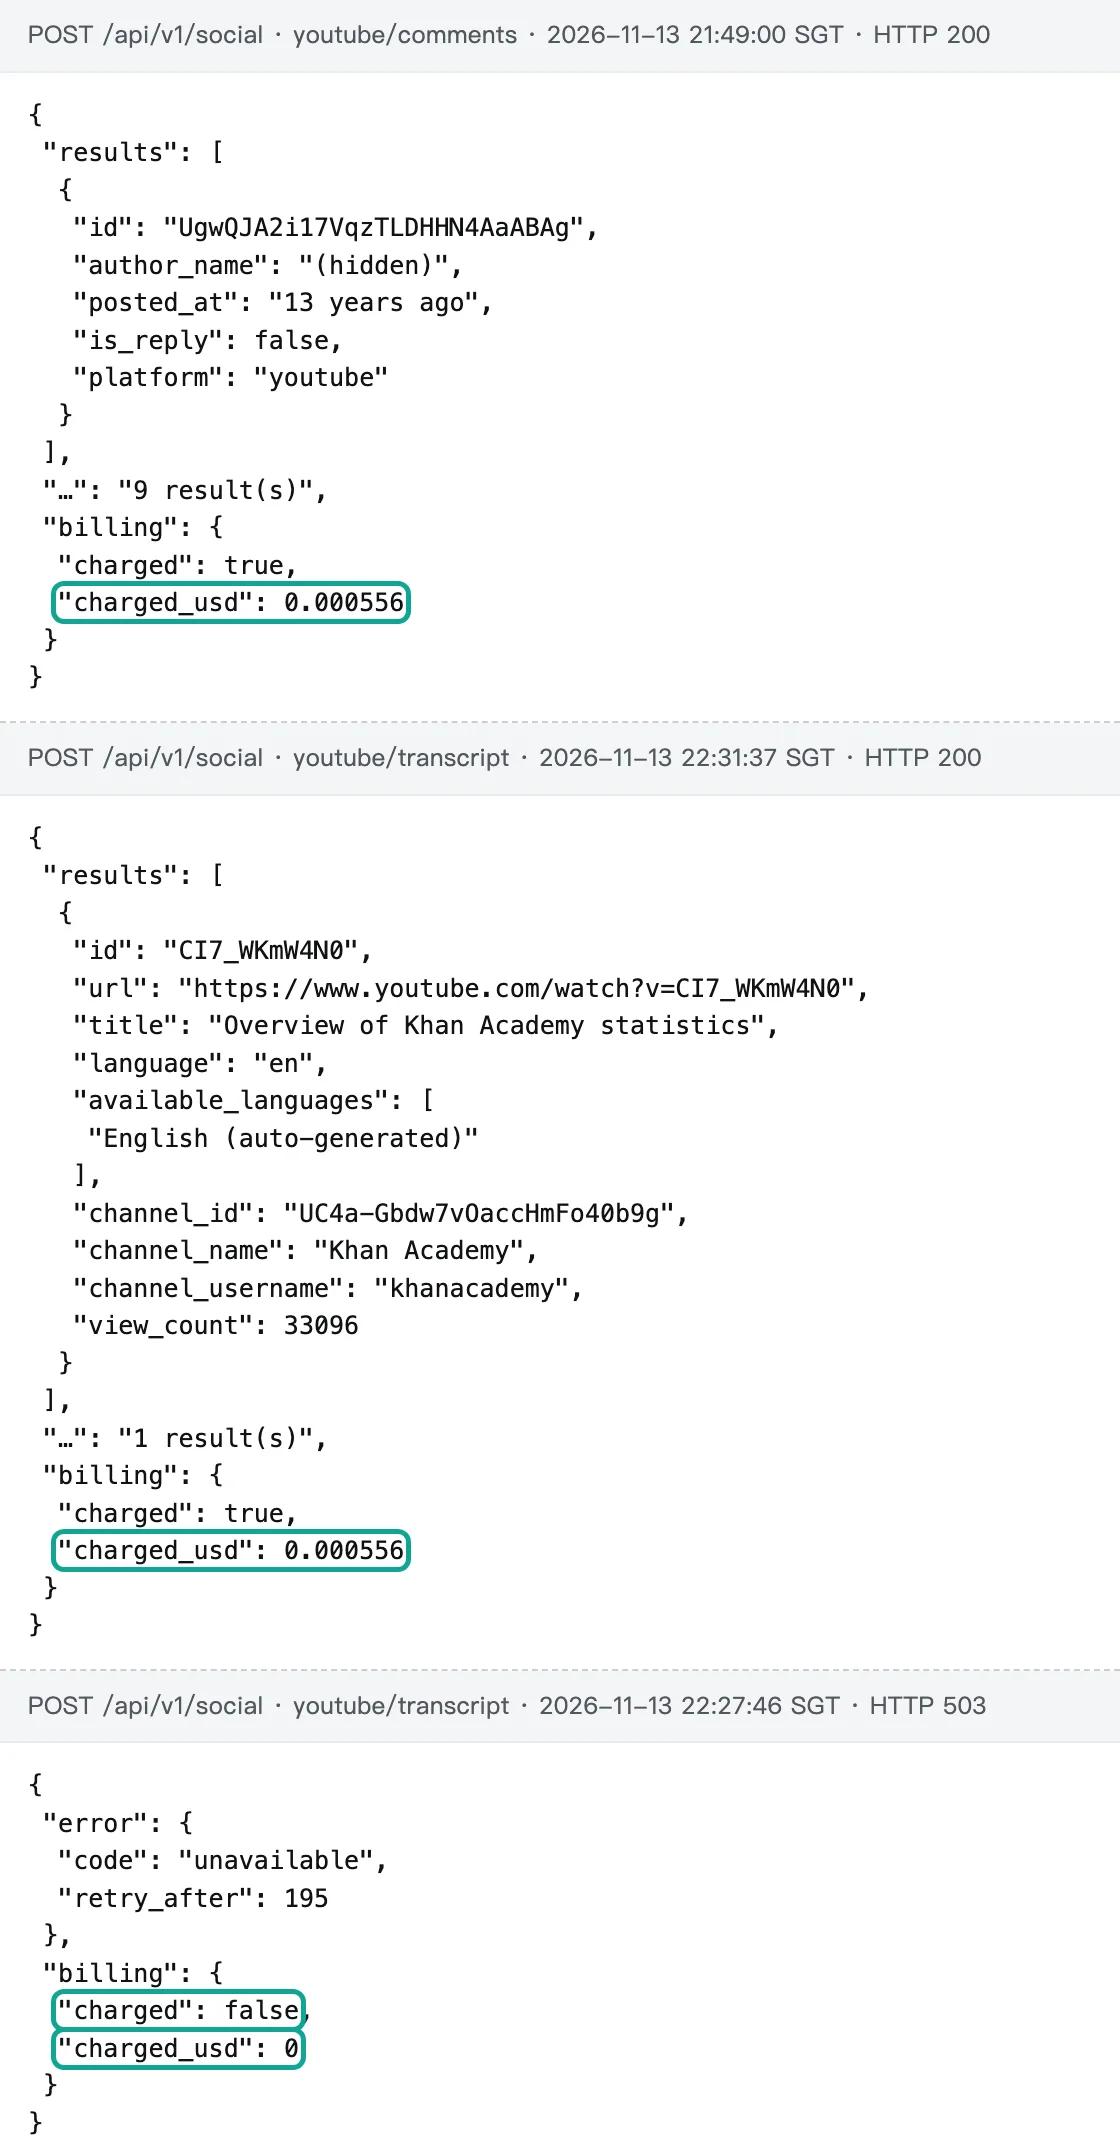
字幕接口前几次返回 503、没扣费,按 retry_after 重试后成功。另外一次是故意的:不带 Key 发搜索,回 401、$0。本文的真调合计实扣 $0.007338,正好是 12 次成功调用的单价之和:3 × $0.000778 + 9 × $0.000556。
换算成每 1,000 条:哪一步差得多
按请求计费时,单价只是账单的一半,另一半是一次回几条。我们这边用「实扣 ÷ 实际返回条数 × 1,000」:搜索三次共回 60 条、扣 $0.002334,每千条 $0.0389;评论按取满一页的两次算,80 条、扣 $0.001112,每千条 $0.0139(三次全算是 89 条、每千条 $0.0187,因为 Khan 那条视频一共只有 9 条评论);视频详情和字幕一次一个,每千个视频就是单价乘 1,000。TikHub 的 openapi.json 和价目都没有写搜索和评论一页返回几条,所以这两项我们只比每次请求的单价;它每千条的价是 $1 ÷ 每页条数,条数要以你自己调到的返回为准。
| 项目 | TikHub 每次(公开单价) | EveryInfra 每次(实扣) | 每次单价比 | 每 1,000 条 EveryInfra(实扣 ÷ 本次返回) | 每 1,000 条 TikHub |
|---|---|---|---|---|---|
| 搜索结果 | $0.001 | $0.000778,本次每次返回 20 条 | 1.3 | $0.0389(3 次共 60 条、$0.002334) | $1 ÷ 每页条数(未公开) |
| 评论 | $0.001 一页 | $0.000556,本次两次各返回 40 条 | 1.8 | $0.0139(2 次共 80 条、$0.001112) | $1 ÷ 每页条数(未公开) |
| 视频详情 | $0.001 | $0.000556 | 1.8 | $0.556 | $1.00 |
| 字幕 | $0.008(V2 $0.001) | $0.000556(22:31–22:32 三次实扣) | 14.4(V2 1.8) | $0.556 | $8.00(V2 $1.00) |
搜索和评论两行,每千条差多少取决于 TikHub 一页返回几条:按上面的算法,它搜索一页返回 26 条及以上,每千条就比我们的 $0.0389 低;评论一页 72 条和我们打平,73 条及以上比我们低。视频详情和字幕两行没有这个变数,都是一次一个,单价比就是成本比;字幕那一行差得最多,$0.008 对 $0.000556,是 14.4 倍。字幕这一行,我们一侧是三次成功调用的实扣,TikHub 一侧是公开单价。还有一点要算进去:两边都按次收钱,和字幕多长无关,所以视频越长,每个词摊到的钱越少;这次最长的一份是 CS50P 全课,$0.000556 拿到 183,775 个词。
失败、空结果和重试:三条路各怎么记账
按次计费的接口,失败要不要付钱,决定了重试的成本。三边的规则都写在公开文档里。官方的配额计算器写「所有请求,包括写错的请求,至少记 1 个单位」,配额满了会回 403 和 quotaExceeded(错误码列表),只能等太平洋时间午夜。TikHub 的 FAQ 写返回 200 就计费、失败不计费,同一页还写参数完全相同的重复请求也逐次计费;字幕接口没字幕时返回 200 并计费,这是它自己的文档写的。我们这边,失败和空结果自动退回,响应里 billing.charged 是 false、charged_usd 是 0,上面截图里那次 503 就是这样记的。
重试的写法跟着规则走。官方路线碰到配额满,重试没有意义,脚本要记住今天用了多少单位、提前停;TikHub 路线碰到网络错误可以重试,但要避免「同一参数打两次」,因为两次都算钱;EveryInfra 路线碰到 503,响应体里有 retryable 和 retry_after,脚本按秒数等,等的那几次不收钱。我们上面那段脚本只处理了 429,要稳一点,可以把 503 也加进去:读 error.retry_after,睡够秒数再发,最多两三次。还有一点容易忽略:EveryInfra 同一个请求体 5 分钟内重放,会回 202 和「已重放」,不会再扣一次,也不会给新数据;想拿新数据要等过了这个窗口,或者改参数。
| 情况 | 官方 Data API | TikHub(按它的 FAQ 和文档) | EveryInfra(按计费规则和本次返回) |
|---|---|---|---|
| 参数写错的请求 | 至少记 1 个单位 | 不计费 | 不扣钱 |
| 配额用完或暂时取不到 | 403 quotaExceeded,等清零 | 公开材料没写 | 503 带 retry_after,不扣钱 |
| 视频没有字幕 | 不适用 | 返回 200,扣 $0.008 | 不扣钱 |
| 同一请求发两次 | 每次都记单位 | 每次都计费 | 5 分钟内重放回 202,不再扣 |
字幕:三条路差别最大的一步
做课程反馈、讲座检索、视频内容审计,要用到字幕:评论说「25:30 这里没听懂」,要回到字幕里看讲师在 25:30 说了什么。官方 API 取不到别人视频的字幕,前面已经写过;Python 社区常用的 youtube-transcript-api 读的是网页上的字幕,2026 年 11 月 5 日发了 1.2.5(PyPI),它的 README 专门有一节写 YouTube 已经开始拦截大多数云服务商的 IP,部署到云上多半会碰到 RequestBlocked 或 IpBlocked;yt-dlp 也能下字幕文件,10 月 26 日的 2026.10.26 版是最近一次正式版。这两个都是开源工具,免费,但稳定性和 IP 要你自己管。
TikHub 的字幕接口每次 $0.008,没字幕也计费,大视频转异步要自己轮询;它价目里还有一个每次 $0.001 的 get_video_captions_v2,但 openapi.json 里查不到它的参数说明。EveryInfra 的 youtube/transcript 每次 $0.000556,返回 text(全文)、segments(带起止时间的分段)、language 和 available_languages,失败不扣钱。这一晚的三次成功调用,回来的数据量差别很大。CS50P 全课 15 小时 57 分,一次回了 24,851 段、183,775 个英文词,available_languages 只有自动生成的英文;MIT 6.100L 第 2 讲 1 小时 18 分,回了 1,721 段、12,593 个词,可选语言有上传的英文字幕、上传的西班牙文字幕和自动英文三种,回来的文本开头是「[SQUEAKING]」「[RUSTLING]」这类上传字幕常见的声音标注;Khan Academy 的总览视频 1 分 36 秒,47 段、318 个词,也只有自动英文。
每一段有 start、duration、text 三个字段。自动字幕的段落在时间上是重叠的:CS50P 第一段从 0.16 秒开始、持续 4.6 秒,第二段在 2.44 秒就开始了。按时间戳对评论时只用 start,别把 start + duration 当成段落的结尾。重叠的程度和字幕来源有关,我们把三份字幕相邻两段逐对比了一遍:CS50P 和 Khan Academy 只有自动字幕,24,850 对相邻段里有 24,807 对重叠(99.8%),Khan 的 46 对全部重叠;MIT 那一讲回来的文本带「[SQUEAKING]」这类上传字幕的声音标注,1,720 对里只有 204 对重叠(11.9%)。也就是说,同一个脚本拿到的「段」,在自动字幕里更像一个滑动窗口,在上传字幕里更接近一句话。按段数统计「讲师说了多少句」只对上传字幕有意义,自动字幕要按词数或按时间切片算。
字幕长度也决定了后续处理的成本。三份字幕的语速按「词数 ÷ 最后一段结束时刻」算:CS50P 全课 957.7 分钟、每分钟 191.9 个词,MIT 第 2 讲 78.9 分钟、每分钟 159.7 个词,Khan 那条 1.6 分钟、每分钟 198.5 个词。CS50P 的 text 全文有 947,499 个字符,交给 AI 工具做摘要前要先按讲次或章节切开。因为两边都按次计费、不按长度计费,摊到每 1,000 个英文词上差别很大:
| 视频 | 英文词数 | EveryInfra 每 1,000 词($0.000556 ÷ 词数 × 1,000) | TikHub `get_video_captions` 每 1,000 词($0.008 ÷ 词数 × 1,000) |
|---|---|---|---|
| CS50P 全课 | 183,775 | $0.0000030 | $0.0000435 |
| MIT 6.100L 第 2 讲 | 12,593 | $0.0000442 | $0.000635 |
| Khan Academy 统计课总览 | 318 | $0.00175 | $0.0252 |
字幕和评论的体量也差得很远,交给 AI 工具做分析前值得先算一下。CS50P 那条视频本次返回的 40 条评论合计 4,047 个词,每条中位数 34 个词;同一条视频的字幕是 183,775 个词,是这 40 条评论的 45 倍。MIT 第 2 讲的 40 条评论合计 1,743 个词、每条中位数 20 个词,字幕 12,593 个词,约 7 倍。Khan 那条的 9 条评论合计 117 个词、每条中位数 9 个词,字幕 318 个词,不到 3 倍。长课的分析成本主要在字幕一侧:先用评论里的时间戳挑出被反复提到的那几段,只把这几段字幕交给模型,比整门课的全文一起送进去省得多,也更容易人工核对。短视频则相反,字幕和评论都短,可以整份一起看。
| 视频 | 时长 | 段数 | 英文词数 | 可选字幕 | 实扣 |
|---|---|---|---|---|---|
| CS50P 全课(freeCodeCamp) | 15:57:48 | 24,851 | 183,775 | 自动英文 | $0.000556 |
| MIT 6.100L 第 2 讲 | 1:18:58 | 1,721 | 12,593 | 上传英文、上传西班牙文、自动英文 | $0.000556 |
| Khan Academy 统计课总览 | 1:36 | 47 | 318 | 自动英文 | $0.000556 |
| 取字幕的办法 | 每次花费 | 能取别人的视频 | 没字幕时 | 要自己处理的 |
|---|---|---|---|---|
官方 captions.download | 200 个配额单位 | 不能,要编辑权限 | 不适用 | OAuth、视频主人授权 |
| youtube-transcript-api / yt-dlp | $0 | 能 | 抛异常 | IP 被拦、代理、版本跟进 |
TikHub get_video_captions | $0.008 | 能 | 200,照常计费 | 大视频异步轮询 |
EveryInfra youtube/transcript | $0.000556 | 能 | 失败不扣 | 回 503 时按 retry_after 重试 |
跨领域例子:用公开课的评论和字幕做受众反馈分析
教育研究里用 YouTube 评论做学习者反馈已经有一批论文。Chalkias 等人 2023 年在 Electronics 上发表的研究,从教育类频道取了 167,987 条评论,用 VADER 和 TextBlob 两种词典法做情感分析,再用 LDA 聚类主题,结论是中性评论最多、其次正面、负面最少,评论里反复出现的是动画、音乐和讲解信息这些视频属性(Learning Analytics on YouTube Educational Videos);他们取数用的就是 YouTube Data API 加 Google Sheets,只用了评论。把字幕接上,能多做一件事:评论里带时间戳的那一部分,可以对回讲师讲到那里的原话。我们三轮取到的评论正好能说明这件事。CS50P 全课那 40 条评论里,有 10 条带时间戳,但其中 8 条是观众自己整理的章节目录或学习打卡(「Day 2 - Completed till 1:20:00」),指向具体疑问的很少;MIT 6.100L 第 2 讲的 40 条里,带时间戳的 4 条,有 3 条都指向 16:55 到 25:43 之间讲字符串切片的那一段,比如有人在 25:30 处补了一个 s[0:5][::-1] 的写法。把字幕接上,这几条评论就有了上下文。25:30 前后,课堂上一个学生问:想把字符 A 也包含进去,第二个值是不是写 -1;讲师说 -1 指的是另一头,又说要自己试一下,没有当场给出写法。25:30 和 25:43 那两条评论补的正好是这个答案:一条给出 s[0:5][::-1],一条说用空的冒号或 -12。16:55 那条评论对应 16 分 40 秒前后讲负数下标和越界报错的那一段;「Skip --> 4:53」那条也对得上,4 分 50 秒前后讲师说要进入新的对象类型,字符串。
| 评论里的时间 | 评论说了什么(概括) | 字幕里那一段在讲什么 |
|---|---|---|
| 4:53 | 提示跳到讲字符串的地方 | 4:50 前后,讲师开始讲新的对象类型字符串 |
| 16:55 | 解释 s[0] 和 s[-1] 的方向 | 16:40 前后,讲负数下标和越界报错 |
| 25:30 | 给出 s[0:5][::-1] | 25:25 前后,学生问怎样把 A 也包含进去,讲师说要试一下 |
| 25:43 | 用空的冒号或 -12 | 同一个提问 |
上图把 MIT 那一讲的字幕按分钟切开,每分钟的词数在 89 到 205 之间,四条评论时间戳标在上面。这一讲 78.9 分钟里,讲师语速没有明显的空档,评论提到的时刻也不是语速特别快或特别慢的地方;能看出来的是位置:4 条里有 3 条落在 16 到 26 分钟讲字符串下标和切片的那 10 分钟里。样本只有 4 条带时间戳的评论,这张图说明的是做法,不是结论:评论多的课取到几百条带时间戳的评论以后,按分钟数一数就能看出哪一段被反复提起。CS50P 那 40 条里带时间戳的 10 条,有 8 条是章节目录或学习打卡,所以统计前要先过滤掉一条评论里列了很多个时间戳的那种。
具体步骤只写方法,不涉及任何个人信息。第一步,用 youtube/user_posts 按频道列出一门课的全部讲次(参数 url 是频道地址,sort 可选 newest、oldest、popular;能力目录写明支持,本次没有实测),或者用本文实测过的 youtube/search 按课名搜,筛掉转载频道。第二步,每讲取一次 youtube/video 存下播放、点赞、评论数,作为分母。第三步,每讲取 youtube/comments,评论多的视频分 popular 和 newest 两次取,用评论 id 去重。第四步,每讲取 youtube/transcript,保留 segments 的起止时间。第五步,用正则抽出评论里的时间戳,落到对应的字幕段;剩下没有时间戳的评论,再做情感和主题分析。第六步,人工抽查:自动字幕的错字、评论里的反讽,都要人看一遍再下结论。作者名在研究报告里一律隐去,只用频道和讲次。每一步的原始返回连同 billing.charged_usd 原样存档,写报告时按「实扣 ÷ 本次返回条数」复算成本,别人拿同一批文件也能核对。
| 一门 12 讲的公开课 | 请求数 | TikHub(公开单价) | EveryInfra(目录单价) | 官方 API |
|---|---|---|---|---|
| 搜索课名 1 次 | 1 | $0.001 | $0.000778 | 1 次搜索 |
| 视频详情 12 次 | 12 | $0.012 | $0.006672 | 12 个单位(也可一次批量 1 个单位) |
| 评论每讲 1 次 | 12 | $0.012 | $0.006672 | 12 个单位起 |
| 字幕每讲 1 次 | 12 | $0.096(V2 $0.012) | $0.006672 | 取不到 |
| 合计 | 37 | $0.121(V2 $0.037) | $0.020794 | 24 单位 + 1 次搜索,字幕缺 |
这笔账有两个前提。一是每讲评论只取一次,评论多的课要按需多取几次,三条路都跟着涨;二是 TikHub 字幕 V2 不在公开文档里,按它算的那个 $0.037 只是价目上的数。把范围放大到一个学院的课程库,算法不变,只是乘以课程数:100 门各 12 讲的课,按公开单价 TikHub 约 $12.10(字幕走 V2 约 $3.70),我们约 $2.08;其中字幕一项 TikHub 是 $9.60,我们是 $0.67,占了两边差额的大头。官方 API 在这个规模下仍然只花配额,100 门课的视频详情和评论合计 2,400 个单位,一天之内就能取完,但 1,200 讲的字幕一讲也取不到。
一个月的账:每天跟踪 30 讲课的新评论
假设一个教研团队要跟踪 30 讲课的视频,每天取一次评论和统计数,每讲的字幕只在开始时取一次,一个月按 30 天算。
| 每月任务 | 次数 | 官方 Data API | TikHub(公开单价) | EveryInfra(目录单价) |
|---|---|---|---|---|
| 每天每讲取一次评论 | 900 | 900 个单位,每天 30 个 | $0.90 | $0.5004 |
| 每天取一次 30 讲的统计数 | 900(官方可 30 个 ID 一次) | 30 个单位,每天 1 个 | $0.90 | $0.5004 |
| 开始时每讲取一次字幕 | 30 | 取不到 | $0.24(V2 $0.03) | $0.01668 |
| 合计 | 1,830 | 930 个单位,$0,缺字幕 | $2.04 | $1.01748 |
官方路线每天只用 31 个单位,离 10,000 还很远,评论正文、精确时间、点赞数都有,只缺字幕。所以「每天盯着已知视频的新评论」这件事,我们的建议是用官方 API;EveryInfra 和 TikHub 适合官方给不了的那一块(别人视频的字幕、不想走审核的一次性大批量搜索),或者团队不想维护 Google Cloud 项目和 OAuth 的情况。如果搜索量超过每天 100 次,比如要每天按 50 个关键词各搜两页找新上传的课,官方就要申请加配额,这时按次计费的两条路才有价格可比:每天 100 次搜索,一个月 3,000 次,TikHub search_video 是 $3.00,我们的 youtube/search 是 $2.334。
什么时候官方 API 或 TikHub 更合适
官方 YouTube Data API 在三种情况下比两家付费接口都合适。第一,你只要评论和统计数,量在每天 10,000 个单位以内:一天 100 万条顶层评论的上限,大多数课程研究用不完,而且免费。第二,你分析的是自己频道的视频:字幕、YouTube Analytics 都能以频道主人的身份拿,数据最全。第三,你的应用要长期对外提供服务、需要 Google 的正式授权,按开发者政策和最低功能要求走审核,后面不会有条款上的意外。另外,官方在 2026 年 6 月 3 日加了 videos.batchGetStats,自己有一个单独的每天 10,000 单位的桶,批量取统计数更省配额。
TikHub 在这些情况下比我们合适。它的 YouTube 接口有 48 个,我们的 YouTube 能力是 8 项(youtube/search、youtube/profile、youtube/user_posts、youtube/video、youtube/comments、youtube/followers、youtube/transcript、youtube/shorts),它有而我们目录里没有的包括:二级评论的单独接口、频道社区帖子和帖子评论、相关视频、热门视频、搜索联想词、视频流地址和下载链接、频道邮箱。要取这些,按公开材料只能找它这样的接口。它的综合搜索 V2(get_general_search_v2,每次 $0.002)支持 upload_date、duration、features(字幕、4K、直播等)多种过滤,我们的 youtube/search 只有 sort 一个可选参数。最后,搜索和评论两项,它的公开材料没写一页返回几条;如果它搜索一页返回 26 条及以上、评论一页 73 条及以上,按每千条算它会更便宜,要以实际返回为准。
按要取的数据选路
把前面几节合起来,按「要取什么」排一张选路表。每一行只写我们核过的理由,价格都是 11 月 13 日的公开单价或目录单价。
| 要取的数据 | 首选 | 理由 | 其次 |
|---|---|---|---|
| 已知视频的评论、每天跟踪 | 官方 Data API | 每页 1 个单位,时间和点赞是精确值,免费 | EveryInfra youtube/comments |
| 已知视频的统计数 | 官方 videos.list 或 videos.batchGetStats | 一次 50 个 ID,1 个单位 | EveryInfra youtube/video |
| 每天超过 100 次的关键词搜索 | EveryInfra youtube/search | 不占官方搜索桶,每次 $0.000778,实测 20 条 | TikHub search_video $0.001 |
| 带上传时间、时长、4K 等过滤的搜索 | TikHub get_general_search_v2 | 我们只有 sort 一个可选参数 | 官方 search.list 的过滤参数 |
| 别人视频的字幕 | EveryInfra youtube/transcript | $0.000556,失败不扣 | TikHub get_video_captions $0.008 |
| 频道社区帖子、相关视频、视频流地址 | TikHub | 我们的目录里没有这些能力 | 无 |
| 频道的 Shorts 列表 | EveryInfra youtube/shorts 或 TikHub get_channel_shorts | 都按次计费;两边都是目录或价目写明支持,本次没有实测 | 官方 playlistItems.list |
选路时还要算上「维护成本」:官方路线要维护一个 Google Cloud 项目、处理配额和审核;TikHub 和 EveryInfra 要维护一个余额。对一个三五人的教研组,后者省事;对一个要长期对外发布产品的团队,前者更稳。
边界:哪些结论不成立
这次测试有五个限制,结论超出这些范围就不一定成立。第一,样本小:三轮真调都在 2026 年 11 月 13 日晚上一个小时内,三门课各一个视频,每个视频的评论只取了一次(本次返回 40、40、9 条),每千条评论 $0.0139 是按两次共 80 条算的;互动率、字幕对评论这些数都只来自这三个视频,只当做法的例子。第二,TikHub 一侧全部是公开单价,我们没有调用它的接口;它搜索和评论一页返回几条没有公开,所以这两项只比了每次单价,没有给出 TikHub 的每千条价。第三,价格会变:TikHub 价目两周里多了 12 行,我们的目录价也可能调整,发布前会各重读一次。第四,官方配额写着「默认配额会变」,不同项目经过审核后的配额也不一样,表里的 5,000 条和 100 万条只是默认值下的天花板。第五,字幕对评论那一节只用了 MIT 一讲里 4 条带时间戳的评论,CS50P 的 10 条大多是章节目录;「评论集中在哪一段」要等取到几百条带时间戳的评论以后才能下结论,本文只演示做法。
研究伦理上也有边界。教育研究用评论做分析,作者名应当隐去,只报告聚合结果;未成年人可能出现在教育类视频的评论区,开发者政策对数据存储时长有明确的 30 天要求,第三方数据接口取到的公开数据,也按同样的谨慎程度保存和删除。我们不对具体项目给法律意见,涉及机构伦理审查的,按你所在机构的规定走。
最近的变化:和 Python 取 YouTube 数据有关的 7 件事
| 日期 | 变化 | 对 Python 脚本意味着什么 |
|---|---|---|
| 2026-11-13 | TikHub 价目到 1,482 行 | 用之前重读单价 |
| 2026-11-10 | google-api-python-client 2.202.0 | 升级时看发布说明 |
| 2026-11-05 | youtube-transcript-api 1.2.5 | 云服务器 IP 仍会被拦 |
| 2026-10-26 | yt-dlp 2026.10.26 | 下字幕文件的开源工具,跟着升级 |
| 2026-09-30 | 评论新增 snippet.imageUrl | 会有只有图、没有字的评论 |
| 2026-06-03 | 新增 videos.batchGetStats | 批量取统计数有单独的配额桶 |
| 2026-06-01 | search.list 单独计数 | 搜索不再占那 10,000 个单位 |
TikHub 价目从 11 月 1 日的 1,470 行、11 月 11 日的 1,481 行,到 11 月 13 日的 1,482 行,接口一直在加;本文用到的 YouTube 单价,发布前我们会再读一次。
2026 年 11 月 10 日,google-api-python-client 发布 2.202.0(发布页)。官方路线的 Python 用户升级时,看一眼发布说明里 YouTube 发现文档有没有变。
2026 年 11 月 5 日,youtube-transcript-api 发布 1.2.5(发布页);10 月 26 日,yt-dlp 发布 2026.10.26。两者都是读网页字幕的开源工具,YouTube 改版后通常要等它们跟进。
2026 年 9 月 30 日,comments 资源加了 snippet.imageUrl,评论可以附图片或动图,文档写 11 月对所有用户开放。做评论文本分析的,要准备好「只有一张图、没有字」的评论。
2026 年 6 月 3 日加的 videos.batchGetStats 和 6 月 1 日的搜索单独计数(修订记录),前文已经算进了每天能取多少条;脚本里写死的配额常量,按这两条重新核一遍。
上手:五分钟跑通上面那段脚本
第一步,在 EveryInfra 控制台建一把 API Key,GitHub 给两个仓库点星可以领 $1 试用额度(24 小时内有效),够这段脚本跑几百次。第二步,pip install requests,把 Key 放进环境变量 EVERYINFRA_API_KEY。第三步,先在 YouTube 数据接口页看能力和字段,在搜索能力页、评论能力页、字幕能力页、视频详情能力页里有每个参数的允许值和试用台。第四步,跑 python3 yt_chain.py "你的课程名" out,看每一步打印的条数和 charged_usd。第五步,要在 Claude、Cursor 这类 AI 工具里直接调,用远程 MCP,同一把 Key;同一套接口还能取 TikTok 等平台的数据,价目在定价页和市场页。
常见问题
tikhub youtube api key 在哪里拿,能免费试吗?
这一问来自 Google 搜索联想词「tikhub youtube api key」(2026 年 11 月 13 日读取)。按 TikHub 定价页,注册后自动送 $0.05 免费额度,但价目里 YouTube 的 48 个接口只有 6 个能用这笔额度,搜索、评论、字幕都不在其中;要试这几项,先充至少 $5。EveryInfra 的 Key 在控制台建,GitHub 点星领的 $1 可以直接调 youtube/*。
youtube data api quota exceeded 怎么办?
这一问来自联想词「youtube data api quota exceeded」。先看是哪个桶满了:2026 年 6 月 1 日起搜索单独计数,每天 100 次,满了只影响 search.list;评论、视频详情共用 10,000 个单位。配额在太平洋时间午夜清零(配额计算器),长期不够就填配额扩展申请表。写错的请求也至少记 1 个单位,脚本里先校验参数再发。
youtube data api free quota 每天能取多少评论?
这一问来自联想词「youtube data api free quota」。commentThreads.list 每页最多 100 条、每页 1 个单位,10,000 个单位全给评论,理论上限是 100 万条顶层评论;回复要另调 comments.list,同样 1 个单位一页。冷门视频一页凑不满 100 条,实际会少很多。
youtube transcript api python 能拿别人视频的字幕吗?
这一问来自联想词「youtube transcript api python」。官方 captions.download 要对视频有编辑权限,取不到别人的;开源的 youtube-transcript-api 读网页上的字幕,免费但从云服务器调常被拦。TikHub get_video_captions 每次 $0.008、没字幕也计费;EveryInfra youtube/transcript 每次 $0.000556,失败不扣。
tikhub youtube api documentation 里查不到的接口能用吗?
这一问来自联想词「tikhub youtube api documentation」。11 月 13 日的价目有 48 个 YouTube 接口,openapi.json 只写了 34 个,get_video_captions_v2($0.001)和 get_channel_email($0.03)等 14 个只在价目里有单价。没有公开的参数说明,能不能用、怎么用要问 TikHub。
youtube data api quota calculator 怎么估一个脚本一天的消耗?
这一问来自联想词「youtube data api quota calculator」。按配额计算器,先把脚本里每个方法每天调几次列出来,再乘各自的单位:search.list 单独按次数算,上限 100 次;commentThreads.list、videos.list 每次 1 个单位;captions.list 每次 50 个单位。比如每天搜 20 次、每次挑 10 个视频各取 2 页评论,再分批取这 200 个视频的统计数,合计是 20 次搜索,加上 400 + 4 = 404 个单位,离 10,000 还很远。写错的请求也要算进去,每次至少 1 个单位。
youtube api python library 选哪个?
这一问来自联想词「youtube api python library」。走官方路线,用 Google 维护的 google-api-python-client(11 月 10 日发布 2.202.0),要 OAuth 时再配 google-auth-oauthlib;只读别人视频的字幕,社区常用 youtube-transcript-api(11 月 5 日发布 1.2.5)或 yt-dlp(2026.10.26 版);按次计费的两家里,TikHub 有自己的 SDK(tikhub 2.2.0),EveryInfra 只要用 requests 发一个 POST。选哪个取决于你要哪类数据,可以对照前面的选路表。
参考资料
- Quota Calculator,Google for Developers,2026-11-13 读取。
- Search: list,Google for Developers,2026-11-13 读取。
- CommentThreads: list,Google for Developers,2026-11-13 读取。
- Comments: list,Google for Developers,2026-11-13 读取。
- Captions: list,Google for Developers,2026-11-13 读取。
- Captions: download,Google for Developers,2026-11-13 读取。
- Videos: list,Google for Developers,2026-11-13 读取。
- YouTube Data API Revision History,Google for Developers,最近一条 2026-11-03。
- Implementation: Pagination,Google for Developers,2026-11-13 读取。
- Python Quickstart,Google for Developers,2026-11-13 读取。
- Quota and Compliance Audits,Google for Developers,2026-11-13 读取。
- YouTube API Services quota extension form,YouTube Help,2026-11-13 读取。
- YouTube API Services Developer Policies,Google for Developers,2026-11-13 读取。
- Required Minimum Functionality,Google for Developers,2026-11-13 读取。
- Videos: batchGetStats,Google for Developers,2026-06-03 上线。
- Manage API keys,Google Cloud,2026-11-13 读取。
- Use automatic captioning,YouTube Help,2026-11-13 读取。
- google-api-python-client,Google APIs on GitHub,2026-11-13 读取。
- google-api-python-client on PyPI,PyPI,2.202.0,2026-11-10。
- google-api-python-client releases,GitHub,2026-11-10。
- youtube-transcript-api,GitHub,2026-11-13 读取。
- youtube-transcript-api on PyPI,PyPI,1.2.5,2026-11-05。
- youtube-transcript-api releases,GitHub,2026-11-05。
- yt-dlp 2026.10.26,GitHub,2026-10-26。
- requests on PyPI,PyPI,2.34.2,2026-05-14。
- os — Miscellaneous operating system interfaces,Python 文档,2026-11-13 读取。
- zoneinfo — IANA time zone support,Python 文档,2026-11-13 读取。
- TikHub 公开价目接口,TikHub,2026-11-13 21:32 新加坡时间读取,1,482 行。
- TikHub openapi.json,TikHub,V5.3.2,2026-11-13 读取。
- TikHub Pricing,TikHub,2026-11-13 读取。
- TikHub FAQ,TikHub,2026-11-13 读取。
- TikHub YouTube API,TikHub,2026-11-13 读取。
- TikHub MCP,TikHub,2026-11-13 读取。
- tikhub on PyPI,PyPI,2.2.0,2026-10-03。
- EveryInfra 能力目录,EveryInfra,2026-11-13 21:31 新加坡时间读取。
- Learning Analytics on YouTube Educational Videos,Chalkias 等,Electronics,2023-09-19。
- CS50's Introduction to Programming with Python,Harvard University,2026-11-13 读取。
- MIT 6.100L Introduction to CS and Programming Using Python,MIT OpenCourseWare,2026-11-13 读取。
- Comments resource,Google for Developers,2026-11-13 读取。
- CommentThreads resource,Google for Developers,2026-11-13 读取。
- YouTube Data API Errors,Google for Developers,2026-11-13 读取。
引用编号 BL-141