TikHub YouTube API en Python: cuota oficial, TikHub y EveryInfra frente a frente en búsqueda, comentarios y transcripciones
Datos de YouTube en Python, tres vías: la API oficial limita la búsqueda a 100 llamadas al día, TikHub cobra desde 0,001 USD y medimos desde 0,000556 USD.
Desde el 1 de junio de 2026, la YouTube Data API v3 oficial cuenta las búsquedas en una cuota propia: 100 llamadas al día por defecto, con un máximo de 50 resultados por llamada. El método que descarga subtítulos exige permiso de edición sobre el vídeo, así que no sirve para sacar la transcripción de una clase pública ajena. Lo leímos en la Quota Calculator y en captions.download el 13 de noviembre de 2026. TikHub publica 48 endpoints de YouTube. Búsqueda, comentarios y detalle de vídeo cuestan 0,001 USD por llamada, y su endpoint de subtítulos get_video_captions cuesta 0,008 USD. De esos 48, solo 1 recibe el descuento por volumen diario y solo 6 aceptan el crédito gratuito de alta. Lo vimos en su endpoint público de precios, consultado sin clave a las 21:32, hora de Singapur, ese mismo día. En EveryInfra lanzamos tres veces la misma cadena «búsqueda, vídeo, comentarios, transcripción», a las 21:35, 21:42 y 21:48, hora de Singapur. La búsqueda costó 0,000778 USD por llamada y devolvió 20 filas. El detalle de vídeo y los comentarios costaron 0,000556 USD por llamada. Dos llamadas de comentarios devolvieron esta vez 40 filas cada una, así que 1.000 comentarios salen a 0,0139 USD según lo cobrado. Cada uno de los tres vídeos devolvió su transcripción entre las 22:31 y las 22:32, a 0,000556 USD por llamada. El curso completo de CS50P, de 15 horas y 57 minutos, llegó en una sola llamada con 24.851 segmentos y 183.775 palabras en inglés.
Si buscas un veredicto corto, está en /es/alternatives/tikhub. La fórmula completa de facturación de TikHub la desmontamos en Precios de TikHub explicados. La paginación en dos niveles de las respuestas a comentarios está en Por qué faltan respuestas en la API de comentarios de YouTube.
Una tabla: Data API oficial, tikhub youtube api y EveryInfra
La columna oficial sale del texto de las páginas de developers.google.com. La de TikHub sale de material público que cualquiera puede leer sin clave: el endpoint de precios, el archivo openapi.json, la página de precios, las preguntas frecuentes y la página de su API de YouTube. Lo leímos todo entre las 21:32 y las 21:34, hora de Singapur, del 13-11-2026. No abrimos cuenta en TikHub ni llamamos a sus endpoints de pago, de modo que cada cifra de TikHub es precio de tarifa y no una factura medida. La columna de EveryInfra usa el catálogo de capacidades, leído a las 21:31, y tres rondas de llamadas reales.
| Concepto | YouTube Data API v3 (oficial) | Endpoints de YouTube de TikHub | EveryInfra `youtube/*` |
|---|---|---|---|
| Forma de cobro | Gratis, con unidades de cuota diaria | Precio por petición | Precio por petición |
| Búsqueda | Cuota propia, 100 llamadas al día, 50 filas como máximo | search_video 0,001 USD, tamaño de página no publicado | youtube/search 0,000778 USD, 20 filas por llamada en nuestra prueba |
| Detalle de vídeo | videos.list 1 unidad, hasta 50 ID | get_video_info 0,001 USD | youtube/video 0,000556 USD |
| Comentarios | commentThreads.list 1 unidad, hasta 100 por página | get_video_comments 0,001 USD, tamaño de página no publicado | youtube/comments 0,000556 USD, 40 filas en cada una de dos llamadas |
| Transcripciones | captions.download 200 unidades, exige permiso de edición | get_video_captions 0,008 USD, se cobra aunque no haya subtítulos | youtube/transcript 0,000556 USD, sin cargo si falla |
| Uso gratuito | 10.000 unidades más 100 búsquedas al día | 0,05 USD al registrarse, válidos en 6 de 48 endpoints de YouTube | 1 USD por dar una estrella a dos repositorios de GitHub, válido 24 horas |
| Descuento por volumen | No (se puede pedir más cuota) | Tramos diarios hasta el 50 %, solo 1 endpoint de YouTube entra | Sin descuento diario |
| Recarga mínima | No hay recarga | 5 USD; con PayPal, 5 USD cuestan 5,55 USD | Los tramos empiezan en 10 USD |
| Acceso desde herramientas de IA | Te escribes tu propia función | Un servidor MCP por plataforma, 37 herramientas de YouTube según su página MCP | Una sola dirección MCP remota, la capacidad va como parámetro |
Lo que más cambia la forma de escribir el script es la cuota de búsqueda y el permiso sobre los subtítulos. El cambio en la búsqueda viene de Google. La entrada del 1 de junio de 2026 en el historial de revisiones anuncia que la Data API pasa a un sistema de cuotas por método. Empieza por videos.insert y search.list. La página de search.list dice ahora «100 calls per day», con 1 unidad por llamada en la cuota Search Queries. Con la regla anterior, una búsqueda costaba 100 unidades, así que 10.000 unidades también daban 100 búsquedas. El tope diario es el mismo. Lo que cambia es que la búsqueda ya no se come las 10.000 unidades que usan comentarios y detalles.
La página de la API de YouTube de TikHub seguía diciendo el 13 de noviembre que una sola búsqueda gasta 100 unidades, que es la regla antigua. En las transcripciones, el método oficial solo descarga subtítulos de vídeos que puedes editar. Para investigar audiencias en vídeos ajenos, como clases públicas, la vía oficial se para en este paso.
La YouTube Data API v3 oficial en 2026: la búsqueda va aparte
El primer párrafo de la Quota Calculator de Google fija las reglas. Cada proyecto recibe al día 100 llamadas a search.list, 100 a videos.insert y 10.000 unidades para el resto de métodos. Las cuotas se reinician a medianoche, hora del Pacífico. Toda petición cuesta al menos una unidad, incluidas las no válidas. Con estas reglas y el precio de cada método se calcula el techo diario de un script de Python.
La búsqueda permite 100 llamadas con un máximo de 50 filas por página (search.list), o sea, 5.000 filas al día. Los hilos de comentarios devuelven hasta 100 filas por página a 1 unidad cada página (commentThreads.list). Si todas las unidades se van a comentarios, el techo es de 1.000.000 de comentarios principales al día. El detalle de vídeo acepta hasta 50 ID por llamada a 1 unidad (videos.list), así que el techo es de 500.000 vídeos.
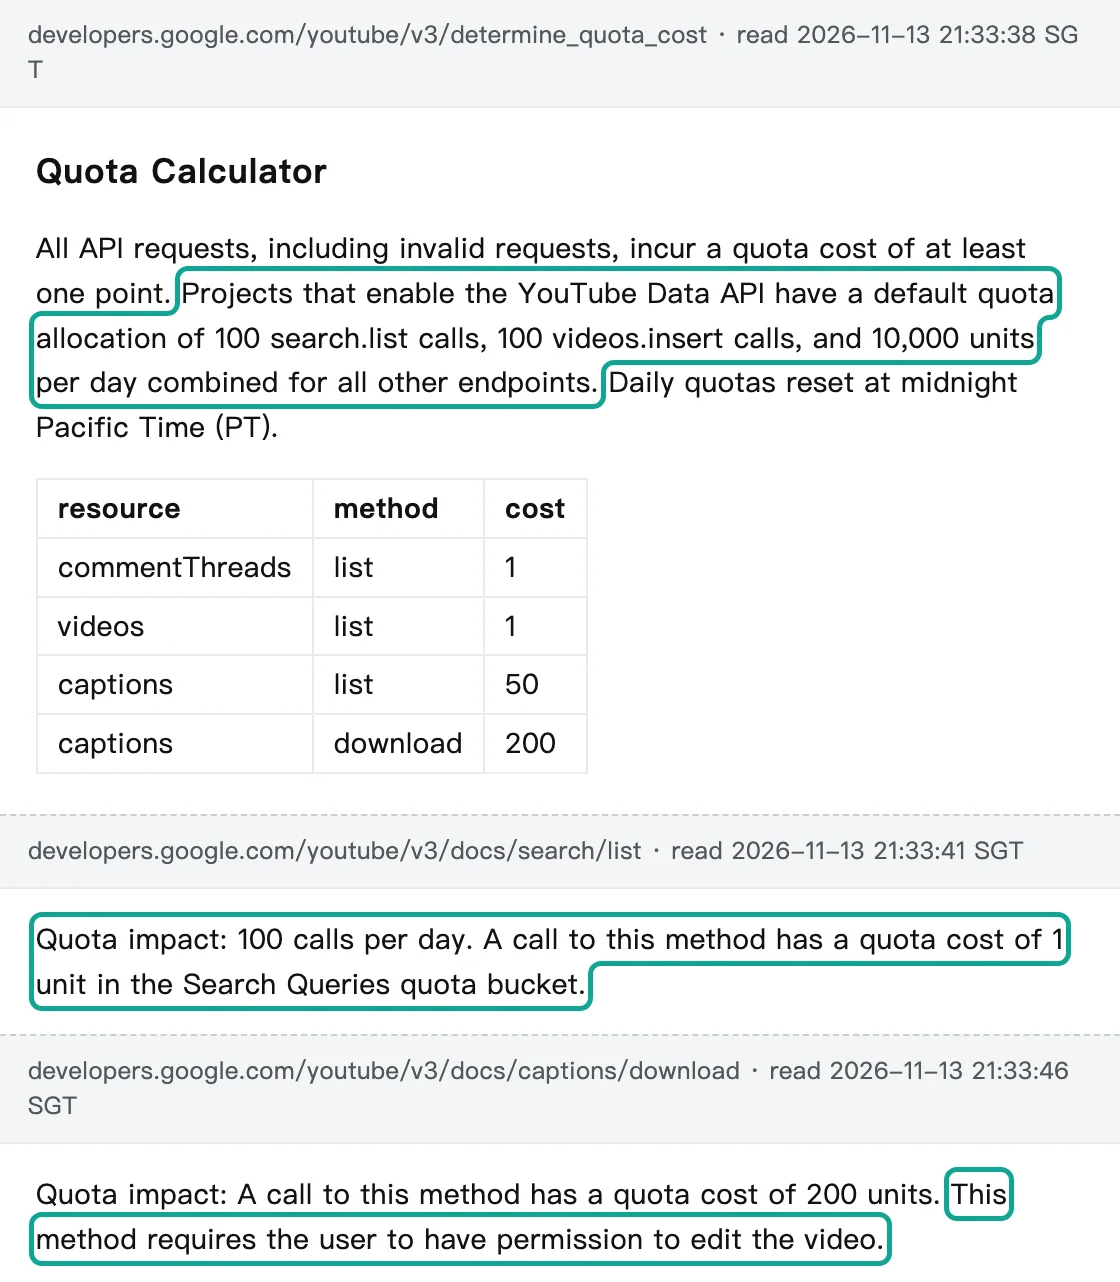
Los tres techos suponen páginas llenas. La propia página de search.list avisa de que la API puede devolver menos elementos que maxResults por ordenación o filtrado interno, y pide que te guíes por nextPageToken. Así que 5.000 es un techo, y el número real es menor.
Un resultado de búsqueda trae el ID del vídeo y un fragmento corto. Para las visitas y los «me gusta» llamas otra vez a videos.list. Un script real gasta dos cuotas a la vez: llamadas de búsqueda y unidades.
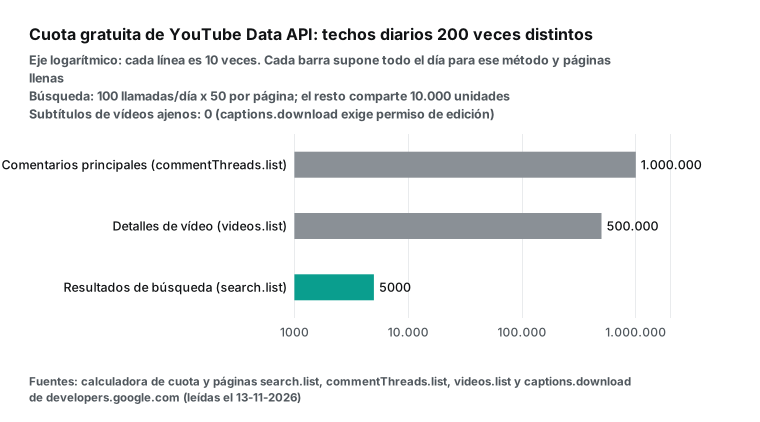
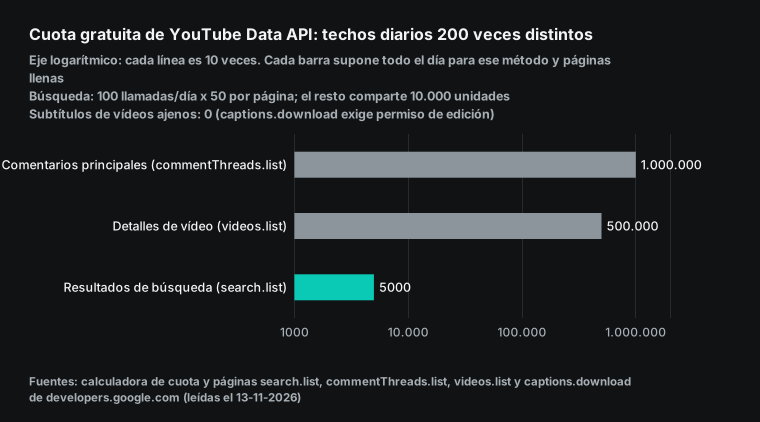
Las transcripciones no tienen barra en el gráfico porque valen cero. captions.list cuesta 50 unidades y solo devuelve la lista de pistas, no el texto. captions.download cuesta 200 unidades, y la página dice que el método exige que el usuario tenga permiso para editar el vídeo. Hay que llamarlo con OAuth como propietario. Para analizar opiniones sobre un curso o estudiar a la competencia, la vía oficial da títulos, descripciones, estadísticas y comentarios, pero no lo que dice quien habla en el vídeo.
La ayuda de YouTube explica que los subtítulos automáticos salen del reconocimiento de voz y que su calidad varía con el acento y el audio (Usar subtítulos automáticos). Eso vale para cualquier vía: revisa a mano una muestra de toda transcripción que consigas.
| Método oficial | Unidades por llamada | Límite por página | Techo diario con la cuota por defecto | ¿Vídeos ajenos? |
|---|---|---|---|---|
search.list | Cuota propia, 1 llamada | 50 filas (5 por defecto) | 100 × 50 = 5.000 filas | Sí |
videos.list | 1 | 50 ID | 10.000 × 50 = 500.000 | Sí |
commentThreads.list | 1 | 100 filas (20 por defecto) | 10.000 × 100 = 1.000.000 | Sí |
comments.list (respuestas) | 1 | 100 filas | Comparte las 10.000 unidades | Sí |
captions.list | 50 | Lista de pistas | 200 llamadas | Solo lista pistas |
captions.download | 200 | Una pista | 50 llamadas | No, exige permiso de edición |
Cuando la cuota no alcanza, Google ofrece el formulario de ampliación de cuota y una auditoría de cumplimiento. La auditoría revisa cómo muestra y guarda datos tu aplicación según las Developer Policies. Para análisis de datos importan sobre todo dos cláusulas. Una limita a 30 días el tiempo que puedes guardar datos no autorizados, como estadísticas; pasado ese plazo hay que borrarlos o refrescarlos. La otra se titula «Scraping» y dice que los clientes de la API no deben hacer scraping de YouTube ni obtener datos de YouTube conseguidos así.
Esa cláusula se aplica al cliente de API que registraste en Google. Si tu proyecto combina la API oficial con una API de datos de terceros, lee el texto pensando en tu caso y consulta con tu equipo legal si hace falta. Aquí no damos una respuesta jurídica.
La lista de precios de la tikhub youtube api, endpoint por endpoint
La ruta del endpoint de precios de TikHub es /api/v1/tikhub/user/get_all_endpoints_info. Enviamos un GET sin clave a las 21:32:42, hora de Singapur, del 13-11-2026. Respondió HTTP 200 con una lista de 1.482 filas, y en la respuesta el servidor marcaba las 05:32:42, hora de Los Ángeles. Nuestro artículo Precios de TikHub explicados contó 1.470 filas el 01-11-2026, y el de alternativa a la API de Twitter de TikHub contó 1.481 el 11-11-2026. La lista no para de crecer, así que las cifras siguientes valen solo para la copia del 13 de noviembre.
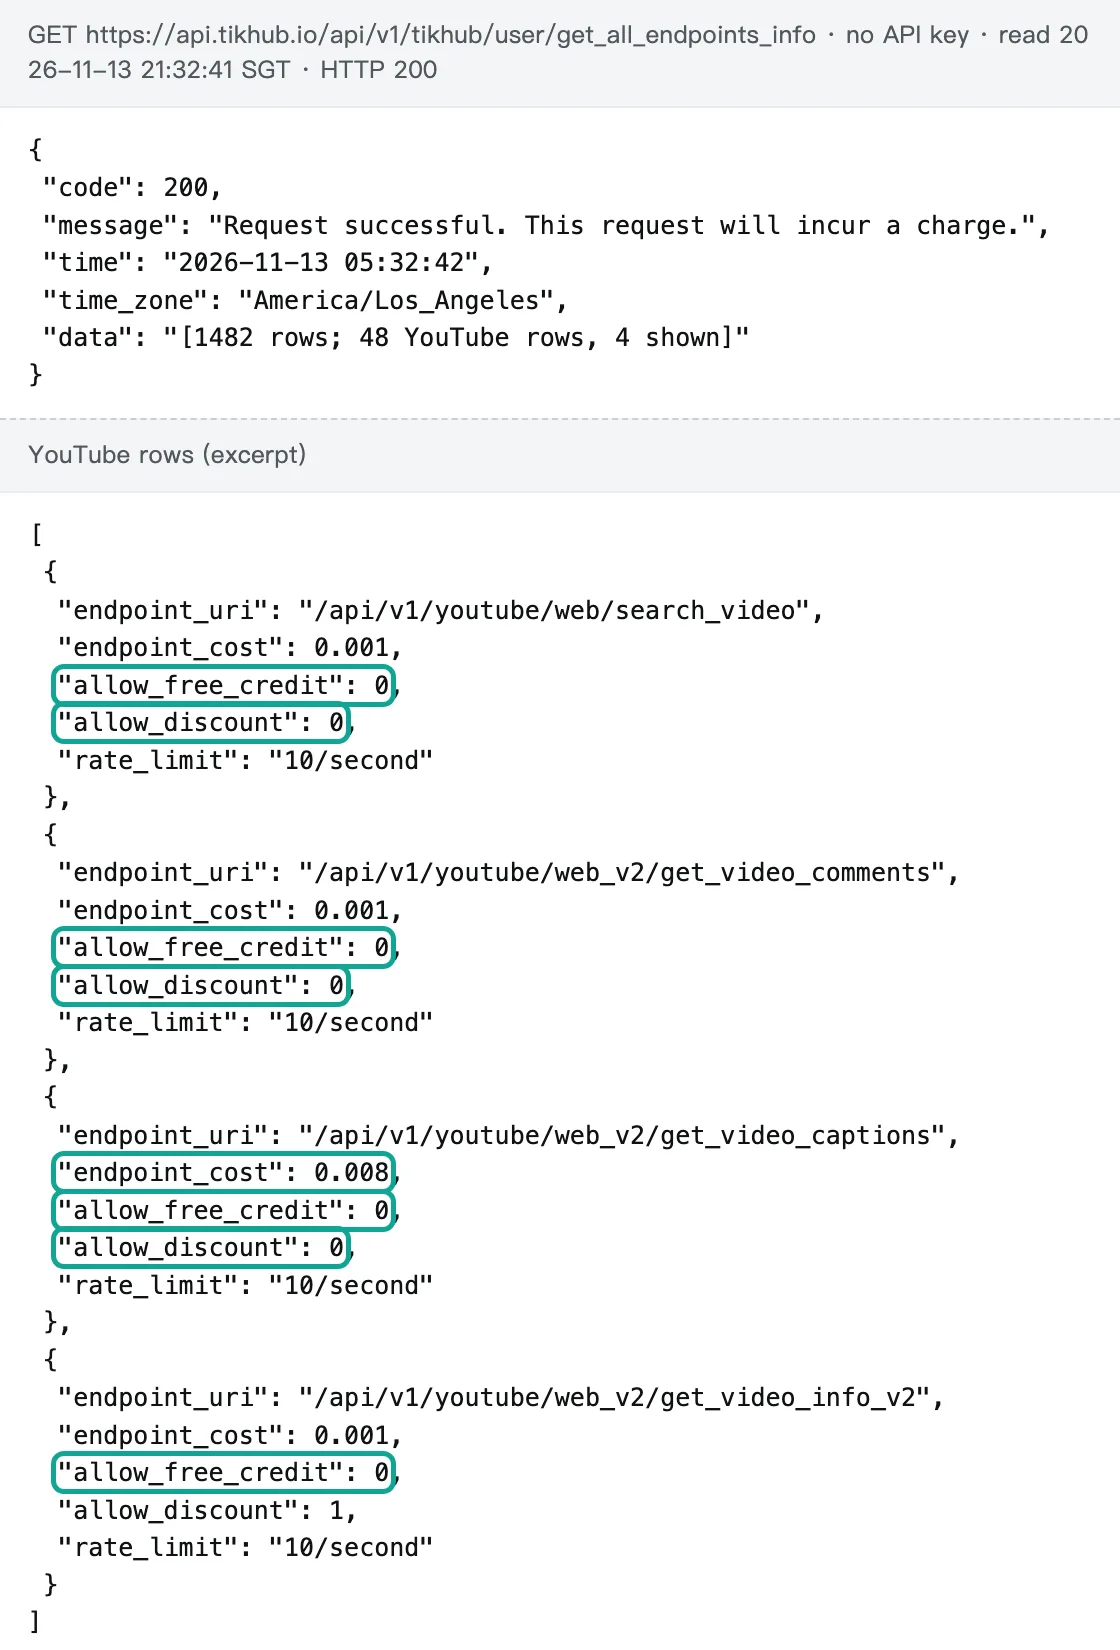
Las 48 filas de YouTube cuelgan de dos grupos, /api/v1/youtube/web/ y /api/v1/youtube/web_v2/. Contamos cuatro campos. En precio, endpoint_cost es 0,001 USD en 38 endpoints y 0,002 USD en 5; hay uno de 0,003 USD, uno de 0,004 USD, uno de 0,008 USD, uno de 0,03 USD y uno gratuito. En velocidad, rate_limit marca 10 por segundo en 46 endpoints; get_video_comments_v2 permite 4 por segundo y el endpoint de resultado de subtítulos marca 2.
Solo 6 endpoints aceptan crédito gratuito (allow_free_credit), y son auxiliares: búsqueda de ID de canal, URL de canal, sugerencias de búsqueda y detalle de vídeo v2. Solo 1 recibe el descuento por tramos (allow_discount): web_v2/get_video_info_v2.
Por tanto, los tramos de la página de precios no se aplican a la búsqueda, los comentarios ni los subtítulos de YouTube. Esos tramos dan un 10 % de descuento desde 1.000 llamadas diarias y un 50 % por encima de 30.000. El crédito de alta de 0,05 USD tampoco sirve para esos tres grupos. Para probar los comentarios de YouTube de TikHub desde Python hay que recargar antes al menos 5 USD. Con PayPal, 5 USD salen por 5,55 USD, y sus preguntas frecuentes lo dicen tal cual. Alipay suma un 2,6 % más 0,30 USD, y USDT un 5 % más 0,30 USD.
| Uso | Endpoint de TikHub (nombre en la lista de precios) | Precio | Crédito gratuito | Descuento por tramos | En la documentación pública |
|---|---|---|---|---|---|
| Búsqueda de vídeos | web/search_video | 0,001 USD | No | No | Sí |
| Búsqueda general V2 (limpia) | web_v2/get_general_search_v2 | 0,002 USD | No | No | Sí |
| Detalle de vídeo | web_v2/get_video_info | 0,001 USD | No | No | Sí |
| Detalle de vídeo V2 | web_v2/get_video_info_v2 | 0,001 USD | No | Sí | Sí |
| Comentarios principales | web_v2/get_video_comments | 0,001 USD | No | No | Sí |
| Respuestas | web_v2/get_video_comment_replies | 0,001 USD | No | No | Sí |
| Subtítulos | web_v2/get_video_captions | 0,008 USD | No | No | Sí |
| Subtítulos V2 | web_v2/get_video_captions_v2 | 0,001 USD | No | No | No |
| Vídeos del canal | web_v2/get_channel_videos | 0,001 USD | No | No | Sí |
| Shorts del canal | web_v2/get_channel_shorts | 0,001 USD | No | No | Sí |
| Correo del canal | web/get_channel_email | 0,03 USD | No | No | No |
La última columna la construimos cruzando la lista de precios con openapi.json, versión V5.3.2, ruta por ruta. El archivo openapi tiene 34 rutas de YouTube y la lista de precios tiene 48. Eso deja 14 endpoints con precio pero sin documentación pública, entre ellos get_video_captions_v2 a 0,001 USD, get_channel_email a 0,03 USD y los endpoints antiguos de comentarios v1. Un desarrollador de Python solo puede llamar a lo que describe la documentación, y openapi.json no trae los parámetros de la fila más barata, Subtítulos V2.
La documentación del endpoint de subtítulos tiene otra línea que conviene leer despacio. Cuando un vídeo no tiene subtítulos, get_video_captions responde HTTP 200 con el mensaje «No transcript is available for this video», y la documentación añade que se factura como siempre, a 0,008 USD. Los vídeos largos se convierten en una tarea asíncrona, que consultas con el job_id en el endpoint gratuito get_video_captions_result. Sus preguntas frecuentes dicen que una petición se cobra cuando devuelve 200 y que las fallidas no se cobran. Juntando las dos cosas, un vídeo sin subtítulos cuenta como éxito: si algunas clases de un curso no tienen subtítulos, pagas 0,008 USD por cada una igualmente.
tikhub youtube api python: cómo es el código en cada vía
Los tres scripts comparten estructura: leen una clave, envían una petición, recorren las páginas y guardan JSON. Se diferencian en tres puntos: cómo te autentificas, cómo paginas y si el paso de la transcripción funciona o no. La vía oficial usa google-api-python-client de Google; la versión 2.202.0 salió el 10-11-2026 (PyPI). TikHub tiene su propio SDK de Python (tikhub 2.2.0 en PyPI, del 3 de octubre de 2026), y también puedes hacer un GET con requests. EveryInfra tiene una sola dirección POST, y nuestro script solo usa requests. Los tres leen la clave de una variable de entorno con os.environ de Python, y ninguno la escribe en un archivo.
El bloque oficial de abajo saca todos los comentarios principales de un vídeo. La configuración sigue la guía rápida de Python de Google. La clave de API se crea en la consola de Google Cloud (claves de API), y la paginación usa nextPageToken (guía de paginación). Es un ejemplo de configuración que no ejecutamos en esta prueba; el recuento de unidades sigue la documentación.
# Ejemplo de configuración: YouTube Data API v3 oficial (pip install google-api-python-client)
import os
from googleapiclient.discovery import build

yt = build("youtube", "v3", developerKey=os.environ["YOUTUBE_API_KEY"])

def todos_los_comentarios(video_id):
    filas, token, unidades = [], None, 0
    while True:
        resp = yt.commentThreads().list(
            part="snippet", videoId=video_id, maxResults=100,
            order="relevance", textFormat="plainText", pageToken=token,
        ).execute()
        unidades += 1                   # 1 unidad por página
        for item in resp["items"]:
            s = item["snippet"]["topLevelComment"]["snippet"]
            filas.append({"texto": s["textOriginal"], "likes": s["likeCount"],
                          "publicado": s["publishedAt"]})
        token = resp.get("nextPageToken")
        if not token:
            return filas, unidades
La vía de TikHub sigue los parámetros de get_video_comments en su openapi.json. El parámetro de paginación es continuation_token. Por defecto, need_format=true devuelve campos limpios, y published_time es un tiempo relativo como «hace 1 día». Este bloque también es un ejemplo de configuración sin ejecutar, porque no abrimos cuentas en la otra empresa. Los 0,001 USD por llamada son precio de tarifa.
# Ejemplo de configuración: endpoint de comentarios web_v2 de TikHub (según openapi.json, sin ejecutar)
import os, requests

H = {"Authorization": f"Bearer {os.environ['TIKHUB_API_KEY']}"}
URL = "https://api.tikhub.io/api/v1/youtube/web_v2/get_video_comments"

def comentarios(video_id, paginas=5):
    filas, token = [], None
    for _ in range(paginas):            # 0,001 USD por página; filas por página no publicadas
        params = {"video_id": video_id, "sort_by": "top", "language_code": "es-ES"}
        if token:
            params["continuation_token"] = token
        data = requests.get(URL, headers=H, params=params, timeout=60).json()["data"]
        filas += data.get("comments", [])
        token = data.get("continuation_token")
        if not token:
            break
    return filas
La vía de EveryInfra recorre la cadena completa «búsqueda, vídeo, comentarios, transcripción». Es el script que usamos en las tres rondas reales, y guardó cada respuesta en bruto. Necesita requests (2.34.2 en PyPI) y el módulo estándar zoneinfo. Cada paso es un POST con "platform":"youtube" y el nombre de la capacidad, con los parámetros dentro de params. Una petición lenta responde status: running con un poll_url, y el script lo consulta hasta tener el resultado. Ante un HTTP 429, espera lo que diga Retry-After.
"""YouTube search -> video -> comments -> transcript with the EveryInfra API.

Usage:
    export EVERYINFRA_API_KEY=...        # never hard-code the key
    python3 yt_chain.py "cs50 python lecture" out_dir

Each step is one POST /api/v1/social call. The script saves every raw
response to out_dir and prints rows returned and USD charged per step.
"""
import json
import os
import sys
import time
from datetime import datetime
from zoneinfo import ZoneInfo

import requests

API = "https://api.everyinfra.com/api/v1/social"
KEY = os.environ["EVERYINFRA_API_KEY"]
SGT = ZoneInfo("Asia/Singapore")
session = requests.Session()
session.headers.update({"Authorization": f"Bearer {KEY}", "User-Agent": "yt-chain-example/1.0"})

def call(action, params, out_dir, tag):
    body = {"platform": "youtube", "action": action, "params": params}
    for attempt in range(4):
        started = datetime.now(SGT).strftime("%Y-%m-%d %H:%M:%S")
        r = session.post(API, json=body, timeout=120)
        if r.status_code == 429:  # rate limit: wait and try again
            time.sleep(int(r.headers.get("Retry-After", 60)))
            continue
        break
    data = r.json()
    # slow jobs answer with status=running and a poll_url
    while isinstance(data, dict) and data.get("status") == "running" and data.get("poll_url"):
        time.sleep(5)
        poll = data["poll_url"]
        if poll.startswith("/"):
            poll = "https://api.everyinfra.com" + poll
        data = session.get(poll, timeout=60).json()
    with open(os.path.join(out_dir, f"{tag}_{action}.json"), "w", encoding="utf-8") as f:
        json.dump({"sgt": started, "http": r.status_code, "request": body, "response": data}, f, ensure_ascii=False, indent=1)
    results = data.get("results") if isinstance(data, dict) else None
    rows = len(results) if isinstance(results, list) else (1 if isinstance(results, dict) else 0)
    charged = (data.get("billing") or {}).get("charged_usd", 0) if isinstance(data, dict) else 0
    err = (data.get("error") or {}).get("code") if isinstance(data, dict) and isinstance(data.get("error"), dict) else None
    print(f"{started} SGT  youtube/{action:<10} http={r.status_code} rows={rows:<4} charged_usd={charged} error={err}")
    return data, rows, charged

def main():
    keyword, out_dir = sys.argv[1], sys.argv[2]
    tag = sys.argv[3] if len(sys.argv) > 3 else "r"
    os.makedirs(out_dir, exist_ok=True)
    total, rows_total = 0.0, 0

    found, n, c = call("search", {"keyword": keyword, "limit": 20}, out_dir, tag)
    total, rows_total = total + c, rows_total + n
    videos = [v for v in found.get("results", []) if v.get("comment_count")]
    if not videos:
        sys.exit("no video with comments in the search results")
    url = videos[0]["url"]
    time.sleep(7)

    for action, params in (
        ("video", {"url": url}),
        ("comments", {"url": url, "sort": "popular", "limit": 40}),
        ("transcript", {"url": url, "language": "en"}),
    ):
        _, n, c = call(action, params, out_dir, tag)
        total, rows_total = total + c, rows_total + n
        time.sleep(7)

    print(f"video={url} rows={rows_total} total_usd={round(total, 6)}")

if __name__ == "__main__":
    main()
Los tres se autentifican con una sola cabecera. Donde más difieren es en la paginación. La API oficial da nextPageToken y TikHub da continuation_token; en ambos casos escribes tú el bucle y cuentas las páginas que pagas. En EveryInfra, youtube/search y youtube/comments reciben un limit y devuelven las filas en una sola llamada; el catálogo indica el rango admitido de cada parámetro. No hay parámetro de paginación, y se cobra por llamada, no por página. Para conseguir más comentarios de los que trae una llamada, pide una vez con sort en popular y otra en newest, o corta por fecha con since, y quita duplicados por id.
Mapa de campos: un mismo comentario, tres formas
Cada vía nombra y da formato a «un comentario» a su manera, y los cruzamos campo por campo. Las fuentes oficiales son el recurso comments y el recurso commentThreads. Las otras dos son el ejemplo de get_video_comments en el openapi.json de TikHub y los response_fields de youtube/comments en nuestro catálogo. La columna de TikHub sale de su ejemplo documentado, no de llamadas nuestras.
| Significado | Data API oficial | TikHub `get_video_comments` (ejemplo de la documentación) | EveryInfra `youtube/comments` |
|---|---|---|---|
| ID del comentario | id | comment_id | id |
| Texto | textOriginal, textDisplay | content | text |
| Autor | authorDisplayName | author.display_name | author_name |
| Fecha de publicación | publishedAt (ISO 8601) | published_time (relativa, como «hace 1 día») | posted_at |
| «Me gusta» | likeCount (entero) | like_count (texto, como "2") | Los más valorados con sort: popular; el total del vídeo está en youtube/video |
| Respuestas | totalReplyCount, parentId | reply_count (texto), reply_level | is_reply, reply_to_id |
| Imagen en el comentario | imageUrl (añadido en septiembre de 2026) | No aparece en la documentación | No está en el catálogo |
En la fecha, la API oficial da una marca ISO al segundo y el ejemplo de TikHub muestra fechas relativas como «hace 1 día». Para una serie temporal del tipo «qué semana tras el estreno tuvo más comentarios», la marca oficial es mejor fuente. En los «me gusta», el valor oficial es un entero y el del ejemplo de TikHub es un texto que hay que convertir.
En las respuestas, la vía oficial pide una llamada aparte a comments.list por parentId, y este artículo prueba esa paginación en dos niveles. Los 89 comentarios que devolvieron nuestras tres rondas eran principales (is_reply fue false en todas las filas).
Para una investigación seria sobre un curso, la tabla deja clara una combinación segura. Usa la API oficial para el texto, la fecha y los «me gusta» de los comentarios. Usa una vía que lea vídeos ajenos para las transcripciones. Y une ambas por el ID del vídeo. El id oficial del comentario y el que devolvemos nosotros son el mismo identificador de YouTube, así que casan directamente; comprueba unas cuantas filas antes de dar por hecho que el comment_id de TikHub usa los mismos.
Prueba real: la misma cadena a las 21:35, 21:42 y 21:48
Cada ronda usó la palabra clave de un curso público distinto. El script escogió el primer resultado con comentarios y pidió su detalle, sus comentarios y su transcripción. El dinero sale de billing.charged_usd en cada respuesta y las filas, de la longitud de results. Guardamos cada respuesta en bruto.
| Ronda (hora de Singapur) | Palabra clave | Vídeo elegido | Búsqueda | Detalle | Comentarios | Transcripción |
|---|---|---|---|---|---|---|
| 21:35 | cs50 python lecture | Curso completo CS50P, resubido por freeCodeCamp, 15 h 57 min, 9.529.399 visitas, 5.433 comentarios | 20 filas, 0,000778 USD | 1, 0,000556 USD | 40 filas, 0,000556 USD | Devuelta a las 22:32, 24.851 segmentos, 0,000556 USD |
| 21:42 | mit 6.100L python lecture | MIT OCW 6.100L, clase 2, 1 h 18 min, 411.084 visitas, 259 comentarios | 20 filas, 0,000778 USD | 1, 0,000556 USD | 40 filas, 0,000556 USD | Devuelta a las 22:31, 1.721 segmentos, 0,000556 USD |
| 21:48 | khan academy statistics | Presentación de estadística de Khan Academy, 1 min 36 s, 33.096 visitas, 9 comentarios | 20 filas, 0,000778 USD | 1, 0,000556 USD | 9 filas, 0,000556 USD | Devuelta a las 22:31, 47 segmentos, 0,000556 USD |
Cada búsqueda devolvió 20 filas. En la primera ronda, el canal cs50 ocupó 13 de los 20 resultados, 11 de ellos clases de CS50P. Dos cursos completos resubidos por freeCodeCamp quedaron primero y tercero, y el resultado 8 fue la clase 1 de MIT OCW 6.100L. La segunda ronda contó otra historia. El canal mitocw solo tuvo 6 de los 20 resultados. Los otros 14 eran de un mismo canal de resubidas, cada uno con menos de 100 visitas y casi todos subidos el 28-10-2026, así que la mediana de visitas de esas 20 filas fue 17. En la tercera ronda, los 20 resultados eran del canal khanacademy, subidos entre 2009 y 2020, con una mediana de unos 1,04 millones de visitas.
Para investigar un curso, filtra las resubidas por author_username o author_id. Si no, los comentarios de un mismo curso se reparten entre dos sitios y las copias con pocas visitas diluyen la muestra. Nosotros listamos primero el author_id de los canales oficiales del curso, nos quedamos solo con sus vídeos y guardamos el resto aparte. Para el número de suscriptores está youtube/profile: el catálogo lo incluye, pero no lo probamos en esta prueba.
En la columna de comentarios, en la tercera ronda youtube/video dio un comment_count de 9 para el vídeo de Khan Academy, y youtube/comments devolvió esta vez exactamente 9 filas. Las dos primeras llamadas devolvieron 40 filas cada una, todas de comentarios principales. Para reunir más en un vídeo con muchos comentarios, pide una vez con popular y otra con newest, o reparte por fechas con since, y quita duplicados por id.
El detalle de vídeo llegó en las tres rondas con 14 campos, y like_count, comment_count y view_count vienen como enteros, así que sirven como denominador.
| Vídeo | Visitas | «Me gusta» / visitas | Comentarios por cada 10.000 visitas |
|---|---|---|---|
| Curso completo CS50P | 9.529.399 | 2,5 % | 5,7 |
| MIT 6.100L, clase 2 | 411.084 | 1,5 % | 6,3 |
| Presentación de Khan Academy | 33.096 | 0,3 % | 2,7 |
Son solo tres vídeos: sirven como ejemplo de qué calcular primero, no para comparar la calidad docente de tres instituciones.
Las 60 filas de búsqueda merecen una primera criba, porque las tres rondas son muy distintas. En la ronda de cs50, la mediana de duración es de 99 minutos y 15 de los 20 vídeos pasan de una hora; el más largo dura 24,5 horas, y los 20 tienen comentarios, 16.375 en total. En la de MIT, la mediana es de 63,5 minutos y 11 vídeos pasan de una hora, pero solo 6 tienen comentarios; los 3 primeros reúnen el 90,8 % de las visitas de la ronda, y casi todo lo demás son las resubidas. En la de Khan Academy, la mediana es de 9,1 minutos, ninguno pasa de una hora, 18 tienen comentarios y las visitas están repartidas: los 3 primeros solo suman el 40,6 %.
| Ronda | Mediana de duración | Más de 1 hora | Vídeos con comentarios | Comentarios en total | Visitas de los 3 primeros | Comentarios por cada 10.000 visitas (mediana) |
|---|---|---|---|---|---|---|
| cs50 python lecture | 99,0 min | 15 / 20 | 20 | 16.375 | 56,2 % | 5,0 |
| mit 6.100L python lecture | 63,5 min | 11 / 20 | 6 | 1.719 | 90,8 % | 5,9 |
| khan academy statistics | 9,1 min | 0 / 20 | 18 | 5.750 | 40,6 % | 2,1 |
Este reparto indica dónde rinde más el dinero. La transcripción se cobra por llamada: en un curso largo como el de cs50, una llamada de 0,000556 USD trae horas de clase, y en un vídeo corto de Khan el mismo precio trae unos cientos de palabras. Antes de lanzar un lote, ordena las filas de búsqueda por duration y comment_count, no pidas youtube/comments en vídeos sin comentarios y salta en bloque los canales de resubidas. En la ronda de MIT, pedir comentarios solo de los 6 vídeos que los tienen deja 20 llamadas en 6.
Las llamadas de transcripción devolvieron 503 las primeras veces, sin cargo, y funcionaron al reintentar con retry_after. Otra llamada fue a propósito: una búsqueda sin clave devolvió 401 a 0 USD. Todas las llamadas reales de este artículo costaron 0,007338 USD, que es justo la suma de las 12 llamadas correctas: 3 × 0,000778 USD + 9 × 0,000556 USD.
Coste por cada 1.000 filas: dónde está la diferencia
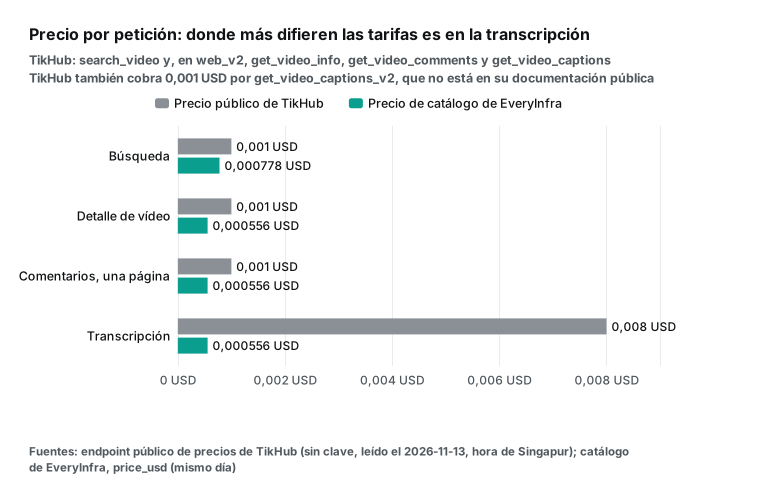
Cuando se cobra por llamada, el precio es solo la mitad de la factura; la otra mitad es cuántas filas trae cada llamada. Por nuestra parte usamos «importe cobrado dividido entre filas devueltas, por 1.000». Tres búsquedas trajeron 60 filas por 0,002334 USD, es decir, 0,0389 USD por cada 1.000. En comentarios usamos las dos llamadas con página llena: 80 filas por 0,001112 USD, o 0,0139 USD por cada 1.000. Con las tres llamadas salen 89 filas y 0,0187 USD por cada 1.000, porque el vídeo de Khan solo tiene 9 comentarios. El detalle de vídeo y la transcripción devuelven un elemento por llamada, así que el coste por cada 1.000 vídeos es el precio por 1.000.
Ni el openapi.json ni la lista de precios de TikHub dicen cuántas filas devuelve una página de búsqueda o de comentarios, así que en esas dos partidas solo comparamos el precio por petición. Su coste por cada 1.000 filas es 1 USD dividido entre las filas por página, y esas filas hay que tomarlas de tus propias llamadas.
| Concepto | TikHub por llamada (tarifa) | EveryInfra por llamada (cobrado) | Relación de precio por llamada | Por 1.000, EveryInfra (cobrado ÷ filas devueltas) | Por 1.000, TikHub |
|---|---|---|---|---|---|
| Resultados de búsqueda | 0,001 USD | 0,000778 USD, esta vez 20 filas por llamada | 1,3 | 0,0389 USD (3 llamadas, 60 filas, 0,002334 USD) | 1 USD ÷ filas por página (no publicado) |
| Comentarios | 0,001 USD por página | 0,000556 USD, 40 filas en cada una de dos llamadas | 1,8 | 0,0139 USD (2 llamadas, 80 filas, 0,001112 USD) | 1 USD ÷ filas por página (no publicado) |
| Detalle de vídeo | 0,001 USD | 0,000556 USD | 1,8 | 0,556 USD | 1,00 USD |
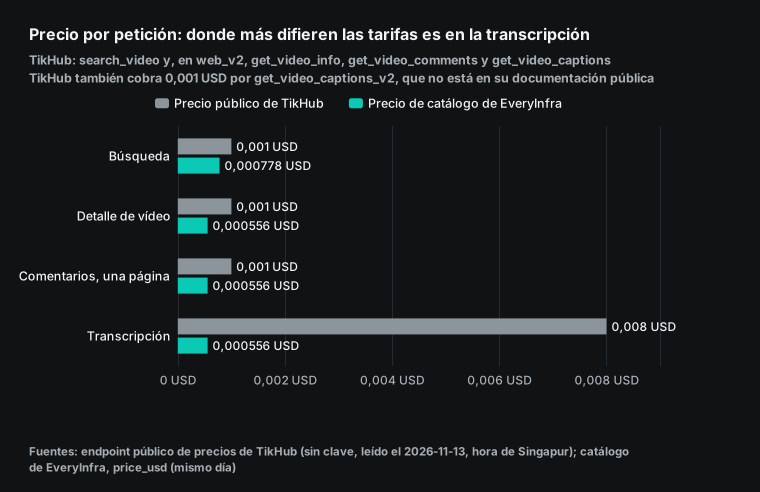
| Transcripciones | 0,008 USD (V2 0,001 USD) | 0,000556 USD, 3 llamadas cobradas entre las 22:31 y las 22:32 | 14,4 (V2 1,8) | 0,556 USD | 8,00 USD (V2 1,00 USD) |
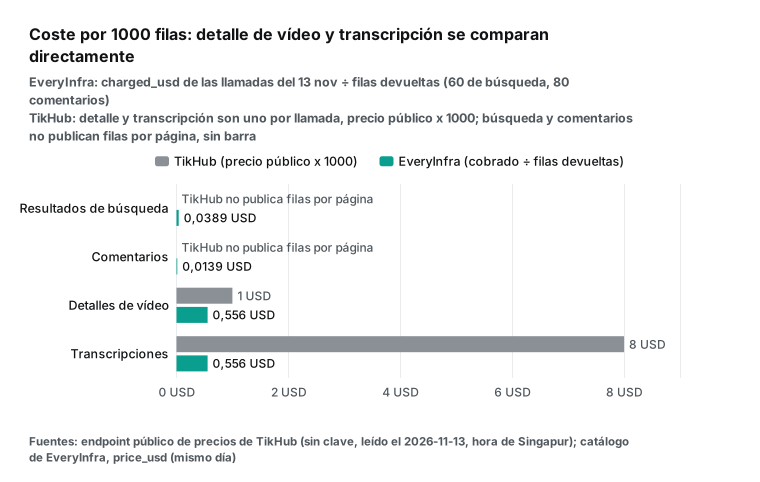
En búsqueda y comentarios, el coste por cada 1.000 filas depende del tamaño de página de TikHub. Con la fórmula de arriba, una página de búsqueda de TikHub con 26 filas o más sale por debajo de nuestros 0,0389 USD por cada 1.000; una de comentarios con 72 filas empata con nosotros, y con 73 o más sale más barata. El detalle de vídeo y la transcripción no tienen esa variable, porque cada llamada trae un elemento, así que la relación de precios es la relación de costes. La transcripción es donde más se separan: 0,008 USD frente a 0,000556 USD, 14,4 veces. En la fila de transcripciones, nuestro lado es lo cobrado en tres llamadas correctas y el de TikHub es tarifa. Las dos vías cobran por llamada, sin importar lo larga que sea la transcripción, así que cuanto más largo es el vídeo, menos cuesta cada palabra: la más larga de esta prueba, el curso completo de CS50P, dio 183.775 palabras por 0,000556 USD.
Fallos, resultados vacíos y reintentos: cómo los cobra cada vía
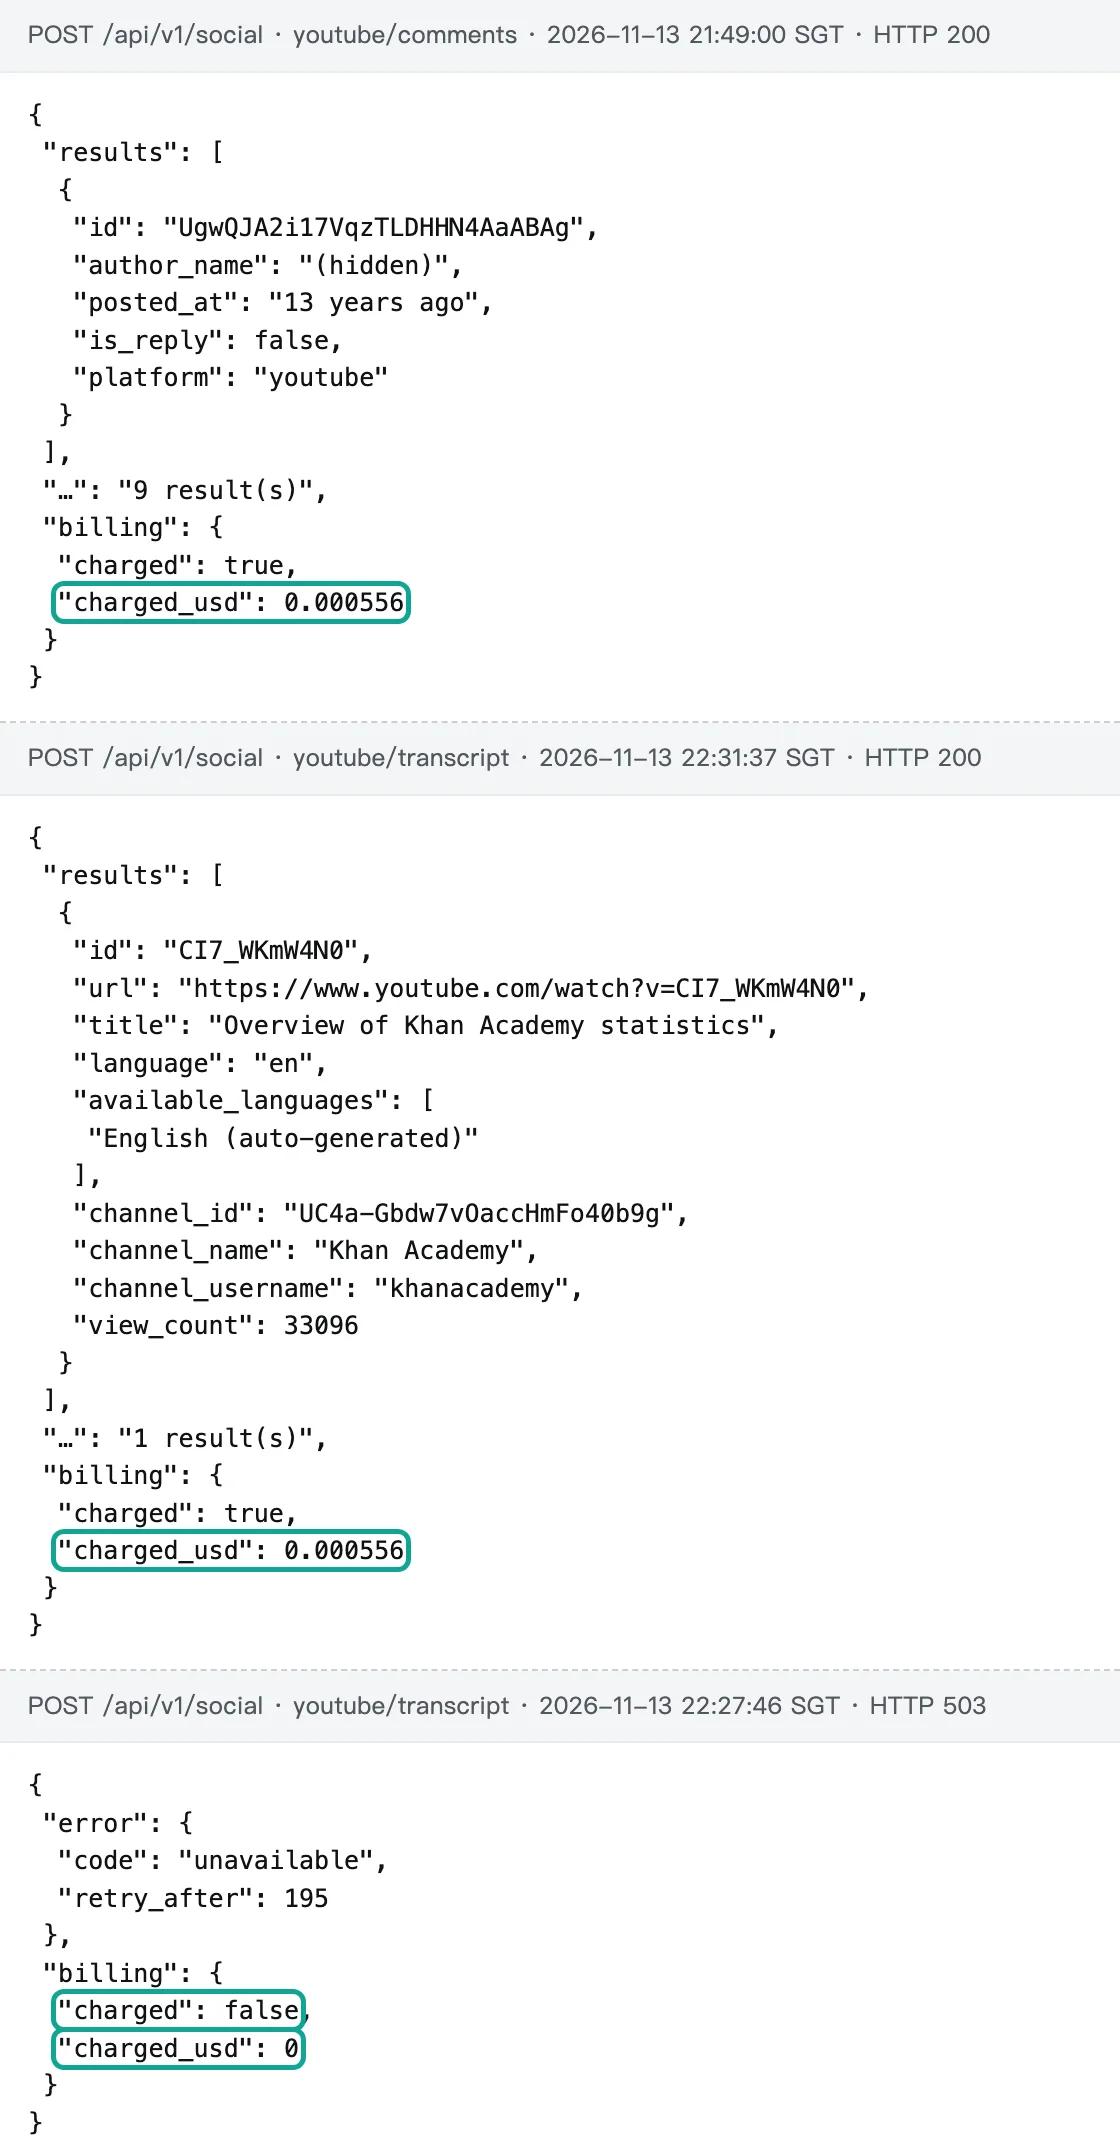
Cuando se cobra por llamada, la regla de los fallos fija lo que cuestan los reintentos, y las tres vías publican la suya. La Quota Calculator oficial dice que toda petición, incluida una no válida, cuesta al menos una unidad. Cuando se agota la cuota, la API devuelve 403 con quotaExceeded (lista de errores) y toca esperar a la medianoche del Pacífico. Las preguntas frecuentes de TikHub dicen que se cobra un 200 y no un fallo, y que las peticiones repetidas con parámetros idénticos se cobran cada una. Su documentación indica además que el endpoint de subtítulos devuelve 200 y cobra cuando el vídeo no tiene subtítulos. Por nuestra parte, los fallos y los resultados vacíos se reembolsan: la respuesta trae billing.charged en false y charged_usd a 0, como en el 503 de la captura de arriba.
| Caso | Data API oficial | TikHub (según sus preguntas frecuentes y documentación) | EveryInfra (según sus reglas de cobro y nuestras respuestas) |
|---|---|---|---|
| Petición no válida | Al menos 1 unidad | No se cobra | No se cobra |
| Cuota agotada o dato no disponible en ese momento | 403 quotaExceeded, esperar al reinicio | No lo indica | 503 con retry_after, no se cobra |
| Vídeo sin subtítulos | No aplica | HTTP 200, se cobran 0,008 USD | No se cobra |
| Misma petición dos veces | Cada una gasta unidades | Cada una se cobra | Repetida en 5 minutos devuelve 202 y no se cobra |
Escribe los reintentos según la regla. En la vía oficial, reintentar tras un error de cuota no sirve: el script debe contar las unidades del día y pararse antes. En TikHub puedes reintentar un error de red, pero evita dos llamadas idénticas, porque se cobran ambas. En EveryInfra, el cuerpo de un 503 trae retryable y retry_after: espera esos segundos antes de volver a enviar, y los intentos fallidos no cuestan nada. Nuestro script solo gestiona el 429. Para hacerlo más robusto, añade el 503: lee error.retry_after, espera y prueba dos o tres veces como mucho. Un último detalle: si repites el mismo cuerpo de petición en menos de 5 minutos, EveryInfra devuelve 202 con un aviso de repetición. No vuelve a cobrar, pero tampoco trae datos nuevos; para eso espera a que pase esa ventana o cambia algún parámetro.
Transcripciones: el paso donde más se separan las vías
Para valorar un curso, buscar dentro de las clases o auditar contenido, hace falta la transcripción. Un comentario dice «me perdí en el 25:30», y para actuar abres la transcripción y lees qué dijo la persona en el 25:30. La API oficial no lee transcripciones de vídeos ajenos, como vimos. La comunidad de Python suele usar la librería abierta youtube-transcript-api, que lee los subtítulos desde la página web; la versión 1.2.5 salió el 05-11-2026 (PyPI). Su README tiene una sección que explica que YouTube ha empezado a bloquear la mayoría de las IP de proveedores de nube, de modo que el código desplegado en un servidor en la nube suele acabar en RequestBlocked o IpBlocked.
yt-dlp también descarga archivos de subtítulos; la versión estable más reciente es la 2026.10.26, del 26-10-2026. Las dos herramientas son gratuitas y de código abierto, pero la estabilidad y las IP corren de tu cuenta.
El endpoint de subtítulos de TikHub cuesta 0,008 USD por llamada y cobra los vídeos sin subtítulos; los vídeos largos se convierten en tareas asíncronas que hay que consultar. Su lista de precios incluye además get_video_captions_v2 a 0,001 USD por llamada, pero openapi.json no documenta sus parámetros. El youtube/transcript de EveryInfra cuesta 0,000556 USD por llamada. Devuelve text (texto completo), segments (tramos con inicio y fin), language y available_languages, y un fallo no cuesta nada. Las tres llamadas correctas trajeron cantidades muy distintas. El curso completo de CS50P dura 15 horas y 57 minutos: una llamada devolvió 24.851 segmentos y 183.775 palabras en inglés, y available_languages solo listaba inglés generado automáticamente. La clase 2 de MIT 6.100L dura 1 hora y 18 minutos y devolvió 1.721 segmentos y 12.593 palabras; tenía subtítulos subidos en inglés, subtítulos subidos en español e inglés automático, y el texto empieza con marcas de sonido como «[SQUEAKING]» o «[RUSTLING]», típicas de los subtítulos subidos. La presentación de Khan Academy dura 1 minuto y 36 segundos: 47 segmentos y 318 palabras, también solo en inglés automático.
Cada segmento tiene tres campos: start, duration y text. En los subtítulos automáticos los segmentos se solapan: el primero de CS50P empieza en 0,16 segundos y dura 4,6, pero el segundo ya empieza en 2,44. Por eso, al casar comentarios con segmentos, usa solo start y no tomes start + duration como el final del tramo.
Cuánto se solapan depende del origen de los subtítulos. Comparamos todos los pares de segmentos vecinos de las tres transcripciones. CS50P y Khan Academy solo tienen subtítulos automáticos: en CS50P se solapan 24.807 de 24.850 pares (99,8 %), y en el vídeo de Khan, los 46. El texto de MIT lleva las marcas de sonido de los subtítulos subidos, y solo se solapan 204 de sus 1.720 pares (11,9 %). Es decir, en los subtítulos automáticos un «segmento» funciona como una ventana deslizante, y en los subidos se parece más a una frase. Contar segmentos como «frases que dijo el profesor» solo tiene sentido con subtítulos subidos; con los automáticos, cuenta palabras o corta por tiempo.
La longitud de la transcripción también fija el coste de lo que viene después. Calculamos el ritmo de habla como palabras divididas entre el final del último segmento. El curso de CS50P dura 957,7 minutos, a 191,9 palabras por minuto; la clase 2 de MIT, 78,9 minutos, a 159,7; el vídeo de Khan, 1,6 minutos, a 198,5. El text completo de CS50P tiene 947.499 caracteres, así que conviene partirlo por clase o capítulo antes de pasárselo a una herramienta de IA para resumirlo. Como las dos vías cobran por llamada y no por longitud, el coste por cada 1.000 palabras en inglés cambia mucho:
| Vídeo | Palabras en inglés | EveryInfra por 1.000 palabras (0,000556 USD ÷ palabras × 1.000) | TikHub `get_video_captions` por 1.000 palabras (0,008 USD ÷ palabras × 1.000) |
|---|---|---|---|
| Curso completo CS50P | 183.775 | 0,0000030 USD | 0,0000435 USD |
| MIT 6.100L, clase 2 | 12.593 | 0,0000442 USD | 0,000635 USD |
| Presentación de estadística de Khan Academy | 318 | 0,00175 USD | 0,0252 USD |
Comentarios y transcripciones también difieren mucho de tamaño. Los 40 comentarios que devolvió el vídeo de CS50P suman 4.047 palabras, con una mediana de 34 por comentario, y su transcripción tiene 183.775: 45 veces más. Los 40 comentarios de la clase 2 de MIT suman 1.743 palabras, con una mediana de 20, frente a 12.593 de transcripción, unas 7 veces más. Los 9 comentarios de Khan suman 117 palabras, con una mediana de 9, y la transcripción tiene 318, menos del triple. En los cursos largos, casi todo el coste del análisis está del lado de la transcripción: usa las marcas de tiempo de los comentarios para encontrar los tramos que se mencionan una y otra vez, y pasa al modelo solo esos tramos. Sale mucho más barato que el texto completo del curso, y una persona lo revisa con más facilidad. En los vídeos cortos, los dos textos son breves y se pueden leer juntos.
| Vídeo | Duración | Segmentos | Palabras en inglés | Subtítulos disponibles | Cobrado |
|---|---|---|---|---|---|
| Curso completo CS50P (freeCodeCamp) | 15:57:48 | 24.851 | 183.775 | Inglés automático | 0,000556 USD |
| MIT 6.100L, clase 2 | 1:18:58 | 1.721 | 12.593 | Inglés subido, español subido, inglés automático | 0,000556 USD |
| Presentación de estadística de Khan Academy | 1:36 | 47 | 318 | Inglés automático | 0,000556 USD |
| Cómo consigues la transcripción | Coste por llamada | Vídeos ajenos | Vídeo sin subtítulos | Lo que gestionas tú |
|---|---|---|---|---|
captions.download oficial | 200 unidades de cuota | No, exige permiso de edición | No aplica | OAuth y consentimiento del propietario |
| youtube-transcript-api o yt-dlp | 0 USD | Sí | Lanza una excepción | Bloqueos de IP, proxies, actualizaciones |
TikHub get_video_captions | 0,008 USD | Sí | HTTP 200, se cobra igual | Consulta asíncrona en vídeos largos |
EveryInfra youtube/transcript | 0,000556 USD | Sí | No se cobra si falla | Reintentar con retry_after si devuelve 503 |
Un ejemplo de otro campo: opiniones del público de clases abiertas a partir de comentarios y transcripciones
En investigación educativa ya se usan los comentarios de YouTube como opinión del alumnado. Chalkias y su equipo publicaron en 2023, en la revista Electronics, un estudio con 167.987 comentarios de canales educativos, reunidos con la YouTube Data API y Google Sheets. Hicieron análisis de sentimiento con dos métodos de léxico, VADER y TextBlob, y agruparon temas con LDA. Los comentarios neutros fueron el grupo mayor, seguidos de los positivos, y los negativos fueron los menos. Los comentarios mencionaban a menudo rasgos del vídeo como la animación, la música y el mensaje (Learning Analytics on YouTube Educational Videos). El estudio usó solo comentarios.
La transcripción añade un paso más: los comentarios que llevan una marca de tiempo se pueden casar con lo que se dijo en ese momento. Nuestras tres rondas de comentarios lo ilustran bien. De los 40 comentarios del curso completo CS50P, 10 llevaban marca de tiempo, pero 8 de esos 10 eran índices de capítulos o diarios de estudio que escribían los propios espectadores, del tipo «Day 2 - Completed till 1:20:00». Pocos apuntaban a una duda concreta.
De los 40 comentarios de la clase 2 de MIT 6.100L, 4 llevaban marca de tiempo, y 3 de ellos señalaban el tramo entre el 16:55 y el 25:43 dedicado al troceado de cadenas (slicing). Un espectador añadió en el 25:30 la expresión s[0:5][::-1]. La transcripción da contexto a esos comentarios. Hacia el 25:30, un estudiante pregunta en clase si, para incluir la letra A, el segundo valor debería ser -1; la profesora responde que -1 apunta al otro extremo y que tendría que probarlo, sin dar la sintaxis en ese momento. Los comentarios del 25:30 y del 25:43 aportan justo esa respuesta: uno propone s[0:5][::-1] y otro, dejar vacío el valor tras los dos puntos o usar -12. El del 16:55 corresponde al tramo, hacia el 16:40, sobre índices negativos y el error por salirse del rango, y el de «Skip --> 4:53» también encaja: hacia el 4:50 la profesora pasa al nuevo tipo de objeto, la cadena.
| Hora del comentario | Qué dice el comentario (resumen) | Qué dice la transcripción en ese tramo |
|---|---|---|
| 4:53 | Saltar a la parte de cadenas | Hacia el 4:50, la profesora empieza el nuevo tipo de objeto, la cadena |
| 16:55 | Explica la dirección de s[0] y s[-1] | Hacia el 16:40, índices negativos y el error por salirse del rango |
| 25:30 | Propone s[0:5][::-1] | Hacia el 25:25, un estudiante pregunta cómo incluir la A y la profesora tendría que probarlo |
| 25:43 | Valor vacío tras los dos puntos o -12 | La misma pregunta |
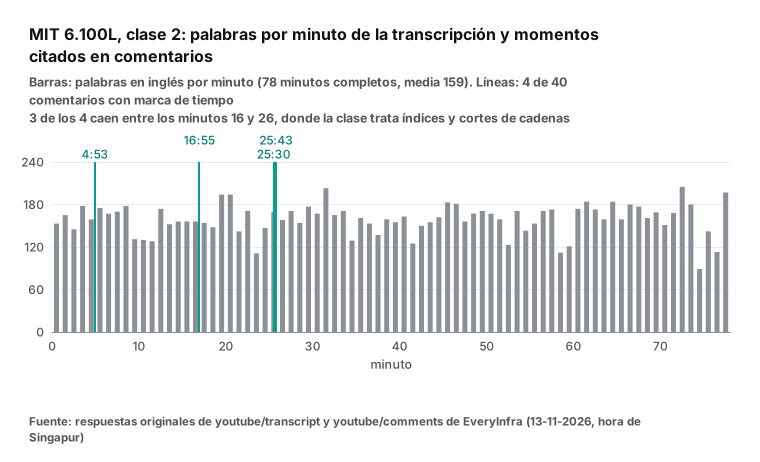
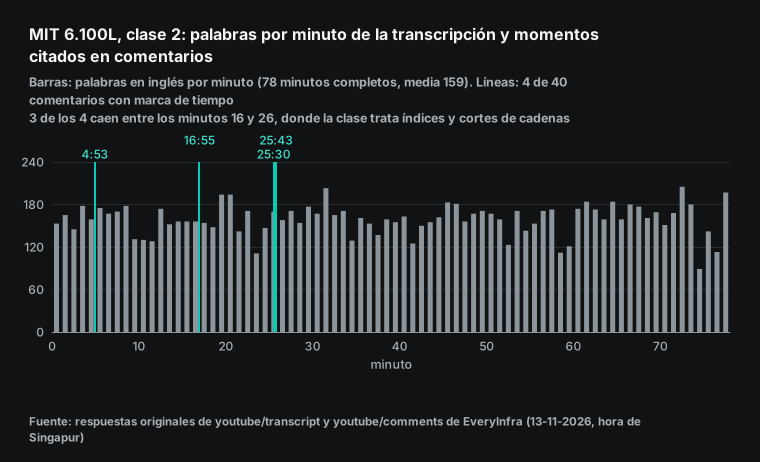
El gráfico corta la transcripción de MIT por minutos, entre 89 y 205 palabras cada uno, y marca encima las cuatro marcas de tiempo de los comentarios. En los 78,9 minutos la profesora no hace pausas claras, y los momentos citados no coinciden con tramos especialmente rápidos o lentos. Lo que sí se ve es la ubicación: 3 de los 4 comentarios caen en los 10 minutos que van del 16 al 26, dedicados a índices y troceado de cadenas. Cuatro comentarios con marca de tiempo son una muestra pequeña, así que el gráfico enseña un método, no un resultado: en un curso con cientos de comentarios con marca de tiempo, contar por minuto muestra qué tramos salen una y otra vez. En CS50P, 8 de los 10 comentarios con marca de tiempo eran índices de capítulos o diarios de estudio, así que antes de contar conviene descartar los comentarios que enumeran muchas marcas.
Los pasos siguientes describen solo el método y no usan datos personales. Primero, lista todas las clases de un curso con youtube/user_posts sobre la URL del canal y sort en newest, oldest o popular, (el catálogo incluye esta capacidad, pero no la probamos en esta prueba), o busca el nombre del curso con youtube/search, que sí probamos, y descarta los canales de resubidas. Segundo, llama una vez a youtube/video por clase y guarda visitas, «me gusta» y número de comentarios como cifras base. Tercero, llama a youtube/comments por clase; en los vídeos con muchos comentarios, pide popular y newest por separado y quita duplicados por id.
Cuarto, llama a youtube/transcript por clase y conserva el inicio y el fin de cada segments. Quinto, extrae las marcas de tiempo de los comentarios con una expresión regular y colócalas sobre los tramos de la transcripción; los comentarios sin marca van al análisis de sentimiento y de temas. Sexto, que una persona revise una muestra, porque los subtítulos automáticos tienen errores y los comentarios pueden ser irónicos. En el informe, oculta los nombres de autor y cita solo el canal y el número de clase. Archiva cada respuesta en bruto con su billing.charged_usd y calcula el coste como importe cobrado entre filas devueltas, para que otros puedan comprobarlo con los mismos archivos.
| Un curso abierto de 12 clases | Peticiones | TikHub (tarifa) | EveryInfra (catálogo) | API oficial |
|---|---|---|---|---|
| Buscar el nombre del curso una vez | 1 | 0,001 USD | 0,000778 USD | 1 llamada de búsqueda |
| Detalle de vídeo, 12 llamadas | 12 | 0,012 USD | 0,006672 USD | 12 unidades (o 1 en un lote) |
| Comentarios, 1 llamada por clase | 12 | 0,012 USD | 0,006672 USD | 12 unidades o más |
| Transcripciones, 1 llamada por clase | 12 | 0,096 USD (V2 0,012 USD) | 0,006672 USD | No disponible |
| Total | 37 | 0,121 USD (V2 0,037 USD) | 0,020794 USD | 24 unidades más 1 búsqueda, sin transcripciones |
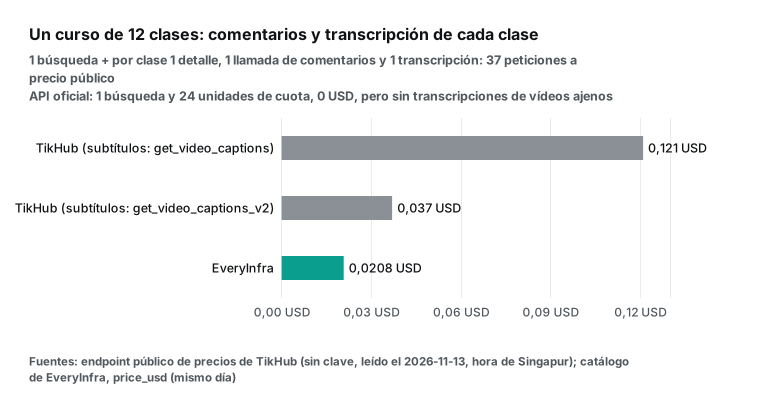
Esta cuenta tiene dos condiciones. La primera: pide los comentarios una vez por clase; un curso con muchos comentarios necesita más llamadas y el coste sube en las tres vías. La segunda: Subtítulos V2 de TikHub no está en la documentación pública, así que su total de 0,037 USD es solo una cifra de tarifa.
Para toda una biblioteca de cursos, basta multiplicar por el número de cursos. Con 100 cursos de 12 clases, la tarifa de TikHub suma unos 12,10 USD (3,70 USD con Subtítulos V2) y nosotros unos 2,08 USD; solo el paso de transcripción son 9,60 USD en TikHub y 0,67 USD con nosotros, la mayor parte de la diferencia. A esa escala, la API oficial sigue costando solo cuota: el detalle y los comentarios de 100 cursos son 2.400 unidades, que caben en un día, pero no consigue ninguna de las 1.200 transcripciones.
Un mes de seguimiento: comentarios nuevos de 30 clases cada día
Pongamos un equipo docente que sigue 30 vídeos de clase. Cada día pide una vez los comentarios y las estadísticas, y la transcripción de cada clase la pide una sola vez al principio. El mes tiene 30 días.
| Tarea mensual | Llamadas | Data API oficial | TikHub (tarifa) | EveryInfra (catálogo) |
|---|---|---|---|---|
| Comentarios, una vez al día por clase | 900 | 900 unidades, 30 al día | 0,90 USD | 0,5004 USD |
| Estadísticas de 30 clases, una vez al día | 900 (oficial: 30 ID en una llamada) | 30 unidades, 1 al día | 0,90 USD | 0,5004 USD |
| Transcripciones, una vez por clase al principio | 30 | No disponible | 0,24 USD (V2 0,03 USD) | 0,01668 USD |
| Total | 1.830 | 930 unidades, 0 USD, sin transcripciones | 2,04 USD | 1,01748 USD |
La vía oficial gasta 31 unidades al día, muy por debajo de 10.000, y da texto, fecha exacta y «me gusta» de los comentarios; solo faltan las transcripciones. Así que para «vigilar cada día los comentarios nuevos de vídeos conocidos», recomendamos la API oficial. EveryInfra y TikHub encajan en lo que la oficial no da: transcripciones de vídeos ajenos y búsquedas grandes puntuales sin pasar una auditoría. También en equipos que no quieren mantener un proyecto de Google Cloud con OAuth.
Si las búsquedas pasan de 100 al día, la cosa cambia. Por ejemplo, 50 palabras clave por dos páginas al día para detectar clases nuevas necesitan más cuota oficial, y entonces las dos vías de pago por llamada se pueden comparar por precio. A 100 búsquedas al día, el mes son 3.000 llamadas: 3,00 USD con search_video de TikHub y 2,334 USD con nuestro youtube/search.
Cuándo encaja mejor la API oficial o TikHub
La YouTube Data API oficial encaja mejor que cualquiera de las dos de pago en tres casos. Primero, cuando solo necesitas comentarios y estadísticas dentro de 10.000 unidades diarias: un techo de 1.000.000 de comentarios principales al día cubre casi cualquier estudio de un curso, y es gratis. Segundo, cuando analizas vídeos de tu propio canal: como propietario tienes subtítulos y YouTube Analytics, que es el conjunto de datos más completo. Tercero, cuando tu aplicación atiende a usuarios durante años y necesita la aprobación formal de Google: pasa la auditoría de las Developer Policies y de la funcionalidad mínima requerida. Además, el 3 de junio de 2026 Google añadió videos.batchGetStats, con su propia cuota de 10.000 unidades diarias, así que las estadísticas en lote gastan menos.
TikHub encaja mejor que nosotros en estos casos. Tiene 48 endpoints de YouTube, y nosotros 8 capacidades: youtube/search, youtube/profile, youtube/user_posts, youtube/video, youtube/comments, youtube/followers, youtube/transcript y youtube/shorts. TikHub ofrece cosas que nuestro catálogo no tiene: un endpoint aparte para respuestas, publicaciones de comunidad del canal y sus comentarios, vídeos relacionados y tendencias, sugerencias de búsqueda, URL de reproducción y descarga, y correo del canal. Para eso, el material público apunta a una API como la suya.
Su búsqueda general V2 (get_general_search_v2, 0,002 USD por llamada) filtra por upload_date, duration y features como subtítulos, 4K o directo, mientras que nuestro youtube/search tiene un solo parámetro opcional, sort. Por último, TikHub no publica cuántas filas trae por página en búsqueda y comentarios: si una página de búsqueda trae 26 filas o más, o una de comentarios 73 o más, sale más barato por cada 1.000 filas. Compruébalo con las filas que devuelvan tus propias llamadas.
Elige la vía según el dato que necesitas
Esta tabla resume las secciones anteriores según «qué quieres conseguir». Cada fila da solo razones que comprobamos, con precios de tarifa o de catálogo del 13 de noviembre de 2026.
| Dato que necesitas | Primera opción | Motivo | Segunda opción |
|---|---|---|---|
| Comentarios de vídeos conocidos, cada día | Data API oficial | 1 unidad por página, fecha exacta y «me gusta», gratis | EveryInfra youtube/comments |
| Estadísticas de vídeos conocidos | videos.list o videos.batchGetStats oficiales | 50 ID por llamada, 1 unidad | EveryInfra youtube/video |
| Más de 100 búsquedas por palabra clave al día | EveryInfra youtube/search | Fuera de la cuota de búsqueda oficial, 0,000778 USD por llamada, 20 filas en nuestra prueba | TikHub search_video a 0,001 USD |
| Búsqueda con filtros de fecha, duración o 4K | TikHub get_general_search_v2 | Nosotros solo tenemos sort como parámetro opcional | Filtros de search.list oficial |
| Transcripciones de vídeos ajenos | EveryInfra youtube/transcript | 0,000556 USD, sin cargo si falla | TikHub get_video_captions a 0,008 USD |
| Publicaciones de comunidad, vídeos relacionados, URL de reproducción | TikHub | Nuestro catálogo no las tiene | Ninguna |
| Lista de Shorts de un canal | EveryInfra youtube/shorts o TikHub get_channel_shorts | Ambos cobran por llamada; los dos figuran en catálogo o tarifa, pero no los probamos en esta prueba | playlistItems.list oficial |
Al elegir, cuenta también el coste de mantenimiento. La vía oficial pide un proyecto de Google Cloud, planificar la cuota y pasar auditorías; TikHub y EveryInfra piden saldo. Para un equipo docente de tres a cinco personas, lo segundo es más sencillo. Para un equipo que publica un producto durante años, lo primero es más seguro.
Límites: dónde no valen estas conclusiones
Esta prueba tiene cinco límites, y fuera de ellos los resultados pueden no valer. Primero, la muestra es pequeña: las tres rondas se hicieron en una hora la noche del 13 de noviembre de 2026, con un vídeo por curso y una sola llamada de comentarios por vídeo, que devolvió 40, 40 y 9 filas; los 0,0139 USD por cada 1.000 comentarios salen de las 80 filas de las dos primeras. Las tasas de interacción y el cruce de comentarios con la transcripción salen solo de estos tres vídeos, así que tómalos como ejemplos del método. Segundo, todas las cifras de TikHub son de tarifa: no llamamos a sus endpoints, y como no publica cuántas filas trae por página en búsqueda y comentarios, en esas dos partidas solo comparamos el precio por llamada, sin coste de TikHub por cada 1.000 filas.
Tercero, los precios cambian. La lista de TikHub ganó 12 filas en dos semanas, y nuestro catálogo también puede cambiar; volvemos a leer los dos antes de publicar. Cuarto, la página oficial de cuotas advierte de que la cuota por defecto puede cambiar, y los proyectos auditados tienen otras. Las cifras de 5.000 y 1.000.000 son techos con la cuota por defecto y nada más. Quinto, la sección que cruza comentarios con la transcripción usa solo 4 comentarios con marca de tiempo de una clase de MIT, y casi todos los 10 de CS50P eran índices de capítulos; para afirmar dónde se concentran los comentarios harían falta cientos, así que aquí solo mostramos el método.
La ética de investigación también pone límites. Un estudio educativo sobre comentarios debe ocultar los nombres de autor y dar solo totales, y en los comentarios de vídeos educativos puede haber menores. Las Developer Policies fijan una regla clara de 30 días para los datos guardados; trata con el mismo cuidado lo que guardes y borres de una API de datos de terceros. No damos asesoramiento jurídico sobre ningún proyecto concreto; si tu trabajo necesita revisión ética, sigue las normas de tu institución.
Cambios recientes: 7 novedades que afectan a los datos de YouTube en Python
| Fecha | Novedad | Qué cambia para tu script |
|---|---|---|
| 2026-11-13 | Lista de TikHub con 1.482 filas | Relee precios antes de usar |
| 2026-11-10 | google-api-python-client 2.202.0 | Lee las notas al actualizar |
| 2026-11-05 | youtube-transcript-api 1.2.5 | Sigue el bloqueo de IP de nube |
| 2026-10-26 | yt-dlp 2026.10.26 | Herramienta abierta para bajar subtítulos; mantenla al día |
| 2026-09-30 | snippet.imageUrl en comentarios | Comentarios con solo imagen |
| 2026-06-03 | Llega videos.batchGetStats | Estadísticas en lote con cuota propia |
| 2026-06-01 | search.list cuenta aparte | La búsqueda ya no gasta las 10.000 unidades |
2026-11-13. La lista de precios de TikHub pasó de 1.470 filas el 1 de noviembre a 1.481 el 11 de noviembre y a 1.482 el 13 de noviembre. Sigue sumando endpoints, así que volvemos a leer los precios de YouTube de este artículo antes de publicar.
2026-11-10. google-api-python-client publicó la 2.202.0 (versiones). Si usas la vía oficial, lee las notas de versión por si cambia el documento de descubrimiento de YouTube al actualizar.
2026-11-05. youtube-transcript-api publicó la 1.2.5 (versiones), y el 2026-10-26 yt-dlp publicó la 2026.10.26. Las dos leen los subtítulos desde la página web, así que un cambio en la página de YouTube suele significar esperar a su siguiente versión.
2026-09-30. El recurso comments añadió snippet.imageUrl, de modo que un comentario puede llevar una imagen o un GIF animado; la documentación dice que llega a todos los usuarios en noviembre. Para analizar el texto de los comentarios, cuenta con que habrá comentarios que solo tengan imagen.
2026-06-01 y 2026-06-03. La cuota propia de búsqueda (historial de revisiones) y videos.batchGetStats ya están en los techos diarios de arriba. Revisa contra estos dos cambios cualquier constante de cuota de tus scripts.
Para empezar: el script de arriba funcionando en cinco minutos
Primero, crea una clave de API en la consola de EveryInfra; dando una estrella a dos repositorios de GitHub recibes 1 USD de crédito de prueba, válido 24 horas, que alcanza para cientos de ejecuciones de este script. Segundo, ejecuta pip install requests y guarda la clave en la variable de entorno EVERYINFRA_API_KEY. Tercero, consulta capacidades y campos en la página de la API de datos de YouTube; las páginas de búsqueda, comentarios, transcripción y detalle de vídeo listan los valores admitidos de cada parámetro y tienen un banco de pruebas.
Cuarto, ejecuta python3 yt_chain.py "nombre de tu curso" salida y mira las filas y el charged_usd que imprime cada paso. Quinto, para llamarlo desde una herramienta de IA como Claude o Cursor, usa el MCP remoto con la misma clave. La misma API cubre también TikTok y otras plataformas, y los precios están en la página de precios y en el mercado.
Preguntas frecuentes
¿Dónde consigo una tikhub youtube api key y se puede probar gratis?
La pregunta sale de la sugerencia de Google «tikhub youtube api key», consultada el 13 de noviembre de 2026. La página de precios de TikHub dice que las cuentas nuevas reciben 0,05 USD de crédito gratuito. Pero solo 6 de los 48 endpoints de YouTube de su lista aceptan ese crédito, y ni la búsqueda, ni los comentarios, ni los subtítulos están entre ellos; para probarlos hay que recargar al menos 5 USD. La clave de EveryInfra se crea en la consola, y el 1 USD de las estrellas de GitHub sirve directamente para youtube/*.
¿Qué hago cuando aparece youtube data api quota exceeded?
La pregunta sale de la sugerencia «youtube data api quota exceeded». Primero, averigua qué cuota se llenó. Desde el 1 de junio de 2026, la búsqueda tiene su propio contador de 100 llamadas diarias, y cuando se llena solo se para search.list; comentarios y detalles comparten 10.000 unidades. Las cuotas se reinician a medianoche del Pacífico (Quota Calculator). Si necesitas más de forma continuada, usa el formulario de ampliación. Una petición no válida también gasta al menos una unidad, así que valida los parámetros antes de enviar.
¿Cuántos comentarios al día da la cuota gratuita de la youtube data api?
La pregunta sale de la sugerencia «youtube data api free quota». commentThreads.list devuelve hasta 100 filas por página a 1 unidad por página. Si todas las 10.000 unidades van a comentarios, el techo es de 1.000.000 de comentarios principales. Las respuestas necesitan llamadas a comments.list, también a 1 unidad por página. Los vídeos pequeños no llenan una página de 100, así que el número real es mucho menor.
¿Las herramientas youtube transcript api python sacan transcripciones de vídeos ajenos?
La pregunta sale de la sugerencia «youtube transcript api python». El captions.download oficial exige permiso de edición sobre el vídeo, así que no. La librería abierta youtube-transcript-api lee los subtítulos de la página web gratis, pero desde servidores en la nube suele quedar bloqueada. get_video_captions de TikHub cuesta 0,008 USD por llamada y cobra los vídeos sin subtítulos. youtube/transcript de EveryInfra cuesta 0,000556 USD por llamada, y un fallo no cuesta nada.
¿Puedo usar los endpoints que faltan en la documentación de la tikhub youtube api?
La pregunta sale de la sugerencia «tikhub youtube api documentation». La lista de precios del 13 de noviembre tiene 48 endpoints de YouTube y openapi.json solo documenta 34. Catorce, entre ellos get_video_captions_v2 a 0,001 USD y get_channel_email a 0,03 USD, tienen precio pero no documentación pública de parámetros. Pregunta a TikHub si se pueden usar y cómo.
Referencias
- Quota Calculator, Google for Developers, consultado el 2026-11-13.
- Search: list, Google for Developers, consultado el 2026-11-13.
- CommentThreads: list, Google for Developers, consultado el 2026-11-13.
- Comments: list, Google for Developers, consultado el 2026-11-13.
- Captions: list, Google for Developers, consultado el 2026-11-13.
- Captions: download, Google for Developers, consultado el 2026-11-13.
- Videos: list, Google for Developers, consultado el 2026-11-13.
- YouTube Data API Revision History, Google for Developers, última entrada del 2026-11-03.
- Implementation: Pagination, Google for Developers, consultado el 2026-11-13.
- Python Quickstart, Google for Developers, consultado el 2026-11-13.
- Quota and Compliance Audits, Google for Developers, consultado el 2026-11-13.
- Formulario de ampliación de cuota de YouTube API Services, Ayuda de YouTube, consultado el 2026-11-13.
- YouTube API Services Developer Policies, Google for Developers, consultado el 2026-11-13.
- Required Minimum Functionality, Google for Developers, consultado el 2026-11-13.
- Videos: batchGetStats, Google for Developers, añadido el 2026-06-03.
- Manage API keys, Google Cloud, consultado el 2026-11-13.
- Usar subtítulos automáticos, Ayuda de YouTube, consultado el 2026-11-13.
- google-api-python-client, Google APIs en GitHub, consultado el 2026-11-13.
- google-api-python-client en PyPI, PyPI, 2.202.0, 2026-11-10.
- Versiones de google-api-python-client, GitHub, 2026-11-10.
- youtube-transcript-api, GitHub, consultado el 2026-11-13.
- youtube-transcript-api en PyPI, PyPI, 1.2.5, 2026-11-05.
- Versiones de youtube-transcript-api, GitHub, 2026-11-05.
- yt-dlp 2026.10.26, GitHub, 2026-10-26.
- requests en PyPI, PyPI, 2.34.2, 2026-05-14.
- os, interfaces varias del sistema operativo, documentación de Python, consultado el 2026-11-13.
- zoneinfo, zonas horarias IANA, documentación de Python, consultado el 2026-11-13.
- Endpoint público de precios de TikHub, TikHub, consultado a las 21:32 hora de Singapur del 2026-11-13, 1.482 filas.
- openapi.json de TikHub, TikHub, V5.3.2, consultado el 2026-11-13.
- TikHub Pricing, TikHub, consultado el 2026-11-13.
- TikHub FAQ, TikHub, consultado el 2026-11-13.
- TikHub YouTube API, TikHub, consultado el 2026-11-13.
- TikHub MCP, TikHub, consultado el 2026-11-13.
- tikhub en PyPI, PyPI, 2.2.0, 2026-10-03.
- Catálogo de capacidades de EveryInfra, EveryInfra, consultado a las 21:31 hora de Singapur del 2026-11-13.
- Learning Analytics on YouTube Educational Videos, Chalkias et al., Electronics, 2023-09-19.
- CS50's Introduction to Programming with Python, Harvard University, consultado el 2026-11-13.
- MIT 6.100L Introduction to CS and Programming Using Python, MIT OpenCourseWare, consultado el 2026-11-13.
- Comments resource, Google for Developers, consultado el 2026-11-13.
- CommentThreads resource, Google for Developers, consultado el 2026-11-13.
- YouTube Data API Errors, Google for Developers, consultado el 2026-11-13.
Referencia BL-141