Codex in Linear 改爬虫:Key 和联网怎么配
Codex in Linear 的云端任务里 secret 到不了代理阶段,默认断网。照官方文档给出工单和环境配置示例,接口侧真调每轮 $0.001904。
OpenAI 在 2026 年 11 月 18 日前后把 Codex in Linear 的说明搬进新的文档站:在 Linear 工单里指派给 Codex 或者 @Codex,它就开一个云端任务,干完把摘要和改动链接贴回工单(OpenAI:Use Codex in Linear)。这条路跑在 Codex Cloud(Legacy)环境里,文档写明 secret 只给安装脚本用、代理阶段开始前就被删掉,代理阶段默认不联网(OpenAI:Codex Cloud (Legacy)),所以「让 Codex 把自写爬虫换成 API 调用,再自己跑一遍验证」这件事,Key 和网络都要事先配好。Codex 和 Linear 一侧我们只读了官方文档,没有真把工单派给 Codex,下面的工单、AGENTS.md 和环境设置都是照文档写的配置示例;真调只做在 EveryInfra 接口一侧。我们在 2026-11-20 00:14 到 00:59(新加坡时间)在本机把一个每天拉 TikTok、YouTube、Reddit 数据的脚本改成三次 POST /api/v1/social 调用,同一个脚本跑了三轮,每轮固定扣 $0.001904;故意写错参数的 5 次请求全部返回 422、没扣钱,而且一次只报一个错,一个请求体里有两个错就要改两轮。
Codex in Linear 是什么:11 月 18 日的文档写了哪些事
先把 Codex in Linear 的装法和边界逐条落到原文。OpenAI 新文档站的页面写得很短:在工单里把 issue 指派给 Codex,或者在评论里写 @Codex,Codex 就创建一个云端对话,把进度回帖到工单的 Activity 里,做完贴一段摘要和对话链接,你在那个链接里看 diff、开 PR(OpenAI:Use Codex in Linear)。Linear 自己的集成页说法一致,另外写明了可用套餐:ChatGPT 的 Plus、Pro、Business、Enterprise、Edu(Linear:Codex Integration)。Enterprise 工作区还要管理员先在工作区设置里开 Codex 云端对话,再在连接器设置里打开 Codex for Linear。
安装只有三步。第一步在 Codex 里连 GitHub,为要改的仓库建一个云端环境;第二步到 Codex 设置的连接器页给你的 Linear 工作区装 Codex for Linear;第三步在任意一张工单的评论里 @Codex 一次,按提示把 Linear 账号连上。Linear 一侧对第三方代理的说明补了两点:装的时候要选它能访问哪些团队,没被授权的团队里的工单派不给它;代理不占 Linear 的付费席位,代理自己的服务另外计价(Linear Docs:Agent platform)。
| 项 | 原文怎么写 | 出处(2026-11-20 读取) |
|---|---|---|
| 套餐 | ChatGPT Plus、Pro、Business、Enterprise、Edu | Linear 集成页 |
| 触发方式 | 指派 issue 给 Codex,或评论里 @Codex;跟帖继续同一个对话 | OpenAI 文档 |
| 选仓库 | 按工单内容挑最匹配的环境,拿不准就用最近用过的;评论里写 @Codex fix this in 组织/仓库 可指定 | OpenAI 文档 |
| 分支 | 跑在环境里第一个仓库的默认分支上 | OpenAI 文档 |
| 自动派活 | Triage 规则里选 Delegate → Codex;用工单创建人的账号跑 | OpenAI 文档、Linear Triage 文档 |
| Triage 规则套餐 | Linear Business 和 Enterprise | Linear Triage 文档 |
| 本机用法 | Codex CLI、IDE 插件、ChatGPT 桌面端接 Linear 的 MCP | OpenAI 文档、Linear Codex MCP 页 |
Linear 的 Triage 规则可以把符合条件的新单直接委派给 Codex,告警或同事在 Triage 里开的「脚本坏了」单子也在其中(Linear Docs:Triage)。OpenAI 文档写明,走 Triage 规则时 Codex 用工单创建人的账号跑对话,所以开单的那个人要连过 Codex;Linear 的指派文档也写了同样的要求:基本 Triage 规则要先把工单指派给一个连过账号的同事,代理会用这个同事的身份开会话(Linear Docs:Assign and delegate issues)。如果告警是机器人账号开的,这条规则就跑不起来。
Codex linear integration 有两条:OpenAI 装进 Linear 的,和 Linear 自己的云端编码代理
搜「codex linear integration」会看到两套东西,名字都带 Codex,计费和 Key 的规矩完全不同。第一套是上面那条:OpenAI 的 Codex for Linear,任务跑在 OpenAI 的 Codex Cloud(Legacy)里,用的是你 ChatGPT 套餐的额度。第二套是 Linear 自己的云端编码代理(Linear 叫 coding sessions),可以选 Claude Code 或 Codex 当执行者,默认模型写的是 GPT-6 Sol,用的是 Linear 工作区的 AI credits(Linear Docs:Linear cloud coding agent)。Linear 11 月 12 日给第二套加了自带 Key:模型费可以记到你自己的 OpenAI 或 Anthropic 账户,沙箱运行时间仍扣 Linear 的 AI credits,而且要的是 API Key,ChatGPT 或 Claude 订阅不行(Linear 更新日志,2026-11-12)。
| 对照项 | OpenAI 的 Codex for Linear | Linear 云端编码代理(可选 Codex) |
|---|---|---|
| 在哪装 | Codex 设置 → 连接器 | Linear 设置 → AI & agents → Cloud coding agent |
| 谁付钱 | ChatGPT 套餐额度(Plus 起) | Linear AI credits;可自带 OpenAI / Anthropic API Key 付模型费 |
| 环境配置 | Codex 设置里的云端环境:安装脚本、环境变量、secret、联网开关 | Linear 设置 → Linear Code → Environments:运行时、环境变量、准备脚本、文件 |
| Key 对代理可见吗 | 环境变量可见;secret 在代理阶段前删除 | 普通环境变量对代理可见;勾选 Secret 的默认对代理不可见,但能在该环境开会话的人都看得到 |
| 下面的配置示例按哪条写 | 这条 | 只作对照 |
Linear 的文档对自家环境变量写得很直白:名字和值对编码代理可见,不要当成对代理隐藏的 secret 来用;另有一个 Secret 勾选项,勾上的值默认不对编码代理可见,但能在这个环境里开会话的人都看得到,文档建议把它当成本机 .env 那样的开发期凭据(Linear Docs:Configure coding environments)。代理阶段跑的测试能不能用上这类 Secret,这一段文档没有写,我们也没在 Linear 里试。OpenAI 这边的 secret 只在安装脚本里可用。按 OpenAI 旧版的规矩,想让代理在任务里真调一次接口来验证改动,Key 就只能放成环境变量,代理读得到它;所以要给这个环境单开一把权限收窄过的 Key,做法写在后面「Key 放哪」那部分。
云端环境的三条硬限制:Key、联网、MCP
Codex in Linear 的任务跑在哪种环境里,文档写得清楚:Codex Cloud(Legacy)继续支持代码审查和 Linear、GitHub 两个集成,新的云端环境暂时不接这两个集成,旧版将来会下线(OpenAI:Cloud environments)。所以下面三条限制都按旧版的文档读。
第一条是 Key。旧版环境有两种存值方式:环境变量在整个任务期间都在,包括安装脚本和代理阶段;secret 多加了一层加密,只在执行时解密,只给安装脚本用,代理阶段开始前就删掉(OpenAI:Codex Cloud (Legacy))。安全文档在讲沙箱时又重复了一遍:云端环境里配的 secret 只在安装期间可用,代理阶段前移除(OpenAI:Agent approvals & security)。另外,安装脚本和代理跑在两个不同的 Bash 会话里,安装脚本里 export 的变量带不进代理阶段,要么写进 ~/.bashrc,要么在环境设置里配。把 Key 放成 secret、再指望 Codex 在代理阶段跑测试时读到它,测试会因为拿不到 Key 失败。
第二条是联网。旧版的代理阶段默认断网,可以按环境打开,并且能配域名白名单和允许的 HTTP 方法;文档推荐的收紧做法是只放行 GET、HEAD、OPTIONS,其余方法(含 POST)一律拦(OpenAI:Agent internet access)。EveryInfra 的数据接口是 POST /api/v1/social,按这个推荐配,Codex 能读免费目录(GET),却发不出真实请求。所以要么在白名单里放 api.everyinfra.com 并放开 POST,要么干脆不让代理联网、只跑离线测试。同一页文档还举了一个提示注入的例子:工单正文里藏一段让代理把仓库内容发到外部网址的指令,代理照做就会泄露数据。工单正文本身就是代理要读的东西,这一条对 Codex in Linear 格外要紧,白名单只放必需的域名。
第三条是 MCP。Linear 的 Codex MCP 页写明,Linear 的 MCP 服务只能给本机的 Codex 任务用,也就是 Codex CLI 和 IDE 插件(Linear:Codex MCP Integration)。OpenAI 的 MCP 文档讲的配置也都落在本机的 ~/.codex/config.toml,桌面端、CLI、IDE 插件共用(OpenAI:Model Context Protocol)。旧版云端环境的文档里没有找到给云端任务挂 MCP 服务的设置。所以在 Linear 里派给 Codex 的活,Codex 是在仓库里改 Python 代码、调 REST 接口;EveryInfra 的远程 MCP 留给你在本机用 Codex CLI 排查时用。
从工单到 PR:Codex 在云端走的七步
把文档里散在几页的说明按时间顺序排一遍,Codex in Linear 处理一张工单大致经过七步。第一步,你在工单里 @Codex 或者把工单委派给它,Linear 把工单内容发给 Codex,OpenAI 文档写明 Codex 收到的是你的工单内容,数据处理按 OpenAI 的隐私政策走。第二步,Codex 按 Linear 建议的仓库挑环境,拿不准就用你最近用过的那个;找不到合适的环境,它会在工单里回一段怎么修的说明,等你修好再重试。第三步,Codex 建容器、按环境里的分支或提交检出仓库,旧版文档写的默认镜像叫 universal,预装了常用语言和工具,Python 版本可以在环境设置里固定(openai/codex-universal)。
第四步跑安装脚本,这一步能联网,secret 也在。requests 这类依赖在这一步装好;容器状态最多缓存 12 小时,改了安装脚本、环境变量或 secret,缓存会自动作废。第五步进入代理阶段:secret 已经删掉,联网按你的设置走,Codex 读 AGENTS.md,在终端里循环地改代码、跑检查。第六步,代理做完给出答复和改动的 diff,同时把摘要和对话链接贴回 Linear 工单,进度一直能在工单的 Activity 里看到。第七步由你来做:打开对话链接看 diff,满意了再开 PR,合并照走你仓库原有的审查规则。
一个假设场景:social_pulse.py 每天拉三样数
下面用一个假设场景说明工单怎么写:一个增长团队有个日常脚本,每天早上拉三样东西:自家和竞品在 TikTok 上几条重点视频的播放、点赞、评论、收藏;一条产品发布视频在 YouTube 上的最新评论;Reddit 上提到某个关键词的新帖。原来的写法是对着网页 HTML 解析,TikTok 那段读页面里一段内嵌 JSON,YouTube 那段靠一个开源下载库,Reddit 那段读旧版网页。假设某天 TikTok 那段开始返回 0 行,告警在 Linear 的 Triage 里开了一张单。这个故障是为了举例设定的,我们没有运行这份旧脚本,也没有去核 TikTok 页面结构有没有变。
三个平台的官方入口各有门槛。Reddit 的开发者文档写明调用要走注册过的 OAuth 令牌,用默认 User-Agent 的客户端会被大幅限速(Reddit Help:Reddit Data API Wiki);YouTube 官方接口每个项目每天默认 10,000 个配额单位,search.list 单独每天 100 次(YouTube Data API:Quota Calculator);TikTok 的研究接口只对通过审核的研究机构开放,审核一般要 4 周(TikTok for Developers:Research Tools)。在这个假设场景里,团队按这三条门槛决定改调现成接口,不再修解析代码。
旧代码大致是下面这样(示意,没有跑):
# 旧版:解析网页,平台一改版就坏
import re, json, requests
from bs4 import BeautifulSoup

def tiktok_stats(url):
    html = requests.get(url, headers={"User-Agent": "Mozilla/5.0"}, timeout=30).text
    blob = BeautifulSoup(html, "html.parser").find("script", id="__UNIVERSAL_DATA_FOR_REHYDRATION__")
    data = json.loads(blob.string)            # 假设场景:页面里找不到这段 JSON 时 blob 为 None,异常被吞掉,写出 0 行
    item = data["__DEFAULT_SCOPE__"]["webapp.video-detail"]["itemInfo"]["itemStruct"]
    return {"views": item["stats"]["playCount"], "likes": item["stats"]["diggCount"]}
改成接口以后,三段解析都换成同一个 call(platform, action, params)。对应的三个能力是 tiktok/video(单条视频详情)、youtube/comments(视频评论)和 reddit/search(关键词搜帖),能力名、必填参数、可选参数和单价都在免费目录里,Codex 可以先读目录再写代码。三个平台的总页在 TikTok 数据接口、YouTube 数据接口、Reddit 数据接口。
工单怎么写:配置示例,未在 Linear 里实跑
Codex 读到的就是工单的标题、正文和你 @它的那条评论。OpenAI 文档在排错一节里写,Codex 改错了地方,就在工单里补上下文,或者在 @Codex 的评论里给明确指令(OpenAI:Use Codex in Linear)。所以工单要写成一份能直接执行的说明:改哪个文件、换成什么、验收标准是什么、哪些事不许做。下面的模板是照文档写的配置示例,我们没有把它派给 Codex,Codex 会选哪个环境、改几轮、diff 长什么样,要以你自己的工单为准:
标题:social_pulse.py 的 TikTok 段返回 0 行,换成 EveryInfra 接口

现象:jobs/social_pulse.py 每天 07:00 跑,tiktok_stats() 返回 0 行,YouTube 和 Reddit 两段偶尔超时。
要做:
1. 删掉 tiktok_stats / yt_comments / reddit_posts 三个网页解析函数,改为调用
   POST https://api.everyinfra.com/api/v1/social(请求体 {"platform","action","params"})。
2. 能力:tiktok/video(url)、youtube/comments(url, sort, limit)、reddit/search(keyword, sort, limit)。
   参数以 GET https://api.everyinfra.com/api/v1/social/catalog?platform=tiktok 等返回为准,不要猜参数名。
3. Key 只从环境变量 EVERYINFRA_API_KEY 读,不写进代码、测试、日志。
4. 处理 202 running(按 poll_url 轮询)、429(按 retry_after 等)、503(退避重试);422 不重试,原样抛出 error 里的 param、allowed、did_you_mean。
验收:
- tests/test_social_pulse.py 用 tests/fixtures/ 里的三份真实返回跑通,不联网。
- 输出 JSON 里每个能力的 rows 和 charged_usd 都有值。
不要做:不改输出文件的字段名;不加新依赖(requests 已有)。
然后在评论里写 @Codex 按工单做,仓库 acme/growth-jobs。仓库名写出来,是因为 Codex 默认按工单内容猜环境,猜不准就退回最近用过的环境;文档给的写法就是在评论里点名仓库(OpenAI:Use Codex in Linear)。「不要猜参数名」那一句对应接口一侧的实测:我们故意把 keyword 写成 query 发了一次,接口当场回 422,告诉你 query 不是这个能力的参数,要的是 keyword。
仓库根目录再放一份 AGENTS.md,Codex 开工前会读它,文档说它用这份文件找项目的测试和检查命令(OpenAI:Custom instructions with AGENTS.md)。和数据接口有关的几行可以这样写,同样是没在 Codex 里实跑过的示例:
## 数据接口
- 调 EveryInfra 前先读 /api/v1/social/catalog?platform=<平台> 的 required_params、optional_params 和 allowed_values。
- 收到 422 时只按 error.param、error.allowed、error.did_you_mean 改那一个参数,再发一次;一次只会报一个错。
- 测试默认离线:用 tests/fixtures/*.json;只有设置了 EVERYINFRA_LIVE=1 才真调,且每次运行最多 3 次请求。
- 不打印 EVERYINFRA_API_KEY,不把它写进任何文件。
Key 放哪:环境变量、secret 和离线测试
按旧版环境的规矩,有三种放法,各有代价。放成 secret:只有安装脚本拿得到,代理阶段读不到,Codex 写完代码后跑的真调测试会失败,适合「安装阶段要用 Key 拉私有依赖、代理阶段完全不碰」的情况。放成环境变量:代理阶段读得到,Codex 能真调验证,代价是这把 Key 对代理和任务日志可见。不放:测试全部用录好的真实返回离线跑,Codex 只负责改代码,真调留到合并后在你自己的调度里跑。
我们推荐第三种为主、第二种为辅。改爬虫这类活,验收看的是代码能不能处理真实返回的结构,三份录好的返回(我们 2026-11-20 真调时存下的就能用)足够让测试覆盖字段、空结果和 422。确实要 Codex 在任务里真调一次时,单开一把只给这个环境用的 Key。EveryInfra 的接入文档写了几种收窄办法:在控制台「API Keys → 权限限制」里只留数据接口一路,被关掉的产品调用返回 403;停用一把 Key 只断这一把;可以设 IP 白名单;用同一把 Key 调 GET /api/v1/account 能看余额和每分钟上限,这个接口不计费(EveryInfra 接入文档)。OpenAI 为按来源 IP 放行的服务公布了云端代理的出口地址段(OpenAI:chatgpt-agents.json,文件生成时间 2026-11-13),文档同时提醒这些地址段是多个客户共用的,鉴权不能省(OpenAI:Cloud environments)。所以 IP 白名单只能当第二道门。
鉴权本身我们验过一次:00:19 不带 Key 发一个参数不全的请求,接口先回 401 missing_key,不报参数错误,也就不暴露参数结构;带上 Key 以后才进入参数检查。这样一来,Codex 在没有 Key 的环境里跑到真调这一步,看到的是 401,而不是一堆让它误以为参数写错的 422。
在本机用 Codex CLI 排查时,可以把 EveryInfra 的远程 MCP 也接上,让 Codex 直接查目录、试调用。我们的 MCP 页给的命令是 codex mcp add everyinfra --url https://api.everyinfra.com/mcp --bearer-token-env-var EVERYINFRA_API_KEY(EveryInfra 远程 MCP),等价的 config.toml 写法如下。Codex 的公开问题列表里有一条:bearer_token_env_var 指向的变量在当前进程里不存在时,codex mcp list 仍显示已配置 Bearer,实际请求却不带鉴权头(openai/codex issue #30125)。改完 shell 环境后要重启 Codex,再用 printenv 核一下变量在不在。
# ~/.codex/config.toml(本机 CLI / IDE 插件用;Linear 派的云端任务读不到这里)
[mcp_servers.everyinfra]
url = "https://api.everyinfra.com/mcp"
bearer_token_env_var = "EVERYINFRA_API_KEY"

[mcp_servers.linear]
url = "https://mcp.linear.app/mcp"
开工前用免费的 /account 核一遍 Key
Codex 的环境里 Key 到底在不在、是哪一把、还剩多少额度,不用花钱就能查。我们在 2026-11-20 00:39(新加坡时间)用跑脚本的同一把 Key 调了一次 GET /api/v1/account,0.22 秒返回 200,不扣费。返回体里有余额(分付费和赠送两桶)、账户每分钟上限 60 次、这把 Key 自己每分钟上限 10 次、Key 的名字和到期时间,以及这把 Key 过去 24 小时的调用次数、成功失败数和花费。Key 本身只回一个打了码的前缀,不回全文。
这个接口适合写进 AGENTS.md 当「开工检查」:Codex 在跑任何真调之前先调一次 /account。回 401 就说明环境变量没注入,多半是把 Key 放成了 secret,这时候停下来在工单里回一句,不要接着去猜参数;回 200 就看 key_requests_per_minute。我们这把 Key 的上限是每分钟 10 次,三次真调没问题,但如果代理在一个循环里反复重试,很快就会收到 429。AGENTS.md 里那句「每次运行最多 3 次请求」就是照这个上限定的。
usage_24h.this_key.spent_usd 是这把 Key 过去 24 小时的花费。Codex 开工前和跑完后各调一次 /account,两次一减就是这次任务的真调成本;给 Codex 单开一把 Key,这个差值里就只有它的调用。
还有一种更省事的分工:先在本机用 Codex CLI 配好 EveryInfra 的 MCP,让本地 Codex 读目录、对着三个能力各真调一次,把返回存进 tests/fixtures/;这些替身文件提交进仓库以后,再在 Linear 里把「换掉旧解析函数」派给云端 Codex。云端那一步只改代码、只跑离线测试,Key 和联网都可以不给。真调发生在你自己的机器上,你看得见每一次请求和扣费;云端任务碰不到 Key,工单正文里就算混进了奇怪的指令,也没有 Key 可漏。我们这次只走了前半段:三轮真调都在本机跑,返回存成了替身文件;后半段把工单派给云端 Codex,我们没有实跑。
换完后的 Python 代码
下面是换完以后的整份脚本,就是我们三轮实测跑的那一份(requests 发请求,Requests 快速上手)。它只做四件事:从环境变量读 Key;对每个能力发一次请求;按状态码分开处理;把每个能力的行数、扣费和耗时写进输出文件。
"""social_pulse.py: daily pull of TikTok video stats, YouTube comments and Reddit posts."""
import json, os, sys, time
import requests

API = "https://api.everyinfra.com/api/v1/social"
KEY = os.environ["EVERYINFRA_API_KEY"]
HEAD = {"Authorization": f"Bearer {KEY}", "Content-Type": "application/json"}

class ParamError(Exception):
    """422: the request is wrong; resending the same body will not help."""

def call(platform, action, params, tries=4):
    body = {"platform": platform, "action": action, "params": params}
    for attempt in range(tries):
        r = requests.post(API, headers=HEAD, json=body, timeout=120)
        if r.status_code == 422:
            err = r.json()["error"]
            raise ParamError(json.dumps({k: err.get(k) for k in
                ("code", "param", "message", "allowed", "did_you_mean", "example")}))
        if r.status_code == 429:
            time.sleep(r.json()["error"].get("retry_after", 20) + 1); continue
        if r.status_code == 503:
            time.sleep(5 * (attempt + 1)); continue
        r.raise_for_status()
        data = r.json()
        if data.get("status") == "running":      # slow capability: poll
            data = poll(data["poll_url"])
        return data
    raise RuntimeError(f"{platform}/{action}: no result after {tries} tries")

def poll(url, every=5, limit=60):
    full = url if url.startswith("http") else "https://api.everyinfra.com" + url
    for _ in range(limit):
        data = requests.get(full, headers=HEAD, timeout=60).json()
        if data.get("status") != "running":
            return data
        time.sleep(every)
    raise RuntimeError("job still running")

def main(out_path):
    jobs = [
        ("tiktok", "video", {"url": "https://www.tiktok.com/@openai/video/7647247430546672909"}),
        ("youtube", "comments", {"url": "https://www.youtube.com/watch?v=JlhQD6GHT3g", "sort": "newest", "limit": 50}),
        ("reddit", "search", {"keyword": "codex cloud", "sort": "newest", "limit": 25}),
    ]
    spent, rows = 0.0, []
    for platform, action, params in jobs:
        t0 = time.time()
        data = call(platform, action, params)
        res = data.get("results")
        n = len(res) if isinstance(res, list) else (1 if res else 0)
        usd = (data.get("billing") or {}).get("charged_usd", 0.0)
        spent += usd
        rows.append({"capability": f"{platform}/{action}", "rows": n, "charged_usd": usd,
                     "seconds": round(time.time() - t0, 2), "results": res})
    with open(out_path, "w") as f:
        json.dump({"spent_usd": round(spent, 6), "jobs": rows}, f, ensure_ascii=False, indent=1)

if __name__ == "__main__":
main(sys.argv[1])几处写法和接口行为一一对应。tiktok/video 返回的 results 是一个对象,youtube/comments 和 reddit/search 返回的是列表,所以行数要分开数;目录里 returns_list 字段就写着哪个能力返回列表(EveryInfra 能力目录)。慢能力会先回 status: running 和 poll_url,要按它轮询,不能拿同一个请求体在 5 分钟内重发,那样会被当成重放。429 带 retry_after 秒数,照着等就行;503 是暂时拿不到数据,失败不扣费,退避后重试。422 单独抛异常,因为同样的请求体重发多少次都还是 422,这一类错误要改代码。
字段和目录的 response_fields 对得上。tiktok/video 这次用到的字段是 view_count、like_count、comment_count、share_count、collect_count、posted_at、author_follower_count;youtube/comments 用到 text、like_count、reply_count、posted_at、is_reply;reddit/search 用到 title、community、like_count、comment_count、posted_at。旧脚本的输出列名是 views、likes 这种,Codex 要做的映射就是这几行,工单里「不改输出文件的字段名」那一条就是为了让它把映射写在脚本里,而不是让下游跟着改。
离线测试怎么写:拿真实返回当替身
工单的验收标准里写了「用 tests/fixtures/ 里的三份真实返回跑通,不联网」,下面就是 Codex 应该交回的那种测试。替身用的是接口的原始返回,所以测试检查的是代码对真实结构的处理:tiktok/video 的结果是对象、另外两个是列表;charged_usd 在 billing 里;422 要抛出带 param 的异常。
# tests/test_social_pulse.py(离线:用 unittest.mock 替换 requests.post)
import json, pathlib
from unittest import mock
import pytest, social_pulse as sp

FIX = pathlib.Path(__file__).parent / "fixtures"

def fake_post(status, name):
    r = mock.Mock(status_code=status)
    r.json.return_value = json.loads((FIX / name).read_text())
    r.raise_for_status = mock.Mock()
    return r

def test_tiktok_video_is_one_object():
    with mock.patch.object(sp.requests, "post", return_value=fake_post(200, "tiktok_video.json")):
        data = sp.call("tiktok", "video", {"url": "https://www.tiktok.com/@openai/video/7647247430546672909"})
    assert isinstance(data["results"], dict)
    assert data["billing"]["charged_usd"] == 0.000556

def test_422_is_not_retried():
    with mock.patch.object(sp.requests, "post", return_value=fake_post(422, "youtube_comments_422.json")) as p:
        with pytest.raises(sp.ParamError) as e:
            sp.call("youtube", "comments", {"url": "x", "sort": "top", "limit": 50})
    assert p.call_count == 1
    assert json.loads(str(e.value))["allowed"] == ["newest", "popular"]
第二个测试守的是一条容易被代理改坏的规矩:422 不重试。代理看到失败,第一反应往往是加重试,这个测试会在它把 422 也塞进重试分支时变红。fixtures 里的文件就是我们 2026-11-20 真调存下的返回原样复制过去,去掉了个人用户名;这样做还有一个好处,平台字段以后再变,你只要换掉替身、看哪几个测试红,就知道 Codex 下一张工单该改哪里。
实测:同一个脚本跑三轮
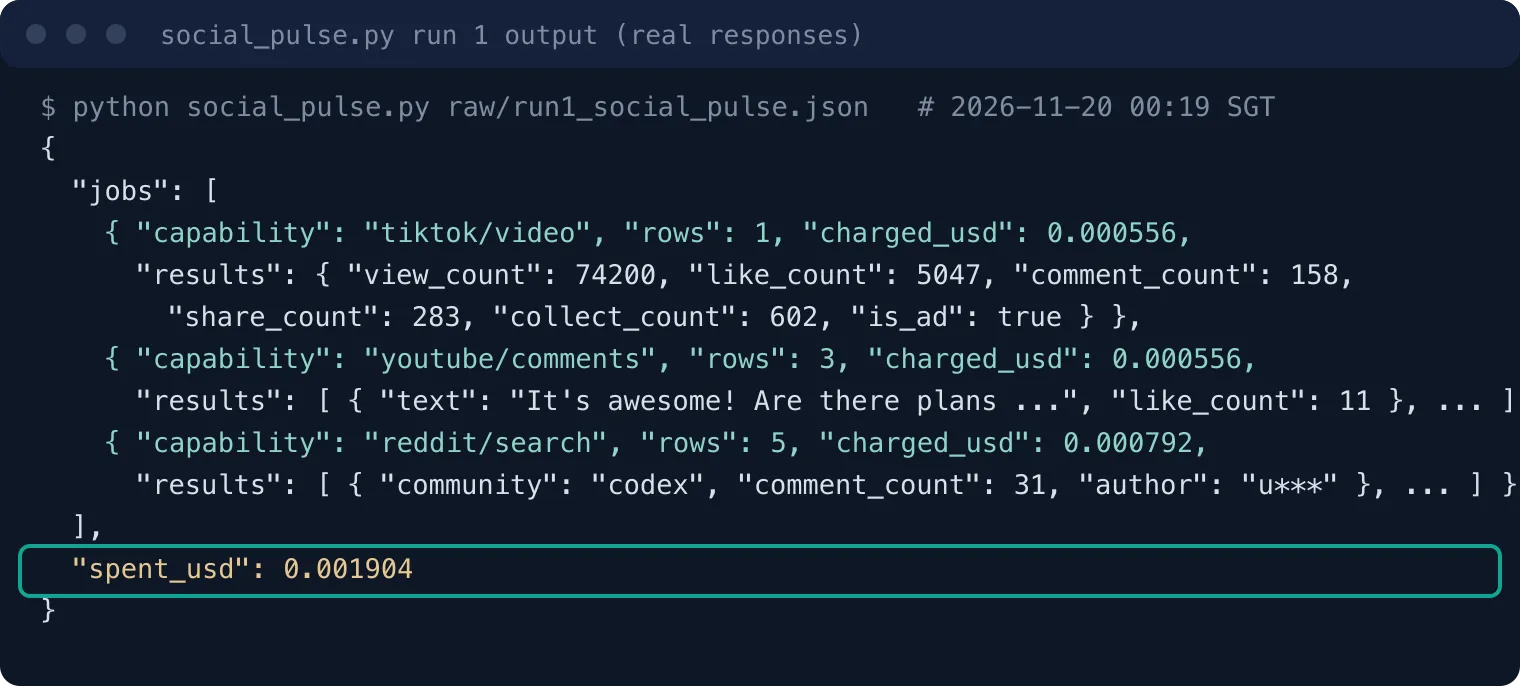
我们在 2026-11-20 00:19、00:38、00:59(新加坡时间)三个时刻各跑了一轮这份脚本,Key 只经环境变量注入。三轮的请求体完全一样,下表是每个能力的返回行数、扣费和耗时。
| 能力 | 第 1 轮 00:19(行 / 扣费 / 秒) | 第 2 轮 00:38 | 第 3 轮 00:59 |
|---|---|---|---|
tiktok/video | 1 / $0.000556 / 8.38 | 1 / $0.000556 / 10.09 | 1 / $0.000556 / 9.75 |
youtube/comments | 3 / $0.000556 / 0.99 | 3 / $0.000556 / 1.36 | 3 / $0.000556 / 1.00 |
reddit/search | 5 / $0.000792 / 4.02 | 5 / $0.000792 / 8.88 | 5 / $0.000792 / 9.17 |
| 合计 | 9 / $0.001904 / 13.39 | 9 / $0.001904 / 20.33 | 9 / $0.001904 / 19.92 |
三轮的扣费一分不差:每轮 $0.000556 + $0.000556 + $0.000792 = $0.001904,和目录里三个能力的 price_usd 相加完全一致。按次计费:youtube/comments 这条视频只有 3 条评论,reddit/search 按最新排序只回了 5 条,扣费和返回 50 条、25 条时一样,钱按调用次数算,跟返回多少行无关。所以给 Codex 的工单里不用替它省 limit,把上限写满就行:youtube/comments 的上限是 100,reddit/search 是 25。
耗时差别比扣费大。tiktok/video 三轮分别是 8.38、10.09、9.75 秒,reddit/search 是 4.02、8.88、9.17 秒,youtube/comments 一直在 0.99 到 1.36 秒之间;一轮三次调用合计 13.4 到 20.3 秒。这 40 分钟里 TikTok 那条视频的播放数三轮都是 74,200,没动;Reddit 一侧有变化:前两轮 reddit/search 回的是同一批 5 条帖子;第三轮之前,2026-11-19 16:50(UTC)r/IA_Italia 冒出一条新帖(讲 2026 年还值不值得花两三千欧元攒一台本地跑模型的电脑,和 Codex 无关),第三轮就把它排进来,同时把最早那条 2026-11-18 22:55 的提醒灯帖挤了出去,结果还是 5 条。那条提醒灯帖还在「最近一个月」的范围里,limit 也写的是 25,所以在这个关键词上,按最新排序时每次只回了 5 条,少于 limit。脚本里要把实际行数写进输出,行数低于 limit 时别当成「就这么多」;测试里断言行数要写「≥0」,不要写死成 5。
youtube/comments 返回的 posted_at 是「11 months ago」这种相对时间。这条 Linear 官方视频发布于 2025 年 12 月 4 日,评论多写于发布后不久,日报里如果要按日期过滤,用目录里的 since 参数让接口先筛,再在脚本里换算相对时间。reddit/search 的目录说明写了时间范围固定为最近一个月,搜不到一个月前的帖子;我们 00:18 用「codex linear」搜,只回 2 条,都跟 Codex 无关,一条是 2026-10-20 发在开源项目推荐版块的看板工具,一条是 2026-10-23 摄影版块的帖子,前一条已经贴着一个月窗口的边。要看更早的讨论,换成按社区取帖的能力,或者在 Codex 的工单里写清楚时间窗口。
拉回来的数要先分广告:「openai codex」10 条视频的播放 99% 在广告里
脚本换好以后,下一个问题是这些数能不能直接进日报。我们 00:18 用 tiktok/search 搜「openai codex」取了 10 条视频(扣 $0.000556),想看看团队如果按关键词跟踪「Codex 声量」,每天会拿到什么。10 条视频的播放加起来 42,335,552 次,其中 is_ad 为 true 的 3 条(OpenAI 官方号 1 条、两位创作者带 ChatGPT 合作标签的 2 条)占了 99.4%(42,074,200 次);剩下 7 条自然发布的视频合计只有 261,352 次。播放最高的一条 3,180 万次,带 #chatgptpartner 标签,评论数是 0。
按播放量加总的「声量」几乎全是投放出来的,一天里多一条合作视频,曲线就会跳两个数量级。所以工单里应该让 Codex 在输出里保留 is_ad 和 is_sponsored 两列(都在 tiktok/video 和 tiktok/search 的 response_fields 里),日报分两栏统计。两个字段的含义不同:is_ad 标的是广告投放,is_sponsored 标的是含赞助内容,这 10 条里有 1 条只有 is_sponsored、1 条两个都是 true。目录的 field_note 还写了部分请求不返回 is_sponsored,缺这个键时要记成「未知」,不能当 false。
另外两个能力的数也看了一遍。Reddit 一侧,00:19 那一轮按最新排序搜「codex cloud」回了 5 帖,发帖时间都在 11 月 18 日 22:55 到 11 月 19 日 15:39(UTC)之间,2 帖来自 r/codex,其中一帖 31 条评论,讲的是给 Codex 的长任务配一个提醒灯,任务需要人回应时灯就亮,免得一直盯着进度(r/codex 原帖);另一帖 2026-11-19 15:39 发出,6 条评论,作者说用 GPT-6 Astra 在 Codex 里写完了一个 Mac 应用的整个 Rust 后端;另外 3 帖分别是招测试用户、比较图像模型和一条推广帖。YouTube 一侧,Linear 官方那条 28 秒的视频只有 3 条评论,发布 11 个月以来没有新增。关键词跟踪类的日报,原始结果里有大量和主题无关或带推广的内容,过滤规则要写进工单的验收标准里,不能指望 Codex 自己猜。
422 报错怎么让 Codex 自己改对
Codex 写代码时最常见的错是参数名和枚举值猜错。我们在 00:14 到 00:19 之间故意发了 5 个错的请求体,全部回 422、全部没扣钱:
| 时刻(新加坡时间) | 能力 | 写错的地方 | `error.code` | 接口给的修正信息 | 耗时 |
|---|---|---|---|---|---|
| 00:14 | reddit/search | 用了 query,没写 keyword | missing_param | query 不是参数,要 keyword;附可用的 example | 0.15 秒 |
| 00:14 | reddit/search | sort 写成 hot | invalid_value | allowed 6 个值,did_you_mean 给 popular、top | 0.21 秒 |
| 00:19 | youtube/comments | max_results 加 sort: top 两个错 | unknown_param | 只报 max_results,allowed 给 url、limit、since、sort | 0.11 秒 |
| 00:19 | tiktok/video | 用了 video_url,没写 url | missing_param | video_url 不是参数,要 url;附可用的 example | 0.23 秒 |
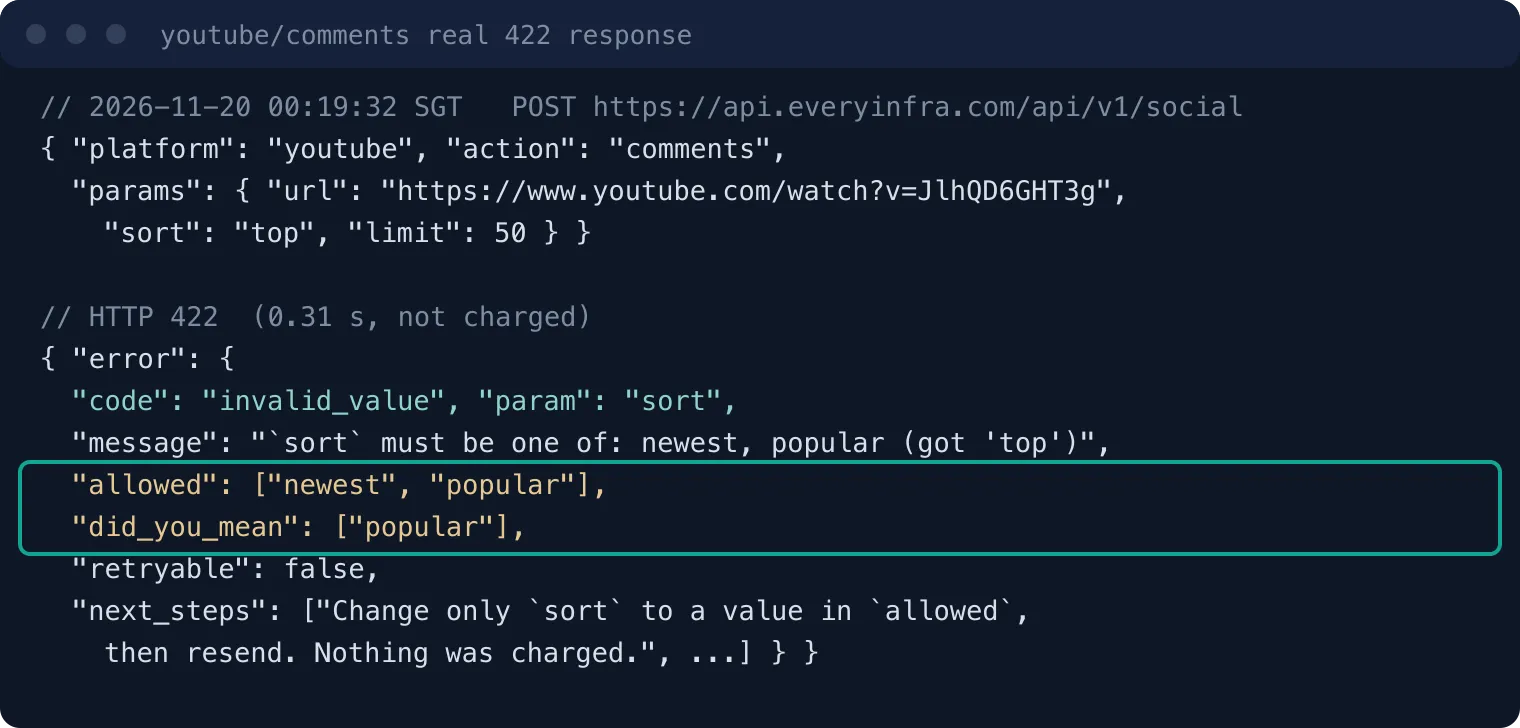
| 00:19 | youtube/comments | 改成 limit 后仍是 sort: top | invalid_value | allowed 是 newest、popular,did_you_mean 给 popular | 0.31 秒 |
5 次里有 2 次是参数名写成了别家接口的习惯写法(query、video_url),3 次带了允许值清单,2 次带 did_you_mean 候选,3 次附了一个能直接跑通的 example 请求体。第三、五行说明了一件 Codex 要知道的事:一次 422 只报一个错。请求体里有两个错,第一次只告诉你 max_results 不是参数,改完再发,才轮到 sort 的值不对。一个按报错逐轮修改的代理,有几个错就要多跑几轮,并且每轮只改报错里点名的那个参数,不要顺手改别的。我们在上面的 AGENTS.md 里写的就是这条规矩。next_steps 第一条末尾写着「Nothing was charged.」,代理可以据此判断这次失败不用记账。
422 的返回体长这样(截取自 00:19 的第二次请求)。Codex 拿到它以后,按 param 定位到代码里的 sort,从 allowed 里选一个值,did_you_mean 只有一个候选 popular,就改成 popular;如果业务上要的是最新评论,就选 newest。这个选择属于业务判断,工单里写清楚「要最新评论」,Codex 就不会只按候选值改。HTTP 规范对 422 的定义是服务器理解请求格式,但处理不了里面的指令(RFC 9110 第 15.5.21 节),和这里的用法一致:请求是合法 JSON,参数不对。
再算一笔时间账。5 次 422 的接口耗时在 0.11 到 0.31 秒之间,平均约 0.2 秒;同一时段成功的调用要 1 到 10 秒。也就是说,代理按报错改一轮,接口这头几乎不花时间,也不花钱,慢的是模型自己读报错、改代码、再跑测试的那几十秒。两个错误分两轮改,接口一共只多用了 0.4 秒左右。反过来,如果代码把 422 也塞进重试分支,4 次重试会拿到 4 个一模一样的 422,白等,还占掉这把 Key 每分钟 10 次里的 4 次。所以前面那条离线测试专门盯住「422 只调一次」。这 5 个 422 返回和那次 401 返回我们都原样存了下来,拿去当测试替身就行。
更多错误码和自动修正的写法,见 API 错误怎么让 AI 自己修;失败和空结果怎么退费、怎么对账,见 失败退费对账。
一天 500 次调用多少钱
接口费按目录的 price_usd 算,每次调用的价钱固定。按假设场景里那个团队的用量拆:每天跟踪 300 条 TikTok 视频(tiktok/video 300 次)、100 条 YouTube 视频的评论(youtube/comments 100 次)、100 个 Reddit 关键词(reddit/search 100 次),合计 500 次。
| 能力 | 单价(2026-11-20 目录) | 每 1,000 次 | 每天次数 | 每天 | 30 天 |
|---|---|---|---|---|---|
tiktok/video | $0.000556 | $0.556 | 300 | $0.1668 | $5.004 |
youtube/comments | $0.000556 | $0.556 | 100 | $0.0556 | $1.668 |
reddit/search | $0.000792 | $0.792 | 100 | $0.0792 | $2.376 |
| 合计 | — | — | 500 | $0.3016 | $9.048 |
如果「500 次」指的是这份脚本整轮跑 500 遍(每轮 3 次调用),那就是每天 500 × $0.001904 = $0.952,30 天 $28.56。最贵的组合是 500 次全用 reddit/search,每天 $0.396,30 天 $11.88。失败和空结果不扣费,所以这几个数是上限。Codex 那一侧的花费另算:Codex in Linear 的任务走 ChatGPT 套餐额度,Plus 是每月 $20(OpenAI Help:What is ChatGPT Plus),Business 标准席位按月付每人每月 $25、按年付 $20(OpenAI Help:ChatGPT Business overview);OpenAI 的定价页写明云端任务可能比本机消息更耗额度,具体看用量面板(OpenAI:Pricing)。用 Triage 规则自动派活还要 Linear Business,每人每月 $16(Linear Pricing)。
和自己维护爬虫的工时比
修爬虫要花多少小时,我们没有找到可靠的统计调查,所以下面只用一个公开数字加三个写明的假设。公开数字是美国劳工统计局的时薪:2025 年软件开发、测试岗位的中位时薪 $64.44(BLS:Software Developers)。三个假设的维护量分别是:每月修 1 小时;每周修 1 小时,一个月按 52 ÷ 12 ≈ 4.33 周算;每周修 1 天,也就是每周 8 小时。按中位时薪换算,三档每月分别是 $64.44、$279.24 和 $2,233.92。这三个小时数是为了比较量级设定的,你的爬虫可能半年不坏,也可能一周坏几次,换成自己团队的实际工时再算一遍更准。
三档放在一起:每月只修 1 小时,按 BLS 中位时薪是 $64.44,约为每天 500 次调用一个月 $9.05 的 7 倍;每周修 1 小时,$279.24,约 31 倍;每周修 1 天,$2,233.92,约 247 倍。这笔账有三条边界。第一,小时数是假设,不是统计数据。第二,工时换算没算自建爬虫的服务器和代理费用,真实的自建成本只会更高。第三,接口只覆盖目录里有的平台和字段,目录外的网站还得自己写,这时 Codex in Linear 帮你修的是爬虫本身。
视频里演示了、文档里没写的步骤
视频教程和文档有三处不一致。我们 00:14 用 youtube/search 搜「codex linear」,前 10 条里和 Codex in Linear 直接相关的有 3 条:Linear 官方频道 2025 年 12 月 4 日的「OpenAI Codex agent」,Linear 官方 2026 年 6 月 11 日的「Introducing coding sessions」(讲的是 Linear 自己的编码代理),以及一位 SEO 博主 2025 年 12 月 8 日发的讲解视频。我们用 youtube/transcript 取字幕:Linear 那条 28 秒的视频没有字幕,接口回了空结果并自动退费;博主那条拿到 9,033 个字符的字幕;coding sessions 那条在 00:38 拿到 6,242 个字符的字幕,扣 $0.000556。这条视频讲的是 Triage 自动化:Datadog 告警、bug 报告进到 Triage 以后,由 Linear 自己的代理去调查和修复;片中有人说过去一个月 Linear 代理合并了将近 700 个 PR。全片没有提到环境变量、secret 或联网设置,配环境这一步只能看文档。
| 视频 | 频道 | 发布 | 时长 | 播放(00:14 搜索结果) | 字幕 |
|---|---|---|---|---|---|
| OpenAI Codex agent | Linear 官方 | 2025-12-04 | 0:28 | 4,727 | 没有字幕,空结果已退费 |
| Introducing coding sessions | Linear 官方 | 2026-06-11 | 7:09 | 19,783 | 6,242 个字符 |
| OpenAI Codex Agent in Linear 讲解 | 一个 SEO 博主频道 | 2025-12-08 | 8:19 | 8,243 | 9,033 个字符 |
对照字幕和文档,第一,博主视频里本机接 Linear 的命令说成「codex connect linear」,OpenAI 和 Linear 两边的文档写的都是 codex mcp add linear --url https://mcp.linear.app/mcp,或者手改 config.toml 再 codex mcp login linear(Linear:Codex MCP Integration),照视频敲命令会报错。第二,视频演示 @Codex 后两分钟出 PR,没提云端环境要先建好、仓库要在环境的仓库表里,Codex 找不到合适环境时会在工单里回一段修复说明再让你重试,这一步文档写了,视频没拍。第三,Linear 的 Codex MCP 页还留着一段说明,说第一次用 MCP 要在 config.toml 里加 rmcp_client = true,OpenAI 新文档的同一段没有这一行;以你本机 Codex 版本的提示为准。
| 步骤 | 视频里怎么说 | 文档里怎么写 |
|---|---|---|
| 本机接 Linear | codex connect linear | codex mcp add linear --url https://mcp.linear.app/mcp |
| @Codex 之前要做的事 | 连 GitHub、在 Linear 里装好就行 | 还要先建一个包含这个仓库的云端环境 |
| MCP 的功能开关 | 没提 | Linear 页面写 rmcp_client = true,OpenAI 新文档没有这一行 |
| 出 PR 要多久 | 大约 2 分钟 | 没有给时间 |
Linear 官方那条视频下有 3 条评论,点赞最多的一条(11 个赞)问的是会不会给 Claude Code 也做同样的集成,另一条说 Cursor 的集成很顺,Claude Code 要做成同样效果得先处理好远程代理。
在 Linear 里看住 Codex:权限、审计和交接
派给 Codex 的活在 Linear 里和派给同事的活一样能追。Linear 的代理文档写了四个地方:代理有自己的用户页,能看到它经手的工单;委派给代理的工单仍然出现在你的 My issues 里,因为你还是负责人;自定义视图可以按 Delegate 筛;Insights 可以按 Delegate 切,统计有多少活交给了代理(Linear Docs:Agent platform)。指派文档补充,指派和委派的历史都记在工单的 Activity 里,谁在什么时候改的都有(Linear Docs:Assign and delegate issues)。权限上,代理不能登录 Linear 应用,不能碰管理功能,也不能管理用户。
对这类「修数据脚本」的工单,我们建议在团队层面加一条代理指引。Linear 的工作区和团队都能写给代理的附加说明,团队级的优先,内容会在代理处理工单时自动带上;文档也写明怎么理解这些说明取决于各家代理(Linear Docs:Agent platform)。一条够用的指引是:「改 jobs/ 目录下的数据脚本时,必须附离线测试;不得在代码、日志、PR 描述里出现任何 Key;PR 描述里写清楚换了哪些能力、单价多少。」最后一句是为了让审 PR 的人当场就能算账。
| 合并前核对 | 怎么核 | 不过就 |
|---|---|---|
| Key 没进代码 | 在 diff 里搜 Bearer、sk-、Key 前缀 | 退回,并停用那把 Key |
| 422 不重试 | 跑 test_422_is_not_retried | 退回 |
| 能力和参数对得上目录 | 对照 /api/v1/social/catalog?platform=… | 在工单里贴目录原文让 Codex 改 |
| 输出字段名没变 | 和旧输出文件比列名 | 补映射 |
| 广告标记保留 | 输出里有 is_ad、is_sponsored | 补列 |
这张表也可以直接写进工单的验收标准,让 Codex 在交回的摘要里逐条回应。长任务要有人盯,Linear 这边靠 Inbox 通知和移动端:2026-11-04 起 Diffs 能在手机上审,代理做完的改动可以在手机上看完再合并(Linear 更新日志,Mobile Diffs)。
卡住时按症状查
下面这张表把文档里提到的报错和我们实测碰到的情况放在一起,按「在 Linear 里看到什么」来查。前三行来自 OpenAI 和 Linear 文档,第四、五行是按文档推出来的,没在 Codex 里复现;后面几行来自 2026-11-20 的接口真调。
| 看到的现象 | 最可能的原因 | 怎么改 |
|---|---|---|
| @Codex 以后 Codex 在工单里回了一段「怎么修」的说明,没有开始干活 | 没有和工单对得上的云端环境,或者环境里没有这个仓库 | 在 Codex 里给仓库建环境;评论里写 in org/repo 指定仓库 |
| Triage 规则把工单派给了 Codex,但没有任务出现 | 建工单的人没有绑定 Codex 账号;或者 Linear 不是 Business / Enterprise | 让告警用一个已绑定 Codex 的成员身份建工单,或者手动 @Codex |
| Codex 改错了地方 | 工单上下文不够,Codex 猜了别的文件 | 在工单里写清文件路径和要删的函数名 |
代理阶段真调回 401 missing_key | Key 放成了 secret,或者安装脚本里 export 的变量没带到代理阶段 | 改成环境变量,或者干脆只跑离线测试 |
| 代理阶段真调报网络错误、连不上 | 代理阶段联网没开,或者只放了 GET | 放行 api.everyinfra.com 和 POST |
422 missing_param / unknown_param | 参数名是从别的接口抄来的(query、video_url、max_results) | 按返回里的 param 和 example 改,一次只改这一个 |
422 invalid_value | 枚举值不在允许范围(sort: hot、sort: top) | 从 allowed 里挑;业务要「最新」就选 newest,别直接套 did_you_mean |
| 429 | 这把 Key 每分钟次数到顶 | 等 retry_after 秒;减少测试里的真调次数 |
| 返回空结果 | 关键词太冷,或者超出 reddit/search 的一个月窗口 | 空结果自动退费;把时间窗口写进工单 |
做不到和要注意的地方
Codex in Linear 跑在旧版环境上,OpenAI 已经写了旧版将来要下线(OpenAI:Cloud environments)。新环境的 Key 规矩更细:分环境变量和网络 secret 两种,网络 secret 在程序里只是一个占位符,代理把真实值在出网时替换进 HTTPS 请求,只对允许的域名生效。等 Linear 集成迁到新环境,Key 的推荐放法会变成网络 secret,域名填 api.everyinfra.com,这样代理进程里拿不到原始 Key。迁移之前,按旧版的规矩配。
工单正文是代理的输入,也是注入的入口。OpenAI 的联网文档专门举了工单里藏指令、让代理把提交信息发到外部网址的例子(OpenAI:Agent internet access)。Triage 规则会把外部来源(客服、告警、表单)开的单自动派给 Codex,外部来源越多,越要把代理阶段的联网收紧到一两个域名。OpenAI 文档最后一句也是:Codex 会出错,答案和 diff 都要人看过再合并。
| 能力 | `price_usd` | 返回 | 必填 | 可选 | `limit` 默认 / 上限 | `field_note` 摘要 |
|---|---|---|---|---|---|---|
tiktok/video | 0.000556 | 单个对象 | url | — | — | 部分请求不带 is_sponsored、repost_count 和几项作者字段 |
youtube/comments | 0.000556 | 列表 | url | since、sort(newest、popular) | 20 / 100 | 部分请求最多回 40 条,且不带点赞数和回复数 |
reddit/search | 0.000792 | 列表 | keyword | sort(6 个值) | 10 / 25,超出按上限截断 | 只覆盖最近一个月;部分请求不带 flair、正文和图片字段 |
表外还有两点:youtube/comments 的 posted_at 是相对时间;tiktok/video 的 cover_image_url 带签名、会过期,存进库的话要另存图片。慢能力会转异步,脚本里的轮询代码要留着。EveryInfra 只提供数据接口,不碰你的 Linear 工作区和 GitHub 仓库,Codex 改出来的 PR 由你审。
行业动向
- 2026-11-18 前后:OpenAI 把 Codex in Linear 的说明迁到新的文档站,补了 Triage 规则自动委派和「用工单创建人账号跑对话」的说明(OpenAI:Use Codex in Linear)。对读者意味着:自动派活前先确认开单人连过 Codex。
- 2026-11-17:AI Engineer 频道发布 OpenAI 两位工程师的分享「New Ways of Working with Codex」,YouTube 搜索结果里显示 16,251 次播放(来自我们 00:14 的
youtube/search返回)。对读者意味着:OpenAI 自己在推「把活委派出去」的用法,Linear 是入口之一。 - 2026-11-13:OpenAI 的云端代理出口地址文件更新(chatgpt-agents.json)。对读者意味着:按 IP 放行的服务要每天核一次地址段,但不能代替 Key。
- 2026-11-12:Linear 的云端编码代理支持自带 OpenAI、Anthropic 等 API Key,模型费直接记到你的账户(Linear 更新日志)。对读者意味着:同样是「Linear 里的 Codex」,走 Linear 自家代理时花的是 API 账户的钱。
- 2026-11-04:Linear 的移动端上线 Diffs 代码审查,同一批更新修复了审查人下拉框里不显示 Codex 的问题(Linear 更新日志,Mobile Diffs)。对读者意味着:Codex 交回的改动可以在手机上审。
- 2026-11-21 之前:OpenAI 定价页写 GPT-5.6 Sol 的促销价至少持续到 11 月 21 日;它和 Linear 编码代理默认的 GPT-6 Sol 是两个模型,Linear 的可选列表里两个都有(OpenAI:Pricing)。对读者意味着:按额度算的 Codex 任务成本,月底前后可能变。
常见问题
Codex in Linear 要什么套餐?
ChatGPT 付费套餐。Linear 集成页列的是 Plus、Pro、Business、Enterprise、Edu(Linear:Codex Integration);OpenAI 文档写的是「付费套餐」,并要求先建好 Codex 云端环境。Enterprise 还要管理员在工作区设置和连接器设置里分别打开。问题来自 Google 联想词「install codex in linear」。
Codex linear MCP 和 Codex in Linear 是一回事吗?
不是同一个东西。Codex in Linear 是在 Linear 工单里派活,任务跑在 OpenAI 云端;Codex linear MCP 是让本机的 Codex CLI、IDE 插件、ChatGPT 桌面端读写 Linear 工单,命令是 codex mcp add linear --url https://mcp.linear.app/mcp。Linear 的页面写明这个 MCP 只能用于本机 Codex 任务(Linear:Codex MCP Integration)。问题来自联想词「codex linear mcp」。
Codex linear plugin 在哪装?
云端这一套没有单独的插件:在 Codex 设置的连接器页装「Codex for Linear」(OpenAI:Use Codex in Linear)。Linear 里还有一个「在编码工具里打开工单」的设置,可以把 Codex 加进 Work on issue 菜单,按 W 再按 O 选工具(Linear Docs:Assign and delegate issues)。问题来自联想词「codex linear plugin」。
Codex 云端任务能联网调外部 API 吗?
能,但要手动开。旧版环境的代理阶段默认断网,可以按环境打开,配域名白名单和允许的 HTTP 方法;只放行 GET、HEAD、OPTIONS 时 POST 会被拦(OpenAI:Agent internet access)。调 EveryInfra 要放行 api.everyinfra.com 和 POST。问题来自 OpenAI 社区帖「Linear connector available in Codex」里对浏览器版 Codex 能力的讨论(OpenAI 社区)。
Codex linear auth:Key 放 secret 为什么测试读不到?
旧版环境的 secret 只给安装脚本用,代理阶段开始前就删掉(OpenAI:Codex Cloud (Legacy))。要让代理读到,就放成环境变量,并给这个环境单开一把收窄过的 Key;或者让测试离线跑。问题来自联想词「codex linear auth」。
Codex 和 Claude Code 在 Linear 里怎么选?
Linear 官方 Codex 视频下点赞最多的评论问的就是 Claude Code。现在 Linear 自己的云端编码代理两个都能选,默认模型是 GPT-6 Sol(Linear Docs:Linear cloud coding agent);r/Linear 也有帖子在讨论同时用 Claude Code 和 Codex 的工作流(r/Linear)。选哪个看你已经付的是 ChatGPT 套餐还是 Linear AI credits。
上手步骤
- 在 EveryInfra 接入文档注册并拿到 API Key,给 Codex 用的环境单开一把,只留数据接口权限。
- 用
GET https://api.everyinfra.com/api/v1/social/catalog?platform=tiktok等读目录,把要用的能力、参数和单价写进工单。 - 把三份真实返回存进
tests/fixtures/,写好AGENTS.md里的「数据接口」一节。 - 在 Codex 的云端环境里配好环境变量
EVERYINFRA_API_KEY(要真调时)和联网白名单(api.everyinfra.com,允许 POST)。 - 在 Linear 工单里 @Codex 或指派给 Codex,看 Activity 里的进度,到对话链接里审 diff、开 PR。
- 合并后在你自己的调度里跑脚本,按输出文件里的
charged_usd核账,价格以 定价页 和目录为准。
Codex 云端任务的另一种用法,每周自动出评论周报,见 Codex Cloud 评论周报,云端环境的基础设置那一篇写得更全。用 Claude Code 子代理并行拉 TikTok 账号的做法,见 Claude Code 子代理拉 TikTok 品牌号。
参考资料
- Use Codex in Linear,OpenAI,2026-11-18 前后,2026-11-20 读取
- Codex Integration,Linear,2026-11-20 读取
- Codex MCP Integration,Linear,2026-11-20 读取
- Codex Cloud (Legacy),OpenAI,2026-11-20 读取
- Codex Cloud (Legacy): internet access,OpenAI,2026-11-20 读取
- Cloud environments,OpenAI,2026-11-20 读取
- Agent approvals & security,OpenAI,2026-11-20 读取
- Model Context Protocol,OpenAI,2026-11-20 读取
- Custom instructions with AGENTS.md,OpenAI,2026-11-20 读取
- Pricing,OpenAI,2026-11-20 读取
- openai/codex-universal,OpenAI,GitHub
- MCP bearer-token env var appears configured even when missing(#30125),openai/codex,2026-06-25
- chatgpt-agents.json,OpenAI,2026-11-13 生成
- What is ChatGPT Plus?,OpenAI 帮助中心,2026-11-20 读取
- ChatGPT Business overview,OpenAI 帮助中心,2026-11-20 读取
- Linear connector available in Codex,OpenAI 开发者社区,2025-07-26
- Agent platform,Linear Docs,2026-11-20 读取
- Assign and delegate issues,Linear Docs,2026-11-20 读取
- Triage,Linear Docs,2026-11-20 读取
- Linear cloud coding agent,Linear Docs,2026-11-20 读取
- Coding sessions,Linear Docs,2026-11-20 读取
- Agents: Getting Started,Linear Developers,2026-11-20 读取
- Bring your own key (BYOK),Linear 更新日志,2026-11-12
- Mobile Diffs,Linear 更新日志,2026-11-04
- Linear Pricing,Linear,2026-11-20 读取
- Use Claude Code, Codex with Linear as a PM or Dev,r/Linear
- OpenAI Codex agent,Linear,YouTube,2025-12-04
- Introducing coding sessions,Linear,YouTube,2026-06-11
- OpenAI Codex Agent in Linear 讲解视频,YouTube,2025-12-08
- New Ways of Working with Codex,AI Engineer,YouTube,2026-11-17
- Software Developers, Quality Assurance Analysts, and Testers,美国劳工统计局,2026-11-20 读取
- Quota Calculator,YouTube Data API 文档,2026-11-20 读取
- Reddit Data API Wiki,Reddit 帮助中心,2026-11-20 读取
- TikTok Research Tools: Access and Eligibility,TikTok for Developers,2026-11-20 读取
- RFC 9110: HTTP Semantics,15.5.21 422 Unprocessable Content,IETF,2022-06
- Requests: Quickstart,Requests 文档
- EveryInfra 能力目录,EveryInfra,2026-11-20 00:14 读取
- EveryInfra 数据接口,EveryInfra,2026-11-20 真调
- EveryInfra 账户接口,EveryInfra,2026-11-20 真调
- OpenAI on TikTok:It's time to fly,OpenAI,TikTok,2026-06-03
- I stopped babysitting Codex. A lamp does it now.,r/codex,2026-11-18(UTC)
引用编号 BL-192