Codex in Linear: clave y red antes de cambiar un scraper
Codex in Linear borra los secrets antes del agente y arranca sin red. Ejemplos según la documentación y pruebas reales de la API: 0,001904 USD por ronda.
Con Codex in Linear, usted asigna un issue a Codex o lo menciona con @Codex en un comentario. Codex abre una tarea en la nube y publica el resultado en el mismo issue (OpenAI: Use Codex in Linear). Esa tarea corre en un entorno Codex Cloud (Legacy). Allí los secrets solo existen para el script de preparación, y la fase del agente no tiene internet por defecto (OpenAI: Codex Cloud (Legacy)).
No delegamos ningún issue real a Codex. Los pasos de Codex y Linear salen de la documentación oficial, y el issue, el AGENTS.md y los ajustes del entorno son ejemplos de configuración. Solo probamos el lado de la API de EveryInfra.
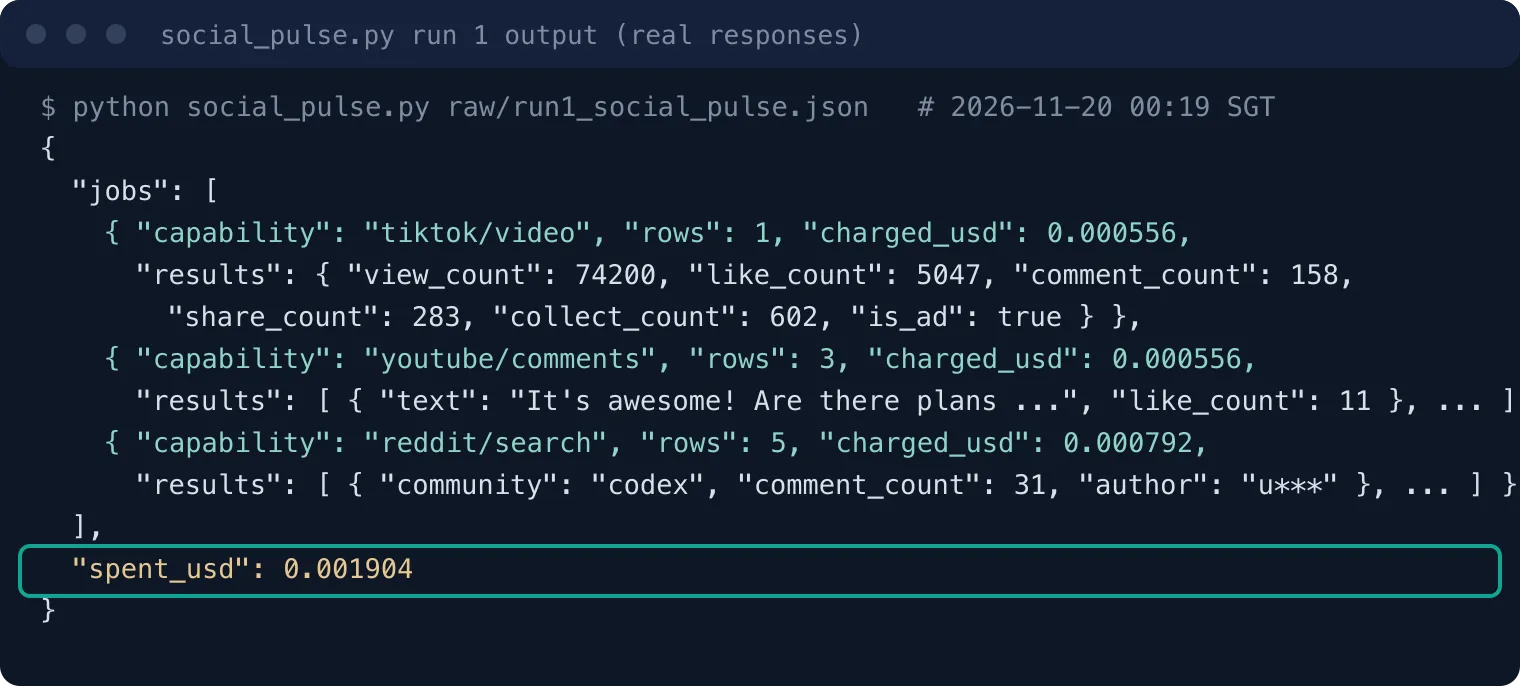
En nuestra propia máquina, reescribimos un scraper diario de TikTok, YouTube y Reddit como tres llamadas a POST /api/v1/social. Lo ejecutamos tres veces el 20 de noviembre de 2026, entre las 00:19 y las 00:59 hora de Singapur. Cada ronda costó exactamente 0,001904 USD. Además, enviamos cinco peticiones con parámetros equivocados. Las cinco devolvieron 422 sin cargo, y cada 422 señaló un solo error.
Qué hace Codex in Linear según la guía del 18 de noviembre
OpenAI llevó la guía de Codex in Linear a su nuevo sitio de documentación hacia el 18 de noviembre de 2026. La página es breve. Usted asigna un issue a Codex o menciona @Codex en un comentario. Codex crea un chat en la nube y publica el avance en el feed de actividad del issue.
Al terminar, Codex publica un resumen y un enlace. Usted abre el enlace, revisa el diff y crea un pull request (OpenAI: Use Codex in Linear). La página de integración de Linear dice lo mismo y nombra los planes: ChatGPT Plus, Pro, Business, Enterprise y Edu (Linear: Codex Integration). En Enterprise, un administrador debe activar antes las tareas en la nube de Codex en la configuración del espacio de trabajo. También debe habilitar el conector «Codex for Linear» en la configuración de conectores.
La instalación tiene tres pasos. Primero, conecte GitHub en Codex y cree un entorno en la nube para el repositorio. Segundo, abra la página de conectores en la configuración de Codex e instale Codex for Linear en su espacio de trabajo. Tercero, mencione @Codex una vez en cualquier comentario y vincule su cuenta de Linear cuando Codex lo pida.
La documentación de agentes de Linear añade dos datos. Al instalar, usted elige a qué equipos puede entrar el agente. Además, los agentes no cuentan como puestos de pago en Linear (Linear Docs: Agent platform).
| Punto | Qué dice la documentación | Fuente (leída el 20 de noviembre de 2026) |
|---|---|---|
| Planes | ChatGPT Plus, Pro, Business, Enterprise, Edu | Página de integración de Linear |
| Cómo se activa | Asignar el issue a Codex o mencionar @Codex; responder en el hilo para seguir | Documentación de OpenAI |
| Elección del repositorio | El entorno que mejor encaja con el issue; si no, el usado más recientemente | Documentación de OpenAI |
| Fijar un repositorio | Escribir @Codex fix this in org/repo | Documentación de OpenAI |
| Rama | Rama por defecto del primer repositorio del entorno | Documentación de OpenAI |
| Delegación automática | Regla de Triage: Delegate → Codex; corre como quien creó el issue | OpenAI y Linear Triage |
| Plan para reglas de Triage | Linear Business y Enterprise | Documentación de Triage de Linear |
| Uso local | Codex CLI, extensión de IDE o ChatGPT de escritorio con el MCP de Linear | OpenAI y página Codex MCP de Linear |
Una regla de Triage puede delegar en Codex los issues nuevos que cumplan una condición. Eso incluye el issue que abre una alerta o un compañero cuando falla un trabajo de datos (Linear Docs: Triage). La guía de OpenAI dice que, con reglas de Triage, Codex abre los chats en nombre de quien creó el issue.
Por eso, la persona o la cuenta que abre el issue debe tener una cuenta de Codex vinculada. La documentación de asignación de Linear da la misma regla para las reglas básicas de Triage: la sesión del agente usa la identidad del compañero asignado de forma automática (Linear Docs: Assign and delegate issues). Un bot de alertas que abre issues no puede iniciar solo una sesión de Codex.
Dos integraciones de Codex con Linear
Si usted busca «codex linear integration», encuentra dos productos. Los dos usan el nombre Codex, pero se pagan de forma distinta y tratan la clave de forma distinta.
El primero es el de arriba: Codex for Linear, de OpenAI. Las tareas corren en Codex Cloud (Legacy) de OpenAI y consumen la cuota de su plan de ChatGPT. El segundo es el agente de programación en la nube de Linear, que Linear llama coding sessions. Puede usar Claude Code o Codex, y el modelo por defecto es GPT-6 Sol. Consume créditos de IA de su espacio de trabajo en Linear (Linear Docs: Linear cloud coding agent).
El 12 de noviembre de 2026, Linear añadió a ese agente la opción «traiga su propia clave». Su proveedor cobra el uso del modelo, y Linear sigue cobrando en créditos de IA el tiempo del sandbox. Linear aclara que hace falta una clave de API, no una suscripción a ChatGPT o Claude (Linear changelog, 12 de noviembre de 2026).
| Punto | Codex for Linear (OpenAI) | Agente en la nube de Linear (opción Codex) |
|---|---|---|
| Dónde se instala | Configuración de Codex → Conectores | Configuración de Linear → AI & agents → Cloud coding agent |
| Quién paga | Cuota del plan de ChatGPT (Plus o superior) | Créditos de IA de Linear; el modelo puede ir a su clave de OpenAI o Anthropic |
| Configuración del entorno | Entorno en la nube de Codex: script de preparación, variables, secrets, interruptor de internet | Linear Code → Environments: runtimes, variables, script de preparación, archivos |
| ¿El agente puede leer la clave? | Variables sí; los secrets se borran antes de la fase del agente | Variables normales sí; los valores marcados como Secret no los ve el agente por defecto, pero sí quien pueda abrir una sesión |
| Base de los ejemplos de configuración | Sí | Solo para comparar |
La documentación de Linear es directa con sus variables de entorno. El agente ve los nombres y los valores, y usted no debe tratarlos como secretos ocultos al agente. Linear tiene además una casilla Secret. Por defecto, el agente no ve un valor con esa casilla marcada, pero sí lo ve cualquier persona que pueda abrir una sesión en ese entorno. La documentación pide tratarlo como un archivo .env local (Linear Docs: Configure coding environments).
La documentación no dice si las pruebas de la fase del agente pueden usar ese Secret, y no lo probamos en Linear. En OpenAI, los secrets solo existen en el script de preparación. Con las reglas legacy de OpenAI, una comprobación real del agente necesita la clave como variable de entorno, y el agente puede leerla. Por eso conviene dar a ese entorno una clave propia con permisos limitados. La sección sobre la clave, más abajo, explica cómo.
Tres límites del entorno en la nube: clave, red y MCP
La documentación dice qué entorno usa Codex in Linear. Codex Cloud (Legacy) sigue dando soporte a Code Review y a las integraciones con Linear y GitHub. OpenAI también dice que piensa retirar la experiencia legacy (OpenAI: Cloud environments). Por eso, los tres límites que siguen salen de la documentación legacy.
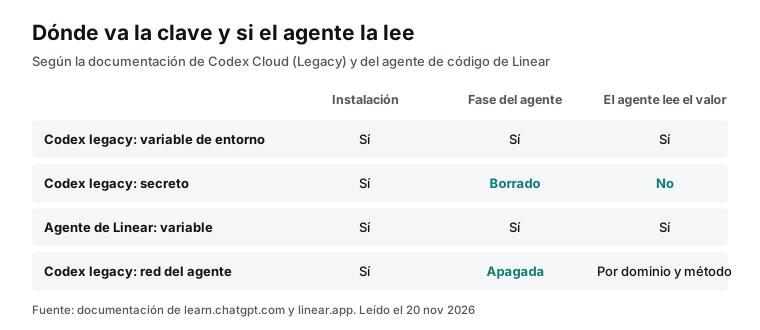
Límite 1: la clave. Un entorno legacy guarda valores de dos formas. Las variables de entorno existen durante toda la tarea, en el script de preparación y en la fase del agente. Los secrets tienen una capa extra de cifrado. Codex los descifra solo para ejecutar la tarea. Solo los scripts de preparación pueden leerlos, y Codex los borra antes de la fase del agente (OpenAI: Codex Cloud (Legacy)).
La página de seguridad repite esta regla (OpenAI: Agent approvals & security). Hay otro detalle: el script de preparación y el agente corren en sesiones de Bash distintas. Un export en el script de preparación no llega al agente. Si usted guarda la clave de API como secret, cualquier prueba real en la fase del agente falla sin clave.
Límite 2: la red. En el entorno legacy, la fase del agente no tiene internet por defecto. Usted puede activarlo por entorno, con una lista de dominios permitidos y una lista de métodos HTTP permitidos. OpenAI sugiere una opción estricta: permitir solo GET, HEAD y OPTIONS, y bloquear POST y los demás métodos (OpenAI: Agent internet access).
La API de datos de EveryInfra es POST /api/v1/social. Con esa opción estricta, Codex puede leer el catálogo gratuito con un GET, pero no puede enviar una petición real. Hay dos salidas. Puede permitir api.everyinfra.com y POST, o puede dejar al agente sin red y usar solo pruebas sin conexión.
La misma página de OpenAI muestra un ejemplo de inyección de instrucciones. El texto de un issue esconde una orden para enviar datos del repositorio a una URL externa. Si el agente la sigue, hay una fuga de datos. En Codex in Linear, el texto del issue es la entrada principal del agente. Por eso conviene limitar la lista a los dominios que la tarea necesita.
Límite 3: MCP. Según la página Codex MCP de Linear, el servidor MCP de Linear solo sirve para tareas locales de Codex, en la CLI o en la extensión de IDE (Linear: Codex MCP Integration). La documentación MCP de OpenAI pone toda la configuración MCP en un archivo local, ~/.codex/config.toml. La app de escritorio, la CLI y la extensión de IDE comparten ese archivo (OpenAI: Model Context Protocol).
No encontramos en la documentación legacy ningún ajuste que conecte un servidor MCP a una tarea en la nube. Así que, para los issues de Linear, Codex edita código Python que llama a una API REST. El servidor MCP remoto de EveryInfra se puede usar en local con Codex CLI.
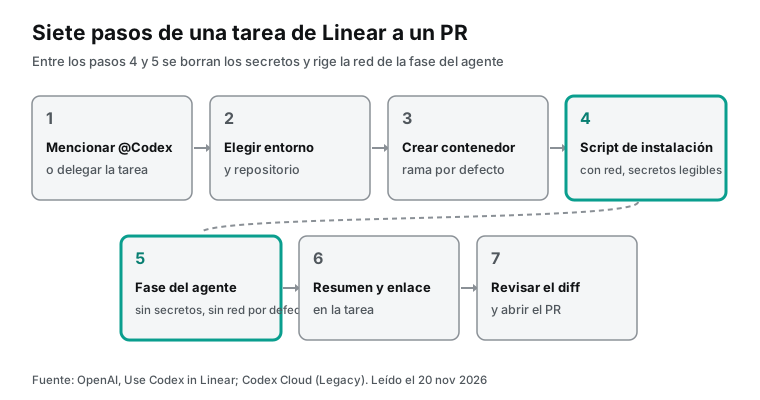
Del issue al pull request: siete pasos en la nube
La documentación reparte el flujo en varias páginas. En orden, Codex in Linear trata un issue en siete pasos.
| Paso | Fase | Internet | Secrets | Variables |
|---|---|---|---|---|
| 1. @Codex o delegar | Linear | — | — | — |
| 2. Elegir entorno | Codex | — | — | — |
| 3. Contenedor y descarga | Codex | — | — | — |
| 4. Script de preparación | Preparación | Activo | Legibles | Legibles |
| 5. Editar y probar | Agente | Apagado por defecto | Borrados | Legibles |
| 6. Resumen en el issue | Codex → Linear | — | — | — |
| 7. Revisión y PR | Usted | — | — | — |
En el paso 1, usted menciona @Codex o delega el issue. Linear envía el contenido del issue a Codex. La guía de OpenAI dice que Codex recibe ese contenido y que su política de privacidad cubre esos datos. En el paso 2, Codex elige un entorno a partir de la sugerencia de repositorio de Linear. Si la petición no está clara, usa su entorno más reciente. Si ningún entorno encaja, Codex responde en el issue con los pasos para arreglarlo, y usted vuelve a intentarlo.
En el paso 3, Codex crea un contenedor y descarga el repositorio. La documentación legacy llama universal a la imagen por defecto, que trae lenguajes y herramientas comunes. Usted puede fijar la versión de Python en la configuración del entorno (openai/codex-universal). En el paso 4 corre el script de preparación, con internet y con secrets. Aquí pip instala requests y otros paquetes.
Codex guarda en caché el estado del contenedor hasta 12 horas. Un cambio en el script de preparación, en las variables o en los secrets borra esa caché. En el paso 5 empieza la fase del agente. Los secrets ya no están, y la red sigue su configuración. Codex lee AGENTS.md, edita el código y ejecuta pruebas en bucle.
En el paso 6, Codex muestra su respuesta y su diff, y publica un resumen con enlace en el issue de Linear. En el paso 7, usted abre el enlace, revisa el diff y abre un pull request. Sus reglas de revisión de siempre se aplican a la fusión.
Un caso hipotético: social_pulse.py
El ejemplo de issue de abajo usa un caso hipotético: un script diario de un equipo de crecimiento. Cada mañana reúne tres cosas. Primero, vistas, «me gusta», comentarios y guardados de una lista de videos de TikTok. Segundo, los comentarios más nuevos de un video de lanzamiento en YouTube. Tercero, las publicaciones nuevas de Reddit que coinciden con una palabra clave.
La versión antigua leía páginas web. La parte de TikTok leía un bloque JSON dentro del HTML. La parte de YouTube usaba un descargador de código abierto. La parte de Reddit leía las páginas antiguas de Reddit. Supongamos que un día la parte de TikTok empieza a devolver 0 filas y una alerta abre un issue en Triage de Linear. Ese fallo es un supuesto para el ejemplo: no ejecutamos el script antiguo ni comprobamos si la página de TikTok cambió.
Las vías oficiales de las tres plataformas tienen sus propios límites. Reddit exige tokens OAuth registrados y limita mucho los user agents por defecto (Reddit Help: Reddit Data API Wiki). La API de datos de YouTube da a cada proyecto 10.000 unidades de cuota al día por defecto. Además, search.list tiene su propio límite de 100 llamadas al día (YouTube Data API: Quota Calculator). La Research API de TikTok es para investigadores aprobados, y la revisión suele tardar unas 4 semanas (TikTok for Developers: Research Tools). En el caso hipotético, el equipo usa estos límites para elegir una API lista en lugar de otra ronda de parches.
El código antiguo se parecía a esto. Es un boceto y no lo ejecutamos:
# Old version: parses web pages and breaks when the page changes
import re, json, requests
from bs4 import BeautifulSoup

def tiktok_stats(url):
    html = requests.get(url, headers={"User-Agent": "Mozilla/5.0"}, timeout=30).text
    blob = BeautifulSoup(html, "html.parser").find("script", id="__UNIVERSAL_DATA_FOR_REHYDRATION__")
    data = json.loads(blob.string)            # assumed case: blob is None when the JSON is missing; the error is swallowed, 0 rows
    item = data["__DEFAULT_SCOPE__"]["webapp.video-detail"]["itemInfo"]["itemStruct"]
    return {"views": item["stats"]["playCount"], "likes": item["stats"]["diggCount"]}
La versión nueva cambia los tres analizadores por una sola función, call(platform, action, params). Hay tres capacidades. tiktok/video da las métricas de un video. youtube/comments da los comentarios de un video. reddit/search da las publicaciones que coinciden con una palabra clave.
El catálogo gratuito lista el nombre de cada capacidad, sus parámetros obligatorios y opcionales, y su precio. Codex puede leer el catálogo antes de escribir código. Las vistas generales de cada plataforma están en las páginas API de TikTok, API de YouTube y API de Reddit.
Cómo escribir el issue: un ejemplo de configuración, sin ejecutar en Linear
Codex lee el título del issue, la descripción y el comentario que lo menciona. La sección de problemas de la guía de OpenAI trata el caso en que Codex trabaja en la parte equivocada del código. La solución es más contexto en el issue, o instrucciones explícitas en el comentario @Codex (OpenAI: Use Codex in Linear).
Así que escriba el issue como un conjunto de instrucciones que una persona podría seguir. Nombre el archivo, el cambio, las comprobaciones de aceptación y los límites. La plantilla de abajo es un ejemplo de configuración basado en la documentación. No la delegamos a Codex. Qué entorno elige Codex, cuántas rondas necesita y cómo queda el diff dependen de su propio issue:
Title: social_pulse.py TikTok step returns 0 rows; switch to EveryInfra API

Symptom: jobs/social_pulse.py runs daily at 07:00. tiktok_stats() returns 0 rows.
The YouTube and Reddit steps sometimes time out.
Do:
1. Delete the three page parsers (tiktok_stats, yt_comments, reddit_posts).
   Call POST https://api.everyinfra.com/api/v1/social with {"platform","action","params"}.
2. Capabilities: tiktok/video (url), youtube/comments (url, sort, limit), reddit/search (keyword, sort, limit).
   Take parameter names from GET https://api.everyinfra.com/api/v1/social/catalog?platform=tiktok (and youtube, reddit).
   Do not guess parameter names.
3. Read the key only from the EVERYINFRA_API_KEY environment variable. Never put it in code, tests or logs.
4. Handle 202 running (poll poll_url), 429 (wait retry_after), 503 (back off and retry).
   Do not retry 422. Raise it with error.param, error.allowed and error.did_you_mean.
Acceptance:
- tests/test_social_pulse.py passes offline with the three real responses in tests/fixtures/.
- The output JSON has rows and charged_usd for each capability.
Do not: rename output fields; add new dependencies (requests is already installed).
La plantilla está en inglés; Codex la lee igual de bien. Después, añada un comentario: @Codex follow the issue, repo acme/growth-jobs. Indique el repositorio, porque Codex deduce el entorno a partir del texto. Si la deducción no es clara, usa el entorno más reciente. La documentación muestra este mismo patrón (OpenAI: Use Codex in Linear).
La línea «no adivine los nombres de parámetros» corresponde a una prueba del lado de la API. Enviamos a propósito query en lugar de keyword. La API devolvió 422 al instante. Dijo que query no es un parámetro de esa capacidad y que hace falta keyword.
Añada también un archivo AGENTS.md en la raíz del repositorio. Codex lo lee antes de empezar. OpenAI dice que Codex usa este archivo para encontrar los comandos de prueba y de lint del proyecto (OpenAI: Custom instructions with AGENTS.md). Las líneas sobre la API de datos pueden quedar así. También es un ejemplo que no ejecutamos en Codex:
## Data API
- Before you call EveryInfra, read required_params, optional_params and allowed_values from
  /api/v1/social/catalog?platform=<platform>.
- On 422, change only the parameter named in error.param, using error.allowed or error.did_you_mean.
  Then send again. Each 422 reports one error.
- Tests run offline by default with tests/fixtures/*.json. Live calls only when EVERYINFRA_LIVE=1,
  with a maximum of 3 requests per run.
- Never print EVERYINFRA_API_KEY. Never write it to any file.
Dónde guardar la clave: variable, secret o pruebas sin conexión
Con las reglas legacy, usted tiene tres opciones, y cada una tiene un costo.
La opción A es un secret. Solo el script de preparación lo lee; la fase del agente no. Una prueba real que Codex ejecute después de escribir el código falla. Esta opción sirve cuando la preparación necesita la clave, por ejemplo para instalar un paquete privado, y el agente nunca la necesita.
La opción B es una variable de entorno. La fase del agente puede leerla, así que Codex puede comprobar su cambio con una llamada real. El costo es que el agente ve la clave y que la clave puede aparecer en los registros de la tarea.
La opción C es no poner clave. Todas las pruebas corren sin conexión con respuestas reales guardadas. Codex solo cambia código, y las llamadas reales corren en su propio programador de tareas después de la fusión.
| Opción | ¿El agente lee la clave? | Prueba real en la tarea | Riesgo principal | Cuándo usarla |
|---|---|---|---|---|
| A. Secret | No | Falla con 401 | Ninguno para el agente | La preparación necesita la clave y el agente no |
| B. Variable de entorno | Sí | Funciona | Clave visible para el agente y en registros | Necesita una comprobación real en la tarea |
| C. Sin clave | No hay clave | Solo sin conexión | Los archivos de prueba envejecen | Solo cambios de código (nuestra opción por defecto) |
Recomendamos la opción C primero y la opción B solo cuando haga falta. Para arreglar un scraper, la prueba de aceptación es «¿el código maneja la forma real de la respuesta?». Tres respuestas guardadas, como las que guardamos el 20 de noviembre de 2026, cubren los campos, los resultados vacíos y los errores 422. Si de verdad necesita una llamada real dentro de la tarea, cree una clave aparte solo para ese entorno.
La documentación de EveryInfra da varias formas de limitar una clave (guía rápida de EveryInfra). En la consola, en «API Keys → límites de permisos», usted puede dejar solo el producto de la API de datos. Un producto desactivado devuelve 403. Puede desactivar una clave sin tocar las demás. Puede fijar una lista de IP permitidas. Con la misma clave, GET /api/v1/account muestra el saldo y el límite por minuto sin cargo.
OpenAI publica los rangos de IP de salida de sus agentes en la nube (OpenAI: chatgpt-agents.json). El archivo que leímos se generó el 13 de noviembre de 2026. OpenAI también dice que esos rangos se comparten entre clientes, así que la autenticación debe seguir en su sitio (OpenAI: Cloud environments). Una lista de IP es una segunda puerta, no la primera.
Probamos una vez el orden de autenticación. A las 00:19 hora de Singapur enviamos una petición incompleta y sin clave. La API devolvió primero 401 missing_key, sin ningún error de parámetros. Así, quien llama sin autenticarse no puede sondear la forma de los parámetros. Con clave, sí se revisan los parámetros. Esto también ayuda a Codex: en un entorno sin clave, una prueba real devuelve 401 y no un 422 que le haga creer que los parámetros están mal.
Para depurar en local con Codex CLI, puede añadir el servidor MCP remoto de EveryInfra. Así Codex puede leer el catálogo y probar llamadas directamente. Nuestra página MCP da este comando: codex mcp add everyinfra --url https://api.everyinfra.com/mcp --bearer-token-env-var EVERYINFRA_API_KEY (MCP remoto de EveryInfra). Abajo está la versión en config.toml.
Hay un issue público en el repositorio de Codex que conviene conocer. A veces la variable que nombra bearer_token_env_var no existe en el proceso que corre. Entonces codex mcp list sigue mostrando autenticación Bearer, pero las peticiones salen sin cabecera (openai/codex issue #30125). Después de cambiar el entorno de su terminal, reinicie Codex. Luego compruebe la variable con printenv.
# ~/.codex/config.toml (local CLI and IDE only; Linear cloud tasks do not read this file)
[mcp_servers.everyinfra]
url = "https://api.everyinfra.com/mcp"
bearer_token_env_var = "EVERYINFRA_API_KEY"

[mcp_servers.linear]
url = "https://mcp.linear.app/mcp"
Hay un reparto de trabajo más simple. Primero, configure el servidor MCP de EveryInfra en su Codex CLI local. Deje que el Codex local lea el catálogo y haga una llamada real por capacidad. Guarde las respuestas en tests/fixtures/ y súbalas al repositorio. Después, delegue «cambiar los analizadores antiguos» al Codex en la nube desde Linear.
En esa tarea en la nube, Codex solo edita código y ejecuta pruebas sin conexión. No necesita clave ni internet. Las llamadas reales ocurren en su propia máquina, donde usted ve cada petición y cada cargo. Si el texto de un issue trae una instrucción extraña, la tarea en la nube no tiene ninguna clave que filtrar. Nosotros solo hicimos la primera mitad. Las tres rondas corrieron en nuestra máquina y guardamos las respuestas como archivos de prueba. La segunda mitad, la tarea en la nube desde Linear, no la ejecutamos.
Revise la clave antes con la llamada gratuita a /account
Usted puede comprobar sin costo que la clave existe, cuál es y cuánto saldo tiene. El 20 de noviembre de 2026, a las 00:39 hora de Singapur, llamamos a GET /api/v1/account con la clave que ejecutó el script. Devolvió 200 en 0,22 segundos, sin cargo.
La respuesta traía el saldo en dos partes, pagado y de bonificación. Traía el límite de la cuenta, 60 peticiones por minuto, y el límite de la clave, 10 peticiones por minuto. También traía el nombre de la clave, su fecha de caducidad y las llamadas, los fallos y el gasto de esa clave en las últimas 24 horas. La clave misma solo volvía como un prefijo enmascarado.
Ponga esta llamada en AGENTS.md como comprobación inicial. Antes de cualquier llamada real, Codex llama una vez a /account. Un 401 significa que falta la variable de entorno; casi siempre, la clave se guardó como secret. En ese caso, Codex debe parar y responder en el issue, sin ponerse a adivinar parámetros.
| Campo de la respuesta de /account | Valor a las 00:39 | Uso en una tarea de Codex |
|---|---|---|
balance.total_usd | Visible, separado en pagado y bonificación | Parar si el saldo es bajo |
rate_limit.requests_per_minute | 60 (cuenta) | Límite para todas las claves juntas |
rate_limit.key_requests_per_minute | 10 (esta clave) | Límite para llamadas reales y reintentos |
key.prefix | Enmascarado | Confirma qué clave está cargada, sin el valor completo |
usage_24h.this_key.spent_usd | Visible | Llamar antes y después de la tarea para saber su costo |
Una respuesta 200 muestra key_requests_per_minute. Nuestra clave permite 10 peticiones por minuto. Tres llamadas reales no son problema, pero un agente que reintenta en bucle recibe pronto un 429. La línea de AGENTS.md «como máximo 3 peticiones por ronda» sigue ese límite.
usage_24h.this_key.spent_usd es el gasto de la clave en las últimas 24 horas. Codex puede llamar a /account antes y después de la tarea, y la diferencia es el costo real de la tarea. Con una clave aparte para Codex, esa diferencia solo contiene sus llamadas.
El código Python después del cambio
Este es el script completo después del cambio. Es el mismo archivo que ejecutamos tres veces. Usa requests (Requests: Quickstart). El script hace cuatro cosas: lee la clave de una variable de entorno, envía una petición por capacidad, trata cada código de estado y escribe filas, cargos y segundos por capacidad en un archivo de salida.
"""social_pulse.py: daily pull of TikTok video stats, YouTube comments and Reddit posts."""
import json, os, sys, time
import requests

API = "https://api.everyinfra.com/api/v1/social"
KEY = os.environ["EVERYINFRA_API_KEY"]
HEAD = {"Authorization": f"Bearer {KEY}", "Content-Type": "application/json"}

class ParamError(Exception):
    """422: the request is wrong; resending the same body will not help."""

def call(platform, action, params, tries=4):
    body = {"platform": platform, "action": action, "params": params}
    for attempt in range(tries):
        r = requests.post(API, headers=HEAD, json=body, timeout=120)
        if r.status_code == 422:
            err = r.json()["error"]
            raise ParamError(json.dumps({k: err.get(k) for k in
                ("code", "param", "message", "allowed", "did_you_mean", "example")}))
        if r.status_code == 429:
            time.sleep(r.json()["error"].get("retry_after", 20) + 1); continue
        if r.status_code == 503:
            time.sleep(5 * (attempt + 1)); continue
        r.raise_for_status()
        data = r.json()
        if data.get("status") == "running":      # slow capability: poll
            data = poll(data["poll_url"])
        return data
    raise RuntimeError(f"{platform}/{action}: no result after {tries} tries")

def poll(url, every=5, limit=60):
    full = url if url.startswith("http") else "https://api.everyinfra.com" + url
    for _ in range(limit):
        data = requests.get(full, headers=HEAD, timeout=60).json()
        if data.get("status") != "running":
            return data
        time.sleep(every)
    raise RuntimeError("job still running")

def main(out_path):
    jobs = [
        ("tiktok", "video", {"url": "https://www.tiktok.com/@openai/video/7647247430546672909"}),
        ("youtube", "comments", {"url": "https://www.youtube.com/watch?v=JlhQD6GHT3g", "sort": "newest", "limit": 50}),
        ("reddit", "search", {"keyword": "codex cloud", "sort": "newest", "limit": 25}),
    ]
    spent, rows = 0.0, []
    for platform, action, params in jobs:
        t0 = time.time()
        data = call(platform, action, params)
        res = data.get("results")
        n = len(res) if isinstance(res, list) else (1 if res else 0)
        usd = (data.get("billing") or {}).get("charged_usd", 0.0)
        spent += usd
        rows.append({"capability": f"{platform}/{action}", "rows": n, "charged_usd": usd,
                     "seconds": round(time.time() - t0, 2), "results": res})
    with open(out_path, "w") as f:
        json.dump({"spent_usd": round(spent, 6), "jobs": rows}, f, ensure_ascii=False, indent=1)

if __name__ == "__main__":
    main(sys.argv[1])
Cada parte del código responde a un comportamiento de la API. tiktok/video devuelve un solo objeto en results. youtube/comments y reddit/search devuelven listas. Por eso el código cuenta las filas de dos formas. El campo returns_list del catálogo indica qué capacidades devuelven listas (catálogo de EveryInfra).
Las capacidades lentas responden primero con status: running y un poll_url. Consulte esa URL. No reenvíe el mismo cuerpo antes de 5 minutos, porque la API lo trata como una repetición. Una respuesta 429 incluye retry_after en segundos, así que espere ese tiempo. Un 503 significa que los datos no están disponibles ahora. Las llamadas fallidas no se cobran, así que espere un poco y vuelva a intentarlo.
Un 422 lanza su propia excepción, porque el mismo cuerpo siempre vuelve a fallar. Ese tipo de error pide un cambio en el código, no otro intento.
Los campos coinciden con los response_fields del catálogo. Para tiktok/video usamos view_count, like_count, comment_count, share_count, collect_count, posted_at y author_follower_count. Para youtube/comments usamos text, like_count, reply_count, posted_at e is_reply. Para reddit/search usamos title, community, like_count, comment_count y posted_at.
La salida antigua usaba columnas como views y likes. El issue dice «no cambie los nombres de los campos de salida». Así que Codex escribe esa correspondencia dentro del script, y los trabajos posteriores no cambian.
Pruebas sin conexión con respuestas reales
La regla de aceptación del issue dice que las pruebas deben pasar sin conexión con tres respuestas reales. La prueba de abajo es del tipo que Codex debería entregar. Los archivos de prueba son respuestas reales de la API. Así, la prueba comprueba cómo trata el código la forma real: tiktok/video devuelve un objeto y las otras dos devuelven listas.
charged_usd está dentro de billing. Un 422 lanza una excepción que lleva param.
# tests/test_social_pulse.py (offline: replace requests.post with unittest.mock)
import json, pathlib
from unittest import mock
import pytest, social_pulse as sp

FIX = pathlib.Path(__file__).parent / "fixtures"

def fake_post(status, name):
    r = mock.Mock(status_code=status)
    r.json.return_value = json.loads((FIX / name).read_text())
    r.raise_for_status = mock.Mock()
    return r

def test_tiktok_video_is_one_object():
    with mock.patch.object(sp.requests, "post", return_value=fake_post(200, "tiktok_video.json")):
        data = sp.call("tiktok", "video", {"url": "https://www.tiktok.com/@openai/video/7647247430546672909"})
    assert isinstance(data["results"], dict)
    assert data["billing"]["charged_usd"] == 0.000556

def test_422_is_not_retried():
    with mock.patch.object(sp.requests, "post", return_value=fake_post(422, "youtube_comments_422.json")) as p:
        with pytest.raises(sp.ParamError) as e:
            sp.call("youtube", "comments", {"url": "x", "sort": "top", "limit": 50})
    assert p.call_count == 1
    assert json.loads(str(e.value))["allowed"] == ["newest", "popular"]
La segunda prueba protege una regla que un agente rompe con facilidad: no reintentar un 422. Cuando un agente ve un fallo, a menudo añade un reintento. Esta prueba falla si el agente mete el 422 en la rama de reintentos.
Los archivos de prueba son copias de las respuestas que guardamos el 20 de noviembre de 2026, sin nombres de usuario. Hay una ventaja más. Cuando una plataforma cambie sus campos, usted sustituye esos archivos y ve qué pruebas fallan. Eso le dice qué debe arreglar el próximo issue para Codex.
Pruebas reales: el mismo script, tres veces
Ejecutamos el script en tres momentos del 20 de noviembre de 2026: a las 00:19, a las 00:38 y a las 00:59 hora de Singapur. La clave llegó solo por una variable de entorno. Los cuerpos de las peticiones fueron iguales en las tres rondas. La tabla muestra filas, cargo y segundos de cada capacidad.
| Capacidad | Ronda 1, 00:19 (filas / cargo / segundos) | Ronda 2, 00:38 | Ronda 3, 00:59 |
|---|---|---|---|
tiktok/video | 1 / 0,000556 USD / 8,38 | 1 / 0,000556 USD / 10,09 | 1 / 0,000556 USD / 9,75 |
youtube/comments | 3 / 0,000556 USD / 0,99 | 3 / 0,000556 USD / 1,36 | 3 / 0,000556 USD / 1,00 |
reddit/search | 5 / 0,000792 USD / 4,02 | 5 / 0,000792 USD / 8,88 | 5 / 0,000792 USD / 9,17 |
| Total | 9 / 0,001904 USD / 13,39 | 9 / 0,001904 USD / 20,33 | 9 / 0,001904 USD / 19,92 |
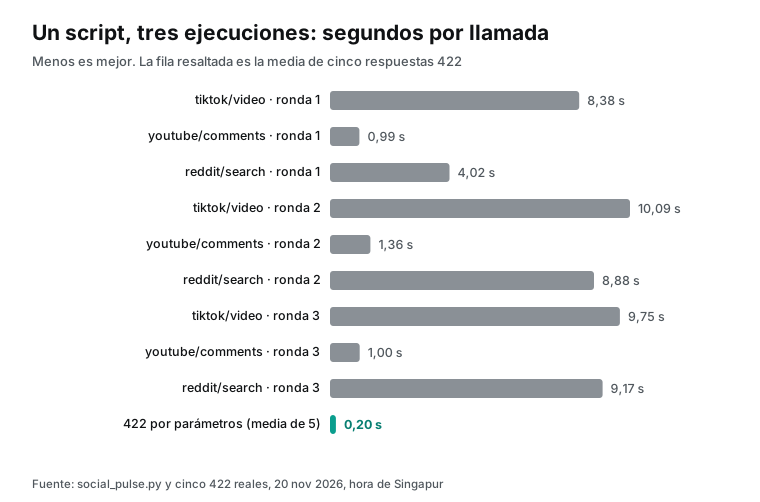
Los cargos coincidieron hasta el último dígito. Cada ronda costó 0,000556 + 0,000556 + 0,000792 = 0,001904 USD. Es la suma de los tres price_usd del catálogo. El video de YouTube solo tiene 3 comentarios, y reddit/search ordenado por más nuevos devolvió 5 publicaciones.
El cargo fue el mismo que con 50 o 25 filas, porque usted paga por llamada, no por fila. Así que el issue no necesita bajar limit para ahorrar. Póngalo en el máximo: 100 para youtube/comments y 25 para reddit/search.
La latencia varió más que el costo. tiktok/video tardó 8,38, 10,09 y 9,75 segundos en las tres rondas. reddit/search tardó 4,02, 8,88 y 9,17 segundos. youtube/comments se mantuvo entre 0,99 y 1,36 segundos. Una ronda de tres llamadas tardó entre 13,4 y 20,3 segundos en total.
En esos 40 minutos, el video de TikTok se quedó en 74.200 vistas. En Reddit, los resultados cambiaron. Las rondas 1 y 2 devolvieron las mismas 5 publicaciones. Luego apareció una publicación nueva, sin relación con Codex, en r/IA_Italia, el 2026-11-19 a las 16:50 UTC.
La ronda 3 incluyó esa publicación nueva y dejó fuera la más antigua, la de la lámpara, del 2026-11-18 a las 22:55 UTC. El resultado volvió a tener 5 filas. La publicación de la lámpara seguía dentro de la ventana de un mes, y limit era 25. Así que, para esta palabra clave, el orden por más nuevos devolvió 5 publicaciones cada vez, menos que limit. Escriba en la salida el número real de filas, y no lea «menos filas que limit» como «no hay más publicaciones». En las pruebas, compruebe «filas ≥ 0», no 5.
youtube/comments devuelve posted_at como texto relativo, por ejemplo «11 months ago». El video de Linear se publicó el 4 de diciembre de 2025, y la mayoría de los comentarios llegaron poco después. Si su informe filtra por fecha, use el parámetro since del catálogo. Convierta las fechas relativas en su script.
El catálogo dice que reddit/search solo cubre el último mes. A las 00:18 buscamos «codex linear» y obtuvimos solo 2 publicaciones. Ninguna trataba de Codex. Una era una herramienta de tablero de tareas, publicada el 2026-10-20 en un subreddit de proyectos de código abierto, ya en el borde de la ventana de un mes. La otra era una foto del 2026-10-23. Para hilos más antiguos, use una capacidad que lea un subreddit, o indique en el issue la ventana de tiempo.
Separe anuncios de publicaciones orgánicas: el 99 % de las vistas de «openai codex» eran anuncios
Cuando el script ya funciona, la siguiente pregunta es si los números pueden ir al informe tal cual. A las 00:18 ejecutamos tiktok/search con «openai codex» y obtuvimos 10 videos por 0,000556 USD. Queríamos ver qué recibe un equipo que mide «cuánto se habla de Codex» por palabra clave.
Los 10 videos sumaban 42.335.552 vistas. Los 3 videos con is_ad en true sumaban 42.074.200 vistas, es decir, el 99,4 %. Uno era de la cuenta oficial de OpenAI, y dos eran de creadores con una etiqueta de socio de ChatGPT. Los 7 videos orgánicos sumaban solo 261.352 vistas. El primer video tenía 31,8 millones de vistas, la etiqueta #chatgptpartner y 0 comentarios.
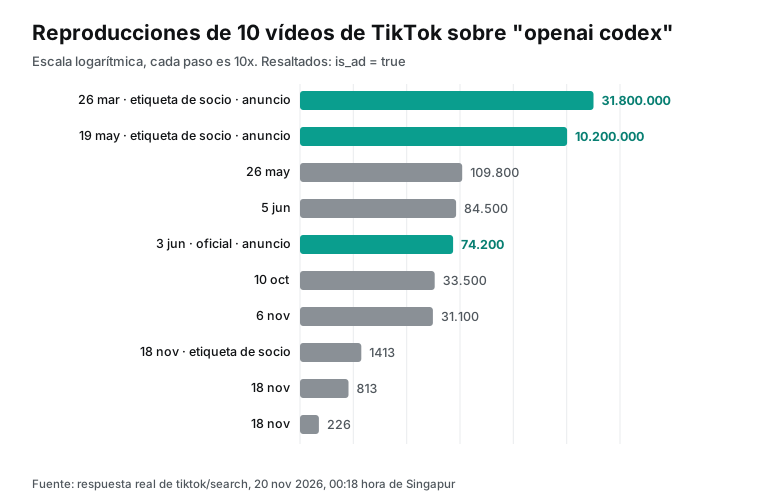
Una cifra de conversación basada en vistas totales es casi todo alcance pagado. Un video más de socio en un día mueve la línea dos órdenes de magnitud. Por eso el issue debe pedir a Codex que conserve las columnas is_ad e is_sponsored. Los dos campos están en los response_fields de tiktok/video y tiktok/search. Así, el informe cuenta las vistas pagadas y las orgánicas en dos columnas.
Los dos campos significan cosas distintas. is_ad marca un anuncio pagado. is_sponsored marca contenido patrocinado. En estos 10 videos, uno tenía solo is_sponsored y otro tenía los dos. El field_note del catálogo también dice que algunas peticiones no devuelven is_sponsored. Cuando falte la clave, anote «desconocido», no false.
También miramos las otras dos capacidades. En Reddit, la ronda de las 00:19 buscó «codex cloud» por más nuevos y devolvió 5 publicaciones. Todas se publicaron entre el 2026-11-18 a las 22:55 y el 2026-11-19 a las 15:39 UTC. Dos venían de r/codex. Una de ellas tenía 31 comentarios y describía una lámpara de escritorio que se enciende cuando una tarea larga de Codex necesita a una persona (publicación de r/codex). La otra es del 19 de noviembre de 2026 a las 15:39 UTC y tiene 6 comentarios. Su autor cuenta que GPT-6 Astra en Codex escribió todo el backend en Rust de una app para Mac.
| Publicada (UTC) | Subreddit | Comentarios | Tema |
|---|---|---|---|
| 2026-11-19, 15:39 | r/codex | 6 | El backend en Rust de una app hecho con Codex |
| 2026-11-19, 12:47 | r/alphaandbetausers | 0 | Búsqueda de testers |
| 2026-11-19, 09:20 | r/singularity | 1 | Comparación de modelos de imagen |
| 2026-11-19, 03:30 | r/AtlasCloudAI | 0 | Promoción |
| 2026-11-18, 22:55 | r/codex | 31 | Una lámpara que se enciende cuando Codex necesita respuesta |
En YouTube, el video de 28 segundos de Linear tiene 3 comentarios en 11 meses. Los informes por palabra clave traen muchos elementos fuera de tema o promocionales. Ponga las reglas de filtro en las comprobaciones de aceptación del issue. No espere que Codex las adivine.
Cómo corrige Codex sus propios errores 422
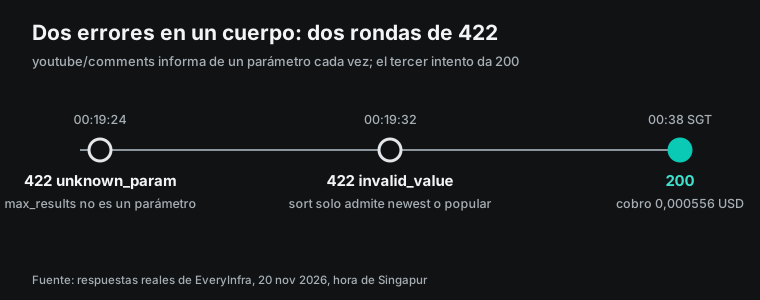
Los errores más comunes de Codex son nombres de parámetros equivocados y valores de enumeración equivocados. Entre las 00:14 y las 00:19 enviamos cinco cuerpos erróneos a propósito. Los cinco devolvieron 422 y ninguno se cobró:
| Hora (Singapur) | Capacidad | Error | `error.code` | Información para corregir | Segundos |
|---|---|---|---|---|---|
| 00:14 | reddit/search | Envió query en lugar de keyword | missing_param | query no es un parámetro; use keyword; example que funciona | 0,15 |
| 00:14 | reddit/search | sort con valor hot | invalid_value | 6 valores allowed; did_you_mean: popular, top | 0,21 |
| 00:19 | youtube/comments | max_results y sort: top (dos errores) | unknown_param | Solo señala max_results; allowed: url, limit, since, sort | 0,11 |
| 00:19 | tiktok/video | Envió video_url en lugar de url | missing_param | video_url no es un parámetro; use url; example que funciona | 0,23 |
| 00:19 | youtube/comments | Ya con limit, pero aún sort: top | invalid_value | allowed: newest, popular; did_you_mean: popular | 0,31 |
Dos de los cinco errores usaban nombres de parámetros de otras API (query, video_url). Tres respuestas listaban los valores permitidos. Dos traían candidatos en did_you_mean. Tres traían un cuerpo example que funciona.
Las filas 3 y 5 muestran algo que Codex debe saber: cada 422 señala un solo error. Nuestro cuerpo tenía dos errores. La primera respuesta solo dijo que max_results no es un parámetro. Después de esa corrección, la respuesta siguiente señaló el valor erróneo de sort.
Un agente que corrige errores ronda a ronda necesita una ronda por cada error. En cada ronda, el agente debe cambiar solo el parámetro que nombra el error, y nada más. Nuestro AGENTS.md de arriba dice exactamente eso. La primera línea de next_steps termina con «Nothing was charged.». Así, el agente sabe que ese fallo no tuvo costo.
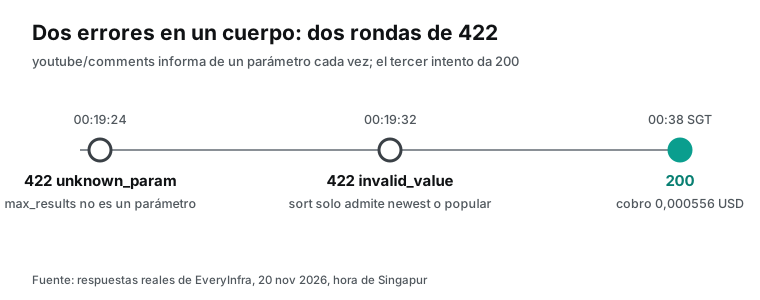
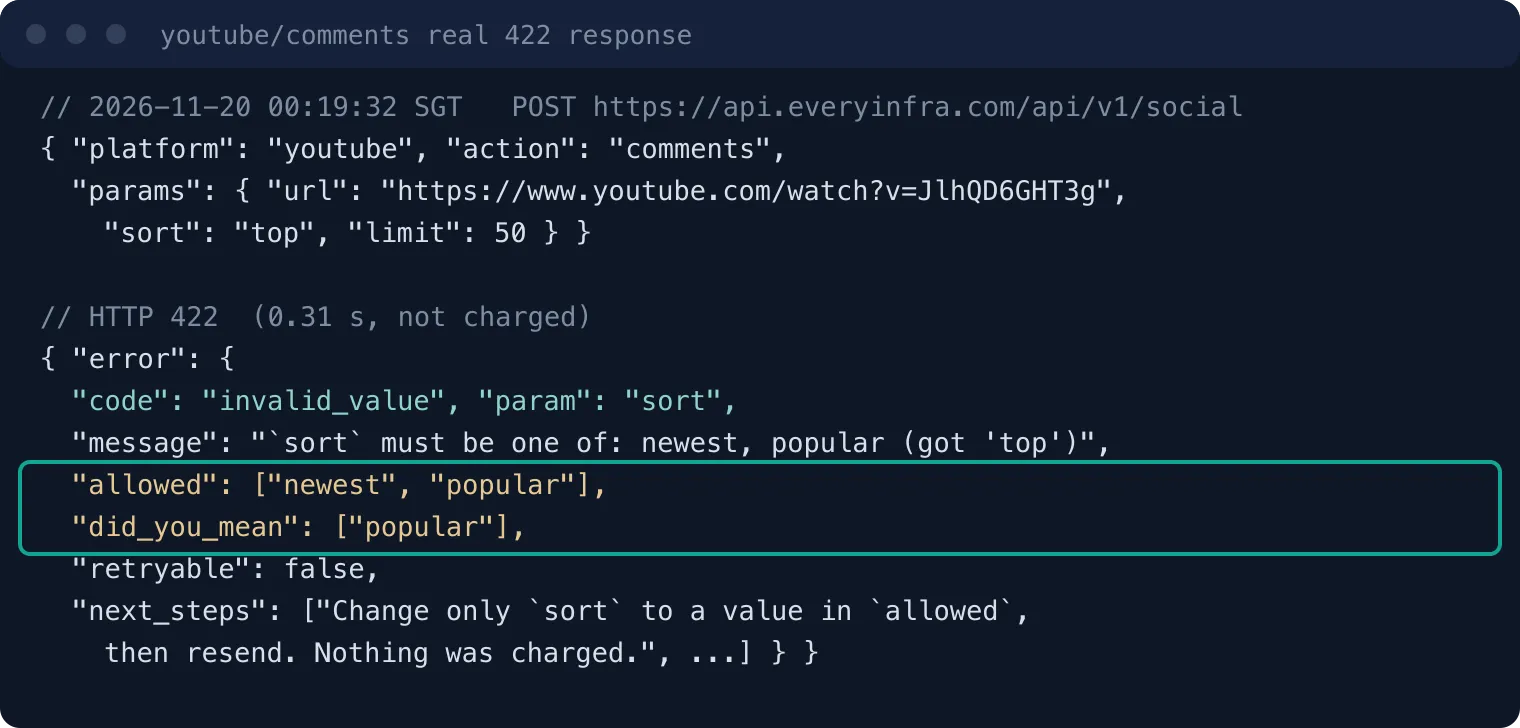
El cuerpo del 422 es como el de la captura. Es de la segunda petición de las 00:19. Codex lee param y encuentra sort en el código. Elige un valor de allowed. did_you_mean tiene un candidato, popular. Si el negocio necesita los comentarios más nuevos, el valor correcto es newest.
Esa elección es una decisión de negocio. Si el issue dice «necesitamos los comentarios más nuevos», Codex no toma sin más el candidato. HTTP define el 422 como un estado en el que el servidor entiende el tipo de contenido y la sintaxis, pero no puede procesar las instrucciones (RFC 9110, sección 15.5.21). Encaja con este uso: la petición es JSON válido y los parámetros están mal.
Ahora mire el costo en tiempo. Las 5 respuestas 422 tardaron entre 0,11 y 0,31 segundos, unos 0,2 segundos de media. Las llamadas correctas del mismo periodo tardaron entre 1 y 10 segundos. Así, una ronda de corrección casi no cuesta tiempo de API ni dinero. Lo lento es el modelo, que lee el error, edita el código y vuelve a ejecutar las pruebas.
Dos errores en dos rondas añadieron solo unos 0,4 segundos de API. Piense ahora en un código que mete el 422 en la rama de reintentos. Cuatro reintentos reciben cuatro 422 idénticos. Pierden tiempo y gastan 4 de las 10 peticiones por minuto de la clave. Por eso la prueba sin conexión de arriba comprueba que un 422 provoca una sola llamada. Guardamos tal cual las cinco respuestas 422 y la respuesta 401, así que puede usarlas como archivos de prueba.
Para más códigos de error y patrones de autocorrección, vea cómo corrigen los agentes de IA los errores de una API. Para reembolsos de fallos y resultados vacíos, vea conciliación de reembolsos por fallo.
Cuánto cuestan 500 llamadas al día
El costo de la API usa el price_usd del catálogo. Cada llamada tiene un precio fijo. Suponemos este uso para el equipo del caso hipotético. Sigue 300 videos de TikTok (300 llamadas a tiktok/video), los comentarios de 100 videos de YouTube (100 llamadas a youtube/comments) y 100 palabras clave de Reddit (100 llamadas a reddit/search). En total, 500 llamadas al día.
| Capacidad | Precio (catálogo, 20 de noviembre de 2026) | Por 1.000 llamadas | Llamadas al día | Por día | 30 días |
|---|---|---|---|---|---|
tiktok/video | 0,000556 USD | 0,556 USD | 300 | 0,1668 USD | 5,004 USD |
youtube/comments | 0,000556 USD | 0,556 USD | 100 | 0,0556 USD | 1,668 USD |
reddit/search | 0,000792 USD | 0,792 USD | 100 | 0,0792 USD | 2,376 USD |
| Total | — | — | 500 | 0,3016 USD | 9,048 USD |
Si «500 veces al día» significa 500 rondas completas del script (3 llamadas cada una), el costo es 500 × 0,001904 = 0,952 USD al día, o 28,56 USD en 30 días. La mezcla más cara son 500 llamadas a reddit/search: 0,396 USD al día u 11,88 USD en 30 días. Los fallos y los resultados vacíos no se cobran, así que estas cifras son techos.
Los costos de Codex van aparte. Las tareas de Codex in Linear consumen la cuota de su plan de ChatGPT. Plus cuesta 20 USD al mes (OpenAI Help: What is ChatGPT Plus). Un puesto estándar de Business cuesta 25 USD por usuario al mes con pago mensual, o 20 USD con pago anual (OpenAI Help: ChatGPT Business overview).
| Plan | Precio (leído el 2026-11-20) | Qué cubre en esta configuración |
|---|---|---|
| ChatGPT Plus | 20 USD al mes | Tareas de Codex in Linear para un usuario |
| ChatGPT Business (estándar) | 25 USD por usuario al mes, o 20 USD con pago anual | Uso de Codex en equipo |
| Linear Business | 16 USD por usuario al mes | Reglas de Triage para delegar de forma automática |
| API de datos de EveryInfra | Por llamada, según el catálogo | Las tres capacidades del script |
La página de precios de OpenAI dice que las tareas en la nube pueden consumir más cuota que los mensajes locales. Revise el panel de uso para ver cifras reales (OpenAI: Pricing). La delegación automática con reglas de Triage también exige Linear Business, a 16 USD por usuario al mes (Linear Pricing).
Comparado con las horas de mantener su propio scraper
No encontramos datos de encuestas fiables sobre cuántas horas exige mantener un scraper. Así que usamos una cifra pública y tres supuestos explícitos. La cifra pública es la mediana de 2025 de la Oficina de Estadísticas Laborales de Estados Unidos para desarrolladores de software, analistas de QA y testers: 64,44 USD por hora (BLS: Software Developers).
| Mantenimiento supuesto | Horas al mes | Tarifa | Costo mensual |
|---|---|---|---|
| 1 hora al mes | 1 | 64,44 USD (mediana BLS) | 64,44 USD |
| 1 hora por semana | 52 ÷ 12 ≈ 4,33 | 64,44 USD | 279,24 USD |
| 1 día (8 horas) por semana | ≈ 34,67 | 64,44 USD | 2.233,92 USD |
Las tres cantidades de horas son supuestos para comparar órdenes de magnitud. Su scraper puede funcionar seis meses sin problemas o romperse varias veces por semana. Con las horas reales de su equipo, la cuenta sale más precisa.
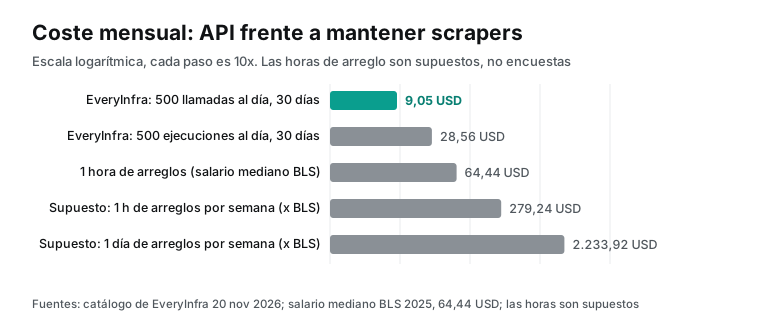
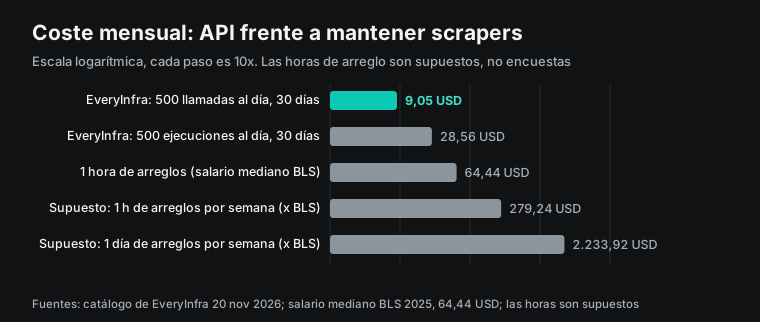
Con los tres supuestos, una hora al mes de arreglos al salario mediano del BLS cuesta 64,44 USD, unas 7 veces los 9,05 USD de 500 llamadas al día durante un mes. Una hora por semana cuesta 279,24 USD, unas 31 veces. Un día por semana cuesta 2.233,92 USD, unas 247 veces.
La comparación tiene tres límites. Primero, las horas son supuestos, no datos de encuestas. Segundo, las cifras de horas no incluyen los servidores ni los proxies que necesita un scraper propio, así que su costo real es mayor. Tercero, la API solo cubre las plataformas y los campos del catálogo. Para otros sitios, usted sigue necesitando su propio scraper. En ese caso, Codex in Linear le ayuda a arreglar el scraper mismo.
Pasos que muestran los videos y que faltan en la documentación
Los tutoriales en video y la documentación difieren en tres puntos. A las 00:14 ejecutamos youtube/search con «codex linear». Tres de los 10 primeros resultados trataban de Codex in Linear: dos del canal de Linear y uno de un creador de contenido sobre SEO. El segundo video de Linear trata del agente propio de Linear, no de Codex for Linear.
| Video | Canal | Publicado | Duración | Vistas (búsqueda de las 00:14) | Subtítulos |
|---|---|---|---|---|---|
| OpenAI Codex agent | Linear | 2025-12-04 | 0:28 | 4.727 | No tiene; reembolsado |
| Introducing coding sessions | Linear | 2026-06-11 | 7:09 | 19.783 | 6.242 caracteres |
| Recorrido de OpenAI Codex Agent in Linear | Un canal de SEO | 2025-12-08 | 8:19 | 8.243 | 9.033 caracteres |
Pedimos los subtítulos con youtube/transcript. El video de 28 segundos de Linear no tenía subtítulos. La API devolvió un resultado vacío y reembolsó el cargo de forma automática. El video del canal de SEO devolvió 9.033 caracteres de subtítulos. El video de coding sessions devolvió 6.242 caracteres a las 00:38 hora de Singapur, por 0,000556 USD. Trata de la automatización de Triage. Las alertas de Datadog y los informes de errores llegan a Triage, y el agente propio de Linear los investiga y los arregla. Una persona dice en el video que el agente de Linear fusionó casi 700 PR en el último mes. El video no menciona variables de entorno, secrets ni ajustes de red. Para esos pasos hay que leer la documentación.
Primero, el video del canal de SEO da como comando local «codex connect linear». La documentación de OpenAI y la de Linear dan codex mcp add linear --url https://mcp.linear.app/mcp. La otra opción es editar config.toml a mano y luego ejecutar codex mcp login linear (Linear: Codex MCP Integration). El comando del video no funciona.
| Paso | Qué dice el video | Qué dice la documentación |
|---|---|---|
| Configuración local | codex connect linear | codex mcp add linear --url https://mcp.linear.app/mcp |
| Antes de @Codex | Conectar GitHub e instalar en Linear | Además, crear un entorno en la nube que incluya el repositorio |
| Opción MCP | No se menciona | Página de Linear: rmcp_client = true; página de OpenAI: sin opción |
| Tiempo hasta el PR | Unos 2 minutos | No da un tiempo |
Segundo, el video muestra un pull request dos minutos después de @Codex. No dice que antes hay que crear un entorno en la nube que incluya el repositorio. La documentación dice que, si ningún entorno encaja, Codex responde en el issue con los pasos para arreglarlo y le pide que lo intente de nuevo. El video se salta ese paso.
Tercero, la página Codex MCP de Linear todavía dice que, la primera vez que se usa MCP, hay que añadir rmcp_client = true a config.toml. La documentación nueva de OpenAI no tiene esa línea. Siga lo que le pida su versión local de Codex.
El video de Linear tenía 3 comentarios. El primero, con 11 «me gusta», preguntaba si Linear planea la misma integración para Claude Code. Otro decía que la integración con Cursor funciona bien y que Claude Code necesitaría buen manejo de agentes remotos.
Vigile a Codex in Linear: acceso, auditoría y traspaso
Usted puede seguir el trabajo de Codex in Linear igual que el de un compañero. La documentación de agentes de Linear da cuatro lugares. Cada agente tiene una página de usuario con sus issues. Los issues delegados siguen en su vista My issues, porque usted sigue siendo el responsable. Las vistas personalizadas pueden filtrar por Delegate. Insights puede separar por Delegate para mostrar cuánto trabajo va a los agentes (Linear Docs: Agent platform).
La documentación de asignación añade que el feed de actividad guarda el historial de asignaciones y delegaciones, con nombres y horas (Linear Docs: Assign and delegate issues). En cuanto al acceso, los agentes no pueden iniciar sesión en la app de Linear, no pueden usar funciones de administración y no pueden gestionar usuarios.
Para los issues que arreglan scripts de datos, añada una guía para agentes a nivel de equipo. Linear le deja escribir indicaciones extra para agentes a nivel de espacio de trabajo y de equipo. La guía del equipo tiene prioridad, y los agentes la reciben cuando trabajan en issues. La documentación también dice que cada agente decide cómo aplicarla (Linear Docs: Agent platform).
Una regla útil: «En los scripts de datos de jobs/, incluya pruebas sin conexión. Nunca ponga una clave en el código, en los registros ni en el texto del PR. En el texto del PR, liste las capacidades que cambió y sus precios». La última frase permite al revisor comprobar el costo durante la revisión.
| Comprobación antes de fusionar | Cómo | Si falla |
|---|---|---|
| No hay clave en el código | Buscar en el diff Bearer, sk- y el prefijo de su clave | Rechazar y desactivar esa clave |
| No se reintenta un 422 | Ejecutar test_422_is_not_retried | Rechazar |
| Capacidades y parámetros iguales al catálogo | Comparar con /api/v1/social/catalog?platform=… | Pegar el texto del catálogo en el issue y pedir a Codex que corrija |
| Nombres de campos de salida sin cambios | Comparar columnas con la salida antigua | Añadir la correspondencia |
| Marcas de anuncio conservadas | La salida tiene is_ad e is_sponsored | Añadir las columnas |
Puede pegar esta tabla en el issue como comprobaciones de aceptación y pedir a Codex que responda a cada línea en su resumen.
Las tareas largas necesitan que alguien las vigile. En Linear, ese papel lo cumplen las notificaciones de Inbox y la app móvil. Desde el 4 de noviembre de 2026, las revisiones de Diffs funcionan en el teléfono. Así, usted puede revisar los cambios de un agente en el móvil antes de fusionar (Linear changelog: Mobile Diffs).
Problemas frecuentes según el síntoma
Esta tabla junta los errores de la documentación con los casos de nuestras llamadas reales. Busque la fila según lo que ve en Linear. Las tres primeras filas salen de la documentación de OpenAI y de Linear. Las filas 4 y 5 se deducen de la documentación; no las reprodujimos en Codex. Las demás salen de nuestras llamadas a la API del 20 de noviembre de 2026.
| Lo que ve | Causa más probable | Cómo arreglarlo |
|---|---|---|
| Tras @Codex, Codex responde con pasos para arreglar algo y no empieza | Ningún entorno en la nube encaja con el issue, o el entorno no incluye el repositorio | Cree un entorno para el repositorio; escriba in org/repo en el comentario |
| Una regla de Triage delega el issue en Codex, pero no empieza ninguna tarea | Quien creó el issue no tiene Codex vinculado, o Linear no está en Business o Enterprise | Haga que las alertas abran issues con un miembro que tenga Codex vinculado, o mencione @Codex a mano |
| Codex edita el lugar equivocado | El issue tiene poco contexto y Codex eligió otros archivos | Escriba la ruta del archivo y los nombres de las funciones que hay que borrar |
Una llamada real en la fase del agente devuelve 401 missing_key | La clave es un secret, o un export del script de preparación no llegó al agente | Use una variable de entorno, o ejecute solo pruebas sin conexión |
| Una llamada real en la fase del agente falla por red | El internet del agente está apagado, o solo se permite GET | Permita api.everyinfra.com y POST |
422 missing_param o unknown_param | Un nombre de parámetro viene de otra API (query, video_url, max_results) | Use param y example de la respuesta; cambie solo ese parámetro |
422 invalid_value | El valor de enumeración no está permitido (sort: hot, sort: top) | Elija de allowed; para lo más nuevo use newest, no el valor de did_you_mean |
| 429 | Se alcanzó el límite por minuto de la clave | Espere retry_after segundos; haga menos llamadas reales en las pruebas |
| Resultado vacío | La palabra clave es poco común, o queda fuera de la ventana de un mes de reddit/search | Los resultados vacíos se reembolsan; ponga la ventana de tiempo en el issue |
Límites y puntos a vigilar
Codex in Linear corre en el entorno legacy, y OpenAI dice que la experiencia legacy se retirará (OpenAI: Cloud environments). El entorno nuevo tiene reglas más finas para las claves. Tiene variables de entorno y network secrets. Un programa solo ve un network secret como un marcador. El proxy pone el valor real en las peticiones HTTPS a los dominios permitidos.
Cuando la integración con Linear pase al entorno nuevo, la configuración recomendada será un network secret para api.everyinfra.com. Así, el proceso del agente nunca tendrá la clave en bruto. Hasta entonces, siga las reglas legacy.
El texto del issue es a la vez la entrada del agente y una vía de inyección. La página de acceso a internet de OpenAI usa este caso. Un issue esconde una orden que envía datos de commits a una URL externa (OpenAI: Agent internet access). Las reglas de Triage pueden delegar de forma automática issues que vienen de fuentes externas, como soporte, alertas y formularios. Cuantas más fuentes externas haya, más conviene limitar el internet de la fase del agente a uno o dos dominios. La guía de OpenAI termina con el mismo consejo: Codex puede equivocarse, así que revise las respuestas y los diffs antes de fusionar.
| Capacidad | `price_usd` | Devuelve | Obligatorio | Opcional | `limit` por defecto / máximo | `field_note` (resumen) |
|---|---|---|---|---|---|---|
tiktok/video | 0,000556 | Un objeto | url | — | — | Algunas peticiones no traen is_sponsored, repost_count y algunos campos del autor |
youtube/comments | 0,000556 | Lista | url | since, sort (newest, popular) | 20 / 100 | Algunas peticiones devuelven como máximo 40 comentarios, sin «me gusta» ni respuestas |
reddit/search | 0,000792 | Lista | keyword | sort (6 valores) | 10 / 25; los valores mayores se recortan | Solo el último mes; algunas peticiones no traen flair, texto ni imágenes |
Fuera de la tabla quedan dos puntos. youtube/comments devuelve valores posted_at relativos.
El cover_image_url de tiktok/video está firmado y caduca, así que guarde la imagen si la necesita después. Las capacidades lentas pasan a modo asíncrono, así que mantenga el código de consulta. EveryInfra solo ofrece la API de datos. No toca su espacio de trabajo de Linear ni su repositorio de GitHub. Usted revisa cada pull request de Codex.
Cambios recientes
| Fecha | Cambio | Fuente |
|---|---|---|
| 2026-11-18 (aprox.) | Guía de Codex in Linear en el nuevo sitio de OpenAI | OpenAI |
| 2026-11-17 | Charla «New Ways of Working with Codex» en AI Engineer | YouTube |
| 2026-11-13 | Nuevo archivo de IP de salida de los agentes de OpenAI | chatgpt-agents.json |
| 2026-11-12 | «Traiga su propia clave» en el agente de Linear | Linear changelog |
| 2026-11-04 | Diffs en el móvil de Linear | Linear changelog |
- Hacia el 18 de noviembre de 2026: OpenAI llevó la guía de Codex in Linear a su nuevo sitio de documentación. La guía cubre la delegación automática con reglas de Triage y dice que los chats corren en nombre de quien creó el issue (OpenAI: Use Codex in Linear). Qué implica: antes de delegar de forma automática, confirme que quien crea el issue tiene Codex vinculado.
- 17 de noviembre de 2026: el canal AI Engineer publicó «New Ways of Working with Codex», de dos ingenieros de OpenAI. Nuestro
youtube/searchde las 00:14 mostró 16.251 vistas. Qué implica: OpenAI presenta la delegación como forma de trabajo, y Linear es una de sus entradas. - 13 de noviembre de 2026: OpenAI actualizó el archivo de IP de salida de sus agentes en la nube (chatgpt-agents.json). Qué implica: los servicios que permiten por IP deben revisar los rangos cada día, y las reglas de IP no sustituyen a una clave.
- 12 de noviembre de 2026: el agente en la nube de Linear añadió «traiga su propia clave» para OpenAI, Anthropic y otros proveedores (Linear changelog). Qué implica: «Codex in Linear» a través del agente propio de Linear se cobra en su cuenta de API.
- 4 de noviembre de 2026: Linear lanzó Diffs en el móvil, y la misma actualización corrigió que Codex no apareciera en la lista de revisores (Linear changelog: Mobile Diffs). Qué implica: usted puede revisar los cambios de Codex en el teléfono.
- Hasta al menos el 21 de noviembre de 2026: la página de precios de OpenAI dice que el precio promocional de GPT-5.6 Sol dura al menos hasta esa fecha (OpenAI: Pricing). GPT-5.6 Sol es un modelo distinto de GPT-6 Sol, el modelo por defecto del agente de Linear; Linear ofrece los dos. Qué implica: el costo de Codex basado en cuota puede cambiar cerca de fin de mes.
Preguntas frecuentes
¿Qué plan necesito para Codex in Linear?
Necesita un plan de pago de ChatGPT. La página de integración de Linear lista Plus, Pro, Business, Enterprise y Edu (Linear: Codex Integration). La guía de OpenAI dice «planes de pago» y exige antes un entorno en la nube de Codex. En Enterprise, un administrador también debe activarlo en la configuración del espacio de trabajo y en la de conectores. Origen de la pregunta: sugerencia de Google «install codex in linear».
¿Codex Linear MCP es lo mismo que Codex in Linear?
No. Codex in Linear delega trabajo desde issues de Linear, y la tarea corre en la nube de OpenAI. Codex Linear MCP permite que Codex local (CLI, extensión de IDE, ChatGPT de escritorio) lea y escriba issues de Linear. El comando es codex mcp add linear --url https://mcp.linear.app/mcp. Linear dice que este servidor MCP solo sirve para tareas locales de Codex (Linear: Codex MCP Integration). Origen de la pregunta: sugerencia de Google «codex linear mcp».
¿Dónde se instala el plugin de Codex para Linear?
La versión en la nube no tiene un plugin aparte. Instale «Codex for Linear» en la página de conectores de la configuración de Codex (OpenAI: Use Codex in Linear). Linear tiene además un ajuste para abrir issues en herramientas de programación. Ese ajuste añade Codex al menú Work on issue, que se abre con W y luego O (Linear Docs: Assign and delegate issues). Origen de la pregunta: sugerencia de Google «codex linear plugin».
¿Una tarea de Codex en la nube puede llamar a una API externa?
Sí, pero hay que activarlo. En el entorno legacy, la fase del agente no tiene red por defecto. Usted puede activar internet por entorno con una lista de dominios y de métodos HTTP permitidos. Si solo permite GET, HEAD y OPTIONS, POST queda bloqueado (OpenAI: Agent internet access). Para EveryInfra, permita api.everyinfra.com y POST. Origen de la pregunta: el hilo de la comunidad de OpenAI «Linear connector available in Codex», que pregunta qué puede hacer Codex con Linear (OpenAI Community).
Codex Linear auth: ¿por qué mi prueba no puede leer una clave guardada como secret?
En el entorno legacy, los secrets solo están disponibles para los scripts de preparación, y Codex los borra antes de la fase del agente (OpenAI: Codex Cloud (Legacy)). Si el agente debe leer la clave, use una variable de entorno con una clave aparte y limitada. O ejecute las pruebas sin conexión. Origen de la pregunta: sugerencia de Google «codex linear auth».
¿Codex o Claude Code en Linear?
El primer comentario del video de Codex de Linear preguntaba por Claude Code. Hoy, el agente en la nube propio de Linear puede usar cualquiera de los dos, y el modelo por defecto es GPT-6 Sol (Linear Docs: Linear cloud coding agent). Un hilo de r/Linear también comenta flujos que usan los dos (r/Linear). Elija según lo que ya paga: un plan de ChatGPT o créditos de IA de Linear.
Cómo empezar
- Regístrese en la guía rápida de EveryInfra y obtenga una clave de API. Cree una clave aparte para el entorno de Codex, solo con la API de datos activada.
- Lea el catálogo, por ejemplo
GET https://api.everyinfra.com/api/v1/social/catalog?platform=tiktok. Ponga en el issue las capacidades, los parámetros y los precios. - Guarde tres respuestas reales en
tests/fixtures/. Añada la sección «Data API» aAGENTS.md. - En el entorno en la nube de Codex, defina
EVERYINFRA_API_KEYcomo variable de entorno si necesita llamadas reales. Permitaapi.everyinfra.comy POST en la configuración de internet. - En Linear, mencione @Codex o delegue el issue. Siga la actividad, revise el diff en el enlace del chat y abra un PR.
- Después de fusionar, ejecute el script en su propio programador de tareas. Compare el
charged_usddel archivo de salida con la página de precios y el catálogo.
Otro uso de las tareas en la nube de Codex es un informe semanal de reseñas, que tratamos en informe semanal de reseñas de apps con Codex Cloud. Ese artículo explica con más detalle lo básico del entorno en la nube. Para una extracción en paralelo de TikTok con subagentes de Claude Code, vea subagentes de Claude Code para cuentas de marca en TikTok.
Referencias
- Use Codex in Linear, OpenAI, hacia el 2026-11-18, leído el 2026-11-20
- Codex Integration, Linear, leído el 2026-11-20
- Codex MCP Integration, Linear, leído el 2026-11-20
- Codex Cloud (Legacy), OpenAI, leído el 2026-11-20
- Codex Cloud (Legacy): internet access, OpenAI, leído el 2026-11-20
- Cloud environments, OpenAI, leído el 2026-11-20
- Agent approvals & security, OpenAI, leído el 2026-11-20
- Model Context Protocol, OpenAI, leído el 2026-11-20
- Custom instructions with AGENTS.md, OpenAI, leído el 2026-11-20
- Pricing, OpenAI, leído el 2026-11-20
- openai/codex-universal, OpenAI, GitHub
- MCP bearer-token env var appears configured even when missing (#30125), openai/codex, 2026-06-25
- chatgpt-agents.json, OpenAI, generado el 2026-11-13
- What is ChatGPT Plus?, Centro de ayuda de OpenAI, leído el 2026-11-20
- ChatGPT Business overview, Centro de ayuda de OpenAI, leído el 2026-11-20
- Linear connector available in Codex, OpenAI Developer Community, 2025-07-26
- Agent platform, Linear Docs, leído el 2026-11-20
- Assign and delegate issues, Linear Docs, leído el 2026-11-20
- Triage, Linear Docs, leído el 2026-11-20
- Linear cloud coding agent, Linear Docs, leído el 2026-11-20
- Coding sessions, Linear Docs, leído el 2026-11-20
- Agents: Getting Started, Linear Developers, leído el 2026-11-20
- Bring your own key (BYOK), Linear changelog, 2026-11-12
- Mobile Diffs, Linear changelog, 2026-11-04
- Linear Pricing, Linear, leído el 2026-11-20
- Use Claude Code, Codex with Linear as a PM or Dev, r/Linear
- OpenAI Codex agent, Linear, YouTube, 2025-12-04
- Introducing coding sessions, Linear, YouTube, 2026-06-11
- OpenAI Codex Agent in Linear is INSANE! : Automate ANYTHING!, YouTube, 2025-12-08
- New Ways of Working with Codex, AI Engineer, YouTube, 2026-11-17
- Software Developers, Quality Assurance Analysts, and Testers, Oficina de Estadísticas Laborales de EE. UU., leído el 2026-11-20
- Quota Calculator, documentación de YouTube Data API, leído el 2026-11-20
- Reddit Data API Wiki, Reddit Help, leído el 2026-11-20
- TikTok Research Tools: Access and Eligibility, TikTok for Developers, leído el 2026-11-20
- RFC 9110: HTTP Semantics, 15.5.21 422 Unprocessable Content, IETF, junio de 2022
- Requests: Quickstart, documentación de Requests
- Catálogo de EveryInfra, EveryInfra, leído el 2026-11-20, 00:14
- API de datos de EveryInfra, EveryInfra, llamadas reales del 2026-11-20
- API de cuenta de EveryInfra, EveryInfra, llamada real del 2026-11-20
- OpenAI en TikTok: It's time to fly, OpenAI, TikTok, 2026-06-03
- I stopped babysitting Codex. A lamp does it now., r/codex, 2026-11-18 (UTC)
Referencia BL-192