Запланированные задачи ChatGPT + MCP: еженедельный радар спроса
Схема запланированной задачи ChatGPT, которая каждый понедельник читает Reddit и Quora через MCP-сервер EveryInfra. Измеренная стоимость API: $0.007226 в неделю. Первый запрос данных в каждом чате требует одного подтверждения.
Да, такое можно собрать, и данные обходятся дёшево: расходы на API EveryInfra для одного еженедельного «радара спроса» составляют $0.007226, или около $0.38 за 52 недели. При планировании нужно учитывать не расходы, а необходимость подтверждения. 26 октября 2026 года в 17:23 по сингапурскому времени (SGT) мы прочитали список инструментов удалённого MCP-сервера EveryInfra.
Из 25 инструментов два, которые получают данные, everyinfra_call_api и everyinfra_search, помечены readOnlyHint=false и destructiveHint=true, потому что каждый вызов стоит денег. В руководстве OpenAI для разработчиков «Add custom MCP server» сказано, что ChatGPT поддерживает инструменты и для чтения, и для записи. Инструмент без readOnlyHint считается действием записи, а действия записи по умолчанию требуют подтверждения. Поэтому при первом вызове в каждом чате появляется запрос: нажмите «Разрешить», и это решение можно запомнить для данного чата. В статье о запланированных задачах сказано, что задача приостанавливается, когда действию требуется подтверждение.
Если вы сидите у экрана, это всего один лишний клик. Чтобы задача работала без присмотра, либо разрешите этому приложению выполнять нужные действия без запроса подтверждения в рабочем пространстве Business или Enterprise, либо разделите работу на две части. Данные получает другой планировщик. ChatGPT только читает их и пишет отчёт.
В этой статье «радар спроса» — это короткий отчёт, который формируется каждый понедельник утром. Он использует фиксированные ключевые слова и фиксированные сообщества. Он ищет на Reddit и Quora жалобы и вопросы за неделю и отбирает по 5 наиболее значимых постов каждого типа со ссылками и кратким резюме в одну строку.
Он помогает продакт-менеджерам, маркетологам SaaS и контент-планировщикам ответить на один вопрос: «О чём пользователи говорили на этой неделе?», и не более того. Он не прогнозирует продажи и не решает, кто прав.


Чаще всего упускают из виду проверку разрешений. Запланированная задача ChatGPT — не фиксированный скрипт. В назначенное время модель заново читает ваши инструкции и сама вызывает инструменты. Перед каждым вызовом ChatGPT проверяет аннотации инструмента и вашу настройку разрешений.
Затем ChatGPT либо вызывает инструмент, либо сначала спрашивает вас. Согласно руководству OpenAI для разработчиков, при первом вызове инструмента без пометки «только для чтения» в каждом чате ChatGPT показывает запрос на подтверждение, и одного нажатия «Разрешить» достаточно, чтобы вызов прошёл. Когда вы сидите у экрана, «спросить вас» означает один лишний клик. В 9:00 в понедельник, когда никто не следит за выполнением, «спросить вас» означает, что задача остановится. В каждом разделе ниже разбирается один вопрос: на каком тарифе и при какой настройке для прохождения этой проверки нужен человек и как сделать так, чтобы она не останавливала запланированную задачу?
Коротко: на что способны запланированные задачи ChatGPT на каждом тарифе
В таблице ниже собраны ограничения из документации OpenAI, важные для этой задачи. Каждая ячейка взята из справочного центра OpenAI в том виде, в каком мы прочитали его 26 октября 2026 года. Для этого теста у нас не было аккаунта ChatGPT, поэтому в таблице приведены сведения из документов, а не результаты наших запусков.
| План | Активные запланированные задачи | Максимальная частота повторения | Собственный MCP | Инструмент для получения данных (без пометки «только для чтения») в запланированной задаче |
|---|---|---|---|---|
| Free, Go | 3 | Раз в день, с указанием периода запуска, например утром или ночью | В справочном центре не указано; по словам одного пользователя форума, на Free по-прежнему нужен режим разработчика | Не задокументировано; не полагайтесь на это |
| Plus | 5 | Ежечасно, в точное время | В справочном центре не указано | Не задокументировано; не полагайтесь на это |
| Pro ($100 / $200 / $500) | 15 | Ежечасно, в точное время | Да; в FAQ справочного центра указаны только права на чтение и получение данных | Согласно руководству для разработчиков, поддерживаются инструменты для чтения и записи; действия записи требуют подтверждения, а ожидающее подтверждение приостанавливает задачу |
| Business | 10 | Ежечасно, в точное время | Только администраторы и владельцы | Доступен; может потребоваться подтверждение, а оно приостанавливает задачу |
| Enterprise, Edu | Enterprise 15, Edu 10 | Ежечасно, в точное время | Администраторы могут назначать ролям право «Создание плагинов с MCP» | То же, плюс управление отдельными действиями |
Лимиты задач, правила повтора и интервалы для Free взяты из раздела «Review scheduled task limits» статьи «Scheduled tasks in ChatGPT». Возможности собственного MCP описаны в FAQ статьи «Connecting custom MCP servers in ChatGPT». Цены Pro взяты из статьи «About ChatGPT Pro tiers». Plus стоит $20 в месяц, согласно статье «What is ChatGPT Plus?».
В справочном центре не сказано, могут ли аккаунты Free добавлять собственные MCP-серверы. В одном ответе на форуме от 7 октября 2026 года говорится, что пользователям Free по-прежнему нужно включить режим разработчика в разделе настроек «Безопасность и вход». Это сообщение пользователя, поэтому мы помечаем его как «не подтверждено».
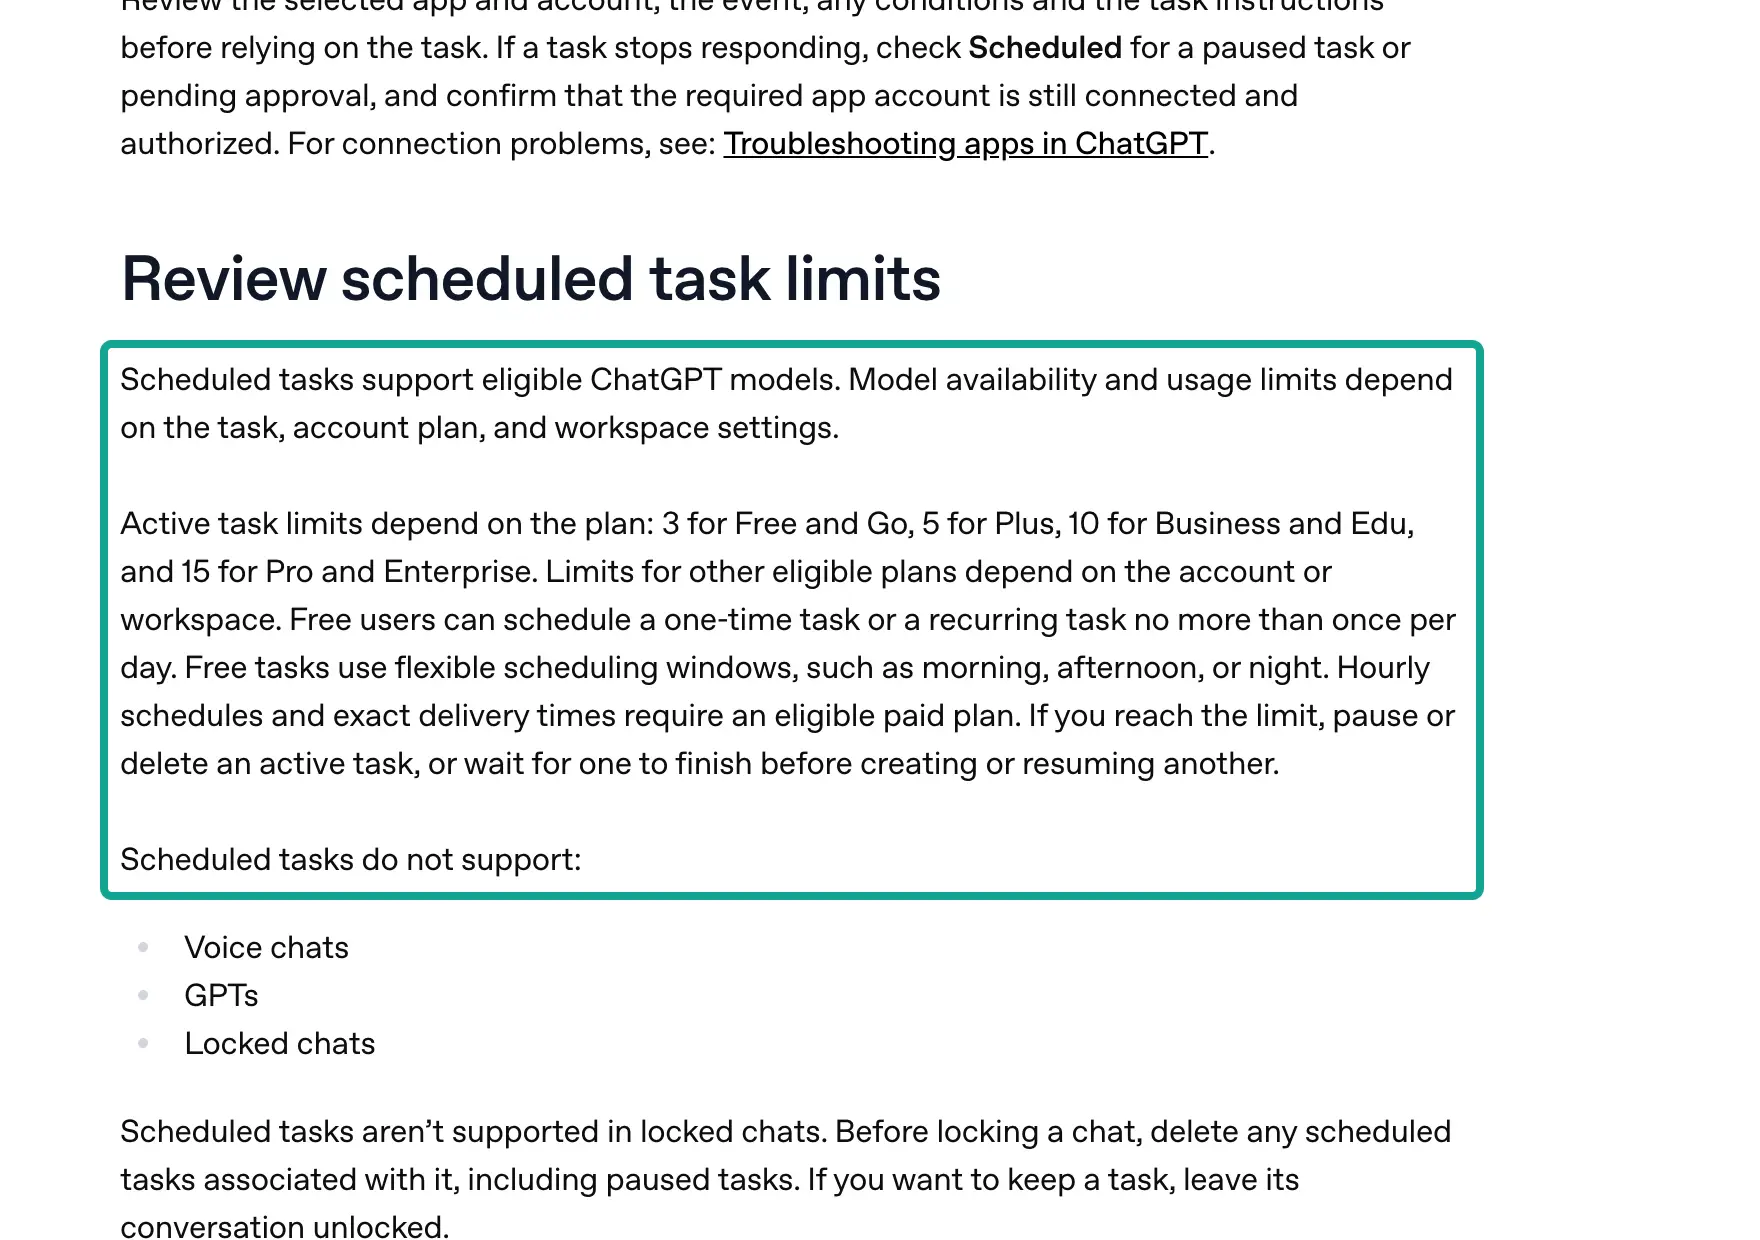
Из этой таблицы следуют два вывода. Во-первых, на тарифах Plus или Pro самый простой путь — не «ChatGPT вызывает наш инструмент данных», а раздельная схема из раздела «Три схемы». В рабочем пространстве Business или Enterprise, где администратор готов разрешить действия этого приложения, самый короткий путь — прямое подключение по MCP. Во-вторых, еженедельный радар не упрётся в лимит повторов ни на одном платном тарифе. Следить нужно за числом активных задач. В Plus доступно 5 слотов, поэтому при одной задаче на категорию товаров все слоты будут заняты уже при 5 категориях.
Один запуск, шесть этапов
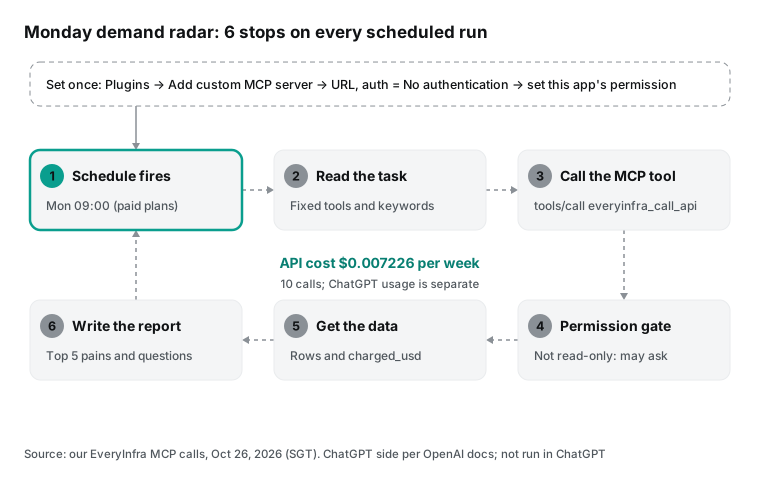
Этапы 1 и 6 относятся к ChatGPT. Этапы 3 и 5 относятся к EveryInfra. От этапов 2 и 4 зависит, будет ли задача каждую неделю выполняться одинаково. Этапу 2 нужны фиксированные значения. При каждом запуске модель заново читает ваши инструкции. Если инструкции оставляют выбор, модель может каждую неделю брать другие ключевые слова, порядок сортировки или лимиты.
Тогда меняются и затраты, и результаты. Страница OpenAI для разработчиков о запланированных задачах даёт тот же совет. Там сказано прямо называть Skill или инструмент в промпте задачи, если процесс не должен зависеть от автоматического выбора инструмента. Там же советуют проверить промпт в обычном чате, прежде чем ставить его в расписание. Этапу 4 посвящён отдельный раздел ниже.
Шаг 1: добавьте собственный MCP-коннектор в ChatGPT (режим разработчика больше не нужен)
1 октября 2026 года руководитель платформы плагинов в OpenAI написал на официальном форуме, что собственным MCP-серверам больше не нужен режим разработчика. Все пользователи, которым доступна эта функция, могут открыть страницу «Плагины», нажать «+» и выбрать в меню «Добавить собственный MCP-сервер». Разрешение рабочего пространства, которое раньше называлось «Режим разработчика», получило новое название. Теперь справочный центр называет его «Создание плагинов с MCP». Шаги приведены на странице для разработчиков «Connect and test your plugin». Введите название и описание. В разделе «Подключение» укажите публичный HTTPS-URL с путём /mcp.
Настройте аутентификацию. Примите предупреждение о рисках. Выберите «Создать как плагин». Затем проверьте инструменты, которые нашёл ChatGPT.
Сначала продумайте аутентификацию. Глава об аутентификации требует, чтобы MCP-серверы, для доступа к которым нужна учётная запись, использовали OAuth 2.1 и публиковали метаданные по адресу /.well-known/oauth-protected-resource. Стороннее руководство — страница AnythingMCP о ChatGPT — показывает в форме три варианта именно в таком порядке: «OAuth», «Без аутентификации» и «OAuth или без аутентификации». Поля для заголовка с API-ключом там нет. В 17:42 SGT мы отправили по одному GET-запросу к каждому пути обнаружения на api.everyinfra.com:
| Путь обнаружения | Статус | Что это значит для ChatGPT |
|---|---|---|
/.well-known/oauth-protected-resource | 404 | OAuth не находит метаданные |
/.well-known/oauth-protected-resource/mcp | 404 | То же |
/.well-known/oauth-authorization-server | 404 | То же |
POST /mcp с User-Agent curl/8.5.0 | 200, 0.119 s | Мы не блокируем проверочный запрос ChatGPT |
Поэтому в ChatGPT нужно выбрать «Без аутентификации» и передать ключ в URL: https://api.everyinfra.com/mcp?key=YOUR_KEY. Мы не проверяли этот вариант непосредственно в ChatGPT. В его пользу говорят два факта. Когда в 17:30 SGT мы вызвали наш MCP-сервер без ключа, ошибка самого сервера указала два способа передать ключ: «header Authorization: Bearer or ?key= query param». Кроме того, шлюз EveryInfra поддерживает для MCP оба способа передачи ключа.
Последнюю строку мы проверили намеренно. 3 сентября 2026 года разработчик сообщил на официальном форуме, что проверочный запрос ChatGPT использовал User-Agent curl/8.5.0. Его файрвол заблокировал запрос как скрипт, а ChatGPT показал только «does not implement OAuth». Мы отправили свой вызов initialize с тем же User-Agent и получили 200.
У ключа в URL есть цена. RFC 6750, раздел 2.3 предупреждает, что URL с токенами, скорее всего, попадут в логи, и не рекомендует этот способ, кроме случаев, когда передать токен в заголовке невозможно. Раздел 5.3 также не рекомендует передавать bearer-токены в URL страниц. ChatGPT хранит URL, и участники рабочего пространства, которым видны настройки приложения, тоже могут его увидеть.
Мы советуем завести для ChatGPT отдельный ключ с тремя ограничениями. Разрешите только возможности reddit/* и quora/* (scope_mode=selected). Задайте лимит расходов в USD (spend_limit_usd, работает с 26 октября 2026 года). Когда расходы по ключу достигают лимита, API возвращает 403 key_spend_limit_reached и ничего не списывает. Наконец, задайте срок действия ключа.
Все три поля описаны в нашем документе OpenAPI. По рецепту из этой статьи плата за API за год составит меньше $0.40. Лимита в $2 хватит на год с запасом, и он ограничит потери, если URL утечёт.
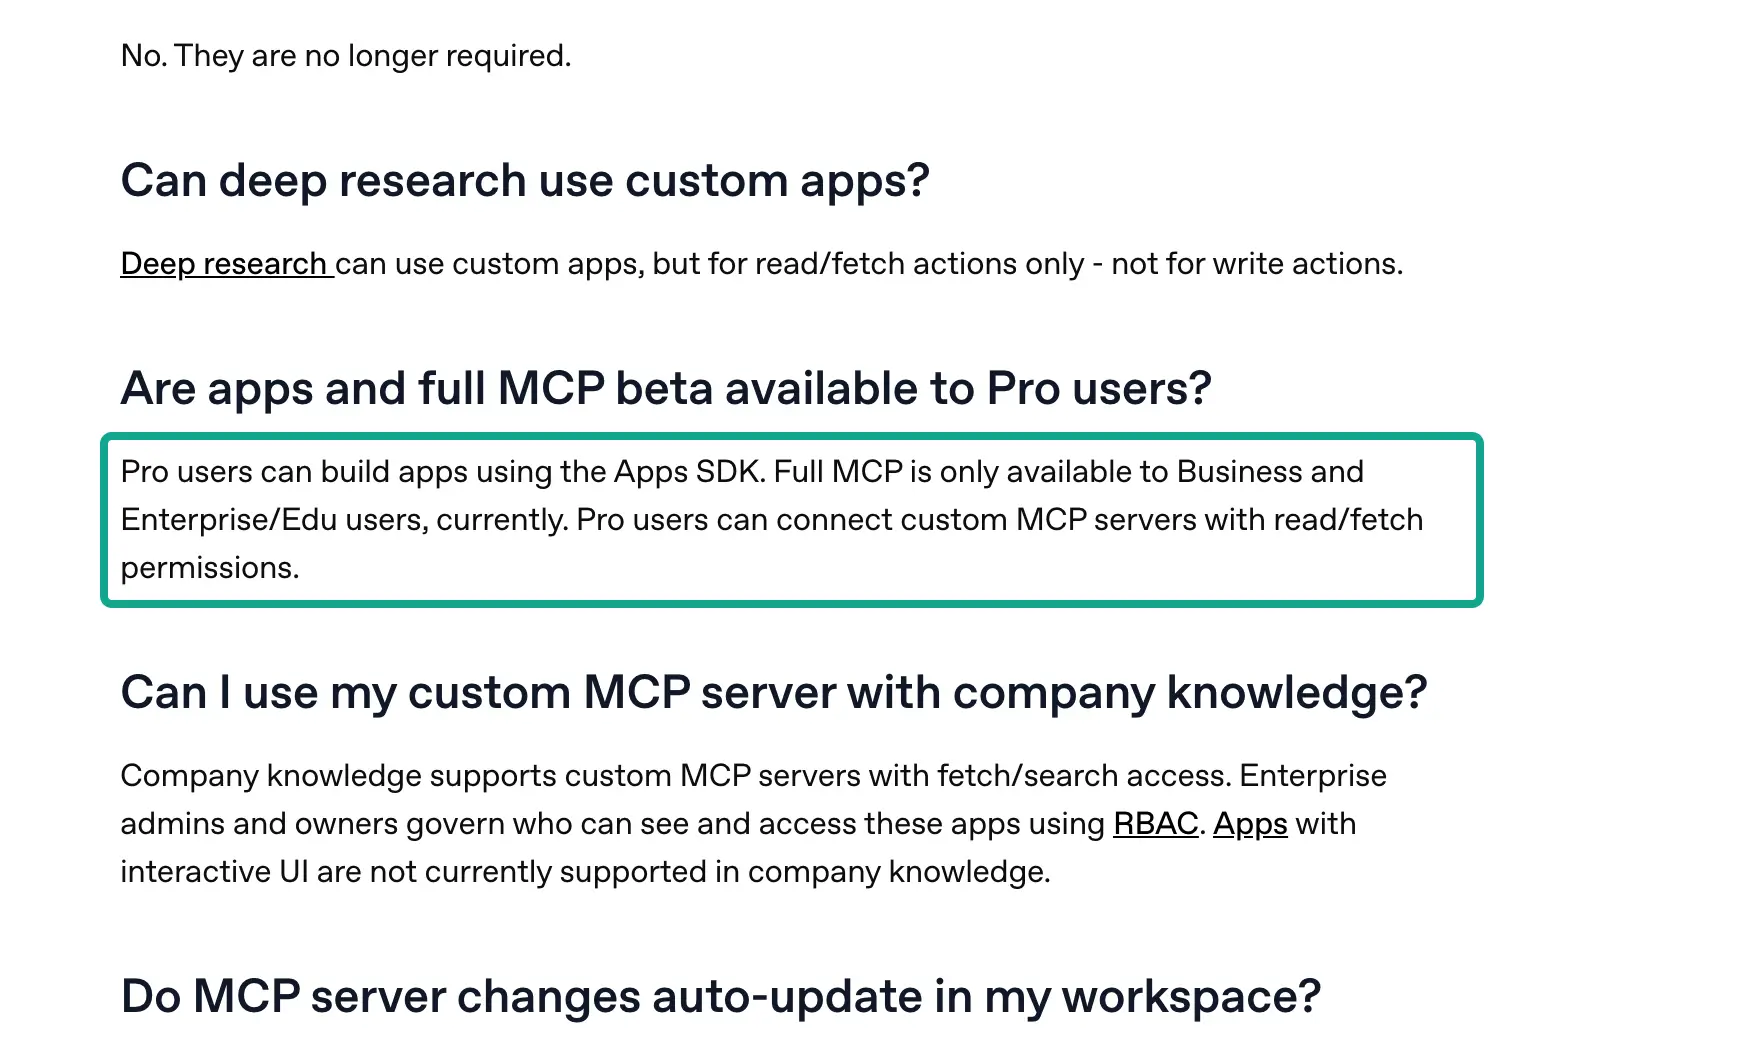
Это утверждение расходится с руководством OpenAI для разработчиков. Страница «Add custom MCP server» начинается с фразы «ChatGPT supports both read and write tools from your server». В её разделе «Reviewing and confirming tool calls» сказано, что ChatGPT определяет инструменты только для чтения по readOnlyHint, а инструменты без этой аннотации считает действиями записи. Действия записи по умолчанию требуют подтверждения. Подтверждение для инструмента можно запомнить в пределах одного чата; в новом чате или после обновления страницы запрос появится снова.
По этому правилу наш инструмент данных работает в ChatGPT: при первом вызове в каждом чате появляется запрос, и вы нажимаете «Разрешить». Инструмент не заблокирован. На аккаунте Pro мы это не проверяли. Если на Pro вы видите другой результат, доверяйте тому, что видите.
Один реальный обмен запросом и ответом: что отправляет ChatGPT и что возвращаем мы
Вызывая инструмент на собственном MCP-сервере, ChatGPT отправляет один JSON-RPC-запрос tools/call. В 17:34:47 SGT мы отправили такой же запрос через curl. Единственное отличие: ключ был в заголовке Authorization.
curl -s https://api.everyinfra.com/mcp \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Accept: application/json, text/event-stream" \
  -d '{"jsonrpc":"2.0","id":4,"method":"tools/call",
       "params":{"name":"everyinfra_call_api",
                 "arguments":{"platform":"reddit","action":"search",
                              "params":{"keyword":"robot vacuum keeps getting stuck","sort":"top","limit":10}}}}'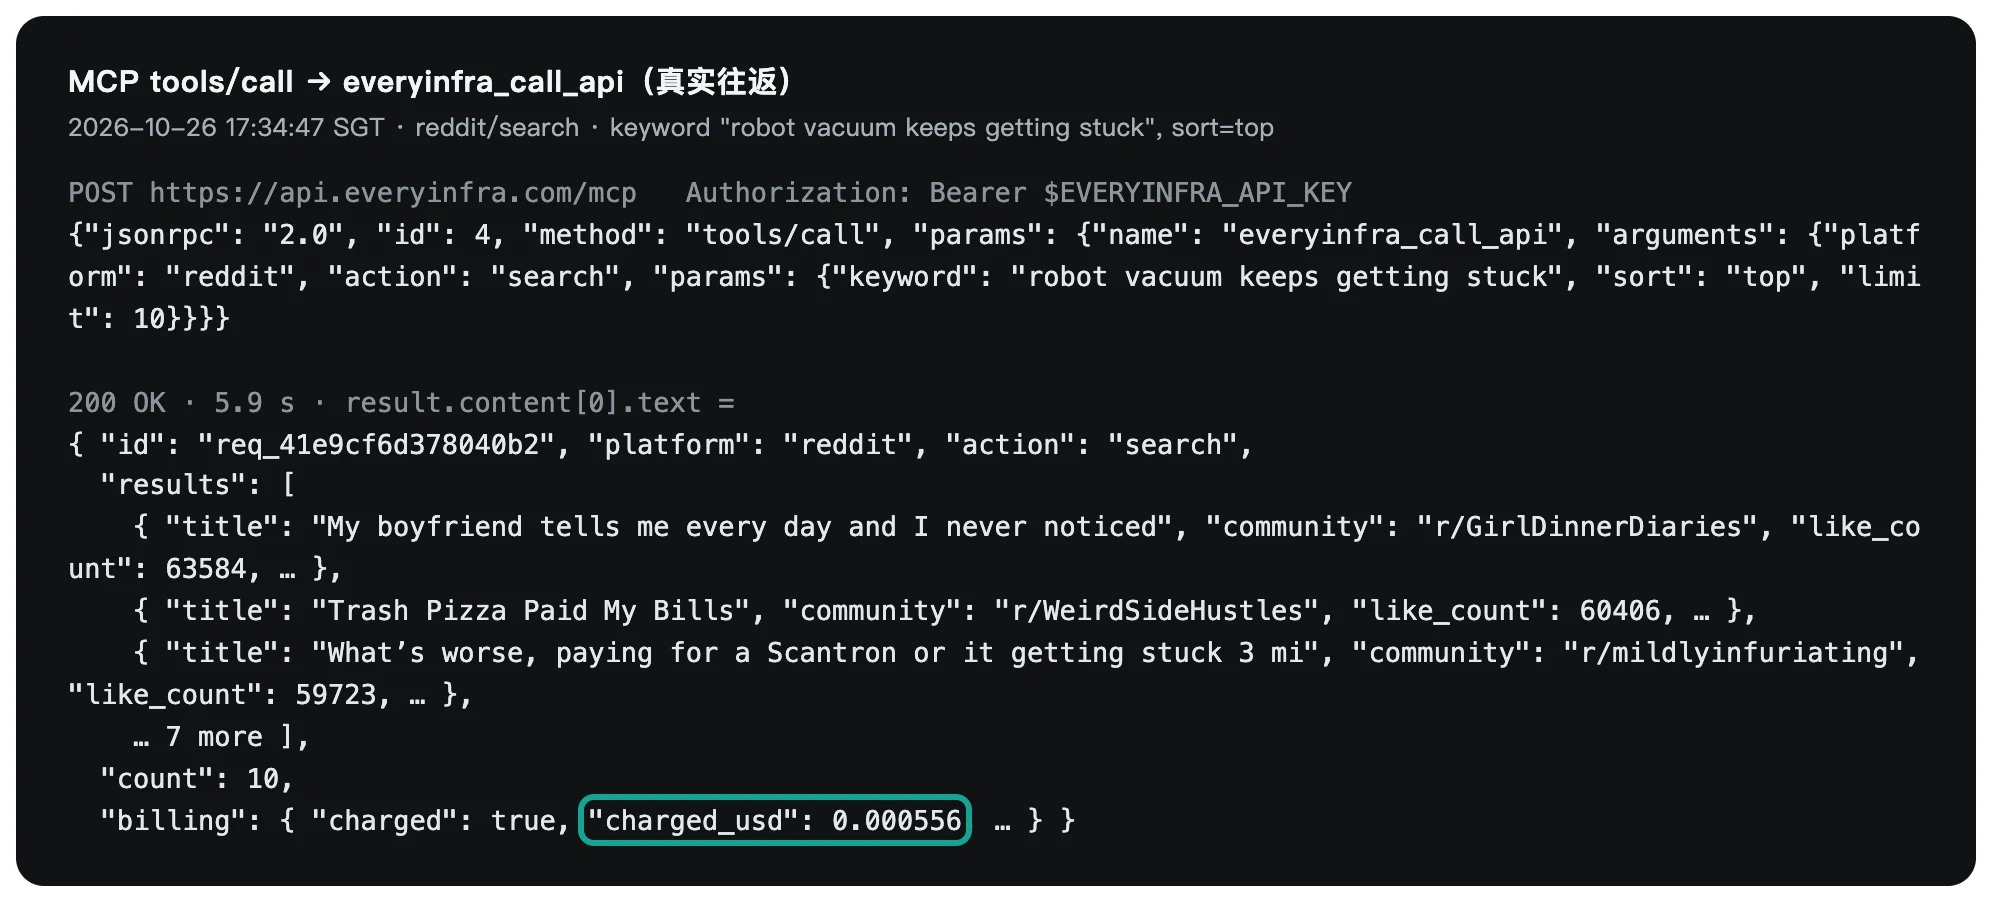
Вызов занял 5,9 секунды, вернул 10 записей и стоил $0.000556. Это совпадает с price_usd для reddit/search в каталоге. Все 10 полей в записях (id, url, title, text, author_username, community, like_count, comment_count, posted_at, platform) есть в response_fields каталога. Полей вне каталога нет. Но ни один из 10 результатов не упоминает «vacuum». Первый результат — пост о знакомствах, набравший 63 584 балла.
Каталог объясняет почему. Временное окно reddit/search зафиксировано на последнем месяце, а sort=top сортирует по рейтингу. Фраза из пяти слов совпадает с постом, если совпадает хотя бы одно слово. В итоге получаются самые популярные посты месяца по всему Reddit, в которых случайно встретилось «stuck» или «getting».
В 17:35:11 SGT мы отправили ту же фразу с sort=relevance. Все 10 результатов упоминали «vacuum», а 2 содержали все пять слов. Значит, API работал правильно. Проблема была в параметре, который выбрала модель.
В чате вы видите плохой результат и меняете запрос. В запланированной задаче никто не смотрит, и модель может каждую неделю платить за не те посты. Поэтому на этапе 2 нужно зафиксировать sort и использовать ключевые фразы из 2–3 слов. Также попросите, чтобы в отчёте для каждого вызова указывалось число возвращённых и подходящих записей. Одного взгляда хватит, чтобы понять, всё ли в порядке с данными за неделю.
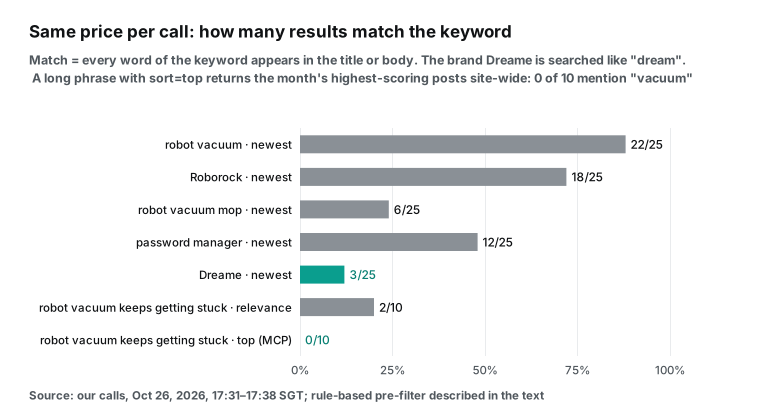
Второй бирюзовый столбец — Dreame, бренд роботов-пылесосов. В 17:31:36 SGT только 3 из 25 результатов касались Dreame. Остальные были постами о снах из r/Dreams и рекламой художественных произведений, потому что поиск воспринял «Dreame» как слово dream. Roborock, название которого не похоже на обычное слово, показал результат намного лучше: 18 из 25. Если название вашего бренда похоже на обычное английское слово, поиск по ключевым словам будет давать много шума. Используйте собственное сообщество бренда через reddit/subreddit_posts (у Dreame есть r/Dreame_Tech) или добавьте к ключевой фразе слово, обозначающее категорию.
Почему инструменты данных запрашивают подтверждение: аннотации 25 инструментов
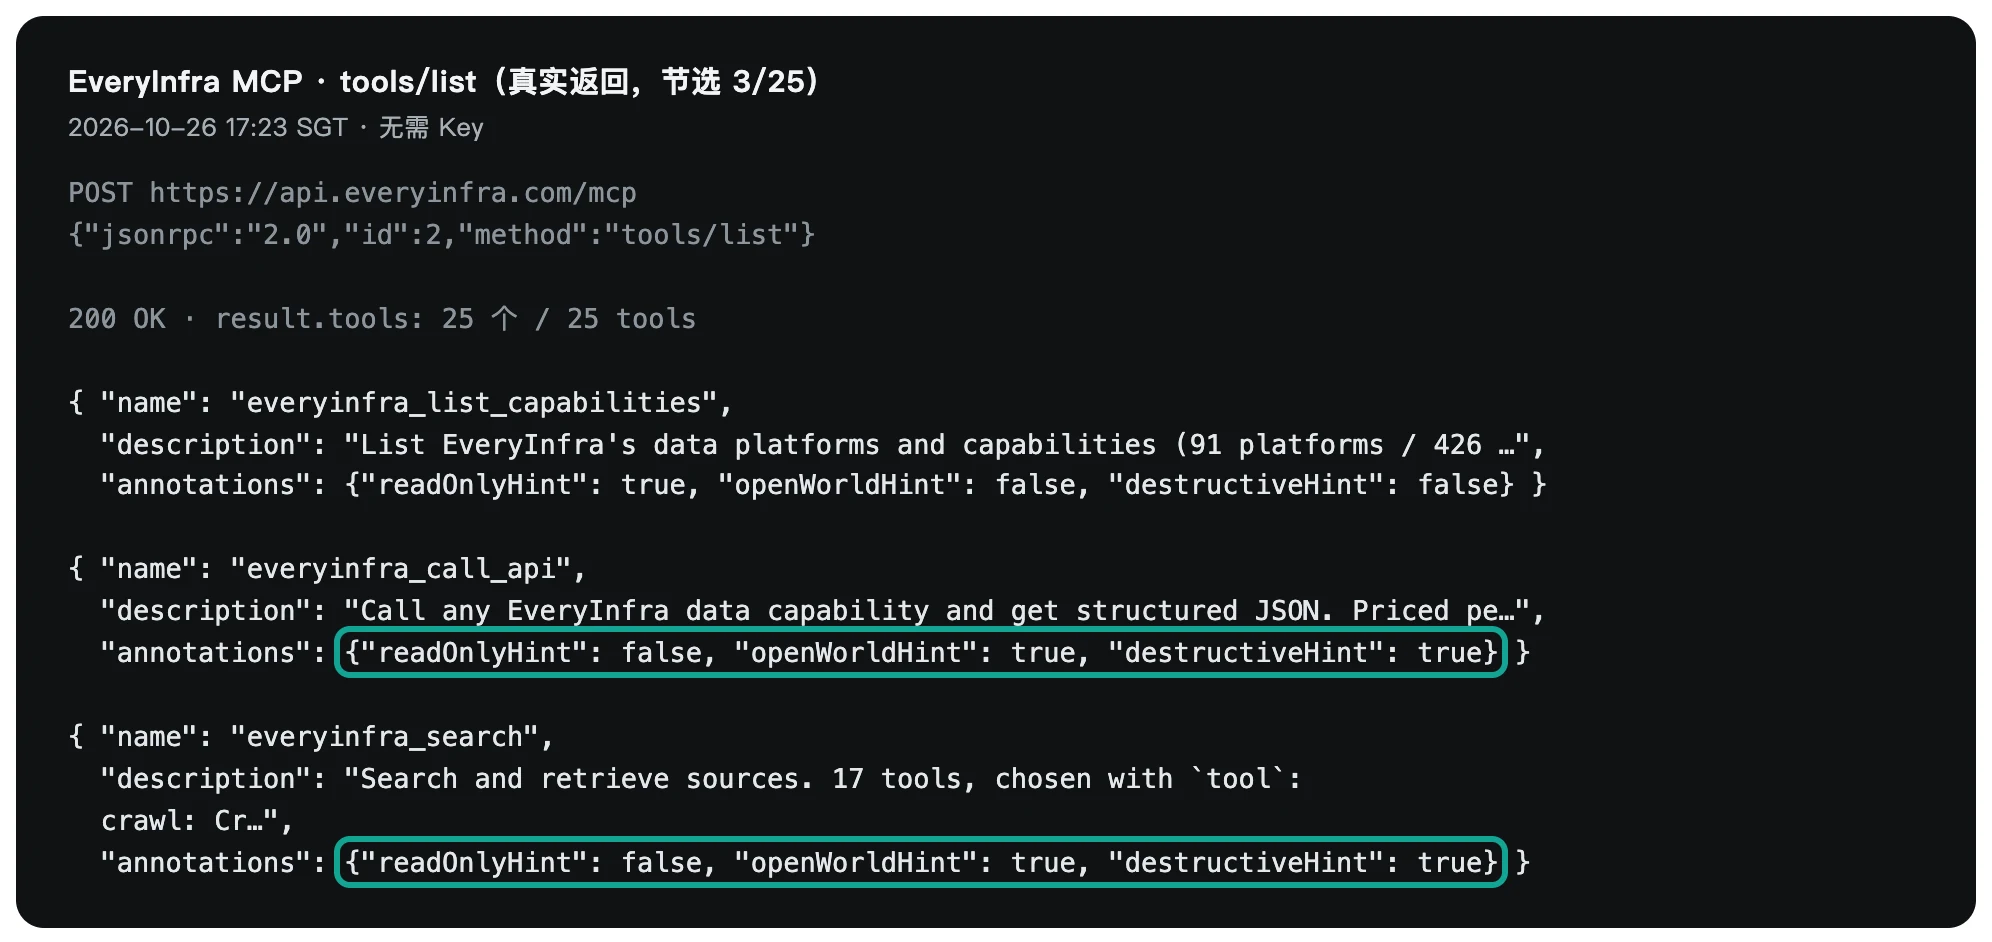
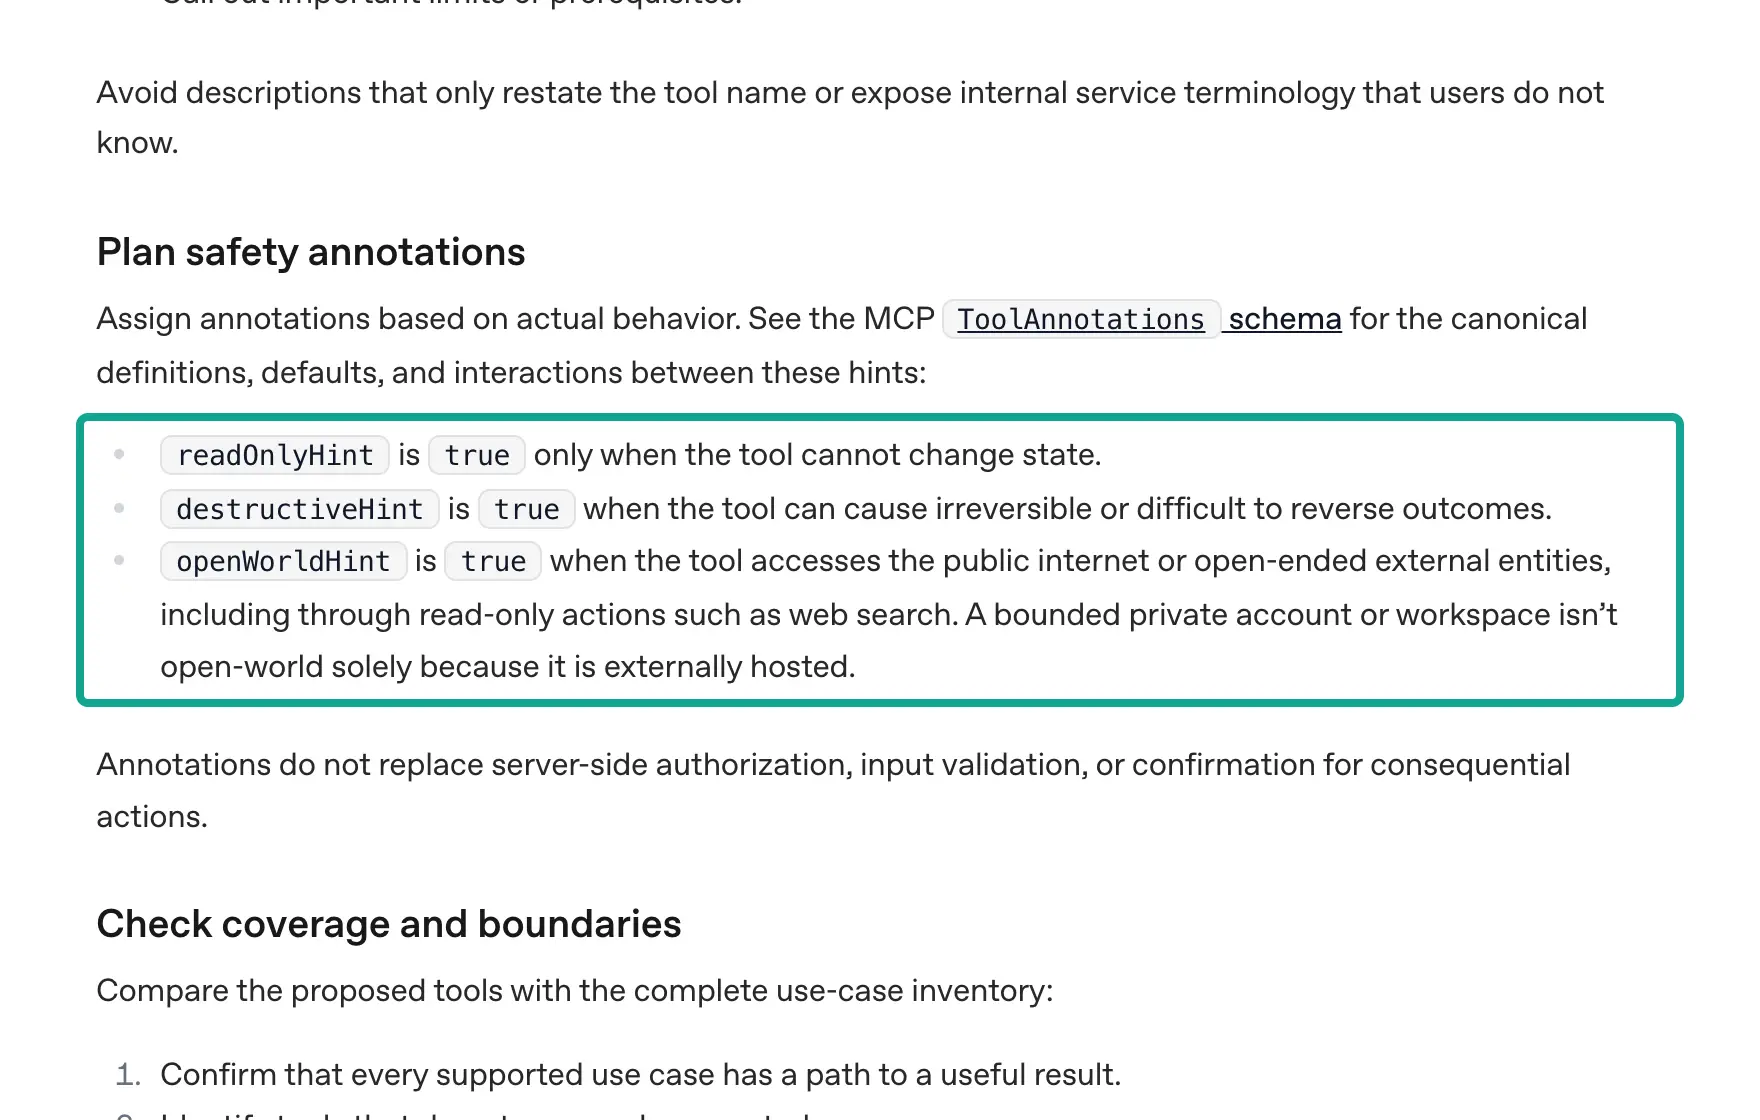
Спецификация MCP задаёт для каждого инструмента несколько аннотаций. Согласно определению ToolAnnotations в спецификации 2025-11-25, readOnlyHint со значением true означает, что инструмент не изменяет своё окружение, а по умолчанию значение равно false. destructiveHint имеет смысл, только если инструмент не помечен как «только для чтения», и по умолчанию равен true. openWorldHint означает, что инструмент работает с открытым множеством внешних сущностей, и по умолчанию равен true. Документация OpenAI по плагинам рекомендует ставить readOnlyHint в true, только если инструмент не может менять состояние.
Там же сказано, что аннотации помогают ChatGPT и Codex решать, когда запрашивать подтверждение и как обеспечивать безопасность. Сама по себе аннотация ничего не делает, но хост по ней решает, когда спрашивать. Например, у Codex есть настройка MCP default_tools_approval_mode. Со значением writes она, согласно странице OpenAI о MCP, «запрашивает подтверждение для инструментов без пометки „только для чтения“». ChatGPT работает так же: на странице «Add custom MCP server» сказано, что он определяет инструменты только для чтения по readOnlyHint, считает инструменты без этой аннотации действиями записи и по умолчанию запрашивает подтверждение для действий записи.
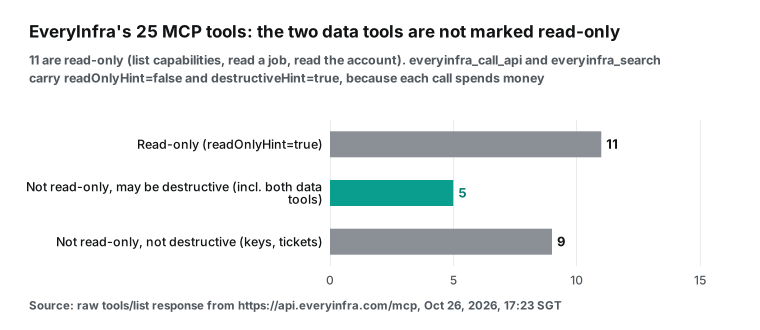
Из наших 25 инструментов 11 предназначены только для чтения. Они выводят списки возможностей, типов капчи, ключей и тикетов. Они получают сведения о задаче и аккаунте, данные об использовании и биллинге, журналы запросов и отдельный тикет. Один из инструментов получает ссылку на пополнение баланса.
Остальные 14 не помечены как «только для чтения», и 5 из них могут быть деструктивными. Два из этих 5 — инструменты данных everyinfra_call_api и everyinfra_search. Остальные 3 не имеют отношения к этой задаче (один из них удаляет ключ). Почему инструменты данных не помечены как «только для чтения»?
На Reddit они ничего не меняют. Но они списывают деньги с вашего кошелька, а это изменение окружения. Наше правило простое. Инструмент, который обращается к внешним сайтам, получает openWorldHint=true. Платный вызов всегда получает destructiveHint=true.
Мы считаем, что это правильно. Если инструмент, который тратит деньги, заявлен как «только для чтения», хост запускает его без вопросов. Тогда, если модель по ошибке зациклится, у вас не будет шанса её остановить.
Помимо аннотаций, в ChatGPT можно самостоятельно настроить разрешения. На странице «Managing app permissions in ChatGPT» перечислены четыре уровня. При уровне «Всегда спрашивать» подтверждение запрашивается перед чтением и внесением изменений. Уровень «Разрешать действия чтения» позволяет читать без подтверждения, но перед изменениями оно запрашивается. При уровне «Разрешать действия с низким риском» такие действия разрешаются автоматически, а для действий с более высоким риском может потребоваться подтверждение либо они могут быть отклонены.
«Разрешать все действия» выполняет поддерживаемые действия без дальнейших запросов. Этот последний уровень можно задать только для одного приложения или одного аккаунта. В селекторах для всего аккаунта и всего рабочего пространства его нет. На той же странице сказано, что кнопка «Всегда разрешать» недоступна участникам управляемых рабочих пространств и для действий, которым нужна дополнительная проверка безопасности. В истории изменений плагинов указано, что эти настройки «когда спрашивать» заработали 12 июня 2026 года.
| Ваша настройка | Что делает наш инструмент данных (без пометки «только для чтения», может быть деструктивным) | Результат в запланированной задаче |
|---|---|---|
| Всегда спрашивать | Спрашивает каждый раз; нажмите «Разрешить» | Задача ждёт вас |
| Разрешать действия чтения | Это не чтение, поэтому спрашивает | То же |
| Разрешать действия с низким риском (по умолчанию) | Помечен как деструктивный, поэтому, скорее всего, не считается низкорисковым: требуется подтверждение | То же |
| Разрешать все действия (только для одного приложения) | Подтверждения для поддерживаемых действий больше не запрашиваются | Может работать без присмотра; пользователи на форуме сообщают, что запланированные запуски всё равно блокировались проверками безопасности |
Второй и третий столбцы отражают наше прочтение документации. ChatGPT не публикует правило, по которому действие считается «низкорисковым». В обычном чате при любом уровне разрешений запрос подтверждения появляется не более одного раза — при первом вызове: выберите «Разрешить» и укажите, что разрешение нужно запомнить для этого чата. После этого в том же чате подтверждение больше не запрашивается. У запланированных задач есть ещё одна особенность; именно о ней говорится в приведённых ниже сообщениях с форума.
4 октября 2026 года пользователь опубликовал на форуме OpenAI сообщение о регрессии. Его еженедельная запланированная задача читает письма в Gmail, проводит исследование и решает, какое письмо отправить. В настройках Gmail было выбрано «Разрешить все действия», а в промпте задачи было дано постоянное разрешение. На шаге, где отправляется письмо и данные записываются в Google Sheets, вызов был заблокирован.
Сообщение было таким: «This tool call was blocked by OpenAI's safety checks», без других подробностей. В отчёте перечислены сбои с 30 сентября по 3 октября. 5 октября другой пользователь вставил промпт задачи того же типа в обычный чат, и все 8 из 8 операций записи в Trello прошли успешно.
В запланированном запуске операции записи были заблокированы. К 8 октября в ответах по-прежнему сообщали, что запись в GitHub в одни дни работала, а в другие нет, тогда как чтение и сортировка почты продолжали работать. Другой отчёт за 6–8 октября описывает более серьёзную проблему. После заблокированной записи в GitHub ежечасные задачи отключались примерно через 64–65 секунд после запуска, и следующий запуск не происходил. Это сообщения пользователей, и OpenAI не публиковала выводов в этих обсуждениях.
В документации OpenAI сказано, что действия, связанные с записью, требуют подтверждения и после этого выполняются. Там не сказано, что запланированные задачи не могут выполнять запись. Из этих сообщений следует, что у некоторых пользователей одобренные операции записи блокировались проверками безопасности во время запланированных запусков. ChatGPT считает наш инструмент для данных действием записи. Поэтому, если радар должен работать надёжно и без присмотра, не помещайте получение данных внутрь запланированной задачи.
Три схемы: какая подойдёт вам
В ChatGPT инструмент для данных требует подтверждения, а подтвердить запланированный запуск некому. Поэтому вариантов три. Снять это ограничение в рабочем пространстве, где это разрешено. Вынести получение данных за пределы ChatGPT, чтобы ChatGPT только читал. Или отказаться от запланированных задач ChatGPT.
| Схема | Для кого | Как | Стоимость и риски |
|---|---|---|---|
| A. Прямое подключение MCP | Рабочие пространства Business и Enterprise | Администратор создаёт и публикует приложение, включает для него «Разрешить все действия» и один раз запускает задачу вручную в обычном чате | Пользователи на форуме сообщают, что запланированные запуски всё равно могут блокироваться проверками безопасности; ключ передаётся в URL, поэтому используйте ключ с ограничениями |
| B. Раздельно: данные собираются снаружи, ChatGPT читает | Plus, Pro, личные аккаунты | В понедельник в 08:00 cron, n8n или GitHub Actions вызывает наш REST API и записывает файл в Google Drive или GitHub. В 09:00 задача ChatGPT читает этот файл через коннектор Drive или GitHub и пишет отчёт | Ещё один планировщик; ChatGPT только читает, и это самый стабильный вариант |
| C. Без запланированной задачи ChatGPT | Тем, кто хочет полной автоматизации и умеет немного программировать | Ваш собственный cron вызывает API OpenAI Responses с удалённым MCP-инструментом (require_approval: "never", allowed_tools), или вы используете облачные запланированные задачи Claude Code | Оплата за токены; не в интерфейсе ChatGPT |
Схема B основана на ответе в той же ветке форума. Его автор занимается корпоративной автоматизацией. ИИ принимает решение и создаёт структурированную запись, а действие выполняет детерминированная программа под вашим контролем (ответ от 7 октября 2026 года). Для радара спроса «действие» означает получение данных. Планировщик может вызывать EveryInfra без подтверждения человека. На этапе ChatGPT система только читает файл, а это надёжная часть схемы.
Мы протестировали ежедневный воркфлоу n8n, который вызывает EveryInfra. Замените в нём ключевые слова и записывайте результат в Google Drive, и первая половина схемы B готова. Для схемы C руководство по MCP в Responses API показывает, как require_approval отключает подтверждения и как allowed_tools импортирует только нужные инструменты. Облачные запланированные задачи Claude Code доступны на тарифах Pro, Max, Team и Enterprise и работают, даже когда ноутбук закрыт. Ни один из этих путей мы в этой статье не тестировали и приводим их только как варианты.
Что должен собирать радар: три набора реальных вызовов
Радар полезен, только если данные относятся к этой неделе и к этой категории. 26 октября 2026 года с 17:31 до 17:41 SGT мы прогнали три набора с одним тестовым ключом. Первый набор относится к SaaS-категории, знакомой многим англоязычным читателям: менеджеры паролей (ключевое слово «password manager», сообщество r/PasswordManagers). Второй набор относится к категории устройств: роботы-пылесосы (ключевые слова «robot vacuum», «Roborock», «Dreame», «robot vacuum mop», сообщество r/RobotVacuums).
В третьем наборе используются ключевые слова на испанском. Всего мы отправили 32 запроса. 22 из них тарифицировались, их общая стоимость составила $0,016397. Остальные 10 пришлись на заранее запланированные проверки обработки ошибок, запросы с превышенным лимитом и пустые результаты; ни один из них ничего не стоил.
Первая проблема связана с временным охватом. Согласно каталогу, временное окно reddit/search зафиксировано на последнем месяце, а его max_limit равен 25. С sort=newest 25 постов охватывают всего несколько часов. «password manager» охватил 7,1 часа, «robot vacuum» 15,6 часа, «Roborock» 24,4 часа, а «Dreame» всего 0,2 часа (в выдачу попал каждый новый пост со словом «dream»).
Если понедельничный запуск берёт только «25 самых новых», вы видите период с воскресного дня до утра понедельника и пропускаете дни со вторника по субботу. Сбор по сообществу работает иначе. reddit/subreddit_posts с sort=top, date_range=past_week и limit=100 вернул все 20 топовых постов недели для r/PasswordManagers. Они охватывают период с 19 по 26 октября, то есть 160,1 часа. Для r/RobotVacuums он вернул 100 постов за 166,3 часа. Оба значения близки к полной неделе.
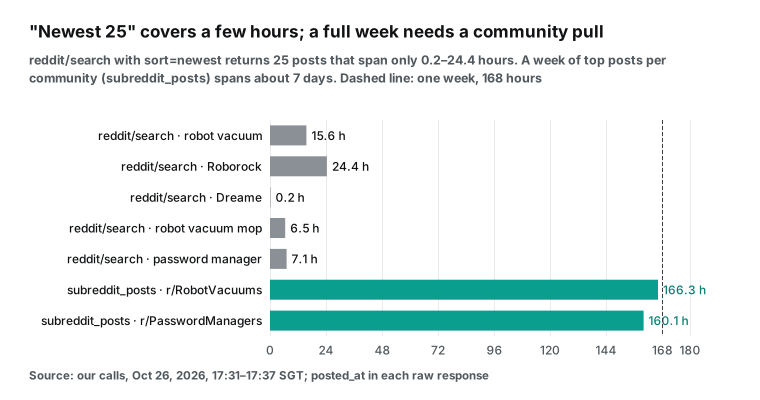
Поэтому основа этой задачи — reddit/subreddit_posts. Поиск по ключевым словам используйте только для того, чтобы находить сообщества, которых вы ещё не знаете. Наш заранее заданный критерий для этого пункта считал, сколько из 25 постов попадает в последние 7 дней. Попали все 25. Значит, по исходному порогу ответ был такой: еженедельных запусков достаточно.
Но этот порог измерял не то. Все 25 постов оказались в последних 7 днях, потому что все они были опубликованы за последние несколько часов. В журнале тестов мы отметили этот критерий как «плохо спроектированный». Вывод мы сделали по охвату, а исходный критерий менять не стали.
Поиск по ключевым словам к тому же приносит шум. 25 результатов по «password manager» пришли из 25 разных сообществ. Оба слова есть только в 12 из них. Среди остальных оказались реклама казино, реклама приложения и вопросы о входе в посторонние приложения. У сбора по сообществу такой проблемы нет, потому что каждый пост взят из выбранного вами сообщества.
Вторая проблема касается того, что содержат посты за неделю. Мы делаем предварительную фильтрацию по фиксированным правилам, заданным в начале нашего скрипта анализа. Пост считается «вопросом», если его заголовок заканчивается вопросительным знаком. Вопросом он считается и тогда, когда заголовок начинается с how, what, which, best или anyone.
Считается, что пост «содержит слова, характерные для жалоб», если в его заголовке или первых 400 символах текста есть слова вроде stuck, broken, issue, avoid или return. В r/PasswordManagers 8 из 20 постов являются вопросами, а слова, характерные для жалоб, есть в 1 посте. В r/RobotVacuums 49 из 100 постов являются вопросами, а такие слова есть в 35.
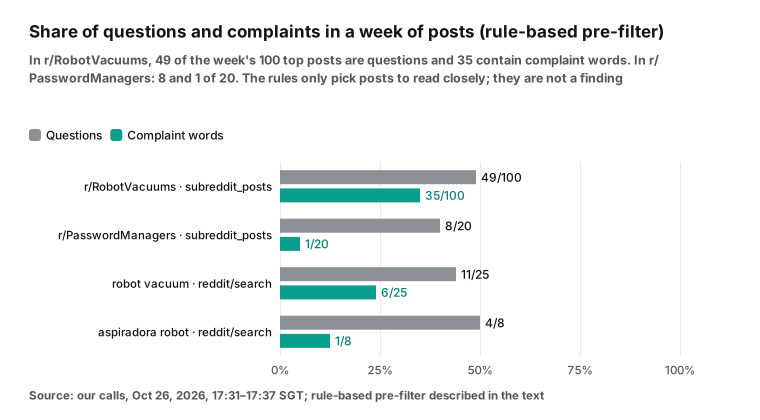
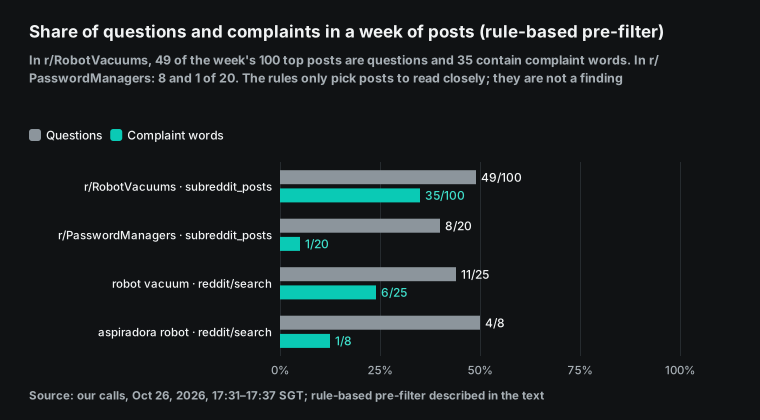
Правила лишь отбирают посты для внимательного чтения и сами по себе выводом не являются. В r/PasswordManagers у поста с наибольшим числом комментариев (76) заголовок «Password manager scene is such a mess right now», и слов, характерных для жалоб, в нём нет. Наш список слов не распознаёт его как жалобу, хотя это самая явная жалоба недели. В двух постах просили рекомендаций для «параноидальных» пользователей (35 и 30 комментариев).
Один пользователь проверил, замечают ли три менеджера паролей смену пароля на 5 сайтах (37 комментариев, 35 баллов, лучший результат недели). В другом посте спрашивали, где аудит безопасности нового продукта (20 комментариев). Настоящую сортировку должна делать задача ChatGPT, потому что модель хорошо понимает сленг и может определить, чем недоволен пользователь. У наших правил одна задача: показать, стало ли на этой неделе больше вопросов или жалоб, чем на прошлой.
Третья проблема связана с комментариями. Мы вызвали reddit/comments с limit=100 для двух постов с наибольшим числом комментариев и получили 73 и 49 комментариев. API возвращает комментарии верхнего уровня и не разворачивает ответы, как объясняется в нашей статье о том, почему комментарии Reddit выглядят неполными. В ветке про «mess» слова, характерные для жалоб, были в 13 комментариях.
Ответы с наибольшим числом голосов советовали автору перестать искать идеальный продукт или развернуть менеджер на своём сервере. В ветке «what do you actually use» один пользователь написал, что ушёл со своего прежнего менеджера из-за недавних проблем с приложением и со службой поддержки. В отзывах в магазинах приложений такие подробности встречаются редко. А именно они нужны продуктовой команде: почему люди переходят на другой продукт и что подрывает их доверие к вендору.
Четвёртая проблема касается объёма на Quora. quora/questions с date_range=past_week_last_7_days и limit=30 нашёл 4 новых вопроса про «password manager» за неделю и 11 за 30 дней. Два из 4 вопросов за неделю касались менеджеров паролей для ИИ-агентов. На той же неделе в r/PasswordManagers появился пост об «интеграции с ИИ-агентами» от крупного вендора. Одна и та же новая тема в двух источниках за одну неделю и есть тот сигнал, ради которого существует радар.
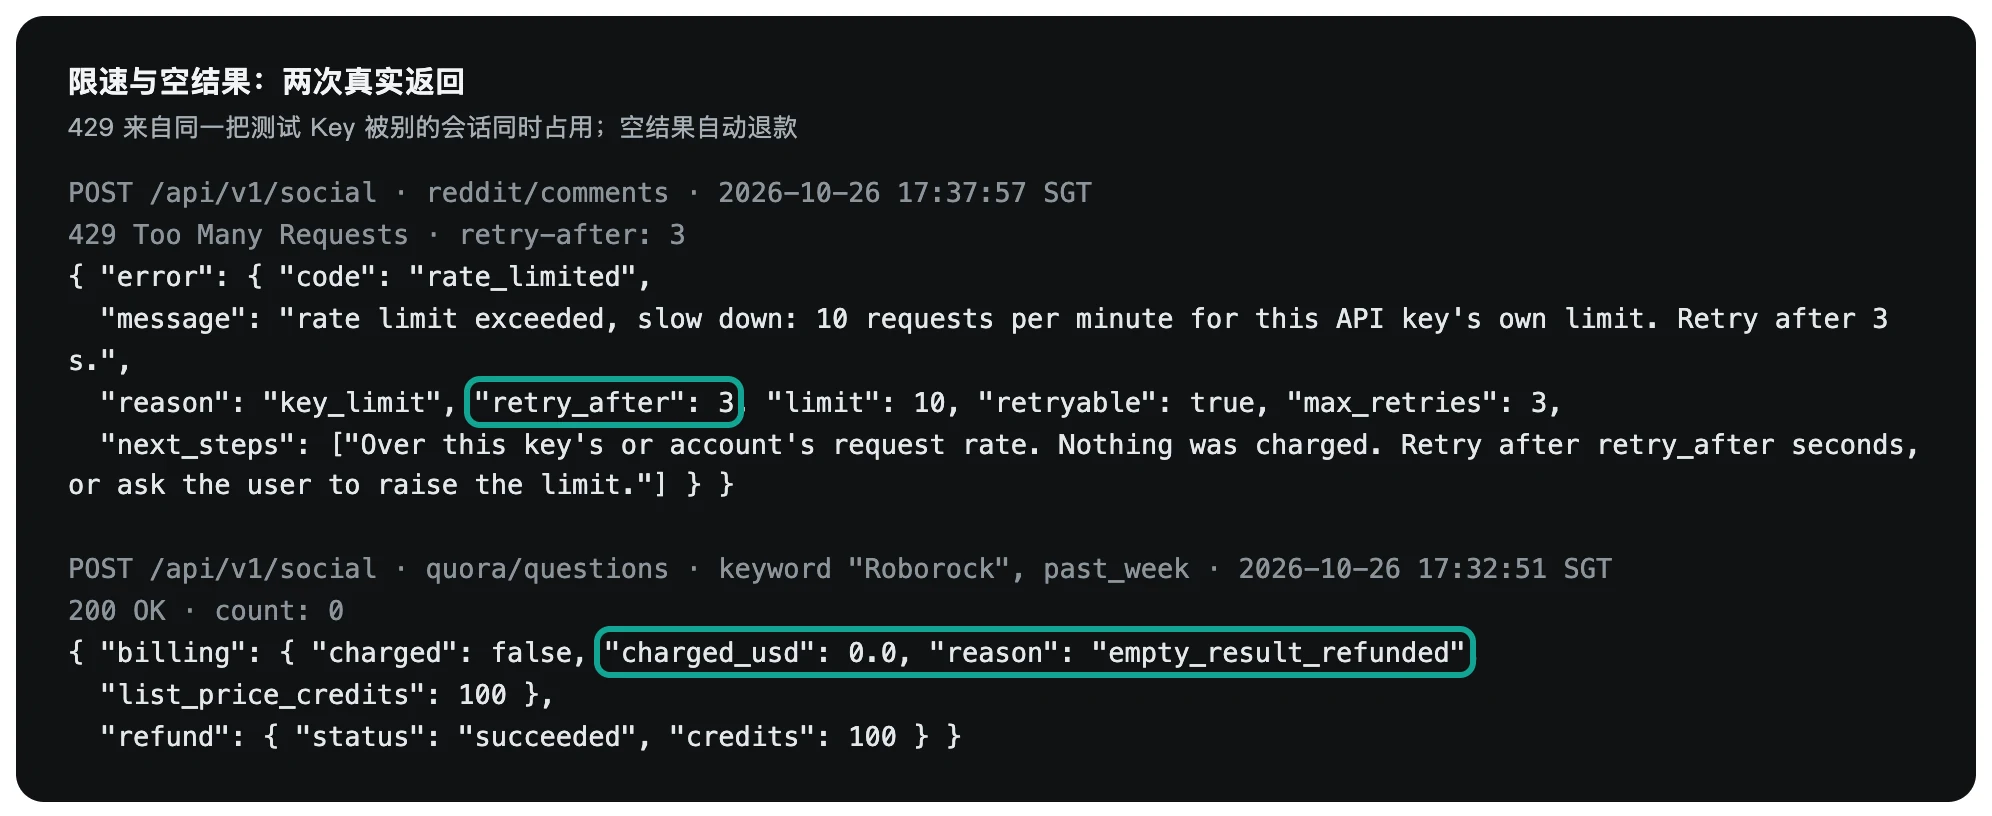
По роботам-пылесосам на Quora нашлось 2 вопроса за неделю и 30 за месяц (это лимит, так что на самом деле их больше). По запросу «Roborock» за неделю нашлось 0 вопросов. Этот вызов ничего не стоил, а в ответе было "reason": "empty_result_refunded". Quora добавляет срез «что думают люди перед покупкой». Объём небольшой, поэтому достаточно выгружать данные раз в месяц.
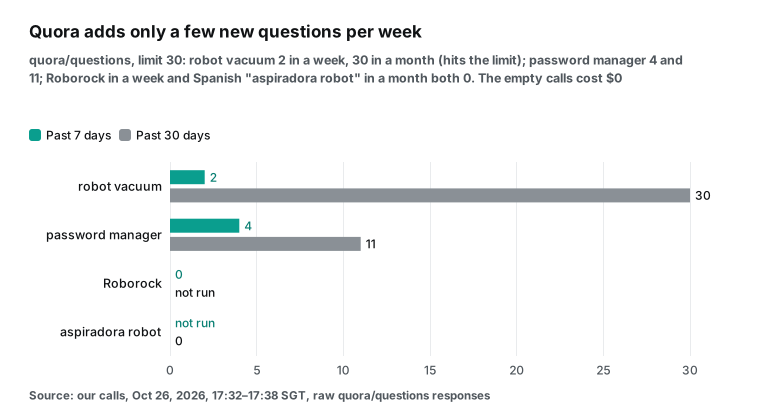
Испанский набор показывает языковую ловушку. reddit/search по «aspiradora robot» (relevance) вернул 8 постов, и 7 из них оказались по теме. Они пришли из латиноамериканских сообществ, например r/AskChile и r/Colombia. А «robot aspirador» (newest) вернул 11 постов, в основном из португалоязычных сообществ, потому что по-португальски робот-пылесос называется aspirador robot. На Quora «aspiradora robot» за месяц вернул 0 результатов (средства возвращены).
«robot aspirador» за год вернул 5 вопросов на английском про «начинающие» (aspiring) робототехнические компании. Поскольку результат не был пустым, вызов стоил $0,001389. Для радара на нескольких языках проверяйте ключевые слова каждого языка отдельно. Не переводите английские ключевые слова в надежде, что это сработает.
| Серия | Возможность и параметры | Записи | Совпадает | Охват | Списано |
|---|---|---|---|---|---|
| Менеджеры паролей | reddit/subreddit_posts r/PasswordManagers, top, past_week, 100 | 20 | все из этого сообщества | 160.1 h | $0.000556 |
| Менеджеры паролей | reddit/search password manager, newest, 25 | 25 | 12 | 7.1 h | $0.000556 |
| Менеджеры паролей | quora/questions password manager, past_week, 30 | 4 | 4 | — | $0.001389 |
| Менеджеры паролей | reddit/comments, ветка «mess», limit 100 | 73 | — | — | $0.000556 |
| Роботы-пылесосы | reddit/subreddit_posts r/RobotVacuums, top, past_week, 100 | 100 | все из этого сообщества | 166.3 h | $0.000556 |
| Роботы-пылесосы | reddit/search Dreame, newest, 25 | 25 | 3 | 0.2 h | $0.000556 |
| Роботы-пылесосы | quora/questions Roborock, past_week, 30 | 0 | — | — | $0 (средства возвращены) |
| Испанский | quora/questions robot aspirador, past_year, 30 | 5 | 0 | — | $0.001389 |
Как написать промпт задачи
С такими цифрами промпт задачи можно сделать строгим. Ниже приведён пример конфигурации запланированной задачи ChatGPT. В самом ChatGPT мы его не запускали. Важны три части.
Для каждого вызова явно указаны платформа, действие и параметры, поэтому модель ничего не выбирает сама. В конце отчёта перечислены вызовы и их стоимость. Если вызов завершился ошибкой или был заблокирован, модель не делает повторную попытку с другими параметрами. Она указывает запланированный вызов, чтобы вы могли выполнить его вручную.
Run every Monday at 09:00 (America/New_York). Use only everyinfra_call_api from the @EveryInfra plugin. Make the calls below in order. Do not change parameters. Do not add calls.
1. platform=reddit, action=subreddit_posts, params={subreddit: "PasswordManagers", sort: "top", date_range: "past_week", limit: 100}
2. platform=reddit, action=subreddit_posts, params={subreddit: "Bitwarden", sort: "top", date_range: "past_week", limit: 50}
3. platform=reddit, action=search, params={keyword: "password manager", sort: "relevance", limit: 25}
4. platform=quora, action=questions, params={keyword: "password manager", date_range: "past_week_last_7_days", limit: 30}
5. From step 1, take the 5 posts with the highest comment_count. For each, call platform=reddit, action=comments, params={url: <post url>, limit: 100}
Output:
- "Complaints this week": top 5. One-line summary, post link, comment count. Describe the issue; do not name individual users.
- "Questions this week": top 5, same format.
- Compare with last week's report. Deduplicate by post url. Mark new topics.
- Appendix: for each call, rows returned, rows that match the keyword, billing.charged_usd, and the total.
If a call fails or is blocked: do not retry with other parameters. List its platform, action, and params in the appendix, then continue.
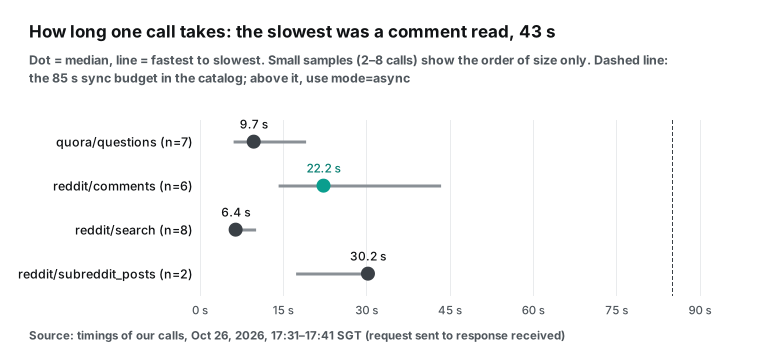
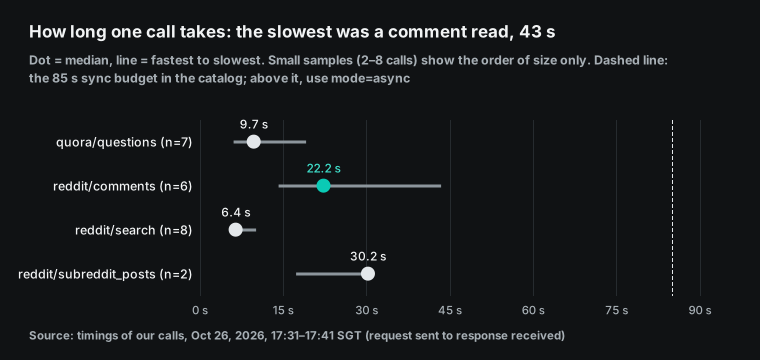
Шаг 5 — самая медленная часть радара. У наших 6 вызовов reddit/comments с 17:33 до 17:41 SGT медиана составила 22,2 секунды, а самый медленный занял 43,4 секунды. ChatGPT не публикует тайм-аут для одного вызова инструмента. В настройках MCP в Codex по умолчанию tool_timeout_sec равен 60 секундам, и это полезный ориентир. Наш каталог отводит на синхронные вызовы 85 секунд. Если нужно больше, добавьте "mode": "async" в тело запроса и получайте результат через everyinfra_get_job.
Пример отчёта на реальных данных этой недели
Чтобы показать, как выглядит хороший отчёт, мы написали пример вручную. В нём используются 20 топовых постов недели из r/PasswordManagers, две ветки комментариев и данные Quora из нашего запуска с 17:31 до 17:41 SGT. ChatGPT его не писал. Пример показывает, что должен содержать еженедельный отчёт и что каждая строка должна ссылаться на реальный пост.
| Раздел | Пункт (число комментариев) | Подтверждение |
|---|---|---|
| Жалоба 1 | «The password manager scene is a mess»: пользователь находит проблему у каждого топового продукта (76) | Заголовок поста и 73 комментария верхнего уровня, в 13 из них есть слова, характерные для жалоб |
| Жалоба 2 | У нового продукта нет публичного аудита безопасности (20) | Заголовок поста |
| Жалоба 3 | Пользователь ушёл с прежнего менеджера из-за недавних проблем с приложением и поддержкой (в ветке с 56 комментариями) | Комментарий верхнего уровня |
| Жалоба 4 | Мало какие продукты сохраняют все поля форм, поэтому пользователи остаются у одного вендора (7) | Заголовок поста |
| Жалоба 5 | Вендор «превращается в Google»: слишком много всего завязано на один аккаунт (в ветке с 56 комментариями) | Комментарий верхнего уровня |
| Вопрос 1 | «What password manager do you actually use and recommend?» (56) | Заголовок и 49 комментариев верхнего уровня |
| Вопрос 2 | Мнения о двух новых продуктах (41) | Заголовок |
| Вопрос 3 | Честные отзывы о хранилище для бизнеса (11) | Заголовок |
| Вопрос 4 | Менеджеры паролей для ИИ-агентов: преимущества и обязательные функции | 2 вопроса на Quora за одну неделю и ещё 1 пост на Reddit об интеграции с агентами |
| Вопрос 5 | «Can a password manager really make your accounts more secure?» (5 ответов) | Quora |
Выделяются два момента. Во-первых, жалобы и вопросы сильно пересекаются. Ветки с наибольшим числом комментариев выглядят как вопросы, но комментарии в них полны жалоб. Поэтому отчёт не может сортировать посты только по заголовку. Лучшее вложение в этом радаре — $0,00278 на 5 вызовов для чтения комментариев.
Во-вторых, ценность отчёта заключается в изменениях от недели к неделе. Одна неделя показывает только давние темы: доверие, аудиты и переход на другой продукт. Через несколько недель тема, которая внезапно растёт, например «менеджеры паролей для ИИ-агентов», становится тем сигналом, который нужен продуктовым и маркетинговым командам. Поэтому в одном из следующих разделов мы проверили сценарий «запустить снова позже: что изменилось?».
Сколько это стоит в неделю
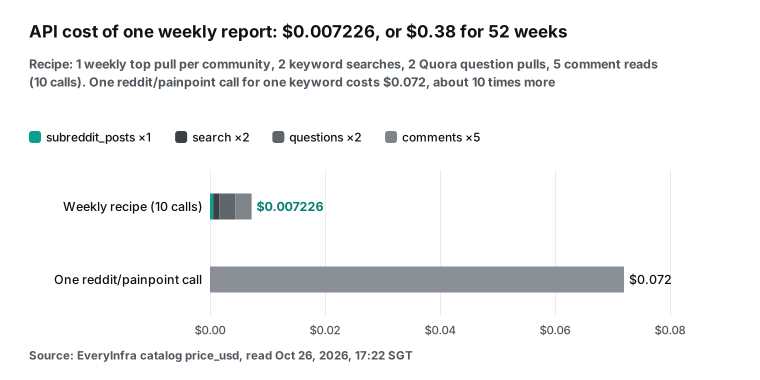
Мы берём price_usd из каталога возможностей по состоянию на 17:22 SGT. Еженедельный рецепт состоит из 10 вызовов: 1 reddit/subreddit_posts, 2 reddit/search, 2 quora/questions и 5 reddit/comments.
| Возможность | Цена за единицу | Вызовов в неделю | Промежуточный итог |
|---|---|---|---|
reddit/subreddit_posts | $0.000556 | 1 | $0.000556 |
reddit/search | $0.000556 | 2 | $0.001112 |
quora/questions | $0.001389 | 2 | $0.002778 |
reddit/comments | $0.000556 | 5 | $0.002780 |
| Итого | 10 | $0.007226 |
52 недели обходятся в $0,375752. Три категории, по радару на каждую, стоят около $1,13 в год. За пустые результаты средства возвращаются, поэтому реальная сумма может быть только меньше. Если вам нужна готовая сводка болевых точек, в каталоге есть и reddit/painpoint за $0,072 за вызов. Эта возможность находит посты по ключевому слову, читает комментарии к ним и возвращает число негативных комментариев и частотные слова. Один такой вызов стоит столько же, сколько 10 недель рецепта. Используйте его один раз, чтобы разведать новую категорию, а не каждую неделю.
Собственная стоимость ChatGPT считается отдельно, и пересчитать её в недельную сумму нельзя. В справочном центре сказано, что у Work и Codex общая структура лимитов. На странице тарифов ChatGPT для Plus указаны диапазоны числа сообщений за 5 часов (от 15 до 160 для GPT-6.1 Sol). Там же предупреждают, что похожие задачи могут расходовать очень разный объём.
В посте в r/codex от 5 октября 2026 года пользователь Plus рассказал о своей ежедневной задаче на 7:00. Она работала 13 минут и израсходовала 29% его 5-часового лимита. Поддержка OpenAI ответила ему, что запланированные задачи выполняются в Work и делят лимит с Codex. При таких масштабах затраты на стороне ChatGPT у радара спроса намного больше, чем $0,007226 платы за API.
Лимиты запросов, пустые результаты и сбои: за что вы платите
В этом тесте мы столкнулись с четырьмя вариантами ситуации «нет данных». Все четыре обошлись в $0, но на запланированную задачу они влияют по-разному.
| Сценарий | Наш реальный ответ | Списано | Что это значит для запланированной задачи |
|---|---|---|---|
| Нет ключа | REST 401 missing_key; MCP возвращает isError: true и называет два способа передать ключ | $0 | Если в URL нет ?key=, модель получает понятную ошибку, а не молчаливый сбой |
| Неверный параметр | sort: "latest" возвращает 422 со списком allowed; sort: "newst" возвращает 422 с did_you_mean: ["newest"] | $0 | Модель может это исправить, но при строгом промпте до этого не доходит |
| Лимит запросов | 4 ответа со статусом 429 начиная с 17:37:57 SGT, retry_after 3 с, limit 10 в минуту | $0 | В это же время тот же тестовый ключ использовали другие сеансы. Пусть модель подождёт несколько секунд и сделает повторную попытку |
| Пустой результат | quora/questions по Roborock, 0 за неделю, empty_result_refunded | $0 | Напишите «на этой неделе новых вопросов нет»; это не сбой |
Здесь важна одна деталь. Мы 4 раза упёрлись в лимит, потому что в то же время этот тестовый ключ использовали другие сеансы. Лимит 10 запросов в минуту задан в настройках именно этого ключа и не является общим лимитом для ключей в продакшене. В документе OpenAPI указан лимит аккаунта 60 запросов в минуту.
Один радар делает 10 вызовов, поэтому в обычных условиях в лимит не упирается. Но если несколько задач по разным категориям используют один ключ и все запускаются в понедельник в 09:00, такое возможно. Разнесите их запуск на несколько минут.
Запланированные задачи ChatGPT не работают: частые причины и решения
В поисковых подсказках после «chatgpt scheduled tasks» первым идёт «not working». Мы сопоставили ограничения из документации OpenAI с сообщениями на форуме. Для этой задачи важны девять причин. Первые пять описаны в официальных материалах. Последние четыре взяты из сообщений пользователей, и мы относимся к ним именно как к сообщениям.
| Симптом | Причина | Источник | Как исправить |
|---|---|---|---|
| Задача не запустилась и отображается как «приостановлена» | Действие, требующее подтверждения, приостанавливает задачу; задачи, которые никто не открывает, могут приостанавливаться; удаление или архивация чата приостанавливает его задачу | Справочный центр: «Scheduled tasks» | Проверяйте в разделе «Запланированные», нет ли ожидающих подтверждений; открывайте отчёт раз в несколько недель |
| Не получается создать новую задачу | Достигнут лимит активных задач (3/5/10/15) | То же | Приостановите или удалите неиспользуемые задачи |
| Задача на тарифе Free выполняется не вовремя | На Free используются интервалы вроде «утром» или «ночью», не чаще раза в день | То же | Для точного времени перейдите на платный тариф |
| Задача не может прочитать файлы проекта | Задачи, созданные в проекте, не могут открывать загруженные в проект файлы | То же | Поместите справочный текст в промпт задачи или туда, откуда его может прочитать коннектор |
| Нельзя создать задачу в GPT, голосовом чате или заблокированном чате | Запланированные задачи их не поддерживают | То же | Создайте её в обычном чате или в Work |
| Запись блокируется (сообщения пользователей) | «blocked by OpenAI's safety checks», хотя тот же промпт работает в обычном чате; в документации сказано только, что запись требует подтверждения | Сообщения на форуме с 4 октября 2026 года | Вынесите получение данных во внешний планировщик, чтобы ChatGPT только читал (схема B) |
| Задача сама отключается после запуска | Примерно через минуту после неудачной записи задача переходит в статус «отключена» | Сообщение на форуме, 6–8 октября 2026 года | То же; проверяйте статус задачи каждую неделю |
| При добавлении собственного MCP-сервера появляется «does not implement OAuth» | Файрвол заблокировал проверочный запрос, или у сервера нет OAuth | Сообщение на форуме, 3 сентября 2026 года | Для EveryInfra выберите «Без аутентификации» |
| Задача расходует много лимита Work | Запланированные задачи выполняются в Work и делят лимит с Codex | r/codex, 5 октября 2026 года; страница тарифов | Пишите короткий и строгий промпт задачи; просите только сводку |
В ветке с просьбой о помощи в r/ChatGPT, где больше 30 ответов, смешалось несколько таких проблем. У одного пользователя ежечасная задача перестала писать в GitHub, а потом сама отключилась. У другого понедельничная задача три недели не появлялась в списке задач. Третий спросил, почему задача не запустилась. Модель ответила, что работу выполнила, но пользователь её не видел. Беспокоиться стоит именно из-за последнего случая.
Рассказ модели о том, что она сделала, доказательством не является. Поэтому наш промпт требует в конце отчёта список вызовов и charged_usd. Был ли вызов, сколько раз и сколько он стоил, нужно брать из наших записей о вызовах. У каждого вызова в консоли есть request_id. В другой ветке автоматическую приостановку называют парадоксом.
Хорошо работающая задача не требует внимания, но задача без внимания может приостановиться как неиспользуемая. Отправляйте понедельничный радар туда, где вы его действительно читаете. Это тоже часть решения.
Повторный запуск в течение часа: как убирать дубликаты от недели к неделе
Еженедельный радар сравнивает каждый понедельник с предыдущим. Мы хотели понять, что меняется между двумя запусками и по какому полю убирать дубликаты. Поэтому мы повторили три вызова из первого набора с теми же параметрами. Перед тестом мы зафиксировали порог «не менее 45 минут между запусками». Первый повтор прошёл с 18:13:31 до 18:14:28 SGT, через 38,7–42,4 минуты после первого запуска, то есть ниже нашего порога.
Так мы и записали в журнале тестов. Поэтому мы сделали второй повтор с 18:21:02 до 18:21:52 SGT, через 46,1–50,0 минуты после первого запуска, что соответствует порогу. 6 дополнительных вызовов стоили $0,003336. С ними весь тест составил 38 запросов, из которых 28 оплачены, на сумму $0,019733.
| Вызов | Первый запуск (SGT) | Записи: первый запуск → повтор 1 → повтор 2 | Новые в повторе 2 | Пропали в повторе 2 |
|---|---|---|---|---|
reddit/search robot vacuum, newest, 25 | 17:31:05 | 25 → 25 → 25 | 1 (пост со скидками) | 1 (самый старый) |
reddit/subreddit_posts r/RobotVacuums, top, past_week, 100 | 17:32:11 | 100 → 24 → 100 | 1 (новый вопрос о порогах высотой 3,8 см) | 1 (топовый пост недели) |
reddit/subreddit_posts r/PasswordManagers, top, past_week, 100 | 17:35:46 | 20 → 19 → 19 | 0 | 1 |
Из таблицы следуют три вывода. Во-первых, past_week — это скользящее окно в 168 часов, которое заканчивается в момент вызова, а не календарная неделя. Топовый пост r/RobotVacuums, «Lol avoid Eureka» с 32 баллами, был опубликован 19 октября 2026 года в 10:09 UTC. В 18:13 SGT, то есть в 10:13 UTC 26 октября, ему было больше 7 дней, и он выпал из окна.
То же случилось в r/PasswordManagers с постом от 19 октября, 10:06 UTC. Если задача всегда запускается в одно и то же время, каждый пост попадает ровно в одну неделю. Если понедельничный запуск начнётся позже, например потому что задача была приостановлена и вы её возобновили, посты на границе окна пропадут. Если раньше, часть постов вы увидите дважды.
Во-вторых, убирайте дубликаты по id или url, а не по заголовку. Посты, которые сохраняются между запусками, сохраняют и те же id и url, даже если у них меняются баллы и число комментариев. Храните список значений id за прошлую неделю в отчёте или в файле схемы B. Помечайте пост как «новый», если его id нет в этом списке.
В нашем испанском наборе один пользователь опубликовал один и тот же вопрос в двух чилийских сообществах с разницей в две с половиной минуты. Это два поста с двумя значениями id. Нормализованный заголовок используйте только как второй фильтр для таких случаев.
В-третьих, и этого мы ожидали меньше всего: число записей нестабильно. С теми же параметрами r/RobotVacuums менее чем за 50 минут вернул 100 записей, затем 24, затем снова 100. 24 записи первого повтора оказались ровно постами с 5 баллами и больше. 76 постов с 0 баллами отсутствовали, и вместе у них было 16 комментариев. Ответ с 24 записями пришёл со статусом 200 и был оплачен как обычно.
Для радара это не так важно, потому что все посты, которые попадают в отчёт, были на месте. Но это важно, если вы считаете посты, чтобы оценить объём за неделю. Поэтому в приложении к отчёту указано число записей по каждому вызову. Если сбор по сообществу вернул меньше половины записей по сравнению с прошлой неделей, выполните этот вызов ещё раз, прежде чем решать, что сообщество затихло.
Есть ещё один эффект, и он свойственен любому ранжированию по голосам. Пост, опубликованный в воскресенье вечером, попадает в понедельничный запуск, успев собрать голоса лишь за несколько часов. На следующей неделе он уже вне окна. Поэтому посты последних дней недели обычно оказываются внизу рейтинга. Если для вас это важно, добавьте в отчёт короткий список «постов за последние 24 часа с наибольшим числом комментариев». Дополнительные вызовы не нужны: отфильтруйте тот же сбор по сообществу по posted_at.
Справочник полей: все поля, которые использует отчёт
Мы сверили поля этих возможностей одно за другим с response_fields в каталоге. В таблице перечислены только поля, которые использует радар. Страницы платформ и возможностей: API данных Reddit, API данных Quora, reddit/search, reddit/subreddit_posts, reddit/comments и quora/questions.
| Возможность | Поле | Описание | Применение в радаре |
|---|---|---|---|
reddit/search, reddit/subreddit_posts | id, url | ID поста и ссылка | Убрать дубликаты и сравнить с прошлой неделей |
| То же | title, text | Заголовок и текст | Входные данные для сортировки |
| То же | community | Название сабреддита без префикса r/ | Понять, где сосредоточены обсуждения |
| То же | like_count, comment_count | Баллы и число комментариев | Ранжировать посты; выбирать посты для чтения комментариев |
| То же | posted_at | Время публикации | Проверить, что пост опубликован на этой неделе |
| То же | flair | Текст метки (flair) поста | Некоторые сообщества используют эту метку для категорий «рекомендация» или «помощь» |
reddit/comments | text, like_count, posted_at | Текст комментария, рейтинг, время | Прочитать подробности жалобы |
quora/questions | title, url, posted_at | Заголовок вопроса, ссылка, время | «Вопросы за неделю» |
| То же | answer_count, follower_count | Ответы и подписчики | Посмотреть, отвечает ли кто-нибудь |
Обе возможности Reddit также возвращают author_username, но радару это поле не нужно. Политика Reddit Responsible Builder Policy запрещает выводить из данных чувствительные характеристики, например сведения о здоровье или политических взглядах. Она также запрещает попытки повторно идентифицировать пользователей. Поэтому в промпте и есть строка «не называй отдельных пользователей».
Те же данные без ChatGPT
Для планировщика в варианте B или чтобы сначала посмотреть данные вручную, вызывайте REST API. Параметры те же, что и в MCP, только без обёртки JSON-RPC:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"reddit","action":"subreddit_posts",
       "params":{"subreddit":"PasswordManagers","sort":"top","date_range":"past_week","limit":100}}'
В 17:35:46 SGT этот запрос вернул 20 постов за неделю за 30,2 секунды и стоил $0,000556. Каталог указывает max_limit для каждой возможности. Для reddit/search это 25 (большие значения урезаются до 25). Для reddit/subreddit_posts и reddit/comments это 100.
Для quora/questions это 200. Оплата взимается за каждый вызов API, а не за запись, поэтому значение limit, равное установленному максимуму, даёт больше всего данных за те же деньги. Все первые шаги описаны в разделе Быстрый старт. Про MCP в целом см. наш приёмочный тест удалённого MCP и страницу MCP-сервера.
Где этот подход перестаёт работать
Во-первых, мы не проверяли поведение ChatGPT на практике. Мы можем только пересказать, что говорилось в документации на 26 октября 2026 года. OpenAI часто меняет правила тарифов и разрешений (на большинстве страниц справочного центра, которые мы цитируем, стояла пометка «обновлено несколько часов назад»), поэтому перепроверьте их, прежде чем на них полагаться. Во-вторых, две страницы OpenAI расходятся в вопросе о том, можно ли в Pro вызывать инструмент для работы с данными. В FAQ справочного центра сказано, что пользовательскому MCP в Pro доступны только операции чтения и получения данных (fetch). В руководстве для разработчиков сказано, что поддерживаются инструменты чтения и записи, причём запись требует подтверждения. Мы опираемся на руководство для разработчиков; тариф Pro мы не тестировали.
В-третьих, наши правила для вопросов и жалоб служат предварительным фильтром. Выборка из 20 или 100 постов показывает, что таких постов «много», но не их долю. Чтобы оценить долю, запускайте радар несколько недель и каждую неделю проверяйте выборки вручную. В-четвёртых, Reddit отключает RSS 13 ноября 2026 года. Кроме того, к марту 2027 года он планирует закрыть публичный API (TechCrunch, 30 сентября 2026 г., первоисточник: пост в r/modnews). Радар на RSS придётся переделать; мы разобрали, как заменить мониторинг Reddit через RSS.
В-пятых, радар показывает, о чём говорят пользователи, а не размер рынка. Не все пользователи Reddit и Quora — покупатели. Сверяйте выводы с данными продаж и поддержки.
Последние изменения
- 25 августа 2026 г.: запланированные задачи могут реагировать на события в приложениях, и ими можно делиться (ChatGPT release notes). Пользователи Plus и Pro могут запускать задачи Work при появлении новых сообщений в Gmail или Slack либо изменениях в pull request на GitHub. У пользователей Free может быть 3 активные задачи. Что это значит для вас: радар по расписанию не меняется, но готовым радаром можно поделиться с коллегой, который подключит собственные приложения.
- 29 сентября 2026 г.: поддерживаемые плагины могут запускать автоматизации по событиям MCP (те же примечания к выпуску; страница для разработчиков: MCP Events). Для этого нужен MCP 2.0 (версия протокола 2026-07-28), а сервер отправляет события через вебхук. Что это значит для вас: EveryInfra — API с получением данных по запросу; он не отправляет события. Чтобы получать «оповещения о новых постах», по-прежнему опрашивайте API по расписанию.
- 1 октября 2026 г.: для пользовательского MCP больше не нужен режим разработчика (ответ сотрудника OpenAI на форуме). Серверы добавляются на странице Plugins; разрешение рабочего пространства переименовано. Что это значит для вас: старые руководства, где предлагают найти переключатель «Developer mode», устарели.
- С 4 октября 2026 г.: пользователи сообщают о блокировке операций записи в запланированных задачах (официальный форум; OpenAI пока не ответила). Операции чтения не затронуты. Что это значит для вас: по документации операции записи требуют подтверждения, после чего выполняются, но инструмент, который тратит деньги или меняет данные без присмотра, надёжнее всего вынести за пределы ChatGPT.
- 30 сентября 2026 г.: Reddit объявляет об отключении RSS 13 ноября и о регистрации приложений до 12 января 2027 г. (r/modnews). Что это значит для вас: радар, который следит за сообществами через RSS, нужно переделать до 13 ноября.
- 26 октября 2026 г.: для ключей EveryInfra можно задать лимит расходов в USD (
spend_limit_usdиkey_spend_limit_reachedв документе OpenAPI). Что это значит для вас: задайте для ключа лимит, прежде чем добавлять его в URL для ChatGPT.
FAQ
«chatgpt tasks» и «chatgpt scheduled tasks»: это одно и то же? Да, это два названия одной функции. В старом интерфейсе она называлась «Tasks». Теперь статья справочного центра называется «Scheduled tasks in ChatGPT», а открыть функцию можно на странице Scheduled на боковой панели. Поддерживаются разовые, повторяющиеся и мониторинговые задачи. Источник: в поисковых подсказках «chatgpt tasks» стоит рядом с «chatgpt scheduled tasks» (данные на 26 октября 2026 г.); справочный центр.
«chatgpt scheduled tasks not working»: что проверить в первую очередь? Откройте страницу Scheduled и проверьте, нет ли статуса «paused» или запроса на подтверждение, ожидающего решения. В справочном центре сказано, что действие, требующее подтверждения, ставит задачу на паузу, а задачи, которые никто не открывает, могут приостанавливаться. Затем проверьте, не создали ли вы задачу в проекте, GPT, голосовом чате или заблокированном чате. Если задача записывает данные, поищите в сведениях о запуске сообщение «blocked by OpenAI's safety checks» (о таком случае сообщали пользователи форума). Источник: подсказки «chatgpt scheduled tasks not working» и «chatgpt scheduled tasks not showing»; справочный центр; сообщение на форуме.
Нужен ли для «chatgpt custom mcp connector» по-прежнему режим разработчика? Нет. Это изменилось 1 октября 2026 г. Откройте Plugins, нажмите «+» и выберите в меню «Add custom MCP server». В рабочем пространстве Business создавать такие серверы могут только администраторы и владельцы. В Enterprise и Edu администраторы назначают это разрешение ролям. Источник: подсказка «chatgpt custom mcp connectors»; ответ сотрудника OpenAI; справочный центр.
Какой лимит у «chatgpt scheduled tasks»? Он зависит от тарифа. Активных задач: 3 в Free и Go, 5 в Plus, 10 в Business и Edu, 15 в Pro и Enterprise. На платных тарифах задачи могут повторяться ежечасно, на Free не чаще раза в день. Задачи, запускаемые по событиям, могут выполняться до 30 раз в час и до 720 раз в сутки суммарно. Источник: подсказка «chatgpt scheduled tasks limit»; справочный центр.
Может ли ChatGPT вызывать инструменты данных EveryInfra, если они не помечены как read-only? Да. В руководстве OpenAI для разработчиков сказано, что ChatGPT поддерживает инструменты чтения и записи. Инструмент без readOnlyHint считается действием записи, а такие действия по умолчанию требуют подтверждения: при первом вызове в каждом чате появляется запрос, вы разрешаете вызов и можете запомнить выбор для этого чата. В новом чате запрос появится снова. В запланированной задаче подтверждать некому, поэтому задача встаёт на паузу. Прежде чем ставить задачу в расписание, один раз запустите её вручную в обычном чате. Источник: Add custom MCP server; наши запросы tools/list 26 октября 2026 г. в 17:23 и 20:04 SGT.
Какую аутентификацию выбрать для EveryInfra в ChatGPT? Выберите «No authentication» и передайте ключ в URL как ?key=. Мы не публикуем метаданные OAuth, и все три эндпоинта автообнаружения возвращают 404, поэтому OAuth не сработает. Используйте отдельный ключ с ограниченным набором возможностей и лимитом расходов в USD. Источник: наша проверка 26 октября 2026 г. в 17:42 SGT; страница для разработчиков об аутентификации.
Сколько стоит еженедельный радар спроса? Стоимость 10 вызовов API составляет $0,007226 в неделю, около $0,38 в год. Средства за пустые результаты возвращаются. Тариф ChatGPT и использование Work учитываются отдельно. Источник: наш расчёт по значениям price_usd в каталоге возможностей на 26 октября 2026 г.; реальные списания совпали с каталогом.
Читайте также
- Ежедневный отчёт в n8n с вызовами EveryInfra: тест планировщика 2.45
- Приёмка удалённого MCP: от «инструменты найдены» до «ими действительно можно пользоваться»
- Reddit отключает RSS 13 ноября: как перестроить мониторинг
- Почему комментарии Reddit выглядят неполными
- Мониторинг репутации на нескольких платформах
- Исследование болевых точек на Reddit: reddit/painpoint
- Тарифы
Источники
- «Scheduled tasks in ChatGPT», OpenAI Help Center, дата обращения: 26 октября 2026 г., <https://help.openai.com/en/articles/10291617-scheduled-tasks-in-chatgpt>
- «ChatGPT Work and Codex», OpenAI Help Center, дата обращения: 26 октября 2026 г., <https://help.openai.com/en/articles/20001275>
- «ChatGPT release notes» (записи от 25 августа, 29 сентября и 20 октября 2026 г.), OpenAI Help Center, <https://help.openai.com/en/articles/6825453-chatgpt-release-notes>
- «Connecting custom MCP servers in ChatGPT», OpenAI Help Center, дата обращения: 26 октября 2026 г., <https://help.openai.com/en/articles/12584461-connecting-custom-mcp-servers-in-chatgpt>
- «Managing app permissions in ChatGPT», OpenAI Help Center, <https://help.openai.com/articles/20001495>
- «Connected apps in ChatGPT», OpenAI Help Center, <https://help.openai.com/en/articles/11487775-apps-in-chatgpt>
- «About ChatGPT Pro tiers», OpenAI Help Center, <https://help.openai.com/articles/9793128>
- «What is ChatGPT Plus?», OpenAI Help Center, <https://help.openai.com/en/articles/6950777-what-is-chatgpt-plus>
- «What is ChatGPT Go?», OpenAI Help Center, <https://help.openai.com/en/articles/11989085-what-is-chatgpt-go>
- «ChatGPT Business release notes» (Team tasks, 29 сентября 2026 г.), OpenAI Help Center, <https://help.openai.com/en/articles/11391654-chatgpt-business-release-notes>
- «ChatGPT Enterprise and Edu release notes», OpenAI Help Center, <https://help.openai.com/en/articles/10128477-chatgpt-enterprise-and-edu-release-notes>
- «Regression: Scheduled Tasks safety checks block authorized Gmail sends and Google Sheets writes», OpenAI Developer Community, 4 октября 2026 г. (сообщение пользователя), <https://community.openai.com/t/1403242>
- «Developer Mode missing from Security & Login on ChatGPT Pro» (ответ сотрудника OpenAI, 1 октября 2026 г.), OpenAI Developer Community, <https://community.openai.com/t/1402157>
- «Feature Request: Use an Identifiable User-Agent for Custom MCP Server Validation», OpenAI Developer Community, 3 сентября 2026 г. (сообщение пользователя), <https://community.openai.com/t/feature-request-use-an-identifiable-user-agent-for-custom-mcp-server-validation/1394731>
- «ChatGPT Scheduled Tasks fail to write to GitHub and automatically disable themselves», OpenAI Developer Community, 8 октября 2026 г. (сообщение пользователя), <https://community.openai.com/t/chatgpt-scheduled-tasks-fail-to-write-to-github-and-automatically-disable-themselves-after-failed-executions-without-user-authorization/1404882>
- «Connect and test your plugin», OpenAI Developers, <https://developers.openai.com/plugins/deploy/connect-chatgpt>
- «Authentication», OpenAI Developers, <https://developers.openai.com/plugins/build/auth>
- «Define tools» (раздел Plan safety annotations), OpenAI Developers, <https://developers.openai.com/plugins/plan/tools>
- «Build an MCP server», OpenAI Developers, <https://developers.openai.com/plugins/build/mcp-server>
- «Plugin UI changelog» (App permission controls, 12 июня 2026 г.), OpenAI Developers, <https://developers.openai.com/plugins/changelog>
- «MCP Events», OpenAI Developers, <https://developers.openai.com/plugins/build/mcp-events>
- «Scheduled tasks» (Codex), OpenAI Developers, <https://developers.openai.com/codex/app/automations>
- «MCP and Connectors» (Responses API), OpenAI Developers, <https://developers.openai.com/api/docs/guides/tools-connectors-mcp>
- «Model Context Protocol», ChatGPT Learn, <https://learn.chatgpt.com/docs/extend/mcp>
- «Pricing» (ChatGPT Work and Codex), ChatGPT Learn, <https://learn.chatgpt.com/docs/pricing>
- «Schema Reference: ToolAnnotations», Model Context Protocol 2025-11-25, <https://modelcontextprotocol.io/specification/2025-11-25/schema#toolannotations>
- «Authorization», Model Context Protocol 2025-11-25, <https://modelcontextprotocol.io/specification/2025-11-25/basic/authorization>
- «RFC 6750: The OAuth 2.0 Authorization Framework: Bearer Token Usage», IETF, октябрь 2012 г., <https://www.rfc-editor.org/rfc/rfc6750>
- «RFC 9728: OAuth 2.0 Protected Resource Metadata», IETF, <https://datatracker.ietf.org/doc/html/rfc9728>
- «MCP Inspector», Model Context Protocol, <https://modelcontextprotocol.io/docs/tools/inspector>
- «Continuing our infrastructure updates: What's changing in the coming months», r/modnews, 30 сентября 2026 г., <https://www.reddit.com/r/modnews/comments/1wubgvt/continuing_our_infrastructure_updates_whats/>
- «Reddit is killing RSS feeds and ending public API access because of AI bots», TechCrunch, 30 сентября 2026 г. (вторичный источник; первоисточник: 31), <https://techcrunch.com/2026/09/30/reddit-is-killing-rss-feeds-ending-public-api-access-because-of-ai-bots/>
- «Responsible Builder Policy», Reddit Help, <https://support.reddithelp.com/hc/en-us/articles/42728983564564-Responsible-Builder-Policy>
- «Scheduled tasks failing», r/ChatGPT (ветка пользователя), <https://www.reddit.com/r/ChatGPT/comments/1x049yo/scheduled_tasks_failing/>
- «Isn't this kind of a paradox for scheduled tasks?», r/ChatGPT (ветка пользователя), <https://www.reddit.com/r/ChatGPT/comments/1wvnhp8/isnt_this_kind_of_a_paradox_for_scheduled_tasks/>
- «Did ChatGPT Scheduled Tasks recently start consuming your Codex/Work usage allowance?», r/codex, 5 октября 2026 г. (сообщение пользователя), <https://www.reddit.com/r/codex/comments/1wxxqwh/did_chatgpt_scheduled_tasks_recently_start/>
- «Automate work with scheduled tasks», Claude Code Docs, <https://code.claude.com/docs/en/routines>
- «ChatGPT Scheduled Tasks: What They Are and How to Use Them», Zapier, 2 сентября 2026 г. (вторичный источник), <https://zapier.com/blog/chatgpt-scheduled-tasks/>
- «ChatGPT MCP: Connect MCP Servers to ChatGPT», AnythingMCP, 25 сентября 2026 г. (вторичный источник), <https://anythingmcp.com/guides/clients/chatgpt>
- Каталог возможностей EveryInfra, дата обращения: 26 октября 2026 г., 17:22 SGT, <https://api.everyinfra.com/api/v1/social/catalog>
- Документ OpenAPI EveryInfra, дата обращения: 26 октября 2026 г., 17:42 SGT, <https://api.everyinfra.com/openapi.json>
- Страница сообщества r/PasswordManagers, <https://www.reddit.com/r/PasswordManagers/>
- «Add custom MCP server» (раздел «Reviewing and confirming tool calls»), OpenAI Developers, дата обращения: 26 октября 2026 г., 20:05 SGT, <https://developers.openai.com/api/docs/guides/custom-mcp-server>
Справка BL-55