SerperのAPIキーとドキュメント:ログインから最初の結果を得るまで
Serperには独立したドキュメントサイトがなく、Playgroundがドキュメントの役割を担っています。キーは作成、名前変更、リセットしかできません。実際に送信した34件のリクエストで、パラメータ、エラー、キーのローテーションを整理しました。
「serper api key」「serper api docs」「serper api login」で検索する人の多くは、同じ壁に突き当たります。Serperには独立したドキュメントサイトがありません。2026年11月5日時点で、serper.dev/docsは404を返しました。実際に「ドキュメント」として機能しているのはPlaygroundで、ログインしないと使えないページです。パラメータのルール、クレジットの消費量、サンプルコードは、すべてこのページのJavaScriptの中にあります。
公開されているserper.devのページと、そのフロントエンドのスクリプトを読みました。そのうえで、同日の00:18から00:54(SGT)にかけて、EveryInfraの検索APIに34件のリクエストを実際に送信しました。結果が返った21件の費用は合計$0.015269でした。残りの13件は、APIキーのヘッダーの誤り、レート制限への到達、空の結果1件など、意図的に失敗させたもので、いずれも費用は$0でした。
このガイドでは料金を比較しません。比較するのは、動作するリクエストにたどり着くまでの道のりです。新規登録から最初の結果まで何ステップかかるのか。キーはどこにあり、いくつ作成でき、漏えいしたらどうすればよいのか。
q、gl、hl、num、page、typeを当社のパラメータと対応付けます。実際のエラーボディも示します。また、Python、n8n、MCPクライアントでキーをどこに設定するかも説明します。料金については、最初のセクションでリンクしているSerperに関する過去の3本の記事をご覧ください。
このガイドで扱う内容と料金情報の参照先
料金を一言でまとめると、Serperの4つのパックは1,000クレジットあたり$0.30〜$1.00で、6か月で失効します。EveryInfraのWeb検索は1回あたり$0.000694(1,000回あたり$0.694)で、有効期限はありません。1,000クエリあたりのコストはSerper APIの代替:料金、無料枠、実測テストをご覧ください。無料の2,500クエリがどのくらい持つかはSerper APIの無料枠を、4つのパックの月ごとの比較はSerper APIの料金を解説をご覧ください。
この記事は、Serperを使っている、または試す予定の開発者向けです。扱うのはセットアップとデバッグだけです。キーの取得場所と送り方を説明します。あわせて、パラメータのルールがどこにあるか、呼び出しが失敗したときの対処法、漏えいしたキーの差し替え方も説明します。
Serperについては、公開情報のみを使用しました。具体的には、ホームページ、新規登録ページ、ログインページ、利用規約、プライバシーポリシー、およびそれらのページから訪問者のブラウザに読み込まれるJavaScriptです。Serperアカウントの作成、Serper APIキーの使用、Serper検索APIの呼び出しは行っていません。そのため、「ログイン後に表示される内容」に関する記述はすべて、これらのスクリプト内のテキストまたは公開されている第三者の投稿に基づいており、その都度出典を明記しています。EveryInfraの数値はすべて、2026年11月5日に実際に取得したレスポンスに基づいています。
比較表:キー、ドキュメント、最初のリクエスト
この表には、確認可能な事実のみを掲載しています。Serperの列は、2026年11月5日に閲覧したserper.devのページとスクリプトに基づいています。EveryInfraの列は、ドキュメント、料金ページ、OpenAPIファイル、公開カタログ、および実際のAPI呼び出しに基づいています。ドキュメント、料金ページ、OpenAPIファイルは2026年11月5日01:25(SGT)に再度確認し、コピーを保存しています。
| 項目 | Serper | EveryInfra |
|---|---|---|
| 新規登録 | 名前、メールアドレス、パスワードに加えて人間であることの確認。登録後にメール認証 | メールアドレス、またはGitHub・Googleで続行 |
| ログイン | メールアドレスとパスワード。認証アプリによる2FAは任意 | 新規登録と同じ |
| 無料枠 | 2,500クエリ、クレジットカード不要 | GitHubリポジトリ2つにスターを付けると$1のトライアルクレジット(24時間有効) |
| APIキーの場所 | ダッシュボードのAPI Keysページ | コンソールのAPI Keys。完全なキーは作成時に1回のみ表示 |
| アカウントあたりのキー数 | 複数(それぞれに名前を付与) | 複数(環境や用途ごとに分割) |
| キー管理 | 作成、名前変更、コピー、リセット | 作成、プロダクト単位のスコープ設定、無効化、IP許可リスト、ローテーション |
| 認証ヘッダー | X-API-KEY: <key>(GET版ではURLにapiKeyを含める) | Authorization: Bearer <key> |
| エンドポイント | https://google.serper.dev/<type> | https://api.everyinfra.com/api/v1/search |
| ドキュメントの場所 | Playground(ログイン後)。ドキュメントサイトなし | /docs、/llms.txt、/openapi.json、無料のツールカタログ |
| 機械可読な仕様 | OpenAPIもllms.txtも見つからず | OpenAPI 3.0.3(61パス)、llms.txt、ツールカタログJSON |
| MCP | Serper公式はなし。ローカルで動作するコミュニティ製サーバーあり | https://api.everyinfra.com/mcpのリモートMCPサーバー |
| エラーの形式 | {"message": "...", "statusCode": 403}(第三者の投稿による) | {"error": {"code", "message", "fault", "retryable", "next_steps", ...}} |
特に重要なのは3つの行です。1つ目は「ドキュメントの場所」です。Serperは、パラメータ、サンプルコード、クレジット消費量を、ログインが必要なインタラクティブなページの中に置いています。人が使う分には便利ですが、AIコーディングアシスタントが読むには余分な手順が必要です。2つ目は「キー管理」です。
Serperのキーページにあるアクションは4つで、削除はありません。キーごとに、できる操作や利用元を制限することもできません。3つ目は認証ヘッダーです。2つのAPIは異なるヘッダーを使用しており、これが最も忘れられやすい変更点です。私たちのテストでは、有効なキーをX-API-KEYで送信すると401が返されました。
Serper APIのログイン:新規登録とログインの手順
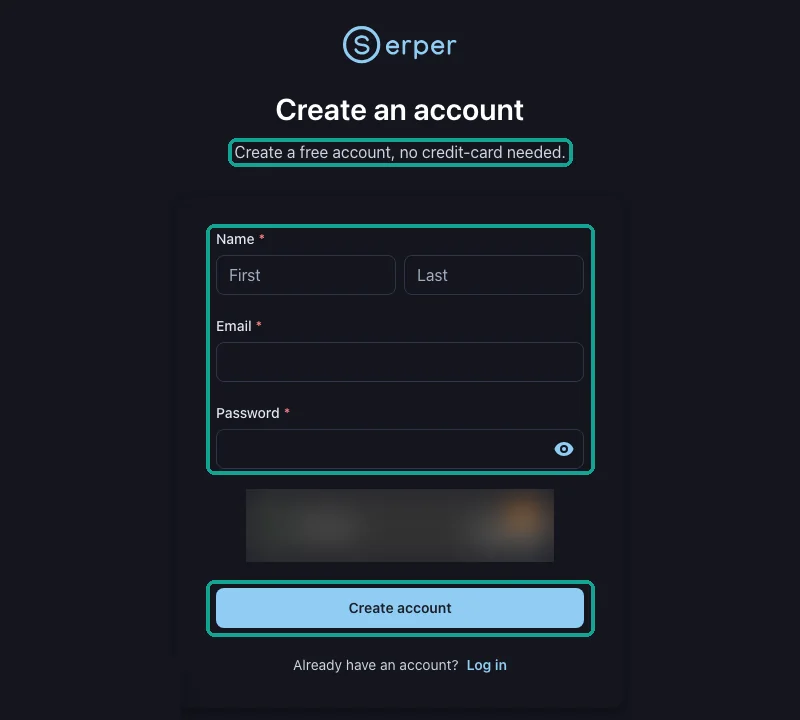
Serperの新規登録ページには「Create an account」「Create a free account, no credit-card needed.」と表示されます。フォームの必須項目は、名前(名・姓)、メールアドレス、パスワードの3つです(serper.dev/signup、2026年11月5日に閲覧)。フォームの下には人間であることの確認があり、これを通過しないと「Create account」ボタンは機能しません。ページのスクリプトは、リクエストとともに2つの確認用トークンを送信します。登録後は「Please verify your email account」というページが表示され、メールの再送信またはログアウトを選べます。有効なリンクを開くと「Your email has been verified.」、古いリンクでは「The verification link is invalid or has expired.」と表示されます。
ログインページには「Log in to your account」と表示され、メールアドレス、パスワード、「Remember me」、「Forgot password?」があります(serper.dev/login)。Settingsで二要素認証を有効にすると、認証アプリのコードも入力します。設定画面の文言は「Scan the QR code below with your authenticator app」です。新規登録とログインのスクリプトには、GoogleやGitHubでのログインは見当たりませんでした。
つまり「serper api login」の方法は、メールアドレスとパスワードの1つだけです。多くの検索結果は、ある小さな仕様で説明がつきます。ログアウトした状態でserper.dev/api-keysを開くと、ログインフォームが表示されます。そのため、「serper api login」の検索結果で最上位に表示されるページは、タイトルが「Log in to your account」なのにURLが/api-keysになっていることがよくあります。
Serperの利用規約には「Updated on May 29, 2024」とあります。アカウントに関して重要なルールが2つあります。1つ目は「Register more than one account at any point in time」の禁止です。つまり、無料クエリを増やすために追加のアカウントを作ると規約違反になります。
2つ目は「Attempt to circumvent any restrictions or limits placed on your Serper API key or account」の禁止です。規約には、SerperがBtoBサービスであることも記載されています。プライバシーポリシーには「Date Last Reviewed: 5 November 2025」とあり、Serperがアクセスログとアクティビティログを収集すると記載されています。
EveryInfraの新規登録は、サイト右上の「Start free」から始まります。ページにはメールアドレスの入力欄と任意の紹介コード欄があり、その下に「Continue with GitHub」と「Continue with Google」があります。こちらも新しいアカウントは作成していません。そのため、登録後の手順はページとドキュメントに基づいています。クイックスタートによると、登録後にコンソールでAPIキーを作成し、完全なキーは1回しか表示されません。
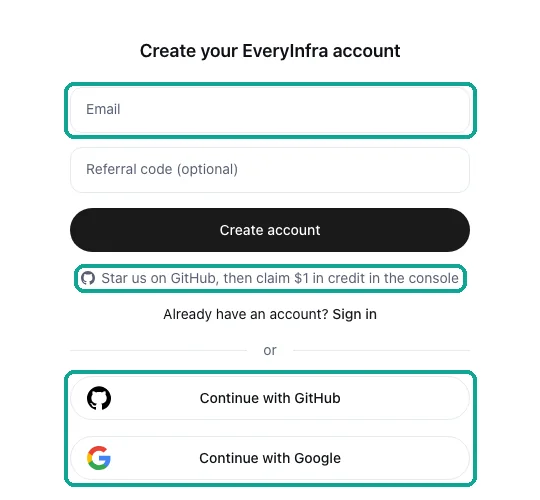
セットアップの主な違いは1ステップです。Serperでは新規登録後、受信トレイで認証リンクを開いてから、メールアドレスとパスワードでログインします。EveryInfraではGitHubかGoogleで続行でき、受信トレイを経由する必要はありません。EveryInfraの1ドル分のトライアルクレジットを受け取る場合は、GitHubに移動して2つのリポジトリにスターを付ける手順が加わりますが、この手順はクレジットを受け取るためのもので、キーの取得には不要です。AIアシスタントがセットアップを実行する場合、受信トレイの手順があるたびに人の操作が必要になり、フローが止まります。
SerperのAPIキーはどこにあり、何ができるのか
SerperのキーはダッシュボードのAPI Keysページにあります。ページタイトルは「API Keys」、サブタイトルは「Your keys to unlock the power of Serper」です。ページのスクリプトは、キーの一覧取得、作成、名前変更という3つのアカウント用エンドポイントを呼び出します。キーには名前が必須で、空欄のままにするとフォームに「Name is required」と表示されます。
各キーには「Reset」アクションもあります。リセットのダイアログには「Are you sure you want to reset this API key? This action cannot be undone and any applications using this key will stop working.」と表示されます。リセット後、ページには「The old API key is not valid anymore. Replace it with the new one.」と表示されます。
ページにはコピーボタンもあり、「API key copied to clipboard」というメッセージが表示されます。つまり、完全なキーはダッシュボードに表示されたままで、ログイン情報を知っている人なら後からいつでもコピーできます。スクリプトには、キーを削除するエンドポイントはありません。1つのキーを特定のプロダクト、利用上限額、特定の送信元IPアドレスに限定する設定もありません。
Settingsページでは、名前、パスワード、二要素認証、支払い用カードを管理できます。「Activity logs」ページには最近のリクエストが一覧表示され、列はTime、Query、Type、Page、Num、Credits、Response time (ms)です。キーで絞り込むこともできます。「Anonymize queries」スイッチをオンにすると、ログにクエリのテキストが保存されなくなります。
| アクション | Serper(API Keysページのスクリプト) | EveryInfra(ドキュメント、料金ページ、OpenAPI) |
|---|---|---|
| 作成 | 可能(名前の入力が必須) | 可能(環境や用途ごとに1つずつ) |
| 名前の変更 | 可能 | 可能(OpenAPIのPATCH /portal/api/keys/{key_id}) |
| キー全体の再表示 | ページ上のコピーボタン | キー全体は作成時に1回のみ表示 |
| リセット・ローテーション | 可能(旧キーは即時に無効) | 可能(コンソールのみ) |
| 削除せずに無効化 | 確認できず | 可能(以降の呼び出しは401を返す) |
| 削除 | 確認できず | コンソールで作成したキーは無効化のみ可能。API経由で作成したキーは削除可能 |
| プロダクト単位のスコープ設定 | 確認できず | 可能(ブロックされたプロダクトは403 capability_deniedを返す) |
| IP許可リスト | 確認できず | 可能(コンソールのみ) |
| キーごとのログ | 可能(「Activity logs」をキーで絞り込み) | 可能(コンソールの呼び出し履歴。OpenAPIにはキーごとの使用量エンドポイントあり) |
| キーごとの利用上限額と有効期限 | 確認できず | 可能(OpenAPIのspend_limit_usdとexpires_at) |
機能が欠けているからといって、Serperが使えないわけではありません。1つのスクリプトに1つのキーを使う開発者1人なら、必要なのは作成とリセットだけです。差が出るのは、チームで使う場合、複数の環境がある場合、AIエージェントを使う場合です。たとえば、1つのキーをノートPC、CI、クライアントと共有したデモ用ノートブックで使っているとします。
ノートブックからキーが漏洩した場合、Serperでリセットすると3か所すべてが同時に動かなくなります。環境ごとにキーを分けていれば、漏洩したキーだけを無効化できます。EveryInfraのドキュメントでは、これを分電盤にたとえています。1つのキーがメインスイッチで、API Keys → Permission limitsで個別の回路を切れます(クイックスタートの認証セクション)。
スクリプトからキーを管理する:EveryInfraのOpenAPIファイルにあるキー関連エンドポイント
キーを管理する手段はコンソールだけではありません。EveryInfraのOpenAPIファイルのAccountセクションには、キー関連のエンドポイントがまとめて記載されています(2026年11月5日01:25 SGTに確認)。いずれも課金されません。ほかのアカウント関連エンドポイントと合わせて、アカウントあたり毎分60リクエストのレート制限が共通で適用されます。
読み取り系エンドポイントには、アカウントの読み取りスコープが必要です。すべてのプロダクトにアクセスできるキーには、デフォルトでaccount:read、requests:read、billing:readが付与されています。一部のプロダクトに限定したキーには、アカウントオーナーがコンソールで有効にした場合にのみ付与されます。書き込み系エンドポイントにはkeys:writeスコープが必要です。このスコープはデフォルトでオフになっており、付与できるのはコンソールにログインしたアカウントオーナーだけです。キーを使って行った変更は、すべてコンソールの通知に表示されます。
| エンドポイント | 内容 | 仕様上の制限 |
|---|---|---|
GET /portal/api/keys | 各キーの名前、マスクされたプレフィックス、ステータス、スコープ、毎分の上限、USD建ての利用上限額、最終使用日時を一覧表示 | キーのシークレットは返さない |
POST /portal/api/keys | キーを作成し、1回だけ返す。ip_allow、expires_at、spend_limit_usdを設定可能 | API経由で作成したキーの権限が呼び出し元のキーより広くなることはなく、書き込みスコープも付与されない。作成できるのはアカウントあたりUTC基準で1日20個まで。利用上限額が設定されたキーではキーを作成できない |
PATCH /portal/api/keys/{key_id} | キーの名前やメモの変更、有効期限の前倒し | API経由で作成したキーまたは呼び出し元のキーのみ。コンソールで作成したキーは無効化のみ可能 |
POST /portal/api/keys/{key_id}/disable | アカウント内の任意のキーを即時に無効化 | コンソールで再度有効にできるのは、アカウントオーナーだけ |
DELETE /portal/api/keys/{key_id} | キーを完全に削除 | API経由で作成したキーまたは呼び出し元のキーのみ |
GET /portal/api/keys/{key_id}/usage | 1つのキーについて、直近数日間の成功数、失敗数、利用額、最終呼び出しを表示 | requests:readが必要 |
漏洩後に効いてくるのがこれらのフィールドです。spend_limit_usdはキーごとの累計利用額の上限(USD)で、課金額から返金額を引いた値で計算され、リセットされることはありません。CI用のキーやデモ用ノートブックのキーに小さな上限を設定しておけば、漏洩しても被害額に上限ができます。expires_atを設定すると、一時的なキーが自動で停止します。ip_allowを設定すると、自身のサーバーのIPアドレスからのみキーを使えるようになります。
SerperのAPI Keysページのスクリプトには、該当するオプションは見つかりませんでした。このセクションはOpenAPIの記述に基づいています。各エンドポイントを呼び出すためのテスト用キーは作成していません。
Serper APIのドキュメント:Playgroundがそのままドキュメント
まず、独立したドキュメントサイトがあるかを確認しました。2026年11月5日時点で、serper.dev/docs、serper.dev/llms.txt、serper.dev/openapi.json、serper.dev/sitemap.xmlはいずれも404を返しました。ホームページのフッターにある「Product」列には、PlaygroundとDashboardに加え、Haystack、Jan AI、CrewAI、LangChainとの連携リンクが並んでいます。「Docs」や「API reference」へのリンクはありません。
SerperのGitHub OrganizationであるSerper-APIには、7つのリポジトリがあります。GitHub上では、いずれもAuto-GPT、chat-ui、Perplexicaなど他プロジェクトのフォークと表示されています。SDKやAPI仕様のリポジトリは1つもありません。
つまり、「serper api documentation」とは実質的にPlaygroundのことです。Playgroundはフォーム形式で、左側で結果タイプを選んでクエリを入力すると、右側に結果とコードが表示されます。そのスクリプトを読み、コードを書く際に押さえておくべき7つの事実をまとめました。
1つ目に、結果タイプはリクエストボディではなくURLの一部です。スクリプトは選択されたタイプをhttps://google.serper.dev/<type>に付け加え、送信前にボディからtypeを削除します。メニューにはsearch、images、videos、places、news、shopping、scholar、patents、autocomplete、product-reviews、lens、maps、reviewsがあり、一部のタイプはアカウントによって利用可否が異なります。Webページのスクレイピングには、別のホストhttps://scrape.serper.devを使います。
「Resolve links」ツールのコストは0クレジットです。第2に、パラメータにはデフォルト値があり、スクリプトはデフォルト値と同じパラメータを削除します。デフォルト値はgl=us、hl=en、page=1、num=10、autocorrect=trueです。
3つ目に、通常の検索の結果件数メニューは、現在10の1択です。imagesは10または100、shoppingは40です。4つ目に、「Mini-batch (up to 100 queries)」スイッチを使うと、複数のクエリを1回のリクエストにまとめられます。5つ目はクレジットです。「Credits: N」ウィジェットに、現在のリクエストのコストがリアルタイムで表示されます。
スクリプトでは、mapsとlensが3クレジット、shoppingとproduct-reviewsが2クレジット、その他のほとんどのタイプが1クレジットに設定されています。Webページのスクレイピングは2クレジットで、スクレイピングが難しいページでは6または10クレジットです。スクリプトには「ほとんどのWebページは通常2クレジットですが、スクレイピングが難しいページでは……6または10クレジットになる場合があります」と書かれています。imagesで10件を超える結果を取得すると、コストは2倍になります。
6つ目はサンプルコードです。コードパネルには、Postmanのオープンソースライブラリpostman-code-generatorsが使われています。言語メニューはこのライブラリのgetLanguageList()呼び出しの結果をそのまま表示しており、デフォルトはNode.jsです。POSTとGETを選択できます。
POSTでは、キーをX-API-KEYヘッダーで送ります。GETでは、すべてのパラメータとapiKeyがURLに入ります。URLに含まれたキーは、サーバーのアクセスログ、ブラウザの履歴、プロキシのログに残ります。そのため、ツールがGETしか扱えない場合を除き、POSTを使ってください。
2025年7月26日のn8nコミュニティの投稿に、この落とし穴の実例があります。あるユーザーがヘッダー付きでGETを送ったところ、403が返されました。返信では、GETではキーをURLに含める必要があり、POSTではヘッダーからキーを読み取ると説明されています(n8nコミュニティのスレッド)。
7つ目はロケーションです。locationフィールドには「サポートされているロケーションの一覧はこちら」と書かれ、api.serper.dev/locationsにリンクしています。この公開リストをダウンロードしたところ、240の国と地域にわたる100,029件のエントリがあり、そのうち郵便番号が48,384件、都市が37,208件、地区が4,309件でした。EveryInfraのlocationフィールドよりはるかに細かい粒度です。EveryInfraのツールカタログでは、「国名または2文字の国コード。都市はその国として扱われます」と指定しています。
| Playgroundのルール | 確認箇所 | コードへの影響 |
|---|---|---|
| タイプはリクエストボディではなくURLで指定 | https://google.serper.dev/ + type | URLを変えてタイプを切り替える |
| デフォルトはgl=us、hl=en、num=10、page=1 | 生成されるコードから省かれる | パラメータを指定しなければ米国・英語 |
| 通常検索のnumは10の1択 | 結果件数メニュー | 追加結果の取得にはpageを使用 |
| タイプごとに消費クレジット数が異なる | 「Credits: N」ウィジェット | mapsとlensは3クレジット |
| 1リクエストあたり最大100クエリ | ミニバッチ切り替え | クレジットはクエリごとに計上 |
| GETではapiKeyがURLに入る | コードパネルのGET/POST切り替え | POSTとヘッダーを使う |
| 100,029件のロケーション | api.serper.dev/locations | 都市・郵便番号単位まで指定可能 |
インタラクティブなページ内にしかないドキュメントには代償があります。1回の検索結果から、その影響を数値で確認しました。00:18:40と00:19:06(SGT)に、EveryInfraのWeb検索でlocation: usを指定して「serper api documentation」を検索し、最初の2ページ分にあたる20件の結果を取得しました。serper.dev上のURLは3件だけで、ホームページ、/api-keys(ログアウト時はログインフォーム)、/signupでした。ドキュメントページは1件もありませんでした。
8件は他プロジェクトのドキュメントで、CrewAI、LangChain(3件、うち1件は古いミラー)、Langflow、Haystack、Sim、Aikeedoでした。4件はAPIディレクトリでした。残りの5件は、GitHub Organization、Mediumの記事、YouTube動画、MCPの掲載ページ、別の検索APIのホームページでした。
| 上位20件の結果の出典 | 件数 | 例 |
|---|---|---|
| serper.devのページ | 3 | ホーム、/api-keys、/signup |
| フレームワーク・プラットフォームのドキュメント | 8 | docs.crewai.com、reference.langchain.com、docs.haystack.deepset.ai、docs.langflow.org |
| APIディレクトリ・マーケットプレイス | 4 | apitracker.io、apis.ioなど |
| その他 | 5 | github.com/Serper-API、medium.com、youtube.com |
英国の読者向けに、SGTの00:45:40に2回目の確認を行いました。location: gbを指定して「serper api key」を検索したところ、最初の2件は今回もSerperのホームページと/api-keysでした。続いて、別の検索APIのホームページ、CrewAIのドキュメント、LangChainのドキュメントが並びました。残りはMediumの比較記事、SERP APIのまとめ記事、Aikeedoのドキュメント、h2oGPTのGitHub Issueでした。
Serperのドキュメントを探す人の多くは、何らかのフレームワークのドキュメントにたどり着きます。そして、Serperの説明はフレームワークごとに少しずつ異なります。
AIコーディングアシスタントにクライアントコードを書かせる開発者には、アシスタントがログインなしで読めるドキュメントが必要です。EveryInfraでは、3つの公開ファイルがその役割を担っています。
| ファイル | 内容 |
|---|---|
| ツールカタログ | 全17種類の検索ツールのパラメータ、デフォルト値、制限、3言語の説明、料金を掲載。APIキー不要 |
| OpenAPIファイル | バージョン3.0.3。2026年11月5日時点で61パス |
/llms.txt | 言語モデル向けのインデックス。最初のブロックには、ベースURL、ヘッダー、不正なパラメータにはdid_you_meanとallowedが返される旨の注記を記載 |
これらのファイルがあれば、アシスタントは記憶に頼って推測せず、コードを書く前にパラメータを確認できます。以下のテストで示すとおり、推測を誤ると422が返されます。Serperのパラメータ仕様はPlaygroundにしか載っていないため、アシスタントが参照するのは主にフレームワーク側の二次的なドキュメントです。たとえばCrewAIのドキュメントには今も「n_results」のデフォルトは10と書かれていますが、Playgroundの通常検索メニューでは現在10しか選べません。
Serper APIドキュメントとEveryInfraのパラメータ比較
結論から言うと、どちらのAPIもJSON形式のリクエストボディを受け取り、JSONを返します。ただし、パラメータ名、結果の種類の指定方法、レスポンスフィールドが異なります。URLを変えるだけでは切り替えられません。Playgroundスクリプト内の通常検索用パラメータと、EveryInfraのwebツールのパラメータを比較しました。情報源は無料のツールカタログで、2026年11月5日00:16(SGT)に参照しました。
| Serperのパラメータ | Playgroundでの意味 | EveryInfraでの対応 | 備考 |
|---|---|---|---|
q | クエリ | q(webツール)、データカタログではkeyword | 名前も意味も同じ |
gl | 2文字の国コード。デフォルトはus | location | glは422を返す。locationは国単位で機能する |
hl | UI言語、デフォルトはen | webにはなし。web/searchではlanguage | hlは422を返す |
num | 1ページあたりの件数(通常検索では10) | num(最大10) | 名前が同じ |
page | ページ番号(1から) | page(1から)、1ページごとに1回課金 | 名前が同じ |
type | URLのパス部分:search、news、images | リクエストボディのtoolフィールド:web、news、media | リクエストボディにtypeを含めると422を返す |
tbs | 期間指定qdr:h/d/w/m/y | after、before(日付) | 日付に変換 |
location | 都市、地域または郵便番号(100,029件) | locationは国単位で機能する | 名前は同じだが意味が異なる |
autocorrect | スペル修正(デフォルトで有効) | なし | 削除する |
| — | — | site(1ドメインのみ) | Serperではq内でsite:を使用 |
注意が必要な行が2つあります。1つ目はlocationです。名前は両者で同じですが、意味が異なります。Serperのlocationは具体的な場所を指し、国はglで指定します。EveryInfraのlocationは国を指し、都市を指定した場合はその都市が属する国として扱われます。
そのため、Serperから移行する際はglの値をlocationにコピーし、Serperで使っていたlocationの値は削除してください。2つ目はhlです。webツールには言語パラメータがありません。言語を指定する必要がある場合は、データカタログの web/search を使用してください。keyword、country、languageを受け付け、料金は$0.001389で、webの2倍です。
結果タイプの指定方法も変わります。SerperではタイプをURLで指定します。EveryInfraの検索エンドポイントはPOST /api/v1/searchの1つだけで、リクエストボディのtoolフィールドで17種類のツールから1つを選びます。この表はカタログの記載をもとに作成しました。対応は目的が近いことを示すだけで、同一の結果を意味するものではありません。
| Serperのタイプ | EveryInfraの検索ツール | データカタログの選択肢 |
|---|---|---|
| search | web | web/search、bing/search、duckduckgo/search |
| news | news | google_news/search |
| images、videos | media(kindはimageまたはvideo) | — |
| places、maps | places | — |
| shopping | shopping | google_shopping/search |
| scholar、patents | scholar(kindはpapersまたはpatents) | — |
| autocomplete | suggest | — |
| lens | lens | — |
| webpage | read | — |
| reviews, product-reviews | 検索では非対応 | マップレビューと商品レビューは、プラットフォーム別にデータカタログで提供 |
クレジットの消費量はタイプによって異なるため、Serperの1,000回の呼び出しあたりの価格もタイプによって異なります。Starterパックでは1,000クレジットが$1.00です。mapsとlensは1回の呼び出しで3クレジットを使うため、1,000回の呼び出しあたり$3.00になります。Ultimateパックでは1,000クレジットが$0.30なので、mapsは1,000回の呼び出しあたり$0.90です。
crosscheckを除くEveryInfraの検索ツールは、すべて1回の呼び出しあたり$0.000694です。グラフでは、公開されている単価をタイプ別に並べています。パックのサイズと有効期限のルールについては、Serper APIの料金体系を解説をご覧ください。
最初のリクエスト:両サービスをcurlで比較
以下は、PlaygroundのPOST形式で書いたSerperへの最初のリクエストです。SerperのAPIキーを持っていないため、実際には実行していません。ページのスクリプトとCrewAIのソースをもとに作成しました。
# Serper: configuration example (not run for this article)
curl -s https://google.serper.dev/search \
  -H "X-API-KEY: $SERPER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"q":"serper api documentation","gl":"us","hl":"en","num":10}'
以下は、EveryInfraで同じ検索を行った例です。2026年11月5日00:18:40(SGT)に実行しました。1.55秒でHTTP 200が返り、結果は10件、billing.charged_usdは0.000694でした。
# EveryInfra: run for this article
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"tool":"web","q":"serper api documentation","location":"us","num":10}'変更点は4つです。URLとヘッダーが変わり、glがlocationになり、hlがなくなります。もう1つ、見落としやすい点があります。ドキュメントでは、{"tool":"web","q":...}のように、パラメータをリクエストボディのトップレベルに置きます。リモートMCPツールeveryinfra_searchでは、{"tool":"web","params":{"q":...}}のように、パラメータをparamsオブジェクト内に置きます。どちらの形式も動作しますが、混在させることはできません。混在させた場合の動作は、後述のMCPセクションで示します。
バッチ処理も変わります。SerperのMini-batchは1リクエストで最大100クエリを受け付けます。EveryInfraの検索APIは1リクエストにつき1クエリです。そのため、100キーワードのバッチは100リクエストになり、1分あたりの上限の範囲内で送信します。アカウントのデフォルトの上限は1分あたり60リクエストなので、100キーワードの処理には約2分かかります。
スピードパックを使うと、上限が1分あたり1,800リクエストに上がります(料金)。コストは変わらず、1クエリあたり$0.000694、100クエリで$0.0694です。また、リクエストが個別になるため、失敗も1件単位で済みます。1つのクエリのパラメータに誤りがある場合、そのリクエストだけが422となり、残りの99件はそのまま実行されます。
レスポンスフィールド:organicとresultsの比較
Serperのホームページにあるサンプルレスポンスは、1つの大きなオブジェクトです。トップレベルにはknowledgeGraph、organic、peopleAlsoAsk、relatedSearchesがあります。organicの各結果にはtitle、link、snippet、positionがあり、一部にはsitelinks、date、attributesも含まれます(serper.devホームページのサンプル)。Playgroundは結果を表示する前にレスポンスからsearchParametersを削除しているため、実際のレスポンスにはリクエストの内容も含まれます。LangChainはタイプごとに異なるキーを読み取ります。searchではorganic、newsではnews、placesではplaces、imagesではimagesです(LangChainのソース)。
EveryInfraのwebレスポンスは{"id","tool","location","results","billing","quota"}です。各結果にはtitle、url、snippetがあり、日付がわかる場合はpublishedも含まれます。00:19:06(SGT)の2ページ目の呼び出しでは、10件中3件にpublishedがありました。データカタログのエントリweb/searchではフィールドが増え、title、url、text、rank、published_at、image_url、sub_linksが返されます(データカタログ)。00:20:09(SGT)の呼び出しでは、10件中3件にpublished_atがありました。
| 用途 | Serper(search) | EveryInfra `web` | EveryInfra `web/search` |
|---|---|---|---|
| タイトル | organic[].title | results[].title | results[].title |
| リンク | organic[].link | results[].url | results[].url |
| スニペット | organic[].snippet | results[].snippet | results[].text |
| 順位 | organic[].position | 配列の順序 | results[].rank |
| 日付 | organic[].date(一部のみ) | results[].published(一部のみ) | results[].published_at(一部のみ) |
| ナレッジパネル、関連する質問 | knowledgeGraph、peopleAlsoAsk | なし | なし |
| この呼び出しのコスト | ホームページには、正常なレスポンスを受け取るたびにクレジットが差し引かれると記載。ドキュメントに記載されたレスポンスフィールドはなし | billing.charged_usd | billing.charged_usd |
最後の行は課金記録に関するものです。SerperのFAQには「クエリに対する正常なレスポンスを受け取るたびに、アカウント残高からクレジットを差し引きます」とあります。残高がゼロになると、新しいクエリは実行できなくなります。使用額を確認するには、DashboardとActivityログを開きます。EveryInfraの各レスポンスには、charged、charged_usd、balance_after_usdを含むbillingオブジェクトが付きます。
バッチジョブでは、レスポンスだけで利用額を照合できます。失敗した呼び出しや結果が空の呼び出しにはcharged: falseが表示されます。webツールはナレッジパネルや関連する質問を返しません。これらのフィールドに依存するコードには新たなロジックが必要です。詳しくは「Serperのほうが適しているケース」のセクションで説明します。
テスト1:Serper形式のリクエストをそのまま送信
切り替え後に最も起こりやすいミスは、URLとヘッダーを変更しても古いパラメータをそのまま残してしまうことです。APIがどう応答するかを確かめるため、このミスを意図的に再現しました。
00:18:28(SGT)に{"tool":"web","q":"serper api documentation","gl":"us","hl":"en","num":10}を送信しました。APIは0.20秒でHTTP 422を返しました。error.codeはunknown_paramでした。messageは「gl is not a parameter of tool web Supported: after, before, location, num, page, q, site」でした。
allowedリストには、有効な7つのパラメータが含まれていました。next_stepsフィールドは「Remove gl; the parameters are listed at catalog_url. Nothing was charged.」でした。APIは呼び出しごとに不明なパラメータを1つだけ報告します。glを削除し、hlは残したまま00:18:47(SGT)に再送信すると、param: hlで同じ422が返りました。
00:19:00(SGT)に、locationをlocatonと綴り間違えて送信しました。0.11秒でdid_you_mean: ["location"]付きの422が返りました。1つ目の手順は「Rename locaton to location (did_you_mean), then resend. Nothing was charged.」でした。2つ目の手順では、送信したパラメータがカタログに実際に記載されている場合はチケットを作成するよう案内していました。
00:19:14(SGT)にボディへ"type":"news"を入れると、typeはwebのパラメータではないため422が返りました。00:19:20(SGT)には、mediaツールにkind: "videos"を送信しました。エラーはinvalid_valueで、allowedにはimageとvideo、did_you_meanにはvideoが設定されていました。
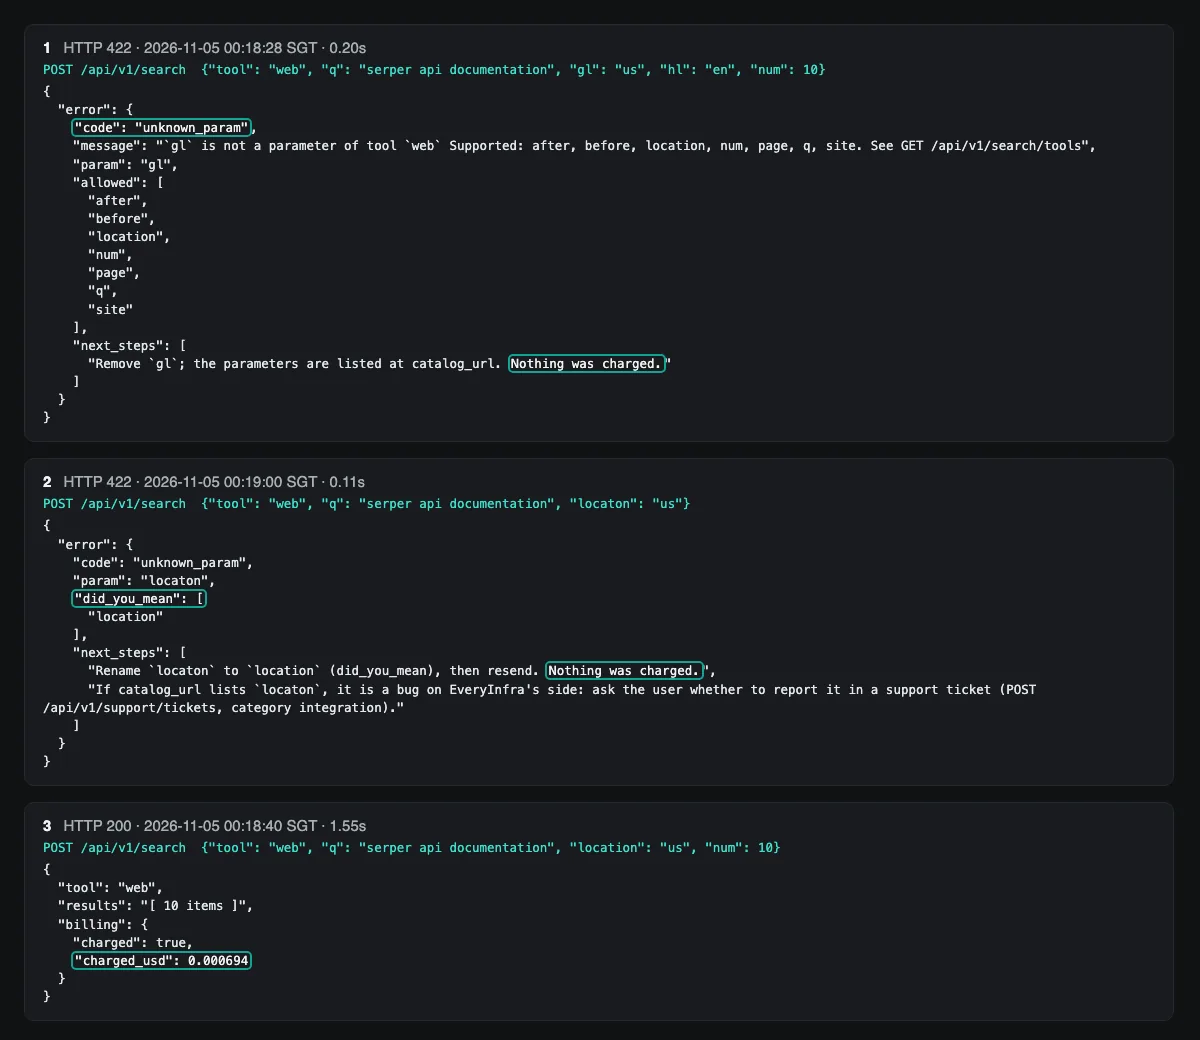
これらのエラーは、AIアシスタントが自分の呼び出しを自ら修正できるように用意されています。422は再試行しても解決しないことをプログラムに伝え、allowedとdid_you_meanは何を変更すべきかをアシスタントに伝えます。HTTPでは、422はサーバーが理解できても処理できないリクエストに対して定義されています(MDN: 422、RFC 9110, section 15.5.21で定義)。名前や値の誤りはまさにこれに当てはまります。当社のエラーボディはRFC 9457のproblem+json形式ではありません。独自のerrorオブジェクトであり、各フィールドについては自己修復型APIエラーのガイドで説明しています。
テスト2:APIキーなし、誤ったヘッダー、レート制限
00:18:21(SGT)に、認証ヘッダーなしでwebを呼び出しました。APIは0.12秒でHTTP 401を返し、code: unauthorizedとmessage: Missing API keyが含まれていました。faultはaccount、retryableはfalseで、next_stepsには「This API key is not accepted; ask the user for a working key (console: API keys). Nothing was charged.」とありました。00:18:34(SGT)には、Serper方式にならって有効なAPIキーをX-API-KEYヘッダーに入れました。同じメッセージを伴う401が再び返りました。
2つ目の結果については正直にお伝えしなければなりません。このエラーは「代わりにAuthorization: Bearerを使ってください」とは教えてくれません。Serperから移行する場合は、上の表のとおり、ヘッダーの行をご自身で変更してください。
SerperについてはAPIキーを持っていないため、公開されている投稿を引用します。上記のn8nのスレッドでは、HTTP 403とボディ{"message":"Unauthorized. Sign up for a free account.","statusCode":403}が示されています。2024年のCrewAIのissue #633のタイトルは「Unauthorized Error (403) when Using SERPER_API_KEY」です。
原因は別サービスのキーでした。残高不足については、2026年10月23日のコミットノートに400 {"message":"Not enough credits"}が記録されています(neo1415/q #339)。2026年10月22日のタスクリストには「400 or 403」とあり、未確認とされています(dbhq-uk/gannet #12)。serper.devではエラーコードの一覧表は見つかりませんでした。
レート制限は意図せず発生しました。当社のテスト用APIキーには1分あたり10回という独自の上限があり、複数の執筆ジョブで共有しています。HTTP 429を00:19:55、00:20:56、00:22:38、00:24:51(SGT)の4回受け取りました。いずれもcode: rate_limited、順に5秒、4秒、22秒、9秒のretry_after、max_retries: 3、そして「Nothing was charged.
Retry after retry_after seconds」という注記が含まれていました。スクリプトは429を受け取るたびに60秒待機し、次の試行はいずれも成功しました。ヘッダーについてはMDNのRetry-After、429コードについてはRFC 6585を参照してください。
| ケース | Serper(公開投稿) | EveryInfra(当社テスト) | 課金額 |
|---|---|---|---|
| APIキーなし・無効なAPIキー | 403 Unauthorized. Sign up for a free account. | 401 unauthorized、Missing API key | いずれも課金なし |
| 誤ったヘッダー | GETではURLにAPIキーが必要 | X-API-KEYは401を返す | なし |
| 残高なし | 400 Not enough credits(第三者の記録) | 402 quota_exhausted(ドキュメント) | なし |
| 不明なパラメータ | ドキュメントに記載なし | 422 unknown_param(allowedとdid_you_mean付き) | なし |
| 不正な値 | ドキュメントに記載なし | 422 invalid_value(allowed付き) | なし |
| レート制限 | パックに応じて毎秒50〜300クエリ(ホームページ) | 429 rate_limited(retry_after付き) | なし |
| 空の結果 | ホームページでは成功したレスポンスのみクレジットを消費すると記載 | 200、charged: false、reason: empty_result_refunded | なし |
空の結果の行については、00:20:17(SGT)に存在しない文字列を引用符で囲んで検索しました。APIはHTTP 200を返し、空のresults配列、billing.charged: false、reason: empty_result_refunded、refund.status: succeededが含まれていました。失敗した呼び出しや空の結果となった呼び出しを自社の記録と照合するには、失敗時の返金照合ガイドを参照してください。
テスト3:同一クエリの10か国比較
glの値をlocationに移しても、locationは機能するでしょうか。00:22〜00:26(SGT)に、numを10に設定し、同じクエリ「google search api」をwebに送りました。locationの値はus、gb、de、fr、es、mx、br、jp、sg、inです。10回の呼び出しはすべてHTTP 200を返し、費用は1回あたり$0.000694、合計$0.00694でした。米国向けの呼び出しは9件、それ以外の呼び出しはそれぞれ10件の結果を返しました。
米国の9件のURLを基準に、それぞれの国で何件が表示されたかを数えました。シンガポールと英国では9件すべてが残りました。インド、日本、フランスは7件、ブラジルとスペインは6件、メキシコとドイツは5件のみでした。
ドイツでは.deドメインの個人サイトとYouTube動画が加わりました。日本ではqiita.com、メキシコではrapidapi.comが加わりました。つまり、国のパラメータによって結果は変わります。英語圏の市場の結果は米国のリストに近いままですが、その他の市場の結果は米国のリストからさらに離れます。地域別ランキングから予想されるとおりです。
このテストでは制限も明らかになりました。EveryInfraのlocationは国単位までのため、テストも国レベルのみで行いました。Serperは市区町村や郵便番号まで指定できます。「ニューヨークの特定のZIPコードのローカル結果」が必要な場合、EveryInfraのwebツールでは対応できません。
サンプルも小規模で、クエリは1つ、各国1回の呼び出しのみです。順位は時間とともに変動します。重複件数はパラメータが機能することを示すものであり、国ごとの長期的な違いを測るものではありません。
テスト4:レイテンシとエラー応答時間
34件のリクエストすべてを結果別に分け、シンガポールからcurlを実行して、ネットワークを含む合計所要時間を計測しました。有料の21件は0.98〜3.48秒で、中央値は1.81秒でした。最速はsuggestの0.98秒、最遅は00:45:40(SGT)の英国向けweb呼び出しで3.48秒でした。空の結果には2.12秒かかりました。検索自体は実行されたためです。
拒否された11件のリクエスト(401、422、429)は0.09〜0.20秒で返りました。これらは認証またはパラメータのチェックで止まり、検索は一切行われていません。Serperのホームページには「一般に、すべてのクエリは1〜2秒で返されます」とあります。Serperはテストしていないため、速度について結論は出していません。
グラフは最初の29リクエストを対象としています。英語版の作成にあたり、さらに5回の呼び出しを行いました。それらを含めると、有料の呼び出し21件すべての中央値は1.81秒です。
| 時刻(SGT) | 呼び出し | 結果 | 秒 | 課金額 |
|---|---|---|---|---|
| 00:45:32 | suggest、「serper api docs」 | 8 | 0.98 | $0.000694 |
| 00:45:40 | web、「serper api key」、location: gb | 10 | 3.48 | $0.000694 |
| 00:45:51 | web、「SERPER_API_KEY」、site: github.com | 10 | 2.67 | $0.000694 |
| 00:47:57 | web、下記のPython関数でSerperのリクエストボディから生成 | 10 | 2.24 | $0.000694 |
| 00:53:26 | suggest、「serper api login」 | 9 | 1.15 | $0.000694 |
エラーがすぐに返れば、コードを書く人の作業も早く進みます。パラメータを間違えても、2秒待たされることはありません。修正方法を含む422レスポンスが0.1秒で返るため、アシスタントは1ターンで修正して再送信できます。一方、200以外のレスポンスをすべて「サービスが混雑中」とみなしてリトライするプログラムは、422にも無駄なリトライを行います。429や503など、retryable: trueのエラーだけをリトライしてください。
テスト5:サジェスト、ニュース、データカタログのエントリ
Serperのautocompleteとnewsのタイプは、EveryInfraのsuggestツールとnewsツールに対応します。00:20:01 SGTに「serper api key」でsuggestを実行すると、10件が返りました。各件にはtitleしかなく、たとえば「serper api key free」「serper api key pricing」「serper api key crewai」「get serper api key」などです。コストは$0.000694でした。
00:21:28(SGT)に「Model Context Protocol」でnewsを実行すると、10件の結果が返り、それぞれにpublishedがありました。値は「17 hours ago」「2 days ago」のような相対表記です。データベースで日付順に並べるには、リクエスト時刻を基準に変換してください。または、データカタログのgoogle_news/searchを使えば、published_atがUTCのISO 8601形式で返り、費用は$0.000792です。
00:20:09(SGT)に、データカタログのエントリweb/searchを、keyword、country: us、language: enを指定して「serper api key」で試しました。10件の結果が返り、費用は$0.001389でした。このエントリでは結果の言語を指定できます。フィールドはtextとrankで、カタログ内の他のプラットフォームの検索結果と同じ構造です。Webの結果を他のプラットフォームのデータと並べて保存する場合に便利です。Webの結果だけが必要で言語の指定も不要なら、webツールのほうが費用は半分で済みます。
web/searchの上位3件は、Serperのホームページ、別の検索APIのホームページ、serper.dev/api-keysでした。7件目は、Serperのダッシュボードでキーを確認する方法についてのClayコミュニティの投稿でした。同じクエリをwebでは実行していないため、結果の順位は比較しません。両エントリが同じリストを返す前提で扱わないでください。
Pythonでのキー設定:変数名の違い
キーはコードではなく環境変数に保存してください。The Twelve-Factor AppとOWASP Secrets Management Cheat Sheetの両方がそう述べています。ローカルでの作業では、python-dotenvで.envファイルを読み込み、そのファイルを.gitignoreに記載しておきます。問題は、Serperには独自のSDKがないため、フレームワークごとに変数名が異なることです。4つのフレームワークの現在のソースコードとドキュメントを確認しました。
| フレームワーク | Serperの変数名 | 出典 |
|---|---|---|
LangChain (GoogleSerperAPIWrapper) | SERPER_API_KEY | LangChainリファレンス |
CrewAI (SerperDevTool) | SERPER_API_KEY | CrewAIドキュメント |
Haystack (SerperDevWebSearch) | SERPERDEV_API_KEY | Haystackソースコード、ドキュメント |
| LiteLLM(検索) | SERPER_API_KEY | LiteLLMドキュメント |
Haystackでは名前に「DEV」が入ります。1台のマシンでLangChainとHaystackの両方を使う場合は、変数を2つ設定するか、HaystackでSecret.from_env_var("SERPER_API_KEY")と記述します。パラメータ名も異なります。CrewAIのSerperDevToolはcountry、locale、n_resultsを使い、ソースコードではそれぞれgl、hl、numに変換されます。使えるのは検索とニュースのタイプだけです。
2026年11月3日の1.15.35リリースの翌日時点のmainブランチを確認しました。LangChainはk、gl、hl、typeを使います。Haystackはtop_kとsearch_paramsを使います。つまり、接続するフレームワークごとに、変数名とパラメータ名を覚える必要があります。
PythonでEveryInfraを使うのに専用のパッケージは不要で、Requestsで十分です。コード内にすでにSerper形式のリクエストボディがある場合は、小さな関数でEveryInfraのリクエストボディに変換できます。以下の関数を2026年11月5日00:47(SGT)に実行しました。
入力は{"q": "serper api key rotate", "gl": "gb", "hl": "en", "num": 10, "tbs": "qdr:y", "autocorrect": true}でした。出力は{"tool": "web", "q": "serper api key rotate", "location": "gb", "num": 10, "page": 1, "after": "2025-11-04"}です。呼び出しはHTTP 200を返し、2.24秒で10件の結果が得られ、費用は$0.000694でした。10件すべてのpublishedの日付が2025年11月4日より後だったので、afterフィルターは機能しています。
import datetime as dt, os, requests

URL = "https://api.everyinfra.com/api/v1/search"
TYPE_TO_TOOL = {"search": "web", "news": "news", "images": "media", "videos": "media",
                "places": "places", "maps": "places", "shopping": "shopping",
                "scholar": "scholar", "patents": "scholar", "autocomplete": "suggest",
                "lens": "lens", "webpage": "read"}
TBS_DAYS = {"qdr:h": 1, "qdr:d": 1, "qdr:w": 7, "qdr:m": 31, "qdr:y": 366}

def from_serper(serper_type, body, today=None):
    """Turn a Serper-style request into an EveryInfra search body."""
    tool = TYPE_TO_TOOL[serper_type]
    out = {"tool": tool, "q": body["q"]}
    if tool == "web":
        if "gl" in body:
            out["location"] = body["gl"]          # country code moves to location
        out["num"] = min(int(body.get("num", 10)), 10)
        out["page"] = int(body.get("page", 1))
        if body.get("tbs") in TBS_DAYS:
            today = today or dt.date.today()
            out["after"] = (today - dt.timedelta(days=TBS_DAYS[body["tbs"]])).isoformat()
    # hl, autocorrect and Serper's city-level location have no web-tool match: dropped
    return out

body = from_serper("search", {"q": "serper api key rotate", "gl": "gb", "hl": "en",
                              "num": 10, "tbs": "qdr:y", "autocorrect": True})
r = requests.post(URL, json=body, timeout=90,
                  headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"})
data = r.json()
if r.status_code != 200 and not data["error"].get("retryable"):
    raise ValueError(data["error"]["next_steps"])   # 401 and 422: fix, do not retry
print(len(data.get("results", [])), data.get("billing", {}).get("charged_usd"))この関数で細かく変換しているのはwebのパスだけです。まずカタログを確認し、mediaとscholarではkindを自分で追加してください。afterは日付を受け取るため、qdr:hの行は1日に切り上げられます。
n8nでのキー設定:HTTP RequestとMCP Client Tool
n8nにはSerper用の組み込みノードがありません。n8n.ioのSerper連携ページは、2026年11月5日時点で404を返しました。一般には汎用のHTTP Requestノードが使われています。Header Authの認証情報で、名前をX-API-KEY、値をキーに設定します(n8n HTTP Requestの認証情報)。
メソッドはPOSTに設定してください。前述の403のスレッドは、GETリクエストが原因でした。以下の設定は、2026年11月5日時点で確認したn8nのドキュメントに基づいています。
EveryInfraは2通りの方法で接続できます。1つ目は、同じHTTP Requestノードを使う方法です。Header Authの名前をAuthorizationに、値をBearer 、スペース、キーの順に設定します。URLはhttps://api.everyinfra.com/api/v1/searchに設定し、リクエストボディはcurlの例からコピーします。
2つ目は、AI AgentワークフローでMCP Client Toolノードを使う方法です。エンドポイントをhttps://api.everyinfra.com/mcpに設定し、Bearer認証を選んで、キーを認証情報に保存します。するとエージェントがeveryinfra_searchなどのツールを一覧で取得し、いつ呼び出すかを判断します。
この記事ではn8nを実際には動かしていないため、どちらの設定もn8nのドキュメントに基づく設定例として扱ってください。毎朝実行する完全なワークフローについては、n8n日次レポートガイドをご覧ください。
MCPクライアントでのキー設定:リモートとローカルの比較
SerperはMCPサーバーを提供していません。GitHubには、marcopesani/mcp-server-serper(MITライセンス、スター171、最終プッシュ2025年3月13日)やgarylab/serper-mcp-server(スター39、最終プッシュ2025年11月10日)などのコミュニティ製サーバーがあります。どちらもnpxまたはuvxで、手元のコンピューター上にローカルプロセスを起動します。キーは、クライアントの設定ファイルのenvブロックにSERPER_API_KEYとして記載します。そのため、クライアントを実行するすべてのマシンで、キーが設定ファイルに平文で保存されます。
EveryInfraは、https://api.everyinfra.com/mcpでリモートMCPサーバーを運用しています。MCP仕様(バージョン2026-07-28)のHTTPトランスポートを使い、キーはAuthorizationヘッダーで送ります。Claude Codeでは、コマンド1つで追加できます(Claude CodeのMCPドキュメント)。その他のクライアントについては、MCPセットアップページとリモートMCPセットアップガイドをご覧ください。
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer $EVERYINFRA_API_KEY"
ツールの一覧はキーなしで取得できます。SGT 00:21頃にキーなしでtools/listを呼び出すと、12個のツールが返りました。everyinfra_searchの入力は、17種類のいずれかを指定するtoolと、paramsオブジェクトです。SGT 00:21:40には、意図的にqをparamsの外に置きました。
レスポンスはHTTP 200で、isError: trueと、「missing_param: q is required」「Next steps: Add the required q. Nothing was charged.」というテキストが含まれていました。SGT 00:21:58に{"tool":"web","params":{"q":"serper api login","location":"us","num":5}}を送信すると、5件の結果が返りました。1件目はタイトルが「Log in to your account」のserper.dev/api-keysで、charged_usdは0.000694と、APIを直接呼び出した場合と同じでした。
MCP仕様には、リモートサーバー向けの認可に関するセクションがあり、OAuthが推奨されています。現在は静的なBearerキーを使っています。どのクライアントからでも送信できますが、キーは自分で保護する必要があります。これは次のセクションで扱います。AIエージェント用の検索ツールのタイプを選ぶには、エージェント向け検索ツールの選び方をご覧ください。
キーが漏えいした場合:各サービスでのキーの差し替え方法
まず最近の実例を見てみましょう。LiteLLMの2026年10月23日付のインシデントレポートに、次のような経緯が書かれています。2026年5月27日、社内の管理者キーを含む設定ファイルが公開リポジトリにコミットされました。そのファイルは約3時間後に削除され、キーは「失効予定」リストに入りました。
そのコミットは10月22日まで公開履歴に残り、人為的ミスにより失効の手順は実行されないままでした。2026年10月10日、攻撃者は4か月前のそのキーを使用しました。キーはまだ有効でした。攻撃者はそこからGitHub組織のオーナートークンにまで到達しました。10月21日、LiteLLMのリリースパイプラインは侵害された1.107.0を公開しました(LiteLLMのインシデントレポート)。
| 日付(2026年) | 出来事 |
|---|---|
| 5月27日 | 管理者キーを含む設定ファイルが公開リポジトリに追加される |
| 5月27日、約3時間後 | ファイルが削除され、キーは「失効予定」リストに載る |
| 5月27日〜10月22日 | コミットは公開履歴に残ったまま、キーは失効されない |
| 10月10日 | 攻撃者がまだ有効な古いキーを使用する |
| 10月21日 | 侵害された1.107.0がリリースされる |
レポートでは、教訓を「漏えいした可能性のあるキーをローテーションしなかったこと」としています。同じ日、Railwayは、顧客の環境変数を保存するシステムに第三者がアクセスした可能性があると発表しました。同社はすべてのユーザーに対し、APIキーを含め、Railwayに保存しているすべての環境変数の値を更新するよう求めました(Railwayの開示情報、2026年10月21日)。ルールはシンプルです。
コードからキーを削除しても、キー自体は無効になりません。サービス側で古いキーを無効化する必要があります。それぞれの手順は次のとおりです。
Serperでは、ログインして「API Keys」を開きます。漏えいしたキーを見つけて「Reset」をクリックします。確認すると古いキーは即座に使えなくなり、ページに新しいキーが表示されます。そのキーを使っていたすべての箇所で、新しいキーに置き換えてください。
1つのキーを複数の箇所で使っていた場合、1か所だけを止めることはできないため、すべてが同時に動かなくなります。次に「Activity logs」を開き、そのキーで絞り込んで、心当たりのないクエリがないか確認します。「Anonymize queries」をオンにしていた場合、ログには件数とクレジットは表示されますが、クエリのテキストは表示されません。
EveryInfraでは、コンソールで漏えいしたキーを無効化します。以降、そのキーを使った呼び出しは401を返します。スクリプトから行うこともできます。keys:writeスコープを持つキーでPOST /portal/api/keys/{key_id}/disableを呼び出します。無効化したキーは、アカウントオーナーだけがコンソールから再度有効にできます。代わりとなる新しいキーを作成してください。環境ごとにキーを分けていれば、他の環境はそのまま動作し続けます。
キーのローテーションと、スコープおよびIP許可リストの変更はコンソールでのみ行えるため、キーが自身の設定を変更することはできません(クイックスタートの認証セクション)。次に、漏えい期間中のリクエストと利用額を呼び出し履歴で確認します。GET /api/v1/accountでも過去24時間の使用状況を確認でき、料金はかかりません。
漏えいが起きる前に備えておくこともできます。キーは次のように分けます。
| キーを使う場所 | 使用する設定 |
|---|---|
| 本番サーバー | 専用キー、サーバーのアドレスを登録したIP許可リスト |
| CI | 専用キー、少額のUSD利用上限 |
| デモ用ノートブックや共有テスト | 専用キー、少額の利用上限と有効期限 |
こうしておけば、どれか1つのキーが漏えいしても、そのキーだけを無効化すれば済みます。他のキーは動作し続け、損失もそのキーの上限内に収まります。
漏えいを代わりに検知してくれる仕組みはありません。GitHubのシークレットスキャンは、リポジトリ内にある既知の形式のキーを検出し、パートナーサービスがそのキーを失効できるよう通知します。2026年11月5日にサポート対象パターンの一覧の掲載数を数えたところ、プロバイダーは207で、SerperもEveryInfraも含まれていませんでした。TruffleHogの2026年11月2日のv3.99.8リリースには、他の3つのSERPサービス向けの検出器はあるものの、Serper向けはありません。Gitleaksのデフォルトルールにも、Serper向けのものはありません。
GitHubは2026年10月13日、Anthropicの2種類のキーをデフォルトのプッシュ保護に追加しました(GitHub Changelog)。2026年10月28日には、固定の形式ではなく文脈で判断するAIベースのプッシュ保護を追加しました。この機能はデフォルトでオフです(GitHub Changelog)。スキャナーが対象のキー形式に対応するまでは、GitHub Advanced Securityのユーザーはその形式向けのカスタムパターンを作成できます。
公開コードを見ると、この変数名がどれほど広く出回っているかがわかります。00:45:51(SGT)に、site: github.comを付けて「SERPER_API_KEY」を検索しました。結果10件はすべて公開GitHubページでした。その中には、CrewAIの403に関するIssue、「configure the serper api key?」というタイトルのh2oGPTのIssue、2つのコミュニティ製MCPサーバーが含まれていました。
NVIDIAのブループリントのREADMEや、2026年7月21日付のHermes Agentの機能リクエストもありました。公開コードに変数名があること自体は普通で、安全です。リスクが生じるのは、コミットされた.envファイル内で名前の隣に値が置かれている場合で、その値を検出するデフォルトのスキャナーはありません。
| 漏えい後の手順 | Serper | EveryInfra |
|---|---|---|
| 古いキーを無効化 | API Keys → Reset、即時 | コンソールで無効化。呼び出しには401が返る |
| 1か所だけ止めて他は維持 | 不可。キー全体がリセットされる | 可能。環境ごとに1つのキーを使用 |
| 被害の抑制 | キーごとの上限やIP設定なし | プロダクトスコープ、IP許可リスト、キーごとのUSD建て利用額上限、有効期限 |
| 漏えい期間中の呼び出しを確認 | Activity logsをキーで絞り込み | コンソールの呼び出し履歴、/api/v1/account |
| 公開リポジトリでの自動検出 | GitHub、TruffleHog、Gitleaksのデフォルトでは非対応 | 同じく非対応 |
Serperのほうが適しているケース
EveryInfraよりSerperが適しているのは、次のようなケースです。
1つ目は、都市、地域、郵便番号単位のローカル検索結果です。Serperのロケーション一覧には郵便番号レベルまで100,029件のエントリがありますが、EveryInfraのlocationは国単位までです。ローカルSEOの順位トラッキングや都市ごとの検索結果の確認には、Serperが適しています。2つ目は、ナレッジパネル、「他の人はこちらも質問」、関連検索などの検索結果ページのモジュールです。SerperはknowledgeGraph、peopleAlsoAsk、relatedSearchesをフィールドとして返します。
EveryInfraのwebツールが返すのは、タイトル、リンク、スニペット、日付のみです。3つ目は高スループットです。Serperのパックでは毎秒50〜300クエリが可能です。EveryInfraのアカウントはデフォルトで毎分60、スピードパックを使えば毎分最大1,800までです(料金)。1秒間に数百件のリクエストを送るなら、Serperのほうがはるかに有利です。
4つ目は、マップのレビューと商品レビューです。Serperには検索タイプとしてreviews、product-reviews、mapsがあります。EveryInfraの検索にはこうしたツールがないため、プラットフォームごとにデータカタログから該当する機能を探す必要があり、セットアップの手間が増えます。5つ目は、1回あたり最大100クエリのバッチリクエストです。
SerperのMini-batchはこれに対応していますが、EveryInfraの検索は1回の呼び出しにつき1クエリです。6つ目は、Serperのフィールドを前提にすでに構築された大規模なコードベースがあり、米国英語の結果だけが必要な場合です。この場合、コードの変更コストが節約額を上回る可能性があるため、移行は見送りましょう。AIエージェントに検索を追加するときや、データ、検索、その他の機能を1つのキーで利用したいときに、切り替えを検討してください。
制約:この調査結果が当てはまらない場合
第1に、ログイン後のダッシュボードに関するSerperの記述は、実際に見た画面ではなく、ページのスクリプト内のテキストに基づいています。スタッフアカウントだけが使えるタイプなど、スクリプトに含まれていても表示されない機能は除外しました。また、スクリプトに記載のないサーバー側の機能は確認できません。第2に、Serperのエラーボディは2025年7月〜2026年10月付けのサードパーティの投稿によるもので、変更されている可能性があります。第3に、EveryInfraの新規登録後の手順と主な機能は、ページ、ドキュメント、料金ページ、OpenAPIファイルをもとに記述しました。新しいアカウントは作成しておらず、スコープ付きキーで呼び出して403を確認することもしていません。
4つ目に、今回の34回の呼び出しには、通常のアカウントとは異なり、毎分10回の上限があるテストキーを使用しました。5つ目に、ロケーションとレイテンシのテストはシンガポールからの単一サンプルです。6つ目に、検索結果の品質やカバレッジは比較していません。
FAQ
アプリでSerperのAPIキーを設定するにはどうすればよいですか?
環境変数として設定し、使っているフレームワークがどの変数名を読み込むかを確認してください。LangChain、CrewAI、LiteLLMはSERPER_API_KEYを、HaystackはSERPERDEV_API_KEYを読み込みます。h2oGPTの「configure the serper api key?」というIssue(h2oai/h2ogpt #914)に、よくある間違いの例があります。
このユーザーは、コードが変数名を想定している箇所にキーそのものを貼り付けていました。それでもアプリは動かず、別のキーを求めるバリデーションエラーが表示されました。
Serperの無料枠は月2,500クエリですか?
Serperのホームページには「Get 2,500 free queries」とあり、「per month」とは書かれていません。2026年7月21日付のHermes Agentの機能リクエストでは「2,500 free queries/month」とされています(NousResearch/hermes-agent #68615)。新規登録後にダッシュボードで確認し、毎月リセットされる前提で計画しないでください。また、利用規約では複数のアカウントを同時に持つことが禁止されています。2,500クエリでどのくらい使えるかは、Serper APIの無料枠をご覧ください。
CrewAIでSerperのキーを使うと403 Unauthorizedが返るのはなぜですか?
まず、キーがserper.devで発行されたものか確認してください。CrewAIのIssue #633では、ユーザーが別のサービスのキーを使っていました。次に、変数名がCrewAIのソースコードが直接読み込むSERPER_API_KEYになっているか、リクエストがPOSTになっているかを確認します。レスポンスボディが「Unauthorized. Sign up for a free account.」の場合は、キーが間違っているか設定されていません。CrewAI Issue #633を参照してください。
Serper APIの完全なリファレンスはありますか?
2026年11月5日時点では見つかりませんでした。serper.dev/docs、/llms.txt、/openapi.jsonはいずれも404を返し、GitHubのOrganizationにもSDKはありません。パラメータ、型、クレジット消費量はPlaygroundで確認でき、Playgroundはサンプルコードも生成します。CrewAI、LangChain、Haystack、LiteLLM、Langflowの各フレームワークのドキュメントは、それぞれその一部をカバーしています。
Serper APIへのログインにGoogleやGitHubを使えますか?
新規登録とログインのスクリプトには、サードパーティログインは見つかりませんでした。Serperのログインはメールアドレスとパスワードで、二要素認証は任意です。EveryInfraはメールアドレス、GitHub、Googleに対応しています。
はじめに:キーの取得から最初の結果まで
試すには、everyinfra.comで新規登録してください。2つのGitHubリポジトリにスターを付け、コンソールで$1のトライアルクレジットを受け取ります(有効期間は24時間)。「APIキー」でキーを作成し、上記のcurlリクエストを送信して、レスポンスのbilling.charged_usdを確認してください。パラメータを無料で確認するには、検索ツールカタログを開いてください。データカタログの検索機能については、Webデータプラットフォームのページ、Bing、DuckDuckGo、Google News、Google Shoppingをご覧ください。コンソールからワンクリックで呼び出しを試すには、インフラマーケットプレイスをご利用ください。
Serperから移行する場合は、以下の項目をこの順番で変更してください。最後の行は変更ではなく、エラー処理のテストです。
| ステップ | Serper | EveryInfra |
|---|---|---|
| 1. URL | https://google.serper.dev/<type> | https://api.everyinfra.com/api/v1/search |
| 2. ヘッダー | X-API-KEY | Authorization: Bearer |
| 3. 結果の種類 | URLのパス | リクエストボディのtoolフィールド |
| 4. 国 | gl | location |
| 5. 言語、スペル修正 | hl、autocorrect | 省略する、またはweb/searchでlanguageを使用 |
| 6. 期間 | tbs | after、before |
| 7. 結果のリンク | organic[].link | results[].url |
| 8. エラーテスト | — | 誤ったパラメータを1つ送信し、コードがallowedとdid_you_meanを読み取れることを確認 |
より広く比較するには、代替サービスとEveryInfraを選ぶ理由をご覧ください。
参考文献
- Serperホームページ(料金、FAQ、レスポンス例)、Serper、2026-11-05閲覧
- アカウント作成、Serper、2026-11-05閲覧
- アカウントにログイン、Serper、2026-11-05閲覧
- APIキー、Serper、2026-11-05閲覧(ログアウト時はログインフォームを表示)
- Playground、Serper、ページのスクリプトを2026-11-05に確認
- 利用規約、Serper、2024-05-29更新、2026-11-05閲覧
- プライバシーポリシー、Serper、2025-11-05見直し、2026-11-05閲覧
- 対応ロケーション、Serper、2026-11-05閲覧
- Serper-APIのGitHub Organization、GitHub、2026-11-05閲覧
- serper.devのWebアーカイブインデックス、Internet Archive、2026-11-05閲覧
- postman-code-generators、Postman、2026-11-05閲覧
- Serper.dev authentication issues、n8nコミュニティ、2025-07-26
- Unauthorized Error (403) when Using SERPER_API_KEY #633、CrewAI、2024-05-17
- serperのAPIキーを設定するには?#914、h2oGPT、2023-10-01
- Serper.devのWeb検索プロバイダープラグインを追加 #68615、Hermes Agent、2026-07-21
- 調査:利用枠を使い切ったプランや拒否されたキーを、その実態どおりに扱う #339、GitHub、2026-10-23
- リリース前に実際のキーでライブチェックを行う #12、GitHub、2026-10-22
- Google Serper Search (SerperDevTool)、CrewAI、2026-11-05閲覧
- serper_dev_tool.py、CrewAI、2026-11-05閲覧
- CrewAI 1.15.35、CrewAI、2026-11-03
- GoogleSerperAPIWrapper、LangChain、2026-11-05閲覧
- google_serper.py、LangChain、2026-11-05閲覧
- SerperDevWebSearch、deepset、2026-11-05閲覧
- Haystack serperdev websearch.py、deepset、2026-11-05閲覧
- Serper Search、LiteLLM、2026-11-05閲覧
- Serper bundle、Langflow、2026-11-05閲覧
- HTTP Request node、n8n、2026-11-05閲覧
- HTTP Request credentials、n8n、2026-11-05閲覧
- MCP Client Tool node、n8n、2026-11-05閲覧
- n8n 2.46.6、n8n、2026-11-04
- mcp-server-serper、GitHub、2026-11-05閲覧
- serper-mcp-server、GitHub、2026-11-05閲覧
- Model Context Protocol Specification 2026-07-28、MCP、2026-11-05閲覧
- MCP Authorization、MCP、2026-11-05閲覧
- Connect Claude Code to tools via MCP、Anthropic、2026-11-05閲覧
- RFC 9110: HTTP Semantics、IETF、2022-06
- RFC 6585: Additional HTTP Status Codes、IETF、2012-04
- RFC 9457: Problem Details for HTTP APIs、IETF、2023-07
- 422 Unprocessable Content、MDN、2026-11-05閲覧
- Retry-After、MDN、2026-11-05閲覧
- Supported secret scanning patterns、GitHub、2026-11-05閲覧
- シークレットスキャンがAnthropicのキーをデフォルトでブロック、Salesforceにも対応、GitHub、2026-10-13
- 定義済みのシークレットパターン以外にもプッシュ保護を適用、GitHub、2026-10-28
- シークレットスキャン用のカスタムパターンの定義、GitHub、2026-11-05閲覧
- TruffleHog v3.99.8、Truffle Security、2026-11-02
- Gitleaks、Gitleaks、2026-11-05閲覧
- LiteLLM v1.107.0リリースの背後にある攻撃チェーン、LiteLLM、2026-10-23
- Security Disclosure: Wednesday October 21st、Railway、2026-10-21
- How to Retrieve Your API Key from Serper.dev Dashboard、Clayコミュニティ、2025-05-10
- Secrets Management Cheat Sheet、OWASP、2026-11-05閲覧
- The Twelve-Factor App: Config、12factor.net、2026-11-05閲覧
- python-dotenv、PyPI、2026-11-05閲覧
- Requests Quickstart、Requests、2026-11-05閲覧
- EveryInfra検索ツールカタログ、EveryInfra、2026-11-05 00:16 SGT閲覧
- EveryInfraデータ機能カタログ、EveryInfra、2026-11-05 00:16 SGT閲覧
- EveryInfra OpenAPI、EveryInfra、2026-11-05閲覧
参考資料 BL-92