Serper API key y documentación: del login al primer resultado
Serper no tiene sitio de documentación: el Playground hace de docs y la clave solo se crea, renombra o reinicia. 38 llamadas reales a parámetros y errores.
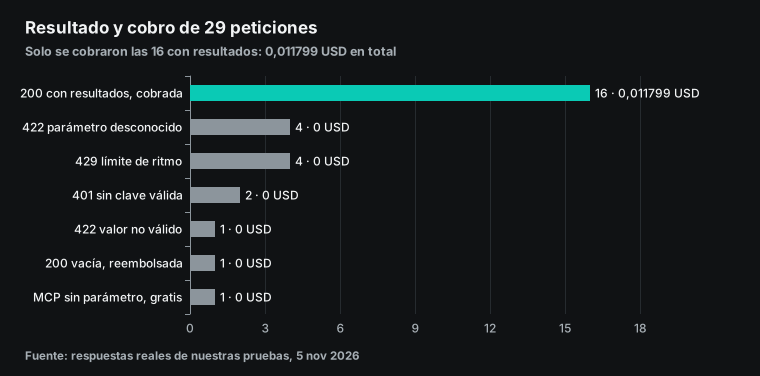
Quien busca «serper api key», «serper api docs» o «serper api login» suele tropezar con lo mismo: Serper no tiene un sitio de documentación propio. El 5 de noviembre de 2026, serper.dev/docs devolvía un 404. La «documentación» real es el Playground, una página que solo funciona después de iniciar sesión, y las reglas de parámetros, el costo en créditos y el código de ejemplo viven en el JavaScript de esa página. Leímos las páginas públicas de serper.dev y sus scripts. Después hicimos 38 llamadas reales a la API de búsqueda de EveryInfra entre las 00:18 y las 00:58 (hora de Singapur) de ese mismo día, es decir, entre las 17:18 y las 17:58 del 4 de noviembre en Madrid. Veinticinco llamadas devolvieron resultados y costaron 0,018740 USD en total. Las otras 13 fueron errores a propósito, una cabecera de clave equivocada, límites de velocidad y un resultado vacío, y todas costaron 0 USD.
Este artículo no compara precios. Compara el camino hasta la primera llamada que funciona: cuántos pasos hay desde el registro, dónde está la clave, cuántas claves se pueden crear y qué hacer si una se filtra. También traduce q, gl, hl, num, page y type a nuestros parámetros, muestra los errores reales y explica dónde poner la clave en Python, Node.js, n8n y clientes MCP. Para los precios, lee nuestros tres artículos anteriores sobre Serper, enlazados en la primera sección.
Qué responde este artículo y dónde están los precios
El resumen de precios en una frase: los cuatro paquetes de Serper cuestan entre 0,30 y 1,00 USD por cada mil créditos y vencen a los 6 meses, mientras que la búsqueda web de EveryInfra cobra 0,000694 USD por llamada (0,694 USD por mil) y el saldo no vence. El costo por cada mil consultas está en Alternativa a Serper API: precios, plan gratis y pruebas, cuánto duran las 2500 consultas gratuitas en Serper API gratis y los cuatro paquetes mes a mes en Precios de Serper API.
Este artículo es para quien ya decidió probar Serper, o ya lo usa, y solo trata de la puesta en marcha y los errores: dónde sacar la clave y cómo enviarla, dónde están las reglas de los parámetros, qué hacer cuando una llamada falla y cómo cambiar una clave filtrada. Antes de escribir comprobamos con nuestra herramienta suggest si existe material en español sobre el tema.
| Búsqueda (hora de Singapur) | Sugerencias devueltas | Qué quiere el lector |
|---|---|---|
| serper api key (00:20) | free, pricing, crewai, google, cost, get serper api key | Dónde sacar la clave y cuánto cuesta |
| serper api login (00:53) | serper api keys, serper api example, serper api github, serper api docs | Llegar a la página de claves y copiar un ejemplo |
| serper api clave (00:56) | clavate, clavel, claver, clarence | Nada útil: no hay volumen de búsqueda en español |
Quien programa en español termina leyendo la documentación en inglés de algún framework, y este artículo intenta cubrir ese hueco con datos medidos.
Del lado de Serper usamos solo material público: la portada, la página de registro, la de inicio de sesión, los términos, la política de privacidad y el JavaScript que esas páginas cargan en cualquier navegador. No creamos una cuenta de Serper, no usamos su clave ni llamamos a su API de búsqueda. Todo lo que describimos «después de iniciar sesión» sale del texto de esos scripts o de publicaciones públicas de terceros, y lo indicamos cada vez. Cada número de EveryInfra sale de una respuesta real del 5 de noviembre de 2026.
La tabla general: clave, documentación y primera petición
La tabla solo recoge hechos verificables. La columna de Serper sale de las páginas y scripts de serper.dev, leídos el 5 de noviembre de 2026. La de EveryInfra sale de la documentación, de la página de precios, del archivo OpenAPI, del catálogo público y de nuestras llamadas. Volvimos a leer la documentación, los precios y el OpenAPI a las 01:25 (hora de Singapur) del 5 de noviembre de 2026 y guardamos copia.
| Punto | Serper | EveryInfra |
|---|---|---|
| Registro | Nombre, correo, contraseña y una verificación humana; luego hay que verificar el correo | Correo, o continuar con GitHub o Google |
| Inicio de sesión | Correo y contraseña; doble factor opcional con una app de autenticación | Igual que el registro |
| Uso gratis | 2500 consultas, sin tarjeta | Dar estrella a dos repositorios de GitHub para 1 USD de prueba, válido 24 horas |
| Dónde está la clave | Página API Keys del panel | API Keys en la consola; la clave completa se muestra una sola vez, al crearla |
| Claves por cuenta | Varias, cada una con nombre | Varias, por entorno o por uso |
| Gestión de la clave | Crear, renombrar, copiar, reiniciar | Crear, limitar por producto, desactivar, lista de IP, rotar |
| Cabecera | X-API-KEY: <clave> (la variante GET pone apiKey en la URL) | Authorization: Bearer <clave> |
| Dirección | https://google.serper.dev/<type> | https://api.everyinfra.com/api/v1/search |
| Dónde está la documentación | Playground (tras iniciar sesión); sin sitio propio | /docs, /llms.txt, /openapi.json y un catálogo de herramientas sin clave |
| Descripción legible por máquinas | No encontramos OpenAPI ni llms.txt | OpenAPI 3.0.3 con 61 rutas, llms.txt y catálogo JSON |
| Documentación en español | No encontramos | Catálogo con descripción de cada parámetro en español y documentación en /es/docs |
| MCP | Serper no tiene servidor propio; hay servidores comunitarios que corren en local | Servidor MCP remoto en https://api.everyinfra.com/mcp |
| Forma del error | {"message": "...", "statusCode": 403} (publicaciones de terceros) | {"error": {"code", "message", "fault", "retryable", "next_steps", ...}} |
Hay tres filas que importan más. La primera es dónde está la documentación: Serper pone parámetros, ejemplos y costos dentro de una página interactiva que exige iniciar sesión. Para una persona es cómodo, pero un asistente de programación con IA necesita un paso más para leerla. La segunda es la gestión de la clave: la página de Serper tiene cuatro acciones y ninguna sirve para borrar, ni para limitar qué puede hacer una clave o desde dónde se usa. La tercera es la cabecera. Las dos API usan cabeceras distintas, y es el cambio que más se olvida: en nuestra prueba, una clave válida enviada en X-API-KEY devolvió 401.
Serper API login: registro e inicio de sesión
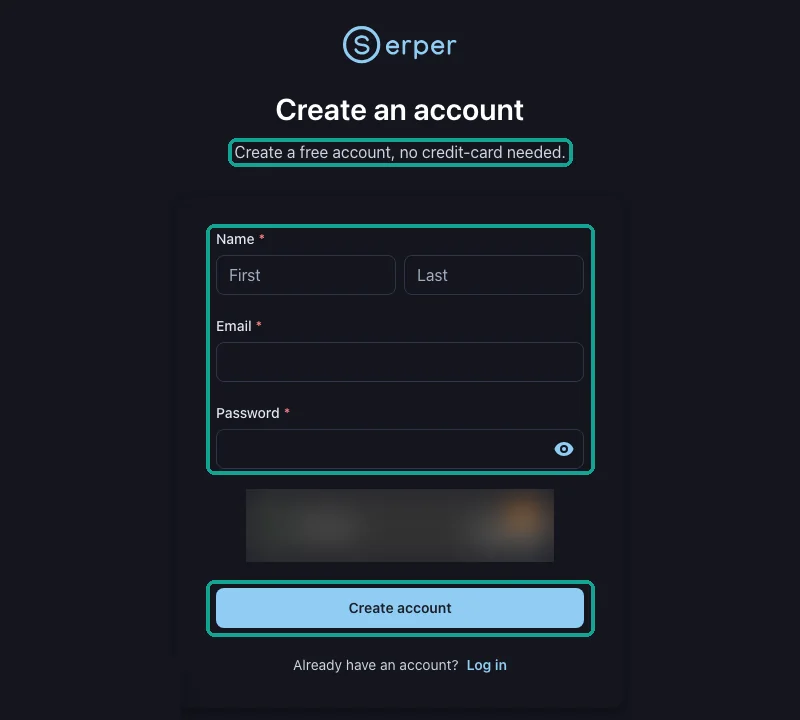
La página de registro de Serper dice «Create an account» y «Create a free account, no credit-card needed.». El formulario pide tres datos obligatorios: nombre (nombre y apellido), correo y contraseña (serper.dev/signup, leído el 5 de noviembre de 2026). Debajo hay una verificación humana, y el botón «Create account» solo funciona después de superarla. El script de la página envía dos tokens de verificación humana junto con los datos. Tras el registro aparece una página que dice «Please verify your email account», con opciones para reenviar el correo o salir. Un enlace válido muestra «Your email has been verified.» y uno caducado muestra «The verification link is invalid or has expired.».
La página de inicio de sesión dice «Log in to your account» y solo tiene correo, contraseña, «Remember me» y «Forgot password?» (serper.dev/login). Si activas el doble factor en los ajustes, después hay que escribir un código de la app de autenticación; el texto de ajustes dice «Scan the QR code below with your authenticator app». En los scripts de registro y de inicio de sesión no encontramos acceso con Google ni con GitHub, así que «serper api login» tiene un solo camino: correo y contraseña. Un detalle explica muchos resultados de búsqueda: si abres serper.dev/api-keys sin sesión, la página muestra el formulario de inicio de sesión. Por eso el resultado que aparece para «serper api login» suele tener el título «Log in to your account» pero la dirección /api-keys.
Los términos de servicio de Serper dicen «Updated on May 29, 2024» e incluyen dos reglas que afectan a las cuentas. La primera prohíbe «Register more than one account at any point in time», así que abrir varias cuentas para sumar consultas gratis va contra los términos. La segunda prohíbe «Attempt to circumvent any restrictions or limits placed on your Serper API key or account». Los términos aclaran además que Serper es un servicio entre empresas y no para consumidores. La política de privacidad indica «Date Last Reviewed: 5 November 2025» y dice que Serper guarda registros de acceso y de actividad.
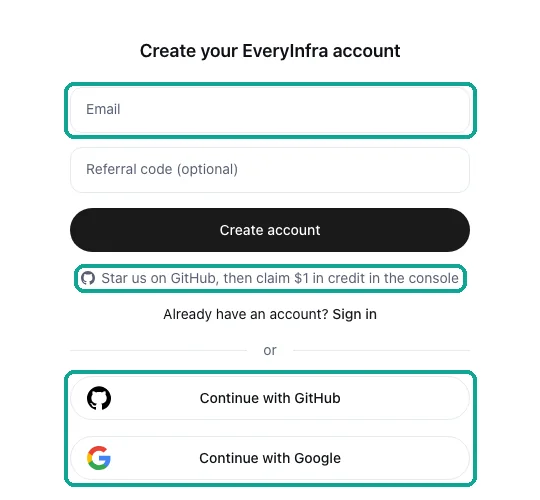
En EveryInfra, el registro empieza en «Empezar gratis», arriba a la derecha. La página tiene un campo de correo, un código de referido opcional y los botones para continuar con GitHub o con Google. Tampoco creamos una cuenta nueva aquí. Por eso describimos lo que pasa después del registro según la página y la documentación: la guía de inicio dice que la clave se crea en la consola y que la clave completa solo se muestra una vez.
La diferencia principal está en un paso. Tras registrarte en Serper tienes que abrir el enlace de verificación del correo y luego iniciar sesión con correo y contraseña; en EveryInfra puedes continuar con GitHub o con Google y no esperar ningún correo. El crédito de prueba de 1 USD de EveryInfra añade una visita a GitHub para dar dos estrellas, pero ese paso es para el saldo, no para la clave. Cuando un asistente de IA hace la configuración por ti, cada «ve a tu correo y pulsa el enlace» necesita a un humano y detiene el proceso.
¿Dónde está la Serper API key y qué se puede hacer con ella?
La clave de Serper está en la página API Keys del panel, con el título «API Keys» y el subtítulo «Your keys to unlock the power of Serper». El script de esa página llama a tres funciones de la cuenta: listar claves, crear una clave y cambiarle el nombre. Toda clave necesita un nombre; si lo dejas vacío, el formulario avisa «Name is required». Cada clave tiene además una acción «Reset». Antes de reiniciar, un aviso pregunta «Are you sure you want to reset this API key? This action cannot be undone and any applications using this key will stop working.» y, al terminar, la página dice «The old API key is not valid anymore. Replace it with the new one.».
La página tiene también un botón de copiar con el mensaje «API key copied to clipboard», así que la clave completa sigue visible en el panel y cualquiera con tu sesión puede volver a copiarla. El tutorial en español de DataCamp sobre Jan-v1 lo confirma desde el otro lado: pide abrir serper.dev/api-keys y copiar «la clave API predeterminada», es decir, la cuenta ya trae una clave creada (DataCamp, 18 de agosto de 2025). El script no tiene función para borrar claves, ni ajustes para limitar una clave a ciertos productos, a un gasto máximo o a ciertas IP. La página de ajustes cubre nombre, contraseña, doble factor y tarjeta de pago. La página «Activity logs» lista las peticiones recientes con las columnas Time, Query, Type, Page, Num, Credits y Response time (ms), se puede filtrar por clave y tiene un interruptor «Anonymize queries» para no guardar el texto de las consultas.
| Acción | Serper (script de API Keys) | EveryInfra (documentación, precios, OpenAPI) |
|---|---|---|
| Crear | Sí, con nombre obligatorio | Sí, una por entorno o uso |
| Renombrar | Sí | Sí (PATCH /portal/api/keys/{key_id} en el OpenAPI) |
| Ver otra vez la clave completa | Botón de copiar en la página | Solo al crearla |
| Reiniciar o rotar | Sí, la vieja deja de valer al instante | Sí, solo en la consola |
| Desactivar sin borrar | No encontrado | Sí, las llamadas devuelven 401 |
| Borrar | No encontrado | Las claves de la consola solo se desactivan; las creadas por API se pueden borrar |
| Limitar por producto | No encontrado | Sí, un producto bloqueado devuelve 403 capability_denied |
| Lista de IP permitidas | No encontrado | Sí, solo en la consola |
| Registro por clave | Sí, Activity logs filtra por clave | Sí, historial de llamadas en la consola; el OpenAPI tiene un endpoint de uso por clave |
| Tope de gasto y caducidad por clave | No encontrado | Sí, spend_limit_usd y expires_at (OpenAPI) |
Que falte una función no hace inútil a Serper. Una persona con una clave para un script solo necesita crear y reiniciar. La diferencia aparece con equipos, varios entornos y agentes de IA. Imagina una clave en tu portátil, en la integración continua y en un cuaderno de demostración que compartiste con un cliente. Si el cuaderno se filtra, el reinicio de Serper rompe los tres sitios a la vez; con claves separadas por entorno, solo desactivas la filtrada. La documentación de EveryInfra lo explica con un cuadro eléctrico: la clave es el interruptor general y API Keys → Límites de permisos baja circuitos sueltos (guía de inicio, sección de autenticación).
Gestionar claves desde un script: los endpoints del OpenAPI de EveryInfra
La consola no es la única vía. La sección Account del archivo OpenAPI de EveryInfra describe un grupo de endpoints para las claves, que leímos a las 01:25 (hora de Singapur) del 5 de noviembre de 2026. Ninguno cobra, y todos comparten con los demás endpoints de cuenta un límite de 60 peticiones por minuto por cuenta. Los de lectura piden permisos de lectura de la cuenta: una clave con acceso a todos los productos trae por defecto account:read, requests:read y billing:read, y una clave limitada a algunos productos solo los recibe si el dueño los activa en la consola. Los de escritura piden el permiso keys:write, que viene desactivado y solo puede conceder el dueño de la cuenta con la sesión iniciada en la consola; cada cambio hecho con una clave aparece en los avisos de la consola.
| Endpoint | Qué hace | Límites según el OpenAPI |
|---|---|---|
GET /portal/api/keys | Lista el nombre, el prefijo enmascarado, el estado, los permisos, el límite por minuto, el tope de gasto en USD y el último uso de cada clave | Nunca devuelve la clave completa |
POST /portal/api/keys | Crea una clave y la devuelve una sola vez; admite ip_allow, expires_at y spend_limit_usd | Una clave creada por API nunca es más amplia que la que la crea ni recibe permisos de escritura; como máximo 20 por cuenta y día UTC; una clave con tope de gasto no puede crear claves |
PATCH /portal/api/keys/{key_id} | Cambia el nombre o la nota, o adelanta la caducidad | Solo para claves creadas por API o para la propia clave que llama; las de la consola solo se desactivan |
POST /portal/api/keys/{key_id}/disable | Desactiva al instante cualquier clave de la cuenta | Solo el dueño puede reactivarla, en la consola |
DELETE /portal/api/keys/{key_id} | Borra una clave para siempre | Solo para claves creadas por API o para la propia clave que llama |
GET /portal/api/keys/{key_id}/usage | Muestra los aciertos, fallos, gasto y última llamada de una clave en los últimos días | Pide requests:read |
Estos campos importan después de una filtración. spend_limit_usd es un tope total en USD para una clave (cargos menos reembolsos, nunca se reinicia): si la clave de la integración continua o del cuaderno de demostración tiene un tope pequeño, la filtración tiene techo. expires_at hace que una clave temporal deje de valer sola, e ip_allow hace que solo funcione desde las direcciones IP de tu servidor. En el script de la página API Keys de Serper no encontramos opciones equivalentes. Esta sección sigue el texto del OpenAPI; no creamos claves de prueba para llamar a cada endpoint.
Serper API documentation: el Playground es la documentación
Primero comprobamos si había un sitio de documentación aparte. El 5 de noviembre de 2026, serper.dev/docs, serper.dev/llms.txt, serper.dev/openapi.json y serper.dev/sitemap.xml devolvían 404. La columna «Product» del pie de la portada solo enlaza el Playground, el panel y las integraciones con Haystack, Jan AI, CrewAI y LangChain; no hay «Docs» ni «API reference». La organización de Serper en GitHub, Serper-API, tiene 7 repositorios y GitHub marca todos como bifurcaciones de otros proyectos, como Auto-GPT, chat-ui y Perplexica. Ninguno es un SDK ni una especificación de la API.
Así que «serper api documentation», en la práctica, significa el Playground: un formulario donde eliges el tipo de resultado y escribes la consulta a la izquierda, y recibes resultados y código a la derecha. Leímos su script y anotamos siete hechos que importan al escribir código contra él.
Primero, el tipo de resultado va en la URL, no en el cuerpo: el script añade el tipo elegido a https://google.serper.dev/<type> y quita type del cuerpo antes de enviar. El menú incluye search, images, videos, places, news, shopping, scholar, patents, autocomplete, product-reviews, lens, maps y reviews, y algunos tipos dependen de la cuenta. La extracción de páginas web usa otro dominio, https://scrape.serper.dev, y hay una herramienta «Resolve links» que cuesta 0 créditos. Segundo, los parámetros tienen valores por defecto y el script elimina los que coinciden con ellos: gl=us, hl=en, page=1, num=10 y autocorrect=true. Esto importa en España y Latinoamérica: si no envías gl ni hl, buscas como si estuvieras en EE. UU. y en inglés.
Tercero, el menú de cantidad de resultados para la búsqueda normal tiene hoy una sola opción, 10; imágenes ofrece 10 o 100 y compras usa 40. Cuarto, el interruptor «Mini-batch (up to 100 queries)» mete una lista de consultas en una sola petición. Quinto, los créditos: un indicador «Credits: N» muestra el costo de la petición. El script cobra 3 créditos por maps y lens, 2 por shopping y product-reviews, y 1 por la mayoría de los demás tipos. La extracción de una página cuesta 2 créditos, o 6 o 10 si la página es difícil; el script dice «Most webpages typically incur 2 credits, but for harder-to-scrape pages ... the cost can be 6 or 10 credits». Pedir más de 10 imágenes cuesta el doble.
Sexto, el código de ejemplo. El panel de código usa la librería de código abierto postman-code-generators, de Postman, y toma la lista de lenguajes directamente de su función getLanguageList(), con Node.js por defecto. Puedes elegir POST o GET: POST manda la clave en la cabecera X-API-KEY y GET mete todos los parámetros y apiKey en la URL. Una clave en la URL acaba en los registros del servidor, en el historial del navegador y en los registros de cualquier proxy, así que usa POST salvo que tu herramienta solo sepa hacer GET. Un hilo de la comunidad de n8n del 26 de julio de 2025 muestra la trampa: un usuario envió GET con cabecera y recibió 403, y la respuesta explicó que con GET la clave va en la URL y que la cabecera solo funciona con POST (hilo de la comunidad de n8n).
Séptimo, las ubicaciones. El campo de ubicación dice «You can find a list of supported locations here» y enlaza a api.serper.dev/locations. Descargamos esa lista pública: tiene 100 029 entradas en 240 países y territorios, con 48 384 códigos postales, 37 208 ciudades y 4309 barrios. Es mucho más fino que el campo location de EveryInfra, que según el catálogo acepta «un nombre de país o código de dos letras» y trata una ciudad como su país.
| Regla del Playground | Dónde está | Qué significa para tu código |
|---|---|---|
| El tipo va en la URL, no en el cuerpo | https://google.serper.dev/ + type | Cambiar de tipo es cambiar de URL |
| Por defecto gl=us, hl=en, num=10, page=1 | Se quitan del código generado | Sin parámetros buscas en inglés de EE. UU. |
| Búsqueda normal: num solo ofrece 10 | Menú de cantidad | Usa page para más resultados |
| El costo en créditos cambia por tipo | Indicador «Credits: N» | maps y lens cuestan 3 créditos |
| Hasta 100 consultas por petición | Interruptor Mini-batch | Se cobra por consulta |
| GET pone apiKey en la URL | Selector GET/POST del panel | Usa POST y la cabecera |
| 100 029 ubicaciones | api.serper.dev/locations | Llega a ciudad y código postal |
Tener la documentación dentro de una página interactiva tiene un costo, y lo medimos con dos búsquedas. A las 00:18:40 y 00:19:06 (hora de Singapur) buscamos «serper api documentation» con la búsqueda web de EveryInfra, location: us, y tomamos las dos primeras páginas, 20 resultados. Solo 3 eran de serper.dev: la portada, /api-keys (un formulario de inicio de sesión sin sesión) y /signup, y ninguna era una página de documentación. Ocho eran documentación de otros proyectos: CrewAI, LangChain (tres, una de ellas una copia antigua), Langflow, Haystack, Sim y Aikeedo. Cuatro eran directorios de API y los otros cinco eran la organización de GitHub, un artículo de Medium, un vídeo de YouTube, una ficha de un servidor MCP y la portada de otra API de búsqueda.
| Origen de los 20 primeros resultados | Cantidad | Ejemplos |
|---|---|---|
| Páginas de serper.dev | 3 | Portada, /api-keys, /signup |
| Documentación de frameworks y plataformas | 8 | docs.crewai.com, reference.langchain.com, docs.haystack.deepset.ai, docs.langflow.org |
| Directorios y mercados de API | 4 | apitracker.io, apis.io y otros |
| Otros | 5 | github.com/Serper-API, medium.com, youtube.com |
Luego repetimos la idea para lectores de España. A las 00:55:47 (hora de Singapur) usamos la entrada web/search del catálogo de datos con keyword: serper api documentación, country: es y language: es. Los 10 resultados estaban en inglés: la portada de Serper, la portada de otra API de búsqueda, la documentación de CrewAI de la versión 1.15.33, /api-keys, la documentación de Aikeedo, apitracker.io, la documentación de Langflow, la organización de GitHub, una ficha en un mercado de API y un artículo de Medium. Fijar el idioma de los resultados no cambia nada si el contenido en español no existe.
Quien pide a un asistente de IA que escriba el código de conexión necesita documentación que el asistente pueda leer sin iniciar sesión. En EveryInfra, tres archivos públicos hacen ese trabajo:
| Archivo | Qué contiene |
|---|---|
| Catálogo de herramientas | Las 17 herramientas de búsqueda con parámetros, valores por defecto, límites, precio y la explicación de cada parámetro en chino, inglés y español; no pide clave |
| Archivo OpenAPI | Versión 3.0.3, con 61 rutas el 5 de noviembre de 2026 |
/llms.txt | Un índice para modelos de lenguaje: dirección base, cabecera y el aviso de que los parámetros malos vuelven con did_you_mean y allowed |
Con esto, un asistente comprueba los parámetros antes de escribir código en vez de adivinar de memoria. Las reglas de Serper viven en el Playground, así que el asistente suele leer versiones de segunda mano: la documentación de CrewAI todavía dice que n_results vale 10 por defecto, mientras el menú del Playground ya solo ofrece 10.
Serper API docs: parámetros comparados con EveryInfra
La respuesta corta: las dos API reciben un cuerpo JSON y devuelven JSON, pero cambian los nombres de los parámetros, la forma de elegir el tipo de resultado y los campos de la respuesta. No basta con cambiar la URL. Comparamos los parámetros de búsqueda normal del script del Playground con los de la herramienta web de EveryInfra, según el catálogo de herramientas, leído a las 00:16 (hora de Singapur) del 5 de noviembre de 2026.
| Parámetro de Serper | Significado en el Playground | Equivalente en EveryInfra | Nota |
|---|---|---|---|
q | Consulta | q (herramienta web); keyword en el catálogo de datos | Mismo nombre y significado |
gl | País, dos letras, por defecto us | location | gl devuelve 422; location funciona a nivel de país |
hl | Idioma de la interfaz, por defecto en | No existe en web; language en web/search | hl devuelve 422 |
num | Resultados por página; 10 en búsqueda normal | num, hasta 10 | Mismo nombre |
page | Página desde 1 | page desde 1; cada página se cobra | Mismo nombre |
type | Segmento de URL: search, news, images | Campo tool del cuerpo: web, news, media | type en el cuerpo devuelve 422 |
tbs | Rango de tiempo qdr:h/d/w/m/y | after, before (fechas) | Hay que convertir a fechas |
location | Ciudad, barrio o código postal; 100 029 entradas | location funciona por país | Mismo nombre, otro significado |
autocorrect | Corrección ortográfica, activa por defecto | No existe | Se quita |
| — | — | site (un solo dominio) | En Serper se escribe site: dentro de q |
Dos filas piden cuidado. La primera es location: el nombre coincide, el significado no. En Serper, location es un lugar concreto y gl fija el país; en EveryInfra, location es el país y una ciudad cuenta como su país. Al migrar, copia el valor de gl en location y descarta el location viejo de Serper. La segunda es hl: la herramienta web no tiene parámetro de idioma. Si lo necesitas, usa web/search del catálogo de datos, que acepta keyword, country y language y cuesta 0,001389 USD, el doble que web.
El tipo de resultado también cambia de sitio. En Serper va en la URL; en EveryInfra la búsqueda tiene una sola dirección, POST /api/v1/search, y el campo tool del cuerpo elige una de 17 herramientas. Armamos la tabla con el texto del catálogo; «equivalente» significa un uso parecido, no resultados idénticos.
| Tipo de Serper | Herramienta de búsqueda de EveryInfra | Opciones del catálogo de datos |
|---|---|---|
| search | web | web/search, bing/search, duckduckgo/search |
| news | news | google_news/search |
| images, videos | media (kind es image o video) | — |
| places, maps | places | — |
| shopping | shopping | google_shopping/search |
| scholar, patents | scholar (kind es papers o patents) | — |
| autocomplete | suggest | — |
| lens | lens | — |
| webpage | read | — |
| reviews, product-reviews | No está en la búsqueda | Reseñas de mapas y de productos, por plataforma, en el catálogo de datos |
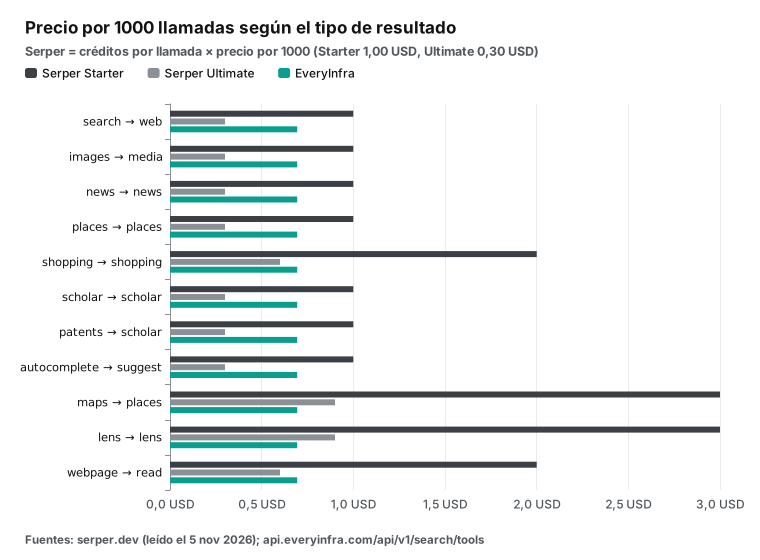
Como el costo en créditos depende del tipo, el precio por cada mil llamadas de Serper también cambia. En el paquete Starter, mil créditos cuestan 1,00 USD; maps y lens gastan 3 créditos por llamada, así que salen a 3,00 USD por cada mil. En el paquete Ultimate, mil créditos cuestan 0,30 USD y maps sale a 0,90 USD por cada mil. Todas las herramientas de búsqueda de EveryInfra, salvo crosscheck, cuestan 0,000694 USD por llamada. El gráfico pone los precios públicos lado a lado por tipo; los tamaños de paquete y el vencimiento están en Precios de Serper API.
La primera petición con curl en los dos lados
Esta es una primera petición a Serper en la forma POST del Playground. No tenemos clave de Serper, así que no la ejecutamos; la armamos a partir del script de la página y del código de CrewAI. Para un lector de España, el ejemplo fija gl y hl en español.
# Serper: ejemplo de configuración (no ejecutado para este artículo)
curl -s https://google.serper.dev/search \
  -H "X-API-KEY: $SERPER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"q":"api de búsqueda de google","gl":"es","hl":"es","num":10}'
Esta es la misma idea en EveryInfra. Ejecutamos la versión con «serper api documentation» y location: us a las 00:18:40 (hora de Singapur) del 5 de noviembre de 2026: devolvió HTTP 200 en 1,55 segundos con 10 resultados y billing.charged_usd igual a 0.000694.
# EveryInfra: ejecutado para este artículo
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"tool":"web","q":"serper api documentation","location":"us","num":10}'
Cambian cuatro cosas: la URL, la cabecera, gl pasa a ser location y hl desaparece. Hay otro detalle fácil de pasar por alto. La documentación pone los parámetros en el primer nivel del cuerpo, como en {"tool":"web","q":...}, mientras que la herramienta MCP everyinfra_search los pone dentro de un objeto params, como en {"tool":"web","params":{"q":...}}. Las dos formas funcionan, pero no se pueden mezclar; más abajo, en la sección de MCP, mostramos lo que pasa si se mezclan.
También cambian los lotes. El Mini-batch de Serper acepta hasta 100 consultas en una petición y la búsqueda de EveryInfra acepta una por petición. Un lote de 100 palabras clave se convierte en 100 peticiones dentro del límite por minuto: la cuenta trae 60 por minuto por defecto, así que 100 palabras tardan unos dos minutos, y un paquete de velocidad sube el límite a 1800 por minuto (precios). El costo no cambia: 0,000694 USD por consulta, 0,0694 USD por 100. Y las peticiones sueltas fallan de una en una: un parámetro mal escrito en una consulta devuelve un 422 y las otras 99 siguen.
Campos de la respuesta: organic frente a results
La respuesta de ejemplo de la portada de Serper es un objeto grande con knowledgeGraph, organic, peopleAlsoAsk y relatedSearches en el primer nivel. Cada resultado orgánico tiene title, link, snippet y position, y algunos traen sitelinks, date y attributes (ejemplo en la portada de serper.dev). El Playground quita searchParameters antes de mostrar resultados, así que una respuesta real también repite la petición. LangChain lee una clave distinta según el tipo: organic para search, news para news, places para places e images para images (código de LangChain).
La respuesta de la herramienta web de EveryInfra es {"id","tool","location","results","billing","quota"}. Cada resultado trae title, url y snippet, y published cuando se conoce la fecha; en la página 2 de las 00:19:06 (hora de Singapur), 3 de 10 resultados la traían. La entrada web/search del catálogo devuelve más campos: title, url, text, rank, published_at, image_url y sub_links (catálogo de datos).
| Uso | Serper (search) | EveryInfra `web` | EveryInfra `web/search` |
|---|---|---|---|
| Título | organic[].title | results[].title | results[].title |
| Enlace | organic[].link | results[].url | results[].url |
| Fragmento | organic[].snippet | results[].snippet | results[].text |
| Posición | organic[].position | Orden del array | results[].rank |
| Fecha | organic[].date (a veces) | results[].published (a veces) | results[].published_at (a veces) |
| Panel de conocimiento, preguntas relacionadas | knowledgeGraph, peopleAlsoAsk | No | No |
| Costo de esta llamada | La portada dice que se descuentan créditos por respuesta correcta; no hay campo documentado | billing.charged_usd | billing.charged_usd |
La última fila tiene que ver con la contabilidad. Las preguntas frecuentes de Serper dicen «Every time you receive successful responses to queries, we will deduct credits from your account balance» y, cuando el saldo llega a cero, no se aceptan más consultas; lo gastado se mira en el panel y en Activity logs. Cada respuesta de EveryInfra trae un objeto billing con charged, charged_usd y balance_after_usd, así que un proceso por lotes puede cuadrar el gasto solo con las respuestas, y los fallos y vacíos muestran charged: false. La herramienta web no devuelve paneles de conocimiento ni preguntas relacionadas; si tu código depende de ellos, necesitará otra lógica, como explicamos en «Cuándo conviene más Serper».
Prueba 1: una petición al estilo Serper enviada tal cual
El error más probable al migrar es cambiar la URL y la cabecera y dejar los parámetros como estaban. Lo hicimos a propósito para ver qué responde la API.
A las 00:18:28 (hora de Singapur) enviamos {"tool":"web","q":"serper api documentation","gl":"us","hl":"en","num":10}. La API devolvió HTTP 422 en 0,20 segundos con error.code igual a unknown_param. El message decía «gl is not a parameter of tool web Supported: after, before, location, num, page, q, site», allowed traía los 7 parámetros válidos y next_steps decía «Remove gl; the parameters are listed at catalog_url. Nothing was charged.». La API informa de un parámetro desconocido por llamada: quitamos gl, dejamos hl y volvimos a enviar a las 00:18:47, y llegó el mismo 422 con param: hl.
A las 00:19:00 escribimos locaton en vez de location. El 422 llegó en 0,11 segundos con did_you_mean: ["location"] y un primer paso que decía «Rename locaton to location (did_you_mean), then resend. Nothing was charged.»; el segundo invitaba a abrir un ticket si el catálogo sí recoge el parámetro enviado. A las 00:19:14 pusimos "type":"news" en el cuerpo y recibimos 422 porque type no es parámetro de web. A las 00:19:20 enviamos kind: "videos" a la herramienta media y el error fue invalid_value, con allowed igual a image y video y did_you_mean igual a video.
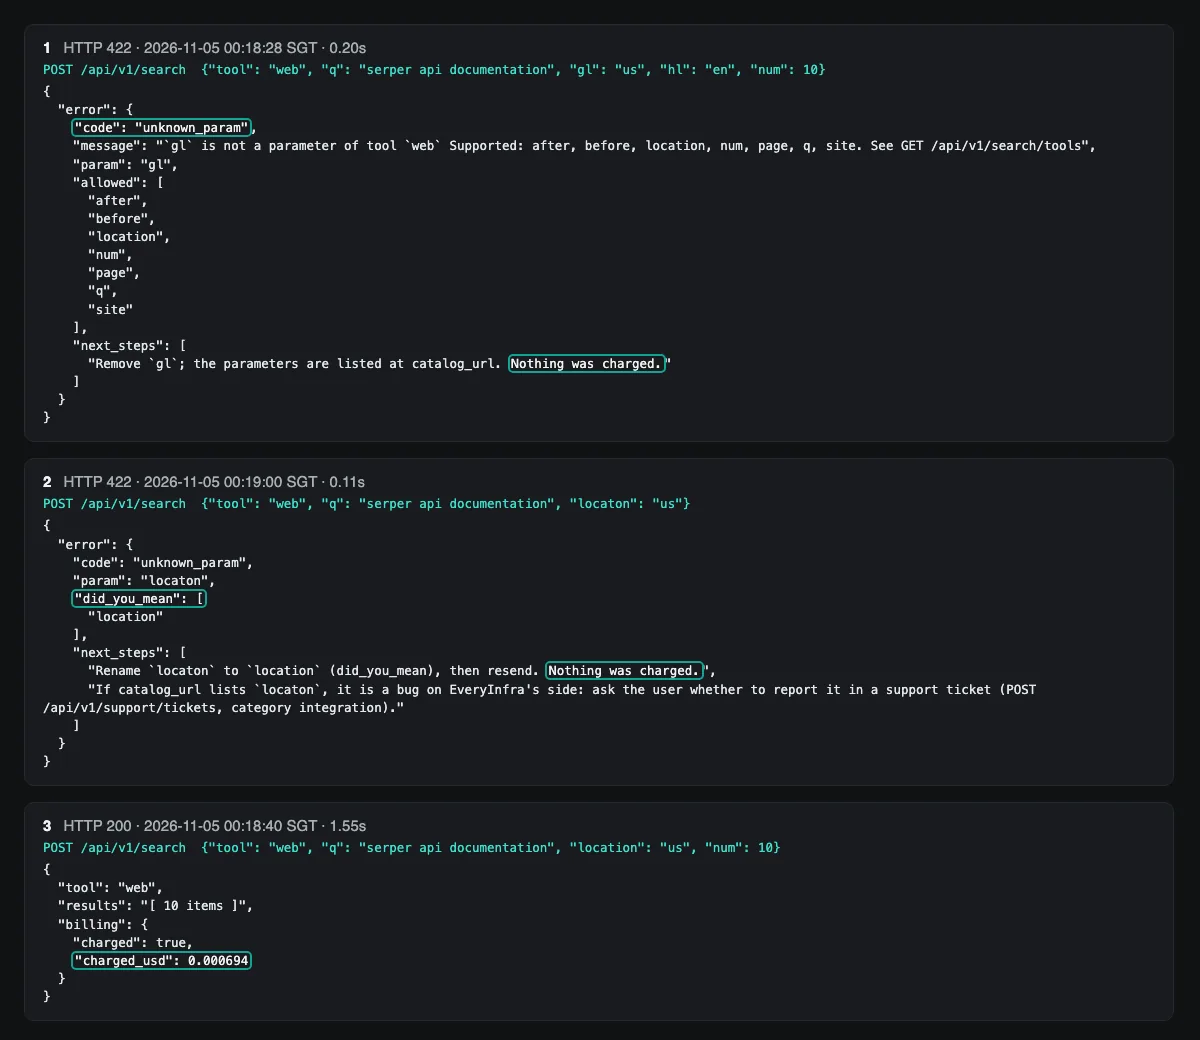
Estos errores están pensados para que un asistente de IA corrija su propia llamada. Un 422 le dice a un programa que reintentar no sirve, y allowed y did_you_mean le dicen al asistente qué cambiar. HTTP define el 422 para una petición que el servidor entiende pero no puede procesar (MDN: 422, definido en RFC 9110, sección 15.5.21), justo el caso de un nombre o un valor equivocado. Nuestro cuerpo de error no sigue el formato problem+json de RFC 9457; es un objeto error propio, y la guía de errores que se corrigen solos explica cada campo.
Prueba 2: sin clave, con la cabecera equivocada y con límite de velocidad
A las 00:18:21 (hora de Singapur) llamamos a web sin cabecera de autenticación. La API devolvió HTTP 401 en 0,12 segundos con code: unauthorized, message: Missing API key, fault igual a account, retryable en false y next_steps con «This API key is not accepted; ask the user for a working key (console: API keys). Nothing was charged.». A las 00:18:34 pusimos una clave válida en la cabecera X-API-KEY, al estilo Serper, y el resultado fue el mismo 401 con el mismo mensaje. Hay que decirlo con claridad: el error no sugiere «usa Authorization: Bearer», así que quien llega desde Serper tiene que cambiar la línea de la cabecera por su cuenta, como indica la tabla de arriba.
Del lado de Serper no tenemos clave, así que citamos publicaciones públicas. El hilo de n8n de arriba muestra HTTP 403 con el cuerpo {"message":"Unauthorized. Sign up for a free account.","statusCode":403}. La incidencia #633 de CrewAI, de 2024, se titula «Unauthorized Error (403) when Using SERPER_API_KEY» y la causa era una clave de otro servicio. Para el saldo agotado, una nota de un proyecto del 23 de octubre de 2026 registra 400 {"message":"Not enough credits"} (neo1415/q #339), y una lista de tareas del 22 de octubre de 2026 dice «400 o 403» y lo marca sin confirmar (dbhq-uk/gannet #12). No encontramos una tabla de códigos de error en serper.dev.
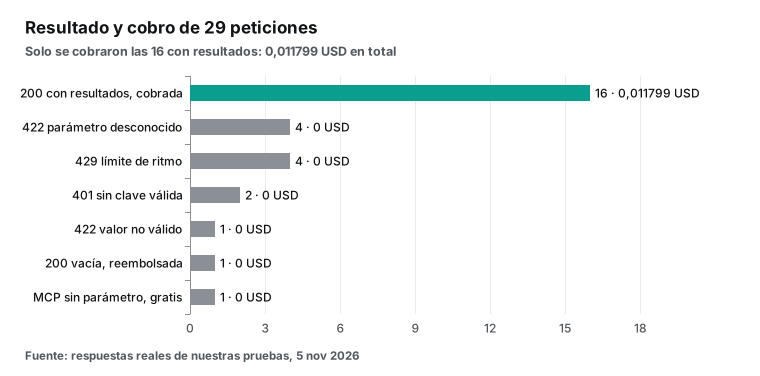
El límite de velocidad apareció solo. Nuestra clave de prueba tiene su propio tope de 10 llamadas por minuto y la comparten varios trabajos de redacción. Recibimos HTTP 429 cuatro veces, a las 00:19:55, 00:20:56, 00:22:38 y 00:24:51 (hora de Singapur), siempre con code: rate_limited, retry_after de 5, 4, 22 y 9 segundos, por orden, max_retries: 3 y la nota «Nothing was charged. Retry after retry_after seconds». Nuestro script esperaba 60 segundos después de cada 429 y el siguiente intento funcionó en los cuatro casos. La cabecera está explicada en MDN: Retry-After y el código 429 en RFC 6585.
| Caso | Serper (publicaciones públicas) | EveryInfra (nuestras pruebas) | Cobro |
|---|---|---|---|
| Sin clave o clave mala | 403 Unauthorized. Sign up for a free account. | 401 unauthorized, Missing API key | Ninguno en los dos |
| Cabecera equivocada | Con GET la clave va en la URL | X-API-KEY devuelve 401 | Ninguno |
| Sin saldo | 400 Not enough credits (registro de terceros) | 402 quota_exhausted (documentación) | Ninguno |
| Parámetro desconocido | Sin documentar | 422 unknown_param con allowed y did_you_mean | Ninguno |
| Valor no válido | Sin documentar | 422 invalid_value con allowed | Ninguno |
| Límite de velocidad | De 50 a 300 consultas por segundo según paquete (portada) | 429 rate_limited con retry_after | Ninguno |
| Resultado vacío | La portada dice que solo cobra respuestas correctas | 200, charged: false, reason: empty_result_refunded | Ninguno |
Para la fila del resultado vacío, a las 00:20:17 (hora de Singapur) buscamos entre comillas una cadena que no existe. La API devolvió HTTP 200 con results vacío, billing.charged: false, reason: empty_result_refunded y refund.status: succeeded. Para cuadrar fallos y vacíos en tu propia contabilidad, mira la guía de conciliación de reembolsos.
Prueba 3: la misma consulta en diez países
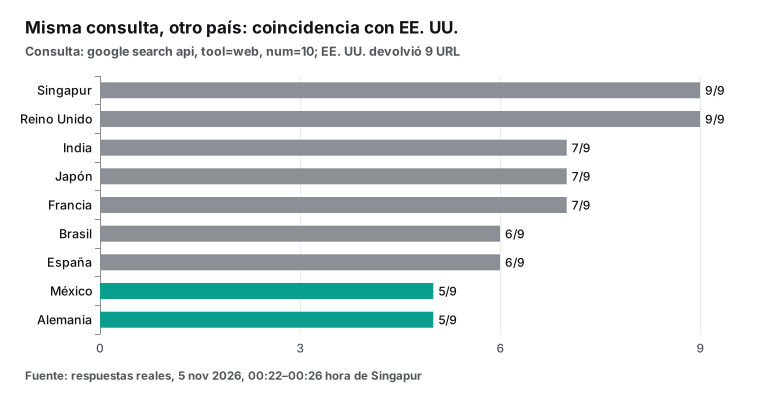
¿Funciona location después de pasarle el valor de gl? Entre las 00:22 y las 00:26 (hora de Singapur) enviamos la misma consulta, «google search api», a web con num en 10 y location en us, gb, de, fr, es, mx, br, jp, sg e in. Las diez llamadas devolvieron HTTP 200 y costaron 0,000694 USD cada una, 0,00694 USD en total. La de EE. UU. trajo 9 resultados y las demás 10.
Tomamos las 9 URL de EE. UU. como base y contamos cuántas aparecían en cada país. Singapur y Reino Unido conservaron las 9; India, Japón y Francia, 7; Brasil y España, 6; México y Alemania, solo 5. Alemania sumó un sitio personal con dominio .de y un vídeo de YouTube, Japón sumó qiita.com y México sumó rapidapi.com. El parámetro de país cambia los resultados, y los mercados en inglés se quedan cerca de la lista de EE. UU. mientras los demás se alejan, como cabe esperar del orden regional de un buscador. Para quien atiende clientes en España y México, esto significa que copiar gl en location sí da resultados locales distintos, aunque solo a nivel de país.
Hicimos dos llamadas más con la mirada puesta en México. A las 00:55:55 (hora de Singapur), «serper api key» con location: mx devolvió 10 resultados en 2,64 segundos; los dos primeros fueron otra vez la portada de Serper y /api-keys, y el noveno fue el hilo de la comunidad de Clay sobre cómo copiar la clave del panel. A las 00:57:20, con un cliente en Node.js, buscamos «api de búsqueda de google» con location: mx: 9 de los 10 títulos estaban en español y 4 de las URL llevaban hl=es-419, la variante de español para Latinoamérica. Es decir, sin parámetro de idioma, una consulta escrita en español ya trae páginas en español; lo que no existe es contenido en español sobre Serper.
Esta prueba también marca un límite. Solo probamos a nivel de país, porque location de EveryInfra no baja de ahí, mientras Serper llega a ciudad y código postal. Si necesitas «resultados locales de un código postal de Guadalajara», la herramienta web de EveryInfra no lo hace. Además, la muestra es pequeña, una consulta y una llamada por país, y las posiciones cambian con el tiempo: los números de coincidencia prueban que el parámetro funciona, no miden diferencias duraderas entre países.
Prueba 4: tiempos de respuesta y lo rápido que llegan los errores
Separamos las 38 peticiones por resultado y medimos el tiempo total desde Singapur, red incluida. Las 25 cobradas tardaron entre 0,98 y 3,48 segundos, con una mediana de 1,81 segundos; la más rápida fue un suggest y la más lenta una búsqueda web con location: gb. El resultado vacío tardó 2,12 segundos, porque la búsqueda sí se hizo. Las 11 peticiones rechazadas (401, 422 y 429) volvieron en 0,09 a 0,20 segundos, porque se detuvieron en la autenticación o en la revisión de parámetros y nunca buscaron. La portada de Serper dice «In general, all queries are returned in 1 to 2 seconds»; no probamos Serper, así que no comparamos velocidades.
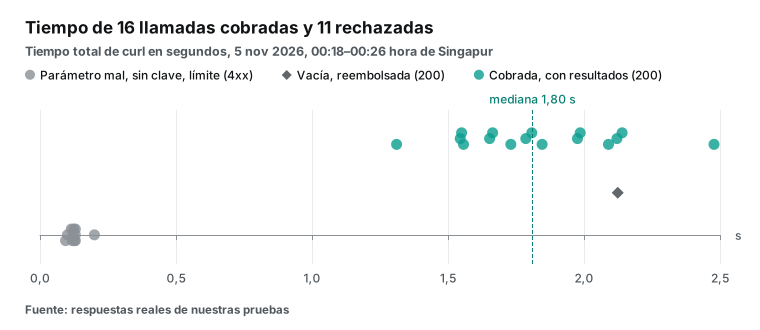
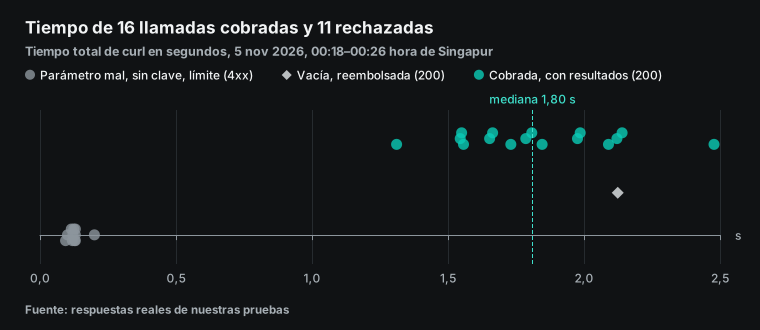
El gráfico cubre las 29 primeras peticiones. Las nueve posteriores, hechas para las versiones en inglés y en español, se resumen aquí.
| Hora (Singapur) | Llamada | Resultados | Segundos | Cobro (USD) |
|---|---|---|---|---|
| 00:45:32 | suggest, «serper api docs» | 8 | 0,98 | 0,000694 |
| 00:45:40 | web, «serper api key», location: gb | 10 | 3,48 | 0,000694 |
| 00:45:51 | web, «SERPER_API_KEY», site: github.com | 10 | 2,67 | 0,000694 |
| 00:47:57 | web, cuerpo convertido desde un cuerpo de Serper | 10 | 2,24 | 0,000694 |
| 00:53:26 | suggest, «serper api login» | 9 | 1,15 | 0,000694 |
| 00:55:47 | web/search, «serper api documentación», es/es | 10 | 1,78 | 0,001389 |
| 00:55:55 | web, «serper api key», location: mx | 10 | 2,64 | 0,000694 |
| 00:56:05 | suggest, «serper api clave» | 4 | 1,23 | 0,000694 |
| 00:57:20 | web desde Node.js, «api de búsqueda de google», location: mx | 10 | 2,05 | 0,000694 |
Que los errores lleguen rápido ayuda a quien programa. Un parámetro mal escrito no cuesta dos segundos de espera: el 422 con la corrección llega en una décima de segundo y un asistente puede corregir y reenviar en el mismo turno. También vale al revés: un programa que reintenta cualquier respuesta distinta de 200 como si el servicio estuviera ocupado desperdicia reintentos en los 422. Reintenta solo los errores con retryable: true, como 429 y 503.
Prueba 5: sugerencias, noticias y la entrada del catálogo de datos
Los tipos autocomplete y news de Serper corresponden a las herramientas suggest y news de EveryInfra. A las 00:20:01 (hora de Singapur), suggest para «serper api key» devolvió 10 filas, cada una solo con title, por 0,000694 USD. A las 00:21:28, news para «Model Context Protocol» devolvió 10 resultados con published en forma relativa, como «17 hours ago» o «2 days ago». Para ordenar por fecha en una base de datos hay que convertirlas con la hora de la petición, o usar google_news/search del catálogo de datos, que devuelve published_at en UTC con formato ISO 8601 por 0,000792 USD.
A las 00:20:09 (hora de Singapur) probamos web/search con «serper api key», country: us y language: en: devolvió 10 resultados por 0,001389 USD, con los campos text y rank en la misma estructura que los resultados de otras plataformas del catálogo. Esa entrada conviene si guardas resultados web junto a datos de otras plataformas o si necesitas fijar el idioma; si solo quieres resultados web, web cuesta la mitad. No consultamos lo mismo con web, así que no comparamos el orden de los resultados ni hay que esperar que las dos entradas devuelvan la misma lista.
La clave en Python: cada framework usa otro nombre
Guarda la clave en una variable de entorno, no en el código; lo dicen The Twelve-Factor App y la hoja de referencia de OWASP sobre secretos. Dos tutoriales en español que aparecen al buscar cómo configurar la clave muestran las dos costumbres. El de IBM sobre un agente ReWOO asigna la clave directamente en el código, SERPER_API_KEY = "your_serper_api_key_here", aunque añade una nota para no subirla nunca a un repositorio público (IBM, tutorial ReWOO en español). El de DataCamp usa export SERPER_API_KEY=... en la terminal, que es la forma correcta.
| Tutorial en español | Dónde pone la clave | Riesgo |
|---|---|---|
| DataCamp, Jan-v1 (2025-08-18) | Variable de entorno con export | Bajo, si no se guarda en un archivo versionado |
| IBM, agente ReWOO | Cadena escrita en el código | Alto si el cuaderno se sube a un repositorio |
| Recomendado | Variable de entorno o .env fuera del control de versiones | El más bajo |
Como Serper no tiene SDK propio, cada framework eligió su nombre de variable; leímos el código y la documentación actuales de cuatro.
| Framework | Nombre de la variable de Serper | Fuente |
|---|---|---|
LangChain (GoogleSerperAPIWrapper) | SERPER_API_KEY | Referencia de LangChain |
CrewAI (SerperDevTool) | SERPER_API_KEY | Documentación de CrewAI |
Haystack (SerperDevWebSearch) | SERPERDEV_API_KEY | Código de Haystack, documentación |
| LiteLLM (búsqueda) | SERPER_API_KEY | Documentación de LiteLLM |
Haystack añade «DEV» al nombre: si una misma máquina ejecuta LangChain y Haystack, define dos variables o escribe Secret.from_env_var("SERPER_API_KEY") en Haystack. Los parámetros tampoco coinciden. El SerperDevTool de CrewAI usa country, locale y n_results, que su código traduce a gl, hl y num, y solo admite los tipos search y news; leímos la rama principal tras la versión 1.15.35 del 3 de noviembre de 2026. LangChain usa k, gl, hl y type, y Haystack usa top_k y search_params. Por eso «serper api key crewai» es una sugerencia propia: cada framework enseña su versión.
En Python, EveryInfra no necesita un paquete especial; basta con requests y una función que lea retryable antes de reintentar.
import os, time, requests

KEY = os.environ["EVERYINFRA_API_KEY"]          # solo desde la variable de entorno
URL = "https://api.everyinfra.com/api/v1/search"

def buscar_web(q, location="es", page=1):
    body = {"tool": "web", "q": q, "location": location, "num": 10, "page": page}
    for _ in range(3):
        r = requests.post(URL, json=body, timeout=90,
                          headers={"Authorization": f"Bearer {KEY}"})
        data = r.json()
        if r.status_code == 200:
            return data["results"], data["billing"]["charged_usd"]
        err = data.get("error", {})
        if not err.get("retryable"):              # 401 y 422: corregir según next_steps
            raise ValueError(f'{err.get("code")}: {err.get("next_steps")}')
        time.sleep(err.get("retry_after", 5))     # 429 y 503: esperar retry_after
    raise RuntimeError("reintentos agotados")
La clave en Node.js: fetch sin librerías
Muchos equipos en Latinoamérica trabajan con JavaScript en el servidor, y el Playground de Serper muestra Node.js por defecto. Node.js trae fetch disponible sin opciones especiales desde la versión 18 (documentación de Node.js), así que no hace falta ninguna librería. Ejecutamos la función de abajo con Node.js 26.11.1 a las 00:57:20 (hora de Singapur) del 5 de noviembre de 2026: devolvió HTTP 200 con 10 resultados en 2,05 segundos y cobró 0,000694 USD.
const URL = "https://api.everyinfra.com/api/v1/search";

async function buscar(q, location = "es", page = 1) {
  for (let intento = 0; intento < 3; intento++) {
    const r = await fetch(URL, {
      method: "POST",
      headers: {
        "Authorization": `Bearer ${process.env.EVERYINFRA_API_KEY}`,
        "Content-Type": "application/json",
      },
      body: JSON.stringify({ tool: "web", q, location, num: 10, page }),
    });
    const data = await r.json();
    if (r.ok) return { resultados: data.results, usd: data.billing.charged_usd };
    if (!data.error?.retryable) throw new Error(`${data.error?.code}: ${data.error?.next_steps}`);
    await new Promise((ok) => setTimeout(ok, (data.error.retry_after ?? 5) * 1000));
  }
  throw new Error("reintentos agotados");
}

const { resultados, usd } = await buscar("api de búsqueda de google", "mx");
console.log(resultados.length, usd);
La versión que ejecutamos guardaba además la respuesta completa en un archivo para nuestros registros; la lógica de reintento es la misma. Si migras desde Serper, recuerda que la cabecera cambia de X-API-KEY a Authorization y que la clave no debe ir nunca en la URL.
La clave en n8n: HTTP Request y MCP Client Tool
n8n no trae un nodo de Serper; la página de integración de Serper en n8n.io devolvía 404 el 5 de noviembre de 2026. Se usa el nodo HTTP Request genérico con una credencial de tipo Header Auth, nombre X-API-KEY y la clave como valor (credenciales de HTTP Request en n8n). El método tiene que ser POST; el hilo del 403 venía de una petición GET. La configuración de abajo sigue la documentación de n8n tal como la leímos el 5 de noviembre de 2026.
EveryInfra se conecta de dos formas. La primera es el mismo nodo HTTP Request, con Header Auth de nombre Authorization y valor Bearer , un espacio y tu clave, la URL https://api.everyinfra.com/api/v1/search y el cuerpo del ejemplo de curl. La segunda es el nodo MCP Client Tool dentro de un flujo AI Agent, con el punto de conexión https://api.everyinfra.com/mcp, autenticación Bearer y la clave en una credencial; el agente lista herramientas como everyinfra_search y decide cuándo llamarlas. No ejecutamos n8n para este artículo, así que las dos configuraciones son ejemplos sacados de la documentación de n8n. Para un flujo completo que corre cada mañana, mira la guía del informe diario con n8n.
La clave en clientes MCP: remoto frente a local
Serper no tiene servidor MCP propio. En GitHub hay servidores de la comunidad, como marcopesani/mcp-server-serper (licencia MIT, 171 estrellas, último cambio el 13 de marzo de 2025) y garylab/serper-mcp-server (39 estrellas, último cambio el 10 de noviembre de 2025). Los dos arrancan un proceso local en tu equipo con npx o uvx, y la clave va en el bloque env del archivo de configuración del cliente como SERPER_API_KEY. Es decir, la clave queda en texto plano en un archivo de configuración de cada máquina que use ese cliente.
EveryInfra opera un servidor MCP remoto en https://api.everyinfra.com/mcp, con el transporte HTTP de la especificación MCP 2026-07-28 y la clave en la cabecera Authorization. En Claude Code se añade con un comando (documentación MCP de Claude Code); para otros clientes, mira la página de configuración MCP y la guía de MCP remoto.
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer $EVERYINFRA_API_KEY"
La lista de herramientas se puede pedir sin clave: hacia las 00:21 (hora de Singapur) llamamos a tools/list sin clave y recibimos 12 herramientas. La entrada de everyinfra_search es tool, una de 17, más un objeto params. A las 00:21:40 pusimos q fuera de params a propósito y la respuesta fue HTTP 200 con isError: true y los textos «missing_param: q is required» y «Next steps: Add the required q. Nothing was charged.». A las 00:21:58 enviamos {"tool":"web","params":{"q":"serper api login","location":"us","num":5}}: llegaron 5 resultados, el primero serper.dev/api-keys con el título «Log in to your account», y charged_usd fue 0.000694, igual que una llamada directa.
La especificación MCP dedica una sección a la autorización de servidores remotos y recomienda OAuth. Hoy usamos una clave Bearer fija: cualquier cliente puede enviarla, pero te toca protegerla, que es el tema de la sección siguiente. Para elegir qué tipo de herramienta de búsqueda dar a un agente de IA, mira cómo elegir herramientas de búsqueda para agentes.
Se filtró tu clave: cómo cambiarla en cada lado
Empecemos con un caso reciente. El informe de incidente que LiteLLM publicó el 23 de octubre de 2026 cuenta que el 27 de mayo de 2026 alguien subió a un repositorio público un archivo de configuración con una clave interna de administración. El archivo se borró unas tres horas después y la clave pasó a una lista «por revocar», pero el commit siguió en el historial público hasta el 22 de octubre y, por un error humano, la revocación nunca se hizo. El 10 de octubre de 2026, un atacante usó esa clave de hace cuatro meses, que seguía activa, llegó hasta un token de propietario de la organización en GitHub y el 21 de octubre el sistema de publicación de LiteLLM sacó una versión 1.107.0 comprometida (informe de incidente de LiteLLM).
| Fecha (2026) | Qué pasó |
|---|---|
| 27 de mayo | Un archivo con una clave de administración llega a un repositorio público |
| 27 de mayo, unas 3 horas después | Se borra el archivo y la clave pasa a la lista «por revocar» |
| Del 27 de mayo al 22 de octubre | El commit sigue en el historial público y la clave nunca se revoca |
| 10 de octubre | Un atacante usa la clave vieja, que sigue activa |
| 21 de octubre | Sale una versión 1.107.0 comprometida |
El informe resume la lección como «failing to rotate a potentially exposed key». Ese mismo día, Railway informó de que un tercero pudo acceder a sistemas que guardan variables de entorno de clientes y pidió a todos cambiar de inmediato todas las variables guardadas en Railway, claves de API incluidas (aviso de Railway, 21 de octubre de 2026).
La regla es sencilla: borrar la clave del código no la anula; hay que invalidarla en el servicio. Así se hace en cada lado.
En Serper, inicia sesión y abre API Keys, busca la clave filtrada y pulsa «Reset». Al confirmar, la vieja deja de funcionar al instante y la página muestra una nueva; cámbiala en cada sitio que la usaba. Si una sola clave servía a varios sitios, todos se cortan a la vez, porque no se puede detener solo uno. Después abre Activity logs, filtra por esa clave y busca consultas que no reconozcas; si activaste «Anonymize queries», verás cantidades y créditos, pero no el texto de las consultas.
En EveryInfra, desactiva la clave filtrada en la consola; las llamadas con ella devolverán 401. También lo puede hacer un script: una clave con el permiso keys:write llama a POST /portal/api/keys/{key_id}/disable, y después solo el dueño de la cuenta puede reactivarla en la consola. Crea otra para reemplazarla y, si tenías una clave por entorno, los demás entornos siguen funcionando. La rotación, los permisos y la lista de IP solo se cambian en la consola, así que una clave no puede modificar sus propios ajustes (guía de inicio, sección de autenticación). Luego revisa el historial de llamadas y el gasto durante la filtración; GET /api/v1/account también muestra el uso de las últimas 24 horas y no cobra nada.
También puedes prepararte antes de una filtración repartiendo las claves así:
| Dónde corre la clave | Ajustes recomendados |
|---|---|
| Servidor de producción | Clave propia, con lista de IP permitidas del servidor |
| Integración continua | Clave propia, con un tope de gasto pequeño en USD |
| Cuaderno de demostración o prueba compartida | Clave propia, con tope de gasto pequeño y fecha de caducidad |
Así, si se filtra una, solo desactivas esa; las demás siguen funcionando y la pérdida no pasa del tope de esa clave.
Nadie va a detectar la filtración por ti. El escaneo de secretos de GitHub reconoce claves con formatos registrados y avisa a los servicios asociados para que las revoquen; el 5 de noviembre de 2026 contamos su lista de patrones admitidos y tiene 207 proveedores, sin Serper ni EveryInfra. La versión v3.99.8 de TruffleHog, del 2 de noviembre de 2026, tiene detectores para otros tres servicios de resultados de búsqueda, pero no para Serper, y las reglas por defecto de Gitleaks tampoco lo incluyen. GitHub añadió dos tipos de clave de Anthropic al bloqueo por defecto al hacer push el 13 de octubre de 2026 (registro de cambios de GitHub) y, el 28 de octubre de 2026, una protección con IA que juzga el contexto en vez de formatos fijos, desactivada por defecto (registro de cambios de GitHub). Mientras ningún escáner conozca el formato de tu clave, quien use GitHub Advanced Security puede escribir patrones personalizados.
| Paso tras una filtración | Serper | EveryInfra |
|---|---|---|
| Anular la clave vieja | API Keys → Reset, al instante | Desactivar en la consola; las llamadas devuelven 401 |
| Cortar un sitio y mantener los demás | No, se reinicia la clave entera | Sí, con una clave por entorno |
| Limitar el daño | Sin tope por clave ni ajuste de IP | Permisos por producto, lista de IP, tope de gasto en USD y caducidad por clave |
| Revisar llamadas durante la filtración | Activity logs filtrado por clave | Historial de la consola, /api/v1/account |
| Detección automática en repositorios públicos | No está en GitHub, TruffleHog ni Gitleaks por defecto | Tampoco |
Cuándo conviene más Serper
Estos son los casos en los que Serper encaja mejor que EveryInfra. Los datos de cada fila salen de las secciones anteriores.
| Necesidad | Serper | EveryInfra |
|---|---|---|
| Resultados por ciudad, barrio o código postal | 100 029 ubicaciones hasta el código postal | location solo por país |
| Panel de conocimiento, «Otras preguntas de los usuarios», búsquedas relacionadas | knowledgeGraph, peopleAlsoAsk, relatedSearches | web devuelve título, enlace, fragmento y fecha |
| Cientos de peticiones por segundo | De 50 a 300 por segundo según paquete | 60 por minuto por defecto, hasta 1800 por minuto con paquete de velocidad (precios) |
| Reseñas de mapas y de productos | Tipos reviews, product-reviews y maps | No está en la búsqueda; hay que buscarlo por plataforma en el catálogo de datos |
| Lotes de 100 consultas por petición | Mini-batch | Una consulta por petición |
Para seguir posiciones de SEO local, por ejemplo entre Madrid y Sevilla, Serper es la herramienta correcta. Hay un sexto caso: mucho código ya escrito sobre los campos de Serper que solo necesita resultados de EE. UU. en inglés. Ahí el cambio de código puede costar más de lo que ahorras, así que espera. Plantéate el cambio cuando vayas a dar búsqueda a un agente de IA o quieras una sola clave para datos, búsqueda y otras capacidades.
Límites: cuándo no valen estas conclusiones
Primero, lo que decimos del panel de Serper con sesión iniciada sale del texto de los scripts, no de pantallas que hayamos visto. Segundo, los cuerpos de error de Serper salen de publicaciones de terceros fechadas entre julio de 2025 y octubre de 2026, y pueden haber cambiado. Tercero, los pasos posteriores al registro y las funciones de las claves de EveryInfra salen de la página, la documentación, los precios y el OpenAPI; no creamos una cuenta ni llamamos con una clave limitada para ver el 403. Cuarto, nuestras 38 llamadas usaron una clave de prueba con tope propio de 10 por minuto. Quinto, las pruebas de ubicación y de tiempos son muestras únicas desde Singapur, y no comparamos la calidad de los resultados.
Preguntas frecuentes
¿Dónde encuentro la serper api key después de registrarme?
En serper.dev/api-keys, con la sesión iniciada; la página se titula «API Keys» y cada clave tiene nombre, botón de copiar y «Reset». El tutorial en español de DataCamp sobre Jan-v1 indica copiar «la clave API predeterminada» de esa página, así que la cuenta ya trae una (DataCamp, 18 de agosto de 2025). Sin sesión, esa dirección muestra el formulario de inicio de sesión.
¿Puedo dejar la clave de Serper escrita en el código, como en algunos tutoriales?
Para una prueba local, sí, pero no la subas nunca a un repositorio. El tutorial en español de IBM sobre ReWOO asigna SERPER_API_KEY directamente en el código y advierte que no se cargue en repositorios públicos (IBM). Ni GitHub, ni TruffleHog, ni Gitleaks reconocen por defecto el formato de una clave de Serper, así que nadie te avisará si se escapa. Usa una variable de entorno o un archivo .env fuera del control de versiones.
¿Por qué CrewAI devuelve 403 Unauthorized con mi clave de Serper?
Comprueba primero que la clave sea de serper.dev: en la incidencia #633 de CrewAI, el usuario tenía la clave de otro servicio. Después comprueba que la variable se llame SERPER_API_KEY, que es la que lee el código de CrewAI, y que la petición sea POST. Si el cuerpo dice «Unauthorized. Sign up for a free account.», la clave es incorrecta o no llegó. Mira la incidencia #633 de CrewAI.
¿Hay documentación de Serper en español?
No la encontramos. El 5 de noviembre de 2026, una búsqueda de «serper api documentación» con country: es y language: es devolvió 10 resultados, todos en inglés, y suggest para «serper api clave» solo devolvió palabras sin relación. Además, serper.dev/docs, /llms.txt y /openapi.json devolvían 404. El catálogo de herramientas de EveryInfra explica cada parámetro también en español y la documentación está en /es/docs.
¿Las 2500 consultas gratis de Serper son por mes?
La portada de Serper dice «Get 2,500 free queries» y no dice «por mes». Una propuesta en el repositorio de Hermes Agent del 21 de julio de 2026 las describe como «2,500 free queries/month» (NousResearch/hermes-agent #68615). Comprueba el panel después de registrarte y no cuentes con una renovación mensual; los términos, además, prohíben tener más de una cuenta a la vez. Cuánto duran esas consultas está en Serper API gratis.
Para empezar: de la clave al primer resultado
Para probar, regístrate en everyinfra.com, da estrella a los dos repositorios de GitHub y reclama en la consola el crédito de prueba de 1 USD, válido 24 horas. Crea una clave en API Keys, envía la petición de curl de arriba y mira billing.charged_usd en la respuesta. Para leer los parámetros gratis, abre el catálogo de herramientas de búsqueda. Para las capacidades de búsqueda del catálogo de datos, mira las páginas de datos web, Bing, DuckDuckGo, Google Noticias y Google Shopping; para probar una llamada con un clic desde la consola, usa el mercado de infraestructura.
Si migras desde Serper, cambia esto en este orden. La última fila es una prueba de tu manejo de errores, no un cambio.
| Paso | Serper | EveryInfra |
|---|---|---|
| 1. URL | https://google.serper.dev/<type> | https://api.everyinfra.com/api/v1/search |
| 2. Cabecera | X-API-KEY | Authorization: Bearer |
| 3. Tipo de resultado | Segmento de la URL | Campo tool del cuerpo |
| 4. País | gl | location |
| 5. Idioma y corrección | hl, autocorrect | Quitarlos, o usar web/search con language |
| 6. Rango de tiempo | tbs | after, before |
| 7. Enlace del resultado | organic[].link | results[].url |
| 8. Prueba de errores | — | Enviar un parámetro mal escrito y comprobar que tu código lee allowed y did_you_mean |
Para una visión más amplia, mira las alternativas y por qué EveryInfra.
Referencias
- Portada de Serper (precios, preguntas frecuentes, respuesta de ejemplo), Serper, leído 2026-11-05
- Create an account, Serper, leído 2026-11-05
- Log in to your account, Serper, leído 2026-11-05
- API Keys, Serper, leído 2026-11-05 (sin sesión muestra el formulario de inicio de sesión)
- Playground, Serper, script leído 2026-11-05
- Terms of Service, Serper, actualizado 2024-05-29, leído 2026-11-05
- Privacy Policy, Serper, revisado 2025-11-05, leído 2026-11-05
- Supported locations, Serper, leído 2026-11-05
- Organización Serper-API en GitHub, GitHub, leído 2026-11-05
- Índice del archivo web de serper.dev, Internet Archive, leído 2026-11-05
- postman-code-generators, Postman, leído 2026-11-05
- Serper.dev authentication issues, comunidad de n8n, 2025-07-26
- Unauthorized Error (403) when Using SERPER_API_KEY #633, CrewAI, 2024-05-17
- Add Serper.dev web search provider plugin #68615, Hermes Agent, 2026-07-21
- Research: read a spent plan or refused key as what it is #339, GitHub, 2026-10-23
- Live checks with real keys before release #12, GitHub, 2026-10-22
- Jan-V1: Guía con proyecto de demostración, DataCamp, 2025-08-18
- Creación de un agente de razonamiento ReWOO con IBM Granite, IBM, leído 2026-11-05
- Google Serper Search (SerperDevTool), CrewAI, leído 2026-11-05
- serper_dev_tool.py, CrewAI, leído 2026-11-05
- CrewAI 1.15.35, CrewAI, 2026-11-03
- GoogleSerperAPIWrapper, LangChain, leído 2026-11-05
- google_serper.py, LangChain, leído 2026-11-05
- SerperDevWebSearch, deepset, leído 2026-11-05
- websearch.py de Haystack serperdev, deepset, leído 2026-11-05
- Serper Search, LiteLLM, leído 2026-11-05
- Serper bundle, Langflow, leído 2026-11-05
- HTTP Request node, n8n, leído 2026-11-05
- HTTP Request credentials, n8n, leído 2026-11-05
- MCP Client Tool node, n8n, leído 2026-11-05
- n8n 2.46.6, n8n, 2026-11-04
- mcp-server-serper, GitHub, leído 2026-11-05
- serper-mcp-server, GitHub, leído 2026-11-05
- Model Context Protocol Specification 2026-07-28, MCP, leído 2026-11-05
- MCP Authorization, MCP, leído 2026-11-05
- Connect Claude Code to tools via MCP, Anthropic, leído 2026-11-05
- RFC 9110: HTTP Semantics, IETF, 2022-06
- RFC 6585: Additional HTTP Status Codes, IETF, 2012-04
- RFC 9457: Problem Details for HTTP APIs, IETF, 2023-07
- 422 Unprocessable Content, MDN, leído 2026-11-05
- Retry-After, MDN, leído 2026-11-05
- Supported secret scanning patterns, GitHub, leído 2026-11-05
- Secret scanning blocks Anthropic keys by default, adds Salesforce, GitHub, 2026-10-13
- Push protection beyond predefined secret patterns, GitHub, 2026-10-28
- Defining custom patterns for secret scanning, GitHub, leído 2026-11-05
- TruffleHog v3.99.8, Truffle Security, 2026-11-02
- Gitleaks, Gitleaks, leído 2026-11-05
- The attack chain behind the v1.107.0 LiteLLM release, LiteLLM, 2026-10-23
- Security Disclosure: Wednesday October 21st, Railway, 2026-10-21
- How to Retrieve Your API Key from Serper.dev Dashboard, comunidad de Clay, 2025-05-10
- Secrets Management Cheat Sheet, OWASP, leído 2026-11-05
- The Twelve-Factor App: Config, 12factor.net, leído 2026-11-05
- Node.js: fetch, Node.js, leído 2026-11-05
- Catálogo de herramientas de búsqueda de EveryInfra, EveryInfra, leído 2026-11-05 a las 00:16 (hora de Singapur)
- Catálogo de capacidades de datos de EveryInfra, EveryInfra, leído 2026-11-05 a las 00:16 (hora de Singapur)
- OpenAPI de EveryInfra, EveryInfra, leído 2026-11-05
Referencia BL-92